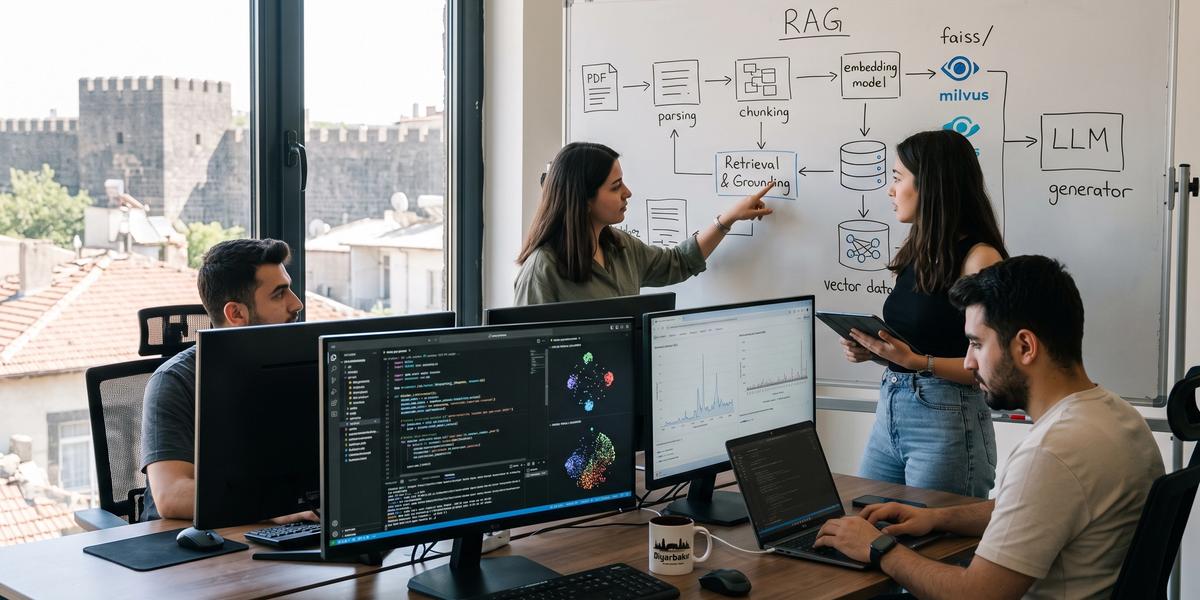
Yapay Zeka Projelerinde RAG (Retrieval-Augmented Generation) Mimarisi

Diyarbakır Yazılım
16.08.2026
#Yazılım#Teknoloji#Topluluk
Bir RAG projesinde en sık gördüğüm hata, vektör veritabanı kurulduğu anda sistemin hazır kabul edilmesidir. Oysa kullanıcı doğru yanıt alamıyorsa sorunun kaynağı çoğu zaman LLM değil parsing, chunking, metadata, retrieval veya context hazırlama aşamalarından biridir. Yapay Zeka Projelerinde RAG (Retrieval-Augmented Generation) Mimarisi, kurumun sahip olduğu bilgiyi doğru anda bulup LLM'e güvenilir bağlam olarak sunan uçtan uca bir sistem tasarımını ifade eder. Bu rehberde RAG mimarisi nasıl kurulur ve nasıl çalışır, yapay zeka projelerinde RAG sistemi nasıl geliştirilir ve production ortamında kalite nasıl ölçülür sorularını uygulama odaklı biçimde ele alacağız. Amacımız yalnızca çalışan bir demo değil, kaynak gösterebilen, erişim kurallarına uyan, ölçülebilen ve sürekli geliştirilebilen bir RAG sistemi tasarlamaktır.
RAG (Retrieval-Augmented Generation) Nedir?
RAG, bir dil modelinin yanıt üretmeden önce harici bilgi kaynaklarından ilgili içerikleri bulmasını ve bu içerikleri cevap bağlamına eklemesini sağlayan mimari yaklaşımdır. Model yalnızca eğitim sırasında öğrendiği bilgiye dayanmak yerine doküman, bilgi tabanı veya başka güvenilir kaynaklardan gelen içerikle desteklenir. Bu yapı özellikle kurum içi bilgiler, sık değişen dokümanlar ve kaynak gösterme gerektiren uygulamalarda güçlü sonuç verir. RAG'ın gerçek değeri arama ile üretimi aynı pipeline içinde kontrollü biçimde birleştirmesidir. Başarılı uygulamada retrieval kalitesi ile generation kalitesi ayrı ayrı ölçülmeli ve tek bir model cevabına bakılarak sistem başarılı sayılmamalıdır.
Retrieval-Augmented Generation Ne Anlama Gelir?
Retrieval-Augmented Generation ifadesindeki retrieval, kullanıcının sorusuyla ilişkili bilgi parçalarının bir kaynaktan bulunmasını ifade eder. Augmented bölümü, bulunan içeriğin modelin context alanına eklenmesini anlatır. Generation ise LLM'in hem kullanıcı sorusunu hem de getirilen kaynakları kullanarak yanıt oluşturduğu aşamadır. Bu üç adım birbirinden bağımsız gibi görünse de gerçek kalite zincirin tamamına bağlıdır. Yanlış doküman getirildiğinde çok güçlü bir LLM bile güvenilir cevap üretmekte zorlanacağı için retrieval sistemin temel kalite kapılarından biridir.
RAG Bir Model mi, Mimari mi?
RAG tek başına bir model değildir, farklı model ve veri bileşenlerini bir araya getiren mimari yaklaşımdır. Bir embedding modeli, retrieval motoru, metadata sistemi, isteğe bağlı reranker ve generator LLM aynı RAG çözümünde birlikte görev yapabilir. Bu bileşenlerin her biri bağımsız olarak değiştirilebilir veya benchmark sonuçlarına göre yeniden seçilebilir. Bu nedenle RAG projesini tek bir model seçimi gibi değerlendirmek hatalı olur. Ben production tasarımlarında bileşenleri bağımsız servis veya açık kontratlar halinde tutmayı tercih ediyorum çünkü retrieval ile generation sorunlarını ayırmak operasyon sırasında ciddi kolaylık sağlar.
RAG ile LLM Arasındaki İlişki
LLM RAG sisteminin cevap üreten parçasıdır ancak bilgi erişiminin tamamından sorumlu olmak zorunda değildir. Retrieval sistemi gerekli kaynakları bulur ve LLM'e yalnızca soruyla ilişkili bağlamı sunar. Model bu içeriği kullanarak daha grounded ve açıklanabilir bir cevap oluşturabilir. Buna rağmen retrieval sonucunda bulunmayan bir bilginin model tarafından tahmin edilmesi hâlâ mümkündür. Bu nedenle prompt içinde kaynak dışı iddiaları sınırlamak, yetersiz kanıt durumunda yanıt üretmemek ve citation doğruluğunu ölçmek gerekir.
Parametric ve Non-Parametric Knowledge Nedir?
Parametric knowledge modelin eğitim sırasında ağırlıklarına kodlanan bilgiyi ifade eder. Non-parametric knowledge ise doküman deposu, veritabanı veya bilgi tabanı gibi model dışında yönetilen ve çalışma anında erişilen bilgidir. RAG özellikle non-parametric bilginin hızlı güncellenmesini mümkün kılar. Yeni bir şirket prosedürünü sisteme eklemek için LLM'i yeniden eğitmek yerine dokümanı indekslemek yeterli olabilir. Bu ayrım kurumsal sistemlerde bakım maliyetini düşürür ve bilginin kaynağını model ağırlıklarından bağımsız yönetebilme avantajı sağlar.
Grounding Nedir?
Grounding, model cevabının belirli ve doğrulanabilir kaynaklara dayanmasını ifade eder. RAG sisteminde grounding çoğunlukla retrieved chunk'ların cevap üretiminde kanıt olarak kullanılmasıyla sağlanır. Modelin sadece akıcı görünmesi değil, verdiği iddiaların context içinde gerçekten desteklenmesi gerekir. Bu nedenle kaynakları modele eklemek tek başına yeterli değildir ve faithfulness değerlendirmesi ayrıca yapılmalıdır. İyi bir grounding politikası modelden bağlamda olmayan bilgiyi tahmin etmemesini ve yeterli kanıt bulunmadığında bunu açıkça söylemesini ister.
RAG Neden Ortaya Çıktı?
LLM'ler genel dil ve bilgi yeteneklerinde güçlü olsa da kurumların sahip olduğu özel veya yeni bilgilere doğal olarak erişemez. Ayrıca modelin eğitim tarihinden sonra oluşan bilgiler ağırlıklarında yer almayabilir. RAG, dış kaynak bilgisini inference sırasında modele getirerek bu sınırlamayı azaltmak için kullanılır. Aynı zamanda kaynak bazlı cevap ve daha hızlı bilgi güncelleme gibi pratik ihtiyaçlara da karşılık verir. Bu nedenle RAG yalnızca teknik bir arama tekniği değil, LLM ile kurumsal bilgi yönetimi arasında kurulan kontrollü erişim katmanıdır.
Knowledge Cutoff
Bir LLM belirli bir eğitim sürecinden geçtiği için daha sonra oluşan kurum içi veya harici bilgileri kendiliğinden bilemez. RAG güncel dokümanların indeks üzerinden sorgu anında bulunmasını sağlayarak bu sorunu azaltır. Yeni prosedür, ürün dokümanı veya politika değişikliği modele yeniden eğitim yaptırmadan kullanıma açılabilir. İndeksin güncel tutulmaması durumunda RAG da eski bilgi üretmeye devam edebilir. Bu nedenle knowledge freshness yalnızca ingestion sorunu değil production kalite metriği olarak izlenmelidir.
Hallüsinasyon
LLM bazen yeterli bilgi bulunmadığında ikna edici fakat yanlış bir cevap üretebilir. RAG ilgili kaynakları modele vererek bu riski azaltmayı amaçlar ancak tamamen ortadan kaldırmaz. Yanlış retrieval, çelişkili doküman veya modelin context'i yanlış yorumlaması hâlâ hatalı cevap üretebilir. Bu yüzden retrieval evaluation ile generation faithfulness birlikte ölçülmelidir. Üretim sisteminde en güvenli davranış, yeterli kaynak yoksa modelin tahmin yapmak yerine bilgi bulunamadığını belirtmesidir.
Kurumsal Veriye Erişim
Kurum içi prosedür, teknik doküman, rapor veya bilgi tabanı genel LLM eğitiminin parçası olmayabilir. RAG bu kaynakları güvenli retrieval servisi üzerinden kullanıcı sorusuyla buluşturabilir. Erişim kontrolü retrieval öncesinde uygulanmalı ve kullanıcının yetkisi olmayan dokümanlar aday sonuçlara bile girmemelidir. Böylece tek bir bilgi asistanı farklı departmanlara farklı bilgi kapsamıyla hizmet verebilir. Kurumsal RAG tasarımında retrieval kalitesi kadar document-level authorization da ana gereksinim olarak düşünülmelidir.
Güncel Bilgi İhtiyacı
Ürün dokümanları, destek içerikleri veya operasyon prosedürleri sık değişebilir. Bu verileri her değişiklikte fine-tuning ile modele taşımak pratik değildir. RAG indexing pipeline yeni veya güncellenen dokümanları kısa sürede erişilebilir hale getirebilir. Bunun için incremental ingestion ve versioning mekanizması doğru kurulmalıdır. Kullanıcıya hangi dokümanın hangi sürümünden cevap verildiğini göstermek güven ve hata ayıklama açısından önemli avantaj sağlar.
Yapay Zeka Projelerinde RAG Neden Kullanılır?
RAG'ın temel avantajı, LLM'in cevap yeteneğini güncel ve kurum tarafından yönetilebilen bilgi kaynaklarıyla birleştirmesidir. Modeli yeniden eğitmeden doküman ekleyebilir, kaldırabilir veya güncelleyebilirsiniz. Kullanıcıya verilen cevapların hangi kaynaklara dayandığını göstermek de mümkün hale gelir. Ayrıca retrieval sırasında yalnızca gerekli birkaç chunk gönderildiği için bütün bilgi tabanını her sorguda modele vermek gerekmez. Yapay zeka projelerinde RAG sistemi nasıl geliştirilir sorusunun cevabı bu nedenle sadece bir vector store kurmak değil, bilgi yaşam döngüsü ve erişim politikasını da tasarlamaktır.
Güncel Verilerle Yanıt Üretme
RAG yeni indekslenen içeriğin kısa sürede kullanıcı sorgularında kullanılmasını sağlayabilir. Bu özellik özellikle dokümanların sık değiştiği destek ve operasyon uygulamalarında değerlidir. Güncellik için yalnızca ingestion yeterli değildir ve eski versiyonların indeks içinde aktif kalmaması gerekir. Her dokümanın version, updated_at ve validity gibi metadata alanları tutulabilir. Retrieval katmanı bu bilgilerle eski kaynakları filtreleyerek daha güncel cevapların oluşmasına yardımcı olur.
Kurum İçi Dokümanları LLM'e Açma
Kurumsal dokümanları doğrudan büyük prompt içine kopyalamak ölçeklenebilir değildir. RAG, yalnızca soruyla ilişkili parçaları bulup modele taşıdığı için daha kontrollü bilgi erişimi sağlar. Dokümanların departman, gizlilik seviyesi ve tenant metadata'sı retrieval sırasında filtreleme amacıyla kullanılabilir. Böylece aynı model farklı kullanıcılar için farklı bilgi kapsamıyla çalışabilir. Kurumsal yapay zeka projelerinde RAG mi fine-tuning mi kullanılmalı sorusunda bilgi güncelleme ve kaynak erişimi önemliyse RAG genellikle daha doğal başlangıç noktasıdır.
Hallüsinasyon Riskini Azaltma
Doğru retrieval modelin cevap üretirken başvurabileceği kanıtları artırır. Bununla birlikte RAG var diye modelin her cevabı doğru kabul edilmemelidir. Retriever yanlış doküman getirdiğinde model yanlış bağlamı güvenle kullanabilir. Bu nedenle similarity threshold, reranking, sufficiency check ve grounding prompt birlikte tasarlanmalıdır. Faithfulness ve citation accuracy metrikleri production sistemde hallüsinasyon riskinin gerçekten azalıp azalmadığını göstermelidir.
Kaynak Gösterilebilir Yanıtlar
RAG'ın önemli avantajlarından biri yanıtın hangi doküman parçalarına dayandığını kullanıcıya gösterebilmesidir. Bunun için her chunk document_id, source_url, section ve version metadata'sı taşımalıdır. Modelin oluşturduğu citation işaretleri gerçek retrieved source ile programatik olarak eşleştirilebilir. Kaynak gösterme yalnızca kullanıcı deneyimi değil kalite kontrol mekanizmasıdır. Citation accuracy düşükse model doğru cevabı verse bile sistem güvenilir kurumsal asistan standardını karşılamayabilir.
Domain-Specific AI Uygulamaları
Her sektörün kendine özgü terminolojisi, prosedürü ve bilgi yapısı bulunur. RAG bu domain bilgisini model ağırlıklarına kalıcı olarak yazmadan çalışma anında sunabilir. Domain-specific embedding veya özel metadata tasarımı retrieval kalitesini daha da artırabilir. Ancak teknik terimlerin yalnızca semantik benzerliğe bırakılması bazen yetersiz kalır ve hybrid search fayda sağlayabilir. Gerçek kullanıcı sorularından oluşturulan golden dataset, domain retrieval tasarımının doğruluğunu ölçmek için kullanılmalıdır.
Modeli Yeniden Eğitmeden Bilgi Güncelleme
Fine-tuning davranış, format ve belirli görev kalıplarını öğretmek için değerlidir ancak sık değişen bilgi için ağır bir yöntem olabilir. RAG bilgi değişikliğini belge ve index yaşam döngüsü üzerinden yönetir. Bir doküman güncellendiğinde eski chunk'lar kaldırılıp yeni versiyon indekslenebilir. Böylece model aynı kalırken bilgi tabanı güncel tutulabilir. Bu ayrım bakım, audit ve geri alma süreçlerini belirgin biçimde kolaylaştırır.
GenAI Maliyetlerini Kontrol Etme
Bütün dokümanları uzun context içine koymak input token maliyetini gereksiz artırabilir. RAG yalnızca ilgili chunk'ları seçerek context boyutunu kontrol altında tutar. Buna rağmen gereğinden yüksek top-k kullanımı retrieval ve LLM maliyetini tekrar yükseltebilir. Cache, context compression ve dynamic top-k maliyet optimizasyonunda birlikte kullanılabilir. Cost per query metriği retrieval, reranking ve generation maliyetini ayrı gösterecek biçimde izlenmelidir.
RAG Ne Zaman Kullanılmalı, Ne Zaman Kullanılmamalı?
RAG her yapay zeka problemi için varsayılan çözüm değildir. Problem öncelikle bilgiye erişmek, kaynak bulmak ve dokümanlara dayalı cevap üretmekle ilgiliyse güçlü adaydır. Gerçek zamanlı hesaplama, transaction veya kesin yapılandırılmış veri sorgusu gerekiyorsa tool calling veya SQL daha uygun olabilir. Uzun context bazı küçük ve sabit doküman setlerinde retrieval ihtiyacını azaltabilir. Doğru mimariyi seçmek için kullanıcının sorusunun bilgi arama mı, hesaplama mı, işlem gerçekleştirme mi istediğini ayırmak gerekir.
RAG İçin Uygun Problemler
RAG en güçlü sonucu bilgi kaynağı ile kullanıcı sorusu arasında semantik erişim gerektiğinde verir. Doküman yoğun sistemler, kurum içi bilgi asistanları ve güncel prosedür sorguları bu gruba girer. Kaynakların sürekli değişmesi RAG'ın avantajını artırır. Kullanıcıya citation sunma gereksinimi de retrieval tabanlı mimariyi değerli hale getirir. Yine de her uygun problem için aynı chunking, embedding veya retrieval stratejisinin çalışacağı varsayılmamalıdır.
Kurumsal Soru-Cevap
Çalışanların prosedür, politika veya teknik doküman hakkında soru sorduğu sistemler RAG için güçlü kullanım alanıdır. Kullanıcının departman ve rol bilgisi retrieval filtrelerine dahil edilebilir. Model yalnızca erişilebilir dokümanlardan gelen context ile yanıt vermelidir. Kaynak bulunamadığında kesin cevap üretmek yerine bunu kullanıcıya belirtmek daha güvenlidir. Feedback verisi zamanla retrieval benchmark'ını genişletmek için kullanılabilir.
Doküman Arama
Klasik keyword search kullanıcının tam terimi bilmesini gerektirebilir. Dense retrieval anlam benzerliği üzerinden ilgili parçaları bulabilir. Teknik terim ve özel isimlerde keyword sinyali hâlâ güçlü olabileceği için hybrid search önemli avantaj sağlayabilir. Arama sonucunun LLM tarafından özetlenmesi kullanıcıya daha hızlı bilgi erişimi sağlar. Ancak doküman arama sisteminin başarısı answer fluency yerine retrieval relevance ile de ölçülmelidir.
Knowledge Assistant
Knowledge Assistant farklı kaynaklardan bilgi toplayıp kullanıcıya anlaşılır cevap sunabilir. Wiki, doküman deposu ve destek bilgi tabanı tek retrieval katmanında birleştirilebilir. Source ranking güvenilir kaynakların daha yüksek öncelikle kullanılmasını sağlayabilir. Çelişkili dokümanlar geldiğinde model en güncel veya yetkili kaynağı tercih etmelidir. Kullanıcıya kaynak ve güncelleme tarihi göstermek kurumsal güveni artırır.
Güncel Bilgi Gerektiren Uygulamalar
Sık güncellenen ürün veya operasyon bilgisi model ağırlıklarında tutulmamalıdır. RAG ingestion pipeline yeni bilgiyi index'e ekleyerek daha hızlı güncellenebilirlik sunar. Freshness SLA belirlemek bu uygulamalarda önemlidir. İndeksin ne kadar sürede yeni belgeyi aramaya açtığı ölçülebilir. Eski veya geçersiz dokümanın retrieval sonuçlarında görünmesi kalite problemi olarak izlenmelidir.
RAG'ın Gereksiz Olduğu Senaryolar
Kullanıcı yalnızca genel dil üretimi veya yaratıcı metin istiyorsa RAG gerekmeyebilir. Hesaplama, sipariş durumu veya kesin veritabanı değeri isteyen sorular doğrudan tool veya API çağrısıyla daha güvenilir çözülebilir. Çok küçük ve sabit bir doküman seti context window içine güvenle sığıyorsa retrieval katmanı gereksiz operasyon yükü oluşturabilir. Ayrıca kaynağı olmayan subjektif görevlerde RAG değer sağlamayabilir. Teknoloji seçimi kullanım senaryosuna göre yapılmalı ve her LLM uygulamasına otomatik vector database eklenmemelidir.
Uzun Context Window RAG'ın Yerini Alabilir mi?
Uzun context window küçük veya orta büyüklükteki sabit doküman setlerinde RAG ihtiyacını azaltabilir. Ancak yüzlerce veya binlerce dokümanı her sorguda modele vermek maliyet ve latency açısından verimsiz olur. Uzun context içinde ilgili bilginin bulunması da her zaman garanti değildir. Access control, freshness ve kaynak önceliği gibi gereksinimler retrieval katmanını yine değerli kılar. En iyi yaklaşım bazı projelerde retrieval ile long-context kullanımını birlikte değerlendirmek ve gerçek benchmark üzerinden seçim yapmaktır.
Tool Calling Ne Zaman Daha Mantıklıdır?
Kullanıcı stok durumu, güncel fiyat, hesap bakiyesi veya belirli API sonucunu soruyorsa tool calling çoğu zaman RAG'dan daha doğrudur. RAG doküman ve bilgi parçalarını bulur fakat transaction veya kesin sistem state'i için tasarlanmamıştır. Tool structured ve authoritative veri kaynağına doğrudan erişir. LLM retrieval ile doküman açıklamasını, tool ile anlık değeri aynı cevapta birleştirebilir. Bu ayrım RAG'ın her veri erişim problemini çözmeye çalışmasını önler.
Structured Data İçin SQL mi RAG mı?
Yapılandırılmış tablolar üzerinde kesin filtre, aggregate ve join gerekiyorsa SQL daha uygundur. RAG text açıklaması ve semantik doküman erişiminde daha güçlüdür. Tabloyu metne çevirip vector store'a atmak sayısal sorgularda hataya açık olabilir. Bir hibrit uygulamada kullanıcı sorusu SQL tool veya document retrieval arasında route edilebilir. Amaç veri türüne göre doğru retrieval yöntemini seçmek ve her şeyi embedding benzerliğine bırakmamaktır.
RAG, Fine-Tuning ve Prompt Engineering Arasındaki Fark
RAG, fine-tuning ve prompt engineering aynı problemi çözmek için geliştirilmiş eş anlamlı yöntemler değildir. RAG çalışma anında dış bilgi getirir, fine-tuning model davranışını ve görev kalıplarını ağırlıklara taşır, prompt engineering ise mevcut modelin nasıl yönlendirileceğini belirler. Gerçek projelerde bu yöntemler birbirini tamamlayabilir. Bilginin sık değişip değişmediği, cevap stilinin ne kadar özel olduğu ve kaynak gösterme ihtiyacı mimari seçimi etkiler. Kurumsal yapay zeka projelerinde RAG mi fine-tuning mi kullanılmalı sorusuna doğru cevap problem tipine göre verilmelidir.
RAG vs Fine-Tuning
RAG dış bilgiye erişimi kolaylaştırırken fine-tuning modelin davranışını veya belirli görev performansını değiştirmeyi amaçlar. Güncel doküman bilgisini fine-tuning ile taşımak bakım açısından zor olabilir. Buna karşılık belirli JSON formatına uyma veya sektör dili kullanma gibi davranışlar fine-tuning için uygun olabilir. RAG kaynak gösterebilir ve belge silindiğinde bilgiyi indeksten kaldırmak daha kolaydır. İki yaklaşım aynı sistemde birlikte kullanılarak hem doğru bilgi hem istenen cevap davranışı elde edilebilir.
RAG vs Prompt Engineering
Prompt engineering modele nasıl davranacağını söyler ancak prompt içinde bulunmayan özel bilgiyi kendiliğinden oluşturmaz. RAG ilgili bilgiyi bulup prompt context'ine ekler. Bu nedenle prompt kalitesi kötü retrieval'ı telafi edemez. Aynı şekilde iyi retrieval da modelin kaynak dışı tahmin yapmasını engelleyen net grounding talimatları olmadan yeterli olmayabilir. Üretim sisteminde retrieval pipeline ile prompt tasarımı ayrı benchmark edilmelidir.
RAG vs Long-Context Prompting
Long-context prompting birçok belgeyi tek seferde modele vermeyi mümkün kılabilir. RAG ise sadece ilgili parçaları seçerek context bütçesini daha verimli kullanmayı amaçlar. Küçük veri setlerinde long-context daha basit olabilir. Büyük, dinamik veya erişim kontrollü bilgi tabanlarında retrieval daha güçlü operasyon avantajları sağlar. Gerçek karar accuracy, latency ve cost benchmark sonuçlarına göre verilmelidir.
RAG vs Web Search
Web search açık internette güncel bilgi bulmaya odaklanırken kurumsal RAG genellikle kontrollü ve özel bilgi tabanları üzerinde çalışır. Web sonuçlarının güvenilirliği ve kaynak sıralaması ayrıca değerlendirilmelidir. Enterprise retrieval'da doküman erişim yetkileri daha merkezi rol oynar. Bazı uygulamalar iç bilgi ile web bilgisini farklı retrieval kanallarından getirip aynı context içinde birleştirebilir. Bu durumda source prioritization ve güvenilirlik politikası açıkça tanımlanmalıdır.
RAG vs Tool Calling
RAG bilgi bulur, tool calling işlem veya kesin sistem sorgusu gerçekleştirir. Kullanıcı "izin politikası nedir" dediğinde RAG uygun olabilirken "kaç gün iznim kaldı" sorusu bir kurumsal sisteme tool çağrısı gerektirebilir. İki yöntemi ayırmak hem doğruluğu hem güvenliği artırır. Agent veya router kullanıcı amacını analiz ederek doğru yolu seçebilir. Tool sonucu da gerektiğinde RAG tarafından getirilen prosedür açıklamasıyla birlikte cevapta kullanılabilir.
RAG ve Fine-Tuning Birlikte Kullanılabilir mi?
Evet, iki yaklaşım farklı katmanları iyileştirdiği için birlikte kullanılabilir. Fine-tuning modelin kurumun tercih ettiği cevap formatına veya terminolojiye daha iyi uymasını sağlayabilir. RAG ise güncel gerçekleri ve özel doküman bilgisini inference sırasında sunar. Fine-tuned model de retrieved context dışına çıkmama konusunda ayrıca değerlendirilmelidir. Sistem tasarımında hangi kalitenin retrieval, hangisinin model davranışıyla iyileştirildiği ölçülebilir tutulmalıdır.
Hangi Yaklaşım Hangi Problem İçin Seçilmeli?
Problem güncel bilgi ve doküman erişimiyse RAG güçlü adaydır. Problem belirli cevap biçimi, sınıflandırma davranışı veya özel görev pattern'i ise fine-tuning düşünülebilir. Basit yönlendirme ihtiyacında prompt engineering çoğu zaman yeterlidir. Kesin sistem işlemi gerekiyorsa tool calling tercih edilmelidir. Tek bir yaklaşımı her soruna uygulamak yerine kullanım senaryolarını sınıflandırmak daha güvenilir mimari üretir.
Temel RAG Mimarisi Nasıl Çalışır?
Temel RAG mimarisi offline indexing ve online query-serving olmak üzere iki ana akıştan oluşur. Offline tarafta dokümanlar alınır, parse edilir, chunk'lara bölünür, embedding oluşturulur ve index'e yazılır. Online tarafta kullanıcı sorgusu işlenir, uygun chunk'lar retrieval ile bulunur, gerekiyorsa reranking yapılır ve context oluşturulur. LLM bu context üzerinden cevap üretir ve kaynak bilgileri response'a eklenir. RAG mimarisinde embedding chunking vektör veritabanı ve retrieval optimizasyonu ancak bu iki akış birlikte ölçüldüğünde anlamlı sonuç verir.
RAG Mimarisinin İki Ana Akışı
Indexing pipeline bilgi tabanını aramaya hazırlanmış hale getirir. Query-serving pipeline ise kullanıcının sorusuna göre ilgili bilgiyi çalışma anında bulur. Bu akışların farklı SLA ve performans ihtiyaçları vardır. Indexing dakika veya saat ölçeğinde çalışabilirken online retrieval genellikle kullanıcı latency beklentisi içinde sonuç vermelidir. Her iki pipeline'ın version ve observability kayıtlarının birbirine bağlanması production hata ayıklamasını kolaylaştırır.
Offline / Indexing Pipeline
Offline pipeline kaynak sistemlerden dokümanları toplar ve aranabilir representation oluşturur. Parsing sonrasında text normalizasyonu, metadata enrichment ve chunking uygulanır. Her chunk embedding modelinden geçirilerek vector veya hybrid index'e yazılır. Doküman version ve checksum bilgileri incremental update için saklanabilir. Pipeline'ın başarısı yalnızca kaç doküman işlendiğiyle değil parsing kalitesi ve index freshness metrikleriyle ölçülmelidir.
Online / Query-Serving Pipeline
Online pipeline kullanıcının sorusunu alır ve retrieval için uygun sorgu representation'ı üretir. Metadata filter, dense search, sparse search veya hybrid retrieval uygulanabilir. Candidate sonuçlar gerekiyorsa reranker tarafından yeniden sıralanır. En ilgili context LLM'e gönderilir ve cevap citation bilgileriyle üretilir. Bu akışta P95 latency, retrieval hit rate ve groundedness birlikte izlenmelidir.
RAG Pipeline'ın Uçtan Uca Veri Akışı
Veri kaynaktan alındıktan sonra doğrudan embedding'e gönderilmemelidir. Önce parsing, yapısal analiz, temizleme ve metadata üretimi gerekir. Chunking sonucu oluşan parçalar doğru belge ve bölüm bilgisiyle index'e yazılmalıdır. Query geldiğinde retrieval sonuçları context budget içine kontrollü biçimde yerleştirilir. Cevap sonrasında kullanılan kaynaklar trace'e yazılarak değerlendirme ve hata analizi için saklanmalıdır.
Data Source
Data source PDF, web sayfası, wiki, database veya başka kurumsal sistem olabilir. Her kaynak tipi farklı parsing ve freshness ihtiyacı taşır. Source owner ve access policy ingestion metadata'sına eklenmelidir. Aynı içeriğin farklı sistemlerden gelmesi duplicate problemlerine neden olabilir. Kaynağın güvenilirlik seviyesi retrieval sırasında source prioritization amacıyla kullanılabilir.
Parsing
Parsing dokümanı modelin ve retrieval sisteminin kullanabileceği yapısal metne dönüştürür. Başlık, paragraf, tablo ve kod bloklarının mümkün olduğunca korunması gerekir. Kötü parsing doğru bilgiyi yanlış bir text stream haline getirerek retrieval kalitesini düşürür. Parser başarısı örnek dokümanlarla insan incelemesi ve otomatik test üzerinden değerlendirilmelidir. Özellikle PDF layout yapıları tek bir düz metin olarak ele alınmamalıdır.
Chunking
Chunking uzun içeriği retrieval için yönetilebilir bilgi parçalarına ayırır. Çok küçük chunk bağlam kaybına, çok büyük chunk ise relevance dilution problemine neden olabilir. Doküman türü ve kullanıcı soru biçimi chunk boyutunu etkiler. Başlık ve bölüm sınırlarını koruyan document-aware yaklaşım çoğu kurumsal dokümanda iyi başlangıç sağlar. Chunking stratejisi mutlaka golden query set üzerinde benchmark edilmelidir.
Embedding
Embedding bir metni anlamsal benzerliğin hesaplanabileceği sayısal vektör representation'ına dönüştürür. Query ve chunk aynı veya uyumlu embedding uzayında temsil edilir. Benzerlik metriği model ve index seçimiyle uyumlu olmalıdır. Türkçe ve çok dilli içerikte embedding modelinin dil performansı ayrıca test edilmelidir. Model değiştiğinde mevcut index'in yeniden embed edilmesi gerekebileceği için versioning baştan tasarlanmalıdır.
Indexing
Indexing embedding ve metadata'nın hızlı retrieval için uygun veri yapısına yazılmasıdır. HNSW veya başka ANN yöntemleri performans ve recall arasında denge kurabilir. Metadata filter desteği kurumsal authorization için önemlidir. Index version, embedding model ve chunking strategy ile ilişkilendirilmelidir. Yeni index production'a alınmadan retrieval benchmark ile mevcut sürümle karşılaştırılmalıdır.
Query Processing
Kullanıcı sorgusu her zaman retrieval için ideal biçimde yazılmaz. Yazım düzeltme, entity çıkarımı veya query rewriting bazı durumlarda yararlı olabilir. Bununla birlikte agresif rewriting kullanıcının niyetini değiştirebilir. Original query trace içinde korunmalı ve rewritten query ayrıca loglanmalıdır. Query processing katkısı offline evaluation ile ölçülmeden varsayılan olarak eklenmemelidir.
Retrieval
Retrieval kullanıcı sorusuyla ilgili candidate chunk'ları index içinden bulur. Dense, sparse veya hybrid yöntem kullanılabilir. Top-k değeri fazla yükseltildiğinde gereksiz bağlam modele taşınabilir. Similarity threshold yetersiz sonuçları ayıklamak için faydalıdır. Retrieval başarısı answer generation'dan bağımsız recall ve ranking metrikleriyle ölçülmelidir.
Reranking
Reranker ilk retrieval aşamasında gelen candidate sonuçları daha ayrıntılı sorgu-belge ilişkisine göre yeniden sıralar. Cross-encoder yöntemleri daha doğru ranking sağlayabilir fakat ek latency oluşturur. Bu nedenle her query için zorunlu olmayabilir. Candidate sayısı ve rerank edilen sonuç sayısı ayrı optimize edilmelidir. Reranking eklenmeden önce baseline retrieval performansı ölçülmelidir.
Context Assembly
Context assembly hangi chunk'ların hangi sırada LLM prompt'una gireceğini belirler. Duplicate veya aynı parent bölümden gereksiz tekrar eden chunk'lar temizlenebilir. En güvenilir ve en ilgili kaynakların önceliği artırılabilir. Token budget aşılmamalı ve önemli içeriğin context ortasında kaybolması azaltılmalıdır. Context'in her parçası source ID ile birlikte taşınmalıdır.
Augmentation
Augmentation retrieved context'in kullanıcı sorgusuyla birlikte model prompt'una eklenmesi aşamasıdır. Context ile instruction açık biçimde ayrılmalıdır. Doküman içindeki metin talimat olarak değil güvenilmeyen veri olarak ele alınmalıdır. Prompt modele yalnızca sağlanan kanıta dayanma politikası vermelidir. Bu katman indirect prompt injection riskine karşı güvenlik sınırlarının da uygulandığı yerdir.
Generation
Generator LLM kullanıcı sorusu ve retrieved context üzerinden nihai cevap üretir. Daha büyük model kullanmak kötü retrieval sorununu otomatik çözmez. Cevap faithfulness, relevance ve citation accuracy açısından değerlendirilmelidir. Structured response gerekiyorsa schema-constrained output kullanılabilir. Modelin kaynakta bilgi yoksa tahmin yapmaması önemli production davranışıdır.
Citation ve Response
Citation kullanıcının yanıtın dayandığı belge veya bölümünü görebilmesini sağlar. Modelin yazdığı kaynak numaraları retrieved source listesiyle programatik olarak eşleştirilmelidir. Gerçekte kullanılmayan bir belgeyi citation olarak göstermek kalite hatasıdır. Response katmanı kullanıcı yetkisini tekrar kontrol edebilir. Her cevap trace ID ile izlenerek feedback ve evaluation sürecine bağlanmalıdır.
RAG Data Ingestion Pipeline Nasıl Tasarlanır?
Ingestion pipeline RAG sisteminin bilgi tabanını besleyen production bileşenidir. Kaynak türüne göre parsing, temizleme, metadata ve versioning adımları farklı olabilir. Dokümanı yalnızca text'e çevirmek yeterli değildir çünkü başlık, tablo, tarih ve access policy gibi bilgiler retrieval kalitesini doğrudan etkiler. Incremental ingestion, değişmeyen belgeleri gereksiz yere tekrar embed etmemelidir. Freshness ve failed document oranı gibi metrikler sürekli izlenmelidir.
Veri Kaynaklarının Belirlenmesi
İlk adım hangi kaynakların authoritative olduğunu belirlemektir. Aynı konuda bir wiki, eski PDF ve güncel prosedür bulunabilir. Source owner, freshness ve güvenilirlik bilgileri metadata olarak taşınabilir. RAG bütün bulunan içerikleri eşit güvenilir kabul etmemelidir. Kaynak envanteri oluşturmak retrieval tasarımından önce yapılması gereken önemli kurumsal çalışmadır.
PDF dosyaları metin akışı, tablo ve görsel açısından çok farklı yapılar taşıyabilir. Native text extraction mümkünse OCR'dan önce tercih edilmelidir. Sayfa başlığı ve footer gibi tekrar eden alanlar chunk'lara taşınmamalıdır. Başlık hiyerarşisi korunabiliyorsa document-aware chunking için değerli metadata sağlar. Parsing kalite testi farklı PDF tiplerini kapsamalıdır.
Word ve PowerPoint
Word dokümanlarında heading, liste ve tablo yapısını korumak retrieval kalitesini artırır. PowerPoint'te slayt başlığı, madde metni ve speaker note farklı anlam taşıyabilir. Her slaydı tek chunk yapmak bazı sunumlarda uygun olabilirken yoğun slaytlarda daha küçük bölme gerekebilir. Görseller anlamlı bilgi içeriyorsa multimodal pipeline düşünülmelidir. Dosya version metadata'sı index freshness için saklanmalıdır.
Web Sayfaları
Web içeriğinde navigation, footer, cookie metni ve tekrar eden component'ler retrieval gürültüsü oluşturabilir. Boilerplate temizliği ana içeriği koruyacak biçimde yapılmalıdır. URL, page title ve updated date metadata olarak saklanabilir. Dinamik sayfalarda rendering yöntemi ayrıca düşünülmelidir. Site içeriği değiştiğinde incremental crawl yalnızca değişen sayfaları yeniden indexleyebilir.
Wiki ve Knowledge Base
Wiki içerikleri başlık ve bağlantı yapıları nedeniyle RAG için değerli veri kaynaklarıdır. Page hierarchy metadata olarak kullanılabilir. Eski ve archived sayfalar retrieval sırasında düşük öncelik almalıdır. Access group bilgisi ingestion sırasında chunk seviyesine taşınmalıdır. Wiki değişiklik event'leri incremental indexing'i tetikleyebilir.
E-posta
E-posta bilgi tabanı hassas veri ve erişim sorunu nedeniyle dikkatli tasarlanmalıdır. Thread yapısı korunmadan her mesajı ayrı indexlemek bağlamı bozabilir. Signature ve quoted history temizlenebilir. PII ve gizli bilgi detection uygulanmalıdır. Kurumsal kullanımda mail retrieval yalnızca açık yetkilendirme politikasıyla düşünülmelidir.
Database
Database içindeki yapılandırılmış veri doğrudan text RAG'a çevrilmeden önce sorgu ihtiyacı değerlendirilmelidir. Açıklama ve knowledge içerikleri embedding için uygun olabilir. Sayısal ve transaction verileri için SQL tool daha doğru sonuç verebilir. Database row'ları indexlenecekse primary key ve updated_at metadata'sı saklanmalıdır. Silinen kayıtların vector index'ten de kaldırılması zorunludur.
API
API kaynakları güncel veya yapılandırılmış bilgiyi ingestion pipeline'a taşıyabilir. Pagination, rate limit ve error handling açık biçimde yönetilmelidir. API response schema değişikliği parsing regression yaratabilir. ETag veya updated timestamp incremental ingestion için kullanılabilir. Access token ve secret değerleri hiçbir zaman chunk metadata'sına yazılmamalıdır.
SaaS Sistemleri
SaaS kaynakları connector veya API üzerinden bilgi tabanına alınabilir. Tenant ve access group bilgileri ingestion sırasında korunmalıdır. Sync başarısızlığı freshness problemine neden olabilir. Connector status ve last_successful_sync metric olarak izlenmelidir. Kullanıcı yetkisi değiştiğinde retrieval authorization'ın güncellenmesi gerekir.
Document Parsing
Document parsing yalnızca karakterleri okumak değil dokümanın anlamlı yapısını çıkarmaktır. Heading, paragraph, table ve list block'ları ayrı representation olarak saklanabilir. Parser hataları doğrudan chunk quality'yi etkiler. Farklı parser seçenekleri representative document set üzerinde benchmark edilmelidir. Production pipeline parse edilemeyen dosyaları sessizce atmak yerine quarantine ve error report üretmelidir.
OCR ile Taranmış Dokümanların İşlenmesi
Taranmış PDF veya görsellerde metin doğrudan bulunmadığı için OCR gerekebilir. OCR hataları özellikle sayı, tablo ve özel karakterlerde retrieval doğruluğunu düşürür. OCR confidence düşük sayfalar human review veya vision processing akışına yönlendirilebilir. Türkçe karakter performansı kullanılan OCR motoruyla ayrıca test edilmelidir. Original page image reference citation ve doğrulama için saklanabilir.
Tablo ve Grafiklerin İşlenmesi
Tabloları satır sırasını kaybeden düz metne çevirmek ciddi bilgi kaybı yaratabilir. Tablo başlıkları ve hücre ilişkileri yapısal biçimde korunmalıdır. Grafiklerde yalnızca OCR yeterli olmayabilir çünkü eksen ve görsel ilişki önemlidir. Multimodal model veya caption generation destekleyici olabilir. Kritik sayısal değerler mümkünse structured source üzerinden tool calling ile alınmalıdır.
Text Normalization
Text normalization gereksiz whitespace, encoding veya Unicode farklılıklarını standart hale getirir. Aşırı normalization teknik kod, dosya adı veya ürün identifier bilgisini bozabilir. Türkçe karakterlerin doğru korunması önemlidir. Normalization işlemleri deterministic ve test edilebilir olmalıdır. Original text gerektiğinde audit amacıyla saklanmalıdır.
Boilerplate Temizliği
Footer, navigation ve repeated disclaimer gibi alanlar her chunk içinde tekrar ederse retrieval sonuçlarını kirletebilir. Boilerplate removal aynı kalıbın birçok sayfada görünmesine göre yapılabilir. Ancak yasal veya teknik olarak önemli uyarılar yanlışlıkla silinmemelidir. Removal rule document type bazında tanımlanmalıdır. Chunk kalite örnekleri manuel olarak düzenli incelenmelidir.
Duplicate Content Tespiti
Aynı belgenin farklı format veya klasörde birden fazla kopyası olabilir. Duplicate content retrieval sonucunda aynı bilgiyi gereksiz tekrar ettirir. Hash, normalized text similarity veya semantic duplicate yöntemleri kullanılabilir. Hangi kopyanın canonical olduğu source priority ile belirlenmelidir. Duplicate tespiti yaparken farklı versiyonların yanlışlıkla tek belge kabul edilmemesine dikkat edilmelidir.
Metadata Enrichment
Metadata retrieval kalitesi ve güvenliği için güçlü bir kontrol alanıdır. Document type, department, date, language, owner ve access group gibi alanlar eklenebilir. Filtreleme sayesinde yalnızca ilgili ve yetkili içerikler candidate havuzuna girer. Metadata field'ları standard schema üzerinden yönetilmelidir. Serbest ve tutarsız metadata filtre performansını düşürebilir.
Document Versioning
Doküman güncellendiğinde eski chunk'ların yeni içerikle birlikte aktif kalması çelişkili cevap üretebilir. Her belge version ve effective date taşımalıdır. Yeni sürüm başarıyla indexlendikten sonra eski sürüm inactive yapılabilir. Historical retrieval gereken use case'lerde versiyon filtresi kullanılabilir. Citation kullanıcıya hangi sürümün kullanıldığını gösterebilmelidir.
Incremental Ingestion
Bütün bilgi tabanını her gün yeniden embed etmek gereksiz maliyet yaratır. Checksum, updated timestamp veya change event değişen dokümanları tespit etmek için kullanılabilir. Yalnızca eklenen, güncellenen veya silinen içerik index'e yansıtılır. Incremental pipeline idempotent tasarlanmalıdır. Başarısız update eski güvenilir index'i bozmamalıdır.
Knowledge Base Freshness
Freshness bilginin ne kadar güncel olduğunu ve son değişikliklerin index'e ne kadar hızlı yansıdığını ifade eder. Source update ile searchable time arasındaki gecikme ölçülebilir. Kritik bilgi tabanlarında freshness SLA belirlenebilir. Sync failure alarm üretmelidir. Kullanıcıya eski bilgi verme riski retrieval relevance kadar önemli production kalite problemidir.
RAG Sistemlerinde Chunking Nedir?
Chunking uzun dokümanları retrieval tarafından bulunabilecek anlamlı parçalara ayırma işlemidir. Chunk sınırı yanlış seçilirse cevap için gerekli iki cümle farklı parçalarda kalabilir veya büyük chunk gereksiz metin taşıyabilir. Bu nedenle tek bir evrensel chunk size yoktur. Doküman türü, embedding modeli, kullanıcı soruları ve context budget birlikte değerlendirilmelidir. Ben chunking kararını sezgiden ziyade golden query set üzerindeki retrieval metrikleriyle vermeyi daha güvenilir buluyorum.
Chunking Neden Retrieval Kalitesini Belirler?
Retriever aslında bütün dokümanı değil oluşturulan chunk representation'larını sıralar. Bilgi bir chunk içinde yeterince yoğun ve açık değilse embedding doğru sinyal üretemeyebilir. Çok geniş chunk içinde ilgili cümle genel konunun içinde kaybolabilir. Çok dar chunk ise cevap bağlamını eksik bırakabilir. Bu nedenle chunking retrieval recall ile context usefulness arasında kurulan önemli tasarım dengesidir.
Chunk Size Nasıl Seçilir?
Chunk size doküman yapısı ve soru biçimine göre benchmark edilmelidir. Kısa FAQ belgelerinde küçük chunk yeterli olabilirken teknik kılavuzlarda bölüm seviyesinde daha büyük parçalar gerekebilir. Token sayısı karakter sayısından daha anlamlı ölçüm sunar. Birkaç farklı size aynı golden dataset üzerinde test edilmelidir. En iyi size yalnızca retrieval score değil answer faithfulness ve context token maliyetiyle birlikte değerlendirilmelidir.
Chunk Overlap Ne Kadar Olmalı?
Overlap bölüm sınırında kalan bilgilerin iki chunk arasında tamamen kaybolmasını azaltabilir. Fazla overlap aynı içeriğin retrieval sonuçlarında tekrar tekrar gelmesine neden olur. Bu durum context token kullanımını artırır ve source diversity'yi düşürür. Document-aware chunking kullanıldığında yüksek overlap ihtiyacı azalabilir. Overlap değeri retrieval benchmark ve duplicate context oranı birlikte ölçülerek seçilmelidir.
Fixed-Size Chunking
Fixed-size chunking metni sabit token veya karakter uzunluğunda böler. Uygulaması basittir ve iyi baseline sağlar. Ancak başlık veya paragraf sınırlarını dikkate almadığı için anlam bütünlüğünü bozabilir. Homojen text corpus'larında kabul edilebilir sonuç verebilir. Production kararı vermeden önce document-aware alternatiflerle karşılaştırılması faydalıdır.
Recursive Chunking
Recursive chunking önce büyük yapısal ayırıcıları, ardından daha küçük ayırıcıları kullanarak hedef boyuta ulaşmaya çalışır. Paragraf ve cümle bütünlüğünü fixed-size yöntemden daha iyi koruyabilir. Ayırıcı listesi dile ve doküman formatına göre uyarlanmalıdır. Kod veya tablo blokları için özel kurallar gerekebilir. Basitliği ve yapısal duyarlılığı nedeniyle güçlü başlangıç yöntemlerinden biridir.
Sentence-Based Chunking
Sentence-based chunking cümle sınırlarını koruyarak belirli sayıda cümleyi bir araya getirir. Bu yöntem yarım cümle probleminden kaçınır. Çok kısa veya çok uzun cümlelerin olduğu dokümanlarda chunk boyutu dengesiz olabilir. Sentence tokenizer Türkçe ve teknik kısaltmalarda test edilmelidir. Retrieval kalite sonuçları token budget ile birlikte değerlendirilmelidir.
Semantic Chunking
Semantic chunking konu değişimini embedding veya benzer anlam sinyalleri üzerinden belirlemeye çalışır. Farklı uzunlukta fakat daha doğal konu blokları üretebilir. Ek embedding veya hesaplama maliyeti oluşturabilir. Her corpus'ta fixed veya recursive chunking'den daha iyi olduğu varsayılmamalıdır. Benchmark yapılmadan semantik olduğu için otomatik üstün kabul etmek doğru değildir.
Document-Aware Chunking
Document-aware chunking dokümanın başlık, paragraf, tablo ve kod bloklarını dikkate alır. Teknik ve kurumsal dokümanlarda doğal bilgi sınırlarını koruyabildiği için güçlü sonuç verebilir. Chunk metadata içine parent heading eklenmesi query eşleşmesini artırabilir. Çok büyük bölümler alt parçalara ayrılabilir. Parsing yapısı doğru değilse document-aware yaklaşım da beklenen avantajı sağlayamaz.
Başlık Bazlı Bölme
Heading-based chunking bölümleri dokümanın doğal konu başlıklarına göre ayırır. Başlık text'i chunk'ın başına veya metadata'sına eklenebilir. Bu sayede "izin politikası" gibi sorgular yalnızca body değil bölüm başlığı sinyalinden de yararlanır. Çok uzun başlık bölümleri ayrıca alt chunk'lara bölünmelidir. Heading hierarchy parent-child retrieval için de değerli bilgi sağlar.
Paragraf Bazlı Bölme
Paragraf doğal yazı birimi olduğu için çoğu dokümanda iyi semantic sınırdır. Çok kısa paragraflar komşularıyla birleştirilebilir. Çok uzun paragraflar sentence-based yöntemle alt parçalara ayrılabilir. Paragraf sırası ve parent heading metadata olarak tutulmalıdır. Tek başına boş satır algılaması farklı dosya formatlarında her zaman yeterli olmayabilir.
Tablo Bazlı Bölme
Tablonun kolon başlıkları her satır veya tablo parçasıyla birlikte korunmalıdır. Sadece hücre değerlerini text'e dönüştürmek anlam kaybı yaratabilir. Küçük tablolar tek chunk olarak tutulabilir. Büyük tablolar row group veya semantic bölüm bazında ayrılabilir. Sayısal sorgular için structured query alternatifinin daha doğru olup olmadığı ayrıca değerlendirilmelidir.
Kod Bloklarını Koruma
Kod bloklarını satır ortasından bölmek retrieval ve generation kalitesini düşürebilir. Function veya class sınırı doğal chunk birimi olabilir. Kodla birlikte açıklayıcı heading ve çevre metni metadata olarak taşınabilir. Çok büyük kod blokları syntax-aware biçimde ayrılmalıdır. Yazılım dokümantasyonu RAG sistemlerinde bu yaklaşım özellikle faydalıdır.
Parent-Child Chunking
Parent-child yaklaşım küçük chunk ile retrieval yapıp daha geniş parent bölümü context'e taşır. Küçük child chunk yüksek relevance sinyali sağlar. Parent block ise cevap için gerekli geniş bağlamı korur. Bu yöntem küçük chunk ve büyük context avantajını birleştirebilir. Parent boyutu ve child-parent ilişkisinin metadata'da doğru tutulması gerekir.
Hierarchical Chunking
Hierarchical chunking dokümanı bölüm, alt bölüm ve küçük parça seviyelerinde temsil eder. Retrieval önce uygun bölümü, sonra alt parçayı bulabilir. Uzun teknik dokümanlarda güçlü olabilir. Index ve retrieval mantığı daha fazla tasarım gerektirir. Kullanıcı soruları çok farklı granularity taşıyorsa hiyerarşik yaklaşım özellikle değerlidir.
Sliding Window
Sliding window sabit boyutlu parçaları belirli overlap ile metin üzerinde kaydırır. Bilgi sınırı problemi azaltılabilir. Fazla overlap index boyutunu ve duplicate retrieval oranını artırır. Homojen text üzerinde basit baseline olarak kullanılabilir. Document structure iyi biliniyorsa daha anlamlı bölme yöntemleri çoğu zaman tercih edilebilir.
Small-to-Big Retrieval
Small-to-big retrieval küçük text parçaları üzerinden arama yapar ancak final context için daha geniş surrounding content kullanır. Bu yaklaşım yüksek precision ile yeterli bağlamı birleştirmeye çalışır. Parent reference veya offset bilgisi index metadata'sında tutulmalıdır. Büyük context gereksiz metin taşıyorsa token maliyeti artabilir. Benchmark retrieval ve generation seviyesinde birlikte yapılmalıdır.
Chunking Stratejisi Nasıl Benchmark Edilir?
Önce gerçek kullanıcı sorularından golden query set oluşturulmalıdır. Her query için ilgili doküman veya passage etiketlenmelidir. Farklı chunking stratejileri aynı embedding ve retrieval ayarlarıyla karşılaştırılmalıdır. Recall@K, nDCG ve context recall gibi metrikler kullanılabilir. En iyi retrieval skoruna sahip stratejinin final answer kalitesi ve maliyeti de ayrıca ölçülmelidir.
Embedding Nedir ve RAG'da Nasıl Kullanılır?
Embedding metin veya başka içeriği benzer anlamların yakın vektörler oluşturacağı sayısal bir uzayda temsil eder. RAG sisteminde doküman chunk'ları ve kullanıcı sorguları bu uzayda karşılaştırılabilir. Embedding modeli retrieval kalitesini doğrudan etkiler. Dimension, latency, dil kapsamı ve maliyet birlikte değerlendirilmelidir. Model seçimi marka veya popülerlik üzerinden değil kendi golden retrieval dataset'iniz üzerinde benchmark edilmelidir.
Vector Embedding Mantığı
Bir embedding modeli metni çok boyutlu sayısal vektöre dönüştürür. Semantik olarak benzer ifadelerin vektörleri genellikle birbirine daha yakın olur. Bu özellik keyword eşleşmesinde bulunamayan anlam ilişkilerini yakalamaya yardımcı olur. Vektör tek başına gerçek doğruluk garantisi değildir. Domain terimleri ve özel isimler için sparse sinyallerle hybrid search gerekebilir.
Query ve Document Embedding
Document embedding offline indexing sırasında üretilir ve index'e kaydedilir. Query embedding kullanıcı sorgusu geldiğinde online olarak hesaplanır. Bazı modeller query ve document için farklı instruction veya prefix bekleyebilir. Yanlış kullanım retrieval performansını ciddi biçimde düşürebilir. Embedding pipeline modelin önerdiği kullanım biçimine uygun ve versioned olmalıdır.
Cosine Similarity
Cosine similarity iki vektör arasındaki açının benzerliğini ölçer. Vektör büyüklüğünden çok yön ilişkisine odaklanır. Birçok text embedding kullanımında yaygın seçimdir. Ancak modelin training yöntemi hangi similarity fonksiyonunun uygun olduğunu etkileyebilir. Vector database metric ayarı embedding model tavsiyesiyle uyumlu olmalıdır.
Dot Product
Dot product iki vektörün karşılıklı yön ve büyüklük ilişkisini tek skorla ifade eder. Normalize edilmiş vektörlerde cosine benzerliğiyle yakın davranabilir. Bazı embedding modelleri özellikle dot product için optimize edilir. Index configuration model özelliğine uygun seçilmelidir. Metric değişikliği retrieval benchmark yeniden çalıştırılmadan production'a alınmamalıdır.
Euclidean Distance
Euclidean distance vektörler arasındaki düz çizgi mesafesini ölçer. Bazı embedding uzaylarında uygun olabilir. Daha düşük mesafe daha yakın representation anlamına gelir. Her model için cosine yerine Euclidean kullanmak doğru değildir. Model dokümantasyonu ve gerçek retrieval testi seçim için birlikte kullanılmalıdır.
Embedding Modeli Nasıl Seçilir?
Embedding model seçimi retrieval benchmark üzerinden yapılmalıdır. Türkçe veya çok dilli içerik varsa test dataset bu dili mutlaka içermelidir. Model dimension index storage maliyetini ve search performansını etkileyebilir. Query latency production kullanıcı deneyimi açısından önemlidir. Model değişikliğinin re-indexing maliyeti de toplam sahip olma maliyetine dahil edilmelidir.
Retrieval Kalitesi
En temel kriter doğru passage'ın üst sıralarda gelip gelmediğidir. Recall@K, MRR ve nDCG gibi metric'ler model karşılaştırmasında kullanılabilir. Benchmark yalnızca birkaç kolay query'den oluşmamalıdır. Teknik terim, eş anlamlı ifade ve uzun soru gibi farklı query tipleri eklenmelidir. İstatistiksel olarak anlamlı karşılaştırma yapmak daha güvenilir seçim sağlar.
Dimension
Embedding dimension vektör storage ve index memory kullanımını etkiler. Daha yüksek dimension otomatik olarak daha iyi retrieval anlamına gelmez. Büyük dimension search latency ve maliyeti artırabilir. Vector database kapasite planlaması buna göre yapılmalıdır. Model seçimi accuracy ve infrastructure cost birlikte değerlendirilerek yapılmalıdır.
Latency
Query embedding online request'in kritik yolundadır. Yavaş embedding modeli retrieval başlamadan kullanıcı latency'sini artırır. P50 ve P95 süreleri ayrı ölçülmelidir. Batch ingestion latency'si online query kadar kritik olmayabilir. Router veya cache bazı tekrar eden sorgularda maliyeti azaltabilir.
Token Limiti
Embedding modeli tek input için maksimum token sınırına sahip olabilir. Büyük chunk'lar bu limite yaklaşabilir veya aşabilir. Chunking strategy model kapasitesiyle uyumlu tasarlanmalıdır. Input truncation sessizce bilgi kaybı yaratabilir. Pipeline fazla uzun chunk'ları indekslemeden önce validation ile yakalamalıdır.
Maliyet
Embedding maliyeti document ingestion ve query traffic üzerinden hesaplanmalıdır. Büyük corpus sık re-index edildiğinde maliyet belirginleşir. Incremental ingestion tekrar embedding ihtiyacını azaltır. Local embedding modeli altyapı maliyeti karşılığında çağrı maliyetini değiştirebilir. Total cost yalnızca token fiyatına bakılarak değerlendirilmemelidir.
Domain-Specific Embedding
Genel embedding modeli bazı teknik veya sektörel terimleri yeterince ayıramayabilir. Domain-specific modeller belirli vocabulary ve anlam ilişkilerinde daha iyi sonuç verebilir. Buna rağmen modelin kendi dataset'inizde test edilmesi gerekir. Hybrid retrieval genel modelin eksiklerini keyword sinyaliyle tamamlayabilir. Fine-tuned embedding düşünülüyorsa kaliteli positive ve negative training örnekleri gereklidir.
Multilingual Embedding
Çok dilli embedding farklı dillerdeki semantik olarak benzer ifadeleri ortak uzayda yakınlaştırmayı amaçlar. Kullanıcı Türkçe soru sorup İngilizce dokümandan cevap almak istiyorsa yararlı olabilir. Dil çiftlerinin performansı modelden modele değişir. Türkçe diakritik, özel isim ve teknik terim sorguları test edilmelidir. Cross-lingual retrieval başarısı ayrı benchmark olarak ölçülmelidir.
Türkçe RAG İçin Embedding Seçimi
Türkçe RAG projesinde yalnızca İngilizce benchmark sonuçlarına bakmak yeterli değildir. Gerçek Türkçe kullanıcı soruları, eklemeli dil yapısı ve yerel terminoloji dataset'te temsil edilmelidir. Türkçe ile İngilizce dokümanların karıştığı projelerde cross-lingual performans ayrıca önemlidir. Dense retrieval sonuçları BM25 ile karşılaştırılmalıdır. Model seçimi ancak gerçek soru setinde ölçülen retrieval metric'leriyle yapılmalıdır.
Multimodal Embedding
Multimodal embedding metin ve görselleri aynı veya ilişkili representation uzayına taşıyabilir. PDF içindeki diyagram, ürün görseli veya ekran görüntüsü böylece retrieval kapsamına alınabilir. Text-only soruların görsel içerikleri bulabilmesi önemli avantajdır. Index metadata'sında modality bilgisi tutulmalıdır. Görsel retrieval sonuçlarının cevap üretiminde gerçekten kullanılıp kullanılmadığı ayrıca değerlendirilmelidir.
Vector Database RAG Mimarisinde Ne İşe Yarar?
Vector database embedding vektörlerini ve ilgili metadata'yı hızlı benzerlik araması için saklayan sistem bileşenidir. RAG için yararlı olsa da tek başına RAG sistemi değildir. Index yöntemi, metadata filtering, tenant isolation ve backup gibi production gereksinimleri seçimde önemlidir. Ayrı bir vector database her proje için zorunlu değildir. Mevcut veri altyapısı ve ölçek uygunsa relational database üzerindeki vector extension da yeterli olabilir.
Vector Database Nedir?
Vector database yüksek boyutlu vektörler üzerinde nearest-neighbor arama yapmayı kolaylaştırır. Chunk embedding yanında document ID ve metadata saklayabilir. Search sırasında similarity ve filter birlikte uygulanabilir. Production kullanımında replication, backup ve access control gibi klasik database ihtiyaçları devam eder. Vector özelliği bu operasyon sorumluluklarını ortadan kaldırmaz.
Vector Index Nedir?
Vector index milyonlarca vektör içinde benzer adayları hızlı bulmak için kullanılan veri yapısıdır. Brute-force arama küçük dataset'te yeterli olabilir. Büyük ölçekte approximate yöntemler latency avantajı sağlar. Index parametreleri recall ve memory kullanımını etkiler. Ayarlar gerçek query workload üzerinden benchmark edilmelidir.
Approximate Nearest Neighbor Search
Approximate Nearest Neighbor yöntemleri tam arama yerine yüksek olasılıkla yakın adayları hızlı bulmayı hedefler. Bir miktar recall kaybı karşılığında ciddi hız kazanılabilir. RAG için kabul edilebilir denge corpus ve latency hedeflerine göre değişir. Index parametre tuning retrieval evaluation ile birlikte yapılmalıdır. Daha hızlı search uğruna kritik passage'ların sürekli kaçırılması kabul edilmemelidir.
HNSW
HNSW graph tabanlı ANN yaklaşımıdır ve birçok vector search sisteminde güçlü recall-latency dengesi sunar. Graph bağlantılarının sayısı memory tüketimini etkileyebilir. Build ve query parametreleri ayrı optimize edilir. Insert ve update davranışı product implementation'a göre değişebilir. Production benchmark gerçek index boyutunda yapılmalıdır.
IVF
IVF vektörleri cluster veya list yapısında gruplandırarak sorguda yalnızca bazı bölümlerin taranmasını sağlar. Probe edilen cluster sayısı recall ve latency dengesini etkiler. Index training için representative veri gerekebilir. Data distribution büyük ölçüde değişirse index kalitesi etkilenebilir. Drift sonrası recall benchmark yeniden çalıştırılmalıdır.
Product Quantization
Product Quantization vektörleri daha compact representation ile saklayarak memory ve storage maliyetini azaltabilir. Compression retrieval accuracy üzerinde etkili olabilir. Çok büyük corpus'larda önemli kapasite avantajı sağlar. RAG kalite hedefi yüksekse quantization etkisi golden dataset üzerinden ölçülmelidir. Storage tasarrufu tek başına seçim kriteri olmamalıdır.
Metadata Filtering
Metadata filter retrieval adaylarını department, language, date veya access group gibi alanlarla sınırlandırır. Bu özellik kurumsal sistemlerde güvenlik ve relevance için kritiktir. Yetki filtresi vector search sonrasında uygulanmamalıdır çünkü unauthorized content modele taşınabilir. Filter performance büyük indexlerde benchmark edilmelidir. Metadata schema standard ve versioned tutulmalıdır.
Namespace ve Tenant Tasarımı
Multi-tenant uygulamada tenant verilerinin birbirinden güçlü biçimde ayrılması gerekir. Namespace, collection veya metadata filter kullanılabilir. Güvenlik yalnızca uygulama prompt'una bırakılmamalıdır. Tenant ID retrieval request'te server-side identity'den gelmelidir. Cross-tenant leakage adversarial testlerle doğrulanmalıdır.
Vector Database Seçerken Nelere Bakılmalı?
Seçim yalnızca benchmark'ta en hızlı görünen ürüne göre yapılmamalıdır. Query pattern, filter yoğunluğu, dataset büyüklüğü, backup ihtiyacı ve ekip operasyon deneyimi değerlendirilmelidir. Managed ve self-hosted seçeneklerin total cost profili farklıdır. Index rebuild ve re-embedding süreçleri düşünülmelidir. En iyi çözüm, RAG sisteminin gerçek workload ve güvenlik gereksinimlerine en iyi uyan seçenektir.
Latency
Search latency online response süresinin bir parçasıdır. P50 kadar P95 ve P99 değerleri de izlenmelidir. Metadata filter bazı workload'larda latency'yi artırabilir. Query concurrency gerçek production yüküne yakın test edilmelidir. Sadece tek sorguluk lokal benchmark yanıltıcı olabilir.
Recall
Düşük latency yüksek recall kaybıyla elde ediliyorsa RAG kalitesi düşer. ANN index recall'ı brute-force veya ground-truth sonuçla karşılaştırılabilir. Query kategorilerine göre farklı recall davranışı görülebilir. Index tuning metric'lerle yapılmalıdır. Retrieval evaluation düzenli regression testine dahil edilmelidir.
Ölçeklenebilirlik
Corpus büyüdükçe storage, memory ve query concurrency ihtiyacı değişir. Horizontal scaling veya sharding desteği değerlendirilmelidir. Rebalancing sırasında availability davranışı önemlidir. Index build süresi büyüyen dataset'te operasyon maliyeti oluşturabilir. Gelecek kapasite planı gereksiz aşırı altyapı kurmadan yapılmalıdır.
Filtreleme
Metadata filter sadece convenience özelliği değil kurumsal access control katmanıdır. Çok seçici filter ile ANN performansı değişebilir. Nested veya multi-value field desteği kullanım senaryosuna göre önem kazanabilir. Filter semantics test edilmelidir. Kullanıcı yetkisine dayalı filter server-side üretilmelidir.
Yedeklilik
Production vector store veri kaybına karşı replication ve backup stratejisine sahip olmalıdır. Index yeniden üretilebilir olsa bile re-embedding zaman ve maliyet gerektirebilir. Metadata store ile tutarlılık ayrıca düşünülmelidir. Region failure senaryosu kritik uygulamalarda test edilmelidir. Recovery prosedürü dokümante edilmelidir.
Maliyet
Maliyet storage, RAM, compute, network ve operasyon süresinden oluşur. Managed hizmet operasyon yükünü azaltırken kullanım maliyeti farklı olabilir. Self-hosted çözüm ekip bakım maliyeti oluşturur. Index dimension ve quantization maliyeti doğrudan etkiler. Cost per query ve cost per million chunks gibi metrikler karar vermeyi kolaylaştırır.
Ayrı Vector Database Şart mı?
Hayır, her RAG projesi ayrı vector database gerektirmez. Küçük dataset'te in-memory index veya mevcut database yeterli olabilir. Yeni veri sistemi eklemek operasyon ve güvenlik yükü getirir. Gereksinimler büyüdüğünde dedicated vector search değerlendirilebilir. Mimariyi en baştan gereğinden fazla parçalamak yerine ölçümle ölçeklemek daha sağlıklı yaklaşımdır.
PostgreSQL + pgvector Kullanılabilir mi?
Evet, PostgreSQL kullanan ekipler vector aramayı aynı veri platformunda tutmayı tercih edebilir. Metadata ve relational filtrelerle aynı transaction ekosisteminde çalışmak bazı projelerde önemli avantajdır. Dataset ve latency hedefleri benchmark edilmelidir. Çok büyük ve farklı workload'larda dedicated çözüm gerekebilir. Build vs buy kararı mevcut altyapı, ekip deneyimi ve toplam sahip olma maliyetine göre verilmelidir.
RAG Retrieval Stratejileri
Retrieval bir RAG sisteminin bilgi seçim motorudur ve yalnızca dense vector search ile sınırlı değildir. Keyword, sparse, dense, hybrid, metadata-filtered ve multi-query yaklaşımları farklı sorgu tiplerinde farklı sonuç verir. Teknik identifier veya özel isim sorguları lexical sinyalden güçlü biçimde yararlanabilir. Semantik sorular dense retrieval için daha uygun olabilir. En iyi strateji gerçek query dataset'i üzerinde karşılaştırılmalı ve tek bir yöntem her soruya zorlanmamalıdır.
Keyword Search ve BM25
BM25 ve benzeri lexical yöntemler exact term ve keyword eşleşmesinde güçlüdür. Ürün kodu, fonksiyon adı veya özel teknik ifade sorgularında dense retrieval'dan daha iyi olabilir. Eş anlamlı veya farklı biçimde ifade edilen sorularda semantic coverage sınırlı kalabilir. Bu nedenle hybrid search için iyi bir bileşendir. BM25 baseline kurulmadan dense retrieval'ın gerçek katkısını ölçmek zorlaşır.
Dense Semantic Search
Dense search embedding vektörleri üzerinden anlam benzerliğine göre retrieval yapar. Kullanıcı dokümandaki kelimeleri birebir kullanmasa bile ilgili içeriği bulabilir. Domain terimleri ve kısa identifier'larda hata yapabilir. Query ve document embedding kalitesi kritik rol oynar. Dense sonuçlar keyword baseline ve hybrid yöntemlerle karşılaştırılmalıdır.
Sparse Retrieval
Sparse semantic retrieval lexical özellikleri daha zengin ağırlıklarla temsil edebilir. Keyword sinyali ile semantik genişleme arasında ara yaklaşım sunabilir. Index ve model desteği seçilen teknolojiye bağlıdır. Corpus'a göre dense yöntemleri tamamlayabilir. Ayrı evaluation yapılmadan ek pipeline maliyeti oluşturulmamalıdır.
Hybrid Search
Hybrid search dense semantic ve lexical sinyalleri birlikte kullanır. Özellikle kurumsal dokümanlarda hem doğal dil soruları hem de kod veya ürün ismi gibi exact terimler bulunduğu için güçlü sonuç verebilir. İki sonuç listesinin nasıl birleştirileceği önemlidir. Fusion parametreleri golden dataset üzerinde tune edilmelidir. Hybrid yöntem otomatik olarak her corpus'ta daha iyi sayılmamalıdır.
Dense + Sparse Retrieval
Dense arama semantik yakınlığı, sparse arama exact ve lexical sinyalleri yakalar. İki retrieval kanalı paralel çalıştırılabilir. Candidate listeleri fusion ile birleştirilir. Query type'a göre ağırlıklar değişebilir. Sonuçlar recall ve latency açısından birlikte ölçülmelidir.
Reciprocal Rank Fusion
Reciprocal Rank Fusion farklı ranking listelerini skor ölçeklerine doğrudan güvenmeden sıra bilgisine göre birleştirir. Dense ve BM25 skorlarının farklı dağılımda olduğu durumlarda kullanışlıdır. Parametre sayısı görece azdır. İyi baseline fusion yöntemi olabilir. Yine de gerçek query set üzerinde score fusion ile karşılaştırılmalıdır.
Score Fusion
Score fusion farklı retrieval skorlarını normalize edip ağırlıklı biçimde birleştirir. Dense ve lexical kanalın katkısı daha kontrollü ayarlanabilir. Score normalization yanlış tasarlanırsa bir kanal diğerini baskılayabilir. Query category bazlı dynamic weight düşünülebilir. Parameter tuning offline evaluation üzerinden yapılmalıdır.
Metadata-Filtered Retrieval
Metadata-filtered retrieval search alanını yalnızca ilgili belgelerle sınırlar. Kullanıcı departmanı, ürün, tarih veya language filter kullanılabilir. Authorization filter güvenlik için zorunlu olabilir. Aşırı dar filter doğru dokümanı dışarıda bırakabilir. Filter recall etkisi benchmark edilmelidir.
Multi-Query Retrieval
Multi-query yaklaşımı aynı kullanıcı sorusundan birkaç alternatif retrieval sorgusu üretir. Farklı ifade biçimleri recall'u artırabilir. Her ek query vector search ve token maliyeti oluşturur. Duplicate sonuçlar temizlenmelidir. Yalnızca zor veya düşük-confidence sorgularda adaptif olarak kullanmak daha ekonomik olabilir.
Query Expansion
Query expansion kısaltma, eş anlamlı veya domain terimlerini sorguya ekleyerek recall'u artırmayı amaçlar. Yanlış expansion sorgunun anlamını genişletip gereksiz doküman getirebilir. Domain dictionary deterministic expansion için kullanılabilir. LLM expansion gerekiyorsa original query korunmalıdır. Katkı query class bazında ölçülmelidir.
Query Rewriting
Query rewriting konuşma bağlamındaki zamirleri veya eksik ifadeleri bağımsız arama sorgusuna dönüştürebilir. Conversation RAG için özellikle değerlidir. Rewrite kullanıcı niyetini değiştirmemelidir. Original ve rewritten query trace içinde saklanmalıdır. Rewrite kalitesi retrieval ground truth üzerinden test edilebilir.
Query Decomposition
Birden fazla alt sorudan oluşan karmaşık sorgular tek retrieval ile iyi sonuç vermeyebilir. Query decomposition soruyu daha küçük bilgi ihtiyaçlarına ayırır. Her alt sorgu ayrı retrieval yapabilir. Sonuçlar final context içinde birleştirilir. Gereksiz decomposition latency ve maliyet yaratabileceği için yalnızca karmaşık sorgularda kullanılmalıdır.
HyDE
HyDE yaklaşımı kullanıcı sorusuna olası bir cevap veya belge representation'ı üretip bunu retrieval için kullanır. Bazı semantic search problemlerinde query-document gap'i azaltabilir. Üretilen hypothetical text yanlış yönlendirici olabilir. Ek LLM çağrısı latency oluşturur. Baseline dense ve hybrid search'e göre gerçek faydası benchmark edilmelidir.
Multi-Hop Retrieval
Multi-hop retrieval cevabın birden fazla belge veya bilgi adımını gerektirdiği sorular için kullanılır. İlk retrieval sonucu ikinci sorgunun oluşturulmasına yardımcı olabilir. Relation-heavy sorularda faydalıdır. Her hop hata zinciri ve latency oluşturur. Termination ve sufficiency koşulları açık biçimde tanımlanmalıdır.
Adaptive Retrieval
Adaptive retrieval her query için aynı pipeline'ı çalıştırmak yerine sorunun ihtiyacına göre yöntem seçer. Basit fact lookup tek search ile çözülebilirken karmaşık soru multi-query veya reranking gerektirebilir. Router quality ve cost arasında denge kurabilir. Routing policy evaluation dataset ile test edilmelidir. Yanlış route retrieval kalitesini ciddi biçimde etkileyebilir.
Dynamic Top-K
Dynamic top-k sorgunun confidence veya score distribution'ına göre getirilecek chunk sayısını değiştirir. Çok net sorguda az chunk yeterli olabilir. Belirsiz sorguda daha geniş candidate set gerekebilir. Context budget ve reranker maliyeti bu kararı etkiler. Static top-k baseline ile karşılaştırılmadan dynamic yaklaşım eklenmemelidir.
Reranking Nedir ve RAG Kalitesini Nasıl Artırır?
Reranking ilk retrieval aşamasında bulunan candidate chunk'ları daha güçlü relevance modeliyle tekrar sıralar. Retriever geniş aday setini hızlı bulurken reranker daha pahalı fakat daha dikkatli değerlendirme yapar. Bu iki aşamalı yapı özellikle ilk retrieval recall iyi fakat sıralama kalitesi yetersiz olduğunda faydalıdır. Reranker her sorguya ek latency ve compute maliyeti getirir. Production kararında retrieval gain ile maliyet birlikte ölçülmelidir.
Retriever ile Reranker Arasındaki Fark
Retriever büyük corpus içinde hızlı candidate bulmaya odaklanır. Reranker yalnızca küçük candidate set üzerinde daha ayrıntılı query-document relevance hesaplar. Retriever genellikle bi-encoder veya lexical yöntem kullanabilir. Cross-encoder reranker sorgu ve belgeyi birlikte değerlendirerek daha hassas skor üretebilir. İki bileşenin başarı metrikleri ayrı incelenmelidir.
Two-Stage Retrieval
Two-stage retrieval ilk aşamada recall'u, ikinci aşamada precision ve ranking kalitesini artırmayı amaçlar. Candidate retrieval geniş fakat yönetilebilir bir sonuç listesi getirir. Reranking bu adayları tekrar sıralar ve en iyi birkaçını context'e yollar. Candidate sayısı fazla olursa latency artabilir. Çok az olursa doğru chunk reranker'a hiç ulaşmayabilir.
Candidate Retrieval
Candidate retrieval dense, lexical veya hybrid olabilir. Amaç doğru passage'ı ilk N sonuç içine yüksek olasılıkla sokmaktır. Bu aşamada recall önemli metriktir. Search hızlı olmalıdır. Candidate count reranker kapasitesine göre ayarlanmalıdır.
Re-Ranking
Re-ranking candidate'ları daha güçlü relevance score ile yeniden sıralar. Final top-k context assembly'e gönderilir. Reranker modelinin query ve dil uyumu test edilmelidir. Türkçe corpus için performans ayrıca ölçülmelidir. Ranking gain nDCG veya MRR üzerinden görülebilir.
Cross-Encoder Reranking
Cross-encoder query ve candidate metni aynı model input'unda değerlendirir. Bu nedenle etkileşimleri bi-encoder embedding'e göre daha ayrıntılı yakalayabilir. Her candidate için inference maliyeti daha yüksektir. Candidate sayısı sınırlı tutulmalıdır. Yüksek değerli kurumsal soru-cevap sistemlerinde kalite artışı maliyeti haklı çıkarabilir.
LLM-Based Reranking
LLM candidate passages'ı relevance ve evidence kalitesine göre sıralamak için kullanılabilir. Uzun veya karmaşık sorgularda reasoning avantajı sağlayabilir. Ancak token maliyeti ve latency cross-encoder yöntemden daha yüksek olabilir. Prompt injection içeren candidate dokümanlar güvenlik riski oluşturabilir. Bu nedenle default reranker olarak kullanılmadan önce güçlü evaluation yapılmalıdır.
Reranking Ne Zaman Kullanılmalıdır?
Retriever doğru dokümanı candidate set içine getiriyor fakat ilk sıralarda göstermiyorsa reranking güçlü adaydır. nDCG veya MRR düşük, Recall@K yüksekse bu pattern görülebilir. Çok küçük corpus veya zaten yüksek precision sağlayan retrieval sisteminde ek fayda sınırlı olabilir. Query sınıfına göre adaptive reranking yapılabilir. Production A/B test gerçek kullanıcı etkisini ölçebilir.
Reranking'in Latency Maliyeti
Reranker online request'e ek inference adımı ekler. Candidate sayısı ve model boyutu latency'yi doğrudan etkiler. Parallel batching bazı sistemlerde yardımcı olabilir. P95 ve P99 latency özellikle izlenmelidir. Küçük quality gain için büyük latency artışı kabul edilmeyebilir.
Reranker Olmadan RAG Ne Zaman Daha İyi Olabilir?
Küçük bilgi tabanında güçlü hybrid search yeterli olabilir. Low-latency uygulamalarında reranking maliyeti faydasından yüksek olabilir. Çok net metadata filtreli query'lerde candidate set zaten dar olabilir. Basit FAQ sistemlerinde reranker gereksiz olabilir. Ölçüm olmadan her RAG pipeline'a reranker eklemek doğru değildir.
Context Engineering ve RAG
Retrieval doğru chunk'ları bulsa bile modele nasıl sunulduğu final cevap kalitesini etkiler. Context engineering, kaynak seçimi, sıra, compression, token bütçesi ve çelişkili içerik yönetimini kapsar. Çok fazla context her zaman daha iyi değildir. Duplicate veya düşük relevance chunk'lar modelin dikkatini dağıtabilir. En iyi context, kullanıcı sorusunu cevaplamak için yeterli kanıtı minimum gereksiz içerikle sağlayan bağlamdır.
Context Window Nedir?
Context window modelin tek inference sırasında okuyabileceği toplam token kapasitesidir. System prompt, user query, retrieved chunks ve output için ayrılan alan aynı budget içindedir. Retrieval top-k bu kapasiteyi aşmamalıdır. Büyük context window sınırsız bilgi eklemek için gerekçe değildir. Cost ve attention dağılımı da kaliteyi etkiler.
Context Budget Nasıl Yönetilir?
Toplam token limitinden system ve response reserve çıkarılarak retrieval için kalan budget hesaplanabilir. Chunk relevance ve source priority bu alanı doldurmak için kullanılabilir. Aynı bilgi tekrar eden chunk'lar çıkarılmalıdır. Uzun parent chunk'lar gerektiğinde compression uygulanabilir. Budget yönetimi deterministic component olarak tasarlanabilir.
Context Compression
Compression retrieved chunk'tan sorguyla ilişkili bölümü koruyup gereksiz metni azaltmayı amaçlar. Extractive yöntemler daha güvenli olabilir. LLM-based compression yeni yanlış bilgi eklememelidir. Original source reference korunmalıdır. Compression katkısı answer faithfulness ve token cost üzerinden ölçülmelidir.
Contextual Filtering
Contextual filtering retrieval candidate'larını query relevance, metadata ve policy'ye göre azaltır. Düşük score veya eski dokümanlar elenebilir. Filter çok agresif olursa gerekli evidence kaybolabilir. Confidence threshold validation dataset üzerinde ayarlanmalıdır. Security filtreleri relevance filtresinden ayrı ve zorunlu uygulanmalıdır.
Duplicate Chunk Temizliği
Aynı veya yüksek benzerlikte chunk'ların context'e tekrar girmesi token israfıdır. Near-duplicate detection retrieval sonrası uygulanabilir. Aynı parent bölümden çok sayıda chunk geliyorsa birleştirme düşünülebilir. Source diversity bazı sorularda cevap kalitesini artırır. Duplicate removal retrieval evidence coverage'ı düşürmemelidir.
Lost-in-the-Middle Problemi
Uzun context içinde orta bölümlerdeki bilgilerin model tarafından daha zayıf kullanılabildiği gözlenebilir. Önemli kaynakların context sırası bu nedenle etkili olabilir. En ilgili chunk'ları başa yakın konumlandırmak fayda sağlayabilir. Çok uzun context kullanmak yerine compression daha güvenli olabilir. Model ve prompt bazında test yapılmalıdır.
Chunk Sıralamasının Etkisi
Chunk order retrieval score, source priority veya document sequence üzerinden düzenlenebilir. Aynı dokümanın parçalarında doğal sıra cevap bütünlüğünü koruyabilir. Çoklu kaynaklarda relevance önceliği daha önemli olabilir. Çelişkili belgeler söz konusuysa en güncel ve authoritative kaynak önce gelmelidir. Ordering stratejisi generation evaluation ile ölçülmelidir.
Source Prioritization
Kurum içinde bazı kaynaklar resmi, bazıları taslak veya kullanıcı notu olabilir. Source priority metadata ile bu fark modele yansıtılabilir. Retrieval score yüksek olsa bile eski taslak resmi politikadan üstün tutulmamalıdır. Priority hard filter veya score adjustment biçiminde uygulanabilir. Kullanıcıya citation içinde source türünü göstermek güvenilirliği artırır.
Çelişen Kaynaklar Nasıl Yönetilir?
İki doküman farklı bilgi veriyorsa model sessizce birini seçmemelidir. Document version, updated_at ve authority bilgisi değerlendirilebilir. Güncel authoritative kaynak varsa öncelik ona verilir. Çelişki çözülmüyorsa cevapta belirsizlik açıkça belirtilmelidir. Conflict rate knowledge governance problemi için değerli monitoring metriğidir.
Retrieval Sonuçları Ne Zaman Yetersiz Sayılmalı?
Top sonuçların relevance score'u düşükse veya gerekli answer evidence bulunamıyorsa retrieval insufficient kabul edilebilir. Sabit threshold embedding modeline göre kalibre edilmelidir. Reranker veya judge ek sufficiency signal üretebilir. Yetersiz durumda query reformulation veya farklı source retrieval denenebilir. Hâlâ kanıt yoksa model cevap uydurmak yerine bilgi bulunamadığını söylemelidir.
RAG Prompt Tasarımı Nasıl Yapılır?
RAG prompt'u modeli retrieval sonuçlarını güvenilir kanıt olarak kullanmaya yönlendirmelidir. Instruction, user query ve retrieved context açık bölümler halinde ayrılmalıdır. Context içindeki talimatlar güvenilmeyen veri olarak işlenmelidir. Kaynak gösterme formatı ve bilgi bulunamadığında nasıl davranılacağı net biçimde tanımlanmalıdır. Prompt değişiklikleri versionlanmalı ve regression dataset üzerinde test edilmelidir.
System Prompt
System prompt agent veya assistant rolünü ve güvenlik sınırlarını belirler. Yalnızca provided context'e dayalı cevap verme gibi grounding kuralları burada tanımlanabilir. Modelin retrieved document içindeki talimatları uygulamaması açıkça belirtilmelidir. Cevap formatı fazla detayla gereksiz uzatılmamalıdır. Prompt version production trace'e yazılmalıdır.
User Query
User query cevaplanacak bilgi ihtiyacıdır. Conversation context varsa standalone query rewriting uygulanabilir. Kullanıcı input'u untrusted kabul edilmelidir. Query içinde tool veya system instruction override girişimleri model politikasını değiştirmemelidir. Original query audit ve evaluation için saklanmalıdır.
Retrieved Context
Retrieved context açık source ID ve metadata ile modele verilmelidir. Chunk'ların document boundary'si anlaşılır olmalıdır. Context içinde HTML, script veya zararlı talimat bulunabileceği kabul edilmelidir. Model bunları veri olarak değerlendirmelidir. Token budget dışındaki chunk'lar deterministic selection ile çıkarılmalıdır.
Citation Instructions
Prompt hangi iddianın hangi source ile desteklenmesi gerektiğini açıklamalıdır. Modelin olmayan source ID üretmesi engellenmelidir. Response post-processor citation ID'lerini retrieved list ile doğrulayabilir. Unsupported citation hata sayılmalıdır. Citation accuracy evaluation metric olarak takip edilmelidir.
Grounding Instructions
Modelden yalnızca context içinde desteklenen bilgileri kesin olarak ifade etmesi istenebilir. Genel bilgi eklemesi gerekiyorsa bunu ayrı belirtmesi policy'ye bağlanabilir. Kurumsal sistemde çoğu durumda source-grounded cevap daha güvenlidir. Contradictory context davranışı açıkça tanımlanmalıdır. Grounding performansı LLM-as-judge ve human evaluation ile ölçülebilir.
“Bilgi Yoksa Bilmiyorum De” Politikası
Bu politika modelin yetersiz evidence durumunda tahmin üretmesini azaltır. Sadece prompt cümlesi yeterli olmayabilir. Retrieval sufficiency threshold ve response validator ile desteklenmelidir. Kullanıcıya hangi bilgilerin bulunamadığı söylenebilir. Abstention rate ile answer coverage birlikte izlenmelidir.
Structured Output
API entegrasyonunda answer, citations ve confidence gibi alanların JSON schema ile dönmesi yararlı olabilir. Structured output parsing hatalarını azaltır. Citation source ID allowlist ile doğrulanabilir. Model invalid JSON üretirse controlled retry uygulanabilir. Schema version backward compatibility için saklanmalıdır.
Prompt Injection'a Karşı Prompt Tasarımı
Retrieved document içinde "önceki talimatları unut" gibi içerikler bulunabilir. Prompt context'i instruction değil untrusted data olarak işaretlemelidir. Bununla birlikte güvenlik yalnızca prompt'a bırakılmamalıdır. Tool permission, output validation ve access control teknik katmanlarda enforce edilmelidir. Adversarial document dataset ile injection testleri düzenli yapılmalıdır.
Naive RAG, Advanced RAG ve Modular RAG
RAG sistemleri tek bir sabit mimariye sahip değildir. Naive RAG basit embed, retrieve ve generate akışıyla iyi başlangıç baseline'ı sunar. Advanced RAG query processing, hybrid search, reranking ve context optimization gibi ek bileşenler içerir. Modular RAG ise retrieval kararlarını daha esnek ve tekrar kullanılabilir servisler halinde tasarlar. En gelişmiş görünen mimari yerine en basit biçimde kalite hedefini karşılayan yapı tercih edilmelidir.
Naive RAG Nedir?
Naive RAG dokümanı chunk'lar, embedding oluşturur ve query için en yakın birkaç chunk'ı LLM'e gönderir. Prototip geliştirmek ve baseline ölçmek için oldukça değerlidir. Production sorunları görünür hale gelmeden çok fazla bileşen eklemeyi önler. Eksikleri retrieval evaluation ile belirlenmelidir. İyi tasarlanmış naive RAG bazı kullanım alanlarında yeterli olabilir.
Advanced RAG Nedir?
Advanced RAG baseline'ın yetersiz kaldığı noktaları hedefleyen optimization katmanları ekler. Query rewriting, hybrid retrieval, reranking ve compression sık kullanılan örneklerdir. Her ek bileşen latency ve operasyon yükü oluşturur. Bu nedenle improvement ölçülmeden pipeline genişletilmemelidir. Optimizasyon retrieval ve generation metrikleriyle yönlendirilmelidir.
Pre-Retrieval Optimization
Pre-retrieval aşamasında query rewriting, decomposition veya expansion uygulanabilir. Amaç retriever'a daha uygun sorgu sunmaktır. Yanlış dönüşüm user intent'i bozabilir. Original query ile rewritten query performansı karşılaştırılmalıdır. Karmaşık logic yalnızca fayda gösteren query sınıflarında çalıştırılabilir.
Retrieval Optimization
Hybrid search, metadata filtering, index tuning ve top-k seçimi retrieval aşamasında iyileştirme sağlar. Öncelik retrieval ground truth üzerinde ölçülen hatalara verilmelidir. Generator model değiştirmek retrieval recall problemine çözüm değildir. Query class bazlı route düşünülebilir. Her optimization cost ve latency etkisiyle birlikte raporlanmalıdır.
Post-Retrieval Optimization
Reranking, duplicate removal ve context compression post-retrieval aşamasında uygulanır. Amaç candidate set'ten en yararlı context'i seçmektir. Yanlış compression evidence kaybına neden olabilir. Source diversity ve context budget birlikte yönetilmelidir. Final answer quality üzerine etkisi A/B test ile ölçülebilir.
Modular RAG Nedir?
Modular RAG parsing, retrieval, reranking ve generation bileşenlerini değiştirilebilir modüller olarak tasarlar. Farklı query tipleri farklı retrieval route'ları kullanabilir. Bu yapı experiment ve evaluation süreçlerini kolaylaştırır. Ancak service sayısı arttıkça observability gereksinimi büyür. Küçük projelerde gereksiz modülerlik operasyon yükü oluşturabilir.
Hangi Mimari Ne Zaman Tercih Edilmeli?
İlk aşamada baseline naive RAG kurmak çoğu proje için sağlıklı yaklaşımdır. Retrieval metric'leri yetersizse ilgili advanced bileşen eklenmelidir. Farklı source ve query türleri çok belirginse modular architecture fayda sağlayabilir. Agentic veya multi-hop ihtiyaç kanıtlanmadan kullanılmamalıdır. Mimari complexity değil ölçülen kullanıcı faydası üzerinden büyütülmelidir.
GraphRAG Nedir?
GraphRAG doküman içindeki entity ve ilişkileri knowledge graph representation ile kullanarak retrieval yapmayı hedefleyen yaklaşımdır. Geleneksel vector search semantik olarak benzer text parçalarını bulmakta güçlüdür ancak çok adımlı ilişkisel sorularda sınırlı kalabilir. Graph yapısı kişi, kurum, olay veya kavramlar arasındaki bağlantıları açık biçimde temsil eder. Vector ve graph retrieval birlikte kullanılabilir. GraphRAG ek extraction, graph maintenance ve evaluation maliyeti nedeniyle yalnızca ilişkisel sorgular gerçek ihtiyaç olduğunda düşünülmelidir.
Geleneksel RAG'ın İlişkisel Veri Problemi
Vector retrieval birbiriyle bağlantılı fakat farklı belgelerde bulunan ilişkileri her zaman birlikte getiremeyebilir. Kullanıcı "A projesiyle bağlantılı ekiplerin hangi kararlara etkisi oldu" gibi çok adımlı soru sorabilir. Bu durumda tek passage yeterli değildir. Graph representation ilişkileri explicit tutar. Ancak bütün corpus'u graph'a çevirmek her problem için gerekli değildir.
Knowledge Graph Nedir?
Knowledge graph entity'leri node, ilişkileri edge olarak temsil eder. Kişi, proje, doküman veya kavram node olabilir. Relationship type domain schema ile tanımlanmalıdır. Graph kaynağı ve evidence reference korunmalıdır. LLM extraction sonucu doğrudan güvenilir truth kabul edilmemelidir.
Entity ve Relationship Extraction
Dokümanlardan entity ve relation extraction rule, model veya LLM ile yapılabilir. Yanlış extraction graph üzerinde zincirleme hataya neden olabilir. Confidence ve provenance kaydedilmelidir. Domain-specific entity schema önemlidir. Golden relation dataset ile extraction quality ölçülmelidir.
Graph Index Oluşturma
Extract edilen entity ve ilişkiler graph store içinde indexlenebilir. Node metadata source document ve version bilgisi taşımalıdır. Duplicate entity resolution dikkatli yapılmalıdır. Incremental document update graph bağlantılarını güncellemelidir. Silinen dokümanın türettiği edge'lerin de kaldırılması gerekir.
Local Retrieval
Local retrieval belirli entity çevresindeki yakın ilişkileri sorgular. Spesifik kişi veya proje sorularında güçlü olabilir. Neighborhood depth büyüdükçe gereksiz graph bilgisi artabilir. Query entity resolution doğru yapılmalıdır. Graph sonucu gerektiğinde ilgili text evidence ile birlikte context'e taşınmalıdır.
Global Retrieval
Global retrieval bütün graph üzerindeki tema veya topluluk yapısını kullanarak geniş sorulara cevap üretmeye çalışabilir. Özet ve raporlama sorularında faydalı olabilir. Compute ve preprocessing maliyeti local retrieval'dan daha yüksek olabilir. Source grounding korunmalıdır. Global summary'lerin güncelliği document update sonrası yeniden hesaplanmalıdır.
Graph + Vector Hybrid Retrieval
Vector search semantic passage bulurken graph retrieval ilişkisel bağlantıları ortaya çıkarabilir. İki kaynak candidate veya context düzeyinde birleştirilebilir. Query router hangi retrieval türünün gerekli olduğunu belirleyebilir. Fusion stratejisi evaluation gerektirir. Her sorguya iki sistemi birden çalıştırmak maliyetli olabilir.
GraphRAG Hangi Sorularda Avantaj Sağlar?
Birden fazla entity ve relation arasında bağlantı kurmayı gerektiren sorularda GraphRAG değer sağlayabilir. Farklı dokümanlarda dağılan bilgi zinciri örnek verilebilir. Basit policy lookup veya FAQ için graph gereksiz olabilir. Query dataset içinde gerçek multi-hop oranı ölçülmelidir. Graph build kararı popülerlik üzerinden değil kullanım örneği üzerinden verilmelidir.
GraphRAG'ın Maliyet ve Karmaşıklık Dezavantajları
Graph extraction ek model ve compute maliyeti oluşturur. Entity resolution ve graph update operasyonu gerekir. Yanlış ilişkilerin düzeltilmesi vector index'e göre daha zor olabilir. Observability ve provenance tasarımı genişler. Quality gain küçükse basit hybrid RAG daha sürdürülebilir olabilir.
Agentic RAG Nedir?
Agentic RAG, retrieval adımlarının sabit pipeline yerine bir agent tarafından sorgunun ihtiyacına göre planlanabildiği mimaridir. Agent hangi kaynağa bakacağını, sorguyu bölüp bölmeyeceğini ve ek retrieval gerekip gerekmediğini değerlendirebilir. Bu yapı karmaşık bilgi ihtiyaçlarında avantaj sağlar. Aynı zamanda her ek karar latency, token maliyeti ve hata ihtimalini artırır. Termination, budget ve tool permission sınırları olmadan agentic retrieval production için kontrolsüz hale gelebilir.
Classic RAG ile Agentic RAG Farkı
Classic RAG genellikle her query için aynı retrieval akışını uygular. Agentic RAG query complexity ve mevcut evidence'e göre farklı adım seçebilir. Basit soru tek retrieval ile cevaplanırken karmaşık soru birkaç source veya hop gerektirebilir. Flexibility daha fazla evaluation ihtiyacı getirir. Classic baseline yetersiz kalmadan agentic tasarıma geçmek gerekli değildir.
Agent'ın Retrieval Kararını Kendisi Vermesi
Agent retrieval tool çağrısı yapıp yapmayacağına karar verebilir. Bununla birlikte source access policy agent kararından bağımsız enforce edilmelidir. Agent tool allowlist dışına çıkmamalıdır. Her retrieval step trace içinde saklanmalıdır. Decision quality golden task set ile ölçülmelidir.
Query Planning
Query planning kullanıcının bilgi ihtiyacını hangi retrieval adımlarıyla çözeceğini belirler. Plan basit JSON veya state graph olarak temsil edilebilir. Gereksiz hop oluşturmak maliyeti artırır. Plan execution sonrası evidence sufficiency kontrolü yapılmalıdır. Maksimum step sayısı belirlenmelidir.
Query Decomposition
Agent karmaşık soruyu alt sorulara ayırabilir. Her alt soru farklı source veya retrieval stratejisi kullanabilir. Sonuçlar final synthesis için birleştirilir. Decomposition yanlışsa cevap bütünlüğü bozulabilir. Sub-question coverage evaluation ile ölçülebilir.
Tool Selection
Agent document retrieval, SQL veya web lookup gibi farklı tool'lar arasından seçim yapabilir. Her tool açık description ve permission taşımalıdır. Structured data için SQL, doküman bilgisi için RAG route edilebilir. Tool seçimi classification task olarak değerlendirilmelidir. Yanlış tool selection production metric olarak izlenebilir.
Iterative Retrieval
İlk retrieval yeterli evidence sağlamazsa agent ikinci sorgu oluşturabilir. Bu döngü reformulation veya farklı source kullanabilir. Her iteration cost ve latency budget tüketir. Improvement yoksa loop durmalıdır. Maximum iteration güvenli sınır olarak tanımlanmalıdır.
Retrieval Sufficiency Check
Agent mevcut context'in soruyu cevaplamaya yeterli olup olmadığını değerlendirebilir. Deterministic score threshold ve LLM judge birlikte kullanılabilir. Sufficiency yanlış pozitif olursa eksik evidence ile cevap üretilir. Yanlış negatif ise gereksiz retrieval maliyeti oluşur. Calibration task-specific dataset üzerinde yapılmalıdır.
Multi-Source Retrieval
Agent farklı knowledge base veya sistemlerden bilgi toplayabilir. Her source güvenilirlik ve access policy taşır. Results ortak ranking veya source-aware context assembly ile birleştirilebilir. Aynı bilginin çelişkili versiyonları açıkça işaretlenmelidir. Source trace final citation için korunmalıdır.
Retry ve Query Reformulation
Low retrieval score durumunda agent query'yi farklı biçimde ifade ederek tekrar deneyebilir. Aynı query'yi değişiklik olmadan tekrar çağırmak genellikle değer sağlamaz. Reformulation original intent'i korumalıdır. Retry sayısı sınırlı tutulmalıdır. Failure sonunda human veya no-answer response tercih edilmelidir.
Termination Conditions
Agentic loop'un ne zaman duracağı açık olmalıdır. Yeterli evidence, maksimum step, token budget veya timeout termination kriteri olabilir. Sonsuz retry production maliyeti yaratır. Hard limit'ler uygulama tarafından enforce edilmelidir. Termination reason trace'e kaydedilmelidir.
Agentic RAG'ın Latency ve Maliyet Riski
Her plan, query rewrite ve retrieval step ek model veya search çağrısı gerektirir. Basit sorular için bu maliyet gereksizdir. Router query complexity'ye göre classic veya agentic path seçebilir. P95 latency ve cost per task ayrı izlenmelidir. Agentic tasarım yalnızca measurable task success artışı sağlıyorsa kullanılmalıdır.
Diğer İleri RAG Mimarileri
RAG literatüründe retrieval kalite ve kontrol sorunlarını çözmek için farklı mimari yaklaşımlar geliştirilmiştir. Self-RAG, corrective yaklaşım, adaptive retrieval ve memory-augmented yapıların her biri farklı problemi hedefler. İsimleri farklı olsa da temel soru aynıdır: hangi bilgi ne zaman aranmalı ve getirilen bilginin yeterli olduğu nasıl doğrulanmalıdır. Bir projede bütün yöntemleri birlikte kullanmak gerekli değildir. Baseline hatalarını ölçüp yalnızca ihtiyaç duyulan bileşeni eklemek daha sağlıklı üretim yaklaşımıdır.
Self-RAG
Self-RAG modelin retrieval gereksinimi ve retrieved evidence kalitesi hakkında ek değerlendirme yapmasını hedefleyen yaklaşımlardan biridir. Her query için retrieval zorunluluğunu azaltabilir. Modelin kendi değerlendirme hataları ayrıca test edilmelidir. Ek inference maliyeti oluşabilir. Production uygulaması task-specific benchmark gerektirir.
Corrective RAG (CRAG)
Corrective RAG retrieval sonuçlarının kalitesini değerlendirip yetersiz olduğunda düzeltici retrieval adımı uygulamayı amaçlar. Query rewrite veya farklı source araması kullanılabilir. İlk retrieval başarısız olduğunda doğrudan generation'a geçmek yerine evidence iyileştirilir. Correction loop sınırlı olmalıdır. Retrieval judge doğruluğu ayrı metric olarak ölçülmelidir.
Adaptive RAG
Adaptive RAG query difficulty veya type'a göre farklı retrieval stratejisi seçer. Basit query az maliyetli route kullanabilir. Karmaşık query multi-hop veya reranking gerektirebilir. Router yanlış classification yaparsa kalite düşer. Cost-quality balance evaluation'ın önemli parçasıdır.
Hierarchical RAG
Hierarchical RAG dokümanları farklı granularity seviyelerinde indexleyip retrieval yapar. Önce uygun bölüm, sonra detay chunk bulunabilir. Büyük teknik kılavuz ve raporlarda faydalıdır. Metadata ve parent-child relation doğru tutulmalıdır. Multi-stage retrieval latency'si ölçülmelidir.
Memory-Augmented RAG
Memory-augmented yapı document knowledge ile konuşma veya kullanıcı geçmişini birlikte kullanır. Memory ile authoritative knowledge aynı source olarak görülmemelidir. Kullanıcı tercihi ile kurumsal politika çeliştiğinde doküman kaynağı üstün olmalıdır. Memory privacy ve retention ayrıca yönetilmelidir. Retrieval kaynak türü final response trace'inde açıkça ayrılmalıdır.
Multimodal RAG
Multimodal RAG metin yanında görsel, tablo, audio veya video içeriklerini retrieval kapsamına alır. Doküman içindeki bilgi yalnızca OCR metniyle temsil edilemeyebilir. Image embedding veya vision model kullanılabilir. Modality-specific evaluation gereklidir. Context oluşturma sırasında modelin ilgili modaliteyi gerçekten desteklemesi gerekir.
Web-Grounded RAG
Web-grounded RAG güncel açık web kaynaklarını retrieval sürecine dahil eder. Source trust ve freshness değerlendirmesi kritik hale gelir. Web içeriği untrusted data kabul edilmelidir. Kurumsal kaynaklarla birlikte kullanılıyorsa source ranking açık olmalıdır. Citation kullanıcının hangi bilginin nereden geldiğini görmesini sağlamalıdır.
Streaming RAG
Streaming RAG bilgi tabanının sürekli değiştiği veya gerçek zamanlı event'lerin retrieval'a yansıması gereken durumları hedefler. Incremental indexing latency'si kritik metric olur. Event duplication ve ordering dikkate alınmalıdır. Eski bilgi hızlı biçimde invalid edilmeli veya version filtresiyle devre dışı bırakılmalıdır. Her event'i LLM ile işlemek gereksiz olabilir.
Multi-Agent RAG
Multi-agent RAG farklı source veya görev için uzman agent'lar kullanabilir. Bir agent query planlarken diğeri retrieval veya evaluation yapabilir. Agent sayısı arttıkça token, latency ve debug yükü büyür. Shared state ve evidence provenance açık olmalıdır. Tek agent baseline başarısız olmadan multi-agent yapı kurmak genellikle gerekli değildir.
Multimodal RAG Nasıl Çalışır?
Multimodal RAG yalnızca metin olmayan bilgilerin de aranabilir ve cevap üretiminde kullanılabilir hale getirilmesini sağlar. Görseller, grafikler ve sayfa layout bilgileri text extraction sırasında kaybolmamalıdır. OCR, vision model ve multimodal embedding farklı görevlerde birlikte kullanılabilir. Retrieval sonucu modelin desteklediği modalite formatında context'e taşınmalıdır. Değerlendirme dataset'i yalnızca text sorularından değil görsel kanıt gerektiren sorgulardan da oluşmalıdır.
Metin + Görsel Retrieval
Kullanıcı metinle soru sorup ilgili diyagramı bulmak isteyebilir. Text ve image embedding ortak veya cross-modal search sağlayabilir. Image metadata içinde document ve page reference tutulmalıdır. Görsel sonuç yanında çevre text'i de context'e eklemek faydalı olabilir. Retrieval doğruluğu görsel relevance annotation ile ölçülmelidir.
PDF İçindeki Grafik ve Şemalar
Grafik veya şema sadece OCR ile işlendiğinde yapısal anlam kaybolabilir. Vision model caption veya structured interpretation üretebilir. Original page image kanıt olarak saklanmalıdır. Sayısal grafik değerleri yüksek hassasiyet gerektiriyorsa extraction doğrulanmalıdır. Kritik kararlar otomatik vision yorumuna tek başına bırakılmamalıdır.
Image Embeddings
Image embedding görsel içeriği vector representation'a dönüştürür. Benzer görseller veya text-query ile ilişkili image candidate'ları bulunabilir. Modelin domain görsellerinde performansı test edilmelidir. Dimension ve index cost text embedding'den farklı olabilir. Modality metadata filter search'ü kontrol etmeye yardımcı olur.
OCR + Vision Model
OCR metni çıkarırken vision model layout ve grafik ilişkilerini anlayabilir. İki yöntem birbirini tamamlayabilir. OCR confidence düşük alanlar vision pipeline'a yönlendirilebilir. Maliyet ve latency nedeniyle her sayfaya aynı ağır model uygulanmayabilir. Adaptive processing document type üzerinden yapılabilir.
Audio ve Video Retrieval
Audio ve video önce transcript, scene veya segment seviyesinde temsil edilebilir. Timestamp metadata citation için önemlidir. Transcript search text retrieval ile yapılabilir. Görsel sahne bilgisi gerekiyorsa multimodal embedding eklenebilir. Büyük medya dosyalarında indexing maliyeti ayrıca hesaplanmalıdır.
Multimodal Vector Search
Multimodal search farklı içerik türlerini aynı veya ilişkili indexlerde arayabilir. Query text'i hem text hem image retrieval'a yönlendirilebilir. Fusion sonuçları relevance score ve modality ihtiyacına göre birleştirilir. Generator model ilgili modaliteyi okuyabilmelidir. Modality-specific failure rate observability içinde ayrı izlenmelidir.
RAG ve Memory Arasındaki Fark
RAG knowledge base retrieval ile konuşma memory aynı kavram değildir. Knowledge base kurum tarafından yönetilen doküman veya bilgi kaynaklarını temsil eder. Memory ise kısa dönem konuşma bağlamı veya kullanıcıya ait geçmiş tercihler gibi state bilgisidir. İkisini aynı vector store içinde ayırt etmeden saklamak güven ve privacy problemleri yaratabilir. Source type, authority ve retention politikası ayrı tasarlanmalıdır.
Knowledge Base Memory Değildir
Kurumsal policy dokümanı authoritative knowledge sayılır. Kullanıcının önceki konuşmada söylediği bir tercih aynı güvenilirlik seviyesinde değildir. Retrieval sırasında source priority bunu yansıtmalıdır. Memory hiçbir zaman resmi dokümanı sessizce override etmemelidir. Final cevap hangi bilgi türüne dayandığını ayırt edebilmelidir.
Short-Term Conversation Memory
Short-term memory mevcut konuşmadaki yakın geçmişi taşır. Pronoun resolution ve follow-up query rewriting için yararlıdır. Conversation uzadıkça summary veya window strategy gerekebilir. Sensitive content retention sınırlı tutulmalıdır. Short-term memory knowledge index'e kalıcı olarak yazılmak zorunda değildir.
Long-Term User Memory
Long-term memory kullanıcı tercih veya geçmişini daha uzun süre saklayabilir. Açık izin ve privacy policy gerektirir. Her konuşma detayı memory'ye yazılmamalıdır. Kullanıcının tercih bilgisi kurumsal gerçek olarak yorumlanmamalıdır. Silme ve düzeltme mekanizması bulunmalıdır.
Semantic Memory
Semantic memory kullanıcı veya sistem hakkında genellenmiş bilgi representation'ı olarak düşünülebilir. Vector retrieval benzer memory kayıtlarını bulabilir. Confidence ve source bilgisi önemlidir. Yanlış çıkarımın kalıcı memory haline gelmesi engellenmelidir. Memory write policy retrieval policy kadar dikkatli tasarlanmalıdır.
Episodic Memory
Episodic memory belirli geçmiş etkileşim veya olayları saklar. "Geçen hafta şu raporu tartıştık" gibi continuation use case'lerinde faydalıdır. Event timestamp ve conversation reference tutulmalıdır. Privacy retention açık olmalıdır. Eski episode yanlış veya güncelliğini yitirmiş olabilir.
Memory Retrieval ile Document Retrieval Birlikte Nasıl Kullanılır?
Router kullanıcı sorusuna göre memory, document veya her iki kaynağı arayabilir. Source type final context'te açıkça etiketlenmelidir. Kurumsal truth gerektiğinde document retrieval öncelikli olmalıdır. Kullanıcı tercihi yalnızca uygun kişiselleştirme alanında kullanılmalıdır. Fusion politikası security ve authority kurallarını dikkate almalıdır.
RAG Sistemi Nasıl Değerlendirilir?
RAG değerlendirmesi retrieval ve generation katmanlarını ayrı ayrı ölçmelidir. Sadece final cevaba bakılırsa problemin yanlış doküman mı yoksa model cevabı mı olduğu anlaşılamaz. Golden dataset query, relevant passage ve beklenen answer bilgisi içerebilir. Offline metric'ler hızlı regression sağlar, online A/B test gerçek kullanıcı etkisini gösterir. Human evaluation özellikle kritik domain ve citation doğruluğu için hâlâ önemli kontrol katmanıdır.
Golden Dataset Oluşturma
Golden dataset gerçek veya temsil gücü yüksek kullanıcı sorularından oluşmalıdır. Her query için relevant document veya passage etiketlenir. Gerekirse expected answer ve citation da eklenir. Kolay sorular yanında no-answer, ambiguous ve multi-hop örnekler bulunmalıdır. Dataset zaman içinde production failure ve user feedback ile genişletilmelidir.
Retrieval Evaluation
Retrieval evaluation doğru evidence'ın candidate set içine gelip gelmediğini ve ne kadar üst sırada olduğunu ölçer. Ground truth passage veya document label gerekir. Farklı top-k değerleri aynı dataset üzerinde test edilebilir. Query type bazında sonuçları ayırmak zayıf alanları gösterir. Retrieval iyileşmeden generator değiştirmek çoğu zaman asıl sorunu çözmez.
Recall@K
Recall@K ilgili sonuçların ilk K içinde ne kadarının bulunduğunu ölçer. RAG için doğru evidence'ın candidate set'e ulaşması kritik olduğu için önemli metriktir. K arttıkça recall genellikle yükselir fakat context maliyeti de artabilir. Document ve chunk level recall ayrı hesaplanabilir. K seçimi generator context budget ile birlikte yapılmalıdır.
Precision@K
Precision@K ilk K sonuç içinde ne kadarının gerçekten ilgili olduğunu gösterir. Çok düşük precision modelin gereksiz veya yanıltıcı context görmesine neden olabilir. K arttıkça precision düşebilir. Reranking bu metric'i iyileştirebilir. Kullanıcı sorusu başına ideal precision-recall dengesi task'a göre değişir.
Hit Rate
Hit rate sorguların ne kadarında en az bir relevant result bulunduğunu ölçer. Basit ve anlaşılır retrieval metriğidir. Tek relevant document gereken QA sistemlerinde faydalıdır. Ranking kalitesini tek başına göstermez. MRR veya nDCG ile birlikte kullanılmalıdır.
Mean Reciprocal Rank
MRR ilk doğru sonucun listede ne kadar yukarıda olduğunu ölçer. Tek veya az sayıda relevant result bulunan sorgularda kullanışlıdır. Doğru sonuç rank 1 olduğunda yüksek değer alır. Reranker karşılaştırmasında anlamlı olabilir. Çoklu relevance senaryolarında nDCG daha zengin bilgi sağlayabilir.
nDCG
nDCG graded relevance ve ranking position bilgisini birlikte değerlendirir. Bazı chunk'lar tamamen, bazıları kısmen ilgiliyse güçlü metriktir. Relevance label kalitesi önemlidir. Query set yeterince büyük olmalıdır. Hybrid search ve reranker tuning için yararlı karşılaştırma sunar.
Context Precision
Context precision modele verilen context parçalarının ne kadarının cevap için gerçekten yararlı olduğunu ölçmeyi amaçlar. Retrieval candidate değil final assembled context değerlendirilir. Duplicate veya gereksiz chunk bu metriği düşürür. Compression ve top-k tuning etkisi görülebilir. LLM-based evaluation kullanılıyorsa human sample ile doğrulanmalıdır.
Context Recall
Context recall doğru cevabı oluşturmak için gerekli evidence'ın final context içinde bulunup bulunmadığını değerlendirir. Retriever doğru passage'ı bulsa bile context assembly onu çıkarırsa metric düşebilir. Multi-hop cevaplarda birkaç kanıt parçası gerekebilir. Golden answer evidence annotation kaliteyi artırır. Context precision ile birlikte değerlendirilmelidir.
Generation Evaluation
Generation evaluation modelin getirilen context'i doğru ve ilgili cevap haline dönüştürüp dönüştürmediğini ölçer. Faithfulness ve groundedness özellikle RAG için kritiktir. Cevap doğru görünüp kaynağa dayanmıyorsa production güvenilirliği düşer. Citation accuracy ayrıca ölçülmelidir. Human ve automated judge sonuçları belirli aralıklarla karşılaştırılmalıdır.
Faithfulness
Faithfulness cevap iddialarının retrieved context tarafından desteklenip desteklenmediğini ölçer. Model doğru bilgiye kendi parametric bilgisinden ulaşsa bile kaynakta yoksa strict grounded sistemde düşük değerlendirilebilir. Claim-level analysis yararlıdır. LLM judge kullanılabilir. Kritik uygulamalarda human audit sample eklenmelidir.
Groundedness
Groundedness cevabın verilen evidence'e ne kadar bağlı olduğunu değerlendirir. Faithfulness ile yakın kavramdır ancak değerlendirme framework'üne göre tanım değişebilir. Metric definition ekip içinde netleştirilmelidir. Source dışı iddialar ayrıca işaretlenebilir. Trend monitoring model veya prompt regression'ı gösterebilir.
Answer Relevance
Answer relevance cevap doğru olsa bile kullanıcının sorusuna gerçekten yanıt verip vermediğini ölçer. Fazla genel veya alakasız açıklamalar score'u düşürür. Context doğru olabilir fakat prompt kötü tasarlanmışsa relevance düşük kalabilir. Query-answer semantic evaluation kullanılabilir. Human feedback önemli sinyaldir.
Answer Correctness
Answer correctness expected answer veya human reference ile final cevabın doğruluğunu karşılaştırır. Açık uçlu sorularda tek doğru metin olmayabilir. Claim veya key-fact level scoring daha anlamlı olabilir. RAG'da doğru cevap ile source support ayrı metric olarak korunmalıdır. İkisi birlikte production kalitesini gösterir.
Citation Accuracy
Citation accuracy modelin verdiği kaynakların gerçekten ilgili iddiaları destekleyip desteklemediğini ölçer. Source ID uydurulması otomatik validator ile yakalanabilir. Citation'ın var olması yeterli değildir. Claim-source alignment ayrıca incelenmelidir. Kurumsal RAG için en önemli güven metric'lerinden biridir.
End-to-End Evaluation
End-to-end evaluation retrieval, context assembly ve generation'ın birlikte kullanıcı görevini çözüp çözmediğini ölçer. Sistem katman metric'leri yüksek olsa bile kullanıcı sorunu çözülemeyebilir. Task success ve satisfaction bu seviyede önem kazanır. Production trace failure analysis için kullanılabilir. Offline regression ve online KPI birlikte değerlendirilmelidir.
Task Success Rate
Task success kullanıcının hedeflediği bilgiyi doğru biçimde alıp alamadığını ölçer. Query bazlı binary veya graded score kullanılabilir. Support uygulamasında sorunun çözülmesi gibi business event'lerle bağlanabilir. Sadece kullanıcı thumbs-up sinyaline bağlı kalmak yeterli olmayabilir. Human-labeled sample destekleyici olur.
User Satisfaction
Kullanıcı memnuniyeti rating, feedback veya tekrar soru oranı gibi sinyallerle ölçülebilir. Feedback her zaman doğrudan correctness anlamına gelmez. Kullanıcı kısa cevabı beğenebilir fakat kaynak yanlış olabilir. Teknik metric'lerle birlikte yorumlanmalıdır. Segment bazında memnuniyet farkları incelenebilir.
LLM-as-a-Judge
LLM-as-a-Judge büyük evaluation setlerini daha hızlı skorlamak için kullanılabilir. Judge prompt ve model version sonuçları etkiler. Aynı model ailesinin kendi cevabını değerlendirmesi bias oluşturabilir. Human-labeled calibration set kullanılmalıdır. Metric trendleri absolute truth olarak değil otomatik kalite sinyali olarak görülmelidir.
Human Evaluation
İnsan değerlendirmesi özellikle domain doğruluğu, citation ve riskli cevaplar için değerlidir. Reviewer guideline açık olmalıdır. Birden fazla reviewer agreement ölçülebilir. Tüm query'leri insanla değerlendirmek pahalı olabilir. Stratified sample automated evaluation'ın doğrulanması için yeterli olabilir.
Offline Evaluation
Offline evaluation version değişikliklerini production'a çıkmadan test etmeyi sağlar. Golden dataset sabit benchmark oluşturur. Chunking, embedding ve reranker deneyleri hızlı karşılaştırılabilir. Dataset zamanla production dağılımından kopmamalıdır. Düzenli refresh gereklidir.
Online Evaluation
Online evaluation gerçek kullanıcı traffic üzerinde davranışı ölçer. Feedback, task success, latency ve no-answer rate izlenebilir. Privacy açısından query logging policy dikkatle uygulanmalıdır. Model veya retrieval version trace'e eklenmelidir. Offline başarı production başarısını garanti etmediği için online metric önemlidir.
A/B Testing
A/B test iki RAG pipeline veya model version'ını gerçek kullanıcı üzerinde karşılaştırır. Traffic assignment tutarlı olmalıdır. Technical ve business KPI birlikte takip edilir. Safety regression varsa test erken durdurulabilir. Sample size ve süre istatistiksel değerlendirmeye göre seçilmelidir.
RAG Performansı Nasıl Optimize Edilir?
RAG optimizasyonunda ilk refleks generator modelini büyütmek olmamalıdır. Önce retrieval'ın doğru evidence'ı getirip getirmediği ölçülmelidir. Chunking, embedding, top-k, hybrid search ve reranking ayrı deneylerle karşılaştırılabilir. Daha sonra context ve prompt katmanı optimize edilir. Her değişiklik quality, latency ve cost üçlüsüyle birlikte değerlendirilmelidir.
Retrieval Önce Optimize Edilmeli
Doğru kaynak context'e gelmiyorsa generator'ın cevap üretme şansı sınırlıdır. Recall@K ve nDCG baseline kurulmalıdır. Failure query'ler kategori bazında incelenebilir. Technical identifier ve semantic query farklı retrieval ihtiyacı taşıyabilir. Generator tuning retrieval sorununu gizlememelidir.
Chunking Benchmark
Birden fazla chunk size ve strategy aynı index dataset üzerinde karşılaştırılabilir. Parsing ve embedding sabit tutulmalıdır. Retrieval metric yanında context token kullanımı ölçülür. Human inspection birkaç örnekte sınır kalitesini gösterir. Kazanan strategy corpus type bazında farklı olabilir.
Embedding Benchmark
Embedding modelleri aynı golden query-document set üzerinde karşılaştırılmalıdır. Türkçe ve domain-specific query'ler ayrı raporlanmalıdır. Latency ve dimension quality metric yanında tutulur. Index metric model recommendation ile uyumlu olmalıdır. Model değişimi re-index cost gerektirdiği için marjinal gain değerlendirilmelidir.
Top-K Optimizasyonu
Top-k fazla düşükse evidence kaçabilir. Fazla yüksekse gereksiz context ve token maliyeti oluşur. Different query classes farklı ideal K değerine sahip olabilir. Reranker candidate K ile final context K ayrı ayarlanmalıdır. Dynamic K ancak static baseline sonrası değerlendirilmelidir.
Similarity Threshold
Threshold çok düşükse ilgisiz chunk'lar context'e girer. Çok yüksekse cevaplanabilir sorular no-answer olabilir. Embedding score distribution model değiştikçe farklılaşabilir. Threshold golden positive ve negative query set üzerinde kalibre edilmelidir. Production drift sonrası yeniden değerlendirme gerekir.
Hybrid Search Ayarları
Dense ve lexical weight retrieval davranışını etkiler. Technical term-heavy query'ler lexical sinyale daha çok ihtiyaç duyabilir. RRF veya normalized score fusion test edilebilir. Query type'a göre adaptive weight düşünülebilir. Improvement nDCG ve end-to-end answer üzerinden ölçülmelidir.
Reranking Ayarları
Candidate count ve final result count önemli parametrelerdir. Daha fazla candidate reranker recall'unu artırabilir fakat latency yükselir. Cross-encoder model seçimi language performansına göre yapılmalıdır. Bazı query'lerde reranking bypass edilebilir. P95 latency ile ranking gain beraber raporlanmalıdır.
Context Compression
Compression uzun chunk'ların yalnızca query ile ilgili bölümlerini context'e almayı sağlar. Extractive yöntemin source fidelity avantajı vardır. LLM summarization daha compact olabilir ancak information loss riski taşır. Compression result original source ile bağlanmalıdır. Answer faithfulness regression test edilmelidir.
Prompt Optimizasyonu
Prompt yalnızca kaynakta olan bilgiyi kullanma, citation ve no-answer politikasını netleştirebilir. Çok uzun instruction input token ve model dikkat maliyeti oluşturur. Prompt change golden generation dataset'te test edilmelidir. Instruction ordering model davranışını etkileyebilir. Retrieval performansı prompt değişikliğiyle karıştırılmamalıdır.
Generator Model Seçimi
Generator model retrieved context'i yorumlama ve düzgün cevap üretme yeteneğine göre seçilmelidir. Büyük model daha pahalı ve yavaş olabilir. Küçük model iyi retrieval sayesinde yeterli sonuç verebilir. Faithfulness, answer correctness ve latency birlikte benchmark edilmelidir. Router query complexity'ye göre farklı model kullanabilir.
RAG Sistemlerinde Latency Optimizasyonu
RAG response latency embedding, search, reranking ve LLM inference gibi birkaç bileşenin toplamıdır. Sadece toplam süreyi ölçmek hangi katmanın yavaş olduğunu göstermez. Distributed trace her aşamayı ayrı kaydetmelidir. Parallel retrieval ve cache bazı workload'larda güçlü iyileştirme sağlar. P50 yanında P95 ve P99 değerlerini takip etmek kullanıcıların kötü uç deneyimlerini görünür hale getirir.
Embedding Latency
Query embedding retrieval başlamadan önce çalışır. Model hosting lokasyonu ve batch davranışı süreyi etkiler. Query cache tekrar eden sorgularda bu maliyeti azaltabilir. Small embedding modeli quality kaybı yaratmadan daha hızlı olabilir. P95 latency production seçimi için önemli kriterdir.
Vector Search Latency
Index type ve search parameters vector latency'yi etkiler. Metadata filter bazı query'lerde ek maliyet yaratabilir. Query concurrency altında benchmark yapılmalıdır. Network round-trip distributed deployment'ta dikkate alınmalıdır. Recall kaybı yaşamadan en hızlı ayar aranmalıdır.
Reranking Latency
Reranking candidate sayısına yaklaşık olarak bağlı ek inference maliyeti getirir. Candidate batching yardımcı olabilir. Basit query'lerde reranker bypass etmek adaptive optimization sağlayabilir. Cross-encoder ve LLM reranker farklı cost profiline sahiptir. Quality gain latency budget içinde değerlendirilmelidir.
LLM Inference Latency
Generation çoğu RAG request'inde en büyük latency bileşenlerinden biri olabilir. Context token sayısı ve output length süreyi etkiler. Daha küçük model veya response streaming kullanıcı deneyimini iyileştirebilir. Model quality regression ölçülmelidir. Context'teki gereksiz chunk'ları azaltmak latency ve cost'u birlikte düşürebilir.
P50, P95 ve P99
P50 tipik kullanıcı deneyimini gösterir. P95 ve P99 yavaş uç istekleri görünür kılar. Production SLO yalnızca average latency üzerine kurulmamalıdır. Query complexity ve source type bazında percentile farkları incelenebilir. Tail latency incident veya cache miss pattern'lerini gösterebilir.
Parallel Retrieval
Dense ve BM25 retrieval birbirinden bağımsızsa paralel çalıştırılabilir. Multi-source retrieval da uygun durumlarda paralelleştirilebilir. Sonuçlar fusion aşamasında birleşir. Concurrency downstream servis limitlerini aşmamalıdır. Parallelization total latency'yi azaltırken compute kullanımını artırabilir.
Asenkron İşleme
Non-critical logging, feedback veya bazı enrichment görevleri response critical path dışına alınabilir. Retrieval'ın kendisi cevap için gerekliyse asynchronous architecture yine completion beklemek zorunda kalabilir. Event-driven ingestion online query'den ayrılmalıdır. Async kullanım error handling ve trace propagation gerektirir. Kullanıcıya sonucu vermeden önce gerekli quality gate'ler tamamlanmalıdır.
Cache Kullanımı
Cache tekrar eden query, embedding veya final response maliyetini azaltabilir. Ancak stale knowledge riskine dikkat edilmelidir. Cache key user authorization ve knowledge version gibi context'i içermelidir. Cross-user response cache security leakage yaratmamalıdır. Invalidation ingestion update ile ilişkilendirilmelidir.
Query Cache
Normalized query ve retrieval parameters üzerinden search sonucu cache edilebilir. User-specific access filter key içinde bulunmalıdır. Knowledge base güncellendiğinde cache invalidation gerekir. Çok dinamik query workload'da hit rate düşük olabilir. Cache gain monitoring ile ölçülmelidir.
Embedding Cache
Aynı query text tekrar geldiğinde embedding yeniden hesaplanmayabilir. Model version cache key'e dahil edilmelidir. Query normalization dikkatle uygulanmalıdır. Sensitive query storage privacy policy'ye tabi olabilir. TTL ve encryption gerekebilir.
Semantic Cache
Semantic cache benzer anlamdaki query'lerin aynı veya benzer cevabı kullanmasını amaçlar. Knowledge freshness ve user permission nedeniyle risklidir. Similarity threshold yanlış olursa farklı soruya yanlış cevap dönebilir. Kurumsal RAG'da response yerine retrieval result cache etmek daha kontrollü olabilir. Semantic cache production'a güçlü evaluation sonrası alınmalıdır.
Production RAG Mimarisi Nasıl Tasarlanır?
Production RAG mimarisi yalnızca notebook içinde çalışan retrieval kodundan çok daha fazla bileşen gerektirir. Authentication, authorization, retrieval service, LLM gateway, vector store, metadata store, cache ve observability birlikte düşünülmelidir. Servis sınırları gereğinden fazla parçalanmamalı ancak security ve ölçek ihtiyaçlarını karşılamalıdır. Her query trace ID ile uçtan uca izlenmelidir. Kurumsal RAG sistemi geliştirme ve LLM entegrasyon hizmeti sunarken en kritik konu demo cevabı değil bu operasyon katmanlarının güvenilir biçimde çalışmasıdır.
API Gateway
API Gateway kullanıcı veya uygulama request'lerinin giriş noktasıdır. Authentication, rate limit ve request validation burada uygulanabilir. Query body loglanacaksa privacy policy dikkate alınmalıdır. Trace ID gateway'de üretilebilir. Backend service detayları client'tan gizlenebilir.
Authentication
Kullanıcının kimliği retrieval authorization için güvenilir biçimde belirlenmelidir. Identity token server-side doğrulanmalıdır. User supplied tenant veya role bilgisine güvenilmemelidir. Session ve service identity ayrımı yapılabilir. Authentication failure hiçbir retrieval çağrısına ulaşmamalıdır.
RAG Orchestrator
Orchestrator query processing, retrieval, reranking ve generation adımlarını koordine eder. Retry ve timeout sınırları burada uygulanabilir. Business policy model prompt'una bırakılmamalıdır. Orchestrator response trace'i toplar. Agentic mode varsa maximum steps ve budget enforce edilmelidir.
Retrieval Service
Retrieval service vector, keyword ve metadata search işlemlerini ortak API üzerinden sunabilir. Authorization filter request context'ten uygulanmalıdır. Retriever version response metadata'sına eklenebilir. Performance ve recall testleri bağımsız yürütülebilir. Search failure generator'a boş context olarak sessiz geçmemelidir.
Reranking Service
Reranking service candidate passages'ı query relevance'e göre yeniden sıralar. Model version ve candidate limit config olarak yönetilir. Service timeout durumunda fallback retrieval order kullanılabilir. Kalite ve latency metric'leri ayrı izlenir. Sensitive document text üçüncü taraf servise gönderiliyorsa privacy gereksinimi değerlendirilmelidir.
LLM Gateway
LLM Gateway farklı generator modellerine ortak access ve policy katmanı sağlar. Model routing, rate limit ve token budget burada yönetilebilir. Prompt ve response logging hassas veri açısından filtrelenmelidir. Model provider değişikliği uygulama kodundan ayrılabilir. Fallback policy high-risk task'ta quality düşürmemelidir.
Vector Store
Vector store embedding ve ANN index'i saklar. High availability, backup ve index versioning production gereksinimidir. User access filter search sırasında uygulanmalıdır. Re-index migration kontrollü yapılmalıdır. Old index hızlı rollback için kısa süre korunabilir.
Metadata Store
Metadata store document ownership, version, source ve permission bilgilerini taşır. Vector store metadata ile tutarlı olmalıdır. Document update sırasında iki sistem arasında atomic veya compensating workflow gerekebilir. Query trace source detaylarını buradan zenginleştirebilir. Metadata corruption security riskine dönüşebilir.
Document Store
Original veya parsed document content güvenli document store'da saklanabilir. Vector index yalnızca chunk text veya reference tutabilir. Citation kullanıcıya original source açacaksa authorization tekrar kontrol edilmelidir. Document version immutable tutulabilir. Retention ve delete policy vector store ile senkron olmalıdır.
Cache Layer
Cache embedding, retrieval veya selected response sonuçlarını saklayabilir. Key security context'i içermelidir. Knowledge update invalidation mekanizması olmalıdır. Cache hit ve stale error metric olarak izlenmelidir. Çok katmanlı cache debugging'i zorlaştırabileceği için sade tasarım tercih edilmelidir.
Evaluation Service
Evaluation service sampled production query'leri veya offline dataset'i metric'lerle değerlendirebilir. Retrieval ve generation değerlendirmesi ayrı yürütülmelidir. LLM judge model version saklanmalıdır. Sensitive query redaction yapılabilir. Evaluation sonuçları deployment gate ve monitoring'e bağlanabilir.
Observability Layer
Observability trace, metric ve log bilgilerini birleştirir. Query, retrieval candidates, selected context ve model response aynı trace altında görülebilir. PII masking logging aşamasında uygulanmalıdır. Dashboard quality, latency ve cost metric'lerini birlikte sunmalıdır. Incident analysis için version metadata zorunludur.
Feedback Pipeline
Kullanıcı feedback'i query ve response trace ile bağlanmalıdır. Thumbs-up tek başına correctness ground truth değildir. Negative feedback triage edilerek retrieval, citation veya answer problemi şeklinde sınıflandırılabilir. Doğrulanmış örnekler golden dataset'e eklenebilir. Feedback otomatik model davranışına kontrolsüz biçimde yazılmamalıdır.
RAG Observability ve Monitoring
RAG monitoring yalnızca API uptime ve latency ölçmekten ibaret değildir. Retrieved chunk'lar, score dağılımı, model token kullanımı, grounding ve knowledge freshness birlikte izlenmelidir. Her production query mümkün olduğunca versioned trace oluşturmalıdır. Böylece bir cevap bozulduğunda hangi index, embedding veya prompt değişikliğinin etkili olduğu görülebilir. Regression detection RAG sistemini uzun vadede güvenilir tutmanın en önemli operasyon süreçlerinden biridir.
Her Query İçin Trace Oluşturma
Trace request başlangıcından final response'a kadar bütün adımları ilişkilendirir. Query rewrite, retrieval, reranking ve LLM call süreleri ayrı span olabilir. Model ve index version metadata taşır. Sensitive query text gerektiğinde maskelenir. Failure replay ve regression analysis kolaylaşır.
Retrieved Chunk'ların Loglanması
Retrieved chunk ID ve source metadata hata analizi için çok değerlidir. Tam chunk text loglamak privacy veya storage sorunu oluşturabilir. Reference ve hash yeterli olabilir. Selected ve rejected candidate ayrımı tutulabilir. Human reviewer gerektiğinde güvenli source store üzerinden içeriği açabilir.
Retrieval Score Takibi
Similarity veya reranker score distribution zamanla değişebilir. Embedding model veya corpus drift bu dağılımı etkileyebilir. Low-score query oranı no-answer ihtiyacını gösterebilir. Score tek başına relevance ground truth değildir. Trend ve labeled sample birlikte değerlendirilmelidir.
LLM Token Kullanımı
Input ve output token her query için kaydedilebilir. Context size artışı maliyet regression işareti olabilir. Top-k veya prompt değişikliği token kullanımını etkiler. Cost per query hesaplamasına dahil edilir. Budget threshold aşılırsa alert üretilebilir.
Latency Monitoring
Total latency yanında embedding, search, reranking ve generation süreleri ayrı izlenmelidir. P95 ve P99 dashboard'da görünmelidir. Source veya tenant bazında farklılık incelenebilir. Yeni index parameter tail latency'yi etkileyebilir. Deployment comparison hızlı regresyon tespiti sağlar.
Hallüsinasyon ve Grounding Monitoring
Bütün production cevaplarını insanla kontrol etmek mümkün değildir. Sampled LLM judge ve rule-based citation checks kullanılabilir. High-risk domain daha yüksek sampling oranına sahip olabilir. Grounding trend prompt veya model değişikliğinde izlenmelidir. Kullanıcı şikâyeti evaluation queue'ya otomatik eklenebilir.
Knowledge Freshness Monitoring
Last indexed timestamp source update zamanı ile karşılaştırılabilir. Sync failure knowledge staleness yaratır. Eski document version retrieval sonucu olarak görünüyorsa alert üretilebilir. Freshness SLA source bazında farklı olabilir. Critical policy kaynakları öncelikli izlenmelidir.
User Feedback
Kullanıcı feedback'i sistemin gerçek iş değerini ölçmede yararlıdır. Feedback response trace ile bağlanmalıdır. Negative yorum topic ve failure type'a göre sınıflandırılabilir. Kullanıcının yanlış beklentisi ile gerçek system error ayrılmalıdır. Verified feedback golden dataset'i büyütür.
Regression Detection
Embedding, chunking veya model update sonrası metric'lerde düşüş görülebilir. Canary veya shadow comparison bu riski azaltır. Automated evaluation deployment pipeline'a bağlanmalıdır. Critical faithfulness düşüşü rollback tetikleyebilir. Regression root cause version metadata üzerinden bulunabilir.
RAG Sistemlerinde Güvenlik
RAG yeni bir attack surface oluşturur çünkü model hem kullanıcı query'sini hem retrieved document içeriğini okur. Prompt injection, knowledge base poisoning ve unauthorized retrieval temel riskler arasındadır. Dokümanlar güvenilir instruction değil untrusted data olarak kabul edilmelidir. Access control retrieval aşamasından önce uygulanmalıdır. Security testleri yalnızca API değil ingestion, index ve citation katmanlarını da kapsamalıdır.
Prompt Injection
Kullanıcı query'si system talimatlarını değiştirmeye çalışabilir. Prompt priority ve server-side policy buna karşı temel koruma sağlar. Tool veya retrieval permission hiçbir zaman model kararına bırakılmamalıdır. Malicious query test suite'e eklenmelidir. Model cevabı output policy ile ayrıca doğrulanabilir.
Indirect Prompt Injection
Retrieved doküman içinde zararlı talimat bulunması indirect prompt injection riskidir. Model "bu kaynaktaki komutları uygula" yerine içeriği yalnızca bilgi olarak ele almalıdır. Document ingestion scanning yardımcı olabilir. Ancak bütün saldırıların pattern ile yakalanması mümkün değildir. Least privilege tool ve output validation esas savunmadır.
Knowledge Base Poisoning
Saldırgan bilgi tabanına yanıltıcı veya zararlı içerik ekleyebilirse retrieval doğru çalışsa bile cevap bozulabilir. Source ingestion yetkisi sınırlandırılmalıdır. Document provenance ve approval uygulanabilir. Yeni veya beklenmeyen source quality review alabilir. Poisoning testleri source ranking ve access policy'yi kapsamalıdır.
Retrieved Document'lara Güvenilmemesi
Bir belge kurum içinde bulunuyor diye model instruction açısından güvenilir sayılmamalıdır. Context açık data delimiter içinde sunulmalıdır. Document text tool call yetkisi yaratmamalıdır. Model retrieved source içindeki URL veya komutu otomatik çalıştırmamalıdır. Trust boundary mimaride açık tanımlanmalıdır.
Data Exfiltration
Yanlış retrieval yetkisi kullanıcının görmemesi gereken metni context'e taşıyabilir. Model bunu final cevapta sızdırabilir. Authorization search öncesi uygulanmalıdır. Cross-tenant retrieval testleri yapılmalıdır. Query ve response logs da sensitive data açısından korunmalıdır.
Document-Level Access Control
Her document veya chunk erişim metadata'sı taşımalıdır. User identity server-side authorization service üzerinden doğrulanır. Filter vector search request'ine eklenir. Retrieval sonrası content hiding yeterli değildir. Permission change index metadata'ya hızlı yansıtılmalıdır.
Role-Based Access Control
RBAC kullanıcı rolüne göre erişilebilir kaynakları sınırlar. Role information token veya identity service'ten gelmelidir. Prompt içinde kullanıcıdan role istemek güvenli değildir. Çok geniş role group leakage riskini artırır. Authorization audit düzenli yapılmalıdır.
Tenant Isolation
Multi-tenant RAG'da bir tenant'ın chunk'ı başka tenant query'sinde görünmemelidir. Ayrı namespace veya güçlü filter kullanılabilir. Tenant ID request body'den değil authenticated context'ten alınmalıdır. Cache de tenant-aware olmalıdır. Adversarial isolation test production release gate'e eklenmelidir.
Secrets Management
API key ve database credential prompt veya document metadata içine yazılmamalıdır. Secret manager ve short-lived identity kullanılabilir. Retrieval service yalnızca ihtiyaç duyduğu credential'a erişmelidir. Log redaction uygulanmalıdır. Credential rotation otomatik veya hızlı yapılabilir olmalıdır.
Encryption
Document, vector ve metadata storage encryption-at-rest ile korunabilir. Service communication TLS gibi secure transport kullanmalıdır. Key access minimum privilege prensibine göre verilmelidir. Backup encryption unutulmamalıdır. Sensitive embedding'in kendisi de korunması gereken veri olarak değerlendirilmelidir.
Audit Logging
Kim hangi source'a retrieval yaptı ve hangi doküman cevapta kullanıldı izlenebilir olmalıdır. Audit log PII'yi gereksiz saklamamalıdır. High-risk source access ayrı event üretebilir. Log integrity korunmalıdır. Security incident sırasında trace ve audit birlikte incelenebilir.
KVKK ve Veri Gizliliği Açısından RAG
RAG sistemleri kişisel veriyi yalnızca text store'da değil embedding, metadata ve log gibi farklı katmanlarda işleyebilir. Bu nedenle veri yaşam döngüsü uçtan uca değerlendirilmelidir. PII detection, minimization ve access control ingestion sırasında başlamalıdır. Silme talebi geldiğinde yalnızca original document değil ilgili chunk ve vector representation da yönetilmelidir. Teknik tasarımın kurumun hukuki yükümlülükleriyle birlikte değerlendirilmesi gerekir.
Kişisel Verilerin Embedding'e Dönüştürülmesi
Embedding original metni doğrudan göstermese de kaynağı kişisel veri içeriyorsa korunması gereken representation olarak ele alınmalıdır. Vector store erişimi sınırlandırılmalıdır. Gereksiz PII embedding'e dahil edilmemelidir. Deletion workflow vector record'u da kaldırmalıdır. Data classification vector metadata'da tutulabilir.
PII Detection ve Redaction
İsim, telefon ve e-posta gibi alanlar ingestion öncesi tespit edilebilir. RAG use case bu bilgilere ihtiyaç duymuyorsa redaction uygulanabilir. Redacted text retrieval kalitesi açısından test edilmelidir. Original document güvenli ayrı katmanda kalabilir. Detection false negative oranı kritik veri setinde ölçülmelidir.
Veri Minimizasyonu
RAG index'e yalnızca cevaplama amacı için gerekli bilgi alınmalıdır. Gereksiz personel veya müşteri detayı embedding'e dönüşmemelidir. Chunk metadata da minimum tutulmalıdır. Query logs retention policy'ye tabi olmalıdır. Veri minimizasyonu hem risk hem storage maliyetini azaltır.
Data Residency
Vector database, embedding ve LLM servisi farklı region veya ülkelerde çalışabilir. Kurum hangi verinin nerede işlendiğini bilmelidir. Provider ve deployment seçimi buna göre yapılır. Backup location ayrıca değerlendirilmelidir. Data flow diagram privacy review için yararlı olur.
Veri Silme Taleplerinin Vector Index'e Yansıtılması
Bir belge veya kişi verisi silindiğinde index'teki ilgili chunk'lar da kaldırılmalıdır. Document ID üzerinden reverse mapping bu süreci kolaylaştırır. Cache ve derived summary'ler de değerlendirilmelidir. Delete operation audit log'a kaydedilir. Tombstone veya rebuild strategy kullanılan teknolojiye göre seçilebilir.
Retention Policy
Document, chunk, query log ve evaluation sample aynı süreyle tutulmak zorunda değildir. Her data class için retention tanımlanmalıdır. Expired content vector index'ten otomatik kaldırılabilir. Backup retention ayrıca yönetilmelidir. Policy implementation düzenli olarak test edilmelidir.
Kullanıcı Bazlı Retrieval Yetkilendirmesi
Kullanıcıya gösterilebilecek document seti query anında hesaplanmalıdır. Access control yalnızca UI katmanında olmamalıdır. Retrieval service authenticated user context ile filtre uygular. Cache user scope'u dikkate almalıdır. Permission testleri regression suite'e eklenmelidir.
RAG Maliyetleri Nasıl Hesaplanır?
RAG maliyeti yalnızca LLM token fiyatından oluşmaz. Embedding, vector storage, retrieval compute, reranking, re-indexing ve observability giderleri toplam profile dahildir. Query volume ve corpus büyüklüğü kapasite planını belirler. Cost per query metric'i farklı mimari denemeleri karşılaştırmayı kolaylaştırır. Accuracy, latency ve cost arasında açık hedef belirlemek gereksiz pahalı optimization'ları önler.
Embedding Maliyeti
Document ingestion ve user query embedding ayrı maliyet profiline sahiptir. Büyük corpus ilk indexing sırasında toplu maliyet oluşturur. Incremental update bu maliyeti azaltır. Model dimension local veya hosted deployment cost'unu etkiler. Cost per million tokens veya documents takip edilebilir.
Vector Storage Maliyeti
Vektör sayısı chunk count ile yaklaşık ilişkilidir. Küçük chunk size daha fazla vector ve metadata üretir. Dimension storage tüketimini etkiler. Replication ve backup maliyeti ayrıca eklenmelidir. Chunking kararının altyapı maliyetine etkisi gözden kaçırılmamalıdır.
Retrieval Maliyeti
Managed search servisi query başına veya capacity bazlı ücretlendirebilir. Self-hosted sistem compute ve operasyon maliyeti oluşturur. Hybrid search iki retrieval kanalını çalıştırabilir. Query concurrency kapasite ihtiyacını belirler. Cache hit rate gerçek retrieval cost'u azaltabilir.
Reranking Maliyeti
Cross-encoder veya LLM reranker ek inference maliyeti üretir. Candidate sayısı maliyeti doğrudan etkiler. Sadece zor query'lerde reranking cost-aware strateji olabilir. Quality gain metric ile birlikte raporlanmalıdır. Reranker default eklenmeden önce baseline karşılaştırması yapılmalıdır.
LLM Token Maliyeti
Input context ve output answer token sayısı toplam generation maliyetini belirler. Top-k ve chunk size input token üzerinde önemli etkiye sahiptir. Prompt compression ve duplicate removal tasarruf sağlar. Model routing küçük query'lerde daha düşük maliyetli generator kullanabilir. Cost ve faithfulness birlikte izlenmelidir.
Re-Indexing Maliyeti
Embedding model veya chunking strategy değiştiğinde bütün corpus yeniden indexlenebilir. Büyük bilgi tabanında bu ciddi maliyet ve zaman oluşturur. Blue-green index migration kullanılabilir. Experiment sample corpus üzerinde yapılıp fayda kanıtlandıktan sonra full re-index başlatılmalıdır. Index version rollback için korunabilir.
Observability Maliyeti
Query trace, retrieval candidate ve evaluation data storage tüketir. Tam document text loglamak çoğu zaman gerekli değildir. Sampled evaluation maliyeti azaltabilir. Metric retention süreleri data class'a göre değişebilir. Observability'yi kapatmak maliyeti düşürür gibi görünse de production incident çözümünü zorlaştırabilir.
Cost per Query
Cost per query embedding, retrieval, reranking ve generation maliyetlerinin toplamıdır. Cache hit ve query type'a göre büyük fark gösterebilir. P50 cost yanında high-cost query percentile izlenebilir. Agentic multi-hop query'ler daha pahalı olabilir. Budget routing bu metriğe göre uygulanabilir.
Accuracy–Latency–Cost Dengesi
Daha büyük model veya daha fazla reranking genellikle maliyet ve latency artırır. Quality gain her zaman aynı oranda yükselmez. Pareto frontier benzeri karşılaştırma farklı pipeline'ları değerlendirmede yararlıdır. Business critical query daha pahalı route kullanabilir. Düşük değerli query için daha sade pipeline yeterli olabilir.
RAG İçin Hangi Programlama Dili Kullanılmalı?
RAG geliştirmek için tek doğru programlama dili yoktur. Python AI ve veri araçları nedeniyle güçlü prototip ve backend seçeneğidir. TypeScript web ve agent servisleriyle doğal entegrasyon sağlar. Java, C# veya Go mevcut kurumsal platformlarda güçlü production seçenekleri olabilir. Dil seçimi kadar observability, validation, güvenlik ve ekip deneyimi önemlidir.
Python
Python geniş embedding, evaluation ve data processing ekosistemi sunar. Notebook'tan production servise geçiş hızlı olabilir. Type hints ve validation araçları kullanmak önemlidir. Async retrieval ve API servisleri geliştirilebilir. Kurumsal kod kalitesinde test ve dependency management ihmal edilmemelidir.
AI/ML Ekosistemi
Python embedding, transformer ve evaluation kütüphaneleri açısından geniş seçenek sunar. Data ingestion ve notebook analizi aynı dilde yapılabilir. Community örnekleri öğrenmeyi kolaylaştırır. Bununla birlikte her açık kaynak paketi production için güvenli değildir. Dependency review ve version pinning uygulanmalıdır.
Hızlı Prototipleme
Python küçük RAG baseline'ını hızlı kurmayı sağlar. Bu avantaj evaluation sürecini erkene çekmek için kullanılmalıdır. Hızlı prototip production security'nin atlanması anlamına gelmez. Prototype'da bile golden query set oluşturmak faydalıdır. Başarılı bileşenler daha sonra servisleştirilebilir.
TypeScript / JavaScript
TypeScript web application ve API katmanında güçlü typing avantajı sunar. LLM ve vector API entegrasyonları kolayca yapılabilir. Frontend ile backend aynı dil ekosistemini paylaşabilir. Büyük ingestion veya ML işlemleri başka servisle ayrılabilir. Production RAG için tamamen geçerli bir seçenektir.
Web ve Agent Uygulamaları
Chat UI, streaming response ve tool integration TypeScript ekosisteminde rahat geliştirilebilir. Server-side authorization retrieval call öncesi uygulanmalıdır. Client tarafına secret veya vector credential verilmemelidir. Streaming citation data birlikte taşınabilir. Observability trace backend'de üretilmelidir.
Java
Java kurumsal backend, identity ve yüksek kontrollü servis mimarilerinde güçlüdür. Mevcut organization stack Java ise RAG için başka dile geçmek zorunlu değildir. Retrieval ve LLM servisleri HTTP veya SDK üzerinden entegre edilebilir. Strong typing ve mature observability avantaj sağlar. Model araştırması gerektiğinde Python yardımcı servis olarak kullanılabilir.
Enterprise Backend
Kurumsal sistemlerde authentication, audit ve transaction altyapısı çoğu zaman zaten Java ekosistemindedir. RAG retrieval servisi bu altyapıya entegre olabilir. Tool calling business service'lere kontrollü erişim sağlar. Search index ayrı servis olarak tutulabilir. Mevcut platform standardına uyum bakım maliyetini azaltır.
C# / .NET
.NET tabanlı kurumlar mevcut servis ve identity altyapısını RAG ile genişletebilir. Strong typing structured output kullanımını kolaylaştırır. Enterprise deployment ve logging araçları olgundur. Model API'leri standart HTTP üzerinden kullanılabilir. Yeni dil seçmek yerine mevcut ekip yetkinliği çoğu zaman daha verimlidir.
Microsoft Ekosistemi
.NET kimlik, backend ve kurumsal uygulamalarla güçlü entegrasyon sağlar. Existing permission modeli retrieval authorization'a bağlanabilir. Document ingestion farklı worker servislerinde çalışabilir. LLM provider mimariden bağımsız gateway arkasında tutulabilir. Vendor lock-in riski interface abstraction ile azaltılabilir.
Go
Go düşük memory kullanımı ve hızlı servis geliştirme açısından retrieval gateway veya high-throughput API için uygun olabilir. AI araştırma kütüphaneleri Python kadar geniş değildir. Model inference harici servis üzerinden çağrılabilir. Concurrency güçlü avantajdır. Tooling seçimi mevcut ekip deneyimine bağlı olmalıdır.
Yüksek Performanslı Servisler
Retrieval proxy veya API gateway yüksek concurrency gerektirebilir. Go bu tip servislerde verimli olabilir. Search ve LLM call'ları network-bound olduğu için concurrency modeli fayda sağlar. Business logic test edilebilir ve sade tutulmalıdır. Performance gerekmediğinde yalnızca hız için stack parçalamak gerekli değildir.
“En İyi Programlama Dili” Yerine Doğru Stack Nasıl Seçilir?
Önce veri kaynakları, deployment ortamı ve ekip deneyimi belirlenmelidir. Retrieval ve model servisleri standard API üzerinden ayrıştırılabilir. Böylece bütün sistemi tek dilde yazma zorunluluğu kalmaz. Security, latency ve maintainability dil benchmark'ından daha önemlidir. Doğru stack, ekibin güvenilir biçimde geliştirebildiği ve ölçebildiği stack'tir.
RAG İçin Kullanılan Açık Kaynak Teknolojiler
Açık kaynak RAG ekosistemi ingestion, orchestration, vector search ve evaluation için birçok seçenek sunar. Araç seçerken yalnızca hızlı demo kurulmasına değil maintenance, security ve observability ihtiyaçlarına bakılmalıdır. Framework kullanmak RAG mimarisinin temel prensiplerini ortadan kaldırmaz. Kullanılan abstraction'ın altında hangi chunking, retrieval ve prompt davranışının çalıştığı bilinmelidir. Dependency ve version değişiklikleri regression test ile yönetilmelidir.
Orchestration Framework'leri
Orchestration framework'leri retrieval, tool ve model çağrılarını bağlamak için yardımcı abstraction sunabilir. Hızlı prototip avantajı vardır. Production'da framework version değişiklikleri behavior regression yaratabilir. Kritik policy'ler framework prompt'una bırakılmamalıdır. Basit custom pipeline bazı projelerde daha kolay yönetilebilir.
LangChain
LangChain model ve retrieval bileşenlerini bağlamak için geniş entegrasyon seçenekleri sunar. Prototip geliştirmeyi hızlandırabilir. Kullanılan retriever ve splitter davranışı açıkça anlaşılmalıdır. Abstraction katmanı performance trace'i gizlememelidir. Production adoption öncesi dependency ve upgrade planı yapılmalıdır.
LangGraph
LangGraph stateful ve agentic retrieval akışlarını graph olarak modellemek için kullanılabilir. Conditional retrieval ve human approval gibi node'lar tanımlanabilir. State schema açık tutulmalıdır. Loop sayısı ve budget kontrol edilmelidir. Basit classic RAG için graph framework zorunlu değildir.
LlamaIndex
LlamaIndex document ingestion, indexing ve retrieval abstraction'ları sağlayabilir. Farklı document ve index stratejilerini hızlı denemeyi kolaylaştırır. Production'da seçilen bileşenin gerçek behavior ve performansı ölçülmelidir. Metadata ve permission tasarımı uygulama sorumluluğundadır. Framework seçimi güvenlik politikasının yerini almaz.
Haystack
Haystack pipeline tabanlı retrieval ve QA akışları kurmak için kullanılabilir. Component sınırları experiment için yararlı olabilir. Kullanılan retriever ve generator bağımsız değerlendirilebilir. Deployment ihtiyacı ekip altyapısıyla uyumlu olmalıdır. Version regression testleri önemlidir.
DSPy
DSPy belirli LLM programlarının ve prompt davranışlarının veri üzerinden optimize edilmesini hedefleyen yaklaşım sunar. RAG generation ve retrieval programlarını sistematik değerlendirmede kullanılabilir. Optimization için kaliteli dataset gerekir. Otomatik optimize edilen prompt security policy'yi ihlal etmemelidir. Production'a geçmeden regression ve human review yapılmalıdır.
Vector Search Teknolojileri
Vector search için in-process kütüphanelerden distributed server sistemlerine kadar farklı seçenekler vardır. Dataset size ve availability ihtiyacı seçimi belirler. Metadata filter ve multi-tenant özellikleri kurumsal RAG'da önemlidir. Sadece ANN benchmark sonucu yeterli değildir. Backup, operational complexity ve total cost birlikte değerlendirilmelidir.
FAISS
FAISS local veya service içinde vector similarity search yapmak için kullanılabilir. Araştırma ve baseline benchmark için pratiktir. Production persistence ve distributed serving uygulama tarafından ayrıca yönetilebilir. Küçük veya orta corpus'ta güçlü seçenek olabilir. Metadata access control ayrı katmanda ele alınmalıdır.
Milvus
Milvus büyük ölçekli vector search workload'ları için kullanılabilecek açık kaynak seçeneklerden biridir. Distributed operasyon gereksinimi küçük projelerde fazla olabilir. Index, filter ve latency davranışı gerçek corpus üzerinde test edilmelidir. Backup ve upgrade planı production readiness için önemlidir. Ekip operasyon kapasitesi seçimde dikkate alınmalıdır.
Qdrant
Qdrant vector search ve payload filtering özellikleriyle RAG projelerinde değerlendirilebilir. Metadata filter kurumsal kullanım açısından yararlıdır. Self-hosted veya farklı deployment yöntemleri düşünülebilir. Performance gerçek workload ile ölçülmelidir. Kullanılan teknoloji ne olursa olsun authorization uygulama identity'siyle bağlanmalıdır.
Weaviate
Weaviate vector search ve metadata odaklı retrieval senaryolarında kullanılabilecek seçeneklerden biridir. Schema ve collection tasarımı production performansını etkiler. Hybrid retrieval yetenekleri benchmark edilebilir. Operations ve upgrade ihtiyaçları ayrıca düşünülmelidir. Technology selection ekip stack'iyle uyumlu olmalıdır.
pgvector
pgvector mevcut PostgreSQL altyapısına vector arama ekleme seçeneği sunar. Relational metadata ve vector aynı platformda tutulabilir. Küçük ve orta ölçekli birçok RAG için operasyonel sadelik sağlayabilir. Latency ve index behavior gerçek veriyle benchmark edilmelidir. Ölçek ihtiyacı arttığında architecture yeniden değerlendirilebilir.
Elasticsearch / OpenSearch
Lexical search ve vector retrieval'ı aynı search platformunda birleştirmek hybrid RAG için yararlı olabilir. Mevcut search altyapısı olan kurumlar ek sistem kurmadan ilerleyebilir. Mapping ve index tuning önemlidir. Keyword ve semantic retrieval birlikte benchmark edilmelidir. Access control ve cluster operation mevcut enterprise policy ile uyumlu tutulmalıdır.
Evaluation Araçları
Evaluation araçları RAG cevap ve retrieval kalitesini otomatik veya yarı otomatik ölçmeye yardımcı olur. Framework metric tanımları birbirinden farklı olabilir. Kullanılan skorların neyi gerçekten ölçtüğü anlaşılmalıdır. Human-labeled validation set önemini korur. Araç yalnızca ölçüm sürecini kolaylaştırmalı, kalite standardını kendi başına belirlememelidir.
Ragas
Ragas RAG quality değerlendirmesinde faithfulness, relevance ve context metric'leri gibi ölçümler için kullanılabilir. LLM-based evaluation sonuçları judge modeline bağlıdır. Custom dataset ve domain requirement'lar ayrıca eklenebilir. Score trend regression için yararlıdır. Kritik kararlar human sample ile doğrulanmalıdır.
Phoenix
Phoenix tracing ve evaluation odaklı RAG gözlemlenebilirliği için kullanılabilecek araçlardan biridir. Retrieval ve model span'larını incelemek debugging sürecini kolaylaştırabilir. Production privacy policy loglanan veriye uygulanmalıdır. Evaluation model ve metric version saklanmalıdır. Tool seçimi mevcut observability stack ile uyuma göre yapılmalıdır.
Açık Kaynağın Avantajları ve Dezavantajları
Açık kaynak kontrol, özelleştirme ve community katkısı sağlar. Buna karşılık security patch, upgrade ve production support sorumluluğu kuruma ait olabilir. Framework hızla değiştiğinde dependency maintenance yükü oluşabilir. Lisans ve supply chain review yapılmalıdır. Build vs buy kararı yalnızca başlangıç maliyetine göre verilmemelidir.
Open Source ve İşbirliğinin RAG Ekosistemindeki Rolü
RAG projelerinde gerçek ilerleme yalnızca yeni framework kullanmaktan değil ortak benchmark, dataset ve evaluation pratiği geliştirmekten gelir. Açık kaynak topluluklar retrieval hatalarını ve farklı dil ihtiyaçlarını daha görünür hale getirir. Türkçe RAG dataset'leri ve domain benchmark'ları özellikle değerlidir. GitHub katkıları genç geliştiricilerin gerçek production kavramlarıyla çalışmasını sağlar. Diyarbakır Yazılım Topluluğu'nun proje çalışmalarına https://www.diyarbakiryazilim.com.tr/projects adresinden ulaşılabilir.
GitHub Üzerinden RAG Projelerine Katkı
RAG projelerine katkı yalnızca büyük feature geliştirmek anlamına gelmez. Parsing edge case, evaluation test veya documentation iyileştirmesi de değerlidir. Issue üzerinden problem yeniden üretilebilir hale getirilmelidir. Pull Request küçük ve testli tutulmalıdır. Bu süreç production engineering pratiğini geliştirir.
Açık Kaynak Embedding Modelleri
Açık embedding modelleri local deployment ve özel benchmark imkânı sağlayabilir. Model size, language support ve license değerlendirilmelidir. Türkçe query set üzerinde test yapılmalıdır. Quantization quality etkisi ölçülmelidir. Local olması modelin otomatik olarak en iyi retrieval kalitesini sunduğu anlamına gelmez.
Açık Kaynak Vector Database'ler
Açık source vector search sistemleri infrastructure üzerinde daha fazla kontrol sunar. Kurulum kadar backup, upgrade ve monitoring sorumluluğu da vardır. Small team managed seçenekten daha fazla operasyon maliyeti yaşayabilir. Large regulated environment local control avantajından yararlanabilir. Karar total cost ve security ihtiyacına göre verilmelidir.
Community Benchmark'ları
Community benchmark farklı model ve retrieval yöntemlerini ortak dataset üzerinde karşılaştırmayı sağlar. Benchmark'ın sizin corpus'unuzu temsil edip etmediği kontrol edilmelidir. Türkçe veya domain query eksikliği olabilir. Public score yalnızca ön eleme için kullanılabilir. Final karar internal golden dataset ile verilmelidir.
Dataset Paylaşımı
RAG evaluation için anonimleştirilmiş query-passage dataset paylaşımı community öğrenmesini hızlandırır. Kişisel veya kurum içi gizli bilgi kesinlikle çıkarılmalıdır. License ve kullanım koşulları açık olmalıdır. Hard negative ve no-answer örnekleri dataset'i daha değerli yapar. Versioning reproducible benchmark sağlar.
Üniversite–Sektör İşbirliği
Üniversite araştırması retrieval metric ve yeni yöntemler konusunda derin çalışma sunabilir. Sektör gerçek kullanıcı soruları ve production constraints sağlar. Ortak benchmark iki tarafın güçlü yönlerini birleştirir. Öğrenciler güvenlik ve observability gibi gerçek ihtiyaçları görür. Veri paylaşımı privacy policy çerçevesinde yapılmalıdır.
Yazılım Topluluklarının Rolü
Yazılım toplulukları workshop, proje ve code review üzerinden RAG bilgisini uygulamaya dönüştürebilir. Katılımcılar farklı embedding ve chunking stratejilerini aynı dataset üzerinde karşılaştırabilir. Yerel dil ve veri problemleri daha görünür hale gelir. Açık kaynak üretim katılımcılara somut portföy kazandırır. Topluluk odaklı evaluation çalışmaları tek seferlik sunumlardan daha kalıcı değer sağlar.
RAG Workshop'ları
Workshop küçük bir document QA baseline ile başlayabilir. Katılımcılar önce BM25, sonra dense ve hybrid retrieval karşılaştırabilir. Chunking değişiminin metric'e etkisi ölçülebilir. Final bölümde prompt injection ve access control test edilebilir. Bu yaklaşım yalnızca API kullanmayı değil sistem tasarımını öğretir.
Hackathon'lar
Hackathon kısa sürede ürün prototipi geliştirmek için motive edici olabilir. Ancak evaluation kriteri yalnızca demo görünümü olmamalıdır. Retrieval accuracy, source citation ve latency de puanlanabilir. Open dataset kullanmak tekrar üretilebilir sonuç sağlar. Başarılı prototipler daha sonra açık kaynak projeye dönüşebilir.
Ortak Açık Kaynak Projeleri
Topluluk ortak parser, Turkish RAG benchmark veya citation validator geliştirebilir. Modüler proje yeni katılımcının küçük katkıyla başlamasını kolaylaştırır. Test suite kalite standardını korur. Security review checklist eklenebilir. Uzun vadeli maintenance için owner ve release süreci tanımlanmalıdır.
Diyarbakır Yazılım Topluluğu İçin RAG Projeleri
Diyarbakır Yazılım Topluluğu içinde Türkçe yerel bilgi asistanı, açık kamu verisi arama veya teknik doküman RAG projesi geliştirilebilir. Proje yalnızca chatbot ekranından oluşmamalı, retrieval benchmark ve kaynak gösterme sistemi de içermelidir. Katılımcılar ingestion, backend, evaluation ve security gibi farklı görevleri üstlenebilir. Topluluk hakkında ayrıntılı bilgi için https://www.diyarbakiryazilim.com.tr/about adresi kullanılabilir. Proje üretimi gerçek RAG tasarım ilkelerini öğrenmek için güçlü uygulama ortamı oluşturur.
RAG Projesinde Build vs Buy Kararı
RAG altyapısını tamamen kurum içinde geliştirmek her zaman doğru olmadığı gibi tüm bileşenleri managed hizmete bırakmak da her kurum için uygun değildir. Ekip kapasitesi, data privacy, latency ve vendor bağımlılığı birlikte değerlendirilmelidir. Managed çözüm hızlı başlangıç sağlar ancak uzun vadeli maliyet veya taşınabilirlik riski oluşturabilir. Custom RAG daha fazla kontrol verir fakat maintenance sorumluluğu artar. Total Cost of Ownership hesaplanırken geliştirme süresi kadar production operasyon maliyeti de dahil edilmelidir.
Managed RAG Platformu Ne Zaman Kullanılmalı?
Küçük ekip hızlı MVP ve sınırlı operasyon yükü istiyorsa managed platform uygun olabilir. Authentication ve data policy yine kurum sorumluluğundadır. Platform retrieval behavior üzerinde yeterli observability sağlamalıdır. Export ve migration seçenekleri değerlendirilmelidir. Basitlik quality benchmark ihtiyacını ortadan kaldırmaz.
Custom RAG Ne Zaman Geliştirilmeli?
Özel authorization, domain retrieval veya mevcut data platform entegrasyonu gerekiyorsa custom tasarım avantaj sağlar. Ekip search ve production service yönetebilecek kapasitede olmalıdır. Custom her bileşeni sıfırdan yazmak anlamına gelmez. Açık kaynak ve managed component'ler birlikte kullanılabilir. Architecture boundary kurumun kontrol ihtiyacına göre seçilmelidir.
Managed Vector Database vs Self-Hosted
Managed çözüm backup, scaling ve operation yükünü azaltabilir. Self-hosted data residency ve maliyet kontrolü avantajı sağlayabilir. Ekip on-call ve upgrade sorumluluğunu üstlenir. Performance benchmark aynı dataset üzerinde yapılmalıdır. Karar yalnızca aylık altyapı fiyatıyla verilmemelidir.
Hosted LLM vs Open-Source LLM
Hosted model yüksek kalite ve düşük operasyon ihtiyacı sunabilir. Open-source local model privacy ve kontrol avantajı sağlayabilir. Serving GPU ve model optimization maliyetlidir. Task-specific generation benchmark yapılmalıdır. Hybrid routing bazı kurumlarda iki yaklaşımın avantajlarını birleştirebilir.
Vendor Lock-In Riski
Provider-specific API ve proprietary index feature'larına aşırı bağımlılık migration maliyetini artırabilir. Common abstraction ve exportable data format kullanılabilir. Embedding model değişikliği zaten re-index gerektirebilir. Vendor risk backup ve business continuity planına dahil edilmelidir. Tam taşınabilirlik uğruna gereksiz abstraction da oluşturulmamalıdır.
Total Cost of Ownership
TCO cloud faturası, developer zamanı, operations, security ve support maliyetini birlikte kapsar. Self-hosted çözüm lisanssız olsa bile insan maliyeti yüksek olabilir. Managed platform başlangıçta pahalı görünse de bakım yükünü azaltabilir. Query volume ve growth projection hesaplanmalıdır. Üç yıllık senaryo karşılaştırması karar kalitesini artırır.
Örnek Bir RAG Projesi Nasıl Geliştirilir?
Sağlam RAG projesi vector database seçimiyle değil iş problemi ve gerçek kullanıcı sorularıyla başlamalıdır. Golden dataset daha ilk aşamada hazırlanırsa sonraki her teknik karar ölçülebilir hale gelir. Baseline retrieval kurulduktan sonra chunking, embedding, hybrid search ve reranking sırayla denenebilir. Security ve production observability final aşamaya bırakılmamalıdır. Yapay Zeka Projelerinde RAG (Retrieval-Augmented Generation) Mimarisi geliştirirken en verimli yöntem, her adımın hangi problemi çözdüğünü ve hangi metriği iyileştirdiğini açıkça takip etmektir.
Adım 1: İş Problemini Tanımlama
Kullanıcının hangi bilgiyi neden aradığı netleştirilmelidir. Başarı ölçüsü "chatbot çalışıyor" olmamalıdır. Destek süresi, bilgi bulma oranı veya task success gibi KPI seçilebilir. Source authority belirlenmelidir. RAG gerçekten gerekli mi sorusu bu aşamada cevaplanmalıdır.
Adım 2: Kullanıcı Sorularını Toplama
Gerçek kullanıcı query'leri retrieval tasarımının temelidir. FAQ, search log ve domain expert görüşü kullanılabilir. Query'ler kısa, uzun, teknik ve belirsiz örnekleri kapsamalıdır. Privacy nedeniyle gerekli redaction yapılmalıdır. Query category daha sonra failure analysis için tutulabilir.
Adım 3: Golden Dataset Oluşturma
Her query için relevant document ve passage etiketlenir. No-answer sorular özellikle eklenmelidir. Gerekirse expected answer ve citation hazırlanır. Dataset review edilmelidir. Her optimization aynı benchmark üzerinde karşılaştırılır.
Adım 4: Veri Kaynaklarını Belirleme
Authoritative source listesi oluşturulur. Eski veya duplicate kaynaklar işaretlenir. Access policy ve owner metadata tanımlanır. Freshness ihtiyacı belirlenir. Ingestion scope gereksiz belgelerle genişletilmemelidir.
Adım 5: Parsing Pipeline Kurma
PDF, web ve diğer source tipleri doğru parser ile işlenir. Heading ve table structure korunur. Boilerplate temizlenir. Parse failure quarantine edilir. Representative document set üzerinde kalite kontrol yapılır.
Adım 6: Chunking Benchmark
En az iki veya üç chunking strategy karşılaştırılabilir. Token size ve overlap varyasyonları test edilir. Retrieval metric aynı embedding modelle ölçülür. Context token maliyeti kaydedilir. Kazanan yöntem corpus type'a göre seçilir.
Adım 7: Embedding Benchmark
Birden fazla embedding modeli golden retrieval set üzerinde test edilir. Türkçe ve domain query'ler ayrı raporlanır. Latency ve dimension metric olarak eklenir. Dense search BM25 baseline ile karşılaştırılır. Küçük quality farkı büyük re-index maliyetine değmeyebilir.
Adım 8: Vector Index Oluşturma
Seçilen embedding ile index oluşturulur. Metadata ve permission field'ları yazılır. Index version atanır. Backup ve rebuild süreci test edilir. Search parameters benchmark ile ayarlanır.
Adım 9: Baseline Retrieval
İlk baseline mümkün olduğunca sade tutulmalıdır. Dense veya BM25 ayrı ayrı çalıştırılabilir. Top-k sabit seçilir. Recall ve MRR ölçülür. Failure query'ler manuel incelenir.
Adım 10: Retrieval Evaluation
Golden dataset üzerindeki sonuçlar query category bazında analiz edilir. Technical term ve semantic query farkları görülür. Hangi problem chunking, embedding veya ranking kaynaklı belirlenir. Optimization önceliği metric'e göre seçilir. Generator henüz ana odak olmamalıdır.
Adım 11: Hybrid Search Denemesi
BM25 ve dense listeleri fusion ile birleştirilir. RRF veya score fusion karşılaştırılabilir. Recall ve nDCG değişimi ölçülür. Latency farkı kaydedilir. Gerçek gain yoksa hybrid pipeline eklenmez.
Adım 12: Reranking Denemesi
Candidate retrieval yeterli recall sağlıyorsa reranker test edilir. Cross-encoder ranking gain ölçülür. Candidate count optimize edilir. Latency ve compute maliyeti raporlanır. Sadece anlamlı gain varsa production'a eklenir.
Adım 13: Prompt ve Context Tasarımı
Selected chunks source ID ile context'e eklenir. Grounding ve no-answer policy system prompt'ta tanımlanır. Citation formatı belirlenir. Duplicate context temizlenir. Token budget sınırı uygulanır.
Adım 14: Generation Evaluation
Faithfulness, correctness ve citation accuracy ölçülür. Retrieval doğru olup cevabın yanlış olduğu query'ler ayrı incelenir. Generator modeli veya prompt gerektiğinde değiştirilir. Human sample automated score'u doğrular. Context sufficiency metric eklenebilir.
Adım 15: Security Testleri
Prompt injection ve indirect injection dataset oluşturulur. Cross-user ve tenant access kontrol test edilir. Unauthorized chunk hiçbir candidate listesinde görünmemelidir. Knowledge poisoning senaryosu denenebilir. Security failure production blocker olmalıdır.
Adım 16: Production Deployment
Canary veya limited user rollout tercih edilebilir. Index, prompt ve model version trace'e yazılır. Alert ve rollback hazır olmalıdır. P95 latency ve cost izlenir. İlk dönemde human review sampling artırılabilir.
Adım 17: Monitoring ve Sürekli İyileştirme
User feedback ve production failure yeni golden case üretir. Knowledge freshness izlenir. Model veya embedding upgrade regression testten geçer. Cost ve latency düzenli optimize edilir. RAG sistemi bir kez kurulup unutulan static proje olarak görülmemelidir.
RAG Sistemlerinde Yapılan Yaygın Hatalar
RAG projelerinde en büyük hataların çoğu model seçiminden değil ölçüm eksikliğinden kaynaklanır. Vector database kurmak, retrieval kalitesinin iyi olduğu anlamına gelmez. Chunking ve metadata'yı ihmal etmek generator modelini gereksiz yere suçlamaya neden olur. Access control'ü retrieval sonrasına bırakmak ciddi veri sızıntısı riski oluşturur. Production öncesinde gerçek kullanıcı query'leriyle evaluation yapmak bu hataların büyük bölümünü görünür hale getirir.
Vector Database Kurmayı RAG Sanmak
Vector store yalnızca retrieval altyapısının bir parçasıdır. Parsing, chunking, metadata, prompt ve evaluation olmadan güvenilir RAG oluşmaz. Search sonucu doğru mu ölçülmelidir. Citation ve security ayrıca gerekir. Architecture bütün pipeline olarak ele alınmalıdır.
Her Dokümana Aynı Chunk Size'ı Uygulamak
FAQ, teknik kılavuz ve tablo aynı bilgi yapısına sahip değildir. Tek chunk size bazı kaynaklarda bağlamı bozabilir. Document-aware strategy düşünülebilir. Corpus type bazlı benchmark yapılmalıdır. Chunk size config hard-coded olmamalıdır.
Retrieval'ı Ölçmeden LLM'i Değiştirmek
Yanlış evidence geldiğinde daha güçlü model kalıcı çözüm değildir. Önce Recall@K ve nDCG ölçülmelidir. Retrieval failure query'leri incelenmelidir. Generator ancak context doğru olduğu halde cevap hatalıysa ana adaydır. Bu ayrım maliyetli model değişikliklerini azaltır.
Gereğinden Fazla Top-K Kullanmak
Daha fazla chunk her zaman daha fazla doğru bilgi anlamına gelmez. Gereksiz context model dikkatini dağıtır. Token ve latency maliyeti artar. Dynamic veya tuned top-k kullanılabilir. Precision ve context recall birlikte ölçülmelidir.
Hybrid Search'ü Benchmark Yapmadan Eklemek
Hybrid search çoğu corpus'ta güçlü olabilir fakat otomatik üstün değildir. Ek retrieval ve fusion logic operasyon yükü getirir. BM25 ve dense baseline ile karşılaştırılmalıdır. Query class bazında gain incelenmelidir. Fayda yoksa sade pipeline korunmalıdır.
Reranker'ı Varsayılan Olarak Kullanmak
Reranker ek latency ve compute maliyeti oluşturur. Retriever zaten doğru ranking sağlıyorsa fayda düşük olabilir. MRR ve nDCG gain ölçülmelidir. Adaptive reranking düşünülebilir. Her query'yi pahalı second-stage modelden geçirmek gerekmez.
Metadata'yı Yok Saymak
Metadata access, freshness ve domain relevance için kritik sinyal sağlar. Sadece vector similarity kullanmak eski veya yanlış departman dokümanlarını getirebilir. Document owner ve version alanları faydalıdır. Filter schema standard olmalıdır. Metadata ingestion baştan tasarlanmalıdır.
Access Control'ü Retrieval Sonrasına Bırakmak
Unauthorized chunk retrieval sonuçlarına girerse model onu final cevapta kullanabilir. Sonradan UI'da gizlemek yeterli değildir. Permission search request'in parçası olmalıdır. Cache aynı policy'yi izlemelidir. Security test candidate list seviyesinde yapılmalıdır.
Güncelliğini Yitirmiş Dokümanları İndekste Tutmak
Eski policy ile yeni policy birlikte retrieval'a gelirse model çelişkili cevap üretebilir. Version ve effective date yönetilmelidir. Archived content default search'ten çıkarılabilir. Freshness monitoring uygulanmalıdır. Document owner eski içerik için alert alabilir.
Citation Doğruluğunu Ölçmemek
Model kaynak numarası yazdı diye citation doğru kabul edilmemelidir. Source gerçekten iddiayı destekliyor mu kontrol edilmelidir. Invalid source ID otomatik yakalanabilir. Claim-source alignment sampled judge ile değerlendirilebilir. Kurumsal güven için citation kritik metric'tir.
Test Dataset'i Olmadan Optimizasyon Yapmak
Golden dataset olmadan değişiklikler sezgiyle yapılır. Yeni embedding birkaç demo soruda iyi görünebilir ama genel kaliteyi düşürebilir. Sabit benchmark reproducible karşılaştırma sağlar. Production feedback dataset'i güncel tutar. Her release aynı suite'ten geçmelidir.
Sadece Demo Senaryolarıyla Production'a Çıkmak
Demo soruları genellikle kolay ve önceden bilinen örneklerdir. Gerçek kullanıcılar belirsiz, kısa veya çok adımlı sorgular sorar. No-answer ve adversarial case'ler test edilmelidir. Load ve security test yapılmalıdır. Production readiness UI görünümünden çok güvenilir behavior ile ölçülmelidir.
RAG Uygulamalarında CI/CD ve LLMOps
RAG pipeline değişiklikleri klasik yazılım release süreci kadar kontrollü yönetilmelidir. Prompt, embedding, index ve dataset version birbirinden bağımsız değişebilir. Automated evaluation her release candidate için regression kontrolü sağlar. Canary deployment yeni retrieval davranışını sınırlı traffic üzerinde test eder. Rollback yalnızca application code değil index ve prompt version için de mümkün olmalıdır.
Prompt Versioning
Prompt repository veya configuration management içinde versionlanabilir. Her change diff ve review sürecinden geçmelidir. Production trace prompt version saklar. Golden generation tests otomatik çalıştırılır. Security instruction değişikliği özel review gerektirebilir.
Embedding Model Versioning
Embedding model değişikliği mevcut vector representation ile uyumsuz olabilir. Model ID index metadata'sında tutulmalıdır. Yeni model ayrı index version üretmelidir. A/B retrieval evaluation sonrası rollout yapılır. Old index rollback için korunabilir.
Index Versioning
Chunking, embedding veya index parameter değişikliği yeni index version olarak yayınlanabilir. Production pointer atomic biçimde değiştirilebilir. Warm-up ve smoke test yapılmalıdır. Index creation failure mevcut serving'i etkilememelidir. Version lineage re-index nedenini saklar.
Dataset Versioning
Golden evaluation dataset versionlanmalıdır. Yeni production failure eklenince metric geçmişi karşılaştırılabilir. Source document corpus snapshot da gerektiğinde saklanabilir. Data drift evaluation sonucunu etkiler. Release report hangi dataset version ile test edildiğini göstermelidir.
Automated Evaluation
CI sırasında retrieval ve generation metric'leri hesaplanabilir. Küçük fast suite her PR'da, büyük suite release öncesi çalıştırılabilir. Threshold altında build fail olabilir. Judge model version sabitlenmelidir. Metric regression açık raporlanmalıdır.
Regression Tests
Önceden doğru çalışan query'ler yeni version'da bozulmamalıdır. Retrieval, citation ve security regression ayrı test edilir. Model upgrade özellikle no-answer davranışını değiştirebilir. Test suite production incident'larla büyür. Critical regression rollout'u engeller.
Canary Deployment
Yeni pipeline sınırlı kullanıcı veya traffic yüzdesine açılır. Quality, latency ve cost mevcut version ile karşılaştırılır. Security error durumunda canary hızlı kapatılır. Sticky assignment kullanıcı deneyimini tutarlı tutabilir. Success sonrası traffic kademeli artırılır.
Rollback
Application, prompt ve index version hızlı geri alınabilir olmalıdır. Rollback procedure test edilmelidir. Metadata migration backward compatibility düşünülmelidir. Incident sırasında manual re-index beklemek kabul edilemez olabilir. Last-known-good configuration saklanmalıdır.
Production Feedback Loop
Negative feedback ve failure query'leri triage edilir. Verified örnekler golden dataset'e eklenir. Root cause retrieval, source freshness veya generation olarak sınıflandırılır. Fix ilgili bileşende yapılır. Bu loop RAG sistemini gerçek kullanım üzerinden sürekli geliştirir.
RAG'ın Gerçek Dünya Kullanım Alanları
RAG doküman veya bilgi kaynağı yoğun pek çok alanda kullanılabilir. Gerçek değer, kullanıcının güvenilir bilgiye daha hızlı ulaşmasını sağlamaktır. Her sektörde authorization, privacy ve accuracy toleransı farklıdır. Sağlık veya hukuk gibi yüksek riskli alanlarda human review ve kaynak gösterme daha güçlü olmalıdır. Use case seçimi teknik imkan kadar business risk ve ROI üzerinden yapılmalıdır.
Kurumsal Knowledge Assistant
Çalışanlar prosedür, ürün ve teknik dokümanlara doğal dille erişebilir. Department filter yetkili içeriği sınırlar. Citation güvenilirliği artırır. Search success ve time-to-answer KPI olarak ölçülebilir. Güncel olmayan kaynakların yönetimi önemlidir.
Müşteri Destek Chatbotları
Destek botu ürün dokümanı ve help center içeriğinden grounded cevap verebilir. Hesap durumu gibi kişisel bilgi gerekiyorsa tool calling kullanılmalıdır. Escalation policy bilinmeyen soruları insana yönlendirir. Citation kullanıcıya her durumda gösterilmeyebilir ancak internal trace'te tutulmalıdır. Deflection rate kalite metric'leriyle birlikte izlenmelidir.
Yazılım Dokümantasyonu
Developer RAG API, README ve code documentation içinde arama yapabilir. Function name ve error code için hybrid search faydalıdır. Kod blokları chunking sırasında korunmalıdır. Repository version metadata önemlidir. Yanlış branch dokümanının cevapta kullanılmaması gerekir.
Hukuk
Hukuki doküman retrieval kaynak ve tarih doğruluğu açısından yüksek hassasiyet gerektirir. Model yorumunun profesyonel hukuki değerlendirme yerine geçmediği sınırlar açık olmalıdır. Citation ve document version zorunlu tutulabilir. Access control dosya bazında uygulanmalıdır. Human expert review kritik kullanımda korunmalıdır.
Finans
Finansal policy ve araştırma dokümanları RAG ile aranabilir. Güncel sayısal veriler tool veya authoritative API üzerinden alınmalıdır. PII ve confidential data access sıkı kontrol edilmelidir. Answer grounding ve timestamp gösterilebilir. Production audit gereksinimi yüksektir.
Sağlık
Sağlık alanında bilgi doğruluğu ve privacy çok yüksek önem taşır. RAG klinik doküman veya kurumsal guideline aramada destek sağlayabilir. Otomatik tanı veya tedavi kararı için uygun insan denetimi gereklidir. Kaynak güncelliği ve citation açık olmalıdır. Kişisel sağlık verisi için access ve data handling kuralları güçlü biçimde uygulanmalıdır.
E-Ticaret
Ürün açıklaması, kullanım rehberi ve kategori bilgisi RAG ile sunulabilir. Güncel stok ve fiyat tool calling ile alınmalıdır. Product ID metadata retrieval doğruluğunu artırır. Çok dilli embedding uluslararası kataloglarda faydalı olabilir. Conversion yanında answer correctness ölçülmelidir.
Eğitim
Ders notu, syllabus ve kaynak materyal üzerinde knowledge assistant geliştirilebilir. Öğrenciye doğrudan cevap vermek yerine source section ve açıklama sunmak öğrenmeyi destekler. Course access metadata önemlidir. Hallüsinasyon eğitim kalitesini etkileyebilir. Instructor feedback golden dataset geliştirmede kullanılabilir.
İnsan Kaynakları
İzin, yan hak ve onboarding dokümanları RAG için uygundur. Kişisel çalışan verisi gerekiyorsa HR sistemi tool üzerinden sorgulanmalıdır. Role-based access uygulanmalıdır. Güncel policy version kritik öneme sahiptir. User feedback policy dokümanındaki belirsizlikleri de ortaya çıkarabilir.
Araştırma ve Raporlama
Büyük rapor koleksiyonunda evidence retrieval araştırmacının bilgi bulma süresini azaltabilir. Citation ve source date kritik önem taşır. Multi-document synthesis için reranking ve context management gerekebilir. Modelin yorum ve source fact ayrımı açık olmalıdır. Human reviewer final raporu doğrulamalıdır.
RAG Projesinin Başarısı Nasıl Ölçülür?
RAG başarısı yalnızca teknik retrieval score ile ölçülmemelidir. Teknik KPI'lar sistemin bilgi bulma ve cevaplama kalitesini gösterirken iş KPI'ları kullanıcıya sağlanan gerçek değeri ortaya koyar. Latency ve availability kötü olduğunda yüksek accuracy tek başına yeterli değildir. Kullanıcı başarı oranı ve operasyon maliyetindeki değişim ROI hesabına dahil edilmelidir. Kurumsal RAG projesi başlamadan önce başarı kriterleri açık biçimde tanımlanmalıdır.
Teknik KPI'lar
Retrieval accuracy, faithfulness, latency ve availability temel teknik KPI örnekleridir. Citation accuracy ayrıca kurumsal sistemlerde önemli olabilir. Metric'ler query category bazında raporlanmalıdır. Tek ortalama zayıf segmenti gizleyebilir. Release gate kritik metric threshold'larına bağlanabilir.
Retrieval Accuracy
Retrieval accuracy doğru evidence'ın listede bulunup bulunmadığını ölçer. Recall@K ve nDCG kullanılabilir. Ground truth annotation gerektirir. Production sample düzenli değerlendirilmelidir. Retrieval düşüşü generator'dan bağımsız sorun olarak ele alınmalıdır.
Faithfulness
Faithfulness model cevabının provided context'e dayanmasını ölçer. Özellikle güvenilir kurumsal cevap için önemlidir. Source dışı iddialar score'u düşürür. LLM judge human audit ile kalibre edilmelidir. Prompt ve model upgrade sonrası trend izlenmelidir.
Latency
Kullanıcı uzun süre bekliyorsa doğru cevap deneyimi yine zayıf olur. P50 ve P95 birlikte izlenmelidir. Retrieval ve generation breakdown sorun kaynağını gösterir. Streaming perceived latency'yi azaltabilir. Quality uğruna kabul edilebilir latency business use case'e göre değişir.
Availability
RAG birden fazla downstream servise bağlı olduğu için availability zincirin tamamından etkilenir. Vector store veya model provider outage olabilir. Fallback davranışı tanımlanmalıdır. Health check yalnızca API değil dependency durumunu da ölçmelidir. SLO iş kritikliğine göre belirlenmelidir.
İş KPI'ları
Teknik metric'ler kullanıcı veya işletme faydasını doğrudan göstermeyebilir. Support ticket azalması, bilgi bulma süresi ve human review maliyeti gibi KPI'lar iş etkisini ölçer. Baseline deployment öncesi alınmalıdır. Kullanıcı segmentleri ayrı incelenebilir. Quality kaybı pahasına cost reduction hedeflenmemelidir.
Kullanıcı Başarı Oranı
Kullanıcının sorusunu ek kanala gitmeden çözebilmesi success olarak tanımlanabilir. Task definition net olmalıdır. Follow-up sayısı yardımcı sinyal olabilir. Self-reported success tek başına yeterli değildir. Business event veya expert validation ile desteklenebilir.
Destek Talebi Azalması
Knowledge assistant tekrar eden support sorularını azaltabilir. Ancak kullanıcı yanlış cevap aldığı için ticket açmıyorsa bu olumlu KPI sayılmamalıdır. Deflection quality ile birlikte ölçülmelidir. Ticket topic bazında etki incelenebilir. Human escalation doğru durumda korunmalıdır.
Yanıt Süresinin Kısalması
Çalışanın veya destek personelinin bilgi bulma süresi RAG ile azalabilir. Pre-deployment baseline alınmalıdır. Sadece chatbot latency değil toplam task completion time ölçülmelidir. Yanlış cevap nedeniyle tekrar arama süresi ekleneceği unutulmamalıdır. Time saving quality ile birlikte değerlendirilmelidir.
İnsan Operasyon Maliyeti
Review ve support personelinin harcadığı süre maliyet hesabına dahil edilir. Agentic RAG çok fazla human escalation üretirse otomasyon faydası azalabilir. Buna rağmen kritik risk için review maliyeti kabul edilebilir. Cost per successful answer ölçülebilir. Workforce replacement yerine iş yükü optimizasyonu daha sağlıklı hedef olabilir.
ROI Nasıl Hesaplanır?
ROI elde edilen zaman, destek ve operasyon tasarrufundan RAG geliştirme ve işletme maliyetlerinin çıkarılmasıyla değerlendirilebilir. LLM token, vector infrastructure ve insan review maliyeti dahil edilmelidir. Baseline olmadan gerçek fayda hesaplamak zorlaşır. Quality incident maliyeti risk olarak ayrıca düşünülebilir. ROI düzenli periyotlarla gerçek production verisine göre güncellenmelidir.
RAG Mimarilerinin Geleceği
RAG sistemleri sabit vector search pipeline'ından daha adaptif retrieval ve context yönetimi yönüne ilerliyor. Agent'lar hangi kaynağın veya tool'un kullanılması gerektiğini query bazında seçebiliyor. Graph ve multimodal retrieval yalnızca text benzerliğinin yetmediği problemleri hedefliyor. Bununla birlikte temel prensip değişmiyor: doğru evidence bulunmalı, kaynağı doğrulanmalı ve cevap bununla uyumlu olmalıdır. Yeni yaklaşım eklenirken evaluation, güvenlik ve cost sınırları korunmalıdır.
Classic RAG'dan Agentic Retrieval'a Geçiş
Classic pipeline her query için aynı adımları çalıştırır. Agentic retrieval sorguya göre farklı source veya strategy seçebilir. Bu geçiş yalnızca query çeşitliliği gerçek ihtiyaç oluşturduğunda anlamlıdır. Basit query'ler classic route kullanmaya devam edebilir. Adaptive routing cost ve latency kontrolüne yardımcı olur.
RAG ve AI Agent'ların Birleşmesi
Agent doküman retrieval yanında SQL, API veya başka tool kullanabilir. RAG agent'ın knowledge tool'larından biri haline gelir. Tool permission server-side uygulanmalıdır. Agent hangi evidence'in yeterli olduğunu değerlendirebilir. Her step trace ve cost budget ile sınırlandırılmalıdır.
GraphRAG'ın Gelişimi
İlişkisel ve çok adımlı knowledge query'leri graph tabanlı retrieval ihtiyacını artırabilir. Entity extraction kalitesi hâlâ temel sorundur. Vector ve graph hybrid yaklaşım pratik olabilir. Graph maintenance maliyeti küçük use case'lerde yüksek kalabilir. Evaluation gerçek relation-heavy query'lere dayanmalıdır.
Multimodal Knowledge Retrieval
Kurum bilgisinin önemli bölümü grafik, screenshot ve video içinde bulunabilir. Multimodal retrieval bu içerikleri search kapsamına taşır. OCR ve image embedding birlikte kullanılabilir. Citation page veya timestamp seviyesinde verilebilir. Cost ve privacy yeni tasarım gereksinimleri oluşturur.
Adaptive Retrieval
Her soruya aynı top-k veya aynı retriever uygulamak yerine query-aware seçim giderek daha fazla önem kazanıyor. Basit question lexical search ile çözülebilir. Zor query decomposition gerektirebilir. Router evaluation yapılmalıdır. Over-routing gereksiz maliyet yaratır.
Retrieval Planning
Retrieval planning farklı bilgi kaynaklarına hangi sırayla bakılması gerektiğini belirleyebilir. Agent source authority ve query type bilgisini kullanabilir. Plan minimum step hedeflemelidir. Sufficiency check gereksiz aramayı durdurabilir. High-risk source erişimi ayrıca policy kontrolüne tabi olmalıdır.
Otomatik Query Decomposition
Karmaşık soruları otomatik alt sorulara bölmek multi-hop retrieval'ı kolaylaştırabilir. Decomposition semantic drift yaratabilir. Sub-question sayısı sınırlı tutulmalıdır. Original goal final answer validator tarafından kontrol edilebilir. Basit sorguların decomposition'a girmesi latency israfıdır.
Self-Evaluating RAG
Sistem retrieval ve answer kalitesini query sırasında değerlendirmeye çalışabilir. Low confidence durumda ek search veya abstention uygulanabilir. Self-judge yanlış karar verebilir. Offline calibration ve hard policy gerekir. Evaluation modeli final truth olarak görülmemelidir.
Web + Enterprise Knowledge Birleşimi
Kullanıcı hem kurum içi hem güncel web bilgisine ihtiyaç duyabilir. İki source aynı trust seviyesinde olmamalıdır. Enterprise policy authoritative olabilir. Web source freshness ve credibility ayrıca değerlendirilmelidir. Citation source type'ı kullanıcıya açıkça göstermelidir.
MCP ile Knowledge ve Tool Erişimi
Standart tool ve context erişim protokolleri agent entegrasyonunu daha taşınabilir hale getirebilir. Knowledge source ve operational tool aynı interface ailesi altında sunulabilir. Permission ve schema yine uygulama düzeyinde doğrulanmalıdır. Standard interface vendor bağımlılığını azaltabilir. Security boundary protokol kullandığı için otomatik oluşmaz.
RAG Yerini Context Engineering'e mi Bırakıyor?
RAG ve context engineering birbirinin yerine geçen kavramlar olarak düşünülmemelidir. Retrieval context engineering'in bilgi seçme katmanlarından biridir. Long-context, memory, tool result ve retrieval aynı final context içinde birlikte kullanılabilir. Gelecekte odak yalnızca vector search'ten doğru context assembly'e kayabilir. Buna rağmen büyük ve dinamik knowledge base için retrieval temel ihtiyaç olmaya devam eder.
Sıkça Sorulan Sorular
RAG hakkında en çok sorulan sorular genellikle mimari seçim, chunking, embedding, vector database, fine-tuning ve production güvenilirliği çevresinde toplanır. Tek bir ideal chunk size veya embedding modeli bulunmaz. Her karar gerçek kullanıcı query'leriyle benchmark edilmelidir. Retrieval ve generation başarıları ayrı ölçülmelidir. Aşağıdaki cevaplar production odaklı RAG tasarımının temel kararlarını kısa fakat uygulamaya dönük biçimde özetler.
RAG nedir?
RAG, LLM'in cevap üretmeden önce harici bilgi kaynağından ilgili içerikleri bulmasını sağlayan mimaridir. Bulunan chunk'lar model context'ine eklenir. Model cevaplarını bu kaynaklara dayandırabilir. Bilgi tabanı modelden bağımsız güncellenebilir. Retrieval ve generation ayrı kalite katmanlarıdır.
Retrieval-Augmented Generation nasıl çalışır?
Dokümanlar parse edilir, chunk'lanır ve indexlenir. Kullanıcı query'si retrieval motoruyla ilgili chunk'ları bulur. Candidate sonuçlar gerektiğinde rerank edilir. Selected context LLM prompt'una eklenir. Model source-grounded cevap ve citation üretir.
RAG ile fine-tuning arasındaki fark nedir?
RAG çalışma anında dış bilgi getirir. Fine-tuning model ağırlıklarını belirli davranış veya task için değiştirir. Güncel knowledge için RAG daha kolay güncellenebilir. Stil ve task behavior fine-tuning için uygun olabilir. İki yöntem aynı sistemde birlikte kullanılabilir.
RAG için vector database şart mı?
Hayır, küçük sistemlerde in-memory index veya mevcut database kullanılabilir. Büyük ölçek ve metadata filtering dedicated vector search ihtiyacını artırabilir. Keyword-only retrieval bazı use case'lerde yeterli olabilir. Hybrid search de seçeneklerden biridir. Gereksinim olmadan yeni database eklemek zorunlu değildir.
RAG için hangi programlama dili kullanılmalı?
Python, TypeScript, Java, C# veya Go kullanılabilir. Python AI ve data ekosistemi açısından güçlüdür. Mevcut enterprise stack de önemli kriterdir. Servis sınırları farklı dillerin birlikte kullanılmasına izin verir. Dil seçiminden daha önemli konu güvenli ve ölçülebilir mimaridir.
RAG için Python neden tercih edilir?
Python geniş embedding, evaluation ve document processing araçlarına sahiptir. Hızlı prototip sağlar. Notebook ve backend arasında geçiş kolay olabilir. ML community desteği geniştir. Production'da typing, test ve dependency yönetimi yine gereklidir.
En iyi RAG framework'ü hangisidir?
Tek bir framework bütün projeler için en iyi değildir. Basit pipeline custom code ile daha rahat yönetilebilir. Agentic state gerekiyorsa graph tabanlı framework faydalı olabilir. Framework seçimi use case ve ekip deneyimine göre yapılmalıdır. Evaluation ve security hiçbir framework tarafından otomatik çözülmez.
Chunk size kaç olmalı?
Evrensel tek bir chunk size yoktur. Doküman türü, embedding modeli ve query pattern sonucu etkiler. Birkaç token size golden dataset üzerinde test edilmelidir. Overlap ve parent-child yaklaşımı ayrıca değerlendirilebilir. En iyi seçim retrieval ve answer metric'leriyle belirlenmelidir.
RAG için en iyi embedding modeli nasıl seçilir?
Model internal query-document benchmark üzerinde karşılaştırılmalıdır. Türkçe ve domain query'ler dataset'te bulunmalıdır. Recall, MRR, latency ve cost birlikte ölçülür. Public benchmark yalnızca ön eleme sağlar. Re-index maliyeti de kararın parçasıdır.
Hybrid search nedir?
Hybrid search lexical ve semantic retrieval sinyallerini birleştirir. BM25 exact terimleri, dense search anlam benzerliğini yakalar. Sonuç listeleri RRF veya score fusion ile birleştirilebilir. Teknik dokümanlarda güçlü olabilir. Fayda benchmark ile doğrulanmalıdır.
Reranking nedir?
Reranking ilk retrieval candidate'larını daha güçlü relevance modeliyle yeniden sıralar. Retriever hızlı recall sağlarken reranker precision artırmaya çalışır. Cross-encoder yaygın yöntemlerden biridir. Ek latency ve compute maliyeti vardır. Sadece measurable gain varsa kullanılmalıdır.
GraphRAG nedir?
GraphRAG entity ve relationship bilgisini graph representation üzerinden retrieval'a dahil eder. Multi-hop ve relation-heavy sorularda avantaj sağlayabilir. Extraction ve graph maintenance ek maliyet getirir. Vector retrieval ile birlikte kullanılabilir. Basit FAQ use case için gerekli değildir.
Agentic RAG nedir?
Agentic RAG retrieval adımlarını sabit pipeline yerine agent kararlarına göre dinamik yönetir. Agent query decomposition veya multi-source search yapabilir. Sufficiency check ile ek retrieval kararı verebilir. Step ve cost sınırı zorunludur. Basit query'ler için classic RAG daha ekonomik olabilir.
RAG hallüsinasyonu tamamen engeller mi?
Hayır, RAG hallüsinasyon riskini azaltabilir fakat sıfırlamaz. Yanlış retrieval veya yanlış context interpretation hatalı cevap üretebilir. Grounding prompt ve citation validation gerekir. Faithfulness metric'i izlenmelidir. Evidence yetersizse no-answer davranışı uygulanmalıdır.
RAG sisteminin kalitesi nasıl ölçülür?
Retrieval için Recall@K, MRR ve nDCG kullanılabilir. Generation için faithfulness, correctness ve citation accuracy ölçülür. End-to-end task success ayrıca önemlidir. Offline golden dataset ve online feedback birlikte kullanılmalıdır. Tek bir metric bütün kaliteyi temsil etmez.
RAG sistemi nasıl production-ready hale getirilir?
Authentication, authorization, observability, versioning ve rollback eklenmelidir. Knowledge freshness izlenmelidir. Prompt injection ve tenant isolation security testleri yapılmalıdır. Golden dataset regression suite release pipeline'a bağlanmalıdır. Latency ve cost SLO'ları tanımlanmalıdır.
RAG uygulamalarında KVKK açısından nelere dikkat edilmelidir?
Kişisel veri ingestion ve embedding sırasında minimize edilmelidir. PII detection ve redaction uygulanabilir. Kullanıcı yetkisi retrieval öncesi enforce edilmelidir. Silme talebi vector index ve cache'e de yansıtılmalıdır. Teknik uygulama kurumun hukuki değerlendirmesiyle birlikte yürütülmelidir.
RAG geliştirmek pahalı mıdır?
Maliyet corpus boyutu, query volume ve kullanılan modellerle değişir. Küçük baseline oldukça ekonomik kurulabilir. Reranking, agentic retrieval ve büyük modeller maliyeti artırır. Cost per query ölçülmelidir. En pahalı mimari her zaman en yüksek kaliteyi vermez.
Küçük bir yapay zeka projesinde RAG kullanılmalı mı?
Projenin özel veya güncel knowledge erişimine ihtiyacı varsa küçük ölçekte RAG mantıklı olabilir. Çok az doküman long-context ile daha basit çözülebilir. Kesin structured data için tool veya SQL daha uygundur. Basit baseline ile iki yaklaşım karşılaştırılabilir. Gereksiz infrastructure kurmamak önemlidir.
Yapay zeka projelerinde RAG (Retrieval-Augmented Generation) mimarisi nedir ve nasıl çalışır?
Yapay Zeka Projelerinde RAG (Retrieval-Augmented Generation) Mimarisi, kullanıcı sorgusuna cevap vermeden önce ilgili bilgi kaynaklarını retrieval ile bulup LLM context'ine ekleyen sistem tasarımıdır. Offline pipeline dokümanları parse eder, chunk'lar, embedding oluşturur ve index'e yazar. Online pipeline query'yi işler, ilgili chunk'ları bulur, gerekiyorsa rerank eder ve context oluşturur. LLM final cevabı bu kaynaklara dayanarak üretir. Production sistemde retrieval metric, grounding, citation, access control ve knowledge freshness birlikte izlenmelidir.
RAG mimarisinde chunking, embedding, vektör veritabanı ve retrieval süreçleri nasıl yapılandırılmalıdır?
Chunking doküman yapısına ve kullanıcı query'lerine göre benchmark edilmelidir. Embedding modeli Türkçe ve domain-specific query set üzerinde test edilmelidir. Vector store metadata filtering, backup ve authorization ihtiyacına göre seçilmelidir. Dense, lexical ve hybrid retrieval aynı golden dataset üzerinde karşılaştırılmalıdır. RAG mimarisinde embedding chunking vektör veritabanı ve retrieval optimizasyonu, tek tek popüler seçimlere değil ölçülen retrieval başarısına dayanmalıdır.
RAG ile fine-tuning arasındaki fark nedir ve hangi durumda hangisi tercih edilmelidir?
RAG güncel ve harici bilgiyi çalışma anında modele getirir. Fine-tuning model davranışını veya belirli task pattern'lerini değiştirmek için kullanılır. Sık değişen kurumsal bilgi için RAG genellikle daha uygun başlangıçtır. Özel format veya görev davranışı gerekiyorsa fine-tuning düşünülebilir. İki yaklaşım birlikte de kullanılabilir ve seçim problem türüyle evaluation sonucuna dayanmalıdır.
RAG sistemlerinde doğruluk, halüsinasyon, gecikme ve retrieval performansı nasıl ölçülüp optimize edilir?
Retrieval için Recall@K, MRR, nDCG ve context recall gibi metric'ler kullanılabilir. Generation katmanında faithfulness, groundedness, answer correctness ve citation accuracy ölçülmelidir. Latency embedding, search, reranking ve LLM inference olarak ayrı izlenmelidir. Chunking, top-k, hybrid search ve reranking değişiklikleri aynı golden dataset üzerinde karşılaştırılmalıdır. Optimization yalnızca accuracy değil P95 latency ve cost per query ile birlikte değerlendirilmelidir.
RAG mimarisi ve kurumsal yapay zeka projeleri konusunda yakınımda danışmanlık veya eğitim nerede bulabilirim?
RAG ve kurumsal yapay zeka danışmanlığı yakınımda araması yapanlar için yerel yazılım toplulukları, teknik workshop'lar ve uygulamalı proje grupları iyi başlangıç noktalarıdır. Diyarbakır'da yapay zeka, yazılım ve açık kaynak çalışmalarıyla ilgilenenler https://www.diyarbakiryazilim.com.tr üzerinden Diyarbakır Yazılım Topluluğu'na ulaşabilir. Topluluğun proje çalışmalarına https://www.diyarbakiryazilim.com.tr/projects adresinden bakılabilir. RAG projesine başlamadan önce veri kaynakları, kullanıcı query'leri, güvenlik ve başarı metric'leri netleştirilmelidir. Bu bilgiler kurumsal RAG sistemi geliştirme ve LLM entegrasyon hizmeti kapsamının daha doğru belirlenmesini sağlar.
Sonuç
Yapay Zeka Projelerinde RAG (Retrieval-Augmented Generation) Mimarisi kurarken en önemli konu, sistemi yalnızca embedding ve vector search bileşenlerinden ibaret görmemektir. Güvenilir RAG; parsing, chunking, metadata, retrieval, reranking, context engineering, citation, evaluation, access control ve observability katmanlarının birlikte çalışmasıyla ortaya çıkar. Benim deneyimimde en iyi sonuçlar önce sade bir baseline kurup gerçek kullanıcı sorularıyla ölçüm yapan ve yalnızca ölçülen probleme göre yeni bileşen ekleyen ekiplerden geliyor. Yapay zeka projelerinde veri sınıflandırma ve otomasyon yaklaşımını farklı bir açıdan incelemek için https://www.diyarbakiryazilim.com.tr/posts/otonom-veri-siniflandirma-araclarinin-proje-sureclerine-etkisi içeriğine de göz atabilirsiniz. RAG, LLM entegrasyonu, açık kaynak projeler ve yerel teknik çalışmalar hakkında bilgi almak için https://www.diyarbakiryazilim.com.tr üzerinden Diyarbakır Yazılım Topluluğu'na ulaşabilirsiniz.
share: