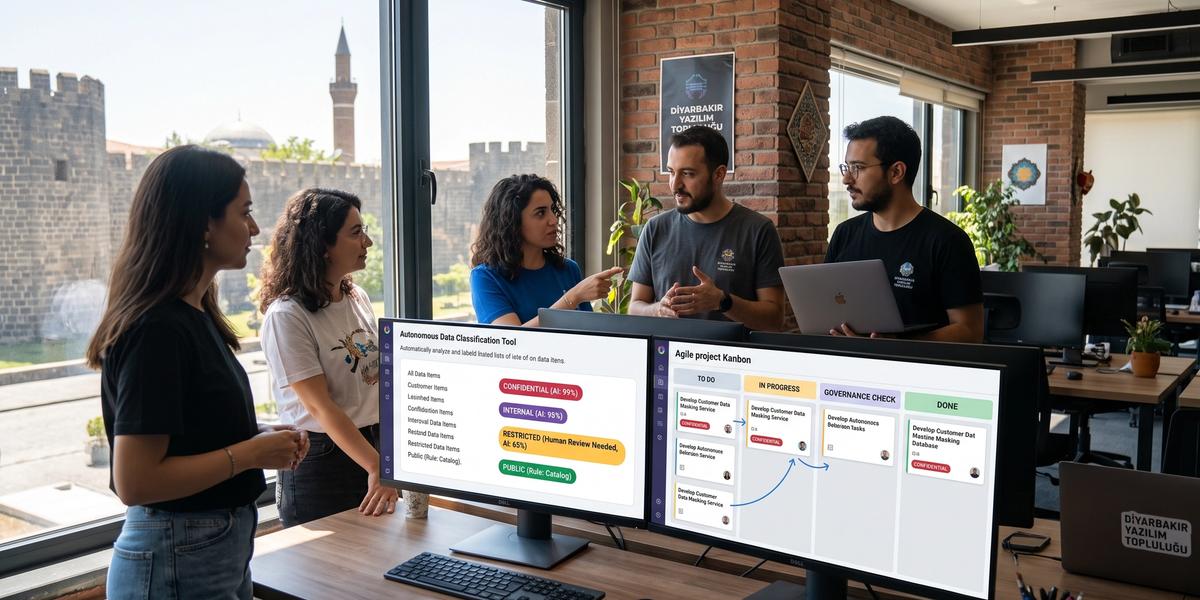
Otonom Veri Sınıflandırma Araçlarının Proje Süreçlerine Etkisi

Diyarbakır Yazılım
16.08.2026
#Yazılım#Teknoloji#Topluluk
Bir projede verinin nerede bulunduğunu, hangi hassasiyet seviyesine sahip olduğunu ve kimlerin erişmesi gerektiğini manuel olarak belirlemek başlangıçta yönetilebilir görünebilir. Veri kaynakları büyüdüğünde ise aynı yöntem analiz süresini uzatır, proje ekiplerinin manuel iş yükünü artırır ve güvenlik kontrollerinde boşluklar oluşturabilir. Otonom Veri Sınıflandırma Araçlarının Proje Süreçlerine Etkisi tam olarak bu noktada ortaya çıkar çünkü sınıflandırma, etiketleme, politika eşleştirme ve bazı düzeltme adımları otomatik hale getirilebilir. Yaklaşık on yıllık yazılım, veri ve otomasyon projelerinde gördüğüm en belirgin kazanım, ekiplerin veriyi anlamak için harcadığı zamanı azaltıp gerçek ürün geliştirme çalışmalarına daha fazla odaklanabilmesidir. Bu rehberde otonom veri sınıflandırma araçları proje süreçlerini nasıl etkiler, yapay zeka ile otomatik veri sınıflandırma nasıl yapılır ve otomatik veri sınıflandırma araçlarının doğruluk maliyet ve zaman avantajları nasıl ölçülür sorularını teknik ve operasyonel açıdan ele alacağız.
Veri Sınıflandırma Nedir?
Veri sınıflandırma, verilerin içeriklerine, hassasiyetlerine, kullanım amaçlarına veya iş değerlerine göre belirli kategorilere ayrılmasıdır. Bu süreç yalnızca güvenlik ekiplerini ilgilendirmez çünkü yazılım geliştirme, test, analitik, yapay zeka ve proje yönetimi kararlarını da doğrudan etkiler. Doğru sınıflandırılmış veri, kimin hangi bilgiye erişebileceğinin daha net belirlenmesini sağlar. Aynı zamanda masking, encryption, retention ve audit gibi politikaların otomatik uygulanmasını kolaylaştırır. Kurumsal ölçekte sınıflandırmanın ortak bir taxonomy üzerinden yapılması, ekipler arasında aynı veri için farklı anlamların kullanılmasını önler.
Veri Sınıflandırmanın Temel Amacı
Veri sınıflandırmanın temel amacı, farklı risk ve kullanım özelliklerine sahip verileri birbirinden ayırarak doğru kontrolü doğru veriye uygulamaktır. Her veriyi en yüksek güvenlik seviyesinde saklamak pratik değildir çünkü maliyet, erişim ve operasyon yükünü artırabilir. Buna karşılık hassas veriyi düşük riskli kabul etmek ciddi güvenlik ve uyumluluk sorunlarına yol açabilir. Sınıflandırma bu iki uç arasında kontrollü bir denge oluşturur. Proje ekipleri açısından en büyük katkı ise hangi veri üzerinde hangi güvenlik, test ve erişim kuralının uygulanacağını daha erken görebilmektir.
Veri Sınıflandırma Seviyeleri
Kuruluşlar veri sınıflandırma seviyelerini kendi risk profillerine göre tanımlayabilir. Yaygın bir model Public, Internal, Confidential ve Restricted seviyelerini kullanır. Bu seviyeler yalnızca isimlendirme değildir çünkü erişim, şifreleme, paylaşım ve saklama politikalarıyla ilişkilendirilmelidir. Aynı veri yaşam döngüsü içinde seviye değiştirebilir ve bu nedenle yeniden değerlendirme gerekir. Otonom sistemler bu değişiklikleri içerik ve bağlama göre sürekli takip edebilir.
Public
Public sınıfındaki veriler genel erişime açık olabilecek içerikleri temsil eder. Kurumsal web sayfaları, kamuya açık duyurular ve yayınlanmış raporlar bu gruba girebilir. Bu verilerin gizlilik ihtiyacı düşük olsa da bütünlük ve doğruluk yine önemlidir. Yanlışlıkla hassas veri Public olarak etiketlenirse güvenlik riski oluşabilir. Bu nedenle otomatik sınıflandırma yalnızca erişim seviyesini değil içeriğin gerçek niteliğini de değerlendirmelidir.
Internal
Internal veriler kurum içinde kullanılmak üzere oluşturulan ve dışarıyla serbestçe paylaşılması istenmeyen bilgileri kapsar. İç prosedürler, toplantı notları ve ekip dokümanları bu kategoriye örnek olabilir. Bu verilerin herkes tarafından erişilebilir olması gerekmeyebilir ancak genellikle Restricted sınıfı kadar sıkı kontrol istemez. Rol tabanlı erişim ve kurum içi paylaşım politikaları uygulanabilir. Otonom sınıflandırma sistemi içerik ve repository bağlamına bakarak Internal etiketi önerebilir.
Confidential
Confidential veriler yetkisiz erişim halinde finansal, operasyonel veya hukuki risk oluşturabilecek bilgileri içerir. Müşteri bilgileri, sözleşmeler ve bazı ticari belgeler bu sınıfta değerlendirilebilir. Bu veriler için erişim yetkisinin daha dar tutulması beklenir. Encryption, masking ve ayrıntılı audit log gibi ek kontroller uygulanabilir. Sınıflandırma motorunun yalnızca kelime eşleşmesine değil veri bağlamına da bakması yanlış etiketleri azaltır.
Restricted
Restricted genellikle en yüksek hassasiyet seviyesini temsil eder. Özel nitelikli kişisel veriler, kritik kimlik bilgileri ve bazı yasal olarak korunan bilgiler bu sınıfa dahil edilebilir. Erişim minimum kişi ve servisle sınırlandırılmalıdır. Veri hareketi, indirme ve dışa aktarım işlemleri ek onay gerektirebilir. Otonom sınıflandırmada bu seviyeye ait düşük güven skorları doğrudan otomatik aksiyon yerine insan incelemesine gönderilmelidir.
İçerik Sınıflandırması ile Hassasiyet Sınıflandırması Arasındaki Fark
İçerik sınıflandırması verinin ne hakkında olduğunu belirlemeye odaklanır. Örneğin bir doküman insan kaynakları, finans veya müşteri destek kategorisine atanabilir. Hassasiyet sınıflandırması ise bu verinin açığa çıkması durumunda oluşabilecek risk seviyesini değerlendirir. Aynı finans dokümanlarının bir kısmı Internal, bir kısmı Restricted olabilir. İyi tasarlanmış otonom sistemler konu ve hassasiyet sınıflandırmasını ayrı boyutlarda yönetir.
Structured, Semi-Structured ve Unstructured Data Sınıflandırması
Structured data tablo, sütun ve veri tipi gibi açık bir şemaya sahiptir. Semi-structured data JSON, XML ve log formatları gibi daha esnek bir yapı kullanır. Unstructured data ise doküman, e-posta, PDF veya serbest metin gibi önceden belirlenmiş şemaya sahip olmayan içerikleri kapsar. Her veri türü aynı sınıflandırma yönteminden aynı sonucu vermez. Bu nedenle kurumsal çözümlerde pattern matching, metadata, NLP ve ML yaklaşımlarının birlikte kullanılması daha dengeli sonuç sağlar.
Manuel, Otomatik ve Otonom Veri Sınıflandırma Arasındaki Fark
Manuel, otomatik ve otonom sınıflandırma arasındaki temel fark yalnızca kullanılan teknoloji değildir. Asıl fark karar verme, doğrulama ve aksiyon alma sorumluluğunun ne kadarının sisteme devredildiğidir. Manuel modelde insan veri üzerinde doğrudan karar verirken otomatik model belirli kurallarla aynı işi hızlandırır. Otonom yaklaşım ise bağlamı analiz edip confidence score üretebilir, gerekiyorsa politika uygulayabilir ve geri bildirimlerden öğrenebilir. Bu ayrım özellikle yüksek hacimli ve sürekli değişen veri ortamlarında proje süresini doğrudan etkiler.
Manuel Veri Sınıflandırma
Manuel sınıflandırmada veri sahipleri veya data steward ekipleri içerikleri tek tek değerlendirir. Küçük veri kümelerinde bu yöntem yüksek doğruluk sağlayabilir çünkü domain bilgisinden doğrudan yararlanılır. Ancak veri hacmi büyüdüğünde süre ve maliyet hızlı biçimde artar. İnsanlar aynı içeriği farklı yorumlayabildiği için sınıflandırma tutarlılığı da düşebilir. Bu nedenle manuel süreç çoğu kurumsal projede tamamen kaldırılmak yerine yüksek riskli ve düşük confidence sonuçlarında doğrulama amacıyla kullanılmalıdır.
Kural Tabanlı Otomatik Sınıflandırma
Kural tabanlı sistemler regex, anahtar kelime veya belirli veri formatlarını kullanarak otomatik etiketleme yapar. Kimlik numarası, kredi kartı biçimi veya belirli belge başlıkları gibi açık örüntülerde etkili olabilir. Kurallar anlaşılır ve açıklanabilir olduğu için governance ekiplerinin kontrol etmesi kolaydır. Buna karşılık bağlam değiştiğinde aynı pattern yanlış sınıflandırma üretebilir. Bu nedenle rule-based yaklaşım genellikle daha gelişmiş modellerin yanında temel bir kontrol katmanı olarak konumlandırılır.
Machine Learning Tabanlı Sınıflandırma
Machine Learning tabanlı modeller geçmişte etiketlenmiş örneklerden veri kategorilerini öğrenebilir. Bu yaklaşım yalnızca sabit kelimelere bağlı kalmadan daha geniş örüntüler yakalayabilir. Modelin kalitesi golden dataset ve etiket kalitesine doğrudan bağlıdır. Yeni veri dağılımı eski eğitim setinden farklılaştığında model drift görülebilir. Düzenli benchmark ve feedback loop bu nedenle production ortamında zorunlu hale gelir.
AI Tabanlı Context-Aware Classification
Context-aware classification veriyi yalnızca tek bir alan veya kelime üzerinden değerlendirmez. Dosyanın bulunduğu repository, kullanıcı rolü, veri kaynağı, komşu sütunlar ve iş süreci gibi bağlamsal bilgiler kararın parçası olabilir. Örneğin “adres” kelimesi tek başına kişisel veri olduğunu kanıtlamaz ancak müşteri profili tablosunda bulunması değerlendirmeyi değiştirir. Bu yaklaşım özellikle unstructured ve semi-structured data üzerinde faydalıdır. Yine de yüksek riskli sınıflandırmalarda confidence threshold ile insan kontrolü birlikte kullanılmalıdır.
Agentic / Otonom Veri Sınıflandırma
Agentic sınıflandırmada sistem yalnızca bir tahmin üretmek yerine belirli hedef doğrultusunda birden fazla adımı sırayla yürütebilir. Veri kaynağını keşfedebilir, metadata toplayabilir, içerik analiz edebilir, sınıflandırma yapabilir ve policy engine üzerinden aksiyon önerebilir. Bazı senaryolarda düşük riskli değişiklikleri doğrudan uygulaması da mümkündür. Ancak otonomi seviyesi veri hassasiyetine göre sınırlandırılmalıdır. Proje ekibi açısından değer, manuel karar zincirlerinin önemli bölümünün kontrollü otomasyona dönüşmesidir.
Detect
Detect aşaması veri kaynağını veya yeni bir değişikliği fark eder. Yeni tablo, dosya, API payload veya schema değişikliği trigger olabilir. Sistem bu olayın sınıflandırma gerektirip gerektirmediğini belirler. Event-driven mimarilerde bu aşama gerçek zamanlı çalışabilir. Doğru detection kapsamı classification coverage metriğini doğrudan etkiler.
Reason
Reason aşaması sistemin topladığı sinyalleri birlikte değerlendirdiği bölümdür. Metadata, içerik, kullanıcı bağlamı ve geçmiş etiketler aynı karar içinde kullanılabilir. Amaç tek bir pattern üzerinden sonuç üretmek yerine daha güçlü gerekçe oluşturmaktır. Bu yaklaşım özellikle belirsiz içeriklerde fayda sağlar. Kararın açıklanabilir biçimde kaydedilmesi audit ve human review açısından önemlidir.
Classify
Classify aşaması veri için kategori veya hassasiyet etiketi üretir. Sonuç Public, Internal, Confidential veya Restricted gibi seviyelerden biri olabilir. Birden fazla taxonomy aynı anda uygulanabilir. Örneğin veri hem “müşteri” konusu hem de “kişisel veri” hassasiyet etiketi taşıyabilir. Confidence score bu sınıflandırmanın ne kadar güvenilir olduğunu gösterir.
Validate
Validate aşamasında üretilen sonuç farklı kurallar veya modellerle doğrulanır. Yüksek riskli veri için ikinci classifier veya data steward kontrolü kullanılabilir. Çelişkili sonuçlar otomatik aksiyon yerine inceleme kuyruğuna gönderilebilir. Böylece yanlış sınıflandırmanın doğrudan production etkisi azaltılır. Validation katmanı otonom sistemlerde güvenlik bariyeri görevi görür.
Act
Act aşaması sınıflandırma sonucuna bağlı olarak politika uygulamasını içerir. Etiket ekleme, masking, encryption, quarantine veya erişim kısıtlama örnek aksiyonlardır. Her sınıf için otomasyon seviyesi aynı olmamalıdır. Geri alınması kolay ve düşük riskli işlemler daha fazla otomatikleştirilebilir. Yüksek etkili erişim iptallerinde approval tabanlı model tercih edilebilir.
Learn
Learn aşaması insan düzeltmelerini ve production sonuçlarını sisteme geri besler. Data steward bir etiketi değiştirdiğinde bu bilgi yeni model eğitiminde kullanılabilir. Aynı hata tekrar oluşuyorsa taxonomy veya rule set güncellenebilir. Bu mekanizma sınıflandırma kalitesinin zaman içinde gelişmesine yardımcı olur. Feedback verisinin güvenilirliği de model kalitesi açısından düzenli kontrol edilmelidir.
Otonom Veri Sınıflandırma Araçları Nasıl Çalışır?
Otonom sınıflandırma platformları genellikle discovery, analysis, classification, policy ve remediation katmanlarından oluşur. İlk aşamada veri kaynakları bulunur ve teknik metadata toplanır. Ardından içerik ve bağlam analiz edilerek sınıflandırma etiketi ile confidence score oluşturulur. Sonuçlar data catalog, DLP, IAM veya workflow sistemlerine aktarılabilir. Otonom Veri Sınıflandırma Araçlarının Proje Süreçlerine Etkisi özellikle bu zincirin insan müdahalesine ihtiyaç duymadan sık tekrar edilebilmesinden kaynaklanır.
Veri Kaynaklarının Keşfedilmesi
İlk adım hangi veri kaynaklarının bulunduğunu keşfetmektir. Database, object storage, SaaS platformu, dosya sistemi veya API kaynağı taranabilir. Bilinmeyen veri kaynağı sınıflandırılamayacağı için discovery coverage kritik bir metriktir. Erişimler read-only ve minimum yetkiyle yapılmalıdır. Yeni kaynak oluştuğunda otomatik keşif süreci yeniden çalışabilmelidir.
Metadata Toplama
Metadata veri hakkında veri sağlar ve sınıflandırma kalitesini önemli ölçüde artırabilir. Tablo adı, sütun adı, veri tipi, dosya sahibi ve storage lokasyonu önemli sinyallerdir. Business metadata ile teknik metadata birleştirildiğinde bağlam daha net anlaşılır. Metadata toplama işlemi hassas içeriği gereksiz yere kopyalamamalıdır. Data catalog entegrasyonu bu bilgilerin merkezi kullanımını kolaylaştırır.
İçerik Analizi
İçerik analizi gerçek veri örneklerini veya doküman metnini değerlendirir. Regex, NER, ML veya LLM tabanlı modeller kullanılabilir. Structured data için örnekleme yöntemi performans ve doğruluk arasında denge sağlar. Unstructured dokümanlarda semantic analysis daha fazla değer sağlayabilir. Hassas veri başka sisteme gönderilecekse data residency ve privacy şartları ayrıca değerlendirilmelidir.
Context Analizi
Context analizi verinin nerede, kim tarafından ve hangi süreçte kullanıldığını dikkate alır. Aynı metin farklı iş bağlamlarında farklı sınıflandırılabilir. Repository adı, data owner, uygulama türü ve erişim modeli ek sinyal sağlar. Bağlam kullanımı false positive oranını azaltmaya yardımcı olabilir. Ancak yanlış metadata bağlamı da hatalı sonuç üretebileceği için kaynak güvenilirliği izlenmelidir.
Semantic Classification
Semantic classification içeriğin kelime eşleşmesinden daha geniş anlamını analiz eder. Özellikle doküman, ticket, e-posta ve açıklama alanlarında fayda sağlar. NLP ve embedding tabanlı yöntemler benzer anlam taşıyan içerikleri ortak kategorilere ayırabilir. Bu yaklaşım yeni ve daha önce görülmemiş ifadelerde rule-based sisteme göre daha esnektir. Yine de model çıktısının açıklanabilirliği ve confidence değeri governance sürecinde tutulmalıdır.
Confidence Score Üretimi
Confidence score sınıflandırma sonucuna sistemin ne kadar güvendiğini gösterir. Bu değer automation policy için çok önemli bir karar girdisidir. Örneğin yüzde 98 güvenle Restricted olarak belirlenen veri otomatik etiketlenebilirken yüzde 62 sonuç human review kuyruğuna gönderilebilir. Threshold seviyeleri tek bir global değer yerine veri türüne göre tanımlanabilir. Düzenli calibration testleri score ile gerçek doğruluk arasındaki ilişkiyi kontrol etmelidir.
Etiketleme ve Tagging
Classification sonucu data catalog, schema metadata veya storage object üzerine etiket olarak yazılabilir. Bu etiket DLP, IAM ve masking sistemlerinin kararlarında kullanılabilir. Etiketin kaynağı ve oluşturulma zamanı audit için kaydedilmelidir. Manuel override yapıldığında önceki etiket geçmişi korunmalıdır. Tagging standardı farklı sistemler arasında tutarlı olursa entegrasyon daha kolay hale gelir.
Policy Mapping
Policy mapping sınıflandırma etiketini güvenlik ve governance kuralıyla eşleştirir. Restricted veri için encryption ve sınırlı erişim zorunlu hale getirilebilir. Internal veri için daha hafif kontroller uygulanabilir. Böylece classification yalnızca raporlanan bir bilgi olmaktan çıkıp gerçek operasyon kararına dönüşür. Policy-as-code kullanımı bu eşleşmeleri version control altında yönetmeyi kolaylaştırır.
Automated Remediation
Automated remediation tespit edilen sınıflandırma sonucuna göre düzeltme uygulayabilir. Yanlış yerde bulunan hassas dosya quarantine edilebilir veya erişim seviyesi azaltılabilir. Ancak bu işlemlerin tamamı doğrudan otomatik olmamalıdır. Geri alınabilir ve düşük riskli aksiyonlar için otonomi seviyesi artırılabilir. Yüksek etkili değişikliklerde approval mekanizması güvenli bir ara katman sağlar.
Sürekli Yeniden Sınıflandırma
Veri zaman içinde değiştiği için tek seferlik classification yeterli değildir. Yeni satırlar, schema değişikliği veya policy güncellemesi aynı dataset'in hassasiyetini değiştirebilir. Event-driven reclassification bu değişiklikleri hızlı biçimde yakalayabilir. Büyük veri kaynaklarında her seferinde tam tarama yerine incremental analiz kullanılabilir. Reclassification rate metriği verinin ne kadar dinamik olduğunu anlamaya yardımcı olur.
Otonom Veri Sınıflandırmada Kullanılan Teknikler
Tek bir teknik bütün veri türlerinde aynı başarıyı vermez. Regex belirli formatlarda güçlüdür ancak semantik bağlamı anlamaz. ML ve LLM modelleri daha esnek sonuçlar sunabilir fakat maliyet ve açıklanabilirlik açısından ek yönetim gerektirir. Bu nedenle üretim sistemlerinde hybrid classification yaklaşımı yaygındır. Makine öğrenmesi ile veri etiketleme sınıflandırma ve proje iş akışı otomasyonu birlikte tasarlandığında farklı teknikler birbirinin eksik yönlerini tamamlayabilir.
Regex ve Pattern Matching
Regex belirli karakter kalıplarını yakalamak için hızlı ve anlaşılır bir yöntemdir. Telefon, e-posta veya belirli kimlik numarası formatları için kullanılabilir. Kurallar CPU açısından genellikle düşük maliyetlidir. Ancak aynı pattern gerçek bağlama göre hassas veya zararsız olabilir. Bu nedenle regex sonucu başka context sinyalleriyle doğrulanmalıdır.
Dictionary-Based Classification
Dictionary tabanlı yöntem belirli kelime ve terim listelerini arar. Kuruma özel proje adları, müşteri terimleri veya hassas iş kavramları bu şekilde tanımlanabilir. Uygulaması kolaydır ve iş ekipleri tarafından anlaşılabilir. Ancak dil değişimi ve eş anlamlı ifadeler coverage sorununa yol açabilir. Dictionary listeleri business glossary ile senkronize tutulmalıdır.
Named Entity Recognition
NER metin içindeki kişi, kurum, konum veya diğer varlıkları tespit eder. PII detection çalışmalarında önemli rol oynayabilir. Türkçe gibi farklı diller için kullanılan modelin dil performansı ayrıca ölçülmelidir. Kuruma özel entity türleri fine-tuning veya özel kurallarla genişletilebilir. NER çıktısı tek başına hassasiyet kararı yerine classification pipeline'ın bir sinyali olmalıdır.
Machine Learning
Machine Learning etiketlenmiş veri örneklerinden sınıflandırma örüntüleri öğrenir. Feature engineering veya embedding yöntemleri kullanılabilir. Model doğruluğu train ve validation dataset kalitesine bağlıdır. Domain değiştiğinde retraining gerekebilir. Production monitoring precision ve recall düşüşlerini erken göstermelidir.
Natural Language Processing
NLP metin tabanlı verilerin yapısını ve anlamını analiz etmek için kullanılır. Tokenization, entity recognition, text classification ve semantic similarity önemli tekniklerdir. Doküman ve e-posta gibi unstructured data üzerinde değerlidir. Dil desteği seçilen modelin gerçek veriyle test edilmesini gerektirir. Türkçe içerik için örneklem tabanlı benchmark yapılması doğru yaklaşımı seçmeye yardımcı olur.
Deep Learning
Deep Learning büyük ve çeşitli veri kümelerinde karmaşık örüntüler öğrenebilir. Özellikle metin, görsel ve çok modlu içerik sınıflandırmasında kullanılabilir. Eğitim ve inference maliyeti daha basit modellere göre yüksek olabilir. Explainability ihtiyacı da ayrıca düşünülmelidir. Kritik verilerde model performansı domain bazında ayrı ölçülmelidir.
Large Language Models
LLM modelleri doküman bağlamını ve doğal dildeki daha ince anlam farklarını değerlendirebilir. Few-shot örneklerle yeni sınıflandırma taxonomy'lerine hızlı adapte olabilirler. Buna karşılık API maliyeti, data residency ve veri paylaşım politikaları dikkatle değerlendirilmelidir. Hassas veri dış sağlayıcıya gönderilecekse kurumsal güvenlik gereksinimleri uygulanmalıdır. Açık kaynak LLM entegrasyonlarını değerlendirmek isteyen ekipler https://www.diyarbakiryazilim.com.tr/posts/acik-kaynak-buyuk-dil-modellerinin-llm-kurumsal-entegrasyonu adresindeki içeriği inceleyebilir.
Knowledge Graph
Knowledge Graph veri varlıkları, iş kavramları, kullanıcılar ve sistemler arasındaki ilişkileri modelleyebilir. Bu ilişkiler classification kararına bağlamsal destek sağlar. Örneğin bir sütunun müşteri tablosuna ve ödeme sürecine bağlı olması hassasiyet skorunu etkileyebilir. Data lineage bilgisi graph üzerinde tutulabilir. Büyük kurumlarda semantic governance için güçlü bir temel oluşturabilir.
Agentic AI
Agentic AI belirli classification hedefleri doğrultusunda birden fazla aracı ve veri kaynağını koordine edebilir. Agent önce metadata inceleyip sonra gerekli örnek veriyi analiz edebilir. Düşük confidence sonucunda farklı classifier çağırabilir veya human review görevi oluşturabilir. Bu yaklaşım manuel workflow adımlarını azaltır. Buna karşılık agent izinleri minimum tutulmalı ve her aksiyon audit edilebilir olmalıdır.
Hybrid Classification
Hybrid classification birden fazla yöntemi aynı pipeline içinde kullanır. Kurallar yüksek kesinlikli pattern'leri yakalarken ML daha geniş örüntüleri değerlendirebilir. LLM zor ve bağlama bağımlı içeriklerde son karar desteği verebilir. Bu yapı maliyeti de optimize eder çünkü pahalı model yalnızca belirsiz örneklere uygulanabilir. Production sistemlerinde en dengeli yaklaşım çoğu zaman hybrid tasarımdır.
Rule + ML
Rule + ML modeli net formatları kurallarla, daha belirsiz içerikleri makine öğrenmesiyle değerlendirir. Bu sayede basit vakalarda hızlı ve düşük maliyetli classification yapılır. ML yalnızca rule eşleşmesi yetersiz kaldığında devreye girebilir. Sonuçlar ortak confidence modelinde birleştirilebilir. Bu yaklaşım özellikle structured data üzerinde etkili olabilir.
ML + LLM
ML modeli yüksek hacimli veriyi düşük maliyetle tarayabilir. Düşük confidence veya istisnai örnekler LLM'e yönlendirilebilir. Böylece her kayıt için LLM çağrısı yapma maliyeti azaltılır. LLM sonucu ML modelinin yeni eğitim örnekleri için aday veri de üretebilir. Bu feedback mekanizması kontrollü human review ile desteklenmelidir.
Rules + LLM + Human Review
Bu model üç aşamalı güvenlik ve doğruluk yaklaşımı sunar. Yüksek kesinlikli pattern önce kurallarla değerlendirilir. Belirsiz durum LLM'e gider ve düşük confidence sonuçlar insana yönlendirilir. Böylece insan emeği yalnızca gerçekten zor vakalara ayrılır. Özellikle Restricted veri sınıflarında bu yapı pratik bir denge sağlar.
Otonom Veri Sınıflandırmanın Proje Yaşam Döngüsüne Etkisi
Otonom sınıflandırma yalnızca data governance ekibinin kullandığı arka plan servisi değildir. Proje başlatmadan production bakımına kadar birçok kararın daha hızlı verilmesini sağlayabilir. Erken aşamada veri riskleri görünür olur, geliştirme sırasında güvenlik kontrolleri otomatikleşir ve test verisi yönetimi daha güvenli hale gelir. Deployment sonrasında da classification drift ve yeni hassas veri akışları izlenebilir. Bu nedenle otonom veri sınıflandırma araçları proje süreçlerini nasıl etkiler sorusunun yanıtı yalnızca zaman tasarrufu değil, daha erken risk görünürlüğü ve daha az manuel koordinasyondur.
Proje Başlatma Aşaması
Proje başlatılırken hangi veri kaynaklarının kullanılacağı çoğu zaman tam olarak bilinmez. Otomatik discovery mevcut ortamı hızla tarayarak başlangıç envanteri oluşturabilir. Hassas veri kaynakları erken görüldüğünde proje kapsamı ve güvenlik gereksinimleri daha doğru belirlenir. Data owner bilgisi de başlangıçta ilişkilendirilebilir. Böylece proje daha ilk haftalarda ileride çıkacak governance sürprizlerini azaltır.
Analiz ve Gereksinim Toplama
Analiz ekibi veri kaynağının içeriğini anlamak için uzun manuel toplantılara ihtiyaç duyabilir. Otomatik sınıflandırma metadata ve içerik analiziyle bu süreci kısaltır. Hangi alanlarda kişisel veya hassas veri olduğu daha erken görülür. Gereksinim dokümanına masking, retention ve erişim maddeleri doğrudan eklenebilir. Bu yaklaşım requirement değişikliklerinin geç aşamada ortaya çıkmasını azaltır.
Tasarım
Tasarım aşamasında veri sınıfı mimari kararları doğrudan etkiler. Restricted veri için ayrı storage, encryption veya daha dar erişim modeli seçilebilir. Data flow diagram sınıflandırma bilgileriyle zenginleştirilebilir. API ve event tasarımı hassas veri hareketini minimuma indirecek şekilde kurulabilir. Sonuçta security ve privacy gereksinimleri mimarinin doğal parçası olur.
Yazılım Geliştirme
Developer hangi alanların hassas olduğunu manuel olarak araştırmak zorunda kalmaz. Schema metadata ve API payload classification geliştirme araçlarına entegre edilebilir. Pull request sırasında yeni hassas veri alanı oluştuğunda uyarı üretilebilir. Loglara yanlışlıkla kişisel veri yazılması daha erken tespit edilebilir. Bu sayede güvenlik düzeltmesi production sonrasına kalmadan kod aşamasında yapılır.
Test
Test ortamına taşınan production verisi önemli risk oluşturabilir. Otonom sınıflandırma test dataset'indeki hassas alanları tespit edip masking veya anonymization workflow'u tetikleyebilir. PII içeren örnekler otomatik olarak işaretlenebilir. Synthetic data kullanılabilecek alanlar belirlenebilir. Test süreci daha hızlı ve compliance açısından daha kontrollü hale gelir.
Deployment
Deployment öncesinde classification ve governance kontrolleri pipeline gate olarak uygulanabilir. Yeni schema migration hassas veri üretiyorsa policy incelemesi zorunlu hale gelebilir. Kritik kontrol başarısız olduğunda release durdurulabilir. Bu durum manuel kontrol listesine göre daha tutarlı sonuç verir. Release evidence otomatik olarak audit store içinde saklanabilir.
Production Operasyonları
Production ortamında veri yapısı zaman içinde değişmeye devam eder. Yeni tablo, dosya veya API alanı otomatik olarak yeniden sınıflandırılabilir. Classification drift alarm üretebilir. Policy engine mevcut erişim ve masking kurallarının yeterli olup olmadığını yeniden değerlendirebilir. Böylece governance bir kere yapılan proje faaliyeti olmaktan çıkar ve sürekli operasyona dönüşür.
Bakım ve Sürekli İyileştirme
Bakım aşamasında human override ve false positive kayıtları önemli geri bildirim sağlar. Bu veriler model ve taxonomy iyileştirmesinde kullanılabilir. İş kuralları değiştiğinde classification policy yeniden versionlanabilir. Yeni domain veya veri kaynağı için pilot çalışma yapılabilir. Böylece sistem zaman içinde daha yüksek coverage ve daha düşük manuel review oranına ulaşabilir.
Proje Analiz ve Gereksinim Süreçlerine Etkisi
Analiz aşamasında en fazla zaman alan işlerden biri doğru veriyi ve veri sahibini bulmaktır. Otonom discovery bu süreci önemli ölçüde kısaltabilir. Hassas veri erken belirlendiğinde security, privacy ve compliance gereksinimleri projenin başında tanımlanabilir. Bu durum sonradan gelen mimari değişikliklerin sayısını azaltır. Time-to-Data süresi proje performansını ölçmek için önemli bir gösterge haline gelir.
Otomatik Data Inventory
Data inventory mevcut veri kaynaklarının merkezi listesidir. Otomatik discovery database, file storage ve SaaS kaynaklarını tarayarak bu listeyi sürekli güncelleyebilir. Manuel spreadsheet kullanımına göre daha güncel sonuç üretir. Owner, schema, lokasyon ve sınıflandırma bilgileri aynı kayda bağlanabilir. Yeni proje ekipleri veriyi aramak yerine doğrudan doğrulanmış inventory üzerinden çalışabilir.
Hassas Veri Kaynaklarının Erken Tespiti
Hassas veri proje başlangıcında fark edilmezse ileride mimari değişiklik gerekebilir. Otomatik tarama bu kaynakları daha erken işaretler. PII, finansal veri veya confidential dokümanlar risk listesine alınabilir. Proje planı güvenlik çalışmaları için doğru süre ayırabilir. Bu yaklaşım son sprintte ortaya çıkan beklenmeyen compliance çalışmalarını azaltır.
Veri Sahiplerinin Belirlenmesi
Data owner belirli bir veri varlığının iş sorumluluğunu taşır. Otomatik metadata analizi repository sahibi, oluşturucu ekip ve erişim geçmişinden owner önerisi çıkarabilir. İnsan onayıyla bu bilgi catalog'a işlenebilir. Net ownership approval süreçlerini hızlandırır. Sahipsiz veri kaynakları ayrıca governance riski olarak raporlanabilir.
Risk Bazlı Gereksinim Analizi
Her dataset aynı gereksinim seviyesine ihtiyaç duymaz. Sınıflandırma sonucu risk bazlı requirement oluşturmayı sağlar. Restricted veri için encryption ve özel access control zorunlu olabilir. Public veri için aynı maliyeti uygulamak gereksizdir. Bu yaklaşım proje kaynaklarını gerçek risk düzeyine göre dağıtır.
Privacy Requirements'ın Otomatik Oluşturulması
Belirli veri türleri tespit edildiğinde standart privacy gereksinimleri otomatik önerilebilir. PII bulunan dataset için masking, retention ve erişim kontrolleri requirement olarak açılabilir. Bu maddeler issue tracker veya backlog sistemine aktarılabilir. İnsan onayı final gereksinimi doğrular. Böylece privacy gereksinimleri unutulan manuel maddeler olmaktan çıkar.
Veri Kaynaklarının Kullanılabilirlik Analizi
Bir veri kaynağının bulunması onu doğrudan kullanılabilir yapmaz. Erişim yetkisi, kalite, owner ve hassasiyet durumu birlikte değerlendirilmelidir. Classification platformu bu sinyalleri tek görünümde sunabilir. Proje ekibi kullanamayacağı dataset'e haftalar harcamadan alternatif arayabilir. Kullanılabilirlik skoru data product seçiminde faydalı olabilir.
Time-to-Data Süresinin Azaltılması
Time-to-Data geliştirici veya analistin ihtiyaç duyduğu veriye güvenli biçimde erişene kadar geçen süredir. Manuel approval zincirleri bu süreyi uzatabilir. Otomatik classification ve policy mapping düşük riskli verilerde erişim akışını hızlandırabilir. Yüksek riskli veri ise doğru approval kanalına otomatik yönlendirilir. Bu metrik pilot proje öncesi ve sonrası ölçülerek gerçek kazanım gösterilebilir.
Agile ve Scrum Projelerine Etkisi
Agile ekiplerde veri yönetişimi ayrı ve yavaş bir süreç olarak kalırsa sprint ritmini bozabilir. Classification bilgisi backlog, Definition of Ready ve Definition of Done kriterlerine dahil edildiğinde governance iş akışın doğal parçası olur. Story risk seviyesi veri hassasiyetine göre belirlenebilir. Sprint başlamadan önce owner ve erişim gereksinimleri netleştirilebilir. Böylece veri güvenliği sonradan eklenen bir kontrol yerine ürün geliştirme disiplininin içine yerleşir.
Product Backlog Yönetimi
Backlog item'ları kullandıkları veri sınıfına göre etiketlenebilir. Restricted veri işleyen story daha yüksek security review ihtiyacı taşıyabilir. Product Owner bu bilgiyi öncelik ve kapasite planında kullanabilir. Governance görevleri ayrı görünmez işler olmak yerine backlog içinde takip edilir. Bu yaklaşım teslimat tahminlerini daha gerçekçi hale getirir.
Sprint Planning
Sprint planning sırasında veri erişimlerinin hazır olup olmadığı kontrol edilebilir. Gerekli dataset classification tamamlanmamışsa story planlamaya alınmayabilir. Böylece sprint ortasında veri izinleri beklemekten kaynaklanan blokaj azalır. Security ve data steward kapasitesi de planlamaya dahil edilir. Otonom sistem gerekli bilgiyi otomatik getirerek toplantı süresini azaltabilir.
Veri Riskine Göre Story Önceliklendirme
Story risk seviyesi işlenen verinin hassasiyetiyle ilişkilendirilebilir. Yüksek riskli değişiklikler daha fazla review ve test gerektirebilir. Acil iş gereksinimi ile data risk birlikte değerlendirilir. Risk skoru backlog görünümünde gösterilebilir. Bu sayede ekip hangi işlerin neden ek kontrol gerektirdiğini daha kolay anlar.
Definition of Ready
Definition of Ready bir işin geliştirmeye başlamaya hazır olup olmadığını gösterir. Veri kullanan story'lerde data owner ve classification bilgisi bu kriterlere eklenebilir. Erişim ihtiyacı önceden netleşir. Gereksiz sprint blokajları azalır. Otomatik kontrol eksik maddeleri sprint planning öncesinde işaretleyebilir.
Data Owner Belirlenmiş mi?
Her kritik veri kaynağının sorumlu bir owner'ı bulunmalıdır. Owner approval ve kullanım koşullarını belirler. Otomatik discovery owner önerisi oluşturabilir. Belirsiz ownership story'nin ilerlemesini geciktirebilir. Definition of Ready kontrolü bu eksikliği erken görünür hale getirir.
Hassasiyet Seviyesi Belirlenmiş mi?
Verinin hassasiyet seviyesi bilinmeden doğru güvenlik gereksinimi çıkarılamaz. Classification etiketi story metadata'sına eklenebilir. Low-confidence sonuç varsa human review tamamlanmalıdır. Hassasiyet değişirse backlog item yeniden değerlendirilebilir. Bu kontrol tasarım ve test kararlarını doğrudan etkiler.
Erişim Gereksinimleri Belirlenmiş mi?
Hangi kullanıcı ve servislerin veriye erişeceği sprint başlamadan önce netleştirilmelidir. Least privilege prensibi uygulanmalıdır. IAM policy classification seviyesine göre oluşturulabilir. Approval süreci önceden tamamlanır. Böylece developer erişim beklemek yerine doğrudan çalışmaya başlayabilir.
Definition of Done
Definition of Done yalnızca kodun tamamlanmasını değil governance kontrollerinin de sonuçlanmasını içerebilir. Classification, masking ve audit evidence bu kapsamda değerlendirilebilir. Otomatik pipeline kontrolleri sonucu story'ye geri yazabilir. Böylece sprint sonunda manuel güvenlik kontrolü için ek süre gerekmez. Ekip tamamlanmış işin hem işlevsel hem yönetişim açısından hazır olduğunu bilir.
Classification Tamamlandı mı?
Yeni veya değişen veri alanları sınıflandırılmalıdır. Pipeline classification sonucu olmadan release'i tamamlanmamış kabul edebilir. Düşük confidence sonuçları human review bekleyebilir. Onaylanan etiket data catalog'a yazılır. Bu kayıt daha sonraki audit ve bakım işlemlerinde kullanılır.
Masking Uygulandı mı?
Hassas veri test veya düşük güvenli ortamlarda masking gerektirebilir. Classification etiketi masking policy'yi otomatik tetikleyebilir. Sonucun gerçekten maskelendiği validation ile kontrol edilmelidir. Hatalı masking fonksiyonel testleri de etkileyebilir. Bu nedenle QA ve governance birlikte değerlendirilmelidir.
Audit Evidence Üretildi mi?
Governance kontrolünün gerçekleştiğini göstermek için evidence gerekir. Pipeline sonucu, classification version ve approval bilgisi audit store'a yazılabilir. Manuel ekran görüntülerine bağımlılık azalır. Evidence belirli retention süresi boyunca saklanabilir. Denetim sırasında hangi sürümde hangi kontrolün geçtiği kolayca görülebilir.
Yazılım Geliştirme Sürecine Etkisi
Developer'ların veri sınıflandırma amacıyla sürekli data steward veya güvenlik ekibine soru sorması üretkenliği azaltabilir. Otomatik sınıflandırma schema, API payload ve log verisi üzerinde erken geri bildirim sağlayabilir. Böylece riskli alanlar doğrudan geliştirme araçlarında görülebilir. Makine öğrenmesi ile veri etiketleme sınıflandırma ve proje iş akışı otomasyonu pull request süreçleriyle birleştiğinde manuel koordinasyon önemli ölçüde azalır. En güçlü kazanım, governance bilgisinin geliştiricinin günlük çalışma akışında görünür hale gelmesidir.
Developer'ın Manuel Veri Analiz Yükünün Azaltılması
Developer yeni bir dataset'i kullanmadan önce sütunları tek tek incelemek zorunda kalabilir. Otomatik classification hazır metadata ve risk etiketleri sunar. Böylece geliştirici veri anlamlandırma için daha az zaman harcar. Belirsiz alanlarda sistem ilgili data owner veya glossary terimini gösterebilir. Bu yaklaşım özellikle büyük kurumsal veri ortamlarında onboarding süresini kısaltır.
Schema Discovery
Schema discovery tablo ve alan yapılarını otomatik olarak belirler. Yeni database bağlantısı geldiğinde metadata catalog'a aktarılır. Column name ve datatype classifier için önemli sinyaller sağlar. Değişiklik geçmişi schema version olarak tutulabilir. Developer ihtiyaç duyduğu veri yapısını manuel doküman aramadan görebilir.
Schema Change Risk Analizi
Yeni kolon eklenmesi yalnızca teknik değişiklik değildir. Eklenen alan PII veya Restricted veri taşıyabilir. Pipeline değişiklik öncesi ve sonrası classification farkını hesaplayabilir. Risk seviyesi yükselmişse ek review açılabilir. Böylece schema migration gizli bir governance değişikliğine dönüşmez.
API Payload Sınıflandırması
API request ve response payload'ları hassas veri taşıyabilir. OpenAPI schema veya örnek trafik üzerinden alanlar sınıflandırılabilir. PII içeren endpoint'ler ek authentication ve logging policy gerektirebilir. API gateway bu etiketleri enforcement için kullanabilir. Yeni endpoint pull request sırasında otomatik scan edilebilir.
Log Verilerinde Hassas Veri Tespiti
Developer hata ayıklamak için request veya kullanıcı bilgisini loglara yazabilir. Bu durum fark edilmeden kişisel verinin merkezi log sistemine taşınmasına neden olabilir. Sensitive data scanner test ve staging loglarını otomatik tarayabilir. Eşleşme bulunduğunda kod satırı veya servis bilgisi geliştiriciye iletilir. Böylece production'da geniş log sızıntısı oluşmadan düzeltme yapılır.
Configuration ve Secret Tespiti
Configuration dosyaları veri sınıflandırma açısından da önemli olabilir. Connection string, token veya kişisel veri içeren statik ayarlar yanlışlıkla repository'ye girebilir. Secret scanning ile data classification farklı amaçlara sahip olsa da birlikte kullanılabilir. Secret scanner kimlik bilgisine odaklanırken classifier daha geniş hassas veri tiplerini değerlendirir. Ortak pipeline sonucu geliştiriciye tek güvenlik görünümü sağlayabilir.
Pull Request Süreçlerine Classification Kontrolü
Pull request açıldığında değişen schema ve veri dosyaları otomatik analiz edilebilir. Yeni hassas veri alanı tespit edilirse reviewer listesine data steward eklenebilir. Policy violation varsa merge engellenebilir. Düşük riskli değişiklikler otomatik geçebilir. Böylece governance kontrolü sprint sonunda değil kod değişikliği sırasında gerçekleşir.
Test ve QA Süreçlerine Etkisi
Test verisi yönetimi otonom sınıflandırmanın en hızlı değer ürettiği alanlardan biridir. Production verisinin kopyalanarak test ortamına taşınması özellikle hassas veri açısından ciddi risk oluşturabilir. Otomatik scanner PII alanlarını bulup masking veya pseudonymization workflow'u başlatabilir. QA ekibi hangi verinin güvenli biçimde kullanılabileceğini daha hızlı anlayabilir. Synthetic data yaklaşımı da sınıflandırma sonucu ile birlikte daha bilinçli uygulanabilir.
Test Verilerinin Otomatik Sınıflandırılması
Test dataset'i production kadar dikkatli yönetilmelidir. Otonom araç test ortamındaki tabloları ve dosyaları tarayabilir. Hassas alanlar otomatik etiketlenebilir. Test başlamadan önce masking gerektiren veri belirlenir. Böylece QA ekibi manuel veri incelemesine daha az zaman ayırır.
Production Verisinin Test Ortamına Taşınma Riski
Production verisini birebir test ortamına taşımak erişim alanını genişletir. Test ortamlarında güvenlik kontrolleri production kadar güçlü olmayabilir. Classification platformu transfer öncesinde veri hassasiyetini değerlendirebilir. Restricted veri varsa pipeline kopyalamayı engelleyebilir. Gerekli durumlarda masking veya synthetic replacement uygulanabilir.
PII Detection
PII detection kişiyi doğrudan veya dolaylı tanımlayabilecek verileri bulmayı hedefler. İsim, e-posta ve telefon gibi açık alanların yanında bağlama bağlı veriler de değerlendirilmelidir. NER ve pattern matching birlikte kullanılabilir. Türkçe içerik için yerel veri örnekleriyle performans testi yapılmalıdır. False negative oranı özellikle privacy açısından dikkatle izlenmelidir.
Test Data Masking
Masking gerçek değeri test için kullanılabilir ancak hassas olmayan bir forma dönüştürür. E-posta adresi biçimi korunup gerçek içerik değiştirilebilir. Böylece uygulama fonksiyonel olarak test edilmeye devam eder. Masking policy classification etiketinden otomatik türetilebilir. Dönüşümün geri alınabilir olup olmadığı veri riskine göre seçilmelidir.
Anonymization
Anonymization verinin belirli kişiyle tekrar ilişkilendirilememesini hedefler. Uygulaması pseudonymization'a göre daha güçlü dönüşüm gerektirebilir. Test ve analitik kullanım için değerli olabilir. Utility kaybı ölçülmelidir çünkü aşırı anonimleştirme veriyi test açısından kullanışsız hale getirebilir. Otonom sistem hangi alanların birlikte değerlendirilmesi gerektiğini metadata üzerinden önerebilir.
Pseudonymization
Pseudonymization kişisel tanımlayıcıları farklı değerlerle değiştirir ancak belirli koşullarda geri ilişkilendirme mümkün olabilir. Test süreçlerinde referential integrity korumak için faydalıdır. Mapping key ayrı ve güvenli sistemde tutulmalıdır. Aynı kişinin farklı tablolarda tutarlı şekilde dönüştürülmesi gerekir. Classification metadata hangi alanlara pseudonymization uygulanacağını belirleyebilir.
Synthetic Data
Synthetic data gerçek kişilere ait kayıtları doğrudan kullanmadan test örnekleri üretir. Veri hassasiyeti yüksek olduğunda güçlü bir alternatif olabilir. Üretilen verinin gerçek dağılımı yeterince temsil edip etmediği ölçülmelidir. Model training ve QA için farklı kalite kriterleri gerekebilir. Sınıflandırma sistemi hangi dataset'lerde synthetic yaklaşımın daha uygun olduğunu gösterebilir.
Test Ortamında Otomatik Compliance Kontrolü
Test ortamı düzenli olarak compliance policy açısından taranabilir. Restricted veri bulunduğunda masking veya access policy kontrol edilir. Eksik güvenlik kuralı release öncesi görünür olur. Audit evidence otomatik üretilir. Böylece production'a geçmeden önce veri yönetişimi açısından gerçek kontrol yapılmış olur.
CI/CD Pipeline'a Otonom Veri Sınıflandırma Nasıl Eklenir?
CI/CD entegrasyonu classification sürecini geliştirme ritmine bağlar. Pre-commit, pull request ve deployment gate gibi farklı aşamalarda farklı seviyede kontrol uygulanabilir. Hızlı kontroller erken aşamada, daha kapsamlı taramalar build veya release sırasında çalıştırılabilir. Kritik governance violation deployment'ı durdurabilir. Bu yaklaşım otomatik veri sınıflandırma araçlarının doğruluk maliyet ve zaman avantajları açısından önemli bir noktadır çünkü pahalı taramalar yalnızca gerekli aşamalarda çalıştırılabilir.
Pre-Commit Kontrolleri
Pre-commit aşamasında hızlı ve yerel kontroller kullanılmalıdır. Hassas örnek veri veya yanlışlıkla eklenen dosya pattern'leri tespit edilebilir. Kontrol çok yavaş olursa geliştirici tarafından devre dışı bırakılma riski artar. Bu nedenle kapsam sınırlı tutulmalıdır. Daha ağır ML veya LLM analizleri CI aşamasına bırakılabilir.
Pull Request Validation
Pull request classification değişikliklerini review öncesinde gösterebilir. Yeni Restricted alan eklenmişse security veya data owner approval istenebilir. Pipeline açıklamasında hangi policy'nin tetiklendiği açıkça yazılmalıdır. False positive için kayıtlı exception süreci bulunmalıdır. Merge sonrasında classification metadata catalog'a aktarılabilir.
Schema Migration Kontrolü
Database migration yeni sütun veya tablo eklediğinde sınıflandırma yeniden çalıştırılabilir. Yeni alanın datatype ve isim bilgisi ilk sinyali sağlar. Test datası üzerinde örnek classification yapılabilir. Risk seviyesi yükselirse release gating devreye girebilir. Migration ile governance değişikliği aynı pull request içinde görülebilir.
Pipeline İçinde Sensitive Data Scan
Build artifact, config ve test dataset'leri sensitive data açısından taranabilir. Scanner yalnızca source code değil oluşturulan package içeriğini de değerlendirmelidir. Bulgu severity ve confidence ile raporlanmalıdır. Yüksek güvenli Restricted veri build'i durdurabilir. Sonuçların artifact version ile ilişkilendirilmesi audit açısından faydalıdır.
Policy-as-Code
Policy-as-Code classification etiketlerinin nasıl davranışa dönüşeceğini kod olarak tanımlar. Örneğin Restricted veri içeren schema için encryption zorunlu tutulabilir. Policy değişiklikleri version control ve review sürecine girer. Test senaryoları policy davranışını doğrular. Böylece manuel governance kararları daha tutarlı hale gelir.
Deployment Gate
Deployment gate release production'a geçmeden önce son kontrolü yapar. Classification tamamlanmamış veya required masking uygulanmamışsa deployment durabilir. Düşük riskli environment için daha esnek policy tanımlanabilir. Production gate daha yüksek güven seviyesi gerektirebilir. Gate sonucu release evidence olarak kaydedilmelidir.
Release Gating
Release gating sadece tek bir pipeline job değildir. Classification, security scan ve owner approval gibi birden fazla kriteri birleştirebilir. Risk seviyesi düşükse otomatik geçiş yapılabilir. Yüksek riskli değişikliklerde insan onayı aranabilir. Bu yapı teslimat hızını risk seviyesiyle dengeler.
Başarısız Governance Kontrolünde Deployment'ın Durdurulması
Governance policy başarısız olduğunda production release devam etmemelidir. Ancak geliştiriciye yalnızca kırmızı hata göstermek yeterli değildir. Hangi veri alanının hangi kurala takıldığı açıkça açıklanmalıdır. Gerekirse geçici exception süreci tanımlanabilir. Exception'ın süresi ve sahibi audit kaydında tutulmalıdır.
DevSecOps ve Veri Sınıflandırma
DevSecOps güvenliği yazılım teslimat akışına dağıtırken veri sınıflandırma aynı yaklaşımı data governance açısından genişletir. Security by Design ve Privacy by Design prensipleri classification metadata ile daha uygulanabilir hale gelir. DLP, IAM, SIEM ve DSPM platformları ortak sınıflandırma etiketlerinden yararlanabilir. Böylece aynı veri hakkında farklı güvenlik araçlarının farklı kararlar vermesi azaltılır. Shift-left data governance, geliştiriciye production öncesinde veri riskini gösteren pratik bir yöntemdir.
Security by Design
Security by Design güvenlik gereksinimlerini tasarımın başlangıcında ele alır. Veri sınıfı bilindiğinde şifreleme ve erişim kontrolleri doğru mimari katmana yerleştirilebilir. Restricted veri için daha dar service account veya ayrı network zone kullanılabilir. Sonradan eklenen kontrollerin oluşturduğu teknik borç azalır. Classification böylece mimari kararın erken girdisine dönüşür.
Privacy by Design
Privacy by Design kişisel veri işleme gereksinimlerini ürün tasarımının içine yerleştirir. PII detection ve data minimization kararları erken aşamada uygulanabilir. Gerekli olmayan alanların hiç toplanmaması tercih edilebilir. Retention süresi classification ile ilişkilendirilebilir. Bu yaklaşım privacy işini yalnızca hukuk veya compliance ekibinin sorumluluğu olmaktan çıkarır.
Shift-Left Data Governance
Shift-left governance veri risklerini lifecycle'ın erken aşamalarına taşır. Developer pull request sırasında yeni hassas alanı görebilir. Data steward yalnızca belirsiz örnekleri inceler. Policy testleri CI içinde otomatik çalışır. Böylece governance feedback süresi günlerden dakikalara inebilir.
Secret Scanning ile Data Classification Arasındaki Fark
Secret scanning parola, token ve private key gibi credential bilgilerini bulmaya odaklanır. Data classification ise müşteri, finans, PII veya ticari veri gibi daha geniş kategorileri değerlendirir. Bir dosya secret içermese bile Restricted olabilir. İki kontrol birbirini tamamlar. Ortak pipeline sonucu geliştiriciye hem credential hem data riskini birlikte gösterir.
DLP Entegrasyonu
DLP sistemleri verinin dışarı çıkmasını veya uygunsuz paylaşılmasını kontrol eder. Classification etiketi DLP policy için güçlü sinyal sağlar. Restricted olarak işaretlenen dosyanın e-posta ile dışarı gönderilmesi engellenebilir. Otomatik etiketleme DLP policy coverage'ını artırır. False positive oranı yüksekse kullanıcı deneyimi bozulabileceği için tuning gerekir.
SIEM Entegrasyonu
SIEM güvenlik olaylarını merkezi olarak toplar ve korelasyon yapar. Classification metadata event'e eklendiğinde aynı olayın iş riski daha doğru hesaplanabilir. Restricted dataset'e erişim ihlali Internal veriye göre daha yüksek öncelik alabilir. Alert routing bu bilgiye göre yapılabilir. Böylece security operations ekibi gerçek veri değerini olay analizine dahil eder.
IAM Entegrasyonu
IAM erişim kararlarını kullanıcı ve servis kimliğine göre yönetir. Classification etiketi access policy için ek bağlam sağlar. Confidential veri yalnızca belirli role açılabilir. Owner approval dinamik workflow ile alınabilir. Erişim şartları veri sınıfı değiştiğinde otomatik yeniden değerlendirilebilir.
DSPM Entegrasyonu
DSPM platformları veri güvenliği duruşunu keşif ve risk analiziyle değerlendirebilir. Classification bu görünürlüğün temel bileşenlerinden biridir. Açık erişimli Restricted dataset yüksek risk olarak işaretlenebilir. Misconfiguration ve hassasiyet birlikte hesaplandığında daha anlamlı öncelik oluşur. Otonom remediation kontrollü şekilde DSPM bulgusundan tetiklenebilir.
DataOps Süreçlerine Etkisi
DataOps veri pipeline'larının hızlı, kaliteli ve güvenilir biçimde işletilmesini hedefler. Classification bu akışa governance boyutu ekler. Dataset, lineage, schema drift ve data contract bilgileri tek workflow içinde değerlendirilebilir. Yeni data product production'a çıkmadan önce otomatik certification kontrolünden geçebilir. Böylece veri ekipleri yalnızca pipeline çalışıyor mu sorusunu değil, doğru sınıflandırma ve politika ile çalışıyor mu sorusunu da yanıtlayabilir.
Data Pipeline Discovery
Data pipeline discovery kaynak ve hedef sistemler arasındaki akışı görünür hale getirir. ETL job, stream ve orchestration metadata'sı toplanabilir. Hassas veri hangi adımlardan geçiyor görülebilir. Pipeline değiştiğinde classification etkisi yeniden hesaplanabilir. Bu görünürlük incident ve compliance analizini hızlandırır.
Dataset Classification
Dataset classification tablo veya dosya grubunun genel hassasiyetini belirler. Sütun seviyesindeki etiketler dataset seviyesinde özetlenebilir. Tek bir Restricted sütun bütün dataset policy'sini etkileyebilir. Business domain etiketi de aynı kayıt üzerinde tutulabilir. Data product tüketicileri risk seviyesini daha hızlı anlayabilir.
Data Quality ile Classification İlişkisi
Classification doğruluğu veri kalitesinden etkilenir. Yanlış veya eksik metadata sınıflandırmayı zorlaştırabilir. Bozuk encoding veya hatalı schema bilgisi scanner performansını düşürebilir. Data quality issue ile classification confidence birlikte izlenebilir. Bu ilişki data steward ve engineering ekiplerinin ortak öncelik belirlemesini sağlar.
Data Lineage
Data lineage verinin kaynaktan hedefe nasıl hareket ettiğini gösterir. Hassas etiket lineage boyunca propagate edilebilir. Restricted kaynaktan türetilen yeni tablo otomatik risk mirası alabilir. Transformation sınıflandırmayı düşürüyorsa masking veya anonymization kanıtı aranabilir. Bu yaklaşım veri kopyalarının görünürlüğünü artırır.
Schema Drift
Schema drift veri yapısının zaman içinde değişmesidir. Yeni kolon veya datatype değişikliği classification sonucunu etkileyebilir. Event-driven scanner drift tespit edildiğinde yeniden analiz yapabilir. Kritik fark pipeline alert oluşturur. Böylece veri sözleşmesi ve governance aynı anda korunur.
Classification Drift
Classification drift aynı verinin zaman içinde farklı kategoriye düşmesini ifade eder. Yeni içerik veya model değişikliği bu duruma neden olabilir. Ani drift yanlış model güncellemesinin işareti olabilir. Human override oranı yükselirse sistem uyarı verebilir. Drift monitoring production classification kalitesi için gereklidir.
Data Contract Enforcement
Data contract producer ve consumer arasında schema ve kalite beklentisini tanımlar. Classification etiketi contract içine eklenebilir. Producer Restricted alan eklediğinde consumer tarafında ek güvenlik kontrolü gerekebilir. Contract validation deployment veya pipeline aşamasında çalışabilir. Bu yöntem veri riskini ekipler arasında açık anlaşmaya dönüştürür.
Automated Data Product Certification
Data product yayınlanmadan önce kalite, ownership ve classification kontrollerinden geçebilir. Gerekli metadata eksikse certification başarısız olur. Düşük riskli data product otomatik onay alabilir. Restricted veri içeren ürün data steward approval gerektirebilir. Sertifikasyon sonucu catalog üzerinde görünür hale gelir.
MLOps ve Yapay Zeka Projelerinde Veri Sınıflandırma
AI ve ML projelerinde veri yalnızca uygulama girdisi değil model davranışının temel kaynağıdır. Training ve validation dataset'lerinde hassas veri bulunması privacy ve governance risklerini büyütebilir. Dataset approval workflow ve model registry entegrasyonu bu riski kontrol eder. Model input ve output da üretim sırasında sınıflandırılmalıdır. Kurumsal otomatik veri sınıflandırma ve AI entegrasyon hizmeti tasarlanırken MLOps pipeline'ın tamamı veri yönetişimi kapsamında ele alınmalıdır.
Training Dataset Sınıflandırması
Training dataset modelin öğrenme davranışını doğrudan etkiler. Hassas ve kişisel veri kullanımı önceden tespit edilmelidir. Dataset provenance ve owner bilgisi kaydedilmelidir. Restricted veri için özel approval gerekebilir. Model card veya registry kaydı classification sonucunu içerebilir.
Validation Dataset Sınıflandırması
Validation dataset de training data kadar dikkatli yönetilmelidir. Aynı hassas veri farklı ortamda kopyalanabilir. Classification etiketi storage ve access policy belirler. Test sonucuyla birlikte dataset version kaydedilmelidir. Böylece model değerlendirmesinin hangi veri üzerinde yapıldığı izlenebilir.
Model Input Data
Production model girdileri gerçek kullanıcı veya müşteri verisi içerebilir. Input classification runtime policy için önemli sinyal sağlar. Restricted input logging'e yazılmamalıdır. Gerekirse prompt veya payload masking uygulanabilir. Model gateway bu kontrolleri merkezi olarak uygulayabilir.
Model Output Data
Model çıktısı da hassas bilgi üretebilir. Training verisinden doğrudan parça üretimi veya kullanıcı bilgisinin response'a taşınması risk oluşturabilir. Output classifier bu içeriği kontrol edebilir. Yüksek riskli response filtrelenebilir veya human review'a gönderilebilir. Bu kontrol özellikle generative AI kullanımında önemlidir.
Hassas Verinin Model Eğitiminde Kullanılması
Hassas veri training için gerçekten gerekli olup olmadığı sorgulanmalıdır. Data minimization uygulanabilir. Gerekliyse masking veya pseudonymization seçenekleri değerlendirilir. Erişim yalnızca model pipeline servislerine sınırlandırılabilir. Dataset usage evidence audit için saklanmalıdır.
Dataset Approval Workflow
Model training başlamadan dataset approval süreci çalışabilir. Classification, owner ve kullanım amacı kontrol edilir. High-risk veri için privacy veya security onayı gerekir. Düşük riskli dataset policy şartlarını sağlıyorsa otomatik geçebilir. Bu model MLOps teslimat hızını kontrol kaybetmeden artırır.
Model Registry ile Data Governance Entegrasyonu
Model registry model version ve artifact bilgilerini saklar. Kullanılan training dataset classification bilgisi modele bağlanabilir. Böylece bir veri policy'si değiştiğinde hangi modellerin etkilendiği bulunur. Dataset lineage model lineage ile birleşir. Retraining veya model withdrawal kararı daha hızlı alınabilir.
Generative AI ve RAG Projelerinde Otonom Veri Sınıflandırma
RAG sistemleri kurumsal dokümanları modele açtığı için veri sınıflandırma doğrudan erişim güvenliğine dönüşür. Knowledge base içindeki her dokümanın hassasiyet seviyesi bilinmelidir. Vector database yalnızca embedding taşıyor diye güvenli kabul edilmemelidir. Kullanıcı yetkisi retrieval aşamasında uygulanmalıdır. Agent'ların hangi veri kaynağına erişebileceği classification ve identity policy ile sınırlandırılmalıdır.
Knowledge Base Sınıflandırması
Knowledge base dokümanları topic ve sensitivity açısından etiketlenmelidir. RAG index oluşturulmadan önce classification yapılabilir. Restricted doküman farklı collection veya erişim politikasında tutulabilir. Metadata retrieval filter olarak kullanılabilir. Doküman değiştiğinde yeniden sınıflandırma yapılmalıdır.
RAG Dokümanlarının Hassasiyet Analizi
RAG dokümanları yalnızca başlığa göre sınıflandırılmamalıdır. İçerik, owner ve kaynak repository birlikte değerlendirilebilir. Confidential paragraf içeren genel doküman daha yüksek risk taşıyabilir. Chunk seviyesinde classification bazı sistemlerde daha doğru erişim sağlar. Ancak metadata yönetimi daha ayrıntılı hale gelir.
Vector Database İçindeki Hassas Veriler
Embedding doğrudan düz metin olmasa da hassas bilgi riski tamamen ortadan kalkmaz. Vector database erişimi güçlü authentication ile korunmalıdır. Metadata içinde gerçek hassas veri gereksiz tutulmamalıdır. Collection seviyesinde classification uygulanabilir. Backup ve data residency politikaları da değerlendirilmelidir.
Prompt Sınıflandırması
Kullanıcı prompt'u hassas bilgi veya yasaklı veri talebi içerebilir. Input classifier prompt'u risk kategorisine ayırabilir. Restricted veri isteyen sorgu ek authorization kontrolüne yönlendirilebilir. Prompt loglanıyorsa hassas alanların maskelenmesi gerekir. Bu yaklaşım LLM gateway katmanında merkezi uygulanabilir.
Response Sınıflandırması
Model response'u kullanıcı yetkisinden daha yüksek hassasiyette bilgi içerebilir. Output classifier bunu yayınlamadan önce kontrol edebilir. Yüksek riskli içerik redaction veya blocking ile durdurulabilir. Confidence düşükse ikinci model veya human review kullanılabilir. Response classification audit log'a eklenmelidir.
Kullanıcı Yetkisine Göre Retrieval Filtering
Retrieval yalnızca semantic similarity ile yapılmamalıdır. Kullanıcı identity ve data classification birlikte uygulanmalıdır. Restricted doküman yetkisiz kullanıcının candidate set'ine hiç girmemelidir. Bu yaklaşım prompt sonrası filtreye göre daha güvenlidir. IAM ve vector metadata entegrasyonu burada kritik rol oynar.
Agent'ların Erişebileceği Verilerin Sınırlandırılması
AI agent geniş veri kaynaklarına eriştiğinde blast radius artabilir. Her agent yalnızca görevi için gerekli dataset'lere erişmelidir. Tool permission ve data classification birlikte değerlendirilir. Restricted kaynak için approval veya kısa süreli access token kullanılabilir. Agent activity audit log içinde kullanıcı kimliğiyle ilişkilendirilmelidir.
Veri Sınıflandırma ile Data Catalog Arasındaki İlişki
Data catalog veriyi bulmayı, anlamayı ve sahiplik bilgisini yönetmeyi kolaylaştırır. Classification catalog içindeki en değerli metadata türlerinden biridir. Otomatik discovery ve active metadata yaklaşımı sayesinde etiketler sürekli güncellenebilir. Business glossary teknik alanları iş kavramlarıyla ilişkilendirir. Bu yapı semantic search ve data product discovery süreçlerini hızlandırır.
Data Catalog Nedir?
Data catalog kurumsal veri varlıklarının aranabilir envanteridir. Tablo, dosya, dashboard ve data product bilgileri tutulabilir. Owner, lineage ve classification metadata aynı arayüzde gösterilebilir. Kullanıcılar doğru veriyi daha hızlı bulur. Catalog başarısı metadata güncelliğine doğrudan bağlıdır.
Active Metadata Nedir?
Active metadata yalnızca pasif katalog bilgisi saklamak yerine event ve otomasyon süreçlerinde metadata kullanır. Classification değiştiğinde IAM veya DLP policy tetiklenebilir. Schema drift yeni scan başlatabilir. Metadata böylece gerçek sistem davranışını etkiler. Otonom classification active metadata yaklaşımının önemli bileşenidir.
Automated Discovery
Automated discovery veri kaynaklarını düzenli tarar. Yeni tablo veya dosya catalog'a otomatik eklenebilir. Manuel kayıt ihtiyacı azalır. Classification pipeline discovery sonrası çalışabilir. Böylece catalog coverage daha yüksek seviyede tutulur.
Business Glossary
Business glossary kurum içindeki ortak iş kavramlarını tanımlar. “Müşteri”, “aktif kullanıcı” veya “gelir” gibi terimlerin ortak anlamı belirlenir. Technical metadata bu kavramlarla ilişkilendirilebilir. Classification modeli glossary bilgisini context olarak kullanabilir. Bu yöntem iş ve teknik ekip arasındaki anlam farkını azaltır.
Semantic Search
Semantic search kullanıcı sorgusunun anlamına göre veri varlıklarını bulur. Yalnızca tablo adındaki kelime eşleşmesine bağlı kalmaz. Classification ve glossary metadata sonucu daha doğru hale getirebilir. Kullanıcı hassas veri arıyorsa erişim policy aynı anda uygulanmalıdır. Search logları data discovery davranışını anlamaya yardımcı olur.
Metadata Enrichment
Metadata enrichment mevcut teknik kayda ek anlam bilgisi ekler. Owner, domain, classification ve quality score bu kapsamda tutulabilir. AI modeli açıklama önerisi üretebilir. Human review kritik business metadata'yı doğrular. Zengin metadata hem search hem governance süreçlerini iyileştirir.
Automated Glossary Mapping
Automated glossary mapping sütun ve dataset'leri business terimlerle eşleştirir. Semantic similarity ve schema bilgisi kullanılabilir. Confidence score düşük eşleşmeler data steward'a gönderilir. Kabul edilen mapping sonraki sınıflandırma kararlarına bağlam sağlar. Bu döngü catalog kalitesini zaman içinde artırabilir.
Business Glossary Otonom Sınıflandırmanın Kalitesini Nasıl Etkiler?
Otonom classifier yalnızca teknik metadata ile çalıştığında bazı iş bağlamlarını kaçırabilir. Business glossary bu eksikliği ortak kavram ve tanımlarla azaltır. Classification taxonomy iş ekiplerinin kullandığı gerçek terimlerle eşleşir. Belirsiz kavramlar daha kontrollü hale gelir. Ancak glossary güncellenmezse eski tanımlar model kararlarını olumsuz etkileyebilir.
Classification Taxonomy Tasarımı
Taxonomy sınıflandırma kategorilerinin açık ve ayrıştırılabilir biçimde tanımlanmasıdır. Çok fazla ve birbirine benzeyen sınıf model doğruluğunu düşürebilir. İş ihtiyacını karşılayacak kadar detaylı ancak yönetilebilir yapı kurulmalıdır. Her sınıf örneklerle açıklanmalıdır. Versioning sonraki değişikliklerin izlenmesini sağlar.
Belirsiz Kavramların Önlenmesi
“Hassas” veya “kritik” gibi terimler ekipler tarafından farklı yorumlanabilir. Glossary bu kavramların açık tanımını oluşturur. Classification modeli de aynı tanımları prompt veya feature olarak kullanabilir. Human review sırasında tartışmalar azalır. Tutarlı terminoloji precision ve recall değerlendirmesini kolaylaştırır.
Business ve Technical Metadata'nın Birleştirilmesi
Technical metadata alan adı ve veri tipini gösterirken business metadata gerçek iş kullanımını açıklar. İki bilgi birleştirildiğinde classification daha güçlü bağlam kazanır. Örneğin “id” sütunu tek başına anlamsız olabilir ancak “müşteri kimliği” glossary mapping'i hassasiyeti artırır. Data catalog bu birleşim için merkezi nokta olabilir. Model feature'ları bu metadata'dan üretilebilir.
Glossary Drift
İş süreçleri değiştikçe kavramların anlamı da değişebilir. Eski glossary terimleri yeni dataset'leri yanlış yönlendirebilir. Kullanılmayan veya çelişkili terimler düzenli gözden geçirilmelidir. Drift detection aynı terimin farklı ekiplerde farklı kullanıldığını gösterebilir. Version history değişikliklerin classification sonuçlarına etkisini analiz etmeye yardımcı olur.
Taxonomy Versioning
Taxonomy değişiklikleri sınıflandırma sonucunu doğrudan etkiler. Yeni kategori eklendiğinde eski dataset'ler yeniden değerlendirilmelidir. Version bilgisi her classification kaydında tutulmalıdır. Böylece aynı verinin neden farklı tarihlerde farklı etiket aldığı açıklanabilir. Model benchmark sonuçları taxonomy version ile eşleştirilmelidir.
AI Önerilerinin Human-in-the-Loop ile Doğrulanması
AI yeni glossary mapping veya sınıf önerisi oluşturabilir. Bu öneriler doğrudan kurumsal taxonomy'ye yazılmamalıdır. Data steward veya domain owner doğrulama yapmalıdır. Kabul edilen örnekler sonraki model geliştirmesinde kullanılabilir. Böylece otomasyon hızı ile iş bilgisinin güvenilirliği dengelenir.
Human-in-the-Loop Neden Hâlâ Gereklidir?
Otonom sistemler yüksek hacimli veriyi hızlı işleyebilir ancak her iş bağlamını hatasız yorumlamaları beklenmemelidir. Özellikle yüksek riskli veri sınıflarında yanlış kararın maliyeti yüksektir. Human-in-the-loop modeli insan emeğini tamamen kaldırmak yerine doğru noktalarda kullanır. Low-confidence sonuçlar, policy çelişkileri ve kritik aksiyonlar insana yönlendirilir. Bu yapı otomasyon oranını artırırken governance kontrolünü korur.
Fully Autonomous Classification Mümkün mü?
Belirli ve düşük riskli veri türlerinde yüksek otonomi mümkündür. Açık pattern ve güçlü confidence score otomatik karar için yeterli olabilir. Ancak tüm kurumsal veriyi tamamen insansız yönetmek pratikte risklidir. Business context ve yasal yorum gerektiren durumlar insan kararına ihtiyaç duyabilir. Otonomi seviyesi veri sınıfına göre kademeli tanımlanmalıdır.
Confidence Threshold
Confidence threshold otomatik karar ile insan incelemesi arasındaki sınırı belirler. Threshold çok yüksek olursa manuel review sayısı artar. Çok düşük olursa yanlış otomatik karar riski yükselir. Her sınıf için farklı eşik kullanılabilir. Pilot sonuçları üzerinden threshold calibration yapılmalıdır.
Low-Confidence Classification
Düşük confidence sonucu sistemin yeterli kanıta sahip olmadığını gösterir. Bu durumda rastgele veya zorunlu sınıf seçmek yerine review kuyruğu oluşturulmalıdır. Reviewer gerekli context ve model gerekçesini görmelidir. Karar sonrası feedback sisteme geri yazılır. Zaman içinde aynı tür örneklerde confidence seviyesi artabilir.
Data Steward Review
Data steward iş ve veri yönetişimi bilgisini birleştirir. Otonom sistem yalnızca belirsiz kayıtları steward'a yönlendirerek manuel iş yükünü azaltabilir. Review ekranında model önerisi ve evidence görünmelidir. Steward düzeltmeleri audit edilmeli ve eğitim verisine aday olmalıdır. Bu yaklaşım uzman zamanını en değerli vakalara ayırır.
Manual Override
Manuel override sistem kararının yetkili kullanıcı tarafından değiştirilmesini sağlar. Override gerekçesi zorunlu tutulmalıdır. Aynı veri sonraki reclassification sırasında tekrar otomatik değiştirilmemelidir veya özel policy uygulanmalıdır. Sürekli aynı model hatası override ediliyorsa root cause araştırılmalıdır. Override rate önemli kalite metriğidir.
Feedback Loop
Feedback loop insan kararını model iyileştirmesine bağlar. Kabul ve red bilgileri düzenli olarak analiz edilir. Yeni training data yalnızca doğrulanmış örneklerden oluşturulmalıdır. Feedback bias riski de izlenmelidir. Bu süreç classification kalitesini sürdürülebilir biçimde artırabilir.
İnsan Onayının Gerektiği Yüksek Riskli Veri Türleri
Özel nitelikli kişisel veri ve kritik ticari bilgi gibi sınıflar daha sık insan onayı gerektirebilir. Tam otomatik access revocation gibi yüksek etkili aksiyonlarda da approval tercih edilir. Model confidence yüksek olsa bile legal context farklı olabilir. Policy risk seviyesine göre approval zorunluluğu tanımlar. Böylece otonomi güvenli sınırlar içinde tutulur.
False Positive ve False Negative Problemi
Her sınıflandırma sistemi hata üretir ve önemli olan bu hataların türünü doğru anlamaktır. False positive gereksiz güvenlik kontrolü ve operasyon maliyeti oluşturur. False negative ise hassas verinin fark edilmeden kalmasına neden olabilir. İki hata türü aynı şekilde değerlendirilmemelidir. Precision, recall, F1 score ve confidence calibration birlikte kullanılarak dengeli model performansı ölçülmelidir.
False Positive Nedir?
False positive hassas olmayan verinin yanlışlıkla hassas olarak sınıflandırılmasıdır. Bu durum gereksiz masking veya access restriction oluşturabilir. Developer ve data analyst işi yavaşlayabilir. Çok yüksek false positive oranı kullanıcıların sisteme güvenini düşürür. Precision metriği bu problemi ölçmek için kullanılır.
False Negative Nedir?
False negative gerçek hassas verinin sistem tarafından fark edilmemesidir. Güvenlik ve compliance açısından daha ciddi sonuç oluşturabilir. Özellikle Restricted veri için düşük false negative hedefi önemlidir. Recall metriği bu kapsamı değerlendirmeye yardımcı olur. Riskli sınıflarda threshold daha düşük tutularak daha fazla örnek yakalanabilir.
Over-Classification'ın Proje Maliyeti
Over-classification gereğinden fazla verinin yüksek hassasiyet sınıfına alınmasıdır. Bu durum erişim approval sayısını artırır. Test data kullanımı zorlaşabilir ve developer bekleme süresi yükselir. Storage ve encryption maliyetleri de artabilir. Classification ROI analizi bu operasyon maliyetini dikkate almalıdır.
Under-Classification'ın Güvenlik Maliyeti
Under-classification hassas verinin düşük riskli kabul edilmesidir. Erişim kontrolleri yetersiz kalabilir. Veri yanlış ortamda veya gereksiz uzun süre saklanabilir. Incident durumunda kapsam daha büyük olabilir. Bu nedenle yüksek riskli sınıflarda recall genellikle precision'dan daha fazla önem kazanabilir.
Precision
Precision sistemin hassas olarak işaretlediği kayıtların ne kadarının gerçekten hassas olduğunu gösterir. Yüksek precision düşük false positive anlamına gelir. Kullanıcı deneyimi açısından önemlidir. Ancak precision tek başına coverage hakkında bilgi vermez. Recall ile birlikte değerlendirilmelidir.
Recall
Recall gerçek hassas kayıtların ne kadarının sistem tarafından yakalandığını gösterir. Yüksek recall düşük false negative oranına işaret eder. Security ve privacy use case'lerinde önemli bir metriktir. Çok agresif threshold recall'u artırırken precision'ı düşürebilir. İş gereksinimine göre denge kurulmalıdır.
F1 Score
F1 Score precision ve recall değerlerini tek metrikte dengeler. Özellikle iki metriğin birlikte önemli olduğu use case'lerde faydalıdır. Ancak sınıf dengesizliği olduğunda tek başına yeterli olmayabilir. Her hassasiyet sınıfı için ayrı F1 hesaplamak daha anlamlıdır. Trend zaman içinde model iyileşmesini gösterebilir.
Confidence Calibration
Calibration modelin yüzde 90 confidence verdiği sonuçların gerçekten yaklaşık yüzde 90 doğru olup olmadığını değerlendirir. Kötü calibration automation policy'yi yanıltabilir. Model accuracy iyi görünse bile confidence değerleri güvenilir olmayabilir. Calibration curve ve bucket analizi kullanılabilir. Human review threshold bu verilere göre ayarlanmalıdır.
Otonom Sınıflandırma Sistemlerinin Performansı Nasıl Ölçülür?
Model performansı yalnızca accuracy değeriyle değerlendirilmemelidir. Precision, recall ve F1 gibi kalite metriklerinin yanında coverage, latency ve throughput operasyon açısından önemlidir. Human override ve reclassification oranı sistemin gerçek production davranışını gösterir. Farklı veri domain'leri ayrı ölçülmelidir. Otomatik veri sınıflandırma araçlarının doğruluk maliyet ve zaman avantajları ancak teknik ve operasyon metrikleri birlikte incelendiğinde gerçekçi biçimde görülebilir.
Precision
Precision yanlış alarm miktarını anlamaya yardımcı olur. Data steward review yüküyle doğrudan ilişkilidir. Düşük precision manuel iş saatlerini artırabilir. Domain bazında farklı değerler görülebilir. Hedef değer risk ve maliyet beklentisine göre belirlenmelidir.
Recall
Recall hassas verinin ne kadarının yakalandığını ölçer. Yüksek riskli veri türlerinde kritik metriktir. Sampling yoluyla ground truth karşılaştırması yapılabilir. Recall zaman içinde model drift nedeniyle düşebilir. Monitoring sistemi bu değişimi alarm olarak gösterebilir.
F1 Score
F1 precision ve recall arasındaki dengeyi özetler. Model karşılaştırmalarında kullanışlıdır. Farklı taxonomy version'ları aynı benchmark set üzerinde değerlendirilebilir. Tek global skor yerine sınıf bazlı skor raporlanmalıdır. Düşük performanslı sınıflar ayrı iyileştirme backlog'una alınabilir.
Classification Coverage
Coverage keşfedilen veri varlıklarının ne kadarının sınıflandırıldığını gösterir. Yüksek model doğruluğu düşük coverage ile birlikteyse kurumsal görünürlük yine eksik kalır. Discovery ve access permission sorunları coverage'ı düşürebilir. Unclassified asset'lar risk listesine alınmalıdır. Hedef zaman içinde yüzde yüze yaklaşmalıdır.
False Positive Rate
False Positive Rate gereksiz hassas etiket sayısını gösterir. Çok yüksek oran governance ticket sayısını artırabilir. Kullanıcılar sürekli yanlış alarm görürse sistemi bypass etmeye çalışabilir. Bu metrik domain ve classifier türüne göre izlenmelidir. Rule tuning veya context enrichment iyileştirme sağlayabilir.
False Negative Rate
False Negative Rate kaç hassas verinin gözden kaçtığını gösterir. Privacy ve security açısından kritik ölçüdür. Ground truth sample set üzerinden hesaplanabilir. Düşük oran için bazı use case'lerde daha fazla false positive kabul edilebilir. Risk appetite bu dengeyi belirler.
Classification Latency
Latency bir veri değişikliğinin sınıflandırma sonucuna dönüşmesine kadar geçen süredir. CI/CD entegrasyonunda yüksek latency developer deneyimini bozar. Event-driven production use case'lerinde saniyeler veya dakikalar önemli olabilir. Batch sistemlerde daha uzun süre kabul edilebilir. Maliyet ile gerçek zaman gereksinimi birlikte değerlendirilmelidir.
Classification Throughput
Throughput belirli sürede kaç veri öğesinin analiz edildiğini gösterir. Büyük data lake veya log ortamlarında önemli metriktir. Model türü ve sampling yöntemi throughput'u etkiler. LLM kullanımı daha yüksek kalite sağlarken işlem hızını düşürebilir. Hybrid pipeline kaynak kullanımını optimize edebilir.
Human Override Rate
Human override rate otomatik sonuçların ne kadarının insanlar tarafından değiştirildiğini gösterir. Yüksek oran model veya taxonomy problemine işaret edebilir. Hangi sınıflarda override yoğun olduğu ayrı incelenmelidir. Düzeltme gerekçesi model geliştirme için değerli veridir. Hedef zaman içinde güvenilir use case'lerde oranı düşürmektir.
Reclassification Rate
Reclassification rate veri etiketlerinin ne sıklıkta değiştiğini gösterir. Veri dinamikliği veya model drift bu değeri etkileyebilir. Ani artış yeni taxonomy değişikliğinden kaynaklanabilir. Çok yüksek oran downstream policy'lerde dalgalanma yaratabilir. Değişiklik nedeni audit metadata içinde tutulmalıdır.
Proje Süreçlerindeki Etki Nasıl Ölçülür?
Classification projesinin gerçek başarısı yalnızca model skorlarından anlaşılmaz. Proje ekibinin veriye ulaşma süresi, approval lead time ve manuel review yükü de ölçülmelidir. Governance ticket sayısı ve compliance finding değişimi operasyon etkisini gösterir. Developer productivity ve change failure rate gibi metrikler teslimat kalitesini ortaya koyar. Pilot öncesi baseline alınması ROI hesabının güvenilirliği açısından çok önemlidir.
Time-to-Data
Time-to-Data ihtiyaç duyulan dataset'e güvenli erişime kadar geçen süredir. Discovery ve classification otomasyonu bu süreyi azaltabilir. Owner ve policy bilgisi catalog'da hazır olduğunda approval daha hızlı ilerler. Pilot öncesi ortalama süre kaydedilmelidir. Sonraki ölçüm gerçek kazanımı gösterir.
Time-to-Production
Time-to-Production değişikliğin fikirden production'a ulaşmasına kadar geçen süreyi gösterir. Geç gelen governance review bu süreyi artırabilir. Shift-left classification riskleri erken yakalayarak beklemeyi azaltabilir. Ancak çok fazla false positive yeni darboğaz oluşturabilir. Bu nedenle hız metriği classification quality ile birlikte değerlendirilmelidir.
Approval Lead Time
Approval lead time data owner veya security onayı için geçen süredir. Otomatik risk değerlendirmesi doğru kişiye doğru request gönderebilir. Düşük riskli durumlar otomatik onaylanabilir. Yüksek riskli request eksiksiz context ile reviewer'a gelir. Bu yapı tekrar soru ve bekleme sayısını azaltır.
Data Discovery Süresi
Data discovery süresi ekiplerin doğru dataset'i bulmak için harcadığı zamanı gösterir. Catalog ve semantic search bu süreyi azaltabilir. Otomatik classification search filtrelerini daha güçlü hale getirir. Kullanıcı hangi dataset'in hassas olduğunu sonuç ekranında görebilir. Bu metrik kullanıcı araştırmalarıyla da desteklenebilir.
Manual Review Hours
Manual review hours data steward ve security ekiplerinin sınıflandırma için harcadığı insan saatidir. Otonom sistemin temel hedeflerinden biri bu süreyi azaltmaktır. Ancak sıfıra indirmek gerekli değildir. İnsan zamanı yüksek riskli örneklere kaydırılmalıdır. Domain bazlı ölçüm nerede daha fazla otomasyon gerektiğini gösterir.
Governance Ticket Sayısı
Governance ticket sayısı manuel soru ve approval yükünü yansıtır. Otomatik policy ve self-service metadata ile bazı ticket türleri ortadan kalkabilir. Buna karşılık yeni sistem başlangıçta daha fazla issue keşfedebilir. Bu nedenle yalnızca toplam sayı değil ticket türü de analiz edilmelidir. Zaman içinde tekrar eden basit ticket'ların azalması olumlu göstergedir.
Developer Productivity
Developer productivity yalnızca yazılan kod satırıyla ölçülmemelidir. Veri bulmak, erişim beklemek ve governance sorusu çözmek için harcanan süre daha anlamlı olabilir. Classification entegrasyonu bu beklemeyi azaltabilir. Developer survey ve cycle time birlikte kullanılabilir. Amaç güvenliği azaltmadan akışı hızlandırmaktır.
Data Steward Workload
Data steward workload manuel review, taxonomy bakımı ve approval süresini içerir. Otonom sistem tekrarlı sınıflandırmayı otomatikleştirebilir. Steward daha çok belirsiz ve iş açısından kritik vakalara odaklanır. Workload dağılımı periyodik ölçülmelidir. Sistem arttıkça insan ekibini aynı oranda büyütme ihtiyacı azalabilir.
Compliance Finding Sayısı
Compliance finding sayısı denetimlerde bulunan veri governance eksiklerini gösterir. Otomatik classification ve evidence collection bu sayıyı azaltabilir. İlk dönemde görünürlük arttığı için bulgu sayısı geçici olarak yükselebilir. Önemli olan tekrar eden aynı kök nedenin azalmasıdır. Trend ve severity birlikte analiz edilmelidir.
Change Failure Rate
Change failure rate veri veya uygulama değişikliğinin production problemi oluşturma oranıdır. Classification kontrollü schema değişiklikleri riskli değişiklikleri daha erken yakalayabilir. Gereksiz policy blokları da ayrı failure türü olarak izlenebilir. Pilot döneminde baseline ile karşılaştırma yapılmalıdır. Amaç hız kadar güvenilir değişiklik oranını da artırmaktır.
Mean Time to Resolution
MTTR governance veya data security probleminin çözülme süresini gösterir. Classification metadata root cause analizini hızlandırabilir. Etkilenen dataset, owner ve lineage bilgisi hazırdır. Otomatik remediation bazı düşük riskli sorunları anında çözebilir. Yüksek riskli olaylarda doğru kişiye hızlı yönlendirme yapılabilir.
Otonom Veri Sınıflandırmanın Proje Maliyetine Etkisi
Otonom sınıflandırma yalnızca lisans maliyeti üzerinden değerlendirilmemelidir. Manuel sınıflandırma saatleri, compute, storage, LLM API kullanımı ve entegrasyon geliştirmesi toplam maliyetin parçalarıdır. Human review tamamen ortadan kalkmayacağı için bu kalem de hesaba katılmalıdır. Buna karşılık daha hızlı proje teslimatı ve daha az compliance işi maddi fayda yaratır. ROI hesabı otomasyon öncesi baseline ve kullanım hacmi üzerinden yapılmalıdır.
Manuel Sınıflandırma Maliyeti
Manuel maliyet data steward ve domain uzmanlarının harcadığı saatlerden oluşur. Büyük veri hacminde bu değer hızla büyür. Tekrarlanan aynı tür incelemeler yüksek operasyon yükü oluşturur. Saat başı maliyet ve ortalama review süresi hesaplanabilir. Otomasyon sonrası kalan insan zamanı karşılaştırılarak tasarruf ölçülür.
Lisanslama Maliyeti
Ticari platformlar kaynak, veri hacmi veya kullanıcı sayısına göre lisanslanabilir. Sadece başlangıç fiyatına bakmak yanıltıcı olabilir. Production ölçeği ve büyüme tahmini dikkate alınmalıdır. Ek connector veya modül ücretleri toplam maliyeti değiştirebilir. TCO hesabı en az birkaç yıllık perspektifle yapılmalıdır.
AI/LLM API Maliyeti
LLM tabanlı classification her kayıt için API çağrısı yaparsa maliyet hızla büyüyebilir. Token hacmi ve model seçimi doğrudan fiyatı etkiler. Rule ve ML ile ön filtreleme LLM çağrı sayısını azaltabilir. Cache veya batch processing kullanılabilir. Classification başına ortalama API maliyeti ayrı metrik olarak izlenmelidir.
Compute Maliyeti
On-prem veya self-hosted model kullanımı compute kaynaklarını artırabilir. GPU ihtiyacı model türüne göre değişir. Hafif classifier CPU üzerinde yeterli olabilir. Gerçek throughput gereksinimi ölçülmeden büyük altyapı kurulması gereksiz maliyet oluşturur. Capacity test pilot aşamasında yapılmalıdır.
Storage Maliyeti
Classification metadata, audit log ve model evidence storage kullanır. Ham verinin kopyalanması maliyeti daha da artırabilir. Mümkünse scanner veriyi yerinde analiz etmelidir. Retention policy eski logları kontrollü silmelidir. Catalog ve audit storage ayrı büyüme profiline sahip olabilir.
Human Review Maliyeti
Human review yüksek riskli ve düşük confidence örneklerde devam eder. Maliyet review sayısı ve ortalama inceleme süresiyle hesaplanabilir. Model iyileştikçe bu değer düşmelidir. Çok yüksek review oranı otomasyonun beklenen faydasını azaltır. Threshold tuning ve taxonomy iyileştirmesi maliyeti kontrol eder.
Integration Maliyeti
Classification platformu tek başına değer üretmez. Data catalog, CI/CD, IAM ve DLP entegrasyonları gerekebilir. Connector geliştirme ve test maliyeti projeye dahil edilmelidir. Standart API ve SDK entegrasyon maliyetini azaltır. Vendor değişikliği halinde migration maliyeti de TCO hesabına eklenmelidir.
Classification Başına Maliyet
Classification başına maliyet toplam işletim maliyetinin sınıflandırılan öğe sayısına bölünmesiyle hesaplanabilir. Rule-based işlem ile LLM işlem maliyeti ayrı izlenebilir. Büyük hacimde küçük birim maliyet farkı önemli bütçe etkisi oluşturur. Maliyet kalite metriğiyle birlikte değerlendirilmelidir. Ucuz ama düşük recall sağlayan sistem gerçek tasarruf sunmayabilir.
ROI Nasıl Hesaplanır?
ROI için önce manuel süreç maliyeti ve proje gecikme süresi baseline olarak ölçülmelidir. Otomasyon sonrası azalan review saatleri ve approval süreleri parasal değere dönüştürülebilir. Compliance bulgusu ve incident riskindeki azalma da tahmini faydaya eklenebilir. Lisans, compute ve entegrasyon maliyetleri toplam yatırımdan düşülür. Hesap gerçek production verisiyle düzenli güncellenmelidir.
Otonom Veri Sınıflandırmanın Başlıca Avantajları
Otonom classification en büyük değerini yüksek hacimli ve sürekli değişen veri ortamlarında gösterir. Discovery daha hızlı olur, etiketleme daha tutarlı hale gelir ve manuel iş azalır. Risk daha erken görünür olduğu için geliştirme ve test süreçlerinde düzeltme maliyeti düşebilir. Compliance evidence otomatik üretilebilir. Data governance ekibi aynı insan kaynağıyla daha geniş veri alanını yönetebilir.
Daha Hızlı Data Discovery
Otomatik scanner veri kaynaklarını sürekli keşfedebilir. Yeni tablo veya dosya kısa sürede catalog'a düşer. Kullanıcı owner ve classification bilgisine tek yerden ulaşır. Manuel spreadsheet güncelleme ihtiyacı azalır. Proje başlangıç süresi bu sayede kısalabilir.
Daha Tutarlı Classification
Ortak model ve taxonomy bütün ekiplerde aynı kuralları uygular. İnsan yorum farkları azalır. Versioning sayesinde değişiklikler kontrollü yapılır. Human override yine mümkün olabilir. Tutarlılık DLP ve IAM policy uygulamasını daha güvenilir hale getirir.
Daha Az Manuel İş
Tekrarlanan basit sınıflandırmalar otomatik yapılabilir. Data steward yalnızca düşük confidence sonuçları inceler. Developer veri etiketini manuel aramak zorunda kalmaz. Approval workflow otomatik yönlendirilir. Bu durum ekiplerin daha değerli işlere odaklanmasını sağlar.
Daha Erken Risk Tespiti
Shift-left classification riskli veri değişikliğini pull request aşamasında gösterebilir. Production'a ulaşmadan düzeltme yapılır. Yeni PII alanı erken fark edilir. Test verisi güvenliği daha iyi kontrol edilir. Erken tespit genel remediation maliyetini azaltabilir.
Daha Hızlı Development
Developer doğru dataset ve access bilgisini daha hızlı bulur. Governance soruları için uzun bekleme azalır. Self-service catalog kullanımı artar. Pipeline otomatik kontrol verdiği için manuel review daha az gerekir. Cycle time ölçülebilir biçimde düşebilir.
Daha Güvenli Test Süreçleri
Test ortamına taşınan veriler otomatik taranabilir. PII tespit edildiğinde masking uygulanır. Synthetic data alternatifleri daha kolay belirlenir. QA ekibi gerçek veri riskini önceden görür. Production sonrası privacy problemi olasılığı azalır.
Daha Hızlı Compliance
Audit evidence otomatik üretilebilir. Hangi dataset'in hangi classification'a sahip olduğu merkezi görünür. Policy ve approval geçmişi saklanır. Denetim için manuel veri toplama süresi azalır. Compliance ekibi daha çok risk analizine odaklanabilir.
Ölçeklenebilir Data Governance
Manuel governance veri hacmiyle doğrusal büyür. Otonom sistem aynı ekip ile daha geniş coverage sağlayabilir. Yeni domain eklemek taxonomy ve connector ile mümkün olur. Human review yalnızca zor örneklere ayrılır. Kurumsal büyüme governance ekibini aynı hızda büyütmeyi gerektirmez.
Otonom Veri Sınıflandırmanın Riskleri ve Dezavantajları
Otonom sistemler önemli fayda sağlasa da kontrolsüz kullanıldığında yeni riskler oluşturabilir. Yanlış sınıflandırma gereksiz erişim engelleri veya veri sızıntısı riskine yol açabilir. Model drift ve taxonomy drift zaman içinde kaliteyi düşürebilir. Vendor lock-in ve yüksek entegrasyon maliyeti teknik borç oluşturabilir. Bu nedenle otonomi seviyesi ölçüm, observability ve human review ile birlikte tasarlanmalıdır.
Yanlış Sınıflandırma
Yanlış classification doğrudan yanlış policy uygulanmasına neden olabilir. Restricted verinin Internal kabul edilmesi güvenlik riski yaratır. Tersi durumda gereksiz erişim engeli oluşur. Confidence score ve review mekanizması bu riski azaltır. Yüksek etkili aksiyonlarda ikinci doğrulama tercih edilmelidir.
Automation Bias
Automation bias kullanıcıların sistem kararını sorgulamadan doğru kabul etmesidir. Model yüksek confidence gösterdiğinde insanlar hatayı fark etmeyebilir. Review ekranında evidence ve gerekçe gösterilmelidir. Kritik örneklerde bağımsız kontrol mekanizması kullanılabilir. Eğitim ve governance kültürü de teknik kontrol kadar önemlidir.
Model Drift
Model drift yeni veri dağılımının eğitim verisinden uzaklaşmasıdır. Precision ve recall zaman içinde düşebilir. Yeni iş terimleri classifier tarafından yanlış yorumlanabilir. Monitoring ve periyodik benchmark bu değişimi yakalar. Gerekirse retraining veya rule güncellemesi yapılır.
Taxonomy Drift
Taxonomy drift sınıf tanımlarının zaman içinde iş ihtiyaçlarıyla uyumsuz hale gelmesidir. Ekipler aynı etiketi farklı anlamda kullanmaya başlayabilir. Glossary ve policy düzenli review edilmelidir. Versioning değişiklik geçmişini korur. Model yeni taxonomy ile tekrar test edilmelidir.
Over-Classification
Over-classification gereksiz kısıtlama yaratır. Kullanıcı daha fazla approval bekler. DLP uyarıları artar. Developer ve data analyst workflow'u yavaşlar. Precision iyileştirmesi bu maliyeti azaltır.
Vendor Lock-In
Vendor'a özel taxonomy ve metadata formatı migration'ı zorlaştırabilir. API erişimi ve export capability seçim aşamasında kontrol edilmelidir. Model veya rule tanımlarının taşınabilir olması önemlidir. Açık standartlar lock-in riskini azaltır. TCO değerlendirmesi exit maliyetini de içermelidir.
Yüksek Entegrasyon Maliyeti
Kurumsal ortamda çok sayıda data source ve security tool bulunabilir. Her connector ayrı geliştirme ve bakım gerektirebilir. Pilot küçük kapsamla başlamalıdır. En yüksek riskli ve değerli kaynaklar önce entegre edilmelidir. Standart API kullanımı yaygınlaştırmayı kolaylaştırır.
Açıklanabilirlik Problemi
ML ve LLM modelleri bazı kararların nedenini açık şekilde göstermeyebilir. Governance ve audit süreçleri bu gerekçeye ihtiyaç duyar. Model evidence, matched entity ve context sinyalleri kullanıcıya gösterilebilir. Yüksek riskli kararlarda black-box yaklaşım yeterli olmayabilir. Explainability seçim kriterlerinden biri olmalıdır.
Tam Otonom Remediation Riski
Yanlış classifier kararı doğrudan access revocation veya quarantine tetikleyebilir. Bu durum iş kesintisine yol açabilir. Düşük riskli ve geri alınabilir aksiyonlarla başlanmalıdır. Approval tabanlı model daha kritik işlemlerde güvenli seçenek sunar. Remediation failure ayrıca monitoring sistemi tarafından izlenmelidir.
Otonom Remediation Ne Kadar Otonom Olmalı?
Remediation otomasyonu her senaryoda aynı seviyede uygulanmamalıdır. Detect-only model başlangıç için düşük risklidir. Sistem olgunlaştıkça recommend ve approval-based action seviyelerine geçilebilir. Fully automated action yalnızca güçlü doğruluk ve geri alınabilir işlem şartlarında kullanılmalıdır. Risk bazlı otomasyon modeli, yanlış kararın iş etkisini doğrudan hesaba katmalıdır.
Detect-Only Mode
Detect-only mod yalnızca problemi tespit eder ve raporlar. Hiçbir veri veya access değişikliği yapmaz. Pilot aşaması için güvenli başlangıçtır. Model doğruluğu gerçek production verisiyle ölçülebilir. İnsan ekip mevcut süreçle müdahale etmeye devam eder.
Recommend Mode
Recommend mod sistemin aksiyon önerisi üretmesini sağlar. Örneğin dosyanın Restricted olarak yeniden etiketlenmesini önerebilir. Kullanıcı öneriyi kabul veya reddeder. Bu feedback model kalitesini artırır. Automation bias riskine karşı gerekçe ve evidence gösterilmelidir.
Approval-Based Action
Approval-based model sistemin aksiyonu hazırlayıp yetkili onayından sonra uygulamasını sağlar. High-risk dataset için pratik bir denge oluşturur. Approval request gerekli bütün context ile gelmelidir. Süreç audit edilebilir. Acil security olaylarında daha hızlı özel workflow tanımlanabilir.
Fully Automated Action
Fully automated mode sistemin insan beklemeden policy uygulamasıdır. Düşük riskli tagging ve metadata güncelleme için uygun olabilir. Access revocation gibi yüksek etkili işlemlerde daha dikkatli kullanılmalıdır. Confidence ve policy şartları çok net tanımlanmalıdır. Her otomatik aksiyon geri izlenebilir olmalıdır.
Reversible Remediation
Geri alınabilir remediation yanlış kararın etkisini azaltır. Tag güncelleme veya temporary quarantine buna örnek olabilir. Sistem previous state bilgisini saklamalıdır. Rollback tek işlemle yapılabilmelidir. Otomasyon seviyesini artırmadan önce reversibility test edilmelidir.
Masking
Masking hassas değeri görünmez veya değiştirilmiş hale getirir. Bazı uygulamalarda geri alınabilir yöntem kullanılabilir. Yanlış classification durumunda orijinal verinin kaybolmaması önemlidir. Policy test ortamında önce doğrulanmalıdır. Masking logları audit için saklanabilir.
Encryption
Encryption hassas verinin yetkisiz okunmasını engeller. Otomatik encryption işleminde key management kritik hale gelir. Yanlış key veya policy veriye erişimi tamamen durdurabilir. Decryption recovery prosedürü test edilmelidir. High-risk ortamda key operasyonları ayrı approval gerektirebilir.
Quarantine
Quarantine veriyi normal erişim alanından geçici olarak ayırır. Şüpheli veya yanlış yerde bulunan Restricted veri için kullanılabilir. İş etkisi erişim kesintisi yaratabileceği için kullanıcı bilgilendirilmelidir. İnceleme sonrası geri dönüş kolay olmalıdır. Audit log hangi policy'nin kararı verdiğini göstermelidir.
Access Revocation
Access revocation yanlış yetkiyi hızlı biçimde kaldırabilir. Ancak yanlış karar kritik iş akışını durdurabilir. Bu nedenle approval veya çok yüksek confidence şartı uygulanabilir. Temporary revoke ile kalıcı revoke ayrılmalıdır. Recovery ve exception mekanizması hazır olmalıdır.
Risk Seviyesine Göre Automation Modeli
Public ve Internal data için yüksek otonomi daha kolay uygulanabilir. Confidential veri orta seviyede approval gerektirebilir. Restricted veri için insan onayı ve ikinci doğrulama tercih edilebilir. Aynı model bütün use case'lere zorlanmamalıdır. Automation policy veri riski ve aksiyon geri alınabilirliğine göre tasarlanmalıdır.
Event-Driven Otonom Veri Sınıflandırma Mimarisi
Event-driven mimari sınıflandırmayı periyodik batch işinden sürekli çalışan governance servisine dönüştürür. Veri oluşturulduğunda, schema değiştiğinde veya policy güncellendiğinde event üretilir. Classification agent bu olayı işleyip policy engine'e sonuç gönderir. Workflow orchestrator gerekli review veya remediation adımını başlatır. Audit store bütün karar zincirini kaydeder.
Veri Oluşturulduğunda Classification
Yeni dataset veya dosya oluşturulduğunda event yayınlanabilir. Scanner metadata ve örnek içeriği analiz eder. İlk classification etiketi kısa sürede oluşturulur. Data catalog kayıt anında zenginleşir. Kullanıcı henüz erişmeden doğru policy uygulanabilir.
Schema Değiştiğinde Reclassification
Schema change yeni hassas alan ekleyebilir. Event sistemi değişikliği anında classifier'a gönderir. Sadece etkilenen bölüm yeniden taranabilir. Risk artmışsa owner veya security ekibine workflow açılır. Full scan maliyeti bu sayede azaltılır.
Data Movement Sonrasında Reclassification
Veri farklı ortama taşındığında risk bağlamı değişebilir. Internal storage'dan public cloud bucket'a kopyalanması buna örnektir. İçerik aynı kalsa bile policy yeniden değerlendirilmelidir. Classification etiketi lokasyon metadata'sıyla birlikte analiz edilir. Gerekirse access control otomatik güncellenir.
Policy Değiştiğinde Re-Evaluation
Yeni compliance veya güvenlik policy'si mevcut data asset'ları etkileyebilir. Event-driven sistem policy version değiştiğinde ilgili dataset'leri yeniden değerlendirir. Tam veri taraması yerine mevcut metadata kullanılabilir. Yalnızca belirsiz varlıklar yeniden scan edilir. Bu yaklaşım büyük ortamda maliyeti kontrol eder.
Event Bus
Event bus data source ve classification servisleri arasında iletişim sağlar. Schema change, file create ve policy update gibi olaylar publish edilebilir. Consumer servisler event'i bağımsız işler. Retry ve dead-letter queue güvenilirliği artırır. Event metadata hassas veri içermemelidir.
Classification Agent
Classification agent event'i alır ve gerekli analiz adımlarını koordine eder. Önce metadata değerlendirip sonra uygun classifier seçebilir. Rule, ML veya LLM pipeline'ını dinamik belirleyebilir. Sonuç confidence score ile policy engine'e gönderilir. Agent izinleri minimum yetkiyle sınırlandırılmalıdır.
Policy Engine
Policy engine classification sonucunu iş kurallarıyla eşleştirir. Hangi aksiyonun otomatik veya approval tabanlı olacağını belirler. Policy version control altında tutulmalıdır. Test senaryoları release öncesinde çalıştırılmalıdır. Karar sonucu audit store'a yazılır.
Workflow Orchestrator
Workflow orchestrator insan ve otomasyon adımlarını sıraya koyar. Data steward review, owner approval ve remediation job burada yönetilebilir. SLA ve timeout bilgisi izlenebilir. Başarısız adımlar retry veya escalation ile ele alınır. Proje yönetim aracıyla entegrasyon visibility sağlar.
Audit Store
Audit store her classification ve policy kararının geçmişini tutar. Data asset, model version, confidence ve aksiyon bilgileri kaydedilir. İnsan override gerekçesi de bu kayda eklenir. Compliance ve incident analizi sırasında kanıt sağlar. Retention policy güvenlik gereksinimine göre belirlenmelidir.
KVKK Açısından Otonom Veri Sınıflandırma
KVKK açısından veri sınıflandırma kişisel ve özel nitelikli kişisel verilerin görünür hale getirilmesine yardımcı olabilir. Ancak otomatik etiketleme tek başına uyumluluk sağlamaz. Veri minimizasyonu, saklama süresi, erişim kontrolü ve audit gibi süreçlerle birlikte uygulanmalıdır. Yanlış sınıflandırma hukuki riske yol açabileceği için yüksek riskli alanlarda insan denetimi önemlidir. Kurumsal sistemde classification metadata compliance kanıtı olarak kullanılabilir.
Kişisel Veri Tespiti
Kişisel veri doğrudan veya dolaylı olarak kişiyi belirleyebilen bilgileri kapsar. Pattern matching, NER ve context analysis birlikte kullanılabilir. Türkçe isim ve adres yapıları gerçek veriyle test edilmelidir. False negative oranı düzenli ölçülmelidir. Tespit edilen veri owner ve processing purpose ile ilişkilendirilebilir.
Özel Nitelikli Kişisel Verilerin Ayrıştırılması
Özel nitelikli kişisel veriler daha yüksek güvenlik kontrolü gerektirebilir. Classification taxonomy bu veri türlerini ayrı kategoride tanımlamalıdır. Confidence düşükse human review zorunlu tutulabilir. Access policy daha dar kapsamlı olabilir. Otomatik remediation doğrudan erişim kesmeden önce approval isteyebilir.
Veri Minimizasyonu
Data minimization yalnızca ihtiyaç duyulan verinin işlenmesini hedefler. Classification gereksiz hassas alanları görünür hale getirir. Proje ekibi bu alanların gerçekten gerekli olup olmadığını sorgulayabilir. Kullanılmayan alanlar ingestion pipeline'dan çıkarılabilir. Bu yaklaşım hem risk hem storage maliyetini azaltabilir.
Saklama Süreleri
Retention policy veri türüne göre farklı olabilir. Classification etiketi uygun saklama süresiyle eşleştirilebilir. Süre dolduğunda silme veya archive workflow'u tetiklenebilir. Legal hold gibi istisnalar ayrıca yönetilmelidir. Silme evidence audit store içinde tutulabilir.
Access Control
Hassas veri yalnızca yetkili kullanıcı ve servislerle sınırlandırılmalıdır. Classification IAM policy için dinamik sinyal sağlar. Veri seviyesi değiştiğinde erişim yeniden değerlendirilebilir. Least privilege temel yaklaşım olmalıdır. Access review periyodik olarak otomatik raporlanabilir.
Masking ve Anonymization
Masking ve anonymization kişisel verinin kullanım riskini azaltabilir. Hangi yöntemin uygulanacağı use case'e göre değişir. Test ortamında masking yeterli olabilirken analitik paylaşım için anonymization tercih edilebilir. Classification bu kararın hangi alanlara uygulanacağını gösterir. Dönüşüm sonrası validation yapılmalıdır.
Audit Trail
Audit trail sınıflandırma ve erişim değişikliklerinin geçmişini gösterir. Hangi modelin hangi etiketi verdiği kaydedilmelidir. İnsan override ve approval bilgileri saklanır. Denetim sırasında karar zinciri yeniden oluşturulabilir. Log bütünlüğü korunmalıdır.
Otomatik Kararlarda İnsan Denetimi
Yüksek etkili otomatik kararlar insan review mekanizmasıyla desteklenmelidir. Yanlış Restricted etiketi iş süreçlerini gereksiz durdurabilir. Tersi durumda kişisel veri korumasız kalabilir. Risk seviyesi approval şartını belirler. Human-in-the-loop governance sistemi bu dengeyi sağlar.
Otonom Veri Sınıflandırma Aracı Nasıl Seçilir?
Araç seçimi yalnızca demo doğruluğuna göre yapılmamalıdır. Structured ve unstructured data desteği, deployment modeli, data residency ve entegrasyon kapasitesi birlikte değerlendirilmelidir. Human-in-the-loop ve auditability production yönetimi açısından kritik özelliklerdir. Classification accuracy gerçek kurum verisiyle pilot test edilmelidir. Toplam maliyet lisans dışında compute, entegrasyon ve operasyon kalemlerini de içermelidir.
Structured ve Unstructured Data Desteği
Kurumun veri türleri seçim kriterinin başlangıcıdır. Sadece database tarayan araç doküman ağırlıklı kurumda yetersiz kalabilir. PDF, e-posta ve object storage desteği ayrıca kontrol edilmelidir. Aynı taxonomy farklı veri türlerinde tutarlı çalışmalıdır. Pilot bütün önemli veri formatlarını kapsamalıdır.
Cloud, SaaS ve On-Prem Coverage
Modern kurumlarda veri tek ortamda bulunmaz. Cloud storage, SaaS uygulaması ve on-prem database birlikte olabilir. Platformun connector coverage'ı entegrasyon süresini etkiler. Eksik connector için API veya SDK desteği önemlidir. Network ve credential güvenliği deployment tasarımına dahil edilmelidir.
Classification Accuracy
Vendor tarafından açıklanan accuracy değeri tek başına yeterli değildir. Kendi golden dataset'iniz üzerinde precision ve recall ölçülmelidir. Türkçe ve domain-specific veri ayrıca test edilmelidir. Low-confidence davranışı incelenmelidir. Pilot sonucu gerçek seçim kararının temeli olmalıdır.
Custom Taxonomy
Hazır sınıflar her kurumun iş modelini karşılamaz. Custom taxonomy desteği yeni kategori ve kurallar eklemeyi sağlamalıdır. Versioning ve test özelliği bulunmalıdır. Taxonomy değişikliği mevcut data asset'larda reclassification yapabilmelidir. Business glossary ile entegrasyon büyük avantaj sağlar.
LLM / ML Yeteneği
Platformun yalnızca rule-based olması bazı unstructured use case'lerde sınırlayıcı olabilir. ML ve LLM desteği bağlam farkını daha iyi değerlendirebilir. Model seçimi, fine-tuning ve prompt kontrolü kullanıcıya açık olmalıdır. API maliyeti şeffaf biçimde ölçülebilmelidir. Hassas verinin modele nasıl gönderildiği güvenlik açısından incelenmelidir.
Human-in-the-Loop
Review queue ve manual override production kullanımı için gereklidir. Reviewer model gerekçesini görebilmelidir. Düzeltmeler feedback olarak sisteme aktarılmalıdır. Role-based review farklı domain'leri doğru uzmana yönlendirir. Human workload metrikleri dashboard üzerinde izlenebilmelidir.
Data Lineage
Lineage hassas verinin sistemler arasında nasıl hareket ettiğini gösterir. Classification etiketi türetilmiş dataset'lere aktarılabilir. Impact analysis daha hızlı yapılır. Yeni policy geldiğinde hangi downstream sistemlerin etkilendiği bulunabilir. Tool doğrudan lineage sunmuyorsa catalog entegrasyonu değerlendirilmelidir.
DLP / IAM / SIEM Entegrasyonu
Classification sonucu güvenlik sistemlerinde kullanılmadığında değerin önemli kısmı kaybolur. DLP paylaşımı kontrol eder. IAM erişim seviyesini uygular. SIEM olay riskini classification ile zenginleştirir. Hazır entegrasyonlar operasyon süresini azaltır.
API ve SDK
API ve SDK özel workflow ve connector geliştirmeyi sağlar. Classification sonucu programatik olarak alınabilmelidir. Event ve webhook desteği event-driven mimari için önemlidir. Authentication güçlü ve ayrıntılı yetkilendirmeli olmalıdır. Rate limit ve bulk işlem özellikleri büyük veri hacminde değerlendirilmelidir.
Deployment Seçenekleri
SaaS, on-prem ve private cloud seçenekleri farklı gereksinimleri karşılar. Hassas veri dış sisteme gönderilemiyorsa local processing gerekli olabilir. Hybrid deployment bazı bileşenleri kurum içinde tutabilir. Upgrade ve operasyon sorumluluğu modele göre değişir. TCO analizi deployment şekline göre yapılmalıdır.
Data Residency
Data residency hassas verinin hangi coğrafyada işlendiğini belirler. SaaS hizmetinde scanner'ın örnek veri taşıyıp taşımadığı incelenmelidir. Metadata ve içerik farklı lokasyonlarda tutulabilir. Kurum policy ve hukuki gereksinimleri seçimde dikkate alınmalıdır. Self-hosted model bu konuda daha fazla kontrol sağlayabilir.
Auditability
Auditability sistem kararlarının geçmişini ve gerekçesini gösterebilme yeteneğidir. Model version, taxonomy version ve confidence kaydedilmelidir. Human override ve policy action aynı zincirde görünmelidir. Compliance ve incident analizi için export özelliği önemlidir. Black-box kararlar yüksek riskli kullanımda sorun oluşturabilir.
Maliyet
Maliyet lisans fiyatından daha geniş değerlendirilmelidir. Compute, API, storage, integration ve human review dahil edilmelidir. Classification başına maliyet hesaplanabilir. Hacim arttıkça fiyatlandırma modelinin davranışı incelenmelidir. Pilot gerçek TCO tahmini için en iyi veriyi sağlar.
Build vs Buy: Özel Sınıflandırma Sistemi mi Hazır Platform mu?
Build vs Buy kararı kurumun veri yapısı, ekip kapasitesi ve kontrol ihtiyacına bağlıdır. Hazır platform hızlı başlangıç ve geniş connector avantajı sağlar. Özel sistem ise domain'e özgü model ve deployment kontrolü sunabilir. Hybrid yaklaşım ortak platformu özel classifier ile birleştirebilir. Kararda Total Cost of Ownership ve vendor lock-in riski birlikte değerlendirilmelidir.
Hazır Platform Kullanmanın Avantajları
Hazır platform discovery, catalog ve workflow özelliklerini kısa sürede sunabilir. Çok sayıda connector geliştirme ihtiyacını azaltır. Vendor güncellemeleri yeni veri kaynaklarını destekleyebilir. Operasyon ekibi daha az altyapı yönetir. Buna karşılık customization sınırı ve lisans maliyeti değerlendirilmelidir.
Özel Sistem Geliştirmenin Avantajları
Özel sistem kurumun taxonomy ve veri tiplerine tam uyarlanabilir. Model tamamen kurum içinde çalıştırılabilir. Maliyet yüksek hacimde daha kontrollü hale gelebilir. İç ekip bütün karar mantığını bilir. Ancak geliştirme, model bakımı ve connector sorumluluğu kuruma geçer.
Hybrid Yaklaşım
Hybrid model hazır platformun discovery ve catalog özelliklerini özel classifier ile birleştirir. Kritik domain için kurum içi model kullanılabilir. Diğer data source'lar vendor classifier ile yönetilebilir. API tabanlı entegrasyon esneklik sağlar. Mimari karmaşayı azaltmak için sorumluluk sınırları açık tanımlanmalıdır.
Vendor Lock-In Değerlendirmesi
Metadata ve taxonomy export edilemiyorsa vendor değişimi zorlaşır. API ve açık format desteği kontrol edilmelidir. Classification rule ve mapping'lerin taşınabilirliği önemlidir. Contract exit şartları teknik değerlendirmeyle birlikte ele alınmalıdır. Uzun vadeli TCO lock-in etkisini içermelidir.
Total Cost of Ownership
TCO lisans veya geliştirme maliyetinin ötesindedir. Model eğitimi, infrastructure, support ve insan review maliyetleri eklenir. Üç ila beş yıllık tahmin daha gerçekçi sonuç verir. Veri hacmi büyüme oranı hesaba katılmalıdır. Build ve Buy seçenekleri aynı kriterlerle karşılaştırılmalıdır.
Veri Sınıflandırma İçin Hangi Programlama Dili Kullanılır?
Tek bir en iyi programlama dili yoktur çünkü veri türü ve sistem mimarisi seçimi belirler. Python NLP ve ML ekosistemi nedeniyle classification projelerinde sık kullanılır. Java ve Go enterprise servislerde güçlü seçeneklerdir. Scala büyük veri pipeline'larında, SQL ise structured data discovery çalışmalarında değerlidir. Doğru teknoloji yığını performans, ekip deneyimi ve entegrasyon gereksinimine göre seçilmelidir.
Python
Python classification prototipi geliştirmek için geniş kütüphane ekosistemi sunar. NLP, ML ve data processing araçları kolay erişilebilir. Araştırma kodundan API servisine geçiş hızlı olabilir. Büyük production yükünde performans için ek mimari önlemler gerekebilir. Ekip deneyimi seçimde önemli etkendir.
NLP ve Machine Learning
Python scikit-learn, PyTorch ve NLP kütüphaneleriyle güçlü seçenekler sunar. NER ve text classification kolay prototiplenebilir. Model evaluation araçları geniştir. Türkçe model entegrasyonu yapılabilir. Production inference performansı ayrıca test edilmelidir.
Hızlı Prototipleme
Python az kodla hızlı deney yapılmasını sağlar. Golden dataset üzerinde farklı model yaklaşımları kolay karşılaştırılabilir. Notebook ortamı data scientist için kullanışlıdır. Başarılı prototip daha sonra servisleştirilebilir. Prototype kodunun doğrudan production standardı kabul edilmemesi gerekir.
Java
Java kurumsal backend sistemleriyle güçlü entegrasyon sunar. Büyük organizasyonlarda mevcut servis altyapısıyla uyumlu olabilir. JVM ekosistemi monitoring ve deployment açısından olgundur. ML modelleri ayrı servis olarak çağrılabilir. Yüksek throughput API katmanı için tercih edilebilir.
Enterprise Entegrasyon
Java mevcut IAM, messaging ve database altyapısıyla kolay entegre olabilir. Uzun süreli kurumsal uygulama desteği güçlüdür. Classification servisi Spring tabanlı API olarak geliştirilebilir. Model inference ayrı Python servisiyle ayrıştırılabilir. Bu yapı ekip sorumluluklarını netleştirir.
Scala
Scala büyük veri işleme platformlarında güçlü seçenektir. Spark tabanlı pipeline'larda classification job doğrudan uygulanabilir. Büyük dataset üzerinde paralel analiz yapılabilir. ML modeli farklı framework'ten servis olarak çağrılabilir. Ekip Scala deneyimine sahip değilse öğrenme maliyeti hesaba katılmalıdır.
Büyük Veri İşleme
Petabyte seviyesine yaklaşan data lake taramalarında distributed processing gerekir. Spark ve Scala bu iş için kullanılabilir. Sampling ve partition pruning maliyeti azaltır. Classification result metadata store'a yazılabilir. Büyük veri performansı gerçek production hacmiyle test edilmelidir.
SQL
SQL structured data discovery için temel araçtır. Column name, data type ve sample value üzerinden ilk sınıflandırma yapılabilir. Rule-based PII detection query'lerle uygulanabilir. Data warehouse içinde işlem yapmak data movement ihtiyacını azaltır. Daha gelişmiş model sonuçları SQL pipeline'a eklenebilir.
Structured Data Discovery
Database metadata tabloları SQL ile kolayca taranabilir. Yeni schema ve column değişiklikleri belirlenebilir. Pattern matching belirli alanlarda hızlı sonuç verir. Query maliyeti büyük tablolarda kontrol edilmelidir. Classification service yalnızca örnek veriyi okuyabilir.
Go
Go yüksek performanslı servisler ve agent geliştirmek için güçlü seçenektir. Tek binary deployment edge veya agent senaryolarını kolaylaştırır. Memory kullanımı kontrollü olabilir. ML modeli remote service olarak çağrılabilir. Event consumer ve connector geliştirmede pratik kullanım sunar.
Yüksek Performanslı Servisler
Go yüksek concurrency gerektiren scanner ve API servislerinde kullanılabilir. Event bus tüketicileri verimli çalışır. Container image boyutu küçük tutulabilir. Observability entegrasyonu kolaydır. Model inference başka servisle ayrıştırıldığında mimari sade kalabilir.
En İyi Programlama Dili Yerine Doğru Teknoloji Yığını Nasıl Seçilir?
Seçim yalnızca benchmark sonucuna göre yapılmamalıdır. Ekip deneyimi ve mevcut platform büyük etkendir. ML için Python, API için Go veya Java ve data lake için Scala birlikte kullanılabilir. Gereksiz dil sayısı operasyon yükünü artırır. Mimari en az sayıda teknolojiyle gerçek ihtiyacı karşılamalıdır.
Open Source Veri Sınıflandırma Ekosistemi
Açık kaynak ekosistemi veri discovery, catalog, PII detection ve metadata yönetimi için güçlü bileşenler sunar. Presidio PII detection, OpenMetadata ve DataHub metadata yönetimi açısından değerlendirilebilir. Apache Atlas bazı büyük veri ortamlarında kullanılabilir. Açık kaynak LLM ve NER modelleri custom classifier geliştirmeyi kolaylaştırır. Buna karşılık entegrasyon ve operasyon sorumluluğu kurum içinde daha yüksek olabilir.
Presidio
Presidio PII detection ve anonymization use case'lerinde kullanılabilir. Pattern ve NLP tabanlı entity detection yaklaşımı sunar. Custom recognizer eklemek mümkündür. Türkçe veya domain-specific performans gerçek veriyle test edilmelidir. Otonom platform içinde bir classifier bileşeni olarak kullanılabilir.
OpenMetadata
OpenMetadata data catalog ve metadata yönetimi için açık kaynak seçenektir. Connector ve lineage desteği data discovery süreçlerini kolaylaştırabilir. Classification tag'leri catalog üzerinde tutulabilir. API üzerinden özel scanner entegrasyonu yapılabilir. Production işletimi için kapasite ve upgrade planı gerekir.
DataHub
DataHub metadata platformu olarak dataset, lineage ve ownership yönetimini destekler. Active metadata use case'leri için event tabanlı entegrasyon kurulabilir. Custom classification metadata eklenebilir. Search ve discovery süreçlerini güçlendirebilir. Kurumsal deployment öncesi connector kapsamı test edilmelidir.
Apache Atlas
Apache Atlas özellikle Hadoop ve büyük veri ekosistemleriyle metadata governance için kullanılabilir. Classification ve lineage kavramlarını destekler. Mevcut data platformu ile entegrasyon yeteneği değerlendirilmelidir. Modern SaaS connector kapsamı sınırlı olabilir. Hybrid mimaride belirli domain'ler için kullanılabilir.
NLP ve NER Modelleri
Açık kaynak NLP modelleri özel classifier geliştirmek için temel sağlar. Türkçe NER modeli PII tespiti için uyarlanabilir. Golden dataset ile fine-tuning yapılabilir. Model lisansı ve kullanım şartları kontrol edilmelidir. Production inference maliyeti self-hosted altyapıyla ölçülmelidir.
Açık Kaynak LLM Kullanımı
Açık kaynak LLM hassas veriyi kurum içinde işleme avantajı sağlayabilir. Model ağırlıkları ve inference altyapısı kurum kontrolünde tutulur. Buna karşılık GPU maliyeti ve operasyon sorumluluğu artar. Quantization veya daha küçük model kullanımı maliyeti azaltabilir. Kurumsal entegrasyon için https://www.diyarbakiryazilim.com.tr/posts/acik-kaynak-buyuk-dil-modellerinin-llm-kurumsal-entegrasyonu adresindeki teknik yaklaşım değerlendirilebilir.
Açık Kaynak mı Ticari Ürün mü?
Açık kaynak daha yüksek kontrol ve özelleştirme sağlar. Ticari ürün daha hızlı connector ve support avantajı sunabilir. İç ekip kapasitesi kararın önemli bölümüdür. Pilot iki modeli aynı dataset üzerinde karşılaştırabilir. TCO ve vendor lock-in birlikte değerlendirilmelidir.
Open Source ve İşbirliğinin Otonom Veri Sınıflandırmadaki Rolü
Otonom classification yalnızca kapalı kurumsal projelerle gelişen bir alan değildir. Açık kaynak model, veri seti ve taxonomy çalışmaları topluluk katkısıyla hızlanabilir. Türkçe veri sınıflandırma projelerinde yerel dataset ve benchmark eksikliği özellikle işbirliği fırsatı oluşturur. Üniversiteler, yazılım toplulukları ve sektör ekipleri ortak çalışma yürütebilir. Bu yaklaşım geliştiricilerin gerçek veri governance problemlerini öğrenmesine de yardımcı olur.
GitHub Üzerinden Katkı
GitHub açık kaynak classifier, connector veya metadata plugin geliştirmek için ortak alan sağlar. Issue ve pull request süreçleri yeni geliştiricilerin katkısını kolaylaştırır. Test dataset ve benchmark sonucu repository içinde paylaşılabilir. Güvenlik hassasiyeti olan gerçek veriler paylaşılmamalıdır. Synthetic veya anonim dataset kullanılmalıdır.
Ortak Classification Taxonomy'leri
Ortak taxonomy farklı projelerin aynı kavramları kullanmasını sağlar. Türkçe PII kategorileri topluluk tarafından standardize edilebilir. Açık tanım ve örnekler model eğitimini kolaylaştırır. Sektöre özel extension yapılabilir. Versioning değişikliklerin kontrollü ilerlemesini sağlar.
Açık Veri Setleri
Açık dataset classifier benchmark için önemlidir. Gerçek kişisel bilgi içermemelidir. Synthetic veya lisanslı veri kullanılabilir. Farklı dil ve domain örnekleri model karşılaştırmasını güçlendirir. Dataset quality açık şekilde belgelenmelidir.
Benchmark Çalışmaları
Benchmark farklı modellerin aynı veri üzerinde karşılaştırılmasını sağlar. Precision, recall ve latency birlikte ölçülmelidir. Hardware ve model version raporda belirtilmelidir. Türkçe dataset ayrı sonuç olarak gösterilebilir. Açık benchmark vendor iddialarını daha nesnel değerlendirmeye yardımcı olur.
Üniversite–Sektör İşbirliği
Üniversiteler NLP ve ML araştırması sağlayabilir. Sektör ekipleri gerçek use case ve requirement getirir. Ortak projeler öğrencilerin production problem görmesini sağlar. Veri paylaşımı privacy kurallarına uygun yapılmalıdır. Açık yayın ve prototype sonuçları ekosisteme katkı sağlar.
Yazılım Topluluklarının Rolü
Yazılım toplulukları farklı deneyim seviyesindeki geliştiricileri ortak projede buluşturabilir. Workshop ve hackathon yoluyla classification use case'leri öğrenilebilir. Açık kaynak repository uzun vadeli katkı alanı oluşturur. Yerel dil ve KVKK odaklı projeler özellikle değerli olabilir. Topluluk çalışmaları kurumsal ve akademik taraf arasında bağlantı kurabilir.
Workshop
Workshop katılımcılara classification pipeline'ını uygulamalı gösterir. Basit regex ile başlayıp ML ve human review aşamasına geçilebilir. Gerçek yerine synthetic dataset kullanılabilir. Katılımcılar precision ve recall ölçmeyi öğrenir. Sonuç küçük açık kaynak proje olarak devam ettirilebilir.
Hackathon
Hackathon kısa sürede çalışan prototype geliştirmeyi teşvik eder. Takımlar PII detection, catalog plugin veya CI scanner üzerinde çalışabilir. Ortak benchmark set sonuçları karşılaştırmayı kolaylaştırır. Mentorlar data governance ve security perspektifi sağlar. Başarılı projeler sonrasında açık kaynak olarak sürdürülebilir.
Açık Kaynak Proje Geliştirme
Uzun vadeli açık kaynak proje net roadmap ve maintainership gerektirir. Issue template ve contribution guide yeni katkıları kolaylaştırır. Test coverage classifier değişikliklerinin kalitesini korur. Release ve model version açık biçimde belgelenmelidir. Topluluk kullanıcı geri bildirimi gerçek use case gelişimini hızlandırır.
Diyarbakır Yazılım Ekosisteminde Veri Sınıflandırma Projeleri
Diyarbakır'daki geliştiriciler için data governance ve AI tabanlı classification alanı yeni proje fırsatları sunabilir. Türkçe PII detection, KVKK odaklı scanner ve CI/CD sensitive data kontrolü yerel ihtiyaçlara karşılık veren örneklerdir. Açık kaynak çalışma bu projelerin farklı kurumlar tarafından test edilmesini sağlayabilir. Diyarbakır Yazılım Topluluğu'nun farklı teknik çalışmalarını https://www.diyarbakiryazilim.com.tr/projects üzerinden incelemek mümkündür. Ortak geliştirme modeli hem yeni yazılımcılar hem deneyimli ekipler için uygulamalı öğrenme alanı oluşturabilir.
Diyarbakır Yazılım Topluluğu ve Açık Kaynak Çalışmaları
Yerel topluluklar geliştiricilerin tek başına ulaşamayacağı farklı deneyimleri bir araya getirir. Açık kaynak çalışma kod review ve ortak problem çözme alışkanlığı kazandırır. Data classification gibi çok disiplinli konu yazılım, security ve AI alanlarını birleştirir. Topluluk projeleri gerçek bir portfolio çıktısı oluşturabilir. Diyarbakır Yazılım Topluluğu hakkında https://www.diyarbakiryazilim.com.tr/about üzerinden bilgi alınabilir.
Yerel Yazılımcılar İçin Data Governance Yetkinlikleri
Data governance yalnızca yöneticiler için bir alan değildir. Developer SQL, metadata, security ve privacy bilgisini birleştirerek uzmanlaşabilir. Classification projeleri Python ve NLP pratiği sağlar. CI/CD entegrasyonu DevSecOps deneyimi kazandırır. Bu kombinasyon kurumsal projelerde değerli yetkinlik seti oluşturur.
Üniversite ve Teknoloji Topluluklarıyla İşbirliği
Üniversite ve teknoloji toplulukları ortak workshop veya proje düzenleyebilir. Öğrenciler model training ve benchmark çalışmalarına katkı verebilir. Sektör ekipleri use case ve mentoring sağlar. Veri güvenliği için synthetic dataset kullanılmalıdır. Ortak çıktılar açık repository olarak paylaşılabilir.
Geliştirilebilecek Örnek Açık Kaynak Projeler
Yerel ihtiyaçlara odaklanan küçük projeler öğrenme için güçlü başlangıçtır. Türkçe PII classifier veya KVKK scanner teknik ve sosyal faydayı birleştirebilir. Data catalog plugin metadata standartlarını öğretir. CI/CD sensitive data scanner DevSecOps yaklaşımını doğrudan uygular. Proje kapsamı küçük başlayıp topluluk katkısıyla büyütülebilir.
Türkçe PII Classifier
Türkçe PII classifier isim, adres ve diğer kişisel veri türlerini tespit edebilir. NER ve regex birlikte kullanılabilir. Synthetic golden dataset hazırlanmalıdır. Precision ve recall açık benchmark olarak yayınlanabilir. Model farklı domain verileriyle zaman içinde geliştirilebilir.
KVKK Data Scanner
KVKK scanner database veya dosya kaynaklarında kişisel veri adaylarını bulabilir. Classification taxonomy KVKK veri türlerine göre tasarlanabilir. Rule ve ML hybrid modeli kullanılabilir. Sonuç raporu data owner review'una gönderilebilir. Açık kaynak plugin yapısı farklı veri kaynaklarını destekleyebilir.
Data Catalog Plugin
Catalog plugin classification sonucunu OpenMetadata veya benzeri platforma yazabilir. Tag, confidence ve model version metadata olarak tutulabilir. Event-driven reclassification desteklenebilir. Plugin API authentication kullanmalıdır. Böyle bir proje metadata engineering konusunda güçlü deneyim sağlar.
CI/CD Sensitive Data Scanner
CI scanner pull request sırasında sample data ve config dosyalarını analiz edebilir. PII veya Restricted content bulunduğunda pipeline uyarı verir. Policy threshold merge kararına bağlanabilir. CLI olarak geliştirilmesi farklı CI platformlarında kullanım sağlar. Açık rule formatı topluluk katkısını kolaylaştırır.
Yazılımcı Olmak İsteyenler Veri Sınıflandırma Alanında Nasıl Uzmanlaşabilir?
Bu alanda uzmanlaşmak için yalnızca yapay zeka bilgisi yeterli değildir. SQL, database, Python, data engineering, cybersecurity ve data governance birlikte öğrenilmelidir. Cloud platformları ve CI/CD pratiği production entegrasyonunu anlamayı kolaylaştırır. Açık kaynak projeler teori ile gerçek kod arasındaki boşluğu kapatır. Küçük PII detection projesiyle başlayıp catalog ve policy entegrasyonuna doğru ilerlemek pratik bir öğrenme yoludur.
SQL ve Database Bilgisi
Structured data classification için database bilgisi temel gereksinimdir. Schema, index ve metadata tabloları anlaşılmalıdır. SQL ile örnek veri analizi yapılabilir. Access control ve query performance bilgisi scanner tasarımında önemlidir. Farklı database sistemlerini öğrenmek connector geliştirmeyi kolaylaştırır.
Python
Python veri analizi ve ML çalışmalarında hızlı başlangıç sağlar. Pandas ve model kütüphaneleri prototype geliştirmeyi kolaylaştırır. REST API ve batch job oluşturulabilir. Testing alışkanlığı production kalitesini artırır. Küçük CLI scanner iyi başlangıç projesidir.
NLP ve Machine Learning
Text classification ve NER temel kavramları öğrenilmelidir. Precision, recall ve F1 gibi metrikler doğru anlaşılmalıdır. Golden dataset hazırlamak model seçimi kadar önemlidir. Embedding ve transformer modelleri sonraki aşamada öğrenilebilir. Domain adaptation gerçek projelerde değerli beceridir.
Data Engineering
Classification sistemi farklı data pipeline'lara entegre edilir. ETL, stream processing ve data lake kavramları öğrenilmelidir. Schema drift ve lineage önemli konulardır. Orchestration araçları workflow otomasyonunu sağlar. Büyük veri performansı production ölçeği açısından gereklidir.
Cybersecurity
Data classification güvenlik kontrolüyle yakından ilişkilidir. IAM, encryption, DLP ve audit kavramları bilinmelidir. Threat modeling classifier'ın kötüye kullanım risklerini anlamaya yardımcı olur. Secret management ve least privilege entegrasyonlarda önemlidir. Security bilgisi teknik kararların iş riskine bağlanmasını sağlar.
Data Governance
Taxonomy, ownership ve data quality governance'ın temel konularıdır. Teknik classifier doğru iş tanımı olmadan sınırlı değer üretir. Business glossary ve stewardship süreçleri öğrenilmelidir. KVKK ve privacy prensiplerinin temel çerçevesi anlaşılmalıdır. Böylece model çıktısı gerçek politika kararına dönüşebilir.
Cloud Platformları
Veri kaynaklarının önemli bölümü cloud servislerinde bulunabilir. Object storage, data warehouse ve IAM hizmetleri öğrenilmelidir. Event-driven servisler reclassification mimarisinde kullanılabilir. Cost monitoring özellikle LLM ve scan workload'larında önemlidir. Multi-cloud temel kavramları connector tasarımını genişletir.
Açık Kaynak Projelere Katkı
Açık kaynak katkı gerçek code review deneyimi sağlar. Küçük documentation veya test issue ile başlanabilir. Classification rule ve connector geliştirmek teknik beceriyi artırır. Topluluk iletişimi de önemli bir profesyonel yetkinliktir. Düzenli katkı güçlü portfolio oluşturabilir.
Örnek Bir Otonom Veri Sınıflandırma Projesi Nasıl Geliştirilir?
Başarılı bir proje doğrudan LLM entegrasyonuyla başlamamalıdır. Önce veri inventory ve taxonomy hazırlanmalıdır. Golden dataset gerçek doğruluk ölçümü için temel oluşturur. Baseline rule classifier düşük maliyetli referans sağlar. Daha sonra ML, LLM, human review ve enterprise entegrasyonları kontrollü biçimde eklenebilir.
Adım 1 — Veri Envanterini Çıkarma
İlk adım hangi data source'ların bulunduğunu belirlemektir. Database, file storage ve SaaS sistemleri listelenir. Owner ve environment bilgisi eklenir. En riskli kaynaklar önceliklendirilir. Pilot kapsamı bu envanterden seçilir.
Adım 2 — Classification Taxonomy Oluşturma
Taxonomy iş ve security ekipleriyle birlikte hazırlanmalıdır. Sınıflar net ve örnekli tanımlanır. Birbirine çok yakın kategoriler azaltılır. Public, Internal, Confidential ve Restricted gibi sensitivity seviyeleri eklenebilir. Version 1 küçük ve yönetilebilir tutulmalıdır.
Adım 3 — Golden Dataset Hazırlama
Golden dataset doğrulanmış örneklerden oluşur. Her örnek domain uzmanı tarafından etiketlenmelidir. Sınıf dengesi mümkün olduğunca korunmalıdır. Training ve test set birbirinden ayrılmalıdır. Model benchmark her sürümde aynı test set üzerinde yapılabilir.
Adım 4 — Baseline Rule-Based Classifier
İlk classifier basit regex ve dictionary kurallarıyla geliştirilebilir. Bu yaklaşım minimum maliyetle başlangıç metriği verir. Hangi veri tiplerinde rule yeterli olduğu anlaşılır. Precision ve recall hesaplanır. Sonraki ML modelinin gerçekten fayda sağlayıp sağlamadığı karşılaştırılır.
Adım 5 — ML / LLM Classification
Rule performansı yetersiz alanlarda ML veya LLM eklenir. Model yalnızca belirsiz kayıtları işleyebilir. Bu hybrid yapı maliyeti düşürür. Prompt veya feature tasarımı version control altında tutulmalıdır. Hassas veri processing policy'ye uygun yapılmalıdır.
Adım 6 — Accuracy Benchmark
Model golden dataset üzerinde ölçülür. Precision, recall ve F1 sınıf bazında raporlanır. Latency ve maliyet de aynı testte ölçülmelidir. Yalnızca accuracy üzerinden karar verilmemelidir. Baseline rule classifier ile karşılaştırma yapılmalıdır.
Adım 7 — Confidence Threshold Belirleme
Threshold automation oranını ve risk seviyesini belirler. Restricted veri için daha yüksek otomatik confidence şartı kullanılabilir. Pilot verisi calibration için kullanılır. Low-confidence örnekler manual review'a gönderilir. Threshold zaman içinde yeniden ayarlanabilir.
Adım 8 — Human-in-the-Loop Tasarlama
Review ekranı hızlı karar vermeyi kolaylaştırmalıdır. Model önerisi, evidence ve context gösterilmelidir. Reviewer düzeltme gerekçesi seçebilir. Feedback yeni training data için saklanır. SLA review queue üzerinde izlenmelidir.
Adım 9 — Data Catalog Entegrasyonu
Onaylanan classification catalog'a yazılır. Dataset, column ve file seviyesinde tag tutulabilir. Confidence ve model version metadata olarak eklenir. Search ve discovery bu etiketleri kullanır. Catalog değişiklik event'i sonraki workflow'ları tetikleyebilir.
Adım 10 — DLP / IAM Entegrasyonu
Classification gerçek güvenlik aksiyonuna bağlanmalıdır. DLP paylaşım policy'sini, IAM erişim şartlarını uygulayabilir. Restricted data daha dar role açılır. İlk aşamada detect-only veya recommend mod tercih edilebilir. Yanlış policy etkisi pilotta ölçülmelidir.
Adım 11 — CI/CD Entegrasyonu
Pull request ve migration işlemleri classifier ile kontrol edilir. Yeni hassas alan uyarı üretir. Policy failure merge veya deployment'ı durdurabilir. Pipeline latency developer deneyimi açısından ölçülmelidir. Hızlı scan ile ağır scan farklı aşamalarda çalıştırılabilir.
Adım 12 — Pilot
Pilot sınırlı ama gerçek iş değeri taşıyan domain'de yapılmalıdır. En riskli veri kaynaklarından biri seçilebilir. Baseline metric önceden alınır. İnsan review ile model sonucu karşılaştırılır. Pilot sonunda accuracy, maliyet ve süreç kazanımı birlikte değerlendirilir.
Adım 13 — Production Deployment
Production rollout kademeli yapılmalıdır. Önce detect-only modla başlanabilir. Confidence ve error metric stabil olduğunda otomasyon artırılır. Audit logging zorunlu olmalıdır. Rollback ve model version yönetimi hazır tutulmalıdır.
Adım 14 — Continuous Monitoring
Production model performansı sürekli izlenmelidir. Override rate ve confidence distribution takip edilir. Classification drift alarm üretir. Latency ve API maliyeti ölçülür. Data quality değişimleri model sonuçlarıyla ilişkilendirilir.
Adım 15 — Feedback ve Reclassification
Human correction ve policy sonuçları feedback olarak toplanır. Yeni veri örüntüleri training set'e eklenebilir. Taxonomy değiştiğinde mevcut asset'lar yeniden değerlendirilir. Reclassification kontrollü batch veya event yöntemiyle yapılır. Böylece sistem static bir proje değil yaşayan platform haline gelir.
Pilot Projeden Kurumsal Ölçeğe Geçiş
Pilot başarıyla çalışsa bile doğrudan bütün kuruma açılmamalıdır. Farklı domain'lerde veri yapısı ve vocabulary değişebilir. Baseline ve accuracy hedefleri her alan için yeniden kontrol edilmelidir. Automation seviyesi kademeli artırılmalıdır. Enterprise-wide deployment governance ve platform ekiplerinin ortak işletim modeliyle desteklenmelidir.
En Riskli Veri Kaynaklarıyla Başlamak
Pilot en fazla iş değeri sağlayacak alandan seçilmelidir. PII veya Restricted veri içeren kaynaklar güçlü adaydır. Ancak kapsam yönetilebilir olmalıdır. Çok geniş pilot başarının ölçülmesini zorlaştırır. Sonuçların iş etkisi net biçimde gösterilmelidir.
Baseline Ölçümü
Otomasyon öncesi mevcut süreç ölçülmelidir. Review saati, discovery süresi ve compliance ticket sayısı kaydedilir. Model accuracy için manuel ground truth oluşturulur. Sonraki aşamada aynı metrikler karşılaştırılır. Baseline olmadan ROI iddiası güvenilir olmaz.
Pilot Dataset
Pilot dataset gerçek domain'i temsil etmelidir. Sadece kolay örneklerden oluşmamalıdır. Hassas ve hassas olmayan sınıflar birlikte bulunmalıdır. Sampling bias kontrol edilmelidir. Dataset version sabitlenerek benchmark tekrar edilebilir hale getirilir.
Accuracy Hedefleri
Her class için hedef precision ve recall belirlenmelidir. Restricted data için recall daha yüksek öncelik taşıyabilir. Internal sınıfında daha dengeli hedef kullanılabilir. Hedefler iş riskiyle ilişkilendirilmelidir. Pilot sonunda yalnızca toplam accuracy raporlanmamalıdır.
Stakeholder Approval
Data owner, security, privacy ve engineering temsilcileri pilot sonucunu değerlendirmelidir. Model performansı yanında operasyon etkisi de incelenir. False positive kullanıcı deneyimi tartışılmalıdır. Production'a geçiş kriterleri ortak kararla belirlenir. Bu onay ownership sorunlarını azaltır.
Kademeli Automation
İlk aşamada detect-only mod kullanılabilir. Sonra recommend ve approval-based action'a geçilir. Hata oranı düşük use case'lerde full automation uygulanabilir. Her aşamada rollback ve monitoring aktif olmalıdır. Böylece risk kontrollü şekilde azaltılır.
Domain Bazlı Yaygınlaştırma
Bir domain'de çalışan model diğerinde aynı başarıyı göstermeyebilir. Finans, insan kaynakları ve müşteri destek ayrı test edilmelidir. Domain-specific dictionary ve training data eklenebilir. Ortak taxonomy korunurken özel extension yapılabilir. Yaygınlaştırma dalgalar halinde ilerlemelidir.
Enterprise-Wide Deployment
Kurumsal rollout merkezi platform ve federated stewardship modelini birleştirebilir. Ortak policy merkezi yönetilir. Domain ekipleri kendi glossary ve review sürecini sürdürür. Dashboard enterprise coverage'ı gösterir. Platform uptime ve support süreçleri production standardına çıkarılmalıdır.
Otonom Veri Sınıflandırmada Observability
Observability olmadan otonom sistemin production'da nasıl davrandığını anlamak zordur. Classification logları model ve policy kararlarını görünür hale getirir. Confidence distribution ve human override değişimleri kalite sorunlarını erken gösterebilir. Drift ve failed remediation ayrı alarm üretmelidir. Audit dashboard teknik ekip ile governance ekibinin ortak görünümünü sağlar.
Classification Logs
Her classification olayında asset, model version ve sonuç kaydedilmelidir. Hassas ham veri loglara yazılmamalıdır. Confidence ve evidence reference saklanabilir. Loglar debugging ve audit için kullanılır. Retention policy maliyet ve compliance ihtiyacına göre belirlenmelidir.
Confidence Distribution
Confidence değerlerinin dağılımı model davranışını anlamaya yardımcı olur. Birden fazla domain'de aniden düşüş data drift işareti olabilir. Çok yüksek confidence ama yüksek override kötü calibration göstergesidir. Dashboard percentile dağılımı sunabilir. Threshold tuning bu verilere göre yapılır.
Human Override Monitoring
Override sayısı ve oranı sınıf bazında izlenmelidir. Aynı rule sürekli düzeltiliyorsa iyileştirme gerekir. Reviewer farklılıkları da analiz edilebilir. Domain bazında model kalitesi görünür olur. Feedback backlog otomatik oluşturulabilir.
Classification Drift Detection
Etiket dağılımındaki beklenmeyen değişim drift sinyali olabilir. Yeni veri kaynağı veya model update nedeni araştırılır. Historical baseline ile karşılaştırma yapılabilir. Büyük sapma otomatik revalidation tetikleyebilir. Kritik domain'de human review oranı geçici artırılabilir.
Taxonomy Drift Detection
Taxonomy kullanımındaki tutarsızlık ayrı izlenmelidir. Bazı sınıflar hiç kullanılmıyorsa gereksiz olabilir. Yeni iş terimleri eski sınıflara zorla yerleştiriliyor olabilir. Data steward feedback önemli sinyaldir. Taxonomy review periyodik yapılmalıdır.
Policy Execution Monitoring
Classification doğru olsa bile policy uygulanmamış olabilir. DLP, IAM veya masking entegrasyonu failure üretebilir. Execution status ayrı metric olarak izlenmelidir. Retry ve escalation mekanizması bulunmalıdır. Governance completion yalnızca classifier sonucu üzerinden değerlendirilmemelidir.
Failed Remediation
Remediation failure güvenlik açığının devam etmesine neden olabilir. İşlem nedeni ve target sistem loglanmalıdır. Otomatik retry sınırlı sayıda yapılabilir. Kalıcı hata insan ekibine yönlendirilir. Failure rate entegrasyon sağlığının önemli metriğidir.
Audit Dashboard
Audit dashboard classification coverage ve policy compliance'ı tek ekranda gösterebilir. Human override ve exception sayıları izlenebilir. Dataset owner ve risk seviyesi filtrelenebilir. Compliance ekibi raporları doğrudan kullanabilir. Dashboard verisi değiştirilemez audit kaydıyla desteklenmelidir.
Otonom Veri Sınıflandırmanın Geleceği
Veri sınıflandırma statik rule set'lerden daha bağlamsal ve event-driven sistemlere doğru ilerliyor. AI Data Steward ve agentic governance kavramları manuel koordinasyonun önemli bölümünü otomatikleştirebilir. Multi-agent modeller farklı classifier ve policy görevlerini ayırabilir. Real-time governance veri oluşturulduğu anda karar üretebilir. Buna rağmen human review, auditability ve kontrol edilebilir otomasyon uzun süre temel gereksinimler arasında kalacaktır.
Static Rules'tan Contextual AI'a Geçiş
Statik rule net pattern'lerde çalışmaya devam edecektir. Contextual AI belirsiz veride ek değer sağlar. Gelecekte iki yaklaşım hybrid biçimde kullanılacaktır. Düşük maliyetli rule ilk filtre görevi görebilir. AI yalnızca zor örneklerde devreye girer.
AI Data Steward'lar
AI Data Steward metadata eksiklerini ve classification önerilerini otomatik hazırlayabilir. İnsan steward'a yalnızca karar gerektiren vakalar gönderilir. Glossary mapping ve owner önerisi yapılabilir. Workflow SLA takip edilebilir. İnsan uzman iş bağlamı ve kritik onay rolünü sürdürür.
Agentic Data Governance
Agentic governance discovery, classification ve policy adımlarını tek hedef doğrultusunda koordine eder. Agent farklı tool API'lerini çağırabilir. Düşük confidence sonucunda başka classifier seçebilir. Riskli aksiyonlarda approval isteyebilir. Güvenlik için tool permission ve audit zorunlu olmalıdır.
Multi-Agent Classification
Farklı agent'lar structured data, document ve policy analizinde uzmanlaşabilir. Coordinator sonuçları birleştirir. Çelişki olduğunda human review açılabilir. Bu yapı büyük ve heterojen data estate için ölçeklenebilir olabilir. Ancak operasyon görünürlüğü ve maliyet dikkatle yönetilmelidir.
Real-Time Governance
Real-time governance veri oluşturulduğu anda classification yapmayı hedefler. Streaming ve API use case'lerinde önemlidir. Policy saniyeler içinde uygulanabilir. Latency ve throughput gereksinimi model seçimini etkiler. Batch ve real-time pipeline birlikte kullanılabilir.
Self-Healing Metadata
Self-healing metadata bozuk veya eksik catalog bilgisini otomatik düzeltmeyi hedefler. Owner değişikliği kullanım sinyalinden tahmin edilebilir. Broken lineage yeniden hesaplanabilir. AI önerisi confidence ile birlikte sunulur. Yüksek etkili metadata değişikliği insan onayı gerektirebilir.
Autonomous Remediation
Otomatik remediation daha fazla governance aksiyonunu sistemin uygulamasını sağlar. Masking ve tagging gibi işlemler daha fazla otonomlaşabilir. Access revocation gibi yüksek riskli işlemler approval gerektirmeye devam edebilir. Reversible action tasarımı önem kazanacaktır. Observability olmadan otonomi seviyesi artırılmamalıdır.
AI-Ready Data Catalog
AI-ready catalog veri varlıklarını model ve agent kullanımına uygun metadata ile sunar. Classification, lineage, quality ve access policy birlikte bulunur. Agent hangi dataset'e erişebileceğini programatik olarak öğrenir. RAG ve MLOps pipeline catalog bilgisini kullanabilir. Bu yapı güvenli AI adoption için temel sağlar.
Data Classification'ın Proje Yönetim Araçlarına Entegrasyonu
Classification metadata doğrudan backlog ve issue tracker içine taşınabilir. Story risk seviyesi otomatik güncellenebilir. Data owner approval task olarak oluşturulabilir. Definition of Ready ve Done kriterleri sistem tarafından kontrol edilebilir. Böylece Otonom Veri Sınıflandırma Araçlarının Proje Süreçlerine Etkisi teknik altyapının ötesine geçerek proje yönetim pratiğine doğrudan yansır.
Sıkça Sorulan Sorular
Otonom veri sınıflandırma projelerinde en sık sorular otomasyon seviyesi, doğruluk, entegrasyon ve compliance çevresinde toplanır. Her kurumun veri türü ve risk profili farklı olduğu için tek bir ideal mimari bulunmaz. Pilot çalışma gerçek veri üzerinde doğru yaklaşımı belirlemenin en güvenilir yoludur. Teknik metriklerin yanında süreç ve maliyet metrikleri de ölçülmelidir. Aşağıdaki yanıtlar başlangıç kararları için pratik bir çerçeve sunar.
Otonom veri sınıflandırma nedir?
Otonom veri sınıflandırma sistemin veri kaynaklarını keşfedip içerik ve metadata analiziyle sınıflandırma yapabilmesidir. Sistem confidence score üretir. Policy mapping ve bazı remediation adımlarını otomatik uygulayabilir. Human review düşük confidence veya yüksek riskli durumlarda devreye girer. Amaç manuel classification yükünü azaltırken governance tutarlılığını artırmaktır.
Otomatik ve otonom veri sınıflandırma arasındaki fark nedir?
Otomatik sistem önceden tanımlanmış işlemleri tekrarlar. Otonom sistem bağlamı değerlendirip hangi adımı uygulayacağına belirli sınırlar içinde karar verebilir. Otonom model detect, reason, classify ve act zincirini koordine edebilir. Geri bildirimlerden öğrenme de eklenebilir. Ancak yüksek riskli aksiyonlarda insan kontrolü korunmalıdır.
Veri sınıflandırma araçları nasıl çalışır?
Araç önce data source ve metadata keşfi yapar. İçerik regex, ML, NLP veya LLM ile analiz edilir. Sonuç taxonomy sınıfına eşlenir. Confidence score ve policy mapping üretilir. Etiket catalog veya security sistemine aktarılır.
Yapay zeka veri sınıflandırmada nasıl kullanılır?
AI özellikle bağlama bağlı ve unstructured data üzerinde kullanılır. NLP ve LLM içerik anlamını değerlendirir. ML geçmiş etiketli örneklerden pattern öğrenebilir. Hybrid sistemler rule ve AI sonuçlarını birleştirir. Human feedback zaman içinde modeli geliştirebilir.
Otonom veri sınıflandırma proje süresini nasıl etkiler?
Discovery ve approval bekleme süresi azalabilir. Developer hangi verinin hassas olduğunu daha erken görür. Test data masking otomatikleşebilir. Governance kontrolü CI/CD içine taşınır. Sonuçta Time-to-Data ve Time-to-Production metrikleri iyileşebilir.
Veri sınıflandırma yazılım geliştirme sürecine nasıl entegre edilir?
Schema ve API metadata geliştirici araçlarına aktarılabilir. Pull request sırasında classification scan çalıştırılır. Yeni hassas alan security review tetikleyebilir. Log ve sample data kontrolü pipeline'a eklenir. Classification sonucu data catalog ve policy sistemine yazılır.
Veri sınıflandırma CI/CD pipeline'a eklenebilir mi?
Evet, pre-commit, pull request ve release aşamalarında eklenebilir. Hızlı kontroller erken çalıştırılmalıdır. Ağır ML veya LLM scan build aşamasına alınabilir. Kritik governance violation deployment'ı durdurabilir. Pipeline sonucu audit evidence olarak saklanabilir.
False positive ve false negative nedir?
False positive hassas olmayan verinin yanlışlıkla hassas işaretlenmesidir. False negative gerçek hassas verinin gözden kaçmasıdır. İlki operasyon maliyeti yaratır. İkincisi security ve privacy riskini yükseltir. Precision ve recall bu hataları ölçmeye yardımcı olur.
Human-in-the-loop neden gereklidir?
Her classification kararı yüzde yüz kesin değildir. Business context modelin sahip olmadığı bilgi gerektirebilir. Low-confidence örnekler insan review'una gider. Yüksek riskli remediation approval gerektirebilir. İnsan feedback'i model geliştirmesinde de kullanılır.
Veri sınıflandırma için hangi programlama dili kullanılmalıdır?
Python NLP ve ML projelerinde güçlü başlangıçtır. SQL structured data discovery için gereklidir. Java ve Go enterprise servislerde kullanılabilir. Scala büyük data pipeline'larında avantaj sağlar. En doğru seçim ekip deneyimi ve mimari ihtiyaca göre yapılmalıdır.
Açık kaynak veri sınıflandırma araçları nelerdir?
Presidio PII detection için değerlendirilebilir. OpenMetadata ve DataHub metadata ve catalog yönetimi sağlar. Apache Atlas belirli büyük veri ekosistemlerinde kullanılabilir. Açık kaynak NER ve LLM modelleri custom classifier için temel oluşturur. Her araç gerçek kurum verisiyle pilot test edilmelidir.
KVKK açısından veri sınıflandırma neden önemlidir?
Classification kişisel ve özel nitelikli kişisel verilerin görünürlüğünü artırır. Access, masking ve retention policy doğru veriye uygulanabilir. Audit evidence daha düzenli tutulur. Data minimization kararları desteklenir. Ancak classification tek başına KVKK uyumu anlamına gelmez.
Otonom veri sınıflandırma araçlarının ROI'si nasıl hesaplanır?
Önce manuel review ve approval maliyeti baseline olarak ölçülmelidir. Otomasyon sonrası azalan saatler parasal değere dönüştürülür. Lisans, compute ve integration maliyeti toplam yatırıma eklenir. Time-to-Production ve compliance finding değişimi ek fayda olarak değerlendirilebilir. ROI gerçek production verisiyle periyodik güncellenmelidir.
AI agent'lar veri sınıflandırmayı tamamen otonom yapabilir mi?
Düşük riskli ve açık örüntülü veride yüksek otomasyon mümkündür. Ancak tüm kurumsal veri için tam otonomi risklidir. Belirsiz context ve legal yorum insan kontrolü gerektirebilir. Agent permission minimum tutulmalıdır. Risk seviyesine göre farklı automation modeli uygulanmalıdır.
Otonom Veri Sınıflandırma Araçları Hakkında Ek Sık Sorulan Sorular
Aşağıdaki sorular özellikle proje ekiplerinin teknik entegrasyon, operasyonel verimlilik ve danışmanlık ihtiyacı açısından sık karşılaştığı başlıkları kapsar. Otonom sistemlerin başarısı yalnızca classifier seçimine bağlı değildir. Doğru taxonomy, data catalog, pipeline entegrasyonu ve human review mekanizması aynı derecede önemlidir. Projenin ilk aşamasında ölçülebilir hedefler belirlemek yanlış yatırım riskini azaltır. Kurumsal ölçekte yaygınlaştırma ise küçük bir pilot ve gerçek production verisiyle doğrulanan sonuçlar üzerine kurulmalıdır.
Otonom veri sınıflandırma araçları proje süreçlerine nasıl entegre edilir?
Entegrasyon genellikle discovery ve data catalog aşamasıyla başlar. Sonraki adım classifier sonucunu CI/CD, IAM, DLP ve proje yönetim araçlarına bağlamaktır. Pull request sırasında yeni hassas alan tespit edildiğinde otomatik governance task açılabilir. Deployment öncesi policy gate kritik ihlalleri durdurabilir. Böylece classification proje planlamasından production operasyonlarına kadar devam eden ortak bir metadata katmanına dönüşür.
Yapay zeka destekli otomatik veri sınıflandırma proje ekiplerinin iş yükünü ve operasyonel verimliliğini nasıl etkiler?
Yapay zeka ile otomatik veri sınıflandırma nasıl yapılır sorusunun pratik yanıtı yalnızca modele veri göndermek değildir. Rule, ML ve LLM katmanları farklı veri tiplerine göre birlikte kullanılabilir. Otomasyon data steward'ın tekrarlı review yükünü azaltırken developer'ın veri arama ve approval bekleme süresini kısaltabilir. Düşük confidence sonuçların insana yönlendirilmesi kalite kontrolünü korur. Gerçek verimlilik Time-to-Data, manual review hours ve approval lead time gibi metriklerle ölçülmelidir.
Otonom veri sınıflandırma sistemlerinde doğruluk, yanlış sınıflandırma ve insan denetimi nasıl yönetilmelidir?
Doğruluk precision, recall, F1 ve sınıf bazlı false positive ile false negative oranlarıyla ölçülmelidir. Confidence calibration otomatik karar eşiklerinin güvenilir olmasını sağlar. Restricted veri için daha yüksek confidence ve human approval uygulanabilir. Manual override nedenleri düzenli olarak analiz edilmelidir. Böylece otomasyon oranı artarken yanlış kararların production etkisi kontrol altında tutulur.
Otomatik veri sınıflandırma araçları veri güvenliği, yönetişim ve KVKK uyumuna nasıl katkı sağlar?
Classification kişisel ve hassas verinin nerede bulunduğunu görünür hale getirir. IAM, DLP, masking ve retention policy bu etiketleri kullanabilir. Audit trail otomatik evidence üretimini kolaylaştırır. KVKK kapsamında kişisel veri tespiti ve data minimization çalışmaları daha sistematik yürütülebilir. Ancak uyumluluk için hukuki süreç, güvenlik kontrolü ve insan denetimi classification platformuyla birlikte çalışmalıdır.
Otonom veri sınıflandırma ve proje süreçleri otomasyonu konusunda yakınımda danışmanlık veya eğitim nerede bulabilirim?
Yapay zeka veri sınıflandırma danışmanlığı yakınımda şeklinde araştırma yapan ekipler için yalnızca hazır bir model kurmak yerine veri envanteri, taxonomy, CI/CD entegrasyonu ve governance workflow'unu birlikte ele alan yaklaşım daha sağlıklıdır. Diyarbakır Yazılım Topluluğu'nun yaklaşımı ve topluluk çalışmaları hakkında https://www.diyarbakiryazilim.com.tr/about üzerinden bilgi alınabilir. Farklı yazılım ve teknoloji projelerini görmek için https://www.diyarbakiryazilim.com.tr/projects adresi incelenebilir. Kurumsal otomatik veri sınıflandırma ve AI entegrasyon hizmeti planlanırken önce küçük bir pilot, ardından ölçülebilir KPI'larla kademeli yaygınlaştırma önerilir. Eğitim tarafında ise SQL, Python, NLP, DataOps, DevSecOps ve data governance konularını aynı uygulama senaryosu içinde ele almak en yüksek öğrenme değerini sağlar.
Sonuç: Otonom Veri Sınıflandırmayı Proje Süreçlerine Nasıl Dahil Etmelisiniz?
Otonom veri sınıflandırma, doğru uygulandığında yalnızca veri etiketleyen bir araç olmaktan çıkar ve proje teslimat akışını doğrudan etkileyen bir platform bileşenine dönüşür. Otonom Veri Sınıflandırma Araçlarının Proje Süreçlerine Etkisi en belirgin şekilde daha hızlı data discovery, daha kısa approval süreleri, erken güvenlik kontrolü ve azalan manuel review yükünde görülür. Başarılı kurulum için önce data inventory ve taxonomy hazırlanmalı, ardından golden dataset üzerinde rule, ML ve LLM yaklaşımları ölçülmelidir. CI/CD, DataOps, MLOps, IAM, DLP ve data catalog entegrasyonları pilot başarıdan sonra kademeli biçimde eklenmelidir. Projenizi veri sınıflandırma, yapay zeka entegrasyonu ve otomasyon açısından değerlendirmek için Diyarbakır Yazılım Topluluğu hakkında https://www.diyarbakiryazilim.com.tr/about adresinden bilgi alabilir ve mevcut çalışmaları https://www.diyarbakiryazilim.com.tr/projects üzerinden inceleyebilirsiniz.
share: