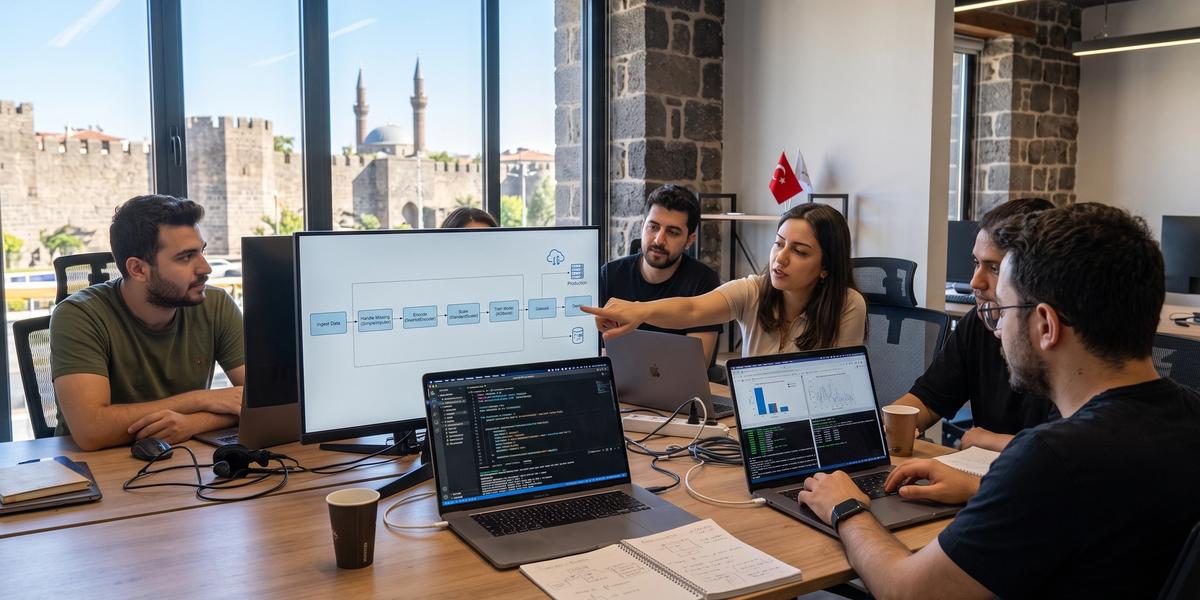
Veri Ön İşleme (Data Preprocessing) Aşamalarında Otomasyon

Diyarbakır Yazılım
16.08.2026
#Yazılım#Teknoloji#Topluluk
Makine öğrenmesi projelerinde model performansını yalnızca algoritma seçimi belirlemez. Çoğu zaman asıl fark, verinin modele hangi kurallarla hazırlandığında ortaya çıkar. Veri Ön İşleme (Data Preprocessing) Aşamalarında Otomasyon, tekrarlanan temizlik ve dönüştürme işlemlerini güvenilir, test edilebilir ve tekrar kullanılabilir pipeline'lara taşıyarak bu süreci daha sürdürülebilir hale getirir. Bu rehberde veri ön işleme süreçleri nasıl otomatikleştirilir, Python ile otomatik data preprocessing pipeline nasıl oluşturulur ve production ortamında veri kalitesi nasıl korunur sorularını uygulama odaklı ele alacağız. Amacımız sadece çalışan bir notebook değil, yeni veri geldiğinde aynı kuralları güvenilir biçimde uygulayan, hata oluştuğunda bunu görünür hale getiren ve model geliştirme sürecini destekleyen bir sistem kurmaktır.
Veri Ön İşleme Nedir?
Veri ön işleme, ham verinin analiz veya makine öğrenmesi modeli için kullanılabilir hale getirilmesini sağlayan işlemler bütünüdür. Bu süreç eksik değer yönetimi, veri tipi düzeltme, duplicate temizliği, aykırı değer işlemleri, encoding, scaling ve feature engineering gibi aşamaları içerebilir. Her veri setine aynı kuralları uygulamak doğru değildir. Kullanılan yöntem veri kaynağına, model türüne ve iş probleminin beklentilerine göre seçilmelidir. Başarılı preprocessing, modeli yalnızca daha iyi eğitmekle kalmaz, aynı zamanda production tahminlerinin daha tutarlı olmasına yardımcı olur.
Data Preprocessing Kavramı
Data preprocessing, verinin modele ulaşmadan önce sistematik olarak kontrol edilmesi ve dönüştürülmesidir. Bir sütunun sayısal tipe çevrilmesi kadar missing value oranının kontrol edilmesi de bu kapsamda düşünülebilir. Amaç veriyi sadece temiz göstermek değildir. Asıl hedef, modelin beklediği yapıda, tekrar üretilebilir ve doğrulanabilir bir veri akışı oluşturmaktır. Bu nedenle preprocessing adımlarının kod, versiyon ve testlerle yönetilmesi production projelerinde önemli hale gelir.
Veri Ön İşleme Neden Gereklidir?
Ham veri çoğu zaman eksik, tekrar eden, hatalı tipte veya farklı ölçeklerde değerler içerir. Makine öğrenmesi algoritmaları bu durumlara karşı her zaman dayanıklı değildir. Örneğin eksik bir sayısal alan model eğitimini tamamen durdurabilir veya yanlış encoding kategori bilgisini bozabilir. Veri ön işleme bu problemleri kontrollü kurallarla yönetir. Ayrıca training ve prediction aşamasında aynı dönüşümlerin kullanılmasını sağlayarak model davranışının daha öngörülebilir olmasına yardımcı olur.
Ham Veri ile Modele Hazır Veri Arasındaki Fark
Ham veri kaynak sistemden geldiği haliyle iş kurallarına veya model beklentilerine uymayabilir. Modele hazır veri ise veri tipi, eksiklik, kategori ve ölçek gibi konularda belirlenmiş kurallardan geçirilmiştir. Ham veride tarih sütunu string olabilirken işlenmiş veride datetime tipine çevrilmiş olabilir. Kategorik alanlar modelin anlayabileceği sayısal temsillere dönüştürülebilir. Aradaki fark yalnızca format değil, veri kalitesi ve tekrar üretilebilirlik seviyesidir.
Veri Ön İşleme Makine Öğrenmesi Sürecinin Neresindedir?
Preprocessing, veri toplama ile model eğitimi arasında yer alan temel hazırlık katmanıdır. Bununla birlikte production sistemlerinde prediction sırasında da aynı preprocessing adımlarının uygulanması gerekir. Bu nedenle preprocessing yalnızca eğitim öncesi tek seferlik bir işlem değildir. Model artifact'ı ile birlikte çalışan transformation logic'in bir parçasıdır. Sağlam bir pipeline, train ve inference akışında aynı kuralları paylaşır.
Veri Temizleme ile Veri Ön İşleme Arasındaki Fark
Veri temizleme genellikle hatalı, eksik veya duplicate kayıtların düzeltilmesine odaklanır. Veri ön işleme ise bunun yanında encoding, scaling, feature engineering ve feature selection gibi daha geniş dönüşümleri de kapsar. Başka bir ifadeyle cleaning, preprocessing sürecinin alt bileşenlerinden biridir. Bir veri seti temiz olabilir ancak model için henüz uygun representation'a sahip olmayabilir. Bu ayrım pipeline tasarımında görevlerin doğru bölünmesini kolaylaştırır.
Feature Engineering ile Veri Ön İşleme Arasındaki Fark
Feature engineering mevcut veriden yeni anlamlı değişkenler üretmeye odaklanır. Veri ön işleme ise veriyi model kullanımına hazırlayan daha geniş bir süreçtir. Örneğin tarihi datetime tipine dönüştürmek preprocessing iken tarihten haftanın gününü çıkarmak feature engineering olarak değerlendirilebilir. İki işlem aynı pipeline içinde birlikte kullanılabilir. Ancak feature engineering adımlarının da training data üzerinden öğrenilmesi gerekiyorsa leakage riski ayrıca yönetilmelidir.
Veri Ön İşleme Aşamaları Nelerdir?
Veri ön işleme tek bir adımdan oluşmaz. Veri alma, profiling, cleaning, imputation, encoding, scaling, feature üretme ve kalite kontrolü birbirini tamamlayan aşamalardır. Her aşamanın amacı ve başarısızlık koşulu açık biçimde tanımlanmalıdır. Production sistemlerinde bazı adımlar otomatik çalışırken bazıları belirli eşiklerde insan onayı gerektirebilir. Bu yapı, makine öğrenmesinde eksik veri aykırı değer ve veri temizleme otomasyonu için güvenilir bir temel oluşturur.
Veri Toplama ve Veri Alma
Preprocessing süreci verinin güvenilir kaynaktan alınmasıyla başlar. Dosya, API, database veya streaming kaynağı kullanılabilir. Veri alınırken source timestamp, batch ID ve schema version gibi metadata saklamak faydalıdır. Veri kaynağına erişilemezse pipeline sessizce devam etmemelidir. Kaynağın başarısı ve alınan satır sayısı ilk kalite sinyallerinden biri olarak loglanmalıdır.
Veri Profilleme
Profiling veri setinin yapısını preprocessing öncesinde anlamayı sağlar. Sütun tipleri, eksiklik oranları, cardinality ve dağılımlar otomatik çıkarılabilir. Bu sonuçlar hangi dönüşümlerin uygulanacağına rehberlik eder. Profiling çıktısı versionlanırsa veri değişimleri zaman içinde karşılaştırılabilir. Böylece preprocessing kurallarının sabit varsayımlar yerine gerçek veri davranışına dayanması sağlanır.
Veri Temizleme
Veri temizleme hatalı format, anlamsız değer ve tutarsız kayıtları düzeltmeye odaklanır. Boş string değerlerin gerçek null olarak işaretlenmesi buna örnektir. Temizlik kuralları mümkün olduğunca deterministic olmalıdır. Kaynak veri üzerinde doğrudan değişiklik yapmak yerine işlenmiş kopya üretmek daha güvenlidir. Temizlik sonrası kalite kontrolleri başlangıç durumuyla karşılaştırılmalıdır.
Eksik Verilerin İşlenmesi
Eksik veriler her sütunda aynı yöntemle ele alınmamalıdır. Sayısal, kategorik ve zaman serisi alanlarında farklı stratejiler gerekebilir. Eksiklik oranı yüksek olan sütun bazen tamamen kaldırılabilir. Bazı durumlarda missingness bilgisi ayrıca feature olarak değerli olabilir. İmputation kararı model performansı ve iş anlamı birlikte değerlendirilerek verilmelidir.
Tekrarlanan Kayıtların İşlenmesi
Duplicate kayıtlar modelin belirli örnekleri gereksiz biçimde fazla öğrenmesine neden olabilir. Exact duplicate ile iş açısından aynı kabul edilen kayıt birbirinden ayrılmalıdır. Hangi kaydın korunacağı timestamp veya source reliability üzerinden belirlenebilir. Duplicate temizliği veri kaybı yaratabileceği için silinen kayıt sayısı loglanmalıdır. Kritik sistemlerde temizlenen kayıtlar audit amacıyla ayrı alanda tutulabilir.
Aykırı Değerlerin İşlenmesi
Aykırı değer her zaman hata değildir. Çok yüksek bir satış tutarı gerçek bir iş olayı olabilir. Bu nedenle outlier detection ile outlier removal aynı şey değildir. IQR, Z-Score veya model tabanlı yöntemler aday değerleri işaretlemek için kullanılabilir. Silme kararı domain bilgisi ve model etkisi değerlendirilerek verilmelidir.
Kategorik Değişkenlerin Dönüştürülmesi
Birçok model string kategori değerlerini doğrudan kullanamaz. One-hot, ordinal veya target encoding gibi yöntemler uygulanabilir. Yöntem seçimi kategori tipi ve cardinality seviyesine göre yapılmalıdır. Production sırasında yeni kategori gelmesi mutlaka planlanmalıdır. Eğitim sırasında öğrenilen encoder aynı biçimde prediction aşamasında kullanılmalıdır.
Veri Ölçeklendirme
Scaling farklı büyüklükteki sayısal sütunları karşılaştırılabilir ölçeğe taşır. StandardScaler ve MinMaxScaler yaygın seçeneklerdir. Aykırı değerlerin yoğun olduğu veri setlerinde RobustScaler daha uygun olabilir. Tree-based modeller çoğu zaman scaling gerektirmez. Bu nedenle ölçeklendirme model türüne göre pipeline içinde condition olarak uygulanabilir.
Feature Engineering
Feature engineering ham sütunlardan model için daha anlamlı değişkenler oluşturur. Tarihten ay, hafta veya gün bilgisi çıkarmak yaygın bir örnektir. Aggregation ve interaction feature'ları da kullanılabilir. Yeni feature sayısı kontrolsüz büyütülmemelidir. Her feature'ın model performansına katkısı ölçülmelidir.
Feature Selection
Feature selection gereksiz veya tekrarlayan değişkenleri azaltmaya yardımcı olur. Düşük varyanslı sütunlar veya yüksek korelasyonlu değişkenler aday olabilir. Model-based önem skorları da seçimde kullanılabilir. Bu işlem sadece training data üzerinde öğrenilmelidir. Aksi halde test bilgisinin seçime sızması data leakage oluşturabilir.
Veri Bölme
Train-test split preprocessing mimarisinin kritik noktalarından biridir. Öğrenilebilir dönüşümler split sonrasında yalnızca training data üzerinde fit edilmelidir. Test data sadece transform aşamasından geçmelidir. Zaman serilerinde random split yerine zaman bazlı ayrım gerekebilir. Doğru bölme yapılmadan hesaplanan model skoru yanıltıcı olabilir.
Veri Kalitesi Kontrolü
Pipeline sonunda veri seti beklenen schema ve kalite kurallarına göre doğrulanmalıdır. Null oranı, satır sayısı, unique constraint ve allowed value kontrolleri yapılabilir. Kritik hata varsa model training aşamasına geçilmemelidir. Warning seviyesindeki sorunlar loglanıp insan incelemesine bırakılabilir. Quality gate, preprocessing otomasyonunu güvenilir hale getiren temel kontrol noktasıdır.
Veri Ön İşleme Otomasyonu Nedir?
Veri ön işleme otomasyonu, tekrar eden data preparation adımlarının elle yapılmak yerine kod ve pipeline üzerinden standart biçimde çalıştırılmasıdır. Bu yaklaşım script seviyesinden orchestration ve event-driven mimariye kadar farklı olgunluk seviyelerine sahip olabilir. Amaç yalnızca zaman kazanmak değildir. Aynı girdi için aynı dönüşümün uygulanması, hata durumunun görünür olması ve yeni verinin güvenilir biçimde işlenmesi temel hedeflerdir. Python ile otomatik data preprocessing pipeline nasıl oluşturulur sorusunun cevabı da bu kontrollü dönüşüm mantığını kod içinde modüler hale getirmekle başlar.
Manuel Preprocessing Nedir?
Manuel preprocessing işlemlerin notebook veya script içinde geliştirici tarafından adım adım uygulanmasıdır. İlk keşif aşamasında bu yaklaşım faydalıdır. Ancak aynı işlemler her yeni dataset'te elle tekrarlandığında hata riski yükselir. Kod sırası veya parametreler fark edebilir. Bu nedenle production'a geçerken manuel adımların fonksiyon ve pipeline yapısına taşınması gerekir.
Otomatik Preprocessing Nedir?
Otomatik preprocessing önceden tanımlanmış veri kurallarının sistem tarafından tekrar uygulanmasıdır. Yeni batch geldiğinde aynı validation, imputation ve transformation akışı çalışabilir. Başarısızlık durumunda pipeline hata üretebilir. İşlenen veri ve transformation version birlikte kaydedilebilir. Böylece preprocessing insan hafızasına bağlı olmaktan çıkar.
Script ile Otomasyon
Tek bir Python script'i preprocessing otomasyonunun ilk aşaması olabilir. Fonksiyonlar belirli sırayla çalıştırılır ve çıktı dosyaya yazılır. Bu yapı notebook'a göre daha tekrar üretilebilir olur. Ancak scheduling, retry ve monitoring genellikle ayrıca eklenmelidir. Küçük projelerde script otomasyonu yeterli başlangıç sağlayabilir.
Pipeline ile Otomasyon
Pipeline veri dönüşümlerini birbirine bağlı adımlar şeklinde tanımlar. Scikit-learn Pipeline model training ile preprocessing'i aynı artifact içinde birleştirebilir. Bir transformer'ın çıktısı sıradaki adıma otomatik aktarılır. Fit ve transform kuralları standardize edilir. Bu yapı data leakage riskini azaltmada önemli avantaj sağlar.
Orchestration ile Otomasyon
Orchestration birden fazla task'ın zamanlama ve dependency ilişkisini yönetir. Ingestion tamamlanmadan cleaning başlamaz. Hata oluştuğunda retry veya alert uygulanabilir. Airflow, Prefect ve Dagster bu yaklaşım için kullanılabilir. Orchestration özellikle günlük veya saatlik preprocessing işlerinde faydalıdır.
Event-Driven Otomasyon
Event-driven yapıda pipeline belirli olay oluştuğunda tetiklenir. Yeni dosya geldiğinde veya mesaj kuyruğuna event yazıldığında preprocessing başlayabilir. Bu model sabit zamanlama beklemek istemeyen sistemlerde kullanışlıdır. Duplicate event ve idempotency konusu ayrıca yönetilmelidir. Hata durumunda event'in tekrar işlenmesi kontrollü olmalıdır.
AutoML Tabanlı Otomasyon
AutoML araçları preprocessing ve model seçimini birlikte optimize etmeye çalışabilir. Farklı encoding, imputation ve model kombinasyonları otomatik test edilebilir. Bu yaklaşım hızlı baseline oluşturmada faydalıdır. Buna rağmen domain kuralları ve veri güvenliği otomatik araca bırakılmamalıdır. Elde edilen pipeline'ın nasıl çalıştığı production'a geçmeden anlaşılmalıdır.
AI Destekli Veri Temizleme
AI tabanlı sistemler kolon anlamı, serbest metin standardizasyonu veya olası kalite problemleri hakkında öneri üretebilir. Bu yaklaşım özellikle rule tanımlamanın zor olduğu metinsel alanlarda yardımcı olabilir. Ancak AI önerileri doğrudan veri üzerinde kontrolsüz uygulanmamalıdır. Değişiklik önce açıklanmalı ve gerekiyorsa insan onayından geçmelidir. Kritik verilerde deterministic kurallar hâlâ ana güvenlik katmanı olmalıdır.
Veri Ön İşleme Neden Otomatikleştirilmelidir?
Manuel preprocessing küçük deneylerde hızlı olabilir ancak veri hacmi ve model sayısı büyüdükçe sürdürülebilirliğini kaybeder. Otomasyon tekrar eden işleri azaltır, aynı kuralların training ve production ortamında uygulanmasını kolaylaştırır ve insan kaynaklı tutarsızlıkları düşürür. Yeni veriler için aynı işlemlerin tekrar çalışması daha kolay hale gelir. Pipeline logları sayesinde hangi dönüşümün ne zaman uygulandığı görülebilir. Kurumsal veri ön işleme ve makine öğrenmesi pipeline otomasyonu hizmeti açısından asıl değer, veri hazırlama sürecini bir defalık iş olmaktan çıkarıp yönetilebilir yazılım bileşenine dönüştürmektir.
Tekrarlanan İşleri Ortadan Kaldırmak
Aynı null temizliği veya encoding işlemini her hafta yeniden yazmak verimli değildir. Otomasyon bu adımları reusable fonksiyon veya transformer haline getirir. Geliştirici aynı işi tekrar etmek yerine kalite ve model geliştirmeye odaklanabilir. Pipeline yeni veri geldiğinde aynı logic'i otomatik çalıştırır. Bu durum ekip içinde bilgi kaybını da azaltır.
İnsan Hatalarını Azaltmak
Manuel işlemlerde yanlış kolon seçimi veya adım sırası hatası oluşabilir. Pipeline bu adımları kod içinde sabitler. Validation eklenerek beklenmeyen veri daha erken yakalanır. Her hata tamamen ortadan kalkmaz. Ancak hata tekrar üretilebilir ve debug edilebilir hale gelir.
Tutarlılığı Artırmak
Aynı preprocessing code training ve production'da kullanıldığında çıktı formatı daha tutarlı olur. Farklı ekip üyelerinin farklı yöntem uygulaması engellenir. Parametreler configuration üzerinden yönetilebilir. Kütüphane version'ları sabitlenebilir. Böylece model davranışındaki değişiklikleri takip etmek kolaylaşır.
Tekrarlanabilirliği Sağlamak
Bir modelin hangi veriye hangi dönüşümler uygulanarak eğitildiği yeniden üretilebilmelidir. Pipeline version ve dataset version birlikte saklanmalıdır. Random işlem varsa seed kontrol edilmelidir. Aynı koşullar tekrarlandığında benzer sonuç alınmalıdır. Bu özellik debug ve audit süreçlerini kolaylaştırır.
Büyük Veri Setlerini İşleyebilmek
Veri büyüdükçe manuel notebook işlemleri yavaş ve kırılgan hale gelir. Otomatik pipeline batch veya distributed processing araçlarıyla ölçeklenebilir. Memory sınırları ölçülmelidir. Pandas yeterli değilse Polars, Dask veya PySpark gibi seçenekler değerlendirilebilir. Araç seçimi gerçek veri hacmi ve işlem şekline göre yapılmalıdır.
Yeni Verileri Otomatik İşlemek
Production model düzenli olarak yeni veriden tahmin üretebilir. Yeni data geldiğinde preprocessing pipeline aynı transformations'ı tekrar uygulamalıdır. Schema değişikliği varsa otomatik validation bunu fark etmelidir. Başarısız batch karantinaya alınabilir. İnsan yalnızca kural dışı durumlarda devreye girer.
Model Geliştirme Süresini Kısaltmak
Reusable pipeline her model denemesinde veri temizleme kodunu yeniden yazma ihtiyacını azaltır. Cross-validation içine preprocessing kolayca dahil edilir. Parametre tuning daha güvenli hale gelir. Dataset hazırlama yerine model karşılaştırmasına daha fazla zaman ayrılabilir. Bu hız ancak quality check korunursa gerçek fayda sağlar.
Training ve Production Arasında Tutarlılık Sağlamak
Training ve serving farklı preprocessing logic kullanırsa model beklenmeyen input görür. Bu problem training-serving skew olarak bilinir. Tek pipeline artifact'ı iki ortamda kullanmak güçlü çözümlerden biridir. Encoding mapping ve imputation değerleri training sırasında öğrenilip saklanmalıdır. Production sadece bu öğrenilmiş dönüşümleri uygular.
Her Veri Ön İşleme Adımı Otomatikleştirilmeli mi?
Her preprocessing kararını tamamen otomatik hale getirmek doğru değildir. Deterministic, sık tekrarlanan ve açık kurala sahip işlemler otomasyona daha uygundur. Domain yorumu gerektiren durumlarda insan kararı önemli olabilir. Örneğin çok yüksek bir finansal değer hata mı yoksa önemli bir müşteri işlemi mi sorusu yalnızca istatistiksel eşikle çözülemeyebilir. Sağlıklı otomasyon, hangi kararın makineye hangi kararın uzmana bırakılması gerektiğini net tanımlar.
Tam Otomasyona Uygun İşlemler
Schema kontrolü, sütun tipi doğrulama ve belirli null kuralları tam otomasyona uygundur. Çünkü sonuçlar açık ve tekrar üretilebilirdir. Allowed value listesi de otomatik kontrol edilebilir. Hata oluştuğunda pipeline fail edebilir. Bu kontroller insan yorumuna çok az ihtiyaç duyar.
Kural Tabanlı Otomasyona Uygun İşlemler
Eksik oranı yüzde belirli eşiğin üzerindeyse uyarı üretmek rule-based otomasyona örnektir. Outlier için IQR ile aday kayıt işaretlemek de mümkündür. Sistem önce kuralı uygular. Son karar gerektiğinde insana bırakılabilir. Böylece yüksek hacimli veri daha hızlı gözden geçirilebilir.
İnsan Kararı Gerektiren İşlemler
İş anlamı yüksek olan değişiklikler insan onayı gerektirebilir. Bir kategori değerinin yanlış mı yoksa yeni ürün tipi mi olduğu otomatik belirlenemeyebilir. Veri kaynağındaki sıra dışı değişiklik önemli business event olabilir. Bu durumda pipeline otomatik silmek yerine alert üretmelidir. İnsan kararı daha sonra kural setine dönüştürülebilir.
Domain Bilgisinin Gerektiği Durumlar
Verinin istatistiksel görünümü her zaman iş anlamını açıklamaz. Sağlık, finans veya üretim verilerinde bazı değerler istatistiksel olarak sıra dışı olabilir. Buna rağmen gerçek ve kritik gözlem olabilir. Domain uzmanı hangi sınırların mantıklı olduğunu belirlemelidir. Preprocessing pipeline bu kuralları otomatik uygulayabilir.
Human-in-the-Loop Veri Hazırlama
Human-in-the-loop yaklaşımında sistem rutin işlemleri yapar ve belirsiz vakaları insana yönlendirir. Bu yapı otomasyon ile kontrol arasında denge sağlar. İncelenen kararlar loglanabilir. Tekrarlanan kararlar ileride rule haline getirilebilir. Böylece pipeline zaman içinde daha olgun hale gelir.
Yanlış Otomasyonun Riskleri
Yanlış otomasyon veri kalitesini sessizce bozabilir. Örneğin her aykırı değeri silmek modelin nadir fakat önemli olayları öğrenmesini engelleyebilir. Her missing value'yu ortalama ile doldurmak dağılımı yapay biçimde değiştirebilir. Otomasyonun sonucu metric ve sample kontrol ile doğrulanmalıdır. Sistemin yaptığı her dönüşüm görünür ve geri alınabilir olmalıdır.
Otomasyon Öncesi Veri Profilleme
Profiling otomasyon kurallarını veri gerçeklerine göre tanımlamayı sağlar. Satır sayısı, veri tipi, null oranı, unique değer ve dağılım bilgisi başlangıçta otomatik çıkarılabilir. Bu rapor preprocessing karar motorunun girdisi olabilir. Örneğin cardinality çok yüksekse one-hot encoding yerine başka yöntem seçilebilir. Profiling aynı zamanda sonraki batch'lerde ortaya çıkan veri değişimlerini karşılaştırmak için baseline görevi görür.
Satır ve Sütun Sayısını Otomatik Belirleme
Dataset shape en basit fakat önemli profil bilgisidir. Beklenen satır sayısında ani düşüş ingestion hatasına işaret edebilir. Beklenmeyen yeni sütun schema drift gösterebilir. Bu değerler her batch için kaydedilmelidir. Eşik dışına çıkıldığında warning veya error üretilebilir.
Veri Tiplerini Algılama
Pandas gibi araçlar veri tiplerini otomatik algılar. Ancak object tipi her zaman gerçek semantic type'ı göstermez. Tarih, boolean veya numeric string ayrıca tespit edilebilir. Otomatik tahmin confidence ile birlikte kullanılabilir. Kritik sütunlar için beklenen type schema içinde açıkça tanımlanmalıdır.
Eksik Veri Oranlarını Hesaplama
Her sütun için null sayısı ve oranı otomatik hesaplanabilir. Bu değer batch bazında izlenirse missingness drift görülebilir. Eşik üzerindeki sütunlar warning alabilir. Kritik alanlarda tek bir null bile error olabilir. Karar iş kurallarına göre verilmelidir.
Unique Değer Analizi
Unique count kategorik sütunun cardinality seviyesini gösterir. Identifier olabilecek sütunlar da bu analizle fark edilebilir. Ani unique artışı yeni kategori veya veri hatası anlamına gelebilir. Encoding stratejisi bu bilgiye göre seçilebilir. Sonuçlar profiling raporunda saklanmalıdır.
Duplicate Analizi
Exact duplicate count otomatik hesaplanabilir. Business key bazlı duplicate ayrıca kontrol edilmelidir. Duplicate oranındaki artış upstream sistem problemine işaret edebilir. Pipeline temizleme öncesi ve sonrası sayıları kaydetmelidir. Böylece veri kaybı şeffaf hale gelir.
Dağılım Analizi
Sayısal kolonlarda ortalama, medyan, quantile ve standart sapma hesaplanabilir. Kategorik alanlarda frekans dağılımı çıkarılabilir. Bu baseline ileride drift detection için kullanılır. Çok çarpık dağılım scaling veya transformation ihtiyacını gösterebilir. Ancak otomatik karar model türüne göre verilmelidir.
Korelasyon Analizi
Sayısal feature'lar arasındaki korelasyon otomatik hesaplanabilir. Çok yüksek correlation redundant feature sinyali olabilir. Target ile korelasyon sadece training dataset içinde incelenmelidir. Correlation causality anlamına gelmez. Feature selection için tek başına karar kriteri olmamalıdır.
Otomatik Veri Kalitesi Raporu Oluşturma
Profiling sonuçları HTML, JSON veya dashboard formatında raporlanabilir. Null, duplicate, distribution ve schema özetleri aynı raporda gösterilebilir. Her batch için rapor saklamak karşılaştırmayı kolaylaştırır. Critical issue'lar ayrı renkte veya severity ile işaretlenebilir. Bu çıktı data engineer ve veri bilimci arasında ortak kontrol yüzeyi oluşturur.
Profil Sonuçlarına Göre Preprocessing Kararı Verme
Profil bilgisi kural motorunun girdisi olabilir. Örneğin null oranı yüzde beşten düşükse imputation, yüzde seksenden yüksekse review önerilebilir. High cardinality kategori için target encoding adayı oluşturulabilir. Bu kararlar otomatik öneri olarak başlayabilir. Production'da uygulanmadan önce domain validation yapılmalıdır.
Eksik Veri İşlemleri Nasıl Otomatikleştirilir?
Eksik veri otomasyonu yalnızca null değerleri bulup doldurmak değildir. Önce eksikliğin oranı, sütun tipi ve iş anlamı değerlendirilmelidir. Daha sonra silme, sabit değer, ortalama, medyan, mod veya model tabanlı imputation seçenekleri karşılaştırılabilir. Makine öğrenmesinde eksik veri aykırı değer ve veri temizleme otomasyonu kurarken her sütuna aynı imputation uygulanması yerine column-specific strategy kullanmak daha güvenlidir. İmputation değeri training data üzerinden öğrenilmeli ve production verisine aynı değer uygulanmalıdır.
Eksik Değerleri Otomatik Tespit Etme
Null, NaN ve boş string gibi farklı missing representation'lar normalize edilmelidir. Bazı sistemlerde "N/A" veya "-999" gibi özel değerler eksik anlamına gelebilir. Bu kodlar schema içinde tanımlanabilir. Her sütunda eksik değer count ve ratio hesaplanmalıdır. Sonuçlar monitoring metric olarak saklanabilir.
Eksiklik Oranına Göre Karar Verme
Eksiklik oranı otomatik karar için başlangıç sinyali sağlar. Düşük oran basit imputation ile yönetilebilir. Çok yüksek oran sütunun kullanılabilirliğini sorgulatabilir. Ancak oran tek başına yeterli değildir. Kritik bir feature yüksek missing içerse bile domain nedeniyle korunabilir.
Satırı Silme
Az sayıda eksik kayıt varsa satır silme düşünülebilir. Bunun veri dağılımını değiştirip değiştirmediği kontrol edilmelidir. Random olmayan missingness durumda silme bias yaratabilir. Silinen satır sayısı loglanmalıdır. Production pipeline'da eşik aşılırsa otomatik silmek yerine fail etmek daha güvenli olabilir.
Sütunu Silme
Bir sütunun büyük bölümü eksikse kaldırma seçeneği değerlendirilebilir. Feature'ın iş açısından önemi dikkate alınmalıdır. Model performansına etkisi test edilmelidir. Schema version bu değişikliği yansıtmalıdır. Production serving tarafında modelin eski sütunu beklemediği doğrulanmalıdır.
Sabit Değer ile Doldurma
Kategorik alanlarda "unknown" gibi sabit değer kullanılabilir. Bu yöntem missingness bilgisini açık biçimde korur. Sayısal alanda özel sentinel değer dikkatli kullanılmalıdır. Model bu değeri gerçek sayı gibi yorumlayabilir. Gerekirse missing indicator feature eklenebilir.
Ortalama ile Doldurma
Mean imputation basit ve hızlıdır. Aykırı değerlerden etkilenebilir. Dağılımın varyansını azaltabilir. Ortalama yalnızca training data üzerinde hesaplanmalıdır. Test ve production aynı learned mean değerini kullanmalıdır.
Medyan ile Doldurma
Median outlier etkisine karşı mean'e göre daha dayanıklıdır. Çarpık dağılımlarda sık kullanılan basit yöntemdir. Training verisinden hesaplanmalıdır. Her feature için ayrı median saklanır. Production pipeline aynı artifact içinden bu değeri kullanır.
Mod ile Doldurma
Mode kategorik veya düşük cardinality alanlarda kullanılabilir. En sık kategoriyle doldurmak bazı sınıfları gereğinden fazla büyütebilir. Missing indicator bu durumu görünür tutabilir. Mode training data üzerinde öğrenilmelidir. Yeni dataset için yeniden hesaplanmamalıdır.
SimpleImputer
Scikit-learn SimpleImputer mean, median, most_frequent veya constant stratejilerini standard biçimde uygular. Pipeline içinde kullanıldığında fit yalnızca training data üzerinde gerçekleşir. Bu durum leakage riskini azaltır. Numeric ve categorical pipeline'larda farklı ayarlar kullanılabilir. Artifact modelle birlikte kaydedilebilir.
KNNImputer
KNNImputer benzer satırları kullanarak eksik değer tahmin eder. Basit yöntemlerden daha fazla hesaplama gerektirir. Scaling ve distance davranışı sonucu etkileyebilir. Büyük dataset'te maliyet artabilir. Baseline SimpleImputer ile karşılaştırılmadan otomatik tercih edilmemelidir.
Iterative Imputation
Iterative imputation feature'lar arasındaki ilişkileri kullanarak eksik değeri tahmin etmeye çalışır. Daha gelişmiş bir yöntemdir. Eğitim süresi ve modelleme maliyeti yükselebilir. Leakage sınırları dikkatle korunmalıdır. Fayda model metric ve imputation quality üzerinden karşılaştırılmalıdır.
Sayısal ve Kategorik Kolonlar İçin Farklı Stratejiler
Numeric ve categorical alanların missing davranışı farklıdır. Numeric sütunda median, categorical sütunda most_frequent kullanılabilir. ColumnTransformer bu ayrımı otomatik uygulamayı kolaylaştırır. Date veya text alanları için farklı transformer gerekebilir. Strategy schema veya feature metadata üzerinden tanımlanabilir.
Eksik Veri Stratejisi Otomatik Seçilebilir mi?
Belirli kurallar ve validation dataset kullanılarak strategy otomatik karşılaştırılabilir. Farklı imputation yöntemleri cross-validation ile test edilebilir. En iyi model skoru tek kriter olmamalıdır. Veri anlamı ve inference maliyeti de değerlendirilmelidir. Kritik domainlerde otomatik seçim insan review ile desteklenmelidir.
İmputation Sonrası Veri Kalitesini Kontrol Etmek
İmputation sonrasında null oranının beklenen seviyeye düştüğü doğrulanmalıdır. Dağılımın aşırı değişip değişmediği kontrol edilebilir. Mean ve variance karşılaştırılabilir. Kategorik frekansların yapay biçimde bozulması izlenebilir. Quality report preprocessing öncesi ve sonrası farkı göstermelidir.
Duplicate Kayıt Temizliği Nasıl Otomatikleştirilir?
Duplicate temizliği önce tekrarın nasıl tanımlandığını belirlemekle başlar. Bazı dataset'lerde tüm sütunların aynı olması duplicate sayılırken bazılarında müşteri kimliği ve tarih kombinasyonu temel alınır. Otomasyon önce candidate duplicate'ları bulmalı, sonra hangi kaydın korunacağına ilişkin açık kuralları uygulamalıdır. Silinen kayıtlar sayı ve gerekirse ID düzeyinde loglanmalıdır. Bu yaklaşım veri kaybını izlenebilir hale getirir.
Exact Duplicate Tespiti
Exact duplicate bütün sütun değerlerinin aynı olduğu satırları ifade eder. Pandas duplicated fonksiyonu gibi yöntemlerle otomatik tespit edilebilir. Row order kararı etkilememelidir. Kaç duplicate bulunduğu loglanmalıdır. Silme sonrası satır count kontrol edilmelidir.
Belirli Kolonlara Göre Duplicate
Business key alanları duplicate tanımında kullanılabilir. Örneğin customer_id ve transaction_id kombinasyonu unique olmalıdır. Aynı key altında farklı değer varsa conflict ayrıca incelenmelidir. Pipeline sadece en son kaydı koruyabilir. Bu kural açıkça konfigüre edilmelidir.
Fuzzy Duplicate Nedir?
Fuzzy duplicate birebir aynı olmayan ancak aynı kaydı temsil edebilecek gözlemlerdir. İsim, adres veya serbest metin gibi alanlarda ortaya çıkar. String similarity veya embedding kullanılabilir. False positive riski yüksektir. Bu nedenle otomatik silmek yerine candidate review daha güvenli olabilir.
Duplicate Silme Kuralları
Kurallar timestamp, source priority veya completeness üzerinden belirlenebilir. En yeni kayıt korunabilir. Daha dolu olan kayıt tercih edilebilir. Source reliability farklıysa güvenilir kaynağa öncelik verilebilir. Bu kural code ve documentation içinde görünür olmalıdır.
Hangi Kaydın Korunacağı Nasıl Belirlenir?
Korunacak kayıt iş kuralına göre seçilmelidir. Sadece DataFrame'deki ilk satırı almak her zaman doğru değildir. Güncellik, veri doluluğu ve source authority birlikte değerlendirilebilir. Tie-breaker kuralı deterministic olmalıdır. Böylece aynı input her çalışmada aynı sonucu üretir.
Duplicate Temizliğinde Veri Kaybını Önlemek
Silme işlemi geri alınabilir olmalıdır. Raw dataset immutable tutulabilir. Removed records ayrı audit dataset'e yazılabilir. Threshold üzerinde duplicate varsa pipeline durdurulabilir. Bu yaklaşım yanlış kuralın büyük veri kaybına yol açmasını önler.
Aykırı Değer İşlemleri Nasıl Otomatikleştirilir?
Outlier yönetimi otomasyonun en dikkat gerektiren alanlarından biridir. İstatistiksel olarak sıra dışı bir değer veri hatası olmayabilir. Bu nedenle sistem önce aday outlier'ları işaretlemeli, ardından silme, baskılama veya robust transformation seçeneklerini değerlendirmelidir. Aykırı değerlerin oranı ve model üzerindeki etkisi ölçülmelidir. Human-in-the-loop yaklaşımı özellikle kritik business verilerinde güvenilir denge sağlar.
Aykırı Değer Nedir?
Aykırı değer genel dağılımdan belirgin biçimde uzak gözlemdir. Tanım feature ve domain'e göre değişebilir. Bir satış tutarının yüksek olması normal kampanya etkisi olabilir. Otomatik sistem istatistiksel sinyal üretir. İş anlamı son kararı şekillendirir.
IQR ile Otomatik Outlier Detection
IQR yöntemi birinci ve üçüncü çeyrek arasındaki mesafeyi kullanır. Alt ve üst sınırlar belirlenebilir. Çarpık dağılımlarda sık kullanılan basit yöntemdir. Her feature için ayrı sınır hesaplanır. Sınırlar yalnızca training data üzerinde öğrenilmelidir.
Z-Score
Z-Score değerin ortalamadan kaç standart sapma uzakta olduğunu gösterir. Normal dağılıma yakın verilerde kullanışlıdır. Outlier'lardan mean ve standard deviation etkilenebilir. Sabit eşik her feature için uygun olmayabilir. Domain ve distribution kontrol edilmelidir.
Isolation Forest
Isolation Forest çok değişkenli outlier detection için kullanılabilir. Nadir ve kolay izole edilen gözlemleri işaretler. Model parametreleri veri yapısını etkiler. Sonuç doğrudan silme kararı değildir. Candidate outlier listesi olarak kullanılması daha güvenlidir.
Local Outlier Factor
LOF yerel komşuluk yoğunluğuna göre sıra dışı noktaları tespit eder. Global dağılımdan farklı local pattern'leri yakalayabilir. Büyük veri setinde maliyet artabilir. Scaling distance tabanlı davranışı etkiler. Model kullanım senaryosuna göre test edilmelidir.
Robust İstatistikler
Median ve IQR outlier etkisine karşı mean ve standard deviation'dan daha dayanıklıdır. Preprocessing kararlarında robust statistics kullanılabilir. Özellikle skewed data için faydalıdır. Ancak outlier problemine tek başına çözüm değildir. Business limit kontrolleriyle birlikte kullanılmalıdır.
Aykırı Değerleri Silmek
Silme en agresif outlier işlemidir. Sadece veri hatası olduğu yüksek güvenle bilinen gözlemlerde kullanılmalıdır. Nadir event'leri silmek modelin kritik örnekleri öğrenmesini engelleyebilir. Silinen satır oranı loglanmalıdır. Eşik aşılırsa pipeline review isteyebilir.
Winsorization ve Baskılama
Winsorization uç değerleri belirli percentile sınırlarına çeker. Veri tamamen silinmez. Bu durum bazı modellerde daha stabil input sağlayabilir. Sınırlar training data üzerinden belirlenmelidir. Production aynı sınırları kullanmalıdır.
RobustScaler Kullanımı
RobustScaler median ve IQR temelli scaling uygular. Outlier etkisine karşı StandardScaler'dan daha dayanıklı olabilir. Tüm modeller için gerekli değildir. Feature dağılımına göre seçilmelidir. Cross-validation ile model etkisi ölçülmelidir.
Aykırı Değer mi, Gerçek İş Olayı mı?
Bu ayrım tamamen istatistiksel yöntemle yapılamaz. Sıra dışı satış gerçek kampanya başarısı olabilir. Çok yüksek sensör değeri ekipman arızasına işaret edebilir. Sistem adayı işaretler. Domain uzmanı anlamı doğrular.
Outlier Yönetiminde Human-in-the-Loop
Human-in-the-loop sistem yüksek riskli outlier kararlarını review kuyruğuna gönderebilir. İnsan tarafından onaylanan kararlar loglanır. Tekrarlanan pattern'ler daha sonra otomatik rule haline getirilebilir. Böylece otomasyon kontrollü biçimde genişler. Kritik veri sessizce değiştirilmez.
Veri Tipi Düzeltme İşlemleri Nasıl Otomatikleştirilir?
Yanlış veri tipi preprocessing hatalarının yaygın kaynaklarından biridir. Numeric değerlerin string gelmesi, tarihin farklı formatlarda bulunması veya boolean alanın metin olarak saklanması pipeline'ı bozabilir. Otomatik type inference kullanılabilir ancak kritik sütunlar için schema zorunlu olmalıdır. Conversion error'ları saklanmalı ve satır bazında incelenebilmelidir. Zorla dönüştürme veri kaybını görünmez hale getirmemelidir.
Sayısal Sütunları Otomatik Algılama
Numeric dtype alanlar doğrudan tespit edilebilir. Object içinde sayısal string bulunan kolonlar ayrıca analiz edilebilir. Başarı oranı threshold ile ölçülebilir. Örneğin değerlerin yüzde doksan dokuzu sayıya dönüşüyorsa kalan hatalar review edilebilir. Conversion sonucu null artışı kontrol edilmelidir.
Kategorik Sütunları Algılama
Düşük veya orta cardinality string alanlar kategorik aday olabilir. Her string alan kategorik değildir. ID ve serbest metin alanları farklı ele alınmalıdır. Cardinality oranı yardımcı sinyal sağlar. Semantic metadata varsa otomatik algılama daha güvenilir olur.
Boolean Alanları Algılama
True/false yanında yes/no veya 1/0 gibi değerler boolean temsil edebilir. Mapping açık tanımlanmalıdır. Bilinmeyen değerler hata veya null olarak işaretlenebilir. Büyük-küçük harf normalizasyonu uygulanabilir. Mapping production ve training için aynı olmalıdır.
Tarih ve Saat Alanlarını Algılama
Date string'leri farklı formatlarda gelebilir. Parser birden fazla formatı test edebilir. Başarısız parse oranı loglanmalıdır. Timezone bilgisi korunmalıdır. Tarih dönüşümü sonrası beklenen aralık validation ile kontrol edilmelidir.
String-to-Numeric Conversion
Para birimi sembolü ve binlik ayracı numeric conversion'ı bozabilir. Önce normalize işlemi uygulanabilir. Locale bilgisi önemlidir. Dönüşmeyen değerler raporlanmalıdır. Coercion sonucu oluşan null sayısı ölçülmelidir.
Hatalı Veri Tiplerinde Coercion
Coercion dönüştürülemeyen değeri null yaparak pipeline'ın devam etmesini sağlayabilir. Bu yaklaşım sessiz veri kaybı yaratabilir. Bu nedenle coercion count zorunlu olarak loglanmalıdır. Eşik aşılırsa pipeline fail etmelidir. Küçük hata oranı warning olarak yönetilebilir.
Veri Tipi Dönüşüm Hatalarını Loglama
Hangi sütunda kaç conversion error oluştuğu kaydedilmelidir. Sample raw values debugging için tutulabilir. Sensitive data maskelenmelidir. Error trend'i upstream değişimi gösterebilir. Monitoring dashboard bu metriği görünür hale getirmelidir.
Kategorik Veri Encoding Nasıl Otomatikleştirilir?
Kategorik veri otomasyonu feature engineering encoding scaling ve normalizasyon süreçleri nasıl otomatikleştirilir sorusunun önemli bölümünü oluşturur. Encoder seçimi kategori türüne, cardinality seviyesine ve modele göre yapılmalıdır. Eğitim sırasında öğrenilen kategori mapping'i production'da tekrar kullanılmalıdır. Yeni kategori geldiğinde pipeline'ın nasıl davranacağı önceden belirlenmelidir. Encoding strategy model validation sonuçlarına göre seçilmelidir.
Ordinal ve Nominal Değişkenleri Ayırmak
Ordinal kategorilerin doğal sırası vardır. Nominal kategorilerde böyle bir sıra yoktur. Bu ayrım metadata veya domain bilgisiyle tanımlanmalıdır. Otomatik cardinality analizi tek başına yeterli değildir. Yanlış ordinal mapping modele yapay sıra bilgisi verir.
One-Hot Encoding
One-hot encoding her kategori için binary sütun oluşturur. Düşük cardinality nominal alanlarda yaygın kullanılır. High cardinality durumda feature sayısı hızla büyür. handle_unknown gibi seçenekler production güvenilirliğini artırır. Encoder training data üzerinde fit edilmelidir.
Ordinal Encoding
Ordinal encoding kategorileri sıralı sayısal değerlere çevirir. Doğal sıra varsa anlamlıdır. Nominal alanda kullanılırsa modele yanlış ilişki verebilir. Unknown category için özel value tanımlanabilir. Mapping schema ile birlikte saklanmalıdır.
Target Encoding
Target encoding kategori değerini hedef istatistiğine göre temsil eder. High cardinality alanlarda faydalı olabilir. Data leakage riski yüksektir. Cross-validation aware uygulama gerektirir. Test veya production target bilgisi kesinlikle kullanılmamalıdır.
Binary Encoding
Binary encoding kategori sayısını daha az feature ile temsil etmeyi amaçlar. High cardinality durumunda one-hot'a alternatif olabilir. Representation model tarafından kolay yorumlanmayabilir. Performans cross-validation ile ölçülmelidir. Production mapping training artifact içinde tutulmalıdır.
Yüksek Cardinality Problemi
Binlerce unique kategori one-hot encoding ile çok geniş feature space oluşturur. Memory ve inference maliyeti artabilir. Rare category grouping düşünülebilir. Hashing veya target encoding alternatif olabilir. Hangi yaklaşımın uygun olduğu model ve veri yapısına göre test edilmelidir.
Bilinmeyen Kategoriler Nasıl Yönetilir?
Production verisinde training sırasında görülmeyen kategori gelebilir. Encoder bu durumda hata vermemelidir. Unknown bucket veya ignore strategy kullanılabilir. Unknown rate monitoring metriği olmalıdır. Ani artış category drift sinyali olabilir.
Encoding Stratejisini Otomatik Seçmek
Cardinality ve model tipi kural bazlı seçimde kullanılabilir. Düşük cardinality için one-hot, yüksek cardinality için alternatif yöntem önerilebilir. AutoML farklı seçenekleri cross-validation ile karşılaştırabilir. Ancak leakage-safe evaluation gereklidir. Seçilen encoder pipeline artifact içinde versionlanmalıdır.
Veri Ölçeklendirme Nasıl Otomatikleştirilir?
Scaling farklı sayısal feature'ların model tarafından daha dengeli işlenmesini sağlar. Otomasyon sırasında hangi scaler'ın kullanılacağı dağılım ve model türüne göre belirlenebilir. Scaler sadece training data üzerinde fit edilmelidir. Production verisi aynı learned parameters ile transform edilmelidir. Bu kural özellikle mesafe tabanlı ve gradient tabanlı modellerde önemlidir.
StandardScaler
StandardScaler feature'ı ortalama ve standart sapma üzerinden dönüştürür. Normal dağılıma yakın alanlarda yaygın kullanılır. Outlier değerlerden etkilenebilir. Mean ve standard deviation training data üzerinden öğrenilir. Modelle birlikte aynı artifact içinde saklanabilir.
MinMaxScaler
MinMaxScaler değerleri belirli aralığa taşır. Genellikle sıfır ile bir arası kullanılır. Outlier değerler aralığı sıkıştırabilir. Production yeni minimum veya maksimum getirebilir. Bu davranış model üzerinde test edilmelidir.
RobustScaler
RobustScaler median ve quantile bilgisini kullanır. Outlier etkisine karşı daha dayanıklıdır. Çarpık veri dağılımlarında avantaj sağlayabilir. Tüm feature'lara otomatik uygulanmamalıdır. Model performance üzerinden karşılaştırılmalıdır.
MaxAbsScaler
MaxAbsScaler değerleri maksimum mutlak değere göre ölçekler. Sparse data yapısını korumada yararlı olabilir. Merkezi kaydırma yapmaz. Outlier maksimumu etkileyebilir. Kullanım senaryosuna göre test edilmelidir.
Normalization
Normalization satır vektörlerini belirli norm değerine göre ölçekleyebilir. Text ve similarity tabanlı problemlerde kullanılabilir. Feature scaling ile aynı kavram değildir. Model beklentisine göre uygulanmalıdır. Gereksiz normalization bilgi kaybına neden olabilir.
Hangi Algoritmalar Ölçeklendirme Gerektirir?
KNN, SVM ve gradient tabanlı modeller scaling'den güçlü biçimde etkilenebilir. Distance metric kullanan modellerde feature scale önemlidir. Tree-based modeller çoğu zaman scaling istemez. Neural network senaryolarında normalization faydalı olabilir. Pipeline model türüne göre uygun preprocessing seçebilir.
Ölçeklendirme Stratejisi Nasıl Seçilir?
Distribution, outlier oranı ve model tipi temel kriterlerdir. Farklı scaler'lar cross-validation içinde karşılaştırılabilir. Scaler'ın etkisi model score ve inference davranışıyla ölçülmelidir. Blind automation yerine rule ve benchmark birlikte kullanılmalıdır. Seçim pipeline config içinde saklanmalıdır.
Tree-Based Modellerde Scaling Gerekli mi?
Decision tree ve birçok boosting yöntemi split threshold kullandığı için scaling'e duyarlı değildir. Bu modellerde scaling çoğu zaman gereksizdir. Yine de pipeline başka modellerle ortak kullanılacaksa condition gerekebilir. Gereksiz scaler compute maliyeti yaratabilir. Model-specific preprocessing daha temiz tasarım sağlar.
Feature Engineering Nasıl Otomatikleştirilir?
Feature engineering otomasyonu ham kolonlardan tekrar kullanılabilir kurallarla yeni değişkenler üretmeyi amaçlar. Tarih, metin ve aggregation tabanlı dönüşümler fonksiyon veya transformer haline getirilebilir. Her feature üretimi deterministic olmalıdır. Training ve serving aynı feature logic'i kullanmalıdır. Otomatik feature üretimi kontrolsüz büyütülürse overfitting ve bakım maliyeti oluşturabilir.
Tarih Verilerinden Feature Üretme
Datetime sütunları birçok model için doğrudan yeterli değildir. Yıl, ay, gün veya hafta günü gibi feature'lar otomatik çıkarılabilir. İş problemine göre saat ve tatil bilgisi de eklenebilir. Timezone doğru yönetilmelidir. Gelecek bilgisine erişen feature leakage oluşturmamalıdır.
Yıl
Yıl feature'ı uzun dönem trendleri yakalamaya yardımcı olabilir. Time series projelerinde dikkatli kullanılmalıdır. Eğitim verisindeki yıl aralığı production'da genişleyebilir. Model extrapolation davranışı kontrol edilmelidir. Yıl tek başına mevsimsellik göstergesi değildir.
Ay
Ay seasonal pattern'leri temsil edebilir. Sayısal 1-12 encoding doğrusal ilişki varsayabilir. Gerekirse cyclical encoding kullanılabilir. Domain'e göre çeyrek bilgisi de üretilebilir. Model performansı üzerinden katkı ölçülmelidir.
Gün
Ayın günü bazı iş süreçlerinde anlamlı olabilir. Maaş günü veya fatura dönemi buna örnektir. Her problem için faydalı değildir. Feature importance ile değerlendirilmelidir. Leakage yaratacak gelecek bilgisi eklenmemelidir.
Haftanın Günü
Hafta günü satış veya kullanım davranışındaki pattern'leri yakalayabilir. Kategorik veya cyclical temsil kullanılabilir. Hafta sonu ayrıca binary feature olarak üretilebilir. Locale farkları dikkate alınmalıdır. Production ve training aynı takvim mantığını kullanmalıdır.
Saat
Saat feature'ı gün içi davranış pattern'lerini yakalayabilir. Cyclical representation yararlı olabilir. Timezone ve daylight saving konusu doğru yönetilmelidir. Ham timestamp'ten deterministic biçimde üretilmelidir. Gereksiz granular feature overfitting yaratabilir.
Sayısal Feature Dönüşümleri
Log, square root veya ratio dönüşümleri sayısal feature'lardan üretilebilir. Zero ve negative değerler validation gerektirir. Dönüşüm domain anlamını bozmamalıdır. Parametre varsa training data üzerinde öğrenilmelidir. Her dönüşüm model score ile test edilmelidir.
Interaction Features
İki feature'ın çarpımı veya oranı yeni ilişki yakalayabilir. Otomatik interaction üretimi feature sayısını hızla büyütür. Domain bilgisi adayları daraltabilir. Regularization overfitting riskini azaltabilir. Cross-validation katkıyı doğrulamalıdır.
Aggregation Features
Müşteri başına toplam harcama veya işlem sayısı güçlü feature olabilir. Aggregation window dikkatle tanımlanmalıdır. Prediction zamanından sonraki verinin kullanılması leakage oluşturur. Point-in-time correctness sağlanmalıdır. Feature store bu süreci merkezi yönetebilir.
Text Feature Extraction
Text alanlardan length, keyword count veya vector representation üretilebilir. TF-IDF klasik bir seçenektir. Embedding de kullanılabilir. Text preprocessing versionlanmalıdır. Sensitive metinlerin pipeline içinde güvenli tutulması gerekir.
Polynomial Features
PolynomialFeatures nonlinear ilişkileri lineer modellere taşıyabilir. Feature sayısı hızla büyüyebilir. Degree dikkatli seçilmelidir. Scaling ve regularization gerekebilir. High-dimensional dataset'te otomatik kullanmak pahalı olabilir.
Automated Feature Engineering
Automated feature engineering olası dönüşüm ve aggregation'ları sistematik biçimde üretir. Hızlı baseline sağlama avantajı vardır. Çok fazla feature compute ve overfitting maliyeti oluşturabilir. Feature selection ile birlikte kullanılmalıdır. Human review anlamlı olmayan feature'ları elemek için faydalıdır.
Featuretools ve Benzeri Yaklaşımlar
Featuretools relational dataset üzerinde automated feature synthesis yaklaşımı sunar. Entity ilişkileri üzerinden aggregation üretilebilir. Data leakage sınırı zaman bilgisiyle doğru tanımlanmalıdır. Büyük veri setlerinde compute maliyeti ölçülmelidir. Üretilen feature lineage saklanmalıdır.
Otomatik Feature Üretmenin Overfitting Riski
Çok sayıda feature modelin noise pattern'lerini öğrenmesine neden olabilir. Cross-validation zorunlu olmalıdır. Test data feature generation kararına dahil edilmemelidir. Feature selection ve regularization kullanılabilir. Sadece training score artışı başarı sayılmamalıdır.
Feature Selection Nasıl Otomatikleştirilir?
Feature selection model için yararlı olmayan veya tekrarlayan değişkenleri azaltmayı amaçlar. Bu süreç training dataset üzerinde öğrenilmeli ve production'a aynı selector artifact'ı taşınmalıdır. Correlation, variance, statistical test veya model-based önem yöntemleri kullanılabilir. Her yöntemin farklı varsayımları vardır. Automated selection pipeline içine alınarak cross-validation sırasında leakage-safe biçimde çalıştırılabilir.
Variance Threshold
Çok düşük varyanslı feature'lar genellikle az bilgi taşır. VarianceThreshold basit eleme sağlar. Eşik training data üzerinde uygulanır. Binary feature'larda düşük varyans yine anlamlı olabilir. Domain review tamamen göz ardı edilmemelidir.
Korelasyon Bazlı Eleme
Yüksek korelasyonlu feature çiftlerinden biri kaldırılabilir. Bu özellikle lineer modellerde faydalı olabilir. Hangi feature'ın kalacağı ek kriter gerektirir. Target leakage kontrol edilmelidir. Correlation sadece doğrusal ilişkiyi ölçer.
SelectKBest
SelectKBest statistical score ile en yüksek K feature'ı seçer. Kullanılan score function problem tipine uygun olmalıdır. K cross-validation ile belirlenebilir. Selector training data üzerinde fit edilir. Production aynı selected columns listesini kullanır.
Recursive Feature Elimination
RFE modeli tekrar eğiterek daha az önemli feature'ları aşamalı kaldırır. Büyük feature setinde maliyetlidir. Kullanılan estimator seçimi sonucu etkiler. Cross-validation ile optimum feature sayısı aranabilir. Production training süresine uygunluğu değerlendirilmelidir.
Model-Based Feature Selection
Tree importance veya regularized linear coefficient kullanılabilir. Model bias feature seçimini etkiler. Seçim ve final model aynı olmak zorunda değildir. Threshold cross-validation ile ayarlanabilir. Stability farklı fold'larda kontrol edilmelidir.
Permutation Importance
Permutation importance feature değerlerini karıştırarak model performansındaki değişimi ölçer. Model-agnostic avantajı vardır. Validation dataset üzerinde hesaplanmalıdır. Korelasyonlu feature'larda önem dağılımı yanıltıcı olabilir. Compute maliyeti feature sayısıyla artar.
Gereksiz Feature'ların Otomatik Kaldırılması
Constant, duplicate veya tamamen null feature'lar otomatik kaldırılabilir. High correlation gibi kararlar warning ile başlayabilir. Removed feature listesi artifact olarak saklanmalıdır. Schema ile uyum kontrol edilmelidir. Model version hangi feature seti kullandığını açıkça bilmelidir.
Scikit-learn Pipeline ile Veri Ön İşleme Otomasyonu
Scikit-learn Pipeline preprocessing ve model adımlarını aynı fit ve predict akışı içinde birleştirir. Bu yapı training data üzerinde öğrenilen transformation parametrelerinin test ve production verisine doğru uygulanmasını kolaylaştırır. Pipeline kullanımı data leakage riskini azaltır. GridSearchCV veya cross-validation ile birlikte çalışabilir. Python ile otomatik data preprocessing pipeline nasıl oluşturulur sorusuna pratik cevaplardan biri, preprocessing adımlarını transformer olarak Pipeline içine yerleştirmektir.
Pipeline Nedir?
Pipeline sıralı estimator ve transformer zinciridir. Her adım önceki adımın çıktısını alır. Son adım genellikle model olabilir. Fit çağrısı bütün zinciri sırayla çalıştırır. Predict sırasında gerekli transform işlemleri otomatik uygulanır.
Pipeline Neden Kullanılır?
Pipeline code tekrarını azaltır. Training ve validation sırasında preprocessing sırasını sabit tutar. Cross-validation leakage riskini azaltır. Model ve preprocessing tek artifact olarak kaydedilebilir. Production serving daha sade hale gelir.
Transformer Nedir?
Transformer veriyi fit ve transform metodlarıyla dönüştüren bileşendir. Scaler, imputer ve encoder buna örnektir. Bazı transformer'lar training data üzerinden parametre öğrenir. Transform aşamasında bu parametreleri yeni veriye uygular. Custom transformer da geliştirilebilir.
Estimator Nedir?
Estimator fit metodu üzerinden veriden öğrenen nesnedir. Classifier ve regressor yaygın örneklerdir. Transformer da estimator interface'ini uygulayabilir. Scikit-learn ortak API sayesinde pipeline bileşenleri birbiriyle uyumlu çalışır. Bu standardization automation için güçlü avantaj sağlar.
fit(), transform() ve fit_transform() Arasındaki Fark
fit training data üzerinden gerekli parametreleri öğrenir. transform öğrenilmiş parametrelerle veriyi dönüştürür. fit_transform iki işlemi art arda yapar. Test data üzerinde fit_transform kullanmak leakage yaratabilir. Validation ve production sadece transform kullanmalıdır.
make_pipeline Kullanımı
make_pipeline adımlara otomatik isim vererek kısa pipeline oluşturmayı sağlar. Küçük pipeline'larda kullanışlıdır. Parametre tuning sırasında otomatik isimlere dikkat edilmelidir. Daha açık isim kontrolü gerekiyorsa Pipeline sınıfı tercih edilebilir. İki yaklaşım aynı temel mantığı kullanır.
Preprocessing ile Modeli Tek Pipeline'da Birleştirmek
Imputer, scaler ve model aynı Pipeline içinde tanımlanabilir. fit training data ile bütün adımları öğrenir. predict yeni data için otomatik preprocessing uygular. Bu yapı training-serving consistency sağlar. Artifact joblib veya benzeri yöntemle saklanabilir.
Pipeline Parametrelerini Yönetmek
Pipeline parametreleri adım adı ve çift alt çizgi syntax'iyle erişilebilir. GridSearchCV farklı scaler veya model parametrelerini test edebilir. Configuration file üzerinden production ayarları yönetilebilir. Parametre değişikliği versionlanmalıdır. Reproducibility için random_state sabitlenebilir.
ColumnTransformer ile Farklı Sütunları Otomatik İşlemek
ColumnTransformer farklı veri tiplerine farklı preprocessing uygulamayı kolaylaştırır. Numeric alanlarda imputation ve scaling, categorical alanlarda imputation ve encoding, text alanlarda vectorization kullanılabilir. Sütun seçimi explicit listeler veya dtype selector üzerinden yapılabilir. Bu yaklaşım tek dataset içindeki heterojen veriyi temiz biçimde yönetir. Feature engineering encoding scaling ve normalizasyon süreçleri nasıl otomatikleştirilir sorusunda ColumnTransformer güçlü bir temel sunar.
Sayısal Kolon Pipeline'ı
Numeric columns için ayrı pipeline oluşturulabilir. İlk adım missing value imputation olabilir. Ardından scaling uygulanabilir. İstenirse outlier transformer eklenebilir. Bu pipeline yalnızca numeric sütunlara uygulanır.
Imputation
Numeric imputation için median veya mean kullanılabilir. Strategy training data üzerinde fit edilir. ColumnTransformer ilgili sütunlara doğru transformer'ı yönlendirir. Missing indicator eklenebilir. Production aynı learned değerleri kullanır.
Scaling
Imputation sonrasında scaler uygulanabilir. StandardScaler veya RobustScaler seçilebilir. Model tree-based ise scaler bypass edilebilir. Pipeline sırası sabit kalır. Parametre tuning ile alternatifler karşılaştırılabilir.
Kategorik Kolon Pipeline'ı
Categorical columns farklı preprocessing gerektirir. Missing value önce unknown veya most_frequent ile doldurulabilir. Ardından encoder uygulanır. Unknown categories production için yönetilmelidir. Output sparse veya dense format model ihtiyacına göre seçilebilir.
Imputation
Kategorik missing değer için constant veya most_frequent strategy kullanılabilir. Unknown etiketi missingness bilgisini korur. Training data mapping'i artifact'a kaydedilir. Null oranı ayrıca monitoring metric olur. İmputation sonrası kategori frekansı kontrol edilebilir.
Encoding
OneHotEncoder sık kullanılan seçenektir. handle_unknown parametresi production hatalarını azaltır. High cardinality alanlarda farklı encoder gerekebilir. Output feature names izlenmelidir. Model açıklanabilirliği için mapping saklanmalıdır.
Text Kolon Pipeline'ı
Text alanlar TF-IDF veya başka text transformer ile işlenebilir. Null değer önce empty string'e dönüştürülebilir. Text cleaning deterministic olmalıdır. Vectorizer training data üzerinde vocabulary öğrenir. Production yeni kelimeleri mevcut vocabulary ile işler.
Passthrough Kolonları
Bazı sütunlar değişmeden modele aktarılabilir. ColumnTransformer passthrough seçeneği bunu sağlar. Sütun sırası kontrol edilmelidir. Gereksiz ID alanları yanlışlıkla passthrough edilmemelidir. Feature list output aşamasında doğrulanmalıdır.
Sayısal ve Kategorik Pipeline'ları Birleştirmek
ColumnTransformer birden fazla sütun grubunu tek preprocessing nesnesinde birleştirir. Numeric ve categorical transformation paralel uygulanabilir. Sonuç tek feature matrix olur. Model aynı Pipeline içinde devam edebilir. Bu yapı artifact management ve serving sürecini belirgin biçimde sadeleştirir.
Uçtan Uca Scikit-learn Preprocessing Pipeline
Uçtan uca pipeline ham verinin train-test split işleminden başlayıp preprocessing, feature selection ve model training aşamasına kadar tek akışta yönetilmesini sağlar. En önemli nokta, fit gerektiren bütün adımların training set dışında bilgi kullanmamasıdır. Prediction sırasında aynı artifact yeni data üzerinde transform ve predict işlemlerini otomatik yürütür. Böylece notebook'ta kullanılan kurallarla production kuralları arasında fark oluşma riski azalır. Bu yaklaşım, Veri Ön İşleme (Data Preprocessing) Aşamalarında Otomasyon için pratik ve güçlü başlangıç mimarisidir.
Ham Veriyi Yüklemek
Veri source'dan alınır ve raw form immutable tutulur. Dataset ID oluşturulabilir. Schema validation ilk aşamada çalıştırılır. Load süresi ve row count loglanır. Başarısız ingestion training başlatmamalıdır.
Train-Test Split
Split preprocessing fit işlemlerinden önce yapılmalıdır. Stratification classification projelerinde kullanılabilir. Time series için chronological split gerekir. Test set deney sırasında korunmalıdır. Random seed reproducibility için sabitlenebilir.
Column Selection
Modelde kullanılacak sütunlar açıkça belirlenmelidir. ID veya leakage taşıyan alanlar çıkarılmalıdır. Schema değişikliği bu listeyi etkileyebilir. Feature list versionlanmalıdır. Production input'ta eksik kolon varsa validation error üretilmelidir.
Missing Value Pipeline
Numeric ve categorical imputation ayrı uygulanır. Values training data üzerinden öğrenilir. Missingness indicator gerekirse eklenir. Test data sadece transform edilir. Imputation sonrası null check yapılabilir.
Encoding Pipeline
Categorical sütunlar uygun encoder ile dönüştürülür. Unknown category davranışı tanımlanır. Encoder mapping model artifact ile birlikte saklanır. High cardinality kontrol edilir. Feature names trace için kaydedilebilir.
Scaling Pipeline
Numeric sütunlar gerekiyorsa scaler'dan geçirilir. Scaler training data üzerinde fit edilir. Model türüne göre scaler bypass edilebilir. Production aynı scaler parametrelerini kullanır. Drift durumunda scaler otomatik yeniden fit edilmemelidir.
Feature Selection
Selector preprocessing pipeline sonrasında eklenebilir. Fit sadece training data üzerinde çalışır. Selected feature mask artifact'ta saklanır. Cross-validation içine dahil edilir. Böylece selection leakage önlenir.
Model Training
Final estimator aynı Pipeline'ın son adımı olabilir. fit çağrısı preprocessing ve modeli birlikte eğitir. Hyperparameter search aynı structure üzerinde çalışır. Evaluation test data üzerinde yapılır. Training metadata versionlarla birlikte kaydedilir.
Prediction
Prediction sırasında ham input aynı Pipeline'a verilir. Pipeline preprocessing'i otomatik uygular. Model yalnızca beklediği transformed feature'ları görür. Manual preprocessing tekrar edilmez. Bu training-serving parity açısından güçlü avantajdır.
Pipeline'ı Kaydetmek
Joblib veya benzeri serialization yöntemi kullanılabilir. Kütüphane version'ları metadata olarak saklanmalıdır. Artifact checksum hesaplanabilir. Storage erişimi kontrollü olmalıdır. Model registry ile pipeline version eşleştirilebilir.
Yeni Veriye Aynı Pipeline'ı Uygulamak
Yeni data öncelikle schema validation'dan geçer. Ardından saved pipeline transform ve predict işlemlerini yapar. Yeni kategori veya schema drift monitoring'e yansır. Pipeline production'da yeniden fit edilmez. Retraining ayrı kontrollü süreç olarak çalışmalıdır.
Data Leakage Nedir ve Otomasyon Sırasında Nasıl Önlenir?
Data leakage modelin eğitim sırasında gerçekte erişmemesi gereken bilgiye ulaşmasıdır. Preprocessing otomasyonu yanlış tasarlanırsa leakage sessizce oluşabilir. Scaling, imputation ve feature selection gibi adımlar train-test split öncesinde fit edilmemelidir. Cross-validation sırasında her fold kendi preprocessing parametrelerini öğrenmelidir. Pipeline abstraction bu sınırı teknik seviyede korumaya yardımcı olur.
Data Leakage Nedir?
Leakage test veya gelecek bilgisinin training sürecine sızmasıdır. Model offline değerlendirmede gerçekçi olmayan yüksek skor gösterebilir. Production performansı daha sonra düşer. Leakage feature, preprocessing veya temporal logic üzerinden oluşabilir. Bu nedenle mimari seviyede önlenmelidir.
Preprocessing Leakage Nasıl Oluşur?
Bütün dataset üzerinde mean hesaplayıp sonra split yapmak leakage örneğidir. Test dağılımı training transformation parametresini etkiler. Feature selection da aynı hatayı yapabilir. Target encoding daha yüksek risk taşır. Fit işlemleri yalnızca training scope içinde gerçekleşmelidir.
Train-Test Ayrımından Önce Scaling Yapmak
Scaler tüm dataset üzerinde fit edilirse test mean ve variance bilgisi training'e sızar. Model değerlendirmesi olduğundan iyi görünebilir. Split önce yapılmalıdır. Scaler training set üzerinde fit edilir. Test sadece transform edilir.
Train-Test Ayrımından Önce Imputation Yapmak
Global median veya mean test verisini de kullanır. Bu küçük görünen hata özellikle küçük dataset'te skoru etkileyebilir. Imputer training pipeline içinde fit edilmelidir. Test ve validation ayrı transform edilir. Cross-validation içinde de aynı kural korunmalıdır.
Feature Selection Leakage
Feature selector tüm dataset ve target kullanırsa test bilgisinden yararlanır. Seçilen feature set gerçek dünyada elde edilemeyecek avantaj sağlar. Selector Pipeline içine konulmalıdır. Her fold kendi selector'ını fit eder. Test data seçime etki etmez.
Target Encoding Leakage
Target encoding doğrudan hedef istatistiğini kullandığı için leakage riski yüksektir. Training satırı kendi target bilgisinden etkilenmemelidir. Out-of-fold encoding kullanılabilir. Test set encoding mapping'i sadece training statistics kullanmalıdır. Production'da target bilgisi doğal olarak bulunmaz.
Pipeline Data Leakage'i Nasıl Önler?
Pipeline fit ve transform sınırlarını standardize eder. Cross-validation her fold için pipeline'ı yeniden fit eder. Preprocessing yalnızca fold training kısmını görür. Validation kısmı sadece transform edilir. Bu yapı manuel kodda oluşabilecek sıralama hatalarını azaltır.
Cross-Validation İçinde Preprocessing
Scaler, imputer ve selector cross-validation loop dışında fit edilmemelidir. Pipeline GridSearchCV veya cross_validate ile birlikte kullanılabilir. Her fold bağımsız preprocessing parametreleri öğrenir. Bu daha gerçekçi model skoru sağlar. Hyperparameter tuning de leakage-safe hale gelir.
Training ve Production Preprocessing Neden Aynı Olmalıdır?
Model eğitim sırasında belirli mapping, scaling ve feature engineering mantığını öğrenir. Production farklı kod kullanırsa modelin input dağılımı değişebilir. Bu durum training-serving skew oluşturur. Tek paylaşılan preprocessing artifact'ı iki ortamda kullanmak güçlü çözümdür. Kütüphane version ve schema farkları da parity test ile kontrol edilmelidir.
Training-Serving Skew Nedir?
Training-serving skew eğitim ve inference sırasında feature üretim farkıdır. Model training'de görmediği representation ile karşılaşır. Skor düşebilir. Hata sessiz olabilir. Shared pipeline bu riski azaltır.
Farklı Encoding Mantığı
Training'de A kategorisi bir sütuna, serving'de başka sıraya giderse prediction bozulur. Encoder mapping artifact olarak saklanmalıdır. Production yeniden fit etmemelidir. Unknown categories ayrı yönetilmelidir. Feature order test edilmelidir.
Farklı Missing Value İşlemleri
Training median kullanırken production mean kullanırsa feature distribution değişir. Aynı imputer artifact kullanılmalıdır. Missing indicator davranışı da eşleşmelidir. Null normalization kuralları ortak olmalıdır. Parity test sample input üzerinden yapılabilir.
Farklı Feature Engineering Kodu
Notebook'ta bir tarih feature'ı farklı, API'de farklı hesaplanabilir. Bu nedenle transformation logic tek package içinde tutulmalıdır. Feature definitions versionlanmalıdır. Training ve serving aynı fonksiyonu çağırmalıdır. Duplicate code parity riskini yükseltir.
Kütüphane Sürümü Farkları
Serialization farklı library version'da uyumsuz olabilir. Transformer davranışı zaman içinde değişebilir. Environment lock file kullanılmalıdır. Docker image veya reproducible environment faydalıdır. Artifact metadata library versions içermelidir.
Tek Bir Paylaşılan Preprocessing Pipeline Kullanmak
Preprocessing ve model tek artifact olarak paketlenebilir. Alternatif olarak versioned preprocessing service kullanılabilir. Temel amaç code reuse değil behavior reuse'dur. Training hangi version'ı kullandıysa serving aynı version'ı çağırmalıdır. Registry bu ilişkiyi saklayabilir.
Training-Serving Parity Testleri
Aynı input hem training pipeline hem serving endpoint üzerinden geçirilebilir. Feature outputs karşılaştırılır. Tolerance dışındaki fark test fail eder. Bu test CI/CD içinde çalıştırılabilir. Production deploy öncesi güçlü güvence sağlar.
Veri Şeması Doğrulamasını Otomatikleştirmek
Schema validation preprocessing başlamadan önce veri yapısının beklenen sözleşmeye uyduğunu kontrol eder. Beklenen kolon, tip, null oranı ve allowed values gibi kurallar otomatik test edilebilir. Schema drift erken yakalanırsa downstream model hatalarının önüne geçilir. Pandera veya Great Expectations gibi araçlar bu süreci kod üzerinden yönetebilir. Data contract yaklaşımı veri üreten ve tüketen ekipler arasında daha net sorumluluk oluşturur.
Data Schema Nedir?
Data schema dataset'in kolon ve type yapısını tanımlar. Nullability ve constraint bilgisi de içerebilir. Machine-readable formatta tutulabilir. Versionlanması faydalıdır. Pipeline girişinde doğrulanabilir.
Data Contract Nedir?
Data contract source ve consumer arasında veri beklentisini tanımlar. Schema yanında freshness, quality ve ownership bilgisi içerebilir. Upstream değişiklikler kontrollü hale gelir. Contract ihlali alert veya pipeline failure üretir. Ekipler arası iletişimi güçlendirir.
Beklenen Kolonların Kontrolü
Modelin beklediği kolonların tamamı mevcut olmalıdır. Eksik critical column varsa pipeline devam etmemelidir. Fazladan kolon warning olabilir. Column order bazı sistemlerde önemli olabilir. Validation açık error message üretmelidir.
Veri Tiplerinin Kontrolü
Numeric, string ve datetime type beklentisi schema'da tanımlanır. Compatible conversion mümkünse yapılabilir. Beklenmeyen tip değişikliği drift sinyali olabilir. Coercion sonucu ayrıca kontrol edilmelidir. Type errors source sistemle paylaşılabilir.
Null Oranlarının Kontrolü
Her sütun için kabul edilebilir null threshold belirlenebilir. Kritik alanlarda zero tolerance uygulanabilir. Oran aşıldığında pipeline fail veya warning üretebilir. Historical baseline threshold seçimine yardımcı olur. Missingness drift ayrıca monitoring'e yazılır.
Minimum ve Maksimum Değerler
Age gibi alanlar business bounds taşıyabilir. Numeric range validation veri hatalarını erken yakalar. Hard limit ve statistical outlier ayrı kavramlardır. Negative price gibi imkânsız değer error olabilir. Rule domain uzmanı tarafından doğrulanmalıdır.
Allowed Values
Status gibi kategorik alanlarda izin verilen değer listesi olabilir. Yeni kategori geldiğinde schema drift alert üretilebilir. Bazı field'larda unknown değer otomatik kabul edilebilir. Severity use case'e göre değişir. Allowed set versionlanmalıdır.
Unique Constraint
ID alanında uniqueness zorunlu olabilir. Duplicate key pipeline'ı durdurabilir. Composite uniqueness de tanımlanabilir. Constraint sadece database katmanına bırakılmamalıdır. Training dataset hazırlığında ayrıca doğrulanmalıdır.
Pandera ile DataFrame Validation
Pandera DataFrame schema ve constraint tanımlamayı kolaylaştırır. Python type ve validation ekosistemiyle uyumludur. Pipeline girişinde veya dönüşüm sonrasında kullanılabilir. Error details debugging için faydalıdır. Schema code ile birlikte version control içinde tutulabilir.
Great Expectations ile Data Quality Tests
Great Expectations veri kalite beklentilerini tanımlamaya yardımcı olur. Null, range, uniqueness ve distribution kontrolleri yapılabilir. Data docs kalite sonuçlarını görünür hale getirebilir. Orchestration tool ile entegre edilebilir. Kullanılan expectation suite versionlanmalıdır.
Schema Drift Nedir?
Schema drift veri yapısının zaman içinde beklenmedik biçimde değişmesidir. Yeni kolon, silinen alan, type değişikliği veya kategori setindeki farklılık bu kapsama girebilir. Pipeline schema drift'i otomatik fark etmelidir. Her drift aynı severity seviyesinde değildir. Kritik model input değişikliği pipeline'ı durdururken opsiyonel yeni kolon warning ile kabul edilebilir.
Yeni Kolon Eklenmesi
Yeni kolon backward compatible olabilir. Model bu alanı kullanmıyorsa pipeline devam edebilir. Ancak veri contract değişikliği loglanmalıdır. Otomatik passthrough yapılmamalıdır. Yeni feature ancak review sonrası modele eklenmelidir.
Kolon Silinmesi
Model input column silindiyse prediction çalışmayabilir. Critical missing column hard error olmalıdır. Upstream owner bilgilendirilmelidir. Default value ile devam kararı açık rule gerektirir. Sessiz fallback yanlış prediction üretebilir.
Kolon Adının Değişmesi
Name change teknik olarak yeni ve silinen kolon gibi görünür. Alias mapping kontrollü biçimde kullanılabilir. Contract update gereklidir. Automatic fuzzy rename risklidir. Human approval daha güvenli olabilir.
Veri Tipinin Değişmesi
Numeric alan string'e dönebilir. Safe conversion mümkünse pipeline uygulayabilir. Conversion failure oranı ölçülmelidir. Source schema bug ise alert gönderilmelidir. Type drift model behavior'ı etkileyebilir.
Kategori Setinin Değişmesi
Yeni ürün veya status değeri normal business evolution olabilir. Encoder unknown category yönetebilmelidir. Unknown rate monitoring'e yazılmalıdır. Büyük artış drift sinyali olabilir. Model retraining gerekip gerekmediği değerlendirilmelidir.
Schema Drift'i Otomatik Tespit Etmek
Current schema baseline ile karşılaştırılabilir. Added, removed ve changed fields raporlanır. Severity rule uygulanır. CI veya runtime validation kullanılabilir. Alert owner'a yönlendirilmelidir.
Pipeline'ı Durdurmak mı Devam Ettirmek mi?
Karar drift'in model riskine göre verilmelidir. Critical field kaybı fail-fast gerektirir. Opsiyonel yeni kolon ignore edilebilir. Policy code içinde açık olmalıdır. Manual override audit edilmelidir.
Hatalı Veriyi Quarantine Alanına Göndermek
Invalid data doğrudan silinmemelidir. Quarantine storage inceleme için kullanılabilir. Batch ID ve error reason saklanır. Düzeltilen data yeniden işlenebilir. Böylece veri kaybı ve debugging problemi azalır.
Otomatik Veri Kalitesi Kapıları Nasıl Kurulur?
Quality gate, veri pipeline'ın belirli kalite koşullarını geçmeden sonraki aşamaya ilerlemesini engeller. Validation sadece başlangıçta değil kritik transformation adımlarından sonra da yapılabilir. Pass, warning ve fail seviyeleri tanımlanmalıdır. Hatalı dataset karantinaya alınabilir ve ilgili ekibe alert gönderilebilir. Bu sistem production preprocessing'i daha güvenilir ve kontrollü hale getirir.
Pipeline Başlamadan Önce Validation
Input schema ve basic quality kontrol edilir. Row count, required columns ve freshness doğrulanabilir. Kritik sorun varsa pipeline başlamaz. Böylece compute boşa harcanmaz. Error source owner'a hızlı iletilir.
Her Transformation Sonrası Validation
Imputation sonrası null count kontrol edilebilir. Encoding sonrası feature shape doğrulanabilir. Scaling sonrası NaN veya inf aranabilir. Her adımda full validation pahalı olabilir. Kritik noktalar seçilmelidir.
Pipeline Sonunda Validation
Final dataset model contract'a uymalıdır. Feature order, data type ve missing checks yapılır. Row count beklenmedik düşmüşse hata üretilir. Data quality score hesaplanabilir. Success durumunda training veya serving aşaması devam eder.
Pass/Fail Kuralları
Her kalite metric için threshold tanımlanabilir. Hard constraint fail üretir. Flexible metric warning olabilir. Threshold historical data ile kalibre edilmelidir. Rule değişiklikleri versionlanmalıdır.
Warning ve Error Seviyeleri
Her sorun pipeline'ı durdurmak zorunda değildir. Warning izleme ve inceleme için yeterli olabilir. Error kritik iş kuralını temsil eder. Severity standardize edilmelidir. Alert mesajı action bilgisini içermelidir.
Hatalı Dataset'i Karantinaya Almak
Fail olan batch ayrı storage'a yazılabilir. Raw data korunur. Error metadata eklenir. Human veya automated repair sonrası replay yapılabilir. Quarantine retention policy ile yönetilmelidir.
Slack/E-posta Alert
Pipeline failure ekip iletişim kanalına gönderilebilir. Alert batch ID ve hata özetini içermelidir. Sensitive değerler paylaşılmamalıdır. Tekrarlanan hatalarda alert fatigue önlenmelidir. Ownership net olmalıdır.
Quality Gate Başarılıysa Sonraki Aşamaya Geçmek
Orchestrator task dependency quality sonucuna bağlanabilir. Pass olmadan training başlamaz. Warning policy'ye göre devam edebilir. Gate sonucu audit log'a yazılır. Böylece modelin hangi quality koşuluyla eğitildiği görülebilir.
Airflow ile Veri Ön İşleme Otomasyonu
Airflow preprocessing workflow'larını task ve dependency yapısıyla zamanlamak için kullanılabilir. Ingestion, validation, cleaning ve save aşamaları ayrı task'lara bölünebilir. Retry, backfill ve failure notification özellikleri production data pipeline'larında yararlıdır. Airflow veri dönüşüm kodunun kendisi değil, bu kodun ne zaman ve hangi sırayla çalışacağını yöneten orchestration katmanıdır. Küçük projelerde gereksiz olabilir ancak düzenli batch işlerinde güçlü kontrol sağlar.
Apache Airflow Nedir?
Apache Airflow workflow orchestration aracıdır. Python ile DAG tanımlamayı sağlar. Task scheduling ve dependency yönetir. Log ve retry mekanizmaları sunar. Data transformation logic ayrı Python kodunda tutulabilir.
DAG Nedir?
DAG task'lar arasındaki yönlü bağımlılık grafiğidir. Döngü içermez. Her task'ın upstream ve downstream ilişkisi tanımlanır. Schedule ile çalıştırılabilir. Run history UI üzerinden izlenebilir.
Preprocessing Adımlarını Task'lara Ayırmak
Pipeline tek dev task yerine anlamlı aşamalara bölünebilir. Her task bağımsız log üretir. Hata kaynağı daha kolay bulunur. Çok küçük task'lara bölmek de overhead yaratabilir. Task boundary veri ve operasyon anlamına göre seçilmelidir.
Ingestion Task
Source'dan data alır. Row count ve source metadata kaydeder. Data immutable raw zone'a yazılabilir. Failure downstream task'ları engeller. Retry network hatalarında uygulanabilir.
Validation Task
Schema ve quality checks çalıştırır. Fail durumunda pipeline durur. Validation report artifact olarak saklanır. Error owner'a bildirilir. Valid batch cleaning'e geçer.
Cleaning Task
Missing normalization, duplicate ve basic cleaning uygulanır. Transformation code versionlanır. Input-output row count kaydedilir. Hatalı kayıtlar quarantine edilebilir. Task idempotent tasarlanmalıdır.
Transformation Task
Encoding, scaling veya feature engineering çalıştırılabilir. Training pipeline'ı ise learned transformers artifact oluşturabilir. Batch serving ise mevcut artifact kullanılır. Feature schema doğrulanır. Output versioned storage'a yazılır.
Quality Check Task
Transformation sonrası final quality checks çalışır. NaN, inf ve schema kontrol edilir. Drift metric hesaplanabilir. Fail olduğunda save veya training task engellenir. Quality score loglanır.
Save Task
Valid processed dataset hedef storage'a yazılır. Dataset version atanır. Write operation atomic olmalıdır. Partial file görünür hale gelmemelidir. Metadata catalog güncellenebilir.
Task Dependency
Validation ingestion'dan sonra çalışmalıdır. Save quality check başarılı olmadan başlamamalıdır. Airflow dependency syntax bu sıralamayı açık tanımlar. Parallelizable task'lar paralel çalışabilir. Dependency graph operasyonu görünür hale getirir.
Scheduling
DAG günlük, saatlik veya başka schedule ile çalıştırılabilir. Schedule source freshness ihtiyacına göre seçilmelidir. Catchup davranışı kontrol edilmelidir. Timezone doğru tanımlanmalıdır. Gereksiz sık çalışma compute maliyetini artırır.
Retry
Geçici network veya service hatalarında retry faydalıdır. Data quality error gibi deterministic hata retry ile düzelmez. Retry count sınırlı olmalıdır. Backoff kullanılabilir. Retry reason metric olarak izlenebilir.
Failure Notification
Task fail olduğunda ilgili ekip bilgilendirilebilir. Alert run ID ve error summary içermelidir. Sensitive data eklenmemelidir. Owner mapping task veya dataset bazında olabilir. Repeated failures incident sürecine dönüşebilir.
Backfill
Geçmiş dönem verisini yeniden işlemek için backfill kullanılabilir. Preprocessing code geçmiş data ile compatible olmalıdır. Version seçimi önemlidir. Büyük backfill production kaynaklarını zorlayabilir. Rate ve partition kontrollü çalıştırılmalıdır.
Airflow Kullanılması Gereken Durumlar
Düzenli batch workflow, dependency ve retry ihtiyacı varsa Airflow değerlidir. Tek küçük script için fazla operasyon yükü oluşturabilir. Ekip orchestration platformunu yönetebilmelidir. Monitoring ve deployment standardı kurulmalıdır. Araç seçimi ihtiyaçtan başlamalıdır.
Prefect ve Dagster ile Preprocessing Otomasyonu
Prefect ve Dagster preprocessing workflow'ları için alternatif orchestration yaklaşımları sunar. Her aracın developer experience, deployment ve observability yaklaşımı farklıdır. En doğru seçim mevcut ekip yetkinliği ve operasyon ihtiyaçlarına göre yapılmalıdır. Workflow sayısı küçükse daha hafif çözüm tercih edilebilir. Büyük platformlarda asset, lineage ve dependency yönetimi daha önemli hale gelir.
Prefect
Prefect Python-first workflow tanımlama yaklaşımı sunar. Task retry ve orchestration özellikleri kullanılabilir. Local development deneyimi kolay olabilir. Deployment mimarisi ekip ihtiyacına göre seçilmelidir. Preprocessing logic workflow kodundan mümkün olduğunca ayrılmalıdır.
Dagster
Dagster data asset odaklı orchestration yaklaşımı sunar. Asset dependency ve materialization görünürlüğü data platformları için faydalıdır. Type ve metadata entegrasyonu güçlü olabilir. Learning curve ekipten ekibe değişir. Production adoption küçük proof-of-concept ile doğrulanmalıdır.
Airflow vs Prefect vs Dagster
Airflow olgun batch orchestration ekosistemine sahiptir. Prefect daha hafif Python workflow deneyimi sunabilir. Dagster asset-centric tasarımda güçlü olabilir. Tek bir kazanan yoktur. Deployment, monitoring ve ekip deneyimi seçimde belirleyicidir.
Hangi Orkestrasyon Aracı Ne Zaman Kullanılmalı?
Mevcut platform standardı varsa yeni araç eklemek gereksiz olabilir. Küçük ekip kolay geliştirme ve düşük operasyon yükü isteyebilir. Büyük data platformu lineage ve asset management'a önem verebilir. Tool benchmark sadece feature listesine göre yapılmamalıdır. Total operational cost dikkate alınmalıdır.
Batch ve Streaming Veri Ön İşleme
Batch preprocessing belirli zaman aralıklarında veri gruplarını işlerken streaming preprocessing olayları sürekli veya düşük gecikmeyle işler. İki yaklaşımın latency, state ve hata yönetimi farklıdır. Mümkün olduğunda business transformation kuralları ortak kütüphane içinde tutulmalıdır. Böylece batch training ile online serving arasında logic farkı azalır. Streaming yalnızca gerçek zaman ihtiyacı varsa seçilmelidir.
Batch Preprocessing Nedir?
Batch processing veriyi dosya veya partition halinde işler. Günlük model training dataset'i buna örnektir. Debug ve replay görece kolaydır. Büyük batch memory ve runtime gerektirebilir. Scheduling orchestration tool ile yönetilebilir.
Streaming Preprocessing Nedir?
Streaming data event geldikçe işlenir. Online fraud detection gibi düşük latency ihtiyacında kullanılır. State management daha zordur. Exactly-once veya at-least-once semantics düşünülmelidir. Data quality check event ve window seviyesinde uygulanabilir.
Gerçek Zamanlı Veri Temizleme
Schema ve basic range validation event sırasında yapılabilir. Invalid event quarantine veya dead-letter topic'e gönderilebilir. Ağır profiling online path'e eklenmemelidir. Low-latency constraint preprocessing tasarımını etkiler. Offline ve online rule parity test edilmelidir.
Event-Driven Pipeline
Yeni event belirli preprocessing flow'u tetikleyebilir. Consumer idempotent olmalıdır. Duplicate event handling gerekir. Retry queue kullanılabilir. Processing result observability sistemine yazılmalıdır.
Kafka ile Streaming
Kafka event stream taşıma katmanı olarak kullanılabilir. Producer ve consumer schema contract önemlidir. Partition key ordering davranışını etkiler. Consumer lag monitoring gerekir. Kafka preprocessing logic'in kendisi değildir.
Batch ve Streaming İçin Aynı İş Kurallarını Kullanmak
Shared transformation library iki path'te de kullanılabilir. Feature definitions merkezi tutulabilir. Online ve offline outputs parity testine tabi tutulmalıdır. Time window semantics aynı olmalıdır. Bu yaklaşım training-serving skew'i azaltır.
Büyük Veride Preprocessing Otomasyonu
Dataset RAM kapasitesini aştığında preprocessing yaklaşımının değişmesi gerekir. Pandas küçük ve orta veri için oldukça kullanışlıdır ancak distributed veya columnar execution ihtiyacı büyüdükçe başka araçlar tercih edilebilir. Polars, Dask ve PySpark farklı ölçek ve execution modelleri sunar. Araç seçimi yalnızca veri boyutuna değil join, aggregation ve cluster altyapısına göre yapılmalıdır. En hızlı görünen framework yerine ekip tarafından güvenilir biçimde işletilebilen çözüm tercih edilmelidir.
Pandas'ın Sınırları
Pandas çoğunlukla tek makine memory'sinde çalışır. Büyük dataset RAM sınırına çarpabilir. Bazı operation'lar single-thread davranabilir. Yine de birçok proje için yeterlidir. Optimization yapılmadan distributed sisteme geçmek gereksiz olabilir.
Polars
Polars columnar ve parallel execution yaklaşımıyla yüksek performans sağlayabilir. Lazy execution büyük pipeline'larda yararlıdır. API Pandas'tan farklılık gösterebilir. Mevcut ekip öğrenme maliyeti değerlendirilmelidir. Gerçek workload benchmark edilmelidir.
Dask
Dask Pandas benzeri API ile partitioned computation sunar. Tek makine veya cluster üzerinde çalışabilir. Her pandas operation birebir aynı performansı vermeyebilir. Partition strategy önemlidir. Scheduler overhead küçük dataset'te gereksiz olabilir.
PySpark
PySpark distributed big data processing için güçlü seçenektir. Büyük join ve aggregation workload'larında kullanılır. Cluster operasyon maliyeti vardır. Small dataset'te overhead yüksek olabilir. Spark ML pipeline entegrasyonu ayrıca değerlendirilebilir.
Pandas vs Polars vs Dask vs PySpark
Pandas en basit single-node seçeneklerden biridir. Polars single-node performance için güçlü olabilir. Dask Python-first distributed yaklaşım sunar. PySpark büyük cluster workload'larında olgun ekosisteme sahiptir. Seçim gerçek benchmark ve altyapı ihtiyacına göre yapılmalıdır.
Lazy Execution
Lazy execution işlem planını hemen çalıştırmak yerine optimize ederek daha sonra yürütür. Gereksiz kolon okumaları azaltılabilir. Query optimization avantajı sağlar. Debug davranışı eager execution'dan farklı olabilir. Monitoring execution plan seviyesinde yapılmalıdır.
Distributed Processing
Distributed processing veriyi partition'lara ayırarak birden fazla worker kullanır. Network shuffle pahalı olabilir. Small file problemi performansı düşürebilir. Fault tolerance ve retry düşünülmelidir. Data partition strategy business key'e göre seçilebilir.
Bellek ve Performans Optimizasyonu
Doğru dtype memory kullanımını azaltabilir. Gereksiz kolonlar erken seçilmelidir. Intermediate dataset'ler kontrol edilmelidir. Vectorized operations tercih edilebilir. Performance profiling optimize edilecek gerçek bottleneck'i göstermelidir.
Feature Store Veri Ön İşleme Otomasyonunda Ne İşe Yarar?
Feature store feature tanımlarını ve serving behavior'ını merkezi yönetmeye yardımcı olur. Özellikle aynı feature'ın farklı modeller tarafından tekrar kullanıldığı kurumlarda değer sağlar. Offline training ve online serving arasında aynı feature logic'ini korumayı kolaylaştırabilir. Point-in-time correctness leakage önleme açısından önemlidir. Küçük projelerde feature store gereksiz olabilir, bu nedenle ihtiyaç gerçek reuse ve serving gereksinimlerinden çıkmalıdır.
Feature Store Nedir?
Feature store machine learning feature'larını tanımlamak, saklamak ve sunmak için kullanılan platform yaklaşımıdır. Feature metadata ve lineage tutabilir. Offline ve online retrieval destekleyebilir. Access control uygulanabilir. Model registry ile ilişkilendirilebilir.
Feature Definition'ları Merkezi Tutmak
Feature hesaplama logic'i ortak repository veya platformda tutulur. Ekipler aynı feature'ı farklı biçimde yazmaz. Version değişiklikleri görünür olur. Training ve serving aynı tanımdan yararlanır. Data contract yönetimi kolaylaşır.
Feature Tekrar Kullanımı
Müşteri toplam harcama gibi feature birçok modelde kullanılabilir. Her ekip yeniden hesaplamaz. Compute maliyeti azalabilir. Semantics standard hale gelir. Owner ve freshness metadata'sı önemlidir.
Offline Feature Store
Training dataset için tarihsel feature değerlerini sunar. Büyük batch query destekleyebilir. Point-in-time lookup önemlidir. Gelecek data leakage önlenmelidir. Storage data lake veya warehouse üzerinde olabilir.
Online Feature Store
Low-latency prediction için feature değerini hızlı sunar. Key-based retrieval kullanabilir. Freshness kritik hale gelir. Online ve offline consistency test edilmelidir. Her model online store gerektirmez.
Point-in-Time Correctness
Training sample yalnızca prediction anına kadar bilinen veriyi kullanmalıdır. Gelecekte oluşan transaction feature'a sızmamalıdır. Feature store timestamp-aware join ile yardımcı olabilir. Backfill sırasında da bu kural korunmalıdır. Leakage testleri temporal dataset üzerinde yapılmalıdır.
Training-Serving Skew'i Azaltmak
Aynı feature definition offline ve online ortamda paylaşılır. Farklı hesaplama kodu azalır. Parity metric düzenli ölçülmelidir. Source freshness farkı yine sorun yaratabilir. Feature store tek başına bütün skew problemini çözmez.
Feature Lineage
Feature'ın hangi source ve transformation'dan geldiği kaydedilir. Model hangi feature version'ı kullandı görülebilir. Debug süresi azalır. Audit için faydalıdır. Upstream değişikliğin etkilenen modelleri bulunabilir.
AutoML Veri Ön İşlemeyi Nasıl Otomatikleştirir?
AutoML preprocessing ve model seçimini birlikte deneyerek hızlı baseline oluşturabilir. Imputation, encoding ve scaling seçenekleri model pipeline'ın bir parçası olarak otomatik karşılaştırılabilir. Bununla birlikte data leakage, business constraints ve security kararları tamamen AutoML sistemine bırakılmamalıdır. Seçilen pipeline production'a geçmeden anlaşılmalı ve test edilmelidir. AutoML iyi bir arama motoru olabilir ancak veri yönetişiminin yerine geçmez.
AutoML Nedir?
AutoML model ve preprocessing seçeneklerini belirli arama stratejisiyle otomatik test eder. Amaç manuel deneme sayısını azaltmaktır. Search budget compute maliyetini belirler. Cross-validation doğru kurulmalıdır. Final model açıklanabilir ve export edilebilir olmalıdır.
Otomatik Imputation
AutoML farklı imputation strategy'lerini deneyebilir. Mean, median veya categorical fill karşılaştırılabilir. Selection validation score'a göre yapılabilir. Business constraints ayrıca uygulanmalıdır. Chosen strategy pipeline artifact içinde saklanmalıdır.
Otomatik Encoding
Kategori cardinality ve model türüne göre farklı encoder test edilebilir. One-hot veya ordinal seçenekleri denenebilir. Target encoding leakage-safe uygulanmalıdır. Unknown categories production policy gerektirir. AutoML sonucu human review'dan geçirilebilir.
Otomatik Scaling
Scaler seçenekleri model pipeline ile birlikte değerlendirilebilir. Tree model scaling olmadan daha iyi çalışabilir. Linear model StandardScaler ile fayda görebilir. Search space gereksiz geniş tutulmamalıdır. Compute budget kontrol edilmelidir.
Otomatik Feature Engineering
Polynomial veya interaction feature üretimi search sürecine dahil edilebilir. Feature explosion riski vardır. Memory ve training time artabilir. Validation score overfitting'i sınırlamak için yeterli olmayabilir. Simplicity penalty düşünülebilir.
Otomatik Feature Selection
Selector method ve threshold arama uzayına alınabilir. Cross-validation içinde fit edilmelidir. Test set seçime karışmamalıdır. Feature stability incelenebilir. Daha az feature aynı skoru veriyorsa sade model tercih edilebilir.
Model Selection ile Birlikte Preprocessing Optimizasyonu
Preprocessing ve model birbirinden bağımsız seçilmemelidir. KNN scaling isterken tree model istemeyebilir. AutoML bu kombinasyonları birlikte test edebilir. Search space domain bilgisiyle daraltılabilir. Production latency final seçimde dahil edilmelidir.
Auto-Sklearn
Auto-Sklearn scikit-learn ekosistemi üzerinde automated model selection yaklaşımı sunar. Farklı preprocessing ve estimator kombinasyonları test edebilir. Dataset size ve compute budget dikkate alınmalıdır. Reproducibility ayarları önemlidir. Production export süreci önceden doğrulanmalıdır.
TPOT
TPOT pipeline kombinasyonlarını evolutionary search ile keşfetmeye çalışır. İlginç preprocessing zincirleri üretebilir. Search maliyeti yüksek olabilir. Elde edilen pipeline sadeleştirilmeye ihtiyaç duyabilir. Production'a doğrudan taşımadan önce review yapılmalıdır.
AutoGluon
AutoGluon otomatik model ve ensemble oluşturma yaklaşımı sunar. Tabular data üzerinde hızlı baseline için kullanılabilir. Preprocessing davranışı framework tarafından yönetilebilir. Artifact size ve inference latency değerlendirilmelidir. Business constraints ayrıca uygulanmalıdır.
FLAML
FLAML compute-efficient AutoML yaklaşımına odaklanır. Search budget sınırlı projelerde değerlendirilebilir. Kullanılan preprocessing seçenekleri incelenmelidir. Production environment compatibility test edilmelidir. Baseline karşılaştırması manuel pipeline ile yapılabilir.
AutoML'in Sınırları
AutoML domain bilgisini tam olarak bilemez. Data contract ve access policy kararlarını çözmez. Leakage yanlış dataset hazırlığında yine oluşabilir. Model seçimi business cost'u her zaman doğru temsil etmez. Human review ve monitoring zorunluluğu devam eder.
Yapay Zeka ile Veri Ön İşleme Otomasyonu
Yapay zeka tabanlı araçlar veri kalitesi problemlerini açıklama, cleaning rule önerme ve free-text standardizasyonunda yardımcı olabilir. Ancak bu kullanım alanlarında model çıktısı deterministic değildir. Özellikle kritik veri üzerinde öneri ile doğrudan değişiklik birbirinden ayrılmalıdır. AI önerileri human approval veya strict validation katmanından geçmelidir. Amaç insanı tamamen çıkarmak değil, yüksek hacimli kalite incelemesini daha verimli hale getirmektir.
LLM ile Veri Kalitesi Problemlerini Açıklamak
LLM profiling report'u okuyup olası sorunları doğal dille açıklayabilir. Null artışı veya category drift hakkında özet üretebilir. Bu açıklama otomatik karar değildir. Metric değerleri source of truth olarak korunmalıdır. Human operator öneriyi değerlendirebilir.
Otomatik Cleaning Kuralı Önerme
Model belirli kolon için normalization rule önerebilir. Örneğin telefon formatlarını standardize etme fikri sunabilir. Rule önce test dataset üzerinde denenmelidir. Beklenmeyen değişiklik sayısı ölçülmelidir. Approved rule deterministic code haline getirilmelidir.
Kolon Anlamını Tahmin Etmek
Column name ve sample values semantic type tahmini için kullanılabilir. E-posta, telefon veya adres gibi field'lar tanınabilir. Confidence düşükse human review gerekir. Sensitive field detection'a yardımcı olabilir. Schema source of truth olarak kalmalıdır.
Semantik Duplicate Detection
Embedding veya LLM benzer anlama gelen kayıtları bulabilir. Exact matching'in yakalayamadığı durumlar için faydalıdır. False positive riski yüksektir. Candidate pair listesi human review'a gönderilebilir. Otomatik silme yerine match score threshold kullanılmalıdır.
Free-Text Verileri Standardize Etmek
Serbest metinlerde farklı yazım biçimleri normalize edilebilir. LLM category mapping önerebilir. Original text korunmalıdır. Mapping deterministic sözlüğe dönüştürülebilir. Kritik alanlarda doğrudan free-form rewrite tercih edilmemelidir.
AI Destekli Imputation
Context kullanarak eksik text veya category tahmini yapılabilir. Bu yaklaşım yüksek belirsizlik taşır. Tahmin original fact olarak sunulmamalıdır. Confidence ve provenance tutulmalıdır. Kritik veri setlerinde klasik imputation daha güvenli olabilir.
AI Kararlarını İnsan Onayından Geçirmek
AI çıktısı review queue'ya gönderilebilir. İnsan approve, reject veya edit kararı verir. Feedback daha sonra rule geliştirmede kullanılabilir. Decision audit log'a yazılır. Bu yapı kontrolsüz otomasyonu önler.
AI Tabanlı Veri Temizlemenin Halüsinasyon Riski
LLM olmayan bir değeri mantıklı görünerek üretebilir. Bu nedenle generated value doğrudan source fact kabul edilmemelidir. Validation ve confidence mekanizması gerekir. Sensitive dataset'te replacement yerine suggestion daha güvenlidir. Human review önemli kontrol katmanıdır.
Veri Ön İşleme Pipeline'ı Nasıl Test Edilir?
Preprocessing pipeline kod gibi test edilmelidir. Unit test tek transformation davranışını, integration test bileşenlerin birlikte çalışmasını ve end-to-end test bütün akışı doğrular. Golden dataset beklenen output'u sabit örneklerle kontrol etmeyi sağlar. Edge case dataset boş, null veya beklenmeyen kategori gibi zor durumları kapsar. Testler CI/CD pipeline içinde otomatik çalıştırılmalıdır.
Unit Test
Tek fonksiyon veya transformer küçük input üzerinde test edilir. Beklenen output açık olmalıdır. Null ve type edge case eklenmelidir. Test hızlı çalışmalıdır. Her bug için regression test eklenebilir.
Transformation Testleri
Scaling, encoding ve imputation output'u kontrol edilir. Shape ve dtype doğrulanabilir. Learned parameters expected range içinde olmalıdır. Invalid value davranışı test edilir. Deterministic output beklenir.
Schema Testleri
Required columns ve types test edilir. Missing column fail etmelidir. Extra column policy doğrulanır. Nullability kuralları test edilir. Schema version compatibility kontrol edilir.
Data Quality Testleri
Null ratio, duplicate count ve allowed values kontrol edilebilir. Threshold üzerinde test fail eder. Sample data gerçek pattern'leri temsil etmelidir. Quality tests unit ve runtime seviyesinde olabilir. Historical incident'lar test suite'e eklenmelidir.
Integration Test
Ingestion, validation ve transformation birlikte test edilir. External service mock kullanılabilir. Artifact save ve load doğrulanır. Error propagation kontrol edilir. Test production'a benzer environment'ta çalışabilir.
End-to-End Test
Raw input'tan final model prediction'a kadar bütün akış yürütülür. Schema, preprocessing ve model compatibility doğrulanır. Known sample expected output ile karşılaştırılır. Deployment öncesi güçlü güvence sağlar. Test süresi uzun olabileceği için release pipeline'da çalıştırılabilir.
Golden Dataset
Golden dataset sabit expected transformations içerir. Küçük fakat temsil gücü yüksek olmalıdır. Version control içinde tutulabilir. Output snapshot ile karşılaştırılabilir. Pipeline değişikliği intentional ise golden output review edilir.
Edge Case Dataset
Tam null sütun, unknown category ve extreme value gibi örnekler eklenir. Empty dataset davranışı test edilir. Unicode ve locale durumları dahil edilebilir. Hedef production'da nadir fakat kırıcı durumları önceden görmek olur. Incident sonrası yeni edge case eklenmelidir.
Regression Test
Daha önce doğru çalışan behavior yeni version'da bozulmamalıdır. Feature count ve output values karşılaştırılabilir. Model performance küçük benchmark'ta kontrol edilebilir. Library upgrade sonrası özellikle önemlidir. Failure deployment'ı engelleyebilir.
Property-Based Testing
Property-based test farklı otomatik input'lar üretir. Örneğin scaler output'unda NaN oluşmaması property olabilir. Hypothesis gibi araçlar kullanılabilir. Edge case discovery'yi artırır. Critical transformation'larda güçlü tamamlayıcı yöntemdir.
CI/CD ile Preprocessing Testlerini Otomatikleştirmek
CI/CD preprocessing kodundaki değişiklikleri production'a çıkmadan önce test etmeyi sağlar. Git push veya pull request sonrası unit, schema ve regression testleri otomatik çalıştırılabilir. Başarısız kalite kapısı deployment'ı engeller. Pipeline artifact versionlanarak modelle eşleştirilebilir. Böylece preprocessing değişiklikleri kontrolsüz biçimde production'a ulaşmaz.
Git Push Sonrası Test Çalıştırmak
Repository update CI job tetikleyebilir. Unit ve lint testleri hızlı çalışır. Small golden dataset kullanılabilir. Failure developer'a geri bildirim verir. Main branch protection uygulanabilir.
Pull Request Quality Gate
PR merge öncesi testlerin geçmesi zorunlu tutulabilir. Schema compatibility kontrol edilir. Code review preprocessing logic değişikliğini inceler. Performance regression threshold eklenebilir. Approval olmadan critical pipeline değişikliği birleşmez.
Schema Compatibility Test
Yeni schema version eski consumer'ları bozuyor mu kontrol edilir. Required column kaldırma breaking change olabilir. Backward compatibility rule uygulanabilir. Contract diff otomatik raporlanabilir. Breaking change explicit migration gerektirir.
Preprocessing Regression Testleri
Golden input eski ve yeni pipeline'dan geçirilir. Feature output farkı ölçülür. Intentional değişiklik review gerektirir. Unexpected drift build'i fail eder. Model metric de küçük sample üzerinde kontrol edilebilir.
Pipeline Artifact Oluşturmak
Testler geçtiğinde versioned pipeline artifact build edilir. Checksum ve dependency metadata eklenir. Artifact registry'ye yüklenebilir. Immutable version kullanılır. Production exact artifact'ı deploy eder.
Production Deployment
Canary veya staged deployment tercih edilebilir. Health check ve parity test çalıştırılır. Error rate izlenir. Rollback hazır olmalıdır. Deployment pipeline version metadata'sını sisteme kaydeder.
Preprocessing Pipeline Nasıl Versiyonlanır?
Preprocessing yalnızca kod version'ından ibaret değildir. Dataset, schema, feature definition, transformer ve model version ilişkileri birlikte takip edilmelidir. Aynı model farklı preprocessing ile çalıştırılırsa prediction behavior değişebilir. Registry veya metadata catalog bu ilişkileri saklayabilir. Rollback sırasında yalnızca model değil doğru preprocessing version da geri alınmalıdır.
Kod Versiyonu
Git commit preprocessing source code'u temsil eder. Release tag kullanılabilir. Artifact metadata commit hash içerebilir. Hotfix history görünür olur. Reproducibility güçlenir.
Veri Versiyonu
Training dataset snapshot veya partition ID ile versionlanabilir. Aynı code farklı data ile farklı sonuç üretir. Dataset lineage saklanmalıdır. Privacy nedeniyle raw data version storage kontrollü olmalıdır. Model registry dataset version'a referans verebilir.
Schema Versiyonu
Schema değişikliği semver benzeri stratejiyle versionlanabilir. Breaking change major increment olabilir. Pipeline hangi schema'ları kabul ettiğini belirtir. Compatibility CI'da test edilir. Upstream owner değişiklikten haberdar edilir.
Feature Versiyonu
Feature formula değiştiğinde version artmalıdır. Aynı isim altında farklı semantic tutmak risklidir. Feature store lineage sağlayabilir. Training ve serving aynı feature version kullanır. Migration plan açık olmalıdır.
Transformer Versiyonu
Scaler veya encoder configuration değişikliği output'u etkiler. Custom transformer code versionlanmalıdır. Serialized parameter values artifact içindedir. Library version metadata eklenir. Compatibility test yapılmalıdır.
Model ile Preprocessing Versiyonunu Eşleştirmek
Model registry preprocessing artifact ID saklayabilir. Serving model yüklerken doğru pipeline'ı da yükler. Yanlış eşleşme deployment error olmalıdır. Bundle artifact yaklaşımı kullanılabilir. Rollback ikisini birlikte geri almalıdır.
Geri Alma ve Rollback
Last-known-good pipeline artifact saklanmalıdır. Deployment pointer önceki version'a döndürülebilir. Data migration varsa backward compatibility düşünülmelidir. Rollback procedure düzenli test edilmelidir. Incident sırasında yeniden build beklenmemelidir.
Data Lineage Nedir?
Data lineage verinin kaynaktan modele kadar hangi adımlardan geçtiğini gösterir. Hangi dataset'in hangi transformation ile işlendiği ve hangi model eğitiminde kullanıldığı takip edilebilir. Bu bilgi debug, audit ve regülasyon açısından değerlidir. Upstream değişiklik olduğunda etkilenen downstream modeller bulunabilir. Otomatik preprocessing sisteminde lineage gözlemlenebilirliğin temel parçalarından biridir.
Veri Nereden Geldi?
Source system ve table veya file ID kaydedilmelidir. Batch timestamp önemlidir. Data owner metadata eklenebilir. Source version mümkünse tutulur. Bu bilgi debugging başlangıç noktasıdır.
Hangi Transformation'lardan Geçti?
Her preprocessing step lineage event oluşturabilir. Transformer version ve parameters kaydedilir. Input-output dataset ilişkisi saklanır. Sensitive value loglanmaz. Audit trail teknik değişimi görünür kılar.
Hangi Pipeline Versiyonu Kullanıldı?
Her run pipeline version ID taşımalıdır. Git commit ve artifact version eklenebilir. Aynı data farklı pipeline ile yeniden işlenebilir. Result comparison kolaylaşır. Incident root cause bulunabilir.
Hangi Dataset Modeli Eğitti?
Model registry training dataset version'a referans vermelidir. Validation dataset de ayrı kaydedilebilir. Preprocessing version ilişkilendirilir. Model score context kazanır. Reproducibility güçlenir.
Lineage'in Debug Sürecindeki Önemi
Model skoru düştüğünde source veya transformation değişikliği araştırılabilir. Hangi batch'te değişim başladığı görülür. Schema drift ile model degradation ilişkilendirilebilir. Debug süresi kısalır. Guesswork azalır.
Audit ve Regülasyon Açısından Lineage
Hangi verinin ne amaçla işlendiği izlenebilir. Sensitive data flow görülebilir. Model kararının training dataset'i bulunabilir. Retention policy uygulanabilir. Hukuki gereksinimler kurumun uzmanlarıyla birlikte değerlendirilmelidir.
Production'da Preprocessing Pipeline Monitoring
Production preprocessing pipeline çalışıyor görünse bile veri kalitesi bozulabilir. Bu nedenle başarı oranı, satır sayısı, null, duplicate, outlier, unknown category ve schema failure gibi metric'ler izlenmelidir. Processing latency ve maliyet de operasyon açısından önemlidir. Baseline değerlerden anlamlı sapma alert üretmelidir. Monitoring yalnızca infrastructure health değil data health bilgisini de göstermelidir.
Pipeline Başarı Oranı
Successful run sayısı toplam run sayısına oranlanabilir. Failure reason kategori bazında ayrılmalıdır. Retry sonrası success ayrı takip edilebilir. Ani düşüş upstream issue gösterebilir. SLO tanımlanabilir.
İşlenen Satır Sayısı
Her batch row count metric üretmelidir. Historical baseline ile karşılaştırılır. Ani düşüş source ingestion sorununa işaret edebilir. Ani artış duplicate issue olabilir. Partition bazında izleme faydalıdır.
İşlem Süresi
Total runtime ve step-level duration izlenmelidir. Data volume ile normalize edilebilir. Ani latency artışı code regression gösterebilir. P95 runtime schedule overlap riskini gösterir. Performance optimization metric'e dayanmalıdır.
Eksik Veri Oranı
Critical feature'ların missing ratio izlenir. Baseline'dan sapma drift olabilir. Threshold aşılırsa alert üretilir. Imputation sonrası oran ayrıca kontrol edilir. Source owner'a issue iletilebilir.
Duplicate Oranı
Duplicate ratio batch quality sinyalidir. Ani artış ingestion replay veya upstream bug gösterebilir. Cleaning öncesi ve sonrası değer saklanır. High ratio pipeline'ı fail ettirebilir. Business key bazlı metric daha anlamlı olabilir.
Outlier Oranı
Outlier candidate oranı zaman içinde takip edilebilir. Ani yükseliş gerçek business event de olabilir. Bu nedenle alert human review'a yönlendirilebilir. Feature bazında metric tutulmalıdır. Automatic deletion yapılmamalıdır.
Bilinmeyen Kategori Oranı
Encoder unknown category count üretebilir. Bu oran category drift sinyalidir. Yeni ürün launch döneminde normal olabilir. Threshold context'e göre belirlenmelidir. Retraining ihtiyacını gösterebilir.
Schema Failure Sayısı
Eksik kolon ve type error gibi failures sayılmalıdır. Source bazında dashboard oluşturulabilir. Repeated failure data contract problemini gösterir. Severity ayrımı yapılmalıdır. Owner accountability net olmalıdır.
Data Quality Score
Birden fazla metric weighted score içinde özetlenebilir. Tek score detay metric'lerin yerini almamalıdır. Trend takibi kolaylaşır. Weight business impact'e göre seçilmelidir. Kritik rule fail olduğunda score yüksek olsa bile pipeline durabilir.
Preprocessing Latency
Online serving için preprocessing latency doğrudan kullanıcı deneyimini etkiler. Batch işlerde schedule window önemlidir. Step-level tracing bottleneck'i gösterir. Heavy transformation optimize edilebilir. Model inference latency ile birlikte izlenebilir.
Pipeline Maliyeti
Compute, storage ve orchestration maliyeti takip edilebilir. Cost per million rows faydalı metriktir. Distributed processing gereksiz kullanılıyorsa maliyet artabilir. Retry ve backfill de maliyete dahildir. Optimization quality ile birlikte yapılmalıdır.
Data Drift Nasıl Otomatik Tespit Edilir?
Data drift production verisinin training dağılımından zaman içinde farklılaşmasıdır. Feature distribution, kategori oranı veya missingness pattern'i değişebilir. Bu durum model performansını etkileyebilir ancak her drift otomatik olarak model hatası anlamına gelmez. Statistical test ve business threshold birlikte kullanılmalıdır. Drift alert sonrası retraining, investigation veya no-action kararı verilebilir.
Data Drift Nedir?
Data drift input distribution'ın zamanla değişmesidir. Model target ilişkisi değişmeden sadece input değişebilir. Concept drift farklı kavramdır. Drift feature bazında ölçülmelidir. Business event'lerle ilişkilendirilebilir.
Feature Distribution Drift
Numeric feature histogram veya quantile dağılımı baseline ile karşılaştırılır. KS test gibi yöntemler kullanılabilir. Büyük sample küçük farkı significant gösterebilir. Effect size dikkate alınmalıdır. Alert threshold domain'e göre seçilmelidir.
Categorical Drift
Kategori frequency dağılımı değişebilir. Yeni category ortaya çıkabilir. Chi-square veya distance metric kullanılabilir. Unknown rate güçlü sinyal olabilir. Business launch dönemleri threshold'u etkileyebilir.
Missingness Drift
Null oranındaki değişim source data problemine işaret edebilir. Missingness pattern feature bazında izlenir. Belirli segmentte artış olabilir. Baseline ve seasonality dikkate alınmalıdır. Critical feature için düşük threshold kullanılabilir.
Statistical Drift Tests
KS, chi-square veya Wasserstein distance gibi yöntemler kullanılabilir. Test seçimi data type'a uygun olmalıdır. P-value tek başına karar vermemelidir. Sample size etkisi yüksektir. Business relevance ile birlikte yorumlanmalıdır.
Population Stability Index
PSI dağılım değişimini bucket bazında ölçmek için kullanılabilir. Risk modeling gibi alanlarda yaygındır. Bin tanımı sonucu etkiler. Threshold körü körüne kullanılmamalıdır. Historical validation yapılmalıdır.
Evidently ile Drift Detection
Evidently data ve model monitoring raporları üretmek için kullanılabilir. Reference ve current dataset karşılaştırılabilir. Drift metric dashboard'a taşınabilir. Tool threshold'ları use case'e göre ayarlanmalıdır. Monitoring platformunun tek başına business karar vermediği unutulmamalıdır.
Drift Alert Eşikleri
Eşik çok düşükse alert fatigue oluşur. Çok yüksekse gerçek problem kaçabilir. Historical production data ile calibration yapılmalıdır. Critical feature farklı threshold kullanabilir. Warning ve error severity ayrılabilir.
Drift Sonrası Ne Yapılmalı?
Önce drift'in nedeni araştırılmalıdır. Source bug, business change veya seasonality olabilir. Model performance de kontrol edilmelidir. Gerekirse retraining tetiklenir. Otomatik retraining production'a kontrolsüz deploy edilmemelidir.
Pipeline Hatası Olduğunda Ne Yapılmalı?
Preprocessing pipeline hata durumunda nasıl davranacağını önceden bilmelidir. Bazı hatalar fail-fast gerektirirken bazı transient hatalar retry ile çözülebilir. Invalid data quarantine alanına alınabilir. Partial failure ve dead-letter queue streaming sistemlerinde kullanışlı olabilir. Incident kaydı root cause ve tekrar önleme sürecini destekler.
Fail Fast
Kritik schema veya access hatasında pipeline erken durmalıdır. Downstream yanlış data işlememelidir. Error açık ve actionable olmalıdır. Alert owner'a gönderilir. Fail-fast sessiz veri bozulmasını önler.
Retry
Network timeout gibi geçici hatalarda retry uygulanabilir. Deterministic validation hatasını tekrar etmek anlamsızdır. Retry count sınırlı olmalıdır. Metric olarak takip edilmelidir. Son failure incident'e dönüşebilir.
Exponential Backoff
Retry aralığını giderek artırır. Downstream service'in toparlanmasına zaman tanır. Jitter eklenebilir. Maximum delay belirlenmelidir. Data freshness SLA aşılmamalıdır.
Hatalı Veriyi Quarantine Etmek
Invalid record veya batch ayrı alana yazılır. Error reason eklenir. Data kaybolmaz. Human veya automated fix sonrası replay yapılabilir. Sensitive storage policy uygulanmalıdır.
Son Başarılı Veriye Dönmek
Bazı serving sistemlerinde last-known-good feature dataset kullanılabilir. Freshness warning kullanıcıya veya monitoring'e yansıtılmalıdır. Her use case stale data kabul etmez. Policy açık tanımlanmalıdır. Silent fallback risklidir.
Partial Failure
Bazı partition başarısız olup diğerleri başarılı olabilir. Output incomplete işaretlenmelidir. Downstream incomplete data kullanmamalıdır. Failed partitions ayrı retry edilebilir. Completion metadata gereklidir.
Dead-Letter Queue
İşlenemeyen event'ler DLQ'ya gönderilebilir. Main stream devam eder. Error metadata saklanır. Replay tooling gerekir. DLQ büyümesi alert üretmelidir.
İnsan Müdahalesi
Belirsiz veya high-impact error human intervention gerektirebilir. Runbook operator'a yol gösterir. Manual correction audit edilmelidir. Tekrarlanan problem automation backlog'a alınmalıdır. İnsan kararı sistemin permanent parçası olabilir.
Incident Kaydı
Production failure incident olarak kaydedilebilir. Root cause ve impact yazılır. Timeline ve affected datasets belirtilir. Follow-up action belirlenir. Yeni regression test eklenebilir.
Idempotent Veri Ön İşleme Nedir?
Idempotent preprocessing aynı veri birden fazla işlendiğinde istenmeyen tekrar veya farklı sonuç üretmemeyi amaçlar. Retry ve event-driven sistemlerde bu özellik önemlidir. Duplicate write veya double counting engellenmelidir. Idempotency key ve deterministic transformation birlikte kullanılabilir. Böylece pipeline hata sonrası güvenli biçimde yeniden çalıştırılabilir.
Aynı Veriyi İki Kez İşleme Problemi
Retry aynı batch'i yeniden çalıştırabilir. Output append ise duplicate records oluşabilir. Batch ID üzerinden işlem kontrol edilebilir. Write operation overwrite veya merge semantics kullanabilir. State store processed IDs tutabilir.
Duplicate Processing
At-least-once message delivery duplicate event üretebilir. Consumer aynı event'i tekrar almaya hazır olmalıdır. Event ID kontrol edilebilir. Aggregation double count engellenmelidir. Monitoring duplicate rate'i izleyebilir.
Idempotency Key
Her batch veya event unique key taşıyabilir. Processed key storage'da saklanır. Aynı key tekrar geldiğinde işlem skip edilebilir. Key generation deterministic olmalıdır. Retention süresi workflow ihtiyacına göre belirlenir.
Deterministic Transformations
Aynı input aynı output üretmelidir. Randomness varsa seed kontrol edilir. External time-dependent lookup dikkatli kullanılmalıdır. Transformation version sabitlenir. Reproducibility debugging'i kolaylaştırır.
Retry Sonrası Veri Tutarlılığı
Retry partial output'u bozmayacak biçimde tasarlanmalıdır. Atomic write veya staging table kullanılabilir. Success sonrası pointer güncellenebilir. Failed temporary files temizlenmelidir. Data consistency test edilmelidir.
KVKK ve Veri Güvenliği Açısından Otomatik Preprocessing
Otomatik preprocessing kişisel ve hassas veriyi büyük ölçekte işleyebileceği için privacy tasarımı baştan yapılmalıdır. Gereksiz kolonların kaldırılması, PII masking, pseudonymization ve retention politikaları pipeline'ın bir parçası olabilir. Loglarda hassas raw value tutulmamalıdır. Access control source ve processed dataset için ayrı uygulanmalıdır. KVKK yükümlülükleri kurumun hukuk ve veri güvenliği ekipleriyle birlikte değerlendirilmelidir.
Kişisel Verileri Tespit Etmek
Schema metadata PII field'ları işaretleyebilir. Pattern ve semantic detection yardımcı olabilir. False negative riski değerlendirilmelidir. Yeni column PII içeriyorsa review gerekir. Classification sonucu lineage metadata'sına yazılabilir.
PII Masking
E-posta veya telefon gibi değerler log ve test ortamında maskelenebilir. Masking format utility korunabilir. Production model gerçekten ihtiyaç duymuyorsa raw değer kaldırılabilir. Key management gerekebilir. Masked data yeniden tanımlanabilir olmamalıdır.
Anonimleştirme
Anonimleştirme kişiyi yeniden tanımlamayı amaç dışı bırakır. Basit hash her zaman anonimlik sağlamaz. Quasi-identifier kombinasyonları risk oluşturabilir. Yöntem hukuki ve teknik değerlendirme gerektirir. Dataset use case'e göre minimize edilmelidir.
Pseudonymization
Kimlik değerleri token veya surrogate ID ile değiştirilebilir. Mapping ayrı güvenli sistemde tutulur. Access minimum privilege ile sınırlandırılır. Model raw identifier'a ihtiyaç duymayabilir. Key rotation ve deletion planı düşünülmelidir.
Gereksiz Kolonları Kaldırmak
Modelin kullanmadığı PII alanları pipeline başında çıkarılabilir. Bu risk yüzeyini azaltır. Feature selection business need ile birlikte yapılmalıdır. Raw source ayrı erişim katmanında kalabilir. Processed dataset minimum veri içermelidir.
Veri Minimizasyonu
Sadece gerekli data işlenmelidir. Extra columns debug kolaylığı için production model dataset'ine taşınmamalıdır. Retention süresi amaca uygun olmalıdır. Sample logs küçük tutulmalıdır. Minimizasyon maliyeti de azaltır.
Hassas Verileri Loglamamak
Debug log raw row içermemelidir. ID ve hash kullanmak daha güvenli olabilir. Error sample maskelenmelidir. Log storage access kontrol edilmelidir. Retention kısa tutulabilir.
Yetkilendirme
Dataset access role veya service identity üzerinden yönetilmelidir. Pipeline service minimum permission ile çalışmalıdır. Production ve development credentials ayrılmalıdır. Audit log access event'lerini kaydedebilir. Secret'lar kod içinde tutulmamalıdır.
Data Retention
Raw, processed ve log data farklı retention süresine sahip olabilir. Expiration otomatik uygulanabilir. Backup retention ayrıca yönetilmelidir. Delete request lineage üzerinden ilgili artifact'ları bulabilmelidir. Policy düzenli test edilmelidir.
Veri Ön İşleme Otomasyonunda Kullanılan Python Kütüphaneleri
Python veri hazırlama, validation, orchestration ve monitoring alanlarında geniş araç ekosistemine sahiptir. Pandas ve NumPy temel veri işlemlerinde, Scikit-learn model pipeline'larında, Pandera ve Great Expectations validation tarafında öne çıkar. Büyük veri için Polars veya PySpark değerlendirilebilir. Featuretools feature üretiminde, Evidently drift monitoring'de kullanılabilir. Araç sayısını artırmak yerine her bileşenin hangi problemi çözdüğü net tutulmalıdır.
Pandas
Pandas tabular data processing için yaygın kullanılır. DataFrame API veri temizlemeyi kolaylaştırır. Küçük ve orta dataset'te güçlüdür. Memory sınırı büyük veri projelerinde önemlidir. Production code vectorized ve testli olmalıdır.
NumPy
NumPy sayısal array işlemlerinin temel kütüphanelerindendir. Pandas ve Scikit-learn altyapısında geniş kullanılır. Vectorized hesaplamalar performans sağlar. NaN handling dikkat ister. Numeric transformation için kullanışlıdır.
Scikit-learn
Scikit-learn transformer, Pipeline ve model API'si sunar. Imputer, scaler ve encoder hazır bileşenlerdir. Cross-validation ile preprocessing'i güvenli şekilde birleştirir. Tabular ML projelerinde güçlü standarttır. Artifact serialization version uyumu gerektirir.
Pandera
Pandera DataFrame schema validation için kullanılabilir. Type ve custom constraint tanımlanabilir. Python code ile uyumludur. Test ve runtime validation uygulanabilir. Data contract yaklaşımını destekler.
Great Expectations
Great Expectations data quality expectation tanımlamayı sağlar. Null, uniqueness ve range testleri yapılabilir. Validation report üretilebilir. Orchestration workflow'a bağlanabilir. Expectation suite versionlanmalıdır.
Polars
Polars hızlı columnar DataFrame işlemleri sunar. Lazy API optimization sağlayabilir. Large single-node workload'larda değerlendirilebilir. Pandas'tan syntax farkları vardır. Gerçek benchmark yapılmalıdır.
PySpark
PySpark distributed data processing için kullanılır. Büyük dataset ve cluster workload'larında faydalıdır. Spark DataFrame API geniştir. Operational overhead küçük projelerde yüksek olabilir. Partition ve shuffle davranışı optimize edilmelidir.
Featuretools
Featuretools automated feature synthesis için kullanılabilir. Relational dataset'lerde aggregation üretir. Temporal cutoff dikkatle yönetilmelidir. Feature explosion kontrol edilmelidir. Lineage metadata yararlıdır.
Imbalanced-learn
Imbalanced-learn class imbalance yöntemleri sunar. Resampling training pipeline içinde uygulanmalıdır. Test data yeniden örneklenmemelidir. SMOTE gibi yöntemler cross-validation içinde çalışmalıdır. Preprocessing pipeline ile entegre edilebilir.
Evidently
Evidently data ve model monitoring raporlarında kullanılabilir. Drift ve data quality metric'leri üretebilir. Reference-current karşılaştırması yapar. Dashboard veya batch report oluşturulabilir. Threshold'lar domain'e göre ayarlanmalıdır.
Veri Ön İşleme Otomasyonu İçin En İyi Programlama Dili Hangisi?
Tek bir programlama dili bütün veri pipeline ihtiyaçları için en iyi değildir. Python makine öğrenmesi ve data preprocessing ekosistemi nedeniyle sık tercih edilir. SQL data warehouse dönüşümlerinde, Scala ve Java büyük veri platformlarında güçlü seçenekler olabilir. R istatistiksel analiz açısından değerlidir. Programlama dilinden daha önemli konu, pipeline'ın test edilebilir, versioned ve training-serving parity sağlayacak biçimde tasarlanmasıdır.
Python
Python ML ve data kütüphaneleri açısından geniş ekosisteme sahiptir. Pandas ve Scikit-learn hızlı development sağlar. Airflow gibi orchestration araçlarıyla uyumludur. Production API geliştirilebilir. Dependency yönetimi dikkatle yapılmalıdır.
R
R istatistiksel analiz ve veri bilimi için güçlü araçlara sahiptir. Araştırma ve modelleme ekiplerinde yaygın olabilir. Production integration kurum altyapısına göre değerlendirilir. Reproducible package management önemlidir. Python'a geçmek zorunlu değildir.
SQL
SQL warehouse içinde filtreleme ve aggregation için oldukça etkilidir. Data transformation source'a yakın çalışabilir. Büyük tablo işlemlerinde network transferini azaltabilir. ML-specific encoding ve model pipeline için başka dil gerekebilir. SQL transformation version control içinde tutulmalıdır.
Scala
Scala Spark ekosisteminde güçlü kullanıma sahiptir. Distributed data platformlarında tercih edilebilir. Learning curve Python'dan farklıdır. Existing Spark team için doğal seçim olabilir. Model serving başka stack kullanabilir.
Java
Java enterprise data platformlarında güçlü production seçeneğidir. Büyük backend sistemleriyle entegrasyon sağlar. ML preprocessing için ayrı servis çağrısı kullanılabilir. Typed contract avantajı vardır. Mevcut ekip standardı önemlidir.
Python Neden Makine Öğrenmesi Pipeline'larında Öne Çıkıyor?
Python veri analizi, ML ve orchestration araçlarını aynı ekosistemde birleştirir. Prototipten production'a geçiş hızlı olabilir. Community kaynakları geniştir. Custom transformer yazmak kolaydır. Buna rağmen code quality ve test disiplini zorunludur.
Programlama Dilinden Daha Önemli Olan Pipeline Tasarımı
Kötü tasarlanmış Python pipeline iyi tasarlanmış SQL veya Java pipeline'dan üstün değildir. Data contract, idempotency, validation ve observability daha önemlidir. Training-serving parity korunmalıdır. Failure behavior açık olmalıdır. Dil seçimi ekip kapasitesine göre yapılmalıdır.
Uçtan Uca Örnek Otomatik Preprocessing Projesi
Uçtan uca proje gerçek bir production akışını küçük ölçekte taklit etmelidir. Ham veri alınır, schema validation ve profiling yapılır, preprocessing pipeline çalışır ve final quality gate sonuç üretir. Model training aynı pipeline artifact'ını kullanır. Airflow günlük çalıştırma, monitoring ve drift detection ile süreci otomatik hale getirir. Bu yapı teori yerine ölçülebilir ve tekrar üretilebilir veri mühendisliği pratiği kazandırır.
Örnek Veri Setini Tanımlamak
Dataset feature ve target alanları açıkça tanımlanır. Business meaning document edilir. Required ve optional columns belirlenir. PII alanları sınıflandırılır. Golden sample hazırlanır.
Ham Veriyi Almak
CSV, database veya API source kullanılabilir. Raw copy immutable storage'a yazılır. Batch ID oluşturulur. Row count ve checksum hesaplanır. Source failure loglanır.
Schema Validation
Required columns ve types kontrol edilir. Null thresholds uygulanır. Unique constraints doğrulanır. Invalid batch quarantine edilir. Validation result artifact olarak saklanır.
Data Profiling
Distribution ve missingness raporu oluşturulur. Duplicate oranı hesaplanır. Category cardinality çıkarılır. Baseline ile karşılaştırılır. Preprocessing configuration doğrulanır.
Missing Value Processing
Numeric median ve categorical constant gibi stratejiler uygulanabilir. Imputer training data üzerinde fit edilir. Missing indicator eklenebilir. Null output kontrol edilir. Strategy versionlanır.
Outlier Processing
IQR aday outlier'ları işaretleyebilir. Critical business feature otomatik silinmez. Winsorization test edilebilir. Outlier ratio loglanır. Human review threshold'u olabilir.
Categorical Encoding
One-hot veya başka encoder kullanılır. Unknown category policy tanımlanır. High cardinality kontrol edilir. Encoder artifact içinde saklanır. Production aynı mapping'i kullanır.
Scaling
Model gerektiriyorsa scaler eklenir. Fit yalnızca training subset üzerinde çalışır. RobustScaler alternatif olabilir. Output NaN check yapılır. Feature distribution izlenir.
Feature Engineering
Date ve interaction feature'ları eklenebilir. Logic deterministic olmalıdır. Temporal leakage kontrol edilir. Feature names metadata'ya yazılır. Contribution model validation ile ölçülür.
Data Quality Gate
Final feature matrix schema kontrolünden geçer. NaN ve inf aranır. Row count threshold doğrulanır. Quality score hesaplanır. Pass olmadan training başlamaz.
Train-Test Split
Split transformation fit işlemlerinden önce yapılır. Stratification uygulanabilir. Time series chronological split kullanır. Test data korunur. Seed metadata'da saklanır.
Pipeline ile Model Training
Preprocessing ve estimator tek Pipeline içinde tanımlanır. Cross-validation çalıştırılır. Hyperparameter tuning leakage-safe olur. Final model fit edilir. Metrics model registry'ye yazılır.
Pipeline Artifact'ını Kaydetmek
Model ve preprocessing artifact serialize edilir. Version ve checksum atanır. Dependency metadata kaydedilir. Registry'ye yüklenir. Access controlled storage kullanılır.
Airflow ile Günlük Çalıştırmak
Ingestion ve validation task'ları DAG içinde tanımlanır. Daily schedule uygulanır. Retry network failures için kullanılır. Quality gate failure alert gönderir. Successful run metadata catalog'a yazılır.
Monitoring
Row count ve missing ratio dashboard'a yazılır. Runtime ve failure rate izlenir. Unknown category rate takip edilir. Cost metric eklenir. SLO ihlali alert üretir.
Drift Detection
Current data training reference ile karşılaştırılır. Numeric ve categorical drift ölçülür. Threshold üzerinde warning oluşturulur. Model performance varsa birlikte incelenir. Retraining kararı kontrollü süreçtir.
Alerting
Critical validation failure iletişim kanalına gönderilir. Run ID ve error reason eklenir. Sensitive sample paylaşılmaz. Owner açıkça belirtilir. Repeated error incident açabilir.
Manuel Preprocessing'den Production Otomasyonuna Geçiş Yol Haritası
Production otomasyonuna tek adımda geçmek gerekmez. Notebook içindeki manuel işlemler önce fonksiyonlaştırılabilir, ardından Pipeline, validation, orchestration ve monitoring katmanları eklenebilir. Her seviye bir öncekinin tekrar üretilebilirliğini artırır. Bu kademeli yaklaşım ekiplerin gereksiz platform yükü olmadan olgunlaşmasını sağlar. En önemli hedef, data preparation logic'i görünür ve test edilebilir hale getirmektir.
Seviye 1: Notebook İçinde Manuel İşlemler
Exploration hızlı yapılır. Data quality problemleri keşfedilir. Kod tekrarları oluşabilir. Production için yeterli değildir. Ama rule discovery açısından değerlidir.
Seviye 2: Fonksiyonlaştırma
Tekrarlanan işlemler fonksiyonlara ayrılır. Input-output davranışı netleşir. Unit test yazılabilir. Notebook bağımlılığı azalır. Reusable module oluşur.
Seviye 3: Scikit-learn Pipeline
Fit ve transform adımları standardize edilir. Preprocessing modelle birleşir. Cross-validation leakage riski azalır. Artifact oluşturulabilir. Serving kolaylaşır.
Seviye 4: Data Validation
Schema ve quality tests eklenir. Invalid data erken yakalanır. Contract yaklaşımı oluşur. Quality gates kurulabilir. Production güvenilirliği artar.
Seviye 5: Orchestration
Workflow schedule edilir. Retry ve dependency yönetilir. Failure notification eklenir. Run history tutulur. Operasyon görünürlüğü artar.
Seviye 6: CI/CD
Kod değişiklikleri otomatik test edilir. Artifact build versionlanır. Deployment gate uygulanır. Rollback mümkün olur. Regression riski azalır.
Seviye 7: Monitoring ve Drift Detection
Data health production'da izlenir. Missingness ve schema failure metric olur. Drift alert eklenir. Incident analizi hızlanır. Retraining kararı veriyle desteklenir.
Seviye 8: Tam MLOps Entegrasyonu
Model registry, lineage ve feature management entegre edilir. Training-serving parity test edilir. Automated evaluation çalışır. Governance ve audit süreçleri bağlanır. Platform ekip ihtiyaçlarına göre ölçeklenir.
Veri Ön İşleme Otomasyonunda Sık Yapılan Hatalar
Preprocessing otomasyonunda en büyük risk, yanlış kararın yüksek hacimde tekrar edilmesidir. Train-test split öncesi preprocessing, schema kontrolü eksikliği ve her veriye aynı missing veya outlier kuralını uygulamak sık görülen problemler arasındadır. Pipeline versionlanmadığında model davranışındaki değişiklikler izlenemez. Monitoring yoksa veri bozulması uzun süre fark edilmeyebilir. Güvenilir otomasyon, neyin otomatik yapılmayacağını da açık biçimde tanımlar.
Train-Test Split'ten Önce Preprocessing Yapmak
Scaler ve imputer bütün dataset üzerinde fit edilirse leakage oluşur. Test bilgisi training'e sızar. Split önce yapılmalıdır. Pipeline bu sınırı korur. Cross-validation içinde de aynı kural geçerlidir.
Data Leakage'i Görmezden Gelmek
Yüksek offline score yanıltıcı olabilir. Target veya future data feature'lara sızabilir. Leakage checklist kullanılmalıdır. Temporal validation önemlidir. Production drop root cause olabilir.
Her Eksik Değeri Ortalama ile Doldurmak
Mean her dağılım için uygun değildir. Categorical data için zaten kullanılamaz. Outlier mean'i etkiler. Median veya domain-specific strategy daha iyi olabilir. Cross-validation ile test edilmelidir.
Her Aykırı Değeri Silmek
Nadir fakat değerli business event'ler kaybolabilir. Outlier detection removal kararı değildir. Flag feature kullanılabilir. Human review gerekebilir. Model impact ölçülmelidir.
Data Schema Kontrolü Yapmamak
Upstream kolon değişikliği sessiz hata oluşturabilir. Schema validation preprocessing girişinde olmalıdır. Required columns kontrol edilir. Type drift yakalanır. Pipeline daha öngörülebilir olur.
Bilinmeyen Kategorileri Hesaba Katmamak
Production'da yeni kategori kaçınılmaz olabilir. Encoder error verebilir. Unknown handling tanımlanmalıdır. Unknown rate monitor edilir. High rate retraining sinyali olabilir.
Training ve Production İçin Farklı Kod Kullanmak
Aynı feature farklı hesaplanabilir. Parity bozulur. Shared package veya artifact kullanılmalıdır. API duplicate transformation yazmamalıdır. Parity test CI'da çalışmalıdır.
Pipeline'ı Versiyonlamamak
Hangi transformation'ın model training'de kullanıldığı bilinmez. Rollback zorlaşır. Regression root cause bulunamaz. Artifact ID zorunlu olmalıdır. Model registry ilişkiyi saklamalıdır.
Data Quality Monitoring Yapmamak
Pipeline success olsa bile data bozulabilir. Missingness ve category drift fark edilmez. Model performansı sonra düşebilir. Data health dashboard gerekir. Alert threshold belirlenmelidir.
Drift'i İzlememek
Production data training dağılımından uzaklaşabilir. Model aynı accuracy seviyesinde kalmayabilir. Drift metric erken sinyal sağlar. Her drift retraining gerektirmez. Business context ile yorumlanmalıdır.
Her Kararı Otomatikleştirmeye Çalışmak
Belirsiz domain kararları makineye tamamen bırakılmamalıdır. Critical outlier veya semantic duplicate human review gerektirebilir. Otomasyon routine işleri hedeflemelidir. Human-in-the-loop kontrol sağlar. Yanlış otomasyon yüksek hacimde zarar verebilir.
Veri Ön İşleme Otomasyonunun Başarısı Nasıl Ölçülür?
Otomasyon başarısı yalnızca pipeline'ın çalışmasıyla ölçülmemelidir. Manuel iş süresinin azalması, failure rate, veri kalite hataları, model performansı ve altyapı maliyeti birlikte değerlendirilmelidir. Veri bilimcinin repetitive işlere ayırdığı zaman azalıyor mu sorusu önemlidir. Production'da hata daha erken yakalanıyor mu ayrıca ölçülmelidir. ROI teknik ve operasyonel kazanımları birlikte değerlendirmelidir.
Manuel İşlem Süresindeki Azalma
Pre-automation baseline alınmalıdır. Aynı dataset hazırlama süresi karşılaştırılır. Human review süresi ayrıca ölçülür. Otomasyon maintenance zamanı dahil edilmelidir. Net time saving hesaplanmalıdır.
Pipeline Çalışma Süresi
Batch runtime önemli operasyon metriğidir. Manual süreden daha hızlı olmak zorunda değildir. Asıl avantaj tekrar üretilebilirlik olabilir. Schedule window içinde bitmesi gerekir. Performance trend izlenmelidir.
Veri Kalitesi Hata Oranı
Schema, null ve duplicate failure oranı takip edilir. Automation sonrası silent error azalmalıdır. False positive validation da ölçülmelidir. Quality incident count karşılaştırılır. Hata severity önemlidir.
Pipeline Failure Rate
Başarısız run oranı operasyon güvenilirliğini gösterir. Retry sonrası success ayrı tutulur. Failure reason kategori bazında incelenir. SLO tanımlanabilir. High rate architecture veya source problemi gösterir.
Tekrarlanan İş Miktarındaki Azalma
Manuel cleaning adımı sayısı takip edilebilir. Reusable pipeline adoption ölçülebilir. Birden fazla model aynı preprocessing component'i kullanabilir. Duplicate code azalır. Ekip standardization artar.
Model Performansına Etkisi
Automation modeli otomatik olarak daha doğru yapmaz. Ancak consistent preprocessing model skorunu daha stabil hale getirebilir. Data leakage azalır. Production-offline gap küçülebilir. Accuracy ve calibration trend izlenmelidir.
Veri Bilimci Zaman Tasarrufu
Data scientist'in cleaning yerine experimentation'a ayırdığı süre ölçülebilir. Support ticket veya manual data fix sayısı azalabilir. Onboarding kolaylaşabilir. Reusable templates geliştirme hızını artırır. Time saving survey ve activity metric ile değerlendirilebilir.
Infrastructure Cost
Automation compute ve storage maliyeti yaratır. Distributed processing gereksiz kullanılıyorsa maliyet yükselir. Cost per processed row izlenebilir. Cache ve incremental processing tasarruf sağlar. Cost kalite ile birlikte değerlendirilmelidir.
ROI
ROI zaman tasarrufu, error reduction ve model value üzerinden hesaplanabilir. Infrastructure ve engineering maintenance maliyeti çıkarılmalıdır. Baseline olmadan doğru hesap zordur. Yıllık veya dönemsel değerlendirme yapılabilir. Sadece cloud faturası ROI değildir.
Yazılımcı Olmak İçin Ne Yapmalı? Veri ve MLOps Yol Haritası
Veri ve MLOps alanında gelişmek isteyen bir yazılımcının önce temel programlama ve veri yapılarıyla sağlam temel oluşturması gerekir. Python, SQL, Pandas ve Scikit-learn pipeline bilgisi birlikte ilerlediğinde preprocessing problemleri daha anlaşılır hale gelir. Daha sonra test, Docker, orchestration ve CI/CD öğrenmek production perspektifini güçlendirir. Gerçek bir data pipeline projesi geliştirmek teorik eğitimden daha kalıcı deneyim sağlar. Açık kaynak katkıları ve code review süreci de yazılım kalitesini geliştirmede önemli rol oynar.
Python Temellerini Öğrenmek
Fonksiyon, class ve exception handling bilinmelidir. Type hints kod okunabilirliğini artırır. Virtual environment kullanılmalıdır. File ve API işlemleri öğrenilmelidir. Unit test temeli erkenden eklenmelidir.
Pandas ve NumPy
DataFrame filtering ve groupby sık kullanılan işlemlerdir. Missing value handling öğrenilmelidir. Vectorized operations performans sağlar. Dtype yönetimi önemlidir. Gerçek dataset üzerinde pratik yapılmalıdır.
SQL
SELECT, JOIN ve aggregation temeldir. Window function veri hazırlamada güçlüdür. Query plan ve index bilgisi performansa yardımcı olur. Data warehouse mantığı öğrenilmelidir. SQL ve Python birlikte kullanılabilir.
Veri Ön İşleme Teknikleri
Missing, duplicate ve outlier kavramları öğrenilmelidir. Encoding ve scaling model ilişkisi anlaşılmalıdır. Leakage örnekleri çalışılmalıdır. Feature engineering pratiği yapılmalıdır. Validation mantığı erkenden öğrenilmelidir.
Scikit-learn Pipeline
Transformer interface öğrenilmelidir. Pipeline ve ColumnTransformer kullanılmalıdır. Cross-validation ile birleştirilmelidir. Custom transformer geliştirilebilir. Artifact save-load pratiği yapılmalıdır.
Veri Testleri
Schema ve data quality testleri yazılmalıdır. Pandera gibi araçlar denenebilir. Edge case dataset hazırlanmalıdır. Regression test mantığı öğrenilmelidir. Test-first yaklaşım data pipeline'ı güçlendirir.
Airflow veya Benzeri Orkestrasyon Aracı
DAG ve dependency mantığı öğrenilmelidir. Retry ve schedule uygulanmalıdır. Local development yapılabilir. Failure notification eklenmelidir. Gerçek küçük pipeline orkestre edilmelidir.
Docker
Reproducible environment için Docker önemlidir. Dependency ve system package sabitlenebilir. Multi-stage build öğrenilebilir. Secret image içine gömülmemelidir. Production parity artar.
Git ve CI/CD
Branch ve pull request workflow öğrenilmelidir. Testler CI içinde çalıştırılabilir. Artifact build otomatikleştirilebilir. Version tagging uygulanabilir. Rollback mantığı anlaşılmalıdır.
MLOps Temelleri
Model registry, experiment tracking ve lineage öğrenilmelidir. Training-serving parity önemlidir. Monitoring ve drift kavramları çalışılmalıdır. Deployment lifecycle anlaşılmalıdır. Security ve governance unutulmamalıdır.
Production Veri Pipeline'ı Geliştirmek
Gerçek source'dan data alıp validation ve preprocessing yapmak iyi portföy projesidir. Orchestration eklenebilir. CI/CD ile deploy edilir. Monitoring dashboard oluşturulur. README architecture kararlarını açıklamalıdır.
Open Source ve İşbirliği ile Veri Pipeline'ları Geliştirmek
Açık kaynak projeleri veri mühendisliği ve preprocessing pratiklerini gerçek codebase üzerinde görmeyi sağlar. GitHub issue ve pull request süreçleri ekip çalışmasını öğretir. Unit test veya documentation katkısı da değerli başlangıçtır. Reusable preprocessing package geliştirmek topluluk içinde ortak öğrenmeyi artırabilir. Proje örneklerini incelemek için https://www.diyarbakiryazilim.com.tr/projects adresi kullanılabilir.
Açık Kaynak Veri Araçlarının Avantajları
Source code görülebilir. Community contribution yeni özellik ve hata düzeltmeleri getirir. Vendor bağımlılığı azalabilir. Maintenance sorumluluğu kullanıcıda olabilir. License koşulları incelenmelidir.
Git ve GitHub Kullanımı
Version control ekip işbirliğinin temelidir. Issue problem tanımını görünür yapar. Pull request review sağlar. Commit history karar geçmişini tutar. Branch protection kaliteyi artırabilir.
Preprocessing Kodlarını Tekrar Kullanılabilir Paketlere Dönüştürmek
Common transformers ayrı package yapılabilir. API stabil tutulmalıdır. Semantic versioning kullanılabilir. Unit test ve documentation eklenmelidir. Farklı projelerde reuse sağlanır.
Unit Test ile Katkı Sağlamak
Bug fix için regression test yazmak değerli katkıdır. Edge case eklenebilir. Test small ve deterministic olmalıdır. Existing behavior anlaşılır hale gelir. Yeni contributor için iyi başlangıçtır.
Issue ve Pull Request Süreci
Issue açık problem ve reproduction adımlarını içermelidir. PR tek odaklı tutulmalıdır. Test sonucu eklenmelidir. Review feedback teknik gelişim sağlar. Merge sonrası release note güncellenebilir.
Veri Kalitesi Kurallarını Ekip Olarak Geliştirmek
Data quality sadece data engineer görevi değildir. Domain uzmanı meaningful bounds belirler. Data scientist model etkisini değerlendirir. Software engineer automation ve tests kurar. Ortak ownership daha güvenilir pipeline oluşturur.
Açık Kaynak MLOps Projelerine Katkı Vermek
Documentation veya integration katkısı yapılabilir. Monitoring ve validation tool'ları incelenebilir. Küçük issue seçmek başlangıç için uygundur. Code standard öğrenilir. Portfolio gerçek collaboration gösterebilir.
Diyarbakır Yazılım Topluluğu ile Veri Bilimi ve Otomasyon
Veri bilimi ve MLOps alanında gelişmenin en verimli yollarından biri gerçek projeler üzerinde birlikte çalışmaktır. Diyarbakır Yazılım Topluluğu içinde veri pipeline, Python, açık kaynak ve otomasyon konularında çalışma grupları oluşturulabilir. Katılımcılar farklı seviyelerde ingestion, validation, preprocessing ve monitoring görevlerini paylaşabilir. Topluluk hakkında bilgi almak için https://www.diyarbakiryazilim.com.tr/about adresi kullanılabilir. Ortak projeler teknik bilgi yanında code review ve ekip çalışma pratiğini de geliştirir.
Diyarbakır Yazılım Topluluğu İçinde Veri Bilimi Çalışmaları
Topluluk içinde tabular ML ve data pipeline odaklı çalışmalar yapılabilir. Küçük dataset'lerle preprocessing benchmark hazırlanabilir. Katılımcılar farklı validation araçlarını deneyebilir. Sonuçlar açık repository üzerinden paylaşılabilir. Bu süreç teoriyi uygulamaya dönüştürür.
Veri Ön İşleme ve MLOps Workshopları
Workshop ham CSV ile başlayabilir. Katılımcılar schema validation ve Scikit-learn Pipeline oluşturabilir. Daha sonra Airflow ve monitoring eklenebilir. Data leakage örnekleri canlı gösterilebilir. Son bölümde production checklist uygulanabilir.
Open Source Pipeline Projeleri
Reusable preprocessing template geliştirilebilir. Pandera schema ve test suite eklenebilir. CI/CD örneği hazırlanabilir. Katılımcılar issue üzerinden katkı verebilir. Project documentation öğrenme kaynağı haline gelir.
Yerel Veri Setleri ile Proje Geliştirmek
Yerel open data projeleri motivasyonu artırabilir. Veri kalitesi problemleri gerçek örneklerle görülebilir. Privacy ve lisans koşulları kontrol edilmelidir. Dataset düzenli güncelleniyorsa automation kurulabilir. Monitoring gerçek değişimleri gösterebilir.
Diyarbakır'daki En İyi Yazılımcılar ile Deneyim Paylaşımı
Deneyim paylaşımı farklı çözüm yaklaşımlarını görmeyi sağlar. Code review yeni geliştiricilerin daha hızlı ilerlemesine yardımcı olur. Production hataları üzerinden öğrenme yapılabilir. Tek bir yaklaşım mutlak doğru kabul edilmemelidir. Topluluk içi teknik tartışma daha güçlü mühendislik kültürü oluşturur.
Topluluk İçinde Code Review ve İşbirliği
Her pull request başka bir katılımcı tarafından incelenebilir. Test, readability ve data leakage noktaları kontrol edilir. Feedback açık ve teknik olmalıdır. Review checklist kullanılabilir. Bu süreç gerçek ekip pratiğine yakındır.
Ortak Veri Otomasyon Projesi Fikirleri
Topluluk farklı açık veri kaynakları üzerinden preprocessing pipeline geliştirebilir. Proje ingestion, validation, cleaning ve monitoring katmanlarını içerebilir. Her katılımcı bir modül üstlenebilir. Sonuç açık kaynak olarak paylaşılabilir. Proje ilerledikçe CI/CD ve orchestration eklenebilir.
Yerel İşletme Verileri
Açık ve izinli işletme verileri category normalization için kullanılabilir. Duplicate adres veya isim örnekleri çalışılabilir. PII içeren veri kullanılmamalıdır. Data source lisansı kontrol edilmelidir. Search ve analytics çıktısı üretilebilir.
Tarım Verileri
Hava, toprak veya üretim verileri time series preprocessing için uygundur. Missingness ve outlier doğal olarak görülebilir. Seasonal drift incelenebilir. Open data source tercih edilmelidir. Pipeline reproducible olmalıdır.
Ulaşım Verileri
Public transport veya traffic data streaming senaryosu için kullanılabilir. Timestamp normalization önemlidir. Missing event ve duplicate message incelenebilir. Batch ve streaming comparison yapılabilir. Privacy riski taşıyan bireysel hareket verilerinden kaçınılmalıdır.
Açık Kamu Verileri
Açık kamu dataset'leri schema drift ve data quality projeleri için değerlidir. Kaynak güncelliği izlenebilir. Ingestion otomasyonu kurulabilir. License ve kullanım koşulları kontrol edilmelidir. Sonuçlar topluluk içinde tekrar üretilebilir hale getirilebilir.
Production Öncesi Veri Ön İşleme Pipeline Kontrol Listesi
Production öncesinde yalnızca model skorunu kontrol etmek yeterli değildir. Train-test ayrımı, leakage, schema validation, unknown categories, versioning, retry, monitoring ve drift detection birlikte doğrulanmalıdır. Training ve serving aynı transformation'ları uygulamalıdır. Failure durumunda ne olacağı test edilmelidir. Bu kontrol listesi küçük projelerde bile production riskini ciddi biçimde azaltır.
Train-Test Ayrımı Doğru Yerde mi?
Split fit gerektiren preprocessing adımlarından önce yapılmalıdır. Time series chronological rule kullanabilir. Validation set bağımsız kalmalıdır. Cross-validation doğru scope'ta çalışmalıdır. Test data tuning'e dahil edilmemelidir.
Data Leakage Test Edildi mi?
Target-derived feature'lar incelenmelidir. Future data kullanımı kontrol edilmelidir. Preprocessing fit scope doğrulanmalıdır. Golden leakage test hazırlanabilir. Domain expert review faydalıdır.
Schema Validation Var mı?
Required columns tanımlı olmalıdır. Type ve null rules test edilmelidir. Schema version bulunmalıdır. Breaking change detection yapılmalıdır. Runtime validation production'da aktif olmalıdır.
Eksik Veri Kuralları Tanımlı mı?
Her feature için strategy bilinmelidir. Default mean kullanılmamalıdır. Missing threshold monitoring'e bağlı olmalıdır. Imputer artifact versionlanmalıdır. Production yeniden fit etmemelidir.
Outlier Kuralları Tanımlı mı?
Outlier detection ve handling ayrılmalıdır. Domain sınırları açık olmalıdır. Automatic removal sınırlı tutulmalıdır. Outlier rate monitor edilmelidir. Human review noktası belirlenmelidir.
Yeni Kategoriler Yönetiliyor mu?
Encoder unknown behavior test edilmelidir. Unknown rate metric olmalıdır. New category error üretmemelidir. High drift alert oluşturabilir. Retraining policy tanımlanmalıdır.
Pipeline Tekrarlanabilir mi?
Seed ve version bilgisi saklanmalıdır. Same input same output üretmelidir. External dependency versionlanmalıdır. Environment reproducible olmalıdır. Artifact immutable olmalıdır.
Pipeline Versiyonlandı mı?
Code, schema ve transformer version bilinmelidir. Artifact ID model registry ile eşleşmelidir. Release history tutulmalıdır. Rollback path hazır olmalıdır. Deployment exact version kullanmalıdır.
Unit ve Integration Testleri Var mı?
Critical transformations unit test'e sahip olmalıdır. Integration test source-to-artifact akışını doğrulamalıdır. Edge cases eklenmelidir. CI otomatik çalıştırmalıdır. Regression failures deploy'u engellemelidir.
Failure ve Retry Mekanizması Var mı?
Transient ve deterministic errors ayrılmalıdır. Retry count sınırlı olmalıdır. Quarantine kullanılabilir. Alert owner'a gitmelidir. Incident runbook hazırlanmalıdır.
Monitoring Var mı?
Pipeline success ve runtime metric olmalıdır. Data health ayrı izlenmelidir. Dashboard erişilebilir olmalıdır. Threshold alarm üretmelidir. Logging privacy uyumlu olmalıdır.
Data Drift İzleniyor mu?
Reference dataset belirlenmelidir. Numeric ve categorical drift ölçülmelidir. Missingness trend takip edilmelidir. Alert business context ile yorumlanmalıdır. Retraining otomatik deploy olmamalıdır.
Alerting Mekanizması Var mı?
Critical failure anında ilgili ekip bilgilendirilmelidir. Alert message actionable olmalıdır. Duplicate alerts azaltılmalıdır. Severity tanımlanmalıdır. Acknowledgement process olabilir.
Training ve Serving Aynı Dönüşümleri mi Kullanıyor?
Shared artifact veya package kullanılmalıdır. Parity test yapılmalıdır. Library versions eşleşmelidir. Feature order doğrulanmalıdır. Fark deployment blocker olmalıdır.
Sık Sorulan Sorular
Veri preprocessing otomasyonu hakkında en sık sorulan sorular genellikle eksik veri, scaling, pipeline, leakage, orchestration ve drift başlıklarında toplanır. Tek bir ideal yöntem bulunmaz. Veri tipi, model ve business rule seçimleri etkiler. Otomasyonun amacı bütün kararları insandan almak değil, tekrar eden ve açık kurallı işleri güvenilir hale getirmektir. Aşağıdaki cevaplar production odaklı temel kararları özetler.
Veri ön işleme nedir?
Veri ön işleme ham veriyi analiz veya model için uygun hale getiren dönüşümlerdir. Cleaning, imputation, encoding ve scaling bu sürece dahildir. Feature engineering de pipeline'ın parçası olabilir. Kurallar repeatable olmalıdır. Production aynı logic'i kullanmalıdır.
Veri ön işleme aşamaları nelerdir?
Veri alma ve profiling ile başlanır. Cleaning ve missing value handling uygulanır. Encoding, scaling ve feature engineering yapılabilir. Train-test ayrımı doğru yerde olmalıdır. Final data quality validation ile süreç tamamlanır.
Veri ön işleme nasıl otomatikleştirilir?
Tekrarlanan adımlar fonksiyon ve transformer haline getirilir. Scikit-learn Pipeline kullanılabilir. Schema validation eklenir. Orchestration schedule ve retry yönetir. Monitoring production davranışını izler.
Python ile otomatik veri temizleme yapılabilir mi?
Evet, Pandas ve Scikit-learn bu amaçla kullanılabilir. Missing, duplicate ve type conversion otomatikleştirilebilir. Pandera validation ekleyebilir. Airflow veya başka orchestrator düzenli çalıştırabilir. Kritik kararlar rule veya human approval gerektirebilir.
Scikit-learn Pipeline nedir?
Pipeline preprocessing ve model adımlarını sıralı biçimde birleştirir. fit training data üzerinde çalışır. predict gerekli transformations'ı otomatik uygular. Cross-validation leakage riskini azaltır. Model ve preprocessing tek artifact olabilir.
ColumnTransformer ne işe yarar?
Farklı sütun gruplarına farklı preprocessing uygular. Numeric columns imputation ve scaling alabilir. Categorical columns encoding kullanabilir. Text columns ayrı transformer kullanabilir. Sonuç tek feature matrix olur.
Data leakage nedir?
Leakage modelin training sırasında ulaşmaması gereken bilgiye erişmesidir. Test statistics preprocessing'e sızabilir. Future event feature'a eklenebilir. Offline score gerçeğinden yüksek görünür. Pipeline ve doğru split bu riski azaltır.
Preprocessing train-test split'ten önce mi yapılmalı?
Fit gerektiren preprocessing split öncesi yapılmamalıdır. Önce train-test ayrımı yapılır. Imputer, scaler ve selector training data üzerinde fit edilir. Test sadece transform edilir. Bu leakage önleme açısından temel kuraldır.
Eksik veriler otomatik olarak nasıl doldurulur?
SimpleImputer mean, median veya most_frequent uygulayabilir. Numeric ve categorical columns farklı strategy kullanmalıdır. İmputation training data üzerinde fit edilir. Production aynı artifact'ı kullanır. Strategy model ve domain'e göre seçilmelidir.
Aykırı değerler otomatik tespit edilebilir mi?
Evet, IQR, Z-Score veya Isolation Forest kullanılabilir. Tespit silme kararı anlamına gelmez. Outlier gerçek business event olabilir. Candidate flag üretmek daha güvenli olabilir. Human review kritik alanlarda önemlidir.
Veri kalitesi nasıl otomatik kontrol edilir?
Schema, null, uniqueness ve range rule'ları tanımlanabilir. Pandera veya Great Expectations kullanılabilir. Quality gate fail durumda pipeline'ı durdurabilir. Metric'ler monitoring'e gönderilir. Hatalı data quarantine edilir.
Pandera ve Great Expectations ne işe yarar?
İki araç da data validation süreçlerini standardize etmeye yardımcı olur. Pandera DataFrame schema tanımlamada güçlüdür. Great Expectations expectation suite ve rapor yaklaşımı sunar. Tool seçimi ekip ve platform ihtiyacına bağlıdır. Her ikisi de kalite kontrolünü kodlaştırmayı kolaylaştırır.
Apache Airflow veri ön işlemede ne işe yarar?
Airflow preprocessing task'larını schedule eder. Dependency, retry ve failure notification yönetir. Transformation code'un kendisi değildir. Günlük batch workflow'larda yararlıdır. Monitoring run history üzerinden yapılabilir.
AutoML veri ön işlemeyi otomatik yapar mı?
Birçok AutoML aracı imputation, encoding ve model seçimini otomatik deneyebilir. Bu hızlı baseline sağlar. Domain kuralları yine insan tarafından verilmelidir. Leakage doğru dataset hazırlığıyla önlenmelidir. Final pipeline production öncesi anlaşılmalıdır.
Data drift nedir?
Data drift production input dağılımının training dağılımından değişmesidir. Numeric veya categorical feature'larda görülebilir. Missingness drift de önemlidir. Statistical tests kullanılabilir. Drift her zaman model failure anlamına gelmez.
Training-serving skew nedir?
Training ve production feature hesaplama farkıdır. Model farklı representation görür. Prediction quality düşebilir. Shared pipeline bu riski azaltır. Parity test ile fark otomatik yakalanabilir.
Büyük veri için Pandas mı PySpark mı?
Küçük ve orta data için Pandas genellikle daha basittir. Cluster ölçeğinde büyük dataset için PySpark güçlü olabilir. Polars veya Dask ara seçenek sunabilir. Data size tek kriter değildir. Join ve infrastructure ihtiyacı da değerlendirilmelidir.
Veri ön işleme için en iyi programlama dili hangisidir?
Python geniş ML ekosistemi nedeniyle güçlü tercihtir. SQL warehouse dönüşümlerinde değerlidir. Scala ve Java enterprise big data sistemlerinde kullanılabilir. R istatistiksel analiz için uygundur. En iyi dil ekip ve mimariye göre değişir.
Veri pipeline geliştiricisi olmak için ne öğrenilmeli?
Python ve SQL temel olmalıdır. Pandas ve data validation öğrenilmelidir. Pipeline, Airflow ve Docker pratiği yapılmalıdır. Git ve CI/CD kullanılmalıdır. Monitoring ve MLOps bilgisi production perspektifi kazandırır.
Open source ve işbirliği veri mühendisliği kariyerine nasıl katkı sağlar?
Gerçek codebase görmeyi sağlar. Issue ve pull request ekip çalışmasını öğretir. Code review yazılım kalitesini geliştirir. Test ve documentation katkısı güçlü başlangıçtır. Açık projeler somut portföy oluşturur.
Sonuç: Güvenilir Veri Ön İşleme Otomasyonu Nasıl Kurulur?
Veri Ön İşleme (Data Preprocessing) Aşamalarında Otomasyon, birkaç cleaning script'ini zamanlamakla sınırlı değildir. Güvenilir sistem; veri profilleme, schema validation, leakage kontrolü, pipeline versioning, training-serving parity, monitoring ve drift detection katmanlarını birlikte ele alır. Benim deneyimimde en sağlıklı yaklaşım önce manuel adımları açık kurallara dönüştürmek, sonra bu kuralları test edilen pipeline içinde otomatikleştirmektir. Her kararı otomatikleştirmeye çalışmak yerine insan değerlendirmesi gereken noktaları bilinçli biçimde korumak daha sürdürülebilir sonuç verir. Kurumsal veri hazırlama ve model geliştirme süreçlerinin başka bir önemli boyutunu incelemek için https://www.diyarbakiryazilim.com.tr/posts/kurumsal-verilerle-llm-fine-tuning-surecleri içeriğine de göz atabilirsiniz.
Önce Veri Kalitesi Kurallarını Tanımlayın
Otomasyon başlamadan önce neyin doğru veri olduğu açık olmalıdır. Schema, null ve range kuralları tanımlanır. Domain expert katkısı alınır. Threshold'lar historical data ile doğrulanır. Kural olmadan otomasyon güvenilir karar veremez.
Tekrarlanan İşleri Pipeline'a Dönüştürün
Notebook kodu fonksiyon ve transformer haline getirilmelidir. Reusable component'ler oluşturulur. Pipeline adım sırasını sabitler. Unit test eklenir. Manuel tekrar azalır.
Data Leakage'i Mimari Seviyede Önleyin
Train-test split doğru yerde yapılmalıdır. Fit işlemleri yalnızca training scope içinde çalışır. Cross-validation preprocessing'i fold içinde yürütür. Target-derived feature kontrol edilir. Temporal leakage ayrıca test edilir.
Validation'ı Pipeline'ın Bir Parçası Yapın
Validation sadece final aşamada olmamalıdır. Input schema kontrol edilir. Critical transformation sonrası quality check yapılabilir. Fail policy tanımlanır. Invalid batch quarantine edilir.
Training ve Production Dönüşümlerini Birleştirin
Shared artifact kullanmak parity riskini azaltır. Encoder ve scaler mapping yeniden hesaplanmaz. Library version eşleşir. Parity tests CI içinde çalışır. Serving exact training transformation'ını kullanır.
Orchestration ile Süreci Otomatik Çalıştırın
Workflow schedule veya event ile tetiklenebilir. Task dependency açık tanımlanır. Retry transient hatalara uygulanır. Failure alert oluşturur. Run metadata kaydedilir.
Monitoring ve Drift Detection Ekleyin
Pipeline success tek başına yeterli değildir. Missingness, unknown category ve schema failure izlenmelidir. Drift reference dataset ile ölçülür. Alert threshold tanımlanır. Model performance ile birlikte yorumlanır.
İnsan Kararı Gereken Noktaları Tam Otomatikleştirmeyin
Outlier, semantic duplicate veya business critical değişiklik insan review gerektirebilir. Sistem candidate issue üretir. Human decision audit edilir. Tekrarlanan kararlar zamanla rule'a dönüşebilir. Bu yaklaşım otomasyonu daha kontrollü ve güvenilir hale getirir.
Veri ön işleme (Data Preprocessing) aşamaları nasıl otomatikleştirilir?
Önce manuel adımlar fonksiyon ve transformer yapısına dönüştürülür. Ardından Scikit-learn Pipeline veya benzeri yapı ile imputation, encoding, scaling ve model adımları birleştirilebilir. Pandera veya Great Expectations ile schema ve kalite kontrolleri eklenir. Airflow, Prefect veya Dagster pipeline'ın zamanlama, retry ve failure yönetimini üstlenebilir. Veri Ön İşleme (Data Preprocessing) Aşamalarında Otomasyon ancak test, versioning ve monitoring ile birlikte kurulduğunda production için güvenilir hale gelir.
Eksik veriler, aykırı değerler ve tekrarlayan kayıtlar otomatik olarak nasıl temizlenir?
Eksik değerler sütun tipine ve eksiklik oranına göre imputation kurallarıyla yönetilebilir. Duplicate kayıtlar exact veya business key bazında tespit edilip belirlenmiş retention kuralına göre işlenebilir. Outlier'lar IQR, Z-Score veya model tabanlı yöntemlerle aday olarak işaretlenebilir. Aykırı değeri doğrudan silmek yerine gerçek iş olayı olup olmadığı değerlendirilmelidir. Kritik veri setlerinde human-in-the-loop kontrolü otomatik temizliğin önemli güvenlik katmanıdır.
Veri dönüştürme, ölçeklendirme ve kategorik değişken kodlama işlemleri hangi araçlarla otomatikleştirilebilir?
Scikit-learn Pipeline ve ColumnTransformer bu işlemleri tek preprocessing zincirinde birleştirmek için güçlü araçlardır. SimpleImputer missing value işlemlerini, OneHotEncoder kategorik encoding'i ve StandardScaler veya RobustScaler numeric scaling'i yönetebilir. Pandas ve Polars daha genel data transformation görevlerinde kullanılabilir. Büyük veri projelerinde PySpark değerlendirilebilir. Seçilen transformer'ların training data üzerinde fit edilmesi ve production'da aynı artifact'ın kullanılması önemlidir.
Otomatik veri ön işleme pipeline’ları makine öğrenmesi modellerinin doğruluğunu ve sürdürülebilirliğini nasıl etkiler?
Otomatik pipeline her veri batch'ine aynı kuralları uygulayarak model input'unu daha tutarlı hale getirir. Data leakage riskini azaltabilir ve cross-validation sürecinin daha doğru çalışmasını sağlar. Training-serving skew azaldığında production performansı offline sonuçlara daha yakın olabilir. Versioning ve monitoring model hatalarının nedenini bulmayı kolaylaştırır. Doğruluk artışı garanti değildir ancak veri hazırlama sürecinin güvenilirliği ve sürdürülebilirliği belirgin biçimde artar.
Veri ön işleme otomasyonu ve makine öğrenmesi pipeline’ları konusunda yakınımda danışmanlık veya eğitim nerede bulabilirim?
Veri ön işleme ve makine öğrenmesi danışmanlığı yakınımda araması yapıyorsanız yerel yazılım topluluklarının workshop ve ortak proje çalışmalarını takip etmek iyi bir başlangıçtır. Diyarbakır'da veri bilimi, Python, otomasyon ve yazılım projeleriyle ilgilenenler https://www.diyarbakiryazilim.com.tr üzerinden Diyarbakır Yazılım Topluluğu'na ulaşabilir. Topluluğun proje çalışmalarını https://www.diyarbakiryazilim.com.tr/projects adresinden inceleyebilirsiniz. Kurumsal veri ön işleme ve makine öğrenmesi pipeline otomasyonu hizmeti planlanırken mevcut veri kaynakları, schema, model akışı ve production beklentileri birlikte değerlendirilmelidir. Böylece eğitim veya proje çalışması yalnızca araç kullanımına değil gerçek production sorunlarının çözümüne odaklanabilir.
Veri hazırlama otomasyonunu sağlam kurmak istiyorsanız ilk adım mevcut manuel işlemlerinizi listelemek ve hangi adımların rule-based biçimde tekrarlandığını belirlemektir. Ardından bunları test edilen Python transformer'larına ve pipeline bileşenlerine dönüştürebilirsiniz. Veri bilimi, MLOps, açık kaynak ve ortak proje çalışmaları hakkında bilgi almak için https://www.diyarbakiryazilim.com.tr adresinden Diyarbakır Yazılım Topluluğu'na ulaşabilirsiniz. Topluluk yapısı ve çalışma yaklaşımı için https://www.diyarbakiryazilim.com.tr/about sayfasını inceleyebilirsiniz. Sağlam preprocessing otomasyonu, modelden önce veriyi güvenilir hale getiren yazılım disiplinini kurmakla başlar.
share: