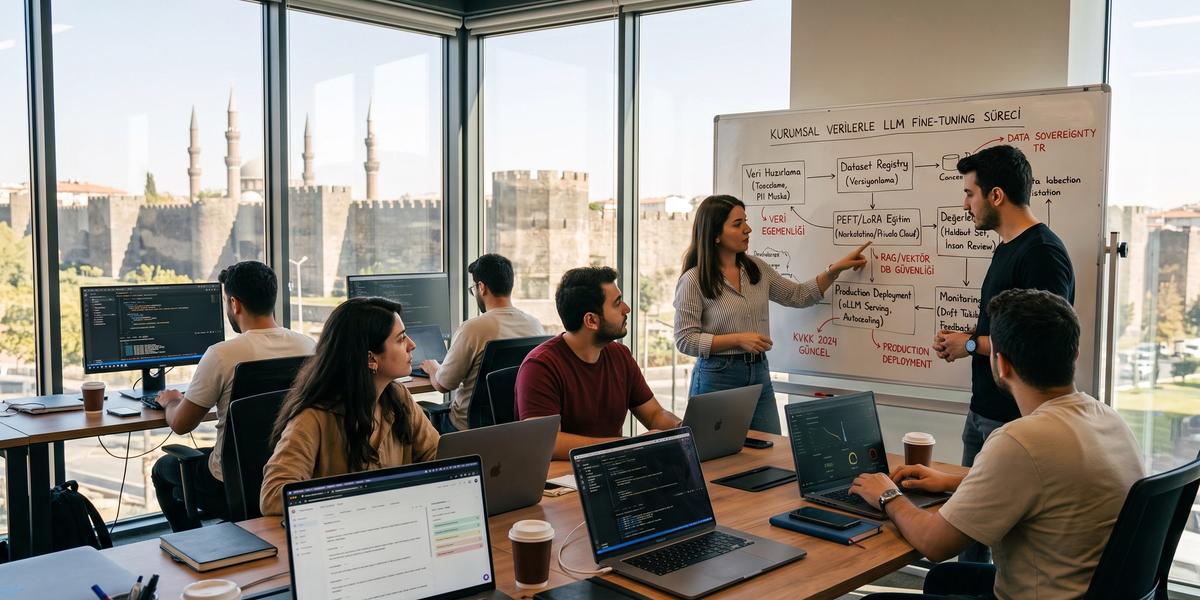
Kurumsal Verilerle LLM Fine-Tuning Süreçleri

Diyarbakır Yazılım
16.08.2026
#Yazılım#Teknoloji#Topluluk
Bir kurumun elinde yıllardır biriken destek kayıtları, teknik dokümanlar, onaylanmış müşteri yanıtları ve uzman görüşleri varsa ilk akla gelen sorulardan biri bu verilerin bir LLM'i kuruma özel hale getirmek için kullanılıp kullanılamayacağıdır. Kurumsal Verilerle LLM Fine-Tuning Süreçleri tam olarak bu noktada veri seçimi, güvenlik, eğitim, değerlendirme ve production yönetimini tek bir yaşam döngüsü içinde ele alır. Ancak her problemi fine-tuning ile çözmek doğru değildir; bazı senaryolarda iyi tasarlanmış prompt engineering veya RAG mimarisi daha düşük maliyetli ve daha yönetilebilir sonuç verebilir. On yılı aşkın yazılım ve veri projelerinde gördüğüm en önemli ders, model eğitiminden önce veri kalitesinin ve başarı kriterlerinin netleştirilmesidir çünkü kötü tanımlanmış hedefler en güçlü modeli bile verimsiz hale getirebilir. Bu rehberde kurumsal verilerle LLM fine-tuning nasıl yapılır, LLM fine-tuning için kurumsal eğitim verisi nasıl hazırlanır, kurumsal yapay zekada RAG mi fine-tuning mi kullanılmalı ve production sonrasında model kalitesi nasıl korunmalıdır sorularını uygulamaya dönük biçimde ele alacağız.
LLM Fine-Tuning Nedir?
LLM fine-tuning, önceden geniş veri kümeleri üzerinde eğitilmiş bir dil modelinin belirli görevler, davranış kalıpları, terminoloji veya çıktı biçimleri için ek eğitimden geçirilmesidir. Amaç modelin sıfırdan yeni bilgi öğrenmesi değil, mevcut yetkinliklerinin hedef kullanım senaryosuna daha uygun hale getirilmesidir. Örneğin genel amaçlı bir modelden kurumsal destek taleplerini belirli JSON şemasında sınıflandırmasını istiyorsanız fine-tuning bu davranışın daha tutarlı oluşmasını sağlayabilir. Eğitim sırasında seçilen örnekler modelin hangi tür girdilere nasıl yanıt vermesi gerektiğini gösterir. Başarılı bir fine-tuning projesi yalnızca training loss düşürmekten ibaret değildir; modelin base sürüme göre gerçekten daha iyi iş sonucu üretip üretmediği ayrı değerlendirme setleriyle ölçülmelidir.
Pre-Training ve Fine-Tuning Arasındaki Fark
Pre-training, modelin büyük miktarda genel metin üzerinde dil yapısını, kavram ilişkilerini ve genel problem çözme örüntülerini öğrenmesini sağlar. Bu aşama çok yüksek compute, geniş veri kümesi ve uzun eğitim süresi gerektirir; çoğu kurum kendi başına sıfırdan pre-training yapmak yerine mevcut bir base model kullanır. Fine-tuning ise daha küçük ve hedefe yönelik veriyle mevcut model davranışını belirli kullanım senaryosuna uyarlamayı amaçlar. Örneğin pre-training bir modele Türkçe dil yapısını kazandırabilirken fine-tuning kurumsal çağrı merkezi yanıtlarının tonunu ve formatını öğretebilir. Bu ayrımı doğru anlamak önemlidir çünkü sürekli değişen kurumsal bilgiyi fine-tuning ile ezberletmeye çalışmak bakım maliyetini yükseltebilir ve bazı projelerde RAG daha doğru seçenek olabilir.
Instruction Fine-Tuning Nedir?
Instruction fine-tuning, modele kullanıcı talimatlarını daha doğru anlamayı ve beklenen biçimde yanıtlamayı öğretmek için instruction-response çiftleriyle yapılan eğitimdir. Eğitim örneklerinde görev açık biçimde tanımlanır ve modelden beklenen ideal çıktı gösterilir. Kurumsal projelerde bu yöntem sınıflandırma, özetleme, bilgi çıkarma, rapor formatlama ve belirli tonla yanıt üretme gibi davranışları güçlendirmek için kullanılabilir. Veri kalitesi burada kritik öneme sahiptir çünkü birbirine benzeyen talimatlara çelişkili yanıtlar verilirse model kararsız davranış öğrenebilir. Instruction fine-tuning sonunda değerlendirme yalnızca doğru cevaba değil, talimata uyum, format bütünlüğü, gereksiz açıklama yapmama ve kurumun belirlediği kurallara ne ölçüde uyulduğuna da bakmalıdır.
Supervised Fine-Tuning (SFT) Nedir?
Supervised Fine-Tuning, modelin doğrulanmış giriş ve hedef çıktı örnekleri üzerinden eğitildiği en yaygın fine-tuning yöntemlerinden biridir. Her eğitim örneği modelin belirli bir girdiye karşı nasıl davranması gerektiğini açıkça gösterir ve loss bu hedef yanıt ile model tahmini arasındaki farka göre hesaplanır. Kurumsal SFT projelerinde domain uzmanlarının onayladığı yanıtlar, sınıflandırmalar ve yapılandırılmış çıktı örnekleri yüksek değer taşır. Çok sayıda düşük kaliteli örnek yerine daha az ama açık, tutarlı ve temsil gücü yüksek örnek kullanmak çoğu zaman daha iyi sonuç verir. SFT bittikten sonra model mutlaka holdout test set üzerinde değerlendirilmelidir çünkü training verisindeki başarı production davranışının aynı olacağı anlamına gelmez.
Continued Pre-Training Nedir?
Continued pre-training, mevcut bir base modelin belirli bir domain corpus'u üzerinde dil modelleme hedefiyle ek eğitime devam etmesidir. Bu yöntem instruction-response örneklerinden çok, modelin hukuk, finans, sağlık veya teknik dokümantasyon gibi belirli bir alanın terminolojisine ve yazım örüntülerine daha fazla aşinalık kazanmasını amaçlar. Büyük miktarda temiz domain metni bulunduğunda yararlı olabilir ancak SFT ile aynı problem için kullanılmaz. Continued pre-training sonrasında çoğu kurumsal proje ayrıca instruction fine-tuning veya SFT uygulayarak model davranışını hedef göreve yönlendirir. Bu aşamada catastrophic forgetting riski mutlaka ölçülmelidir çünkü domain uyarlaması yapılırken modelin genel yetkinliklerinde istenmeyen gerilemeler görülebilir.
Parameter-Efficient Fine-Tuning (PEFT) Nedir?
PEFT, modelin bütün parametrelerini güncellemek yerine küçük bir parametre alt kümesi veya ek adapter katmanları üzerinde eğitim yapmayı amaçlayan yöntemler ailesidir. LoRA, QLoRA, prefix tuning ve prompt tuning bu yaklaşımın yaygın örnekleridir. Büyük modellerde full fine-tuning için gereken GPU belleği ve training maliyeti yüksek olduğundan PEFT kurumsal pilotlarda güçlü bir başlangıç seçeneği sunar. Ayrıca aynı base model üzerinde farklı departman veya görevler için ayrı adapter dosyaları tutmak mümkün olabilir. Ancak PEFT daha ekonomik diye her zaman yeterli kabul edilmemelidir; modelin hedef göreve adaptasyon seviyesi, base model kapasitesi ve benchmark sonuçları seçim kararını belirlemelidir.
Fine-Tuning Modelde Neyi Değiştirir?
Fine-tuning modelin belirli girdilere verdiği cevapların olasılık dağılımını hedef veri doğrultusunda değiştirir. Bu değişim modelin çıktı formatını, terminoloji kullanımını, görev davranışını ve belirli soru türlerine yaklaşımını etkileyebilir. Ancak modelin içine güvenilir ve güncel bir kurumsal veritabanı yerleştirilmiş gibi düşünmek doğru değildir. Fine-tuning davranışı şekillendirmede güçlüdür, fakat değişken gerçeklerin güncel tutulmasında tek başına uygun yöntem olmayabilir. Kurumsal projelerde bu nedenle modelde neyin davranış olarak öğrenileceği ve hangi bilginin RAG veya harici sistem üzerinden sağlanacağı proje başında açık biçimde ayrılmalıdır.
Model Ağırlıkları
Full fine-tuning sırasında modelin çok sayıda veya tüm ağırlıkları training verisine göre güncellenebilir. PEFT yöntemlerinde ise ana ağırlıkların büyük bölümü sabit tutulurken daha küçük adapter parametreleri optimize edilir. Ağırlık değişiklikleri modelin belirli token dizilerine verdiği olasılıkları etkiler ve bu durum yanıt davranışında gözlemlenir. Eğitim verisinin dengesiz veya hatalı olması bu nedenle model davranışını beklenmeyen yönde değiştirebilir. Kurumsal kullanımda ağırlık değişiminin etkisi yalnızca hedef görevde değil, genel benchmark ve güvenlik testlerinde de kontrol edilmelidir.
Davranış Kalıpları
Modelin hangi soruya ne kadar ayrıntılı cevap verdiği, hangi adımları izlediği ve hangi görevlerde belirli kalıpları kullandığı fine-tuning ile etkilenebilir. Örneğin teknik destek modeline önce teşhis sorusu sorması, ardından çözüm adımlarını belirli sırayla vermesi öğretilebilir. Davranış verisinin iyi örneklenmesi modelin production'da daha tutarlı çalışmasını sağlar. Buna karşılık yanlış veya çelişkili örnekler modelin farklı kullanıcılara farklı prosedür uygulamasına neden olabilir. Bu yüzden kurumsal fine-tuning dataset'i gerçek iş sürecini temsil eden onaylanmış davranış örneklerinden oluşturulmalıdır.
Format ve Üslup
Fine-tuning'in en başarılı kullanım alanlarından biri tutarlı çıktı formatı ve iletişim üslubudur. Modelden sürekli belirli JSON alanlarını üretmesi, kısa müşteri yanıtları vermesi veya kurumsal rapor formatını takip etmesi istenebilir. Bu tür görevlerde eğitim verisinin tamamında aynı şema ve yazım standardının uygulanması gerekir. Training örnekleri farklı biçimlerde hazırlanırsa model de production'da format dalgalanması gösterebilir. Format compliance metriği bu nedenle fine-tuned model evaluation sürecinde ayrı olarak izlenmeli ve yalnızca anlamsal doğruluğa güvenilmemelidir.
Domain-Specific Terminoloji
Kurumsal veya sektörel terminoloji genel modeller tarafından her zaman doğru bağlamda kullanılmayabilir. Fine-tuning, kurum içi kısaltmaların, ürün adlarının, teknik ifadelerin ve iş süreçlerinde kullanılan özel kavramların daha tutarlı kullanılmasına yardımcı olabilir. Ancak değişken ürün detaylarını veya sürekli güncellenen fiyat bilgisini bu yöntemle modele yerleştirmek doğru strateji olmayabilir. Terminoloji ile gerçek bilgi birbirinden ayrılmalıdır. Modelin dili ve davranışı fine-tuning ile uyarlanırken güncel kurumsal gerçeklerin retrieval veya güvenilir API kaynaklarından alınması çoğu zaman daha yönetilebilir bir mimari oluşturur.
Kurumsal Verilerle Fine-Tuning Ne Anlama Gelir?
Kurumsal verilerle fine-tuning, şirketin sahip olduğu veya kullanım hakkına sahip olduğu verilerin belirli bir model davranışını geliştirmek amacıyla eğitim dataset'ine dönüştürülmesi anlamına gelir. Bu süreç yalnızca dokümanları training sistemine yüklemek değildir çünkü veri seçimi, hukuki kullanım hakkı, PII temizliği, kalite kontrolü ve versioning birlikte yönetilmelidir. Kurum içi destek kayıtlarından iyi yanıt örnekleri üretmek mümkünken aynı kayıtlardaki kişisel bilgilerin doğrudan eğitimde kullanılması uygun olmayabilir. Training verisinin kaynağı ve dönüşüm adımları izlenebilir olmalıdır. Kurumsal Verilerle LLM Fine-Tuning Süreçleri güvenilir hale ancak veri yönetişimi ile model geliştirme aynı proje planında buluştuğunda gelir.
Proprietary Data Nedir?
Proprietary data bir kurumun kendi operasyonları, ürünleri, müşterileri veya iç süreçleri sonucunda oluşan ve kamuya açık olmayan verileri ifade eder. İç dokümantasyon, destek konuşmaları, uzman yanıtları ve belirli iş kuralları bu kategoriye girebilir. Bu veriler kurum için rekabet ve operasyon açısından değerli olabilir fakat otomatik olarak training amacıyla kullanılabilecekleri anlamına gelmez. Kullanım izinleri, sözleşmeler ve kişisel veri gereksinimleri ayrıca kontrol edilmelidir. Fine-tuning projesi başlamadan önce proprietary verinin sahipliği ve model eğitimindeki kullanım kapsamı hukuk, güvenlik ve data owner ekipleri tarafından birlikte değerlendirilmelidir.
Kurumsal Veri Kaynakları Nelerdir?
Kurumsal fine-tuning verisi çok farklı sistemlerden gelebilir ve her kaynağın kalite profili birbirinden farklıdır. Destek kayıtları gerçek kullanıcı dili konusunda güçlü örnekler sunarken e-posta zincirleri gürültülü, kişisel bilgi içeren veya çelişkili olabilir. Teknik dokümantasyon domain terminolojisini temsil ederken CRM kayıtları daha fazla privacy kontrolü gerektirir. Bu nedenle kaynakları tek havuzda toplayıp doğrudan eğitime vermek yerine her kaynak için ayrı kalite ve risk değerlendirmesi yapılmalıdır. İdeal dataset, kullanım senaryosunu gerçekçi biçimde temsil eden ancak gereksiz kişisel ve gizli bilgi taşımayan doğrulanmış örneklerden oluşmalıdır.
Dokümanlar
Kurumsal dokümanlar prosedür, politika, teknik açıklama ve ürün bilgisinin önemli kaynaklarıdır. Ancak sürekli güncellenen dokümanları fine-tuning ile modele ezberletmek yerine RAG ile güncel biçimde sunmak çoğu zaman daha doğru olur. Fine-tuning açısından dokümanlar özellikle kurumun yazım tonu, görev kalıpları veya terminolojisi için örnek üretme kaynağı olabilir. Eski ve çelişkili belgeler önce temizlenmelidir. Her dokümanın sahibi, sürümü ve kullanım izni kayıt altına alınmadan training dataset'ine alınmaması veri yönetişimi açısından daha güvenli bir yaklaşımdır.
CRM Kayıtları
CRM sistemleri müşteri etkileşimleri, satış notları ve ilişki geçmişi gibi yüksek değerli veri içerir. Aynı zamanda kişisel bilgi ve ticari hassasiyet seviyesi yüksek olabileceği için fine-tuning öncesi güçlü temizleme gerektirir. Müşteri adı, iletişim bilgisi veya sözleşmeye bağlı veriler training set'e doğrudan taşınmamalıdır. CRM kayıtlarından görev örnekleri üretilecekse mümkün olan en düşük veri miktarı kullanılmalıdır. Domain davranışı için gerekli olmayan kişisel ayrıntıların redaction veya pseudonymization ile kaldırılması hem güvenliği hem de veri kalitesini artırır.
Destek Talepleri
Destek talepleri gerçek kullanıcı problemlerini ve başarılı çözüm kalıplarını gösterdiği için SFT açısından çok değerli olabilir. Ancak bütün ticket'lar eşit kalitede değildir; yanlış teşhis, eksik çözüm veya eski ürün bilgisi içeren kayıtlar modeli yanlış davranışa yönlendirebilir. Yalnızca çözüldüğü ve doğrulandığı bilinen örnekler tercih edilmelidir. Müşteri kimlik bilgileri ve özel veriler temizlenmelidir. Ayrıca aynı problemin yüzlerce benzer örneği dataset'i dengesiz hale getirebileceği için duplicate ve near-duplicate analizi yapılmalıdır.
E-posta ve Yazışmalar
E-posta ve kurum içi yazışmalar gerçek iletişim tonunu yansıtır fakat yüksek gürültü ve privacy riski taşıyabilir. İmza blokları, alıcı bilgileri, kişisel detaylar ve konuyla ilgisiz uzun zincirler training kalitesini düşürür. Fine-tuning için kullanılacaksa önce görev açısından anlamlı kısımlar ayrıştırılmalıdır. Kurumun onaylı iletişim standardını temsil etmeyen kişisel üslupların modele taşınması istenmeyen sonuç oluşturabilir. Bu nedenle e-postalar genellikle doğrudan training kaynağı olmaktan çok, uzmanlar tarafından temizlenmiş ve yeniden yapılandırılmış örnek üretim kaynağı olarak değerlendirilmelidir.
Çağrı Merkezi Transkriptleri
Çağrı merkezi transkriptleri gerçek müşteri dili, sorun anlatma biçimleri ve başarılı temsilci yanıtları açısından güçlü bir veri kaynağıdır. Buna karşılık konuşma dili, otomatik transkripsiyon hataları ve kişisel bilgi içeriği önemli temizlik ihtiyacı oluşturur. Önce konuşmacı rolleri doğru ayrılmalı ve yanlış transkripsiyonlar mümkün olduğunca düzeltilmelidir. Yüksek kaliteli örnekler müşteri sorunu ile onaylanmış çözümü açık biçimde eşleştirmelidir. Eğitim amacıyla kullanılacak verilerin gereksiz müşteri kimliği taşımaması ve temsilci hatalarının gold-standard cevap olarak kabul edilmemesi gerekir.
ERP Verileri
ERP sistemleri finans, tedarik, üretim ve operasyon süreçleri hakkında yapılandırılmış veriler içerir. Bu veriler classification veya structured extraction use case'leri için örnek oluşturabilir ancak güncel gerçekleri modele ezberletmek amacıyla kullanılmamalıdır. Finansal bilgiler ve ticari hassasiyet nedeniyle erişim kapsamı çok dar tutulmalıdır. Training için gerekli olan alanlar data minimization prensibiyle seçilmelidir. Çoğu projede ERP gerçeklerine production sırasında API veya güvenli retrieval üzerinden erişmek, fine-tuning'i ise model davranışı ve format için kullanmak daha güvenli bir mimari oluşturur.
Teknik Dokümantasyon
Teknik dokümantasyon ürün mimarisi, hata kodları ve prosedür terminolojisi açısından güçlü bir domain kaynağıdır. Continued pre-training veya domain örnek üretimi için değerlendirilebilir. Ancak sürüm bilgisi hızla değişiyorsa modele doğrudan bilgi ezberletmek bakım sorunu yaratabilir. Bu durumda fine-tuning ile teknik yanıt biçimi ve terminoloji öğretilirken gerçek doküman içeriği RAG üzerinden sağlanabilir. Training set'e alınacak teknik içeriklerin güncel, onaylı ve doğru sürüme ait olduğunun doğrulanması modelin eski prosedürleri öğrenmesini önlemek açısından önemlidir.
Kod Depoları
Kod repository'leri kuruma özel framework kullanımı, coding pattern ve internal API örnekleri içerebilir. Yazılım geliştirme modeli fine-tune edilecekse belirli kod örnekleri değerli olabilir. Bununla birlikte repository içinde secret, private key, connection string ve lisans kısıtlı üçüncü taraf kodlar bulunabilir. Training öncesi secret scanning ve lisans kontrolü zorunlu hale getirilmelidir. Ayrıca eski veya deprecated kod örnekleri ayıklanmalı, yalnızca kurumun güncel mühendislik standartlarını temsil eden ve kullanımı onaylanmış parçalar dataset'e dahil edilmelidir.
Onaylanmış İnsan Yanıtları
Domain uzmanları veya deneyimli çalışanlar tarafından onaylanmış yanıtlar SFT için en değerli veri türlerinden biridir. Çünkü bu örneklerde modelin hangi girdiye hangi seviyede, hangi formatta ve hangi iş kuralıyla yanıt vermesi gerektiği doğrudan gösterilebilir. İnsan onayının yalnızca dilbilgisi değil iş doğruluğu açısından verilmesi gerekir. Aynı soruya farklı uzmanların çelişkili yanıtları varsa training öncesinde ortak standarda bağlanmalıdır. Gold-standard yanıtların versioning ile korunması model değerlendirme ve sonraki retraining süreçlerinde güvenilir referans sağlar.
Her Kurumsal Veri Eğitim Verisi Olarak Kullanılabilir mi?
Hayır, kurumun sahip olduğu her veri otomatik olarak LLM fine-tuning dataset'ine uygun değildir. Kişisel veri, credential, sözleşme ile kısıtlı içerik, eski prosedür ve doğrulanmamış bilgi model eğitimine alınmamalıdır. Ayrıca gerçek iş problemine katkı sağlamayan büyük veri hacmi sadece training maliyetini yükseltir ve sinyal kalitesini düşürebilir. Eğitim verisi seçiminde hukuki kullanım hakkı, bilgi doğruluğu, temsil gücü ve güvenlik birlikte değerlendirilmelidir. Kurumsal dataset oluşturmanın temel amacı mümkün olan en fazla veriyi toplamak değil, modelin hedef davranışı güvenilir biçimde öğrenmesini sağlayacak en yüksek kaliteli örnekleri seçmektir.
Fine-Tuning'e Gerçekten İhtiyacınız Var mı?
Fine-tuning teknik açıdan etkileyici görünse de her LLM projesinin doğal sonraki adımı değildir. Önce problemin güncel bilgi eksikliği mi, tutarsız davranış mı, format sorunu mu yoksa domain terminolojisi mi olduğu belirlenmelidir. Bilgi problemi varsa RAG çoğu zaman daha hızlı ve yönetilebilir çözüm sunar. Davranış veya çıktı formatı problemi varsa fine-tuning daha anlamlı olabilir. Kurumsal yapay zekada RAG mi fine-tuning mi kullanılmalı sorusunun yanıtı teknoloji tercihiyle değil, problemi bilgi ve davranış bileşenlerine ayırarak verilmelidir.
Önce Prompt Engineering Denenmeli mi?
Evet, çoğu kurumsal kullanım senaryosunda fine-tuning öncesi iyi bir prompt baseline oluşturmak gerekir. System prompt, birkaç örnek ve yapılandırılmış output talimatı hedef kaliteyi sağlıyorsa ek training maliyetine ihtiyaç olmayabilir. Prompt baseline aynı zamanda fine-tuning sonrası kazanımı ölçmek için referans noktası oluşturur. Model yalnızca kötü prompt nedeniyle düşük performans gösteriyorsa training problemin gerçek nedenini çözmez. Bu yüzden bir projede ilk adım, aynı test set üzerinde güçlü prompt engineering sonucu ile fine-tuned model sonucunu karşılaştırabilecek ölçüm altyapısını kurmaktır.
RAG Ne Zaman Yeterlidir?
RAG, modelin güncel veya değişken kurumsal bilgilere erişmesi gereken durumlarda çoğu zaman yeterlidir. Kullanıcı şirket prosedürü, ürün özelliği veya son politika değişikliğini soruyorsa ilgili dokümanın retrieval ile modele verilmesi güncellik sağlar. Ayrıca kaynak gösterme ihtiyacı bulunan sistemlerde hangi belgenin kullanıldığı açıkça gösterilebilir. RAG pipeline'ı doküman güncellendiğinde modeli yeniden eğitmek zorunda bırakmaz. Modelin temel davranışı yeterli, sorun yalnızca doğru bilgiye erişim ise fine-tuning yerine retrieval kalitesini, erişim yetkisini ve context tasarımını iyileştirmek daha verimli olabilir.
Fine-Tuning Ne Zaman Gereklidir?
Fine-tuning modelin belirli davranışı sık ve tutarlı biçimde göstermesi gerektiğinde değer kazanır. Marka tonunda yazım, özel sınıflandırma etiketleri, belirli JSON şeması, domain terminolojisi ve dar görevlerde daha küçük model kullanımı buna örnektir. Prompt ile çok uzun talimat vermek zorunda kalıyor veya her istekte aynı örnekleri context'e ekliyorsanız fine-tuning inference maliyetini de azaltabilir. Bununla birlikte hedef davranışın ölçülebilir olması gerekir. Fine-tuning kararı alınmadan önce baseline, kalite hedefi, maliyet hedefi ve güvenlik kriterleri tanımlanmalıdır.
Tutarlı Çıktı Formatı
Structured output gerektiren uygulamalarda modelin aynı şemayı sürekli üretmesi önemlidir. Prompt engineering yeterli sonuç vermiyorsa SFT ile çok sayıda doğru format örneği gösterilebilir. Örneğin müşteri talebini kategori, öncelik ve gerekçe alanlarıyla JSON üretmek kurumsal otomasyon için tipik bir kullanım alanıdır. Eğitim örneklerinin şeması tamamen tutarlı olmalıdır. Evaluation sırasında yalnızca içerik doğruluğu değil parse edilebilirlik, zorunlu alanların varlığı ve geçerli enum kullanımı gibi format kontrolleri de otomatik test edilmelidir.
Kurumsal Dil ve Marka Tonu
Bir modelin sürekli aynı iletişim tonunu kullanması müşteri deneyimi açısından önemli olabilir. Kurumsal dil kısa, resmi, teknik veya daha samimi bir çizgide tanımlanabilir. Prompt ile bu tonu sağlamak mümkün olsa da çok çeşitli girdilerde davranış dalgalanabilir. Onaylanmış yanıt çiftleriyle yapılan SFT modelin yazım biçimini daha doğal hale getirebilir. Ancak marka tonu eğitim verisi oluşturulurken farklı departmanlardan gelen çelişkili örnekler temizlenmeli ve ortak style guide training dataset'inin temel referansı olmalıdır.
Domain-Specific Terminoloji
Modelin sektör veya kurum içi terimleri yanlış anlaması kullanıcı güvenini azaltabilir. Fine-tuning belirli kavramların doğru biçimde kullanılmasını ve doğru görevlerle ilişkilendirilmesini sağlayabilir. Örneğin teknik destek sisteminde kurumun ürün modülleri ve hata sınıfları doğru terminolojiyle öğretilir. Buna rağmen değişen ürün gerçekleri eğitim verisine kalıcı bilgi olarak gömülmemelidir. Terminoloji davranışı fine-tuning ile, güncel ürün durumu ise RAG veya API üzerinden sağlandığında bakım yükü daha kontrollü hale gelir.
Sınıflandırma ve Extraction
Dar kapsamlı classification ve information extraction görevleri fine-tuning için güçlü adaylardır. Model belirli kategori setini veya JSON şemasını çok sayıda doğru örnek üzerinden öğrenebilir. Genel amaçlı büyük model yerine daha küçük fine-tuned model kullanmak latency ve inference maliyetini azaltabilir. Eğitim dataset'inde sınıflar dengeli temsil edilmelidir. Evaluation precision, recall, F1 ve schema validation ile yapılmalı, özellikle düşük frekanslı ancak yüksek riskli sınıfların performansı ayrıca raporlanmalıdır.
Özel Reasoning Kalıpları
Bazı kurumsal görevlerde modelin belirli karar prosedürünü takip etmesi istenir. Örneğin bir destek talebini önce ürün sürümüne, sonra hata türüne, ardından escalation gereksinimine göre değerlendirmek gibi bir iş akışı olabilir. Fine-tuning bu davranış kalıbını örnekler üzerinden güçlendirebilir. Ancak modelin gizli düşünme sürecini zorunlu biçimde üretmesi yerine güvenilir ara çıktılar veya karar alanları tasarlamak daha yönetilebilir olur. İş kuralının güncel bölümleri gerektiğinde external policy engine veya retrieval katmanından sağlanmalıdır.
Daha Küçük Bir Modelle Maliyeti Düşürme
Büyük bir model güçlü genel yetkinlik sunabilir fakat dar bir kurumsal görev için gereğinden pahalı olabilir. Yüksek kaliteli dataset ile daha küçük bir model fine-tune edilerek aynı görevde kabul edilebilir kalite yakalanabilir. Bu yaklaşım inference latency ve GPU maliyetini ciddi biçimde azaltabilir. Model distillation ve fine-tuning birlikte değerlendirilebilir. Ancak küçük model seçimi yalnızca maliyet gerekçesiyle yapılmamalı, base model ve fine-tuned model aynı holdout test üzerinde kalite, güvenlik ve latency açısından karşılaştırılmalıdır.
Fine-Tuning'in Yanlış Kullanıldığı Senaryolar
Fine-tuning'in en sık yanlış kullanımı modeli kurumun bütün güncel bilgisini ezberleyen bir veritabanına dönüştürmeye çalışmaktır. Bu yöntem doküman değiştikçe yeniden eğitim gerektirir ve kaynak gösterilebilirliği zayıflatır. Bir diğer hata veri kalite sorunlarını model eğitimiyle kapatmaya çalışmaktır; çelişkili ve yanlış veriler daha fazla training ile düzelmez. Fine-tuning ayrıca erişim kontrolü yerine kullanılamaz çünkü model artifact'ı kendi başına kullanıcı yetkilendirmesi yapmaz. Problem güncellik, kaynak gösterme veya permission ise ilgili katmanlar ayrıca tasarlanmalıdır.
Güncel Bilgiyi Modele Ezberletmek
Fiyat, prosedür, ürün sürümü veya organizasyon bilgisi sık değişiyorsa bu gerçekleri fine-tuning ile modele yerleştirmek bakım maliyetini yükseltir. Model training anındaki bilgiyi öğrenebilir ancak sonraki değişiklikleri kendiliğinden bilemez. Retraining döngüsü gecikirse model eski bilgiyi güvenle söyleyebilir. Bu nedenle güncel gerçekler retrieval veya API üzerinden sağlanmalıdır. Fine-tuning ise modelin bu bilgiyi nasıl kullanacağına, nasıl formatlayacağına veya hangi davranış kurallarını izleyeceğine odaklanmalıdır.
Sürekli Değişen Dokümanları Eğitime Dahil Etmek
Sık güncellenen politika ve kullanım dokümanlarını eğitim verisine kalıcı biçimde dahil etmek version yönetimini zorlaştırır. Bir politika değiştiğinde eski bilgi model ağırlıklarında kalabilir. Bunun ne ölçüde unutulduğunu garanti etmek kolay değildir. RAG yaklaşımı yeni belgeyi index'e ekleyerek daha hızlı güncelleme sağlar. Fine-tuning dataset'i daha uzun ömürlü davranış örnekleri ve terminoloji üzerine kurulursa retraining sıklığı azaltılabilir.
Kaynak Gösterme Gerektiren Sistemler
Kullanıcı yanıtın hangi kurumsal kaynağa dayandığını görmek istiyorsa fine-tuning tek başına bunu güvenilir biçimde sağlayamaz. Model training sırasında gördüğü bir bilgiyi hangi belgeden öğrendiğini production'da doğru şekilde işaretleyemez. RAG ise retrieved dokümanları citation metadata ile yanıt akışına ekleyebilir. Hukuki, finansal veya denetlenebilir bilgi sistemlerinde bu özellik önemlidir. Fine-tuning gerekiyorsa kaynaklı yanıt üretme davranışını öğretmek için kullanılabilir, ancak gerçek kaynak retrieval katmanından gelmelidir.
Veri Sorunlarını Model Eğitimiyle Çözmeye Çalışmak
Yanlış etiket, duplicate kayıt ve çelişkili kurumsal politika training sırasında kendiliğinden düzelmez. Model bu hataları da öğrenebilir. Dataset curation bu nedenle fine-tuning projesinin en önemli mühendislik işlerinden biridir. Önce data quality problemleri giderilmeli, sonra eğitim yapılmalıdır. Daha büyük model veya daha fazla epoch kötü dataset'in temel sorununu çözmez; bazı durumlarda yalnızca hatalı örüntüleri daha güçlü öğrenir.
RAG mi Fine-Tuning mi?
RAG ve fine-tuning birbirinin rakibi değil, farklı problem türlerini çözen iki yaklaşımdır. RAG modele çalışma anında güncel ve yetkili bilgi getirirken fine-tuning modelin davranışını ve görev performansını değiştirmeye odaklanır. Kurumsal yapay zekada RAG mi fine-tuning mi kullanılmalı sorusunun en sağlıklı yanıtı önce bilgi problemi ile davranış problemini ayırmaktır. Kullanıcı sorusuna doğru belgeyi bulamıyorsanız retrieval iyileştirilmelidir. Model doğru belgeyi görmesine rağmen sürekli yanlış format veya zayıf görev davranışı gösteriyorsa fine-tuning güçlü aday haline gelir.
RAG Nasıl Çalışır?
RAG sisteminde kullanıcı sorusu önce retrieval katmanına gider ve ilgili kurumsal içerikler aranır. Semantic search, keyword search veya hybrid yöntemler kullanılabilir. Yetkilendirme kontrolünden geçen doküman parçaları model context'ine eklenir. Model yanıtını bu güncel içerik üzerinden üretir. Doküman değiştiğinde modeli yeniden eğitmek yerine index güncellenebilir ve bu özellik kurumsal bakım maliyetini önemli ölçüde azaltır.
Fine-Tuning Nasıl Çalışır?
Fine-tuning modelin parametrelerini veya adapter ağırlıklarını eğitim örnekleri üzerinden optimize eder. Training sırasında model girdiye göre hedef yanıt üretmeyi öğrenir. Sonrasında aynı davranışı yeni girdilere genellemeye çalışır. Bilgi modeli çalışma anında dış kaynaktan almak yerine eğitim sırasında davranış olarak içselleştirilir. Bu nedenle fine-tuning daha çok görev kalıbı, format, üslup ve domain adaptasyonu için uygundur.
Bilgi ve Davranış Problemlerini Ayırmak
Bir model doğru kurumsal cevabı bilmiyorsa ilk soru bu bilginin model context'ine ulaşıp ulaşmadığıdır. Bilgi mevcut dokümanda var ancak retrieval bulamıyorsa fine-tuning değil RAG iyileştirmesi gerekir. Model doğru bilgiyi görüyor fakat yanlış formatta veya uygun olmayan tonla yanıt veriyorsa davranış problemi vardır. Bu durumda fine-tuning yararlı olabilir. Bu ayrım yapılmadan başlatılan projeler gereksiz eğitim maliyeti ve bakım yükü oluşturabilir.
Veri Güncelliği Açısından Karşılaştırma
RAG güncel bilgi gerektiren sistemlerde avantajlıdır çünkü doküman veya database güncellendiğinde index kısa sürede yenilenebilir. Fine-tuning ise retraining ve deployment gerektirir. Sık değişen bilgi ağırlıklara işlendiğinde eski bilginin tamamen çıkarıldığını kanıtlamak zor olabilir. Bu nedenle ürün özellikleri, fiyat ve prosedür gibi değişken içerikler RAG için daha uygundur. Fine-tuning uzun ömürlü davranış ve format kuralları için daha iyi sonuç verir.
Maliyet Açısından Karşılaştırma
RAG embedding, vector database, retrieval ve daha uzun prompt maliyetleri oluşturur. Fine-tuning ise training GPU maliyeti, veri hazırlama ve model yaşam döngüsü maliyetlerini getirir. Buna karşılık fine-tuned küçük model bazı dar görevlerde uzun prompt ihtiyacını azaltarak inference maliyetini düşürebilir. Toplam maliyet yalnızca training fiyatıyla hesaplanmamalıdır. Retrieval altyapısı, retraining, monitoring ve insan değerlendirmesi de TCO içine eklenmelidir.
Latency Açısından Karşılaştırma
RAG her istekte retrieval adımı eklediği için ek network ve search latency oluşturabilir. Fine-tuned model gerekli davranışı ağırlıklarda taşıdığı için belirli görevlerde daha kısa pipeline sunabilir. Ancak model boyutu büyükse inference süresi yine yüksek olabilir. Hybrid sistemlerde retrieval ve fine-tuned serving birlikte çalıştığından latency bütçesi baştan ölçülmelidir. P95 ve P99 değerleri production kapasite planında ortalama latency'den daha anlamlı olabilir.
Kaynak Gösterilebilirlik Açısından Karşılaştırma
RAG retrieved doküman metadata'sını yanıtla birlikte sunabildiği için kaynak gösterme konusunda belirgin avantaj sağlar. Fine-tuned model belirli bilgiyi hangi eğitim kaynağından öğrendiğini güvenilir biçimde söyleyemez. Regülasyon veya denetim gerektiren kurumsal sistemlerde bu fark önemlidir. Fine-tuning ile modelin citation formatına uyması öğretilebilir ancak citation'ın gerçek belgesi yine retrieval katmanından gelmelidir. Kaynak doğrulaması gereken sistemlerde RAG çoğu zaman temel bileşen olmalıdır.
Güvenlik ve Veri Gizliliği Açısından Karşılaştırma
RAG veriyi model ağırlıklarına kalıcı olarak taşımadan çalışma anında sunabilir ancak retrieval erişimleri doğru yetkilendirilmelidir. Fine-tuning training verisinin model tarafından ezberlenme riskini değerlendirmeyi gerektirir. Özellikle PII ve secret temizliği eğitim öncesinde yapılmalıdır. Üçüncü taraf training API kullanılıyorsa veri işleme şartları ayrıca incelenmelidir. Güvenlik kararı yalnızca RAG veya fine-tuning tercihinden değil, veri hareketi ve model artifact yönetiminden oluşan bütün mimariden etkilenir.
Bakım Maliyeti Açısından Karşılaştırma
RAG tarafında document ingestion, index güncelleme ve retrieval kalitesi sürekli yönetilir. Fine-tuning tarafında dataset versioning, training, evaluation, model registry ve retraining süreçleri bulunur. Sık değişen bilgi için fine-tuning bakım maliyeti hızla artabilir. Sabit görev davranışı için ise RAG'e sürekli uzun örnekler eklemek yerine fine-tuned model daha sade olabilir. Kurumlar her iki yaklaşımın yaşam döngüsü maliyetini production ölçeğinde değerlendirmelidir.
RAG + Fine-Tuning Hibrit Mimarisi
Birçok kurumsal kullanım senaryosunda en güçlü sonuç RAG ve fine-tuning'in birlikte kullanılmasıyla elde edilir. Fine-tuning modele nasıl davranacağını, hangi formatı kullanacağını ve kurumsal terminolojiyi öğretir. RAG ise güncel ve kullanıcı yetkisine uygun bilgiyi çalışma anında sağlar. Bu yaklaşım “fine-tune style, retrieve facts” prensibiyle özetlenebilir. Özellikle müşteri destek, iç bilgi asistanı ve teknik doküman sistemlerinde hibrit mimari hem güncellik hem tutarlı davranış açısından dengeli sonuç verir.
Fine-Tuning ile Davranışı Öğretmek
Fine-tuned model kurumsal yanıt tonunu, çıktı yapısını ve görev kurallarını öğrenebilir. Örneğin her destek yanıtında önce problemi özetlemesi, ardından doğrulanmış çözüm adımlarını vermesi öğretilebilir. Böylece prompt içinde uzun davranış talimatları sürekli tekrarlanmaz. Model gerçek bilgiyi ise retrieval context'inden alır. Bu ayrım model davranışını daha istikrarlı ve güncel bilgiyi daha yönetilebilir hale getirir.
RAG ile Güncel Bilgiyi Sağlamak
RAG katmanı şirket dokümanı, ürün bilgisi veya güncel policy gibi sürekli değişebilecek gerçekleri getirir. Fine-tuned model bu context'i nasıl yorumlayacağını bilir. Doküman güncellendiğinde model retraining gerekmeden yeni bilgi kullanılabilir. Yetkilendirme retrieval aşamasında uygulanabilir. Böylece aynı fine-tuned model farklı kullanıcı gruplarına yalnızca izinli içerikten yanıt üretir.
Fine-Tune Style, Retrieve Facts Yaklaşımı
Bu yaklaşım modelin davranış ve üslubunu training ile, gerçek bilgiyi retrieval ile yönetir. Kurumsal marka tonu ve structured output fine-tuning üzerinden gelir. Güncel fiyat, prosedür veya ürün özellikleri retrieval'dan sağlanır. Sistem böylece eski bilginin ağırlıklarda kalma riskini azaltır. Ayrıca her iki katmanın ayrı ayrı test edilebilmesi debugging sürecini kolaylaştırır.
Hibrit Mimari Ne Zaman Mantıklıdır?
Kullanım senaryosu hem güncel kurumsal bilgi hem tutarlı model davranışı gerektiriyorsa hibrit yapı mantıklıdır. Özellikle uzun system prompt ve çok sayıda örnek nedeniyle token maliyeti yükseliyorsa fine-tuning bu davranış bilgisini model tarafına taşıyabilir. RAG ise güncel context'i daha kısa ve hedefli biçimde sağlar. Ancak iki ayrı sistem bileşeni operasyon yükünü artırır. Bu nedenle gerçek kalite kazanımı baseline ve A/B testleriyle doğrulanmalıdır.
Örnek Kurumsal Hibrit Akış
Örnek bir akışta kullanıcı sorusu önce kimlik ve yetki bilgisiyle birlikte retrieval servisine gönderilir. İlgili dokümanlar yalnızca kullanıcının erişebildiği kaynaklardan seçilir. Context oluşturulduktan sonra fine-tuned model belirlenen format ve kurumsal dilde yanıt üretir. Guardrail katmanı güvenlik ve hassas veri kontrolü uygular. Son olarak kullanılan kaynaklar yanıtla birlikte kullanıcıya gösterilir ve kalite sinyalleri monitoring sistemine aktarılır.
Kullanıcı Sorusu
Hibrit akış kullanıcı sorusunun normalize edilmesi ve gerekli metadata ile zenginleştirilmesiyle başlar. Kullanıcı rolü, departmanı ve uygulama bağlamı retrieval yetkilendirmesinde kullanılabilir. Prompt içeriğinde hassas veri olup olmadığı ayrıca kontrol edilebilir. Soru doğrudan modele gönderilmeden önce retrieval ihtiyacı belirlenir. Bu aşama doğru tasarlanırsa hem güvenlik hem de sonraki retrieval kalitesi önemli ölçüde iyileşir.
Retrieval
Retrieval katmanı semantik ve keyword yöntemleriyle ilgili kurumsal belgeleri bulur. Chunk boyutu ve metadata filtreleri kaliteyi doğrudan etkiler. Yalnızca yüksek benzerlik puanı değil doküman güncelliği ve onay durumu da dikkate alınabilir. Retrieved parçalar model context sınırını gereksiz doldurmamalıdır. Başarılı retrieval için ayrı recall ve relevance benchmark'ları oluşturmak yararlıdır.
Yetkilendirme
Retrieval sonucu kullanıcı yetkisine göre filtrelenmelidir. Bir belgenin semantik olarak ilgili olması kullanıcının o belgeyi görmeye yetkili olduğu anlamına gelmez. IAM ve document ACL bilgileri retrieval pipeline'a entegre edilebilir. Yetkisiz içerik model context'ine hiç girmemelidir. Bu kontrol fine-tuned modelin güvenlik davranışından bağımsız ve teknik olarak zorunlu katman olarak tasarlanmalıdır.
Context Oluşturma
Seçilen doküman parçaları modelin kolay anlayacağı ve kaynak metadata'sını koruyan biçimde birleştirilir. Aynı bilginin tekrar eden chunk'ları temizlenebilir. Context sıralaması relevance ve kaynak güvenilirliğine göre yapılabilir. Çok uzun context latency ve token maliyetini artırır. Prompt template fine-tuned modelin training sırasında gördüğü yapıyla uyumlu olduğunda daha kararlı sonuç alınabilir.
Fine-Tuned Model
Fine-tuned model retrieved bilgiyi belirlenen görev davranışıyla işler. Kurumsal terminoloji, format ve üslup training sırasında öğrenilmiş olabilir. Modelden context dışında bilgi üretmemesi istenebilir ancak bu davranış ayrıca evaluation ile test edilmelidir. Model version ve adapter version request metadata'sına eklenmelidir. Böylece production hataları belirli model sürümüyle ilişkilendirilebilir.
Guardrail
Guardrail katmanı model çıktısında hassas veri, yasaklı içerik, format hatası veya policy ihlali olup olmadığını kontrol eder. Bazı kontroller rule-based, bazıları ayrı classifier ile uygulanabilir. High-risk response insan review'a yönlendirilebilir. Guardrail başarısız olduğunda kullanıcıya güvenli fallback yanıtı verilebilir. Bu katman fine-tuning'in yerine geçmez ancak production güvenliğini tamamlar.
Kaynaklı Yanıt
Son yanıt kullanılan doküman kaynaklarıyla birlikte sunulduğunda kullanıcı güveni artar. Citation metadata retrieval aşamasından gelmeli ve model tarafından uydurulmamalıdır. Kaynakların güncel ve erişilebilir olması gerekir. Kullanıcı geri bildirimleri retrieval ve model kalitesini ayrı ayrı değerlendirmek için saklanabilir. Bu yaklaşım denetlenebilir kurumsal bilgi sistemleri için güçlü bir temel oluşturur.
Kurumsal Fine-Tuning Projesine Başlamadan Önce Başarı Kriterleri
Başarı kriterleri tanımlanmadan başlatılan fine-tuning projeleri genellikle teknik demo üretir ancak iş değeri ölçemez. İlk olarak hangi iş probleminin çözüleceği ve mevcut modelin nerede başarısız olduğu netleştirilmelidir. Baseline model aynı test set üzerinde ölçülür ve fine-tuning sonrası beklenen iyileşme sayısal hedefe bağlanır. Latency, maliyet, güvenlik ve kabul edilebilir hata seviyesi yalnızca accuracy kadar önemlidir. Go veya No-Go kararı model eğitimi bittikten sonra önceden belirlenmiş kriterlere göre verilmelidir.
İş Problemini Tanımlamak
Fine-tuning projesi “kuruma özel model istiyoruz” gibi genel hedefle başlamamalıdır. Bunun yerine müşteri talebi sınıflandırma doğruluğunu artırmak, structured output oranını yükseltmek veya inference maliyetini düşürmek gibi ölçülebilir problem tanımlanmalıdır. Kullanıcı ve iş süreci açık biçimde belirlenmelidir. Modelin hata yaptığı örnekler toplanmalıdır. Böylece training dataset doğrudan gerçek probleme hizmet eder.
Baseline Model Performansını Ölçmek
Fine-tuning öncesi aynı base model iyi bir prompt ile değerlendirilmelidir. Bu baseline olmazsa training sonrasında kazanımın nereden geldiği anlaşılamaz. Accuracy, format compliance, latency ve maliyet ölçülebilir. Human evaluation gerekli use case'lerde baseline'a dahil edilmelidir. Sonraki bütün deneyler aynı test set ve rubric ile karşılaştırılmalıdır.
Hedef Metrikleri Belirlemek
Hedef metrikler kullanım senaryosuna göre seçilmelidir. Classification için F1, structured output için schema compliance, müşteri yanıtı için human rating kullanılabilir. Tek bir genel accuracy değeri yeterli değildir. Güvenlik ve latency gibi ikincil metrikler de production kabul kriterine eklenmelidir. Hedef değerler eğitim başlamadan önce belirlenirse sonradan sonuçlara göre kriter değiştirme riski azalır.
Kabul Edilebilir Hata Seviyesini Belirlemek
Her model belirli oranda hata üretir ve kritik konu hangi hatanın kabul edilebilir olduğunu tanımlamaktır. Düşük riskli içerik üretiminde küçük stil hataları tolere edilebilirken finansal sınıflandırmada false negative daha ciddi sonuç doğurabilir. Hata türleri business impact ile eşleştirilmelidir. Human review gerektiren eşikler tanımlanabilir. Production release bu risk sınırlarını geçmemelidir.
Latency Hedefleri
Kullanıcı deneyimi ve backend otomasyonu için latency hedefleri baştan belirlenmelidir. Ortalama süre yerine P50, P95 ve P99 değerleri ölçülmelidir. Fine-tuned model daha küçükse latency iyileşebilir, ancak ek guardrail veya RAG katmanları toplam süreyi yükseltebilir. Time to First Token ayrı izlenebilir. Production kapasite planı gerçek concurrency yüküyle test edilmelidir.
Maliyet Hedefleri
Training bütçesi kadar inference maliyeti de önemlidir. Hedef request başına veya bin token başına maliyet olarak tanımlanabilir. Daha küçük fine-tuned model büyük API modeline göre tasarruf sağlayabilir. Bununla birlikte GPU amortismanı, model operasyonu ve retraining maliyeti TCO içine alınmalıdır. Pilot sonucunda kalite ve maliyet birlikte karşılaştırılmalıdır.
Güvenlik ve Compliance Gereksinimleri
Training verisinin nerede işleneceği ve model artifact'ın nerede saklanacağı baştan belirlenmelidir. KVKK, GDPR, data residency ve şirket içi security policy gereksinimleri mimari kararları etkiler. PII redaction ve secret scanning zorunlu olabilir. Üçüncü taraf sağlayıcı kullanılacaksa veri işleme şartları incelenmelidir. Güvenlik kriterleri son production gate'te değil proje planının başlangıcında yer almalıdır.
Fine-Tuning Go/No-Go Kriterleri
Go/No-Go kriteri modelin production'a çıkıp çıkamayacağını nesnel biçimde belirler. Örneğin F1 değerinin baseline'a göre belirli oranda yükselmesi, safety regression olmaması ve latency hedefinin karşılanması şart koşulabilir. Human evaluation sonucu da kriterlerden biri olabilir. Maliyet hedefi aşılırsa teknik kalite iyi olsa bile deployment reddedilebilir. Bu yaklaşım demo başarısını gerçek production readiness seviyesinden ayırır.
Base Model Nasıl Seçilir?
Base model seçimi fine-tuning projesinin maliyet, kalite ve deployment seçeneklerini doğrudan etkiler. En büyük modelin otomatik olarak en doğru seçim olduğu düşünülmemelidir. Türkçe performansı, lisans, context window, donanım ihtiyacı ve commercial use şartları birlikte değerlendirilmelidir. Modelin hedef görevde baseline performansı pilot dataset üzerinde ölçülmelidir. Küçük ancak iyi seçilmiş bir model fine-tuning sonrası daha düşük maliyetle yeterli kalite sunabilir.
Açık Kaynak ve Kapalı Model Kararı
Açık ağırlıklı modeller on-prem deployment, adapter yönetimi ve veri kontrolü açısından esneklik sağlayabilir. Kapalı API modelleri ise altyapı işletme yükünü azaltabilir ve managed fine-tuning seçenekleri sunabilir. Kurumun data residency ve güvenlik gereksinimleri seçimde önemli rol oynar. Model lisansı ve commercial use şartları açıkça incelenmelidir. Karar yalnızca model benchmark skoruna göre değil, uzun vadeli TCO ve vendor dependency açısından da verilmelidir.
Model Boyutu
Model boyutu parametre sayısını ve çoğu zaman GPU bellek ile inference maliyetini etkiler. Büyük model daha geniş genel yetkinlik sunabilir ancak dar bir kurumsal görevde gereksiz maliyet yaratabilir. Küçük model ise iyi fine-tuning ile classification veya extraction gibi görevlerde güçlü sonuç verebilir. Seçim yapılırken hedef görev, latency ve deployment altyapısı birlikte değerlendirilmelidir. Aynı dataset üzerinde farklı boyutların baseline ve fine-tuned sonuçlarını karşılaştırmak en sağlıklı yöntemdir.
1B–3B
1B–3B aralığındaki modeller düşük GPU ihtiyacı ve hızlı inference avantajı sağlar. Dar sınıflandırma, extraction veya basit structured output görevleri için değerlendirilebilir. Genel reasoning kapasitesi daha büyük modeller kadar güçlü olmayabilir. İyi hazırlanmış domain dataset ile belirli görevde ekonomik çözüm haline gelebilir. Production deployment özellikle edge veya sınırlı GPU ortamında kolaylaşabilir.
7B–8B
7B–8B modeller kurumsal fine-tuning projelerinde kalite ve kaynak ihtiyacı arasında pratik denge sunabilir. LoRA veya QLoRA ile tek veya az sayıda güçlü GPU üzerinde pilot eğitim yapılabilir. Türkçe ve domain performansı model ailesine göre ayrıca test edilmelidir. Inference quantization ile maliyet daha da düşürülebilir. Çok görevli asistan yerine belirli iş akışı modellerinde güçlü aday olabilir.
13B–14B
13B–14B modeller daha yüksek kapasite sunarken GPU bellek ihtiyacı da artar. Domain reasoning ve daha çeşitli görevlerde küçük modellere göre avantaj sağlayabilir. QLoRA ile training maliyeti kontrol edilebilir. Serving tarafında quantization ve uygun GPU planlaması gerekir. Bu model boyutu seçilmeden önce 7B sınıfının hedef kaliteyi karşılayıp karşılamadığı ölçülmelidir.
30B+
30B üzerindeki modeller daha geniş kapasite sunar ancak training ve inference operasyonu belirgin biçimde zorlaşır. Multi-GPU veya yüksek bellekli accelerator ihtiyacı ortaya çıkabilir. Kurumsal use case gerçekten bu kapasiteyi gerektiriyorsa değerlendirilebilir. Aksi halde küçük model fine-tuning ve iyi RAG mimarisi daha ekonomik olabilir. Benchmark farkının donanım maliyetini karşılayıp karşılamadığı ölçülmelidir.
70B+
70B ve üzeri modeller yüksek kalite sunabilse de kendi altyapısında fine-tuning ve serving önemli yatırım gerektirir. Full fine-tuning çoğu kurum için yüksek maliyetlidir. PEFT ve quantization ile ihtiyaç azaltılabilir ancak deployment yine güçlü GPU kaynakları ister. Managed API seçenekleri operasyon yükünü azaltabilir. Bu boyut ancak küçük modellerin test edilmiş şekilde hedef kaliteyi karşılamadığı durumlarda mantıklı hale gelir.
Context Window
Context window modelin tek istekte işleyebileceği token miktarını belirler. RAG veya uzun doküman analizi use case'lerinde daha büyük context avantaj sağlar. Ancak büyük context her zaman daha iyi retrieval anlamına gelmez ve inference maliyetini artırabilir. Fine-tuning sequence length eğitim GPU belleğini de etkiler. Gerçek kullanım senaryosundaki prompt uzunluğu ölçülerek model seçimi yapılmalıdır.
Türkçe Dil Performansı
Kurumsal uygulama Türkçe ağırlıklıysa modelin Türkçe performansı mutlaka kendi test setinizle ölçülmelidir. İngilizce benchmark başarısı Türkçe domain dilinde aynı sonucu garanti etmez. Yazım, terminoloji, ek yapıları ve uzun cümleler test edilmelidir. Türkçe teknik ve müşteri dili ayrı örnekler içerebilir. Base model seçimi before fine-tuning aşamasında bu farklı veri tipleriyle değerlendirilmelidir.
Domain Performansı
Modelin finans, hukuk, yazılım veya teknik destek gibi hedef domain'deki baseline yeteneği önemlidir. Çok zayıf base model küçük fine-tuning dataset'iyle istenen seviyeye ulaşmayabilir. Domain test set'i gerçek kullanım örneklerinden oluşturulmalıdır. Genel benchmark yerine task-specific evaluation uygulanmalıdır. Fine-tuning'in katkısı aynı modelin önceki sonucu ile karşılaştırılmalıdır.
Model Lisansı
Açık model kullanmak lisanssız kullanım anlamına gelmez. Model lisansı commercial deployment, modification ve redistribution şartları içerebilir. Kurumsal ürün içinde kullanmadan önce hukuk ekibiyle değerlendirme yapılmalıdır. Adapter veya merged model dağıtımının lisans etkisi de incelenmelidir. Dataset lisansları ayrıca bağımsız kontrol edilmelidir.
Commercial Use İzinleri
Bazı modeller araştırma kullanımına açık olsa da ticari kullanım için farklı şartlara sahip olabilir. Kullanım hacmi, gelir veya dağıtım şekli lisans koşullarını etkileyebilir. Managed sağlayıcı sözleşmeleri de ayrı kısıtlar getirebilir. Production mimarisi kurulmadan önce kullanım hakkı netleştirilmelidir. Sonradan model değiştirmek training ve evaluation maliyetini yeniden oluşturabilir.
Donanım Gereksinimleri
Model boyutu, precision ve training yöntemi GPU bellek ihtiyacını belirler. Full fine-tuning PEFT'e göre çok daha yüksek kaynak ister. Sequence length ve batch size da memory kullanımını etkiler. Training öncesi küçük profiling job çalıştırmak gerçek kapasite ihtiyacını gösterir. Inference donanımı training ortamından ayrı planlanmalıdır.
Inference Maliyeti
Fine-tuning projesinin toplam maliyetinde production inference çoğu zaman training'den daha büyük paya ulaşabilir. Request hacmi, token miktarı ve GPU utilization düzenli izlenmelidir. Küçük model seçimi maliyeti önemli ölçüde düşürebilir. Quantization ve batching ayrıca optimize edilebilir. Model seçiminde kalite başına maliyet metriği kullanmak yalnızca parametre sayısına bakmaktan daha anlamlıdır.
Fine-Tuning Desteği
Her model aynı fine-tuning araçları veya adapter yöntemleriyle uyumlu olmayabilir. Hugging Face, PEFT veya managed API desteği deployment süresini etkiler. Model architecture üzerinde hangi target module'ların LoRA için uygun olduğu incelenmelidir. Quantization desteği de önemlidir. Toolchain olgunluğu kurumsal bakım maliyetini doğrudan etkileyebilir.
Kurumsal Eğitim Verisi Nasıl Toplanır?
LLM fine-tuning için kurumsal eğitim verisi nasıl hazırlanır sorusunun ilk aşaması doğru veriyi seçmektir. Veri envanteri çıkarılmalı, data owner belirlenmeli ve kullanım izinleri kontrol edilmelidir. Yüksek kaliteli gerçek örnekler gold-standard veri olarak seçilir. Production log'ları doğrudan training'e aktarılmak yerine PII temizliği ve kalite kontrolünden geçirilmelidir. Gerekirse gerçek veri açığını kapatmak için insan onaylı sentetik örnekler üretilir.
Veri Envanteri Oluşturmak
Hangi kaynakların eğitim için potansiyel değer taşıdığı önce envanter halinde çıkarılmalıdır. Kaynak sistemi, owner, hassasiyet seviyesi, veri tarihi ve kullanım hakkı kaydedilebilir. Dataset'e alınacak içerikler bu envanterden seçilir. Bilinmeyen veya sahipsiz kaynaklar doğrudan kullanılmamalıdır. Envanter sonraki lineage ve audit süreçlerinin de temelini oluşturur.
Veri Kaynağı Sahiplerini Belirlemek
Her data source için iş anlamını ve kullanım koşullarını bilen bir owner bulunmalıdır. Model ekibi teknik olarak veriye erişebiliyor olsa bile kullanım kararını tek başına vermemelidir. Owner hangi kayıtların güncel ve doğru olduğunu belirlemeye yardımcı olur. Training dataset onayı bu sorumlulukla ilişkilendirilebilir. Owner değişiklikleri metadata içinde güncellenmelidir.
Kullanım İzinlerini Kontrol Etmek
Verinin kurum içinde bulunması eğitim amacıyla kullanılabileceği anlamına gelmez. Müşteri sözleşmeleri, privacy gereksinimleri ve lisans koşulları kontrol edilmelidir. Üçüncü taraf içeriklerin training hakkı ayrıca incelenmelidir. Kullanım amacı açık şekilde belgelenmelidir. Dataset card içinde izin kapsamı ve kısıtlar kayıt altına alınabilir.
Yüksek Kaliteli Örnekleri Seçmek
Training dataset'in değerini örnek sayısından çok örnek kalitesi belirler. Doğru, güncel ve target davranışı açık biçimde gösteren kayıtlar seçilmelidir. Aynı türde tekrar eden yüzlerce örnek sınıf dengesini bozabilir. Uzman onayı özellikle kritik domain görevlerinde önemlidir. Seçim kriterleri belgelenerek sonraki dataset sürümlerinde aynı standart korunmalıdır.
Production Loglarından Veri Üretmek
Production log'ları gerçek kullanıcı davranışını yansıttığı için değerli olabilir. Ancak raw log içinde PII, secret, sistem bilgisi ve hatalı response bulunabilir. Önce filtreleme ve redaction uygulanmalıdır. Başarılı ve başarısız örnekler ayrı etiketlenmelidir. Fine-tuning'e yalnızca doğrulanmış hedef yanıtlar alınmalıdır.
Domain Uzmanlarından Gold-Standard Yanıtlar Toplamak
Uzmanlar gerçek use case'ler için ideal cevaplar hazırlayabilir. Bu yöntem küçük fakat yüksek kaliteli SFT dataset'i üretmek için çok değerlidir. Annotation rubric bütün uzmanlara aynı standartta uygulanmalıdır. Çelişkili yanıtlar consensus review ile çözülmelidir. Gold-standard set hem training hem evaluation tasarımında referans olarak kullanılabilir.
Sentetik Eğitim Verisi Oluşturmak
Gerçek veri az olduğunda güçlü teacher model kullanılarak sentetik instruction-response örnekleri üretilebilir. Ancak sentetik içerik doğrudan doğru kabul edilmemelidir. Domain uzmanı veya otomatik validation ile kalite kontrolü yapılmalıdır. Aynı modelin hatalarını çoğaltma riski vardır. Gerçek ve sentetik veri dengeli kullanılmalıdır.
Hangi Kurumsal Veriler Fine-Tuning Dataset'ine Alınmamalı?
Training dataset güvenilirliğini artırmanın en önemli yöntemlerinden biri neyin dışarıda bırakılacağını bilmektir. Yetkisiz kişisel veriler, secret'lar, eski belgeler, doğrulanmamış yanıtlar ve lisans durumu belirsiz içerikler model eğitimine alınmamalıdır. Çelişkili kurumsal politikalar da model davranışını bozabilir. Veri filtreleme yalnızca güvenlik için değil kalite için de gereklidir. Dataset inclusion ve exclusion kriterleri yazılı bir policy olarak tanımlanmalıdır.
Yetkisiz Kişisel Veriler
Kişisel veri yalnızca teknik olarak erişilebilir olduğu için training'e dahil edilmemelidir. Kullanım amacı ve hukuki dayanak kontrol edilmelidir. Gereksiz tanımlayıcılar redaction veya anonymization ile kaldırılmalıdır. Özellikle müşteri konuşmaları dikkatle değerlendirilmelidir. Fine-tuning için gereken minimum veri kullanılmalıdır.
Parolalar ve API Key'ler
Password, API key ve token gibi secret'lar hiçbir eğitim dataset'inde bulunmamalıdır. Model bunları ezberleyebilir veya artifact içinde risk oluşturabilir. Secret scanner training pipeline'ın zorunlu kontrolü olmalıdır. Tespit edilen gerçek credential derhal rotate edilmelidir. Temizleme sonrası dataset yeniden taranmalıdır.
Finansal veya Hassas Kimlik Verileri
Finansal hesap bilgileri ve yüksek hassasiyetli kimlik verileri training açısından ciddi risk taşır. Görev için zorunlu değilse tamamen çıkarılmalıdır. Gerekli use case'lerde anonymization veya sentetik alternatif değerlendirilmelidir. Erişim dar role sınırlandırılmalıdır. Training artifact güvenliği de bu risk seviyesine göre yükseltilmelidir.
Güncelliğini Yitirmiş Belgeler
Eski prosedür ve teknik dokümanlar modeli yanlış davranışa yönlendirebilir. Dataset curation sırasında document version ve tarih kontrol edilmelidir. Deprecated içerikler ayrı archive olarak tutulabilir ancak training'e alınmamalıdır. Güncel gerçekleri RAG ile sunmak daha iyi olabilir. Domain davranışı için yalnızca geçerli standartlar kullanılmalıdır.
Yanlış veya Doğrulanmamış İçerikler
Production kayıtlarındaki her cevap doğru değildir. Kullanıcı yorumları, başarısız destek yanıtları ve taslak dokümanlar model için yanlış sinyal oluşturabilir. Yalnızca doğruluğu kontrol edilmiş örnekler gold-standard kabul edilmelidir. Hatalı örnekler gerekiyorsa negative training veya evaluation için ayrı tutulabilir. Training'e karışmamaları için dataset governance uygulanmalıdır.
Lisans Durumu Belirsiz İçerikler
Üçüncü taraf doküman ve kodların training hakkı ayrıca değerlendirilmelidir. İnternetten veya vendor materyalinden alınmış içerik kurum repository'sinde bulunuyor diye serbest kullanım anlamına gelmez. Lisans bilgisi metadata ile tutulmalıdır. Belirsiz içerikler dataset'e alınmamalıdır. Kurumsal hukuk ve procurement ekipleri gerekirse sürece dahil edilmelidir.
Birbiriyle Çelişen Kurumsal Politikalar
Aynı konu hakkında farklı departmanların çelişkili prosedürleri varsa model hangisinin doğru olduğunu öğrenemez. Önce policy owner tarafından tek geçerli sürüm belirlenmelidir. Eski sürümler training'den çıkarılmalıdır. Çelişki çözülmeden daha fazla örnek eklemek kaliteyi artırmaz. Dataset governance iş süreçlerindeki belirsizliği model eğitiminden önce çözmelidir.
KVKK, GDPR ve Kurumsal Veri Gizliliği
LLM fine-tuning sürecinde veri güvenliği KVKK ve model değerlendirme yöntemleri birbirinden bağımsız ele alınmamalıdır. Training verisinin kullanım amacı, saklama süresi ve işleme lokasyonu açıkça tanımlanmalıdır. Üçüncü taraf model sağlayıcı kullanılıyorsa veri işleme sözleşmeleri ve residency şartları incelenmelidir. Kişisel veri mümkün olduğunca azaltılmalı ve gereksiz alanlar temizlenmelidir. Teknik ekip hukuki yorum yapmaya çalışmak yerine hukuk, güvenlik ve data governance ekipleriyle ortak süreç kurmalıdır.
Fine-Tuning İçin Hukuki Dayanak
Kişisel veya sözleşmeye bağlı verinin model eğitiminde kullanılabilmesi için uygun hukuki dayanak ve kullanım amacı değerlendirilmelidir. Mevcut verinin farklı amaçla toplanmış olması training için otomatik izin anlamına gelmez. Kurumun hukuk ve privacy ekipleri karar sürecine dahil edilmelidir. Dataset card kullanım amacını kayıt altına alabilir. Belirsiz durumda veri training'e alınmamalıdır.
Veri Minimizasyonu
Training için yalnızca hedef göreve gerekli veri kullanılmalıdır. Gereksiz isim, telefon veya müşteri kimliği kaldırılabilir. Model davranışını öğretmek için çoğu zaman gerçek kimlik bilgisine ihtiyaç yoktur. Minimal dataset güvenlik riskini ve storage maliyetini azaltır. Data minimization otomatik redaction ile desteklenebilir.
Amaçla Sınırlılık
Veri hangi amaçla toplandıysa training kullanımının bu kapsamla ilişkisi değerlendirilmelidir. Bir müşteri destek kaydının farklı bir model projesinde kullanılması yeni değerlendirme gerektirebilir. Training amacı açık şekilde belgelenmelidir. Dataset'in başka amaçlarla yeniden kullanımına kontrol uygulanmalıdır. Bu yaklaşım governance açısından izlenebilirlik sağlar.
Saklama Süresi
Raw training data süresiz saklanmamalıdır. Retention süresi iş ve hukuki gereksinimlere göre belirlenmelidir. Training tamamlandıktan sonra geçici ara dosyalar silinebilir. Model registry ve dataset registry farklı retention politikasına sahip olabilir. Silme işlemleri audit edilebilir olmalıdır.
Veri Silme Talepleri
Dataset içinde belirli kişiye ait veri bulunuyorsa silme talepleri teknik açıdan zor hale gelebilir. Bu yüzden baştan anonymization kullanmak riski azaltır. Dataset lineage hangi kaydın hangi sürümde kullanıldığını göstermelidir. Model ağırlıklarından belirli bir örneği çıkarmak kolay değildir. Gerektiğinde retraining veya model retirement politikası önceden tanımlanmalıdır.
Üçüncü Taraf Model Sağlayıcıları
Managed fine-tuning hizmeti kullanıldığında veri kurum sınırları dışındaki altyapıda işlenebilir. Sağlayıcının training verisini nasıl sakladığı ve başka amaçlarla kullanıp kullanmadığı sözleşmeyle incelenmelidir. Bölgesel processing seçeneği önemlidir. Security ve compliance değerlendirmesi procurement sürecine dahil edilmelidir. Hassas use case'lerde on-prem veya private cloud tercih edilebilir.
Veri Residency
Verinin hangi ülke veya bölgede işlendiği bazı kurumlar için kritik gereksinimdir. Cloud GPU veya API seçimi bu şartı etkiler. Dataset backup ve model checkpoint lokasyonları da değerlendirilmelidir. Sadece primary storage'a bakmak yeterli değildir. Architecture documentation veri akışlarını açık biçimde göstermelidir.
Veri İşleme Sözleşmeleri
Üçüncü taraf hizmetlerde veri işleme sorumlulukları yazılı sözleşmelerle tanımlanmalıdır. Retention, deletion ve subprocessor şartları incelenmelidir. Incident notification süreci de anlaşılmalıdır. Fine-tuning verisinin başka model eğitimlerinde kullanılıp kullanılmayacağı açık olmalıdır. Teknik ekip sözleşme şartlarını gerçek sistem ayarlarıyla eşleştirmelidir.
PII ve Hassas Veri Temizleme
Fine-tuning verisini güvenli hale getirmenin önemli adımlarından biri PII ve secret temizliğidir. Otomatik detection tek başına yeterli olmayabilir; rule, NER ve manuel sampling birlikte kullanılabilir. Redaction, masking, tokenization ve pseudonymization farklı kullanım amaçlarına göre seçilir. Secret detection ayrıca API key, token ve private key gibi credential türlerini hedeflemelidir. Temizleme tamamlandıktan sonra dataset yeniden taranmalı ve sonuç audit kaydına eklenmelidir.
PII Detection
PII detection isim, e-posta, telefon ve diğer kişisel tanımlayıcıları bulmayı amaçlar. Regex belirli formatlarda güçlüdür, NER ise bağlamsal ifadeleri yakalayabilir. Türkçe veride model performansı özel test set ile ölçülmelidir. False negative riski sampling ile kontrol edilmelidir. Detection sonucu doğrudan temizleme pipeline'ına aktarılabilir.
Redaction
Redaction hassas değerin tamamen kaldırılması veya sabit placeholder ile değiştirilmesidir. Training görevi gerçek değere ihtiyaç duymuyorsa güçlü bir yöntemdir. Örneğin müşteri adı yerine PERSON etiketi kullanılabilir. Bu dönüşüm modelin kişisel bilgiyi ezberleme riskini azaltır. Redaction sonrası cümlenin anlamı korunup korunmadığı test edilmelidir.
Masking
Masking verinin belirli bölümünü gizleyerek formatın bir kısmını korur. Test ve bazı structured görevlerde yararlı olabilir. Örneğin kart numarasının yalnızca son dört hanesi bırakılabilir. Fine-tuning için gerçek değer gerekli değilse daha güçlü redaction tercih edilebilir. Masking policy data classification seviyesine göre otomatik uygulanabilir.
Tokenization
Tokenization hassas değeri geri eşlenebilir bir token ile değiştirir. Referans bütünlüğü gereken bazı kurumsal dataset'lerde kullanılabilir. Mapping tablosu ayrı ve güçlü korunan sistemde tutulmalıdır. Model training ortamının mapping'e erişmesi gerekmeyebilir. Token formatının gerçek bilgi sızdırmamasına dikkat edilmelidir.
Pseudonymization
Pseudonymization gerçek kimliği farklı bir değerle değiştirir ancak belirli koşullarda geri ilişkilendirme mümkün olabilir. Aynı kişinin farklı kayıtlarında tutarlı token kullanılması bazı conversation use case'lerinde yararlı olabilir. Mapping key güvenli tutulmalıdır. Bu yöntem anonymization ile aynı şey değildir. Hukuki risk değerlendirmesi buna göre yapılmalıdır.
Anonymization
Anonymization verinin belirli kişiyle yeniden ilişkilendirilememesini hedefler. Eğitim için gerçek kimlik gerekli değilse güçlü güvenlik sağlar. Ancak utility kaybı test edilmelidir. Çok fazla alan kaldırılırsa domain sinyali zayıflayabilir. Risk ve model performansı arasında dengeli dönüşüm tasarlanmalıdır.
Secret Detection
Secret scanning training verisi, source repository ve pipeline loglarında ayrı çalışmalıdır. API key, access token, private key ve connection string gibi credential'lar aranmalıdır. Gerçek secret bulunduğunda yalnızca dataset'ten silmek yeterli değildir, credential rotate edilmelidir. Scanner rule set kurum teknolojilerine göre özelleştirilebilir. Temizleme sonrası ikinci tarama zorunlu olmalıdır.
API Keys
API key'ler genellikle belirli prefix veya karakter yapısına sahip olabilir. Pattern matching ve entropy analizi birlikte kullanılabilir. Tespit edilen key eğitim verisinden çıkarılmalıdır. Gerçek sistemde aktifse derhal rotate edilmelidir. Dataset pipeline benzer secret'ların yeniden girişini engellemelidir.
Access Tokens
Access token kısa ömürlü olsa bile training dataset'e alınmamalıdır. JWT veya vendor token formatları scanner tarafından tanınabilir. Token payload içinde kullanıcı bilgisi bulunabilir. Redaction token'ın tamamına uygulanmalıdır. Log kaynağı da yeniden yapılandırılarak ileride token yazılması engellenmelidir.
Private Keys
Private key en kritik credential türlerinden biridir. PEM header gibi belirgin pattern'ler kolay tespit edilebilir. Training dataset'te bulunması ciddi security incident kabul edilmelidir. Key revoke veya rotate edilmelidir. Repository ve backup'lar da aynı olay kapsamında taranmalıdır.
Connection Strings
Connection string database hostname, kullanıcı adı ve bazen parola içerebilir. Regex ve known scheme detection ile bulunabilir. Training için genellikle gerekli değildir. Sensitive bölümler tamamen redaction ile kaldırılmalıdır. Uygulama loglarının bu bilgiyi üretmemesi için source sistem de düzeltilmelidir.
Temizleme Sonrası Yeniden Tarama
Birinci temizleme adımı bütün hassas veriyi yakalamayabilir. Dataset ikinci scanner veya farklı rule set ile yeniden taranmalıdır. Random sample human review ek güvence sağlar. Tarama sonucu dataset version ile ilişkilendirilmelidir. Production training yalnızca onaylı ve temizlenmiş sürüm üzerinden başlamalıdır.
Dataset Governance Nasıl Kurulur?
Kurumsal fine-tuning projesinde dataset, model kadar önemli bir artifact olarak yönetilmelidir. Owner ve data steward sorumlulukları tanımlanmalı, onay mekanizması kurulmalı ve lineage korunmalıdır. Dataset card kaynağı, amacı, temizlik yöntemleri ve bilinen sınırlamaları açıklayabilir. Versioning olmadan hangi modelin hangi veriyle eğitildiğini güvenilir biçimde izlemek mümkün değildir. Dataset governance özellikle audit ve retraining süreçlerinde teknik borcu önemli ölçüde azaltır.
Dataset Owner
Dataset owner verinin iş açısından kullanım sorumluluğunu taşır. Training amacı ve erişim kapsamı için onay verebilir. İçerik güncelliğinin takibinden sorumlu ekip belirlenir. Owner değiştiğinde metadata güncellenmelidir. Sahipsiz dataset production training'e alınmamalıdır.
Data Steward
Data steward metadata, kalite ve classification konularında operasyonel sorumluluk üstlenir. Duplicate ve yanlış etiket sorunlarını takip edebilir. Annotation standardının uygulanmasını destekler. Dataset değişikliklerini owner ile birlikte değerlendirir. Human review sürecinde önemli rol oynar.
Onay Mekanizması
Training dataset version production eğitimine geçmeden approval almalıdır. Data owner, security ve gerekiyorsa privacy ekipleri sürece dahil edilir. Otomatik scan sonuçları reviewer'a sunulur. Approval kaydı immutable audit store içinde saklanabilir. Sonradan değişiklik yapılırsa yeni version yeniden onaylanmalıdır.
Data Lineage
Lineage her training örneğinin hangi kaynak ve dönüşüm adımlarından geldiğini gösterir. PII redaction, deduplication ve normalization gibi işlemler izlenebilir olmalıdır. Dataset sorununda kaynağa geri dönmek kolaylaşır. Model version lineage ile ilişkilendirilebilir. Bu yapı incident ve audit analizinde güçlü kanıt sağlar.
Dataset Card
Dataset card verinin amacı, kaynakları, lisans durumu ve bilinen sınırlamalarını açıklayan dokümandır. Class distribution ve preprocessing bilgileri eklenebilir. PII temizleme yöntemi açıkça belirtilmelidir. Model ekibi training öncesi bu kartı review eder. Dataset version değiştikçe card da güncellenmelidir.
Veri Kaynağının İzlenebilirliği
Her örneğin hangi sistemden geldiği bilinmelidir. Bu bilgi veri silme, düzeltme veya quality incident durumunda önemlidir. Kaynak id'leri privacy riskini artırmadan internal metadata olarak tutulabilir. Origin kaybolursa yanlış bilgi düzeltmek zorlaşır. Training pipeline provenance bilgisini otomatik üretmelidir.
Dataset Versioning
Dataset değişiklikleri semantic veya tarih tabanlı sürümle takip edilebilir. Her training job exact version kullanmalıdır. Mutable dosya klasörleri reproducibility açısından risklidir. Dataset hash değişiklik doğrulamasına yardımcı olur. Model registry hangi modelin hangi dataset version ile eğitildiğini göstermelidir.
Değişiklik Kaydı
Yeni örnek ekleme, veri silme ve label düzeltmeleri changelog içinde kaydedilmelidir. Değişikliğin nedeni belirtilmelidir. Büyük taxonomy değişiklikleri benchmark sonucunu etkileyebilir. Dataset release note model ekibine bu farkı açıklar. Retraining kararları değişiklik büyüklüğüne göre verilebilir.
Training Dataset Kalitesi Nasıl Artırılır?
Fine-tuning başarısında veri miktarından önce kalite gelir. Duplicate ve near-duplicate örnekler eğitim dağılımını bozabilir. Yanlış etiketler modelin hatalı davranışı güçlendirmesine neden olur. Format ve terminoloji bütün dataset boyunca tutarlı olmalıdır. Edge case ve düşük frekanslı sınıflar bilinçli şekilde temsil edilmelidir.
Quality Over Quantity İlkesi
Daha fazla veri her zaman daha iyi model anlamına gelmez. Binlerce düşük kaliteli örnek yerine yüzlerce doğrulanmış örnek daha güçlü sinyal sağlayabilir. Dataset büyüklüğü hedef görev ve model boyutuna göre deneysel değerlendirilmelidir. Noise oranı arttıkça training sonucu zayıflayabilir. Pilot küçük ve yüksek kaliteli set ile başlamalıdır.
Duplicate Örneklerin Temizlenmesi
Aynı örneğin çok sayıda tekrarı modelin belirli pattern'i aşırı öğrenmesine neden olabilir. Exact hash ile duplicate kayıtlar bulunabilir. Train ve test arasında duplicate bulunması evaluation sonucunu yapay olarak yükseltir. Deduplication split öncesi ve sonrası kontrol edilmelidir. Duplicate oranı dataset quality metriği olarak raporlanabilir.
Near-Duplicate Detection
Kelimeleri küçük farklılık gösteren aynı içerikler exact hash ile yakalanamayabilir. Embedding similarity veya n-gram yöntemleri near-duplicate tespiti için kullanılabilir. Özellikle destek ticket'larında şablon içerikler sık görülür. Aşırı benzer örneklerin bir kısmı çıkarılabilir. Test contamination da bu yöntemle daha iyi kontrol edilir.
Yanlış Etiketlerin Düzeltilmesi
Classification dataset'inde label hatası model performansını doğrudan düşürür. Confusion matrix ve disagreement analizi şüpheli örnekleri bulabilir. Domain uzmanı yeniden review yapmalıdır. Label değişikliği kayıt altına alınmalıdır. Zor örnekler annotation rubric iyileştirmesine de yardımcı olur.
Format Tutarlılığı
Instruction ve response formatı bütün dataset boyunca aynı olmalıdır. JSON alan adları, enum değerleri ve boş alan davranışı standardize edilmelidir. Chat formatında role sırası korunmalıdır. Farklı formatlar modelin output compliance seviyesini düşürür. Validation script training öncesi schema kontrolü yapmalıdır.
Dil ve Terminoloji Tutarlılığı
Aynı kavram için farklı ekiplerin farklı terimler kullanması modeli kararsız hale getirebilir. Business glossary training data için referans olmalıdır. Türkçe ve İngilizce teknik terimlerin kullanım standardı belirlenmelidir. Eski terminoloji gerekiyorsa user input örneği olarak tutulabilir fakat assistant hedef yanıt güncel standardı kullanmalıdır. Terminoloji versioning domain değişimlerinde yardımcı olur.
Edge Case'lerin Eklenmesi
Sadece kolay örneklerle eğitilen model production'daki sıra dışı girdilerde zayıf kalabilir. Boundary case, eksik bilgi ve belirsiz talep örnekleri dataset'e eklenmelidir. Modelin gerektiğinde soru sorması veya güvenli fallback vermesi öğretilebilir. Edge case oranı gerçek kullanım davranışına göre belirlenmelidir. Evaluation set özellikle kritik zor örnekleri içermelidir.
Sınıf Dengesizliğini Yönetmek
Bazı kategori örnekleri diğerlerinden çok daha fazla olabilir. Model çoğunluk sınıfına yönelerek yüksek genel accuracy ama düşük azınlık recall üretebilir. Sampling ve class-aware veri üretimi kullanılabilir. Sentetik örnekler dikkatli şekilde eklenebilir. Her sınıfın precision ve recall değeri ayrı raporlanmalıdır.
Eğitim Verisi Formatı Nasıl Olmalı?
Dataset formatı modelin hangi görevi öğreneceğini doğrudan etkiler. Instruction-response, chat, classification, structured JSON ve tool calling formatları farklı kullanım amaçlarına hizmet eder. Eğitim sırasında kullanılan template ile inference template uyumlu olmalıdır. Role token ve special token ayarları model ailesine göre doğru yapılandırılmalıdır. Dataset validation script yanlış formatlı kayıtları training başlamadan reddetmelidir.
Instruction–Response Formatı
Instruction-response formatında bir görev tanımı ve ideal yanıt bulunur. Tek turlu sınıflandırma, özetleme veya extraction için basit ve etkilidir. Instruction açık ve gerçek production kullanımına benzer olmalıdır. Response yalnızca istenen hedef davranışı içermelidir. Gereksiz açıklamalar modelin production'da verbosity seviyesini etkileyebilir.
Chat/Conversation Formatı
Chat dataset çok turlu kullanıcı ve assistant etkileşimlerini temsil eder. System mesajı global davranış ve policy tanımlarını içerebilir. User mesajları gerçek kullanıcı dilini yansıtmalıdır. Assistant cevapları gold-standard olarak hazırlanmalıdır. Modelin chat template yapısına uygun tokenization kullanılmalıdır.
System
System mesajı modelin genel görev ve sınırlarını tanımlar. Eğitim verisinde gereğinden uzun ve her örnekte farklı system prompt kullanılması tutarsızlık yaratabilir. Ortak davranış kuralları standardize edilmelidir. Değişken bilgiler system prompt'a gömülmemelidir. Production prompt yapısı training ile uyumlu olmalıdır.
User
User örnekleri gerçek kullanım dilini temsil etmelidir. Sadece düzgün ve ideal sorularla training yapmak production çeşitliliğini yansıtmaz. Yazım hataları, kısa talepler ve belirsiz ifadeler kontrollü oranda eklenebilir. Hassas gerçek kullanıcı verisi temizlenmelidir. User distribution gerçek loglardan anonim biçimde modellenebilir.
Assistant
Assistant hedef yanıtı kurumun istediği ideal davranışı göstermelidir. Yanlış veya gereksiz detay içeren cevaplar training'e alınmamalıdır. Format ve terminoloji standardı korunmalıdır. Güvenli fallback ve belirsizlik durumları da örneklenmelidir. Domain uzmanı onayı yüksek riskli use case'lerde zorunlu tutulabilir.
Classification Formatı
Classification dataset girdiyi ve hedef class label'ı içerir. Etiket isimleri kısa ve çelişkisiz olmalıdır. Sınıf tanımları annotation guideline içinde açıkça belirtilmelidir. Multi-label senaryoda output schema sabit tutulmalıdır. Evaluation precision, recall ve confusion matrix ile yapılmalıdır.
Structured JSON Output Formatı
Structured output otomasyon sistemleri için güvenilir parse edilebilir yanıt sağlar. JSON schema training örnekleri boyunca aynı tutulmalıdır. Nullable alanlar ve enum değerleri açıkça tanımlanmalıdır. Model output'u schema validator ile otomatik test edilebilir. Production'da invalid JSON fallback mekanizması bulunmalıdır.
Tool Calling Eğitim Formatı
Tool calling dataset modelin hangi durumda hangi aracı çağıracağını öğretir. Tool name, argument schema ve kullanım şartları doğru örneklenmelidir. Gereksiz tool çağrısı negative example olarak gösterilebilir. Modelin araç sonucu üzerinden final cevap üretmesi de training'e dahil edilmelidir. Yetkisiz tool çağrıları safety evaluation'da test edilmelidir.
Multi-Turn Conversation Dataset
Multi-turn dataset bağlamın turlar arasında nasıl korunacağını öğretir. Kullanıcının önceki bilgisine göre sonraki cevap şekillenebilir. Uzun konuşmalarda sequence length ve truncation etkisi değerlendirilmelidir. Her turda gerçek gold-standard davranış sağlanmalıdır. Production conversation yapısı training örnekleriyle benzer olmalıdır.
Train, Validation ve Test Dataset'leri
Dataset'in train, validation ve test olarak doğru ayrılması evaluation güvenilirliğinin temelidir. Training set model optimizasyonu için kullanılır. Validation hyperparameter ve early stopping kararlarını destekler. Test set final performans ölçümünde training sürecinden izole tutulmalıdır. Holdout ve temporal split yöntemleri contamination riskini azaltabilir.
Training Set
Training set model ağırlıklarını veya adapter parametrelerini güncellemek için kullanılır. En büyük veri bölümü genellikle burada bulunur. Duplicate ve kalite kontrolleri tamamlanmış olmalıdır. Test örnekleri hiçbir şekilde training'e karışmamalıdır. Dataset version job metadata'sına yazılmalıdır.
Validation Set
Validation set training sırasında modelin genelleme performansını izler. Hyperparameter değişiklikleri bu sonuçlara göre yapılabilir. Early stopping için validation loss kullanılabilir. Validation örnekleri training sırasında gradient update için kullanılmamalıdır. Sınıf dağılımı production kullanımına yakın olmalıdır.
Test Set
Test set final model kararında kullanılır. Training ve hyperparameter tuning sırasında görülmemelidir. Benchmark sonuçları base model ile aynı set üzerinde karşılaştırılır. Human evaluation için test alt kümesi seçilebilir. Test set değişirse eski sonuçlarla doğrudan karşılaştırma dikkatle yapılmalıdır.
Holdout Dataset Neden Önemlidir?
Holdout set model geliştirme ekibinin tuning kararlarından mümkün olduğunca bağımsız kalır. Çok sayıda deney sonrasında validation set'e dolaylı overfitting oluşabilir. Holdout final go/no-go kontrolü sağlar. Production'a çıkmadan hemen önce çalıştırılabilir. Sonuç model registry'ye kaydedilmelidir.
Production Benzeri Test Seti
Evaluation gerçek kullanıcı dağılımını temsil etmelidir. Sadece temiz ve kısa örnekler modelin production performansını abartabilir. Gerçek uzunluk, dil ve edge case oranları test set'e yansıtılmalıdır. Hassas gerçek kullanıcı verisi anonymize edilmelidir. Periodik yeni production örnekleri ayrı regression set'e eklenebilir.
Veri Sızıntısını Önlemek
Train ve test arasında aynı veya çok benzer örnek bulunması sonucu yapay yükseltir. Exact ve semantic duplicate detection uygulanmalıdır. Sentetik veri üretirken teacher modelin test set'e erişmemesi sağlanmalıdır. Benchmark soruları training'e dahil edilmemelidir. Split pipeline reproducible olmalıdır.
Temporal Split Kullanımı
Zaman bazlı split modelin geleceğe genelleme yeteneğini daha gerçekçi ölçebilir. Eski kayıtlar training, daha yeni kayıtlar test olarak seçilebilir. Bu yöntem domain drift etkisini de gösterir. Özellikle support ve business process verilerinde faydalıdır. Data leakage riski tarih metadata'sıyla kontrol edilmelidir.
Data Contamination Nedir?
Data contamination evaluation set'inin training veya model geliştirme sürecine sızmasıdır. Bu durumda model test sorularını gerçekten genellemek yerine daha önce görmüş olabilir. Sonuçlar production kalitesini olduğundan yüksek gösterir. Duplicate, benchmark ve train-test contamination ayrı kontrol edilmelidir. Kurumsal benchmark güvenilirliği için contamination scanning zorunlu süreç haline gelmelidir.
Train–Test Contamination
Test örnekleri training set içinde bulunursa evaluation geçersiz hale gelir. Exact duplicate kolay yakalanabilir. Semantik olarak yeniden yazılmış örnekler daha zor olabilir. Embedding similarity kontrolü yardımcı olur. Split öncesi ve sonrası contamination report üretilmelidir.
Duplicate Contamination
Aynı source kayıt farklı dosyalarda tekrar edebilir. Train ve test'e farklı kopyalar düşebilir. Source id ve hash birlikte kullanılabilir. Near-duplicate detection daha güçlü kontrol sağlar. Duplicate temizliği evaluation öncesinde tamamlanmalıdır.
Benchmark Contamination
Public benchmark soruları training corpus içinde bulunmuş olabilir. Açık modellerde bu riski tamamen ortadan kaldırmak zor olabilir. Kurumsal özel test set bu yüzden değerlidir. Benchmark skorları tek karar kriteri olmamalıdır. Gerçek use case holdout sonuçları daha fazla önem taşır.
Contamination Nasıl Tespit Edilir?
Exact hash, n-gram overlap ve embedding similarity yöntemleri kullanılabilir. Source lineage kayıtları da yardımcı olur. Şüpheli eşleşmeler manuel review'a gönderilebilir. Büyük dataset için sampling uygulanabilir. Contamination metric experiment report içinde tutulmalıdır.
Evaluation Sonuçlarını Nasıl Yanıltır?
Model test örneğini training sırasında gördüyse yüksek accuracy gerçek genelleme anlamına gelmez. Production'a çıkınca performans beklenenden düşük olabilir. Bu durum yanlış model selection kararına yol açar. Overfitting görünmez hale gelir. Bağımsız holdout dataset riski azaltır.
Sentetik Veri ile Fine-Tuning
Sentetik veri gerçek örneklerin az veya privacy açısından zor olduğu durumlarda dataset'i genişletebilir. Güçlü bir teacher model farklı soru ve cevap varyasyonları üretebilir. Ancak sentetik verinin gerçek kullanıcı dağılımını temsil edip etmediği kontrol edilmelidir. İnsan onayı ve otomatik validation kaliteyi artırır. Sentetik veri gerçek gold-standard verinin tamamen yerine geçmemelidir.
Sentetik Veri Ne Zaman Kullanılmalı?
Azınlık sınıflarında örnek sayısı düşükse sentetik veri yardımcı olabilir. Yeni ürün veya görev için gerçek log henüz yoksa başlangıç dataset'i üretilebilir. Hassas veriyi doğrudan kullanmak istemeyen kurumlar anonim senaryo üretebilir. Ancak production dağılımı ortaya çıktığında gerçek feedback ile güncelleme yapılmalıdır. Sentetik oranı kontrollü tutulmalıdır.
Teacher Model ile Veri Üretimi
Daha güçlü bir model instruction-response çiftleri üretebilir. Prompt gerçek taxonomy ve style guide ile hazırlanmalıdır. Teacher output'un doğru olduğu varsayılmamalıdır. Rule ve domain expert review uygulanmalıdır. Model ve prompt version metadata içinde tutulmalıdır.
İnsan Onaylı Sentetik Veri
Sentetik örnekler domain uzmanına inceletildiğinde kalite önemli ölçüde artabilir. Reviewer doğru, yanlış veya düzeltilebilir etiketleri kullanabilir. Onaylanan veri gold-standard alt kümesine alınabilir. Review maliyeti tamamen manuel üretimden yine daha düşük olabilir. Disagreement rate kalite metriği olarak izlenebilir.
Self-Instruct Yaklaşımı
Self-Instruct benzeri yöntemlerde model yeni instruction ve response örnekleri üretir. Duplicate ve düşük kaliteli örnekler filtrelenmelidir. Task çeşitliliği kontrol edilmelidir. Modelin kendi hatalarını çoğaltma riski bulunur. İnsan ve rule validation önemli güvenlik katmanı sağlar.
Sentetik Veride Bias Riski
Teacher model kendi bias'larını sentetik dataset'e aktarabilir. Tek modelden veri üretmek bu riski büyütebilir. İnsan review ve farklı source data kullanımı yardımcı olur. Class distribution bilinçli kontrol edilmelidir. Kritik kullanımda fairness evaluation uygulanmalıdır.
Model Collapse Riski
Uzun süre yalnızca model ürettiği verilerle eğitim yapmak çeşitliliği azaltabilir. Sentetik örnekler birbirine benzer hale gelebilir. Gerçek insan verisi ve gold-standard örnekler korunmalıdır. Dataset diversity metric izlenebilir. Retraining flywheel gerçek production feedback'i içermelidir.
Sentetik ve Gerçek Veri Dengesi
Tek bir ideal oran yoktur. Domain ve gerçek veri availability seviyesine göre deney yapılmalıdır. Validation gerçek kullanıcı dağılımını temsil etmelidir. Sentetik verinin katkısı ablation test ile ölçülebilir. Kalite yükselmiyorsa daha fazla sentetik veri eklemek gerekli değildir.
Supervised Fine-Tuning (SFT)
SFT kurumsal model özelleştirmesinde en doğrudan yöntemlerden biridir. Model, doğrulanmış input ve ideal output çiftleri üzerinden hedef davranışı öğrenir. Classification, extraction, müşteri hizmetleri ve structured output görevlerinde güçlü sonuç verebilir. Başarı training dataset kalitesi ve base model kapasitesine bağlıdır. SFT sonrası base model yetkinliklerinde regression olup olmadığı ayrıca test edilmelidir.
SFT Nasıl Çalışır?
Model her training örneğinde input token'larından hedef assistant response'u üretmeye çalışır. Loss hedef token olasılıklarına göre hesaplanır. Optimizer parametreleri bu loss'u azaltacak şekilde günceller. PEFT kullanılıyorsa yalnızca adapter parametreleri değişebilir. Validation loss ve task metric training boyunca izlenmelidir.
SFT İçin Veri Gereksinimleri
SFT dataset'i hedef use case'i gerçekçi biçimde temsil etmelidir. Doğru instruction, ideal response ve tutarlı format bulunmalıdır. PII ve secret temizliği yapılmalıdır. Edge case'ler yeterli oranda eklenmelidir. Miktar yerine quality-first yaklaşım tercih edilmelidir.
Instruction-Tuned Base Model Kullanmak
Kurumsal assistant görevleri için instruction-tuned base model genellikle daha iyi başlangıç sağlar. Model zaten kullanıcı talimatlarını takip etmeyi öğrenmiştir. SFT daha çok kurum davranışına odaklanabilir. Raw base model kullanımı daha fazla veri ve training gerektirebilir. Pilot iki seçenek arasında karşılaştırma yapabilir.
SFT'nin Kurumsal Kullanım Alanları
SFT özellikle tekrarlayan ve ölçülebilir görevlerde değerlidir. Müşteri yanıtı, sınıflandırma, extraction ve structured report üretimi tipik örneklerdir. Kod üretimi veya kurum style'ında metin de uygulanabilir. Her use case ayrı evaluation rubric gerektirir. Tek adapter'ı çok farklı görevlerle aşırı yüklemek kaliteyi düşürebilir.
Müşteri Hizmetleri
Müşteri destek modeli onaylanmış yanıt örnekleriyle kurumun dil ve çözüm yaklaşımını öğrenebilir. Gerçek müşteri bilgileri temizlenmelidir. Güncel ürün bilgisi RAG üzerinden sağlanabilir. Model yalnızca izinli prosedürü kullanmalıdır. Human evaluation müşteri deneyimi açısından önemlidir.
Doküman Sınıflandırma
Model dokümanları kurumsal kategori setine göre etiketleyebilir. Label definition açık ve çelişkisiz olmalıdır. Azınlık sınıfları dataset'te temsil edilmelidir. F1 ve confusion matrix değerlendirme için uygundur. Düşük confidence kayıtlar insana yönlendirilebilir.
Bilgi Çıkarma
Unstructured metinden belirli alanları structured biçimde çıkarmak SFT için güçlü use case'tir. JSON schema sabit tutulmalıdır. Missing field davranışı training'de gösterilmelidir. Hallucinated field değerleri özel test edilmelidir. Schema validation otomatik gate olarak kullanılabilir.
Rapor Üretme
Model belirli kurumsal rapor yapısını öğrenebilir. Başlık, bölüm sırası ve dil tonu örneklerle gösterilir. Gerçek veri production sırasında güvenilir source'tan gelmelidir. Fine-tuning report formatını standardize eder. Human reviewer son kalite kontrolünü sürdürebilir.
Kod Üretimi
İç framework ve coding standard örnekleri model davranışını uyarlamak için kullanılabilir. Secret ve lisanslı kod temizliği yapılmalıdır. Deprecated pattern'ler dataset'e alınmamalıdır. Unit test ve static analysis evaluation'a eklenebilir. Production code review insan sorumluluğunda kalmalıdır.
Structured Output
Structured output API entegrasyonlarında önemlidir. Model belirli JSON veya XML şemasını sürekli üretmeyi öğrenebilir. Format violation otomatik ölçülebilir. Field semantics ayrıca doğrulanmalıdır. Tool calling sistemlerinde bu davranış downstream otomasyonu güvenilir hale getirir.
PEFT Nedir?
PEFT büyük bir modelin tamamını yeniden eğitmeden daha küçük parametre kümeleriyle uyarlama sağlar. GPU ve storage maliyeti azaltılabilir. Adapter dosyaları base modelden ayrı versionlanabilir. Bir base model üzerinde farklı departmanlara ait adapter'lar çalıştırılabilir. Kurumsal pilotlar için hızlı ve ölçülebilir başlangıç sunar.
Full Fine-Tuning ile PEFT Arasındaki Fark
Full fine-tuning model ağırlıklarının büyük bölümünü günceller. PEFT ana ağırlıkları sabit tutarak küçük parametre setini optimize eder. Bu nedenle memory kullanımı daha düşüktür. Ancak bazı görevlerde full fine-tuning daha yüksek adaptasyon sağlayabilir. Seçim benchmark sonucuna dayanmalıdır.
Adapter-Based Fine-Tuning
Adapter yaklaşımında model katmanlarına küçük trainable bileşenler eklenir. Base model değişmeden kalabilir. Her task için ayrı adapter tutulabilir. Serving sırasında uygun adapter yüklenir. Bu yapı multi-tenant kurumsal sistemlerde avantajlı olabilir.
LoRA
LoRA ağırlık güncellemesini düşük rank matrisler üzerinden temsil eder. Trainable parameter sayısı önemli ölçüde azalır. Büyük modelde daha düşük GPU memory ile training yapılabilir. Rank ve target module seçimi kaliteyi etkiler. Adapter ayrı artifact olarak saklanabilir.
QLoRA
QLoRA quantized base model üzerinde LoRA training yapmayı sağlar. Base model 4-bit gibi düşük precision formatta tutulabilir. Memory ihtiyacı daha da azalır. Quality etkisi task ve model ailesine göre ölçülmelidir. Sınırlı GPU kaynağı olan kurumlar için güçlü seçenektir.
Prefix Tuning
Prefix tuning modele learnable virtual token benzeri parametreler ekler. Ana model ağırlıkları sabit kalır. Görev davranışı bu ek parametreler üzerinden yönlendirilir. Bazı generation görevlerinde kullanılabilir. LoRA ile performans ve tooling desteği açısından karşılaştırma yapılmalıdır.
Prompt Tuning
Prompt tuning input seviyesinde learnable prompt embedding'leri kullanır. Model ağırlıkları değiştirilmez. Büyük modellerde belirli görevlerde etkili olabilir. Serving pipeline'ın bu virtual prompt'ları desteklemesi gerekir. Kurumsal use case için kalite ve operational simplicity birlikte değerlendirilmelidir.
Hangi PEFT Yöntemi Ne Zaman Seçilmeli?
LoRA tooling ve geniş kullanım nedeniyle iyi başlangıç seçeneğidir. GPU belleği sınırlıysa QLoRA avantaj sağlar. Prompt veya prefix tuning belirli research veya task senaryolarında değerlendirilebilir. Aynı holdout dataset üzerinde küçük deneyler yapılmalıdır. Seçim yalnızca training süresine göre verilmemelidir.
LoRA ile LLM Fine-Tuning
LoRA kurumsal fine-tuning projelerinde maliyet ve esneklik açısından en sık değerlendirilen yöntemlerden biridir. Modelin büyük ağırlık matrislerini doğrudan güncellemek yerine düşük rank ek matrisleri eğitir. Bu yaklaşım GPU memory kullanımını azaltır. Adapter artifact'ı base modelden ayrı tutulabilir. Hyperparameter seçimi task performansını belirgin biçimde etkileyebilir.
LoRA Nasıl Çalışır?
LoRA belirli weight update'lerini iki küçük matrisin çarpımıyla yaklaşıklar. Rank düşük tutulduğu için trainable parameter sayısı azalır. Base weight frozen kalabilir. Training sonunda adapter ayrıca kullanılabilir veya merge edilebilir. Bu yapı experiment hızını artırır.
Rank (r) Nedir?
Rank LoRA update matrisinin kapasitesini belirler. Çok düşük rank model adaptasyonunu sınırlayabilir. Çok yüksek rank memory ve overfitting riskini artırabilir. Task complexity seviyesine göre deney yapılmalıdır. Validation metric seçim için kullanılmalıdır.
LoRA Alpha
LoRA alpha adapter update'lerinin ölçeklenmesinde kullanılan hyperparameter'dır. Rank ile birlikte etkili olur. Çok yüksek değer training stabilitesini bozabilir. Model ve task'a göre tuning yapılmalıdır. Experiment tracking bütün değerleri kaydetmelidir.
LoRA Dropout
LoRA dropout adapter tarafında regularization sağlar. Küçük dataset'te overfitting riskini azaltabilir. Çok yüksek dropout öğrenmeyi zayıflatabilir. Validation loss izlenerek ayarlanmalıdır. Her görev aynı değeri gerektirmez.
Target Modules
LoRA'nın hangi model katmanlarına uygulanacağı target modules ile belirlenir. Attention projection katmanları yaygın adaylardır. Model architecture isimleri doğru tespit edilmelidir. Daha fazla target module kapasiteyi ve memory kullanımını artırabilir. Ablation test gerçek katkıyı gösterir.
Learning Rate
LoRA training çoğu zaman full fine-tuning'den farklı learning rate aralığı kullanabilir. Çok yüksek değer training'i kararsız hale getirebilir. Çok düşük değer yeterli öğrenmeyi engeller. Learning curve takip edilmelidir. Birkaç kısa pilot run ile aralık belirlenebilir.
Adapter Ağırlıkları
Training sonunda oluşan LoRA adapter küçük bir model artifact'ıdır. Base model version ile uyumluluğu kayıt altına alınmalıdır. Adapter da hassas artifact olarak korunmalıdır. Model registry içinde versionlanabilir. Yetkisiz export sınırlandırılmalıdır.
Adapter Merge
Adapter weight base model ağırlıklarıyla merge edilerek tek model artifact oluşturulabilir. Serving basitleşebilir. Ancak adapter değiştirme esnekliği azalır. Merge sonrası model checksum ve evaluation yeniden yapılmalıdır. Rollback için ayrı unmerged artifact korunabilir.
Bir Base Model Üzerinde Birden Fazla Adapter
Aynı base model farklı departman veya task adapter'larıyla kullanılabilir. Bu yaklaşım GPU belleği ve model yönetiminde tasarruf sağlayabilir. Router request metadata'sına göre doğru adapter'ı seçer. Tenant isolation dikkatle uygulanmalıdır. Her adapter bağımsız evaluation ve versioning sürecine sahip olmalıdır.
QLoRA ile Fine-Tuning
QLoRA, LoRA'nın memory avantajını quantization ile birleştirir. Base model düşük precision formatta tutulurken adapter parametreleri eğitilir. Bu sayede daha büyük modeller daha sınırlı GPU üzerinde fine-tune edilebilir. Sınırlı altyapıya sahip kurumlar için maliyet avantajı sağlayabilir. Quality regression mutlaka benchmark ile ölçülmelidir.
Quantization Nedir?
Quantization model ağırlıklarını daha düşük bit hassasiyetinde temsil eder. Böylece memory kullanımı ve bazı inference maliyetleri düşer. 8-bit veya 4-bit yöntemler yaygındır. Accuracy etkisi modele ve göreve göre değişir. Training ve inference quantization ayrı değerlendirilebilir.
4-Bit Training
QLoRA base model ağırlıklarını 4-bit olarak yükleyebilir. Adapter training daha yüksek precision hesaplarla devam edebilir. Memory ihtiyacı belirgin biçimde azalır. Gradient checkpointing gibi yöntemlerle ek tasarruf yapılabilir. Training stability gerçek model üzerinde test edilmelidir.
NF4
NF4 belirli dağılımlara uygun 4-bit quantization formatlarından biridir. QLoRA uygulamalarında yaygın şekilde kullanılabilir. Memory tasarrufu sağlar. Toolchain desteği model ailesine göre kontrol edilmelidir. Quality etkisi benchmark ile doğrulanmalıdır.
Memory Kullanımını Azaltmak
QLoRA'nın temel avantajı GPU bellek ihtiyacını düşürmesidir. Quantization, gradient accumulation ve checkpointing birlikte kullanılabilir. Sequence length memory profilini önemli ölçüde etkiler. OOM sorunu yalnızca batch size düşürerek çözülmemelidir. Profiling ile gerçek bottleneck bulunmalıdır.
LoRA ve QLoRA Arasındaki Fark
LoRA base modeli normal precision veya daha yüksek memory footprint ile tutabilir. QLoRA base model ağırlıklarını quantized biçimde kullanır. Bu nedenle daha düşük GPU memory gerekir. Training speed ve quality farkı task'a göre değişebilir. Pilot karşılaştırması yapılmalıdır.
QLoRA Ne Zaman Tercih Edilmeli?
GPU belleği sınırlıysa ve daha büyük base model kullanılması gerekiyorsa QLoRA güçlü adaydır. Pilot ve research aşamasında maliyet avantajı sunar. Full precision LoRA ile kalite farkı kabul edilebilir olmalıdır. Toolchain uyumluluğu kontrol edilmelidir. Production serving stratejisi training yönteminden bağımsız planlanabilir.
Full Fine-Tuning Ne Zaman Gerekir?
Full fine-tuning bütün model parametrelerini daha kapsamlı biçimde güncelleme imkanı sunar. Büyük dataset ve güçlü compute bulunduğunda derin domain adaptasyonu için değerlendirilebilir. Ancak maliyet, catastrophic forgetting ve model artifact büyüklüğü önemli dezavantajlardır. PEFT hedef kaliteyi sağlıyorsa full training gereksiz olabilir. Karar mutlaka karşılaştırmalı deneyle verilmelidir.
Tüm Parametreleri Eğitmenin Avantajları
Full training modelin bütün katmanlarında adaptasyon sağlar. PEFT'in kapasitesinin yetmediği karmaşık domain değişimlerinde avantaj verebilir. Büyük ve çeşitli dataset daha iyi kullanılabilir. Ancak modelin genel yetkinliklerini değiştirme riski de artar. Regression benchmark zorunludur.
GPU ve Bellek Gereksinimleri
Full fine-tuning optimizer state ve gradient nedeniyle çok yüksek memory gerektirir. Büyük modellerde multi-GPU veya distributed training zorunlu hale gelebilir. Mixed precision ve sharding yardımcı olur. Infrastruktur maliyeti PEFT'e göre belirgin yükselir. Capacity planning training öncesi yapılmalıdır.
Büyük Dataset Gereksinimi
Tüm parametreleri güncellemek küçük dataset üzerinde overfitting riskini artırabilir. Daha geniş ve çeşitli veri gerekir. Data quality yine miktardan daha önemlidir. Domain coverage dikkatle ölçülmelidir. Training duration ve compute maliyeti artar.
Catastrophic Forgetting Riski
Full fine-tuning modelin önceki genel yetkinliklerini bozabilir. Domain dataset çok dar ise model farklı görevlerde gerileyebilir. General benchmark training sonrası yeniden çalıştırılmalıdır. Mixed data veya düşük learning rate yardımcı olabilir. PEFT bu riski azaltan alternatiflerden biridir.
PEFT Yerine Full Fine-Tuning Seçim Kriterleri
PEFT hedef kaliteyi karşılamıyor ve yeterli veri ile compute mevcutsa full fine-tuning değerlendirilebilir. Domain değişimi model davranışının çok geniş bölümünü etkiliyorsa avantaj sağlayabilir. Quality gain maliyeti haklı çıkarmalıdır. Security ve serving operasyonu da hesaba katılmalıdır. Karar teknik benchmark ve TCO birlikte değerlendirilerek verilmelidir.
Continued Pre-Training ile Domain Adaptation
Continued pre-training, modelin belirli domain corpus'una daha fazla maruz kalmasını sağlar. Finans, hukuk, sağlık ve teknik dokümantasyon gibi yoğun terminoloji içeren alanlarda değerlendirilebilir. Bu aşama genellikle instruction davranışından önce domain language adaptation amacı taşır. Sonrasında SFT ile görev davranışı öğretilebilir. Büyük corpus ve compute ihtiyacı PEFT tabanlı SFT'den daha yüksek olabilir.
Continued Pre-Training ve SFT Farkı
Continued pre-training raw domain metni üzerinden language modeling yapar. SFT ise instruction ve ideal response çiftleri kullanır. Birincisi domain bilgisinin dil örüntülerine adaptasyon, ikincisi görev davranışı sağlar. Aynı projede art arda uygulanabilir. Hangi aşamanın gerçekten gerekli olduğu baseline ile test edilmelidir.
Domain Corpus Hazırlama
Corpus temiz, güncel ve domain'i temsil eden metinlerden oluşmalıdır. Duplicate ve boilerplate içerikler kaldırılmalıdır. PII ve lisans kontrolleri yapılmalıdır. Çok düşük kaliteli web scrape kullanımı risklidir. Corpus statistics dataset card içinde tutulmalıdır.
Finans Verileriyle Domain Adaptation
Finans domain'i yoğun terminoloji ve hassas veri içerir. Public veya kullanım hakkı açık kaynaklar tercih edilebilir. Gerçek müşteri finans verisi gereksizse kullanılmamalıdır. Evaluation finans terminolojisi ve task accuracy üzerinden yapılmalıdır. Safety ve compliance testleri ayrıca gereklidir.
Hukuk Verileriyle Domain Adaptation
Hukuk metinleri uzun ve özel terminolojiye sahiptir. Yetkili corpus seçimi önemlidir. Güncel mevzuat RAG ile sağlanabilir. Fine-tuning hukuki yazım ve classification görevlerine odaklanabilir. İnsan hukuk uzmanı evaluation sürecine katılmalıdır.
Sağlık Verileriyle Domain Adaptation
Sağlık verisi yüksek privacy ve safety riski taşır. Kişisel sağlık bilgileri dikkatle yönetilmelidir. Public bilimsel corpus daha güvenli başlangıç olabilir. Model safety evaluation zorunludur. Gerçek klinik kullanım yüksek insan denetimi gerektirir.
Teknik Dokümantasyonla Domain Adaptation
Teknik domain corpus ürün ve mühendislik terminolojisini modele tanıtabilir. Deprecated dokümanlar çıkarılmalıdır. Version metadata tutulmalıdır. Sık değişen gerçekler retrieval'dan gelmelidir. Domain adaptation daha çok kavram ve dil yapısına odaklanmalıdır.
Continued Pre-Training Sonrası SFT
Domain adaptation sonrası model hedef göreve ayrıca SFT ile yönlendirilebilir. Bu iki aşama farklı dataset kullanır. Önce domain language, sonra instruction behavior öğretilir. Her aşama arasında benchmark yapılmalıdır. Gereksiz training adımı maliyeti artırabileceği için ablation test yararlıdır.
Fine-Tuning Hyperparameter'ları
Hyperparameter ayarları modelin öğrenme hızı, memory kullanımı ve overfitting davranışını etkiler. Learning rate, batch size, epoch ve sequence length en temel parametrelerdir. Tek bir doğru değer bütün modeller için geçerli değildir. Küçük deneyler ve validation sonuçlarıyla tuning yapılmalıdır. Her run experiment tracking sisteminde kaydedilmelidir.
Learning Rate
Learning rate optimizer güncelleme büyüklüğünü belirler. Çok yüksek değer model davranışını bozabilir. Çok düşük değer eğitim süresini uzatır. PEFT ve full fine-tuning farklı aralıklar gerektirebilir. Learning curve izlenmelidir.
Batch Size
Batch size aynı adımda işlenen örnek sayısını belirler. Büyük batch GPU memory kullanımını artırır. Gradient accumulation ile effective batch büyütülebilir. Çok küçük batch training noise seviyesini etkileyebilir. Model ve dataset üzerinde deney yapılmalıdır.
Gradient Accumulation
Gradient accumulation birkaç küçük batch'in gradient'lerini toplayarak daha büyük effective batch sağlar. Sınırlı GPU memory ortamında yararlıdır. Training süresi uzayabilir. Optimizer step sayısı doğru hesaplanmalıdır. Logging gerçek effective batch'i göstermelidir.
Epoch Sayısı
Epoch dataset'in kaç kez işlendiğini gösterir. Küçük dataset'te çok fazla epoch overfitting yaratabilir. Validation loss ve task metric takip edilmelidir. Early stopping kullanılabilir. Tek sabit sayı yerine gözleme dayalı karar verilmelidir.
Sequence Length
Sequence length tek örneğin maksimum token uzunluğunu belirler. Uzun sequence GPU memory kullanımını ciddi artırır. Gereksiz padding azaltılmalıdır. Production prompt uzunluğu dikkate alınmalıdır. Truncation önemli bilgiyi kesmemelidir.
Warmup
Warmup training başlangıcında learning rate'i yavaşça artırır. Büyük modellerde training stabilitesine yardımcı olabilir. Toplam step sayısına göre oran belirlenebilir. Çok uzun warmup öğrenmeyi yavaşlatır. Scheduler ile birlikte değerlendirilmelidir.
Weight Decay
Weight decay regularization sağlayarak aşırı fitting'i azaltabilir. PEFT yöntemlerinde etkisi target parametre yapısına göre değişebilir. Çok yüksek değer öğrenmeyi sınırlar. Validation sonuçlarıyla ayarlanmalıdır. Experiment metadata içinde kaydedilmelidir.
Scheduler
Scheduler training boyunca learning rate'in nasıl değişeceğini belirler. Linear ve cosine gibi yöntemler kullanılabilir. Dataset ve total step sayısı etkili olur. Farklı scheduler sonuçları kısa pilotlarla karşılaştırılabilir. Seçim default değere körü körüne bırakılmamalıdır.
Gradient Clipping
Gradient clipping aşırı büyük gradient değerlerini sınırlar. Training kararsızlığını azaltabilir. Loss spike görülen deneylerde yardımcı olur. Threshold model ve optimizer'a göre ayarlanmalıdır. Loglarda gradient norm izlenebilir.
Overfitting Nasıl Önlenir?
Overfitting modelin training örneklerini iyi öğrenip yeni örneklere zayıf genellemesi durumudur. Küçük kurumsal dataset'lerde önemli risktir. Training ve validation loss birlikte izlenmelidir. Dataset çeşitliliği ve early stopping yardımcı olur. Base model yetkinliklerinde regression testleri de yapılmalıdır.
Training Loss ve Validation Loss
Training loss düşerken validation loss yükselmeye başlıyorsa overfitting sinyali olabilir. Sadece training curve izlemek yanıltıcıdır. Task-specific metric de birlikte takip edilmelidir. Checkpoint selection validation sonucuna göre yapılabilir. Ani divergence data veya hyperparameter sorununu gösterebilir.
Early Stopping
Early stopping validation performansı iyileşmediğinde training'i durdurur. Gereksiz epoch ve GPU maliyetini azaltır. Patience değeri dikkatle seçilmelidir. Noise nedeniyle çok erken stop riskine karşı yeterli validation size gerekir. Best checkpoint ayrı saklanmalıdır.
Epoch Sayısını Sınırlamak
Küçük dataset üzerinde çok sayıda epoch ezberleme riskini artırır. İlk pilot düşük epoch ile başlamalıdır. Validation sonuçlarına göre artırılabilir. Daha fazla epoch otomatik olarak daha iyi kalite anlamına gelmez. Human evaluation de kontrol edilmelidir.
Dataset Çeşitliliğini Artırmak
Farklı kullanıcı dili, edge case ve task varyasyonları genelleme yeteneğini artırır. Aynı şablonun yüzlerce varyasyonu gerçek diversity sayılmaz. Production dağılımı örneklenmelidir. Sentetik veri dikkatli kullanılabilir. Class balance düzenli analiz edilmelidir.
Regularization
Dropout ve weight decay gibi yöntemler overfitting'i azaltabilir. PEFT özelinde LoRA dropout kullanılabilir. Hyperparameter etkisi validation set ile ölçülmelidir. Çok güçlü regularization öğrenmeyi engelleyebilir. Küçük ablation deneyleri faydalıdır.
Base Model Yetkinliklerini Korumak
Fine-tuning hedef görevi iyileştirirken genel dil ve safety yetkinliklerini bozmamalıdır. General benchmark ve kurumsal regression set birlikte çalıştırılmalıdır. Mixed dataset gerekebilir. PEFT genel ağırlıkları sabit tutarak riski azaltabilir. Production go/no-go yalnızca hedef task başarısına bakmamalıdır.
Catastrophic Forgetting Nedir?
Catastrophic forgetting modelin fine-tuning sırasında önceki genel yetkinliklerinden bazılarını kaybetmesidir. Özellikle dar domain dataset ve yüksek learning rate riski artırabilir. Model hedef görevde iyileşirken genel sorularda veya safety davranışında gerileyebilir. Bu yüzden base ve fine-tuned model geniş regression set üzerinde karşılaştırılmalıdır. PEFT ve mixed training bazı durumlarda riski azaltır.
Fine-Tuning Sonrası Genel Yetkinlik Kaybı
Model yalnızca kurum içi dar örnekleri aşırı öğrenirse genel dil performansı düşebilir. Basit genel sorular veya farklı format talepleri test edilmelidir. Hedef task başarısı tek metric olmamalıdır. Regression threshold önceden belirlenmelidir. Büyük kayıp varsa training stratejisi değiştirilmelidir.
Benchmark Regression
Fine-tuned model base benchmark sonuçlarıyla karşılaştırılır. Safety, language ve reasoning testleri seçilebilir. Küçük regression kabul edilebilir olabilir ancak kritik görevlerde sınır tanımlanmalıdır. Model version registry içinde sonuçları saklamalıdır. Her retraining aynı testleri yeniden çalıştırmalıdır.
Genel Veri ile Karışık Eğitim
Domain örneklerine belirli oranda genel instruction data eklemek genel yetkinliği korumaya yardımcı olabilir. Oran deneysel belirlenmelidir. Lisans ve kalite kontrolü yapılmalıdır. Çok fazla genel veri domain adaptasyonunu zayıflatabilir. Ablation sonuçları karar vermeye yardımcı olur.
PEFT ile Riski Azaltmak
PEFT ana model ağırlıklarının çoğunu sabit tuttuğu için catastrophic forgetting riskini azaltabilir. Adapter yalnızca belirli davranışı öğrenir. Yine de output davranışı değiştiği için regression test gereklidir. Multi-adapter kullanımında her adapter ayrı değerlendirilmelidir. Base model version değişirse adapter uyumluluğu tekrar test edilmelidir.
Base Model ve Fine-Tuned Model Karşılaştırması
Aynı test set üzerinde side-by-side evaluation yapılmalıdır. Hedef task, general benchmark, safety ve latency birlikte ölçülür. Human pairwise comparison kalite farkını daha görünür hale getirebilir. Cost-per-quality metriği de eklenebilir. Fine-tuned model yalnızca gerçek anlamlı kazanım varsa production'a alınmalıdır.
Fine-Tuning Altyapısı Nasıl Kurulur?
Fine-tuning altyapısı data sensitivity, GPU ihtiyacı, bütçe ve operasyon kapasitesine göre seçilir. Lokal workstation küçük pilotlar için yeterli olabilir. On-prem veya private cloud daha yüksek veri kontrolü sağlar. Public cloud GPU esnek kapasite sunar. Managed fine-tuning API operasyonu kolaylaştırırken veri işleme şartlarının dikkatle incelenmesini gerektirir.
Lokal GPU Workstation
Küçük PEFT deneyleri güçlü bir workstation üzerinde yapılabilir. Veri cihaz üzerinde kalabilir. Tek kullanıcı ve sınırlı parallelism için uygundur. Production pipeline ve audit özellikleri zayıf olabilir. Pilot sonrası daha yönetilen altyapıya geçiş planlanmalıdır.
On-Premise GPU Sunucusu
On-prem sunucu veri egemenliği ve network kontrolü sağlar. GPU, storage ve driver yönetimi kurum sorumluluğundadır. Multi-user scheduler gerekebilir. Donanım yatırım maliyeti yüksektir. Yüksek ve sürekli kullanımda uzun vadeli avantaj sağlayabilir.
Private Cloud
Private cloud self-service infrastructure ile veri kontrolünü birleştirebilir. GPU pool merkezi yönetilebilir. IAM ve network segmentation uygulanır. Platform engineering yatırımı gerekir. Experiment tracking ve model registry ortak servis haline getirilebilir.
Public Cloud GPU
Public cloud ihtiyaç anında güçlü GPU kiralama imkanı sunar. Pilot ve burst workload için esnektir. Egress ve storage maliyetleri hesaplanmalıdır. Data residency ve security policy kontrol edilmelidir. Spot instance bazı training workload'larında maliyeti düşürebilir.
Managed Fine-Tuning API
Managed API infrastructure yönetimini büyük ölçüde ortadan kaldırır. Dataset yüklenir ve training provider tarafından yürütülür. Operasyon kolaylığı yüksektir. Buna karşılık veri kullanım şartları ve model export yetenekleri sınırlı olabilir. Vendor lock-in ve TCO değerlendirilmelidir.
Hangi Deployment Modeli Kurumlar İçin Uygun?
Tek bir doğru deployment modeli yoktur. Hassas veri ve sık training varsa on-prem veya private cloud güçlü seçenek olabilir. Hızlı pilot ve düşük ekip kapasitesinde managed API avantaj sağlar. Hybrid model de kullanılabilir. Karar security, maliyet ve operasyon kriterleriyle verilmelidir.
On-Premise Fine-Tuning
On-prem fine-tuning verinin kurum kontrolündeki network ve storage içinde kalmasını sağlar. Özellikle hassas veri veya air-gapped gereksinimi bulunan kurumlarda değerlidir. Ancak GPU, driver, container ve storage operasyonu kurumun sorumluluğundadır. Capacity planning ve observability gerekir. Maliyet yalnızca donanım satın alma fiyatıyla değerlendirilmemelidir.
Neden On-Premise?
Veri egemenliği ve özel security policy en güçlü gerekçelerdir. Network dışına çıkması yasak dataset kurum içinde kalır. Hardware sürekli kullanılabiliyorsa uzun vadeli maliyet avantajı olabilir. Model artifact kontrolü artar. Buna karşılık uzman platform ekibi gerekir.
Veri Egemenliği
Training data, checkpoint ve loglar kurum sınırında kalır. Region ve third-party processor riski azalır. Access policy doğrudan kurum IAM sistemiyle uygulanabilir. Backup lokasyonları kontrol edilir. Audit gereksinimleri daha kolay karşılanabilir.
Network İzolasyonu
Training cluster internetten izole edilebilir. Dataset exfiltration riski azalır. Package ve model artifact içeri almak için kontrollü mirror gerekir. Air-gap ortamında dependency management planlanmalıdır. Logging ve monitoring yerel sistemlerde çalışmalıdır.
GPU Gereksinimleri
GPU sayısı model boyutu ve training method'a göre belirlenir. QLoRA daha düşük memory kullanır. Full fine-tuning multi-GPU gerektirebilir. Utilization monitoring yapılmalıdır. Donanım boşta kalma maliyeti TCO'ya eklenmelidir.
NVMe ve Storage
Training checkpoint ve dataset IO hızlı storage gerektirebilir. NVMe yüksek throughput sağlar. Dataset registry ve model registry ayrı lifecycle kullanabilir. Backup ve encryption uygulanmalıdır. Storage büyümesi experiment sayısıyla takip edilmelidir.
CUDA ve Driver Yönetimi
GPU driver, CUDA ve library uyumluluğu sık sorun oluşturabilir. Container image ile environment standardize edilebilir. Version matrix belgelenmelidir. Upgrade önce staging node üzerinde test edilmelidir. Reproducibility için image digest saklanmalıdır.
Containerization
Training environment container içine alınarak dependency farkı azaltılabilir. Image version experiment metadata'sına eklenir. GPU runtime doğru yapılandırılmalıdır. Root privilege minimum tutulmalıdır. Internal registry kullanılması supply chain güvenliğini artırır.
Air-Gapped Fine-Tuning
Air-gapped ortam internet erişimi olmadan training yapar. Model weight, package ve dependency önceden güvenli bundle halinde taşınmalıdır. Signature ve hash doğrulanmalıdır. Offline experiment tracking ve registry gerekir. Update süreci kontrollü staging zone üzerinden yürütülmelidir.
Fine-Tuning İçin Açık Kaynak Araçlar
Açık kaynak ekosistemi fine-tuning pipeline kurmayı önemli ölçüde kolaylaştırır. Transformers model loading ve training için temel sağlar. PEFT adapter yöntemlerini, TRL farklı optimization workflow'larını destekleyebilir. bitsandbytes quantization, DeepSpeed ve FSDP distributed training için kullanılabilir. Araç seçerken yalnızca özellik değil sürüm uyumluluğu ve operasyon ekosistemi değerlendirilmelidir.
Hugging Face Transformers
Transformers çok sayıda model architecture ve tokenizer için ortak API sağlar. Trainer veya custom PyTorch loop kullanılabilir. Model card ve repository entegrasyonu güçlüdür. Kurumsal ortamda dependency version sabitlenmelidir. Model lisansları ayrıca kontrol edilmelidir.
PEFT
PEFT kütüphanesi LoRA ve diğer parameter-efficient yöntemleri kolaylaştırır. Adapter config versionlanabilir. Farklı model aileleriyle kullanım desteklenebilir. Target module ayarları doğru seçilmelidir. Library version experiment metadata'sına yazılmalıdır.
TRL
TRL supervised ve preference training gibi workflow'lar için araçlar sağlar. SFT trainer kullanımını kolaylaştırabilir. Dataset formatting dikkatle yapılmalıdır. Yeni version değişiklikleri release note üzerinden takip edilmelidir. Production pipeline testlerle sabitlenmelidir.
bitsandbytes
bitsandbytes düşük precision optimizer ve quantization seçenekleri sunabilir. QLoRA training'de yaygın kullanılabilir. GPU ve driver uyumluluğu kontrol edilmelidir. Performance benchmark alınmalıdır. Container image içinde version sabitlenmelidir.
Axolotl
Axolotl configuration tabanlı fine-tuning workflow sunabilir. Farklı PEFT ve model ayarlarını yönetmeyi kolaylaştırır. YAML config experiment artifact olarak saklanabilir. Tool abstraction kullanılırken gerçek hyperparameter etkisi anlaşılmalıdır. Kurumsal pipeline'a entegrasyon test edilmelidir.
Unsloth
Unsloth belirli model ve training senaryolarında memory ve hız optimizasyonu sağlayabilir. Desteklenen model aileleri kontrol edilmelidir. Performance iddiaları kendi donanımınızda benchmark edilmelidir. Reproducibility ve library versioning korunmalıdır. Kritik production pipeline önce staging'de doğrulanmalıdır.
DeepSpeed
DeepSpeed distributed training ve memory optimization özellikleri sunar. Büyük model full fine-tuning için yararlı olabilir. ZeRO aşamaları farklı memory trade-off sağlar. Network ve storage throughput önemlidir. Configuration experiment tracking sistemine kaydedilmelidir.
PyTorch FSDP
FSDP model parameter ve optimizer state'lerini GPU'lar arasında shard ederek büyük training workload'larını destekler. Native PyTorch ekosistemi avantaj sağlar. Distributed setup dikkatli yapılandırılmalıdır. Checkpoint formatı production workflow'a uygun olmalıdır. Multi-node test yapılmalıdır.
Fine-Tuning Deneylerinin İzlenmesi
Experiment tracking olmadan hangi training run'ın neden daha iyi olduğunu güvenilir biçimde anlamak zordur. Hyperparameter, dataset version, base model, code commit ve random seed kaydedilmelidir. Training metric'ler ile evaluation sonucu aynı run'a bağlanmalıdır. Adapter ve checkpoint artifact'ları versionlanmalıdır. Kurumsal ortamda bu bilgiler reproducibility ve audit için zorunlu hale gelir.
Experiment Tracking
Her run benzersiz id ile kaydedilmelidir. Training başlangıç ve bitiş zamanı tutulur. Config ve environment metadata eklenir. Sonuçlar karşılaştırılabilir dashboard'da gösterilir. Başarısız run'lar da kayıt altında kalmalıdır.
Hyperparameter Logging
Learning rate, batch size, epoch ve LoRA parametreleri kaydedilmelidir. Sonradan exact run tekrar edilebilmelidir. Config dosyası artifact olarak saklanabilir. Manuel notebook değişiklikleri azaltılmalıdır. Parametre farkı ile metric değişimi analiz edilir.
Dataset Version
Training run hangi dataset version kullandığını açıkça göstermelidir. Dataset hash doğrulama sağlar. Mutable path kullanılmamalıdır. Preprocessing version ayrıca kaydedilebilir. Bu bilgi model lineage için gereklidir.
Base Model Version
Model adı tek başına yeterli değildir. Exact revision veya commit hash tutulmalıdır. Vendor modeli güncellerse behavior değişebilir. Adapter yalnızca uyumlu base version ile kullanılmalıdır. Registry bu bağımlılığı açıkça göstermelidir.
Code Commit
Training script'in exact Git commit'i kaydedilmelidir. Working tree dirty ise run uyarı verebilir. Pipeline code review üzerinden geçmelidir. Reproducibility için commit önemli kanıttır. Security incident durumunda kullanılan kod kolay bulunur.
Random Seed
Random seed training reproducibility'yi destekler. Tam determinism her GPU operation'da garanti olmayabilir. Yine de seed kaydı deney karşılaştırmasını iyileştirir. Split ve sampling seed ayrı tutulabilir. Sonuç farkları açıklanabilir hale gelir.
Training Metrics
Loss, learning rate ve gradient norm gibi metric'ler takip edilmelidir. Validation task metric aynı dashboard'da bulunabilir. Ani spike training instability gösterebilir. GPU utilization operational metric olarak eklenebilir. Metric retention policy belirlenmelidir.
Artifact Tracking
Checkpoint, adapter, tokenizer ve config artifact olarak tutulmalıdır. Hash ve size metadata eklenebilir. Onaylanmamış checkpoint production'a gitmemelidir. Registry erişimi role-based olmalıdır. Artifact retention maliyet açısından yönetilmelidir.
Reproducibility Neden Kurumsal Ortamda Önemlidir?
Bir modelin nasıl üretildiği tekrar oluşturulamıyorsa audit ve incident yönetimi zorlaşır. Aynı dataset, code ve environment ile training yeniden çalıştırılabilmelidir. Container image ve dependency versioning bu amaçla kullanılır. Dataset hash ve model card training provenance'ı güçlendirir. Reproducibility aynı zamanda güvenilir model karşılaştırması sağlar.
Aynı Eğitimi Tekrarlayabilmek
Bir production modelinin nasıl üretildiği net olmalıdır. Aynı config ile benzer sonuç alınabilmelidir. Hardware farkları küçük variation yaratabilir. Training pipeline declarative hale getirilmelidir. Manual notebook adımları azaltılmalıdır.
Container Image Versioning
Training image bütün dependency'leri belirli sürümde paketler. Image digest immutable referans sağlar. Registry içinde retention uygulanır. Security scan yapılmalıdır. Deney metadata'sı image digest'i içermelidir.
Dependency Locking
Python package veya CUDA library değişiklikleri training davranışını etkileyebilir. Lock file exact version saklar. Dependency update ayrı test sürecinden geçmelidir. Floating version kullanılmamalıdır. Supply chain güvenliği açısından signature ve trusted registry önemlidir.
Dataset Hash
Dataset hash içeriğin değişip değişmediğini gösterir. Aynı version etiketi altında dosya değiştirilmesini önlemeye yardımcı olur. Preprocessed output için de hash üretilebilir. Registry metadata'sında saklanmalıdır. Audit sırasında doğrulama yapılabilir.
Model Card
Model card modelin amacı, base version, dataset ve evaluation sonuçlarını açıklar. Bilinen sınırlamalar yazılmalıdır. Safety ve intended use bilgisi eklenmelidir. Production owner belirtilmelidir. Her model version için güncel tutulmalıdır.
Denetim İçin Eğitim Kaydı
Training job kim tarafından başlatıldı ve hangi veri kullanıldı bilgisi audit log'da tutulmalıdır. Approval kayıtları ilişkilendirilir. Infrastructure lokasyonu ve tool version eklenebilir. Artifact hash doğrulama sağlar. Bu kayıt compliance ve incident süreçlerinde değerlidir.
Fine-Tuned LLM Nasıl Değerlendirilir?
Fine-tuned model yalnızca training loss üzerinden değerlendirilmemelidir. Baseline model ile aynı task-specific test set üzerinde karşılaştırılmalıdır. Format compliance, hallucination, safety, latency ve inference maliyeti ayrı metriklerdir. Human evaluation özellikle dil ve iş kalitesi gerektiren use case'lerde önemlidir. Production'a yalnızca bütün kritik kriterleri karşılayan sürüm alınmalıdır.
Fine-Tuning Öncesi Baseline
Base model iyi prompt ile test edilmelidir. Bu sonuç improvement referansı oluşturur. Aynı dataset ve rubric kullanılmalıdır. Cost ve latency de baseline'a eklenmelidir. Fine-tuning ancak anlamlı kazanım gösteriyorsa mantıklıdır.
Task-Specific Accuracy
Göreve özel metric gerçek iş başarısını gösterir. Classification için accuracy veya F1 kullanılabilir. Extraction için field-level precision ölçülebilir. Metin generation için rubric gerekir. Tek metric bütün use case'leri temsil etmez.
Format Compliance
Modelin istenen JSON veya template'e uyma oranı ölçülmelidir. Schema validator otomatik kontrol yapabilir. Missing ve invalid field oranı ayrı raporlanabilir. Fine-tuning structured output use case'inde bu metric kritik olabilir. Base model ile karşılaştırılmalıdır.
Hallucination Rate
Modelin verilen context veya bilinen gerçek dışında bilgi üretme oranı ölçülmelidir. RAG use case'inde citation support kontrol edilebilir. Domain uzmanı sample review yapabilir. Fine-tuning hallucination problemini otomatik çözmez. Bazı dataset'ler aşırı güvenli yanlış davranış bile öğretebilir.
Safety Evaluation
Prompt injection, hassas veri ve yetkisiz talimat testleri yapılmalıdır. Base model safety davranışı fine-tuning sonrası gerileyebilir. Red-team set düzenli çalıştırılmalıdır. Failure severity sınıflandırılmalıdır. Production gate minimum safety threshold gerektirmelidir.
Latency
Inference latency gerçek deployment altyapısında ölçülmelidir. Batch size ve concurrency sonuçları etkiler. P50, P95 ve P99 raporlanmalıdır. Time to First Token kullanıcı deneyimi açısından önemlidir. Quantization etkisi ayrıca test edilmelidir.
Token Kullanımı
Fine-tuned model daha kısa prompt kullanabiliyorsa input token maliyeti azalabilir. Output verbosity de token kullanımını etkiler. Ortalama ve percentile değerleri izlenmelidir. RAG context boyutu maliyeti artırabilir. Token metriği kullanıcı başına maliyet hesabına bağlanmalıdır.
Inference Maliyeti
API veya GPU serving maliyeti request hacmine göre hesaplanmalıdır. Model boyutu, quantization ve batching etkili olur. Fine-tuning sonrası küçük model kullanımı tasarruf sağlayabilir. Ancak quality regression kabul edilebilir sınırda olmalıdır. Cost-per-successful-task metriği daha anlamlı olabilir.
Otomatik LLM Evaluation
Otomatik evaluation hızlı ve tekrar edilebilir model karşılaştırması sağlar. Exact match, precision, semantic similarity ve schema validation gibi yöntemler task'a göre seçilir. LLM-as-a-Judge serbest metin kalitesini değerlendirmede yardımcı olabilir fakat bias riski taşır. Birden fazla metric birlikte kullanılmalıdır. Kritik use case'lerde otomatik değerlendirme human review ile tamamlanmalıdır.
Exact Match
Exact match model çıktısının hedef cevapla birebir aynı olup olmadığını ölçer. Kısa classification veya canonical answer için uygundur. Serbest metinde fazla katı olabilir. Normalization uygulanabilir. Task yapısına göre kullanımı değerlendirilmelidir.
Precision, Recall ve F1
Classification ve extraction görevlerinde temel metric'lerdir. Precision yanlış pozitifleri, recall kaçırılan doğru örnekleri gösterir. F1 denge sağlar. Class bazında sonuç raporlanmalıdır. High-risk class için recall daha önemli olabilir.
Semantic Similarity
Semantic similarity model yanıtı ile referansın anlam olarak yakınlığını ölçer. Farklı kelimelerle doğru cevap üreten sistemlerde kullanışlıdır. Tek başına factual correctness garantisi vermez. Embedding model seçimi sonucu etkiler. Human validation ile birlikte kullanılmalıdır.
Schema Validation
Structured output geçerli schema ile otomatik doğrulanabilir. Missing field ve type mismatch tespit edilir. Business rule validation ayrıca eklenebilir. Parse success rate önemli production metric'tir. Fine-tuning improvement net biçimde görülebilir.
Rule-Based Evaluation
Belirli kelime, format veya policy kuralları kodla kontrol edilebilir. Yasak ifade veya zorunlu alan test edilebilir. Rule açıklanabilir ve deterministiktir. Semantik kaliteyi tek başına ölçmez. LLM judge ile birlikte kullanılabilir.
LLM-as-a-Judge
Güçlü bir model başka model yanıtlarını rubric üzerinden değerlendirebilir. Tone, completeness ve relevance gibi serbest metin özelliklerinde kullanışlıdır. Judge prompt standardize edilmelidir. Birden fazla run variation kontrol edilebilir. Human correlation ölçülmelidir.
LLM Judge Bias Riski
Judge model belirli yazım stilini veya uzun cevabı gereksiz avantajlı değerlendirebilir. Kendi model ailesine benzer çıktıları tercih edebilir. Blind ve pairwise evaluation kullanılabilir. Human benchmark ile kalibre edilmelidir. Tek karar mekanizması haline getirilmemelidir.
Human Evaluation
İnsan değerlendirmesi özellikle kurumsal doğruluk, ton ve kullanışlılık gibi otomatik metric'lerin tam ölçemediği alanlarda gereklidir. Domain uzmanları rubric üzerinden model yanıtlarını değerlendirebilir. Blind ve pairwise test bias'ı azaltır. Annotator agreement değerlendirme kalitesini gösterir. Base ve fine-tuned model aynı örnekler üzerinde karşılaştırılmalıdır.
Domain Uzmanlarının Rolü
Domain uzmanı model yanıtının gerçek iş kuralına uygunluğunu değerlendirir. Teknik olarak akıcı ama yanlış cevapları yakalayabilir. Reviewer sayısı ve görev kapsamı planlanmalıdır. High-risk use case daha fazla uzman kontrolü gerektirir. Feedback dataset iyileştirmesine aktarılır.
Evaluation Rubric Oluşturmak
Rubric reviewer'ların aynı kriterleri kullanmasını sağlar. Accuracy, completeness, tone ve safety ayrı puanlanabilir. Her seviye örnekle açıklanmalıdır. Ambiguous kriterler annotator disagreement yaratır. Pilot review sonrası rubric güncellenebilir.
Blind Evaluation
Reviewer hangi cevabın base veya fine-tuned modelden geldiğini bilmez. Böylece expectation bias azalır. Cevaplar random sırada gösterilebilir. Model identity sonuç kaydında gizli tutulur. Son analizde skorlar eşleştirilir.
Pairwise Comparison
Reviewer aynı soruya iki model yanıtını yan yana karşılaştırır. Hangisinin daha iyi olduğu seçilir. Serbest puanlamaya göre bazı durumlarda daha tutarlı olabilir. Tie seçeneği bulunmalıdır. Statistical confidence sample size ile hesaplanabilir.
Inter-Annotator Agreement
Farklı reviewer'ların aynı örneğe ne kadar benzer karar verdiğini gösterir. Düşük agreement rubric belirsizliği veya zor task anlamına gelebilir. Disagreement örnekleri ortak review'a alınır. Rubric iyileştirilir. Model quality yorumunda bu metric dikkate alınmalıdır.
Base Model vs Fine-Tuned Model A/B Testi
İki model aynı production-benzeri örnekler üzerinde karşılaştırılır. Online veya offline A/B yapılabilir. Quality, latency ve cost birlikte ölçülür. Kullanıcı feedback'i ek sinyal sağlar. Fine-tuned model yalnızca anlamlı kazanım varsa promote edilmelidir.
Güvenlik ve Safety Evaluation
Fine-tuning base modelin safety davranışını değiştirebilir. Bu nedenle prompt injection, jailbreak ve sensitive data extraction testleri her model version için yeniden çalıştırılmalıdır. Bias ve toxicity ayrıca ölçülmelidir. Yetkisiz işlem talimatları tool calling modellerinde kritik use case'tir. Red-team evaluation production release'in zorunlu kapılarından biri olmalıdır.
Prompt Injection Testleri
Model harici doküman veya kullanıcı mesajındaki zararlı talimatları nasıl ele alıyor test edilmelidir. RAG sistemlerinde retrieved içerik injection taşıyabilir. System policy override girişimleri hazırlanır. Guardrail etkisi ölçülür. Başarısız örnekler regression set'e eklenir.
Jailbreak Testleri
Jailbreak kullanıcı tarafından policy sınırını aşmaya yönelik taleplerdir. Farklı phrasing ve multi-turn yöntemleri test edilmelidir. Fine-tuning safety regression oluşturabilir. Model refusal davranışı iş use case'ini gereksiz engellememelidir. Balance human review ile değerlendirilir.
Hassas Veri Çıkarma Testleri
Model training data içindeki PII veya secret'ı tekrar üretmeye çalışıyor mu test edilmelidir. Canary string kullanılabilir. Membership inference ve prompt variation uygulanabilir. High-risk leakage release blocker olmalıdır. Dataset temizliği yeniden gözden geçirilmelidir.
Toxicity
Modelin saldırgan veya uygunsuz içerik üretme eğilimi ölçülebilir. Kurumsal tone use case'lerinde önemli olabilir. Automated classifier ve human review birlikte kullanılabilir. Domain-specific hassas ifadeler eklenmelidir. Fine-tuning sonrası base modele göre regression kontrol edilir.
Bias
Model farklı kullanıcı grupları için haksız veya tutarsız davranabilir. Test set representative örnekler içermelidir. Domain-specific fairness kriteri belirlenebilir. Sentetik veri bias'ı çoğaltabilir. Sonuçlar model card içinde belgelenmelidir.
Yetkisiz İşlem Talimatları
Tool calling model kullanıcı yetkisi olmayan işlemleri başlatmamalıdır. Authorization external layer tarafından uygulanmalıdır. Model yalnızca intent üretse bile backend policy kontrolü gerekir. Red-team senaryoları permission escalation test etmelidir. Fine-tuning güvenlik sınırı yerine geçmemelidir.
Red-Team Evaluation
Red-team ekip sistemi saldırgan bakış açısıyla test eder. Prompt, retrieval, tool ve model katmanları birlikte değerlendirilir. Bulgu severity ile sınıflandırılır. Fix sonrası regression testi yapılır. Production öncesi ve büyük retraining sonrası tekrar edilmelidir.
Fine-Tuned Modellerde Veri Ezberleme Riski
Fine-tuning sırasında model bazı training örneklerini istemeden ezberleyebilir. Özellikle küçük dataset, tekrar eden veri ve hassas kişisel bilgiler riski artırır. Memorization testleri training data extraction ve canary yöntemleriyle yapılabilir. PII temizliği en güçlü önleyici adımlardan biridir. Model artifact'ın da hassas varlık kabul edilmesi bu nedenle önemlidir.
Memorization Nedir?
Memorization modelin training örneğini yeni bağlama genellemek yerine doğrudan hatırlamasıdır. Her ezberleme zararlı değildir ancak hassas veri söz konusuysa risklidir. Duplicate kayıtlar olasılığı artırabilir. Training ve test yöntemleriyle ölçülmelidir. Dataset minimization uygulanmalıdır.
Training Data Extraction
Saldırgan özel prompt'larla training örneklerini modelden çıkarmaya çalışabilir. Bu risk güvenlik testinde değerlendirilmelidir. Known training strings üzerinde test yapılabilir. Model response logging hassas tutulmalıdır. Başarılı extraction ciddi bulgu kabul edilmelidir.
PII Memorization
Kişisel bilgiler training'e girdiğinde model bunları belirli prompt'larda tekrar üretebilir. Bu yüzden PII detection ve redaction training öncesinde yapılmalıdır. Real PII yerine synthetic placeholder kullanılabilir. Leakage testleri yapılmalıdır. High-risk data mümkünse tamamen dışarıda bırakılmalıdır.
Canary Testleri
Canary benzersiz ve yapay string training set'e kontrollü şekilde eklenebilir. Modelin bu string'i ne kadar kolay tekrar ürettiği memorization sinyali verir. Gerçek secret kullanılmamalıdır. Farklı prompt variation test edilir. Sonuç risk değerlendirmesine eklenir.
Membership Inference
Membership inference belirli bir örneğin training set'te olup olmadığını tahmin etmeye çalışır. Confidence farkları saldırı sinyali oluşturabilir. Büyük modellerde risk değerlendirmesi research yöntemlerine dayanabilir. Sensitive use case'lerde ek test yapılmalıdır. Dataset minimization ve regularization yardımcı olabilir.
Memorization Riskini Azaltmak
PII ve duplicate temizliği ilk savunma katmanıdır. Gereksiz epoch ve overfitting azaltılmalıdır. Regularization ve PEFT kullanılabilir. High-risk dataset için daha sık leakage test uygulanır. Model export erişimi sınırlandırılır.
Model Artifact'ı da Hassas Veri Sayılmalı mı?
Fine-tuned model veya adapter training verisinin türetilmiş çıktısı olduğu için hassas varlık olarak ele alınmalıdır. Modelin içinde training örneklerinin belirli ölçüde ezberlenme riski bulunabilir. Adapter dosyası küçük olsa bile kurum davranışı veya domain bilgisi taşıyabilir. Model registry yetkilendirme ve encryption sağlamalıdır. Retention ve deletion policy dataset kadar model artifact için de tanımlanmalıdır.
Adapter Dosyalarının Riski
Adapter base modelden küçük olabilir ancak kurumun özel eğitimini temsil eder. Yetkisiz paylaşım intellectual property kaybına yol açabilir. Leakage riski değerlendirilmelidir. Registry erişimi role-based olmalıdır. Export işlemleri audit edilmelidir.
Checkpoint Güvenliği
Training checkpoint ara model state'ini içerir. Production modelden daha az kontrol edilen geçici dosyalar risk oluşturabilir. Encryption at rest uygulanmalıdır. Gereksiz eski checkpoint'ler retention policy ile silinmelidir. Storage erişimleri minimum tutulmalıdır.
Model Registry Yetkilendirmesi
Model registry yalnızca yetkili kullanıcı ve pipeline'ların artifact okumasına izin vermelidir. Production promote yetkisi ayrı role verilebilir. Immutable versioning kullanılmalıdır. Audit log export işlemlerini kaydeder. Service account minimum privilege ile çalışır.
Artifact Encryption
Model ve adapter dosyaları storage üzerinde şifrelenebilir. Backup aynı korumaya sahip olmalıdır. Key management central KMS ile yapılabilir. Transfer sırasında TLS kullanılmalıdır. Air-gap ortamda offline key handling ayrıca planlanmalıdır.
Model Export Yetkileri
Modeli local dosya olarak indirme yetkisi sınırlı tutulmalıdır. Production serving için API erişimi export'tan farklı role sahip olabilir. Yüksek riskli model yalnızca serving ortamında çalıştırılabilir. Download event audit edilir. Yetkisiz paylaşım DLP ile izlenebilir.
Model Silme ve Retention Politikası
Eski model sürümleri sonsuza kadar saklanmamalıdır. Rollback için belirli sayıda approved version tutulabilir. Hassas dataset ile eğitilmiş modelin retirement prosedürü olmalıdır. Registry ve backup birlikte temizlenmelidir. Silme kaydı audit için saklanabilir.
Fine-Tuned Model Versioning
Model versioning production güvenilirliği için temel gereksinimdir. Her sürüm base model, dataset, code ve evaluation sonuçlarıyla ilişkilendirilmelidir. Staging ve production status açık olmalıdır. Rollback edilebilir approved sürümler korunmalıdır. Semantic versioning benzeri yaklaşım model değişikliklerini ekipler için anlaşılır hale getirir.
Model Registry
Registry model artifact ve metadata için merkezi sistemdir. Version, owner ve approval status tutulur. Dataset lineage ile bağlantı kurulur. Security erişimleri uygulanır. Deployment pipeline yalnızca registry'den approved model almalıdır.
Semantic Versioning
Major, minor ve patch benzeri sürüm yaklaşımı model değişikliklerini kategorize edebilir. Base model değişimi major kabul edilebilir. Yeni dataset ile retraining minor olabilir. Metadata düzeltmesi patch olarak tutulabilir. Kurum kendi standardını belirlemelidir.
Dataset–Model İlişkisi
Her model hangi dataset version ile eğitildiğini göstermelidir. Dataset hash saklanmalıdır. Retraining lineage açık biçimde izlenebilir. Silme talebi durumunda etkilenen modeller bulunabilir. Model card bu bilgiyi özetler.
Approved Model
Approved model bütün required evaluation ve security gate'lerini geçen sürümdür. Production'a adaydır. Approval kim tarafından verildiği kaydedilir. Değişiklik yapılırsa yeni version gerekir. Approval otomatik metrik ve insan onayını birleştirebilir.
Staging Model
Staging model production benzeri ortamda test edilen aday sürümdür. Gerçek traffic sample veya shadow test kullanılabilir. Latency ve safety metric izlenir. Production data logging privacy policy'ye uygun yapılmalıdır. Başarılı sonuç promotion sağlar.
Production Model
Production model aktif kullanıcı trafiğini işler. Exact artifact digest kaydedilmelidir. Monitoring ve alerting zorunludur. Version değişikliği controlled rollout ile yapılır. Registry status deployment sistemiyle senkron tutulmalıdır.
Rollback Edilebilir Model Sürümleri
Yeni model kalite veya latency sorunu yaratırsa önceki approved sürüme hızlı dönülebilmelidir. Serving config rollback desteklemelidir. Eski artifact silinmemelidir. Compatibility test yapılmalıdır. Rollback olayı feedback ve root cause sürecine aktarılmalıdır.
Production'a Deployment
Fine-tuned model production'a çıkarken serving mimarisi, quantization, container ve autoscaling kararları alınır. LoRA adapter ayrı yüklenebilir veya base model ile merge edilebilir. vLLM benzeri serving çözümleri throughput optimizasyonu sağlayabilir. Kubernetes GPU scheduling ile altyapı yönetilebilir. Deployment canary veya staged rollout ile yapılmalıdır.
Adapter Olarak Serving
Base model sabit tutulup LoRA adapter runtime sırasında yüklenebilir. Bu yöntem multi-adapter use case için esneklik sağlar. Adapter switch latency ve memory etkisi ölçülmelidir. Base model compatibility korunmalıdır. Registry doğru eşleşmeyi sağlamalıdır.
LoRA Adapter Merge
Adapter base modelle merge edilirse serving pipeline sadeleşebilir. Runtime adapter yönetimi gerekmez. Ancak farklı task adapter'ları için ayrı merged model gerekir. Merge sonrası full evaluation yapılmalıdır. Artifact size ve storage maliyeti artabilir.
Quantized Inference
Quantization GPU memory ve bazen latency maliyetini azaltır. 8-bit veya 4-bit seçenekler değerlendirilebilir. Quality regression test edilmelidir. Hardware ve serving engine desteği önemlidir. Production benchmark gerçek prompt distribution ile yapılmalıdır.
vLLM ile Serving
vLLM yüksek throughput LLM serving için kullanılabilir. Continuous batching benzeri yöntemler GPU utilization artırabilir. Desteklenen model ve quantization formatları kontrol edilmelidir. Metrics monitoring sistemine aktarılmalıdır. Production config version control altında tutulmalıdır.
Container Deployment
Model server container image içinde paketlenebilir. Model weight ayrıca volume veya registry'den alınabilir. Image security scanning uygulanmalıdır. Runtime user non-root olmalıdır. Version ve digest deployment manifest'e yazılmalıdır.
Kubernetes
Kubernetes model serving pod'larını yönetebilir. GPU resource request tanımlanır. Rolling update ve canary strategy uygulanabilir. Node pool farklı GPU tiplerine ayrılabilir. Network ve secret policy güvenli yapılandırılmalıdır.
Autoscaling
Request sayısı veya queue depth'e göre replica sayısı artırılabilir. GPU startup süresi autoscaling davranışını etkiler. Minimum warm replica latency'yi düşürebilir. Cost ve SLA dengelenmelidir. Scale event'leri monitoring'de izlenmelidir.
GPU Scheduling
GPU kaynakları pahalı olduğu için scheduler utilization artırmalıdır. Model boyutu ve memory ihtiyacına göre placement yapılır. MIG veya sharing seçenekleri hardware'e göre değerlendirilebilir. Noisy neighbor etkisi test edilmelidir. Production ve training pool ayrılabilir.
Multi-Adapter Serving
Multi-adapter serving tek base model üzerinden farklı kurumsal görev veya departman adapter'larını çalıştırmayı sağlar. Bu yaklaşım GPU memory ve operasyon maliyetini azaltabilir. Request router doğru adapter'ı seçer. Tenant isolation kritik hale gelir. Her adapter'ın independent versioning ve evaluation süreci olmalıdır.
Tek Base Model Üzerinden Birden Fazla Fine-Tune
Aynı base model farklı task'lar için adapter taşıyabilir. Base weight tek kez GPU memory'ye yüklenir. Adapter daha küçük artifact olduğu için hızlı değiştirilebilir. Compatibility dikkatle korunmalıdır. Model upgrade bütün adapter'ların yeniden test edilmesini gerektirir.
Departman Bazlı Adapter
Finans, destek ve hukuk ekipleri farklı adapter kullanabilir. Ortak base model operasyonu sadeleştirir. Departman jargonları birbirine karışmaz. Routing kullanıcı role göre yapılabilir. Data access yine external authorization ile korunmalıdır.
Müşteri Bazlı Adapter
B2B platform farklı müşteriler için özel adapter tutabilir. Tenant-specific behavior sağlanabilir. Artifact erişimi tenant sınırlarına göre korunmalıdır. Training data karışmamalıdır. Operational overhead adapter sayısı arttıkça izlenmelidir.
Adapter Routing
Router request metadata'sına göre adapter seçer. Yanlış routing data ve behavior leakage oluşturabilir. Tenant id güvenilir authentication kaynağından gelmelidir. Fallback adapter policy tanımlanmalıdır. Routing log audit edilir.
GPU Bellek Avantajları
Base model memory'de ortak tutulduğu için her task için tam model yüklemek gerekmez. Adapter size daha küçüktür. Bu sayede daha fazla customization aynı GPU pool'da çalışabilir. Adapter switching overhead ölçülmelidir. Serving engine desteği önemlidir.
Tenant İzolasyonu
Bir tenant'ın adapter veya data context'i başka tenant'a sızmamalıdır. Routing ve cache isolation test edilmelidir. Logging tenant-aware olmalıdır. Model memory paylaşımı security review gerektirir. High-risk müşteriler ayrı serving pool kullanabilir.
Production Monitoring
Production model performansı yalnızca uptime ile izlenemez. Request, error, latency, token, GPU utilization ve output quality birlikte takip edilmelidir. Safety violation rate ayrı alert üretmelidir. Model version her metric'e label olarak eklenmelidir. Bu sayede rollout sonrası regression hızlı tespit edilir.
Request Sayısı
Request hacmi kapasite ve maliyet planlamasının temelidir. Tenant ve endpoint bazında izlenebilir. Ani artış abuse veya ürün değişikliğini gösterebilir. Rate limit gerekebilir. Trend retraining data flywheel boyutunu da etkiler.
Error Rate
HTTP error, model timeout ve schema failure ayrı izlenmelidir. Error rate artışı yeni deployment problemi olabilir. Backend dependency hatası model hatasından ayrılmalıdır. Alert threshold tanımlanır. Root cause loglarla ilişkilendirilir.
P50, P95 ve P99 Latency
Latency dağılımı tail performance görünürlüğü sağlar. Ortalama değer yüksek percentile problemlerini gizleyebilir. Model version ve hardware pool bazında izlenmelidir. Canary rollout'ta karşılaştırılır. SLA violation alert üretir.
Time to First Token
Streaming chat uygulamalarında kullanıcı ilk token süresini doğrudan hisseder. Queue ve model load süresi etkiler. Prompt uzunluğu da önemli faktördür. Warm replica ve batching optimize edilebilir. P95 TTFT izlenmelidir.
Token Kullanımı
Input ve output token maliyetin önemli belirleyicisidir. Fine-tuning daha kısa system prompt ile tasarruf sağlayabilir. RAG context büyümesi ayrıca ölçülmelidir. Kullanıcı veya task bazında token trendi izlenebilir. Anormal artış prompt bug gösterebilir.
GPU Utilization
Düşük utilization gereksiz altyapı maliyeti anlamına gelebilir. Çok yüksek sürekli kullanım latency yaratabilir. Memory ve compute ayrı izlenmelidir. Batching ve replica sayısı optimize edilir. Training workload production GPU pool'undan ayrılabilir.
Output Quality
Production quality için otomatik sample evaluation yapılabilir. User feedback ve human review sinyal sağlar. Model drift zaman içinde görülebilir. Quality metric model version ile ilişkilendirilir. Kritik düşüş rollout rollback tetikleyebilir.
Safety Violation Rate
Guardrail veya safety classifier tarafından yakalanan olay oranı izlenmelidir. Yeni model sonrası artış regression işareti olabilir. False positive ayrıca analiz edilmelidir. High-severity event incident sürecine aktarılır. Trend retraining kararında kullanılabilir.
Model Drift Nasıl Takip Edilir?
Production kullanıcıları, terminoloji ve iş süreçleri değiştikçe model performansı düşebilir. Input distribution drift ve user behavior change ayrı izlenmelidir. Domain terminology değişimi yeni dataset ihtiyacı doğurabilir. Quality metric trendleri ve feedback bu değişimi gösterir. Retraining yalnızca takvimle değil drift trigger ile de başlatılabilir.
Input Distribution Drift
Prompt length, topic ve language dağılımı zaman içinde değişebilir. Training dataset production dağılımından uzaklaşabilir. Embedding distribution veya feature statistics izlenebilir. Büyük değişim evaluation set güncellemesini gerektirir. Model performansı yeni segmentlerde ayrıca ölçülmelidir.
Kullanıcı Davranışı Değişiklikleri
Kullanıcılar ürünü farklı amaçlarla kullanmaya başlayabilir. Yeni prompt kalıpları modelin zayıf olduğu alanları ortaya çıkarır. Request category trendi izlenmelidir. Unsupported use case için guardrail gerekir. Ürün ekibi feedback ile model roadmap'ini günceller.
Domain Terminolojisinin Değişmesi
Yeni ürün ve süreçler yeni terimler getirir. Model eski terminolojiye bağlı kalabilir. Glossary değişiklikleri training backlog'u tetikleyebilir. RAG güncel bilgiyi sağlar ancak style veya classification taxonomy de değişebilir. Dataset version bu değişimi yansıtmalıdır.
Quality Metric Drift
Online evaluation skorları zamanla düşebilir. Sample composition kontrol edilmelidir. Model aynı kalsa bile kullanıcı dağılımı değişmiş olabilir. Alert threshold trend bazlı belirlenebilir. Retraining veya prompt update değerlendirilebilir.
Feedback Trendleri
Thumbs down, manual correction ve escalation oranları izlenebilir. Tekil feedback gürültülü olabilir. Trend ve kategori bazlı analiz daha anlamlıdır. High-value failure örnekleri dataset'e adaydır. Privacy temizliği yapılmadan training'e alınmamalıdır.
Fine-Tuning Data Flywheel
Data flywheel production feedback'in kontrollü biçimde yeni eğitim verisine dönüştürülmesini sağlar. Hatalı cevaplar işaretlenir ve insanlar doğru cevabı oluşturur. Yeni dataset version hazırlanır ve evaluation'dan geçirilir. Model retraining sonrası canary deployment ile test edilir. Bu döngü tek seferlik fine-tuning'i sürdürülebilir LLMOps sürecine dönüştürür.
Production Feedback Toplamak
Kullanıcı rating ve structured reason toplanabilir. Raw conversation privacy açısından dikkatle saklanmalıdır. Feedback model version ile ilişkilendirilir. Domain ve severity etiketleri eklenebilir. Yalnızca yüksek değerli örnekler review kuyruğuna alınır.
Hatalı Yanıtları İşaretlemek
Yanlış factual, format veya safety response farklı kategorilerde etiketlenmelidir. Root cause RAG, prompt veya model kaynaklı olabilir. Her hata fine-tuning gerektirmez. Failure taxonomy ekip kararını kolaylaştırır. Kritiklik önceliklendirme sağlar.
İnsan Tarafından Düzeltilmiş Yanıtlar
Domain uzmanı model cevabını ideal hale getirir. Düzeltme gold-standard eğitim örneğine dönüşebilir. PII temizliği tekrar uygulanmalıdır. Reviewer agreement önemli use case'lerde kontrol edilir. Corrected example lineage korunmalıdır.
Yeni Dataset Sürümü
Onaylanmış yeni örnekler versionlanmış dataset'e eklenir. Changelog değişiklikleri açıklar. Class distribution yeniden analiz edilir. Holdout test set bağımsız kalır. Dataset approval sonrası training başlar.
Yeniden Eğitim
Retraining otomatik pipeline ile tekrarlanabilir. Hyperparameter aynı veya yeni deneyle güncellenebilir. Base model version değişirse ayrı benchmark gerekir. Training artifact registry'ye kaydedilir. Cost metric izlenir.
Evaluation
Yeni model önceki production model ile karşılaştırılır. Regression ve safety testleri çalışır. Human pairwise evaluation gerekli olabilir. Cost ve latency dahil edilir. Go/no-go kriteri geçilmezse model promote edilmez.
Kontrollü Deployment
Yeni sürüm canary kullanıcı grubuna açılabilir. Online metric karşılaştırılır. Safety violation ve error rate izlenir. Problem varsa rollback yapılır. Başarı sonrası traffic kademeli artırılır.
Fine-Tuning Ne Zaman Yenilenmeli?
Retraining sabit takvimle yapılabileceği gibi veri veya performans trigger'ına göre de başlatılabilir. Her hafta model eğitmek gereksiz maliyet oluşturabilir. Business KPI ve model drift daha anlamlı sinyal olabilir. Güvenlik olayı veya ciddi policy değişikliği acil retraining gerektirebilir. Retraining policy model card içinde belgelenmelidir.
Sabit Takvimle Retraining
Aylık veya üç aylık training kolay planlanabilir. Düzenli yeni data biriken use case'lerde uygundur. Ancak yeterli değişiklik yoksa gereksiz compute harcanır. Her takvim öncesi dataset delta kontrol edilebilir. Evaluation yine zorunludur.
Veri Değişikliğine Göre Retraining
Yeni domain veya büyük taxonomy değişikliği retraining tetikleyebilir. Dataset delta büyüklüğü threshold ile ölçülebilir. Küçük düzeltmeler hemen training gerektirmeyebilir. Change log karar için kullanılır. Version dependency korunmalıdır.
Performans Eşiğine Göre Retraining
Online quality metric belirli seviyenin altına düşerse retraining başlatılabilir. Alert yanlış pozitif üretebilir. Önce root cause analiz edilmelidir. RAG veya infrastructure problemi model training ile çözülmez. Model kaynaklıysa yeni dataset hazırlanır.
Business KPI Değişikliğine Göre Retraining
Ürün hedefi değiştiğinde model behavior hedefi de değişebilir. Örneğin yanıt kısalığı veya escalation politikası farklılaşabilir. Yeni KPI training rubric'e yansıtılır. Dataset buna göre güncellenir. Eski ve yeni model business A/B test ile karşılaştırılır.
Model Drift Trigger
Input veya quality distribution drift belirli threshold'u geçerse retraining değerlendirilebilir. Drift yalnızca data change nedeniyle olabilir. Yeni örneklerin annotation süreci başlar. Pilot training ve evaluation yapılır. Otomatik trigger doğrudan production promotion yapmamalıdır.
Güvenlik Olayı Sonrası Retraining
Model hassas veri sızıntısı veya policy regression gösterirse hemen incident süreci çalışır. Model rollback edilebilir. Dataset ve training root cause analiz edilir. Gerekirse temiz dataset ile retraining yapılır. Safety gate daha güçlü hale getirilir.
CI/CD ve LLMOps ile Fine-Tuning Otomasyonu
LLMOps pipeline dataset validation'dan production promotion'a kadar tekrar edilebilir süreç sağlar. Her model değişikliği otomatik evaluation ve safety gate'ten geçer. Registry approved artifact'ı tutar. Canary release ve rollback production riskini azaltır. Kurumsal LLM fine-tuning ve yapay zeka model özelleştirme hizmeti tasarlanırken bu otomasyon model training kadar önemlidir.
Dataset Validation Pipeline
Training başlamadan schema, duplicate, PII ve secret kontrolü yapılır. Dataset hash üretilir. Class distribution raporlanır. Policy failure training'i durdurur. Sonuç audit store'a kaydedilir.
Training Pipeline
Approved dataset ve config ile reproducible job başlatılır. Environment container image ile sabitlenir. Metric experiment tracking sistemine gönderilir. Checkpoint registry'ye yazılır. Failure otomatik raporlanır.
Automated Evaluation
Training sonrası task metric ve regression test otomatik çalışır. Base veya production modelle karşılaştırma yapılır. Schema ve safety testleri eklenir. Threshold geçilmezse promotion engellenir. Report model card'a bağlanır.
Safety Gate
Prompt injection, PII leakage ve policy violation testleri gate oluşturur. High-severity failure release blocker olmalıdır. Manual security approval belirli modellerde eklenebilir. Sonuç versionlanır. Exception süresi sınırlı tutulmalıdır.
Model Registry
Başarılı artifact registry'ye candidate status ile yazılır. Dataset, code ve metric lineage bulunur. Approval sonrası staging status alır. Access control uygulanır. Production yalnızca approved artifact kullanır.
Staging Deployment
Model production-benzeri infrastructure üzerinde çalıştırılır. Load test ve integration test uygulanır. RAG ve tool entegrasyonları doğrulanır. Latency metric alınır. Canary öncesi son teknik kontroldür.
Canary Release
Küçük traffic yüzdesi yeni modele yönlendirilir. Quality, safety ve latency karşılaştırılır. Kullanıcı feedback izlenir. Threshold aşılırsa otomatik rollback yapılabilir. Başarı traffic expansion sağlar.
Production Promotion
Canary başarılıysa model production status alır. Traffic kademeli artırılabilir. Registry state ve deployment config senkronize edilir. Release note yayınlanır. Monitoring yoğunlaştırılabilir.
Rollback
Önceki approved model hızlı biçimde geri yüklenebilmelidir. Config rollback otomatik olmalıdır. Incident model version ile ilişkilendirilir. New training durdurulabilir. Root cause sonrası düzeltme yeniden pipeline'a girer.
Fine-Tuning Maliyeti Nasıl Hesaplanır?
Fine-tuning maliyeti yalnızca GPU saatinden ibaret değildir. Veri hazırlama, domain uzmanı, evaluation, storage, inference ve retraining kalemleri birlikte hesaplanmalıdır. Bazı projelerde insan review training compute'tan daha pahalı olabilir. TCO birkaç yıllık perspektifle değerlendirilmelidir. Başarılı modelin iş değeri bu toplam maliyetle karşılaştırılmalıdır.
GPU Training Maliyeti
GPU tipi ve training süresi temel maliyeti oluşturur. Cloud saat ücreti veya on-prem amortisman hesaplanabilir. Utilization düşükse gerçek maliyet yükselir. PEFT ve QLoRA tasarruf sağlayabilir. Failed experiment maliyeti de toplam bütçeye eklenmelidir.
Veri Hazırlama Maliyeti
Discovery, temizleme ve formatlama önemli iş gücü gerektirir. PII ve duplicate kontrolü automation ile azaltılabilir. Data engineering zamanı hesaplanmalıdır. Dataset governance platform maliyeti eklenebilir. Kaliteli veri yatırımı model başarısını doğrudan etkiler.
Domain Uzmanı Maliyeti
Gold-standard cevap ve human evaluation uzman zamanı gerektirir. Saat maliyeti yüksek olabilir. Review yalnızca high-value örneklere odaklanmalıdır. Annotation tool verimliliği artırır. Inter-annotator agreement tekrar işi azaltabilir.
Evaluation Maliyeti
Automated judge API, human review ve benchmark infrastructure maliyet oluşturur. Her model version'da tekrar edilir. Safety red-team ayrıca bütçe gerektirir. Evaluation azaltılmamalıdır. Başarısız production deployment maliyeti daha yüksek olabilir.
Storage Maliyeti
Dataset, checkpoint ve loglar zamanla büyür. Full model artifact'ları büyük yer kaplar. Adapter kullanımı storage tasarrufu sağlar. Retention policy gereksiz checkpoint'leri siler. Backup maliyeti dahil edilmelidir.
Inference Maliyeti
Production request hacmi büyüdükçe en büyük kalem olabilir. GPU veya API token maliyeti hesaplanmalıdır. Batching ve quantization optimize edilir. Küçük fine-tuned model avantaj sağlayabilir. Cost-per-request düzenli izlenmelidir.
Retraining Maliyeti
Model tek sefer eğitilmez. Yeni data ve drift retraining gerektirir. Pipeline otomasyonu insan maliyetini azaltır. Takvim ve trigger politikası gereksiz training'i önler. Yıllık TCO içinde tahmini retraining sayısı kullanılmalıdır.
Toplam Sahip Olma Maliyeti (TCO)
TCO bütün teknik ve insan maliyetlerini birleştirir. Infrastructure, lisans, operasyon ve governance dahil edilir. Vendor lock-in ve migration riski eklenebilir. Üç yıllık senaryo karşılaştırması yapılabilir. RAG, API ve fine-tuned self-hosted alternatifleri aynı modelle değerlendirilmelidir.
Fine-Tuning ile Inference Maliyetini Düşürmek
Fine-tuning'in önemli iş gerekçelerinden biri daha küçük modelle aynı görevi yapabilmektir. Büyük modelden küçük modele geçiş GPU veya API maliyetini azaltabilir. Distillation ve quantization ek kazanç sağlar. Daha kısa system prompt token kullanımını düşürür. Ancak kalite kaybı mutlaka production-benzeri test set üzerinde ölçülmelidir.
Büyük Modelden Küçük Modele Geçiş
Önce büyük model baseline oluşturabilir. Daha küçük model aynı task dataset ile fine-tune edilir. Quality gap ölçülür. Kabul edilebilir fark varsa maliyet avantajı hesaplanır. Throughput ve latency ayrıca karşılaştırılır.
Distillation
Teacher model daha küçük student model için eğitim sinyali üretebilir. Response ve soft target yöntemleri kullanılabilir. Student dar kurumsal göreve odaklanır. Training maliyeti artar ama inference tasarrufu sağlayabilir. Gerçek evaluation ile doğrulanmalıdır.
Quantization
Quantization model ağırlıklarını düşük precision temsil eder. Memory kullanımı ve serving maliyeti azalabilir. Accuracy regression task'a göre değişir. 8-bit ve 4-bit seçenekler test edilmelidir. Hardware desteği önemlidir.
Prompt Boyutunu Azaltmak
Fine-tuning sık kullanılan talimat ve örnekleri model davranışına taşıyabilir. Böylece her request'te uzun few-shot prompt göndermek gerekmez. Input token maliyeti düşer. Context window daha fazla gerçek bilgiye ayrılabilir. Fine-tuning quality gain ayrıca değerlendirilmelidir.
Daha Kısa System Prompt Kullanmak
Kurumsal style ve format training ile öğrenilirse system prompt sadeleşebilir. Güvenlik ve runtime policy yine prompt veya guardrail'de kalabilir. Her talimatın model ağırlığına taşınması doğru değildir. Prompt ve training responsibility ayrılmalıdır. Token saving production volume ile hesaplanabilir.
RAG ve Fine-Tuning Maliyet Dengesi
RAG context token maliyetini artırabilir ancak retraining ihtiyacını azaltır. Fine-tuning prompt'u küçültebilir fakat eğitim ve bakım maliyeti getirir. Hibrit yapı toplam maliyet açısından optimize edilebilir. Retrieval yalnızca gerekli document chunk'larını getirmelidir. TCO gerçek request hacmiyle hesaplanmalıdır.
Model Distillation ve Fine-Tuning
Distillation büyük bir teacher modelin davranışını daha küçük student modele aktarmayı amaçlar. Kurumsal görev için teacher tarafından sentetik örnekler üretilebilir. Student model bu örnekler ve gerçek gold-standard veriyle fine-tune edilir. Böylece daha düşük inference maliyeti hedeflenir. Quality ve safety farkı dikkatle ölçülmelidir.
Teacher–Student Model Yaklaşımı
Teacher güçlü genel modeldir. Student daha küçük ve ekonomik model olabilir. Teacher farklı task örnekleri üretir veya soft guidance sağlar. Student SFT ile uyarlanır. Human review kritik örnekleri doğrular.
Büyük Modelden Sentetik Veri Üretmek
Teacher model gerçek use case dağılımına benzer prompt'lar üzerinde cevap üretir. Privacy açısından gerçek müşteri verisi yerine anonim senaryolar kullanılabilir. Output validation yapılmalıdır. Teacher hataları filtrelenmelidir. Dataset diversity kontrol edilmelidir.
Küçük Modeli Kurumsal Göreve Uyarlamak
Student sadece gerekli task'larda optimize edilir. General capability daha sınırlı olabilir. Production system scope bunu kabul etmelidir. Task-specific benchmark önemlidir. Guardrail ve fallback büyük modele yönlendirme sağlayabilir.
Kalite–Maliyet Dengesi
Küçük model biraz daha düşük kaliteyle büyük maliyet tasarrufu sağlayabilir. Kabul edilebilir fark business use case'e bağlıdır. High-risk görevlerde kalite daha fazla öncelik taşır. Cost-per-correct-response ölçülebilir. Online A/B gerçek karar verir.
Distillation Ne Zaman Fine-Tuning'den Daha Mantıklı?
Aslında distillation çoğu zaman fine-tuning ile birlikte kullanılır. Hedef büyük model davranışını küçük modele taşımaksa distillation değerlidir. Mevcut küçük model zaten yeterliyse doğrudan fine-tuning daha basit olabilir. Teacher API maliyeti hesaplanmalıdır. Operational simplicity karar kriteridir.
Kurumsal Fine-Tuning Kullanım Senaryoları
Fine-tuning en iyi değeri dar, tekrar eden ve ölçülebilir iş görevlerinde üretir. Müşteri hizmetleri, classification, extraction ve kurumsal rapor formatı güçlü örneklerdir. Güncel bilgi RAG ile tamamlanabilir. Her use case aynı model veya adapter'ı kullanmak zorunda değildir. Task-specific evaluation başarıyı belirler.
Müşteri Hizmetleri
Model kurum tonu ve destek prosedürüyle yanıt üretmeyi öğrenebilir. Güncel ürün bilgisi retrieval'dan sağlanır. Escalation davranışı örneklenir. PII temizliği zorunludur. Human review yüksek riskli cevaplarda devam eder.
Çağrı Merkezi
Transkript sınıflandırma ve özetleme modeli fine-tune edilebilir. Konuşma dili ve transcription noise training'de temsil edilmelidir. PII temizlenir. Call reason ve outcome extraction structured output olarak üretilebilir. Agent assist latency hedefi önemlidir.
Hukuki Doküman İşleme
Sözleşme clause classification veya extraction yapılabilir. Hukuki gerçekleri modelden bağımsız doğrulamak gerekir. Human lawyer evaluation zorunlu olabilir. Güncel mevzuat RAG üzerinden sunulur. Hassas doküman güvenliği yüksek seviyede tutulur.
Finansal Sınıflandırma
Transaction veya document category modelle sınıflandırılabilir. False negative ve false positive iş etkisi ayrı değerlendirilir. Training data privacy gerektirir. Structured output güçlü use case'tir. Human approval kritik kararları korur.
Teknik Destek
Model ticket triage ve çözüm formatını öğrenebilir. Teknik doküman RAG ile getirilebilir. Eski çözüm örnekleri ayıklanmalıdır. Hata kodu ve product version context olarak kullanılır. Escalation policy fine-tuning ile davranışa dönüşebilir.
Kurumsal Rapor Yazımı
Model belirli rapor şablonunu ve tonu öğrenebilir. Gerçek rakamlar database veya API'den alınmalıdır. Fine-tuning format ve anlatım için kullanılmalıdır. Hallucinated metric özel test edilmelidir. Human approval final raporda devam edebilir.
Structured Data Extraction
Invoice, ticket veya sözleşmeden belirli alanlar çıkarılabilir. JSON schema training'de sabit tutulur. Missing value policy öğretilir. Field-level precision ölçülür. Düşük confidence human review'a gönderilebilir.
Yazılım Geliştirme
Model internal framework ve coding convention öğrenebilir. Kod repository secret ve lisans açısından temizlenir. Test generation ve code completion use case değerlendirilebilir. Static analysis evaluation pipeline'a eklenir. Human code review devam eder.
Marka Tonunda İçerik Üretimi
Onaylanmış içerik örnekleri kurumun yazım tonunu gösterebilir. Style guide training dataset ile uyumlu olmalıdır. Modelin gerçek bilgi üretme yetkisi ayrıca kontrol edilir. RAG güncel ürün bilgisini sağlayabilir. Human editor final content'i review edebilir.
Örnek Kurumsal Fine-Tuning Mimarisi
Production-ready mimari veri kaynaklarından başlayıp feedback loop'a kadar devam eder. Ingestion sonrası PII ve secret redaction uygulanır. Curated dataset registry'de versionlanır. Training ve evaluation pipeline model artifact üretir. Approval sonrası inference service deploy edilir ve monitoring yeni feedback'i toplar.
Kurumsal Veri Kaynakları
CRM, ticket, doküman ve code repository kaynak olabilir. Her source owner ve sensitivity metadata taşır. Access read-only service account ile yapılır. Data usage approval kontrol edilir. Inventory merkezi tutulur.
Data Ingestion
Raw data kontrollü staging alanına alınır. Source id ve timestamp korunur. Gereksiz alanlar daha başta çıkarılır. Transfer şifreli yapılır. Ingestion log audit edilir.
PII ve Secret Redaction
Scanner hassas alanları tespit eder. Redaction ve anonymization policy uygulanır. Secret bulunduğunda security incident açılabilir. Clean output yeniden taranır. Sadece temiz data curation aşamasına geçer.
Dataset Curation
Duplicate, yanlış ve eski örnekler temizlenir. Gold-standard cevaplar seçilir. Format standardize edilir. Class distribution analiz edilir. Dataset card hazırlanır.
Dataset Registry
Curated dataset immutable version olarak kaydedilir. Owner, hash ve approval status tutulur. Training yalnızca approved version kullanır. Access control uygulanır. Retention policy bulunur.
Training Pipeline
Config ve model revision versionlanır. Job container içinde çalışır. Metric experiment tracking sistemine gönderilir. Adapter veya checkpoint artifact oluşur. Failure report üretilir.
Evaluation Pipeline
Task, safety ve regression test otomatik çalışır. Human review gerekli use case'te tetiklenir. Base model comparison yapılır. Go/no-go threshold uygulanır. Report registry metadata'sına bağlanır.
Model Registry
Candidate model artifact ve lineage burada tutulur. Approval status açıkça görünür. Staging ve production version ayrılır. Export erişimi sınırlandırılır. Rollback sürümleri korunur.
Approval Gate
Model metric ve security sonucu reviewer'a sunulur. Domain owner ve security approval gerekebilir. Threshold altında model reddedilir. Exception kayıtlı ve süreli olmalıdır. Production promotion yalnızca gate sonrası yapılır.
Inference Service
Approved model API üzerinden servis edilir. Authentication ve rate limit uygulanır. RAG veya tool integration burada çalışabilir. Model version response metadata'sında tutulabilir. Structured logging privacy-aware olmalıdır.
Monitoring
Latency, error, token ve quality metric izlenir. Safety violation alert üretir. Drift analizi yapılır. User feedback model version ile bağlanır. Dashboard operations ekibi tarafından kullanılır.
Feedback Loop
Hatalı production örnekleri review kuyruğuna girer. İnsan düzeltmesi yeni dataset candidate olur. PII temizliği tekrar yapılır. New dataset version retraining pipeline'a girer. Kontrollü döngü sürekli iyileştirme sağlar.
Production'a Çıkmadan Önce Fine-Tuning Kontrol Listesi
Production öncesi checklist modelin yalnızca teknik olarak çalıştığını değil güvenli ve yönetilebilir olduğunu doğrular. Business case ve RAG alternatifi değerlendirilmelidir. Dataset kullanımı, PII taraması ve versioning tamamlanmalıdır. Baseline, safety ve human evaluation sonuçları bulunmalıdır. Rollback, monitoring ve retraining politikası release öncesinde hazır olmalıdır.
Business Case Onaylandı mı?
Fine-tuning'in çözdüğü iş problemi açık mı kontrol edilmelidir. Success metric tanımlanmalıdır. Expected cost saving veya quality gain bulunmalıdır. Product owner onayı alınabilir. Teknik demo business case yerine geçmemelidir.
RAG Alternatifi Değerlendirildi mi?
Problem güncel bilgi ise RAG daha uygun olabilir. Prompt baseline kurulmalıdır. Hybrid seçenek test edilmelidir. Fine-tuning gerçek davranış kazanımı göstermelidir. Karar belgelenmelidir.
Dataset'in Kullanım İzni Var mı?
Her source için usage right kontrol edilmelidir. PII ve lisans şartları değerlendirilmelidir. Data owner approval bulunmalıdır. Belirsiz veri çıkarılmalıdır. Dataset card izin bilgisini içermelidir.
PII ve Secret Taraması Yapıldı mı?
Training data multiple scanner ile kontrol edilmelidir. High-risk sample human review yapılmalıdır. Gerçek secret rotate edilmelidir. Clean dataset yeniden taranmalıdır. Scan report saklanmalıdır.
Dataset Versionlandı mı?
Immutable version ve hash bulunmalıdır. Training job exact version kullanmalıdır. Mutable folder kabul edilmemelidir. Changelog hazırlanmalıdır. Registry lineage modelle ilişkilendirilmelidir.
Holdout Test Seti Ayrıldı mı?
Holdout training ve tuning süreçlerinden izole olmalıdır. Contamination scan yapılmalıdır. Production-benzeri örnekler bulunmalıdır. Final go/no-go burada ölçülmelidir. Test set versionlanmalıdır.
Baseline Ölçüldü mü?
Base model güçlü prompt ile test edilmelidir. Quality, latency ve cost kaydedilmelidir. Fine-tuned model aynı set üzerinde karşılaştırılmalıdır. Baseline olmadan improvement ölçülemez. Report experiment tracking'e eklenmelidir.
Güvenlik Testleri Tamamlandı mı?
Prompt injection, jailbreak ve leakage testleri çalışmalıdır. Tool authorization ayrı test edilmelidir. High-severity failure olmamalıdır. Red-team sonucu review edilmelidir. Safety gate release'i kontrol etmelidir.
Memorization Testi Yapıldı mı?
Canary ve extraction testleri değerlendirilebilir. PII leakage sample prompt'larla aranmalıdır. Duplicate-heavy data risk olarak incelenmelidir. High-risk memorization release'i durdurmalıdır. Dataset yeniden temizlenebilir.
Human Evaluation Yapıldı mı?
Domain expert sample set'i değerlendirmelidir. Rubric ve pairwise comparison kullanılabilir. Agreement metric izlenir. Base ve fine-tuned sonuç karşılaştırılır. Human result go/no-go kararına eklenir.
Model Registry'ye Kaydedildi mi?
Model artifact, config ve lineage registry'de bulunmalıdır. Status candidate veya approved olarak belirlenir. Access control uygulanır. Hash saklanır. Deployment yalnızca registry artifact'ı kullanır.
Rollback Planı Hazır mı?
Önceki production model korunmalıdır. Traffic hızlı geri yönlendirilebilmelidir. Config rollback test edilmelidir. Incident owner belirlenmelidir. Rollback sonrasında root cause süreci çalışmalıdır.
Monitoring Kuruldu mu?
Latency, error ve quality metric dashboard'da görünmelidir. Safety alert ayarlanmalıdır. Model version label bulunmalıdır. Drift monitoring aktif olmalıdır. Alert ownership tanımlanmalıdır.
Retraining Politikası Belirlendi mi?
Retraining trigger ve approval süreçleri açık olmalıdır. Dataset change veya quality drift kriteri tanımlanabilir. Takvim kullanılıyorsa gerekçesi bulunmalıdır. Her retraining aynı evaluation gate'ten geçmelidir. Policy model card'da yer almalıdır.
Sık Yapılan Fine-Tuning Hataları
Kurumsal fine-tuning projelerinde en sık görülen sorunlar çoğu zaman model architecture'dan değil süreç tasarımından kaynaklanır. Fine-tuning'i bilgi veritabanı gibi görmek, kalitesiz veriyi artırmak ve test set'i training'e karıştırmak ciddi hatalardır. PII temizliği ve base baseline ihmal edilmemelidir. Training loss tek başına kalite göstergesi değildir. Production feedback döngüsü kurulmadığında model kısa sürede güncel iş ihtiyaçlarından uzaklaşabilir.
Fine-Tuning'i Bilgi Veritabanı Sanmak
Model ağırlıkları güvenilir ve güncel database yerine geçmez. Değişen gerçekler RAG veya API üzerinden gelmelidir. Fine-tuning behavior ve format için daha uygundur. Source citation training üzerinden güvenilir yapılamaz. Mimari problem türüne göre ayrılmalıdır.
Kalitesiz Veriyi Fazla Veriyle Telafi Etmek
Noise, yanlış label ve çelişkili örnekler daha fazla data ile otomatik düzelmez. Quality review yapılmalıdır. Duplicate oranı düşürülmelidir. Gold-standard set oluşturulmalıdır. Küçük temiz dataset ile baseline almak daha güvenlidir.
Test Verisini Eğitime Karıştırmak
Contamination evaluation skorunu yapay yükseltir. Model production'da beklenen genelleme göstermez. Hash ve semantic duplicate kontrolü yapılmalıdır. Holdout ayrı tutulmalıdır. Split reproducible olmalıdır.
PII Temizliği Yapmamak
Training data leakage riski oluşturur. Model kişisel bilgiyi ezberleyebilir. Redaction ve anonymization uygulanmalıdır. Secret taraması eklenmelidir. Model artifact hassas kabul edilmelidir.
Base Model Baseline'ını Ölçmemek
Fine-tuning sonrası improvement bilinemez. İyi prompt ile base model test edilmelidir. Cost ve latency de kaydedilmelidir. Aynı test set kullanılmalıdır. Training yatırımının gerçek değeri ancak böyle ölçülür.
Yalnızca Training Loss'a Bakmak
Loss düşmesi gerçek task başarısı anlamına gelmez. Validation ve holdout metric gerekir. Human quality ayrıca farklı olabilir. Overfitting training loss içinde görünmez. Production criterion task-specific olmalıdır.
Catastrophic Forgetting'i Test Etmemek
Model hedef task'ta iyileşirken genel yetkinliği kaybedebilir. Safety regression görülebilir. General benchmark çalıştırılmalıdır. Base model karşılaştırması yapılmalıdır. PEFT riski azaltabilir ancak test yine gerekir.
Evaluation Setini Sonradan Hazırlamak
Model sonuçlarını gördükten sonra test set oluşturmak bias yaratabilir. Success criteria training öncesi belirlenmelidir. Holdout dataset baştan ayrılmalıdır. Evaluation rubric önceden hazırlanmalıdır. Böylece objective go/no-go kararı verilir.
Production Feedback Döngüsü Kurmamak
Model kullanıcı davranışı değiştikçe gerileyebilir. Hatalı cevaplar yeni training sinyaline dönüşmelidir. Feedback privacy-aware toplanmalıdır. Dataset versioning ile flywheel kurulmalıdır. Retraining controlled evaluation'dan geçmelidir.
Model Artifact Güvenliğini Unutmak
Fine-tuned model kurumun özel davranışını ve bazı training sinyallerini taşır. Registry public olmamalıdır. Encryption ve access control uygulanmalıdır. Export audit edilmelidir. Old checkpoint retention policy ile yönetilmelidir.
Sık Sorulan Sorular
Kurumsal fine-tuning projelerinde ekiplerin en sık sorduğu sorular veri miktarı, RAG karşılaştırması, güvenlik, GPU ve maliyet çevresinde toplanır. Her sorunun yanıtı model boyutu ve kullanım senaryosuna göre değişebilir. Tek bir sayı veya yöntem bütün kurumlara uygun değildir. Pilot çalışma gerçek veriniz ve KPI'larınız üzerinde karar vermenin en güvenilir yoludur. Aşağıdaki yanıtlar başlangıç için teknik ve operasyonel çerçeve sunar.
Kurumsal verilerle LLM fine-tuning nasıl yapılır?
Önce business case ve baseline tanımlanır. Kurumsal veri inventory'den seçilir, PII ve secret temizliği yapılır. Dataset versionlanıp train, validation ve test olarak ayrılır. PEFT veya uygun training yöntemiyle model eğitilir. Otomatik ve insan evaluation sonrasında güvenlik gate'lerini geçen sürüm production'a alınır.
Fine-tuning için ne kadar veri gerekir?
Tek bir minimum sayı yoktur. Görev zorluğu, model kapasitesi ve örnek kalitesi belirleyicidir. Dar classification use case yüzlerce kaliteli örnekle başlayabilir. Geniş davranış adaptasyonu daha fazla veri gerektirir. Learning curve üzerinden yeni verinin marjinal katkısı ölçülmelidir.
RAG mi fine-tuning mi daha iyi?
Problem güncel bilgi ise RAG çoğu zaman daha uygundur. Problem davranış, format veya style ise fine-tuning avantajlıdır. İki yöntem birlikte kullanılabilir. Source citation gerekiyorsa RAG güçlüdür. Karar baseline ve TCO analiziyle verilmelidir.
RAG ve fine-tuning birlikte kullanılabilir mi?
Evet ve birçok kurumsal sistemde güçlü bir kombinasyondur. Fine-tuning model davranışını öğretir. RAG güncel bilgiyi sağlar. Retrieval authorization güvenliği korur. Hybrid architecture ayrı metric'lerle test edilmelidir.
Fine-tuning kurumsal bilgileri modele ezberletir mi?
Model bazı training örneklerini öğrenebilir ve belirli durumlarda ezberleyebilir. Bu yüzden sürekli değişen bilgiyi eğitimle yerleştirmek önerilmez. PII ve secret temizlenmelidir. Güncel bilgi RAG ile sağlanabilir. Memorization testleri uygulanmalıdır.
Fine-tuning için hangi model seçilmelidir?
Türkçe performansı, task baseline, lisans, maliyet ve hardware gereksinimi birlikte değerlendirilmelidir. En büyük model otomatik olarak en iyi değildir. Küçük model dar görevde daha ekonomik olabilir. Açık ve kapalı modeller pilotta karşılaştırılabilir. Commercial use şartları kontrol edilmelidir.
LoRA ile QLoRA arasındaki fark nedir?
LoRA düşük rank adapter eğitir. QLoRA buna ek olarak base model'i düşük bit quantization ile yükler. Böylece memory ihtiyacı daha da azalır. Quality farkı modele göre değişir. Sınırlı GPU ortamında QLoRA avantajlı olabilir.
PEFT nedir?
PEFT modelin tamamını eğitmeden küçük trainable parametrelerle uyarlama yöntemidir. LoRA ve QLoRA örnektir. GPU ve storage maliyetini azaltır. Adapter bağımsız versionlanabilir. Kurumsal pilotlar için pratik başlangıçtır.
Fine-tuning için GPU gerekli mi?
Modern LLM training için GPU çoğu pratik senaryoda önemlidir. Çok küçük modeller CPU üzerinde çalışabilir ancak süre yüksek olabilir. PEFT GPU gereksinimini azaltır. Managed API infrastructure ihtiyacını kullanıcıdan gizler. Inference GPU ihtiyacı ayrıca değerlendirilmelidir.
LLM kendi sunucumuzda fine-tune edilebilir mi?
Açık ağırlıklı modeller on-prem GPU sunucuda fine-tune edilebilir. CUDA, driver ve container ortamı yönetilmelidir. Data kurum içinde kalabilir. Hardware kapasitesi model boyutuna uygun olmalıdır. Security ve observability altyapısı ayrıca kurulmalıdır.
Fine-tuning sırasında verilerimiz güvende midir?
Güvenlik deployment modeline ve süreç tasarımına bağlıdır. PII temizliği, encryption ve access control uygulanmalıdır. Üçüncü taraf sağlayıcı şartları incelenmelidir. Model artifact hassas varlık olarak korunmalıdır. Audit logging zorunlu hale getirilmelidir.
Kişisel veriler fine-tuning için kullanılabilir mi?
Bu konu teknik olduğu kadar hukuki değerlendirme gerektirir. Uygun dayanak ve amaç kontrol edilmelidir. Mümkünse anonymization ve data minimization uygulanmalıdır. Gereksiz PII training'e alınmamalıdır. Hukuk ve privacy ekipleri sürece dahil edilmelidir.
Fine-tuned model eğitim verisini sızdırabilir mi?
Belirli koşullarda memorization ve extraction riski bulunabilir. Özellikle duplicate veya hassas veri risklidir. Canary ve leakage testleri yapılmalıdır. PII redaction en güçlü önlemlerden biridir. Model export yetkileri sınırlanmalıdır.
Fine-tuning hallucination sorununu çözer mi?
Fine-tuning hallucination problemini tamamen çözmez. Hatta yanlış eğitim verisi yanlış güveni artırabilir. Güncel gerçekler RAG ile sağlanmalıdır. Hallucination evaluation ayrıca yapılmalıdır. Guardrail ve source-grounding yardımcı olur.
Fine-tuning ne kadar sürer?
Süre model boyutu, dataset, sequence length ve GPU sayısına bağlıdır. PEFT küçük dataset'te saatler içinde tamamlanabilir. Full training günler sürebilir. Queue ve data preparation çoğu zaman training'den daha uzun olabilir. Pilot profiling gerçek süreyi gösterir.
Fine-tuning maliyeti ne kadardır?
Tek bir sabit fiyat yoktur. GPU, data preparation, expert review ve evaluation maliyetleri bulunur. Managed API fiyatı farklı hesaplanabilir. Retraining ve inference TCO içine eklenmelidir. Küçük pilot gerçek bütçe tahmini sağlar.
Fine-tuned model nasıl test edilir?
Holdout dataset üzerinde task-specific metric çalıştırılır. Base model baseline ile karşılaştırılır. Safety ve leakage testleri yapılır. Human evaluation gerekiyorsa eklenir. Latency ve cost production-benzeri ortamda ölçülür.
Fine-tuned model ne zaman yeniden eğitilmelidir?
Yeni data, domain drift veya quality regression retraining tetikleyebilir. Sabit takvim de kullanılabilir. Her retraining öncesi gerçek ihtiyaç doğrulanmalıdır. Dataset version güncellenir. Model yeniden bütün evaluation gate'lerinden geçer.
Açık kaynak model mi API tabanlı model mi tercih edilmeli?
Data control ve customization öncelikliyse açık model avantaj sağlar. Operasyon kolaylığı önemliyse managed API tercih edilebilir. Lisans, TCO ve latency birlikte değerlendirilmelidir. Vendor lock-in hesaba katılmalıdır. Pilot iki yaklaşımı karşılaştırabilir.
Kurumsal kullanım için fine-tuning mi model distillation mı daha avantajlı?
Distillation daha küçük modele güçlü model davranışı aktarmak için kullanılır. Fine-tuning belirli modeli kurumsal göreve uyarlamaya odaklanır. İki yöntem birlikte de uygulanabilir. Maliyet düşürme hedefinde distillation değerlidir. En doğru seçim kalite ve serving maliyeti benchmark'ıyla belirlenir.
Kurumsal LLM Fine-Tuning Hakkında Ek Sık Sorulan Sorular
Aşağıdaki sorular özellikle kurumların proje başlangıcında veri hazırlama, mimari seçim, güvenlik ve danışmanlık açısından en fazla ihtiyaç duyduğu konuları özetler. Fine-tuning projesinin başarısı yalnızca training job'ın tamamlanmasıyla ölçülmemelidir. Veri governance, evaluation ve production monitoring aynı disiplinin parçalarıdır. Özellikle LLM fine-tuning sürecinde veri güvenliği KVKK ve model değerlendirme yöntemleri baştan birlikte tasarlanmalıdır. Kurumsal ölçekte güvenilir sonuç için küçük pilot, açık KPI ve kontrollü rollout yaklaşımı daha sağlıklı ilerleme sağlar.
Kurumsal verilerle LLM fine-tuning süreci nasıl yapılır?
Kurumsal verilerle LLM fine-tuning süreci önce gerçek business problem ve baseline model performansının tanımlanmasıyla başlar. Veri kaynakları inventory üzerinden seçilir, usage right kontrol edilir ve PII ile secret temizliği uygulanır. Gold-standard örnekler train, validation ve bağımsız holdout test setlerine ayrılır. LoRA, QLoRA veya uygun training yöntemiyle model eğitilir ve task, safety, memorization, latency ile maliyet testlerinden geçirilir. Production'a yalnızca önceden belirlenen go/no-go kriterlerini karşılayan, model registry'de versionlanmış ve rollback planı bulunan sürüm alınmalıdır.
LLM fine-tuning için kurumsal veriler nasıl hazırlanmalı, temizlenmeli ve formatlanmalıdır?
Önce hangi kayıtların hedef görevi gerçekten temsil ettiği seçilmeli ve eski, çelişkili veya doğrulanmamış içerikler çıkarılmalıdır. PII, API key, private key ve connection string gibi hassas alanlar taranmalı ve uygun redaction ya da anonymization yöntemi uygulanmalıdır. Duplicate ve near-duplicate içerikler temizlenerek sınıf dağılımı dengelenmelidir. Instruction-response, chat veya JSON formatı use case'e göre standardize edilmeli ve bütün örneklerde aynı yapı korunmalıdır. Son dataset versionlanmalı, hash ile doğrulanmalı ve kaynak lineage bilgisiyle birlikte dataset registry içinde saklanmalıdır.
Fine-tuning ile RAG arasındaki fark nedir ve kurumsal kullanımda hangisi tercih edilmelidir?
Fine-tuning modelin davranışını, üslubunu, formatını veya belirli task performansını değiştirmeye odaklanır. RAG ise çalışma anında güncel ve yetkili kurumsal bilgiyi modele sağlar. Sürekli değişen gerçekler ve kaynak gösterme gereksinimi varsa RAG daha uygun olabilir. Tutarlı structured output, marka tonu veya dar classification görevi gerekiyorsa fine-tuning güçlü seçenek haline gelir. Birçok kurumsal sistemde en iyi yaklaşım davranışı fine-tuning ile, güncel gerçekleri RAG ile sağlayan hibrit mimaridir.
Kurumsal LLM fine-tuning süreçlerinde veri güvenliği, KVKK uyumu ve model performansı nasıl yönetilir?
Training verisinin hukuki kullanım kapsamı ve data owner onayı proje başında doğrulanmalıdır. PII ve secret temizliği otomatik scanner ve human sampling ile yapılmalı, dataset minimization uygulanmalıdır. Model ve dataset artifact'ları role-based access, encryption ve audit log ile korunmalıdır. Performance tarafında base model baseline, task-specific metric, safety evaluation ve memorization testleri birlikte kullanılmalıdır. Production sonrasında drift, safety violation ve kullanıcı feedback'i izlenerek retraining kontrollü LLMOps pipeline üzerinden yürütülmelidir.
Kurumsal verilerle LLM fine-tuning eğitimi veya danışmanlığını yakınımda nerede bulabilirim?
LLM fine-tuning ve yapay zeka danışmanlığı yakınımda şeklinde araştırma yapan ekipler için yalnızca model training sunan bir yaklaşım yerine veri hazırlama, güvenlik, RAG karşılaştırması, evaluation ve production serving adımlarını birlikte değerlendiren süreç daha faydalıdır. Diyarbakır Yazılım Topluluğu'nun yaklaşımı ve teknik çalışmaları hakkında https://www.diyarbakiryazilim.com.tr/about üzerinden bilgi alınabilir. Topluluk ve proje çalışmalarını görmek için https://www.diyarbakiryazilim.com.tr/projects adresi incelenebilir. AI çözümlerinde istemci ve sunucu iletişiminin uygulama mimarisine nasıl bağlandığı konusunda https://www.diyarbakiryazilim.com.tr/posts/ai-cozumlerinde-istemci-sunucu-client-server-ag-iletisimi adresindeki içerik de faydalı bir teknik tamamlayıcı olabilir. Kurumsal LLM fine-tuning ve yapay zeka model özelleştirme hizmeti planlanırken küçük bir pilot, ölçülebilir benchmark ve güvenli production rollout ile başlamak uzun vadede daha sağlıklı sonuç verir.
Sonuç: Güvenli ve Sürdürülebilir Kurumsal LLM Fine-Tuning Stratejisi
Kurumsal LLM özelleştirmesinde başarı modeli eğitmekten çok doğru problemi, doğru veriyi ve doğru evaluation sürecini bir araya getirmekle ilgilidir. Kurumsal Verilerle LLM Fine-Tuning Süreçleri davranış problemi ile bilgi problemini ayırarak başlamalı, RAG alternatifi mutlaka değerlendirilmelidir. Eğitim verisi kullanım hakkı, PII temizliği ve versioning tamamlanmadan training başlatılmamalıdır. PEFT ile küçük ve ölçülebilir pilot oluşturmak, ardından safety, memorization, latency ve business KPI testleriyle production kararını vermek riski azaltır. Kurumunuza uygun LLM, RAG, fine-tuning ve production AI mimarisini değerlendirmek için Diyarbakır Yazılım Topluluğu hakkında https://www.diyarbakiryazilim.com.tr/about adresinden bilgi alabilir ve teknik proje örneklerini https://www.diyarbakiryazilim.com.tr/projects üzerinden inceleyebilirsiniz.
Önce Problemin Bilgi mi Davranış mı Olduğunu Belirleyin
Model yanlış cevap veriyorsa önce nedenini doğru sınıflandırmak gerekir. İlgili bilgi context'e ulaşmıyorsa sorun retrieval olabilir. Model doğru context'i görüp yanlış formatta davranıyorsa fine-tuning adayıdır. Bu ayrım gereksiz training maliyetini önler. Mimari karar problem türü üzerinden verilmelidir.
Fine-Tuning'den Önce Baseline Oluşturun
İyi prompt ve gerekiyorsa RAG ile base model performansı ölçülmelidir. Accuracy, latency ve cost kaydedilir. Human evaluation gerektiğinde baseline'a dahil edilir. Fine-tuned model aynı set üzerinde karşılaştırılır. Kazanım ölçülemiyorsa training yatırımı anlamlı değildir.
Veri Kalitesini Veri Miktarının Önüne Koyun
Çok büyük ama kirli dataset güçlü model üretmez. Gold-standard örnekler daha değerlidir. Duplicate, yanlış label ve eski içerik temizlenmelidir. Domain uzmanı kritik örnekleri doğrulamalıdır. Learning curve yeni verinin gerçekten fayda sağlayıp sağlamadığını gösterir.
Kurumsal Veriyi Eğitimden Önce Yönetin
Data owner, usage right ve classification bilgisi belirlenmelidir. PII ve secret temizlenmelidir. Dataset lineage korunmalıdır. Versioning ve approval uygulanmalıdır. Governance olmayan training kısa vadede hızlı görünse de uzun vadede büyük risk yaratır.
PEFT ile Küçük ve Ölçülebilir Başlayın
LoRA veya QLoRA pilot maliyetini düşürür. Küçük dataset ve tek use case ile başlamak debugging'i kolaylaştırır. Base model ve adapter version açık tutulur. Benchmark sonucu yeterliyse daha büyük training gerekmeyebilir. Production complexity kontrollü büyür.
Evaluation'ı Eğitimden Önce Tasarlayın
Test set ve rubric training sonucu görülmeden hazırlanmalıdır. Baseline aynı kriterlerle ölçülür. Holdout contamination'dan korunur. Safety ve business metric birlikte değerlendirilir. Sonuçlara göre kriter değiştirmekten kaçınılır.
Güvenlik ve Compliance'ı Sonradan Eklemeyin
Data processing ve model artifact güvenliği ilk mimari karardan itibaren planlanmalıdır. PII cleaning, encryption ve access control training pipeline'ın parçası olmalıdır. Third-party provider sözleşmeleri incelenmelidir. Safety evaluation production gate içinde bulunmalıdır. Güvenlik ayrı son kontrol değil yaşam döngüsü disiplinidir.
Model ile Birlikte Dataset'i de Versionlayın
Hangi modelin hangi veriyle eğitildiği her zaman bilinebilmelidir. Dataset hash, code commit ve base model revision kaydedilmelidir. Retraining lineage açık tutulur. Rollback doğru artifact'a yapılır. Audit ve incident süreçleri büyük ölçüde kolaylaşır.
Production Feedback'ini Yeni Eğitim Verisine Dönüştürün
Hatalı production cevapları değerli training sinyalidir. Ancak doğrudan dataset'e eklenmemelidir. İnsan düzeltmesi ve privacy temizliği uygulanmalıdır. Yeni dataset version kontrollü oluşturulur. Retraining aynı evaluation pipeline'dan geçer.
Fine-Tuning'i Tek Seferlik Eğitim Değil Sürekli Bir LLMOps Süreci Olarak Yönetin
Model release sonrasında kullanıcı davranışı ve domain değişmeye devam eder. Monitoring, drift detection ve feedback sürekli çalışmalıdır. Retraining gerektiğinde reproducible pipeline devreye girer. Model registry, safety gate ve canary rollout her sürümde uygulanır. Böylece fine-tuning bir demo çalışması olmaktan çıkar ve güvenli, ölçülebilir, sürdürülebilir kurumsal AI operasyonuna dönüşür.
share: