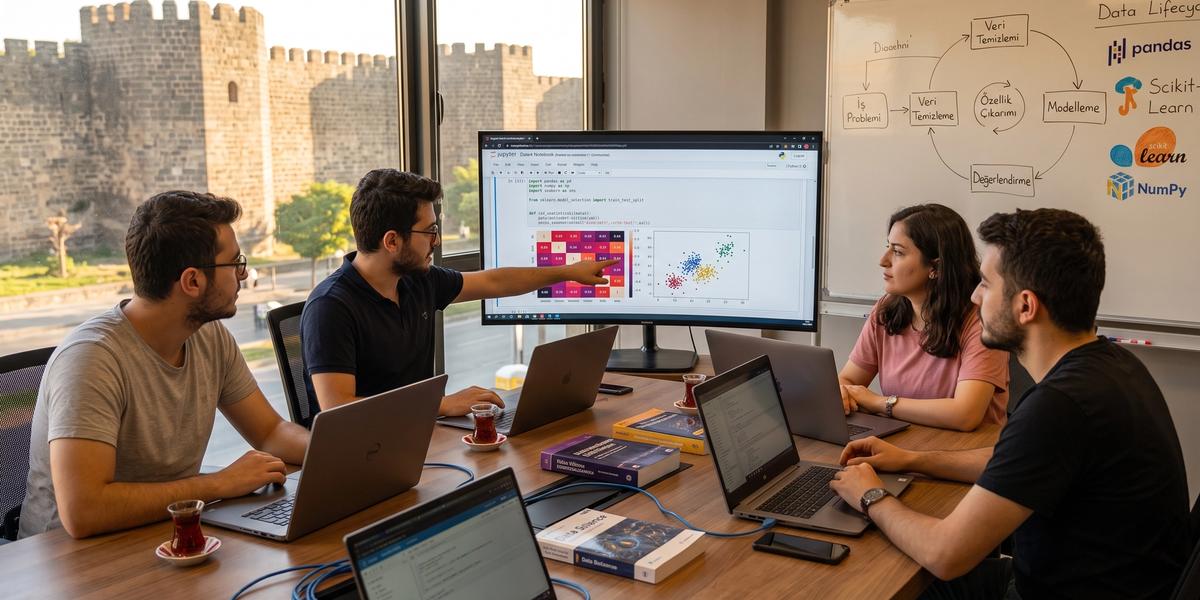
Veri Madenciliği (Data Mining) Süreçlerinde Python Kütüphaneleri

Diyarbakır Yazılım
16.08.2026
#Yazılım#Teknoloji#Topluluk
Elinizde binlerce ya da milyonlarca satır veri olabilir, fakat bu verinin tek başına iş değeri üretmesi beklenmemelidir. Asıl değer, verideki örüntüleri bulduğunuzda, doğru soruları sorduğunuzda ve çıkan sonucu gerçek bir karara dönüştürdüğünüzde ortaya çıkar. Veri Madenciliği (Data Mining) Süreçlerinde Python Kütüphaneleri tam bu noktada veri toplama, temizleme, analiz, modelleme ve görselleştirme adımlarını tek bir ekosistem içinde birleştirir. Yaklaşık on yıllık veri ve yazılım projelerinde en sık gördüğüm hata, ekiplerin önce algoritma seçip iş problemini daha sonra tanımlamasıdır; oysa iyi bir veri madenciliği projesi her zaman açık bir problem tanımıyla başlamalıdır. Bu rehberde Python ile veri madenciliği nasıl yapılır, veri madenciliği için en iyi Python kütüphaneleri nelerdir ve Pandas Scikit-learn NumPy ve Matplotlib ile veri madenciliği süreçleri nasıl uçtan uca tasarlanır sorularına uygulamaya dönük yanıtlar bulacaksınız.
Veri Madenciliği Nedir?
Veri madenciliği, büyük veya karmaşık veri kümeleri içinden anlamlı örüntüler, ilişkiler ve tahmin gücü taşıyan yapılar çıkarmayı amaçlayan analitik süreçtir. Bu süreç yalnızca model eğitmekten ibaret değildir çünkü veri kalitesi, değişken seçimi, problem tanımı ve sonuçların yorumlanması aynı derecede önem taşır. İşletmeler veri madenciliğini müşteri segmentasyonu, churn tahmini, satış analizi, anomali tespiti ve ürün birliktelikleri gibi çok farklı problemler için kullanabilir. Teknik tarafta istatistik, makine öğrenmesi ve veri manipülasyonu bir arada çalışır. Başarılı projelerde model sonucu doğrudan bir karar, süreç veya ürün özelliğiyle ilişkilendirilir.
Veri Madenciliğinin Temel Amacı
Veri madenciliğinin temel amacı ham veriden karar vermeyi kolaylaştıracak yapılar çıkarmaktır. Bir e-ticaret işletmesi müşterilerin hangi ürünleri birlikte aldığını anlayabilir, bir finans ekibi sıra dışı işlemleri belirleyebilir veya bir üretim sistemi arıza riskini daha erken tahmin edebilir. Buradaki amaç yalnızca yüksek doğruluklu model kurmak değildir. Modelin iş problemine katkısı, maliyet etkisi ve açıklanabilirliği de değerlendirilmelidir. Bu nedenle veri madenciliği teknik bir çalışma kadar iş analizi ve sonuç yorumlama disiplinidir.
Veri Madenciliği, Veri Bilimi ve Makine Öğrenmesi Arasındaki Fark
Veri bilimi, veri toplama, analiz, modelleme, deney tasarımı ve sonuçların iletişimi gibi geniş bir çalışma alanını kapsar. Veri madenciliği bu alanın içinde özellikle örüntü, ilişki ve tahmin keşfine odaklanır. Makine öğrenmesi ise veriden öğrenen algoritmaların geliştirilmesi ve uygulanmasıyla daha yakından ilişkilidir. Bir projede üç kavram aynı anda kullanılabilir ve pratikte aralarındaki sınırlar her zaman keskin değildir. Önemli olan, kullanılan yöntemin iş problemine neden uygun olduğunu açık biçimde anlatabilmektir.
Veri Madenciliğinde Kullanılan Temel Teknikler
Veri madenciliğinde kullanılan teknikler problemin türüne göre değişir. Sınıflandırma ve regresyon etiketli veriyle tahmin yaparken kümeleme etiketsiz veride doğal grupları bulmaya çalışır. Birliktelik kuralları ürün veya olayların birlikte görülme örüntülerini analiz eder. Anomali tespiti normal davranıştan farklı kayıtları belirlemeye odaklanır. Boyut indirgeme ise çok sayıda değişkeni daha yönetilebilir bir temsil alanına dönüştürmeye yardımcı olur.
Sınıflandırma
Sınıflandırma, bir gözlemi önceden tanımlanmış sınıflardan birine atama problemidir. Müşterinin churn edip etmeyeceğini, bir e-postanın spam olup olmadığını veya bir işlemin riskli olup olmadığını tahmin etmek bu kapsama girer. Scikit-learn içinde lojistik regresyon, karar ağaçları, random forest ve farklı sınıflandırıcılar bulunur. Başarı yalnızca accuracy ile ölçülmemeli, özellikle dengesiz veri setlerinde precision, recall ve F1 gibi metrikler kullanılmalıdır. Modelin yanlış sınıflandırma maliyeti de iş açısından ayrıca değerlendirilmelidir.
Regresyon
Regresyon, sürekli sayısal bir değeri tahmin etmeyi amaçlar. Ev fiyatı, satış miktarı, talep veya müşteri yaşam boyu değeri örnek verilebilir. Linear regression basit ve açıklanabilir başlangıç sağlar. Daha karmaşık ilişkiler için gradient boosting veya tree tabanlı modeller kullanılabilir. MAE, RMSE ve R² gibi metrikler model performansını farklı açılardan gösterir.
Kümeleme
Kümeleme, etiket bulunmayan veri içinde benzer gözlemleri gruplamaya çalışır. Müşteri segmentasyonu bu yöntemin en yaygın kullanım alanlarından biridir. K-Means hızlı ve anlaşılır bir başlangıç sunarken DBSCAN yoğunluk temelli farklı yapıdaki kümeleri bulabilir. Küme sayısı ve ölçekleme sonucu belirgin biçimde etkiler. Silhouette Score gibi metrikler teknik değerlendirme sunarken gerçek iş anlamı ayrıca incelenmelidir.
Birliktelik Kuralları
Birliktelik kuralları farklı öğelerin birlikte görülme eğilimini analiz eder. Market sepet analizi bunun klasik örneğidir. “A ürününü alan müşterilerin ne kadarı B ürününü de alıyor?” sorusu support, confidence ve lift gibi metriklerle değerlendirilebilir. Apriori ve FP-Growth sık kullanılan algoritmalardır. Sonuçlar çapraz satış, paketleme ve kampanya tasarımında kullanılabilir.
Anomali Tespiti
Anomali tespiti çoğunluk davranışından farklı görünen kayıtları bulmaya odaklanır. Finansal dolandırıcılık, sistem hatası veya sensör bozukluğu bu yöntemle araştırılabilir. Isolation Forest ve Local Outlier Factor Scikit-learn içinde kullanılabilecek seçeneklerdir. Anomali her zaman hata anlamına gelmez ve insan değerlendirmesi gerekebilir. Threshold seçimi false positive oranını ciddi biçimde etkiler.
Boyut İndirgeme
Boyut indirgeme çok sayıda özelliği daha az sayıda yeni değişkenle temsil etmeyi amaçlar. PCA en bilinen yöntemlerden biridir. Görselleştirme, gürültü azaltma ve bazı modellerde training süresini düşürme amacıyla kullanılabilir. Bileşenlerin açıklanan varyans oranı değerlendirilmelidir. Çok fazla bilgi kaybı oluşturacak agresif indirgeme model kalitesini düşürebilir.
Veri Madenciliği İçin Neden Python?
Python, veri madenciliği projelerinde hem başlangıç kolaylığı hem de geniş kütüphane desteği nedeniyle güçlü bir seçenektir. Aynı dil içinde veri okuma, temizleme, istatistik, makine öğrenmesi, görselleştirme ve API geliştirme yapılabilir. Bu durum notebook ortamında başlayan bir deneyi production servisine taşımayı kolaylaştırır. Ayrıca geniş açık kaynak topluluğu sayesinde pek çok yöntem için güvenilir referans ve örnek bulunur. Python veri analizi ve veri madenciliği danışmanlığı yakınımda şeklinde hizmet arayan kurumların da genellikle bu ekosistemi tercih etmesinin temel nedenlerinden biri, geliştirme ve bakım ekosisteminin genişliğidir.
Python'ın Veri Madenciliğindeki Avantajları
Python okunabilir sözdizimi sayesinde veri analizi kodlarının ekip içinde daha kolay paylaşılmasını sağlar. NumPy ve Pandas temel veri manipülasyonunu, Scikit-learn modelleme işlerini, Matplotlib ve Seaborn ise görselleştirmeyi karşılar. Notebook kullanımı keşifsel analizde hızlı geri bildirim verir. API, batch job ve pipeline geliştirirken aynı dilin kullanılabilmesi geçiş maliyetini azaltır. Buna rağmen performans kritik bazı işlemlerde Polars, PySpark veya native extension gibi seçenekler değerlendirilmelidir.
Python Ekosisteminin Gücü
Python ekosisteminin en önemli avantajı farklı aşamaların birbiriyle uyumlu kütüphaneler üzerinden ilerlemesidir. Pandas DataFrame çıktısı kolayca Scikit-learn pipeline'ına verilebilir. NumPy array yapısı neredeyse bütün bilimsel kütüphanelerde ortak temel olarak kullanılır. Plotting, model evaluation ve feature engineering araçları aynı geliştirme ortamında bulunabilir. Bu bütünlük veri madenciliği projelerinde prototipten production'a geçişi önemli ölçüde hızlandırır.
Python Veri Madenciliği İçin En İyi Programlama Dili mi?
Tek bir “en iyi” programlama dili bütün veri madenciliği problemleri için geçerli değildir. Python geniş kullanım alanı ve öğrenme kolaylığı nedeniyle güçlü genel amaçlı seçimdir. R istatistiksel analiz ve akademik çalışma tarafında güçlüdür. Java yüksek performanslı kurumsal backend sistemlerinde avantaj sağlayabilir. SQL ise structured data üzerinde vazgeçilmezdir ve pratikte Python ile birlikte kullanılmalıdır.
Python vs R
R istatistiksel modelleme ve veri görselleştirme konusunda güçlü geçmişe sahiptir. Python ise veri bilimi dışında backend, otomasyon ve MLOps gibi alanlarla daha rahat bütünleşir. Araştırma ağırlıklı ekip R'ı tercih edebilir. Production entegrasyonu yoğun projelerde Python çoğu zaman daha esnek olur. En doğru seçim ekip deneyimi ve mevcut teknoloji yığınına göre yapılmalıdır.
Python vs Java
Java büyük ölçekli enterprise backend sistemlerinde güçlü performans ve olgun deployment yapısı sunar. Python veri analizi ve model geliştirme hızında daha avantajlıdır. Pek çok kurum modeli Python ile geliştirip Java servisinden çağırabilir. Bu iki dil birbirinin alternatifi olmak zorunda değildir. Mimari karar, latency, ekip yapısı ve mevcut uygulama altyapısına göre verilmelidir.
Python vs SQL
SQL structured veri seçme, filtreleme ve aggregation işlemleri için çok etkilidir. Python daha karmaşık feature engineering, modelleme ve görselleştirme sağlar. Büyük veriyi gereksiz yere database dışına çıkarmak performans problemi oluşturabilir. Ön işlemenin bir bölümü SQL içinde yapılabilir. En iyi sonuç çoğu zaman SQL ve Python'ın birlikte kullanılmasıyla elde edilir.
Hangi Durumlarda Python Tercih Edilmeli?
Python veri hazırlama, makine öğrenmesi ve görselleştirmenin aynı projede gerektiği durumlarda güçlü tercihtir. Hızlı proof of concept geliştirmek isteyen ekipler için uygundur. Açık kaynak model ve kütüphanelere kolay erişim sağlar. API ve otomasyon katmanına geçiş de rahattır. Ancak terabaytlarca veri tek makinede işlenecekse Pandas yerine dağıtık veya daha verimli veri motorları düşünülmelidir.
Veri Madenciliği Süreci Nasıl İlerler?
Veri madenciliği projesi yalnızca veri setini açıp model eğiterek ilerlememelidir. İş problemi, veri kalitesi ve deployment hedefi baştan düşünülmelidir. CRISP-DM bu süreci sistematik hale getiren yaygın yöntemlerden biridir. KDD ise knowledge discovery bakış açısıyla veri seçme, temizleme, dönüştürme ve örüntü bulma aşamalarını ele alır. İki çerçeve de teknik çalışmayı iş hedefiyle bağlamaya yardımcı olur.
CRISP-DM Modeli
CRISP-DM veri madenciliği projelerini iş anlayışı, veri anlayışı, veri hazırlama, modelleme, değerlendirme ve deployment olarak aşamalara ayırır. Bu yapı lineer olmak zorunda değildir. Modelleme sırasında fark edilen veri problemi nedeniyle veri hazırlama aşamasına geri dönülebilir. İş problemi değişirse bütün proje yeniden değerlendirilebilir. Bu iteratif yapı gerçek veri projelerine oldukça uygundur.
İş Problemini Anlama
İlk aşamada hangi kararın iyileştirileceği açıkça tanımlanmalıdır. “Churn modeli yapalım” yerine “yüksek riskli müşterileri kampanya öncesinde belirleyelim” daha iyi problemdir. Success metric ve business KPI belirlenmelidir. Model çıktısını kimin kullanacağı net olmalıdır. Problem doğru tanımlanmazsa teknik başarı gerçek değer üretmeyebilir.
Veriyi Anlama
Veri kaynakları, kolon anlamları ve kalite sorunları analiz edilir. Eksik değer, aykırı kayıt ve tarih aralığı incelenir. Target leakage riski araştırılır. Kategori dağılımları ve temel istatistikler çıkarılır. Bu aşama çoğu zaman model seçiminden daha fazla zaman alır.
Veri Hazırlama
Eksik değer doldurma, encoding, normalization ve feature creation burada yapılır. Data leakage olmaması için train ve test ayrımı doğru noktada uygulanmalıdır. Tekrarlanan kayıtlar temizlenebilir. İş kurallarına göre hatalı kayıtlar çıkarılabilir. Pipeline kullanımı bu adımları tekrar edilebilir hale getirir.
Modelleme
Baseline model ile başlanmalıdır. En karmaşık algoritma ilk seçenek olmamalıdır. Birden fazla model aynı split üzerinde karşılaştırılabilir. Hyperparameter optimization son aşamada yapılmalıdır. Modelleme süreci iş metriğine uygun evaluation ile desteklenmelidir.
Değerlendirme
Model teknik metric ve business impact açısından incelenir. Validation başarısı test set üzerinde doğrulanır. Dengesiz sınıflarda accuracy tek başına yeterli değildir. Hata analizi yapılmalıdır. Modelin production kullanımında hangi riskleri oluşturabileceği ayrıca değerlendirilmelidir.
Yayına Alma
Model API, batch job veya dashboard içinde kullanılabilir. Production input'larının training ile aynı preprocessing pipeline'ından geçmesi gerekir. Monitoring kurulmalıdır. Model drift ve veri kalitesi izlenmelidir. Deployment sonrası kullanıcı feedback'i yeni model geliştirmesine girdi sağlar.
KDD Süreci
KDD, Knowledge Discovery in Databases yaklaşımıyla veri içinden anlamlı bilginin çıkarılmasına odaklanır. Veri seçimi, preprocessing, transformation, data mining ve interpretation gibi aşamalar içerir. CRISP-DM'e göre iş süreci tarafı daha az belirgin olabilir. Akademik ve metodolojik anlatımlarda sık kullanılır. Pratik projede iki yaklaşım birlikte düşünülerek teknik ve iş adımları dengelenebilir.
CRISP-DM ve KDD Arasındaki Fark
CRISP-DM iş problemini ve deployment'ı daha açık biçimde merkeze alır. KDD bilgi keşfi sürecinin teknik adımlarına daha fazla odaklanır. İki yaklaşım birbirini dışlamaz. Veri temizleme, dönüşüm ve modelleme her ikisinde de önemlidir. Kurumsal projelerde CRISP-DM'in iş odaklı yapısı ekip iletişimini kolaylaştırabilir.
Veri Madenciliği Süreçlerinde Kullanılan Python Kütüphaneleri
Veri Madenciliği (Data Mining) Süreçlerinde Python Kütüphaneleri denildiğinde tek bir paket yerine birbirini tamamlayan bir araç setinden söz etmek gerekir. NumPy sayısal temeli sağlar, Pandas tablo verisini yönetir ve SciPy istatistiksel hesaplamaları destekler. Matplotlib, Seaborn ve Plotly görsel analiz katmanını oluşturur. Scikit-learn ise preprocessing, modelleme ve evaluation süreçlerini ortak bir API altında birleştirir. Bu kütüphaneler doğru sırayla kullanıldığında Python ile veri temizleme özellik çıkarımı kümeleme ve sınıflandırma yöntemleri oldukça yönetilebilir hale gelir.
NumPy: Sayısal Hesaplamanın Temeli
NumPy Python veri ekosisteminin temel sayısal kütüphanelerinden biridir. Çok boyutlu array yapısı, vektörleştirilmiş işlemler ve matematik fonksiyonları sunar. Pandas ve Scikit-learn dahil birçok kütüphane NumPy yapılarından yararlanır. Büyük döngüler yerine vectorized operation kullanmak önemli hız avantajı sağlar. Veri madenciliği projelerinde doğrudan veya diğer kütüphanelerin altında sürekli kullanılır.
ndarray Yapısı
ndarray sabit tipte çok boyutlu veri saklayan temel NumPy yapısıdır. Python listelerine göre sayısal işlemlerde daha verimlidir. Shape, dtype ve axis kavramları iyi öğrenilmelidir. Matrix ve tensor benzeri veriler rahatça temsil edilir. ML pipeline'larının çoğu ndarray girdisini doğrudan kabul eder.
Vektör ve Matris İşlemleri
NumPy vektör ve matris işlemlerini kısa ve hızlı kodla yapmayı sağlar. Dot product, transpose ve element-wise operasyonlar temel örneklerdir. Feature matrix çoğu ML probleminde NumPy array olarak temsil edilir. Python loop yerine vectorized işlem tercih edilir. Bu yaklaşım hem performansı hem kod okunabilirliğini artırır.
Broadcasting
Broadcasting farklı shape yapılarındaki array'lerin belirli kurallarla birlikte işlem yapmasını sağlar. Bir matrix'in her satırından aynı mean vector çıkarılabilir. Bu özellik normalization ve feature transformation işlemlerini kolaylaştırır. Shape uyumluluğu anlaşılmazsa beklenmeyen sonuç üretilebilir. Debug sırasında array shape'lerini kontrol etmek önemli alışkanlıktır.
NumPy Ne Zaman Kullanılmalı?
Yoğun sayısal hesaplama, matrix operation ve custom feature transformation gereken durumlarda NumPy doğrudan kullanılabilir. Tablo metadata ve column label önemliyse Pandas daha kullanışlıdır. Model input'unu düşük seviyede kontrol etmek istendiğinde NumPy avantaj sağlar. Scientific computing kütüphaneleriyle uyumludur. Performans kritik hesaplamalarda Python listelerine göre güçlü seçimdir.
Pandas: Veri Toplama, Temizleme ve Manipülasyon
Pandas veri madenciliği projelerinde en sık kullanılan kütüphanelerden biridir. CSV, Excel, JSON ve SQL kaynaklarından veri almayı kolaylaştırır. Eksik değer, duplicate, filtreleme ve join işlemleri güçlü DataFrame API'siyle yönetilir. EDA ve preprocessing aşamalarında büyük zaman kazandırır. Buna karşılık veri tek makine belleğini aşıyorsa Polars, Dask veya PySpark gibi alternatiflere geçmek gerekebilir.
Series ve DataFrame
Series tek boyutlu etiketli veri yapısıdır. DataFrame ise satır ve sütunlardan oluşan iki boyutlu tablo yapısıdır. Column name ve index sayesinde veri daha okunabilir hale gelir. Filtreleme ve aggregation işlemleri oldukça rahattır. Çoğu veri madenciliği projesi DataFrame yapısı üzerinden ilerler.
CSV, Excel, JSON ve SQL Verilerini Okuma
Pandas farklı kaynaklardan veri okumak için hazır fonksiyonlar sunar. read_csv ve read_excel sık kullanılan seçeneklerdir. read_sql ile database sorgusu sonucu DataFrame'e alınabilir. JSON veriler normalize edilebilir. Çok büyük kaynaklarda chunk-based okuma tercih edilmelidir.
Eksik Verilerin Yönetimi
Eksik değerler drop, fill veya model tabanlı yöntemlerle ele alınabilir. Önce eksikliğin neden oluştuğu anlaşılmalıdır. Basit mean veya median doldurma her kolon için doğru olmayabilir. Missingness kendi başına bilgi taşıyabilir. Scikit-learn imputer ile pipeline içinde preprocessing yapmak data leakage riskini azaltır.
Tekrarlanan Verilerin Temizlenmesi
Duplicate kayıtlar analiz sonucunu bozabilir. Pandas duplicated ve drop_duplicates fonksiyonlarıyla kolay kontrol sağlar. Exact duplicate yanında business key duplicate ayrıca incelenmelidir. Aynı müşterinin farklı sistemlerde farklı id ile bulunması daha ileri entity resolution gerektirebilir. Temizleme kuralı belgelenmelidir.
Filtreleme, Gruplama ve Birleştirme
Boolean filtering belirli koşulları sağlayan satırları seçer. groupby aggregation analizde sık kullanılır. merge ve join farklı tabloları ortak anahtar üzerinden birleştirir. Yanlış join cardinality duplicate satır üretebilir. Birleştirme öncesi key uniqueness kontrol edilmelidir.
Pandas Ne Zaman Kullanılmalı?
Veri tek makine belleğine sığıyorsa ve tablo formatında ise Pandas çok güçlü seçenektir. Hızlı EDA ve preprocessing için uygundur. Notebook tabanlı analizde kullanım kolaylığı sağlar. Çok büyük data veya yüksek paralellik ihtiyacında sınırlarına ulaşabilir. Bu durumda Polars, Dask veya Spark düşünülmelidir.
SciPy: Bilimsel ve İstatistiksel Hesaplamalar
SciPy NumPy üzerine kurulu bilimsel hesaplama kütüphanesidir. İstatistik, optimizasyon, sinyal işleme ve mesafe hesaplama araçları sunar. Veri madenciliği projelerinde hypothesis test ve optimization gibi ihtiyaçlarda değerli olabilir. NumPy array ile doğal biçimde çalışır. Her projede zorunlu değildir ancak daha ileri analizlerde önemli boşlukları doldurur.
İstatistiksel Fonksiyonlar
SciPy.stats dağılımlar, testler ve descriptive statistics araçları sağlar. T-test, chi-square ve normality test gibi yöntemler uygulanabilir. İstatistiksel anlamlılık iş anlamlılığıyla karıştırılmamalıdır. Sample size sonucu etkiler. Varsayımlar test öncesi kontrol edilmelidir.
Optimizasyon
SciPy optimization modülü farklı objective function'ları optimize edebilir. Parametre tahmini ve custom problem çözümünde kullanılabilir. Constraint tanımlanabilir. Başlangıç noktası sonucu etkileyebilir. Optimization failure durumları ayrıca kontrol edilmelidir.
Mesafe ve Benzerlik Hesaplamaları
Euclidean, cosine ve farklı distance metric'leri SciPy içinde bulunur. Clustering ve nearest-neighbor analizlerinde kullanılabilir. Feature scale distance sonucunu ciddi biçimde etkiler. Standardization gerekebilir. Problem türüne göre uygun metric seçilmelidir.
Matplotlib: Temel Veri Görselleştirme
Matplotlib Python'da temel plotting altyapısını sağlar. Histogram, scatter, line ve bar chart gibi grafikler üretilebilir. Veri dağılımını görmek ve model hatalarını incelemek için çok değerlidir. Düşük seviyede geniş özelleştirme sunar. Seaborn ve bazı diğer görselleştirme kütüphaneleri de Matplotlib üzerine inşa edilmiştir.
Histogram
Histogram sayısal değişkenin dağılımını gösterir. Skewness ve çoklu mod gibi yapılar kolay fark edilir. Bin sayısı görsel yorumu etkiler. Aykırı değerler ayrıca incelenebilir. Feature transformation ihtiyacı histogram üzerinden anlaşılabilir.
Scatter Plot
Scatter plot iki sayısal değişken arasındaki ilişkiyi görselleştirir. Korelasyon, cluster ve outlier gözlemlenebilir. Çok fazla veri noktasında transparency kullanılabilir. Color üçüncü bir kategoriyi gösterebilir. Non-linear ilişkiler model seçiminde ipucu verir.
Box Plot
Box plot median, quartile ve olası outlier değerleri gösterir. Kategoriler arasındaki dağılım farklarını karşılaştırmak için kullanışlıdır. Aykırı nokta otomatik olarak hatalı veri anlamına gelmez. Domain bilgisiyle değerlendirilmelidir. Preprocessing kararları bu grafikle desteklenebilir.
Line ve Bar Grafikler
Line chart zaman serisi trendlerini göstermede etkilidir. Bar chart kategorik karşılaştırmalar için kullanılır. Axis ölçeği yanlış seçilirse görsel yanıltıcı olabilir. Çok fazla kategori okunabilirliği düşürür. Grafikler karar vericinin anlayacağı sadelikte hazırlanmalıdır.
Seaborn: İstatistiksel Görselleştirme
Seaborn Matplotlib üzerinde daha yüksek seviyeli ve istatistik odaklı grafik API'si sunar. DataFrame ile doğrudan çalışması keşifsel analizde büyük kolaylık sağlar. Distribution, categorical ve correlation grafiklerini az kodla oluşturur. Default style görsel olarak güçlüdür. Karmaşık özelleştirme gerektiğinde Matplotlib API'sine erişilebilir.
Korelasyon Isı Haritaları
Heatmap feature correlation matrix'ini görsel olarak gösterir. Yüksek ilişkili değişkenler hızlı fark edilir. Korelasyon nedensellik anlamına gelmez. Categorical feature'lar için farklı ilişki ölçüleri gerekebilir. Multicollinearity analizi model türüne göre yapılmalıdır.
Dağılım Analizi
Seaborn histplot, kdeplot ve violinplot gibi seçenekler sunar. Feature distribution class bazında incelenebilir. Train ve test dağılımı karşılaştırılabilir. Drift sinyalleri görsel olarak görülebilir. Grafik yalnızca decoration değil veri quality aracı olarak kullanılmalıdır.
Kategorik Veri Görselleştirme
Countplot ve boxplot kategoriler arasındaki farkları gösterebilir. Class imbalance hızlı fark edilir. Target rate category bazında analiz edilebilir. Çok cardinality olan alanlarda grouping gerekebilir. Görsel analiz feature engineering kararlarını destekler.
Matplotlib vs Seaborn
Matplotlib daha düşük seviyeli kontrol sağlar. Seaborn istatistiksel grafiklerde daha hızlı başlangıç sunar. İki kütüphane aynı projede birlikte kullanılabilir. Seaborn plot'u Matplotlib üzerinden özelleştirilebilir. Ekip genellikle her ikisinin temel kullanımını öğrenmelidir.
Plotly: Etkileşimli Veri Görselleştirme
Plotly kullanıcı etkileşimli grafikler üretmeye odaklanır. Zoom, hover ve filtering gibi özellikler özellikle dashboard kullanımında değerlidir. Büyük veri setlerinde browser rendering sınırı dikkate alınmalıdır. Python notebook ve web uygulamalarına entegre edilebilir. İş birimleriyle analiz paylaşırken statik grafiklerden daha güçlü keşif deneyimi sağlayabilir.
İnteraktif Grafiklerin Avantajları
Kullanıcı belirli noktaya hover yaparak ek bilgi görebilir. Zoom ile yoğun veri alanları incelenebilir. Filter ve legend interaction keşif hızını artırır. Tek grafik üzerinden farklı segmentler analiz edilebilir. Buna karşılık çok karmaşık etkileşim kullanıcıyı yorabilir.
Dashboard Kullanım Senaryoları
Model metric, satış analizi ve segmentasyon çıktıları dashboard üzerinden paylaşılabilir. Plotly Dash veya farklı web framework'leri kullanılabilir. Dashboard yalnızca rapor değil monitoring aracı olabilir. Data refresh ve permission yönetilmelidir. Kritik metriklerin tanımı kullanıcıya açık olmalıdır.
Scikit-learn ile Veri Madenciliği
Scikit-learn klasik makine öğrenmesi ve veri madenciliği projelerinde en güçlü Python kütüphanelerinden biridir. Preprocessing, classification, regression, clustering, anomaly detection ve model selection araçlarını ortak API altında sunar. Fit, transform ve predict yapısı öğrenildiğinde farklı algoritmalar arasında geçiş kolaylaşır. Pipeline ve ColumnTransformer veri hazırlama ile modeli tek akışta birleştirir. Bu nedenle Pandas Scikit-learn NumPy ve Matplotlib ile veri madenciliği öğrenen biri için Scikit-learn modelleme tarafının doğal merkezidir.
Scikit-learn Nedir?
Scikit-learn NumPy ve SciPy ekosistemi üzerine kurulu klasik makine öğrenmesi kütüphanesidir. Çok sayıda supervised ve unsupervised algoritma içerir. API yapısı tutarlıdır. Model evaluation ve cross validation araçları bulunur. Deep learning için ana araç değildir, ancak tabular veri projelerinin büyük bölümünde yeterlidir.
Veri Ön İşleme Araçları
Scikit-learn preprocessing modülü scaling, encoding ve imputation işlemleri sağlar. Bu adımlar pipeline içine alınabilir. Train ve test üzerinde aynı transformation uygulanır. Leakage riski azalır. Production preprocessing ile training preprocessing aynı object üzerinden yönetilebilir.
StandardScaler
StandardScaler feature'ları ortalaması sıfır ve standard deviation değeri bir olacak şekilde dönüştürür. Distance-based ve linear modellerde yararlı olabilir. Tree modeller için çoğu zaman gerekli değildir. Scaler yalnızca training verisinde fit edilmelidir. Pipeline bunu otomatik güvenli hale getirir.
MinMaxScaler
MinMaxScaler değerleri belirli aralığa dönüştürür. Neural network veya bounded input gerektiren yöntemlerde kullanılabilir. Outlier değerlerden etkilenebilir. Train üzerinde fit edilmelidir. New production value range dışına çıkabilir.
OneHotEncoder
OneHotEncoder kategorik değişkenleri binary kolonlara dönüştürür. Nominal kategoriler için yaygındır. High-cardinality feature çok fazla kolon üretebilir. handle_unknown parametresi production için önemlidir. ColumnTransformer içinde rahatça kullanılabilir.
LabelEncoder
LabelEncoder genellikle target label'ları sayısal hale getirmek için kullanılır. Feature encoding için doğrudan tercih etmek kategorilere yapay sıra verebilir. Classification class isimleri kolayca dönüştürülebilir. inverse_transform original label'a dönüş sağlar. Kullanım amacı doğru anlaşılmalıdır.
Eğitim ve Test Verisinin Ayrılması
train_test_split veriyi eğitim ve test olarak ayırmayı kolaylaştırır. Stratify classification class oranını koruyabilir. Zaman serisi verisinde random split uygun olmayabilir. Test set model selection sürecinde sürekli kullanılmamalıdır. Ayrı validation veya cross validation tercih edilebilir.
Gözetimli Öğrenme
Supervised learning input ve target label birlikte kullanır. Model training sırasında bu eşleşmeden öğrenir. Classification ve regression iki ana problem türüdür. Train-test ayrımı gerekir. Evaluation metric iş problemine uygun seçilmelidir.
Classification
Classification discrete label tahmin eder. Logistic Regression, Random Forest ve SVM gibi seçenekler kullanılabilir. Imbalanced dataset özel dikkat gerektirir. Probability calibration bazı use case'lerde önemlidir. Confusion matrix hata türlerini anlamayı kolaylaştırır.
Regression
Regression continuous target tahmin eder. Linear Regression basit baseline'dır. Random Forest Regressor ve Gradient Boosting nonlinear ilişkilerde güçlüdür. Target transformation gerekebilir. Residual analysis model hatalarının yapısını gösterir.
Gözetimsiz Öğrenme
Unsupervised learning target label olmadan veri içindeki yapıları keşfeder. Clustering en yaygın kullanım alanıdır. Scale ve distance metric sonuç üzerinde önemlidir. Teknik cluster her zaman iş segmenti anlamına gelmez. Sonuç domain uzmanlarıyla yorumlanmalıdır.
K-Means
K-Means veriyi belirli K sayıda cluster'a ayırır. Cluster center'ları minimize edilen mesafeye göre belirlenir. Feature scaling önemlidir. K sayısı elbow ve silhouette ile incelenebilir. Spherical cluster varsayımı her veri için uygun değildir.
DBSCAN
DBSCAN yoğunluk temelli clustering yapar. Cluster sayısını önceden istemez. Noise noktaları ayrı işaretler. Epsilon ve min_samples kritik parametrelerdir. Değişken yoğunluklu veri setlerinde sonuç zorlaşabilir.
Hierarchical Clustering
Hierarchical clustering gözlemler veya cluster'lar arasında hiyerarşi oluşturur. Dendrogram yapısı ilişkileri yorumlamayı kolaylaştırır. Büyük veri setlerinde maliyet artabilir. Distance ve linkage seçimi sonucu değiştirir. Segmentasyon analizi için görsel olarak faydalıdır.
Boyut İndirgeme
Boyut indirgeme feature sayısını azaltmayı amaçlar. Visualization ve model efficiency için kullanılabilir. Information loss kontrol edilmelidir. Scaling çoğu yöntemde önemlidir. PCA klasik başlangıç seçeneğidir.
PCA
PCA en yüksek varyansı açıklayan yeni doğrusal bileşenler üretir. Feature'lar önceden scale edilmelidir. Explained variance ratio kaç bileşen seçileceğine yardımcı olur. Bileşenler original feature kadar kolay yorumlanmayabilir. High-dimensional numeric data için kullanışlıdır.
Anomali Tespiti
Anomaly detection normalden farklı gözlemleri belirler. Fraud, sistem hatası ve kalite kontrol gibi alanlarda kullanılır. Label az olduğunda unsupervised yöntemler değerlidir. Threshold business risk ile belirlenmelidir. İnsan review bazı use case'lerde zorunlu olabilir.
Isolation Forest
Isolation Forest anomalileri random partition ile daha hızlı izole edilen noktalar olarak değerlendirir. High-dimensional tabular data için kullanışlıdır. Contamination parametresi önemli olabilir. Output score threshold ile sınıfa çevrilebilir. Known anomaly set varsa validation yapılmalıdır.
Local Outlier Factor
LOF bir gözlemin yerel yoğunluğunu komşularıyla karşılaştırır. Local anomaly tespitinde etkilidir. Neighbor sayısı sonucu değiştirir. Novelty detection ve training mode farkı anlaşılmalıdır. Büyük veri setinde nearest neighbor maliyeti artabilir.
Birliktelik Kuralları ve Sepet Analizi İçin Python
Sepet analizi ürünlerin birlikte satın alınma örüntülerini ortaya çıkarmak için kullanılır. Association rule mining support, confidence ve lift gibi ölçüler üzerinden ilişkiyi değerlendirir. Python tarafında mlxtend bu çalışma için pratik araçlar sunar. Apriori anlaşılır başlangıç sağlarken FP-Growth daha büyük veri setlerinde daha verimli olabilir. Sonuçlar ürün paketleme, kampanya ve recommendation kararlarına dönüştürülebilir.
Association Rule Mining Nedir?
Association rule mining itemset'ler arasındaki birlikte görülme ilişkilerini analiz eder. “A ürünü varsa B ürünü ne sıklıkta görülüyor?” temel sorudur. Bu ilişki nedensellik anlamına gelmez. Çok sık ürünler yanıltıcı yüksek confidence oluşturabilir. Lift bu nedenle önemli tamamlayıcı metriktir.
Apriori Algoritması
Apriori sık itemset'leri adım adım genişleterek bulur. Anti-monotonicity prensibi search space'i azaltır. Büyük ve yoğun basket dataset'lerinde yavaş olabilir. Minimum support threshold sonucu ciddi biçimde etkiler. Eğitim amaçlı ve orta ölçekli analizlerde oldukça anlaşılırdır.
FP-Growth Algoritması
FP-Growth aday itemset üretmeden sık örüntüleri ağaç yapısıyla bulur. Apriori'ye göre birçok veri setinde daha verimli olabilir. Memory davranışı data distribution'a bağlıdır. Minimum support yine kritik parametredir. Büyük basket analizlerinde güçlü alternatiftir.
mlxtend Kütüphanesi
mlxtend frequent_patterns modülü Apriori ve association_rules araçlarını sunar. Data genellikle one-hot basket matrix formatına dönüştürülür. Support threshold ile frequent itemset çıkarılır. Ardından confidence ve lift gibi metric'ler hesaplanır. Pandas ile doğal biçimde birlikte çalışır.
Frequent Itemsets Oluşturma
Transaction data ürün bazlı boolean matrix'e çevrilir. Her satır sepeti, her kolon ürünü temsil eder. Apriori veya FP-Growth sık kombinasyonları bulur. Minimum support çok düşük seçilirse sonuç sayısı patlayabilir. İş açısından anlamlı threshold belirlenmelidir.
Support
Support belirli itemset'in bütün transaction'lar içinde görülme oranıdır. Çok düşük support nadir ilişkiyi temsil eder. Ancak yüksek değer her zaman değerli kural anlamına gelmez. Campaign use case'e göre minimum seviye seçilir. Seasonality support'u etkileyebilir.
Confidence
Confidence A ürününü içeren sepetlerin ne kadarında B'nin de bulunduğunu gösterir. Yüksek confidence cazip görünür. Ancak B zaten çok popülerse ilişki yanıltıcı olabilir. Lift ile birlikte okunmalıdır. Segment bazlı confidence daha anlamlı olabilir.
Lift
Lift iki ürünün bağımsızlığa göre ne kadar daha sık birlikte görüldüğünü gösterir. Birden büyük değer pozitif association işareti olabilir. Çok küçük support ile yüksek lift dikkatli yorumlanmalıdır. Business relevance kontrol edilmelidir. Kampanya kararında margin ve stock bilgisi de eklenmelidir.
E-Ticaret Sepet Analizi Örneği
Bir e-ticaret sitesinde sipariş satırları transaction id ve product id formatında hazırlanabilir. Basket matrix oluşturulduktan sonra FP-Growth ile sık kombinasyonlar bulunabilir. Örneğin kahve makinesi alanların belirli filtre ürününü de sık satın aldığı görülebilir. Bu ilişki product detail sayfasında cross-sell olarak kullanılabilir. Gerçek ticari etki A/B test ile ölçülmelidir.
Veri Ön İşleme ve Feature Engineering Kütüphaneleri
Model performansının önemli bölümü veri ön işleme ve feature engineering kalitesine bağlıdır. Eksik değer, kategorik veri ve aykırı gözlem doğru ele alınmalıdır. Scaling bazı algoritmalar için zorunludur. Feature selection gereksiz değişkenleri azaltabilir. Imbalanced-learn dengesiz sınıflandırma problemlerinde Scikit-learn ile uyumlu araçlar sunar.
Eksik Verilerin Yönetimi
Eksik değerler önce neden oluştuğuna göre analiz edilmelidir. Basit doldurma her durumda doğru değildir. Numeric için median, kategorik için most frequent seçenek olabilir. Iterative veya KNN imputation daha gelişmiş alternatiflerdir. İmputation pipeline içinde fit edilmelidir.
Aykırı Değerlerin Tespit Edilmesi
Outlier istatistiksel olarak sıra dışı gözlemdir. Her aykırı değer hatalı değildir. IQR, z-score veya model tabanlı yöntemler kullanılabilir. Business rule ile doğrulama önemlidir. Silme kararı target bilgisi kullanılarak verilirse leakage oluşabilir.
Kategorik Verilerin Kodlanması
Model kategorik değerleri çoğu zaman sayısal temsile ihtiyaç duyar. One-hot encoding nominal kategorilerde güvenlidir. Ordinal kategoriler gerçek sıralamaya göre kodlanabilir. High-cardinality durumda target encoding gibi yöntemler değerlendirilebilir. Target encoding yalnızca train fold içinde uygulanmalıdır.
Normalizasyon ve Standardizasyon
Scaling feature'ları karşılaştırılabilir büyüklüğe getirir. StandardScaler mean ve standard deviation kullanır. MinMaxScaler belirli aralığa taşır. Tree-based model çoğu zaman scaling gerektirmez. Distance ve linear model için genellikle faydalıdır.
Özellik Seçimi
Feature selection gereksiz veya zayıf değişkenleri çıkarır. Filter, wrapper ve embedded yöntemler vardır. Mutual information ve model importance kullanılabilir. Feature seçimi cross validation içinde yapılmalıdır. Test set bilgisinin kullanılması leakage yaratır.
Özellik Üretimi
Feature engineering ham veriden daha anlamlı değişken üretir. Tarihten hafta günü, satın alma geçmişinden recency veya frequency çıkarılabilir. Domain bilgisi burada büyük avantaj sağlar. Çok fazla manuel feature overfitting riskini artırabilir. Yeni feature'ın gerçek katkısı ablation test ile ölçülmelidir.
Dengesiz Veri Setleri İçin imbalanced-learn
Imbalanced-learn dengesiz classification dataset'leri için sampling araçları sunar. Scikit-learn pipeline yapısıyla uyumludur. Fraud ve churn gibi azınlık sınıfın önemli olduğu problemler için faydalıdır. Sampling yalnızca training data üzerinde uygulanmalıdır. Test set doğal dağılımını korumalıdır.
Oversampling
Oversampling minority class örneklerini artırır. Basit random duplication yapılabilir. Overfitting riski vardır. Synthetic yöntemler alternatif sunar. Sampling ratio business ve model davranışına göre ayarlanmalıdır.
Undersampling
Undersampling majority class örneklerinin bir kısmını çıkarır. Training hızını artırabilir. Ancak değerli bilgi kaybı oluşturabilir. Çok büyük majority class durumunda kullanışlıdır. Hangi örneklerin çıkarıldığı stratejiye bağlıdır.
SMOTE
SMOTE minority class komşuları arasında sentetik örnekler üretir. Tabular continuous feature'larda sık kullanılır. Kategorik veri için farklı varyantlar gerekebilir. Cross validation fold dışında uygulanmamalıdır. Sentetik örneklerin gerçek iş mantığına aykırı olmadığından emin olunmalıdır.
Modelleme İçin Gelişmiş Python Kütüphaneleri
Scikit-learn güçlü bir temel sunarken bazı problemler için daha gelişmiş kütüphaneler gerekir. XGBoost, LightGBM ve CatBoost özellikle tabular supervised learning görevlerinde yüksek performans sağlar. Statsmodels istatistiksel model açıklaması ve inference tarafında değerlidir. TensorFlow, Keras ve PyTorch deep learning ihtiyaçlarını karşılar. Hangi kütüphanenin seçileceği problem, veri boyutu ve production gereksinimine göre belirlenmelidir.
XGBoost
XGBoost gradient boosted decision tree algoritmasının güçlü ve olgun uygulamasıdır. Tabular classification ve regression problemlerinde sık kullanılır. Missing value ve regularization özellikleri sunar. Hyperparameter tuning gerekebilir. Feature importance ve SHAP ile açıklanabilirlik desteklenebilir.
LightGBM
LightGBM büyük tabular veri setlerinde hızlı gradient boosting sağlar. Histogram tabanlı training kullanır. High-cardinality categorical feature desteği değerlendirilebilir. Memory kullanımı birçok durumda verimlidir. Small dataset'te overfitting kontrol edilmelidir.
CatBoost
CatBoost kategorik değişkenlerle güçlü çalışma yeteneği sunar. Encoding işlemlerinin bir bölümünü model içinde yönetebilir. Default parametrelerle iyi baseline verebilir. Text ve categorical feature desteği bulunur. Training speed ve model size use case'e göre incelenmelidir.
Statsmodels
Statsmodels istatistiksel inference ve açıklanabilir regression modelleri için değerlidir. Coefficient, p-value ve confidence interval gibi çıktılar sağlar. Ekonometrik ve istatistiksel analizlerde güçlüdür. Prediction odaklı projelerde Scikit-learn daha pratik olabilir. İki kütüphane farklı amaçlara hizmet eder.
TensorFlow ve Keras
TensorFlow deep learning için geniş ekosistem sunar. Keras yüksek seviyeli model tanımlama API'si sağlar. Neural network ve representation learning projelerinde kullanılır. Tabular küçük dataset için her zaman gerekli değildir. Serving ve deployment seçenekleri proje mimarisiyle birlikte değerlendirilmelidir.
PyTorch
PyTorch esnek neural network geliştirme ve research ekosistemi sunar. Dynamic computation yapısı deney geliştirmeyi kolaylaştırır. NLP ve computer vision tarafında yaygın kullanılır. Custom loss ve architecture rahat uygulanabilir. Production için TorchScript veya farklı serving seçenekleri kullanılabilir.
Hangi Kütüphane Hangi Problem İçin Kullanılmalı?
Basit tabular problem için Scikit-learn iyi başlangıçtır. Yüksek performanslı boosting gerekiyorsa XGBoost, LightGBM veya CatBoost değerlendirilebilir. İstatistiksel açıklama önemliyse Statsmodels öne çıkar. Görsel, metin veya karmaşık representation learning problemi varsa PyTorch veya TensorFlow daha uygundur. En doğru seçim benchmark ve production TCO üzerinden verilmelidir.
Büyük Veri Madenciliğinde Python
Pandas veri tek makine belleğine sığdığı sürece oldukça etkilidir. Veri büyüdükçe memory ve işlem süresi sınıra ulaşabilir. Polars daha verimli single-node işlemler için, Dask dağıtık veya paralel Pandas benzeri kullanım için değerlendirilebilir. PySpark ise büyük veri kümelerini cluster üzerinde işlemek için güçlü seçenektir. Büyük veri madenciliği için en iyi Python kütüphaneleri nelerdir sorusunun yanıtı bu nedenle veri hacmi ve altyapı tipine bağlıdır.
Pandas'ın Ölçeklenme Sınırları
Pandas çoğu işlemi memory içinde yürütür. Veri RAM'i aşarsa performans ve stability problemi oluşur. Tek thread davranışı bazı operasyonları sınırlar. Chunk processing geçici çözüm olabilir. Daha büyük workload için Polars, Dask veya Spark düşünülmelidir.
Polars
Polars Rust tabanlı yüksek performanslı DataFrame kütüphanesidir. Parallel execution ve query optimization avantajı sağlar. Lazy API büyük veri transformation işlerinde faydalıdır. Pandas'a göre syntax farklılıkları vardır. Tek makinede daha yüksek performans isteyen ekipler için güçlü alternatiftir.
Dask
Dask Pandas ve NumPy benzeri API ile paralel ve dağıtık hesaplama sağlar. Dataset partition'lara bölünür. Local multi-core veya cluster üzerinde çalışabilir. Her Pandas operation birebir aynı performansı vermeyebilir. Task graph ve partition size doğru ayarlanmalıdır.
PySpark
PySpark Apache Spark'ın Python API'sidir. Çok büyük veri kümelerini cluster üzerinde dağıtık işlemek için kullanılır. DataFrame ve Spark SQL güçlü veri transformation özellikleri sağlar. MLlib belirli machine learning algoritmaları sunar. Spark cluster operasyonu ve tuning ayrı uzmanlık gerektirir.
Apache Spark Nedir?
Apache Spark distributed data processing framework'üdür. Büyük veriyi partition'lara bölerek farklı worker node'larda işler. Batch ve streaming use case'leri destekler. In-memory execution birçok işte performans sağlar. Cluster manager ve resource planning gerekir.
Spark DataFrame
Spark DataFrame distributed tabular data abstraction'dır. SQL benzeri transformation yapılabilir. Catalyst optimizer query planı optimize eder. Lazy execution sayesinde işlemler toplu planlanır. Python UDF gereksiz kullanılırsa performans düşebilir.
Spark MLlib
MLlib distributed machine learning araçları sunar. Classification, regression ve clustering algoritmaları bulunur. Spark DataFrame ile çalışır. Çok büyük veri üzerinde training avantajlı olabilir. Daha gelişmiş modeller için dış kütüphane gerekebilir.
Pandas vs Polars vs Dask vs PySpark
Pandas küçük ve orta veri için en kolay başlangıçtır. Polars tek makinede yüksek performans ve memory verimliliği sağlar. Dask Pandas benzeri deneyimi paralel hale getirir. PySpark cluster ölçeğinde büyük veri için daha uygundur. Seçim yalnızca benchmark değil ekip deneyimi ve operasyon maliyetiyle yapılmalıdır.
Veri Madenciliği Pipeline'ı Nasıl Oluşturulur?
Pipeline veri alma, temizleme, feature engineering, training ve evaluation adımlarını tekrar edilebilir hale getirir. Manuel notebook adımları production'da kolayca farklılaşabilir. Scikit-learn Pipeline preprocessing ile modeli tek object olarak yönetir. Bu yapı data leakage riskini azaltır. Python veri madenciliği ve makine öğrenmesi proje geliştirme hizmeti sunulan kurumsal projelerde pipeline tasarımı model algoritmasından en az model kadar önemlidir.
Veriyi Alma
Veri database, API, file veya data warehouse kaynağından gelebilir. Source schema ve tarih aralığı kaydedilmelidir. Raw data mümkünse immutable tutulmalıdır. Training run source snapshot ile ilişkilendirilebilir. Data quality check ingestion sonrasında yapılmalıdır.
Temizleme
Eksik, duplicate ve hatalı kayıtlar belirli kurallarla temizlenir. Rule'lar kod olarak versionlanmalıdır. Manual Excel düzeltmeleri reproducibility'yi bozar. Temizleme raporu üretilebilir. Silinen satır oranı quality metric olarak takip edilebilir.
Feature Engineering
Ham kolonlardan modele daha anlamlı feature'lar üretilir. Tarih, müşteri geçmişi veya davranış aggregation kullanılabilir. Future data kullanılmamalıdır. Feature hesaplama production ile training'de aynı olmalıdır. Feature store büyük sistemlerde yardımcı olabilir.
Model Eğitimi
Baseline model ile başlanır. Training config versionlanır. Random seed kaydedilir. Experiment tracking sonuçları saklar. Candidate model evaluation sonrası seçilir.
Model Değerlendirme
Validation ve test metric ayrı tutulur. Classification, regression veya clustering problemine uygun ölçüler seçilir. Hata segmentasyonu yapılır. Business threshold ayrıca değerlendirilir. Sonuçlar model card veya rapor içinde kaydedilebilir.
Scikit-learn Pipeline Kullanımı
Pipeline preprocessing ve estimator adımlarını sırayla uygular. Fit sırasında transformation yalnızca training data üzerinde öğrenilir. Predict sırasında aynı işlemler otomatik uygulanır. Cross validation bütün pipeline üzerinde çalışabilir. Production deployment daha güvenilir hale gelir.
Data Leakage Nasıl Önlenir?
Scaler, imputer ve encoder test data üzerinde fit edilmemelidir. Target'tan türetilen feature'lar dikkatle incelenmelidir. Time-based problemde future information kullanılmamalıdır. Pipeline leakage riskini azaltır. Feature review ayrıca yapılmalıdır.
Pipeline'ın Tekrarlanabilirliğe Katkısı
Manuel preprocessing adımları yerine kodlanmış pipeline kullanılır. Aynı raw input aynı transformation'dan geçer. Cross validation daha güvenilir olur. Model artifact preprocessing'i de içinde taşır. Deployment ekiplerinin ayrı preprocessing kodu yazma ihtiyacı azalır.
Veri Madenciliği Modelleri Nasıl Değerlendirilir?
Model evaluation problem türüne göre yapılmalıdır. Classification için accuracy, precision, recall ve F1 gibi metrikler kullanılır. Regression için MAE, RMSE ve R² tercih edilebilir. Clustering için Silhouette ve Davies-Bouldin skorları yardımcıdır. Cross validation ve hyperparameter optimization model seçimini daha güvenilir hale getirir.
Classification Metrikleri
Classification metric seçimi sınıf dağılımı ve hata maliyetine göre yapılmalıdır. Accuracy balanced problemde yararlı olabilir. Precision yanlış pozitifleri, recall yanlış negatifleri daha iyi yansıtır. F1 bu iki metriği dengeler. ROC-AUC threshold'dan bağımsız ranking yeteneği hakkında bilgi verir.
Accuracy
Accuracy doğru tahminlerin toplam tahminlere oranıdır. Dengesiz veri setlerinde yanıltıcı olabilir. Yüzde 99 normal sınıf varsa her şeye normal diyen model yüksek accuracy alır. Confusion matrix ile birlikte değerlendirilmelidir. İş problemi hata türlerini ayırmayı gerektirebilir.
Precision
Precision pozitif tahminlerin ne kadarının gerçekten pozitif olduğunu ölçer. False positive maliyeti yüksekse önemlidir. Spam veya yanlış alarm use case'lerinde değerlidir. Threshold arttıkça precision genellikle yükselir. Recall ile trade-off vardır.
Recall
Recall gerçek pozitiflerin ne kadarının yakalandığını ölçer. Fraud ve kritik risk tespitinde yüksek recall gerekebilir. Çok düşük threshold false positive artırabilir. Business capacity review yükünü sınırlar. Precision ile birlikte değerlendirilmelidir.
F1 Score
F1 precision ve recall'un harmonik ortalamasıdır. Dengesiz problemde tek sayı ile dengeli görünüm sağlar. Ancak farklı hata maliyetlerini doğrudan içermez. Weighted veya macro F1 multi-class problemde kullanılabilir. Class-level metric yine görülmelidir.
ROC-AUC
ROC-AUC modelin pozitif ve negatif örnekleri sıralama yeteneğini ölçer. Threshold seçmeden karşılaştırma yapılabilir. Çok dengesiz veride PR-AUC daha anlamlı olabilir. AUC yüksek olsa bile business threshold kötü olabilir. Calibration ayrıca değerlendirilmelidir.
Regression Metrikleri
Regression hatası farklı ölçeklerde ölçülebilir. MAE absolute error ortalamasını verir. RMSE büyük hataları daha fazla cezalandırır. R² açıklanan varyans hakkında bilgi sunar. Metric target business anlamıyla birlikte yorumlanmalıdır.
MAE
MAE tahmin ile gerçek değer arasındaki mutlak farkların ortalamasıdır. Target ile aynı birimde olduğu için kolay yorumlanır. Büyük hataları RMSE kadar ağır cezalandırmaz. Outlier'a daha dayanıklıdır. Business maliyeti lineer ise iyi metric olabilir.
MSE ve RMSE
MSE squared error ortalamasıdır. RMSE bunun kareköküdür ve target birimine döner. Büyük hatalara daha fazla ağırlık verir. Outlier etkisi yüksektir. Critical large error önemliyse uygun olabilir.
R²
R² modelin target varyansının ne kadarını açıkladığını gösterir. Bir değerine yakın sonuç daha iyi açıklama anlamına gelir. Negative R² mümkündür. Tek başına prediction error miktarını söylemez. MAE veya RMSE ile birlikte kullanılmalıdır.
Clustering Metrikleri
Clustering ground truth label olmadan değerlendirildiği için farklı metric'ler gerekir. Silhouette aynı cluster içi yakınlık ve diğer cluster uzaklığını birlikte değerlendirir. Davies-Bouldin cluster compactness ve separation'a bakar. Teknik skor yüksek olsa bile cluster iş açısından anlamsız olabilir. Human interpretation mutlaka gerekir.
Silhouette Score
Silhouette değeri eksi bir ile bir arasında değişir. Yüksek değer gözlemlerin kendi cluster'ına iyi uyduğunu gösterir. K sayısı seçiminde kullanılabilir. Non-convex cluster yapısında yanıltıcı olabilir. Business segment kalitesi ayrıca incelenmelidir.
Davies-Bouldin Score
Davies-Bouldin cluster benzerliği ve ayrışmasını ölçer. Daha düşük değer genellikle daha iyidir. K-Means model seçimine yardımcı olabilir. Distance metric sonucu etkiler. Tek başına karar vermek doğru değildir.
Cross Validation
Cross validation modelin farklı training-validation split'lerinde nasıl genellediğini gösterir. K-Fold yaygın yöntemdir. Classification için StratifiedKFold class oranını korur. Time series için özel split gerekir. Hyperparameter selection cross validation üzerinden yapılabilir.
Hyperparameter Optimization
Model parametreleri training öncesinde belirlenen hyperparameter'lardır. Search yöntemi validation performansına göre iyi kombinasyonları bulur. Çok geniş search compute maliyetini artırır. Baseline olmadan tuning'e başlamak gereksizdir. Test set tuning sürecinin dışında kalmalıdır.
GridSearchCV
GridSearchCV belirtilen bütün parametre kombinasyonlarını dener. Search space küçük olduğunda kullanışlıdır. Cross validation ile metric hesaplar. Büyük grid çok maliyetli olabilir. Pipeline ile birlikte kullanıldığında preprocessing de fold içinde doğru uygulanır.
RandomizedSearchCV
RandomizedSearchCV parametre dağılımlarından sınırlı sayıda kombinasyon örnekler. Geniş search space'te daha verimli olabilir. n_iter compute bütçesini kontrol eder. Parametre distribution doğru tanımlanmalıdır. İlk tuning aşamasında iyi seçenek olabilir.
Python Kütüphaneleri Nasıl Seçilmeli?
Kütüphane seçimi popülerliğe göre değil veri boyutu, problem tipi, performans ve production gereksinimine göre yapılmalıdır. Küçük tabular data için Pandas ve Scikit-learn yeterli olabilir. Büyük veri için Polars veya PySpark gerekir. Deep learning problemi PyTorch veya TensorFlow'a ihtiyaç duyar. En az araçla ihtiyacı karşılayan teknoloji yığını uzun vadede daha yönetilebilir olur.
Veri Boyutuna Göre Seçim
Data birkaç GB ve RAM'e sığıyorsa Pandas yeterli olabilir. Daha büyük single-node workload için Polars avantajlıdır. Memory limit aşılıyorsa Dask veya Spark değerlendirilir. Veri boyutu kadar transformation complexity önemlidir. Benchmark gerçek data üzerinde yapılmalıdır.
Problem Tipine Göre Seçim
Classification için Scikit-learn veya boosting kütüphaneleri uygundur. Time series veya statistical inference için Statsmodels değerlendirilebilir. Deep learning için PyTorch veya TensorFlow gerekir. Association mining için mlxtend kullanılabilir. Problem kütüphane seçiminden önce tanımlanmalıdır.
Performansa Göre Seçim
Runtime ve memory kullanımı gerçek workload ile ölçülmelidir. Daha hızlı görünen kütüphane entegrasyon maliyeti yaratabilir. CPU ve GPU gereksinimi birlikte değerlendirilir. Data transfer bottleneck olabilir. End-to-end benchmark yalnızca tek fonksiyon benchmark'ından daha anlamlıdır.
Öğrenme Kolaylığına Göre Seçim
Ekip yeni teknoloji için öğrenme süresi harcar. Pandas ve Scikit-learn geniş eğitim kaynağına sahiptir. Çok niş kütüphane bakım riski oluşturabilir. Yeni ekip üyesinin onboarding süresi düşünülmelidir. Basit teknoloji çoğu zaman daha sürdürülebilirdir.
Production Kullanımına Göre Seçim
Model serving, versioning ve monitoring ihtiyacı değerlendirilmelidir. Kütüphanenin serialization desteği önemlidir. Dependency stability ve security update takip edilmelidir. Python environment container ile sabitlenebilir. Production compatibility PoC aşamasında test edilmelidir.
Python Veri Madenciliği Kütüphaneleri Karşılaştırma Tablosu
Karşılaştırma yapılırken kullanım alanı, veri büyüklüğü, öğrenme kolaylığı ve production desteği birlikte düşünülmelidir. NumPy sayısal temel, Pandas tablo analizi, Scikit-learn klasik ML, Polars hızlı DataFrame, PySpark büyük veri ve PyTorch deep learning tarafında öne çıkar. Tek bir proje hepsine ihtiyaç duymaz. Gereksiz bağımlılık sayısını artırmak deployment ve security yönetimini zorlaştırır. Aşağıdaki tablo başlangıç seçimi için pratik bir özet sunar.
Kütüphane
Temel Kullanım
Uygun Veri Ölçeği
Öne Çıkan Nokta
NumPy
Sayısal hesaplama
Küçük ve orta
Vektörleştirilmiş işlemler
Pandas
Veri temizleme ve analiz
Küçük ve orta
Kolay DataFrame kullanımı
Scikit-learn
Klasik makine öğrenmesi
Küçük ve orta
Tutarlı modelleme API'si
Polars
Yüksek performanslı DataFrame
Orta ve büyük
Hız ve memory verimliliği
Dask
Paralel veri işleme
Orta ve büyük
Pandas benzeri dağıtık kullanım
PySpark
Dağıtık büyük veri
Büyük ve çok büyük
Cluster ölçeğinde işleme
PyTorch
Deep learning
Modele bağlı
Esnek model geliştirme
Uçtan Uca Örnek Bir Veri Madenciliği Projesi
Uçtan uca örnek proje müşteri churn tahmini üzerinden düşünülebilir. Önce business problem tanımlanır ve churn gerçekleşmeden önce hangi müşterilerin riskli olduğunun bulunması hedeflenir. Veri Pandas ile yüklenir, temizlenir ve Seaborn ile analiz edilir. Scikit-learn preprocessing ve model pipeline kurulur. Model evaluation sonrası sonuç business ekipleriyle yorumlanır ve production kullanımına hazırlanır.
Problem Tanımının Oluşturulması
Hedef “churn model yapmak” değil, belirli zaman penceresinde churn edecek müşterileri erken tespit etmektir. Prediction horizon tanımlanmalıdır. Kullanılacak feature'ların prediction anında mevcut olması gerekir. Campaign capacity threshold seçimini etkiler. Success metric recall ve campaign ROI birlikte olabilir.
Veri Setinin Yüklenmesi
CSV veya SQL kaynağından müşteri davranış verisi alınabilir. Pandas DataFrame içinde kolon tipleri kontrol edilir. Tarih alanları datetime'a çevrilir. Duplicate customer kayıtları incelenir. Target dağılımı raporlanır.
Pandas ile Veri Temizleme
Eksik değer oranları hesaplanır. Hatalı yaş veya negatif tutar gibi business rule violation temizlenir. Duplicate kayıtlar kontrol edilir. Kategorik değer yazım farklılıkları standardize edilir. Bütün dönüşümler kodla tekrar edilebilir olmalıdır.
Seaborn ile Keşifsel Veri Analizi
Churn oranı kategori bazında görselleştirilebilir. Numeric feature dağılımları incelenir. Correlation heatmap hazırlanır. Outlier ve segment farkları gözlemlenir. Bu analiz yeni feature fikirleri oluşturabilir.
Scikit-learn ile Veri Ön İşleme
Numeric feature StandardScaler'dan geçirilebilir. Categorical feature OneHotEncoder ile dönüştürülür. Eksik değer imputer ile doldurulur. ColumnTransformer bütün adımları birleştirir. Test leakage riski azaltılır.
Modelin Eğitilmesi
Logistic Regression baseline olarak seçilebilir. Sonra Random Forest veya gradient boosting karşılaştırılır. Class weight kullanılabilir. Training cross validation ile yapılır. Experiment result kaydedilir.
Model Performansının Ölçülmesi
Precision, recall ve F1 test set üzerinde hesaplanır. ROC-AUC ve PR-AUC eklenebilir. Campaign kapasitesine göre threshold belirlenir. Confusion matrix hata türlerini gösterir. Segment bazında performance ayrıca incelenir.
Sonuçların Yorumlanması
Feature importance veya coefficient analizi yapılabilir. Modelin neden risk verdiği açıklanmalıdır. İş ekibi prediction'ı kullanarak aksiyon planlar. Yanlış pozitiflerin maliyeti değerlendirilir. Model karar destek aracı olarak konumlandırılır.
Modelin İyileştirilmesi
Yeni feature'lar eklenebilir. Hyperparameter search yapılabilir. Data imbalance yöntemleri denenebilir. Calibration uygulanabilir. Her değişiklik baseline ve test metric ile karşılaştırılmalıdır.
Veri Madenciliği Öğrenmek İsteyenler İçin Yol Haritası
Veri madenciliği öğrenmek isteyen biri doğrudan karmaşık modellere geçmemelidir. Python, SQL ve temel istatistik sağlam başlangıç oluşturur. NumPy ve Pandas veri üzerinde rahat çalışmayı sağlar. Ardından Scikit-learn ile supervised ve unsupervised yöntemlere geçilebilir. En hızlı öğrenme, gerçek bir veri seti üzerinde baştan sona proje tamamlamaktır.
Yazılımcı Olmak İçin Ne Yapmalı?
Yazılım ve veri alanına girmek için sürekli proje üretmek teorik eğitim kadar önemlidir. Python syntax öğrenildikten sonra küçük veri işleme script'leri yazılmalıdır. Git kullanımı erken öğrenilmelidir. SQL temel sorgular düzenli pratik edilmelidir. Daha sonra makine öğrenmesi ve deployment konularına geçilebilir.
Python Temellerini Öğrenmek
Değişkenler, fonksiyonlar, listeler, dictionary ve class yapıları anlaşılmalıdır. File IO ve exception handling öğrenilmelidir. Virtual environment kullanımı alışkanlık haline gelmelidir. Küçük script projeleri yapılmalıdır. Kütüphane kullanmadan önce temel dil yapısı sağlam olmalıdır.
SQL Öğrenmek
SELECT, WHERE, GROUP BY ve JOIN temel konulardır. Window function daha ileri analizlerde önemlidir. Veri kaynağında doğru aggregation yapmak Python workload'unu azaltır. Query performance temel seviyede anlaşılmalıdır. Gerçek database üzerinde pratik yapılmalıdır.
İstatistik ve Olasılık Bilgisi
Ortalama, varyans, dağılım ve olasılık temel kavramlardır. Hypothesis testing ve confidence interval anlaşılmalıdır. Correlation ve causation ayrımı bilinmelidir. Model metric'lerinin istatistiksel anlamı daha doğru yorumlanır. Uygulamalı örnekler teori öğrenimini kolaylaştırır.
NumPy ve Pandas Öğrenmek
Array ve DataFrame üzerinde rahat çalışmak veri projelerinin temelidir. Filtering, groupby ve merge pratiği yapılmalıdır. Missing data yönetimi öğrenilmelidir. Vectorized operation performans avantajı sağlar. Gerçek CSV dataset ile düzenli alıştırma yapılmalıdır.
Makine Öğrenmesine Geçmek
Önce train-test split ve baseline model öğrenilmelidir. Regression ve classification ile başlanabilir. Metric seçimi anlaşılmalıdır. Daha sonra clustering ve feature engineering'e geçilir. Deep learning gereksiz yere ilk adım olmamalıdır.
Başlangıç Seviyesi Proje Önerileri
Iris classification, Titanic survival veya basit satış analizi başlangıç için uygundur. Amaç en yüksek skor değil pipeline mantığını öğrenmektir. Veri temizleme ve görselleştirme mutlaka yapılmalıdır. README içinde problem ve sonuç anlatılmalıdır. GitHub repository düzenli tutulmalıdır.
Orta Seviye Proje Önerileri
Churn prediction, basket analysis veya customer segmentation daha kapsamlı deneyim sağlar. Pipeline ve cross validation kullanılmalıdır. Model comparison yapılabilir. API veya dashboard eklemek projeyi production'a yaklaştırır. Test ve documentation portfolio değerini artırır.
Portföy Nasıl Oluşturulur?
Portföy yalnızca notebook linklerinden oluşmamalıdır. Problem, veri kaynağı, yöntem ve sonuç açıkça anlatılmalıdır. README temiz olmalıdır. Kod modüler hale getirilebilir. Gerçek problem çözme becerisi skor listesinden daha değerlidir.
Open Source ve İşbirliği
Python veri ekosisteminin güçlü olmasının temel nedenlerinden biri açık kaynak geliştirme kültürüdür. NumPy, Pandas ve Scikit-learn binlerce geliştiricinin ortak katkısıyla gelişir. Açık kaynak projelere katkı yalnızca teknik bilgi değil code review ve ekip iletişimi becerisi kazandırır. Git ve GitHub kullanımı bu sürecin temelidir. Küçük documentation veya test katkısı bile kariyer açısından değerli deneyim oluşturabilir.
Python Ekosisteminde Açık Kaynağın Önemi
Python veri araçlarının büyük bölümü açık kaynak olarak geliştirilir. Kullanıcı issue açabilir ve kod değişikliğine katkı sağlayabilir. Şeffaf development süreci bug fix ve yeni özellikleri hızlandırır. Kurumlar vendor lock-in olmadan güçlü araçlar kullanabilir. Lisans ve security update takibi yine kurum sorumluluğundadır.
Git ve GitHub Kullanımı
Git version control sağlar. Branch ve commit geçmişi ekip çalışmasını düzenler. GitHub pull request ve issue workflow sunar. Veri projelerinde notebook dışında script ve config de versionlanmalıdır. Büyük dataset repository'ye doğrudan eklenmemelidir.
Açık Kaynak Projelere Nasıl Katkı Sağlanır?
İlk katkı büyük feature olmak zorunda değildir. Documentation typo düzeltmek bile başlangıç olabilir. Issue listesinde newcomer-friendly etiketler aranabilir. Contribution guideline okunmalıdır. Küçük ve net pull request review sürecini kolaylaştırır.
Issue Çözmek
Bug veya feature issue seçilir. Problem local environment'ta yeniden üretilir. Test eklenir. Fix küçük tutulur. Maintainer feedback'ine göre değişiklik yapılır.
Pull Request Göndermek
Branch açılır ve anlamlı commit hazırlanır. PR açıklaması problemi ve çözümü anlatır. Test sonucu eklenebilir. Code style project standardına uymalıdır. Review yorumları öğrenme fırsatı olarak görülmelidir.
Dokümantasyona Katkı Sağlamak
Dokümantasyon yeni kullanıcıların projeyi öğrenmesini kolaylaştırır. Eksik örnekler tamamlanabilir. API açıklaması netleştirilebilir. Türkçe içerik veya tutorial katkısı yapılabilir. Documentation contribution teknik iletişim becerisini geliştirir.
Test Yazmak
Test mevcut davranışı korur. Bug fix için regression test eklenebilir. Edge case düşünme becerisi gelişir. Data library'lerde numerical tolerance önemlidir. İyi test katkısı maintainer için yüksek değere sahiptir.
Veri Bilimi Projelerinde Ekip Çalışması
Data scientist, data engineer ve software engineer farklı sorumluluklar üstlenebilir. Ortak Git workflow ekip koordinasyonunu sağlar. Experiment result standart biçimde paylaşılmalıdır. Data definition konusunda business ekipleri sürece katılmalıdır. Model başarısı bireysel notebook değil ekip sistemi olarak ele alınmalıdır.
Açık Kaynak Katkısının Yazılımcı Kariyerine Etkisi
Açık source contribution gerçek code review deneyimi gösterir. Recruiter yalnızca kurs sertifikası değil gerçek proje görebilir. Communication ve issue çözme becerisi görünür hale gelir. Maintainer feedback teknik gelişimi hızlandırır. Uzun vadeli düzenli katkı güçlü network oluşturabilir.
Diyarbakır Yazılım Topluluğu ve Veri Bilimi Ekosistemi
Yerel yazılım toplulukları veri bilimi öğrenen kişilerin yalnız çalışırken karşılaştığı bilgi ve motivasyon sorunlarını azaltabilir. Ortak proje, workshop ve teknik sohbetler gerçek problem çözme pratiği sağlar. Diyarbakır Yazılım Topluluğu farklı yazılım alanlarında üretim ve paylaşım ortamı oluşturmayı hedefleyen yerel bir teknoloji topluluğudur. Topluluk hakkında daha fazla bilgi için https://www.diyarbakiryazilim.com.tr/about adresi incelenebilir. Veri madenciliği gibi disiplinler ortak açık kaynak projeler sayesinde yerel geliştiriciler için güçlü öğrenme alanına dönüşebilir.
Diyarbakır Yazılım Topluluğu Nedir?
Diyarbakır Yazılım Topluluğu yazılım geliştirme ve teknoloji alanında bilgi paylaşımını destekleyen bir topluluk yapısıdır. Geliştiricilerin farklı konular üzerinde birlikte çalışmasını teşvik eder. Veri bilimi, backend, yapay zeka ve açık kaynak gibi alanlar ortak üretim fırsatı sunar. Topluluk yapısı yeni başlayanlarla deneyimli kişilerin etkileşim kurmasını kolaylaştırır. Güncel çalışmalar ve proje örnekleri https://www.diyarbakiryazilim.com.tr/projects üzerinden incelenebilir.
Veri Bilimi ve Python Öğrenirken Toplulukların Önemi
Tek başına öğrenme sırasında sorun çözme süresi uzayabilir. Topluluk içindeki code review ve teknik tartışma farklı yaklaşım görmeyi sağlar. Ortak dataset üzerinde çalışma gerçek ekip pratiği oluşturur. Yeni başlayan kişi production deneyimine sahip geliştiricilerden geri bildirim alabilir. Düzenli proje üretmek öğrenme sürekliliğini artırır.
Yerel Yazılımcılarla Ortak Veri Madenciliği Projeleri
Yerel açık veri setleri üzerinden ortak analiz projeleri geliştirilebilir. Tarım, ulaşım veya küçük işletme verileri use case olabilir. Proje GitHub repository üzerinden ekip halinde yönetilebilir. Dashboard ve model çıktıları topluluk etkinliğinde paylaşılabilir. Bu yapı öğrenmeyi gerçek probleme bağlar.
Diyarbakır'daki En İyi Yazılımcılar Nasıl Bulunur ve Onlardan Nasıl Öğrenilir?
“En iyi” kavramını yalnızca unvan veya takipçi sayısıyla değerlendirmek doğru değildir. Açık kaynak katkısı, gerçek proje deneyimi ve bilgi paylaşma isteği daha anlamlı göstergelerdir. Meetup, workshop ve GitHub aktiviteleri geliştiricileri tanımayı kolaylaştırır. Birlikte küçük proje yapmak teknik seviyeyi anlamanın en iyi yollarından biridir. Mentor ilişkisi tek taraflı ders yerine karşılıklı üretim üzerinden kurulabilir.
Workshop, Meetup ve Açık Kaynak Çalışmalarının Katkısı
Workshop belirli konuyu kısa sürede uygulamalı öğrenme fırsatı sunar. Meetup farklı deneyimleri duymayı sağlar. Açık kaynak proje uzun vadeli birlikte çalışma zemini oluşturur. Etkinlik sonrası repository üzerinde devam etmek öğrenmeyi kalıcı hale getirir. Katılımcıların kendi örneklerini sunması iletişim becerisini geliştirir.
Yerel Problemler İçin Veri Madenciliği Proje Fikirleri
Yerel problemler gerçek veriyle çalışmak için güçlü motivasyon oluşturur. Tarım verimi, trafik yoğunluğu ve küçük işletme müşteri davranışları analiz edilebilir. Açık kamu verileri kullanılabilir. Kişisel veri içeren kaynaklarda anonimleştirme gerekir. Projeler küçük başlayıp zaman içinde açık source platformlara dönüştürülebilir.
Tarım Verilerinin Analizi
Yağış, sıcaklık ve ürün verimi ilişkileri analiz edilebilir. Regression modelleri kullanılabilir. Bölgesel clustering yapılabilir. Açık meteoroloji verileri değerlendirilebilir. Sonuçların uzman görüşüyle yorumlanması önemlidir.
Ulaşım Verilerinin Analizi
Trafik veya toplu taşıma verileri zaman bazında incelenebilir. Yoğunluk tahmini yapılabilir. Anomali günleri belirlenebilir. Harita verisiyle görselleştirme eklenebilir. Privacy taşıyan konum verileri dikkatle yönetilmelidir.
Yerel İşletmeler İçin Müşteri Segmentasyonu
Satış verilerinden RFM feature'ları oluşturulabilir. K-Means ile segmentasyon yapılabilir. Segmentler kampanya davranışıyla test edilebilir. Küçük işletme için basit model yeterli olabilir. Sonuç dashboard üzerinden sunulabilir.
Açık Kamu Verilerinin Analizi
Kamuya açık veri setleri eğitim projeleri için güçlü kaynaklardır. Ekonomi, çevre ve ulaşım gibi alanlar incelenebilir. Veri kalite sorunları gerçek hayat pratiği sağlar. Kaynak ve lisans bilgisi korunmalıdır. Sonuçlar açık repository ile paylaşılabilir.
Veri Madenciliğinde Sık Yapılan Hatalar
Veri madenciliği projelerindeki başarısızlıkların önemli bölümü algoritma seçiminden önce ortaya çıkar. Problem tanımlanmadan model kurmak teknik çalışmayı amaçsız hale getirir. Veri temizliğini atlamak yanlış sonuç üretir. Data leakage model performansını olduğundan iyi gösterebilir. Yanlış metric ve tek algoritmaya aşırı güvenmek de production riskini artırır.
Problemi Tanımlamadan Model Kurmak
Model neyi optimize edeceğini business hedefinden öğrenmez. Ekip problem ve kullanıcı aksiyonunu açıkça tanımlamalıdır. Prediction horizon belirlenmelidir. Success metric baştan seçilmelidir. Aksi halde yüksek accuracy bile iş değeri oluşturmayabilir.
Veri Temizliğini İhmal Etmek
Missing, duplicate ve yanlış kayıtlar model davranışını bozar. “Model zaten öğrenir” yaklaşımı risklidir. Data quality report hazırlanmalıdır. Temizleme rule versionlanmalıdır. Raw ve clean data ayrılmalıdır.
Data Leakage
Future veya target bilgisi feature içine sızarsa model gerçek dışı yüksek skor alır. Scaler test data üzerinde fit edilmemelidir. Time split problemde random split kullanılmamalıdır. Pipeline leakage riskini azaltır. Feature review zorunludur.
Yanlış Değerlendirme Metriği Kullanmak
Fraud gibi dengesiz problemde accuracy yanıltıcıdır. Business hata maliyeti metric seçimini belirlemelidir. Precision ve recall ayrı okunmalıdır. Regression'da MAE ve RMSE farklı anlam taşır. KPI ve ML metric birlikte izlenmelidir.
Tek Bir Algoritmaya Güvenmek
Baseline olmadan tek model seçmek doğru değildir. Basit model bazen daha iyi geneller. Farklı algoritmalar aynı testte karşılaştırılmalıdır. Complexity gain ölçülmelidir. En yüksek skor her zaman en iyi production seçimi değildir.
Model Sonuçlarını Yorumlamamak
Prediction'ın neden üretildiği incelenmelidir. Feature importance ve error analysis yapılabilir. Model yanlış segmentte kötü çalışabilir. Domain uzmanı sonuçları değerlendirmelidir. Decision support sistemi açıklanabilir olmalıdır.
Büyük Veri Setlerinde Performansı Göz Ardı Etmek
Notebook'ta çalışan Pandas işlemi production'da saatler sürebilir. Memory kullanımına bakılmalıdır. Algorithmic complexity önemlidir. Polars veya Spark alternatifleri test edilmelidir. End-to-end runtime KPI olarak takip edilmelidir.
Sık Sorulan Sorular
Veri madenciliği öğrenen veya kurumsal proje geliştiren ekiplerin soruları genellikle kütüphane seçimi, Python gereksinimi, büyük veri ve kariyer yolu çevresinde toplanır. Tek araç bütün problemlere uymaz. Veri büyüklüğü, problem tipi ve production hedefi seçimleri değiştirir. Başlangıçta NumPy, Pandas ve Scikit-learn çoğu öğrenme senaryosu için yeterli temeli sağlar. Daha ileri seviyede Polars, PySpark ve gelişmiş model kütüphanelerine geçilebilir.
Veri madenciliği için hangi Python kütüphaneleri kullanılır?
NumPy, Pandas, SciPy, Matplotlib ve Scikit-learn temel araçlardır. Seaborn ve Plotly görselleştirmeyi güçlendirir. XGBoost ve LightGBM gelişmiş tabular modelleme sağlar. mlxtend association rule mining için kullanılabilir. Büyük veri için Polars, Dask ve PySpark değerlendirilebilir.
Veri madenciliği için Python öğrenmek şart mı?
Python zorunlu değildir ancak güçlü avantaj sağlar. R, SQL, Java ve farklı araçlar kullanılabilir. Bununla birlikte Python geniş ekosistemi sayesinde öğrenmeyi ve production entegrasyonunu kolaylaştırır. SQL bilgisi Python kadar önemlidir. En iyi sonuç çoğu zaman birden fazla teknolojinin birlikte kullanılmasından gelir.
Pandas veri madenciliği için yeterli mi?
Pandas veri hazırlama ve analiz için güçlüdür. Ancak model training için Scikit-learn veya başka kütüphane gerekir. Visualization için Seaborn ve Matplotlib eklenebilir. Büyük veri için Pandas sınırlarına ulaşabilir. Dolayısıyla tek başına tam veri madenciliği ekosistemi değildir.
Scikit-learn veri madenciliğinde ne işe yarar?
Scikit-learn preprocessing, classification, regression ve clustering sağlar. Model evaluation ve cross validation araçları içerir. Pipeline data leakage riskini azaltır. Klasik machine learning use case'lerinin büyük bölümünü kapsar. API yapısı yeni başlayanlar için anlaşılırdır.
NumPy ve Pandas arasındaki fark nedir?
NumPy numeric array ve matrix işlemlerine odaklanır. Pandas etiketli tablo ve mixed data type yönetimini kolaylaştırır. Pandas alt seviyede NumPy'dan yararlanır. Sayısal hesaplama için NumPy daha temel yapıdır. Data analysis için Pandas daha kullanıcı dostudur.
Veri madenciliği için en iyi programlama dili hangisidir?
Tek bir doğru cevap yoktur. Python genel amaçlı ve geniş ekosistemli seçenektir. R istatistik için güçlüdür. SQL veri erişimi için vazgeçilmezdir. Java belirli enterprise sistemlerde avantaj sağlayabilir.
Python ile Apriori algoritması uygulanabilir mi?
Evet, mlxtend kütüphanesi Apriori implementasyonu sağlar. Basket data one-hot formatına çevrilir. Frequent itemset çıkarılır. Association rule metric'leri hesaplanır. Büyük dataset için FP-Growth daha hızlı olabilir.
Büyük veri madenciliğinde hangi Python kütüphanesi kullanılmalı?
Veri tek makinede işlenebiliyorsa Polars iyi seçenek olabilir. Distributed processing için Dask veya PySpark kullanılabilir. Spark çok büyük cluster workload için güçlüdür. Dataset size ve transformation type karar verir. Benchmark gerçek workload ile yapılmalıdır.
Veri madenciliği öğrenmeye nereden başlanmalı?
Python ve SQL temelleriyle başlanmalıdır. Sonra NumPy ve Pandas öğrenilmelidir. Temel istatistik ile birlikte Scikit-learn'e geçilebilir. Küçük proje yapmak en hızlı ilerlemeyi sağlar. GitHub portfolio öğrenmeyi görünür hale getirir.
Yazılımcı olmak için ne yapmalı?
Temel programlama ve problem çözme becerileri öğrenilmelidir. Düzenli kod yazılmalıdır. Git ve test alışkanlığı edinilmelidir. Gerçek proje tamamlamak önemlidir. Topluluk ve code review süreci gelişimi hızlandırır.
Open source ve işbirliği veri bilimi kariyerine nasıl katkı sağlar?
Açık kaynak gerçek code review deneyimi sunar. Farklı geliştiricilerden geri bildirim alınır. Git workflow pratiği kazanılır. Portfolio somut hale gelir. Teknik network genişler.
Diyarbakır Yazılım Topluluğu veri bilimi öğrenenlere nasıl katkı sağlayabilir?
Topluluk ortamı ortak proje ve bilgi paylaşımı sağlar. Python ve veri bilimi workshop'ları yapılabilir. Açık dataset üzerinde ekip projeleri geliştirilebilir. Deneyimli geliştiriciler code review ile destek olabilir. Topluluk çalışmaları hakkında https://www.diyarbakiryazilim.com.tr/about üzerinden bilgi alınabilir.
Veri Madenciliği Hakkında Ek Sık Sorulan Sorular
Aşağıdaki sorular özellikle Python kütüphane seçimi, veri hazırlama, modelleme, büyük veri ve danışmanlık açısından sık karşılaşılan konuları özetler. Veri Madenciliği (Data Mining) Süreçlerinde Python Kütüphaneleri yalnızca araç isimlerini bilmekten ibaret değildir. Doğru kütüphane veri boyutu ve iş problemine göre seçilmelidir. Veri kalitesi, model evaluation ve production tasarımı aynı sürecin parçalarıdır. Güvenilir analitik ve AI çıktıları hakkında ek teknik yaklaşım için https://www.diyarbakiryazilim.com.tr/posts/dogruluk-ve-halusinasyon-kontrolu-guvenilir-ai-ciktilari adresindeki içerik de incelenebilir.
Veri madenciliği (Data Mining) süreçlerinde en çok kullanılan Python kütüphaneleri hangileridir?
NumPy sayısal hesaplama, Pandas veri manipülasyonu ve Scikit-learn klasik makine öğrenmesi için en sık kullanılan temel kütüphanelerdendir. SciPy istatistiksel ve bilimsel hesaplamaları destekler. Matplotlib ve Seaborn keşifsel görselleştirme için kullanılır. XGBoost, LightGBM ve CatBoost tabular modelleme projelerinde sık tercih edilir. Büyük veri hacmi arttığında Polars, Dask veya PySpark gibi araçlara geçilebilir.
Pandas, NumPy ve SciPy veri temizleme ve ön işleme süreçlerinde nasıl kullanılır?
Pandas eksik değer, duplicate, filtering, groupby ve join işlemlerinde kullanılır. NumPy vektörleştirilmiş sayısal dönüşümler ve matrix işlemleri sağlar. SciPy istatistiksel testler ve benzerlik hesaplamalarıyla analizi destekler. Bu üç kütüphane birlikte güçlü preprocessing altyapısı oluşturur. Machine learning aşamasına geçildiğinde Scikit-learn transformer'larıyla pipeline içine alınmaları daha güvenli ve tekrar edilebilir sonuç sağlar.
Scikit-learn ile sınıflandırma, kümeleme ve tahmin gibi veri madenciliği işlemleri nasıl yapılır?
Önce veri training ve test olarak ayrılır. Preprocessing ColumnTransformer veya Pipeline içinde tanımlanır. Classification için Logistic Regression veya Random Forest, clustering için K-Means veya DBSCAN ve regression için farklı estimator'lar kullanılabilir. Model fit metoduyla eğitilir ve predict ile tahmin üretir. Sonuç problem tipine uygun metric'lerle değerlendirilir ve cross validation ile genelleme performansı kontrol edilir.
Büyük veri kümelerinde Python kütüphanesi seçerken performans, ölçeklenebilirlik ve kullanım amacı nasıl değerlendirilmelidir?
İlk olarak verinin tek makine belleğine sığıp sığmadığı belirlenmelidir. Pandas yeterliyse gereksiz dağıtık altyapı kurulması maliyet oluşturur. Daha yüksek single-node performans için Polars, paralel işlem için Dask ve cluster ölçeğinde veri için PySpark düşünülebilir. Transformation ve modelleme workload'ları ayrı değerlendirilmelidir. Karar gerçek veri üzerinde latency, memory, ekip deneyimi ve production operasyon maliyeti birlikte ölçülerek verilmelidir.
Veri madenciliği ve Python kütüphaneleri eğitimi veya danışmanlığını yakınımda nerede bulabilirim?
Python veri analizi ve veri madenciliği danışmanlığı yakınımda şeklinde araştırma yapan ekiplerin yalnızca algoritma eğitimi değil veri hazırlama, model evaluation, pipeline ve production entegrasyonunu birlikte ele alan çalışma modeli tercih etmesi daha faydalıdır. Diyarbakır Yazılım Topluluğu hakkında https://www.diyarbakiryazilim.com.tr/about üzerinden bilgi alınabilir. Topluluk ve teknik proje çalışmalarını görmek için https://www.diyarbakiryazilim.com.tr/projects adresi incelenebilir. Python veri madenciliği ve makine öğrenmesi proje geliştirme hizmeti planlanırken küçük bir gerçek veri seti üzerinde ölçülebilir pilot oluşturmak güçlü başlangıçtır. Eğitim tarafında ise Python, SQL, Pandas, Scikit-learn, model değerlendirme ve Git konularını tek bir proje boyunca birlikte uygulamak öğrenmeyi çok daha kalıcı hale getirir.
Sonuç
Veri Madenciliği (Data Mining) Süreçlerinde Python Kütüphaneleri doğru kullanıldığında veri toplama, temizleme, modelleme ve değerlendirme adımlarını ortak bir çalışma akışında birleştirir. NumPy ve Pandas başlangıç veri işlemlerini, Scikit-learn klasik modelleme ve pipeline ihtiyacını, Matplotlib ve Seaborn ise görsel analizi karşılar. Veri büyüdüğünde Polars, Dask veya PySpark gibi araçlarla ölçeklenebilirlik artırılabilir. En önemli nokta, kullanılan kütüphane sayısını artırmak değil iş problemini en basit ve güvenilir teknoloji yığınıyla çözmektir. Veri bilimi ve Python projeleri hakkında teknik çalışmalar görmek için https://www.diyarbakiryazilim.com.tr/projects adresini inceleyebilir ve Diyarbakır Yazılım Topluluğu hakkında https://www.diyarbakiryazilim.com.tr/about üzerinden bilgi alabilirsiniz.
Veri Madenciliği İçin Minimum Python Araç Seti
Başlangıç için Python, NumPy, Pandas, Matplotlib ve Scikit-learn yeterli bir araç seti oluşturur. SQL bilgisi bu paketin ayrılmaz tamamlayıcısıdır. Seaborn keşifsel analiz hızını artırabilir. Jupyter Notebook öğrenme ve prototype için kullanılabilir. Git ile kodun versionlanması ilk projeden itibaren alışkanlık haline getirilmelidir.
Başlangıçtan İleri Seviyeye Önerilen Kütüphane Sırası
İlk aşamada NumPy ve Pandas öğrenilmelidir. Ardından Matplotlib ve Seaborn ile veri görselleştirme pratiği yapılabilir. Scikit-learn ile preprocessing, classification, regression ve clustering öğrenilir. Sonraki aşamada XGBoost, LightGBM ve imbalanced-learn gibi daha özel kütüphanelere geçilebilir. Büyük veri veya deep learning ihtiyacı doğduğunda Polars, PySpark, PyTorch veya TensorFlow eklenmelidir.
Bir Sonraki Adım: Gerçek Bir Veri Setiyle Proje Geliştirmek
Teorik bilgi ancak gerçek veri setinde uygulandığında kalıcı hale gelir. Küçük bir müşteri segmentasyonu, churn tahmini veya sepet analizi projesi seçebilirsiniz. Veriyi temizleyin, EDA yapın, baseline model kurun ve metric'leri açık biçimde raporlayın. Sonucu GitHub üzerinde anlaşılır README ve tekrar çalıştırılabilir kodla paylaşın. Birlikte proje geliştirme, Python veri analizi ve veri madenciliği çalışmaları için Diyarbakır Yazılım Topluluğu'nun güncel içerik ve çalışmalarını https://www.diyarbakiryazilim.com.tr/projects üzerinden inceleyebilirsiniz.
share: