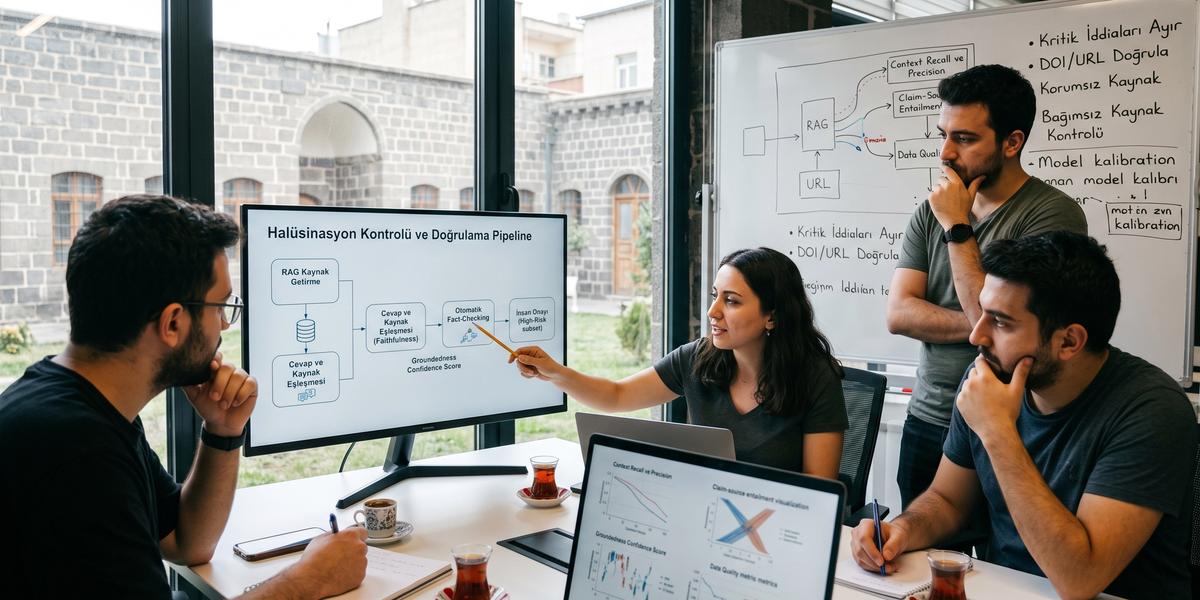
Doğruluk ve Halüsinasyon Kontrolü: Güvenilir AI Çıktıları

Diyarbakır Yazılım
16.08.2026
#Yazılım#Teknoloji#Topluluk
Bir yapay zeka cevabının akıcı, kendinden emin ve teknik görünmesi onun doğru olduğu anlamına gelmez. Özellikle büyük dil modelleri, eksik bilgiye sahip olduklarında bile dil kalıbı açısından güçlü ve ikna edici cümleler üretebilir. Doğruluk ve Halüsinasyon Kontrolü: Güvenilir AI Çıktıları konusu bu nedenle yalnızca model kalitesiyle değil, kaynak doğrulama, RAG, değerlendirme setleri, insan onayı ve production monitoring ile birlikte ele alınmalıdır. On yılı aşkın yazılım ve AI entegrasyonu deneyiminde gördüğüm en önemli noktalardan biri, ekiplerin model çıktısını “cevap” olarak değil “doğrulanması gereken aday sonuç” olarak görmeye başladığında sistem güvenilirliğinin belirgin biçimde artmasıdır. Bu rehberde yapay zeka halüsinasyonları nasıl tespit edilir ve azaltılır, LLM çıktılarında doğruluk ve factuality kontrolü nasıl yapılır ve kurumsal sistemlerde güvenilir üretim zinciri nasıl tasarlanır sorularını uygulamaya dönük biçimde ele alacağız.
Yapay Zeka Halüsinasyonu Nedir?
Yapay zeka halüsinasyonu, modelin doğrulanabilir gerçeklerle uyuşmayan, verilen kaynağa dayanmayan veya hiç var olmayan bilgileri doğruymuş gibi üretmesi durumudur. Bu hata yalnızca açıkça yanlış bir tarih veya isim vermek şeklinde görülmez. Model var olmayan bir makaleye atıf yapabilir, gerçek bir kaynağa yanlış iddia yükleyebilir veya verilen dokümanda bulunmayan sonucu kaynakta varmış gibi sunabilir. Halüsinasyon problemi özellikle kullanıcı cevabın hangi bölümünün doğrulanabilir olduğunu ayırt edemediğinde daha tehlikeli hale gelir. Bu nedenle güvenilir sistem tasarımında yalnızca “cevap doğru mu?” değil, “cevap hangi kaynağa dayanıyor ve hangi bölümünde belirsizlik var?” soruları da sorulmalıdır.
AI Halüsinasyonu Nasıl Tanımlanır?
AI halüsinasyonu, çıktının model tarafından dilsel olarak tutarlı biçimde üretilmesine rağmen olgusal veya bağlamsal açıdan desteklenmemesi olarak tanımlanabilir. Bir model gerçek olmayan şirket, kişi, ürün, mevzuat maddesi veya araştırma sonucu oluşturabilir. RAG kullanan sistemlerde ise model getirilen kaynakları yanlış yorumlayarak kaynakla çelişen sonuç üretebilir. Bu yüzden hallucination detection yalnızca web üzerinde bilgi aramak değil, model çıktısı ile referans kaynak arasındaki ilişkiyi ölçmek anlamına gelir. Kurumsal değerlendirme süreçlerinde bu ayrım net yapılmazsa yüksek bir dil kalitesi skoru yanlış biçimde doğruluk skoru gibi yorumlanabilir.
Yanlış Cevap ile Halüsinasyon Arasındaki Fark
Her yanlış cevap aynı tür hata değildir. Kullanıcının sorusu belirsiz olduğu için model yanlış varsayım yapmış olabilir. Hesaplama hatası, retrieval hatası veya eski veri kullanımı da yanlış sonuca yol açabilir. Halüsinasyon ise çoğunlukla desteklenmeyen bilgi üretiminin daha belirgin biçimidir. Sistem tasarımında hata türünü ayırmak önemlidir çünkü çözüm, yanlış retrieval için başka, hatalı reasoning için başka, uydurulmuş kaynak için başka olacaktır.
Halüsinasyon, Factuality, Faithfulness ve Groundedness Arasındaki Fark
Bu dört kavram sıkça birbirinin yerine kullanılsa da aynı şeyi ölçmez. Factuality cevabın gerçek dünyadaki olgularla ne kadar uyumlu olduğunu değerlendirir. Faithfulness cevabın verilen context veya kaynaklara sadık kalıp kalmadığını inceler. Groundedness ise cevabın belirli ve doğrulanabilir kaynaklara dayanma derecesini ifade eder. Halüsinasyon ise bu doğruluk veya dayanak ilişkilerinden birinin bozulduğu geniş hata sınıfı olarak düşünülebilir.
Factuality Nedir?
Factuality, model çıktısındaki olgusal iddiaların doğrulanabilir gerçeklerle ne ölçüde uyuştuğunu değerlendirir. Tarih, isim, sayı, olay ve teknik özellikler factuality kontrolüne dahil edilir. Bir cevap kaynağa sadık görünse bile kaynak eski veya yanlışsa factuality düşük olabilir. Bu nedenle factuality yalnızca verilen context’e bakılarak değil gerektiğinde dış doğrulama kaynaklarıyla ölçülmelidir. Özellikle güncel bilgi gerektiren sorularda doğruluk tarihi de kontrolün parçası olmalıdır.
Faithfulness Nedir?
Faithfulness, modelin verilen doküman veya context dışına taşıp taşmadığını ölçer. RAG sisteminde kullanıcıya yalnızca getirilen dokümanlara dayanarak cevap verilmesi isteniyorsa bu metrik çok önemlidir. Model context’te bulunmayan iddialar eklediğinde cevap olgusal olarak doğru olsa bile faithfulness düşebilir. Bu durum özellikle düzenlemeye tabi içeriklerde risk oluşturur çünkü sistemden yalnızca onaylı kaynaklara dayanması beklenebilir. Faithfulness değerlendirmesi kaynak cümleleri ile cevap iddialarını eşleştirerek yapılabilir.
Groundedness Nedir?
Groundedness, üretilen cevabın açık biçimde sağlanan bilgi tabanına veya doğrulanmış kaynaklara bağlanabilmesini ifade eder. Cevaptaki her önemli iddianın destekleyici bir referansa sahip olması groundedness seviyesini artırır. Modelin doğru olduğunu tahmin ettiği ama kaynakta bulunmayan bilgi grounded kabul edilmez. Bu yaklaşım RAG ile yapay zeka halüsinasyonlarını azaltma ve kaynak doğrulama yöntemleri açısından temel kontrol noktalarından biridir. Production sistemlerinde groundedness skoru belirli eşik altında kaldığında cevap vermeme veya insan incelemesine yönlendirme tercih edilebilir.
AI Neden Yanlış Bilgiyi Bu Kadar İkna Edici Sunar?
Büyük dil modelleri temel olarak dil örüntülerini güçlü biçimde öğrenir ve olası sonraki tokenları üretir. Bu mekanizma, doğru bilgiyle yanlış bilginin dilsel akıcılığını doğrudan ayırmaz. Bir cümle istatistiksel olarak çok doğal göründüğü için model tarafından yüksek olasılıkla üretilebilir ancak yine de gerçek dünyada yanlış olabilir. Kullanıcı açısından problem, dilsel özgüven ile olgusal güvenilirliğin birbirine karıştırılmasıdır. Bu nedenle kullanıcı arayüzünde kaynak, belirsizlik ve doğrulama durumu mümkün olduğunca görünür olmalıdır.
Halüsinasyonları Tamamen Ortadan Kaldırmak Mümkün mü?
Bugünkü model ve sistem yaklaşımlarında halüsinasyonu her kullanım alanında sıfıra indirmek gerçekçi bir hedef değildir. RAG, prompt sınırlandırma, kaynak doğrulama ve evaluation yöntemleri oranı ciddi biçimde azaltabilir. Bununla birlikte yanlış retrieval, güncel olmayan kaynak veya modelin context’i yanlış yorumlaması gibi yeni hata noktaları devam eder. Güvenilir sistem hedefi “model asla yanlış yapmaz” yaklaşımından çok “yanlış üretim yakalanabilir, ölçülebilir ve gerektiğinde engellenebilir” yaklaşımı olmalıdır. Özellikle yüksek riskli sistemlerde insan onayı bu nedenle hâlâ önemlidir.
Yapay Zeka Halüsinasyonu Türleri Nelerdir?
Halüsinasyon tek bir hata biçimi değildir ve kullanım alanına göre farklı türlerde ortaya çıkabilir. Olgusal hatalar en kolay fark edilen gruptur ancak kaynak, bağlam, kod ve görsel yorumlama hataları da oldukça önemlidir. Bir sistemin yalnızca genel accuracy metriğiyle değerlendirilmesi bu farklı hata türlerini gizleyebilir. Test seti her halüsinasyon kategorisini ayrı senaryolarla ölçmelidir. Hata sınıflandırması production monitoring sırasında hangi kontrol katmanının iyileştirilmesi gerektiğini de gösterir.
Olgusal Halüsinasyonlar
Olgusal halüsinasyon, modelin gerçek dünyaya ilişkin yanlış bir iddiayı doğru gibi sunmasıdır. Bu hata kişi, kurum, tarih, sayı veya olay bilgisinde görülebilir. Özellikle cevap uzun olduğunda birkaç doğru bilginin arasına tek bir yanlış iddia karışması kullanıcı tarafından fark edilmeyebilir. Bu nedenle fact checking iddia seviyesinde yapılmalıdır. Yüksek riskli alanlarda otomatik fact extraction ve doğrulama pipeline’ı kullanılması değerlidir.
Yanlış İsimler
Model birbirine benzeyen kişi veya kurum isimlerini karıştırabilir. Gerçekte var olmayan bir uzman adı oluşturabilir. Aynı soyadına sahip kişilerin görevleri birbiriyle karışabilir. İsim doğrulaması resmi kaynak veya birincil kayıt üzerinden yapılmalıdır. Kullanıcıya sunulan citation doğrudan ilgili kişiyi desteklemelidir.
Yanlış Tarihler
Tarih hataları özellikle güncel olaylarda sık görülür. Model benzer iki etkinliğin tarihini birleştirebilir. Eski training bilgisi nedeniyle güncel görev tarihini yanlış söyleyebilir. Yayın tarihi ile olay tarihi birbirine karıştırılabilir. Tarih doğrulamasında kaynağın hem yayın hem olay zamanına bakmak gerekir.
Yanlış Sayısal Veriler
Model sayı üretirken yakın ama yanlış değerler verebilir. Yüzde, para, kullanıcı sayısı veya araştırma sonucu gibi değerlerde küçük fark bile önemli olabilir. Sayıların kaynaktan doğrudan alınması veya deterministic hesapla doğrulanması daha güvenlidir. Büyük sayılar ve oranlar özellikle ikinci kaynakla kontrol edilmelidir. Financial ve scientific use case’lerde arithmetic tool kullanımı model tahminine tercih edilmelidir.
Yanlış Yer ve Olay Bilgileri
Model benzer şehir, etkinlik veya kurumları birbirine bağlayabilir. Bir olayın gerçekleştiği yer yanlış belirtilmiş olabilir. Haber özetlerinde bu hata yanlış aktör ve zaman bilgisiyle birleşebilir. Birincil haber açıklaması veya resmi duyuru kullanılmalıdır. Location metadata mümkünse structured source üzerinden doğrulanmalıdır.
Kaynak ve Referans Halüsinasyonları
Kaynak halüsinasyonu modelin hiç var olmayan referanslar üretmesi veya gerçek kaynağı yanlış temsil etmesidir. Akademik ve kurumsal kullanımda en tehlikeli hata türlerinden biridir. Kaynağın biçimsel olarak profesyonel görünmesi kullanıcıyı yanıltabilir. DOI, yazar ve yayın bilgisi doğrulanmadan citation kullanılmamalıdır. Kaynak isteyen prompt tek başına güvenilir referans üretimi sağlamaz.
Var Olmayan Makaleler
Model gerçek akademisyen isimlerini kullanarak hayali makale başlığı oluşturabilir. Başlık alan terminolojisine uygun olduğu için son derece inandırıcı görünebilir. Kaynağın yayıncı veya akademik indeks üzerinde bulunup bulunmadığı kontrol edilmelidir. Sadece arama motorunda benzer başlık görmek yeterli değildir. Özellikle akademik içerikte kaynak metadata otomatik doğrulamadan geçirilmelidir.
Sahte DOI ve URL'ler
Model DOI formatını bilir ve biçimsel olarak geçerli görünen fakat var olmayan tanımlayıcılar üretebilir. Benzer durum URL’lerde de görülür. Bir adres yapısal olarak gerçek görünse bile sayfa bulunmayabilir. DOI resolver veya ilgili yayıncı üzerinden doğrulama yapılmalıdır. Link health kontrolü source verification pipeline’a eklenebilir.
Gerçek Kaynağa Yanlış Bilgi Atfetme
Bu hata, kaynağın gerçekten var olması nedeniyle daha zor fark edilir. Model gerçek bir makaleyi veya raporu gösterir ancak kaynağın söylemediği bir iddiayı ona atfeder. Citation presence bu nedenle citation accuracy anlamına gelmez. Kaynağın ilgili bölümünün gerçekten iddiayı destekleyip desteklemediği kontrol edilmelidir. Kurumsal fact checking süreçlerinde source-entailment değerlendirmesi kullanılabilir.
Bağlamsal Halüsinasyonlar
Bağlamsal halüsinasyon modelin verilen konuşma veya doküman bağlamını yanlış yorumlamasıdır. Kullanıcının daha önce belirttiği koşul gözden kaçabilir. İki farklı belgeye ait bilgiler tek olaymış gibi birleştirilebilir. Uzun context pencerelerinde bu tür hatalar artabilir. Context segmentation ve reference tagging bu riski azaltmaya yardımcı olur.
Mantıksal ve Muhakeme Hataları
Model tüm öncülleri doğru okusa bile hatalı sonuca ulaşabilir. Oran, nedensellik veya karşılaştırma hataları buna örnektir. Özellikle çok adımlı problemlerde intermediate step doğrulaması faydalıdır. Deterministic hesaplama veya rule engine kullanılabilecek yerde tamamen LLM reasoning’e güvenmek gerekmez. Yüksek riskli kararlar için sonuç ve gerekçe ayrı ayrı doğrulanmalıdır.
Kod Halüsinasyonları
Kod üreten modeller gerçek olmayan library veya method isimleri önerebilir. API’nin eski sürümüne ait kullanımı güncelmiş gibi sunabilir. Kod syntax açısından doğru görünse bile çalışmayabilir veya güvenlik açığı taşıyabilir. Bu nedenle generated code otomatik test ve static analysis süreçlerinden geçmelidir. Dokümantasyon doğrulaması özellikle dependency ve API kullanımında zorunlu hale getirilmelidir.
Var Olmayan Kütüphaneler
Model bilinen package naming kalıplarına benzeyen hayali paket isimleri üretebilir. Geliştirici bu paketi yüklemeye çalışırken supply-chain saldırısına bile maruz kalabilir. Package repository üzerinde gerçek publisher ve download geçmişi kontrol edilmelidir. Dependency allowlist yaklaşımı kurumsal sistemlerde faydalıdır. Model önerdi diye package otomatik kurulumu yapılmamalıdır.
Var Olmayan Metot ve API'ler
Model gerçek library için olmayan method çağrıları üretebilir. Benzer API’lerin method isimleri birbirine karışabilir. IDE autocomplete veya official docs ile doğrulama yapılmalıdır. Compile ve unit test bu tür hataları hızlı yakalar. API çağrılarında version pinning güvenilirliği artırır.
Eski Sürüme Ait Kod Örnekleri
Model geçmiş sürümde geçerli olan kullanım örneğini güncelmiş gibi sunabilir. Breaking change sonrası parametre veya import yolu değişmiş olabilir. Official changelog ve current documentation kontrol edilmelidir. Production dependency version ile örnek kod aynı ortamda test edilmelidir. Bu hata özellikle hızlı gelişen AI framework’lerinde sık görülür.
Multimodal Halüsinasyonlar
Multimodal modeller görsel veya belge içeriklerini yorumlarken metin modelinden farklı hata türleri üretebilir. Görselde olmayan nesne tanımlanabilir. Küçük yazı veya sayı yanlış okunabilir. Grafik eksenleri yanlış yorumlanabilir. Kritik görsel analizlerde model çıktısı insan veya deterministik vision pipeline ile doğrulanmalıdır.
Görsel İçeriği Yanlış Yorumlama
Model grafik, tablo veya fotoğrafın bağlamını yanlış anlayabilir. Ekseni yanlış okuyup trend yönünü ters ifade edebilir. Belgedeki küçük notu ana sonuç gibi yorumlayabilir. Görselden çıkarılan iddialar ayrı validation’dan geçirilmelidir. Sayısal grafiklerde mümkünse kaynak data tercih edilmelidir.
Görselde Olmayan Nesneleri Tanımlama
Model beklentiye dayalı olarak görselde bulunmayan nesne veya yazıyı tarif edebilir. Düşük çözünürlük ve kalabalık sahneler riski artırır. Object detection sonucu ile generative description karşılaştırılabilir. Kritik güvenlik uygulamalarında tek multimodal modelin yorumuna güvenilmemelidir. Belirsiz görüntü için modelin açıkça emin olmadığını ifade etmesi tercih edilmelidir.
Büyük Dil Modelleri Neden Halüsinasyon Üretir?
Halüsinasyon tek bir teknik sebepten kaynaklanmaz. Modelin token tahmin yaklaşımı, eğitim verisi, prompt, context, retrieval ve reward yapısı birlikte rol oynar. Bir sistemde sorunun yalnızca “model kötü” diye açıklanması çözümü zorlaştırır. Önce hatanın hangi katmandan geldiği ayrılmalıdır. Root cause sınıflandırması yapılmadan model değiştirmek aynı hatanın başka biçimde devam etmesine neden olabilir.
Bir Sonraki Token'ı Tahmin Etme Mantığı
Büyük dil modeli temel olarak önceki tokenlara göre olası sonraki token dağılımını üretir. Bu mekanizma doğruluk veritabanı gibi çalışmaz. Dilsel olarak makul devam, gerçek dünyada yanlış olabilir. Model bazen eksik bilgiyi tutarlı bir anlatıyla tamamlar. Grounding ve retrieval bu nedenle dış bilgi desteği sağlar.
Eğitim Verilerinin Eksik veya Hatalı Olması
Eğitim verisi tüm dünya bilgisini eksiksiz içermez. Veri içinde yanlış, çelişkili veya düşük kaliteli içerikler bulunabilir. Model bu örüntüleri de öğrenebilir. Nadir alanlarda güvenilir bilgi temsili daha zayıf olabilir. Domain-specific RAG ve evaluation bu boşluğu azaltabilir.
Güncel Olmayan Bilgi
Statik model güncel olayları training tarihinden sonra bilemez. Kullanıcı güncel bilgi isterken model eski bilgiye dayanarak cevap üretebilir. Modelin akıcı olması bilginin güncel olduğu anlamına gelmez. Fresh retrieval veya web tabanlı verification gerekir. Cevapta bilgi tarihi belirtilmesi kullanıcı güvenini artırır.
Belirsiz veya Eksik Promptlar
Eksik prompt modelin varsayım yapmasını teşvik eder. Kullanıcı hangi ülke, dönem veya kaynak türünü kastettiğini belirtmemiş olabilir. Model varsayımını açıkça söylemek yerine tek bir cevap seçebilir. Prompt tasarımında gerekli context ve sınırlar belirtilmelidir. Kritik sistemlerde missing parameter validation uygulanabilir.
Bağlam Penceresi Sorunları
Uzun konuşma veya doküman context içinde önemli bilgi kaybolabilir. Model baştaki koşulu gözden kaçırabilir. Çok fazla ilgisiz içerik retrieval kalitesini düşürebilir. Context window büyük olsa bile her token eşit dikkat almaz. Retrieval ve context construction kısa ve ilgili bilgi vermeye odaklanmalıdır.
Modelin Bilmediğini Bilmemesi
Model internal knowledge sınırını her zaman doğru tahmin edemez. Bilmediği soruya yine de makul görünen cevap üretebilir. Calibration zayıfsa confidence ile doğruluk arasında güçlü ilişki olmayabilir. Abstention davranışı özel prompt ve evaluation ile geliştirilebilir. “Bilmiyorum” cevabı bazı use case’lerde başarılı sonuç olarak değerlendirilmelidir.
Tahmin Etmenin “Bilmiyorum” Demekten Daha Fazla Ödüllendirilmesi
Kullanıcılar çoğu zaman doğrudan cevap beklediği için model davranışı cevap üretmeye eğilimli olabilir. Bu durum belirsiz sorularda risk yaratır. Evaluation yalnızca answer rate ölçerse abstention cezalandırılmış olur. Yüksek riskli sistemde doğru biçimde cevap vermeme ayrı başarı metriği olarak tanımlanmalıdır. Reward ve prompt tasarımı bunu desteklemelidir.
Retrieval ve RAG Kaynaklı Hatalar
RAG yanlış belge getirirse model yanlış context üzerinden cevap üretebilir. Relevant doküman hiç bulunmayabilir. Chunk çok küçük veya çok büyük olabilir. Retrieval sonucu eski veya yetkisiz bilgi içerebilir. Bu nedenle retrieval quality generation quality’den ayrı ölçülmelidir.
Kullanıcının Yanlış Varsayımlarının Modele Aktarılması
Kullanıcı sorusunda yanlış bir öncül bulunabilir. Model bu öncülü sorgulamadan kabul ederse yanlış cevabı pekiştirir. “X olayı 2025’te olduğuna göre” gibi bir ifade aslında yanlış tarih içerebilir. Modelin önemli premise’leri doğrulaması istenebilir. Kritik sorularda premise validation ayrı adım olarak tasarlanabilir.
AI Çıktılarında Doğruluk Neden Önemlidir?
Yanlış AI çıktısının etkisi kullanım alanına göre değişir. Bir fikir taslağındaki hata küçükken hukuki veya sağlık kararındaki hata ciddi sonuçlar doğurabilir. Bu nedenle doğrulama yoğunluğu risk bazlı olmalıdır. Kullanıcı güveni bir kez kaybedildiğinde doğru çıktılar bile şüpheyle karşılanmaya başlanır. Kurumsal AI sistemleri için doğruluk ve halüsinasyon değerlendirme hizmeti tasarlanırken teknik metriklerin yanında iş etkisi de dikkate alınmalıdır.
Yanlış Bilginin Kullanıcı Güvenine Etkisi
Kullanıcı bir sistemin birkaç kez kaynak uydurduğunu fark ettiğinde tüm cevapları sorgulamaya başlar. Bu durum adoption oranını düşürür. Çalışanlar AI çıktısını kullanmak yerine eski manuel süreçlerine dönebilir. Kaynak gösterimi ve düzeltme mekanizması güveni korumaya yardımcı olur. Güvenilirlik yalnızca model accuracy değil ürün deneyimi problemidir.
Akademik Araştırmalardaki Riskler
Var olmayan akademik kaynaklar araştırma kalitesini bozar. Yanlış citation başka makalelere taşınabilir. Öğrenci veya araştırmacı doğrulamadan referans kullanabilir. DOI ve paper metadata doğrulaması kritik hale gelir. AI research assistant yalnızca kaynak keşfi yardımcısı olarak görülmeli ve nihai atıf insan tarafından kontrol edilmelidir.
Sağlık Alanındaki Riskler
Sağlık bilgisindeki hata doğrudan kullanıcı davranışını etkileyebilir. Yanlış ilaç veya tanı önerisi ciddi risk yaratır. Model klinik karar verici olarak kullanılmamalıdır. Resmi ve onaylı tıbbi kaynaklar kullanılmalı, insan uzman denetimi uygulanmalıdır. Belirsizlik durumunda cevap vermeme eşiği düşük tutulmalıdır.
Hukuki Kullanımlardaki Riskler
Model var olmayan mevzuat maddesi veya dava kararı üretebilir. Hukuki metinlerde küçük tarih farkı bile sonucu değiştirebilir. Güncel resmi mevzuat kaynağı kullanılmalıdır. Citation yalnızca gerçek olmakla kalmamalı, iddiayı doğru desteklemelidir. Nihai hukuki değerlendirme uzman kontrolünden geçmelidir.
Finansal Kararlardaki Riskler
Yanlış fiyat, oran veya şirket verisi finansal kararı etkileyebilir. Model güncel olmayan veriyi bugünkü değer gibi sunabilir. Deterministic hesap ve canlı veri kaynağı kullanılmalıdır. Risk skoru yüksek çıktılar otomatik aksiyon üretmemelidir. İnsan approval ve audit trail gereklidir.
Haber ve İçerik Üretimindeki Riskler
Yanlış isim veya olay bilgisi hızla yayılan içeriklerde itibar kaybına yol açabilir. Haber üretiminde tarih ve kaynak doğrulaması zorunludur. Model tarafından oluşturulan alıntılar mutlaka kontrol edilmelidir. “Kaynak var” görünümü doğruluk garantisi değildir. Editoryal süreç AI sonrası da devam etmelidir.
Yazılım Geliştirmedeki Riskler
AI yanlış API veya güvenlik açığı içeren kod önerebilir. Kod compile olsa bile güvenli olmayabilir. Dependency hallucination supply-chain riski yaratabilir. Unit test, static analysis ve review pipeline’ın parçası olmalıdır. AI coding assistant hız sağlar fakat kalite kapıları kaldırılmamalıdır.
Müşteri Hizmetleri ve Kurumsal AI Riskleri
Müşteri asistanı yanlış fiyat veya sözleşme bilgisi verdiğinde şirket bağlamında ciddi sorun oluşabilir. RAG yalnızca onaylı kurumsal kaynaklardan yapılmalıdır. Cevap confidence düşükse agent insana devretmelidir. Her yanıt için source trace tutulabilir. Complaint verisi evaluation setine eklenmelidir.
AI Çıktısının Doğru Olduğu Nasıl Kontrol Edilir?
AI çıktısını doğrulamak için önce hangi cümlelerin doğrulanabilir iddia içerdiğini belirlemek gerekir. Sonra bu iddialar güvenilir kaynaklarla karşılaştırılır. Kaynağın gerçek olması tek başına yetmez, ilgili iddiayı gerçekten desteklemesi gerekir. Güncellik tarihi ve bağlam da kontrol edilmelidir. LLM çıktılarında doğruluk ve factuality kontrolü nasıl yapılır sorusunun en pratik cevabı, iddia düzeyinde sistematik doğrulama yapmaktır.
Önce Doğrulanabilir İddiaları Ayırın
Bir cevapta görüş, öneri ve olgusal iddia birbirinden ayrılmalıdır. “Bu yaklaşım daha iyi olabilir” yorumsal bir ifade iken “bu ürün 2024’te piyasaya çıktı” doğrulanabilir iddiadır. Fact checker önce ikinci tür cümlelere odaklanır. Named entity ve number extraction otomatikleştirilebilir. Böylece doğrulama maliyeti kritik iddialara yönlendirilir.
İsimler
Kişi, kurum ve ürün isimleri yanlış eşleşebilir. Resmi kaynak üzerinden varlığı doğrulanmalıdır. Benzer isimli iki entity ayrıştırılmalıdır. Ünvan ve görev tarihi ayrıca kontrol edilmelidir. Entity resolution sistemi bu süreçte yardımcı olabilir.
Tarihler
Tarih iddiaları resmi duyuru veya güvenilir yayınla karşılaştırılmalıdır. Yayın tarihi ile olay tarihi ayrılmalıdır. Zaman dilimi farkı bazı event’lerde önemlidir. Güncel bilgi gerekiyorsa stale source kullanılmamalıdır. Date extraction otomatik kontrol listesine eklenebilir.
Sayılar
Sayılar kaynak cümlesiyle birebir karşılaştırılmalıdır. Ölçek ve para birimi kontrol edilmelidir. Milyon ile milyar karışıklığı ciddi hata yaratır. Yuvarlama politikası belirtilmelidir. Hesaplanmış değerler deterministic formülle tekrar doğrulanmalıdır.
İstatistikler
İstatistik yalnızca sayı değil yöntem bağlamı da gerektirir. Örneklem büyüklüğü ve dönem önemlidir. Model aynı çalışmadan farklı yüzde uydurabilir. Birincil rapor kullanılmalıdır. İstatistik metni kullanıcıya bağlamıyla sunulmalıdır.
Alıntılar
Alıntı birebir kaynakta geçmelidir. Model yakın anlamlı cümleyi doğrudan quote gibi sunmamalıdır. Speaker ve tarih doğrulanmalıdır. Paraphrase ile quotation açıkça ayrılmalıdır. Kaynak sayfasındaki exact text kontrol edilmelidir.
Kaynaklar
Kaynağın URL veya DOI düzeyinde varlığı doğrulanmalıdır. Publisher güvenilirliği incelenmelidir. Sayfanın güncel olup olmadığı kontrol edilmelidir. Citation’ın iddiayı gerçekten desteklediği görülmelidir. Sadece modelin kaynak vermesi doğrulama işlemi değildir.
Her İddia İçin Birincil Kaynak Arayın
Mümkün olduğunda iddianın asıl üreticisine ait kaynak tercih edilmelidir. Resmi şirket açıklaması, mevzuat sitesi, akademik makalenin yayıncı sayfası veya resmi veri tabanı birincil kaynak olabilir. İkincil yayınlar bağlam için değerlidir ancak kritik detaylar birincil kaynakla doğrulanmalıdır. Source hierarchy otomatik verifier içinde tanımlanabilir. Yüksek riskli alanlarda düşük otoriteli kaynak tek başına yeterli sayılmamalıdır.
Bilgiyi Birden Fazla Bağımsız Kaynakla Karşılaştırın
Tek kaynak hatalı veya eski olabilir. İkinci bağımsız kaynak kritik iddiayı doğrulamaya yardımcı olur. Ancak birbirini kopyalayan sayfalar bağımsız sayılmaz. Source provenance mümkünse incelenmelidir. Özellikle yüksek etkili kararlar için en az iki güçlü kaynak kuralı uygulanabilir.
Bilginin Güncellik Tarihini Kontrol Edin
Doğru bilgi zaman içinde eski hale gelebilir. Fiyat, görev, mevzuat veya software version bilgisi buna örnektir. Source last-updated veya publication date kontrol edilmelidir. RAG index freshness metriği tutulmalıdır. Güncel sorularda model internal knowledge yerine current retrieval kullanmalıdır.
Kaynağın Gerçekten Var Olup Olmadığını Kontrol Edin
Model sahte paper veya URL üretebilir. Reference resolver otomatik olarak HTTP, DOI veya catalog sorgusu yapabilir. 404 sonucu doğrudan hallucination sinyali olabilir. Ancak paywall veya geçici bağlantı problemi ayrı ele alınmalıdır. Source existence check citation accuracy pipeline’ın ilk aşamalarından biri olmalıdır.
Kaynağın İddiayı Gerçekten Destekleyip Desteklemediğini Kontrol Edin
Gerçek kaynak yanlış iddia için kullanılabilir. Bu nedenle retrieval yapılmış olması validation değildir. İddia ve kaynak passage arasında entailment ölçülebilir. İnsan reviewer kritik örnekleri inceleyebilir. Citation precision bu ilişkiyi ölçmek için kullanılabilir.
Kaynağın Güvenilirliğini Değerlendirin
Her kaynak aynı ağırlıkta değildir. Resmi kurum ve birincil belge çoğu olgusal iddia için daha güçlüdür. Kullanıcı içeriği deneyim bilgisinde değerli olabilir fakat bilimsel iddiada tek başına yeterli değildir. Source class metadata verifier’a eklenebilir. Risk yükseldikçe kabul edilen source seviyesi yükseltilmelidir.
Birincil Kaynaklar
Birincil kaynak iddianın doğrudan üretildiği veya kaydedildiği yerdir. Resmi rapor veya ürün dokümantasyonu örnek olabilir. En güçlü doğrulama kaynaklarından biridir. Yine de kaynak içinde yanlış veya güncel olmayan bilgi bulunabileceği unutulmamalıdır. Publication context ayrıca kontrol edilmelidir.
Akademik Kaynaklar
Peer-reviewed paper ve akademik yayınlar araştırma iddialarında önemlidir. DOI ve yayıncı doğrulaması yapılmalıdır. Preprint ile hakemli yayın ayrılmalıdır. Çalışmanın gerçek sonucuyla model yorumunun uyumu kontrol edilmelidir. Tek çalışma genel gerçek gibi sunulmamalıdır.
Resmî Kurumlar
Mevzuat, istatistik ve kamu duyurularında resmi kurum kaynakları önceliklidir. Domain ve yayın tarihi doğrulanmalıdır. Arşiv sayfası ile güncel sayfa ayrılmalıdır. Resmi açıklamanın kapsamı dışına çıkılmamalıdır. Kurumsal verifier source allowlist kullanabilir.
Uzman Yayınlar
Alan uzmanı yayınlar teknik bağlam sağlar. Editoryal kalite ve kaynak gösterimi değerlendirilmelidir. Birincil belgenin yorumlandığı durumlarda original source da kontrol edilmelidir. Güncel teknik konularda güçlü ikincil kaynak olabilir. Yine de yüksek riskli iddia için tek kaynak yeterli olmayabilir.
Kullanıcı Tarafından Oluşturulan İçerikler
Forum ve community içerikleri pratik deneyim açısından değerlidir. Fakat doğruluk standardı değişkendir. Kişisel yorum olgusal kanıt gibi kullanılmamalıdır. Repeated consensus yardımcı sinyal olabilir. Kritik kararlar daha yüksek otoriteli kaynaklarla doğrulanmalıdır.
5 Adımlı AI Çıktısı Doğrulama Kontrolü
Her kullanıcı veya ekip karmaşık bir fact checking sistemi kurmak zorunda değildir. Basit beş adımlı yaklaşım bile günlük AI kullanımındaki birçok hatayı yakalayabilir. Önce çıktıyı taslak kabul etmek, sonra doğrulanabilir iddiaları ayırmak gerekir. Kaynaklar bulunmalı ve kritik bilgiler ikinci bağımsız kaynakla kontrol edilmelidir. Risk yüksekse son karar uzman veya sorumlu insan tarafından verilmelidir.
1. AI Çıktısını Taslak Kabul Edin
İlk cevap nihai gerçek olarak görülmemelidir. Bu yaklaşım kullanıcıyı otomatik güven davranışından çıkarır. Metin önce düzenlenebilir ve doğrulanabilir taslak olarak değerlendirilir. Özellikle yayınlanacak içeriklerde fact checking aşaması ayrı tutulmalıdır. Kurum içi kullanım standardında bu davranış açıkça tanımlanabilir.
2. Doğrulanabilir İddiaları İşaretleyin
İsim, sayı ve tarih içeren cümleler hızlıca belirlenebilir. Kaynak gerektiren olgusal iddialar işaretlenir. Görüş ve öneriler farklı sınıfta tutulur. Otomatik claim extraction bu süreci ölçeklendirebilir. Kritik claim listesi verifier pipeline’a gönderilir.
3. Her İddianın Kaynağını Bulun
Her kritik iddia için doğrudan destekleyici kaynak aranır. Source retrieval yalnızca keyword eşleşmesine bırakılmamalıdır. Birincil kaynak mümkünse tercih edilir. Kaynak yoksa iddia çıkarılabilir veya belirsiz olarak işaretlenebilir. Modelin kendisinin ürettiği citation ayrıca doğrulanmalıdır.
4. Kritik Bilgileri İkinci Bir Kaynakla Doğrulayın
Özellikle sayı ve yüksek etkili iddialar ikinci kaynakla doğrulanmalıdır. Kaynaklar birbirinden bağımsız olmalıdır. Aynı basın açıklamasını kopyalayan haberler bağımsız verification sayılmaz. Çelişki varsa cevapta belirsizlik belirtilmelidir. İnsan reviewer hangi kaynağın daha otoriter olduğunu değerlendirebilir.
5. Yüksek Riskli Çıktılarda İnsan Onayı Alın
Sağlık, hukuk, finans ve güvenlik gibi alanlarda otomatik doğrulama tek başına yeterli değildir. Uzman reviewer kaynak ve sonucu birlikte incelemelidir. Human approval kayıt altına alınabilir. Sistem onay olmadan downstream aksiyon üretmemelidir. Bu yaklaşım AI’yi asistan rolünde tutar.
Kaynak ve Atıf Halüsinasyonları Nasıl Tespit Edilir?
Kaynak doğrulama, hallucination kontrolünün en somut alanlarından biridir. Reference metadata doğrulanabilir olduğu için birçok adım otomatikleştirilebilir. Makale başlığı, yazar, DOI, URL ve yayın tarihi kontrol edilmelidir. Daha önemlisi kaynağın ilgili iddiayı gerçekten destekleyip desteklemediği incelenmelidir. Gerçek kaynağa sahte iddia atfetme hatası yalnızca link kontrolüyle yakalanamaz.
Bir Referansın Gerçek Olup Olmadığı Nasıl Kontrol Edilir?
Reference exact title ile aranabilir. Publisher sayfası kontrol edilir. DOI varsa resolver üzerinden açılmalıdır. Yazar ve yıl metadata ile uyuşmalıdır. Kaynak bulunamıyorsa citation kullanılmamalıdır.
Makale Başlığı ve Yazar Kontrolü
Başlık küçük farklarla hayali üretilebilir. Exact match kontrolü yapılmalıdır. Yazar sırası ve kurum bilgisi doğrulanabilir. Aynı başlıklı farklı yayınlar ayrıştırılmalıdır. Bibliographic database kullanmak manual search’e göre daha güvenilir olabilir.
DOI Kontrolü
DOI biçim olarak geçerli görünebilir fakat resolver’da bulunmayabilir. DOI ile dönen başlık ve yazar citation ile eşleşmelidir. Redirect edilen publisher domain kontrol edilmelidir. Modelin yalnızca DOI formatını taklit etmiş olabileceği unutulmamalıdır. Automated verifier bu adımı saniyeler içinde yapabilir.
URL Kontrolü
URL’nin açılması ilk kontroldür. Sayfa içeriği citation ile ilişkili olmalıdır. Tracking veya redirect linkleri normalized hale getirilebilir. Archived page kullanılıyorsa tarih belirtilmelidir. Domain spoofing riskine karşı host doğrulanmalıdır.
Yayın Tarihi Kontrolü
Yayın tarihi modelin söylediği olay dönemini doğrulayabilir. Güncellenmiş sayfalarda original publish ve modified date ayrılmalıdır. Akademik makalede online-first ve issue date farklı olabilir. Kullanıcıya hangi tarih kullanıldığı açıkça belirtilmelidir. Güncellik gerektiren iddialar stale publication’dan alınmamalıdır.
Alıntının Kaynakta Gerçekten Geçip Geçmediğini Kontrol Etmek
Doğrudan quote exact phrase olarak kaynakta bulunmalıdır. Model paraphrase’i quotation mark içinde vermemelidir. Search veya text extraction ile kontrol yapılabilir. Quote context’ten koparılmamalıdır. Kritik alıntılar insan tarafından ayrıca incelenebilir.
Gerçek Kaynağa Sahte İddia Atfedilmesini Tespit Etmek
Bu durumda citation resolver başarılı olur ancak source-entailment başarısızdır. İddia ile destekleyici passage birlikte değerlendirilmelidir. Natural language inference modeli otomatik ön kontrol yapabilir. High-risk claim insan reviewer’a yönlendirilebilir. Citation presence ile citation support ayrı metrikler olmalıdır.
Prompt Engineering ile Halüsinasyon Nasıl Azaltılır?
Prompt engineering halüsinasyon oranını azaltabilir ancak tek başına güvenilirlik garantisi vermez. Modele hangi kaynakları kullanabileceğini ve hangi durumda cevap vermemesi gerektiğini açıkça belirtmek faydalıdır. Structured output serbest metin alanını sınırlandırabilir. Bununla birlikte model verilen talimatı her zaman kusursuz takip etmeyebilir. Prompt kontrolü RAG, validation ve evaluation katmanlarıyla birlikte kullanılmalıdır.
Modele Yeterli Bağlam Vermek
Eksik context modelin tahmin yapmasına neden olabilir. Gerekli tanım, dönem ve kaynak açıkça verilmelidir. Çok fazla ilgisiz context de kaliteyi düşürebilir. Relevant context selection önemlidir. Prompt mümkün olduğunca kısa fakat yeterli bilgi içermelidir.
Görevin Sınırlarını Açıkça Belirtmek
Modelden yalnızca belirli konu veya kaynak kapsamında yanıt istenebilir. Yetkisiz çıkarım yapmaması belirtilebilir. Cevap formatı açık yazılmalıdır. Belirsizlik durumunda nasıl davranacağı tanımlanmalıdır. Test seti modelin bu sınırları ne kadar iyi takip ettiğini ölçmelidir.
Yalnızca Verilen Kaynaklardan Yanıt İstemek
Bu yöntem faithfulness seviyesini artırabilir. Model external knowledge kullanmaması konusunda yönlendirilir. Her claim için source ID istenebilir. Context dışında bilgi gerekiyorsa cevap vermemesi belirtilir. Yine de prompt instruction tek başına enforcement değildir.
Kaynakta Bulunmayan Bilgiler İçin “Bilmiyorum” Demesini İstemek
Abstention davranışı açıkça tanımlanabilir. Modelin düşük evidence durumunda tahmin yapması engellenmeye çalışılır. Evaluation setine cevapsız sorular eklenmelidir. Doğru abstention başarı olarak puanlanmalıdır. Production threshold ile birlikte bu davranış daha güçlü hale gelir.
Belirsizliği Açıkça Belirtmesini İstemek
Model kesinlik derecesini sözlü biçimde ifade edebilir. “Kaynaklar bu noktada çelişiyor” gibi ifade kullanıcıya faydalıdır. Ancak sözlü confidence gerçek calibration anlamına gelmez. Sistem skoru ayrı hesaplanmalıdır. Belirsizlik ifadesi kullanıcı arayüzünde görünür tutulabilir.
Yapılandırılmış Çıktı Formatları Kullanmak
Structured output modelin beklenen alanların dışına çıkmasını azaltır. Claim, source ve confidence ayrı alanlar olabilir. Parser ve validator uygulanabilir. Downstream automation daha güvenli hale gelir. Serbest metin açıklama gerektiğinde ayrı field kullanılabilir.
JSON Schema
JSON Schema required field ve tipleri tanımlar. Model output bu schema’ya göre validate edilir. Claim ve evidence array ayrılabilir. Geçersiz sonuç controlled retry alabilir. Schema doğruluğu factual doğrulukla karıştırılmamalıdır.
Enum ve Kısıtlı Alanlar
Enum serbest değer üretimini sınırlar. Risk seviyesi yalnızca belirli seçeneklerden biri olabilir. Model hayali status değeri oluşturamaz. Validation daha kolaydır. Bu yöntem factuality değil output control sağlar.
Kaynak İstemek Tek Başına Neden Yeterli Değildir?
Model kaynak formatı üretmeyi öğrenmiştir. Bu nedenle “kaynak ver” komutu sahte citation oluşturabilir. Source existence ve entailment ayrıca doğrulanmalıdır. RAG context içindeki source ID’lerin kullanılması daha güvenlidir. Kaynak doğrulama ayrı sistem sorumluluğu olmalıdır.
RAG ile Halüsinasyonları Azaltmak
RAG modelin yalnızca parametrelerindeki bilgiye dayanmak yerine sorgu anında ilgili dokümanları kullanmasını sağlar. Bu yöntem özellikle kurumsal ve güncel bilgi kullanımında güçlüdür. RAG ile yapay zeka halüsinasyonlarını azaltma ve kaynak doğrulama yöntemleri doğru retrieval ve context construction tasarımına bağlıdır. Yanlış belge getirildiğinde RAG güvenilirliği artırmak yerine hatayı güçlendirebilir. Bu nedenle retrieval ve generation iki ayrı kalite katmanı olarak izlenmelidir.
RAG Nedir?
RAG, retrieval-augmented generation yaklaşımıdır. Kullanıcı sorusuna uygun dokümanlar önce bilgi tabanından bulunur. Bu içerikler model prompt’una eklenir. Model yanıtı bu context üzerinden üretir. Güncel veya kurumsal bilgi modelin yeniden eğitilmesini gerektirmeden kullanılabilir.
Grounding Nedir?
Grounding model cevabını belirli veri veya kaynaklara bağlama işlemidir. RAG bunun yaygın yöntemlerinden biridir. Kullanıcı cevabın hangi source passage’dan geldiğini görebilir. Grounded answer doğrulanabilirlik sağlar. Ancak kaynak doğru değilse grounding tek başına factuality garantisi değildir.
RAG Sistemi Nasıl Çalışır?
RAG pipeline doküman toplama ile başlar. İçerikler parse edilir ve chunk’lara ayrılır. Embedding oluşturulur ve retrieval index’e yazılır. Kullanıcı sorusunda ilgili parçalar getirilir. Context hazırlanıp LLM’e gönderilir ve yanıt kaynaklarla birlikte üretilir.
Doküman Toplama
Kaynak sistemlerden yalnızca onaylı içerik alınmalıdır. Doküman version ve timestamp saklanmalıdır. Duplicate içerik temizlenebilir. Access control metadata korunmalıdır. Kaynak güvenilirliği ingestion aşamasında sınıflandırılabilir.
Chunking
Doküman retrieval için daha küçük parçalara ayrılır. Çok kısa chunk context kaybına neden olabilir. Çok uzun chunk ilgisiz bilgi taşıyabilir. Başlık ve section sınırları korunmalıdır. Chunk strategy evaluation ile test edilmelidir.
Embedding
Embedding metni semantic vector’a dönüştürür. Domain ve dil performansı önemlidir. Model version index metadata’da saklanmalıdır. Embedding değişirse re-index gerekebilir. Retrieval benchmark aynı query setiyle karşılaştırılmalıdır.
Retrieval
Kullanıcı sorgusuna yakın chunk’lar bulunur. Vector, keyword veya hybrid search kullanılabilir. Top-k ve filter ayarları kaliteyi etkiler. ACL retrieval aşamasında uygulanmalıdır. Retrieval recall ayrıca ölçülmelidir.
Context Oluşturma
Getirilen chunk’lar düzenli prompt context’ine dönüştürülür. Duplicate ve düşük relevance içerikler çıkarılabilir. Source ID eklenir. Token budget kontrol edilir. Modelin her iddiayı kaynakla ilişkilendirmesi istenebilir.
Yanıt Üretimi
LLM context üzerinden cevap oluşturur. Citation event veya inline source ID üretilebilir. Context dışında bilgi eklememesi istenir. Faithfulness checker sonuçtan sonra çalışabilir. Düşük groundedness durumunda cevap engellenebilir.
RAG Halüsinasyonu Nasıl Azaltır?
RAG modele güncel ve domain-specific evidence sağlar. Modelin parametric memory üzerinden tahmin yapma ihtiyacı azalır. Citation üretimi kolaylaşır. Kullanıcı veya verifier cevabı kaynağa göre kontrol edebilir. Yine de retrieval ve interpretation hataları devam ettiği için RAG tek başına yeterli değildir.
RAG Neden Halüsinasyonu Tamamen Ortadan Kaldırmaz?
RAG pipeline birden fazla hata noktası içerir. Yanlış doküman retrieval yapılabilir. Doğru belge olsa bile gerekli bölüm bulunmayabilir. Model context’i yanlış yorumlayabilir. Kaynak kendisi eski veya hatalı olabilir.
Yanlış Doküman Getirme
Semantic similarity her zaman factual relevance anlamına gelmez. Benzer kelimeli ama farklı konu dokümanı seçilebilir. Reranker kaliteyi artırabilir. Metadata filter kullanılabilir. Retrieval precision düzenli ölçülmelidir.
Eksik Retrieval
Doğru cevabı destekleyen kaynak index’te olsa bile top-k içinde gelmeyebilir. Chunking hatası bilgiyi bölebilir. Query rewriting yardımcı olabilir. Context recall metriği bu problemi gösterir. Kritik RAG sistemlerinde retrieval failure ayrı alarm üretebilir.
Güncelliğini Yitirmiş Kaynak
Index eski doküman içeriyorsa model eski bilgiye grounded cevap üretir. Bu cevap faithfulness açısından iyi ama factuality açısından kötü olabilir. Source freshness metadata tutulmalıdır. TTL veya re-index policy uygulanmalıdır. Güncel sorularda eski kaynak filtrelenmelidir.
Kaynağın Yanlış Olması
Kurumsal dokümanda yanlış bilgi bulunabilir. Model bu hatayı doğru biçimde aktarabilir. RAG kaynağın güvenilirliğini otomatik garanti etmez. Approved source workflow gerekir. Source owner ve version bilgisi izlenmelidir.
Modelin Kaynağı Yanlış Yorumlaması
Model verilen passage’dan hatalı sonuç çıkarabilir. Negation veya istisna gözden kaçabilir. Tablo satırları yanlış eşleştirilebilir. Faithfulness verifier source-answer entailment ölçebilir. Yüksek riskli bilgi için human review eklenebilir.
RAG Sistemlerinde Doğruluk Kontrolü Nasıl Yapılır?
RAG sisteminde tek bir overall accuracy metriği yeterli değildir. Önce retrieval’ın doğru evidence getirip getirmediği ölçülmelidir. Ardından modelin bu evidence üzerinden doğru ve ilgili cevap üretip üretmediği değerlendirilmelidir. Context precision, recall, answer relevance ve faithfulness birlikte kullanılabilir. Bu ayrım sorun çıktığında yanlış katmanı optimize etme riskini azaltır.
Retrieval Kalitesini Ayrı Ölçmek
Retrieval’ın görevi gerekli source passage’ları bulmaktır. Ground truth document veya passage listesi test setinde tutulabilir. Recall@k ve precision benzeri metrikler kullanılabilir. Hatalı retrieval model değiştirilerek çözülmeyebilir. Embedding, chunking ve reranker ayrı test edilmelidir.
Yanıt Kalitesini Ayrı Ölçmek
Doğru context verilse bile model yanlış cevap üretebilir. Answer correctness ve relevance bu katmanı ölçer. Reference answer veya human rubric kullanılabilir. Model version değişiklikleri regression testine alınmalıdır. Retrieval ve generation score birlikte dashboard’da gösterilebilir.
Context Precision
Context precision getirilen parçaların ne kadarının gerçekten ilgili olduğunu ölçer. Çok fazla ilgisiz chunk modelin dikkatini dağıtabilir. Top-k gereğinden yüksek tutulmamalıdır. Reranker precision artırabilir. Sorgu sınıfına göre farklı threshold kullanılabilir.
Context Recall
Context recall doğru cevabı oluşturmak için gerekli bilgilerin ne kadarının retrieval’da bulunduğunu ölçer. Eksik evidence modelin tahmin yapmasına neden olur. Gold source set ile ölçülebilir. Query rewriting recall artırabilir. Precision ve recall dengesi birlikte optimize edilmelidir.
Answer Relevance
Answer relevance cevabın kullanıcı sorusuna ne kadar doğrudan karşılık verdiğini ölçer. Kaynak doğru olsa bile model gereksiz bilgi ekleyebilir. Çok uzun cevap relevance skorunu düşürebilir. Task-specific rubric kullanılmalıdır. Kullanıcı feedback’i production sinyali sağlayabilir.
Faithfulness
Faithfulness cevaptaki iddiaların context tarafından desteklenip desteklenmediğini ölçer. Her claim için supporting passage aranabilir. LLM-as-a-judge otomatik skor üretebilir. Kritik örnekler insan tarafından doğrulanmalıdır. Low faithfulness response production’da engellenebilir.
Kaynak–Cevap Eşleşmesi
Citation’ın gerçekten ilgili claim’i desteklemesi gerekir. Source link varlığı yeterli değildir. Claim-level mapping yapılabilir. Citation precision ve recall birlikte takip edilmelidir. Kullanıcıya yanlış kaynak göstermek güvenilirliği ciddi biçimde düşürür.
AI Halüsinasyonları Nasıl Ölçülür?
AI sistemlerinde hallucination detection groundedness confidence score ve fact checking yöntemleri birlikte kullanıldığında daha anlamlı sonuç elde edilir. Tek bir accuracy oranı farklı hata tiplerini gizleyebilir. Hallucination rate, factual accuracy, faithfulness ve citation metrics ayrı raporlanmalıdır. Abstention ve calibration özellikle risk bazlı sistemlerde önemlidir. Verification cost ise bir cevabın insan tarafından doğrulanmasının ne kadar zor olduğunu gösteren değerli ama sık ihmal edilen metriktir.
Hallucination Rate
Hallucination rate test çıktılarının ne kadarında desteklenmeyen veya yanlış iddia bulunduğunu ölçer. Claim-level veya answer-level hesaplanabilir. Answer-level ölçüm tek küçük hatayı tüm cevabı başarısız sayabilir. Kullanım amacına göre tanım açık yazılmalıdır. Model version karşılaştırmasında aynı evaluation set kullanılmalıdır.
Factual Accuracy
Factual accuracy doğrulanabilir iddiaların ne kadarının doğru olduğunu ölçer. Ground truth veya external source gerekir. Sayı ve tarih gibi structured claim’ler otomatik kontrol edilebilir. Açık uçlu claim insan değerlendirmesi isteyebilir. Domain-specific accuracy ayrı raporlanmalıdır.
Faithfulness Score
Faithfulness score cevabın verilen context’e sadakatini ölçer. RAG sistemi için temel metric’tir. Doğru ama context dışı bilgi düşük score alabilir. Bu özellikle yalnızca onaylı belgeye dayanması gereken uygulamalarda önemlidir. Automatic judge ile ölçeklenebilir fakat calibration gerekir.
Groundedness Score
Groundedness score cevabın belirli evidence ile desteklenme derecesini ölçer. Claim başına source mapping kullanılabilir. Source strength ayrı ağırlık alabilir. Düşük score abstention trigger olabilir. Production threshold risk seviyesine göre farklılaşabilir.
Citation Accuracy
Citation accuracy referansların doğru claim’i destekleme performansını değerlendirir. Citation link’in gerçek olması yeterli değildir. Precision ve recall ayrı hesaplanabilir. Gereksiz citation precision’ı düşürebilir. Eksik citation recall’ı düşürür.
Citation Precision
Gösterilen citation’ların ne kadarının gerçekten claim’i desteklediğini ölçer. Sahte veya ilgisiz referans precision’ı düşürür. Source-entailment değerlendirmesi gerekir. Kullanıcı güveni açısından yüksek precision önemlidir. Az ama doğru citation çoğu zaman daha değerlidir.
Citation Recall
Kaynak gerektiren iddiaların ne kadarının citation ile desteklendiğini ölçer. Birkaç claim kaynaklı, geri kalanı kaynaksızsa recall düşer. Critical claim’ler daha yüksek ağırlık alabilir. Rule-based claim detector kullanılabilir. Kullanıcıya kaynak gereksinimi açık gösterilebilir.
False Positive ve False Negative
Hallucination detector doğru cevabı yanlış kabul edebilir. Bu false positive kullanıcı deneyimini bozar. Yanlış cevabı doğru kabul etmek false negative’dir ve daha riskli olabilir. Threshold risk alanına göre ayarlanmalıdır. Confusion matrix validation set üzerinde incelenmelidir.
Abstention Rate
Abstention rate modelin ne kadar sıklıkla cevap vermemeyi seçtiğini gösterir. Çok düşük oran reckless answering anlamına gelebilir. Çok yüksek oran sistem faydasını azaltır. Accuracy ile birlikte değerlendirilmelidir. Riskli use case’lerde doğru abstention ayrı başarı metriğidir.
Calibration ve Confidence
Calibration confidence score ile gerçek doğruluk arasındaki uyumu ölçer. Yüzde 80 güven verilen cevapların yaklaşık yüzde 80’i doğru olmalıdır. Dilsel kesinlik calibration değildir. Model logprob veya verifier score kullanılabilir. Threshold human review routing için kullanılabilir.
Verification Cost: Bir AI Cevabını Doğrulamak Ne Kadar Zor?
Bazı cevaplar doğru olsa bile doğrulamak çok pahalı olabilir. On kaynak taramak gerekiyorsa kullanıcı kazancı azalır. Verification cost süre, kaynak sayısı veya insan dakika cinsinden ölçülebilir. İyi sistem yalnızca doğru cevap değil kolay doğrulanabilir cevap üretmelidir. Citation quality bu maliyeti önemli ölçüde azaltabilir.
Güvenilir Bir AI Evaluation Seti Nasıl Oluşturulur?
Evaluation set gerçek kullanıcı davranışını temsil etmelidir. Sadece kolay benchmark soruları production hatalarını yakalamaz. Cevaplanamaz, güncel ve adversarial sorular özellikle eklenmelidir. Ground truth mümkün olduğunca uzman veya doğrulanmış kaynakla oluşturulmalıdır. Aynı test setinin model güncellemelerinde tekrar çalıştırılması regression kontrolünün temelidir.
Gerçek Kullanıcı Sorularını Toplamak
Production loglardan anonimleştirilmiş soru örnekleri alınabilir. En sık kullanılan task’lar temsil edilmelidir. Sadece başarılı conversation’lar seçilmemelidir. Complaint ve failure örnekleri özellikle değerlidir. PII temizleme zorunludur.
Ground Truth Oluşturmak
Her test sorusu için kabul edilen doğru cevap veya evidence set tanımlanmalıdır. Uzman review kullanılabilir. Kaynak link ve version saklanmalıdır. Değişken bilgiler için ground truth tarihi eklenmelidir. Birden fazla doğru cevap varsa rubric bunu desteklemelidir.
Kolay, Orta ve Zor Sorular Eklemek
Dataset yalnızca tek zorluk seviyesinden oluşmamalıdır. Kolay sorular retrieval temelini test eder. Orta sorular context birleştirme gerektirebilir. Zor sorular multi-hop reasoning içerebilir. Sonuç difficulty segmentine göre raporlanmalıdır.
Bilinmeyen veya Cevaplanamaz Sorular Eklemek
Modelin doğru abstention davranışı test edilmelidir. Kaynakta bulunmayan sorular özellikle eklenir. Sistem uydurma yerine “yeterli bilgi yok” demelidir. Abstention precision ve recall ölçülebilir. Bu testler hallucination riskini görünür hale getirir.
Güncel Bilgi Gerektiren Testler Eklemek
Model freshness yeteneği ayrıca test edilmelidir. Güncel policy veya version soruları kullanılabilir. Static knowledge ile retrieval davranışı ayrıştırılır. Source timestamp evaluation’a dahil edilir. Stale answer failure olarak işaretlenir.
Adversarial Testler Oluşturmak
Kullanıcı yanlış premise veya misleading context verebilir. Prompt injection benzeri girişler eklenebilir. Modelin kaynak dışına çıkıp çıkmadığı ölçülür. High-risk claim’lerde özel saldırı örnekleri hazırlanır. Red team bulguları dataset’e eklenebilir.
Edge Case'leri Test Etmek
Nadir ama kritik senaryolar production’da büyük etki yaratabilir. Empty result, conflicting source ve malformed input örnekleri kullanılmalıdır. Uzun context test edilmelidir. Dil ve encoding edge case’leri eklenebilir. Model update edge case regression yaratabilir.
Model Güncellemelerinde Aynı Test Setini Tekrar Çalıştırmak
Yeni model her metric’te daha iyi olmayabilir. Aynı golden set karşılaştırma sağlar. Regression threshold release gate olabilir. Yeni failure örnekleri sete eklenir. Versioned evaluation history tutulmalıdır.
LLM-as-a-Judge ile Otomatik Doğrulama
LLM-as-a-Judge ikinci bir modelin çıktıyı rubric’e göre değerlendirmesini sağlar. Açık uçlu cevaplarda otomatik evaluation maliyetini ciddi biçimde azaltabilir. Maker-checker yaklaşımı üretim ve kontrol rollerini ayırır. Bununla birlikte judge model de halüsinasyon veya bias üretebilir. İnsan evaluation ile düzenli calibration yapılması gerekir.
LLM-as-a-Judge Nedir?
Bir LLM başka modelin cevabını verilen kriterlere göre puanlar. Correctness, relevance veya faithfulness değerlendirilebilir. Reference answer judge’a verilebilir. Rubric açık ve kısa olmalıdır. Judge output structured formatta alınabilir.
İkinci Bir Modelle Çıktı Kontrolü
Generator’dan bağımsız model farklı hata profiline sahip olabilir. Cevap ve evidence ikinci modele gönderilir. Checker desteklenmeyen claim’leri işaretler. Aynı model ailesi kullanılırsa correlated error riski devam edebilir. Kritik task’larda bağımsız yöntem eklenmelidir.
Maker–Checker Yaklaşımı
Maker cevabı üretir. Checker doğruluk ve policy kontrolü yapar. Başarısız cevap tekrar üretilebilir veya insana yönlendirilebilir. Roller teknik olarak ayrı servis olabilir. Audit maker ve checker sonuçlarını birlikte saklar.
Çoklu Model Doğrulaması
Birden fazla judge sonucu karşılaştırılabilir. Majority veya weighted vote kullanılabilir. Maliyet artar. Disagreement human review trigger olabilir. Kritik az hacimli task’larda değerli olabilir.
LLM Hakemlerinin Avantajları
Açık uçlu metinleri hızlı değerlendirebilirler. İnsan rubric’ini büyük dataset’e ölçekleyebilirler. Claim-level açıklama üretebilirler. Farklı domain instruction ile uyarlanabilirler. Evaluation süresini önemli ölçüde azaltabilirler.
LLM Hakemlerinin Kendi Halüsinasyon Riski
Judge model doğru cevabı yanlış puanlayabilir. Kaynakta olmayan gerekçe üretebilir. Favori format veya uzun cevap bias’ı gösterebilir. Calibration dataset bu nedenle gereklidir. Judge sonucu mutlak gerçek kabul edilmemelidir.
İnsan Değerlendirmesi Ne Zaman Gereklidir?
Yüksek riskli veya judge disagreement olan örnekler insana gitmelidir. Yeni domain launch sırasında insan örneklemesi yüksek tutulabilir. Regülasyon veya kamuya açık yayınlarda review zorunlu olabilir. Judge drift düzenli human audit ile kontrol edilmelidir. İnsan değerlendirmesi az fakat stratejik noktalarda kullanılabilir.
Human-in-the-Loop: İnsan Kontrolü Nerede Devreye Girmeli?
İnsan kontrolünün her cevapta aynı yoğunlukta olması verimli değildir. Risk bazlı model daha doğru yaklaşımdır. Düşük riskli yaratıcı görevler otomatik tamamlanabilir. Orta riskli içerikler örneklem veya threshold tabanlı review alabilir. Yüksek riskli çıktılar uzman onayı olmadan karar veya aksiyona dönüşmemelidir.
Düşük Riskli AI Çıktıları
Fikir üretimi ve ilk taslak bu sınıfa girebilir. Hata etkisi düşüktür. Kullanıcı final karar vericidir. Otomatik evaluation yeterli olabilir. Yine de açık yanlışların kullanıcıya ulaşmasını engellemek faydalıdır.
Orta Riskli AI Çıktıları
Kurumsal içerik, müşteri e-postası veya iç rapor orta risk taşıyabilir. Kaynak doğrulama gerekebilir. Confidence düşükse human review yapılabilir. Otomatik guardrail ve fact check uygulanmalıdır. Audit sample tutulabilir.
Yüksek Riskli AI Çıktıları
Karar veya aksiyon doğuran çıktılar yüksek risklidir. Sağlık ve finans bunun tipik örnekleridir. Human approval zorunlu olabilir. Evidence ve confidence reviewer’a açık gösterilmelidir. Model nihai otorite olmamalıdır.
Sağlık
AI klinik tanı veya tedavi kararı vermemelidir. Resmi tıbbi kaynaklar kullanılmalıdır. Uzman hekim review gerekir. Confidence düşükse cevap sınırlandırılmalıdır. Kullanıcıya sistemin kapsamı açıkça belirtilmelidir.
Hukuk
Mevzuat ve karar citation’ları doğrulanmalıdır. Güncel resmi kaynak kullanılmalıdır. Model hukuki tavsiye otoritesi olmamalıdır. Uzman hukukçu son değerlendirmeyi yapmalıdır. Audit kullanılan source version’ı saklamalıdır.
Finans
Canlı fiyat ve oran deterministic data source’tan alınmalıdır. Model hesaplamayı tool üzerinden yapmalıdır. Investment action otomatikleşmemelidir. Human approval gerekebilir. Risk disclaimer tek başına kontrol değildir.
Güvenlik
Güvenlik önerisi yanlış yapılandırmaya yol açabilir. Privileged action otomatik uygulanmamalıdır. Runbook ve policy source kullanılmalıdır. Security engineer review gerekebilir. High-impact değişiklik rollback planı içermelidir.
Kamuya Açık Yayınlar
Yanlış bilgi kurumsal itibarı etkiler. İsim, tarih ve sayı doğrulanmalıdır. Legal veya editorial approval gerekebilir. Citation source arşivlenebilir. AI-generated draft review sonrası yayınlanmalıdır.
İnsan Onayı İçin Risk Eşiği Belirleme
Risk score domain, confidence, action impact ve data sensitivity üzerinden hesaplanabilir. Tek confidence threshold yeterli olmayabilir. High-risk topic otomatik olarak review’a yönlendirilebilir. Eşikler production incident sonuçlarına göre güncellenmelidir. Review kapasitesi de operasyon planına dahil edilmelidir.
AI Asistan mı Olmalı, Karar Verici mi?
Birçok kurumsal use case’te asistan rolü daha güvenlidir. AI veri toplar, seçenek sunar ve taslak üretir. Nihai karar sorumlu kullanıcıda kalır. Automation seviyesi hata maliyetine göre artırılabilir. Yüksek riskli domain’de tam karar yetkisi verilmemelidir.
Üretim Ortamında Güvenilir AI Mimarisi Nasıl Kurulur?
Güvenilir AI yalnızca model prompt’u ile kurulmaz. Input validation, approved source, retrieval, generation, guardrail, fact-checking ve human review katmanları birlikte çalışmalıdır. Logging ve trace her kararın nasıl üretildiğini göstermelidir. Production monitoring kalite düşüşünü model güncellemesi sonrasında hızlı yakalamalıdır. Doğruluk ve Halüsinasyon Kontrolü: Güvenilir AI Çıktıları için en güçlü yaklaşım defense-in-depth mantığıdır.
Girdi Kontrolleri
Kullanıcı sorusu parse ve validate edilmelidir. Riskli domain sınıflandırılabilir. Eksik parametre için clarification istenebilir. Prompt injection sinyali değerlendirilebilir. Kullanıcının yanlış premise’i önemliyse doğrulanmalıdır.
Güvenilir Veri Kaynakları
Source allowlist oluşturulabilir. Her belge owner ve freshness metadata taşımalıdır. Unknown source production RAG’e doğrudan girmemelidir. Source version saklanmalıdır. Governance veri lifecycle’ını yönetmelidir.
Retrieval Katmanı
Hybrid search kullanılabilir. ACL filter zorunludur. Reranker relevance artırabilir. Retrieval quality metric düzenli izlenir. Low recall durumunda cevap üretimi sınırlandırılabilir.
LLM Üretim Katmanı
Model context’e dayalı cevap üretmelidir. Temperature use case’e göre düşük tutulabilir. Structured claim ve citation formatı kullanılabilir. Model version pin edilmelidir. Generation trace metadata içermelidir.
Guardrails
Input ve output validation uygulanır. Policy violation tespit edilir. Schema kontrol edilir. Hassas içerik maskelenebilir. Guardrail fact checker yerine geçmez.
Fact-Checking Katmanı
Cevaptaki claim’ler çıkarılır. Source passage ile karşılaştırılır. Gerektiğinde external verifier çağrılır. Kritik sayı ve tarih deterministic kontrol edilir. Başarısız cevap block veya review alır.
Kaynak Kontrolü
Citation existence doğrulanır. Source authority sınıflandırılır. Publication date kontrol edilir. Claim-source entailment ölçülür. Fake citation production’a çıkmamalıdır.
Confidence ve Abstention Eşikleri
System confidence birden fazla sinyalden hesaplanabilir. Retrieval score, verifier result ve model confidence birleştirilebilir. Threshold altında cevap verilmez. Riskli domain’de eşik daha yüksek olabilir. Calibration düzenli yapılmalıdır.
Human-in-the-Loop
Review queue high-risk çıktıları toplar. Reviewer evidence ve model reasoning summary görebilir. Approval veya correction kaydedilir. Correction dataset’e geri beslenebilir. Audit sorumluluğu açık tutar.
Logging ve Trace
Request, model version ve source ID loglanır. Ham hassas veri varsayılan olarak saklanmamalıdır. Trace retrieval ve verifier adımlarını gösterir. Incident analysis kolaylaşır. Retention policy uygulanır.
Production Monitoring
Hallucination rate sample üzerinden izlenebilir. User feedback ve complaint metric eklenir. Source freshness alarmı çalışır. Model update regression tetikleyebilir. Quality SLO operational dashboard’da bulunmalıdır.
AI Guardrails Halüsinasyonu Önleyebilir mi?
Guardrail halüsinasyonu azaltmaya yardımcı olabilir ancak tek başına factuality sistemi değildir. Input ve output sınırlarını enforce eder. Schema veya kaynak zorunluluğu uygulayabilir. İş kuralı ihlallerini yakalayabilir. Fact checking ise iddianın gerçek olup olmadığını ayrıca değerlendirir.
Guardrail Nedir?
Guardrail model input veya output’un belirli kurallara uymasını sağlayan kontrol katmanıdır. Policy, format veya security kontrolü yapabilir. Deterministic veya model tabanlı olabilir. Failure davranışı block veya retry olabilir. Risk seviyesine göre farklı policy uygulanabilir.
Girdi Guardrail'leri
Prompt length sınırlandırılabilir. PII tespit edilebilir. Injection pattern işaretlenebilir. Restricted topic filtrelenebilir. Missing context durumunda request reddedilebilir.
Çıktı Guardrail'leri
Response schema doğrulanabilir. Sensitive data leakage kontrol edilir. Forbidden content tespit edilebilir. Claim kaynak ilişkisi ön kontrolden geçebilir. Invalid çıktı kullanıcıya doğrudan gönderilmez.
Kaynak Zorunluluğu
Belirli task’larda her olgusal claim citation gerektirebilir. Source ID RAG context’ten gelmelidir. Unknown citation reddedilebilir. Citation coverage ölçülür. Bu yöntem hallucination riskini azaltır fakat kaynak doğruluğu ayrıca kontrol edilmelidir.
Schema Validation
Structured output validasyon sağlar. Required evidence field zorunlu yapılabilir. Invalid type otomatik reddedilir. Downstream sistem daha güvenli olur. Schema factual correctness sağlamaz.
İş Kuralı Doğrulaması
Model çıktısı domain kurallarıyla karşılaştırılabilir. Örneğin indirim oranı belirli sınırı aşamaz. Rule engine deterministic kontrol sağlar. Model bu kontrolü bypass edemez. Business validation hallucination etkisini azaltır.
Guardrail ile Fact-Checking Arasındaki Fark
Guardrail “çıktı izin verilen yapı ve politika içinde mi?” sorusuna odaklanır. Fact checking “iddia gerçek mi?” sorusuna odaklanır. İkisi farklı kontrol tipidir. Yüksek güvenilirlik için birlikte kullanılmalıdır. Tek bir katmana aşırı görev yüklenmemelidir.
Güven Skoru Kullanmak Yeterli mi?
Confidence score yararlı bir sinyaldir ancak tek başına doğruluk göstergesi değildir. Model yanlış cevaba da yüksek güven gösterebilir. Calibration testi yapılmadan threshold belirlemek risklidir. Groundedness ve verifier score ile birlikte kullanılmalıdır. “Bilmiyorum” davranışı güvenilirliğin önemli parçasıdır.
Confidence Score Nedir?
Confidence sistemin cevaba duyduğu tahmini güven seviyesidir. Logprob, retrieval score veya verifier sonucu kullanılabilir. Tek sayıya indirgenmesi kolay yorum sağlar. Ancak score source ve method bilgisi olmadan anlamlı değildir. Calibration dataset üzerinde test edilmelidir.
Model Özgüveni ile Gerçek Doğruluk Arasındaki Fark
Model akıcı ve kesin konuşabilir. Bu dilsel özgüven factual accuracy değildir. Internal probability yanlış bilgiye de yüksek olabilir. Kullanıcı arayüzü kesin dil ile score’u karıştırmamalıdır. External verification daha güçlü sinyaldir.
Calibration Nedir?
Calibration tahmin edilen confidence ile gerçek başarı oranının eşleşmesini ölçer. Güven yüzde 70 olan cevapların yaklaşık yüzde 70’i doğru olmalıdır. Reliability diagram kullanılabilir. Domain değişince calibration bozulabilir. Periyodik yeniden ölçüm gerekir.
AI Ne Zaman “Bilmiyorum” Demeli?
Evidence yetersizse abstention tercih edilmelidir. Source conflict varsa belirsizlik belirtilmelidir. Low retrieval recall sinyal olabilir. High-risk domain daha konservatif threshold kullanmalıdır. “Bilmiyorum” cevabı failure olarak değil güvenlik davranışı olarak değerlendirilmelidir.
Cevap Vermemek Neden Bazen Daha Güvenilirdir?
Yanlış ama kesin cevap kullanıcıyı doğrudan hatalı aksiyona yönlendirebilir. Cevap vermeme kullanıcıyı insan uzmana veya source’a yönlendirir. Özellikle sağlık ve hukukta bu önemlidir. Sistem usefulness ile safety arasında denge kurmalıdır. Controlled abstention güvenilirlik metriği olmalıdır.
Kod Üreten AI Sistemlerinde Halüsinasyon Kontrolü
Kod üretiminde doğrulama avantajlıdır çünkü birçok hata otomatik testle yakalanabilir. Package existence, compile, unit test ve static analysis deterministic araçlarla kontrol edilebilir. Generated code doğrudan production branch’e merge edilmemelidir. Sandbox execution riskli davranışı izole eder. İnsan review özellikle güvenlik ve mimari kararlarında devam etmelidir.
Var Olmayan Paket ve Kütüphaneleri Tespit Etmek
Dependency resmi registry üzerinde kontrol edilmelidir. Publisher doğrulanmalıdır. Package age ve release history incelenebilir. Unknown dependency block edilebilir. Allowlist kurumsal pipeline’a eklenebilir.
API ve Dokümantasyon Kontrolü
Kullanılan method official docs’ta aranmalıdır. Signature current version ile karşılaştırılır. Deprecated API uyarıları incelenir. Code example doküman version’ıyla eşleştirilir. Model önerisi tek kaynak değildir.
Sürüm Uyumluluğunu Doğrulamak
Dependency lock file gerçek version’ı gösterir. Generated code aynı version üzerinde test edilmelidir. Breaking change changelog incelenebilir. CI matrix farklı version’ları çalıştırabilir. Production version pin edilmelidir.
Unit Test Kullanmak
Expected behavior testlerle doğrulanır. AI-generated code test case’leri de model tarafından üretilebilir ancak review gerekir. Edge case eklenmelidir. Regression test mevcut davranışı korur. Test geçmesi security garantisi değildir.
Static Analysis Kullanmak
Static analyzer code çalıştırmadan risk bulabilir. Type ve null hataları yakalanabilir. Security scanner unsafe pattern bulabilir. Lint quality sorunlarını azaltır. AI code aynı standart pipeline’dan geçmelidir.
Güvenli Sandbox Ortamında Çalıştırmak
Generated code izole container veya sandbox içinde çalıştırılabilir. Network ve file permission sınırlandırılır. Resource limit uygulanır. Malicious veya hatalı kod production sistemine erişmez. Result ve logs validation için kullanılır.
AI Tarafından Üretilen Kodu İnsan İncelemesinden Geçirmek
Reviewer code intent ve maintainability kontrol eder. Güvenlik etkisi değerlendirilir. Dependency seçimi sorgulanır. AI’nın yanlış assumption yaptığı yerler fark edilebilir. Human review özellikle yüksek etkili değişikliklerde korunmalıdır.
Güvenilir AI İçin Hangi Araçlar Kullanılabilir?
Güvenilirlik için tek araç kategorisi yeterli değildir. Evaluation, hallucination detection, observability, RAG scoring ve fact checking araçları farklı sorunları çözer. Açık kaynak framework’ler kuruma kendi test setini oluşturma esnekliği sağlar. Tool seçimi moda göre değil mevcut pipeline ve risk modeline göre yapılmalıdır. Otomasyon arttıkça tool sonuçlarının da düzenli olarak insan örneklemesiyle doğrulanması gerekir.
AI Evaluation Platformları
Prompt ve model version karşılaştırması yapabilirler. Dataset tabanlı test çalıştırabilirler. Metric history saklanabilir. Human annotation workflow sunabilirler. CI/CD integration release gate oluşturabilir.
Hallucination Detection Araçları
Claim extraction ve evidence comparison yapabilirler. Groundedness score üretebilirler. Source mismatch işaretleyebilirler. Model-based detector false positive üretebilir. Domain calibration gereklidir.
Observability ve Tracing Araçları
Prompt, retrieval ve response akışını trace ederler. Model version ve latency görünür olur. Source ID kaydedilebilir. Sensitive logging policy uygulanmalıdır. Incident root cause analysis kolaylaşır.
RAG Evaluation Araçları
Context precision ve recall hesaplayabilirler. Faithfulness değerlendirebilirler. Retriever ve generator ayrı karşılaştırılabilir. Golden dataset gerekir. Production sampling ile drift izlenebilir.
Fact-Checking Sistemleri
Claim’i external source ile doğrularlar. Search ve database connector kullanabilirler. Source authority scoring eklenebilir. Structured entity doğrulaması güçlüdür. Açık uçlu claim’lerde insan review gerekebilir.
Açık Kaynak Evaluation Framework'leri
Kurum metric logic’ini inceleyebilir. Custom evaluator yazılabilir. Vendor bağımlılığı azalır. Community benchmark ve connector’lardan yararlanılır. Bakım ve security review yine kurum sorumluluğundadır.
Güvenilir AI Sistemleri Geliştirirken Sık Yapılan Hatalar
En yaygın hata tek bir kontrol yöntemini çözüm olarak görmektir. Prompt engineering veya RAG tek başına güvenilirlik sağlamaz. Tek accuracy skoru hata profilini gizler. Model güncellemeleri regression yaratabilir. Gerçek kullanıcı soruları test setine dahil edilmediğinde production başarısı yanlış tahmin edilir.
AI'nın Verdiği Kaynaklara Otomatik Güvenmek
Model fake citation üretebilir. Gerçek link yanlış claim’i destekleyebilir. DOI doğrulanmalıdır. Source passage kontrol edilmelidir. Citation verifier ayrı çalışmalıdır.
Sadece Prompt Engineering'e Güvenmek
Prompt davranışı iyileştirir ancak enforce etmez. Model instruction dışına çıkabilir. Source ve fact validation gerekir. Evaluation ile prompt etkisi ölçülmelidir. Guardrail ayrı katman olmalıdır.
RAG Kullanmanın Sorunu Tamamen Çözdüğünü Düşünmek
Retriever hata yapabilir. Source eski olabilir. Model context’i yanlış yorumlayabilir. Faithfulness ayrı ölçülmelidir. RAG pipeline uçtan uca test edilmelidir.
Tek Bir Accuracy Skoruna Bakmak
Accuracy farklı hata türlerini saklayabilir. Citation ve groundedness ayrı olmalıdır. High-risk subset ayrıca raporlanmalıdır. Abstention behavior ölçülmelidir. Verification cost dikkate alınmalıdır.
Test Verisini Gerçek Kullanıcı Sorularından Ayırmak
Sentetik benchmark kolay olabilir. Production kullanıcıları farklı dil kullanır. Misspelling ve ambiguity eklenmelidir. Complaint örnekleri değerlidir. Dataset düzenli güncellenmelidir.
İnsan Denetimini Tamamen Kaldırmak
Automation maliyeti düşürür ancak kritik hatalar devam edebilir. High-risk task’larda human review korunmalıdır. Sampling düşük riskte bile faydalıdır. Reviewer correction learning signal üretir. Sorumluluk modeli açık olmalıdır.
Model Güncellemelerinden Sonra Regression Test Yapmamak
Yeni model bazı task’larda daha kötü olabilir. Prompt compatibility değişebilir. Golden set yeniden çalıştırılmalıdır. Failure threshold release’i durdurabilir. Canary production testing uygulanabilir.
Güncel Bilgi Gerektiren Soruları Statik Model Bilgisine Bırakmak
Model training sonrası olayları bilemeyebilir. Fresh retrieval kullanılmalıdır. Source date kontrol edilmelidir. Web veya database connector gerekebilir. Cevapta current-data evidence gösterilmelidir.
AI Çıktılarında Risk Bazlı Doğrulama Modeli
Her AI çıktısına aynı doğrulama maliyetini uygulamak gereksizdir. Risk seviyesi arttıkça kaynak kontrolü, verifier ve insan onayı daha güçlü hale getirilmelidir. Düşük riskli taslak üretimi hızlı bırakılabilir. Kritik riskli sistemlerde otomatik action yerine insan approval tercih edilmelidir. Bu model doğrulama maliyetini iş etkisiyle dengeler.
Düşük Risk: Taslak ve Fikir Üretimi
Brainstorm ve ilk metin taslağı bu seviyededir. Hata kolayca düzeltilebilir. Kullanıcı final edit yapar. Otomatik content guardrail yeterli olabilir. Kaynak gerekmeyen yaratıcı görevlerde fact checker zorunlu değildir.
Orta Risk: İçerik ve İş Süreçleri
Kurumsal doküman ve müşteri cevabı bu sınıfa girebilir. Factual claim doğrulanmalıdır. Confidence düşükse review yapılabilir. Citation ve source date gösterilebilir. Monitoring örnekleme ile devam eder.
Yüksek Risk: Karar ve Aksiyon Üreten Sistemler
AI sistem değişikliği veya müşteri durum kararı öneriyorsa risk artar. Tool permission sınırlandırılmalıdır. Evidence verifier çalışmalıdır. Human approval gerekebilir. Audit trail tutulmalıdır.
Kritik Risk: Sağlık, Hukuk, Finans ve Güvenlik
Kritik domain’de false information ciddi sonuç doğurabilir. Approved source zorunludur. Multiple verifier kullanılabilir. Uzman insan onayı şart olabilir. Automatic action minimum tutulmalıdır.
Her Risk Seviyesi İçin Önerilen Kontrol Katmanı
Düşük riskte basic guardrail yeterli olabilir. Orta riskte RAG ve source checking eklenir. Yüksek riskte fact checker ve human review gerekir. Kritik riskte expert approval ve audit zorunlu olabilir. Threshold kurum risk politikasıyla tanımlanmalıdır.
Yazılımcı Olmak İçin Ne Yapmalı? Güvenilir AI Geliştirme Yol Haritası
Güvenilir AI geliştirmek yalnızca prompt yazmayı öğrenmek anlamına gelmez. Programlama, API, veri, test ve observability birlikte öğrenilmelidir. RAG ve vector search mantığı önemlidir. Evaluation kültürü geliştirme sürecinin parçası olmalıdır. Gerçek proje üzerinde hata analizi yapmak teorik öğrenmeden daha kalıcı deneyim sağlar.
Programlama Temellerini Öğrenmek
Değişken, fonksiyon ve veri yapıları anlaşılmalıdır. Error handling önemlidir. Test yazma alışkanlığı erken kazanılmalıdır. Network ve HTTP temeli öğrenilmelidir. AI framework’leri bu temellerin üzerine kurulmalıdır.
API ve Veri Yapılarını Öğrenmek
REST ve JSON temel kavramlardır. Authentication ve timeout öğrenilmelidir. Schema validation uygulanmalıdır. Database ve vector store farkı anlaşılmalıdır. API hata yönetimi production güvenilirliği için önemlidir.
Python ile AI Uygulamaları Geliştirmek
Python AI ecosystem için güçlü başlangıç sağlar. Model API ve RAG pipeline kurulabilir. Evaluation script yazılabilir. Async network kullanımı öğrenilebilir. Production mimarisi yine dil bağımsız ilkeler gerektirir.
RAG ve Vector Database Mantığını Öğrenmek
Embedding ve similarity search anlaşılmalıdır. Chunking deneyleri yapılmalıdır. Metadata filter kullanılmalıdır. Retrieval metric ölçülmelidir. RAG’in her sorunu çözmediği pratikte görülmelidir.
AI Evaluation Öğrenmek
Golden dataset oluşturulmalıdır. Accuracy ve faithfulness farkı öğrenilmelidir. LLM-as-a-judge kullanılabilir. Human evaluation rubric hazırlanmalıdır. Regression pipeline’a bağlanmalıdır.
Test ve Observability Becerileri Kazanmak
Unit ve integration test yazılmalıdır. Trace ID kullanılmalıdır. Prompt ve model version kaydedilmelidir. Quality metric dashboard’a taşınmalıdır. Incident root cause analizi yapılabilmelidir.
Gerçek Bir Güvenilir AI Projesi Geliştirmek
Küçük domain seçilebilir. Approved dokümanlarla RAG kurulabilir. Citation verifier eklenebilir. Cevaplanamaz soru testleri hazırlanabilir. Production benzeri monitoring ile proje tamamlanmalıdır.
Güvenilir AI Geliştirmek İçin En İyi Programlama Dili Hangisi?
Güvenilir AI için tek en iyi dil yoktur. Python model ve data tooling açısından güçlüdür. JavaScript ve TypeScript frontend ile AI API entegrasyonunda avantajlıdır. Java ve C# kurumsal backend sistemlerinde güçlü seçeneklerdir. Dil seçiminden daha önemli olan test, güvenlik, evaluation ve veri yönetimi becerileridir.
Python
AI ve data ecosystem geniştir. RAG ve evaluation framework’leri kolay erişilebilir. Prototipleme hızlıdır. Production API servisleri de geliştirilebilir. Type ve performance gereksinimi iyi yönetilmelidir.
JavaScript ve TypeScript
Web tabanlı AI uygulamalarında sık kullanılır. Streaming ve client API geliştirmek kolaydır. TypeScript schema hatalarını azaltır. Backend runtime olarak da kullanılabilir. Secret yönetimi ve validation yine zorunludur.
Java
Kurumsal sistemlerde güçlüdür. Büyük backend platformlarıyla kolay bütünleşir. Static typing bakım avantajı sağlar. AI servislerine HTTP veya gRPC ile bağlanabilir. Model logic yalnızca Python’a bağlı olmak zorunda değildir.
C#
Kurumsal .NET ekosisteminde AI entegrasyonları geliştirilebilir. Güçlü tooling ve type system sunar. Backend API ve worker service yazılabilir. Cloud ve identity entegrasyonu kolaylaşabilir. Güvenilirlik ilkeleri diğer dillerle aynıdır.
Programlama Dilinden Daha Önemli Olan AI Engineering Becerileri
Evaluation tasarlayabilmek temel beceridir. Veri kaynağı güvenilirliğini değerlendirmek gerekir. Network ve security bilinmelidir. Observability ve regression kültürü önemlidir. İyi AI engineer model çıktısını test edilebilir sistem davranışına dönüştürür.
Open Source ve İşbirliği Güvenilir AI İçin Neden Önemlidir?
Açık kaynak evaluation araçları kullanılan metric ve algoritmaların incelenmesini kolaylaştırır. Topluluk katkıları farklı hata örneklerinin daha hızlı paylaşılmasını sağlar. Açık benchmarklar model ve pipeline karşılaştırmasını daha şeffaf hale getirir. Tekrarlanabilir testler güvenilirliğin yalnızca kişisel görüşe bağlı kalmasını önler. Kurumlar kullandıkları framework’lere issue, test ve pull request ile katkı sunabilir.
Açık Kaynak Evaluation Araçlarının Avantajları
Metric implementation görülebilir. Custom evaluator eklenebilir. Data kurum içinde tutulabilir. Vendor lock-in azalabilir. Community issue’ları bilinen limitleri gösterir.
Test Setlerini Toplulukla Geliştirmek
Farklı kullanıcı grupları farklı edge case getirir. Ortak dataset kapsamı artırır. PII içeren veri paylaşılmamalıdır. Lisans açıkça belirlenmelidir. Versioned test set tekrar edilebilir sonuç sağlar.
Hataları Issue Olarak Raporlamak
Reproducible example hazırlanmalıdır. Model ve framework version belirtilmelidir. Sensitive data temizlenmelidir. Expected ve actual behavior yazılmalıdır. Community fix üretimini kolaylaştırır.
Pull Request ile Güvenilirlik Araçlarına Katkı Vermek
Yeni metric veya bug fix geliştirilebilir. Test case eklenmelidir. Contribution guideline takip edilmelidir. Review kaliteyi artırır. Genel çözüm upstream’e taşındığında bakım yükü azalır.
Açık Benchmarkların Önemi
Model karşılaştırmaları tekrar edilebilir hale gelir. Dataset ve scoring açık olmalıdır. Hardware ve prompt configuration belirtilmelidir. Tek benchmark production başarısı anlamına gelmez. Kurum kendi domain setini yine çalıştırmalıdır.
Tekrarlanabilir AI Testleri Oluşturmak
Randomness mümkün olduğunca kontrol edilmelidir. Model version pin edilmelidir. Dataset snapshot tutulmalıdır. Evaluator version kaydedilmelidir. CI her release’te aynı testi çalıştırmalıdır.
Diyarbakır Yazılım Topluluğu ve Güvenilir AI Çalışmaları
Güvenilir AI konusu yalnızca büyük teknoloji merkezlerinde ele alınması gereken bir alan değildir. Yerel yazılım toplulukları evaluation, RAG ve açık kaynak araçlar üzerine uygulamalı çalışmalar düzenleyebilir. Ortak test setleri ve örnek projeler geliştiricilerin gerçek hata türlerini görmesini sağlar. Diyarbakır Yazılım Topluluğu’nun çalışma yaklaşımı hakkında https://www.diyarbakiryazilim.com.tr/about adresinden bilgi edinilebilir. Topluluk temelli öğrenme, farklı deneyim seviyelerindeki geliştiricilerin aynı proje üzerinde ölçülebilir kalite hedefleriyle çalışmasını kolaylaştırır.
Diyarbakır Yazılım Topluluğu İçinde AI Bilgi Paylaşımı
AI güvenilirliği üzerine düzenli teknik oturumlar yapılabilir. Katılımcılar aynı model çıktısını farklı verifier yöntemleriyle inceleyebilir. RAG failure örnekleri paylaşılabilir. Metric sonuçları karşılaştırılabilir. Bu yaklaşım soyut tartışmayı uygulamalı öğrenmeye dönüştürür.
Güvenilir AI Üzerine Workshop ve Çalışma Grupları
Workshop’ta küçük RAG sistemi kurulabilir. Cevaplanamaz sorular test edilebilir. Citation checker geliştirilebilir. Human evaluation rubric hazırlanabilir. Sonuçlar ortak repository’de tutulabilir.
Yerel Açık Kaynak AI Projeleri Geliştirmek
Türkçe factuality dataset hazırlanabilir. Evaluation CLI geliştirilebilir. Source verification tool oluşturulabilir. Proje lisansı açık seçilebilir. Topluluk yeni katkılara issue üzerinden alan açabilir.
AI Evaluation Hackathonları Düzenlemek
Takımlar aynı dataset üzerinde farklı yaklaşım geliştirebilir. RAG ve verifier sonuçları karşılaştırılır. Accuracy yanında verification cost ölçülebilir. İnsan hakem rubric kullanır. Etkinlik sonunda açık teknik rapor üretilebilir.
Gerçek Veriler Üzerinde Halüsinasyon Testleri Oluşturmak
Kişisel ve gizli bilgiler çıkarılmalıdır. Gerçek kullanıcı soru kalıpları korunabilir. Güncel ve cevapsız sorular eklenebilir. Türkçe entity ve tarih hataları ölçülebilir. Dataset versioned olarak geliştirilebilir.
Diyarbakır'daki En İyi Yazılımcılar ile Bilgi ve Deneyim Paylaşımı
Yerel geliştiricilerin farklı alan deneyimleri ortak AI projelerinde değer sağlar. Backend, data ve security uzmanları aynı güvenilirlik problemine farklı açıdan yaklaşabilir. Topluluk etkinlikleri bu bilgi alışverişini kolaylaştırır. Proje çıktıları yeni katılımcılar için öğrenme kaynağı olur. Çalışma örneklerini görmek için https://www.diyarbakiryazilim.com.tr/projects adresi incelenebilir.
Uçtan Uca Örnek: Güvenilir Bir AI Asistanı Nasıl Tasarlanır?
Güvenilir bir asistan tasarımında önce kullanım amacı ve risk seviyesi belirlenir. Ardından yalnızca onaylı kaynaklardan oluşan bilgi havuzu hazırlanır. RAG retrieval ile evidence bulunur ve model kaynak gösteren yanıt üretir. Factuality verifier ile kritik iddialar kontrol edilir. Production monitoring ve regression testleri sistemin zaman içinde aynı kalite seviyesinde kalmasını sağlar.
Kullanım Senaryosunu Tanımlama
Asistanın hangi sorulara cevap vereceği yazılır. Kapsam dışı sorular belirlenir. Kullanıcı grupları tanımlanır. Başarı metric’leri seçilir. Risk ve veri sensitivity kaydedilir.
Risk Seviyesini Belirleme
Cevap hatasının etkisi değerlendirilir. İç bilgi asistanı ile karar sistemi farklı risk taşır. Source doğrulama seviyesi buna göre seçilir. Human review ihtiyacı belirlenir. Threshold policy dokümante edilir.
Güvenilir Kaynak Havuzu Oluşturma
Doküman owner ve version belirlenir. Approved source list hazırlanır. Eski dokümanlar kaldırılır. Access control metadata korunur. Freshness monitoring kurulur.
RAG Pipeline'ı Kurma
Parsing ve chunking yapılır. Embedding index oluşturulur. Retrieval benchmark edilir. Reranking eklenebilir. Context yalnızca yetkili source’lardan gelir.
Kaynak Gösteren Yanıtlar Üretme
Model her claim için source ID üretebilir. Citation yalnızca context içindeki belgeye izinli olabilir. UI kaynak pasajı gösterebilir. Source link access policy’yi korur. Citation accuracy ölçülür.
Otomatik Factuality Kontrolü
Critical claim’ler çıkarılır. Evidence ile entailment kontrol edilir. Sayı ve tarih deterministic validator’dan geçebilir. Low score block edilir. Failure reason loglanır.
İnsan Onay Mekanizması
Riskli cevap review queue’ya gider. Reviewer evidence görür. Düzeltme veya onay verir. Correction evaluation dataset’e eklenebilir. Audit timestamp tutulur.
Evaluation Seti Oluşturma
Gerçek kullanıcı soruları alınır. Answerable ve unanswerable örnekler eklenir. Ground truth oluşturulur. Adversarial senaryolar dahil edilir. Dataset versionlanır.
Production Monitoring
Faithfulness ve feedback trend izlenir. Source freshness alarmı kurulur. Low confidence rate takip edilir. Incident örnekleri kaydedilir. Quality SLO dashboard’da görünür olur.
Regression Testleri
Model veya prompt değişince golden set çalıştırılır. Metric farkı threshold ile değerlendirilir. Kritik failure release’i durdurur. Canary sonrası production sample incelenir. Eski version rollback için hazır tutulabilir.
AI Çıktısı Yayınlanmadan Önce Son Kontrol Listesi
Yayın öncesi kısa bir kontrol listesi büyük hataların önemli bölümünü yakalayabilir. Her olgusal iddianın kaynağı ve güncelliği kontrol edilmelidir. Sayı, tarih ve alıntılar ayrı doğrulanmalıdır. Belirsizlik saklanmamalı, kullanıcıya açıkça belirtilmelidir. Kritik kullanımda uzman onayı tamamlanmadan çıktı yayınlanmamalıdır.
Her Olgusal İddia Doğrulandı mı?
Claim extraction yapılmalıdır. Kritik iddialar işaretlenir. Source doğrulaması tamamlanır. Desteksiz claim çıkarılır. Review kaydı tutulabilir.
Kaynaklar Gerçek mi?
URL ve DOI açılmalıdır. Publisher doğrulanmalıdır. Metadata eşleştirilmelidir. Fake reference engellenmelidir. Broken link yeniden kontrol edilmelidir.
Kaynaklar İddiaları Destekliyor mu?
Relevant passage bulunmalıdır. Claim-source entailment değerlendirilir. Sadece kaynak adı yeterli değildir. Yanlış attribution düzeltilir. Citation precision korunur.
Bilgiler Güncel mi?
Publication date incelenir. Version veya mevzuat değişikliği kontrol edilir. Stale source işaretlenir. Güncel retrieval yapılır. Kullanıcıya bilgi tarihi belirtilebilir.
Sayılar ve Tarihler Kontrol Edildi mi?
Sayısal değer kaynakla karşılaştırılır. Unit ve currency doğrulanır. Date timezone gerekirse kontrol edilir. Hesaplama yeniden yapılır. Yuvarlama açık tutulur.
Belirsizlikler Açıkça Belirtildi mi?
Çelişkili source saklanmamalıdır. Confidence düşükse belirtilmelidir. Tahmin ile gerçek ayrılmalıdır. Missing information kullanıcıya söylenmelidir. Kesin olmayan ifade kesinmiş gibi sunulmamalıdır.
Kritik Alanlarda Uzman Kontrolü Yapıldı mı?
Domain expert final review yapmalıdır. Evidence görünür olmalıdır. Approval kaydedilmelidir. AI önerisi tek başına karar olmamalıdır. Sorumluluk açık biçimde insan rolünde kalmalıdır.
AI'nın Uydurabileceği Alanlar Sınırlandırıldı mı?
Structured schema kullanılabilir. Source-only answering uygulanabilir. Unknown durumda abstention istenir. Tool output deterministic olabilir. Serbest generation alanı risk bazında azaltılabilir.
Sık Sorulan Sorular
AI halüsinasyonu nedir?
AI halüsinasyonu modelin desteklenmeyen veya yanlış bilgiyi doğruymuş gibi üretmesidir. Sahte kaynak, yanlış tarih veya uydurulmuş API bunun örneğidir. Dilsel akıcılık hatanın fark edilmesini zorlaştırır. Halüsinasyon factuality ve faithfulness testleriyle ölçülebilir. Kaynak doğrulama ve abstention riski azaltır.
ChatGPT neden yanlış bilgi verir?
Büyük dil modelleri dil örüntülerine göre token üretir ve doğrudan doğruluk veritabanı gibi çalışmaz. Training bilgisi eksik veya eski olabilir. Kullanıcı prompt’u belirsiz olabilir. Retrieval yanlış source getirebilir. Bu nedenle model çıktısı özellikle önemli konularda doğrulanmalıdır.
Bir AI cevabının doğru olup olmadığı nasıl anlaşılır?
Önce doğrulanabilir claim’ler ayrılır. Birincil kaynaklar bulunur. Tarih ve sayı kontrol edilir. Kritik bilgi ikinci bağımsız kaynakla karşılaştırılır. High-risk domain’de uzman review yapılır.
AI'nın verdiği kaynaklara güvenilir mi?
Otomatik olarak güvenilmemelidir. Model var olmayan source üretebilir. Gerçek source’a yanlış claim atfedebilir. URL, DOI ve content doğrulanmalıdır. Kaynak göstermek tek başına güvenilirlik garantisi değildir.
AI tarafından verilen kaynak nasıl doğrulanır?
Source title exact olarak aranır. Publisher ve author kontrol edilir. DOI resolver kullanılabilir. Citation passage claim ile karşılaştırılır. Publication date ve version incelenir.
RAG halüsinasyonları tamamen önler mi?
Hayır. RAG yanlış doküman getirebilir. Source eski veya hatalı olabilir. Model context’i yanlış yorumlayabilir. Faithfulness ve retrieval quality ayrı ölçülmelidir. RAG güçlü fakat tek başına yeterli olmayan bir katmandır.
Prompt engineering halüsinasyonu azaltır mı?
Evet, doğru prompt model davranışını iyileştirebilir. Source-only cevap ve abstention talimatı faydalıdır. Ancak instruction her zaman kusursuz uygulanmaz. Fact checker ve validation yine gerekir. Prompt etkisi evaluation ile ölçülmelidir.
AI'nın “bilmiyorum” demesi sağlanabilir mi?
Prompt ve policy ile teşvik edilebilir. Low evidence threshold kullanılabilir. Cevaplanamaz sorular evaluation setine eklenmelidir. Doğru abstention başarı olarak ölçülmelidir. High-risk sistemlerde bu davranış özellikle önemlidir.
Halüsinasyon oranı nasıl ölçülür?
Test cevaplarındaki unsupported claim oranı hesaplanabilir. Claim-level veya answer-level metric seçilebilir. Human annotation veya LLM judge kullanılabilir. Groundedness ve factuality ayrı raporlanmalıdır. Aynı golden set model versionlarında tekrar çalıştırılmalıdır.
Güvenilir AI çıktısı için insan kontrolü gerekli mi?
Her düşük riskli görevde zorunlu değildir. Risk yükseldikçe insan review değeri artar. Sağlık, hukuk ve finans gibi alanlarda uzman onayı önemlidir. Otomatik evaluator insan yükünü azaltabilir. Human-in-the-loop tamamen kaldırılmadan optimize edilebilir.
AI ile yazılan kod nasıl doğrulanır?
Package ve API existence kontrol edilir. Code compile edilmelidir. Unit test ve static analysis çalıştırılır. Sandbox execution yapılabilir. Human code review özellikle güvenlik açısından korunmalıdır.
Güvenilir AI geliştirmek için en iyi programlama dili hangisidir?
Tek en iyi dil yoktur. Python AI ve evaluation tooling için güçlüdür. TypeScript web uygulamalarında avantajlıdır. Java ve C# kurumsal backend için uygundur. Asıl önemli beceriler test, veri yönetimi, security ve evaluation’dır.
Open source ve işbirliği AI güvenilirliğini nasıl geliştirir?
Açık metric implementation incelenebilir. Community farklı failure örnekleri ekleyebilir. Benchmark tekrar edilebilir hale gelir. Issue ve pull request kaliteyi artırır. Kurum kendi domain testini yine bağımsız olarak çalıştırmalıdır.
Güvenilir AI ve Halüsinasyon Kontrolü Hakkında Ek Sorular
Yapay zeka sistemlerinde halüsinasyon nedir ve neden oluşur?
Halüsinasyon, modelin doğrulanabilir destek olmadan yanlış veya uydurulmuş bilgi üretmesidir. Bunun temelinde token tahmin mantığı, eksik training verisi, stale knowledge, belirsiz prompt ve retrieval hataları bulunabilir. Model dilsel olarak güçlü olduğu için yanlış cevap da ikna edici görünebilir. Yapay zeka halüsinasyonları nasıl tespit edilir ve azaltılır sorusunun doğru cevabı tek bir teknik değil, source validation, RAG, evaluation ve abstention katmanlarının birlikte kullanılmasıdır. Doğruluk ve Halüsinasyon Kontrolü: Güvenilir AI Çıktıları yaklaşımı üretim sonrasında da sürekli ölçüm gerektirir.
AI çıktılarının doğruluğu ve güvenilirliği nasıl kontrol edilir?
Önce isim, tarih, sayı ve kaynak gibi doğrulanabilir iddialar ayrılmalıdır. Her kritik claim mümkünse birincil kaynakla doğrulanmalıdır. İkinci bağımsız kaynak önemli bilgileri tekrar kontrol etmelidir. Güncellik ve source-entailment birlikte değerlendirilmelidir. Kurumsal uygulamalarda bu süreç otomatik verifier ve insan review birleşimiyle ölçeklendirilebilir.
RAG, kaynak doğrulama ve grounding yöntemleri yapay zeka halüsinasyonlarını nasıl azaltır?
RAG modelin güncel ve onaylı evidence kullanmasını sağlar. Grounding cevabı belirli source passage’lara bağlar. Source verification citation’ın gerçek ve ilgili claim’i destekliyor olduğunu kontrol eder. Retrieval yanlışsa veya source eskiyse hata devam edebileceği için context precision, recall ve faithfulness ayrıca ölçülmelidir. API tabanlı AI servislerinin hata ve erişim yönetimi konusunda https://www.diyarbakiryazilim.com.tr/posts/api-uzerinden-ai-servis-tuketimi-ve-hata-yonetimi adresindeki içerik de tamamlayıcı bir teknik çerçeve sunar.
AI sistemlerinde halüsinasyon oranı, factual accuracy ve groundedness hangi yöntemlerle ölçülür?
Hallucination rate desteklenmeyen iddia oranını ölçebilir. Factual accuracy claim’lerin gerçek dünyadaki doğruluğunu değerlendirir. Groundedness ve faithfulness ise cevabın verilen evidence ile ilişkisini ölçer. Citation precision, recall, abstention rate ve calibration ek kalite sinyalleri sağlar. En sağlıklı sonuç gerçek kullanıcı sorularından oluşturulmuş versioned evaluation seti üzerinde aynı metrikleri düzenli tekrar çalıştırmakla elde edilir.
Güvenilir AI çıktıları ve halüsinasyon kontrolü konusunda yakınımda danışmanlık veya eğitim nerede bulabilirim?
Yapay zeka doğruluk ve LLM danışmanlığı yakınımda şeklinde araştırma yaparken yalnızca model kurulumu sunan çalışmalardan çok evaluation, RAG, source verification, observability ve human review konularını birlikte ele alan yaklaşımlar değerlendirilmelidir. Kurumsal yapay zeka sistemleri için doğruluk ve halüsinasyon değerlendirme hizmeti mutlaka gerçek kullanıcı sorularından oluşan test seti ve production monitoring içermelidir. Diyarbakır Yazılım Topluluğu’nun proje çalışmalarına https://www.diyarbakiryazilim.com.tr/projects adresinden ulaşabilirsiniz. Topluluğun yaklaşımı ve çalışma alanları için https://www.diyarbakiryazilim.com.tr/about adresi incelenebilir. Sağlıklı bir danışmanlık süreci model seçmekten önce hangi hata türlerinin iş açısından kabul edilemez olduğunu belirlemekle başlamalıdır.
Sonuç: Güvenilir AI, Hatasız AI Demek Değildir
Doğruluk ve Halüsinasyon Kontrolü: Güvenilir AI Çıktıları yaklaşımının temel fikri, modelin hiçbir zaman hata yapmayacağı varsayımından vazgeçmektir. Güvenilir sistem; hatayı azaltan, kaynak gösteren, belirsizliği ifade eden, düşük evidence durumunda cevap vermeyen ve kritik çıktıları insan kontrolüne yönlendiren sistemdir. RAG, factuality kontrolü, groundedness, citation validation ve evaluation aynı zincirde çalışmalıdır. Model güncellemeleri sonrasında regression test yapılmalı ve production kalite metrikleri sürekli izlenmelidir. Kurumunuzda güvenilir AI, RAG, evaluation veya halüsinasyon kontrolü üzerine çalışma planlamak için https://www.diyarbakiryazilim.com.tr adresi üzerinden Diyarbakır Yazılım Topluluğu ile iletişime geçebilirsiniz.
Güvenilirliğin Temeli: Kaynak, Doğrulama ve Ölçüm
Kaynak olmadan doğrulama zorlaşır. Doğrulama olmadan confidence yanıltıcı olabilir. Ölçüm olmadan sistemin iyileşip iyileşmediği bilinmez. Bu üç bileşen birlikte tasarlanmalıdır. Evaluation sonuçları teknik kararların temel girdisi olmalıdır.
Halüsinasyonu Önlemek Yerine Yakalanabilir Hale Getirmek
Halüsinasyonu sıfırlama hedefi yerine detection coverage artırılmalıdır. Claim verifier ve source checker kullanılabilir. Low confidence output block edilebilir. Kullanıcı feedback’i incident sinyali olarak değerlendirilir. Sistem hatayı görünür ve yönetilebilir hale getirir.
AI + Otomatik Kontrol + İnsan Denetimi Yaklaşımı
AI üretim hızını sağlar. Otomatik verifier ölçeklenebilir ilk kontrolü yapar. İnsan uzman kritik belirsizlikleri değerlendirir. Bu katmanlar birbirinin yerine geçmez. Risk seviyesi hangi katmanın ne kadar yoğun kullanılacağını belirler.
Güvenilir AI Sistemleri İçin Bir Sonraki Adım
İlk adım mevcut AI kullanım senaryolarını risk seviyesine göre sınıflandırmaktır. Ardından gerçek kullanıcı sorularından golden evaluation set oluşturulmalıdır. RAG ve source verification ölçülmelidir. Production monitoring ve regression pipeline kurulmalıdır. Bu adımlar tamamlandığında güvenilirlik kişisel kanaat olmaktan çıkıp ölçülebilir bir mühendislik sürecine dönüşür.
share: