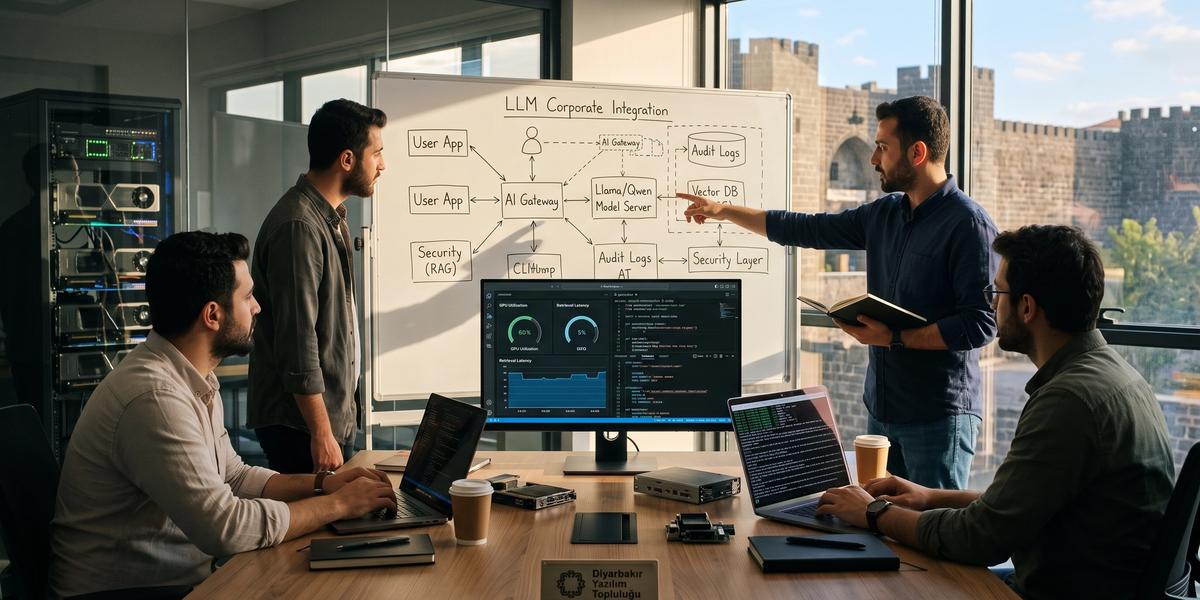
Açık Kaynak Büyük Dil Modellerinin (LLM) Kurumsal Entegrasyonu

Diyarbakır Yazılım
16.08.2026
#Yazılım#Teknoloji#Topluluk
Bir şirket içinde büyük dil modeli çalıştırmak, yalnızca bir modeli indirip GPU üzerinde ayağa kaldırmak anlamına gelmez. Gerçek kurumsal kullanımda veri güvenliği, yetkilendirme, model lisansı, performans, RAG, gözlemlenebilirlik, maliyet ve yaşam döngüsü yönetimi aynı mimarinin parçalarıdır. Açık Kaynak Büyük Dil Modellerinin (LLM) Kurumsal Entegrasyonu doğru planlandığında şirket verileri üzerinde daha yüksek kontrol sağlanabilir ve farklı uygulamalar ortak bir yapay zeka platformundan yararlanabilir. Yaklaşık on yıllık yazılım ve sistem entegrasyonu deneyiminde gördüğüm en yaygın hata, başarılı bir PoC çalışmasının doğrudan production mimarisi kabul edilmesidir. Bu rehberde açık kaynak LLM kurumsal sistemlere nasıl entegre edilir, şirketler için açık kaynak büyük dil modeli nasıl kurulur ve production ortamında güvenilir bir platform nasıl oluşturulur sorularını teknik ve uygulanabilir bir yaklaşımla ele alacağız.
Açık Kaynak LLM Nedir?
Açık kaynak LLM kavramı, kullanım hakkı verilen bir modelden daha fazlasını ifade edebilir. Modelin ağırlıkları, mimarisi, eğitim kodu ve lisans şartlarının ne kadar açık olduğu birbirinden ayrı konulardır. Bu nedenle bir modeli yalnızca indirilebildiği için tam anlamıyla açık kaynak kabul etmek doğru değildir. Kurumsal ekiplerin özellikle lisans, redistribution hakkı ve derived model koşullarını incelemesi gerekir. Teknik seçim yapılırken açıklık seviyesi kadar modelin güvenlik ve sürdürülebilirlik özellikleri de değerlendirilmelidir.
Büyük Dil Modeli (LLM) Nedir?
Büyük dil modeli, geniş metin veri kümeleri üzerinden dil örüntülerini öğrenen bir makine öğrenmesi modelidir. Kullanıcıdan aldığı token dizisini değerlendirerek olası devam tokenlarını üretir. Bu yapı metin oluşturma, sınıflandırma, özetleme, bilgi çıkarma ve araç çağırma gibi farklı görevlerde kullanılabilir. Kurumsal uygulamada modelin genel yetenekleri tek başına yeterli değildir. İş alanına ait veri, güvenlik politikası ve kullanıcı yetkileri de modelin çevresindeki platform tarafından yönetilmelidir.
Açık Kaynak LLM Ne Anlama Gelir?
Açık kaynak LLM ifadesi pratikte farklı seviyelerde açıklığı kapsayabilir. Bazı modeller hem kod hem ağırlık tarafında geniş kullanım hakkı sunarken bazıları yalnızca model ağırlıklarını indirilebilir hale getirir. Kurumsal kullanımda bu ayrım hukuki ve operasyonel sonuçlar doğurabilir. Fine-tuning yapmak, modeli müşteriye sunmak veya türetilmiş bir modeli dağıtmak farklı lisans hükümlerine tabi olabilir. Bu nedenle teknik ekip ve hukuk ekibi modeli birlikte değerlendirmelidir.
Open Source ve Open Weight Arasındaki Fark
Open source ve open weight aynı anlama gelmez. Open weight yaklaşımında model parametreleri erişilebilir olabilir ancak eğitim verisi veya eğitim kodu tamamen açık olmayabilir. Open source tanımı ise kullanılan lisans ve kaynakların açıklığı açısından daha geniş beklentiler oluşturur. Kurumsal risk analizi sırasında modelin hangi parçalarının gerçekten erişilebilir olduğu kaydedilmelidir. Bu kayıt daha sonra model registry ve governance sürecinin parçası haline getirilebilir.
Model Mimarisi
Model mimarisi kullanılan attention yapısını, katman sayısını ve temel model tasarımını açıklar. Mimari bilgisi inference motoru uyumluluğu açısından önemlidir. Bazı modeller belirli runtime sürümleri veya özel kernel desteği isteyebilir. Mimari aynı zamanda context ve KV cache davranışını etkileyebilir. Bu nedenle deployment kararı sadece model dosyasının boyutuna bakılarak verilmemelidir.
Model Ağırlıkları
Model ağırlıkları öğrenme sürecinde oluşan parametre değerleridir. Ağırlıkların indirilebilir olması self-hosting için temel gereksinimlerden biridir. Ancak indirilebilir olması kullanım hakkının sınırsız olduğu anlamına gelmez. Ticari kullanım ve redistribution şartları lisans metninden doğrulanmalıdır. Kurum içinde kullanılan her ağırlık sürümü checksum ile kayıt altına alınmalıdır.
Eğitim Kodu
Eğitim kodunun paylaşılması modelin nasıl oluşturulduğunu anlamayı kolaylaştırabilir. Bununla birlikte büyük modellerin sıfırdan yeniden eğitilmesi çoğu kurum için gerçekçi değildir. Eğitim kodu daha çok yöntem, güvenlik ve reproducibility incelemesinde değer sağlar. Fine-tuning yapılacaksa kullanılan training stack ayrıca güvenlik taramasından geçirilmelidir. Türetilmiş modelin hangi pipeline tarafından üretildiği model registry içinde saklanmalıdır.
Eğitim Verisi Bilgisi
Eğitim verisinin kapsamı model risk değerlendirmesi açısından önemlidir. Her model üreticisi tüm eğitim verisini ayrıntılı olarak yayınlamayabilir. Bu durumda model card ve veri özeti dikkatle incelenmelidir. Telif, kişisel veri ve bias riskleri kullanım senaryosuna göre değerlendirilmelidir. Hassas kullanım alanlarında yalnızca genel benchmark sonuçlarına güvenilmemelidir.
Model Lisansı
Model lisansı kullanım, dağıtım ve türetilmiş model haklarını belirler. Commercial use izni kurumsal projeler için temel kontrol noktalarından biridir. Bazı lisanslar kullanıcı sayısı, kullanım amacı veya redistribution konusunda özel koşullar içerebilir. Lisans sürümünün model sürümüyle birlikte kayıt altına alınması gerekir. Model güncellemesinde lisansın değişmediği ayrıca kontrol edilmelidir.
Proprietary LLM ile Açık Model Arasındaki Fark
Proprietary modeller çoğunlukla hizmet olarak sunulur ve model altyapısının önemli bölümü hizmet sağlayıcı tarafından yönetilir. Açık ağırlıklı modeller ise kurumun kendi altyapısında çalıştırılabilir ve inference katmanı üzerinde daha fazla kontrol sağlar. Buna karşılık GPU, güncelleme, izleme ve güvenlik sorumluluğu kurumun üzerine geçer. Managed API düşük başlangıç operasyonu sunarken self-hosting veri ve altyapı kontrolünü artırabilir. En doğru tercih kullanım senaryosu, trafik hacmi ve veri sınıflandırmasına göre yapılmalıdır.
Kurumlar Neden Açık Kaynak LLM Kullanıyor?
Kurumların açık modelleri değerlendirmesindeki en önemli nedenlerden biri verinin hangi sistemlerden geçtiğini daha doğrudan kontrol edebilmektir. Özellikle hassas doküman, müşteri bilgisi veya şirket içi bilgi tabanı kullanılan projelerde on-premise inference tercih edilebilir. Açık modeller ayrıca model switching ve fine-tuning konusunda esneklik sağlayabilir. Bunun yanında GPU ve platform operasyonunun kurum tarafından yönetilmesi yeni sorumluluklar getirir. Bu nedenle karar yalnızca veri gizliliği söylemi üzerinden değil, toplam operasyon modeli üzerinden verilmelidir.
Veri Gizliliği
Self-hosted modelde prompt ve model çıktılarının kurum kontrolündeki network içinde tutulması mümkündür. Bu durum hassas verinin dış servislere gönderilmesini azaltabilir. Ancak uygulama logları, trace kayıtları ve vector database yine kişisel veya kurumsal veri içerebilir. Güvenlik yalnızca inference sunucusuyla sınırlı düşünülmemelidir. Veri akışının baştan sona haritalanması gerekir.
Veri Egemenliği
Veri egemenliği, verinin yalnızca nerede saklandığını değil hangi hukuki ve idari kontroller altında bulunduğunu da kapsar. On-premise deployment bazı kurumlara daha doğrudan denetim imkanı verebilir. Private cloud veya sovereign cloud seçenekleri de değerlendirmeye dahil edilebilir. Backup, telemetry ve model registry verilerinin konumu unutulmamalıdır. Gerçek egemenlik tüm veri yaşam döngüsü üzerinden değerlendirilmelidir.
Vendor Lock-In Riskinin Azaltılması
Açık modeller farklı inference motorlarıyla çalıştırılabildiğinde tek bir API sağlayıcısına bağımlılık azalabilir. Bununla birlikte framework, GPU veya vector database bağımlılığı devam edebilir. Vendor-neutral API tasarımı bu riski daha da azaltır. Uygulamaların doğrudan belirli bir modele bağlanması yerine AI Gateway kullanılması geçişi kolaylaştırabilir. Exit strategy ilk mimari aşamada hazırlanmalıdır.
Model Üzerinde Teknik Kontrol
Self-hosting inference ayarları üzerinde geniş teknik kontrol sunar. Quantization, context limiti, batching ve GPU dağılımı ihtiyaca göre düzenlenebilir. Modelin hangi sürümünün production ortamında çalıştığı kesin olarak sabitlenebilir. Network erişimi ve log politikası kurum standartlarına uyarlanabilir. Buna karşılık bu kontrolün sürdürülebilmesi için platform ekibinin gerekli uzmanlığa sahip olması gerekir.
Özelleştirme ve Fine-Tuning
Açık ağırlıklı modeller LoRA veya QLoRA gibi yöntemlerle kuruma özel davranışlara uyarlanabilir. Bununla birlikte her bilgi ihtiyacı fine-tuning gerektirmez. Güncel şirket belgeleri için çoğu zaman RAG daha hızlı ve yönetilebilir sonuç verir. Fine-tuning özellikle çıktı formatı, ton veya belirli görev davranışlarının değiştirilmesinde değerlidir. Eğitim verisinin hazırlanması ve değerlendirilmesi ayrı bir kalite süreci gerektirir.
Maliyet Kontrolü
Yüksek ve düzenli trafik bulunan sistemlerde self-hosted GPU altyapısı ekonomik olabilir. Düşük ve düzensiz trafikte ise boşta kalan GPU kapasitesi toplam maliyeti artırabilir. Gerçek karşılaştırma token başına maliyet, GPU utilization ve mühendislik operasyonu üzerinden yapılmalıdır. Sadece GPU satın alma bedeline bakmak eksik sonuç verir. Hybrid model birçok kurum için daha dengeli bir yaklaşım olabilir.
Offline ve Air-Gapped Çalışma
Açık ağırlıklı modeller internet bağlantısı olmayan ortamlarda çalıştırılabilir. Model artifact, container image ve dependency paketlerinin kontrollü biçimde iç ortama alınması gerekir. Güvenlik taramaları ve checksum doğrulamaları bu süreçte özellikle önemlidir. RAG verisi tamamen iç network içinde tutulabilir. Ancak model ve güvenlik güncellemeleri için offline transfer prosedürü hazırlanmalıdır.
Açık Kaynak Ekosistemi ve Topluluk İnovasyonu
Açık model ekosistemi inference, quantization, evaluation ve RAG alanlarında hızlı araç gelişimi sağlar. Farklı modellerin ortak runtime üzerinde denenebilmesi kurumsal benchmark süreçlerini kolaylaştırır. Bununla birlikte community projesinin bakım durumu dikkatle izlenmelidir. Kritik platform bileşenlerinde uzun vadeli destek ihtiyacı ayrıca değerlendirilmelidir. Kurumlar yalnızca tüketici olmak yerine kullandıkları projelere katkı da sağlayabilir.
Açık Kaynak LLM Her Kurum İçin Doğru Seçim mi?
Her kurumun self-hosted model çalıştırması gerektiğini söylemek doğru değildir. Bazı kullanım senaryolarında managed API daha düşük maliyetli ve operasyonel olarak daha kolay olabilir. Veri hassasiyeti arttığında veya offline çalışma gerektiğinde self-hosting daha anlamlı hale gelir. Trafik düşükse pahalı GPU'ların büyük bölümü boşta kalabilir. Karar matrisi veri, performans, maliyet ve ekip kapasitesini birlikte değerlendirmelidir.
Self-Hosting'in Avantajları
Self-hosting model endpoint'i ve veri akışı üzerinde yüksek kontrol sağlar. Network segmentasyonu ve özel authentication politikaları uygulanabilir. Model sürümü sabitlenebilir ve istenen inference motoruyla çalıştırılabilir. Hassas prompt verisi kurum dışına çıkmadan işlenebilir. Özelleştirme ve fine-tuning süreçleri daha doğrudan yönetilebilir.
Self-Hosting'in Operasyonel Maliyeti
GPU sunucularının kurulumu ve bakımı önemli operasyon yükü oluşturur. Driver, CUDA, inference engine ve model sürümleri arasında uyumluluk yönetilmelidir. High availability ve kapasite planlaması ayrıca yapılmalıdır. Güvenlik patch ve monitoring işlemleri sürekli devam eder. Bu nedenle self-hosted altyapı ücretsiz model kullanmakla eş anlamlı değildir.
Managed API'nin Avantajları
Managed API altyapı kurmadan hızlı başlangıç sağlar. GPU kapasitesi ve serving optimizasyonu hizmet sağlayıcı tarafından yönetilir. Düşük trafikli projelerde kullanılan kadar ödeme modeli avantajlı olabilir. Ancak veri işleme şartları ve hizmet bağımlılığı dikkatle değerlendirilmelidir. Kritik sistemlerde fallback veya alternatif provider planı bulunmalıdır.
Hybrid Model Yaklaşımı
Hybrid yaklaşım bazı görevları kurum içi modelde, bazı görevları dış API üzerinde çalıştırabilir. Hassas veriler self-hosted modelde tutulurken genel amaçlı işlemler managed API'ye yönlendirilebilir. AI Gateway routing kararlarını merkezi olarak uygulayabilir. Bu model maliyet ve veri güvenliği arasında denge kurar. Uygulamanın provider detaylarını bilmemesi geçiş esnekliğini artırır.
Karar Matrisi
Karar matrisi teknik tartışmayı ölçülebilir kriterlere dönüştürür. Veri hassasiyeti, trafik, latency, ekip yetkinliği ve regülasyon ayrı puanlanabilir. GPU maliyeti üç yıllık toplam maliyet üzerinden değerlendirilmelidir. Her kullanım senaryosu aynı altyapıya zorlanmamalıdır. Sonuç self-hosted, managed veya hybrid seçeneklerden biri olabilir.
Veri Hassasiyeti
Hassas veri self-hosting kararında en güçlü etkenlerden biridir. Kişisel, ticari veya düzenlemeye tabi veriler dış servis kullanımını sınırlayabilir. Ancak on-premise altyapıda da erişim ve log kontrolü gerekir. RAG dokümanları ayrı veri sınıflandırmasına tabi tutulmalıdır. Kullanıcı yetkileri retrieval aşamasında uygulanmalıdır.
Trafik Hacmi
Yüksek ve sabit trafik GPU kullanım oranını artırabilir. Bu durumda self-hosted kapasitenin birim maliyeti düşebilir. Düşük trafik ise GPU kaynaklarının büyük bölümünü boş bırakabilir. Peak ve ortalama trafik ayrı hesaplanmalıdır. Concurrency tahmini capacity planının temel girdilerinden biridir.
Latency
Latency kullanıcı deneyimini doğrudan etkiler. On-premise model network açısından kullanıcıya yakın olabilir. Ancak yetersiz GPU veya batching kuyruğu gecikmeyi artırabilir. Time to First Token ve toplam cevap süresi ayrı ölçülmelidir. Model seçimi kalite kadar latency hedefiyle de uyumlu olmalıdır.
Ekip Yetkinliği
Self-hosted LLM platformu AI mühendisi dışında platform ve güvenlik uzmanlığı da gerektirir. GPU sorunları klasik uygulama sunucularından farklı olabilir. Observability ve model evaluation için ek yetkinlik gerekir. Küçük ekiplerde managed çözüm daha sürdürülebilir olabilir. Ekip büyüdükçe platformlaştırma yatırımı anlamlı hale gelir.
GPU Maliyeti
GPU maliyeti donanım veya cloud kiralama bedelinden oluşur. Elektrik, rack, bakım ve boş kapasite de gerçek maliyete eklenmelidir. Bir modelin VRAM'e sığması production kapasitesi için yeterli değildir. Concurrency ve context length bellek kullanımını büyütür. Benchmark gerçek kullanım senaryosuyla yapılmalıdır.
Regülasyon
Regülasyon bazı verilerin veya iş süreçlerinin belirli kontrol mekanizmaları altında çalışmasını gerektirebilir. Veri lokasyonu, audit log ve insan onayı önemli hale gelebilir. Modelin açık olması otomatik uyumluluk sağlamaz. Kullanım amacı ve risk sınıfı ayrıca değerlendirilmelidir. Hukuk ve veri koruma ekipleri tasarım aşamasına dahil edilmelidir.
Kurumsal Kullanım İçin Açık LLM Nasıl Seçilir?
Kurumsal model seçimi popülerlik sıralamasına göre yapılmamalıdır. Model kalitesi, Türkçe performansı, context ihtiyacı, tool calling ve structured output birlikte test edilmelidir. Aynı model farklı quantization seviyelerinde farklı sonuç verebilir. Lisans ve donanım gereksinimi teknik performans kadar önemlidir. En sağlıklı yöntem kurumun kendi golden dataset'iyle aday modelleri karşılaştırmaktır.
Model Kalitesi
Model kalitesi gerçek iş görevleri üzerinde ölçülmelidir. Genel benchmark sonuçları başlangıç referansı sağlar ancak kurumun kullanım senaryosunu tam temsil etmez. Müşteri destek, doküman sorgulama veya rapor oluşturma görevlerinin kriterleri farklıdır. Correctness ve hallucination ayrı ölçülmelidir. İnsan değerlendirmesi otomatik metriklerle birlikte kullanılabilir.
Model Boyutu ve Parametre Sayısı
Büyük model her görevde daha iyi sonuç anlamına gelmez. Daha küçük bir model düşük latency ve maliyet avantajı sağlayabilir. Basit sınıflandırma veya extraction görevlerinde küçük model yeterli olabilir. Büyük model yalnızca ihtiyaç duyulan karmaşık görevler için kullanılabilir. Multi-model routing bu yaklaşımı production ortamında uygulanabilir hale getirir.
Context Window
Context window modelin tek istekte işleyebildiği token miktarını sınırlar. Çok uzun context her zaman daha iyi retrieval anlamına gelmez. Context büyüdükçe KV cache bellek tüketimi artabilir. RAG sistemi yalnızca gerekli parçaları modele vermelidir. Gerçek doküman uzunlukları benchmark sırasında kullanılmalıdır.
Türkçe Performansı
Türkçe performansı kurumsal projelerde ayrı test edilmelidir. Genel çok dilli benchmark sonuçları şirket terminolojisini temsil etmeyebilir. Yazım, ek yapısı ve uzun cümleler retrieval ve generation kalitesini etkileyebilir. Türkçe golden dataset oluşturmak daha güvenilir seçim sağlar. Hukuk, finans ve teknik dokümanlar ayrı örneklenmelidir.
Çok Dilli Performans
Uluslararası kurumlarda aynı sistem birden fazla dilde hizmet verebilir. Modelin yalnızca İngilizce performansı yeterli değildir. Kullanıcı sorusu ile doküman dilinin farklı olduğu senaryolar test edilmelidir. Cross-lingual retrieval ayrıca ölçülmelidir. Dil bazında farklı model routing yapılması da mümkündür.
Tool Calling Yeteneği
Tool calling modelin yapılandırılmış bir araç çağrısı üretebilmesini sağlar. CRM sorgulama veya ticket oluşturma gibi agentic uygulamalarda önemlidir. Tool adı ve parametre doğruluğu benchmark edilmelidir. Modelin yetkisiz aracı çağırması platform tarafından engellenmelidir. Tool execution kararı yalnızca model çıktısına bırakılmamalıdır.
Structured Output Yeteneği
Kurumsal entegrasyonlarda JSON veya belirli schema çıktıları sık kullanılır. Modelin geçerli structured output üretme oranı ölçülmelidir. Schema enforcement serving veya gateway katmanında desteklenebilir. Hatalı JSON downstream uygulamaları bozabilir. Bu nedenle output validation production tasarımının parçasıdır.
Reasoning Yeteneği
Bazı görevler çok adımlı analiz gerektirir. Ancak daha uzun reasoning süreci latency ve token maliyetini artırabilir. Her kullanıcı isteğinin en güçlü modele gitmesi gerekli değildir. Basit ve zor görevler ayrı benchmark edilmelidir. Routing sistemi yalnızca ihtiyaç olduğunda daha güçlü modele geçebilir.
Donanım Gereksinimleri
Donanım gereksinimi model ağırlığının VRAM boyutuyla sınırlı değildir. KV cache ve concurrent session bellek kullanımını artırır. Tensor parallelism birden fazla GPU kullanımını mümkün kılabilir. Modelin quantization seçeneği kapasiteyi ciddi biçimde etkiler. Production benchmark hedef concurrency ile yapılmalıdır.
Lisans
Lisans seçimin başında değerlendirilmelidir. Teknik PoC tamamlandıktan sonra lisans engeliyle karşılaşmak ciddi zaman kaybı oluşturur. Commercial use, redistribution ve fine-tuning hakları incelenmelidir. Model-specific lisanslarda ek kullanım koşulları olabilir. Hukuk onayı model registry kaydına eklenmelidir.
Güvenlik ve Model Card Kalitesi
Model card eğitim yaklaşımı ve bilinen limitler hakkında önemli bilgi sunar. Güvenlik testleri ve riskler açıkça belirtilmişse due diligence kolaylaşır. Kaynağı belirsiz model artifact'ları production ortamına alınmamalıdır. Publisher ve checksum doğrulaması yapılmalıdır. Güvenilir model seçimi supply-chain güvenliğinin ilk adımıdır.
Popüler Açık ve Açık Ağırlıklı LLM Aileleri Nasıl Karşılaştırılır?
Model ailelerini marka popülerliği üzerinden seçmek sağlıklı değildir. Her ailenin farklı boyut, lisans, dil ve inference özellikleri bulunur. Model sürümleri hızla değiştiği için statik bir en iyi model listesi kısa sürede anlamını kaybedebilir. Kurumun kendi benchmark seti adayları aynı donanım ve inference ayarlarıyla test etmelidir. Son karar kalite, latency, lisans ve maliyetin birlikte değerlendirilmesiyle verilmelidir.
Llama Ailesi
Llama ailesi açık ağırlıklı model ekosisteminde yaygın şekilde desteklenen seçeneklerden biridir. Çok sayıda inference motoru ve araç bu modellerle uyumlu çalışır. Kurumsal kullanımda model sürümüne ait güncel lisans koşulları mutlaka okunmalıdır. Türkçe ve domain performansı kurum içinde ayrıca ölçülmelidir. Popüler olması otomatik olarak en uygun seçim olduğu anlamına gelmez.
Mistral / Mixtral Ailesi
Mistral ve Mixtral ailesi farklı model boyutları ve mimari seçenekleriyle değerlendirilebilir. Bazı modeller düşük kaynak kullanımı ile güçlü performans dengesi sunabilir. Mixture of Experts mimarisi serving davranışını farklılaştırabilir. Lisans koşulları model sürümü bazında incelenmelidir. Kurumsal testte throughput ve latency değerleri gerçek workload ile ölçülmelidir.
Qwen Ailesi
Qwen ailesi çok dilli ve farklı boyut seçenekleri nedeniyle kurumsal değerlendirmelerde yer alabilir. Türkçe performansı yalnızca genel leaderboard üzerinden değerlendirilmemelidir. Tool calling ve structured output senaryoları ayrıca test edilmelidir. Model boyutu ve quantization serving maliyetini doğrudan etkiler. Kullanılacak sürümün lisans ve model card bilgileri kayıt altına alınmalıdır.
Gemma Ailesi
Gemma ailesi farklı ölçeklerde modeller sunar. Küçük modeller edge veya sınırlı GPU ortamlarında ilgi çekici olabilir. Büyük modeller daha fazla kalite sağlarken hardware ihtiyacını artırabilir. Lisans ve acceptable use şartları deployment öncesinde incelenmelidir. Kurumsal benchmark şirketin kendi doküman ve görev setiyle yapılmalıdır.
DeepSeek Ailesi
DeepSeek ailesi özellikle reasoning ve kodlama görevlerinde değerlendirilen modeller arasında yer alabilir. Ancak her model sürümü farklı deployment gereksinimlerine sahip olabilir. Security due diligence ve lisans kontrolü standart süreçten geçirilmelidir. Büyük modeller için multi-GPU serving gerekebilir. Kullanım senaryosuna göre daha küçük distilled veya quantized seçenekler karşılaştırılabilir.
Granite Ailesi
Granite ailesi kurumsal kullanım ve farklı görev türleri için değerlendirilebilen seçenekler arasında yer alır. Model card ve lisans bilgileri teknik seçim öncesinde incelenmelidir. Structured output, RAG ve kodlama performansı kullanım senaryosuna göre test edilmelidir. Model boyutunun mevcut GPU altyapısıyla uyumu doğrulanmalıdır. Kurumsal karar aynı benchmark süreci içinde diğer adaylarla karşılaştırılarak verilmelidir.
Diğer Açık Model Aileleri
Açık model ekosistemi sürekli yeni seçenekler üretir. Sadece büyük ve bilinen ailelere odaklanmak bazı görevler için daha verimli küçük modelleri kaçırmaya neden olabilir. Domain-specific veya language-specific modeller belirli senaryolarda daha iyi sonuç verebilir. Buna karşılık bakım ve community desteği daha sınırlı olabilir. Approved model süreci bu nedenle teknik performansın yanında sürdürülebilirliği de değerlendirmelidir.
Model Ailesinden Çok Benchmark Neden Önemlidir?
Model ailelerinin yayınlanan skorları farklı benchmark koşullarından gelebilir. Kurumun verisi ve kullanıcı soruları bu testlerden farklıdır. Aynı model quantization veya prompt değişikliğinde farklı kalite gösterebilir. Bu nedenle golden dataset üzerinde kontrollü A/B değerlendirmesi daha anlamlıdır. En iyi model, kurumun hedef kalite ve maliyet dengesini sağlayan modeldir.
Model Lisansı Kurumsal Kullanımdan Önce Nasıl İncelenir?
Model lisansı üretim ortamına geçmeden önce hukuk ve teknik ekip tarafından birlikte incelenmelidir. Commercial use izni, redistribution ve fine-tuning hakları açıkça anlaşılmalıdır. Kullanıcıya sunulan ürün modeli doğrudan veya dolaylı olarak yeniden dağıtıyor olabilir. Acceptable use hükümleri kurumun kullanım senaryosuyla çelişebilir. Lisans onayı model version kaydıyla birlikte saklanmalıdır.
Apache 2.0
Apache 2.0 geniş kullanım hakları sunan yaygın açık kaynak lisanslarından biridir. Patent hükümleri ve attribution şartları ayrıca incelenmelidir. Model artifact'ın gerçekten bu lisans altında yayınlandığı resmi kaynaktan doğrulanmalıdır. Fine-tuned model dağıtımında gerekli bildirimler korunmalıdır. Hukuk ekibi kullanım senaryosuna göre nihai değerlendirmeyi yapmalıdır.
MIT
MIT lisansı kısa ve esnek yapısıyla bilinir. Ticari kullanım ve modification açısından geniş haklar sağlayabilir. Ancak copyright ve lisans bildiriminin korunması gerekir. Modelin başka bileşenlerle birlikte sunulması ek lisans yükümlülükleri doğurabilir. Dependency lisansları ayrıca incelenmelidir.
Model-Spesifik Community Lisansları
Bazı model aileleri özel community lisansı kullanır. Bu lisanslarda kullanım ölçeği veya belirli uygulama alanları için ek koşullar bulunabilir. Lisans ismine bakarak klasik açık kaynak lisansı varsayılmamalıdır. Her yeni sürümün lisans metni ayrı kontrol edilmelidir. Kurumsal model registry lisans sürümünü kayıt altında tutmalıdır.
OpenRAIL Türevi Lisanslar
OpenRAIL türevi lisanslar kullanım haklarının yanında belirli kullanım kısıtları içerebilir. Amaç bazı zararlı kullanım biçimlerini sınırlamaktır. Kurumsal ürünün bu şartlarla uyumlu olup olmadığı incelenmelidir. Redistribution sırasında lisans bildirimleri korunmalıdır. Hukuki yorum için kurumun hukuk ekibi karar vermelidir.
Commercial Use İzni
Kurumsal kullanımın ticari kullanım sayılıp sayılmadığı açıkça belirlenmelidir. İç kullanım dahi bazı lisans koşullarında özel hükümlere tabi olabilir. Müşteriye sunulan SaaS ürünü farklı değerlendirme gerektirebilir. Lisans belirsizse production kararı ertelenmelidir. Kullanım hakkı teknik performanstan önce gelen temel koşuldur.
Redistribution Hakkı
Model dosyasını müşteriye veya başka bir sisteme dağıtmak lisans açısından ayrı bir eylemdir. SaaS endpoint sunmak ile ağırlıkları teslim etmek aynı değildir. Container image içinde model artifact bulunması redistribution sayılabilir. Dağıtım mimarisi hukuk ekibiyle paylaşılmalıdır. Gerekli attribution ve lisans dosyaları ürün paketine eklenmelidir.
Fine-Tuning ve Derived Model Hakları
Fine-tuning sonucunda oluşan model türetilmiş çalışma kabul edilebilir. Lisans bu modelin nasıl kullanılabileceğini veya dağıtılabileceğini belirleyebilir. Fine-tuned ağırlığın ayrı lisans bildirimi gerekebilir. Eğitim verisinin kullanım hakkı da ayrıca kontrol edilmelidir. Derived model metadata model registry içinde tutulmalıdır.
Attribution Gereksinimleri
Bazı lisanslar ürün veya dokümantasyon içinde attribution ister. Bu gereksinimin nerede gösterileceği önceden planlanmalıdır. API servisinde bile notice dosyaları gerekebilir. Model update olduğunda attribution metni değişebilir. Otomatik compliance kontrolü süreçte yardımcı olabilir.
Acceptable Use Kısıtları
Acceptable use şartları belirli içerik veya kullanım türlerini yasaklayabilir. Kurumun kullanım senaryosu bu kısıtlarla karşılaştırılmalıdır. Özellikle yüksek riskli veya düzenlemeye tabi uygulamalarda inceleme daha ayrıntılı yapılmalıdır. Kullanıcıların modeli farklı amaçlarla kullanabildiği platformlarda governance gerekir. Policy enforcement teknik olarak AI Gateway ve uygulama katmanında desteklenebilir.
Hukuk Ekibi İçin Lisans Kontrol Listesi
Kontrol listesi model adı, sürüm, resmi kaynak ve lisans linkini içermelidir. Commercial use, redistribution ve fine-tuning hakları ayrı cevaplanmalıdır. Attribution ve acceptable use gereksinimleri kaydedilmelidir. Model update sırasında lisans değişikliği kontrolü yapılmalıdır. Nihai onay model registry içinde versiyon bazlı saklanmalıdır.
Model Due Diligence Süreci Nasıl Kurulur?
Model due diligence production'a girecek her model için standart kontrol süreci oluşturur. Model card, publisher, lisans, benchmark ve güvenlik bilgileri birlikte incelenir. Kaynağı belirsiz veya modifiye edilmiş artifact doğrudan kullanılmamalıdır. Model risk sınıflandırması kullanım alanıyla birlikte yapılmalıdır. Onay tamamlandığında model approved catalog içine alınabilir.
Model Card İncelemesi
Model card yetenekler, eğitim yaklaşımı ve bilinen sınırlamalar hakkında başlangıç bilgisi verir. Supported language ve context özellikleri buradan kontrol edilebilir. Güvenlik değerlendirmeleri ayrıca incelenmelidir. Model card eksikse risk skoru yükseltilebilir. Kurumsal benchmark yine bağımsız olarak yapılmalıdır.
Model Kaynağının Doğrulanması
Model yalnızca resmi publisher veya kurum tarafından onaylanmış mirror üzerinden indirilmelidir. Community re-upload dosyaları ek supply-chain riski oluşturabilir. Publisher hesabı ve release bilgisi kontrol edilmelidir. Checksum model registry kaydına eklenmelidir. Kurum içinde approved artifact repository kullanılması faydalıdır.
Training Data Bilgisi
Eğitim verisi hakkında yayınlanan bilgi kullanım riskini değerlendirmeye yardımcı olur. Veri kaynaklarının tamamen bilinmediği modellerde hukuki ve etik risk ayrıca incelenmelidir. Domain-specific model eğitiminde kullanılan dataset'in hakkı doğrulanmalıdır. Kurum kendi fine-tuning datası için provenance kaydı tutmalıdır. Data governance model governance ile birlikte çalışmalıdır.
Benchmark Sonuçlarının İncelenmesi
Yayınlanan benchmark sonuçları aday seçimini daraltmak için kullanılabilir. Ancak test koşulları ve prompt formatı incelenmelidir. Kurum kendi benchmark'ını tekrar yapmalıdır. Quantized sürüm ayrıca değerlendirilmelidir. Sonuçlar model registry içinde saklanabilir.
Bilinen Limitler
Her modelin hallucination, dil veya context konusunda sınırları vardır. Kullanım alanı bu limitlerle eşleştirilmelidir. Finansal karar gibi hassas görevlerde insan onayı gerekebilir. Output guardrail bazı riskleri azaltabilir. Model limitleri kullanıcı arayüzünde uygun şekilde yönetilmelidir.
Güvenlik Testleri
Prompt injection ve jailbreak testleri deployment öncesi yapılmalıdır. Hassas veri sızıntısı senaryoları ayrıca değerlendirilmelidir. Tool calling modellerinde zararlı action üretimi test edilmelidir. Red team senaryoları model sürümü değiştikçe yeniden çalıştırılmalıdır. Sonuçlar risk kaydına eklenmelidir.
Lisans Onayı
Teknik ekip modeli seçmeden önce lisans riskini görünür hale getirmelidir. Hukuk ekibi gerekli kullanım ve dağıtım haklarını değerlendirmelidir. Onay yalnızca model ailesine değil sürüme verilmelidir. Yeni release lisans değişikliği içerebilir. Approval metadata model registry içinde tutulmalıdır.
Model Risk Sınıflandırması
Model riski yalnızca modelin kendisine göre belirlenmez. Kullanım amacı, bağlanan veri ve agent yetkileri risk seviyesini değiştirir. Basit iç doküman araması ile otomatik finansal işlem yapan agent aynı sınıfta olmamalıdır. Risk seviyesi approval ve monitoring yoğunluğunu belirler. Periodic review ile sınıflandırma güncellenebilir.
Kurumsal Açık Kaynak LLM Referans Mimarisi
Production mimarisi kullanıcı uygulamasından inference GPU'suna kadar birden fazla kontrol katmanı içermelidir. AI Gateway ortak endpoint, authentication ve routing görevlerini üstlenebilir. Guardrails giriş ve çıkış üzerinde güvenlik kuralları uygular. RAG katmanı kurum verisini yetkili biçimde getirir. Observability ve governance katmanı tüm işlemleri izlenebilir hale getirir.
Kullanıcı ve Uygulama Katmanı
Kullanıcı doğrudan inference endpoint'ine bağlanmamalıdır. Web, mobil veya iş uygulaması kimlik bilgisini kurumsal authentication sisteminden almalıdır. Uygulama hangi iş senaryosunun çalıştığını AI Gateway'e belirtir. Kullanıcı yetkileri retrieval ve tool execution katmanlarına taşınmalıdır. Frontend yalnızca kullanıcı deneyimi sunan bir katman olmalıdır.
AI Gateway Katmanı
AI Gateway tüm model istekleri için merkezi giriş noktası görevi görür. Rate limit, authentication ve routing burada uygulanabilir. Model değiştirilse bile uygulamanın endpoint'i aynı kalabilir. Audit ve cost metrikleri merkezi olarak toplanabilir. Fallback ve cache stratejileri de bu katmanda yönetilebilir.
Authentication ve Authorization
Authentication kullanıcının kim olduğunu doğrular. Authorization ise hangi model, veri veya tool'a erişebileceğini belirler. Bu iki işlem birbirinden ayrılmalıdır. RAG retrieval kullanıcının ACL bilgisiyle filtrelenmelidir. Service account ve insan kullanıcı kimlikleri ayrı tutulmalıdır.
Guardrails Katmanı
Guardrails input ve output içeriğini kontrol eden ek güvenlik katmanıdır. Prompt injection veya PII tespiti yapılabilir. Structured output schema enforcement uygulanabilir. Guardrail modeli tek güvenlik önlemi olarak görülmemelidir. Authorization ve tool permission uygulama katmanında ayrıca zorunlu olmalıdır.
LLM Inference Katmanı
Inference katmanı model ağırlıklarını GPU üzerinde çalıştırır. Continuous batching throughput değerini artırabilir. Tensor parallelism büyük modeli birden fazla GPU'ya yayabilir. Serving katmanı health check ve autoscaling metrikleri üretmelidir. Model version değişikliği kontrollü rollout ile yapılmalıdır.
RAG Katmanı
RAG kullanıcı sorusuyla ilgili kurumsal doküman parçalarını bulur. Bu içerik modele context olarak eklenir. Modelin şirket bilgisini parametrelerine tekrar eğitmek gerekmez. Doküman güncellenince index yeniden işlenebilir. Yetki kontrolü retrieval sırasında uygulanmalıdır.
Vector Database
Vector database embedding temsillerini saklar ve similarity search yapar. Metadata filter kullanıcı ve doküman yetkilerini uygulamada önemlidir. Multi-tenant yapılarda tenant izolasyonu açık biçimde tasarlanmalıdır. Backup ve restore planı gereklidir. Index rebuild süresi RTO hesabına dahil edilmelidir.
Embedding ve Reranking
Embedding modeli sorgu ve doküman parçalarını vektör temsiline dönüştürür. Türkçe performansı ayrıca ölçülmelidir. Initial retrieval sonrasında reranker daha ilgili sonuçları üst sıraya taşıyabilir. Bu iki model generation LLM'den bağımsız seçilebilir. Retrieval quality ayrı benchmark edilmelidir.
Observability ve Evaluation
LLM observability latency ve token metriğinin ötesine geçmelidir. Retrieval sonuçları ve model output quality izlenmelidir. Trace her request'in gateway, retrieval ve model adımlarını ilişkilendirebilir. Sensitive prompt verisi loglanmadan önce maskeleme uygulanmalıdır. Evaluation sonuçları model değişimlerini karşılaştırmak için saklanmalıdır.
Governance ve Audit
Governance hangi modelin hangi amaçla kullanılabileceğini tanımlar. Model owner ve data owner sorumlulukları belirlenmelidir. Deployment değişiklikleri approval sürecinden geçebilir. Audit log kullanıcı, model ve erişilen kaynak bilgilerini ilişkilendirebilir. Decommissioning süreci artık kullanılmayan model ve veriyi güvenli biçimde kaldırmalıdır.
Açık Kaynak LLM İçin Deployment Modelleri
Açık kaynak LLM farklı altyapı modellerinde çalıştırılabilir. Developer laptop prototipleme için uygundur ancak production ihtiyaçlarını temsil etmez. On-premise GPU veri kontrolünü artırırken operasyon sorumluluğunu da yükseltir. Kubernetes büyük ekiplerde standardizasyon ve scaling sağlayabilir. Deployment modeli veri sınıflandırması, trafik ve ekip yetkinliğine göre seçilmelidir.
Developer Laptop / Local
Local çalışma model ve prompt denemeleri için hızlıdır. Ollama benzeri araçlar geliştirici deneyimini kolaylaştırabilir. Ancak laptop benchmark sonucu production capacity planı olarak kullanılmamalıdır. Kullanıcı authentication ve HA gibi kontroller genellikle yoktur. Bu ortam yalnızca development amaçlı değerlendirilmelidir.
On-Premise GPU Server
On-premise GPU server kurum network'ü içinde inference çalıştırmayı sağlar. Hassas veri dışarı çıkmadan işlenebilir. GPU driver ve hardware bakımını kurum yönetir. High availability için birden fazla node gerekebilir. Kapasite gerçek concurrency hedefiyle test edilmelidir.
Private Cloud
Private cloud kaynak yönetimini sanallaştırılmış altyapı üzerinden kolaylaştırabilir. GPU pool farklı ekipler arasında paylaşılabilir. Network ve storage policy merkezi uygulanabilir. Self-service deployment mümkün hale getirilebilir. Platform maliyeti ve operasyon yükü yine kurumda kalır.
Public Cloud VPC
Public cloud VPC içinde self-hosted model çalıştırmak managed API ile on-premise arasında bir seçenek sunar. GPU kapasitesine hızlı erişim avantaj sağlayabilir. Network egress ve data residency dikkatle değerlendirilmelidir. Private endpoint ve encryption kullanılmalıdır. GPU kullanım oranı maliyet açısından sürekli izlenmelidir.
Kubernetes
Kubernetes model serving bileşenlerini standart deployment olarak yönetebilir. Replica, rolling update ve service discovery özellikleri yararlıdır. GPU scheduling için ek configuration gerekir. Model artifact download süresi pod startup'ını etkileyebilir. Küçük deployment için Kubernetes zorunlu değildir.
Hybrid Cloud
Hybrid cloud bazı modellerin on-premise, bazı modellerin cloud üzerinde çalışmasına izin verir. AI Gateway routing ile bu farkı uygulamadan gizleyebilir. Hassas data local modelde tutulabilir. Yoğun trafik gerektiğinde cloud kapasitesi kullanılabilir. Network latency ve veri politikası routing kurallarına dahil edilmelidir.
Air-Gapped Deployment
Air-gapped deployment dış network bağlantısı bulunmayan ortamlarda kullanılır. Model, container ve dependency artifact'ları kontrollü transfer edilir. Checksum ve imza doğrulaması zorunlu hale getirilmelidir. Security database güncellemeleri offline paketlerle taşınabilir. Operasyon prosedürü düzenli olarak test edilmelidir.
Edge Deployment
Edge deployment modeli kullanıcıya veya veri kaynağına yakın çalıştırabilir. Küçük ve quantized modeller sınırlı donanımda uygun olabilir. Network bağlantısına bağımlılık azalır. Merkezi governance ve model update süreci yine gereklidir. Device güvenliği ve artifact signing önem kazanır.
Ollama ile vLLM Arasındaki Fark Nedir?
Ollama ve vLLM farklı kullanım önceliklerine sahip araçlardır. Ollama geliştirici deneyimi ve hızlı local prototipleme için oldukça pratiktir. vLLM ise yüksek concurrency ve GPU verimliliği gerektiren production serving senaryolarında değerlendirilebilir. Bir PoC'nin Ollama üzerinde başarılı olması aynı mimarinin yüksek trafik altında yeterli olacağı anlamına gelmez. Şirket içi Ollama kurulumu hakkında daha ayrıntılı uygulama yaklaşımı için https://www.diyarbakiryazilim.com.tr/posts/ollama-ile-llama-ve-qwen-modellerini-sirket-ici-agda-calistirmak adresindeki içeriği inceleyebilirsiniz.
Geliştirme ve Prototipleme
Geliştirici bilgisayarında hızlı model denemek için basit runtime önemli avantaj sağlar. Model çekme ve API oluşturma sürecinin kısa olması deney hızını artırır. Prompt ve RAG prototipi kolayca hazırlanabilir. Buna karşılık production authentication ve multi-user capacity ayrı tasarlanmalıdır. Local başarı performans garantisi değildir.
Production Inference
Production inference aynı anda çok sayıda kullanıcıyı desteklemelidir. Queue, batching ve GPU utilization burada önem kazanır. Health check ve replica yönetimi gerekir. Model endpoint yalnızca internal network içinde doğrudan bırakılmamalıdır. AI Gateway üzerinden erişim daha kontrollü yapı sağlar.
Concurrency
Concurrency aynı anda aktif olan request sayısını ifade eder. Model tek kullanıcıda hızlı görünürken çoklu kullanıcıda ciddi kuyruk oluşturabilir. Serving motoru request'leri etkin biçimde schedule etmelidir. Capacity benchmark gerçek concurrency seviyesinde yapılmalıdır. P95 latency bu testlerde önemli metriktir.
Continuous Batching
Continuous batching farklı request'lerin token generation süreçlerini ortak GPU batch içinde değerlendirebilir. Bu yöntem throughput değerini artırabilir. Request uzunlukları farklı olsa bile GPU kaynakları daha verimli kullanılabilir. Batch ayarı latency üzerinde de etki yaratır. Production tuning gerçek trafik profiliyle yapılmalıdır.
GPU Utilization
GPU utilization düşükse pahalı donanım yeterince kullanılmıyor olabilir. Çok yüksek utilization ise queue ve latency artışına neden olabilir. Memory ve compute kullanımı ayrı ölçülmelidir. Model boyutu GPU belleğinin büyük bölümünü kaplayabilir. KV cache için gerekli headroom bırakılmalıdır.
OpenAI-Compatible API
OpenAI-compatible API uygulamaların model sağlayıcısından daha bağımsız geliştirilmesini kolaylaştırır. Aynı client farklı self-hosted modellerle çalışabilir. Bununla birlikte her model tool calling veya schema özelliklerini aynı seviyede desteklemeyebilir. Gateway response normalization uygulayabilir. API uyumluluğu davranış uyumluluğu anlamına gelmez.
Hangi Senaryoda Hangisi Kullanılmalı?
Local development ve düşük trafikli internal kullanımda basit runtime yeterli olabilir. Yüksek concurrency ve güçlü GPU serving ihtiyacında production odaklı inference motoru tercih edilmelidir. Karar isim üzerinden değil benchmark üzerinden verilmelidir. Deployment ekibi latency ve throughput hedeflerini önceden tanımlamalıdır. Gerektiğinde development ve production için farklı runtime kullanılması doğaldır.
Kurumsal LLM Serving Katmanı Nasıl Tasarlanır?
Serving katmanı yalnızca modeli GPU'da yükleyen process değildir. API, queue, batching, cache, parallelism ve autoscaling özelliklerini birlikte yönetir. Modelin tek request performansı yerine çok kullanıcılı davranışı ölçülmelidir. High availability için replica ve health check mekanizması bulunmalıdır. Kullanıcılar inference servisinin kendisine değil gateway üzerinden erişmelidir.
OpenAI-Compatible Endpoint
Ortak API formatı uygulamaların farklı model motorlarına geçmesini kolaylaştırır. Chat completion ve streaming davranışı standardize edilebilir. Model-specific özellikler ayrı capability metadata ile yönetilebilir. Client uygulaması vendor-specific SDK'ya bağımlı bırakılmamalıdır. Gateway compatibility katmanı sunabilir.
REST ve Streaming Response
REST endpoint basit entegrasyon sağlar. Streaming response kullanıcıya ilk tokenı daha hızlı gösterebilir. Uzun cevaplarda algılanan performansı iyileştirir. Proxy timeout ve connection limitleri buna göre ayarlanmalıdır. Client disconnect olduğunda generation işleminin iptal edilmesi kaynak tasarrufu sağlar.
Request Queue
Queue GPU kapasitesinin üzerinde gelen istekleri kontrollü biçimde sıraya alır. Sınırsız queue kaynak tüketimini büyütebilir. Timeout ve priority policy uygulanmalıdır. Kritik uygulamalara farklı queue sınıfı verilebilir. Queue length autoscaling için sinyal olarak kullanılabilir.
Continuous Batching
Batching throughput optimizasyonunun önemli parçasıdır. Farklı request'ler GPU üzerinde ortak adımlarda işlenebilir. Yüksek batch daha iyi throughput sağlarken latency artışı yaratabilir. Optimal değer model ve GPU'ya göre değişir. Benchmark olmadan sabit sayı seçilmemelidir.
KV Cache
KV cache generation sırasında önceki token hesaplamalarını bellekte tutar. Uzun context ve çoklu concurrent session VRAM kullanımını artırır. Model ağırlıkları GPU'ya sığsa bile KV cache için alan kalmayabilir. Serving motoru cache yönetimini optimize etmelidir. Capacity hesabında mutlaka dikkate alınmalıdır.
Tensor Parallelism
Tensor parallelism tek modelin hesaplamasını birden fazla GPU'ya dağıtabilir. Büyük modeller böylece tek GPU belleği sınırını aşabilir. GPU'lar arası hızlı bağlantı performans için önemlidir. Network veya interconnect bottleneck oluşabilir. Ölçekleme lineer kabul edilmemelidir.
Multi-GPU Serving
Multi-GPU kullanımında model parallelism ve replica parallelism farklı amaçlara hizmet eder. Büyük modeli bölmek için tensor parallelism kullanılabilir. Daha fazla request kapasitesi için aynı modelin farklı replica'ları çalıştırılabilir. İş yüküne göre iki yaklaşım birlikte uygulanabilir. GPU topology deployment scheduler tarafından dikkate alınmalıdır.
Autoscaling
Autoscaling queue length, GPU utilization veya request metriğine göre replica artırabilir. GPU node başlatma süresi CPU servislerinden çok daha uzun olabilir. Model artifact'ın memory'e yüklenmesi ek startup süresi oluşturur. Minimum warm replica sayısı belirlenebilir. Ani trafik için yalnızca reactive autoscaling yeterli olmayabilir.
High Availability
Tek GPU node production için önemli hata noktasıdır. Birden fazla serving replica load balancer arkasında çalışabilir. Model artifact ortak veya hızlı erişilen storage'da tutulabilir. Health check GPU ve model durumunu gerçekten doğrulamalıdır. Node kaybı senaryosu düzenli olarak test edilmelidir.
GPU ve Donanım Kapasitesi Nasıl Hesaplanır?
GPU kapasite hesabında yalnızca model parametre sayısına bakmak eksik sonuç verir. Ağırlık precision seviyesi, KV cache, context ve concurrency aynı anda VRAM tüketir. Throughput ve Time to First Token hedefleri compute kapasitesini belirler. Gerçek kullanıcı başına token üretim hızı ayrıca ölçülmelidir. Production kapasitesi mutlaka hedef workload ile benchmark edilmelidir.
Parametre Sayısı ve VRAM İlişkisi
Parametre sayısı model ağırlığının yaklaşık bellek ihtiyacını belirler. FP16 ağırlıklar her parametre için yaklaşık iki byte gerektirir. Ancak runtime overhead ve cache ek bellek tüketir. Quantization ağırlık boyutunu azaltabilir. Bu nedenle teorik hesap ile gerçek VRAM kullanımı ayrı ölçülmelidir.
Precision'ın Belleğe Etkisi
Precision model ağırlıklarının bellekte hangi sayı formatıyla tutulduğunu belirler. Daha düşük precision VRAM tasarrufu sağlayabilir. Bunun karşılığında kalite veya kernel uyumluluğu etkilenebilir. Her model quantization seviyesinde aynı davranışı göstermez. Kurumsal benchmark kullanılan gerçek precision ile yapılmalıdır.
FP16 / BF16
FP16 ve BF16 yüksek kaliteyi korumak için yaygın kullanılan precision seviyeleridir. Bellek ihtiyacı quantized sürümlere göre daha yüksektir. Büyük model çoklu GPU gerektirebilir. GPU'nun native desteklediği format performansı etkileyebilir. Production öncesi gerçek serving testi yapılmalıdır.
FP8
FP8 desteklenen donanım ve runtime üzerinde bellek ve compute verimliliği sağlayabilir. Her model ve inference motoru aynı seviyede destek sunmaz. Quality regression test edilmelidir. Kernel ve GPU generation uyumluluğu kontrol edilmelidir. Benchmark sonuçları FP16 ile karşılaştırılmalıdır.
INT8
INT8 quantization ağırlık belleğini önemli ölçüde azaltabilir. Birçok görevde kalite kaybı sınırlı kalabilir. Ancak model ve quantization tekniğine göre sonuç değişir. Throughput avantajı donanım desteğine bağlıdır. Golden dataset üzerinde regression ölçülmelidir.
INT4
INT4 daha yüksek VRAM tasarrufu sağlar. Küçük GPU üzerinde daha büyük model çalıştırmayı mümkün kılabilir. Buna karşılık kalite kaybı bazı görevlerde belirginleşebilir. Türkçe ve structured output senaryoları ayrıca test edilmelidir. Sadece genel benchmark skoruna güvenilmemelidir.
KV Cache Bellek Kullanımı
KV cache aktif sequence sayısı ve context length ile büyür. Çoklu kullanıcı workload'unda ciddi VRAM tüketebilir. Uzun context destekleyen modelin maksimum context'ini sürekli kullanmak ekonomik değildir. Gateway request bazlı limit uygulayabilir. Cache metriği serving platformunda izlenmelidir.
Context Length'in VRAM'e Etkisi
Context uzadıkça attention ve cache ihtiyacı büyür. RAG sistemi ilgili birkaç parçayı seçerek gereksiz context kullanımını azaltabilir. Kullanıcıların sınırsız belge göndermesine izin verilmemelidir. Token budget iş senaryosuna göre belirlenmelidir. Uzun context benchmark'ı ayrıca yapılmalıdır.
Concurrent User Sayısı
Concurrent user toplam kayıtlı kullanıcı sayısıyla aynı değildir. Aynı anda generation yapan kullanıcı sayısı capacity planı için önemlidir. Kullanıcıların ortalama response süresi concurrency değerini etkiler. Peak saatler ayrıca ölçülmelidir. Queue ve timeout değerleri bu tahmine göre belirlenmelidir.
Tokens per Second
Tokens per Second generation throughput için temel performans ölçüsüdür. Kullanıcı başına ve sistem toplamı ayrı izlenebilir. Büyük batch toplam throughput değerini yükseltebilir. Buna karşılık tek kullanıcı latency değeri değişebilir. SLA hedefi gerçek kullanıcı beklentisine göre belirlenmelidir.
Time to First Token
Time to First Token kullanıcının ilk cevabı ne kadar hızlı gördüğünü ölçer. Prompt processing, queue ve model latency bu değeri etkiler. Streaming uygulamalarda kullanıcı deneyimi açısından çok önemlidir. P95 ve P99 değerleri takip edilmelidir. Semantic cache TTFT değerini bazı isteklerde ciddi biçimde düşürebilir.
Kullanıcı Başına Kapasite Hesabı
Kullanıcı başına kapasite ortalama prompt ve response token sayısından hesaplanabilir. Aynı anda aktif kullanıcı oranı ayrıca tahmin edilmelidir. Model throughput değeri bu workload ile karşılaştırılır. Queue için güvenlik payı bırakılmalıdır. Sonuç load test ile doğrulanmalıdır.
Quantization Kurumsal LLM Kalitesini Nasıl Etkiler?
Quantization model ağırlıklarını daha düşük precision ile temsil ederek GPU bellek ihtiyacını azaltır. Bu yöntem daha küçük altyapıda daha büyük model çalıştırmaya yardımcı olabilir. Ancak kalite kaybı her görevde aynı değildir. Türkçe, reasoning ve structured output gibi senaryolar ayrı incelenmelidir. Kurumsal karar yalnızca VRAM kazancına göre verilmemelidir.
Quantization Nedir?
Quantization model ağırlıklarını daha düşük bit sayısıyla temsil etme yöntemidir. Bellek ve bazı donanımlarda inference maliyeti azalabilir. Farklı quantization algoritmaları farklı kalite sonuçları üretir. Model publisher tarafından sağlanan sürümler tercih edilebilir. Kaynağı bilinmeyen quantized artifact'lar supply-chain kontrolünden geçirilmelidir.
8-bit ve 4-bit Model Kullanımı
8-bit sürümler kalite ve bellek arasında dengeli bir seçenek olabilir. 4-bit modeller daha fazla tasarruf sağlar. Küçük GPU üzerinde PoC çalıştırmak için faydalıdır. Production kullanımında gerçek domain benchmark zorunludur. Tool calling accuracy gibi metrikler ayrıca karşılaştırılmalıdır.
VRAM Kazancı
Quantization model ağırlıklarının VRAM tüketimini düşürür. Boşalan bellek KV cache veya daha fazla concurrent request için kullanılabilir. Bununla birlikte runtime ek memory ihtiyacı devam eder. Teorik ağırlık boyutu gerçek toplam VRAM kullanımı değildir. Load test sırasında peak memory ölçülmelidir.
Latency Etkisi
Düşük precision her zaman daha hızlı inference anlamına gelmez. GPU ve kernel desteği performans sonucunu belirler. Bazı quantized formatlarda dequantization overhead olabilir. TTFT ve token generation speed ayrı ölçülmelidir. En hızlı format model ve donanıma göre değişebilir.
Quality Regression
Quality regression quantization sonrası model çıktısının bozulmasını ifade eder. Basit sohbet testleri bu farkı göstermeyebilir. Kurumsal golden dataset üzerinde correctness ölçülmelidir. JSON schema ve tool call sonuçları ayrıca incelenmelidir. Kabul edilebilir regression iş senaryosuna göre tanımlanmalıdır.
Quantized Model Benchmark Nasıl Yapılır?
Aynı prompt seti farklı precision sürümlerinde çalıştırılmalıdır. Temperature ve inference ayarları mümkün olduğunca sabit tutulmalıdır. Correctness, latency ve GPU kullanımı birlikte kaydedilmelidir. İnsan değerlendirmesi gereken görevler ayrıca örneklenebilir. Sonuç model registry içine benchmark metadata olarak eklenebilir.
AI Gateway Neden Kurumsal LLM Mimarisinin Kritik Katmanıdır?
AI Gateway uygulamalar ile modeller arasındaki ortak kontrol noktasıdır. Her uygulamanın doğrudan farklı model endpoint'lerine bağlanması yönetimi zorlaştırır. Authentication, rate limit, routing ve audit merkezi hale getirilebilir. Model veya provider değiştiğinde uygulama koduna müdahale ihtiyacı azalır. Bu yapı Açık Kaynak Büyük Dil Modellerinin (LLM) Kurumsal Entegrasyonu için uzun vadeli platform esnekliği sağlar.
Merkezi Model Endpoint'i
Uygulamalar tek bir kurumsal endpoint kullanabilir. Gateway arkadaki modeli routing policy ile seçer. Model version değişikliği client uygulamalarından gizlenebilir. Endpoint standardizasyonu developer deneyimini iyileştirir. Access policy ortak noktada uygulanır.
Authentication
Gateway her istekte kullanıcı veya application identity doğrulayabilir. SSO token veya service credential kullanılabilir. Model endpoint'e anonim erişim kapatılmalıdır. Authentication sonucu authorization kurallarına aktarılır. Identity bilgisi audit trace içinde saklanabilir.
API Key Yönetimi
API key yalnızca uygulama kimliği olarak kullanılabilir. Her proje için ayrı key verilmesi audit görünürlüğünü artırır. Key expiration ve rotation uygulanmalıdır. Secret repository içinde tutulmamalıdır. Daha gelişmiş yapılarda kısa ömürlü token tercih edilebilir.
Rate Limiting
Rate limit tek kullanıcının tüm GPU kapasitesini tüketmesini engeller. Kullanıcı, proje veya uygulama bazında sınır uygulanabilir. Token bazlı limit request sayısından daha doğru olabilir. Burst kullanım için ayrı politika tanımlanabilir. Limit aşıldığında anlaşılır hata dönülmelidir.
Budget Kontrolü
Budget kontrolü belirli proje veya ekip için token tüketimini sınırlar. Self-hosted sistemde bile GPU kapasitesi sınırlı kaynaktır. Kullanım metriği chargeback veya showback için kullanılabilir. Büyük model erişimi daha yüksek quota tüketebilir. Maliyet görünürlüğü ürün ekiplerinin doğru model seçmesini teşvik eder.
Audit Logging
Gateway her request için kullanıcı, model ve latency metadata'sı kaydedebilir. Prompt içeriği hassassa doğrudan loglanmamalıdır. Hash veya redacted metadata kullanılabilir. Security incident sırasında trace bilgisi değerlidir. Log retention KVKK ve güvenlik politikasına göre belirlenmelidir.
Guardrails
Input ve output guardrail gateway katmanında merkezi uygulanabilir. Her uygulamanın kendi kontrolünü sıfırdan yazması gerekmez. PII detection veya prompt injection kontrolü ortak servis olarak çalışabilir. Uygulamaya özel policy yine desteklenmelidir. Guardrail failure davranışı risk seviyesine göre tanımlanmalıdır.
Routing
Routing isteği uygun modele yönlendirir. Dil, görev tipi, latency hedefi veya kullanıcı yetkisi kriter olabilir. Basit istekler küçük modelde çalıştırılabilir. Zor görev daha büyük modele escalate edilebilir. Routing policy evaluation sonuçlarıyla düzenli güncellenmelidir.
Fallback
Primary model erişilemezse fallback model kullanılabilir. Fallback modelin kalite ve tool compatibility seviyesi önceden test edilmelidir. Her hata durumunda otomatik fallback doğru olmayabilir. Güvenlik policy farklı modelde aynı şekilde uygulanmalıdır. Fallback olayı observability sistemine kaydedilmelidir.
Caching
Cache tekrarlanan isteklerde GPU kullanımını azaltabilir. Exact prompt cache deterministik görevlerde etkilidir. Semantic cache benzer soruları eşleştirebilir. Hassas veri kullanıcılar arasında karışmamalıdır. Cache key authorization context bilgisi içermelidir.
Multi-Model Routing Nasıl Çalışır?
Multi-model routing her görevi tek büyük modele göndermek yerine uygun model seçimini otomatikleştirir. Bu yaklaşım maliyet ve latency değerlerini iyileştirebilir. Küçük model basit görevleri hızlı biçimde çözerken daha güçlü model yalnızca gerekli isteklerde kullanılır. Health check ve fallback routing güvenilirliği artırır. Vendor-neutral API uygulamaların bu model değişimlerinden etkilenmesini azaltır.
Kullanım Senaryosuna Göre Routing
Belge özetleme, extraction ve reasoning görevleri farklı modeller gerektirebilir. Gateway request metadata üzerinden görev tipini belirleyebilir. Her kullanım senaryosu approved model listesine bağlanabilir. Güvenlik seviyesi yüksek görevler yalnızca on-premise modele yönlendirilebilir. Routing kararı audit logda görülebilmelidir.
Model Kalitesine Göre Routing
Evaluation sonuçları model yetkinlik profili oluşturabilir. Türkçe hukuk sorularında güçlü olan model o göreve atanabilir. Structured output başarısı düşük model API otomasyonunda kullanılmayabilir. Quality score routing policy için giriş olabilir. Model update sonrasında skorlar yeniden hesaplanmalıdır.
Latency-Based Routing
Gateway model endpoint'lerin gerçek latency metric'lerini takip edebilir. Yoğun replica yerine daha hızlı sağlıklı endpoint seçilebilir. Coğrafi lokasyon da routing kararına eklenebilir. P95 latency threshold aşılırsa fallback tetiklenebilir. Kalite farkı büyükse sadece latency'ye göre seçim yapılmamalıdır.
Cost-Based Routing
Cost-based routing daha ucuz modeli varsayılan seçenek yapabilir. Self-hosted sistemde maliyet GPU saniyesi veya token tahmini üzerinden hesaplanabilir. Managed API kullanılıyorsa provider fiyatı eklenebilir. Kalite eşiği sağlanmadığında daha güçlü modele geçilir. Bu yaklaşım bütçeyi merkezi olarak yönetmeye yardımcı olur.
Small Model → Large Model Escalation
Küçük model önce isteği çözmeye çalışabilir. Confidence veya evaluation sinyali yetersizse büyük modele geçilebilir. Bu yöntem yüksek trafik ortamında maliyet avantajı sağlayabilir. Escalation kararının yanlış pozitif oranı ölçülmelidir. Kullanıcı aynı request için iki model latency'sini yaşamamalıdır.
Fallback Model
Fallback model ana model arızalandığında hizmet sürekliliği sağlar. Aynı API schema'yı desteklemesi entegrasyonu kolaylaştırır. Model kalitesi minimum kabul edilen seviyenin altında olmamalıdır. Fallback üzerinde de authorization ve guardrail uygulanmalıdır. Failover düzenli test edilmelidir.
Model Health Check
Model endpoint health yalnızca TCP port üzerinden ölçülmemelidir. Basit inference probe gerçek serving durumunu doğrulayabilir. GPU memory error veya model unload durumu tespit edilmelidir. Gateway sağlıksız modeli routing dışına alır. Recovery sonrasında trafik kademeli geri verilebilir.
Vendor-Neutral API Tasarımı
Uygulamalar tek provider'a özel parametrelerle dolmamalıdır. Ortak chat, embedding ve tool schema tanımlanabilir. Provider-specific özellikler opsiyonel capability olarak sunulabilir. Böylece model geçiş maliyeti azalır. Exit strategy teknik olarak uygulanabilir hale gelir.
Semantic ve Prompt Caching ile LLM Maliyeti Nasıl Azaltılır?
Caching tekrarlanan soruların her seferinde GPU üzerinde yeniden çalıştırılmasını engelleyebilir. Exact cache aynı prompt için hızlı ve güvenilir sonuç verir. Semantic cache benzer anlamdaki soruları da eşleştirebilir. Ancak kullanıcı yetkisi ve hassas veri cache tasarımını doğrudan etkiler. Yanlış tasarlanmış cache farklı kullanıcılar arasında bilgi sızıntısına neden olabilir.
Exact Prompt Cache
Exact cache request'in tam anahtar eşleşmesini kullanır. Deterministik ve sık tekrarlanan görevlerde güvenlidir. System prompt ve model version cache key'e dahil edilmelidir. Authorization context farklıysa aynı cevap paylaşılmamalıdır. Model güncellendiğinde cache invalidation yapılmalıdır.
Semantic Cache
Semantic cache embedding benzerliğine göre daha önceki request'i bulur. Benzer kullanıcı soruları aynı cevapla karşılanabilir. Threshold çok düşükse yanlış eşleşme oluşabilir. Domain bazında farklı threshold gerekebilir. Hassas RAG yanıtlarında kullanıcı veya tenant izolasyonu zorunludur.
Cache Hit Rate
Cache hit rate caching yatırımının gerçek etkisini gösterir. Çok düşük hit oranı gereksiz sistem yükü oluşturabilir. Sık kullanılan kurumsal soru-cevap uygulamalarında oran daha yüksek olabilir. Hit ve miss latency ayrı izlenmelidir. Maliyet tasarrufu GPU token kullanımındaki düşüş üzerinden hesaplanabilir.
Cache Invalidation
Kurumsal bilgi değiştiğinde eski cevap cache'de kalmamalıdır. Doküman version veya knowledge-base update invalidation tetikleyebilir. Model ve prompt version cache key içinde bulunmalıdır. TTL tek başına yeterli olmayabilir. Kritik bilgiler event-based invalidation ile güncellenebilir.
Hassas Verilerin Cache'de Saklanması
Cache response kişisel veya ticari bilgi içerebilir. Encryption at rest uygulanmalıdır. Retention süresi minimum tutulmalıdır. Hassas alanlar cache dışı bırakılabilir. Access log cache erişimlerini de kapsamalıdır.
Kullanıcı Yetkisine Göre Cache İzolasyonu
Aynı soru farklı kullanıcılar için farklı yetkili belgeler üzerinden yanıtlanabilir. Bu nedenle cache key kullanıcı veya authorization scope bilgisi içermelidir. Tenant verileri kesin biçimde ayrılmalıdır. Shared cache yalnızca public veya ortak bilgi için kullanılabilir. Access policy değiştiğinde ilgili cache kayıtları temizlenmelidir.
Kurumsal Veriler Açık Kaynak LLM'e Nasıl Bağlanır?
Kurumsal veriyi modele bağlamanın en yaygın yöntemlerinden biri RAG mimarisidir. Dokümanlar embedding ile indexlenir ve kullanıcı sorusuyla ilgili parçalar retrieval aşamasında seçilir. Böylece modelin yeniden eğitilmesi gerekmeden güncel bilgi kullanılabilir. Yetkilendirme retrieval katmanında uygulanmalıdır. Açık kaynak LLM on-premise deployment RAG ve vektör veritabanı entegrasyonu tasarlanırken veri kaynağı izinleri korunmalıdır.
RAG Nedir?
RAG, retrieval ve generation adımlarını birleştirir. Kullanıcı sorusuyla ilgili içerik önce bilgi tabanından bulunur. Seçilen içerik LLM prompt'una context olarak eklenir. Model cevabı bu kaynaklara dayanarak üretir. Citation ve faithfulness metrikleri sistem kalitesini artırabilir.
Neden Modeli Baştan Eğitmek Yerine RAG Kullanılır?
Kurumsal bilgi sürekli değişir. Her doküman değişikliğinde modeli yeniden eğitmek pratik değildir. RAG index güncellendiğinde yeni bilgi hemen kullanılabilir. Doküman yetkileri metadata üzerinden uygulanabilir. Fine-tuning ise daha çok davranış veya format değişikliği için uygundur.
Veri Kaynakları
Kurumsal bilgi tek sistemde bulunmaz. Dosya sunucuları, DMS, CRM ve ERP farklı veri modelleri kullanabilir. Her connector veri sahibi ve erişim yetkisini korumalıdır. Ingestion sırasında metadata kaybedilmemelidir. Veri kaynağı güncellemeleri incremental sync ile takip edilebilir.
SharePoint
SharePoint üzerindeki dokümanlar RAG kaynağı olabilir. Kullanıcı ve grup izinleri ingestion sırasında metadata olarak alınmalıdır. Silinen veya taşınan belge index'te güncellenmelidir. Connector servis hesabı gereğinden fazla yetki almamalıdır. Retrieval sonucu kullanıcı ACL bilgisiyle filtrelenmelidir.
Confluence
Confluence sayfaları ekip bilgisinin önemli bölümünü taşıyabilir. Space ve page permission bilgileri korunmalıdır. Sayfa güncellemeleri incremental olarak index'e işlenebilir. HTML parsing başlık ve tablo yapısını korumalıdır. Kullanıcının göremediği sayfa RAG sonucunda da görünmemelidir.
Dosya Sunucuları
Dosya sunucularında PDF, Office ve metin dosyaları bulunabilir. Dosya sistemindeki grup izinleri metadata'ya aktarılmalıdır. Parser dosya formatına göre doğru içerik çıkarmalıdır. Eski veya duplicate dokümanlar index kalitesini düşürebilir. Ingestion lifecycle silme işlemlerini de takip etmelidir.
DMS
Doküman yönetim sistemleri versiyon ve erişim bilgisi açısından zengin metadata sunar. RAG yalnızca güncel veya onaylı sürümü kullanabilir. Doküman sınıflandırması retrieval policy'ye aktarılabilir. Gizli belgeler ayrı index veya namespace içinde tutulabilir. Audit hangi belgenin cevap üretiminde kullanıldığını kaydedebilir.
CRM
CRM verisi müşteri bazlı ve yüksek hassasiyetli olabilir. Kullanıcı sadece yetkili olduğu müşteri kayıtlarına erişmelidir. Tüm CRM verisini indiscriminately embedding yapmak doğru değildir. Gerekirse gerçek zamanlı API retrieval tercih edilebilir. PII minimization uygulanmalıdır.
ERP
ERP verisi finansal ve operasyonel kayıtlar içerebilir. Güncelliğin kritik olduğu veriler vector database yerine canlı API üzerinden alınabilir. LLM raw SQL erişimi almamalıdır. Tool layer izin verilen sorguları sınırlamalıdır. Write işlemleri insan onayı gerektirebilir.
SQL Veritabanları
SQL veri tabanlarına doğrudan model erişimi risklidir. Query generation kontrol katmanı üzerinden yapılmalıdır. Read-only view veya güvenli API tercih edilebilir. Kullanıcı yetkisi satır seviyesinde uygulanmalıdır. Query logları audit sistemine aktarılmalıdır.
API'ler
API'ler güncel kurumsal veriye kontrollü erişim sağlar. Tool schema yalnızca izin verilen operasyonları sunmalıdır. Authentication service identity üzerinden yapılmalıdır. Model API credential'ı doğrudan görmemelidir. High-risk write action için kullanıcı onayı eklenmelidir.
Kurumsal RAG Pipeline'ı Nasıl Tasarlanır?
RAG pipeline ingestion ile başlayıp generation ile biten bir veri akışıdır. Parsing ve chunking kalitesi retrieval sonucunu doğrudan etkiler. Embedding tek başına yeterli olmayabilir ve hybrid search ile reranking kaliteyi artırabilir. Context construction gereksiz tokenları modele göndermemelidir. Pipeline her aşamada evaluation ve observability üretmelidir.
Data Ingestion
Ingestion kaynak sistemden doküman ve metadata alır. Full sync yanında incremental update desteklenmelidir. Deleted document index'ten kaldırılmalıdır. Kaynak ACL bilgisi korunmalıdır. Ingestion failure alarm üretmelidir.
Document Parsing
Parser PDF, Office veya HTML yapısını metne dönüştürür. Tablo ve başlıkların kaybolması retrieval kalitesini düşürebilir. OCR yalnızca gerekli belgelerde kullanılmalıdır. Parser version değiştiğinde index rebuild gerekebilir. Extraction quality örnek dokümanlarla test edilmelidir.
Chunking
Chunking dokümanı retrieval için daha küçük parçalara ayırır. Çok küçük chunk context kaybına, çok büyük chunk gereksiz token kullanımına neden olabilir. Başlık ve paragraf sınırları mümkün olduğunca korunmalıdır. Domain'e göre farklı chunk stratejisi kullanılabilir. Chunk ID kaynak belgeyle ilişkilendirilmelidir.
Embedding
Embedding metni vektör temsiline dönüştürür. Türkçe ve domain performansı benchmark edilmelidir. Query ve document encoder uyumu önemlidir. Model update index'in yeniden hesaplanmasını gerektirebilir. Embedding version metadata olarak saklanmalıdır.
Vector Storage
Vector storage embedding ve metadata'yı saklar. Filter performansı ACL uygulanırken önemlidir. Tenant izolasyonu fiziksel veya mantıksal olabilir. Backup ve replication stratejisi bulunmalıdır. Index size capacity planına dahil edilmelidir.
Retrieval
Retrieval kullanıcı sorgusuna en yakın doküman parçalarını seçer. Top-k değerinin yüksek olması her zaman daha iyi sonuç vermez. Yetkisiz chunk retrieval aşamasında filtrelenmelidir. Query rewriting bazı kullanım senaryolarında kaliteyi artırabilir. Retrieval recall golden dataset ile ölçülmelidir.
Hybrid Search
Hybrid search vector similarity ile keyword aramayı birleştirir. Kurumsal kod, ürün adı veya mevzuat numarası gibi exact terimlerde keyword search değerlidir. Semantic query ise doğal dil sorularında fayda sağlar. İki skor uygun ağırlıkla birleştirilebilir. Türkçe domain testleri optimal ayarı belirlemelidir.
Reranking
Reranker ilk retrieval sonuçlarını daha ayrıntılı modelle yeniden sıralar. Generation context'e daha ilgili chunk'ların girmesini sağlayabilir. Ek inference maliyeti ve latency oluşturur. Küçük candidate set üzerinde çalıştırılması verimlidir. Recall ve precision etkisi ayrı ölçülmelidir.
Context Construction
Context construction seçilen chunk'ları model prompt'una düzenli biçimde yerleştirir. Kaynak adı ve doküman referansı eklenebilir. Duplicate chunk'lar çıkarılmalıdır. Token budget aşılmamalıdır. Modelin yalnızca verilen kaynağa dayanması system instruction ile desteklenebilir.
LLM Generation
Generation aşamasında model retrieval context'i kullanarak cevap üretir. Faithfulness modelin kaynak dışı bilgi ekleyip eklemediğini ölçer. Citation çıktısı kullanıcı güvenini artırabilir. Cevap bulunamıyorsa model bunu açıkça belirtmelidir. Hallucination'ı tamamen engellemek yerine ölçmek ve azaltmak hedeflenmelidir.
RAG'de Yetki Kontrolü Nasıl Uygulanır?
RAG güvenliğinin en kritik noktalarından biri doküman izinlerinin korunmasıdır. Kullanıcının normalde erişemediği belge retrieval sonucuna girmemelidir. Prompt içine erişim kuralları yazmak yeterli değildir çünkü model security boundary değildir. ACL ve metadata filtreleme retrieval query seviyesinde uygulanmalıdır. Kurumsal açık kaynak LLM sistemlerinde veri güvenliği yetkilendirme ve model yönetimi bu katmandan başlamalıdır.
Neden Prompt İçinde Yetki Kontrolü Yeterli Değildir?
Model prompt instruction'ı yanlış yorumlayabilir veya injection saldırısıyla yönlendirilebilir. Güvenlik kararı olasılıksal model davranışına bırakılamaz. Yetkisiz belge modele hiç gönderilmemelidir. Authorization retrieval sisteminde deterministik olarak uygulanmalıdır. Model yalnızca yetkili context üzerinde çalışmalıdır.
Document-Level ACL
Document-level ACL belgenin hangi kullanıcı veya gruplara açık olduğunu tanımlar. Ingestion sırasında kaynak sistemden alınabilir. Retrieval query kullanıcı grubuna göre filtrelenir. Belge yetkisi değiştiğinde index metadata güncellenmelidir. Cache de aynı authorization scope'u dikkate almalıdır.
Chunk-Level ACL
Bazı dokümanlarda farklı bölümler farklı yetkilere sahip olabilir. Chunk-level ACL daha hassas kontrol sağlar. Ancak metadata boyutu ve yönetim yükü artabilir. Kaynak sistem bu ayrımı destekliyorsa korunmalıdır. Yetki mirası açık biçimde tanımlanmalıdır.
Metadata Filtering
Vector query metadata condition ile sınırlandırılabilir. Tenant, department ve confidentiality level filtreleri uygulanabilir. Filter query injection'a açık olmamalıdır. Kullanıcıdan gelen metadata değeri doğrudan güvenilir kabul edilmemelidir. Authorization service tarafından üretilen scope kullanılmalıdır.
User ve Group Mapping
Kurumsal identity provider kullanıcı ve grup bilgisini sağlar. Bu grup bilgileri document ACL ile eşleştirilebilir. Group değişikliği kısa sürede retrieval katmanına yansıtılmalıdır. Stale authorization cache risk yaratabilir. Kullanıcı lifecycle merkezi identity sistemiyle yönetilmelidir.
RBAC
RBAC role göre veri veya işlev erişimini belirler. Department veya görev bazlı roller uygulanabilir. Model seçimi de role bağlı olabilir. Admin kullanıcı tüm belgeye otomatik erişmemelidir. Data owner politikası ayrı değerlendirilmelidir.
ABAC
ABAC kullanıcı, belge ve bağlam özelliklerine göre karar verir. Department, location veya confidentiality etiketi kullanılabilir. Daha esnek ancak daha zor yönetilen bir modeldir. Policy merkezi authorization engine'de tutulmalıdır. Karar logları audit için saklanmalıdır.
Retrieval-Time Authorization
Authorization retrieval gerçekleşirken uygulanmalıdır. Önce tüm dokümanı getirip sonra filtrelemek veri sızıntısı riskini artırır. Query yalnızca izinli namespace veya metadata scope içinde çalışmalıdır. Reranker da sadece yetkili sonuçları görmelidir. Bu prensip RAG güvenliğinin temelidir.
Cross-Tenant Data Leakage Önleme
Multi-tenant sistemde bir müşterinin verisi diğerine görünmemelidir. Ayrı collection veya güçlü tenant filter kullanılabilir. Cache tenant bazında izole edilmelidir. Evaluation dataset cross-tenant attack senaryoları içermelidir. Audit anormal tenant erişim girişimlerini tespit edebilir.
RAG mı Fine-Tuning mi?
RAG ve fine-tuning birbirinin alternatifi olmaktan çok farklı sorunları çözen yöntemlerdir. Güncel kurumsal bilgi eklemek için RAG genellikle daha uygundur. Model davranışı veya çıktı biçimini değiştirmek için fine-tuning değerlidir. Prompt engineering en düşük maliyetli ilk adım olarak denenebilir. Bazı sistemlerde RAG ve fine-tuning birlikte kullanılabilir.
Bilgi Eklemek İçin RAG
Kurumsal belgeler sık değişebilir. RAG güncel içeriği yeniden model eğitmeden kullanır. Belge silindiğinde index'ten kaldırılabilir. Kullanıcı ACL retrieval seviyesinde korunabilir. Bu nedenle dinamik bilgi tabanları için güçlü bir çözümdür.
Davranış Değiştirmek İçin Fine-Tuning
Fine-tuning modelin belirli cevap biçimi veya görev davranışına uyarlanmasını sağlar. Eğitim örneklerinin kalitesi sonucu doğrudan etkiler. Yeni şirket politikası eklemek için uygun yöntem olmayabilir. Eğitim sonrası regression test yapılmalıdır. Base model update olduğunda fine-tuning tekrar gerekebilir.
Prompt Engineering
Prompt engineering model davranışını kod değiştirmeden yönlendirmeyi sağlar. System prompt üzerinden rol ve çıktı formatı tanımlanabilir. Çok karmaşık prompt bakım maliyetini artırır. Prompt version control altında tutulmalıdır. Her model değişiminde compatibility testi yapılmalıdır.
LoRA / QLoRA
LoRA ve QLoRA tam model eğitmeden daha küçük adapter parametreleri üzerinde çalışır. GPU ihtiyacını azaltabilir. Birden fazla domain adapter yönetmek mümkündür. Adapter ve base model version ilişkisi model registry'de tutulmalıdır. Quality benchmark full model ile karşılaştırılmalıdır.
Full Fine-Tuning
Full fine-tuning tüm model parametrelerini günceller. Yüksek compute ve veri ihtiyacı oluşturur. Çoğu kurumsal kullanım için ilk seçenek değildir. Veri kalitesi ve catastrophic forgetting riski değerlendirilmelidir. Büyük yatırım öncesinde RAG ve LoRA seçenekleri test edilmelidir.
RAG + Fine-Tuning Hybrid Yaklaşımı
Fine-tuning modelin davranışını düzenlerken RAG güncel bilgi sağlar. Örneğin şirketin yazışma standardına uygun cevap üretimi fine-tuning ile geliştirilebilir. Güncel prosedürler RAG üzerinden getirilebilir. İki sistem bağımsız olarak versionlanmalıdır. Evaluation hem bilgi doğruluğunu hem davranış kalitesini ölçmelidir.
Karar Matrisi
Bilgi sık değişiyorsa RAG önceliklidir. Davranış ve format standardizasyonu gerekiyorsa fine-tuning değerlendirilebilir. Basit yönlendirme prompt ile çözülebiliyorsa ek eğitim gereksizdir. Latency ve operasyon maliyeti de karara dahil edilmelidir. Hybrid yaklaşım yalnızca ölçülebilir fayda varsa kullanılmalıdır.
Türkçe Açık Kaynak LLM Performansı Nasıl Ölçülür?
Türkçe LLM değerlendirmesi yalnızca genel çok dilli benchmark sonuçlarından yapılmamalıdır. Kurumsal terminoloji, mevzuat ve teknik doküman dili günlük sohbetten oldukça farklı olabilir. RAG retrieval tarafında embedding ve reranker kalitesi ayrıca önemlidir. Golden dataset gerçek kullanıcı sorularından oluşturulmalıdır. Model seçimi dil ve domain bazlı skorlarla yapılmalıdır.
Genel Benchmark Neden Yeterli Değildir?
Genel benchmark belirli akademik veya geniş kapsamlı görevleri ölçer. Şirketin gerçek doküman yapısını temsil etmeyebilir. Model benchmark'ta güçlü görünürken Türkçe support ticket üzerinde düşük performans verebilir. Domain terminolojisi özel test gerektirir. Bu nedenle benchmark yalnızca ön eleme aracı olmalıdır.
Türkçe Dil Yetkinliği
Türkçe eklemeli dil yapısı modelin anlam ve üretim kalitesini etkileyebilir. Uzun cümleler ve resmi dil ayrıca test edilmelidir. Yazım hatalı kullanıcı soruları da dataset'e eklenmelidir. Çıktı akıcılığı ve doğruluğu ayrı puanlanabilir. İnsan değerlendirmesi önemli rol oynar.
Kurumsal Terminoloji
Şirket içi ürün, süreç ve kısaltmalar genel eğitim verisinde bulunmayabilir. RAG bu terminolojiyi context olarak sağlayabilir. Modelin kısaltmaları yanlış genişletme oranı ölçülmelidir. Golden dataset gerçek şirket terimlerini içermelidir. Terminoloji sözlüğü retrieval ve prompt katmanına eklenebilir.
Hukuk ve Mevzuat Dili
Hukuki metinler uzun ve bağlama duyarlı cümleler içerir. Modelin yalnızca akıcı cevap vermesi yeterli değildir. Kaynağa bağlılık ve citation doğruluğu ölçülmelidir. İnsan hukuk uzmanı evaluation sürecine dahil edilmelidir. Model çıktısı hukuki karar yerine destek amaçlı kullanılmalıdır.
Finans Terminolojisi
Finansal kavramlarda küçük hata büyük iş etkisi yaratabilir. Sayısal doğruluk ve dönem bilgisi ayrıca test edilmelidir. Model canlı hesaplama için tool kullanabilir. RAG doküman tarihi context'e eklenmelidir. Yüksek riskli kararlar insan onayı gerektirmelidir.
Teknik Dokümantasyon
Teknik dokümanlarda kod, command ve version bilgisi önemlidir. Model eski sürüm önerisi verebilir. Retrieval doküman version metadata'sını kullanmalıdır. Code block doğruluğu ayrı evaluation metriği olabilir. Güvenli olmayan command önerileri guardrail ile sınırlandırılmalıdır.
Türkçe RAG Retrieval
Generation modeli iyi olsa bile retrieval zayıfsa cevap kalitesi düşer. Türkçe embedding modeli ayrı benchmark edilmelidir. Keyword ve semantic hybrid search güçlü sonuç verebilir. Reranker etkisi ölçülmelidir. Recall@k ve relevance skorları dataset üzerinden hesaplanabilir.
Türkçe Golden Dataset Oluşturma
Golden dataset gerçek kullanıcı sorularından ve uzman cevaplarından oluşturulmalıdır. Kişisel veriler anonimleştirilmelidir. Farklı departman ve zorluk seviyeleri dengeli dağıtılmalıdır. Dataset version control altında tutulmalıdır. Model update'leri aynı test seti üzerinde karşılaştırılmalıdır.
Kuruma Özel LLM Evaluation Framework Nasıl Kurulur?
Evaluation modeli production'a almadan önce ve aldıktan sonra sürekli kalite ölçmeyi sağlar. Golden dataset, task-specific eval ve insan değerlendirmesi birlikte kullanılmalıdır. Correctness, faithfulness ve hallucination farklı metriklerdir. Tool calling ve structured output için deterministik kontroller eklenebilir. Sonuçlar model lifecycle kararlarının temel girdisi olmalıdır.
Golden Dataset
Golden dataset beklenen doğru cevap veya değerlendirme kriterlerini içeren kontrollü test setidir. Gerçek kullanım senaryolarını temsil etmelidir. Hassas veri temizlenmelidir. Dataset zaman içinde yeni failure örnekleriyle büyütülmelidir. Version değişikliği sonuç karşılaştırmasında kayıt altına alınmalıdır.
Task-Specific Evals
Her görev aynı kalite metriğine sahip değildir. Extraction için field accuracy kullanılabilir. RAG için faithfulness ve retrieval relevance daha önemlidir. Agent için tool selection ve action accuracy ölçülebilir. Evaluation kullanım senaryosuna göre tasarlanmalıdır.
Correctness
Correctness cevabın olgusal veya iş kuralı açısından doğru olup olmadığını ölçer. Otomatik grader kullanılabilir ancak insan doğrulaması gerekebilir. Sayısal görevlerde deterministic kontrol mümkündür. Kaynağa dayalı sorularda reference answer kullanılabilir. Model update regression burada hızlı görünür.
Relevance
Relevance cevap ve retrieval içeriğinin kullanıcı sorusuyla ilişkisini ölçer. Uzun ama gereksiz cevap düşük relevance alabilir. Reranker optimizasyonu bu metriği iyileştirebilir. İnsan değerlendirmesi örneklem üzerinden kullanılabilir. Kullanıcı feedback'i production sinyali sağlayabilir.
Faithfulness
Faithfulness modelin verilen RAG context'e sadık kalmasını ölçer. Kaynakta olmayan iddialar düşük skor oluşturur. Citation doğruluğu ayrıca incelenebilir. System prompt modeli kaynak dışı tahminden kaçınmaya yönlendirebilir. Evaluation düzenli scheduled job olarak çalıştırılabilir.
Hallucination
Hallucination modelin desteklenmeyen bilgi üretmesidir. Tamamen sıfırlanması gerçekçi değildir. Hedef riskli kullanım senaryolarında oranı kabul edilen seviyenin altında tutmaktır. RAG ve source citation yardımcı olabilir. İnsan onayı yüksek etkili kararlarda ek kontrol sağlar.
Safety
Safety evaluation zararlı veya politika dışı çıktıları ölçer. Prompt injection ve jailbreak testleri dataset'e dahil edilebilir. Tool-enabled agent için zararlı action denemeleri ayrıca yapılmalıdır. Guardrail değişiklikleri de regression testten geçmelidir. Safety metric production SLO haline getirilebilir.
Structured Output Accuracy
Structured output accuracy modelin beklenen JSON schema'yı doğru üretme oranını gösterir. Syntax doğruluğunun yanında field tipi ve değer validasyonu yapılmalıdır. Gateway schema enforcement uygulayabilir. Retry strategy kontrollü olmalıdır. Çok düşük başarı downstream otomasyonu güvensiz hale getirir.
Tool Calling Accuracy
Tool calling accuracy doğru aracın doğru parametrelerle çağrılıp çağrılmadığını ölçer. Modelin tool çağırmaması gereken sorular da test setine eklenmelidir. Unauthorized tool çağrıları ayrıca safety metric olabilir. Execution öncesi parameter validation yapılmalıdır. Tool schema değiştiğinde evaluation tekrar çalıştırılmalıdır.
Human Evaluation
İnsan değerlendirmesi özellikle ton, domain doğruluğu ve usefulness gibi alanlarda önemlidir. Uzmanlar standardized rubric kullanmalıdır. Rastgele birkaç cevap yerine temsil edici örneklem seçilmelidir. İnsan skorları otomatik eval ile karşılaştırılabilir. Agreement düşükse değerlendirme kriterleri gözden geçirilmelidir.
Açık Kaynak LLM'in Güvenliği Nasıl Sağlanır?
Self-hosted model kurum network'ünde çalıştığı için otomatik güvenli hale gelmez. Prompt injection, sensitive data leakage ve resource exhaustion gibi riskler devam eder. Tool-enabled agent sistemlerinde malicious action riski daha da artar. RAG knowledge base poisoning ayrıca ele alınmalıdır. Güvenlik model, veri, network ve uygulama katmanlarında birlikte uygulanmalıdır.
Prompt Injection
Prompt injection kullanıcı girdisinin model talimatlarını manipüle etmeye çalışmasıdır. Model güvenlik boundary olarak kullanılmamalıdır. Tool ve data access ayrı authorization katmanında sınırlandırılmalıdır. Input detector yardımcı sinyal sağlayabilir. Kritik action için deterministic policy uygulanmalıdır.
Indirect Prompt Injection
Indirect injection kötü niyetli talimatın kullanıcının prompt'unda değil, okunan dokümanda bulunmasıdır. RAG veya web içerikleri bu saldırıyı taşıyabilir. Retrieved content instruction olarak değil data olarak işlenmelidir. Tool execution için allowlist kullanılmalıdır. External content güvenilir kabul edilmemelidir.
Jailbreak
Jailbreak modelin safety instruction'larını aşmaya yönelik prompt tekniklerini ifade eder. Tek bir filter tüm varyasyonları yakalayamaz. Defense in depth yaklaşımı kullanılmalıdır. Model output risk sınıfına göre kontrol edilebilir. Safety testleri yeni model versionlarında tekrarlanmalıdır.
Sensitive Data Leakage
Model prompt, RAG veya memory üzerinden hassas bilgi görebilir. Kullanıcı ACL doğru uygulanmazsa cevapta veri sızıntısı oluşabilir. PII detection yardımcı olabilir. Trace ve cache verileri de leakage riski taşır. Data minimization her katmanda uygulanmalıdır.
Model Extraction
Model extraction saldırıları yoğun sorgular üzerinden model davranışını kopyalamaya çalışabilir. Rate limit bu saldırının maliyetini artırır. Anormal query pattern izlenmelidir. Public endpoint erişimi sınırlandırılmalıdır. Model artifact ve serving network ayrı korunmalıdır.
Denial of Wallet / Resource Exhaustion
Çok uzun prompt veya yoğun request GPU kapasitesini tüketebilir. Self-hosted ortamda maliyet faturadan çok hizmet kesintisi şeklinde görülür. Token limit ve rate limit uygulanmalıdır. Request queue sınırlanmalıdır. Kullanıcı bazlı quota sistemi faydalıdır.
Malicious Tool Calls
Model zararlı veya beklenmeyen tool action üretebilir. Tool-level permission modeli zorunludur. Write işlemleri read işlemlerinden ayrı sınıflandırılmalıdır. High-risk action insan onayı gerektirebilir. Tool execution logları audit sistemine aktarılmalıdır.
Knowledge Base Poisoning
RAG kaynağına kötü niyetli belge eklenirse model yanlış bilgi üretebilir. Ingestion source approval uygulanmalıdır. Doküman owner ve version metadata'sı tutulmalıdır. Güvenilmeyen kaynaklar ayrı index içinde tutulabilir. Critical knowledge değişiklikleri approval sürecine tabi tutulmalıdır.
Input ve Output Guardrails Nasıl Uygulanır?
Guardrail kullanıcı girdisini ve model çıktısını policy açısından kontrol eder. PII tespiti, injection sinyali ve schema validation gibi görevler uygulanabilir. Tek guardrail tüm güvenlik sorunlarını çözmez. Authorization ve tool permission deterministic sistemlerde kalmalıdır. Guardrail sonucu observability içinde kayıt altına alınmalıdır.
Input Validation
Input uzunluğu ve dosya tipi sınırlandırılmalıdır. Beklenmeyen binary veya control karakterleri kontrol edilebilir. Token limiti kaynak tüketimini sınırlar. Application-specific schema doğrulaması yapılabilir. Validation hatası kullanıcıya açık şekilde açıklanmalıdır.
Prompt Injection Detection
Injection detector şüpheli prompt kalıplarını tespit etmeye yardımcı olur. False positive olabileceği için tek karar mekanizması olmamalıdır. Riskli request daha sınırlı tool setine yönlendirilebilir. Retrieved document da benzer kontrolden geçebilir. Detection metric'leri değerlendirilmelidir.
PII Detection
PII detection prompt veya response içindeki kişisel veriyi belirleyebilir. Bazı alanlar maskelenerek modele gönderilebilir. İş senaryosu gerçekten kişisel veri gerektiriyorsa yetki ve retention uygulanmalıdır. Türkçe kimlik ve adres formatları test edilmelidir. Detection sonuçları gereksiz yere ham veri olarak loglanmamalıdır.
Content Moderation
Content moderation kurum politikasına aykırı içerikleri sınıflandırabilir. Kullanım senaryosuna göre farklı eşikler uygulanabilir. İç çalışan asistanı ile müşteri chatbot'u aynı policy'ye sahip olmayabilir. False positive kullanıcı deneyimini etkileyebilir. Policy açık ve ölçülebilir olmalıdır.
Output Validation
Model çıktısı downstream sisteme gönderilmeden doğrulanmalıdır. JSON parse ve schema kontrolü yapılabilir. URL, SQL veya command gibi riskli alanlar ayrıca kontrol edilmelidir. Geçersiz çıktı kontrollü retry ile düzeltilebilir. Sınırsız retry kaynak tüketimini artırmamalıdır.
Structured Output Enforcement
Serving motoru destekliyorsa constrained decoding kullanılabilir. Bu yöntem geçerli schema üretme oranını artırır. Yine de semantic field doğruluğu ayrıca kontrol edilmelidir. Tool parameter range limitleri application layer'da uygulanmalıdır. Structured output execution izni anlamına gelmez.
Domain Restriction
Bazı kurumsal asistanlar yalnızca belirli konu alanında cevap vermelidir. Retrieval sonucu yoksa model genel bilgi uydurmamalıdır. Domain classifier request'i uygun modele veya policy'ye yönlendirebilir. Kullanıcıya kapsam açıkça belirtilmelidir. Off-domain cevap oranı evaluation metriği olabilir.
Guard Model Yaklaşımı
Ayrı guard model input veya output riskini sınıflandırabilir. Ana modelden bağımsız olması farklı güvenlik sinyali sağlar. Ek latency ve GPU maliyeti oluşturabilir. Küçük guard modeller düşük maliyetle çalışabilir. Kritik uygulamalarda deterministic kurallarla birlikte kullanılmalıdır.
Model Supply-Chain Güvenliği
Model artifact'ları büyük boyutlu yazılım bağımlılıkları gibi ele alınmalıdır. Resmi publisher doğrulaması ve checksum kontrolü yapılmalıdır. Unsafe serialization formatları code execution riski taşıyabilir. Model serving container'ları vulnerability scanning sürecinden geçmelidir. Approved model catalog supply-chain kontrolünün merkezi noktası olmalıdır.
Model Nereden İndirildi?
Model kaynağı kayıt altına alınmalıdır. Doğrudan resmi publisher repository'si veya kurum mirror'ı tercih edilmelidir. Kaynağı belirsiz dosyalar production'a alınmamalıdır. Download tarihi ve version tutulmalıdır. Artifact daha sonra internal model registry'ye kopyalanabilir.
Publisher Doğrulaması
Publisher hesabının gerçekten model üreticisine ait olduğu doğrulanmalıdır. Benzer isimli sahte repository riski vardır. Release notes ve official reference karşılaştırılabilir. Kurumsal approval yalnızca doğrulanmış source'a verilmelidir. Publisher değişikliği yeniden review gerektirebilir.
Hash / Checksum Doğrulama
Checksum artifact'ın transfer sırasında değişmediğini doğrular. SHA-256 gibi güçlü hash kullanılabilir. Hash internal registry kaydına eklenmelidir. Air-gapped transfer sırasında tekrar doğrulama yapılmalıdır. Artifact değiştiğinde yeni approval süreci gerekir.
Zararlı Model Dosyaları
Model dosyası yalnızca data içermeyebilir. Bazı serialization formatları yükleme sırasında kod çalıştırma riski taşıyabilir. Güvenli formatlar tercih edilmelidir. Loader configuration remote code execution özelliğini gereksiz yere açmamalıdır. Model sandbox veya izole ortamda incelenebilir.
Unsafe Serialization
Pickle benzeri serialization yöntemleri güvenilmeyen kaynaktan yüklenmemelidir. Mümkün olduğunda saf tensor formatları tercih edilmelidir. Runtime'ın remote custom code yükleme davranışı kontrol edilmelidir. Security policy approved format listesi oluşturabilir. Model import pipeline otomatik tarama yapabilir.
Dependency Vulnerabilities
Inference engine Python ve native dependency'ler kullanır. Bu bileşenlerde güvenlik açığı bulunabilir. SBOM üretilmeli ve container scanning yapılmalıdır. CUDA ve driver security update'leri de takip edilmelidir. Model güvenliği application dependency güvenliğinden ayrı değildir.
Container Image Scanning
Model serving container image registry'ye push edildiğinde taranmalıdır. OS package ve Python dependency CVE'leri kontrol edilmelidir. Critical risk production promotion'ı engelleyebilir. Base image update süreci düzenli olmalıdır. İlgili güvenlik yaklaşımı container platform güvenliğiyle birlikte yönetilmelidir.
Model Artifact Signing
Approved model artifact kurum içi signer tarafından imzalanabilir. Deployment yalnızca doğrulanmış artifact kullanabilir. Signature checksum ve version ile ilişkilendirilir. Signing key güvenliği ayrıca yönetilmelidir. Compromise durumunda key revoke edilmelidir.
Software Bill of Materials
SBOM serving container ve yazılım dependency'lerini görünür hale getirir. Yeni CVE yayınlandığında etkilenen image'lar bulunabilir. Runtime ve library versionları kayıt altına alınır. Model artifact bilgisi SBOM'a ek metadata olarak bağlanabilir. Deployment provenance daha güçlü hale gelir.
AI Bill of Materials
AI Bill of Materials model, dataset, adapter ve AI-specific dependency ilişkilerini görünür hale getirmeyi amaçlar. Base model ve fine-tuning adapter version bilgisi kaydedilebilir. Embedding ve reranker modelleri de sistem bileşenidir. Lisans ve risk metadata'sı ilişkilendirilebilir. Governance ekibi hangi uygulamanın hangi model bileşenlerini kullandığını görebilir.
Kurum İçi Model Registry Nasıl Kurulur?
Model registry kurum tarafından onaylanmış modellerin merkezi envanteridir. Yalnızca model dosyasını saklamak yeterli değildir. Lisans, benchmark, security status ve owner bilgisi aynı kayıtla ilişkilendirilmelidir. Deployment sistemi sadece approved status taşıyan model sürümlerini kullanmalıdır. Kurumsal açık kaynak LLM kurulumu ve yapay zeka entegrasyon hizmeti tasarlanırken model registry temel governance bileşenlerinden biri olmalıdır.
Approved Model Catalog
Approved catalog production'da kullanılmasına izin verilen modelleri listeler. Her model version ayrı kayıt olmalıdır. Kullanım senaryosu veya risk seviyesi modele bağlanabilir. Yeni model doğrudan catalog'a eklenmemelidir. Due diligence ve evaluation tamamlanmalıdır.
Model Version
Model version reproducibility için gereklidir. Sadece model adı yeterli değildir. Commit veya artifact hash kaydedilmelidir. Quantized sürüm ayrı version olarak değerlendirilmelidir. Production rollback bu kayıt üzerinden yapılabilir.
License Metadata
Lisans adı ve sürümü model kaydına eklenmelidir. Hukuk approval tarihi tutulmalıdır. Commercial use ve redistribution notları saklanabilir. Lisans değişikliği yeni model review tetiklemelidir. Ürün ekipleri yalnızca approved lisanslı model seçebilmelidir.
Benchmark Results
Model benchmark sonuçları golden dataset version ile birlikte saklanmalıdır. Latency ve GPU maliyeti de kaydedilebilir. Quantization sonuçları karşılaştırmalı tutulmalıdır. Model update regression kararı kolaylaşır. Kullanım senaryosu bazlı skorlar routing sistemine aktarılabilir.
Security Status
Security status supply-chain ve red team kontrollerinin sonucunu gösterir. Approved, restricted veya blocked gibi seviyeler kullanılabilir. Critical finding varsa deployment engellenebilir. Security review tarihi saklanmalıdır. Periyodik yeniden değerlendirme yapılmalıdır.
Risk Classification
Risk sınıfı model ile kullanım senaryosunun birlikte değerlendirilmesini sağlar. Aynı model düşük riskli iç özetleme ve yüksek riskli agent işleminde farklı statü alabilir. Governance policy approval seviyesini buna göre belirler. Monitoring yoğunluğu riskle artabilir. Kullanım amacı registry metadata'sında tutulmalıdır.
Deployment Status
Model development, staging veya production durumunda olabilir. Hangi cluster veya endpoint'te çalıştığı kaydedilmelidir. Canary version görünür olmalıdır. Decommission edilen model yeni deployment için seçilememelidir. CMDB veya platform catalog ile entegrasyon yapılabilir.
Model Owner
Her production modelin sorumlu sahibi bulunmalıdır. Model owner evaluation ve lifecycle kararlarını takip eder. Security ve data owner ile koordinasyon sağlar. Yeni release çıktığında upgrade değerlendirmesini başlatır. Owner ayrılırsa sorumluluk otomatik olarak yeniden atanmalıdır.
Açık Kaynak Model Güncellemeleri Nasıl Yönetilir?
Yeni model sürümü çıktığında doğrudan production'a almak ciddi regression riski yaratır. Lisans ve security review yeniden yapılmalıdır. Offline evaluation mevcut version ile karşılaştırılmalıdır. Canary deployment gerçek trafik üzerinde kontrollü test sağlar. Rollback planı yeni sürüm devreye alınmadan önce hazır olmalıdır.
Yeni Model Sürümünün Tespiti
Model registry upstream release kaynaklarını izleyebilir. Yeni version otomatik notification oluşturabilir. Ancak otomatik production deployment yapılmamalıdır. Release notes ve model card değişikliği incelenmelidir. Upgrade kararı kullanım senaryosuna göre verilmelidir.
License Değişikliği Kontrolü
Yeni model release farklı lisans kullanabilir. Aynı ailede önceki lisansın devam ettiği varsayılmamalıdır. Hukuk ekibi yeni şartları değerlendirmelidir. Attribution veya acceptable use değişikliği olabilir. Approval tamamlanmadan production promotion yapılmamalıdır.
Security Review
Artifact publisher ve checksum tekrar doğrulanmalıdır. Yeni dependency veya custom code incelenmelidir. Red team testleri önemli sürümlerde yeniden çalıştırılabilir. Model safety davranışı değişebilir. Sonuç security status metadata'sına işlenmelidir.
Offline Evaluation
Golden dataset üzerinde yeni ve mevcut model karşılaştırılır. Correctness ve hallucination değişimi ölçülür. Tool calling compatibility kontrol edilir. Türkçe performans regression özellikle izlenmelidir. Minimum threshold altında kalan model production'a alınmamalıdır.
Performance Benchmark
Yeni model aynı donanım üzerinde test edilmelidir. TTFT, throughput ve memory kullanımı karşılaştırılır. Kalite artışı ciddi latency maliyeti oluşturabilir. Concurrency testi production trafik profiline yakın yapılmalıdır. Sonuç kapasite planını etkileyebilir.
Canary Deployment
Canary model trafiğin küçük bir bölümünü alır. Error ve quality metric'leri mevcut modelle karşılaştırılır. Kullanıcı grubu kontrollü seçilebilir. Kritik tool action'lar ilk aşamada canary dışında tutulabilir. Sorun görülürse trafik hızla eski modele çevrilir.
Production Promotion
Promotion yalnızca evaluation ve canary başarıyla tamamlandıktan sonra yapılmalıdır. Model artifact hash'i sabitlenmelidir. Gateway routing yeni version'a kademeli artırılabilir. Dashboard değişim anını işaretlemelidir. Eski model belirli süre rollback için hazır tutulmalıdır.
Rollback
Rollback endpoint'i önceki model version'a yönlendirir. Prompt veya tool schema yeni modele özel değiştiyse compatibility dikkate alınmalıdır. Model artifact local storage'da hazır tutulabilir. Rollback kararı SLO ihlaline bağlanabilir. İşlem düzenli olarak test edilmelidir.
Model Değiştirirken Kullanıcı Deneyimi Nasıl Korunur?
Model değişimi yalnızca backend operasyonu değildir. Cevap tonu, formatı ve tool davranışı kullanıcı deneyimini değiştirebilir. Shadow ve A/B testing bu farkları production öncesi ölçmeye yardımcı olur. Prompt compatibility ayrıca kontrol edilmelidir. Geri dönüş planı kullanıcı etkisini azaltır.
Parallel Model Deployment
Eski ve yeni model aynı anda çalıştırılabilir. Gateway belirli request'leri iki modele yönlendirebilir. Kullanıcı yalnızca primary cevabı görür. Yeni modelin output'u offline karşılaştırılır. Ek GPU kapasitesi gerektiği unutulmamalıdır.
Shadow Testing
Shadow testing gerçek trafik örneklerini yeni modele kopyalar. Kullanıcıya yeni model cevabı gösterilmez. Latency ve quality karşılaştırması yapılabilir. Hassas veri politikası shadow ortamında da korunmalıdır. Bu yöntem canary öncesi güçlü sinyal sağlar.
A/B Testing
A/B test kullanıcı gruplarını iki farklı model veya prompt'a ayırır. Kullanıcı satisfaction ve task success ölçülebilir. Gruplar rastgele veya belirli segmentlere göre seçilebilir. Güvenlik seviyesi iki varyantta eşit olmalıdır. Sonuç istatistiksel anlamlılıkla değerlendirilmelidir.
Output Regression
Yeni model doğru bilgi verse bile output formatını bozabilir. JSON schema veya markdown davranışı değişebilir. Automatic regression testler bu farkı yakalar. Frontend veya downstream parser etkilenebilir. Compatibility threshold release kriteri olmalıdır.
Prompt Compatibility
Aynı system prompt farklı model ailelerinde farklı davranabilir. Prompt version model version ile birlikte yönetilmelidir. Yeni modele geçişte prompt tuning gerekebilir. Eski prompt'un blind reuse edilmesi beklenmeyen sonuç yaratabilir. Evaluation her kombinasyonu ayrı test etmelidir.
Tool Calling Compatibility
Tool schema desteği modeller arasında farklılık gösterebilir. Parametre isimleri doğru üretilemeyebilir. Required field ve enum accuracy test edilmelidir. Model change agent davranışını değiştirebilir. High-risk tool senaryoları özel regression setine alınmalıdır.
Model Rollback
Rollback kullanıcı deneyimindeki ciddi bozulmayı hızlıca geri alır. Gateway endpoint değişmeden backend modeli değiştirebilir. Eski model artifact hazır durumda tutulmalıdır. Prompt compatibility korunmalıdır. Rollback sonrası incident review yapılmalıdır.
LLM Observability Nasıl Kurulur?
LLM observability request'in gateway, retrieval ve inference adımlarını birlikte izlemelidir. Sadece HTTP latency problemi açıklamak için yetersiz kalabilir. Prompt ve response metadata hassas veri içermeyecek şekilde kaydedilmelidir. GPU utilization ve eval score aynı dashboard'da korele edilebilir. Model version her trace içinde bulunmalıdır.
Trace
Trace tek kullanıcı isteğinin tüm işlem zincirini gösterir. Gateway, retrieval, reranking ve inference adımları ilişkilendirilir. Hangi model ve prompt version kullanıldığı kaydedilebilir. Hassas içerik redaction uygulanmalıdır. Incident sırasında trace kök neden analizini hızlandırır.
Span
Span trace içindeki tek operasyonu temsil eder. Vector search veya model generation ayrı span olabilir. Her span latency ve error bilgisi taşıyabilir. Böylece toplam gecikmenin hangi katmandan geldiği anlaşılır. Span attribute cardinality kontrollü tutulmalıdır.
Prompt ve Response Metadata
Ham prompt'u saklamak yerine token sayısı, template version ve classification bilgisi tutulabilir. Debug amacıyla içerik kaydı gerekiyorsa erişim sınırlandırılmalıdır. PII redaction uygulanmalıdır. Response quality score metadata olarak eklenebilir. Retention süresi data policy ile uyumlu olmalıdır.
Token Usage
Input ve output token sayısı kapasite ve maliyet için temel metriktir. Kullanıcı veya proje bazında raporlanabilir. Çok uzun prompt pattern'i optimize edilebilir. Cache etkisi token tasarrufu üzerinden görülebilir. Model routing maliyet kararlarında bu veriyi kullanabilir.
TTFT
TTFT kullanıcıya ilk tokenın gelme süresidir. Queue ve prompt processing bu metriği etkiler. Streaming uygulamalarda algılanan hız açısından önemlidir. P95 TTFT SLO belirlenebilir. Ani artış GPU saturation gösterebilir.
Latency
Toplam latency isteğin tamamlanma süresini gösterir. Response token sayısına bağlı olduğu için normalize edilmiş metrik de yararlı olabilir. Retrieval ve model latency ayrı izlenmelidir. P95 ve P99 değerleri kullanıcıların kötü deneyimini gösterir. Ortalama tek başına yeterli değildir.
Error Rate
Error rate model ve platform güvenilirliğini ölçer. Timeout, OOM ve invalid output ayrı sınıflandırılmalıdır. Gateway error ile inference error ayrılmalıdır. Model version değişiminde error spike görülebilir. Alert threshold request hacmine göre normalize edilmelidir.
GPU Metrics
GPU utilization, memory ve temperature izlenmelidir. OOM eventi model serving'i etkileyebilir. Power ve throttling performans sorununa işaret edebilir. Node bazlı metrikler model replica bilgisiyle eşleştirilmelidir. Capacity trendi yeni donanım ihtiyacını öngörebilir.
Cost
Self-hosted maliyet GPU kullanım süresi üzerinden tahmin edilebilir. Elektrik veya cloud rental oranı modele atanabilir. Token başına internal cost hesaplanabilir. Proje bazlı showback bütçe görünürlüğü sağlar. Cost metric quality skoruyla birlikte değerlendirilmelidir.
Eval Scores
Production örnekleri üzerinde sürekli evaluation yapılabilir. Faithfulness, correctness ve safety skorları zaman içinde izlenebilir. Model drift veya knowledge-base değişimi quality düşüşü yaratabilir. Dashboard model version release tarihlerini göstermelidir. SLO ihlalinde rollback tetiklenebilir.
Kurumsal LLM İçin Hangi SLO'lar Tanımlanmalı?
LLM platformu için SLO yalnızca uptime olmamalıdır. P95 latency, TTFT, throughput ve quality aynı hizmet kalitesinin parçalarıdır. RAG kullanan sistemlerde retrieval kalite hedefi ayrıca tanımlanmalıdır. Safety ihlal oranı kritik uygulamalarda SLO olabilir. Hedefler iş senaryosunun gerçek ihtiyacına göre belirlenmelidir.
Availability
Availability model endpoint'in kullanılabilir olduğu süreyi ölçer. Gateway ve inference ayrı SLI olarak izlenebilir. High availability gereksinimi kullanım senaryosuna göre değişir. Kritik müşteri sistemi daha yüksek hedef isteyebilir. Planlı bakım policy içinde tanımlanmalıdır.
P95 / P99 Latency
P95 ve P99 en yavaş kullanıcı deneyimlerini görünür kılar. Büyük prompt ve yoğun queue değerleri tail latency'yi artırabilir. Model routing farklı latency sınıfları oluşturabilir. SLO task tipine göre ayrı belirlenebilir. Long-form generation ile short extraction aynı hedefe sahip olmamalıdır.
Time to First Token
TTFT chatbot uygulamalarında kullanıcı deneyimi için önemlidir. İlk token hızlı geldiğinde uzun cevap daha kabul edilebilir hissedilebilir. Queue time en önemli etkilerden biridir. Warm model replica TTFT değerini iyileştirebilir. P95 hedefi dashboard'da izlenmelidir.
Throughput
Throughput sistemin zaman biriminde işlediği token veya request miktarını gösterir. Peak saatlerde gerekli kapasite buradan hesaplanabilir. Batch ayarı throughput ve latency arasında denge kurar. GPU eklemek lineer artış sağlamayabilir. Load test SLO hedefini doğrulamalıdır.
Error Rate
Error rate teknik başarısızlık oranıdır. OOM, timeout ve gateway rejection ayrı sınıflandırılmalıdır. Invalid structured output da application error olarak ölçülebilir. SLO threshold düşük tutulmalıdır. Hata dağılımı root cause analizine yardımcı olur.
Quality SLO
Quality SLO doğru veya kabul edilebilir cevap oranını tanımlar. Golden dataset veya production sampling üzerinden ölçülebilir. Kullanım senaryosuna özel metric gerekir. Model update bu eşiğin altına düşmemelidir. Quality ile latency arasında bilinçli trade-off yapılabilir.
Safety SLO
Safety SLO zararlı veya policy dışı çıktı oranını takip eder. Critical ihlallerin toleransı çok düşük olabilir. Guardrail false positive oranı ayrıca izlenmelidir. Red team dataset düzenli çalıştırılmalıdır. Safety regression production promotion'ı durdurabilir.
Retrieval Quality SLO
RAG sisteminde doğru doküman bulunmadan güçlü generation mümkün değildir. Recall@k veya expert relevance kullanılabilir. ACL filtrelerinin kalite üzerindeki etkisi ölçülmelidir. Index update sonrası regression testi yapılmalıdır. Retrieval SLO generation SLO'dan ayrı görünür olmalıdır.
Açık Kaynak LLM Maliyeti Nasıl Hesaplanır?
Self-hosted LLM maliyeti yalnızca GPU fiyatı değildir. Storage, network, Kubernetes ve mühendislik operasyonu toplam maliyete dahildir. On-premise sistemlerde elektrik ve veri merkezi maliyeti de hesaba katılmalıdır. Model başına ve kullanıcı başına birim maliyet hesaplanabilir. En anlamlı karşılaştırmalardan biri 1 milyon token başına gerçek toplam maliyettir.
GPU Satın Alma veya Kiralama
GPU satın alma yüksek başlangıç yatırımı gerektirir. Cloud kiralama değişken kapasite için daha esnek olabilir. Sürekli yüksek kullanımda satın alma ekonomik hale gelebilir. Depreciation ve bakım maliyeti hesaba katılmalıdır. Capacity headroom nedeniyle tüm GPU sürekli kullanılmayabilir.
Storage
Model artifact'ları onlarca veya yüzlerce GB olabilir. Birden fazla model ve quantized version storage ihtiyacını büyütür. Vector database ve trace verisi ayrıca alan tüketir. Backup kopyaları maliyeti artırır. Lifecycle policy kullanılmayan model sürümlerini arşivleyebilir.
Network
Model artifact transferi ve multi-region replication network maliyeti oluşturabilir. Cloud ortamında egress ücretleri önemlidir. Kullanıcı ile inference arasındaki latency network topolojisine bağlıdır. On-premise GPU için yüksek hızlı internal network gerekebilir. Multi-GPU parallelism daha hızlı interconnect isteyebilir.
Kubernetes ve Platform Maliyeti
Kubernetes yönetimi control plane ve operasyon ekibi gerektirir. GPU scheduling ve observability ek bileşenler oluşturur. Küçük tek model deployment için bu yatırım gereksiz olabilir. Çok ekipli platformda ise standardizasyon sağlar. Maliyet kullanıcı sayısı ve servis sayısıyla birlikte değerlendirilmelidir.
Engineering Maliyeti
Platform engineer, AI engineer ve security uzmanlarının zamanı toplam maliyetin önemli bölümüdür. Upgrade ve incident yönetimi süreklidir. Self-service platform otomasyonla bu maliyeti zaman içinde azaltabilir. İlk kurulum maliyetiyle yıllık operasyon maliyeti ayrı hesaplanmalıdır. Managed API karşılaştırmasında bu kalem unutulmamalıdır.
Support ve Operasyon
Production model 7/24 kritik sistemleri destekliyorsa on-call ihtiyacı oluşabilir. Driver ve runtime sorunları uzman müdahalesi gerektirir. Community support her incident için yeterli olmayabilir. Enterprise support bazı bileşenlerde değerlendirilebilir. SLA gereksinimi maliyet hesabını doğrudan etkiler.
Electricity ve Data Center
On-premise GPU yüksek elektrik tüketir. Cooling ve rack maliyeti toplam sahip olma maliyetine eklenmelidir. Power capacity veri merkezi planını etkileyebilir. GPU utilization düşükse enerji verimsizliği artar. Gerçek cost per token hesabında elektrik payı bulunmalıdır.
Model Başına Maliyet
Her model farklı GPU ve memory footprint'e sahiptir. Büyük model daha az request kapasitesi sağlayabilir. Serving replica sayısı model maliyetini artırır. Ortak GPU pool kaynak paylaşımını iyileştirebilir. Model routing küçük modellerin ekonomik kullanımını artırır.
Kullanıcı Başına Maliyet
Aylık toplam platform maliyeti aktif kullanıcı sayısına bölünebilir. Ancak yoğun kullanıcılar daha fazla token tüketebilir. Department bazlı usage accounting daha adil sonuç verir. Cache kullanımı maliyeti düşürebilir. Kullanıcı başına metric ürün değer analiziyle birlikte kullanılmalıdır.
1 Milyon Token Başına Gerçek Maliyet
Gerçek token maliyeti GPU, elektrik, platform ve engineering giderlerini içermelidir. Belirli dönemde işlenen toplam token sayısıyla karşılaştırılır. Düşük utilization birim maliyeti ciddi artırabilir. Managed API fiyatıyla ancak bu tam hesap üzerinden kıyaslama yapılmalıdır. Quality farkı da kararın ekonomik değerini etkiler.
Self-Hosted LLM ile API Maliyeti Nasıl Karşılaştırılır?
API ve self-hosting karşılaştırması tek fiyat tablosuyla yapılamaz. Managed API çoğunlukla değişken maliyet sunarken GPU altyapısı daha sabit maliyetlidir. Düşük trafikte API ekonomik olabilir. Yüksek ve stabil workload self-hosting break-even noktasına ulaşabilir. Hybrid routing iki maliyet modelinin avantajlarını birlikte kullanabilir.
Sabit ve Değişken Maliyet
Self-hosted GPU kullanılmasa bile maliyet üretir. API ise çoğu zaman kullanılan token kadar ücretlendirilebilir. Trafik tahmini yanlışsa self-hosting yatırım geri dönüşü uzar. Yüksek kullanımda API maliyeti hızla büyüyebilir. Üç farklı trafik senaryosu üzerinden hesap yapmak faydalıdır.
GPU Utilization
GPU utilization self-hosted ekonomisinin ana değişkenidir. Yüzde yirmi kullanım ile yüzde seksen kullanım arasında token başı maliyet ciddi değişir. Batching utilization değerini artırabilir. Multi-tenant platform GPU paylaşımını iyileştirir. Idle capacity ayrı raporlanmalıdır.
Break-Even Noktası
Break-even self-hosted toplam maliyetinin API maliyetiyle eşitlendiği kullanım seviyesidir. Model quality ve token miktarı hesaplamaya dahil edilmelidir. Mühendislik maliyeti unutulmamalıdır. Hardware amortisman süresi varsayımı açık yazılmalıdır. Karar düzenli aralıklarla yeniden hesaplanabilir.
Düşük Trafikte API Avantajı
Düşük trafik pahalı GPU'nun boş kalmasına yol açar. Managed API yalnızca kullanım olduğunda maliyet oluşturabilir. PoC ve küçük ekip uygulamalarında bu model pratiktir. Hassas veri kullanım şartları yine değerlendirilmelidir. Hybrid gateway gerekli istekleri self-hosted modele yönlendirebilir.
Yüksek ve Stabil Trafikte Self-Hosting
Sürekli yüksek request hacmi GPU kullanımını artırır. Sabit donanım maliyeti daha çok token üzerine dağıtılır. Bu durumda birim maliyet düşebilir. Kapasite ve HA için ek headroom yine gerekir. Model optimization ciddi ekonomik fayda sağlayabilir.
Hybrid Cost Optimization
Hybrid model basit görevleri küçük self-hosted modele yönlendirebilir. Peak trafik veya özel reasoning isteği external API'ye gönderilebilir. Veri hassasiyeti routing policy'ye dahil edilir. Gateway kullanım ve maliyet metriğini toplar. Bu yaklaşım tek altyapıya zorunlu bağımlılığı azaltır.
Açık Kaynak LLM'de Veri Gizliliği ve KVKK
Self-hosted model kullanmak KVKK uyumunu otomatik sağlamaz. Prompt, RAG dokümanı, embedding, log ve trace verileri kişisel veri içerebilir. Hangi verinin hangi amaçla işlendiği ve ne kadar süre tutulduğu belirlenmelidir. Data minimization ve silme süreçleri teknik olarak uygulanabilir olmalıdır. Bu bölüm hukuki görüş yerine teknik tasarım perspektifi sunar ve kurumun veri koruma ile hukuk ekipleriyle birlikte değerlendirilmelidir.
Prompt'larda Kişisel Veri
Kullanıcılar serbest metin alanına kişisel veri yazabilir. Gerekli değilse PII maskelenebilir. Hassas prompt loglanmamalıdır. İşleme amacı uygulama tasarımında açık olmalıdır. Kullanıcı erişimi ve retention policy belirlenmelidir.
Model Çıktılarında Kişisel Veri
Model RAG kaynağından kişisel veri üretebilir. Kullanıcının bu veriye gerçekten yetkili olması gerekir. Output PII detection ek kontrol sağlayabilir. Cevap cache'i kullanıcılar arasında paylaşılmamalıdır. Audit gerektiğinde hangi kaynağın kullanıldığı görülebilmelidir.
RAG Dokümanları
RAG corpus kişisel veya hassas kurumsal bilgi içerebilir. Data classification ingestion öncesi yapılmalıdır. Document ACL retrieval aşamasında korunmalıdır. Silinen kullanıcı veya dokümanın index verisi de temizlenmelidir. Backup retention bu yaşam döngüsüne dahil edilmelidir.
Embedding ve Vector Database
Embedding doğrudan okunabilir metin değildir ancak veri güvenliği kapsamı dışında varsayılmamalıdır. Vector database erişimi sınırlandırılmalıdır. Tenant ve ACL metadata'sı korunmalıdır. Encryption at rest uygulanabilir. Kullanıcı silme talebi ilişkili vector kayıtlarını da kapsayabilir.
Loglar ve Trace'ler
Debug amacıyla kaydedilen prompt ve response zamanla ayrı hassas veri deposuna dönüşebilir. Default olarak metadata logging tercih edilmelidir. İçerik gerekiyorsa masking ve access control uygulanmalıdır. Retention kısa tutulmalıdır. Production log erişimi sadece gerekli ekiplere verilmelidir.
Data Minimization
Model yalnızca işi için gerekli veriyi görmelidir. Tüm müşteri kaydını göndermek yerine gerekli alanlar seçilebilir. Retrieval top-k gereğinden fazla context üretmemelidir. Tool API minimum response döndürmelidir. Bu yaklaşım hem güvenliği hem maliyeti iyileştirir.
Retention
Prompt ve trace verisi süresiz saklanmamalıdır. Kullanım amacı ve audit ihtiyacı retention süresini belirler. Cache daha kısa yaşam süresine sahip olabilir. Backup kopyalarının retention politikası ayrıca tanımlanmalıdır. Otomatik silme job'ları izlenmelidir.
Kullanıcı Verisinin Silinmesi
Kullanıcı verisi birden fazla sistemde bulunabilir. Source database, vector index, cache ve log kopyaları birlikte değerlendirilmelidir. Silme workflow tüm ilgili identifier'ları takip etmelidir. Backup politikasında silinen verinin davranışı tanımlanmalıdır. İşlem audit kaydına alınmalıdır.
Şifreleme
Data at rest ve in transit şifrelenmelidir. TLS tüm service-to-service bağlantılarda kullanılabilir. Vector database storage encryption desteklemelidir. Secret ve encryption key ayrı yönetilmelidir. Key rotation prosedürü düzenli test edilmelidir.
Audit Trail
Audit trail kimin hangi LLM uygulamasını ve veri kaynağını kullandığını gösterebilir. Ham prompt kaydetmek zorunlu değildir. User ID, model version ve document ID metadata'sı yeterli olabilir. Access log değiştirilmesi zor storage'da tutulabilir. Retention güvenlik ve veri koruma politikasıyla uyumlu olmalıdır.
Data Sovereignty ile Data Residency Arasındaki Fark
Data residency verinin fiziksel olarak nerede tutulduğuna odaklanır. Data sovereignty ise verinin hangi hukuki ve yönetsel kontrol altında bulunduğunu da kapsar. Bir VPC belirli ülkede olsa bile telemetry başka bölgeye gidebilir. Model artifact ve prompt log konumu ayrı ayrı değerlendirilmelidir. On-premise ve air-gapped yapı daha yüksek kontrol sağlayabilir ancak governance sorumluluğunu artırır.
Verinin Fiziksel Konumu
Database ve object storage region bilgisi açık olmalıdır. Backup kopyasının farklı bölgede olup olmadığı kontrol edilmelidir. Managed observability servisleri ayrıca veri taşıyabilir. DR lokasyonu da data residency kapsamındadır. Mimari diyagram veri akışını göstermelidir.
Veriye Kimin Erişebildiği
Fiziksel konum tek başına yeterli değildir. Admin ve support erişimleri ayrıca değerlendirilmelidir. Privileged access audit edilmelidir. External vendor erişimi gerekiyorsa kapsam sınırlandırılmalıdır. Encryption key ownership önemli bir kontrol noktasıdır.
Prompt ve Telemetry'nin Konumu
Inference on-premise olsa bile telemetry dış servise gönderilebilir. Prompt logging kapalı olsa bile trace attribute hassas bilgi taşıyabilir. Tüm observability exporter konfigürasyonu incelenmelidir. Data egress firewall ile sınırlandırılabilir. Telemetry retention ayrı policy olmalıdır.
Model Artifact'larının Konumu
Model ağırlıkları da kurumsal artifact envanterinin parçasıdır. Internal model registry kullanılabilir. Air-gapped ortamda dış kaynaktan kontrollü transfer yapılmalıdır. Lisans redistribution şartları storage tasarımını etkileyebilir. Artifact backup lokasyonu kaydedilmelidir.
On-Premise
On-premise kurumun fiziksel altyapısı üzerinde yüksek kontrol sağlar. Veri ve model aynı network içinde tutulabilir. Bunun karşılığında hardware ve security operasyonu kurum tarafından yürütülür. DR için ikinci lokasyon gerekebilir. On-premise kullanım otomatik güvenlik sağlamaz.
Sovereign Cloud
Sovereign cloud belirli egemenlik ve operasyon gereksinimlerine göre tasarlanmış cloud seçeneklerini ifade edebilir. Hangi garanti ve kontrolün gerçekten sunulduğu sözleşme üzerinden değerlendirilmelidir. Admin erişimi ve key ownership incelenmelidir. Data residency ile aynı kavram değildir. Kurumun hukuk ve güvenlik ekipleri koşulları birlikte değerlendirmelidir.
Air-Gapped Sistem
Air-gapped sistem dış network erişimini fiziksel veya güçlü mantıksal kontrollerle sınırlar. Hassas ortamlarda yüksek data control sağlar. Model update ve security patch süreçleri zorlaşır. Offline artifact transfer mekanizması gerekir. Audit ve operasyon prosedürleri düzenli test edilmelidir.
Avrupa Birliği AI Act Açık Modelleri Nasıl Etkiler?
Açık model kullanmak Avrupa Birliği AI Act kapsamındaki tüm yükümlülüklerden otomatik muafiyet anlamına gelmez. General-Purpose AI model hükümleri, açık model istisnaları ve sistemik risk koşulları modelin niteliğine göre farklı sonuçlar doğurabilir. Ayrıca downstream entegratör kendi kullanım sisteminin sorumluluklarını değerlendirmelidir. Teknik dokümantasyon, veri yönetişimi ve risk yönetimi önemini korur. Hukuki sınıflandırma güncel düzenleme ve resmi rehberler üzerinden kurumun hukuk ekibiyle yapılmalıdır.
General-Purpose AI Model Kavramı
General-Purpose AI farklı görevlerde kullanılabilen genel amaçlı modelleri ifade eden düzenleyici bir kavramdır. Model provider ve downstream sistem sağlayıcısının rolleri farklı olabilir. Açık ağırlıklı model kullanılması bu rol analizini ortadan kaldırmaz. Modelin kurumsal sisteme nasıl entegre edildiği ayrıca önemlidir. Teknik ekip compliance inventory için kullanılan model ve version bilgisini kaydetmelidir.
Open-Source İstisnalarının Kapsamı
Düzenleme belirli açık ve ücretsiz modeller için bazı istisnalar içerebilir. Ancak istisnanın uygulanabilirliği modelin yayın biçimi ve risk durumuna göre değerlendirilmelidir. Açık model ifadesi tek başına yeterli hukuki sınıflandırma değildir. Model documentation ve license bilgisi incelenmelidir. Güncel resmi rehber takip edilmelidir.
İstisnaların Geçerli Olmadığı Durumlar
Bazı risk veya kullanım koşullarında açık model istisnalarının kapsamı sınırlanabilir. Özellikle sistemik risk gibi sınıflandırmalar farklı yükümlülükler doğurabilir. Downstream high-risk use case ayrıca düzenlemeye tabi olabilir. Bu nedenle yalnızca model lisansına bakılarak compliance kararı verilmemelidir. Kurum içi legal review gereklidir.
Systemic Risk
Systemic risk geniş etkili ve güçlü genel amaçlı modeller için özel değerlendirme alanıdır. Modelin hesaplama gücü ve yetenek seviyesi gibi kriterler dikkate alınabilir. Kurumsal entegratör kullandığı modelin resmi sınıflandırmasını takip etmelidir. Model update durumunda risk durumu değişebilir. Governance sürecine regulatory monitoring eklenmelidir.
Teknik Dokümantasyon
Teknik dokümantasyon modelin özellikleri ve kullanım sınırlarını anlamayı sağlar. Kurum kendi entegrasyon mimarisini de dokümante etmelidir. Model version, data flow ve guardrail bilgileri kayıt altında tutulmalıdır. Riskli kullanım kararları açıklanabilir olmalıdır. Change management dokümantasyonu güncel tutmalıdır.
Copyright Policy
Model provider tarafındaki copyright yükümlülükleri model seçimi sırasında incelenmelidir. Downstream kullanımda üretilen içeriğin kullanım şartları ayrıca değerlendirilmelidir. RAG corpus için doküman kullanım hakkı önemlidir. Fine-tuning dataset'i lisans açısından doğrulanmalıdır. Hukuk ekibi model ve veri lisanslarını birlikte incelemelidir.
Training Data Summary
Bazı düzenleyici yükümlülükler training data hakkında özet bilgi gerektirebilir. Kurumsal ekip model publisher dokümantasyonunu due diligence sırasında saklayabilir. Kendi fine-tuning sürecinde kullanılan veri kaynakları daha ayrıntılı kayıt altına alınmalıdır. Dataset provenance governance için değerlidir. Veri silme veya lisans değişikliği durumunda etkilenen modeller bulunabilir.
Downstream Entegratörün Sorumlulukları
Modeli kullanan kurum son kullanıcı sisteminin risklerinden sorumlu olabilir. Authentication, human oversight ve data protection tasarım kararları kurumun kontrolündedir. Agent'a verilen tool yetkileri model provider tarafından yönetilmez. High-risk kullanım ayrıca değerlendirme gerektirir. Governance yalnızca model seçim sürecinde bitmemelidir.
Agentic AI Açık Kaynak LLM Mimarisiyle Nasıl Entegre Edilir?
Agentic AI modeli yalnızca cevap üreten bir bileşen olmaktan çıkarıp tool kullanan bir karar yardımcısına dönüştürür. Bu yaklaşım yetki ve audit riskini ciddi biçimde artırır. Tool calling, memory ve RAG birlikte yönetilmelidir. Yüksek riskli işlemler insan onayı olmadan yürütülmemelidir. Agent platformu modelden bağımsız authorization kuralları uygulamalıdır.
LLM ile Agent Arasındaki Fark
LLM metin girdisine cevap üretir. Agent ise hedef doğrultusunda birden fazla adım planlayıp tool çağırabilir. Bu nedenle agent daha geniş sistem yetkisine sahip olabilir. Security boundary model prompt'u değildir. Tool executor deterministic authorization uygulamalıdır.
Tool Calling
Tool calling modelin hangi işlevi kullanacağını structured formatta belirtmesini sağlar. Tool schema minimum gerekli parametreleri içermelidir. Modelin çağrısı execution izni anlamına gelmez. Authorization engine kullanıcı ve tool yetkisini kontrol eder. High-risk action ayrıca approval isteyebilir.
MCP
MCP benzeri standart protokoller model ve tool entegrasyonunu daha taşınabilir hale getirebilir. Tool server'lar açık capability sunabilir. Authentication ve authorization protokolün dışında ihmal edilmemelidir. Güvenilmeyen tool server production'a bağlanmamalıdır. Tool registry approved endpoint listesini yönetebilir.
Agent Memory
Agent memory önceki etkileşim veya görev bilgisini saklayabilir. Bu veri kişisel ve hassas içerik taşıyabilir. Kullanıcı bazında izolasyon uygulanmalıdır. Retention açıkça tanımlanmalıdır. Memory poisoning riskine karşı source ve write policy kullanılabilir.
RAG
Agent RAG üzerinden kurumsal bilgiye erişebilir. Retrieval ACL kullanıcı yetkisini korumalıdır. Tool ile getirilen data ve RAG context farklı güven seviyelerine sahip olabilir. Source metadata modele açık biçimde sunulabilir. Agent kaynak dışı tahmin yaptığında confidence düşük kabul edilebilir.
Sub-Agent
Sub-agent belirli göreve ayrılmış daha dar yetkili bileşen olabilir. Finans agent ve doküman agent farklı tool setine sahip olabilir. Least privilege bu yapıda daha kolay uygulanır. Parent agent her alt agent'ın sonucunu kontrol etmelidir. Trace tüm agent zincirini göstermelidir.
Multi-Agent
Multi-agent mimarisi farklı uzmanlık rollerini bir araya getirebilir. Ancak iletişim adımları latency ve maliyeti artırır. Her agent'ın yetki sınırı açık olmalıdır. Bir agent diğerinin güvenlik kararını bypass edememelidir. Basit problem için gereksiz multi-agent kullanılmamalıdır.
Human Approval
Yüksek etkili action kullanıcının açık onayını gerektirebilir. Para transferi veya kayıt silme buna örnektir. Onay ekranı modelin planladığı işlemi anlaşılır biçimde göstermelidir. Kullanıcı onayı belirli action ve parametre için geçerli olmalıdır. Audit log approval bilgisini saklamalıdır.
AI Agent'larda Yetki Yönetimi Nasıl Yapılır?
Agent security modelin ne söyleyebildiğinden çok hangi işlemleri yapabildiğiyle ilgilidir. Least privilege her tool ve servis kimliği için uygulanmalıdır. Read ve write yetkileri ayrılmalıdır. Kullanıcı delegation modeli agent'ın kullanıcı adına yaptığı işlemleri sınırlar. High-risk action için insan onayı güçlü bir güvenlik katmanıdır.
Least Privilege
Agent yalnızca görevi için gerekli araçlara erişmelidir. Tüm kurumsal API'lerin tek agent'a verilmesi risklidir. Tool scope kullanım senaryosu bazında ayrılabilir. Temporary token kısa süreli olmalıdır. Access review düzenli yapılmalıdır.
Tool-Level Permissions
Her tool ayrı permission tanımına sahip olmalıdır. CRM read ile CRM update aynı role bağlanmamalıdır. Tool executor authorization kararı vermelidir. Model yalnızca tool önerisi üretir. Permission değişiklikleri audit edilir.
User Delegation
Agent kullanıcının sahip olmadığı yetkiyi otomatik kazanmamalıdır. Kullanıcı token scope bilgisi downstream tool'a taşınabilir. Delegated credential kısa ömürlü olmalıdır. Service account üzerinde global yetki kullanılması engellenmelidir. User context trace içinde tutulabilir.
Service Identity
Agent platformunun kendi service identity'si bulunmalıdır. Her agent veya tool executor ayrı kimlik kullanabilir. Static shared credential kullanımından kaçınılmalıdır. Workload identity daha güvenli model sağlayabilir. Identity rotation otomatik yönetilmelidir.
Secret Management
API key veya database password prompt içine eklenmemelidir. Secret executor tarafından güvenli vault'tan alınmalıdır. Model secret değerini görmemelidir. Secret usage audit edilebilir. Rotation agent deployment'ını bozmadan yapılmalıdır.
Read vs Write Tools
Read tool veri getirirken write tool sistem durumunu değiştirir. Risk seviyeleri bu nedenle farklıdır. Write action daha sıkı authorization gerektirir. Bazı işlemler iki aşamalı confirmation kullanabilir. Tool catalog risk sınıfını metadata olarak tutmalıdır.
High-Risk Action Approval
Yüksek riskli action otomatik yürütülmemelidir. Model kullanıcıya yapılacak işlemi açık biçimde sunmalıdır. Kullanıcı parametreleri görerek onay verir. Approval expire edilebilir ve başka action için kullanılamaz. Olay audit trail içinde saklanır.
Agent Audit Trail
Audit trail agent'ın hangi tool'u hangi kullanıcı adına çağırdığını gösterir. Tool input ve sonucu hassas veri içeriyorsa redaction uygulanabilir. Parent ve sub-agent trace ilişkisi korunmalıdır. Security investigation sırasında timeline oluşturulabilir. Retention risk seviyesine göre belirlenmelidir.
High Availability ve Disaster Recovery
Production LLM platformu tek GPU node'a bağımlı olmamalıdır. Model serving replica'ları load balancer arkasında çalışabilir. Vector database ve model registry için de backup gerekir. Multi-zone veya multi-region deployment iş kritikliğine göre değerlendirilebilir. RTO ve RPO yalnızca inference değil RAG data katmanını da kapsamalıdır.
Bir GPU Node Çökerse Ne Olur?
Load balancer sağlıksız node'u trafik dışına almalıdır. Diğer replica kapasitesi kalan trafiği karşılayabilmelidir. Tek replica varsa tüm servis durabilir. Model startup süresi recovery zamanını uzatabilir. Warm standby kritik sistemlerde faydalıdır.
Multi-Replica Model Serving
Aynı model birden fazla replica üzerinde çalıştırılabilir. Trafik load balancer ile dağıtılır. Replica sayısı peak load ve failure senaryosuna göre belirlenir. GPU resource reservation yapılmalıdır. Rolling upgrade sırasında minimum kapasite korunmalıdır.
Load Balancing
Load balancer request'i sağlıklı model replica'larına yönlendirir. Queue depth veya active sequence bilgisi routing kararına eklenebilir. Sticky session çoğu inference senaryosunda gerekmeyebilir. Streaming connection süreleri dikkate alınmalıdır. Health check gerçek inference testi içerebilir.
Model Artifact Backup
Model artifact tekrar indirilebilir olsa bile production recovery için internal kopya değerlidir. Upstream repository kaldırılmış olabilir. Approved checksum ve lisans metadata'sı birlikte saklanmalıdır. Backup farklı storage lokasyonunda tutulabilir. Restore testi model loading ile doğrulanmalıdır.
Vector Database Backup
Vector index kaybı RAG sistemini işlevsiz hale getirebilir. Source dokümanlardan yeniden oluşturmak saatler sürebilir. Snapshot veya native backup kullanılabilir. Metadata ve ACL bilgisi birlikte korunmalıdır. Restore sonrası retrieval benchmark yapılmalıdır.
Multi-Zone Deployment
Multi-zone aynı region içindeki altyapı arızalarına dayanıklılık sağlar. GPU kapasitesi her zone'da mevcut olmayabilir. Network latency değerlendirilmeli ve storage erişimi ortak olmalıdır. Load balancer zone-aware çalışabilir. Failover düzenli test edilmelidir.
Multi-Region Deployment
Multi-region daha geniş felaket senaryolarına karşı koruma sağlar. Model artifact replication kolaydır ancak vector data synchronization daha zor olabilir. Data residency politikası region seçimini etkiler. Active-active veya active-passive model belirlenmelidir. Maliyet iş kritikliğine göre değerlendirilmelidir.
RTO ve RPO
RTO kabul edilen hizmet dönüş süresidir. RPO kabul edilen veri kaybı miktarını ifade eder. Inference stateless olsa bile vector database ve conversation memory stateful olabilir. Backup ve replication bu hedeflere göre yapılandırılmalıdır. Drill ile gerçek süre ölçülmelidir.
Açık Kaynak ve İşbirliği Ekosistemi
Açık LLM platformu tek bir model veya framework'ten oluşmaz. Inference motoru, gateway, observability ve vector database farklı projelerle kurulabilir. Bu esneklik güçlüdür ancak component lifecycle yönetimi gerektirir. Community desteği hızlı inovasyon sağlar. Kritik sistemlerde bakım durumu ve enterprise support ihtiyacı ayrıca değerlendirilmelidir.
Hugging Face Ekosistemi
Hugging Face ekosistemi model paylaşımı ve araç entegrasyonu açısından geniş kaynak sunar. Kurum modelleri doğrudan internetten production'a çekmemelidir. Approved mirror ve checksum süreci kullanılabilir. Model card due diligence için önemli kaynaktır. Private veya internal registry yaklaşımı güvenliği artırır.
Inference Motorları
Inference motoru model ağırlıklarını gerçek API hizmetine dönüştürür. Runtime seçiminde model compatibility, batching ve GPU utilization değerlendirilmelidir. Tek motor tüm modellerde aynı performansı vermeyebilir. Production benchmark şarttır. Upgrade süreci model version ile birlikte test edilmelidir.
vLLM
vLLM yüksek throughput ve production inference senaryolarında değerlendirilebilir. Continuous batching ve memory yönetimi güçlü kullanım alanlarıdır. OpenAI-compatible API entegrasyonu uygulama geçişini kolaylaştırabilir. GPU ve model compatibility version bazında kontrol edilmelidir. Yük testi gerçek concurrency ile yapılmalıdır.
llama.cpp
llama.cpp CPU ve farklı donanım ortamlarında quantized model çalıştırma açısından değerlendirilebilir. Edge ve local deployment için yararlı olabilir. GPU acceleration seçenekleri platforma göre değişir. Büyük production workload için performans benchmark edilmelidir. Artifact format ve quantization kalitesi test edilmelidir.
Ollama
Ollama local model deneyimini kolaylaştırır. Geliştirici PoC ve ekip içi denemelerde hızlı sonuç verir. Production güvenlik, concurrency ve HA gereksinimleri ayrıca tasarlanmalıdır. Model erişimi kurumsal gateway arkasına alınabilir. Local runtime seçimi platform architecture kararının tamamı değildir.
AI Gateway Araçları
Gateway ekosistemi model routing ve API yönetimini merkezi hale getirir. Seçimde authentication, rate limit ve observability özellikleri değerlendirilmelidir. Vendor-neutral API desteği önemlidir. Tool kolay kuruluyor diye security control ihmal edilmemelidir. Kurum mevcut API management altyapısıyla entegrasyonu da değerlendirebilir.
LiteLLM
LiteLLM farklı model provider ve endpoint'leri ortak API altında yönetmek için değerlendirilebilir. Routing ve compatibility özellikleri platformlaştırma açısından faydalı olabilir. Production deployment authentication ve secret yönetimiyle birlikte yapılmalıdır. Model-specific capability farkları test edilmelidir. Gateway availability kritik hale geldiği için HA planlanmalıdır.
Apache APISIX ve Benzeri Gateway'ler
Genel amaçlı API gateway çözümleri authentication ve rate limit katmanında kullanılabilir. LLM-specific token accounting için ek plugin veya servis gerekebilir. Streaming desteği kontrol edilmelidir. Timeout ayarları uzun generation isteklerine göre düzenlenmelidir. Mevcut kurumsal gateway altyapısını genişletmek bazı ekipler için daha verimli olabilir.
Observability
LLM observability klasik application monitoring ile kalite metriklerini birleştirir. Trace, token ve evaluation bilgisi aynı request altında ilişkilendirilebilir. Kullanılan araç seçilirken veri gizliliği önemlidir. Self-hosted seçenekler hassas prompt verisi için avantaj sağlayabilir. Telemetry dışa çıkış policy'si açık olmalıdır.
Langfuse
Langfuse LLM trace ve evaluation süreçleri için değerlendirilebilen açık kaynak araçlardan biridir. Prompt version ve latency bilgisi izlenebilir. Self-hosted deployment veri kontrolü sağlayabilir. Ham prompt logging policy ile sınırlandırılmalıdır. Kurum kendi monitoring altyapısıyla entegrasyon yapmalıdır.
OpenTelemetry Ekosistemi
OpenTelemetry standart trace ve metric yaklaşımı sunar. LLM request'leri mevcut uygulama trace'leriyle ilişkilendirilebilir. Vendor-neutral telemetry lock-in riskini azaltır. Attribute'larda hassas veri taşınmamalıdır. Sampling ve retention yüksek trafik ortamına göre ayarlanmalıdır.
RAG ve Vector Database Ekosistemi
Vector database seçiminde yalnızca benchmark throughput değeri yeterli değildir. Metadata filter, backup ve tenant isolation özellikleri önemlidir. Hybrid search desteği kurumsal terminolojide faydalı olabilir. Open standard ve export seçenekleri lock-in riskini azaltır. Retrieval quality kullanılan database kadar embedding ve chunking tasarımına da bağlıdır.
Açık Kaynak Projelere Kurumsal Katkı
Kurum kullandığı projelerde bug fix veya dokümantasyon katkısı yapabilir. Bu yaklaşım uzun vadede bakım kalitesini artırabilir. İç fork üzerinde yıllarca özel patch tutmak bakım yükü oluşturur. Genel faydalı değişikliklerin upstream'e gönderilmesi tercih edilebilir. Hukuk ve open source contribution policy belirlenmelidir.
Fork Etmek mi Upstream'e Katkı Sağlamak mı?
Fork kısa vadede özel ihtiyaçları hızlı çözebilir. Ancak upstream güncellemeleriyle merge maliyeti zaman içinde büyür. Genel değişiklikler mümkünse ana projeye katkı olarak gönderilmelidir. Güvenlik patch'i beklenemiyorsa geçici internal fork kullanılabilir. Exit kriteri baştan tanımlanmalıdır.
Community Support ile Enterprise Support Arasındaki Fark
Community forumları geniş bilgi paylaşımı sağlayabilir. Kritik production incident için garanti edilmiş yanıt süresi sunmayabilir. Enterprise support SLA ve uzman desteği sağlayabilir. Her bileşenin aynı seviyede support'a ihtiyacı yoktur. İş kritikliğine göre yatırım yapılmalıdır.
Açık Kaynak Stack Vendor Lock-In'i Tamamen Ortadan Kaldırır mı?
Açık kaynak kullanmak vendor lock-in riskini azaltabilir ancak tamamen ortadan kaldırmaz. API, GPU, vector database ve framework seviyesinde farklı bağımlılıklar oluşabilir. Portable API ve açık veri formatları geçiş maliyetini düşürür. Model artifact ve prompt'ların başka sisteme taşınabilir olması önemlidir. Exit strategy belirli aralıklarla gerçek migration testiyle doğrulanmalıdır.
API Lock-In
Provider-specific request ve response formatları client kodunu bağımlı hale getirir. Gateway ortak schema sunabilir. Tool calling formatı farklılıkları normalization gerektirebilir. Client doğrudan provider SDK'sına bağlanmamalıdır. Integration test ikinci provider üzerinde çalıştırılabilir.
Model Lock-In
Prompt ve fine-tuning belirli model davranışına aşırı bağımlı olabilir. Yeni modele geçiş regression yaratabilir. Golden dataset migration riskini azaltır. RAG kurumsal bilgiyi model parametresinden ayırır. Model abstraction katmanı portability sağlar.
GPU Lock-In
Serving stack belirli GPU ve kernel özelliklerine bağımlı olabilir. Farklı accelerator'a geçiş runtime değişikliği gerektirebilir. Container image tek başına hardware portability garantisi vermez. Benchmark alternatif donanımda yapılmalıdır. Capacity plan hardware supply riskini de dikkate almalıdır.
Vector Database Lock-In
Proprietary index veya query özelliği migration maliyetini artırabilir. Ham doküman ve embedding export edilebilir olmalıdır. Metadata schema vendor-neutral tasarlanabilir. Retrieval interface uygulamadan soyutlanmalıdır. Exit testi örnek dataset üzerinde yapılabilir.
Framework Lock-In
Agent veya RAG framework'ü application logic'i kendine özel yapıya bağlayabilir. Domain logic mümkün olduğunca framework dışında tutulmalıdır. Tool schema açık standart kullanmalıdır. Framework değişikliği unit ve evaluation testleriyle doğrulanmalıdır. Basit ihtiyaç için ağır abstraction kullanılmamalıdır.
Open Standards ve Portable API'ler
Açık API ve telemetry standardı geçişi kolaylaştırır. Model endpoint ortak schema kullanabilir. OpenTelemetry observability verisini taşınabilir hale getirir. OCI benzeri artifact standartları deployment yönetimine yardımcı olabilir. Açık standart kullanmak yine de implementation testini gerektirir.
Exit Strategy
Exit strategy kullanılan model veya platformdan nasıl çıkılacağını tanımlar. Data export ve model replacement adımları dokümante edilmelidir. İkinci modelle yılda bir compatibility testi yapılabilir. Contract ve license gereksinimleri değerlendirilmelidir. Gerçek taşınabilirlik yalnızca dokümanla değil testle kanıtlanır.
Kurumsal Açık Kaynak LLM İçin Ekip Rolleri
Production LLM platformu tek bir AI geliştiricisinin sorumluluğu olarak bırakılmamalıdır. Platform, data ve security uzmanları farklı katmanları yönetir. Hukuk ve data protection ekipleri veri ile lisans kararlarına katılır. Product owner kullanım senaryosunun iş değerini ve kabul kriterlerini tanımlar. Responsible AI rolü yüksek etkili kullanım alanlarında governance koordinasyonu sağlayabilir.
AI / ML Engineer
AI engineer model değerlendirme ve inference optimizasyonunda çalışır. Prompt, RAG ve fine-tuning deneylerini yönetebilir. Golden dataset oluşturulmasına katkı sağlar. Model quality regression'ı izler. Platform güvenliği tek başına bu rolün sorumluluğu değildir.
Platform Engineer
Platform engineer GPU cluster, Kubernetes ve serving altyapısını yönetir. AI Gateway ve observability deployment'ı kurabilir. HA ve capacity planını takip eder. Developer ekiplerine self-service endpoint sunar. Infrastructure as Code kullanımı standardizasyon sağlar.
Data Engineer
Data engineer RAG ingestion ve veri pipeline'larını yönetir. Source sistem metadata ve ACL bilgisinin korunmasını sağlar. Incremental sync ve data quality süreçlerini kurar. Embedding index lifecycle yönetimine katkı verir. Data owner ile retention konusunda çalışır.
Security Engineer
Security engineer threat model ve access policy tasarımını yapar. Prompt injection ve supply-chain risklerini değerlendirir. Secret ve network security kontrollerini kurar. Red team testlerini koordine edebilir. Incident response runbook hazırlanmasına katkı sağlar.
LLMOps / MLOps Engineer
LLMOps model registry ve deployment lifecycle süreçlerini yönetir. Evaluation pipeline ve model promotion otomasyonunu kurar. Canary ve rollback mekanizmasını standardize eder. Model version metadata'sını takip eder. Production metric'lerini quality sonuçlarıyla ilişkilendirir.
Data Protection / Hukuk
Bu ekip veri işleme amacı ve lisans koşullarını değerlendirir. KVKK ve sözleşme gereksinimlerinin teknik tasarıma yansımasını kontrol eder. Model lisansı ve training data riskleri incelenir. Retention policy için guidance sağlar. Teknik ekip hukuki yorum yapmamalıdır.
Responsible AI Ekibi
Responsible AI ekibi kullanım risklerini ve insan etkisini değerlendirebilir. Fairness, açıklanabilirlik ve güvenli kullanım kriterleri oluşturabilir. High-risk use case approval süreçlerine katılabilir. Incident ve complaint mekanizmasını takip edebilir. Model seçimi yalnızca teknik skor üzerinden yapılmaz.
Product Owner
Product owner kullanım senaryosunun iş hedefini belirler. Başarı metriği ve kullanıcı beklentisi tanımlanır. Model quality hedefi ürün ihtiyacıyla eşleştirilir. Kullanıcı feedback'i roadmap'e aktarılır. Gereksiz teknik gösterim yerine gerçek değer üretimine odaklanır.
Kurumsal LLM Governance Modeli
Governance hangi modelin hangi kullanım amacıyla çalışabileceğini belirler. Approved model list ve use-case risk classification temel araçlardır. Deployment ve değişiklikler kontrollü süreçten geçmelidir. Model owner ve data owner sorumlulukları açık olmalıdır. Decommissioning artık kullanılmayan modellerin güvenli biçimde sistemden çıkarılmasını sağlar.
Approved Model List
Liste teknik ve hukuki review tamamlanan modelleri içerir. Her version ayrı statüye sahip olabilir. Development ve production approval farklı olabilir. Kullanım senaryosu kısıtları metadata olarak eklenebilir. Uygulamalar sadece bu listeden model seçmelidir.
Use-Case Risk Classification
İç doküman özetleme ile otomatik kredi kararı aynı risk seviyesinde değildir. Data sensitivity ve action impact birlikte değerlendirilmelidir. Risk sınıfı guardrail ve approval seviyesini belirler. High-risk agent insan onayı gerektirebilir. Sınıflandırma periodic review ile güncellenmelidir.
Model Owner
Model owner belirli model sürümünün teknik lifecycle sorumlusudur. Benchmark ve upgrade durumunu izler. Security veya lisans değişikliğinde aksiyon başlatır. Production deployment'ları takip eder. Model decommission kararına katkı verir.
Data Owner
Data owner RAG kaynağının kimler tarafından kullanılabileceğini belirler. ACL ve retention politikasını onaylar. Yeni kullanım senaryosunda veri erişim riskini değerlendirir. Ingestion pipeline data owner kararını teknik olarak uygular. Model owner veri erişimini tek başına genişletememelidir.
Deployment Approval
Production deployment öncesinde quality, security ve lisans kriterleri kontrol edilir. Approval otomatik pipeline gate ile uygulanabilir. High-risk use case ek insan onayı gerektirebilir. Kanıtlar model registry'de saklanmalıdır. Bypass işlemleri sınırlı ve audit edilebilir olmalıdır.
Change Management
Model, prompt ve RAG pipeline değişikliği kaliteyi etkileyebilir. Bu nedenle version control uygulanmalıdır. Change request evaluation sonucu içermelidir. Canary rollout tercih edilmelidir. Rollback planı her değişikliğin parçası olmalıdır.
Periodic Review
Model güvenlik ve kalite durumu zaman içinde değişebilir. Yeni CVE veya lisans güncellemesi ortaya çıkabilir. Golden dataset düzenli tekrar çalıştırılmalıdır. Kullanım hacmi ve risk sınıfı değişebilir. Approved status belirli aralıklarla yeniden doğrulanmalıdır.
Incident Management
LLM incident yalnızca sistem kesintisi değildir. Veri sızıntısı veya zararlı agent action da incident olabilir. Severity ve escalation süreci tanımlanmalıdır. Trace ve audit log inceleme için hazır tutulmalıdır. Incident sonrası evaluation setine yeni failure örneği eklenebilir.
Decommissioning
Kullanılmayan model production routing'den çıkarılmalıdır. Artifact retention lisans ve audit ihtiyacına göre belirlenebilir. Endpoint ve credential kapatılmalıdır. Vector index veya adapter ilişkileri kontrol edilmelidir. Model registry status decommissioned olarak güncellenmelidir.
Açık Kaynak LLM Maturity Model
Kurumsal LLM yetkinliği bir anda en gelişmiş platform seviyesine çıkmak zorunda değildir. Bireysel denemelerden merkezi model serving'e, ardından gateway ve governance katmanına geçilebilir. Her seviye bir öncekinin operasyon sorunlarını çözmelidir. Teknoloji eklemek tek başına olgunluk değildir. Süreç, ownership ve measurement seviyenin gerçek göstergeleridir.
Seviye 0 — Bireysel Denemeler
Geliştiriciler local makinelerde farklı modeller dener. Merkezi security veya model approval bulunmaz. Bu seviye öğrenme için yararlıdır. Hassas veri kullanılmamalıdır. Başarılı denemeler standard platforma taşınmalıdır.
Seviye 1 — Merkezi Self-Hosted Model
Kurum ortak bir model endpoint'i sunar. Authentication ve temel monitoring eklenir. Uygulamalar merkezi inference kullanmaya başlar. Model version kontrolü sağlanır. RAG ve gelişmiş governance henüz sınırlı olabilir.
Seviye 2 — Gateway ve RAG
AI Gateway model erişimini merkezileştirir. RAG kurumsal veri entegrasyonunu sağlar. ACL retrieval katmanına taşınır. Rate limit ve token accounting uygulanır. Kullanım senaryoları platform üzerinde çoğalmaya başlar.
Seviye 3 — Observability ve Governance
Trace ve quality evaluation düzenli çalışır. Model registry ve approved catalog oluşturulur. Security ve lisans approval süreçleri standardize edilir. SLO ve incident management uygulanır. Model değişiklikleri canary rollout ile yapılır.
Seviye 4 — Multi-Model Platform
Farklı model boyutları ve sağlayıcılar aynı gateway arkasında çalışır. Routing kalite ve maliyete göre yapılabilir. Fallback ve semantic cache kullanılır. Team bazlı quota uygulanır. Model benchmark sonuçları otomatik routing kararlarını besleyebilir.
Seviye 5 — Self-Service Enterprise AI Platform
Ürün ekipleri approved model ve RAG kaynaklarını self-service biçimde kullanabilir. Governance policy platform tarafından otomatik uygulanır. Evaluation ve observability varsayılan özellik haline gelir. Model lifecycle büyük ölçüde otomatikleşir. Merkezi platform ekibi standartlar ve shared capabilities üzerine odaklanır.
PoC'den Production'a Geçiş Yol Haritası
Başarılı PoC yalnızca teknik fizibiliteyi gösterir. Production için veri sınıflandırması, lisans, security ve capacity çalışmaları ayrıca tamamlanmalıdır. RAG yetkilendirme ve observability sonradan eklenen seçenekler olarak görülmemelidir. Canary deployment gerçek kullanıcı etkisini kontrollü biçimde ölçer. Sürekli evaluation model yaşam döngüsünü sürdürülebilir hale getirir.
Aşama 1 — Kullanım Senaryosunu Seçin
İlk proje dar ve ölçülebilir olmalıdır. İş değeri açıkça tanımlanmalıdır. Kullanıcı ve veri sahibi belirlenmelidir. Başarı metriği production öncesi yazılmalıdır. Her şeyi yapan genel asistanla başlamak çoğu zaman gereksizdir.
Aşama 2 — Veri Sınıflandırması Yapın
Kullanılacak prompt ve dokümanların hassasiyet seviyesi belirlenmelidir. Kişisel veri içeren kaynaklar işaretlenmelidir. Erişim grupları tanımlanmalıdır. External API kullanımına izin verilip verilmediği kararlaştırılmalıdır. Bu bilgi deployment modelini doğrudan etkiler.
Aşama 3 — Model Adaylarını Belirleyin
İki veya üç model adayının seçilmesi değerlendirmeyi kolaylaştırır. Model boyutu ve license ön eleme kriteridir. Türkçe ve tool calling ihtiyacı dikkate alınmalıdır. Aynı sınıfta küçük ve büyük model karşılaştırılabilir. Aday listesi model registry taslağına eklenebilir.
Aşama 4 — Lisans Kontrolü Yapın
Technical PoC'den önce temel lisans uygunluğu doğrulanmalıdır. Commercial use ve redistribution kontrol edilmelidir. Fine-tuning planı varsa derived model şartları incelenmelidir. Hukuk approval kaydı alınmalıdır. Uygun olmayan model erken elenmelidir.
Aşama 5 — Türkçe ve Domain Benchmark Yapın
Golden dataset gerçek kullanıcı görevlerinden oluşturulmalıdır. Türkçe dil ve domain terminolojisi ayrı puanlanmalıdır. Quality ile latency birlikte ölçülmelidir. Quantized version farklı benchmark edilmelidir. Sonuç model selection kararını desteklemelidir.
Aşama 6 — Inference Altyapısını Kurun
Seçilen model için GPU serving katmanı oluşturulur. Health check ve resource monitoring eklenir. Production concurrency ile load test yapılır. Model artifact internal registry'den yüklenmelidir. Tek node kritik sistem için yeterli olmayabilir.
Aşama 7 — AI Gateway Ekleyin
Uygulamalar inference endpoint'e doğrudan bağlanmamalıdır. Gateway authentication ve rate limit sağlar. Model routing ve fallback merkezi hale gelir. Token accounting eklenir. Future model migration kolaylaşır.
Aşama 8 — RAG Entegrasyonu Yapın
Kurumsal veri connector üzerinden alınır. Parsing, chunking ve embedding pipeline oluşturulur. Retrieval quality benchmark edilir. Data source metadata korunur. Kullanıcıya citation gösterilmesi faydalıdır.
Aşama 9 — Guardrails ve ACL Ekleyin
Retrieval authorization kullanıcı identity'sine bağlanır. Prompt injection testleri yapılır. PII policy belirlenir. Tool action varsa permission modeli uygulanır. Guardrail failure davranışı tanımlanır.
Aşama 10 — Observability Kurun
Trace, latency ve GPU metric toplanır. Model ve prompt version her request ile ilişkilendirilir. Quality evaluation scheduled olarak çalışır. Hassas içerik loglanmaz. Dashboard SLO metriklerini gösterir.
Aşama 11 — Load ve Security Testi Yapın
Peak concurrency load test ile simüle edilir. OOM ve timeout davranışı gözlemlenir. Prompt injection ve data leakage senaryoları test edilir. RAG ACL saldırı testine alınır. Bulgu kapanmadan production'a geçilmemelidir.
Aşama 12 — Canary Production Deployment
Küçük kullanıcı grubuyla gerçek trafik başlatılır. Quality ve latency mevcut beklentiyle karşılaştırılır. Error ve safety metric izlenir. Sorun yoksa trafik kademeli artırılır. Rollback endpoint hazır tutulur.
Aşama 13 — Sürekli Evaluation ve Model Lifecycle
Production sonrası çalışma bitmez. Yeni model ve prompt versionları regression testten geçer. Kullanıcı feedback golden dataset'e eklenir. Security ve lisans durumu periyodik gözden geçirilir. Model decommission süreci uygulanır.
Kurumsal Entegrasyonda En Sık Yapılan Hatalar
LLM projelerinde teknik PoC'nin hızlı başarı sağlaması bazı temel risklerin gözden kaçmasına neden olabilir. En yaygın hatalar lisans, authorization ve capacity süreçlerini production sonrasına bırakmaktır. RAG kullanırken yetkiyi yalnızca prompt içinde uygulamak ciddi veri riski yaratır. Observability olmadan model kalite sorunlarının kök nedenini bulmak zordur. Self-hosted yapının otomatik olarak güvenli veya ucuz olduğu varsayılmamalıdır.
“İndirilebiliyorsa Açık Kaynaktır” Varsayımı
Model ağırlığının indirilebilmesi lisansın tamamen açık olduğu anlamına gelmez. Eğitim kodu ve veri bilgisi kapalı olabilir. Commercial use özel koşul içerebilir. Open source ve open weight ayrımı yapılmalıdır. Hukuk approval production öncesinde alınmalıdır.
Model Lisansını İncelemeden Production'a Almak
Teknik benchmark başarılı olsa bile lisans kullanım senaryosunu engelleyebilir. Redistribution veya SaaS sunumu farklı şartlara tabi olabilir. Lisans sorununu release aşamasında fark etmek proje maliyetini artırır. Model due diligence erken yapılmalıdır. Version değişiminde kontrol tekrarlanmalıdır.
Ollama ile PoC Yapıp Production Mimarisini Aynı Bırakmak
Local PoC hızlı deneme için doğrudur. Production ise concurrency, HA ve authentication gerektirir. Tek process model endpoint kritik servis için yeterli olmayabilir. Gateway ve observability eklenmelidir. Serving motoru production workload ile benchmark edilmelidir.
Her Uygulamayı Doğrudan Model Endpoint'ine Bağlamak
Doğrudan bağlantı authentication ve routing kontrolünü dağıtır. Model değiştirmek onlarca application update gerektirebilir. Ortak AI Gateway bu bağımlılığı azaltır. Rate limit ve audit merkezi uygulanır. Endpoint internete doğrudan açılmamalıdır.
AI Gateway Kullanmamak
Gateway olmadan her ekip kendi authentication ve cost takibini yapar. Policy tutarsız hale gelir. Multi-model routing zorlaşır. Fallback ve cache farklı şekillerde uygulanır. Merkezi gateway platform operasyonunu ciddi biçimde sadeleştirebilir.
GPU'yu Sadece Model Boyutuna Göre Hesaplamak
Modelin GPU belleğine sığması production kapasitesi anlamına gelmez. KV cache ve concurrency ek VRAM tüketir. Uzun context memory ihtiyacını artırır. Throughput compute sınırına takılabilir. Gerçek load test yapılmalıdır.
Türkçe Benchmark Yapmamak
İngilizce leaderboard şirketin Türkçe kullanıcı deneyimini göstermez. Kurumsal terminoloji ayrıca test edilmelidir. Embedding ve reranker da Türkçe değerlendirilmelidir. Hukuk ve finans gibi alanlarda uzman review gerekir. Golden dataset olmadan model seçimi varsayıma dayanır.
RAG Yetkilerini Prompt'a Bırakmak
Prompt güvenlik katmanı değildir. Model yetkisiz belgeyi gördüyse data leakage riski oluşmuştur. Authorization retrieval query içinde uygulanmalıdır. ACL ve metadata filter kullanılmalıdır. Cross-tenant testleri yapılmalıdır.
Input/Output Guardrails Kullanmamak
Kullanıcı girdisi zararlı veya hassas veri içerebilir. Model çıktısı invalid JSON veya riskli command üretebilir. Validation katmanı bu sorunları azaltır. Tool execution ayrıca authorization gerektirir. Guardrail tek başına yeterli olmamakla birlikte önemli savunma katmanıdır.
Model Supply Chain'i Denetlememek
Kaynağı belirsiz model artifact güvenilir kabul edilmemelidir. Publisher ve checksum doğrulanmalıdır. Unsafe serialization riski kontrol edilmelidir. Container dependency'leri scan edilmelidir. Internal approved model registry kullanılmalıdır.
Observability Olmadan Production'a Çıkmak
Latency sorununun modelden mi retrieval'dan mı geldiği anlaşılamaz. Quality regression fark edilmeyebilir. GPU saturation incident'e dönüşebilir. Trace ve eval metric production öncesi hazır olmalıdır. Kullanıcı complaint tek monitoring yöntemi olmamalıdır.
Rollback Planı Oluşturmamak
Yeni model beklenmeyen output değişikliği yaratabilir. Eski artifact hazır tutulmalıdır. Gateway routing hızlı geri çevrilebilir olmalıdır. Prompt compatibility kontrol edilmelidir. Rollback düzenli test edilmelidir.
Yeni Model Sürümünü Otomatik Production'a Almak
Yeni release daha güçlü görünse bile regression içerebilir. Lisans şartı değişmiş olabilir. Offline evaluation ve security review yapılmalıdır. Canary deployment kullanılmalıdır. Otomatik bildirim ile otomatik promotion birbirinden ayrılmalıdır.
API ile Self-Hosting Maliyetini Yanlış Karşılaştırmak
Yalnızca GPU fiyatıyla API token fiyatını karşılaştırmak eksiktir. Engineering ve electricity maliyeti eklenmelidir. GPU utilization sonucu ciddi biçimde değiştirir. HA için ekstra kapasite gerekir. Gerçek 1 milyon token maliyeti hesaplanmalıdır.
“Self-Hosted = Otomatik Güvenli” Varsayımı
Self-hosted sistemde saldırı yüzeyi ortadan kalkmaz. Authentication ve network policy yine gerekir. Prompt injection ve data leakage uygulama seviyesinde devam eder. GPU sunucusu ve dependency'ler patch edilmelidir. Security operasyonu doğrudan kurumun sorumluluğuna geçer.
Sık Sorulan Sorular
Açık kaynak LLM nedir?
Açık kaynak LLM kaynakları ve kullanım hakları belirli açıklık seviyesinde paylaşılmış büyük dil modelidir. Bununla birlikte piyasada açık ağırlıklı olup tam açık kaynak tanımına girmeyen modeller de bulunur. Model ağırlığı, kod, eğitim bilgisi ve lisans ayrı incelenmelidir. Kurumsal kullanım için commercial use ve redistribution şartları doğrulanmalıdır. Model due diligence süreci bu ayrımı kayıt altına almalıdır.
Open source ile open weight arasındaki fark nedir?
Open weight model ağırlıklarının indirilebilir olduğunu ifade eder. Open source ise daha geniş kaynak ve lisans açıklığı beklentisi taşır. Eğitim kodu veya training data bilgisi open weight modelde paylaşılmayabilir. Lisans kullanım hakkını ayrıca belirler. Kurum bu terimleri model seçiminde birbirinin yerine kullanmamalıdır.
Kurumlar neden açık kaynak LLM kullanır?
Kurumlar veri kontrolü ve self-hosting esnekliği için açık modelleri değerlendirebilir. Vendor bağımlılığını azaltmak başka bir avantajdır. Fine-tuning ve custom inference seçenekleri daha geniş olabilir. Air-gapped sistemlerde model internet olmadan çalıştırılabilir. Buna karşılık GPU ve operasyon sorumluluğu kurum tarafından yönetilmelidir.
Açık kaynak LLM güvenli midir?
Modelin açık olması otomatik güvenlik sağlamaz. Supply-chain, prompt injection ve data leakage riskleri bulunur. Publisher ve checksum doğrulaması yapılmalıdır. RAG ACL ve tool permission uygulama seviyesinde enforce edilmelidir. Security testing model lifecycle boyunca tekrarlanmalıdır.
Açık kaynak LLM KVKK açısından avantajlı mıdır?
On-premise çalışma verinin dış hizmetlere gönderilmesini azaltabilir. Bu durum bazı veri kontrol hedefleri için avantaj sağlayabilir. Ancak prompt, embedding ve loglar yine kişisel veri içerebilir. Data minimization, retention ve silme süreçleri gereklidir. Nihai uyumluluk değerlendirmesi kurumun hukuk ve veri koruma ekipleri tarafından yapılmalıdır.
Kurumsal kullanım için hangi açık LLM seçilmeli?
Tek bir model tüm kurumlar için en iyi değildir. Türkçe performansı, model boyutu ve tool calling ihtiyacı değerlendirilmelidir. Lisans ve hardware maliyeti zorunlu kriterdir. Kurumun golden dataset'iyle benchmark yapılmalıdır. En yüksek genel benchmark skoru yerine hedef kullanım için en iyi toplam sonuç seçilmelidir.
Türkçe için hangi LLM daha iyi sonuç verir?
Model sürümleri hızla değiştiği için sabit bir isim vermek sağlıklı değildir. Kullanılacak model adayları aynı Türkçe dataset üzerinde test edilmelidir. Domain terminolojisi genel dil performansından daha önemli olabilir. Embedding ve retrieval kalitesi ayrıca ölçülmelidir. Model seçimi kurumun gerçek sorularına göre yapılmalıdır.
LLM'i kurum içinde çalıştırmak için hangi GPU gerekir?
GPU ihtiyacı model boyutu ve precision seviyesine bağlıdır. Context length ve concurrent kullanıcı sayısı ek VRAM tüketir. Quantization gereksinimi azaltabilir. Büyük model tensor parallelism ile birden fazla GPU üzerinde çalıştırılabilir. Kesin kapasite gerçek load test ile belirlenmelidir.
Ollama production için yeterli midir?
Ollama bazı düşük trafikli internal kullanım senaryolarında yeterli olabilir. Ancak yüksek concurrency ve HA gereksiniminde production serving motorları ayrıca değerlendirilmelidir. Authentication ve gateway katmanı eklenmelidir. GPU utilization benchmark edilmelidir. Seçim kullanım ölçeğine göre yapılmalıdır.
vLLM nedir ve neden kullanılır?
vLLM büyük dil modellerini yüksek throughput ile sunmak için kullanılan inference motorlarından biridir. Continuous batching ve memory yönetimi production workload için avantaj sağlayabilir. OpenAI-compatible API entegrasyonu kolaylaştırır. Model ve GPU compatibility kontrol edilmelidir. Gerçek performans kullanılan model üzerinde benchmark edilmelidir.
Açık LLM için Kubernetes zorunlu mudur?
Hayır, küçük deployment tek GPU sunucusunda çalışabilir. Kubernetes daha çok multi-replica, standard deployment ve platform yönetiminde faydalıdır. Küçük ekip için gereksiz operasyon yükü oluşturabilir. Büyük kurumsal platformda self-service ve scaling avantajı sağlar. Mimari ekip kapasitesine göre seçilmelidir.
RAG mı fine-tuning mi kullanılmalı?
Güncel kurumsal bilgi için RAG genellikle daha uygundur. Davranış ve format değiştirmek için fine-tuning değerlendirilebilir. İlk aşamada prompt engineering denenebilir. Bazı projelerde RAG ve fine-tuning birlikte kullanılabilir. Karar bilgi güncelliği ve quality hedefi üzerinden verilmelidir.
AI Gateway nedir ve neden gereklidir?
AI Gateway uygulamalar ile model endpoint'leri arasında merkezi katmandır. Authentication, rate limit ve routing uygular. Model değişikliğini client uygulamalardan gizler. Cost ve audit metriğini ortak noktada toplar. Multi-model kurumsal platformda önemli bir kontrol katmanıdır.
Self-hosted LLM gerçekten daha ucuz mudur?
Her zaman değildir. Düşük trafikte managed API daha ekonomik olabilir. Yüksek GPU utilization self-hosted maliyetini düşürür. Engineering ve elektrik maliyeti hesaplamaya dahil edilmelidir. Break-even trafik senaryosu kurum özelinde hesaplanmalıdır.
Açık kaynak LLM kullanmak vendor lock-in'i ortadan kaldırır mı?
Tamamen ortadan kaldırmaz. API, framework ve GPU bağımlılıkları devam edebilir. Vendor-neutral gateway ve açık standartlar geçişi kolaylaştırır. Model ve vector data export edilebilir olmalıdır. Exit strategy düzenli migration testleriyle doğrulanmalıdır.
Açık kaynak modeller AI Act'ten muaf mıdır?
Açık model kullanmak tüm yükümlülüklerden otomatik muafiyet anlamına gelmez. İstisnaların kapsamı model ve kullanım koşullarına göre değişebilir. General-Purpose AI ve sistemik risk hükümleri ayrıca değerlendirilmelidir. Downstream uygulamanın sorumlulukları devam edebilir. Güncel hukuki değerlendirme resmi düzenlemeler ve kurumun hukuk ekibi üzerinden yapılmalıdır.
Açık Kaynak LLM Kurumsal Entegrasyonu Hakkında Ek Sorular
Açık kaynak büyük dil modelleri (LLM) kurumsal sistemlere nasıl entegre edilir?
Açık kaynak model önce kurumsal model registry sürecinden geçirilmelidir. Ardından vLLM veya uygun serving motoru üzerinden kontrollü inference endpoint oluşturulabilir. Uygulamalar modele doğrudan bağlanmak yerine authentication, routing, rate limit ve audit sağlayan AI Gateway kullanmalıdır. Kurumsal veriler RAG üzerinden bağlanırken doküman ACL bilgileri retrieval aşamasında uygulanmalıdır. Açık Kaynak Büyük Dil Modellerinin (LLM) Kurumsal Entegrasyonu için güvenlik, observability, evaluation ve model lifecycle süreçlerinin ilk production sürümünden itibaren kurulması gerekir.
Kurumsal kullanım için açık kaynak LLM seçerken performans, lisanslama ve donanım gereksinimleri nasıl değerlendirilmelidir?
İlk adım kurumun kendi golden dataset'i üzerinde Türkçe ve domain benchmark yapmaktır. Correctness kadar structured output, tool calling ve hallucination davranışı da ölçülmelidir. Aynı anda lisansın commercial use, redistribution ve fine-tuning şartları hukuk ekibi tarafından incelenmelidir. Donanım hesabında model ağırlığına ek olarak KV cache, context ve concurrency dikkate alınmalıdır. Teknik projeler ve uygulama yaklaşımı hakkında https://www.diyarbakiryazilim.com.tr/projects adresindeki çalışmaları da inceleyebilirsiniz.
Açık kaynak LLM’lerde on-premise kurulum, veri güvenliği ve KVKK uyumu nasıl sağlanır?
On-premise model private network içinde çalıştırılmalı ve API erişimi kurumsal authentication üzerinden kontrol edilmelidir. Prompt, RAG ve embedding verisinin nerede saklandığı açık biçimde haritalanmalıdır. Kullanıcı yetkisi prompt'a bırakılmamalı, retrieval-time authorization uygulanmalıdır. Log ve trace kayıtlarında kişisel veri minimizasyonu ile retention politikası kullanılmalıdır. KVKK değerlendirmesi yalnızca inference sunucusuna değil source data, cache, vector database ve backup dahil tüm veri akışına uygulanmalıdır.
RAG, fine-tuning ve AI ajanları açık kaynak LLM’lerin kurumsal entegrasyonunda nasıl kullanılmalıdır?
Güncel şirket bilgisini modele bağlamak için RAG uygun bir başlangıçtır. Fine-tuning bilgi depolamaktan çok model davranışı ve çıktı formatını değiştirmek için değerlendirilmelidir. Agent sistemi tool kullanacaksa modelin tool çağrısı doğrudan işlem yetkisi olarak kabul edilmemelidir. Least privilege, service identity ve high-risk action approval uygulanmalıdır. RAG, fine-tuning ve agent katmanlarının her biri ayrı version, evaluation ve audit süreçlerine sahip olmalıdır.
Açık kaynak LLM kurulumu ve kurumsal yapay zeka entegrasyonu konusunda yakınımda danışmanlık veya eğitim nerede bulabilirim?
Açık kaynak LLM ve kurumsal yapay zeka danışmanlığı yakınımda şeklinde arama yaparken yalnızca model kurulumu sunan hizmetlere odaklanmamak gerekir. Sağlıklı bir çalışma inference serving, GPU capacity, RAG, AI Gateway, veri güvenliği, KVKK, evaluation ve observability konularını aynı mimari içinde ele almalıdır. Diyarbakır Yazılım Topluluğu'nun yaklaşımı ve topluluk çalışmaları hakkında https://www.diyarbakiryazilim.com.tr/about adresinden bilgi edinebilirsiniz. Kurumsal açık kaynak LLM kurulumu ve yapay zeka entegrasyon hizmeti planlanırken PoC'den production'a kadar ölçülebilir bir yol haritası oluşturmak uzun vadeli operasyonu kolaylaştırır. Teknik ekibin yalnızca model seçimine değil güvenlik, RAG yetkileri ve model yaşam döngüsüne de hakim olması önemlidir.
Sonuç
Açık Kaynak Büyük Dil Modellerinin (LLM) Kurumsal Entegrasyonu yalnızca güçlü bir modeli GPU sunucusunda çalıştırma işi değildir. Production seviyesinde başarılı bir sistem AI Gateway, authorization, RAG, vector database, guardrails, observability, evaluation ve model registry katmanlarının birlikte çalışmasını gerektirir. Self-hosting veri kontrolünü artırabilir ancak güvenlik ve operasyon sorumluluğunu doğrudan kuruma taşır. Türkçe benchmark, lisans kontrolü, retrieval-time authorization ve sürekli model evaluation süreçleri baştan tasarlanırsa platform daha güvenilir biçimde büyütülebilir. Kurumunuz için açık kaynak LLM mimarisi, on-premise deployment, RAG, AI Gateway veya kurumsal yapay zeka entegrasyonu konusunda çalışma planlamak için https://www.diyarbakiryazilim.com.tr adresi üzerinden Diyarbakır Yazılım Topluluğu'na ulaşabilirsiniz.
share: