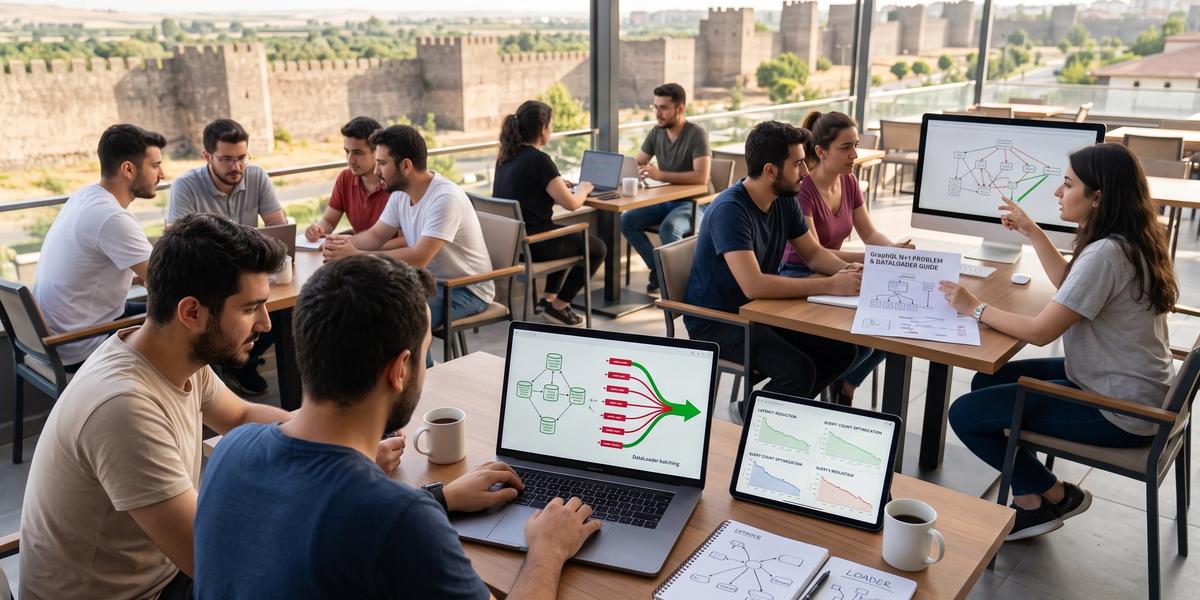
GraphQL Performans İyileştirmeleri ve N+1 Problemi

Diyarbakır Yazılım
16.08.2026
#Yazılım#Teknoloji#Topluluk
GraphQL ilk bakışta geliştirici deneyimini oldukça rahatlatır. İstemci ihtiyaç duyduğu alanları seçer, tek bir endpoint üzerinden farklı veri modellerine ulaşır ve çoğu zaman gereksiz ağ trafiği azalır. Fakat production ortamında gerçek yük başladığında aynı esneklik, kontrol edilmeyen veri erişimi nedeniyle ciddi performans maliyetleri doğurabilir. Özellikle GraphQL Performans İyileştirmeleri ve N+1 Problemi konusu, yalnızca birkaç resolver düzenlemekten çok daha geniş bir backend mühendisliği alanını kapsar. Bu rehberde GraphQL N+1 problemi nasıl çözülür, GraphQL API performansı nasıl optimize edilir, DataLoader ile GraphQL N+1 sorgu problemi çözümü nasıl uygulanır ve ölçülebilir bir performans standardı nasıl oluşturulur sorularını pratik örneklerle ele alacağız.
GraphQL Performansı Neden Zor Bir Problemdir?
GraphQL performansını zorlaştıran temel unsur, istemci esnekliği ile backend maliyetinin birbirinden kolayca kopabilmesidir. İstemcinin basit görünen bir sorgusu veritabanında onlarca sorguya, başka servislere yapılan çağrılara ve yüksek CPU kullanımına dönüşebilir. Bu nedenle yalnızca HTTP yanıt süresine bakmak yeterli değildir. Resolver çalışma süreleri, SQL sayısı, batch büyüklüğü ve response boyutu birlikte değerlendirilmelidir. GraphQL API performansı nasıl optimize edilir sorusunun yanıtı da bu nedenle tek bir araçtan değil, uçtan uca ölçüm ve veri erişimi stratejisinden oluşur.
GraphQL'in İstemciye Sağladığı Esneklik
GraphQL istemciye ihtiyaç duyduğu alanları seçme özgürlüğü verir. Bu özellik mobil uygulamalarda ve farklı arayüzlerde gereksiz veri transferini azaltabilir. Aynı schema üzerinden farklı ekranlar farklı alan kombinasyonları isteyebilir. Ancak backend tarafı her alanın gerçek maliyetini iyi yönetmezse özgürlük kontrolsüz kaynak tüketimine dönüşebilir. Bu yüzden schema tasarımı yapılırken yalnızca kullanılabilirlik değil, sorgu maliyeti de düşünülmelidir.
Tek HTTP Request'in Arkasında Çok Sayıda Backend İşlemi
Tek bir GraphQL isteği dışarıdan yalnızca bir HTTP çağrısı gibi görünür. Bunun arkasında onlarca resolver, SQL sorgusu, cache erişimi ve harici servis çağrısı bulunabilir. Kullanıcı 200 milisaniyelik tek bir yanıt görürken sunucu çok daha fazla iş yapıyor olabilir. Özellikle nested ilişkiler bu maliyeti hızlı biçimde büyütür. Bu nedenle request sayısı tek başına gerçek backend yükünü göstermez.
REST ile GraphQL Performans Modeli Arasındaki Fark
REST mimarisinde endpoint davranışı çoğunlukla sunucu tarafından daha belirgin biçimde tanımlanır. GraphQL tarafında ise istemci hangi alanların çalışacağını önemli ölçüde belirleyebilir. Bu durum aynı endpoint için çok farklı maliyet profilleri oluşturur. Bir sorgu ucuzken başka bir sorgu aynı endpoint üzerinden yüzlerce kat pahalı olabilir. Bu nedenle GraphQL ölçümlerinde operation adı ve operation maliyeti ayrı bir önem taşır.
GraphQL Performance Pipeline
GraphQL performansı yalnızca resolver seviyesinde oluşmaz. İstek parse edilir, doğrulanır, execution planına alınır, alanlar çözülür, veriler alınır ve sonuç serialize edilir. Her aşama kendi gecikmesini ve CPU maliyetini üretir. Büyük sorgularda parse ve validation maliyeti dahi gözle görülür hale gelebilir. Sağlıklı bir performans incelemesi bu zincirin tamamını kapsamalıdır.
Parse
Parse aşamasında gelen GraphQL dokümanı sözdizimsel yapıya dönüştürülür. Küçük sorgularda bu maliyet genellikle düşüktür. Çok büyük ve tekrar eden sorgularda parse süresi toplam CPU kullanımına katkıda bulunabilir. Persisted query yaklaşımı bu maliyetin bir bölümünü azaltmaya yardımcı olabilir. Ölçüm yaparken parse süresini tamamen yok saymamak gerekir.
Validate
Validation aşaması sorgunun schema kurallarına uygunluğunu kontrol eder. Field varlığı, argument tipleri ve fragment kullanımı burada doğrulanır. Büyük schema ve büyük sorgular doğrulama maliyetini artırabilir. Trusted document veya persisted query yaklaşımı bazı senaryolarda doğrulama sürecini daha öngörülebilir hale getirir. Bununla birlikte güvenlik kontrolleri performans uğruna devre dışı bırakılmamalıdır.
Execute
Execute aşaması GraphQL operasyonunun gerçek çalışma sürecini başlatır. Root resolver'lar ve alt alanlar belirlenen bağımlılıklara göre çalıştırılır. Bağımsız alanlar paralel çalışabilirken parent verisine ihtiyaç duyan alanlar beklemek zorunda kalır. Bu yapı yanlış resolver tasarımında waterfall davranışı oluşturabilir. Execution süresinin tracing ile görünür hale getirilmesi bu nedenle değerlidir.
Resolve
Resolver bir GraphQL field değerinin nasıl üretileceğini belirler. Bazı resolver'lar yalnızca parent üzerindeki mevcut alanı döndürür. Bazıları ise veritabanına veya başka bir API'ye erişir. Performans problemleri genellikle bu ikinci gruptaki resolver'larda yoğunlaşır. Resolver başına süre ve çağrı sayısı ölçüldüğünde N+1 gibi sorunlar daha kolay görülür.
Data Fetch
Data fetch çoğu GraphQL sisteminde toplam maliyetin en önemli bölümüdür. SQL sorguları, cache erişimleri ve harici servis istekleri burada yer alır. Bir resolver'ın hızlı olması, arkasındaki sorgunun verimli olduğu anlamına gelmez. Query planı, index kullanımı ve batch davranışı ayrıca incelenmelidir. Özellikle production optimizasyonunda en büyük kazanımlar çoğu zaman bu katmandan gelir.
Serialize
Sonuç üretildikten sonra response istemciye gönderilebilecek biçime çevrilir. Büyük response objeleri serialization sırasında CPU ve bellek tüketimini artırabilir. Çok büyük listeler aynı zamanda ağ trafiğini de büyütür. Pagination ve response size limitleri bu maliyeti kontrol altında tutar. Performans ölçümlerine response boyutunu eklemek bu nedenle yararlıdır.
GraphQL'de En Sık Görülen Performans Problemleri
GraphQL sistemlerinde performans sorunları genellikle tek bir nedenden kaynaklanmaz. N+1 sorguları, sınırsız listeler, pahalı alanlar, yetersiz cache kullanımı ve seri çalışan resolver'lar birbirini güçlendirebilir. Bir problem çözüldüğünde başka bir darboğaz görünür hale gelebilir. Bu nedenle optimizasyon öncesinde ölçülebilir bir baseline oluşturmak önemlidir. Sağlıklı yaklaşım, en büyük maliyeti oluşturan noktadan başlayarak adım adım ilerlemektir.
N+1 Query
N+1 problemi, bir ana sorgudan sonra listedeki her kayıt için ek sorgu çalıştırılmasıdır. Örneğin 100 post için önce post listesi alınır ve sonra her postun yazarı ayrı ayrı sorgulanır. Böylece 101 SQL sorgusu oluşabilir. Trafik arttıkça veritabanı connection pool ve latency değerleri hızla kötüleşir. DataLoader veya uygun JOIN yaklaşımı bu paterni büyük ölçüde azaltabilir.
Deeply Nested Queries
Derin nested sorgular object graph üzerinde uzun bir çözümleme zinciri oluşturabilir. User, posts, comments ve comment author gibi ilişkiler iç içe geçtiğinde maliyet katlanabilir. Depth limiti bu riskin bir bölümünü kontrol eder. Ancak depth tek başına sorgunun gerçek maliyetini göstermez. Query complexity hesabı da birlikte kullanılmalıdır.
Expensive Fields
Bazı alanlar basit görünmesine rağmen pahalı hesaplama yapabilir. Aggregation, arama, raporlama veya harici API çağrısı yapan field'lar buna örnektir. Bu alanların maliyeti schema üzerinde görünür değildir. Field complexity tanımlamak bu farkı modele dahil eder. Gerektiğinde pahalı alanlar ayrı query veya açık opt-in yapısıyla sunulabilir.
Büyük Listeler
Limitsiz listeler GraphQL performansının en sık gözden kaçan risklerinden biridir. Binlerce kaydın aynı response içinde alınması hem backend hem de istemciyi zorlar. Serialization maliyeti ve ağ trafiği de hızla artar. Her liste için makul bir maksimum page size belirlenmelidir. Nested listelerde de aynı sınırların uygulanması gerekir.
Yetersiz Pagination
Pagination yalnızca kullanıcı arayüzü kolaylığı değildir. Aynı zamanda backend kaynaklarını sınırlandıran önemli bir performans kontrolüdür. first veya limit değerlerinin sınırsız bırakılması büyük sorgulara kapı açar. Sunucu tarafında maksimum değer uygulanması gerekir. Büyük veri setlerinde cursor pagination çoğu zaman daha öngörülebilir sonuç verir.
Over-Fetching Backend
GraphQL istemci tarafındaki over-fetching sorununu azaltabilir. Ancak resolver'ların veritabanından gereğinden fazla kolon çekmesi backend tarafında aynı problemi sürdürebilir. İstemci yalnızca id isterken tüm entity kolonlarını almak gereksiz maliyet yaratır. GraphQL field selection bilgisi SQL projection ile eşleştirilebilir. Bunun uygulanması sırasında resolver bakım maliyeti de hesaba katılmalıdır.
Cache Eksikliği
Sık kullanılan verilerin her request içinde yeniden hesaplanması gereksiz yük oluşturur. DataLoader request cache, entity cache ve response cache farklı ihtiyaçlara cevap verir. Bu katmanların birbirine karıştırılması yanlış invalidation kararlarına yol açabilir. Cache anahtarları authentication ve tenant bağlamını doğru biçimde yansıtmalıdır. Hit ve miss oranları production ortamında mutlaka izlenmelidir.
Resolver Waterfall
Resolver waterfall bağımsız işlemlerin gereksiz yere seri çalıştırılmasıyla oluşur. Bir işlem 80 milisaniye, diğeri 100 milisaniye sürüyorsa seri çalışma toplam süreyi yaklaşık 180 milisaniyeye çıkarabilir. Bağımsız işlemler uygun olduğunda paralel yürütülebilir. Promise.all benzeri yapıların bilinçli kullanımı latency değerini düşürebilir. Bununla birlikte aşırı paralellik downstream sistemleri zorlayabilir.
Slow External Services
GraphQL resolver'ları çoğu zaman başka servislerle iletişim kurar. Yavaş çalışan tek bir downstream servis tüm operation latency değerini artırabilir. Timeout ve cancellation olmadığı durumda kaynaklar gereksiz yere tutulabilir. Harici servis sürelerini ayrı span olarak izlemek faydalıdır. Bulkhead ve concurrency limitleri de sistemin tamamını korumaya yardımcı olur.
N+1 Problemi Nedir?
N+1, GraphQL performans sorunları konuşulduğunda ilk incelenmesi gereken veri erişimi paternlerinden biridir. Problem genellikle field-level resolver modelinin doğal sonucu olarak ortaya çıkar. Ana kayıtlar tek sorguda gelirken ilişkili kayıtlar her parent için tekrar sorgulanır. Bu davranış küçük veri setinde fark edilmeyebilir fakat production yükünde ciddi maliyet üretir. GraphQL N+1 problemi nasıl çözülür sorusuna yanıt ararken önce query count değerinin nasıl büyüdüğünü görmek gerekir.
"1 + N" Ne Anlama Gelir?
Buradaki 1 ana listeyi getiren sorgudur. N ise listedeki her kayıt için çalışan ek sorguların sayısını ifade eder. 50 kayıt varsa toplam 51 sorgu görülebilir. Liste büyüdükçe toplam maliyet doğrusal biçimde artar. Nested ilişkiler eklendiğinde büyüme daha da sert hale gelebilir.
Liste Sorgularında N+1
Liste resolver'ı çoğunlukla birden fazla parent nesnesi döndürür. Child resolver her parent için ayrı veri erişimi yaparsa N+1 oluşur. Örneğin ürün listesinde her ürünün kategorisi ayrı sorgulanabilir. Bu yapı geliştirme ortamında fark edilmeyebilir. Query logging açıldığında tekrar eden SQL pattern'i açık biçimde görülür.
Nested Relationship'larda N+1
Nested ilişkiler N+1 problemini birkaç seviyeye taşıyabilir. Post listesi, yorumlar ve yorum yazarları ayrı ayrı resolver çalıştırabilir. Her katmanda yeni sorgular üretildiğinde toplam query sayısı hızla artar. Bu durum yalnızca veritabanını değil connection pool kapasitesini de etkiler. Batching her ilişki seviyesinde ayrı değerlendirilmelidir.
N+1'in Database Query Sayısına Etkisi
Query sayısı N+1 problemindeki en kolay ölçülebilen göstergelerden biridir. Aynı operation için kayıt sayısı arttıkça SQL sayısının da artması güçlü bir uyarıdır. Sağlıklı batching sonrasında query sayısının büyük ölçüde sabit kalması beklenir. Örneğin 10 ve 100 kayıt arasında SQL sayısı iki veya üç civarında kalabilir. Bu davranış regression test ile korunabilir.
N+1'in Latency ve CPU'ya Etkisi
Her ek SQL sorgusu network round trip ve database execution maliyeti taşır. Sorgular kısa sürse bile yüzlerce tekrar toplam latency değerini büyütür. Database tarafında parse, planlama ve execution CPU tüketimi artar. Connection pool daha uzun süre dolu kalabilir. Bu nedenle N+1 yalnızca query count problemi değildir.
GraphQL Resolver Modeli N+1 Problemini Neden Kolayca Üretir?
GraphQL resolver modeli alan bazlı çalıştığı için geliştirmeyi modüler hale getirir. Fakat bu modüler yapı farklı resolver'ların aynı operation içinde birbirinden habersiz veri çağrısı yapmasına neden olabilir. Parent listesi büyüdükçe child resolver çağrı sayısı da büyür. Resolver kodu tek başına incelendiğinde problem görünmeyebilir. Asıl maliyet operation seviyesinde resolver çağrılarının toplamına bakıldığında anlaşılır.
Field-Level Resolver
Her GraphQL field kendi resolver fonksiyonuna sahip olabilir. Bu yapı kod organizasyonu açısından pratiktir. Ancak her resolver kendi SQL sorgusunu çalıştırırsa gereksiz tekrar oluşur. Özellikle relation alanlarında bu durum sık görülür. DataLoader field-level modeli batch veri erişimiyle uyumlu hale getirir.
Resolver Independence
Resolver'ların bağımsız olması geliştirme sırasında anlaşılır sınırlar sağlar. Buna karşılık aynı veri kaynağına yapılan çağrılar otomatik biçimde birleştirilmez. İki resolver aynı kullanıcıyı istediğinde iki ayrı sorgu oluşabilir. Request-scoped memoization bu tekrarı azaltabilir. DataLoader'ın deduplication davranışı burada önemli rol oynar.
Parent–Child Resolution
Child resolver çoğu zaman parent nesnesinden bir kimlik alır. Ardından bu kimliği kullanarak ilişkili kaydı fetch eder. Bir parent yerine yüz parent geldiğinde aynı resolver yüz kez çalışabilir. Batching kullanılmadığında her çalışma ayrı sorgu üretir. Bu yüzden parent-child ilişkileri performans incelemesinde öncelikli alanlardır.
Aynı Resolver'ın N Kez Çalışması
Resolver fonksiyonunun hızlı görünmesi yanıltıcı olabilir. Bir çağrı yalnızca birkaç milisaniye sürse bile yüz çağrı toplamda önemli gecikme oluşturur. Ayrıca database bağlantıları ve CPU kaynakları daha fazla tüketilir. Resolver execution count metriği bu durumu görünür hale getirir. Tek operation içindeki tekrar sayısı özellikle listelerde izlenmelidir.
Resolver'ın Sibling Resolver'lardan Habersiz Olması
Sibling resolver'lar çoğu GraphQL implementasyonunda birbirlerinin veri ihtiyaçlarını doğrudan bilmez. Bu nedenle aynı kaynağa benzeyen çağrılar ayrı ayrı planlanabilir. Merkezi request context içinde loader kullanmak bu çağrıları ortak batching katmanına taşır. Böylece resolver bağımsızlığı korunurken veri erişimi birleştirilebilir. Bu yaklaşım kod organizasyonunu da daha tutarlı hale getirir.
Basit Bir N+1 Örneği
Basit bir posts örneği N+1 probleminin nasıl büyüdüğünü net biçimde gösterir. Önce tüm post kayıtlarını getiren bir sorgu çalışır. Ardından her postun author alanı ayrı resolver tarafından çözülür. Author resolver her seferinde database'e giderse toplam query sayısı kayıt sayısıyla birlikte büyür. DataLoader ile GraphQL N+1 sorgu problemi çözümü tam olarak bu noktada değer üretir.
Posts Sorgusu
İlk adım posts listesini tek SQL sorgusuyla almaktır. Bu sorgu 10, 50 veya 100 kayıt döndürebilir. Root resolver açısından işlem oldukça verimli görünebilir. Sorun child field'lar çalışmaya başladığında ortaya çıkar. Bu nedenle yalnızca root resolver süresine bakmak yeterli değildir.
Her Post İçin Author Resolver
Her post nesnesi authorId bilgisi taşıyabilir. Author resolver bu kimlik üzerinden kullanıcı tablosuna erişebilir. Loader kullanılmazsa her post ayrı SELECT sorgusu oluşturur. Aynı yazar birden fazla postta bulunsa bile sorgu tekrarlanabilir. Request-level memoization bu tekrarın bir bölümünü ortadan kaldırır.
100 Post İçin 101 SQL Query
100 post tek sorguda alınırsa başlangıçta bir SQL çalışır. Sonra her post için ayrı author sorgusu çalıştığında 100 ek sorgu oluşur. Toplam sayı 101 olur. Trafik altında bu pattern veritabanına yüzlerce gereksiz round trip gönderir. Batching sonrasında aynı operation çoğu zaman iki sorguya indirilebilir.
Nested Comments Eklenirse Ne Olur?
Posts sorgusuna comments alanı eklendiğinde yeni bir ilişki katmanı oluşur. Her post için comments sorgulanırsa ek N sorgu daha gelir. Her comment için user sorgulanırsa sayı yeniden katlanır. Bu durum birkaç nested seviyede yüzlerce sorguya dönüşebilir. Bu nedenle query shape üretim ortamında mutlaka gözlemlenmelidir.
Query Sayısının Katlanarak Büyümesi
N+1 her zaman yalnızca N kadar ek sorgu anlamına gelmez. Birden fazla nested relation aynı pattern'i üretirse maliyet birbirini büyütebilir. Query count metriği kayıt sayısıyla birlikte hızlı yükselir. Bu durum p95 ve p99 latency değerlerinde daha görünür hale gelir. Production öncesinde farklı liste boyutlarıyla test yapmak önemlidir.
N+1 Problemi Nasıl Tespit Edilir?
N+1 tespitinde tahmin yerine ölçüm kullanılmalıdır. SQL logları, tracing, resolver çağrı sayıları ve connection pool metrikleri birlikte incelendiğinde güçlü bir teşhis elde edilir. Özellikle tek GraphQL operation başına query count değeri çok yararlıdır. Aynı SQL pattern'inin farklı parametrelerle tekrar etmesi önemli bir işarettir. Production ortamında bu verilerin operation name ile ilişkilendirilmesi sorunlu sorguları daha hızlı bulmayı sağlar.
SQL Query Logging
SQL logging N+1 teşhisinin en basit başlangıç noktasıdır. Aynı SELECT sorgusunun farklı id değerleriyle art arda çalışması dikkat çekicidir. Development ortamında query loglarını doğrudan incelemek mümkündür. Production ortamında ise log hacmi nedeniyle sampling veya metrik yaklaşımı tercih edilebilir. Kişisel verilerin loglara yazılmamasına da dikkat edilmelidir.
Tek GraphQL Request Başına Query Count
Her operation için kaç SQL sorgusu çalıştığını ölçmek güçlü bir performans metriğidir. Aynı operation farklı kayıt sayılarında karşılaştırılabilir. Sağlıklı batching varsa query count değerinin sınırlı kalması beklenir. Ani artışlar regression belirtisi olabilir. Bu metriği CI ve production monitoring süreçlerine taşımak oldukça değerlidir.
Tekrarlayan SQL Pattern'leri
N+1 sorguları çoğu zaman aynı SQL şablonunun tekrar edilmesiyle görünür. Yalnızca bind parametreleri değişir. Query fingerprint yaklaşımı bu sorguları gruplayabilir. Bir request içinde aynı fingerprint yüzlerce kez görülüyorsa inceleme yapılmalıdır. Batching sonrasında bu tekrar tek bir IN sorgusuna dönüşebilir.
Resolver Execution Count
Resolver çağrı sayısı veri erişiminin nerede çoğaldığını gösterir. Bir author resolver'ın tek request içinde 100 kez çalışması her zaman problem değildir. Problem, her çağrının ayrı I/O işlemi üretmesidir. Execution count ile SQL count birlikte değerlendirildiğinde daha doğru sonuç elde edilir. Bu iki metriğin korelasyonu N+1 teşhisini kolaylaştırır.
Database Connection Pool Saturation
N+1 problemi connection pool üzerinde doğrudan baskı yaratabilir. Çok sayıda kısa sorgu aynı anda bağlantı beklemeye başlayabilir. Pool wait time yükseldiğinde request latency de büyür. Active connection sayısı sürekli maksimuma yaklaşıyorsa veri erişimi gözden geçirilmelidir. Batching çoğu zaman aynı kapasiteyle daha fazla request işlenmesini sağlar.
APM / Distributed Tracing
Distributed tracing GraphQL operation içindeki resolver ve database çağrılarını zaman çizelgesinde gösterir. Tekrarlayan küçük span'lar N+1 pattern'ini görünür hale getirebilir. Harici servis çağrıları da aynı trace içinde incelenebilir. Böylece sorun yalnızca database ile sınırlı düşünülmez. Trace ID üzerinden uçtan uca latency analizi yapılabilir.
N+1 İçin En Basit Teşhis Metriği: Query Count
Query count ölçümü düşük maliyetli ve son derece açıklayıcıdır. N+1 problemini fark etmek için her zaman ileri seviye tracing altyapısı gerekmez. Tek operation için kayıt sayısı büyürken SQL sayısının nasıl değiştiğine bakmak çoğu zaman yeterlidir. Bu ölçüm bir budget haline getirildiğinde regression daha erken yakalanır. Özellikle kritik GraphQL operation'ları için kabul edilebilir query sayısı açık biçimde tanımlanabilir.
Operation Başına SQL Sayısı
Her named operation için SQL query sayısı ayrı izlenebilir. Böylece yoğun kullanılan sorguların veri erişimi profili görülür. Query sayısı yalnızca ortalama olarak tutulmamalıdır. p95 benzeri dağılımlar anormal request'leri daha iyi gösterebilir. Operation name bulunmadığında fingerprint kullanılabilir.
Baseline Oluşturmak
Optimizasyondan önce mevcut davranış kaydedilmelidir. 1, 10, 100 ve daha fazla kayıtla aynı operation çalıştırılabilir. SQL sayısı ve latency değerleri ölçülür. Bu baseline sonradan yapılan değişikliklerin etkisini karşılaştırmak için kullanılır. Ölçüm olmadan performans iyileştirmesi kolayca yanlış yorumlanabilir.
Query Count Budget
Query count budget bir operation için kabul edilebilir maksimum SQL sayısını tanımlar. Örneğin liste sorgusu için en fazla dört SQL beklenebilir. Yeni kod bu değeri aşarsa test başarısız olabilir. Budget tamamen sabit olmak zorunda değildir. İş ihtiyacına göre operation bazında belirlenmesi daha doğru olur.
CI'da Query Count Regression Test
CI testleri N+1 probleminin yeniden ortaya çıkmasını önleyebilir. Test sırasında sorgu sayacı aktif edilir. Belirli bir GraphQL operation çalıştırılır ve SQL sayısı doğrulanır. Kayıt sayısı büyütülerek query count değerinin sabit kaldığı kontrol edilir. Bu test özellikle resolver değişikliklerinden sonra güçlü bir güvence sağlar.
Production'da Anormal Query Count Alarmı
Production trafiğinde beklenmeyen query shape'leri ortaya çıkabilir. Operation başına SQL sayısı belirli eşiği aştığında alarm üretilebilir. Eşik doğrudan sabit bir sayı veya normal davranıştan sapma şeklinde tanımlanabilir. Alarm operation name ve trace bilgisiyle zenginleştirilmelidir. Böylece problemli request hızlı biçimde incelenebilir.
DataLoader Nedir?
DataLoader, aynı request içinde benzer veri erişimlerini batch haline getirmek ve tekrar eden key'leri memoize etmek için kullanılan bir yaklaşımdır. GraphQL resolver modeline özellikle iyi uyum sağlar çünkü farklı resolver çağrılarını ortak bir veri erişim katmanında birleştirir. Her resolver yine bağımsız biçimde load çağrısı yapabilir. Loader bu çağrıları kısa bir pencere içinde toplar ve tek batch sorgusuna dönüştürür. Bu mekanizma N+1 sorununu azaltırken resolver kodunun okunabilirliğini korumaya yardımcı olur.
DataLoader'ın Amacı
DataLoader'ın temel amacı çok sayıda küçük veri erişimini daha az sayıda toplu işleme çevirmektir. Aynı zamanda request içinde aynı key için tekrar fetch yapılmasını engeller. Bu davranış latency ve database round trip sayısını azaltabilir. DataLoader shared cache yerine request-level yardımcı mekanizma olarak düşünülmelidir. Bu ayrım production tasarımında önemlidir.
Batch Loading
Batch loading birden fazla key'i tek çağrıda veri kaynağına göndermeyi sağlar. Örneğin 20 user id tek tek sorgulanmak yerine bir IN query içinde alınabilir. Bu yaklaşım database round trip sayısını azaltır. Aynı prensip başka servislerin batch endpoint'lerinde de uygulanabilir. Batch fonksiyonunun input ve output eşleşmesi doğru kurulmalıdır.
Request-Level Memoization
Memoization aynı request içinde aynı key'in tekrar yüklenmesini önler. Bir kullanıcı farklı resolver'lar tarafından birkaç kez istenebilir. İlk load sonrasında sonuç request cache içinde tutulur. Sonraki çağrılar aynı değeri yeniden kullanabilir. Request bittiğinde bu cache'in yaşam süresi de bitmelidir.
Deduplication
Deduplication aynı key için birden fazla load çağrısının tek fetch işlemine dönüşmesini sağlar. Örneğin author id 42 on farklı postta kullanılıyorsa database'e on ayrı sorgu gitmez. Loader aynı key'i tek batch girdisi olarak değerlendirebilir. Bu davranış özellikle tekrar eden relation verilerinde güçlü kazanım sağlar. Cache ayarları değiştirilirse deduplication davranışı ayrıca test edilmelidir.
GraphQL ile Neden İyi Uyum Sağlar?
GraphQL field resolver'ları doğal olarak bağımsız load çağrıları üretir. DataLoader bu bağımsızlığı bozmadan çağrıları arka planda gruplar. Resolver yalnızca ihtiyacı olan key'i loader'a verir. Batching mantığı merkezi batch function içinde kalır. Böylece schema kodu ile veri erişimi optimizasyonu daha temiz biçimde ayrılabilir.
DataLoader N+1 Problemini Nasıl Çözer?
DataLoader resolver'lardan gelen key'leri kısa süre içinde toplar. Ardından tüm key'leri tek batch fonksiyonuna verir. Batch fonksiyonu çoğunlukla WHERE id IN (...) benzeri toplu sorgu çalıştırır. Sonuçlar input key sırasına göre resolver çağrılarına geri dağıtılır. Böylece yüzlerce ayrı sorgu birkaç toplu sorguya indirilebilir.
Resolver'lardan Gelen Key'leri Toplamak
Her resolver load çağrısı yaparken yalnızca kendi key'ini bilir. Loader aynı execution penceresindeki çağrıları toplar. Bu nedenle resolver'ların birbirini bilmesine gerek kalmaz. Key listesi batch function çalışmadan önce oluşturulur. Aynı key'ler gerektiğinde tekilleştirilebilir.
Tek Batch Function Çağrısı
Toplanan key'ler tek batch function çağrısına iletilir. Bu fonksiyon veri erişiminin merkezi noktasıdır. Database query, authorization ve mapping kararları burada dikkatli biçimde ele alınabilir. Fonksiyonun performansı bütün resolver'ları etkiler. Bu nedenle ayrı metriklerle izlenmesi faydalıdır.
WHERE id IN (...)
Relational database kullanımında en yaygın batch tekniği IN sorgusudur. Birden fazla primary key tek SQL içinde gönderilir. Uygun index varsa lookup oldukça verimli olabilir. Çok büyük key listelerinde database parameter limitleri göz önünde bulundurulmalıdır. maxBatchSize bu noktada yararlı bir kontrol sağlar.
Sonuçları Resolver'lara Dağıtmak
Database sonuçları her zaman input key sırasıyla dönmez. DataLoader batch function sonuçları input sırasına göre yeniden düzenlemelidir. Eksik kayıtlar için null veya uygun error değeri kullanılabilir. Yanlış ordering ciddi veri eşleşme hatalarına yol açabilir. Bu davranış unit test ile açık biçimde doğrulanmalıdır.
101 Query'yi 2 Query'ye İndirmek
100 post için önce posts sorgusu çalışır. Author id değerleri loader tarafından toplanır. Ardından bütün author kayıtları tek batch sorgusuyla alınır. Böylece toplam SQL sayısı 101 yerine yaklaşık iki olabilir. Gerçek sayı schema ve veri kaynağına göre değişse de kazanımın mantığı aynıdır.
DataLoader Batch Function Kuralları
DataLoader kullanmak tek başına doğru batching garantisi vermez. Batch function belirli mapping kurallarına uymalıdır. En önemli kurallar output uzunluğu ve sırasının input key dizisiyle uyumlu olmasıdır. Missing record ve duplicate key durumları da açık biçimde ele alınmalıdır. Bu kuralların test edilmemesi production ortamında zor fark edilen veri hatalarına neden olabilir.
Input Key Array
Batch function bir key dizisi alır. Bu key'ler id, composite key veya başka bir tanımlayıcı olabilir. Input dizisinin sırası mapping için önem taşır. Fonksiyon key listesini query oluşturmak için kullanır. Key tipinin mümkün olduğunca stabil ve açık olması tercih edilir.
Output Array
Batch function her input key için bir output elemanı döndürmelidir. Output değerleri entity, null veya error olabilir. Database sonucu doğrudan döndürmek çoğu zaman yeterli değildir. Çünkü database sıralaması input ile aynı olmayabilir. Mapping adımı bu nedenle açık biçimde uygulanmalıdır.
Aynı Uzunluk Zorunluluğu
Input dizisinde on key varsa output dizisinde de on eleman bulunmalıdır. Bazı kayıtların bulunmaması bu kuralı değiştirmez. Eksik pozisyon null veya error ile temsil edilir. Uzunluk farklı olduğunda loader hangi sonucu hangi key'e vereceğini güvenilir biçimde belirleyemez. Testlerde bu senaryo mutlaka kapsanmalıdır.
Aynı Sıra Zorunluluğu
Output sırası input key sırasını takip etmelidir. SQL sonucu farklı sırada dönebilir. Bu nedenle sonuçlar genellikle map yapısına alınır ve key sırasına göre yeniden oluşturulur. Aksi durumda bir kullanıcının verisi başka key'e atanabilir. Bu hem doğruluk hem de güvenlik açısından ciddi bir problemdir.
Missing Record
Her key veritabanında mevcut olmak zorunda değildir. Silinmiş veya erişilemeyen kayıtlar batch sonucunda bulunmayabilir. Loader bu durumu öngörülebilir biçimde temsil etmelidir. null ve Error seçenekleri farklı GraphQL davranışları üretir. Uygulamanın hata politikasına göre açık bir standart belirlenmelidir.
null
null kullanımı kaydın bulunmamasını normal bir durum olarak temsil edebilir. Optional relation alanlarında bu yaklaşım uygundur. GraphQL schema alanının nullability tanımıyla uyumlu davranmak gerekir. Authorization nedeniyle null döndürülüyorsa existence leakage riski ayrıca değerlendirilmelidir. Client tarafının bu durumu doğru işlemesi de önemlidir.
Error
Error kullanımı belirli bir key için yükleme hatasını temsil eder. DataLoader bazı implementasyonlarda her key için ayrı error sonucu taşıyabilir. Bu sayede bütün batch tek bir eksik kayıt nedeniyle başarısız olmak zorunda kalmaz. GraphQL error propagation davranışı schema nullability ile birlikte değerlendirilmelidir. Hata mesajlarında hassas bilgi paylaşılmamalıdır.
Duplicate Key
Aynı key batch içinde birden fazla kez istenebilir. Request cache aktif olduğunda DataLoader bu çağrıları çoğunlukla tekilleştirir. Cache kapalı senaryolarda duplicate key davranışı değişebilir. Batch function duplicate input gelme ihtimaline karşı doğru mapping yapmalıdır. Unit testlerde aynı key'in birkaç kez istendiği durum denenmelidir.
DataLoader Neden Request Başına Oluşturulmalıdır?
DataLoader'ın cache davranışı request kapsamı için tasarlanmalıdır. Global singleton kullanımı farklı kullanıcı ve tenant isteklerinin aynı cache üzerinde buluşmasına neden olabilir. Bu durum stale data üretmenin ötesinde ciddi authorization problemleri oluşturabilir. Loader request context oluşturulurken hazırlanmalı ve request tamamlandığında atılmalıdır. Bu yaklaşım request-level memoization avantajını güvenli sınırlar içinde tutar.
Per-Request Cache
Per-request cache yalnızca mevcut GraphQL operasyonunun yaşam süresi boyunca kullanılır. Aynı entity aynı request içinde tekrar istenirse ikinci database çağrısı önlenir. Başka request başladığında yeni cache oluşur. Böylece kullanıcılar arası veri karışması engellenir. Request tamamlandığında ayrıca manuel global invalidation ihtiyacı doğmaz.
Global Singleton Kullanmanın Riski
Global loader uygulamanın tüm kullanıcıları arasında aynı cache'i paylaşabilir. Bir kullanıcı için yüklenen entity sonraki kullanıcıya cache üzerinden dönebilir. Yetki bağlamı farklıysa bu ciddi veri sızıntısı doğurur. Stale kayıtların uzun süre tutulması da başka bir problemdir. Bu nedenle request-scoped oluşturma varsayılan yaklaşım olmalıdır.
Stale Data
Loader cache request sınırını aşarsa değişen veriler eski haliyle dönmeye devam edebilir. Mutation sonrasında aynı request içinde bile cache güncellenmesi gerekebilir. Global cache kullanıldığında stale data süresi daha belirsiz hale gelir. Shared cache gerekiyorsa ayrı bir cache katmanı ve invalidation politikası tasarlanmalıdır. DataLoader bu ihtiyacın doğrudan yerine geçmez.
Kullanıcılar Arası Data Leakage
Aynı id farklı authorization koşullarında farklı sonuç üretebilir. Global cache bu farkı göz ardı edebilir. Bir kullanıcının erişebildiği kayıt başka kullanıcı için cache hit olarak dönebilir. Bu durum özellikle multi-tenant sistemlerde büyük risktir. Loader yaşam süresi authentication context ile aynı request sınırında tutulmalıdır.
Authorization Bypass Riski
Authorization yalnızca resolver girişinde kontrol ediliyorsa cache davranışı beklenmeyen bypass yolları oluşturabilir. Aynı key farklı permission bağlamlarında farklı sonuç vermelidir. Loader cache key'i gerekli authorization bağlamını yansıtmalıdır. Daha güvenli yaklaşım request başına ayrı loader kullanmaktır. Hassas sistemlerde loader katmanında da permission sınırları korunmalıdır.
GraphQL Context İçinde DataLoader Yönetimi
GraphQL context request-scoped dependency taşımak için uygun bir yerdir. Authentication bilgisi, tenant kimliği ve DataLoader örnekleri burada birlikte yönetilebilir. Resolver'lar yeni loader oluşturmak yerine context içindeki loader'ı kullanır. Bu yapı batching davranışının request boyunca ortak kalmasını sağlar. Loader factory yaklaşımı çok sayıda loader bulunan projelerde yönetimi kolaylaştırabilir.
Request Context
Request context her GraphQL request için yeniden oluşturulmalıdır. Loader'lar bu aşamada initialize edilebilir. Database connection bilgileri ve request metadata da gerektiğinde context üzerinden taşınabilir. Context global mutable state gibi kullanılmamalıdır. Yaşam süresinin request ile sınırlı olduğu net olmalıdır.
Authentication Context
Authentication sonucu elde edilen kullanıcı bilgisi context içine eklenebilir. Loader batch function gerektiğinde bu bilgiyi authorization için kullanır. Böylece veri erişimi mevcut kullanıcı bağlamıyla ilişkilendirilir. Cache anahtarları da gerekirse bu bağlamı hesaba katar. Kullanıcı nesnesinin gereksiz hassas alanları context boyunca taşınmamalıdır.
Tenant Context
Multi-tenant sistemlerde tenant bilgisi veri erişiminin temel parçasıdır. Loader query'leri tenant filtresi olmadan çalıştırılmamalıdır. Composite key içinde tenantId kullanılması güvenli sınır oluşturabilir. Cache key de tenant ayrımını korumalıdır. Bu yaklaşım tenant'lar arası veri karışmasını önler.
Loader Factory
Loader factory request için gerekli loader örneklerini merkezi biçimde oluşturur. Bu yapı tekrar eden initialization kodunu azaltır. Authorization ve tenant bağımlılıkları factory üzerinden batch function'lara aktarılabilir. Loader konfigürasyonlarının test edilmesi de kolaylaşır. Büyük schema yapılarında modüler factory tasarımı bakım maliyetini azaltabilir.
Request Tamamlanınca Cache'in Atılması
Request-scoped loader için cache yaşam süresi operation ile sınırlıdır. Request tamamlandığında loader referansları da serbest bırakılır. Böylece uzun süreli stale data birikimi oluşmaz. Bellek kullanımı da daha öngörülebilir hale gelir. Shared cache ihtiyacı varsa ayrı bir cache sistemi kullanılmalıdır.
One-to-One İlişkilerde DataLoader
One-to-one ilişkiler DataLoader kullanımının en anlaşılır örneklerinden biridir. Parent kayıt foreign key taşır ve child entity bu key üzerinden yüklenir. Birden fazla parent için key'ler toplandığında tek batch lookup yapılabilir. Primary key index sayesinde bu sorgular genellikle hızlıdır. Resolver kodu da yalnızca loader.load çağrısıyla sade tutulabilir.
Post → Author
Her post üzerinde authorId bulunabilir. Author resolver id değerini user loader'a verir. Loader bütün id değerlerini batch halinde sorgular. Aynı author birden fazla postta varsa memoization ek kazanç sağlar. Bu pattern GraphQL N+1 örneklerinde en sık kullanılan modellerden biridir.
Order → Customer
Sipariş listesinde her order farklı customer kaydına bağlı olabilir. Customer resolver tek tek database çağrısı yaptığında N+1 oluşur. Customer id değerleri batch query ile birlikte alınabilir. Authorization gerekiyorsa tenant ve kullanıcı bağlamı da sorguya dahil edilmelidir. Böylece performans ile veri sınırı aynı katmanda korunur.
Comment → User
Yorum listelerinde aynı kullanıcı birçok yorumun sahibi olabilir. Loader hem batching hem de deduplication avantajı sağlar. Yüz yorum için yüz kullanıcı sorgusu yerine tek batch sorgusu çalışabilir. Tekrarlayan kullanıcılar ayrıca yeniden fetch edilmez. Bu örnek memoization değerini de açık biçimde gösterir.
Primary Key Batch Loading
Primary key üzerinden batch loading genellikle basit ve hızlıdır. WHERE id IN (...) sorgusu uygun index'i kullanabilir. Batch size yine de kontrol altında tutulmalıdır. Çok büyük key listeleri database parameter limitlerine yaklaşabilir. Query planı gerçek veri hacmiyle test edilmelidir.
One-to-Many İlişkilerde DataLoader
One-to-many ilişkilerde batch function tek entity yerine her key için bir liste döndürür. Örneğin user id değerlerine göre posts kayıtları topluca çekilebilir. Gelen sonuçlar foreign key üzerinden gruplanır. Her input key için ayrı array oluşturulur. Hiç kaydı olmayan parent için boş array dönmek çoğu schema tasarımında en uygun davranıştır.
User → Posts
User listesinde her kullanıcı için posts alanı istenebilir. Ayrı sorgular N+1 problemi oluşturur. Tüm user id değerleri tek WHERE user_id IN (...) sorgusuna verilebilir. Sonuçlar userId üzerinden gruplanır. Loader her kullanıcıya kendi post listesini döndürür.
Post → Comments
Post comments ilişkisi de aynı batching modeline uygundur. Post id değerleri toplu sorguya gönderilir. Comments tablosunda post_id index bulunması önemlidir. Sonuçlar postId anahtarına göre gruplanır. Pagination gerekiyorsa her parent için limit uygulama yöntemi ayrıca tasarlanmalıdır.
Foreign Key Bazlı Grouping
Batch query birden fazla parent'a ait child kayıtlarını birlikte döndürür. Uygulama tarafı bu sonuçları foreign key üzerinden gruplar. Map benzeri bir yapı grouping için kullanılabilir. Sonra input key sırası takip edilerek array sonuçları oluşturulur. Bu mapping fonksiyonu unit test ile doğrulanmalıdır.
Key Başına Array Döndürmek
One-to-many loader her key için array döndürmelidir. Bir parent'ın birden fazla child kaydı olabilir. Input dizisi on parent içeriyorsa output da on array içermelidir. Bazı array'ler boş olabilir. Bu yapı DataLoader'ın uzunluk ve sıra kurallarını korur.
Boş Collection Yönetimi
Child kaydı olmayan parent için çoğu zaman boş array dönmek uygundur. null döndürmek schema anlamını değiştirebilir. Empty collection istemci tarafında daha öngörülebilir davranış sağlar. Mapping kodunda eksik group key için varsayılan boş array oluşturulmalıdır. Bu senaryo test kapsamına eklenmelidir.
Composite Key ile DataLoader
Her veri erişimi tek bir numeric id ile tanımlanmaz. Tenant, locale veya filtre gibi ek parametreler aynı entity sonucunu değiştirebilir. Böyle durumlarda composite key kullanılması gerekir. Cache key'in stabil olması aynı mantıksal isteğin doğru biçimde memoize edilmesini sağlar. cacheKeyFn benzeri mekanizmalar object key kullanılan loader'larda önem kazanır.
Tenant ID + Entity ID
Multi-tenant sistemde yalnızca entityId yeterli değildir. Aynı id farklı tenant içinde farklı kaydı temsil edebilir. Key içinde tenantId ve entityId birlikte bulunmalıdır. Batch query iki koşulu da güvenli biçimde uygulamalıdır. Cache key de aynı ayrımı korumalıdır.
Locale + ID
Lokalize içeriklerde aynı entity farklı locale değerlerinde farklı sonuç verebilir. Loader key'i locale ve id bileşimini taşımalıdır. Yalnızca id kullanılırsa yanlış dilde cache sonucu dönebilir. Stable string veya tuple benzeri yapı tercih edilebilir. Mapping kuralları bütün locale değerleri için test edilmelidir.
Parent ID + Filter
Liste loader'larında child sonuçları filtreye göre değişebilir. Örneğin postId ile birlikte status filtresi kullanılabilir. Aynı parent id farklı filter için farklı collection üretir. Bu nedenle filter cache key'in bir parçası olmalıdır. Filter değerlerinin canonical biçimde temsil edilmesi önemlidir.
Stable Cache Key
Object key kullanıldığında referans eşitliği beklenmeyen cache miss sonuçları doğurabilir. Mantıksal olarak aynı key iki farklı object instance olarak üretilebilir. Stable cache key bu iki isteği aynı değer olarak tanımlar. String serialization veya kontrollü key builder kullanılabilir. Key üretiminde property sırasının değişmemesi gerekir.
cacheKeyFn
cacheKeyFn object key'leri stabil cache anahtarına dönüştürmek için kullanılabilir. Fonksiyon aynı mantıksal girdide her zaman aynı çıktıyı üretmelidir. Tenant ve authorization gibi gerekli context bileşenleri unutulmamalıdır. Çok uzun key üretimi de gereksiz bellek tüketebilir. Bu davranış için unit test yazmak faydalıdır.
Multi-Tenant Sistemlerde DataLoader
Multi-tenant yapılarda DataLoader performans kadar veri izolasyonu açısından da dikkatli tasarlanmalıdır. Tenant bilgisi yalnızca resolver seviyesinde değil, batch query ve cache key seviyesinde de korunmalıdır. Aynı entity id farklı tenant içinde tekrar edebilir. Request-scoped loader önemli bir güvenlik sınırı oluşturur. Tenant doğrulaması query oluşturulurken açık biçimde uygulanmalıdır.
Tenant ID'nin Batch Query'ye Dahil Edilmesi
Batch query tenant filtresi olmadan çalıştırılmamalıdır. WHERE koşulu entity id kadar tenant id bilgisini de içermelidir. Birden fazla tenant'ın aynı batch içinde bulunması genellikle kaçınılması gereken bir durumdur. Request context tek tenant ile sınırlandırılabilir. Bu yaklaşım sorgu mantığını da sadeleştirir.
Tenant-Aware Cache Key
Cache key yalnızca entity id içerirse tenant çakışması oluşabilir. Tenant id key'in ayrılmaz bir parçası olmalıdır. Request-scoped loader kullanılsa bile bu yaklaşım kodun güvenlik modelini açık hale getirir. Shared cache katmanlarında tenant-aware key zorunlu hale gelir. Key üretimi merkezi yardımcı fonksiyonla standartlaştırılabilir.
Tenant'lar Arası Cache Sızıntısını Önlemek
Loader'ı global tutmamak ilk önemli adımdır. Tenant context her request için doğrulanmalı ve loader oluşturulurken aktarılmalıdır. Cache key ve batch query aynı tenant sınırını takip etmelidir. Testlerde iki farklı tenant için aynı entity id senaryosu denenmelidir. Sonuçların birbirine karışmadığı açık biçimde doğrulanmalıdır.
Authorization Boundary
Tenant ayrımı authorization modelinin bir bölümüdür. Kullanıcı yalnızca ilgili tenant içindeki verilere erişebilmelidir. Loader performans katmanı bu sınırı zayıflatmamalıdır. Batch query permission koşullarını korumalıdır. Hata ve null davranışı resource existence bilgisini istemeden açığa çıkarmamalıdır.
Authorization ve DataLoader
DataLoader kullanırken authorization performans optimizasyonundan ayrı düşünülmemelidir. Aynı id farklı kullanıcılar için farklı erişim sonucuna sahip olabilir. Cache davranışı bu farkı doğru biçimde yansıtmalıdır. Request-scoped loader çoğu senaryoda güvenli başlangıç sağlar. Daha karmaşık permission modellerinde authorization batch function içine kadar taşınabilir.
Authorization Resolver'da mı Loader'da mı Yapılmalı?
Tek bir evrensel cevap yoktur. Basit permission kontrolü resolver girişinde yapılabilir. Veri erişimi satır seviyesinde değişiyorsa loader query'sinin authorization filtresi taşıması daha güvenli olabilir. Kritik nokta cache'in yetkisiz sonucu yanlış kullanıcıya taşımamasıdır. Mimari karar testlerle doğrulanmalıdır.
Her Key İçin Permission Kontrolü
Batch içinde birden fazla entity bulunabilir. Kullanıcı bazılarına erişebilirken bazılarına erişemeyebilir. Batch function her key için doğru permission sonucunu üretmelidir. Yetkisiz kayıt null veya error politikasıyla temsil edilebilir. Bütün batch'i tek bir genel karar üzerinden değerlendirmek yanlış sonuç verebilir.
Aynı ID'nin Farklı Kullanıcılarda Farklı Sonuç Vermesi
Entity id sabit olsa bile görünür alanlar kullanıcıya göre değişebilir. Bir kullanıcı tam entity alırken başka kullanıcı null görebilir. Global cache bu farkı güvenli biçimde yönetemez. Request-scoped loader bu nedenle güçlü bir varsayılandır. Shared cache kullanılıyorsa authorization etkisi ayrıca tasarlanmalıdır.
Cache'in Authorization Bağlamıyla İlişkisi
Cache key yalnızca veri kimliğini değil, gerektiğinde görünürlük bağlamını da temsil etmelidir. Aksi durumda farklı permission sonuçları birbirine karışabilir. Request cache yaşam süresini dar tutmak bu riski azaltır. Shared entity cache tarafında public ve private veri ayrımı yapılabilir. Her cache katmanının güvenlik varsayımı belgelenmelidir.
Unauthorized Resource Existence Sızıntısı
Yetkisiz kullanıcıya farklı hata mesajı dönmek kaydın varlığını açığa çıkarabilir. Batch loader bu davranışı istemeden oluşturabilir. null ve error politikası security review sırasında değerlendirilmelidir. Response timing farkları bile bazı hassas sistemlerde bilgi sızıntısı oluşturabilir. Performans optimizasyonu güvenlik davranışını değiştirmemelidir.
DataLoader Cache Gerçekte Ne Yapar?
DataLoader cache çoğunlukla request içindeki tekrarları önleyen memoization mekanizmasıdır. Redis gibi request'ler arası paylaşılan bir cache değildir. Aynı key aynı request içinde ikinci kez istendiğinde tekrar fetch yapılmasını engeller. Yaşam süresi kısa olduğu için invalidation yükü daha düşüktür. Bu farkı anlamak caching mimarisinin doğru kurulması için önemlidir.
Request İçindeki Aynı Key'i Tekrar Fetch Etmemek
Bir entity farklı resolver yollarından tekrar istenebilir. Loader ilk sonucu request cache içinde tutar. İkinci load aynı promise veya sonucu kullanabilir. Böylece aynı veri kaynağına gereksiz çağrı yapılmaz. Bu davranış özellikle tekrar eden ilişkilerde query sayısını azaltır.
Memoization
Memoization aynı girdinin sonucunu kısa süreli saklama yaklaşımıdır. DataLoader bunu request yaşam süresi içinde uygular. Bu özellik batching'den farklı ama tamamlayıcıdır. Batch aynı anda gelen farklı key'leri birleştirir. Memoization ise tekrar eden aynı key'i yeniden yüklemeyi önler.
Redis Cache ile Farkı
Redis genellikle request'ler arasında paylaşılabilen bir cache katmanıdır. DataLoader cache ise varsayılan olarak tek request sınırında kullanılır. Redis için TTL ve invalidation stratejisi gerekir. DataLoader cache request sonunda doğal olarak ortadan kalkar. İki mekanizma birlikte kullanılabilir ama aynı görevi yapmaz.
Application Cache ile Farkı
Application cache process seviyesinde veya dağıtık biçimde uzun süreli olabilir. DataLoader cache çok daha kısa yaşamlıdır. Application cache stale data yönetimi gerektirir. Loader cache çoğu durumda request tamamlandığında sonlanır. Bu nedenle iki katmanın metrikleri ve sorumlulukları ayrı tutulmalıdır.
Response Cache ile Farkı
Response cache bütün GraphQL operation sonucunu saklayabilir. DataLoader ise entity veya relation fetch seviyesinde çalışır. Response cache key'i operation, variables ve authentication context içerebilir. Loader cache resolver çağrılarını optimize eder. İki yaklaşım farklı katmanlarda performans kazancı sağlar.
DataLoader Cache Ne Zaman Temizlenmeli?
Request sırasında mutation yapıldığında daha önce yüklenen entity eski hale gelebilir. Aynı request içinde mutation sonrasında tekrar query çalışıyorsa stale sonuç oluşabilir. clear, clearAll ve prime operasyonları bu durumu yönetmek için kullanılabilir. Hangi loader'ların etkilendiği açık biçimde bilinmelidir. Cache consistency özellikle birden fazla relation loader olduğunda test edilmelidir.
Mutation Sonrası Stale Entity
Bir entity loader ile yüklendikten sonra mutation ile değiştirilebilir. Cache temizlenmezse sonraki load eski entity'yi döndürebilir. Bu durum aynı request içinde tutarsız response üretebilir. Mutation başarılı olduktan sonra ilgili key clear edilebilir. Ardından yeni değer prime ile eklenebilir.
clear
clear belirli bir key için cache kaydını kaldırır. Mutation yalnızca tek entity'yi etkilediğinde uygun bir yöntemdir. Sonraki load tekrar veri kaynağına gider. Böylece güncel değer alınabilir. Composite key kullanılan loader'larda doğru key yapısı kullanılmalıdır.
clearAll
clearAll loader içindeki bütün memoized değerleri temizler. Geniş etkili mutation'larda kullanılabilir. Ancak gereksiz kullanımı request içinde memoization avantajını azaltır. Mümkün olduğunda yalnızca etkilenen key'leri temizlemek daha verimlidir. Davranış mutation türüne göre belirlenmelidir.
prime
prime belirli bir key için cache'e bilinen bir değer yerleştirir. Mutation sonucu güncel entity zaten elde edilmişse yeniden fetch ihtiyacını azaltabilir. Prime edilen verinin authorization bağlamıyla uyumlu olması gerekir. Eski değer cache'te varsa önce clear gerekebilir. Bu akış testlerle doğrulanmalıdır.
Mutation Sonrası Cache Consistency
Bir entity değiştiğinde yalnızca primary entity loader etkilenmeyebilir. Relation listeleri de eski hale gelebilir. Örneğin post oluşturulduğunda userPosts loader cache'i de güncellenmelidir. İlişkili loader'ların invalidation haritası belgelenebilir. Karmaşık mutation akışlarında shared cache invalidation da aynı anda ele alınmalıdır.
DataLoader prime() Kullanımı
prime doğru kullanıldığında gereksiz ikinci fetch işlemlerini önleyebilir. Mutation zaten güncel entity'yi döndürüyorsa aynı değeri loader cache'e koymak mantıklıdır. Fakat prime işlemi doğrulanmamış veya eksik entity ile yapılırsa yanlış veri üretilebilir. Projection kullanan loader'larda entity shape farkları da önemlidir. Bu nedenle prime kullanımı merkezi kurallarla yönetilmelidir.
Mutation Response'unu Cache'e Yazmak
Mutation database'den güncel kaydı döndürebilir. Bu kayıt loader'ın beklediği entity biçimiyle uyumluysa cache'e prime edilebilir. Sonraki resolver aynı entity'yi yeniden sorgulamaz. Bu küçük optimizasyon yoğun mutation akışlarında faydalı olabilir. Yetki ve tenant bağlamı değişmemelidir.
İlişkili Loader'ları Güncellemek
Bir mutation birden fazla cache görünümünü etkileyebilir. Entity loader yanında relation loader da stale hale gelebilir. Örneğin comment eklemek postComments sonucunu değiştirir. İlgili relation key clear edilebilir. Bazı durumlarda yeni collection doğrudan prime etmek yerine tekrar fetch daha güvenli olabilir.
Stale Data Riski
Yanlış prime kullanımı stale data problemini çözmek yerine büyütebilir. Mutation response bazı kolonları içermiyorsa eksik entity cache'e yazılabilir. Sonraki resolver bu eksik nesneyi tam veri sanabilir. Loader'ın beklediği veri contract'ı açık olmalıdır. Projection bazlı loader'larda ayrı cache yaklaşımı değerlendirilebilir.
Prime Edilmiş Verinin Doğrulanması
Prime öncesinde key ile entity kimliğinin eşleştiği doğrulanmalıdır. Tenant bilgisi de aynı bağlamda olmalıdır. Entity shape loader contract'ına uygun olmalıdır. Testler mutation sonrasında tekrar load davranışını kontrol etmelidir. Cache içeriği kullanıcılar arasında paylaşılmamalıdır.
Batch Size Nasıl Ayarlanmalı?
Batch size için her sisteme uyan tek bir sayı yoktur. Database türü, parameter limiti, sorgu planı ve veri hacmi sonucu etkiler. Çok küçük batch'ler round trip sayısını gereksiz artırır. Çok büyük batch'ler ise sorgu planını, memory kullanımını ve latency değerini olumsuz etkileyebilir. Doğru değer load test ve production metriğiyle belirlenmelidir.
Batch Ne Kadar Büyük Olmalı?
Başlangıç değeri gerçek trafik yapısına göre seçilmelidir. Ortalama ve p95 batch size ölçümleri burada yol gösterir. Çoğu request zaten küçük batch oluşturuyorsa yüksek limitin faydası sınırlıdır. Büyük listelerde database parameter sınırları kontrol edilmelidir. Nihai karar benchmark verisine dayanmalıdır.
maxBatchSize
maxBatchSize tek batch içinde kabul edilen key sayısını sınırlar. Örneğin 1000 key birkaç daha küçük batch'e bölünebilir. Bu yöntem database sorgularının aşırı büyümesini önleyebilir. Ancak çok düşük değer tekrar round trip sayısını artırır. Ayar gözleme dayalı yapılmalıdır.
Database Parameter Limitleri
Database sürücüleri ve motorları bind parameter konusunda farklı sınırlara sahip olabilir. Çok büyük IN listeleri bu limitlere yaklaşabilir. Query builder davranışı da ek parametreler oluşturabilir. Batch limitleri veri katmanının gerçek sınırlarıyla uyumlu olmalıdır. Production öncesinde yüksek key sayısıyla test yapılmalıdır.
Çok Büyük IN Query'lerinin Riski
Çok büyük IN listeleri query planlama maliyetini artırabilir. Database farklı execution planı seçebilir. Network payload ve parsing maliyeti de büyüyebilir. Bazı durumlarda temporary table veya başka batch stratejileri daha uygun olabilir. EXPLAIN ANALYZE gerçek maliyeti görmek için kullanılmalıdır.
Çok Küçük Batch'lerin Verimsizliği
Batch size sürekli iki veya üç seviyesinde kalıyorsa batching kazanımı sınırlı olabilir. Özellikle beklenen liste çok daha büyükse resolver timing incelenmelidir. Sequential await çağrıları loader'ın aynı pencereye key toplamasını engelleyebilir. Loader'ın yanlış kapsamda oluşturulması da benzer sonuç üretir. Batch size metriği bu sorunu ortaya çıkarır.
Batch Size 1 Oluyorsa Problem Nedir?
DataLoader kullanıldığı halde batch size sürekli 1 ise N+1 problemi tam olarak çözülmemiş olabilir. Loader yalnızca cache işlevi görüyor ve batching fırsatını kaçırıyor olabilir. Bunun en yaygın nedenleri sequential await, loader'ın resolver içinde oluşturulması ve scheduling davranışıdır. Resolver execution timeline incelendiğinde sorun daha kolay görülür. Production'da batch size distribution izlemek bu nedenle önemlidir.
DataLoader Var Ama Batching Yok
Kod tabanında DataLoader bulunması otomatik performans garantisi değildir. Her load hemen await edilirse çağrılar aynı batch penceresinde buluşmayabilir. Batch function bu durumda sürekli tek key ile çalışır. Query count beklenenden yüksek kalır. Bu nedenle loader kullanım biçimi de performans testine dahil edilmelidir.
Sequential Await
Döngü içinde her load çağrısını tek tek await etmek batching'i bozabilir. Birinci load tamamlanmadan ikinci key loader'a ulaşmaz. Böylece her key ayrı batch oluşturur. Önce promise'leri toplamak ve uygun biçimde birlikte beklemek daha iyi sonuç verebilir. Resolver framework davranışı da hesaba katılmalıdır.
Resolver Timing
Resolver'ların hangi sırada ve ne zaman çalıştığı batching sonucunu etkiler. Aynı event loop penceresine düşen çağrılar daha kolay gruplanır. Uzun senkron işler veya beklemeler pencereyi bölebilir. Tracing ile load çağrılarının zamanlaması görülebilir. Sorun yalnızca database tarafında aranmalıdır düşüncesi bu nedenle eksiktir.
Loader'ın Resolver İçinde Oluşturulması
Her resolver çağrısında yeni DataLoader oluşturulursa key'ler hiçbir zaman ortak batch içinde toplanmaz. Her loader yalnızca tek key görür. Request-level memoization da kaybolur. Loader context oluşturulurken bir kez hazırlanmalıdır. Resolver'lar aynı instance üzerinden load çağrısı yapmalıdır.
Batch Scheduling
DataLoader implementasyonu key toplamak için belirli scheduling davranışı kullanır. Varsayılan scheduler çoğu kullanım için yeterlidir. Çok özel throughput ihtiyaçlarında custom scheduling düşünülebilir. Batch penceresini büyütmek latency değerini de artırabilir. Bu nedenle scheduling değişikliği ölçüm olmadan yapılmamalıdır.
Custom Batch Scheduling
Custom batch scheduling key'lerin ne kadar süre toplanacağını kontrol etmeye yarar. Daha geniş batch penceresi daha büyük batch üretebilir. Buna karşılık her request birkaç milisaniye daha fazla bekleyebilir. Bu nedenle throughput ve latency arasında açık bir denge bulunur. Scheduler değişikliği yalnızca gerçek ölçümler bunu gerektiriyorsa uygulanmalıdır.
Event Loop Tick
Birçok DataLoader uygulaması aynı event loop tick içindeki load çağrılarını gruplayabilir. Resolver'lar birbirine yakın zamanda çalıştığında batching doğal biçimde oluşur. Sequential await bu davranışı parçalayabilir. Event loop gecikmesi de production ortamında batch zamanlamasını etkileyebilir. Ölçüm için loader duration ve batch size birlikte izlenebilir.
Batch Window
Batch window key toplamak için beklenen kısa zaman aralığıdır. Pencere büyüdükçe daha fazla key toplanabilir. Fakat ilk load çağrısı sonuç almak için daha uzun bekler. Düşük latency gerektiren sistemlerde agresif pencere uygun olmayabilir. Trafik profiline göre benchmark yapılmalıdır.
Daha Büyük Batch vs Daha Yüksek Latency
Büyük batch database round trip sayısını azaltabilir. Buna karşılık batch oluşmasını bekleme süresi request latency değerini artırabilir. Database query süresi de batch büyüdükçe doğrusal davranmayabilir. Bu nedenle yalnızca batch size'ı büyütmek hedef olmamalıdır. Toplam p95 latency ve throughput birlikte değerlendirilmelidir.
Throughput–Latency Dengesi
Throughput birim zamanda işlenen request sayısını gösterir. Latency ise tek request'in tamamlanma süresini ölçer. Batching throughput değerini yükseltirken az miktarda bekleme ekleyebilir. Uygun denge ürün beklentisine göre belirlenmelidir. Production testlerinde iki metriğin birlikte izlenmesi gerekir.
DataLoader mı SQL JOIN mi?
DataLoader ve SQL JOIN birbirinin doğrudan alternatifi değildir. Her ikisi de farklı veri erişimi şekillerinde güçlü olabilir. JOIN tek round trip ile ilişkili veriyi getirebilirken DataLoader dinamik GraphQL selection yapısına daha iyi uyum sağlayabilir. Relation cardinality ve duplicate row riski karar üzerinde etkilidir. En doğru yaklaşım gerçek query planı ve benchmark sonucu ile seçilmelidir.
JOIN Avantajları
JOIN ilişkili veriyi tek SQL içinde getirebilir. Basit one-to-one ilişkilerde oldukça verimli olabilir. Database optimizer uygun index'lerle güçlü plan oluşturabilir. Network round trip sayısı düşer. İlişki her zaman gerekiyorsa JOIN özellikle iyi bir seçenek olabilir.
DataLoader Avantajları
DataLoader relation yalnızca istendiğinde çalışır. Dinamik GraphQL field selection ile doğal uyum sağlar. Aynı loader farklı resolver'lar tarafından paylaşılabilir. Farklı veri kaynakları için de batching yaklaşımı kullanılabilir. Query sayısı kontrollü tutulurken schema esnekliği korunabilir.
Relation Cardinality
One-to-one ilişkiler JOIN için daha basit olabilir. One-to-many ilişkilerde JOIN parent satırlarını çoğaltabilir. Yüksek cardinality response setini ciddi biçimde büyütebilir. Bu durumda ayrı batch query daha verimli olabilir. Gerçek veri dağılımı kararın temel parçasıdır.
Duplicate Row Problemi
JOIN bir parent için birden fazla child olduğunda parent kolonlarını tekrar edebilir. Bu tekrar network ve memory maliyetini artırabilir. ORM katmanı sonuçları yeniden entity yapısına dönüştürmek için ek iş yapar. Büyük listelerde bu maliyet belirgin hale gelir. Ayrı batch query duplicate row problemini azaltabilir.
Çok Büyük JOIN Result Set
Birden fazla one-to-many relation aynı JOIN içinde birleştirildiğinde satır sayısı hızla büyüyebilir. Örneğin her post için çok sayıda comment ve tag varsa Cartesian benzeri büyüme oluşabilir. Database ve uygulama gereksiz miktarda veri işler. Bu senaryoda relation'ları ayrı batch sorgularıyla almak daha dengeli olabilir. EXPLAIN ANALYZE ve gerçek response boyutu birlikte incelenmelidir.
Dinamik Field Selection
GraphQL istemcisi relation alanını her zaman istemeyebilir. Sabit JOIN kullanımı gereksiz veri fetch edilmesine yol açabilir. DataLoader child resolver yalnızca alan istendiğinde çalıştığı için daha esnektir. Alternatif olarak field selection analiz edilip conditional JOIN uygulanabilir. Ancak bu yaklaşım kod ve test yükünü artırabilir.
DataLoader Yerine Eager Loading Ne Zaman Kullanılmalı?
Eager loading bazı ilişkilerin operation içinde kesin olarak kullanılacağı durumlarda basit ve verimli olabilir. ORM include veya preload özelliği ilişkili veriyi önceden getirir. Böylece child resolver database'e tekrar gitmez. Ancak GraphQL sorgusu relation alanını istemediğinde gereksiz veri fetch edilebilir. Bu nedenle eager loading kararı schema kullanım şekline göre verilmelidir.
ORM Include / Preload
Birçok ORM ilişkileri include veya preload ile önceden yükleyebilir. Bu yöntem N+1 problemini azaltabilir. Oluşan SQL sorgularının gerçekte nasıl çalıştığı query loglarından kontrol edilmelidir. Bazı ORM'ler JOIN, bazıları ek toplu sorgular kullanabilir. Performans davranışı varsayılmamalıdır.
Basit İlişkiler
Basit ve küçük cardinality ilişkiler eager loading için uygun olabilir. Örneğin her order için tek customer her zaman gerekiyorsa önceden yükleme kolaydır. Resolver kodu da sadeleşir. Gereksiz kolonlar select ile sınırlandırılabilir. Yine de gerçek query planı kontrol edilmelidir.
Her Zaman Gerekli Relation
Bir relation GraphQL operation'larının neredeyse tamamında kullanılıyorsa eager loading mantıklı olabilir. Böylece ayrı loader katmanı gereksiz hale gelebilir. Ancak schema zamanla değişebilir. Kullanım metrikleri kararın güncel kalmasına yardımcı olur. Varsayım yerine operation örnekleri incelenmelidir.
Dynamic GraphQL Selection ile Uyumsuzluk
GraphQL istemcisi hangi field'ı istediğini dinamik olarak belirler. Eager loading ise relation'ı çoğu zaman önceden fetch eder. Relation istenmediğinde bu veri boşa alınmış olur. Büyük veya pahalı relation'larda maliyet artabilir. Conditional preload veya DataLoader bu durumda daha uygun olabilir.
Gereksiz Veri Fetch Etme Riski
Performans yalnızca query sayısını azaltmak değildir. Gereksiz satır ve kolonların alınması da maliyet yaratır. Eager loading query count değerini düşürürken byte miktarını artırabilir. Database CPU ve network kullanımı birlikte ölçülmelidir. En düşük query sayısı her zaman en hızlı çözüm değildir.
ORM'lerde Gizli N+1 Problemi
ORM kullanımı SQL yazma yükünü azaltabilir fakat N+1 riskini ortadan kaldırmaz. Lazy loading gibi özellikler resolver içinde fark edilmeden yeni sorgular çalıştırabilir. Kod tek satır görünmesine rağmen database logunda yüzlerce sorgu oluşabilir. Bu nedenle ORM abstraction altında üretilen SQL mutlaka gözlemlenmelidir. GraphQL performans incelemesinde ORM query logları vazgeçilmezdir.
Lazy Loading
Lazy loading relation erişildiği anda database sorgusu çalıştırabilir. Liste içindeki her entity için relation okunursa N+1 oluşur. Kodun görünüşü bu maliyeti saklayabilir. Production sistemlerinde lazy loading kullanımına açık sınırlar koymak faydalıdır. Query count testleri bu problemi erken yakalar.
Prisma
Prisma ile GraphQL geliştirirken findMany, include ve select davranışları dikkatle kullanılmalıdır. Relation erişimi nasıl yapıldığına göre ek sorgular oluşabilir. DataLoader veya uygun query strategy N+1 problemini azaltabilir. ORM tarafından üretilen SQL logları incelenmelidir. Büyük operation'larda benchmark yapılmadan yaklaşım seçilmemelidir.
TypeORM
TypeORM relation stratejileri eager ve lazy davranışlar gösterebilir. Resolver içinde relation'a erişmek beklenmeyen query sayısına yol açabilir. Query logging açıkken operation başına SQL sayısı gözlemlenebilir. Query builder ile explicit JOIN veya batch loading uygulanabilir. Kullanılan yaklaşım schema erişim modeline göre seçilmelidir.
Hibernate
Hibernate lazy association kullanımı N+1 probleminin yaygın kaynaklarından biridir. Fetch join, EntityGraph ve batch fetch size gibi araçlar farklı durumlarda kullanılabilir. GraphQL DataLoader da field-level çözümleme için ek seçenek sunar. Hibernate statistics ve SQL logları gerçek davranışı gösterir. Her relation için aynı stratejiyi uygulamak doğru olmayabilir.
Entity Framework
Entity Framework tarafında lazy loading ve navigation property erişimi beklenmeyen sorgular oluşturabilir. Include ile ilişkiler önceden yüklenebilir. Projection yaklaşımı yalnızca gereken alanları çekmeye yardımcı olur. GraphQL resolver yapısı ile query planı birlikte değerlendirilmelidir. SQL logging ve query count testleri burada da önemlidir.
ORM Query Loglarını İncelemek
ORM abstraction SQL maliyetini görünmez hale getirmemelidir. Development ve test ortamında query logging düzenli kullanılmalıdır. Aynı fingerprint'in tekrar sayısı N+1 için güçlü bir göstergedir. Slow query log tek başına yeterli değildir çünkü N+1 çoğu zaman çok sayıda hızlı sorgudan oluşur. Query count metriği bu nedenle ayrıca izlenmelidir.
Prisma ile GraphQL N+1 Optimizasyonu
Prisma kullanılan GraphQL projelerinde doğru yaklaşım operation yapısına göre değişebilir. findMany ile root liste alınırken include veya select ile ilişkiler kontrollü biçimde getirilebilir. Dinamik relation erişiminde DataLoader tercih edilebilir. Çok özel ve yoğun sorgularda raw SQL daha fazla kontrol sağlayabilir. Hangi yöntemin iyi olduğu query count ve latency ölçümüyle belirlenmelidir.
findMany
findMany root listeler için doğal başlangıç noktasıdır. Pagination ve select olmadan kullanıldığında gereğinden fazla veri çekebilir. take ve cursor gibi seçeneklerle liste boyutu sınırlandırılabilir. Relation'ların daha sonra nasıl çözüleceği ayrıca tasarlanmalıdır. Query logları gerçek SQL davranışını göstermelidir.
include
include relation verilerini query sonucuna dahil etmeyi kolaylaştırır. Relation her zaman isteniyorsa pratik olabilir. GraphQL istemcisi relation istemediğinde gereksiz veri fetch edilebilir. Büyük one-to-many ilişkiler response setini büyütebilir. Bu nedenle include kullanımını field selection ile uyumlu hale getirmek değerlidir.
select
select yalnızca gerekli kolonların alınmasını sağlar. Backend over-fetching maliyetini azaltabilir. GraphQL requested fields ile eşleştirildiğinde güçlü bir projection yöntemi oluşturur. Ancak fragment ve computed field senaryoları mapping kodunu zorlaştırabilir. Basit ve sık kullanılan operation'larda uygulamak daha kolaydır.
DataLoader
DataLoader relation resolver'larını batch halinde çalıştırmaya yardımcı olur. Request-scoped loader Prisma client ile birlikte kullanılabilir. Batch function id listesine göre toplu query çalıştırır. Sonuç ordering kurallarına göre yeniden düzenlenir. Batch size ve query count metrikleri production ortamında izlenmelidir.
Raw SQL
Raw SQL bazı yoğun sorgularda ORM abstraction üzerinden daha fazla kontrol sağlar. Özel JOIN, CTE veya window function ihtiyaçlarında faydalı olabilir. Bununla birlikte type safety ve bakım maliyeti ayrıca değerlendirilmelidir. Parameter binding güvenli biçimde kullanılmalıdır. Raw SQL kullanmak ölçüm ihtiyacını ortadan kaldırmaz.
Hangi Yaklaşım Ne Zaman?
Basit relation için include yeterli olabilir. Dinamik field çözümünde DataLoader daha uygun olabilir. Büyük aggregation veya özel query planında raw SQL değerlendirilebilir. select gereksiz kolonları azaltmak için pek çok yaklaşımın yanında kullanılabilir. Karar gerçek operation şekilleri ve benchmark ile verilmelidir.
Hibernate/JPA ile N+1 Problemi
Hibernate ve JPA tarafında N+1 çoğu zaman association loading stratejilerinden kaynaklanır. Lazy loading GraphQL resolver içinde her entity için yeni query tetikleyebilir. Fetch join ve EntityGraph belirli operation'larda ilişkileri önceden yükleyebilir. Batch fetch size benzer id sorgularını toplu hale getirebilir. GraphQL DataLoader ise resolver katmanında daha açık batching kontrolü sağlar.
Lazy Loading
Lazy association property erişildiği anda SQL çalıştırabilir. Liste resolver'larında bu davranış kolayca N+1 üretir. Transaction sınırı dışında erişim başka problemlere de yol açabilir. GraphQL resolver'larında relation yükleme stratejisi açık biçimde planlanmalıdır. Hibernate statistics ile sorgu sayısı doğrulanabilir.
Fetch Join
Fetch join gerekli relation'ı aynı SQL ile getirebilir. One-to-one veya sınırlı cardinality durumlarında güçlü bir çözümdür. Birden fazla collection fetch edildiğinde result set hızla büyüyebilir. Pagination ile birlikte bazı kısıtlar oluşabilir. Gerçek query planı ve satır sayısı test edilmelidir.
EntityGraph
EntityGraph hangi association'ların fetch edileceğini daha kontrollü tanımlayabilir. Farklı kullanım senaryoları için ayrı graph yapıları oluşturulabilir. GraphQL field selection ile tam dinamik eşleşme yine ek kod gerektirebilir. Çok kullanılan query şekilleri için yararlı olabilir. SQL çıktısı her zaman gözlemlenmelidir.
Batch Fetch Size
Batch fetch size lazy relation yüklemelerini toplu sorgulara dönüştürmeye yardımcı olabilir. Bu yaklaşım query sayısını önemli ölçüde azaltabilir. Batch boyutu database limitleri ve veri dağılımına göre seçilmelidir. Tek başına bütün GraphQL N+1 senaryolarını çözmeyebilir. Production metrikleri sonucu doğrulamalıdır.
GraphQL DataLoader
DataLoader GraphQL resolver seviyesinde açık batching mekanizması sağlar. Hibernate repository veya query katmanını batch function içinde kullanmak mümkündür. Request-scoped kullanım authorization güvenliğini korumaya yardımcı olur. Relation yalnızca istendiğinde fetch edilir. Bu esneklik dinamik GraphQL query shape için değerlidir.
Database Query'lerini GraphQL Field Selection'a Göre Optimize Etmek
GraphQL istemcisi istediği alanları açıkça belirttiği için backend bu bilgiyi SQL projection oluşturmakta kullanabilir. İstemci yalnızca id ve name istiyorsa büyük text veya JSON kolonlarını çekmek gereksiz olabilir. Relation alanı istenmiyorsa JOIN yapılmaması da önemli kazanç sağlar. Bununla birlikte selection parsing kodu fragments ve aliases nedeniyle dikkatli tasarlanmalıdır. Optimizasyonun bakım maliyeti elde edilen performans kazancıyla dengelenmelidir.
GraphQLResolveInfo
GraphQLResolveInfo operation ve field selection hakkında bilgi taşır. Resolver hangi alt alanların istendiğini buradan inceleyebilir. Bu bilgi SQL select listesini optimize etmek için kullanılabilir. Fragment kullanımı doğru çözülmelidir. Doğrudan string kontrolü gibi kırılgan yöntemlerden kaçınılmalıdır.
Requested Fields
Requested fields istemcinin gerçekten ihtiyaç duyduğu alanları gösterir. Bu liste database projection ile eşleştirilebilir. Böylece kullanılmayan kolonların okunması azaltılır. Computed field'ların başka kolon bağımlılıkları unutulmamalıdır. Mapping katmanı schema değişikliklerinde test edilmelidir.
SQL Projection
SQL projection yalnızca gerekli kolonları SELECT etmeyi ifade eder. Geniş tablolar ve büyük text alanlarında önemli kazanç sağlayabilir. Database buffer ve network kullanımı azalabilir. ORM select özellikleri bu amaçla kullanılabilir. Projection performansını gerçek query planıyla doğrulamak gerekir.
Yalnızca İstenen Kolonları SELECT Etmek
GraphQL istemcisi sınırlı alan istiyorsa database de mümkün olduğunca aynı sınırı takip edebilir. Bu yaklaşım özellikle geniş entity modellerinde etkilidir. Daha az veri serialization süresini de azaltabilir. Ancak resolver'ın sonradan ihtiyaç duyacağı dependency kolonları dahil edilmelidir. Aksi durumda ek query veya runtime hata oluşabilir.
Relation İstenmediyse JOIN Yapmamak
İstemci relation istemiyorsa JOIN çoğu zaman gereksizdir. Conditional query building bu maliyeti azaltabilir. DataLoader kullanıldığında child resolver zaten yalnızca alan seçildiğinde çalışır. Eager loading stratejilerinde bu ayrım daha dikkatli yapılmalıdır. Operation shape metrikleri hangi relation'ların gerçekten sık istendiğini gösterebilir.
Field-Level Optimization'ın Riskleri
Field-level optimization veri erişimini azaltabilir fakat resolver kodunu daha zor yönetilebilir hale getirebilir. Fragment, alias ve computed field bağımlılıkları selection analizini zorlaştırır. Çok fazla conditional SQL üretimi query plan çeşitliliğini artırabilir. Projection cache kullanılıyorsa schema değişiklikleriyle uyum korunmalıdır. Bu nedenle yalnızca ölçülebilir kazanç sağlayan alanlarda uygulanması daha sağlıklıdır.
Resolver Karmaşıklığı
Her field kombinasyonu için farklı query oluşturmak resolver kodunu büyütebilir. Hata ayıklama zorlaşabilir. Yeni schema alanları projection mapping'i etkileyebilir. Merkezi yardımcı fonksiyonlar tekrarları azaltabilir. Bakım maliyeti performans kazancının bir parçası olarak değerlendirilmelidir.
Fragment'lar
GraphQL fragment'ları requested field analizinde göz önünde bulundurulmalıdır. Alan doğrudan selection set içinde görünmeyebilir. Fragment spread üzerinden dahil edilmiş olabilir. Selection parser bütün fragment zincirini çözmelidir. Testlerde nested ve reusable fragment örnekleri bulunmalıdır.
Alias'lar
Alias response alan adını değiştirir fakat gerçek schema field aynı kalır. Projection analizi alias adına göre yapılırsa yanlış kolon seçilebilir. AST seviyesinde gerçek field name kullanılmalıdır. Aynı field birden fazla alias ile istenebilir. Bu senaryo query complexity hesabında da etkili olabilir.
Computed Fields
Computed field doğrudan tek database kolonuna karşılık gelmeyebilir. Hesaplama için birden fazla kolon gerekebilir. Projection yalnızca görünen GraphQL field'a bakarsa gerekli dependency kolonlarını atlayabilir. Computed field dependency haritası tanımlamak faydalı olabilir. Performans kazancı uğruna doğruluk bozulmamalıdır.
Projection Cache
Sık kullanılan field kombinasyonları için projection planı cache edilebilir. Cache key operation fingerprint veya normalized selection olabilir. Schema değiştiğinde cache invalidation düşünülmelidir. High cardinality projection cache bellek kullanımını artırabilir. Yalnızca gerçekten tekrar eden query shape'lerde değer üretir.
Database Index'leri GraphQL Performansını Nasıl Etkiler?
DataLoader query sayısını azaltabilir fakat kötü index kullanılan büyük sorguyu otomatik olarak hızlandırmaz. Batch query doğru index olmadan table scan yapabilir. Foreign key, pagination ve composite filtreler uygun index tasarımı gerektirir. Query planı gerçek production benzeri veri hacminde incelenmelidir. GraphQL performans optimizasyonu database erişim yolunu da kapsamalıdır.
Primary Key Index
Primary key lookup DataLoader'ın en yaygın kullanım alanıdır. Çoğu database primary key için otomatik index oluşturur. IN query bu index üzerinden hızlı çalışabilir. Çok büyük key listelerinde plan davranışı yine incelenmelidir. Execution time ve rows read metrikleri birlikte değerlendirilmelidir.
Foreign Key Index
One-to-many loader genellikle foreign key üzerinden sorgu yapar. Foreign key kolonu index'siz ise batch query büyük tabloda pahalı hale gelebilir. Örneğin comments post_id üzerinden yükleniyorsa bu kolon için index gerekebilir. Insert maliyeti de index kararında hesaba katılmalıdır. Query kullanım sıklığına göre karar verilmelidir.
Composite Index
Tenant id ve entity id birlikte filtreleniyorsa composite index yararlı olabilir. Kolon sırası sorgu pattern'ine göre seçilmelidir. Yalnızca teorik index eklemek yeterli değildir. EXPLAIN çıktısı optimizer'ın index'i gerçekten kullanıp kullanmadığını gösterir. Write yükü de index sayısıyla birlikte değerlendirilmelidir.
Pagination Index
Cursor pagination kullanılan alanlarda sıralama kolonuna uygun index gerekir. created_at ve id gibi kombinasyonlar yaygın örneklerdir. Index yoksa database büyük sort işlemi yapabilir. Cursor predicate index ile uyumlu tasarlanmalıdır. Büyük veri setinde offset yaklaşımına göre daha stabil sonuç alınabilir.
Covering Index
Covering index query için gereken kolonların büyük bölümünü index üzerinden sağlayabilir. Bazı yoğun read senaryolarında table lookup maliyetini azaltabilir. Ancak index boyutu büyür. Write ve storage maliyeti artabilir. Bu yaklaşım yalnızca sıcak ve önemli query pattern'lerinde değerlendirilmelidir.
DataLoader Batched Lookup Index'i
Batch lookup hangi kolonlara göre yapılıyorsa index tasarımı bu erişimi desteklemelidir. Primary key dışında tenant, locale veya foreign key kullanılabilir. Büyük batch query index'siz kaldığında N+1'den kurtulurken başka darboğaz yaratılabilir. Query planı batch boyutlarıyla birlikte incelenmelidir. Index seçimi gerçek veri dağılımına dayanmalıdır.
EXPLAIN ANALYZE ile Resolver Query Optimizasyonu
EXPLAIN ANALYZE resolver arkasındaki SQL sorgusunun gerçek çalışma maliyetini görmeye yardımcı olur. Optimizer'ın hangi scan, join ve sort stratejisini seçtiği incelenebilir. Estimated rows ile actual rows arasındaki büyük farklar istatistik veya veri dağılımı sorununa işaret edebilir. Batch query'nin gerçekten daha hızlı olup olmadığı da burada doğrulanabilir. Test verisinin production ölçeğine yakın olması önemlidir.
Sequential Scan
Sequential scan tablonun büyük bölümünün okunması anlamına gelebilir. Küçük tabloda normal bir seçim olabilir. Büyük tabloda beklenmeyen sequential scan önemli maliyet yaratabilir. Filter kolonları için uygun index olup olmadığı kontrol edilmelidir. Her sequential scan otomatik olarak problem kabul edilmemelidir.
Index Scan
Index scan uygun koşullarda daha az satır okuyarak sonuç üretebilir. Batch lookup için doğru index yüksek değer sağlar. Bununla birlikte çok geniş result set optimizer'ı sequential scan seçmeye yöneltebilir. Query selectivity burada önemlidir. Plan gerçek batch size değerleriyle test edilmelidir.
Rows Estimated vs Actual
Estimated rows optimizer'ın tahminidir. Actual rows execution sırasında gerçek okunan veya üretilen satır sayısını gösterir. İki değer arasında büyük fark kötü plan seçimine neden olabilir. Database statistics güncelliği kontrol edilmelidir. Veri dağılımındaki dengesizlik de ayrı incelenmelidir.
Sort Cost
Pagination ve ordered list sorgularında sort maliyeti önemli olabilir. Uygun index sort ihtiyacını azaltabilir. Büyük sort işlemleri memory limitini aşarsa disk kullanımı görülebilir. Cursor pagination index ile birlikte bu maliyeti düşürebilir. EXPLAIN çıktısında sort method ve rows değerleri incelenmelidir.
Join Strategy
Database nested loop, hash join veya merge join gibi farklı stratejiler seçebilir. Hangi stratejinin iyi olduğu veri hacmine bağlıdır. Çok büyük relation'larda yanlış cardinality tahmini kötü plana yol açabilir. JOIN ile DataLoader karşılaştırılırken bu plan farklılıkları dikkate alınmalıdır. Tek bir küçük test sonucu genelleştirilmemelidir.
Batch Query'nin Gerçek Maliyeti
N+1'i tek batch sorguya çevirmek query sayısını azaltır. Ancak batch query'nin kendisi de ölçülmelidir. Çok büyük IN listesi veya index eksikliği maliyeti yükseltebilir. Execution time, rows read ve buffer kullanımına bakılabilir. Gerektiğinde batch size ayarlanarak tekrar benchmark yapılmalıdır.
GraphQL Query Complexity Nedir?
Query complexity bir GraphQL sorgusunun olası kaynak maliyetini sayısal olarak modellemeye çalışır. Her field için temel maliyet verilebilir. Nested listeler ve argument değerleri maliyeti artırabilir. Amaç yalnızca çok derin sorguları değil, sığ ama pahalı sorguları da sınırlamaktır. GraphQL performansında caching batching pagination ve query complexity optimizasyonu birlikte ele alındığında daha dengeli bir koruma modeli oluşur.
Field Cost
Her field varsayılan veya özel bir cost değeri taşıyabilir. Basit scalar alanlar düşük maliyetli olabilir. Database veya harici servis erişimi yapan field daha yüksek cost alabilir. Bu değerler gerçek production ölçümleriyle güncellenmelidir. Tam kusursuz model yerine tutarlı koruma mekanizması hedeflenmelidir.
Nested Field Cost
Nested alanlar parent sayısına bağlı olarak birçok kez çalışabilir. Complexity modeli bu çarpanı hesaba katmalıdır. Bir comment author alanı tek başına ucuz görünse bile bin comment üzerinde pahalı olabilir. Nested maliyet toplama yöntemi schema tasarımına göre belirlenir. Liste cardinality tahmini burada önemlidir.
List Multiplier
Liste alanları child field maliyetini çoğaltabilir. first veya limit argument değeri multiplier olarak kullanılabilir. Kullanıcı 10 yerine 1000 kayıt isterse hesaplanan cost buna göre yükselir. Maksimum page size complexity modelini daha öngörülebilir hale getirir. Limitsiz listeler cost hesabını zorlaştırır.
Argument-Based Cost
Bazı field'ların maliyeti argument değerine göre değişir. Search sorgusunda filtre genişliği veya pagination limiti buna örnektir. Runtime argument'ları complexity hesabına dahil edilebilir. Bu sayede aynı field farklı kullanımda farklı cost üretir. Kullanıcı ve tenant bazlı budget bu modelle birleştirilebilir.
Maximum Complexity
Server her operation için maksimum complexity sınırı belirleyebilir. Sınırı aşan sorgu execution başlamadan reddedilir. Böylece pahalı sorgu database'e ulaşmadan durdurulabilir. Limit gerçek kullanıcı ihtiyaçlarını engellemeyecek biçimde seçilmelidir. Internal ve public API için farklı budget uygulanabilir.
Neden Sadece Query Depth Limiti Yeterli Değildir?
Depth limiti yalnızca nested seviyelerin sayısını kontrol eder. Sığ ama yüzlerce field ve büyük listeler içeren bir sorgu yine pahalı olabilir. Expensive computed field da depth değeri düşükken yüksek CPU tüketebilir. Bu nedenle complexity modeli depth kontrolünü tamamlamalıdır. Pagination limitleri ve rate limiting de aynı koruma katmanının parçalarıdır.
Sığ Ama Çok Geniş Query
Bir query yalnızca iki seviye derin olabilir. Fakat aynı seviyede çok sayıda field veya alias isteyebilir. Her field harici işlem yapıyorsa toplam maliyet büyük olabilir. Depth kontrolü bu sorguyu engellemez. Field cost ve width etkisini complexity hesabına eklemek gerekir.
Büyük first Değeri
first: 10000 gibi bir değer query depth'i değiştirmez. Buna rağmen on bin entity ve child resolver çalışabilir. Response boyutu ve database maliyeti büyük ölçüde artar. Maximum page size doğrudan uygulanmalıdır. Complexity hesabı first değerini multiplier olarak kullanabilir.
Expensive Computed Field
Tek seviyedeki computed field yoğun CPU veya aggregation işlemi yapabilir. Query depth düşük kalır. Fakat operation yine pahalıdır. Field-specific complexity cost bu maliyeti temsil eder. Gerektiğinde bu field ayrı izin veya rate limit ile korunabilir.
Complexity'nin Depth'ten Daha Gerçekçi Olması
Complexity gerçek maliyeti modellemek için daha fazla sinyal kullanır. Field türü, liste boyutu ve argument değeri hesaba katılabilir. Depth yalnızca yapısal derinliği gösterir. İki kontrol birlikte kullanıldığında daha dengeli sonuç alınır. Production verileri cost modelini zaman içinde iyileştirebilir.
Query Depth Limiting
Depth limiting GraphQL object graph üzerinde aşırı derin gezintileri engeller. Özellikle recursive veya birbirine bağlı schema modellerinde önemlidir. Kullanıcı normalde ihtiyaç duymadığı kadar derin query gönderdiğinde execution başlamadan reddedilebilir. Fragment expansion doğru biçimde hesaba katılmalıdır. Limit kullanım senaryolarına göre seçilmeli ve complexity kontrolüyle birlikte kullanılmalıdır.
Maximum Depth
Maximum depth operation için izin verilen en yüksek nested seviyeyi belirler. Çok düşük değer gerçek istemci sorgularını bozabilir. Çok yüksek değer koruma etkisini azaltır. Production operation örnekleri incelenerek başlangıç değeri seçilebilir. Limit değişiklikleri gözlemlenebilir olmalıdır.
Nested Object Graph
GraphQL schema bazı alanlarda döngüsel object graph oluşturabilir. User friends user gibi ilişkiler teorik olarak sürekli derinleşebilir. Depth limiti bu yapının kontrolsüz kullanılmasını engeller. Pagination da her seviyedeki liste genişliğini sınırlar. İki kontrol birlikte uygulanmalıdır.
Fragment Kullanımı
Fragment'lar query'nin gerçek derinliğini gizleyebilir. Depth hesaplayıcı fragment spread'leri çözmelidir. Recursive fragment GraphQL validation tarafından ayrıca ele alınır. Nested fragment kombinasyonları test edilmelidir. Ham query metnine basit string analizi yapmak güvenilir değildir.
Legitimate Deep Query'ler
Bazı gerçek iş akışları doğal olarak derin GraphQL sorguları gerektirebilir. Bu sorguları doğrudan engellemek istemci deneyimini bozabilir. Persisted query veya trusted document yaklaşımıyla özel izin verilebilir. Kullanıcı rolüne göre farklı limit de uygulanabilir. İstisnalar ölçüm ve gözlem altında tutulmalıdır.
Depth Limiti Nasıl Seçilmeli?
İlk adım production query shape dağılımını incelemektir. Normal operasyonların p95 depth değeri başlangıç referansı olabilir. Sınır gerçek trafiğin makul üstünde belirlenebilir. En yüksek depth sorgularının maliyeti ayrıca incelenmelidir. Limit tek başına güvenlik politikası kabul edilmemelidir.
Dynamic Query Complexity
Dynamic complexity aynı field'ın farklı argument değerlerinde farklı maliyet taşımasını sağlar. Özellikle pagination, search ve aggregation alanlarında bu yaklaşım daha gerçekçi sonuç verir. first: 10 ile first: 1000 aynı cost değerine sahip olmamalıdır. Runtime argument'ları hesaplamaya katılabilir. Tenant veya kullanıcı seviyesinde ayrı query budget uygulanması da mümkündür.
first ve limit Argument'ları
Liste büyüklüğü child resolver sayısını doğrudan etkileyebilir. Complexity hesabı first veya limit değerini multiplier olarak kullanabilir. Sunucu maksimum page size uyguladığı için üst sınır bilinir. Varsayılan argument değerleri de cost hesabına dahil edilmelidir. Kullanıcı argument göndermediğinde limitsiz davranış oluşmamalıdır.
Search Field
Search field maliyeti query parametresine ve index yapısına göre değişebilir. Full-text search veya geniş filtreler yüksek maliyet üretebilir. Sabit yüksek cost veya argument bazlı model kullanılabilir. Search sonuçları mutlaka pagination ile sınırlandırılmalıdır. Database timeout da ek koruma sağlayabilir.
Aggregation Field
Aggregation field count, sum veya daha ağır hesaplamalar çalıştırabilir. Büyük tabloda bu alanlar pahalı olabilir. Complexity değeri normal scalar field'dan yüksek tutulabilir. Cached veya precomputed sonuçlar gerektiğinde kullanılabilir. Her request içinde yeniden hesaplama zorunlu olmamalıdır.
Query Cost'un Runtime Argument'larına Göre Hesaplanması
Runtime argument'ları gerçek request niyetini daha iyi gösterir. first, radius veya date range gibi değerler cost hesabını değiştirebilir. Hesap execution başlamadan yapılmalıdır. Maksimum cost aşıldığında request reddedilebilir. Error mesajı istemciye düzeltilebilir sınır bilgisi verebilir.
User/Tenant Bazlı Cost Budget
Her kullanıcı grubu aynı kaynak limitine ihtiyaç duymayabilir. Internal servisler daha yüksek cost budget alabilir. Public kullanıcılar daha sınırlı budget ile çalışabilir. Tenant planı veya kullanım kotası da hesaba katılabilir. Authorization kontrolü ile complexity budget birbirinden açık biçimde ayrılmalıdır.
Cost-Based Rate Limiting
Klasik rate limiting yalnızca request sayısını ölçer. GraphQL'de iki request arasında çok büyük maliyet farkı olabilir. Cost-based rate limiting her operation'ın hesaplanan complexity değerini bütçeden düşürür. Böylece çok pahalı sorgular daha fazla kota tüketir. Bu yaklaşım public GraphQL API'lerinde daha adil kaynak kontrolü sağlayabilir.
Request Sayısı Yerine Query Cost
Bir saniyede on basit query düşük maliyetli olabilir. Tek bir ağır nested query ise çok daha fazla kaynak tüketebilir. Sadece request sayısına bakmak bu farkı göremez. Complexity puanı rate limit hesabına dahil edilebilir. Bu model schema maliyetleri doğru tanımlandıkça daha anlamlı hale gelir.
Kullanıcı Başına Cost Budget
Her kullanıcı belirli zaman penceresi için cost budget alabilir. Basit request'ler az puan tüketir. Pahalı request daha fazla puan düşürür. Budget aşıldığında yeni sorgular geçici olarak reddedilebilir. Error response istemciye retry bilgisi sağlayabilir.
Token-Bucket Benzeri Yaklaşım
Token bucket modeli query cost için uyarlanabilir. Her kullanıcı zaman içinde yenilenen token miktarına sahip olur. Operation cost kadar token tüketilir. Yeterli token yoksa request sınırlandırılır. Burst trafiği belirli ölçüde desteklemek için bucket kapasitesi ayarlanabilir.
Basit ve Karmaşık GraphQL Request'lerini Ayırmak
Operation complexity metrikleri request'leri maliyet gruplarına ayırabilir. Basit sorgular hızlı path üzerinden daha yüksek oranla kabul edilebilir. Pahalı operation'lar daha düşük concurrency veya farklı budget ile çalıştırılabilir. Bu yaklaşım downstream sistemleri korumaya yardımcı olur. Sınıflandırma production ölçümleriyle güncellenmelidir.
Pagination GraphQL Performansı İçin Neden Zorunludur?
Pagination GraphQL performansının temel koruma katmanlarından biridir. Limitsiz listeler DataLoader kullanılsa bile çok fazla entity ve resolver üretir. Her listede sunucu tarafı maksimum boyut bulunmalıdır. Nested listeler de aynı disipline ihtiyaç duyar. Cursor veya offset seçimi veri büyüklüğü ve kullanım şekline göre yapılmalıdır.
Limitsiz Listelerin Riski
Limitsiz liste büyük tablonun tamamını döndürebilir. Database, application memory ve network aynı anda yük altında kalır. Child resolver'lar da her kayıt için çalışabilir. Query complexity büyük maliyeti ancak liste sınırı biliniyorsa daha doğru hesaplar. Bu nedenle limitsiz collection alanlarından kaçınılmalıdır.
Maximum Page Size
İstemci first veya limit değeri gönderebilir. Sunucu bu değeri güvenilir kabul etmemelidir. Maksimum page size örneğin 50 veya 100 olarak sınırlandırılabilir. Doğru sayı ürün kullanımına ve veri boyutuna göre seçilir. Aşan değer reddedilebilir veya üst sınıra çekilebilir.
Nested List Pagination
Sadece root listede pagination yeterli değildir. Posts içinde comments gibi nested collection da sınırlandırılmalıdır. Aksi durumda küçük root liste büyük child veri seti üretebilir. Her nested list için ayrı pagination contract tanımlanabilir. Complexity hesabı child page size değerini de kullanmalıdır.
Pagination Olmadan DataLoader'ın Yeterli Olmaması
DataLoader query sayısını azaltabilir fakat dönen kayıt sayısını azaltmaz. On bin id tek batch içinde sorgulansa bile sonuç seti hâlâ büyüktür. Serialization ve network maliyeti devam eder. Child resolver sayısı da yüksek kalabilir. Bu nedenle batching ve pagination birlikte kullanılmalıdır.
Offset ve Cursor Pagination Karşılaştırması
Offset pagination basit arayüzlerde kolay uygulanır. Cursor pagination ise büyük ve sürekli değişen veri setlerinde daha stabil olabilir. Performans farkı database index ve sort kolonlarına bağlıdır. Büyük offset değerleri database'in çok sayıda satırı atlamasını gerektirebilir. Cursor yaklaşımı uygun index ile doğrudan son görülen konumdan devam edebilir.
Offset Pagination
Offset pagination limit ve offset kullanarak sayfalama yapar. Sayfa numarası deneyimi için pratiktir. Küçük veri setlerinde yeterli performans sağlayabilir. Offset büyüdükçe database daha fazla satırı taramak zorunda kalabilir. Veri değişirken duplicate veya missing item riski de oluşabilir.
Cursor Pagination
Cursor pagination son görülen kaydın sıralama bilgisini kullanır. Uygun index ile büyük veri setlerinde daha stabil olabilir. Cursor opaque biçimde istemciye verilebilir. Sıralamanın deterministic olması önemlidir. createdAt yanında id gibi tie-breaker alanı kullanılabilir.
Büyük Veri Setlerinde Performans
Milyonlarca satırlık tabloda büyük offset değerleri pahalı hale gelebilir. Cursor predicate index üzerinden daha az satır okuyabilir. Gerçek fark query planı ile doğrulanmalıdır. Her kullanım senaryosunda cursor otomatik olarak daha hızlı değildir. Sort ve filter yapısı performansı belirler.
Veri Değişirken Tutarlılık
Yeni kayıtlar eklenirken offset tabanlı sayfalama kayma yaşayabilir. Aynı kayıt iki kez görülebilir veya bazı kayıtlar atlanabilir. Cursor yaklaşımı stable ordering ile daha tutarlı sonuç verebilir. Yine de silme ve güncelleme senaryoları düşünülmelidir. Cursor contract açık biçimde tanımlanmalıdır.
Index Kullanımı
Her iki pagination yöntemi de uygun index gerektirir. Cursor yaklaşımında order ve predicate kolonları önemlidir. Composite index gerektiğinde filter kolonlarını da içerebilir. EXPLAIN ANALYZE gerçek index kullanımını gösterir. Index tasarımı yalnızca pagination koduna bakılarak yapılmamalıdır.
Relay Connection Pattern
Relay Connection Pattern cursor tabanlı pagination için standart bir GraphQL yapı sunar. edges, node, cursor ve pageInfo alanları istemciye düzenli pagination bilgisi sağlar. first ve after ileri yönlü gezinmeyi destekler. last ve before geri yönlü kullanımda değerlendirilebilir. Pattern kullanılırken maksimum page size sunucu tarafında korunmalıdır.
edges
edges listesi her kayıt için node ve cursor bilgisini bir arada taşır. İstemci veri ve pagination konumunu aynı yapıdan alabilir. Edge seviyesinde ek metadata da sunulabilir. Büyük edge listeleri yine page size ile sınırlandırılmalıdır. Schema tasarımı gereksiz wrapper maliyetinden çok kullanılabilirliği hedeflemelidir.
node
node gerçek domain entity'sini temsil eder. İstemci ihtiyaç duyduğu alanları node altında seçer. Child resolver'lar burada yine N+1 oluşturabilir. DataLoader relation yüklemeleri için kullanılabilir. Pagination N+1 problemini tek başına çözmez.
cursor
Cursor istemcinin belirli konumdan devam etmesini sağlar. Genellikle opaque string olarak sunulur. İçeride sıralama anahtarlarının encode edilmiş hali bulunabilir. Cursor istemci tarafından anlamlandırılmak zorunda olmamalıdır. Server cursor formatını backward compatibility düşünerek yönetmelidir.
pageInfo
pageInfo sonraki veya önceki sayfanın bulunup bulunmadığını bildirir. hasNextPage ve hasPreviousPage yaygın alanlardır. startCursor ve endCursor gezinmeyi kolaylaştırır. Bu bilgilerin hesaplanması için çoğu zaman page size'dan bir fazla kayıt çekilebilir. Gereksiz COUNT sorgusu kullanmak şart değildir.
first / after
first alınacak maksimum kayıt sayısını belirler. after ise devam edilecek cursor bilgisini taşır. Server first değerine üst sınır uygulamalıdır. Cursor predicate uygun index ile desteklenmelidir. Invalid cursor davranışı açık error policy ile yönetilmelidir.
last / before
last ve before geri yönlü pagination için kullanılabilir. Query order yönünün doğru ters çevrilmesi gerekebilir. Index tasarımı bu erişimi desteklemelidir. Gereksiz karmaşık kullanım yoksa API yalnızca ihtiyaç duyulan yönü sunabilir. Schema ergonomisi gerçek ürün ihtiyacına göre belirlenmelidir.
totalCount Alanının Gizli Maliyeti
Pagination uygulanırken totalCount alanı sık talep edilir. Büyük tablolarda kesin COUNT işlemi beklenenden pahalı olabilir. İstemci her sayfada totalCount istiyorsa aynı maliyet tekrar eder. Approximate veya cached count bazı kullanım senaryolarında daha iyi olabilir. En önemli soru, kullanıcı deneyiminin gerçekten kesin toplam sayıya ihtiyaç duyup duymadığıdır.
COUNT(*) Maliyeti
COUNT(*) büyük ve filtreli tablolarda ciddi maliyet oluşturabilir. Database motoru ve index yapısı sonucu etkiler. Karmaşık authorization filtreleri sayımı daha da pahalı hale getirebilir. Query planı incelenmelidir. Her pagination request'inde otomatik count çalıştırılmamalıdır.
Büyük Tablolar
Tablo büyüdükçe count operasyonunun maliyeti artabilir. Özellikle dinamik filtrelerde hazır cached değer kullanmak zorlaşır. Kullanıcı yalnızca sonraki sayfanın varlığını bilmek istiyorsa totalCount gereksizdir. pageInfo çoğu akış için yeterli olabilir. Schema tasarımı gerçek istemci ihtiyacına göre sade tutulmalıdır.
Approximate Count
Approximate count kesin sayı yerine tahmini değer döndürür. Dashboard veya genel büyüklük göstergesi için yeterli olabilir. Database statistics veya ayrı aggregation sistemi kullanılabilir. İstemciye değerin tahmini olduğu açıkça belirtilmelidir. Kritik finansal veya işlem sayılarında uygun olmayabilir.
Cached Count
Sık kullanılan toplam değer önceden hesaplanıp cache edilebilir. Mutation veya event akışı cache'i güncelleyebilir. Böylece her request içinde büyük COUNT sorgusu çalıştırılmaz. Consistency beklentisi açık biçimde belirlenmelidir. Birkaç saniyelik gecikmenin kabul edildiği ekranlarda oldukça kullanışlıdır.
totalCount Gerçekten Gerekli mi?
Birçok arayüz yalnızca daha fazla kayıt olup olmadığını bilmek ister. Bu durumda totalCount gereksiz maliyet olabilir. hasNextPage bilgisi daha ucuz yöntemle hesaplanabilir. Ürün ekibiyle ihtiyaç netleştirilmelidir. Performans kazancının önemli bölümü gereksiz işi hiç yapmamaktan gelir.
GraphQL Caching Katmanları
GraphQL caching tek bir mekanizmadan oluşmaz. Request-scoped DataLoader cache, entity cache, resolver cache ve full response cache farklı yaşam sürelerine sahiptir. Gateway veya CDN katmanı da uygun sorgularda ek cache sağlayabilir. Her katmanda cache key ve invalidation kuralları ayrı tanımlanmalıdır. Authentication ve tenant ayrımı özellikle kişiselleştirilmiş verilerde korunmalıdır.
DataLoader Cache
DataLoader cache tek request içindeki tekrarları önler. Yaşam süresi kısa olduğu için stale data riski daha sınırlıdır. Aynı entity farklı resolver yollarından istendiğinde tekrar fetch yapılmaz. Shared cache değildir. Request tamamlandığında cache de sona ermelidir.
Entity Cache
Entity cache belirli entity kayıtlarını request'ler arasında saklayabilir. Redis benzeri sistemler bu amaçla kullanılabilir. Cache key entity türü, id ve gerektiğinde tenant bilgisini içermelidir. Mutation sonrası invalidation gerekir. TTL veri tazeliği beklentisine göre belirlenmelidir.
Resolver Cache
Bazı pahalı resolver sonuçları field seviyesinde cache edilebilir. Cache key parent id, argument ve authorization context içerebilir. Computed veya external service field'larında faydalı olabilir. Invalidation davranışı açık olmalıdır. High cardinality key üretimi gözlemlenmelidir.
Full Response Cache
Full response cache aynı operation ve variables kombinasyonunun bütün sonucunu saklar. Public veya düşük kişiselleştirme içeren query'lerde güçlü olabilir. Authentication context yanlış ele alınırsa veri sızıntısı oluşabilir. Mutation sonrası hangi response'ların invalidate edileceği planlanmalıdır. Persisted query kullanımı cache key üretimini kolaylaştırabilir.
API Gateway Cache
Gateway GraphQL request'lerini merkezi noktada cache edebilir. Operation hash ve variables key üretiminde kullanılabilir. Kullanıcıya özel veriler private cache olarak ele alınmalıdır. TTL ve invalidation stratejisi backend davranışıyla uyumlu olmalıdır. Cache hit rate izlenmelidir.
CDN / Edge Cache
Public ve tekrar eden GraphQL sorguları edge üzerinde cache edilebilir. POST request davranışı bazı CDN yapılandırmalarında ek çalışma gerektirir. Persisted query ve GET kullanımı cache edilebilirliği kolaylaştırabilir. Personalized response public cache'e konulmamalıdır. Cache-Control politikası açık biçimde tasarlanmalıdır.
Request Cache ile Shared Cache Arasındaki Fark
Request cache tek operation boyunca yaşar ve kullanıcılar arasında paylaşılmaz. Shared cache ise birden fazla request ve process tarafından kullanılabilir. Bu nedenle shared cache invalidation, TTL ve authorization açısından daha fazla sorumluluk taşır. Redis veya Memcached gibi sistemler request ötesi reuse sağlar. Hangi verinin hangi katmanda cache edildiği mimari belgede açıkça gösterilmelidir.
Request Lifetime
Request cache yaşam süresi GraphQL operation ile sınırlıdır. Bu kısa ömür cache consistency yönetimini kolaylaştırır. Aynı request içindeki tekrarlar azaltılır. Kullanıcılar arası veri paylaşımı oluşmaz. DataLoader çoğu zaman bu katmanı sağlar.
Redis
Redis process'ler arasında paylaşılan cache oluşturabilir. Entity veya response cache için kullanılabilir. TTL ve invalidation mekanizması gerekir. Key tasarımı tenant ve authorization ihtiyaçlarını yansıtmalıdır. Hit ve miss oranları izlenmelidir.
Memcached
Memcached basit distributed cache kullanımında değerlendirilebilir. Veri geçici olarak tutulur. Application cache contract'ı yine uygulama tarafından tanımlanmalıdır. Invalidation ve key tasarımı ihmal edilmemelidir. GraphQL'e özel bir cache çözümü değildir.
Cross-Request Cache
Cross-request cache aynı veriyi farklı HTTP request'leri arasında tekrar kullanır. Bu özellik database yükünü ciddi biçimde azaltabilir. Buna karşılık stale data ve authorization riski getirir. Public ve private veri ayrımı yapılmalıdır. Cache anahtarları operation context'i doğru temsil etmelidir.
Cache Invalidation
Cache invalidation shared cache tasarımının en önemli konularından biridir. Mutation sonrasında ilgili entity ve response kayıtları eski hale gelebilir. Event-driven invalidation veya kısa TTL kullanılabilir. İlişkili cache key'lerini takip etmek zor olabilir. Cache politikası entity yaşam döngüsüyle birlikte tasarlanmalıdır.
Redis ile GraphQL Entity Caching
Redis GraphQL resolver'larının sık kullandığı entity verilerini request'ler arasında cache etmek için kullanılabilir. Loader batch function önce cache kontrolü yapabilir ve yalnızca miss olan key'leri database'den alabilir. Bu yaklaşım batching ile shared caching'i birlikte kullanır. Tenant-aware key tasarımı ve mutation invalidation güvenliğin önemli parçasıdır. Cache hit rate ve backend latency ayrı ölçülmelidir.
Entity Cache Key
Entity cache key tür ve id bilgisini içermelidir. Örneğin tenant ve locale de gerekiyorsa key'e eklenmelidir. Key formatı bütün servislerde tutarlı olmalıdır. Çok uzun veya değişken key yapıları yönetimi zorlaştırabilir. Version prefix schema değişikliklerinde yararlı olabilir.
TTL
TTL cache kaydının ne kadar süre geçerli kalacağını belirler. Çok uzun TTL stale data riskini artırabilir. Çok kısa TTL hit oranını düşürebilir. Veri değişim sıklığına göre farklı entity türleri farklı TTL kullanabilir. Production hit rate ve stale tolerance birlikte değerlendirilmelidir.
Cache Hit
Cache hit verinin database yerine cache'ten bulunduğunu gösterir. Yüksek hit rate database yükünü azaltabilir. Ancak yüksek hit tek başına iyi tasarım göstergesi değildir. Yanlış veya stale veri hızlı dönüyor olabilir. Correctness ve cache freshness birlikte izlenmelidir.
Cache Miss
Cache miss sonucunda veri kaynağına gidilir. DataLoader miss key'lerini toplu database sorgusuna dönüştürebilir. Dönen değerler Redis'e yazılabilir. Negative caching bazı missing record senaryolarında değerlendirilebilir. Miss oranındaki ani değişimler cache problemi gösterebilir.
Mutation Sonrası Invalidation
Entity değiştiğinde ilgili Redis key temizlenmelidir. Bazı sistemler write-through veya event-driven invalidation kullanır. Relation cache'leri de etkilenebilir. Invalidation başarısızlığını izlemek önemlidir. Kritik verilerde kısa TTL ek güvenlik katmanı sağlayabilir.
Tenant-Aware Keys
Multi-tenant veri aynı id değerini farklı tenant'larda kullanabilir. Redis key tenant bilgisini mutlaka ayırmalıdır. Örneğin tenantId entity type ve id birlikte kullanılabilir. Authorization seviyesi de gerekiyorsa ayrıca düşünülmelidir. Key builder merkezi fonksiyonla yönetilebilir.
Full GraphQL Response Caching
Full response caching aynı GraphQL operation sonucunu doğrudan yeniden kullanabilir. Özellikle public, read-heavy ve sık tekrarlanan sorgularda güçlü performans kazancı sağlar. Cache key operation, variables ve authentication bağlamını doğru temsil etmelidir. Kişiselleştirilmiş response yanlış key ile paylaşılırsa veri sızıntısı oluşabilir. TTL ve invalidation politikası operation türüne göre belirlenmelidir.
Operation
Cache key operation kimliğini taşımalıdır. Raw query yerine normalized hash veya persisted query id kullanılabilir. Operation name tek başına yeterli olmayabilir çünkü aynı isim farklı dokümanlarda kullanılabilir. Fingerprint daha güvenilir seçimdir. Schema değişikliklerinde cache versioning düşünülebilir.
Variables
Aynı operation farklı variables ile farklı sonuç üretir. Variables cache key'in bir parçası olmalıdır. Canonical serialization aynı anlamdaki variable objelerinin aynı key üretmesini sağlar. Hassas değerlerin key içinde açık metin tutulması uygun olmayabilir. Hash yaklaşımı değerlendirilebilir.
Authentication Context
Kullanıcıya özel response shared public cache'te tutulmamalıdır. Cache key gerektiğinde user, role veya tenant bağlamını yansıtmalıdır. Bununla birlikte user id bazlı cache cardinality çok büyüyebilir. Public ve private operation'ları ayırmak daha sade olabilir. Authorization modeli cache tasarımının başlangıcında düşünülmelidir.
Cache Key
İyi cache key aynı sonucu üreten request'leri aynı kayda yönlendirir. Farklı sonuçları ise kesin biçimde ayırır. Operation hash, variables ve gerekli context bileşenleri birlikte kullanılabilir. Key versioning deploy sonrası invalidation yönetimini kolaylaştırabilir. Key formatı gözlemlenebilir ve belgeli olmalıdır.
TTL
Response cache TTL veri tazeliği beklentisine göre seçilir. Sık değişen kişisel verilerde kısa TTL gerekebilir. Public referans verisinde daha uzun süre kullanılabilir. Mutation sonrası aktif invalidation varsa TTL ikinci güvenlik katmanı olur. Hit rate ve stale incident değerleri birlikte değerlendirilmelidir.
Personalized Response Riski
Kişiselleştirilmiş response yanlış cache paylaşımı nedeniyle başka kullanıcıya dönebilir. Bu çok ciddi güvenlik problemidir. Public cache yalnızca gerçekten public data için kullanılmalıdır. Private cache key authentication context'i güvenli biçimde içermelidir. Security testlerinde iki farklı kullanıcı aynı operation ile denenmelidir.
CDN Üzerinden GraphQL Cache
GraphQL response'ları uygun tasarımda CDN üzerinden cache edilebilir. En büyük zorluk çok sayıda operation ve variables kombinasyonunu güvenli cache key'e dönüştürmektir. Persisted query kullanımı bu süreci kolaylaştırabilir. Public ve private data ayrımı CDN seviyesinde açık olmalıdır. Cache-Control header'ları ve invalidation davranışı birlikte tasarlanmalıdır.
POST Request Problemi
GraphQL sorguları çoğunlukla POST ile gönderilir. Bazı CDN cache mekanizmaları GET request'lerini daha doğal destekler. POST body üzerinden cache key üretmek ek yapılandırma gerektirebilir. Persisted query bu karmaşayı azaltabilir. Güvenlik ve URL uzunluğu limitleri de düşünülmelidir.
Persisted Query
Persisted query büyük GraphQL dokümanı yerine kısa kimlik veya hash kullanılmasını sağlar. CDN cache key daha stabil hale gelebilir. Server izin verilen sorguyu store üzerinden bulur. Ağ payload'ı küçülebilir. Trusted document modeli güvenlik avantajı da sağlayabilir.
GET Request
Read-only persisted query uygun olduğunda GET üzerinden çağrılabilir. CDN standart HTTP cache davranışını daha kolay uygulayabilir. Variables query string içinde güvenli biçimde encode edilmelidir. Hassas veri URL içine konulmamalıdır. Mutation operasyonları GET ile çalıştırılmamalıdır.
CDN Cache Key
CDN cache key operation kimliği ve variables değerini temsil etmelidir. Public data için authentication bilgisi key'e gerek olmayabilir. Private data CDN public cache'e girmemelidir. Accept language gibi response'u etkileyen header'lar gerekirse key'e dahil edilir. Key cardinality ve hit rate düzenli ölçülmelidir.
Public ve Private Data Ayrımı
Public data kullanıcıdan bağımsız aynı sonucu üretir. Private data authentication veya tenant bağlamına göre değişir. İki tür aynı caching politikasına sahip olmamalıdır. Public response edge cache için daha uygundur. Private response güvenli application veya user-scoped cache gerektirebilir.
Persisted Query Nedir?
Persisted query GraphQL dokümanının önceden bilinen bir kimlik veya hash üzerinden çağrılmasını sağlar. İstemci her request'te uzun query metnini göndermek zorunda kalmaz. Server ilgili dokümanı store üzerinden bulabilir. Bu yaklaşım network payload ve cache edilebilirlik açısından fayda sağlayabilir. Safelist ile birlikte kullanıldığında izin verilmeyen arbitrary query'leri sınırlamak da mümkündür.
Query Hash
GraphQL dokümanı hash değeriyle tanımlanabilir. Aynı doküman aynı hash'i üretir. İstemci hash gönderdiğinde server kayıtlı query'yi bulabilir. Hash collision pratikte güçlü algoritmalarla son derece düşük ihtimaldir. Hash aynı zamanda cache key bileşeni olarak kullanılabilir.
Automatic Persisted Queries
Automatic Persisted Queries istemcinin önce hash göndermesine izin veren bir modeldir. Server query'yi bilmiyorsa istemci tam dokümanı tekrar gönderebilir. Sonraki çağrılar hash ile devam eder. Bu yaklaşım network payload'ını azaltabilir. Public API güvenlik politikası için tek başına allowlist yerine geçmez.
Server-Side Query Store
Server-side store önceden onaylanmış query dokümanlarını tutabilir. İstemci yalnızca tanımlayıcı gönderir. Deploy sürecinde query seti güncellenebilir. Bu yapı schema değişikliklerinin istemci sorgularıyla birlikte yönetilmesini kolaylaştırabilir. Store erişimi düşük latency ile tasarlanmalıdır.
Network Payload Azaltma
Büyük GraphQL dokümanları her request'te gönderildiğinde network byte miktarı artar. Persisted query kısa hash ile bu yükü azaltır. Mobil ağlarda küçük payload faydalı olabilir. Response boyutu yine ayrı bir maliyettir. Compression ve pagination aynı optimizasyon stratejisinin diğer parçalarıdır.
Cache Edilebilirlik
Stabil query kimliği cache key üretimini kolaylaştırır. Operation hash ve variables birlikte kullanılabilir. CDN ve gateway katmanında tekrar eden sorgular daha kolay tanınabilir. Authentication context doğru ayrılmalıdır. Cache hit rate üretim trafiğinde ölçülmelidir.
Persisted Query ve Safelist Arasındaki Fark
Persisted query ve safelist benzer altyapılar kullanabilse de amaçları farklı olabilir. APQ çoğunlukla network optimizasyonuna odaklanır. Trusted documents veya allowlist ise hangi query'lerin çalışmasına izin verildiğini kontrol eder. Public API'lerde arbitrary query riskini azaltmak için allowlist değerlendirilebilir. Internal geliştirme ortamında daha esnek politika kullanılabilir.
APQ
APQ istemcinin query hash üzerinden tekrar kullanımını kolaylaştırır. Server bilinmeyen hash için tam query isteyebilir. Bu nedenle varsayılan APQ her arbitrary query'yi engellemez. Performans ve network açısından değerlidir. Güvenlik hedefi varsa ek safelist politikası gerekir.
Trusted Documents
Trusted documents yalnızca önceden kayıtlı GraphQL dokümanlarının çalışmasına izin verir. Build veya deploy sürecinde doküman listesi oluşturulabilir. Server bilinmeyen operation'ı reddeder. Bu yaklaşım query governance için güçlüdür. Dinamik third-party istemci ihtiyaçlarında daha sınırlayıcı olabilir.
Query Allowlist
Allowlist izin verilen operation setini açık biçimde tanımlar. İzin dışındaki query execution başlamadan reddedilir. Query complexity ile birlikte ek güvenlik sağlar. Liste yönetimi CI/CD sürecine entegre edilebilir. Schema değişiklikleriyle uyumluluk otomatik test edilebilir.
Arbitrary Query'leri Engellemek
Public GraphQL endpoint istemcinin tamamen serbest query üretmesine izin veriyorsa maliyet kontrolü zorlaşır. Allowlist bu alanı sınırlandırabilir. Buna rağmen pagination, timeout ve rate limit yine gereklidir. Trusted query de pahalı tasarlanmış olabilir. Performance budget her kayıtlı operation için ayrıca uygulanmalıdır.
Internal vs Public GraphQL API
Internal API kontrollü istemci setine sahip olabilir. Public API çok daha geniş ve öngörülemeyen kullanım alır. Bu nedenle safelist, complexity ve rate limit politikaları farklı olabilir. Tek güvenlik profili her iki kullanım için uygun olmayabilir. API sınıflandırması mimarinin erken aşamasında yapılmalıdır.
Resolver Waterfall Nedir?
Resolver waterfall bağımsız işlemlerin birbirini gereksiz yere beklemesi durumudur. Bir resolver önce database çağrısını bekler ve ancak sonra bağımsız harici servisi çağırırsa süreler üst üste eklenir. Paralel çalışabilecek operasyonlar uygun biçimde aynı anda başlatılabilir. Promise.all benzeri teknikler bu durumda yardımcı olur. Bununla birlikte paralellik downstream kapasitesini aşmamalıdır.
Sequential Await
Arka arkaya await kullanımı işlemleri seri hale getirir. İkinci işlem birinci sonuca ihtiyaç duymuyorsa bu bekleme gereksizdir. İki I/O işlemi aynı anda başlatılabilir. Kod readability korunarak paralel promise'ler oluşturulabilir. Tracing gerçek waterfall noktalarını gösterebilir.
Bağımsız İşleri Seri Çalıştırmak
Bağımsız database ve API çağrıları seri çalıştığında toplam latency artar. Her çağrı kısa olsa bile toplam süre birikir. Dependency graph açık biçimde düşünülmelidir. Gerçek bağımlılık olmayan işler paralel hale getirilebilir. Fakat concurrency limiti göz ardı edilmemelidir.
Latency'nin Toplanması
Birinci downstream 80 milisaniye ve ikinci 100 milisaniye sürerse seri toplam yaklaşık 180 milisaniye olur. Paralel durumda teorik alt sınır daha uzun olan çağrıya yaklaşabilir. Gerçek süre scheduling ve diğer overhead nedeniyle biraz farklı olur. Resolver trace timeline bu farkı gösterir. Optimizasyon öncesi ve sonrası p95 ölçülmelidir.
Parallel Resolver Execution
GraphQL bağımsız sibling field'ları paralel çözebilir. Resolver içindeki veri erişimi de bu modele uygun tasarlanabilir. Ancak yüzlerce paralel database query göndermek N+1 problemini daha kötü hale getirebilir. Batching ile concurrency kontrolü birlikte kullanılmalıdır. Amaç sadece paralellik değil, kontrollü paralelliktir.
Promise.all
Promise.all bağımsız asenkron işleri birlikte beklemek için kullanılabilir. İşlerin önceden başlatılması waterfall süresini azaltabilir. Bir promise reject olduğunda hata davranışı ayrıca düşünülmelidir. Çok büyük listeyi sınırsız Promise.all ile çalıştırmak downstream saturation yaratabilir. Concurrency limiter gerektiğinde eklenmelidir.
Paralel Resolver Çalıştırmanın Riskleri
Paralellik latency azaltırken backend kapasitesini zorlayabilir. Çok sayıda resolver aynı anda database connection isterse pool hızla dolabilir. Harici servis rate limitleri de aşılabilir. Bu nedenle concurrency limit, bulkhead ve batching birlikte düşünülmelidir. Production metrikleri active connection ve downstream error rate değerlerini göstermelidir.
Database Connection Pool
Her database sorgusu connection gerektirebilir. Aşırı paralellik pool kapasitesini kısa sürede tüketir. Request'ler connection beklemeye başladığında latency yükselir. DataLoader query sayısını azaltarak bu baskıyı düşürebilir. Pool size rastgele büyütülmemelidir.
External API Rate Limit
Downstream API belirli request sınırına sahip olabilir. Paralel resolver'lar bu sınırı aniden aşabilir. Batch endpoint varsa kullanmak daha verimli olabilir. Client-side concurrency limiter çağrı hızını kontrol edebilir. Retry stratejisi thundering herd oluşturmamalıdır.
Downstream Saturation
Bir servis kapasitesinin üzerinde çağrı aldığında latency ve hata oranı birlikte artabilir. GraphQL gateway bu yükü istemeden büyütebilir. Concurrency limit ve timeout sistemi koruyabilir. Bulkhead farklı downstream bağımlılıklarını birbirinden izole eder. Saturation metriği tracing ile ilişkilendirilmelidir.
Concurrency Limit
Concurrency limit aynı anda çalışan belirli işlem sayısını sınırlar. Database veya harici servis bazında farklı limitler uygulanabilir. Aşırı düşük değer throughput'u azaltır. Aşırı yüksek değer downstream sistemi zorlar. Uygun değer load test ile belirlenmelidir.
Bulkhead Pattern
Bulkhead kaynakların bir bağımlılık tarafından tamamen tüketilmesini engeller. Her downstream için ayrı concurrency havuzu oluşturulabilir. Bir servis yavaşladığında diğer resolver'lar etkilenmeden çalışabilir. Timeout ve circuit breaker ile birlikte kullanılabilir. GraphQL gibi birçok backend kaynağını birleştiren sistemlerde değerlidir.
Database Connection Pool ve GraphQL
GraphQL operation'ları tek HTTP request içinde çok sayıda database sorgusu üretebildiği için connection pool kritik bir kapasite bileşenidir. N+1 problemi aktif bağlantı sayısını ve wait time değerini yükseltebilir. Pool size artırmak sorunu geçici olarak saklayabilir. Önce query sayısı ve query süresi optimize edilmelidir. Batching sonrasında aynı pool kapasitesiyle daha fazla request işlenebilir.
N+1'in Pool Üzerindeki Etkisi
N+1 çok sayıda kısa SQL sorgusu oluşturur. Her sorgu connection alıp bırakır. Yüksek concurrency altında pool sürekli dolu kalabilir. Wait queue büyüdükçe p95 latency yükselir. DataLoader bu sorguları birleştirerek connection kullanımını azaltabilir.
Pool Size
Pool size database kapasitesine göre belirlenmelidir. Uygulama instance sayısı arttığında toplam connection sayısı da artar. Her instance için büyük pool vermek database limitini aşabilir. Query optimizasyonu yapılmadan yalnızca pool büyütmek risklidir. Capacity planlama tüm servisleri birlikte değerlendirmelidir.
Pool Wait Time
Pool wait time uygulamanın boş connection beklediği süreyi gösterir. Query süreleri kısa olduğu halde request latency yüksekse önemli bir sinyaldir. N+1 veya aşırı concurrency bu metriği yükseltebilir. Alarm eşikleri p95 ve p99 üzerinden izlenebilir. Batching değişikliğinin etkisi bu metrikte açıkça görülebilir.
Active Connections
Active connection sayısı database üzerindeki anlık yükü gösterir. Sürekli maksimuma yakın değer saturation belirtisidir. Idle ve waiting bağlantılar da birlikte incelenmelidir. Operation bazlı tracing hangi sorguların bağlantıları tükettiğini gösterebilir. Capacity artışı optimizasyon sonrası değerlendirilmelidir.
Batched Query Sonrası Kapasite Kazancı
101 query iki query'ye indiğinde connection acquire sayısı ciddi biçimde azalabilir. Database CPU ve network round trip sayısı da düşer. Aynı altyapı daha fazla concurrent request kaldırabilir. Kazanç load test ile ölçülmelidir. Yalnızca tek request benchmark'ı kapasite farkını tam göstermez.
Query Timeout Stratejileri
Timeout her katmanda sınırsız beklemeyi engelleyen önemli bir dayanıklılık kontrolüdür. GraphQL operation, resolver, database ve external service için ayrı timeout seviyeleri bulunabilir. Alt katman timeout değerleri üst katman bütçesiyle uyumlu olmalıdır. Rastgele timeout değerleri zincir boyunca gereksiz retry ve kaynak tüketimi oluşturabilir. Uçtan uca latency budget üzerinden tasarım yapmak daha sağlıklıdır.
GraphQL Operation Timeout
Operation timeout bütün GraphQL isteğinin maksimum çalışma süresini sınırlar. Süre aşılırsa execution iptal edilebilir. Cancellation alt katmanlara iletilirse gereksiz database işi durdurulur. Timeout değeri normal p99 latency'nin biraz üzerinde seçilebilir. Kritik uzun-running operation'lar için ayrı politika gerekebilir.
Resolver Timeout
Bazı resolver'lar harici servis nedeniyle ayrı timeout ihtiyacı taşıyabilir. Resolver timeout operasyon bütçesinden daha kısa olmalıdır. Fallback davranışı schema nullability ve ürün ihtiyacına göre belirlenir. Her timeout error olarak tüm response'u bozmak zorunda değildir. Hata oranı ve timeout count izlenmelidir.
Database Statement Timeout
Statement timeout aşırı uzun SQL sorgularını durdurur. Expensive search veya kötü query planında sistemi koruyabilir. Timeout değeri request bütçesiyle uyumlu olmalıdır. Sorgu iptal edildiğinde connection sağlıklı biçimde pool'a dönmelidir. Slow query analizi timeout'a güvenmek yerine kök nedeni çözmelidir.
External Service Timeout
Harici servis çağrıları sınırsız bekletilmemelidir. Connect ve read timeout ayrı tanımlanabilir. Retry uygulanıyorsa toplam budget içinde kalmalıdır. GraphQL resolver cancellation sinyali downstream request'e iletilebilir. Slow dependency tüm operation'ı kontrolsüz biçimde bloklamamalıdır.
Katmanlar Arasında Timeout Budget
Toplam operation bütçesi örneğin 1000 milisaniye ise alt katman timeout'ları bunun içinde planlanmalıdır. Database 900 milisaniye ve external service 900 milisaniye ayrı ayrı beklerse toplam hedef aşılabilir. Dependency graph süreleri paylaşmalıdır. Seri ve paralel işler farklı bütçe davranışı gösterir. Tracing gerçek tüketimi izlemeye yardımcı olur.
Client Disconnect Sonrası İşlemi Durdurmak
İstemci bağlantısı koptuktan sonra backend işini sürdürmek çoğu durumda gereksiz kaynak tüketir. Cancellation propagation request sinyalini resolver, database ve harici servis katmanlarına taşıyabilir. Özellikle pahalı sorgularda önemli kapasite kazanımı sağlar. Her sürücü cancellation desteğini farklı biçimde uygular. İptal davranışı hata ve transaction güvenliği açısından test edilmelidir.
Cancellation Propagation
HTTP request iptal sinyali GraphQL execution context'e aktarılabilir. Resolver'lar bu sinyali downstream çağrılara iletir. Böylece istemcinin artık beklemediği işler sonlandırılabilir. Cancellation her asenkron kütüphanede otomatik çalışmaz. Kullanılan sürücülerin desteği doğrulanmalıdır.
Database Query Cancellation
Database driver cancellation veya abort signal destekliyorsa uzun query durdurulabilir. Bu yaklaşım connection'ın gereksiz süre meşgul kalmasını engeller. Transaction durumu doğru yönetilmelidir. Bazı database sistemlerinde cancellation anlık olmayabilir. Production metriklerinde cancelled query sayısı izlenebilir.
External API Cancellation
HTTP client abort sinyali downstream request'e iletebilir. Kullanıcı bağlantısı koptuğunda sonuç artık gerekli olmayabilir. Harici servis üzerindeki gereksiz yük azalır. Retry mekanizması cancellation sonrası tekrar çağrı yapmamalıdır. Trace üzerinde cancelled span durumu görünür olabilir.
Gereksiz CPU/DB Maliyetini Önlemek
İptal edilmeyen işler kullanıcıya değer üretmeden kaynak tüketir. Yüksek trafik sistemlerinde bu maliyet kapasiteyi etkileyebilir. Özellikle büyük aggregation ve search query'leri önemlidir. Cancellation timeout mekanizmasını tamamlayan bir kontroldür. İkisi birlikte daha öngörülebilir kaynak kullanımı sağlar.
Federation'da N+1 Problemi
GraphQL Federation ortamında N+1 yalnızca tek database içinde oluşmaz. Gateway birden fazla subgraph arasında entity çözümlemesi yaparken ekstra round trip üretebilir. Subgraph içindeki __resolveReference çağrıları da tek tek veri erişimi yapabilir. Entity batching ve request-scoped DataLoader burada yine önemlidir. Query plan incelenmeden federation performansı sağlıklı biçimde anlaşılmaz.
GraphQL Gateway
Gateway client operation'ını subgraph çağrılarına böler. Query plan hangi fetch işlemlerinin seri veya paralel çalışacağını belirler. Çok sayıda küçük subgraph çağrısı latency oluşturabilir. Gateway tracing bu çağrıları görünür hale getirir. Operation bazlı query plan analizi yapılmalıdır.
Subgraph
Subgraph kendi veri kaynağından sorumludur. Gateway batching yapsa bile subgraph resolver'ı içeride N+1 üretebilir. Database query count subgraph seviyesinde ayrı ölçülmelidir. DataLoader her incoming request kapsamında kullanılabilir. Gateway optimizasyonu subgraph içindeki kötü veri erişimini otomatik olarak çözmez.
Entity Resolver
Entity resolver federated reference üzerinden entity yükler. Bir operation aynı entity türünden çok sayıda reference gönderebilir. Resolver her reference için ayrı database query yaparsa N+1 oluşur. Batch loading bu çağrıları birleştirebilir. Entity batch size metriği izlenmelidir.
_entities
_entities alanı federation entity reference'larını çözmek için kullanılabilir. Çok sayıda representation tek request içinde gelebilir. Subgraph bu girdileri toplu veri erişimine çevirmelidir. Tek tek ORM lookup pahalı hale gelebilir. Request-level DataLoader bu senaryoya iyi uyum sağlar.
__resolveReference
__resolveReference entity'nin reference üzerinden nasıl yükleneceğini belirler. Fonksiyon doğrudan findById yapıyorsa çok sayıda çağrı N+1 oluşturabilir. Ortak loader üzerinden load çağrısı daha uygun olabilir. Tenant ve authorization bilgisi context'ten aktarılmalıdır. Batch behavior integration test ile doğrulanmalıdır.
Subgraph İçinde DataLoader
Her subgraph kendi request-scoped loader'larını oluşturabilir. Entity reference ve normal field resolver aynı loader'ı paylaşabilir. Böylece duplicate id'ler tek fetch'e düşer. Batch query subgraph database index'leriyle uyumlu olmalıdır. Loader metrikleri subgraph adına göre izlenebilir.
Cross-Subgraph Waterfall
Federation query plan bir subgraph sonucunu başka subgraph çağrısı için beklemek zorunda kalabilir. Gerçek dependency varsa bu davranış kaçınılmazdır. Fakat gereksiz sequential fetch latency'yi büyütür. Parallel fetch ve entity batching round trip sayısını azaltabilir. Gateway tracing cross-service waterfall noktalarını açık biçimde gösterebilir.
Query Plan
Query plan operation'ın subgraph'lara nasıl dağıtıldığını gösterir. Sequential ve parallel fetch adımları burada görülebilir. Çok fazla entity fetch performans problemi işareti olabilir. Plan schema değişiklikleriyle birlikte değişebilir. Kritik operation'lar için plan regression takibi yapılabilir.
Sequential Fetch
Sequential fetch bir subgraph sonucunun diğer çağrı için gerekli olduğu durumda kullanılır. Gereksiz sequence toplam latency'yi artırır. Schema ownership ve entity boundary tasarımı bu davranışı etkiler. Query plan optimizasyonu federation mimarisinin bir parçasıdır. Her waterfall DataLoader ile çözülemez.
Parallel Fetch
Bağımsız subgraph çağrıları paralel yapılabilir. Bu yaklaşım end-to-end latency değerini azaltabilir. Downstream concurrency kapasitesi yine korunmalıdır. Gateway aynı anda çok fazla subgraph call üretmemelidir. Bulkhead ve timeout uygulanabilir.
Entity Batching
Birden fazla entity reference tek subgraph request içinde batch edilebilir. Bu network round trip sayısını azaltır. Subgraph da içeride database batch loading kullanmalıdır. Gateway batching tek başına database N+1'i engellemez. İki katman birlikte ölçülmelidir.
Gateway → Subgraph Round Trips
Her network round trip latency ekler. Aynı subgraph'a tekrarlayan küçük çağrılar throughput'u düşürebilir. Query plan round trip sayısını görünür hale getirir. Persisted operation örnekleriyle benchmark yapılabilir. Cross-service call count temel federation metriği olmalıdır.
GraphQL Federation Performansı Nasıl İzlenir?
Federation performansı yalnızca gateway toplam latency değerinden anlaşılmaz. Her subgraph'ın latency, error rate ve entity batch size değerleri ayrı izlenmelidir. Query plan hangi servisin bekleme zincirinde olduğunu gösterir. Cross-service call count artışı schema değişikliğinin performans etkisini ortaya çıkarabilir. Distributed tracing gateway ve subgraph span'larını aynı trace içinde birleştirmelidir.
Gateway Latency
Gateway latency client'ın gördüğü toplam sürenin önemli bölümüdür. p50, p95 ve p99 ayrı izlenmelidir. Operation name veya fingerprint ile kırılım yapılabilir. Gateway CPU ve queue süreleri de değerlendirilmelidir. Yüksek latency her zaman gateway kodundan kaynaklanmaz.
Subgraph Latency
Her subgraph çağrısının süresi ayrı ölçülmelidir. Bir subgraph sürekli yavaşsa operation'ların tamamını etkileyebilir. p95 dağılımı ortalamadan daha açıklayıcı olabilir. Database ve external service span'ları alt nedenleri gösterir. Timeout rate de aynı dashboard'da bulunmalıdır.
Subgraph Error Rate
Yük altında artan error rate saturation işareti olabilir. Timeout, 5xx ve domain error türleri ayrılmalıdır. Gateway retry davranışı hataları büyütebilir. Subgraph adı ve operation fingerprint düşük cardinality label olarak kullanılabilir. Raw query label yapılmamalıdır.
Query Plan
Query plan değişiklikleri deployment sonrası performansı etkileyebilir. Kritik persisted operation'lar için plan snapshot alınabilir. Sequential fetch sayısındaki artış incelenebilir. Yeni entity boundary beklenmeyen round trip oluşturabilir. Plan tek başına değil gerçek trace ile birlikte yorumlanmalıdır.
Entity Batch Size
Entity batch size federation batching verimini gösterir. Sürekli 1 olan batch değerleri fırsat kaçırıldığını gösterebilir. Çok büyük batch ise subgraph sorgularını zorlayabilir. p50 ve p95 dağılımları izlenmelidir. Batch duration metriği de birlikte değerlendirilmelidir.
Cross-Service Call Count
Tek operation'ın kaç downstream servis çağrısı ürettiği önemli bir metriktir. Aynı operation için bu sayının deployment sonrası artması regression olabilir. Call count query complexity ile ilişkilendirilebilir. Persisted query'ler için budget tanımlanabilir. Bu metrik gateway capacity planlamasına da yardımcı olur.
GraphQL Schema Tasarımının Performansa Etkisi
Schema yalnızca domain modelini temsil etmez, aynı zamanda istemcinin hangi maliyetleri oluşturabileceğini belirler. Çok derin object graph, limitsiz listeler ve pahalı convenience field'lar backend kaynaklarını zorlayabilir. Search ve aggregation alanları özel cost kontrolü gerektirebilir. Schema review sürecinde performans etkisi ayrı başlık olarak ele alınmalıdır. İyi schema tasarımı sonradan yapılacak birçok savunma ihtiyacını azaltır.
Çok Derin Object Graph
Birbirine tekrar bağlanan entity modelleri istemcinin uzun nested path oluşturmasına izin verebilir. Bu yapı resolver ve downstream çağrı sayısını büyütebilir. Depth ve complexity limitleri koruma sağlar. Bazı ilişkileri ayrı root query yapmak daha açık olabilir. Schema ergonomisi ile backend maliyeti dengelenmelidir.
Unbounded List
Pagination argument'ı olmayan liste alanı kontrolsüz sonuç üretebilir. Küçük tabloda sorun görünmez. Veri büyüdükçe response size ve resolver sayısı artar. Her collection alanının maksimum sınırı olmalıdır. Default page size da açık biçimde tanımlanmalıdır.
Expensive Convenience Fields
Convenience field istemci kodunu basitleştirebilir fakat backend'de pahalı işlem yapabilir. Örneğin her entity için canlı aggregation hesaplamak risklidir. Field cost yüksek tanımlanabilir. Cache veya async precomputation kullanılabilir. Kullanıcı gerçekten ihtiyaç duyduğunda explicit opt-in sağlanabilir.
Aggregation Fields
Aggregation alanları büyük veri setinde yoğun database işi oluşturabilir. count, sum ve percentile gibi hesaplamalar request başına çalıştırılmamalı olabilir. Precomputed veya cached değer değerlendirilebilir. Complexity cost normal field'lardan yüksek tutulabilir. Timeout ve authorization birlikte uygulanmalıdır.
Search Fields
Search field geniş ve pahalı filtreler üretebilir. Query argument'ları validation ile sınırlandırılmalıdır. Maximum result size ve timeout uygulanmalıdır. Uygun search index kullanılmalıdır. Search operasyonları normal entity lookup ile aynı cost kabul edilmemelidir.
Schema Design Review
Yeni field eklenirken veri kaynağı ve maliyeti sorulmalıdır. Liste mi, tek entity mi, harici servis mi gibi özellikler belgelenebilir. Pagination ve complexity değeri schema review sırasında belirlenebilir. Authorization ve cache stratejisi de aynı aşamada konuşulmalıdır. Bu yaklaşım performans sorunlarını production öncesinde azaltır.
Expensive Field'lar Nasıl Yönetilmeli?
Pahalı field'lar tamamen yasaklanmak zorunda değildir. Ama maliyetleri görünür ve kontrollü olmalıdır. Complexity, permission, caching ve async processing birlikte kullanılabilir. Bazı alanlar varsayılan response yerine explicit opt-in gerektirebilir. Çok pahalı raporlama işlemleri ayrı query veya background job akışına taşınabilir.
Field Complexity
Pahalı resolver daha yüksek complexity cost alabilir. Bu değer query budget hesabına dahil edilir. Aynı operation içinde çok sayıda pahalı field istenmesi sınırlandırılabilir. Gerçek resolver duration metriği cost değerini güncellemeye yardımcı olur. Cost sabit kalmak zorunda değildir.
Permission
Bazı pahalı alanlar yalnızca belirli roller için gerekli olabilir. Permission kontrolü gereksiz execution başlamadan yapılmalıdır. Yetkisiz kullanıcı için backend işi çalıştırılmamalıdır. Role göre ayrı cost budget da uygulanabilir. Security ve performance aynı kontrol noktasında fayda sağlar.
Caching
Pahalı field sonucu sık tekrar ediyorsa cache değerlendirilebilir. Cache key parent id ve argument değerlerini doğru içermelidir. TTL veri tazeliğine göre belirlenir. Mutation veya source update sonrası invalidation gerekir. Cache hit rate ölçülmelidir.
Async Processing
Uzun süren raporlama veya medya işleme resolver içinde senkron bekletilmemelidir. İş background worker'a gönderilebilir. GraphQL mutation job id döndürebilir. İstemci job durumunu daha sonra sorgulayabilir. Arka plan işlem yaklaşımı hakkında ek teknik içerik için https://www.diyarbakiryazilim.com.tr/posts/zamanlanmis-gorevler-cron-jobs-ve-arka-plan-isleyicileri adresindeki rehber incelenebilir.
Explicit Opt-In
Pahalı field varsayılan olarak her response'a dahil edilmemelidir. GraphQL zaten istemcinin alan seçmesine izin verir. Client yalnızca gerektiğinde field'ı isteyebilir. Complexity cost bu talebi kontrol altında tutar. Dokümantasyonda alanın maliyeti açık biçimde belirtilmelidir.
Ayrı Query Tasarımı
Çok pahalı işlem normal entity field'ı yerine ayrı query olarak tasarlanabilir. Bu yaklaşım kullanım niyetini daha görünür yapar. Ayrı rate limit ve timeout uygulanabilir. Cache politikası da bağımsız yönetilebilir. Schema üzerinde maliyet sınırı daha açık hale gelir.
GraphQL Performance Observability
Performans optimizasyonu gözlemlenebilirlik olmadan sürdürülebilir değildir. Operation name, resolver duration, database query count ve DataLoader batch size gibi metrikler birlikte takip edilmelidir. Cache hit rate ve query complexity de operation maliyetini açıklamaya yardımcı olur. Response size network ve serialization yükünü görünür hale getirir. Raw query veya user id gibi high-cardinality label'lardan kaçınılmalıdır.
Operation Name
Named operation metrikleri anlamlı gruplara ayırmayı kolaylaştırır. Anonymous query'lerde fingerprint kullanılabilir. Operation name tek başına her zaman eşsiz değildir. İstemci standardı olarak named operation zorunluluğu getirilebilir. Dashboard ve alarm kuralları bu isim üzerinden oluşturulabilir.
Operation Fingerprint
Fingerprint query'nin normalize edilmiş kimliğidir. Variables değerleri çıkarılarak aynı query shape tek grupta toplanabilir. Bu yaklaşım cardinality'yi kontrol altında tutar. Raw query metnini label yapmaktan daha güvenlidir. Persisted query hash doğrudan fingerprint olarak kullanılabilir.
Resolver Duration
Resolver duration hangi field'ın gecikme oluşturduğunu gösterir. Her resolver için span üretmek yüksek hacimde maliyetli olabilir. Sampling veya seçilmiş field grupları kullanılabilir. p95 değerleri ortalamadan daha açıklayıcıdır. Database ve external call süreleri ayrıca ayrılmalıdır.
Database Query Count
Tek operation içindeki SQL sayısı N+1 için temel metriktir. Baseline değerinden sapma regression gösterebilir. Query count ile response item count birlikte incelenebilir. DataLoader batching sonrası sayının daha sabit kalması beklenir. CI testleri bu davranışı koruyabilir.
DataLoader Batch Size
Batch size loader'ın batching fırsatını ne kadar kullandığını gösterir. Ortalama tek başına yeterli değildir. p50 ve p95 dağılımları daha açıklayıcıdır. Sürekli batch size 1 yanlış kullanım işareti olabilir. Çok büyük değer database baskısını artırabilir.
Cache Hit Rate
Cache hit rate cache katmanının ne kadar işe yaradığını gösterir. DataLoader request cache ve Redis entity cache ayrı ölçülmelidir. Yüksek hit rate düşük latency ile ilişkilendirilebilir. Ancak stale data hataları ayrıca takip edilmelidir. Cache performansı doğrulukla birlikte değerlendirilmelidir.
Query Complexity
Her operation'ın hesaplanan complexity değeri metriğe yazılabilir. Latency ve query count ile korelasyon analizi yapılabilir. Çok pahalı operation'lar kolayca bulunur. Budget aşım sayısı güvenlik metriği olarak da izlenebilir. Raw field kombinasyonlarını label yapmak yerine numeric histogram tercih edilebilir.
Response Size
Response byte miktarı serialization ve network maliyetini gösterir. Büyük listeler burada hızla fark edilir. Compression öncesi ve sonrası boyut ayrı ölçülebilir. Maximum response size budget tanımlanabilir. Ani büyüme schema veya query shape regression gösterebilir.
GraphQL İçin İzlenmesi Gereken Metrikler
GraphQL üretim sistemlerinde yalnızca request rate ve error rate yeterli değildir. p50, p95 ve p99 latency dağılımları tail latency sorunlarını gösterir. Resolver p95, SQL queries per operation ve database pool wait kök nedeni bulmayı kolaylaştırır. DataLoader batch size ve cache hit oranı optimizasyonların gerçekten çalışıp çalışmadığını gösterir. Bu metriklerin operation fingerprint ile ilişkilendirilmesi performans incelemesini hızlandırır.
Request Rate
Request rate sistemin trafik hacmini gösterir. Toplam değer yanında operation bazlı dağılım önemlidir. Ani trafik artışı latency sorununu açıklayabilir. Rate ile complexity birlikte değerlendirildiğinde gerçek workload daha iyi anlaşılır. Basit ve pahalı operation'ların etkisi ayrılmalıdır.
Error Rate
Error rate uygulama sağlığının temel göstergesidir. GraphQL HTTP 200 içinde field error döndürebildiği için yalnızca HTTP status izlemek yeterli değildir. GraphQL errors sayısı ayrıca ölçülmelidir. Timeout ve complexity rejection ayrı kategoriler olmalıdır. Operation bazlı error rate alarmı faydalıdır.
p50 Latency
p50 tipik kullanıcı deneyimini gösterir. Medyan değer ortalamaya göre outlier etkisinden daha az etkilenir. Tek başına tail latency sorunlarını göstermez. p95 ve p99 ile birlikte değerlendirilmelidir. Optimizasyon sonrası genel iyileşme p50 değerinde görülebilir.
p95 Latency
p95 request'lerin yüzde 95'inin tamamlandığı süreyi gösterir. Production performansında sık kullanılan bir göstergedir. N+1 veya pool saturation tail latency'yi belirgin artırabilir. Operation bazında p95 izlemek daha anlamlıdır. SLO hedefleri bu metrik üzerine kurulabilir.
p99 Latency
p99 en yavaş request grubunu görünür hale getirir. Connection wait, GC veya downstream timeout gibi sorunlar burada daha net görülebilir. Trafik az olduğunda p99 gürültülü olabilir. Yeterli örnek sayısı gereklidir. Kritik operation'larda ayrı dashboard tutulabilir.
Resolver p95
Resolver p95 belirli field'ın tail latency davranışını gösterir. Ortalama hızlı görünen resolver bazen çok yavaşlayabilir. Database ve harici servis span'ları nedeni açıklayabilir. High-cardinality field path kullanımı dikkatle yönetilmelidir. Kritik resolver'lar öncelikli izlenebilir.
SQL Queries per Operation
SQL queries per operation N+1 için doğrudan sinyal üretir. Kayıt sayısı büyürken query count artıyorsa batching incelenmelidir. Operation fingerprint düşük cardinality grouping sağlar. Budget aşımı alarm oluşturabilir. CI ve production aynı metriği farklı amaçlarla kullanabilir.
Database Pool Wait
Pool wait database connection bulunamadığında oluşan bekleme süresidir. Yüksek değer query sayısı veya concurrency problemini gösterebilir. Active connection ile birlikte incelenmelidir. Batching sonrasında düşmesi beklenebilir. Pool büyütmeden önce kök neden ölçülmelidir.
DataLoader Batch Size
Batch size loader verimliliğinin temel metriğidir. Distribution ölçümü tek ortalamadan daha yararlıdır. Batch size 1 oranı ayrıca izlenebilir. Çok büyük batch'ler database latency ile korele edilebilir. Loader adı kontrollü cardinality ile label olarak kullanılabilir.
Cache Hit/Miss
Cache hit ve miss oranı backend fetch yükünü açıklar. Redis, response cache ve DataLoader cache ayrı metrikler üretmelidir. Hit oranındaki ani düşüş deploy veya invalidation problemi gösterebilir. Miss latency ayrıca ölçülebilir. Cache kullanımını tek sayı üzerinden değerlendirmek yanıltıcı olabilir.
DataLoader İçin Production Metrikleri
DataLoader production ortamında yalnızca varlığıyla değil gerçek davranışıyla değerlendirilmelidir. Batch count, batch size distribution ve deduplication rate en önemli sinyallerdendir. Batch error rate ve loader duration veri kaynağındaki problemleri görünür hale getirir. p50 ve p95 batch size birlikte izlendiğinde farklı trafik profilleri anlaşılır. Bu metrikler DataLoader'ın gerçekten N+1'i azaltıp azaltmadığını doğrular.
Batch Count
Tek operation içinde kaç batch çalıştığı ölçülebilir. Aynı loader için gereğinden fazla batch scheduling veya sequential await sorunu gösterebilir. Request büyüklüğüyle birlikte değerlendirilmelidir. Batch count deployment sonrası karşılaştırılabilir. Budget kritik operation'larda tanımlanabilir.
Batch Size Distribution
Batch size histogramı loader'ın key'leri nasıl gruplayabildiğini gösterir. Sadece average kullanmak küçük ve büyük batch dağılımını gizleyebilir. Histogram veya percentile değerleri tercih edilebilir. Batch size 1 yüzdesi ayrı gösterilebilir. Database latency ile birlikte analiz yapılmalıdır.
p50 Batch Size
p50 batch size tipik batch büyüklüğünü gösterir. Değer sürekli 1 ise batching davranışı incelenmelidir. Trafik doğal olarak tek entity query ağırlıklıysa bu normal olabilir. Operation türüyle korelasyon kurulmalıdır. Tek metrik üzerinden karar verilmemelidir.
p95 Batch Size
p95 batch size büyük batch'lerin ne kadar büyüdüğünü gösterir. Database parameter limitine yaklaşan değerler risk oluşturabilir. maxBatchSize ayarı değerlendirilebilir. Batch duration ile birlikte incelenmelidir. Büyük batch her zaman yüksek performans anlamına gelmez.
Deduplication Rate
Deduplication rate aynı key'in request içinde ne kadar tekrarlandığını gösterir. Yüksek oran memoization avantajının güçlü olduğunu gösterebilir. Aynı entity birçok resolver yolunda kullanılıyor olabilir. Çok düşük oran yine de batching değerini azaltmaz. Bu metrik cache davranışını anlamaya yardımcı olur.
Batch Error Rate
Batch function hata oranı veri kaynağı problemlerini gösterir. Tek key hatası ile tüm batch hatası ayrılmalıdır. Database timeout ve authorization error kategorileri farklı tutulabilir. Yük altında artış saturation işareti olabilir. Trace id ile hata örnekleri incelenebilir.
Loader Duration
Loader duration batch function'ın ne kadar sürede sonuç verdiğini gösterir. Database query ve mapping zamanı ayrı ölçülebilir. Büyük batch'lerde duration değişimi izlenmelidir. Cache hit loader süresini düşürebilir. p95 loader duration operation latency ile korele edilmelidir.
GraphQL Metrics'te High Cardinality Riski
Metric label olarak kontrolsüz değer kullanmak monitoring sistemini pahalı ve zor yönetilir hale getirir. Raw query, variables ve user id high cardinality üretir. Bunun yerine operation name veya fingerprint gibi sınırlı kimlikler kullanılmalıdır. Hassas veri de metrik label'larına yazılmamalıdır. Gerekli detay trace veya güvenli log örneğinde tutulabilir.
Raw Query'yi Label Yapmamak
Her raw query farklı string olabilir. Whitespace veya variable değerleri bile yeni seri oluşturabilir. Bu durum metric storage üzerinde büyük cardinality üretir. Normalize edilmiş fingerprint daha uygundur. Raw query gerektiğinde sampling ile güvenli trace içinde tutulabilir.
Variables'ı Label Yapmamak
Variables kullanıcı id, arama metni veya tarih gibi çok farklı değerler içerebilir. Metric label olarak kullanılması seri sayısını hızla büyütür. Hassas veri riski de oluşur. Complexity veya page size gibi numeric değerler histogram şeklinde ölçülebilir. Değerler label yapılmamalıdır.
User ID'yi Label Yapmamak
User id milyonlarca farklı değer üretebilir. Metric backend için yüksek cardinality oluşturur. Ayrıca kişisel veri yönetimi açısından gereksizdir. Kullanıcı segmenti gerekiyorsa düşük cardinality role veya plan sınıfı değerlendirilebilir. Detaylı kullanıcı incelemesi log erişim politikasıyla ayrı yapılmalıdır.
Operation Name Kullanmak
Operation name kontrollü bir metrik label olabilir. Client'ların named operation kullanması teşhis sürecini kolaylaştırır. Aynı isim farklı dokümana karşılık gelebiliyorsa fingerprint eklenebilir. Operation isimleri kullanıcı girdisinden doğrudan alınmamalıdır. Naming standardı belirlemek faydalıdır.
Operation Fingerprint
Fingerprint normalize edilmiş query shape için stabil kimlik üretir. Variables değerlerini içermez. Böylece cardinality daha sınırlı kalır. Persisted query hash doğal fingerprint işlevi görebilir. Dashboard ve alarm kurallarında operation name ile birlikte kullanılabilir.
OpenTelemetry ile Resolver Tracing
OpenTelemetry GraphQL operation, resolver, database ve external service çağrılarını aynı trace içinde ilişkilendirmeye yardımcı olur. Trace ID bir request'in uçtan uca izlenmesini sağlar. Her resolver için span oluşturmak yüksek trafikte maliyetli olabileceği için sampling düşünülmelidir. Database query count ve batch size gibi metric sinyalleri tracing ile birlikte kullanılabilir. Amaç yalnızca veri toplamak değil, bottleneck'i hızlı biçimde tanımlayabilmektir.
GraphQL Operation Span
Operation span bütün GraphQL request süresini kapsar. Operation name veya fingerprint güvenli attribute olarak eklenebilir. Complexity ve response size gibi numeric bilgiler de kaydedilebilir. Raw query varsayılan olarak eklenmemelidir. Span status GraphQL error davranışına uygun belirlenmelidir.
Resolver Span
Resolver span belirli field'ın çalışma süresini gösterir. Çok fazla scalar resolver span üretmek telemetry maliyetini artırabilir. I/O yapan veya kritik resolver'lar öncelikli izlenebilir. Parent type ve field name düşük cardinality attribute olabilir. Sampling policy trafik hacmine göre ayarlanmalıdır.
Database Span
Database span SQL çağrısının süresini ve database sistemini gösterebilir. Query text hassas veri içermeyecek şekilde yönetilmelidir. Aynı operation içindeki tekrar eden span'lar N+1 sinyali verir. Batch query sonrası span sayısının düşmesi beklenir. Connection wait ayrı ölçülebiliyorsa kök neden analizi kolaylaşır.
External Service Span
Harici API çağrıları ayrı span olarak görünmelidir. Service name ve status code faydalı attribute'lardır. Timeout ve retry davranışı trace üzerinden izlenebilir. Aynı downstream'e seri çağrılar waterfall işareti olabilir. Batch endpoint kullanımı round trip sayısını azaltabilir.
Trace ID
Trace ID metric alarmından ayrıntılı request örneğine geçiş sağlar. Log ve trace aynı kimlikle ilişkilendirilebilir. Kullanıcıya açık hata mesajında trace id paylaşımı kurum politikasına göre yapılabilir. Hassas veri içermemelidir. Incident incelemesinde oldukça yararlıdır.
Bottleneck'in Uçtan Uca Görülmesi
Tek resolver metriği bütün resmi göstermeyebilir. Trace gateway, resolver, database ve downstream sürelerini yan yana gösterir. Böylece gerçek bekleme zinciri görünür hale gelir. N+1, waterfall ve timeout problemleri daha kolay ayrılır. Optimizasyon sonrası trace karşılaştırması sonucu doğrular.
N+1 Problemi Nasıl Test Edilir?
N+1 problemi otomatik testlerle yakalanabilir ve yeniden ortaya çıkması engellenebilir. Test database üzerinde query counter kullanmak basit ve etkili bir yöntemdir. Aynı operation 1 ve 100 kayıtla çalıştırılarak SQL sayısının nasıl değiştiği ölçülür. Sağlıklı batching varsa sayı büyük ölçüde sabit kalmalıdır. Regression test bu davranışı CI sürecinde sürekli doğrulayabilir.
Test Database
Performance assertion için gerçek database davranışına yakın test ortamı kullanılmalıdır. In-memory alternatif farklı query davranışı gösterebilir. Schema ve index'ler production ile uyumlu olmalıdır. Test verisi deterministik biçimde hazırlanabilir. Query counter connection veya ORM instrumentation üzerinden uygulanabilir.
Query Counter
Query counter test boyunca çalışan SQL sorgularını sayar. Belirli operation başlamadan sayaç sıfırlanabilir. Test bittikten sonra beklenen maksimum değer doğrulanır. Setup query'leri sayaç dışında tutulmalıdır. Aynı mekanizma farklı ORM'ler için adapter ile soyutlanabilir.
1 Kayıt
Bir kayıtla test başlangıç davranışını gösterir. N+1 bu durumda çoğu zaman fark edilmez. Örneğin iki SQL sorgusu normal görünebilir. Bu değer baseline için saklanır. Asıl kontrol daha büyük kayıt sayısıyla karşılaştırmadır.
100 Kayıt
Aynı operation yüz kayıtla tekrar çalıştırılır. N+1 varsa SQL sayısı yüz civarında büyüyebilir. DataLoader varsa sayı birkaç sorguda kalmalıdır. Response correctness de aynı anda doğrulanmalıdır. Test yalnızca performans uğruna yanlış veri döndürmeyi kabul etmemelidir.
Query Sayısının Sabit Kalmasını Doğrulamak
İdeal batching kayıt sayısından bağımsız sınırlı query count üretir. Tam sabit sayı her schema için gerekli olmayabilir. Önemli olan doğrusal N artışının olmamasıdır. Test üst sınır veya growth ratio kullanabilir. Beklenen davranış kod yanında belgelenmelidir.
Regression Test
Resolver değişikliği N+1 problemini yeniden getirebilir. Regression test deploy öncesinde bu değişimi yakalar. Critical operation seti CI içinde çalıştırılabilir. Test süresi kontrol altında tutulmalıdır. Gerektiğinde daha geniş benchmark nightly pipeline'da yapılabilir.
DataLoader Unit Testleri
DataLoader unit testleri batch function contract'ını güvence altına alır. Input ordering, missing key ve duplicate key senaryoları mutlaka test edilmelidir. Partial error davranışı GraphQL error policy ile uyumlu olmalıdır. Cache behavior aynı key'in tekrar yüklenip yüklenmediğini doğrular. Bu testler production'daki zor fark edilen mapping hatalarını önemli ölçüde azaltır.
Batch Function Input
Batch function'ın beklenen key dizisini aldığı doğrulanmalıdır. Farklı key tipleri test edilebilir. Composite key varsa tenant ve id eşleşmesi kontrol edilmelidir. Büyük batch için limit davranışı ayrıca test edilebilir. Input mutation yapılmamalıdır.
Output Ordering
Database mock sonucu input'tan farklı sırada hazırlanabilir. Batch function output'u tekrar doğru sıraya getirmelidir. Bu test mapping algoritmasını doğrudan doğrular. Aynı id birkaç kez kullanılıyorsa davranış ayrıca incelenmelidir. Ordering hatası veri bütünlüğü problemi oluşturabilir.
Missing Key
Input içindeki bazı key'ler veri kaynağında bulunmayabilir. Output aynı pozisyonda null veya Error içermelidir. Array uzunluğu değişmemelidir. GraphQL nullability davranışı integration testte ayrıca görülebilir. Missing record normal ve beklenen bir senaryo kabul edilmelidir.
Duplicate Key
Aynı key için birden fazla load çağrısı yapılabilir. Cache aktifse batch function'ın key'i bir kez görmesi beklenebilir. Cache kapalı senaryoda davranış farklı olabilir. İki çağrının aynı doğru sonucu aldığı doğrulanmalıdır. Deduplication metriği production davranışını tamamlar.
Partial Error
Batch içindeki tek key'in hata üretmesi bütün sonuçları bozmak zorunda değildir. Implementasyon key bazlı Error değerini destekleyebilir. Diğer key'ler doğru sonuç almalıdır. GraphQL response error path doğrulanabilir. Hassas database error mesajı doğrudan client'a verilmemelidir.
Cache Behavior
Aynı key iki kez load edildiğinde fetch sayısı kontrol edilir. clear çağrısından sonra tekrar fetch beklenebilir. prime kullanımında veri kaynağına hiç gidilmemesi test edilebilir. Mutation sonrası invalidation senaryosu ayrıca yazılmalıdır. Request lifecycle integration seviyesinde doğrulanmalıdır.
GraphQL Integration Testlerinde Performance Assertion
Integration test GraphQL execution ile gerçek veri erişimi arasındaki ilişkiyi doğrular. SQL query sayısı, external request sayısı ve response correctness birlikte kontrol edilebilir. Query complexity ve pagination limitleri de aynı test seviyesinde değerlendirilebilir. Böylece yalnızca unit test ile görülemeyen resolver etkileşimleri ortaya çıkar. Kritik operation'lar için performance assertion CI sürecinin parçası haline getirilebilir.
SQL Query Sayısı
Operation çalıştırılırken query counter aktif edilir. Beklenen maksimum SQL sayısı assertion olarak tanımlanır. Farklı liste boyutlarıyla test tekrarlanır. Bu yöntem N+1 regression'ını hızlı yakalar. Database setup sorguları ölçümden ayrılmalıdır.
External Request Sayısı
Resolver başka servise çağrı yapıyorsa request count ölçülebilir. Batch endpoint kullanıldığında sayı sınırlı kalmalıdır. Mock server veya test double çağrıları sayabilir. Aynı resource için tekrar çağrı yapılmadığı doğrulanabilir. Retry senaryoları ayrı test edilmelidir.
Response Correctness
Performance optimizasyonu doğru response üretmeye devam etmelidir. DataLoader ordering hatası response değerlerini karıştırabilir. Test hem field değerlerini hem null durumlarını doğrulamalıdır. Authorization davranışı da aynı operation içinde test edilebilir. Hızlı ama yanlış response kabul edilebilir değildir.
Maximum Complexity
Limit altındaki query başarıyla çalışmalıdır. Limit üstündeki query execution başlamadan reddedilmelidir. Database query counter sıfır kalabilir. Error code istemci için anlaşılır olmalıdır. Runtime argument bazlı cost senaryosu ayrıca test edilmelidir.
Pagination Limits
İstemci maksimum değerin üzerinde first gönderebilir. Server beklenen davranışla request'i reddetmeli veya değeri sınırlamalıdır. Negative veya invalid değerler de test edilmelidir. Nested listelerde limit ayrıca doğrulanmalıdır. Pagination güvenliği resolver'lara dağılmamalıdır.
GraphQL Load Testing
Load testing tek bir query'yi tekrar çalıştırmaktan daha fazlasıdır. Gerçek production query mix, nested sorgular ve farklı kullanıcı concurrency değerleri simüle edilmelidir. Warm cache ile cold cache sonuçları ayrı ölçülmelidir. p95 ve p99 latency yanında database CPU, connection wait ve error rate izlenmelidir. k6 veya Artillery gibi araçlar bu workload'u üretmek için kullanılabilir.
k6
k6 GraphQL endpoint'e HTTP yükü göndermek için kullanılabilir. Operation ve variables farklı senaryolarla hazırlanabilir. Threshold tanımları p95 latency veya error rate üzerinde uygulanabilir. Test sırasında backend metrikleri ayrıca izlenmelidir. Sonuç yalnızca client latency tablosuna bakılarak değerlendirilmemelidir.
Artillery
Artillery farklı request akışlarını modellemek için kullanılabilir. GraphQL POST body senaryoları tanımlanabilir. Kullanıcı geliş hızları ve test fazları ayrı ayarlanabilir. Persisted query ve normal query profilleri karşılaştırılabilir. Backend tracing örnekleri load test sırasında incelenebilir.
Gerçekçi Query Mix
Production trafiğinde bütün request'ler aynı operation değildir. Basit ve pahalı query oranları gerçek loglardan çıkarılabilir. Load test bu dağılımı mümkün olduğunca yansıtmalıdır. Yalnızca en hafif sorguyla yapılan test kapasiteyi olduğundan yüksek gösterebilir. En ağır sorguyla sürekli test de gerçek kullanıcı davranışını temsil etmeyebilir.
Nested Queries
Nested query workload N+1 ve complexity kontrollerini test eder. Farklı depth ve list size kombinasyonları kullanılabilir. Query budget aşan örneklerin reddedildiği doğrulanmalıdır. Normal kullanıcı sorguları ise kabul edilebilir latency içinde kalmalıdır. Resolver trace'leri bottleneck'i açıklamaya yardımcı olur.
Concurrent Users
Concurrency database pool ve downstream servis kapasitesini sınar. Tek request benchmark'ında görünmeyen saturation sorunları burada ortaya çıkar. Kullanıcı sayısı kademeli artırılmalıdır. Breakpoint sonrası error rate ve latency değişimi incelenir. Capacity hedefi bu sonuçlarla belirlenebilir.
Warm Cache
Warm cache senaryosunda sık kullanılan entity ve response kayıtları cache'te bulunur. Bu durum normal yoğun trafiğe yakın olabilir. Cache hit rate ölçülmelidir. Backend database yükündeki azalma görülebilir. Cache sıcaklığı test raporunda açıkça belirtilmelidir.
Cold Cache
Cold cache deploy sonrası veya cache flush durumunu temsil eder. Bütün request'lerin database'e yönelmesi kısa süreli yük artışı oluşturabilir. Sistem bu durumu güvenli biçimde kaldırabilmelidir. Stampede koruması değerlendirilebilir. Warm ve cold sonuçları ayrı raporlanmalıdır.
Performance Benchmark Nasıl Yapılmalı?
Benchmark optimizasyon öncesi ve sonrası aynı koşullar altında yapılmalıdır. Database query count, latency dağılımları, CPU ve connection pool metrikleri birlikte kaydedilmelidir. Tek bir ortalama süre performans farkını açıklamak için yeterli değildir. Veri seti ve concurrency seviyesi raporda belirtilmelidir. Değişikliğin gerçek etkisi ancak karşılaştırılabilir baseline üzerinden anlaşılır.
Optimizasyon Öncesi Baseline
Mevcut sistem davranışı değiştirilmeden önce ölçülmelidir. Aynı operation seti ve veri hacmi kullanılmalıdır. Cache durumu açıkça kaydedilmelidir. Query count ve latency dağılımı baseline oluşturur. Sonraki değişiklikler bu değerlerle karşılaştırılır.
Database Query Count
Query count N+1 iyileştirmesinde en açıklayıcı ölçümdür. 101 sorgunun iki sorguya düşmesi doğrudan görülebilir. Ancak query süresi de birlikte değerlendirilmelidir. Tek batch query çok pahalıysa sadece sayı yeterli değildir. Rows read ve query plan ek bilgi sağlar.
p50/p95/p99 Latency
Latency percentile değerleri farklı kullanıcı deneyimlerini gösterir. p50 tipik davranışı temsil eder. p95 ve p99 tail latency problemlerini gösterir. N+1 optimizasyonu çoğu zaman yüksek percentiles üzerinde daha güçlü etki yaratabilir. Aynı concurrency altında karşılaştırma yapılmalıdır.
Database CPU
Çok sayıda küçük query database CPU tüketimini artırabilir. Batching sonrası CPU kullanımında düşüş görülebilir. Fakat büyük JOIN veya IN query CPU maliyetini yeniden yükseltebilir. Sadece application latency değil database resource kullanımı da raporlanmalıdır. Capacity kazancı bu metrikle daha net görülür.
Connection Pool
Pool active connection ve wait time değerleri benchmark sırasında izlenmelidir. N+1 kaldırıldığında acquire sayısı ve wait time düşebilir. Concurrency yükseldikçe fark daha belirgin hale gelir. Pool size test boyunca aynı tutulmalıdır. Aksi durumda karşılaştırma yanıltıcı olur.
Optimizasyon Sonrası Karşılaştırma
Yeni sonuçlar baseline ile aynı tabloda karşılaştırılmalıdır. Query count, p95 latency ve database CPU farkı açıkça gösterilebilir. Sadece iyileşen metrikler değil kötüleşenler de raporlanmalıdır. Response correctness aynı test setinde doğrulanmalıdır. Karar bütün metriklerin ortak sonucuna göre verilmelidir.
GraphQL Performance Budget
Performance budget bir GraphQL operation'ın kabul edilebilir kaynak sınırlarını tanımlar. Maximum latency, query complexity, database query sayısı ve response size bu bütçenin parçaları olabilir. Pagination ve downstream call sayısı da ek limit olarak kullanılabilir. Budget CI ve production monitoring süreçlerinde aynı standardı oluşturur. Böylece performans kişisel yorum yerine ölçülebilir mühendislik hedefi haline gelir.
Maximum Operation Latency
Kritik operation için p95 veya p99 latency hedefi belirlenebilir. Tek request maksimum süre yerine percentile SLO daha anlamlı olabilir. Operation timeout ayrıca hard limit sağlar. Regression benchmark bütçeyi aşarsa pipeline uyarı verebilir. Hedef gerçek kullanıcı beklentisine dayanmalıdır.
Maximum Query Complexity
Operation execution başlamadan complexity sınırı kontrol edilebilir. Limit schema maliyet modeline göre belirlenir. Public ve internal kullanım için farklı budget uygulanabilir. Persisted query'ler önceden validate edilebilir. Budget değişiklikleri version kontrolünde tutulabilir.
Maximum Database Queries
Operation başına maksimum SQL sayısı N+1 koruması sağlar. Kritik listeler için düşük ve sabit değer hedeflenebilir. CI testleri bu sınırı doğrular. Production alarmı anormal request'leri yakalar. Database query sayısı büyüyen veri setinde yeniden test edilmelidir.
Maximum Page Size
Her listede maximum page size bulunmalıdır. Bu değer response, database ve resolver yükünü sınırlar. Nested listeler için daha düşük değer gerekebilir. İstemci limite uymadığında açık hata almalıdır. Budget query complexity hesabına da dahil edilmelidir.
Maximum Response Size
Büyük response memory, serialization ve network maliyetini artırır. Byte seviyesinde üst sınır tanımlanabilir. Sınır yaklaşan request'ler telemetry üzerinden izlenebilir. Client query tasarımı gerektiğinde sadeleştirilebilir. Compression response size riskini tamamen ortadan kaldırmaz.
Maximum Downstream Calls
GraphQL operation başka servislere çok sayıda request üretebilir. Maksimum downstream call count budget olarak tanımlanabilir. Federation ve microservice yapılarında özellikle değerlidir. Batch endpoint kullanımını teşvik eder. Regression test cross-service N+1 problemini yakalayabilir.
CI/CD'de GraphQL Performance Gate
Performans kontrolleri yalnızca production incident sonrasında yapılmamalıdır. CI/CD pipeline kritik operation'lar için N+1 regression, complexity, persisted query ve benchmark kontrolleri çalıştırabilir. Schema breaking change testi istemci uyumluluğunu korur. Representative benchmark performans budget aşımını deploy öncesinde gösterir. Bu yaklaşım optimizasyonların zaman içinde korunmasını sağlar.
N+1 Regression Test
Test database üzerinde operation çalıştırılır ve SQL sayısı ölçülür. Kayıt sayısı büyütülerek query count artışı kontrol edilir. Beklenen budget aşılırsa pipeline başarısız olabilir. Test kritik resolver setine odaklanabilir. Bu yöntem DataLoader'ın yanlışlıkla kaldırılmasını erken yakalar.
Query Complexity Test
Bilinen pahalı query örnekleri CI içinde doğrulanabilir. Limit üstü operation'ın reddedildiği görülür. Legitimate persisted query'lerin budget içinde kaldığı da kontrol edilir. Schema değişikliği cost değerini artırırsa fark görünür hale gelir. Test runtime argument senaryolarını kapsamalıdır.
Persisted Query Validation
Persisted query dokümanları yeni schema karşısında validate edilebilir. Silinen veya değişen field kullanımı deploy öncesinde bulunur. Complexity budget aynı aşamada hesaplanabilir. Query store manifest version kontrolünde tutulabilir. Client ve server release koordinasyonu kolaylaşır.
Schema Breaking Change Test
Schema diff istemcileri bozabilecek değişiklikleri tespit eder. Field kaldırma veya type değişimi build sürecinde görülebilir. Performans açısından yeni unbounded list veya pahalı field da review edilebilir. Automated rule set geliştirilebilir. Schema governance yalnızca backward compatibility ile sınırlı kalmamalıdır.
Representative Benchmark
Her commit için tam load test pahalı olabilir. Bunun yerine representative operation seti kısa benchmark olarak çalıştırılabilir. Query count ve execution time kıyaslanabilir. Büyük regression erken yakalanır. Daha kapsamlı load test belirli aralıklarla çalıştırılabilir.
Performance Budget Failure
Budget aşımı otomatik pipeline failure veya review gerektiren uyarı oluşturabilir. Her küçük değişimde gereksiz bloklama olmaması için eşikler gerçekçi seçilmelidir. Baseline güncellemesi gerekirse neden belgelenmelidir. Yeni pahalı davranış sessizce kabul edilmemelidir. Performance budget ekip için ortak sözleşme işlevi görür.
GraphQL Güvenliği ile Performansın Kesiştiği Noktalar
GraphQL performans kontrollerinin önemli bir bölümü aynı zamanda güvenlik kontrolüdür. Çok derin veya çok geniş query sunucu kaynaklarını tüketebilir. Büyük pagination argument'ları ve pahalı search alanları kötüye kullanılabilir. Complexity, rate limit, timeout ve page size bu riskleri azaltır. Güvenlik politikası ile performans budget aynı kaynak tüketimi modelini paylaşabilir.
Query DoS
Query DoS düşük request sayısıyla yüksek backend maliyeti üretmeye çalışır. GraphQL esnekliği bu tür pahalı operation'lara imkan verebilir. Complexity limiti execution öncesinde koruma sağlar. Rate limiting query cost ile birlikte daha etkili olur. Timeout son savunma katmanlarından biridir.
Deep Query Attack
Çok derin nested query recursive object graph üzerinde büyük resolver zinciri oluşturabilir. Depth limiti bu davranışı doğrudan sınırlar. Fragment expansion hesaba katılmalıdır. Complexity kontrolü ek maliyeti daha gerçekçi ölçer. Pagination nested list genişliğini ayrıca sınırlar.
Wide Query Attack
Query sığ olsa bile çok sayıda field veya alias içerebilir. Her alan pahalı resolver çalıştırabilir. Depth limiti bu saldırıyı yakalayamaz. Field count ve complexity modeli gerekir. Alias sayısına ek limit konulması da değerlendirilebilir.
Alias Abuse
Aynı pahalı field farklı alias'larla tekrar tekrar istenebilir. GraphQL bunu ayrı response alanları olarak çözebilir. Complexity hesabı her alias kullanımını maliyete dahil etmelidir. Deduplication bazı backend fetch'leri azaltabilir ama computed iş yine tekrarlanabilir. Alias limiti public API'lerde ek koruma sağlayabilir.
Large Pagination Arguments
first veya limit için çok yüksek değer verilmesi büyük workload üretir. Sunucu her zaman maximum page size uygulamalıdır. Argument value complexity multiplier olarak kullanılabilir. Limitsiz liste kesinlikle bırakılmamalıdır. Validation execution başlamadan yapılmalıdır.
Expensive Search
Search endpoint geniş wildcard veya karmaşık filtrelerle database'i zorlayabilir. Input validation ve timeout uygulanmalıdır. Search complexity normal lookup'tan yüksek olabilir. Result set pagination ile sınırlandırılmalıdır. Gerekirse search için ayrı rate limit uygulanabilir.
Cost-Based Protection
Cost-based protection request sayısı yerine tahmini kaynak tüketimini temel alır. Complexity puanı kullanıcı budget'ından düşülebilir. Büyük listeler ve pahalı field'lar daha fazla cost üretir. Bu model güvenlik ile kapasite planlamasını yakınlaştırır. Cost değerleri production gözlemleriyle güncellenmelidir.
Introspection Kapatmak N+1 Problemini Çözer mi?
Introspection kapatmak N+1 problemini çözmez. N+1 resolver ve veri erişimi davranışından kaynaklanır. Introspection yalnızca schema bilgisinin sorgulanabilirliğini etkiler. Query cost, pagination ve batching tamamen farklı kontrollerdir. Güvenliği yalnızca schema'yı gizlemeye dayandırmak doğru bir yaklaşım değildir.
Introspection'ın Gerçek Rolü
Introspection istemcinin schema yapısını keşfetmesini sağlar. Development araçları bu özellikten yararlanabilir. Production politikası kullanım ihtiyacına göre belirlenebilir. Ancak database query count üzerinde doğrudan etkisi yoktur. N+1 başka yöntemlerle çözülmelidir.
Query Cost ile Farkı
Query cost operation'ın kaynak maliyetini modellemeye çalışır. Introspection ise schema metadata erişimidir. Introspection kapalı olsa bile kullanıcı bilinen field'larla pahalı query gönderebilir. Complexity limiti bu maliyeti kontrol eder. İki konu aynı güvenlik mekanizması değildir.
Security by Obscurity Riski
Schema bilgisini gizlemek tek güvenlik savunması olmamalıdır. İstemci query formatını zaten uygulama üzerinden öğrenebilir. Authorization, rate limit ve cost kontrolü gerçek güvenlik sınırlarıdır. Introspection politikası ek tedbir olabilir. Temel veri erişim kontrolünün yerine geçmez.
Complexity ve Rate Limit'in Asıl Kontroller Olması
Complexity pahalı operation'ı execution öncesinde sınırlar. Rate limit kullanıcı kaynak tüketimini zaman içinde kontrol eder. Pagination ve timeout bu iki kontrolü tamamlar. Authorization hangi verinin erişilebilir olduğunu belirler. Birlikte kullanıldıklarında daha güçlü koruma modeli oluşur.
Sık Yapılan DataLoader Hataları
DataLoader basit API'sine rağmen yanlış kullanıldığında beklenen performans kazancını sağlamayabilir. Global instance, resolver içinde yeni loader ve hatalı result ordering en yaygın problemlerdendir. Çok büyük batch boyutu database'i zorlayabilir. Authorization ile cache davranışını ayrı düşünmek güvenlik riski yaratır. Mutation sonrası cache temizliği de aynı request içinde veri tutarlılığı için önemlidir.
Global DataLoader Kullanmak
Global loader kullanıcılar ve request'ler arasında cache paylaşabilir. Stale data ve authorization leakage riski oluşturur. Multi-tenant sistemlerde problem daha da büyür. Loader request context içinde oluşturulmalıdır. Shared cache ihtiyacı ayrı bir sistemle çözülmelidir.
Resolver İçinde Yeni Loader Oluşturmak
Her resolver invocation yeni loader oluşturursa batching gerçekleşmez. Her instance yalnızca tek key görebilir. Memoization avantajı da kaybolur. Loader request başlangıcında bir kez hazırlanmalıdır. Resolver aynı context instance'ını kullanmalıdır.
Batch Sonuçlarını Yanlış Sırada Döndürmek
Database sonuç sırası input key sırasıyla aynı olmayabilir. Sonuç doğrudan return edilirse yanlış entity yanlış resolver'a gidebilir. Batch function explicit mapping yapmalıdır. Missing record için placeholder unutulmamalıdır. Unit test bu hatayı kolayca yakalar.
Çok Büyük Batch Kullanmak
Sınırsız batch key listesi büyük IN query oluşturabilir. Database parameter sınırları aşılabilir. Query planı ve latency kötüleşebilir. maxBatchSize ile kontrollü parçalama yapılabilir. Değer benchmark sonucu seçilmelidir.
Authorization'ı Cache'ten Bağımsız Düşünmek
Cache aynı id için önceki authorization sonucunu tekrar kullanabilir. Request-scoped loader riski azaltır. Tenant ve user context batch query tarafından korunmalıdır. Shared cache daha dikkatli key tasarımı gerektirir. Security testleri farklı kullanıcıları aynı id üzerinde denemelidir.
Mutation Sonrası Cache'i Temizlememek
Mutation entity'yi değiştirdikten sonra loader eski değeri tutabilir. clear veya prime kullanılabilir. Relation loader'lar da stale hale gelebilir. Aynı request içinde sonraki resolver yanlış veri döndürebilir. Mutation integration testleri bu senaryoyu kapsamalıdır.
DataLoader'ı Redis Cache Sanmak
DataLoader varsayılan olarak request-level batching ve memoization sağlar. Redis request'ler arası shared cache olabilir. İki mekanizmanın yaşam süresi ve invalidation ihtiyacı farklıdır. DataLoader request bittikten sonra uzun süreli cache sağlamaz. İhtiyaca göre iki katman birlikte kullanılabilir.
Sık Yapılan GraphQL Performans Hataları
GraphQL performans sorunları çoğu zaman yalnızca bir teknoloji eksikliğinden değil yanlış varsayımlardan doğar. N+1'i yalnızca ORM problemi görmek resolver ve federation kaynaklı tekrarları gözden kaçırır. Depth limiti koyup complexity kontrolünü unutmak pahalı sığ sorgulara açık kapı bırakır. Pagination, downstream batching ve production query shape gözlemi birlikte yürütülmelidir. Ortalama latency yerine tail latency ve gerçek workload ölçümleri kullanılmalıdır.
N+1'i Yalnızca ORM Problemi Sanmak
N+1 ORM olmadan da kolayca oluşur. Resolver doğrudan SQL veya harici API çağrısı yapabilir. Federation entity resolver da aynı pattern'i üretebilir. Problem tekrarlayan veri erişimi davranışıdır. Çözüm veri kaynağına göre batching veya JOIN olabilir.
Depth Limiti Koyup Complexity'yi Unutmak
Depth yalnızca nested seviye sayısını sınırlar. Sığ ama geniş query pahalı olabilir. Büyük pagination argument'ı depth değerini artırmaz. Field cost ve list multiplier complexity modeline dahil edilmelidir. İki kontrol birlikte kullanılmalıdır.
Pagination'a Maximum Limit Koymamak
İstemcinin first değerini tamamen serbest bırakmak risklidir. Tek request binlerce entity çekebilir. DataLoader query sayısını düşürse bile result set büyüklüğü devam eder. Sunucu maximum page size uygulamalıdır. Nested listeler için de aynı kural geçerlidir.
Her Field İçin Ayrı Downstream Request Atmak
Microservice ortamında her field başka servise ayrı çağrı yapabilir. Bu pattern network seviyesinde N+1 oluşturur. Service-level batch endpoint kullanılabilir. DataLoader key'leri batch endpoint'e yönlendirebilir. Cross-service call count izlenmelidir.
Yalnızca Ortalama Latency Ölçmek
Average latency outlier davranışını gizleyebilir. Kullanıcıların bir bölümü çok daha yavaş response alabilir. p95 ve p99 bu problemi görünür yapar. N+1 ve pool saturation tail latency'de belirgin olabilir. SLO percentile tabanlı kurulmalıdır.
Production Query Shape'lerini İzlememek
Test ortamındaki query örnekleri gerçek kullanıcı davranışını tam temsil etmeyebilir. Production operation fingerprint dağılımı analiz edilmelidir. En sık ve en pahalı query'ler ayrı bulunabilir. Yeni istemci sürümü farklı shape üretebilir. Observability bu değişimi erken gösterir.
totalCount Maliyetini Görmezden Gelmek
Pagination eklemek performans sorununu tamamen çözmeyebilir. Her sayfada COUNT(*) çalıştırmak pahalı olabilir. Büyük tabloda totalCount ayrı bottleneck haline gelir. hasNextPage yeterliyse count kaldırılabilir. Cached veya approximate count değerlendirilebilir.
DataLoader Ekleyip Batch Size'ı Ölçmemek
DataLoader kodda bulunabilir fakat sürekli batch size 1 çalışabilir. Bu durumda N+1 kazanımı beklenen seviyede değildir. Production batch size distribution izlenmelidir. Sequential await veya loader scope sorunu tespit edilebilir. Optimizer yalnızca kod incelemesine güvenmemelidir.
N+1 Optimizasyonu İçin Karar Ağacı
N+1 optimizasyonunda tek çözümü her ilişkiye uygulamak yerine veri erişiminin yapısını sorgulamak daha etkilidir. Relation'ın kaç kez fetch edildiği, her operation'da gerekli olup olmadığı ve başka serviste bulunup bulunmadığı ilk sorulardır. Query depth ve shared cache ihtiyacı da kararı etkiler. Bazı durumlarda DataLoader, bazı durumlarda JOIN veya eager loading daha iyi sonuç verir. Karar ölçüm, query planı ve gerçek workload üzerinden verilmelidir.
Aynı Relation N Kez mi Fetch Ediliyor?
Aynı relation liste boyunca tekrar fetch ediliyorsa N+1 ihtimali yüksektir. SQL log veya tracing ile bu tekrar doğrulanabilir. Query count kayıt sayısıyla birlikte büyüyorsa batching değerlendirilmelidir. Aynı key tekrar ediyorsa memoization da ek fayda sağlar. Önce gerçek tekrar sayısı ölçülmelidir.
Evet → Batching / DataLoader
Resolver key'leri DataLoader üzerinden load edebilir. Loader aynı request içindeki key'leri tek batch function'a gönderir. Database veya servis toplu çağrı desteklemelidir. Ordering ve authorization kuralları korunmalıdır. Sonuç query count testiyle doğrulanmalıdır.
Relation Her Zaman mı Gerekli?
Relation neredeyse bütün operation'larda isteniyorsa eager loading düşünülebilir. Böylece child resolver ek fetch yapmaz. Ancak büyük collection relation'larında result set büyümesi oluşabilir. Field selection metrikleri kullanım oranını gösterebilir. Karar varsayıma dayanmamalıdır.
Evet → JOIN / Eager Loading Değerlendir
Basit one-to-one ilişki için JOIN oldukça verimli olabilir. ORM preload da benzer amaçla kullanılabilir. Query plan ve duplicate row miktarı ölçülmelidir. Pagination davranışı test edilmelidir. DataLoader ile benchmark karşılaştırması yapılabilir.
Child Data Başka Service'te mi?
Child entity ayrı microservice içinde bulunuyorsa SQL JOIN mümkün değildir. Resolver her parent için HTTP çağrısı yaparsa network N+1 oluşur. Service batch endpoint sağlamak önemli kazanç yaratır. DataLoader bu endpoint için request batching katmanı olabilir. Gateway ve service tracing birlikte izlenmelidir.
Evet → Service-Level Batch Endpoint
Batch endpoint birden fazla id değerini tek network call içinde kabul eder. Downstream round trip sayısı azalır. Response input key'lerle güvenli biçimde eşleştirilmelidir. Batch size ve rate limit birlikte düşünülmelidir. Timeout ve partial error politikası açık olmalıdır.
Query Çok Derin mi?
Derin query resolver zinciri ve child listeleri büyütebilir. Yalnızca N+1 çözmek toplam maliyeti kontrol etmek için yeterli değildir. Query depth ölçülmelidir. Complexity list multiplier ile gerçek maliyeti daha iyi temsil eder. Legitimate operation'lar için uygun limit seçilmelidir.
Depth + Complexity Limit
Depth yapısal derinliği sınırlar. Complexity field ve list maliyetini hesaba katar. İki kontrol execution öncesinde uygulanabilir. Aşan request database'e ulaşmadan reddedilebilir. Rate limiting bu modelle birlikte kullanılabilir.
Aynı Veri Request'ler Arasında Tekrar mı Kullanılıyor?
DataLoader yalnızca tek request içindeki tekrarları azaltır. Aynı entity farklı request'lerde sık kullanılıyorsa shared cache değerlendirilebilir. Veri tazeliği ve invalidation ihtiyacı önemlidir. Public ve private veri ayrımı yapılmalıdır. Cache hit rate potansiyel kazancı gösterebilir.
Shared Entity Cache
Redis benzeri cache entity sonuçlarını request'ler arasında saklayabilir. Loader batch function önce cache kontrolü yapabilir. Miss key'ler database'den toplu alınabilir. Mutation sonrası invalidation gerekir. Tenant-aware cache key kullanılmalıdır.
Aynı Operation Çok Sık mı Çalışıyor?
Sık tekrarlanan read operation response caching için uygun olabilir. Operation variables dağılımı incelenmelidir. Kişiselleştirme seviyesi cache edilebilirliği etkiler. Persisted query kimliği stabil cache key sağlar. Hit rate tahmini gerçek trafik verisine dayanmalıdır.
Persisted Query / Response Cache
Persisted query operation kimliğini stabil hale getirir. Response cache sık tekrar eden sonuçları yeniden kullanabilir. Variables ve authentication context doğru key'e dahil edilmelidir. Public data CDN seviyesinde de cache edilebilir. Mutation invalidation politikası unutulmamalıdır.
Örnek Production-Ready GraphQL Data Fetching Akışı
Production-ready GraphQL akışı request geldiği anda authentication ile başlar ve metrics kaydıyla tamamlanır. Query parse ve validation sonrasında depth ve complexity kontrolü yapılabilir. Request-scoped loader'lar context içine eklenir ve resolver load çağrılarını batch haline getirir. Indexed database query ve request-level memoization veri erişimi maliyetini düşürür. Bütün akış tracing ve performans budget ile gözlemlenebilir hale getirilmelidir.
1. Request Authentication
Request önce kullanıcı veya servis kimliği açısından doğrulanır. Authentication sonucu GraphQL context'e eklenir. Tenant bilgisi de bu aşamada belirlenebilir. Loader'lar authorization context ile birlikte oluşturulur. Yetkisiz request pahalı execution başlamadan reddedilir.
2. Query Parse ve Validation
GraphQL dokümanı parse edilir ve schema karşısında doğrulanır. Bilinmeyen field veya hatalı argument burada yakalanır. Persisted query kullanılıyorsa document store üzerinden query bulunabilir. Validation hatasında resolver çalıştırılmaz. Bu aşama güvenlik kontrollerinin temel parçasıdır.
3. Depth / Complexity Kontrolü
Operation'ın depth ve complexity değeri hesaplanır. Pagination argument'ları dynamic cost içine dahil edilebilir. Budget aşılırsa request execution başlamadan reddedilir. Kullanıcı veya tenant bazlı ayrı limit uygulanabilir. Rejection sayısı metric olarak izlenmelidir.
4. Request-Scoped Loader'ların Oluşturulması
Her request için yeni loader instance'ları hazırlanır. Authentication ve tenant context batch function'a aktarılır. Global singleton kullanılmaz. Loader factory çok sayıda veri kaynağını merkezi biçimde yönetebilir. Request tamamlandığında cache de sona erer.
5. Root Resolver
Root resolver temel entity veya liste sorgusunu çalıştırır. Pagination burada uygulanır. Yalnızca gerekli kolonlar alınabilir. Query count baseline içinde tutulmalıdır. Root sonucu child resolver'lara parent veri sağlar.
6. Child Resolver Load Çağrıları
Child resolver doğrudan database'e gitmek yerine loader.load çağrısı yapar. Parent id veya composite key loader'a iletilir. Resolver sonucu promise olarak döndürebilir. Aynı key tekrar edilirse memoization devreye girer. Authorization sınırı context üzerinden korunur.
7. DataLoader Batching
Loader aynı scheduling penceresindeki key'leri toplar. Duplicate key'ler gerektiğinde tekilleştirilir. maxBatchSize sınırı uygulanabilir. Batch function bir veya birkaç toplu query çalıştırır. Batch size metriği kaydedilir.
8. Indexed Database Query
Toplu sorgu uygun index üzerinden çalışmalıdır. Primary veya foreign key index query pattern'ine göre seçilir. EXPLAIN ANALYZE planı doğrular. Query timeout güvenlik sınırı sağlar. Sonuçlar input key sırasına göre map edilir.
9. Per-Request Memoization
Yüklenen değerler request cache içinde tutulur. Aynı key sonraki resolver tarafından tekrar istendiğinde yeni query oluşmaz. Mutation sonrası clear veya prime gerekebilir. Cache başka kullanıcılarla paylaşılmaz. Request sonunda doğal biçimde atılır.
10. Response Serialization
Resolved GraphQL response JSON formatına çevrilir. Büyük response CPU ve network maliyetini artırabilir. Maximum response size izlenebilir. Compression gerektiğinde kullanılabilir. Pagination response büyüklüğünü kontrol altında tutar.
11. Metrics ve Trace Kaydı
Operation latency, query count ve batch size metrikleri kaydedilir. Trace database ve downstream span'ları ilişkilendirir. Response size ve complexity de eklenebilir. Raw variables metric label yapılmamalıdır. Performance budget aşımı alarm üretebilir.
Production'a Çıkmadan Önce GraphQL Performans Kontrol Listesi
Production öncesi kontrol listesi performans hatalarının sürpriz olarak ortaya çıkmasını azaltır. N+1, DataLoader scope, query complexity ve pagination limitleri birlikte doğrulanmalıdır. Database index ve timeout kontrolleri yalnızca uygulama koduna bakılarak geçilmemelidir. Query count ve batch size gerçek operation örneklerinde ölçülmelidir. Load test sonucu performance budget ile karşılaştırılmalıdır.
N+1 Query Test Edildi mi?
Kritik listeler farklı kayıt sayılarıyla çalıştırılmalıdır. SQL query count ölçülmelidir. Kayıt sayısı artarken query sayısının doğrusal büyümediği doğrulanmalıdır. Nested ilişkiler ayrıca test edilmelidir. Regression testi CI'a eklenmelidir.
DataLoader Request-Scoped mu?
Loader her request için yeniden oluşturulmalıdır. Global singleton bulunmamalıdır. Context lifecycle integration test ile doğrulanabilir. İki kullanıcı aynı entity id ile test edilebilir. Cache'in request'ler arasında taşınmadığı görülmelidir.
Batch Result Ordering Doğru mu?
Database sonucu karışık sırada döndürülerek unit test yapılmalıdır. Output input key sırasını takip etmelidir. Missing record için placeholder bulunmalıdır. Duplicate key senaryosu da denenmelidir. Yanlış mapping production öncesinde yakalanmalıdır.
Authorization Loader İçinde Korunuyor mu?
Batch query tenant ve permission sınırını ihlal etmemelidir. Aynı id farklı kullanıcılarla test edilmelidir. Yetkisiz kayıt cache üzerinden dönmemelidir. Error mesajı resource existence bilgisini açığa çıkarmamalıdır. Authorization davranışı performans optimizasyonuyla değişmemelidir.
maxBatchSize Değerlendirildi mi?
Database parameter limitleri bilinmelidir. p95 batch size tahmin edilmeli veya test edilmelidir. Çok büyük IN query benchmark edilmelidir. Gerekirse maxBatchSize uygulanmalıdır. Değer sabit varsayım yerine ölçümle seçilmelidir.
Database Index'leri Var mı?
Batch lookup kolonları uygun index'e sahip olmalıdır. Foreign key ve cursor pagination index'leri ayrıca kontrol edilmelidir. EXPLAIN ANALYZE gerçek planı göstermelidir. Unused index eklememek de önemlidir. Read ve write maliyeti birlikte değerlendirilmelidir.
Pagination Maximum'u Var mı?
Her liste için maksimum page size tanımlanmalıdır. Nested listeler de dahil edilmelidir. İstemcinin aşırı first değeri kabul edilmemelidir. Default page size belirlenmelidir. Integration test limit davranışını doğrulamalıdır.
Query Depth Limiti Var mı?
Schema object graph için makul maximum depth belirlenmelidir. Fragment expansion hesaba katılmalıdır. Legitimate operation'ların limit altında kaldığı doğrulanmalıdır. Limit üstü query execution öncesinde reddedilmelidir. Depth tek başına yeterli kabul edilmemelidir.
Query Complexity Limiti Var mı?
Field cost ve list multiplier tanımlanmalıdır. Runtime argument'lar gerektiğinde hesaba katılmalıdır. Maximum complexity kullanıcı tipine göre değişebilir. Pahalı query örnekleri test edilmelidir. Rejection metriği production'da izlenmelidir.
Timeout Tanımlı mı?
GraphQL operation için timeout bulunmalıdır. Database statement ve external service timeout değerleri toplam budget ile uyumlu olmalıdır. Cancellation propagation desteklenmelidir. Timeout error rate izlenmelidir. Retry davranışı toplam süreyi aşmamalıdır.
Query Count İzleniyor mu?
Operation başına SQL query sayısı production metriği olmalıdır. Critical operation'lar için baseline bulunmalıdır. Ani artış alarm üretebilir. Query fingerprint database tarafında tekrar pattern'lerini gösterebilir. CI aynı metriği regression için kullanabilir.
Resolver Latency İzleniyor mu?
I/O yapan resolver'lar için duration metriği veya trace bulunmalıdır. p95 değerleri özellikle önemlidir. Scalar resolver'lar için aşırı telemetry üretmek gerekmez. Database ve external süreler ayrı görülmelidir. Slow resolver listesi düzenli incelenebilir.
DataLoader Batch Size İzleniyor mu?
Batch size distribution production davranışını doğrular. Batch size 1 oranı takip edilmelidir. p95 değerleri database limitlerine yaklaşmamalıdır. Loader duration ile korelasyon kurulmalıdır. Sadece DataLoader kullanılıyor olması yeterli kabul edilmemelidir.
p95/p99 Operation Latency İzleniyor mu?
Ortalama latency tek başına yeterli değildir. p95 genel kullanıcıların yavaş bölümünü gösterir. p99 tail problemlerini daha net ortaya çıkarır. Operation name veya fingerprint ile kırılım yapılmalıdır. SLO hedefleri bu metriklerle ilişkilendirilebilir.
Load Test Yapıldı mı?
Production benzeri query mix kullanılmalıdır. Concurrency kademeli artırılmalıdır. Warm ve cold cache senaryoları ayrı test edilmelidir. Database CPU ve pool wait izlenmelidir. Test sonucu performance budget ile karşılaştırılmalıdır.
Performance Budget Tanımlandı mı?
Latency, query count ve complexity sınırları yazılı hale getirilmelidir. Page size ve response size da dahil edilebilir. CI gate bu budget'ı otomatik doğrulayabilir. Production alarmı aynı hedefleri izleyebilir. Budget ekip içinde ortak performans standardı oluşturur.
GraphQL Performance Maturity Model
GraphQL performansı zaman içinde gelişen bir mühendislik yetkinliği olarak değerlendirilebilir. İlk seviyede resolver'lar doğrudan veri kaynağına gider ve ölçüm sınırlıdır. Sonraki seviyelerde DataLoader, pagination, caching ve observability eklenir. İleri aşamada CI performance gate ve cost-aware governance devreye girer. Bu model her ekibin mevcut seviyesini görüp bir sonraki yatırımı seçmesine yardımcı olabilir.
Seviye 0: Naive Resolver'lar
Resolver'lar doğrudan database veya servis çağrısı yapar. Query count düzenli ölçülmez. N+1 problemleri veri büyüdükçe ortaya çıkar. Pagination sınırları eksik olabilir. İlk hedef gözlemlenebilirlik ve query count baseline oluşturmaktır.
Seviye 1: DataLoader ile N+1 Önleme
Request-scoped loader'lar relation fetch çağrılarını batch eder. Query count belirgin biçimde düşer. Unit ve integration test ordering davranışını doğrular. Batch size production ortamında ölçülmeye başlanır. Authorization loader tasarımının parçası olur.
Seviye 2: Pagination + Query Limits
Listeler maksimum page size ile sınırlandırılır. Query depth ve complexity kontrolleri eklenir. Büyük argument değerleri execution öncesinde reddedilir. Query DoS riski azalır. Performance budget daha açık hale gelir.
Seviye 3: Multi-Layer Cache
Request cache yanında shared entity veya response cache kullanılır. TTL ve invalidation politikaları tanımlanır. Public ve private data ayrılır. Cache hit rate production metriği haline gelir. Mutation consistency test edilir.
Seviye 4: Resolver-Level Observability
Operation ve resolver latency tracing ile görünür hale gelir. SQL query count, batch size ve cache hit metrikleri birlikte izlenir. Bottleneck tahmin yerine ölçümle bulunur. High-cardinality riskleri kontrol edilir. p95 ve p99 operation SLO'ları tanımlanabilir.
Seviye 5: CI Performance Regression Gates
N+1 regression testleri CI içinde çalışır. Query complexity ve persisted query validation otomatik hale gelir. Representative benchmark performans budget'ı doğrular. Büyük regression deploy öncesinde engellenir. Performance standardı ekip süreçlerine yerleşir.
Seviye 6: Cost-Aware Query Governance
Her operation hesaplanan cost üzerinden yönetilir. Cost-based rate limiting kullanıcı veya tenant budget'ına bağlanır. Persisted query setleri önceden analiz edilir. Federation cross-service maliyeti de modele dahil edilir. Kaynak yönetimi gerçek workload verisiyle sürekli güncellenir.
Sık Sorulan Sorular
GraphQL performansı hakkında sorular çoğu zaman DataLoader ve N+1 çevresinde başlasa da production ortamında kapsam çok daha geniştir. Pagination, query complexity, caching, database index ve observability birlikte düşünülmelidir. Bir optimizasyonun gerçekten işe yarayıp yaramadığı yalnızca kod görünümünden anlaşılmaz. Query count, p95 latency ve batch size gibi ölçümler gerçek sonucu gösterir. Aşağıdaki kısa açıklamalar en sık karşılaşılan teknik soruları özetler.
GraphQL N+1 problemi nedir?
N+1 problemi önce bir liste sorgusu, ardından listedeki her kayıt için ayrı relation sorgusu çalışmasıdır. 100 kayıt için 101 SQL sorgusu oluşabilir. Nested ilişkiler sayıyı daha da büyütebilir. Problem database round trip ve connection pool yükünü artırır. DataLoader veya uygun JOIN stratejisiyle azaltılabilir.
GraphQL'de N+1 problemi neden oluşur?
Field-level resolver modeli her parent için child resolver çalıştırabilir. Resolver bağımsız biçimde database'e giderse tekrar eden sorgular oluşur. ORM lazy loading de aynı davranışı gizlice üretebilir. Federation entity resolver'ları network seviyesinde benzer problem oluşturabilir. Query logging ve tracing kök nedeni gösterir.
DataLoader nedir?
DataLoader request içindeki benzer key fetch işlemlerini batch etmeye yardımcı olan bir mekanizmadır. Aynı key için request-level memoization sağlar. Resolver'lar loader.load ile bağımsız kalabilir. Batch function toplu veri erişimi yapar. Shared Redis cache ile aynı şey değildir.
DataLoader N+1 problemini nasıl çözer?
Resolver'lardan gelen id değerleri kısa bir pencere içinde toplanır. Batch function bütün id'leri tek query ile yükler. Sonuçlar input key sırasına göre resolver'lara dağıtılır. 101 SQL sorgusu iki sorguya yaklaşabilir. Gerçek kazanım query count metriğiyle doğrulanmalıdır.
DataLoader her request için yeniden oluşturulmalı mı?
Evet, genel olarak request-scoped kullanım önerilir. Böylece memoization yalnızca aynı GraphQL operation içinde paylaşılır. Global cache kullanıcılar arasında stale veya yetkisiz veri sızıntısı oluşturabilir. Loader context oluşturulurken hazırlanabilir. Request tamamlandığında loader cache de atılır.
DataLoader cache ile Redis cache arasındaki fark nedir?
DataLoader cache tek request içindeki tekrarları önler. Redis cache birden fazla request veya instance arasında paylaşılabilir. Redis için TTL ve invalidation gerekir. DataLoader cache request sonunda doğal olarak sona erer. İki mekanizma farklı katmanlarda birlikte kullanılabilir.
DataLoader mı JOIN mi daha performanslıdır?
Tek bir kesin cevap yoktur. One-to-one ve her zaman gerekli relation için JOIN çok verimli olabilir. Dinamik GraphQL selection ve yüksek cardinality relation için DataLoader daha dengeli sonuç verebilir. Büyük JOIN duplicate row üretme riski taşır. Karar query planı ve benchmark sonucuyla verilmelidir.
Prisma'da N+1 problemi nasıl çözülür?
Prisma'da include, select, uygun relation query stratejileri ve DataLoader kullanılabilir. Root listede pagination uygulanmalıdır. Relation her zaman gerekli değilse koşulsuz include gereksiz veri çekebilir. Query logging ile gerçek SQL sayısı ölçülmelidir. Özel yoğun sorgularda raw SQL de değerlendirilebilir.
Hibernate GraphQL N+1 problemi nasıl çözülür?
Hibernate tarafında lazy loading davranışı dikkatle incelenmelidir. Fetch join, EntityGraph ve batch fetch size farklı senaryolarda kullanılabilir. GraphQL DataLoader relation resolver'larını batch edebilir. Hibernate SQL log ve statistics gerçek query sayısını gösterir. Yaklaşım relation cardinality ve query shape'e göre seçilmelidir.
Query complexity nedir?
Query complexity GraphQL operation'ın tahmini kaynak maliyetini puanlamaya yarar. Field cost, list multiplier ve argument değerleri hesaba katılabilir. Maximum complexity aşılırsa execution başlamadan request reddedilebilir. Depth limitinden daha fazla maliyet sinyali kullanır. Production ölçümleri cost değerlerini iyileştirmeye yardımcı olur.
Query depth nedir?
Query depth nested field seviyelerinin derinliğini ifade eder. Çok derin object graph resolver zincirini büyütebilir. Maximum depth aşımı execution öncesinde engellenebilir. Fragment'lar hesaplamaya dahil edilmelidir. Depth tek başına query maliyetini tam göstermez.
GraphQL query depth kaç olmalıdır?
Her schema için geçerli tek bir ideal sayı yoktur. Production operation'larının normal depth dağılımı incelenmelidir. Limit legitimate query'leri engellemeyecek ama aşırı nested kullanımı sınırlayacak seviyede olmalıdır. Complexity kontrolü birlikte uygulanmalıdır. Değer kullanım verisine göre zamanla güncellenebilir.
GraphQL query complexity nasıl hesaplanır?
Her field için temel cost tanımlanabilir. Nested listeler child cost değerini page size ile çarpabilir. first veya limit gibi runtime argument'lar modele dahil edilebilir. Search ve aggregation alanları daha yüksek maliyet alabilir. Toplam değer operation budget ile karşılaştırılır.
GraphQL'de pagination neden önemlidir?
Pagination database ve response boyutunu sınırlar. DataLoader kullanılsa bile on bin entity almak pahalıdır. Maximum page size sınırsız resource kullanımını engeller. Nested listelerde de pagination gerekir. Cursor veya offset yaklaşımı veri yapısına göre seçilebilir.
Cursor pagination mı offset pagination mı daha iyidir?
Küçük veri setlerinde offset son derece pratik olabilir. Büyük ve sürekli değişen veri setinde cursor daha stabil olabilir. Cursor uygun index ile büyük offset taramasını önleyebilir. Sayfa numarası deneyiminde offset daha kolaydır. Karar kullanım ihtiyacı ve query planına göre verilmelidir.
Persisted query nedir?
Persisted query önceden bilinen GraphQL dokümanının hash veya id ile çağrılmasıdır. Network payload'ı küçültebilir. Cache key üretimini kolaylaştırabilir. Trusted documents yaklaşımıyla arbitrary query kullanımı sınırlandırılabilir. APQ ile allowlist aynı güvenlik anlamına gelmez.
GraphQL response cache edilebilir mi?
Evet, uygun operation'lar full response cache'e alınabilir. Cache key operation, variables ve gerekli authentication context'i içermelidir. Public ve private data birbirinden ayrılmalıdır. Mutation sonrası invalidation tasarlanmalıdır. Persisted query cache key yönetimini kolaylaştırabilir.
GraphQL CDN üzerinde cache edilebilir mi?
Public read operation'ları uygun yapılandırmayla CDN üzerinde cache edilebilir. Persisted query ve GET kullanımı bu süreci kolaylaştırabilir. Personalized response public edge cache'e konulmamalıdır. Cache key variables değerini doğru temsil etmelidir. Cache-Control politikası backend davranışıyla uyumlu olmalıdır.
GraphQL Federation'da N+1 nasıl çözülür?
Gateway ve subgraph seviyeleri ayrı incelenmelidir. Entity reference'lar batch halinde subgraph'a gönderilebilir. Subgraph içinde __resolveReference request-scoped DataLoader kullanabilir. Cross-service round trip sayısı query plan üzerinden izlenmelidir. Gateway batching database N+1 problemini tek başına çözmez.
N+1 problemi production'da nasıl tespit edilir?
Operation başına SQL query count temel sinyaldir. Aynı SQL fingerprint'in tekrar sayısı izlenebilir. Resolver execution count ve DataLoader batch size ek bilgi sağlar. Database pool wait saturation etkisini gösterir. Distributed tracing bütün çağrı zincirini görünür hale getirir.
GraphQL API performansı hangi metriklerle ölçülmelidir?
Request rate, error rate, p50, p95 ve p99 latency temel metriklerdir. SQL queries per operation ve resolver p95 kök neden analizi için değerlidir. DataLoader batch size ve cache hit rate veri erişimi verimliliğini gösterir. Query complexity ve response size kaynak maliyetini tamamlar. Federation varsa subgraph latency ve cross-service call count da izlenmelidir.
DataLoader batch size kaç olmalıdır?
Tek bir ideal sayı yoktur. Database parameter limitleri ve gerçek trafik dağılımı karar üzerinde etkilidir. p50 ve p95 batch size production'da ölçülmelidir. Çok büyük batch query planını kötüleştirebilir. maxBatchSize benchmark sonucu belirlenmelidir.
GraphQL API load test nasıl yapılır?
Gerçekçi query mix ve concurrent user profili oluşturulmalıdır. Nested query, warm cache ve cold cache senaryoları ayrı denenmelidir. p95 ve p99 latency yanında database CPU ve pool wait izlenmelidir. k6 veya Artillery gibi araçlar workload üretmek için kullanılabilir. Sonuçlar tanımlı performance budget ile karşılaştırılmalıdır.
Ek Sık Sorulan Sorular
GraphQL performans projelerinde teknik ekiplerin yanı sıra ürün ve operasyon ekipleri de benzer sorular sorar. Özellikle sorgu sürelerinin azaltılması, N+1'in etkisi ve danışmanlık kapsamı sık gündeme gelir. Bu soruların yanıtı tek bir araçtan ziyade ölçüm, veri erişimi ve kapasite yönetiminin birlikte ele alınmasını gerektirir. Kurumsal GraphQL API performans optimizasyon hizmeti arayan ekipler için öncelikle mevcut workload ve production metrikleri değerlendirilmelidir. GraphQL performans ve backend danışmanlığı yakınımda araması yapan ekipler de teknik deneyimi, ölçüm yöntemini ve sürdürülebilir iyileştirme yaklaşımını birlikte değerlendirmelidir.
GraphQL performansı nasıl optimize edilir ve sorgu süreleri nasıl azaltılır?
İlk adım p95 latency, SQL query count ve resolver duration gibi metriklerle baseline oluşturmaktır. Ardından N+1, waterfall, limitsiz pagination ve kötü database query planları öncelik sırasına göre ele alınır. DataLoader, JOIN, caching ve cursor pagination gibi yöntemler ölçüm sonucuna göre seçilir. Complexity ve timeout kontrolleri kaynak tüketimini sınırlar. Optimizasyon sonrası aynı workload yeniden benchmark edilerek gerçek kazanım doğrulanır.
GraphQL’de N+1 problemi nedir ve neden performans sorunlarına yol açar?
N+1 problemi bir ana liste sorgusundan sonra her kayıt için ayrı veri erişimi yapılmasıdır. Bu durum 100 kayıt için 101 veya daha fazla SQL sorgusu oluşturabilir. Her sorgu network round trip, database CPU ve connection kullanım maliyeti taşır. Trafik arttığında connection pool wait ve p95 latency hızla yükselebilir. Batching bu tekrar eden erişimleri daha az sayıda toplu sorguya dönüştürür.
DataLoader kullanılarak GraphQL N+1 sorgu problemi nasıl çözülür?
Resolver'lar doğrudan veri kaynağına gitmek yerine request-scoped loader üzerinden key gönderir. DataLoader aynı execution penceresindeki key'leri toplar. Batch function bütün key'leri tek WHERE IN sorgusu veya service batch endpoint üzerinden yükler. Sonuçlar input key sırasına göre resolver'lara geri dağıtılır. Query count ve batch size metrikleri uygulamanın gerçekten batching yaptığını doğrular.
GraphQL API’lerinde caching, batching, pagination ve query complexity kontrolleri nasıl uygulanmalıdır?
Batching request seviyesinde N+1 tekrarlarını azaltır. Caching aynı verinin gereksiz yeniden hesaplanmasını veya fetch edilmesini önler. Pagination liste büyüklüğünü sınırlar. Query complexity pahalı operation'ları execution öncesinde kontrol eder. Bu katmanların birlikte uygulanması GraphQL Performans İyileştirmeleri ve N+1 Problemi için daha sürdürülebilir bir production modeli oluşturur.
GraphQL performans optimizasyonu ve N+1 problemi çözümü konusunda yakınımda danışmanlık veya eğitim nerede bulabilirim?
Diyarbakır Yazılım Topluluğu'nun çalışma alanları ve teknik projeleri incelenerek backend ve GraphQL konularındaki yaklaşım hakkında fikir edinilebilir. Projeler için https://www.diyarbakiryazilim.com.tr/projects adresi kullanılabilir. Topluluk ve çalışma odağı hakkında daha fazla bilgi için https://www.diyarbakiryazilim.com.tr/about adresi ziyaret edilebilir. Danışmanlık ihtiyacında mevcut schema, resolver yapısı, database query count ve production metrikleriyle başlamak daha doğru sonuç verir. Böylece yalnızca belirtiye değil, sistemin gerçek darboğazına yönelik bir iyileştirme planı oluşturulabilir.
Sonuç: GraphQL Performansını Sürdürülebilir Şekilde Nasıl İyileştirirsiniz?
GraphQL performansını sürdürülebilir biçimde iyileştirmek tek bir DataLoader eklemekten daha geniş bir yaklaşım gerektirir. N+1 çözülse bile pagination, query complexity, caching, database index ve federation round trip problemleri devam edebilir. En doğru yöntem önce production davranışını ölçmek, sonra en pahalı veri erişimini azaltmak ve sonucu aynı metriklerle tekrar doğrulamaktır. GraphQL Performans İyileştirmeleri ve N+1 Problemi bu nedenle resolver kodu kadar database ve observability disiplinini de kapsar. Kurumsal ölçekte performans çalışması planlıyorsanız Diyarbakır Yazılım Topluluğu'nun teknik çalışma ve proje yaklaşımını https://www.diyarbakiryazilim.com.tr/about üzerinden inceleyebilirsiniz.
N+1'i Resolver Seviyesinde Görünmez Bir Maliyet Olarak Ele Alın
Tek resolver çağrısı hızlı görünebilir. Aynı resolver yüz kez çalıştığında toplam maliyet büyük hale gelir. Bu yüzden resolver execution count ve SQL query count birlikte izlenmelidir. N+1 küçük test verisinde görünmese bile production trafiğinde ciddi sonuç doğurabilir. Veri erişimi operation seviyesinde değerlendirilmelidir.
DataLoader'ı Request-Scoped Batching Mekanizması Olarak Kullanın
Loader her request için ayrı oluşturulmalıdır. Resolver'lar aynı instance üzerinden load çağrısı yapmalıdır. Batch function ordering ve missing key kurallarını korumalıdır. Authorization ve tenant context veri erişimine dahil edilmelidir. Batch size production ortamında mutlaka ölçülmelidir.
JOIN, Eager Loading ve DataLoader Arasında Ölçerek Karar Verin
Her relation için DataLoader zorunlu değildir. Basit one-to-one ilişki JOIN ile daha hızlı olabilir. Dinamik field selection DataLoader kullanımını daha uygun hale getirebilir. Eager loading her zaman gereken relation için sade çözüm sunabilir. Karar query planı ve benchmark verisine dayanmalıdır.
Pagination ve Query Complexity'yi Güvenlik Kontrolü Haline Getirin
Pagination backend workload büyüklüğünü sınırlar. Complexity sorgunun tahmini maliyetini execution öncesinde kontrol eder. Depth limiti ek yapısal koruma sağlar. Cost-based rate limit pahalı operation'ları daha adil biçimde sınırlar. Bu kontroller performans kadar güvenlik açısından da önemlidir.
Cache Katmanlarını Birbirinden Ayırın
DataLoader cache request-level memoization sağlar. Redis entity cache request'ler arasında veri paylaşabilir. Response cache bütün operation sonucunu saklayabilir. CDN yalnızca uygun public response'larda kullanılmalıdır. Her katmanın TTL, key ve invalidation kuralı ayrı tanımlanmalıdır.
Database Query Count'u Birinci Sınıf GraphQL Metriği Yapın
SQL query count N+1 problemini doğrudan görünür hale getirir. Operation fingerprint ile ilişkilendirildiğinde regression kolay bulunur. CI testinde budget kullanılabilir. Production'da anormal artış alarm oluşturabilir. Query count latency ve database CPU ile birlikte değerlendirilmelidir.
DataLoader Batch Size'ı Production'da İzleyin
Loader kodda bulunuyor diye batching çalışıyor varsayılmamalıdır. Batch size 1 oranı açık sinyal sağlar. p50 ve p95 dağılımları gerçek trafik davranışını gösterir. Büyük batch query latency ile ilişkilendirilebilir. Gerektiğinde scheduling ve maxBatchSize ayarları ölçümle değiştirilmelidir.
Federation'daki Cross-Service N+1'i Ayrı Optimize Edin
Federation ortamında database query sayısı kadar network round trip de önemlidir. Gateway query planı sequential fetch davranışını gösterebilir. Entity batching subgraph çağrılarını azaltır. Subgraph içinde request-scoped DataLoader database N+1'i çözer. Gateway ve subgraph metrikleri aynı trace içinde izlenmelidir.
CI'da N+1 Regression Testleri Çalıştırın
Performance regression yalnızca production'da fark edilmemelidir. Critical operation'lar test database üzerinde çalıştırılabilir. Kayıt sayısı büyürken SQL sayısının sabit kaldığı doğrulanabilir. Query complexity ve pagination limitleri aynı pipeline'da test edilebilir. Böylece performans standartları kod değişiklikleri boyunca korunur.
GraphQL Performansını Tek Bir DataLoader Çözümü Değil Uçtan Uca Veri Erişimi ve Query Cost Yönetimi Problemi Olarak Ele Alın
DataLoader N+1 için güçlü bir araçtır fakat bütün performans problemlerini çözmez. Database index, query planı, pagination, caching, timeout ve response size aynı sistemin parçalarıdır. Federation kullanılıyorsa cross-service çağrılar ayrıca ölçülmelidir. Production observability optimizasyonların gerçekten değer üretip üretmediğini gösterir. İyi sonuç, tek bir teknik seçimden değil ölçülen ve düzenli olarak doğrulanan uçtan uca veri erişimi tasarımından gelir.
share: