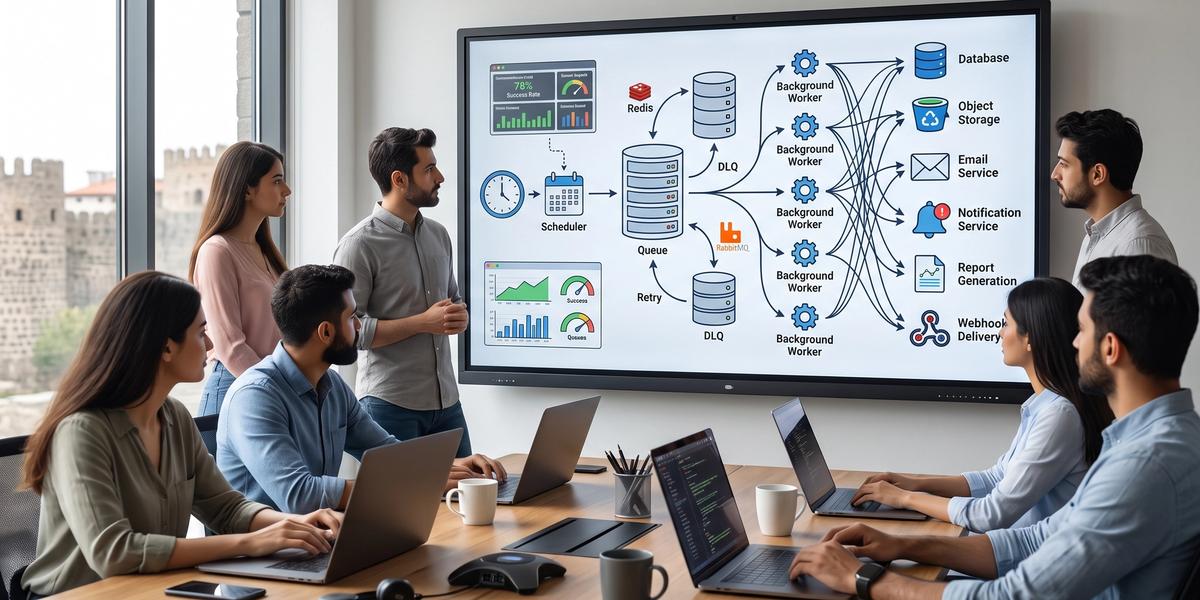
Zamanlanmış Görevler (Cron Jobs) ve Arka Plan İşleyicileri

Diyarbakır Yazılım
16.08.2026
#Yazılım#Teknoloji#Topluluk
Bir uygulamada kullanıcı hiçbir şey yapmadan her gece rapor oluşturmak, belirli aralıklarla yedek almak, binlerce e-postayı sıraya koymak veya uzun süren veri işlemlerini web isteğinden ayırmak istediğinizde aynı soru karşınıza çıkar: Bu işi nerede ve nasıl çalıştırmalıyım? Zamanlanmış Görevler (Cron Jobs) ve Arka Plan İşleyicileri bu sorunun iki temel parçasını oluşturur, fakat ikisini aynı şey gibi düşünmek üretim ortamında beklenmedik sorunlara yol açabilir. Yaklaşık on yıllık backend geliştirme deneyimimde en sık gördüğüm sorunlardan biri, aslında queue üzerinden yürütülmesi gereken ağır bir işlemin doğrudan cron satırına yazılmasıdır. Küçük projede sorunsuz görünen bu yaklaşım, trafik ve veri miktarı arttığında çakışan görevler, çift kayıtlar, kayıp işler ve izlenemeyen hatalar üretmeye başlayabilir. Bu rehberde cron job ve arka plan görevleri nasıl oluşturulur, Linux sunucuda zamanlanmış görevler cron ile nasıl yönetilir, cron job ile background worker ve job queue arasındaki farklar ve production ortamında güvenilir otomasyon mimarisinin nasıl kurulacağı adım adım ele alınacaktır.
Zamanlanmış Görev Nedir?
Zamanlanmış görev, belirlenmiş bir zaman veya tekrar kuralı gerçekleştiğinde otomatik olarak başlatılan iştir. Bu görev gece alınan veritabanı yedeği kadar basit olabileceği gibi, günlük raporların hazırlanıp kullanıcıya gönderilmesini başlatan bir süreç de olabilir. Burada önemli nokta, zamanlamanın işi mutlaka kendisinin yapmak zorunda olmamasıdır. Sağlıklı bir mimaride scheduler çoğu zaman yalnızca doğru zamanda bir iş üretir ve gerçek işleme queue ile worker katmanına bırakılır. Böylece zamanlama, yürütme, yeniden deneme ve ölçeklendirme sorumlulukları birbirinden ayrılır.
Cron Job Nedir?
Cron job, Unix ve Linux tabanlı sistemlerde bir komutun belirli zamanlarda otomatik çalıştırılmasını sağlayan görev tanımıdır. Örneğin her gece saat 03.00'te yedek scripti başlatmak veya her beş dakikada bir geçici kayıtları kontrol etmek için cron kullanılabilir. Cron'un güçlü tarafı basit, yaygın ve işletim sistemi seviyesinde kolay erişilebilir olmasıdır. Buna karşılık cron tek başına gelişmiş retry, dağıtık kilitleme, job geçmişi veya queue yönetimi sağlamaz. Bu nedenle cron'u bir iş yürütme platformundan çok güvenilir bir zaman tetikleyicisi olarak düşünmek genellikle daha doğru sonuç verir.
Background Job Nedir?
Background job, kullanıcı isteğinin tamamlanmasını bekletmeden arka planda çalıştırılan görevdir. Örneğin kullanıcı CSV dışa aktarma talebi verdiğinde HTTP isteğini birkaç dakika açık tutmak yerine bir job oluşturabilir ve işi worker'a devredebilirsiniz. Kullanıcıya talebin alındığı hemen bildirilir, worker dosyayı hazırlar ve süreç tamamlandığında kullanıcıya bildirim gönderilir. Bu model uygulamanın yanıt sürelerini düşürür ve ağır işlerin web sunucularından ayrılmasını sağlar. Ayrıca retry, concurrency, priority ve monitoring gibi üretim ortamı ihtiyaçlarının daha kontrollü yönetilmesine yardımcı olur.
Scheduler Nedir?
Scheduler, belirli bir görevin ne zaman başlatılması gerektiğine karar veren bileşendir. Cron daemon, systemd timer, Celery Beat, BullMQ Job Scheduler ve Kubernetes CronJob bu rolün farklı örnekleridir. Scheduler'ın temel sorusu genellikle "hangi iş ne zaman tetiklenmeli?" şeklindedir. İdeal tasarımda scheduler uzun hesaplamaları doğrudan üstlenmez ve mümkünse queue'ya küçük bir job mesajı bırakır. Bu ayrım scheduler'ın hızlı kalmasını ve gerçek işin bağımsız worker kapasitesiyle ölçeklenmesini sağlar.
Worker Nedir?
Worker, queue'dan görev alan ve gerçek iş mantığını çalıştıran süreçtir. E-posta oluşturmak, görsel dönüştürmek, API çağrısı yapmak veya rapor üretmek worker'ın üstlenebileceği işlere örnektir. Worker sayısını artırarak aynı kuyruktaki işlerin daha hızlı tüketilmesi mümkün olur. Fakat worker tasarımında timeout, idempotency, retry ve graceful shutdown gibi konular baştan ele alınmalıdır. Yalnızca "mesajı al ve fonksiyonu çalıştır" yaklaşımı küçük testlerde yeterli görünse de production ortamında güvenilirlik için daha fazla kontrol gerekir.
Queue Nedir?
Queue, yapılmayı bekleyen job'ların worker'lara ulaştırılmadan önce tutulduğu ara katmandır. Producer yeni bir görev oluşturur, queue bu görevi saklar ve uygun worker işi alarak çalıştırır. Bu yapı ani trafik artışlarında gelen bütün işleri aynı anda çalıştırmak yerine yükün zamana yayılmasına yardımcı olur. Redis tabanlı çözümler, RabbitMQ veya veritabanı tabanlı kuyruklar farklı ihtiyaçlara göre bu görevi üstlenebilir. Queue seçerken yalnızca hız değil persistence, acknowledgement, operasyon maliyeti, teslim garantileri ve hata davranışı da değerlendirilmelidir.
Zamanlama ile Asenkron İşleme Arasındaki Fark
Zamanlama bir işin ne zaman başlaması gerektiğiyle, asenkron işleme ise işin kullanıcı isteğinden bağımsız nasıl yürütüleceğiyle ilgilenir. Her cron job background job olabilir, fakat her background job cron tarafından başlatılmaz. Örneğin gece 02.00'de başlayan rapor zaman tabanlıdır, ödeme sonrası gönderilen fatura e-postası ise olay tabanlıdır. Buna rağmen iki iş de aynı queue ve worker altyapısını kullanabilir. Bu ayrımı erken yapmak mimarinin zamanla büyümesini kolaylaştırır ve cron job ile background worker ve job queue arasındaki farklar konusunda en temel zihinsel modeli oluşturur.
Cron Job ile Background Worker Arasındaki Fark
Cron job ile worker karşılaştırılırken bunları birbirinin alternatifi gibi görmek sık yapılan bir hatadır. Cron ağırlıklı olarak zamanı takip eder, worker ise yapılacak işi işler. Üretim ortamında bu iki yapı çoğu zaman birlikte kullanılır ve aralarına queue eklenir. Böylece cron yalnızca görevin zamanının geldiğini bildirirken worker gerçek yükü taşır. Bu ayrım, uzun süren veya başarısız olabilecek işlerde operasyonel kontrolü belirgin biçimde artırır.
Time-Driven Execution
Time-driven execution, bir işlemin belirli bir saate veya periyoda göre başlatılmasıdır. "Her gün 01.30'da çalış", "her pazartesi rapor oluştur" ve "beş dakikada bir kontrol et" gibi kurallar bu modele girer. Cron expression veya scheduler ayarı burada ana tetikleyicidir. İşin başlaması kullanıcı hareketine bağlı olmadığı için schedule doğruluğu ve time zone yönetimi önem kazanır. Özellikle finansal kapanış veya yedek süreçlerinde geç başlayan ya da hiç başlamayan görevlerin ayrıca izlenmesi gerekir.
Event-Driven Execution
Event-driven execution, belirli bir olay oluştuğunda job başlatılması anlamına gelir. Kullanıcı kayıt olduğunda hoş geldin e-postası oluşturmak veya sipariş tamamlandığında fatura üretmek buna örnektir. Burada tetikleyici saat değil uygulamada gerçekleşen olaydır. Olay doğrudan worker'a bağlanmak yerine queue'ya yazıldığında hata izolasyonu ve ölçeklendirme daha kolay yönetilebilir. Trafik arttıkça bu fark özellikle önem kazanır çünkü event sayısı zaman tabanlı görevlerden çok daha değişken olabilir.
Scheduler'ın Görevi
Scheduler'ın görevi işi doğru zamanda üretmek veya başlatmaktır. İşin bütün veri işleme sürecini scheduler içinde yürütmek çoğu production sistemi için gereksiz risk oluşturur. Scheduler kısa sürede tamamlanan bir enqueue işlemi yaparsa bir sonraki schedule için hızlı şekilde hazır hale gelir. Ayrıca worker tarafındaki concurrency değişiklikleri scheduler tasarımını etkilemez. Ben pratikte scheduler'ı mümkün olduğunca küçük tutmayı ve iş mantığının tamamını test edilebilir worker fonksiyonlarına taşımayı tercih ederim.
Worker'ın Görevi
Worker'ın görevi kendisine teslim edilen job'ı kurallara uygun şekilde tamamlamak ve sonucu kaydetmektir. Başarılı işlemden sonra acknowledgement vermesi, geçici hata varsa retry mekanizmasını kullanması ve kalıcı hata oluştuğunda job'ı uygun hata akışına taşıması beklenir. Worker aynı zamanda job ID, attempt sayısı ve correlation ID gibi bilgileri loglara eklemelidir. Böylece bir sorun olduğunda tek bir job'ın yaşam döngüsü uçtan uca izlenebilir. Worker'ın operasyonel sorumlulukları kodun kendisi kadar önemli olduğu için gözlemlenebilirlik sonradan eklenen bir özellik olmamalıdır.
Cron'un Doğrudan Ağır İş Yapmasının Riskleri
Cron içinde saatler süren bir script çalıştırmak ilk başta kolay görünür, fakat önceki çalıştırma bitmeden sonraki schedule geldiğinde iki süreç aynı anda başlayabilir. Aynı kayıtların iki kez işlenmesi, veritabanında lock yarışları ve CPU kullanımının aniden yükselmesi bu durumun tipik sonuçlarıdır. Script yarıda çökerse cron çoğu zaman hangi kayıtta kaldığını veya hangi parçanın yeniden denenmesi gerektiğini kendi başına bilemez. Ayrıca deployment sırasında çalışan süreçlerin nasıl sonlandırılacağı belirsiz hale gelebilir. Bu nedenle ağır işleri parçalara bölerek queue üzerinden worker'lara dağıtmak daha güvenilir bir yaklaşım oluşturur.
Scheduler → Queue → Worker Pattern
Bu pattern production otomasyonlarında en kullanışlı yapılardan biridir. Scheduler zamanı geldiğinde yalnızca küçük bir job oluşturur, queue görevi saklar ve worker uygun kapasite olduğunda işi işler. Worker başarısız olduğunda queue retry politikasını uygulayabilir ve belirlenen deneme sayısı aşıldığında job DLQ'ya taşınabilir. Scheduler ile worker birbirinden ayrıldığı için worker sayısı bağımsız biçimde artırılabilir veya azaltılabilir. Özellikle kurumsal cron job ve background worker otomasyon hizmeti tasarlanırken bu yapı güvenilir bir başlangıç noktası sunar.
Bir İş Ne Zaman Arka Plana Taşınmalıdır?
Her işlemi background job yapmak doğru olmadığı gibi bütün işlemleri HTTP isteği içinde tutmak da sürdürülebilir değildir. Karar verirken kullanıcının sonucu ne kadar hızlı beklediğine, işlemin ne kadar sürdüğüne ve geçici hatalara açık olup olmadığına bakmak gerekir. Harici servis bağlantıları, büyük dosyalar ve toplu veri işlemleri background execution için güçlü adaylardır. Ayrıca işin retry edilmesi gerekiyorsa queue kullanımı süreci daha yönetilebilir hale getirir. Aşağıdaki durumlar pratik karar vermek için iyi bir çerçeve sunar.
Kullanıcının Sonucu Hemen Beklemediği İşler
Kullanıcı işlemin sonucunu aynı ekran isteği içinde görmek zorunda değilse arka plana taşıma değerlendirilebilir. Örneğin hesap özeti oluşturma veya büyük veri dışa aktarma süreci birkaç dakika sürebilir. Kullanıcıya "hazırlanıyor" durumu gösterip sonucu daha sonra sunmak hem kullanıcı deneyimini hem sunucu kaynaklarını iyileştirir. Job'ın durumunu ayrı bir status alanında saklamak sürecin takip edilmesini kolaylaştırır. Tamamlandığında uygulama içi bildirim veya e-posta ile bilgi verilebilir.
Uzun Süren İşlemler
HTTP timeout sınırına yaklaşabilecek her işlem background job adayıdır. Uzun hesaplamalar web sunucusunun worker slotlarını gereksiz yere meşgul edebilir ve diğer isteklerin gecikmesine neden olabilir. Queue kullanıldığında uzun işler ayrı worker havuzunda çalıştırılabilir. Gerekirse işlem chunk'lara bölünerek checkpoint noktaları eklenebilir. Böylece tek bir başarısızlık bütün süreci sıfırdan başlatmak zorunda bırakmaz.
Retry Gerektiren İşlemler
Geçici hatalarla karşılaşması normal olan işler genellikle queue üzerinden daha güvenli yürütülür. Ağ kesintısı, geçici veritabanı problemi veya HTTP 503 yanıtı nedeniyle kullanıcı isteğinin doğrudan başarısız olması her zaman gerekli değildir. Background worker hatayı sınıflandırıp kontrollü bir gecikmeyle tekrar deneyebilir. Maksimum deneme sayısı aşıldığında job DLQ'ya gönderilebilir ve ekip bilgilendirilebilir. Böylece retry davranışı uygulamanın farklı noktalarına dağılmak yerine merkezi bir politika haline gelir.
Harici API Çağrıları
Harici API'ler sizin kontrolünüz dışında olduğu için gecikme ve geçici hata ihtimali taşır. API yanıt vermediğinde web isteğini uzun süre açık tutmak yerine işi kuyruğa almak daha dayanıklı bir seçenek olabilir. Worker timeout, rate limit ve Retry-After bilgisini ayrı olarak yönetebilir. Provider destekliyorsa idempotency key kullanmak tekrar denemelerde çift yan etki riskini azaltır. REST API tarafındaki sürüm değişikliklerini yönetme yaklaşımı için https://www.diyarbakiryazilim.com.tr/posts/rest-api-versiyonlama-stratejileri-ve-istemci-yonetimi adresindeki içerik de yararlı bir devam kaynağıdır.
Toplu Veri İşleme
On binlerce kaydın tek işlemde güncellenmesi web isteği içinde yönetilmesi zor bir yüktür. Bu tür işleri küçük batch'lere bölmek hem veritabanı üzerindeki baskıyı azaltır hem hata sonrasında kaldığınız yerden devam etmeyi kolaylaştırır. Her batch ayrı job olarak kuyruğa alınabilir ve worker kapasitesine göre paralel işlenebilir. Ancak paralellik yükseltilirken database connection sayısı ve lock davranışı gözlenmelidir. Hız kazanmak için veritabanını boğmak sağlıklı bir optimizasyon değildir.
Dosya ve Medya İşleme
Görsel resize, video dönüştürme, PDF üretme veya arşiv hazırlama gibi işler çoğunlukla yoğun kaynak tüketir. Dosyanın tamamını queue mesajına koymak yerine object storage üzerinde saklayıp job payload içinde referans taşımak daha uygun olur. Worker gerekli dosyayı indirir, işlemi tamamlar ve çıktıyı tekrar depolama alanına yazar. Büyük medya görevleri için CPU ve memory limitlerini diğer worker türlerinden ayrı tanımlamak faydalıdır. Bu ayrım normal e-posta veya webhook job'larının ağır medya işleri yüzünden beklemesini önler.
E-posta ve Bildirim
E-posta ve push notification işlemleri background worker için klasik kullanım alanlarıdır. Kullanıcı kaydı sırasında e-posta sağlayıcısının yanıtını bekletmek yerine job oluşturmak uygulamanın daha hızlı cevap vermesini sağlar. Worker sağlayıcı limitlerine göre gönderim hızını ayarlayabilir ve geçici hatalarda retry uygulayabilir. Aynı bildirimin iki kez gönderilmesini önlemek için idempotency veya unique constraint kullanılabilir. Kritik bildirimler için ayrı priority queue kullanmak da toplu kampanya mesajlarının önemli mesajları geciktirmesini engeller.
Rapor Oluşturma
Büyük raporlar çoğu zaman çok sayıda sorgu, hesaplama ve dosya üretimi gerektirir. Bu süreci request-response döngüsünden çıkarmak web uygulamasının performansını daha öngörülebilir hale getirir. Rapor job'ı başladığında durum "processing", tamamlandığında "completed" olarak saklanabilir. Üretilen dosya object storage'a koyulup kullanıcıya kısa süreli indirme bağlantısı sunulabilir. Periyodik raporlarda scheduler yalnızca rapor job'ını queue'ya ekler ve gerçek hesaplamayı worker gerçekleştirir.
Webhook İşleme
Webhook endpoint'i genellikle gönderici sisteme hızlı bir HTTP yanıtı döndürmelidir. Gelen payload doğrulandıktan ve güvenli biçimde kaydedildikten sonra ağır işin queue'ya aktarılması iyi bir uygulamadır. Böylece dış sistem gereksiz yere yanıt beklemez ve sizin uygulamanız retry politikasını kendi kontrolünde yönetebilir. Event ID veya provider tarafından verilen benzersiz anahtar kullanılarak aynı webhook'un tekrar gönderilmesi güvenli hale getirilebilir. Webhook consumer tasarımında signature doğrulaması ile idempotency birlikte ele alınmalıdır.
Hangi İşler Senkron Kalmalıdır?
Background job kullanmak güçlüdür, fakat her küçük işi kuyruğa göndermek gereksiz altyapı maliyeti oluşturabilir. Kullanıcının sonraki adıma geçebilmesi için sonucun hemen bilinmesi gereken işlemler senkron kalmaya daha uygundur. Çok kısa ve düşük hata ihtimalli veritabanı işlemleri de genellikle doğrudan request içinde tamamlanabilir. Ayrıca aynı transaction içinde kesin biçimde tamamlanması gereken temel iş kurallarını sırf queue kullanmak için bölmek veri tutarsızlığı yaratabilir. Burada amaç her şeyi asenkron yapmak değil, doğru işi doğru yürütme modeline yerleştirmektir.
Kullanıcının Sonucu Görmeden Devam Edemediği İşler
Giriş doğrulaması, form validation veya ödeme öncesi stok kontrolü gibi sonuçlar kullanıcının sonraki adımını doğrudan belirleyebilir. Böyle durumlarda sonucu background worker'a bırakmak gereksiz bir bekleme durumu yaratır. Kullanıcı "başarılı mı, başarısız mı?" sorusuna hemen cevap bekliyorsa işlem mümkün olduğunca senkron tutulmalıdır. Elbette işlemin ardından yapılabilecek e-posta veya analitik kaydı gibi yan işler yine queue'ya gönderilebilir. Böylece kritik sonuç senkron, ikincil yan etkiler asenkron yürütülür.
Çok Kısa ve Güvenilir İşlemler
Birkaç milisaniyede tamamlanan ve dış servise bağlı olmayan işlemleri queue'ya taşımak her zaman avantaj sağlamaz. Queue kullanımı serialization, broker erişimi, worker tüketimi ve monitoring gibi ek bileşenler getirir. Bu maliyet, küçük bir veritabanı güncellemesinden daha yüksek olabilir. Eğer işlem kısa, deterministik ve mevcut transaction içinde güvenli biçimde tamamlanabiliyorsa senkron kalması daha anlaşılır olur. Tasarım kararını sadece "background daha ölçeklenebilir" düşüncesiyle vermek yerine gerçek ölçümlere dayandırmak gerekir.
Transaction İçinde Kalması Gereken İş Mantığı
Bazı iş kuralları birden fazla veritabanı değişikliğinin birlikte başarılı veya birlikte başarısız olmasını gerektirir. Bu parçaların birini queue'ya taşımak transaction sınırını bölebilir ve ara durumda kayıt bırakabilir. Örneğin sipariş oluşturma ile stok rezervasyonu kesin atomiklik gerektiriyorsa veri modeli buna göre tasarlanmalıdır. Queue publish işleminin transaction ile uyumlu olması gerektiğinde transactional outbox pattern değerlendirilebilir. Böylece veritabanı değişikliği ve daha sonra yayımlanacak event aynı transaction içinde güvence altına alınabilir.
Gereksiz Background Job Karmaşıklığından Kaçınmak
Queue kullanmak yalnızca teknik bir kütüphane eklemek anlamına gelmez. Broker, worker deployment, retry kuralları, DLQ, monitoring ve operasyon süreçleri de sisteme dahil olur. Bir iş 20 milisaniyede güvenilir biçimde bitiyorsa bu yükü eklemek gereksiz olabilir. Önce gerçek darboğazı ölçmek, ardından asenkron modele geçmenin faydasını hesaplamak daha sağlıklıdır. Basit sistemi gereksiz parçalarla büyütmemek de iyi mimarinin önemli bir parçasıdır.
Cron Nasıl Çalışır?
Linux sunucuda zamanlanmış görevler cron ile nasıl yönetilir sorusunu anlamak için cron'un işletim sistemi içindeki temel parçalarını bilmek gerekir. Cron servisi belirlenen zaman tablolarını okur ve eşleşen komutları uygun kullanıcı bağlamında başlatır. Kullanıcı crontab dosyaları ile sistem seviyesindeki cron dizinleri aynı amaca hizmet etse de yetki ve yönetim biçimleri farklıdır. Dağıtıma göre dosya yolları ve servis isimleri küçük farklılıklar gösterebilir. Production ortamında hangi cron tanımının nereden geldiğinin açık olması operasyon sırasında ciddi zaman kazandırır.
cron Daemon
Cron daemon, arka planda çalışan ve zaman tanımlarını düzenli olarak kontrol eden sistem servisidir. Zaman koşulu eşleştiğinde ilgili komutu tanımlanan kullanıcı adına çalıştırır. Daemon'ın çalışmaması durumunda doğru yazılmış crontab satırları bile tetiklenmez. Bu nedenle cron sorunu incelenirken yalnızca expression değil servis durumu da kontrol edilmelidir. Systemd kullanan dağıtımlarda servis adı dağıtıma göre cron veya crond biçiminde görülebilir.
crontab
Crontab, cron görevlerinin zaman ve komut bilgilerini içeren tablodur. Kullanıcılar çoğu sistemde crontab -e komutuyla kendi görevlerini düzenleyebilir. Bir satır genel olarak zaman alanları ve çalıştırılacak komuttan oluşur. Crontab sözdizimi kısa olduğu için kolay görünür, fakat environment ve shell davranışı göz ardı edildiğinde beklenmedik sonuçlar oluşabilir. Bu nedenle production görevlerinde komutun absolute path kullanması ve çıktısının loglanması iyi bir başlangıçtır.
User Crontab
User crontab belirli bir kullanıcı hesabına ait görevleri barındırır. Bu görevler cron tarafından o kullanıcının yetkileriyle çalıştırılır ve ayrı bir kullanıcı alanı yazılması gerekmez. Uygulama otomasyonlarını root hesabı yerine sınırlı yetkili bir servis kullanıcısı altında çalıştırmak çoğu durumda daha güvenlidir. Dosya izinleri ve environment ayarları bu kullanıcının erişebildiği kaynaklara göre düzenlenmelidir. Böylece bir scriptte güvenlik sorunu oluşsa bile erişebileceği sistem kaynakları sınırlanmış olur.
System Crontab
System crontab sistem yöneticisinin farklı kullanıcılar adına görev tanımlamasına olanak verir. Kullanıcı crontab'ından farklı olarak komut satırında çalıştırılacak kullanıcı alanı bulunabilir. Sistem bakım işleri, paketle birlikte gelen görevler veya merkezi yönetilen otomasyonlar burada tutulabilir. Değişiklik yapılırken dosyanın formatı ve dağıtımın cron uygulaması dikkate alınmalıdır. Ayrıca değişikliğin kim tarafından ve neden yapıldığını takip etmek için schedule tanımlarını configuration management veya Git ile sürümlemek faydalıdır.
/etc/cron.d
/etc/cron.d dizini paketlerin veya sistem yöneticilerinin ayrı cron dosyaları yerleştirmesine imkan verir. Her görevi tek büyük crontab içine koymak yerine uygulama bazlı dosyalarla yönetmek okunabilirliği artırabilir. Buradaki satırlarda genellikle çalıştırılacak kullanıcı da açık biçimde belirtilir. Dosya adları, izinler ve syntax cron uygulamasının beklediği biçime uygun olmalıdır. Production otomasyonunda dosyanın deployment sürecinin bir parçası olarak yönetilmesi elle yapılan değişiklikleri azaltır.
/etc/cron.daily
/etc/cron.daily günlük çalışması gereken scriptlerin yerleştirilebildiği geleneksel cron dizinlerinden biridir. Dağıtımın yapılandırmasına göre bu scriptler belirli bir günlük zaman penceresinde çalıştırılır. Tam olarak saat 03.17 gibi kesin bir zaman gerekiyor ise normal cron expression daha açık bir tercih olabilir. Paket bakım scriptleri ve rutin sistem görevleri bu dizin modelinden yararlanabilir. Uygulama seviyesinde hassas schedule ihtiyaçları varsa gerçek çalışma saatinin işletim sistemi yapılandırmasından kontrol edilmesi gerekir.
/etc/cron.hourly
/etc/cron.hourly yaklaşık saatlik periyotla çalıştırılan sistem görevleri için kullanılan bir dizindir. Basit bakım scriptleri için kolaylık sağlar ve her dosyanın ayrı cron expression tanımlamasını gerektirmez. Bununla birlikte "her saatin tam 00 dakikasında" gibi kesin gereksinimlerde dağıtımın bu dizini nasıl tetiklediği kontrol edilmelidir. Scriptin bir saatten uzun sürme ihtimali varsa overlap davranışı ayrıca düşünülmelidir. Uzun işlerde dizine script koymak yerine lock ve queue tabanlı daha kontrollü bir süreç tercih edilebilir.
Cron Expression Nasıl Okunur?
Klasik cron expression beş zaman alanıyla bir komutun hangi dakika, saat, ay günü, ay ve hafta günü çalışacağını tanımlar. Bazı kütüphaneler saniye alanı eklediği için altı alanlı cron biçimi de kullanır, bu nedenle kullanılan aracın formatını kontrol etmek önemlidir. Expression okurken her alanı soldan sağa ayrı bir filtre gibi düşünmek öğrenmeyi kolaylaştırır. Wildcard, range, list ve step ifadeleri farklı tekrar desenleri oluşturur. Production'a alınmadan önce expression'ın sonraki birkaç çalışma zamanını bir test aracıyla doğrulamak iyi bir alışkanlıktır.
Minute
Minute alanı klasik cron ifadesinin ilk alanıdır ve 0 ile 59 arasındaki dakika değerlerini temsil eder. 0 kullanılması işin saatin başında çalışacağı anlamına gelir. 30 ise ilgili saat koşulu sağlandığında otuzuncu dakikayı ifade eder. Wildcard kullanıldığında her dakika eşleşir ve bu nedenle yanlış kullanım yüksek frekanslı işlere yol açabilir. Özellikle maliyetli görevlerde dakika alanını production öncesinde iki kez kontrol etmek faydalıdır.
Hour
Hour alanı gün içindeki saati 0 ile 23 arasında ifade eder. Örneğin 2 değeri gece 02.00 saat dilimini temsil eder. Saat alanının anlamı sistem veya scheduler time zone ayarına bağlı olduğu için yalnızca expression'a bakmak yeterli değildir. Sunucu UTC çalışırken iş beklendiği yerel saate göre farklı anda tetiklenebilir. Bu nedenle schedule dokümantasyonuna time zone bilgisini de yazmak pratikte birçok hatayı önler.
Day of Month
Day of Month alanı ayın hangi günlerinde çalışılacağını belirtir ve genellikle 1 ile 31 arasında değer alır. 1 değeri ayın ilk gününü ifade eder. Ancak 31 gibi değer kullanılırken her ayın 31 gün olmadığı unutulmamalıdır. Ay sonu işlerinde sadece sabit gün numarası kullanmak yerine uygulama seviyesinde "ayın son günü" kontrolü yapmak daha güvenilir olabilir. Finansal rapor gibi kritik görevlerde takvim kurallarının açık biçimde test edilmesi gerekir.
Month
Month alanı görevin yılın hangi aylarında çalışacağını belirler. Sayısal değerler genellikle 1 ile 12 arasındadır ve bazı cron uygulamaları ay isimlerinin kısaltmalarını da destekler. Yalnızca belirli dönemlerde çalışan bakım veya raporlama işleri için bu alan kullanışlıdır. Ancak uygulamanın kullanılan cron implementasyonundaki isim desteğine güvenmeden önce dokümantasyon kontrol edilmelidir. Taşınabilirlik önemliyse sayısal ifadeler çoğu ortamda daha açık bir seçimdir.
Day of Week
Day of Week alanı haftanın belirli günlerini seçmek için kullanılır. Cron implementasyonuna bağlı olarak pazar günü 0 veya 7 ile ifade edilebilir. Hafta içi görevlerde 1-5 gibi aralıklar sık görülür. İş takviminde resmi tatillerin de atlanması gerekiyorsa cron tek başına yeterli değildir çünkü yalnızca haftanın gününü bilir. Bu durumda scheduler tetikledikten sonra uygulama iş takvimi kontrolü yapabilir.
Wildcard
Wildcard karakteri olan *, ilgili alandaki bütün geçerli değerlerin eşleşmesi anlamına gelir. Dakika alanında wildcard kullanıldığında her dakika, saat alanında kullanıldığında her saat değerlendirilebilir. Yeni başlayanların en sık yaptığı hatalardan biri gereğinden fazla wildcard kullanarak görevi beklenenden daha sık çalıştırmaktır. Ağır işlerde bu durum kısa sürede yüzlerce job üretebilir. Expression değişikliği öncesinde birkaç günlük sonraki çalışma zamanlarını hesaplamak bu riski azaltır.
Range
Range ifadesi iki değer arasındaki bütün zaman değerlerini seçmek için tire karakterini kullanır. Örneğin hafta günü alanındaki 1-5 çoğu klasik cron yorumunda pazartesiden cumaya kadar olan günleri temsil eder. Saat alanındaki 9-17 ise belirtilen diğer koşullara bağlı olarak mesai saatleri aralığını ifade edebilir. Range kullanımı uzun listeleri daha okunabilir hale getirir. Bununla birlikte saat dilimi ve cron implementasyonu yine schedule sonucunu belirleyen önemli faktörlerdir.
List
List, virgülle ayrılmış birden fazla değeri aynı alanda seçmeye yarar. Örneğin 9,12,18 saat alanında üç farklı saati hedefleyebilir. Bu yöntem düzensiz fakat önceden bilinen çalışma saatleri için kullanışlıdır. Liste büyüdükçe expression okunabilirliği azalabileceği için iş kuralının uygulama içinde tutulması daha anlaşılır hale gelebilir. Schedule değişikliklerinin sık olduğu sistemlerde yapılandırmayı koddan ayırmak yönetimi kolaylaştırır.
Step
Step ifadesi belirli aralıklarla tekrar eden değerleri tanımlar ve genellikle */5 gibi yazılır. Dakika alanındaki */5 görevin her beş dakikada bir değerlendirilmesini sağlar. Step kullanımında başlangıç noktası ve scheduler implementasyonunun davranışı iyi anlaşılmalıdır. Çok kısa step değerleri ağır işler için queue birikmesine neden olabilir. Job ortalama sekiz dakika sürüyorsa her beş dakikada yeni instance üretmek overlap kontrolü gerektirir.
Sık Kullanılan Cron İfadeleri
Cron expression öğrenmenin en kolay yolu sık kullanılan desenleri gerçek örneklerle görmektir. Aşağıdaki ifadeler klasik beş alanlı cron formatı düşünülerek açıklanmaktadır. Kullandığınız framework altı alanlı veya farklı syntax kabul ediyorsa aynı örnekleri doğrudan kopyalamadan önce dokümantasyonu kontrol etmelisiniz. Ayrıca expression'ın çalışma saati her zaman scheduler'ın time zone ayarıyla birlikte değerlendirilmelidir. Kritik görevlerde bir expression'ı ezberden yazmak yerine sonraki çalışma zamanlarını doğrulamak daha güvenli olur.
Her Dakika
* * * * * klasik cron formatında her dakika çalışmayı ifade eder. Bu ifade heartbeat veya çok hafif polling işleri için kullanılabilir. Ancak ağır bir scriptin her dakika çalıştırılması önceki instance bitmeden yenisinin başlamasına yol açabilir. Böyle bir ihtiyaç varsa cron yalnızca queue'ya küçük bir job bırakmalı ve worker kapasitesi ayrıca yönetilmelidir. Production ortamında her dakika çalışan görevlerin log hacmi ve maliyeti de göz önünde bulundurulmalıdır.
Her 5 Dakikada Bir
*/5 * * * * görevi beş dakikalık aralıklarla tetikler. Cache yenileme, hafif durum kontrolü veya kısa veri senkronizasyonları bu aralığı kullanabilir. Job beş dakikadan uzun sürebiliyorsa overlap ihtimali vardır ve lock mekanizması düşünülmelidir. Alternatif olarak scheduler her tetiklemede unique key ile queue job'ı oluşturabilir. Bu sayede aynı işin gereksiz duplicate instance üretmesi daha kontrollü yönetilir.
Her Saat
0 * * * * görevi her saatin sıfırıncı dakikasında çalıştırır. Saatlik özet, cache refresh veya periyodik veri toplama işleri için sık kullanılır. Birden fazla sunucunun aynı anda aynı kaynağa bağlandığı sistemlerde tam saatlerde yük sıçraması görülebilir. Böyle durumlarda jitter veya rastgele gecikme kullanmak daha dengeli yük dağılımı sağlayabilir. Görevin tam saat şartı yoksa birkaç dakikalık dağıtım birçok altyapıda fayda sağlar.
Her Gün
0 2 * * * örnek olarak her gün saat 02.00'de çalışmayı ifade eder. Yedek, rapor, veri temizleme veya günlük özet süreçlerinde benzer ifadeler kullanılır. Buradaki 02.00'ın hangi time zone'a ait olduğu mutlaka tanımlanmalıdır. Sunucu UTC ise kullanıcıların beklediği yerel saat farklı olabilir. Günlük kritik görevlerde yalnızca failure değil hiç çalışmama durumu için de missed-run alarmı kurulmalıdır.
Hafta İçi
0 9 * * 1-5 klasik yorumda hafta içi günlerde saat 09.00'da çalışır. İş günü raporları veya ofis saatine bağlı görevler için bu desen kullanılabilir. Ancak resmi tatiller cron tarafından bilinmez ve ayrı bir iş takvimi kontrolü gerekebilir. Bir başka önemli konu, görevin kullanıcının business time zone'una göre çalışıp çalışmadığıdır. Schedule ile gerçek iş kuralını birbirinden ayırmak bu tür takvim ihtiyaçlarında esneklik sağlar.
Haftada Bir
0 3 * * 0 birçok cron ortamında pazar günü saat 03.00 için kullanılan bir örnektir. Haftalık bakım, arşivleme veya uzun rapor işlemleri için uygun olabilir. Ancak pazar gününün sayı gösterimi cron uygulamasına göre kontrol edilmelidir. Haftalık görev uzun sürüyorsa bir sonraki çalışma uzak olduğu için sorun fark edilmesi gecikebilir. Bu nedenle haftalık işlerde heartbeat ve success timestamp saklamak özellikle değerlidir.
Ayda Bir
0 4 1 * * her ayın birinci günü saat 04.00'te çalışacak bir görev örneğidir. Aylık faturalama özeti, arşiv oluşturma veya retention işlemleri bu modele girebilir. İşin ayın son günü çalışması gerekiyorsa sabit gün yaklaşımının takvim sorunları dikkate alınmalıdır. Aylık görevlerde test sıklığı düşük olduğu için staging ortamında schedule simülasyonu yapmak yararlıdır. Bir hata ancak bir ay sonra fark edilmemeli, job fonksiyonu bağımsız biçimde test edilebilmelidir.
Belirli Saatlerde
0 8,12,18 * * * örneği görevin her gün üç farklı saatte çalışmasını sağlayabilir. Bu model gün içinde belirli toplu rapor veya senkronizasyon zamanları olduğunda kullanılabilir. Saat listesi büyüdükçe crontab okunabilirliği düşebilir. İş takvimleri sık değişiyorsa schedule bilgisini merkezi bir yapılandırma veya scheduler hizmetinde tutmak daha kullanışlı olabilir. Her değişiklikten sonra next-run değerlerini kontrol etmek operasyon hatalarını azaltır.
Cron Kısayolları
Bazı cron uygulamaları yaygın tekrar desenleri için özel kısayollar sunar. Bu ifadeler beş alanlı cron satırlarından daha okunabilir olabilir, ancak her ortamın aynı kısayolları desteklediği varsayılmamalıdır. Özellikle container image veya farklı Unix sistemleri arasında taşınan uygulamalarda kullanılan cron implementasyonu kontrol edilmelidir. Kısayollar görev niyetini daha açık gösterebildiği için basit schedule'larda tercih edilebilir. Production deployment öncesi gerçek ortamda expression desteğini test etmek yine gereklidir.
@reboot
@reboot sistem veya cron daemon başladıktan sonra görevi bir kez tetiklemek için kullanılabilir. Uygulama başlangıcında cache hazırlama veya belirli bakım adımlarını başlatma gibi işler akla gelebilir. Ancak servis dependency yönetimi önemliyse systemd service bağımlılıkları çoğu zaman daha kontrollü bir yöntem sunar. Ağ veya veritabanı henüz hazır değilken başlayan bir @reboot görevi başarısız olabilir. Bu nedenle startup işlerinde dependency readiness ve retry davranışı ayrıca tasarlanmalıdır.
@hourly
@hourly desteklenen cron ortamlarında saatlik çalışma niyetini daha okunabilir biçimde ifade eder. Tam olarak hangi dakikada çalıştığı uygulamaya göre normal cron davranışıyla ilişkilidir ve ortamda doğrulanmalıdır. Basit bakım işleri için kullanımı rahattır. Dakika hassasiyeti veya farklı saat aralıkları gerekiyorsa normal expression daha açık olabilir. Operasyon ekibinin schedule'ı tek bakışta anlayabilmesi için hangi format kullanılırsa kullanılsın dokümantasyon eklemek faydalıdır.
@daily
@daily günlük çalışması gereken görevler için kısa bir tanımdır. Her gece yapılan cleanup veya günlük sayaç toplama gibi işler buna örnek olabilir. Ancak business tarafı "her gün İstanbul saatiyle 08.30" gibi kesin bir saat bekliyorsa açık cron expression kullanmak daha anlaşılırdır. Time zone davranışı yine cron ortamının sistem saatine bağlı olabilir. Bu nedenle kısayol kullanmak time zone kararını ortadan kaldırmaz.
@weekly
@weekly haftalık çalışan görevleri daha kısa biçimde tanımlar. Haftalık rapor, indeks bakımı veya arşivleme gibi işler için düşünülebilir. Görevin haftanın hangi günü ve saatinde çalıştığı implementasyonda kontrol edilmelidir. İş gereksinimi kesin bir pazartesi 07.00 zamanı istiyorsa normal expression daha net olur. Ayrıca haftalık işlerin missed-run kontrolü unutulmamalıdır çünkü bir kaçırma uzun süre fark edilmeyebilir.
@monthly
@monthly aylık tekrarlanan görevler için kullanılan bir cron kısayoludur. Basit aylık bakım veya özet işlerinde okunabilirliği artırır. Fakat finansal dönem gibi belirli saat ve takvim koşulları varsa açık expression ve business logic daha fazla kontrol sağlar. Aylık süreçlerin idempotent olması özellikle önemlidir çünkü manuel yeniden çalıştırma ihtimali sık görülür. Aynı aya ait rapor tekrar çalıştırıldığında ikinci bir sonuç üretmek yerine mevcut sonucu güvenli biçimde güncelleyebilmelidir.
@yearly
@yearly yılda bir kez çalışacak görevlerin kısa tanımıdır. Sertifika raporu, yıllık arşiv veya dönem başlangıcı işlemleri gibi az sıklıklı süreçlerde kullanılabilir. Yılda bir çalışan kodun doğal olarak daha az gerçek kullanım gördüğü unutulmamalıdır. Bu nedenle görevin yalnızca schedule geldiğinde test edilmesi güvenli değildir. Job fonksiyonunun manuel ve otomatik testlerle doğrulanması, yıllık çalışmada sürpriz yaşama riskini azaltır.
Cron Job Çalışırken Hangi Environment Kullanılır?
Cron job'ın terminalde elle çalışıp cron altında başarısız olmasının en yaygın nedeni environment farkıdır. Kullanıcının interaktif shell'i PATH, aliases, environment variables ve çalışma dizini gibi çok sayıda ayarı yüklerken cron genellikle daha sınırlı bir ortamla çalışır. Script yalnızca geliştiricinin terminalindeki varsayımlara dayanıyorsa cron altında komut veya secret bulamayabilir. Bu nedenle cron tanımını ayrı bir runtime ortamı olarak düşünmek gerekir. Absolute path, açık environment tanımı ve kontrollü working directory kullanımı birçok sorunu daha oluşmadan engeller.
Minimal Environment
Cron görevleri çoğu zaman interaktif terminalden daha az environment variable ile başlar. Kullanıcının shell profile dosyasında tanımlanan değişkenler otomatik olarak yüklenmeyebilir. Bu yüzden terminalde çalışan bir uygulama cron altında database URL veya API key bulamayabilir. Gerekli değişkenler güvenli bir environment dosyasından veya secret yönetim sisteminden açıkça sağlanmalıdır. Production ortamında secret değerlerini doğrudan crontab satırına yazmak yerine erişimi sınırlı bir yapılandırma kullanmak daha güvenlidir.
PATH Problemleri
Terminalde python, node veya özel bir CLI komutu bulunurken cron'un PATH değeri daha kısa olabilir. Bu durumda cron loglarında "command not found" benzeri hatalar görülebilir. En basit çözüm çalıştırılabilir dosyaların absolute path değerlerini kullanmaktır. Alternatif olarak crontab içinde kontrollü bir PATH tanımlanabilir. Hangi yöntem seçilirse seçilsin production sunucuda gerçek cron kullanıcısı adına komutu test etmek yararlıdır.
Working Directory
Cron job çoğu zaman geliştiricinin beklediği proje dizininde başlamaz. Relative path kullanan config, template veya dosya işlemleri bu nedenle başarısız olabilir. Script başında açık biçimde çalışma dizinine geçmek veya uygulamayı working directory'den bağımsız tasarlamak daha güvenlidir. Örneğin cd /srv/app && /usr/bin/python ... yaklaşımı niyeti açık hale getirir. Daha iyi bir seçenek ise dosya yollarını uygulamanın yapılandırmasından veya absolute path değerlerinden üretmektir.
Environment Variables
Database connection string, API token ve uygulama modu gibi ayarlar çoğu backend uygulamasında environment variable üzerinden sağlanır. Cron bu değerleri otomatik olarak interaktif shell'den miras almayabilir. Bu nedenle job'ın hangi environment değerleriyle çalışacağı deployment tasarımının bir parçası olmalıdır. Secret içeren değerlerin loglara yazılmadığından da emin olunmalıdır. Systemd service veya container ortamları bu değişkenlerin daha kontrollü yönetilmesini kolaylaştırabilir.
Absolute Path Kullanımı
Absolute path kullanmak cron görevlerinin environment bağımlılığını azaltan basit fakat etkili bir uygulamadır. Yorumlayıcı, script ve önemli dosyalar için tam yol kullanıldığında PATH veya working directory kaynaklı belirsizlikler azalır. Örneğin yalnızca python worker.py yazmak yerine gerçek Python binary ve script yolu belirtilebilir. Bu yaklaşım sunucudaki birden fazla runtime sürümü olduğunda da hangi sürümün kullanılacağını netleştirir. Deployment sırasında path değişiyorsa sabit symlink veya release yönetim stratejisi kullanılabilir.
Shell Farkları
Geliştiricinin terminali Bash veya Zsh kullanırken cron komutu farklı bir shell altında çalışabilir. Belirli shell özelliklerine dayanan scriptler bu nedenle terminalde çalışıp cron altında bozulabilir. Shell bağımlılığı varsa script shebang satırıyla açıkça belirtilmeli veya cron tanımında uygun shell yapılandırılmalıdır. Portable shell komutları kullanmak da bu riski azaltır. Özellikle pipe, source ve gelişmiş expansion kullanılan scriptlerde shell davranışı test edilmelidir.
Cron Job'ın Elle Çalışıp Cron'da Çalışmamasının Nedenleri
Bu problem cron kullanan ekiplerin en sık karşılaştığı operasyon konularından biridir. "Komutu terminalde çalıştırıyorum, oluyor" bilgisi tek başına cron'un doğru çalıştığını kanıtlamaz çünkü iki ortam birbirinden farklıdır. PATH, izin, working directory, virtual environment ve shell seçimi başlıca kontrol noktalarıdır. Sorunu çözerken cron'un çalıştırdığı tam kullanıcı ve environment yeniden üretilmeye çalışılmalıdır. Rastgele değişiklik yapmak yerine log, exit code ve environment karşılaştırmasıyla ilerlemek daha hızlı sonuç verir.
PATH
Cron'un PATH değeri terminalinizdekinden farklı olduğunda uygulama gerekli binary dosyasını bulamayabilir. Hata bazen stderr loglanmadığı için sessizce kaybolmuş gibi görünür. Önce gerçek binary yolunu which benzeri yöntemlerle belirleyip cron komutunda tam yol kullanmak iyi bir teşhis adımıdır. PATH'i crontab içinde açıkça tanımlamak da mümkündür. Ancak dependency sayısı fazla ise uygulamanın environment'ını tek bir wrapper script ile kurmak yönetimi kolaylaştırabilir.
Permission
Cron job doğru komutu bulsa bile çalıştırıldığı kullanıcının dosya veya servis erişimi yetersiz olabilir. Yazma izni olmayan log dizini, okunamayan config dosyası veya database bağlantı yetkisi sorun çıkarabilir. Terminalde root veya farklı kullanıcıyla yapılan test bu problemi gizleyebilir. Bu nedenle komut mümkünse cron job'ın gerçek kullanıcısı altında manuel olarak denenmelidir. Gerekli izinler en düşük yetki prensibine göre verilmeli ve sırf işi çalıştırmak için root kullanmaktan kaçınılmalıdır.
Working Directory
Relative path kullanan scriptler cron altında farklı bir dizinden başladığında beklenen dosyaları bulamaz. Bu hata özellikle template, .env veya local config okumaya çalışan uygulamalarda sık görülür. Cron satırında çalışma dizinine açıkça geçmek sorunu hızlı biçimde ortaya çıkarabilir. Uygulama tarafında ise path değerlerini process current directory yerine uygulama kökünden üretmek daha sağlamdır. Böylece script hem cron hem worker hem de manuel komut altında daha tutarlı davranır.
Environment Variable
Terminal profile dosyasında export edilen değişkenler cron tarafından yüklenmeyebilir. Job bu nedenle üretim veritabanı adresini veya gerekli API anahtarını göremeyebilir. Sorunu anlamak için secret değerlerini göstermeden environment anahtarlarının varlığını loglamak yararlı olabilir. Gerekli değişkenler kontrollü biçimde job runtime'ına enjekte edilmelidir. Environment eksikliğini kod içine sabit secret yazarak çözmek güvenlik açısından doğru değildir.
Virtual Environment
Python projelerinde terminalde aktif olan virtual environment cron tarafından otomatik olarak etkinleştirilmez. Cron sistem Python'unu kullanırsa gerekli paketler bulunamayabilir veya farklı sürümler yüklenebilir. En güvenli yöntem virtual environment içindeki Python binary'sini absolute path ile çağırmaktır. Böylece shell activation adımına bağımlılık azalır. Aynı ilke Node.js version manager gibi kullanıcı shell'ine bağlı runtime kurulumlarında da dikkate alınmalıdır.
File Ownership
Dosya ownership problemi cron job'ın okuma veya yazma işlemlerini engelleyebilir. Özellikle deployment root ile yapılıp job sınırlı kullanıcıyla çalışıyorsa yeni oluşturulan dizinler erişilemez hale gelebilir. Log, upload, cache ve geçici dosya dizinlerinin ownership değerleri deployment sırasında doğrulanmalıdır. Job'ın oluşturduğu dosyaların sonraki worker veya web process tarafından okunabilmesi de ayrıca düşünülmelidir. Uygun grup izinleri ve kontrollü umask kullanımı bu tür paylaşım sorunlarını azaltabilir.
Shell Farkı
Cron shell'i terminalde kullandığınız shell ile aynı olmayabilir ve bu fark syntax hatalarına yol açabilir. Özellikle Bash'e özel array veya expansion kullanan komutlar başka shell altında çalışmayabilir. Uzun cron komutlarını doğrudan crontab içine sıkıştırmak yerine test edilebilir bir script dosyasına taşımak daha okunabilir olur. Scriptin shebang satırı hangi yorumlayıcının kullanılacağını açıkça belirleyebilir. Bu yaklaşım hem local testleri hem production hata ayıklamasını kolaylaştırır.
Cron Job Logları Nasıl Tutulmalı?
Cron job çalıştığında yalnızca "başladı" bilgisini değil ne yaptığını, ne kadar sürdüğünü ve nasıl tamamlandığını görebilmek gerekir. Logsuz cron otomasyonu üretim ortamında görünmeyen bir sürece dönüşür ve sorunlar çoğu zaman kullanıcı bildirince fark edilir. stdout ve stderr ayrı anlamlar taşımalı, job kimliği loglara eklenmeli ve log saklama politikası belirlenmelidir. Yapılandırılmış log formatı merkezi log sistemlerinde filtreleme ve analiz işini kolaylaştırır. Ayrıca logların sınırsız büyümemesi için rotation ve retention planlanmalıdır.
stdout
stdout normal çalışma bilgisinin yazıldığı standart çıktı akışıdır. Job'ın başlangıç zamanı, işlenen kayıt sayısı ve başarılı tamamlanma özeti burada tutulabilir. Ancak her kayıt için gereksiz ayrıntı yazmak log hacmini hızla büyütebilir. Log seviyeleri ve örnekleme yaklaşımı kullanım durumuna göre belirlenmelidir. Production teşhisinde "job başladı, kaç kayıt işledi, ne kadar sürdü, hangi job ID ile tamamlandı" bilgileri genellikle iyi bir minimum oluşturur.
stderr
stderr hata ve uyarı çıktılarının tutulduğu standart hata akışıdır. Bir cron job başarısız olduğunda stderr'in kaybolması hatanın nedenini bulmayı zorlaştırır. Bu akış merkezi log sistemine veya uygun dosyaya yönlendirilmelidir. Stack trace veya hata ayrıntıları loglanırken credential ve kişisel veri sızdırılmamasına dikkat edilmelidir. Hata kaydı job ID ve attempt numarası içerirse tekrar denemeler arasında bağlantı kurmak daha kolay olur.
Syslog
Cron daemon ve bazı sistem servisleri çalıştırma bilgilerini syslog veya journal altyapısına iletebilir. Bu kayıtlar job'ın tetiklenip tetiklenmediğini anlamak için yararlıdır. Ancak daemon logunda komutun başladığını görmek, iş mantığının başarılı tamamlandığı anlamına gelmez. Uygulama seviyesinde success ve failure logları ayrıca tutulmalıdır. Sistem logları ile uygulama loglarını job ID veya timestamp üzerinden ilişkilendirmek teşhis süresini kısaltır.
Dosyaya Redirect
Küçük sistemlerde stdout ve stderr'i dosyaya yönlendirmek basit bir çözüm olabilir. Örneğin append redirect kullanılarak her çalıştırmanın çıktısı aynı dosyada saklanabilir. Fakat log rotation yapılmazsa dosya zamanla disk alanını tüketebilir. Birden fazla instance aynı dosyaya yazdığında satırların iç içe geçme ihtimali de vardır. Daha büyük production ortamlarında merkezi structured logging genellikle daha yönetilebilir bir yaklaşım sağlar.
Structured Logging
Structured logging log mesajlarını serbest metin yerine alanlardan oluşan düzenli kayıtlar şeklinde üretir. job_id, job_type, attempt, duration_ms ve status gibi alanlar arama işlemini kolaylaştırır. Bu yapı queue ve worker metriklerini loglarla ilişkilendirmeyi de sağlar. Hata analizinde yalnızca mesaj aramak yerine belirli job türünün başarısızlık oranı sorgulanabilir. JSON tabanlı structured log formatları merkezi log platformlarıyla sık kullanılan bir seçenektir.
Log Rotation
Dosya tabanlı log tutuluyorsa rotation production operasyonunun zorunlu parçalarından biridir. Günlük veya boyut bazlı döndürme ile eski logların sıkıştırılması disk kullanımını sınırlar. Retention süresi hata inceleme ihtiyacı ve yasal gereksinimlere göre belirlenebilir. Çok kısa retention geçmiş olayları incelemeyi zorlaştırırken sınırsız retention gereksiz depolama tüketir. Ayrıca worker container'larında yerel dosyaya güvenmek yerine logların merkezi sisteme aktarılması çoğu zaman daha uygun olur.
Job ID Eklemek
Her job için benzersiz bir kimlik kullanmak logları birbirine bağlamanın en kolay yollarından biridir. Job başladığında, retry edildiğinde ve tamamlandığında aynı kimlik loglara yazılmalıdır. Dağıtık tracing kullanılıyorsa correlation ID ve trace ID de job metadata'sında taşınabilir. Böylece kullanıcı isteğinden enqueue işlemine, worker çalışmasına ve harici API çağrısına kadar aynı süreci takip etmek mümkün olur. Job ID olmadan eş zamanlı çalışan yüzlerce görevin logları arasında belirli bir olayı ayırmak çok daha zor hale gelir.
Cron Job Failure Nasıl Tespit Edilir?
Bir cron job'ın başarısız olduğunu tespit etmek için yalnızca log dosyasına bakmak yeterli değildir. Sistem, failure durumunu otomatik algılamalı ve gerektiğinde sorumlu ekibe bildirmelidir. Exit code en temel sinyaldir, fakat heartbeat, success ping ve missed-run kontrolü ile birlikte kullanıldığında daha güçlü hale gelir. Özellikle iş açısından kritik schedule'larda "çalıştı fakat hata verdi" ile "hiç başlamadı" durumları birbirinden ayrılmalıdır. Arka plan işleyicilerinde retry queue monitoring ve hata yönetimi nasıl yapılır sorusunun ilk cevabı da bu ayrımı ölçülebilir hale getirmektir.
Exit Code
Unix process'lerinde sıfır exit code genellikle başarıyı, sıfır dışındaki değerler ise hata durumunu ifade eder. Cron scripti gerçek hatayı yakalayıp yine sıfır koduyla çıkarsa monitoring sistemi problemi göremez. Bu nedenle uygulama hatalarının doğru exit code ile process seviyesine yansıtılması önemlidir. Wrapper script kullanılıyorsa alt komutun exit code değerinin kaybolmaması gerekir. Kritik job'larda hangi exit code'un hangi hata sınıfını temsil ettiği dokümante edilebilir.
Error Log
Failure durumunda yeterli bağlam içeren error log oluşturulmalıdır. Yalnızca "işlem başarısız" yazmak teşhis için çoğu zaman yetersizdir. Job ID, hata türü, ilgili business key ve güvenli bağlam bilgisi eklenmelidir. Secret, token veya hassas payload değerleri doğrudan loga yazılmamalıdır. Error log ile alert bağlantısı kurulursa ekip hata oluştuğunda doğrudan ilgili kayda ulaşabilir.
Heartbeat
Heartbeat, sistemin belirli aralıklarla "hayattayım" sinyali göndermesi prensibine dayanır. Scheduled job her başarılı çalışmada bir timestamp güncelleyebilir veya monitoring endpoint'ine sinyal gönderebilir. Beklenen süre içinde heartbeat gelmezse job'ın hiç başlamadığı veya tamamlanamadığı anlaşılabilir. Özellikle sessizce duran cron daemon sorunlarını yakalamak için bu yöntem faydalıdır. Heartbeat penceresi job'ın normal gecikme ve çalışma süresi dikkate alınarak belirlenmelidir.
Success Ping
Success ping job başarıyla tamamlandıktan sonra dış veya iç monitoring sistemine gönderilen sinyaldir. Sinyalin yalnızca komut başladıktan sonra değil gerçek iş mantığı başarıyla tamamlandıktan sonra gönderilmesi gerekir. Aksi halde yarıda başarısız olan bir job yanlışlıkla başarılı görünebilir. Success ping ile expected schedule karşılaştırıldığında missing execution daha kolay yakalanır. Kritik işlemlerde ping'in kendisinin başarısız olma ihtimali de göz önünde bulundurularak local success timestamp saklanabilir.
Failure Notification
Failure notification hatanın ilgili ekibe zamanında ulaşmasını sağlar. Her tekil geçici hatada alarm üretmek alert yorgunluğuna yol açabileceği için kurallar iş etkisine göre belirlenmelidir. Örneğin ilk retry başarısızlığı yalnızca loglanırken tüm denemeler tükendiğinde yüksek öncelikli alarm üretilebilir. Kritik ödeme veya yedek job'larında daha erken bildirim gerekebilir. Alert içinde job adı, schedule, hata özeti ve inceleme bağlantısı bulunması müdahaleyi hızlandırır.
Missed-Run Detection
Missed-run detection, çalışması beklenen job'ın hiç başlamadığı durumları yakalar. Bu problem normal failure'dan farklıdır çünkü process başlamadığı için uygulama error logu da oluşmayabilir. Monitoring sistemi expected run time ile last successful run değerlerini karşılaştırmalıdır. Belirlenen deadline aşıldığında alarm üretilir. Günlük finansal rapor gibi görevlerde missed-run alarmı çoğu zaman normal error alert kadar önemlidir.
Cron Job'ın Hiç Çalışmaması Nasıl Tespit Edilir?
Bir görev hata verdiğinde en azından process'in başladığını gösteren izler bulunabilir, fakat hiç başlamayan bir cron job sessizce kaybolabilir. Bu nedenle schedule monitoring yalnızca failure loglarına bağlı olmamalıdır. Sistem hangi job'ın ne zaman çalışması gerektiğini bilmeli ve gerçek çalışma kayıtlarıyla bu beklentiyi karşılaştırmalıdır. Last successful run ve heartbeat bu kontrol için temel verilerdir. Production otomasyonunda "alarm yoksa sorun yok" yaklaşımı yalnızca alarm sisteminiz missed run durumunu da ölçüyorsa güvenilir olur.
Failure ile Missed Run Farkı
Failure, job'ın başladığı fakat başarılı tamamlanamadığı durumdur. Missed run ise beklenen zaman geldiği halde job'ın hiç başlamaması veya scheduler tarafından oluşturulmamasıdır. İki problem farklı sinyaller ürettiği için aynı monitoring kuralıyla yakalanamayabilir. Failure log ve exit code ile görülürken missed run çoğunlukla zaman karşılaştırması gerektirir. Sağlam sistemlerde iki durum için ayrı metrik ve alarm tanımlanır.
Expected Run Time
Expected run time, scheduler kuralına göre bir sonraki job'ın hangi anda başlamasının beklendiğini ifade eder. Monitoring sistemi bu bilgiyi hesaplayarak gerçek job başlangıçlarıyla karşılaştırabilir. Birkaç dakikalık normal gecikme kabul edilebiliyorsa tolerance penceresi tanımlanmalıdır. Kritik işlerde bu pencere daha kısa tutulabilir. Expression veya time zone değiştiğinde expected run hesaplamasının da aynı yapılandırmayı kullanması önemlidir.
Last Successful Run
Last successful run değeri bir job'ın en son ne zaman başarıyla tamamlandığını gösterir. Günlük çalışan görevde bu timestamp 30 saat önceye aitse sistemde sorun olma ihtimali yüksektir. Yalnızca last start bilgisini tutmak yeterli değildir çünkü başlayan job başarısız olmuş olabilir. Success timestamp güvenilir bir datastore içinde saklanmalıdır. Dashboard üzerinde beklenen periyotla birlikte gösterildiğinde operasyon ekibi gecikmeyi kolayca fark edebilir.
Heartbeat Monitoring
Heartbeat monitoring scheduled job'ın düzenli olarak bir yaşam sinyali üretmesini bekler. Her schedule sonunda başarı sinyali veya belirli aşamalarda progress heartbeat gönderilebilir. Sinyal beklenen pencerede gelmezse alarm oluşur. Çok uzun job'larda yalnızca final success ping kullanmak yanlış alarm üretebileceği için periyodik heartbeat daha uygun olabilir. Job öldüğünde heartbeat kesileceği için hanging veya stalled süreçlerin tespiti de kolaylaşır.
Deadline Alert
Deadline alert, bir görevin belirli zamana kadar tamamlanması gerektiği iş kurallarını izler. Örneğin günlük rapor 08.00'de hazır olmalıysa scheduler 07.00'de başlamış olsa bile yalnızca "job başladı" bilgisi yeterli değildir. Monitoring 08.00 deadline'ına kadar başarı durumunu beklemelidir. Süre aşılırsa job hâlâ çalışıyor olsa bile kullanıcı etkisi başlamış olabilir. Bu yaklaşım teknik metrikleri gerçek iş beklentisiyle ilişkilendirir.
Time Zone Cron Job'ları Nasıl Etkiler?
Time zone, cron ve scheduler sistemlerinde en çok gözden kaçan konulardan biridir. Aynı 0 9 * * * ifadesi UTC kullanan sunucuda ve Europe/Istanbul kullanan scheduler'da farklı gerçek zamanları temsil eder. Dağıtık sistemde her bileşenin kendi yerel saatine güvenmek hata riskini artırır. Bu nedenle schedule'ın hangi time zone'a göre tanımlandığı açıkça dokümante edilmelidir. Teknik zamanlama ile kullanıcının business time kavramını ayrı düşünmek özellikle uluslararası uygulamalarda işleri kolaylaştırır.
Server Time Zone
Klasik cron çoğunlukla sunucunun yerel saat ayarından etkilenir. Sunucu UTC olarak yapılandırılmışsa crontab'daki 09.00 değeri de UTC üzerinden yorumlanabilir. Uygulama ekibi bunu İstanbul saati sanıyorsa job beklenenden farklı zamanda başlayacaktır. Sunucu time zone değerini deployment dokümantasyonunda açıkça belirtmek yararlıdır. Ayrıca altyapı değişikliğinde bu ayarın sessizce değişmemesi için otomatik kontroller eklenebilir.
UTC
UTC dağıtık sistemlerde ortak zaman referansı olarak kullanıldığında birçok karşılaştırmayı kolaylaştırır. Log timestamp, database zamanları ve event kayıtlarının UTC tutulması farklı bölgelerdeki ekiplerin aynı olay üzerinde konuşmasını kolaylaştırır. Schedule da UTC tutulabilir, ancak business tarafının yerel saat beklentisi varsa dönüşüm açık şekilde yapılmalıdır. "Her gün yerel saat 09.00" ile "her 24 saatte bir UTC 06.00" aynı iş kuralı değildir. Bu fark özellikle daylight saving kullanan bölgelerde daha belirgin hale gelir.
Europe/Istanbul
Europe/Istanbul time zone adı uygulama ve scheduler yapılandırmalarında Türkiye saatini açık biçimde belirtmek için kullanılabilir. Sabit sayı şeklinde UTC offset yazmak yerine IANA time zone adı kullanmak zaman kurallarını daha anlaşılır hale getirir. Türkiye'nin mevcut saat uygulaması nedeniyle yerel iş süreçleri için bu bölge adı pratik bir seçimdir. Yine de schedule davranışı kullanılan framework ve runtime'ın time zone verilerine bağlıdır. Loglarda UTC tutup kullanıcı arayüzünde Europe/Istanbul dönüşümü yapmak sık kullanılan bir yaklaşımdır.
Container Time Zone
Container içindeki time zone host sistemle aynı olmak zorunda değildir. Birçok minimal container image varsayılan olarak UTC çalışır. Cron veya uygulama scheduler'ı container içinde çalışıyorsa bu fark schedule saatini etkileyebilir. Image içinde time zone verisinin bulunup bulunmadığı ve TZ ayarının nasıl yapıldığı kontrol edilmelidir. Daha güvenli yaklaşım schedule time zone'unu uygulama yapılandırmasında açık biçimde belirlemek ve container'ın varsayımlarına mümkün olduğunca az güvenmektir.
Cloud Scheduler Time Zone
Yönetilen scheduler hizmetleri çoğu zaman schedule başına time zone seçeneği sunabilir, ancak davranış sağlayıcının özelliklerine bağlıdır. Bu nedenle bir cron expression başka platforma taşındığında yalnızca expression kopyalanmamalıdır. Time zone, missed-run, retry ve concurrency davranışları da beraber incelenmelidir. Yönetilen scheduler'ın gerçek tetikleme garantileri iş gereksinimiyle karşılaştırılmalıdır. Özellikle dakika hassasiyetindeki görevlerde servis dokümantasyonundaki gecikme toleransları önem taşır.
Schedule'ı UTC Tutmanın Avantajları
Schedule'ı UTC tutmak farklı sunucular ve bölgeler arasında ortak bir referans oluşturur. Operasyon ekibi loglarla schedule'ı karşılaştırırken ek belirsizlik yaşamaz. Infrastructure as code dosyalarında da aynı zaman anlamı korunur. Buna karşılık kullanıcıların yerel saat beklentisi varsa business logic içinde doğru dönüşüm yapılması gerekir. Dolayısıyla UTC teknik standardizasyon sağlar, fakat yerel iş saatlerinin anlamını ortadan kaldırmaz.
Daylight Saving Time Cron İçin Neden Sorun Olabilir?
Daylight Saving Time kullanan bölgelerde saatlerin ileri veya geri alınması bazı yerel saatlerin yılda bir kez hiç oluşmamasına veya iki kez oluşmasına neden olabilir. Tam bu saate planlanan cron job bu yüzden atlanabilir veya iki kez çalışabilir. Bu sorun yalnızca teorik değildir ve özellikle finansal, faturalama veya bildirim süreçlerinde yan etki oluşturabilir. UTC scheduling birçok altyapı problemine karşı daha öngörülebilir davranış sağlar. Bununla birlikte iş gereksinimi "yerel saat 09.00" diyorsa DST kuralları business time zone üzerinden bilinçli biçimde ele alınmalıdır.
Tekrarlanan Saat
Saat geri alındığında bazı yerel saat aralıkları iki kez yaşanabilir. Scheduler implementasyonuna bağlı olarak aynı yerel zaman için job iki kez tetiklenebilir veya özel bir davranış uygulanabilir. Job idempotent değilse çift e-posta veya çift finansal kayıt gibi sonuçlar oluşabilir. Bu nedenle zamanlama katmanındaki korumaya tamamen güvenmek yerine business-level idempotency eklemek daha güvenlidir. Schedule testlerinde DST geçiş tarihlerini simüle etmek özellikle uluslararası uygulamalarda önemlidir.
Atlanan Saat
Saat ileri alındığında belirli bir yerel zaman aralığı hiç gerçekleşmeyebilir. Örneğin 02.30 yerel saati o gün yoksa tam o saate planlanan görev tetiklenmeyebilir. Scheduler'ın bu durumda catch-up yapıp yapmadığı kullanılan teknolojiye göre değişir. Kritik işlerde "tam o anda çalış" yerine "bu iş günü içinde bir kez çalış" gibi business-level kontrol daha dayanıklı olabilir. Missed-run monitoring bu tür özel takvim durumlarını da görünür hale getirir.
UTC ile Scheduling
UTC kendi içinde DST geçişi uygulamadığı için teknik schedule çizgisini daha öngörülebilir tutar. Her 24 saatte aynı UTC saatinde çalışan görev, altyapı açısından düzenli bir periyot oluşturur. Ancak kullanıcı açısından yerel saat DST dönemine göre değişebilir. Bu nedenle iş gereksiniminin mutlak UTC zamanı mı yoksa yerel business zamanı mı istediği netleştirilmelidir. Yanlış problemi UTC'ye taşımak yalnızca hatanın görünümünü değiştirir.
Business Time Zone
Business time zone, iş kuralının kullanıcı veya kurum açısından hangi yerel saate göre yorumlanacağını belirtir. "Mağaza kapandıktan sonra çalış" gibi bir gereksinim sunucu saatinden bağımsız olarak yerel çalışma saatine bağlıdır. Scheduler bu time zone'u destekliyorsa açık biçimde yapılandırılmalıdır. Desteklemiyorsa uygulama UTC tetiklenip business zamanı içinde koşul kontrolü yapabilir. Böylece altyapı zamanı ile iş zamanı birbirinden ayrılmış olur.
DST-Safe Job Tasarımı
DST-safe tasarım sadece doğru time zone seçmekten ibaret değildir. Job aynı business periyodu için ikinci kez çalışsa bile idempotent davranmalı ve kaçırılan run sonradan güvenli biçimde telafi edilebilmelidir. Business key olarak tarih veya dönem kimliği kullanılabilir. Örneğin "2026-03-31 günlük kapanış" anahtarı unique constraint ile tek sonuç üretmeye zorlanabilir. Bu yaklaşım scheduler davranışındaki sınır durumlarını veri katmanında güvence altına alır.
systemd Timer Nedir?
systemd timer, systemd kullanan Linux sistemlerinde servisleri zaman veya süre koşullarına göre tetikleyen bir mekanizmadır. Cron'a benzer zamanlama ihtiyacını karşılar fakat service dependency, journal logging, resource limit ve güvenlik seçenekleriyle daha sıkı bütünleşebilir. Genellikle bir .timer unit tetikleme kuralını, karşılık gelen .service unit ise gerçek komutu tanımlar. Bu ayrım zamanlama ile execution yapılandırmasını okunabilir hale getirir. Sunucu seviyesinde yönetilen production görevlerinde systemd timer birçok durumda güçlü bir alternatiftir.
.service Unit
.service unit çalıştırılacak process'i ve çalışma koşullarını tanımlar. Kullanıcı, environment, working directory ve executable gibi ayarlar bu dosyada açık biçimde belirtilebilir. Böylece uzun shell komutlarını cron satırına sıkıştırmak yerine servis konfigürasyonu okunabilir halde tutulur. Resource ve security seçenekleri de aynı unit üzerinden uygulanabilir. Timer yalnızca bu servisin ne zaman tetikleneceğini belirlediği için görev sorumlulukları daha açık hale gelir.
.timer Unit
.timer unit bir service'in hangi zaman koşullarında aktive edileceğini tanımlar. Calendar tabanlı veya boot sonrası geçen süreye bağlı tetiklemeler oluşturulabilir. Timer durumu systemctl list-timers gibi araçlarla gözlemlenebilir. Bir sonraki ve önceki çalışma zamanlarını sistem seviyesinde görmek cron'a göre operasyonel kolaylık sağlayabilir. Kritik görevlerde timer aktif olsa bile service'in başarı durumu ayrıca izlenmelidir.
OnCalendar
OnCalendar takvim tabanlı zamanlama ifadeleri tanımlamak için kullanılır. Günlük, haftalık veya daha özel takvim kuralları bu seçenekle belirtilebilir. systemd'nin calendar syntax'ı klasik cron expression ile aynı değildir, bu nedenle ifadeyi doğrudan çevirmeden önce test etmek gerekir. systemd-analyze calendar benzeri araçlarla sonraki çalıştırma zamanları doğrulanabilir. Bu doğrulama production değişikliklerinden önce schedule hatalarını yakalamaya yardımcı olur.
OnBootSec
OnBootSec sistem açıldıktan belirli süre sonra service'i tetiklemek için kullanılabilir. Örneğin boot işleminden beş dakika sonra bakım kontrolü başlatılabilir. Bu seçenek ağ veya diğer servislerin hazır hale gelmesi için başlangıç gecikmesi vermekte kullanışlıdır. Bununla birlikte gerçek dependency varsa yalnızca süre beklemek yerine systemd dependency tanımları daha doğru olabilir. Süre bazlı yaklaşım readiness garantisi vermez ve yavaş açılan sistemlerde yine erken çalışabilir.
OnUnitActiveSec
OnUnitActiveSec ilgili unit'in son aktivasyonundan belirli süre sonra yeniden tetikleme oluşturabilir. Bu davranış sabit takvim saatinden farklı olarak önceki aktivasyona göre süre hesaplamaya yarar. Periyodik bakım veya polling görevlerinde faydalı olabilir. Job süresi ile tekrar aralığının nasıl etkileştiği tasarım sırasında kontrol edilmelidir. İşin kesin business saatinde çalışması gerekiyorsa calendar tabanlı schedule daha uygun olabilir.
timers.target
timers.target systemd timer unit'lerinin sistem başlangıcı ve hedef yönetimiyle bütünleştiği standart target'lardan biridir. Timer'ın enable edilmesi boot sonrasında otomatik olarak aktif hale gelmesini sağlar. Sadece unit dosyasını oluşturmak timer'ın mutlaka aktif olduğu anlamına gelmez. Deployment sırasında enable ve start durumları otomatik doğrulanmalıdır. Monitoring ayrıca timer'ın disabled veya failed duruma geçmesini tespit etmelidir.
Cron mu systemd Timer mı?
Cron ve systemd timer aynı temel ihtiyaca hizmet edebilir, fakat operasyon özellikleri farklıdır. Çok basit ve taşınabilir scriptlerde cron daha hızlı anlaşılırken systemd kullanılan sunucularda timer yaklaşımı logging, dependency ve resource yönetimi konusunda daha fazla kontrol sunabilir. Seçimi sadece syntax kolaylığına göre yapmak yerine bakım ve hata senaryolarını da değerlendirmek gerekir. Container veya Kubernetes ortamında ise işletim sistemi cron'undan tamamen farklı bir scheduler modeli daha uygun olabilir. Araç seçimi uygulamanın nerede çalıştığı ve operasyon ekibinin hangi altyapıyı yönettiğiyle birlikte yapılmalıdır.
Basitlik
Cron'un en büyük avantajlarından biri birkaç karakterlik expression ile hızlı görev tanımlanabilmesidir. Küçük sunucu otomasyonlarında bu basitlik oldukça değerlidir. systemd timer ise ayrı timer ve service unit'leri nedeniyle başlangıçta daha fazla yapılandırma gerektirebilir. Buna karşılık görev büyüdükçe açık servis ayarları bakım kolaylığı sağlayabilir. Basitlik değerlendirilirken yalnızca ilk kurulum değil uzun vadeli troubleshooting maliyeti de hesaba katılmalıdır.
Taşınabilirlik
Cron Unix benzeri birçok ortamda uzun süredir kullanılan yaygın bir mekanizmadır. systemd timer ise systemd bulunan Linux dağıtımlarına bağlıdır. Farklı sistemlere taşınması gereken scriptlerde cron daha geniş uyumluluk sağlayabilir. Bununla birlikte modern application deployment container veya orchestration katmanına taşındığında schedule'ın işletim sisteminden bağımsız hale gelmesi de mümkündür. Taşınabilirlik hedefi baştan belirlenirse yanlış seviyede scheduler bağımlılığı oluşması önlenir.
Logging
Cron çıktısı redirect veya sistem loglarıyla yönetilebilir, ancak uygulama ekibinin bunu açık biçimde yapılandırması gerekir. systemd service çıktısı journal altyapısıyla daha doğal şekilde bütünleşebilir. journalctl üzerinden unit bazlı log incelemek operasyon sırasında kullanışlıdır. Yine de yalnızca servis logları background job observability ihtiyacını tamamen çözmez. Job ID, business context ve metrikler uygulama seviyesinde ayrıca üretilmelidir.
Dependency Management
systemd service unit'leri diğer servislerin başlama sırası ve dependency ilişkilerini tanımlamak için güçlü seçenekler sunar. Cron genellikle zamanı geldiğinde komutu çalıştırır ve diğer servislerin hazır olup olmadığını kendiliğinden yönetmez. Ağ veya mount dependency'si olan sistem görevlerinde systemd bu açıdan avantajlı olabilir. Uygulama seviyesindeki database readiness yine gerçek bağlantı kontrolü gerektirebilir. Dependency bildirimi ile runtime health kontrolünü birbirinin alternatifi olarak görmemek gerekir.
Resource Limits
systemd service üzerinden CPU, memory ve process sınırları belirlemek işletim sistemi seviyesinde daha kontrollü execution sağlar. Ağır bir cron scriptinin bütün sunucu kaynaklarını tüketmesi böylece sınırlandırılabilir. Cron tek başına aynı seviyede resource policy tanımlamaz ve ek araçlara ihtiyaç duyabilir. Worker süreçlerinde de benzer kaynak sınırları container veya orchestrator seviyesinde uygulanabilir. Kritik nokta, background işlerin web uygulaması kaynaklarını kontrolsüz biçimde tüketmemesidir.
Missed Runs
Sunucu schedule anında kapalıysa klasik cron genellikle o çalıştırmayı sonradan otomatik telafi etmez. systemd timer'ın persistent davranışı belirli kaçırılmış zamanları boot sonrasında tetiklemek için kullanılabilir. Ancak her missed run'ın mutlaka sonradan çalışması doğru değildir. Örneğin her beş dakikalık cache refresh job'ının sunucu iki saat kapalı kaldıktan sonra 24 kez çalışması gereksiz olabilir. Catch-up politikasını işin anlamına göre belirlemek gerekir.
Security Sandboxing
systemd service seçenekleri process'e ek güvenlik sınırlamaları uygulamayı kolaylaştırabilir. Filesystem erişimi, privilege yükseltme ve geçici dizin izolasyonu gibi kontroller unit seviyesinde yönetilebilir. Cron altında da sınırlı kullanıcı kullanmak mümkündür, ancak aynı ayrıntıdaki sandbox ayarları doğrudan cron özelliği değildir. Hassas bakım görevlerinde systemd bu açıdan daha kontrollü bir runtime sunabilir. Güvenlik yapılandırması yine job'ın gerçekten ihtiyaç duyduğu kaynaklara göre test edilmelidir.
systemd Persistent=true Ne İşe Yarar?
Persistent=true, calendar tabanlı systemd timer'ın sistem kapalıyken kaçırdığı bir tetiklemeyi yeniden açılış sonrasında telafi edebilmesini sağlar. Bu davranış özellikle günlük yedek veya düzenli bakım gibi "bir kez yapılması önemli" görevlerde faydalıdır. Ancak catch-up her görev için doğru değildir ve eski schedule'ın artık anlam taşımadığı durumlar olabilir. Timer'ın boot sonrasında başlatacağı gecikmiş işi idempotent tasarlamak yine gereklidir. Production politikası "kaçırılan iş çalıştırılsın mı, atlansın mı?" sorusuna açık cevap vermelidir.
Sunucu Kapalıyken Kaçırılan Schedule
Sunucu gece 02.00'de kapalıysa o saate ait normal cron işi çoğunlukla gerçekleşmez. Persistent systemd timer ise son tetikleme bilgisini kullanarak kaçırılmış calendar event durumunu değerlendirebilir. Sistem yeniden açıldığında gecikmiş servis başlatılabilir. Bu özellik günlük yedek gibi önemli görevlerde kullanışlıdır. Ancak işin artık geçerli olup olmadığı uygulama içinde ayrıca kontrol edilebilir.
Boot Sonrası Catch-Up
Catch-up, kaçırılan zamanlamanın sistem yeniden kullanılabilir olduğunda telafi edilmesidir. Boot anında birçok servis aynı anda başladığı için ağır catch-up işleri kaynak yarışına girebilir. Başlangıç gecikmesi veya randomized delay eklemek bu yükü dağıtmaya yardımcı olabilir. Job idempotent değilse manuel ve otomatik catch-up'ın aynı anda çalışması duplicate sonuç üretebilir. Bu nedenle boot sonrası execution da normal production run kadar kontrollü olmalıdır.
Backup ve Maintenance İşleri
Backup ve maintenance işleri persistent timer için uygun adaylar olabilir çünkü schedule kaçırılsa bile işin daha sonra yapılması hâlâ değerlidir. Örneğin günlük yedeğin gece alınamaması sabah hiç alınmamasından daha kötü olabilir. Buna karşılık yedek job'ın başka instance ile çakışmaması için lock kullanılmalıdır. Yedek tamamlandıktan sonra checksum, upload ve verification aşamaları da ayrı başarı kriterleri olarak ele alınmalıdır. Sadece process exit code'un sıfır olması gerçek restore edilebilirliği kanıtlamaz.
Her Görev İçin Kullanılmalı mı?
Persistent davranış her scheduled görev için otomatik tercih olmamalıdır. Sık çalışan cache refresh veya durum polling job'larının eski instance'larını telafi etmek çoğu zaman gereksizdir. Bazı işlerde yalnızca en güncel durum önemlidir ve geçmiş schedule'ların çalışması ek yük yaratır. İş gereksinimi kaçırılmış run'ın değerini belirlemelidir. Bu karar schedule configuration içinde açıkça dokümante edilirse sonraki bakımda yanlış varsayımlar azalır.
systemd Timer ile Thundering Herd Nasıl Önlenir?
Birden fazla sunucu aynı image ve aynı timer configuration ile tam aynı anda açılırsa bütün instance'lar aynı işi aynı saniyede başlatabilir. Bu durum veritabanı, object storage veya harici API üzerinde ani yük oluşturur. Problem yalnızca worker sayısını azaltarak değil schedule başlangıçlarını dağıtarak da yönetilebilir. Randomized delay ve jitter bu amaçla kullanılan temel tekniklerdir. Fleet-level scheduling düşüncesi tek bir sunucunun zamanlamasından çok bütün filonun aynı kaynağa nasıl yüklendiğine odaklanır.
Aynı Anda Başlayan Sunucular
Auto scaling veya bakım sonrası yüzlerce makine aynı zaman aralığında boot edebilir. Her makinede aynı timer varsa tamamı birkaç saniye içinde aynı maintenance job'ını başlatabilir. Tek makinede sorun yaratmayan job böylece toplu yük altında downstream sistemi zorlayabilir. Schedule'a rastgele gecikme eklemek instance'ları zamana yayar. Dağıtık lock gerekiyorsa yalnızca bir instance'ın işi yürütmesini sağlamak için ayrıca kullanılabilir.
Database Load Spike
Aynı anda başlayan bakım job'ları aynı tabloya ağır sorgular gönderdiğinde database CPU ve connection kullanımı hızla yükselebilir. Bu durum normal kullanıcı sorgularının gecikmesine de neden olur. İşleri küçük batch'lere bölmek ve başlangıç zamanlarını yaymak yükü yumuşatır. Query timeout ve rate limit gibi korumalar da worker tarafında uygulanabilir. Database kapasitesi background işlere göre değil genel hizmet SLO'suna göre korunmalıdır.
RandomizedDelaySec
RandomizedDelaySec systemd timer tetiklemelerine belirli bir rastgele gecikme penceresi eklemek için kullanılabilir. Böylece aynı schedule'a sahip makinelerin birebir aynı anda service başlatma ihtimali azalır. Görevin tam saniyede başlaması gerekmiyorsa bu yöntem fleet seviyesinde yük dağılımı sağlar. Gecikme penceresi işin deadline gereksinimini aşmamalıdır. Örneğin günlük maintenance için birkaç dakika kabul edilebilirken hassas zamanlı işlem için aynı tolerans uygun olmayabilir.
Jitter
Jitter, sabit zaman veya retry gecikmesine rastgele değişken ekleme yaklaşımıdır. Amaç binlerce process'in aynı anda aynı bağımlılığa yüklenmesini önlemektir. Bu teknik yalnızca systemd timer'da değil background retry sistemlerinde de yaygın biçimde kullanılır. Random aralığın alt ve üst sınırları iş gereksinimine göre seçilmelidir. Çok küçük jitter yeterli dağılım sağlamazken çok büyük değer deadline ihlali oluşturabilir.
Fleet-Level Scheduling
Fleet-level scheduling, tek bir host yerine bütün makine grubunun toplam davranışını planlamayı gerektirir. Her node'un aynı bakım işini yapması gerçekten gerekli mi sorusu burada önem kazanır. Bazı görevler leader election ile yalnızca tek node tarafından yürütülebilir, bazıları ise bütün node'larda fakat farklı zamanlarda çalışmalıdır. Merkezi scheduler kullanmak da host bazlı timer sayısını azaltabilir. Doğru model işin local host state'i mi yoksa ortak business verisi mi işlediğine göre seçilmelidir.
systemd Timer Güvenliği
Zamanlanmış bir görevin otomatik çalışması güvenlik açısından "insan müdahalesi olmadan yetki kullanan process" anlamına gelir. Bu nedenle hangi kullanıcıyla çalıştığı, hangi dosyalara erişebildiği ve ne kadar kaynak tüketebildiği açık biçimde sınırlandırılmalıdır. systemd service unit'leri bu kontrollerin çoğunu merkezi şekilde tanımlamaya yardımcı olur. Root hesabını varsayılan çözüm olarak kullanmak yerine dedicated user ve least privilege yaklaşımı tercih edilmelidir. Güvenlik seçenekleri uygulandıktan sonra gerçek job akışıyla test edilmelidir çünkü aşırı kısıtlama da production arızasına yol açabilir.
Dedicated User
Her bakım veya uygulama görevi root yetkisine ihtiyaç duymaz. Dedicated user yalnızca gerekli dosya ve servis kaynaklarına erişebilecek şekilde oluşturulabilir. Bu sayede job kodunda güvenlik açığı oluşsa bile etki alanı sınırlandırılır. Dosya ownership ve group ayarları bu kullanıcı modeline göre düzenlenmelidir. Aynı kullanıcıya birbirinden bağımsız çok sayıda hassas görevin yetkisini vermek yerine işlev bazlı ayrım da değerlendirilebilir.
DynamicUser
systemd'nin DynamicUser özelliği bazı servisler için runtime sırasında dinamik ve kalıcı olmayan kullanıcı kimliği oluşturulmasına yardımcı olabilir. Kalıcı kullanıcı hesabı yönetme ihtiyacını azaltırken process'in root olmayan kimlikle çalışmasını sağlar. Ancak job'ın kalıcı dosya sahipliği veya belirli dizin erişimi gereksinimleri varsa bu davranış dikkatle planlanmalıdır. Her workload DynamicUser için uygun değildir. Kullanılacak unit seçenekleri gerçek dosya ve network ihtiyaçlarıyla birlikte test edilmelidir.
NoNewPrivileges
NoNewPrivileges process ve alt process'lerin yeni privilege kazanmasını sınırlandıran güvenlik kontrollerinden biridir. Basit scheduled scriptlerin privilege escalation mekanizmalarına ihtiyacı çoğunlukla yoktur. Bu seçeneğin etkinleştirilmesi saldırı yüzeyini azaltabilir. Buna rağmen script setuid binary veya özel capability gerektiriyorsa çalışma davranışı etkilenebilir. Güvenlik ayarları production'a alınmadan önce aynı servis koşullarında entegrasyon testi yapılmalıdır.
PrivateTmp
PrivateTmp servise daha izole geçici dizin görünümü sağlayabilir. Geçici dosyalar üzerinden başka process'lerle istenmeyen etkileşim riskini azaltmaya yardımcı olur. Job ortak /tmp dosyalarını paylaşmaya dayanıyorsa bu ayar davranışı değiştirebilir. Sağlıklı tasarımda kritik veri alışverişi rastgele geçici dosya isimlerine bağlı olmamalıdır. Gerekiyorsa açık ve erişim kontrollü çalışma dizinleri kullanılmalıdır.
ProtectSystem
ProtectSystem gibi systemd seçenekleri servis process'inin sistem dosyalarına yazma yetkisini sınırlandırabilir. Salt okuma erişimi yeterli olan scheduled job'lar için bu güçlü bir koruma sağlar. Uygulama yalnızca belirli data dizinine yazıyorsa izinler buna göre daraltılabilir. Önce job'ın gerçekten hangi path'lere yazdığı ölçülmelidir. Güvenlik politikasını geniş yetkiden başlayıp bırakmak yerine gerekli erişimi açıkça tanımlamak daha iyi sonuç verir.
CPU ve Memory Limits
Scheduled job'ın runaway duruma geçerek sunucunun bütün CPU veya memory kapasitesini tüketmesi diğer hizmetleri etkileyebilir. systemd resource kontrolleri process kullanımını sınırlamak için kullanılabilir. Limitler rastgele değil gerçek job profiline göre belirlenmelidir. Çok düşük limit sürekli timeout veya OOM sorununa, çok yüksek limit ise izolasyonun etkisiz kalmasına yol açabilir. Monitoring ile gerçek kullanım gözlenerek limitlerin zaman içinde ayarlanması gerekir.
Cron Job Çakışması Nedir?
Cron job çakışması, önceki çalıştırma henüz bitmeden aynı görevin yeni schedule nedeniyle tekrar başlamasıdır. Bu durum yalnızca performans problemi değildir ve aynı verinin iki kez işlenmesi gibi business hataları da doğurabilir. İş süresi schedule aralığına yakınsa overlap ihtimali baştan değerlendirilmelidir. Lock, idempotency ve queue deduplication farklı katmanlarda koruma sağlayabilir. En güvenli yaklaşım bunlardan yalnızca birine güvenmek yerine iş etkisine göre birden fazla savunma katmanı oluşturmaktır.
Önceki İş Bitmeden Yeninin Başlaması
Her beş dakikada çalışan bir job bazen sekiz dakika sürüyorsa ikinci instance ilk iş bitmeden başlayacaktır. Bu davranış cron açısından hata değildir çünkü cron yalnızca schedule'ı takip eder. Uygulama overlap'i istemiyorsa açık biçimde engellemelidir. File lock, distributed lock veya queue üzerinde unique job yaklaşımı kullanılabilir. İş süresi düzenli olarak schedule aralığını aşıyorsa asıl çözüm kapasiteyi veya schedule tasarımını yeniden değerlendirmektir.
Duplicate Processing
Çakışan iki process aynı pending kayıt listesini okuyup aynı kayıtları işleyebilir. Sonuç iki e-posta, iki fatura veya aynı dosyanın iki kez üretilmesi olabilir. Database unique constraint ve idempotency key gibi business-level korumalar bu riski azaltır. Lock kullanılsa bile lock süresinin dolması veya process crash gibi senaryolarda duplicate execution hâlâ mümkündür. Bu nedenle kritik işlerde "iki kez çalışırsa ne olur?" sorusu tasarımın temel testlerinden biri olmalıdır.
Database Lock
Aynı kayıtları güncelleyen iki job database lock contention oluşturabilir. Uzun transaction'lar diğer uygulama sorgularını da bekletebilir ve genel performansı etkileyebilir. Worker concurrency artarken database kapasitesinin de birlikte izlenmesi gerekir. Gerekli durumlarda satır seviyesinde lock veya advisory lock kullanılabilir. Lock süresini mümkün olduğunca kısa tutmak ve harici API çağrılarını açık database transaction içinde bekletmemek daha sağlıklı olur.
Kaynak Tüketimi
Overlap yalnızca veri tutarlılığı değil kaynak tüketimi açısından da sorun yaratabilir. İki ağır backup process'i aynı disk ve CPU kaynaklarını kullanarak birbirini yavaşlatabilir. İş daha uzun sürdükçe üçüncü instance'ın da başlaması zincirleme büyümeye yol açabilir. Concurrency limiti ve lock bu döngüyü kesebilir. Monitoring'de overlapping run sayısının ayrı metrik olarak izlenmesi sorunu erken fark etmeyi kolaylaştırır.
Race Condition
Race condition, iki process'in aynı state üzerinde zamanlamaya bağlı beklenmedik sonuç üretmesidir. "Önce kontrol et, sonra yaz" biçimindeki işlemler concurrency altında özellikle risklidir. Her iki worker aynı anda kaydın işlenmediğini görüp daha sonra ikisi de işlem yapabilir. Atomic database operation, unique constraint veya uygun lock mekanizması bu durumu önleyebilir. Sadece uygulama seviyesinde boolean kontrol etmek çoğu zaman yeterli değildir.
Aynı Cron Job'ın Aynı Anda İki Kez Çalışması Nasıl Önlenir?
Overlap önlemek için kullanılabilecek yöntem job'ın tek sunucuda mı yoksa dağıtık ortamda mı çalıştığına göre değişir. Tek host için file lock veya flock yeterli olabilirken birden fazla instance bulunan sistemlerde Redis veya database tabanlı distributed lock gerekebilir. Lock kullanımı execution tekrarını azaltır, fakat business-level idempotency'nin yerini tutmaz. Network partition ve process crash gibi durumlarda lock davranışı ayrıca düşünülmelidir. Kritik görevlerde kilit mekanizmasının kendisi de monitoring ve timeout kurallarına sahip olmalıdır.
File Lock
File lock aynı host üzerindeki iki process'in ortak bir kilit dosyası üzerinden koordinasyon kurmasına yardımcı olabilir. Bir process lock'ı aldığında diğer process görevi başlatmadan çıkabilir veya bekleyebilir. Tek sunuculu cron işleri için basit ve düşük maliyetli bir çözümdür. Birden fazla container veya host aynı görevi çalıştırıyorsa local filesystem lock yeterli değildir. Ayrıca stale lock davranışı ve process ölümü senaryoları kullanılan lock yöntemine göre doğru yönetilmelidir.
flock
flock Linux ortamında file locking için sık kullanılan bir araçtır. Cron komutunu lock altında çalıştırarak önceki instance devam ederken yenisinin başlaması engellenebilir. Process sona erdiğinde file descriptor tabanlı lock'ın bırakılması stale file sorunlarını azaltır. Ancak bu koruma yalnızca aynı lock dosyasını gören host veya filesystem bağlamında etkilidir. Dağıtık deployment için merkezi lock mekanizması gerekebilir.
Database Lock
Database lock birden fazla application instance'ın ortak veritabanı üzerinden koordinasyon yapmasını sağlayabilir. Transaction veya özel lock tablosu kullanılarak belirli job key için tek owner seçilebilir. Database zaten bütün instance'ların eriştiği ortak bileşense ek altyapı gerektirmemesi avantajdır. Buna karşılık uzun süreli lock'lar database connection tüketebilir ve failure recovery dikkat ister. Lock mekanizması uygulamanın normal transaction trafiğini gereksiz yere etkilememelidir.
Redis Distributed Lock
Redis tabanlı distributed lock birden fazla worker veya scheduler instance'ının ortak key üzerinden koordinasyon kurmasına yardımcı olabilir. Lock key, TTL ve ownership token birlikte tasarlanmalıdır. Worker crash ettiğinde lock'ın sonsuza kadar kalmaması için TTL gerekir. Fakat iş TTL'den uzun sürerse ikinci worker lock'ı alabilir ve duplicate execution başlayabilir. Bu nedenle renewal ve fencing gibi konular kritik işlerde dikkatle değerlendirilmelidir.
Advisory Lock
Bazı veritabanları uygulamanın iş anahtarlarına göre advisory lock almasına imkan verir. Bu yöntem tablo satırı değiştirmeden koordinasyon sağlamak için kullanılabilir. Lock'ın session veya transaction ömrüne nasıl bağlı olduğu database ürününe göre farklılık gösterebilir. Connection pool kullanıldığında lock'ın hangi bağlantı üzerinde tutulduğu özellikle önemlidir. Advisory lock kullanılmadan önce failure ve connection reset davranışı test edilmelidir.
Leader Election
Leader election bir grup instance arasından yalnızca bir tanesinin scheduler rolünü üstlenmesini sağlayabilir. Bu model her instance'ın aynı schedule'ı bağımsız çalıştırmasını engeller. Leader düşerse başka instance rolü devralabilir. Ancak geçiş sırasında kısa süreli çift lider veya belirsizlik ihtimali tasarımda ele alınmalıdır. Scheduler'ın job üretmesi idempotent olduğunda leader transition senaryoları daha güvenli yönetilebilir.
Distributed Lock Kullanırken Nelere Dikkat Edilmeli?
Distributed lock basit bir "key varsa çalışma" kontrolünden daha fazla ayrıntı içerir. Network gecikmesi, worker crash, TTL süresinin dolması ve aynı lock'ı başka process'in devralması gibi durumlar gerçek production sistemlerinde yaşanır. Bu nedenle lock'ı idempotency yerine koymak risklidir. Lock duplicate ihtimalini azaltırken idempotency duplicate gerçekleşse bile business sonucunu korur. Kritik işlemlerde iki yaklaşım birlikte kullanıldığında daha güçlü güvenlik elde edilir.
Lock TTL
TTL lock'ın owner kaybolduğunda sonsuza kadar kilitli kalmasını önler. Ancak süre job'ın normal çalışma süresinden kısa seçilirse iş devam ederken lock expire olabilir. İkinci worker lock'ı alıp aynı işi çalıştırdığında duplicate execution oluşur. Çok uzun TTL ise crash sonrası yeni worker'ın işi devralmasını geciktirir. Süre gerçek p95 veya p99 job duration ölçümleri üzerinden belirlenmeli ve gerekirse renewal uygulanmalıdır.
Worker Crash
Worker lock aldıktan sonra aniden çökerse release kodu çalışamayabilir. TTL olmayan lock bu durumda kalıcı şekilde stuck hale gelebilir. TTL kullanılması lock'ın zamanla serbest kalmasını sağlar. Fakat worker external side effect'i yaptıktan sonra crash etmişse yeni worker aynı işlemi yeniden yapabilir. Bu noktada business idempotency lock mekanizmasından daha önemli hale gelir.
Lock Renewal
Uzun süren işler lock TTL değerini periyodik olarak yenilemek zorunda kalabilir. Renewal yalnızca lock'ın gerçek owner'ı tarafından yapılmalıdır. Worker network bağlantısını kaybederse lock süresi dolabilir ve başka worker ownership alabilir. Eski worker bağlantı geri geldiğinde hâlâ işi çalıştırıyor olabilir. Fencing token gibi mekanizmalar eski owner'ın artık geçersiz olduğunu downstream sistemlere göstermek için kullanılabilir.
Stale Lock
Stale lock gerçek owner artık çalışmadığı halde sistemde kalan kilittir. Sonsuz lock süresi bu problemi özellikle tehlikeli hale getirir. TTL, lease ve ownership doğrulaması stale lock riskini azaltır. Operasyon ekibi lock age metriğini veya beklenmedik uzun lock durumlarını izleyebilir. Bir lock'ı manuel silmeden önce gerçekten aktif owner olmadığını doğrulamak duplicate execution riskini azaltır.
Fencing Token
Fencing token her yeni lock ownership için artan veya benzersiz bir sıra değeri üretme yaklaşımıdır. Downstream sistem yalnızca en yeni token'a sahip owner'ın yazmasını kabul edebilir. Böylece eski worker lock süresi bittikten sonra çalışmaya devam etse bile artık geçersiz olduğu anlaşılır. Bu yöntem kritik distributed coordination problemlerinde lock güvenliğini artırır. Her datastore fencing semantics desteklemediği için uygulanabilirlik mimariye göre değerlendirilmelidir.
Lock'ın Idempotency Yerine Geçmemesi
Hiçbir distributed lock mekanizması bütün failure senaryolarında duplicate execution'ın teorik olarak yok olacağını garanti etmez. Lock expire olabilir, network bölünebilir veya process side effect sonrasında acknowledgement vermeden çöker. Bu nedenle aynı business operasyonu ikinci kez çalıştığında güvenli sonuç üretmek gerekir. Payment, e-posta veya stok güncelleme gibi işlemlerde unique business key kullanılabilir. Lock performansı korur, idempotency ise veri doğruluğunu koruyan son savunma katmanıdır.
Arka Plan İşleyicisi Mimarisi
Arka plan işleyicisi mimarisi producer, queue, broker, worker ve monitoring gibi birbirinden ayrılmış bileşenlerden oluşur. Bu parçalar işi üretmek, güvenli biçimde taşımak, yürütmek ve sonuçları gözlemlemek için birlikte çalışır. Küçük sistemde bazı roller aynı teknoloji içinde birleşebilir, ancak kavramsal ayrımı bilmek sorunları anlamayı kolaylaştırır. Örneğin Redis hem queue verisini barındırabilir hem de başka uygulama ihtiyaçları için kullanılabilir, fakat worker yine ayrı process rolüdür. Production tasarımında failure'ın hangi bileşende oluşabileceği tek tek değerlendirilmelidir.
Producer
Producer yeni job oluşturan uygulama bileşenidir. Bir HTTP endpoint, scheduler veya başka bir worker producer rolünü üstlenebilir. Producer mümkün olduğunca küçük ve doğrulanabilir payload oluşturmalıdır. Queue publish başarısız olduğunda ne yapılacağı business önemine göre belirlenmelidir. Database değişikliğiyle queue publish aynı iş akışının parçasıysa transactional outbox gibi yöntemler düşünülmelidir.
Queue
Queue worker tarafından işlenmeyi bekleyen job'ların mantıksal sırasıdır. FIFO davranışı yaygın olsa da priority, delayed job veya özel routing kuralları kullanılabilir. Queue uzun süre büyüyorsa worker kapasitesi gelen job hızına yetişmiyor olabilir. Bu nedenle depth ve age metrikleri birlikte izlenmelidir. Her job türünü tek queue'ya koymak başlangıçta kolay olsa da farklı SLA ve kaynak gereksinimleri oluştuğunda ayrıştırma gerekebilir.
Broker
Broker producer ile worker arasındaki mesaj taşıma altyapısını sağlar. Redis veya RabbitMQ farklı background job sistemlerinde broker rolünde kullanılabilir. Broker'ın persistence, acknowledgement ve failover davranışı seçilen ürüne ve yapılandırmaya bağlıdır. "Queue kullanıyoruz, dolayısıyla job kaybolmaz" varsayımı doğru değildir. Durability beklentisi broker ayarlarıyla ve uygulama semantics ile açık biçimde doğrulanmalıdır.
Worker
Worker queue'dan job alır, payload'u doğrular ve iş mantığını yürütür. İş tamamlanınca acknowledgement verir veya framework'ün başarı mekanizmasını kullanır. Failure durumunda hata sınıflandırmasına göre retry veya DLQ akışına geçilir. Worker deployment sırasında yeni job almayı durdurup in-flight işi mümkünse tamamlamalıdır. Bu graceful shutdown yaklaşımı gereksiz redelivery ve duplicate execution oranını azaltır.
Result Store
Her background job için sonuç saklamak gerekli değildir. Kullanıcının rapor sonucunu daha sonra alacağı veya progress göstereceğiniz işlerde result store yararlı olabilir. Status, output reference, error summary ve completion timestamp burada tutulabilir. Büyük çıktının kendisini result store içine koymak yerine object storage referansı saklamak daha uygun olabilir. Retention politikası da belirlenmelidir çünkü tamamlanmış milyonlarca job sonucu zamanla gereksiz veri oluşturabilir.
Dead-Letter Queue
Dead-Letter Queue, normal retry politikasını tamamlayamayan job'ların ayrıldığı alandır. Amaç problemi görünmez hale getirmek değil, tekrar tekrar ana queue'yu meşgul eden işleri kontrollü biçimde izole etmektir. DLQ içinde job payload'u, hata nedeni ve attempt bilgisi inceleme için saklanabilir. Owner ve retention politikası olmadan DLQ kısa sürede unutulan bir depoya dönüşür. Non-zero DLQ depth çoğu kritik sistemde alarm üretmesi gereken bir durumdur.
Monitoring
Monitoring queue sisteminin gerçekten sağlıklı çalışıp çalışmadığını ölçer. Worker sayısı, queue depth, queue age, failure rate, retry count ve processing duration temel sinyallerdendir. Yalnızca CPU ve memory izlemek business gecikmesini göstermeyebilir. Örneğin CPU düşük görünürken queue'daki en eski kritik job 20 dakikadır bekliyor olabilir. Bu nedenle teknik altyapı metrikleri job yaşam döngüsü metrikleriyle tamamlanmalıdır.
Queue Neden Kullanılır?
Queue'nun temel faydası işi üretme hızı ile işi işleme hızını birbirinden ayırmasıdır. Kullanıcı isteği hızlı şekilde job bırakabilir ve worker kapasitesi mevcut hızında kuyruğu tüketebilir. Bu ayrım ani trafik artışında sistemin bütün işleri aynı anda çalıştırmasını engelleyerek tampon görevi görür. Queue ayrıca retry, horizontal scaling ve failure isolation için uygun bir kontrol noktası oluşturur. Fakat queue sınırsız kapasite değildir ve backpressure politikası olmadan yalnızca problemi daha ileri bir zamana erteleyebilir.
Request-Response Döngüsünü Kısaltmak
Uzun iş request içinde tutulduğunda kullanıcı yanıt için bekler ve web server connection'ı açık kalır. Job queue'ya eklendiğinde uygulama çoğu zaman hızlı bir kabul yanıtı verebilir. İş daha sonra worker tarafından tamamlanır. Kullanıcı status endpoint veya bildirim üzerinden sonucu takip edebilir. Bu yaklaşım özellikle rapor, export ve medya işleme gibi doğal olarak gecikmeli işlemlerde daha iyi kullanıcı deneyimi sağlar.
Load Buffering
Bir anda on bin job gelmesi worker'ların on bin işi aynı saniyede çalıştırması gerektiği anlamına gelmez. Queue gelen işleri bekleterek işlem yükünü worker kapasitesine göre zamana yayar. Bu tampon downstream database veya API'nin korunmasına yardımcı olur. Ancak queue büyüme hızı sürekli pozitifse sistem kalıcı olarak kapasite altında çalışıyor demektir. Bu durumda autoscaling, rate limiting veya producer throttling gibi ek önlemler gerekir.
Retry
Queue sistemleri başarısız job'ların kontrollü şekilde yeniden denenmesini kolaylaştırır. Retry sayısı, delay ve backoff politikası job türüne göre belirlenebilir. Kalıcı validation hatalarını tekrar tekrar denemek ise kaynak israfıdır. Retryable ve permanent failure sınıflarını ayırmak temel tasarım kararlarından biridir. Denemeler tükendiğinde DLQ veya açık failure state oluşturulmalıdır.
Horizontal Scaling
Queue consumer modelinde worker instance sayısı artırılarak aynı queue daha yüksek kapasiteyle tüketilebilir. Bu horizontal scaling özellikle I/O ağırlıklı job'larda etkili olabilir. Ancak worker sayısını artırmak database veya third-party API kapasitesini otomatik artırmaz. Downstream rate limit sınırı varsa concurrency kontrollü tutulmalıdır. Scaling kararı queue depth yanında queue age ve target latency üzerinden verilmelidir.
Failure Isolation
Background worker'ın çökmesi web uygulamasının doğrudan çökmesi anlamına gelmemelidir. Queue iki runtime arasında tampon oluşturarak failure domain'lerini ayırır. Örneğin görsel işleme worker'ı memory sorunu yaşasa bile login endpoint'leri normal çalışabilir. Farklı job türlerini ayrı queue ve worker pool'larında çalıştırmak izolasyonu daha da güçlendirir. Kritik ve bulk işlerin aynı kaynak havuzunda tutulması bu faydayı azaltabilir.
Backpressure
Backpressure producer'ın worker kapasitesinden sürekli daha hızlı job üretmesi durumunda sistemin uyguladığı kontrol mekanizmasıdır. Queue tek başına büyüyebilir, fakat büyümenin bir sınırı vardır. Rate limit, admission control, producer throttling ve load shedding gibi yöntemlerle yeni yük azaltılabilir. Autoscaling kapasite uygunsa worker sayısını artırabilir. En iyi çözüm çoğu zaman bu yöntemlerin iş önceliğine göre birlikte kullanılmasıdır.
Work Queue Pattern
Work Queue Pattern, bir iş havuzundaki görevlerin bir veya daha fazla worker arasında paylaştırılmasını sağlar. Amaç aynı job'ın tüm consumer'lara yayınlanması değil, genellikle tek bir uygun worker tarafından işlenmesidir. Worker'lar competing consumers biçiminde aynı queue'dan iş alabilir. Bu yapı throughput'u worker sayısıyla artırmayı kolaylaştırır. Yine de delivery semantics nedeniyle duplicate execution olabileceği varsayılarak job'lar idempotent tasarlanmalıdır.
Producer
Work queue içindeki producer bir iş birimini queue'ya ekler. Job mümkün olduğunca bağımsız ve worker'ın ihtiyaç duyduğu minimum bağlamı taşımalıdır. Producer'ın işi kendisinin gerçekleştirmeye başlamaması responsibility ayrımını korur. Enqueue başarısının business transaction ile ilişkisi gerektiğinde outbox pattern ile güvence altına alınabilir. Producer rate'i worker kapasitesinden çok yüksekse backpressure sinyalleri gözlenmelidir.
Bir Job
Bir job tek bir anlamlı iş birimini temsil etmelidir. Çok büyük job'lar hata halinde baştan tekrar çalışmak zorunda kalırken aşırı küçük job'lar broker ve orchestration maliyetini yükseltebilir. Doğru granularity kullanılan işleme göre değişir. Örneğin milyon kayıtlık export 1000 kayıtlık chunk job'larına bölünebilir. Her job kendi job ID, attempt ve idempotency bilgisini taşımalıdır.
Bir Worker Tarafından İşleme
Work queue modelinde amaç her job'ın bir worker tarafından sahiplenilip işlenmesidir. Worker görevi aldığında delivery semantics'e göre acknowledgement zamanlaması önem kazanır. Ack iş tamamlanmadan verilirse worker crash sonrası job kaybolabilir. Ack çok geç verilirse crash durumunda redelivery ve duplicate execution görülebilir. Bu nedenle framework'ün acknowledgement modelini anlamak production güvenilirliği için önemlidir.
Competing Consumers
Competing consumers aynı queue'dan job almaya çalışan birden fazla worker'dır. Broker her işi uygun consumer'lardan birine dağıtarak paralel işleme sağlar. Worker sayısı arttıkça kapasite yükselir, fakat ortak downstream kaynaklar sınır olabilir. Job'ların işlem süreleri çok farklıysa dağıtım adaleti için prefetch ayarları önem kazanabilir. Uzun job alan worker'ın birçok ek işi önceden çekmesi diğer worker'ların boş kalmasına neden olabilir.
Worker Scaling
Worker scaling queue throughput ihtiyacına göre consumer sayısının ayarlanmasıdır. Sabit worker sayısı küçük ve öngörülebilir trafikte yeterli olabilir. Değişken yükte queue depth veya age tabanlı autoscaling daha verimli sonuç verebilir. Scale-to-zero maliyeti azaltırken cold start gecikmesi oluşturabilir. Kritik queue'larda minimum worker sayısını sıfırdan büyük tutmak daha düşük latency sağlayabilir.
Publish/Subscribe ile Work Queue Arasındaki Fark
Work queue ve publish/subscribe benzer mesaj altyapılarını kullanabilse de business amacı farklıdır. Work queue'da bir job genellikle tek worker tarafından yapılacak iş olarak görülür. Publish/subscribe modelinde aynı event birden fazla bağımsız subscriber tarafından tüketilebilir. "Sipariş oluşturuldu" event'i faturalama, analitik ve bildirim servislerine aynı anda anlamlı olabilir. Model seçimi mesajın "yapılacak iş" mi yoksa "gerçekleşmiş olay" mı olduğu sorusuyla kolaylaşır.
Bir Mesaj Bir Worker
Work queue yaklaşımında tek job'ın consumer grubundaki bir worker tarafından işlenmesi beklenir. Amaç işi kopyalamak değil worker'lar arasında dağıtmaktır. Örneğin 10 görsel resize job'ı beş worker arasında paylaştırılabilir. Delivery failure nedeniyle aynı job farklı zamanda başka worker'a yeniden teslim edilebilir. Bu nedenle "bir worker" kavramı exactly-once garantisi olarak yorumlanmamalıdır.
Bir Event Birden Fazla Subscriber
Publish/subscribe modelinde bir event'in birden fazla bağımsız tüketicisi olabilir. Kullanıcı kaydoldu event'i e-posta, CRM senkronizasyonu ve analitik servisleri tarafından ayrı ayrı işlenebilir. Her subscriber kendi başarısızlık ve retry politikasına sahip olabilir. Bir subscriber'ın hatası diğerinin event'i işlemesini engellememelidir. Event schema versioning bu model büyüdükçe önemli hale gelir.
Fan-Out
Fan-out tek event'in birden fazla hedef iş akışını başlatmasıdır. Büyük rapor üretiminde tek parent job yüzlerce alt job oluşturarak veri parçalarını paralel işleyebilir. Pub/sub sistemlerinde ise aynı business event birden fazla topic veya subscriber'a dağıtılabilir. Fan-out kapasiteyi artırırken toplam job sayısını hızlı biçimde büyütebilir. Downstream sistemlerin rate limitleri ve aggregation adımı bu nedenle dikkatle planlanmalıdır.
Event-Driven Architecture
Event-driven architecture servislerin birbirini doğrudan çağırmak yerine gerçekleşen olaylara tepki verebildiği bir modeldir. Bu yaklaşım bazı bağımlılıkları azaltır ve yeni consumer eklemeyi kolaylaştırır. Buna karşılık event ordering, duplicate delivery ve schema evolution gibi konular devreye girer. Her sistemin event-driven olması gerekmez. İş akışı basitse doğrudan queue veya senkron çağrı daha kolay yönetilebilir.
Hangi Senaryoda Hangisi?
"Bu işi bir worker yapsın" diyorsanız work queue doğal bir modeldir. "Bu olay gerçekleşti ve ilgilenen herkes kendi işlemini yapsın" diyorsanız publish/subscribe daha uygundur. E-posta gönderme job'ı work queue, order-created olayı pub/sub örneği olabilir. Aynı sistem iki modeli beraber kullanabilir. Önemli olan mesaj semantics'ini isim ve payload seviyesinde açık tutmaktır.
Background Job Payload Nasıl Tasarlanmalı?
Job payload yalnızca veri taşıyan küçük bir obje gibi görünse de uzun vadede worker uyumluluğunu ve güvenliğini doğrudan etkiler. Büyük binary veri, gereksiz kişisel bilgiler veya framework'e özgü serialization objeleri queue üzerinde operasyon sorunlarına yol açabilir. Payload mümkün olduğunca küçük, versioned ve referans tabanlı olmalıdır. Worker ihtiyaç duyduğu güncel veriyi database veya object storage üzerinden okuyabilir. Ancak job'ın zaman içindeki business anlamı değişebiliyorsa hangi verinin snapshot olarak saklanacağı ayrıca değerlendirilmelidir.
Küçük Payload
Küçük payload broker memory ve network kullanımını azaltır. Mesajların hızlı serialize ve deserialize edilmesini sağlar. Yüzlerce kilobyte veya megabyte veri taşımak queue throughput'unu gereksiz yere düşürebilir. Çoğu iş için object ID ve birkaç kontrol alanı yeterlidir. Payload boyutu için uygulama seviyesinde maksimum limit belirlemek beklenmedik büyümeleri erken yakalar.
Object ID Taşımak
Job içine bütün database kaydını koymak yerine object ID taşımak yaygın bir yaklaşımdır. Worker işi aldığında kaydın güncel halini veritabanından okuyabilir. Bu yöntem payload'u küçültür ve schema değişikliklerinde eski serialized objelerin sorun yaratmasını azaltır. Ancak job oluşturulduğu andaki snapshot önemliyse yalnızca ID yeterli olmayabilir. Bu durumda gerekli immutable alanları açık biçimde payload'a eklemek veya versioned snapshot saklamak gerekir.
Büyük Dosyayı Queue'ya Koymamak
Video, PDF veya büyük CSV dosyasının binary içeriğini doğrudan queue mesajına koymak çoğu durumda iyi bir fikir değildir. Broker memory, persistence ve replication maliyeti hızla artar. Dosya önce object storage'a yüklenebilir ve queue payload'ında yalnızca güvenli bir object key taşınabilir. Worker gerekli anda dosyayı storage üzerinden alır. Dosyanın retention süresi job retry penceresinden kısa olmamalıdır.
Object Storage Reference
Object storage reference büyük veri ile queue mesajını birbirinden ayırır. Payload içinde bucket adı yerine soyut object ID kullanmak güvenlik ve provider bağımsızlığı açısından daha iyi olabilir. Worker'ın yalnızca ihtiyaç duyduğu prefix veya object için erişim yetkisi bulunmalıdır. Signed URL kullanılacaksa expiration süresi retry ve queue delay senaryolarına göre ayarlanmalıdır. Uzun süre bekleyen job'ın süresi dolmuş URL yüzünden sürekli fail etmesi önlenmelidir.
Versioned Payload
Queue'da saatler veya günler bekleyebilen job'lar deployment sonrasında yeni worker sürümü tarafından işlenebilir. Payload schema değiştiğinde eski job'ların hâlâ anlaşılabilir olması gerekir. Bu nedenle payload içine açık version alanı eklemek yararlı olabilir. Worker eski sürümleri dönüştürebilir veya desteklenmeyen schema için kontrollü hata üretebilir. Deployment öncesinde queue'da eski job kalıp kalmadığını görmek de migration planının bir parçasıdır.
Schema Evolution
Schema evolution producer ve worker'ın farklı sürümlerinin bir süre birlikte çalışabileceği gerçeğini kabul eder. Yeni zorunlu alan eklemek eski job'ların bozulmasına yol açabilir. Backward-compatible değişiklikler rolling deployment sürecini kolaylaştırır. Büyük kırılmalarda yeni job type veya payload version kullanmak daha güvenli olabilir. Queue mesajlarını normal API contract'ları kadar ciddi bir interface olarak görmek uzun vadede sorunları azaltır.
Job Payload'a Hassas Veri Koymak Güvenli midir?
Queue payload'u loglanabilir, retry kayıtlarında tutulabilir, broker diskine yazılabilir veya monitoring ekranında görüntülenebilir. Bu nedenle hassas veriyi sıradan application object'i gibi payload'a koymak güvenlik ve uyumluluk riski doğurur. En iyi yaklaşım mümkün olan en az veriyi taşımak ve hassas kaynağa kontrollü referans vermektir. Broker encryption yararlıdır, fakat verinin gereksiz kopyalarını ortadan kaldırmaz. Payload tasarımında veri minimizasyonu temel varsayım olmalıdır.
PII
PII olarak değerlendirilebilecek kişisel veriler job payload'una yalnızca gerçekten gerekiyorsa eklenmelidir. E-posta adresi yerine user ID taşımak çoğu durumda yeterli olabilir. Worker gerekli bilgiyi yetkili datastore'dan okuyabilir. Queue retention süresi kişisel veri saklama politikasını da etkiler. Logların payload'u otomatik yazdırmadığından emin olmak ayrıca önemlidir.
Credentials
API key, password veya token gibi credentials doğrudan job payload'unda taşınmamalıdır. Worker secret manager veya güvenli environment üzerinden gerekli credential'a erişmelidir. Payload içine credential koymak retry, log ve DLQ üzerinden secret'ın birçok kopyasını oluşturabilir. Credential rotate edildiğinde eski queued job'larda stale secret kalması da ayrı sorun yaratır. Merkezi secret yönetimi bu riski önemli ölçüde azaltır.
Payment Data
Ödeme verileri yüksek hassasiyet taşıdığı için payload tasarımında daha sıkı veri minimizasyonu gerekir. Tam kart bilgisi gibi değerler background queue içinde taşınmamalıdır. Provider tarafından verilen güvenli payment reference veya transaction ID kullanmak daha uygun bir yaklaşımdır. Worker yalnızca iş için gerekli minimum identifier ile çalışmalıdır. Retry idempotency key ile korunmalı ve aynı finansal etkinin iki kez oluşması engellenmelidir.
Broker Encryption
Broker bağlantılarında transport encryption kullanmak network üzerinden geçen mesajların korunmasına yardımcı olur. Disk encryption veya broker'ın kendi at-rest güvenlik özellikleri de ihtiyaçlara göre değerlendirilebilir. Buna rağmen encryption fazla veri toplamanın çözümü değildir. Yetkili bir uygulama veya yanlış yapılandırılmış log sistemi plaintext payload'u yine görebilir. Bu nedenle encryption ile data minimization birlikte uygulanmalıdır.
Data Minimization
Data minimization job'ın gerçekten ihtiyaç duyduğu minimum bilgiyi taşımasını hedefler. Büyük domain object yerine ID ve gerekli birkaç flag kullanmak iyi bir örnektir. Bu yaklaşım payload boyutunu düşürdüğü gibi güvenlik riskini de azaltır. Worker ek veriyi çalışma anında yetkili kaynaktan okuyabilir. Yalnızca audit veya immutable snapshot ihtiyacı varsa gerekli alanlar kontrollü biçimde saklanmalıdır.
Reference-Based Payload
Reference-based payload gerçek hassas veriyi mesaj içine gömmek yerine güvenli kaynağın identifier değerini taşır. Örneğin document_id worker'ın dosyaya erişmesi için yeterli olabilir. Worker kendi identity ve permissions modeliyle kaynağı okur. Böylece queue leak olsa bile doğrudan hassas içeriğin tamamı açığa çıkmaz. Referansın tahmin edilmesi kolay olsa bile authorization kontrolü worker veya storage katmanında korunmalıdır.
Job Identity Nasıl Tasarlanmalıdır?
Production background sisteminde tek bir ID çoğu zaman bütün ihtiyaçları karşılamaz. Teknik job instance'ını, business operasyonunu, kullanıcı isteğini ve retry denemesini birbirinden ayırmak gerekir. Job ID, business key, correlation ID ve idempotency key bu farklı ihtiyaçlara cevap verir. İsimler ekip içinde standart hale getirilirse log ve trace sorguları çok daha anlaşılır olur. Kimlik tasarımı özellikle duplicate execution ve incident incelemesinde büyük değer sağlar.
Job ID
Job ID queue içindeki belirli job instance'ını tanımlar. Her enqueue için yeni bir kimlik üretilebilir veya framework özel kurallarla ID oluşturabilir. Loglar ve job history bu ID üzerinden ilişkilendirilebilir. Aynı business işlem retry edildiğinde framework aynı job ID'yi koruyabilir veya yeni instance üretebilir. Bu davranış kullanılan queue sisteminde açık biçimde bilinmelidir.
Business Key
Business key teknik job'dan bağımsız olarak gerçek iş nesnesini tanımlar. Örneğin invoice:2026-08:customer-42 benzeri bir anahtar aynı aylık faturanın birden fazla teknik denemede tanınmasını sağlar. Database unique constraint bu anahtar üzerinde uygulanabilir. Job ID değişse bile business key aynı kalır. Bu ayrım idempotency tasarımını daha anlaşılır hale getirir.
Correlation ID
Correlation ID aynı iş akışına ait farklı servis ve job kayıtlarını ilişkilendirir. Bir HTTP request queue'ya job ekleyip worker başka API çağırıyorsa aynı correlation ID zincir boyunca taşınabilir. Incident sırasında tek değerle bütün ilgili logları bulmak büyük kolaylık sağlar. Correlation ID güvenlik bilgisi değildir ve yetkilendirme için kullanılmamalıdır. Ama observability açısından oldukça faydalı bir bağlam anahtarıdır.
Idempotency Key
Idempotency key aynı business operasyonunun tekrar gönderildiğini tanımaya yarar. Payment veya webhook işleminde aynı key ile ikinci istek geldiğinde önceki sonuç döndürülebilir veya yeni yan etki engellenebilir. Key scope ve retention süresi iş kuralına göre tanımlanmalıdır. Çok kısa retention geç gelen duplicate'ları kaçırabilir. Çok geniş scope ise aslında farklı işlemleri yanlışlıkla aynı kabul edebilir.
Trace ID
Trace ID distributed tracing sisteminde bir isteğin veya iş akışının uçtan uca izini temsil eder. Producer enqueue span oluşturabilir ve trace context'i job metadata'sında worker'a aktarabilir. Worker yeni span ile aynı trace'i devam ettirebilir. Harici API çağrıları da alt span olarak eklenebilir. Böylece HTTP süresi ile background processing süresi tek görsel zincirde incelenebilir.
Attempt Number
Attempt number job'ın kaçıncı çalıştırma denemesinde olduğunu gösterir. İlk attempt ile beşinci retry'nin loglarını ayırmak için önemlidir. Hata yalnızca belirli denemelerde ortaya çıkıyorsa backoff veya dependency davranışı hakkında ipucu sağlar. Job payload'u değişmeden attempt metadata'sı queue sistemi tarafından tutulabilir. Alertlerde "attempt 5/5" gibi bilgi ekibin failure'ın kalıcı hale geldiğini anlamasını kolaylaştırır.
At-Least-Once Delivery Nedir?
At-least-once delivery, bir mesajın kaybolmasını azaltmak için gerektiğinde tekrar teslim edilebildiği delivery modelidir. Bunun doğal sonucu aynı job'ın birden fazla kez çalıştırılabilmesidir. Worker işi tamamladıktan sonra acknowledgement vermeden çökerse broker job'ın tamamlanıp tamamlanmadığını bilemeyebilir ve tekrar teslim eder. Bu davranış production sistemlerinde olağan kabul edilmelidir. Dolayısıyla doğru hedef duplicate execution'ı imkansız varsaymak değil, duplicate oluştuğunda business sonucunu güvenli hale getirmektir.
Worker Job'ı İşler
Worker queue'dan mesajı alır ve business işlemini çalıştırmaya başlar. Bu sırada mesaj broker açısından active veya in-flight durumda olabilir. Worker database güncellemesini veya harici API çağrısını tamamlayabilir. Fakat broker henüz bu başarıyı bilmeyebilir. İş ile acknowledgement arasında her zaman bir failure penceresi bulunduğunu kabul etmek gerekir.
Ack Öncesi Worker Çöker
Worker yan etkiyi başarıyla tamamladıktan hemen sonra process crash yaşayabilir. Ack broker'a ulaşmadığı için mesaj işlenmemiş gibi görünebilir. Broker veya queue sistemi belirli süre sonra job'ı tekrar kullanılabilir hale getirir. Yeni worker aynı işi yeniden çalıştırır. Idempotency yoksa ikinci yan etki oluşabilir.
Mesaj Yeniden Teslim Edilir
Redelivery güvenilir message processing sistemlerinin önemli davranışlarından biridir. Amaç crash nedeniyle işin tamamen kaybolmasını önlemektir. Yeni worker payload'u aldığında bunun ilk çalışma mı yoksa yeniden teslim mi olduğunu her zaman business açısından bilemeyebilir. Attempt metadata'sı yardımcı olsa da güvenlik için idempotency key daha önemlidir. Consumer kodu duplicate possibility varsayımıyla yazılmalıdır.
Duplicate Execution
Duplicate execution aynı business job'ın birden fazla kez worker tarafından çalıştırılmasıdır. Bu durum broker hatası olmak zorunda değildir ve at-least-once modelin doğal yan etkisidir. Eğer işlem "balance = balance + 100" gibi non-idempotent ise iki çalışma farklı sonuç üretir. "Bu payment ID daha önce işlendi mi?" kontrolü gibi yöntemler çift etkiyi engelleyebilir. Database unique constraint genellikle uygulama seviyesindeki kontrolü daha güçlü hale getirir.
Production'da Neden Normaldir?
Dağıtık sistemlerde process ve network failure tamamen ortadan kaldırılamaz. İş tamamlandığı halde acknowledgement kaybolabilir veya worker'ın durumu broker tarafından geç fark edilebilir. Bu nedenle duplicate delivery olasılığını sıfır kabul etmek gerçekçi değildir. Güvenilir sistemler bu olasılığı tasarıma dahil eder. Idempotency, unique constraints ve audit kayıtları bu yaklaşımın temel araçlarıdır.
Exactly-Once Processing Gerçekten Mümkün müdür?
"Exactly once" ifadesi farklı sistemlerde farklı seviyelerde garanti anlamına gelebilir. Bir broker aynı mesajı belirli koşullarda tek kez teslim etmeye çalışabilir, fakat external side effect ile broker state arasında yine dağıtık transaction problemi oluşabilir. Bu nedenle exactly-once delivery ile exactly-once business effect aynı şey değildir. Production tasarımında hangi sınır içinde hangi garantinin verildiği açıkça tanımlanmalıdır. Çoğu background job sistemi için idempotency ile tek business sonucu üretmek pratikte daha güvenilir hedeftir.
Exactly-Once Delivery
Exactly-once delivery mesaj altyapısının aynı mesajı consumer'a yalnızca bir kez ulaştırma iddiasını ifade edebilir. Ancak consumer mesajı aldıktan sonra kendi database veya harici servisiyle ayrı transaction yapar. Bu external işlem başarıyla bitip broker acknowledgement başarısız olursa mesajın durumu belirsiz hale gelir. Dolayısıyla broker garantisi bütün business zinciri otomatik kapsamaz. Gerçek sistem sınırı açıkça çizilmelidir.
Exactly-Once Effect
Exactly-once effect aynı business işlemin tekrar çalıştırılsa bile yalnızca tek kalıcı yan etki üretmesini amaçlar. Idempotency key ve database unique constraint bu yaklaşımın güçlü araçlarıdır. Örneğin aynı payment reference ikinci kez işlenirse yeni tahsilat yerine mevcut sonuç döndürülebilir. Worker iki kez çalışmış olsa bile business state tek sonuçta kalır. Production sistemlerinde çoğu zaman aranan garanti budur.
Distributed Systems Trade-Off
Broker, database ve external API birbirinden bağımsız sistemler olduğunda tek atomik transaction oluşturmak zordur. Network partition veya process crash hangi adımın tamamlandığı konusunda belirsizlik yaratabilir. İki fazlı commit her ortamda mevcut veya uygun değildir. Bu nedenle outbox, idempotency ve retry gibi pattern'ler pratik çözüm sağlar. Sistem hangi failure durumunda duplicate, delay veya manual reconciliation kabul ettiğini açıkça tanımlamalıdır.
Idempotency ile Tek İş Sonucu
Idempotent worker aynı business key ile tekrar çağrıldığında ikinci yan etki oluşturmaz. İlk çalışma sonuç kaydını atomik biçimde oluşturur. İkinci çalışma unique constraint'e çarparak mevcut sonucu okuyabilir veya güvenli şekilde no-op yapabilir. Bu model retry ve redelivery davranışını çok daha güvenli hale getirir. İdempotency özellikle finans, notification ve provisioning işlemlerinde kritik öneme sahiptir.
Marketing Terimleri ile Gerçek Garanti Farkı
Bir ürün "exactly once" ifadesi kullandığında garanti sınırını teknik olarak okumak gerekir. Garanti broker içindeki delivery'yi kapsarken sizin database ve third-party API side effect'lerinizi kapsamayabilir. Architecture review sırasında "hangi failure penceresinde aynı işlem tekrar olabilir?" sorusu sorulmalıdır. Dokümantasyondaki semantics test senaryolarıyla doğrulanmalıdır. Ürün etiketi yerine gerçek business etkisini koruyan tasarım yapılmalıdır.
Idempotency Nedir?
Idempotency aynı işlemin birden fazla kez uygulanmasının nihai sonucu ilk uygulamayla aynı bırakması prensibidir. Background job sistemlerinde retry ve redelivery nedeniyle bu özellik güvenilirliğin temel taşlarından biridir. Her işlemi doğal olarak idempotent yapmak mümkün olmayabilir, fakat business key ve transaction tasarımıyla etkisi kontrol edilebilir. Özellikle para, stok ve bildirim gibi yan etkilerde idempotency açık biçimde planlanmalıdır. "Job normalde bir kez çalışır" varsayımı production failure senaryolarında yeterli değildir.
Aynı İş İki Kez Çalışırsa Aynı Sonuç
İdempotent bir işlem ikinci kez çağrıldığında yeni bir yan etki üretmez. Örneğin kullanıcının durumunu "active" yapmak iki kez uygulansa da sonuç yine active olur. Buna karşılık her çağrıda yeni kayıt eklemek doğal olarak idempotent değildir. Non-idempotent işlemler için unique business key kullanılabilir. Hedef worker kaç kez çağrılırsa çağrılsın gerçek dünya sonucunun tek olmasıdır.
Idempotent Update
status = 'completed' biçimindeki assignment aynı değer tekrar yazıldığında genellikle idempotent davranır. Buna rağmen update yanında başka yan etkiler varsa bütün operasyon otomatik olarak idempotent sayılmaz. Örneğin status update sonrası her çağrıda e-posta gönderiliyorsa duplicate notification oluşabilir. İşlemin tamamını tek business operasyon olarak değerlendirmek gerekir. Yan etkilerin her biri idempotency key ile korunabilir.
Non-Idempotent Increment
counter = counter + 1 her çalıştırmada sonucu değiştirdiği için doğal olarak non-idempotent bir işlemdir. Job iki kez çalışırsa sayaç iki artar. Bu iş gerçekten tek kez uygulanmalıysa event ID ile processed-event tablosu kullanılabilir. Aynı event ikinci kez geldiğinde increment yapılmadan işlem tamamlanabilir. Unique constraint bu kontrolün race condition altında da güvenli kalmasına yardımcı olur.
Finansal İşlemlerde Idempotency
Finansal işlemlerde duplicate execution gerçek para hareketine dönüşebileceği için idempotency kritik önemdedir. Her tahsilat veya transfer için stabil bir business idempotency key üretilebilir. Provider destekliyorsa aynı key external API çağrısında da kullanılmalıdır. Local database üzerinde de işlem reference değeri unique tutulabilir. Network timeout sonrası provider'ın işlemi yapıp yapmadığı belirsiz kaldığında status sorgulama ve reconciliation akışı gerekebilir.
Bildirimlerde Idempotency
Duplicate e-posta veya push notification finansal kayıp oluşturmasa da kullanıcı güvenini ve deneyimini olumsuz etkileyebilir. Bildirim türü, kullanıcı ve business event ID birleşiminden unique anahtar üretilebilir. Worker aynı anahtarı tekrar gördüğünde mevcut delivery sonucunu kontrol edebilir. Provider request timeout durumunda provider message ID saklamak reconciliation için faydalıdır. Kritik bildirimlerde "gönderildi mi?" ile "teslim edildi mi?" durumları ayrı ele alınmalıdır.
Enqueue Idempotency
Idempotency yalnızca worker çalışırken uygulanmaz, job'ın queue'ya eklenme aşamasında da duplicate üretimi azaltılabilir. Aynı event iki kez işlendiğinde iki ayrı job eklenmesi bazen gereksiz yük oluşturur. Unique job key veya database constraint enqueue seviyesinde deduplication sağlayabilir. Buna rağmen yalnızca enqueue deduplication'a güvenmek yeterli değildir çünkü redelivery worker aşamasında yine duplicate oluşturabilir. En güçlü yaklaşım producer ve consumer seviyesinde birbirini tamamlayan korumalar kullanmaktır.
Aynı Job'ın Kuyruğa İki Kez Eklenmesini Önleme
Producer retry yaparken enqueue sonucunun başarılı olup olmadığı belirsiz kalabilir. Aynı request yeniden gönderildiğinde ikinci job oluşabilir. Stabil unique job key bu iki enqueue girişimini aynı business iş olarak tanımayı sağlar. Queue framework destekliyorsa duplicate job creation engellenebilir. Desteklemiyorsa database tabanlı enqueue kayıtları veya unique constraint kullanılabilir.
Unique Job Key
Unique job key job türü ve business identifier'dan üretilebilir. Örneğin günlük rapor için tarih ve tenant ID birlikte anahtar oluşturabilir. Aynı dönem raporu tekrar enqueue edildiğinde sistem mevcut job'ı bulabilir. Key'in hangi zaman aralığında unique olması gerektiği iş kuralına göre belirlenmelidir. Yanlış geniş scope geçerli yeni işleri engelleyebilir.
Deduplication Window
Deduplication window aynı job'ın belirli süre içinde tekrar enqueue edilmesini önler. Webhook veya kullanıcı double-click senaryolarında kısa pencere etkili olabilir. Fakat aynı business operation daha uzun süre sonra duplicate gelirse pencere sona ermiş olabilir. Kritik işlemlerde kalıcı business key kontrolü daha güvenli olabilir. Window daha çok yük azaltma optimizasyonu olarak görülmeli, finansal doğruluğun tek garantisi olmamalıdır.
Database Unique Constraint
Database unique constraint duplicate enqueue veya business operation kayıtlarını atomik seviyede engelleyebilir. İki producer aynı anda aynı key'i yazmaya çalışsa bile veritabanı yalnızca bir kaydı kabul eder. Bu özellik uygulama seviyesindeki "önce var mı kontrol et" yarışından daha güçlüdür. Constraint hatası beklenen duplicate durumu olarak ele alınabilir. Sonrasında mevcut job veya business kaydı okunarak idempotent sonuç döndürülebilir.
Processing Idempotency
Processing idempotency worker'ın aynı job'ı birden fazla kez alabileceği varsayımıyla tasarlanır. Job queue'ya bir kez eklenmiş olsa bile worker crash veya acknowledgement problemi nedeniyle tekrar teslim edilebilir. Bu nedenle business yan etkisi başlamadan önce işin daha önce tamamlanıp tamamlanmadığı kontrol edilir. Ancak bu kontrol ile yan etki arasındaki race condition da çözülmelidir. Database transaction, unique constraint ve atomic operation bu noktada önem kazanır.
Processed Jobs Tablosu
Processed jobs tablosu işlenmiş idempotency key değerlerini saklamak için kullanılabilir. Worker transaction içinde bu key'i unique olarak eklemeye çalışır. Key zaten varsa job'ın daha önce işlendiği anlaşılır. Bu yöntem database ile yapılan business update aynı transaction içine alınabiliyorsa oldukça güçlüdür. Tablo retention süresi duplicate'ların ne kadar geç gelebileceğine göre belirlenmelidir.
Redis SET NX
Redis SET NX anahtar yalnızca mevcut değilse değer yazma davranışıyla basit deduplication veya lock senaryolarında kullanılabilir. TTL eklemek key'lerin sonsuza kadar kalmasını engelleyebilir. Ancak Redis kaybı, replication ve persistence davranışı business garantisi için değerlendirilmelidir. Kritik finansal işlemlerde yalnızca geçici Redis key'ine güvenmek yeterli olmayabilir. Database'deki kalıcı business constraint daha güçlü bir son güvenlik katmanı sağlayabilir.
Unique Constraint
Unique constraint aynı business result'ın iki kez oluşturulmasını database seviyesinde engeller. Örneğin her sipariş için yalnızca bir invoice row bulunması gerekiyorsa order_id unique olabilir. İki worker aynı anda invoice oluşturmaya çalışsa bile biri başarılı olur. Diğeri duplicate constraint hatasını beklenen idempotent durum olarak ele alabilir. Bu yaklaşım concurrency altında uygulama seviyesindeki basit check'ten daha güvenlidir.
Upsert
Upsert kayıt varsa güncelleme, yoksa oluşturma işlemini tek database operation içinde yönetmeye yardımcı olabilir. İdempotent state update işlemlerinde kullanışlıdır. Ancak her upsert otomatik olarak doğru business sonucu üretmez. Increment veya timestamp gibi her çalışmada değişen alanlar tekrar execution'da farklı sonuç oluşturabilir. SQL davranışı ve conflict key iş kuralına göre dikkatle seçilmelidir.
Natural Business Key
Natural business key teknik UUID yerine iş dünyasında zaten benzersiz olan değeri kullanır. Örneğin provider transaction reference veya invoice period plus customer kombinasyonu buna örnek olabilir. Bu anahtar idempotency'nin business anlamını daha açık hale getirir. Ancak gerçekten benzersiz ve zaman içinde stabil olduğundan emin olunmalıdır. Değişebilen kullanıcı adı gibi alanlar idempotency key için uygun değildir.
External API Çağrılarında Idempotency
Background worker harici API çağırdığında local transaction ile external side effect arasında atomiklik yoktur. API işlemi tamamlayıp response network üzerinde kaybolursa worker başarısız olduğunu düşünebilir ve retry yapabilir. Provider idempotency key destekliyorsa bu belirsizlik önemli ölçüde azaltılabilir. Destek yoksa provider status sorgusu, external reference ve reconciliation mekanizması gerekebilir. Özellikle ödeme, e-posta ve webhook gönderiminde bu durum baştan tasarlanmalıdır.
Provider Idempotency Key
Provider idempotency key aynı business request'in tekrar gönderildiğini dış servise bildirir. Aynı key ile tekrar çağrı yapıldığında provider yeni yan etki oluşturmak yerine önceki sonucu döndürebilir. Key worker retry'leri boyunca değişmemelidir. Her attempt için yeni key üretmek idempotency faydasını ortadan kaldırır. Provider'ın key retention süresi ve endpoint kapsamı dokümantasyondan kontrol edilmelidir.
Payment API
Payment API çağrıları duplicate side effect açısından en hassas örneklerden biridir. Worker charge request gönderip timeout aldığında ödemenin gerçekleşip gerçekleşmediği belirsiz olabilir. Aynı idempotency key ile tekrar çağrı provider destekliyorsa güvenli recovery sağlar. Local transaction kaydı provider reference ile ilişkilendirilmelidir. Düzenli reconciliation işlemleri local ve provider state arasındaki farkları tespit edebilir.
Email Provider
Email provider çağrısında timeout alınması mesajın hiç gönderilmediği anlamına gelmez. Provider request'i kabul edip response kaybolmuş olabilir. Worker körlemesine retry yaparsa kullanıcı duplicate e-posta alabilir. Provider message ID veya idempotency özelliği destekleniyorsa kullanılmalıdır. Destek yoksa notification business key ve delivery history ile duplicate olasılığı azaltılabilir.
Webhook Delivery
Kendi sisteminizden müşterilere webhook gönderirken event ID stabil tutulmalıdır. Receiver aynı event'i birden fazla kez alabileceğini bilmeli ve idempotent consumer tasarlamalıdır. Delivery worker timeout veya 5xx durumunda retry uygulayabilir. Her attempt timestamp, HTTP status ve response özetiyle kaydedilmelidir. Müşteriye geçmiş teslimatları ve manuel replay seçeneğini sunmak operasyon deneyimini iyileştirir.
Ambiguous Response Problemi
Ambiguous response, isteğin karşı tarafta uygulanıp uygulanmadığının kesin bilinmediği durumdur. Network timeout bunun tipik örneğidir. Bu senaryoda doğrudan "başarısız" kabul edip yeni side effect oluşturmak risklidir. Önce idempotency key ile retry veya provider status query uygulanmalıdır. Distributed sistemlerde belirsizliği tamamen yok etmek yerine güvenli reconciliation akışı tasarlamak gerekir.
Transactional Outbox Pattern Nedir?
Transactional Outbox Pattern, database değişikliği ile message publish işlemi arasında oluşan dual-write problemini azaltmak için kullanılan bir yöntemdir. Uygulama business kaydını ve yayımlanması gereken event'i aynı database transaction içinde yazar. Ayrı outbox worker bu kayıtları okuyup queue veya message broker'a gönderir. Böylece database commit başarılıyken publish'in tamamen unutulması riski azalır. Delivery yine duplicate olabilir, bu nedenle consumer tarafındaki idempotency gereksinimi devam eder.
Database Update + Queue Publish Problemi
Bir request önce database update yapıp sonra queue publish ediyorsa iki işlem arasında crash olabilir. Database değişikliği commit olmuş fakat queue mesajı hiç oluşmamış olabilir. Sıralamayı ters çevirirseniz mesaj yayınlanıp database rollback olabilir. Bu iki bağımsız sistemi tek transaction gibi yönetmek kolay değildir. Outbox pattern bu aradaki tutarsızlık penceresini database transaction üzerinden kontrol eder.
Dual Write
Dual write aynı business işleminde iki bağımsız storage veya sistemin güncellenmesi anlamına gelir. Birinci yazma başarılı, ikinci başarısız olduğunda state ayrışır. Basit retry bile hangi tarafın gerçekten başarılı olduğunu anlamayı gerektirebilir. Distributed transaction her ortam için uygun olmayabilir. Outbox ve idempotent consumer bu problemi pratik biçimde yönetmek için sık kullanılan araçlardır.
Outbox Table
Outbox table yayımlanmayı bekleyen event kayıtlarını uygulamanın kendi veritabanında tutar. Event type, aggregate ID, payload, created time ve publish status gibi alanlar içerebilir. Business transaction ile aynı database içinde olduğu için atomik commit sağlanabilir. Worker kayıtları batch halinde okuyup broker'a yayınlar. Başarılı publish sonrası state güncellenir veya kayıt retention politikasına göre temizlenir.
Aynı Transaction İçinde Event Yazma
Business row ve outbox event aynı transaction içinde yazıldığında ikisi birlikte commit veya rollback olur. Bu, "sipariş var ama order-created event hiç oluşmadı" riskini azaltır. Transaction içinde broker çağrısı yapılmadığı için external network failure database transaction'ı uzun süre açık tutmaz. Event payload'unun gerekli minimum bilgiyi içermesi önemlidir. Schema versioning burada da uygulanmalıdır.
Outbox Worker
Outbox worker publish edilmemiş kayıtları belirli aralıklarla veya event mechanism üzerinden alır. Birden fazla worker kullanılıyorsa aynı row'un iki worker tarafından sahiplenmesini engellemek için locking veya SKIP LOCKED yaklaşımı kullanılabilir. Publish başarıyla gerçekleşip status update öncesinde worker crash ederse event tekrar yayınlanabilir. Bu nedenle consumer duplicate-safe olmalıdır. Outbox worker'ın backlog age metriği ayrıca izlenmelidir.
Duplicate-Safe Delivery
Outbox pattern lost event riskini azaltırken exactly-once delivery sağlamaz. Publish başarılı olup outbox row işaretlenmeden önce process çökerse aynı event yeniden publish edilebilir. Event ID stabil tutulursa consumer duplicate'ı tanıyabilir. Processed-event table veya business unique constraint kullanılabilir. Böylece at-least-once delivery güvenli business sonucuna dönüştürülebilir.
Database-Backed Job Queue Ne Zaman Mantıklıdır?
Ayrı message broker eklemek her proje için gerekli değildir. Küçük ve orta ölçekli sistemlerde mevcut relational database üzerinde job table kullanmak operasyon maliyetini azaltabilir. Transactional enqueue büyük avantajdır çünkü business update ile job oluşturma aynı transaction içinde yapılabilir. Bununla birlikte çok yüksek throughput veya gelişmiş routing ihtiyaçlarında database queue sınırlarına yaklaşabilir. Seçim yalnızca benchmark değil ekip deneyimi ve operasyon yükü üzerinden de yapılmalıdır.
Ayrı Broker Gerektirmemesi
Database-backed queue mevcut veritabanını kullandığı için Redis veya RabbitMQ gibi ek altyapı gerektirmez. Küçük ekiplerde bu basitlik önemli operasyon avantajı sağlar. Backup, monitoring ve failover süreçleri zaten database için kurulmuş olabilir. Buna karşılık job trafiği normal application query'leriyle aynı kaynağı paylaşır. Yoğun queue yükünün kullanıcı sorgularını etkilememesi için kapasite izlenmelidir.
Transactional Enqueue
Job row'unu business transaction içinde oluşturmak database-backed queue'nun güçlü yanlarından biridir. Sipariş oluşurken e-posta job'ı aynı transaction içinde eklenebilir. Transaction rollback olursa job da oluşmaz. Bu model bazı dual-write problemlerini doğal biçimde ortadan kaldırır. Worker delivery ve retry tarafında idempotency ihtiyacı yine devam eder.
Küçük ve Orta Sistemler
Job hacmi saniyede çok yüksek değerlere ulaşmıyorsa relational database yeterli queue performansı sağlayabilir. Özellikle ekip ayrı broker yönetmek istemiyorsa daha az bileşen iyi bir tercih olabilir. Ölçek ihtiyacı gerçek ölçümlerle takip edilmelidir. Queue table indeksleri ve retention stratejisi doğru tasarlanmazsa zamanla sorgular yavaşlayabilir. Başarılı job kayıtlarının sınırsız tutulmaması gerekir.
Throughput Sınırları
Database queue yüksek concurrency altında row lock, index update ve connection kullanımını artırabilir. Worker sayısını sınırsız yükseltmek throughput'u doğrusal artırmayabilir. Bir noktadan sonra database ana darboğaz haline gelir. Queue ve application workload aynı cluster'daysa etkiler birbirini besleyebilir. Bu durumda ayrı broker veya partitioning mimarisi değerlendirilebilir.
SKIP LOCKED
SKIP LOCKED destekleyen relational database'lerde birden fazla worker'ın aynı pending tablodan farklı job'ları seçmesine yardımcı olabilir. Worker lock altında olan row'ları beklemek yerine diğer uygun job'lara geçer. Böylece competing consumer modeli daha verimli uygulanabilir. Transaction süresi kısa tutulmalı ve işin tamamı database lock açıkken yapılmamalıdır. Genellikle job sahiplenilir, state güncellenir ve uzun processing ayrı aşamada gerçekleşir.
Redis Tabanlı Queue
Redis düşük gecikmeli veri yapıları nedeniyle background queue sistemlerinde sık kullanılan bir altyapıdır. BullMQ, Sidekiq ve RQ gibi farklı ekosistemlerde Redis tabanlı job processing yaklaşımları bulunur. Redis hızlıdır, fakat durability ve failover davranışı seçilen persistence ile deployment modeline bağlıdır. Queue'nun business önemine göre veri kaybı toleransı açıkça belirlenmelidir. Redis'i yalnızca "memory database" veya "çok hızlı" etiketiyle seçmek yerine failure senaryoları da test edilmelidir.
BullMQ
BullMQ Node.js ve TypeScript ekosisteminde Redis tabanlı job queue işlevleri sunar. Worker, retries, delayed jobs, priorities ve job scheduling gibi özelliklerle backend otomasyonlarında kullanılabilir. Queue ile web process'i ayırmak Node.js uygulamalarında ağır veya gecikmeli işleri yönetmeyi kolaylaştırır. Production kullanımında Redis persistence, worker concurrency ve graceful shutdown ayrıca yapılandırılmalıdır. Scheduler API gibi sürüme bağlı özellikler için kullanılan BullMQ sürümünün resmi dokümantasyonu takip edilmelidir.
Sidekiq
Sidekiq Ruby ekosisteminde background job processing için yaygın kullanılan Redis tabanlı seçeneklerden biridir. İşleri worker thread'leri üzerinden işleyerek I/O ağırlıklı görevlerde yüksek concurrency sağlayabilir. Job payload'larının küçük ve serialization açısından güvenli tutulması önemlidir. Redis durability ve Sidekiq retry davranışı sistem gereksinimleriyle birlikte değerlendirilmelidir. Ruby uygulamasındaki database connection pool boyutu worker concurrency ile uyumlu olmalıdır.
RQ
RQ Python projelerinde Redis üzerinden background job çalıştırmak için daha sade bir yaklaşım sunar. Küçük ve orta projelerde anlaşılır worker modeli nedeniyle tercih edilebilir. Basitlik avantajına rağmen retry, monitoring ve deployment gereksinimleri yine production tasarımının parçasıdır. Python fonksiyonlarını queue'ya taşırken payload ve serialization sınırları düşünülmelidir. İş büyüdükçe queue ayrımı ve worker ölçeklendirme planı oluşturulmalıdır.
Avantajları
Redis tabanlı queue'lar düşük latency ve kolay kurulum nedeniyle geliştirici deneyimi açısından güçlüdür. Aynı Redis altyapısının ekipte zaten bulunması deployment maliyetini azaltabilir. Delayed job, retry ve concurrency özellikleri framework seviyesinde kolay kullanılabilir. Buna karşılık Redis'in application cache ile job queue için aynı instance üzerinde kullanılması kaynak izolasyonunu azaltabilir. Kritik queue için capacity ve persistence gereksinimleri ayrı planlanmalıdır.
Persistence
Redis persistence ayarları restart veya node failure sırasında hangi verinin korunacağını etkiler. RDB snapshot ve AOF gibi mekanizmaların davranışı deployment modeline göre değerlendirilmelidir. Job kaybının kabul edilemediği sistemde varsayılan ayarların yeterli olduğu varsayılmamalıdır. Managed Redis kullanılsa bile failover ve backup semantics kontrol edilmelidir. Queue framework'ün Redis failure karşısındaki davranışı ayrıca test edilmelidir.
Redis Failure Riski
Redis erişilemez olduğunda producer job enqueue edemeyebilir ve worker yeni iş alamayabilir. Bu durumda uygulamanın fallback davranışı business önemine göre belirlenmelidir. Enqueue kritikse request başarısız bırakılabilir veya outbox üzerinden daha sonra publish edilebilir. Redis geri geldiğinde retry storm oluşmaması için worker concurrency ve backoff kontrollü olmalıdır. Failure drill yaparak gerçek recovery sürecini test etmek üretim hazırlığının önemli parçasıdır.
RabbitMQ Tabanlı Background Jobs
RabbitMQ message broker olarak acknowledgement, routing ve queue durability gibi güçlü mesajlaşma özellikleri sunar. Background job sistemlerinde özellikle güvenilir delivery ve farklı routing ihtiyaçları olduğunda değerlendirilebilir. Exchange ve queue kavramlarının doğru anlaşılması başlangıçta Redis tabanlı basit queue çözümlerine göre daha fazla öğrenme gerektirebilir. Buna karşılık mesaj topolojisini iş akışına göre açık biçimde tasarlama imkanı sağlar. Business-critical job'larda persistence ve acknowledgement ayarlarının nasıl davrandığı failure testleriyle doğrulanmalıdır.
Durable Queue
Durable queue broker restart sonrasında queue tanımının korunmasına yardımcı olur. Ancak yalnızca queue'nun durable olması mesajların da mutlaka kalıcı olduğu anlamına gelmez. Mesaj persistence ve broker confirmation ayarları ayrıca önem taşır. Producer başarılı publish bilgisini nasıl aldığına dikkat etmelidir. Kritik job akışında durability zincirinin her parçası birlikte değerlendirilmelidir.
Acknowledgement
Acknowledgement worker'ın mesajı başarıyla işlediğini broker'a bildirmesidir. Ack çok erken verilirse worker crash sonrası iş kaybolabilir. İş tamamlandıktan sonra ack vermek redelivery olasılığını artırsa da veri kaybı riskini azaltır. Worker side effect sonrası ack öncesi çökerse duplicate delivery oluşabilir. Bu nedenle consumer idempotency acknowledgement modelinin doğal tamamlayıcısıdır.
Prefetch
Prefetch worker'ın aynı anda kaç mesajı önceden alabileceğini etkiler. Yüksek değer throughput'u artırabilir, fakat uzun süren job'larda iş dağılımını dengesiz hale getirebilir. Bir worker birçok mesajı rezerve ederken diğerleri boş kalabilir. Job duration dağılımı ve concurrency modeli ölçülerek değer ayarlanmalıdır. Prefetch tuning yalnızca hız değil fairness ve recovery süresi açısından da değerlendirilmelidir.
Routing
RabbitMQ exchange ve routing key kullanarak mesajları farklı queue'lara yönlendirebilir. Critical, bulk veya tenant bazlı iş akışları bu şekilde ayrıştırılabilir. Routing topolojisi gereğinden fazla detaylandırılırsa operasyon yönetimi zorlaşabilir. Basit başlayan sistem yalnızca gerçek SLA farkı oluştuğunda yeni queue ekleyebilir. Queue isimleri ve ownership bilgisi standartlaştırılmalıdır.
Dead-Letter Exchange
Dead-letter exchange başarısız, reject edilen veya belirli koşulları karşılayan mesajları ayrı akışa yönlendirmek için kullanılabilir. DLQ tasarımının broker özelliğiyle sınırlı kalmaması gerekir. Hata bağlamı, alerting ve replay prosedürü uygulama tarafında da tanımlanmalıdır. Mesajın neden dead-letter olduğunun görülebilmesi incident incelemesini kolaylaştırır. Replay işlemi sorun düzeltilmeden toplu olarak yapılmamalıdır.
Business-Critical Jobs
Business-critical job'larda mesaj kaybı, duplicate ve gecikme riskleri açık biçimde modellenmelidir. RabbitMQ güçlü araçlar sunar fakat yanlış acknowledgement veya persistence ayarı yine iş kaybına yol açabilir. Publisher confirmation, durable topology ve idempotent consumer birlikte değerlendirilebilir. Queue depth ve consumer health sürekli izlenmelidir. Teknik garanti business SLO ile ilişkilendirilmeden tamamlanmış sayılmamalıdır.
Celery Nedir?
Celery Python ekosisteminde dağıtık background task işleme için kullanılan bir task queue sistemidir. Worker süreçleri broker üzerinden görev alır ve istenirse result backend ile sonuç durumu saklanabilir. Redis ve RabbitMQ gibi farklı broker seçenekleriyle çalışabilmesi esneklik sağlar. Celery Beat periyodik görevleri üretmek için scheduler rolü üstlenebilir. Production kullanımında yalnızca task decorator yazmak yeterli değildir ve retry, time limit, worker concurrency ile monitoring de planlanmalıdır.
Python Background Task Queue
Celery Python fonksiyonlarını background task olarak çalıştırmak için yerleşik bir model sunar. Web uygulaması task'ı broker'a gönderir ve Celery worker bağımsız process içinde çalıştırır. Bu yapı Django, Flask veya başka Python servisleriyle kullanılabilir. Task'ın web request context'ine gizli biçimde bağımlı olmaması gerekir. Gereken bütün business context güvenli payload veya database referansı üzerinden sağlanmalıdır.
Broker
Celery producer ve worker arasında görev taşıması için broker kullanır. Broker seçimi delivery, operasyon ve throughput beklentisine göre yapılmalıdır. Redis kolay kurulum sunarken RabbitMQ farklı messaging semantics seçenekleri sağlayabilir. Broker'ın erişilemez olduğu durumda task publish'in nasıl ele alınacağı önemlidir. Kritik enqueue işlemlerinde transaction ile publish arasındaki ilişki ayrıca tasarlanmalıdır.
Worker
Celery worker queue'lardan task alıp Python kodunu çalıştırır. Concurrency modeli seçilen pool türüne ve workload karakterine göre değişebilir. CPU-bound işler için process tabanlı yaklaşım, I/O ağırlıklı görevler için farklı modeller değerlendirilebilir. Worker memory kullanımı ve task süresi düzenli izlenmelidir. Deployment sırasında graceful shutdown davranışı ve in-flight task'ların durumu önceden test edilmelidir.
Result Backend
Result backend task sonucunu veya durumunu saklamak için kullanılabilir. Her fire-and-forget task'ın sonucunu saklamak zorunlu değildir. Gereksiz sonuç saklama storage büyümesine neden olabilir. Kullanıcının async sonucu sorgulaması gereken işlerde status ve output reference faydalıdır. Retention süresi ve backend kapasitesi task hacmine göre belirlenmelidir.
Celery Beat
Celery Beat periyodik task'ları belirlenen schedule'a göre producer olarak oluşturan scheduler bileşenidir. Gerçek işi Beat process'i değil Celery worker yürütür. Aynı schedule için birden fazla Beat instance çalıştırılırsa duplicate task üretme riski oluşabilir. Bu nedenle scheduler ownership modeli açık olmalıdır. High availability gerekiyorsa kullanılan scheduler backend'in leader veya locking davranışı özel olarak tasarlanmalıdır.
Chain, Group ve Chord
Celery canvas yapıları task'lar arasında daha gelişmiş iş akışları kurmaya yardımcı olur. Chain ardışık, group paralel ve chord paralel grubun ardından callback benzeri senaryolar için kullanılabilir. Bu yapıların failure semantics'i basit tek task'tan daha farklıdır. Uzun workflow'larda retry ve partial failure davranışı test edilmelidir. Çok uzun yaşayan ve insan onayı gerektiren süreçlerde durable workflow engine daha uygun olabilir.
Celery Beat ile Zamanlanmış Görevler
Celery Beat Python uygulamasında periyodik görevlerin worker queue'larına gönderilmesini sağlar. Schedule kod içinde veya uygun scheduler backend üzerinde tanımlanabilir. Beat'in görevi işi kendisi yürütmek değil doğru zamanda task mesajı üretmektir. Bu ayrım worker concurrency ve retry sisteminin scheduler'dan bağımsız kalmasını sağlar. Production ortamında aynı schedule için tek aktif scheduler kuralı özellikle önemlidir.
beat_schedule
beat_schedule Celery configuration içinde periyodik task tanımları oluşturmak için kullanılabilir. Task adı, schedule ve gerekli args burada açık biçimde tutulabilir. Configuration'ı Git üzerinden sürümlemek değişiklik geçmişini görünür hale getirir. Schedule güncellemesi deployment ile ilişkilendirildiğinde hangi sürümün hangi zamanı ürettiği daha kolay takip edilir. Büyük sistemlerde schedule ownership ve review süreci ayrıca tanımlanmalıdır.
Crontab Schedule
Celery Beat crontab benzeri zaman kurallarıyla task schedule etmeye imkan verir. Gün, saat ve dakika koşulları business ihtiyacına göre tanımlanabilir. Time zone ayarı expression'ın gerçek çalışma zamanını etkiler. Schedule değişiklikleri testte next-run hesaplarıyla doğrulanmalıdır. Kritik periyodik task'lar worker tarafında yine idempotent olmalıdır.
Interval Schedule
Interval schedule görevin sabit bir süre aralığıyla tekrarlanmasını sağlar. Örneğin belirli saniye veya dakika aralığında polling task oluşturulabilir. Bu model duvar saatindeki belirli noktadan ziyade periyodik çalışmaya odaklanır. Job süresi interval'dan uzun olabiliyorsa duplicate veya overlap riski incelenmelidir. Lock veya unique job yaklaşımı gerekebilir.
Time Zone
Celery configuration içindeki time zone ayarı periodic task zamanlarının yorumlanmasını etkiler. UTC ortak bir teknik referans sağlarken business schedule için IANA time zone adı kullanılabilir. Worker ve Beat configuration'ın birbirinden farklı time zone varsayımlarına sahip olmaması gerekir. Log timestamp değerlerini UTC tutmak operasyon analizini kolaylaştırabilir. Kullanıcıya gösterilen zamanlar gerektiğinde yerel bölgeye dönüştürülebilir.
Tek Scheduler Çalıştırma
Aynı schedule tanımını iki bağımsız Beat instance çalıştırırsa ikisi de aynı anda task üretebilir. Bu nedenle varsayılan tasarım tek aktif scheduler olmalıdır. High availability isteniyorsa aktif scheduler ownership kontrollü biçimde devredilmelidir. Worker idempotency yine son koruma katmanı olarak kalır. Scheduler instance sayısını worker gibi körlemesine horizontal scale etmek doğru değildir.
Duplicate Schedule Riski
Duplicate schedule aynı business periyodu için birden fazla task oluşturulmasına yol açabilir. Deployment sırasında eski Beat process'i kapanmadan yenisi başladığında kısa süreli overlap yaşanabilir. Stabil business key ve enqueue deduplication bu riski azaltabilir. Monitoring expected run ile actual task count arasındaki farkı izleyebilir. Bir schedule için iki task görülmesi normal değilse alarm kuralı oluşturulmalıdır.
BullMQ Nedir?
BullMQ Node.js ve TypeScript uygulamalarında Redis tabanlı queue ve background worker ihtiyaçlarını yönetmek için kullanılan bir kütüphanedir. Delayed job, retry, priority, concurrency ve scheduler özellikleri backend otomasyonlarında güçlü bir araç seti sunar. Web process job üretirken ayrı Worker process'leri gerçek işi yürütebilir. Production sisteminde Redis persistence ve queue monitoring ayrı tasarım konularıdır. Sürüm değişikliklerinde özellikle scheduler ve repeat API'leri için resmi BullMQ dokümantasyonu esas alınmalıdır.
Redis Tabanlı Queue
BullMQ queue state'ini Redis üzerinde yönetir. Producer job ekler ve Worker ilgili queue'dan işi alır. Redis erişilebilirliği bu nedenle job sisteminin temel bağımlılıklarından biridir. Redis restart ve failover davranışının queue durability beklentisiyle uyumlu olması gerekir. Application cache ile aynı Redis kaynaklarını paylaşmak mümkün olsa da kritik sistemlerde kaynak izolasyonu düşünülmelidir.
Worker
BullMQ Worker belirli queue'dan job alıp handler fonksiyonunu çalıştırır. Concurrency ayarı aynı worker process'in eş zamanlı iş sayısını belirlemede kullanılabilir. I/O-bound task'larda daha yüksek concurrency faydalı olabilir. CPU-bound işlemler Node.js event loop'u bloke edebileceği için ayrı process veya farklı worker stratejisi gerekebilir. Worker kapanırken active job davranışı graceful shutdown ile yönetilmelidir.
Delayed Jobs
Delayed job belirli bir gecikmeden sonra işlenmeye uygun hale gelen görevdir. Hatırlatma, geçici bekleme veya scheduled follow-up senaryolarında kullanışlıdır. Delayed job kesin gerçek zamanlı timer olarak görülmemelidir çünkü yoğun queue ve worker kapasitesi execution zamanını geciktirebilir. Business requirement "en erken şu zamanda çalış" ise bu davranış genellikle uygundur. Kesin deadline gerekiyorsa queue age ve late execution ayrıca izlenmelidir.
Retries
BullMQ job options üzerinden belirli sayıda attempt ve backoff politikası uygulanabilir. Bütün hataları aynı şekilde retry etmek yerine handler içinde failure classification yapmak daha güvenlidir. Validation error kalıcı olabilirken network timeout geçici olabilir. Backoff ve jitter downstream servisin toparlanmasına zaman verir. Attempts tükendiğinde failed job'ların nasıl izleneceği ve temizleneceği belirlenmelidir.
Priority
Priority farklı job'ların işlenme önceliğini belirlemeye yardımcı olur. Password reset veya kritik notification gibi işler bulk export'tan önce işlenebilir. Ancak tek queue içinde çok farklı workload'lar olduğunda priority tek başına tam izolasyon sağlamaz. Ağır bulk job'lar worker kaynaklarını uzun süre tutabilir. Kritik işler için dedicated queue ve worker pool daha güçlü bir ayrım sağlayabilir.
Concurrency
Concurrency aynı worker'ın birden fazla job'ı eş zamanlı işleyebilme kapasitesini ifade eder. Değer arttıkça throughput yükselirken database connections ve external API çağrıları da artabilir. I/O-bound job'larda yüksek concurrency fayda sağlayabilir. CPU-bound task event loop'u yoğun kullanıyorsa aynı yaklaşım beklenen sonucu vermeyebilir. Ölçüm yapılmadan concurrency değerini yalnızca yüksek sayı seçmek sağlıklı değildir.
BullMQ Job Schedulers
BullMQ Job Schedulers tekrar eden job'ların modern scheduler API üzerinden tanımlanmasına yardımcı olur. Scheduler belirli repeat seçeneklerine göre yeni job instance'ları üretir ve worker'lar bu job'ları normal queue akışında işler. Sabit interval veya cron pattern kullanılabilir. Production yönetiminde stabil scheduler ID ile upsert yaklaşımı duplicate configuration riskini azaltır. Kullanılan sürümün API davranışını doğrulamak önemlidir çünkü BullMQ'nun eski repeatable job yaklaşımı yeni sürümlerde değiştirilmiştir.
Recurring Job
Recurring job belirli kural üzerinden tekrar tekrar üretilen job'dır. Her occurrence normal worker tarafından işlenebilir. Scheduler'ın tekrar kuralı ile worker'ın processing süresi birbirinden ayrı kavramlardır. Queue çok yoğunsa job'ın gerçek başlama zamanı schedule zamanından sonra olabilir. Kritik schedule'larda bu gecikme queue age veya late-start metriğiyle izlenmelidir.
Cron Pattern
BullMQ Job Scheduler cron benzeri pattern ile belirli zamanlarda job üretmeye imkan verir. Kullandığı expression formatı klasik sistem cron'undan farklı alan sayısına sahip olabileceği için dokümantasyon kontrol edilmelidir. Time zone gerekiyorsa scheduler seçeneklerinde açık biçimde tanımlanmalıdır. Pattern değişikliği stabil scheduler ID üzerinden yönetildiğinde deployment daha kontrollü olur. Production öncesi birkaç next-run örneği hesaplanmalıdır.
Fixed Interval
Fixed interval belirli milisaniye aralıklarında tekrar eden schedule tanımlamak için kullanılabilir. Polling veya heartbeat benzeri görevlerde kullanışlıdır. Interval job processing süresinden kısa olduğunda queue birikmesi yaşanabilir. Worker kapasitesi ve business duplicate davranışı buna göre değerlendirilmelidir. Sabit interval'ın tam duvar saati ihtiyacıyla aynı şey olmadığı unutulmamalıdır.
upsertJobScheduler
upsertJobScheduler stabil scheduler identifier üzerinden tekrar kuralını oluşturmak veya güncellemek için kullanılır. Upsert yaklaşımı deployment sırasında aynı scheduler'ı ikinci kez yanlışlıkla eklemek yerine mevcut yapılandırmayı güncellemeyi kolaylaştırır. Scheduler ID environment ve tenant scope açısından dikkatli seçilmelidir. Configuration değişiklikleri Git üzerinde sürümlenebilir. Deployment sonrasında aktif scheduler listesi doğrulanmalıdır.
Start Date
Start Date tekrar eden schedule'ın hangi tarihten itibaren aktif olacağını sınırlar. Kampanya veya geçici süreçlerin önceden tanımlanmasında kullanışlıdır. Time zone ve ISO tarih dönüşümleri dikkatle ele alınmalıdır. Start date'in job'ın anında çalışmasını garanti eden ayrı bir business kural olmadığı unutulmamalıdır. Worker kapasitesi yoksa schedule üretilse bile processing daha sonra başlayabilir.
End Date
End Date scheduler'ın belirli tarihten sonra yeni tekrar üretmemesini sağlar. Dönemsel rapor, kampanya veya geçici entegrasyon görevlerinde otomatik kapanış için faydalıdır. Tarihin hangi time zone'da yorumlandığı açık olmalıdır. End date geçtiğinde mevcut queued job'ların ne olacağı ayrıca belirlenmelidir. Scheduler kapanması active veya waiting job'ları otomatik iptal etmek zorunda değildir.
Repeat Limit
Repeat limit schedule'ın yalnızca belirli sayıda job üretmesini sağlar. Deneme kampanyası veya sınırlı tekrar gerektiren bakım işlerinde kullanılabilir. Limitin scheduler occurrence sayısını mı yoksa başarılı completion sayısını mı temsil ettiği kullanılan API semantics açısından kontrol edilmelidir. Failed job retry'leri ayrıca attempt sayısına sahip olabilir. Business gereksinimi "on başarılı çalışma" ise yalnızca scheduler repeat limit yeterli olmayabilir.
BullMQ Job Scheduler ile Eski Repeatable Jobs Arasındaki Fark
BullMQ'nun güncel sürümlerinde Job Scheduler yaklaşımı eski repeatable job API'sinin yerini alan ana model haline gelmiştir. Bu değişiklik özellikle production configuration yönetiminde stabil scheduler kimliği ve upsert kullanımını öne çıkarır. Eski örnek kodların internet üzerinde hâlâ bulunması yeni projelerde yanlış API seçimine yol açabilir. Kullanılan BullMQ major sürümü package lock üzerinden doğrulanmalı ve resmi migration dokümanı incelenmelidir. Yeni geliştirmelerde sürümle uyumlu scheduler API'si tercih edilmelidir.
Yeni Scheduler API
Yeni scheduler API tekrar eden iş tanımını ayrı bir scheduler kavramı altında yönetir. Worker tarafından işlenecek gerçek job'lar scheduler tarafından üretilir. Bu ayrım schedule configuration'ın yaşam döngüsünü daha açık hale getirir. Scheduler'ları listeleme, güncelleme ve kaldırma işlemleri production yönetimini kolaylaştırır. Eski repeatable job kodu doğrudan yeni major sürüme taşınmadan önce migration planı hazırlanmalıdır.
Upsert
Upsert aynı scheduler ID için configuration'ı oluşturma veya güncelleme davranışı sağlar. Deployment scriptinin her çalışmasında yeni duplicate schedule üretme riskini azaltır. Aynı ID'nin iki farklı business schedule için yanlışlıkla kullanılmaması gerekir. Naming convention environment ve job type bilgisi içerebilir. Configuration sonrası gerçek scheduler state'i API üzerinden doğrulanabilir.
Duplicate Configuration
Schedule configuration deployment ile tekrar tekrar uygulanırken stabil identity kullanılmazsa duplicate scheduler tanımları oluşabilir. Sonuç aynı business job'ın aynı zamanda birden fazla üretilmesi olabilir. Upsert modelinin doğru kullanımı bu riski azaltır. Yine de worker idempotency son güvenlik katmanı olarak korunmalıdır. Monitoring expected run sayısı ile actual enqueue sayısını karşılaştırabilir.
Production Schedule Management
Production schedule yönetimi yalnızca kod satırı yazmaktan ibaret değildir. Scheduler ID, owner, time zone, next run ve enabled durumu merkezi olarak görülebilmelidir. Schedule değişiklikleri code review sürecinden geçebilir. Deployment sonrasında istenen configuration'ın gerçekten Redis ve scheduler state'ine yansıdığı kontrol edilmelidir. Eski scheduler kayıtlarının temizlenmesi de release checklist içinde yer almalıdır.
Background Job Retry Nasıl Tasarlanır?
Retry, başarısız olan her işi sınırsız tekrar çalıştırmak değildir. İyi bir retry politikası hatanın geçici olup olmadığını, kaç deneme yapılacağını, denemeler arasında ne kadar bekleneceğini ve toplam retry bütçesini tanımlar. Retry edilen iş idempotent değilse her yeni attempt business yan etkisini büyütebilir. Backoff ve jitter downstream servis üzerinde ek yük oluşmasını önlemeye yardımcı olur. Denemeler tükendiğinde failure görünür hale getirilmeli ve DLQ veya manual recovery süreci devreye girmelidir.
Maximum Attempts
Maximum attempts bir job'ın toplam kaç kez çalıştırılabileceğini sınırlar. Sonsuz retry genellikle production sorununu çözmek yerine queue'yu doldurur. Değer dependency'nin tipik recovery süresi ve job'ın business deadline'ı üzerinden seçilmelidir. Beş dakikada anlamını kaybeden bir bildirim için saatler süren retry uygun olmayabilir. Kritik işlemlerde attempts tükendiğinde insan müdahalesi veya reconciliation akışı gerekebilir.
Delay
Retry delay başarısız attempt ile sonraki deneme arasındaki bekleme süresidir. Hemen retry yapmak downstream servis hâlâ bozukken aynı hatayı tekrar üretir. Kısa network glitch için birkaç saniye, rate limit için provider'ın Retry-After değeri uygun olabilir. Delay sabit veya backoff algoritmasına göre artabilir. Job deadline'ı delay hesabının üst sınırını belirlemelidir.
Retry Policy
Retry policy hata türü, attempt sayısı, backoff ve maximum delay gibi kuralları bir arada tanımlar. Farklı job türlerinin aynı policy'yi kullanması şart değildir. Payment API ve günlük analytics job farklı business önemine sahiptir. Policy kod içine dağılmak yerine ortak helper veya configuration üzerinden yönetilebilir. Böylece operasyon ekibi hangi hatanın nasıl davranacağını daha kolay anlayabilir.
Failure Classification
Failure classification hataları retryable ve permanent gibi kategorilere ayırır. HTTP 503 çoğunlukla geçiciyken invalid payload genellikle kalıcıdır. Hata mesajındaki string'e göre kırılgan koşullar yazmak yerine typed error veya status code kullanılabilir. Beklenmeyen hata sınıfı güvenli bir varsayımla sınırlı retry alabilir. Classification metrikleri hangi hata türlerinin sistemi en çok etkilediğini gösterir.
Retry Budget
Retry budget yalnızca attempt sayısını değil toplam süre ve downstream yükünü de sınırlar. Binlerce job aynı anda beş retry yapıyorsa toplam çağrı sayısı kısa sürede katlanabilir. Sistem genelinde retry rate metriği izlenmelidir. Dependency outage sırasında circuit breaker veya global throttling kullanılabilir. Böylece retry mekanizması asıl arızadan daha büyük ikinci bir probleme dönüşmez.
Hangi Hatalar Retry Edilmelidir?
Retry kararı hatanın yeniden denendiğinde başarı ihtimali olup olmadığına göre verilmelidir. Geçici network ve service availability sorunları çoğunlukla retry için uygundur. Ancak her status code aynı davranışı gerektirmez. Provider'ın sözleşmesi ve Retry-After gibi header'lar dikkate alınmalıdır. Retry yapılacak her işin idempotent olması veya idempotency key ile korunması önemlidir.
Network Timeout
Network timeout geçici bağlantı problemi nedeniyle oluşabilir ve retry için adaydır. Fakat request karşı tarafa ulaşmış, yalnızca response dönmemiş olabilir. Bu durumda external side effect belirsizdir. Provider idempotency key destekliyorsa aynı key ile retry yapılmalıdır. Destek yoksa status sorgusu veya reconciliation akışı daha güvenli olabilir.
Connection Reset
Connection reset ara network cihazı veya server bağlantıyı beklenmedik biçimde kapattığında görülebilir. Geçici olabileceği için kontrollü retry uygulanabilir. Hemen binlerce retry yapmak yerine backoff ve jitter kullanılmalıdır. Aynı host sürekli reset üretiyorsa circuit breaker devreye girebilir. Hata oranı monitoring üzerinde dependency bazında izlenmelidir.
HTTP 429
HTTP 429 rate limit aşıldığını gösterir ve çoğu durumda hemen retry yapmak durumu kötüleştirir. Provider Retry-After header gönderiyorsa mümkün olduğunca bu bilgi kullanılmalıdır. Global ve tenant bazlı rate limiter ile yeni çağrı hızı düşürülmelidir. Jitter aynı anda bekleyen job'ların yeniden tek anda başlamasını önler. Uzun süreli rate limit business deadline'ı etkiliyorsa kullanıcı veya operasyon ekibi bilgilendirilebilir.
HTTP 502
HTTP 502 gateway katmanında geçici upstream problemi gösterebilir. Kısa ve kontrollü retry çoğu entegrasyonda uygundur. Ancak provider dokümantasyonu özel anlam tanımlıyorsa o kurala uyulmalıdır. Exponential backoff downstream servise recovery zamanı verir. Sürekli 502 alan job'lar maximum attempts sonrasında DLQ veya failure state'e taşınmalıdır.
HTTP 503
HTTP 503 hizmetin geçici olarak kullanılamadığını gösterebilir. Retry için uygun olsa da yoğun outage sırasında aynı anda binlerce retry risklidir. Backoff, jitter ve circuit breaker birlikte kullanılarak servis korunabilir. Provider bakım penceresi bilgisi varsa retry süresi buna göre ayarlanabilir. Job business deadline'ı geçiyorsa artık retry yerine farklı failure akışı seçilebilir.
Temporary Database Error
Deadlock veya geçici connection problemi gibi bazı database hataları retry ile düzelebilir. Transaction tamamen rollback olduğundan emin olunmadan tekrar işlem yapmak risklidir. Retry yalnızca küçük ve idempotent transaction seviyesinde uygulanmalıdır. Sürekli hata database overload göstergesi olabilir ve concurrency azaltılması gerekebilir. Database retry'leri de genel retry budget içinde değerlendirilmelidir.
Hangi Hatalar Retry Edilmemelidir?
Kalıcı hataları tekrar tekrar çalıştırmak queue kapasitesini tüketir ve gerçek sorunların görünürlüğünü azaltır. Invalid payload veya business rule violation yeni attempt ile kendiliğinden düzelmez. Bu tip hatalar erken fail edilip uygun status ve hata bağlamıyla kaydedilmelidir. Bazı durumlarda düzeltme sonrası manuel replay yapılabilir. Otomatik retry ile manual remediation gerektiren failure birbirinden ayrılmalıdır.
Validation Error
Gerekli alanı eksik veya formatı yanlış payload her retry'de aynı sonucu üretir. Bu nedenle validation error çoğunlukla permanent failure olarak ele alınmalıdır. Hata producer bug'ından kaynaklanıyorsa metric ve alert ile görünür hale getirilmelidir. Payload hassas veri içermeden inceleme için saklanabilir. Kod düzeltildikten sonra uygun job'lar seçilerek replay edilebilir.
Invalid Payload
Desteklenmeyen schema version veya bozuk serialization invalid payload örnekleridir. Worker bu job'ı tekrar tekrar çalıştırmak yerine hemen izole etmelidir. DLQ üzerinden payload ve producer version incelenebilir. Schema validation enqueue ve worker girişinde birlikte uygulanabilir. Böylece hatalı producer deployment'ı kısa sürede tespit edilir.
Authorization Failure
Kalıcı credential veya permission problemi aynı request'i hemen tekrar göndermekle düzelmez. HTTP 401 veya 403 durumunda credential refresh gibi bilinen recovery mekanizması yoksa retry durdurulmalıdır. Secret rotation veya scope hatası operasyon alarmı gerektirebilir. Sınırsız retry provider üzerinde gereksiz yük üretir. Credential düzeltildikten sonra failed job'lar kontrollü biçimde replay edilebilir.
Silinmiş Resource
Job'ın işlemeye çalıştığı resource bilinçli olarak silinmişse retry çoğu zaman anlamsızdır. Worker business kurala göre no-op success veya permanent failure seçebilir. Örneğin silinmiş kullanıcıya marketing e-postası göndermek yerine job sessizce tamamlanabilir. Buna karşılık kritik kayıt kaybı varsa alarm gerekebilir. Karar teknik değil business anlamına göre verilmelidir.
Business Rule Failure
"Sipariş iptal edilmiş", "hesap kapalı" veya "işlem dönemi sona ermiş" gibi durumlar teknik hata değildir. Retry sistemi bu iş kurallarını geçici network problemi gibi görmemelidir. Worker sonucu rejected veya skipped gibi ayrı state ile kaydedebilir. Bu ayrım failure rate metriğinin anlamlı kalmasını sağlar. Business rejection'ın kullanıcıya nasıl gösterileceği ayrıca tasarlanmalıdır.
Permanent Failure
Permanent failure yeni attempt ile değişmeyeceği bilinen durumdur. Bu job doğrudan failed veya DLQ state'e taşınabilir. Failure context root cause analizi için yeterli olmalıdır. Operasyon ekibi hangi permanent failure'ların aksiyon gerektirdiğini bilmelidir. Düzeltilebilir veri hataları için manual replay prosedürü bulunabilir.
Exponential Backoff Nedir?
Exponential backoff her başarısız attempt sonrasında bekleme süresini giderek artıran retry yaklaşımıdır. Amaç geçici arıza devam ederken dependency'ye sürekli yüksek hızda istek göndermemektir. İlk denemeler hızlı olabilir, sonraki retry'ler daha uzun aralıklarla yapılır. Maximum delay sürenin kontrolsüz büyümesini önler. Jitter eklendiğinde aynı anda başarısız olan çok sayıda job'ın aynı anda geri dönme riski de azalır.
İlk Retry
İlk retry genellikle kısa bir gecikmeden sonra yapılabilir çünkü hata çok kısa network dalgalanması olabilir. Bununla birlikte zero-delay retry çoğu zaman aynı problem devam ederken gereksiz çağrı üretir. Birkaç saniyelik başlangıç delay'i yaygın bir seçimdir. Kritik düşük-latency işlerde değer daha küçük olabilir. Karar dependency'nin normal recovery profiline göre verilmelidir.
Artan Bekleme Süresi
Her yeni attempt'te bekleme süresi katlanarak artırılabilir. Örneğin 2, 4, 8 ve 16 saniye gibi bir dizi uygulanabilir. Böylece uzun outage sırasında request yoğunluğu hızla azalır. Tam formül sistem gereksinimine göre değişebilir. Business deadline aşılmadan önce toplam retry süresi hesaplanmalıdır.
Maximum Delay
Exponential büyüme teorik olarak çok büyük gecikmelere ulaşabilir. Maximum delay üst sınır belirleyerek retry aralığını kontrollü tutar. Örneğin birkaç dakikadan sonra daha fazla büyüme durdurulabilir. Maximum delay business urgency ve dependency recovery süresine göre seçilmelidir. Job'ın toplam yaşam süresi de ayrıca timeout veya expiration ile sınırlandırılabilir.
Dependency'ye Recovery Zamanı Vermek
Servis 503 döndürüyorsa her milisaniye yeni request göndermek recovery sürecini uzatabilir. Backoff trafik basıncını azaltarak servisin toparlanmasına alan sağlar. Birden fazla consumer aynı dependency'yi kullanıyorsa global retry davranışı özellikle önemlidir. Circuit breaker toplu yükü daha hızlı kesebilir. Health geri döndüğünde kontrollü half-open denemeleri yapılabilir.
Sabit Retry Aralığından Farkı
Sabit retry aralığında her attempt aynı süre sonra yapılır. Küçük ve kısa arızalarda bu basit model yeterli olabilir. Büyük outage sırasında ise sürekli aynı request rate'i korunur. Exponential backoff zamanla yükü azaltır. Jitter ile birlikte kullanıldığında large fleet davranışı daha dengeli hale gelir.
Jitter Neden Gereklidir?
Exponential backoff kullanan binlerce job aynı anda hata aldıysa hepsi aynı matematiksel süreyi bekleyerek yine aynı anda retry yapabilir. Bu durum dependency iyileşirken yeni bir trafik dalgası oluşturur. Jitter retry delay değerine rastgelelik ekleyerek job'ları zamana dağıtır. Aynı teknik scheduled maintenance ve timer başlangıçlarında da yararlıdır. Dağıtık sistemlerde küçük rastgelelik çoğu zaman büyük senkron yük sıçramalarını azaltır.
Aynı Anda Başarısız Olan Job'lar
Downstream servis çöktüğünde binlerce active job birkaç saniye içinde aynı hata kodunu alabilir. Hepsi aynı retry algoritmasına sahip olduğunda zamanlamaları senkron hale gelir. Bu senkronizasyon queue'nun normal dağılımını bozar. Jitter her job'a farklı küçük gecikme ekleyerek topluluğu yayar. Monitoring retry rate grafiğinde bu davranışın etkisi görülebilir.
Aynı Anda Retry
Bütün job'ların 60 saniye sonra yeniden denenmesi 60. saniyede yeni bir yük zirvesi oluşturur. Servis henüz tam toparlanmadıysa tekrar çökebilir. Randomized delay bu tek noktadaki yükü bir zaman penceresine dağıtır. Worker concurrency ve rate limit de ek koruma sağlar. Amaç retry'nin kontrollü trafik üretmesidir.
Thundering Herd
Thundering herd çok sayıda process veya request'in aynı kaynak için aynı anda harekete geçmesidir. Cache expiration, timer schedule veya retry mekanizması bunu tetikleyebilir. Downstream capacity normal ortalama yükü kaldırsa bile ani spike nedeniyle başarısız olabilir. Jitter, request coalescing ve rate limiting gibi teknikler etkisini azaltır. Problem tek job seviyesinde değil toplam sistem davranışıyla değerlendirilmelidir.
Randomized Retry Delay
Randomized retry delay sabit backoff değerinin etrafında veya belirli aralıkta rastgele bekleme süresi seçer. Her job farklı zamanda yeniden denendiği için load distribution iyileşir. Random aralığın çok geniş olması latency SLO'yu bozabilir. Çok dar olması ise herd etkisini yeterince azaltmayabilir. Değer gerçek concurrency ve downstream capacity ölçümlerine göre ayarlanmalıdır.
Full Jitter
Full jitter yaklaşımında job çoğu zaman sıfır ile hesaplanan backoff üst sınırı arasında rastgele delay seçer. Bu yöntem retry'leri geniş aralığa yayabilir. Farklı jitter algoritmaları farklı workload'larda kullanılabilir. Hangi yöntemin seçildiğinden çok aynı anda oluşan retry dalgasını engelleme hedefi önemlidir. Load test sırasında toplu failure senaryosu simüle edilerek sonuç gözlenmelidir.
Retry Storm Nedir?
Retry storm, bir dependency arızası sonrasında çok sayıda job'ın tekrar tekrar istek göndererek asıl arızadan daha fazla trafik oluşturmasıdır. Worker sayısı yüksek olduğunda bu trafik saniyeler içinde büyüyebilir. Dependency toparlanmak için kapasiteye ihtiyaç duyarken retry yükü onu yeniden zorlayabilir. Backoff, jitter, circuit breaker ve global rate limiting bu döngüyü kırmak için birlikte kullanılabilir. Monitoring retry rate'in normal değerinin katlarına çıkmasını erken alarm olarak görmelidir.
Downstream Service Arızası
Bir API veya database geçici olarak erişilemez hale geldiğinde bütün active job'lar aynı anda fail olabilir. Normalde dağınık olan işlem trafiği böylece retry kuyruğunda toplanır. Servis geri geldiğinde birikmiş job'lar tek anda saldırmamalıdır. Concurrency ve rate limit geçici olarak daha düşük tutulabilir. Recovery planı normal steady-state ayarlarından farklı olabilir.
Binlerce Retry
On bin job üç kez retry olduğunda teorik olarak otuz bin ek attempt oluşabilir. Her attempt network, CPU ve log maliyeti üretir. Hata devam ediyorsa bu denemelerin çoğu faydasızdır. Retry budget ve circuit breaker toplam çağrı sayısını sınırlar. İş önceliğine göre kritik job'lara ayrılmış kapasite bırakmak da faydalıdır.
Kendi Sistemini de Çökertme
Downstream outage yalnızca dış servisi değil sizin worker ve broker altyapınızı da etkileyebilir. Failed job'lar hızla yeniden queue'ya girer, log hacmi artar ve Redis memory yükselebilir. Worker CPU'su gerçek iş yerine sürekli hata üretmeye harcanabilir. Rate limit ve circuit breaker sistemi sakinleştirir. Incident sırasında yeni düşük öncelikli producer trafiğini azaltmak gerekebilir.
Backoff
Backoff ardışık retry'ler arasındaki süreyi artırarak toplam request rate'ini düşürür. Bu mekanizma retry storm kontrolünün temel parçalarından biridir. Sabit küçük delay büyük outage için yeterli olmayabilir. Maximum delay ve total attempt sınırı birlikte tanımlanmalıdır. Kritik job deadline'ı backoff politikasının üst sınırını belirler.
Jitter
Jitter aynı backoff değerine sahip job'ların tekrar senkron hale gelmesini engeller. Binlerce retry farklı zamanlarda dağıldığı için dependency üzerindeki peak load düşer. Rate limiting ile birlikte kullanıldığında daha güçlü koruma sağlar. Retry metrics üzerinden dağılım gözlenebilir. Jitter parametresi load test sırasında failure injection ile doğrulanmalıdır.
Circuit Breaker
Circuit breaker dependency sürekli fail ettiğinde yeni çağrıları geçici olarak durdurur. Bu davranış gereksiz timeout beklemelerini ve retry trafiğini azaltır. Belirli bekleme süresinden sonra sınırlı denemeyle servis health'i test edilebilir. Başarı görülürse normal trafik kademeli olarak açılır. Queue job'ları circuit açıkken kontrollü delay ile yeniden planlanabilir.
Circuit Breaker ile Background Worker
Circuit breaker worker'ın sürekli hata veren downstream servise sınırsız çağrı göndermesini önleyen stateful bir koruma mekanizmasıdır. Genel olarak closed, open ve half-open durumlarıyla açıklanır. Closed durumda çağrılar normal gider, hata eşiği aşıldığında circuit open hale gelir ve yeni çağrılar kısa devre edilir. Bekleme sonrasında half-open state az sayıda test çağrısına izin verir. Retry sistemiyle birlikte kullanıldığında dependency outage sırasında daha kontrollü recovery sağlar.
Closed
Closed durumda circuit normal çalışma modundadır ve request'ler downstream servise iletilir. Sistem success ve failure oranlarını takip eder. Belirlenen hata eşiği aşılmadıkça state değişmez. Birkaç tekil hata circuit'i hemen açmamalı, gerçek failure pattern'i izlenmelidir. Threshold servis trafik hacmi ve hassasiyetine göre ayarlanmalıdır.
Open
Open durumda worker downstream servise yeni çağrı göndermeyi geçici olarak durdurur. Job doğrudan retry için geciktirilebilir veya uygun failure state'e alınabilir. Bu davranış hem timeout bekleme maliyetini hem servis üzerindeki baskıyı azaltır. Open süresi çok uzun seçilirse servis düzelmesine rağmen gereksiz gecikme oluşabilir. Çok kısa seçilirse circuit sürekli açılıp kapanabilir.
Half-Open
Half-open state belirli sayıda test request ile servisin toparlanıp toparlanmadığını kontrol eder. Testler başarılıysa circuit yeniden closed olabilir. Başarısızlık devam ederse open state'e geri dönülür. Aynı anda çok fazla half-open request göndermek recovery anında yeni spike yaratabilir. Bu nedenle probe concurrency küçük tutulmalıdır.
Downstream API Koruması
Circuit breaker yalnızca sizin worker'ı değil downstream API'yi de korur. Arızalı servise sürekli trafik gönderilmemesi onun recovery kapasitesini artırabilir. Özellikle ortak üçüncü taraf API'lerde rate limit ihlalinin önüne geçilir. Monitoring circuit state değişikliklerini metric ve event olarak kaydetmelidir. Uzun süre open kalan circuit operasyon alarmı gerektirebilir.
Retry ile Birlikte Kullanım
Retry ve circuit breaker birbirinin alternatifi değildir. Retry tek job'ın geçici hatayı aşmasına çalışırken circuit breaker bütün dependency seviyesinde toplu failure davranışını kontrol eder. Circuit open olduğunda job'lar uzun delay ile yeniden planlanabilir. Jitter aynı anda geri dönmelerini engeller. Bu politikaların birbirini çarpan şekilde aşırı attempt üretmemesi için toplam retry budget hesaplanmalıdır.
Dead-Letter Queue (DLQ) Nedir?
Dead-Letter Queue normal işleme ve retry sürecini tamamlayamayan mesajların ayrı tutulduğu alandır. Bir job maksimum deneme sayısına ulaştığında, kalıcı hata verdiğinde veya poison message olarak değerlendirildiğinde DLQ'ya aktarılabilir. Bu alanın amacı başarısız işleri unutmak değil ana queue'nun sağlıklı akışını korurken inceleme fırsatı sağlamaktır. DLQ depth, error type ve age düzenli izlenmelidir. Replay yalnızca kök neden düzeltildikten sonra kontrollü biçimde yapılmalıdır.
Retry Limiti Dolan Job
Job maximum attempts değerine ulaştığında aynı hata üzerinde daha fazla otomatik deneme yapmak çoğu zaman faydasızdır. İş DLQ veya terminal failed state'e taşınabilir. Son hata, attempt history ve business key saklanmalıdır. Operasyon ekibi hangi job'ların kullanıcı etkisi oluşturduğunu önceliklendirebilir. Retry limitinin dolması alarm üretmek için güçlü bir sinyaldir.
Permanent Failure
Validation veya business rule gibi kalıcı hatalarda retry beklenmeden DLQ kullanılabilir. Bu yaklaşım queue kaynaklarının gereksiz kullanılmasını önler. Permanent failure kategorisi metric olarak ayrı tutulmalıdır. Aynı hata türü hızla artıyorsa yeni deployment veya producer bug'ı olabilir. Payload ve code version bilgisi root cause analizini kolaylaştırır.
Poison Message
Poison message her denemede worker'ı aynı şekilde başarısız eden job'dır. Örneğin desteklenmeyen payload schema veya belirli veri kombinasyonu bug tetikleyebilir. Bu job sürekli retry edilirse worker kapasitesini gereksiz tüketir. Belirli attempt sonrasında otomatik quarantine veya DLQ akışına alınmalıdır. Sonrasında gerçek hata düzeltilmeden toplu replay yapılmamalıdır.
Failure Context
DLQ kaydı yalnızca orijinal payload'dan oluşmamalıdır. Job type, job ID, attempt sayısı, error category, stack trace reference ve failure timestamp gibi bağlam yararlıdır. Hassas veri korunmalı ve secret değerleri temizlenmelidir. Context incident sırasında yeniden üretim süresini azaltır. Code version bilgisi deployment kaynaklı hataları tespit etmeye de yardımcı olur.
Manual Investigation
DLQ'daki her job otomatik replay edilmemelidir. Önce hata örüntüsü ve root cause belirlenmelidir. Bazı job'lar artık business açısından geçersiz olabilir ve replay edilmemelidir. Kritik örnekler staging ortamında güvenli veriyle yeniden üretilebilir. İnceleme sonucu ve alınan aksiyon audit log içinde tutulabilir.
DLQ Bir Çöp Kutusu mudur?
DLQ başarısız mesajların unutulduğu bir depoya dönüşürse sistemin güvenilirlik hedefi ciddi biçimde zayıflar. Her DLQ'nun owner'ı, retention süresi, alarm politikası ve replay prosedürü olmalıdır. Queue depth sıfırdan büyük olduğunda bunun normal mi yoksa müdahale gerektiren durum mu olduğu bilinmelidir. Failure türleri düzenli analiz edilerek tekrarlayan yazılım ve veri sorunları giderilmelidir. İyi işletilen DLQ production sisteminin öğrenme ve recovery araçlarından biridir.
Failure Archive
DLQ geçmiş başarısızlıkların kontrollü arşivi olarak kullanılabilir. Ancak sınırsız saklama storage maliyeti ve hassas veri riskini artırır. Retention business ve uyumluluk ihtiyacına göre belirlenmelidir. Eski job'lar silinmeden önce gerekli audit bilgisi ayrı sistemde tutulabilir. Archive politikası replay ihtimaliyle dengelenmelidir.
Root Cause Analysis
DLQ aynı error type için biriken job'ları gruplayarak kök neden analizine yardımcı olur. Bir deployment sonrasında belirli payload version hızla fail ediyorsa pattern açıkça görülebilir. Error fingerprint veya exception type ile aggregation yapılabilir. Tek tek bin job incelemek yerine ortak hata kaynağı çözülür. Düzeltme sonrasında yalnızca etkilenen job grubu replay edilir.
Alerting
Kritik queue için DLQ depth sıfırın üzerine çıktığında alarm üretmek çoğu zaman anlamlıdır. Bulk veya düşük öncelikli queue'da threshold kullanılabilir. Alert yalnızca sayı değil en eski DLQ job age bilgisini de içerebilir. Uzun süre çözülmeyen tek kritik job büyük iş etkisi yaratabilir. Alarm ilgili ekip veya service owner'a yönlendirilmelidir.
Replay
Replay başarısız job'ın yeniden normal işleme akışına alınmasıdır. Kök neden düzeltilmeden replay yapmak aynı failure'ı tekrar üretir. İş idempotent değilse replay öncesinde mevcut side effect kontrol edilmelidir. Seçici replay toplu replay'e göre daha güvenlidir. Job sayısı yüksekse kontrollü rate ile yeniden queue'ya eklenmelidir.
Retention
DLQ retention ne kadar süre failed payload ve metadata saklanacağını belirler. Süre çok kısa olursa ekip incident incelemeden veri kaybolabilir. Çok uzun retention kişisel veri ve storage maliyetini artırabilir. Business önemine göre farklı queue'lar farklı retention kullanabilir. Policy otomatik cleanup job ile uygulanabilir.
Owner
Her DLQ için sorumlu ekip belli olmalıdır. Owner olmayan queue'daki failed job'lar genellikle kimsenin radarına girmez. Dashboard ve alert routing ownership bilgisini kullanabilir. Runbook hangi hata sınıfında kimin müdahale edeceğini açıklamalıdır. Servis ownership değiştiğinde queue ve DLQ ownership metadata'sı da güncellenmelidir.
DLQ Replay Nasıl Yapılmalı?
DLQ replay üretim ortamında dikkatli yapılması gereken bir recovery operasyonudur. Önce failure'ın gerçek nedeni düzeltilmeli, ardından hangi job'ların güvenli şekilde tekrar çalıştırılabileceği belirlenmelidir. Bütün DLQ'yu tek tuşla normal queue'ya geri döndürmek yeni bir trafik dalgası oluşturabilir. Idempotency ve mevcut business state kontrol edilmelidir. Replay işleminin kim tarafından, ne zaman ve hangi filtreyle yapıldığı audit log içinde saklanmalıdır.
Sorunu Önce Düzeltme
Replay'in ilk adımı job'ın neden fail ettiğini anlamaktır. Kod bug'ı varsa yeni worker sürümü deploy edilmeden replay yapılmamalıdır. Dependency hâlâ erişilemiyorsa job'lar tekrar DLQ'ya dönecektir. Data validation problemi varsa gerekli data correction önce uygulanmalıdır. Root cause ortadan kaldırılmadan yapılan replay yalnızca kaynak tüketir.
Job Payload İnceleme
Failed payload schema ve business identifier açısından doğrulanmalıdır. Hassas veriler operasyon ekranında maskelenmelidir. Job artık geçersiz bir resource'a işaret ediyorsa replay yerine terminal state seçilebilir. Eski payload version yeni worker tarafından desteklenmiyorsa migration gerekebilir. Küçük örnek set staging veya kontrollü production canary ile denenebilir.
Selective Replay
Selectively replay yalnızca belirli error type, zaman aralığı veya job type'ı yeniden çalıştırır. Bu yöntem büyük DLQ'da risk alanını sınırlar. İlk olarak küçük bir batch gönderilip success ve failure metric'leri izlenebilir. Sonuç iyiyse batch boyutu artırılır. Bütün mesajları tek anda göndermek downstream sistemde ani yük oluşturabilir.
Idempotency
Replay edilen job daha önce kısmen side effect üretmiş olabilir. Bu nedenle worker'ın mevcut business state'i kontrol etmesi gerekir. Idempotency key veya unique constraint ikinci yan etkiyi engeller. External API çağrısında stabil provider idempotency key kullanılmalıdır. Replay operasyonu idempotency test edilmeden production'da uygulanmamalıdır.
Retry Counter Reset
Bazı queue sistemlerinde replay sırasında attempt counter'ın nasıl ele alınacağı seçilebilir. Counter sıfırlanırsa job yeniden tam retry bütçesine sahip olabilir. Aynı permanent hata devam ediyorsa bu gereksiz yük üretir. Sorun düzeltildiyse sınırlı yeni attempt makul olabilir. Policy job type ve failure nedeni üzerinden belirlenmelidir.
Replay Audit Log
Kim hangi job'ları neden replay etti sorusunun sonradan cevaplanabilmesi önemlidir. Replay filter, kullanıcı, timestamp, count ve change ticket bilgisi audit log içine yazılabilir. Finansal veya hassas süreçlerde bu kayıt daha da değerlidir. Replay sonucunun başarı oranı da aynı operasyonla ilişkilendirilebilir. Böylece incident sonrası değerlendirme gerçek verilere dayanır.
Poison Job Nedir?
Poison job her çalıştırıldığında aynı veya benzer failure üreterek worker kapasitesini tüketen görevdir. Job payload'ındaki özel veri, schema uyumsuzluğu veya kod bug'ı bu davranışı tetikleyebilir. Sonsuz retry poison job'ı daha tehlikeli hale getirir çünkü aynı iş sürekli queue'ya döner. Maximum attempts ve DLQ bu döngüyü keser. Monitoring aynı job ID veya error fingerprint'in tekrar sayısını izleyerek poison pattern'i erken tespit edebilir.
Her Denemede Fail Eden Job
Job ilk, ikinci ve üçüncü attempt'te aynı validation hatasını veriyorsa yeni retry'nin başarı ihtimali düşüktür. Failure classification bu durumu permanent olarak işaretleyebilir. Worker gereksiz yere CPU ve network tüketmez. Error context DLQ'ya eklenir. Sonrasında data veya code düzeltmesi yapılarak seçici replay uygulanabilir.
Queue'yu Bloke Etme
Bazı queue veya ordering modellerinde sürekli fail eden tek mesaj arkadaki diğer işleri de geciktirebilir. Özellikle strict ordering gereken partition'larda poison message büyük etki yaratır. Failure isolation için belirli attempt sonrasında mesajın karantinaya alınması gerekebilir. Business ordering gereksinimi ile availability arasında trade-off oluşabilir. Bu karar açık şekilde dokümante edilmelidir.
Permanent Failure Detection
Aynı deterministic input aynı code version ile sürekli aynı hatayı üretiyorsa permanent failure sinyali güçlenir. Validation ve schema hataları doğrudan permanent sınıfa alınabilir. Beklenmeyen exception'larda ilk birkaç retry tanı için yararlı olabilir. Error fingerprint job history ile karşılaştırılabilir. Sınıflandırma zaman içinde gerçek incident verileriyle geliştirilebilir.
DLQ
Poison job ana queue'dan çıkarıldığında diğer işlerin akışı korunur. DLQ içinde job bağlamı ve son hata saklanabilir. Alert ilgili owner'a yönlendirilmelidir. Job sayısı az olsa bile poison error yeni deployment bug'ının işareti olabilir. Bu nedenle yalnızca depth değil error type da gözlenmelidir.
Otomatik Quarantine
Automatic quarantine belirli hata koşullarında job'ı normal retry akışından çıkarır. Örneğin üç kez aynı validation signature alan job karantinaya alınabilir. Bu davranış system health'i korurken manual investigation fırsatı yaratır. Yanlış classification geçici job'ların erken durmasına yol açabileceği için rule'lar ölçülmelidir. Quarantine state kullanıcı arayüzünde gerekiyorsa ayrı status olarak gösterilebilir.
Worker Concurrency Nedir?
Worker concurrency bir worker process veya worker havuzunun aynı anda kaç job işleyebildiğini ifade eder. Doğru değer workload'un CPU-bound veya I/O-bound olmasına, database connection sayısına ve downstream rate limitlerine bağlıdır. Concurrency'yi artırmak her zaman daha yüksek throughput sağlamaz. Ortak kaynaklar doygunluğa ulaştığında latency yükselir ve failure oranı artabilir. Bu nedenle ayar load test ve gerçek queue metrikleri üzerinden yapılmalıdır.
Tek Worker Tek Job
En basit model worker'ın aynı anda yalnızca bir job işlemesidir. CPU-heavy veya kritik serialization gerektiren işler için bu yaklaşım uygun olabilir. Operasyon davranışı anlaşılırdır ve resource kullanımı daha öngörülebilir olur. Buna karşılık I/O bekleyen job'larda worker büyük bölümde boş kalabilir. Throughput ihtiyacı arttığında worker sayısı horizontal olarak artırılabilir.
Bir Worker Birden Fazla Job
Tek worker process belirli concurrency ile birden fazla job'ı aynı anda yürütebilir. I/O-bound API çağrılarında bu kaynak kullanımını iyileştirebilir. Ancak her active job database connection alıyorsa connection pool hızla tükenebilir. Memory kullanımı job payload ve runtime state ile birlikte artar. Concurrency değeri downstream capacity ile uyumlu olmalıdır.
Worker Process Sayısı
Bir host veya pod içinde birden fazla worker process çalıştırmak CPU core kullanımını artırabilir. Process tabanlı model CPU-bound task'larda gerçek paralellik sağlayabilir. Her process'in ayrı memory ve database pool maliyeti vardır. Container resource limitleri toplam process sayısına göre hesaplanmalıdır. Autoscaling varsa pod sayısı ile process concurrency birlikte tuning edilmelidir.
Thread/Async Concurrency
Thread veya async concurrency I/O bekleme sürelerini başka job'larla değerlendirmeye yardımcı olur. Node.js async modelinde network çağrıları sırasında event loop başka işleri ilerletebilir. Python ekosisteminde framework ve worker pool modeline göre farklı concurrency seçenekleri bulunur. Blocking library kullanımı async avantajını azaltabilir. Workload profili ölçülmeden model seçilmemelidir.
Horizontal Scaling
Horizontal scaling yeni worker instance ekleyerek kapasiteyi artırır. Queue tabanlı mimari bu modeli doğal biçimde destekler çünkü consumer'lar aynı job havuzundan iş alabilir. Fakat shared database ve external API kapasitesi sabit kalabilir. Worker sayısını artırmakla downstream rate limit ihlali oluşuyorsa global limiter gerekir. Scaling metrikleri yalnızca CPU değil queue latency hedeflerine dayanmalıdır.
CPU-Bound ve I/O-Bound Job Farkı
Worker concurrency ayarını doğru yapmak için job'ın zamanını nerede harcadığını bilmek gerekir. CPU-bound job işlem süresinin çoğunu hesaplama yaparak geçirirken I/O-bound job ağ, disk veya database yanıtını bekler. Aynı concurrency stratejisi iki workload için farklı sonuç verir. CPU-bound işlerde process paralelliği ve core sayısı önem kazanır. I/O-bound işlerde daha yüksek async veya thread concurrency kaynak kullanımını iyileştirebilir.
CPU-Bound
Video encode, büyük image transform veya yoğun hesaplama CPU-bound işlere örnektir. Bu job'lar active olduklarında core kapasitesini sürekli kullanabilir. Aynı process içinde aşırı concurrency CPU context switching ve latency artışı yaratabilir. Worker sayısı fiziksel veya allocated core sayısına göre ölçülmelidir. Ağır CPU job'ları normal I/O job'larından ayrı queue'da çalıştırmak izolasyon sağlar.
I/O-Bound
HTTP request, database query ve object storage erişimi çoğu zaman I/O-bound davranış gösterir. Worker response beklerken CPU büyük ölçüde boş olabilir. Aynı process'in başka job işlemesi throughput'u artırabilir. Ancak external rate limit ve connection pool yeni sınırlar oluşturur. Concurrency bu bağımlılıkların kapasitesine göre ayarlanmalıdır.
Concurrency Ayarı
Concurrency için evrensel tek doğru sayı yoktur. Başlangıç değeri workload türüne göre seçilip load test ile ölçülmelidir. Throughput artarken p95 processing time ve failure rate gözlenmelidir. Bir noktadan sonra daha fazla concurrency yalnızca contention oluşturabilir. Bu nokta kapasite sınırını anlamak için önemlidir.
Worker Sayısı
Worker instance sayısı concurrency ile birlikte toplam parallel job kapasitesini belirler. On pod ve pod başına on concurrency teorik olarak yüz active job anlamına gelebilir. Database yalnızca elli connection kaldırıyorsa bu yapı problem çıkarabilir. Total concurrency hesapları cluster seviyesinde yapılmalıdır. Autoscaling upper bound downstream limitlerle uyumlu olmalıdır.
Thread vs Process
Thread daha düşük memory maliyetiyle I/O concurrency sağlayabilir. Process ayrı memory alanı ve gerçek CPU paralelliği sunabilir. Programlama dilinin runtime modeli bu seçimi doğrudan etkiler. Thread-safe olmayan library veya global state kullanımı risk oluşturabilir. Benchmark gerçek job koduyla yapılmalıdır.
Event Loop
Event loop tabanlı runtime'larda blocking CPU işlemi diğer async job'ları da geciktirebilir. Node.js worker içinde uzun CPU loop çalıştırmak bütün process'in I/O responsiveness değerini düşürebilir. CPU-heavy iş ayrı worker thread veya process'e taşınabilir. Event loop lag metriği bu problemi görünür hale getirir. I/O concurrency avantajından yararlanmak için handler kodunun gerçekten non-blocking olması gerekir.
Worker Sayısı Nasıl Belirlenir?
Worker sayısını belirlemek için yalnızca CPU yüzdesine bakmak yeterli değildir. Queue'ya gelen iş hızı, ortalama processing time, queue age, memory kullanımı ve downstream rate limit birlikte değerlendirilmelidir. Basit kapasite hesabında worker throughput'unun arrival rate'ten uzun vadede yüksek olması gerekir. Aksi halde queue sürekli büyür. Hedef yalnızca queue'yu boşaltmak değil kabul edilen queue latency SLO'sunu korumaktır.
Queue Depth
Queue depth bekleyen job sayısını gösterir ve kapasite problemi hakkında ilk sinyali verir. Depth kısa trafik dalgasında yükselip sonra normale dönüyorsa sistem sağlıklı olabilir. Sürekli artıyorsa consumer capacity arrival rate'in gerisindedir. Ancak tek başına depth her queue için aynı anlamı taşımaz. Bin adet 10 milisaniyelik job ile bin adet 10 dakikalık job aynı yük değildir.
Job Processing Time
Ortalama ve p95 processing time worker kapasite hesabının temel girdileridir. Bir worker dakikada kaç job bitirebiliyor sorusu gerçek ölçümle cevaplanmalıdır. Processing time artışı downstream degradation veya code regression gösterebilir. Job türüne göre histogram tutmak performans farklılıklarını ortaya çıkarır. Autoscaling planı worst-case değil beklenen percentile ve güvenlik payı üzerinden yapılabilir.
Arrival Rate
Arrival rate belirli zaman aralığında queue'ya eklenen job sayısıdır. Worker completion rate uzun vadede bundan düşükse backlog kaçınılmazdır. Peak ve normal rate ayrı ölçülmelidir. Çok kısa spike queue ile absorbe edilebilirken saatler süren yüksek rate daha fazla capacity gerektirir. Capacity planning iş trafiğinin günlük ve haftalık desenlerini dikkate almalıdır.
CPU
CPU worker'ın compute kapasitesi hakkında yararlı sinyal sağlar. CPU-bound işlerde yüksek kullanım scale-out ihtiyacını gösterebilir. I/O-bound sistemde CPU düşükken queue yine büyüyebilir. Bu durumda external dependency veya connection limit darboğaz olabilir. CPU tek scaling metriği olarak kullanılmamalıdır.
Memory
Her active job memory kullanıyorsa concurrency artışı pod veya host memory limitini aşabilir. OOM kill worker crash ve job redelivery oluşturur. Memory high-water mark job türüne göre ölçülmelidir. Büyük payload veya dosyayı tamamen memory'ye almak problemin kaynağı olabilir. Streaming ve chunking ile memory footprint düşürülebilir.
Downstream Rate Limit
Worker capacity external API'nin izin verdiği request rate'ten yüksek olabilir. Bu durumda daha fazla worker yalnızca 429 sayısını artırır. Global rate limiter bütün instance'ların toplam trafiğini kontrol etmelidir. Tenant bazlı limit varsa fairness ayrıca uygulanabilir. Autoscaler maksimum worker sayısı bu dış sınıra göre kısıtlanabilir.
Target Queue Latency
Target queue latency job'ın enqueue edildikten sonra processing başlamasına kadar kabul edilen bekleme süresidir. Kritik password reset için saniyeler, bulk export için dakikalar kabul edilebilir. Worker sayısı bu SLO'ya göre belirlenebilir. Queue age target'ı aştığında scale-out tetiklenebilir. Bu yaklaşım sadece backlog sayısından daha doğrudan kullanıcı etkisini ölçer.
Queue Depth Nedir?
Queue depth bir queue içinde waiting veya belirli durumlarda toplam bekleyen job sayısını ifade eder. Kapasite ve backlog hakkında yararlı bir metriktir, ancak tek başına yeterli değildir. Job processing süreleri ve priority dağılımı aynı depth değerinin farklı anlamlara gelmesine neden olur. Queue growth rate ve oldest job age ile birlikte değerlendirmek daha doğru sonuç verir. Uzun süre artan depth saturation veya downstream bottleneck işareti olabilir.
Waiting Jobs
Waiting jobs henüz worker tarafından alınmamış görevleri gösterir. Ani artış trafik spike veya worker kaybı nedeniyle oluşabilir. Worker count normal olduğu halde waiting hızla büyüyorsa processing capacity yetersiz olabilir. Job type bazında dağılım görmek hangi workload'un backlog oluşturduğunu gösterir. Alert threshold queue'nun normal hacmine göre belirlenmelidir.
Active Jobs
Active jobs worker tarafından sahiplenilmiş ve işlenmekte olan görevlerdir. Active sayı total concurrency ile ilişkili olmalıdır. Worker sayısı yüksek olduğu halde active job sıfırsa consumer bağlantısı veya routing problemi olabilir. Çok uzun süre active kalan job stuck veya timeout ihtimalini gösterir. Active age metriği long-running job sorunlarını ortaya çıkarabilir.
Queue Growth Rate
Queue growth rate backlog'un ne kadar hızlı arttığını veya azaldığını gösterir. Depth tek anda yüksek olabilir fakat hızla düşüyorsa sistem recovery modundadır. Depth orta seviyede olup sürekli artıyorsa daha ciddi kapasite problemi vardır. Arrival ve completion rate arasındaki fark bu metriği açıklar. Capacity planning için trend en az anlık değer kadar önemlidir.
Worker Capacity
Worker capacity belirli süre içinde tamamlanabilen job sayısıdır. Job duration ve total concurrency bu kapasiteyi belirler. Heterojen job'lar aynı queue'da ise tek ortalama yanıltıcı olabilir. Job type bazında throughput ölçmek daha doğru olur. Capacity arrival rate'i güvenli payla aşmalıdır.
Saturation
Saturation worker veya downstream kaynağın sınırına ulaştığını gösterir. Bütün worker slotları dolu, queue büyüyor ve processing time artıyorsa sistem doygun olabilir. Daha fazla worker eklemek database'i daha da zorlayabilir. Gerçek bottleneck belirlenmeden scale etmek risklidir. CPU, connection pool, rate limit ve queue latency birlikte incelenmelidir.
Queue Age Neden Queue Depth'ten Daha Değerli Olabilir?
Queue depth kaç iş beklediğini, queue age ise bu işlerin ne kadar süredir beklediğini gösterir. Kullanıcı deneyimi açısından çoğu zaman ikinci soru daha önemlidir. Düşük hacimli kritik queue'da yalnızca üç job olabilir, fakat en eskisi yirmi dakikadır bekliyorsa ciddi problem vardır. Buna karşılık on bin hızlı batch job birkaç saniyede tüketiliyorsa yüksek depth tek başına alarm gerektirmeyebilir. Queue age doğrudan latency SLO ile ilişkilendirilebildiği için güçlü bir operasyon metriğidir.
En Eski Bekleyen Job
Oldest waiting job queue'nun en kötü bekleme süresini gösterir. Bu değer sürekli yükseliyorsa worker'lar backlog'u yakalayamıyor olabilir. Priority queue'da düşük öncelikli job'ın çok yaşlanması starvation sinyali olabilir. Kritik queue için age threshold alarm olarak kullanılabilir. Timestamp ölçümlerinde clock consistency sağlanmalıdır.
User-Visible Delay
Kullanıcı export talebi verdikten sonra job 15 dakika bekliyorsa processing süresi kısa olsa bile deneyim yavaştır. Queue age bu görünmeyen bekleme bölümünü ortaya çıkarır. Yalnızca worker duration metriği böyle bir sorunu kaçırır. Enqueue-to-completion latency daha kapsamlı bir kullanıcı etkisi ölçüsüdür. SLO bu uçtan uca süreye göre tanımlanabilir.
Queue Latency
Queue latency enqueue ile worker processing başlangıcı arasındaki süredir. Worker capacity yetmediğinde ilk yükselen metriklerden biri olabilir. Priority ve scheduling delay ile birlikte yorumlanmalıdır. Delayed job bilinçli olarak beklediği için normal waiting job'dan ayrı ölçülmelidir. Dashboard metric definition'ı açık biçimde belgelemelidir.
SLO
Queue SLO belirli job sınıfının kabul edilen maksimum veya percentile bekleme süresini tanımlar. Örneğin kritik job'ların yüzde 99'u 30 saniye içinde başlamalı denebilir. Bu hedef autoscaling ve alert threshold belirlemesini kolaylaştırır. Yalnızca infrastructure health yerine business beklentisi ölçülür. SLO ihlalleri incident review'da kapasite ve priority kararlarını yönlendirebilir.
Low-Volume Critical Queue
Düşük hacimli kritik queue için depth bazlı autoscaling yetersiz olabilir. Bir job bile yüksek business önem taşıyabilir. Queue age veya event-driven scale trigger daha uygun olabilir. Minimum bir warm worker cold start gecikmesini önleyebilir. Queue'nun düşük hacmi monitoring önemini azaltmaz.
Worker Autoscaling Nasıl Yapılır?
Worker autoscaling gelen job yüküne göre worker instance sayısını otomatik ayarlar. CPU-based scaling kolay olsa da queue workload'larında her zaman doğru sinyal değildir. Queue depth ve özellikle queue age doğrudan backlog ile ilişkili olduğu için daha kullanışlı olabilir. Minimum ve maximum worker sayıları downstream capacity ile uyumlu tutulmalıdır. Scale-out kadar scale-in davranışı da graceful shutdown ile güvenli yönetilmelidir.
CPU-Based Scaling
CPU-based scaling ortalama worker CPU kullanımı yükseldiğinde yeni instance ekler. CPU-bound workload için doğal bir metriktir. I/O-bound job'larda CPU düşükken queue büyüyebileceği için geç tepki verebilir. Worker process external API bekliyorsa CPU kullanımının düşük olması boş kapasite anlamına gelmez. CPU metriği queue sinyalleriyle birlikte kullanılabilir.
Queue-Depth-Based Scaling
Queue-depth-based scaling bekleyen job sayısına göre worker sayısını artırır. Basit ve anlaşılırdır, fakat job süreleri farklı olduğunda depth'in anlamı değişir. Hızlı bin job kısa sürede bitebilirken yüz ağır job daha büyük kapasite gerektirebilir. Target jobs per worker gibi yaklaşım kullanılabilir. Maximum scale downstream rate limit ile sınırlandırılmalıdır.
Queue-Age-Based Scaling
Queue age hedeflenen latency'yi doğrudan ölçtüğü için autoscaling için güçlü bir sinyaldir. Oldest job belirli eşiği aşınca daha fazla worker eklenebilir. Scale-out gecikmesi ve pod startup süresi threshold belirlerken hesaba katılmalıdır. Age düştüğünde worker sayısı yavaşça azaltılabilir. Çok hızlı scale-in ve scale-out oscillation oluşturabilir.
Event-Driven Scaling
Event-driven scaling queue veya message broker metriğini doğrudan kullanarak worker deployment'ını ayarlar. Kubernetes ortamında KEDA bu model için yaygın bir seçenektir. Queue boşken worker sayısı azaltılabilir ve yeni mesaj geldiğinde scale-out yapılabilir. Cold start süresi kritik job'larda gecikme yaratabilir. Minimum replicas değeri iş SLO'suna göre belirlenmelidir.
Minimum Worker
Minimum worker sayısı trafik olmasa bile hazır tutulacak kapasiteyi belirler. Sıfır minimum maliyeti azaltabilir fakat ilk job için startup gecikmesi oluşturur. Kritik veya düşük latency queue'larda bir veya daha fazla warm worker faydalıdır. Stateful initialization yapan worker'larda cold start daha uzun olabilir. Gerçek startup süresi ölçülerek karar verilmelidir.
Maximum Worker
Maximum worker sayısı autoscaler'ın kontrolsüz biçimde downstream kaynakları aşmasını önler. Database connection kapasitesi ve third-party rate limit önemli sınırlar oluşturur. Queue çok büyüdü diye yüzlerce worker açmak database'i çökertmemelidir. Maximum değeri kapasite testlerinden elde edilen güvenli total concurrency üzerinden hesaplanabilir. Büyük backlog sırasında producer throttling de gerekebilir.
Kubernetes KEDA ile Worker Autoscaling
KEDA, Kubernetes üzerinde event-driven workload'ların external metrics üzerinden ölçeklendirilmesine yardımcı olur. Queue depth veya broker'a özgü metrikler worker deployment için scale trigger olarak kullanılabilir. Redis, RabbitMQ ve Kafka gibi kaynaklarla farklı scaler seçenekleri bulunur. Scale-to-zero maliyet avantajı sağlarken cold start etkisi yaratabilir. KEDA kullanmak worker idempotency, graceful shutdown veya rate limiting ihtiyaçlarını ortadan kaldırmaz.
Queue Metric
KEDA scaler worker sayısını broker'dan okunan queue metriğine göre belirleyebilir. Metric'in neyi temsil ettiği açıkça anlaşılmalıdır. Waiting count, lag veya başka broker-specific değer farklı scaling davranışı üretir. Threshold gerçek job processing kapasitesiyle ilişkilendirilmelidir. Metric erişilemez olduğunda autoscaler failure davranışı da test edilmelidir.
Redis
Redis tabanlı queue'larda uygun KEDA scaler ile waiting workload üzerinden scale yapılabilir. Queue library'sinin Redis'te tuttuğu data structure ile scaler'ın beklediği metric uyumlu olmalıdır. Authentication secret güvenli biçimde Kubernetes Secret veya secret manager üzerinden sağlanmalıdır. Redis erişilemezken hem queue hem autoscaling etkilenebilir. Bu failure senaryosu runbook içinde yer almalıdır.
RabbitMQ
RabbitMQ queue length veya başka broker metric'leri worker scaling sinyali olarak kullanılabilir. Mesaj sayısı job duration ile birlikte değerlendirilmelidir. Prefetch nedeniyle bazı mesajlar broker queue length dışında consumer üzerinde rezerve edilmiş olabilir. Bu nedenle active ve ready message davranışı anlaşılmalıdır. Scale-in sırasında consumer bağlantılarının graceful kapanması önemlidir.
Kafka
Kafka consumer lag event-driven worker scaling için doğal bir metriktir. Ancak partition sayısı gerçek parallelism üst sınırı oluşturabilir. Yüz pod açmak on partition varsa throughput'u aynı oranda artırmaz. Consumer group rebalancing sık scale değişiminde ek maliyet yaratabilir. Autoscaling stabilization ve partition strategy birlikte planlanmalıdır.
Scale-to-Zero
Scale-to-zero queue boşken worker pod sayısını sıfıra indirerek kaynak maliyetini azaltabilir. Yeni job geldiğinde KEDA worker deployment'ını tekrar büyütür. İlk job pod scheduling ve application startup süresini bekler. Bulk veya gecikmeye toleranslı queue'lar için bu genellikle kabul edilebilir. Kritik düşük latency job'larda minimum replica birden büyük tutulabilir.
Cold Start
Cold start yeni worker pod'ın scheduled, image pull ve application initialization adımlarını tamamlaması için geçen süredir. Büyük image veya yavaş dependency bağlantıları bu süreyi uzatır. Queue age SLO düşükse cold start doğrudan kullanıcı deneyimini etkiler. Image optimizasyonu ve minimum warm worker kullanımı süreyi azaltabilir. Autoscaler threshold cold start süresini hesaba katmalıdır.
Priority Queue Nedir?
Priority queue job'ların yalnızca geliş sırasına göre değil business önemine göre işlenmesini sağlar. Kritik kullanıcı işlemleri bulk bakım işlerinden önce alınabilir. Ancak priority kullanımı starvation riskini de beraberinde getirir. Sürekli yüksek öncelikli trafik varsa düşük öncelikli işler hiç sıra alamayabilir. Çok farklı SLA'larda dedicated queue ve reserved worker capacity kullanmak daha öngörülebilir olabilir.
Critical
Critical priority doğrudan kullanıcı erişimi, güvenlik veya finansal deadline etkileyen job'lar için ayrılabilir. Bu sınıfın hacmi kontrollü tutulmalıdır. Her ekip kendi işini critical olarak işaretlerse priority sistemi anlamını kaybeder. Ayrı SLO ve alarm threshold tanımlanabilir. Reserved capacity kritik job'ların bulk traffic altında beklemesini önler.
High
High priority önemli fakat sistemin en kritik olmayan işlerini temsil edebilir. Örneğin kullanıcı bildirimleri veya hızlı tamamlanması beklenen entegrasyon görevleri bu sınıfa girebilir. Critical ile normal arasındaki fark ekipçe açık tanımlanmalıdır. Priority inflation düzenli review ile önlenmelidir. Metric'ler job type ve priority bazında izlenebilir.
Normal
Normal priority sistemdeki varsayılan job sınıfı olabilir. Çoğu rutin background işlem burada yürütülebilir. Bu sınıf için genel queue latency SLO tanımlanabilir. İş gerçekten farklı kaynak gerektiriyorsa yalnızca priority yerine ayrı queue düşünülmelidir. Basit priority modeli operasyon yönetimini kolay tutar.
Bulk
Bulk priority büyük veri işleme, export veya toplu notification gibi yüksek hacimli fakat daha esnek deadline'a sahip görevleri temsil edebilir. Bu job'lar critical worker kapasitesini tüketmemelidir. Ayrı worker pool veya rate limit kullanmak faydalıdır. Gece batch işlerinde daha yüksek throughput açılabilir. Business saatlerinde concurrency düşürülerek online trafik korunabilir.
Low Priority
Low priority cleanup veya yeniden hesaplama gibi ertelenebilir işleri içerir. Sürekli higher-priority traffic varsa starvation riski oluşur. Maximum age veya reserved capacity ile bu risk azaltılabilir. Düşük öncelik "önemsiz" anlamına gelmez ve retention gibi işleri sonsuza kadar ertelemek sorun yaratabilir. Age-based alert kullanılmalıdır.
Priority Inversion Nedir?
Priority inversion kritik bir işin düşük öncelikli veya uzun süren işlerin tuttuğu kaynaklar yüzünden beklemesi durumudur. Queue sırası doğru olsa bile bütün worker slotları bulk job'larla doluysa yeni critical job hemen başlayamaz. Database connection veya shared lock da aynı etkiyi yaratabilir. Dedicated worker pool ve reserved capacity bu riski azaltır. Priority tasarımı yalnızca queue metadata'sı değil bütün resource path üzerinden değerlendirilmelidir.
Bulk Job Flood
Bir kampanya veya export işlemi kısa sürede binlerce bulk job üretebilir. Aynı queue ve worker pool kullanılıyorsa bütün concurrency slotları bu işlerle dolabilir. Sonradan gelen küçük fakat kritik job boş worker bekler. Rate limit ve ayrı queue bu etkiyi azaltır. Producer'ın tek anda sınırsız fan-out yapması da önlenebilir.
Password Reset'in Beklemesi
Password reset e-postası kullanıcı tarafından hemen beklenen bir işlemdir. Aynı notification queue'sunda milyon marketing e-postası varsa reset mesajı dakikalarca gecikebilir. Yüksek priority vermek ilk adımdır, fakat bütün worker'lar uzun bulk işlerle doluysa yine bekleyebilir. Dedicated critical notification queue daha güvenli olabilir. Bu ayrım user-visible latency SLO üzerinden gerekçelendirilebilir.
Dedicated Queue
Dedicated queue kritik job'ları fiziksel veya mantıksal olarak bulk işlerden ayırır. Böylece kendi backlog, retry ve worker ayarları kullanılabilir. Queue sayısını gereksiz artırmak operasyon yükü oluşturabilir. Yalnızca farklı SLA veya kaynak gereksinimi varsa ayrım yapılmalıdır. Ownership ve monitoring her queue için açık olmalıdır.
Dedicated Worker Pool
Dedicated worker pool yalnızca belirli queue veya priority sınıfını tüketir. Bulk job'lar bu worker kapasitesini kullanamaz. Kritik iş için minimum hazır kapasite sağlanır. Toplam cluster maliyeti artabilir fakat SLO daha öngörülebilir hale gelir. Autoscaling her pool için ayrı metric kullanabilir.
Reserved Capacity
Reserved capacity toplam worker gücünün belirli bölümünü kritik işler için boş tutar. Dedicated pool kadar keskin ayrım gerektirmeden priority inversion riskini azaltabilir. Sistem yoğunken bile critical job'ın başlayabileceği slot bulunur. Kullanım düşükken boş kapasite maliyeti oluşabilir. İş etkisi yüksekse bu maliyet kabul edilebilir olabilir.
Tek Queue mu Çoklu Queue mu?
Tek queue başlangıçta en basit operasyondur ve küçük sistemlerde yeterli olabilir. Job türleri farklı SLA, retry veya resource profili kazandıkça çoklu queue mimarisi faydalı hale gelir. CPU-heavy video işi ile düşük latency e-posta işi aynı queue'da tutulduğunda birbirini etkileyebilir. Ayrı queue failure isolation ve worker tuning sağlar. Buna rağmen her mikro job türü için yeni queue oluşturmak yönetimi gereksiz büyütür.
Basit Sistemlerde Tek Queue
Trafik düşük ve job türleri benzer ise tek queue kullanmak anlaşılırdır. Tek worker deployment ve monitoring dashboard yönetimi kolaydır. İlk günden gereksiz partitioning yapmak bakım maliyetini artırabilir. Metric'ler job type label ile ayrılarak ilerideki ihtiyaç gözlenebilir. Gerçek SLO farkı ortaya çıktığında yeni queue eklemek daha sağlıklıdır.
Job Type Bazlı Queue
E-posta, video, export ve webhook gibi job türlerinin resource profilleri farklı olabilir. Type bazlı queue her worker pool için uygun concurrency ayarı kullanılmasını sağlar. CPU-heavy video worker yüksek memory alırken webhook worker daha çok I/O concurrency kullanabilir. Failure bir queue'yu etkilediğinde diğerleri çalışmaya devam edebilir. Queue isimleri job responsibility'sini açıkça ifade etmelidir.
Priority Bazlı Queue
Critical ve bulk workload farklı queue'lara ayrılabilir. Böylece ayrı worker kapasitesi ve autoscaling policy uygulanır. Yalnızca queue içi priority'den daha güçlü izolasyon sağlar. Ancak producer doğru queue seçimini yapmalıdır. Routing logic merkezi ve test edilebilir olmalıdır.
Farklı SLA'lar
Password reset 30 saniye, CSV export 10 dakika SLO'ya sahip olabilir. Bu iki işi aynı backlog metriğiyle yönetmek anlamlı değildir. Ayrı queue her sınıf için farklı age threshold ve alert sağlar. Capacity planning de user impact üzerinden yapılabilir. SLA gerçekten farklı değilse ayrım gereksiz olabilir.
Farklı Worker Concurrency
I/O-heavy job yüksek concurrency, CPU-heavy job düşük concurrency gerektirebilir. Aynı worker pool içinde tek ayar iki workload için de ideal olmaz. Çoklu queue farklı concurrency profilleri sağlar. Database connection pool boyutları da worker tipine göre ayarlanabilir. Resource request ve limit değerleri Kubernetes deployment seviyesinde ayrıştırılabilir.
Failure Isolation
Bir job type sürekli crash veya timeout üretirse kendi queue'sunda izole kalması faydalıdır. Tek queue'da failed veya slow job diğer workload'ların latency'sini artırabilir. Ayrı worker deployment sorunu rollback veya pause etmeyi kolaylaştırır. Queue bazlı circuit breaker veya rate limit de uygulanabilir. Bu izolasyon incident blast radius değerini küçültür.
Worker Graceful Shutdown Nasıl Yapılır?
Worker pod veya process deployment, autoscaling ve node maintenance sırasında düzenli olarak kapatılır. Process aniden öldürülürse active job yarıda kalabilir ve broker tarafından yeniden teslim edilebilir. Graceful shutdown yeni job kabulünü durdurup mevcut işi güvenli şekilde tamamlamak için zaman tanır. Bu süreç platformun termination deadline değeriyle uyumlu olmalıdır. Yine de hard kill her zaman mümkün olduğu için job idempotency korunmalıdır.
SIGTERM
Linux ve container ortamında SIGTERM process'e kontrollü kapanma isteği iletmek için yaygın kullanılan sinyaldir. Worker bu sinyali yakalayıp shutdown sürecini başlatmalıdır. Yeni job almaya devam etmek yerine consumer pause edilebilir. Active işlerin tamamlanması beklenir. Platform deadline sonunda SIGKILL gönderebileceği için süre sınırsız değildir.
Yeni Job Almayı Durdurma
Graceful shutdown başladığında worker yeni job claim etmemelidir. Aksi halde kapanma süresi uzar ve sürekli yeni in-flight iş oluşur. Queue consumer pause veya connection drain mekanizması kullanılabilir. Mevcut active job sayısı monitoring üzerinden gözlenebilir. Sıfıra indiğinde process temiz biçimde kapanabilir.
In-Flight Job'ı Tamamlama
Active job kısa sürede bitebiliyorsa shutdown sırasında tamamlanmasına izin vermek duplicate riskini azaltır. Job çok uzun sürüyorsa checkpoint ve resumable design daha uygun olur. Shutdown deadline'dan uzun işlere güvenmek risklidir. Worker progress state kaydedebilir. Process öldürülse bile yeni worker kaldığı noktadan devam edebilir.
Acknowledgement
Job başarıyla tamamlandıktan sonra acknowledgement verildiğinden emin olunmalıdır. Shutdown handler job bitmeden connection'ı kapatırsa ack kaybolabilir. Broker mesajı yeniden teslim eder ve duplicate execution oluşabilir. Graceful flow bu sırayı kontrollü yönetmelidir. Idempotency yine bu pencereye karşı koruma sağlar.
Shutdown Deadline
Kubernetes termination grace period veya process manager timeout shutdown için üst süre belirler. Worker'ın normal job duration değeri bu süreyle uyumlu olmalıdır. 30 dakika süren job'a 30 saniyelik grace period vermek güvenilir completion sağlamaz. Long-running job chunking ile daha küçük birimlere bölünebilir. Deadline metric ve loglarda görünür olmalıdır.
SIGKILL Riski
Graceful süre sona erdiğinde platform process'i zorla öldürebilir. SIGKILL handler tarafından yakalanamaz ve cleanup kodu çalışmaz. Bu nedenle sistem yalnızca graceful shutdown'a güvenmemelidir. Lease, visibility timeout ve idempotency crash recovery için gereklidir. Failure injection testlerinde worker active job sırasında zorla öldürülerek davranış gözlenmelidir.
Deployment Sırasında Background Job'lara Ne Olur?
Yeni sürüm deploy edilirken worker process'leri yeniden başlatılır ve active job'ların durumu kullanılan queue sisteminin semantics'ine göre değişir. Graceful termination varsa job tamamlanabilir. Process aniden durursa job redelivery veya stalled recovery mekanizmasıyla başka worker'a geçebilir. Yeni worker sürümünün eski payload'ları anlayabilmesi rolling deployment için önemlidir. Deployment senaryosu yalnızca web request'leri değil queue'da bekleyen eski job'ları da kapsamalıdır.
Worker Restart
Worker restart normal operasyonun parçasıdır ve hata senaryosu gibi tasarlanmalıdır. Process belleğindeki geçici state kaybolabilir. Job state yalnızca memory'de tutuluyorsa recovery zorlaşır. Gerekli progress durable store'a yazılmalıdır. Restart sonrası worker queue consumer olarak yeniden bağlanıp işi devam ettirebilmelidir.
In-Flight Job
Deployment geldiğinde bazı worker'lar job üzerinde çalışıyor olabilir. Graceful shutdown bu job'lara tamamlanma süresi verir. Çok uzun job'lar rollout'u geciktirebilir. Checkpoint ve chunking deployment süresini daha yönetilebilir hale getirir. In-flight count rollout dashboard'unda izlenebilir.
Job Redelivery
Worker job'ı tamamladığı halde ack vermeden durursa broker tekrar teslim edebilir. Yeni sürüm aynı job'ı baştan çalıştırabilir. Business side effect duplicate-safe olmalıdır. Versioned payload yeni worker'ın eski mesajı okuyabilmesini sağlar. Migration sırasında breaking payload değişikliklerinden kaçınılmalıdır.
Idempotency
Deployment kaynaklı redelivery idempotency'nin neden yalnızca teorik bir konu olmadığını gösterir. Worker restart production'da düzenli gerçekleşir. Aynı business key ile ikinci execution güvenli olmalıdır. Unique constraint ve provider idempotency key birlikte kullanılabilir. Deployment testleri duplicate execution senaryosunu da içermelidir.
Graceful Termination
Orchestrator eski pod'a SIGTERM gönderdiğinde worker yeni job almayı durdurmalıdır. Active job tamamlanınca process kapanabilir. Readiness probe erken false yapılarak yeni iş yönlendirilmesi azaltılabilir. Queue consumer semantics web load balancer'dan farklı olduğu için framework'e uygun shutdown yöntemi kullanılmalıdır. Termination grace period gerçek processing süresine göre ayarlanmalıdır.
Rolling Deployment
Rolling deployment sırasında eski ve yeni worker sürümleri aynı anda çalışabilir. Payload ve database schema iki sürüm tarafından da anlaşılabilir olmalıdır. Önce backward-compatible migration yapmak güvenlidir. Yeni payload yalnızca bütün consumer'lar desteklediğinde producer tarafından üretilmelidir. Queue sistemleri deployment compatibility planına dahil edilmelidir.
Worker Crash Sonrası Job Nasıl Kurtarılır?
Worker crash olduğunda active job'ın sonsuza kadar kaybolmaması için ownership mekanizması süreli olmalıdır. Visibility timeout veya lease bu amacı sağlar. Worker belirli aralıklarla heartbeat göndererek hâlâ işi işlediğini gösterebilir. Heartbeat kesilirse job stalled olarak değerlendirilip yeniden queue'ya alınabilir. Bu recovery duplicate execution oluşturabileceği için idempotency temel gereksinim olarak kalır.
Visibility Timeout
Visibility timeout worker'ın aldığı mesajın belirli süre diğer consumer'lardan gizlenmesini sağlar. Worker süre içinde işi tamamlayıp ack vermezse mesaj yeniden görünür hale gelebilir. Timeout job süresinden çok kısa seçilirse normal çalışan job duplicate edilebilir. Çok uzun seçilirse crash sonrası recovery gecikir. Long-running job için timeout renewal veya heartbeat gerekebilir.
Lease
Lease worker'a job üzerinde belirli süreli sahiplik verir. Worker sağlıklı olduğu sürece lease'i yenileyebilir. Yenileme durursa başka worker job'ı devralabilir. Bu model crash recovery ile stuck job riskini dengeler. Lease ownership token ile korunmalıdır.
Heartbeat
Worker processing sırasında heartbeat göndererek aktif olduğunu belirtir. Job süresi uzun olduğunda bu sinyal lease renewal için kullanılabilir. Heartbeat thread veya event loop bloke olursa yanlış stalled detection oluşabilir. CPU-heavy job'larda ayrı heartbeat mekanizması gerekebilir. Monitoring worker heartbeat age değerini de izleyebilir.
Stalled Job
Stalled job active görünmesine rağmen sahibi worker artık ilerlemeyen görevdir. Worker crash, network partition veya event loop block bu duruma yol açabilir. Queue sistemi belirli timeout sonrası job'ı yeniden işlenebilir hale getirebilir. Stalled count artışı worker sağlık sorununun işareti olabilir. Aynı job sürekli stalled oluyorsa poison veya resource problemi araştırılmalıdır.
Requeue
Requeue stalled veya geçici başarısız job'ı yeniden waiting state'e taşır. Yeni worker job'ı tekrar alabilir. Requeue öncesinde attempt sayısı ve retry policy uygulanmalıdır. Sonsuz requeue poison job döngüsü oluşturabilir. Maximum attempts sonrasında DLQ kullanılmalıdır.
Duplicate Processing
Eski worker aslında hâlâ çalışırken lease süresi dolarsa yeni worker aynı job'ı başlatabilir. Bu durum distributed systems içinde tamamen göz ardı edilemez. Business side effect unique key ile korunmalıdır. Fencing token kritik ortak kaynağa yazmayı kontrol edebilir. Recovery mekanizması ile idempotency birlikte tasarlanmalıdır.
Job Lease Nedir?
Job lease bir worker'ın belirli job üzerinde geçici sahiplik hakkını temsil eder. Bu sahiplik sonsuz değildir ve worker'ın sağlıklı olduğunu göstermek için yenilenebilir. Worker crash ettiğinde lease zaman aşımına uğrar ve başka worker işi devralabilir. Lease crash recovery sağlar, fakat duplicate execution olasılığını tamamen ortadan kaldırmaz. Bu nedenle worker'ın aynı işi ikinci kez çalıştırmaya dayanıklı olması gerekir.
Worker Ownership
Worker job'ı aldığında ownership token veya lease bilgisi oluşturulabilir. Bu bilgi hangi worker'ın job üzerinde yetkili olduğunu belirler. Status update yapılırken owner doğrulanabilir. Eski worker lease kaybettikten sonra sonucu yazmaya çalışırsa reddedilebilir. Bu kontrol stale worker etkisini azaltır.
Lease Timeout
Lease timeout ownership'in ne kadar süre geçerli olduğunu belirler. İşin normal heartbeat aralığından yeterince uzun olmalıdır. Çok kısa timeout network jitter nedeniyle gereksiz takeover yaratabilir. Çok uzun timeout crash recovery'yi yavaşlatır. Değer gerçek processing ve network ölçümleriyle ayarlanmalıdır.
Lease Renewal
Worker sağlıklı olduğu sürece lease'i düzenli aralıklarla yeniler. Renewal işlemi job processing'den bağımsız bir heartbeat path üzerinde yürütülebilir. Worker bloke olursa renewal da durabilir. Renewal başarısız olduğunda job handler'ın güvenli şekilde durması gerekebilir. Aksi halde iki owner aynı anda çalışabilir.
Worker Crash
Crash sonrası worker lease'i manuel release edemez. Timeout mekanizması bu nedenle önemlidir. Lease süresi dolduğunda job yeniden claim edilebilir. Eski worker restart olsa bile eski ownership geçerli kabul edilmemelidir. Business idempotency tekrar processing'e karşı son korumadır.
Başka Worker'ın Job'ı Devralması
Lease sona erdiğinde başka worker job'ı yeniden işleyebilir veya checkpoint'ten devam edebilir. Resumable job tasarımı büyük işlerde recovery süresini azaltır. Yeni worker önce mevcut progress state'i doğrulamalıdır. Side effect daha önce tamamlandıysa idempotency kontrolü işi no-op yapabilir. Takeover olayı log ve metric olarak kaydedilmelidir.
Long-Running Job Nasıl Tasarlanmalıdır?
Saatler süren tek bir dev job operational risk oluşturur. Deployment, worker crash veya timeout durumunda bütün işlemi baştan yapmak gerekebilir. Büyük işi küçük chunk'lara bölmek, checkpoint kaydetmek ve progress state tutmak recovery'yi kolaylaştırır. Her chunk idempotent olmalı ve kısmi başarısızlık güvenli biçimde tekrar işlenebilmelidir. Kullanıcıya yalnızca yüzde değil hangi aşamada olduğu da gösterilebilir.
Tek Dev Job'dan Kaçınmak
Milyon kaydı tek transaction veya tek worker run içinde işlemek risklidir. Process son kayıtta crash ederse saatlerce çalışma kaybedilebilir. Job memory kullanımı ve lock süresi de büyür. İş doğal batch sınırlarına bölünebilir. Parent job veya workflow toplam progress'i takip edebilir.
Chunking
Chunking büyük veri setini küçük ve bağımsız bölümlere ayırır. Örneğin 100 bin kayıt 1000 kayıtlık job'lar halinde işlenebilir. Chunk boyutu broker overhead ile recovery maliyeti arasında denge kurmalıdır. Çok küçük chunk aşırı message sayısı üretir. Çok büyük chunk ise failure recovery'yi zorlaştırır.
Checkpoint
Checkpoint job'ın güvenli biçimde ilerleme durumunu kaydettiği noktadır. Worker crash sonrası baştan başlamak yerine son checkpoint'ten devam edebilir. Checkpoint state durable storage içinde tutulmalıdır. External side effect ile checkpoint update arasında idempotency gerekir. Aksi halde crash sonrası bazı adımlar iki kez uygulanabilir.
Progress State
Progress state job'ın kaç parça tamamladığını ve hangi aşamada olduğunu gösterir. Kullanıcı arayüzü bu bilgiyi status endpoint üzerinden okuyabilir. Progress update çok sık yapılırsa database write yükü artabilir. Belirli batch aralıklarında veya önemli aşamalarda güncellemek yeterli olabilir. Terminal success veya failure state her zaman açık olmalıdır.
Resumable Processing
Resumable processing job'ın crash veya deployment sonrası kaldığı yerden devam etmesini sağlar. Bu tasarım long-running workload için güçlüdür. State machine veya checkpoint index kullanılabilir. Her adımın tekrar çalıştırılması güvenli olmalıdır. Resume logic normal success path kadar test edilmelidir.
Partial Failure Recovery
Büyük job'ın 100 chunk'ından yalnızca ikisi fail ettiyse bütün 100 chunk'ı tekrar çalıştırmak gereksiz olabilir. Failed chunk'lar ayrı retry alabilir. Parent progress yalnızca bütün gerekli parçalar başarıyla tamamlandığında complete olur. Bazı business akışlarda kısmi sonuç kabul edilebilir. Bu politika kullanıcıya açık status ile gösterilmelidir.
Job Timeout Neden Gereklidir?
Timeout hiçbir job'ın sonsuza kadar worker slotunu tutmamasını sağlar. Hanging HTTP request, kilitlenen database query veya kod bug'ı worker kapasitesini yavaşça tüketebilir. Hard ve soft timeout farklı recovery davranışları sunabilir. Timeout değeri normal p99 processing süresinden düşük seçilmemelidir. Timeout sonrası external side effect belirsiz kalabileceği için retry öncesinde idempotency ve cleanup dikkate alınmalıdır.
Hanging HTTP Request
HTTP client timeout tanımlamazsa downstream bağlantı sonsuza yakın süre bekleyebilir. Worker slotu bu sırada başka job işleyemez. Connect ve read timeout ayrı ayrı yapılandırılabilir. Timeout sonrası request'in karşı tarafta uygulanıp uygulanmadığı belirsiz olabilir. Idempotency key veya status query güvenli retry için önemlidir.
Database Query
Kötü query planı veya lock bekleyen sorgu job'ı uzun süre bloke edebilir. Database statement timeout bu durumu sınırlayabilir. Timeout yalnızca worker seviyesinde değil database client seviyesinde de kullanılabilir. Query plan ve index problemi kök neden olarak çözülmelidir. Retry ederek yavaş query'yi sürekli yeniden çalıştırmak sorunu büyütebilir.
Worker Pool Exhaustion
Timeout olmayan birkaç stuck job bütün concurrency slotlarını zamanla doldurabilir. Yeni job'lar queue'da beklemeye başlar ve age yükselir. Worker process hâlâ "çalışıyor" göründüğü için basit health check sorunu fark etmeyebilir. Active job age ve processing timeout metric'leri bu durumu gösterir. Timeout sonrası slot serbest bırakılmalıdır.
Hard Timeout
Hard timeout süre aşımında task'ı zorla durdurabilir. Bu davranış cleanup kodunun çalışmamasına neden olabilir. File handle, temporary state veya partial side effect kalabilir. Hard timeout son savunma katmanı olarak kullanılmalıdır. Worker işlemi idempotent olacak şekilde tasarlanmalıdır.
Soft Timeout
Soft timeout uygulamaya süre dolmadan kontrollü cleanup yapma fırsatı verir. Job current state'i checkpoint'e yazabilir veya external request'i iptal etmeye çalışabilir. Belirli grace süresi sonra hard timeout uygulanabilir. Handler timeout exception'ını normal failure classification içinde ele almalıdır. Soft timeout'un framework runtime modelinde nasıl çalıştığı test edilmelidir.
Cleanup
Timeout sonrası geçici dosya, lock ve partial resource temizliği gerekebilir. Cleanup işlemi kendi başına başarısız olabilir. Distributed lock yalnızca gerçek owner tarafından release edilmelidir. External side effect geri alınamıyorsa compensation veya reconciliation gerekir. Cleanup kodu error log üretmeli fakat orijinal failure context'i kaybetmemelidir.
Job Cancellation Nasıl Tasarlanmalıdır?
Background job cancellation process'i rastgele öldürmekten daha güvenli biçimde tasarlanmalıdır. Kullanıcı iptal istediğinde job status üzerinde cancellation flag saklanabilir. Worker belirli checkpoint'lerde bu flag'i kontrol edip kontrollü biçimde durabilir. External API side effect başladıysa iptal artık tam geri alma anlamına gelmeyebilir. Bu nedenle kullanıcıya cancellation semantics açık biçimde gösterilmelidir.
Kullanıcı İptali
Uzun export veya rapor işlemlerinde kullanıcı görevi artık istemeyebilir. İptal talebi job state'e yazılır. Waiting job queue'dan kaldırılabilir veya worker başlamadan skip edebilir. Active job için cooperative cancellation gerekir. Kullanıcıya "iptal talebi alındı" ile "iptal tamamlandı" durumları ayrı gösterilebilir.
Cancellation Flag
Cancellation flag durable datastore içinde job'ın iptal istendiğini belirtir. Worker her batch veya önemli adım öncesinde bu değeri okuyabilir. Flag tek başına process'i durdurmaz. Job kodunun bu sinyale tepki vermesi gerekir. Çok sık kontrol performance maliyeti, çok seyrek kontrol yavaş iptal oluşturur.
Cooperative Cancellation
Cooperative cancellation worker'ın güvenli noktada kendi isteğiyle işi sonlandırmasıdır. Bu yaklaşım hard kill'e göre cleanup yapma fırsatı verir. Transaction yarıda bırakılmaz ve temporary resource temizlenebilir. External çağrı devam ediyorsa client cancellation destekleyebilir. Desteklemiyorsa response beklenmesi veya timeout gerekebilir.
Checkpoints
Checkpoint'ler cancellation kontrolü için doğal noktalardır. Bir chunk tamamlandığında worker cancellation flag'i kontrol edebilir. İptal varsa yeni chunk başlatmaz. Tamamlanan chunk'lar business gereksinimine göre korunabilir veya compensation uygulanabilir. Job status canceled olarak kaydedilir.
External API Side Effects
External API isteği gönderildikten sonra kullanıcı iptal etse bile karşı taraftaki işlem gerçekleşmiş olabilir. Cancellation bu yan etkiyi otomatik geri alamaz. Provider cancellation endpoint sunuyorsa ayrı compensation job kullanılabilir. Finansal işlerde status reconciliation gerekebilir. Kullanıcı arayüzü "iptal edildi" ifadesini ancak gerçek business state doğrulandığında göstermelidir.
Job Progress Nasıl Takip Edilir?
Uzun süren işlerde kullanıcının yalnızca "processing" mesajı görmesi yetersiz olabilir. Progress percentage, current step ve processed item count sürecin gerçekten ilerlediğini gösterir. Bu bilgiler durable status store içinde saklanabilir. Update sıklığı database yükünü artırmayacak şekilde ayarlanmalıdır. Progress tamamlanma garantisi değildir ve terminal success state ayrı tutulmalıdır.
Percentage
Percentage toplam iş miktarı biliniyorsa kullanıcı için anlaşılır bir göstergedir. 500 kaydın 250'si işlendiğinde yüzde 50 gösterilebilir. Bazı workflow'larda adımların ağırlığı eşit olmadığı için basit oran yanıltıcı olabilir. Büyük finalization adımı varsa yüzde 99'da uzun süre kalmak kullanıcıyı şaşırtabilir. Progress modeli gerçek iş akışına göre tasarlanmalıdır.
Current Step
Current step "veri hazırlanıyor", "dosya oluşturuluyor" veya "yükleniyor" gibi anlamlı durum gösterebilir. Toplam yüzde hesaplanamayan işlerde özellikle faydalıdır. Step değerleri backend internal implementation ayrıntısından çok kullanıcıya anlamlı olacak şekilde seçilmelidir. Loglarda daha teknik step code ayrıca tutulabilir. Status transition'lar state machine ile kontrol edilebilir.
Processed Item Count
Processed item count batch işlerinde somut ilerleme metriğidir. Kullanıcı veya operasyon ekibi kaç kaydın işlendiğini görebilir. Total count biliniyorsa kalan iş hesaplanabilir. Counter update atomic yapılmalıdır. Her item için database write yerine batch başına güncelleme performansı iyileştirir.
Status Store
Status store job state ve progress bilgisini worker process'inden bağımsız saklar. Database, Redis veya uygun result backend kullanılabilir. Kullanıcı UI process restart olsa bile durumu okuyabilmelidir. Terminal state'ler belirli retention sonrası temizlenebilir. Store schema job version ve error summary gibi alanları da içerebilir.
User Notification
Job tamamlandığında kullanıcı sürekli polling yapmak zorunda olmayabilir. E-posta, push veya uygulama içi notification ile completion bilgisi gönderilebilir. Notification job'ın kendisi de background worker üzerinden çalıştırılabilir. Aynı completion event iki kez gelirse duplicate notification önlenmelidir. Kullanıcı uygulamayı açtığında güncel status store her zaman son gerçek durumu göstermelidir.
Kubernetes CronJob Nedir?
Kubernetes CronJob, tekrar eden schedule'a göre Kubernetes Job nesneleri oluşturan controller tabanlı kaynaktır. Job da çalıştırılacak Pod'ları yönetir ve batch workload için uygun lifecycle sağlar. Bu model cluster içinde periyodik bakım, rapor veya veri işlemleri için kullanılabilir. CronJob'ın aynı schedule için bazı koşullarda birden fazla Job oluşturabileceği ihtimali kabul edilmelidir. Bu nedenle Kubernetes dokümantasyonunun da önerdiği gibi işlerin idempotent tasarlanması production açısından önemlidir.
CronJob Controller
CronJob controller cluster içinde schedule zamanlarını takip eder ve uygun olduğunda Job oluşturur. Controller sürekli gerçek zamanlı garanti veren bir timer olarak düşünülmemelidir. Control plane gecikmeleri veya downtime missed schedule oluşturabilir. startingDeadlineSeconds bu gecikmelerin ne kadarının kabul edileceğini sınırlayabilir. Monitoring scheduled timestamp ile actual start arasındaki farkı ölçebilir.
Job
Kubernetes Job bir batch işlemin belirli sayıda başarılı Pod completion elde etmesini yönetir. CronJob her occurrence için yeni Job oluşturabilir. Job retry ve backoff ayarları CronJob schedule davranışından ayrı değerlendirilmelidir. Job history debugging için yararlıdır. Fakat history sınırsız bırakılırsa cluster metadata gereksiz büyüyebilir.
Pod
Job gerçek uygulama container'ını Pod içinde çalıştırır. Pod resource request ve limit değerleri scheduled işin ihtiyaçlarına göre belirlenmelidir. Container exit code Job success veya failure davranışını etkiler. Secret ve service account least privilege ile yapılandırılmalıdır. Pod logları merkezi sisteme gönderilirse completed Pod silinse bile incident incelemesi mümkün olur.
Cron Schedule
CronJob schedule alanı cron benzeri expression ile tekrar zamanını tanımlar. Kubernetes sürüm ve özelliklerine göre time zone desteği gibi seçenekler ayrıca kontrol edilmelidir. Schedule production'a alınmadan önce next-run hesaplarıyla doğrulanmalıdır. Job duration schedule aralığından uzun olabiliyorsa concurrencyPolicy seçimi önem kazanır. Business idempotency yine korunmalıdır.
Batch Workload
CronJob uzun yaşayan web service yerine tamamlanıp çıkan batch workload için uygundur. Backup, report generation ve periodic cleanup bu modele iyi örneklerdir. Sürekli event tüketen worker Deployment olarak çalıştırılmalıdır. Çok sık schedule edilen birkaç saniyelik görevlerde controller overhead de göz önünde bulundurulabilir. İşin gerçek execution modeline uygun Kubernetes resource seçilmelidir.
Kubernetes CronJob concurrencyPolicy
concurrencyPolicy aynı CronJob tarafından oluşturulan Job'ların overlap durumunda nasıl davranacağını belirler. Allow varsayılan olarak eş zamanlı çalışmaya izin verir, Forbid önceki Job devam ederken yenisini başlatmaz ve Replace mevcut Job'ı yeni occurrence ile değiştirmeyi hedefler. Bu ayar farklı CronJob nesneleri arasındaki çakışmayı kontrol etmez. Uzun süren görevlerde business semantics düşünülmeden yalnızca Forbid seçmek missed schedule davranışını değiştirebilir. Hangi policy seçilirse seçilsin idempotency önemli kalır.
Allow
Allow önceki Job devam ederken yeni schedule için başka Job oluşmasına izin verir. İşler tamamen bağımsız ve paralel çalışmaya uygunsa en yüksek throughput sağlayabilir. Aynı database kayıtlarını güncelliyorlarsa race condition oluşabilir. Resource spike da dikkate alınmalıdır. Overlap normal değilse metric ve alert eklenmelidir.
Forbid
Forbid önceki Job hâlâ çalışıyorsa yeni concurrent run'ı engeller. Backup veya cleanup gibi aynı anda iki instance'ın çalışmaması gereken görevlerde yararlı olabilir. Ancak schedule occurrence skipped sayılabilir ve deadline davranışıyla birlikte değerlendirilmelidir. Önceki Job stuck kalırsa sonraki çalışmalar da gecikebilir. Job timeout ve monitoring bu nedenle önemlidir.
Replace
Replace yeni schedule geldiğinde devam eden eski Job'ın yerine yenisinin geçmesini sağlar. Yalnızca en güncel çalışmanın önemli olduğu bazı işlerde mantıklı olabilir. Eski Job yarıda kesildiğinde partial side effect kalabilir. Job cancellation ve idempotency tasarımı buna uygun olmalıdır. Finansal veya tamamlanması zorunlu batch işlerinde Replace dikkatli kullanılmalıdır.
Uzun Süren Job'larda Seçim
Job süresi schedule aralığından uzunsa overlap davranışı kaçınılmaz olarak gündeme gelir. Eğer her occurrence mutlaka işlenmeli ise queue veya farklı workflow modeli CronJob'dan daha uygun olabilir. Yalnızca en güncel state önemliyse Replace değerlendirilebilir. Aynı anda iki run tehlikeliyse Forbid kullanılır. Karar teknik kolaylıktan çok business semantics'e dayanmalıdır.
Duplicate Execution Riski
ConcurrencyPolicy duplicate business effect ihtimalini tamamen ortadan kaldırmaz. Controller veya failure recovery koşullarında aynı schedule için birden fazla execution oluşabilir. Job içindeki idempotency key business period'a bağlanmalıdır. Database unique constraint ikinci sonucu engelleyebilir. Kubernetes scheduler davranışını son güvenlik katmanı olarak görmek doğru değildir.
Kubernetes startingDeadlineSeconds
startingDeadlineSeconds kaçırılmış bir CronJob occurrence'ın ne kadar gecikmeyle hâlâ başlatılabileceğini sınırlar. Control plane veya controller geçici olarak schedule anını kaçırmışsa bu değer recovery politikasını etkiler. Çok kısa değer gereksiz skip, çok uzun değer stale işlerin geç başlamasına yol açabilir. Job'ın business değerinin ne kadar süre sonra kaybolduğu burada temel kriterdir. Örneğin beş dakikalık cache refresh ile günlük backup aynı deadline'ı kullanmamalıdır.
Kaçırılan Schedule
Controller schedule anında Job oluşturamazsa occurrence missed kabul edilebilir. Bunun nedeni control plane downtime veya başka koşullar olabilir. Her missed run'ın sonradan çalıştırılması gerekli değildir. Business logic eski occurrence'ın hâlâ değerli olup olmadığını belirlemelidir. Missed run metric ve event olarak izlenmelidir.
Geç Başlatma Sınırı
Deadline gecikmiş occurrence'ın kabul edileceği maksimum süreyi tanımlar. Örneğin 10 dakika sonra anlamını kaybeden polling job için küçük değer kullanılabilir. Backup job birkaç saat geç de olsa değerli olabilir. Değer belirlenirken normal controller gecikmesi için yeterli tolerance bırakılmalıdır. Aşırı düşük ayar beklenmeyen skip sayısını artırabilir.
Controller Downtime
Kubernetes control plane veya CronJob controller geçici sorun yaşayabilir. Sistem geri geldiğinde hangi missed occurrence'ların değerlendirileceği deadline ayarına bağlıdır. Uzun downtime sonrasında çok sayıda eski işin aynı anda başlaması istenmeyebilir. Business period deduplication ve rate limit ek koruma sağlar. Recovery senaryosu staging testlerinde simüle edilebilir.
Stale Job Çalıştırmayı Önleme
Bazı işlerde eski schedule artık anlamsızdır. Örneğin dakikalık cache refresh job iki saat sonra çalıştırılırsa hemen sonraki güncel run ile aynı işi tekrar yapabilir. Deadline eski occurrence'ın otomatik atlanmasını sağlayabilir. Böylece gereksiz load azaltılır. Kritik veri pipeline'ında ise eski occurrence'ın atlanması kabul edilemez ve farklı workflow gerekir.
Kubernetes CronJob History Limits
CronJob tarafından oluşturulan eski Job nesnelerini sınırsız tutmak cluster metadata'sını gereksiz büyütebilir. History limits başarılı ve başarısız Job'lardan kaç tanesinin saklanacağını kontrol etmeye yardımcı olur. Bir miktar geçmiş troubleshooting için değerlidir. Loglar yalnızca Pod üzerinde kalıyorsa çok agresif cleanup incident incelemesini zorlaştırabilir. Merkezi logging kullanıldığında Kubernetes object history daha kısa tutulabilir.
successfulJobsHistoryLimit
successfulJobsHistoryLimit tamamlanan başarılı Job geçmişinin kaç örneğinin saklanacağını belirler. Son birkaç başarılı run deployment doğrulaması için yararlıdır. Çok yüksek değer binlerce CronJob bulunan cluster'da metadata büyümesine yol açabilir. Merkezi metrik ve loglar uzun dönem geçmişi ayrı yerde saklayabilir. Değer operasyon ihtiyacına göre ayarlanmalıdır.
failedJobsHistoryLimit
failedJobsHistoryLimit failed Job nesnelerinin tutulma sayısını kontrol eder. Hata incelemesi için success history'den daha değerli olabilir. Ancak kalıcı failure sürekli yeni Job oluşturuyorsa object sayısı yine büyüyebilir. Alert problem ilk oluştuğunda ekibi bilgilendirmelidir. History yalnızca geçmişi saklar, monitoring'in yerini tutmaz.
Cluster Temizliği
Çok sayıda completed Job API server ve controller list işlemlerine ek yük getirebilir. History limitleri cluster temizliğine yardımcı olur. TTL controller veya başka cleanup mekanizmaları da bazı batch workload'larda kullanılabilir. Silmeden önce gerekli log ve audit bilgisinin merkezi sisteme aktarıldığından emin olunmalıdır. Cleanup politikası namespace ve job importance'a göre farklı olabilir.
Troubleshooting İçin History
Son failed Job spec ve Pod event'lerini görmek incident sırasında oldukça faydalıdır. Image tag, environment veya exit reason doğrudan Kubernetes object üzerinden incelenebilir. Bütün history sıfır tutulursa bu bilgi hızlı kaybolabilir. Merkezi logging ve deployment metadata eksikse birkaç history object saklamak daha güvenlidir. Retention kararını gerçek troubleshooting pratiği yönlendirmelidir.
Kubernetes CronJob'lar Idempotent Olmalı mı?
Evet, Kubernetes CronJob tarafından çalıştırılan business işlemler mümkün olduğunca idempotent tasarlanmalıdır. Controller duplicate Job olasılığını tamamen ortadan kaldırmaz ve pod failure retry'leri aynı işi tekrar çalıştırabilir. Idempotency yalnızca Kubernetes'e özel değil bütün at-least-once processing sistemleri için temel bir dayanıklılık özelliğidir. Business key, unique constraint ve safe retry yaklaşımı kullanılabilir. Özellikle backup, billing ve notification işlemlerinde duplicate sonucunun etkisi önceden test edilmelidir.
Duplicate Job Oluşabilmesi
Schedule controller çeşitli failure ve timing koşullarında beklenenden fazla Job oluşturabilir. Uygulama "CronJob her zaman tam bir kez çalışır" varsayımına güvenmemelidir. Her run business period anahtarıyla tanımlanabilir. Aynı period ikinci kez görülürse mevcut sonuç döndürülebilir. Monitoring duplicate run sayısını görünür hale getirebilir.
At-Least-Once Davranışı
Batch sistemlerinde işi kaybetmemek için tekrar execution çoğu zaman kabul edilen trade-off'tur. Pod crash sonrası Job yeniden Pod oluşturabilir. İş ilk Pod tarafından kısmen tamamlandıysa duplicate side effect riski vardır. Safe retry için state transactionally saklanmalıdır. External API çağrılarında idempotency key kullanılmalıdır.
Business-Level Idempotency
Kubernetes resource name business uniqueness garantisi değildir. Gerçek koruma database veya business datastore'da uygulanmalıdır. Günlük rapor için date ve tenant ID unique key olabilir. Aynı key ile ikinci run aynı raporu yeniden kullanabilir veya güvenli güncelleme yapabilir. Bu yaklaşım manuel rerun işlemlerini de daha güvenli hale getirir.
Safe Retry
Safe retry işin herhangi bir failure noktasından sonra tekrar çalıştırılabilmesini hedefler. Transaction ve checkpoint kullanımı partial state'i azaltır. External side effect'in durumu doğrulanmalıdır. Job'ın baştan çalışması ile kaldığı yerden devam etmesi business sonucunu değiştirmemelidir. Failure injection testleri bu güveni ölçer.
Serverless Cron Nedir?
Serverless cron, sürekli bir sunucu veya scheduler process yönetmeden belirli zamanlarda function veya job tetikleme modelidir. Yönetilen platform schedule altyapısını sağlar ve uygulama yalnızca tetiklenen kodu çalıştırır. Düşük frekanslı ve kısa işler için operasyon yükünü azaltabilir. Buna karşılık function timeout, memory sınırı ve platform delivery semantics dikkate alınmalıdır. Çok uzun veya stateful workflow'lar için queue veya durable workflow engine daha uygun olabilir.
Sunucu Yönetmeden Schedule
Managed scheduler altyapısı cron daemon patch, process supervision ve host availability gibi işleri kullanıcıdan uzaklaştırır. Ekip yalnızca schedule ve target function yapılandırmasına odaklanır. Bu operasyon kolaylığı küçük servislerde değerlidir. Yine de cloud service outage ve retry semantics göz ardı edilmemelidir. Monitoring managed platform dışında business completion seviyesinde yapılmalıdır.
Function Trigger
Schedule zamanı geldiğinde platform bir serverless function veya HTTP endpoint tetikleyebilir. Function doğrudan küçük işi yapabilir veya queue'ya job bırakabilir. İkinci yaklaşım uzun işlerde daha güvenlidir. Function timeout olmadan tamamlanması beklenmemelidir. Enqueue işlemi idempotent business key ile korunabilir.
Pay-per-Execution
Serverless model düşük frekanslı job'larda sürekli açık worker maliyetini azaltabilir. Kullanım arttıkça execution ve downstream maliyetler takip edilmelidir. Çok yoğun sürekli job sistemlerinde dedicated worker daha ekonomik olabilir. Cost per job metriği karar vermeyi kolaylaştırır. Maliyet optimizasyonu güvenilirlik gereksinimini düşürmemelidir.
Timeout
Serverless platformlar function execution için üst süre sınırı uygular. Çok uzun veri işini tek function içine koymak bu nedenle risklidir. Chunking ve queue fan-out uzun süreçleri küçük parçalara bölebilir. Function timeout sonrası aynı event tekrar tetiklenebilir. Idempotency burada da gereklidir.
Platform Limits
Memory, concurrency, payload size ve execution duration limitleri provider'a göre değişebilir. Platform seçilmeden önce workload profiliyle karşılaştırılmalıdır. Büyük binary payload'u function event içinde taşımak yerine storage reference kullanılabilir. Concurrency burst downstream database'i aşabilir. Managed service kullanmak capacity planning ihtiyacını tamamen ortadan kaldırmaz.
Serverless Cron Kullanım Senaryoları
Serverless cron en çok kısa, stateless ve belirli aralıklarla çalışması gereken işler için uygundur. Daily report tetikleme, hafif cleanup veya API polling bu profile girer. İş uzun sürecekse function yalnızca queue job üretip gerçek processing'i worker'a bırakabilir. Bu pattern serverless scheduler kolaylığını durable queue sistemiyle birleştirir. Her senaryoda timeout, retry ve duplicate execution davranışı baştan tanımlanmalıdır.
Daily Report
Günlük küçük rapor belirli saatte serverless function ile oluşturulabilir. Veri hacmi büyükse function yalnızca report job'ını queue'ya ekleyebilir. Business date idempotency key olarak kullanılabilir. Kullanıcıya sonuç object storage reference ile sunulabilir. Missed report alarmı expected schedule üzerinden kurulmalıdır.
Cleanup
Kısa cleanup işlemleri serverless cron için uygundur. Eski geçici kayıtları batch halinde silmek function timeout içinde kalabilir. Büyük tabloyu tek seferde silmek yerine limited batch kullanmak daha güvenlidir. Her run kaldığı yerden devam edebilmelidir. Delete işlemleri audit veya retention policy ile uyumlu olmalıdır.
API Polling
Belirli aralıklarla harici API'den durum kontrolü yapmak serverless cron ile kolayca tetiklenebilir. Rate limit ve timeout yine uygulanmalıdır. Polling sonuçları event üretip queue'ya aktarılabilir. Aynı external item iki poll'da görülürse deduplication gerekebilir. API webhook destekliyorsa gereksiz polling yerine event-driven model değerlendirilebilir.
Cache Refresh
Cache refresh kısa ve stateless bir scheduled function olarak çalışabilir. Cache refresh başarısız olsa bile uygulama stale data ile çalışabiliyorsa risk düşüktür. Aynı key'i birden fazla function güncellese de operation idempotent olabilir. Stampede riskini önlemek için distributed lock veya single-flight yaklaşımı kullanılabilir. Refresh duration ve failure rate izlenmelidir.
Lightweight Data Sync
Küçük veri senkronizasyonları belirli interval ile serverless function içinde yapılabilir. Sync büyüdükçe pagination ve checkpoint ihtiyacı oluşur. Function her run'da belirli sayıda kayıt işleyip continuation state bırakabilir. Çok uzun süreç queue worker'a taşınabilir. External API cursor bilgisi durable store'da tutulmalıdır.
AI Agent Heartbeat
Periyodik kontrol yapan bir agent'ın sürekli açık process olması gerekmeyebilir. Scheduler belirli aralıklarla kısa kontrol görevi tetikleyebilir. Agent yeni veri yoksa hızlı biçimde çıkabilir ve compute maliyeti düşer. İş gerekiyorsa queue veya workflow başlatılabilir. External action üreten agent job'larında idempotency ve permission sınırları özellikle önemlidir.
Serverless Cron Hangi İşler İçin Uygun Değildir?
Serverless cron her scheduled workload için doğru seçim değildir. Saatler süren processing, yüksek memory ihtiyacı veya uzun süre state tutan workflow'lar platform sınırlarına çarpabilir. Human approval veya günler süren bekleme içeren süreçlerde durable workflow engine daha doğal bir modeldir. Ayrıca tam belirlenen milisaniyede çalışma gereksinimi serverless scheduler'ların genel garanti modeliyle uyuşmayabilir. Platform özellikleri business requirements ile karşılaştırılmalıdır.
Çok Uzun İşler
Function execution limitini aşabilecek job'lar serverless cron içinde tek parça çalıştırılmamalıdır. Timeout process'i yarıda kesebilir. Chunking ile küçük job'lara bölmek veya dedicated worker kullanmak daha güvenlidir. Progress durable store'da tutulmalıdır. Long-running business process gerekiyorsa workflow engine değerlendirilebilir.
Çok Büyük Memory İhtiyacı
Büyük dataset'i tamamen memory'ye alan iş function memory sınırına ulaşabilir. OOM failure tekrar execution ile aynı şekilde devam eder. Streaming ve chunking problemi azaltabilir. Yine de workload sürekli yüksek memory istiyorsa container worker daha uygun olabilir. Resource profile ölçülmeden platform seçilmemelidir.
Durable Multi-Step Workflow
Birden fazla adımın saatler veya günler boyunca state tutması gerekiyorsa cron function tek başına yeterli değildir. Step failure, retry ve wait state'in durable tutulması gerekir. Workflow engine bu sorumlulukları doğal biçimde yönetebilir. Cron yalnızca workflow instance başlatabilir. İş state'i function memory'sine bağlı olmamalıdır.
Stateful Processing
Uzun süre process memory'sinde state tutan algoritmalar serverless lifecycle ile uyumsuz olabilir. Function her execution'da yeni environment üzerinde başlayabilir. State dış datastore'a taşınmalıdır. Bu mümkün değilse dedicated worker daha uygun olabilir. Stateful design failure recovery açısından da ayrıca değerlendirilmelidir.
Sıkı Exactly-Time Gereksinimleri
Çoğu cron ve cloud scheduler tam milisaniye garantisi vermez. Control plane, queue veya cold start nedeniyle kısa gecikmeler olabilir. Finansal piyasa gibi sıkı real-time requirement varsa farklı scheduling ve execution altyapısı gerekebilir. Business requirement'ın gerçekten exactly-time mı yoksa deadline içinde execution mı istediği netleştirilmelidir. SLO ölçümü bu farkı görünür hale getirir.
Durable Workflow Engine Nedir?
Durable workflow engine çok adımlı ve uzun süre yaşayan süreçlerin state'ini kalıcı olarak saklayıp failure sonrası devam ettirmeye odaklanan sistemdir. Retry, wait, timer, external event ve human approval gibi aşamalar workflow state içinde tanımlanabilir. Bu yapı basit queue job'dan daha fazla orchestration ihtiyacını karşılar. Her background işlem workflow engine gerektirmez. Süreç günler sürüyor ve adımlar arasında güvenilir state gerekiyorsa değerli hale gelir.
Workflow State
Workflow state hangi adımların tamamlandığını ve sırada ne olduğunu durable biçimde saklar. Worker veya orchestrator restart olsa bile süreç bilgisi kaybolmaz. Büyük business payload yerine gerekli state referansları tutulabilir. State migration ve versioning uzun yaşayan workflow'larda önemlidir. Yeni deployment eski workflow instance'larını anlayabilmelidir.
Retry
Workflow engine step bazında retry policy uygulayabilir. Her adımın farklı retryable failure kuralları olabilir. Örneğin API çağrısı backoff ile retry edilirken validation failure doğrudan terminal state'e geçebilir. Attempt history workflow görünümünde saklanabilir. Bu davranış uygulama içine elle state machine yazma ihtiyacını azaltır.
Step Persistence
Step tamamlandığında sonucu veya completion state durable olarak kaydedilir. Process crash sonrası tamamlanmış adımların tekrar çalıştırılması gerekmeyebilir. Side effect içeren step yine idempotent olmalıdır. Persistence engine'in exactly-once business effect garantisi olarak yorumlanmamalıdır. External API çağrılarında idempotency key korunmalıdır.
Wait
Workflow saatler veya günler boyunca bekleme state'inde kalabilir ve bu sırada worker resource tüketmek zorunda değildir. Örneğin üç gün sonra follow-up gönderme süreci timer state olarak saklanabilir. Process memory'sinde sleep kullanmaya gerek kalmaz. Deployment veya restart wait state'i kaybetmez. Bu özellik uzun business süreçlerinde önemli avantaj sağlar.
Human Approval
Bazı süreçler devam etmeden önce insan onayı gerektirir. Workflow engine approval event gelene kadar durable state'te bekleyebilir. Onay timeout veya escalation kuralları tanımlanabilir. Kullanıcı iki kez onay gönderirse event idempotency uygulanmalıdır. Audit trail kim ve ne zaman onay verdiğini kaydedebilir.
External Event
Workflow harici webhook veya message gelene kadar bekleyebilir. Event correlation key doğru workflow instance'ına yönlendirme sağlar. Aynı event iki kez gelirse duplicate-safe handling gerekir. Timeout halinde alternatif branch çalıştırılabilir. Bu model polling ihtiyacını azaltabilir.
Cron mu Queue mu Workflow Engine mi?
Cron, queue ve workflow engine birbirinin doğrudan alternatifi değildir ve farklı problem katmanlarını çözer. Basit periyodik script için cron yeterli olabilir, tek async iş için queue uygundur ve uzun çok adımlı süreçte workflow engine değer kazanır. Aynı sistemde cron bir workflow başlatabilir, workflow ise queue worker'larına activity gönderebilir. Araç sayısını artırmadan önce gerçek gereksinim belirlenmelidir. Basit işi ağır orchestration platformuna taşımak da yanlış seçim olabilir.
Basit Periyodik Script
Her gece birkaç saniyelik cleanup yapan tek sunuculu script için cron yeterli olabilir. İş idempotent ve izlenebilir olmalıdır. Log ve missed-run alarmı yine eklenmelidir. Script büyüyüp dakikalar veya saatler sürmeye başlarsa queue değerlendirilir. Basitlik gerçek ihtiyaç olduğu sürece avantajdır.
Tek Asenkron Job
Kullanıcı export talebi oluşturduğunda tek background job queue üzerinden çalıştırılabilir. Workflow engine gerektirmek fazla olabilir. Worker retry ve progress state işin ihtiyacını karşılayabilir. Job uzun sürüyorsa chunking eklenebilir. Kullanıcı sonuç hazır olduğunda notification alabilir.
Kritik Background Work
Ödeme, provisioning veya webhook delivery gibi işler güvenilir queue processing gerektirir. Retry, idempotency ve DLQ temel ihtiyaçlardır. Transactional outbox producer tarafını güçlendirebilir. Business deadline alert ile izlenebilir. İş birden fazla uzun adıma yayılıyorsa workflow engine sonraki adım olabilir.
Multi-Step Workflow
Birbiri ardına veya paralel çalışan birçok adım failure recovery'yi zorlaştırır. Manuel state table yazmak yerine workflow engine orchestration sağlayabilir. Her step ayrı retry policy kullanabilir. Parallel branch'ler daha sonra join edilebilir. Workflow state incident sırasında sürecin nerede kaldığını gösterir.
Saatler/Günler Süren Süreç
Uzun süre bekleyen business process için worker process'i açık tutmak verimsizdir. Workflow timer veya wait state durable biçimde saklanabilir. Process ihtiyaç olduğunda yeniden aktif edilir. Deployment ve worker restart state'i kaybettirmez. Bu özellik uzun onboarding veya approval süreçlerinde önemlidir.
Human-in-the-Loop
İnsan onayı, manuel inceleme veya kullanıcı yanıtı bekleyen süreç queue job'dan farklıdır. Job saatlerce active beklemek yerine workflow state'e geçebilir. Event geldiğinde sonraki adım çalışır. Timeout ve reminder schedule aynı workflow içinde tanımlanabilir. Audit trail business süreç kontrolünü kolaylaştırır.
Event-Driven ve Time-Driven İş Akışları Nasıl Birleştirilir?
Gerçek uygulamalarda süreçler yalnızca zaman veya yalnızca event üzerinden ilerlemez. Bir event yeni job başlatabilir, job daha sonra scheduled follow-up oluşturabilir ve timeout süresi dolduğunda başka event üretilebilir. Bu kombinasyon kullanıcı davranışına göre esnek otomasyon sağlar. Delayed job ve durable workflow timer bu geçişleri yönetmekte kullanışlıdır. Her trigger aynı business instance'ı correlation ve idempotency key ile tanıyabilmelidir.
Cron Tetiklemesi
Cron belirli zamanlarda batch veya workflow başlatabilir. Örneğin her gece gün sonu reconciliation süreci tetiklenebilir. Cron bütün kayıtları doğrudan işlememeli ve job'ları queue'ya dağıtabilir. Business date aynı run için idempotency key olabilir. Missed-run kontrolü schedule seviyesinde uygulanmalıdır.
Event Tetiklemesi
Kullanıcı veya external system event oluştuğunda workflow başlatılabilir. Order-created veya document-uploaded örnekleri doğal event trigger'dır. Event consumer mümkün olduğunca hızlı ve idempotent olmalıdır. Ağır processing queue'ya aktarılır. Event ID duplicate delivery için stabil kalmalıdır.
Time Condition
Event geldikten sonra belirli saat koşulu beklenebilir. Örneğin iş mesai saatleri dışında geldiyse sonraki iş günü sabahı processing başlayabilir. Bu logic application scheduler veya workflow timer ile uygulanabilir. Time zone business context içinde açık olmalıdır. DST kullanan bölgelerde local calendar test edilmelidir.
Delayed Job
Delayed job belirli süre sonra işlemeye uygun hale gelir. Password reset reminder veya kısa follow-up için kullanışlıdır. Queue delay'in exact execution time olmadığını unutmamak gerekir. Worker capacity düşükse job daha geç başlayabilir. Deadline önemliyse queue age alert eklenmelidir.
Scheduled Follow-Up
Bir event sonrası üç gün içinde yanıt gelmezse follow-up gönderme ihtiyacı sık görülür. İlk event durable timer veya delayed job oluşturabilir. Yanıt gelirse scheduled follow-up iptal edilmelidir. Cancellation race condition nedeniyle follow-up handler business state'i tekrar kontrol etmelidir. Böylece geç cancellation durumunda yanlış mesaj gönderilmez.
Timeout Event
Workflow belirli süre external event bekleyip gelmezse timeout branch çalıştırabilir. Bu event notification veya escalation job üretebilir. Timeout ile external response aynı anda gelirse race condition oluşabilir. State transition atomic olmalıdır. Yalnızca bir branch'in business side effect üretmesi garanti altına alınmalıdır.
AI Agent'larda Scheduled Job Kullanımı
AI tabanlı otomasyonlarda her agent'ın sürekli açık process olarak çalışması gerekmeyebilir. Periyodik kontrol yapan agent'lar scheduler tarafından belirli aralıklarla başlatılarak yalnızca ihtiyaç olduğunda compute kullanabilir. Bu model raporlama, veri değişikliği kontrolü ve anomaly detection gibi senaryolarda maliyeti düşürebilir. Agent external action üretiyorsa normal background job güvenlik kuralları yine geçerlidir. Permission, idempotency, audit ve timeout olmadan scheduled agent da sıradan otomasyon kadar riskli olabilir.
Heartbeat Pattern
Heartbeat pattern agent'ın belirli aralıklarla yeni iş olup olmadığını kontrol etmesini sağlar. Scheduler kısa bir agent run başlatır. Yapılacak iş yoksa process hızlı biçimde sonlanır. İş varsa queue veya workflow üzerinden devam edilebilir. Heartbeat'in kendisi missed-run monitoring ile izlenmelidir.
Periyodik Veri Kontrolü
Agent belirli veri kaynaklarını periyodik olarak kontrol edip değişiklik varsa aksiyon üretebilir. Her seferinde bütün dataset'i taramak yerine cursor veya last-seen timestamp kullanılabilir. State durable store içinde tutulmalıdır. Aynı kayıt iki kez görülürse idempotency uygulanmalıdır. Data source rate limitlerine uyulmalıdır.
Raporlama
Scheduled agent belirli aralıklarla metrik veya kayıtları özetleyip rapor oluşturabilir. Büyük veri toplama adımı normal worker pipeline ile hazırlanabilir. Agent yalnızca hazır structured data üzerinde analiz yapabilir. Output version, source timestamp ve generation time saklanmalıdır. Hassas veri prompt veya log içinde gereksiz yere taşınmamalıdır.
Anomaly Detection
Periyodik job son metrikleri kontrol edip beklenmeyen sapma olduğunda event üretebilir. Her dakika sürekli agent process çalıştırmak yerine scheduler belirli interval ile kısa kontrol yapabilir. Threshold ve model sonucu false positive üretmemesi için izlenmelidir. Kritik aksiyon otomatik uygulanacaksa human approval veya policy guard gerekebilir. Detection job'ın kendisi de monitoring kapsamına alınmalıdır.
Sürekli Agent Yerine Scheduled Agent
Sürekli açık agent düşük frekanslı görevde gereksiz compute tüketebilir. Scheduled execution yalnızca kontrol gerektiğinde runtime açar. State memory yerine durable storage üzerinden yüklenmelidir. Cold start süresi iş gereksinimine uygunsa bu model maliyet açısından verimlidir. Çok düşük latency event response gerekiyorsa event-driven worker daha uygun olabilir.
Compute Cost Optimizasyonu
Compute cost azaltmak için job frequency gerçek veri değişim hızına göre ayarlanabilir. Her dakika gerekli olmayan kontrol saatlik yapılabilir. Ön filtreleme ucuz kodla yapılır ve yalnızca anlamlı durumda daha maliyetli processing başlatılabilir. Queue batching benzer işleri tek işlemde birleştirebilir. Cost per successful action metriği schedule tuning için yararlı olabilir.
Arka Plan İşlerinde Güvenlik
Background worker kullanıcı arayüzünden görünmediği için güvenlik gereksinimleri daha düşük değildir. Worker database, queue, object storage ve external API credential'larına erişebilir. Bu nedenle dedicated identity ve least privilege temel yaklaşımdır. Queue payload ve loglarda hassas veri mümkün olduğunca azaltılmalıdır. Secret rotation ve network policy normal web servisleri kadar worker altyapısında da uygulanmalıdır.
Dedicated Worker User
Worker process mümkünse kendisine özel düşük yetkili kullanıcı veya service account ile çalışmalıdır. Web application ve worker farklı kaynaklara ihtiyaç duyuyorsa aynı credential'ı paylaşmak gereksiz yetki verir. Dedicated identity audit kayıtlarında hangi process'in işlemi yaptığını da gösterir. Container root user'dan kaçınılabilir. File permission ve secret access buna göre düzenlenmelidir.
Least Privilege
Worker yalnızca işini yapmak için gerekli izinlere sahip olmalıdır. E-posta worker'ın bütün database tablolarını yazabilmesi gerekmeyebilir. Object processing worker yalnızca belirli bucket prefix'ine erişebilir. Permission daraltıldıkça compromised worker'ın etki alanı küçülür. Yetki değişiklikleri audit ve review sürecinden geçmelidir.
Queue Credentials
Queue credential producer ve consumer rollerine göre ayrılabiliyorsa kullanılmalıdır. Producer'ın queue yönetim yetkisine ihtiyacı olmayabilir. Worker yalnızca belirli queue'ları consume edebilir. Credential source code veya image içine gömülmemelidir. Rotation worker restart ve connection handling ile test edilmelidir.
Secret Manager
API key ve database password merkezi secret manager üzerinden yönetilebilir. Worker runtime gerekli secret'a identity bazlı erişir. Secret payload veya job metadata içine kopyalanmaz. Rotation uygulama kodu değiştirmeden yapılabilir. Log sistemi secret değerlerini maskelemelidir.
Network Access
Worker'ın bütün internete veya bütün internal network'e erişmesi her zaman gerekli değildir. Network policy yalnızca gerekli database, broker ve API endpoint'lerine izin verebilir. Compromised worker'ın lateral movement imkanı azalır. External webhook worker için ayrı egress policy uygulanabilir. DNS ve proxy gereksinimleri test edilmelidir.
Payload Encryption
Hassas payload gerekiyorsa transport ve gerekirse application-level encryption değerlendirilebilir. Broker TLS bağlantısı network üzerindeki trafiği korur. At-rest encryption disk snapshot riskini azaltır. Buna rağmen worker processing sırasında plaintext veriyi görecektir. En iyi koruma gereksiz hassas veriyi queue'ya hiç koymamaktır.
Job'lar Hangi Yetkilerle Çalışmalıdır?
Bir scheduled veya background job'ın yetkisi yaptığı iş kadar sınırlı olmalıdır. Root veya geniş database admin rolü kullanmak setup'ı kolaylaştırabilir fakat incident etkisini ciddi biçimde büyütür. Her job türünün hangi database, API ve storage işlemlerine gerçekten ihtiyaç duyduğu çıkarılmalıdır. Farklı queue worker'ları ayrı identity kullanabilir. Yetki modeli kod review kadar production güvenliğinin de parçasıdır.
Root'tan Kaçınmak
Çoğu application job root yetkisine ihtiyaç duymaz. Root ile çalışan script yanlış path veya command nedeniyle bütün host üzerinde değişiklik yapabilir. Dedicated system user daha güvenli bir default'tur. Gerekli tek privileged işlem için dar kapsamlı capability veya ayrı servis düşünülebilir. Root kullanımının gerçekten neden gerekli olduğu dokümante edilmelidir.
Database Role
Worker için ayrı database role belirli tablo ve operation yetkileriyle sınırlanabilir. Read-only rapor worker ile write yapan provisioning worker aynı role ihtiyaç duymaz. Connection string secret manager üzerinden sağlanmalıdır. Row-level security veya schema separation multi-tenant ihtiyaçlarda ek koruma sağlayabilir. Database audit log worker identity üzerinden sorgulanabilir.
API Scope
OAuth veya API token scope değerleri yalnızca worker'ın kullandığı endpoint'leri kapsamalıdır. E-posta gönderim worker'ının hesap yönetim yetkisine ihtiyacı yoktur. Scope daraltmak leaked token etkisini azaltır. Token rotation retry yapan uzun job'ları nasıl etkiliyor test edilmelidir. 401 durumunda sınırsız retry yerine credential alarmı üretilmelidir.
Object Storage Permission
Worker yalnızca gereken bucket ve prefix üzerinde read veya write yetkisi almalıdır. Image processing worker input alanını okuyup output alanına yazabilir. Delete yetkisi gerekmiyorsa verilmemelidir. Signed URL veya workload identity yöntemleri kullanılabilir. Public bucket erişimi background processing kolaylığı için açılmamalıdır.
Per-Queue Worker Identity
Farklı queue worker'larının ayrı identity kullanması blast radius'u küçültür. Billing worker ve marketing worker aynı secret setine ihtiyaç duymaz. Kubernetes service account veya cloud workload identity queue bazlı ayrıştırılabilir. Deployment ve secret yönetimi biraz artar fakat güvenlik sınırı daha açık olur. Özellikle hassas business job'larda bu ayrım değerlidir.
Schedule-as-Code Nedir?
Schedule-as-Code cron, timer veya cloud scheduler tanımlarını elle sunucuda düzenlemek yerine sürümlenebilir configuration olarak yönetme yaklaşımıdır. Schedule değişiklikleri Git history, pull request ve review sürecinden geçebilir. Hangi zamanın ne zaman değiştiği audit edilebilir. Yanlış değişiklik rollback ile geri alınabilir. Production schedule'ların görünmeyen manuel crontab satırlarına dönüşmesini engellemek ekip operasyonunu belirgin biçimde iyileştirir.
Cron Config'i Git'te Tutmak
Cron tanımları repository içinde configuration dosyası olarak saklanabilir. Deployment pipeline dosyayı hedef sisteme kontrollü biçimde uygular. Sunucuda elle yapılan değişiklikler drift kontrolüyle tespit edilebilir. Secret değerler repository içine yazılmamalıdır. Schedule dosyası owner ve açıklama bilgisi de taşıyabilir.
Schedule Versioning
Versioning expression ve time zone değişikliklerinin geçmişini korur. Incident sırasında "bu job ne zaman her beş dakikadan her dakikaya alındı?" sorusu kolayca cevaplanabilir. Commit ile application code version ilişkilendirilebilir. Rollback daha hızlı olur. Schedule migration release note içinde açıkça belirtilmelidir.
Pull Request
Schedule değişikliklerinin pull request üzerinden yapılması ikinci bir kişinin expression'ı görmesini sağlar. Yanlış wildcard veya time zone değişikliği production'a gitmeden yakalanabilir. PR içinde next-run örnekleri otomatik gösterilebilir. Business owner kritik saat değişikliğini onaylayabilir. Infrastructure review checklist kullanılabilir.
Review
Review yalnızca syntax kontrolü değildir. Job duration ile yeni interval çakışıyor mu, downstream kapasite yeterli mi ve missed-run policy doğru mu soruları sorulmalıdır. Büyük frekans artışı maliyet ve database load yaratabilir. Time zone etkisi ayrıca değerlendirilmelidir. Bu tür sorular schedule değişikliğini normal code change kadar görünür hale getirir.
Audit Trail
Git history değişikliğin kim tarafından ve hangi gerekçeyle yapıldığını gösterir. Regulated veya finansal sistemlerde bu kayıt değerlidir. Deployment log hangi commit'in production'a uygulandığını ayrıca kaydedebilir. Manuel emergency change varsa sonradan repository'ye reconcile edilmelidir. Drift uzun süre bırakılmamalıdır.
Rollback
Yanlış schedule hızla çok sayıda job üretebilir. Versioned configuration önceki güvenli ayara geri dönmeyi kolaylaştırır. Rollback yalnızca scheduler config'ini düzeltir, daha önce üretilmiş duplicate job'ları otomatik temizlemez. Queue backlog ayrıca incelenmelidir. Gerekirse belirli scheduler ID geçici olarak disable edilir.
Cron Expression'ları CI/CD'de Test Etmek
Cron expression bir configuration değeri olduğu için test dışında bırakılmamalıdır. Syntax validation, next-run preview ve time zone testleri CI pipeline içinde otomatik yapılabilir. Değişikliğin mevcut job duration ile overlap oluşturup oluşturmadığı bile analiz edilebilir. Deployment sonrası gerçek scheduler state'i ayrıca doğrulanmalıdır. Böylece schedule hataları kullanıcı fark etmeden önce yakalanır.
Syntax Validation
CI kullanılan scheduler'ın gerçek parser'ı veya uyumlu validator ile expression'ı kontrol edebilir. Beş alan ve altı alan farkı bu aşamada yakalanabilir. Unsupported token veya typo deployment'ı durdurabilir. Validation yalnızca regex'e dayanmak yerine mümkünse gerçek library ile yapılmalıdır. Version upgrade parser davranışını değiştirebileceği için testler güncel tutulmalıdır.
Next-Run Preview
PR çıktısında expression'ın sonraki beş veya on çalışma zamanı gösterilebilir. Reviewer niyet ile gerçek sonucu kolayca karşılaştırır. Time zone açık biçimde yanında yazılmalıdır. Ay sonu veya DST sınırı varsa özel test case eklenebilir. Bu basit çıktı yanlış schedule riskini ciddi biçimde azaltır.
Time Zone Testi
Schedule'ın beklenen business time zone ile aynı sonucu verdiği otomatik testle doğrulanabilir. UTC ve Europe/Istanbul gibi bölgeler için örnek timestamp'ler kullanılabilir. DST kullanan kullanıcı bölgelerinde geçiş tarihleri test edilmelidir. Container default time zone'una bağlı testlerden kaçınılmalıdır. Time zone test fixture içinde açıkça tanımlanmalıdır.
Overlap Analysis
Yeni interval job'ın p95 duration değerinden kısa ise CI uyarı verebilir. Bu veri monitoring sisteminden otomatik alınabilir veya config içinde tahmini duration tutulabilir. Overlap izin veriliyorsa policy açıkça belirtilir. Forbid veya lock gerekiyorsa checklist bunu doğrular. Schedule değişikliği kapasite değişikliği olarak da değerlendirilir.
Deployment Sonrası Verification
CI başarılı olsa bile production scheduler'a config'in gerçekten uygulandığı kontrol edilmelidir. Active scheduler listesi, next run ve time zone değerleri doğrulanabilir. Eski duplicate schedule kayıtları aranabilir. İlk gerçek run için temporary deployment monitor oluşturulabilir. Success ping geldiğinde değişiklik doğrulanmış sayılabilir.
Background Job Configuration'ı Kod Olarak Yönetmek
Queue definition, retry policy, DLQ ve concurrency gibi ayarlar production davranışının doğrudan parçasıdır. Bu değerlerin yalnızca dashboard üzerinde elle değiştirilmesi drift ve audit problemi oluşturabilir. Infrastructure veya application configuration içinde sürümlenmesi daha güvenilir yönetim sağlar. Environment'a göre değişen değerler açık override mekanizmasıyla tutulabilir. GitOps yaklaşımı gerçek cluster state ile repository state arasındaki farkı azaltır.
Queue Definition
Queue isimleri, routing ve durability ayarları configuration olarak tanımlanabilir. Producer ile worker aynı contract üzerinden queue adını kullanır. Rename işlemleri migration planıyla yapılmalıdır. Eski worker veya producer bir süre eski queue'yu kullanabilir. Deployment sırası message loss oluşturmamalıdır.
Retry Policy
Maximum attempts, backoff ve retryable error listesi code veya versioned config içinde tutulabilir. Değişiklik PR review'dan geçer. Aynı job type için farklı environment'larda aşırı farklı policy kullanılmaması tercih edilir. Production tuning gerekiyorsa gerekçe commit history'de kalır. Metric sonuçları policy revizyonunu yönlendirebilir.
DLQ
Hangi queue'nun hangi DLQ'ya bağlandığı configuration ile yönetilebilir. Retention ve alert threshold da aynı policy'nin parçasıdır. Yeni queue eklenirken DLQ unutulmaması otomatik validation ile kontrol edilebilir. Owner metadata eklenebilir. Runbook linki de operasyon config'ine dahil edilebilir.
Concurrency
Worker concurrency deployment configuration içinde açık değerdir. Değişiklik downstream capacity ile birlikte review edilmelidir. On worker'dan yüz worker'a geçmek yalnızca application throughput değişikliği değildir. Database pool ve API rate limit etkilenir. Load test sonucu PR açıklamasına eklenebilir.
Worker Resources
CPU ve memory request-limit değerleri worker type'a göre versioned tutulabilir. CPU-heavy ve I/O-heavy worker aynı profile zorlanmamalıdır. OOM veya throttling metrikleri resource tuning için kullanılabilir. Autoscaling maximum değeri resource availability ile uyumlu olmalıdır. Deployment değişiklikleri cost metriğiyle birlikte değerlendirilebilir.
GitOps
GitOps repository state'i desired production configuration olarak kullanır. Controller veya pipeline gerçek ortamı bu state'e yaklaştırır. Elle yapılan değişiklikler drift olarak görünür. Rollback commit üzerinden yapılabilir. Queue ve worker config'in de uygulama kodu kadar kontrollü değişmesini sağlar.
Background Job Observability
Background job sistemi kullanıcı isteğinden bağımsız çalıştığı için görünürlük özellikle önemlidir. Structured logs, metrics, traces ve job history birlikte kullanıldığında hem tek job hem sistem genelindeki sorunlar analiz edilebilir. Yalnızca error log toplamak queue latency veya worker saturation gibi problemleri göstermez. Correlation ID web request ile async execution arasındaki bağı kurar. Error context yeterli fakat güvenli olacak şekilde tasarlanmalıdır.
Structured Logs
Structured log her kayıt için job ID, job type, attempt, tenant ve status gibi alanlar sağlar. Merkezi log sisteminde filtreleme kolaylaşır. Serbest metin içindeki ID'leri regex ile aramak zorunda kalmazsınız. Hassas payload değerleri alanlara eklenmemelidir. Log schema ekip genelinde standartlaştırılabilir.
Metrics
Metrics sistemin zaman içindeki genel davranışını gösterir. Completion rate, failure rate, queue depth ve duration histogram temel örneklerdir. High-cardinality job ID metric label olarak kullanılmamalıdır. Job type ve queue gibi sınırlı cardinality alanları daha uygundur. Dashboard SLO ve capacity kararlarını desteklemelidir.
Traces
Distributed tracing HTTP request'ten enqueue ve worker processing'e kadar async sınırı aşabilir. Producer trace context'i job metadata'sında taşır. Worker consumer span oluşturup downstream API span'larını ekler. Böylece toplam latency'nin queue beklemesinden mi processing'den mi geldiği görülür. Sampling policy yüksek hacimli queue'larda maliyet açısından ayarlanabilir.
Job History
Job history belirli job'ın state transition'larını saklar. Enqueue, started, retry, failed ve completed timestamp'leri incelenebilir. Kullanıcı desteğinde belirli export neden gecikti sorusu bu geçmişle cevaplanabilir. Sınırsız history storage büyütebilir. Retention iş ve destek ihtiyacına göre belirlenmelidir.
Correlation ID
Correlation ID farklı log, trace ve service kayıtlarını tek iş akışında birleştirir. HTTP request producer'a, oradan worker'a aktarılabilir. Bir worker başka job oluşturursa aynı root correlation devam ettirilebilir. Bu değer authorization amacıyla kullanılmamalıdır. Incident incelemesinde arama anahtarı olarak büyük zaman kazandırır.
Error Context
Hata logu sadece exception mesajı değil güvenli operasyon bağlamı içermelidir. Job type, business key, attempt ve dependency adı yararlı alanlardır. PII ve secret değerleri maskelenmelidir. Stack trace merkezi log sisteminde saklanabilir. Error fingerprint benzer hataları gruplayarak root cause analizini hızlandırır.
Background Job İçin İzlenmesi Gereken Metrikler
Background sisteminin sağlığını ölçmek için tek bir metrik yeterli değildir. Enqueued ve completed rate throughput'u, failure ve retry count güvenilirliği, queue depth ve age backlog durumunu gösterir. Processing duration worker performansını, enqueue-to-completion latency ise kullanıcının gerçek bekleme süresini ölçer. DLQ depth başarısız recovery durumlarını görünür kılar. Active worker sayısı sıfıra düştüğünde queue henüz büyümeden alarm üretmek mümkündür.
Enqueued Jobs
Enqueued jobs belirli zaman aralığında sisteme kaç yeni iş girdiğini gösterir. Normal baseline bilinirse beklenmeyen trafik sıçramaları kolay fark edilir. Sıfıra düşmesi producer veya scheduler arızasını da gösterebilir. Job type bazında rate izlemek hangi feature'ın yük oluşturduğunu açıklar. Capacity planning arrival rate trendine dayanabilir.
Completed Jobs
Completed jobs worker sisteminin gerçek throughput'unu gösterir. Enqueue rate completed rate'ten uzun süre yüksekse backlog büyür. Completion metriği success ve terminal skipped durumlarını ayrı tutmalıdır. Deployment sonrası throughput düşüşü performance regression işareti olabilir. Queue bazında takip edilmesi daha anlamlıdır.
Failed Jobs
Failed job rate hem anlık incident hem code quality problemi gösterebilir. Absolute count yanında yüzde oran izlemek trafik değişimlerini normalize eder. Failure reason label düşük cardinality kategorilerle tutulabilir. Belirli dependency hatası yükseliyorsa circuit breaker veya provider incident araştırılır. Kalıcı failure'lar DLQ metriğiyle ilişkilendirilmelidir.
Retry Count
Retry count failure recovery mekanizmasının ne kadar sık devreye girdiğini gösterir. Job'lar sonunda başarılı olsa bile yüksek retry rate downstream instabiliteye işaret edebilir. Retry storm erken bu metrikte görülebilir. Attempt distribution p95 gibi analizler hangi job'ların zorlandığını gösterir. Policy değişikliklerinin etkisi de bu metrik üzerinden ölçülebilir.
Queue Depth
Queue depth bekleyen iş miktarını gösterir. Kısa spike normal olabilir, sürekli growth kapasite problemidir. Threshold queue type'a göre değişmelidir. Bulk queue yüksek depth ile sağlıklı olabilirken critical queue küçük backlog'da bile sorun yaşayabilir. Queue age ile birlikte alarm üretmek daha anlamlıdır.
Queue Age
Queue age en eski waiting job'ın ne kadar süredir beklediğini gösterir. User-visible latency için güçlü bir proxy'dir. Depth düşük olsa bile high age kritik olabilir. Priority starvation bu metrikle görünür hale gelir. SLO doğrudan age threshold üzerinden tanımlanabilir.
Processing Duration
Processing duration worker job'ı aldıktan completion'a kadar geçen süredir. Average yanında p50, p95 ve p99 histogram değerleri izlenmelidir. Yavaşlayan dependency duration'ı yükseltebilir. Code deployment sonrası regression kolayca görülebilir. Timeout değerleri gerçek duration dağılımına göre ayarlanmalıdır.
Enqueue-to-Completion Latency
Bu metrik queue waiting ve processing süresini birlikte ölçer. Kullanıcının async sonuç için gerçek bekleme süresine en yakın göstergelerden biridir. Queue boşken processing regression, worker yetersizken waiting latency yükselir. İki alt metrik ayrı tutulduğunda kök neden daha kolay bulunur. SLO bu uçtan uca süre üzerinden tanımlanabilir.
DLQ Depth
DLQ depth normal recovery ile çözülemeyen job sayısını gösterir. Kritik queue için herhangi bir pozitif değer alarm olabilir. Age ile birlikte en eski unresolved failure görünür hale gelir. Sürekli artış code veya data bug'ı gösterebilir. DLQ cleanup alarmı susturmak için değil problem çözüldükten sonra yapılmalıdır.
Active Workers
Active worker sayısı consumer kapasitesinin mevcut olup olmadığını gösterir. Değer beklenmedik şekilde sıfıra düşerse queue henüz büyümeden alarm verilebilir. Autoscaling kullanılıyorsa desired ve actual worker count birlikte incelenmelidir. Worker healthy görünürken queue consumption yoksa broker connection problemi olabilir. Heartbeat metric bu farkı ortaya çıkarabilir.
Scheduled Job İçin İzlenmesi Gereken Metrikler
Scheduled job monitoring queue worker monitoring'den farklı sinyaller gerektirir. En önemli soru beklenen her schedule'ın gerçekten gerçekleşip gerçekleşmediğidir. Expected runs ve actual runs karşılaştırması missed run tespitini sağlar. Success rate ile duration execution sağlığını, late start ise scheduler veya capacity gecikmesini gösterir. Overlapping run metriği schedule aralığının iş süresiyle uyumsuz hale geldiğini gösterebilir.
Expected Runs
Expected runs cron expression ve time zone üzerinden hesaplanan planlı çalışma sayısıdır. Monitoring bunu gerçek run sayısıyla karşılaştırabilir. Schedule config değiştiğinde expected model de güncellenmelidir. Manuel run'lar ayrı etiketlenebilir. Bu metrik missed-run detection için temel referanstır.
Actual Runs
Actual runs scheduler veya worker tarafından gerçekten başlatılan execution sayısıdır. Expected'dan düşükse missed run, yüksekse duplicate schedule ihtimali vardır. Run business period ve job ID ile tanımlanmalıdır. Tek schedule iki worker execution üretirse fark görünür hale gelir. Manual replay'ler ayrı kategori tutulabilir.
Missed Runs
Missed run beklenen zaman penceresinde actual run oluşmamasıdır. Error log olmadığı için ayrı metric gerekir. Deadline tolerance job type'a göre değişebilir. Kritik daily settlement gibi işler için alarm hemen ilgili ekibe gitmelidir. Missed run nedenleri scheduler health, deployment ve time zone açısından incelenmelidir.
Success Rate
Success rate tamamlanan scheduled run'ların toplam run'a oranıdır. Retry sonrası başarı policy'ye göre ayrıca gösterilebilir. Sürekli yüzde 99 görünmesi tek kritik failure'ın önemini gizlememelidir. Job importance ve deadline bazlı SLO daha anlamlı olabilir. Trend deployment etkisini görmeye yardımcı olur.
Duration
Scheduled job duration zamanla artıyorsa overlap riski oluşabilir. Örneğin her saat çalışan job 50 dakikaya yaklaşmaya başladıysa kapasite sorunu yakındır. p95 duration schedule interval ile dashboard üzerinde karşılaştırılabilir. Data volume growth trendi incelenmelidir. Job chunking veya query optimizasyonu gerekebilir.
Late Start
Late start expected schedule ile gerçek execution başlangıcı arasındaki farktır. Queue üzerinden çalışan scheduled job'da worker backlog bu değeri yükseltebilir. Kubernetes controller veya cloud scheduler gecikmesi de etkili olabilir. Business deadline varsa birkaç dakikalık delay bile kritik olabilir. Alert threshold job SLO'ya göre belirlenmelidir.
Overlapping Runs
Overlapping runs aynı scheduled işin birden fazla instance'ının eş zamanlı çalıştığını gösterir. Bu beklenen değilse hemen araştırılmalıdır. Job duration artışı veya duplicate scheduler sebep olabilir. Lock failure da başka bir ihtimaldir. Overlap business side effect açısından idempotency kontrolüyle birlikte incelenmelidir.
Background Job SLO Nasıl Tanımlanır?
Background job SLO yalnızca "worker ayakta" gibi infrastructure health hedeflerinden oluşmamalıdır. Kullanıcının veya business sürecinin gerçekten beklediği completion süresi ve başarı oranı tanımlanmalıdır. Queue delay, processing time ve terminal failure hedefleri ayrı değerlendirilebilir. Critical job deadline belirli bir saat veya süre olabilir. DLQ threshold ise normal recovery'nin ötesindeki problem seviyesini ölçer.
Completion Success Rate
Belirli zaman penceresinde job'ların yüzde kaçının başarıyla tamamlanması gerektiği tanımlanabilir. Retry sonrası başarı dahil edilip edilmediği açık olmalıdır. Business rejection teknik failure'dan ayrı tutulabilir. Critical job için daha yüksek hedef gerekebilir. SLO error budget operasyon kararlarını destekleyebilir.
Maximum Queue Delay
Maximum queue delay waiting job'ın kabul edilebilecek en uzun bekleme süresidir. Password reset ve bulk report için farklı değerler gerekir. Bu hedef queue-age alert threshold'unu doğrudan belirler. Autoscaling target daha düşük bir seviyede devreye girebilir. Böylece alarm gelmeden capacity artırılmaya çalışılır.
p95 Completion Time
p95 completion time job'ların yüzde 95'inin enqueue'dan completion'a kadar ne kadar sürede bittiğini gösterir. Average latency tail problem'lerini gizleyebilir. p95 kullanıcıların büyük kısmının deneyimini daha iyi yansıtır. Critical workload için p99 da izlenebilir. Job type bazında ayrı histogram gerekir.
Critical Job Deadline
Bazı işler göreceli latency yerine mutlak deadline'a sahiptir. Günlük rapor saat 08.00'de hazır olmalıdır veya settlement belirli kesimden önce bitmelidir. Monitoring bu deadline'a göre status kontrol etmelidir. Job 07.50'de başlamış olsa da 08.05'te bitmesi SLO ihlalidir. Business deadline teknik schedule'dan ayrı metric olmalıdır.
DLQ Threshold
DLQ threshold kaç unresolved failure'ın kabul edilebileceğini tanımlar. Finansal queue için değer sıfır olabilir. Bulk analytics queue küçük geçici DLQ sayısını farklı öncelikle ele alabilir. Count yanında age threshold kullanmak faydalıdır. Tek kritik job günlerce beklememelidir.
Alerting Nasıl Tasarlanmalıdır?
İyi alerting her hatayı yüksek öncelikli bildirim yapmak yerine kullanıcı veya business etkisi oluşan durumları seçer. Worker count zero, artan queue age ve missed scheduled run güçlü sinyallerdir. Failure rate ve DLQ threshold job önemine göre farklı seviyelerde alarm üretebilir. Duration anomaly code veya dependency regression'ı erken yakalayabilir. Her alert owner, runbook ve anlamlı context içermelidir.
Worker Count Zero
Normalde sürekli consumer olması gereken queue'da worker count sıfırsa yeni işler işlenemez. Queue depth henüz sıfırken bile bu durum problem olabilir. Autoscaling scale-to-zero bilerek kullanılıyorsa alarm policy farklı olmalıdır. Desired replicas ile actual active consumers ayrımı yapılabilir. Broker heartbeat doğrudan gerçek consumer sayısını göstermede faydalıdır.
Queue Depth Artışı
Depth tek eşik yerine growth trend üzerinden izlenebilir. Beş dakikada iki katına çıkan queue hızlı incident sinyalidir. Bulk queue için normal daily spike yanlış alarm üretmemelidir. Seasonality veya dynamic threshold değerlendirilebilir. Age metriği alarmın business önemini artırır.
Queue Age
Queue age doğrudan bekleme süresini gösterdiği için kullanıcı etkisine yakındır. Critical job target'ı aşarsa yüksek öncelikli alarm üretilebilir. Bulk queue için daha geniş tolerance kullanılabilir. Age sürekli yükseliyorsa worker kapasitesi arrival rate'e yetişmiyor olabilir. Dashboard active worker ve processing duration ile birlikte gösterilmelidir.
Failure Rate
Tekil failure normal olabilir, fakat oran kısa sürede yükselirse systemic problem vardır. Error type ve dependency bazında breakdown kök nedeni gösterir. Yeni deployment timestamp'i grafik üzerinde işaretlenebilir. Retry sonrası başarı oranı ayrıca izlenmelidir. Alert threshold normal baseline'a göre belirlenmelidir.
DLQ Non-Zero
Kritik queue için ilk DLQ job doğrudan müdahale gerektirebilir. Daha düşük öncelikli queue'larda count veya age threshold kullanılabilir. Alert error fingerprint ve örnek job ID içermelidir. Payload'ın hassas içeriği notification içine konulmamalıdır. Runbook replay öncesinde root cause analizini şart koşmalıdır.
Missed Scheduled Run
Expected schedule geldiği halde run kaydı yoksa normal error log oluşmayabilir. Bu nedenle missed-run alert bağımsız olmalıdır. Deadline tolerance schedule'ın normal gecikmesini hesaba katar. Time zone config ile monitoring calculation aynı kaynaktan beslenmelidir. Scheduler outage hızlı biçimde bu alarm üzerinden fark edilir.
Job Duration Anomaly
Job normalde iki dakika sürerken aniden on dakikaya çıkıyorsa failure oluşmadan kapasite sorunu başlayabilir. Duration anomaly database slowdown, external API latency veya data growth göstergesi olabilir. Historical percentile üzerinden threshold belirlenebilir. Aynı zamanda overlap riski artar. Alert job type ve dependency metric'leriyle ilişkilendirilmelidir.
Distributed Tracing Background Jobs'da Nasıl Kullanılır?
Background job HTTP request'ten ayrı process'te çalıştığı için normal trace zinciri enqueue noktasında kopabilir. Trace context job metadata'sında taşındığında worker consumer span ile aynı uçtan uca akışa bağlanabilir. Enqueue span queue publish süresini, worker span processing süresini ve external API span downstream latency'yi gösterir. Correlation ID log sorguları için tamamlayıcıdır. Trace sampling yüksek hacimli worker sistemlerinde maliyet ve debug ihtiyacına göre ayarlanmalıdır.
HTTP Request Trace
Kullanıcı request'i ilk root trace'i başlatabilir. API validation ve database işlemleri ilk span'ları oluşturur. Job enqueue edildiğinde trace context message metadata içine yazılır. HTTP response döndükten sonra trace daha sonra worker tarafından devam ettirilebilir. Böylece async sınır kullanıcı akışından kopmaz.
Enqueue Span
Enqueue span producer'ın queue publish operasyonunu gösterir. Broker latency veya publish error burada görülebilir. Job type ve queue adı düşük cardinality attribute olarak eklenebilir. Hassas payload trace'e yazılmamalıdır. Publish başarılı olduktan sonra job ID span event olarak kaydedilebilir.
Worker Span
Worker job aldığında consumer veya processing span oluşturur. Queue waiting time ayrı attribute veya span link ile gösterilebilir. Attempt sayısı trace'e eklenebilir. Retry her attempt için ayrı span üretip aynı job context'ine bağlanabilir. Uzun job'larda alt adımlar child span olarak izlenebilir.
Correlation ID
Trace sistemi kullanılamadığı veya sampling nedeniyle trace saklanmadığı durumlarda correlation ID logları birleştirir. Producer aynı ID'yi job payload metadata'sına koyabilir. Worker bütün loglarda bu değeri kullanır. External request header'a uygun correlation değeri eklenebilir. ID herhangi bir secret içermemelidir.
External API Span
Worker'ın downstream HTTP çağrıları ayrı span olarak kaydedilebilir. DNS, connect ve server latency gibi ayrıntılar instrumentation seviyesine göre görülebilir. HTTP status ve retry attempt ilişkilendirilebilir. Token veya request body hassas içerik olarak trace'e eklenmemelidir. Dependency bazında p95 latency worker slowdown nedenini gösterir.
Uçtan Uca İş Akışı
Uçtan uca trace kullanıcı request'inden background completion'a kadar bütün latency dağılımını görmeyi sağlar. Queue waiting, worker processing ve external API süreleri ayrıştırılabilir. "Export neden 20 dakika sürdü?" sorusunun cevabı ölçülebilir hale gelir. Multi-job fan-out akışlarında span links kullanılabilir. Trace ile metric ve log birlikte incident çözüm süresini kısaltır.
Background Worker Performansı Nasıl Optimize Edilir?
Worker performansı yalnızca concurrency değerini yükselterek optimize edilmez. Prefetch, batch processing, database connection pool, queue sharding ve payload boyutu birlikte throughput'u etkiler. Önce profiling ve metrics ile gerçek bottleneck bulunmalıdır. CPU, network, database veya broker hangisi sınırsa optimizasyon o katmana odaklanmalıdır. Her değişiklik p95 latency, failure rate ve resource cost ile birlikte ölçülmelidir.
Concurrency
Concurrency artırmak I/O-bound işlerde throughput'u yükseltebilir. Fakat database connection veya external rate limit doygunluğa ulaştığında daha fazla concurrency zarar verir. Load test farklı değerleri karşılaştırmalıdır. Total cluster concurrency pod sayısıyla birlikte hesaplanmalıdır. Autoscaling maximum değeri bu sonuçlara göre seçilebilir.
Prefetch
Prefetch worker'ın önceden kaç job rezerve ettiğini belirler. Yüksek prefetch broker round-trip sayısını azaltabilir. Job duration değişkense fairness bozulabilir. Uzun job alan worker'ın ek işleri tutması diğer consumer'ların boş kalmasına yol açabilir. Metric'lerle uygun denge bulunmalıdır.
Batch Processing
Benzer küçük job'ları batch halinde işlemek database ve network round-trip sayısını azaltabilir. Örneğin yüz analytics event tek insert ile yazılabilir. Batch büyüklüğü latency ve memory ile dengelenmelidir. Bir item fail ettiğinde bütün batch'in retry davranışı tasarlanmalıdır. Partial error desteği varsa yalnızca sorunlu item yeniden işlenebilir.
Connection Pool
Her job yeni database connection açarsa latency ve kaynak maliyeti artar. Worker process kontrollü connection pool kullanabilir. Pool size concurrency'den düşükse job'lar connection bekleyebilir. Çok yüksek pool total database connection sınırını aşabilir. Cluster genelindeki toplam worker sayısı üzerinden hesap yapılmalıdır.
Queue Sharding
Tek queue veya broker partition throughput sınırına ulaştığında workload sharding değerlendirilebilir. Tenant, region veya job key üzerinden ayrı queue partition oluşturulabilir. Sharding routing ve monitoring yönetimini zorlaştırır. Gerçek bottleneck kanıtlanmadan uygulanmamalıdır. Rebalancing ve hot shard riski ayrıca düşünülmelidir.
Payload Boyutu
Büyük payload broker memory ve network maliyetini yükseltir. Serialization süresi worker CPU'sunu da kullanır. Object ID ve storage reference payload'u küçültür. Maximum message size uygulama seviyesinde enforce edilebilir. Metric olarak payload byte histogram tutmak büyümeyi erken gösterir.
Backpressure Nedir?
Backpressure producer'ın job üretme hızının worker tüketim kapasitesini uzun süre aştığı durumda yeni yükü kontrol etme mekanizmasıdır. Queue bir süre tampon görevi görür fakat sonsuza kadar büyüyemez. Rate limit, producer throttling, worker scaling ve gerektiğinde load shedding birlikte kullanılabilir. Sistem hangi job'ın kabul edilmeye devam edeceğini business önceliğine göre seçmelidir. Backpressure olmadan queue yalnızca kapasite probleminin görünmesini geciktirir.
Producer Worker'dan Hızlı
Producer saniyede 1000 job üretirken worker yalnızca 700 job bitiriyorsa her saniye 300 job backlog oluşur. Kısa spike kabul edilebilir, sürekli durum sürdürülemez. Queue growth rate bunu açıkça gösterir. Capacity artırılabilir veya producer hızı sınırlandırılabilir. İş modeli gereksiz job üretimini azaltacak şekilde de değiştirilebilir.
Queue Growth
Sürekli büyüyen queue sonunda broker memory, disk veya retention sınırlarını zorlar. Queue age yükselerek kullanıcı gecikmesini artırır. Alarm yalnızca mutlak depth değil growth rate üzerinden de kurulmalıdır. Yeni deployment sonrası growth değişimi performance regression gösterebilir. Recovery plan backlog'u güvenli rate ile eritmelidir.
Rate Limit
Rate limit sistemin belirli sürede kabul veya işleme yapabileceği job sayısını sınırlar. Downstream service kapasitesine göre worker tarafında uygulanabilir. Producer tarafındaki rate limit gereksiz queue büyümesini önler. Tenant bazlı limiter noisy neighbor etkisini azaltır. Limit aşımında reject, delay veya lower priority politikası seçilebilir.
Producer Throttling
Producer throttling queue age yükseldiğinde yeni job üretim hızını düşürür. Batch process daha küçük hızda enqueue yapabilir. User-facing request ise "işlem yoğun, daha sonra deneyin" veya bekleme mesajı verebilir. Kritik job'lar throttling dışında tutulabilir. Feedback signal güvenli ve gecikmesiz olmalıdır.
Worker Scaling
Backlog geçici ve downstream capacity uygunsa worker sayısını artırmak iyi çözümdür. Autoscaler queue depth veya age kullanabilir. Ancak scaling sonsuz değildir. Database ve API rate limit üst sınır oluşturur. Maximum worker değeri güvenli kapasiteye göre sınırlandırılmalıdır.
Load Shedding
Load shedding sistemin kapasitesini korumak için bazı düşük öncelikli işleri bilinçli olarak reddetmesi veya ertelemesidir. Her job'ın aynı business değeri olmadığı durumlarda faydalıdır. Optional analytics veya cache refresh kritik transaction'lardan önce feda edilebilir. Bu davranış sessiz veri kaybı olmamalıdır. Shed edilen iş metric ve audit kayıtlarında görünmelidir.
Rate Limiting Background Jobs'da Nasıl Kullanılır?
Background worker concurrency yüksek olduğunda harici API veya ortak database kısa sürede aşırı yüklenebilir. Rate limiting belirli zaman aralığında izin verilen işlem sayısını kontrol eder. Global, tenant ve queue bazlı limitler farklı fairness ihtiyaçlarını karşılayabilir. HTTP 429 alındığında provider Retry-After bilgisi varsa policy buna uyum sağlamalıdır. Rate limiter distributed worker instance'ları arasında ortak toplamı ölçebilmelidir.
Third-Party API Limitleri
Harici API'ler saniye, dakika veya hesap bazında request limitleri uygulayabilir. Worker sayısını artırmak bu limitleri değiştirmez. Provider quota bilgisi merkezi limiter configuration'a yansıtılmalıdır. Limit değişirse code deployment gerektirmeden config güncellenebilir. 429 oranı capacity ve limiter doğruluğu için izlenmelidir.
Global Rate Limit
Global rate limit bütün worker instance'ların toplam trafiğini sınırlar. Her pod kendi başına saniyede 100 request gönderirse on pod toplam 1000 request oluşturabilir. Provider limiti 200 ise local limiter yeterli değildir. Merkezi Redis token bucket veya broker özelliği kullanılabilir. Limiter failure durumundaki davranış da tasarlanmalıdır.
Per-Tenant Rate Limit
Multi-tenant sistemde tek müşteri bütün worker kapasitesini tüketmemelidir. Tenant ID üzerinden ayrı limit uygulanabilir. Büyük tenant için daha yüksek plan quota tanımlanabilir. Critical tenant traffic bile global dependency limitini aşmamalıdır. Fairness metriği tenant bazında queue latency gösterebilir.
Per-Queue Rate Limit
Farklı queue'lar aynı external API'yi kullanıyorsa queue bazlı quota paylaşımı yapılabilir. Bulk queue daha düşük rate, critical queue daha yüksek reserved rate alabilir. Toplam yine global limit altında tutulmalıdır. Configuration sade tutulmalı ve operasyon ekibi gerçek effective rate'i görebilmelidir. Yanlış nested limiter beklenenden çok düşük throughput oluşturabilir.
HTTP 429
429 worker'ın provider limitine ulaştığını gösterir. Job immediate retry yapmamalıdır. Retry-After veya bilinen reset time kullanılabilir. Metric olarak 429 oranı alert veya autoscaling sınırı için sinyal olabilir. Sürekli 429 daha fazla worker yerine daha sıkı rate limiting gerektirir.
Retry-After
Retry-After provider'ın ne kadar beklenmesi gerektiğini belirtebilir. Worker bu süreyi backoff hesabında öncelikli kullanabilir. Çok sayıda job aynı Retry-After süresini alırsa jitter eklemek faydalıdır. Header formatı HTTP standardına uygun parse edilmelidir. Deadline bu bekleme süresini aşıyorsa terminal failure veya alternatif işlem gerekebilir.
Multi-Tenant Background Jobs
Multi-tenant sistemde background job'lar yalnızca toplam throughput açısından değil müşteriler arasında adalet açısından da yönetilmelidir. Tek büyük tenant queue'yu doldurduğunda küçük müşterilerin kritik işleri gecikmemelidir. Tenant ID payload metadata'sında güvenli biçimde taşınabilir ve rate limit uygulanabilir. Queue partitioning veya fair scheduling kullanılabilir. Priority müşterinin plan seviyesine göre ayarlansa bile güvenlik izolasyonu ayrı kontrol edilmelidir.
Tenant ID
Her job hangi tenant'a ait olduğunu açık biçimde taşımalıdır. Worker database query'lerinde tenant scope'u zorunlu kullanmalıdır. Tenant ID authorization yerine tek başına güvenlik kontrolü değildir. Log ve metric'lerde high-cardinality riski nedeniyle tenant label dikkatli kullanılmalıdır. Incident için gerektiğinde sampled veya audit log üzerinden arama yapılabilir.
Fairness
Fairness bütün tenant'ların makul süre içinde worker kapasitesine erişebilmesini sağlar. Saf FIFO büyük tenant burst'ünde küçük müşterileri bekletebilir. Weighted fair queue veya per-tenant concurrency limiti kullanılabilir. Business plan farklılıkları varsa weight değişebilir. Fairness metric'i tenant queue age dağılımına bakabilir.
Noisy Neighbor
Noisy neighbor tek tenant'ın aşırı job üretip ortak kaynakları tüketmesidir. Database, external API ve worker concurrency aynı anda etkilenebilir. Tenant rate limit ve quota problemi sınırlar. Büyük batch job ayrı queue'ya taşınabilir. Alarm tenant traffic normal baseline'ın çok üzerine çıktığında tetiklenebilir.
Tenant Rate Limit
Per-tenant rate limit belirli müşteri için izin verilen job veya API işlem hızını sınırlar. Limit subscription plan veya downstream contract'a bağlı olabilir. Burst kapasitesi ayrıca tanımlanabilir. Tenant queue büyürse kullanıcıya tahmini bekleme süresi gösterilebilir. Limit değişiklikleri audit edilmelidir.
Queue Partitioning
Tenant veya tenant grubu bazlı queue partitioning izolasyonu artırabilir. Çok fazla tenant için ayrı fiziksel queue operasyon yükü yaratır. Hash-based partition veya birkaç service tier queue daha dengeli olabilir. Hot partition monitoring ile tespit edilmelidir. Rebalancing iş sırasında duplicate üretmemelidir.
Priority
Tenant priority business sözleşmesine göre farklılaştırılabilir. Bununla birlikte yüksek priority müşteriler düşük priority tenant'ları tamamen aç bırakmamalıdır. Reserved capacity veya maximum wait policy fairness sağlar. Critical system job tenant priority'den ayrı daha yüksek sınıfta olabilir. Priority kuralları şeffaf ve ölçülebilir olmalıdır.
Backup İşleri Cron ile Nasıl Tasarlanmalıdır?
Backup işi yalnızca belirli saatte dump komutu çalıştırmaktan daha fazla adıma sahiptir. Schedule, overlap lock, dosya bütünlüğü, upload, verification ve restore test birlikte düşünülmelidir. Backup başarılı logu yalnızca command exit code'a dayanmamalıdır. Üretilen dosyanın gerçekten okunabilir ve restore edilebilir olduğu düzenli olarak doğrulanmalıdır. Failure alert kritik olmalı çünkü çalışmayan yedek çoğu zaman ancak ihtiyaç anında fark edilirse çok geç olur.
Schedule
Backup schedule düşük trafik zamanı ve recovery point objective gereksinimine göre belirlenmelidir. Günlük backup RPO ihtiyacını karşılamıyorsa daha sık snapshot gerekebilir. Time zone açık biçimde tanımlanmalıdır. Schedule missed-run monitoring ile izlenmelidir. Bir backup kaçırıldığında catch-up politikasının ne olduğu bilinmelidir.
Lock
Önceki backup bitmeden yenisinin başlaması disk ve database yükünü artırabilir. File veya distributed lock overlap'i önleyebilir. Lock TTL job'ın gerçek duration değerine göre ayarlanmalıdır. Backup idempotency lock'ın yerini tamamen tutmaz. Lock acquisition failure log ve metric olarak görünmelidir.
Backup
Backup step gerçek snapshot veya dump işlemini üretir. Tool exit code kontrol edilmelidir. stderr loglanmalı ve secret değerleri maskelenmelidir. Büyük database için streaming veya incremental yöntemler değerlendirilebilir. Backup işlemi production query latency'sini etkiliyorsa replica veya managed snapshot kullanımı düşünülebilir.
Checksum
Checksum dosyanın upload veya storage sırasında bozulup bozulmadığını kontrol etmeye yardımcı olur. Backup oluşturulduktan sonra hash hesaplanabilir. Upload sonrasında aynı değer doğrulanabilir. Checksum restore edilebilirliği tek başına kanıtlamaz. Yine de transfer integrity için faydalı bir kontrol katmanıdır.
Upload
Backup local diskte kalırsa host kaybında backup da kaybolabilir. Güvenli object storage veya ayrı backup location kullanılmalıdır. Upload encryption ve least-privilege credentials ile yapılmalıdır. Büyük dosya multipart veya resumable transfer kullanabilir. Upload tamamlanmadan local cleanup yapılmamalıdır.
Verification
Verification backup metadata ve dosya bütünlüğünün beklenen durumda olduğunu kontrol eder. Boyut sıfır veya olağan dışı düşükse failure sayılabilir. Checksum doğrulanabilir. Database dump için restore test daha güçlü kanıttır. Success ping verification tamamlandıktan sonra gönderilmelidir.
Failure Alert
Backup failure yüksek öncelikli alarm olmalıdır. Tek failure bile RPO penceresini etkileyebilir. Alert son başarılı backup zamanı ve mevcut RPO riskini göstermelidir. Retry kontrollü yapılabilir. Sürekli failure normal operasyon bildirimi içinde kaybolmamalıdır.
Restore Test
Yedeğin gerçek değeri restore edilebildiğinde ortaya çıkar. Düzenli otomatik restore testleri ayrı ortamda uygulanabilir. Database açılıp temel integrity query'leri çalıştırılabilir. Test sonucu metric ve audit log olarak saklanmalıdır. Backup success ile restore success ayrı SLO olarak takip edilebilir.
E-posta Gönderim İşleri Background Worker ile Nasıl Tasarlanır?
E-posta gönderimi kullanıcı request'inden ayrılması en faydalı background işlerden biridir. Web uygulaması küçük bir notification job üretir ve worker provider çağrısını kontrollü biçimde yapar. Idempotency duplicate mesajları azaltır, provider retry ve rate limit mekanizmaları geçici sorunları yönetir. Bounce handling e-postanın gerçekten teslim edilip edilmediğini ayrı event olarak ele alır. Password reset gibi kritik mesajlar bulk kampanya e-postalarından farklı priority veya queue kullanmalıdır.
Queue
E-posta job'ı recipient ID, template ID ve business event ID gibi küçük payload ile queue'ya eklenebilir. Tam HTML veya büyük attachment queue mesajına koymak yerine storage reference kullanılabilir. Worker send time'da gerekli kullanıcı bilgisini okuyabilir. Sensitive data minimization uygulanmalıdır. Queue age user-visible notification latency'yi gösterir.
Idempotency
Aynı business event için yalnızca bir e-posta gönderilmesi gerekiyorsa unique notification key üretilebilir. Database delivery table key üzerinde unique constraint taşıyabilir. Worker ikinci execution'da mevcut delivery state'i görür. Provider idempotency destekliyorsa aynı key external request'te de kullanılabilir. Timeout sonrası duplicate gönderim riski böylece azalır.
Provider Retry
Network timeout ve provider 5xx durumları kontrollü retry alabilir. Validation veya invalid recipient gibi kalıcı hata tekrar edilmemelidir. Backoff ve jitter outage sırasında trafik dalgasını azaltır. Attempts tükendiğinde job failed veya DLQ state'e alınır. Provider health metric alarm sistemine bağlanabilir.
Rate Limit
E-posta provider hesap veya domain bazında gönderim limiti uygulayabilir. Worker global limiter ile toplam request rate'i kontrol eder. Bulk kampanya düşük priority queue'dan kademeli gönderilebilir. Transactional e-posta için reserved capacity ayrılabilir. 429 response Retry-After bilgisiyle yönetilmelidir.
Bounce Handling
Provider e-posta kabul etse bile daha sonra bounce oluşabilir. Webhook event'leri delivery state'i güncelleyebilir. Hard bounce alan adresler tekrar tekrar gönderimden çıkarılabilir. Webhook consumer event ID üzerinden idempotent olmalıdır. Bounce rate sender reputation ve veri kalitesi açısından izlenmelidir.
Priority
Password reset, login verification ve güvenlik bildirimi yüksek öncelik taşıyabilir. Marketing campaign job'ları aynı worker capacity'yi tüketmemelidir. Ayrı queue veya reserved worker pool kullanılabilir. Priority policy business türüne göre merkezi tanımlanmalıdır. Kullanıcı etkisi queue age SLO ile ölçülmelidir.
Webhook Delivery Worker'ı Nasıl Tasarlanır?
Webhook delivery sistemi müşterinin endpoint'ine event gönderir ve dış network koşullarına dayanıklı olmalıdır. Payload, signature, timeout, retry ve delivery history temel parçalarıdır. Receiver geçici olarak kapalı olabilir ve worker exponential backoff ile yeniden deneyebilir. Her event stabil event ID taşımalıdır. Attempts tükendiğinde DLQ veya failed delivery state kullanıcı tarafından görülebilir.
Event Payload
Webhook payload küçük, versioned ve dokümante edilmiş olmalıdır. Event ID ve event type açık alanlar olarak bulunabilir. Hassas veri gereksiz yere gönderilmemelidir. Schema değişiklikleri backward-compatible yapılmalıdır. Receiver'ın aynı event'i tekrar alabileceği dokümantasyonda belirtilmelidir.
Signature
Webhook signature receiver'ın payload'un gerçekten sizin sisteminizden geldiğini doğrulamasını sağlar. Shared secret veya uygun cryptographic signing yöntemi kullanılabilir. Timestamp replay attack riskini azaltmaya yardımcı olur. Secret rotation iki anahtarın kısa süre birlikte geçerli olmasını gerektirebilir. Signature hesaplama canonical payload üzerinde yapılmalıdır.
Timeout
Webhook endpoint'e sonsuz süre beklenmemelidir. Connect ve response timeout kısa tutulabilir. Receiver ağır processing yapıyorsa kendi tarafında queue kullanıp hızlı 2xx dönmelidir. Timeout ambiguous delivery oluşturabilir çünkü endpoint request'i işlemiş olabilir. Event ID receiver idempotency'sini destekler.
Retry
Network ve geçici 5xx durumları retry için uygundur. 4xx response çoğu zaman permanent failure olabilir, fakat 429 ayrı ele alınmalıdır. Maximum attempts ve total retry window müşteriye açıkça dokümante edilebilir. Her attempt delivery history'ye yazılır. Manuel replay gerektiğinde stabil event ID korunabilir.
Exponential Backoff
İlk retry kısa, sonraki retry'ler giderek daha uzun aralıklarla yapılabilir. Bu davranış down olan müşteri endpoint'ine sürekli istek göndermeyi önler. Jitter aynı anda başarısız çok sayıda webhook'un geri dönüşünü dağıtır. Maximum delay business freshness gereksinimiyle sınırlanır. Retry schedule kullanıcı panelinde gösterilebilir.
DLQ
Attempts tükendiğinde webhook event failed delivery veya DLQ state'e alınabilir. Müşteri endpoint'i düzelttikten sonra selective replay yapılabilir. Payload ve attempt history incelenebilir olmalıdır. Replay sırasında aynı event ID kullanılmalıdır. DLQ age operasyon ve müşteri desteği için izlenmelidir.
Delivery History
Delivery history event'in hangi URL'ye, ne zaman ve hangi response code ile gönderildiğini kaydeder. Response body tamamen saklanacaksa hassas veri riski değerlendirilmelidir. Kullanıcı panelinde son birkaç attempt görülebilir. Support ekibi sorun çözmek için bu geçmişten yararlanır. Retention policy storage maliyetini sınırlar.
Raporlama İşleri Nasıl Zamanlanır?
Raporlama işleri cron ile doğrudan ağır SQL çalıştırmak yerine scheduler, queue ve worker katmanlarına ayrıldığında daha güvenilir olur. Cron veya başka scheduler belirli saatte report job üretir. Büyük veri farklı worker'lara fan-out edilip sonuçlar birleştirilebilir. Final dosya object storage üzerinde saklanır ve kullanıcıya notification gönderilir. Business period idempotency key olarak kullanıldığında aynı günlük veya aylık rapor duplicate üretmez.
Cron Trigger
Cron report generation başlangıcını belirli business saatinde tetikler. Cron yalnızca küçük enqueue işlemi yapmalıdır. Report date ve tenant ID job payload'a eklenebilir. Missed cron run ayrı monitoring ile tespit edilir. Time zone raporun hangi güne ait olduğunu doğrudan etkileyebilir.
Queue
Report job queue'da worker capacity olana kadar bekleyebilir. Critical report için ayrı queue veya priority kullanılabilir. Queue age report deadline ile ilişkilendirilmelidir. Büyük report job chunk'lara bölünebilir. Queue durability business önemine göre yapılandırılmalıdır.
Fan-Out
Çok büyük rapor farklı data partition'ları için paralel job'lara ayrılabilir. Her child job kendi bölümünü üretir. Parent workflow bütün child completion'ları takip eder. Partial failure yalnızca ilgili chunk'ın retry edilmesini sağlar. Downstream database load fan-out concurrency ile sınırlanmalıdır.
Report Generation
Worker gerekli veriyi okuyup CSV, Excel veya PDF gibi output oluşturabilir. Büyük dosya memory'ye tamamen alınmadan streaming yöntemiyle yazılabilir. Temporary dosya yönetimi worker disk limitine göre yapılmalıdır. Output metadata ve checksum kaydedilebilir. Generation code business date'e göre deterministik olursa idempotency kolaylaşır.
Object Storage
Üretilen rapor worker local diskinde kalmamalıdır. Object storage durable erişim sağlar. User-specific access control veya signed URL kullanılabilir. Retention rapor türüne göre uygulanmalıdır. Aynı report key versioning veya overwrite policy ile yönetilebilir.
Notification
Rapor tamamlandığında ayrı notification job oluşturulabilir. Böylece report worker e-posta provider gecikmesini beklemez. Notification business key duplicate gönderimi önler. Kullanıcı uygulamayı açtığında status store üzerinden dosyaya erişebilir. Notification failure raporun kendisini failed saymak zorunda değildir ve ayrı state olarak izlenebilir.
Veri Temizleme ve Retention Job'ları
Retention job'ları eski kayıtları güvenli biçimde silmek için düzenli çalışır. Büyük tabloda milyonlarca kaydı tek transaction içinde silmek database üzerinde ciddi lock ve replication yükü oluşturabilir. Batch size ile küçük parçalar halinde ilerlemek daha güvenlidir. Silme koşulu idempotent olmalı ve audit gereksinimleri karşılanmalıdır. Kritik data delete işlemleri backup ve compliance politikalarıyla birlikte tasarlanmalıdır.
Daily Cleanup
Her gün düşük trafik saatinde cleanup schedule edilebilir. Ancak job'ın illa gece çalışması gerekip gerekmediği workload'a göre belirlenmelidir. Continuous small cleanup bazı sistemlerde büyük gece batch'inden daha dengeli olabilir. Missed run oluşursa sonraki job eski kayıtları yine bulabilir. Bu doğal idempotency cleanup işlerinde avantaj sağlar.
Batch Size
Batch size her transaction'da kaç kayıt silineceğini belirler. Küçük batch lock süresini ve replication lag'i azaltır. Çok küçük batch ise fazla round-trip oluşturur. Database metric'leri üzerinden uygun değer bulunabilir. Job her batch arasında kısa delay ekleyerek online workload'u koruyabilir.
Safe Delete
Silme query'si net retention cutoff ve doğru tenant scope kullanmalıdır. Yanlış WHERE koşulu geri dönüşü zor veri kaybına yol açabilir. Dry-run count veya sample query production öncesinde doğrulanabilir. Kritik tabloda soft delete veya archive aşaması kullanılabilir. Delete job least-privilege database role ile çalışmalıdır.
Idempotency
"Cutoff'tan eski kayıtları sil" işlemi doğal olarak tekrar çalıştırıldığında aynı nihai state'e yaklaşır. İlk job yarıda kaldıysa ikinci run kalan kayıtları temizleyebilir. Bu özellik retry'yi kolaylaştırır. Yine de audit event aynı kayıt için iki kez üretilmemelidir. Side effect'ler ayrı idempotency key ile korunabilir.
Database Lock
Büyük delete transaction table veya index üzerinde uzun lock oluşturabilir. Batch processing lock süresini azaltır. Query plan ve index retention column için optimize edilmelidir. Replication lag ve vacuum davranışı database ürününe göre izlenmelidir. Maintenance job online trafiğin SLO'sunu bozmamalıdır.
Audit
Hangi retention policy'nin kaç kayıt sildiği audit açısından değerli olabilir. Tek tek hassas row içeriği loglanmak zorunda değildir. Job ID, cutoff, count ve duration yeterli olabilir. Compliance gereksinimi varsa approval veya policy version kaydedilebilir. Cleanup config schedule-as-code ile sürümlenebilir.
Background Job Sistemlerinde En Sık Yapılan Hatalar
Background job altyapısında sorunların büyük bölümü kullanılan queue teknolojisinden değil temel tasarım kararlarından kaynaklanır. Fire-and-forget çağrıyı queue sanmak, uzun işi cron içine koymak ve idempotency'yi atlamak ilk sıradadır. Infinite retry ve immediate retry failure anında sistemi daha da zorlar. DLQ, monitoring ve graceful shutdown eksikliği sorunların geç fark edilmesine neden olur. Time zone, overlap ve duplicate scheduler gibi ayrıntılar küçük sistemde görünmese de production trafiğinde belirgin hale gelir.
Fire-and-Forget'i Queue Sanmak
Web process içinde async fonksiyon başlatıp response döndürmek durable background job değildir. Process restart olursa iş kaybolabilir. Job state ve retry mekanizması bulunmaz. Gerçek queue message'ı worker lifecycle'dan bağımsız saklar. Business önemli işlerde fire-and-forget yerine durable enqueue kullanılmalıdır.
Cron İçinde Saatler Süren İş Yapmak
Uzun script overlap, deployment ve recovery problemleri oluşturur. Cron yalnızca zamanı tetiklemeli, ağır iş queue'ya taşınmalıdır. Job chunking ile küçük birimlere bölünebilir. Worker concurrency bağımsız ölçeklenebilir. Cron failure ve missed run ayrıca izlenmelidir.
Job'ları Idempotent Tasarlamamak
At-least-once delivery duplicate execution oluşturabilir. Idempotency yoksa retry double payment veya duplicate notification üretebilir. Business key ve unique constraint kullanılmalıdır. External API idempotency özellikleri değerlendirilmelidir. Failure injection testleri aynı job'ı iki kez çalıştırmalıdır.
Infinite Retry
Sonsuz retry permanent failure'ı asla çözmez. Queue kaynaklarını tüketir ve log gürültüsü oluşturur. Maximum attempts ile terminal state belirlenmelidir. DLQ root cause incelemesi sağlar. Retry budget dependency outage sırasında sistemi korur.
Immediate Retry
Hata aldıktan milisaniye sonra tekrar aynı çağrıyı yapmak çoğu geçici arızada faydasızdır. Downstream servis hâlâ bozuk olabilir. Backoff ve jitter kullanılmalıdır. 429 durumunda Retry-After takip edilmelidir. Immediate retry yalnızca çok özel ve ölçülmüş senaryolarda tercih edilmelidir.
DLQ Kullanmamak
Attempts tükendiğinde job'ın nerede tutulacağı belli değilse failure kaybolabilir. DLQ terminal sorunları görünür hale getirir. Payload ve error context güvenli biçimde saklanabilir. Owner ve replay prosedürü tanımlanmalıdır. Her queue için DLQ şart olmayabilir, fakat kritik işlerde güçlü bir araçtır.
DLQ'yu İzlememek
DLQ oluşturup alert eklememek başarısız işleri yalnızca başka yere taşır. Depth ve age monitoring gerekir. Error type aggregation root cause bulmayı kolaylaştırır. Non-zero critical DLQ alarm üretebilir. Düzenli review tekrar eden sistem sorunlarını ortaya çıkarır.
Bütün Job'ları Tek Queue'ya Koymak
Başlangıçta tek queue normaldir, fakat farklı SLA ve resource profilleri büyüdükçe birbirini etkiler. CPU-heavy job critical e-posta işini geciktirebilir. Dedicated queue ve worker pool izolasyon sağlar. Yine de gereksiz yüzlerce queue oluşturulmamalıdır. Ayrım gerçek iş gereksinimine dayanmalıdır.
Büyük Payload Taşımak
Queue içinde büyük dosya veya domain object taşımak broker kaynaklarını tüketir. Object storage reference kullanılabilir. Payload versioning daha kolay hale gelir. PII minimization güvenliği artırır. Maximum payload size otomatik doğrulanabilir.
Graceful Shutdown Yapmamak
Worker deployment sırasında aniden öldürülürse active job tekrar teslim edilebilir. SIGTERM handler yeni iş almayı durdurmalıdır. In-flight job için completion süresi tanınmalıdır. Hard kill yine mümkün olduğu için idempotency korunur. Shutdown testleri release öncesinde yapılmalıdır.
Queue Depth İzlememek
Worker ayakta görünse bile processing kapasitesi yetersiz olabilir. Queue depth ve growth rate backlog'u gösterir. Age kullanıcı etkisini daha iyi açıklar. Alert threshold job type'a göre belirlenmelidir. Capacity plan düzenli gözden geçirilmelidir.
Time Zone'u Görmezden Gelmek
Cron expression tek başına gerçek çalışma saatini söylemez. Server, container ve scheduler time zone farklı olabilir. Business time zone açıkça tanımlanmalıdır. Schedule testleri next-run timestamp göstermelidir. DST kullanan bölgeler ayrıca test edilmelidir.
Overlap Kontrolü Yapmamak
Job duration schedule interval'ı aşabilir. Önceki run bitmeden yenisi başladığında duplicate processing ve resource spike oluşur. Lock veya concurrency policy kullanılabilir. Worker idempotency yine gereklidir. Overlapping runs ayrı metric olarak izlenebilir.
Aynı Scheduler'dan Birden Fazla Instance Çalıştırmak
Bazı scheduler sistemleri aynı schedule için birden fazla aktif instance olduğunda duplicate job üretir. Worker gibi scheduler'ı doğrudan horizontal scale etmek yanlış olabilir. Leader election veya tek aktif scheduler modeli kullanılmalıdır. Schedule enqueue business key ile deduplicate edilebilir. Deployment sırasında eski ve yeni scheduler overlap penceresi test edilmelidir.
Production-Ready Cron Job Checklist
Production cron job yalnızca doğru expression yazılmış bir komut değildir. Schedule, execution, safety ve monitoring katmanlarının birlikte kontrol edilmesi gerekir. Aşağıdaki başlıklar yeni cron görevini yayına almadan önce kısa bir operasyon review'ü olarak kullanılabilir. Her maddeye verilen cevap configuration veya runbook içinde kaydedildiğinde sonraki bakım kolaylaşır. Özellikle time zone, idempotency ve missed-run alert eksikleri production'da en pahalı sürprizlere dönüşebilir.
Schedule
Schedule kontrolünde expression'ın teknik olarak geçerli olması tek başına yeterli değildir. İşin hangi business saatine göre çalışacağı, bir önceki instance devam ederken ne olacağı ve kaçırılan run'ın nasıl telafi edileceği bilinmelidir. Next-run değerleri test aracıyla doğrulanmalıdır. Schedule interval gerçek job duration dağılımıyla karşılaştırılmalıdır. Böylece production'a alınmadan önce zamanlama kaynaklı risklerin önemli bölümü görülebilir.
Time zone doğru mu?
Schedule'ın hangi time zone'a göre yorumlandığını açıkça doğrulayın. Sunucu UTC çalışırken business tarafının Europe/Istanbul beklemesi birkaç saatlik kayma oluşturabilir. Container ve host time zone aynı olmak zorunda değildir. Monitoring expected run hesabı da aynı time zone'u kullanmalıdır. Configuration içinde bölge adını açıkça tutmak ilerideki altyapı değişikliklerinde belirsizliği azaltır.
Expression test edildi mi?
Cron expression'ın yalnızca syntax'ını değil gerçek sonraki çalışma zamanlarını test edin. Özellikle ay sonu, hafta günü ve step ifadeleri kolay yanlış yorumlanabilir. CI içinde sonraki birkaç timestamp otomatik gösterilebilir. Kullanılan scheduler beş alan mı altı alan mı bekliyor kontrol edilmelidir. Production deployment sonrası gerçek next-run değeri tekrar doğrulanmalıdır.
Overlap mümkün mü?
Job'ın p95 veya worst-case duration değeri schedule interval ile karşılaştırılmalıdır. Önceki run bitmeden yeni run başlayabiliyorsa bunun business açısından kabul edilip edilmediği açık olmalıdır. Kabul edilmiyorsa lock veya scheduler concurrency kontrolü eklenmelidir. Lock bozulsa bile job idempotent olmalıdır. Overlap count monitoring'e eklenirse sürenin zamanla uzaması erken fark edilir.
Execution
Execution katmanı cron'un hangi binary, kullanıcı ve çalışma ortamını kullanacağını belirler. Terminalde çalışan komutun cron'da aynı şekilde çalışacağı varsayılmamalıdır. Absolute path, dedicated user ve timeout temel kontrollerdir. Environment variables ve working directory açık şekilde tanımlanmalıdır. Failure durumunda doğru exit code üretildiği de test edilmelidir.
Absolute path
Binary ve script için absolute path kullanmak cron environment farklarını azaltır. python veya node komutunun PATH üzerinden bulunmasına güvenmek yerine gerçek executable açıkça belirtilebilir. Config ve çalışma dosyalarının path'leri de kontrol edilmelidir. Deployment path değişiyorsa stabil symlink veya release pointer kullanılabilir. Aynı komut cron kullanıcısı adına manuel test edilmelidir.
Dedicated user
Job mümkünse root yerine sınırlı yetkili servis kullanıcısıyla çalıştırılmalıdır. Kullanıcının yalnızca gerekli dosya, database ve network erişimi bulunmalıdır. Log ve temporary directory ownership bu hesaba uygun olmalıdır. Secret erişimi identity bazlı sınırlandırılabilir. Bu yaklaşım job kodunda sorun olduğunda blast radius'u küçültür.
Timeout
Her production job için mantıklı bir üst çalışma süresi belirleyin. Sonsuza kadar hanging process worker veya host kaynaklarını tüketebilir. Timeout normal p99 duration'dan yeterince yüksek olmalıdır. Süre aşımında cleanup ve retry davranışı tanımlanmalıdır. Long-running job düzenli timeout'a yaklaşıyorsa chunking veya mimari değişiklik düşünülmelidir.
Safety
Safety katmanı job tekrar veya concurrency altında çalıştığında business sonucunun bozulmamasını hedefler. Scheduler düzeyindeki koruma tek başına yeterli değildir. Idempotency ikinci execution'ı güvenli hale getirirken lock gereksiz eş zamanlılığı azaltır. External API side effect'lerinde provider idempotency mekanizmaları kullanılabilir. Veri katmanında unique constraint safety'nin güçlü son savunma noktalarından biridir.
Idempotent mi?
Aynı job yanlışlıkla iki kez çalıştırıldığında ne olacağını test edin. İkinci execution çift fatura, çift e-posta veya tekrar increment oluşturuyorsa iş güvenli değildir. Stabil business key ve unique constraint eklenebilir. External provider'a yapılan retry aynı idempotency key'i kullanmalıdır. Manual rerun operasyonu da idempotency sayesinde daha güvenli hale gelir.
Lock gerekli mi?
Aynı job instance'larının concurrent çalışması resource veya data problemi yaratıyorsa lock kullanımı değerlendirilmelidir. Tek host için file lock yeterli olabilirken dağıtık sistem merkezi lock gerektirir. TTL ve renewal doğru ayarlanmalıdır. Lock'ın idempotency yerine geçmediği unutulmamalıdır. Lock acquisition failure log ve alert politikasına dahil edilmelidir.
Monitoring
Monitoring job'ın yalnızca hata verdiğinde değil hiç çalışmadığında da fark edilmesini sağlamalıdır. Success log, failure alert ve missed-run alert üç farklı soruyu cevaplar. Son başarılı çalışma timestamp'i dashboard üzerinde görünür olmalıdır. Duration ve overlap metrikleri performans bozulmasını erken gösterir. Monitoring job ile birlikte deploy edilmeli, sonradan eklenmeyi beklememelidir.
Success log
Job başarıyla tamamlandığında structured success kaydı üretmelidir. Job ID, duration ve processed count gibi temel alanlar eklenebilir. Success log yalnızca script başında değil gerçek business completion sonrasında yazılmalıdır. Central logging içinde kolay aranabilir format kullanılmalıdır. Hassas payload değerleri başarı loguna dahil edilmemelidir.
Failure alert
Terminal failure ilgili ekibe otomatik bildirilmelidir. Alert job adı, business impact, attempt count ve hata kategorisi içerebilir. Tek geçici retry için yüksek öncelikli alarm gerekmeyebilir. Attempts tükendiğinde daha güçlü bildirim üretilebilir. Runbook bağlantısı incident çözümünü hızlandırır.
Missed-run alert
Job hiç başlamadıysa normal failure alert tetiklenmeyebilir. Expected schedule ile last successful run karşılaştırılmalıdır. Belirlenen deadline geçtiğinde missed-run alarmı oluşturulur. Time zone monitoring hesabında scheduler ile aynı olmalıdır. Bu kontrol özellikle günlük veya haftalık kritik job'larda zorunlu kabul edilmelidir.
Production-Ready Background Worker Checklist
Production worker checklist queue dayanıklılığından job payload'ına, retry tasarımından operasyon metriklerine kadar bütün lifecycle'ı kapsamalıdır. Worker yalnızca development ortamında task çalıştırabildiği için production-ready sayılmaz. Crash, duplicate delivery, deployment, downstream outage ve broker failure senaryoları test edilmelidir. Queue age ve DLQ alert gibi operasyon kontrolleri ilk deployment'ta hazır olmalıdır. Aşağıdaki maddeler yeni worker service için kısa fakat güçlü bir review çerçevesi sunar.
Queue
Queue'nun message durability, acknowledgement ve failure davranışı açık biçimde bilinmelidir. Broker restart sırasında job kaybı toleransı business requirement ile karşılaştırılmalıdır. Waiting, active ve failed state'ler monitoring sistemine aktarılmalıdır. Queue ownership ve retention politikasının sorumlusu belli olmalıdır. Kritik işlerde broker backup veya failover mekanizması düzenli test edilmelidir.
Durable mı?
Queue ve mesaj persistence ayarlarının gerçekten beklenen durability'yi sağladığını doğrulayın. Sadece ürünün "durable" özelliği var demek yeterli değildir. Producer confirmation, broker disk state ve consumer acknowledgement zinciri birlikte değerlendirilmelidir. Failure testinde broker restart edilerek waiting job'ların davranışı gözlenebilir. Veri kaybı kabul edilmiyorsa outbox veya ek persistence katmanı gerekebilir.
DLQ var mı?
Attempts tükendiğinde job'ın nereye gideceği açık olmalıdır. DLQ varsa owner, retention, alert ve replay prosedürü de bulunmalıdır. Failed mesajlar sonsuza kadar normal queue'da dönmemelidir. DLQ payload'u hassas veri açısından kontrol edilmelidir. Critical queue için DLQ non-zero alarmı tanımlanmalıdır.
Job
Job tasarımı güvenilir background processing'in temelidir. Payload küçük ve versioned olmalı, iş tekrar çalıştırıldığında güvenli sonuç üretmelidir. Business key ile technical job ID birbirinden ayrılmalıdır. Uzun işlerde chunking ve progress state düşünülmelidir. External side effect'ler provider idempotency özelliğiyle mümkün olduğunca korunmalıdır.
Idempotent mi?
Aynı job'ın iki worker tarafından çalıştırıldığı test senaryosu oluşturun. Database unique constraint veya idempotency table ikinci business effect'i engellemelidir. External API çağrısı stabil key kullanmalıdır. Side effect sonrasında worker crash senaryosu özellikle test edilmelidir. Retry güvenliği yalnızca happy path testinden anlaşılmaz.
Payload küçük mü?
Job payload'ına büyük dosya veya bütün domain object koymayın. Object ID ve storage reference çoğu durumda yeterlidir. Maximum byte limit uygulama seviyesinde kontrol edilebilir. Küçük payload broker throughput ve network maliyetini iyileştirir. PII minimization güvenlik açısından ek fayda sağlar.
Versioned mı?
Queue'da eski worker sürümünden kalan job'lar yeni deployment sonrasında işlenebilir. Payload version alanı migration ve backward compatibility yönetimini kolaylaştırır. Breaking change yeni version handler ile ele alınabilir. Eski version desteği kaldırılmadan önce backlog kontrol edilmelidir. Rolling deployment sırasında producer ve consumer sürümleri birlikte test edilmelidir.
Retry
Retry mekanizması failure'ın geçici olup olmadığına göre davranmalıdır. Bütün exception'ları aynı şekilde yeniden çalıştırmak queue kaynaklarını boşa harcar. Maximum attempts, backoff ve jitter önceden belirlenmelidir. Total retry window business deadline'ı aşmamalıdır. Attempts tükendiğinde terminal failure görünür olmalıdır.
Retryable failure ayrımı var mı?
Network timeout ile invalid payload aynı retry politikasını kullanmamalıdır. Typed error veya HTTP status üzerinden classification yapılabilir. Permanent failure doğrudan DLQ veya rejected state'e geçebilir. Unknown error sınırlı sayıda retry alabilir. Failure category metric olarak tutulursa policy zaman içinde iyileştirilebilir.
Backoff var mı?
Retry'ler arasında artan gecikme downstream servise recovery zamanı verir. Immediate retry yalnızca hatayı daha sık üretmemelidir. Maximum delay ve total attempts birlikte belirlenmelidir. Provider Retry-After bilgisi varsa backoff hesabına dahil edilmelidir. Load test toplu outage senaryosunu içermelidir.
Jitter var mı?
Aynı anda fail eden binlerce job aynı backoff süresinden sonra birlikte dönmemelidir. Jitter retry zamanlarını dağıtır. Random window latency SLO'yu aşmayacak kadar kontrollü olmalıdır. Retry storm testinde dağılım metric üzerinden gözlenebilir. Systemd timer ve scheduled fleet işlerinde benzer teknik kullanılabilir.
Worker
Worker runtime deployment ve crash senaryolarına dayanıklı olmalıdır. Graceful shutdown, timeout ve resource limit temel kontrollerdir. Process memory state'ine kalıcı business bilgi emanet edilmemelidir. Worker stateless olacak şekilde tasarlanırsa horizontal scaling kolaylaşır. Heartbeat ve active job metric'leri process health kontrolünü tamamlar.
Graceful shutdown
SIGTERM geldiğinde worker yeni job almayı durdurmalıdır. In-flight job mümkünse completion'a kadar çalıştırılır. Termination deadline iş süresiyle uyumlu olmalıdır. Ack doğru sırada gönderilmelidir. Hard kill ihtimali nedeniyle idempotency yine korunmalıdır.
Timeout
Her job türünün normal çalışma süresine uygun timeout değeri olmalıdır. Hanging network veya database call bütün worker slotlarını tüketmemelidir. Client-level timeout ile worker-level timeout birlikte kullanılabilir. Timeout error retryable olup olmadığına göre sınıflandırılmalıdır. Çok sık timeout performance veya dependency problemi göstergesidir.
Resource limit
CPU ve memory limit worker'ın cluster üzerindeki blast radius'unu sınırlar. Limit gerçek workload profiling sonucuna göre belirlenmelidir. OOM kill job redelivery ve duplicate riskini artırır. CPU throttle processing duration'ı uzatabilir. Resource metric'leri queue latency ile birlikte değerlendirilmelidir.
Operations
Worker production'a alındığında ekip sistemin ne zaman sağlıksız olduğunu ölçebilmelidir. Queue depth backlog miktarını, age kullanıcı gecikmesini ve failure rate reliability durumunu gösterir. DLQ alert recovery dışına çıkan işleri görünür yapar. Dashboard tek bakışta arrival, completion ve worker capacity ilişkisini göstermelidir. Runbook en sık failure senaryoları için uygulanabilir adımlar içermelidir.
Queue depth
Waiting job sayısını düzenli metric olarak toplayın. Threshold queue'nun normal trafik hacmine göre belirlenmelidir. Tek anlık spike yerine growth rate de izlenebilir. Worker count ve processing rate aynı dashboard'da gösterilmelidir. Yüksek depth otomatik olarak daha fazla worker anlamına gelmemeli, downstream limitler kontrol edilmelidir.
Queue age
Oldest waiting job age kullanıcı etkisini doğrudan gösterir. Critical queue için düşük threshold kullanılabilir. Bulk queue daha yüksek beklemeye toleranslı olabilir. Autoscaling age threshold'un altında devreye girebilir. Age trend sürekli yükseliyorsa capacity veya dependency problemi vardır.
Failure rate
Failed job sayısı trafikle normalize edilerek oran olarak izlenmelidir. Error category breakdown root cause bulmayı hızlandırır. Deployment marker grafikte gösterilebilir. Retry sonrası success ayrı metric olabilir. SLO failure rate üzerinden tanımlanabilir.
DLQ alert
DLQ'da unresolved job kalması ekip tarafından görünmelidir. Critical queue için ilk job alarm üretebilir. Count yanında oldest age de izlenmelidir. Alert payload değil güvenli job ID ve error summary içermelidir. Replay runbook kök neden düzeltilmeden toplu işlem yapılmasını engellemelidir.
Uçtan Uca Güvenilir Scheduled Background Job Mimarisi
Güvenilir scheduled background sistem kurmanın en iyi yolu tek bir araç seçmekten çok sorumlulukları doğru sırayla ayırmaktır. İş gereksinimi önce tanımlanır, ardından time-driven veya event-driven trigger belirlenir. Scheduler mümkün olduğunca yalnızca enqueue yapar ve worker business işlemini idempotent biçimde yürütür. Retry, DLQ, timeout ve observability baştan eklenir. Son olarak schedule ve worker configuration sürümlenir, failure ile replay senaryoları düzenli test edilir.
1. İş Gereksinimini Tanımlayın
Önce job'ın neden var olduğunu ve ne zaman başarılı sayıldığını belirleyin. Kullanıcının deadline beklentisini yazın. Duplicate çalışmanın business etkisini tanımlayın. İş kaçırılırsa sonradan çalışmalı mı sorusunu cevaplayın. Teknik araç seçimi bu gereksinimlerden sonra yapılmalıdır.
2. Time-Driven mı Event-Driven mı Belirleyin
İş belirli saatte mi yoksa bir event oluştuğunda mı başlamalı belirleyin. Gereksiz polling yerine event kullanmak kaynak tüketimini azaltabilir. Periyodik reconciliation gibi görevler time-driven kalabilir. Bazı süreçler iki modeli birlikte kullanabilir. Trigger semantics dokümante edilmelidir.
3. Scheduler Seçin
Tek Linux host için cron veya systemd timer yeterli olabilir. Kubernetes ortamında CronJob veya uygulama scheduler'ı düşünülebilir. Cloud-native küçük işler için managed scheduler kullanılabilir. Multi-step süreçte workflow engine timer daha uygun olabilir. Seçim operasyon ortamıyla uyumlu olmalıdır.
4. Cron'u Sadece Tetikleyici Olarak Kullanın
Ağır processing'i cron process içinde tutmamaya çalışın. Cron küçük enqueue komutu çalıştırabilir. Böylece schedule hızlı tamamlanır. Retry ve scaling worker katmanına taşınır. Cron'un kendisi missed-run monitoring ile izlenir.
5. Job'ı Queue'ya Yazın
Producer küçük ve versioned payload oluşturur. Job ID ve business key eklenir. Queue publish failure business önemine göre ele alınır. Büyük data storage reference üzerinden taşınır. Enqueue latency metric olarak tutulabilir.
6. Transactional Outbox Gereksinimini Değerlendirin
Job enqueue bir database update ile aynı business transaction'a bağlıysa dual-write riski analiz edilmelidir. "Database commit oldu ama job oluşmadı" senaryosu kabul edilemiyorsa outbox kullanılabilir. Event aynı transaction içinde kaydedilir. Outbox worker daha sonra broker'a publish eder. Consumer duplicate-safe olmalıdır.
7. Job ID ve Idempotency Key Oluşturun
Technical job instance ile business operation kimliği ayrılmalıdır. Job ID observability için, idempotency key duplicate effect'i önlemek için kullanılır. Business key stabil olmalıdır. Retry attempt boyunca idempotency key değişmemelidir. External provider'a da mümkünse aynı business key aktarılır.
8. Worker'ı Idempotent Tasarlayın
Worker aynı job'ı iki kez çalıştırdığında tek business sonuç üretmelidir. Unique constraint, processed jobs table veya upsert kullanılabilir. External side effect provider idempotency ile korunur. Concurrency race condition test edilmelidir. Manuel replay de aynı güvenlik modelinden yararlanır.
9. Timeout Ekleyin
Network, database ve job seviyesinde uygun timeout değerleri belirleyin. Hanging call worker slotunu sonsuza kadar tutmamalıdır. Timeout normal duration distribution'a göre seçilir. Soft cleanup ve hard deadline ayrı olabilir. Timeout metric olarak izlenmelidir.
10. Retryable Hataları Sınıflandırın
Network 503 ile validation error aynı davranmamalıdır. Typed error category kullanın. Retryable failure sınırlı attempts alır. Permanent failure doğrudan terminal state'e geçebilir. Unknown error için güvenli default politika belirleyin.
11. Exponential Backoff + Jitter Ekleyin
Geçici outage sırasında immediate retry kullanmayın. Delay attempt sayısıyla artabilir. Maximum delay tanımlayın. Jitter binlerce job'ın aynı anda dönmesini engeller. Provider Retry-After varsa policy onu dikkate almalıdır.
12. DLQ Oluşturun
Attempts tükendiğinde job kaybolmamalıdır. DLQ error context ve payload reference saklayabilir. Owner ve alert tanımlanmalıdır. Retention ve replay policy dokümante edilmelidir. Kök neden düzelmeden toplu replay yapılmamalıdır.
13. Worker Concurrency Belirleyin
CPU-bound ve I/O-bound profile göre başlangıç concurrency seçin. Database connection ve API rate limit sınırlarını hesaplayın. Load test ile throughput ve p95 duration ölçün. Total cluster concurrency değerini göz önünde bulundurun. Daha yüksek sayı her zaman daha iyi değildir.
14. Priority Queue Gereksinimini Değerlendirin
Critical ve bulk job'lar aynı SLA'ya sahip değilse priority veya ayrı queue kullanın. Priority inversion riskini düşünün. Reserved capacity kritik işleri koruyabilir. Queue sayısını gereksiz artırmayın. Kararı user-visible latency üzerinden gerekçelendirin.
15. Graceful Shutdown Uygulayın
SIGTERM geldiğinde worker yeni job almayı durdursun. Active job completion için makul süre verin. Ack sırasını doğru yönetin. Platform termination grace period değerini gerçek duration ile uyumlu tutun. Hard kill senaryosunu failure testinde simüle edin.
16. Queue-Depth Autoscaling Kurun
Backlog arttığında worker capacity otomatik büyüyebilir. Queue depth başlangıç metric'i olabilir. Age daha doğrudan latency hedefi sağlar. Maximum replicas downstream limitlere göre sınırlandırılmalıdır. Scale-in graceful shutdown ile yapılmalıdır.
17. Log, Metric ve Trace Ekleyin
Job ID bütün structured loglara yazılmalıdır. Queue depth, age, duration ve failure metric olarak toplanmalıdır. Trace context HTTP request'ten worker'a aktarılabilir. Error context güvenli biçimde saklanmalıdır. Dashboard SLO odaklı tasarlanmalıdır.
18. Missed-Run ve DLQ Alertleri Ekleyin
Scheduler hiç çalışmadığında error log oluşmayabilir. Expected run ile actual run karşılaştırılmalıdır. DLQ non-zero kritik queue'da alarm üretmelidir. Alert owner ve runbook içermelidir. Notification gürültüsü business impact'e göre ayarlanmalıdır.
19. Failure ve Replay Testleri Yapın
Worker active job sırasında zorla öldürülebilir. Broker restart, database timeout ve external 503 simüle edilebilir. Aynı job iki kez çalıştırılarak idempotency doğrulanır. DLQ'dan selective replay denenir. Recovery yalnızca tasarım belgesinde değil gerçek testte kanıtlanmalıdır.
20. Schedule ve Worker Config'ini Git'te Sürümleyin
Cron expression, retry policy ve concurrency değerleri version control altında tutulmalıdır. Pull request review production davranışındaki değişiklikleri görünür yapar. CI syntax ve next-run testlerini çalıştırabilir. Deployment sonrası active config doğrulanmalıdır. Rollback önceki güvenli configuration'a hızlı dönüş sağlar.
Zamanlanmış Görevler İçin En İyi Programlama Dili Hangisidir?
Zamanlanmış veya background iş için tek bir "en iyi programlama dili" yoktur. Ekip deneyimi, mevcut uygulama stack'i, workload türü ve operasyon araçları seçimde daha önemlidir. Python, TypeScript, Go, Ruby ve PHP'nin her birinde güvenilir job sistemleri kurulabilir. Framework seçimi retry veya idempotency gibi dağıtık sistem prensiplerini ortadan kaldırmaz. Dil değiştirmek yerine queue semantics, timeout ve observability temellerini doğru uygulamak çoğu projede daha büyük fark yaratır.
Python
Python data processing, automation ve backend işleri için güçlü bir ekosisteme sahiptir. Celery ve RQ background processing seçenekleri sunar. Data science veya ETL kodunun aynı dilde worker'a taşınması ekip verimliliği sağlar. CPU-bound Python workload için process modeli ve memory kullanımı dikkate alınmalıdır. Type ve payload contract'larını açık tutmak büyük sistemlerde bakım kolaylığı sağlar.
Celery
Celery broker, worker, retry ve periodic task ekosistemiyle olgun bir seçenektir. Çok sayıda task ve queue yöneten Python uygulamalarında güçlü özellikler sunar. Celery Beat schedule üretimi için kullanılabilir. Production config ilk başta fazla seçenekli görünebilir, bu nedenle küçük ve açık policy ile başlamak yararlıdır. Task idempotency ve broker durability ekip tarafından ayrıca tasarlanmalıdır.
RQ
RQ daha sade bir Redis queue yaklaşımı isteyen Python ekipleri için değerlendirilebilir. Fonksiyonları background job olarak çalıştırma modeli anlaşılırdır. Küçük projede operational entry barrier düşüktür. Sistem büyüdükçe retry, monitoring ve queue separation ihtiyaçları ayrıca ele alınmalıdır. Basit framework seçmek production discipline ihtiyacını kaldırmaz.
Data jobs
Python veri işleme kütüphaneleri nedeniyle ETL ve raporlama worker'larında doğal bir seçim olabilir. Pandas benzeri araçlar memory kullanımını artırabileceği için büyük dataset'lerde chunking önemlidir. CPU-heavy processing ayrı worker pool'a alınabilir. Data job'lar idempotent partition key kullanabilir. Output object storage üzerinde versioned saklanabilir.
JavaScript ve TypeScript
Node.js ve TypeScript web backend ile worker kodunu aynı dilde tutmak isteyen ekipler için güçlü bir seçenektir. I/O ağırlıklı job'larda async runtime yüksek concurrency sağlayabilir. BullMQ Redis tabanlı queue ihtiyaçlarını karşılayan yaygın araçlardan biridir. CPU-heavy task'lar event loop'u bloke edebileceği için ayrı process veya worker threads düşünülmelidir. TypeScript payload schema tanımlarını açık ve versioned tutmaya yardımcı olabilir.
BullMQ
BullMQ retries, delayed job, worker concurrency ve Job Scheduler özellikleriyle Node.js background processing için kullanılabilir. Redis operasyonu tasarımın önemli parçasıdır. Scheduler API major sürümler arasında değişebildiği için dependency upgrade dikkatle yapılmalıdır. Queue metrics ve failed job history production dashboard'a bağlanmalıdır. Worker shutdown ve idempotency framework dışındaki application sorumlulukları olarak kalır.
Node.js workers
Node.js worker I/O-bound API ve database işleri için yüksek async concurrency kullanabilir. Handler içinde synchronous CPU-heavy işlem event loop'u bloke edebilir. Bu job'lar ayrı process veya farklı hizmete taşınabilir. Connection pool concurrency ile uyumlu olmalıdır. Event loop lag ve processing duration izlenmelidir.
Go
Go düşük runtime overhead ve concurrency modeli nedeniyle lightweight worker servislerinde güçlü bir seçenektir. Tek binary deployment operational basitlik sağlayabilir. Goroutine kullanımı kolay olsa da sınırsız concurrency downstream sistemi zorlayabilir. Worker pool ve semaphore ile sınırlandırma gerekir. Queue client'ın acknowledgement ve retry semantics'i dikkatle uygulanmalıdır.
Lightweight workers
Go worker container'ları düşük memory footprint ile çok sayıda replica çalıştırabilir. Startup süresi kısa olduğu için autoscaling senaryolarında avantaj sağlayabilir. Bununla birlikte asıl bottleneck external API ise fazla replica fayda sağlamaz. Resource metric ve queue age birlikte izlenmelidir. Binary version payload schema compatibility ile koordine edilmelidir.
High concurrency
Goroutine'ler çok sayıda I/O operation yönetmeyi kolaylaştırır. Ancak uygulama seviyesinde concurrency limiti konulmalıdır. Database pool ve rate limiter bu sınırla uyumlu olmalıdır. Context cancellation timeout ve graceful shutdown için kullanılabilir. High concurrency yalnızca benchmark sonucu artırıyorsa uygulanmalıdır.
Ruby
Ruby uygulamalarında Sidekiq Redis tabanlı background processing için güçlü bir ekosistem oluşturmuştur. Rails uygulamasıyla entegrasyon geliştirici deneyimini kolaylaştırabilir. Thread concurrency database pool ayarlarıyla uyumlu olmalıdır. Job args küçük ve serialization açısından güvenli tutulmalıdır. Retry ve idempotency business işlevine göre ayrıca tasarlanmalıdır.
Sidekiq
Sidekiq worker'ları aynı process içinde thread concurrency kullanabilir. I/O ağırlıklı Rails işleri için bu verimli olabilir. Database connection pool concurrency sayısından küçükse worker'lar bekleyebilir. Redis availability ve persistence production planına dahil edilmelidir. Job'lar deployment sırasında eski schema ile uyumlu kalmalıdır.
PHP
PHP ekosisteminde framework tabanlı queue sistemleri background processing için yaygın seçenekler sunar. Web request lifecycle dışında sürekli worker process çalıştırmak deployment ve memory yönetimi gerektirir. Supervisor, systemd veya container orchestration ile worker lifecycle yönetilebilir. Payload ve retry prensipleri diğer dillerle aynıdır. Framework seçimi idempotency ihtiyacını değiştirmez.
Symfony Messenger
Symfony Messenger message bus ve async transport modeliyle background processing kurmaya yardımcı olur. Retry strategy ve failed transport gibi mekanizmalar production iş akışında kullanılabilir. Transport seçiminin delivery semantics'i anlaşılmalıdır. Handler idempotent tasarlanmalıdır. Worker deployment sırasında graceful stop uygulanmalıdır.
Laravel Queues
Laravel Queues farklı backend'ler üzerinden background job çalıştırma modeli sunar. E-posta, notification ve uzun işlemler request'ten ayrılabilir. Worker timeout ve retry ayarları production workload'a göre belirlenmelidir. Unique job özellikleri yardımcı olsa da business idempotency database seviyesinde korunmalıdır. Queue monitoring ve failed jobs düzenli takip edilmelidir.
Programlama Dilinden Daha Önemli Olan Dağıtık Sistem Temelleri
Hangi dili seçerseniz seçin aynı job iki kez çalışabilir, worker crash edebilir ve network timeout belirsiz yan etki oluşturabilir. Bu problemlerin çözümü syntax değil distributed systems prensipleridir. Idempotency, retry classification, backoff, queue semantics ve observability bütün dillerde geçerlidir. İyi ekip framework API'sini öğrenmek kadar failure modelini de öğrenir. Bu bilgi yeni teknolojiye geçildiğinde de doğrudan kullanılabilir.
Open Source ve İşbirliği ile Background Job Ekosistemi
Background processing alanındaki birçok önemli araç açık kaynak toplulukları tarafından geliştirilmektedir. Kaynak kodu, issue'lar ve release notları gerçek production davranışını anlamak için güçlü öğrenme kaynaklarıdır. Yalnızca tutorial kopyalamak yerine kullanılan sürümün changelog ve migration notlarını takip etmek gerekir. Küçük dokümantasyon katkıları bile ekosistemi öğrenmek için iyi başlangıçtır. Diyarbakır'da geliştiriciler benzer projeleri birlikte üretmek için https://www.diyarbakiryazilim.com.tr/projects sayfasındaki proje çalışmalarını inceleyebilir.
Celery
Celery'nin açık kaynak yapısı worker, broker ve scheduler davranışını doğrudan incelemeyi mümkün kılar. Issue'larda gerçek production problemleri ve edge case'ler görülebilir. Yeni sürüm notları breaking change veya deprecation takibi için önemlidir. Küçük documentation veya test katkıları ekosistemi anlamaya yardımcı olur. Kendi demo projenizde worker crash ve retry senaryolarını uygulamak teoriyi pekiştirir.
BullMQ
BullMQ açık kaynak repository ve dokümantasyonu queue davranışını öğrenmek için değerlidir. Scheduler API ve migration değişiklikleri release notlarından takip edilmelidir. Redis üzerinde job state'in nasıl tutulduğunu anlamak troubleshooting becerisini geliştirir. Issue örnekleri stalled job ve concurrency gibi gerçek durumları gösterir. TypeScript ile küçük worker projesi geliştirmek iyi bir portföy çalışması olabilir.
RabbitMQ
RabbitMQ messaging fundamentals öğrenmek background job mimarisinin daha derin anlaşılmasını sağlar. Exchange, routing, acknowledgement ve dead-letter kavramları yalnızca tek framework'e bağlı değildir. Local container ortamında farklı acknowledgement senaryoları test edilebilir. Consumer crash ve broker restart deneyleri yapılabilir. Bu testler delivery semantics'i teoriden daha anlaşılır hale getirir.
Redis
Redis yalnızca cache değil queue ve coordination sistemlerinde de sık kullanılır. Persistence, replication ve eviction davranışlarını bilmek job altyapısı açısından önemlidir. Cache için uygun eviction policy queue için riskli olabilir. Ayrı instance veya database isolation değerlendirilebilir. Failure testleri Redis restart ve connection loss durumlarını içermelidir.
Sidekiq
Sidekiq Ruby background processing ekosistemini öğrenmek için iyi bir açık kaynak örneğidir. Thread concurrency ve Redis interaction gerçek production konularını gösterir. Job serialization sınırlarını incelemek deployment compatibility açısından yararlıdır. Retry ve dead job davranışı uygulamalı test edilebilir. Ekipler aynı fikirleri farklı dillere taşıyarak teknoloji bağımsız düşünmeyi öğrenebilir.
Kubernetes
Kubernetes Job ve CronJob kaynakları batch workload orchestration temellerini öğretir. concurrencyPolicy, deadline ve history limit gibi özellikleri küçük cluster üzerinde deneyebilirsiniz. Pod failure ve node drain senaryoları worker lifecycle bilgisini geliştirir. Resource limits ve service account güvenliği de aynı proje içinde öğrenilebilir. Declarative configuration Git üzerinden sürümlenebilir.
KEDA
KEDA event-driven autoscaling kavramını pratikte öğrenmek için güçlü bir araçtır. Queue metric'inden Kubernetes worker scale etme deneyimi modern production altyapısına yakın bir proje sunar. Scale-to-zero ve cold start etkisi ölçülebilir. Maximum replica downstream rate limit ile karşılaştırılabilir. Dashboard queue age ile pod sayısını aynı grafikte gösterebilir.
Açık Kaynak Worker Monitoring Araçları
Queue teknolojisine göre worker ve job durumlarını gösteren farklı açık kaynak monitoring araçları bulunabilir. Bu araçlar development ve incident incelemesinde yararlı olsa da production observability yalnızca tek dashboard'a bağlanmamalıdır. Metrics ve logs merkezi monitoring sistemine aktarılmalıdır. Tool erişimi hassas payload gösterebileceği için authorization gerektirir. Monitoring panelini public internete açık bırakmak güvenli değildir.
GitHub Üzerinden Katkı
Open source katkı yalnızca büyük feature yazmak anlamına gelmez. Documentation typo düzeltmek, reproducible bug example hazırlamak veya test eklemek iyi başlangıçtır. Issue açmadan önce mevcut issue ve contribution guide okunmalıdır. Küçük fakat iyi açıklanmış pull request geliştirici iletişim becerisini de geliştirir. Background queue kütüphanesine yapılan katkı dağıtık sistem kavramlarını gerçek kod üzerinde görme fırsatı verir.
Yazılımcı Olmak İçin Background Job Konusunda Neler Öğrenilmeli?
Background job konusunda güçlü olmak için yalnızca bir queue kütüphanesinin API'sini bilmek yeterli değildir. Linux process modeli, HTTP hata davranışı, database transaction'ları ve message delivery semantics birlikte anlaşılmalıdır. Docker ve Kubernetes worker deployment tarafını, observability ise production sorunlarını görünür hale getirir. Distributed systems temelleri retry, duplicate ve partial failure konularını ortak çerçevede açıklar. Bu konuları küçük projelerle uygulamak yalnızca teorik okuma yapmaktan daha kalıcı öğrenme sağlar.
Linux
Process, signal, exit code, file permission ve environment bilgisi cron ile worker yönetiminin temelidir. SIGTERM ve SIGKILL farkını anlamak graceful shutdown tasarımında doğrudan kullanılır. PATH ve working directory cron troubleshooting için önemlidir. File descriptor ve disk kullanımı long-running worker'larda operasyon konusu haline gelir. Linux log ve process araçlarını rahat kullanmak incident çözüm süresini kısaltır.
Cron
Cron expression okumak, user ve system crontab farkını bilmek başlangıç becerisidir. Time zone ve environment davranışı ayrıca öğrenilmelidir. Overlap ve missed-run kontrolünü cron'un kendisinin otomatik çözmediği anlaşılmalıdır. Basit backup veya script projesi iyi pratik sağlar. Daha sonra aynı işi queue mimarisine taşıyarak farklar gözlemlenebilir.
systemd
Service ve timer unit yazmak Linux production operasyonunu anlamaya yardımcı olur. Environment, dedicated user ve journal logging pratikte kullanılabilir. Persistent timer ve randomized delay gibi özellikler schedule tasarımını geliştirir. Resource ve security seçenekleri worker process'lere uygulanabilir. Bir cron scriptini systemd timer'a taşımak iyi laboratuvar çalışmasıdır.
HTTP
Background worker'lar sık sık external API çağırdığı için HTTP status ve timeout bilgisi önemlidir. 429, 502 ve 503 gibi status'ların retry davranışı anlaşılmalıdır. Connect timeout ile read timeout ayrımı bilinmelidir. Idempotent method kavramı application idempotency ile karıştırılmamalıdır. Webhook signature ve delivery retry de HTTP bilgisini kullanır.
Database Transactions
Transaction atomiklik ve concurrency problemlerini anlamak için temel konudur. Unique constraint idempotency'nin güçlü aracıdır. Row lock, deadlock ve isolation level worker concurrency'yi etkiler. Transactional outbox dual-write problemini çözmek için bu temele dayanır. External API çağrısını uzun transaction içinde tutmanın riskleri uygulamalı öğrenilmelidir.
Redis
Redis data structures, persistence ve TTL background queue sistemlerinde sık karşılaşılır. Distributed lock tasarımında key expiration ve ownership önemlidir. Queue framework Redis üzerinde hangi state'i tuttuğunu anlamak troubleshooting sağlar. Memory eviction riskleri bilinmelidir. Local Redis üzerinde failure ve restart testleri yapılabilir.
Message Queues
Acknowledgement, redelivery, durable message ve dead-letter kavramları öğrenilmelidir. Work queue ile pub/sub farkı anlaşılmalıdır. At-least-once delivery'nin duplicate execution doğurduğu test edilmelidir. Prefetch ve concurrency throughput'u etkiler. Queue depth ile age monitoring pratikte uygulanmalıdır.
Distributed Systems
Partial failure, network partition ve exactly-once sınırları background processing'in merkezindedir. Idempotency ve retry bu problemleri yönetmek için kullanılır. Distributed lock'ın kusursuz garanti olmadığını anlamak önemlidir. Fencing token ve leader election ileri konular olarak öğrenilebilir. Teoriyi küçük failure simulation projeleriyle birleştirmek çok faydalıdır.
Docker
Worker'ı container içinde çalıştırmak environment ve process lifecycle bilgisini geliştirir. PID 1 signal handling ve graceful shutdown test edilebilir. Image size cold start süresini etkiler. Secret değerler image içine gömülmemelidir. Healthcheck ile gerçek queue consumer health arasındaki fark anlaşılmalıdır.
Kubernetes
Deployment worker, Job batch process ve CronJob scheduled process olarak farklı amaçlara hizmet eder. Resource requests, limits ve autoscaling queue sistemini doğrudan etkiler. Pod termination worker graceful shutdown ile test edilmelidir. KEDA event-driven scaling için ek pratik sağlar. Service account ve NetworkPolicy background worker güvenliğini güçlendirir.
Observability
Logs, metrics ve traces production sorunlarının nasıl göründüğünü öğretir. Queue depth, age ve processing duration dashboard oluşturulabilir. Job ID ile structured log araması yapılabilir. Trace context async boundary üzerinden taşınabilir. Alert tasarımında symptom ile root cause farkı öğrenilmelidir.
Portföy İçin Background Job Projeleri
Background processing becerisini göstermek isteyen geliştirici için gerçek failure senaryoları içeren projeler basit CRUD uygulamalarından daha öğreticidir. Proje yalnızca job çalıştırmamalı, retry, DLQ, idempotency ve monitoring de göstermelidir. README içinde mimari kararların neden verildiği açıklanabilir. Docker Compose veya Kubernetes manifest ile tekrar kurulabilir ortam sunmak değerlendirmeyi kolaylaştırır. Aşağıdaki fikirler farklı diller ve queue sistemleriyle geliştirilebilir.
E-posta Queue Sistemi
Kullanıcı event'lerinden e-posta job üreten küçük platform geliştirilebilir. Redis veya RabbitMQ queue kullanılabilir. Retry, rate limit ve idempotency key eklenebilir. Fake e-posta provider ile 429 ve 503 simüle edilebilir. Dashboard queue age ve delivery history gösterebilir.
Scheduled Backup Platformu
Belirli schedule ile test database yedeği alan bir platform geliştirilebilir. Cron veya systemd timer enqueue yapabilir. Worker dump, checksum, upload ve verification adımlarını yürütür. Başarısız upload retry ve DLQ'ya gider. Restore test sonucu ayrı metric olarak gösterilebilir.
Image Processing Worker
Kullanıcı görsel yüklediğinde resize job oluşturulabilir. Orijinal dosya object storage'da tutulur ve queue yalnızca key taşır. Worker thumbnail varyantları üretir. CPU concurrency ve memory limit ölçülebilir. Aynı image job iki kez çalıştırılarak idempotency test edilebilir.
Webhook Delivery Platformu
Event endpoint'lerini kaydeden ve webhook delivery job üreten mini servis güçlü bir portföy projesidir. Signature, timeout, exponential backoff ve delivery history uygulanabilir. Test receiver farklı HTTP status'lar döndürebilir. DLQ ve manual replay paneli eklenebilir. Event ID duplicate-safe consumer örneğini gösterir.
CSV Export Queue
Kullanıcı büyük CSV export talebi verir ve HTTP request hızlı kabul yanıtı döner. Worker data'yı chunk halinde okuyup stream ile file oluşturur. Progress percentage status store'da tutulur. Dosya object storage'a yüklenir. Completion notification ayrı job olarak çalışır.
Distributed Cron Dashboard
Birden fazla scheduled job'ın expected ve actual run bilgilerini gösteren dashboard geliştirilebilir. Missed-run detection temel özelliktir. Time zone ve next-run preview eklenebilir. Distributed lock ile duplicate scheduler senaryosu test edilebilir. Her run job ID üzerinden logs ile ilişkilendirilebilir.
Celery Worker Projesi
Python Celery ile birkaç queue ve worker tipi oluşturulabilir. Celery Beat scheduled task üretir. Redis veya RabbitMQ broker kullanılabilir. Retry ve task time limit uygulamaları gösterilebilir. Worker crash testleri README içinde belgelenebilir.
BullMQ Job Scheduler
TypeScript ve BullMQ ile recurring job yönetim servisi geliştirilebilir. Stabil scheduler ID ve upsert modeli kullanılabilir. Worker retries, concurrency ve failed jobs dashboard'a eklenebilir. Redis restart failure senaryosu test edilebilir. Schedule-as-code yaklaşımı repository içinde örneklenebilir.
Kubernetes CronJob + KEDA Demo
Kubernetes CronJob belirli aralıklarla producer çalıştırabilir ve queue'ya batch job ekleyebilir. Worker Deployment KEDA üzerinden backlog metriğine göre scale olabilir. Scale-to-zero ve cold start ölçülebilir. concurrencyPolicy ve startingDeadlineSeconds örnekleri ayrı manifestlerde gösterilebilir. Grafana benzeri dashboard ile queue age ve replica sayısı karşılaştırılabilir.
Diyarbakır Yazılım Topluluğu İçin Proje Fikirleri
Background job konuları ekip halinde çalışıldığında çok daha verimli öğrenilir çünkü aynı projede Linux, backend, database ve operasyon bilgisi birleşir. Diyarbakır Yazılım Topluluğu bünyesinde küçük workshop serileriyle cron'dan dağıtık queue sistemlerine doğru ilerleyen uygulamalı bir öğrenme yolu oluşturulabilir. Katılımcılar yalnızca çalışan demo değil failure ve recovery senaryoları da hazırlayabilir. Proje sonuçları GitHub üzerinde açık kaynak yayınlanarak yeni geliştiricilerin katkısına açılabilir. Topluluk hakkında daha fazla bilgi için https://www.diyarbakiryazilim.com.tr/about adresi incelenebilir.
Cron ve systemd Timer Atölyesi
İlk atölyede basit Linux cron job kurulabilir. Aynı görev daha sonra systemd timer'a taşınabilir. Environment, PATH ve user permission farkları uygulamalı gösterilebilir. Persistent timer ve missed-run senaryosu test edilebilir. Katılımcılar iki yaklaşımın avantajlarını kendi gözlemleriyle karşılaştırabilir.
Redis + BullMQ Workshop
TypeScript producer ve Worker ile küçük queue sistemi kurulabilir. Retry, delayed job ve concurrency özellikleri adım adım eklenebilir. Redis kapatılarak failure davranışı gözlenebilir. Job Scheduler ile recurring iş oluşturulabilir. Son aşamada queue depth ve failed jobs için küçük monitoring ekranı hazırlanabilir.
Python + Celery Background Worker Projesi
Python ile web endpoint'i job enqueue eder ve Celery worker işi yürütür. Celery Beat periyodik görev üretir. Redis veya RabbitMQ broker kullanılarak iki alternatif denenebilir. Retry ve idempotency örnekleri eklenebilir. Worker restart sırasında active task davranışı gözlenebilir.
RabbitMQ Queue Lab
Exchange, queue ve routing key kavramları küçük senaryolarla gösterilebilir. Manual acknowledgement ile worker crash simüle edilebilir. Prefetch değiştirildiğinde job dağılımı gözlenebilir. Dead-letter exchange kurulabilir. Katılımcılar aynı mesajın duplicate delivery ihtimalini uygulamalı görür.
Kubernetes CronJob Atölyesi
Minikube veya benzer local cluster üzerinde CronJob oluşturulabilir. Allow, Forbid ve Replace davranışları uzun süren test job'ıyla gözlenebilir. startingDeadlineSeconds ve history limit ayarları denenebilir. Pod failure simüle edilebilir. Sonuçlar idempotency açısından birlikte tartışılabilir.
Open Source Job Monitoring Dashboard
Topluluk ortak bir queue monitoring dashboard projesi geliştirebilir. İlk sürüm depth, age, failure ve worker count gösterebilir. Daha sonra multiple queue ve tenant filtreleri eklenebilir. Alert rule configuration repository içinde tutulabilir. Katılımcılar frontend, backend ve observability tarafında farklı görevler üstlenebilir.
Distributed Systems Çalışma Grubu
Haftalık çalışma grubunda at-least-once, idempotency, outbox ve distributed lock konuları örneklerle incelenebilir. Her hafta küçük failure experiment hazırlanabilir. Bir worker ack öncesi öldürülüp sonuç gözlenebilir. Sonraki hafta Redis lock TTL hatası simüle edilebilir. Bu yaklaşım kavramların yalnızca tanım olarak değil gerçek davranış olarak öğrenilmesini sağlar.
Sık Sorulan Sorular
Cron job nedir?
Cron job Linux ve Unix tabanlı sistemlerde belirli zamanlarda otomatik komut çalıştırmak için kullanılan görev tanımıdır. Schedule klasik cron expression ile belirtilebilir. Cron basit script, backup veya queue producer tetiklemek için kullanılabilir. Ağır işleri doğrudan cron process içinde yürütmek yerine worker sistemine aktarmak çoğu production ortamında daha güvenlidir. Ayrıca cron job'ın failure ve missed-run durumları ayrı monitoring ile takip edilmelidir.
Background job nedir?
Background job kullanıcının aktif HTTP isteğinden bağımsız olarak arka planda işlenen görevdir. E-posta, rapor, export ve image processing yaygın örneklerdir. Producer job'ı queue'ya ekler ve worker daha sonra işler. Retry ve scaling request lifecycle'dan bağımsız yönetilir. Kullanıcı sonucu status veya notification üzerinden daha sonra görebilir.
Cron job ile background worker arasındaki fark nedir?
Cron esas olarak işin ne zaman başlatılacağını belirler. Background worker ise queue'dan aldığı işin gerçek processing adımlarını yürütür. Birbirinin alternatifi olmak zorunda değildirler. Production pattern olarak cron scheduler job'ı queue'ya ekler ve worker işler. Bu ayrım scaling, retry ve monitoring kontrolünü artırır.
Cron job nasıl oluşturulur?
Linux kullanıcıları çoğu sistemde crontab -e üzerinden schedule ve komut tanımlayabilir. Expression dakika, saat, ay günü, ay ve hafta günü alanlarından oluşur. Command için absolute path kullanmak environment problemlerini azaltır. stdout ve stderr loglanmalıdır. Production job'da time zone, overlap ve missed-run alert de eklenmelidir.
Cron mu systemd timer mı kullanılmalı?
Basit ve taşınabilir işler için cron çoğu zaman yeterlidir. systemd kullanılan sunucularda timer ve service unit logging, dependency ve resource control açısından daha fazla imkan sunabilir. Persistent catch-up gereken bazı görevlerde systemd timer avantajlıdır. Container veya Kubernetes ortamında ise host scheduler yerine platform scheduler daha uygun olabilir. Seçim uygulamanın çalıştığı altyapı ve operasyon ihtiyaçlarına göre yapılmalıdır.
Cron job neden çalışmıyor?
En yaygın nedenler PATH, permission, working directory ve environment variable farklarıdır. Terminalde aktif virtual environment cron tarafından otomatik yüklenmeyebilir. Cron kullanıcısı ilgili dosyaya erişemiyor olabilir. Önce stdout ve stderr loglanmalı, ardından komut gerçek cron kullanıcısı altında test edilmelidir. Daemon ve crontab syntax durumu da kontrol edilmelidir.
Aynı cron job'ın iki kez çalışması nasıl önlenir?
Tek host üzerinde file lock veya flock kullanılabilir. Dağıtık sistemde database veya Redis tabanlı lock değerlendirilebilir. Lock TTL ve crash recovery doğru tasarlanmalıdır. Bununla birlikte lock duplicate ihtimalini tamamen ortadan kaldırmadığı için worker idempotent olmalıdır. Business-level unique constraint en güçlü koruma katmanlarından biridir.
Background job neden queue üzerinden çalıştırılır?
Queue producer ile worker hızını birbirinden ayırır. Ani trafik artışında bütün işleri aynı anda çalıştırmak yerine backlog olarak tamponlar. Retry ve horizontal scaling için merkezi bir kontrol noktası sağlar. Worker failure web request'lerinden izole edilir. Queue depth ve age üzerinden kapasite ölçülebilir.
Celery nedir?
Celery Python ekosisteminde distributed background task processing için kullanılan bir sistemdir. Broker üzerinden task'lar worker'lara taşınır. Redis veya RabbitMQ gibi broker seçenekleri kullanılabilir. Retry, concurrency ve result backend gibi özellikler sunar. Production kullanımında task idempotency ve monitoring ayrıca tasarlanmalıdır.
Celery Beat nedir?
Celery Beat periyodik task'ları schedule'a göre üreten scheduler bileşenidir. Task'ın gerçek processing'ini worker yürütür. Crontab veya interval schedule kullanılabilir. Aynı schedule için birden fazla aktif Beat instance duplicate task üretebilir. Bu nedenle scheduler ownership modeli production'da açık olmalıdır.
BullMQ nedir?
BullMQ Node.js ve TypeScript uygulamalarında Redis tabanlı background job ve queue işleme için kullanılan bir kütüphanedir. Worker, retry, delay, priority ve concurrency gibi özellikler sağlar. Modern sürümlerinde recurring job yönetimi Job Schedulers üzerinden yapılabilir. Redis durability ve failure davranışı production tasarımına dahil edilmelidir. Worker'lar idempotent ve graceful shutdown destekli yazılmalıdır.
BullMQ Job Scheduler nedir?
BullMQ Job Scheduler belirli repeat seçeneklerine göre yeni job'lar üreten scheduler mekanizmasıdır. Sabit interval veya cron pattern kullanılabilir. Stabil scheduler ID ile upsertJobScheduler configuration yönetimini kolaylaştırır. Eski repeatable job API örnekleri kullanılan major sürümle uyumlu olmayabilir. Bu nedenle scheduler kodu BullMQ'nun kullanılan sürümüne ait resmi dokümantasyonla doğrulanmalıdır.
Retry nasıl tasarlanmalıdır?
Önce failure retryable ve permanent olarak sınıflandırılmalıdır. Maximum attempts ve total retry window belirlenmelidir. Geçici hatalarda exponential backoff ve jitter kullanılabilir. HTTP 429 gibi durumlarda Retry-After dikkate alınmalıdır. Attempts tükendiğinde job görünür terminal state veya DLQ'ya taşınmalıdır.
Exponential backoff nedir?
Exponential backoff her yeni retry attempt öncesinde bekleme süresini artırır. Bu yöntem downstream servis arızasında sürekli yüksek request rate'i oluşmasını azaltır. Maximum delay ile büyüme sınırlandırılır. Jitter eklendiğinde aynı anda fail olan job'lar farklı zamanlara dağıtılır. Böylece retry storm riski düşer.
Dead-letter queue nedir?
Dead-letter queue normal retry sürecini tamamlayamayan mesajların ayrı tutulduğu alandır. Permanent failure ve poison job'lar burada incelenebilir. DLQ owner, retention ve alert politikasına sahip olmalıdır. Kök neden düzeltildikten sonra selective replay uygulanabilir. DLQ yalnızca başarısız mesajların unutulduğu bir depo olmamalıdır.
Idempotency neden önemlidir?
Queue sistemlerinde aynı job retry veya redelivery nedeniyle birden fazla kez çalışabilir. Idempotency ikinci execution'ın yeni business yan etkisi üretmesini engeller. Payment, notification ve inventory işlemlerinde özellikle önemlidir. Unique constraint ve business key sık kullanılan yöntemlerdir. External API destekliyorsa provider idempotency key de kullanılmalıdır.
At-least-once delivery nedir?
At-least-once delivery mesajın kaybolmaması için gerektiğinde tekrar teslim edilebildiği modeldir. Worker side effect yaptıktan sonra ack öncesi çökerse aynı job tekrar gelebilir. Bu nedenle duplicate execution sistemin normal olasılıklarından biridir. Consumer idempotent tasarlanmalıdır. Exactly-once business effect çoğu zaman idempotency ile hedeflenir.
Kubernetes CronJob nasıl çalışır?
Kubernetes CronJob belirlenen schedule'a göre Job nesneleri oluşturur. Job gerekli Pod'ları başlatıp batch workload'u yürütür. concurrencyPolicy overlap davranışını, startingDeadlineSeconds gecikmiş schedule sınırını etkiler. History limitleri eski Job nesnelerinin saklanma miktarını kontrol eder. Business işlem duplicate-safe ve idempotent olmalıdır.
Background worker nasıl ölçeklendirilir?
Worker sayısı queue arrival rate ve processing time üzerinden hesaplanabilir. CPU yalnızca tek metric olarak kullanılmamalıdır. Queue depth ve özellikle queue age scaling için güçlü sinyallerdir. Kubernetes ortamında KEDA event-driven autoscaling için kullanılabilir. Maximum worker sayısı database ve external API kapasitesiyle sınırlandırılmalıdır.
Cron job'lar nasıl izlenir?
Her cron job success, failure ve missed-run sinyali üretmelidir. Last successful run timestamp saklanabilir. Duration ve overlapping run metric'leri performans sorunlarını gösterir. Heartbeat belirli pencerede gelmezse alarm üretilebilir. Logs job ID ve güvenli execution context içermelidir.
Background job için Python mı TypeScript mi tercih edilmelidir?
Seçim mevcut ekip ve uygulama stack'ine göre yapılmalıdır. Python Celery ve RQ gibi güçlü seçeneklere, TypeScript ise BullMQ gibi modern Redis tabanlı çözümlere sahiptir. Data-heavy workload Python için doğal olabilirken mevcut Node.js backend ile TypeScript operational sadelik sağlayabilir. Dil ne olursa olsun idempotency, retry, timeout ve observability aynı öneme sahiptir. En iyi seçenek ekibin production'da güvenilir biçimde işletebildiği teknolojidir.
Zamanlanmış görevler (Cron Jobs) nasıl oluşturulur ve yönetilir?
Zamanlanmış görev oluşturmak için önce işin hangi zaman diliminde ve hangi sıklıkta çalışacağı belirlenmelidir. Linux ortamında cron, systemd kullanan hostlarda timer, Kubernetes üzerinde CronJob ve uygulama katmanında scheduler kullanılabilir. Production yönetiminde expression, time zone ve owner bilgisinin version control altında tutulması önemlidir. Job'ın çalışma çıktıları loglanmalı ve last successful run değeri izlenmelidir. Daha kritik sistemlerde schedule yalnızca queue'ya job bırakan küçük bir tetikleyici olarak kullanılır.
Cron Jobs ile arka plan işleyicileri (Background Workers) arasındaki farklar nelerdir?
Cron job zaman tabanlı tetiklemeyi, background worker ise asenkron processing'i temsil eder. Cron belirli saatte bir komut başlatabilir fakat gelişmiş retry, queue buffering veya horizontal scaling sağlamaz. Worker queue'dan görev alarak bu yeteneklerin uygulanmasına uygun bir execution katmanı oluşturur. Bu nedenle production sistemlerinde ikisini birlikte kullanmak oldukça yaygındır. Cron schedule geldiğinde job enqueue eder ve worker gerçek işi yürütür.
Uzun süren veya yoğun görevlerde Cron Job yerine task queue ve background worker ne zaman kullanılmalıdır?
İş HTTP timeout sınırını aşabiliyor, yoğun CPU veya network kullanıyor, retry gerektiriyor veya schedule interval'ından uzun sürebiliyorsa queue güçlü bir adaydır. Cron uzun işlemi doğrudan çalıştırmak yerine küçük producer olarak kullanılabilir. Job'lar chunk'lara ayrılıp birden fazla worker tarafından işlenebilir. Queue backlog ani trafik artışını absorbe eder ve autoscaling worker kapasitesini artırabilir. Long-running işlerde checkpoint ve idempotency recovery sürecini daha güvenilir hale getirir.
Zamanlanmış görevlerde hata yönetimi, retry, loglama ve monitoring süreçleri nasıl yapılandırılmalıdır?
Önce job'ın failure ve missed-run durumları birbirinden ayrılmalıdır. Geçici hatalar sınırlı attempt, exponential backoff ve jitter ile retry edilmeli, kalıcı hatalar gereksiz tekrar almamalıdır. Structured log içinde job ID, attempt ve duration bulunmalıdır. Queue depth, queue age, failure rate ve DLQ depth metrikleri merkezi dashboard'da izlenmelidir. Kritik schedule için expected run ile actual run karşılaştırılarak missed-run alarmı oluşturulmalıdır.
Cron Jobs ve arka plan işleyicileri konusunda yakınımda danışmanlık veya eğitim nerede bulabilirim?
Cron job ve backend otomasyon danışmanlığı yakınımda şeklinde araştırma yapıyorsanız yerel yazılım toplulukları pratik eğitim ve proje geliştirme açısından iyi bir başlangıç noktası olabilir. Diyarbakır'da backend, Linux, queue sistemleri ve production otomasyonu konularını birlikte çalışmak isteyen geliştiriciler Diyarbakır Yazılım Topluluğu çalışmalarını inceleyebilir. Topluluk odaklı atölyeler teorik bilgiyi küçük production benzeri projeler üzerinde denemeyi kolaylaştırır. Özellikle cron, systemd, Redis, Celery, BullMQ ve Kubernetes CronJob gibi başlıklar ortak proje çalışmalarına uygundur. Etkinlik ve topluluk bilgileri için https://www.diyarbakiryazilim.com.tr adresi kullanılabilir.
Sonuç
Zamanlanmış Görevler (Cron Jobs) ve Arka Plan İşleyicileri güvenilir backend otomasyonu kurmanın birbirini tamamlayan iki temel parçasıdır. Cron ve scheduler katmanı "ne zaman", queue "hangi işler bekliyor" ve worker ise "iş nasıl yürütülecek" sorusuna cevap verdiğinde sistem çok daha anlaşılır hale gelir. Production tarafında gerçek farkı yaratan konular ise idempotency, timeout, kontrollü retry, DLQ, graceful shutdown, queue age monitoring ve missed-run alarmıdır. Basit projede yalnızca cron ile başlayabilirsiniz, ancak veri ve trafik büyüdüğünde Scheduler → Queue → Worker modeline geçmek operasyonel kontrolü belirgin biçimde artırır. Backend otomasyonu, açık kaynak projeleri ve uygulamalı yazılım çalışmaları hakkında toplulukla bağlantı kurmak için https://www.diyarbakiryazilim.com.tr adresini ziyaret edebilirsiniz.
share: