Büyük Ölçekli Yazılım Projelerinde Tech Stack Seçimi

Diyarbakır Yazılım
16.08.2026
#Yazılım#Teknoloji#Topluluk
Büyük bir yazılım projesine başlarken en heyecan verici konu çoğu zaman hangi teknolojilerin kullanılacağıdır. Ancak on yıllık proje deneyimimde gördüğüm en pahalı hataların önemli bir bölümü, teknoloji isimlerinin iş ihtiyaçlarından önce konuşulmasıyla başladı. Büyük Ölçekli Yazılım Projelerinde Tech Stack Seçimi, yalnızca bir programlama dili veya framework belirlemek değil, sistemin yıllar boyunca nasıl geliştirileceğini, işletileceğini ve büyütüleceğini belirleyen bir karar sürecidir. Bu nedenle büyük ölçekli yazılım projelerinde tech stack nasıl seçilir sorusunun cevabı, popüler teknoloji listelerinden çok daha geniş bir çerçeve gerektirir. Bu rehberde frontend, backend, veritabanı, bulut, DevOps, güvenlik, maliyet, ekip yetkinliği ve mimari kararları birlikte değerlendirerek savunulabilir bir teknoloji yığını oluşturmanın yollarını ele alacağız.
Tech Stack Nedir?
Tech stack, bir yazılım sisteminin geliştirilmesi ve çalıştırılması için kullanılan teknoloji bileşenlerinin bütünüdür. Bu kavram yalnızca frontend framework ile backend programlama dilinden oluşmaz; veri tabanı, mesajlaşma altyapısı, izleme araçları, deployment modeli ve güvenlik bileşenleri de teknoloji yığınının parçalarıdır. Kurumsal projelerde teknoloji yığını seçerken hangi kriterler değerlendirilir sorusuna doğru cevap verebilmek için önce bu bütünsel bakış açısını kabul etmek gerekir. Bir teknolojinin tek başına güçlü olması, diğer bileşenlerle birlikte iyi bir sistem oluşturacağı anlamına gelmez. İyi bir tech stack, teknik özellikler kadar ekip kapasitesi, işletme modeli, maliyet ve uzun vadeli bakım gereksinimleriyle uyumlu olmalıdır.
Tech Stack Hangi Katmanlardan Oluşur?
Kurumsal sistemlerde teknoloji yığını birbiriyle bağlantılı birçok katmandan oluşur. Kullanıcının gördüğü arayüzden veri tabanına, servis iletişiminden güvenlik altyapısına kadar her katman diğerlerinin davranışını etkileyebilir. Örneğin backend üzerinde seçilen concurrency modeli, veritabanı bağlantı havuzundan bulut maliyetlerine kadar geniş bir etki yaratabilir. Bu nedenle teknoloji bileşenlerini bağımsız seçimler olarak değil, birbirini etkileyen bir sistem olarak değerlendirmek gerekir. Büyük projelerde frontend backend veritabanı bulut ve DevOps teknoloji seçimi yapılırken bu bağımlılıkların erken aşamada görünür hâle getirilmesi ciddi avantaj sağlar.
Frontend
Frontend katmanı kullanıcıların sistemle doğrudan etkileşime geçtiği bölümdür ve yalnızca görsel arayüz oluşturmak için seçilmez. Kullanıcı deneyimi, sayfa açılış süresi, SEO gereksinimleri, erişilebilirlik ve tarayıcı desteği teknoloji kararını etkiler. Büyük kurumsal panellerde yoğun istemci tarafı etkileşimi gerekirken içerik odaklı sistemlerde server-side rendering daha önemli olabilir. Ekipteki frontend uzmanlığı da framework seçimini doğrudan etkiler, çünkü güçlü bir teknoloji yanlış ekip yapısında bakım yüküne dönüşebilir. Bu yüzden frontend tercihini trendlerden değil, gerçek kullanıcı senaryolarından çıkarmak daha güvenilir sonuç verir.
Backend
Backend katmanı iş kurallarının, entegrasyonların, veri erişiminin ve güvenlik kontrollerinin önemli bölümünü taşır. Node.js Java Spring .NET ve Python kurumsal backend karşılaştırması yapılırken yalnızca benchmark sonuçlarına bakmak yeterli değildir. Transaction yoğunluğu, eşzamanlı bağlantı sayısı, entegrasyon biçimleri, geliştirici havuzu ve uygulamanın operasyonel davranışı birlikte değerlendirilmelidir. Yüksek işlem hacmine sahip finansal bir sistemle içerik yönetimi yapan kurumsal bir platformun backend ihtiyaçları aynı olmayabilir. Bu nedenle backend teknolojisi seçerken workload ve domain gereksinimleri kararın temelini oluşturmalıdır.
Database
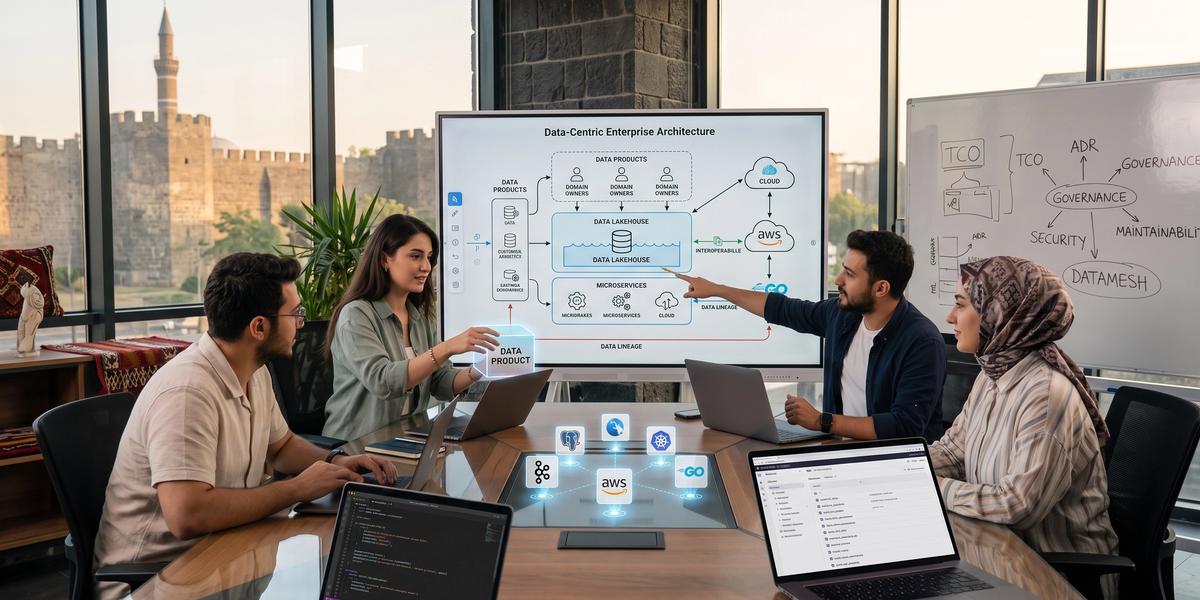
Database seçimi verinin nasıl tutulacağını, sorgulanacağını ve güvence altına alınacağını belirleyen uzun vadeli bir karardır. Birçok ekip SQL veya NoSQL tartışmasına çok erken başlar ve gerçek erişim modellerini ikinci plana atar. Oysa transaction ihtiyacı, veri ilişkileri, tutarlılık seviyesi, raporlama gereksinimleri ve veri büyüme hızı çok daha anlamlı kriterlerdir. Veri modelinin gelecekte değişeceği varsayımı da schema evolution yaklaşımını etkiler. Veri odaklı kurumsal mimariler konusunda daha geniş bir bakış için https://www.diyarbakiryazilim.com.tr/posts/veri-merkezli-data-centric-kurumsal-mimariler adresindeki içeriği de inceleyebilirsiniz.
Cache
Cache katmanı gecikmeyi azaltmak ve tekrarlanan veri erişimlerinin maliyetini düşürmek için kullanılır. Ancak her sisteme otomatik olarak cache eklemek doğru bir yaklaşım değildir. Cache invalidation, tutarsız veri ve operasyonel takip gibi yeni problemler oluşturabilir. Önce performans probleminin gerçekten veri erişiminden kaynaklandığını ölçmek daha sağlıklıdır. Cache kullanılacaksa veri ömrü, invalidation stratejisi ve hata durumunda sistemin nasıl davranacağı açık biçimde tasarlanmalıdır.
Messaging
Messaging teknolojileri servislerin birbirinden bağımsız çalışmasını ve bazı işlerin asenkron yürütülmesini sağlayabilir. Queue tabanlı işleme ile event streaming aynı ihtiyacı çözmediği için seçim öncesinde kullanım amacı netleştirilmelidir. Teslim garantisi, mesaj sıralaması, throughput beklentisi ve retention süresi kararın önemli parçalarıdır. Messaging eklemek aynı zamanda izleme, hata yönetimi ve yeniden işleme mekanizmaları gerektirir. Bu nedenle mesajlaşma altyapısı yalnızca mimariyi modern göstermek için değil, ölçülebilir bir problemi çözmek için kullanılmalıdır.
Infrastructure
Infrastructure katmanı uygulamanın nerede ve hangi kaynaklarla çalışacağını belirler. Sanal makineler, container altyapısı, serverless servisler ve yönetilen bulut hizmetleri farklı operasyon modelleri sunar. Doğru seçim workload davranışına, ekip kapasitesine, regülasyonlara ve maliyet beklentisine bağlıdır. Yüksek kontrol ihtiyacı olan sistemlerle değişken trafik alan sistemlerin altyapı tercihleri doğal olarak farklılaşabilir. Bu nedenle infrastructure kararı uygulama mimarisinden bağımsız ele alınmamalıdır.
CI/CD
CI/CD, geliştirilen yazılımın güvenli ve tekrarlanabilir biçimde test edilip dağıtılmasını sağlar. Büyük ekiplerde manuel deployment süreçleri hata ihtimalini artırır ve teslim hızını düşürür. Build süresi, test süresi, rollback desteği ve environment yönetimi CI/CD yaklaşımının önemli parçalarıdır. İyi tasarlanmış pipeline, geliştirici deneyimini de doğrudan iyileştirir. Teknoloji seçerken ilgili ekosistemin otomasyon araçlarıyla ne kadar rahat bütünleştiğini değerlendirmek bu nedenle önemlidir.
Observability
Observability sistemin üretim ortamındaki davranışını anlayabilme kapasitesidir. Log, metric ve trace verilerinin bir arada değerlendirilmesi özellikle dağıtık sistemlerde büyük önem taşır. Sadece hata meydana geldiğinde log dosyasına bakmak büyük sistemlerde yeterli değildir. Teknoloji yığını seçilirken kullanılan framework ve runtime'ın izleme araçlarıyla entegrasyonu incelenmelidir. Operasyon ekibinin problemi hızlı tanımlayabilmesi, çoğu zaman ham performans farkından daha büyük bir iş değeri üretir.
Security
Security, teknoloji yığınının sonradan eklenen bir katmanı değil temel seçim kriterlerinden biri olmalıdır. Kimlik doğrulama, yetkilendirme, secret yönetimi, dependency güvenliği ve güncelleme politikası erken aşamada değerlendirilmelidir. Kullanılan framework'ün güvenlik güncellemelerini ne kadar süre aldığı önemli bir göstergedir. Aynı şekilde dependency ağacının yönetilebilir olması da supply chain riskini azaltır. Güvenlik yaklaşımı teknoloji seçiminden production operasyonuna kadar kesintisiz devam etmelidir.
Tech Stack ile Software Architecture Aynı Şey mi?
Tech stack ile software architecture birbiriyle ilişkili olsa da aynı kavram değildir. Tech stack hangi teknolojilerin kullanılacağını anlatırken mimari, bu bileşenlerin nasıl organize edildiğini ve birbirleriyle nasıl iletişim kurduğunu tanımlar. Java kullanmak bir teknoloji seçimidir, Java tabanlı modular monolith kurmak ise mimari bir karardır. Benzer şekilde PostgreSQL kullanmak stack kararıyken her servisin ayrı veritabanına sahip olması mimari yaklaşımdır. Kurumsal yazılım mimarisi ve tech stack danışmanlığı hizmeti bu nedenle teknoloji listesinden çok kararların birlikte nasıl çalışacağını değerlendirmelidir.
Büyük Ölçekli Projede Stack Seçimi Neden Stratejik Karardır?
Büyük sistemlerde teknoloji kararları yıllarca devam eden geliştirme, işe alım ve operasyon maliyetlerini etkiler. Bir framework değiştirilebilirken temel veri modeli veya kimlik altyapısı gibi kararların değiştirilmesi çok daha pahalı olabilir. Bu nedenle stack seçimi yalnızca geliştirici ekibinin teknik tercihi olarak görülmemelidir. Ürün hedefleri, güvenlik, bütçe, insan kaynağı ve büyüme beklentileri karar sürecine dahil edilmelidir. İyi bir seçim kısa vadede hızlı geliştirme sağlarken uzun vadede de işletilebilir ve sürdürülebilir kalmalıdır.
“En İyi Tech Stack” Diye Bir Şey Var mı?
Tek başına her proje için geçerli bir en iyi tech stack yoktur. Aynı teknoloji bir projede harika sonuç verirken başka bir projede gereksiz maliyet veya operasyon yükü oluşturabilir. Bunun temel nedeni her sistemin iş modeli, trafik yapısı, güvenlik gereksinimleri ve ekip deneyiminin farklı olmasıdır. Bu yüzden teknoloji seçiminde amaç en güçlü aracı bulmak değil, mevcut bağlam için en uygun karar setini oluşturmaktır. Büyük Ölçekli Yazılım Projelerinde Tech Stack Seçimi yapılırken bu yaklaşım gereksiz teknoloji değişimlerini de önemli ölçüde azaltır.
Teknoloji Seçiminde Context Neden Önemlidir?
Context bir teknolojinin hangi koşullarda kullanılacağını tanımlar ve karar sürecinin başlangıç noktasıdır. Kullanıcı sayısı düşük fakat transaction değeri yüksek bir sistemle milyonlarca anonim ziyaret alan bir platform aynı şekilde tasarlanmaz. Benzer biçimde on kişilik deneyimli bir ekip ile yüzlerce geliştiricinin çalıştığı organizasyonun standartlaşma ihtiyacı farklıdır. Regülasyonlar, bütçe, teslim süresi ve mevcut altyapı da bağlamın parçalarıdır. Bu bilgiler netleşmeden yapılan teknoloji karşılaştırmaları çoğu zaman teorik seviyede kalır.
Benchmark Lideri Olmak Neden Yeterli Değildir?
Benchmark sonuçları belirli koşullarda teknolojilerin ham performansını karşılaştırmak için yararlı olabilir. Ancak gerçek production sistemi yalnızca saniyedeki istek sayısından ibaret değildir. Veritabanı erişimi, network gecikmesi, harici servisler, logging ve iş kuralları toplam performansı önemli ölçüde etkiler. Ayrıca ekip üretkenliği ile hata çözme süresi benchmark sonuçlarında görünmez. Bu nedenle benchmark verileri kararın bir girdisi olmalı, kararın kendisi hâline gelmemelidir.
Popülerlik ile Uygunluk Arasındaki Fark
Popüler teknolojiler geniş topluluk, daha fazla dokümantasyon ve daha güçlü geliştirici havuzu sağlayabilir. Buna rağmen popülerlik tek başına belirli bir projenin gereksinimlerini karşıladığı anlamına gelmez. Bazı projelerde daha olgun ve daha az heyecan uyandıran bir çözüm çok daha düşük risk taşıyabilir. Karar verirken popülerliği ekosistem sağlığının bir göstergesi olarak kullanmak mantıklıdır. Fakat son seçim workload, ekip ve operasyon koşullarıyla doğrulanmalıdır.
Boring Technology Yaklaşımı
Boring Technology yaklaşımı, iyi bilinen ve operasyonel davranışı anlaşılmış teknolojilerin değerini vurgular. Büyük bir sistemde her bileşenin yeni olması, öğrenme ve hata çözme maliyetini artırabilir. Ekip aynı anda hem yeni domain problemleriyle hem de bilinmeyen altyapı davranışlarıyla uğraşmak zorunda kalabilir. Olgun teknolojiler dokümantasyon, tooling ve production deneyimi açısından önemli avantaj sağlayabilir. Yenilik gerekiyorsa bunu sistemin her noktasına yaymak yerine gerçek fayda sağlayan sınırlı alanlarda kullanmak daha dengeli olur.
Innovation Nerede Kullanılmalı?
Yeni teknolojiler belirli bir iş problemini açık biçimde daha iyi çözüyorsa değerlendirilmelidir. Örneğin mevcut teknolojinin performans, geliştirme hızı veya maliyet açısından ciddi sınırı varsa yeni bir çözüm anlamlı olabilir. Ancak yenilik kullanımının PoC ve ölçülebilir kriterlerle desteklenmesi gerekir. Kritik çekirdek bileşenlerde deneysel seçim yapmak daha yüksek risk doğururken çevresel servislerde deneme yapmak daha güvenli olabilir. İnovasyonun amacı yeni teknoloji kullanmak değil, sistemin ölçülebilir bir ihtiyacını daha iyi karşılamaktır.
Tech Stack Seçimine Teknolojilerden Değil Gereksinimlerden Başlamak
İyi bir teknoloji seçimi toplantısı “hangi framework'ü kullanalım?” sorusuyla başlamamalıdır. Önce sistemin ne yapması, kaç kullanıcıya hizmet vermesi ve hangi kalite hedeflerini karşılaması gerektiği yazılmalıdır. Business, functional ve non-functional requirements bu aşamada ortak bir karar zemini sağlar. Gereksinimler net olduğunda uygun olmayan adaylar doğal biçimde elenir. Böylece teknik tartışmalar kişisel tercihlerden ölçülebilir kriterlere taşınır.
Business Requirements
Business requirements sistemin hangi iş sonucunu üretmesi gerektiğini açıklar. Gelir modeli, müşteri segmenti, büyüme hedefi ve teslim zamanı teknoloji kararının sınırlarını etkileyebilir. Örneğin pazara üç ayda çıkması gereken bir ürün ile beş yıllık dönüşüm programının teknoloji stratejisi aynı olmayabilir. Teknik ekip bu hedefleri anlamadan verdiği kararlarda gereğinden fazla altyapı kurabilir. Bu nedenle teknoloji seçiminden önce iş hedeflerinin ölçülebilir şekilde tanımlanması önemlidir.
Functional Requirements
Functional requirements kullanıcıların ve sistemlerin gerçekleştireceği işlevleri tanımlar. Sipariş oluşturma, rapor üretme, ödeme işleme veya canlı bildirim gönderme gibi özellikler teknik ihtiyaçları doğrudan etkiler. Bu gereksinimler entegrasyon, veri modeli ve transaction tasarımını belirlemede yardımcı olur. Kritik kullanım senaryolarını önceliklendirmek teknoloji seçiminde daha sağlıklı karşılaştırma sağlar. Özellikle PoC aşamasında gerçek functional requirements üzerinden ilerlemek soyut demo çalışmalarından daha değerlidir.
Non-Functional Requirements
Non-functional requirements sistemin işlevleri hangi kalite seviyesinde gerçekleştirmesi gerektiğini açıklar. Performance, availability, security, maintainability ve compliance bu grubun temel örnekleridir. Büyük projelerde teknolojiler arasındaki gerçek fark çoğu zaman bu gereksinimler üzerinde ortaya çıkar. İşlevsel olarak aynı işi yapabilen iki teknoloji operasyon ve ölçek davranışında çok farklı sonuçlar verebilir. Bu nedenle non-functional requirements mümkün olduğunca ölçülebilir hedeflerle belgelenmelidir.
Performance
Performance gereksinimi sistemin belirli işlemleri hangi hızda tamamlaması gerektiğini tanımlar. “Sistem hızlı olmalı” gibi ifadeler teknoloji seçmek için yeterli değildir. Bunun yerine p95 latency, p99 latency veya saniyedeki işlem sayısı gibi ölçüler kullanılmalıdır. Farklı endpoint veya iş akışlarının farklı performans hedefleri olabilir. Bu hedefler PoC ve production testlerinde aynı ölçüm yaklaşımıyla doğrulanmalıdır.
Scalability
Scalability sistemin artan yük karşısında nasıl kapasite ekleyebileceğini ifade eder. Her projenin sınırsız ölçeklenmeye ihtiyacı yoktur ve gereğinden fazla ölçek hedeflemek maliyeti artırabilir. Beklenen kullanıcı büyümesi, peak trafik ve veri hacmi gerçekçi şekilde modellenmelidir. Teknoloji seçiminde horizontal scaling desteği kadar state yönetimi ve veri katmanı da değerlendirilmelidir. Ölçeklenebilirlik hedefleri mümkün olduğunca iş tahminleriyle ilişkilendirilmelidir.
Availability
Availability sistemin hangi oranda erişilebilir olması gerektiğini gösterir. Yüzde 99,9 ile yüzde 99,99 hedefleri arasında altyapı ve maliyet açısından ciddi fark olabilir. Kritik servislerin tamamının aynı availability seviyesine sahip olması gerekmeyebilir. Kullanıcıya en fazla değer sağlayan iş akışları için daha yüksek hedef belirlemek daha ekonomik bir yaklaşım olabilir. Tech stack bu hedefleri destekleyecek redundancy ve recovery seçeneklerine sahip olmalıdır.
Security
Security gereksinimleri sistemin koruması gereken veri ve işlemlere göre değişir. Kimlik verileri, finansal kayıtlar veya hassas kurumsal belgeler farklı güvenlik kontrolleri gerektirebilir. Framework ve platform seçiminde authentication, authorization, encryption ve audit yetenekleri değerlendirilmelidir. Güvenlik ekibinin kullanılan teknolojiyi destekleyebilmesi de pratik açıdan önemlidir. Erken aşamada ele alınan güvenlik gereksinimleri sonradan yapılacak pahalı mimari değişiklikleri azaltır.
Maintainability
Maintainability kod tabanının ve altyapının yıllar boyunca ne kadar rahat değiştirilebildiğini ifade eder. Büyük ekiplerde anlaşılır kod yapısı, stabil framework davranışı ve güçlü tooling ciddi değer üretir. Küçük bir performans avantajı uğruna bakım maliyetini yükseltmek çoğu projede iyi bir takas değildir. Upgrade süreçlerinin kolaylığı ve backward compatibility de bu kriterin parçasıdır. Teknoloji seçiminde yalnızca ilk geliştirme süresi değil sonraki yıllardaki değişiklik maliyeti de düşünülmelidir.
Compliance
Compliance özellikle regülasyona tabi projelerde teknoloji seçeneklerini doğrudan sınırlayabilir. Veri lokasyonu, audit kayıtları, encryption gereksinimleri ve erişim kontrolü gibi konular altyapı kararlarını etkiler. Bazı yönetilen servisler gerekli sertifikasyonları sağlayarak operasyon yükünü azaltabilir. Buna karşılık belirli veri yerleşimi gereksinimleri bazı servisleri kullanılamaz hâle getirebilir. Bu nedenle compliance değerlendirmesi proje sonuna bırakılmamalıdır.
Hard Constraints
Hard constraints pazarlık edilemeyen veya değiştirilemeyen proje sınırlarıdır. Mevcut kurumsal lisanslar, belirli veri merkezleri, zorunlu entegrasyon protokolleri veya mevzuat gereksinimleri bu gruba girebilir. Bu sınırlamalar aday teknolojilerin önemli bölümünü daha değerlendirme başında eleyebilir. Hard constraints açıkça belgelenmezse ekip uygulanamayacak seçenekler üzerinde zaman kaybedebilir. Karar matrisi oluşturulurken bu kriterler puan yerine doğrudan eleme koşulu olarak ele alınabilir.
Nice-to-Have Requirements
Nice-to-have requirements faydalı ancak zorunlu olmayan özellikleri ifade eder. Daha kısa build süresi, daha geniş plugin ekosistemi veya belirli bir yönetim ekranı buna örnek olabilir. Bu özellikler temel gereksinimlerle aynı ağırlığa sahip olmamalıdır. Aksi durumda ekip güzel görünen özellikler için kritik güvenlik veya operasyon hedeflerinden taviz verebilir. Weighted decision matrix içinde nice-to-have kriterlerine daha düşük ağırlık vermek dengeli bir değerlendirme sağlar.
Workload'u Tanımlamadan Stack Seçmeyin
Workload, sistemin gerçek çalışma biçimini anlatan teknik profil olarak düşünülebilir. Kullanıcı sayısı kadar aynı anda aktif kullanıcı sayısı, istek yoğunluğu, veri hacmi ve trafik dalgalanmaları da önemlidir. Aynı aylık kullanıcı sayısına sahip iki ürün tamamen farklı altyapı davranışları gösterebilir. Bu yüzden kapasite planlaması yalnızca toplam kullanıcı üzerinden yapılmamalıdır. Sağlam bir workload modeli backend, veri tabanı, cache, messaging ve cloud seçimlerini çok daha anlamlı hâle getirir.
Kullanıcı Sayısı
Kullanıcı sayısı sistemin potansiyel erişim büyüklüğü hakkında ilk göstergelerden biridir. Ancak kayıtlı kullanıcı sayısı doğrudan altyapı yükü anlamına gelmez. Bir milyon kayıtlı kullanıcının yalnızca küçük bölümü günlük aktif olabilir. Kullanıcı segmentleri ve kullanım sıklığı birlikte incelendiğinde daha gerçekçi kapasite tahmini yapılabilir. Bu nedenle teknoloji seçiminde kayıtlı kullanıcı sayısını tek başına ölçek göstergesi olarak kullanmamak gerekir.
Concurrent Users
Concurrent users aynı anda sistemi aktif biçimde kullanan kullanıcı sayısını ifade eder. Backend concurrency modeli, connection pool ve realtime altyapısı açısından bu metrik önemlidir. Özellikle websocket veya uzun süre açık bağlantı kullanan sistemlerde concurrent user sayısı toplam request sayısından daha anlamlı olabilir. Peak dönemlerde bu değerin nasıl değiştiği de ayrıca hesaplanmalıdır. PoC testlerinin beklenen concurrent user seviyesini taklit etmesi teknoloji karşılaştırmasını güçlendirir.
Request per Second
Request per second servislerin belirli zaman diliminde işlemek zorunda olduğu istek sayısını gösterir. Ortalama RPS tek başına yeterli değildir çünkü sistemler genellikle kısa süreli trafik artışları yaşar. Peak RPS, endpoint dağılımı ve request maliyeti birlikte değerlendirilmelidir. Basit bir health check ile yoğun veritabanı sorgusu aynı ağırlığa sahip değildir. Load test senaryolarında gerçek endpoint karışımını kullanmak daha doğru sonuç sağlar.
Data Volume
Data volume yalnızca disk üzerinde tutulan toplam veri miktarı değildir. Günlük veri artışı, index boyutları, backup hacmi ve retention politikası da bu hesaplamaya dahil edilmelidir. Büyük veri kümeleri sorgu performansını ve restore sürelerini doğrudan etkileyebilir. Veri büyümesinin birkaç yıllık projeksiyonu database ve storage kararlarını daha güvenli hâle getirir. Bu değerlendirme aynı zamanda cloud maliyetlerinin erken tahmin edilmesine yardımcı olur.
Read / Write Ratio
Read ve write oranı veri katmanının hangi tür yük altında çalışacağını anlamaya yardımcı olur. Okuma ağırlıklı sistemlerde caching ve read replica gibi yaklaşımlar etkili olabilir. Yazma yoğun sistemlerde ise transaction davranışı, lock mekanizmaları ve storage throughput daha önemli hâle gelir. Oranı yalnızca sistem geneli için değil kritik tablolar ve kullanım senaryoları için ölçmek faydalıdır. Bu bilgi veritabanı teknolojisi kadar veri modelini de etkileyebilir.
Batch Workloads
Batch workloads büyük veri gruplarını belirli zamanlarda toplu olarak işleyen operasyonları ifade eder. Gece çalışan raporlama işleri, veri aktarımı veya faturalama süreçleri tipik örneklerdir. Bu işler kullanıcı trafiği düşükken bile yoğun CPU, memory veya database load oluşturabilir. Batch işlerinin ana sistemle kaynak rekabeti yaratmaması için ayrı kapasite stratejisi gerekebilir. Stack seçiminde scheduler, queue ve worker modeli bu nedenle değerlendirilmelidir.
Real-Time Workloads
Real-time workloads verinin veya olayların çok düşük gecikmeyle işlenmesini gerektirir. Canlı konum, mesajlaşma, trading veya operasyon ekranları buna örnek olabilir. Bu tür sistemlerde connection modeli, event processing ve network davranışı klasik request-response uygulamalarından farklıdır. Real-time ihtiyacın hangi fonksiyonlar için gerçekten gerekli olduğu netleştirilmelidir. Her işlemi real-time tasarlamak sistemi gereksiz biçimde zorlaştırabilir.
Geographic Distribution
Geographic distribution kullanıcıların ve verinin farklı bölgelerde bulunmasını ifade eder. Kullanıcı kitlesi tek ülkedeyse multi-region mimari gerekmeyebilir. Buna karşılık küresel kullanıcı tabanı latency ve data residency gereksinimlerini değiştirebilir. CDN, bölgesel deployment ve veri replikasyonu bu noktada değerlendirilir. Coğrafi dağılım kararları özellikle cloud provider ve disaster recovery stratejisiyle birlikte düşünülmelidir.
Peak Traffic
Peak traffic sistemin normal ortalamanın üzerinde yük aldığı dönemleri gösterir. Kampanya, maaş günü, bilet satışı veya dönemsel raporlama gibi olaylar kısa sürede büyük trafik artışı yaratabilir. Ortalama kapasiteye göre tasarlanan sistem bu dönemlerde başarısız olabilir. Buna karşılık yalnızca teorik en kötü senaryoya göre sürekli kapasite ayırmak da maliyeti yükseltir. Autoscaling, queue ve cache gibi mekanizmalar peak davranışına göre değerlendirilmelidir.
Performance Gereksinimleri Nasıl Tanımlanır?
Performance hedefleri ölçülebilir olmadığı sürece ekip içinde farklı yorumlara açık kalır. Kullanıcı deneyimini doğrudan etkileyen işlemler için latency hedefleri, yoğun işlem yapan servisler için throughput hedefleri belirlenebilir. Ortalama değerlerin yanında p95 ve p99 değerleri de izlenmelidir. CPU ve memory profili ise kapasite planlamasının önemli girdileridir. Gerçekistic production workload üzerinden test edilen hedefler teknoloji seçiminde güvenilir veri sağlar.
Throughput
Throughput sistemin belirli sürede tamamlayabildiği işlem miktarını ifade eder. Yüksek throughput gerektiren servislerde concurrency modeli ve veri erişim stratejisi önemli hâle gelir. Ancak yüksek throughput her sistem için temel hedef değildir. Kritik olan gerekli iş hacmini beklenen latency sınırları içinde karşılamaktır. Bu nedenle throughput hedefi iş hacmi tahminleriyle bağlantılı kurulmalıdır.
Average Latency
Average latency genel performans eğilimini görmek için yararlı bir metriktir. Fakat uç kullanıcı deneyimindeki yavaş istekleri tek başına görünür kılmayabilir. Bir sistemin ortalaması düşük olsa bile kullanıcıların belirli bölümü ciddi gecikme yaşayabilir. Bu nedenle average latency mutlaka percentile değerleriyle birlikte okunmalıdır. Teknoloji karşılaştırmasında tek bir ortalama sayı üzerinden karar vermek yanıltıcı olabilir.
p95 Latency
p95 latency isteklerin yüzde 95'inin hangi sürenin altında tamamlandığını gösterir. Kullanıcı deneyimini değerlendirmek için ortalama latency'den daha anlamlı olabilir. Özellikle dış servis çağrıları ve database query davranışları p95 değerini etkileyebilir. Load test sırasında p95 hedeflerinin belirli trafik seviyesinde korunup korunmadığı izlenmelidir. Bu ölçüm performans regresyonlarını production öncesinde yakalamaya yardımcı olur.
p99 Latency
p99 latency en yavaş yüzde birlik istek grubunun davranışını anlamaya yardımcı olur. Kritik finansal veya gerçek zamanlı sistemlerde bu uç değerler önemli olabilir. Garbage collection, network timeout veya connection pool sorunları p99 üzerinde belirgin hâle gelebilir. Teknoloji seçerken runtime davranışını bu tür yük testlerinde görmek faydalıdır. Her projede çok agresif p99 hedefi belirlemek ise gereksiz kaynak maliyeti yaratabilir.
CPU ve Memory Requirements
CPU ve memory gereksinimleri uygulamanın altyapı maliyetini doğrudan etkiler. Aynı throughput seviyesini sağlayan iki runtime farklı kaynak profilleri gösterebilir. Bu fark özellikle yüzlerce instance çalışan sistemlerde önemli maliyet etkisi oluşturabilir. Bununla birlikte düşük memory kullanımı tek başına daha iyi geliştirici verimliliği anlamına gelmez. Kaynak tüketimi TCO hesaplaması içinde ekip maliyetiyle birlikte değerlendirilmelidir.
Benchmark ile Gerçek Production Workload Arasındaki Fark
Sentetik benchmark'lar teknolojileri kontrollü koşullarda kıyaslamak için faydalıdır. Production ortamında ise authentication, logging, database, network ve harici entegrasyonlar devreye girer. Bu bileşenler ham framework performansından çok daha büyük gecikmeler yaratabilir. Ayrıca production load sabit ve temiz bir dağılım göstermez. Bu nedenle final karar mümkün olduğunca gerçek use case içeren PoC ve realistic load test ile doğrulanmalıdır.
Scalability Tech Stack Seçimini Nasıl Etkiler?
Scalability ihtiyacı yalnızca daha fazla sunucu ekleyebilmek anlamına gelmez. Uygulamanın state modeli, veri tabanı davranışı, cache yapısı ve async processing yaklaşımı birlikte ölçeklenmelidir. Bazı sistemler vertical scaling ile yıllarca rahatça çalışabilirken bazıları erken dönemde horizontal scaling ihtiyacı gösterebilir. Burada gerçekçi büyüme tahmini yapmak çok önemlidir. Gereksiz ölçek varsayımları sistemi başlangıçtan itibaren pahalı ve yönetimi zor hâle getirebilir.
Vertical Scaling
Vertical scaling mevcut sunucuya daha fazla CPU, memory veya storage kapasitesi eklemektir. Basitliği nedeniyle birçok sistem için ilk kapasite artırma yöntemi olabilir. Uygulamada dağıtık koordinasyon gerektirmediği için operasyon maliyeti düşüktür. Bununla birlikte fiziksel ve mali sınırlar bulunduğundan sonsuza kadar devam edemez. Büyük ölçek hedefi olan sistemlerde vertical scaling geçerli bir aşama olarak görülmeli, başarısız bir mimari işareti sayılmamalıdır.
Horizontal Scaling
Horizontal scaling yükü birden fazla uygulama instance'ı veya node arasında dağıtır. Stateless servisler bu modele daha kolay uyum sağlar. Ancak veri katmanı, session state ve background job koordinasyonu ek tasarım gerektirebilir. Horizontal scaling kullanmak otomatik olarak yüksek ölçek sağlandığı anlamına gelmez. Sistemin en yavaş veya en stateful bileşeni toplam kapasiteyi sınırlamaya devam edebilir.
Stateless Services
Stateless services request'ler arasında local instance üzerinde zorunlu state tutmaz. Bu yaklaşım load balancer arkasında yeni instance eklemeyi kolaylaştırır. Session veya kalıcı durum merkezi bir datastore ya da başka güvenilir bileşen üzerinden yönetilir. Bununla birlikte her state'i harici sisteme taşımak ek network maliyeti oluşturabilir. Uygulama tasarımı gerçek ihtiyaçlara göre stateless davranışı mümkün olduğunca desteklemelidir.
Stateful Systems
Stateful sistemler belirli işlemler veya veriler için node seviyesinde durum tutabilir. Database, streaming broker ve bazı cache sistemleri doğal olarak stateful davranır. Bu bileşenlerde scaling ve failover stateless servislerden daha fazla planlama ister. Replication, quorum ve storage dayanıklılığı gibi kavramlar kararın parçası olur. Tech stack değerlendirmesinde stateful bileşenlerin operasyon yükü göz ardı edilmemelidir.
Data Partitioning
Data partitioning büyük veri kümelerini belirli kurallarla bölerek yükü dağıtmayı amaçlar. Tenant, tarih veya anahtar aralığı gibi kriterler kullanılabilir. Yanlış partition anahtarı hotspot oluşmasına ve sorguların zorlaşmasına yol açabilir. Bu nedenle partitioning erken optimizasyon olarak değil, ölçülen ölçek ihtiyacına göre uygulanmalıdır. Seçilen veritabanının repartitioning ve operational tooling desteği de değerlendirilmelidir.
Caching
Caching tekrarlanan okumaları daha hızlı bir katmandan karşılayarak backend yükünü azaltabilir. Özellikle read-heavy uygulamalarda ciddi kapasite kazancı sağlayabilir. Fakat stale data, invalidation ve cache stampede gibi problemler yeni hata senaryoları oluşturur. Cache olmadan sistemin ne kadar trafik taşıyabildiğini bilmek doğru kapasite planlaması için önemlidir. Bu nedenle caching ölçümle doğrulanan darboğazlarda kullanılmalıdır.
Queue-Based Load Levelling
Queue-based load levelling ani yük artışlarını kuyruğa alarak worker kapasitesine uygun hızda işlemeyi sağlar. Kullanıcının sonucu anında beklemek zorunda olmadığı operasyonlarda etkili bir yöntemdir. Email gönderimi, rapor üretimi veya dosya işleme tipik örneklerdir. Queue kullanımı retry, idempotency ve dead-letter yönetimi gibi yeni gereksinimler getirir. Bu nedenle messaging altyapısının operasyon davranışı da stack değerlendirmesine dahil edilmelidir.
Scaling İhtiyacını Gereğinden Fazla Tahmin Etmemek
Birçok proje ilk günden milyonlarca eşzamanlı kullanıcıya göre tasarlanarak gereksiz maliyet üretir. İş tahminleri belirsizken çok karmaşık dağıtık mimari kurmak geliştirme hızını azaltabilir. Ölçek hedefleri beklenen kullanıcı büyümesi ve gerçek trafik verileri üzerinden kademeli belirlenmelidir. Sistem kapasite sınırlarını gözlemlemek için metric ve load test altyapısı kurulabilir. Böylece mimari gerçek gereksinim ortaya çıktığında kontrollü biçimde genişletilebilir.
Reliability ve Availability Gereksinimleri
Reliability sistemin doğru davranışı sürdürebilmesini, availability ise kullanıcı tarafından erişilebilir kalmasını ifade eder. Büyük projelerde bu kavramlar yalnızca altyapı ekibinin konusu değildir. Uygulama tasarımı, database, deployment stratejisi ve üçüncü taraf servisler toplam güvenilirliği etkiler. SLA ve SLO gibi ölçüler hedefleri görünür hâle getirir. Stack seçerken hata senaryolarının nasıl yönetileceği normal çalışma senaryoları kadar önemlidir.
SLA
SLA hizmet sağlayıcı ile müşteri veya iş birimi arasındaki resmi hizmet seviyesi taahhüdüdür. Availability, response time veya destek süresi gibi ölçümler içerebilir. Teknoloji seçimi SLA hedeflerini sağlayabilecek altyapı ve operasyon modelini desteklemelidir. Çok yüksek SLA hedefleri daha fazla redundancy ve operasyon yatırımı gerektirir. Bu nedenle taahhütler teknik kapasite ve iş değeriyle uyumlu belirlenmelidir.
SLO
SLO ekiplerin belirli bir hizmet kalitesi için takip ettiği ölçülebilir hedefi ifade eder. Örneğin başarılı request oranı veya belirli latency sınırı SLO olarak kullanılabilir. SLO, teknik ekiplerin güvenilirlik ile geliştirme hızı arasında bilinçli karar vermesine yardımcı olur. Kullanılan observability altyapısının bu hedefleri ölçebilmesi gerekir. Stack değerlendirmesinde metric üretme ve takip kolaylığı bu nedenle önemli bir operability kriteridir.
Error Budget
Error budget belirlenen SLO'nun izin verdiği hata veya kesinti miktarını ifade eder. Ekip bu bütçeyi kullanarak yeni özellik teslimi ile güvenilirlik yatırımı arasında denge kurabilir. Error budget hızla tüketiliyorsa yeni değişikliklerden önce reliability problemlerine odaklanmak gerekebilir. Bu yaklaşım teknoloji kararlarını duygusal tartışmalardan ölçülebilir sonuçlara taşır. Stack'in hata oranlarının izlenebilir olması error budget modelinin uygulanmasını kolaylaştırır.
Fault Tolerance
Fault tolerance sistemin belirli bileşenler başarısız olduğunda çalışmaya devam edebilme yeteneğidir. Retry, replication, circuit breaker ve graceful fallback gibi teknikler kullanılabilir. Ancak her servisi her hataya karşı tamamen dayanıklı yapmak ciddi maliyet oluşturabilir. Kritik kullanıcı akışları için hangi arızaların tolere edilmesi gerektiği belirlenmelidir. Seçilen teknoloji ve platformun bu mekanizmaları anlaşılır biçimde desteklemesi operasyon riskini azaltır.
High Availability
High availability tek bir bileşenin arızasının tüm hizmeti durdurmamasını hedefler. Birden fazla availability zone, replica veya redundant servis kullanılabilir. Yine de sadece instance sayısını artırmak gerçek high availability sağlamaz. Database, DNS, identity ve deployment süreçlerindeki single point of failure noktaları ayrıca incelenmelidir. Mimari testleri gerçek failover senaryolarını içermelidir.
Graceful Degradation
Graceful degradation belirli bir bileşen çalışmadığında sistemin tamamen kapanmak yerine sınırlı özelliklerle hizmet vermesidir. Örneğin öneri sistemi kapalıyken temel satın alma akışı çalışmaya devam edebilir. Bu yaklaşım kullanıcı deneyimini ve availability hedeflerini iyileştirir. Bunun için kritik ve kritik olmayan fonksiyonların mimaride ayrıştırılması gerekir. Teknoloji yığını hata durumlarını açık biçimde ele almayı kolaylaştırmalıdır.
Disaster Recovery Stack Kararını Nasıl Değiştirir?
Disaster recovery büyük bir arıza sonrasında sistemin ne kadar sürede ve ne kadar veri kaybıyla geri dönebileceğini belirler. Bu hedefler database, cloud topology, backup ve replication seçimlerini doğrudan etkiler. RTO ve RPO değerleri aşırı düşük belirlendiğinde altyapı maliyeti hızlı biçimde artabilir. Bu nedenle iş etkisi analizi yapılmadan teknik hedef belirlemek doğru değildir. Disaster recovery planının düzenli test edilmesi de teknoloji seçiminden en az teknoloji seçimi kadar önemlidir.
RTO Nedir?
RTO bir kesinti sonrasında hizmetin kabul edilebilir en uzun geri dönüş süresini ifade eder. Bir saatlik RTO ile birkaç dakikalık RTO tamamen farklı altyapı gerektirebilir. Kritik servislerin farklı RTO hedeflerine sahip olması mümkündür. Bu hedef deployment, backup restore ve failover otomasyonunun seviyesini belirler. Stack seçilirken kullanılan platformun hedef RTO'yu pratikte destekleyip desteklemediği test edilmelidir.
RPO Nedir?
RPO felaket durumunda kabul edilebilir maksimum veri kaybı aralığını tanımlar. Sıfıra yakın RPO senkron replikasyon veya benzeri gelişmiş yöntemler gerektirebilir. Daha yüksek RPO kabul edilebilen sistemlerde düzenli backup yeterli olabilir. Veri önemine göre tablolar veya domainler arasında farklı RPO seviyeleri tanımlanabilir. Database ve storage seçimi bu hedeflerle birlikte yapılmalıdır.
Backup Strategy
Backup strategy yalnızca verinin kopyasını oluşturmak değil geri dönüş sürecini garanti altına almaktır. Full, incremental ve point-in-time recovery seçenekleri veri modeline göre değerlendirilmelidir. Backup dosyalarının aynı failure domain içinde tutulması ciddi risk yaratabilir. Restore testleri düzenli yapılmadığında çalışan backup sistemi varmış gibi görünmesine rağmen recovery başarısız olabilir. Teknoloji seçiminde otomatik backup kadar restore süreçlerinin kalitesi de önemlidir.
Multi-AZ
Multi-AZ yaklaşımı hizmeti aynı bölgedeki farklı availability zone'lara dağıtır. Böylece tek bir zone arızasının hizmeti tamamen durdurma riski azaltılır. Yönetilen database hizmetleri bu modeli daha kolay uygulayabilir. Bununla birlikte uygulamanın connection ve failover davranışı test edilmelidir. Multi-AZ birçok kurumsal sistem için multi-region'a göre daha dengeli maliyet ve dayanıklılık sunabilir.
Multi-Region
Multi-region mimari hizmeti birden fazla coğrafi bölgeye dağıtır. Küresel latency, data residency veya bölgesel felaket senaryoları için gerekebilir. Ancak veri replikasyonu, consistency ve operasyon modeli önemli ölçüde zorlaşır. Birçok sistem için multi-region gereksinimi varsayımdan çok ölçülebilir iş ihtiyacına dayanmalıdır. Aksi durumda yatırım getirisi düşük bir altyapı yükü oluşabilir.
Active-Passive
Active-passive yapıda ana bölge normal trafiği işlerken ikinci ortam recovery için hazır tutulur. Active-active modele göre veri tutarlılığı ve operasyon yönetimi daha basit olabilir. Failover süresi RTO hedefine uygun biçimde otomatik veya kontrollü tasarlanabilir. Passive ortamın gerçekten çalıştığından emin olmak için düzenli tatbikat yapılmalıdır. Bu model birçok kurumsal sistem için güçlü bir disaster recovery seçeneği olabilir.
Active-Active
Active-active modelde birden fazla bölge aynı anda canlı trafik işler. Çok düşük RTO ve küresel kullanıcı latency'si açısından avantaj sağlayabilir. Buna karşılık veri tutarlılığı, conflict çözümü ve routing önemli tasarım konuları hâline gelir. Operasyon ekibinin bu modeli destekleyecek deneyime sahip olması gerekir. Sırf yüksek availability hedefi var diye active-active kullanmak her zaman ekonomik değildir.
Team Expertise Tech Stack Seçiminde Neden Kritik?
Teknoloji ne kadar güçlü olursa olsun onu geliştiren ve işleten ekibin kapasitesi sonucu belirler. Production sorunları sırasında dokümantasyon okumaya yeni başlayan bir ekiple yıllardır aynı runtime'ı yöneten ekibin risk profili farklıdır. Ekip deneyimi yalnızca programlama bilgisi değil deployment, monitoring ve troubleshooting becerisini de kapsar. Bu nedenle teknoloji seçimi bir insan kaynağı kararıdır. Güçlü ekip uyumu çoğu zaman teorik olarak daha hızlı bir teknolojiden daha fazla değer sağlar.
Mevcut Teknik Yetkinlik
Mevcut teknik yetkinlik ekibin hangi teknolojileri güvenli biçimde geliştirebildiğini ve işletebildiğini gösterir. Kod yazabilmek tek başına üretim deneyimi anlamına gelmez. Framework upgrade, memory problemi veya deployment hatası gibi operasyon durumlarındaki deneyim ayrıca değerlendirilmelidir. Ekipte bulunan bilgi yeni projede önemli bir başlangıç avantajı yaratabilir. Ancak mevcut yetkinlik teknoloji fit değerlendirmesini tamamen geçersiz kılmamalıdır.
Öğrenme Eğrisi
Öğrenme eğrisi yeni teknolojiye geçişin gerçek maliyetlerinden biridir. Eğitim süresinin yanında ilk aylarda yapılan tasarım hataları da bu maliyete dahildir. Yeni bir runtime seçildiğinde ekip production sorunlarını tanımak için zamana ihtiyaç duyar. Proje teslim tarihi kısıtlıysa bu etki daha kritik hâle gelir. Teknoloji değerlendirmesinde öğrenme süresi plan ve bütçe içine açıkça eklenmelidir.
Senior Expertise
Senior expertise mimari kararların ve zor production problemlerinin güvenli biçimde yönetilmesini sağlar. Yeni teknolojide yalnızca junior veya orta seviye bilgi varsa risk görünenden yüksek olabilir. Özellikle dağıtık sistemler, güvenlik ve veri mimarisi deneyimi teknoloji bilgisinden bağımsız olarak değerlidir. Senior geliştirici bulunabilirliği işe alım stratejisini de etkiler. Stack seçerken birkaç yıllık büyüme döneminde gerekli uzmanları bulmanın mümkün olup olmadığı araştırılmalıdır.
Production Operasyon Deneyimi
Production operasyon deneyimi bir teknolojinin gerçek koşullarda nasıl davrandığını öğrenmiş olmayı ifade eder. Memory leak, connection exhaustion, dependency problemi veya deployment regression gibi konular teorik eğitimlerde her zaman görünmez. Bu nedenle ekip deneyimini yalnızca kullanılan dil üzerinden ölçmek eksik olur. On-call ve incident geçmişi daha anlamlı sinyaller sağlayabilir. Operasyon bilgisi düşükse yönetilen servisler veya daha olgun tooling tercih edilerek risk azaltılabilir.
Technology Familiarity vs Technology Fit
Tanıdık teknoloji kullanmak teslim hızını artırabilir fakat her zaman doğru teknik uyumu sağlamaz. Bunun tersine mükemmel teknik özelliklere sahip yeni bir teknoloji ekip açısından çok yüksek öğrenme maliyeti yaratabilir. Sağlıklı karar bu iki faktörün dengelenmesini gerektirir. Gereksinim farkı küçükse tanıdık teknoloji çoğu zaman daha düşük risk taşır. Belirgin teknik fayda varsa yeni teknoloji PoC ve eğitim planıyla kontrollü biçimde benimsenebilir.
Yetenek Havuzu ve İşe Alım Maliyeti
Büyük projelerde teknoloji yığını yalnızca bugünkü ekibe göre seçilemez. Proje büyüdükçe yeni geliştiriciler, DevOps uzmanları ve teknik liderler işe alınabilir. Kullanılan teknolojinin yerel ve uzaktan yetenek havuzu işe alım süresini doğrudan etkiler. Nadir uzmanlık gerektiren stack maaşları ve onboarding maliyetini yükseltebilir. Bu yüzden talent availability toplam sahip olma maliyetinin gerçek parçalarından biridir.
Developer Availability
Developer availability belirli bir teknoloji için yeterli geliştiricinin bulunabilirliğini ifade eder. Popüler ekosistemler genellikle daha geniş aday havuzu sunar. Buna rağmen aday sayısından çok gerekli deneyim seviyesinde kaç kişinin bulunabildiği önemlidir. Büyük ekip kurmayı planlayan organizasyonlar bu veriyi karar matrisine eklemelidir. Yetenek havuzu düşük teknolojiler kritik pozisyonlarda teslim riskine yol açabilir.
Senior Developer Bulunabilirliği
Senior developer bulunabilirliği ölçek büyüdükçe daha önemli hâle gelir. Mimari karar, code review ve incident çözümü için deneyimli geliştiricilere ihtiyaç duyulur. Çok yeni veya dar ekosistemlerde senior aday sayısı sınırlı olabilir. Bu durum işe alım süresini uzatabilir ve mevcut birkaç uzmana bağımlılık yaratabilir. Tech stack değerlendirmesinde senior talent piyasası mutlaka ayrı bir kriter olarak ele alınmalıdır.
Maaş ve Hiring Cost
Teknoloji seçimi developer maaşlarına ve hiring cost'a doğrudan etki edebilir. Nadir uzmanlık gerektiren teknolojiler için daha yüksek ücret veya daha uzun işe alım süreci gerekebilir. Recruitment süresindeki gecikme de projenin fırsat maliyetini artırır. Bu nedenle yalnızca cloud faturalarını karşılaştırarak TCO hesaplamak eksik olur. İnsan kaynağı maliyetleri çoğu yazılım projesinde altyapı maliyetinden daha büyük olabilir.
Onboarding Süresi
Onboarding süresi yeni geliştiricinin üretken katkı yapabilecek seviyeye gelme zamanıdır. Framework yapısı, local environment, dokümantasyon ve tooling bu süreyi etkiler. Çok sayıda özel araç içeren stack yeni ekip üyeleri için öğrenme yükünü artırabilir. Standardize edilmiş proje şablonları onboarding süresini ciddi biçimde azaltabilir. Developer experience bu nedenle büyük organizasyonlarda doğrudan finansal bir kriterdir.
Local vs Remote Talent
Yerel ve remote yetenek havuzları farklı işe alım seçenekleri sunar. Remote çalışma daha geniş uzman havuzuna erişim sağlarken iletişim, zaman dilimi ve organizasyon süreçleri açısından yeni ihtiyaçlar oluşturabilir. Yerel ekipler yüz yüze bilgi paylaşımı ve topluluk bağlantıları açısından avantaj sağlayabilir. Teknoloji seçimi organizasyonun çalışma modeliyle uyumlu olmalıdır. Yeteneğin nereden bulunacağına ilişkin plan stack kararından sonra değil, karar sırasında oluşturulmalıdır.
Yerel Yazılım Topluluklarının Rolü
Yerel yazılım toplulukları bilgi paylaşımı ve yetenek gelişimi açısından önemli bir destek ağı oluşturabilir. Teknik etkinlikler geliştiricilerin farklı teknolojiler hakkında gerçek kullanım deneyimlerini paylaşmasını sağlar. Bu etkileşim işe alım süreçlerinden mentorluk ilişkilerine kadar geniş bir katkı üretir. Özellikle bölgesel teknoloji ekosisteminin büyümesi şirketlerin uzun vadeli yetenek erişimini güçlendirebilir. Kurumsal teknoloji stratejisi oluştururken yalnızca global trendleri değil bulunduğunuz bölgedeki teknik kapasiteyi de değerlendirmek faydalıdır.
Diyarbakır Yazılım Topluluğu Gibi Yerel Ekosistemler
Diyarbakır Yazılım Topluluğu gibi yerel ekosistemler geliştiriciler arasında sürdürülebilir bilgi paylaşımını destekler. Proje deneyimlerinin, mimari yaklaşımların ve teknoloji tercihleriyle ilgili gerçek geri bildirimlerin paylaşılması ekiplerin karar kalitesini artırabilir. Yerel topluluklar yeni geliştiricilerin deneyimli kişilerle bağlantı kurmasına da yardımcı olur. Bu bağlamda topluluğun yaklaşımı ve çalışmaları hakkında bilgi almak için https://www.diyarbakiryazilim.com.tr/about adresini inceleyebilirsiniz. Güçlü teknik ekosistemler uzun vadede hem bireysel geliştiricilerin hem de kurumsal ekiplerin gelişimini destekler.
Meetup ve Teknik Etkinlikler
Meetup ve teknik etkinlikler geliştiricilerin gerçek proje deneyimlerini paylaşabildiği pratik öğrenme ortamlarıdır. Dokümantasyonda görünmeyen production sorunları bu tür etkinliklerde sıkça konuşulur. Ekipler yeni teknolojiler hakkında pazarlama söylemi yerine uygulayıcıların görüşlerini dinleyebilir. Bu etkinlikler işe alım ve iş birliği bağlantıları da oluşturabilir. Yerel ekosistemle düzenli temas teknoloji değerlendirmelerinde daha gerçekçi perspektif kazandırır.
Mentorluk
Mentorluk deneyim aktarımını hızlandırarak ekiplerin daha bilinçli teknik kararlar vermesine yardımcı olur. Özellikle yeni runtime veya mimari yaklaşımlarda deneyimli bir kişinin rehberliği erken hataları azaltabilir. Mentorluk yalnızca kod yazımına değil operasyon ve mimari düşünmeye de odaklanmalıdır. Büyük organizasyonlarda iç mentorluk programları bilgi silolarını azaltır. Topluluk temelli mentorluk ise şirket sınırlarının dışında yeni bakış açıları sunabilir.
Açık Kaynak Katkıları
Açık kaynak katkıları geliştiricilerin kullandıkları teknolojileri daha derinden öğrenmesine yardımcı olur. Issue çözmek, dokümantasyon geliştirmek veya küçük bir pull request hazırlamak bile ekosistemin çalışma biçimini gösterir. Bu deneyim ekiplerin dependency değerlendirmesinde daha bilinçli olmasını sağlar. Kurumsal ekiplerin kontrollü açık kaynak katkıları teknik yetenek gelişimini de destekleyebilir. Ancak contribution politikaları güvenlik ve fikri mülkiyet kurallarıyla birlikte tanımlanmalıdır.
En İyi Programlama Dili Nasıl Seçilir?
Programlama dili seçimi çoğu teknoloji tartışmasının merkezinde yer alsa da tek başına sistem başarısını belirlemez. Dilin ecosystem, tooling, performans, geliştirici havuzu ve operational behavior özellikleri birlikte düşünülmelidir. Java, C#, TypeScript, Go, Python ve Rust gibi diller farklı güçlü yönlere sahiptir. Doğru soru hangi dilin genel olarak daha iyi olduğu değil, hangi dilin belirli workload ve ekip için daha uygun olduğudur. Node.js Java Spring .NET ve Python kurumsal backend karşılaştırması da ancak bu bağlam üzerinden anlamlı sonuç üretir.
Evrensel Bir “En İyi Programlama Dili” Var mı?
Evrensel olarak tüm projeler için en iyi programlama dili bulunmaz. Diller farklı tasarım öncelikleri, runtime özellikleri ve ekosistemlerle gelir. Bir veri bilimi iş yükünde güçlü olan dil yoğun transaction servisinde aynı avantajı sunmayabilir. Ekip deneyimi ve hiring pool da teknik özellikler kadar önemlidir. Bu nedenle dil seçimi bir sıralama yarışından çok gereksinim eşleştirme çalışmasıdır.
Java / Kotlin
Java ve Kotlin kurumsal backend sistemlerinde olgun JVM ekosisteminden yararlanır. Geniş kütüphane desteği, güçlü tooling ve uzun yıllara dayanan production deneyimi önemli avantaj sağlar. Spring tabanlı geliştirme özellikle karmaşık domain ve entegrasyon projelerinde yaygın bir model sunar. Bununla birlikte JVM tuning, memory kullanımı ve startup karakteristiği workload'a göre değerlendirilmelidir. Büyük ve uzun ömürlü kurumsal sistemlerde ekip deneyimi güçlü olduğunda güvenilir bir seçenek olabilir.
C# / .NET
C# ve .NET modern backend geliştirme için güçlü runtime, tooling ve kurumsal entegrasyon seçenekleri sunar. Özellikle mevcut Microsoft ekosistemi bulunan organizasyonlarda identity, developer tooling ve altyapı entegrasyonu kolaylaşabilir. .NET aynı zamanda container ve cross-platform deployment senaryolarında da kullanılabilir. Framework seçimi sırasında LTS sürümleri ve upgrade stratejisi değerlendirilmelidir. Ekipte C# deneyimi bulunması teslim ve operasyon riskini önemli ölçüde azaltabilir.
TypeScript / Node.js
TypeScript ve Node.js özellikle I/O ağırlıklı servisler ve hızlı ürün geliştirme için güçlü bir ekosistem sunabilir. Frontend ve backend tarafında aynı dil ailesinin kullanılması bazı ekiplerde onboarding ve code sharing avantajı yaratır. Event loop modeli yüksek sayıda eşzamanlı I/O işlemi için etkili olabilir. CPU yoğun workloads için ise worker veya ayrı servis yaklaşımı gerekebilir. Dependency yönetimi ve package supply chain güvenliği büyük kurumsal projelerde özellikle dikkatle ele alınmalıdır.
Go
Go sade dil yapısı, hızlı derleme ve güçlü concurrency modeliyle backend ve platform servislerinde tercih edilebilir. Tek binary deployment operasyon açısından kolaylık sağlayabilir. Memory ve CPU profili birçok network servisinde verimli sonuçlar üretebilir. Buna karşılık ekipte Go deneyimi ve ihtiyaç duyulan domain kütüphanelerinin olgunluğu değerlendirilmelidir. Teknolojinin güçlü yönleri gerçek workload ile PoC üzerinden doğrulanmalıdır.
Python
Python geniş kütüphane ekosistemi ve hızlı geliştirme deneyimi sayesinde birçok iş alanında güçlüdür. Veri bilimi, machine learning, otomasyon ve bazı web backend projelerinde önemli avantaj sunar. Runtime performansı gereksinime göre async yapı, worker modeli veya ayrı yüksek performanslı bileşenlerle desteklenebilir. Büyük kurumsal uygulamalarda type checking, dependency yönetimi ve standart proje yapısı önem kazanır. Python seçimi özellikle ML ve veri ağırlıklı sistemlerle entegrasyon gerekiyorsa anlamlı olabilir.
Rust
Rust yüksek performans ve memory safety hedefleriyle sistem programlama ve performans hassas servislerde güçlü bir seçenek olabilir. Runtime overhead'in düşük olması bazı workload'larda belirgin avantaj sağlar. Buna karşılık öğrenme eğrisi ve geliştirici havuzu birçok kurumsal ekip için diğer dillere göre daha sınırlı olabilir. Her backend servisini Rust ile geliştirmek bu nedenle gerekli değildir. Ölçülebilir performans veya güvenlik avantajı bulunan belirli bileşenlerde değerlendirmek daha dengeli olabilir.
Dil Seçimini Belirleyen Gerçek Faktörler
Programlama dili kararını domain, workload, ecosystem, talent, operability ve performans birlikte belirlemelidir. Sadece benchmark tablosuna bakmak uzun vadeli bakım maliyetini görünmez hâle getirir. Benzer biçimde sadece ekip alışkanlığına göre seçim yapmak gerçek teknik gereksinimlerin kaçırılmasına yol açabilir. Weighted decision matrix bu faktörleri karşılaştırmak için kullanılabilir. PoC ise teorik değerlendirmelerin gerçek workload altında doğrulanmasını sağlar.
Domain
Domain sistemin çözmeye çalıştığı iş alanını ve kurallarını ifade eder. Finans, e-ticaret, lojistik veya medya sistemlerinin teknik öncelikleri farklı olabilir. Bazı ekosistemlerde belirli domainler için olgun kütüphaneler ve entegrasyonlar bulunur. Bu avantaj geliştirme hızını ve hata riskini doğrudan etkileyebilir. Dil seçerken yalnızca syntax değil domain ekosisteminin gücü de değerlendirilmelidir.
Workload
Workload programlama dilinin ve runtime'ın hangi koşullarda çalışacağını belirler. CPU yoğun işler, I/O yoğun servisler ve realtime bağlantılar farklı runtime davranışlarından faydalanabilir. Tek bir dil her workload için aynı verimliliği sunmayabilir. Buna rağmen küçük performans farkları gereksiz polyglot yapı için tek başına gerekçe olmamalıdır. Gerçek yük profili ölçülerek karar verilmelidir.
Ecosystem
Ecosystem framework, kütüphane, testing, monitoring ve development tooling bütününü kapsar. Olgun ekosistem geliştiricilerin standart problemleri yeniden çözme ihtiyacını azaltır. Dependency kalitesi ve maintenance durumu da ekosistemin önemli bir parçasıdır. Büyük projelerde uzun süre desteklenen çözümler tercih edilmelidir. Ekosistem değerlendirmesi yalnızca paket sayısına bakılarak yapılmamalıdır.
Talent
Talent faktörü gerekli teknoloji için geliştirici ve teknik lider bulunabilirliğini ifade eder. Geniş yetenek havuzu işe alım süresini ve ücret baskısını azaltabilir. Ekip içi eğitim kapasitesi de bu değerlendirmeye dahil edilmelidir. Nadir teknoloji kullanmak bazı projelerde stratejik fayda sağlayabilir ancak insan kaynağı riski açıkça hesaplanmalıdır. Yıllarca devam edecek sistemlerde bu kriter özellikle önemlidir.
Operability
Operability sistemin production ortamında deploy, debug ve yönetim kolaylığıdır. Dil ve runtime'ın profiling, logging ve monitoring desteği bu alanda önemlidir. Production sorunlarını hızlı teşhis edebilmek uptime üzerinde doğrudan etki yaratır. Container image boyutu veya startup süresi bazı deployment modellerinde ek kriter olabilir. Operability çoğu karşılaştırmada gözden kaçsa da kurumsal projelerde kritik bir seçim faktörüdür.
Performance
Performance gerekli iş hacmini kabul edilebilir kaynak kullanımıyla karşılayabilme yeteneğidir. Her servisin maksimum benchmark performansına ihtiyacı bulunmaz. Önemli olan beklenen workload altında latency ve throughput hedeflerini güvenli marjla karşılamaktır. Daha hızlı runtime için ciddi hiring ve maintenance maliyeti oluşuyorsa toplam değer yeniden değerlendirilmelidir. Karar gerçek load test sonuçlarıyla desteklenmelidir.
Tek Dil mi Polyglot Stack mi?
Tek dil kullanmak standartlaşma ve geliştirici hareketliliği açısından önemli avantajlar sağlayabilir. Polyglot stack ise belirli problemlerde uzman teknolojilerden yararlanma imkânı sunar. Büyük organizasyonlarda bu iki yaklaşım arasında bilinçli sınırlar belirlemek gerekir. Her takımın istediği dili kullanması kısa vadede özgürlük verirken uzun vadede operasyon ve hiring yükünü artırabilir. Polyglot kararları ölçülebilir teknik faydaya dayanmalıdır.
Tek Dil Kullanmanın Avantajları
Tek dil yaklaşımı ekipler arasında code review ve bilgi paylaşımını kolaylaştırır. Ortak tooling, CI/CD ve security scanning süreçleri daha rahat standardize edilir. Geliştiricilerin servisler arasında hareket etmesi de daha kolay hâle gelir. Kütüphane ve framework çeşitliliği sınırlı kaldığı için cognitive load azalabilir. Yine de dil gerçek workload gereksinimlerini karşılamıyorsa sırf standardizasyon adına kullanılmamalıdır.
Polyglot Programming Ne Zaman Mantıklıdır?
Polyglot programming farklı problem alanlarında belirgin teknik avantaj sağlandığında anlamlı olabilir. Örneğin ana uygulama stack'i dışında yoğun ML işlerinde Python kullanmak doğal bir seçimdir. Benzer şekilde düşük latency gerektiren sınırlı bir sistem bileşeni farklı runtime'dan faydalanabilir. Her yeni dil için deployment, monitoring ve hiring maliyetleri hesaplanmalıdır. Sağlanan fayda bu ek maliyetten büyük değilse mevcut stack'te kalmak daha mantıklıdır.
Cognitive Load
Cognitive load geliştiricilerin sistemi anlayabilmek için zihinsel olarak takip etmek zorunda olduğu bilgi miktarıdır. Çok sayıda dil, framework, deployment modeli ve veritabanı bu yükü yükseltir. Yeni ekip üyesinin üretken olması daha uzun sürebilir. Incident sırasında farklı teknolojiler arasında geçiş yapmak da hata çözme süresini artırabilir. Stack sadeleştirme bu nedenle doğrudan developer experience yatırımıdır.
Tooling Fragmentation
Tooling fragmentation farklı teknolojiler için ayrı build, test, security ve monitoring araçlarının kullanılmasını gerektirir. Bu durum platform ekibinin bakım yükünü yükseltir. Aynı güvenlik politikasını tüm stack'lere uygulamak daha zor hâle gelebilir. CI/CD pipeline şablonlarının sayısı arttıkça upgrade ve standardizasyon maliyeti büyür. Yeni teknoloji eklenirken tooling maliyeti mutlaka karar hesabına dahil edilmelidir.
Hiring Complexity
Polyglot stack işe alım sürecinde daha fazla uzmanlık profili gerektirebilir. Her teknoloji için senior seviye bilgi bulundurmak küçük ekiplerde özellikle zor olabilir. İnsan kaynağının birkaç kişiye bağımlı kalması bus factor riskini yükseltir. Yeni servis dili seçerken en az birkaç yıllık işe alım ihtiyacı düşünülmelidir. Teknik faydası düşük teknoloji çeşitliliği bu nedenle organizasyon açısından pahalı olabilir.
Her Servisin Farklı Dil Kullanması Anti-Pattern mi?
Her servisin bağımsız olması her servisin farklı teknoloji kullanması gerektiği anlamına gelmez. Tam teknoloji özgürlüğü büyük organizasyonlarda ciddi standardizasyon sorunları yaratabilir. Güvenlik, monitoring, deployment ve support süreçleri gereksiz sayıda varyasyon taşır. İstisnalar güçlü teknik gerekçelerle ve belirli governance süreciyle yönetilebilir. Genel olarak approved stack veya paved road yaklaşımı daha dengeli sonuç verir.
Frontend Teknolojisi Nasıl Seçilir?
Frontend framework seçimi yalnızca geliştirici popülerliği üzerinden yapılmamalıdır. Uygulamanın UI complexity seviyesi, SEO gereksinimi, rendering modeli, browser support ve design system ihtiyaçları birlikte değerlendirilmelidir. Büyük organizasyonlarda framework upgrade maliyeti de uzun vadeli önemli bir faktördür. Hiring pool ve ekip deneyimi ilk teslim hızını doğrudan etkiler. Doğru frontend stack kullanıcı deneyimini iyileştirirken geliştirme ve bakım sürecini de sadeleştirmelidir.
UI Complexity
UI complexity ekranların ne kadar state, etkileşim ve gerçek zamanlı davranış içerdiğini gösterir. Basit içerik sayfasıyla karmaşık operasyon paneli aynı frontend architecture gerektirmez. Yoğun client-side state gerektiren sistemlerde güçlü state yönetimi ve component modeli önem kazanır. Daha basit sayfalarda ağır client framework gereksiz performans maliyeti yaratabilir. Teknoloji tercihi gerçek ekran örnekleri üzerinden değerlendirilmelidir.
SEO
SEO gereksinimi public web uygulamalarında rendering stratejisini doğrudan etkileyebilir. Arama motorlarının kolayca okuyabileceği HTML üretmek içerik projelerinde önemlidir. SSR, static generation veya hibrit modeller bu nedenle değerlendirilebilir. Admin panel gibi giriş gerektiren uygulamalarda SEO kriteri çok daha düşük öneme sahiptir. Frontend mimarisini tüm projeler için aynı SEO varsayımıyla tasarlamak doğru değildir.
SSR / CSR
SSR ve CSR farklı performans ve geliştirme davranışları sunar. Server-side rendering ilk içerik gösterimi ve SEO açısından fayda sağlayabilir. Client-side rendering ise yoğun etkileşimli uygulamalarda daha basit bir runtime modeli sunabilir. Modern framework'ler iki yaklaşımı aynı projede hibrit biçimde kullanabilir. Seçim sayfa türleri, cache stratejisi ve altyapı maliyetleriyle birlikte yapılmalıdır.
Accessibility
Accessibility ürünün farklı kullanıcı grupları tarafından kullanılabilir olmasını sağlar. Klavye navigasyonu, semantic HTML ve ekran okuyucu desteği frontend kararının parçasıdır. Kullanılan component library'nin erişilebilirlik özellikleri ciddi geliştirme zamanı kazandırabilir. Ancak kütüphaneye güvenip manuel testleri tamamen bırakmak doğru değildir. Erişilebilirlik gereksinimleri design system içinde standart hâle getirilmelidir.
Design System
Design system ortak component, stil ve kullanım kuralları oluşturarak büyük ekiplerde UI tutarlılığı sağlar. Birden fazla ürün veya ekip aynı component altyapısını paylaşabilir. Framework seçimi design system'in sürdürülebilir biçimde geliştirilmesini desteklemelidir. Versioning ve backward compatibility yaklaşımı burada önem kazanır. İyi bir design system tekrar eden frontend işlerini azaltırken kullanıcı deneyimini de standartlaştırır.
Browser Support
Browser support kullanıcıların hangi tarayıcı ve cihazlarla sisteme eriştiğini temel almalıdır. Kurumsal uygulamalarda eski tarayıcı desteği hâlâ özel bir gereksinim olabilir. Public ürünlerde gerçek analytics verileri daha doğru hedef belirlemeye yardımcı olur. Geniş uyumluluk hedefi bundle ve geliştirme maliyetini artırabilir. Bu nedenle destek matrisi iş gereksinimi olarak açıkça tanımlanmalıdır.
Hiring Pool
Frontend ekosisteminin geliştirici havuzu uzun vadeli ekip büyümesini etkiler. Yaygın teknolojiler daha geniş aday grubuna ulaşmayı kolaylaştırabilir. Ancak framework bilgisi tek başına frontend mühendisliği kalitesini garanti etmez. Testing, accessibility, performance ve architecture deneyimi de önemlidir. Hiring kriterleri teknoloji ismi yerine bu yetkinlikleri kapsayacak şekilde oluşturulmalıdır.
Framework Upgrade Cost
Framework upgrade cost yıllar içinde biriken teknik bakım maliyetidir. Sık breaking change yapan framework'ler büyük kod tabanlarında ciddi migration çalışması gerektirebilir. LTS yaklaşımı ve migration tooling bu riski azaltır. Upgrade'leri uzun süre ertelemek security ve ecosystem uyumluluğu sorunlarına neden olabilir. Stack seçerken yalnızca bugünkü API kalitesine değil sürüm yönetimi geçmişine de bakılmalıdır.
Backend Stack Nasıl Seçilir?
Backend stack seçimi domain kuralları, transaction ihtiyaçları, concurrency modeli ve entegrasyon yoğunluğu üzerinden yapılmalıdır. Her servis için en yüksek performansı hedeflemek yerine sistemin gerçek darboğazları anlaşılmalıdır. Background job, event processing ve real-time communication ihtiyaçları runtime seçimini etkileyebilir. Ekip deneyimi ve operasyon tooling'i de teknik uygunluk kadar önemlidir. İyi backend stack güvenilir, anlaşılır ve sürdürülebilir geliştirme modeli oluşturmalıdır.
Domain Complexity
Domain complexity iş kurallarının ne kadar fazla ilişki ve invariant içerdiğini gösterir. Karmaşık domainlerde güçlü type system, test altyapısı ve modüler tasarım desteği değerli olabilir. Framework'ün domain modelini gereksiz teknik detaylarla doldurmaması da önemlidir. Basit CRUD sistemlerinde ise ağır abstraction katmanları geliştirme hızını düşürebilir. Stack karmaşıklığı iş probleminin gerçek yapısıyla orantılı olmalıdır.
Transaction Requirements
Transaction requirements işlemlerin hangi atomiklik ve tutarlılık garantilerine ihtiyaç duyduğunu tanımlar. Finansal kayıt veya envanter hareketleri güçlü transaction davranışı gerektirebilir. Dağıtık transaction ihtiyaçları mimariyi önemli ölçüde zorlaştırır. Çoğu durumda domain sınırlarını doğru tasarlamak dağıtık transaction ihtiyacını azaltabilir. Backend ve database seçimi bu gereksinimler üzerinden birlikte değerlendirilmelidir.
Concurrency Model
Concurrency model bir backend runtime'ın aynı anda çok sayıda işi nasıl işlediğini belirler. Thread tabanlı, event-loop tabanlı veya async modeller farklı davranışlar gösterebilir. Workload çoğunlukla I/O ağırlıklıysa bazı modeller belirgin avantaj sağlayabilir. CPU yoğun işlerde ise farklı paralellik stratejileri gerekebilir. Runtime seçimi ekip tarafından anlaşılmayan concurrency modeline dayanıyorsa production hata riski artabilir.
Integration Requirements
Kurumsal backend sistemleri çoğu zaman çok sayıda harici servis ve eski sistemle entegre olur. REST, SOAP, messaging, dosya aktarımı veya özel protokoller aynı projede bulunabilir. Kullanılan framework'ün bu entegrasyonlar için olgun kütüphaneler sunması geliştirme süresini azaltır. Timeout, retry ve circuit breaker politikaları standartlaştırılmalıdır. Entegrasyon yoğunluğu backend stack seçiminde ekosistem olgunluğunu daha önemli hâle getirir.
Background Jobs
Background jobs kullanıcı request'inden bağımsız yürütülebilen görevleri ifade eder. Raporlama, email, dosya işleme ve data synchronization bu gruba girebilir. Job scheduler, retry, idempotency ve visibility gereksinimleri baştan düşünülmelidir. Bazı framework'ler bu işler için güçlü ekosistem sunarken bazı projelerde ayrı worker altyapısı gerekir. Seçim workload hacmine ve job kritikliği seviyesine göre yapılmalıdır.
Event Processing
Event processing sistemde oluşan olayların asenkron biçimde tüketilmesini sağlar. Büyük hacimli event akışlarında ordering, replay ve idempotency kritik konular hâline gelir. Framework'ün broker entegrasyonu ve observability desteği önemli avantaj sağlayabilir. Event-driven yaklaşım gereksiz kullanıldığında sistem davranışını anlamayı zorlaştırabilir. Bu yüzden event processing yalnızca gerçek bağımsızlık veya throughput ihtiyacı bulunan alanlarda uygulanmalıdır.
Real-Time Communication
Real-time communication websocket, server-sent events veya benzeri uzun bağlantı modellerini içerebilir. Bu kullanım concurrency, connection state ve scaling davranışını etkiler. Load balancer ve reverse proxy bileşenlerinin de uzun bağlantıları doğru yönetmesi gerekir. Backend runtime'ın connection başına kaynak tüketimi gerçek yük altında test edilmelidir. Realtime ihtiyacı olmayan fonksiyonları bu modele taşımak ise gereksiz teknik yük oluşturur.
Database Seçimine SQL vs NoSQL Diye Başlamayın
Veritabanı seçiminde SQL veya NoSQL etiketlerini başlangıç noktası yapmak çoğu zaman problemi fazla basitleştirir. Önce verinin nasıl yazılacağı, hangi sorguların çalışacağı ve hangi transaction garantilerinin gerekli olduğu anlaşılmalıdır. Consistency, schema evolution, data volume ve operasyon deneyimi kararın temelini oluşturur. Relational ve NoSQL sistemlerin her biri belirli kullanım alanlarında güçlüdür. Doğru database modeli gerçek data access patterns üzerinden seçilir.
Data Access Patterns
Data access patterns uygulamanın veriye hangi anahtarlar, filtreler ve ilişkiler üzerinden eriştiğini tanımlar. Database tasarımı bu sorgular bilinmeden sağlıklı yapılamaz. Sık kullanılan read ve write yolları ayrı ayrı incelenmelidir. Index tasarımı ve partitioning yaklaşımı da bu bilgilerden çıkar. Teknoloji seçimi gerçek sorgu örnekleriyle PoC üzerinde test edilirse daha güvenilir sonuç verir.
Transaction Requirements
Veritabanı transaction gereksinimleri işlemlerin hangi bütünlük garantilerine sahip olması gerektiğini açıklar. Birden fazla kaydın tek iş adımı olarak güncellenmesi gereken durumlarda güçlü transaction modeli avantaj sağlar. Eventual consistency bazı domainlerde kabul edilebilirken bazılarında ciddi iş riski yaratabilir. Bu karar teknik ekip tarafından tek başına verilmemelidir. İş süreçlerinin veri tutarlılığı beklentileri açıkça tanımlanmalıdır.
Consistency
Consistency kullanıcıların ve servislerin hangi noktada güncel veriyi görmesi gerektiğini belirler. Strong consistency ve eventual consistency farklı trade-off'lar sunar. Dağıtık veri sistemlerinde daha yüksek availability hedefi bazı tutarlılık tercihlerini etkileyebilir. Her veri türünün aynı consistency seviyesine ihtiyacı bulunmaz. Domain bazlı değerlendirme daha ekonomik ve yönetilebilir tasarım sağlar.
Schema Evolution
Schema evolution veri modelinin zaman içinde nasıl değiştirileceğini ifade eder. Büyük projelerde schema değişiklikleri kaçınılmazdır ve deployment stratejisiyle uyumlu yürütülmelidir. Backward compatible migration yaklaşımı zero-downtime deployment açısından önemlidir. Database tooling'in migration süreçlerini desteklemesi ekip verimliliğini artırır. Flexible schema kullanmak ise otomatik olarak schema yönetimi ihtiyacını ortadan kaldırmaz.
Query Patterns
Query patterns sistemin hangi tür sorguları ne sıklıkta çalıştıracağını gösterir. Karmaşık join, aggregation veya ad-hoc raporlama gereksinimleri relational sistemleri güçlü aday yapabilir. Basit key lookup veya belirli document erişimleri farklı veri modellerine uygun olabilir. Sorguların latency hedefleri de seçimde önemlidir. Database benchmark'ı gerçek query setiyle yapılmadığında sonuçlar yanıltıcı olabilir.
Data Volume
Data volume depolama kapasitesinin yanında index, backup ve replication maliyetlerini de etkiler. Veri büyümesinin aylık ve yıllık tahminleri yapılmalıdır. Çok büyük veri hacmi olduğunda partition ve archive stratejileri gündeme gelebilir. Ancak gelecekte büyüyebilir varsayımıyla gereksiz dağıtık database seçmek doğru değildir. Ölçek kararı ölçülebilir büyüme modeline dayanmalıdır.
Operational Experience
Database operasyon deneyimi seçimde kritik ancak sık unutulan bir faktördür. Backup, restore, replication, upgrade ve performance tuning konularında deneyim gerekir. Yeni database engine kullanıldığında on-call ekibinin hata çözme kapasitesi düşebilir. Yönetilen hizmetler bu yükün bir bölümünü azaltabilir ancak tamamen ortadan kaldırmaz. Stack kararında ekibin gerçek production deneyimi dikkate alınmalıdır.
Relational Database Ne Zaman Tercih Edilmeli?
Relational database güçlü transaction, ilişkisel veri modeli ve gelişmiş sorgu yetenekleri gerektiğinde doğal bir seçimdir. Çoğu kurumsal sistemin önemli bölümü bu özelliklerden doğrudan faydalanır. PostgreSQL, MySQL ve SQL Server geniş ekosistem ve yıllara dayanan production deneyimi sunar. Relational modelin sınırları anlaşılmadan NoSQL'e geçmek gereksiz operasyon yükü oluşturabilir. Özellikle tutarlı domain verisi ve raporlama ihtiyacı bulunan projelerde relational sistemler güçlü başlangıç noktasıdır.
PostgreSQL
PostgreSQL güçlü SQL desteği, transaction özellikleri ve geniş extension ekosistemiyle birçok kurumsal workload için kullanılabilir. JSON desteği bazı yarı yapılandırılmış veri senaryolarında esneklik sağlar. Büyük sistemlerde replication, backup ve connection yönetimi yine dikkatli planlanmalıdır. Yönetilen servis seçenekleri operasyon yükünü azaltabilir. PostgreSQL yeterli mi sorusunun cevabı her zaman gerçek veri hacmi ve sorgu modeli üzerinden verilmelidir.
MySQL
MySQL geniş kullanım alanı ve olgun operasyon ekosistemiyle birçok web ve kurumsal uygulamada kullanılabilir. Read-heavy workload'larda replication seçenekleri etkili olabilir. Transaction ve index tasarımı gerçek sorgu ihtiyaçlarına göre yapılmalıdır. Mevcut ekip deneyimi varsa geçiş ve işletme riski daha düşük olabilir. Alternatif database seçmek için ölçülebilir bir ihtiyaç bulunması daha sağlıklı yaklaşım olur.
SQL Server
SQL Server özellikle Microsoft tabanlı kurumsal ekosistemlerde güçlü entegrasyon seçenekleri sunabilir. Transaction, reporting ve yönetim araçları birçok iş yükü için olgun özellikler sağlar. Lisans ve altyapı maliyetleri TCO hesabına dahil edilmelidir. Cloud ve on-premise kullanım modelleri organizasyon ihtiyacına göre karşılaştırılabilir. Mevcut operasyon ekibinin deneyimi kararın önemli parçasıdır.
ACID Transactions
ACID transactions verinin belirli bütünlük kuralları altında güvenilir biçimde değiştirilmesini sağlar. Özellikle para, envanter veya sözleşme gibi kritik kayıtlar için güçlü transaction garantileri önemlidir. Bu gereksinim varsa relational database doğal adaylardan biridir. Dağıtık transaction ihtiyacını azaltmak için domain sınırları dikkatle tasarlanmalıdır. Transaction modeli iş kurallarını doğru yansıtmalıdır.
Complex Queries
Complex queries birçok tabloyu ilişkilendiren, filtreleyen veya aggregate eden sorguları içerebilir. Relational database bu tür sorgular için güçlü optimizer ve SQL yetenekleri sağlar. Operasyonel sistemlerde çok ağır rapor sorgularını ayrı read model veya data warehouse'a taşımak gerekebilir. Yine de ana uygulama verisinin ilişkisel yapısı büyük kolaylık sunabilir. Query ihtiyaçları erken dönemde örneklenerek database kararı desteklenmelidir.
Referential Integrity
Referential integrity ilişkili kayıtların veri tabanı seviyesinde tutarlı kalmasını sağlar. Foreign key gibi mekanizmalar belirli veri hatalarını uygulama katmanına ulaşmadan engelleyebilir. Büyük ekiplerde bu koruma önemli güvenlik ağı oluşturur. Bazı yüksek ölçekli sistemlerde performans veya dağıtım gereksinimleri nedeniyle farklı yaklaşımlar gerekebilir. Bu karar ölçüm ve açık trade-off analiziyle verilmelidir.
NoSQL Ne Zaman Gerçekten Gereklidir?
NoSQL sistemler belirli veri modelleri ve ölçek davranışlarında önemli avantajlar sunabilir. Document, key-value, wide-column ve graph database'ler aynı kategori altında bulunmasına rağmen farklı problemlere yöneliktir. Bu yüzden “NoSQL daha iyi ölçeklenir” gibi genel ifadeler teknoloji seçmek için yeterli değildir. Access pattern ve consistency gereksinimleri hangi veri modelinin uygun olduğunu belirlemelidir. NoSQL seçiminin operasyon ve expertise maliyeti de mutlaka hesaba katılmalıdır.
Document Database
Document database birbiriyle ilişkili veriyi tek document yapısında saklamanın doğal olduğu use case'lerde etkili olabilir. Değişken schema ve aggregate bazlı erişim modeli avantaj sağlayabilir. Buna karşılık sık cross-document transaction veya karmaşık join ihtiyacı kullanım modelini zorlaştırabilir. Document boyutu ve update pattern dikkatle incelenmelidir. Teknoloji kararı örnek gerçek document yapılarıyla doğrulanmalıdır.
Key-Value Store
Key-value store belirli bir anahtar üzerinden çok hızlı veri erişimi gereken durumlar için uygundur. Session, cache ve basit lookup senaryoları tipik kullanım alanlarıdır. Karmaşık sorgu ihtiyacı varsa bu veri modeli hızla sınırlayıcı olabilir. Persistence ve consistency özellikleri ürüne göre dikkatle değerlendirilmelidir. Key-value sistemi ana database yerine tamamlayıcı bileşen olarak kullanmak birçok projede daha doğal olabilir.
Wide-Column
Wide-column sistemler çok büyük dağıtık veri hacimlerinde belirli access pattern'ler için güçlü ölçek özellikleri sunabilir. Veri modeli çoğu zaman sorgu ihtiyaçlarına göre denormalize edilir. Bu yaklaşım relational modelden farklı düşünme biçimi gerektirir. Ekipte operasyon ve veri modelleme deneyimi yoksa öğrenme maliyeti yüksek olabilir. Gerçek ölçek ihtiyacı kanıtlanmadan bu tür sistemlere geçmek gereksiz risk oluşturabilir.
Graph Database
Graph database yoğun ilişki sorgularının temel iş problemi olduğu durumlarda anlamlı olabilir. Sosyal bağlantılar, ağ analizi veya çok adımlı ilişki traversalları tipik kullanım örnekleridir. Basit CRUD ve normal raporlama için graph database gerekmeyebilir. Query modeli ve veri büyümesi PoC üzerinde test edilmelidir. Graph sistemini yalnızca esnek model sunduğu için seçmek doğru yaklaşım değildir.
NoSQL'u Sadece “Scale” İçin Seçmenin Riski
NoSQL seçimini yalnızca gelecekte yüksek scale olabilir düşüncesine bağlamak ciddi risk yaratabilir. Modern relational database'ler birçok büyük workload'u uygun index, partition ve replica stratejileriyle karşılayabilir. NoSQL'e geçiş transaction, query ve operasyon modellerini değiştirebilir. Bu değişiklik ekibin hızını azaltabilir ve yeni hata senaryoları oluşturabilir. Önce relational sınırların gerçekten problem oluşturduğunu ölçmek daha güvenli yaklaşımdır.
Polyglot Persistence'ın Maliyeti
Polyglot persistence farklı veri ihtiyaçları için birden fazla database engine kullanılmasıdır. Doğru kullanıldığında her workload için uygun veri modelinden yararlanma fırsatı sağlar. Buna karşılık backup, monitoring, güvenlik, uzmanlık ve data governance süreçleri her yeni sistemle genişler. Küçük teknik kazançlar için database sayısını artırmak uzun vadeli operasyon yükü yaratabilir. Her yeni veri teknolojisi açık business veya scalability gerekçesine sahip olmalıdır.
Birden Fazla Database Engine
Birden fazla database engine ekiplerin farklı veri modellerinden faydalanmasını sağlar. Ancak her engine için provisioning, upgrade ve recovery prosedürü gerekir. Platform ekibinin standart automation oluşturma yükü artar. Developer'ların da farklı query ve consistency modellerini öğrenmesi gerekir. Yeni database eklenirken bu toplam maliyet karar matrisine dahil edilmelidir.
Backup
Her database teknolojisinin backup ve restore yöntemi farklı olabilir. Çok sayıda engine kullanıldığında ortak recovery politikası oluşturmak zorlaşır. Backup'ın varlığı değil restore edilebilir olması önemlidir. Düzenli recovery tatbikatları her teknoloji için ayrı test edilmelidir. Bu operasyon yükü polyglot persistence kararının gerçek maliyetlerinden biridir.
Monitoring
Farklı database sistemleri farklı performance metric ve failure mode'lara sahiptir. Monitoring dashboard ve alert kurallarının her engine için özelleştirilmesi gerekebilir. On-call ekibinin hangi sinyalin kritik olduğunu bilmesi önemlidir. Ortak observability standardı bu yükü bir miktar azaltabilir. Buna rağmen teknoloji sayısı arttıkça incident çözme cognitive load'u yükselir.
Security
Database güvenliği identity, network erişimi, encryption ve patch süreçlerini kapsar. Her engine farklı authentication ve privilege modeline sahip olabilir. Security ekibinin tüm teknolojileri düzenli değerlendirmesi gerekir. Zayıf kullanılan bir yan database ana sistem kadar ciddi risk oluşturabilir. Polyglot yapı güvenlik kapsamını büyüttüğü için bu maliyet önceden hesaplanmalıdır.
Expertise
Her database engine farklı tuning ve troubleshooting bilgisi gerektirir. Birkaç geliştiricinin yalnızca kendi servisindeki database'i bilmesi bilgi siloları oluşturabilir. Incident sırasında uzman kişiye ulaşamamak recovery süresini uzatabilir. Eğitim ve dokümantasyonla bu risk azaltılabilir. Yine de yeni database eklemek gerçek bir organizasyon kapasitesi gerektirir.
Data Governance
Data governance verinin kim tarafından, hangi amaçla ve ne kadar süre tutulacağını yönetir. Birden fazla database engine olduğunda veri keşfi ve sınıflandırması zorlaşabilir. KVKK veya GDPR gibi gereksinimler tüm datastore'larda aynı şekilde uygulanmalıdır. Data retention ve silme süreçlerinin otomatik olması önemlidir. Polyglot persistence kararı governance süreçlerinin bu çeşitliliği yönetebileceği varsayımına dayanmalıdır.
Cache Teknolojisi Nasıl Seçilir?
Cache teknolojisi seçimine önce cache gerçekten gerekli mi sorusuyla başlanmalıdır. Performans problemi ölçülmeden cache eklemek gereksiz state ve invalidation problemi oluşturabilir. Gereksinim doğrulandığında local memory, distributed cache veya özel key-value sistemi seçenekleri karşılaştırılabilir. Veri tutarlılığı ve cache miss durumundaki sistem davranışı baştan tasarlanmalıdır. Cache operasyon maliyeti toplam architecture kararının bir parçasıdır.
Cache Gerçekten Gerekli mi?
Cache kullanmadan önce performans darboğazının gerçek kaynağı ölçülmelidir. Yanlış index, gereksiz network çağrısı veya verimsiz kod bazen cache ihtiyacı gibi görünebilir. Sorun temel seviyede çözülebiliyorsa yeni cache katmanı eklememek daha basittir. Cache doğru yerde kullanıldığında ciddi throughput avantajı sağlar. Karar metric ve load test verileriyle desteklenmelidir.
Redis
Redis distributed cache, session, rate limiting ve belirli data structure ihtiyaçlarında kullanılabilir. Hızlı erişim modeli birçok read-heavy sistemde değer sağlar. Persistence ve high availability ayarları kullanım senaryosuna göre belirlenmelidir. Redis'i primary database gibi kullanmak veri dayanıklılığı gereksinimlerini ayrıca değerlendirmeyi gerektirir. Yönetilen hizmetler operasyon yükünü azaltabilir ancak maliyet hesabına dahil edilmelidir.
In-Memory Cache
In-memory cache aynı application instance üzerinde çok hızlı veri erişimi sağlar. Tek instance veya tekrar üretilebilir cache verileri için basit çözüm olabilir. Horizontal scaling durumunda instance'lar arasında cache tutarsızlığı oluşabilir. Uygulama restart olduğunda verinin kaybolmasının sorun olup olmadığı değerlendirilmelidir. Local cache genellikle basitlik avantajı sağladığı yerlerde tercih edilmelidir.
Distributed Cache
Distributed cache birden fazla uygulama instance'ının ortak cache verisine erişmesini sağlar. Session veya paylaşılan lookup verileri için yararlı olabilir. Bunun karşılığında network çağrısı ve ayrı bir failure domain eklenir. Cache servisi down olduğunda uygulamanın tamamen çökmesi istenmeyen bir tasarımdır. Fallback davranışı ve timeout politikaları önceden belirlenmelidir.
Cache Invalidation
Cache invalidation güncellenen verinin eski kopyalarının ne zaman silineceğini veya yenileneceğini belirler. TTL basit bir yöntem olsa da her use case için yeterli değildir. Event tabanlı invalidation daha güncel veri sağlayabilir ancak ekstra altyapı gerektirir. Kullanıcıların ne kadar stale data görebileceği iş gereksinimi olarak tanımlanmalıdır. Cache tasarımının en kritik kısmı çoğu zaman hangi verinin cache'leneceğinden çok invalidation modelidir.
Operational Cost
Cache yeni bir infrastructure bileşeni olduğu için monitoring, scaling, backup ve patch süreçleri oluşturabilir. Yönetilen cache servisleri operasyon yükünü azaltırken aylık maliyeti yükseltebilir. Self-hosted çözüm daha düşük servis maliyeti sunabilir ancak personel zamanı gerektirir. Bu fark TCO içinde değerlendirilmelidir. Cache performans kazancı gerçek operasyon maliyetinden daha büyük olmalıdır.
Messaging ve Event Streaming Teknolojisi Nasıl Seçilir?
Messaging sistemi seçerken queue ve event stream kullanım modelleri birbirinden ayrılmalıdır. Delivery guarantee, ordering, throughput ve retention ihtiyaçları kararın temelidir. Kafka, RabbitMQ veya yönetilen messaging servisleri farklı güçlü yönlere sahiptir. Ekip operasyon deneyimi de önemli bir seçim kriteridir. Mesajlaşma altyapısı uygulama mimarisine güçlü etkide bulunduğu için yalnızca teknoloji popülerliğine göre seçilmemelidir.
Queue vs Event Stream
Queue modeli genellikle bir işin bir consumer tarafından işlenmesi amacıyla kullanılır. Event stream ise olay geçmişinin belirli süre tutulduğu ve farklı consumer'ların aynı event'leri bağımsız okuyabildiği senaryolarda daha uygundur. İki yaklaşımın operasyon ve veri modelleri farklıdır. İş ihtiyacının hangisine daha yakın olduğu belirlenmelidir. Gereksiz event streaming altyapısı basit background job sistemi için fazla ağır olabilir.
Delivery Guarantees
Delivery guarantee mesajın kaybolma veya tekrar işlenme davranışını tanımlar. At-most-once, at-least-once ve farklı exactly-once yaklaşımları farklı trade-off'lara sahiptir. Çoğu uygulamada idempotent consumer tasarımı at-least-once delivery ile güvenilir sonuç verebilir. Exactly-once ifadesinin kapsamı teknolojiye göre farklı anlamlar taşıyabilir. Gereksinim domain operasyonları üzerinden açıkça tanımlanmalıdır.
Ordering
Ordering mesajların hangi sırada tüketilmesi gerektiğini ifade eder. Global ordering yüksek throughput hedefleriyle çelişebilir. Çoğu domain için yalnızca belirli entity veya partition içindeki sıra önemlidir. Partition key seçimi bu nedenle kritik olabilir. Ordering gereksinimi gereğinden geniş tanımlanırsa scaling kapasitesi gereksiz biçimde sınırlanabilir.
Throughput
Messaging throughput saniyede işlenmesi gereken mesaj hacmini gösterir. Ortalama ve peak değerler ayrı ayrı tahmin edilmelidir. Mesaj boyutu da broker kapasitesini doğrudan etkiler. Teknoloji benchmark'ı gerçek message size ve consumer davranışıyla yapılmalıdır. Gereken hacim düşükse daha basit queue hizmeti operasyon açısından daha uygun olabilir.
Retention
Retention mesajların veya event'lerin ne kadar süre tutulacağını belirler. Queue sistemlerinde mesaj genellikle işlendiğinde kaldırılırken event streaming sistemlerinde uzun süre saklanabilir. Uzun retention replay ve audit avantajı sağlarken storage maliyetini yükseltir. Compliance gereksinimleri de retention süresini etkileyebilir. Saklama politikası business ve data governance ekipleriyle birlikte belirlenmelidir.
Kafka
Kafka yüksek throughput event streaming ve event retention kullanım modellerinde güçlü bir platformdur. Partition modeli consumer scaling için etkili mekanizmalar sunar. Buna karşılık cluster operasyonu ve event tasarımı belirli uzmanlık gerektirir. Yönetilen seçenekler bu yükün bir bölümünü azaltabilir. Kafka yalnızca microservices kullanıldığı için otomatik olarak gerekli kabul edilmemelidir.
RabbitMQ
RabbitMQ klasik message queue ve routing senaryolarında olgun özellikler sunar. Background job, work queue ve belirli pub-sub modellerinde etkili olabilir. Exchange ve routing yapısı esnek mesaj dağıtımı sağlar. Yüksek hacimli uzun süreli event retention ihtiyacında başka modeller daha uygun olabilir. Seçim gerçek messaging pattern üzerinden yapılmalıdır.
Managed Messaging Services
Managed messaging services broker provisioning, patch ve bazı scaling işlemlerini servis sağlayıcıya bırakır. Küçük platform ekiplerinde operasyon yükünü ciddi biçimde azaltabilir. Buna karşılık kullanım maliyeti ve provider-specific API bağımlılığı değerlendirilmelidir. Availability ve data residency özellikleri compliance ihtiyacına uygun olmalıdır. Managed servis tercihinde exit strategy de karar kaydına eklenmelidir.
Monolith, Modular Monolith veya Microservices?
Mimari stil seçimi teknoloji yığınının büyüklüğünü ve operasyon yükünü güçlü biçimde etkiler. Monolith ve modular monolith birçok büyük sistem için yeterli ölçek ve daha basit operasyon sunabilir. Microservices bağımsız deployment ve scaling gereksinimleri gerçekten varsa değer üretir. Sadece büyük proje olduğu için microservices kullanmak gerekli değildir. Organizasyon yapısı ve domain sınırları bu kararda altyapı kadar önemlidir.
Monolith
Monolith uygulama bileşenlerini tek deployable unit içinde çalıştırır. Bu yapı local development, transaction yönetimi ve deployment açısından basit olabilir. Kod tabanı büyüdükçe modül sınırları korunmazsa geliştirme zorlaşabilir. Sorun çoğu zaman monolith olmasından çok iç yapının düzensiz olmasından kaynaklanır. İyi tasarlanmış monolith birçok ürün için uzun süre etkili çalışabilir.
Modular Monolith
Modular monolith tek deployment içinde açık domain ve modül sınırları oluşturmayı amaçlar. Microservices'in bazı organizasyonel faydalarını dağıtık sistem maliyeti olmadan sunabilir. Modüller arasında kontrollü dependency kuralları uygulanabilir. Gelecekte belirli modülleri ayrı servise çıkarmak da daha kolay hâle gelir. Yeni büyük projelerde bağımsız deployment ihtiyacı kesin değilse güçlü bir başlangıç seçeneğidir.
Microservices
Microservices sistemin bağımsız deploy edilebilen servislerden oluşmasını sağlar. Büyük ekiplerin farklı domainlerde bağımsız hareket etmesine yardımcı olabilir. Buna karşılık network, observability, messaging, data consistency ve incident management yükünü artırır. Her servis ayrı ürün gibi sahiplenilmediğinde yapı hızlı biçimde dağılabilir. Microservices teknik ölçekten çok organizasyonel ölçek gereksinimi olduğunda daha fazla değer üretir.
Independent Deployment Gerçekten Gerekli mi?
Independent deployment microservices için önemli motivasyonlardan biridir. Ekiplerin birbirini beklemeden servis yayınlaması büyük organizasyonlarda teslim hızını artırabilir. Ancak ekipler zaten aynı release cadence içinde çalışıyorsa bu avantaj sınırlı kalabilir. Deployment bağımsızlığı için API compatibility ve versioning disiplini gerekir. Bu ihtiyaç ölçülmeden mimariyi dağıtmak gereksiz operasyon maliyeti oluşturabilir.
Independent Scaling Gerçekten Gerekli mi?
Bazı servisler diğerlerinden çok daha fazla yük alıyorsa independent scaling maliyet avantajı sağlayabilir. Ancak modern monolith uygulamaları da horizontal scaling ile yüksek trafik taşıyabilir. Tek bir endpoint'in yoğun olması tüm sistemi microservices'e bölmek için yeterli gerekçe değildir. Gerekirse yalnızca darboğaz oluşturan bileşen ayrıştırılabilir. Ölçüm verisi bu kararı tahminden daha güvenilir hâle getirir.
Premature Microservices Problemi
Premature microservices domain sınırları ve ekip yapısı henüz netleşmeden sistemi erken parçalara ayırmaktır. Bu durumda servis sınırları sık değişir ve dağıtık refactoring maliyeti yükselir. Ekip network ve deployment problemleriyle uğraşırken ürün geliştirme hızı düşebilir. Başlangıçta modular monolith kullanmak domain bilgisinin olgunlaşması için daha fazla esneklik sağlayabilir. Microservices geçişi gerçek ihtiyaç oluştuğunda kontrollü şekilde yapılabilir.
Microservices Tech Stack'i Nasıl Karmaşıklaştırır?
Microservices yalnızca uygulamayı küçük servislere bölmez, yeni platform bileşenleri de gerektirir. Service discovery, API gateway, distributed tracing, secrets ve deployment yönetimi önem kazanır. Incident response tek process loguna bakmaktan çok daha zor olabilir. Bu nedenle microservices kararının platform ve operasyon maliyeti açıkça hesaplanmalıdır. Organizasyon bu altyapıyı sürdürebilecek ekip kapasitesine sahip değilse daha basit mimari daha güvenli olabilir.
Service Discovery
Service discovery servis instance'larının birbirini dinamik biçimde bulmasını sağlar. Container orchestration sistemleri bu işlevi platform seviyesinde sağlayabilir. Yanlış discovery veya DNS davranışı dağıtık hata zincirleri oluşturabilir. Timeout ve retry politikaları discovery modeliyle birlikte tasarlanmalıdır. Servis sayısı azsa bu ek altyapının gerçek faydası değerlendirilmelidir.
API Gateway
API gateway dış istemciler ile backend servisleri arasında ortak giriş noktası oluşturabilir. Authentication, routing, rate limiting ve bazı cross-cutting ihtiyaçlar merkezi yönetilebilir. Buna rağmen gateway'e fazla business logic eklemek yeni bir monolith oluşturabilir. Gateway availability açısından kritik bileşene dönüşür. Seçilen ürünün debugging ve observability özellikleri bu nedenle önemlidir.
Messaging
Microservices servisler arası bağımlılığı azaltmak için messaging altyapısından faydalanabilir. Ancak async iletişim veri akışını anlamayı zorlaştırabilir. Event schema, retry ve idempotency politikaları standartlaştırılmalıdır. Broker failure ve consumer lag production operasyonunun yeni parçaları olur. Messaging yalnızca servisler var diye değil uygun interaction modeli bulunduğunda kullanılmalıdır.
Distributed Tracing
Distributed tracing bir request'in birden fazla servis içindeki yolculuğunu takip etmeye yardımcı olur. Microservices ortamında tek bir log satırı sorunun kaynağını açıklamayabilir. Trace context'in servisler arasında doğru aktarılması gerekir. Sampling stratejisi observability maliyetini etkileyebilir. OpenTelemetry gibi standartlar farklı teknolojilerin ortak trace modeli kullanmasını kolaylaştırır.
Configuration
Çok sayıda servis olduğunda environment bazlı configuration yönetimi hızla büyür. Config değişikliklerinin versionlanması ve audit edilmesi önemlidir. Uygulama ayarlarıyla secret değerleri birbirinden ayrılmalıdır. Merkezi config sistemi operasyon kolaylığı sağlayabilir ancak yeni dependency oluşturur. Basit ve standart yaklaşım servis sayısı arttıkça daha fazla değer üretir.
Secrets
Secrets database password, API key ve certificate gibi hassas değerleri kapsar. Bunların source code veya normal config dosyalarında tutulmaması gerekir. Merkezi secret management, rotation ve audit yetenekleri sağlayabilir. Servis sayısı arttıkça manual secret yönetimi sürdürülemez hâle gelir. Platform standartları secrets erişimini uygulama ekipleri için mümkün olduğunca kolaylaştırmalıdır.
Deployment
Microservices mimarisinde deployment sayısı servis sayısıyla birlikte artar. Her servis için pipeline, health check ve rollback mekanizması gerekir. Ortak template kullanımı platform ekibinin bakım yükünü azaltır. Bağımsız deployment'ın faydası ancak pipeline'lar güvenilir ve hızlıysa gerçekleşir. Aksi durumda servis sayısı teslim süreçlerini daha yavaş hâle getirebilir.
Incident Response
Dağıtık sistemlerde incident response birden fazla servisi ve ekibi kapsayabilir. Sorumlu servisi hızlı belirlemek için ownership ve observability bilgilerinin açık olması gerekir. Runbook ve escalation prosedürleri operasyon süresini azaltır. Servisler arasında belirsiz sahiplik kesinti süresini uzatabilir. Microservices kullanan organizasyonlarda incident yönetimi mimarinin resmi parçası olarak görülmelidir.
Serverless mı Containers mı?
Serverless ve containers farklı operasyon kontrolü ve maliyet modelleri sunar. Serverless değişken trafik ve event-driven workload için operasyon kolaylığı sağlayabilir. Containers ise runtime kontrolü ve uzun süre çalışan servislerde daha fazla esneklik sunar. İki yaklaşım aynı sistem içinde farklı servisler için birlikte de kullanılabilir. Karar workload davranışı, ekip deneyimi ve provider bağımlılığı üzerinden verilmelidir.
Serverless
Serverless altyapı provisioning ve scaling işlemlerinin büyük bölümünü platforma bırakır. Ekipler düşük operasyon yüküyle event-driven fonksiyonlar geliştirebilir. Billing modeli düzensiz trafikte maliyet avantajı sağlayabilir. Buna karşılık runtime sınırları, cold start ve vendor-specific entegrasyonlar değerlendirilmelidir. Kritik sistemlerde observability ve local development deneyimi PoC sırasında test edilmelidir.
Variable Traffic
Variable traffic uzun süre düşük kalan ve belirli dönemlerde hızla yükselen workload'u ifade eder. Serverless bu davranışta otomatik scaling avantajı sunabilir. Sürekli yüksek yükte ise kullanım bazlı fiyatlama container veya sabit kapasiteden pahalı olabilir. Gerçek trafik dağılımı maliyet modeline uygulanmalıdır. FinOps değerlendirmesi yalnızca aylık request sayısına değil execution süresi ve veri transferine de bakmalıdır.
Operational Simplicity
Serverless altyapı patch ve instance yönetiminin önemli bölümünü sağlayıcıya bırakabilir. Bu durum küçük platform ekipleri için ciddi avantajdır. Buna rağmen uygulama seviyesinde tracing, retry ve deployment yönetimi devam eder. Operasyon ortadan kalkmaz, yalnızca sorumluluğun bir bölümü hizmet sağlayıcıya taşınır. Ekip provider'ın monitoring ve debugging araçlarını etkin kullanabilmelidir.
Vendor Constraints
Serverless hizmetler execution süresi, runtime veya network erişimi gibi belirli sınırlar uygulayabilir. Provider-specific event ve identity servisleri uygulamayı ekosisteme daha sıkı bağlayabilir. Bu bağlanma her zaman kötü değildir fakat bilinçli bir karar olmalıdır. Migration ihtimali varsa adapter veya açık standart kullanımı değerlendirilebilir. Exit cost ADR içinde açıkça belgelenmelidir.
Containers
Containers uygulama runtime'ını standart paket içinde çalıştırma imkânı sunar. Development ve production ortamları arasında daha tutarlı deployment modeli kurulabilir. Uzun süre çalışan servisler, özel runtime bağımlılıkları ve daha fazla kontrol gerektiren işler için uygundur. Container kullanmak Kubernetes kullanmak zorunda olduğunuz anlamına gelmez. Daha basit container platformları birçok proje için yeterli olabilir.
Runtime Control
Container modeli işletim sistemi library'leri ve runtime version üzerinde daha fazla kontrol sağlar. Özel binary, native dependency veya belirli network davranışı gereken projelerde bu esneklik değerlidir. Ancak daha fazla kontrol aynı zamanda patch sorumluluğu getirir. Base image güncellemeleri güvenlik sürecinin parçası olmalıdır. Platform automation bu operasyon yükünü önemli ölçüde azaltabilir.
Long-Running Processes
Long-running process sürekli çalışan worker veya service workload'larını ifade eder. Container modeli bu tip işler için doğal bir deployment ortamı sağlar. Uzun bağlantılar veya sürekli stream processing serverless sınırlarına uygun olmayabilir. Resource limit ve graceful shutdown davranışı doğru tasarlanmalıdır. Orchestrator sağlık durumunu izleyerek başarısız instance'ları yeniden başlatabilir.
Portability
Container image'ları farklı çalışma ortamlarında benzer packaging modeli sunar. Bu özellik portability açısından avantaj sağlasa da uygulamanın kullandığı managed services yine provider bağımlılığı yaratabilir. Sadece container kullanmak tam cloud bağımsızlığı sağlamaz. Network, identity ve storage katmanları ayrıca değerlendirilmelidir. Portability hedefi gerçek migration senaryolarıyla tanımlanmalıdır.
Kubernetes Gerçekten Gerekli mi?
Kubernetes güçlü container orchestration özellikleri sunar ancak her proje için gerekli değildir. Küçük servis sayısı ve sınırlı operasyon ekibi olan projelerde daha basit platformlar daha düşük maliyetli olabilir. Kubernetes'in değeri büyük service fleet, güçlü platform team ve standardizasyon ihtiyacında artar. Cluster operasyonu, upgrades, networking ve security ciddi uzmanlık gerektirir. Teknolojiyi prestij göstergesi olarak değil açık operasyon ihtiyacına göre değerlendirmek gerekir.
Kubernetes Ne Zaman Mantıklıdır?
Kubernetes çok sayıda container workload'un ortak standartlarla yönetilmesi gerektiğinde anlamlı olabilir. Self-service deployment, policy enforcement ve platform automation büyük ekiplerde güçlü fayda sağlar. Buna rağmen cluster bakım yükü ve platform uzmanlığı ihtiyacı göz ardı edilmemelidir. Kullanım kararı servis sayısı kadar organizasyonun operasyon olgunluğuna da bağlıdır. Gereksinimler daha basitse yönetilen container platformları daha ekonomik olabilir.
Çok Sayıda Service
Çok sayıda service deployment ve resource management işlemlerini standardize etme ihtiyacını artırır. Kubernetes declarative deployment modeli bu noktada değer sağlayabilir. Ortak health check, autoscaling ve rollout yöntemleri oluşturulabilir. Bununla birlikte birkaç servis için aynı platform fazla operasyon yükü yaratabilir. Servis sayısı tek başına değil release sıklığı ve ekip sayısıyla birlikte değerlendirilmelidir.
Platform Team
Kubernetes'in başarılı kullanımı çoğu zaman güçlü bir platform team gerektirir. Bu ekip cluster, security, observability ve developer experience konularında ortak çözümler oluşturur. Uygulama ekiplerinin düşük seviye Kubernetes ayrıntılarıyla sürekli uğraşması verimliliği düşürebilir. Platform ekibi golden path sağlayarak bu yükü azaltır. Böyle bir ekip yoksa teknolojinin gerçek işletme maliyeti özellikle dikkatle hesaplanmalıdır.
Multi-Tenant Infrastructure
Multi-tenant infrastructure birden fazla ekip veya workload'un ortak cluster kaynaklarını paylaşmasını sağlayabilir. Namespace, quota ve policy mekanizmaları izolasyon oluşturmak için kullanılabilir. Güvenlik sınırlarının hangi seviyede olması gerektiği açıkça belirlenmelidir. Çok güçlü izolasyon gereksinimlerinde ayrı cluster yaklaşımı daha uygun olabilir. Platform tasarımı organizasyon yapısı ve risk profiliyle uyumlu olmalıdır.
Compliance
Compliance Kubernetes kullanımında network policy, audit, image security ve access control gereksinimlerini artırabilir. Cluster seviyesinde güçlü governance kurulması gerekir. Policy as code yaklaşımı standardizasyonu destekleyebilir. Yönetilen Kubernetes hizmetleri bazı altyapı sorumluluklarını azaltabilir. Buna rağmen uygulama ve cluster konfigürasyonu için organizasyon sorumluluğu devam eder.
Kubernetes Kullanmak İçin Operasyonel Olgunluk
Operasyonel olgunluk yalnızca cluster kurabilmek anlamına gelmez. Incident response, backup, upgrade, security patch ve observability süreçlerinin düzenli çalışması gerekir. Ekipler production sorunlarında networking ve scheduling davranışını anlayabilmelidir. Platform automation yoksa manuel işlemler hızla risk oluşturabilir. Kubernetes kararı organizasyonun bu süreçleri sürdürebileceği varsayımıyla verilmelidir.
Kubernetes'in Gizli Maliyeti
Kubernetes lisans maliyeti düşük görünse bile insan kaynağı ve operasyon maliyeti yüksek olabilir. Cluster upgrade, add-on yönetimi, security ve developer support sürekli emek gerektirir. Çok küçük workload'da bu personel maliyeti sağlanan faydayı aşabilir. Platform ekibi büyüdükçe toplam maliyet daha görünür hâle gelir. TCO hesabında yalnızca compute ve managed cluster ücretleri değil mühendislik zamanı da yer almalıdır.
Cloud Provider Nasıl Seçilir?
Cloud provider seçimi region, managed services, fiyatlandırma, support ve compliance ihtiyaçlarının birlikte değerlendirilmesini gerektirir. AWS, Azure ve Google Cloud geniş hizmet portföyleri sunar ancak organizasyonun mevcut ekosistemi karar üzerinde önemli etki yaratabilir. Büyük bir geçiş yalnızca liste fiyatı farkıyla gerekçelendirilmemelidir. Ekip deneyimi ve mevcut enterprise anlaşmaları TCO'yu etkileyebilir. Provider değerlendirmesi gerçek workload ve birkaç yıllık kullanım projeksiyonu üzerinden yapılmalıdır.
AWS
AWS geniş managed service seçenekleri ve global region yapısıyla birçok enterprise workload'u destekleyebilir. Servis çeşitliliği ekiplerin birçok altyapı ihtiyacını yönetilen hizmetlerle çözmesini sağlar. Buna karşılık çok sayıda servis arasından seçim yapmak governance ihtiyacını artırabilir. Pricing modeli workload bazında dikkatle analiz edilmelidir. Organizasyonun mevcut AWS deneyimi varsa geçiş ve operasyon riski daha düşük olabilir.
Azure
Azure özellikle Microsoft tabanlı identity ve enterprise ekosistemi bulunan kurumlarda entegrasyon avantajı sağlayabilir. Yönetilen database, container, serverless ve veri hizmetleri geniş seçenekler sunar. Mevcut lisans ve kurumsal anlaşmalar toplam maliyet üzerinde etkili olabilir. Region ve compliance gereksinimleri proje bazında doğrulanmalıdır. Teknoloji kararı mevcut organizasyon altyapısıyla birlikte değerlendirilmelidir.
Google Cloud
Google Cloud container, veri ve analytics workload'larında güçlü managed services sunabilir. Belirli teknik özellikler bazı projelerde önemli avantaj sağlayabilir. Ancak kurumun mevcut uzmanlığı ve enterprise süreçleri kararın önemli parçasıdır. Region availability ve maliyet modeli gerçek deployment senaryosu üzerinden incelenmelidir. Cloud seçimi tek bir servis özelliğine bağlı yapılmamalıdır.
Existing Enterprise Ecosystem
Mevcut enterprise ecosystem identity, network, monitoring ve procurement süreçlerinde büyük yatırım içeriyor olabilir. Yeni provider seçmek bu entegrasyonların yeniden kurulmasını gerektirebilir. Mevcut ekosistemde kalmak teknik olarak ikinci en iyi seçeneği kullanmak anlamına gelse bile toplam maliyette daha avantajlı olabilir. Bunun tersine mevcut platform kritik ihtiyacı karşılamıyorsa alternatif değerlendirilmelidir. Karar tüm geçiş maliyetini içermelidir.
Region Availability
Region availability latency, data residency ve disaster recovery tasarımını doğrudan etkiler. Kullanıcılara yakın region bulunması bazı uygulamalarda performansı iyileştirir. Compliance gereksinimleri verinin belirli ülkelerde tutulmasını zorunlu kılabilir. İhtiyaç duyulan managed service'in ilgili region'da gerçekten bulunduğu doğrulanmalıdır. Region seçimi yalnızca compute kapasitesi üzerinden yapılmamalıdır.
Managed Services
Managed services database, messaging ve observability gibi altyapıların operasyon yükünü azaltabilir. Küçük platform ekipleri için bu avantaj yüksek değer yaratır. Buna karşılık provider-specific özellikler lock-in seviyesini artırabilir. Yönetilen hizmetin SLA, backup ve scaling davranışı incelenmelidir. Premium maliyet çalışan mühendislik zamanıyla birlikte karşılaştırılmalıdır.
Pricing
Cloud pricing çok sayıda değişkene bağlı olduğu için yalnızca instance fiyatı üzerinden karşılaştırılmamalıdır. Storage, data transfer, managed services ve support toplam maliyeti önemli ölçüde değiştirebilir. Reserved capacity veya commitment modelleri belirli workload'larda tasarruf sağlayabilir. Variable traffic için kullanım bazlı servisler daha ekonomik olabilir. FinOps modeli production sonrasında değil architecture aşamasında başlamalıdır.
Support
Enterprise support kritik incident sırasında çözüm süresini etkileyebilir. Sağlayıcının support planı, response süreleri ve uzman erişimi değerlendirilmelidir. Her sorunu vendor'ın çözmesini bekleyen operasyon modeli ise risklidir. Ekip temel troubleshooting kapasitesini kendi içinde korumalıdır. Vendor support tamamlayıcı güvence olarak görülmelidir.
Compliance
Cloud provider'ın sunduğu sertifikasyonlar compliance sürecini kolaylaştırabilir. Ancak sağlayıcının compliant olması uygulamanın otomatik olarak compliant olduğu anlamına gelmez. Shared responsibility modeli dikkatle anlaşılmalıdır. Identity, encryption ve audit konfigürasyonları müşterinin sorumluluğunda kalabilir. Bu nedenle compliance gereksinimleri mimari ve operasyon kontrolleriyle birlikte değerlendirilmelidir.
Multi-Cloud Gerçekten Gerekli mi?
Multi-cloud yaklaşımı teoride vendor riskini azaltabilir ve farklı sağlayıcıların güçlü hizmetlerinden yararlanmayı sağlayabilir. Pratikte ise platform, network, identity ve insan kaynağı yükünü ciddi biçimde artırır. Her iki cloud üzerinde eşdeğer çalışma hedefi uygulamayı en düşük ortak özellik setine sınırlayabilir. Gerçek iş gereksinimi bulunmadan multi-cloud kurmak yüksek TCO yaratabilir. Bu nedenle yaklaşım belirli risk veya regülasyon gerekçeleriyle doğrulanmalıdır.
Multi-Cloud'un Beklenen Faydaları
Multi-cloud farklı provider failure risklerini azaltmak veya belirli coğrafi ihtiyaçları karşılamak için kullanılabilir. Procurement stratejisinde pazarlık gücü oluşturma amacı da olabilir. Belirli servislerin daha güçlü olduğu provider'lardan faydalanmak teknik avantaj sağlayabilir. Ancak tüm bu faydaların gerçekleşmesi için operasyon ekibinin iki ekosistemi de yönetebilmesi gerekir. Beklenen faydalar ölçülebilir hedeflere dönüştürülmelidir.
Operasyonel Karmaşıklık
İki cloud provider iki farklı identity, networking, logging ve security modelini beraberinde getirir. Platform ekiplerinin otomasyon ve monitoring kapsamı genişler. Incident sırasında problemin provider bağımlılığından mı uygulamadan mı kaynaklandığını anlamak zorlaşabilir. Eğitim ve sertifikasyon maliyetleri de artar. Multi-cloud kararında bu insan kaynağı maliyetleri mutlaka hesaba katılmalıdır.
Data Transfer
Cloud'lar arasında veri transferi latency ve egress maliyeti oluşturabilir. Büyük veri hacimlerinde bu maliyet önemli boyuta ulaşabilir. Sürekli cross-cloud replication network tasarımını ve consistency modelini zorlaştırır. Veri akışları architecture diagram üzerinde açıkça gösterilmelidir. Multi-cloud planı oluşturulurken gerçek günlük transfer hacimleri üzerinden maliyet hesaplanmalıdır.
Skill Requirements
Multi-cloud ekiplerin iki farklı platformun servislerini ve operasyon davranışını öğrenmesini gerektirir. Her iki tarafta senior uzmanlık bulundurmak pahalı olabilir. Platform abstraction bazı detayları gizleyebilir ancak provider-specific sorunları tamamen ortadan kaldırmaz. On-call ekibi kritik servislerde temel troubleshooting yapabilmelidir. Skill gap belirlenmeden multi-cloud stratejisine geçilmemelidir.
Vendor Lock-In'i Gerçekten Çözer mi?
Multi-cloud kullanmak vendor lock-in'i otomatik olarak ortadan kaldırmaz. Uygulama yine belirli database, identity veya deployment araçlarına bağımlı olabilir. İki sağlayıcıya aynı anda bağımlı hâle gelmek de mümkündür. Lock-in riski kullanım yerine migration cost üzerinden ölçülmelidir. Bazı managed service bağımlılıkları sağladığı verimlilik nedeniyle kabul edilebilir olabilir.
Vendor Lock-In Nasıl Değerlendirilir?
Vendor lock-in bir teknoloji veya hizmetten ayrılmanın maliyetini ifade eder. Lock-in her zaman kötü değildir ve bazı managed hizmetler ciddi geliştirme avantajı sağlayabilir. Önemli olan bağımlılığın seviyesini ve çıkış maliyetini bilinçli biçimde bilmektir. Infrastructure, database, API, data ve identity lock-in farklı risk profillerine sahiptir. Her kritik bağımlılık için migration senaryosu düşünülmelidir.
Infrastructure Lock-In
Infrastructure lock-in deployment modelinin belirli sağlayıcının özelliklerine güçlü biçimde bağlanmasıdır. Özel network veya compute servisleri migration sürecini zorlaştırabilir. Infrastructure as code kullanmak configuration bilgisinin görünür kalmasını sağlar. Ancak aynı kodun farklı provider'da çalışması her zaman mümkün değildir. Çıkış planı gerçek yeniden kurulum maliyeti üzerinden değerlendirilmelidir.
Database Lock-In
Database lock-in özel query dili, data model veya managed feature kullanımından kaynaklanabilir. Veri hacmi büyüdükçe migration süresi ve risk artar. Export formatı ve replication seçenekleri erken dönemde incelenmelidir. Adapter kullanmak bazı uygulama bağımlılıklarını azaltabilir. Bununla birlikte database abstraction'ın her özelliği gizlemesi beklenmemelidir.
API Lock-In
API lock-in uygulamanın provider-specific SDK veya servis arayüzlerine bağlanmasını ifade eder. Bu bağımlılık kod tabanının birçok noktasına yayılırsa migration zorlaşabilir. Kritik entegrasyonlar internal adapter arkasında tutulabilir. Bu yaklaşım değişim ihtimali yüksek servislerde faydalıdır. Her API için abstraction oluşturmak ise gereksiz geliştirme maliyeti yaratabilir.
Data Lock-In
Data lock-in verinin dışarı çıkarılmasının teknik veya mali olarak zor olmasıdır. Çok büyük veri hacmi export sürelerini ve network maliyetini artırabilir. Proprietary format kullanımı migration işlemini zorlaştırabilir. Open format ve düzenli export testleri riski azaltır. Veri sahipliği sözleşme ve architecture kararlarında açık biçimde tanımlanmalıdır.
Identity Lock-In
Identity sistemi kullanıcı ve servis kimliklerinin merkezinde bulunduğu için yüksek migration maliyeti yaratabilir. Authentication protocol, user data export ve federation desteği önemli seçim kriterleridir. OpenID Connect veya SAML gibi açık standartlar taşınabilirliği artırabilir. Kullanıcı şifrelerinin migration davranışı ayrıca incelenmelidir. Identity kararı one-way door niteliğine yakın kabul edilerek daha dikkatli verilmelidir.
Developer Tool Lock-In
Developer tool lock-in build, CI/CD veya özel deployment araçlarına bağımlılıktan oluşabilir. Kod tabanı belirli platform workflow'una çok sıkı bağlanırsa değişim maliyeti yükselir. Standart artifact formatları ve script tabanlı build süreçleri esneklik sağlayabilir. Buna rağmen verimli managed developer tools kullanmaktan tamamen kaçınmak da doğru değildir. Fayda ile değiştirme maliyeti birlikte değerlendirilmelidir.
Lock-In Her Zaman Kötü müdür?
Lock-in her zaman kaçınılması gereken bir durum değildir. Yönetilen database veya serverless hizmeti geliştirme ve operasyon süresini ciddi biçimde azaltabilir. Bu kazanç, gelecekteki olası migration maliyetinden daha yüksek olabilir. Sorun bağımlılığı fark etmeden ve çıkış maliyetini hesaplamadan karar vermektir. Bilinçli lock-in çoğu kurumsal sistemde makul bir trade-off olabilir.
Exit Strategy Teknoloji Seçiminin Parçası Olmalı mı?
Exit strategy kritik teknoloji veya vendor seçimleri için baştan düşünülmelidir. Amaç her hizmetten kolayca ayrılabilecek soyut sistem kurmak değildir. Bunun yerine veri export, migration cost ve replacement plan gibi unsurların bilinmesidir. Özellikle irreversible kararlarda bu yaklaşım risk yönetimini güçlendirir. Exit plan ADR içinde tutulursa yıllar sonra kararın bağlamı daha kolay anlaşılır.
Veriler Export Edilebilir mi?
Veri export edilebilirliği migration ve yasal veri taşınabilirliği açısından önemlidir. Sağlayıcının hangi formatlarda export sunduğu incelenmelidir. Büyük veri hacminde export süresinin gerçekçi olup olmadığı test edilebilir. Backup formatının yalnızca aynı ürün tarafından okunabilmesi ek risk yaratabilir. Kritik sistemlerde periyodik export tatbikatı yararlı olabilir.
Open Standards Kullanılıyor mu?
Open standards farklı ürünler arasında entegrasyon ve migration kolaylığı sağlayabilir. HTTP, SQL, OpenTelemetry veya standart kimlik protokolleri buna örnektir. Standart kullanmak tamamen vendor bağımsızlığı sağlamaz fakat değiştirme maliyetini azaltabilir. Proprietary özelliklerin sağladığı büyük faydalar varsa bunlar bilinçli biçimde kullanılabilir. ADR içinde kullanılan özel bağımlılıklar açıkça belirtilmelidir.
Migration Cost
Migration cost kod değişikliği, veri aktarımı, eğitim ve parallel run maliyetlerinden oluşabilir. Sadece lisans veya cloud fiyatı üzerinden migration kararı verilmemelidir. Büyük sistemlerde test ve risk azaltma süreci ciddi mühendislik zamanı gerektirir. Bu maliyet yaklaşık aralıklarla bile olsa teknoloji seçiminde tahmin edilmelidir. Yüksek migration cost daha uzun destek ömrüne sahip teknoloji seçimini önemli hâle getirir.
Replacement Adapter
Replacement adapter değişme ihtimali yüksek vendor API'lerini uygulama domain'inden ayırmak için kullanılabilir. Böylece sağlayıcı değiştiğinde kodun daha küçük bölümü güncellenir. Payment, email veya object storage entegrasyonlarında bu model yararlı olabilir. Ancak her dependency için adapter eklemek gereksiz abstraction oluşturabilir. Değişim olasılığı ve migration maliyeti yüksek alanlara odaklanmak daha doğru olur.
Exit Plan'i ADR İçinde Belgelemek
ADR teknoloji kararının nedenini ve sonuçlarını kayıt altına alır. Exit plan aynı kayıtta tutulduğunda gelecekteki ekipler bağımlılığın bilinçli seçildiğini görebilir. Veri export yöntemi, olası alternatif ve migration tetikleyicileri kısa biçimde yazılabilir. Bu kayıt yıllar sonra technology review sırasında önemli bağlam sağlar. Belgelenmeyen exit plan ise ekip değiştikçe kolayca unutulur.
Open Source Tech Stack Seçiminde Nasıl Değerlendirilir?
Open source teknoloji seçerken yalnızca popülerlik veya GitHub star sayısına bakmak yeterli değildir. Maintainer activity, release cadence, security patch hızı ve governance yapısı daha değerli sinyaller sağlayabilir. Projenin kritik dependency olup olmadığı da risk seviyesini etkiler. Bus factor düşük projeler uzun vadede bakım riski taşıyabilir. Kurumsal kullanım öncesinde teknik ve hukuki değerlendirme birlikte yapılmalıdır.
GitHub Star Sayısı Yeterli mi?
GitHub star sayısı bir projenin görünürlüğü hakkında fikir verebilir ancak kalite garantisi değildir. Yıllardır bakım almayan projeler de yüksek star sayısına sahip olabilir. Aktif release, issue çözümü ve security patch geçmişi daha anlamlıdır. Kullanılan proje sürümünün ne kadar düzenli destek aldığı incelenmelidir. Karar popülerlik metriği yerine project health göstergelerine dayanmalıdır.
Maintainer Activity
Maintainer activity projenin hâlen aktif biçimde geliştirildiğini ve sorunlara yanıt verildiğini gösterebilir. Commit sayısından çok kritik issue ve pull request'lerin nasıl ele alındığı önemlidir. Birkaç kişiye aşırı bağımlı proje risk taşıyabilir. Büyük kurumsal kullanımda maintainer modelinin sürdürülebilir olması önemlidir. Governance bilgileri bu değerlendirmeyi destekler.
Release Cadence
Release cadence projenin ne sıklıkla güncellendiğini gösterir. Çok seyrek release bakım eksikliğine işaret edebilirken aşırı sık breaking release kurumsal upgrade yükü oluşturabilir. Düzenli ve öngörülebilir sürüm modeli tercih edilir. LTS sürümleri büyük projeler için ek avantaj sağlayabilir. Upgrade stratejisi proje başlangıcında belirlenmelidir.
Issue Response
Issue response topluluğun ve maintainer'ların gerçek kullanım sorunlarına yaklaşımını gösterir. Kritik bug'ların aylarca açık kalması production riski oluşturabilir. Issue sayısını tek başına negatif sinyal olarak değerlendirmek doğru değildir çünkü büyük projelerde doğal olarak daha fazla issue bulunabilir. Önemli olan çözüm kalitesi ve önceliklendirme biçimidir. Kullanılacak kritik özelliklerle ilgili açık issue'lar ayrıca incelenmelidir.
Security Patch Hızı
Security patch hızı bilinen açıkların ne kadar hızlı giderildiğini gösterir. Kurumsal sistemlerde dependency'nin güvenlik güncellemelerini düzenli alması kritik önem taşır. CVE yayınlandıktan sonra uzun süre patch çıkmaması risk seviyesini yükseltir. Security advisory kanalının bulunması da olumlu göstergedir. Kritik open source bileşenler için update süreci otomatik takip edilmelidir.
Bus Factor
Bus factor projenin kaç kişinin aktif katkısına bağımlı olduğunu ifade eder. Tek maintainer tarafından yürütülen kritik bir library uzun vadeli risk taşıyabilir. Organizasyon, maintainer'ın ayrılması durumunda projenin devam edip etmeyeceğini değerlendirmelidir. Foundation veya geniş contributor tabanı riski azaltabilir. Kritik dependency seçiminde bus factor teknik kalite kadar önemli olabilir.
Roadmap
Roadmap projenin gelecekte hangi yönde gelişmesinin planlandığını gösterir. Kurumsal ihtiyaçlarla tamamen ters yöne giden roadmap gelecekte migration gerektirebilir. Public roadmap bulunmaması otomatik olarak kötü işaret değildir. Ancak major version ve deprecation planlarının anlaşılır olması avantaj sağlar. Uzun ömürlü projelerde teknoloji yönünün organizasyon hedefleriyle uyumu değerlendirilmelidir.
Governance
Governance open source projenin kararlarının kim tarafından ve hangi süreçle alındığını açıklar. Tek şirkete veya tek kişiye bağımlı governance modeli farklı riskler oluşturabilir. Foundation veya açık karar süreçleri daha öngörülebilir yapı sağlayabilir. Lisans değişikliği olasılığı da governance ile ilişkilidir. Kritik teknoloji seçiminde proje yönetim modeli teknik özelliklerle birlikte incelenmelidir.
Open Source ve İşbirliği Büyük Projeleri Nasıl Etkiler?
Open source ekosistemi kurumsal ekiplerin ortak çözümlerden yararlanmasını ve bilgi paylaşmasını sağlar. Community support sorun çözme hızını artırabilir. Internal ve upstream contribution ekiplerin kullandığı araçları daha iyi anlamasına yardımcı olur. Bununla birlikte kontrolsüz fork yaklaşımı uzun vadeli bakım maliyeti yaratabilir. Kurumsal open source policy bu katkıları güvenli ve sürdürülebilir çerçevede yönetmelidir.
Community Support
Aktif community geniş kullanım deneyiminin paylaşılmasını sağlar. Forum, issue tracker ve teknik içerikler production problemlerinin çözümünde yardımcı olabilir. Topluluk büyüklüğünden çok soruların kalitesi ve güncelliği önemlidir. Kurumsal ekipler kritik teknolojiler için resmi support seçeneğini de değerlendirebilir. Community ve commercial support birlikte güçlü güvence oluşturabilir.
Knowledge Sharing
Knowledge sharing ekiplerin aynı problemleri tekrar tekrar çözmesini önler. Internal teknik dokümantasyon ve community içerikleri bu süreci destekler. Open source teknolojilerde geniş örnek kod ve problem çözümü kaynağı bulunabilir. Buna rağmen internet üzerindeki her çözüm production kalitesinde değildir. Kurumsal ekipler doğrulanmış internal guidance oluşturarak bilgiyi standardize etmelidir.
Internal Contribution
Internal contribution şirket içinde kullanılan open source araçlara yönelik geliştirmeleri kapsayabilir. Ekipler bug fix veya adapter oluşturarak teknolojiyle ilgili derin bilgi kazanabilir. Değişikliklerin yalnızca iç fork'ta tutulması maintenance yükü oluşturur. Uygunsa upstream contribution değerlendirilmelidir. Fikri mülkiyet ve security politikaları contribution sürecini açık biçimde tanımlamalıdır.
Upstream Contribution
Upstream contribution yapılan iyileştirmenin ana open source projeye gönderilmesidir. Değişiklik kabul edildiğinde gelecekteki sürümlerde özel patch taşıma ihtiyacı azalır. Ekip aynı zamanda maintainer topluluğuyla doğrudan iletişim kurar. Contribution süreci coding standard ve test kalitesini geliştirebilir. Kurumsal policy bu katkıları kontrollü biçimde desteklemelidir.
Fork Etmenin Uzun Vadeli Maliyeti
Fork kısa vadede gerekli değişikliği hızlı yapma imkânı sağlayabilir. Ancak upstream ilerledikçe merge ve security patch maliyeti büyür. Özel fork uzun süre güncellenmezse bilinen açıklar taşımaya başlayabilir. Kritik fork'lar için açık ownership ve upgrade planı oluşturulmalıdır. Mümkünse değişiklik upstream'e katkı olarak gönderilmelidir.
Kurumsal Open Source Policy
Kurumsal open source policy hangi lisansların ve projelerin kullanılabileceğini tanımlar. Security scanning, legal review ve contribution süreçleri ortak standarda bağlanabilir. Geliştiricilerin her dependency için uzun manuel onay beklemesi verimliliği düşürebilir. Approved catalog ve otomatik kontroller daha dengeli model sunar. Politika güvenliği korurken developer experience'ı da göz önünde bulundurmalıdır.
Open Source Lisansları Stack Kararını Nasıl Etkiler?
Open source lisansları yazılımın nasıl kullanılabileceğini, dağıtılabileceğini ve değiştirilebileceğini belirler. MIT ve Apache 2.0 gibi permissive lisanslarla GPL veya AGPL gibi copyleft modellerin yükümlülükleri farklıdır. Source-available lisanslar ise open source kavramıyla aynı koşulları taşımayabilir. Kritik dependency'ler hukuk veya compliance ekipleri tarafından değerlendirilmelidir. Lisans kontrolü production öncesinde değil dependency seçimi sırasında yapılmalıdır.
MIT
MIT lisansı genellikle geniş kullanım ve dağıtım esnekliği sağlayan permissive bir lisans olarak bilinir. Kurumsal projelerde sık kullanılmasının nedenlerinden biri yükümlülüklerinin görece basit olmasıdır. Buna rağmen copyright notice ve lisans koşulları yine takip edilmelidir. Dependency inventory lisans bilgilerini içermelidir. Hukuki yorum gereken durumlarda uzman değerlendirmesi yapılmalıdır.
Apache 2.0
Apache 2.0 permissive kullanım modeliyle birlikte açık patent hükümleri de içerir. Birçok kurumsal açık kaynak projede tercih edilen lisanslardan biridir. Notice ve attribution gereksinimleri release sürecinde yönetilmelidir. Dependency scanning araçları lisans tespitini otomatikleştirebilir. Kullanım koşulları hukuk ekibi tarafından organizasyon politikasına göre değerlendirilmelidir.
GPL
GPL copyleft yaklaşımı nedeniyle dağıtım senaryolarında ek yükümlülükler doğurabilir. Uygulamanın GPL bileşeniyle nasıl bağlandığı hukuki değerlendirme gerektirebilir. Her kullanım senaryosu aynı sonucu doğurmadığı için genelleme yapmak doğru değildir. Kurumsal policy hangi kullanım biçimlerinin kabul edilebilir olduğunu açıkça tanımlamalıdır. Kritik projelerde legal review erken yapılmalıdır.
AGPL
AGPL network üzerinden sunulan yazılımlar açısından GPL'den daha geniş yükümlülükler oluşturabilir. SaaS ve web uygulamalarında bu nedenle özel dikkat gerektirir. Bir library veya database ürününün AGPL olması doğrudan teknik yasak anlamına gelmez. Ancak kullanım modelinin organizasyonun fikri mülkiyet politikasıyla uyumu değerlendirilmelidir. Hukuki karar teknik ekip tarafından varsayımla verilmemelidir.
Source-Available Licenses
Source-available lisanslar kaynak kodu görünür kılabilir fakat kullanım veya ticari dağıtım üzerinde ek kısıtlamalar içerebilir. Bu nedenle open source lisanslarıyla aynı kabul edilmemelidir. Cloud veya rakip hizmet sunma sınırlamaları bazı ürünlerde bulunabilir. Lisans değişiklikleri gelecekteki kullanım planını etkileyebilir. Kritik platform seçimi yapılırken güncel lisans koşulları dikkatle incelenmelidir.
Legal Review
Legal review teknik ekibin lisans koşullarını yorumlama riskini azaltır. Her küçük dependency için manuel hukuk süreci kurmak ölçeklenebilir olmayabilir. Approved license catalog ve otomatik scanning daha verimli bir model sunar. Belirsiz veya yüksek riskli lisanslar uzman incelemesine yönlendirilebilir. Bu süreç CI/CD ve dependency governance ile entegre edilmelidir.
Software Supply Chain Security
Modern uygulamalar çok sayıda üçüncü taraf dependency ve build aracı kullanır. Bu nedenle supply chain security teknoloji seçiminin temel parçalarından biri hâline gelmiştir. Dependency risk, CVE takibi, SBOM, artifact signing ve registry güvenliği birlikte ele alınmalıdır. Açık kaynak kullanmamak supply chain riskini otomatik olarak ortadan kaldırmaz. Amaç kullanılan bileşenlerin kaynağını, sürümünü ve güvenlik durumunu görünür hâle getirmektir.
Dependency Risk
Her dependency yeni kod, bakım modeli ve supply chain ilişkisi ekler. Küçük convenience package'lar bile kritik güvenlik yüzeyi oluşturabilir. Dependency sayısını gereksiz artırmamak bakım işini kolaylaştırır. Kullanılan paketlerin maintainer ve release geçmişi incelenmelidir. Otomatik dependency update ve security scanning süreçleri bu riski yönetmeye yardımcı olur.
CVE
CVE bilinen güvenlik açıklarının standart biçimde takip edilmesini sağlar. Dependency scanner araçları kullanılan sürümlerdeki bilinen açıkları tespit edebilir. Her CVE aynı risk seviyesine sahip değildir ve uygulamanın kullanım şekline göre değerlendirilmelidir. Kritik açıklar için patch SLA tanımlanmalıdır. Teknoloji ekosisteminin güvenlik güncelleme hızı stack seçiminde önemli sinyaldir.
SBOM
SBOM uygulamanın içerdiği software component listesini görünür hâle getirir. Güvenlik açığı ortaya çıktığında hangi sistemlerin etkilendiğini hızlı belirlemeye yardımcı olur. Büyük organizasyonlarda dependency inventory manuel yöntemlerle yönetilemez. Build pipeline içinde otomatik SBOM üretmek daha güvenilir yaklaşım sunar. Compliance ve incident response süreçleri bu veriden faydalanabilir.
Dependency Pinning
Dependency pinning build sırasında hangi sürümlerin kullanılacağını sabitleyerek tekrar üretilebilirlik sağlar. Kontrolsüz latest sürüm kullanımı beklenmeyen değişikliklerin production'a girmesine yol açabilir. Lock file ve artifact repository bu modeli destekler. Pinning güncellemelerin tamamen durdurulması anlamına gelmemelidir. Düzenli ve test edilmiş upgrade süreciyle birlikte kullanılmalıdır.
Signed Artifacts
Signed artifacts build çıktısının beklenen kaynaktan geldiğini doğrulamaya yardımcı olur. Container image veya package gibi artifact'ler release pipeline içinde imzalanabilir. Deployment policy yalnızca doğrulanmış artifact'lerin production'a geçmesine izin verebilir. Bu yaklaşım supply chain saldırı riskini azaltır. Key yönetimi ve rotation süreci de güvenlik modelinin parçasıdır.
Package Registry Security
Package registry dependency ve internal artifact dağıtımının merkezinde yer alır. Private registry erişimleri güçlü identity ve authorization ile korunmalıdır. Public package isimleriyle oluşabilecek dependency confusion riskleri dikkate alınmalıdır. Registry audit log ve vulnerability scanning özellikleri faydalıdır. Build sisteminin yalnızca güvenilir kaynaklardan package çekmesi policy ile zorunlu tutulabilir.
Framework ve Runtime Olgunluğu Nasıl Ölçülür?
Framework olgunluğu yalnızca kaç yıldır var olduğu üzerinden ölçülmez. LTS policy, backward compatibility, security support, documentation ve production adoption daha anlamlı göstergelerdir. Sık breaking change yapan ekosistemler büyük projelerde upgrade maliyetini yükseltebilir. End-of-life tarihleri teknoloji roadmap'iyle uyumlu olmalıdır. Olgun runtime ekiplerin yıllar boyunca daha öngörülebilir bakım yapmasına yardımcı olur.
LTS Policy
LTS policy belirli sürümlerin ne kadar süre güvenlik ve hata düzeltmesi alacağını açıklar. Uzun ömürlü projelerde bu süre upgrade planının temel girdisidir. Çok kısa destek pencereleri büyük sistemleri sürekli migration baskısı altında bırakabilir. Release tarihleri roadmap ile birlikte planlanmalıdır. Critical runtime seçimlerinde resmi support politikasının açık olması avantajdır.
Backward Compatibility
Backward compatibility yeni sürümlerin mevcut uygulamalarla ne kadar uyumlu kaldığını gösterir. Güçlü compatibility büyük kod tabanlarında upgrade riskini azaltır. Breaking change kaçınılmaz olduğunda migration tooling ve dokümantasyon önemli hâle gelir. Upgrade maliyeti yıllık bakım planına dahil edilmelidir. Teknolojinin geçmiş major sürüm geçişleri bu konuda iyi bir sinyal sağlayabilir.
Breaking Change Frequency
Sık breaking change ekiplerin feature geliştirmek yerine migration çalışmasına zaman ayırmasına neden olabilir. Hızlı gelişen framework'lerde bu maliyet başlangıçta görünmeyebilir. Büyük organizasyonlarda onlarca repository aynı değişiklikten etkilenebilir. Standard tooling ve automated codemod bu yükü azaltabilir. Stack seçerken release history incelemek gelecekteki bakım yükü hakkında fikir verir.
Security Support
Security support runtime ve framework'ün bilinen açıklar için ne kadar hızlı patch sunduğunu gösterir. EOL olmuş sürümlerde güvenlik güncellemesi alınamaması ciddi risk oluşturur. Kurumsal projeler support pencerelerini teknoloji radarında takip etmelidir. Security patch'lerinin geriye dönük sürümlere ne kadar taşındığı da önemlidir. Upgrade planı support bitmeden önce hazırlanmalıdır.
Documentation
İyi documentation geliştirici üretkenliğini ve onboarding hızını doğrudan etkiler. Sadece API referansı değil deployment, security ve troubleshooting bilgileri de bulunmalıdır. Güncel olmayan dokümantasyon yanlış implementation riskini artırır. Framework seçerken kritik kullanım senaryolarını dokümantasyon üzerinden çözmeye çalışmak iyi test olabilir. Güçlü documentation uzun vadeli developer experience avantajı sağlar.
Production Adoption
Production adoption teknolojinin gerçek sistemlerde denenmiş olduğunu gösteren sinyallerden biridir. Büyük kullanım örnekleri scaling ve operations hakkında daha fazla bilgi üretilmesini sağlar. Bununla birlikte başka şirketlerin kullanması sizin workload'unuz için otomatik uygunluk anlamına gelmez. Referanslardan problem çözme modeli öğrenilebilir. Kendi PoC ve requirement analizi yine final kararın temelidir.
End-of-Life Riski
End-of-life teknolojinin resmi destek süresinin sona ermesini ifade eder. Kritik runtime'ın yakın zamanda EOL olması güvenlik ve maintenance maliyeti oluşturur. Teknoloji seçerken birkaç yıllık roadmap incelenmelidir. Mevcut legacy sistemlerde EOL tarihi modernization trigger olarak kullanılabilir. Upgrade veya replacement planı son destek gününe bırakılmamalıdır.
Total Cost of Ownership Nasıl Hesaplanır?
Total Cost of Ownership teknoloji yığınının yalnızca satın alma veya cloud fiyatını değil tüm yaşam döngüsü maliyetini ifade eder. Development, developer salaries, training, cloud, licensing, monitoring, security, incident response ve migration maliyetleri bu hesabın parçalarıdır. Bir teknoloji başlangıçta ucuz görünürken uzun vadede uzmanlık veya bakım nedeniyle daha pahalı olabilir. TCO en az üç ila beş yıllık perspektifle değerlendirilmelidir. Kurumsal projelerde teknoloji seçerken toplam sahip olma maliyeti ve uzun vadeli bakım neden önemlidir sorusunun cevabı tam olarak bu yaşam döngüsü etkisinde yatar.
Development Cost
Development cost bir özelliği güvenli biçimde production'a taşıma süresini içerir. Framework productivity, library availability ve testing tooling bu maliyeti etkiler. Çok hızlı runtime her zaman daha düşük development cost anlamına gelmez. Ekip yeni teknolojiyi öğreniyorsa ilk teslimler beklenenden uzun sürebilir. Teknoloji karşılaştırmasında gerçek feature geliştirme denemeleri yararlı veri sağlar.
Developer Salaries
Developer salaries çoğu yazılım projesinde toplam maliyetin büyük bölümünü oluşturur. Nadir teknoloji uzmanları daha yüksek ücret gerektirebilir. Buna karşılık daha üretken ekosistem daha az kişiyle aynı çıktıyı sağlayabilir. Maaş verisi hiring time ve retention riskiyle birlikte değerlendirilmelidir. TCO hesabında insan kaynağını ihmal etmek büyük hata olur.
Training
Training yeni teknolojiye geçişin doğrudan ve dolaylı maliyetidir. Kurs, workshop ve eğitim süresinin yanında ilk production hataları da öğrenme maliyetinin parçasıdır. Ekipte mentor veya senior expertise varsa geçiş daha hızlı olabilir. Eğitim planı release timeline ile birlikte oluşturulmalıdır. Yeni teknoloji seçiminin gerçek ROI'si bu maliyet eklendikten sonra değerlendirilmelidir.
Cloud
Cloud maliyeti compute, storage, network ve managed services toplamından oluşur. Kullanım büyüdükçe küçük birim fiyat farkları büyük faturaya dönüşebilir. Buna karşılık engineering productivity sağlayan managed service premium'u makul olabilir. Resource utilization metric'leri düzenli takip edilmelidir. Cloud mimarisi FinOps disiplininden ayrı ele alınmamalıdır.
Licensing
Licensing maliyetleri database, monitoring veya enterprise framework ürünlerinde önemli olabilir. Per-core, per-user veya kullanım bazlı lisans modelleri farklı büyüme davranışları gösterir. İlk yıl düşük görünen maliyet scale arttığında hızla büyüyebilir. Sözleşme yenileme ve fiyat değişim riski de değerlendirilmelidir. Open source alternatiflerin operasyon maliyetiyle birlikte karşılaştırma yapılmalıdır.
Monitoring
Monitoring maliyeti log, metric, trace storage ve observability platform lisanslarını kapsar. Yüksek hacimli log sistemleri beklenenden pahalı olabilir. Retention ve sampling politikaları maliyet kontrolünde önemlidir. Kullanılmayan telemetry toplamak hem maliyet hem operasyon gürültüsü yaratır. Observability bütçesi production tasarımının başında tahmin edilmelidir.
Security
Security maliyeti scanning, identity, secret management ve compliance araçlarını kapsayabilir. Güvenliği sonradan eklemek genellikle başlangıçtan tasarlamaktan daha pahalıdır. Managed security servisleri mühendislik süresini azaltabilir. Buna rağmen güvenlik sahipliği tamamen araca devredilemez. TCO içinde güvenlik operasyonu sürekli gider olarak değerlendirilmelidir.
Incident Response
Incident response maliyeti kesinti sırasında harcanan mühendislik zamanı ve iş kaybını içerir. Operasyonu zor teknoloji düşük altyapı maliyetine rağmen pahalı olabilir. Mean Time to Recovery gibi metrikler gerçek operasyon etkisini gösterir. Güçlü observability ve bilinen failure mode'lar bu süreyi azaltır. TCO değerlendirmesi reliability verilerini de içermelidir.
Upgrade
Upgrade maliyeti framework, runtime ve database sürümlerini desteklenen seviyede tutma işidir. Sık breaking change büyük ekiplerde ciddi planlama gerektirir. Otomatik test kapsamı upgrade riskini azaltır. Upgrade'i sürekli ertelemek daha büyük tek seferlik migration sorununa dönüşebilir. Teknolojinin release modeli TCO hesabına dahil edilmelidir.
Migration
Migration maliyeti mevcut teknolojiden yeni sisteme geçişte oluşan mühendislik ve operasyon gideridir. Data migration, dual run ve kullanıcı geçişi uzun sürebilir. Migration sırasında iki sistemin aynı anda işletilmesi geçici cloud maliyetini yükseltir. Rollback planı ayrıca geliştirme gerektirir. Kritik one-way door kararlarında potansiyel migration maliyeti en baştan düşünülmelidir.
Retirement
Retirement eski sistemin güvenli biçimde kapatılmasını ifade eder. Data archive, erişim kesme ve dependency temizleme işlemleri zaman gerektirir. Eski servis unutulursa security ve cloud maliyeti üretmeye devam edebilir. Decommission checklist ve ownership tanımlanmalıdır. Teknoloji yaşam döngüsü seçimle değil retirement ile tamamlanır.
FinOps Stack Seçiminde Neden Önemlidir?
FinOps teknik kullanım ile finansal etkiyi aynı karar modelinde birleştirir. Cost per request, user veya tenant gibi metric'ler architecture maliyetini iş hacmiyle ilişkilendirir. Data egress ve managed service premium gibi giderler teknoloji seçiminde görünür olmalıdır. Sadece toplam cloud faturası neyin pahalı olduğunu açıklamaz. Birim ekonomi yaklaşımı scaling kararlarının daha bilinçli verilmesini sağlar.
Cost per Request
Cost per request belirli trafik hacmini işlemenin birim maliyetini gösterir. Farklı runtime veya infrastructure seçenekleri aynı workload üzerinde karşılaştırılabilir. Peak kapasite ve idle kaynaklar bu metriği etkiler. Performans optimizasyonunun finansal değerini ölçmek için de kullanılabilir. Tek başına değil revenue veya business value metric'leriyle birlikte yorumlanmalıdır.
Cost per User
Cost per user altyapı giderini aktif kullanıcı sayısıyla ilişkilendirir. Kullanıcı büyümesiyle maliyetin doğrusal mı yoksa daha hızlı mı arttığını gösterebilir. Freemium ve premium segmentler için ayrı hesaplama yapılabilir. Bu metric ürün fiyatlandırmasıyla teknoloji maliyetini ilişkilendirmeyi kolaylaştırır. Tech stack scaling davranışı finansal olarak daha görünür hâle gelir.
Cost per Tenant
Multi-tenant sistemlerde cost per tenant müşteri bazlı altyapı maliyetini ölçmek için yararlıdır. Büyük tenant'ların diğer müşterilere göre ne kadar kaynak kullandığı görülebilir. Bu bilgi pricing ve capacity planning kararlarını destekler. Tenant isolation modeli maliyet dağılımını etkileyebilir. Platform metric'leri tenant bilgisiyle ilişkilendirilmelidir.
Data Egress
Data egress cloud dışına veya farklı region'a veri aktarım maliyetidir. Büyük media, analytics veya multi-cloud sistemlerde önemli gider oluşturabilir. Architecture diagram üzerinde yoğun veri akışları işaretlenmelidir. CDN ve bölgesel işleme bazı transferleri azaltabilir. Provider karşılaştırmasında egress fiyatları mutlaka gerçek trafik hacmine uygulanmalıdır.
Managed Service Premium
Managed service premium self-hosted altyapıya göre daha yüksek birim fiyat anlamına gelebilir. Buna rağmen patch, backup ve operasyon yükünü azalttığı için toplam maliyet daha düşük olabilir. Karşılaştırma yalnızca servis faturası üzerinden yapılmamalıdır. Platform mühendisi zamanı ve incident maliyeti de hesaba katılmalıdır. Managed hizmetin gerçek değeri bu toplam perspektifle ortaya çıkar.
Idle Capacity
Idle capacity kullanılmadığı hâlde ayrılmış compute ve memory kaynaklarını ifade eder. Sabit kapasite kullanan sistemlerde düşük utilization maliyeti artırabilir. Autoscaling ve doğru resource request ayarları bu israfı azaltabilir. Aşırı düşük kapasite ise peak dönemlerde reliability problemi yaratır. FinOps hedefi yalnızca maliyet düşürmek değil maliyet ile reliability arasında denge kurmaktır.
Build vs Buy Kararı
Her altyapı bileşenini kendiniz geliştirmek teknik kontrol sağlasa da ciddi opportunity cost yaratabilir. Commodity capability olarak görülen authentication, email, search veya observability ihtiyaçları hazır ürünlerle daha hızlı çözülebilir. Buna karşılık ürünün rekabet avantajını oluşturan çekirdek iş fonksiyonlarında özel geliştirme daha anlamlı olabilir. Build vs buy kararı teknik ekip kadar ürün ve finans ekiplerini de ilgilendirir. Toplam maliyet ve stratejik değer birlikte değerlendirilmelidir.
Commodity Capability Nedir?
Commodity capability birçok ürünün benzer biçimde ihtiyaç duyduğu ancak doğrudan rekabet avantajı yaratmayan yetenektir. Email gönderimi, standart authentication veya temel monitoring buna örnek olabilir. Bu alanları sıfırdan geliştirmek yüksek bakım maliyeti oluşturabilir. Hazır hizmet kullanmak ekip kapasitesini ürünün özgün problemlerine yönlendirebilir. Yine de güvenlik, maliyet ve lock-in kriterleri değerlendirilmelidir.
Authentication
Authentication güvenlik açısından kritik ve hata maliyeti yüksek bir capability'dir. Hazır identity çözümleri MFA, federation ve password policy gibi özellikleri sağlayabilir. Kendi authentication sistemini geliştirmek sürekli güvenlik bakımı gerektirir. Özel domain gereksinimi yoksa build yaklaşımı dikkatle sorgulanmalıdır. Identity provider seçerken export ve standard protocol desteği incelenmelidir.
Email delivery basit görünmesine rağmen reputation, bounce ve spam yönetimi gibi operasyon sorunları içerir. Yönetilen servisler bu altyapının önemli bölümünü hazır sağlayabilir. Uygulama içinde provider adapter kullanmak gelecekte servis değişimini kolaylaştırabilir. Delivery metric ve retry politikaları izlenmelidir. Kendi mail altyapısını işletmek çoğu ürün için doğrudan rekabet avantajı sağlamaz.
Search
Search basit database query'den gelişmiş full-text ve ranking sistemlerine kadar geniş bir alanı kapsar. Gereksinim basitse relational database'in mevcut search yetenekleri yeterli olabilir. Daha gelişmiş ihtiyaçlarda özel search engine veya managed service değerlendirilebilir. Yeni search cluster eklemek ayrı monitoring ve scaling yükü getirir. Önce gerçek kullanıcı arama davranışı ölçülmelidir.
Payments
Payments güvenlik, compliance ve finansal operasyon gereksinimleri nedeniyle özel uzmanlık ister. Hazır ödeme altyapıları birçok riskli fonksiyonu standart API ile sunabilir. Buna rağmen provider entegrasyonunun domain'den ayrılması faydalı olabilir. Failure, retry ve reconciliation süreçleri uygulamanın sorumluluğunda kalabilir. Build kararı ancak ödeme altyapısı ürünün doğrudan rekabet avantajıysa düşünülmelidir.
Observability
Observability platformunu tamamen sıfırdan geliştirmek çoğu ekip için yüksek maliyetlidir. Hazır open source veya managed çözümler log, metric ve trace ihtiyaçlarının büyük bölümünü karşılayabilir. Asıl yatırım telemetry standardı ve doğru dashboard'ların oluşturulmasında yapılmalıdır. Provider değişimi olasılığı varsa OpenTelemetry gibi standartlar yardımcı olabilir. Buy veya managed yaklaşımında veri hacmi maliyetleri özellikle takip edilmelidir.
Ne Zaman Kendimiz Geliştirmeliyiz?
Kendiniz geliştirme kararı ilgili capability ürünün rekabet avantajını doğrudan oluşturduğunda daha anlamlıdır. Hazır çözümler kritik gereksinimi karşılamıyorsa özel geliştirme gerekebilir. Kontrol, latency veya compliance gibi nedenler de build kararını destekleyebilir. Buna rağmen uzun vadeli maintenance ownership açıkça kabul edilmelidir. İnşa edilen her platform bileşeni gelecekte ayrı ürün gibi bakım ister.
Competitive Differentiator Testi
Competitive Differentiator Testi basit bir soruyla başlayabilir: Bu capability müşterinin bizi seçmesinde gerçek fark yaratıyor mu? Cevap hayırsa hazır çözüm kullanmak çoğu zaman daha ekonomik olabilir. Cevap evetse özel geliştirme stratejik yatırım hâline gelebilir. Teknik ekip bu değerlendirmeyi ürün ve iş ekipleriyle birlikte yapmalıdır. Böylece engineering kapasitesi en yüksek iş değerine yönlendirilir.
Security Stack Seçiminin Baştan Bir Parçası Olmalı
Security teknoloji yığınının son kontrol listesi değil tasarım girdisidir. Authentication, authorization, encryption, secret management ve audit logging gereksinimleri mimariyi doğrudan etkiler. Framework ve platformun güvenlik update modeli seçim sırasında incelenmelidir. Supply chain ve patch management süreçleri de aynı stratejinin parçasıdır. Güvenliği erken tasarlamak hem riski hem de sonradan yapılacak pahalı değişiklikleri azaltır.
Authentication
Authentication kullanıcının veya servisin kimliğini doğrular. Password, MFA, federation ve machine identity ihtiyaçları sistem türüne göre değişebilir. Standart protocol kullanımı entegrasyon ve portability açısından avantaj sağlar. Authentication servisinin availability seviyesi tüm sistem için kritik olabilir. Identity architecture stack seçiminin temel kararlarından biridir.
Authorization
Authorization doğrulanmış kimliğin hangi işlemleri yapabileceğini belirler. Role-based veya attribute-based modeller domain gereksinimlerine göre seçilebilir. Yetki kontrollerinin yalnızca frontend üzerinde yapılması güvenli değildir. Backend ve data erişim katmanlarında tutarlı policy uygulanmalıdır. Büyük sistemlerde merkezi policy modeli yönetilebilirliği artırabilir.
Encryption
Encryption verinin transit ve at-rest durumlarında korunmasına yardımcı olur. TLS çoğu network iletişiminin temel gereksinimidir. Database ve storage encryption özellikleri platform seçiminde değerlendirilmelidir. Key management ve rotation süreçleri encryption kadar önemlidir. Compliance gereksinimleri belirli algoritma veya key yönetim standartları talep edebilir.
Secret Management
Secret management password, token ve key değerlerinin güvenli saklanmasını sağlar. Secret değerleri source repository veya normal environment dosyalarında kontrolsüz tutulmamalıdır. Merkezi vault veya cloud secret hizmetleri rotation ve audit avantajı sunar. Uygulamaların secret'lara minimum yetkiyle erişmesi gerekir. Developer experience güvenli yöntemi kolay kullanılır hâle getirmelidir.
Audit Logging
Audit logging kritik işlemlerin kim tarafından ve ne zaman gerçekleştirildiğini kaydeder. Güvenlik araştırmaları ve compliance kontrolleri için önemli veri sağlar. Audit log normal application logundan farklı retention ve bütünlük gereksinimine sahip olabilir. Hassas verilerin log içine kontrolsüz yazılması engellenmelidir. Tasarım başında hangi event'lerin audit kapsamına girdiği belirlenmelidir.
Supply Chain Security
Supply chain security dependency, build ve artifact akışının güvenilir kalmasını hedefler. Package scanning, SBOM ve signed artifacts bu yaklaşımın parçalarıdır. CI/CD credential'ları da kritik security asset olarak korunmalıdır. Dependency update süreci otomatik fakat kontrollü yürütülmelidir. Stack seçilen ekosistemin supply chain tooling desteğine göre değerlendirilmelidir.
Patch Management
Patch management framework, runtime, işletim sistemi ve dependency güncellemelerinin düzenli uygulanmasını sağlar. Kritik güvenlik patch'leri için hedef süre belirlenmelidir. Otomatik testler patch uygulama riskini azaltır. Uzun süre güncellenmeyen sistemler security debt biriktirir. LTS ve predictable release modeli patch sürecini kolaylaştırır.
Compliance Teknoloji Seçimini Nasıl Sınırlar?
Compliance gereksinimleri veri lokasyonu, audit, encryption ve erişim kontrolü gibi alanlarda teknoloji seçeneklerini sınırlar. KVKK, GDPR, PCI DSS, ISO 27001 veya SOC 2 bağlama göre farklı sorumluluklar doğurabilir. Teknoloji seçimi yalnızca sertifika logosu üzerinden yapılmamalıdır. Uygulamanın gerçek configuration ve operasyon süreçleri de gereksinimleri karşılamalıdır. Compliance ekibinin mimari değerlendirmeye erken katılması sonradan değişiklik ihtiyacını azaltır.
KVKK / GDPR
KVKK ve GDPR kişisel verinin işlenmesi, saklanması ve erişimi konusunda önemli yükümlülükler oluşturabilir. Veri minimization, retention ve deletion süreçleri teknoloji tasarımını etkiler. Kullanıcının verisini export veya silme talepleri sistem genelinde uygulanabilmelidir. Backup verisindeki kişisel bilgilerin yönetimi de düşünülmelidir. Veri akışlarının hangi sistemlerde işlendiği inventory ile görünür tutulmalıdır.
PCI DSS
PCI DSS ödeme kartı verisi işleyen sistemlerde belirli güvenlik kontrolleri gerektirir. Kart verisini sistemde hiç tutmamak compliance scope'u önemli ölçüde azaltabilir. Hazır ödeme hizmetleri bu nedenle stratejik avantaj sağlayabilir. Network segmentation, access control ve logging gereksinimleri architecture üzerinde etkilidir. Scope teknoloji seçiminden önce anlaşılmalıdır.
ISO 27001
ISO 27001 bilgi güvenliği yönetim sistemine yönelik süreç ve kontrol yaklaşımı sunar. Teknoloji araçları bu süreçleri destekleyebilir ancak sertifikasyon yalnızca ürün seçimiyle sağlanmaz. Asset inventory, risk yönetimi ve access control gibi süreçler organizasyon düzeyindedir. Stack'in audit ve security tooling desteği uygulamayı kolaylaştırabilir. Teknoloji governance yapısı kurumsal güvenlik politikalarıyla uyumlu olmalıdır.
SOC 2
SOC 2 kontrolleri özellikle hizmet organizasyonlarında güvenlik ve operasyon süreçlerinin değerlendirilmesinde önemlidir. Access control, logging, change management ve incident response gibi alanlar teknoloji tasarımını etkileyebilir. CI/CD audit trail ve identity entegrasyonu faydalıdır. Yönetilen cloud hizmetlerinin sunduğu raporlar supplier değerlendirmesinde yardımcı olabilir. Bununla birlikte son sistem konfigürasyonunun sorumluluğu organizasyonda kalır.
Data Residency
Data residency verinin hangi ülke veya bölgede tutulabileceğini belirler. Cloud provider ve region seçimi bu gereksinimden doğrudan etkilenebilir. Backup ve replica lokasyonları da aynı kapsamda değerlendirilmelidir. Bazı managed services gerekli region'da bulunmayabilir. Architecture kararları veri sınıflandırması ve lokasyon politikasıyla birlikte yapılmalıdır.
Auditability
Auditability sistemde gerçekleşen kritik değişikliklerin izlenebilir olmasını sağlar. Configuration, deployment ve kullanıcı işlemleri için güvenilir audit trail gerekebilir. Immutable veya korumalı log depolama bazı gereksinimlerde önem kazanır. Kimlik bilgilerinin loglarla doğru ilişkilendirilmesi gerekir. Stack seçiminde audit yetenekleri operasyon ve compliance perspektifiyle test edilmelidir.
Operability Bir Tech Stack Kriteridir
Bir sistemin production'da rahat yönetilebilmesi teknoloji kalitesinin önemli göstergesidir. Kolay deployment, hızlı debugging, anlaşılır failure mode ve güçlü on-call desteği doğrudan reliability'yi etkiler. Geliştirme sırasında güzel görünen teknoloji production operasyonunda zor davranabilir. PoC bu nedenle yalnızca feature geliştirme testi olmamalıdır. Deployment ve incident senaryoları da gerçekçi biçimde denenmelidir.
Sistem Kolay Deploy Ediliyor mu?
Deployment süreci mümkün olduğunca otomatik ve tekrar üretilebilir olmalıdır. Manual server değişiklikleri drift ve hata riski yaratır. Blue-green veya canary gibi stratejiler kritik sistemlerde risk azaltabilir. Rollback mekanizması deployment kadar önemlidir. Teknoloji ve platform pipeline otomasyonunu kolaylaştırmalıdır.
Kolay Debug Ediliyor mu?
Debugging production sorunlarının çözüm süresini doğrudan etkiler. Anlaşılır stack trace, profiling ve local reproduction tooling önemli avantaj sağlar. Dağıtık sistemlerde trace ve correlation ID ihtiyacı artar. Debugging yalnızca IDE deneyimiyle sınırlı görülmemelidir. Production telemetry stack kararının gerçek parçasıdır.
Failure Mode'lar Anlaşılabiliyor mu?
Her teknoloji belirli failure mode'lara sahiptir. Memory pressure, connection exhaustion, queue lag veya database lock gibi davranışlar ekip tarafından anlaşılmalıdır. Failure mode görünür değilse incident sırasında tahmin yürütmek zorunda kalınır. Runbook ve metric'ler kritik durumları erken göstermelidir. Teknoloji olgunluğu bu alanda ciddi avantaj sağlar.
On-Call Ekibi Sistemi Yönetebiliyor mu?
On-call ekibinin sistemi güvenli biçimde yönetebilmesi operability'nin pratik testidir. Gece oluşan bir incident yalnızca ilgili teknolojinin tek uzmanına bağlı kalmamalıdır. Dashboard, alarm ve runbook'lar ortak anlayış oluşturmalıdır. Gereksiz teknoloji çeşitliliği on-call cognitive load'unu artırır. Stack standardization bu nedenle reliability açısından da önemlidir.
Incident Sırasında Vendor'a Bağımlılık Var mı?
Managed service kullanıldığında bazı incident'ler vendor müdahalesi gerektirebilir. Support SLA ve escalation kanalları kritik sistemler için önceden bilinmelidir. Ekip kendi tarafında hangi diagnostic verileri toplayabileceğini bilmelidir. Her problemi vendor'a devretmek operasyon kapasitesini zayıflatır. Bağımlılık seviyesi architecture risk değerlendirmesine dahil edilmelidir.
Observability Desteği Nasıl Değerlendirilir?
Observability bir sistemin iç durumunu dış sinyaller üzerinden anlayabilme kapasitesidir. Logs, metrics ve traces birlikte kullanıldığında dağıtık sistem davranışı daha görünür hâle gelir. Profiling ve business metrics de performans ve ürün problemlerini anlamaya yardımcı olur. Stack'in telemetry üretimi standart yöntemlerle yapılabiliyorsa operasyon kolaylaşır. OpenTelemetry bu standardizasyon için değerlendirilmesi gereken yaklaşımlardan biridir.
Logs
Logs sistemdeki event ve hatalar hakkında ayrıntılı bağlam sağlar. Structured logging büyük sistemlerde arama ve analiz kolaylığı sunar. Hassas verilerin loglanmaması security açısından önemlidir. Log seviyeleri ve retention politikası maliyeti kontrol altında tutmalıdır. Correlation ID request zincirini farklı servisler arasında takip etmeyi kolaylaştırır.
Metrics
Metrics sistem davranışını zaman serisi olarak ölçmeye yardımcı olur. CPU, memory ve latency teknik metric'lerin yanında queue lag veya error rate gibi servis metric'leri de izlenebilir. Doğru metric seti alerting kalitesini artırır. Her değeri metric'e çevirmek gürültü yaratabilir. SLO ve business hedefleri ölçüm tasarımına yön vermelidir.
Traces
Traces bir request'in farklı servisler arasındaki yolunu gösterir. Dağıtık sistemlerde latency'nin hangi servis veya dependency'de oluştuğunu bulmayı kolaylaştırır. Trace sampling yüksek trafik sistemlerinde maliyet kontrolü sağlar. Context propagation tüm stack boyunca doğru uygulanmalıdır. Framework'ün automatic instrumentation desteği developer yükünü azaltabilir.
OpenTelemetry
OpenTelemetry telemetry verisinin vendor bağımsız standartlarla üretilmesine yardımcı olur. Logs, metrics ve traces için ortak instrumentation yaklaşımı oluşturabilir. Bu durum observability vendor değişimini bir miktar kolaylaştırır. Framework ve runtime desteği stack değerlendirmesinde avantaj sağlayabilir. Yine de storage ve dashboard tarafında kullanılan ürünler ayrıca değerlendirilmelidir.
Profiling
Profiling CPU ve memory kullanımının kod seviyesinde nerede yoğunlaştığını gösterir. Performance problemlerini tahmin yerine veriyle çözmeye yardımcı olur. Runtime'ın production-safe profiling desteği önemli avantajdır. Sürekli profiling bazı büyük sistemlerde regresyonları erken yakalayabilir. Tooling maliyeti ve veri hassasiyeti ayrıca değerlendirilmelidir.
Alerting
Alerting gerçek kullanıcı etkisi oluşturan problemler için doğru kişileri bilgilendirmelidir. Her metric değişimi alarm üretirse on-call ekibi kısa sürede alarm yorgunluğu yaşayabilir. SLO ve symptom-based alert yaklaşımı daha anlamlı olabilir. Alert'in action alınabilir olması gerekir. Teknoloji stack'i gerekli metric ve event'leri güvenilir biçimde üretmelidir.
Business Metrics
Business metrics teknik sağlığın kullanıcı sonucu üzerindeki etkisini gösterir. Sipariş başarı oranı, ödeme dönüşümü veya tamamlanan işlem sayısı buna örnektir. CPU normal olsa bile business metric düşüyorsa sistemde ciddi problem bulunabilir. Teknik ve iş metric'lerini aynı incident bağlamında görmek güçlü avantaj sağlar. Observability stratejisi yalnızca altyapı verilerine odaklanmamalıdır.
Testability Tech Stack Seçiminde Neden Önemlidir?
Testability bir sistemin doğru davrandığını hızlı ve güvenilir biçimde doğrulayabilme yeteneğidir. Unit, integration, contract, E2E, performance ve security testing farklı riskleri kapsar. Framework'ün test tooling kalitesi geliştirici feedback süresini doğrudan etkiler. Test kurulumu çok zor olan teknolojiler büyük ekiplerde değişiklik hızını azaltabilir. Stack seçimi sırasında gerçek bir feature'ın testlerinin ne kadar kolay yazılabildiği denenmelidir.
Unit Testing
Unit testing küçük kod birimlerinin hızlı biçimde doğrulanmasını sağlar. Test framework'ünün hızlı ve stabil olması geliştirici feedback süresini iyileştirir. Aşırı mocking ise gerçek davranıştan uzak testler oluşturabilir. Domain logic mümkün olduğunca framework bağımsız test edilebilir tasarlanmalıdır. Runtime ekosisteminin mature testing tools sunması büyük avantajdır.
Integration Testing
Integration testing database, messaging veya dış servis adaptörlerinin birlikte çalışmasını doğrular. Container tabanlı test environment gerçek dependency'lerle test yapmayı kolaylaştırabilir. Test süresi çok uzarsa developer'lar local çalıştırmaktan kaçınabilir. Kritik entegrasyonlar pipeline içinde otomatik doğrulanmalıdır. Stack'in test environment oluşturma kolaylığı DX kriteri olarak değerlendirilmelidir.
Contract Testing
Contract testing servisler arası API beklentilerinin uyumlu kaldığını doğrular. Microservices yapısında bağımsız deployment riskini azaltabilir. Consumer ve provider ekipleri breaking change'leri release öncesinde görebilir. Her endpoint için gereksiz contract altyapısı kurmak ise bakım maliyeti oluşturabilir. En kritik servis sınırlarında uygulanması daha anlamlıdır.
E2E Testing
E2E testing gerçek kullanıcı akışını uçtan uca doğrular. En yüksek güven seviyesini sağlarken genellikle daha yavaş ve kırılgan olabilir. Bu nedenle tüm test stratejisi yalnızca E2E üzerine kurulmalıdır demek doğru değildir. Kritik business flow'lar için sınırlı ve güvenilir test seti daha faydalıdır. Frontend ve backend stack test otomasyon araçlarıyla uyumlu olmalıdır.
Performance Testing
Performance testing latency, throughput ve resource kullanımını gerçekçi workload altında ölçer. Test yalnızca release öncesinde bir defa yapılmamalıdır. Kritik servislerde regression threshold pipeline veya düzenli testlerle takip edilebilir. Production benzeri data volume kullanmak sonuçların değerini artırır. PoC aşamasında candidate stack'lerin aynı workload ile karşılaştırılması özellikle faydalıdır.
Security Testing
Security testing dependency scanning, static analysis, dynamic test ve penetration test gibi farklı katmanları kapsar. Tek bir araç tüm güvenlik risklerini tespit edemez. CI/CD içinde otomatik kontroller hızlı feedback sağlar. Daha derin testler periyodik veya kritik release öncesinde yürütülebilir. Stack'in security tooling ekosistemi seçim kriteri olarak değerlendirilmelidir.
Chaos Testing
Chaos testing sistemin kontrollü hata durumlarında nasıl davrandığını doğrular. Instance kaybı, network gecikmesi veya dependency failure gibi senaryolar test edilebilir. Bu yaklaşım özellikle yüksek availability hedefli dağıtık sistemlerde faydalıdır. İlk aşamada küçük ve güvenli experiment'lerle başlanmalıdır. Amaç sistemi rastgele bozmak değil failure varsayımlarını doğrulamaktır.
Developer Experience Büyük Takımlarda Nasıl Ölçülür?
Developer Experience büyük organizasyonlarda teslim hızını ve hata oranını doğrudan etkileyen bir mühendislik kriteridir. Local setup, build time, test feedback, CI duration ve debugging süresi ölçülebilir. Kötü DX yüz geliştiricilik ekipte her gün büyük toplam zaman kaybına dönüşür. Documentation ve cognitive load da bu deneyimin önemli parçalarıdır. Teknoloji yığını yalnızca runtime performansıyla değil geliştiricilerin günlük akışıyla da değerlendirilmelidir.
Local Environment Kurulum Süresi
Yeni geliştiricinin projeyi local ortamda çalıştırması saatler değil günler sürüyorsa ciddi verimlilik problemi vardır. Çok sayıda manuel dependency ve gizli configuration onboarding süresini artırır. Container veya automated setup script bu süreci standartlaştırabilir. Kurulum dokümantasyonu düzenli test edilmelidir. Platform ekibi yeni laptop senaryosunu periyodik olarak doğrulayabilir.
Build Time
Build time geliştiricinin kod değişikliğinden sonuç almasına kadar geçen sürenin önemli bölümüdür. Uzun build süreleri küçük değişikliklerin bile akışını böler. Incremental build ve cache mekanizmaları büyük repository'lerde ciddi fayda sağlar. Build süresi metric olarak takip edilebilir. Framework ve language tooling bu konuda teknoloji seçimini etkileyebilir.
Test Feedback Time
Test feedback time geliştiricinin yaptığı değişikliğin doğru olup olmadığını ne kadar hızlı görebildiğini gösterir. Dakikalar süren unit test setleri geliştirme akışını yavaşlatır. Test pyramid ve paralel execution süreyi azaltabilir. Flaky testler güveni zedelediği için ayrıca ölçülmelidir. Stack test araçlarının hızlı ve deterministik çalışmasını desteklemelidir.
CI Duration
CI duration pull request'in merge olmaya hazır hâle gelme süresini etkiler. Çok uzun pipeline ekiplerin bekleme süresini yükseltir. Cache, parallel jobs ve test selection optimizasyonları kullanılabilir. Güvenlik kontrollerini hız için kaldırmak doğru değildir. Amaç gerekli quality gate'leri mümkün olan en hızlı feedback ile sunmaktır.
Debugging
Debugging deneyimi IDE, logging ve production telemetry araçlarının birlikte kalitesini kapsar. Stack trace anlaşılır değilse basit hata bile uzun investigation gerektirebilir. Local debugger yanında distributed trace ve profiling büyük sistemlerde önemlidir. Runtime'ın güçlü diagnostic araçları operasyon maliyetini azaltır. Developer feedback içinde debugging sorunları düzenli olarak toplanmalıdır.
Documentation
Internal documentation architecture, setup ve common operations hakkında ortak bilgi kaynağı oluşturur. Güncel olmayan dokümantasyon yanlış bilgiden dolayı ek zaman kaybı yaratır. Docs-as-code yaklaşımı değişiklikleri kodla birlikte review etmeyi kolaylaştırabilir. Framework seçimi dış dokümantasyon kalitesi açısından da değerlendirilmelidir. İyi documentation ekip büyüdükçe daha yüksek değer üretir.
Cognitive Load
Cognitive load geliştiricinin feature geliştirmek için kaç farklı kavram ve aracı anlaması gerektiğini gösterir. Aşırı teknoloji çeşitliliği bu yükü artırır. Platform abstraction ve golden path günlük işlemleri sadeleştirebilir. Ekiplerin yalnızca sahip oldukları domain ve gerekli platform bilgisine odaklanması ideal modeldir. Tech stack standardization bu nedenle developer experience'ın önemli bileşenidir.
Platform Engineering Tech Stack Seçimini Nasıl Etkiler?
Platform engineering uygulama ekiplerinin altyapı ve delivery ihtiyaçlarını self-service biçimde karşılamayı amaçlar. Internal Developer Platform, golden path ve template yaklaşımı teknoloji standardizasyonunu kolaylaştırır. Büyük organizasyonlarda her ekibin aynı CI/CD ve security problemini tekrar çözmesini engeller. Policy as code governance kurallarını otomatik hâle getirebilir. Platform yatırımı teknoloji özgürlüğü ile operasyon güvenilirliği arasında dengeli bir model sağlar.
Internal Developer Platform
Internal Developer Platform uygulama ekiplerine ortak deployment, observability ve infrastructure capability'leri sunabilir. Amaç yeni bir portal geliştirmek değil tekrarlanan operasyon yükünü azaltmaktır. Kullanıcıları platformun kendisi olan geliştiricilerin geri bildirimi önemlidir. Platform gerçek ihtiyaçlara göre ürün gibi yönetilmelidir. Zorunlu fakat verimsiz platform yaklaşımı ekipleri shadow tooling oluşturmaya itebilir.
Golden Path
Golden path organizasyonda önerilen ve en iyi desteklenen geliştirme yolunu tanımlar. Yeni servis oluşturmak için standart template, pipeline ve monitoring hazır olabilir. Ekip isterse gerekçeyle farklı yol seçebilir. Varsayılan yol güvenli ve hızlı olduğunda doğal olarak benimsenir. Bu model merkezi kontrol ile team autonomy arasında dengeli yaklaşım sunar.
Self-Service Infrastructure
Self-service infrastructure ekiplerin ticket beklemeden standart kaynak oluşturabilmesini sağlar. Database, queue veya deployment environment kontrollü template'lerle provision edilebilir. Guardrail ve policy mekanizmaları güvenliği korur. Bu yaklaşım platform ekibinin manuel işlem yükünü azaltır. Infrastructure talep süresindeki düşüş developer productivity metric'i olarak takip edilebilir.
Templates
Templates yeni servislerin aynı directory, testing ve deployment standartlarıyla başlamasını sağlar. Security scanning ve observability başlangıçtan hazır olabilir. Template'lerin zamanla güncellenmesi ve eski projelere değişikliklerin taşınması planlanmalıdır. Aşırı katı template farklı workload ihtiyaçlarını sınırlayabilir. Temel standartlar ile özelleştirme noktaları açıkça ayrılmalıdır.
Policy as Code
Policy as Code güvenlik ve governance kurallarını otomatik doğrulanabilir hâle getirir. Yasak container configuration veya eksik encryption ayarı pipeline sırasında tespit edilebilir. Manuel architecture review yükü azalırken kurallar daha tutarlı uygulanır. Policy değişiklikleri version control içinde review edilebilir. Geliştiricilere yalnızca hata değil düzeltme yolu da gösterilmelidir.
Stack Standardization
Stack standardization desteklenen teknoloji sayısını yönetilebilir seviyede tutar. Ortak monitoring, deployment ve security araçları daha kolay oluşturulur. Standardizasyon inovasyonu tamamen engellemek anlamına gelmemelidir. Trial ve exception süreçleri yeni teknolojilerin kontrollü değerlendirilmesini sağlar. Amaç her ekibi aynı teknolojiye zorlamak değil organizasyonun taşıyabileceği çeşitlilik seviyesini belirlemektir.
Standardization mı Team Autonomy mi?
Kurumsal teknoloji yönetiminde tam standardizasyon ile sınırsız takım özgürlüğü arasında denge gerekir. Tek stack operasyonu kolaylaştırırken bazı domain ihtiyaçlarını karşılamayabilir. Tam özgürlük ise tooling fragmentation ve hiring problemleri yaratabilir. Paved road ve approved technology catalog daha dengeli yaklaşım sunar. İstisnalar ölçülebilir gerekçelerle yönetildiğinde hem inovasyon hem sürdürülebilirlik korunabilir.
Tek Kurumsal Stack
Tek kurumsal stack hiring, tooling ve developer mobility açısından güçlü standardizasyon sağlar. Güvenlik ve deployment politikaları ortak biçimde uygulanabilir. Buna rağmen tüm workload'ların aynı teknolojiye uygun olduğu varsayımı risklidir. ML, realtime veya low-level sistemler farklı gereksinimlere sahip olabilir. Ana stack yanında sınırlı özel teknoloji kategorileri daha dengeli olabilir.
Tam Teknoloji Özgürlüğü
Tam teknoloji özgürlüğü ekiplerin problem için istedikleri aracı seçmesini sağlar. Küçük ve çok senior ekiplerde kısa vadede hızlı sonuç verebilir. Büyük organizasyonlarda ise onlarca runtime ve database oluşabilir. Platform ve security ekipleri bu çeşitliliği desteklemekte zorlanır. Özgürlük operasyon ve ownership sorumluluğuyla birlikte tanımlanmalıdır.
Paved Road Yaklaşımı
Paved Road yaklaşımı organizasyonun en iyi desteklediği teknoloji yolunu sunar. Bu yolu kullanan ekip hazır CI/CD, monitoring ve infrastructure şablonlarından faydalanır. Farklı teknoloji seçmek mümkündür fakat ek operasyon sorumluluğu gerekebilir. Böylece merkezi zorunluluktan çok teşvik temelli standardizasyon oluşur. Platformun kalitesi yükseldikçe adoption doğal biçimde artar.
Approved Technology Catalog
Approved Technology Catalog organizasyonun desteklediği runtime, framework, database ve platform seçeneklerini listeler. Her teknoloji için owner, support status ve kullanım kriteri yazılabilir. Yeni projeler karar verirken belirsizlik yaşamaz. EOL veya Hold durumuna geçen teknolojiler migration planına alınabilir. Technology Radar ile birlikte kullanıldığında governance daha görünür hâle gelir.
İstisna Süreci
İstisna süreci standart stack'in karşılamadığı gerçek gereksinimler için alternatif kullanım yolu sunar. Ekip teknik faydayı, riskleri ve operasyon planını belgeleyebilir. Architecture review bu gerekçeyi değerlendirir. Onaylanan istisnanın belirli review tarihi olabilir. Böylece teknoloji çeşitliliği tamamen engellenmeden kontrollü tutulur.
Conway's Law Tech Stack Kararını Nasıl Etkiler?
Conway's Law organizasyonun iletişim yapısının üretilen sistem tasarımına yansıdığını ifade eder. Takım sınırları, service ownership ve iletişim kanalları mimariyi doğrudan etkiler. Çok sayıda microservice oluşturup her servisi farklı ekiplere bölmek ciddi communication overhead yaratabilir. Architecture ve organization structure birlikte tasarlanmalıdır. Team Topologies yaklaşımı bu ilişkiyi düşünmek için yararlı bir çerçeve sunar.
Architecture ile Organization Structure İlişkisi
Architecture organizasyondaki ekiplerin birlikte çalışma biçiminden bağımsız değildir. Tek ekip tarafından geliştirilen on microservice gerçek bağımsızlık sağlamayabilir. Bunun tersine farklı business domain'lerine sahip büyük ekipler ayrı servis sınırlarından faydalanabilir. Mimari decomposition ekip ownership modeliyle uyumlu olmalıdır. Teknik sınırlar organizasyon sınırlarını desteklediğinde koordinasyon maliyeti azalır.
Team Boundaries
Team boundaries ekiplerin hangi domain ve servislerden sorumlu olduğunu açıklar. Belirsiz sınırlar birçok ekibin aynı kod üzerinde sürekli koordinasyon kurmasına neden olur. Domain ownership daha hızlı karar alınmasını sağlar. Service sınırları ekip kapasitesinden çok küçük oluşturulmamalıdır. Bir ekibin sahip olduğu servis sayısı on-call yükünü de etkiler.
Service Ownership
Service ownership geliştirme, deployment ve production sorumluluğunun açık bir ekipte bulunmasını sağlar. Sahipsiz servisler security update ve incident sırasında sorun yaratır. Ownership bilgisi service catalog içinde görünür olabilir. Ekip sayısı değiştiğinde sahiplik de düzenli güncellenmelidir. Microservices başarısı teknoloji kadar bu operasyon modeline bağlıdır.
Communication Overhead
Servisler arasındaki her bağımlılık aynı zamanda ekipler arasında olası iletişim ihtiyacı oluşturur. Çok parçalı mimari feature geliştirme sırasında fazla koordinasyon gerektirebilir. API contract bu bağımlılığı azaltabilir fakat tamamen ortadan kaldırmaz. Architecture değerlendirmesinde teknik dependency graph yanında team dependency graph da incelenmelidir. Gereksiz servis sınırları organizasyon verimliliğini düşürebilir.
Team Topologies
Team Topologies ekiplerin stream-aligned, platform veya enabling gibi farklı sorumluluklarla organize edilmesini ele alan bir yaklaşımdır. Tech stack governance bu ekip modelleriyle birlikte düşünülebilir. Platform team ortak tooling sağlarken ürün ekipleri domain değerine odaklanabilir. Cognitive load ekip sınırlarının belirlenmesinde önemli kriterdir. Organizasyon modeli büyüdükçe architecture kararlarını doğrudan etkiler.
Monorepo mu Polyrepo mu?
Repository stratejisi code ownership, build tooling ve release süreçlerini etkiler. Monorepo ortak değişiklik ve code sharing açısından avantaj sunarken polyrepo bağımsız ownership ve release modeli sağlayabilir. Her iki yaklaşım büyük ölçekli sistemlerde başarılı kullanılabilir. Karar ekip yapısı ve tooling kapasitesine göre verilmelidir. Repository modeli architecture sınırlarını zorunlu olarak belirlememelidir.
Monorepo Avantajları
Monorepo birden fazla proje veya paketi ortak repository içinde tutar. Cross-project refactoring tek değişiklik seti içinde yapılabilir. Ortak lint, build ve dependency politikaları daha kolay uygulanabilir. Repository büyüdükçe güçlü build cache ve selective test tooling gerekir. Tooling yatırımı yoksa CI süresi önemli probleme dönüşebilir.
Polyrepo Avantajları
Polyrepo servis veya proje başına ayrı repository kullanır. Ownership ve access control daha açık olabilir. Takımlar bağımsız release cadence yönetebilir. Buna karşılık ortak dependency değişiklikleri birçok repository'de ayrı güncelleme gerektirir. Automation eksikse version drift kolayca oluşabilir.
Build Tooling
Build tooling repository stratejisinin başarılı çalışmasında önemli rol oynar. Monorepo selective build ve cache olmadan yavaşlayabilir. Polyrepo ise dependency update automation ve ortak pipeline template'lerine ihtiyaç duyar. Build sistemi developer feedback süresini korumalıdır. Repository modeli mevcut tooling kapasitesiyle birlikte seçilmelidir.
Ownership
Code ownership hangi ekip veya kişilerin belirli alanlardan sorumlu olduğunu görünür kılar. Monorepo içinde directory bazlı ownership uygulanabilir. Polyrepo doğal repository sınırı sunar fakat gerçek domain ownership yine belgelenmelidir. Review kuralları kritik kod alanlarını koruyabilir. Ownership değişiklikleri organizasyon yapısıyla birlikte güncellenmelidir.
Independent Releases
Independent releases servislerin farklı zamanlarda production'a çıkmasını sağlar. Polyrepo bunu doğal olarak destekleyebilir ancak monorepo içinde de selective pipeline ile mümkündür. Asıl gereksinim artifact versioning ve backward compatibility disiplinidir. Repository yapısı tek başına deployment bağımsızlığını garanti etmez. Release modeli architecture ve team ownership ile birlikte tasarlanmalıdır.
Code Sharing
Code sharing ortak utility ve type tanımlarının ekipler arasında kullanılmasını kolaylaştırabilir. Monorepo bu paylaşımı teknik olarak çok kolay hâle getirebilir. Aşırı paylaşım servislerin birbirine kod seviyesinde bağlanmasına yol açabilir. Stable package sınırları ve versioning yaklaşımı önemlidir. Paylaşılan kod yalnızca gerçek ortak capability olduğunda kullanılmalıdır.
AI ve ML İçeren Büyük Sistemlerde Stack Seçimi
AI ve ML özellikleri bulunan sistemlerde application stack ile model geliştirme stack'ini aynı teknolojiye zorlamak gerekli değildir. Python ecosystem model geliştirme ve data processing için güçlü araçlar sunarken ana uygulama farklı runtime üzerinde çalışabilir. Model serving, GPU infrastructure ve vector search özel operasyon gereksinimleri oluşturur. Evaluation ve observability klasik application metric'lerinin ötesine geçer. Bu nedenle ML bileşenleri açık interface'lerle ayrıştırılarak ana sistemin geri kalanıyla entegre edilmelidir.
Application Stack ile ML Stack'i Ayırmak
Application stack kullanıcı, transaction ve business logic ihtiyaçlarına odaklanır. ML stack ise training, inference ve data pipeline gereksinimleri taşır. İki alanın aynı dil veya framework'te olması zorunlu değildir. API veya messaging boundary kullanılarak teknoloji bağımsızlığı sağlanabilir. Bu ayrım ekiplerin kendi uzmanlık alanında doğru araçları seçmesini kolaylaştırır.
Python Ecosystem
Python geniş ML ve data science library ekosistemi nedeniyle model geliştirmede yaygın bir seçenektir. Araştırma ve production modelleri arasında aynı dilin kullanılması bazı ekiplerde avantaj sağlayabilir. Production serving performansı workload'a göre ayrıca değerlendirilmelidir. Dependency ve environment yönetimi reproducibility açısından önemlidir. Python seçimi ana application stack'in de Python olması gerektiği anlamına gelmez.
Model Serving
Model serving eğitilmiş modelin production request'lerine cevap vermesini sağlar. Latency, throughput ve model boyutu deployment tasarımını etkiler. Batch inference ile online inference farklı altyapı gerektirebilir. Model versioning ve rollback mekanizması normal application release'lerinden ayrı yönetilebilir. Serving teknoloji seçimi gerçek model ve trafik profiliyle test edilmelidir.
GPU Infrastructure
GPU infrastructure büyük model training veya belirli inference workload'larında gerekebilir. GPU kaynakları pahalı olduğu için utilization yakından takip edilmelidir. Autoscaling ve batch scheduling maliyet verimliliğini artırabilir. Her ML özelliği için GPU gerekli değildir. Model ve latency ihtiyacı ölçülerek infrastructure seçilmelidir.
Data Pipelines
ML sistemlerinin kalitesi büyük ölçüde doğru ve güncel veriye bağlıdır. Data pipelines veri toplama, temizleme ve feature üretme süreçlerini yönetir. Batch ve streaming ihtiyaçları ayrı değerlendirilmelidir. Pipeline lineage ve data quality monitoring production güvenilirliği için önemlidir. ML stack kararı data platform architecture ile birlikte yapılmalıdır.
Vector Search
Vector search embedding tabanlı benzerlik sorgularında kullanılabilir. Her AI özelliğinin ayrı vector database gerektirdiğini varsaymak doğru değildir. Mevcut database'in vector desteği küçük ve orta ölçekli workload için yeterli olabilir. Index boyutu, latency ve update frequency gerçek ihtiyaç üzerinden ölçülmelidir. Ayrı teknoloji ancak belirgin performans veya ölçek avantajı sağlıyorsa eklenmelidir.
Observability ve Evaluation
ML sistemlerinde observability yalnızca CPU ve request latency ölçmekle sınırlı değildir. Model quality, drift ve output evaluation gibi metric'ler de gerekir. Model versiyonu ile request sonuçlarının ilişkilendirilmesi debugging açısından önemlidir. Evaluation süreci otomatik test ve production feedback ile desteklenebilir. Model davranışı business metric'leriyle birlikte takip edilmelidir.
AI Coding Araçları Stack Seçimini Değiştiriyor mu?
AI destekli coding araçları geliştirici üretkenliğini etkileyebilir ancak temel teknoloji seçim kriterlerini ortadan kaldırmaz. Documentation availability ve geniş ecosystem bu araçların daha doğru öneriler üretmesine yardımcı olabilir. Generated code yine code review, test ve security kontrollerinden geçmelidir. Yeni veya çok az kullanılan teknolojilerde model bilgisinin sınırlı olması ek risk yaratabilir. Bu nedenle olgun ecosystem'in değeri AI destekli geliştirme döneminde farklı bir boyut daha kazanır.
Developer Productivity
AI coding araçları tekrar eden kod, test taslağı ve dokümantasyon işlerinde zaman kazandırabilir. Kazanç ekip ve kullanım senaryosuna göre değişir. Üretkenlik yalnızca yazılan satır sayısıyla ölçülmemelidir. Review süresi ve hata oranı da takip edilmelidir. Stack seçimi bu araçlara göre değil temel gereksinimlere göre yapılmaya devam etmelidir.
Documentation Availability
Geniş ve güncel documentation hem geliştiriciler hem coding araçları için daha fazla doğru bağlam sağlar. Az dokümante edilen framework'lerde yanlış API önerileri daha sık görülebilir. Official documentation yine temel doğrulama kaynağı olarak kullanılmalıdır. Internal code standard ve architecture guide ekip içinde doğru yönlendirme sağlar. Olgun ekosistem bu nedenle onboarding açısından da güçlü avantaj taşır.
Model Training Data Coverage
Yaygın diller ve framework'ler hakkında daha fazla public örnek bulunması coding araçlarının destek kalitesini etkileyebilir. Ancak üretilen kodun güncel API'yi kullandığı garanti değildir. Eski sürümlere ait örnekler yanlış implementation üretebilir. Dependency version ve official docs üzerinden doğrulama yapılmalıdır. Bu nedenle AI output'u güvenilir source code review sürecinin yerine geçmez.
Generated Code Review
Generated code diğer tüm kodlar gibi review ve test gerektirir. Security flaw, yanlış error handling veya gereksiz dependency içerebilir. Büyük ekiplerde AI kullanım standartları code review politikasına eklenebilir. Kritik business logic'te geliştirici sorumluluğu devam eder. Araç üretkenliği artırabilir fakat ownership'i devralmaz.
Mature Ecosystem'in Yeni Avantajı
Mature ecosystem güçlü documentation, test library ve yaygın problem çözümü örnekleri sunar. AI coding araçları bu geniş bilgi tabanından daha etkili yararlanabilir. Bununla birlikte ecosystem maturity zaten AI araçlarından önce de önemliydi. Yeni dönemde bu avantaj developer productivity açısından daha görünür hâle gelmiştir. Teknoloji seçimi yine security, operability ve TCO kriterleriyle birlikte yapılmalıdır.
Proof of Concept ile Tech Stack Nasıl Doğrulanır?
PoC teknoloji seçimindeki varsayımları düşük maliyetle test etmek için kullanılmalıdır. Amaç güzel demo hazırlamak değil en yüksek riskli sorulara cevap bulmaktır. Gerçek use case, gerçekçi veri hacmi ve production benzeri load kullanılmalıdır. Operability ve developer experience da performans kadar test edilmelidir. İyi PoC sonunda teknoloji hakkında yalnızca “çalışıyor” değil, hangi koşullarda çalıştığı bilgisi elde edilir.
PoC'nin Amacı
PoC'nin amacı belirsiz teknik riskleri kanıtla azaltmaktır. Hangi soruların cevaplanacağı başlamadan önce yazılmalıdır. Örneğin p95 latency, transaction davranışı veya deployment süresi hedeflenebilir. PoC ürün geliştirme projesine dönüşmemelidir. Sonuçlar candidate stack'leri karar kriterlerine göre karşılaştırmalıdır.
Gerçek Use Case Kullanmak
Gerçek use case teknolojinin domain ihtiyaçlarıyla nasıl çalıştığını gösterir. Basit hello world benchmark gerçek proje davranışını temsil etmez. Kritik business flow içeren küçük bir slice daha değerli sonuç verir. Authentication, database ve external integration mümkün olduğunca dahil edilmelidir. Böylece framework'ün gerçek geliştirme ergonomisi de ölçülebilir.
Gerçek Veri Kullanmak
Gerçek veya anonimleştirilmiş üretim benzeri veri sorgu ve memory davranışını daha doğru gösterir. Çok küçük test dataset'i index veya query problemlerini gizleyebilir. Data distribution ve edge case'ler özellikle önemlidir. Hassas production verisi doğrudan test ortamına taşınmamalıdır. Synthetic data gerçek dağılımı taklit edecek şekilde üretilebilir.
Realistic Load Test
Realistic load test gerçek request mix, concurrency ve peak davranışını taklit eder. Tek endpoint'i maksimum hızda çağırmak production yükünü temsil etmeyebilir. Read ve write oranları gerçek kullanım verisine yakın tutulmalıdır. Test sırasında CPU, memory, database ve queue metric'leri birlikte izlenmelidir. Sonuçlar acceptance criteria ile karşılaştırılmalıdır.
Operability Test
PoC sırasında uygulama yalnızca çalıştırılmamalı, bozulması da test edilmelidir. Instance restart, dependency timeout ve deployment rollback gibi senaryolar uygulanabilir. Log ve trace üzerinden problemin ne kadar kolay bulunduğu ölçülmelidir. On-call ekibinden bir kişinin sistemi yönetmesi iyi test olabilir. Operasyon yükü final teknoloji kararına doğrudan yansıtılmalıdır.
Developer Experience Test
Candidate stack üzerinde gerçek feature geliştirmek developer experience hakkında güçlü veri sağlar. Local setup, test yazma, debugging ve build süreleri ölçülebilir. Birden fazla geliştiricinin aynı denemeyi yapması kişisel tercihin etkisini azaltır. Ekip geri bildirimi yapılandırılmış form veya scorecard ile toplanabilir. DX sonucu performans ve maliyet sonuçlarıyla birlikte değerlendirilmelidir.
PoC İçin Acceptance Criteria
PoC acceptance criteria başlamadan önce belirlenirse değerlendirme daha objektif olur. Performance, scalability, security, integration, deployment, observability, developer productivity ve cost temel kriterler olabilir. Her kriter mümkün olduğunca ölçülebilir hedefe dönüştürülmelidir. “Kolay” veya “hızlı” gibi ifadeler yerine süre ve threshold kullanılmalıdır. Final karar sonuçlarla birlikte varsayımları da belgelemelidir.
Performance
Performance kriteri beklenen workload altında latency ve throughput hedeflerini tanımlar. p95 ve p99 gibi percentile değerleri kullanılabilir. Test aynı hardware veya cloud configuration üzerinde yapılmalıdır. Resource utilization da sonuçla birlikte kaydedilmelidir. Böylece ham hız ve maliyet birlikte karşılaştırılabilir.
Scalability
Scalability kriteri yük arttığında kapasitenin nasıl genişlediğini ölçer. Instance sayısı arttırıldığında throughput'un ne kadar değiştiği gözlemlenebilir. Database veya external dependency'nin yeni bottleneck olup olmadığı izlenmelidir. Scaling süresi de autoscaling modellerinde önemlidir. Sonuç gerçek büyüme tahminiyle ilişkilendirilmelidir.
Security
Security acceptance criteria authentication, authorization ve dependency risklerini kapsayabilir. Varsayılan configuration'ın güvenli olup olmadığı incelenmelidir. Secret management ve encryption entegrasyonu test edilmelidir. Security scanning pipeline'a eklenebiliyor mu sorusu önemlidir. Kritik risk varsa performans avantajı teknoloji seçimini tek başına kurtarmamalıdır.
Integration
Integration kriteri mevcut enterprise sistemleriyle bağlantının ne kadar kolay kurulabildiğini ölçer. API, messaging veya identity entegrasyonlarından gerçek örnekler kullanılmalıdır. Gerekli driver ve SDK'ların olgunluğu değerlendirilmelidir. Error handling ve timeout davranışı da test edilmelidir. Başarılı request kadar başarısız dependency senaryosu da önemlidir.
Deployment
Deployment kriteri build'den production benzeri ortama kadar geçen süreci değerlendirir. CI/CD otomasyonu, rollback ve configuration yönetimi test edilmelidir. Artifact boyutu ve startup süresi bazı platformlarda önemli olabilir. Zero-downtime requirement varsa rollout sırasında doğrulanmalıdır. Manuel adım sayısı mümkün olduğunca düşük olmalıdır.
Observability
Observability kriteri log, metric ve trace üretiminin ne kadar kolay olduğunu ölçer. Kritik request'in servisler arasında izlenebilmesi test edilebilir. Framework instrumentation desteği geliştirici zamanını azaltabilir. Telemetry overhead ve maliyet de gözlemlenmelidir. Problem simülasyonu yapılıp root cause bulma süresi ölçülebilir.
Developer Productivity
Developer productivity basit feature'ı güvenli biçimde geliştirme süresiyle ölçülebilir. Setup, coding, test ve debugging süreleri ayrı kaydedilebilir. Yalnızca teknolojiyi zaten bilen kişinin performansına bakmak adil olmayabilir. Birkaç geliştiriciden veri toplamak daha dengeli sonuç verir. Sonuç subjective feedback ile quantitative metric'leri birlikte içermelidir.
Cost
PoC cost değerlendirmesi production ölçeğine extrapolate edilebilir resource kullanımını ölçmelidir. CPU, memory, storage ve network tüketimi kaydedilmelidir. Managed service veya lisans fiyatları eklenmelidir. İnsan kaynağı ve operasyon farkları da not edilmelidir. En ucuz altyapı her zaman en düşük TCO anlamına gelmez.
Weighted Decision Matrix Nasıl Oluşturulur?
Weighted Decision Matrix farklı teknoloji seçeneklerini ortak kriterlerle karşılaştırmak için kullanışlı bir yöntemdir. Önce kriterler belirlenir, sonra business önemine göre ağırlık verilir. Candidate stack'ler ölçüm, PoC ve gerçek veri üzerinden puanlanır. Her puanın yanında evidence ve assumption tutulması değerlendirmeyi daha güvenilir yapar. Matematiksel toplam karar desteğidir, kararın tamamı değildir.
Kriterleri Belirlemek
Kriterler proje gereksinimlerinden çıkarılmalıdır. Performance, security, hiring, cost ve operability örnek kategoriler olabilir. Her projede aynı kriter setini kullanmak doğru değildir. Hard constraint olan konular puan yerine eleme kriteri olabilir. Liste fazla büyürse karar sinyali gürültü içinde kaybolabilir.
Weight Vermek
Weight her kriterin proje için göreceli önemini gösterir. Örneğin compliance kritik bir finans sisteminde yüksek ağırlık alabilir. İç admin aracında ise development speed daha önemli olabilir. Ağırlıklar teknik ekip tarafından tek başına belirlenmemelidir. Business ve operasyon paydaşlarının katılımı kararın kabulünü güçlendirir.
Candidate Stack'leri Puanlamak
Candidate stack'ler aynı ölçek üzerinden değerlendirilmelidir. Puan mümkün olduğunca evidence ile desteklenmelidir. “Bu framework hızlıdır” yerine load test sonucu kullanılabilir. Ekip deneyimi için mevcut personel ve hiring verisi değerlendirilebilir. Puanlama sonrasında farkın neden oluştuğu da tartışılmalıdır.
Evidence Eklemek
Evidence puanın hangi veriye dayandığını gösterir. Benchmark, PoC sonucu, incident geçmişi veya vendor dokümantasyonu kullanılabilir. Kaynak olmayan subjektif değerlendirmeler açıkça opinion olarak işaretlenmelidir. Bu yaklaşım gelecekte kararın yeniden incelenmesini kolaylaştırır. ADR'ye decision matrix özeti eklemek faydalı olabilir.
Assumption'ları Belgelemek
Teknoloji kararlarının önemli bölümü geleceğe ilişkin varsayımlara dayanır. Kullanıcı sayısı, trafik büyümesi veya ekip büyüklüğü tahmin olabilir. Bu varsayımlar değiştiğinde kararın yeniden değerlendirilmesi gerekebilir. Belgelenmeyen assumption yıllar sonra gerçekmiş gibi kabul edilebilir. Review trigger'ları bu varsayımlara bağlanabilir.
False Precision'dan Kaçınmak
Karar matrisinde 8,4 ile 8,3 puan arasındaki fark gerçek dünyada anlamlı olmayabilir. Subjective puanlara fazla matematiksel kesinlik vermek yanlış güven oluşturur. Yakın sonuçlarda risk, reversibility ve ekip tercihi ayrıca değerlendirilmelidir. Matrix tartışmayı yapılandırmak için vardır. Final kararı otomatik veren algoritma gibi kullanılmamalıdır.
Tech Stack Kararları ADR ile Nasıl Belgelenir?
Architecture Decision Record önemli teknik kararların bağlamını ve gerekçesini kaydeder. Yıllar sonra bir teknolojinin neden seçildiğini hatırlamak yalnızca ekip hafızasına bırakılmamalıdır. Context, decision drivers, alternatives, decision ve consequences temel bölümleri oluşturabilir. Review date eklemek kararın hangi koşullarda yeniden ele alınacağını belirler. ADR kısa, okunabilir ve version control içinde erişilebilir olmalıdır.
Architecture Decision Record Nedir?
ADR belirli bir architecture kararının neden verildiğini belgeleyen kısa kayıttır. Uzun tasarım dokümanı olmak zorunda değildir. Amaç gelecekteki ekibin mevcut kararın bağlamını anlayabilmesidir. Seçilmeyen alternatiflerin neden elendiği de önemli bilgidir. Teknoloji governance sürecinin temel yapı taşlarından biri olabilir.
Context
Context kararın verildiği proje koşullarını açıklar. Kullanıcı sayısı, deadline, ekip yapısı ve mevcut altyapı gibi bilgiler yer alabilir. Bu bilgiler zamanla değişebileceği için kararın sonsuza kadar doğru kabul edilmemesi gerekir. Gelecekteki review context değişimini görebilir. Kısa fakat spesifik context ADR'nin değerini artırır.
Decision Drivers
Decision drivers karar üzerinde en fazla etkisi bulunan kriterlerdir. Performance, compliance, hiring veya delivery speed bu kategoride olabilir. Tüm requirement listesini tekrar etmek yerine gerçekten ayırt edici faktörler yazılmalıdır. Ağırlıklı decision matrix ile bağlantı kurulabilir. Böylece kararın neden belirli yöne gittiği anlaşılır.
Alternatives
Alternatives değerlendirilen diğer teknoloji veya architecture seçeneklerini içerir. Sadece final seçeneği belgelemek karar sürecini görünmez bırakır. Her alternatifin temel avantaj ve dezavantajı kısa biçimde yazılabilir. PoC sonuçları varsa link veya özet eklenebilir. Gelecekte koşullar değiştiğinde eski alternatifler tekrar değerlendirilebilir.
Decision
Decision hangi seçeneğin seçildiğini açık ve doğrudan belirtir. Belirsiz ifadeler gelecekte farklı yorumlara yol açabilir. Kullanım sınırı varsa aynı bölümde yazılmalıdır. Örneğin belirli servis kategorileri için farklı stack izin verilebilir. Karar tarihi ve owner bilgisi governance sürecini destekler.
Consequences
Consequences kararın olumlu ve olumsuz sonuçlarını açıkça yazar. Her teknolojinin trade-off içerdiğini kabul etmek önemlidir. Yeni eğitim ihtiyacı veya vendor bağımlılığı burada belgelenebilir. Pozitif sonuçlar kadar kabul edilen riskler de yazılmalıdır. Bu bölüm future review için en değerli referanslardan biridir.
Review Date
Review date kararın hangi tarihte veya hangi trigger sonrasında yeniden değerlendirileceğini belirtir. Her ADR'nin yıllık review gerektirmesi şart değildir. EOL, scale veya cost değişimi daha anlamlı trigger olabilir. Review tarihi teknoloji governance sürecini proaktif hâle getirir. Gereksiz migration yerine ihtiyaç bazlı değerlendirme yapılmasını sağlar.
Reversible ve Irreversible Technology Decisions
Teknoloji kararlarının değiştirme maliyeti aynı değildir. Database, identity ve core language gibi kararlar one-way door niteliğine daha yakın olabilir. UI library veya linter gibi seçimler ise daha kolay geri döndürülebilir. Karar süresini reversibility seviyesine göre ayarlamak ekiplerin hızını artırır. Kolay değişen seçimler için aylarca analiz yapmak kadar zor değişen seçimleri birkaç saatte vermek de verimsizdir.
One-Way Door
One-way door kararlar değiştirilmesi çok pahalı veya riskli seçimlerdir. Bu kararlar daha kapsamlı PoC, security review ve TCO analizi gerektirir. Veri ve kimlik altyapısı tipik örneklerdir. Exit strategy özellikle bu kararlarda önemlidir. Daha fazla analiz süresi burada genellikle iyi yatırımdır.
Database
Database değişimi veri migration, query rewrite ve uzun dual-run süreçleri gerektirebilir. Veri hacmi büyüdükçe geçiş maliyeti yükselir. Bu nedenle core database seçimi access pattern ve operasyon deneyimiyle dikkatle değerlendirilmelidir. Export ve replication imkanları exit plan içinde yer almalıdır. İlk seçim mükemmel olmak zorunda değildir ancak savunulabilir olmalıdır.
Identity
Identity sistemi kullanıcı hesapları ve erişim politikalarının merkezindedir. Migration sırasında password, MFA ve federation bilgilerinin taşınması zor olabilir. Open standards bağımlılığı azaltabilir. Identity provider değişimi kullanıcı deneyimini de etkileyebilir. Bu nedenle erken seçimler security ve exit strategy açısından dikkatle değerlendirilmelidir.
Core Language
Core language kod tabanının büyük bölümünü ve hiring stratejisini etkiler. Yıllar sonra tüm sistemi başka dile taşımak yüksek maliyetlidir. Dil seçimi ecosystem, talent ve operability kriterlerini birlikte değerlendirmelidir. Küçük syntax tercihleri ana karar olmamalıdır. Uzun vadeli support ve ekip büyümesi daha önemli faktörlerdir.
Multi-Tenancy Model
Multi-tenancy model verinin ve compute kaynaklarının müşteriler arasında nasıl paylaşıldığını belirler. Tenant başına database, shared schema veya farklı modeller security ve maliyet açısından farklı sonuçlar üretir. Sistem büyüdükten sonra modeli değiştirmek zor olabilir. Compliance ve noisy-neighbor riskleri erken değerlendirilmelidir. Bu nedenle multi-tenancy architecture one-way door'a yakın kabul edilebilir.
Two-Way Door
Two-way door kararlar nispeten düşük maliyetle değiştirilebilen seçimlerdir. Bu konularda uzun karar süreçleri delivery hızını gereksiz düşürebilir. Küçük PoC veya kısa deneme çoğu zaman yeterlidir. Ekip gerektiğinde yeni seçeneğe geri dönebilir. Reversibility seviyesi governance yoğunluğunu belirlemelidir.
UI Library
UI library değişimi yine emek gerektirir ancak core database migration kadar riskli olmayabilir. Component sınırları iyi tasarlanmışsa geçiş kademeli yapılabilir. Takım hızını artıran library hızlı deneyle değerlendirilebilir. Accessibility ve design system uyumu temel kriterlerdir. Gereksiz uzun vendor analizi çoğu zaman gerekli değildir.
Linter
Linter kod standardını otomatik kontrol eder ve kolay değiştirilebilir tooling kategorisindedir. Kurallar ekip ihtiyacına göre zaman içinde güncellenebilir. Seçim için uzun architecture committee süreci gerekmeyebilir. Otomatik formatting ve editor integration developer experience'ı artırır. Değişim maliyeti düşük olduğu için hızlı karar verilebilir.
Monitoring Vendor
Monitoring vendor belirli abstraction ve data formatları kullanıldığında görece değiştirilebilir olabilir. OpenTelemetry gibi standartlar migration maliyetini azaltır. Yine de dashboard ve alert definition'larının taşınması emek gerektirir. Data retention ve export politikaları değerlendirilmelidir. Core application mimarisine göre daha reversible bir karar olarak yönetilebilir.
Karar Süresini Reversibility'ye Göre Ayarlamak
Karar süresi değiştirmenin maliyetiyle orantılı olmalıdır. Kolay geri alınabilir seçimlerde hızlı experiment yaklaşımı ekip hızını korur. Zor değişen seçimlerde daha fazla evidence ve stakeholder review gerekir. Bu yaklaşım architecture governance'ın darboğaz olmasını engeller. Ekipler önemli kararlar için enerjilerini koruyabilir.
Architecture Fitness Functions ile Stack'i Sürekli Doğrulamak
Architecture Fitness Functions mimarinin önemli kalite özelliklerini otomatik veya düzenli ölçümlerle doğrular. Dependency rules, performance threshold, security controls, bundle size, availability ve cost gibi kriterler takip edilebilir. Böylece architecture yalnızca tasarım dokümanında kalan niyet olmaktan çıkar. İhlaller erken fark edildiği için teknik borç büyümeden müdahale edilebilir. Büyük sistemlerde bu yaklaşım governance'ı daha ölçeklenebilir hâle getirir.
Dependency Rules
Dependency rules modüllerin hangi katmanlara bağımlı olabileceğini tanımlar. Modular monolith içinde domain sınırlarını korumak için otomatik test kullanılabilir. Yanlış dependency build sırasında engellenebilir. Bu yaklaşım architecture review ihtiyacını azaltır. Kurallar çok katı olmamalı ve gerçek tasarım hedefini yansıtmalıdır.
Performance Threshold
Performance threshold belirli endpoint veya job için kabul edilen maksimum latency ya da minimum throughput değerini tanımlar. Regression testleri bu sınırı düzenli kontrol edebilir. Her commit'te tam load test çalıştırmak gerekli olmayabilir. Kritik release veya nightly test modeli kullanılabilir. Threshold gerçek SLO ve user experience hedeflerinden türetilmelidir.
Security Controls
Security controls encryption, dependency risk veya access policy gibi gereksinimleri otomatik doğrulayabilir. Policy as code deployment öncesinde yanlış configuration'ı engelleyebilir. Container image scanning fitness function olarak kullanılabilir. Kritik açık bulunan artifact production'a çıkarılmayabilir. Otomasyon güvenlik ekibinin manuel kontrol yükünü azaltır.
Bundle Size
Frontend bundle size kullanıcıların indirdiği JavaScript miktarını etkiler. Belirli threshold aşılırsa CI uyarı veya hata verebilir. Yeni dependency eklerken maliyet görünür hâle gelir. Tek başına bundle size tüm performansı açıklamaz. Yine de kullanıcı deneyimi için yararlı bir fitness function olabilir.
Availability
Availability gerçek production SLO verisi üzerinden sürekli takip edilebilir. Hedefin altına düşüldüğünde architecture veya operasyon yatırımı gerekebilir. Synthetic test ve health monitoring tamamlayıcı sinyaller sağlar. Availability yalnızca aylık rapor olarak değil release kararlarında da kullanılabilir. Error budget yaklaşımı geliştirme hızıyla reliability arasında bağ kurar.
Cost Threshold
Cost threshold belirli workload veya tenant için kabul edilen maliyet sınırını izlemeye yardımcı olur. Cost per request düzenli ölçülebilir. Yeni architecture değişikliği maliyeti belirgin yükseltiyorsa ekip erken uyarı alabilir. Böylece cloud cost yalnızca ay sonunda görülen sürpriz olmaktan çıkar. FinOps metric'leri architecture fitness modeline dahil edilebilir.
Tech Stack Governance Nasıl Yapılır?
Tech stack governance organizasyonun hangi teknolojileri hangi koşullarda kullandığını yönetir. Technology Radar, architecture review ve exception process bu sürecin araçlarıdır. Amaç inovasyonu engellemek değil teknoloji çeşitliliğini sürdürülebilir seviyede tutmaktır. Adopt, Trial, Assess ve Hold kategorileri karar durumunu görünür kılabilir. Governance süreci hızlı ve şeffaf olmadığında ekipler resmi süreci bypass etmeye başlayabilir.
Technology Radar
Technology Radar organizasyonun teknoloji tercihlerini ortak görünümde yayınlamasını sağlar. Diller, framework'ler, database ve platform araçları farklı kategorilerde listelenebilir. Her entry için kısa gerekçe ve owner bulunabilir. Radar periyodik review ile güncel tutulmalıdır. Yeni proje ekipleri teknoloji kararına sıfırdan başlamamış olur.
Adopt
Adopt kategorisi production kullanımı için güçlü biçimde desteklenen teknolojileri ifade eder. Platform tooling, documentation ve uzmanlık bu seçenekler için hazır olmalıdır. Yeni projeler varsayılan olarak bu teknolojilerden başlayabilir. Adopt statüsü teknolojinin sonsuza kadar kullanılacağı anlamına gelmez. EOL veya stratejik değişim durumunda kategori güncellenebilir.
Trial
Trial kategorisi belirli production veya pilot use case'lerde kontrollü kullanım için uygun teknolojileri içerir. Ekipler gerçek deneyim oluşturarak daha fazla evidence toplar. Trial kullanımı sınırlı scope ve açık owner ile yapılmalıdır. Sonuçlar Technology Radar review sırasında paylaşılabilir. Başarılı denemeler Adopt yönüne ilerleyebilir.
Assess
Assess kategorisi potansiyeli bulunan ancak production için yeterli evidence olmayan teknolojileri kapsar. Ekipler araştırma veya PoC yapabilir. Kritik sistemlerde doğrudan kullanmak için erken olabilir. Technical community sonuçları paylaşarak ortak öğrenme oluşturabilir. Assess aşaması hype kaynaklı hızlı adoption riskini azaltır.
Hold
Hold kategorisi yeni kullanımının önerilmediği veya migration planına alınmış teknolojileri gösterir. Güvenlik, EOL veya yüksek bakım maliyeti buna neden olabilir. Mevcut sistemlerin hemen rewrite edilmesi gerektiği anlamına gelmez. Kontrollü modernization planı hazırlanabilir. Yeni projelerde aynı teknoloji borcunun tekrar oluşması engellenir.
Architecture Review
Architecture review kritik ve zor değişen kararların uzmanlarla değerlendirilmesini sağlar. Review checklist üzerinden security, reliability ve TCO konuları incelenebilir. Her küçük teknik seçim için committee onayı gerektirmek ekip hızını düşürür. Review scope reversibility ve risk seviyesine göre belirlenmelidir. Amaç kontrol noktası olmak değil karar kalitesini artırmaktır.
Exception Process
Exception process standart teknoloji setinin karşılamadığı gereksinimler için resmi yol sağlar. Ekip neden alternatif gerektiğini evidence ile açıklayabilir. Operasyon ownership ve exit strategy de belgelenebilir. İstisna belirli süre sonra yeniden değerlendirilebilir. Böylece governance esnekliğini kaybetmeden teknoloji çeşitliliğini yönetir.
Tech Stack Ne Sıklıkla Yeniden Değerlendirilmeli?
Tech stack her release'de değiştirilmesi gereken bir yapı değildir. Sürekli teknoloji değişimi delivery hızını düşürür ve migration maliyeti oluşturur. Bunun yerine yıllık review ve belirli trigger'lar daha sağlıklı yaklaşım sunar. EOL, security, cost, scale veya hiring problemi yeniden değerlendirme sebebi olabilir. Amaç güncel görünmek değil mevcut kararın hâlâ iş ihtiyacını karşılayıp karşılamadığını kontrol etmektir.
Her Release'de Değil
Yeni framework sürümü veya yeni trend çıktığında stack değiştirmek sürdürülebilir değildir. Kurumsal sistemler stability ve predictable maintenance gerektirir. Teknoloji değişimi ölçülebilir değer üretmelidir. Mevcut stack gereksinimleri karşılıyorsa değişmemek de bilinçli bir karardır. Innovation sınırlı experiment alanlarında denenebilir.
Yıllık Technology Review
Yıllık technology review stack'in support, security, cost ve ekip durumu açısından kontrol edilmesini sağlar. Her bileşenin yeniden seçilmesi gerekmez. Riskli veya yaklaşan EOL teknolojiler önceliklendirilebilir. Technology Radar bu review sonucuna göre güncellenebilir. Böylece modernization planı reaktif değil düzenli hâle gelir.
EOL Trigger
End-of-life tarihi yaklaşan runtime veya framework yeniden değerlendirme gerektirir. Security patch desteği bittikten sonra production riski hızla artabilir. Upgrade path varsa migration erken planlanmalıdır. Büyük major upgrade'ler aylar sürebilir. EOL tarihi teknoloji inventory içinde otomatik takip edilebilir.
Security Trigger
Kritik security açığı veya sürdürülemeyen dependency technology review başlatabilir. Tek CVE her zaman platform değişimi gerektirmez. Patch bulunmaması veya maintainer projesinin terk edilmesi daha ciddi sinyaldir. Risk exposure ve alternatif maliyeti birlikte değerlendirilmelidir. Security trigger hızlı fakat evidence temelli karar süreci gerektirir.
Cost Trigger
Cloud veya lisans maliyetinin beklenenden hızlı büyümesi stack review nedeni olabilir. Cost per user ve request gibi metric'ler problemi daha görünür kılar. Önce configuration ve utilization optimizasyonları denenmelidir. Teknoloji migration en pahalı optimizasyonlardan biridir. Ancak kalıcı architecture maliyeti varsa alternatif PoC değerlendirilebilir.
Scale Trigger
Sistem mevcut teknoloji sınırlarına yaklaşmaya başladığında scale trigger oluşur. CPU veya database kapasitesi sürekli darboğaz hâline gelebilir. Önce index, caching veya horizontal scaling gibi mevcut seçenekler değerlendirilmelidir. Ölçümler gerçek limitin teknoloji kaynaklı olduğunu gösteriyorsa migration düşünülebilir. Teorik gelecekteki scale beklentisi tek başına trigger olmamalıdır.
Hiring Trigger
Uzun süre gerekli geliştirici bulunamaması teknoloji stratejisini etkileyebilir. Kritik bir stack yalnızca birkaç kişiye bağlıysa bus factor yükselir. Eğitim programı veya remote hiring önce değerlendirilebilir. Talent problemi kalıcıysa daha yaygın teknolojiye migration ekonomik olabilir. Hiring verisi technology review sürecine düzenli girdi sağlamalıdır.
Legacy Stack Nasıl Modernize Edilir?
Legacy modernization tüm sistemi tek seferde yeniden yazmak anlamına gelmez. Big-bang rewrite uzun teslim süresi ve yüksek business risk taşır. Strangler Fig Pattern, adapter layer ve incremental migration daha kontrollü yaklaşım sunabilir. Data migration ve dual run en zor aşamalardan biridir. Her adım rollback planıyla birlikte ilerlemelidir.
Big-Bang Rewrite Problemi
Big-bang rewrite eski sistemi tamamen bırakıp yeni sistemi tek büyük proje olarak geliştirmeyi hedefler. Yıllar içinde biriken gizli business rules yeni sistemde kolayca kaçırılabilir. Rewrite sürerken eski sisteme yeni özellik ekleme ihtiyacı devam eder. Scope sürekli büyüyebilir ve teslim tarihi uzaklaşabilir. Bu nedenle kademeli modernization çoğu kurumsal sistemde daha düşük risk taşır.
Strangler Fig Pattern
Strangler Fig Pattern yeni fonksiyonların eski sistemin çevresinde kademeli geliştirilmesini sağlar. Trafik veya capability parça parça yeni sisteme yönlendirilir. Eski sistem zaman içinde küçülür. Bu model gerçek production feedback alarak migration yapmaya imkân verir. Doğru routing ve data ownership tasarımı sürecin temelidir.
Adapter Layer
Adapter layer eski sistem ile yeni servisler arasındaki teknik farkı izole edebilir. Yeni domain kodu legacy protocol ayrıntılarını bilmek zorunda kalmaz. Migration ilerledikçe adapter'ın sorumluluğu azalabilir. Adapter kalıcı yeni legacy katmanına dönüşmemelidir. Ownership ve retirement planı başlangıçtan tanımlanmalıdır.
Incremental Migration
Incremental migration sistemi küçük ve ölçülebilir adımlarla dönüştürür. Her adım production'a çıkar ve business value üretmeye devam eder. Risk küçük parçalara bölündüğü için rollback daha kolaydır. Migration sırası dependency ve değer üzerinden planlanmalıdır. Uzun dönüşüm programlarında bu yaklaşım ekip motivasyonunu da koruyabilir.
Data Migration
Data migration modernization projelerinin en yüksek riskli parçalarından biridir. Schema mapping, data quality ve referential integrity problemleri erken test edilmelidir. Büyük veri hacminde online migration ve change data capture gerekebilir. Verification script'leri kaynak ve hedef veriyi karşılaştırmalıdır. Cutover planı RTO ve RPO hedefleriyle uyumlu olmalıdır.
Dual Run
Dual run eski ve yeni sistemin belirli süre aynı işlemleri paralel yürütmesini sağlar. Sonuçlar karşılaştırılarak yeni sistemin doğruluğu ölçülebilir. Ancak iki sistemi aynı anda işletmek maliyet ve operasyon yükünü artırır. Veri tutarlılığı ve side effect'ler dikkatle tasarlanmalıdır. Süre başlangıçtan sınırlı tutulmalıdır.
Rollback Plan
Rollback plan migration başarısız olduğunda güvenli biçimde önceki duruma dönme yöntemini tanımlar. Data migration sonrasında rollback sadece eski deployment'ı açmak kadar basit olmayabilir. Veri değişikliklerinin tersine çevrilmesi veya dual write gerekebilir. Plan production cutover öncesinde test edilmelidir. Rollback mümkün değilse karar one-way door olarak daha fazla inceleme gerektirir.
Büyük Ölçekli Projelerde Sık Yapılan Tech Stack Hataları
Büyük projelerde teknoloji hataları çoğu zaman teknolojinin kötü olmasından değil yanlış gerekçeyle seçilmesinden kaynaklanır. Resume-driven development, hype, premature microservices ve gereksiz polyglot yaklaşım buna örnektir. Team expertise, security ve TCO'nun göz ardı edilmesi uzun vadede büyük maliyet yaratır. PoC ve exit strategy olmadan alınan kararlar belirsizliği artırır. İyi governance bu hataları tamamen yok etmese de erken görünür kılar.
Resume-Driven Development
Resume-driven development geliştiricinin proje ihtiyacından çok kişisel kariyer ilgisine göre teknoloji seçmesidir. Yeni teknoloji öğrenmek değerli olsa da production sistemi deney alanı olarak kullanılmamalıdır. Teknik fayda measurable requirement ile gösterilmelidir. Öğrenme ihtiyacı controlled PoC veya internal project ile karşılanabilir. Kurumsal karar organizasyonun uzun vadeli çıkarını temel almalıdır.
Hype'a Göre Seçim
Yeni teknolojilerin görünürlüğü gerçek uygunluk algısını etkileyebilir. Hype döneminde production maturity ve hiring riskleri yeterince görünmeyebilir. Popüler tartışmalar yerine workload ve PoC sonuçları kullanılmalıdır. Technology Radar yeni araçları Assess veya Trial kategorisinde kontrollü değerlendirmeye yardımcı olur. Trend takip etmek faydalıdır fakat kararın kendisi olmamalıdır.
Premature Microservices
Domain sınırları netleşmeden microservices'e geçmek servislerin sürekli yeniden bölünmesine neden olabilir. Distributed transaction, tracing ve deployment maliyetleri erken dönemde ürün geliştirme hızını azaltır. Modular monolith daha düşük operasyon yüküyle domain bilgisinin olgunlaşmasını sağlayabilir. Microservices gerçek team scaling veya independent deployment ihtiyacı doğduğunda değerlendirilebilir. Büyük proje olmak tek başına gerekçe değildir.
Premature Kubernetes
Birkaç servis için Kubernetes kurmak platform ekibine gereksiz operasyon işi çıkarabilir. Cluster upgrade, networking ve security yönetimi sürekli emek ister. Yönetilen container platformları daha basit başlangıç sağlayabilir. Servis sayısı ve platform ihtiyaçları büyüdüğünde Kubernetes tekrar değerlendirilebilir. Infrastructure complexity gerçek organizasyon kapasitesiyle uyumlu olmalıdır.
Gereksiz Polyglot Stack
Her ekip farklı dil ve database kullandığında kısa vadeli özgürlük uzun vadeli support yüküne dönüşebilir. Tooling ve security standardization zorlaşır. Developer mobility azalır ve hiring daha parçalı hâle gelir. Yeni teknoloji açık teknik avantaj sağlamıyorsa approved stack içinde kalmak daha sağlıklıdır. Polyglot kullanım istisna olarak değil gerekçeli strateji olarak yönetilmelidir.
Gereksiz NoSQL
NoSQL bazen yalnızca gelecekte ölçek ihtiyacı olabilir düşüncesiyle seçilir. Bu seçim transaction ve query esnekliğinden gereksiz taviz verilmesine yol açabilir. Modern relational sistemler birçok büyük workload için yeterlidir. Access pattern gerçekten farklı veri modeli gerektiriyorsa NoSQL güçlü seçenektir. Karar gerçek query ve scale verisiyle desteklenmelidir.
Team Expertise'i Görmezden Gelmek
Teknoloji özellikleri ekip kapasitesinden bağımsız değildir. Production deneyimi olmayan stack ciddi incident riski yaratabilir. Eğitim ve hiring planı yoksa ilk teslim süresi uzar. Mevcut expertise güçlü bir karar kriteridir ancak tek kriter olmamalıdır. Technology fit ile familiarity birlikte değerlendirilmelidir.
Security'yi Sonradan Eklemek
Security gereksinimlerini production öncesinde düşünmek pahalı architecture değişiklikleri yaratabilir. Identity, encryption ve audit ihtiyaçları veri ve servis sınırlarını etkiler. Framework security modelinin erken anlaşılması gerekir. CI/CD scanning ve secret management başlangıçtan kurulmalıdır. Security by design yaklaşımı hem risk hem bakım maliyetini azaltır.
TCO'yu Hesaplamamak
Başlangıç maliyeti düşük teknoloji uzun vadede yüksek hiring veya operation cost oluşturabilir. Cloud faturası TCO'nun yalnızca bir parçasıdır. Training, monitoring, incident ve migration maliyetleri ayrıca hesaplanmalıdır. En az üç ila beş yıllık perspektif daha gerçekçi karşılaştırma sağlar. Technology decision business case ile desteklenmelidir.
Vendor Lock-In'i İncelememek
Managed service kullanmak hızlı geliştirme sağlayabilir fakat migration cost oluşturabilir. Sorun lock-in değil bağımlılığın bilinmeden kabul edilmesidir. Data export ve alternative service seçenekleri baştan incelenmelidir. Kritik vendor dependency ADR içinde belgelenmelidir. Sağlanan fayda çıkış riskinden büyükse bilinçli lock-in kabul edilebilir.
PoC Yapmamak
Dokümantasyon ve benchmark gerçek project behavior hakkında sınırlı bilgi verir. Riskli technology choice PoC ile test edilmediğinde production'da beklenmeyen sorunlar çıkabilir. Gerçek use case ve load kullanmak önemlidir. PoC'nin scope'u küçük fakat risk odaklı olmalıdır. Sonuç decision matrix'e evidence olarak eklenmelidir.
Exit Strategy Tanımlamamak
Technology veya vendor seçimi yapılırken gelecekte değişim ihtimali tamamen yok sayılamaz. Exit strategy olmaması migration sırasında veri ve API bağımlılıklarının geç fark edilmesine neden olur. Export, adapter ve open standard seçenekleri önceden değerlendirilebilir. Her teknoloji için tam portability gerekmese de risk bilinmelidir. Kritik one-way door seçimlerinde exit plan özellikle önemlidir.
Büyük Ölçekli Yazılım İçin Önerilen Stack Seçim Süreci
Büyük Ölçekli Yazılım Projelerinde Tech Stack Seçimi tek toplantıda verilen teknoloji listesi olmamalıdır. Süreç business context ile başlayıp requirements, workload, constraints ve team capability analizine ilerlemelidir. Candidate stack'ler scorecard ve PoC ile değerlendirilmelidir. Security, operability, TCO ve exit strategy final karardan önce incelenmelidir. ADR ve architecture fitness functions ise kararın zaman içinde yönetilmesini sağlar.
1. Business Context'i Tanımla
İlk adım sistemin hangi iş problemini çözdüğünü netleştirmektir. Hedef kullanıcı, gelir modeli, büyüme beklentisi ve delivery timeline yazılmalıdır. Teknik kararlar bu bağlamdan bağımsız alınmamalıdır. Projenin başarısını hangi business metric'lerin göstereceği belirlenebilir. Context teknoloji tartışmasının ortak başlangıç noktasını oluşturur.
2. Functional ve Non-Functional Requirements'ı Yaz
Sistem özellikleri ve kalite hedefleri açıkça belgelenmelidir. Functional requirements kritik user flow'ları tanımlar. Non-functional requirements performance, security ve availability seviyelerini belirler. Ölçülebilir olmayan ifadeler mümkün olduğunca metric'e dönüştürülmelidir. Bu gereksinimler tüm sonraki teknoloji değerlendirmesinin temelidir.
3. Workload Modeli Oluştur
Kullanıcı, concurrency, RPS, data volume ve peak trafik tahminleri hazırlanmalıdır. Read ve write oranı gibi database davranışları ayrıca modellenmelidir. Batch ve realtime workload'lar ayrılmalıdır. Varsayımlar açıkça yazılmalıdır. Gerçek trafik verisi geldikçe model güncellenebilir.
4. Hard Constraints'i Belirle
Compliance, mevcut altyapı veya zorunlu entegrasyon gibi değiştirilemeyen sınırlar belirlenmelidir. Bu koşullar candidate seçeneklerini erken daraltabilir. Hard constraint ile preference birbirine karıştırılmamalıdır. Her sınırın kaynağı belgelenmelidir. Gereksiz teknik tartışmalar böylece azaltılır.
5. Team Capability Audit Yap
Ekipteki language, framework, database ve operations deneyimi değerlendirilmelidir. Senior expertise ve on-call kapasitesi ayrıca incelenmelidir. Yeni teknoloji gerekiyorsa training ve hiring planı oluşturulmalıdır. Talent market availability de audit'in parçası olabilir. Bu bilgi decision matrix'te ayrı kriter olarak kullanılmalıdır.
6. Candidate Stack'leri Belirle
Gereksinimleri karşılayabilecek sınırlı sayıda candidate stack seçilmelidir. On farklı seçeneği eşit detayda analiz etmek karar süresini gereksiz uzatır. Mevcut approved stack doğal başlangıç adayı olabilir. Farklı teknoloji ancak belirgin avantaj sağlıyorsa karşılaştırmaya eklenmelidir. Candidate'lar aynı scope ve workload üzerinden değerlendirilmelidir.
7. Weighted Scorecard Oluştur
Kriterlere business önemi doğrultusunda ağırlık verilmelidir. Candidate stack'ler evidence ile puanlanmalıdır. Subjective puanların yanında gerekçe yazılmalıdır. Hard constraint'i karşılamayan seçenek doğrudan elenebilir. Scorecard karar konuşmasını daha objektif hâle getirir.
8. PoC Çalıştır
En belirsiz veya riskli candidate'lar gerçek use case ile PoC üzerinde denenmelidir. Performance ve operability testleri birlikte yapılmalıdır. Gerçekistic load ve data kullanılmalıdır. Developer feedback de kaydedilmelidir. Sonuçlar scorecard puanlarını güncellemek için kullanılabilir.
9. Security ve Operability Review Yap
Final aday security control, patch ve supply chain açısından incelenmelidir. Deployment, monitoring ve incident behavior test edilmelidir. On-call ekibinin teknolojiyle çalışabilmesi önemlidir. Compliance gereksinimleri tekrar doğrulanmalıdır. Bu review production sonrasında sürpriz riskleri azaltır.
10. TCO Hesapla
Development, hiring, infrastructure ve licensing maliyetleri birlikte hesaplanmalıdır. Training, incident ve upgrade maliyetleri de tahmine eklenmelidir. Üç ila beş yıllık senaryo daha anlamlı sonuç verir. Scale arttığında birim maliyetin nasıl değiştiği incelenmelidir. En düşük ilk maliyet yerine en iyi toplam değer hedeflenmelidir.
11. ADR Yaz
Final kararın context, alternatives ve consequences bilgileri ADR içinde kaydedilmelidir. PoC ve scorecard sonuçlarına referans eklenebilir. Kabul edilen riskler açıkça belirtilmelidir. Owner ve review trigger yazılmalıdır. Bu kayıt gelecekteki ekiplerin aynı tartışmayı sıfırdan yapmasını engeller.
12. Exit Strategy Tanımla
Kritik vendor ve teknoloji bağımlılıklarının değiştirme maliyeti değerlendirilmelidir. Data export ve migration yöntemi belgelenebilir. Open standard ve adapter kullanımının gerekli olup olmadığı belirlenmelidir. Her dependency için aynı düzeyde exit plan oluşturmak gerekmez. One-way door kararlar daha ayrıntılı plan gerektirir.
13. Architecture Fitness Functions Oluştur
Kararın dayandığı önemli quality attribute'lar mümkün olduğunca otomatik ölçülmelidir. Performance threshold, dependency rule veya security policy buna örnek olabilir. Sistem büyüdükçe architecture drift erken tespit edilir. Cost ve availability metric'leri de fitness function hâline getirilebilir. Böylece teknoloji uygunluğu yalnızca başlangıçta değil sürekli doğrulanır.
14. Periyodik Olarak Yeniden Değerlendir
Stack belirli trigger veya periyodik review ile tekrar kontrol edilmelidir. EOL, security, hiring ve cost önemli değerlendirme nedenleridir. Review yapmak mutlaka teknoloji değiştirmek anlamına gelmez. Mevcut karar hâlâ uygunsa devam etmek en doğru sonuç olabilir. Governance değişim için değil bilinçli karar için vardır.
Enterprise Tech Stack Selection Checklist
Enterprise teknoloji seçimi çok sayıda kriter içerdiği için kontrol listesi karar sürecinin eksiklerini görünür kılar. Business, technical, team, security, cost, ecosystem, architecture ve validation alanları birlikte incelenmelidir. Checklist kararın kendisi değildir fakat kritik soruların unutulmasını engeller. Yanıtı belirsiz maddeler PoC veya risk analizi gerektirebilir. Liste proje koşullarına göre genişletilebilir.
Business
Business bölümü teknoloji kararının iş ihtiyacına gerçekten bağlanıp bağlanmadığını kontrol eder. Hedef ve kritik use case net değilse teknik değerlendirme erken başlamış demektir. Growth assumption'ların belgelenmesi capacity planning için önemlidir. Her hedefin aynı teknoloji sonucu üretmesi gerekmez. Business context kararın diğer tüm bölümlerine yön verir.
İş hedefi belli mi?
Projenin hangi iş sonucunu üretmesi gerektiği açık biçimde tanımlanmalıdır. Gelir, operasyon verimliliği veya kullanıcı deneyimi gibi hedefler ölçülebilir olabilir. Teknoloji seçimi bu sonuca katkı sağlamalıdır. Hedef belirsizse ekip teknik özellikleri gereğinden fazla önemseyebilir. Net business objective teknoloji tartışmasını daha hızlı sonuçlandırır.
Kritik use case tanımlı mı?
Kritik use case sistem başarısız olduğunda en fazla iş etkisi oluşturan akışı gösterir. Ödeme, sipariş veya operasyon işlemi buna örnek olabilir. PoC ve performance test bu akışı mutlaka içermelidir. Availability hedefi de kritik use case üzerinden belirlenebilir. Tüm ekranları eşit önemde görmek yanlış architecture yatırımına neden olabilir.
Büyüme varsayımları belgeli mi?
Kullanıcı, trafik ve veri büyümesi tahminleri açıkça yazılmalıdır. Varsayım ile gerçek requirement birbirinden ayrılmalıdır. Çok agresif tahmin gereksiz infrastructure cost oluşturabilir. Aşırı düşük tahmin ise yakın gelecekte migration ihtiyacı yaratabilir. Varsayımlar düzenli olarak gerçek metric'lerle güncellenmelidir.
Technical
Technical bölüm workload, latency ve availability hedeflerinin ölçülebilir olup olmadığını kontrol eder. Bu hedefler teknoloji karşılaştırmasını somutlaştırır. Yalnızca teknolojinin özellik listesine bakmak yeterli değildir. Gerçek performance target ve scale model gereklidir. Technical requirement'lar PoC acceptance criteria ile doğrudan bağlantılı olmalıdır.
Workload ölçüldü mü?
Mevcut sistem varsa gerçek trafik metric'leri kullanılmalıdır. Yeni projede tahmini workload modeli hazırlanabilir. RPS, concurrency, data volume ve peak davranış ayrı yazılmalıdır. Batch ve realtime işler unutulmamalıdır. Workload bilinmeden yapılan capacity plan çoğunlukla tahmine dayanır.
Latency hedefi var mı?
Kritik request'ler için p95 veya p99 latency hedefi belirlenebilir. Her endpoint'e aynı threshold uygulamak gerekli değildir. Kullanıcı deneyimi açısından önemli işlemler önceliklendirilebilir. Hedef gerçek network ve dependency koşullarında test edilmelidir. Production monitoring aynı metric'i sürekli izlemelidir.
Availability hedefi var mı?
Availability hedefi iş etkisine göre belirlenmelidir. Yüzde 99,9 ile daha yüksek hedefler arasında ciddi maliyet farkı olabilir. Kritik ve yardımcı servisler farklı SLO'lara sahip olabilir. Hedef gerçek monitoring verisiyle ölçülebilir olmalıdır. Disaster recovery planı aynı availability stratejisini desteklemelidir.
Team
Team bölümü teknoloji kararının gerçek organizasyon kapasitesiyle uyumunu kontrol eder. Ekip teknolojiyi bilmiyorsa eğitim ve hiring maliyeti ortaya çıkar. Senior talent ve on-call kapasitesi özellikle production riskini etkiler. Yeni teknoloji seçimi yalnızca geliştirme aşaması üzerinden değerlendirilmemelidir. Sistem yıllarca aynı veya büyüyen ekip tarafından yönetilecektir.
Ekip teknolojiyi biliyor mu?
Ekipteki bilgi yalnızca tutorial seviyesinde olmamalıdır. Production deployment, debugging ve upgrade deneyimi ayrıca değerlendirilmelidir. Yetkinlik düşükse PoC bu açığı görünür kılabilir. Training planı proje timeline'ına eklenmelidir. Mevcut expertise güçlü bir risk azaltma faktörüdür.
Senior talent bulunabiliyor mu?
Senior uzmanlar architecture ve zor incident'lerde önemli rol oynar. Nadir teknoloji hiring süresini uzatabilir. Remote talent havuzu seçenekleri genişletebilir. Ancak birkaç kritik kişiye bağımlı olmak bus factor riskini artırır. Talent market teknoloji roadmap'inin gerçek girdisidir.
On-call yönetilebilir mi?
On-call ekibinin stack'in tüm kritik bileşenlerini anlayabilmesi gerekir. Fazla teknoloji çeşidi gece incident'lerinde hata çözme süresini yükseltebilir. Dashboard, runbook ve ownership bilgisi hazır olmalıdır. Vendor support gerekli olsa bile ekip temel diagnostic becerisini korumalıdır. Operability seçimin merkezi kriterlerinden biri olmalıdır.
Security
Security checklist compliance, patch ve supply chain risklerini değerlendirir. Teknoloji güçlü security defaults ve güncel support sunmalıdır. Identity, encryption ve secret management entegrasyonları doğrulanmalıdır. Dependency riskleri otomatik taranmalıdır. Güvenlik gereksinimleri feature delivery'den ayrı bir son aşama olmamalıdır.
Compliance karşılanıyor mu?
Projenin tabi olduğu regülasyon veya kurumsal policy açıkça bilinmelidir. Data residency, audit ve encryption şartları stack seçimini etkileyebilir. Provider sertifikaları önemli olsa da uygulama configuration'ı ayrıca sorumluluk taşır. Compliance uzmanı yüksek riskli kararları değerlendirmelidir. Eksik gereksinim production öncesinde pahalı değişiklik yaratabilir.
Patch politikası var mı?
Runtime, framework ve operating system patch'leri için düzenli süreç oluşturulmalıdır. Critical vulnerability durumunda hedef çözüm süresi belirlenmelidir. Automated testing update riskini azaltır. EOL sürümler production'da görünür biçimde takip edilmelidir. Patch ownership her sistem için açık olmalıdır.
Supply-chain riski incelendi mi?
Dependency ve build araçlarının güvenilirliği değerlendirilmelidir. SBOM ve vulnerability scanning kullanımı faydalıdır. Package registry erişimi ve artifact signing kritik sistemlerde ek koruma sağlar. Kullanılmayan dependency'ler düzenli temizlenmelidir. Supply chain security sürekli süreç olarak ele alınmalıdır.
Cost
Cost bölümü sadece cloud faturası değil toplam sahip olma maliyetini kontrol eder. İnsan kaynağı, lisans, monitoring ve migration giderleri de hesaba katılmalıdır. Üç ila beş yıllık model kısa dönem fiyat farklarının ötesini gösterir. Egress ve managed service premium özellikle gözden kaçabilir. Technology decision finansal olarak da savunulabilir olmalıdır.
3–5 yıllık TCO hesaplandı mı?
Uzun vadeli TCO development ve operation yaşam döngüsünü birlikte gösterir. İlk yıl ücretsiz veya düşük maliyetli olan hizmetler ileride farklı fiyat davranışı gösterebilir. Hiring ve training giderleri modele eklenmelidir. Upgrade ve potential migration maliyetleri tahmini olarak dahil edilebilir. Senaryo bazlı hesaplama belirsizliği daha görünür hâle getirir.
Egress maliyetleri dahil mi?
Cloud dışı veya cross-region data transfer beklenmedik gider oluşturabilir. Media ve analytics workload'larında bu maliyet özellikle yüksek olabilir. Architecture diagram üzerinden yoğun veri akışı noktaları belirlenebilir. Provider pricing gerçek tahmini GB hacmiyle hesaplanmalıdır. Multi-cloud planlarında egress mutlaka ayrı satır olmalıdır.
Migration cost değerlendirildi mi?
Technology change yalnızca yeni sistemi kurma maliyetinden ibaret değildir. Data migration, dual run, testing ve training ciddi ek maliyet üretir. Migration sırasında eski sistem de işletilmeye devam edebilir. Exit strategy yaklaşık migration cost içermelidir. Çok pahalı migration gerektiren kararlar daha fazla upfront değerlendirme hak eder.
Ecosystem
Ecosystem checklist community activity, LTS ve open source project health gibi uzun vadeli sinyalleri inceler. İlk geliştirme deneyimi iyi olan technology birkaç yıl sonra support sorunu yaşayabilir. Documentation ve maintainer activity bu riski değerlendirmeye yardımcı olur. Production adoption ek bilgi sağlar. Ecosystem kalitesi ekip verimliliğini yıllar boyunca etkileyebilir.
Community aktif mi?
Aktif community issue ve kullanım bilgisinin sürekli paylaşılmasını sağlar. Forum veya repository hareketliliği incelenebilir. Yalnızca star sayısı yeterli ölçüm değildir. Kritik soruların nasıl cevaplandığı daha anlamlıdır. Büyük proje için community yanında commercial support da değerlendirilebilir.
LTS desteği var mı?
LTS desteği runtime ve framework upgrade planını daha öngörülebilir hâle getirir. Destek süresi proje roadmap'iyle uyumlu olmalıdır. Security patch'lerin hangi sürümlere verildiği bilinmelidir. Kısa support cycle büyük sistemlerde sürekli migration yükü oluşturabilir. EOL tarihleri technology inventory içinde takip edilmelidir.
Open-source project health yeterli mi?
Project health maintainer activity, release cadence, governance ve security response üzerinden değerlendirilebilir. Tek geliştiriciye bağımlı kritik proje daha yüksek risk taşır. Roadmap ve contribution yapısı uzun vadeli sürdürülebilirlik hakkında fikir verir. Lisans değişiklikleri de göz önünde bulundurulmalıdır. Kritik dependency'ler periyodik olarak yeniden incelenmelidir.
Architecture
Architecture checklist sistemin gereksiz dağıtık yapı veya platform bileşeni taşıyıp taşımadığını sorgular. Microservices ve Kubernetes belirli problemlerde değer sağlar ancak her büyük projede zorunlu değildir. Stack'in değiştirme maliyeti ve modülerliği de önemlidir. Basitlik uzun vadeli operability açısından güçlü avantajdır. Architecture complexity gerçek business complexity'yi aşmamalıdır.
Gereksiz microservice var mı?
Her service bağımsız deployment, monitoring ve ownership maliyeti oluşturur. Yeterli domain veya team sınırı yoksa servis ayrımı değer üretmeyebilir. Modular monolith daha düşük operasyon maliyeti sağlayabilir. Service sayısı business capability üzerinden yeniden gözden geçirilmelidir. Dağıtık yapı yalnızca teknik moda göre büyütülmemelidir.
Gereksiz Kubernetes var mı?
Kubernetes platform ekibi ve operasyon yatırımı gerektirir. Birkaç container için daha basit managed platform yeterli olabilir. Cluster kullanımının hangi problemi çözdüğü açıkça yazılmalıdır. Eğer cevap yalnızca standard olmak ise maliyet tekrar değerlendirilmelidir. Organizasyon büyüdüğünde migration ihtiyacı doğarsa Kubernetes daha sonra benimsenebilir.
Stack kolay değiştirilebilir mi?
Tüm stack'in kolay değiştirilebilir olması gerçekçi hedef değildir. Bunun yerine kritik dependency'lerin migration cost'u bilinmelidir. Open standards ve modular boundary bazı değişiklikleri kolaylaştırabilir. One-way door kararlar daha fazla inceleme gerektirir. Reversibility seviyesi ADR içinde belgelenmelidir.
Validation
Validation bölümü teknoloji kararının gerçek test ve evidence ile doğrulanıp doğrulanmadığını kontrol eder. PoC ve production benzeri load test en değerli araçlardır. ADR kararın nedenini geleceğe taşır. Sadece workshop görüşleri üzerinden yapılan seçim yüksek belirsizlik içerir. Ölçüm ve documentation birlikte karar kalitesini yükseltir.
PoC yapıldı mı?
PoC en yüksek riskli teknoloji varsayımlarını test etmelidir. Gerçek use case ve data kullanılması sonuçların değerini artırır. Sadece hello world demo yeterli değildir. Performance ve operability aynı çalışmada ölçülebilir. Sonuçlar final decision matrix'e eklenmelidir.
Production benzeri load test edildi mi?
Load test gerçek concurrency, request mix ve data volume'a yakın olmalıdır. Sadece maksimum RPS ölçmek production davranışını göstermeyebilir. Latency percentile ve resource utilization birlikte izlenmelidir. Dependency failure senaryoları ayrıca test edilebilir. Capacity margin iş büyüme varsayımıyla ilişkilendirilmelidir.
Decision ADR olarak kaydedildi mi?
ADR kararın bağlamını, alternatiflerini ve sonuçlarını belgeler. Ekip değişse bile neden aynı teknolojiye devam edildiği anlaşılır. Kabul edilen riskler açıkça görünür kalır. Review trigger eklemek gelecekte yeniden değerlendirmeyi kolaylaştırır. Kritik teknoloji kararlarının sözlü hafızaya bırakılmaması gerekir.
Sık Sorulan Sorular
Kurumsal teknoloji seçimi birçok değişken içerdiği için aynı sorular farklı projelerde tekrar gündeme gelir. Aşağıdaki cevaplar tek bir teknolojiyi her durumda doğru ilan etmek yerine karar kriterlerini öne çıkarır. Büyük ölçekli yazılım projelerinde tech stack nasıl seçilir sorusunun temel cevabı requirement, workload, ekip ve toplam maliyetin birlikte değerlendirilmesidir. Teknoloji listesi ancak bu analizden sonra anlam kazanır. Gerektiğinde PoC ve mimari danışmanlık süreci belirsizliği azaltmak için kullanılabilir.
Büyük Ölçekli Bir Proje İçin En İyi Tech Stack Hangisidir?
Her büyük proje için ortak bir en iyi tech stack bulunmaz. İş hedefleri, workload, ekip uzmanlığı, güvenlik ve compliance ihtiyaçları doğru seçimi değiştirir. Java veya .NET bazı kurumsal sistemlerde güçlü uyum sağlarken Node.js, Go veya Python farklı workload'larda daha uygun olabilir. Database ve cloud kararları da aynı bağlam içinde verilmelidir. En iyi stack, gereksinimlere karşı evidence ile savunulabilen ve ekibin uzun vadede yönetebildiği stack'tir.
En İyi Programlama Dili Hangisidir?
Evrensel en iyi programlama dili yoktur. Programlama dili domain, workload, talent ve ecosystem bağlamında değerlendirilmelidir. CPU yoğun hizmetle I/O yoğun API aynı özelliklerden faydalanmayabilir. Ekip üretkenliği de ham runtime performansından daha büyük ekonomik etki yaratabilir. Dil seçimi PoC ve decision matrix ile desteklenirse kişisel tercihler karar üzerindeki etkisini azaltır.
Java mı .NET mi Node.js mi Go mu?
Java, .NET, Node.js ve Go farklı avantajlara sahip olgun backend seçenekleridir. Java ve .NET geniş kurumsal ekosistem ve tooling sunarken Node.js I/O ağırlıklı uygulamalarda ve TypeScript ekiplerinde hızlı geliştirme avantajı sağlayabilir. Go sade deployment ve concurrency modelinde güçlü olabilir. Seçim ekip expertise, domain, latency ve operations hedeflerine göre yapılmalıdır. Aynı gerçek use case üzerinde PoC yapmak karşılaştırmayı çok daha anlamlı hâle getirir.
Büyük Projelerde PostgreSQL Yeterli midir?
PostgreSQL birçok büyük ölçekli kurumsal workload için güçlü bir relational database seçeneğidir. Transaction, complex query, JSON ve geniş ekosistem özellikleri pek çok kullanım senaryosunu karşılayabilir. Yine de “büyük proje” tek başına database yeterliliğini belirlemez. Data volume, query pattern, write throughput ve availability gereksinimleri test edilmelidir. Sınır ortaya çıkmadan yalnızca gelecekte scale olabilir düşüncesiyle daha karmaşık database seçmek gerekli değildir.
NoSQL Ne Zaman Kullanılmalı?
NoSQL belirli data access pattern veya dağıtık scale gereksinimi relational modelle iyi karşılanmadığında değerlendirilmelidir. Document, key-value, wide-column ve graph modellerinin kullanım alanları birbirinden farklıdır. Transaction ve consistency gereksinimleri doğru teknoloji seçimini etkiler. Sadece schema esnekliği veya scale söylemi yeterli gerekçe değildir. Gerçek query ve data volume PoC üzerinde doğrulanmalıdır.
Microservices Büyük Projeler İçin Zorunlu mudur?
Microservices büyük projeler için zorunlu değildir. Modular monolith birçok büyük sistemde daha düşük operasyon yükü ve güçlü domain sınırları sağlayabilir. Microservices independent deployment, team autonomy veya independent scaling gerçekten gerektiğinde değer üretir. Dağıtık tracing, messaging ve incident response maliyetleri kararın parçasıdır. Organizasyon henüz bu ihtiyaçlara sahip değilse daha basit yapı daha doğru olabilir.
Kubernetes Ne Zaman Kullanılmalıdır?
Kubernetes çok sayıda container service'in ortak platform standartlarıyla yönetildiği organizasyonlarda değer sağlar. Güçlü platform team, self-service infrastructure ve policy gereksinimleri kullanım gerekçesini güçlendirir. Küçük projelerde managed container hizmetleri daha düşük operasyon maliyeti sunabilir. Cluster upgrade ve security ownership mutlaka hesaba katılmalıdır. Kubernetes yalnızca popüler olduğu için değil çözmesi gereken platform problemi açık olduğunda seçilmelidir.
Serverless Büyük Ölçekli Sistemlere Uygun mudur?
Serverless belirli büyük ölçekli workload'larda gayet uygun olabilir. Variable traffic ve event-driven operasyonlarda otomatik scaling önemli avantaj sağlar. Sürekli yüksek kullanımda maliyet modeli ve platform sınırları dikkatle incelenmelidir. Vendor-specific entegrasyonlar exit strategy açısından değerlendirilmelidir. Büyük sistemler serverless ve container yaklaşımını farklı workload'lar için birlikte de kullanabilir.
Tech Stack Seçerken Ekip Deneyimi Ne Kadar Önemlidir?
Ekip deneyimi en önemli teknoloji seçimi kriterlerinden biridir. Production operasyon, debugging ve upgrade bilgisi risk seviyesini doğrudan etkiler. Buna rağmen yalnızca ekip bildiği için teknik olarak uygun olmayan teknolojiye bağlı kalmak da doğru değildir. Technology fit ile familiarity dengelenmelidir. Yeni teknoloji belirgin fayda sağlıyorsa PoC, eğitim ve hiring planıyla kontrollü biçimde benimsenebilir.
Açık Kaynak Teknolojiler Enterprise İçin Güvenli midir?
Açık kaynak teknolojiler uygun governance ve security süreçleriyle enterprise sistemlerde güvenle kullanılabilir. Lisans, maintainer activity, CVE response ve dependency health incelenmelidir. SBOM ve automated scanning supply chain riskini yönetmeye yardımcı olur. Open source olması otomatik olarak güvenli veya güvensiz olduğu anlamına gelmez. Kritik konu projenin olgunluğu ve organizasyonun bakım sürecidir.
Vendor Lock-In Her Zaman Kötü müdür?
Vendor lock-in her zaman kötü değildir. Yönetilen servis daha hızlı teslim, yüksek reliability ve düşük operasyon yükü sağlayabilir. Bu fayda olası migration maliyetinden daha yüksek olabilir. Bağımlılığın türü, data export ve exit cost açıkça bilinmelidir. Bilinçli lock-in ile fark edilmeden oluşmuş bağımlılık birbirinden ayrılmalıdır.
Tech Stack İçin PoC Nasıl Yapılır?
PoC gerçek use case, production benzeri veri ve realistic load kullanmalıdır. Amaç teknolojinin bütün özelliklerini denemek değil en kritik belirsizlikleri çözmektir. Performance, security, operability ve developer experience kriterleri birlikte ölçülebilir. Acceptance criteria başlangıçtan yazılmalıdır. Sonuçlar karar matrisi ve ADR için evidence olarak kullanılmalıdır.
Tech Stack Kararı Nasıl Belgelenir?
Architecture Decision Record teknoloji kararlarını belgelemek için pratik yöntemdir. Context, alternatives, decision drivers ve consequences kısa biçimde yazılır. PoC ve TCO sonuçlarına bağlantı eklenebilir. Review trigger gelecekte hangi durumda kararın tekrar açılacağını belirtir. ADR repository içinde version control altında tutulduğunda ekipler kolayca erişebilir.
Tech Stack Ne Sıklıkla Değiştirilmelidir?
Tech stack belirli bir periyotta zorunlu olarak değiştirilmemelidir. EOL, security, cost, scale veya hiring problemi gibi gerçek trigger'lar değerlendirme başlatmalıdır. Mevcut teknoloji gereksinimleri karşılıyorsa devam etmek çoğu zaman en düşük riskli karardır. Sürekli migration feature delivery kapasitesini azaltır. Yıllık technology review stack'in sağlığını kontrol etmek için yeterli başlangıç modeli olabilir.
Büyük Bir Projede Teknoloji Standardizasyonu Gerekli midir?
Büyük organizasyonlarda belirli düzeyde standardizasyon tooling, security ve hiring maliyetini azaltır. Buna rağmen tek bir teknolojiyi her workload'a zorlamak doğru değildir. Paved road ve approved technology catalog dengeli yaklaşım sağlar. Özel gereksinimler exception process üzerinden değerlendirilebilir. Amaç çeşitliliği sıfırlamak değil organizasyonun sürdürebileceği seviyede tutmaktır.
Büyük ölçekli yazılım projelerinde doğru tech stack nasıl seçilir?
Doğru seçim iş hedeflerini, functional requirements'ı ve non-functional requirements'ı netleştirerek başlar. Ardından workload, ekip yetkinliği, güvenlik, compliance ve TCO değerlendirilir. İki veya üç güçlü candidate stack aynı kriterlerle scorecard üzerinden karşılaştırılabilir. Kritik varsayımlar gerçek use case içeren PoC ile doğrulanmalıdır. Final karar ADR olarak belgelenmeli ve gelecekte yeniden değerlendirme trigger'ları tanımlanmalıdır.
Tech stack seçiminde ölçeklenebilirlik, güvenlik ve ekip yetkinliği nasıl değerlendirilmelidir?
Ölçeklenebilirlik gerçek kullanıcı ve trafik projeksiyonları üzerinden ölçülmelidir. Güvenlik framework defaults, dependency health, identity, encryption ve patch modeliyle değerlendirilir. Ekip yetkinliği yalnızca dil bilgisi değil production operasyon deneyimini de kapsar. Bu kriterlere project priority'ye göre ağırlık verilebilir. PoC sonuçları teori ile gerçek kullanım arasındaki farkı görünür kılar.
Kurumsal projelerde teknoloji seçerken toplam sahip olma maliyeti ve uzun vadeli bakım neden önemlidir?
Bir sistemin maliyeti ilk development bütçesiyle sınırlı değildir. Developer salaries, training, cloud, licensing, monitoring, security, upgrade ve migration yıllar boyunca devam eder. Başlangıçta hızlı görünen teknoloji uzun vadede zor hiring veya sık breaking change nedeniyle pahalı olabilir. TCO üç ila beş yıllık perspektifle hesaplandığında bu etkiler daha görünür olur. Sürdürülebilir stack yalnızca bugün çalışan değil yıllar sonra da güvenli biçimde geliştirilebilen stack'tir.
Vendor lock-in ve entegrasyon riskleri tech stack seçiminde nasıl azaltılır?
Öncelikle bağımlılığın türü ve potansiyel migration maliyeti belirlenmelidir. Open standards, adapter layer ve export edilebilir veri formatları bazı riskleri azaltabilir. Her vendor API'sini soyutlamak gerekli değildir. En yüksek lock-in ve business etkisine sahip bileşenler önceliklendirilmelidir. Exit strategy ve kabul edilen bağımlılıklar ADR içinde açık biçimde belgelenebilir.
Yakınımda büyük ölçekli yazılım projeleri için tech stack danışmanlığı veren firma nasıl bulabilirim?
Teknoloji yığını seçimi ve yazılım mimarisi danışmanlığı yakınımda şeklinde araştırma yaparken yalnızca kullanılan teknoloji isimlerine değil danışmanlık yaklaşımına bakmak gerekir. İyi bir değerlendirme business requirements, workload, security, TCO ve ekip kapasitesini birlikte ele almalıdır. Referans proje yaklaşımı ve mimari karar süreci de incelenebilir. Diyarbakır Yazılım Topluluğu'nun proje ve çalışma alanlarını görmek için https://www.diyarbakiryazilim.com.tr/projects adresini inceleyebilirsiniz. Topluluk ve yaklaşım hakkında daha fazla bilgi için https://www.diyarbakiryazilim.com.tr/about sayfası da yararlı bir başlangıç noktasıdır.
Sonuç: Büyük Ölçekli Sistemlerde Doğru Tech Stack, En Güçlü Teknoloji Değil En Savunulabilir Karar Setidir
Büyük Ölçekli Yazılım Projelerinde Tech Stack Seçimi, birkaç teknoloji logosunu yan yana koyup favori framework'ü belirlemekten çok daha kapsamlıdır. Sağlıklı bir karar business context, workload, security, scalability, ekip kapasitesi, developer experience, operability, TCO ve exit strategy üzerinden şekillenir. On yıllık proje deneyiminde en sürdürülebilir sistemlerin ortak yönünün her zaman en yeni araçları kullanmaları değil, neden belirli kararları verdiklerini açıkça bilmeleri olduğunu gördüm. İyi stack aynı zamanda gelecekte değişebilecek varsayımları belgeler, PoC ile riskleri doğrular ve ADR ile kararın kurumsal hafızada kalmasını sağlar. Kurumsal yazılım mimarisi ve tech stack danışmanlığı hizmeti kapsamında yaklaşımınızı değerlendirmek, mevcut teknoloji yığınınızı gözden geçirmek veya yeni bir büyük ölçekli proje için karar çerçevesi oluşturmak istiyorsanız Diyarbakır Yazılım Topluluğu hakkında https://www.diyarbakiryazilim.com.tr/about adresinden bilgi alabilir ve proje çalışmalarını https://www.diyarbakiryazilim.com.tr/projects üzerinden inceleyebilirsiniz.
share: