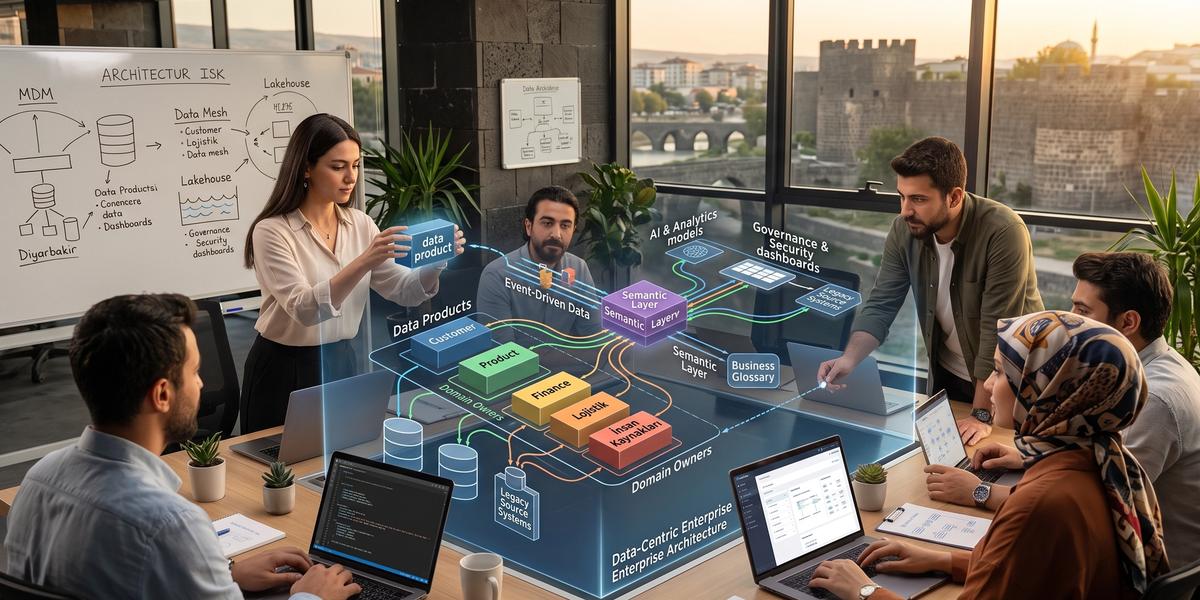
Veri Merkezli (Data-Centric) Kurumsal Mimariler

Diyarbakır Yazılım
16.08.2026
#Yazılım#Teknoloji#Topluluk
Bir kurumun verisi yıllar boyunca yaşarken, uygulamalar birkaç yıl içinde değişebilir, birleşebilir veya tamamen kullanımdan kalkabilir. Bu nedenle Veri Merkezli (Data-Centric) Kurumsal Mimariler, veriyi belirli bir uygulamanın yan ürünü olarak değil, kendi sahibi, yaşam döngüsü, kalite seviyesi ve erişim modeli olan kurumsal bir varlık olarak ele alır. Yaklaşık on yıllık kurumsal yazılım ve veri mimarisi deneyimimde en sık gördüğüm sorun, şirketlerin veri sorunlarını yeni araç satın alarak çözmeye çalışmasıdır. Oysa doğru başlangıç noktası araç değil, hangi verinin kim tarafından üretildiğini, kimin sorumlu olduğunu, hangi iş anlamını taşıdığını ve hangi tüketicilere hangi koşullarda sunulacağını tanımlamaktır. Bu rehberde data-centric kurumsal mimari nasıl tasarlanır sorusundan data products, data mesh, governance, semantic layer, lakehouse, event-driven entegrasyon, veri güvenliği ve AI kullanımına kadar üretim ortamında gerçekten karşılaşılan konuları birlikte ele alacağız.
Veri Merkezli (Data-Centric) Mimari Nedir?
Veri merkezli mimari, sistem tasarımında ana referans noktasını uygulamalardan veriye taşıyan bir yaklaşımdır. Bu modelde veri yalnızca bir uygulamanın iç veritabanında tutulan kayıtlar olarak görülmez, farklı uygulamalar tarafından güvenilir biçimde kullanılabilen uzun ömürlü bir kurumsal kaynak olarak tasarlanır. Örneğin müşteri bilgisi CRM, e-ticaret, destek ve finans sistemlerinde ayrı ayrı tanımlanmak yerine ortak kimlik, kalite ve sahiplik kurallarıyla yönetilir. Bu yaklaşım uygulamaların bağımsız gelişmesine izin verirken kurum genelinde aynı kavramın farklı anlamlara gelmesini de azaltır. Başarılı bir veri merkezli yapı, teknoloji seçiminden önce sahiplik, sözleşme, semantik anlam, erişim ve yönetişim kararlarını görünür hale getirir.
Veriyi Kurumsal Varlık Olarak Görmek
Bir veriyi kurumsal varlık olarak görmek, onun yalnızca bir tablo veya dosya olmadığını kabul etmekle başlar. Müşteri, ürün, sipariş, ödeme veya çalışan gibi temel veri alanlarının sahibi, kullanım amacı, kalite beklentisi ve erişim koşulu açık biçimde tanımlanmalıdır. Benim deneyimimde sahipliği belirsiz veriler, ilk başta teknik olarak çalışsa bile zaman içinde güven kaybına uğrar ve ekipler kendi kopyalarını oluşturmaya başlar. Kurumsal varlık yaklaşımı bu döngüyü kırmak için verinin kim tarafından üretildiğini ve hangi kurallarla değiştirilebildiğini görünür kılar. Böylece veri, uygulama değişikliklerinden bağımsız olarak kurum içinde değer üretmeye devam eden sürdürülebilir bir kaynak haline gelir.
Uygulamadan Bağımsız Veri Ne Demektir?
Uygulamadan bağımsız veri, belirli bir yazılım ürününün iç modeline veya yaşam süresine tamamen bağlı olmayan veri anlamına gelir. Örneğin müşteri adresi yalnızca satış uygulamasının özel alan isimleriyle tanımlanırsa başka sistemlerin aynı veriyi anlaması zorlaşır. Bunun yerine kurumsal tanımlar, açık şemalar, veri sözleşmeleri ve standart arayüzler kullanıldığında farklı uygulamalar aynı bilgiyi daha güvenli şekilde paylaşabilir. Bu yaklaşım bir uygulama değiştirildiğinde verinin yeniden anlamlandırılması veya baştan taşınması ihtiyacını azaltır. Özellikle ERP, CRM veya özel geliştirilmiş sistemlerin zaman içinde değiştiği büyük yapılarda uygulamadan bağımsız veri tasarımı önemli bir süreklilik avantajı sağlar.
Data-Centric Mimarinin Temel Prensipleri
Data-centric mimarinin temel prensipleri verinin paylaşılabilir, anlaşılabilir, bulunabilir, güvenilir, yönetilebilir ve yeniden kullanılabilir olmasını hedefler. Bu prensipler yalnızca teknik standartlardan ibaret değildir, ekiplerin veriyi üretme ve tüketme biçimini de değiştirir. İyi tasarlanmış bir kurumsal veri ortamında geliştirici bir veri setini bulduğunda sahibini, anlamını, güncellenme sıklığını ve kullanım kısıtlarını ayrı ayrı araştırmak zorunda kalmaz. Bu bilgiler metadata, katalog, sözleşme ve otomatik kontroller aracılığıyla birlikte sunulur. Böyle bir temel kurulmadan yapılan büyük ölçekli platform yatırımları genellikle çok sayıda araç üretir fakat veri güvenini aynı ölçüde artırmaz.
Paylaşılabilirlik
Paylaşılabilirlik, bir verinin yalnızca onu üreten uygulama tarafından değil, yetkili diğer sistemler tarafından da kullanılabilmesini ifade eder. Bunun için veriyi doğrudan kaynak veritabanına erişim vererek paylaşmak yerine API, event, veri ürünü veya kontrollü sorgu arayüzleri sunmak daha sağlıklıdır. Böylece tüketiciler üretici sistemin iç tablo yapısına bağımlı kalmaz ve şema değişikliklerinden daha az etkilenir. Paylaşılabilirlik aynı zamanda erişim yetkilerinin, veri sınıflandırmasının ve kullanım amacının açık biçimde yönetilmesini gerektirir. İyi bir paylaşım modeli, verinin daha fazla kullanılmasını sağlarken kontrolsüz çoğaltma ve güvenlik risklerini de sınırlayabilir.
Interoperability
Interoperability, farklı sistemlerin veriyi yalnızca teknik olarak okuyabilmesini değil, aynı anlamla yorumlayabilmesini hedefler. Aynı müşteri kavramı bir sistemde bireysel kullanıcıyı, başka bir sistemde fatura hesabını temsil ediyorsa teknik entegrasyon başarılı görünse bile iş anlamı bozulabilir. Ortak şemalar, açık veri formatları, standart kimlikler ve semantic definitions bu nedenle önemlidir. Kurumlar birlikte çalışabilirliği artırmak için format standardından önce kavramların anlamı üzerinde uzlaşmalıdır. Bu yaklaşım yeni uygulamaların mevcut veri ekosistemine eklenmesini kolaylaştırırken dönüşüm kodlarının ve özel adaptörlerin sayısını da azaltır.
Discoverability
Discoverability, kurum içinde var olan bir verinin ihtiyaç duyan kişi tarafından bulunabilmesi anlamına gelir. Bir veri setinin teknik olarak mevcut olması, insanların onun varlığını bilmediği bir ortamda pek değer taşımaz. Data catalog, metadata, business glossary ve sahiplik bilgileri sayesinde kullanıcılar belirli bir iş kavramıyla ilgili doğru kaynağa daha hızlı ulaşabilir. Örneğin pazarlama ekibi aktif müşteri sayısını hesaplamak istediğinde hangi tabloyu kullanacağını tahmin etmek yerine onaylanmış data product kaydına gidebilmelidir. Bulunabilirlik yükseldikçe aynı verinin farklı ekipler tarafından tekrar tekrar oluşturulması da belirgin biçimde azalır.
Trust
Trust, kullanıcıların bir veriye bakıp onun doğru, güncel ve amacı için yeterli olduğuna inanabilmesini ifade eder. Güven yalnızca data quality testi çalıştırarak oluşmaz, verinin sahibi, kaynağı, dönüşüm geçmişi ve kalite ölçümleri de görünür olmalıdır. Bir veri ürününde güncellik hedefi iki saat olarak tanımlanmışsa tüketici bu hedefin son günlerde karşılanıp karşılanmadığını görebilmelidir. Lineage ve observability bilgileri sorun çıktığında nedenini araştırmayı kolaylaştırır. Böylece ekipler kendi kontrol tablolarını üretmek yerine ortak veri kaynaklarını kullanmaya daha istekli hale gelir.
Governance
Governance, verinin kim tarafından, hangi amaçla ve hangi kurallar altında kullanılabileceğini belirleyen yönetişim yapısıdır. Etkili yönetişim yalnızca doküman hazırlamaktan ibaret değildir, mümkün olan kuralların platform ve pipeline seviyesinde otomatik uygulanması gerekir. Örneğin kişisel veri içeren sütunlar sınıflandırıldığında masking ve erişim politikalarının otomatik devreye girmesi yönetimi güçlendirir. Veri sahibi, steward, platform ekibi ve tüketicilerin sorumlulukları açıkça ayrıldığında karar süreçleri de hızlanır. Bu nedenle veri merkezli mimaride governance, geliştirme hızını düşüren bir kontrol kapısı değil güvenli ölçeklenmenin temelidir.
Reusability
Reusability, aynı verinin her yeni proje için baştan hazırlanması yerine güvenilir bir veri ürününün farklı tüketiciler tarafından tekrar kullanılabilmesidir. Satış, finans ve analitik ekiplerinin aynı sipariş gerçeğini farklı ETL süreçleriyle üretmesi hem maliyet hem kalite sorunu yaratır. Ortak bir sipariş data product oluşturulduğunda ekipler kendi kullanım amaçlarına uygun görünümler veya servisler üretebilir fakat çekirdek tanım korunur. Yeniden kullanılabilirlik veri ürünlerinin açık belgeler, kararlı şemalar ve erişim arayüzleri sunmasını gerektirir. İyi tasarlandığında yeni bir analitik raporun veya AI kullanımının devreye alınma süresi haftalardan günlere düşebilir.
Application-Centric ve Data-Centric Mimari Arasındaki Fark
Application-centric yaklaşımda sistem tasarımı genellikle uygulamaların ihtiyaçları etrafında şekillenir ve her uygulama kendi verisini kendi sınırlarında yönetir. Data-centric yaklaşımda ise uygulamalar değişebilir bileşenler, veri ise daha uzun ömürlü ve paylaşılabilir kurumsal kaynak olarak kabul edilir. Bu fark özellikle büyük organizasyonlarda entegrasyon maliyeti, veri tekrarları ve AI hazırlığı üzerinde doğrudan etki yaratır. Uygulama merkezli yapılarda yeni bir sistem eklendiğinde çok sayıda noktadan noktaya entegrasyon gerekebilirken veri merkezli yapılarda standart arayüzler ve veri ürünleri kullanılabilir. İki yaklaşım tamamen birbirini dışlamak zorunda değildir fakat kurumsal ölçekte veriye ortak yaşam döngüsü kazandırmak için data-centric prensiplerin açıkça tanımlanması gerekir.
Application-Centric Architecture
Application-Centric Architecture, her uygulamanın kendi işlevleri, veri modeli ve entegrasyon sınırları etrafında tasarlandığı geleneksel bir modeldir. Bu yapı küçük sistemlerde hızlı sonuç verebilir çünkü ekip uygulamasını bağımsız geliştirebilir ve iç veri modelini istediği gibi değiştirebilir. Sorun organizasyon büyüdüğünde ortaya çıkar, çünkü müşteri, ürün veya sipariş gibi ortak kavramlar birçok uygulamada farklı biçimlerde kopyalanmaya başlar. Ardından ekipler verileri senkronize etmek için özel entegrasyonlar geliştirir ve değişikliklerin etkisi giderek daha geniş bir alana yayılır. Bu nedenle uygulama merkezli yaklaşımın sınırlarını bilmek, veri merkezli dönüşümün neden gerekli olduğunu anlamak açısından önemlidir.
Data-Centric Architecture
Data-Centric Architecture, veriyi belirli uygulama sınırlarından çıkararak kurumsal seviyede tanımlanmış bir varlık haline getirir. Uygulamalar veriyi üretir, kullanır veya günceller fakat kurumsal kavramın tek sahibi olmak zorunda değildir. Veri ürünleri, ortak metadata, erişim politikaları ve sözleşmeler sayesinde farklı sistemler aynı bilgiyi daha tutarlı biçimde tüketebilir. Bu model özellikle veri hacminin, ekip sayısının ve analitik kullanımın arttığı kurumlarda önemli avantaj sağlar. Amaç bütün veriyi tek fiziksel platforma toplamak değil, verinin yaşam döngüsünü ortak kurallarla yönetmektir.
Data Ownership
Data ownership, bir veri alanının doğruluğu, tanımı ve kullanım kuralları konusunda hangi ekip veya rolün hesap verebilir olduğunu belirler. Application-centric yapıda sahiplik çoğu zaman uygulamayı yöneten teknik ekibe varsayılan olarak bırakılır. Data-centric yapıda ise sahiplik iş alanı, veri ürünü ve kurumsal yönetişim bağlamında açıkça tanımlanır. Örneğin müşteri iletişim bilgisinin teknik olarak CRM içinde tutulması, kavramsal sahibinin mutlaka CRM geliştirme ekibi olduğu anlamına gelmez. Doğru sahiplik modeli, veri sorunlarının çözümsüz kalmasını önler ve tüketicilerin doğru kişiye hızlı biçimde ulaşmasını sağlar.
Integration
Application-centric entegrasyon çoğu zaman iki uygulamanın özel ihtiyaçlarına göre geliştirilen doğrudan bağlantılara dayanır. Sistem sayısı arttıkça bu bağlantılar birbirine bağlı bir ağ oluşturur ve herhangi bir değişiklik birden fazla entegrasyonu etkileyebilir. Data-centric yaklaşımda veri paylaşımı data product, API, event interface veya standart sorgu katmanları üzerinden yapılır. Böylece tüketiciler üretici uygulamanın iç yapısına daha az bağımlı olur. Kurumsal veri mimarisinde data lake data warehouse API ve event-driven entegrasyonu birlikte tasarlamak, farklı hız ve tüketim ihtiyaçlarını tek bir yaklaşımın içine zorlamaktan daha sağlıklı sonuç verir.
Data Duplication
Data duplication, aynı bilginin farklı sistemlerde kontrolsüz biçimde çoğalması ve zamanla birbirinden farklı hale gelmesi problemidir. Bazı veri kopyaları performans veya analitik ihtiyaç nedeniyle bilinçli olarak oluşturulabilir ve bu tek başına yanlış değildir. Asıl sorun hangi kopyanın yetkili kaynak olduğunun ve nasıl güncellendiğinin bilinmemesidir. Data-centric mimari lineage, ownership, canonical definitions ve veri ürünleriyle kopyaların amacını görünür hale getirir. Bu sayede gereksiz veri tekrarları azaltılırken ihtiyaç duyulan kontrollü kopyaların da yönetilebilir olması sağlanır.
Vendor Lock-In
Vendor lock-in, verinin ve iş mantığının belirli bir ürünün özel formatlarına veya servislerine aşırı bağımlı hale gelmesidir. Uygulama merkezli tasarımlarda veri çoğu zaman uygulamanın kendi şeması, API yapısı ve lisans modeli içinde sıkışabilir. Data-centric yaklaşım açık formatlar, bağımsız data contracts ve standart veri erişim modelleri kullanarak geçiş maliyetini azaltmayı hedefler. Bu, hiçbir ürün bağımlılığı olmayacağı anlamına gelmez fakat kritik verinin bir yazılım ürününün iç yapısıyla eş anlamlı hale gelmesini engeller. Uzun vadede açık standartlara yatırım yapmak teknoloji değiştirme kararlarında kuruma daha fazla hareket alanı sağlar.
Kurumsal Çeviklik
Kurumsal çeviklik, yeni ürün, rapor, entegrasyon veya iş modelinin mevcut altyapı tarafından ne kadar hızlı desteklenebildiğiyle yakından ilişkilidir. Her veri talebinin merkezi bir ekibe veya özel entegrasyon projesine dönüştüğü kurumlarda değişiklik yavaş ilerler. Data-centric mimari, bulunabilir ve yeniden kullanılabilir veri ürünleri sayesinde yeni kullanım senaryolarının daha hızlı kurulmasını mümkün kılar. Platform ekipleri standart yollar sunduğunda domain ekipleri altyapı ayrıntılarıyla uğraşmadan kendi veri ürünlerini yayınlayabilir. Böylece çeviklik yalnızca daha hızlı kod yazmakla değil, veriye güvenli ve standart erişimi hızlandırmakla elde edilir.
AI Hazırlığı
AI hazırlığı, yalnızca model veya GPU kapasitesine sahip olmakla ölçülmez, güvenilir ve anlamı açık verilere erişebilmek temel gerekliliktir. Verinin hangi kaynaktan geldiği bilinmiyorsa, kalite seviyesi ölçülmüyorsa veya erişim izinleri belirsizse AI projeleri hızla riskli hale gelebilir. Data-centric mimari metadata, lineage, semantic context ve data products sayesinde AI uygulamalarına daha kontrollü veri temeli sunar. Özellikle RAG, agent ve tahmin sistemlerinde verinin güncelliği ile yetkilendirme kuralları model kalitesi kadar önemlidir. Bu nedenle AI hazırlığı çoğu kurumda önce veri mimarisi olgunluğu meselesidir.
Data-Centric ile Data-Driven Aynı Şey midir?
Data-centric ve data-driven kavramları birbirine yakın görünse de aynı şeyi anlatmaz. Data-driven yaklaşım kararların ölçülebilir verilere dayanmasını hedefleyen organizasyonel bir çalışma biçimidir. Data-centric architecture ise bu kararları ve dijital ürünleri destekleyen verinin nasıl tasarlandığı, sahiplenildiği, yönetildiği ve sunulduğuyla ilgilenir. Bir şirket çok sayıda dashboard kullanarak data-driven görünürken arka planda çelişkili metrikler ve kopyalanmış veri setleriyle çalışabilir. Bu nedenle kalıcı data-driven kültür oluşturmak isteyen kurumların sağlam bir data-centric temel kurması büyük avantaj sağlar.
Data-Driven Organizasyon Nedir?
Data-driven organizasyon, önemli kararların yalnızca sezgiye değil ölçülebilir verilere ve açık metriklere dayandığı organizasyondur. Satış stratejisi, ürün geliştirme, operasyon planlama veya müşteri deneyimi gibi alanlarda karar öncesinde veri analizi yapılır. Ancak dashboard sayısının artması tek başına data-driven olunduğunu göstermez, kullanılan verinin güvenilirliği ve karar sürecine etkisi önemlidir. Sağlıklı bir data-driven kültürde çalışanlar metriklerin ne anlama geldiğini bilir ve kaynağına erişebilir. Böylece veri yalnızca raporlama aracı değil, karar kalitesini artıran ortak bir dil haline gelir.
Data-Centric Architecture Nedir?
Data-centric architecture, veriyi uygulamaların geçici iç çıktısı yerine uzun ömürlü, paylaşılabilir ve yönetilebilir bir kurumsal kaynak olarak ele alan mimari yaklaşımdır. Bu yaklaşımda veri sahibi, sözleşmesi, kalite hedefi, lineage bilgisi ve erişim modeli tanımlanır. Data products ve semantic layer gibi yapılar farklı tüketicilerin ortak kavramları aynı şekilde anlamasını kolaylaştırır. Teknik platform önemli olsa da asıl değer standartlaştırılmış veri yaşam döngüsünden gelir. Bu nedenle data-centric architecture bir ürün satın alma projesi değil, mimari ve organizasyonel çalışma biçimi değişimidir.
Data-Driven Olup Data-Centric Olmamak Mümkün mü?
Evet, bir organizasyon çok sayıda analitik karar almasına rağmen data-centric olmayabilir. Örneğin her departman kendi rapor tablolarını oluşturuyor, kendi müşteri tanımını kullanıyor ve sonuçlara göre karar alıyorsa davranış düzeyinde data-driven sayılabilir. Ancak bu ortamda kaynakların doğruluğu, metrik tutarlılığı ve yeniden kullanılabilirlik zayıf olabilir. Zaman içinde ekipler birbirinin sayılarını sorgulamaya başlar ve karar süreçleri hızlanmak yerine yavaşlayabilir. Data-centric yaklaşım bu sorunu ortak tanımlar, sahiplik ve veri ürünleri üzerinden daha sürdürülebilir hale getirir.
İki Yaklaşım Nasıl Birlikte Kullanılır?
Data-driven kültür ve data-centric architecture birbirini tamamlayan iki farklı katman olarak düşünülmelidir. Data-centric yapı güvenilir veri üretir, data-driven organizasyon ise bu veriyi karar ve ürün geliştirme süreçlerinde kullanır. Örneğin semantic layer içindeki onaylanmış gelir metriği tüm departmanlara sunulurken yönetim kararlarını aynı tanım üzerinden verebilir. Veri ürünlerinin kullanım ölçümleri de hangi verilerin gerçek iş değeri oluşturduğunu göstermeye yardımcı olur. Böylece mimari yatırım ile organizasyonel karar kültürü birbirini besleyen tek bir sistem haline gelir.
Veri Merkezli Mimarinin İşletmeye Faydaları
Veri merkezli mimarinin işletmeye sağladığı en önemli fayda, veriyi tekrar tekrar üretmek yerine güvenilir bir temel üzerinden yeniden kullanabilmektir. Bu yaklaşım entegrasyon süresini kısaltabilir, kalite sorunlarını daha erken yakalayabilir ve farklı ekiplerin aynı kavram için farklı tanımlar oluşturmasını azaltabilir. Ayrıca KVKK, erişim yönetimi ve audit gibi konular veri seviyesinde ele alındığı için uyum süreçleri daha görünür hale gelir. AI ve analytics projeleri de veri bulma ve temizleme aşamasında daha az zaman harcayarak iş sonucuna daha hızlı ilerleyebilir. İşletme açısından gerçek değer, veri platformunun teknik büyüklüğünden değil, doğru veriye ulaşma ve güvenli şekilde kullanma süresinin azalmasından gelir.
Data Silo'larını Azaltmak
Data silo, belirli bir ekip veya uygulama içinde bulunan verinin kurumun geri kalanından kopuk kalmasıdır. Silolar genellikle kötü niyetli tasarımın değil, bağımsız projelerin yıllar boyunca birbirinden habersiz büyümesinin sonucudur. Data catalog, data product ve ortak erişim arayüzleri sayesinde mevcut veri görünür hale getirildiğinde yeni kopyalar üretme ihtiyacı azalır. Domain ownership sayesinde bir alanın verisi merkezi ekibin bilgisine bağımlı olmadan ilgili iş birimi tarafından sürdürülebilir. Bu yapı siloları tamamen ortadan kaldırmasa bile kontrollü ve anlaşılır sınırlar oluşturur.
Veri Tekrarını Azaltmak
Veri tekrarını azaltmak için ilk adım fiziksel kopyaları yasaklamak değil, her kopyanın neden var olduğunu anlamaktır. Analitik sorgu performansı, bölgesel regülasyon veya operasyonel süreklilik nedeniyle aynı verinin birden fazla fiziksel kopyası gerekebilir. Sorun bu kopyaların bağımsız gerçekler haline gelmesidir. Canonical data, lineage ve source of truth tanımları hangi kaynağın yetkili olduğunu açıkça belirtir. Böylece kurum hem gerekli performans kopyalarını kullanabilir hem de anlam bakımından tek bir kurumsal gerçeği koruyabilir.
Entegrasyon Süresini Kısaltmak
Yeni bir uygulamanın kurumsal veriye bağlanması her seferinde özel proje gerektiriyorsa mimari ölçeklenmekte zorlanır. Standart API, event schema, data product ve self-service platform bileşenleri entegrasyon süreçlerini tekrar kullanılabilir hale getirir. Geliştiriciler kaynak sistemin iç tablolarını öğrenmek yerine tanımlı sözleşmeler üzerinden veri tüketebilir. Schema registry ve versiyonlama mekanizmaları değişikliklerin tüketiciler üzerindeki etkisini daha erken görünür kılar. Bu sayede entegrasyon süresi yalnızca kod yazma açısından değil test, koordinasyon ve hata çözme bakımından da kısalır.
Data Quality'yi Artırmak
Data quality, verinin kullanım amacı için ne kadar doğru, eksiksiz, tutarlı ve güncel olduğunu ölçer. Kalite kontrolleri yalnızca raporlama katmanında yapılırsa hatalar kaynağından çok uzakta fark edilir. Data-centric mimari kalite kurallarını producer ve data product seviyesine yaklaştırır. Quality SLO, otomatik test ve observability sayesinde bozulmalar tüketicilere ulaşmadan veya kısa sürede tespit edilebilir. Bu yaklaşım veri kalitesini tek bir kalite ekibinin görevi olmaktan çıkarıp üretici ve platform ekiplerinin ortak sorumluluğuna dönüştürür.
Compliance'ı Kolaylaştırmak
Compliance süreçlerinde en zor sorulardan biri kişisel veya hassas verinin nerede bulunduğunu güvenilir biçimde tespit etmektir. Metadata, classification ve lineage olmadan bu soruya manuel envanterlerle cevap vermek zaman alır ve hızla güncelliğini kaybedebilir. Veri merkezli mimaride sınıflandırma ve erişim politikaları doğrudan veri varlıklarıyla ilişkilendirilebilir. Retention, masking, audit ve deletion süreçleri de aynı metadata üzerinden otomatikleştirilebilir. Böylece uyum kontrolleri yalnızca dönemsel denetimlerde yapılan işlemler olmaktan çıkıp günlük veri operasyonlarının bir parçasına dönüşür.
AI ve Analytics'i Hızlandırmak
AI ve analytics ekiplerinin önemli bölümü çoğu zaman model geliştirmek yerine doğru veriyi bulmak, temizlemek ve anlamlandırmakla uğraşır. Güvenilir data products ve semantic layer mevcut olduğunda bu başlangıç maliyeti belirgin biçimde azalır. Bir müşteri davranış modeli oluşturulurken müşteri kimliği, sipariş geçmişi ve segment tanımları yeniden icat edilmek zorunda kalmaz. Metadata ve lineage modelin hangi kaynaklara dayandığını belgelemeyi de kolaylaştırır. Böylece deney aşamasından production kullanımına geçiş daha kontrollü ve daha hızlı yapılabilir.
Legacy Sistem Bağımlılığını Azaltmak
Legacy sistemler çoğu kurum için iş açısından kritik veriler barındırdığı için bir gecede değiştirilemez. Data-centric yaklaşım bu sistemleri hemen kaldırmaya çalışmak yerine verilerini standart arayüzler ve data products üzerinden erişilebilir hale getirebilir. CDC, API wrapper veya event publishing gibi yöntemler eski sistem ile yeni platform arasında kontrollü bir geçiş katmanı oluşturur. Yeni tüketiciler eski veritabanı şemasına doğrudan bağlanmadığı için gelecekte sistem değişimi daha kolay yapılır. Bu yöntem teknik borcu anında ortadan kaldırmaz fakat bağımlılığı kademeli biçimde azaltır.
Single Source of Truth Nedir?
Single Source of Truth, belirli bir veri veya iş kavramı için hangi kaynağın yetkili referans olduğunu açık biçimde tanımlama yaklaşımıdır. Bu kavram bütün kurumun tek bir veritabanına taşınması anlamına gelmez. Operasyonel işlemler, analitik kullanım ve semantic definitions farklı fiziksel sistemlerde bulunabilir ancak her biri için referans noktası açık olmalıdır. Örneğin müşteri temel kimliği MDM sisteminde, finansal raporlama gerçeği warehouse içinde ve gelir metriğinin tanımı semantic layer üzerinde yönetilebilir. Önemli olan fiziksel merkezilik değil, hangi sorunun hangi güvenilir kaynaktan cevaplanacağının bilinmesidir.
Tek Veritabanı ile Aynı Şey midir?
Single Source of Truth ile tek veritabanı aynı şey değildir. Büyük bir organizasyonda tüm operasyonel, analitik ve arşiv verisini tek fiziksel veritabanına taşımak çoğu zaman ne gerçekçi ne de faydalıdır. Bunun yerine her veri alanının yetkili kaynağı ve türetilmiş kopyalarının ilişkisi tanımlanmalıdır. Örneğin sipariş kaydı operasyonel sistemde yetkili olabilirken günlük satış metriği kurumsal warehouse içinde onaylanmış bir gerçek olabilir. Bu ayrım performans ihtiyaçlarını korurken kurum genelinde anlam tutarlılığı sağlar.
Operational Source of Truth
Operational Source of Truth, günlük iş işlemleri açısından yetkili kabul edilen veri kaynağıdır. Siparişin durumu, aktif abonelik veya ödeme sonucu gibi bilgiler genellikle operasyonel sistemde oluşturulur. Bu kaynaktan analytics platformuna veri taşınabilir fakat analitik kopya her zaman işlem anındaki yetkili kaynak olmayabilir. CDC ve event süreçleri operasyonel değişikliklerin diğer sistemlere güvenilir biçimde aktarılmasını kolaylaştırır. Kaynak rolü açıkça tanımlandığında tüketiciler hangi durumda operasyonel sisteme, hangi durumda analitik platforma bakmaları gerektiğini bilir.
Analytical Source of Truth
Analytical Source of Truth, raporlama, analiz ve karar destek amaçları için onaylanmış veri katmanını ifade eder. Bu katman farklı kaynaklardan gelen bilgileri ortak zaman, müşteri veya ürün tanımlarıyla birleştirebilir. Warehouse, lakehouse veya belirli gold data products analitik referans görevi görebilir. Burada önemli olan yalnızca tablonun bulunması değil, dönüşümlerin belgelenmesi ve metriklerin doğrulanmasıdır. İyi tasarlanmış analitik gerçek katmanı farklı ekiplerin aynı rapor için farklı hesaplamalar üretmesini azaltır.
Semantic Source of Truth
Semantic Source of Truth, iş kavramlarının ve metriklerin ortak anlamının yönetildiği referans katmanıdır. Gelir, aktif müşteri, churn veya sipariş gibi kavramların formülleri ve kullanım bağlamları burada tanımlanabilir. Fiziksel veri birden fazla platformda bulunurken semantic definition tek ve onaylanmış kalabilir. BI araçları, AI sistemleri ve veri uygulamaları aynı semantic modelden yararlandığında sayı tutarlılığı yükselir. Bu nedenle semantic source of truth, fiziksel veri depolamasından farklı ama en az onun kadar önemli bir kurumsal bileşendir.
Master ve Reference Data
Master data, müşteri, ürün, tedarikçi veya çalışan gibi kurumun temel iş varlıklarını tanımlar. Reference data ise ülke, para birimi, kategori veya durum kodu gibi birçok sistem tarafından ortak kullanılan daha sabit değerleri kapsar. Bu veri türleri farklı uygulamalarda bağımsız oluşturulduğunda kimlik ve sınıflandırma uyuşmazlıkları meydana gelir. MDM ve reference data management süreçleri ortak tanımları ve golden record yaklaşımını destekler. Data products bu kayıtları standart arayüzlerle diğer sistemlere sunarak yeniden kullanım ve tutarlılık sağlar.
Fiziksel Merkezilik Yerine Mantıksal Tutarlılık
Veri merkezli mimari bütün verinin tek fiziksel noktada tutulmasını zorunlu kılmaz. Bazı veriler operasyonel veritabanında, bazıları lakehouse içinde, bazıları da belirli bir domain platformunda kalabilir. Mantıksal tutarlılık, bu kaynakların hangi kurallarla birbirine bağlandığını ve hangi kavramın nerede yönetildiğini açık hale getirir. Global identifiers, data contracts, semantic definitions ve lineage bu tutarlılığı sağlayan temel araçlardır. Böylece kurum dağıtık altyapının esnekliğini kullanırken veri anlamının parçalanmasını sınırlayabilir.
Kurumsal Veri Mimarisinin Temel Katmanları
Kurumsal veri mimarisi tek bir ürün veya veri deposundan oluşmaz, kaynaktan tüketime kadar birbirini tamamlayan katmanlardan meydana gelir. Source systems, ingestion, storage, processing, semantic layer, data products, serving, governance ve security birlikte değerlendirilmelidir. Her kurum bu katmanları aynı araçlarla kurmak zorunda değildir, hatta bazı katmanlar aynı teknoloji üzerinde çalışabilir. Önemli olan sorumlulukların ve veri akışının açık biçimde tanımlanmasıdır. Bu katman yaklaşımı özellikle veri merkezli mimaride data governance ve veri yönetimi nasıl yapılır sorusuna teknik ve organizasyonel olarak daha düzenli cevap vermeyi sağlar.
Source Systems
Source Systems, verinin ilk üretildiği operasyonel uygulamalar, cihazlar, dış servisler ve iş sistemleridir. ERP, CRM, ödeme sistemleri, web uygulamaları veya IoT kaynakları bu gruba girebilir. Veri mimarisi açısından kaynakların sahipliği, değişim hızı ve kritik alanları envanterlenmelidir. Kaynak şemalarının doğrudan kurumsal model olarak kabul edilmesi uzun vadede bağımlılık yaratabilir. Bu nedenle kaynak veriyi korurken kurumsal anlamı sonraki katmanlarda açık biçimde oluşturmak daha dengeli bir yaklaşımdır.
Ingestion Layer
Ingestion Layer, verinin kaynak sistemlerden veri platformuna veya diğer tüketicilere kontrollü biçimde taşındığı katmandır. Batch yükleme, API extraction, CDC ve event streaming gibi yöntemler farklı ihtiyaçlara göre kullanılabilir. Her veriyi gerçek zamanlı taşımaya çalışmak gereksiz maliyet ve operasyon yükü oluşturabilir. Ingestion seçiminde kaynak sistem yükü, gecikme ihtiyacı, hata toleransı ve replay gereksinimi değerlendirilmelidir. Standart ingestion yolları platform ekiplerinin domain ekiplerine self-service hizmet sunmasını da kolaylaştırır.
Storage Layer
Storage Layer, farklı veri tiplerinin kalıcı olarak saklandığı katmandır. Warehouse, data lake, lakehouse, object storage ve özel veritabanları kullanım amacına göre birlikte bulunabilir. Depolama seçiminde yalnızca kapasite değil sorgu modeli, güncelleme biçimi, güvenlik ve maliyet de dikkate alınmalıdır. Açık dosya ve tablo formatları verinin belirli bir compute motoruna bağımlılığını azaltabilir. Sağlıklı bir storage layer, veriyi saklamanın yanında yaşam döngüsü, retention ve erişim politikalarını da destekler.
Processing Layer
Processing Layer, ham verinin temizlenmesi, birleştirilmesi, doğrulanması ve iş kullanımına uygun hale getirilmesinden sorumludur. SQL, Python, Spark veya streaming motorları farklı iş yüklerinde kullanılabilir. Buradaki temel karar kullanılan dil değil, dönüşümlerin test edilebilir ve gözlemlenebilir olmasıdır. İş mantığının dağınık script dosyalarında saklanması zaman içinde bakım maliyetini artırır. Version control, CI/CD ve data quality kontrolleri processing katmanını daha güvenilir hale getirir.
Semantic Layer
Semantic Layer, fiziksel tablolar ile iş kullanıcılarının kullandığı kavramlar arasında ortak anlam katmanı oluşturur. Gelir, aktif kullanıcı, müşteri veya churn gibi metriklerin tanımları burada merkezi hale getirilebilir. Aynı veri farklı BI araçlarında kullanılsa bile metrik hesapları ortak kalabilir. AI sistemleri de semantic context sayesinde yalnızca kolon adlarına değil iş anlamına dayanan cevaplar üretebilir. Bu katman özellikle büyük organizasyonlarda teknik veri modelini iş diliyle buluşturan önemli bir köprü görevi görür.
Data Product Layer
Data Product Layer, veri setlerini tüketilebilir, sahipli ve güvenilir ürünler haline getirir. Bir data product yalnızca tablo içermez, owner, schema, documentation, quality SLO ve access interface gibi bileşenleri birlikte sunar. Tüketici veriyi kullanmadan önce kiminle iletişime geçeceğini veya hangi kalite seviyesini beklemesi gerektiğini görebilir. Domain ekipleri kendi iş bilgilerini veri ürününe yansıtırken platform ekipleri standart yayınlama altyapısı sağlayabilir. Bu model veri tüketimini proje bazlı entegrasyondan tekrar kullanılabilir ürün yaklaşımına taşır.
Serving Layer
Serving Layer, işlenmiş verinin uygulama, analitik sistem, AI modeli veya kullanıcı tarafından tüketildiği katmandır. SQL endpoint, API, event stream, feature interface veya dosya paylaşımı gibi farklı serving biçimleri bulunabilir. Aynı data product farklı tüketim ihtiyaçları için birden fazla output port sunabilir. Örneğin analitik ekip SQL üzerinden sorgularken operasyonel uygulama REST API kullanabilir. Serving tasarımında gecikme, sorgu hacmi, yetkilendirme ve maliyet birlikte değerlendirilmelidir.
Governance ve Metadata Layer
Governance ve Metadata Layer, veri varlıklarının anlamını, sahibini, sınıflandırmasını, lineage bilgisini ve kullanım politikalarını görünür hale getirir. Bu katman yalnızca katalog ekranından oluşmamalı, pipeline ve erişim süreçleriyle doğrudan bağlantılı çalışmalıdır. Metadata değiştiğinde ilgili kalite veya güvenlik kurallarının otomatik uygulanması active metadata yaklaşımını mümkün kılar. Data catalog, business glossary ve policy engine bu yapının farklı parçalarını oluşturabilir. İyi bir governance katmanı ekipleri yavaşlatmak yerine doğru standartları hazır yollarla sunarak geliştirme süresini kısaltır.
Security Layer
Security Layer, verinin hangi kullanıcı, servis veya uygulama tarafından hangi şartlarda kullanılabileceğini kontrol eder. Encryption, tokenization, masking, row-level security, column-level security, RBAC ve ABAC gibi yöntemler farklı riskleri adresler. Veri sınıflandırması güvenlik politikalarının otomatik uygulanması için temel oluşturur. Özellikle kişisel veya finansal verilerde erişim kararının yalnızca uygulama seviyesinde bırakılması yeterli olmayabilir. Data-centric security, korumayı doğrudan veri varlığına ve kullanım bağlamına bağlayarak daha tutarlı denetim sağlar.
Data Lake, Data Warehouse ve Data Lakehouse Arasındaki Fark
Data warehouse, data lake ve data lakehouse aynı probleme farklı önceliklerle yaklaşan veri depolama ve analitik modelleridir. Warehouse yapılandırılmış analitik ve güçlü yönetişim için uzun süredir kullanılan bir modelken data lake çok çeşitli ham veriyi ekonomik biçimde saklamayı kolaylaştırır. Lakehouse yaklaşımı ise lake esnekliği ile warehouse özelliklerini ortak veri katmanında birleştirmeyi hedefler. Seçim yapılırken popülerlik yerine veri tipi, sorgu yükü, latency, ekip yetkinliği ve maliyet dikkate alınmalıdır. Birçok büyük kurumda bu üç yaklaşımın bazı özellikleri aynı mimari içinde birlikte bulunabilir.
Data Warehouse
Data Warehouse, analitik sorgular ve raporlama için yapılandırılmış verinin düzenli biçimde tutulduğu sistemdir. Genellikle schema, kalite ve iş kuralları veri platformuna yüklenmeden veya dönüşüm aşamasında açıkça tanımlanır. BI raporları ve finansal analizler için yüksek sorgu performansı ve yönetilebilirlik sağlar. Ancak yapılandırılmamış veya çok yüksek hacimli ham verilerin tamamını warehouse içine almak maliyetli olabilir. Bu nedenle warehouse çoğu kurumda analitik source of truth ve business-ready data katmanı olarak kullanılmaya devam eder.
Data Lake
Data Lake, yapılandırılmış, yarı yapılandırılmış ve yapılandırılmamış veriyi geniş ölçekte saklamak için kullanılan esnek depolama yaklaşımıdır. Object storage üzerinde dosya tabanlı saklama maliyet avantajı sağlayabilir. Ancak yalnızca veriyi lake içine koymak kullanılabilir bir veri platformu oluşturmaz. Metadata, kalite, katalog ve sahiplik eksikse lake zaman içinde bulunması zor veri yığınlarına dönüşebilir. Bu nedenle modern data lake tasarımında governance ve open table formats en az depolama kapasitesi kadar önemlidir.
Data Lakehouse
Data Lakehouse, data lake üzerinde warehouse benzeri güvenilirlik ve tablo yönetimi özellikleri sağlamayı hedefleyen mimari yaklaşımdır. Object storage üzerinde tutulan veriye ACID transactions, schema evolution, time travel ve performans optimizasyonu gibi yetenekler eklenebilir. Böylece aynı veri farklı compute motorları tarafından açık formatlar üzerinden kullanılabilir. Lakehouse özellikle büyük ölçekli analytics, data science ve AI iş yüklerini ortak depolama katmanında buluşturmak isteyen kurumlar için yararlı olabilir. Yine de lakehouse tek başına ownership, semantic layer veya governance sorunlarını çözmez.
Lakehouse Neden Ortaya Çıktı?
Lakehouse yaklaşımı, geleneksel data lake yapılarında görülen güvenilirlik ve yönetim sorunları ile warehouse maliyetlerini dengelemek amacıyla ortaya çıktı. Kurumlar ham veriyi düşük maliyetle saklarken aynı veri üzerinde güvenilir analitik yapmak istiyordu. Açık tablo formatları object storage üzerinde transaction ve metadata yönetimini güçlendirdi. Böylece ayrı lake ve warehouse kopyaları arasında sürekli veri taşıma ihtiyacı bazı kullanım senaryolarında azaltılabildi. Lakehouse bu nedenle yalnızca yeni bir depolama terimi değil, storage ile compute ayrımını daha açık biçimde kullanan bir mimari modeldir.
ACID Transactions
ACID Transactions, veri değişikliklerinin tutarlı ve güvenilir biçimde uygulanmasını sağlayan işlem özelliklerini ifade eder. Büyük analitik tablolar üzerinde eş zamanlı yazma, güncelleme veya merge işlemleri yapılırken bu garantiler önem kazanır. Geleneksel dosya tabanlı lake yapılarında yarım kalan işlemler veya tutarsız metadata sorun yaratabilir. Lakehouse tablo formatları transaction log veya metadata mekanizmalarıyla bu riski azaltır. Böylece analytics ve streaming iş yükleri aynı veri katmanını daha güvenli biçimde paylaşabilir.
Open Table Formats
Open Table Formats, object storage üzerindeki dosyaları yönetilebilir analitik tablolar haline getiren açık standartlara dayalı yapılardır. Schema evolution, partition metadata, snapshot ve transaction gibi özellikler sunabilirler. En önemli avantajlardan biri veriyi belirli bir compute motorunun özel dosya yapısına bağımlı bırakmamalarıdır. Farklı sorgu ve işleme motorları aynı tablo metadata yapısını okuyabildiğinde platform esnekliği artar. Ancak format seçimi yapılırken mevcut araç desteği, operasyon modeli ve ekip deneyimi birlikte değerlendirilmelidir.
Apache Iceberg
Apache Iceberg, büyük analitik veri setleri için geliştirilen açık tablo formatlarından biridir. Snapshot tabanlı yapı, schema evolution ve partition evolution gibi özelliklerle büyük tabloların yönetimini kolaylaştırır. Birden fazla sorgu motorunun aynı tablolar üzerinde çalışabilmesi multiengine platformlar açısından önemli avantaj sağlar. Özellikle object storage tabanlı lakehouse tasarımlarında veri dosyalarının fiziksel düzenini tüketici uygulamalardan soyutlamaya yardımcı olur. Kullanım kararı verilirken katalog entegrasyonu, engine desteği ve bakım operasyonları birlikte planlanmalıdır.
Delta Lake
Delta Lake, data lake üzerinde transaction ve güvenilir tablo yönetimi sağlamak amacıyla kullanılan açık kaynaklı bir tablo teknolojisidir. Transaction log yaklaşımı sayesinde ACID işlemleri, schema enforcement ve time travel gibi özellikler sunar. Batch ve streaming iş yüklerinin aynı veri üzerinde çalışması gereken projelerde kullanışlı olabilir. Ekosistem ve seçilen compute motorlarıyla entegrasyon seviyesi mimari karar açısından önem taşır. Her açık formatta olduğu gibi seçim yalnızca özellik listesine göre değil uzun vadeli platform bağımsızlığına göre yapılmalıdır.
Apache Hudi
Apache Hudi, özellikle değişen kayıtların sık güncellendiği ve incremental processing ihtiyacının yüksek olduğu data lake kullanım senaryolarına odaklanan açık tablo formatıdır. Upsert, change capture ve incremental query özellikleri onu hızlı değişen veri setlerinde güçlü bir seçenek haline getirebilir. Büyük transaction tablolarında yalnızca yeni veya değişen kayıtları işlemek işlem maliyetini azaltabilir. Bununla birlikte operasyon modeli ve seçilen sorgu motorlarının Hudi desteği dikkatle değerlendirilmelidir. Formatın gerçek avantajı kullanım senaryosuyla eşleştiğinde ortaya çıkar.
Hangi Mimari Ne Zaman Kullanılmalı?
Data warehouse, lake veya lakehouse seçimi bütün kurum için tek bir cevapla yapılmamalıdır. Düzenli finansal raporlama ve güçlü SQL analitiği için warehouse yeterli ve basit bir çözüm olabilir. Çok çeşitli ham veri ve data science iş yükleri için lake veya lakehouse daha uygun hale gelebilir. Açık formatlar ve multiengine ihtiyaçları arttıkça lakehouse modeli daha anlamlı olabilir. Doğru yaklaşım kullanım senaryosunu, maliyeti ve operasyonel yükü değerlendirip mümkün olan en sade mimariyle başlamaktır.
Medallion Architecture Nedir?
Medallion Architecture, veriyi ham durumdan iş kullanıma hazır hale getirirken genellikle Bronze, Silver ve Gold katmanlarına ayıran veri işleme modelidir. Bu yaklaşım dönüşümlerin hangi aşamada yapıldığını anlaşılır hale getirir ve ham verinin gerektiğinde yeniden işlenebilmesini kolaylaştırır. Bronze katman kaynağa yakın veriyi, Silver temizlenmiş ve uyumlandırılmış veriyi, Gold ise iş kullanımına hazır çıktıları temsil eder. Ancak her kurumun tam olarak üç fiziksel katman kurması zorunlu değildir. Asıl değer verinin ham halinden güvenilir ürüne doğru ilerleyen yaşam döngüsünü açık ve test edilebilir kılmaktır.
Bronze Layer
Bronze Layer, kaynaktan alınan verinin mümkün olduğunca az değişiklikle saklandığı ilk katmandır. Bu katman hata durumunda replay yapabilmek ve kaynak geçmişini korumak için önemlidir. Kaynak timestamp, ingestion zamanı ve teknik metadata burada birlikte tutulabilir. Ham veri doğrudan tüm tüketicilere açılmamalı çünkü kalite ve anlam bakımından henüz iş kullanımına hazır olmayabilir. Bronze katmanın amacı son kullanıcı tablosu üretmek değil güvenilir bir yeniden işleme başlangıç noktası sağlamaktır.
Raw data
Raw data, kaynak sistemden geldiği biçime mümkün olduğunca yakın tutulan veridir. Bu yaklaşım dönüşüm hatalarının daha sonra düzeltilmesini ve pipeline süreçlerinin yeniden çalıştırılmasını kolaylaştırır. Ham verinin gerçekten ham tutulması, kaynak metadata bilgisinin de korunmasını gerektirir. Örneğin ingest timestamp, source file veya source transaction identifier sorun incelemelerinde çok değerli olabilir. Ancak raw data erişimi güvenlik ve kişisel veri kurallarından muaf değildir, gerekli sınıflandırma ve erişim kontrolleri burada da uygulanmalıdır.
Replay
Replay, geçmiş ham verinin yeniden işlenebilmesi yeteneğidir. Bir dönüşüm kuralında hata bulunduğunda yalnızca yeni kayıtları düzeltmek yeterli olmayabilir ve geçmiş veri yeniden üretilmek istenebilir. Bronze veya event log gibi kalıcı kaynaklar bu olanağı sağlar. Replay tasarımı idempotency, sıralama ve duplicate handling kurallarıyla birlikte düşünülmelidir. Özellikle streaming sistemlerde replay yeteneği veri kaybını önleyen önemli bir operasyon mekanizmasıdır.
Silver Layer
Silver Layer, ham verinin temizlendiği, standardize edildiği ve farklı kaynaklarla uyumlandırıldığı ara katmandır. Veri tipleri, kimlikler, tarih formatları ve temel quality kontrolleri burada ele alınabilir. Aynı iş kavramını temsil eden kaynaklar ortak modellere dönüştürülebilir. Bu katman doğrudan son iş metriği olmak zorunda değildir fakat güvenilir kurumsal gerçeklerin temelini oluşturur. İyi Silver tasarımı Gold data products üretirken tekrar tekrar aynı temizleme işlemlerinin yapılmasını engeller.
Cleansing
Cleansing, yanlış format, eksik değer veya teknik kirlenme gibi veri problemlerinin tanımlı kurallarla ele alınmasıdır. Her eksik değeri varsayılan bir değerle doldurmak gerçek bir cleansing stratejisi değildir çünkü iş anlamını bozabilir. Kuralın hangi alan için neden uygulandığı ve hatalı kayıtların nasıl izlendiği belgelenmelidir. Bazı kayıtlar düzeltilirken bazıları quarantine alanına alınabilir. Otomatik kalite ölçümleri cleansing sürecinin veri kalitesini gerçekten artırıp artırmadığını göstermeye yardımcı olur.
Conformance
Conformance, farklı kaynaklardan gelen aynı iş kavramlarının ortak tanım, format veya kimlik yapısına uyumlandırılmasıdır. Örneğin ülke kodları bir kaynakta isim, diğerinde iki harfli kod olarak tutulabilir. Ortak reference data ile bu değerler standardize edildiğinde analiz ve entegrasyon daha güvenilir hale gelir. Müşteri veya ürün kimliklerinin eşleştirilmesi de conformance çalışmalarının önemli bölümüdür. Bu süreç semantic consistency açısından data-centric mimarinin temel taşlarından biridir.
Enterprise truth
Enterprise truth, kurum genelinde belirli bir kavram için güvenilir ve ortak kabul edilmiş veri görünümünü ifade eder. Bu her zaman tek fiziksel tablo olmak zorunda değildir fakat tanım ve üretim kuralı açık olmalıdır. Silver seviyesinde oluşturulan uyumlandırılmış müşteri veya ürün kayıtları birçok Gold ürünün ortak girdisi olabilir. Böylece farklı ekiplerin aynı temel gerçeği farklı yöntemlerle yeniden üretmesi azaltılır. Enterprise truth, merkezi kontrol ile domain bilgisini dengeli biçimde bir araya getirdiğinde daha sürdürülebilir olur.
Gold Layer
Gold Layer, verinin belirli iş kullanım senaryoları için hazırlandığı yüksek değerli katmandır. Yönetim raporları, müşteri segmentleri, finansal metrikler veya data products bu seviyede üretilebilir. Gold verinin adı ve yapısı teknik kaynak tablolarından çok iş kavramlarına göre tasarlanmalıdır. Kalite hedefleri ve kullanım dokümantasyonu burada özellikle önemlidir çünkü çok sayıda tüketici doğrudan bu çıktılara bağımlı olabilir. İyi tasarlanmış Gold katmanı veri platformunu gerçek iş çıktılarıyla buluşturur.
Business-ready data
Business-ready data, ek teknik yorum gerektirmeden belirli bir iş amacı için kullanılabilecek seviyede hazırlanmış veridir. Kolon adları, birimler, zaman tanımları ve metrik hesapları hedef kullanıcı tarafından anlaşılır olmalıdır. Kaynak sistem kodlarının doğrudan son kullanıcıya sunulması çoğu zaman business-ready deneyim oluşturmaz. Veri sözlüğü, semantic definitions ve örnek sorgular kullanım kolaylığını artırır. Bu yaklaşım analistlerin veri temizlemek yerine analiz ve karar destek çalışmalarına daha fazla zaman ayırmasını sağlar.
Data products
Gold katmanındaki veri her zaman data product değildir, çünkü data product veri içeriğine ek olarak sahiplik, sözleşme ve hizmet beklentisi içerir. Örneğin temiz bir müşteri tablosu owner veya documentation olmadan yayınlanırsa tüketici açısından hâlâ eksik bir üründür. Data product yaklaşımı veriyi kullanan ekibin ihtiyaçlarını ürün düşüncesiyle ele alır. SLO, erişim arayüzü ve kalite ölçümleri de teslimatın parçasıdır. Böylece Gold data basit bir pipeline çıktısından sürdürülebilir bir kurumsal servise dönüşür.
Medallion Architecture'ın Sınırlamaları
Medallion Architecture verinin dönüşüm aşamalarını anlatmak için faydalı olsa da bütün kurumsal veri mimarisini tek başına tanımlamaz. Ownership, data contracts, semantic layer, security ve federated governance gibi konular Bronze, Silver ve Gold isimleriyle çözülmez. Ayrıca her dataset için üç fiziksel kopya üretmek maliyet ve yönetim yükü oluşturabilir. Streaming veya operational serving gibi kullanım senaryoları bu katman modelinin dışında ek tasarım gerektirir. Bu nedenle Medallion Architecture bir veri işleme deseni olarak kullanılmalı, kurumsal mimarinin tamamı olarak görülmemelidir.
Data Product Nedir?
Data Product, belirli bir tüketici ihtiyacını karşılamak için sahipliği, veri içeriği, metadata bilgisi, kalite hedefleri ve erişim arayüzü birlikte yönetilen veri ürünüdür. Dataset yalnızca teknik veri kümesini ifade edebilirken data product kullanıcının veriyi güvenle bulup anlayabilmesini ve kullanabilmesini hedefler. Ürünün sahibi kimdir, ne kadar günceldir, hangi şemayı sunar ve değişiklikler nasıl duyurulur gibi sorular cevaplanmalıdır. Bu yaklaşım özellikle çok sayıda domain ve tüketici bulunan organizasyonlarda veri paylaşımını daha öngörülebilir hale getirir. Data product düşüncesi veriyi pipeline çıktısından sorumluluğu olan bir hizmete dönüştürür.
Dataset ile Data Product Arasındaki Fark
Dataset, belirli bir veri kümesinin teknik temsilidir ve tek başına ürün deneyimi sunmak zorunda değildir. Data product ise datasetin yanında owner, metadata, schema, documentation, quality, SLO ve access interface gibi bileşenleri içerir. Bir tablo teknik olarak doğru olsa bile kimin yönettiği ve ne anlama geldiği bilinmiyorsa tüketicinin onu güvenle kullanması zordur. Data product yaklaşımı bu boşluğu ürün yönetimi prensipleriyle kapatır. Böylece tüketici yalnızca veri dosyası değil, kullanımı ve desteği tanımlanmış bir kurumsal hizmet alır.
Data Product'ın Temel Bileşenleri
İyi bir data product teknik ve operasyonel birkaç bileşeni birlikte sunmalıdır. Owner hesap verebilirliği, schema teknik yapıyı, metadata bağlamı ve documentation kullanım bilgisini sağlar. Quality ile SLO veri hizmetinin beklenen güven düzeyini belirlerken access interface tüketicilerin ürüne nasıl ulaşacağını açıklar. Bu bileşenlerden biri eksik olduğunda ürünün sürdürülebilirliği veya kullanım kolaylığı zayıflayabilir. Platform ekipleri standart şablonlar sunarak her domainin bu bileşenleri sıfırdan tasarlamasını önleyebilir.
Owner
Owner, data product'ın iş anlamı, kullanılabilirliği ve yaşam döngüsü konusunda hesap verebilir kişiyi veya ekibi ifade eder. Teknik pipeline başka bir ekip tarafından çalıştırılsa bile ürün sahibi tüketici beklentilerinin yönetilmesinden sorumlu olmalıdır. Ownership adı bir katalog alanına yazılıp unutulmamalı, incident ve değişiklik süreçlerinde gerçekten kullanılmalıdır. İyi bir owner kullanım istatistiklerini takip eder ve gereksiz ürünlerin emekliye ayrılmasını da yönetir. Bu rol veri ürününün kurumsal sorumluluk taşımasını sağlar.
Data
Data, ürünün tüketiciye sunduğu temel bilgi varlığıdır. Tablo, event stream, API çıktısı veya dosya gibi farklı biçimlerde sunulabilir. Veri içeriğinin kapsamı, tarih aralığı ve hariç tutulan kayıtlar açıkça belirtilmelidir. Bir data product gereğinden fazla alan içermek yerine belirli kullanım ihtiyaçlarını karşılayan anlaşılır sınırlar taşımalıdır. Bu yaklaşım güvenlik, maliyet ve bakım açısından daha kontrollü ürünler oluşturur.
Metadata
Metadata, verinin kendisi hakkında anlam, teknik yapı ve operasyon bilgisi sağlar. Owner, classification, freshness, lineage ve kullanım istatistikleri metadata kapsamında değerlendirilebilir. Metadata ne kadar otomatik üretilebilirse o kadar güncel kalır. Manuel katalog alanları başlangıç için yararlı olsa da sürekli güncelleme gerektiren bilgiler pipeline ve platform servislerinden çekilmelidir. İyi metadata, data product'ın bulunabilir ve yönetilebilir olmasını doğrudan destekler.
Schema
Schema, data product'ın sunduğu alanları, veri tiplerini ve temel yapısal sözleşmeyi tanımlar. Tüketiciler uygulamalarını bu şemaya göre geliştirdiği için kontrolsüz değişiklikler ciddi kırılmalara yol açabilir. Schema evolution kuralları hangi değişikliklerin geriye uyumlu olduğunu açıkça belirtmelidir. Yeni alan eklemek çoğu durumda güvenli olabilirken kolon silmek veya anlamını değiştirmek breaking change oluşturabilir. Schema yönetimi bu nedenle data contract ve versioning süreçleriyle birlikte ele alınmalıdır.
Documentation
Documentation, data product'ın ne amaçla kullanılacağını, alanların ne anlama geldiğini ve önemli sınırlamaları açıklar. Yalnızca otomatik schema çıktısı çoğu zaman yeterli dokümantasyon oluşturmaz. Tüketicilerin örnek sorgular, iş kuralları ve bilinen kısıtları görebilmesi kullanım hatalarını azaltır. Dokümantasyon üretim sürecinin parçası olduğunda değişikliklerle birlikte güncellenmesi daha kolay hale gelir. İyi dokümante edilmiş ürün destek taleplerini de belirgin biçimde azaltabilir.
SLO
SLO, data product'ın hizmet seviyesi beklentisini ölçülebilir biçimde tanımlar. Freshness, availability veya quality score gibi göstergeler için hedef değerler belirlenebilir. Örneğin günlük satış ürününün her gün saat 08.00'e kadar güncellenmesi bir freshness SLO olabilir. Hedeflerin gerçek tüketici ihtiyacına göre seçilmesi önemlidir, gereksiz yüksek SLO maliyeti artırabilir. Ölçülebilir hedefler owner ile consumer arasındaki beklentiyi daha açık hale getirir.
Quality
Quality, data product içindeki verinin kullanım amacı için yeterli doğruluk ve tutarlılığa sahip olmasını ifade eder. Quality kuralları uniqueness, completeness, validity veya referential consistency gibi ölçümleri içerebilir. Her veri alanı için aynı kalite eşiğini uygulamak yerine iş etkisine göre öncelik belirlemek daha sağlıklıdır. Sonuçların katalog veya observability ekranında görünür olması tüketici güvenini artırır. Quality sorumluluğu yalnızca platform ekibine bırakılmadığında sorunlar kaynağa daha yakın çözülür.
Access interface
Access interface, tüketicilerin data product'a hangi yöntemle ulaşacağını tanımlar. SQL endpoint, REST API, event stream veya secure file sharing farklı ihtiyaçlara göre kullanılabilir. Bir ürün aynı anda birden fazla erişim biçimi sunabilir fakat her arayüz için güvenlik ve performans beklentileri ayrı yönetilmelidir. Tüketici doğrudan iç storage konumuna bağlanmak zorunda kalmadığında ürünün iç implementasyonu daha rahat değiştirilebilir. Bu ayrım data product'ın uzun vadeli bağımsızlığını güçlendirir.
Data Product Lifecycle
Data Product Lifecycle, ürünün fikir aşamasından kullanımdan kaldırılmasına kadar geçen yaşam döngüsünü kapsar. İhtiyaç tanımı, tasarım, yayınlama, adoption ölçümü, değişiklik, versiyonlama ve retirement süreçleri açıkça yönetilmelidir. Kullanılmayan ürünleri sonsuza kadar platformda tutmak veri kataloglarını ve operasyonu gereksiz büyütür. Consumer feedback ve kullanım metrikleri hangi ürünlerin geliştirilmeye devam etmesi gerektiğini gösterebilir. Böylece veri platformu yalnızca yeni dataset üreten değil, gerçek ürün portföyünü yöneten bir yapıya dönüşür.
İyi Bir Data Product Hangi Özelliklere Sahip Olmalıdır?
İyi bir data product yalnızca doğru veri sunmakla kalmaz, tüketicinin onu bulmasını, anlamasını ve güvenli biçimde kullanmasını da kolaylaştırır. Discoverable, addressable, understandable, trustworthy, interoperable, secure, governed ve observable özellikleri bu deneyimin temelini oluşturur. Her özelliğin tek bir araçla sağlanması gerekmez, önemli olan platform genelinde tutarlı biçimde sunulmasıdır. Bir ürün teknik olarak güçlü olsa bile bulunamıyorsa veya sahibi belli değilse kurumsal değer oluşturması zordur. Bu nedenle data product başarısı üretim teknolojisinden çok tüketici deneyimiyle ölçülmelidir.
Discoverable
Discoverable bir data product, tüketicinin katalog veya arama sistemi üzerinden kolayca bulabileceği üründür. Ürün adı, açıklama, domain, owner ve business glossary bağlantıları arama deneyimini güçlendirir. Kullanıcı yalnızca tablo adını biliyorsa discoverability oldukça sınırlıdır. İş kavramlarıyla arama yapılabilmesi teknik olmayan ekiplerin de doğru ürüne ulaşmasını sağlar. Findability arttıkça kurum içinde aynı ihtiyacı karşılayan yeni ve gereksiz datasetlerin oluşması azalır.
Addressable
Addressable data product, tüketicinin açık ve kararlı bir adres veya arayüz üzerinden erişebildiği üründür. Bu adres bir API endpoint, catalog identifier, SQL object veya event topic olabilir. Fiziksel dosya yollarının sık değişmesi tüketiciler için kırılgan bağımlılık oluşturur. Stable interface sayesinde ürünün iç storage veya processing yapısı değiştirilebilir. Böylece üretici yenilik yaparken tüketici sözleşmesini koruyabilir.
Understandable
Understandable bir data product, teknik ve iş anlamı açısından açıklanmış üründür. Kolon isimleri tek başına yeterli olmayabilir, hesaplama kuralları, ölçü birimleri ve istisnalar da belgelenmelidir. Business glossary ile bağlantı kurulması farklı ekiplerin aynı kavramı ortak biçimde yorumlamasını sağlar. Örnek kullanım ve sık yapılan hatalar dokümantasyonu daha pratik hale getirir. Veri kolay anlaşıldığında yanlış analiz ve destek ihtiyacı belirgin biçimde azalır.
Trustworthy
Trustworthy data product, kalite ve hizmet beklentilerini düzenli olarak karşılayan ve bunu görünür ölçümlerle gösteren üründür. Freshness, completeness veya incident geçmişi tüketicinin güven değerlendirmesine yardımcı olabilir. Lineage sayesinde verinin hangi kaynaklardan üretildiği görülebilir. Kalite problemi çıktığında owner ve iletişim kanalı açık olmalıdır. Güven ürün hakkında iddia edilen bir özellik değil, ölçümler ve operasyon davranışıyla zaman içinde kazanılan bir niteliktir.
Interoperable
Interoperable data product, diğer veri ürünleri ve sistemlerle ortak standartlar üzerinden birlikte çalışabilir. Kimlik, tarih, para birimi ve referans kodlarının ortak modeller kullanması entegrasyonu kolaylaştırır. Kapalı veya özel formatlar tüketicileri belirli teknolojiye bağımlı hale getirebilir. Açık şemalar ve standart erişim arayüzleri ürünlerin farklı platformlarda kullanılmasını destekler. Interoperability özellikle domainler arası analitik ve AI kullanımında büyük önem taşır.
Secure
Secure data product, erişim, şifreleme ve veri koruma politikalarını ürün tasarımının parçası olarak uygular. Güvenlik tüketiciye ham veriyi verdikten sonra eklenen ayrı bir işlem olmamalıdır. Classification metadata, hassas alanlar için masking veya farklı yetki düzeyleri uygulanmasını kolaylaştırır. Audit kayıtları hangi kullanıcının hangi veriye ne zaman eriştiğini gösterebilir. Bu yaklaşım verinin daha geniş paylaşımını mümkün kılarken kontrol seviyesini de korur.
Governed
Governed data product, kurumsal ve domain seviyesindeki veri politikalarına uyumlu biçimde yönetilir. Owner, retention, classification, access ve quality kuralları ürünle birlikte tanımlanır. Federated governance modelinde bazı standartlar merkezi belirlenirken domain özel kuralları yerel ekipler tarafından yönetilebilir. Policy-as-code yaklaşımı uygulanabilir kuralların CI/CD ve runtime süreçlerinde doğrulanmasını sağlar. Böylece governance manuel onay listesi yerine ürün yaşam döngüsünün doğal parçasına dönüşür.
Observable
Observable data product, teknik ve veri kaynaklı sorunların ölçümler üzerinden izlenebildiği üründür. Freshness, volume, schema change ve distribution gibi sinyaller beklenmeyen değişiklikleri erken gösterebilir. Pipeline başarılı görünse bile veri boş gelmiş olabilir, bu nedenle application monitoring tek başına yeterli değildir. Lineage ile bir incidentın hangi tüketicileri etkilediği hızlı biçimde anlaşılabilir. İyi observability, data product owner'ın sorunları kullanıcı bildiriminden önce fark etmesine yardımcı olur.
Data Product Ownership Nasıl Belirlenir?
Data product ownership belirlenirken yalnızca teknik sistemi yöneten ekibe bakmak yeterli değildir. Verinin iş anlamını en iyi bilen domain, operasyonel üretici, steward ve platform ekiplerinin sorumlulukları ayrıştırılmalıdır. Genellikle domain ekipleri iş anlamından, platform ekipleri ortak altyapıdan, steward rolleri kalite ve tanımların sürdürülebilirliğinden sorumlu olur. Consumer ekipleri de veriyi sözleşmesine uygun kullanmak ve sorunları doğru kanallardan bildirmekle yükümlüdür. Sağlıklı ownership modeli tek bir kahraman rol yaratmak yerine sorumluluk sınırlarını görünür hale getirir.
Producer Ownership
Producer Ownership, veriyi ilk oluşturan sistem veya ekibin kaynak kalitesi ve değişiklikleri konusunda sorumluluk taşımasını ifade eder. Bir alan yanlış üretiliyorsa downstream ekiplerin sürekli düzeltme yapması sürdürülebilir değildir. Producer ekip schema değişikliklerini data contract üzerinden tüketicilere bildirmelidir. Kaynak sistemde yapılan değişikliklerin veri ürünlerine etkisi CI/CD aşamasında kontrol edilebilir. Bu yaklaşım kalite sorunlarını oluştuğu noktaya yakın çözmeyi teşvik eder.
Domain Ownership
Domain Ownership, belirli bir iş alanına ait verinin o alanı en iyi bilen ekip tarafından sahiplenilmesidir. Finans, müşteri, ürün veya lojistik gibi domainler kendi veri anlamlarını merkezi veri ekibinden daha iyi bilir. Bu model data mesh yaklaşımının temel parçalarından biridir. Ancak domain ekiplerine sorumluluk verirken self-service platform ve ortak governance standartları da sağlanmalıdır. Aksi durumda ownership dağıtımı yeni silolar oluşturabilir.
Data Product Owner
Data Product Owner, belirli bir veri ürününün tüketici değeri ve yaşam döngüsünden sorumludur. Ürünün kimler tarafından kullanıldığını, hangi SLO'ları karşılaması gerektiğini ve hangi değişikliklerin öncelikli olduğunu takip eder. Bu rol yalnızca backlog yöneten bir proje rolü olmamalıdır. Kullanıcı ihtiyaçları ile teknik sürdürülebilirlik arasında denge kurması gerekir. Özellikle kritik veri ürünlerinde açık bir owner tüketici güvenini ve iletişim hızını artırır.
Data Steward
Data Steward, veri tanımları, kalite kuralları ve governance uygulamalarının günlük sürdürülebilirliğinde önemli rol oynar. Steward genellikle iş kavramlarını teknik metadata ile bağlayan köprü görevi görür. Business glossary, classification ve kalite istisnaları konusunda domain ekipleriyle birlikte çalışabilir. Bu rolün yalnızca dokümantasyon sorumlusu olarak görülmesi etkisini azaltır. Steward karar süreçlerinde aktif olduğunda veri anlamı ve kalite yönetimi daha kalıcı hale gelir.
Platform Team
Platform Team, domain ekiplerinin veri ürünlerini güvenli ve hızlı biçimde oluşturabileceği ortak altyapıyı sağlar. Ingestion, storage, CI/CD, catalog, security ve observability gibi yetenekleri self-service servisler halinde sunabilir. Platform ekibi bütün domain verisinin sahibi olmamalıdır. Bunun yerine platform as a product yaklaşımıyla geliştirme deneyimini iyileştirmeye odaklanmalıdır. İyi platform ekipleri tekrar eden altyapı işlerini otomatikleştirerek domain ekiplerinin iş verisine odaklanmasını sağlar.
Consumer Responsibility
Consumer Responsibility, veri tüketen ekiplerin de sözleşmeye ve kullanım politikalarına uygun davranması gerektiğini ifade eder. Tüketici bir data product'ın internal storage yapısına izinsiz bağımlı hale gelmemeli ve ilan edilen interface üzerinden erişmelidir. Breaking change ihtiyacı olduğunda kendi bağımlılık bilgisini güncel tutmak da tüketici sorumluluğudur. Hassas veriyi yeni bir yerde kopyalarken retention ve güvenlik kurallarını korumalıdır. Bu yaklaşım veri ekosistemini yalnızca producer yükü olmaktan çıkarıp karşılıklı sorumluluk modeline dönüştürür.
Data Contracts Nedir?
Data Contracts, veri üreten ve tüketen taraflar arasında schema, semantics, quality, freshness, availability, ownership ve versioning gibi beklentileri açık hale getiren makine tarafından da okunabilir sözleşmelerdir. Amaç yalnızca dokümantasyon yazmak değil, bu beklentileri geliştirme ve çalışma anında doğrulayabilmektir. Bir producer kolon adını değiştirdiğinde bu değişikliğin downstream tüketicileri kırıp kırmayacağı sözleşme üzerinden kontrol edilebilir. Contract yaklaşımı özellikle çok sayıda domain bulunan yapılarda ekipler arası koordinasyonu sistematik hale getirir. Sağlıklı uygulandığında veri değişikliklerini sürpriz olmaktan çıkarıp planlanabilir mühendislik sürecine dönüştürür.
Producer ve Consumer Arasındaki Sözleşme
Data contract, producer ile consumer arasında yalnızca teknik şema değil hizmet beklentisi konusunda da ortak çerçeve oluşturur. Producer hangi alanları, hangi anlamla ve hangi güncellik seviyesinde sunacağını belirtir. Consumer ise bu sözleşmeye hangi bağımlılıklarla bağlı olduğunu ve breaking change durumunda nasıl geçiş yapacağını bilir. Sözleşmenin version control içinde tutulması değişiklik geçmişini görünür hale getirir. Bu model sözlü koordinasyonu azaltarak dağıtık ekiplerin daha bağımsız hareket etmesini sağlar.
Schema
Schema sözleşmenin alan adları, veri tipleri ve yapısal ilişkiler bölümünü oluşturur. Tüketici uygulamalarının büyük bölümü en doğrudan bu yapıya bağımlıdır. Nullable durumunun değiştirilmesi veya kolon tipinin farklılaştırılması gibi işlemler beklenmedik kırılmalar yaratabilir. Contract validation schema değişikliklerini deployment öncesinde kontrol etmeye yardımcı olur. Böylece producer hızlı geliştirme yaparken consumer stabilitesi korunabilir.
Semantics
Semantics, bir alanın teknik tipinden bağımsız olarak hangi iş anlamını taşıdığını açıklar. customer_id alanının hesap mı, gerçek kişi mi yoksa cihaz mı temsil ettiği yalnızca string tipinden anlaşılamaz. İş tanımlarının contract içinde veya bağlı glossary kaydında yer alması yanlış kullanımı azaltır. Semantic değişiklikler schema aynı kalsa bile breaking change etkisi yaratabilir. Bu nedenle contract yönetiminde anlam değişiklikleri de teknik değişiklikler kadar görünür olmalıdır.
Quality Rules
Quality Rules, data product'ın hangi veri kalite koşullarını karşılaması gerektiğini tanımlar. Birincil kimliğin unique olması, kritik alanların null olmaması veya toplam tutarın negatif olmaması gibi kurallar eklenebilir. Bu kontroller producer pipeline içinde mümkün olduğunca erken çalıştırılmalıdır. Sonuçların observability sistemine aktarılması kalite trendlerini takip etmeyi kolaylaştırır. Contract ile tanımlanan kalite kuralları tüketici beklentisini ölçülebilir hale getirir.
Freshness
Freshness, verinin kaynak değişikliklerini ne kadar gecikmeyle yansıttığını ifade eder. Her ürün için milisaniye seviyesinde güncellik gerekmez ve gereksiz düşük latency ciddi maliyet oluşturabilir. İş ihtiyacı günlük, saatlik veya saniyelik güncellik gerektirebilir. Contract içinde freshness hedefinin açıkça tanımlanması tüketicinin doğru ürünü seçmesini sağlar. Observability sistemi bu hedefin ihlal edildiğini otomatik olarak bildirebilir.
Completeness
Completeness, beklenen verinin ne kadarının eksiksiz biçimde teslim edildiğini ölçer. Pipeline başarılı çalışsa bile kaynak kayıtların bir bölümü gelmemiş olabilir. Kayıt sayısı, partition completeness veya zorunlu alan doluluk oranı gibi metrikler kullanılabilir. Kritik veri ürünlerinde completeness hedefi SLO ile birlikte tanımlanabilir. Böylece sessiz veri kayıpları uygulama hatası oluşmadan fark edilebilir.
Availability
Availability, data product arayüzünün tüketiciler tarafından kullanılabilir olduğu süreyi ifade eder. API veya query service gibi online arayüzlerde uptime doğrudan önemli olabilir. Batch tabanlı bir ürün için ise belirli saatlerde datasetin hazır bulunması daha anlamlı bir availability tanımı olabilir. SLA ve SLO kavramları ürünün iş kritikliğine göre ayrıştırılmalıdır. İhtiyacın üzerinde yüksek availability hedeflemek maliyeti artırabileceği için gerçek kullanım senaryosuna göre tasarım yapılmalıdır.
Ownership
Ownership, sözleşmede sorun, değişiklik veya soru durumunda hangi ekip veya kişinin sorumlu olduğunu belirtir. Owner bilgisinin yalnızca katalogda tutulması yerine contract ile ilişkilendirilmesi otomasyon açısından yararlıdır. Incident alert doğrudan ilgili owner'a yönlendirilebilir. Ownership değiştiğinde sözleşme metadata'sının da güncellenmesi gerekir. Açık sahiplik data product'ın kurumsal sürekliliğini güçlendirir.
Versioning
Versioning, data contract değişikliklerinin kontrollü biçimde yönetilmesini sağlar. Geriye uyumlu değişiklikler aynı major versiyon içinde ilerleyebilirken breaking change yeni bir major sürüm gerektirebilir. Eski ve yeni versiyonun belirli süre birlikte çalışması tüketicilere migration zamanı verir. Versioning stratejisi API, event ve dataset sözleşmeleri arasında mümkün olduğunca ortak hale getirilmelidir. Böylece değişiklik yönetimi ekip bazlı tercihler yerine kurumsal standart kazanır.
Data Contracts Nasıl Uygulanır?
Data contracts uygulaması, sözleşmenin metin belgesi olarak yazılmasıyla değil geliştirme ve çalışma süreçlerine entegre edilmesiyle değer üretir. Contract as Code yaklaşımında schema, quality ve SLO kuralları YAML veya JSON gibi makine tarafından okunabilir formatlarda saklanabilir. Git üzerinden yapılan değişiklikler review edilir ve CI/CD pipeline içinde doğrulanır. Runtime validation ise production verisinin sözleşmeye uymaya devam edip etmediğini kontrol eder. Bu yapı contract'ı toplantılarda unutulan bir dokümandan otomatik veri güvenliği mekanizmasına dönüştürür.
Contract as Code
Contract as Code, data contract tanımlarının kod gibi version control altında yönetilmesi yaklaşımıdır. Değişiklikler pull request üzerinden incelenebilir ve geçmiş sürümler karşılaştırılabilir. Bu yöntem producer ile consumer ekiplerinin aynı sözleşme üzerinden tartışmasını kolaylaştırır. Otomatik validation araçları deployment öncesi uyumsuzlukları tespit edebilir. Böylece sözleşme yaşayan bir mühendislik bileşenine dönüşür.
YAML / JSON
YAML ve JSON, data contract tanımlarını makine tarafından okunabilir biçimde saklamak için yaygın kullanılan formatlardır. Schema, owner, quality rule ve SLO bilgileri bu yapılarda standart alanlarla ifade edilebilir. İnsan tarafından okunabilir olmaları review sürecini de kolaylaştırır. Ancak format seçmek tek başına standart oluşturmaz, alanların anlamı ve versiyonlama kuralları da tanımlanmalıdır. Kurum genelinde ortak contract template kullanmak ekipler arası birlikte çalışabilirliği artırır.
Git Repository
Git Repository, contract dosyalarının değişiklik geçmişini ve review sürecini yönetmek için uygun bir temel sunar. Her değişiklik commit ve pull request üzerinden izlenebilir. CODEOWNERS benzeri sahiplik modelleri belirli domain sözleşmelerinin doğru kişiler tarafından onaylanmasını sağlayabilir. Release tag'leri contract versiyonlarıyla ilişkilendirilebilir. Bu yaklaşım veri yönetişimi ile yazılım geliştirme süreçleri arasında ortak çalışma modeli oluşturur.
CI/CD Validation
CI/CD Validation, data contract kurallarının deployment gerçekleşmeden önce otomatik olarak doğrulanmasını sağlar. Schema uyumluluğu, zorunlu metadata veya naming standards gibi kontroller pipeline içinde çalıştırılabilir. Breaking change tespit edildiğinde deployment durdurulabilir veya özel onay süreci tetiklenebilir. Bu yöntem sorunları production ortamına ulaşmadan yakalamayı kolaylaştırır. Governance kuralları otomatikleştikçe manuel inceleme ihtiyacı daha değerli istisnalara ayrılabilir.
Runtime Validation
Runtime Validation, production ortamındaki gerçek verinin contract beklentilerini karşılayıp karşılamadığını sürekli kontrol eder. Schema doğru olsa bile veri dağılımı, completeness veya freshness zamanla bozulabilir. Runtime kontroller bu değişimleri erken tespit etmeye yardımcı olur. İhlal durumunda incident oluşturulabilir veya downstream yayın durdurulabilir. Böylece data contract yalnızca geliştirme zamanında değil çalışma süresince de uygulanmış olur.
Data Quality Enforcement
Data Quality Enforcement, contract içinde tanımlanan kalite kurallarının pipeline veya platform tarafından otomatik uygulanmasıdır. Kritik kurallar ihlal edildiğinde veri quarantine alanına alınabilir veya yayınlama işlemi engellenebilir. Daha düşük öncelikli ihlaller warning olarak raporlanabilir. Her hatada pipeline durdurmak doğru değildir, çünkü iş etkisi farklı olabilir. Enforcement seviyesi veri kritikliğine ve tüketici beklentisine göre belirlenmelidir.
Observability
Observability, sözleşme hedeflerinin zaman içinde nasıl performans gösterdiğini izlemeyi sağlar. Freshness, volume, schema ve quality metrikleri dashboard üzerinde takip edilebilir. Contract violation geçmişi tekrarlayan veri sorunlarının bulunmasına yardımcı olur. Lineage bağlantısı hangi downstream ürünlerin etkilendiğini gösterebilir. Bu sayede veri operasyonu reaksiyon veren yapıdan ölçülebilir güvenilirlik yönetimine dönüşür.
Alerting
Alerting, contract veya SLO ihlallerinde doğru kişiye doğru seviyede bildirim gönderilmesini sağlar. Her küçük sapmanın kritik alarm üretmesi alarm yorgunluğuna yol açabilir. Uyarılar iş etkisi, süre ve etkilenen tüketici sayısına göre önceliklendirilebilir. Owner metadata'sı alert routing için doğrudan kullanılabilir. İyi tasarlanmış alarm sistemi veri incident yönetimini hızlandırırken gereksiz bildirim sayısını sınırlar.
Data Contract Lifecycle Nasıl Yönetilir?
Data contract lifecycle, sözleşmenin tanımlanması, gözden geçirilmesi, yayınlanması, doğrulanması, izlenmesi, versiyonlanması ve kullanım dışına alınması aşamalarını kapsar. Bir contract yayınlandıktan sonra değişmeyecek belge olarak görülmemelidir. İş ihtiyaçları ve kaynak sistemler değiştikçe sözleşmeler de kontrollü biçimde gelişir. Değişikliklerin consumer etkisi ve migration ihtiyacı her aşamada değerlendirilmelidir. Lifecycle yaklaşımı sözleşmeleri bir defalık proje çıktısı olmaktan çıkarıp uzun ömürlü veri yönetim mekanizmasına dönüştürür.
Define
Define aşamasında data product'ın şeması, semantic anlamı, kalite hedefleri ve sahipliği tanımlanır. Sözleşme gerçek tüketici ihtiyacına dayanmalı, yalnızca producer sistemin mevcut yapısını kopyalamamalıdır. Kritik alanlar ve değişiklik riskleri başlangıçta belirlenebilir. İlgili domain glossary tanımları contract ile ilişkilendirilmelidir. İyi tanımlanmış başlangıç ileride yaşanacak yanlış anlaşılmaların önemli bölümünü azaltır.
Review
Review aşamasında producer, consumer, domain ve gerektiğinde governance temsilcileri sözleşmeyi birlikte değerlendirir. Amaç her değişiklik için uzun toplantılar yapmak değil, önemli etkileri görünür kılmaktır. Pull request ve otomatik validation review sürecini hızlandırabilir. Breaking change veya hassas veri değişiklikleri daha güçlü onay gerektirebilir. Risk bazlı review modeli ekiplerin hızını korurken kritik hataların önüne geçer.
Publish
Publish aşamasında onaylanmış contract tüketiciler tarafından erişilebilir hale getirilir. Data catalog, developer portal veya schema registry uygun yayın kanalları olabilir. Contract versiyonu ile gerçek data product sürümünün eşleşmesi önemlidir. Tüketici hangi sürümün production ortamında aktif olduğunu açıkça görebilmelidir. Otomatik yayın mekanizması dokümantasyon ile çalışan sistem arasındaki farkı azaltır.
Validate
Validate aşamasında data product'ın sözleşmeye teknik ve anlamsal olarak uyduğu kontrol edilir. Schema validation, quality test ve required metadata kontrolleri bu kapsamda çalıştırılabilir. Bazı testler CI/CD içinde, bazıları runtime seviyesinde uygulanabilir. Sonuçların merkezi observability sistemine aktarılması hata trendlerini görünür hale getirir. Validation contract yaklaşımını teorik taahhütten ölçülebilir güvenilirliğe taşır.
Monitor
Monitor aşamasında contract hedeflerinin production ortamında sürekli karşılanıp karşılanmadığı izlenir. Freshness, availability ve quality SLO'ları belirli zaman aralıklarında ölçülebilir. Tek bir ihlal kadar uzun dönem eğilimleri de önemlidir. Sürekli kötüleşen kalite metriği gelecekte daha büyük bir incidentın habercisi olabilir. Monitoring verisi owner'ın ürün geliştirme önceliklerini belirlemesine de yardımcı olur.
Version
Version aşaması contract değişikliklerinin tüketicilere kontrollü biçimde sunulmasını sağlar. Küçük ve geriye uyumlu değişiklikler mevcut sürüm üzerinde ilerleyebilir. Anlam veya şema bakımından kırıcı değişiklikler yeni major sürüm oluşturabilir. Tüketicilere geçiş süresi verilmesi production kesintilerini azaltır. Version geçmişi aynı zamanda veri ürününün nasıl geliştiğini gösteren değerli bir audit kaydıdır.
Deprecate
Deprecate aşaması artık önerilmeyen contract veya data product sürümünün kontrollü biçimde kullanım dışına çıkarılmaya başlanmasıdır. Tüketicilere alternatif sürüm ve son kullanım tarihi açıkça bildirilmelidir. Catalog ve developer portal üzerinde deprecated durumu görünür olmalıdır. Yeni bağımlılıkların eski sürüme eklenmesi mümkünse engellenmelidir. Bu süreç platformda sonsuza kadar eski sürüm taşınmasını önler.
Retire
Retire aşaması eski contract veya data product sürümünün tamamen kapatılmasıdır. Kapatma öncesinde aktif tüketicilerin kalmadığı usage metadata üzerinden doğrulanmalıdır. Retention veya audit gereksinimleri varsa geçmiş verinin nasıl saklanacağı ayrıca planlanır. Eski endpoint, topic veya dataset kontrollü biçimde kaldırılır. Düzenli retirement süreci veri platformunun teknik borcunu ve destek maliyetini azaltır.
Schema Evolution Nasıl Yönetilmelidir?
Schema evolution, veri ürünlerinin zaman içinde değişmesine izin verirken mevcut tüketicilerin gereksiz yere kırılmasını önleyen yönetim sürecidir. Her değişiklik aynı etkiyi oluşturmaz, bazıları backward-compatible olurken bazıları breaking change niteliği taşır. Versioning, consumer impact analysis ve deprecation window bu değişikliklerin güvenli biçimde yönetilmesini sağlar. Producer ekiplerin sadece kendi deployment başarısını değil downstream sonuçları da görmesi gerekir. İyi schema evolution modeli hızlı geliştirme ile veri sözleşmesi kararlılığı arasında denge kurar.
Backward-Compatible Change
Backward-compatible change, mevcut tüketicilerin değişiklik yapmadan çalışmaya devam edebildiği şema değişikliğidir. Optional yeni bir alan eklemek çoğu durumda buna örnek olabilir. Yine de tüketici teknolojilerinin bilinmeyen alanlara nasıl davrandığı test edilmelidir. Semantic anlamı değiştirmek teknik şema aynı kalsa bile geriye uyumluluğu bozabilir. Bu nedenle compatibility hem yapı hem anlam seviyesinde değerlendirilmelidir.
Forward-Compatible Change
Forward-compatible change, eski producer veya veri sürümlerinin daha yeni consumer beklentileriyle belirli ölçüde çalışabilmesini ifade eder. Event-driven sistemlerde rolling deployment süreçlerinde bu özellik önem kazanır. Consumer bilinmeyen alanları veya eksik optional alanları güvenli biçimde işleyebilmelidir. Schema registry compatibility kontrolleri teknik düzeyde yardımcı olabilir. Ancak gerçek iş davranışının uyumluluğu integration testleriyle ayrıca doğrulanmalıdır.
Breaking Change
Breaking change, mevcut tüketicilerin kod veya model değişikliği yapmadan çalışamayacağı değişikliktir. Kolon silmek, veri tipini uyumsuz biçimde değiştirmek veya alan anlamını değiştirmek buna örnek olabilir. Böyle değişiklikler gizlice yayınlanmak yerine yeni sürüm ve migration planıyla sunulmalıdır. Lineage ve usage metadata etkilenecek tüketicileri belirlemeye yardımcı olur. Planlı breaking change yönetimi platform güvenini korumanın önemli parçalarından biridir.
Versioning
Versioning, eski ve yeni schema sürümlerinin açık biçimde ayırt edilmesini sağlar. Semantic versioning benzeri yöntemler major ve minor değişiklikler için kurumsal standart oluşturabilir. API, event ve dataset sürümlerinin benzer prensiplerle yönetilmesi geliştirici deneyimini iyileştirir. Versiyon sayısını gereksiz çoğaltmak da bakım yükü yaratabilir. Bu nedenle yalnızca anlamlı compatibility sınırlarında yeni sürüm oluşturmak daha sağlıklıdır.
Consumer Impact Analysis
Consumer Impact Analysis, bir schema değişikliğinin hangi downstream uygulama, rapor veya data product'ı etkileyebileceğini analiz eder. Data lineage ve query usage metadata bu değerlendirmeyi otomatikleştirebilir. Yalnızca resmi dokümantasyonda kayıtlı tüketicilere güvenmek çoğu kurumda yeterli değildir. Gerçek sorgu ve erişim kayıtları gizli bağımlılıkları ortaya çıkarabilir. Impact analysis üretici ekibe değişiklik öncesinde gerçek risk görünümü sağlar.
Deprecation Window
Deprecation Window, eski schema veya API sürümünün yeni sürüm yayınlandıktan sonra desteklenmeye devam edeceği geçiş süresidir. Bu süre tüketicilerin planlı biçimde migration yapmasını sağlar. İş kritikliğine göre birkaç hafta veya daha uzun dönem tanımlanabilir. Süre boyunca kullanım ölçümleri takip edilerek geride kalan tüketiciler belirlenmelidir. Açık son tarih eski sürümlerin sonsuza kadar platformda tutulmasını engeller.
Migration Guide
Migration Guide, tüketicilerin eski sürümden yenisine nasıl geçeceğini pratik olarak açıklayan dokümandır. Değişen alanlar, yeni örnek sorgular ve beklenen davranışlar net biçimde gösterilmelidir. Yalnızca değişiklik listesini yayınlamak yeterli olmayabilir, tüketicinin kodunda ne yapması gerektiği anlatılmalıdır. Büyük değişikliklerde otomatik dönüştürme araçları veya compatibility layer sunulabilir. İyi migration guide breaking change maliyetini önemli ölçüde azaltır.
Data Mesh Nedir?
Data Mesh, büyük ve çok domainli organizasyonlarda veri sahipliğini merkezi bir veri ekibinden iş domainlerine dağıtan organizasyonel ve mimari yaklaşımdır. Dört temel prensibi domain-oriented ownership, data as a product, self-service data platform ve federated computational governance olarak öne çıkar. Amaç merkezi ekibin bütün veri talepleri için darboğaz haline gelmesini önlerken ortak standartları kaybetmemektir. Data mesh yalnızca her departmana ayrı veri altyapısı kurmak anlamına gelmez. data-centric architecture ve data mesh arasındaki farklar incelendiğinde data-centric yaklaşımın genel veri tasarım prensibi, data mesh'in ise özellikle sahiplik ve organizasyon ölçeklenmesi için kullanılan bir model olduğu görülür.
Domain-Oriented Ownership
Domain-Oriented Ownership, müşteri, satış, lojistik veya finans gibi iş alanlarının kendi verilerinden sorumlu olmasını öngörür. Domain ekipleri iş anlamını merkezi platform ekiplerinden daha yakından bildiği için kaliteli veri ürünü üretme potansiyeline sahiptir. Ancak sorumluluğun dağıtılması merkezi standartların kaldırılması anlamına gelmez. Ortak metadata, security ve quality politikaları platform tarafından desteklenmelidir. Böylece domain bağımsızlığı ile kurumsal tutarlılık birlikte korunabilir.
Data as a Product
Data as a Product, domain ekiplerinin ürettiği veriyi diğer ekiplerin kullanacağı gerçek bir ürün gibi ele almasını ister. Tüketici ihtiyaçları, kullanılabilirlik, dokümantasyon ve kalite hedefleri tasarımın parçasıdır. Dataset yayınlayıp işi tamamlanmış saymak data mesh yaklaşımının ruhuna uymaz. Data product owner kullanım ve geri bildirim verilerini izleyerek ürünü geliştirmelidir. Bu yaklaşım domainler arası veri paylaşımını daha güvenilir hale getirir.
Self-Service Data Platform
Self-Service Data Platform, domain ekiplerinin ingestion, storage, processing, quality, security ve publishing ihtiyaçlarını merkezi ekipten manuel yardım almadan karşılayabileceği ortak platformdur. Hazır şablonlar ve golden paths yeni data product oluşturma süresini kısaltır. Platform yoksa her domain kendi altyapısını kurmaya başlayabilir ve duplicate infrastructure problemi doğar. Self-service seviyesinin iyi developer experience sunması benimseme açısından önemlidir. Data mesh ölçeğinin sürdürülebilmesi büyük ölçüde bu platform yeteneğine bağlıdır.
Federated Computational Governance
Federated Computational Governance, bazı kuralların kurum genelinde merkezi olarak belirlenirken domain özel kararların yerel ekiplerce yönetildiği yönetişim modelidir. Computational ifadesi politikaların mümkün olduğunca makine tarafından uygulanabilir olmasını vurgular. Örneğin PII classification merkezi standartken belirli bir domainin kalite eşiği domain tarafından tanımlanabilir. Policy-as-code ve platform kontrolleri bu yapının manuel toplantılara bağımlılığını azaltır. Böylece hız ile kontrol arasında daha uygulanabilir denge kurulabilir.
Data Mesh'in Çözmeye Çalıştığı Problem
Data Mesh'in temel hedefi merkezi veri ekiplerinin organizasyon büyüdükçe oluşan ölçeklenme sorununu azaltmaktır. Tek bir ekip yüzlerce kaynak ve iş domaininin anlamını aynı derinlikte bilemez. Talepler biriktiğinde data onboarding ve değişiklik süreleri uzar. Domain ownership ile bilgi kaynağa yakın tutulurken self-service platform ortak altyapı sunar. Modelin başarısı yalnızca organizasyon şemasını değiştirmekten değil, yetkinlik ve platform yatırımını birlikte yapmaktan gelir.
Data Mesh Ne Zaman Kullanılmalıdır?
Data Mesh her şirket için varsayılan mimari değildir. Organizasyon büyükse, çok sayıda bağımsız business domain varsa ve merkezi data team sürekli darboğaz oluşturuyorsa anlamlı hale gelebilir. Domain ekiplerinin veri mühendisliği sorumluluğu alabilecek yetkinlik ve kapasiteye sahip olması da önemlidir. Küçük ekiplerde tam data mesh modeli gereksiz rol ve platform maliyeti yaratabilir. Bu nedenle mimari karar organizasyon büyüklüğü, domain olgunluğu ve mevcut darboğazlar üzerinden verilmelidir.
Büyük Organizasyonlar
Büyük organizasyonlarda veri kaynağı, ekip ve kullanım senaryosu sayısı hızla artar. Merkezi bir veri ekibinin bütün domain bilgisini yönetmesi zaman içinde zorlaşır. Data mesh domainlerin kendi veri ürünlerini sahiplenmesine izin vererek bu yükü dağıtabilir. Ancak büyük organizasyon olmak tek başına yeterli sebep değildir, ortak platform ve governance yeteneklerinin de hazır olması gerekir. Aksi halde dağıtık model koordinasyon maliyetini daha da artırabilir.
Çok Sayıda Business Domain
Bir kurumda bağımsız süreçleri ve kavramları olan çok sayıda business domain bulunuyorsa merkezi veri modelinin tüm ayrıntıları tek ekipte toplaması güçleşebilir. Satış, finans, lojistik ve insan kaynakları gibi alanların kendi iş dilleri vardır. Domain ownership bu bilgiyi veri ürününe daha doğrudan yansıtabilir. Ortak entity ve reference data konularında yine kurumsal koordinasyon gerekir. Bu denge data mesh'in domain bağımsızlığı ile enterprise consistency arasında kurduğu temel ilişkidir.
Merkezi Data Team Bottleneck'i
Merkezi data team bottleneck'i, bütün ingestion, modelleme ve raporlama taleplerinin tek ekipte birikmesi durumudur. Talepler arttıkça iş birimleri yeni veri ihtiyaçları için haftalarca bekleyebilir. Domain ekiplerine uygun sorumluluk ve self-service araçları vermek bu kuyruğu azaltabilir. Merkezi ekip ise bütün işleri yapmak yerine platform ve standart geliştirmeye odaklanabilir. Bu dönüşüm doğru uygulanırsa veri kapasitesi ekip sayısıyla daha iyi ölçeklenebilir.
Domain Yetkinliğinin Yeterli Olduğu Durumlar
Data mesh, domain ekipleri veri kalitesi, modelleme ve operasyon sorumluluğunu taşıyabilecek seviyedeyse daha sağlıklı çalışır. Yalnızca iş bilgisine sahip ama veri mühendisliği kapasitesi olmayan ekiplerin üzerine ürün sorumluluğu bırakmak ters etki yaratabilir. Platform ekibi eğitim, template ve otomasyonla bu yetkinlik açığını azaltabilir. Bazı kurumlarda önce merkezi platform olgunlaştırılıp daha sonra ownership dağıtmak daha uygun olur. Organizasyon tasarımı teknik mimariden ayrı düşünülmemelidir.
Küçük Şirketlerde Data Mesh Gerekli mi?
Küçük şirketlerde tam ölçekli data mesh çoğu zaman gerekli değildir. Az sayıda domain ve küçük veri ekibinde ownership zaten doğal olarak ilgili kişilere yakın olabilir. Ekstra federasyon rolleri ve kapsamlı platform yatırımı gereksiz operasyon yükü oluşturabilir. Buna rağmen data product, ownership ve contract gibi data mesh prensipleri küçük ölçekte de oldukça değerlidir. Bu nedenle kavramları kullanmak ile tam organizasyon modelini uygulamak arasında ayrım yapmak gerekir.
Data Mesh Neden Başarısız Olabilir?
Data mesh projeleri çoğu zaman teknolojiden değil organizasyon ve sorumluluk tasarımından kaynaklanan nedenlerle başarısız olur. Domainlere yeni görevler verilirken platform desteği sağlanmazsa ekipler veri işini ek yük olarak görmeye başlar. Merkezi governance tamamen kaldırıldığında semantic fragmentation ve duplicate infrastructure oluşabilir. Ownership belirsiz kaldığında data product adı altında yine sahipsiz datasetler yayınlanır. Başarılı model için sorumluluk, self-service platform, ortak standartlar ve ölçülebilir ürün beklentileri birlikte kurulmalıdır.
Domain'lere Fazla Sorumluluk Vermek
Domain ekiplerine sahiplik vermek, bütün veri mühendisliği altyapısını sıfırdan kurmalarını beklemek anlamına gelmez. Böyle bir yaklaşım ekiplerin ana ürün sorumluluklarını zorlaştırabilir. Platform ekibi ingestion, security, deployment ve observability gibi tekrar eden işlerde hazır servisler sunmalıdır. Domain ekibi esas olarak iş anlamı ve veri kalitesi üzerinde yoğunlaşmalıdır. Sorumluluk ile destek arasındaki denge kurulmadığında data mesh benimsenmesi hızla düşebilir.
Self-Service Platform Eksikliği
Self-service platform eksikliği data mesh'in en ciddi uygulama risklerinden biridir. Her domain Kafka cluster, storage ve catalog entegrasyonunu kendi kurmaya çalışırsa altyapı tekrarı kaçınılmaz hale gelir. Güvenlik ve governance standartları da ekipten ekibe farklılaşabilir. Merkezi platform standart yolları otomatik sunarak bu yükü azaltır. Platform kurulmadan ownership dağıtmak çoğu zaman merkezi darboğazı dağıtık teknik borca dönüştürür.
Governance Eksikliği
Data mesh merkezi kontrolün tamamen kaldırılması anlamına gelmez. Ortak security, metadata, interoperability ve compliance kuralları olmadan domainler birbirinden kopuk veri adaları oluşturabilir. Federated governance global ve local karar sınırlarını açık biçimde tanımlamalıdır. Mümkün olan politikalar platform üzerinde otomatik uygulanmalıdır. Böylece domain özgürlüğü kurum genelindeki güven ve birlikte çalışabilirliği zayıflatmaz.
Data Product Ownership Belirsizliği
Data Product Ownership belirsiz olduğunda data mesh yalnızca yeni isimlerle eski dataset üretim modeline dönüşebilir. Her ürün için aktif owner ve sorumluluk sınırı tanımlanmalıdır. Incident, schema değişikliği ve consumer taleplerinde kimin karar vereceği açık olmalıdır. Owner rolünün gerçek zaman ve yetkiyle desteklenmesi gerekir. Yalnızca katalog alanına bir isim yazmak sürdürülebilir sahiplik oluşturmaz.
Duplicate Infrastructure
Duplicate Infrastructure, domainlerin aynı teknik yetenekleri birbirinden bağımsız kurması durumunda ortaya çıkar. Birden fazla ingestion framework, katalog veya güvenlik çözümü bakım maliyetini hızla artırabilir. Self-service platform ortak yetenekleri merkezi olarak sağlayarak bu tekrarı azaltır. Domainlere özel araç ihtiyacı varsa istisna süreci tanımlanabilir. Standart ile esneklik arasında bilinçli sınır çizmek data mesh ekonomisi açısından önemlidir.
Maliyet Artışı
Data mesh doğru planlanmadığında ekip, platform ve altyapı maliyetlerini artırabilir. Her domainin ayrı compute veya storage kaynakları kullanması kaynak verimliliğini düşürebilir. Cost per data product gibi ölçümler harcamaların hangi ürünler için yapıldığını görünür hale getirir. Merkezi platform ortak kaynak ve otomasyon sağlayarak maliyetleri dengeleyebilir. Mimari başarı yalnızca hız değil toplam sahip olma maliyetiyle de ölçülmelidir.
Semantic Fragmentation
Semantic Fragmentation, domainlerin aynı iş kavramını birbirinden farklı tanımlaması sonucu kurumsal anlamın parçalanmasıdır. Domain bağımsızlığı bu riski artırabilir. Enterprise glossary, ortak entity modelleri ve semantic layer kritik kavramlarda tutarlılık sağlar. Her kavramın merkezi olarak yönetilmesi gerekmez fakat domainler arası kullanılan metrikler ortaklaşmalıdır. Bu denge data mesh'in gerçek işletme değeri üretmesi için kritik öneme sahiptir.
Hub-and-Spoke Data Architecture
Hub-and-Spoke Data Architecture, merkezi platform yetenekleri ile domain bazlı veri sahipliğini bir arada kullanan dengeli bir modeldir. Hub ortak governance, platform, metadata ve güvenlik yeteneklerini sağlarken spoke ekipleri domain data products üzerinde çalışır. Bu yapı tam merkezi model ile tam dağıtık data mesh arasında pratik bir geçiş yaklaşımı olabilir. Özellikle data mesh için organizasyonel olarak hazır olmayan fakat domain ownership geliştirmek isteyen kurumlarda iyi sonuç verir. Başarılı uygulamada hub darboğaz olmamalı, spoke ekiplerinin hızlı çalışmasını sağlayan enablement merkezi olarak davranmalıdır.
Merkezi Hub'ın Sorumlulukları
Merkezi hub platform standartları, ortak metadata, security, governance automation ve temel architecture guidance sağlar. Domain ekiplerinin tekrar eden altyapı işlerini kendilerinin yapmasını engellemek temel hedeflerden biridir. Shared ingestion, catalog ve observability servisleri hub tarafından sunulabilir. Hub bütün data product geliştirmelerini kendi üzerine almamalıdır. Rolü merkezi üretim ekibinden ortak yetenek sağlayan platform ekibine dönüşmelidir.
Domain Spoke'ların Sorumlulukları
Domain spoke ekipleri kendi iş alanlarının verisini ve data products portföyünü yönetir. İş tanımları, kalite hedefleri ve tüketici ihtiyaçları domain bilgisiyle şekillendirilir. Platformun sunduğu standart yollar üzerinden ürün yayınlamak operasyon yükünü azaltır. Domain ekipleri ortak governance politikalarına uyarken yerel iş kurallarında esnek kalabilir. Böylece kurumsal standart ile domain yakınlığı birlikte korunur.
Merkezi Platform + Federated Ownership
Merkezi platform ile federated ownership birleşimi birçok kurum için uygulanabilir bir denge sunar. Infrastructure, security ve metadata yetenekleri ortak sağlanırken veri anlamı ve ürün sorumluluğu domainlere dağıtılır. Bu model teknik standardizasyonun faydasını koruyup merkezi data team bottleneck'ini azaltabilir. Ownership sınırları ve platform service catalog açık biçimde tanımlanmalıdır. Kurum büyüdükçe bu model daha gelişmiş data mesh yapısına evrilebilir.
Hangi Organizasyonlarda Daha Uygundur?
Hub-and-spoke modeli orta ve büyük ölçekli, birden fazla domaini bulunan fakat tam dağıtık veri organizasyonuna henüz geçmemiş şirketlerde uygundur. Merkezi data platform yatırımı bulunan kurumlar bu yapıyı daha kolay benimseyebilir. Domain ekiplerinde yeterli veri yetkinliği yoksa hub enablement ve eğitim görevi üstlenebilir. Organizasyon zamanla ownership kapasitesini artırdıkça daha fazla sorumluluk spoke tarafına aktarılabilir. Bu nedenle model kademeli dönüşüm için esnek bir başlangıç noktası sunar.
Data Fabric Nedir?
Data Fabric, dağıtık veri kaynakları arasında erişim, metadata, entegrasyon ve otomasyonu birleştirmeyi amaçlayan teknik mimari yaklaşımıdır. Data mesh daha çok ownership ve organizasyon modeline odaklanırken data fabric verinin fiziksel olarak nerede bulunduğundan bağımsız biçimde bulunmasını ve kullanılmasını kolaylaştırır. Active metadata, knowledge graph, virtualization ve otomatik policy uygulamaları bu yaklaşımda sık kullanılan kavramlardır. Fabric bütün veriyi tek yere taşımayı zorunlu kılmaz. Amaç farklı platformlar arasında ortak metadata ve erişim deneyimi oluşturmaktır.
Unified Data Access
Unified Data Access, farklı veri kaynaklarına ortak erişim deneyimi sunmayı hedefler. Kullanıcı warehouse, lake veya operasyonel kaynakların her birine farklı yöntemlerle bağlanmak zorunda kalmayabilir. Federation ve semantic access layer bu deneyimi destekleyebilir. Ancak ortak erişim performans ve güvenlik sınırlarını ortadan kaldırmaz. Hangi sorguların hangi kaynağa gitmesi gerektiği ve hangi verinin taşınacağı mimari olarak yönetilmelidir.
Metadata
Metadata data fabric yaklaşımının temel bağlayıcı katmanlarından biridir. Farklı kaynaklarda bulunan schema, lineage, classification ve usage bilgileri ortak graph veya catalog üzerinde birleştirilebilir. Bu metadata erişim ve otomasyon kararlarında aktif olarak kullanılabilir. Örneğin hassas veri etiketi birden fazla platformda ortak policy uygulamasını tetikleyebilir. Böylece fabric yalnızca bağlantı sağlayan katman değil, veri bağlamını kullanan akıllı entegrasyon modeli haline gelir.
Automation
Automation data fabric içinde veri keşfi, classification, lineage ve erişim yönetimi gibi süreçleri daha ölçeklenebilir hale getirir. Manuel metadata girişi yüzlerce sistem bulunan kurumlarda hızla güncelliğini kaybedebilir. Otomatik tarama ve event-based metadata güncellemesi veri varlıklarını daha güncel tutar. Policy engine metadata değişikliklerine göre yeni kurallar uygulayabilir. Bu yaklaşım yönetişim maliyetini azaltırken standardın platform genelinde daha tutarlı uygulanmasını sağlar.
Knowledge Graph
Knowledge Graph, veri varlıkları, iş kavramları, sahipler ve süreçler arasındaki ilişkileri graph yapısında temsil edebilir. Bir müşteri metriğinin hangi datasetlerden üretildiğini ve hangi dashboardlarda kullanıldığını ilişkiler üzerinden göstermek mümkündür. Semantic search ve impact analysis bu modelden faydalanabilir. AI agent'lar da kurumsal veri bağlamını anlamak için knowledge graph bilgisinden yararlanabilir. Ancak graph değer üretmek için güvenilir metadata ve düzenli güncelleme mekanizmasına ihtiyaç duyar.
Data Integration
Data Integration, farklı kaynaklardan gelen verilerin taşınması, birleştirilmesi veya ortak erişim modeline bağlanması sürecidir. Data fabric bu entegrasyonu metadata ve otomasyonla daha dinamik hale getirmeyi amaçlar. Fiziksel kopyalama, virtualization ve event sharing aynı mimari içinde farklı ihtiyaçlara göre kullanılabilir. Her veriyi tek merkezi platforma taşımak yerine en uygun entegrasyon yöntemini seçmek mümkündür. Bu yaklaşım özellikle hybrid ve multicloud ortamlarında değer kazanır.
Data Fabric'in Avantajları
Data Fabric'in temel avantajı dağıtık veri ortamlarında ortak erişim ve metadata deneyimi sağlayabilmesidir. Farklı cloud, warehouse ve operasyonel kaynaklar arasında veri bulma süresi azaltılabilir. Active metadata ile güvenlik ve governance otomasyonu daha güçlü hale gelir. Virtualization bazı kullanım senaryolarında gereksiz data movement ihtiyacını azaltabilir. Yine de fabric'in değeri doğru metadata ve entegrasyon standartları kurulduğunda ortaya çıkar.
Data Fabric'in Sınırlamaları
Data Fabric organizasyonel ownership sorunlarını tek başına çözmez. Verinin sahibi belli değilse veya domain ekipleri kalite sorumluluğu almıyorsa güçlü metadata araçları yalnızca problemi daha görünür hale getirir. Federation sorguları kaynak sistem performansına bağlı olabilir ve her kullanım için uygun değildir. Çok sayıda otomasyon bileşeni platform işletimini zorlaştırabilir. Bu nedenle fabric teknik bağlantı modeli olarak kullanılmalı, veri yönetişimi ve ürün sahipliği ayrıca tasarlanmalıdır.
Data Mesh ve Data Fabric Arasındaki Fark
Data Mesh ve Data Fabric sıkça birbirinin alternatifi gibi anlatılsa da farklı problemleri hedefler. Data Mesh ağırlıklı olarak sahiplik, organizasyon ölçeği ve data product sorumluluğuyla ilgilenir. Data Fabric ise metadata, bağlantı, entegrasyon ve otomasyon üzerinden dağıtık veri altyapısını yönetmeye odaklanır. Bir kurum domain ownership için mesh prensiplerini kullanırken teknik connectivity katmanında fabric yaklaşımından yararlanabilir. Bu nedenle iki kavramı ürün seçimi gibi karşılaştırmak yerine hangi problemi çözdüklerine bakmak daha doğru olur.
Organizasyonel Problem vs Teknik Problem
Data Mesh temel olarak organizasyonel ölçeklenme problemine cevap verir. Merkezi ekip bütün domainlerin veri taleplerini yönetemediğinde ownership'i dağıtmayı önerir. Data Fabric ise farklı teknik kaynaklar arasında veri erişimi ve metadata bağlantısını kolaylaştırmaya odaklanır. Bu iki problem birçok büyük kurumda aynı anda bulunabilir. Böyle bir durumda mesh ve fabric prensipleri birlikte tasarlanabilir.
Ownership
Ownership Data Mesh yaklaşımında temel prensiptir ve domain ekiplerine açık sorumluluk verir. Data Fabric doğrudan organizasyonel sahiplik modeli tanımlamak zorunda değildir. Fabric metadata içinde owner bilgisini taşıyabilir fakat bu bilginin nasıl belirleneceği yönetim modeline bağlıdır. Bu nedenle ownership problemi yaşayan kurumun yalnızca fabric teknolojisi kurması yeterli olmaz. Rol ve hesap verebilirlik ayrıca tasarlanmalıdır.
Governance
Data Mesh federated computational governance ile merkezi ve domain politikalarını birlikte yönetmeyi hedefler. Data Fabric ise bu politikaların teknik olarak farklı veri sistemlerinde uygulanmasını kolaylaştırabilir. Metadata tabanlı policy engine iki yaklaşımı birbirine bağlayan güçlü bir bileşendir. Örneğin domain classification bilgisini fabric bütün platformlarda aynı erişim kuralına dönüştürebilir. Böylece organizasyonel governance ile teknik enforcement arasında köprü kurulur.
Integration
Data Fabric entegrasyon konusunu Data Mesh'ten daha doğrudan ele alır. Federation, virtualization, metadata-driven pipelines ve unified access gibi mekanizmalar farklı kaynakların bağlanmasını sağlar. Data Mesh ise domainler arası veri paylaşımını çoğunlukla data products üzerinden organize eder. Data products fiziksel olarak fabric servisleri aracılığıyla sunulabilir. Böylece ürün modeli ile teknik bağlantı modeli birbirini tamamlar.
Metadata
Metadata her iki yaklaşım için önemli olsa da Data Fabric içinde merkezi teknik role sahiptir. Active metadata otomasyon ve bağlantı kararlarını yönlendirebilir. Data Mesh metadata'yı discoverability, ownership ve governance için kullanır. Ortak metadata standartları mesh domainlerinin birbirini anlayabilmesini kolaylaştırır. Bu nedenle metadata platformu mesh ve fabric birlikte kullanıldığında doğal bir ortak katman haline gelir.
Birlikte Kullanılabilirler mi?
Evet, Data Mesh ve Data Fabric birlikte kullanılabilir ve birçok kurumsal senaryoda bu yaklaşım mantıklıdır. Mesh domain ownership ile data product modelini tanımlarken Fabric bu ürünlerin dağıtık kaynaklar arasında bulunmasını ve erişilmesini kolaylaştırabilir. Merkezi metadata platformu iki modeli bir araya getirebilir. Kurumlar isimlere odaklanmak yerine hangi yeteneğin hangi iş sorununu çözdüğünü açıkça belirlemelidir. Böylece kavramsal tartışmalar yerine ölçülebilir mimari sonuçlara odaklanmak mümkün olur.
Data Mesh, Data Fabric ve Lakehouse Karşılaştırması
Data Mesh, Data Fabric ve Lakehouse aynı kategoride çözümler değildir. Data Mesh ownership ve organizasyon modeline, Data Fabric connectivity ve metadata katmanına, Lakehouse ise storage ve compute mimarisine odaklanır. Bu nedenle biri seçildiğinde diğerlerinden vazgeçilmesi gerekmez. Büyük bir kurum domain ownership için mesh, unified metadata için fabric ve analitik storage için lakehouse kullanabilir. Tasarım sırasında bu katmanların sorumluluklarını karıştırmamak mimarinin anlaşılabilirliğini artırır.
Data Mesh: Ownership
Data Mesh açısından temel soru verinin kim tarafından sahiplenildiği ve ürün olarak nasıl sunulduğudur. Domain ekipleri iş anlamı ve veri kalitesi konusunda aktif sorumluluk alır. Merkezi platform bütün data work'ü kendisi yapmak yerine enablement sağlar. Data products domainler arası paylaşım birimi haline gelir. Bu model organizasyon büyüdüğünde merkezi veri ekibinin sınırlarını aşmayı hedefler.
Data Fabric: Connectivity ve Metadata
Data Fabric farklı veri platformları arasında bağlantı ve metadata sürekliliği kurmaya odaklanır. Unified catalog, lineage ve active metadata bu modelin önemli unsurlarıdır. Veri fiziksel olarak farklı cloud veya on-premise sistemlerde kalabilir. Fabric katmanı discovery ve policy uygulamalarını ortaklaştırabilir. Böylece dağıtık altyapı tek bir kullanıcı deneyimine daha yakın hale gelir.
Lakehouse: Storage ve Compute
Lakehouse veri depolama ve analitik compute iş yüklerinin nasıl organize edildiğiyle ilgilenir. Açık tablo formatları object storage üzerinde transaction ve schema yönetimi sunabilir. Farklı compute motorları ortak data layer üzerinde çalışabilir. Storage ve compute ayrımı ölçeklenebilirlik ve maliyet yönetimi açısından avantaj sağlayabilir. Ancak Lakehouse ownership veya iş semantic sorunlarını tek başına çözmez.
Üçünü Aynı Mimaride Kullanmak
Bir kurum üç yaklaşımı farklı katmanlarda birlikte kullanabilir. Domain ekipleri Data Mesh prensipleriyle data products sahiplenebilir, metadata ve access Data Fabric yaklaşımıyla birleştirilebilir, fiziksel analitik veri Lakehouse üzerinde tutulabilir. Bu durumda platform ekiplerinin sınırları ve sorumlulukları açıkça dokümante edilmelidir. Aynı yeteneği farklı ürünlerle tekrar kurmaktan kaçınmak maliyeti kontrol eder. Kavramları rakip ürünler olarak değil birbirini tamamlayan mimari modeller olarak görmek daha gerçekçi sonuç verir.
Semantic Layer Nedir?
Semantic Layer, teknik veri modelleri ile iş dilindeki kavramlar arasında ortak anlam katmanı oluşturan mimari bileşendir. Gelir, aktif kullanıcı, müşteri veya churn gibi metrikler merkezi ve yeniden kullanılabilir biçimde tanımlanabilir. Böylece farklı BI araçları veya AI uygulamaları aynı iş mantığını tekrar tekrar yazmak zorunda kalmaz. Semantic layer veri fiziksel olarak farklı kaynaklarda bulunsa bile iş tanımını tutarlı tutabilir. Kurumsal ölçekte bu katman, yalnızca rapor tutarlılığı için değil AI sistemlerinin bağlamı doğru yorumlaması için de büyük değer taşır.
Business Meaning'i Merkezi Hale Getirmek
Business meaning'i merkezi hale getirmek, aynı kavramın farklı ekipler tarafından farklı yorumlanmasını azaltır. Örneğin müşteri sayısı bazı raporlarda hesabı, bazılarında gerçek kişiyi ifade edebilir. Semantic layer hangi bağlamda hangi tanımın kullanılacağını açık hale getirir. Tanımlar business glossary ve metric definitions ile ilişkilendirilebilir. Bu yapı toplantılarda sayıların neden farklı çıktığını tartışmak yerine kararın kendisine odaklanmayı kolaylaştırır.
Metric Definition
Metric definition bir iş metriğinin hangi formül, filtre, zaman aralığı ve veri kaynaklarıyla hesaplandığını açıkça belirtir. Yalnızca metrik adını paylaşmak yeterli değildir çünkü aynı gelir kavramı brüt veya net değer olarak yorumlanabilir. Merkezi metric definitions BI ve analytics ekiplerinin aynı hesaplamayı yeniden kullanmasını sağlar. Değişiklikler version control ve review süreciyle yönetilebilir. Bu yaklaşım metric layer'ı kurumsal semantic source of truth haline getirir.
Revenue
Revenue metriği ilk bakışta basit görünse de vergi, iade, indirim ve para birimi gibi ayrıntılar sonucu ciddi biçimde değiştirebilir. Semantic layer hangi işlemlerin gelire dahil olduğunu açıkça tanımlamalıdır. Farklı ülke veya ürün grupları için gerekli kurallar tek model altında yönetilebilir. Finans ve satış ekiplerinin aynı tanımı kullanması rapor tutarlılığını artırır. Revenue örneği semantic definitions neden teknik tablodan ayrı düşünülmelidir sorusuna güçlü bir örnektir.
Customer
Customer kavramı kişi, şirket, hesap veya ödeme yapan taraf gibi farklı anlamlara gelebilir. Her sistem kendi customer_id alanına sahip olduğunda bu fark kolayca gözden kaçabilir. Semantic model müşteri türlerini ve ilişkilerini açık biçimde tanımlayabilir. MDM ile ortak kimlik eşleştirmesi de bu modele bağlanabilir. Böylece analitik ve AI uygulamalarında müşteri kavramı daha tutarlı kullanılır.
Active user
Active user metriği bir kullanıcının hangi davranış gerçekleştiğinde aktif sayıldığını tanımlar. Login yapmak, işlem oluşturmak veya belirli bir özelliği kullanmak farklı ürünlerde farklı anlam taşıyabilir. Zaman penceresi de günlük, haftalık veya aylık olabilir. Semantic layer bu filtreleri merkezi hale getirerek dashboardlar arasında sayı farkını azaltır. Ürün ekipleri metriğin tanımını değiştirdiğinde etkilenebilecek raporlar lineage üzerinden izlenebilir.
Churn
Churn, bir müşteri veya kullanıcının hangi şartlarda kaybedilmiş kabul edildiğini ifade eder. Abonelik iptali bazı işlerde doğrudan churn iken kullanım aktivitesinin uzun süre durması başka işlerde daha anlamlı olabilir. Payda ve zaman aralığı tanımı churn oranını önemli ölçüde etkiler. Semantic layer bu hesaplamayı açık biçimde standartlaştırır. Böylece yönetim aynı metriğin farklı departmanlarda farklı anlamlarla kullanılmasının önüne geçebilir.
Semantic Model
Semantic Model, iş varlıkları, ilişkiler ve metriklerin kullanıcıların anlayabileceği kavramlarla ifade edildiği modeldir. Fiziksel tablo isimlerinden bağımsız bir soyutlama sağlayabilir. BI sorguları ve AI tool'ları bu model üzerinden güvenli ve tutarlı veri erişimi elde edebilir. Modelin domain sahipleriyle birlikte geliştirilmesi teknik ekiplerin iş anlamını yanlış yorumlama riskini azaltır. Versioning ve governance semantic model için de uygulanmalıdır.
Business Glossary
Business Glossary, kurumda kullanılan temel iş terimlerinin açık ve ortak tanımlarını içerir. Customer, order, revenue veya active user gibi kavramlar burada açıklanabilir. Glossary yalnızca belge deposu değil dataset, metric ve data product metadata'sıyla bağlantılı olmalıdır. Böylece kullanıcı bir terimi aradığında hangi veri varlıklarıyla ilişkili olduğunu görebilir. İyi glossary semantic consistency ve onboarding açısından önemli kolaylık sağlar.
Semantic Layer ile BI Tutarlılığı
BI araçları farklı ekipler tarafından bağımsız kullanıldığında aynı metriğin çok sayıda farklı hesaplaması oluşabilir. Semantic layer ortak metric definitions sunarak bu tekrarları azaltır. Dashboard aracı değişse bile iş mantığı korunabilir. Merkezi model üzerinde yapılan değişiklikler bütün tüketicilere kontrollü biçimde yansıtılabilir. Bu yapı raporlama güvenini ve bakım verimliliğini birlikte artırır.
AI İçin Semantic Layer
AI sistemleri kolon adlarını okuyabilir fakat iş kavramlarını doğru yorumlamak için ek bağlama ihtiyaç duyar. Semantic layer metrik tanımları, entity ilişkileri ve business glossary bilgilerini AI araçlarına sunabilir. Böylece modelin yanlış tabloyu veya yanlış hesaplamayı seçme riski azalır. Tool layer üzerinden sadece onaylı semantic query arayüzleri açmak güvenliği de güçlendirir. Kurumsal AI kullanımında semantic layer, ham database erişimine göre daha kontrollü ve açıklanabilir bir yaklaşım sağlar.
Enterprise Data Model Gerekli midir?
Enterprise Data Model, kurum genelindeki temel veri varlıklarını ve ilişkilerini ortak çerçevede tanımlamak için yararlıdır ancak her tabloyu merkezi olarak tasarlamak anlamına gelmemelidir. Conceptual ve logical modeller ortak iş kavramlarını netleştirirken domain modelleri yerel ihtiyaçlarda esneklik sağlar. Büyük merkezi model projeleri yıllarca sürüp gerçek kullanıma ulaşmadan eskime riski taşır. Bu nedenle kritik enterprise entities için ortak model, domain detaylarında ise federated yaklaşım daha uygulanabilir olabilir. Amaç kusursuz tek model kurmak değil, domainler arası veri paylaşımını kolaylaştıracak yeterli ortak dili oluşturmaktır.
Conceptual Data Model
Conceptual Data Model, iş dünyasındaki temel varlıkları ve aralarındaki yüksek seviyeli ilişkileri teknik ayrıntıya girmeden gösterir. Customer, Product, Order ve Supplier gibi kavramlar bu seviyede tanımlanabilir. Domainler arası ortak dil oluşturmak için özellikle yararlıdır. Teknik ekip ile iş ekiplerinin aynı modeli tartışabilmesi iletişimi kolaylaştırır. Model mümkün olduğunca sade tutulmalı ve gerçek iş kararlarını desteklemelidir.
Logical Data Model
Logical Data Model, conceptual modeldeki varlıkları daha ayrıntılı özellikler ve ilişkilerle tanımlar. Ancak henüz belirli bir veritabanı teknolojisine tamamen bağlı değildir. Primary key, ilişki ve temel normalizasyon kararları bu seviyede ele alınabilir. Data products ve semantic model tasarımında ortak referans sağlayabilir. Domain ekiplerinin kendi modelleriyle enterprise entity sınırlarını eşleştirmesine yardımcı olur.
Physical Data Model
Physical Data Model, verinin seçilen database, warehouse veya lakehouse üzerinde nasıl fiziksel olarak saklanacağını tanımlar. Partition, index, column type ve storage format gibi teknik kararlar bu seviyede alınır. Aynı logical model farklı platformlarda farklı physical yapılara sahip olabilir. Bu ayrım teknoloji değişimlerinin iş modeline etkisini azaltır. Performans optimizasyonları physical modelde yapılırken semantic anlamın korunması önemlidir.
Canonical Model
Canonical Model, farklı sistemlerin veri alışverişinde ortak bir temsil kullanmasını sağlayan modeldir. Her uygulamanın diğer uygulamanın özel şemasını öğrenmesi yerine ortak canonical schema üzerinden entegrasyon yapılabilir. Ancak aşırı geniş canonical modeller yönetimi zorlaştırabilir. Domain veya kullanım bağlamına göre sınırlı canonical definitions daha sürdürülebilir olabilir. Özellikle event ve API entegrasyonlarında bu model veri anlamını standartlaştırmaya yardımcı olur.
Domain Modelleri ile Enterprise Model Arasındaki Denge
Enterprise model bütün domain detaylarını merkezi olarak kontrol etmeye çalıştığında geliştirme yavaşlayabilir. Tamamen bağımsız domain modelleri ise ortak kavramların parçalanmasına yol açabilir. Sağlıklı denge kritik shared entities ve identifiers için enterprise standart, domain içi ayrıntılar için yerel esneklik sağlamaktır. Mapping ve semantic relationships iki seviye arasındaki bağlantıyı kurabilir. Federated governance bu model kararlarının nasıl alınacağını açıklaştırır.
Metadata-Driven Architecture Nedir?
Metadata-Driven Architecture, sistem davranışlarının mümkün olduğunca metadata tarafından yönlendirildiği mimari yaklaşımdır. Schema, classification, ownership, lineage ve quality rule gibi bilgiler yalnızca dokümantasyon amacıyla tutulmaz, otomasyon süreçlerinde aktif olarak kullanılır. Örneğin PII etiketi bulunan bir kolon otomatik olarak masking politikasına bağlanabilir. Yeni data product metadata'sı ingestion veya catalog publishing süreçlerini tetikleyebilir. Bu yaklaşım platform ekiplerinin yüzlerce veri ürününde aynı kuralları manuel olarak uygulama ihtiyacını azaltır.
Technical Metadata
Technical Metadata, tablo, kolon, veri tipi, partition, dosya formatı ve job bağımlılığı gibi teknik bilgileri kapsar. Bu bilgiler büyük ölçüde sistemlerden otomatik toplanabilir. Schema change detection ve lineage üretiminde önemli rol oynar. Geliştiriciler bir veri varlığının teknik yapısını hızlı biçimde anlayabilir. Technical metadata business ve operational metadata ile birleştiğinde daha zengin bir veri bağlamı ortaya çıkar.
Business Metadata
Business Metadata, verinin iş anlamını ve kullanım bağlamını açıklar. Business glossary tanımları, owner, domain ve metric açıklamaları bu kategoriye girer. Teknik kolon adlarının gerçek iş anlamını tek başına vermediği durumlarda kritik önem taşır. Domain ekiplerinin business metadata kalitesinde aktif rol alması gerekir. Catalog içinde teknik ve business metadata birlikte gösterildiğinde kullanıcı deneyimi belirgin biçimde iyileşir.
Operational Metadata
Operational Metadata, pipeline run, freshness, volume, query frequency ve incident gibi çalışma zamanı bilgilerini içerir. Bu veri data observability ve platform optimizasyonu için kullanılır. Bir datasetin ne zaman güncellendiği veya hangi kullanıcılar tarafından sık sorgulandığı operational metadata üzerinden görülebilir. Kullanılmayan veri ürünlerinin belirlenmesinde de değer sağlar. Active metadata sistemleri bu sinyallere göre otomatik aksiyon alabilir.
Social Metadata
Social Metadata, kullanıcı yorumları, derecelendirmeler, kullanım örnekleri ve topluluk etkileşimlerinden oluşur. Bir data product teknik olarak doğru olsa bile kullanıcı deneyimi hakkında önemli bilgiler sağlayabilir. Sık sorulan sorular veya tavsiye edilen kullanım örnekleri catalog içinde paylaşılabilir. Bu bilgi yeni tüketicilerin doğru ürünü seçmesini kolaylaştırır. Sosyal metadata resmi quality metriklerinin yerini tutmaz fakat kullanıcı güveni için yararlı tamamlayıcıdır.
Active Metadata
Active Metadata, metadata bilgisinin yalnızca depolanması değil sistem davranışını otomatik olarak yönlendirmesi yaklaşımıdır. Yeni bir PII alanı tespit edildiğinde access policy otomatik güncellenebilir. Freshness SLO ihlali owner'a alarm gönderebilir. Yeni data product belirli kalite koşullarını sağladıktan sonra catalog içinde approved durumuna geçebilir. Bu yaklaşım metadata'yı pasif katalog bilgisinden platform kontrol katmanına dönüştürür.
Metadata'nın Otomasyonda Kullanılması
Metadata otomasyonda kullanıldığında veri platformu kuralları yüzlerce ürün üzerinde daha tutarlı uygulanabilir. Classification security policy'yi, ownership alert routing'i, quality score publishing kararını yönlendirebilir. Pipeline template'leri schema metadata üzerinden otomatik oluşturulabilir. Bu model manuel operasyonu azaltırken standardizasyonu güçlendirir. Ancak yanlış metadata yanlış otomasyon üreteceği için metadata quality ayrıca ölçülmelidir.
Data Catalog Ne İşe Yarar?
Data Catalog, kurum içindeki veri varlıklarının bulunmasını, anlaşılmasını ve yönetilmesini kolaylaştıran merkezi keşif katmanıdır. Dataset, data product, metric, dashboard ve owner bilgileri ortak arayüzde gösterilebilir. İyi katalog yalnızca tablo listesinden oluşmaz, business glossary, lineage, quality ve usage metadata'yı birlikte sunar. Böylece kullanıcı doğru veriyi bulmak için ekipler arasında mesaj trafiği oluşturmak zorunda kalmaz. Catalog aynı zamanda data marketplace yaklaşımının ve data product adoption ölçümünün önemli altyapılarından biridir.
Search ve Discovery
Search ve Discovery, catalog kullanıcılarının iş kavramı veya teknik terim üzerinden doğru veriyi bulmasını sağlar. Arama yalnızca tablo adına göre çalışırsa teknik olmayan kullanıcılar zorlanabilir. Business glossary, açıklama ve usage metadata sonuç sıralamasını iyileştirebilir. Certified veya trusted data products sonuçlarda daha görünür gösterilebilir. İyi search deneyimi time-to-find data metriğini doğrudan düşürür.
Ownership
Catalog içinde ownership bilgisi her data product ve kritik dataset için görünür olmalıdır. Kullanıcı sorun veya erişim ihtiyacında hangi ekiple iletişim kuracağını bilmelidir. Owner bilgisinin organizasyon değişiklikleriyle otomatik güncellenmesi tercih edilir. Sahipsiz veri varlıkları belirli aralıklarla raporlanabilir. Bu özellik governance'ın günlük kullanımda gerçekten işe yarayan parçalarından biridir.
Classification
Classification, verinin hassasiyet ve iş kritikliğine göre etiketlenmesini sağlar. PII, finansal, gizli veya public gibi kategoriler kullanılabilir. Catalog bu bilgiyi kullanıcıya gösterirken security engine aynı metadata üzerinden policy uygulayabilir. Otomatik classification araçları ilk taramayı hızlandırabilir fakat kritik alanlarda insan doğrulaması gerekebilir. Sınıflandırmanın güncel kalması KVKK ve güvenlik kontrolleri açısından önemlidir.
Lineage
Lineage, bir veri varlığının hangi kaynaklardan üretildiğini ve hangi downstream tüketicilere aktığını gösterir. Catalog içinde görsel lineage kullanıcıların veri kökenini anlamasını kolaylaştırır. Schema değişikliği öncesinde impact analysis yapılabilir. Incident sırasında hatalı kaynağın hangi raporları etkilediği hızlı biçimde görülebilir. Bu özellik data trust ve change management için büyük değer taşır.
Quality
Catalog quality bilgilerini gösterdiğinde kullanıcı data product seçerken yalnızca açıklamaya değil ölçülebilir sinyallere de bakabilir. Freshness, completeness veya quality score gibi göstergeler ürün sayfasında sunulabilir. Son test zamanı ve incident geçmişi güven değerlendirmesine yardımcı olur. Kötü kaliteye sahip veri tamamen gizlenmek yerine durumu açıkça belirtilerek kullanılabilir. Böylece tüketici kullanım riskini bilinçli biçimde değerlendirebilir.
Data Marketplace
Data Marketplace, veri ürünlerinin kurum içinde keşfedilip erişim talebi verilebildiği tüketici odaklı deneyimdir. Catalog altyapısı bu deneyimin temelini oluşturabilir. Kullanıcı ürünü bulur, açıklamasını ve kalite seviyesini inceler, ardından otomatik erişim workflow'u başlatabilir. Approved use cases ve sample queries kullanım hızını artırır. Bu model veri platformunu teknik envanterden self-service tüketim kanalına dönüştürür.
Catalog ile Data Product İlişkisi
Catalog data product'ın kendisi değildir fakat ürünün bulunabilirliğini ve yönetimini sağlar. Data product metadata, owner, contract, quality ve interface bilgilerini catalog üzerinde yayınlayabilir. Catalog usage verileri ürün adoption ölçümünde kullanılabilir. Deprecated veya retired ürün durumları da burada açıkça gösterilmelidir. Böylece catalog data product lifecycle'ın merkezi görünürlük katmanına dönüşür.
Data Lineage Nedir?
Data Lineage, verinin kaynaktan tüketime kadar hangi sistem, dönüşüm ve veri ürünlerinden geçtiğini gösteren izlenebilirlik bilgisidir. Lineage yalnızca teknik merak için değil impact analysis, root cause analysis ve compliance gibi operasyonlarda doğrudan kullanılır. Dataset ve column seviyesinde farklı ayrıntı düzeyleri bulunabilir. Otomatik lineage toplama manuel dokümantasyona göre daha güncel sonuç sağlar. Özellikle yüzlerce pipeline bulunan kurumsal yapılarda lineage veri değişikliklerinin güvenli yönetimi için önemli bir temel oluşturur.
Column-Level Lineage
Column-Level Lineage, belirli bir hedef kolonun hangi kaynak kolonlardan ve dönüşümlerden üretildiğini gösterir. Finansal metrik veya PII alanı gibi kritik verilerde ayrıntılı izlenebilirlik sağlar. Bir kaynak kolon değiştiğinde hangi hedef alanların etkilenebileceği görülebilir. AI ve compliance kullanımında verinin kaynağını daha kesin açıklamaya yardımcı olur. Ancak bütün platformlarda column-level lineage toplamak teknik entegrasyon ve parsing desteği gerektirebilir.
Dataset-Level Lineage
Dataset-Level Lineage, tablo veya data product düzeyinde upstream ve downstream ilişkileri gösterir. Column-level ayrıntıya göre daha kolay toplanabilir ve birçok impact analysis için yeterli olabilir. Bir kaynak dataset başarısız olduğunda etkilenen downstream ürünler hızlıca belirlenebilir. Catalog görselleştirmeleri dataset lineage bilgisini kullanıcılar için anlaşılır hale getirir. Bu seviye lineage platform olgunluğu için iyi bir başlangıç noktasıdır.
End-to-End Lineage
End-to-End Lineage, verinin operasyonel kaynaktan son rapor, API veya AI kullanımına kadar bütün yolunu takip etmeyi hedefler. Farklı ingestion, transformation ve serving teknolojileri arasında metadata entegrasyonu gerektirir. Bu görünüm audit ve kritik incident yönetiminde çok değerlidir. Farklı sistemlerin lineage formatlarını ortak modele taşımak için açık metadata standartları kullanılabilir. Tam kapsam bir anda kurulmak yerine kritik veri ürünlerinden başlanması daha uygulanabilir olabilir.
Impact Analysis
Impact Analysis, planlanan bir veri değişikliğinin hangi downstream tüketicileri etkileyebileceğini önceden belirler. Schema değişikliği, pipeline kaldırma veya domain migration gibi işlemlerde kullanılır. Lineage grafiği etkilenen data products, dashboard ve uygulamaları gösterebilir. Usage metadata ile aktif ve pasif bağımlılıklar ayrıştırılabilir. Bu bilgi change review sürecini daha hızlı ve güvenli hale getirir.
Root Cause Analysis
Root Cause Analysis, bir veri problemine yol açan asıl upstream kaynağı belirleme sürecidir. Hatalı dashboard değerinin nerede oluştuğunu elle pipeline zinciri takip ederek bulmak zaman alabilir. Lineage ve observability sinyalleri problem noktalarını daraltır. İlk bozuk veri dağılımının hangi job veya source sonrasında başladığı görülebilir. Bu sayede incident çözüm süresi önemli ölçüde azaltılabilir.
Compliance
Compliance açısından lineage kişisel veya düzenlemeye tabi verinin nereden geldiğini ve nereye aktığını göstermeye yardımcı olur. Bir PII alanının hangi downstream datasetlere kopyalandığı görülebilir. Erasure veya retention işlemlerinde ilgili veri akışlarını belirlemek kolaylaşır. Audit ekipleri belirli raporun hangi kaynaklardan üretildiğini kanıtlayabilir. Lineage böylece yalnızca teknik operasyon değil kurumsal uyum altyapısının da parçası olur.
Data Quality Nasıl Yönetilmelidir?
Data Quality yönetimi doğruluk, completeness, consistency, validity, uniqueness ve timeliness gibi birden fazla boyutu birlikte değerlendirmelidir. Her veri alanına aynı kalite hedefini koymak yerine iş kritikliğine göre önceliklendirme yapmak daha verimlidir. Kalite kuralları data contract içinde tanımlanıp producer ve data product seviyesinde otomatik çalıştırılabilir. Quality sonuçları owner ve consumer tarafından görünür olmalıdır. Başarılı kalite yönetimi yalnızca hataları bulmak değil, tekrar eden sorunların kaynağını iyileştirmektir.
Accuracy
Accuracy, verinin gerçek dünyadaki durumu ne kadar doğru temsil ettiğini ölçer. Bir adresin formatı geçerli olabilir fakat yanlış kişiye aitse validity testini geçmesine rağmen accuracy sorunu vardır. Doğruluğu ölçmek bazen harici referans veya iş doğrulaması gerektirir. Kritik alanlarda örnekleme ve reconciliation yöntemleri kullanılabilir. Accuracy ölçümleri veri ürününün kullanım amacına göre tanımlanmalıdır.
Completeness
Completeness, gerekli veri alanlarının veya kayıtların ne ölçüde mevcut olduğunu gösterir. Null oranı temel bir metrik olabilir fakat her null değerin hata olmadığını bilmek gerekir. Kaynak sistemin belirli bir saatlik partition'ı göndermemesi kayıt completeness problemi oluşturabilir. İş açısından zorunlu alanlar contract içinde açıkça tanımlanmalıdır. Trend izleme beklenmeyen eksiklik artışlarını erken tespit etmeye yardımcı olur.
Consistency
Consistency, aynı bilginin farklı veri kaynakları veya kayıtlar arasında çelişmemesini ifade eder. Müşteri statüsü iki sistemde farklı görünüyorsa hangi kaynağın yetkili olduğu belirlenmelidir. MDM, reference data ve canonical definitions consistency sorunlarını azaltabilir. Cross-dataset reconciliation kuralları kritik verilerde otomatik çalıştırılabilir. Tutarlılık yalnızca teknik karşılaştırma değil source of truth kararlarıyla birlikte yönetilmelidir.
Validity
Validity, bir değerin tanımlı format veya iş kuralına uygun olup olmadığını gösterir. Tarih formatı, kod listesi veya değer aralığı kontrolleri buna örnektir. Schema validation teknik validity sağlarken domain rule'ları iş validity'sini kontrol eder. Geçersiz kayıtlar doğrudan silinmek yerine quarantine edilip incelenebilir. Kuralların contract içinde tanımlanması producer ve consumer beklentisini ortaklaştırır.
Uniqueness
Uniqueness, tekil olması gereken kayıt veya kimliklerin gerçekten tekrar etmemesini ölçer. Customer ID veya transaction ID gibi alanlarda duplicate kayıt ciddi analitik hatalara yol açabilir. Streaming sistemlerde retry ve at-least-once delivery duplicate event oluşturabileceği için idempotency tasarımı önemlidir. Quality testleri uniqueness oranını düzenli olarak kontrol edebilir. Sorun ortaya çıktığında yalnızca duplicate kayıtları silmek yerine üretim nedenini düzeltmek gerekir.
Timeliness
Timeliness, verinin iş kullanımına ihtiyaç duyulan zaman içinde hazır olup olmadığını ifade eder. Günlük finans raporunun birkaç dakika gecikmesi sorun olmayabilirken fraud event'inin saatler sonra gelmesi kabul edilemez. Her data product için iş ihtiyacına uygun freshness SLO belirlenmelidir. Gecikmenin hangi pipeline aşamasında oluştuğu observability ile takip edilebilir. Böylece gerçek zaman ihtiyacı olmayan veriler için gereksiz altyapı maliyeti önlenebilir.
Quality SLO'ları
Quality SLO'ları veri kalitesi beklentilerini ölçülebilir hizmet hedeflerine dönüştürür. Örneğin kritik customer ID alanında uniqueness yüzde 99,99 veya partition completeness yüzde 100 hedeflenebilir. Hedefler gerçek tüketici ihtiyacına göre tanımlanmalıdır. Sürekli ihlal edilen SLO ürün riskinin görünür olmasını sağlar. Quality SLO yaklaşımı veri kalitesini soyut hedef olmaktan çıkarıp operasyonel güvenilirlik metriğine dönüştürür.
Data Observability Nedir?
Data Observability, veri pipeline ve data products üzerindeki beklenmeyen değişiklikleri freshness, volume, schema, distribution ve lineage gibi sinyaller üzerinden izleme yaklaşımıdır. Geleneksel application monitoring yalnızca job başarısını gösterebilir fakat işlenen verinin doğru olup olmadığını söylemeyebilir. Pipeline başarılı çalışırken boş dosya gelmesi tipik bir veri incident örneğidir. Observability veri davranışını izleyerek bu sessiz sorunları daha erken yakalamayı hedefler. Incident management ve ownership süreçleriyle birleştiğinde veri güvenilirliğini ölçülebilir biçimde geliştirebilir.
Freshness
Freshness observability, verinin beklenen zaman aralığında güncellenip güncellenmediğini izler. Her dataset için sabit eşik kullanmak yerine normal güncelleme ritmine göre baseline oluşturulabilir. Gecikme business-critical ürünlerde daha hızlı alarm üretebilir. Upstream lineage hangi kaynağın geciktiğini belirlemeye yardımcı olur. Freshness metriği tüketicilerin eski veriyle karar vermesini önlemek açısından önemlidir.
Volume
Volume monitoring, dataset veya partition içindeki kayıt sayısının beklenen aralıkta olup olmadığını kontrol eder. Ani yüzde 90 düşüş kaynak extraction problemini gösterebilir. Beklenmeyen büyük artış duplicate event veya yanlış join sonucu oluşabilir. Mevsimsel değişimlerin yanlış alarm üretmemesi için tarihsel baseline kullanılabilir. Volume sinyali basit olmasına rağmen birçok veri incidentını erken yakalayabilir.
Schema
Schema observability, kolon ekleme, silme, veri tipi değiştirme veya nested structure değişikliklerini izler. Contract dışında gerçekleşen değişiklikler tüketicileri kırabilir. Schema registry ve metadata scanning otomatik değişiklik tespiti sağlayabilir. Değişiklik owner ve etkilenen consumer ekiplerine iletilebilir. Bu özellik özellikle çok sayıda bağımsız producer bulunan yapılarda önemli koruma sağlar.
Distribution
Distribution monitoring, veri değerlerinin istatistiksel dağılımındaki beklenmeyen değişimleri tespit eder. Ortalama, null oranı, kategori dağılımı veya quantile değerleri takip edilebilir. Schema değişmeden veri anlamı bozulduğunda distribution sinyalleri sorunu gösterebilir. Örneğin bütün sipariş tutarlarının aniden sıfıra dönmesi teknik pipeline başarısına rağmen ciddi problemdir. Doğru baseline ve iş bağlamı yanlış alarm oranını azaltır.
Lineage
Lineage observability içinde incident etkisinin belirlenmesi için kullanılır. Bozulan upstream data product'ın hangi downstream dashboard veya AI modelini etkilediği hızlı biçimde görülebilir. Alert önceliği etkilenen tüketici sayısına göre yükseltilebilir. Root cause analysis sırasında zincirin ilk bozulduğu nokta incelenebilir. Böylece observability tek dataset izlemesinden kurumsal veri bağımlılığı yönetimine genişler.
Data Incident Management
Data Incident Management, veri sorunlarının tespit, önceliklendirme, çözüm ve öğrenme süreçlerini standartlaştırır. Incident owner ve etkilenen consumer bilgileri otomatik oluşturulabilir. Post-incident review tekrar eden hataların asıl nedenini ele almalıdır. Sadece pipeline yeniden çalıştırmak kalıcı çözüm sağlamayabilir. Zaman içinde mean time to detect ve mean time to resolve gibi metrikler platform güvenilirliğini ölçmek için kullanılabilir.
Application Observability ile Farkı
Application observability CPU, memory, latency, error rate veya request başarısı gibi uygulama davranışlarına odaklanır. Data observability ise verinin güncelliği, hacmi, schema ve distribution gibi veri sinyallerini izler. Bir uygulama teknik olarak tamamen sağlıklı çalışırken yanlış veriyi başarılı biçimde işleyebilir. Bu nedenle kurumsal data platformlarda iki gözlem türü birlikte kullanılmalıdır. Ortak incident management sistemi teknik ve veri kaynaklı sorunları aynı operasyon çerçevesinde yönetebilir.
Batch ve Streaming Data Architecture
Batch ve streaming mimarileri verinin ne kadar hızlı işlenmesi gerektiğine göre farklı avantajlar sunar. Batch belirli aralıklarla büyük veri gruplarını işlerken streaming olayları sürekli ve düşük gecikmeyle işler. Near-real-time ve CDC iki yaklaşım arasında pratik ara modeller sağlayabilir. Her veriyi streaming yapmak işletim ve maliyet yükünü gereksiz artırabilir. Doğru seçim iş kararının gerçek latency ihtiyacına, veri hacmine ve hata toleransına göre yapılmalıdır.
Batch Processing
Batch Processing, verinin dakika, saat veya günlük gibi belirli aralıklarla toplu olarak işlenmesidir. Finans raporlama, günlük aggregations veya büyük tarihsel dönüşümler için oldukça etkilidir. Toplu işleme operasyon olarak streaming sistemlerden daha basit olabilir. Replay ve backfill işlemleri de batch ortamında kolay yönetilebilir. Gerçek zaman gerektirmeyen workload'larda batch genellikle daha ekonomik ve sürdürülebilir seçimdir.
Near-Real-Time
Near-Real-Time, birkaç saniye veya dakika gecikmenin kabul edilebilir olduğu veri işleme modelidir. Micro-batch veya sık CDC yüklemeleriyle uygulanabilir. Birçok dashboard ve operasyonel analitik için gerçek streaming seviyesinde latency gerekmeyebilir. Bu yaklaşım düşük gecikme ile operasyon sadeliği arasında denge kurar. İş ihtiyacını doğru tanımlamak gereksiz real-time altyapı yatırımını önler.
Streaming
Streaming, event veya kayıtların üretildikçe sürekli biçimde işlendiği modeldir. Fraud detection, canlı telemetry veya anlık kullanıcı deneyimi gibi kullanım senaryolarında değerlidir. Event ordering, duplicate handling ve state management tasarımın önemli parçalarıdır. Streaming pipeline'larının test ve observability süreçleri batch'e göre daha farklı ihtiyaçlar taşıyabilir. Bu nedenle gerçek iş değeri olmadan streaming tercih edilmemelidir.
CDC
CDC, operasyonel database değişikliklerini insert, update ve delete seviyesinde yakalayıp diğer sistemlere aktarma yöntemidir. Log-based CDC kaynak veritabanına ek sorgu yükünü azaltabilir. Analytics platformlarını daha düşük gecikmeyle beslemek veya migration sürecini desteklemek için kullanılabilir. CDC eventlerinin sıralama, duplicate ve schema evolution kuralları iyi tasarlanmalıdır. Kaynak database transactionlarını doğrudan domain event sanmak da önemli bir modelleme hatası olabilir.
Event Streaming
Event Streaming, domain veya sistem olaylarının sürekli event log üzerinden yayınlanıp tüketilmesini sağlar. Kafka benzeri platformlar yüksek hacimli event akışlarını farklı consumer gruplarına sunabilir. Eventlerin iş anlamı ve schema sözleşmesi açık olmalıdır. Replay özelliği yeni consumerların geçmiş olayları yeniden işlemesine imkan verir. Event streaming operasyonel entegrasyon ve data product dağıtımı için güçlü bir temel olabilir.
Hangi Veri İçin Hangisi Kullanılmalı?
Seçim yaparken ilk soru verinin ne kadar hızlı gelmesi değil iş kararının ne kadar hızlı verilmesi gerektiğidir. Günlük finansal kapanış için streaming kurmak gereksiz olabilir. Fraud alarmı veya stok rezervasyonu ise düşük latency gerektirebilir. Batch, micro-batch, CDC ve streaming aynı kurumda farklı data products için birlikte kullanılabilir. Mimari standardizasyon bütün workload'ları tek modele zorlamak değil uygun seçenekleri hazır platform yolları olarak sunmaktır.
Event-Driven Data Architecture
Event-Driven Data Architecture, sistemlerin önemli iş olaylarını event olarak yayınlayıp diğer sistemlerin bu olaylara bağımsız biçimde tepki vermesini sağlayan modeldir. OrderCreated veya PaymentCompleted gibi domain events uygulamalar arasında güçlü veri paylaşım birimleri olabilir. Event bus producer ile consumer arasındaki zaman bağımlılığını azaltır. Schema registry, versioning ve replay event yaşam döngüsünün güvenilirliğini artırır. Event-driven yaklaşım operasyonel entegrasyon ile real-time data products arasında doğal bir köprü oluşturabilir.
Events
Event, geçmişte gerçekleşmiş ve iş açısından anlam taşıyan bir durumu temsil eder. İyi event adı teknik işlemden çok iş olayını ifade eder. OrderCreated veya CustomerAddressChanged gibi isimler tüketicinin olayı anlamasını kolaylaştırır. Event payload gereğinden fazla kaynak sistem ayrıntısı taşımamalıdır. Her event tekrar işlenebileceği için identifier ve timestamp gibi metadata alanları önemlidir.
Event Bus
Event Bus, producerların event yayınladığı ve consumerların bağımsız biçimde abone olduğu iletişim altyapısıdır. Bu model doğrudan servis bağlantılarının sayısını azaltabilir. Consumer grupları aynı event stream'i farklı amaçlarla işleyebilir. Availability, retention ve partitioning ayarları iş kritikliğine göre planlanmalıdır. Event bus bütün entegrasyon sorunlarını çözmez, event tasarımı ve governance ayrıca gereklidir.
Event Schema
Event Schema, event payload içindeki alanların yapısını ve veri tiplerini tanımlar. Producer ve consumer ekipleri bu sözleşmeye göre bağımsız geliştirme yapabilir. Schema'nın keyfi değişmesi çok sayıda downstream sistemi etkileyebilir. Compatibility kuralları deployment öncesinde doğrulanmalıdır. Schema ile business semantics birlikte dokümante edildiğinde event daha yeniden kullanılabilir hale gelir.
Schema Registry
Schema Registry, event schema'larının merkezi olarak yayınlandığı ve versiyonlandığı servistir. Producer yeni schema yayınlamadan önce compatibility kontrolü yapılabilir. Consumer doğru sürümü kullanarak payload'ı güvenli biçimde okuyabilir. Registry event governance'ın teknik enforcement noktalarından biri haline gelir. Ancak semantic değişikliklerin de review edilmesi gerektiği unutulmamalıdır.
Event Versioning
Event Versioning, event sözleşmesindeki değişikliklerin kontrollü biçimde yönetilmesini sağlar. Yeni optional alanlar çoğu zaman geriye uyumlu olabilir. Alan silme veya anlam değişikliği yeni versiyon gerektirebilir. Eski ve yeni event versiyonları belirli migration döneminde paralel çalışabilir. Consumer usage bilgisi eski sürümün ne zaman kapatılabileceğini göstermeye yardımcı olur.
Event Replay
Event Replay, geçmişte yayınlanmış eventlerin yeniden tüketilmesini sağlar. Yeni bir consumer geçmiş veriden kendi state'ini oluşturabilir. Hatalı processing kodu düzeltildikten sonra belirli offset'ten yeniden işleme yapılabilir. Idempotency ve duplicate handling replay tasarımının önemli gereksinimleridir. Doğru retention politikası replay penceresinin ne kadar geçmişe gidebileceğini belirler.
Event-Driven Data Product
Event-Driven Data Product, veriyi batch dataset yerine kararlı event interface üzerinden tüketicilere sunan veri ürünüdür. Owner, schema, SLO ve quality beklentileri stream için de tanımlanmalıdır. Tüketici event bus iç yapısına değil data product sözleşmesine bağımlı olmalıdır. Streaming observability lag, event rate ve schema gibi sinyalleri izleyebilir. Böylece event stream yalnızca teknik topic olmaktan çıkıp sahipli kurumsal veri ürününe dönüşür.
Change Data Capture (CDC) Nedir?
Change Data Capture, operasyonel veri tabanında gerçekleşen ekleme, güncelleme ve silme işlemlerini yakalayıp diğer sistemlere aktarma yöntemidir. CDC özellikle legacy migration, real-time analytics ve data synchronization projelerinde kullanışlıdır. Log-based yöntemler kaynak database transaction loglarını okuyarak değişiklikleri düşük ek yükle aktarabilir. Ancak database değişiklikleri her zaman business event anlamına gelmez, bu iki kavram ayrıştırılmalıdır. Duplicate handling, ordering ve schema evolution CDC tasarımında dikkat edilmesi gereken temel konulardır.
Database Log-Based CDC
Database Log-Based CDC, değişiklikleri kaynak veritabanının transaction logundan okuyarak yakalar. Tabloyu sürekli sorgulayan polling yaklaşımına göre kaynak sistem üzerinde daha düşük ek yük oluşturabilir. Insert, update ve delete işlemleri sıralı eventler halinde downstream sistemlere aktarılabilir. Log retention ve connector recovery süreçleri operasyonel olarak planlanmalıdır. Özellikle yüksek hacimli veri replikasyonu için etkili bir yöntemdir.
Outbox Pattern
Outbox Pattern, uygulamanın database işlemi ile event yayınlama süreci arasında tutarlılık sağlamaya yardımcı olur. Uygulama business değişikliğiyle birlikte outbox tablosuna event kaydını aynı transaction içinde yazar. CDC veya publisher bu kaydı event bus'a aktarır. Böylece database commit başarılı olup event yayınlamanın başarısız olduğu ikili yazma problemi azaltılır. Consumer tarafında yine idempotent processing tasarımı gerekir.
CDC ile Streaming
CDC değişiklikleri event platformuna aktarıldığında operasyonel database ile streaming data pipeline arasında köprü kurulabilir. Downstream processing sistemi kayıtları gerçek zamana yakın biçimde dönüştürebilir. Ancak raw CDC eventlerinin domain semantics açısından yetersiz olabileceği unutulmamalıdır. Gerekirse processing katmanında daha anlamlı domain veya data product eventleri üretilmelidir. Bu ayrım teknik replikasyon ile iş entegrasyonunu birbirine karıştırmayı önler.
CDC ile Data Product Üretmek
CDC verisi data product üretimi için güçlü bir kaynak olabilir. Raw change events Silver modelde conformed kayıt haline getirildikten sonra domain data product olarak yayınlanabilir. Owner, schema ve quality kuralları bu ürünün parçası olmalıdır. Consumerların raw database log semantics öğrenmesi beklenmemelidir. Bu yöntem legacy kaynakları modern veri ürünlerine kademeli biçimde bağlamak için etkilidir.
Duplicate Event Problemi
Distributed streaming sistemlerde aynı eventin birden fazla kez teslim edilmesi normal bir durum olabilir. Consumer tarafında idempotent processing tasarımı duplicate etkisini azaltır. Unique event identifier veya transaction identifier tekrarların tespit edilmesine yardımcı olur. Exactly-once iddiası bütün uçtan uca sistemde her zaman kolay sağlanmaz. Bu nedenle iş operasyonlarının tekrar çalıştırıldığında güvenli davranması temel tasarım hedefi olmalıdır.
Operational ve Analytical Data Nasıl Ayrılır?
Operational ve analytical data farklı sorgu ve güncelleme özelliklerine sahip olduğu için aynı sistemde aynı modelle yönetilmeye çalışıldığında performans ve tasarım sorunları oluşabilir. OLTP sistemleri kısa ve güvenilir transactionlara, OLAP sistemleri geniş taramalı analitik sorgulara optimize edilir. Operational data source of truth olarak kalırken warehouse veya lakehouse analitik kopyalar sunabilir. Real-time serving ihtiyaçları için ayrıca düşük latency store kullanılabilir. Aynı veri farklı serving modellerinde bulunabilir fakat lineage ve ownership ilişkisi açık olmalıdır.
OLTP
OLTP sistemleri sipariş oluşturma, ödeme kaydetme veya kullanıcı güncelleme gibi kısa operasyonel transactionları yönetir. Yüksek eş zamanlı yazma ve güçlü transaction garantileri önemlidir. Analitik sorguların büyük tabloları taraması operasyonel performansı olumsuz etkileyebilir. Bu nedenle OLTP verisi CDC veya batch ingestion yoluyla analitik platforma aktarılabilir. Kaynak sistem yine operasyonel gerçeğin yetkili kaynağı olarak kalabilir.
OLAP
OLAP sistemleri büyük veri kümeleri üzerinde aggregation ve analitik sorgular için optimize edilir. Columnar storage ve parallel execution gibi teknikler geniş taramaları hızlandırabilir. Kullanıcılar uzun dönem trendlerini veya çok boyutlu raporları bu sistemlerde çalıştırabilir. OLAP verisi çoğu zaman birden fazla operasyonel kaynaktan birleştirilir. İş kuralları ve semantic definitions analitik tutarlılık için açık biçimde yönetilmelidir.
Operational Data Store
Operational Data Store, birden fazla operasyonel kaynaktan gelen güncel veriyi belirli operasyonel sorgular için bir araya getirebilir. Warehouse kadar tarihsel veya ağır analitik odaklı olmayabilir. Müşteri hizmetleri ekranı gibi birleştirilmiş güncel görünüm gereken durumlarda kullanılabilir. Güncellik ve transaction ihtiyaçları mimari seçimi etkiler. ODS yeni source of truth yaratmamalı, kaynak sistemlerle ilişkisi açıkça tanımlanmalıdır.
Analytics Warehouse
Analytics Warehouse, raporlama ve karar destek için uyumlandırılmış kurumsal veriyi sunar. Tarihsel kayıtlar, dimensions ve business metrics burada yönetilebilir. Kaynak sistemlerden farklı olarak analitik sorgulara uygun fiziksel model kullanılır. Semantic layer warehouse üzerinde ortak metrikler oluşturabilir. Güvenilir warehouse birçok kurumda analytical source of truth görevi görür.
Real-Time Serving
Real-Time Serving, düşük latency ile güncel verinin uygulama veya AI kullanımına sunulduğu katmandır. Feature store, key-value store veya özel query service bu amaçla kullanılabilir. Analytics warehouse her zaman milisaniye cevap süresi için uygun değildir. Data product aynı iş gerçeğini farklı serving interface üzerinden sunabilir. Sync ve freshness kuralları bu kopyaların güvenilir kalmasını sağlar.
Aynı Verinin Farklı Serving Modelleri
Aynı veri farklı tüketim ihtiyaçları nedeniyle birden fazla fiziksel serving modelinde bulunabilir. Analist SQL tablosu, uygulama API, agent ise semantic tool interface kullanabilir. Bu durum data duplication olarak görülse de kontrollü ve lineage ile izlenen kopyalar mimari açıdan kabul edilebilir. Source of truth ve regeneration süreci açıkça tanımlanmalıdır. Böylece performans esnekliği ile veri tutarlılığı birlikte yönetilebilir.
Data-Centric Mimarilerde API'lerin Rolü
API'ler data-centric mimarilerde veriyi kaynak sistemin iç yapısından bağımsız biçimde sunmanın önemli yollarından biridir. Data API, REST, GraphQL, gRPC, event interface ve query interface farklı tüketim ihtiyaçlarına hizmet eder. Data product bir veya daha fazla output port üzerinden erişim sağlayabilir. API tasarımında schema contract, authorization, versioning ve observability veri platformu kadar önemlidir. Kaynak veritabanına doğrudan erişim yerine kontrollü interface sunmak değişiklik ve güvenlik yönetimini kolaylaştırır.
Data API
Data API, belirli bir data product veya veri domainine programatik erişim sağlayan arayüzdür. Tüketici fiziksel database şemasını öğrenmek yerine açık sözleşme üzerinden veri alır. Rate limit, authorization ve versioning API seviyesinde yönetilebilir. Özellikle operasyonel veya düşük latency tüketim senaryolarında yararlıdır. Data API aynı data product'ın SQL veya event interface ile birlikte sunduğu output portlardan biri olabilir.
REST
REST, HTTP tabanlı ve geniş ekosistem desteğine sahip yaygın API yaklaşımıdır. Resource odaklı veri erişimi ve basit entegrasyonlarda güçlüdür. Data product belirli entity veya aggregate'leri REST endpoint üzerinden sunabilir. Pagination, caching ve versioning kuralları baştan düşünülmelidir. Büyük analitik veri aktarımlarında REST her zaman en verimli yöntem olmayabileceği için kullanım bağlamı önemlidir.
GraphQL
GraphQL, consumer'ın ihtiyaç duyduğu alanları sorgu içinde seçmesine izin veren esnek API yaklaşımıdır. Birden fazla entity relationship bulunan veri servislerinde tüketici deneyimini iyileştirebilir. Ancak sorgu maliyeti ve authorization daha ayrıntılı kontrol gerektirir. Semantic model ile birlikte kullanıldığında iş varlıklarına zengin erişim sunabilir. Her kullanım senaryosunda REST'in yerine geçmesi gerekmez, özellikle kontrollü query ihtiyacında değerlidir.
gRPC
gRPC, yüksek performanslı servis iletişimi ve güçlü schema tanımları için kullanılabilir. Protocol Buffers interface contract'ı açık biçimde tanımlar. İç servisler arasında düşük latency veri erişimi gereken durumlarda etkili olabilir. Browser veya dış ekosistem entegrasyonu ihtiyaçları ayrıca değerlendirilmelidir. Data product serving tasarımında performans gereksinimi ve tüketici teknolojileri seçim üzerinde belirleyici olmalıdır.
Event Interface
Event Interface, data product değişikliklerini sürekli event stream üzerinden sunar. Consumer polling yapmak yerine yeni olayları doğrudan tüketebilir. Schema registry ve event versioning interface güvenilirliğini artırır. Replay desteği yeni consumerların geçmiş eventlerden state oluşturmasını sağlar. Real-time entegrasyon ve reactive application tasarımlarında güçlü bir output port olabilir.
Query Interface
Query Interface, tüketicilerin data product üzerinde SQL veya benzeri sorgu diliyle esnek analiz yapmasını sağlar. Büyük analitik veri setleri için API üzerinden satır satır veri taşımaktan daha verimli olabilir. Row ve column security query engine seviyesinde uygulanabilir. Semantic layer query interface üzerinde ortak metrikler sunabilir. Workload isolation yoğun sorguların diğer tüketicileri etkilemesini önlemek için önemlidir.
Data Product Output Ports
Data Product Output Ports, aynı veri ürününün farklı tüketim yöntemlerini standart arayüzler halinde sunmasını ifade eder. Bir ürün SQL table, REST API ve event stream çıkışlarını birlikte sağlayabilir. Her output port aynı semantic gerçeği farklı performans veya kullanım ihtiyacına uyarlar. Tüketiciler internal implementation yerine bu kararlı arayüzlere bağımlı olur. Bu model data product'ın gerçek servis davranışı kazanmasına yardımcı olur.
Data Virtualization ve Zero-Copy Yaklaşımı
Data Virtualization ve zero-copy yaklaşımları veriyi her kullanım için fiziksel olarak yeni bir platforma taşımadan erişilebilir hale getirmeyi hedefler. Federation farklı kaynaklara ortak query katmanı sunarken zero-copy sharing mevcut veri üzerinde kontrollü paylaşım sağlar. Bu yöntemler data movement maliyetini ve duplicate storage ihtiyacını azaltabilir. Ancak performans, kaynak yükü, güvenlik ve network maliyeti mutlaka değerlendirilmelidir. Bazı workload'larda fiziksel veri kopyalamak hâlâ daha iyi performans ve izolasyon sağlayabilir.
Data Virtualization Nedir?
Data Virtualization, farklı veri kaynaklarını fiziksel olarak birleştirmeden ortak mantıksal görünüm üzerinden sorgulama yaklaşımıdır. Kullanıcı tek query interface üzerinden birden fazla database veya lake kaynağına erişebilir. Bu yöntem hızlı entegrasyon ve discovery için yararlı olabilir. Kaynak sistem latency ve availability özellikleri sorgu performansını doğrudan etkileyebilir. Bu nedenle virtualization her workload için fiziksel warehouse alternatifi olarak görülmemelidir.
Federation
Federation, tek sorgunun birden fazla bağımsız veri kaynağında çalıştırılmasını sağlar. Query engine sorgunun parçalarını ilgili kaynaklara yönlendirebilir. Cross-cloud veya hybrid data access için kullanışlıdır. Büyük join işlemlerinde network transferi ve kaynak performansı sorun oluşturabilir. Optimizer ve query pushdown özellikleri federation performansını belirleyen önemli faktörlerdir.
Query Pushdown
Query Pushdown, filtre veya aggregation gibi işlemlerin veriyi merkezi engine'e taşımadan kaynak sistemde çalıştırılmasını sağlar. Bu yöntem network transferini azaltabilir ve kaynak sistemin kendi index veya compute avantajlarını kullanabilir. Her connector aynı pushdown yeteneğini sunmayabilir. Sorgu planının gözlemlenebilir olması performans sorunlarını analiz etmeyi kolaylaştırır. Pushdown data virtualization'ın pratik performansında önemli rol oynar.
Zero-Copy Sharing
Zero-Copy Sharing, verinin ayrı fiziksel kopyasını oluşturmadan başka kullanıcı veya hesaplara erişim verilmesini sağlar. Böylece storage tekrarı ve senkronizasyon ihtiyacı azaltılabilir. Yetkilendirme ve audit merkezi veri üzerinde uygulanabilir. Cross-region veya farklı platform senaryolarında fiziksel sınırlar yine dikkate alınmalıdır. Data product erişimini zero-copy ile sunmak bazı analitik iş yüklerinde oldukça verimli olabilir.
Ne Zaman Veri Taşımak Gerekir?
Veri taşımak performans, izolasyon, regülasyon veya çalışma sürekliliği nedeniyle gerekli olabilir. Kaynak sistem ağır analitik sorguları kaldıramıyorsa ayrı analitik kopya oluşturmak daha güvenlidir. Bölgesel data residency kuralları fiziksel yerleşimi zorunlu kılabilir. ML training gibi yüksek throughput workload'lar veriyi compute'a yakın tutmaktan fayda görebilir. Bu nedenle zero-copy hedefi mutlak kural değil, veri hareketini gereksiz olduğu yerlerde azaltma prensibi olmalıdır.
Performans ve Governance Trade-Off'ları
Virtualization data movement'ı azaltırken kaynak performansına bağımlılığı artırabilir. Fiziksel kopyalar daha iyi izolasyon sağlarken ek governance ve senkronizasyon yükü oluşturur. Hassas verinin kaç fiziksel kopyasının bulunduğu compliance açısından önemlidir. Query federation merkezi access policy sağlayabilir fakat kaynak sistem yetkileriyle uyumlu çalışmalıdır. Mimari karar performans, maliyet ve governance hedeflerinin birlikte değerlendirilmesini gerektirir.
Kurumsal Master Data Management (MDM)
Master Data Management, müşteri, ürün ve tedarikçi gibi kurumun temel iş varlıklarının ortak kimlik ve tanımlarla yönetilmesini sağlar. Farklı sistemlerde aynı entity için birden fazla kayıt oluştuğunda entity resolution ve golden record süreçleri kullanılır. MDM data-centric architecture içinde bütün veriyi merkezi sisteme taşımaktan çok ortak referans oluşturma görevi görür. Data products MDM tarafından yönetilen master kayıtları standart interface üzerinden diğer domainlere sunabilir. Bu yapı özellikle merger, çok kanallı satış ve geniş uygulama portföyü bulunan kurumlarda veri tutarlılığını güçlendirir.
Customer Master
Customer Master, farklı uygulamalardaki müşteri kayıtlarını ortak kimlik altında yönetir. Aynı kişi CRM, e-ticaret ve destek sisteminde farklı ID'lerle bulunabilir. Matching ve entity resolution süreçleri bu kayıtların ilişkilendirilmesine yardımcı olur. Golden record hangi alanın hangi kaynaktan öncelikli alınacağını tanımlayabilir. Customer data product bu ortak kimliği diğer sistemlere güvenli biçimde sunabilir.
Product Master
Product Master, ürün kimliği, kategori, özellik ve temel referans bilgilerinin ortak yönetimini sağlar. E-ticaret, ERP ve depo sistemlerinde farklı ürün kodları kullanıldığında entegrasyon zorlaşabilir. Ortak product identifier ve hierarchy analitik tutarlılığı artırır. Domain özel ürün özellikleri merkezi modelin dışında eklenebilir. Product data product bu master bilgiyi farklı consumerlara yeniden kullanılabilir biçimde sağlayabilir.
Supplier Master
Supplier Master, tedarikçi kayıtlarının ortak kimlik ve temel bilgilerle yönetilmesini hedefler. Aynı şirket farklı satın alma sistemlerinde farklı isimlerle kayıtlı olabilir. Duplicate supplier kayıtları ödeme, risk ve raporlama sorunları yaratabilir. Entity resolution ve ortak tax identifier gibi alanlar eşleştirmeyi destekler. Supplier master procurement ve finance data products için güvenilir temel oluşturabilir.
Golden Record
Golden Record, aynı entity hakkında farklı kaynaklardan gelen bilgiler arasında en güvenilir birleşik kaydı temsil eder. Her alan aynı kaynaktan gelmek zorunda değildir. Örneğin iletişim bilgisi CRM'den, finansal durum ERP'den alınabilir. Survivorship rules hangi kaynağın hangi alan için öncelikli olduğunu belirler. Golden record süreci açık lineage sunarsa tüketiciler bilginin nasıl oluşturulduğunu anlayabilir.
Entity Resolution
Entity Resolution, farklı kayıtların aynı gerçek dünya varlığına ait olup olmadığını belirleme sürecidir. Exact identifiers yanında isim, adres veya iletişim bilgileri üzerinden probabilistic matching kullanılabilir. Yanlış birleşme ve kaçırılan eşleşmeler quality metric olarak izlenmelidir. Human review yüksek riskli durumlarda sürecin parçası olabilir. Entity resolution özellikle customer 360 ve fraud kullanım senaryolarında kritik rol oynar.
MDM ile Data Product İlişkisi
MDM güvenilir master identity üretirken data product bu bilgiyi tüketilebilir hizmet olarak sunar. MDM veritabanına doğrudan erişim vermek yerine versioned API, table veya event interface kullanılabilir. Owner ve quality SLO ürün seviyesinde görünür hale gelir. Domainler ortak master kimliğini kullanarak kendi data products modellerini daha tutarlı oluşturabilir. Böylece MDM merkezi kayıt sistemi, data product ise paylaşım ve tüketim modeli görevini üstlenir.
Reference Data Management
Reference Data Management, ülke, para birimi, organizasyon birimi veya ürün kategorisi gibi birçok sistem tarafından ortak kullanılan referans değerlerin yönetimini sağlar. Bu veriler küçük hacimli görünse de farklı kod setleri kullanıldığında entegrasyon ve raporlama sorunları büyüyebilir. Ortak sahiplik, versiyonlama ve dağıtım mekanizması oluşturmak önemlidir. Reference data data products veya API üzerinden diğer sistemlere sunulabilir. Değişikliklerin etkisi özellikle finansal ve operasyonel raporlarda geniş olabileceği için kontrollü lifecycle uygulanmalıdır.
Para Birimi
Para birimi referans verisi ISO kodları, semboller ve temel tanımları içerir. Farklı sistemlerde TRY, TL veya yerel isimlerin bağımsız kullanılması dönüşüm hatalarına yol açabilir. Ortak currency identifier analitik ve entegrasyonu kolaylaştırır. Döviz kuru ise zamanla değişen transaction veya market data olduğu için reference data'dan ayrı modellenebilir. Bu ayrım semantic ve temporal doğruluğu korumaya yardımcı olur.
Ülke
Ülke referans verisi ISO kodları, isimler ve bölgesel sınıflandırmaları ortak biçimde yönetir. Ülke isimlerinin farklı dil veya yazım biçimleri veri birleştirmeyi zorlaştırabilir. Canonical country code bu problemi azaltır. Tarihsel ülke değişiklikleri veya özel iş sınıflandırmaları versioning gerektirebilir. Ortak reference data API bütün sistemlerin aynı kod setini kullanmasını kolaylaştırır.
Organizasyon
Organizasyon reference data, departman, iş birimi veya bölge gibi kurum içi hiyerarşileri tanımlar. Organizasyon yapısı değiştikçe tarihsel raporların doğru kalması için effective date yönetimi önemlidir. Bir çalışanın geçmişte hangi birime bağlı olduğunu bilmek analitik açıdan gerekli olabilir. Ortak organization hierarchy finans ve HR raporları arasındaki farkları azaltır. Sahiplik genellikle ilgili kurumsal fonksiyon ile data governance arasında paylaşılır.
Ürün Kategorisi
Ürün kategorisi reference data, ürünlerin ortak sınıflandırma yapısında gruplanmasını sağlar. Marketing, finance ve inventory sistemlerinin farklı kategori hiyerarşileri kullanması karşılaştırmaları zorlaştırabilir. Enterprise taxonomy ile domain özel alt sınıflar arasında denge kurulabilir. Category change geçmişi analitik sonuçları etkileyebileceği için versioning gerekir. Product Master ve reference data birlikte yönetildiğinde ürün analitiği daha tutarlı hale gelir.
Reference Data Ownership
Reference Data Ownership, ortak kod ve sınıflandırmaların kim tarafından değiştirilebileceğini açık biçimde tanımlar. Küçük görünen bir kod değişikliği yüzlerce downstream sistemi etkileyebilir. Owner değişiklik talebini değerlendirirken impact analysis kullanmalıdır. Otomatik dağıtım ve versioning tüketicilerin güncel referansları kullanmasını kolaylaştırır. Açık sahiplik reference data'nın güvenilir source of truth olarak kalmasını sağlar.
Data Security Veri Merkezli Nasıl Tasarlanır?
Data-centric security, güvenliği yalnızca uygulama sınırlarında değil doğrudan veri varlıkları ve kullanım bağlamı üzerinden tasarlar. Data classification hangi verinin hassas olduğunu belirler, encryption ve tokenization koruma sağlar, row veya column security ise erişimi ayrıntılı biçimde kontrol eder. RBAC rol bazlı, ABAC ise kullanıcı, veri ve bağlam özelliklerine göre daha dinamik karar verebilir. Zero Trust yaklaşımında erişim her talepte kimlik, yetki ve bağlam üzerinden doğrulanır. Bu yapı veri farklı platformlara taşındığında dahi güvenlik politikasının mümkün olduğunca veriyi takip etmesini hedefler.
Data Classification
Data Classification, veriyi hassasiyet, düzenleyici gereksinim ve iş kritikliğine göre kategorilere ayırır. Public, internal, confidential veya PII gibi sınıflar kullanılabilir. Classification metadata güvenlik politikalarının otomatik uygulanmasını destekler. Yeni kolonlar scanning araçlarıyla aday sınıfa atanabilir. Kritik sınıflandırmaların owner veya steward tarafından doğrulanması veri güvenliğini güçlendirir.
Encryption
Encryption, veriyi yetkisiz kişilerin okuyamayacağı biçimde şifreleyerek korur. Data at rest ve data in transit için farklı encryption mekanizmaları uygulanmalıdır. Key management güvenlik modelinin en önemli parçalarından biridir. Anahtarların erişimi veri erişiminden ayrı kontrol edilebilir. Encryption güçlü koruma sağlasa da yetkili kullanıcının fazla veri görmesini engellemediği için access control ile birlikte kullanılmalıdır.
Tokenization
Tokenization, hassas değeri gerçek veriyi açığa çıkarmayan başka bir token ile değiştirme yöntemidir. Kart numarası veya belirli kişisel identifiers için kullanılabilir. Token mapping güvenli ve ayrı sistemde tutulabilir. Uygulamalar gerçek değere ihtiyaç duymadan token üzerinden işlemler yapabilir. Bu yöntem hassas verinin platform genelinde yayılmasını azaltmaya yardımcı olur.
Dynamic Masking
Dynamic Masking, kullanıcı veya rolün yetkisine göre sorgu sonucundaki hassas alanları farklı biçimde göstermeyi sağlar. Aynı dataset için analist kısmi değer görürken yetkili servis tam değere erişebilir. Fiziksel kopya üretmeden farklı görünürlük seviyeleri sağlamak önemli avantajdır. Policy engine classification metadata'yı masking kararında kullanabilir. Bu yaklaşım self-service analytics ortamlarında güvenli paylaşımı kolaylaştırır.
Row-Level Security
Row-Level Security, kullanıcının yalnızca yetkili olduğu kayıtları görmesini sağlar. Bölge yöneticisinin sadece kendi bölgesine ait satış kayıtlarını görmesi buna örnek olabilir. Policy query engine veya semantic layer seviyesinde uygulanabilir. Yetki kurallarının farklı dashboardlarda tekrar yazılması yerine merkezi politika kullanmak daha güvenlidir. Performans etkisi ve cache davranışı tasarım sırasında test edilmelidir.
Column-Level Security
Column-Level Security, belirli kullanıcıların hassas kolonlara erişimini sınırlar. Kimlik numarası veya maaş gibi alanlar yalnızca yetkili roller tarafından görülebilir. Datasetin tamamını ayrı kopyalara bölmek yerine kolon bazlı kontrol sağlanabilir. Classification metadata policy uygulamasını otomatikleştirebilir. BI ve query araçlarının bu kuralları doğru uyguladığından emin olmak gerekir.
RBAC
RBAC, kullanıcı veya servislerin önceden tanımlanmış roller üzerinden yetkilendirilmesini sağlar. Data Analyst, Finance Reader veya Data Steward gibi roller kullanılabilir. Yönetimi basit olduğu için birçok kurumda temel access control modeli olarak kullanılır. Çok ayrıntılı bağlam gereksinimlerinde rol sayısı hızla artabilir. Bu durumda ABAC ile birlikte kullanmak daha esnek politika yönetimi sağlayabilir.
ABAC
ABAC, erişim kararını kullanıcı, veri ve çevresel özellikler üzerinden verir. Kullanıcının departmanı, verinin classification seviyesi ve erişim bölgesi aynı policy içinde değerlendirilebilir. Dinamik ve geniş ölçekli veri ortamlarında RBAC'e göre daha esnek olabilir. Metadata kalitesi ABAC kararlarının doğruluğu için kritik öneme sahiptir. Policy-as-code yaklaşımı kuralların test ve versioning süreçlerini kolaylaştırır.
Zero Trust Data Access
Zero Trust Data Access, ağ içinde bulunmanın otomatik güven anlamına gelmediği prensibine dayanır. Her veri erişimi kimlik, yetki, cihaz veya kullanım bağlamına göre doğrulanabilir. Least privilege yaklaşımı kullanıcıların yalnızca ihtiyaç duyduğu veriye erişmesini hedefler. Audit trail bütün erişim kararlarını kaydeder. Data-centric mimaride zero trust, dağıtık veri platformları için ortak güvenlik modeli oluşturmaya yardımcı olur.
KVKK ve Veri Yönetişimi
KVKK uyumu veri merkezli mimaride envanter, sınıflandırma, erişim, retention ve lineage süreçleriyle birlikte ele alınmalıdır. Kişisel verinin nerede bulunduğunu ve hangi amaçla işlendiğini bilmiyorsanız yalnızca güvenlik aracı kullanmak yeterli olmaz. Data minimization gereksiz alanların toplanmasını azaltırken retention politikaları verinin ihtiyaçtan uzun tutulmasını önler. Consent ve right to erasure süreçleri data lineage ile desteklenebilir. Uyum politikalarının mümkün olduğunca platform seviyesinde otomatik uygulanması manuel hataları azaltır.
Kişisel Veri Sınıflandırması
Kişisel veri sınıflandırması, hangi kolon veya data product'ın kişisel veri içerdiğini görünür hale getirir. İsim, iletişim bilgisi, kimlik numarası veya davranışsal veri farklı hassasiyet seviyelerine sahip olabilir. Otomatik scanning ilk keşfi hızlandırabilir. Steward doğrulaması yanlış pozitif veya eksik sınıflandırmayı azaltır. Classification metadata access, masking ve retention politikalarını tetikleyebilir.
Data Minimization
Data Minimization, yalnızca belirli iş amacı için gerçekten gerekli kişisel verinin toplanmasını ve kullanılmasını hedefler. Her data product'ın kaynak sistemdeki bütün kolonları kopyalaması bu prensiple uyumlu değildir. Tüketici ihtiyacına göre minimal schema tasarlamak risk yüzeyini azaltır. Gereksiz kişisel verinin pipeline boyunca taşınmaması storage ve compliance maliyetini de düşürür. Data product review sürecinde alan bazlı gereklilik değerlendirmesi yapılabilir.
Retention
Retention, verinin ne kadar süreyle saklanacağını ve süre sonunda nasıl silineceğini tanımlar. Bütün veri setleri için sonsuz saklama yaklaşımı hem maliyet hem uyum riski oluşturur. Data classification ve iş gereksinimi farklı retention süreleri belirleyebilir. Lifecycle policy storage seviyesinde otomatik uygulanabilir. Silme işlemlerinin lineage kapsamındaki türetilmiş kopyaları da dikkate alması gerekir.
Consent
Consent, belirli kişisel veri işlemlerinin uygun izin ve kullanım amacıyla ilişkilendirilmesini gerektirir. İzin bilgisinin yalnızca uygulama içinde tutulması downstream analytics sistemlerinin bağlamı kaybetmesine yol açabilir. Consent metadata veya purpose binding veri ürünleriyle birlikte taşınabilir. Kullanıcının izin durumu değiştiğinde ilgili süreçlerin güncellenmesi gerekir. Bu model kişisel veri kullanımının teknik pipeline boyunca izlenebilirliğini artırır.
Right to Erasure
Right to Erasure süreçlerinde belirli kişinin verisinin hangi sistem ve türetilmiş datasetlerde bulunduğunu bilmek gerekir. MDM ve ortak identifiers veri eşleştirmesini kolaylaştırır. Data lineage hangi downstream kopyaların etkilenebileceğini gösterebilir. Silme işlemi her veri türünde aynı şekilde uygulanamayacağı için yasal ve iş gereksinimleri dikkate alınmalıdır. Süreç audit trail ile kayıt altına alınmalıdır.
Audit Trail
Audit Trail, veriye kimlerin eriştiğini, hangi policy değişikliklerinin yapıldığını ve önemli işlemlerin ne zaman gerçekleştiğini kaydeder. Güvenlik ve compliance incelemelerinde bu kayıtlar kritik kanıt oluşturabilir. Audit verisi değiştirilemez veya korumalı storage alanında tutulmalıdır. Çok yüksek hacimli sorgu ortamlarında saklama ve arama maliyeti ayrıca planlanmalıdır. Merkezi audit modeli çoklu platformlarda denetim sürecini kolaylaştırır.
Data Lineage ile KVKK Uyumu
Data Lineage kişisel verinin kaynaktan türetilmiş rapor veya data product'a kadar nasıl yayıldığını gösterir. Bu görünürlük erasure, retention ve impact analysis işlemlerini kolaylaştırır. Bir PII kolonunun hangi downstream tablolarına taşındığı otomatik olarak belirlenebilir. Lineage classification metadata ile birleştiğinde compliance coverage daha iyi ölçülebilir. Böylece KVKK uyumu manuel envanterden daha dinamik veri yönetim sürecine dönüşür.
Data Governance Nedir?
Data Governance, verinin politika, standart, sahiplik, erişim, kalite, yaşam döngüsü ve compliance kurallarıyla yönetilmesini sağlayan organizasyonel ve teknik çerçevedir. Etkili governance yalnızca komite toplantıları veya uzun dokümanlardan oluşmaz. Kuralların mümkün olduğunca platform ve data product lifecycle içine gömülmesi gerekir. Merkezi standartlar ile domain özel ihtiyaçlar arasında açık karar sınırları tanımlanmalıdır. Böylece governance geliştirmeyi engelleyen onay mekanizması yerine güvenli ve öngörülebilir veri paylaşım altyapısı haline gelir.
Policies
Policies, veri kullanımında uyulması gereken üst seviye kuralları tanımlar. PII erişimi, retention veya dış paylaşım gibi konular policy kapsamında olabilir. Politika açık ve uygulanabilir ifadelerle yazılmalıdır. Makine tarafından uygulanabilecek bölümler policy-as-code haline getirilebilir. Böylece kurum genelinde aynı risk için tutarlı kontrol sağlanır.
Standards
Standards, data products, schema, metadata ve naming gibi alanlarda ortak teknik uygulama kuralları oluşturur. Standartların amacı ekiplerin her projede aynı kararları baştan tartışmasını önlemektir. Golden path ve template'ler standardı kolay uygulanabilir hale getirir. Aşırı ayrıntılı standartlar geliştirme hızını gereksiz düşürebilir. Minimum gerekli standartları belirlemek ve gerektiğinde geliştirmek daha sürdürülebilir yaklaşımdır.
Ownership
Ownership veri kararlarında kimin hesap verebilir olduğunu açıklar. Domain owner, data product owner ve steward gibi roller farklı sorumluluklar üstlenebilir. Sahipsiz veri kalite ve değişiklik sorunlarının çözümünü geciktirir. Ownership catalog ve contract metadata içinde görünür olmalıdır. Organizasyon değişikliklerinde sahiplik kayıtlarının güncel kalması otomasyon için önemlidir.
Access
Access governance, hangi kullanıcının hangi veriye hangi amaçla erişebileceğini belirler. Least privilege ve purpose-based access temel prensipler olabilir. Self-service access request workflow kullanıcı deneyimini iyileştirir. Onay süreci classification ve role metadata üzerinden otomatikleştirilebilir. Audit kayıtları erişim kararlarının daha sonra incelenmesini sağlar.
Quality
Quality governance, kritik veri varlıkları için kalite boyutlarını, hedefleri ve sorumluları tanımlar. Her dataset aynı seviyede kontrol gerektirmez. Business-critical data products için daha güçlü SLO ve incident süreçleri kullanılabilir. Quality sonuçları catalog içinde tüketicilere gösterilmelidir. Governance bu şekilde kaliteyi soyut prensipten ölçülebilir operasyon standardına dönüştürür.
Lifecycle
Lifecycle governance, verinin oluşturulması, kullanılması, versiyonlanması, saklanması ve kaldırılması süreçlerini kapsar. Data product retirement ve retention burada önemli konulardır. Kullanılmayan datasetlerin yıllarca platformda kalması maliyet ve risk oluşturur. Usage metadata retirement kararlarını destekleyebilir. Lifecycle yaklaşımı veri platformunun sürekli temiz ve yönetilebilir kalmasını sağlar.
Compliance
Compliance governance, kurumun ilgili yasal ve sektörel veri gereksinimlerini karşılamasını sağlar. Classification, audit, retention ve access politikaları bu hedefi destekler. Kanıt üretme sürecinin otomatik metadata üzerinden yapılabilmesi denetimleri hızlandırır. Compliance ekibi ile data platform ekipleri ortak kontrol modelleri geliştirmelidir. Böylece uyum sonradan eklenen manuel süreç yerine mimari tasarımın parçası olur.
Merkezi ve Federated Data Governance
Merkezi governance bütün standartların tek ekip tarafından tanımlandığı modelken federated governance global kurallarla domain kararlarını birlikte yönetir. Küçük organizasyonlarda merkezi model basit ve yeterli olabilir. Büyük ve çok domainli yapılarda her veri kararının merkezi ekipten geçmesi darboğaz yaratabilir. Federated model domainlere kontrollü karar alanı verirken security ve interoperability gibi global kuralları korur. Computational governance bu standartların araçlar ve CI/CD süreçleri tarafından otomatik uygulanmasını destekler.
Central Governance
Central Governance, temel veri politikalarının ve standartların merkezi ekip tarafından yönetildiği modeldir. Tutarlılık sağlamak ve erken dönem platformlarda ortak yön oluşturmak için faydalıdır. Ancak bütün access veya schema kararlarının merkezi onay gerektirmesi organizasyon büyüdükçe yavaşlık yaratabilir. Merkezi ekip yüksek riskli ve ortak konulara odaklanmalıdır. Operasyonel ve domain özel kararlar zamanla federated modele devredilebilir.
Federated Governance
Federated Governance, ortak kuralları korurken bazı veri kararlarını domain ekiplerine dağıtır. Global security ve metadata standartları merkezi belirlenebilir. Domainler kendi quality SLO veya iş semantic detaylarını yönetebilir. Karar sınırlarının açık RACI veya policy modeliyle tanımlanması gerekir. Bu yapı data mesh gibi dağıtık ownership modellerinin güvenli ölçeklenmesini destekler.
Global Policies
Global Policies, bütün domainlerin uyması gereken kurum çapındaki veri kurallarını tanımlar. PII protection, encryption, audit ve zorunlu metadata buna örnek olabilir. Bu politikalar mümkün olduğunca platform tarafından otomatik uygulanmalıdır. Domain ekipleri her projede aynı güvenlik kontrolünü yeniden tasarlamamalıdır. Global policy sayısının gereksiz büyümemesi de geliştirici deneyimi için önemlidir.
Domain Policies
Domain Policies, belirli iş alanının kendi veri kullanım ve kalite ihtiyaçlarını tanımlar. Finans verisindeki reconciliation kuralı müşteri davranış verisi için anlamlı olmayabilir. Domain ekipleri iş bilgisini kullanarak daha uygun kalite hedefleri belirleyebilir. Bu politikalar global standartlarla çelişmemelidir. Federated review modeli gerektiğinde global ve local kararları uzlaştırabilir.
Computational Governance
Computational Governance, veri politikalarının manuel kontrol yerine kod, metadata ve platform servisleriyle otomatik uygulanmasını hedefler. Örneğin classification etiketi encryption veya masking politikasını doğrudan tetikleyebilir. CI/CD pipeline required metadata olmadan data product yayınlanmasını engelleyebilir. Bu yaklaşım governance'ın ekip sayısıyla birlikte ölçeklenmesini kolaylaştırır. Kurallar otomatik olduğu için auditability de güçlenir.
Policy-as-Code
Policy-as-Code, erişim, güvenlik veya governance kurallarının version-controlled kod biçiminde tanımlanmasıdır. Değişiklikler review ve test süreçlerinden geçirilebilir. Farklı ortamlar aynı policy repository üzerinden yönetilebilir. Otomatik testler beklenmeyen yetki genişlemelerini deployment öncesinde yakalayabilir. Bu yaklaşım governance ile platform engineering arasında güçlü bağlantı kurar.
Data Governance as Code Nasıl Uygulanır?
Data Governance as Code, yönetişim kurallarını makine tarafından okunabilir, test edilebilir ve otomatik uygulanabilir hale getirme yaklaşımıdır. Policy dosyaları Git üzerinde versionlanabilir, CI/CD içinde doğrulanabilir ve runtime engine tarafından uygulanabilir. Quality rules, access policy ve zorunlu metadata kontrolleri aynı prensiple yönetilebilir. Böylece governance ekipler arası e-posta trafiğine bağlı kalmaz. Özellikle çok sayıda data product bulunan yapılarda bu model hem hız hem auditability açısından önemli avantaj sağlar.
Machine-Readable Policy
Machine-Readable Policy, bir governance kuralının sistem tarafından yorumlanabilecek formatta tanımlanmasıdır. YAML, JSON veya policy language kullanılabilir. Örneğin confidential sınıfındaki verinin yalnızca belirli roller tarafından okunabileceği açık kural olarak yazılabilir. Policy engine erişim anında bu kuralı değerlendirebilir. İnsan açıklaması ile makine tanımının aynı kaynaktan üretilmesi tutarlılığı artırır.
GitOps
GitOps yaklaşımı governance configuration değişikliklerini Git repository üzerinden yönetir. Her policy değişikliği pull request, review ve audit history bırakır. Onaylanan değişiklik otomasyonla platform ortamlarına uygulanabilir. Rollback eski commit veya release üzerinden yapılabilir. Bu model güvenlik ve veri politikalarının kontrolsüz manuel değişmesini azaltır.
CI/CD Validation
CI/CD Validation data product veya pipeline deployment sırasında governance kurallarını kontrol eder. Owner, classification ve contract gibi zorunlu metadata alanları doğrulanabilir. Güvenlik politikasıyla çelişen configuration deploymentı engelleyebilir. Test sonuçları review sürecinde görünür hale gelir. Böylece governance kontrolü geliştirme yaşam döngüsüne erken aşamada girer.
Automated Quality Rules
Automated Quality Rules, data contract veya metadata içinde tanımlanan kalite beklentilerinin otomatik çalıştırılmasını sağlar. Unique key, completeness veya range kontrolü pipeline içinde uygulanabilir. Quality result belirli threshold altında kaldığında data product publishing durdurulabilir. Daha düşük riskli hatalarda warning üretilebilir. Otomasyon kalite yönetimini bireysel script bağımlılığından çıkarır.
Automated Access Policy
Automated Access Policy, kullanıcı ve veri metadata'sına göre erişim kararlarının otomatik verilmesini sağlar. Role, department, classification ve purpose gibi bilgiler policy değerlendirmesinde kullanılabilir. Manuel ticket onayları yalnızca istisnalara ayrılabilir. Access expiration belirli süreli projelerde otomatik uygulanabilir. Bu yaklaşım self-service veri erişimini güvenlikten ödün vermeden hızlandırabilir.
Auditability
Auditability, governance kararlarının kim tarafından, ne zaman ve hangi gerekçeyle değiştirildiğinin izlenebilir olmasıdır. Git history policy değişikliklerini kayıt altına alır. Runtime access logs gerçek erişim kararlarını gösterir. CI/CD sonuçları hangi kontrollerin deployment sırasında çalıştığını kanıtlayabilir. Bu bütünlük denetim ve incident incelemelerini daha hızlı ve güvenilir hale getirir.
Self-Service Data Platform Nedir?
Self-Service Data Platform, domain ve data ekiplerinin ortak veri yeteneklerini merkezi ekibe manuel talep açmadan güvenli biçimde kullanabildiği platform modelidir. Ingestion, transformation, storage, quality, catalog, security, observability ve publishing gibi işler hazır servisler veya golden paths olarak sunulur. Platformun amacı bütün esnekliği kaldırmak değil, en sık kullanılan doğru yolu kolaylaştırmaktır. İyi developer experience platform adoption için teknik özellikler kadar önemlidir. Böyle bir yapı kurumsal data-centric mimari ve veri platformu danışmanlığı çalışmalarında genellikle ölçeklenebilirliğin en kritik bileşenlerinden biri olarak ele alınır.
Data Ingestion
Self-service ingestion servisleri ekiplerin database, API veya event kaynaklarını standart yöntemlerle platforma bağlamasını sağlar. Connector template'leri security, retry ve metadata standartlarını hazır biçimde uygular. Domain ekipleri her kaynak için yeni framework geliştirmek zorunda kalmaz. Provisioning işlemleri portal veya configuration-as-code üzerinden yapılabilir. Böylece yeni veri kaynağının platforma eklenme süresi belirgin biçimde azalır.
Transformation
Transformation yeteneği SQL, Python veya distributed processing frameworkleri için standart execution ortamı sunabilir. CI/CD, testing ve lineage otomatik biçimde pipeline'a eklenmelidir. Domain ekipleri business logic'e odaklanırken platform deployment ayrıntılarını yönetir. Standard template uygulamalar arasında benzer kalite ve observability seviyesi oluşturur. Özel workload ihtiyaçları için kontrollü extension noktaları bırakmak platform esnekliğini korur.
Storage
Self-service storage kullanıcıların doğru güvenlik ve lifecycle ayarlarıyla veri alanı oluşturmasını kolaylaştırır. Bucket, schema veya table provisioning otomasyonla yapılabilir. Encryption, retention ve tagging gibi standartlar varsayılan olarak uygulanmalıdır. Kullanıcıların düşük seviyeli cloud configuration ile uğraşması gerekmez. Bu yaklaşım platformun güvenli varsayılanlar üzerinden hızlı kullanım sunmasını sağlar.
Quality
Self-service quality servisleri domain ekiplerinin hazır kural tipleri üzerinden veri testleri tanımlamasını sağlar. Uniqueness, completeness ve schema checks gibi yaygın kontroller kolayca eklenebilir. Sonuçlar observability ve catalog ile entegre edilmelidir. Domain özel business rules için custom test desteği bulunabilir. Böylece kalite platformun isteğe bağlı eklentisi değil data product publishing sürecinin doğal parçası olur.
Catalog
Catalog entegrasyonu yeni data product yayınlandığında metadata'nın otomatik olarak görünür hale gelmesini sağlar. Owner, schema, lineage ve quality bilgileri pipeline'lardan çekilebilir. Kullanıcı ek dokümantasyonu portal üzerinden tamamlayabilir. Yayın süreci catalog approval ve access workflow ile birleştirilebilir. Bu sayede self-service platform üretim kadar discovery tarafını da destekler.
Security
Self-service security kullanıcının güvenlik kurallarını manuel olarak sıfırdan yapılandırmasını gerektirmemelidir. Data classification ve domain bilgisine göre güvenli varsayılanlar otomatik uygulanabilir. Access request ve approval workflow platform tarafından sunulabilir. Secrets ve key management ortak servisler üzerinden yönetilir. Böylece hız artarken güvenlik standardı ekipten ekibe farklılaşmaz.
Observability
Observability platformun oluşturduğu her data product ve pipeline için varsayılan özellik olmalıdır. Logs, metrics, freshness ve quality sinyalleri otomatik bağlanabilir. Owner based alert routing manuel configuration ihtiyacını azaltır. Platform ekipleri ortak dashboardlar üzerinden genel reliability seviyesini takip edebilir. Domain ekipleri kendi ürünlerinin incident ve SLO verisine kolayca erişebilir.
Data Product Publishing
Data Product Publishing, hazır template ve workflow üzerinden ürünün catalog, contract, access ve observability bilgilerinin birlikte yayınlanmasını sağlar. Kullanıcı yalnızca dataset oluşturup işi bitirmiş sayılmaz. Required metadata ve quality kontrolleri publishing gate olarak kullanılabilir. Ürün onaylandıktan sonra tüketicilere marketplace veya portal üzerinden sunulur. Bu süreç data product standardını kurumsal ölçekte uygulanabilir hale getirir.
Data Platform Team'in Rolü Nedir?
Data Platform Team'in temel görevi bütün veri işlerini yapmak değil, domain ve data ekiplerinin doğru işleri hızlı ve güvenli biçimde yapabileceği ortak platform ürününü geliştirmektir. Platform as a Product yaklaşımı kullanıcı ihtiyaçlarını ve developer experience metriğini merkeze alır. Golden paths, infrastructure automation, governance automation ve enablement servisleri ekiplerin tekrar eden teknik işlerini azaltır. Platform adoption ve time-to-first-data-product gibi göstergeler takım başarısını ölçmek için kullanılabilir. İyi platform ekibi kendisini merkezi onay kapısı değil ölçeklenebilir yetenek sağlayıcısı olarak konumlandırır.
Platform as a Product
Platform as a Product, iç veri platformunun gerçek kullanıcıları ve ürün yol haritası olan bir hizmet olarak yönetilmesini ifade eder. Domain geliştiricileri ve data engineers platformun müşterileri olarak görülür. Kullanım zorlukları ve feedback düzenli biçimde toplanmalıdır. Sadece altyapı uptime'ı değil adoption ve developer productivity de ölçülür. Bu yaklaşım güçlü ama kullanılmayan platformlar oluşturma riskini azaltır.
Golden Paths
Golden Paths, yaygın veri işleri için güvenli ve önerilen hazır uygulama yollarıdır. Yeni batch pipeline, streaming product veya API publishing için template sağlanabilir. Security, metadata ve observability bu yollara varsayılan olarak eklenir. Kullanıcı özel ihtiyaç olduğunda farklı yol seçebilir fakat temel kullanım kolay kalır. Golden path platform standardizasyonunu zorunlu dokümanlardan daha etkili hale getirir.
Infrastructure Automation
Infrastructure Automation storage, compute, network ve permission kaynaklarının configuration-as-code üzerinden oluşturulmasını sağlar. Manuel ortam kurulumu hem yavaş hem hata eğilimli olabilir. Standart modüller compliance ve tagging kurallarını otomatik uygular. Environment creation dakikalar içinde tekrarlanabilir hale gelebilir. Bu yapı domain ekiplerinin düşük seviyeli platform operasyonuna ayırdığı zamanı azaltır.
Governance Automation
Governance Automation metadata, access, quality ve compliance kontrollerini platform workflow'larına entegre eder. Data product publish edilirken required owner ve classification bilgisi otomatik doğrulanabilir. Hassas veri için masking policy varsayılan uygulanabilir. Manual approval yalnızca yüksek riskli istisnalara ayrılır. Böylece governance hız düşüren ayrı süreç yerine platform davranışı haline gelir.
Developer Experience
Developer Experience platformun ne kadar kolay öğrenildiğini, kullanıldığını ve sorun çözüldüğünü ifade eder. İyi dokümantasyon, CLI, portal, template ve hızlı feedback loop önemlidir. Kullanıcı basit pipeline oluşturmak için çok sayıda ticket açıyorsa platform self-service değildir. Time-to-first-success ve support ticket sayısı experience metriği olarak izlenebilir. Developer experience iyileştikçe platform adoption doğal biçimde yükselir.
Domain Enablement
Domain Enablement, platform ekibinin domainlere yalnızca araç değil bilgi ve çalışma modeli desteği vermesidir. Eğitim, office hours, örnek data products ve architecture guidance sunulabilir. İlk pilot ürünlerde platform ekibi domainle birlikte çalışabilir. Amaç kalıcı bağımlılık yaratmak değil domain yetkinliğini artırmaktır. Zamanla domain ekipleri daha bağımsız biçimde güvenilir data products üretebilir.
Veri Merkezli Mimari İçin En İyi Programlama Dili Hangisidir?
Veri merkezli mimari için tek bir en iyi programlama dili yoktur. SQL veri dönüşümü ve analitik modelleme için güçlü, Python otomasyon ve data engineering için esnek, Java ve Scala streaming ve distributed systems tarafında yaygın, Go ve Rust ise platform servislerinde güçlü seçenekler olabilir. Dil seçimi workload, ekip deneyimi, runtime gereksinimi ve ekosistem desteğine göre yapılmalıdır. Architecture, data contract, ownership ve modelleme kararları kullanılan dilden daha uzun ömürlüdür. Bu nedenle önce veri akışını ve ürün sınırını doğru tasarlayıp ardından en sade uygun dili seçmek daha sağlıklı bir yaklaşımdır.
SQL
SQL kurumsal veri platformlarında en temel dillerden biridir. Declarative yapısı dönüşüm, aggregation ve veri kalite kontrollerini anlaşılır biçimde ifade etmeyi kolaylaştırır. Warehouse ve lakehouse motorlarının büyük bölümü SQL desteği sunar. Version control ve testing yaklaşımıyla birlikte kullanıldığında production-grade data transformation için güçlü temel oluşturur. Data engineer olmak isteyen kişiler için SQL öğrenmek yüksek getirili yatırımlardan biridir.
Python
Python data pipeline, automation, ML ve API entegrasyonları için geniş ekosisteme sahiptir. Basit scriptlerden distributed processing uygulamalarına kadar farklı seviyelerde kullanılabilir. Data engineering projelerinde orchestration ve custom transformation için sık tercih edilir. Ancak bütün transformation işlerini Python koduna taşımak her zaman gerekli değildir. SQL ile daha açık ifade edilen işlemler için SQL kullanmak bakım kolaylığı sağlayabilir.
Java
Java yüksek hacimli backend ve streaming sistemlerinde güçlü performans ve geniş ekosistem sunar. Kafka ve birçok distributed data technology Java ekosistemiyle yakın çalışır. Type safety ve production tooling büyük ekipler için avantaj sağlayabilir. Öğrenme ve geliştirme hızı bazı veri analizi görevlerinde Python'a göre daha ağır olabilir. Bu nedenle Java özellikle platform servisleri ve uzun ömürlü streaming uygulamalarında değerlendirilmelidir.
Scala
Scala distributed data processing dünyasında özellikle Spark ekosistemi nedeniyle uzun süre önemli rol oynamıştır. Functional programming özellikleri veri dönüşümlerini güçlü biçimde ifade edebilir. JVM üzerinde çalıştığı için Java ekosisteminden yararlanır. Ekipte Scala yetkinliği yoksa operasyon ve onboarding maliyeti dikkate alınmalıdır. Dil seçimi yalnızca performans değil sürdürülebilir ekip kapasitesi üzerinden yapılmalıdır.
Go
Go platform engineering, network services ve cloud-native tooling için sade ve performanslı bir seçenektir. Hızlı derleme ve kolay deployment özellikleri platform servislerinde avantaj sağlar. Data platform controller, connector veya internal API geliştirmek için kullanılabilir. Analitik transformation ekosistemi SQL ve Python kadar geniş değildir. Bu nedenle Go daha çok platform ve serving katmanı görevlerinde öne çıkar.
Rust
Rust yüksek performans ve memory safety gerektiren veri altyapısı bileşenlerinde güçlü bir seçenektir. Modern query engines ve data tooling projelerinde kullanımının arttığı görülmektedir. Ancak öğrenme eğrisi ve geliştirici bulunabilirliği kurum için değerlendirilmelidir. Basit ETL işlerini Rust ile yazmak genellikle gereksiz olabilir. Yoğun compute, storage engine veya performance-critical platform bileşenlerinde daha anlamlı hale gelir.
Programlama Dilinden Daha Önemli Olan Mimari Kararlar
Veri modelleme, ownership, contract ve serving interface kararları çoğu zaman programlama dilinden daha uzun ömürlüdür. Yanlış domain sınırı Python yerine Java kullanılarak düzelmez. Güvenilmez data product hızlı kodla da güvenilir hale gelmez. Dil seçimi implementasyon aracıdır, mimari hedef değildir. Önce veri yaşam döngüsü ve tüketici beklentisi tasarlanmalı, sonra uygun araç seçilmelidir.
Workload'a Göre Dil Seçimi
Workload'a göre dil seçmek teknoloji tercihini daha nesnel hale getirir. Data transformation yoğun SQL, custom automation Python, streaming JVM tabanlı dil, platform service Go veya Rust gerektirebilir. Aynı kurumda farklı workload'lar için birden fazla dil kullanmak doğaldır. Yine de destek maliyetini azaltmak için sınırlı ve standardize dil portföyü tercih edilmelidir. Platform ekipleri her onaylı dil için build, deployment ve observability standartları sunabilir.
Data transformation
Data transformation için SQL çoğu analitik işlemde sade ve okunabilir başlangıç sağlar. Set-based işlemler warehouse ve lakehouse optimizer'ları tarafından verimli çalıştırılabilir. Karmaşık custom parsing veya external API erişimi gerektiğinde Python gibi genel amaçlı dil eklenebilir. Dönüşüm kodunun test edilebilir ve lineage üretilebilir olması dilden daha önemlidir. dbt benzeri yaklaşımlar SQL transformation'ı yazılım mühendisliği pratikleriyle birleştirebilir.
Streaming
Streaming workload'larında Java, Scala veya Python farklı frameworklere göre kullanılabilir. Low-latency ve yüksek throughput gereksinimleri runtime seçimini etkiler. State management ve serialization desteği dil seçiminden daha kritik olabilir. Schema registry ve contract süreçleri streaming uygulamasına entegre edilmelidir. Ekip deneyimi production incident çözüm hızı açısından mutlaka değerlendirilmelidir.
API
API geliştirmede Java, Go, Python veya başka backend dilleri kullanılabilir. Seçim latency, concurrency, ekip deneyimi ve mevcut platform standartlarına göre yapılmalıdır. Data product contract interface teknolojisinden bağımsız tutulmalıdır. API observability ve authorization standartları bütün dillerde aynı güvenlik seviyesini korumalıdır. Mümkünse kurumun mevcut servis platformuyla uyumlu dil kullanmak operasyon yükünü azaltır.
Machine learning
Machine learning tarafında Python geniş kütüphane ekosistemi nedeniyle yaygın tercihtir. Model training, feature engineering ve experiment süreçlerini hızlı geliştirilebilir hale getirir. Production serving farklı performans ihtiyaçları nedeniyle başka runtime kullanabilir. Modelin kullandığı data products ve lineage bilgisi dili aşan mimari konulardır. Güvenilir training data olmadan güçlü model kütüphanesi tek başına yeterli değildir.
Platform engineering
Platform engineering için Go, Java, Python ve Rust gibi diller farklı servis türlerinde kullanılabilir. Controller veya cloud service integration için Go sade operasyon modeli sunabilir. Automation scriptleri için Python hızlı geliştirme sağlayabilir. Yüksek performanslı engine bileşenlerinde Rust tercih edilebilir. Platform standardı ekiplerin rastgele dil seçmesini değil workload'a göre desteklenen seçeneklerden yararlanmasını sağlamalıdır.
Data Engineering İçin SQL ve Python Neden Önemlidir?
SQL ve Python birlikte data engineering için güçlü ve tamamlayıcı iki temel beceri sunar. SQL veri sorgulama, dönüşüm ve modelleme işlerinde veri tabanına yakın ve deklaratif çalışma sağlar. Python ise API entegrasyonu, orchestration, automation ve özel veri işleme ihtiyaçlarında esnektir. Çoğu gerçek projede iki dili aynı pipeline'ın farklı katmanlarında görmek mümkündür. Ancak framework öğrenmeden önce veri modelleme, transaction, partitioning ve kalite gibi temel kavramları anlamak daha kalıcı yetkinlik sağlar.
SQL ile Data Transformation
SQL ile data transformation filtreleme, join, aggregation ve window calculation gibi birçok analitik işlemi açık biçimde ifade edebilir. Modern query engines optimizasyonu execution plan seviyesinde yönetir. Bu nedenle geliştirici düşük seviyeli işlem ayrıntılarına daha az odaklanır. SQL kodu version control ve testlerle üretim kalitesine getirilebilir. Veri modelini iyi anlamak performanslı SQL yazmanın temelidir.
Python ile Pipeline ve Automation
Python pipeline orchestration, API ingestion ve custom automation görevlerinde esneklik sağlar. Çok sayıda data connector ve processing library ekosistemi geliştirme hızını artırır. Ancak pipeline logic'in tek dosyalık scriptler halinde büyümesine izin vermemek gerekir. Modüler kod, test ve logging standardı production reliability için önemlidir. Python data platform API'leri ve infrastructure automation ile de rahat biçimde entegre olabilir.
dbt ile Analytics Engineering
dbt analytics engineering yaklaşımında SQL dönüşümlerini dependency graph, testing ve documentation ile birleştirir. Analyst ve data engineer ekiplerinin aynı version control sürecinde çalışmasını kolaylaştırabilir. Model lineage otomatik üretilebilir. Test ve documentation data product kalitesine katkı sağlar. Araçtan bağımsız olarak bu yaklaşım SQL transformation süreçlerine yazılım mühendisliği disiplini kazandırması açısından değerlidir.
Spark ve PySpark
Spark büyük ölçekli distributed data processing için kullanılan yaygın frameworklerden biridir. PySpark Python API üzerinden Spark execution engine'e erişim sağlar. Büyük batch transformation veya bazı streaming işlerinde kullanılabilir. Küçük veri setleri için distributed framework kullanmak gereksiz operasyon yükü oluşturabilir. Workload büyüklüğü ve performans ihtiyacı framework seçiminden önce ölçülmelidir.
Framework Seçiminden Önce Veri Modelini Anlamak
Veri modeli bilinmeden seçilen framework yalnızca yanlış tasarımı daha hızlı çalıştırabilir. Entity ilişkileri, grain, keys ve temporal behavior anlaşılmalıdır. Partitioning ve join stratejileri de model bilgisine dayanır. Ekipler araç tutoriallarından önce gerçek veri akışını çizdiğinde daha iyi mimari kararlar verir. Teknolojiler değişse de veri modelleme bilgisi uzun yıllar değerini korur.
Veri Merkezli Mimari için Open Source Teknolojiler
Open source teknolojiler veri merkezli mimarilerde açık standartlar, topluluk işbirliği ve teknoloji bağımsızlığı açısından önemli seçenekler sunar. PostgreSQL, Kafka, Flink, Spark, Iceberg, Trino, dbt Core, OpenLineage, DataHub ve OpenMetadata farklı katmanlarda değerlendirilebilir. Bütün araçları aynı projede kullanmak gerekmemelidir. Seçim yapılırken kullanım senaryosu, ekip kapasitesi, operasyon maliyeti ve standardizasyon öncelikleri değerlendirilmelidir. Açık kaynak güçlü bir araç seti sunar fakat iyi mimari yine ownership, contracts ve governance kararlarına dayanır.
PostgreSQL
PostgreSQL güvenilir relational database özellikleri ve geniş açık kaynak ekosistemiyle birçok operasyonel ve analitik kullanımda güçlü temeldir. Transaction, indexing ve extensibility özellikleri üretim uygulamaları için uygundur. Küçük ve orta ölçekli data platform ihtiyaçlarında da kullanılabilir. Her workload'ı tek PostgreSQL instance üzerinde çalıştırmak yerine operasyonel ve analitik yükleri ayırmak önemlidir. Açık standartlara yakın SQL desteği geliştirici yetkinliğinin farklı sistemlere taşınmasını kolaylaştırır.
Apache Kafka
Apache Kafka yüksek hacimli event streaming ve durable log altyapısı sağlar. Producer ve consumer sistemleri zaman açısından birbirinden ayırabilir. Event replay ve consumer groups farklı kullanım senaryolarını destekler. Schema governance ve topic ownership ayrıca tasarlanmalıdır. Kafka yalnızca mesaj taşıma aracı değil event-driven data products için güçlü platform bileşeni olabilir.
Apache Flink
Apache Flink stateful stream processing için güçlü açık kaynak frameworklerinden biridir. Event time, windowing ve exactly-once state gibi özellikler gerçek zamanlı data processing senaryolarını destekler. Streaming transformation ve real-time analytics için kullanılabilir. Operasyonel öğrenme ve cluster yönetimi ekip kapasitesi gerektirir. Basit near-real-time ihtiyaçlarda daha sade çözümler yeterli olabilir.
Apache Spark
Apache Spark distributed batch processing ve geniş data engineering ekosistemiyle uzun süredir kullanılan güçlü frameworklerden biridir. Büyük veri dönüşümleri ve ML workload'ları için kullanılabilir. SQL, Python ve Scala API'leri farklı ekiplerin aynı engine üzerinde çalışmasını kolaylaştırır. Küçük işler için cluster overhead gereksiz olabilir. Spark seçimi veri hacmi ve processing ihtiyacıyla gerekçelendirilmelidir.
Apache Iceberg
Apache Iceberg açık tablo formatı olarak object storage üzerindeki analitik veriye schema evolution, snapshot ve partition management özellikleri kazandırır. Farklı query engines aynı tablo formatını kullanabilir. Vendor bağımlılığını azaltmak isteyen lakehouse mimarileri için önemli seçenektir. Catalog ve engine compatibility mimari tasarımın parçasıdır. Formatın açık olması governance ve operasyon ihtiyacını ortadan kaldırmaz.
Trino
Trino dağıtık SQL query engine olarak farklı veri kaynakları üzerinde federated sorgular çalıştırabilir. Data lake, relational database ve başka platformları ortak SQL interface altında birleştirebilir. Data virtualization veya lakehouse serving için kullanılabilir. Connector pushdown ve network transferi performansı doğrudan etkiler. Workload isolation ve resource management büyük kullanım ortamlarında planlanmalıdır.
dbt Core
dbt Core SQL transformation süreçlerini model dependency, testing ve documentation yaklaşımıyla yönetmeyi kolaylaştırır. Analytics engineering ekipleri için açık kaynak temel sunar. Version control ve CI/CD ile birlikte kullanılabilir. Data product modelinde Gold veya semantic-ready tabloların güvenilir üretimini destekleyebilir. Araç seçimi yapılırken mevcut warehouse veya lakehouse desteği değerlendirilmelidir.
OpenLineage
OpenLineage veri lineage metadata'sı için açık standart yaklaşımı sunar. Farklı processing araçlarının job, run ve dataset ilişkilerini ortak biçimde yayınlamasına yardımcı olur. Bu sayede metadata platformlarının birçok özel entegrasyon geliştirme ihtiyacı azalabilir. End-to-end lineage için bütün platform bileşenlerinin yeterli metadata üretmesi gerekir. Açık standardın kullanılması araç değiştirme esnekliğini artırır.
DataHub
DataHub açık kaynak metadata platformu olarak catalog, lineage, ownership ve discovery gibi yetenekler sunar. Çok sayıda veri sistemi için metadata entegrasyonları bulunabilir. Active metadata ve domain modeling yaklaşımları data-centric platformlarda değerlendirilebilir. Kurulumdan sonra metadata ownership ve governance süreçleri ayrıca tasarlanmalıdır. Araç tek başına kurumsal veri yönetimini otomatik olarak olgunlaştırmaz.
OpenMetadata
OpenMetadata data discovery, governance, lineage ve quality metadata için açık kaynak platform seçeneklerinden biridir. Farklı database ve BI sistemlerinden metadata toplayabilir. Data products ve ownership görünürlüğü için kullanılabilir. Kurumsal ölçekte entegrasyon, erişim ve operational support gereksinimleri değerlendirilmelidir. Açık kaynak olması ihtiyaç duyulan operasyon kapasitesini ortadan kaldırmaz.
Open Source ve İşbirliği Kurumsal Veri Mimarisini Nasıl Güçlendirir?
Open source yaklaşımı kurumsal veri mimarisinde yalnızca lisans maliyetini düşüren seçenek olarak görülmemelidir. Açık standartlar, taşınabilir veri formatları ve topluluk tarafından geliştirilen entegrasyonlar vendor lock-in riskini azaltabilir. Şirketler kullandıkları projelere upstream contribution yaparak kendi ihtiyaçlarının da ekosistemde sürdürülebilir olmasına katkı sağlayabilir. Inner source yaklaşımı şirket içindeki platform kodlarının farklı ekipler tarafından ortak geliştirilmesini destekler. Bu çalışma biçimi özellikle veri platformlarında standardizasyon ile ekip katılımını bir araya getirebilir.
Açık Standartlar
Açık standartlar farklı teknoloji ve ekiplerin ortak veri sözleşmeleri üzerinden çalışmasını kolaylaştırır. Schema, lineage, table format veya API definitions kapalı ürün sınırlarından daha uzun ömürlü olabilir. Araç değişse bile data contract ve semantic definitions korunabilir. Standardın gerçek ekosistem desteği ve governance modeli değerlendirilmelidir. Açık standart kullanmak teknik seçimlerde kuruma daha fazla hareket alanı sağlar.
Vendor Lock-In'i Azaltmak
Vendor lock-in'i azaltmak bütün ticari ürünlerden kaçınmak anlamına gelmez. Kritik veri ve sözleşmelerin taşınabilir formatlarda tutulması daha önemli hedeftir. Open table formats ve standard SQL interface birden fazla compute engine seçeneği sağlayabilir. Metadata export ve API erişimi de platform geçişlerinde önemlidir. Mimari karar ürünün bugün sunduğu özellik kadar gelecekte çıkış maliyetini de hesaba katmalıdır.
Open Table Formats
Open Table Formats data lakehouse verisini belirli bir vendor query engine'ine bağımlı kalmadan yönetmeye yardımcı olur. Iceberg, Delta Lake ve Hudi gibi formatlar transaction ve metadata özellikleri sunar. Multiengine erişim platform esnekliği sağlayabilir. Seçilen formatın farklı araçlardaki destek düzeyi kontrol edilmelidir. Açık format kullanımı data movement ve migration maliyetlerini azaltabilecek önemli mimari karardır.
Open Metadata Standards
Open metadata standards lineage, schema veya data product metadata'sının farklı sistemler arasında paylaşılmasını kolaylaştırır. Her araç için özel entegrasyon geliştirme ihtiyacı azaltılabilir. Metadata platformu değişse bile temel veri ilişkilerinin korunması mümkün olur. Açık standartlar AI ve governance araçlarının aynı metadata graph üzerinde çalışmasını da kolaylaştırabilir. Kurumlar metadata stratejisinde taşınabilirliği erken aşamada düşünmelidir.
Upstream Contribution
Upstream contribution, kurumun kullandığı açık kaynak projenin ana repository'sine bug fix, documentation veya feature katkısı yapmasıdır. Yerel patch taşımak yerine değişikliğin ana projeye alınması bakım maliyetini azaltabilir. Ekipler proje mimarisini daha iyi öğrenir ve toplulukla teknik ilişki kurar. Katkı süreci code review yetkinliğini de geliştirir. Kurumsal açık kaynak politikası güvenlik ve lisans kontrollerini desteklemelidir.
Community Governance
Community Governance açık kaynak projenin kararlarının nasıl alındığını ve roadmap'in kimler tarafından yönlendirildiğini belirler. Sağlıklı governance tek bir şirketin ani kararlarına bağımlılığı azaltabilir. Kurum teknoloji seçerken yalnızca GitHub yıldız sayısına değil aktif maintainer ve release davranışına da bakmalıdır. Açık issue ve proposal süreçleri projenin geleceğini anlamayı kolaylaştırır. Uzun ömürlü data platform bileşenlerinde community health önemli seçim kriteridir.
Şirket İçi Inner Source
Inner Source, şirket içindeki platform veya data tooling kodunun açık kaynak çalışma yöntemlerine benzer biçimde farklı ekiplerin katkısına açılmasıdır. Domain ekipleri ortak connector veya quality rule geliştirebilir. Merkezi platform ekibi code review ve architecture standards sağlar. Böylece tekrar eden çözümler ortak repository içinde paylaşılır. Bu yaklaşım organizasyon içinde teknik bilgi yayılımını ve ortak sahipliği güçlendirebilir.
Data Product ve Data Contract Açık Standartları
Data product ve data contract tanımlarının açık standartlara dayanması farklı platformlar ve ekipler arasında birlikte çalışabilirliği güçlendirir. Technology-independent specifications ürünün owner, schema, quality ve interface bilgilerini belirli bir vendor formatına bağlamadan tanımlamayı hedefler. JSON ve YAML gibi taşınabilir formatlar CI/CD ve catalog entegrasyonlarını kolaylaştırır. Farklı açık standart girişimleri aynı problemi farklı kapsamlarla ele alabilir. Kurumlar herhangi bir standardı seçmeden önce ekosistem desteğini, versioning yaklaşımını ve kendi data product modeline uyumunu değerlendirmelidir.
Open Data Product Specification
Open Data Product Specification yaklaşımı data product metadata'sını ortak ve makine tarafından okunabilir biçimde ifade etmeyi hedefler. Owner, schema, service level ve interface gibi bileşenler standardize edilebilir. Böyle bir tanım catalog ve platform arasında taşınabilirliği artırabilir. Vendor özel data product tanımlarına bağımlılığı azaltmak uzun vadede fayda sağlar. Kurumun mevcut governance ihtiyaçlarının spesifikasyonla nasıl eşleştiği değerlendirilmelidir.
Open Data Contract Standard
Open Data Contract Standard yaklaşımı producer ve consumer arasındaki veri sözleşmesini ortak formatta tanımlamayı amaçlar. Schema, quality, ownership ve SLO gibi alanlar makine tarafından okunabilir hale getirilebilir. Farklı CI/CD ve validation araçları aynı contract dosyasını kullanabilir. Standardın extensibility modeli domain özel ihtiyaçlar için önemlidir. Açık contract formatı ekipler ve platformlar arası taşınabilirliği artırır.
Data Contract Specification
Data Contract Specification, veri sözleşmesinin hangi alanları ve semantic kuralları içereceğini tanımlar. Kurumlar açık spesifikasyonu kendi governance ihtiyaçlarıyla genişletebilir. Contract validation engine bu tanımı deployment ve runtime aşamasında okuyabilir. Versioning kuralları consumer migration süreçlerini kolaylaştırır. En değerli sonuç contract'ın belirli üründen bağımsız bir kurumsal varlık haline gelmesidir.
Data Product Ontologies
Data Product Ontologies, veri ürünleri, domainler, sahipler ve tüketiciler arasındaki ilişkileri ortak kavramsal modelle ifade etmeye çalışır. Metadata graph içinde hangi ürünün hangi domain veya business concept ile ilişkili olduğu tanımlanabilir. Semantic search ve automation bu ilişkilerden faydalanabilir. AI agent'lar data product discovery yaparken ontology bilgisini kullanabilir. Modelin pratik kalması ve kurumun gerçek ihtiyaçlarından kopmaması önemlidir.
Technology-Independent Specifications
Technology-Independent Specifications, data product tanımını storage veya vendor ayrıntısından bağımsız tutar. Aynı contract farklı warehouse veya lakehouse platformlarında uygulanabilir. Bu yaklaşım migration ve multicloud stratejilerini kolaylaştırır. Teknik implementation metadata ayrı katmanda tutulabilir. Böylece iş sözleşmesinin yaşam süresi altyapı ürününden daha uzun olabilir.
JSON ve YAML Tabanlı Tanımlar
JSON ve YAML tabanlı tanımlar hem insan hem otomasyon tarafından işlenebilen basit formatlar sağlar. Git üzerinde versioning ve pull request review kolayca yapılabilir. Schema validation contract dosyasının kendi yapısını kontrol edebilir. Pipeline ve catalog aynı dosyadan metadata üretebilir. Formatın sadeliği data governance as code yaklaşımının benimsenmesini kolaylaştırır.
Interoperability
Interoperability açık data product ve contract standartlarının temel hedeflerinden biridir. Farklı domainler ve platformlar aynı metadata kavramlarını paylaşabildiğinde entegrasyon daha kolay olur. Contract tanımı bir vendor ürününden diğerine taşınabilir. Automation araçları ortak schema üzerinden çalışabilir. Bu yaklaşım uzun vadede veri ekosisteminin değişen teknolojilere daha dayanıklı olmasını sağlar.
Data-Centric Mimari AI Sistemlerini Nasıl Etkiler?
Data-centric mimari AI sistemlerine güvenilir training data, metadata, semantic context, lineage, access control ve freshness sağlayarak doğrudan temel oluşturur. Model ne kadar güçlü olursa olsun yanlış veya güncelliğini kaybetmiş kurumsal veriyle güvenilir sonuç üretmek zordur. Data products AI pipeline'larının yeniden kullanılabilir ve sahipli veri kaynaklarına bağlanmasını sağlar. Lineage model çıktısının hangi verilerden üretildiğini açıklamaya yardımcı olur. Model governance ile data governance birlikte ele alındığında AI sistemlerinin production kullanımı daha kontrollü hale gelir.
Trusted Training Data
Trusted Training Data, kaynağı, kalitesi ve kullanım izni bilinen eğitim verisidir. Rastgele data lake klasörlerinden veri toplamak model reproducibility ve compliance sorunları yaratabilir. Certified data products eğitim kaynağı olarak kullanılabilir. Dataset version ve lineage bilgisi hangi model sürümünün hangi veriyle eğitildiğini gösterir. Bu yapı model değerlendirmesini ve yeniden üretilebilirliği güçlendirir.
AI Data Products
AI Data Products, model training, retrieval veya inference için hazırlanmış sahipli veri ürünleridir. Feature dataset, curated document corpus veya labeled training data buna örnek olabilir. Owner, quality ve freshness beklentileri klasik data product modelinde olduğu gibi tanımlanmalıdır. AI ekipleri source data'yı her projede baştan temizlemek zorunda kalmaz. Böylece deney ile production arasındaki veri farkı azaltılabilir.
Metadata
Metadata AI sistemlerinin verinin bağlamını ve kullanım koşullarını anlamasına yardımcı olur. Dataset açıklaması, owner, classification ve semantic tags retrieval veya tool selection süreçlerinde kullanılabilir. Model yalnızca tablo adlarına göre karar vermek yerine zengin veri bağlamından yararlanır. Authorization kararları metadata ile birlikte uygulanabilir. Güvenilir metadata AI agent kullanımında özellikle önemli hale gelir.
Semantic Context
Semantic Context, AI sistemine kurumun iş kavramlarının anlamını sağlar. Revenue veya active customer gibi terimler semantic layer üzerinden açık biçimde tanımlanabilir. Agent veya natural language query sistemi doğru metric definition'ı kullanabilir. Bu yaklaşım benzer isimli tablolar arasında yanlış seçim riskini azaltır. Semantic context AI ile enterprise data arasındaki anlam köprüsüdür.
Lineage
Lineage AI modelinin veya RAG cevabının dayandığı veri kaynaklarını izlemeyi kolaylaştırır. Eğitim datasetinin hangi upstream verilerden üretildiği görülebilir. Bir kaynakta problem bulunursa etkilenen modeller impact analysis ile belirlenebilir. Retrieval sonuçları document source lineage ile ilişkilendirilebilir. Bu özellik model governance ve audit için önemli izlenebilirlik sağlar.
Access Control
AI sisteminin veri erişimi kullanıcıdan daha geniş olmamalıdır. Agent adına çalışan servisler hangi data products ve kolonlara erişebileceği konusunda açık policy ile sınırlandırılmalıdır. Retrieval sırasında kullanıcı yetkisi metadata filtering veya query policy ile uygulanabilir. Raw database credentials modele verilmemelidir. Data-centric access control AI kullanımında güvenli sınırlar oluşturur.
Data Freshness
AI sisteminin doğru cevap üretmesi için bazı kullanım senaryolarında veri freshness kritik olabilir. Güncel stok veya hesap durumu eski index üzerinden sorulursa model dil açısından düzgün ama iş açısından yanlış cevap verebilir. Data product freshness SLO retrieval pipeline tarafından kontrol edilebilir. Index update ve source update zamanı ayrı izlenmelidir. Böylece kullanıcıya verinin güncellik seviyesi gerektiğinde açıkça gösterilebilir.
Model Governance
Model Governance model sürümü, risk sınıfı, değerlendirme, kullanım amacı ve deployment kararlarını yönetir. Data governance ile bağlantı kurulduğunda her modelin hangi data products ve izinler üzerinden çalıştığı görülebilir. Training dataset değişikliği model revalidation ihtiyacını tetikleyebilir. Audit trail kritik model değişikliklerini kaydeder. Böylece AI yaşam döngüsü kurumsal veri yaşam döngüsüyle birlikte yönetilir.
RAG Mimarilerinde Kurumsal Veri Nasıl Kullanılır?
RAG mimarisinde kurumsal veri source data, chunking, embedding, vector index, metadata filtering, authorization, retrieval ve citation adımlarıyla hazırlanabilir. Kaynak dokümanların güvenilirliği ve erişim politikaları index oluşturma aşamasından itibaren korunmalıdır. Vector database source of truth değil, canonical veriden türetilmiş arama indexi olarak görülmelidir. Metadata filtering kullanıcının yetkili olmadığı belgelerin retrieval sonucuna girmesini engellemeye yardımcı olur. Citation ve traceability cevapların hangi kurumsal kaynaklara dayandığını göstermesi açısından kritik öneme sahiptir.
Source Data
RAG için source data güvenilir, güncel ve kullanım izni açık kurumsal kaynaklardan seçilmelidir. Eski doküman kopyaları veya sahibi belli olmayan dosyalar retrieval kalitesini düşürür. Data catalog veya document catalog source ownership bilgisini sağlayabilir. Canonical content ile türetilmiş index arasındaki ilişki lineage ile izlenmelidir. Kaynak kalitesi RAG sisteminin cevap kalitesinin temel sınırını oluşturur.
Chunking
Chunking büyük dokümanları retrieval için daha küçük anlamlı parçalara ayırma işlemidir. Çok küçük parçalar bağlam kaybı yaratırken aşırı büyük parçalar arama hassasiyetini azaltabilir. Başlık, bölüm ve paragraf yapısını dikkate alan chunking çoğu kurumsal belgede daha iyi sonuç verir. Chunk metadata'sında document ID ve section bilgisi tutulmalıdır. Bu bilgiler citation ve access control aşamalarında tekrar kullanılabilir.
Embedding
Embedding metin veya veri içeriğini semantic similarity aramasında kullanılabilecek vektör temsiline dönüştürür. Model seçimi dil, domain ve veri tipine göre değerlendirilmelidir. Embedding versiyonu değiştiğinde index yeniden oluşturulabilir. Canonical source text saklandığı sürece vector representation türetilmiş veri olarak görülebilir. Bu ayrım source of truth yönetimini sadeleştirir.
Vector Index
Vector Index embeddingleri hızlı similarity search için düzenleyen türetilmiş veri yapısıdır. Index source data'nın yerine geçmemelidir. Rebuild ve synchronization süreci açık biçimde tanımlanmalıdır. Metadata filtering için document owner, classification ve timestamp gibi alanlar indexle birlikte tutulabilir. Index freshness RAG observability'nin önemli metriklerinden biridir.
Metadata Filtering
Metadata Filtering retrieval sorgusunu domain, tarih, doküman tipi veya erişim etiketi gibi özelliklere göre sınırlar. Bu yöntem hem sonuç kalitesini hem güvenliği artırabilir. Kullanıcının department veya role bilgisi erişim filtresine dönüştürülebilir. Filtre sonrası semantic search daha ilgili adaylar üzerinde çalışır. Metadata kalitesi düşükse retrieval filtering de güvenilir olmayacağı için source metadata yönetimi önemlidir.
Authorization
Authorization RAG sisteminde yalnızca UI seviyesinde uygulanmamalıdır. Retrieval engine kullanıcının gerçekten erişebileceği chunkları döndürmelidir. Hassas belge model promptuna girdikten sonra son cevaptan saklamaya çalışmak yeterli güvenlik sağlamaz. Policy check retrieval öncesi veya sırasında uygulanmalıdır. Audit log hangi kullanıcının hangi kaynakların sonucunu gördüğünü kaydedebilir.
Retrieval
Retrieval kullanıcı sorusuyla en ilgili kurumsal kaynak parçalarını seçme sürecidir. Vector similarity yanında keyword search, metadata filtering ve reranking birlikte kullanılabilir. Hybrid retrieval bazı domainlerde daha dengeli sonuç verir. Retrieval quality bağımsız benchmark setleriyle ölçülmelidir. Model cevabından önce doğru kaynağı bulmak RAG başarısının en önemli aşamalarından biridir.
Citation ve Traceability
Citation ve traceability model cevabının hangi kaynak parçalarına dayandığını kullanıcıya ve audit sistemine gösterebilir. Her chunk canonical document identifier ile ilişkilendirilmelidir. Kaynak güncellendiğinde eski citationların hangi sürüme ait olduğu izlenebilmelidir. Bu yapı kurumsal kullanıcıların cevapları doğrulamasını kolaylaştırır. Güvenilir RAG sisteminde kaynak gösterimi kullanıcı deneyiminin temel parçasıdır.
Vector Database Enterprise Source of Truth mudur?
Vector database çoğu kurumsal mimaride enterprise source of truth olarak görülmemelidir. Vector index, canonical veriden embedding modeli ve chunking kurallarıyla türetilmiş bir arama yapısıdır. Kaynak belge veya veri değiştiğinde index yeniden üretilebilir. Bu nedenle canonical data güvenilir document store, database veya data product üzerinde tutulmalı, vector database retrieval hızlandıran derived layer olarak tasarlanmalıdır. Bu ayrım freshness, audit ve model değişikliklerinin yönetimini büyük ölçüde kolaylaştırır.
Vector Database'in Gerçek Rolü
Vector database'in temel rolü embeddingler arasında hızlı benzerlik araması yapmaktır. RAG, semantic search ve recommendation benzeri kullanım senaryolarında güçlü serving katmanı olabilir. Kaynağın bütün iş kurallarını veya transaction history'sini taşımak zorunda değildir. Index silinse bile canonical data üzerinden yeniden üretilebilmelidir. Böylece vector database mimaride replaceable derived component olarak kalır.
Derived Index Nedir?
Derived Index, temel veriden belirli sorgu veya retrieval performansı için üretilmiş ikincil veri yapısıdır. Search index, materialized view ve vector index bu kategoriye girebilir. Gerçek kaynağın yerine geçmek yerine onu farklı erişim biçiminde sunar. Generation logic ve source lineage açıkça kaydedilmelidir. Derived data'nın yeniden üretilebilir olması operasyonel dayanıklılığı artırır.
Canonical Data Nerede Tutulmalı?
Canonical Data güvenilir transaction database, document repository, warehouse veya sahipli data product üzerinde tutulabilir. Seçim veri tipine ve kullanım şekline bağlıdır. Önemli olan kaynağın versioning, retention, security ve ownership süreçlerinin açık olmasıdır. Vector veya search index bu kaynağın kontrollü türevi olarak oluşturulur. Böylece veri anlamı retrieval teknolojisine bağımlı kalmaz.
Vector Index Nasıl Yeniden Oluşturulur?
Vector Index yeniden oluşturma süreci source extraction, chunking, embedding ve indexing adımlarını tekrarlanabilir pipeline haline getirmelidir. Model versiyonu ve chunking configuration version control altında tutulabilir. Blue-green index yaklaşımı yeni index tamamen hazır olmadan eski sürümün kapatılmasını önler. Rebuild sırasında authorization metadata'nın korunması gerekir. Otomatik validation yeni indexin retrieval kalitesini production geçişinden önce test edebilir.
Freshness Problemi
Vector index source data'dan bağımsız güncellendiğinde freshness problemi oluşabilir. Kaynak belge değişmiş fakat embedding henüz yenilenmemiş olabilir. Index lag metriği observability sisteminde takip edilebilir. Event-driven update veya sık incremental indexing gecikmeyi azaltabilir. Çok kritik güncel bilgi gereken durumlarda retrieval sonrası canonical source doğrulaması ek güven sağlayabilir.
AI Agent'lar İçin Data Architecture
AI Agent'lar kurumsal veriyle çalışırken doğrudan raw database erişimi yerine semantic layer, data products, tool layer ve policy layer üzerinden sınırlandırılmış arayüzler kullanmalıdır. Agent'ın hangi işlemi hangi kullanıcı adına yaptığı audit kaydında izlenebilmelidir. Yüksek etkili değişikliklerde human approval mekanizması kullanılabilir. Semantic layer agent'ın iş kavramlarını daha doğru yorumlamasına yardımcı olur. Data-centric mimari agent yeteneklerini güvenlik, açıklanabilirlik ve kurumsal kontrol içinde sunmanın temel yollarından biridir.
Raw Database Access'ın Riskleri
Raw database access agent'a gereğinden geniş yetki ve teknik yapı sunabilir. Model yanlış tabloyu sorgulayabilir veya hassas kolonu istemeden cevaba dahil edebilir. Internal schema değişiklikleri agent tool kullanımını kırabilir. Query cost ve write operation riskleri de kontrol edilmelidir. Bu nedenle sınırlı semantic veya data product interface daha güvenli başlangıç sunar.
Semantic Layer
Semantic layer agent'a iş kavramları ve onaylanmış metrikler üzerinden sorgu yapma olanağı verir. Kullanıcı "aktif müşteri" dediğinde agent ortak metric definition kullanabilir. Fiziksel tabloların ayrıntısı tool implementasyonu içinde kalır. Access policy semantic query aşamasında uygulanabilir. Böylece agent davranışı daha tutarlı ve değişikliklere dayanıklı hale gelir.
Data Products
Data products agent'ın hangi kurumsal verilere güvenilir biçimde erişebileceğini tanımlar. Owner, quality ve freshness metadata'sı tool selection için kullanılabilir. Agent certified ürünleri düşük kaliteli ad hoc datasetlere tercih edebilir. Interface kararlı olduğu için backend storage değişiklikleri agent promptunu etkilemez. Bu yapı AI tüketimini mevcut veri governance modeliyle hizalar.
Tool Layer
Tool Layer agent'ın database veya business system ile kontrollü fonksiyonlar üzerinden etkileşim kurmasını sağlar. GetCustomerSummary veya CreateSupportDraft gibi sınırlı araçlar raw SQL erişiminden daha güvenli olabilir. Input validation ve rate limit bu katmanda uygulanabilir. Tool schema ve description semantic context sağlar. Her tool çağrısı audit log ile kaydedilebilir.
Policy Layer
Policy Layer agent'ın hangi aracı hangi kullanıcı ve bağlam altında kullanabileceğini belirler. User role, data classification ve işlem riski birlikte değerlendirilebilir. Bazı araçlar yalnızca read-only, bazıları approval required olabilir. Policy-as-code kuralların versioning ve testini kolaylaştırır. Agent sistemi bu katmanı atlayarak backend'e doğrudan erişmemelidir.
Audit
Audit agent'ın hangi veri kaynaklarını sorguladığını ve hangi işlemleri gerçekleştirdiğini izlenebilir hale getirir. User identity ve agent identity birlikte kaydedilmelidir. Kritik kararların kullanılan data product ve tool versiyonuyla ilişkilendirilmesi faydalıdır. Incident incelemelerinde bu kayıtlar önemli bağlam sağlar. Audit yalnızca compliance için değil agent davranışını geliştirmek için de kullanılabilir.
Human Approval
Human Approval yüksek etkili veya geri döndürülmesi zor agent işlemlerinde insan doğrulaması ekler. Para transferi, veri silme veya kritik müşteri değişikliği gibi işlemler doğrudan otomatik yürütülmeyebilir. Agent öneri ve gerekli bağlamı hazırlayıp yetkili kullanıcıya sunabilir. Approval kararı audit trail içinde kaydedilir. Risk bazlı yaklaşım düşük riskli işlemlerde gereksiz kullanıcı sürtünmesini önler.
Multicloud Data Architecture
Multicloud Data Architecture, verinin AWS, Azure, Google Cloud ve on-premise ortamlar arasında dağıtık biçimde yönetilmesini ele alır. Amaç bütün platformları eşit kullanmak değil, veri taşınabilirliğini ve governance sürekliliğini korumaktır. Open table formats, unified catalog ve cross-cloud query bazı kullanım senaryolarında vendor bağımlılığını azaltabilir. Data movement network maliyeti, latency ve compliance açısından dikkatle yönetilmelidir. Mümkün olduğunda compute'u veriye yaklaştırmak ve gereksiz kopyalamayı azaltmak daha verimli yaklaşım sağlar.
AWS
AWS ortamında object storage, managed database ve analytics servisleri data platform katmanlarında kullanılabilir. Multicloud stratejisinde AWS verisinin açık formatlarda tutulması başka engine'lerle erişimi kolaylaştırabilir. Identity ve network policy diğer cloud ortamlarıyla güvenli bağlantı kurmalıdır. Data transfer maliyeti architecture decision içinde açıkça hesaplanmalıdır. Platform ekipleri cloud özel servis kullanımı ile taşınabilirlik hedefini dengeli biçimde değerlendirmelidir.
Azure
Azure kurumsal identity ve data servisleriyle hybrid ve cloud veri mimarilerinde güçlü seçenekler sunabilir. Multicloud yapıda metadata ve access policy'nin diğer platformlarla ortak modele bağlanması önemlidir. Data products cloud location bilgisini tüketici açısından gereksiz ayrıntı haline getirebilir. Cross-cloud transferin güvenlik ve maliyet etkisi ölçülmelidir. Tek platform özelliği yerine kurumsal ihtiyaç üzerinden servis seçmek daha sağlıklı olur.
Google Cloud
Google Cloud analytics ve data processing servisleri büyük ölçekli workload'larda değerlendirilebilir. Multicloud ortamda veri formatı ve catalog metadata'sının taşınabilir olması vendor bağımlılığını azaltır. Query federation bazı cross-cloud kullanım senaryolarını kolaylaştırabilir. Network egress ve latency tasarımda gözden kaçırılmamalıdır. Data product interface uygulama ile cloud platform arasındaki bağımlılığı azaltabilir.
On-Premise
On-Premise sistemler regülasyon, legacy entegrasyon veya mevcut altyapı yatırımları nedeniyle kurumsal veri mimarisinin parçası olmaya devam edebilir. Multicloud yaklaşımı on-premise veriyi zorunlu olarak cloud'a taşımak anlamına gelmez. CDC, federation veya controlled API üzerinden entegrasyon yapılabilir. Unified metadata mevcut on-premise kaynakların da catalog içinde bulunmasını sağlar. Bu model hybrid veri ortamını tek governance çerçevesine bağlamayı kolaylaştırır.
Open Table Formats
Open Table Formats multicloud data lakehouse tasarımında veriyi belirli compute motorundan daha bağımsız tutabilir. Object storage üzerinde ortak tablo metadata'sı farklı engine'ler tarafından okunabilir. Cloudlar arası fiziksel veri kopyalama yine network ve security gereksinimlerine bağlıdır. Catalog strategy format kadar önemli rol oynar. Açık format kullanımı gelecekte platform değişikliklerinde migration maliyetini azaltabilir.
Unified Catalog
Unified Catalog farklı cloud ve on-premise sistemlerdeki veri varlıklarını ortak discovery ve governance deneyiminde birleştirir. Kullanıcı verinin fiziksel yerini bilmeden doğru data product'ı bulabilir. Owner, classification ve lineage metadata cloud sınırlarını aşan ortak modelde tutulabilir. Access policy her platformda aynı şekilde uygulanamayabilir fakat merkezi intent tanımı korunabilir. Böylece multicloud ortamda veri görünürlüğü dağılmaz.
Cross-Cloud Query
Cross-Cloud Query veriyi fiziksel olarak taşımadan veya sınırlı taşıyarak farklı cloud kaynaklarını ortak sorguda birleştirmeyi sağlar. Federation engine bu işlemi kolaylaştırabilir. Network latency ve egress cost büyük dataset joinlerinde önemli hale gelir. Query pushdown ve filtering transfer miktarını azaltabilir. Sık kullanılan ağır sorgular için fiziksel materialization daha ekonomik olabilir.
Data Movement'ı Azaltmak
Data Movement'ı azaltmak multicloud maliyet ve governance yönetiminin temel prensiplerinden biridir. Her pipeline'ın aynı veriyi farklı cloudlara kopyalaması sürdürülebilir değildir. Compute'u veriye yaklaştırmak, zero-copy sharing veya federation kullanmak bazı durumlarda daha uygundur. Kopya gerektiğinde source of truth ve retention açıkça tanımlanmalıdır. Data transfer metriği FinOps dashboardlarında düzenli olarak izlenebilir.
Veri Merkezli Mimari Performansı Nasıl Yönetilir?
Veri merkezli mimaride performans tek bir database tuning çalışması değildir, storage, compute, partitioning, clustering, caching, query optimization ve workload isolation birlikte değerlendirilir. Data products farklı consumer ihtiyaçları için farklı serving modelleri kullanabilir. Compute ve storage ayrımı workload'ların bağımsız ölçeklenmesini sağlayabilir. Materialized views veya cache sık kullanılan sorguları hızlandırırken freshness trade-off oluşturabilir. Performans kararları gerçek query telemetry ve maliyet verisi üzerinden verilmelidir.
Storage ve Compute Ayrımı
Storage ve compute ayrımı verinin kalıcı depolaması ile sorgu veya processing kaynaklarının bağımsız ölçeklenmesini sağlar. Farklı workload'lar aynı storage üzerinde ayrı compute cluster kullanabilir. Bu yaklaşım workload isolation ve maliyet kontrolü sağlar. Network ve data locality performans üzerinde yine etkili olabilir. Açık table formats bu modeli multiengine platformlarda daha esnek hale getirebilir.
Partitioning
Partitioning büyük veri setlerini belirli anahtar veya tarih aralığına göre fiziksel bölümlere ayırır. Query yalnızca gerekli partitionları okuduğunda taranan veri ve maliyet azalır. Aşırı küçük partition oluşturmak metadata ve file overhead yaratabilir. Partition key gerçek query patternlerine göre seçilmelidir. Modern table formats partition evolution ile yapının zaman içinde değişmesine izin verebilir.
Clustering
Clustering veriyi belirli kolonlara göre fiziksel olarak yakın yerleştirerek filtre ve join performansını iyileştirebilir. Partitioning kadar sert sınırlar oluşturmak zorunda değildir. Sık kullanılan filtre kolonları clustering için uygun aday olabilir. Veri değiştikçe reclustering maliyeti oluşabilir. Query telemetry hangi clustering stratejisinin gerçekten fayda sağladığını ölçmek için kullanılmalıdır.
Caching
Caching sık kullanılan veri veya query sonuçlarını hızlı erişim katmanında tutar. Dashboard ve low-latency API kullanımında response süresini önemli ölçüde azaltabilir. Cache invalidation ve freshness temel tasarım problemidir. Kritik güncel veri için daha kısa TTL veya event-driven invalidation gerekebilir. Cache canonical source of truth olarak görülmemelidir.
Query Optimization
Query Optimization sorguların daha az veri tarayıp daha verimli execution plan kullanmasını hedefler. Predicate pushdown, join strategy ve statistics bu süreci etkileyebilir. Kötü veri modeli yalnızca optimizer ile tamamen düzeltilemez. Sık kullanılan ağır sorgular query history üzerinden belirlenmelidir. Performance engineering gerçek workload verisine dayandığında daha etkili sonuç verir.
Materialized Views
Materialized Views sık kullanılan pahalı sorguların önceden hesaplanmış sonucunu saklar. Dashboard latency ve compute cost azaltılabilir. Güncelleme sıklığı freshness ihtiyacına göre planlanmalıdır. Çok sayıda view yeni duplicate data ve bakım yükü oluşturabilir. Data product serving tasarımında yalnızca gerçek kullanım değeri olan materializationlar tutulmalıdır.
Workload Isolation
Workload Isolation ağır batch jobların interaktif analitik veya API sorgularını etkilemesini önler. Ayrı compute pools, queues veya resource groups kullanılabilir. Business-critical workload'lara daha yüksek priority verilebilir. Shared storage üzerinde farklı compute cluster modeli bu ayrımı kolaylaştırır. Isolation performans kadar maliyet attribution için de yararlıdır.
Cost-Based Optimization
Cost-Based Optimization query engine'in farklı execution planlarını istatistik ve tahmini maliyete göre değerlendirmesidir. Güncel statistics olmadan optimizer yanlış join order seçebilir. Büyük data platformlarda query plan inspection önemli troubleshooting aracıdır. Data layout ve partition design optimizer yeteneklerini desteklemelidir. Performans optimizasyonu yalnızca manuel tuning değil engine özelliklerini doğru veri modeliyle birleştirme işidir.
Data Architecture Maliyetleri Nasıl Kontrol Edilir?
Data architecture maliyetleri storage, compute, data transfer, duplicate data ve idle resources gibi birden fazla kaynaktan oluşur. En pahalı teknoloji her zaman en hızlı veya en güvenilir çözüm değildir. Cost per data product ve kullanım metriği harcamayı gerçek iş değeriyle ilişkilendirmeye yardımcı olur. FinOps for Data yaklaşımı domain owner ve platform ekibinin maliyet sorumluluğunu ortaklaştırır. Maliyet optimizasyonu kalite veya güvenlikten vazgeçmek değil gereksiz tüketimi görünür hale getirip uygun mimari seçmek anlamına gelir.
Storage Cost
Storage Cost veri hacmi, retention süresi ve kullanılan storage tier tarafından belirlenir. Ham veriyi sonsuza kadar hızlı storage üzerinde tutmak gereksiz maliyet oluşturabilir. Lifecycle policy eski veriyi daha ekonomik katmana taşıyabilir. Duplicate datasets kullanım metadata'sıyla tespit edilebilir. Open formats migration ve archive stratejilerini daha esnek hale getirebilir.
Compute Cost
Compute Cost batch jobs, streaming processing ve query workload'larından oluşur. Idle clusterlar veya kötü optimize edilmiş sorgular harcamayı hızlı artırabilir. Auto-scaling ve workload scheduling kaynak kullanımını iyileştirebilir. Query cost owner ve data product bazında raporlanabilir. Performans ile maliyet birlikte optimize edilmelidir.
Data Transfer
Data Transfer özellikle cross-region ve multicloud yapılarda önemli maliyet kalemi olabilir. Büyük datasetleri sık sık cloudlar arasında taşımak storage maliyetinden daha pahalı hale gelebilir. Query pushdown ve data locality transferi azaltabilir. Mimaride her kopyanın neden gerekli olduğu açıkça sorgulanmalıdır. Transfer metriği platform FinOps dashboardlarında görünür olmalıdır.
Duplicate Data
Duplicate Data yalnızca storage değil compute, quality ve governance maliyeti de oluşturur. Aynı veri beş farklı pipeline tarafından üretiliyorsa her biri ayrı bakım gerektirir. Catalog ve lineage gereksiz kopyaları tespit etmeye yardımcı olur. Kontrollü performance copy ile gereksiz semantic duplicate birbirinden ayrılmalıdır. Data products yeniden kullanımı artırarak tekrar üretim ihtiyacını azaltabilir.
Idle Resources
Idle Resources kullanılmadığı halde açık kalan compute veya service kaynaklarıdır. Development ve test ortamlarında bu durum sık görülür. Automatic shutdown ve schedule politikaları maliyeti azaltabilir. Serverless veya on-demand compute bazı workload'larda daha verimli olabilir. Kullanım telemetry kaynak sizing kararlarını veriyle destekler.
Cost per Data Product
Cost per Data Product belirli ürünün storage, compute ve serving maliyetini görünür hale getirir. Bu metrik adoption ve business value ile birlikte değerlendirildiğinde ürün portföyü kararlarını destekler. Çok pahalı ama hiç kullanılmayan data product retirement adayı olabilir. Ortak platform maliyetlerinin adil allocation modeli belirlenmelidir. Finansal görünürlük domain ekiplerinin mimari kararları daha bilinçli vermesine yardımcı olur.
FinOps for Data
FinOps for Data cloud ve veri platformu harcamalarını engineering, finance ve business ekiplerinin ortak sorumluluğunda yönetir. Cost allocation tags, usage metrics ve budget alerts temel araçlardır. Domainlere yalnızca toplam fatura değil hangi workload'ın ne kadar maliyet oluşturduğu gösterilmelidir. Optimization önerileri iş etkisiyle birlikte değerlendirilmelidir. Bu yaklaşım data platform büyümesinin mali açıdan sürdürülebilir kalmasını destekler.
Legacy Sistemlerden Data-Centric Mimariye Geçiş
Legacy sistemlerden veri merkezli mimariye geçiş çoğu kurumda bir defalık büyük taşıma projesi olarak değil kademeli dönüşüm olarak ele alınmalıdır. Önce mevcut veri envanteri ve kritik domainler belirlenir, ardından legacy sistemler API, CDC veya data product katmanıyla wrap edilebilir. İlk pilot ürün gerçek bir business use case üzerinden oluşturulmalıdır. Yeni tüketicilerin legacy iç şemaya doğrudan bağlanması engellenerek bağımlılık zamanla azaltılır. Incremental migration riski dağıtırken kurumun yeni platform yetkinliğini gerçek kullanım üzerinden geliştirmesini sağlar.
Mevcut Veri Envanterini Çıkarmak
İlk adım hangi sistemlerde hangi kritik verilerin bulunduğunu ve kimlerin kullandığını anlamaktır. Catalog taraması, database metadata ve stakeholder görüşmeleri birlikte kullanılabilir. Bütün tabloları ayrıntılı belgelemek yerine business-critical entities ile başlanabilir. Owner ve consumer bilgisi envanterin değerini artırır. Bu çalışma migration önceliğini belirlemek için temel sağlar.
Critical Data Domain'leri Belirlemek
Critical Data Domain'leri iş değeri ve bağımlılık sayısına göre belirlemek dönüşümü odaklı hale getirir. Müşteri, sipariş veya ürün gibi çok kullanılan alanlar iyi başlangıç noktaları olabilir. Her domain için mevcut source of truth ve kalite sorunları analiz edilmelidir. İlk dönüşüm bütün kurumu aynı anda kapsamamalıdır. Başarılı pilotlar sonraki domainler için tekrar kullanılabilir pattern üretir.
Legacy Sistemleri Wrap Etmek
Legacy sistemleri wrap etmek iç database şemasını dış tüketicilerden soyutlayan interface oluşturmayı ifade eder. API, CDC adapter veya event publisher kullanılabilir. Yeni uygulamalar eski tablo yapısına doğrudan bağlanmaz. Legacy sistem değiştirildiğinde wrapper arkasındaki implementasyon güncellenebilir. Bu yöntem bağımlılıkları kademeli biçimde azaltır.
CDC Kullanmak
CDC legacy database değişikliklerini modern platforma düşük gecikmeyle taşımak için etkili yöntem olabilir. Kaynak uygulamaya büyük kod değişikliği yapmak gerekmeden data stream oluşturulabilir. Raw CDC eventleri doğrudan consumer interface olarak kullanılmamalıdır. Silver transformation ve data product katmanı iş anlamı ekleyebilir. Bu yaklaşım migration süresince eski ve yeni sistemlerin paralel çalışmasını kolaylaştırır.
Data Product Pilot'u Oluşturmak
İlk data product pilot'u gerçek tüketici ve ölçülebilir iş sonucu olan kullanım senaryosundan seçilmelidir. Yalnızca teknoloji demo'su platform değerini kanıtlamakta zorlanır. Owner, contract, quality ve access interface pilotta baştan uygulanmalıdır. Time-to-access ve consumer satisfaction gibi metrikler ölçülebilir. Başarılı pilot kurum içinde data-centric çalışma biçiminin somut örneğini oluşturur.
Incremental Migration
Incremental Migration sistemleri ve data products'ı küçük adımlarla yeni mimariye taşır. Her adım production feedback üretir ve sonraki tasarımları iyileştirir. Legacy ve yeni platform belirli süre paralel çalışabilir. Migration status catalog ve lineage üzerinden izlenebilir. Bu yaklaşım tek büyük cutover riskini azaltır.
Big-Bang Migration'dan Kaçınmak
Big-Bang Migration bütün sistemi tek tarihte yeni platforma taşımayı hedefler ve büyük kurumsal veri ortamlarında yüksek risk taşıyabilir. Gizli tüketiciler ve bilinmeyen quality sorunları geç fark edilebilir. Kademeli ürün geçişi bu riskleri daha küçük parçalara böler. Consumer migration pencereleri planlı biçimde yönetilebilir. Özellikle kritik operasyonel verilerde kontrollü geçiş daha güvenli ve öğrenilebilir süreç sağlar.
Veri Merkezli Mimariye Geçiş Yol Haritası
Veri merkezli dönüşüm yol haritası teknoloji satın almakla değil gerçek business use case, domain ve ownership tanımlamakla başlamalıdır. Catalog ve quality baseline mevcut durumun görünürlüğünü sağlar. İlk data product ve data contract küçük ama değerli kullanım senaryosunda uygulanabilir. Governance automation ve self-service platform daha fazla domain katıldıkça ölçeklenmeyi destekler. Ölçülebilir sonuçlar üzerinden ilerlemek veri mimarisi ve data-centric dönüşüm danışmanlığı yakınımda gibi aramalarda hizmet arayan işletmelerin de sağlayıcılardan istemesi gereken en somut yaklaşım olmalıdır.
1. Business Use Case Belirleyin
Dönüşüme teknoloji listesiyle değil çözülmesi gereken business problemiyle başlayın. Örneğin müşteri 360 görünümünün haftalar sürmesi veya satış raporlarının birbiriyle uyuşmaması somut kullanım senaryosudur. Mevcut süre, kalite ve maliyet baseline'ı ölçülmelidir. Böylece yeni mimarinin gerçekten iyileşme sağlayıp sağlamadığı görülebilir. İlk use case kurumun geri kalanı için anlaşılır başarı örneği oluşturmalıdır.
2. Data Domain'leri Belirleyin
Business use case ile ilişkili veri domainleri belirlenmelidir. Müşteri, ürün, sipariş veya ödeme gibi domain sınırları iş dili üzerinden tanımlanabilir. Domainler organizasyon şemasını birebir kopyalamak zorunda değildir. Shared entities ve cross-domain ilişkiler ayrıca belgelenmelidir. Doğru domain sınırı ownership ve data product tasarımının temelini oluşturur.
3. Ownership Tanımlayın
Her kritik data product ve domain için açık owner belirlenmelidir. Owner'ın karar yetkisi ve sorumluluğu yalnızca isim olarak kalmamalıdır. Data steward ve platform team rolleri de ayrıştırılmalıdır. Incident ve schema change süreçleri bu ownership modeline bağlanmalıdır. Böylece veri sorunları sahipsiz ticketlara dönüşmez.
4. Data Catalog Oluşturun
Catalog başlangıçta bütün kurumun mükemmel envanterini çıkarmaya çalışmamalıdır. Kritik data products, datasets ve owners ile başlamak daha uygulanabilir olur. Teknik metadata mümkün olduğunca otomatik toplanmalıdır. Business glossary domain ekipleriyle birlikte geliştirilmelidir. Catalog kullanım metrikleri discovery deneyiminin gelişip gelişmediğini gösterebilir.
5. Data Quality Baseline'ı Belirleyin
Mevcut data quality ölçülmeden dönüşüm sonrası iyileşme gösterilemez. Kritik alanlarda completeness, uniqueness, freshness ve accuracy göstergeleri seçilebilir. İlk ölçümlerin mükemmel olması beklenmemelidir. Amaç sorunları saklamak değil görünür hale getirmektir. Baseline sonraki SLO hedeflerinin gerçekçi belirlenmesini sağlar.
6. İlk Data Product'ı Oluşturun
İlk data product gerçek consumer ihtiyacını çözmelidir. Owner, documentation, schema, quality ve interface minimum ürün bileşenleri olarak bulunmalıdır. Platform çok büyük kurulmadan da pilot ürün geliştirilebilir. Consumer feedback ürün lifecycle kararlarını şekillendirir. Pilot süreçte öğrenilenler standart template'e dönüştürülebilir.
7. Data Contract Ekleyin
Data contract producer ve consumer beklentilerini ilk ürün üzerinde görünür hale getirir. Schema ve quality rules makine tarafından okunabilir formatta tanımlanabilir. CI/CD validation küçük ölçekte başlatılabilir. Breaking change süreci pilot ekiplerle test edilir. Contract yaklaşımı işe yaradıktan sonra diğer data products'a yaygınlaştırılır.
8. Governance'ı Otomatikleştirin
Manuel governance süreçleri ürün sayısı arttıkça darboğaz oluşturabilir. Classification, access ve required metadata kontrolleri platform pipeline'ına taşınmalıdır. Policy-as-code değişikliklerin test ve auditini kolaylaştırır. Yüksek riskli istisnalar insan review sürecinde kalabilir. Automation domain ekiplerinin governance standardını daha kolay uygulamasını sağlar.
9. Self-Service Platform Kurun
İlk birkaç data product sonrası tekrar eden altyapı işleri belirgin hale gelir. Bu işler golden path ve self-service servisler olarak platforma taşınabilir. Ingestion, quality, catalog ve publishing otomasyonu öncelikli olabilir. Platform kullanıcı feedback'iyle ürün gibi geliştirilmelidir. Amaç bütün olası teknolojileri sunmak değil en sık ihtiyaçları kolaylaştırmaktır.
10. Ölçerek Ölçekleyin
Data-centric dönüşüm yalnızca kaç dataset üretildiğiyle ölçülmemelidir. Time-to-find, time-to-access, adoption, quality ve consumer satisfaction gibi sonuç metrikleri takip edilmelidir. İşe yaramayan patternler erken değiştirilmelidir. Yeni domainlere yalnızca platform kapasitesi ve ownership hazır olduğunda geçilmelidir. Ölçerek ölçeklemek büyük ve kontrolsüz dönüşüm programlarının riskini azaltır.
Data-Centric Mimari Başarısı Nasıl Ölçülür?
Data-centric mimari başarısı teknik altyapı büyüklüğü yerine verinin bulunması, erişilmesi ve güvenilir biçimde kullanılmasıyla ölçülmelidir. Time-to-Find Data, Time-to-Access ve Time-to-Insight tüketici deneyimini doğrudan gösterir. Data Product Adoption, quality score ve SLO compliance ürün güvenilirliği hakkında sinyal verir. Duplicate dataset ve data incident sayısı operasyon kalitesini ölçer. Platform adoption ve consumer satisfaction ise self-service yatırımının kurum tarafından gerçekten benimsendiğini gösterir.
Time-to-Find Data
Time-to-Find Data kullanıcının ihtiyaç duyduğu doğru veri kaynağını bulmasının ne kadar sürdüğünü ölçer. Catalog öncesi ve sonrası süre karşılaştırılabilir. Çok sayıda arama yapıp yine doğru ürünü bulamamak discovery problemine işaret eder. Search analytics hangi kavramlarda metadata eksik olduğunu gösterebilir. Bu metriğin düşmesi data platformun doğrudan verimlilik değeridir.
Time-to-Access
Time-to-Access data product bulunduğunda gerçek erişimin ne kadar sürede sağlandığını ölçer. Günler süren manuel ticket süreçleri self-service hedefiyle uyumlu değildir. Classification ve role metadata otomatik onayı mümkün kılabilir. Yüksek riskli verilerde ek kontrol süresi doğal olabilir. Metrik risk sınıfına göre segment edilirse daha anlamlı sonuç verir.
Time-to-Insight
Time-to-Insight iş sorusundan güvenilir analiz veya karar çıktısına ulaşma süresidir. Data discovery, access, preparation ve metric definition aşamalarının toplam etkisini gösterir. Data products ve semantic layer bu süreyi azaltmayı hedefler. Yalnızca query hızını ölçmek gerçek kullanıcı deneyimini yansıtmaz. İş ekiplerinin yeni analiz üretme süresi daha anlamlı başarı göstergesi olabilir.
Data Product Adoption
Data Product Adoption ürünün kaç consumer, query veya uygulama tarafından kullanıldığını ölçer. Yüksek adoption ortak veri ürününün tekrar kullanım değerini gösterebilir. Kullanılmayan ürünler bakım maliyeti oluşturur ve retirement adayı olabilir. Adoption metriği yalnızca erişim sayısı değil aktif ve değerli kullanım üzerinden değerlendirilmelidir. Owner roadmap önceliklerini bu bilgilerle belirleyebilir.
Data Quality Score
Data Quality Score birden fazla kalite boyutunu özetleyerek ürün güvenilirliği hakkında hızlı görünüm sunabilir. Completeness, validity ve freshness ağırlıklı olarak birleştirilebilir. Tek skor ayrıntılı metriklerin yerini tutmamalıdır. Trend değişimi ürün kalitesinin zaman içinde iyileşip iyileşmediğini gösterebilir. Business-critical alanlara daha yüksek ağırlık vermek skoru daha anlamlı hale getirir.
SLO Compliance
SLO Compliance data products'ın tanımlı freshness, availability veya quality hedeflerini hangi oranda karşıladığını ölçer. Sürekli hedefi kaçıran ürünün iş beklentisi veya altyapısı yeniden değerlendirilmelidir. Gereksiz yüksek SLO da maliyet artırabileceği için hedefler zamanla güncellenebilir. Compliance sonuçları consumerlara görünür olabilir. Bu metrik veri ürünlerini operasyonel servis mantığıyla yönetmeyi kolaylaştırır.
Duplicate Dataset Sayısı
Duplicate Dataset Sayısı aynı iş gerçeğini benzer şekilde tekrar üreten veri varlıklarının miktarını gösterir. Catalog ve lineage bu kopyaları tespit etmeye yardımcı olabilir. Her duplicate kötü değildir, performans veya regülasyon amacıyla kontrollü kopyalar gerekebilir. Ama sahipsiz ve yeniden oluşturulabilir kopyalar teknik borçtur. Data product adoption arttıkça gereksiz duplicate sayısının azalması beklenebilir.
Data Incident Sayısı
Data Incident Sayısı platform güvenilirliği hakkında temel göstergelerden biridir. Ancak yalnızca toplam sayı değil severity ve çözüm süresi de takip edilmelidir. Observability devreye alındığında ilk dönemde daha fazla incident görünmesi normal olabilir çünkü önceden fark edilmeyen sorunlar ortaya çıkar. Uzun vadede tekrar eden incidentların azalması kalite olgunluğunu gösterir. Root cause kategorileri platform yatırımlarının nereye yapılacağını belirleyebilir.
Consumer Satisfaction
Consumer Satisfaction veri platformu kullanıcılarının ürünleri ve self-service deneyimini nasıl değerlendirdiğini ölçer. Kısa anket, feedback veya support data kullanılabilir. Teknik reliability yüksek olsa bile discovery veya documentation kötü ise kullanıcı memnuniyeti düşük kalabilir. Nitel yorumlar metriklerin açıklamadığı sorunları ortaya çıkarır. Platform roadmap'i gerçek kullanıcı geri bildiriminden düzenli olarak yararlanmalıdır.
Platform Adoption
Platform Adoption domain ekiplerinin standart self-service yollarını ne ölçüde kullandığını gösterir. Ekipler sürekli platform dışı özel çözümler kuruyorsa ihtiyaç veya developer experience sorunu olabilir. Golden path kullanım oranı ve yeni data product provisioning yöntemleri ölçülebilir. Adoption zorunlulukla değil kullanıcıya gerçek kolaylık sağlayarak artırılmalıdır. Yüksek benimseme ortak governance ve observability coverage seviyesini de yükseltir.
Veri Merkezli Mimarilerde Yapılan Yaygın Hatalar
Veri merkezli dönüşümlerde en yaygın hata kavramı yeni bir merkezi database veya data lake kurma projesine indirgemektir. Ownership, data contracts, semantic definitions ve governance olmadan teknoloji değişse bile eski veri problemleri devam eder. Her veriyi real-time yapmak veya organizasyon hazır olmadan data mesh uygulamak maliyet ve operasyon yükünü artırabilir. Platformdan önce ürün satın almak gerçek kullanıcı ihtiyaçlarının gözden kaçmasına yol açar. En önemli prensip güvenilir veri yaşam döngüsünü ve sorumluluk modelini teknoloji seçiminden önce netleştirmektir.
Data-Centric'i Merkezi Database Olarak Görmek
Data-centric mimari bütün veriyi tek database'e toplamak anlamına gelmez. Fiziksel merkezilik performans, regülasyon ve domain bağımsızlığı nedeniyle her zaman uygun değildir. Asıl hedef verinin anlamı, ownership'i ve sözleşmelerinin açık olmasıdır. Dağıtık kaynaklar ortak metadata ve governance ile birlikte çalışabilir. Bu ayrım yanlış platform beklentilerini azaltır.
Her Şeyi Data Lake'e Atmak
Data lake'e veri kopyalamak tek başına veri platformu oluşturmaz. Owner, schema ve quality olmadan lake hızla kullanılması zor veri alanına dönüşebilir. Ham veri saklama ile business-ready data product birbirinden ayrılmalıdır. Catalog ve lifecycle policy verinin yönetilebilir kalmasını sağlar. Data lake depolama katmanıdır, governance modelinin yerine geçmez.
Data Product Yerine Dataset Yayınlamak
Dataset yayınlayıp adını data product olarak değiştirmek yaklaşımın gerçek değerini sağlamaz. Owner, documentation, quality SLO ve access interface ürünün parçası olmalıdır. Consumer feedback ve lifecycle yönetimi de ürün davranışının göstergesidir. Sahipsiz tablolar zamanla güven kaybeder. Data product tanımını açık checklist ile kurumsal standarda bağlamak faydalıdır.
Ownership Belirlememek
Ownership yoksa veri sorunu çıktığında kimsenin net sorumluluk almaması sık görülür. Platform ekibi iş anlamını, domain ekibi teknik pipeline'ı tam olarak sahiplenmeyebilir. Açık RACI ve product owner modeli bu boşluğu azaltır. Owner bilgisi catalog ve alerting sistemlerinde kullanılmalıdır. Sahiplik sürekli güncel tutulmadığında governance hızla eski hale gelir.
Data Contract Kullanmamak
Data contract olmadan producer değişiklikleri downstream consumerları beklenmedik biçimde kırabilir. Schema ve semantic beklentiler sözlü bilgiye dönüşür. CI/CD compatibility checks bu riski azaltabilir. Contract yeni geliştirme hızını düşürmek yerine değişiklik etkisini erken görünür kılar. Özellikle çok ekipli yapılarda sözleşme güçlü koordinasyon aracıdır.
Semantic Katmanı Atlamak
Semantic layer olmadan her BI veya AI uygulaması kendi metric definition'ını oluşturabilir. Aynı revenue veya active customer metriği farklı sonuçlar vermeye başlar. Kullanıcılar veriye güvenmek yerine rapor karşılaştırmakla zaman harcar. Merkezi metric definitions bu tekrarları azaltır. Semantic katman teknik storage tasarımından bağımsız kritik kurumsal yatırımdır.
Governance'ı Manuel Bırakmak
Manuel governance az sayıda dataset için çalışabilir fakat ürün sayısı arttığında ölçeklenmez. Access ve classification onayları haftalar sürebilir. Policy-as-code ve metadata-driven automation tekrar eden kontrolleri hızlandırır. İnsan review yüksek riskli istisnalara ayrılabilir. Böylece governance ekiplerin önündeki kuyruk olmaktan çıkar.
Her Veriyi Real-Time Yapmak
Real-time processing teknik olarak etkileyici olsa da her iş ihtiyacı için gerekli değildir. Günlük rapor için saniyelik latency elde etmeye çalışmak maliyet ve operasyon yükünü artırabilir. İş kararının gerçek zaman ihtiyacı önce ölçülmelidir. Batch ve near-real-time çözümler birçok kullanım için yeterlidir. Streaming gerçek değer oluşturduğu yerlerde kullanılmalıdır.
Data Mesh'i Organizasyon Hazır Olmadan Uygulamak
Data mesh yalnızca organizasyon şemasını değiştirerek uygulanamaz. Domain ekiplerinde veri yetkinliği ve self-service platform desteği yoksa ownership dağıtımı yeni sorunlar oluşturur. İlk olarak platform ve data product prensipleri merkezi ortamda olgunlaştırılabilir. Ardından uygun domainlerde sorumluluk kademeli dağıtılır. Organizasyonel hazırlık teknolojik hazırlık kadar önemlidir.
Platformdan Önce Teknoloji Satın Almak
Teknoloji satın almak platform stratejisi oluşturmakla aynı şey değildir. Kullanıcı ihtiyaçları ve golden paths tanımlanmadan çok sayıda araç edinmek entegrasyon yükünü artırabilir. Önce hangi developer journey'nin kolaylaştırılacağı belirlenmelidir. Ardından en sade araç seti seçilebilir. Platform başarısı kullanılan ürün sayısıyla değil kullanıcıların işini ne kadar kolaylaştırdığıyla ölçülür.
Data Quality'yi Downstream'de Düzeltmek
Kalite sorunlarını yalnızca dashboard veya AI pipeline aşamasında düzeltmek hatayı kaynağından uzaklaştırır. Aynı problem farklı consumerlar tarafından tekrar tekrar çözülür. Quality checks producer veya data product katmanına mümkün olduğunca yakın taşınmalıdır. Root cause source systemde ele alınmalıdır. Bu yaklaşım uzun vadede toplam data engineering maliyetini azaltır.
AI'yı Güvenilmez Verinin Üzerine Kurmak
AI projesi veri governance eksikliğini otomatik olarak çözmez. Sahipsiz, güncelliği bilinmeyen ve semantic anlamı belirsiz veriler model çıktısını doğrudan etkiler. Önce güvenilir data products ve lineage temeli oluşturulmalıdır. Model monitoring data quality monitoring ile birlikte çalışmalıdır. AI yatırımı sağlam kurumsal veri temeli üzerinde daha sürdürülebilir sonuç verir.
Diyarbakır Yazılım Topluluğu ile Data Engineering ve Open Source İşbirliği
Data engineering yalnızca büyük teknoloji merkezlerinde gelişen bir uzmanlık alanı olmak zorunda değildir. Diyarbakır'da geliştiricilerin, üniversite öğrencilerinin ve şirketlerin ortak açık kaynak projeler üzerinde çalışması bölgesel teknik kapasiteyi doğrudan geliştirebilir. Diyarbakır Yazılım Topluluğu üzerinden çalışma grupları, workshoplar ve ortak projeler oluşturmak teori ile production pratiği arasındaki mesafeyi azaltabilir. Topluluğun yürüttüğü veya paylaştığı çalışmalar hakkında daha fazla bilgi için https://www.diyarbakiryazilim.com.tr/projects adresi incelenebilir. Özellikle PostgreSQL, Kafka, dbt, metadata ve data product konularında küçük ama çalışan açık kaynak projeler üretmek bölgedeki geliştiricilerin gerçek portföy oluşturmasına yardımcı olur.
Yerel Data Engineering Çalışma Grubu Oluşturmak
Yerel bir data engineering çalışma grubu düzenli teknik öğrenme ve ortak üretim için güçlü başlangıç olabilir. Üyeler SQL, data modeling, Kafka, governance veya lakehouse gibi başlıkları dönemsel olarak ele alabilir. Sadece sunum yapmak yerine küçük kod depoları ve örnek data products üretmek öğrenmeyi kalıcı hale getirir. Deneyimli geliştiriciler code review üzerinden yeni katılımcılara pratik destek sağlayabilir. Süreklilik için küçük ve düzenli buluşmalar, büyük ama seyrek etkinliklerden daha etkili olabilir.
Açık Kaynak Data Platform Projesi Geliştirmek
Açık kaynak data platform projesi katılımcıların gerçek mimari kararları deneyimlemesini sağlar. Örneğin PostgreSQL kaynağından CDC ile event alıp lakehouse tablosuna yazan ve catalog metadata'sı yayınlayan küçük platform oluşturulabilir. Proje production ölçeğini taklit etmek zorunda değildir. Data contracts, testing ve documentation özelliklerinin erken eklenmesi öğretici değeri artırır. Ortak repository farklı yetkinlik seviyelerindeki geliştiricilerin görev almasını kolaylaştırır.
Ortak Veri Setleri Üzerinde Çalışmak
Ortak ve izinli veri setleri data modeling ve analytics pratikleri için kullanılabilir. Katılımcılar aynı kaynaktan farklı data products tasarlayarak mimari kararlarını karşılaştırabilir. Quality rules ve semantic definitions birlikte tartışılabilir. Hassas veya kişisel veri kullanılmaması eğitim ortamında güvenli çalışma sağlar. Projelerin dokümante edilmesi yeni katılımcıların çalışmaya hızlı dahil olmasını kolaylaştırır.
GitHub Üzerinden İşbirliği
GitHub ortak data projelerinin kod, issue, review ve documentation süreçlerini yönetmek için uygun çalışma alanı sunar. Katılımcılar gerçek açık kaynak iş akışlarını deneyimleyebilir. Küçük issue'lar yeni başlayanların katkı yapmasını kolaylaştırır. Pull request ve code review teknik tartışmayı görünür ve öğrenilebilir hale getirir. Bu çalışma modeli bireysel öğrenmeyi ekip mühendisliği deneyimine dönüştürür.
Issue
Issue proje içindeki hata, geliştirme veya dokümantasyon görevlerini açık biçimde tanımlar. Yeni katılımcılar uygun zorluk seviyesindeki işlerden başlayabilir. Kabul kriterlerinin net yazılması görevin tamamlanmasını kolaylaştırır. Mimari karar gerektiren issue'larda kısa tasarım tartışması yapılabilir. Düzenli issue yönetimi açık kaynak projenin sürdürülebilir ilerlemesini sağlar.
Pull request
Pull request kod değişikliğinin proje ana dalına alınmadan önce incelenmesini sağlar. Geliştirici yaptığı değişikliği, test yöntemini ve etkilediği bölümleri açıklayabilir. CI testleri data contract veya quality checks çalıştırabilir. Review yorumları teknik öğrenmenin önemli parçasıdır. Küçük ve odaklı pull requestler incelemeyi daha verimli hale getirir.
Code review
Code review yalnızca hata bulma süreci değil ortak mühendislik bilgisini geliştirme aracıdır. SQL model, schema, naming ve observability gibi konular birlikte değerlendirilebilir. Yorumlar kişiye değil koda ve teknik gerekçeye odaklanmalıdır. Yeni katılımcılar deneyimli geliştiricilerin karar düşüncesini görür. Zaman içinde ortak coding ve data engineering standartları doğal biçimde oluşur.
Documentation
Documentation açık kaynak projenin yeni kullanıcılar tarafından anlaşılmasını sağlar. Kurulum, architecture, data model ve contribution adımları açık biçimde anlatılmalıdır. Örnek query ve diagramlar öğrenmeyi kolaylaştırabilir. Dokümantasyon kod değişiklikleriyle birlikte güncellenmelidir. İyi belge projenin tek bir kişiye bağımlı kalmasını önler.
Kafka, PostgreSQL ve dbt Workshop'ları
Kafka, PostgreSQL ve dbt workshopları birbirini tamamlayan gerçek veri akışı üzerinden kurgulanabilir. Katılımcılar PostgreSQL içinde veri üretip Kafka eventlerini işleyebilir ve dbt ile analitik model oluşturabilir. Her araç ayrı sunum olarak anlatılmak yerine uçtan uca data product örneğinin parçası yapılabilir. Schema evolution ve quality test gibi production konuları da workshop içine eklenebilir. Bu yaklaşım katılımcının teknolojileri gerçek mimari bağlam içinde öğrenmesini sağlar.
Üniversite Topluluk Şirket İşbirliği
Üniversite, topluluk ve şirket işbirliği öğrencilerin gerçek iş problemleriyle daha erken karşılaşmasını sağlayabilir. Şirketler anonimleştirilmiş problemler veya teknik mentorluk sunabilir. Üniversite tarafı temel teori ve araştırma desteği sağlayabilir. Topluluk ise bu iki alan arasında sürekli etkinlik ve açık proje ortamı oluşturabilir. Diyarbakır Yazılım Topluluğu hakkında daha fazla bilgi için https://www.diyarbakiryazilim.com.tr/about adresi ziyaret edilebilir.
Data Hackathon Düzenlemek
Data hackathon yalnızca kısa sürede dashboard üretme yarışması olarak planlanmamalıdır. Takımlardan data contract, quality check, data product documentation ve küçük serving interface geliştirmeleri istenebilir. Böylece katılımcılar gerçek data engineering yaşam döngüsünü deneyimler. Değerlendirme yalnızca görsel çıktı değil mimari gerekçe ve veri güvenilirliği üzerinden yapılabilir. Hackathon sonunda projelerin açık repository olarak devam etmesi etkinliğin etkisini uzatır.
Diyarbakır'daki En İyi Yazılımcılar Veri Merkezli Sistemler İçin Hangi Yetkinliklere Sahip Olmalı?
Veri merkezli sistemlerde güçlü yazılımcı olmak yalnızca belirli frameworkleri bilmek anlamına gelmez. SQL, veri modelleme, distributed systems, API ve event architecture, data quality, security, cloud ve open source çalışma deneyimi birlikte değer üretir. Business domain'i anlamak teknik kararlara iş bağlamı kazandırır. İyi mühendis yalnızca hangi teknolojiyi kullanacağını değil neden kullandığını ve hangi trade-off'u kabul ettiğini açıklayabilir. Bu yetkinlikler Diyarbakır'da yerel teknoloji ekosisteminin kurumsal data engineering projelerinde daha güçlü rol almasını sağlayabilir.
SQL Yetkinliği
SQL yetkinliği veriyle çalışan yazılımcıların en temel becerilerinden biridir. Join, aggregation, window function ve query plan konularını anlamak yalnızca raporlama için değil veri modelleme için de gereklidir. Geliştirici doğru grain ve key seçmeden iyi SQL yazamaz. Performance tuning gerçek execution plan üzerinden öğrenilmelidir. SQL farklı veri platformlarında taşınabilir bir temel yetkinlik sağlar.
Veri Modelleme
Veri modelleme entity, relationship, grain ve temporal behavior kararlarını kapsar. Kötü model iyi framework kullanılarak otomatik olarak düzelmez. Operational ve analytical modellerin farklı ihtiyaçları anlaşılmalıdır. Domain boundaries ve shared entities kurumsal ölçekte ayrıca önem kazanır. Güçlü modelleme becerisi teknoloji değişse bile değerini korur.
Distributed Systems Bilgisi
Distributed systems bilgisi streaming ve büyük data platformlarında hata davranışlarını anlamayı sağlar. Network failure, retry, ordering ve eventual consistency gibi kavramlar gerçek production incidentlarında sürekli karşımıza çıkar. Exactly-once gibi ifadeler pazarlama cümlesi yerine gerçek uçtan uca davranış üzerinden değerlendirilmelidir. Idempotency önemli temel pratiktir. Bu bilgi data engineer ile platform engineer rollerinin ortak teknik zemininin önemli parçasıdır.
API ve Event Architecture
API ve event architecture verinin uygulamalar arasında nasıl güvenli ve kararlı paylaşılacağını belirler. REST, gRPC veya Kafka seçmekten önce interface contract ve ownership düşünülmelidir. Event schema versioning consumer kırılmalarını azaltır. Data product output ports bu teknolojileri ortak ürün modeli altında birleştirebilir. Güçlü mühendis farklı iletişim modellerinin uygun olduğu durumları ayırt edebilmelidir.
Data Quality
Data quality yalnızca analistin işi değildir. Producer sistemden data product serving katmanına kadar kalite kontrolleri tasarlanmalıdır. Geliştirici completeness, uniqueness ve freshness gibi ölçümleri iş anlamıyla ilişkilendirebilmelidir. Test otomasyonu production pipeline'ın parçası olmalıdır. Kalite problemi çıktığında downstream patch yerine source root cause çözümüne odaklanmak önemlidir.
Security
Security veri mühendisliğinin ayrılmaz parçasıdır. Encryption, access control, secrets management ve data classification temel olarak bilinmelidir. PII içeren verinin development ortamına kontrolsüz kopyalanmaması gerekir. Least privilege ve audit pratikleri pipeline tasarımında dikkate alınmalıdır. Güvenlik bilgisi mühendisin daha güvenilir data products üretmesini sağlar.
Cloud
Cloud bilgisi storage, compute, network ve managed data services seçimlerini daha bilinçli yapmayı sağlar. Ancak cloud sertifikası tek başına iyi data architecture tasarımını garanti etmez. Egress cost, identity ve availability trade-off'ları anlaşılmalıdır. Open formats ve data portability cloud stratejisinin parçası olmalıdır. Temel prensipleri bilen mühendis farklı cloud sağlayıcılarına daha kolay uyum sağlar.
Open Source Katkıları
Open source katkıları geliştiricinin gerçek repository, issue ve review süreçleriyle çalışmasını sağlar. Küçük documentation veya bug fix katkısı bile güçlü öğrenme deneyimi olabilir. Kodun farklı kullanıcılar tarafından nasıl değerlendirildiğini görmek mühendislik bakışını geliştirir. Upstream project architecture okumak yeni teknolojileri daha derin anlamayı sağlar. Düzenli katkı teknik portföy ve topluluk ağı için de değerlidir.
Business Domain'i Anlama
Business domain'i anlamadan data product tasarlamak çoğu zaman teknik olarak doğru ama iş açısından anlamsız sonuç üretir. Müşteri, sipariş veya revenue kavramlarının gerçek süreçte nasıl oluştuğu öğrenilmelidir. Domain experts ile çalışma data model kalitesini yükseltir. Data engineer yalnızca kolon isimlerine bakmak yerine iş olaylarını anlamalıdır. Bu yetkinlik semantic layer ve data contract tasarımında özellikle önemlidir.
Data Architecture Kararlarını Gerekçelendirme
İyi mühendis seçimlerini popüler teknoloji isimleriyle değil gereksinim ve trade-off'larla açıklayabilir. Neden batch yerine streaming, neden API yerine query interface veya neden lakehouse yerine warehouse seçildiği net olmalıdır. Architecture Decision Record benzeri belgeler bu düşünceyi kalıcı hale getirir. Maliyet, ekip kapasitesi ve operasyon yükü teknik özelliklerle birlikte değerlendirilmelidir. Bu yaklaşım daha sade ve sürdürülebilir sistemler üretir.
Yazılımcı Olmak İçin Ne Yapmalı? Data Engineering Yol Haritası
Data engineering alanına girmek isteyen biri için en sağlam yol temel programlama, SQL, Python, PostgreSQL, veri modelleme, ETL, API, Kafka, warehouse, lakehouse, cloud ve governance konularını aşamalı biçimde öğrenmektir. Bütün teknolojileri aynı anda öğrenmeye çalışmak yerine küçük uçtan uca projeler daha kalıcı sonuç verir. Örneğin PostgreSQL'den veri alıp Python ile işleyerek analitik modele dönüştürmek iyi başlangıç projesidir. Ardından event streaming, data quality ve open source contribution eklenebilir. Gerçek repository ve production benzeri sorunlarla çalışmak yalnızca video izlemekten çok daha güçlü öğrenme sağlar.
Programlama Temelleri
Programlama temelleri değişken, fonksiyon, veri yapısı, hata yönetimi ve test gibi konuları kapsar. Belirli framework öğrenmeden önce bu kavramları anlamak gerekir. Küçük CLI veya API uygulamaları pratik için yararlıdır. Git kullanımı erken aşamada öğrenilmelidir. Sağlam temel yeni data engineering araçlarını daha hızlı öğrenmeyi sağlar.
SQL Öğrenmek
SQL data engineering yol haritasının merkezinde olmalıdır. SELECT, JOIN ve GROUP BY sonrasında window functions, CTE ve execution plan konularına geçilebilir. Gerçek datasetler üzerinde veri temizleme ve modelleme egzersizleri yapılmalıdır. Query performansı index ve partition bilgisiyle birlikte öğrenilmelidir. SQL pratiği analitik düşünme becerisini de geliştirir.
Python Öğrenmek
Python dosya işleme, API kullanımı, automation ve pipeline geliştirme için öğrenilebilir. İlk aşamada temel dil yapısı ve test pratikleri yeterlidir. Daha sonra data processing ve orchestration kütüphanelerine geçilebilir. Kodun modüler ve okunabilir tutulması önemlidir. Basit bir ingestion pipeline üretim benzeri deneyim için iyi projedir.
PostgreSQL
PostgreSQL relational database temellerini pratik olarak öğrenmek için güçlü ortam sağlar. Table design, index, transaction ve constraint kavramları gerçek uygulamalar üzerinde görülebilir. EXPLAIN ile query plan incelemek performance bilgisi kazandırır. CDC veya API projelerinde de kaynak database olarak kullanılabilir. Bu öğrenim daha büyük data platformlarını anlamayı kolaylaştırır.
Veri Modelleme
Veri modelleme entity, key, relationship ve grain kavramlarını anlamayı gerektirir. Normalization ve dimensional modeling farklı kullanım ihtiyaçları için öğrenilmelidir. Aynı veri setini operational ve analytical model olarak ayrı tasarlamak yararlı egzersizdir. Slowly changing dimensions gibi zaman boyutlu problemler ilerleyen aşamada çalışılabilir. Data product tasarımında modelleme bilgisi doğrudan kullanılır.
ETL ve ELT
ETL ve ELT verinin kaynak sistemden hedef platforma nasıl taşınıp dönüştürüldüğünü anlamayı sağlar. Küçük batch pipeline kurarak extraction, transformation ve loading adımları öğrenilebilir. Retry, idempotency ve logging production davranışı için eklenmelidir. Data quality testleri pipeline'ın parçası yapılmalıdır. Araçtan bağımsız temel akış anlaşıldığında yeni frameworkler daha kolay öğrenilir.
API
API bilgisi data engineer'ın dış sistemlerden veri almasını ve kendi data products'ını servis olarak sunmasını sağlar. HTTP, authentication, pagination ve rate limit temel konulardır. Küçük REST API geliştirip veritabanıyla bağlamak iyi pratiktir. Contract ve versioning kavramları erken öğrenilmelidir. Data platformlarda API entegrasyonları sık karşılaşılan gerçek işlerden biridir.
Kafka ve Event Streaming
Kafka ve event streaming öğrenirken önce producer, consumer, partition, offset ve retention kavramları anlaşılmalıdır. Basit event üretip consumer ile işlemek başlangıç için yeterlidir. Daha sonra schema registry, replay ve idempotency eklenebilir. Database CDC ile Kafka bağlantısı gerçekçi proje oluşturur. Streaming yalnızca araç komutları değil distributed systems davranışıyla birlikte öğrenilmelidir.
Data Warehouse
Data warehouse öğrenimi dimensional modeling, analytical SQL ve metric design konularını içerir. Fact ve dimension tabloları üzerinde küçük satış modeli kurulabilir. Incremental load ve history yönetimi eklenebilir. BI query performansı gözlemlenebilir. Warehouse mantığını anlamak lakehouse ve semantic layer konularını öğrenmeyi kolaylaştırır.
Lakehouse
Lakehouse öğrenirken object storage, columnar file formats ve open table formats temel alınmalıdır. Parquet ve Iceberg benzeri teknolojilerin ne problemi çözdüğü anlaşılmalıdır. Snapshot ve schema evolution pratik olarak test edilebilir. Farklı query engines ile aynı tabloyu okumak interoperability kavramını somutlaştırır. Lakehouse'u yalnızca yeni bir data lake adı olarak görmekten kaçınılmalıdır.
Cloud
Cloud öğrenirken önce storage, compute, network ve identity temel servisleri anlaşılmalıdır. Daha sonra managed data services değerlendirilebilir. Maliyet hesabı her küçük proje için yapılmalıdır. Infrastructure-as-code kullanmak tekrar edilebilir ortam kurmayı öğretir. Tek sağlayıcının ürün listesini ezberlemek yerine temel mimari prensiplere odaklanmak daha kalıcıdır.
Data Governance
Data governance başlangıç seviyesinde bile ownership, classification, access ve quality kavramlarıyla öğrenilebilir. Kendi kişisel projenizde dataset owner ve schema contract tanımlamak iyi pratiktir. Catalog veya metadata aracı ekleyerek discovery süreci deneyimlenebilir. PII benzeri örnek alanlar için masking uygulanabilir. Governance gerçek proje içinde öğrenildiğinde soyut politika olmaktan çıkar.
Open Source Bir Data Projesine Katılmak
Open source bir data projesine katılmak öğrenilen becerileri gerçek ekip ortamında uygulama imkanı verir. İlk katkının büyük feature olması gerekmez. Documentation düzeltmek, test eklemek veya küçük issue çözmek iyi başlangıçtır. Pull request review süreci kod kalitesi ve iletişim becerisi geliştirir. Diyarbakır Yazılım Topluluğu projelerini takip etmek için https://www.diyarbakiryazilim.com.tr/projects adresi kullanılabilir.
Production-Ready Data-Centric Architecture Kontrol Listesi
Production-ready bir data-centric architecture yalnızca pipeline'ların çalışmasıyla tamamlanmış sayılmaz. Domain, ownership, catalog, contract, schema evolution, lineage, quality, observability, semantic definitions, PII protection, access policy ve platform adoption birlikte değerlendirilmelidir. Bu kontrol listesi mimari review toplantılarında uygulama ekibi, data team ve governance temsilcileri tarafından birlikte kullanılabilir. Her maddeye yalnızca evet veya hayır vermek yerine kanıt, owner ve iyileştirme planı eklemek daha yararlıdır. Düzenli tekrarlandığında kontrol listesi platform olgunluğunun zaman içindeki gelişimini görünür hale getirir.
Data domain'ler tanımlı mı?
Data domain'lerin tanımlı olması ownership ve data product sınırlarının anlaşılmasını sağlar. Domainler yalnızca departman isimlerinden türetilmemelidir. İş capability ve veri anlamı dikkate alınmalıdır. Shared entities domainler arası ilişki olarak ayrıca modellenebilir. Domain map kurum büyüdükçe düzenli olarak güncellenmelidir.
Her kritik verinin owner'ı belli mi?
Kritik verinin owner'ı belli değilse incident ve değişiklik kararları yavaşlar. Owner iş anlamı ve lifecycle konusunda gerçek hesap verebilirliğe sahip olmalıdır. Catalog kaydı güncel tutulmalıdır. Organizasyon değişikliklerinde ownership transfer süreci çalışmalıdır. Sahipsiz kritik data product production-ready kabul edilmemelidir.
Data products kataloglanıyor mu?
Data products tüketicilerin kolay bulabileceği catalog içinde yayınlanmalıdır. Owner, documentation, schema ve quality bilgileri aynı sayfada görünmelidir. Search iş kavramları üzerinden çalışabilmelidir. Usage ve certification metadata kullanıcıya doğru ürün seçimi konusunda yardımcı olabilir. Kataloglanmayan ürün self-service ekosistemde görünmez kalır.
Data contract'lar makine-okunabilir mi?
Data contracts yalnızca wiki sayfasında tutulduğunda otomatik enforcement mümkün olmaz. YAML, JSON veya benzeri format sözleşmenin pipeline tarafından okunmasını sağlar. Schema ve quality kuralları CI/CD içinde doğrulanabilir. Version history Git üzerinden yönetilebilir. Makine okunabilirlik contract yaklaşımını ölçeklenebilir hale getirir.
Schema evolution politikası var mı?
Schema evolution politikası hangi değişikliklerin geriye uyumlu veya breaking olduğunu açıkça belirtmelidir. Producer ekip bu kuralları deployment öncesinde görmelidir. Consumer impact analysis lineage üzerinden desteklenebilir. Deprecation window migration için yeterli zaman sağlamalıdır. Politika olmadan her schema değişikliği potansiyel production riski haline gelir.
Data lineage izleniyor mu?
Lineage kritik data products için upstream ve downstream bağımlılıkları göstermelidir. Dataset-level başlangıç için yeterli olabilir. Kritik PII veya finans verilerinde column-level ayrıntı gerekebilir. Lineage mümkün olduğunca otomatik toplanmalıdır. Incident ve impact analysis süreçlerinde aktif kullanılıyorsa gerçek değer üretir.
Quality SLO'ları mevcut mu?
Quality SLO data product'ın hangi kalite seviyesini hedeflediğini ölçülebilir hale getirir. Completeness, uniqueness veya freshness için hedefler belirlenebilir. Hedefler consumer ihtiyacına dayanmalıdır. SLO sonuçları owner ve tüketicilere görünür olmalıdır. Sürekli ihlal edilen hedef için iyileştirme veya hedef revizyonu yapılmalıdır.
Data observability kurulmuş mu?
Data observability pipeline başarı bilgisinin ötesinde veri davranışını izlemelidir. Freshness, volume, schema ve distribution sinyalleri temel kapsam olabilir. Alert routing owner metadata'yla bağlanmalıdır. Incident geçmişi ve çözüm süresi takip edilmelidir. Observability olmadan birçok veri problemi kullanıcı bildirimine kadar görünmez kalabilir.
Semantic definitions merkezi mi?
Kritik metrik ve iş kavramları ortak semantic definitions üzerinden yönetilmelidir. Revenue, active customer veya churn gibi terimlerin ekipler arasında farklılaşması karar kalitesini düşürür. Semantic layer veya governed metric repository kullanılabilir. Değişiklikler review ve versioning sürecinden geçmelidir. Merkezi tanım fiziksel verinin merkezi tutulmasını gerektirmez.
PII sınıflandırılıyor mu?
PII sınıflandırması hassas verinin nerede bulunduğunu anlamanın temelidir. Classification metadata catalog ve security policy ile bağlanmalıdır. Otomatik scanning coverage seviyesini artırabilir. Kritik alanlarda insan doğrulaması yapılmalıdır. Sınıflandırılmayan kişisel veri access ve retention kontrollerinin dışında kalma riski taşır.
Access policy otomatik uygulanıyor mu?
Access policy yalnızca dokümanda tanımlanmışsa operasyon sırasında unutulabilir. Policy engine role ve classification metadata üzerinden kuralları otomatik uygulayabilir. Self-service request workflow risk bazlı onay sunabilir. Audit kayıtları kararları görünür hale getirir. Automation özellikle yüzlerce data product bulunan platformlarda önem kazanır.
Batch/streaming seçimi use-case bazlı mı?
Batch veya streaming seçimi teknoloji tercihi değil iş latency gereksinimi üzerinden verilmelidir. Her veri için real-time hedeflemek maliyet ve operasyon yükünü artırır. Günlük reporting batch ile daha sade çözülebilir. Fraud veya canlı telemetry streaming gerektirebilir. Platform her iki kullanım için standart golden paths sunabilir.
Platform self-service mi?
Self-service platform kullanıcıların temel ingestion, storage ve publishing işlemleri için sürekli ticket açmasını gerektirmemelidir. Güvenli varsayılanlar platform içinde hazır olmalıdır. Documentation ve template kullanıcıların kendi başına başarılı olmasını destekler. Support talep sayısı ve provisioning süresi ölçülebilir. Gerçek self-service kullanım kolaylığı ile governance'ı birlikte sağlar.
Data product adoption ölçülüyor mu?
Data product adoption ölçülmezse hangi ürünlerin gerçekten değer ürettiği bilinemez. Query count, active consumers ve downstream dependency sayısı kullanılabilir. Yüksek maliyetli ama kullanılmayan ürünler retirement adayı olabilir. Adoption feedback roadmap kararlarını destekler. Platformun amacı mümkün olduğunca çok ürün üretmek değil değerli ürünlerin tekrar kullanımını artırmaktır.
Sık Sorulan Sorular
Veri merkezli mimari hakkında sorular genellikle kavramların birbirine yakın isimlerinden ve farklı katmanlarda çözüm üretmelerinden kaynaklanır. Data mesh, data fabric, lakehouse, data product ve data contract aynı problemin farklı isimleri değildir. Her biri ownership, connectivity, storage, ürünleştirme veya sözleşme gibi farklı sorumlulukları ele alır. Bu nedenle bir kavramı seçmeden önce hangi sorunun çözülmek istendiğini belirlemek gerekir. Aşağıdaki yanıtlar en sık karşılaşılan soruları kısa ama uygulamaya dönük biçimde açıklamaktadır.
Data-centric architecture nedir?
Data-centric architecture, veriyi uygulamaların iç çıktısı yerine uzun ömürlü kurumsal varlık olarak tasarlayan yaklaşımdır. Ownership, data product, contract, metadata, semantic layer ve governance temel bileşenler arasındadır. Amaç bütün veriyi tek database'e taşımak değildir. Dağıtık verinin ortak anlam ve kurallarla yönetilmesi hedeflenir. Uygulamalar değişse bile veri yaşam döngüsü ve iş anlamı korunabilir.
Data-centric ve data-driven arasındaki fark nedir?
Data-driven organizasyon kararlarını veriyle desteklerken data-centric architecture bu verinin nasıl üretildiğini ve yönetildiğini tanımlar. Bir şirket çok sayıda dashboard kullanarak data-driven olabilir fakat verisi dağınık ve güvensiz olabilir. Data-centric yaklaşım ortak veri temeli oluşturur. İki kavram birbirini tamamlar. Sağlam data-centric temel sürdürülebilir data-driven kültürü kolaylaştırır.
Data mesh nedir?
Data mesh büyük organizasyonlarda veri ownership'ini domain ekiplerine dağıtan yaklaşımdır. Data as a product, self-service platform ve federated governance temel prensipleridir. Merkezi data team bottleneck'ini azaltmayı hedefler. Her şirkette uygulanması gerekmez. Domain yetkinliği ve platform olgunluğu modelin başarısını doğrudan etkiler.
Data fabric nedir?
Data fabric dağıtık veri kaynaklarını metadata, automation ve unified access üzerinden birbirine bağlayan teknik yaklaşımdır. Veriyi tek platforma taşımak zorunda değildir. Federation, virtualization ve active metadata kullanılabilir. Ownership sorununu tek başına çözmez. Data mesh ile aynı kurumda birlikte kullanılabilir.
Data mesh ve data fabric arasındaki fark nedir?
Data mesh ağırlıklı olarak organizasyon ve ownership problemine odaklanır. Data fabric ise teknik connectivity, metadata ve automation sorunlarını ele alır. Mesh data product sorumluluğunu domainlere dağıtır. Fabric bu ürünlerin farklı platformlarda bulunmasını ve erişilmesini kolaylaştırabilir. Bu nedenle iki yaklaşım alternatif değil tamamlayıcı olabilir.
Data lakehouse nedir?
Data lakehouse object storage esnekliği üzerinde warehouse benzeri transaction ve table management özellikleri sunmayı hedefleyen mimari yaklaşımdır. Open table formats önemli rol oynar. Batch, analytics ve AI workload'ları ortak data layer üzerinde çalışabilir. Lakehouse ownership veya semantic sorunları tek başına çözmez. Storage ve compute mimarisinin bir parçası olarak değerlendirilmelidir.
Data product nedir?
Data product sahipliği, schema'sı, metadata'sı, quality hedefi ve access interface'i tanımlı tüketilebilir veri ürünüdür. Basit datasetten daha geniş sorumluluk taşır. Consumer'ın ürünü bulması ve anlaması kolay olmalıdır. SLO ve lifecycle yönetimi ürün davranışını güçlendirir. Domain ekipleri data products üzerinden veri paylaşımını daha sürdürülebilir hale getirebilir.
Dataset ile data product arasındaki fark nedir?
Dataset teknik bir veri kümesidir. Data product datasetin yanında owner, documentation, quality, SLO ve interface sunar. Dataset kullanılabilir olabilir fakat sahipsiz veya anlaşılmaz kalabilir. Data product tüketici deneyimini ve hesap verebilirliği tasarımın parçası yapar. Bu nedenle her dataset otomatik olarak data product sayılmaz.
Data contract nedir?
Data contract producer ile consumer arasındaki schema, semantics, quality ve hizmet beklentilerini tanımlar. Makine tarafından okunabilir formatta tutulduğunda otomatik validation yapılabilir. Versioning breaking change yönetimini kolaylaştırır. Contract Git ve CI/CD süreçleriyle entegre edilebilir. Böylece veri değişiklikleri daha öngörülebilir hale gelir.
Single Source of Truth tek veritabanı anlamına mı gelir?
Hayır, Single Source of Truth tek fiziksel veritabanı anlamına gelmez. Operational, analytical ve semantic truth farklı sistemlerde bulunabilir. Önemli olan hangi sorunun hangi yetkili kaynaktan cevaplanacağının bilinmesidir. Türetilmiş kopyalar lineage ile source'a bağlanabilir. Mantıksal tutarlılık fiziksel merkezilikten daha önemlidir.
Data mesh küçük şirketler için uygun mudur?
Küçük şirketlerde tam data mesh organizasyonu çoğu zaman gereksiz olabilir. Domain sayısı azsa merkezi ekip doğal olarak yeterli ölçek sunabilir. Buna rağmen data product, ownership ve contract prensipleri küçük ekiplerde de değerlidir. Self-service platform yatırımı gerçek darboğaz oluştuğunda büyütülebilir. Yaklaşım organizasyon ihtiyacına göre kademeli uygulanmalıdır.
Data engineering için en iyi programlama dili hangisidir?
Tek bir en iyi dil yoktur. SQL analitik transformation, Python automation ve ML, Java veya Scala streaming, Go veya Rust platform servisleri için güçlü olabilir. Workload ve ekip kapasitesi seçimi belirlemelidir. Veri modeli ve architecture kararları dilden daha önemlidir. Az sayıda dili iyi desteklemek kurumsal platformda operasyonu kolaylaştırır.
SQL mi Python mı öğrenilmeli?
Data engineering için mümkünse ikisi de öğrenilmelidir. SQL veri sorgulama ve modelleme için temel beceridir. Python custom processing, API ve automation tarafında esneklik sağlar. Önce SQL ile veri düşünme becerisi, ardından Python ile pipeline geliştirme iyi bir öğrenme sırası olabilir. Gerçek projelerde bu iki dil sıkça birlikte kullanılır.
Data-centric architecture AI için neden önemlidir?
AI sistemleri güvenilir, güncel ve anlamı açık kurumsal veriye ihtiyaç duyar. Data-centric architecture data products, lineage, metadata ve semantic context sunar. Access control modelin yetkisiz veriye ulaşmasını engeller. Training ve retrieval kaynakları daha iyi izlenebilir. Bu temel olmadan AI projesi veri temizleme ve güven sorunlarına takılabilir.
Vector database source of truth olabilir mi?
Vector database genellikle source of truth olarak tasarlanmamalıdır. Embedding ve vector index canonical veriden türetilmiş yapılardır. Kaynak değiştiğinde index yeniden üretilebilir. Canonical document veya data product ayrı güvenilir sistemde tutulmalıdır. Bu ayrım freshness, audit ve model değişikliklerini yönetmeyi kolaylaştırır.
Open source data platform kurulabilir mi?
Evet, PostgreSQL, Kafka, Iceberg, Trino, dbt Core ve açık metadata araçlarıyla güçlü açık kaynak data platformları oluşturulabilir. Ancak araçları bir araya getirmek platform ürününü otomatik oluşturmaz. Self-service, security, observability ve governance ayrıca tasarlanmalıdır. Ekiplerin bu bileşenleri işletme kapasitesi değerlendirilmelidir. Mümkün olan en sade açık kaynak mimariyle başlamak daha sürdürülebilir sonuç verir.
Veri merkezli (data-centric) kurumsal mimari nedir ve uygulama merkezli mimariden farkı nedir?
Veri merkezli kurumsal mimari veriyi uygulamaların geçici iç yapısından daha uzun ömürlü kurumsal varlık olarak ele alır. Uygulama merkezli modelde her sistem kendi veri şemasını ve entegrasyonlarını yönetirken data-centric model ortak ownership, contracts, metadata ve data products kullanır. Bu yaklaşım uygulama değişikliklerinin kurumsal veri üzerindeki etkisini azaltır. Fiziksel verinin mutlaka tek yerde tutulması gerekmez. Fark verinin yaşam döngüsü, paylaşımı ve iş anlamının uygulama sınırlarından bağımsız yönetilmesidir.
Veri merkezli mimari kurumlarda veri silolarını ve veri tekrarını nasıl azaltır?
Veri merkezli mimari mevcut data products'ı catalog üzerinden bulunabilir hale getirerek ekiplerin aynı veriyi baştan üretme ihtiyacını azaltır. Source of truth ve lineage hangi kaynağın yetkili olduğunu görünür kılar. Domain ownership veri sorunlarının doğru ekipte çözülmesini sağlar. Standart API, query veya event interface'leri farklı uygulamaların aynı kurumsal veriyi yeniden kullanmasını kolaylaştırır. Kontrollü performans kopyaları tutulabilir fakat kopyaların kaynağı ve yenilenme biçimi açık biçimde yönetilir.
Kurumsal veri merkezli mimaride veri yönetişimi, veri kalitesi ve ortak veri modeli nasıl oluşturulur?
Önce kritik data domainleri, owners ve shared entities tanımlanmalıdır. Conceptual enterprise model ortak kavramları belirlerken domain modelleri yerel ayrıntılarda esnek kalabilir. Quality rules data contracts içinde tanımlanıp CI/CD ve runtime aşamasında otomatik kontrol edilebilir. Catalog, lineage, classification ve business glossary governance görünürlüğünü sağlar. Global policies ile domain policies federated governance modeli altında birlikte yönetildiğinde hız ile kurumsal tutarlılık daha dengeli hale gelir.
Veri merkezli mimariye geçiş ölçeklenebilirlik, yapay zekâ ve analitik projelerine nasıl katkı sağlar?
Veri merkezli mimari yeniden kullanılabilir data products oluşturarak her analitik veya AI projesinin veriyi sıfırdan hazırlama ihtiyacını azaltır. Self-service platform domain ekiplerinin merkezi data team beklemeden kontrollü veri ürünü üretmesini sağlar. Semantic layer ortak metrikleri ve iş kavramlarını AI ve BI sistemlerine sunar. Lineage ve metadata training veya retrieval kaynaklarının izlenebilirliğini artırır. Böylece ölçeklenebilirlik yalnızca daha fazla compute kullanmakla değil veri erişimi ve sahiplik modelini ölçeklendirmekle sağlanır.
Yakınımda veri merkezli kurumsal mimari ve veri yönetimi danışmanlığı veren yazılım firması nasıl bulabilirim?
Yakınınızdaki bir sağlayıcıyı değerlendirirken yalnızca kullandığı teknoloji isimlerine değil data architecture, governance, security, data product ve migration yaklaşımına bakmanız gerekir. Sağlayıcıdan mevcut veri envanteri, ownership modeli, pilot data product ve ölçülebilir dönüşüm yol haritası talep etmek faydalıdır. Diyarbakır ve çevresinde yazılım ekosistemi, topluluk çalışmaları ve işletmelere yönelik teknik yaklaşımlar için Diyarbakır Yazılım Topluluğu kaynaklarından yararlanabilirsiniz. İşletmeler için standart geliştirme yaklaşımını görmek üzere https://www.diyarbakiryazilim.com.tr/posts/isletmeler-icin-standartlastirilmis-gelistirme-ortamlari adresi incelenebilir. İyi danışmanlık çalışması size yalnızca araç listesi değil, mevcut durumdan üretimde çalışan data products ve ölçülebilir governance modeline giden uygulanabilir plan sunmalıdır.
Sonuç: Uygulamaları Değil Verinin Yaşam Döngüsünü Merkeze Alın
Veri Merkezli (Data-Centric) Kurumsal Mimariler kurumların sürekli değişen uygulama portföyüne rağmen veri anlamını, kalitesini ve sahipliğini koruyabilmesi için güçlü bir çalışma modeli sunar. Başarının anahtarı bütün veriyi tek platforma taşımak değil doğru domain, owner, contract, semantic definition, quality SLO ve governance ilişkisini kurmaktır. Data mesh, data fabric ve lakehouse gibi yaklaşımlar farklı katmanlardaki sorunları çözer ve doğru sınırlarla birlikte kullanılabilir. AI ve analytics projeleri de güvenilir data products üzerine kurulduğunda daha hızlı, açıklanabilir ve yönetilebilir hale gelir. Kurumunuzda bu dönüşümü değerlendirirken teknoloji satın almadan önce verinin kaynaktan tüketime kadar yaşam döngüsünü çizmek en güçlü başlangıç adımlarından biridir.
Veriyi Uygulamadan Daha Uzun Ömürlü Bir Varlık Olarak Tasarlayın
Uygulamalar zaman içinde değişebilir fakat müşteri, ürün ve sipariş gibi temel iş kavramları yaşamaya devam eder. Veri modelini yalnızca mevcut uygulamanın iç yapısına göre tasarlamak gelecekte migration maliyeti oluşturur. Ortak identifiers, contracts ve semantic definitions verinin uygulamadan daha bağımsız kalmasını sağlar. Source of truth ve lineage değişiklik sırasında süreklilik sunar. Bu bakış açısı kurumsal mimarinin kısa proje döngülerinden daha uzun ömürlü veri temeli oluşturmasını sağlar.
Dataset Değil Güvenilir Data Product'lar Üretin
Kurumsal veri platformunun başarısını üretilen tablo sayısıyla ölçmek yerine tüketilen ve güvenilen data products üzerinden değerlendirin. Her kritik ürünün owner, documentation, schema, quality ve interface bilgisi bulunmalıdır. Consumer feedback ve adoption metriği ürünün gerçek değerini gösterir. Kullanılmayan ürünler emekliye ayrılmalıdır. Bu ürün yaklaşımı veri platformunu bir depo olmaktan çıkarıp kurumun tekrar kullanılabilir bilgi servisleri ağına dönüştürür.
Data Contract ile Producer Consumer İlişkisini Açık Hale Getirin
Producer ve consumer arasındaki beklentiler yalnızca ekip hafızasında kaldığında değişiklikler production sürprizlerine dönüşür. Data contract schema, semantics, quality ve SLO beklentilerini görünür hale getirir. Contract as code yaklaşımı değişiklikleri Git, CI/CD ve runtime validation süreçleriyle bağlar. Versioning consumer migration için kontrollü zaman yaratır. Bu yapı ekiplerin daha bağımsız çalışmasını sağlarken veri güvenilirliğini korur.
Metadata, Semantics ve Governance'ı Otomatikleştirin
Metadata yalnızca katalog ekranında duran açıklama değildir. Classification security policy'yi, ownership alert routing'i ve lineage impact analysis'i yönlendirebilir. Semantic definitions BI ve AI sistemlerinin aynı iş dilini kullanmasını sağlar. Governance as code tekrar eden kontrolleri otomatik hale getirir. Bu yetenekler birlikte çalıştığında veri platformu manuel koordinasyona daha az bağımlı ve daha ölçeklenebilir hale gelir.
Data Mesh, Fabric ve Lakehouse'u Rakip Değil Tamamlayıcı Modeller Olarak Değerlendirin
Data Mesh ownership sorununu, Data Fabric connectivity ve metadata problemini, Lakehouse ise storage ve compute katmanını ele alır. Aynı organizasyon üç yaklaşımın da bazı prensiplerinden yararlanabilir. Önemli olan popüler mimari ismine uymak değil gerçek sorumluluk sınırlarını belirlemektir. Gereksiz teknoloji tekrarı oluşmaması için her bileşenin rolü açıkça tanımlanmalıdır. Bu yaklaşım mimariyi kavram yarışından çıkarıp ölçülebilir iş ve mühendislik sonuçlarına odaklar.
AI Sistemlerini Güvenilir Kurumsal Veri Temeli Üzerine Kurun
AI modelleri, RAG sistemleri ve agent'lar ancak bağlandıkları kurumsal veri kadar güvenilir olabilir. Canonical sources, data products, semantic layer, access policies ve lineage birlikte tasarlanmalıdır. Vector database gibi türetilmiş serving katmanları enterprise source of truth yerine geçmemelidir. Agent'lar raw database erişimi yerine kontrollü tool ve policy layer üzerinden çalışmalıdır. Kurumsal veri platformunuzu bu prensiplerle geliştirmek, açık kaynak işbirliklerini takip etmek veya Diyarbakır Yazılım Topluluğu çalışmalarına ulaşmak için https://www.diyarbakiryazilim.com.tr/about ve https://www.diyarbakiryazilim.com.tr/projects adreslerinden devam edebilirsiniz.
share: