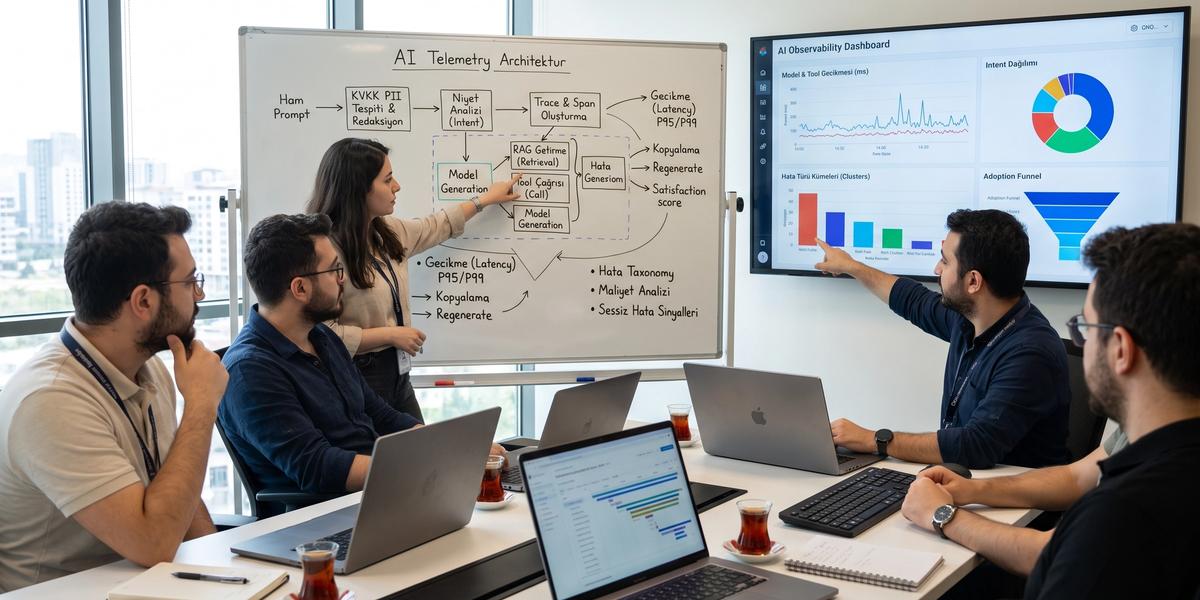
AI Sistemlerinde Kullanıcı Etkileşim Loglarının Analizi

Diyarbakır Yazılım
16.08.2026
#Yazılım#Teknoloji#Topluluk
Bir AI uygulamasının teknik olarak ayakta olması, kullanıcı için başarılı olduğu anlamına gelmez. Sunucu HTTP 200 döndürebilir, model yanıt üretebilir ve yine de kullanıcı aradığı sonuca ulaşamamış olabilir. AI Sistemlerinde Kullanıcı Etkileşim Loglarının Analizi tam olarak bu görünmeyen alanı anlamamızı sağlar; kullanıcı ne istedi, sistem ne yaptı, hangi model ve prompt çalıştı, hangi tool çağrıldı, ne kadar gecikme yaşandı ve kullanıcı sonuçtan memnun kaldı mı gibi sorulara cevap üretir. Bu rehberde AI sistemlerinde kullanıcı etkileşim logları nasıl analiz edilir, yapay zeka uygulamalarında kullanıcı davranışı ve prompt log analizi nasıl kurgulanır ve bu veriler product, engineering, quality ve business ekipleri tarafından nasıl birlikte kullanılabilir sorularını uygulama odaklı ele alacağız. Hedefimiz yalnızca daha fazla log toplamak değil, daha az veriyle daha doğru karar üreten, KVKK açısından kontrollü ve production ortamında gerçekten işe yarayan bir observability sistemi kurmaktır.
AI Sistemlerinde Kullanıcı Etkileşim Logu Nedir?
AI kullanıcı etkileşim logu, kullanıcının AI sistemiyle kurduğu etkileşimi ve bu etkileşimin arka planda nasıl işlendiğini açıklayan olay kayıtları bütünüdür. Bir prompt, model cevabı, retrieval sonucu, tool çağrısı, kullanıcı geri bildirimi veya iş sonucu ayrı event olarak kaydedilebilir. Bu kayıtlar yalnızca teknik hata ayıklama için değil, kullanıcı davranışı ve AI kalite analizi için de kullanılır. En sağlıklı yapıda her event ortak session, conversation ve trace kimlikleriyle birbirine bağlanır. Böylece tek bir kullanıcı sorusunun sistem içinde hangi adımlardan geçtiği uçtan uca görülebilir.
Geleneksel Uygulama Loglarından Farkı Nedir?
Geleneksel uygulama logları çoğu zaman endpoint, status code, exception ve response time gibi teknik sinyallere odaklanır. AI sistemlerinde ise model cevabının içeriği, kullanıcı niyeti, retrieval kalitesi ve tool seçimi de başarıyı belirler. Aynı HTTP 200 cevabı bir kullanıcı için başarılı, başka bir kullanıcı için başarısız olabilir. Bu nedenle kullanıcı hedefi ve model davranışı telemetry modeline dahil edilmelidir. AI observability teknik health ile semantic quality bilgisini aynı analitik çerçevede birleştirmelidir.
AI Sistemleri Neden Farklı Bir Loglama Yaklaşımı Gerektirir?
AI sistemleri deterministik değildir ve aynı prompt farklı koşullarda farklı cevaplar üretebilir. Model, prompt, retrieval, tool ve memory bileşenleri aynı request içinde birbirini etkiler. Bu nedenle yalnızca request-response kaydı root cause analysis için yetersiz kalabilir. LLM uygulamalarında loglama gözlemlenebilirlik ve performans metrikleri, model çıktısının nasıl üretildiğini açıklayacak trace ve span yapısıyla desteklenmelidir. Ayrıca kişisel veri ve kurumsal gizli bilgi taşıyabilecek prompt içeriği nedeniyle privacy tasarımı klasik log sistemlerinden daha önemli hale gelir.
Kullanıcı Etkileşim Loglarında Hangi Veriler Bulunur?
İyi tasarlanmış etkileşim logları kullanıcı girişini, AI cevabını, kullanılan model ve prompt versiyonunu, süre bilgilerini ve kullanıcı aksiyonlarını ilişkilendirir. Bunun yanında token miktarı, maliyet, retrieval sonuçları, tool çağrıları ve error bilgisi de kaydedilebilir. Her veri alanını saklamak gerekli değildir ve data minimization temel prensip olmalıdır. Hassas veri raw biçimde loglanmak yerine redaction veya structured classification ile korunabilir. Telemetry schema product ve engineering ihtiyaçlarını birlikte karşılayacak biçimde tasarlanmalıdır.
Kullanıcı Prompt'u
Kullanıcı prompt'u AI sisteminin hangi ihtiyaca cevap vermeye çalıştığını anlamanın en doğrudan kaynaklarından biridir. Ancak prompt içinde kişisel bilgi, müşteri verisi veya şirket sırrı bulunabilir. Raw prompt saklamak yerine redacted text, intent label veya embedding gibi alternatifler değerlendirilebilir. Prompt kaydı model quality ve failure analizi için yüksek değer taşır. Buna rağmen saklama süresi ve erişim yetkisi açık biçimde tanımlanmalıdır.
Model Yanıtı
Model yanıtı relevance, correctness ve safety değerlendirmesi için temel gözlemdir. Raw response saklanacaksa PII ve confidential information açısından kontrol edilmelidir. Bazı sistemlerde yalnızca hash, evaluation score veya redacted response yeterli olabilir. Response ile user feedback aynı interaction ID üzerinden ilişkilendirilmelidir. Bu bağlantı hangi cevap türlerinin kullanıcı memnuniyeti yarattığını anlamayı kolaylaştırır.
Timestamp ve Süre Bilgisi
Timestamp kullanıcı davranışını zaman ekseninde analiz etmeyi sağlar. Request başlangıcı, first token zamanı ve completion zamanı ayrı kaydedilebilir. Bu sayede end-to-end latency ve time to first token ölçülür. Conversation içindeki mesaj aralıkları da abandonment veya frustration sinyali verebilir. Zaman bilgisi UTC gibi tutarlı formatta tutulmalı ve timezone dönüşümü analitik katmanda yapılmalıdır.
Model ve Prompt Versiyonu
Her interaction hangi model ve prompt versiyonuyla üretildiğini taşımalıdır. Aksi halde kalite değişikliğinin nedenini sonradan bulmak zorlaşır. Model yükseltmesi sonrasında satisfaction düşerse cohort bazlı karşılaştırma yapılabilir. Prompt version tracking A/B test sonuçlarını daha güvenilir hale getirir. Version bilgisinin deployment metadata ile aynı source of truth üzerinden gelmesi önemlidir.
Token ve Maliyet Bilgisi
Input ve output token sayısı maliyet analizi için gereklidir. AI chatbot kullanıcı loglarında hata analizi token maliyeti ve yanıt kalitesi ölçümü birlikte yapılmalıdır çünkü en pahalı cevap her zaman en kaliteli cevap değildir. Cost per interaction ve cost per successful task ayrı metrikler olarak izlenebilir. Uzun conversation'larda context büyümesi token maliyetini hızla artırabilir. Bu nedenle maliyet kullanıcı ve task başarısıyla birlikte değerlendirilmelidir.
Kullanıcı Aksiyonları ve Feedback
Kullanıcının cevabı kopyalaması, paylaşması, regenerate etmesi veya conversation'ı terk etmesi önemli davranış sinyalleridir. Explicit thumbs up veya rating varsa interaction ile ilişkilendirilmelidir. Feedback gelmemesi memnuniyet anlamına gelmez. Implicit davranışlar memnuniyet modeli için tamamlayıcı sinyal sağlar. Product analytics ve AI eval ekipleri bu veriyi ortak taxonomy üzerinden kullanmalıdır.
AI Log Analitiğinde Temel Veri Modeli
AI log analizinin başarısı yalnızca event sayısına değil doğru veri modeline bağlıdır. User, session, conversation, interaction, trace ve span kavramları birbirine karıştırılırsa funnel ve root cause analizi zorlaşır. Her seviyenin farklı soruyu cevaplaması gerekir. User uzun dönem davranışı, conversation task akışını, trace ise teknik execution zincirini temsil eder. Event kimlikleri bütün bu katmanları güvenli biçimde birbirine bağlamalıdır.
User Nedir?
User sistemi kullanan kişi veya kimliği doğrulanmış hesabı temsil eder. Analytics amacıyla gerçek kullanıcı kimliği yerine pseudonymous identifier tercih edilebilir. Bir user birden fazla session ve conversation oluşturabilir. User-level retention ve adoption bu seviyede hesaplanır. Yetkisiz kişisel veri birleştirmesinden kaçınmak için identity mapping sınırlı erişime sahip olmalıdır.
Session Nedir?
Session belirli zaman aralığında gerçekleşen kullanıcı aktivitesi grubudur. Kullanıcı uygulamayı açıp birkaç conversation yürüttüğünde bunlar aynı session altında olabilir. Session timeout kuralı product behavior'a göre seçilmelidir. First-session success gibi metrikler onboarding başarısını ölçmekte değerlidir. Session kimliği conversation kimliğiyle aynı kavram değildir.
Conversation Nedir?
Conversation kullanıcının belirli bir konu veya hedef çevresinde AI ile sürdürdüğü mesaj dizisidir. Bir conversation birçok turn içerebilir. Conversation-level satisfaction ve completion bu seviyede ölçülür. Kullanıcının farklı amaçlara geçtiği uzun chat'lerde conversation segmentation gerekebilir. Conversation ID kullanıcı feedback ve business outcome event'lerini ilişkilendirmek için önemlidir.
Interaction veya Turn Nedir?
Interaction veya turn bir kullanıcı mesajı ve bunun tetiklediği AI davranışı çevresindeki en küçük kullanıcı deneyimi birimidir. Tek turn birkaç model call, retrieval ve tool operation içerebilir. Prompt ve response metric'leri çoğunlukla bu seviyede hesaplanır. Turn ID user-facing event ile backend trace arasında köprü görevi görür. Aynı turn retry içeriyorsa final result ile intermediate attempts ayrılmalıdır.
Trace Nedir?
Trace tek bir kullanıcı isteğinin backend içinde geçtiği uçtan uca execution akışını temsil eder. Retrieval, model, tool, database ve API çağrıları aynı trace altında toplanabilir. Root cause analysis için en güçlü yapılardan biridir. Bir interaction birden fazla trace oluşturabilecek mimarilerde ilişki açık tutulmalıdır. Trace ID log, metric ve evaluation sistemleri arasında ortak korelasyon anahtarı olabilir.
Span Nedir?
Span trace içindeki tek işlem veya alt işlemi temsil eder. Model call, vector search veya external API request ayrı span olabilir. Span başlangıç ve bitiş zamanı latency breakdown sağlar. Parent-child ilişkisi execution ağacını gösterir. Error ve token metadata span seviyesinde saklanarak detaylı analiz yapılabilir.
Generation Nedir?
Generation LLM tarafından üretilen belirli model cevabını temsil eder. Aynı interaction regenerate veya retry nedeniyle birden fazla generation içerebilir. Model adı, temperature, token kullanımı ve output bu seviyede saklanabilir. Kullanıcıya gösterilen final generation ayrıca işaretlenmelidir. Böylece intermediate failed attempt kullanıcı deneyimiyle karıştırılmaz.
Tool Call ve Retrieval Event Nedir?
Tool call agent veya model tarafından harici işlem çağrısını temsil eder. Retrieval event ise bilgi tabanı veya search katmanından context alma işlemini gösterir. Her iki event execution sonucu ve latency bilgisi taşımalıdır. Başarısız tool çağrısı final model cevabını etkileyebilir. Retrieval ve generation sonuçlarını ayırmak failure analysis açısından zorunludur.
Event ID'leri Nasıl İlişkilendirilmelidir?
Event schema farklı analitik seviyeler arasında güvenli join yapılmasını sağlamalıdır. user_id, session_id, conversation_id, trace_id ve span_id farklı amaçlar taşır. Kimlikler mümkün olduğunca immutable ve globally unique olmalıdır. PII içeren doğal anahtarlar doğrudan kullanılmamalıdır. Referential integrity analitik pipeline testleriyle kontrol edilmelidir.
user_id
user_id aynı kullanıcının zaman içindeki davranışını ilişkilendirir. Raw e-posta veya telefon yerine pseudonymous ID kullanılmalıdır. Silme talebi geldiğinde mapping üzerinden ilgili loglar bulunabilir. Anonymous kullanıcılar için temporary identifier oluşturulabilir. Cross-device identity birleştirme privacy kurallarına uygun olmalıdır.
session_id
session_id belirli kullanım oturumunu temsil eder. Session-level funnel ve latency analizi yapılabilir. Client veya server tarafından üretilebilir. Timeout veya logout sonrası yeni session başlamalıdır. Kimlik collision ihtimali teknik olarak engellenmelidir.
conversation_id
conversation_id multi-turn chat içindeki mesajları bir araya getirir. Conversation length ve completion bu ID üzerinden hesaplanabilir. Kullanıcı yeni konu başlattığında aynı conversation'ın devam edip etmediği product tasarımına bağlıdır. Feedback conversation seviyesinde verilebilir. Bu nedenle interaction-level event'lerle doğru ilişki kurulmalıdır.
trace_id
trace_id backend execution zincirini birleştirir. Observability sistemleri tarafından otomatik üretilebilir. Frontend interaction ID ile ilişkilendirilmesi kullanıcı deneyimi ve teknik root cause analizini birleştirir. Distributed servislerde context propagation doğru uygulanmalıdır. Trace kopukluğu debugging değerini ciddi biçimde azaltır.
span_id
span_id trace içindeki tek operasyonu tanımlar. Parent span ID execution ağacını kurar. Model, retrieval ve tool katmanları ayrı span oluşturabilir. Latency ve error metadata operasyon seviyesinde tutulur. Span isimlendirme standardı ekipler arasında tutarlı olmalıdır.
AI Kullanıcı Etkileşimleri İçin Event Schema Nasıl Tasarlanır?
Event schema telemetry sisteminin ortak sözlüğüdür. Farklı ekiplerin aynı kullanıcı davranışını farklı isimlerle kaydetmesi analitik sonuçları parçalar. Event name, version, timestamp, actor, entity ve context alanları standardize edilebilir. Raw text gibi hassas alanlar schema içinde ayrı güvenlik sınıfı taşımalıdır. Şema versionlandığında eski ve yeni event'ler birlikte analiz edilebilir.
Kullanıcı Prompt Event'i
Prompt event kullanıcı mesajının sisteme girişini temsil eder. Interaction ID ve conversation ID zorunlu alanlar arasında olabilir. Raw text yerine redacted text veya intent label saklama seçeneği policy'ye göre belirlenir. Prompt length ve language gibi türetilmiş metadata daha güvenli analytics sağlar. Client timestamp ve server receive timestamp ayrı tutulabilir.
AI Response Event'i
Response event kullanıcıya gösterilen AI cevabını temsil eder. Model version, prompt version, latency ve token bilgisi eklenebilir. Cevap içeriği privacy policy'ye göre raw veya redacted tutulabilir. Streaming response'ta first token ve final token timestamp ayrılmalıdır. Final user-visible generation ayrıca işaretlenmelidir.
Feedback Event'i
Feedback event thumbs up, thumbs down, rating veya serbest metin yorumunu içerir. Feedback hangi response'a verildiyse interaction ve generation ID ile bağlanmalıdır. Kullanıcı geri bildirimi sonradan değiştirilebiliyorsa update event modeli kullanılabilir. Free-text feedback PII içerebilir ve redaction gerektirir. Feedback absence negatif veya pozitif sinyal olarak otomatik yorumlanmamalıdır.
Kullanıcı Action Event'i
Copy, save, share, regenerate ve close gibi davranışlar action event olarak kaydedilebilir. Action hangi response üzerinde gerçekleştiyse entity reference tutulmalıdır. Bu event'ler implicit satisfaction sinyali olabilir. Bununla birlikte copy her zaman olumlu anlam taşımaz. Product context metric yorumunda dikkate alınmalıdır.
Tool Call Event'i
Tool call event çağrılan tool adını, input type'ını, status bilgisini ve duration değerini taşıyabilir. Hassas tool argument raw olarak loglanmamalıdır. Retry sayısı ve error category eklenebilir. Tool output kullanıcıya gösterildiyse response ile ilişki kurulmalıdır. Tool success teknik başarıyı gösterir, task success'i değil.
Retrieval Event'i
Retrieval event kullanıcı sorgusunun hangi index veya knowledge source üzerinde çalıştığını gösterir. Candidate count, retrieved document ID ve score bilgileri tutulabilir. Full document text yerine source reference saklamak privacy ve storage açısından daha güvenlidir. Query rewrite varsa original ve rewritten query ayrı metadata olarak tutulabilir. Retrieval event RAG failure analizinin temel bileşenidir.
Error ve Retry Event'leri
Error event hata sınıfını, kaynak span'i ve retryability bilgisini taşımalıdır. Raw stack trace hassas veri içerebilir ve güvenli log kanalında tutulmalıdır. Retry event hangi attempt'in tekrarlandığını göstermelidir. Kullanıcı final başarı aldıysa intermediate error yine teknik observability açısından değerlidir. Error taxonomy ekipler arasında ortaklaştırılmalıdır.
Business Outcome Event'i
AI interaction gerçek iş sonucuna bağlanabiliyorsa business outcome event çok yüksek değer taşır. Sipariş tamamlanması, ticket kapanması veya rezervasyon yapılması buna örnektir. Bu event conversation veya task ID ile bağlanmalıdır. Böylece AI kullanımının yalnızca engagement değil gerçek sonuç üzerindeki etkisi ölçülür. Outcome attribution modeli dikkatli tasarlanmalıdır.
Event Schema Versiyonlama
Schema zaman içinde değişeceği için version alanı zorunlu tutulabilir. Breaking change yeni major version gerektirebilir. Data warehouse transformation katmanı eski event'leri ortak canonical forma dönüştürebilir. Producer ve consumer compatibility testleri CI içinde çalıştırılabilir. Şema değişikliği documentation ve owner bilgisiyle birlikte yönetilmelidir.
Hangi Kullanıcı Etkileşim Metrikleri Takip Edilmeli?
AI ürün metriği yalnızca mesaj sayısı değildir. Kullanıcının sistemi tekrar kullanması, görevi tamamlaması ve belirli AI özelliklerini gerçekten benimsemesi daha anlamlı sinyaller sağlar. Adoption, retention, abandonment ve task completion birlikte izlenmelidir. Segment bazlı analiz yeni kullanıcılarla power user'ların davranışını ayırır. Executive dashboard için az sayıda güçlü metric seçmek yüzlerce vanity metric toplamaktan daha değerlidir.
Aktif AI Kullanıcı Sayısı
Aktif kullanıcı belirli dönem içinde anlamlı AI etkileşimi yapan kullanıcı olarak tanımlanabilir. Tek sayfa açılışı activity sayılmamalıdır. Daily, weekly ve monthly active AI users ayrı takip edilebilir. Kullanıcının en az bir completed interaction gerçekleştirmesi activation kuralına eklenebilir. Metric tanımı product kullanım şekline göre netleştirilmelidir.
Kullanıcı Başına Conversation Sayısı
Bu metric kullanıcıların AI özelliğini ne kadar sık kullandığını gösterir. Çok yüksek sayı olumlu engagement veya düşük first-turn success anlamına gelebilir. Bu nedenle satisfaction ve completion ile birlikte okunmalıdır. Cohort bazında yeni ve eski kullanıcı farkı incelenebilir. Distribution ortalama değerden daha anlamlı olabilir.
Conversation Başına Prompt Sayısı
Prompt sayısı conversation complexity hakkında sinyal verir. Kısa bir bilgi sorgusunda on prompt gerekmesi friction gösterebilir. Karmaşık araştırma görevlerinde çok turn doğal olabilir. Intent kategorisine göre baseline oluşturmak gerekir. Tek metric üzerinden başarı yorumu yapılmamalıdır.
Ortalama Conversation Uzunluğu
Conversation length mesaj veya süre cinsinden ölçülebilir. Uzun conversation yüksek değer veya frustration anlamına gelebilir. Task type ve kullanıcı segmenti ayrımı yapılmalıdır. Median ve percentile distribution ortalamadan daha açıklayıcı olabilir. Completion event ile birlikte analiz edilmelidir.
Tekrar Kullanım Oranı
Repeat usage AI ürünün kalıcı değer üretip üretmediğini anlamaya yardımcı olur. Kullanıcının belirli süre içinde tekrar AI interaction gerçekleştirmesi ölçülebilir. İlk deneyimi başarılı kullanıcıların repeat rate'i ayrıca incelenebilir. Feature release sonrası metric değişimi takip edilebilir. Retention analysis ile birlikte yorumlanmalıdır.
Feature Adoption Rate
AI ürün içinde farklı özellikler varsa her birinin adoption oranı ölçülmelidir. Tool use, file upload veya RAG search gibi özellikler ayrı takip edilebilir. Feature exposure ile actual use birbirinden ayrılmalıdır. Kullanıcı özelliği görmeden kullanmadıysa bu adoption failure değildir. Product experiment tasarımı exposure bilgisini loglamalıdır.
AI Feature Retention
Feature retention özelliği ilk kez kullanan kullanıcıların daha sonra tekrar kullanıp kullanmadığını gösterir. Novelty etkisi ile kalıcı değer arasındaki farkı anlamaya yardımcı olur. D1, D7 veya W4 retention gibi pencereler kullanılabilir. Intent veya cohort bazında ayrıştırılmalıdır. Quality metric ile korelasyon incelenebilir.
Abandonment Rate
Abandonment conversation veya task tamamlanmadan kullanıcının süreci terk etmesini ölçer. Tek başına kısa session abandonment sayılmamalıdır. Kullanıcının hedefi zaten ilk cevapta çözülmüş olabilir. Task-specific completion event daha doğru yorum sağlar. Latency ve frustration sinyalleriyle birlikte incelenmelidir.
Task Completion Rate
Task completion AI sisteminin kullanıcı hedefini gerçekleştirme oranını ölçer. Bu metric product başarısı açısından en değerli ölçülerden biridir. Tamamlanma explicit action, business event veya classifier üzerinden belirlenebilir. Human-labeled sample metric doğruluğunu kontrol etmelidir. Teknik request success ile karıştırılmamalıdır.
Escalation Rate
Escalation AI interaction'ın insan desteğine veya başka kanala yönlenme oranıdır. Bazı görevlerde escalation doğru ve güvenli sonuç olabilir. Bu nedenle düşük oran her zaman hedef değildir. Intent ve reason bazında ayrıştırma gerekir. Unnecessary escalation ile appropriate escalation ayrı metric olarak izlenebilir.
Kullanıcı Niyetinin Loglardan Analiz Edilmesi
Intent analizi kullanıcıların AI sistemi gerçekte ne için kullandığını anlamayı sağlar. Prompt saymak yerine kullanım senaryolarını sınıflandırmak product roadmap açısından daha değerlidir. Zero-shot, LLM, embedding veya rule tabanlı yöntemler kullanılabilir. Intent taxonomy çok geniş veya çok dar tasarlanmamalıdır. Zaman içinde yeni intent'lerin ortaya çıkması product demand ve intent drift sinyali verebilir.
Intent Classification Nedir?
Intent classification kullanıcı mesajını belirli amaç kategorisine atama işlemidir. Destek isteme, metin üretme, veri sorgulama veya işlem gerçekleştirme örnek intent'ler olabilir. Classification product analytics ve routing için birlikte kullanılabilir. Online routing modelinden ayrı offline analytics classifier tercih edilebilir. Taxonomy business ekipleriyle birlikte tanımlanmalıdır.
Kullanıcı Prompt'larından Intent Nasıl Çıkarılır?
Prompt metni normalization ve PII redaction sonrasında classification modeline verilebilir. Tek turn yerine conversation context bazı intent'lerde daha doğru sonuç sağlayabilir. Confidence düşükse unknown veya other category kullanılmalıdır. İnsan tarafından etiketlenmiş sample classification kalitesini ölçmek için gereklidir. Intent label telemetry event'e sonradan enrichment olarak eklenebilir.
Zero-Shot Intent Classification
Zero-shot yöntem önceden training dataset olmadan label description üzerinden sınıflandırma yapabilir. Hızlı taxonomy denemelerinde kullanışlıdır. Label'lar birbirine çok benziyorsa hata oranı artabilir. Maliyet yüksek hacimde önemli hale gelir. Human evaluation ile calibration yapılmalıdır.
LLM Tabanlı Intent Classification
LLM karmaşık veya uzun prompt'larda güçlü semantic sınıflandırma sağlayabilir. Structured output kullanmak label formatını güvenilir hale getirir. Prompt ve model version classification sonuçlarını etkiler. Batch processing maliyeti online sınıflandırmadan daha uygun olabilir. Sensitive prompt'ların dış modele gönderilmesi privacy review gerektirir.
Embedding Tabanlı Intent Classification
Prompt embedding'i intent centroid veya labeled example embedding'leriyle karşılaştırılabilir. Yüksek hacimde maliyet avantajı sağlayabilir. Yeni intent eklemek görece kolaydır. Threshold altında unknown category üretmek faydalıdır. Embedding model version değişikliği taxonomy dağılımını etkileyebilir.
Hierarchical Intent Taxonomy
Hierarchical taxonomy kullanıcı ihtiyacını ana kategori ve alt kategori düzeyinde temsil eder. Çok sayıda flat label yerine daha yönetilebilir yapı sağlar. Product ve analytics ekipleri farklı granularity kullanabilir. Classifier önce ana intent sonra alt intent tahmin edebilir. Taxonomy versionlanmalı ve geçmiş loglara yeniden uygulanabilmelidir.
Ana Intent
Ana intent kullanıcı amacının geniş kategorisidir. Bilgi edinme, içerik üretme veya işlem yapma gibi sınıflar kullanılabilir. Executive ve product dashboard için yeterli olabilir. Ana intent yüksek precision ile sınıflandırılmalıdır. Unknown oranı ayrıca izlenmelidir.
Alt Intent
Alt intent daha ayrıntılı kullanıcı ihtiyacını gösterir. Bilgi edinme altında ürün politikası veya teknik destek gibi ayrımlar bulunabilir. Product roadmap bu granularity'den yararlanır. Çok küçük alt kategoriler istatistiksel gürültü yaratabilir. Minimum sample threshold uygulanabilir.
Kullanıcı Hedefi
Kullanıcı hedefi intent'ten daha outcome odaklıdır. Örneğin "iade politikasını öğrenmek" ile "iade işlemini tamamlamak" farklı goal türleridir. Task completion goal üzerinden tanımlanabilir. Conversation içinde goal değişebilir. Multi-turn goal tracking daha gelişmiş analiz sağlar.
Intent Drift Nasıl Tespit Edilir?
Intent distribution zaman içinde değişebilir. Yeni ürün özelliği belirli intent'i hızla büyütebilir. Unknown veya low-confidence cluster artışı yeni ihtiyaç sinyali olabilir. Weekly distribution divergence metric kullanılabilir. Drift product değişimiyle açıklanamıyorsa kullanıcı davranışı ve classifier birlikte incelenmelidir.
AI Sistemlerinde Kullanıcı Yolculuğu Nasıl Analiz Edilir?
AI kullanıcı yolculuğu klasik sabit ekran funnel'ından daha esnektir. Kullanıcı önce soru sorabilir, cevabı refine edebilir, tool kullandırabilir ve en sonunda dış sistemde action alabilir. Bu nedenle AI-native funnel intent ile başlayıp business outcome ile biten event zinciri olarak tasarlanabilir. Multi-turn conversation akışları ayrıca incelenmelidir. Drop-off yalnızca sayfa terk etme değil, hedefe ulaşamama olarak tanımlanmalıdır.
Geleneksel Funnel Analitiği Neden Yetersiz Kalır?
Klasik funnel belirli ekran veya buton sırasını varsayar. AI conversation ise kullanıcıya göre farklı route izler. Aynı hedefe bir kullanıcı tek prompt, diğeri beş prompt ile ulaşabilir. Bu nedenle page-view funnel gerçek task akışını tam göstermez. Intent ve outcome odaklı event modeli daha uygundur.
AI-Native Funnel Tasarımı
AI-native funnel kullanıcı amacını ve sistemin bu amaca verdiği cevabı birlikte izler. Intent, response, refinement, action ve outcome temel aşamalar olabilir. Her stage event veya inferred state ile tanımlanır. Funnel task type'a göre değişebilir. Universal tek funnel bütün AI kullanım senaryolarına uygun olmayabilir.
Intent
Intent kullanıcının başlangıç hedefini temsil eder. Funnel'ın anlamlı denominator'ını oluşturur. Aynı intent içinde farklı kullanıcı segmentleri karşılaştırılabilir. Confidence düşük intent'ler ayrı tutulmalıdır. Taxonomy değişikliği trend analizini etkileyebilir.
AI Response
AI response kullanıcının intent'ine verilen ilk sistem çıktısıdır. Quality score ve latency bu stage ile ilişkilendirilebilir. Kullanıcının hemen action alması güçlü success sinyali olabilir. Regenerate veya reformulation friction gösterebilir. Response event model version bilgisini taşımalıdır.
Refinement
Refinement kullanıcının önceki cevabı geliştirmek için yeni prompt vermesidir. Bazı görevlerde doğal collaborative davranıştır. Bazı kısa bilgi görevlerinde ise düşük answer quality sinyali olabilir. Intent-specific baseline gereklidir. Refinement count satisfaction ile birlikte analiz edilmelidir.
Action
Action kullanıcının AI cevabından sonra gerçekleştirdiği somut davranıştır. Copy, save veya tool execution örnek olabilir. Product değerini response görüntülenmesinden daha iyi gösterir. Her action aynı business value'ya sahip değildir. Event taxonomy action severity veya value taşıyabilir.
Business Outcome
Business outcome AI desteğinin gerçek iş sonucuna bağlandığı noktadır. Ticket kapanması veya işlem tamamlanması buna örnektir. Attribution window açık tanımlanmalıdır. Outcome farklı sistemden geliyorsa event stitching gerekir. Cost per successful outcome önemli executive metric olabilir.
Conversation Flow Analizi
Conversation flow turn'lar arasındaki intent ve action geçişlerini inceler. Kullanıcı sık sık aynı intent'e dönüyorsa sistem yeterince çözüm üretmiyor olabilir. Tool çağrısı sonrası refinement davranışı analiz edilebilir. State transition matrix yaygın pattern'leri gösterir. Flow sonuçları UX iyileştirmesine dönüşmelidir.
Sankey Diagram ile Intent Geçişleri
Sankey diagram intent veya state geçişlerini görsel olarak gösterebilir. En sık kullanıcı yolu hızlı biçimde anlaşılır. Çok fazla kategori görseli okunmaz hale getirebilir. Top intent'ler ve grouped other category kullanılabilir. Görsel analitik kararın yerine değil keşif sürecine hizmet etmelidir.
Multi-Turn Kullanıcı Yolculukları
Multi-turn conversation'da kullanıcı hedefi zaman içinde değişebilir. İlk intent yalnızca bütün conversation'ı açıklamayabilir. Turn-level classification ve conversation summary birlikte kullanılabilir. Task completion hangi alt hedefin tamamlandığıyla ilişkilendirilmelidir. Long conversation'lar ayrıca frustration açısından incelenebilir.
Drop-Off Noktalarının Belirlenmesi
Drop-off kullanıcı beklenen sonraki action'ı gerçekleştirmediğinde oluşabilir. Yüksek latency veya düşük quality bu davranışla ilişkili olabilir. Conversation kapanması her zaman failure değildir. Task type ve first-response resolution kontrol edilmelidir. Qualitative sample incelemesi metric yorumunu güçlendirir.
Kullanıcı Memnuniyeti Loglardan Nasıl Ölçülür?
Kullanıcı memnuniyetini tek bir feedback butonuna indirgemek doğru değildir. Explicit feedback güçlü fakat sparse bir sinyaldir. Copy, save, regenerate ve abandonment gibi implicit davranışlar daha geniş coverage sağlar. Bu sinyaller birlikte satisfaction score oluşturmak için kullanılabilir. Model human-labeled satisfaction dataset ile kalibre edilmelidir.
Explicit Feedback
Explicit feedback kullanıcının doğrudan verdiği değerlendirmedir. Basit olduğu için yorumlanması kolaydır. Ancak feedback veren kullanıcılar bütün kullanıcıları temsil etmeyebilir. Negatif deneyim yaşayanlar daha fazla feedback bırakabilir. Bu nedenle selection bias hesaba katılmalıdır.
Thumbs Up / Down
Thumbs up/down düşük friction ile feedback toplamayı sağlar. Binary sinyal kolay analiz edilir. Neden beğenilmediğini tek başına açıklamaz. Down sonrası reason taxonomy sunulabilir. Interaction ve model version ile ilişkilendirilmelidir.
Rating
Rating daha ayrıntılı memnuniyet ölçeği sunar. Beş yıldız veya on puan kullanılabilir. Kullanıcılar scale'i farklı yorumlayabilir. Distribution ve cohort farkları izlenmelidir. Rating fatigue azaltmak için sampling uygulanabilir.
Serbest Metin Feedback
Serbest metin feedback kullanıcıya sorunun nedenini anlatma imkânı verir. NLP veya LLM ile tema çıkarılabilir. PII redaction uygulanmalıdır. Az sayıda olsa bile yüksek kaliteli product insight üretir. Failure taxonomy geliştirmede kullanılabilir.
Implicit Feedback
Implicit feedback kullanıcının davranışından türetilen memnuniyet sinyalidir. Daha yüksek coverage sağlar. Ancak her davranışın anlamı bağlama göre değişir. Örneğin regenerate negatif sinyal olabilir fakat yaratıcı kullanımda alternatif isteme amacı taşıyabilir. Intent-specific interpretation gereklidir.
Cevabı Kopyalama
Copy action kullanıcının cevabı kullanmak istediğini gösterebilir. Yazı veya kod üretiminde güçlü positive signal olabilir. Bazı kullanıcılar hatalı cevabı incelemek için de kopyalayabilir. Bu nedenle completion ve feedback ile birlikte analiz edilmelidir. Copy rate content type bazında karşılaştırılabilir.
Cevabı Kaydetme
Save action cevabın gelecekte değerli olacağını düşündüren sinyal olabilir. Knowledge ve research görevlerinde anlamlıdır. Product içinde save özelliği herkes tarafından görülmüyorsa exposure kontrol edilmelidir. Save sonrası tekrar erişim ayrıca ölçülebilir. Retention ile ilişkisi incelenebilir.
Cevabı Paylaşma
Share action yüksek perceived value gösterebilir. Enterprise sistemde ekip içi collaboration davranışını ölçebilir. Sensitive content paylaşımı policy kapsamında olmalıdır. Share event destination type gibi metadata taşıyabilir. Business outcome'a bağlanırsa daha anlamlı hale gelir.
Regenerate
Regenerate ilk cevabın yeterli bulunmadığına işaret edebilir. Birden fazla art arda regenerate frustration sinyali daha güçlüdür. Creative task'ta alternatif arama davranışı da olabilir. Intent ve prompt type'a göre baseline belirlenmelidir. Regenerate sonrası satisfaction değişimi analiz edilmelidir.
Prompt'u Yeniden Yazma
Reformulation kullanıcının sistemi daha iyi yönlendirmeye çalıştığını gösterebilir. İlk cevabın intent'i anlamadığını düşündürebilir. Prompt similarity ile reformulation seviyesi ölçülebilir. Küçük detay eklemek normal refinement olabilir. Büyük yeniden ifade frustration için daha güçlü sinyal olabilir.
Conversation'ı Terk Etme
Abandonment session kapanması veya uzun inactivity üzerinden inferred edilebilir. Kullanıcı ilk cevapta işini çözmüşse olumlu sonuç olabilir. Bu nedenle business outcome ve copy/save event'leri kontrol edilmelidir. Short unsuccessful session daha anlamlı negatif sinyal olabilir. Task completion classifier yardımcı olabilir.
User Satisfaction Score
Satisfaction score explicit ve implicit sinyalleri tek model içinde birleştirebilir. Thumbs down, repeated reformulation ve abandonment negatif ağırlık alabilir. Copy veya successful action pozitif ağırlık alabilir. Weight'ler human-labeled dataset üzerinden öğrenilebilir. Score açıklanabilir ve düzenli kalibre edilmelidir.
Sentiment Analysis
Kullanıcının mesajındaki sentiment frustration veya satisfaction sinyali sağlayabilir. Ancak teknik veya kısa prompt'larda sentiment güvenilir olmayabilir. Türkçe ve domain dil performansı test edilmelidir. Sentiment tek başına user satisfaction olarak kullanılmamalıdır. Conversation trend içinde daha anlamlı olabilir.
Kullanıcı Frustration Sinyallerinin Tespiti
Frustration çoğu zaman kullanıcı açıkça şikâyet etmeden loglarda görünür. Aynı sorunun tekrar sorulması, kısa sürede regenerate yapılması veya insan desteğine geçiş güçlü sinyallerdir. Bu olaylar conversation bağlamında birlikte değerlendirildiğinde daha güvenilir sonuç verir. Frustration score product ekiplerine sorunlu kullanıcı akışlarını önceliklendirme imkânı sağlar. High-value veya yeni kullanıcı segmentlerinde bu sinyal özellikle değerlidir.
Aynı Soruyu Tekrar Sorma
Prompt semantic similarity ile aynı sorunun tekrarlandığı tespit edilebilir. Kullanıcı küçük wording değişiklikleri yapabilir. Repetition kısa bilgi görevlerinde failure sinyali olabilir. Eğitim veya brainstorming kullanımında normal olabilir. Intent bazlı threshold uygulanmalıdır.
Prompt Reformulation
Reformulation kullanıcının önceki cevabı düzeltmek için prompt'u yeniden ifade etmesidir. Büyük semantic overlap ve yeni constraint kombinasyonu ölçülebilir. Sık reformulation instruction-following problemini gösterebilir. Prompt template veya UX iyileştirmesi çözüm olabilir. Model değişikliği tek seçenek değildir.
Art Arda Regenerate Kullanımı
Tek regenerate alternatif arama davranışı olabilir. Üç veya daha fazla regenerate daha güçlü frustration sinyali oluşturabilir. Model temperature ve creative task etkisi göz önüne alınmalıdır. Regenerate zincirinde response quality score karşılaştırılabilir. Kullanıcı hangi generation'da conversation'ı bitirdiği incelenmelidir.
Negatif Dil ve Sentiment
"Yanlış", "olmadı" veya benzeri ifadeler açık negatif sinyal olabilir. Rule ve classifier birlikte kullanılabilir. Kullanıcının quoted text içinde negatif dil kullanması yanlış pozitif yaratabilir. Conversation context gereklidir. Human sample precision kontrolü yapmalıdır.
Kısa Sürede Conversation Abandonment
İlk response sonrası hızlı abandonment düşük satisfaction gösterebilir. Ancak cevap yeterli olduğu için kullanıcı ayrılmış da olabilir. Copy, click veya business outcome event kontrol edilmelidir. First-token latency yüksekse abandonment teknik problemle ilişkili olabilir. Multivariate analysis daha güvenilir sonuç verir.
İnsan Desteğine Geçiş
Escalation frustration veya doğru güvenlik davranışı olabilir. Kullanıcı birkaç başarısız turn sonrası escalation yapıyorsa frustration ihtimali yüksektir. İlk turn'de policy nedeniyle escalation normal olabilir. Reason code loglanmalıdır. AI'nin hangi noktada escalation önermesi gerektiği ayrıca optimize edilebilir.
Frustration Score Nasıl Oluşturulur?
Score repetition, reformulation, negative sentiment, regenerate ve abandonment sinyallerini ağırlıklı biçimde birleştirebilir. Intent ve task complexity normalizasyonu yapılmalıdır. İnsan etiketli conversation sample model calibration için gereklidir. Score kullanıcı deneyimini otomatik triage etmeye yardımcı olur. Yüksek score conversation'lar eval dataset için öncelikli seçilebilir.
AI Yanıt Kalitesinin Etkileşim Loglarından Ölçülmesi
Yanıt kalitesi sadece kullanıcının beğenisine göre ölçülmemelidir. Relevance, correctness, faithfulness, completeness, safety ve tone farklı kalite boyutlarıdır. LLM-as-a-Judge yüksek hacimli otomatik değerlendirme sağlar, human evaluation ise calibration ve yüksek riskli örneklerde gereklidir. Kullanıcı davranışı eval score ile birleştirildiğinde model başarısının gerçek deneyim üzerindeki etkisi daha iyi anlaşılır. AI kalite dashboard bu boyutları ayrı göstermelidir.
Relevance
Relevance cevabın kullanıcı sorusuyla ne kadar ilgili olduğunu ölçer. Doğru bilgi verilse bile farklı konuya cevap verildiyse relevance düşüktür. LLM judge veya embedding similarity yardımcı olabilir. Kısa ve açık query'lerde human agreement genellikle daha yüksektir. Intent-specific criteria tanımlanabilir.
Correctness
Correctness cevabın gerçek veya beklenen bilgiyle uyumunu değerlendirir. Reference answer varsa otomatik karşılaştırma yapılabilir. Açık uçlu görevlerde claim-level evaluation daha uygundur. High-risk domainlerde human expert review gerekir. Kullanıcı memnuniyeti correctness'in yerine geçmez.
Faithfulness
Faithfulness cevap iddialarının verilen context veya retrieved source tarafından desteklenmesini ölçer. RAG sistemlerinde kritik metriktir. Model parametric bilgisinden doğru fakat source dışı bilgi ekleyebilir. Strict grounded kullanımda bu yine problem sayılabilir. Citation ve claim alignment birlikte değerlendirilmelidir.
Hallucination Rate
Hallucination rate desteklenmeyen veya yanlış iddiaların oranını ölçmeye çalışır. Tanım use case'e göre netleştirilmelidir. Claim extraction ve evidence verification pipeline kurulabilir. Human audit otomatik judge sonuçlarını kontrol etmelidir. Yüksek riskli interaction'lar daha yüksek sampling oranına sahip olabilir.
Completeness
Completeness kullanıcının gerekli alt sorularının tamamının cevaplanıp cevaplanmadığını inceler. Çok uzun cevap her zaman daha complete değildir. Expected checklist veya rubric kullanılabilir. Multi-part query decomposition evaluation'ı kolaylaştırır. User reformulation eksik cevap sinyali olabilir.
Safety
Safety cevabın policy ve risk sınırlarına uyup uymadığını değerlendirir. Unsafe response rate ayrı izlenmelidir. Refusal'ın gereksiz olması da user experience problemi yaratabilir. Safety judge ve policy rule birlikte kullanılabilir. High-risk sample human review gerektirebilir.
Tone ve User Experience
Doğru cevap bile uygunsuz tone nedeniyle kullanıcı deneyimini bozabilir. Uzunluk, açıklık ve formality task'a göre değerlendirilmelidir. Brand guideline rubric oluşturulabilir. Kullanıcı segmentlerine göre tone preference farklı olabilir. Prompt version değişiklikleri bu metriği etkileyebilir.
LLM-as-a-Judge
LLM-as-a-Judge büyük conversation setlerini hızlı değerlendirmeyi sağlar. Judge model ve prompt version sonuçları etkiler. Human-labeled calibration set ile agreement ölçülmelidir. Judge kendi model ailesine bias gösterebilir. Tek truth source yerine ölçeklenebilir kalite sinyali olarak kullanılmalıdır.
Human Evaluation
Human evaluation gerçek kullanıcı deneyimi ve domain doğruluğunu değerlendirmede önemlidir. Reviewer guideline açık olmalıdır. Birden fazla reviewer agreement ölçülebilir. Bütün logların elle incelenmesi mümkün değildir. Stratified sampling en değerli örnekleri seçmeyi sağlar.
Kullanıcı Feedback'i ile Eval Sonuçlarını Birleştirme
Eval score ve user feedback aynı interaction üzerinde karşılaştırılabilir. Yüksek judge score fakat düşük satisfaction product expectation farkını gösterebilir. Düşük judge score fakat yüksek feedback kullanıcıların farklı ihtiyaç önceliği olduğunu gösterebilir. Segment analizi bu farkı açıklayabilir. Quality model roadmap kararlarına böyle yön verebilir.
Silent Failure: Teknik Olarak Başarılı Ama Kullanıcı Açısından Başarısız Etkileşimler
Silent failure AI ürünlerinin en kritik analiz alanlarından biridir. Sistem hata vermediği halde kullanıcı hedefini tamamlayamaz. Klasik monitoring bu durumu healthy olarak gösterebilir. Repeated prompt, regenerate ve abandonment gibi davranışlar silent failure'ı görünür hale getirir. Task success metric teknik request success'in yanında zorunlu olmalıdır.
HTTP 200 Neden Başarı Anlamına Gelmez?
HTTP 200 yalnızca request'in teknik olarak başarılı işlendiğini gösterir. Model alakasız veya yanlış cevap üretmiş olabilir. Tool yanlış parametreyle başarılı sonuç dönmüş olabilir. Kullanıcı hedefi yine tamamlanmamış olabilir. Product analytics teknik status'tan bağımsız success tanımı kullanmalıdır.
Task Success ile Request Success Farkı
Request success backend operasyonunun tamamlanmasını ifade eder. Task success kullanıcı amacının gerçekleşmesini ifade eder. Bir conversation içinde tüm request'ler 200 olup task başarısız olabilir. Business outcome veya classifier task success'i belirleyebilir. Dashboard iki metriği ayrı göstermelidir.
Kullanıcı Hedefine Ulaşma Oranı
Goal completion explicit action veya inferred state üzerinden ölçülebilir. Kullanıcı "rapor oluştur" dediğinde dosyanın gerçekten oluşması goal success'tir. Sadece metin cevabı success sayılmamalıdır. Tool-backed task'larda outcome event önemlidir. Hedef tanımı intent taxonomy ile ilişkilendirilebilir.
Silent Failure Sinyalleri
Silent failure tek event yerine davranış kombinasyonuyla daha iyi tespit edilir. Aynı sorunun tekrar edilmesi veya tool sonucunun reddedilmesi güçlü sinyaldir. Regenerate ve hızlı abandonment da kullanılabilir. Frustration score triage için yardımcı olur. Human-labeled failure sample classifier geliştirmeyi sağlar.
Tekrar Sorma
Aynı soru kısa süre içinde tekrar geliyorsa ilk cevap muhtemelen yeterli değildir. Semantic similarity raw string eşleşmesinden daha iyi olabilir. Çok turn eğitim görevleri false positive yaratabilir. Intent-specific threshold kullanılmalıdır. High repetition interaction evaluation queue'ya alınabilir.
Tool Sonucunu Reddetme
Kullanıcı tool sonucuna "yanlış" veya "bunu istemedim" diyebilir. Bu durum tool selection veya parameter mapping hatası olabilir. Tool technically success olsa bile business outcome failure'dır. Rejection reason classifier kullanılabilir. Tool quality dashboard'a ayrı metric eklenmelidir.
Regenerate
Regenerate ilk cevabın tercih edilmediğini gösterir. Aynı interaction'da tekrar sayısı severity sinyali verir. Creative use case normal davranış olabilir. Satisfaction ve task type ile birlikte yorumlanmalıdır. Regenerate sonrası model değişikliği yapılmışsa version effect incelenebilir.
Session Terk Etme
Kullanıcının başarısız turn sonrası session'ı kapatması silent failure olabilir. Öncesinde copy veya success event varsa bu yorum değişir. Latency ve error-free status birlikte incelenmelidir. First-session abandonment retention açısından özellikle kritiktir. Product team sample replay ile nedenleri araştırabilir.
AI Sistemlerinin Teknik Performans Metrikleri
Teknik performans kullanıcı deneyiminin temel katmanlarından biridir. End-to-end latency, time to first token, token kullanımı, error ve timeout oranları düzenli izlenmelidir. Ortalama latency tail behavior'ı gizlediği için P95 ve P99 önemlidir. Cost metric'leri kalite ve task success ile birlikte değerlendirilmelidir. Ucuz fakat başarısız interaction gerçek tasarruf sağlamaz.
End-to-End Latency
End-to-end latency kullanıcı request'i gönderdiği andan final response tamamlanana kadar geçen süredir. Retrieval ve tool latency bu sürenin içindedir. Streaming uygulamada completion latency tek kullanıcı deneyimi metriği değildir. Span breakdown bottleneck'i gösterir. Intent bazında latency farklılıkları incelenebilir.
Time to First Token
Time to first token streaming AI uygulamalarında algılanan hız için önemlidir. Model veya orchestration gecikmesini görünür hale getirir. Retrieval uzun sürüyorsa ilk token gecikebilir. Çok düşük first-token süresi final quality'yi garanti etmez. Product SLO kullanıcı beklentisine göre belirlenmelidir.
P50, P95 ve P99 Latency
P50 tipik deneyimi, P95 ve P99 ise yavaş uç istekleri gösterir. Ortalama değer birkaç aşırı request tarafından yanıltılabilir. Tail latency özellikle enterprise tool integration'larında önemlidir. Model, region ve intent bazında percentile analizi yapılabilir. Release sonrası regression hızlı biçimde tespit edilir.
Token Kullanımı
Input ve output token ayrı izlenmelidir. Conversation uzadıkça context token büyüyebilir. Retrieval top-k ve prompt template token maliyetini etkiler. Token count quality score ile ilişkilendirilmelidir. Gereksiz uzun context maliyet ve latency sorununa dönüşebilir.
Cost per Interaction
Cost per interaction model ve tool maliyetinin tek kullanıcı turn'üne düşen değeridir. Ortalama yanında percentile dağılım izlenebilir. Agentic loop bazı interaction'ları çok pahalı hale getirebilir. High-cost outlier'lar ayrı incelenmelidir. Başarısız interaction maliyeti ayrı raporlanabilir.
Cost per Conversation
Conversation birden fazla model call içerdiği için toplam maliyet daha anlamlı olabilir. Kullanıcının goal tamamlaması için gereken toplam AI harcaması ölçülür. Long conversation'lar maliyeti artırır. Cost per successful conversation executive metric için değerlidir. Retention ile ekonomik ilişki kurulabilir.
Error Rate
Error rate teknik exception ve service failure oranını gösterir. Model provider ve tool error ayrı kategorilerde tutulmalıdır. Retry sonunda success olan request de intermediate error içerebilir. User-visible failure oranı ayrıca hesaplanmalıdır. Error taxonomy root cause önceliklendirmesini kolaylaştırır.
Timeout Rate
Timeout downstream servis veya model latency problemine işaret edebilir. Hard timeout user-visible failure yaratabilir. Soft timeout fallback route tetikleyebilir. Timeout reason ve dependency adı loglanmalıdır. P95 artışı timeout yükselmeden önce erken sinyal olabilir.
Retry Rate
Retry transient problemlerin sıklığını gösterir. Yüksek retry final success olsa bile maliyet ve latency artırır. Tool veya provider bazında ayrıştırılmalıdır. Agent loop retry ile business retry karıştırılmamalıdır. Retry policy exponential backoff ve maksimum attempt sınırı içermelidir.
Trace ve Span Analizi ile Root Cause Analysis
Bir kullanıcı kötü deneyim yaşadığında asıl soru sistemin hangi katmanında sorun çıktığıdır. Trace model, retrieval, tool, database ve API adımlarını aynı execution zincirinde gösterir. Span seviyesinde latency, error ve metadata incelenerek sorun izole edilir. Bu yaklaşım prompt problemi ile tool problemini karıştırmayı önler. Root cause taxonomy product ve engineering ekiplerinin aynı dili kullanmasını sağlar.
Bir Kullanıcı İsteğinin Trace'i Nasıl Okunur?
Önce root span ve total duration incelenir. Ardından child span'ler zaman sırasına göre takip edilir. Hangi adımın longest duration veya error ürettiği görülür. User-visible interaction ID trace ile bağlanmalıdır. Quality issue varsa teknik olarak başarılı span'ler semantic açıdan ayrıca değerlendirilir.
Model Call Span'leri
Model span model adı, prompt version, token ve latency bilgisi taşır. Finish reason ve provider error eklenebilir. Response content policy'ye göre redacted tutulabilir. Retry model call'ları parent-child ilişkiyle görülebilir. Model regression version comparison ile analiz edilir.
Retrieval Span'leri
Retrieval span query, index version ve candidate sonuç metadata'sını taşır. Search latency ve filter behavior görünür olur. Correct document gelmediyse model failure değildir. Reranker ayrı span olarak tutulabilir. Retrieval quality offline eval ile ilişkilendirilebilir.
Tool Call Span'leri
Tool span tool adı, status ve duration içerir. Input parameters raw yerine schema-safe veya masked tutulabilir. Tool output validation sonucu ayrıca kaydedilebilir. Tool technically success olsa bile wrong selection mümkün olabilir. Tool accuracy metric user outcome ile bağlanmalıdır.
Database ve API Span'leri
External dependency latency ve error burada görülür. Database query text hassas bilgi içerebilir ve safe logging gerekir. API status ve retry count kaydedilebilir. Upstream outage AI response davranışını etkileyebilir. Dependency SLO trace analiziyle bağlanabilir.
Hatanın Kaynağının İzole Edilmesi
Root cause classification yalnızca exception'a göre yapılmamalıdır. Prompt, model, retrieval, tool, data ve UX ayrı failure family olarak tutulabilir. Human reviewer yanlış sınıflandırmaları düzeltebilir. Zaman içinde otomatik classifier geliştirilebilir. Failure taxonomy roadmap önceliğini belirler.
Prompt Problemi
Prompt instruction yetersiz veya çelişkili olabilir. Aynı model farklı prompt version'ında kalite değişimi gösteriyorsa güçlü sinyaldir. A/B test ve offline eval kullanılabilir. System prompt gereksiz uzun olabilir. Prompt düzeltmesi model değişiminden daha ucuz çözüm sunabilir.
Model Problemi
Model reasoning, instruction-following veya domain bilgisinde yetersiz olabilir. Aynı prompt başka modelde daha iyi sonuç veriyorsa model source ihtimali yükselir. Temperature ve decoding ayarı ayrıca kontrol edilmelidir. Model upgrade quality-cost trade-off ile değerlendirilir. Human eval benchmark gerekli olabilir.
Retrieval Problemi
Doğru source context'e gelmediyse generation katmanı eksik evidence ile çalışır. Retrieval score ve retrieved IDs incelenmelidir. Chunking veya embedding problemi olabilir. Query rewrite user intent'i bozmuş olabilir. Correct document candidate set'e hiç girmiyorsa reranker çözüm değildir.
Tool Problemi
Yanlış tool seçilmiş veya doğru tool yanlış parametreyle çağrılmış olabilir. Tool schema description model için yetersiz olabilir. Downstream service data hatalı olabilir. Tool result validation eklenebilir. User rejection güçlü failure sinyali sağlar.
Veri Problemi
Source data eski, eksik veya yanlış olabilir. Model ve retrieval doğru çalışsa bile cevap başarısız olur. Data freshness metric önemlidir. Schema drift tool response'u bozabilir. Owner ve lineage bilgisi root cause çözümünü hızlandırır.
UX Problemi
AI doğru cevap üretse bile kullanıcı bunu göremeyebilir veya nasıl kullanacağını anlayamayabilir. Çok uzun response, görünmeyen citation veya belirsiz action button UX problemidir. Behavioral logs bu farkı gösterir. Model değişikliği çözüm olmayabilir. Product experiment gerekli olabilir.
RAG Sistemlerinde Kullanıcı Etkileşim Logları
RAG sistemlerinde kullanıcı interaction'ını yalnızca prompt ve final response ile loglamak yeterli değildir. Retrieval query, document ID, score, context ve citation davranışı ayrıca izlenmelidir. Bu sayede retrieval failure ile model failure birbirinden ayrılır. Kullanıcı tekrar soru soruyorsa önce doğru evidence'ın getirildiği kontrol edilmelidir. RAG observability retrieval ve generation katmanlarını bağımsız metric'lerle değerlendirmelidir.
Kullanıcı Sorgusunun Kaydedilmesi
Original query intent analizinin temelidir. Query rewrite uygulanıyorsa iki versiyon ayrı tutulmalıdır. Raw text privacy policy'ye göre redacted olabilir. Query language ve length metadata'sı faydalıdır. Conversation context bağımlılığı ayrıca işaretlenebilir.
Retrieval Sonuçlarının Loglanması
Candidate sonuçların en azından document ID ve ranking bilgisi saklanabilir. Full chunk text zorunlu değildir. Reranker öncesi ve sonrası listeler ayrılabilir. Retrieval latency span üzerinden ölçülür. Offline relevance label ile production sample değerlendirilebilir.
Retrieved Document ID'leri
Document ID citation ve provenance için kritiktir. Doküman version bilgisi de eklenmelidir. Eski document retrieval quality problemine dönüşebilir. Access control nedeniyle unauthorized ID log consumer'a açılmamalıdır. Source owner debugging için metadata sağlayabilir.
Retrieval Score'ları
Embedding similarity veya reranker score distribution izlenebilir. Low-score query oranı knowledge coverage problemini gösterebilir. Farklı embedding model version'larında score scale değişebilir. Threshold doğrudan karşılaştırılmamalıdır. Labeled relevance sample calibration sağlar.
Context Precision ve Context Recall
Context precision final context'teki bilgilerin ne kadarının gerçekten ilgili olduğunu ölçer. Context recall gerekli evidence'ın context içinde bulunup bulunmadığını değerlendirir. LLM-based evaluation bu metric'leri ölçeklendirebilir. Human sample ile agreement kontrol edilmelidir. Top-k ve reranking tuning bu sonuçlara göre yapılabilir.
Citation Kullanım Analizi
Kullanıcı citation link'ine tıklıyor mu ölçülebilir. Citation accuracy ayrı quality metric'tir. Model olmayan source ID üretmemelidir. Citation click bazı kullanıcı segmentlerinde trust sinyali olabilir. Source type bazında davranış incelenebilir.
Retrieval Failure ile Model Failure Nasıl Ayrılır?
Önce gerekli evidence retrieval sonuçlarında var mı kontrol edilir. Yoksa retrieval failure ihtimali yüksektir. Evidence var fakat final response yanlışsa generation veya prompt problemi olabilir. Automated classifier bu ayrımı eval pipeline'da yapabilir. Root cause oranları roadmap yatırım kararını yönlendirir.
AI Agent Sistemlerinde Log Analizi
Agent sistemleri tek model çağrısından daha fazla execution state üretir. Tool seçimi, loop sayısı, memory erişimi ve handoff davranışı izlenmelidir. Aynı task başarısız olduğunda hangi agent step'in problemi oluşturduğu trace üzerinden bulunmalıdır. Agentic sistemlerde yüksek token maliyetinin nedeni gereksiz loop olabilir. Bu nedenle step-level telemetry zorunlu hale gelir.
Agent Trace Nedir?
Agent trace task boyunca alınan karar ve tool adımlarını gösterir. Planner, tool ve final answer span'leri aynı trace içinde bulunabilir. Step input ve output structured metadata ile saklanabilir. Sensitive reasoning içeriği loglanmamalıdır. Execution state debugging için yeterli seviyede tutulmalıdır.
Tool Call Success Rate
Tool call success teknik completion oranını ölçer. Business correctness ayrı metric olmalıdır. Tool bazında error ve timeout oranları izlenir. Retry sonrası success ayrıca gösterilebilir. Tool degradation agent quality'yi doğrudan etkileyebilir.
Tool Selection Accuracy
Agent doğru problemi doğru tool'a yönlendirmiş mi değerlendirilir. Labeled task set kullanılabilir. Yanlış tool seçimi user frustration üretir. Tool descriptions veya routing prompt iyileştirilebilir. Accuracy intent bazında raporlanmalıdır.
Agent Loop Sayısı
Loop count agent'ın task tamamlamak için kaç step kullandığını gösterir. Fazla loop maliyet ve latency artırabilir. Complex task doğal olarak daha fazla step gerektirebilir. Intent-normalized metric daha anlamlıdır. Maximum loop guardrail ile runaway behavior engellenmelidir.
Retry Davranışı
Agent aynı tool'u tekrar tekrar çağırabilir. Retry reason loglanmalıdır. Yeni parameter veya strategy yoksa tekrar değersiz olabilir. Repeated failed attempts frustration ve cost yaratır. Termination policy metric üzerinden optimize edilebilir.
Memory Read / Write Logları
Agent memory'den ne zaman bilgi okuduğu ve ne zaman yazdığı izlenebilir. Raw memory content privacy nedeniyle sınırlı tutulmalıdır. Memory hit rate ve stale memory failure ölçülebilir. Yanlış memory final cevabı bozabilir. Write policy daha sıkı audit gerektirebilir.
Agent Handoff'ları
Bir agent task'ı başka agent veya human'a devredebilir. Handoff reason loglanmalıdır. Gereksiz handoff latency ve complexity artırır. Successful handoff task completion ile ilişkilendirilmelidir. Multi-agent tasarımda ownership trace içinde açık kalmalıdır.
Multi-Agent Sistemlerin İzlenmesi
Multi-agent sistemde parent, sub-agent ve step ilişkileri doğru modellenmelidir. Tek trace altında farklı agent span'leri toplanabilir. Agent-specific cost ve failure rate ölçülür. Handoff chain gereksiz uzuyorsa architecture sadeleştirilebilir. Shared state erişimleri ayrıca audit edilebilir.
Parent Agent
Parent agent ana task orchestration'ını yönetir. Sub-agent seçimi ve final synthesis bu seviyede olabilir. Parent error bütün task'ı etkiler. Routing accuracy ayrıca ölçülmelidir. Trace root span parent agent'a bağlanabilir.
Sub-Agent
Sub-agent belirli uzmanlık veya tool set'iyle alt görev yürütür. Success ve latency ayrı metric olarak tutulmalıdır. Parent tarafından yanlış çağrılması routing failure olabilir. Sub-agent version değişiklikleri trace metadata'da yer almalıdır. Shared prompt configuration dikkatle yönetilmelidir.
Agent Session
Agent session task boyunca paylaşılan state'i temsil edebilir. Kullanıcı session'ıyla aynı olmak zorunda değildir. Session memory ve intermediate artifact reference taşıyabilir. ID correlation debugging için önemlidir. Retention privacy policy'ye bağlıdır.
Agent Step
Agent step tek planlama veya action birimidir. Step number ve parent reference tutulmalıdır. Tool call veya model generation step içinde yer alabilir. Step-level cost runaway loop tespitini kolaylaştırır. Final task success ile step sequence ilişkilendirilebilir.
Binlerce AI Conversation'ı Otomatik Analiz Etme
Conversation sayısı büyüdükçe manuel log inceleme sürdürülemez hale gelir. Summarization, structured extraction, embedding ve clustering yöntemleri büyük hacmi anlamlı temalara ayırır. Her conversation için kısa structured summary üretilmesi analytics sorgularını kolaylaştırır. Semantic clustering yeni intent ve failure pattern'lerini ortaya çıkarabilir. Otomatik analiz yine human sample ile doğrulanmalıdır.
Manuel Log İncelemenin Ölçek Problemi
On binlerce conversation'ı insanla tek tek okumak yüksek maliyetlidir. Reviewer consistency de zaman içinde düşebilir. Manual review yalnızca sampled veya high-risk interaction'lara odaklanmalıdır. Otomatik enrichment büyük hacmi ön filtreler. Human effort daha değerli edge case'lere yönlendirilir.
Conversation Summarization
Conversation özetleri kullanıcı goal, outcome ve failure bilgisini kısa forma dönüştürebilir. LLM structured prompt kullanılabilir. Raw conversation yerine summary analytics için daha güvenli olabilir. Özet hallucination riskine karşı confidence veya source reference taşımalıdır. Human validation sample gerekir.
Structured Summary Oluşturma
JSON schema içinde intent, success, frustration, tool use ve failure reason alanları çıkarılabilir. Structured output downstream warehouse analizini kolaylaştırır. Schema versionlanmalıdır. Unknown değerler zorla sınıflandırılmamalıdır. Extraction model değişikliği distribution shift yaratabilir.
Embedding Üretimi
Conversation veya summary embedding semantic similarity analizi sağlar. Raw prompt saklamadan bazı clustering senaryoları mümkün hale gelir. Embedding yine sensitive representation olarak korunmalıdır. Model version metadata tutulmalıdır. Re-embedding maliyeti büyük dataset'te planlanmalıdır.
Semantic Clustering
Embedding'ler benzer conversation'ları cluster'lara ayırmak için kullanılabilir. Önceden taxonomy bulunmayan kullanım senaryolarında keşif sağlar. Cluster sayısı ve stability önemlidir. Human analyst cluster sample'larını incelemelidir. Product insight structured taxonomy'ye dönüştürülebilir.
UMAP
UMAP yüksek boyutlu embedding'leri daha düşük boyuta indirgemek için kullanılabilir. Görselleştirme ve clustering öncesi yardımcı olur. Parametreler cluster görünümünü etkiler. İki boyutlu grafik gerçek semantic mesafeyi tam temsil etmez. Exploration amacıyla kullanılmalıdır.
HDBSCAN
HDBSCAN yoğunluk tabanlı clustering yapar ve outlier noktaları noise olarak bırakabilir. Cluster sayısını önceden belirleme zorunluluğu yoktur. UMAP sonrası kullanılabilir. Minimum cluster size sonuçları etkiler. Stability ve human interpretability kontrol edilmelidir.
Cluster'ların LLM ile Etiketlenmesi
Her cluster'dan representative sample seçilip LLM'e tema adı ürettirilebilir. Label kısa ve product diliyle uyumlu olmalıdır. Model cluster olmayan pattern uydurabilir. Human approval önerilir. Label taxonomy daha sonra versionlanabilir.
Intent Cluster'ları
Intent cluster'ları kullanıcıların sistemi hangi amaçlarla kullandığını keşfetmeye yardımcı olur. Mevcut taxonomy dışında yeni kullanım alanları bulunabilir. Cluster frequency trendleri ürün değişimini gösterir. High-value cluster'lar roadmap için önceliklendirilir. Sample quality kontrolü gerekir.
Failure Cluster'ları
Negative feedback veya low-score conversation'lar ayrıca cluster edilebilir. Aynı prompt failure pattern'i ortaya çıkabilir. Retrieval, tool veya UX sorunları ayrı temalar oluşturabilir. Cluster size ve business impact birlikte değerlendirilmelidir. En büyük cluster her zaman en kritik sorun değildir.
Edge Case ve Outlier Analizi
Cluster dışında kalan nadir conversation'lar önemli edge case olabilir. Security veya yüksek riskli failure burada bulunabilir. Anomaly-based sampling bu örnekleri seçer. Human review sonucu regression dataset'e eklenebilir. Nadir kullanım senaryoları product opportunity de olabilir.
AI Kullanıcı Loglarından Otomatik İçgörü Çıkarma
Kullanıcı logları sadece monitoring verisi değil product discovery kaynağıdır. En sık intent, başarısız task, feature request ve churn sinyalleri sistematik olarak çıkarılabilir. Structured summaries ve clustering bu analizi ölçeklendirir. Insight doğrudan roadmap kararı olmadan önce business validation gerektirir. Kullanıcı davranışını doğru okumak model optimizasyonu kadar ürün gelişimini de yönlendirir.
En Yaygın Kullanım Senaryoları
Intent distribution kullanıcıların ürünü gerçekten ne için kullandığını gösterir. Marketing mesajı ile gerçek kullanım farklı olabilir. Volume yanında retention ve satisfaction da incelenmelidir. Yüksek hacimli fakat düşük başarı use case problem gösterebilir. Product positioning bu veriyle güncellenebilir.
En Sık Karşılaşılan Problemler
Failure taxonomy sayıları hangi sorunların tekrarlandığını gösterir. Model, retrieval veya UX kaynaklı problemler ayrıştırılır. Severity ve affected user count birlikte raporlanmalıdır. Root cause çözüm backlog'una bağlanır. Fix sonrası aynı metric'in düşmesi beklenir.
Karşılanmayan Kullanıcı İhtiyaçları
Kullanıcı sık sık desteklenmeyen işlemi istiyorsa unmet need oluşur. "Bunu yapamıyorum" cevapları cluster edilebilir. High-value kullanıcı segmentlerinde frequency ayrıca incelenir. Yeni tool veya data integration ihtiyacı ortaya çıkabilir. Product research bu sinyali qualitative görüşmelerle doğrulayabilir.
Feature Request Tespiti
Prompt ve feedback içinde "keşke", "bunu da yapabilse" gibi ifadeler sınıflandırılabilir. LLM structured extraction kullanılabilir. Duplicate request'ler semantic clustering ile gruplanır. Request frequency ile business value birlikte değerlendirilir. Feedback kanalı olmayan kullanıcıların ihtiyaçları da loglardan görünür hale gelir.
Churn Risk Sinyalleri
Decreasing usage, repeated frustration ve failed task kombinasyonu churn riski gösterebilir. User-level model kullanılabilir. Sensitive kullanıcı profillemesi privacy policy ile uyumlu olmalıdır. Risk score customer success action'ına bağlanabilir. Correlation causal churn nedeni olarak yorumlanmamalıdır.
Yeni Ürün Fırsatlarının Belirlenmesi
Beklenmeyen intent cluster'ları yeni ürün alanı gösterebilir. Kullanıcılar AI sistemini mevcut ürün tanımının dışında değerli bir iş için kullanıyor olabilir. Retention ve willingness-to-pay sinyali ayrıca incelenmelidir. Product experiment küçük segmentte yapılabilir. Log insight keşif başlangıcı olarak görülmelidir.
Kullanıcı Cohort Analizi
Aggregate metric'ler farklı kullanıcı gruplarındaki problemleri gizleyebilir. Yeni kullanıcılar, power user'lar, ücretsiz ve ücretli kullanıcılar farklı davranış gösterebilir. Model veya prompt version cohort'u teknik release etkisini anlamayı kolaylaştırır. Kullanım senaryosuna göre cohort oluşturmak quality metric'lerini daha anlamlı hale getirir. Cohort tanımları stabil ve document edilmiş olmalıdır.
Yeni ve Mevcut Kullanıcılar
Yeni kullanıcı ilk deneyimde daha fazla yönlendirmeye ihtiyaç duyabilir. Existing user prompt'ları daha kısa ve task-specific olabilir. First-session success ayrı takip edilmelidir. Model değişikliği yeni kullanıcıları farklı etkileyebilir. Onboarding UX bu analizden yararlanır.
Power User'lar
Power user yüksek kullanım veya yüksek değerli task yapan kullanıcı olarak tanımlanabilir. Bu grup advanced feature adoption hakkında bilgi verir. Cost per user yüksek olabilir. Satisfaction düşüşü retention açısından önemli risk yaratır. Feedback programlarına dahil edilebilir.
Ücretsiz ve Ücretli Kullanıcılar
Free ve paid kullanıcıların latency veya model erişimi farklı olabilir. Quality metric'ler plan bazında karşılaştırılmalıdır. Paid kullanıcı task complexity'si daha yüksek olabilir. Basit raw satisfaction comparison yanıltıcı olabilir. Intent mix kontrol edilmelidir.
Yüksek ve Düşük Memnuniyet Cohort'ları
Satisfaction score üzerinden kullanıcı grupları oluşturulabilir. Prompt pattern ve model usage farkları incelenir. Düşük memnuniyet cohort'unda belirli failure type yoğunlaşabilir. Product intervention test edilebilir. Cohort membership zaman içinde değişebilir.
Kullanım Senaryosuna Göre Cohort'lar
Writing, coding veya support gibi intent cohort'ları model performansını daha doğru gösterir. Her use case için ideal response length farklı olabilir. Latency tolerance da değişebilir. One-size-fits-all quality metric yerine task-specific benchmark oluşturulur. Product roadmap daha hedefli hale gelir.
Model veya Prompt Versiyonuna Göre Cohort'lar
Deployment sonrası user interaction'lar version cohort'una atanır. Quality, latency ve retention karşılaştırılabilir. Exposure random değilse selection bias değerlendirilmelidir. A/B test daha güçlü causal evidence sağlar. Version metadata eksiksiz olmalıdır.
AI Kalitesi ile Kullanıcı Retention'ı Arasındaki İlişki
Kullanıcıların AI ürününe geri dönmesi ilk birkaç deneyimin kalitesiyle güçlü ilişki gösterebilir. Ancak correlation doğrudan causation değildir. İlk session success ile sonraki retention birlikte analiz edilebilir. Eval score, latency ve outcome event aynı model içinde incelenebilir. Product experiment gerçek causal etkiyi ölçmede daha güçlüdür.
İlk AI Deneyimi Neden Kritik?
Kullanıcının ilk interaction'ı ürün hakkındaki güveni hızlı biçimde şekillendirir. İlk cevap yanlış veya çok yavaşsa kullanıcı tekrar denemeyebilir. Onboarding use case'leri yüksek kaliteyle optimize edilmelidir. First-turn success metric ayrı izlenebilir. Yeni kullanıcı cohort'unda model fallback daha konservatif olabilir.
First-Session Success Rate
İlk session içinde en az bir meaningful task tamamlanması activation metric olabilir. Completion definition açık olmalıdır. User feedback yoksa implicit outcome kullanılabilir. Segment ve acquisition channel bazında farklılık incelenebilir. Retention ile ilişkisi cohort analysis ile ölçülür.
Eval Score ile Retention Korelasyonu
Interaction-level eval score user-level retention ile aggregate edilebilir. High-quality first session kullanıcıları daha yüksek retention gösterebilir. Sample size ve confounder kontrolü gerekir. Paid plan veya task complexity ilişkiyi etkileyebilir. Korelasyon product hypothesis üretir, causal kanıt değildir.
Kullanıcıya Gerçek Değer Sağlayan Aksiyonların Ölçülmesi
Copy veya completed tool action gerçek değer sinyali olabilir. Bir kullanıcı çok mesaj atıyor fakat hiç outcome üretmiyorsa engagement yanıltıcı olabilir. Value action taxonomy oluşturulmalıdır. Retention hangi action'larla daha güçlü ilişkili incelenir. Executive dashboard task success'i mesaj sayısının önüne koyabilir.
Correlation ve Causation Ayrımı
Yüksek satisfaction ve retention birlikte artabilir. Ancak daha deneyimli kullanıcılar hem daha iyi prompt yazıyor hem daha fazla kalıyor olabilir. Bu confounding relationship'i etkiler. Randomized experiment veya quasi-experiment causal etkiyi daha iyi ölçer. Analytics sonuçları buna göre yorumlanmalıdır.
AI Loglarından Failure Taxonomy Oluşturma
Failure taxonomy ekiplerin kötü AI deneyimlerini ortak dilde sınıflandırmasını sağlar. Model failure, prompt failure, retrieval failure ve UX failure ayrı çözüm yolları gerektirir. Tüm negatif feedback'i "model kötü" olarak değerlendirmek yanlış yatırım kararına yol açar. Taxonomy human-reviewed sample üzerinden geliştirilmelidir. Production loglarına otomatik classifier uygulanarak trendler izlenebilir.
Model Failure
Model doğru context'e rağmen yanlış veya yetersiz cevap üretir. Instruction-following veya reasoning problemi olabilir. Model version comparison yardımcı olur. Temperature ve output constraint kontrol edilmelidir. Gerekirse model değişikliği değerlendirilir.
Prompt Failure
System veya task prompt modeli yanlış yönlendirebilir. Gereksiz uzun instruction önemli kuralları gölgeleyebilir. A/B test prompt etkisini ölçer. Prompt version tracking zorunludur. Basit prompt düzeltmesi büyük model değişikliğinden daha etkili olabilir.
Retrieval Failure
Doğru evidence retrieval'a gelmez veya yanlış document yüksek rank alır. Chunking, embedding ve query rewrite incelenir. Context recall düşük olabilir. Reranker yalnızca candidate set içindeki sonuçları düzeltebilir. Retrieval evaluation ayrı çalıştırılmalıdır.
Tool Failure
Tool timeout, parameter error veya yanlış tool selection oluşabilir. Technical success doğru business result garantisi değildir. Tool output schema validation kullanılabilir. Retry policy gereksiz loop yaratmamalıdır. Tool-specific metrics izlenmelidir.
Authorization Failure
Kullanıcı gerekli source veya tool'a yetkili olmayabilir. Doğru refusal güvenli davranıştır. Yanlış authorization configuration gereksiz failure yaratabilir. Access denied reason loglanmalıdır. PII içermeyen audit metadata tutulmalıdır.
Latency Failure
Cevap doğru olsa bile kullanıcı bekleme süresi nedeniyle conversation'ı terk edebilir. P95/P99 ve abandonment ilişkisi incelenmelidir. Slow dependency trace ile bulunur. Streaming perceived latency'yi azaltabilir. SLA task criticality'ye göre değişebilir.
Safety Failure
Model unsafe response veya gereksiz refusal üretebilir. Policy classifier ve human audit kullanılabilir. False positive safety behavior user experience'i etkiler. Failure type severity taşımalıdır. High-risk event yüzde yüz saklanabilir.
UX Failure
Yanıt formatı veya arayüz kullanıcı hedefini zorlaştırabilir. Model doğru cevabı üretmesine rağmen action görünür olmayabilir. Long text scroll friction yaratabilir. Session replay veya behavioral event analizi yardımcı olur. Model ekibi dışında product fix gerekebilir.
Business Logic Failure
AI ve tool teknik olarak doğru çalışsa da iş kuralı yanlış olabilir. Yanlış eligibility veya pricing logic buna örnektir. Business outcome failure oluşur. Domain owner incelemesi gerekir. Rule version telemetry içinde saklanmalıdır.
Production Loglarından Eval Dataset Oluşturma
Production interaction'ları gerçek kullanıcı dağılımını yansıttığı için eval dataset için çok değerlidir. Negatif feedback, low-score ve edge case conversation'lar sistematik olarak seçilebilir. İnsan review sonrasında golden dataset'e eklenebilir. Her production failure bir regression test fırsatına dönüşür. Production → Eval → Fix → Deployment döngüsü AI ürün kalitesinin sürekli gelişmesini sağlar.
Kötü Etkileşimlerin Otomatik Seçilmesi
Thumbs down, frustration score ve task failure filtreleri candidate seçebilir. Sadece explicit feedback'e bağlı kalınmamalıdır. Sampling farklı failure family'leri dengeli kapsamalıdır. Privacy redaction dataset oluşturma öncesi uygulanmalıdır. Human reviewer final label verir.
Edge Case'lerin Dataset'e Eklenmesi
Nadir prompt veya tool path'leri production'da ortaya çıkabilir. Anomaly-based sampling bu örnekleri bulur. Security ve long-tail language case'leri özellikle değerlidir. Dataset versionlanmalıdır. Edge case fix sonrası regression korunur.
Golden Dataset Oluşturma
Golden dataset yüksek kaliteli human-labeled interaction setidir. Expected behavior ve quality rubric içerir. Model veya prompt release öncesi kullanılır. Kolay ve zor örnekler dengeli olmalıdır. Production distribution'dan kopmaması için düzenli güncellenmelidir.
Offline Eval
Offline eval candidate değişiklikleri production'a çıkmadan test eder. Same dataset üzerinde model ve prompt karşılaştırılır. Quality, latency ve cost ölçülebilir. Deterministic replay mümkün olmayan tool'lar mock edilebilir. Threshold release gate olarak kullanılabilir.
Online Eval
Online eval production traffic üzerinde gerçek kullanıcı etkisini ölçer. User feedback ve task completion dahil edilir. Safety ve latency sürekli izlenir. A/B test veya shadow evaluation kullanılabilir. Sensitive interaction sampling policy'ye bağlıdır.
Regression Testleri
Daha önce düzeltilen failure yeniden ortaya çıkmamalıdır. Her kritik incident için test case eklenebilir. Prompt ve model change suite'i otomatik çalıştırır. Threshold altında deployment engellenebilir. Dataset drift nedeniyle testler düzenli review edilmelidir.
Production → Eval → Fix → Deployment Feedback Loop
Production failure otomatik triage edilir. Representative sample eval dataset'e girer. Root cause'a göre prompt, model, retrieval veya UX düzeltmesi yapılır. Offline evaluation sonrası controlled deployment gerçekleşir. Production metric iyileşmesi döngüyü doğrular.
Prompt ve Model Değişikliklerinin Kullanıcı Davranışına Etkisi
Model veya prompt değişikliği yalnızca offline benchmark üzerinden değerlendirilmemelidir. Kullanıcı davranışı, latency ve maliyet aynı anda değişebilir. Yeni model quality artırırken response süresini uzatabilir. A/B test bu trade-off'u gerçek traffic üzerinde gösterir. Cohort ve statistical significance dikkate alınmalıdır.
Prompt Version Tracking
Her interaction exact prompt version ID taşımalıdır. Dynamic prompt component'leri varsa template ve variable set ayrı loglanabilir. Raw system prompt her consumer'a açılmamalıdır. Version change release event ile ilişkilendirilir. Regression analysis kolaylaşır.
Model Version Tracking
Provider model adı yanında exact deployment veya snapshot version saklanmalıdır. Vendor alias zaman içinde değişebilir. Routing sistemi farklı user'ları farklı modellere gönderebilir. Exposure loglanmazsa analysis yanlış olur. Model version cost ve quality dashboard'da temel dimension olmalıdır.
A/B Test Tasarımı
Kullanıcılar random biçimde control ve treatment'a atanmalıdır. Sticky assignment multi-turn conversation tutarlılığını korur. Primary metric önceden belirlenmelidir. Safety guardrail metric test sırasında izlenir. Sample size yeterli olmadan erken karar verilmemelidir.
Quality–Latency–Cost Trade-Off
Yeni model quality'yi artırırken token ve latency maliyeti yükseltebilir. Tek metric optimization business değerini bozabilir. Cost per successful task daha bütüncül metric'tir. Intent bazlı model routing denge sağlayabilir. High-value task daha pahalı model kullanabilir.
Kullanıcı Cohort'larına Göre Sonuç Analizi
Average result segment farkını gizleyebilir. Yeni kullanıcılar treatment'tan yararlanırken power user'lar kötü etkilenebilir. Intent, plan ve region gibi dimension'lar incelenebilir. Multiple comparison hatasına dikkat edilmelidir. Pre-specified key cohorts daha güvenilir analiz sağlar.
İstatistiksel Anlamlılık
Observed metric farkının random noise ile açıklanma olasılığı değerlendirilir. Confidence interval effect size kadar önemlidir. Büyük sample çok küçük anlamsız farkı significant gösterebilir. Business significance ayrıca değerlendirilmelidir. Experiment stopping rule önceden belirlenmelidir.
KVKK ve Kullanıcı Etkileşim Loglarında Gizlilik
AI prompt'ları kişisel veya kurumsal hassas veri taşıyabileceği için loglama tasarımında privacy ilk günden düşünülmelidir. Her şeyi raw biçimde toplamak analytics için kolay görünse de risk ve saklama maliyetini artırır. Data minimization, PII detection, redaction ve retention policy temel kontrol katmanlarıdır. Kullanıcı silme taleplerinin telemetry sistemine de yansıması gerekir. KVKK uygulaması kurumun hukuk ve veri koruma ekipleriyle birlikte değerlendirilmelidir.
AI Prompt'ları Kişisel Veri İçerebilir mi?
Evet, kullanıcılar isim, iletişim bilgisi veya hassas içerikleri prompt içine yazabilir. Kurumsal kullanıcılar müşteri veya proje bilgisi de paylaşabilir. Bu nedenle prompt varsayılan olarak non-sensitive kabul edilmemelidir. PII classification ingestion noktasında çalışabilir. Kullanım amacı ve retention süresi açıkça tanımlanmalıdır.
Data Minimization
Analiz için gerçekten gerekli alanlar tutulmalıdır. Intent dağılımı gerekiyorsa raw prompt saklamak zorunlu olmayabilir. Token count ve latency gibi metadata çoğu teknik analiz için yeterlidir. Hassas text kısa süreli hot storage'da tutulabilir veya hiç saklanmayabilir. Daha az veri daha düşük risk anlamına gelir.
PII Detection
PII detection rule, regex ve model tabanlı yöntemleri birleştirebilir. Türkçe özel isim ve adres yapıları ayrıca test edilmelidir. False negative kritik risktir. Detection confidence düşük kayıtlar daha konservatif işlenebilir. PII type metadata raw value olmadan saklanabilir.
İsim
İsimler entity recognition ile tespit edilebilir. Her capitalized kelime isim değildir. Domain dictionary yardımcı olabilir. Redaction analitik değer kaybını sınırlayacak biçimde yapılmalıdır. Pseudonymous placeholder kullanılabilir.
E-posta
E-posta regex ile yüksek doğrulukla bulunabilir. Domain bilgisi bazı analytics için gerekli olabilir. User identity raw e-posta üzerinden join edilmemelidir. Hash tek başına her durumda anonymization sağlamaz. Mapping access sınırlı tutulmalıdır.
Telefon
Telefon numaraları farklı formatlarda gelebilir. Ülke kodu ve boşluk normalization detection'a yardımcı olur. Raw numara logda saklanmamalıdır. Son birkaç haneyi göstermek bile bazı use case'lerde gereksizdir. Masking standard uygulanmalıdır.
TCKN
TCKN yüksek hassasiyetli kişisel veri olarak ele alınmalıdır. Pattern detection yanında checksum benzeri doğrulama kullanılabilir. Loglardan tamamen kaldırmak çoğu analitik kullanım için uygundur. Security event olarak yalnızca detection type saklanabilir. Access kontrolü güçlü olmalıdır.
Adres
Adres detection free-text yapısı nedeniyle daha zordur. Named entity ve pattern yaklaşımı birlikte kullanılabilir. Exact address çoğu AI analytics için gerekli değildir. Location granularity gerekiyorsa coarse region türetilebilir. Raw value redacted tutulmalıdır.
Kurumsal Gizli Bilgiler
Kurumsal sırlar klasik PII taxonomy dışında olabilir. Proje kodu, müşteri listesi veya finansal bilgi örnektir. DLP pattern ve source context kullanılabilir. Enterprise AI sistemlerinde confidential classification ayrı kategori olmalıdır. Log access security policy ile uyumlu tutulmalıdır.
PII Redaction ve Masking
Redaction değeri tamamen kaldırır veya placeholder ile değiştirir. Masking bazı karakterleri gizler. Analytics ihtiyacına göre yöntem seçilir. Redaction model ve intent classification öncesi uygulanabilir. Original content gerekiyorsa ayrı güvenli storage ve sınırlı retention kullanılmalıdır.
Anonimleştirme ve Pseudonymization
Anonimleştirme yeniden kimliklendirmeyi pratik olarak mümkün olmayacak seviyeye taşımayı amaçlar. Pseudonymization ise kimliği ayrı anahtarla tekrar bağlanabilir hale getirir. User-level retention için pseudonymous ID gerekebilir. Mapping yüksek güvenlikli sistemde tutulmalıdır. Teknik yöntem hukuk değerlendirmesinin yerine geçmez.
Log Retention Politikası
Her log aynı süreyle saklanmamalıdır. Raw prompt daha kısa, aggregate metric daha uzun tutulabilir. Security event farklı retention gerektirebilir. Automatic expiration uygulanmalıdır. Backup ve derived dataset retention da policy kapsamına alınmalıdır.
Kullanıcı Verisinin Silinmesi
Silme talebi raw log, derived summary ve user mapping'i kapsayabilir. Data lineage ilgili kayıtları bulmayı kolaylaştırır. Aggregate anonim metric her durumda aynı şekilde değerlendirilmeyebilir. Delete workflow audit edilmelidir. Backup lifecycle ayrıca yönetilmelidir.
Role-Based Access Control
Product analyst raw prompt görmek zorunda olmayabilir. Engineering yalnızca redacted trace metadata ile çalışabilir. Sensitive content erişimi ayrı role bağlanmalıdır. Least privilege prensibi uygulanır. Access review düzenli yapılmalıdır.
Audit Log
Kim sensitive log'a ne zaman eriştiği kaydedilmelidir. Audit log'un kendisi değiştirilemez veya güçlü biçimde korunmuş olmalıdır. Query reason veya ticket reference eklenebilir. High-risk export event ayrıca izlenebilir. Incident investigation bu kayıtları kullanır.
Ham Prompt Saklamadan Kullanıcı Davranışı Analizi
AI analytics yapmak için raw prompt'u süresiz saklamak zorunlu değildir. Intent-only event, redacted prompt, on-the-fly classification ve aggregate metrics güçlü alternatifler sunar. Bu yaklaşım privacy riskini azaltırken product insight üretmeye devam eder. Analitik derinlik ile veri minimizasyonu arasında dengeli tasarım yapılmalıdır. En hassas sistemlerde raw prompt hiç kalıcı storage'a yazılmayabilir.
Intent-Only Analytics
Prompt giriş anında intent classifier çalıştırılabilir. Sonrasında yalnızca intent label ve confidence saklanır. Raw text memory'de kısa süre tutulup silinebilir. Product usage analysis için çoğu zaman yeterlidir. Classifier bias ve unknown oranı izlenmelidir.
Prompt Redaction
PII ve sensitive entity çıkarıldıktan sonra prompt saklanabilir. Placeholder semantic yapıyı korur. Redacted text clustering ve quality analysis için kullanılabilir. Detection failure riski nedeniyle yüksek hassasiyet gerekir. Security sampling düzenli yapılmalıdır.
On-the-Fly Classification
Prompt event ingestion sırasında intent, safety ve topic sınıflarına dönüştürülebilir. Raw value warehouse'a hiç gönderilmez. Online classifier latency kullanıcı path'ini etkilememelidir. Asynchronous enrichment daha uygun olabilir. Model version metadata saklanmalıdır.
Aggregated Metrics
Daily intent count veya average latency gibi aggregate değerler düşük privacy riski taşır. User-level detay gerekmeden trend analizi yapılabilir. Small-cell suppression yeniden tanımlama riskini azaltabilir. Aggregate table retention daha uzun olabilir. Raw event retention kısa tutulabilir.
Privacy ile Analitik Derinlik Arasındaki Denge
Daha fazla raw data her zaman daha iyi decision üretmez. Önce business question tanımlanmalıdır. Soru aggregate metric ile cevaplanabiliyorsa prompt saklamak gereksizdir. High-value debugging için sampled secure raw data yeterli olabilir. Privacy-by-design ürün güvenini artırır.
AI Sistemlerinde Güvenlik Logları
AI log analitiği yalnızca product ve quality amaçlı değildir. Prompt injection, jailbreak ve sensitive data extraction girişimleri security telemetry olarak izlenebilir. Normal kullanıcı hatası ile malicious behavior birbirinden ayrılmalıdır. Güvenlik event'leri daha yüksek retention veya yüzde yüz capture gerektirebilir. Detection rule ve model çıktıları güvenlik ekibiyle ortak yönetilmelidir.
Prompt Injection Girişimleri
Kullanıcı system instruction'ı değiştirmeye veya tool sınırlarını aşmaya çalışabilir. Rule ve classifier injection pattern'ini işaretleyebilir. Retrieved document içindeki indirect injection ayrıca loglanmalıdır. Event severity ve action sonucu saklanmalıdır. False positive normal kullanıcı deneyimini bozmamalıdır.
Jailbreak Davranışları
Jailbreak policy bypass etmeye yönelik tekrarlı denemeleri içerir. Tek riskli prompt ile coordinated abuse ayrılmalıdır. Session-level pattern önemlidir. Safety response success metric olarak tutulabilir. User sanction kararı ayrı policy gerektirir.
Sensitive Data Extraction Denemeleri
Kullanıcı sistem prompt'u, secret veya diğer kullanıcı verisini istemeye çalışabilir. Request detection ve output leakage check birlikte izlenmelidir. Attempt başarılı olmasa bile security event olabilir. High severity interaction yüzde yüz saklanabilir. Incident response workflow'a bağlanmalıdır.
Tool Abuse
Agent tool'larının istenmeyen amaçla çağrılması ciddi risk yaratabilir. Permission ve rate limit model kararından bağımsız enforce edilmelidir. Tool call trace security analizine dahil edilir. Repeated denied request abuse sinyali olabilir. Business-critical tool'lar daha güçlü audit gerektirir.
Anormal Kullanım Pattern'leri
Ani request spike veya sıra dışı token kullanımı abuse gösterebilir. Bot activity normal power user davranışıyla karışabilir. Rate, timing ve intent distribution birlikte değerlendirilmelidir. Unsupervised anomaly detection yardımcı olabilir. Human security analyst kritik kararları review etmelidir.
Abuse ve Normal Kullanıcı Davranışının Ayrıştırılması
Heavy usage tek başına abuse değildir. Developer veya analyst doğal olarak yüksek hacimde AI kullanabilir. Behavior history ve policy violation signal birlikte değerlendirilmelidir. Risk score açıklanabilir olmalıdır. Yanlış positive account restriction kullanıcı güvenini zedeler.
Yüksek Hacimli AI Loglarında Sampling Stratejileri
Milyonlarca interaction'ın tamamını LLM ile değerlendirmek maliyetli olabilir. Sampling maliyeti kontrol ederken kalite sinyalini korumayı sağlar. Random sample genel tabloyu, error-based sample sorunlu alanları gösterir. Stratified yaklaşım farklı intent ve cohort'ların temsil edilmesini sağlar. Kritik security veya business failure event'leri sample yerine yüzde yüz saklanabilir.
Neden Her Etkileşimi Ayrıntılı Analiz Etmek Maliyetlidir?
LLM judge ve embedding her conversation için token ve compute maliyeti üretir. Storage da hızla büyür. Aynı repetitive successful interaction'ları tekrar değerlendirmek düşük marjinal değer sağlayabilir. Sampling compute'ı high-value alanlara yönlendirir. Coverage metric yöntemin ne kadar veriyi temsil ettiğini göstermelidir.
Random Sampling
Random sampling genel distribution'ı unbiased biçimde tahmin etmeye yardımcı olur. Nadir failure'ları kaçırabilir. Daily fixed-size sample kolay uygulanır. Statistical confidence interval hesaplanabilir. Segment imbalance varsa stratified yaklaşım daha iyi olabilir.
Stratified Sampling
Intent, plan veya model version gibi gruplardan belirli oranlarda sample alınır. Küçük fakat önemli cohort'ların görünürlüğü korunur. Weighting final aggregate metric'te düzeltilmelidir. Sampling strata önceden tanımlanmalıdır. Çok fazla strata operasyonu zorlaştırabilir.
Error-Based Sampling
Error veya timeout içeren interaction'lar yüksek oranda seçilebilir. Technical root cause analysis için değerlidir. Silent failure'ları tek başına kapsamaz. User behavior signal ile birlikte kullanılmalıdır. Error sample regression dataset'e dönüşebilir.
Low-Score Sampling
Eval veya satisfaction score düşük interaction'lar review için seçilir. Threshold değişikliği sample distribution'ı etkiler. Model judge bias olabilir. Random control sample karşılaştırma sağlar. Low-score örnekler failure cluster analizinde değerlidir.
High-Value User Sampling
Kurumsal veya kritik kullanıcıların interaction'ları daha yüksek oranla analiz edilebilir. Bu yaklaşım business impact'i artırır. Privacy ve fairness açısından policy açık olmalıdır. High-value demek daha fazla raw data erişimi anlamına gelmemelidir. Aggregated veya redacted değerlendirme tercih edilebilir.
Anomaly-Based Sampling
Latency, token veya semantic embedding outlier'ları seçilebilir. Nadir edge case'leri yakalar. Unsupervised yöntemler false positive üretebilir. Human review sample değerini doğrular. Security ve product discovery için ortak kullanılabilir.
%100 Saklanması Gereken Kritik Olaylar
Security violation, serious safety failure veya önemli business transaction error'ları tamamen saklanabilir. Raw content yine data minimization ve redaction kurallarına tabidir. Critical event taxonomy açık olmalıdır. Retention genel loglardan farklı olabilir. Audit ve incident response gereksinimleri belirleyicidir.
Open Source AI Observability ve İşbirliği Ekosistemi
AI observability altyapısında vendor-neutral telemetry uzun vadeli taşınabilirlik sağlar. OpenTelemetry trace ve metric standardizasyonu için güçlü temel sunar. OpenInference AI-specific semantic conventions yaklaşımıyla model, retrieval ve tool span'lerini daha anlamlı hale getirmeye yardımcı olabilir. Self-hosted ve cloud seçeneklerinin security ve operasyon profilleri farklıdır. Açık kaynak projeleri incelerken instrumentation standardını vendor UI'dan ayrı düşünmek gerekir.
OpenTelemetry
OpenTelemetry trace, metric ve log toplama için açık standartlar sunar. Distributed AI servislerinde context propagation sağlar. Collector farklı backend'lere telemetry gönderebilir. AI-specific attributes custom veya extension convention ile eklenebilir. Instrumentation vendor lock-in riskini azaltır.
OpenInference
OpenInference LLM, retrieval ve tool operation'ları için semantic telemetry yaklaşımı sağlar. Span'lerin AI kavramlarıyla standardize edilmesini kolaylaştırır. Farklı framework'lerden gelen trace'leri ortaklaştırabilir. Sensitive content attribute'ları policy ile filtrelenmelidir. Vendor-neutral observability tasarımına katkı sağlar.
Açık Kaynak LLM Observability Araçları
Açık kaynak çözümler tracing, prompt versioning ve eval gibi özellikler sunabilir. Araç seçimi yalnızca UI görünümüne göre yapılmamalıdır. Storage, retention ve access control yetenekleri önemlidir. Community maintenance ve upgrade planı değerlendirilmelidir. Telemetry formatının export edilebilir olması avantajdır.
Vendor-Neutral Telemetry
Instrumentation uygulama kodunu tek backend'e bağımlı hale getirmemelidir. Standard trace ve event schema farklı sistemlere gönderilebilir. Migration maliyeti azalır. Analytics warehouse doğrudan canonical event formatını tüketebilir. Tool-specific özellikler optional enrichment olarak tutulabilir.
Self-Hosted ve Cloud Yaklaşımı
Self-hosted daha fazla veri kontrolü sağlar ancak operasyon yükü getirir. Cloud hızlı başlangıç ve managed scaling sunabilir. Sensitive prompt transferi data residency açısından değerlendirilmelidir. Cost query hacmiyle değişir. Hybrid model bazı kurumlarda daha uygun olabilir.
Vendor Lock-In Nasıl Azaltılır?
OpenTelemetry veya benzeri standard instrumentation kullanılabilir. Raw event'ler kendi warehouse veya object storage'da tutulabilir. Prompt ve eval schema vendor formatından bağımsız versionlanabilir. Export API ve retention policy sözleşmede incelenmelidir. Abstraction gereksiz seviyede büyütülmemelidir.
AI Analytics Dashboard'ında Hangi KPI'lar Olmalı?
Tek dashboard bütün ekiplerin ihtiyacını karşılamaz. Executive ekip adoption ve cost per successful task görmek isterken engineering latency ve trace failure'a odaklanır. Product intent ve retention, AI quality ise eval score ve failure cluster izler. Trust & Safety ayrı risk göstergelerine ihtiyaç duyar. Dashboard'lar ortak event modelinden beslenmeli ancak audience'a göre sadeleştirilmelidir.
Executive Dashboard
Executive dashboard az sayıda iş değeri metric'i içermelidir. Adoption, retention, task completion ve cost per successful task güçlü başlangıç setidir. Teknik detay gerektiğinde drill-down yapılabilir. Trend ve target aynı görselde sunulabilir. Vanity metric yoğunluğu azaltılmalıdır.
Adoption
AI özelliğini gerçekten kullanan kullanıcı oranını gösterir. Exposure denominator doğru tanımlanmalıdır. Segment ve plan bazında izlenebilir. Release sonrası trend karşılaştırılır. Usage quality ile birlikte okunmalıdır.
Retention
Kullanıcının AI özelliğine tekrar dönme oranıdır. Cohort retention product value için güçlü sinyaldir. D1 veya W4 use case'e göre seçilir. First-session success ile ilişkisi gösterilebilir. Plan bazında farklılık incelenir.
Task Completion
Task completion kullanıcı hedefinin gerçekleşme oranını ölçer. Executive seviyede mesaj sayısından daha değerlidir. Intent mix sonucu etkiler. High-value task completion ayrıca gösterilebilir. Human escalation doğru completion olarak tanımlanabilir.
Cost per Successful Task
AI maliyetini gerçek iş sonucuna böler. Model, tool ve infrastructure cost dahil edilebilir. Quality-cost trade-off daha anlamlı hale gelir. Intent bazında farklılık gösterir. Optimization yalnızca token azaltmaya indirgenmez.
Product Dashboard
Product dashboard kullanıcı davranışı ve feature value'ya odaklanır. Intent distribution, satisfaction ve conversation completion temel metric olabilir. Feature adoption release etkisini gösterir. Funnel ve cohort analizine drill-down sağlanmalıdır. Feedback theme trendleri ayrıca eklenebilir.
Intent Distribution
Kullanıcıların sistemi hangi amaçlarla kullandığını gösterir. Yeni intent büyümesi roadmap sinyali olabilir. Unknown oranı classifier health'i gösterir. Cohort bazında farklılık incelenir. Haftalık trend product değişimini görünür yapar.
Satisfaction
Explicit ve implicit feedback'ten oluşturulan score kullanılabilir. Confidence veya coverage bilgisi gösterilmelidir. Intent bazında breakdown önemlidir. Model version değişikliği trendle ilişkilendirilir. Human feedback örnekleri qualitative drill-down sağlar.
Conversation Completion
Conversation hedefinin başarıyla sonlanma oranıdır. Abandonment ile birlikte izlenir. Multi-turn uzunluk metric'i ek bağlam sağlar. Task type'a göre threshold değişebilir. First-turn completion ayrıca değerli olabilir.
Feature Adoption
Tool, file upload veya retrieval gibi AI özelliklerinin kullanımını gösterir. Exposure denominator zorunludur. İlk kullanım ve tekrar kullanım ayrılmalıdır. Satisfaction feature bazında karşılaştırılır. Düşük adoption discoverability problemi olabilir.
Engineering Dashboard
Engineering dashboard latency, token, errors ve trace failure'a odaklanır. Dependency bazında breakdown sağlanmalıdır. Release marker trend üzerine eklenebilir. Tail latency average'dan önce görünür olmalıdır. Alert threshold SLO'lara bağlanmalıdır.
Latency
P50, P95 ve P99 gösterilmelidir. Model, tool ve retrieval breakdown sağlanır. Intent veya region dimension eklenebilir. Time to first token ayrı metric'tir. Regression deployment marker ile izlenir.
Token Usage
Input ve output token trendi ayrı gösterilir. Conversation context growth izlenebilir. Model ve prompt version dimension olarak kullanılır. High-cost outlier listesi sunulabilir. Optimization quality kaybı yaratmamalıdır.
Errors
Error rate dependency ve category bazında gösterilir. User-visible ve recovered retry failure ayrılır. Top exception trendleri görünür olur. Incident marker dashboard'a eklenebilir. Error budget SLO ile bağlanabilir.
Trace Failures
Broken context propagation veya missing span observability kalitesini düşürür. Trace completeness metric tutulabilir. Orphan span oranı izlenebilir. Instrumentation regression CI testleriyle azaltılabilir. Trace sampling policy dashboard'da belirtilmelidir.
AI Quality Dashboard
Quality dashboard model cevabının semantic başarısına odaklanır. Eval score, hallucination, relevance ve failure cluster birlikte gösterilmelidir. Dataset coverage ve judge version görünür olmalıdır. User feedback karşılaştırması eklenebilir. Release marker quality trend analizini kolaylaştırır.
Eval Scores
Faithfulness, correctness ve completeness ayrı score olarak tutulabilir. Aggregate tek score detay kaybı yaratabilir. Human-calibrated confidence belirtilmelidir. Model version dimension kullanılır. Low-score sample review linki bulunabilir.
Hallucination
Unsupported claim rate veya hallucination classifier sonucu izlenebilir. RAG ve non-RAG interaction ayrılmalıdır. High-risk intent farklı threshold kullanabilir. Human audit coverage gösterilmelidir. Trend increase deployment blocker olabilir.
Relevance
Query-response relevance kullanıcı amacına uyumu gösterir. Judge ve user reformulation sinyali birlikte değerlendirilebilir. Low relevance cluster product or prompt issue olabilir. Intent bazında raporlanır. Tail sample human review gerekir.
Failure Clusters
Semantic clustering tekrarlayan quality problemlerini gösterir. Cluster size ve affected users birlikte listelenir. Root cause label human approval alabilir. Fix owner atanabilir. Release sonrası cluster volume düşüşü izlenir.
Trust & Safety Dashboard
Trust & Safety dashboard güvenlik ve policy risklerine odaklanır. Prompt injection, policy violation ve PII leakage kritik metric'lerdir. Severity seviyeleri açık olmalıdır. High-risk event'ler drill-down access control ile korunmalıdır. Trend normal traffic volume ile normalize edilmelidir.
Prompt Injection
Detected attempt sayısı ve success rate izlenir. Indirect ve direct injection ayrılabilir. False positive sample review yapılır. Model ve application guardrail version gösterilir. High severity alert anlık olabilir.
Policy Violations
Unsafe output veya blocked request rate gösterilir. Over-refusal ayrıca izlenmelidir. Policy category breakdown kullanılır. Judge model version önemlidir. Human review selected sample üzerinde çalışır.
PII Leakage
Response içinde sensitive data detection kritik metric'tir. Source prompt'tan gelen PII ile unauthorized leakage ayrılmalıdır. High severity incident otomatik alert üretebilir. Detection coverage düzenli test edilir. Raw data erişimi sınırlandırılır.
AI Etkileşim Logları İçin Örnek Veri Pipeline'ı
Sağlam AI telemetry pipeline uygulamadan event toplamayla başlayıp redaction, enrichment, warehouse ve evaluation katmanlarına ilerler. Observability platform trace analizi sağlarken BI katmanı product ve executive metric üretir. PII redaction mümkün olduğunca erken aşamada uygulanmalıdır. Evaluation pipeline sampled conversation'ları kalite skoruna dönüştürür. Alerting hem teknik hem semantic failure'ları kapsamalıdır.
Uygulamadan Event Toplama
Frontend ve backend ortak event taxonomy kullanmalıdır. Event ID client ve server arasında taşınabilir. Duplicate event idempotent ingestion ile yönetilir. Offline client event gecikmesi göz önüne alınmalıdır. Schema validation producer tarafında uygulanabilir.
Telemetry Collector
Collector farklı servislerden trace ve event toplar. Buffering kısa süreli downstream kesintilere dayanıklılık sağlar. OpenTelemetry Collector benzeri yapı kullanılabilir. Sensitive attribute filter burada uygulanabilir. Export destination environment'a göre değişebilir.
PII Redaction
Redaction collector veya dedicated privacy service üzerinde çalışabilir. Prompt ve response field'ları taranır. Detection failure metric tutulur. Redacted placeholder semantic analysis için korunabilir. High-risk content secure quarantine'a gidebilir.
Event Enrichment
Intent, user cohort ve model metadata event'e sonradan eklenebilir. Enrichment asynchronous çalışabilir. Raw event immutable tutulabilir. Enrichment version metadata taşımalıdır. Warehouse canonical table bu sonuçları birleştirir.
Data Warehouse
Warehouse product ve business analytics sorgularını destekler. Event, conversation ve daily aggregate tabloları ayrılabilir. Partitioning maliyet ve performansı iyileştirir. Sensitive column access policy uygulanır. Data retention lifecycle otomatikleştirilebilir.
Observability Platform
Trace ve span drill-down engineering debugging için kullanılır. Model ve tool span'leri AI semantic metadata taşır. Sampling policy görünür olmalıdır. High-cardinality attribute kontrol edilmelidir. Alert rules SLO ve error taxonomy ile bağlanır.
Analytics ve BI Katmanı
Canonical metrics semantic layer içinde tanımlanabilir. Adoption veya task completion herkes için aynı formülle hesaplanır. Dashboard row-level sensitive data göstermemelidir. Cohort ve trend analysis kolaylaşır. Metric ownership document edilmelidir.
Evaluation Pipeline
Sampled interaction'lar judge veya human eval sürecine girer. Rubric use case'e göre seçilir. Eval results interaction ID üzerinden warehouse'a geri yazılır. Judge version ve prompt saklanır. Regression dataset bu pipeline'dan beslenir.
Alerting Sistemi
Technical latency ve semantic quality alerts ayrı severity kullanabilir. Hallucination spike veya tool error anlık uyarı oluşturabilir. Alert fatigue önlenmelidir. Owner ve runbook linki eklenebilir. Production release marker correlation analysis sağlar.
Kullanıcı Log Analizi İçin Adım Adım Uygulama Yol Haritası
Kurumsal AI log analizi ve LLM observability hizmeti planlanırken her şeyi aynı anda kurmaya çalışmak gerekmez. İlk aşamada iş hedefi ve temel event taxonomy tanımlanabilir. Daha sonra trace, privacy, KPI, intent ve eval katmanları kademeli biçimde eklenir. Clustering ve advanced pattern discovery ancak temel telemetry güvenilir hale geldikten sonra anlamlıdır. Production feedback loop son aşamada model ve product geliştirme süreçlerine bağlanmalıdır.
Aşama 1 — İş Hedefini Belirleyin
Önce hangi soruyu cevaplamak istediğinizi netleştirin. Kullanıcı başarısı, maliyet veya support reduction farklı telemetry ihtiyacı doğurur. Vanity metric yerine business outcome seçilmelidir. Owner ve decision process tanımlanmalıdır. Ölçüm sonraki product aksiyonuna bağlanmalıdır.
Aşama 2 — Event Taxonomy Oluşturun
Prompt, response, feedback, tool ve outcome event'leri standardize edilir. Naming convention belirlenir. Required fields schema ile tanımlanır. Versioning planı oluşturulur. Ekipler aynı event sözlüğünü kullanır.
Aşama 3 — Trace ve Session Yapısını Kurun
user, session, conversation ve trace ilişkileri netleştirilir. Distributed context propagation uygulanır. Interaction ID frontend ve backend arasında taşınır. Trace completeness test edilir. Root cause analysis mümkün hale gelir.
Aşama 4 — Gizlilik Kontrollerini Uygulayın
PII detection ve redaction ingestion'ın erken noktasına eklenir. Raw prompt retention sınırlanır. Access control ve audit log kurulur. Delete workflow tasarlanır. Hukuki gereksinimler ilgili ekiplerle doğrulanır.
Aşama 5 — Temel KPI'ları Oluşturun
Adoption, task completion, satisfaction, latency ve cost ölçülür. Metric definition semantic layer'da standardize edilir. Dashboard audience'a göre ayrılır. Baseline period saklanır. İlk release marker karşılaştırma sağlar.
Aşama 6 — Intent Classification Ekleyin
Taxonomy gerçek kullanıcı sample'larından oluşturulur. Zero-shot classifier başlangıç olabilir. Human-labeled validation set hazırlanır. Unknown intent oranı izlenir. Product analytics use case bazında derinleşir.
Aşama 7 — Evals Ekleyin
Relevance, correctness ve safety rubric tanımlanır. Sampled production logs evaluate edilir. Human calibration yapılır. Eval score dashboard'a yazılır. Release gate'e kritik metric eklenebilir.
Aşama 8 — Clustering ve Pattern Discovery Kurun
Conversation summary ve embedding üretilir. Semantic clustering yeni intent ve failure pattern'lerini çıkarır. Human analyst cluster label'larını doğrular. Unmet need ve edge case'ler roadmap'e girer. Taxonomy düzenli güncellenir.
Aşama 9 — Dashboard ve Alerting Oluşturun
Executive, product ve engineering dashboard'ları ayrılır. P95 latency ve task failure alert kuralları eklenir. Quality degradation selected metric ile izlenir. Alert owner ve runbook tanımlanır. Historical trend release marker ile gösterilir.
Aşama 10 — Production Feedback Loop'u Otomatikleştirin
Negative interaction eval dataset'e otomatik aday olur. Root cause sınıflandırılır. Fix offline eval ile doğrulanır. Controlled deployment yapılır. Production metric değişimi döngüyü kapatır.
En Sık Yapılan Hatalar
AI loglama projelerinde en yaygın hata çok veri toplayıp az anlam üretmektir. Prompt ve response kaydetmek tek başına observability sağlamaz. Session, trace, business outcome ve feedback ilişkisi kurulmadığında root cause analizi eksik kalır. Privacy kontrolü sonradan eklenirse risk büyür. En iyi yaklaşım önce minimum güvenilir telemetry çekirdeğini kurup ihtiyaç oldukça genişletmektir.
Sadece Prompt ve Response Kaydetmek
Bu iki alan user experience'in yalnızca görünen kısmını gösterir. Retrieval veya tool failure görünmez kalır. Latency breakdown yapılamaz. Business outcome ilişkilendirilemez. Trace ve event modeline ihtiyaç vardır.
Session ve Conversation ID Kullanmamak
Turn'lar birbirine bağlanamaz. Multi-turn frustration tespit edilemez. Retention ve conversation completion yanlış hesaplanır. Feedback doğru response ile ilişkilendirilemez. Stable IDs temel gereksinimdir.
Kullanıcı Sonucunu Ölçmemek
Mesaj sayısı user value göstermez. AI cevap verip task başarısız olabilir. Business outcome veya completion event gerekir. Executive metric yanlış yönlenebilir. Cost per successful task hesaplanamaz.
HTTP 200'ü Başarı Olarak Kabul Etmek
Technical success semantic success değildir. Wrong answer yine 200 döner. Tool yanlış sonuç üretebilir. User frustration görünmez kalır. Task success ayrı metric olarak izlenmelidir.
Her Logu Süresiz Saklamak
Storage maliyeti ve privacy riski artar. Raw prompt için kısa retention yeterli olabilir. Aggregate metrics daha uzun saklanabilir. Security event farklı policy kullanabilir. Automatic deletion uygulanmalıdır.
PII Temizlemeden Analytics Sistemine Veri Göndermek
Prompt doğrudan kişisel veri içerebilir. Warehouse erişim yüzeyi geniş olabilir. Redaction ingestion öncesi veya erken aşamada yapılmalıdır. Sensitive columns role-based erişime tabi olmalıdır. Privacy testleri CI içinde çalıştırılabilir.
Ortalama Latency'ye Bakıp P95/P99'u İhmal Etmek
Average çoğu kullanıcı için iyi görünürken tail latency ciddi sorun olabilir. Enterprise tool çağrıları uç gecikme yaratabilir. Abandonment yüksek tail ile ilişkili olabilir. P95 ve P99 ayrı gösterilmelidir. SLO tail metric üzerine kurulabilir.
Kullanıcı Feedback'ini Trace ile İlişkilendirmemek
Thumbs down nedeni teknik root cause ile bağlanamaz. Hangi model veya tool'un problem yarattığı bilinmez. Feedback interaction ID taşımalıdır. Trace join analizi kolaylaşır. Quality roadmap daha doğru belirlenir.
Production Hatalarını Eval Dataset'e Eklememek
Aynı failure release sonrasında tekrar ortaya çıkabilir. Real user edge case benchmark'a girmelidir. Regression suite sürekli büyümelidir. Human review expected behavior tanımlar. Production learning kalıcı hale gelir.
Milyonlarca Conversation'ı Manuel Analiz Etmeye Çalışmak
İnsan kapasitesi bu hacmi taşıyamaz. Sampling ve automated summarization kullanılmalıdır. Clustering common patterns'i çıkarır. Human review high-value örneklere odaklanır. Maliyet ve consistency iyileşir.
Sık Sorulan Sorular
AI log analitiği konusunda en sık sorulan sorular hangi verilerin tutulacağı, privacy, trace yapısı ve chatbot başarısının nasıl ölçüleceği çevresinde toplanır. Her sistemin risk seviyesi ve iş hedefi farklıdır. Bu nedenle tek bir evrensel event schema bulunmaz. Yine de session, trace, user outcome ve privacy ilkeleri çoğu production AI uygulamasında temel yapı taşlarıdır. Aşağıdaki cevaplar uygulama sırasında sık karşılaşılan kararları özetler.
AI kullanıcı etkileşim loglarında hangi veriler tutulmalıdır?
Interaction ID, timestamp, model version, prompt version ve temel latency bilgisi güçlü başlangıç setidir. Tool ve retrieval event'leri ayrıca ilişkilendirilmelidir. User feedback ve business outcome mümkünse loglanmalıdır. Raw prompt ve response yalnızca gerçekten gerekli olduğunda ve privacy kontrolleriyle tutulmalıdır. Data minimization bütün schema tasarımına uygulanmalıdır.
AI prompt'larını loglamak KVKK açısından uygun mudur?
Bu sorunun cevabı kullanım amacı, veri türü, hukuki dayanak ve kurum politikasına bağlıdır. Prompt kişisel veri içerebilir ve varsayılan olarak güvenli kabul edilmemelidir. PII detection, redaction ve retention policy kullanılabilir. Raw prompt yerine intent-only analytics değerlendirilebilir. Kurumun hukuk ve veri koruma ekipleriyle birlikte karar verilmelidir.
Trace, span, session ve conversation arasındaki fark nedir?
Session belirli kullanım oturumunu temsil eder. Conversation kullanıcı ile AI arasındaki konu veya task mesaj dizisidir. Trace tek interaction'ın backend execution akışını gösterir. Span trace içindeki model, retrieval veya tool gibi tek operasyonu temsil eder. Bu dört kimlik birlikte user journey ve root cause analizini mümkün hale getirir.
Kullanıcı niyeti AI loglarından nasıl çıkarılır?
Prompt veya redacted summary üzerinden intent classification yapılabilir. Zero-shot LLM, embedding veya supervised model kullanılabilir. Hierarchical taxonomy ana ve alt intent ayrımı sağlar. Unknown category yeni kullanım senaryolarını görünür tutar. Human-labeled validation set classifier kalitesini ölçmelidir.
Chatbot başarısı hangi metriklerle ölçülür?
Task completion, satisfaction, retention ve escalation temel product metric'leridir. Relevance, correctness ve faithfulness AI kalite boyutlarını ölçer. P95 latency ve cost per successful task teknik ve ekonomik performansı gösterir. Tek metric bütün başarıyı temsil etmez. Intent ve cohort bazında analiz yapılmalıdır.
Kullanıcı memnuniyeti feedback olmadan ölçülebilir mi?
Evet, implicit davranışlardan tahmin edilebilir. Regenerate, reformulation ve abandonment negatif sinyaller olabilir. Copy, save ve completed action pozitif sinyaller sağlayabilir. Bu sinyaller intent'e göre farklı anlam taşır. Human-labeled satisfaction dataset ile model kalibre edilmelidir.
Milyonlarca AI konuşması nasıl analiz edilir?
Önce structured summary ve embedding üretilebilir. Semantic clustering yaygın intent ve failure pattern'lerini çıkarır. Sampling ile yüksek değerli interaction'lar LLM judge veya human review'a gönderilir. Aggregate metrics bütün traffic'i izler. Böylece manuel inceleme yalnızca temsil gücü yüksek örneklere odaklanır.
LLM logları ne kadar süre saklanmalıdır?
Tek bir doğru retention süresi yoktur. Raw prompt, redacted event ve aggregate metric farklı sürelerle tutulabilir. Security veya audit gereksinimleri ayrıca değerlendirilir. Storage maliyeti ve privacy riski birlikte düşünülmelidir. Automatic deletion policy uygulanmalıdır.
OpenTelemetry AI sistemlerinde kullanılabilir mi?
Evet, distributed trace ve metric toplama için kullanılabilir. AI-specific model, retrieval ve tool attributes eklenebilir. OpenInference gibi semantic convention yaklaşımları entegrasyonu kolaylaştırabilir. Sensitive attributes export öncesi filtrelenmelidir. Vendor-neutral telemetry mimarisine katkı sağlar.
AI observability ile klasik log monitoring arasındaki fark nedir?
Klasik monitoring teknik health ve exception'lara ağırlık verir. AI observability buna model quality, retrieval, tool behavior ve user outcome boyutlarını ekler. HTTP success yeterli başarı ölçütü değildir. Semantic failure ayrıca değerlendirilir. Trace teknik ve kullanıcı deneyimi verisini birbirine bağlar.
AI etkileşim logları model geliştirmede nasıl kullanılır?
Production failure'lar eval dataset'e dönüştürülebilir. Low-score ve edge case interaction'lar regression test olarak saklanabilir. Intent cluster'ları modelin zayıf kullanım alanlarını gösterir. Prompt ve model version A/B test ile karşılaştırılır. Böylece production kullanım doğrudan model geliştirme döngüsünü besler.
AI sistemlerinde kullanıcı etkileşim logları nasıl analiz edilir?
Önce user, session, conversation, interaction ve trace seviyeleri ortak veri modeli içinde tanımlanmalıdır. Ardından intent, task completion, satisfaction, quality, latency ve cost metric'leri aynı event akışından üretilir. AI Sistemlerinde Kullanıcı Etkileşim Loglarının Analizi yapılırken yalnızca prompt-response çiftleri değil retrieval, tool, retry ve business outcome event'leri de değerlendirilmelidir. Semantic clustering binlerce conversation içindeki tekrar eden kullanım ve failure pattern'lerini görünür hale getirir. Privacy kontrolleri bütün pipeline'ın başlangıcında uygulanmalıdır.
Yapay zeka uygulamalarında hangi kullanıcı etkileşimleri ve metrikler loglanmalıdır?
Prompt event, AI response, feedback, user action, tool call, retrieval ve error event'leri temel kapsamı oluşturur. Aktif kullanıcı, task completion, abandonment ve retention product tarafında izlenebilir. LLM uygulamalarında loglama gözlemlenebilirlik ve performans metrikleri açısından P95 latency, token kullanımı, error ve retry oranları da gereklidir. AI quality için relevance, faithfulness ve correctness metric'leri eklenebilir. Her alanın gerçekten gerekli olup olmadığı data minimization yaklaşımıyla kontrol edilmelidir.
Kullanıcı etkileşim logları model performansını, yanıt kalitesini ve kullanıcı deneyimini iyileştirmek için nasıl kullanılır?
Negatif feedback ve frustration sinyalleri problemli conversation'ları otomatik seçmek için kullanılabilir. Trace üzerinden sorun model, retrieval, prompt, tool veya UX katmanına ayrılır. Representative örnekler golden eval dataset'e eklenir ve fix öncesi-sonrası karşılaştırılır. Product ekipleri intent ve drop-off analizinden kullanıcı akışı sorunlarını bulabilir. Böylece log sistemi yalnızca gözlem aracı değil sürekli iyileştirme mekanizmasına dönüşür.
AI sistemlerinde kullanıcı logları analiz edilirken KVKK, veri gizliliği ve anonimleştirme nasıl sağlanmalıdır?
Raw prompt ve response varsayılan olarak hassas veri taşıyabilecek alanlar kabul edilmelidir. PII detection ve redaction mümkün olduğunca event ingestion aşamasında uygulanmalıdır. User identity pseudonymous ID ile temsil edilebilir ve erişim role-based kontrol edilmelidir. Retention süreleri veri türüne göre sınırlandırılmalı, kullanıcı silme talepleri derived dataset'lere de yansıtılmalıdır. Ham prompt gerekmeyen analizlerde intent-only veya aggregated analytics daha güvenli seçenek sunar.
AI kullanıcı etkileşim loglarının analizi ve gözlemlenebilirlik (observability) çözümleri konusunda yakınımda danışmanlık nerede bulabilirim?
Yapay zeka log analizi ve LLM danışmanlığı yakınımda araması yapıyorsanız observability konusunu yalnızca log altyapısı olarak değil product analytics, AI quality ve privacy birlikte ele alan ekiplerle çalışmak önemlidir. Diyarbakır'da yazılım, veri ve yapay zeka projeleriyle ilgilenenler https://www.diyarbakiryazilim.com.tr üzerinden Diyarbakır Yazılım Topluluğu'na ulaşabilir. Topluluğun proje çalışmalarına https://www.diyarbakiryazilim.com.tr/projects adresinden bakabilirsiniz. Kurumsal AI log analizi ve LLM observability hizmeti planlanırken event schema, privacy, trace yapısı, quality eval ve business KPI'lar birlikte tasarlanmalıdır. Böylece observability sistemi sadece hata olduğunda açılan bir ekran değil ürün geliştirme sürecinin sürekli çalışan veri katmanı haline gelir.
Sonuç
AI Sistemlerinde Kullanıcı Etkileşim Loglarının Analizi, modelin cevap verip vermediğini kontrol etmekten çok daha geniş bir mühendislik ve ürün disiplinidir. Güvenilir sistem user journey, trace, model quality, tool davranışı, maliyet, task completion ve privacy verilerini ortak bir event modeli altında birleştirir. Pratikte önerdiğim yaklaşım önce minimum event taxonomy ve trace yapısını kurmak, ardından intent, eval, clustering ve automated feedback loop katmanlarını ölçülen ihtiyaca göre eklemektir. Veri madenciliği ve Python tabanlı analiz süreçlerini farklı bir açıdan incelemek için https://www.diyarbakiryazilim.com.tr/posts/veri-madenciligi-data-mining-sureclerinde-python-kutuphaneleri içeriğine de göz atabilirsiniz. AI observability, veri analizi ve ortak yazılım projeleri hakkında bilgi almak için https://www.diyarbakiryazilim.com.tr/about ve https://www.diyarbakiryazilim.com.tr adresleri üzerinden Diyarbakır Yazılım Topluluğu'na ulaşabilirsiniz.
share: