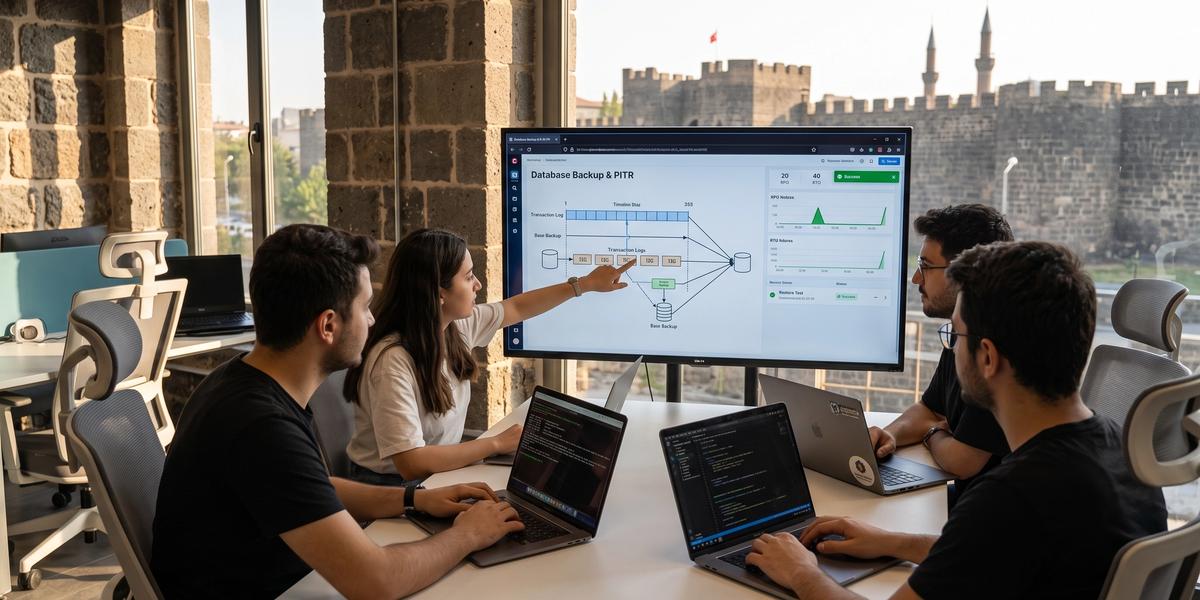
Veritabanı Yedekleme ve Restorasyon Otomasyonları

Diyarbakır Yazılım
16.08.2026
#Yazılım#Teknoloji#Topluluk
Bir veritabanının gerçekten güvende olup olmadığını, yedekleme görevinin ekranda yeşil görünmesi belirlemez. Asıl ölçüt, ihtiyaç anında doğru veriyi istenen zamana geri döndürebilmek ve bunu kabul edilebilir bir sürede yapabilmektir. Bu nedenle Veritabanı Yedekleme ve Restorasyon Otomasyonları yalnızca günlük dump dosyaları üretmekten ibaret görülmemelidir. Sağlam bir yaklaşım; yedek oluşturma, şifreleme, farklı konuma taşıma, saklama, bütünlük kontrolü, restore testi, izleme ve felaket kurtarma adımlarını tek bir süreç olarak ele alır. Bu rehberde veritabanı yedekleme ve geri yükleme nasıl otomatikleştirilir sorusundan PostgreSQL, MySQL, SQL Server, MongoDB, Oracle, bulut servisleri, PITR, immutable backup ve düzenli recovery testlerine kadar geniş bir uygulama çerçevesi bulacaksınız.
Veritabanı Yedekleme Nedir?
Veritabanı yedekleme, veri kaybı veya hizmet kesintisi durumunda kullanılabilecek güvenilir bir veri kopyası oluşturma işlemidir. Bu kopya yalnızca tabloları değil, ihtiyaca göre şema bilgilerini, transaction kayıtlarını, kullanıcı tanımlarını, prosedürleri ve sistem metadata'sını da içerebilir. İyi bir backup stratejisi, verinin nereye yazıldığını, ne kadar süre saklanacağını ve hangi yöntemle geri getirileceğini baştan tanımlar. İşin en önemli tarafı, yedeğin üretildiği gün değil restore edilmesi gereken gündür. Bu yüzden backup tasarımı her zaman recovery hedeflerinden geriye doğru kurulmalıdır.
Database Backup Neden Gereklidir?
Database backup, beklenmedik bir olaydan sonra veriyi yeniden kullanılabilir hale getirebilmek için gereklidir. Donanım arızası, yanlış sorgu, uygulama hatası veya güvenlik olayı birkaç saniye içinde kritik kayıtların kaybolmasına yol açabilir. Replikasyon bu riski tek başına ortadan kaldırmaz çünkü mantıksal hatalar çoğu zaman replica sistemlere de taşınır. Yedek, geçmişteki güvenilir bir duruma dönebilmek için bağımsız bir recovery noktası sağlar. Bu nedenle veritabanı operasyonlarının temel hedeflerinden biri, yalnızca veri üretmek değil geri dönüş kapasitesini sürekli korumaktır.
Veri Kaybına Neden Olan Başlıca Senaryolar
Veri kaybı her zaman disk bozulmasıyla başlamaz ve çoğu gerçek olay daha sıradan nedenlerden çıkar. Yanlış çalışan bir deployment, hatalı bir SQL komutu veya eksik test edilmiş migration dakikalar içinde geniş bir veri kümesini etkileyebilir. Güvenlik olaylarında ise saldırgan, üretim verisinin yanında ulaşabildiği backup dosyalarını da silebilir veya şifreleyebilir. Bu nedenle risk analizi sadece teknik altyapıyı değil insan hatasını, erişim yetkilerini ve operasyon süreçlerini de kapsamalıdır. Her risk tipi için hangi recovery noktasına dönüleceği önceden belirlenirse kriz anındaki karar süresi belirgin biçimde azalır.
Donanım Arızası
Disk, storage controller, sunucu veya veri merkezi altyapısındaki fiziksel arızalar veritabanının erişilemez hale gelmesine neden olabilir. RAID veya replikasyon bazı donanım sorunlarının etkisini azaltır fakat bunlar geçmiş veri sürümlerini koruyan bir backup yerine geçmez. Özellikle birden fazla bileşenin aynı anda başarısız olduğu durumlarda bağımsız ve farklı lokasyondaki yedekler önem kazanır. Kurtarma tasarımında arızalı sunucuya erişmeden yeni altyapı oluşturulabilmesi hedeflenmelidir. Bu yaklaşım, tek bir fiziksel bileşene bağımlılığı azaltır ve gerçek disaster recovery kapasitesi oluşturur.
Kullanıcı Hatası
Yanlış DELETE, UPDATE veya DROP komutu veritabanı kaybının en sık görülen nedenlerinden biridir. Yetkili bir kullanıcının yaptığı hata teknik olarak geçerli bir işlem olduğu için veritabanı motoru bunu normal biçimde uygular. Replikasyon varsa aynı komut kısa süre içinde replica sistemlere de aktarılabilir. Bu senaryoda belirli bir zamana dönüş sağlayan PITR veya olaydan önce alınmış doğrulanmış bir backup gerekir. Yetki sınırlandırması, sorgu onayı ve restore testi birlikte kullanıldığında kullanıcı hatasının etkisi ciddi biçimde azaltılabilir.
Yazılım Hatası
Uygulamadaki bir bug, verileri yanlış formatta güncelleyebilir veya beklenmeyen toplu değişiklikler yapabilir. Bu tür hatalar çoğu zaman veritabanı açısından geçerli transaction'lar olduğu için doğrudan algılanmaz. Sorun saatler sonra fark edilirse yalnızca son backup'a dönmek kabul edilemez miktarda veri kaybı yaratabilir. Transaction log, WAL veya binlog tabanlı recovery seçenekleri burada büyük değer sağlar. Uygulama gözlemlenebilirliği ile backup izleme sistemlerinin birlikte çalışması, olayın başlangıç zamanını daha doğru belirlemeye yardımcı olur.
Veri Bozulması
Veri bozulması disk, dosya sistemi, bellek, yazılım hatası veya kontrol dışı yazma işlemleri nedeniyle oluşabilir. Sorunun en zor tarafı, bozulmanın hemen fark edilmeyip backup dosyalarına da taşınabilmesidir. Bu nedenle yalnızca en yeni backup'ı korumak yerine birden fazla tarihsel recovery noktası saklamak gerekir. Checksum kontrolleri ve düzenli restore testleri erken uyarı sağlayabilir. Veri doğrulama adımlarında yalnızca dosyanın açılması değil tablo, ilişki ve iş mantığı seviyesinde kontroller de yapılmalıdır.
Ransomware
Ransomware olaylarında saldırgan yalnızca aktif veriyi değil erişebildiği backup alanlarını da hedefleyebilir. Backup sunucusu üretim sistemiyle aynı kimlik bilgilerini kullanıyorsa saldırının etkisi genişler. Immutable depolama, ayrı hesaplar, ayrı erişim anahtarları ve off-site kopyalar bu riski azaltır. Backup silme yetkisinin günlük operasyon hesaplarından ayrılması da önemli bir güvenlik katmanıdır. Kurtarma tatbikatları, saldırı sonrasında hangi kopyanın güvenilir olduğunu hızlı biçimde belirleyebilmek için düzenli olarak yapılmalıdır.
Yanlış Deployment
Deployment sırasında çalışan migration veya veri dönüşüm kodu üretim verisini beklenmedik biçimde değiştirebilir. Bu yüzden kritik deployment işlemlerinden önce kontrollü bir recovery point oluşturmak faydalıdır. Backup kimliği ile deployment veya migration kimliği eşleştirildiğinde olay sonrası analiz kolaylaşır. Sorun oluştuğunda forward fix mi yoksa restore mu yapılacağı RTO, veri kaybı ve değişikliğin kapsamına göre değerlendirilmelidir. CI/CD sürecine otomatik backup ve validation adımları eklemek bu kararları daha güvenli hale getirir.
Backup ile Restore Arasındaki Fark
Backup, kullanılabilir bir veri kopyası oluşturma işlemidir; restore ise bu kopyayı çalışır bir veritabanına dönüştürme sürecidir. Başarılı backup görevi, başarılı restore garantisi vermez. Dosyanın eksiksiz olması, kullanılan aracın sürümü, şifreleme anahtarının erişilebilirliği ve gerekli transaction kayıtlarının korunması restore sonucunu doğrudan etkiler. Bu nedenle operasyon ekipleri backup success rate kadar restore success rate değerini de takip etmelidir. Düzenli otomatik restore testleri, backup stratejisinin gerçekten çalışıp çalışmadığını gösterecek en güvenilir yöntemlerden biridir.
Backup ile Archive Arasındaki Fark
Backup'ın temel amacı bir arıza veya hata sonrasında sistemi geri döndürmektir. Archive ise genellikle uzun süreli saklama, mevzuat, geçmiş kayıt veya nadiren erişilen verilerin korunması amacıyla kullanılır. Backup daha kısa recovery sürelerine göre tasarlanırken archive maliyet ve uzun dönem saklama hedeflerine göre optimize edilir. Aynı dosyanın uzun süre tutulması onu otomatik olarak iyi bir archive stratejisine dönüştürmez. Erişim süresi, format sürdürülebilirliği, şifreleme anahtarları ve saklama politikaları iki kullanım biçiminde ayrı ayrı değerlendirilmelidir.
Backup, Replication ve High Availability Arasındaki Fark
Backup, replication ve high availability aynı problemi çözmez. Backup geçmişteki güvenilir bir noktaya dönüş sağlar, replication veriyi başka bir node'a taşır, high availability ise servis kesintisini azaltmayı hedefler. Sağlam altyapılarda bu üç yaklaşım birbirinin alternatifi değil tamamlayıcısıdır. Örneğin replica sunucu donanım arızasında hızlı failover sağlayabilir fakat yanlış DELETE işlemini geri alamaz. Bu yüzden mimari tasarım yapılırken veri kaybı ve servis kesintisi ayrı riskler olarak ele alınmalıdır.
Database Replication Nedir?
Database replication, veritabanındaki değişikliklerin başka bir veritabanı örneğine aktarılmasıdır. Replication senkron veya asenkron biçimde kurulabilir ve okuma ölçeklendirmesi, yüksek erişilebilirlik veya coğrafi yedeklilik amacıyla kullanılabilir. Replica çoğu zaman primary üzerindeki transaction'ları çok kısa gecikmeyle uygular. Bu özellik donanım arızasına karşı güçlüdür fakat mantıksal hatalara karşı tek başına koruma sağlamaz. Replication tasarlanırken lag, failover davranışı ve veri tutarlılığı düzenli olarak ölçülmelidir.
High Availability Nedir?
High availability, bir bileşen başarısız olduğunda uygulamanın hizmet vermeye devam edebilmesini amaçlayan mimari yaklaşımdır. Bu yapı genellikle birden fazla database node'u, otomatik failover, health check ve yönlendirme bileşenleri içerir. HA tasarımının temel metriği hizmet kesintisinin ne kadar kısa tutulabildiğidir. Ancak hızlı failover, geçmiş veriye geri dönme ihtiyacını ortadan kaldırmaz. Bu nedenle HA sistemi yanında bağımsız backup ve recovery süreçleri bulunmalıdır.
Replica Neden Backup Değildir?
Replica, primary üzerindeki değişiklikleri takip ettiği için yanlış işlemleri de çoğu durumda aynen uygular. Bir tablo silinirse veya kayıtlar yanlış güncellenirse değişiklik replica üzerinde de görülebilir. Backup ise belirli bir zaman noktasındaki veri durumunu bağımsız biçimde koruyabilir. Ayrıca immutable veya off-site backup, production erişiminden ayrı güvenlik sınırları oluşturabilir. Bu fark nedeniyle replica altyapısı güçlü olsa bile düzenli backup gereksinimi devam eder.
Yanlış DELETE İşleminin Replica'ya Yayılması
Bir kullanıcı yanlışlıkla geniş kapsamlı DELETE çalıştırdığında transaction primary üzerinde commit edilir. Replication sistemi bu transaction'ı normal bir değişiklik olarak replica node'lara iletir. Replica gecikmesi çok düşükse hatayı fark edip replication'ı durdurmak için yalnızca saniyeler olabilir. Bu durumda timestamp tabanlı PITR veya hatadan önceki recovery noktası daha güvenilir bir çözümdür. Olay müdahale prosedürlerinde yanlış veri değişiklikleri için açık recovery adımları tanımlanmalıdır.
Backup + HA Birlikte Nasıl Tasarlanır?
HA katmanı kısa süreli kesintileri azaltırken backup katmanı tarihsel geri dönüş kapasitesi sağlar. Primary ve replica node'ları aynı hata alanında bulunuyorsa bölgesel felaketlere karşı ek koruma gerekir. Bu nedenle backup kopyalarının farklı storage, hesap veya region üzerinde tutulması tercih edilmelidir. HA failover testleri ve backup restore testleri ayrı ayrı planlanmalıdır. En güçlü tasarım, servis devamlılığını ve veri geri kazanımını birbirinden bağımsız olarak doğrulayabilen tasarımdır.
Snapshot ile Database Backup Arasındaki Fark
Snapshot, storage seviyesinde hızlı bir veri görüntüsü oluştururken database backup veritabanı motorunun mantığını dikkate alabilir. Snapshot çok hızlı üretilebilir ve büyük disklerde avantaj sağlayabilir. Ancak veritabanı buffer'larında veya transaction sisteminde bulunan işlemler dikkate alınmadığında tutarlılık sorunu çıkabilir. Database-aware yöntemler transaction sınırlarını, log kayıtlarını ve recovery mekanizmalarını daha iyi yönetir. Bu nedenle snapshot seçimi yapılırken yalnızca oluşturma süresine değil restore davranışına da bakılmalıdır.
Storage Snapshot Nedir?
Storage snapshot, disk veya volume'un belirli bir zamandaki blok görünümünü kaydeden bir storage özelliğidir. Çoğu sistem snapshot oluştururken tüm veriyi yeniden kopyalamak yerine değişen blokları izler. Bu nedenle snapshot üretimi hızlı ve depolama açısından verimli olabilir. Fakat veritabanının iç durumunu bilmeyen storage katmanı transaction tutarlılığını tek başına garanti edemez. Snapshot öncesi ve sonrası database işlemlerinin nasıl yönetileceği açık biçimde tasarlanmalıdır.
Database-Aware Backup Nedir?
Database-aware backup, veritabanı motorunun desteklediği yöntemlerle tutarlı recovery verisi oluşturur. Bu yaklaşım transaction log, WAL, binlog, checkpoint ve metadata gibi database bileşenlerini dikkate alır. Böylece restore sırasında veritabanının kendi recovery mekanizması güvenli biçimde kullanılabilir. Büyük sistemlerde physical backup, küçük veya taşınabilir veri setlerinde logical backup tercih edilebilir. Araç seçimi yapılırken RPO, RTO ve veri büyüklüğü birlikte değerlendirilmelidir.
Crash-Consistent Snapshot
Crash-consistent snapshot, sistem elektrik kesintisine uğramış gibi disk üzerindeki mevcut blok durumunu yakalar. Bellekte henüz diske yazılmamış veriler snapshot içinde bulunmayabilir. Modern veritabanları açılış sırasında transaction log kullanarak bu durumu belli ölçüde toparlayabilir. Yine de snapshot'ın her koşulda kullanılabilir olduğu varsayılmamalıdır. Restore testi yapılarak veritabanının recovery davranışı gerçek ortamda doğrulanmalıdır.
Application-Consistent Snapshot
Application-consistent snapshot oluşturulurken uygulama veya veritabanı kontrollü bir tutarlı noktaya getirilir. Gerekirse yazma işlemleri kısa süreli durdurulur, buffer'lar diske aktarılır veya veritabanının snapshot entegrasyonu kullanılır. Bu yöntem crash-consistent snapshot'a göre daha öngörülebilir recovery sağlayabilir. Otomasyon pipeline'ı snapshot öncesi hazırlık ve snapshot sonrası normal çalışma adımlarını kapsamalıdır. Başarılı snapshot oluşturma işlemi de düzenli restore testiyle doğrulanmalıdır.
Snapshot Tek Başına Yeterli midir?
Snapshot tek başına bütün backup gereksinimlerini karşılamayabilir. Snapshot'lar çoğu zaman aynı storage altyapısına bağlıdır ve storage hesabı kaybedildiğinde birlikte erişilemez hale gelebilir. Uzun dönem saklama, farklı region, immutable koruma ve object-level restore gibi ihtiyaçlar ek mekanizmalar gerektirir. İyi tasarım snapshot hızını database-native backup güvenilirliğiyle birleştirebilir. Bu nedenle snapshot, backup stratejisinin tek bileşeni değil kontrollü bir parçası olarak düşünülmelidir.
Veritabanı Backup Türleri
Backup türü seçimi veri büyüklüğü, recovery hedefi, storage maliyeti ve operasyon kapasitesine göre yapılır. Full backup her şeyi tek noktada toplarken incremental yaklaşım yalnızca değişiklikleri saklayarak süre ve alan tasarrufu sağlayabilir. Logical ve physical yöntemler restore esnekliği açısından farklı özellikler sunar. Hot, warm ve cold backup ise veritabanının çalışma durumuyla ilgilidir. Database backup otomasyonunda full incremental ve point-in-time recovery yöntemleri birlikte değerlendirildiğinde hem hızlı hem esnek bir recovery mimarisi kurulabilir.
Full Backup
Full backup, belirlenen veri kümesinin tamamını tek bir backup seti içinde korur. Restore süreci genellikle daha kolay anlaşılır çünkü temel veri tek bir ana kopyada bulunur. Buna karşılık büyük veritabanlarında oluşturma süresi ve storage tüketimi yüksek olabilir. Haftalık full backup ile günlük veya saatlik incremental backup birlikte kullanılabilir. Full backup'ın düzenli olarak restore edilmesi, sonraki zincirlerin güvenilirliği için önemli bir kontrol sağlar.
Incremental Backup
Incremental backup, önceki backup'tan sonra değişen verileri saklar. Böylece günlük backup boyutu ve aktarım süresi düşürülebilir. Restore sırasında ise full backup ile gerekli incremental zincirinin doğru sırada uygulanması gerekir. Zincirin bir parçası eksik olduğunda recovery başarısız olabilir. Bu nedenle catalog, checksum ve retention yönetimi incremental tasarımda özel önem taşır.
Differential Backup
Differential backup, son full backup'tan sonra değişen verilerin tamamını içerir. Her yeni differential backup önceki differential dosyasına bağımlı olmak yerine aynı full backup'a dayanır. Bu özellik restore zincirini incremental modele göre kısaltabilir. Ancak full backup'tan zaman geçtikçe differential dosyasının boyutu büyür. Schedule tasarlanırken restore hızı ve storage maliyeti arasında uygun denge kurulmalıdır.
Synthetic Full Backup
Synthetic full backup, mevcut full ve incremental veriler birleştirilerek yeni bir full backup oluşturulması yaklaşımıdır. Bu işlem üretim veritabanından tekrar tüm veriyi okumadan gerçekleştirilebilir. Ağ ve kaynak kullanımını azaltması özellikle uzak storage ortamlarında fayda sağlayabilir. Ancak kullanılan backup aracının catalog ve bütünlük yönetimi güvenilir olmalıdır. Synthetic full dosyasının restore testi yapılmadan sağlam olduğu kabul edilmemelidir.
Logical Backup
Logical backup verileri SQL ifadeleri, tablo kayıtları veya veritabanının mantıksal nesneleri üzerinden dışa aktarır. PostgreSQL için pg_dump ve MySQL için dump araçları bu yaklaşımın yaygın örnekleridir. Logical backup farklı sürümlere veya farklı ortamlara taşıma açısından esnek olabilir. Büyük veri hacimlerinde backup ve restore süreleri belirgin biçimde uzayabilir. Bu nedenle logical yöntem, veri büyüklüğü ve recovery hedefi göz önüne alınarak seçilmelidir.
Physical Backup
Physical backup veritabanının veri dosyalarını veya blok seviyesindeki fiziksel yapısını korur. Büyük veritabanlarında logical dump yöntemlerine göre daha hızlı backup ve restore sağlayabilir. Ancak motor sürümü, dosya formatı ve platform uyumluluğu gibi bağımlılıklar daha güçlü olabilir. PITR tasarımlarında physical base backup ve transaction log kombinasyonu sık kullanılır. Restore prosedürü gerçek boyuta yakın test verisiyle ölçülmelidir.
Hot Backup
Hot backup veritabanı aktif biçimde hizmet verirken alınan backup'tır. Kullanıcı ve uygulama işlemleri devam ettiği için transaction tutarlılığı backup aracının mekanizmalarıyla korunur. Kesintinin kabul edilemediği sistemlerde hot backup önemli avantaj sağlar. Buna karşılık CPU, I/O veya network üzerinde ek yük oluşabilir. Backup penceresi ve kaynak sınırları production performansını bozmayacak biçimde ayarlanmalıdır.
Warm Backup
Warm backup sırasında veritabanı sınırlı biçimde çalışmaya devam edebilir veya bazı yazma işlemleri geçici olarak kısıtlanabilir. Bu yaklaşım hot ve cold backup arasında bir denge sunar. Sistemin kullanım biçimine göre kısa süreli bakım pencerelerinde uygulanabilir. Recovery tutarlılığı için hangi işlemlerin durdurulduğu açıkça belgelenmelidir. Otomasyon akışı bakım moduna geçiş ve normal çalışma adımlarını güvenli biçimde yönetmelidir.
Cold Backup
Cold backup, veritabanı tamamen durdurulduktan sonra alınan fiziksel kopyadır. Yazma işlemi olmadığı için dosya tutarlılığı daha kolay sağlanabilir. Buna karşılık backup süresi boyunca servis kesintisi gerekir. Yüksek erişilebilirlik gerektiren sistemlerde bu nedenle genellikle uygun değildir. Küçük, düşük kritikliğe sahip veya bakım penceresi geniş sistemlerde uygulanabilir bir seçenek olabilir.
Logical Backup ve Physical Backup Arasındaki Fark
Logical ve physical backup arasındaki temel fark, verinin hangi seviyede kopyalandığıdır. Logical yöntem nesneleri ve kayıtları veritabanı mantığıyla dışa aktarırken physical yöntem veri dosyalarını veya blokları korur. Logical backup taşınabilirlik ve seçici restore açısından güçlüdür. Physical backup ise özellikle büyük veritabanlarında recovery süresini azaltabilir. En iyi tasarım çoğu zaman tek yönteme bağlı kalmak yerine iş gereksinimine göre iki yöntemi birlikte kullanır.
Logical Backup Avantajları
Logical backup insan tarafından anlaşılabilir veya veritabanı araçlarıyla seçici biçimde işlenebilir veri üretir. Belirli tablo, şema veya nesneleri ayrı ayrı restore etmek mümkün olabilir. Farklı ortamlara veri taşıma ve geliştirme ortamı üretme süreçlerinde esneklik sağlar. Küçük ve orta ölçekli veritabanlarında yönetimi oldukça pratiktir. Yine de büyük sistemlerde restore süresinin düzenli olarak ölçülmesi gerekir.
Taşınabilirlik
Logical backup çoğu zaman fiziksel dosya formatına göre daha taşınabilir bir yapı sunar. Farklı sunuculara, yeni cluster'lara veya bazı sürüm geçişlerine veri aktarmak kolaylaşabilir. Bu özellik migration projelerinde değerli olabilir. Taşınabilirlik yine de veri türleri, uzantılar ve sürüm uyumluluğu açısından test edilmelidir. Gerçek geçişten önce izole bir ortamda restore denemesi yapılmalıdır.
Object-Level Restore
Object-level restore yalnızca ihtiyaç duyulan tablo, şema veya nesnenin geri yüklenmesini sağlar. Bu özellik tek bir tablonun yanlışlıkla silindiği durumlarda tüm veritabanını restore etme ihtiyacını azaltabilir. Custom format gibi desteklenen backup biçimleri seçici restore için ek esneklik sunar. Ancak ilişkili nesneler ve foreign key bağlantıları gözden geçirilmelidir. Seçici restore sonrasında uygulama seviyesinde veri tutarlılığı kontrol edilmelidir.
Logical Backup Dezavantajları
Logical backup veriyi satır veya nesne seviyesinde işlediği için büyük veritabanlarında yavaşlayabilir. Backup sırasında CPU tüketimi artabilir ve restore işlemi uzun sürebilir. Index oluşturma, constraint uygulama ve veri yükleme aşamaları özellikle büyük veri hacminde RTO'yu etkiler. Tek dosyalı formatlar paralel işlem kapasitesini sınırlayabilir. Bu nedenle büyük sistemlerde format ve paralellik seçenekleri dikkatle seçilmelidir.
Büyük Veritabanlarında Restore Süresi
Terabayt ölçeğindeki veritabanlarında logical restore saatler veya daha uzun sürebilir. Verinin okunması kadar yazılması, index oluşturulması ve constraint kontrolleri de süreye eklenir. Backup dosyasının sıkıştırılmış olması network avantajı sağlasa da restore sırasında decompression CPU tüketebilir. Paralel restore destekleyen formatlar bu süreyi azaltabilir. Gerçek RTO ancak production'a yakın altyapıda yapılan benchmark ile ölçülebilir.
Physical Backup Avantajları
Physical backup büyük veri hacimlerinde daha hızlı recovery sağlayabilir. Veri satır satır yeniden oluşturulmadığı için disk seviyesindeki aktarım daha verimli olabilir. Transaction log zinciriyle birlikte kullanıldığında PITR için güçlü bir temel oluşturur. Büyük production sistemlerinde RTO hedefini karşılamak için sık tercih edilir. Bununla birlikte sürüm ve platform bağımlılıkları restore planına dahil edilmelidir.
Daha Hızlı Büyük Ölçekli Recovery
Physical restore sırasında hazır veri dosyalarının geri yerleştirilmesi logical import işlemlerine göre daha hızlı olabilir. Özellikle indexlerin yeniden hesaplanmasının gerekmediği yöntemlerde önemli zaman kazanılır. Network ve storage throughput burada kritik performans faktörleridir. Paralel aktarım ve hızlı storage kullanımı recovery süresini daha da azaltabilir. Yine de tahmini süre yerine düzenli ölçülen gerçek restore süresi kullanılmalıdır.
Physical Backup Dezavantajları
Physical backup genellikle veritabanı motorunun sürümüne ve fiziksel dosya yapısına daha bağımlıdır. Başka bir major sürüme doğrudan restore her zaman mümkün olmayabilir. Tek tablo restore gibi seçici recovery işlemleri logical yönteme göre daha zor olabilir. Backup setinin transaction log zinciriyle doğru eşleşmesi gerekir. Bu nedenle catalog yönetimi ve sürüm uyumluluğu operasyon prosedürlerinde açıkça tutulmalıdır.
Hangi Senaryoda Hangisi Kullanılmalı?
Küçük ve orta ölçekli sistemlerde taşınabilirlik gerekiyorsa logical backup iyi bir başlangıç olabilir. Büyük veritabanlarında kısa RTO hedefi varsa physical backup daha uygun olabilir. Tek bir tabloyu sık restore etme ihtiyacı olan yapılarda logical yedek ek avantaj sağlar. PITR gereksinimi olan production sistemlerinde physical base backup ile transaction log yaklaşımı güçlü bir seçenektir. Birçok kurum, farklı hata senaryolarını kapsamak için iki yöntemi birlikte kullanır.
RPO ve RTO Nedir?
RPO ve RTO, backup tasarımının teknik tercihlerden önce belirlenmesi gereken iki temel hedefidir. RPO kabul edilebilir veri kaybı aralığını, RTO ise hizmetin ne kadar sürede geri dönmesi gerektiğini ifade eder. Örneğin RPO 15 dakika ise recovery noktasının olaydan en fazla 15 dakika geride olması beklenir. RTO 60 dakika ise veritabanı ve bağlı sistemlerin bir saat içinde kullanılabilir hale gelmesi hedeflenir. Backup sıklığı, log arşivleme, storage ve otomasyon kararları bu hedeflere göre verilmelidir.
Recovery Point Objective (RPO)
Recovery Point Objective, olay sonrasında kabul edilebilecek maksimum veri kaybı aralığıdır. RPO bir saat ise son geçerli recovery noktası olaydan en fazla bir saat önce olmalıdır. Sadece günlük full backup kullanan bir sistem bu hedefi karşılayamayabilir. WAL, binlog veya transaction log arşivleme daha düşük RPO değerleri sağlar. RPO iş birimleriyle birlikte belirlenmeli ve teknik olarak düzenli ölçülmelidir.
Recovery Time Objective (RTO)
Recovery Time Objective, hizmetin kabul edilebilir seviyede yeniden çalışması için hedeflenen süredir. Backup dosyasını indirmek, altyapı oluşturmak, restore yapmak ve doğrulama çalıştırmak bu sürenin içindedir. Bu nedenle yalnızca database restore komutunun çalışma süresi RTO olarak kabul edilmemelidir. Otomasyon manuel beklemeleri azaltarak gerçek recovery süresini kısaltabilir. Düzenli tatbikatlar hedef ile gerçek süre arasındaki farkı ortaya çıkarır.
Maximum Tolerable Downtime
Maximum Tolerable Downtime, işletmenin bir hizmet kesintisine en fazla ne kadar süre dayanabileceğini ifade eder. Bu değer RTO için üst sınır belirlenirken önemli bir iş girdisidir. Finansal zarar, müşteri etkisi, operasyon kaybı ve mevzuat yükümlülükleri değerlendirilmelidir. Her veritabanının aynı toleransa sahip olduğu varsayılmamalıdır. Kritik sistemlere daha hızlı recovery altyapısı ayrılırken düşük kritik sistemlerde maliyet optimizasyonu yapılabilir.
Work Recovery Time
Work Recovery Time, teknik sistem geri geldikten sonra iş süreçlerinin normal düzene dönmesi için gereken ek süreyi ifade eder. Veritabanının açılması her zaman kullanıcıların hemen çalışmaya başlayacağı anlamına gelmez. Veri doğrulama, uygulama kontrolü, kuyrukların işlenmesi ve manuel operasyonlar ek zaman yaratabilir. Bu süre disaster recovery planına dahil edilmezse gerçek iş kaybı yanlış hesaplanabilir. Recovery tatbikatlarında teknik ve operasyonel süreler ayrı ayrı ölçülmelidir.
Gerçek Recovery Süresi Nasıl Ölçülür?
Gerçek recovery süresi olay başlangıcından hizmetin doğrulanmış biçimde açılmasına kadar geçen toplam süreyle ölçülmelidir. Backup seçimi, indirme, altyapı hazırlama, restore, validation ve trafik yönlendirme adımları ayrı metrikler olarak kaydedilebilir. Böylece hangi aşamanın darboğaz olduğu net biçimde görülür. P50 ve P95 restore süreleri farklı veri büyüklüklerinde karşılaştırılabilir. Ölçüm sonuçları RTO hedefleriyle düzenli olarak karşılaştırılmalıdır.
İş Kritikliğine Göre RPO/RTO Belirleme
Her veritabanına aynı RPO ve RTO değerini vermek gereksiz maliyet oluşturabilir. Gelir üreten, müşteri işlemi taşıyan veya kritik operasyon yöneten sistemlere daha sık recovery point ve hızlı restore kapasitesi ayrılabilir. Raporlama veya arşiv amaçlı sistemlerde daha geniş hedefler kabul edilebilir. Envanterde her veritabanının sahibi, kritiklik seviyesi ve bağımlılıkları kayıt altına alınmalıdır. Bu sınıflandırma backup schedule ve storage politikasını doğrudan yönlendirmelidir.
Backup Sıklığı Nasıl Belirlenir?
Backup sıklığı tahminle değil kabul edilebilir veri kaybı hedefiyle belirlenmelidir. Yüksek işlem hacimli bir sistemde günlük backup çoğu zaman yeterli değildir. Düşük RPO hedeflerinde sürekli log arşivleme veya daha sık incremental backup gerekir. Backup işleminin production performansına etkisi de schedule hazırlanırken ölçülmelidir. İyi bir plan, recovery ihtiyacı ile sistem yükü arasında sürdürülebilir denge kurar.
Dakikalık Backup
Dakikalık backup veya log aktarımı çok düşük RPO isteyen sistemlerde kullanılabilir. Her dakika tam backup almak genellikle mantıklı değildir ve bunun yerine transaction log zinciri tercih edilir. Otomasyon yalnızca dosya üretimini değil gecikme ve başarısızlık kontrolünü de yapmalıdır. Storage üzerindeki dosya sayısı arttığı için lifecycle yönetimi önem kazanır. Restore prosedürü çok sayıda küçük recovery parçasıyla test edilmelidir.
Saatlik Backup
Saatlik backup birçok orta kritik sistem için pratik bir denge sunabilir. Incremental veya logical yöntemle uygulanarak storage yükü azaltılabilir. RPO hedefi bir saatten düşükse yalnızca saatlik backup yeterli değildir. Bu durumda transaction log veya continuous archiving ile aradaki boşluk kapatılabilir. Backup pencereleri gün içindeki yoğun transaction saatleri dikkate alınarak planlanmalıdır.
Günlük Backup
Günlük backup düşük değişim hızına sahip sistemlerde temel koruma sağlayabilir. Ancak 24 saate kadar veri kaybı kabul edilmiyorsa ek recovery mekanizmaları gerekir. Günlük backup çoğu zaman uzun süre saklanan haftalık veya aylık kopyaların temelini oluşturur. Dosya boyutu, duration ve başarı durumu günlük olarak izlenmelidir. Restore testi sadece aylık değil iş kritikliğine göre daha sık çalıştırılabilir.
Haftalık Full Backup
Haftalık full backup ile günlük incremental veya differential backup sık kullanılan bir modeldir. Bu yaklaşım full backup maliyetini sınırlarken recovery zincirini yönetilebilir tutabilir. Haftalık full dosyanın bozulması sonraki backup zincirini etkileyebileceği için checksum kontrolü önemlidir. En az bir off-site kopya tutulması ek güvenlik sağlar. Haftalık döngü, iş yoğunluğu düşük zaman dilimine göre schedule edilmelidir.
İşlem Hacmine Göre Schedule
Backup schedule hazırlanırken transaction miktarı ve değişen veri hacmi göz önüne alınmalıdır. Gece düşük trafik olduğu varsayımı her sistem için doğru değildir. Global kullanıcı kitlesi olan uygulamalarda yoğunluk gün boyunca devam edebilir. Monitoring verileri kullanılarak CPU, I/O ve network açısından daha uygun zaman aralıkları seçilebilir. Birden fazla veritabanının backup işlemleri stagger edilerek kaynak çakışması azaltılabilir.
Backup Frequency ile RPO Arasındaki İlişki
Backup frequency doğrudan olmasa bile RPO üzerinde güçlü etkiye sahiptir. Günlük backup kullanan ve log arşivlemeyen sistemin pratik RPO değeri bir güne yaklaşabilir. Saatlik backup bu aralığı küçültür fakat düşük RPO gereksinimlerinde hâlâ yetersiz olabilir. Continuous log arşivleme birkaç dakikalık veya daha düşük veri kaybı hedeflerine yaklaşmayı sağlar. Gerçek RPO sadece schedule üzerinden değil son kullanılabilir recovery point'in yaşı üzerinden ölçülmelidir.
Point-in-Time Recovery (PITR) Nedir?
Point-in-Time Recovery, veritabanını yalnızca son backup'a değil seçilen belirli bir zamana geri döndürme yöntemidir. Sistem önce bir base backup'ı restore eder ve ardından transaction kayıtlarını hedef zamana kadar uygular. Yanlış DELETE, UPDATE, migration veya uygulama bug'ı gibi olaylarda bu yetenek kritik önem taşır. PITR tasarımının çalışması için base backup ile log zincirinin eksiksiz korunması gerekir. Düzenli restore testi olmadan PITR desteğinin gerçekten hazır olduğu varsayılmamalıdır.
Belirli Bir Zamana Geri Dönme Mantığı
PITR sırasında olayın gerçekleştiği zamandan hemen önceki güvenli nokta hedeflenir. Örneğin yanlış işlem 14:32:18'de yapıldıysa recovery target bu zamandan birkaç saniye önce seçilebilir. Timestamp tek başına yeterli değilse transaction veya log position kullanılabilir. Doğru hedefi belirlemek için uygulama logları ve database audit kayıtları değerlidir. Kurtarma sonunda kritik tablolar ve uygulama davranışı ayrıca doğrulanmalıdır.
Base Backup + Transaction Log Modeli
Base backup veritabanının başlangıç recovery görüntüsünü sağlar. Transaction log ise base backup sonrasında oluşan değişiklikleri sırayla temsil eder. Restore sırasında base kopya açılır ve log kayıtları hedef noktaya kadar uygulanır. Zincirde eksik dosya bulunması recovery işlemini durdurabilir. Bu nedenle log upload monitoring ve retention politikası base backup kadar önemlidir.
PITR Hangi Sorunları Çözer?
PITR özellikle mantıksal hatalarda güçlü bir recovery aracıdır. Kullanıcının yanlış sorgu çalıştırması, migration'ın beklenmeyen sonuç üretmesi veya uygulamanın verileri bozması gibi olaylarda kullanılabilir. Son full backup'a dönmek yerine olaydan saniyeler veya dakikalar önceki noktaya dönüş mümkün olabilir. Böylece kaybedilen doğru transaction miktarı azaltılır. Recovery hedefi seçildikten sonra doğrulama yapılmadan production trafiği açılmamalıdır.
Yanlış DELETE
Yanlış DELETE çoğu zaman veritabanı motoru tarafından normal transaction olarak işlenir. İşlem commit edildikten sonra rollback yapılamıyorsa PITR güvenli seçeneklerden biri olur. Recovery ortamı olaydan hemen önceki noktaya getirilebilir. Gerekiyorsa yalnızca kayıp kayıtlar buradan production sistemine taşınabilir. Bu yöntem tüm production sistemini geçmişe döndürmeden seçici veri kurtarma imkânı sağlayabilir.
Yanlış UPDATE
Yanlış UPDATE binlerce veya milyonlarca kaydı hatalı değere çevirebilir. Sorun hemen fark edilmezse sonraki doğru transaction'lar da aynı tabloları etkileyebilir. PITR ile hatadan önceki veri durumu ayrı bir ortamda oluşturulabilir. Eski ve yeni veriler karşılaştırılarak doğru kayıtlar seçilebilir. Recovery sonrasında uygulama seviyesinde hesap ve ilişki kontrolleri yapılmalıdır.
Hatalı Migration
Hatalı migration şema yapısını veya verileri geri döndürülmesi zor biçimde değiştirebilir. Migration öncesi recovery point oluşturmak bu riski önemli ölçüde azaltır. PITR, migration başlangıcının hemen öncesine dönüş seçeneği sağlar. Ancak migration sonrasında gerçekleşen yeni business transaction'ların kaybı ayrıca değerlendirilmelidir. Bu nedenle restore ile forward fix kararı olayın kapsamına göre verilmelidir.
Application Bug
Application bug yanlış kayıt oluşturabilir, verileri silebilir veya alanları hatalı biçimde güncelleyebilir. Hatanın başlangıç zamanını belirlemek için application logları ile database logları birlikte incelenebilir. PITR ortamı olay öncesine getirildiğinde doğru veri karşılaştırması yapılabilir. Sorunun kod tarafı düzeltilmeden production geri açılırsa hata tekrar edebilir. Recovery planında veri kurtarma ile uygulama düzeltmesi birlikte yönetilmelidir.
Recovery Target Nasıl Belirlenir?
Recovery target olayın başlamasından hemen önceki güvenli nokta olmalıdır. Bunun için audit log, deployment kaydı, kullanıcı aktivitesi ve application logları karşılaştırılabilir. Timestamp en kolay yöntemdir ancak saat senkronizasyonu hataları göz önünde bulundurulmalıdır. Bazı sistemlerde transaction ID veya log position daha kesin kontrol sağlar. Hedef nokta seçildikten sonra restore ortamında kritik işlemler doğrulanmalıdır.
Timestamp
Timestamp ile recovery belirli tarih ve saate kadar transaction'ların uygulanmasını sağlar. Tüm sistemlerin NTP ile senkron tutulması olay zamanının doğru belirlenmesini kolaylaştırır. Uygulama ve database saatleri farklıysa birkaç saniyelik hata bile yanlış recovery noktasına neden olabilir. Kritik olaylarda önce ayrı test restore yapılması faydalıdır. Timestamp seçimi log kayıtlarıyla desteklenmelidir.
Transaction / Log Position
Transaction veya log position, recovery hedefini belirli bir log konumuna kadar sınırlamayı sağlar. Bu yöntem timestamp belirsiz olduğunda daha kesin olabilir. MySQL binlog position veya benzeri log konumları buna örnek verilebilir. Doğru position değeri olay analizinden çıkarılmalıdır. Restore işlemi hedef transaction'ın uygulanmadığı doğrulanana kadar test ortamında kontrol edilmelidir.
PostgreSQL Backup Otomasyonu
PostgreSQL backup otomasyonu logical ve physical yöntemleri birlikte kullanabilecek esnekliğe sahiptir. Küçük veritabanlarında pg_dump yeterli olurken büyük sistemlerde pg_basebackup, WAL arşivleme veya özel backup araçları daha uygun olabilir. PostgreSQL MySQL veritabanı otomatik yedekleme scripti nasıl hazırlanır sorusuna verilecek doğru cevap yalnızca birkaç komut yazmak değildir. Script'in hata yönetimi, şifreleme, upload, retention, checksum, loglama ve restore doğrulamasını da kapsaması gerekir. Cron veya systemd timer ile schedule edilen görevler merkezi monitoring sistemi tarafından izlenmelidir.
pg_dump
pg_dump PostgreSQL için logical backup üretir ve tek veritabanı seviyesinde çalışır. Plain, custom ve directory format seçenekleri farklı restore ihtiyaçlarına göre kullanılabilir. Küçük ve orta ölçekli sistemlerde taşınabilir ve yönetilebilir bir çözüm sunar. Büyük veritabanlarında backup ve restore süresi dikkatle ölçülmelidir. Otomasyonda exit code, dosya boyutu ve checksum kontrolü zorunlu hale getirilmelidir.
Plain Format
Plain format genellikle SQL komutlarından oluşan okunabilir bir çıktı üretir. Dosya psql gibi araçlarla doğrudan çalıştırılabilir. Basitlik avantajına karşılık seçici ve paralel restore seçenekleri daha sınırlıdır. Çok büyük backup dosyalarında restore süresi uzayabilir. Bu format küçük veri kümeleri ve kolay taşınabilirlik gereken senaryolarda kullanışlıdır.
Custom Format
Custom format pg_restore ile esnek biçimde kullanılabilen bir backup çıktısıdır. Tablo veya şema gibi nesnelerin seçici restore edilmesine imkân sağlar. Sıkıştırma desteği storage ihtiyacını azaltabilir. Paralel restore özellikleri recovery süresini iyileştirebilir. Production kullanımında restore komutları önceden test edilerek runbook içine eklenmelidir.
Directory Format
Directory format backup verilerini bir dizin yapısı içinde ayrı parçalar halinde saklar. Paralel dump ve restore işlemleri için uygundur. Büyük veritabanlarında işlem süresini azaltmak amacıyla tercih edilebilir. Çok sayıda dosyanın off-site storage'a aktarılması için paketleme veya object storage stratejisi gerekebilir. Checksum ve manifest üretmek bütünlük kontrolünü kolaylaştırır.
pg_restore
pg_restore custom veya directory format gibi pg_dump çıktılarını geri yüklemek için kullanılır. Seçici restore, parallel restore ve nesne sırası kontrolü gibi seçenekler sunar. Restore öncesinde hedef veritabanı, roller ve gerekli extension'lar hazırlanmalıdır. Komutun başarılı dönmesi tek başına uygulama verisinin doğru olduğunu kanıtlamaz. Restore sonrasında schema, row count ve kritik sorgular mutlaka doğrulanmalıdır.
Parallel Restore
Parallel restore birden fazla nesnenin aynı anda yüklenmesini sağlayarak recovery süresini azaltabilir. CPU, disk IOPS ve storage throughput yeterliyse önemli performans artışı elde edilebilir. Çok yüksek paralellik ise kaynak doygunluğu nedeniyle ters etki yaratabilir. En uygun worker sayısı benchmark ile belirlenmelidir. P50 ve P95 restore süreleri düzenli testlerde takip edilmelidir.
pg_basebackup
pg_basebackup PostgreSQL cluster seviyesinde physical base backup oluşturmak için kullanılan yerleşik araçlardan biridir. WAL tabanlı PITR tasarımlarında başlangıç kopyası olarak değerlendirilebilir. Backup sırasında gerekli yetkiler ve replication bağlantısı doğru yapılandırılmalıdır. Büyük verilerde network throughput ve disk hızı backup süresini doğrudan etkiler. Oluşturulan base backup düzenli recovery testiyle doğrulanmalıdır.
Physical Backup
PostgreSQL physical backup veri dizisinin recovery için gerekli fiziksel yapısını korur. Büyük veritabanlarında logical dump'a göre daha kısa restore süreleri sağlayabilir. WAL arşivleriyle birlikte kullanıldığında PITR kapasitesi oluşur. Backup ve WAL zinciri farklı retention kurallarıyla yönetilirse recovery noktaları kırılabilir. Bu nedenle backup catalog iki veri setini birlikte takip etmelidir.
PostgreSQL Backup Script Otomasyonu
PostgreSQL backup script'i yalnızca pg_dump komutunu çalıştırıp dosya kaydetmemelidir. Script disk alanı kontrolü yapmalı, tarih ve database kimliği içeren güvenli dosya adı üretmeli, hata kodlarını kontrol etmeli ve log tutmalıdır. Başarılı backup sonrasında sıkıştırma, şifreleme, checksum ve off-site upload adımları çalıştırılabilir. Retention işlemi yeni yedeğin başarıyla doğrulandığından emin olduktan sonra uygulanmalıdır. En güçlü yapı, backup'tan sonra ayrı ortamda otomatik restore testi başlatan yapıdır.
Cron ve systemd Timer
Cron basit zamanlanmış görevler için hızlı ve yaygın bir seçenektir. systemd timer ise servis bağımlılıkları, loglama ve başarısızlık yönetimi açısından ek kontrol sağlayabilir. Her iki yöntemde de backup komutunun kullanıcı hesabı ve çevre değişkenleri dikkatle yönetilmelidir. Şifreler script içine açık biçimde yazılmamalıdır. Scheduler başarısız olsa bile dead man's switch benzeri mekanizmayla beklenen backup'ın oluşmadığı fark edilmelidir.
PostgreSQL WAL ve Point-in-Time Recovery
PostgreSQL Write-Ahead Log, veri dosyası değişikliklerinden önce transaction kayıtlarının loglanmasını sağlar. WAL arşivleme, base backup sonrası işlemlerin saklanmasına ve belirli bir zamana kadar yeniden uygulanmasına imkân verir. PITR'ın güvenilir olması için yalnızca WAL üretmek yeterli değildir; arşiv kopyalarının eksiksiz ve zamanında off-site alana aktarılması gerekir. Eksik tek bir WAL dosyası recovery zincirini kesebilir. Bu nedenle archive success, backlog, retention ve restore testi birlikte izlenmelidir.
WAL Nedir?
WAL PostgreSQL'in dayanıklılık ve crash recovery mekanizmasının temel bileşenlerinden biridir. Transaction değişiklikleri veri sayfalarına yazılmadan önce WAL kayıtları oluşturulur. Sistem çökmesi sonrasında loglar kullanılarak tutarlı durum yeniden oluşturulabilir. Backup tasarımında WAL dosyaları base backup sonrasındaki değişiklikleri temsil eder. PITR hedefi için gerekli WAL segmentlerinin tamamı erişilebilir olmalıdır.
WAL Archiving
WAL archiving tamamlanan WAL segmentlerinin ayrı bir depolama alanına kopyalanmasıdır. Archive komutu başarısız olduğunda segmentlerin birikmesi disk kapasitesini etkileyebilir. Monitoring, son başarılı archive zamanını ve bekleyen WAL miktarını takip etmelidir. Off-site veya object storage kullanılması sunucu kaybına karşı ek koruma sağlar. Archive dosyaları encryption ve retention politikalarıyla yönetilmelidir.
Base Backup
Base backup PITR zincirinin başlangıç noktasıdır. Recovery sırasında önce bu kopya açılır ve ardından gerekli WAL kayıtları uygulanır. Base backup çok eskiyse recovery sırasında işlenecek WAL miktarı artar ve RTO uzayabilir. Bu nedenle base backup sıklığı yalnızca storage maliyetine göre belirlenmemelidir. Düzenli benchmark, en uygun full veya base backup aralığının bulunmasına yardım eder.
Continuous Archiving
Continuous archiving WAL segmentlerinin kesintisiz biçimde güvenli storage'a aktarılmasını hedefler. Bu yaklaşım düşük RPO gereksinimleri için temel oluşturur. Upload gecikmesi arttığında gerçek RPO değeri de kötüleşir. Sistem yalnızca archive komutunun exit code'unu değil hedef storage'da dosyanın bulunduğunu da doğrulamalıdır. Sürekli arşivleme akışı kesildiğinde hızlı alarm üretilmelidir.
Recovery Target Time
Recovery target time PostgreSQL'in WAL kayıtlarını hangi zamana kadar uygulayacağını belirler. Yanlış işlemin gerçekleştiği saat biliniyorsa hedef birkaç saniye öncesi olarak seçilebilir. Saat senkronizasyonu kritik olduğu için database ve uygulama sunucularında ortak zaman kaynağı kullanılmalıdır. Restore tamamlandıktan sonra hedef olayın gerçekten uygulanmadığı kontrol edilmelidir. Production yönlendirmesi validation bitmeden yapılmamalıdır.
Recovery Timeline
PostgreSQL timeline yapısı recovery sonrasında oluşan yeni geçmiş dallarını takip eder. Bir PITR işleminden sonra sistem eski transaction geçmişinden ayrılıp yeni timeline üzerinde ilerleyebilir. Birden fazla recovery denemesinde doğru timeline seçimi önem taşır. Backup catalog timeline bilgisini recovery noktalarıyla ilişkilendirmelidir. Karmaşık DR senaryolarında timeline davranışı önceden test edilmelidir.
WAL Retention
WAL retention istenen recovery penceresini karşılayacak kadar uzun olmalıdır. Base backup saklanırken ona bağlı WAL segmentleri erken silinirse backup kullanılamaz hale gelebilir. Retention politikası base backup ve WAL bağımlılıklarını birlikte hesaplamalıdır. Storage maliyetini azaltmak için lifecycle kuralları kullanılabilir. Silme işlemi yalnızca güvenli recovery noktalarının korunacağı doğrulandıktan sonra yapılmalıdır.
Eksik WAL Dosyasının Recovery'ye Etkisi
PITR sırasında gerekli tek bir WAL segmentinin eksik olması recovery zincirini kesebilir. Bu sorun çoğu zaman gerçek olay yaşanana kadar fark edilmeyebilir. Backup monitoring, WAL sequence boşluklarını otomatik kontrol etmelidir. Restore testleri bu tür eksikleri production krizi yaşanmadan ortaya çıkarır. Kritik sistemlerde WAL kopyalarının birden fazla güvenli storage üzerinde tutulması değerlendirilebilir.
PostgreSQL İçin Açık Kaynak Backup Araçları
PostgreSQL ekosisteminde farklı backup ölçeklerine ve kullanım biçimlerine uygun çeşitli açık kaynak araçları bulunur. Seçim yaparken full ve incremental desteği, parallel backup, WAL arşivleme, object storage entegrasyonu ve restore otomasyonu birlikte değerlendirilmelidir. Araç ne kadar gelişmiş olursa olsun recovery prosedürü işletmenin kendi altyapısında doğrulanmalıdır. Monitoring ve catalog özellikleri operasyon kalitesini doğrudan etkiler. Küçük ortamda pg_dump yeterli olabilirken büyük ve düşük RPO hedefli sistemlerde özel araçlar daha uygun hale gelir.
pgBackRest
pgBackRest PostgreSQL için full, differential ve incremental backup yetenekleri sunan açık kaynak bir çözümdür. Paralel işlem, sıkıştırma, retention ve repository yönetimi gibi özellikleriyle büyük sistemlerde kullanılabilir. WAL arşivleme ve recovery akışlarıyla birlikte çalışabilir. Repository güvenliği ve encryption ayarları altyapı politikasına göre yapılandırılmalıdır. Seçimden önce gerçek veri boyutunda backup ve restore benchmark yapılması yararlıdır.
Barman
Barman PostgreSQL backup ve disaster recovery operasyonlarını merkezi biçimde yönetmek için kullanılabilen açık kaynak araçlardan biridir. Birden fazla PostgreSQL sunucusunun backup durumlarını takip etmeyi kolaylaştırabilir. WAL arşivleme ve recovery süreçleriyle birlikte kullanılabilir. Merkezi sistem kullanıldığında Barman sunucusunun kendisi için de yüksek erişilebilirlik ve backup stratejisi düşünülmelidir. Restore runbook'ları otomasyonla düzenli biçimde test edilmelidir.
WAL-G
WAL-G PostgreSQL WAL ve base backup verilerini object storage üzerinde yönetmek için kullanılabilen araçlardan biridir. Bulut tabanlı depolama ve sıkıştırma senaryolarında pratik bir yaklaşım sunabilir. Backup hızını storage ve network kapasitesi belirgin biçimde etkiler. Kimlik bilgileri secret manager veya workload identity benzeri güvenli yöntemlerle sağlanmalıdır. Backup upload başarısı yanında restore ve WAL indirme süreçleri de izlenmelidir.
pg_dump / pg_basebackup
pg_dump ve pg_basebackup PostgreSQL'in yerleşik araçları olduğu için birçok ortamda temel backup katmanını oluşturabilir. pg_dump logical, pg_basebackup ise physical backup yaklaşımı sağlar. Küçük sistemlerde ek platform kurmadan yeterli koruma elde etmek mümkün olabilir. Ancak retention, off-site upload, monitoring ve restore testing gibi işlemler ayrı otomasyon gerektirir. Bu araçların basitliği, operasyon kontrollerinin göz ardı edilmesi anlamına gelmemelidir.
Hangi Araç Hangi Senaryoda Seçilmeli?
Küçük bir PostgreSQL veritabanında günlük logical backup gerekiyorsa pg_dump yeterli olabilir. Büyük ve PITR gerektiren sistemlerde physical backup ile WAL yönetimini otomatikleştiren araçlar daha uygun hale gelir. Object storage odaklı yapılarda WAL-G gibi çözümler değerlendirilebilir. Merkezi çoklu sunucu yönetiminde catalog ve yönetim özellikleri daha önemli olur. Karar, özellik listesine değil gerçek restore süresi, operasyon kolaylığı ve güvenlik gereksinimlerine dayanmalıdır.
MySQL Yedekleme Otomasyonu
MySQL ortamlarında backup stratejisi logical dump, physical backup ve binary log zincirinin birlikte kullanılmasıyla güçlendirilebilir. Küçük sistemlerde mysqldump yeterli olurken büyük veritabanlarında parallel veya physical yöntemler daha iyi RTO sağlayabilir. Backup from replica yaklaşımı primary üzerindeki yükü azaltabilir fakat replica lag mutlaka izlenmelidir. Otomasyon içinde compression, encryption, checksum ve off-site transfer adımları bulunmalıdır. Restore senaryosu test edilmeden backup sisteminin hazır olduğu kabul edilmemelidir.
mysqldump
mysqldump MySQL verilerini logical formatta dışa aktarmak için kullanılan klasik araçlardan biridir. Küçük ve orta ölçekli veritabanlarında kullanımı kolaydır. Büyük tablolarda backup ve restore süresi ciddi biçimde uzayabilir. Transaction tutarlılığı için kullanılan storage engine ve dump seçenekleri doğru seçilmelidir. Otomatik görevler dosya boyutunu, exit code'u ve hedef storage upload durumunu doğrulamalıdır.
MySQL Shell Dump Utilities
MySQL Shell dump araçları paralel export ve import seçenekleriyle büyük veri setlerinde daha yüksek performans sağlayabilir. Çoklu worker kullanımı backup ve restore süresini azaltabilir. Paralellik seviyesi storage ve CPU kapasitesine göre ayarlanmalıdır. Hedef ortamın sürüm ve özellik uyumluluğu migration öncesinde test edilmelidir. Otomasyon, üretilen dosyaların bütünlük ve erişilebilirlik kontrolünü ayrıca yapmalıdır.
Physical Backup
MySQL physical backup büyük veri hacimlerinde logical dump'a göre daha kısa recovery süresi sağlayabilir. Veri dosyaları fiziksel seviyede korunduğu için restore sırasında satır bazlı yeniden import ihtiyacı azalır. Hot backup desteği production kesintisini önlemek açısından değerlidir. Kullanılan aracın sürüm uyumluluğu ve prepare aşaması doğru yönetilmelidir. Full ve incremental zincirleri düzenli restore testleriyle doğrulanmalıdır.
Backup from Replica
Replica üzerinden backup almak primary üzerindeki CPU ve I/O yükünü azaltabilir. Ancak replica gerideyse alınan backup beklenenden eski recovery point içerebilir. Backup başlamadan önce lag kontrolü yapılmalı ve belirlenen eşik aşılmışsa job durdurulmalıdır. Replica consistency durumu da doğrulanmalıdır. RPO hesaplamasında backup zamanı değil replica üzerindeki gerçek veri zamanı kullanılmalıdır.
Compression
Compression backup storage ihtiyacını ve network aktarımını azaltabilir. Buna karşılık sıkıştırma işlemi CPU kullanımı yaratır ve backup süresini etkileyebilir. Düşük CPU kapasitesine sahip database sunucularında compression seviyesi kontrollü seçilmelidir. Restore sırasında decompression hızının RTO üzerindeki etkisi de ölçülmelidir. En iyi oran, en küçük dosya değil kabul edilebilir backup ve restore performansını sağlayan ayardır.
Parallel Backup ve Restore
Parallel backup ve restore birden fazla tablo veya dosyanın eş zamanlı işlenmesini sağlar. Büyük sistemlerde süreyi önemli ölçüde kısaltabilir. Çok yüksek concurrency ise disk ve network darboğazı yaratabilir. Benchmark farklı worker değerleriyle yapılmalıdır. Production dışı düzenli restore testleri gerçek performans eğilimini gösterir.
Otomatik Backup Script'i
Otomatik MySQL backup script'i ön kontrol, backup, compression, encryption, upload, verification ve retention adımlarını kapsamalıdır. Hata oluştuğunda script başarısız exit code üretmeli ve monitoring sistemi alarm göndermelidir. Parolalar komut satırına veya script içine açık biçimde yazılmamalıdır. Backup dosyası oluşturulduktan sonra checksum ve minimum boyut kontrolü yapılabilir. Belirli aralıklarla script'in devamında otomatik restore pipeline'ı tetiklenmesi en güçlü doğrulamalardan biridir.
MySQL Binary Log ile Point-in-Time Recovery
MySQL binary log veritabanında gerçekleşen değişikliklerin sıralı kayıtlarını tutar ve PITR için kullanılabilir. Full backup restore edildikten sonra gerekli binlog dosyaları hedef noktaya kadar uygulanabilir. Böylece son full backup ile olay anı arasındaki doğru transaction'lar yeniden işlenir. Binlog zinciri eksikse recovery hedefi kısıtlanır. Retention ve continuous binlog backup bu nedenle RPO stratejisinin temel parçası olmalıdır.
Binary Log Nedir?
Binary log MySQL üzerinde veri değiştiren transaction'ların kayıtlarını içerir. Replikasyon ve point-in-time recovery gibi süreçlerde temel rol oynar. Binlog etkinliği ve formatı sistem tasarımına göre yapılandırılmalıdır. Log dosyalarının retention süresi backup recovery penceresiyle uyumlu olmalıdır. Arşivlenen binlog dosyaları checksum ve upload kontrolüyle izlenmelidir.
Full Backup + Binlog Zinciri
Full backup recovery için başlangıç görüntüsünü sağlar. Binlog dosyaları ise bu backup'tan sonra oluşan değişiklikleri taşır. Restore sırasında full kopya açılır ve loglar doğru sırayla uygulanır. Zincirde eksiklik varsa hedef zamana ulaşmak mümkün olmayabilir. Backup catalog full kopyanın hangi binlog konumundan başladığını kaydetmelidir.
mysqlbinlog
mysqlbinlog binary log içeriğini okumak ve recovery sırasında uygulamak için kullanılabilir. Timestamp veya position gibi filtrelerle belirli transaction aralığı seçilebilir. Üretim recovery'sinde komutlar doğrudan çalıştırılmadan önce çıktının test ortamında doğrulanması güvenli olur. Time zone ayarları timestamp tabanlı işlemlerde özellikle önemlidir. Otomatik runbook kullanılan dosyaları ve hedef position bilgisini kaydetmelidir.
Timestamp ile Recovery
Timestamp ile recovery belirli zamana kadar binlog eventlerinin uygulanmasını sağlar. Yanlış işlemin başladığı zaman loglardan belirlenebilir. Clock senkronizasyonu zayıfsa timestamp seçimi hatalı olabilir. Bu nedenle uygulama ve database loglarının zaman bilgileri karşılaştırılmalıdır. Restore tamamlandıktan sonra hatalı transaction'ın uygulanmadığı doğrulanmalıdır.
Event Position ile Recovery
Event position binary log içindeki belirli konuma kadar recovery yapılmasını sağlar. Timestamp belirsiz olduğunda daha kesin kontrol sunabilir. Olayın hemen öncesindeki güvenli position değeri log analiziyle belirlenir. Restore komutları bu position sınırına göre hazırlanır. Sonuç ayrı ortamda doğrulanmadan production'a uygulanmamalıdır.
Continuous Binlog Backup
Continuous binlog backup log dosyalarını düzenli ve hızlı biçimde production dışındaki güvenli storage'a taşır. Böylece database sunucusu kaybolsa bile PITR verisinin korunması amaçlanır. Upload gecikmesi doğrudan RPO üzerinde etki yaratır. Monitoring son gönderilen binlog zamanını ve sequence sürekliliğini takip etmelidir. Off-site kopyalar encryption ve immutable retention ile güçlendirilebilir.
Binlog Retention Politikası
Binlog retention istenen recovery penceresinden daha kısa olmamalıdır. Full backup korunurken ona gerekli binlog dosyalarının silinmesi backup değerini düşürür. Retention hesaplaması full backup zinciriyle birlikte yapılmalıdır. Storage maliyetini yönetmek için eski ve artık gerekli olmayan loglar güvenli biçimde temizlenebilir. Silme işlemleri catalog bilgisi ve en son restore testi dikkate alınarak otomatikleştirilmelidir.
Percona XtraBackup ile Otomatik MySQL Backup
Percona XtraBackup büyük MySQL veritabanlarında hot physical backup yaklaşımı için değerlendirilebilen açık kaynak araçlardan biridir. Full ve incremental backup desteği, büyük veri hacminde storage ve süre optimizasyonu sağlayabilir. Backup sonrasında prepare aşamasının doğru yürütülmesi restore için kritik önemdedir. Otomasyon yalnızca backup üretmemeli, prepare ve restore adımlarını da düzenli test etmelidir. Production yükü, disk hızı ve backup hedefi gerçek ortamda benchmark edilmelidir.
Hot Physical Backup
Hot physical backup database hizmet verirken fiziksel yedek alınmasına imkân sağlar. Bu özellik kesintinin kabul edilemediği sistemlerde önemlidir. Backup sırasında ek I/O oluşabileceği için production etkisi izlenmelidir. Hız sınırları veya uygun backup penceresi kullanılarak yük kontrol edilebilir. Restore kapasitesi gerçek veri boyutunda düzenli olarak sınanmalıdır.
Full Backup
Full backup başlangıç recovery setini oluşturur. Incremental zincirleri çoğu zaman bu full kopyaya bağlıdır. Dosyalar güvenli storage'a taşındıktan sonra checksum ile doğrulanmalıdır. Retention politikası full ve bağlı incremental backup'ları birlikte ele almalıdır. En az bir full backup'ın düzenli restore testi yapılmalıdır.
Incremental Backup
Incremental backup önceki noktadan sonra değişen blokları korur. Büyük veritabanlarında backup süresini ve storage kullanımını azaltabilir. Restore sırasında incremental parçaların doğru sırayla hazırlanması gerekir. Eksik parça recovery zincirini bozabilir. Catalog ve verification otomasyonu bu nedenle büyük önem taşır.
Prepare Aşaması
Prepare aşaması physical backup setini restore edilebilir duruma getirmek için gerekli transaction işlemlerini uygular. Full ve incremental backup zincirlerinde doğru sıra korunmalıdır. Prepare süresi de toplam recovery zamanına dahil edilmelidir. Otomasyon prepare çıktısını ve hata kodunu kontrol etmelidir. Tatbikatlar bu adımı gerçek runbook içinde mutlaka çalıştırmalıdır.
Restore
Restore aşamasında hazırlanmış backup veri dizisine geri taşınır veya uygun yöntemle recovery ortamına açılır. Dosya sahipliği ve izinler doğru yapılandırılmalıdır. Database servisi açıldıktan sonra engine seviyesinde sağlık kontrolü yapılmalıdır. Ardından schema, row count ve kritik sorgular doğrulanmalıdır. Production trafiği uygulama smoke testleri tamamlanmadan yönlendirilmemelidir.
Büyük MySQL Veritabanlarında Kullanımı
Büyük MySQL sistemlerinde physical backup RTO açısından önemli avantaj sağlayabilir. Ancak storage throughput, backup repository hızı ve network kapasitesi gerçek performansı belirler. Multi-terabyte veri setlerinde restore süresi önceden test edilmeden tahmin edilmemelidir. Incremental backup storage maliyetini azaltırken recovery zincirini uzatabilir. Tasarım kararı RPO, RTO ve operasyon ekibinin yönetim kapasitesiyle birlikte verilmelidir.
MariaDB Yedekleme ve Restore Otomasyonu
MariaDB backup stratejisinde logical dump, physical backup, binary log ve replica seçenekleri birlikte değerlendirilebilir. Küçük sistemlerde mariadb-dump kolay yönetilirken büyük ortamlarda physical yöntemler daha iyi recovery süresi sağlayabilir. Galera Cluster gibi yapılarda backup node seçimi cluster sağlığını etkilemeyecek biçimde yapılmalıdır. Replica üzerinden backup alınırken lag ve consistency kontrol edilmelidir. Her yöntemde off-site kopya, encryption ve restore testi tasarımın parçası olmalıdır.
mariadb-dump
mariadb-dump veritabanı nesnelerini logical formatta dışa aktarmak için kullanılabilir. Taşınabilirlik ve seçici veri taşıma açısından pratiktir. Büyük veri hacimlerinde export ve import süreleri RTO hedefini aşabilir. Transaction tutarlılığı için uygun seçenekler kullanılmalıdır. Otomatik job dosya bütünlüğünü ve restore sonucunu kontrol etmelidir.
mariabackup
mariabackup fiziksel yedekleme ihtiyacı bulunan MariaDB ortamlarında kullanılabilen bir araçtır. Büyük verilerde logical dump'a göre daha hızlı recovery hedeflenebilir. Backup setinin restore öncesi hazırlanması gerekebilir. Tool sürümü ile database sürümü uyumluluğu kontrol edilmelidir. Backup ve restore akışları aynı otomasyon pipeline'ı içinde test edilmelidir.
Binary Log
MariaDB binary log değişiklik geçmişini saklayarak replication ve PITR için kullanılabilir. Full backup sonrasındaki transaction'lar gerekli log zinciri üzerinden yeniden uygulanabilir. Log retention istenen recovery penceresini kapsamalıdır. Off-site binlog transferi düşük RPO için önemlidir. Monitoring sequence boşluklarını ve upload gecikmesini takip etmelidir.
Galera Cluster'da Backup
Galera Cluster'da backup alınacak node seçimi cluster performansını etkileyebilir. Backup sırasında I/O yükü artabileceği için uygun node ayrılması düşünülebilir. Node'un senkron ve sağlıklı olduğu backup başlamadan önce doğrulanmalıdır. Cluster bulunması geçmiş recovery ihtiyacını ortadan kaldırmaz. Bu nedenle bağımsız backup ve PITR stratejileri korunmalıdır.
Replica Üzerinden Backup
Replica üzerinden backup primary üzerindeki yükü azaltabilir. Ancak lag varsa alınan veri gerçek zamandan daha eski olabilir. Backup job replica gecikmesini ölçerek belirlenen RPO eşiğine göre karar vermelidir. Replica üzerindeki schema ve transaction durumu da kontrol edilmelidir. Restore testi backup'ın gerçekten kullanılabilir olduğunu göstermelidir.
SQL Server Backup ve Restore Otomasyonu
SQL Server backup stratejisinde full, differential ve transaction log backup birlikte kullanılabilir. Recovery model seçimi PITR kapasitesini ve transaction log davranışını doğrudan etkiler. SQL Server Agent veya PowerShell ile schedule ve otomasyon kurulabilir. Backup dosyalarının ayrı storage üzerinde tutulması, encryption ve retention politikalarıyla korunması gerekir. Restore chain otomasyonu ve STOPAT testleri gerçek recovery hazırlığını güçlendirir.
Full Backup
SQL Server full backup veritabanının ana recovery kopyasını oluşturur. Differential ve log backup zincirlerinde temel başlangıç noktası olarak kullanılabilir. Büyük veritabanlarında backup compression süre ve storage avantajı sağlayabilir. Backup checksum seçenekleri bütünlük kontrolüne katkı sunar. Full backup'ın düzenli restore testi yapılmalıdır.
Differential Backup
Differential backup son full backup'tan beri değişen extents verisini içerir. Restore sırasında en son uygun full backup ve ardından seçilen differential backup uygulanabilir. Bu yapı çok sayıda incremental parça yerine daha kısa recovery zinciri sağlayabilir. Differential dosyası zaman içinde büyüyebileceği için full backup sıklığı önemlidir. Schedule gerçek değişim miktarına göre optimize edilmelidir.
Transaction Log Backup
Transaction log backup Full Recovery Model kullanılan sistemlerde düşük RPO ve PITR için temel araçtır. Log backup'larının düzenli alınması log chain'in devamlılığını korur. Log zincirinde eksiklik recovery seçeneklerini sınırlayabilir. Çok seyrek log backup RPO hedefini kötüleştirebilir. Backup monitoring son başarılı log backup yaşını takip etmelidir.
SQL Server Agent ile Schedule
SQL Server Agent backup job'larını belirli zamanlarda çalıştırmak için kullanılabilir. Full, differential ve transaction log görevleri farklı schedule'lara ayrılabilir. Job history monitoring sistemiyle birlikte izlenmelidir. Bir görevin çalışmaması yalnızca Agent ekranında kalmamalı ve merkezi alarm üretmelidir. Scheduler altyapısının kendisi de tek hata noktası olmaktan çıkarılmalıdır.
PowerShell Otomasyonu
PowerShell SQL Server ve Windows ortamlarında backup operasyonlarını otomatikleştirmek için güçlü bir araçtır. Database listesini dinamik almak, storage yönetmek, log toplamak ve API entegrasyonu yapmak mümkündür. Credentials script içine açık biçimde yazılmamalıdır. Error handling ve exit code davranışı merkezi monitoring ile uyumlu olmalıdır. PowerShell restore doğrulama görevleri için de kullanılabilir.
Ola Hallengren Backup Solution
Ola Hallengren tarafından geliştirilen bakım scriptleri SQL Server backup işlemlerinde yaygın olarak kullanılan açık kaynak bir seçenek sunar. Full, differential ve log backup politikalarının standartlaştırılmasına yardımcı olabilir. Kullanıma alınmadan önce kurumun storage, naming, retention ve monitoring ihtiyaçlarına göre yapılandırılmalıdır. Hazır script kullanmak restore testini gereksiz hale getirmez. Upgrade ve değişiklikler version control içinde takip edilmelidir.
SQL Server Recovery Models
SQL Server recovery model veritabanının transaction log yönetimini ve PITR seçeneklerini belirleyen temel ayarlardan biridir. Simple, Full ve Bulk-Logged modeller farklı recovery ihtiyaçlarına cevap verir. Yanlış recovery model seçimi backup sistemi düzgün görünse bile beklenen recovery noktasının oluşturulamamasına neden olabilir. Model değişiklikleri log chain üzerinde etkili olabileceği için kontrollü yapılmalıdır. RPO ve RTO hedefleri recovery model seçiminin ana girdilerinden olmalıdır.
Simple Recovery Model
Simple Recovery Model transaction log alanının daha otomatik yeniden kullanılmasına izin verir. Transaction log backup ile belirli zamana dönüş kapasitesi bulunmaz. Bu nedenle son full veya differential backup sonrası değişiklikler kaybedilebilir. Düşük kritikliğe sahip veritabanlarında daha basit operasyon sağlayabilir. Kullanılmadan önce iş biriminin veri kaybı toleransı doğrulanmalıdır.
Full Recovery Model
Full Recovery Model düzenli transaction log backup ile point-in-time restore kapasitesi sağlar. Log chain'in korunması kritik önem taşır. Log backup görevi uzun süre çalışmazsa disk kullanımı ve RPO üzerinde sorunlar oluşabilir. Full backup tek başına log chain yönetiminin yerine geçmez. Restore tatbikatlarında full, differential ve log backup zinciri birlikte uygulanmalıdır.
Bulk-Logged Recovery Model
Bulk-Logged Recovery Model bazı toplu işlemlerde log miktarını azaltmak amacıyla kullanılabilir. Ancak belirli dönemlerde PITR seçenekleri Full Recovery Model'e göre sınırlanabilir. Model geçişleri planlı bakım süreçlerinin parçası olmalıdır. Backup ekibi yapılan değişiklikten haberdar olmalıdır. Kritik operasyon öncesinde ve sonrasında recovery kapasitesi doğrulanmalıdır.
Recovery Model RPO ve PITR'ı Nasıl Etkiler?
Recovery model hangi transaction geçmişinin restore için kullanılabileceğini belirler. Full Recovery Model ve sık log backup düşük RPO hedeflerini destekler. Simple modelde son backup sonrası değişikliklerin tamamı kurtarılamayabilir. İş kritikliği arttıkça PITR gereksinimi de daha belirgin hale gelir. Recovery model değişiklikleri configuration management içinde izlenmelidir.
Transaction Log Chain
Transaction log chain ardışık log backup'larının oluşturduğu recovery dizisidir. Bir PITR işleminde hedef zamana ulaşmak için gerekli log dosyalarının tamamı bulunmalıdır. Dosyalardan biri eksikse zincir kesilir. Catalog her backup'ın LSN bilgilerini takip ederek doğru sırayı belirlemeye yardımcı olabilir. Restore testi chain bütünlüğünün en güvenilir doğrulamasıdır.
Broken Log Chain Problemi
Broken log chain gerekli transaction log parçalarının birbirini takip etmemesi durumudur. Recovery model değişikliği veya yanlış backup yönetimi bu probleme yol açabilir. Chain kırıldığında beklenen noktaya kadar restore mümkün olmayabilir. Monitoring yalnızca son job başarısını değil log zincirinin devamlılığını da kontrol etmelidir. Yeni full backup ile yeni güvenilir recovery tabanı oluşturmak gerekebilir.
SQL Server Point-in-Time Restore
SQL Server point-in-time restore full backup, uygun differential backup ve transaction log backup'larının doğru sırayla uygulanmasına dayanır. STOPAT gibi seçeneklerle hedef zaman belirlenebilir. Son aktif log bölümünü korumak için bazı olaylarda tail-log backup kullanılabilir. Recovery zinciri elle yönetildiğinde hata riski arttığı için otomasyon önemli avantaj sağlar. Tatbikatlarda en yeni backup seçimi, restore sırası ve validation tamamen uçtan uca denenmelidir.
Full Backup'ı Restore Etmek
Recovery süreci genellikle uygun full backup'ın restore edilmesiyle başlar. Daha sonraki differential veya log backup'ları uygulanacaksa veritabanı recovery tamamlanmadan uygun durumda bırakılır. Dosya yolları ve storage konumları yeni sunucuda farklı olabilir. Otomasyon logical file bilgilerini okuyup doğru hedefleri oluşturmalıdır. Full restore süresi RTO ölçümünün önemli parçasıdır.
Differential Backup'ı Restore Etmek
Full backup sonrasında uygun differential backup uygulanarak daha güncel veri durumuna hızlı biçimde ulaşılabilir. Seçilen differential dosyanın doğru full backup'a bağlı olması gerekir. Catalog bilgisi yanlış eşleşmeyi önlemelidir. Differential restore sonrasında log backup'ları hedef zamana kadar uygulanabilir. Otomasyon her adımın başarı durumunu doğrulamalıdır.
Transaction Log'ları Uygulamak
Transaction log backup'ları doğru LSN sırasıyla uygulanmalıdır. Dosyalardan biri eksik olduğunda recovery zinciri kesilebilir. Büyük recovery pencerelerinde çok sayıda log dosyası olduğu için manuel işlem hata riskini artırır. Catalog tabanlı otomasyon gerekli dosyaları sıralayabilir. Her restore denemesinde kullanılan backup kimlikleri rapora eklenmelidir.
STOPAT Kullanımı
STOPAT belirli zamana kadar log kayıtlarının uygulanmasını sağlar. Yanlış DELETE veya hatalı deployment senaryolarında olay öncesi nokta hedeflenebilir. Timestamp seçiminde sistem saatlerinin senkron olması gerekir. Hedef an test restore ile doğrulanmalıdır. Production recovery kararı doğrulama sonuçlarına göre verilmelidir.
Tail-Log Backup
Tail-log backup erişilebilir durumdaki son transaction log bölümünü kaybetmemek amacıyla alınabilir. Bazı arıza senaryolarında son full log backup'tan sonra gerçekleşen işlemleri korumaya yardımcı olur. Database durumuna göre tail-log alma yöntemi değişebilir. Olay anında bu adımın unutulmaması için runbook içine açık biçimde eklenmelidir. Tatbikatlar tail-log senaryosunu da kapsamalıdır.
Recovery Chain Otomasyonu
Recovery chain otomasyonu uygun full, differential ve log backup'larını catalog üzerinden seçebilir. Dosyaların doğru sırayla uygulanması manuel hata riskini azaltır. Hedef timestamp veya LSN parametre olarak alınabilir. Restore tamamlandığında validation query'leri otomatik çalıştırılabilir. Sonuçlar süreler ve kullanılan recovery noktasıyla birlikte raporlanmalıdır.
MongoDB Backup ve Restore Otomasyonu
MongoDB backup yaklaşımı deployment tipine göre farklılık gösterir. Küçük sistemlerde mongodump kullanılabilirken replica set, sharded cluster ve yönetilen ortamlarda farklı backup seçenekleri gerekebilir. Oplog verisi belirli senaryolarda point-in-time recovery imkânı sağlar. Consistency kontrolü özellikle dağıtık MongoDB yapılarında önemlidir. Backup işlemi kadar restore ve application validation adımları da düzenli otomasyona bağlanmalıdır.
mongodump
mongodump MongoDB verilerini logical BSON çıktısı olarak dışa aktarabilir. Küçük ve orta ölçekli veri setlerinde kullanım kolaylığı sağlar. Büyük sistemlerde backup süresi ve production etkisi ölçülmelidir. Authentication ve network güvenliği doğru yapılandırılmalıdır. Otomatik job oluşturulan dump dosyalarının bütünlüğünü kontrol etmelidir.
mongorestore
mongorestore dump çıktılarının MongoDB ortamına geri yüklenmesini sağlar. Restore hedefi production'dan izole edilerek güvenli test yapılabilir. Database veya collection seviyesinde recovery seçenekleri ihtiyaca göre değerlendirilebilir. Restore sonrasında indexler, collection sayıları ve kritik sorgular kontrol edilmelidir. Uygulama smoke testleri tamamlanmadan recovery başarılı sayılmamalıdır.
Replica Set Backup
Replica set yapısında backup secondary node üzerinden alınarak primary yükü azaltılabilir. Secondary gecikmesi ve replication sağlığı backup başlamadan önce kontrol edilmelidir. Dağıtık transaction ve consistency davranışı kullanılan yönteme göre değerlendirilmelidir. Replica bulunması tek başına backup değildir. Off-site ve bağımsız recovery noktaları korunmalıdır.
Oplog ile Point-in-Time Recovery
Oplog replica set üzerindeki operasyon geçmişini tutar. Uygun base backup ile birlikte kullanıldığında belirli noktaya kadar değişiklikler yeniden uygulanabilir. Oplog boyutu ve retention süresi recovery penceresini etkiler. Backup sistemi gerekli oplog aralığının korunup korunmadığını izlemelidir. PITR süreci gerçek olay öncesinde düzenli test edilmelidir.
MongoDB Atlas Backup
Yönetilen MongoDB ortamlarında platformun sunduğu otomatik backup ve recovery özellikleri kullanılabilir. Yönetilen servis operasyon yükünü azaltabilir fakat retention, region ve recovery kapsamı yine kullanıcı tarafından anlaşılmalıdır. Varsayılan ayarlar her RPO ve RTO hedefini karşılamayabilir. Restore işleminin ne kadar sürdüğü gerçek testlerle ölçülmelidir. Kritik veriler için hesap ve erişim ayrımı ayrıca planlanmalıdır.
Sharded Cluster Backup
Sharded cluster backup birden fazla shard'ın tutarlı recovery noktasını korumayı gerektirir. Tek bir shard'ın kopyasını almak tüm cluster için yeterli değildir. Config server verileri ve shard zamanlaması kullanılan yönteme göre birlikte yönetilmelidir. Otomasyon cluster topology bilgisini dikkate almalıdır. Restore testleri gerçek sharded yapıya yakın ortamda yapılmalıdır.
Oracle Database Backup Otomasyonu
Oracle Database backup stratejisinde RMAN temel araçlardan biridir. Full ve incremental backup, archive redo log ve point-in-time recovery senaryoları birlikte tasarlanabilir. Backup catalog kullanımı büyük ortamlarda recovery setlerinin merkezi takibini kolaylaştırabilir. Storage ve network performansı büyük veritabanlarında recovery süresini doğrudan etkiler. Otomasyon backup üretmenin ötesinde restore validation ve düzenli DR testlerini de kapsamalıdır.
RMAN
RMAN Oracle Database için backup ve recovery işlemlerini yöneten yerleşik araçtır. Physical backup, incremental strateji ve recovery operasyonlarında kullanılabilir. Script'ler schedule edilerek backup görevleri otomatikleştirilebilir. Catalog ve log çıktıları merkezi monitoring sistemiyle izlenmelidir. RMAN backup'larının düzenli restore testi yapılmalıdır.
Full Backup
Full backup recovery için temel veri kopyasını sağlar. Büyük veritabanlarında backup süresi storage throughput ile sınırlanabilir. Compression storage maliyetini azaltırken CPU kullanımı oluşturabilir. Backup dosyaları production dışında güvenli alanda tutulmalıdır. Restore süresi gerçek RTO hedefiyle karşılaştırılmalıdır.
Incremental Backup
Incremental backup değişen blokları koruyarak backup süresini azaltabilir. Full backup ile birlikte planlandığında storage kullanımını optimize eder. Recovery zincirinin bütünlüğü için her incremental parça korunmalıdır. Retention politikası bağımlılıkları dikkate almalıdır. Otomatik validation zincirin kullanılabilir olduğunu kontrol etmelidir.
Archive Redo Log
Archive redo log transaction geçmişinin recovery için saklanmasını sağlar. PITR hedeflerinde gerekli logların tamamı erişilebilir olmalıdır. Log upload gecikmesi gerçek RPO değerini etkiler. Archive alanının dolması production operasyonlarını etkileyebileceği için kapasite izlenmelidir. Off-site kopyalar ek güvenlik sağlar.
Point-in-Time Recovery
Point-in-time recovery veritabanını olay öncesindeki belirli zamana getirmek için kullanılabilir. Full veya incremental backup başlangıç noktası olarak kullanılır. Gerekli archive redo log kayıtları hedef zamana kadar uygulanır. Recovery target olay loglarından doğrulanmalıdır. İşlem sonunda uygulama ve veri bütünlüğü kontrolleri yapılmalıdır.
RMAN Recovery Catalog
Recovery catalog backup metadata'sını merkezi biçimde saklamaya yardımcı olabilir. Hangi backup setlerinin hangi recovery noktalarını desteklediğini görmek operasyonu kolaylaştırır. Catalog da kritik bir bileşen olduğu için kendi backup ve erişim planına sahip olmalıdır. Yetkiler least privilege yaklaşımıyla sınırlandırılmalıdır. Restore runbook catalog erişimi olmadığında uygulanabilecek alternatif prosedürü de içermelidir.
Cloud Veritabanlarında Otomatik Backup
Cloud database servisleri otomatik snapshot, retention ve point-in-time restore gibi özelliklerle backup operasyonunu kolaylaştırabilir. Ancak yönetilen backup kullanmak kullanıcı sorumluluğunu tamamen ortadan kaldırmaz. Retention süresi, bölgesel kopyalama, hesap ayrımı, encryption ve restore süresi açıkça değerlendirilmelidir. Platform tarafından sunulan varsayılan ayarlar iş hedefleriyle karşılaştırılmalıdır. Kurumsal veritabanı yedekleme restorasyon ve felaket kurtarma hizmeti planlanırken cloud-native özelliklerle bağımsız recovery gereksinimleri birlikte düşünülmelidir.
Amazon RDS
Amazon RDS otomatik backup ve point-in-time restore seçenekleri sunan yönetilen bir veritabanı servisidir. Backup penceresi ve retention ayarları iş gereksinimlerine göre yapılandırılmalıdır. Cross-region ve cross-account kopyalar bazı risk senaryolarında ek koruma sağlayabilir. Restore süresi database büyüklüğü ve servis davranışına göre değişebilir. Düzenli otomatik restore testi gerçek recovery kapasitesini ölçmek için önemlidir.
Amazon Aurora
Amazon Aurora yönetilen backup ve recovery özellikleriyle operasyon yükünü azaltabilir. Continuous backup yaklaşımı düşük RPO hedeflerine katkı sağlayabilir. Buna rağmen hesap erişimi, region bağımlılığı ve disaster recovery tasarımı ayrıca değerlendirilmelidir. Restore sonrası endpoint ve application configuration değişiklikleri otomasyona dahil edilmelidir. Gerçek RTO yalnızca dokümantasyondan değil yapılan tatbikatlardan çıkarılmalıdır.
Azure SQL Database
Azure SQL Database otomatik backup ve point-in-time restore yetenekleri sunar. Retention seçenekleri iş ve mevzuat gereksinimleriyle eşleştirilmelidir. Farklı region üzerinde recovery gereksinimi varsa coğrafi tasarım ayrıca planlanmalıdır. Backup'ın yönetilen olması restore sonrası uygulama doğrulamasını gereksiz kılmaz. Düzenli testler recovery süresini ve bağımlılıkları ortaya çıkarır.
Azure Database for PostgreSQL
Azure Database for PostgreSQL yönetilen backup ve recovery seçenekleri sunabilir. Kullanıcı, retention ve point-in-time restore sınırlarını kullandığı servis modeline göre kontrol etmelidir. Kritik sistemlerde region ve hesap riskleri ayrıca değerlendirilmelidir. Restore işlemi sonrası DNS, connection string ve application secret güncellemeleri gerekebilir. Bu adımlar Recovery as Code yaklaşımıyla otomatikleştirilebilir.
Google Cloud SQL
Google Cloud SQL otomatik backup ve PITR gibi yönetilen recovery özellikleri sunabilir. Backup planı servis tarafından sağlanan özelliklerin dışındaki iş gereksinimlerini de dikkate almalıdır. Retention, region ve erişim kontrolleri düzenli olarak gözden geçirilmelidir. Restore sonrası uygulama bağlantılarının doğru hedefe yönlenmesi gerekir. Otomatik validation sorguları recovery başarısını doğrulamalıdır.
Managed Backup'ın Avantajları
Managed backup altyapı kurma ve bazı rutin operasyonları yönetme yükünü azaltabilir. Otomatik schedule, storage yönetimi ve platform entegrasyonu hızlı başlangıç sağlar. Küçük ekipler için operasyon kolaylığı önemli avantajdır. Buna rağmen business-level RPO ve RTO hedefleri platform varsayımlarından bağımsız olarak tanımlanmalıdır. Yönetilen özelliklerin gerçekten çalıştığı restore testleriyle ölçülmelidir.
Managed Backup'ın Sınırlamaları
Managed backup her zaman istediğiniz retention, hesap izolasyonu veya restore senaryosunu sunmayabilir. Bazı hizmetlerde snapshot başka platforma kolay taşınamaz. Hesap erişimi kaybedildiğinde backup erişiminin de etkilenmesi mümkündür. Restore süreleri büyük veritabanlarında tahmin edilenden uzun olabilir. Kritik sistemlerde platform özelliklerine ek bağımsız koruma katmanları değerlendirilmelidir.
Amazon RDS Backup ve Restore Otomasyonu
Amazon RDS üzerinde backup operasyonu automated backups, manual snapshots, point-in-time restore ve ek kopyalama seçenekleriyle tasarlanabilir. Kritik veriler için tek region veya tek account bağımlılığını azaltmak önemli olabilir. Snapshot kopyaları farklı erişim sınırlarıyla tutulabilir. Restore sonrası endpoint değişeceği için application configuration otomasyonu ayrıca planlanmalıdır. En etkili kontrol, düzenli olarak yeni bir test instance oluşturup yedeği restore ederek validation çalıştırmaktır.
Automated Backups
Automated backups RDS servisinin belirlenen retention dönemi içinde otomatik recovery noktaları oluşturmasını sağlar. Backup window production yükü göz önünde bulundurularak seçilmelidir. Retention süresi iş gereksinimine göre ayarlanmalıdır. PITR kapasitesi için log mekanizmalarının servis tarafından nasıl yönetildiği anlaşılmalıdır. Otomatik backup kullanılması restore testini gereksiz hale getirmez.
Manual Snapshots
Manual snapshots belirli olaylardan önce kalıcı recovery noktası oluşturmak için kullanılabilir. Migration, büyük deployment veya kritik bakım öncesi faydalı olabilir. Snapshot isimleri deployment veya change ID ile ilişkilendirildiğinde yönetim kolaylaşır. Gereksiz snapshot'lar maliyet oluşturabileceği için lifecycle politikası gerekir. Silme işlemleri approval veya policy kontrolüne bağlanabilir.
Point-in-Time Restore
Point-in-time restore seçilen zaman noktasına yakın yeni bir database instance oluşturmayı sağlar. Yanlış veri değişikliklerinde kullanışlı bir recovery seçeneğidir. Yeni instance farklı endpoint üreteceği için uygulama bağlantısı otomatik güncellenmelidir. Restore sonrası schema ve veri validation yapılmalıdır. Hedef noktaya dönüş süresi düzenli olarak ölçülmelidir.
Cross-Region Snapshot Copy
Cross-region snapshot copy bölgesel kesinti riskine karşı ek kopya sağlar. Kopyalama süresi ve encryption key erişimi dikkate alınmalıdır. Recovery region içindeki network ve subnet altyapısı önceden hazırlanabilir. Kopya güncelliği RPO hedefiyle karşılaştırılmalıdır. Region failover tatbikatları sadece snapshot'ın varlığını değil uygulama erişimini de test etmelidir.
Cross-Account Backup
Cross-account backup üretim hesabının ele geçirilmesi veya erişim problemi yaşaması durumunda ek koruma sağlayabilir. Backup hesabında farklı yöneticiler ve sınırlı delete yetkileri kullanılabilir. Encryption key politikaları iki hesapta restore yapılabilecek biçimde tasarlanmalıdır. Kopyalama başarısı merkezi olarak izlenmelidir. Erişim ayrımı düzenli güvenlik incelemelerinde doğrulanmalıdır.
AWS Backup Entegrasyonu
AWS Backup farklı kaynaklar için merkezi policy ve retention yönetimi sağlayabilir. Database backup politikaları diğer altyapı kaynaklarıyla tek çerçevede takip edilebilir. Policy değişiklikleri version control yaklaşımıyla kayıt altına alınabilir. Vault erişimi ve silme yetkileri ayrı güvenlik katmanı olarak ele alınmalıdır. Restore testleri AWS Backup catalog içindeki kopyalardan otomatik başlatılabilir.
Otomatik Restore Testing
Otomatik restore testing belirli aralıklarla bir backup veya snapshot seçip izole ortamda restore eder. Yeni instance açıldıktan sonra connection testi, schema kontrolü ve kritik sorgular çalıştırılır. Sonuç başarılıysa test ortamı TTL veya workflow sonunda otomatik silinir. Başarısızlık durumunda alarm ve ayrıntılı log üretilmelidir. Bu yöntem backup'ın gerçekten kullanılabilir olduğunu kanıtlayan en değerli kontrollerden biridir.
Backup Otomasyon Pipeline'ı Nasıl Tasarlanır?
Backup pipeline yalnızca scheduler ile çalışan tek bir dump komutundan oluşmamalıdır. İyi bir akış pre-check, backup creation, compression, encryption, checksum, off-site upload, retention, verification, restore test ve alerting adımlarını kapsar. Her aşama idempotent olacak şekilde tasarlanırsa tekrar çalıştırma ve hata yönetimi kolaylaşır. Job metadata'sı merkezi catalog içinde tutulduğunda recovery anında en doğru backup hızlı biçimde bulunabilir. Pipeline'ın başarısı, son adımda verinin gerçekten geri açıldığının doğrulanmasıyla ölçülmelidir.
Schedule
Schedule RPO gereksinimine göre backup'ın ne sıklıkla başlatılacağını belirler. Production yoğunluğu ve diğer bakım görevleri zamanlama kararını etkiler. Birden fazla database aynı anda yedeklenmemeliyse job'lar stagger edilebilir. Scheduler'ın çalışmaması ayrı alarm üretmelidir. Son beklenen backup zamanı monitoring tarafından bağımsız olarak kontrol edilmelidir.
Pre-Backup Checks
Pre-backup checks veritabanı sağlığını ve hedef storage kapasitesini kontrol eder. Replica üzerinden backup alınacaksa lag değeri burada değerlendirilir. Disk alanı yetersizse job başlamadan güvenli biçimde durdurulabilir. Authentication ve network erişimi önceden test edilebilir. Bu kontroller yarıda kalan büyük backup işlemlerini azaltır.
Backup Creation
Backup creation seçilen logical veya physical yöntemle veri kopyasını oluşturur. Kullanılan komut ve parametreler version control içinde tutulmalıdır. Exit code başarılı olsa bile beklenen çıktı dosyasının varlığı kontrol edilmelidir. Backup kimliği zaman, database ve policy bilgisiyle ilişkilendirilebilir. Bu metadata sonraki restore otomasyonunda kullanılır.
Compression
Compression storage ve network kullanımını azaltabilir. Ancak CPU tüketimini artırdığı için production etkisi ölçülmelidir. Compression algoritması backup ve restore süreleri birlikte değerlendirilerek seçilmelidir. Çok yüksek sıkıştırma seviyesi kısa RTO hedeflerinde uygun olmayabilir. Benchmark sonuçları policy içine dahil edilmelidir.
Encryption
Backup encryption veri production ortamından çıktıktan sonra da gizliliği korur. Dosya seviyesinde veya storage seviyesinde encryption kullanılabilir. Key erişimi backup dosyasından ayrı güvenlik sınırında tutulmalıdır. Restore sırasında gerekli key bulunamazsa backup pratikte kullanılamaz. Anahtar yönetimi düzenli recovery testlerinin parçası olmalıdır.
Checksum
Checksum backup dosyasının aktarım veya storage sırasında bozulup bozulmadığını kontrol etmeye yardımcı olur. Backup oluşturulduktan sonra hesaplanan checksum hedef storage'a yükleme sonrası yeniden doğrulanabilir. Tek başına checksum database seviyesinde tutarlılığı kanıtlamaz. Bunun için restore ve validation gerekir. Yine de dosya bozulmasını erken yakalamak açısından etkili bir kontroldür.
Off-Site Upload
Off-site upload backup'ı production sisteminden farklı hata alanına taşır. Aynı sunucudaki veya aynı storage üzerindeki backup fiziksel arızalarda birlikte kaybolabilir. Farklı region veya farklı account kullanımı ek izolasyon sağlayabilir. Upload başarısı yalnızca API yanıtıyla değil hedefteki obje varlığıyla doğrulanmalıdır. Transfer süresi gerçek RPO değerini etkileyebileceği için izlenmelidir.
Retention
Retention backup'ların ne kadar süre saklanacağını belirler. Günlük, haftalık, aylık ve yıllık katmanlar farklı recovery ihtiyaçlarını karşılayabilir. Çok kısa retention geçmiş hata noktalarını kaybetme riski yaratır. Çok uzun retention ise maliyet ve veri koruma yükümlülüklerini artırabilir. Policy iş gereksinimi, mevzuat ve recovery esnekliğiyle birlikte belirlenmelidir.
Verification
Verification backup dosyasının beklenen özelliklere sahip olduğunu kontrol eder. Dosya boyutu, checksum, catalog kaydı ve encryption metadata'sı temel kontroller olabilir. Beklenenden çok küçük backup önemli bir anomali sinyalidir. Verification restore testinin yerine geçmez. En güçlü yaklaşım dosya seviyesinden application seviyesine kadar birden fazla doğrulama katmanı kullanır.
Automated Restore
Automated restore uygun backup'ı seçip izole bir ortama otomatik olarak geri yükler. Infrastructure provisioning gerektiğinde IaC ile yeni ortam oluşturulabilir. Restore tamamlandığında database health check çalıştırılır. Başarısızlık backup sistemindeki gerçek sorunu erken gösterir. Süre bilgisi RTO ölçümüne kaydedilmelidir.
Data Validation
Data validation restore edilen verinin yalnızca açıldığını değil doğru olduğunu kontrol eder. Schema sayıları, kritik tablo row count değerleri ve referential integrity testleri uygulanabilir. İş mantığı seviyesinde kritik sorgular da çalıştırılmalıdır. Beklenen değer aralıkları version control içinde tutulabilir. Validation sonucu backup catalog'a eklenerek son doğrulanmış recovery noktası görülebilir.
Cleanup
Cleanup geçici dosyaları ve restore test ortamlarını güvenli biçimde kaldırır. Backup başarısız olsa bile eski geçici dosyaların birikmesi disk alanını doldurmamalıdır. Silme işlemleri production backup'larını yanlışlıkla etkilemeyecek korumalar içermelidir. TTL mekanizması test ortamlarının unutulmasını önleyebilir. Cleanup sonucu da pipeline loglarına yazılmalıdır.
Monitoring ve Alerting
Monitoring backup'ın oluşup oluşmadığını, ne kadar sürdüğünü ve ne kadar güncel olduğunu takip etmelidir. Alerting yalnızca job fail olduğunda değil beklenen backup hiç başlamadığında da çalışmalıdır. Backup freshness kritik metriklerden biridir. Restore test hataları yüksek öncelikli alarm üretmelidir. Uyarılar doğru operasyon ekibine ve gerektiğinde nöbet sistemine yönlendirilmelidir.
Backup Job'ları Nasıl Schedule Edilir?
Backup schedule için cron, systemd timer, SQL Server Agent, Kubernetes CronJob, cloud scheduler veya workflow engine gibi farklı seçenekler kullanılabilir. Araç seçimi ortamın işletim modeli ve gözlemlenebilirlik ihtiyacına göre yapılmalıdır. Scheduler tek hata noktası haline gelmemelidir. Job başlamasa bile monitoring beklenen backup'ın eksikliğini fark etmelidir. Büyük altyapılarda merkezi orchestration policy tutarlılığını ve audit sürecini kolaylaştırır.
Cron
Cron Linux sistemlerinde basit backup görevleri için yaygın bir scheduler'dır. Küçük ortamlarda hızlı kurulum sağlar. Environment değişkenleri ve PATH farklılıkları nedeniyle komutlar interaktif terminalden farklı davranabilir. Job çıktısı merkezi log sistemine yönlendirilmelidir. Cron servisi çalışmıyorsa backup eksikliğini bağımsız freshness alarmı yakalamalıdır.
systemd Timer
systemd timer servis tabanlı Linux ortamlarında schedule yönetimi için kullanılabilir. Unit bağımlılıkları, loglama ve failure davranışı cron'a göre daha kontrollü biçimde tanımlanabilir. Backup service ayrı kullanıcı hesabıyla çalıştırılabilir. Restart ve retry politikaları dikkatle yapılandırılmalıdır. Timer'ın kendisi monitoring kapsamına alınmalıdır.
SQL Server Agent
SQL Server Agent database bakım ve backup görevlerini schedule etmek için doğal bir seçenektir. Full, differential ve log job'ları ayrı schedule ile yönetilebilir. Job history merkezi dashboard'a aktarılmalıdır. Agent servisi durduğunda beklenen backup'ın eksikliği ayrıca algılanmalıdır. Restore testleri için farklı bir job veya dış orchestration kullanılabilir.
Kubernetes CronJob
Kubernetes CronJob container tabanlı backup görevlerini schedule etmek için kullanılabilir. Job image'ı backup aracı ve script'leri versioned biçimde içerebilir. Secret erişimi Kubernetes Secret veya harici secret manager ile yönetilmelidir. Persistent storage veya object storage hedefleri doğru tasarlanmalıdır. Job success yanında gerçekten üretilen backup artifact'i bağımsız olarak doğrulanmalıdır.
Cloud Scheduler
Cloud scheduler servisleri serverless veya managed backup workflow başlatmak için kullanılabilir. API veya function tetikleyerek database backup süreci başlatılabilir. Identity izinleri least privilege yaklaşımıyla verilmelidir. Scheduler region veya servis kesintisine karşı kritik sistemlerde ek yöntem düşünülmelidir. Beklenen run gerçekleşmediğinde freshness alarmı devreye girmelidir.
Workflow Engine
Workflow engine çok adımlı backup, restore ve validation süreçlerinde güçlü kontrol sağlar. Retry, timeout, approval ve conditional step gibi özellikler recovery otomasyonunu kolaylaştırır. Her adımın çıktısı merkezi olarak kayıt altına alınabilir. Workflow tanımları version control içinde tutulmalıdır. Özellikle cross-database ve DR senaryolarında orchestration açısından avantaj sağlar.
Event-Driven Backup
Event-driven backup belirli bir olay gerçekleştiğinde backup başlatır. Büyük migration, deployment veya kritik configuration değişikliği öncesinde otomatik recovery point oluşturulabilir. Event kaynağı ile backup kimliği ilişkilendirilirse geri dönüş kolaylaşır. Sadece event-driven yaklaşım periyodik backup ihtiyacını ortadan kaldırmaz. İki model birlikte kullanıldığında daha güçlü koruma sağlanabilir.
Scheduler Single Point of Failure Nasıl Önlenir?
Scheduler'ın başarısızlığı tüm backup görevlerinin sessizce durmasına neden olabilir. Bu yüzden backup freshness kontrolü scheduler'dan bağımsız bir monitoring sistemi tarafından yapılmalıdır. Kritik ortamlarda yedek scheduler veya farklı orchestration mekanizması değerlendirilebilir. Konfigürasyon version control ve IaC ile yeniden oluşturulabilir olmalıdır. Dead man's switch yaklaşımı belirlenen sürede heartbeat gelmediğinde alarm üretebilir.
Cross-Database Backup Orchestration
Bir kurumda PostgreSQL, MySQL ve SQL Server gibi birden fazla database motoru birlikte çalışabilir. Her sistemin backup aracı farklı olsa da schedule, retention, encryption, monitoring ve catalog politikaları merkezi hale getirilebilir. Merkezi orchestration standardı artırır ve unutulan database riskini azaltır. Job'ların aynı anda çalışması CPU, network ve storage üzerinde yük oluşturabileceği için stagger yaklaşımı uygulanmalıdır. Tek panelde backup freshness ve restore test sonuçlarını görmek operasyon ekibinin müdahale hızını artırır.
PostgreSQL, MySQL ve SQL Server'ı Merkezi Yönetmek
Merkezi yönetimde her database motoru kendi native backup aracını kullanmaya devam edebilir. Orchestrator yalnızca job parametrelerini, schedule ve sonuçları standardize eder. Böylece PostgreSQL için pg_dump, MySQL için uygun dump aracı ve SQL Server için native backup aynı policy altında takip edilebilir. Motor özel restore adımları ayrı workflow olarak tanımlanır. Ortak metadata modeli merkezi catalog oluşturmayı kolaylaştırır.
Backup Job'larını Stagger Etmek
Tüm backup job'larının gece yarısında başlaması storage üzerinde ani yük oluşturabilir. Stagger yaklaşımı görevleri farklı zaman aralıklarına yayar. Kritik veritabanları önce, daha düşük kritik sistemler daha sonra schedule edilebilir. İşlem süresi değiştikçe çakışmalar monitoring ile tespit edilmelidir. Dinamik scheduler yük durumuna göre başlangıç zamanını ayarlayabilir.
CPU ve I/O Çakışmalarını Önlemek
Backup işlemleri CPU, disk ve network kaynaklarını yoğun kullanabilir. Aynı host veya storage üzerinde çalışan birden fazla job production performansını düşürebilir. Resource limit, I/O throttle ve job concurrency politikaları kullanılabilir. Monitoring backup sırasında latency değişimini takip etmelidir. Schedule gerçek kullanım verisine göre düzenli olarak güncellenmelidir.
Merkezi Configuration
Merkezi configuration backup policy'lerinin tutarlı biçimde uygulanmasını sağlar. Database adı, kritiklik, RPO, retention, encryption ve storage hedefi tek tanımda tutulabilir. Değişiklikler Git üzerinden review sürecine bağlanabilir. Yanlış retention veya eksik encryption ayarı policy validation ile engellenebilir. Configuration as Code yaklaşımı audit sürecini kolaylaştırır.
Merkezi Monitoring
Merkezi monitoring tüm database backup durumlarını tek görünümde toplar. Backup success tek başına yeterli değildir ve freshness, duration, size, restore success gibi metrikler de gösterilmelidir. Kritik sistemlerde RPO compliance dashboard üzerinde izlenebilir. Alarm routing database sahibine göre otomatik yapılabilir. Bu yaklaşım unprotected database sayısını azaltmaya yardımcı olur.
Merkezi Backup Catalog
Merkezi backup catalog hangi database için hangi recovery noktalarının bulunduğunu kayıt altına alır. Backup türü, timestamp, size, checksum, storage konumu ve restore test sonucu metadata olarak saklanabilir. Olay anında en uygun backup'ın hızlı bulunmasını sağlar. PITR zincirlerinde log başlangıç ve bitiş bilgileri catalog'a eklenmelidir. Catalog'ın kendisi yüksek erişilebilir ve yedekli tasarlanmalıdır.
Backup from Replica Stratejisi
Backup from replica yaklaşımı backup yükünü primary database üzerinden uzaklaştırmak için kullanılabilir. Özellikle büyük physical veya logical backup işlemleri CPU ve I/O tükettiğinde bu yöntem production performansını koruyabilir. Fakat replica lag gerçek RPO değerini etkileyebilir. Replica sağlığı ve transaction güncelliği kontrol edilmeden backup başlatılmamalıdır. Backup'ın hangi replica konumundan üretildiği catalog içinde tutulmalıdır.
Primary Üzerindeki Backup Yükü
Backup production disklerini yoğun okuyabilir ve CPU tüketebilir. Sıkıştırma işlemi işlemci yükünü daha da artırabilir. Büyük sistemlerde backup sırasında query latency yükselmesi görülebilir. Kaynak kullanımı gözlemlenerek backup penceresi veya throttle ayarları optimize edilmelidir. Replica kullanımı bu yükün bir bölümünü production primary'den uzaklaştırabilir.
Replica Üzerinden Backup Alma
Replica üzerinden backup almak primary kullanıcı trafiğini daha az etkileyebilir. Backup başlamadan replication state kontrol edilmelidir. Lag kabul edilen eşiğin üzerindeyse job ertelenebilir veya başka replica seçilebilir. Replica backup node'u olarak ayrılmışsa kapasite planı buna göre yapılmalıdır. Restore testinde alınan backup'ın gerçek veri zamanı raporlanmalıdır.
Replica Lag Riski
Replica lag backup'ın güncelliğini doğrudan etkiler. Saat 10:00'da backup alınmış olsa bile replica 20 dakika gerideyse gerçek recovery point 09:40 olabilir. Bu durum dashboard üzerinde açıkça gösterilmelidir. RPO hesabı backup başlangıç zamanına göre yapılmamalıdır. Otomasyon lag eşiğini aştığında backup'ı başarısız sayabilir.
RPO'ya Etkisi
Replica tabanlı backup RPO hedefini fark edilmeden kötüleştirebilir. Backup schedule sık olsa bile replication gecikmesi recovery noktasını eski hale getirir. Catalog replica'nın son uyguladığı log position veya transaction zamanını saklayabilir. Monitoring RPO compliance hesabında bu bilgiyi kullanmalıdır. Kritik sistemlerde düşük lag sağlayan dedicated backup replica değerlendirilebilir.
Consistency Kontrolü
Backup alınacak replica'nın tutarlı ve sağlıklı durumda olması gerekir. Replication error veya eksik transaction varsa backup güvenilir olmayabilir. Job öncesinde replica state, lag ve gerekli database health kontrolleri çalıştırılmalıdır. Backup sonrasında checksum ve restore validation yapılmalıdır. Consistency kontrolü yalnızca replica'nın online olmasıyla sınırlı tutulmamalıdır.
Backup Retention Politikası Nasıl Tasarlanır?
Retention politikası recovery penceresi, mevzuat, storage maliyeti ve operasyon gereksinimleri arasında denge kurar. Her backup'ı süresiz tutmak sürdürülebilir değildir, çok kısa saklama ise geç fark edilen veri sorunlarında recovery şansını azaltır. Günlük, haftalık, aylık ve yıllık katmanlar farklı ihtiyaçlar için kullanılabilir. Retention mekanizması incremental zincirlerin bağımlılıklarını bilmelidir. Silme işlemi otomatik olsa bile son doğrulanmış recovery noktalarını koruyan güvenlik kontrolleri bulunmalıdır.
Günlük Yedekler
Günlük yedekler kısa dönem operasyonel recovery için kullanılır. Son birkaç gün veya hafta içinde oluşan hatalara hızlı dönüş sağlar. Sıklık RPO gereksinimine göre ek saatlik veya log tabanlı backup ile desteklenebilir. Günlük dosyalar daha hızlı storage katmanında tutulabilir. Saklama süresi veri değişim hızı ve maliyete göre belirlenmelidir.
Haftalık Yedekler
Haftalık yedekler günlük kopyalardan daha uzun süre saklanabilir. Genellikle belirli bir günün full backup'ı haftalık recovery noktası olarak seçilir. Günlük zincir silinse bile daha eski dönemlere dönüş imkânı sağlar. Retention politikası bu kopyaları otomatik etiketleyebilir. Haftalık backup'ın restore testi aylık tatbikatlarda kullanılabilir.
Aylık Yedekler
Aylık yedekler daha uzun dönem recovery veya mevzuat ihtiyaçları için saklanabilir. Storage maliyetini azaltmak amacıyla daha düşük maliyetli tier kullanılabilir. Ancak archive tier'dan geri alma süresi RTO hedefini etkileyebilir. Encryption key erişimi uzun dönem boyunca korunmalıdır. Format ve database sürümü değişikliklerinde eski backup'ların restore edilebilirliği test edilmelidir.
Yıllık Arşivler
Yıllık arşivler uzun süreli saklama gereksinimlerinde kullanılabilir. Bu dosyaların restore edilmesi seyrek olduğu için format sürdürülebilirliği önem kazanır. Çok eski database sürümlerine ait backup'lar yeni sistemlerde doğrudan açılamayabilir. Gerekirse eski engine sürümünü yeniden oluşturabilecek IaC veya container tanımları saklanmalıdır. Retention mevzuat gereksiniminden daha uzun olmamalıdır.
Grandfather-Father-Son Modeli
Grandfather-Father-Son modeli günlük, haftalık ve aylık backup katmanlarını birlikte kullanır. Son günlük kopyalar kısa dönem, haftalık kopyalar orta dönem ve aylık kopyalar uzun dönem recovery sağlar. Bu yaklaşım storage kullanımını kontrol altında tutarken tarihsel esneklik sunar. Her katmanın retention süresi iş ihtiyacına göre değiştirilmelidir. Model immutable ve off-site kopyalarla güçlendirilebilir.
Compliance Retention
Compliance retention verinin yasal veya sözleşmesel gereksinimlere göre belirli süre saklanmasını kapsar. Backup içindeki kişisel veriler de bu yükümlülüklere dahildir. Süre sona erdiğinde güvenli silme mekanizması gerekebilir. Immutable policy çok uzun ayarlanırsa silme yükümlülükleriyle çatışma riski doğabilir. Hukuki ve teknik ekipler retention politikasını birlikte değerlendirmelidir.
Storage Maliyeti ile Recovery Esnekliği Dengesi
Daha fazla recovery noktası saklamak esneklik sağlar fakat storage maliyetini artırır. Eski backup'ları düşük maliyetli storage tier'a taşımak çözüm olabilir. Bunun karşılığında restore başlangıç süresi uzayabilir. Cost per protected GB metriği farklı policy seçeneklerini karşılaştırmaya yardımcı olur. Karar yalnızca maliyete değil beklenen recovery senaryolarına göre verilmelidir.
3-2-1 Backup Kuralı Nedir?
3-2-1 yaklaşımı verinin üç kopyasını, iki farklı medya veya storage türünü ve bir off-site kopyayı hedefler. Bu prensip tek bir altyapı arızasının tüm backup'ları birlikte kaybetmesini önlemeye yardımcı olur. Modern cloud ortamlarında farklı account ve farklı region kullanımı ek izolasyon sağlayabilir. Yine de kopya sayısı kadar restore edilebilirlik de önemlidir. Her kopyanın gerçekten erişilebilir ve doğrulanmış olduğu düzenli testlerle kontrol edilmelidir.
3 Veri Kopyası
Üç veri kopyası genellikle production veri ve iki ayrı backup kopyası olarak düşünülebilir. Kopyaların aynı fiziksel hata alanında bulunmaması önemlidir. Aynı storage üzerindeki üç klasör gerçek bağımsızlık sağlamaz. Erişim politikalarının da birbirinden ayrılması güvenliği artırır. Kopyaların güncelliği ve restore durumu merkezi catalog üzerinden izlenmelidir.
2 Farklı Medya
İki farklı medya veya storage türü ortak arıza riskini azaltmayı amaçlar. Örneğin local disk ile object storage birlikte kullanılabilir. Her iki ortamın aynı yönetici hesabına bağlı olması güvenlik açısından ayrı risk yaratabilir. Kopya yöntemi kadar erişim ve silme sınırları da farklılaştırılmalıdır. Restore testleri her storage türünden ayrı ayrı yapılmalıdır.
1 Off-Site Kopya
Off-site kopya veri merkezi veya ana region kaybına karşı koruma sağlar. Fiziksel olarak farklı lokasyon veya cloud region seçilebilir. Kopyalama süresi RPO hedefini etkileyebilir. Network bağlantısı kesildiğinde backlog birikmesi monitoring tarafından görülmelidir. DR testlerinde off-site kopyadan tam restore yapılmalıdır.
Cloud Object Storage
Cloud object storage backup verileri için ölçeklenebilir ve lifecycle destekli bir hedef sağlayabilir. Versioning, object lock ve tiering gibi özellikler backup tasarımını güçlendirebilir. Access key güvenliği ayrı secret yönetimiyle korunmalıdır. Upload sonrasında checksum veya object metadata doğrulaması yapılmalıdır. Restore hızının network ve egress koşullarına bağlı olduğu unutulmamalıdır.
Farklı Region
Farklı region üzerinde backup tutmak bölgesel hizmet kesintilerine karşı ek koruma sağlar. Cross-region kopyalama otomatik hale getirilebilir. Encryption key ve IAM policy'leri recovery region içinde de çalışmalıdır. Veri yerleşimi ve mevzuat gereksinimleri region seçiminde dikkate alınmalıdır. DR testleri yalnızca veritabanını değil network ve uygulama katmanlarını da kapsamalıdır.
Farklı Account / Subscription
Farklı account veya subscription backup'ın production kimlik bilgilerinden bağımsız tutulmasını sağlar. Production hesabının ele geçirilmesi durumunda saldırganın backup silme ihtimali azaltılabilir. Cross-account rol ve key izinleri kontrollü tasarlanmalıdır. Backup hesabında günlük operasyon yetkileri sınırlı tutulabilir. Recovery işlemi için gerekli erişim düzenli tatbikatlarda doğrulanmalıdır.
Immutable ve Air-Gapped Backup
Immutable ve air-gapped backup özellikle ransomware ve yetkili hesap ele geçirilmesi risklerine karşı önem kazanır. Immutable kopya belirlenen süre boyunca silinemez veya değiştirilemez. Air-gapped yaklaşım ise backup ile production arasında kalıcı doğrudan erişimi azaltır. Bu yöntemler hatalı retention veya erişim tasarımının yerine geçmez. Recovery anahtarları, restore prosedürü ve hesap ayrımı birlikte planlandığında güçlü bir savunma katmanı oluşur.
Immutable Backup Nedir?
Immutable backup belirli süre boyunca değiştirilemeyen veya silinemeyen veri kopyasıdır. Ransomware backup alanına erişse bile mevcut recovery noktalarını yok edememesi hedeflenir. Immutability süresi retention ihtiyacıyla uyumlu olmalıdır. Yanlış ayarlanmış çok uzun kilit süresi storage maliyetini artırabilir. Restore işlemi immutable kopyadan düzenli olarak test edilmelidir.
WORM
WORM yaklaşımı verinin bir kez yazıldıktan sonra belirli süre değiştirilememesini ifade eder. Backup dosyaları için güçlü koruma sağlayabilir. Yetkili yöneticinin bile silme kapasitesi policy'ye göre sınırlandırılabilir. Kullanılan storage çözümünün gerçek davranışı test edilmelidir. Compliance ve operational retention ihtiyaçları birlikte değerlendirilmelidir.
Object Lock
Object Lock object storage üzerinde backup objelerinin silinmesini veya değiştirilmesini sınırlandırabilir. Governance ve compliance benzeri modlar farklı koruma seviyeleri sunabilir. Policy yanlış yapılandırılırsa beklenen koruma oluşmayabilir. Backup upload sonrasında lock durumunun doğrulanması faydalıdır. Recovery testinde kilitli objelerin okunabilir olduğu kontrol edilmelidir.
Logically Air-Gapped Backup
Logically air-gapped backup üretim sistemi ile backup alanı arasındaki sürekli erişim bağını azaltır. Backup aktarımı sınırlı servis kimliği veya kontrollü workflow üzerinden yapılabilir. Production admin hesabının backup silme yetkisi olmayabilir. Bu yaklaşım saldırganın tek kimlik bilgisiyle tüm veri kopyalarına ulaşmasını zorlaştırır. Restore için ayrı ve denetimli erişim süreci tanımlanmalıdır.
Ransomware'a Karşı Koruma
Ransomware'a dayanıklı backup için immutable storage, ayrı account, ayrı credentials ve düzenli restore testi birlikte kullanılmalıdır. Sadece backup dosyasının başka klasörde bulunması yeterli koruma sağlamaz. Saldırgan production erişimiyle backup alanını silebiliyorsa recovery riski yüksektir. Backup delete protection ve object lock bu nedenle değerlidir. Tatbikatlarda saldırı sonrası hangi kopyanın güvenilir olduğu belirlenmelidir.
Backup Administrator Hesabının Ele Geçirilmesi Riski
Backup administrator hesabı çok geniş yetkilere sahipse tek bir credential kaybı tüm backup'ları riske atabilir. Daily backup operasyonu ile retention silme yetkileri ayrılabilir. MFA, just-in-time access ve ayrı approval süreçleri kullanılabilir. Immutable policy yönetici yetkisinin etkisini sınırlayabilir. Audit log'ları hesap davranışını sürekli izlemelidir.
Backup Encryption Nasıl Yapılır?
Veritabanı backup'larının şifrelenmesi storage kaybı veya yetkisiz erişim durumunda veri gizliliğini korur. Encryption at rest, in transit ve backup file encryption farklı katmanlarda birlikte kullanılabilir. Key management iyi tasarlanmazsa şifreli backup gerektiğinde açılamayabilir. Veritabanı yedeklerinde şifreleme bulut depolama retention ve restore testi nasıl yapılır sorusu bu nedenle tek bir güvenlik ayarına indirgenmemelidir. Anahtar yedekliliği, rotation, erişim kontrolü ve restore testi aynı süreç içinde ele alınmalıdır.
Encryption at Rest
Encryption at rest backup verisinin storage üzerinde şifreli tutulmasını sağlar. Cloud storage veya disk katmanında platform özellikleri kullanılabilir. Kimin key'e erişebileceği IAM policy ile sınırlandırılmalıdır. Storage encryption tek başına dosyanın başka yere kopyalandığında da şifreli kalacağı anlamına gelmeyebilir. Bu nedenle dosya seviyesi encryption ek güvenlik sağlayabilir.
Encryption in Transit
Encryption in transit backup verisinin ağ üzerinden aktarılırken korunmasını sağlar. TLS veya güvenli transfer protokolleri kullanılmalıdır. Backup sunucusu ile object storage arasındaki bağlantı da bu kapsama dahildir. Sertifika doğrulaması kapatılmamalıdır. Network transferinin şifreli olduğu otomasyon configuration kontrolleriyle doğrulanabilir.
Backup File Encryption
Backup file encryption dosyanın storage ortamından bağımsız biçimde şifreli kalmasını sağlar. Dosya farklı lokasyona taşındığında da koruma devam eder. Encryption anahtarı backup ile aynı dizinde tutulmamalıdır. Otomasyon encrypt adımı başarısızsa unencrypted dosyayı off-site göndermemelidir. Restore testleri şifre çözme adımını gerçek prosedür içinde çalıştırmalıdır.
KMS ile Key Management
KMS servisleri encryption key yaşam döngüsünü merkezi biçimde yönetmeye yardımcı olur. Backup job doğrudan anahtar materyalini saklamak yerine kontrollü API kullanabilir. Erişim least privilege ve audit log ile sınırlandırılabilir. Farklı account veya region recovery senaryolarında key erişimi ayrıca planlanmalıdır. KMS kesintisi sırasında restore ihtimali için risk analizi yapılmalıdır.
Encryption Key Backup Problemi
Şifreli backup korunurken encryption key kaybedilirse veri geri getirilemez. Bu nedenle anahtar dayanıklılığı backup verisinin dayanıklılığı kadar önemlidir. Key'in backup ile aynı erişim sınırında tutulması tek hata alanı oluşturabilir. Recovery yetkileri ayrı süreçle yönetilebilir. DR tatbikatında key erişimi özellikle doğrulanmalıdır.
Key Rotation
Key rotation belirli aralıklarla yeni encryption key kullanılmasını sağlar. Eski backup'ların eski anahtarla açılabilmesi gerekeceği için anahtar geçmişi güvenli biçimde korunmalıdır. Rotation sonrası restore testi yapılması faydalıdır. Otomasyon yeni key kimliğini backup metadata'sına ekleyebilir. Key lifecycle retention politikasıyla birlikte planlanmalıdır.
Restore Sırasında Anahtar Erişimi
Restore sırasında gerekli encryption key'e hızlı ve yetkili erişim gerekir. Production dışındaki DR region veya recovery account aynı erişime sahip olmayabilir. Bu nedenle key policy'leri felaket anı senaryosuna göre test edilmelidir. Manuel approval çok uzun sürüyorsa RTO etkilenebilir. Güvenlik ile hızlı recovery arasında önceden tanımlanmış kontrollü denge kurulmalıdır.
Backup Credential Güvenliği
Backup sistemi production verisine geniş erişim gerektirebildiği için credential güvenliği kritik öneme sahiptir. Backup kullanıcıları yalnızca ihtiyaç duydukları işlemleri yapabilmelidir. Şifrelerin script içine yazılması veya ortak admin hesabının kullanılması risklidir. Secret manager, workload identity ve ayrı restore yetkileri daha güvenli yaklaşım sağlar. Erişimler düzenli audit edilmeli ve kullanılmayan hesaplar kaldırılmalıdır.
Dedicated Backup User
Dedicated backup user yalnızca backup görevleri için ayrılmış kimlik sağlar. Böylece application veya DBA hesabının gereksiz yere otomasyonda kullanılması önlenir. Yetkiler backup türüne göre sınırlandırılabilir. Kullanıcı aktiviteleri audit log içinde kolayca ayrıştırılır. Credential rotation uygulama hesaplarından bağımsız yapılabilir.
Least Privilege
Least privilege backup hesabına yalnızca gerekli minimum yetkilerin verilmesini amaçlar. Logical dump için read erişimi yeterli olabilecek senaryolarda admin rolü verilmemelidir. Restore işlemi farklı ve daha yüksek yetkili hesapla yapılabilir. İzinler zaman içinde büyüme eğilimi gösterebileceği için periyodik review gerekir. Policy as Code bu kontrolleri otomatikleştirebilir.
Secret Manager Kullanımı
Secret manager parolaları ve token'ları merkezi güvenli depoda tutar. Backup job çalışma anında gerekli secret'a erişebilir. Değerler source code veya script dosyasında bulunmaz. Erişim audit edilebilir ve rotation otomatik hale getirilebilir. Secret manager erişimi başarısız olduğunda backup job açık hata üretmelidir.
Hard-Coded Password Kullanmamak
Hard-coded password source code, script veya configuration dosyasında kalıcı credential bırakır. Repository'ye yanlışlıkla gönderildiğinde uzun süre fark edilmeden erişim riski yaratabilir. Environment secret veya secret manager kullanmak daha güvenlidir. Komut satırında parola göstermek process list üzerinden sızıntı riski doğurabilir. Backup otomasyonu credential yönetimini ilk tasarım aşamasında çözmelidir.
Workload Identity
Workload identity statik key yerine çalışan iş yükünün kendi kimliğiyle cloud kaynaklarına erişmesini sağlar. Bu yaklaşım uzun ömürlü access key ihtiyacını azaltabilir. Yetkiler job, service account veya workload seviyesinde sınırlandırılabilir. Token yaşam süresi kısa tutulabilir. Backup upload işlemleri bu sayede daha güvenli hale getirilebilir.
Backup ve Restore Yetkilerini Ayırmak
Backup alma ve restore yapma yetkileri farklı risk seviyelerine sahiptir. Günlük backup job'ın production üzerinde restore veya delete yetkisi bulunması gerekmeyebilir. Restore işlemi approval gerektiren ayrı bir kimlikle yapılabilir. Bu ayrım credential ele geçirilmesi durumunda etki alanını küçültür. Yetki matrisi runbook ve IAM policy içinde açıkça tanımlanmalıdır.
Backup Monitoring Nasıl Yapılır?
Backup monitoring yalnızca job'ın başarılı veya başarısız görünmesini takip etmemelidir. Backup freshness, duration, size, storage capacity, checksum ve upload durumu birlikte izlenmelidir. Özellikle son başarılı backup'ın yaşı gerçek RPO görünümü sağlar. Heartbeat yaklaşımı backup job hiç çalışmadığında bile alarm üretir. Restore test sonuçları dashboard içinde backup metrikleriyle yan yana gösterilmelidir.
Backup Job Status
Backup job status temel success veya failure bilgisini sağlar. Her çalışmanın başlangıç ve bitiş zamanı kaydedilmelidir. Hata mesajları merkezi log sistemine gönderilmelidir. Retry davranışı açık biçimde tanımlanmalıdır. Sürekli başarısız job yüksek öncelikli alarm üretmelidir.
Backup Freshness
Backup freshness son kullanılabilir recovery noktasının ne kadar eski olduğunu gösterir. Bu metrik RPO compliance açısından job success'ten daha değerlidir. Job başarılı görünse bile eski replica üzerinden backup alınmış olabilir. PITR sistemlerinde son arşivlenen log zamanı freshness hesabına dahil edilmelidir. Eşik aşılırsa otomatik alarm üretilmelidir.
Backup Duration
Backup duration zaman içindeki performans değişimini gösterir. Sürenin ani artması storage, network veya veri büyümesi sorununa işaret edebilir. P50 ve P95 değerleri trend olarak izlenebilir. Uzayan job'lar diğer schedule görevleriyle çakışabilir. Capacity planning için bu metrik düzenli değerlendirilmelidir.
Backup Size
Backup size veri büyümesini ve anormal değişiklikleri izlemek için yararlıdır. Beklenenden çok küçük dosya eksik tablo veya başarısız dump belirtisi olabilir. Ani büyüme retention ve storage maliyetini etkileyebilir. Boyut geçmiş günlerle karşılaştırılmalıdır. Yüzdesel değişim eşikleri anomaly detection için kullanılabilir.
Storage Capacity
Backup storage kapasitesi dolduğunda yeni backup oluşturulamayabilir. Free space veya quota merkezi monitoring'e eklenmelidir. Growth trend yaklaşan kapasite sorununu önceden gösterebilir. Lifecycle policy beklendiği gibi çalışmıyorsa eski dosyalar birikebilir. Kritik eşiklere gelmeden otomatik bildirim oluşturulmalıdır.
Checksum Failure
Checksum failure backup dosyasının beklenen içerikle eşleşmediğini gösterir. Transfer veya storage bozulması bunun nedeni olabilir. Böyle bir backup recovery catalog içinde geçersiz olarak işaretlenmelidir. Mümkünse otomatik yeni backup başlatılabilir. Aynı problem tekrar ediyorsa storage ve network altyapısı incelenmelidir.
Upload Failure
Upload failure local backup oluşturulmuş olsa bile off-site korumanın gerçekleşmediği anlamına gelir. Bu durum local job success olarak gizlenmemelidir. Retry kontrollü backoff ile yapılabilir. Uzun süreli bağlantı problemi backlog oluşturabileceği için local disk kapasitesi izlenmelidir. Son başarılı off-site copy zamanı ayrı metrik olmalıdır.
Heartbeat / Dead Man's Switch
Heartbeat backup job'ın beklenen zamanda çalıştığını bağımsız sisteme bildirir. Belirlenen süre boyunca heartbeat gelmezse alarm üretilir. Bu yaklaşım scheduler'ın tamamen durduğu sessiz arızaları yakalar. Backup success mesajından bağımsız tutulması daha güvenlidir. Kritik job'lar için farklı heartbeat eşikleri belirlenebilir.
Alert Routing
Alert doğru ekibe ulaşmadığında teknik olarak üretilmesi yeterli değildir. Database sahibi, operasyon ekibi ve nöbet sistemi severity seviyesine göre tanımlanmalıdır. Tekrarlayan düşük öncelikli alarmlar alarm yorgunluğu oluşturabilir. RPO ihlali ve restore test failure yüksek önem taşımalıdır. Alert routing envanter ve ownership bilgisiyle otomatik eşleştirilebilir.
Backup Anomaly Detection
Backup anomaly detection geçmiş davranıştan farklılaşan backup özelliklerini erken fark etmeyi amaçlar. Boyut, süre, data growth, object sayısı ve upload zamanı gibi metrikler karşılaştırılabilir. Basit istatistiksel eşikler bile birçok problemi erken gösterebilir. Daha gelişmiş modeller geçmiş trend ve seasonality verisini kullanabilir. Anomali tespiti otomatik restore testinin yerine geçmez fakat hangi backup'ların öncelikli incelenmesi gerektiğini belirleyebilir.
Beklenenden Küçük Backup
Backup boyutunun normalden çok küçük olması eksik veri veya başarısız export işareti olabilir. Bir tablo dışlanmış veya job erken bitmiş olabilir. Boyut önceki benzer backup'larla karşılaştırılmalıdır. Sabit eşik yerine yüzdesel değişim daha anlamlı olabilir. Şüpheli backup otomatik restore testine gönderilebilir.
Ani Backup Boyutu Artışı
Backup boyutundaki ani artış veri büyümesi veya beklenmeyen kayıt çoğalması gösterebilir. Application bug aynı veriyi tekrar tekrar yazmış olabilir. Storage maliyeti ve backup süresi de bu durumdan etkilenir. Database table size raporu ile backup metriği birlikte incelenmelidir. Anomali kaynağı açıklanmadan retention veya compression ayarı değiştirilmemelidir.
Backup Süresinin Uzaması
Backup duration'ın artması I/O, CPU, network veya veri büyümesi problemlerine işaret edebilir. Aynı zaman diliminde başka yoğun job'lar çalışıyor olabilir. Trend grafiği yavaş performans bozulmasını erken gösterebilir. Uzayan backup penceresi RPO ve operasyon schedule üzerinde etki yaratabilir. Root cause analizi kaynak metrikleriyle birlikte yapılmalıdır.
Data Growth Anomalisi
Data growth anomalisi normal kullanım trendinden beklenmeyen sapmadır. Bir tablo veya collection çok hızlı büyüyor olabilir. Bu durum backup maliyeti yanında restore süresini de artırır. Monitoring tablo seviyesinde büyüme verisini backup size ile ilişkilendirebilir. Kapasite ve retention kararları bu trendlere göre güncellenmelidir.
Eksik Tablo / Object
Logical backup sırasında yanlış filtre veya yetki problemi bazı tabloların dışarıda kalmasına neden olabilir. Job exit code başarılı olsa bile eksik nesne riski bulunabilir. Backup manifest içinde beklenen object listesi tutulabilir. Restore sonrasında schema object sayısı karşılaştırılmalıdır. Kritik tablolar ayrıca explicit validation listesine eklenmelidir.
AI Tabanlı Anomali Tespiti
Makine öğrenmesi tabanlı modeller backup süreleri, boyutları ve veri büyümesi gibi metriklerde normal davranış aralıklarını öğrenebilir. Bu yöntem sabit eşiklerin yakalamadığı yavaş değişimleri fark etmeye yardımcı olabilir. Model çıktısı otomatik silme veya recovery kararı vermek yerine öncelikli inceleme sinyali olarak kullanılmalıdır. Eğitim verisi hatalı backup dönemlerini içeriyorsa sonuçlar yanıltıcı olabilir. Basit kurallar, sağlam monitoring ve restore testleri her zaman temel katman olarak korunmalıdır.
Automated Restore Testing Nedir?
Automated restore testing backup sisteminin gerçekten çalıştığını düzenli olarak kanıtlayan otomasyon yaklaşımıdır. Sistem belirlenen backup'ı seçer, izole recovery ortamı oluşturur, restore işlemini çalıştırır ve ardından veri doğrulaması yapar. Test tamamlandığında geçici altyapı otomatik kaldırılabilir. Başarısızlık durumunda sadece backup ekibi değil ilgili database sahibi de bilgilendirilebilir. Veritabanı Yedekleme ve Restorasyon Otomasyonları içinde en yüksek değer sağlayan uygulamalardan biri düzenli restore testidir.
Neden Sadece Backup Dosyasını Kontrol Etmek Yetmez?
Dosyanın var olması onun restore edilebilir olduğunu göstermez. Encryption key eksik olabilir, backup zinciri kırılmış olabilir veya dump dosyasında kritik tablolar bulunmayabilir. Checksum yalnızca dosya bütünlüğünü kontrol eder. Database restore gerçek engine davranışını sınar. Application validation ise verinin iş açısından kullanılabilir olduğunu gösterir.
İzole Test Ortamı Oluşturmak
Restore testi production'dan ayrı bir network ve database ortamında yapılmalıdır. Yanlışlıkla gerçek uygulama trafiğinin test database'e bağlanması engellenmelidir. IaC ile geçici instance veya container oluşturulabilir. Test ortamına production credentials taşınmamalıdır. İş tamamlandığında kaynaklar otomatik silinmelidir.
Son Backup'ı Otomatik Seçmek
Backup catalog son başarılı ve policy açısından geçerli backup'ı belirleyebilir. Yalnızca en yeni dosyaya bakmak PITR zincirlerindeki bağımlılıkları gözden kaçırabilir. Seçim algoritması full ve log ilişkisini dikkate almalıdır. Rastgele geçmiş backup seçerek tarihsel restore kabiliyeti de test edilebilir. Seçilen recovery noktası raporda açıkça gösterilmelidir.
Database Restore
Restore otomatik workflow içinde gerçek araçlarla gerçekleştirilmelidir. Test kolay olsun diye farklı yöntem kullanmak production runbook'unu doğrulamaz. Süre, throughput ve hata mesajları ölçülmelidir. Restore tamamlandığında database'in bağlantı kabul edip etmediği kontrol edilir. Ardından schema ve veri validation adımlarına geçilir.
Validation
Validation restore başarısını birden fazla seviyede doğrular. Database'in açılması ilk adımdır fakat yeterli değildir. Kritik tablolar, row count, referential integrity ve business query sonuçları kontrol edilebilir. Application smoke testleri gerçek kullanım yolunu sınar. Başarılı backup ancak bu kontrolleri geçtiğinde doğrulanmış recovery point olarak işaretlenebilir.
Test Ortamını Otomatik Silmek
Restore test ortamları sürekli açık bırakılırsa maliyet ve güvenlik riski oluşturabilir. Workflow sonunda database, disk ve network kaynakları kaldırılmalıdır. Test başarısız olsa bile TTL mekanizması ikinci güvenlik katmanı sağlar. Log ve test sonucu gerekli süre boyunca merkezi sistemde saklanabilir. Production backup dosyaları cleanup sırasında kesinlikle silinmemelidir.
Test Sonucunu Raporlamak
Restore test raporu kullanılan backup, başlangıç zamanı, bitiş zamanı ve toplam recovery süresini içermelidir. Validation sonuçları ayrı alanlarda gösterilmelidir. Başarısız adım varsa hata mesajı ve ilgili log bağlantısı rapora eklenebilir. Zaman içindeki RTO trendi dashboard üzerinde takip edilebilir. Raporlar audit ve disaster recovery hazırlığı açısından önemli kanıt oluşturur.
Otomatik Restore Doğrulama Seviyeleri
Restore doğrulaması yalnızca tek kontrolle yapılmamalıdır. Dosya, database, veri, iş mantığı ve uygulama seviyeleri birbirinden farklı hata türlerini yakalar. Bir backup dosyasının checksum doğrulamasından geçmesi schema'nın eksiksiz olduğu anlamına gelmez. Database'in açılması da kritik transaction'ların doğru çalıştığını kanıtlamaz. Bu nedenle çok katmanlı validation gerçek recovery güvenini belirgin biçimde artırır.
Dosya Seviyesi
Dosya seviyesi kontroller backup artifact'inin temel olarak mevcut ve bozulmamış olduğunu doğrular. Exists, size ve checksum en yaygın üç kontroldür. Bu katman hızlı çalışır ve her backup sonrasında uygulanabilir. Database içeriğinin mantıksal doğruluğunu göstermez. Yine de daha pahalı restore testlerinden önce etkili ilk filtredir.
Exists
Exists kontrolü beklenen backup dosyasının gerçekten hedef storage üzerinde bulunup bulunmadığını kontrol eder. Job success logu olsa bile upload başarısız olabilir. Object storage API üzerinden obje metadata'sı okunabilir. Dosya adı ve backup kimliği catalog ile karşılaştırılmalıdır. Eksik artifact backup job'ı başarısız olarak işaretlemelidir.
Size
Size kontrolü backup dosyasının beklenen büyüklük aralığında olup olmadığını değerlendirir. Sıfır byte veya aşırı küçük dosyalar açık hata sinyalidir. Önceki backup'larla yüzdesel karşılaştırma yapılabilir. Compression oranı değiştiğinde eşikler buna göre güncellenmelidir. Anormal boyut otomatik restore testi başlatmak için kullanılabilir.
Checksum
Checksum dosyanın oluşturma ve transfer sonrası aynı içeriğe sahip olduğunu doğrular. Backup üretiminde checksum hesaplanıp catalog'a yazılabilir. Off-site upload sonrasında yeniden hesaplanarak karşılaştırılır. Uyuşmazlık dosya bozulmasına işaret eder. Bozuk artifact retention zincirinden çıkarılmadan önce yeni güvenilir backup oluşturulmalıdır.
Database Seviyesi
Database seviyesi kontrol restore edilen motorun sağlıklı çalışıp çalışmadığını doğrular. Connection testi ve schema kontrolü bu seviyede temel adımlardır. Database açılıyorsa bile tüm nesneler eksiksiz olmayabilir. Engine logları restore sonrası incelenmelidir. Kritik warning veya corruption işaretleri test sonucunu başarısız sayabilir.
Database Açılıyor mu?
Restore sonrasında database servisinin başlaması ilk temel doğrulamadır. Health query veya basit connection testi kullanılabilir. Service up olsa bile recovery mode devam ediyor olabilir. Read veya write kapasitesi test senaryosuna göre kontrol edilmelidir. Açılış süresi toplam RTO hesabına dahil edilmelidir.
Schema Tam mı?
Schema kontrolü beklenen tablo, view, index, function ve diğer nesnelerin bulunup bulunmadığını değerlendirir. Baseline metadata version control içinde tutulabilir. Kritik nesneler ayrı listeyle kontrol edilmelidir. Migration sürümü uygulamanın beklediği seviyede olmalıdır. Schema eksikliği restore testini başarısız saymalıdır.
Veri Seviyesi
Veri seviyesi validation backup içindeki kayıtların mantıksal bütünlüğünü kontrol eder. Row count, referential integrity ve checksum yöntemleri kullanılabilir. Tüm satırların tek tek karşılaştırılması büyük sistemlerde pahalı olabilir. Bu nedenle kritik tablolar ve örneklem kontrolleri seçilebilir. Veri seviyesi testler backup'ın yalnızca açılabilir değil kullanılabilir olduğunu gösterir.
Row Counts
Row count kritik tabloların beklenen kayıt sayısını içerip içermediğini hızlı biçimde gösterir. Kesin sayı yerine kabul edilen aralık veya production snapshot metadata'sı kullanılabilir. Partition veya temporal tablolar ayrıca değerlendirilebilir. Büyük tablolarda count sorgusu pahalı olabileceği için metadata tabanlı yaklaşım düşünülebilir. Beklenmeyen sapma alarm üretmelidir.
Referential Integrity
Referential integrity ilişkili tablolar arasındaki bağlantıların korunup korunmadığını kontrol eder. Foreign key constraint bulunmayan legacy sistemlerde özel sorgular gerekebilir. Restore sonrası eksik parent kayıtları ciddi veri problemi gösterebilir. Kritik ilişkiler test listesine alınmalıdır. Validation sorguları version control içinde tutulabilir.
Checksum
Veri seviyesinde checksum seçilen tablo veya veri parçalarının içerik tutarlılığını karşılaştırmak için kullanılabilir. Production tarafında alınmış referans değer ile restore sonucu kıyaslanabilir. Büyük tablolarda tam checksum maliyetli olabilir. Partition veya örneklem bazlı yaklaşım kullanılabilir. Sonuçlar backup metadata'sıyla ilişkilendirilmelidir.
İş Mantığı Seviyesi
İş mantığı seviyesi validation teknik olarak doğru görünen verinin uygulama kurallarını karşılayıp karşılamadığını test eder. Örneğin toplam bakiye, aktif sipariş veya günlük işlem sayısı gibi kritik kontroller yapılabilir. Bu sorgular iş birimleriyle birlikte tanımlanmalıdır. Database schema değiştikçe testler güncellenmelidir. Recovery'nin iş açısından kullanışlı olduğunu gösteren en değerli katmanlardan biridir.
Kritik Sorgular
Kritik sorgular uygulamanın temel ekran veya raporlarını besleyen veri erişimlerini temsil eder. Restore ortamında bu sorguların hatasız çalışması beklenir. Sonuçların mantıklı aralıklarda olması ayrıca kontrol edilebilir. Sadece SELECT başarısı yeterli olmayabilir. Önemli hesaplamaların örnek sonuçları baseline ile karşılaştırılmalıdır.
Kritik Transaction'lar
Kritik transaction testleri yeni kayıt oluşturma veya kontrollü güncelleme gibi uygulama işlemlerini sınar. Test ortamı olduğu için güvenli sentetik veri kullanılabilir. Transaction commit ve rollback davranışı kontrol edilir. Trigger veya stored procedure gibi bileşenlerin çalıştığı doğrulanır. Test sonunda oluşturulan veriler temizlenmelidir.
Uygulama Seviyesi
Uygulama seviyesi validation database'in gerçek istemciyle birlikte çalışıp çalışmadığını test eder. Restore edilmiş database'e izole bir application instance bağlanabilir. Login, kritik API çağrısı veya temel kullanıcı akışı kontrol edilebilir. Böylece connection string, driver ve schema uyumluluğu da test edilmiş olur. Bu katman recovery'nin teknik sınırdan gerçek hizmet seviyesine geçtiğini gösterir.
Smoke Test
Smoke test uygulamanın temel fonksiyonlarının hızlı biçimde çalıştığını doğrular. Login, ana sayfa, kritik API ve basit veri okuma adımları kullanılabilir. Tüm fonksiyonların ayrıntılı testi yerine en önemli yollar seçilir. Test kısa sürdüğü için her restore denemesinde çalıştırılabilir. Başarısızlık production failover'ını durdurmalıdır.
Health Check
Health check uygulamanın database bağlantısı ve kritik bağımlılıklarıyla sağlıklı iletişim kurduğunu kontrol eder. Sadece HTTP 200 yanıtı yeterli olmayabilir. Endpoint gerçek database sorgusu çalıştırmalıdır. Timeout ve dependency hata mesajları kaydedilmelidir. Recovery workflow health check geçmeden trafik aktivasyonuna ilerlememelidir.
CI/CD Pipeline İçinde Backup ve Restore Testi
CI/CD sürecine backup ve restore kontrolü eklemek database değişikliklerinin riskini azaltabilir. Kritik migration öncesi otomatik recovery point oluşturulabilir. Migration sonrasında schema ve veri validation çalıştırılabilir. Büyük değişikliklerde test ortamında restore pipeline tetiklenerek rollback kapasitesi doğrulanabilir. Deployment hızını tamamen durdurmadan risk seviyesine göre farklı kontrol katmanları uygulanabilir.
Deployment Öncesi Snapshot / Backup
Deployment öncesi snapshot veya backup geri dönüş için güvenli başlangıç noktası oluşturur. Her deployment için full backup almak maliyetli olabilir. Risk seviyesine göre snapshot, logical backup veya işaretlenmiş PITR noktası kullanılabilir. Backup kimliği deployment ID ile eşleştirilmelidir. Deployment başarısız olduğunda doğru recovery noktası otomatik bulunabilir.
Migration Öncesi Recovery Point
Schema veya veri migration'ı başlamadan hemen önce recovery point oluşturmak geri dönüş planını güçlendirir. PITR destekleyen sistemlerde timestamp ve log position kaydedilebilir. Recovery point metadata'sı migration kaydıyla ilişkilendirilmelidir. Büyük migration öncesi restore tatbikatı yapılması faydalıdır. Değişiklik tamamlandıktan sonra eski noktanın retention süresi policy'ye göre yönetilir.
Schema Migration Sonrası Validation
Migration sonrasında beklenen schema sürümü ve kritik nesneler kontrol edilmelidir. Index, constraint ve column değişiklikleri otomatik test edilebilir. Application smoke testleri yeni schema ile uyumluluğu doğrular. Beklenmeyen hata varsa deployment durdurulabilir. Validation sonuçları release raporuna eklenmelidir.
Otomatik Rollback
Otomatik rollback yalnızca geri dönüş işlemi gerçekten güvenliyse kullanılmalıdır. Bazı schema değişiklikleri veri kaybına neden olabileceği için basit down migration yeterli olmayabilir. Backup veya PITR recovery farklı bir rollback yolu sunabilir. Sistem recovery kararı vermeden önce veri kaybı etkisini değerlendirmelidir. Kritik production sistemlerinde approval adımı korunabilir.
Restore Test Pipeline
Restore test pipeline belirli release veya periyodik zamanlarda backup'ı izole ortama geri yükler. Ardından schema, veri ve uygulama testleri çalıştırılır. Süre bilgisi RTO trendine eklenir. Pipeline failure release kalitesi açısından görünür hale getirilebilir. Bu sayede backup sistemi yazılım teslim sürecinin ölçülen bir parçası olur.
Database Migration Disaster Testleri
Database migration disaster testleri planlı değişikliğin başarısız olması durumunu simüle eder. Migration yarıda kesilebilir veya hatalı veri üretme senaryosu çalıştırılabilir. Ekip backup, PITR veya forward fix yöntemlerinden doğru olanını uygular. Gerçek recovery süresi ölçülür. Öğrenilen noktalar runbook ve deployment standardına eklenir.
Database Migration ve Backup Otomasyonu
Database migration ile backup otomasyonu birlikte tasarlandığında değişiklik yönetimi daha güvenli hale gelir. Her migration öncesinde uygun recovery point oluşturulabilir. Migration kimliği backup catalog kaydıyla eşleştirilerek hangi sürüme hangi verinin karşılık geldiği görülebilir. Sonrasında health check ve validation otomatik çalıştırılır. Sorun olduğunda forward fix ile restore arasında veriye ve kesinti hedefine göre bilinçli seçim yapılır.
Migration Öncesi Backup
Migration öncesi backup kritik schema veya veri değişikliklerinden önce güvenli geri dönüş noktası sağlar. Her değişiklikte aynı backup türünü kullanmak gerekmez. Küçük migration için PITR bookmark yeterli olabilirken büyük dönüşümde özel full backup tercih edilebilir. Backup tamamlanmadan migration başlamamalıdır. Verification sonucu deployment sistemine aktarılmalıdır.
Migration ID ile Backup Eşleştirme
Migration ID backup metadata'sına yazıldığında recovery operasyonu kolaylaşır. Olay anında hangi backup'ın hangi değişiklik öncesine ait olduğu hızlı biçimde anlaşılır. Deployment SHA veya release number da metadata olarak kullanılabilir. Catalog query ile doğru recovery point otomatik seçilebilir. Bu ilişki audit sürecini de güçlendirir.
Migration Sonrası Health Check
Migration sonrasında database bağlantısı ve kritik schema öğeleri doğrulanmalıdır. Application health check yeni schema ile çalışmayı test eder. Kritik sorguların latency değerleri karşılaştırılabilir. Migration teknik olarak başarılı olsa bile performans sorunu üretmiş olabilir. Monitoring release öncesi baseline ile sonrası arasında fark göstermelidir.
Rollback Point
Rollback point değişiklik başarısız olduğunda dönülebilecek net recovery noktasını ifade eder. Timestamp, transaction position veya özel backup ID olabilir. Bu bilgi deployment sistemi tarafından kayıt altına alınmalıdır. Recovery prosedürü hangi veri kaybının oluşacağını açıkça belirtmelidir. Rollback point'in kullanılabilir olduğu test edilmelidir.
Forward Fix vs Restore Kararı
Her hata restore gerektirmez. Küçük ve hızlı düzeltilebilir sorunlarda forward fix daha az veri kaybı yaratabilir. Geniş veri bozulmasında restore daha güvenli olabilir. Karar RTO, RPO, etkilenen kayıt sayısı ve sonraki transaction'ların korunma ihtiyacına göre verilmelidir. Olay prosedürü iki seçeneğin karar kriterlerini önceden tanımlamalıdır.
Zero-Downtime Migration
Zero-downtime migration uygulama hizmetini durdurmadan schema değişikliği yapmayı hedefler. Expand-contract gibi yöntemler database ve application sürümlerini aşamalı uyumlu tutabilir. Backup ve PITR yine gerekli güvenlik katmanıdır. Migration sırasında uzun lock veya replication lag izlenmelidir. Geri dönüş senaryosu deployment başlamadan önce belirlenmelidir.
Backup as Code ve Recovery as Code
Backup as Code, backup policy ve job tanımlarını elle yapılan ayarlar yerine version control içinde kod olarak yönetir. Recovery as Code ise restore ve disaster recovery adımlarını tekrar edilebilir workflow haline getirir. Bu yaklaşım değişikliklerin review edilmesini, test edilmesini ve yeniden üretilebilmesini kolaylaştırır. Terraform, Ansible ve workflow araçları farklı katmanlarda kullanılabilir. En büyük fayda, kriz anında uzun manuel komut listelerine bağımlılığı azaltmaktır.
Backup Policy'lerini Kod Olarak Yönetmek
Backup policy tanımları schedule, retention, encryption ve storage hedeflerini kod içinde ifade edebilir. Her database sınıfı için standart policy oluşturulabilir. Yeni database eklendiğinde doğru policy otomatik uygulanabilir. Drift detection eksik veya değiştirilmiş ayarları fark edebilir. Policy değişiklikleri Pull Request üzerinden incelenebilir.
Git Versioning
Git backup configuration değişikliklerinin geçmişini tutar. Kim tarafından hangi retention veya schedule değişikliğinin yapıldığı görülebilir. Yanlış değişiklik önceki sürüme döndürülebilir. Code review operasyon hatalarını azaltır. Secret değerler repository içine eklenmemelidir.
Terraform
Terraform recovery altyapısı ve bazı cloud backup kaynaklarını kod olarak tanımlamak için kullanılabilir. Network, database instance, IAM ve storage bileşenleri birlikte provision edilebilir. DR ortamı sürekli açık tutulmak zorunda kalmadan gerektiğinde oluşturulabilir. State güvenliği ayrıca korunmalıdır. Plan çıktıları değişiklik öncesinde review edilmelidir.
Ansible
Ansible database sunucularında backup araçlarının kurulumu ve configuration yönetimi için kullanılabilir. Cron, systemd timer ve backup script dağıtımı standardize edilebilir. Environment farklılıkları inventory ve variable yapısıyla yönetilebilir. Secret değerler güvenli yöntemle sağlanmalıdır. Restore ortamı hazırlama adımları da playbook içine alınabilir.
Policy as Code
Policy as Code backup standartlarının otomatik kontrol edilmesini sağlar. Örneğin kritik database'in encryption olmadan backup alması pipeline tarafından engellenebilir. Minimum retention ve off-site kopya şartları kural haline getirilebilir. Yeni database deployment sırasında policy compliance kontrol edilir. Böylece güvenlik ve recovery gereksinimleri dokümanda kalmaz.
Restore Workflow'larını Kodlamak
Restore workflow kod olarak tanımlandığında her tatbikatta aynı adımlar uygulanır. Backup seçimi, infrastructure provisioning, restore, validation ve cleanup bir akış içinde otomatikleştirilebilir. Manuel hatalar azalır. Workflow logları audit kaydı oluşturur. Production activation gibi riskli adımlar approval gerektirebilir.
Pull Request ile Backup Policy Değişikliği
Backup policy değişikliğini Pull Request üzerinden yapmak kontrol ve şeffaflık sağlar. Retention azaltma veya encryption ayarı değiştirme gibi riskli işlemler ikinci göz tarafından incelenebilir. Otomatik testler policy kurallarını kontrol eder. Değişiklik merge edildikten sonra deployment sistemi ayarı uygular. Audit ihtiyacında tüm geçmiş kolayca görülebilir.
Infrastructure as Code ile Recovery Ortamı Oluşturmak
Recovery ortamının manuel kurulması RTO süresini uzatabilir ve yapılandırma hatası riskini artırabilir. Infrastructure as Code ile database instance, network, IAM ve secret erişimi önceden tanımlanabilir. Disaster recovery sırasında aynı kod hedef region üzerinde çalıştırılarak yeni ortam oluşturulabilir. Ardından restore ve validation workflow otomatik devam eder. Test tamamlandığında veya failback sonrasında geçici altyapı kontrollü biçimde kaldırılabilir.
Terraform ile Recovery Infrastructure
Terraform recovery region içindeki network, database ve storage kaynaklarını kod olarak oluşturabilir. Modüller production ile benzer güvenlik ve yapılandırma standartlarını koruyabilir. Recovery tatbikatı sırasında plan ve apply süresi ölçülmelidir. Provider erişimi ve state backend'i felaket senaryosunda kullanılabilir olmalıdır. Kod düzenli test edilmezse kriz anında sürpriz hatalar çıkabilir.
Database Instance Oluşturma
Recovery için database instance boyutu RTO ve performans hedeflerine uygun seçilmelidir. Çok küçük geçici instance restore süresini gereksiz uzatabilir. IaC engine version, storage ve parameter ayarlarını standardize eder. Production ile uyumluluk otomatik kontrol edilebilir. Instance hazır olduğunda restore workflow tetiklenir.
Networking
Recovery database'in uygulama tarafından erişilebilmesi için network altyapısı hazır olmalıdır. VPC, subnet, firewall ve private endpoint ayarları IaC içinde tanımlanabilir. DR region'da eksik route veya DNS ayarı recovery'yi geciktirebilir. Network testleri tatbikatın parçası olmalıdır. Gereksiz public erişim açılmamalıdır.
IAM
Recovery workflow backup storage, KMS ve database kaynaklarına gerekli IAM izinlerine sahip olmalıdır. Yetkiler production'dan bağımsız veya cross-account olabilir. Disaster anında manuel rol oluşturmak RTO'yu uzatabilir. IaC kontrollü minimum izinleri önceden tanımlar. Audit log recovery sırasında kullanılan erişimleri kaydetmelidir.
Secret Provisioning
Recovery ortamı application ve database secret'larına güvenli biçimde erişebilmelidir. Secret değerleri IaC koduna yazılmamalıdır. Secret manager veya workload identity kullanılabilir. DR region secret replication veya erişim politikası önceden test edilmelidir. Application connection bilgileri restore tamamlandıktan sonra otomatik güncellenebilir.
Restore
Altyapı hazır olduğunda uygun backup catalog üzerinden seçilir. Restore engine'in native yöntemiyle otomatik olarak başlatılır. PITR gerekiyorsa hedef timestamp veya log position workflow parametresi olur. Süre ve hata metrikleri kaydedilir. Restore tamamlandığında validation aşamasına geçilir.
Validation
Recovery ortamındaki database connection, schema, veri ve application seviyesinde kontrol edilmelidir. Critical query set otomatik çalıştırılabilir. Row count ve migration version karşılaştırılır. Uygulama smoke testleri temel kullanıcı yollarını doğrular. Tüm kontroller geçmeden trafik DR ortamına yönlendirilmemelidir.
Automatic Teardown
Test veya geçici recovery kaynakları kullanılmadığında maliyet oluşturmaya devam eder. Automatic teardown workflow sonunda bu kaynakları kontrollü biçimde kaldırır. TTL, workflow başarısız olsa bile unutulan kaynakları temizleyebilir. Silme kuralları production kaynaklarını etkilemeyecek güvenlik kontrolleri içermelidir. Log ve raporlar teardown sonrasında saklanabilir.
Kubernetes Üzerindeki Veritabanlarını Yedekleme
Kubernetes üzerinde çalışan stateful database'lerde yalnızca container image veya manifest yedeklemek veriyi korumaz. Persistent Volume, CSI snapshot ve database-native backup birlikte değerlendirilmelidir. StatefulSet uygulama yaşam döngüsünü yönetirken veri tutarlılığı için veritabanının kendi backup mekanizması önemini korur. Operator tabanlı çözümler backup süreçlerini cluster API ile entegre edebilir. Recovery testi yeni namespace veya geçici cluster üzerinde otomatik yapılabilir.
StatefulSet
StatefulSet stateful uygulamalara sabit kimlik ve persistent storage bağlantısı sağlar. Pod yeniden oluşturulduğunda aynı volume ile devam edebilir. Bu dayanıklılık backup anlamına gelmez. Yanlış veri değişikliği volume üzerinde kalmaya devam eder. Database-native backup ayrı olarak planlanmalıdır.
Persistent Volumes
Persistent Volumes database verisini pod yaşam döngüsünden bağımsız saklar. Volume silme veya storage arızası yine veri kaybına neden olabilir. Storage class özellikleri snapshot ve replication desteği sunabilir. Volume backup ile database tutarlılığı ayrı konulardır. Restore senaryosu yeni PVC üzerinde test edilmelidir.
CSI Snapshots
CSI snapshots Kubernetes storage katmanında volume snapshot oluşturmayı sağlar. Hızlı recovery ve clone senaryolarında faydalı olabilir. Database yazma işlemleri sırasında snapshot consistency mekanizması düşünülmelidir. Application-consistent snapshot için pre-hook veya database entegrasyonu gerekebilir. Snapshot farklı hata alanına kopyalanmıyorsa tek başına yeterli koruma sayılmamalıdır.
Velero
Velero Kubernetes kaynaklarını ve desteklenen storage snapshot süreçlerini backup etmek için kullanılabilir. Namespace, deployment ve configuration recovery'sinde yardımcı olabilir. Stateful database için database-native backup gereksinimini tamamen ortadan kaldırmaz. Cluster resource backup ile database veri backup'ı ayrı katmanlarda planlanmalıdır. Tam DR testi iki katmanın birlikte restore edilmesini doğrulamalıdır.
Database-Native Backup'ın Gerekliliği
Database-native backup transaction tutarlılığı ve engine recovery mekanizmalarını dikkate alır. Kubernetes storage snapshot tek başına WAL, binlog veya transaction log mantığını bilmez. PITR gereksinimi olduğunda native log arşivleme önem kazanır. Operator'lar bu mekanizmaları otomatikleştirebilir. Restore prosedürü database engine seviyesinde doğrulanmalıdır.
Operator Tabanlı Backup
Database operator backup schedule, retention ve restore işlemlerini Kubernetes custom resource üzerinden yönetebilir. Bu yaklaşım configuration'ı GitOps sürecine dahil etmeyi kolaylaştırır. Operator sürümü ve backup formatı uyumluluğu takip edilmelidir. Secret ve object storage erişimleri güvenli biçimde sağlanmalıdır. Operator tarafından başlatılan backup'lar da bağımsız restore testiyle doğrulanmalıdır.
Kubernetes CronJob
Kubernetes CronJob logical veya native backup komutlarını düzenli çalıştırabilir. Job container içinde gerekli tool version sabitlenebilir. Resource request ve limit production pod'ları etkilemeyecek şekilde ayarlanmalıdır. Job output merkezi log sistemine gönderilmelidir. Backup artifact'i object storage üzerinde doğrulanmalıdır.
Disaster Recovery Otomasyonu
Disaster Recovery otomasyonu büyük kesinti durumunda altyapı oluşturma, doğru recovery point'i seçme, database restore, application configuration ve trafik yönlendirme adımlarını hızlandırır. Manuel runbook kriz anında insan hatasına ve uzun beklemelere açık olabilir. Otomatik workflow karar gerektiren noktalarda approval bırakıp tekrar eden teknik işleri makineye devredebilir. Recovery sonrası validation tamamlanmadan trafik açılmamalıdır. Diyarbakır Yazılım Topluluğu'nun disaster recovery odaklı içeriklerine https://www.diyarbakiryazilim.com.tr/posts/bulut-tabanli-olaganustu-durum-kurtarma-disaster-recovery üzerinden ulaşılabilir.
Disaster Detection
DR süreci gerçek felaketin doğru biçimde tespit edilmesiyle başlar. Tek bir health check hatası otomatik full failover için yeterli olmayabilir. Birden fazla bağımsız sinyal kullanılabilir. Bölgesel erişim, database health ve application error oranı birlikte değerlendirilir. Kritik kararlar için insan approval adımı bırakılabilir.
Recovery Point Seçimi
Recovery point seçimi RPO ve olay türüne göre yapılır. En yeni backup her zaman güvenilir değildir çünkü veri bozulması yedeğe taşınmış olabilir. Catalog son doğrulanmış recovery noktalarını gösterir. Ransomware olayında saldırıdan önceki temiz nokta seçilmelidir. Hedef seçim kararı audit kaydına yazılmalıdır.
Recovery Infrastructure Provisioning
DR ortamı IaC ile otomatik oluşturulabilir. Network, IAM, database ve storage kaynakları tek workflow içinde hazırlanabilir. Recovery region'daki quota ve kapasite önceden kontrol edilmelidir. Provisioning süresi gerçek RTO'nun parçasıdır. Düzenli tatbikatlar bu sürenin öngörülebilir kalmasını sağlar.
Database Restore
Uygun recovery point seçildikten sonra database native yöntemle restore edilir. PITR gerekiyorsa log zinciri hedef zamana kadar uygulanır. Restore progress ve süre metrikleri izlenir. Hata olduğunda workflow güvenli noktada durmalıdır. Restore sonrası validation başlamadan trafik açılmaz.
Application Configuration
Yeni recovery database farklı endpoint veya credential kullanabilir. Application connection string ve secret değerleri otomatik güncellenmelidir. Feature flag veya maintenance mode kullanılabilir. Configuration değişikliği versioned ve geri alınabilir olmalıdır. Uygulama yeniden başladığında health check çalıştırılmalıdır.
DNS / Traffic Switching
Validation tamamlandıktan sonra trafik DR ortamına yönlendirilebilir. DNS TTL önceden uygun değere ayarlanmış olmalıdır. Load balancer veya global routing sistemi alternatif endpoint'e geçebilir. Trafik kademeli açılarak hata oranı izlenebilir. Geri dönüş mekanizması hazır tutulmalıdır.
Validation
DR validation database ve uygulamanın gerçek kullanıcı yükünü karşılayabilecek durumda olduğunu doğrular. Critical query, smoke test ve dependency kontrolleri çalıştırılır. Veri recovery target ile karşılaştırılır. Monitoring dashboard yeni region verilerini göstermelidir. Başarılı validation resmi recovery tamamlanma zamanını belirler.
Failback
Failback geçici DR ortamından normal primary ortama geri dönüş sürecidir. Failover kadar dikkatli planlanmalıdır. DR ortamında oluşan yeni transaction'ların primary sisteme güvenli taşınması gerekir. Veri senkronizasyonu tamamlanmadan trafik geri çevrilmemelidir. Failback tatbikatlarda ayrıca test edilmelidir.
Disaster Recovery Test Türleri
Disaster recovery hazırlığı tek tip testle ölçülemez. Backup validation düşük maliyetli ve sık çalıştırılabilirken full DR test gerçek kapasiteyi daha kapsamlı sınar. Tabletop exercise ekiplerin karar süreçlerini test eder. GameDay ve chaos engineering kontrollü hata senaryolarıyla operasyon davranışını gözlemlemeyi sağlar. Test seviyesi sistem kritikliğine göre planlanmalı ve çıkan aksiyonlar takip edilmelidir.
Backup Validation
Backup validation dosya ve metadata kontrolleriyle başlar. Checksum, size ve freshness hızlı sinyaller sağlar. Database restore yapılmadığı için tam recovery garantisi vermez. Her backup sonrasında çalıştırılabilir. Daha kapsamlı testler için ilk filtre olarak kullanılır.
Tabletop Exercise
Tabletop exercise gerçek sistemi değiştirmeden ekiplerin senaryo üzerinden karar vermesini sağlar. Kim backup seçer, kim failover onayı verir ve kim müşterileri bilgilendirir soruları ele alınır. Runbook boşlukları hızlı biçimde ortaya çıkar. Teknik olmayan paydaşlar da sürece dahil edilebilir. Sonuçlar aksiyon listesi olarak takip edilmelidir.
Restore Test
Restore test gerçek backup'ın ayrı ortama geri yüklenmesini sınar. Backup'ın teknik olarak kullanılabilir olduğunu kanıtlar. Süre ölçülerek RTO ile karşılaştırılır. Veri ve application validation eklenirse test değeri artar. Kritik sistemlerde düzenli otomatik restore önerilir.
Partial Failover
Partial failover sistemin belirli bir bileşenini DR ortamına taşır. Risk full failover'a göre daha kontrollüdür. Database replica veya belirli servisler test edilebilir. Network ve application configuration davranışı gözlemlenir. Kademeli DR olgunluğu oluşturmak için faydalı olabilir.
Full DR Test
Full DR test production'a yakın tam recovery sürecini uçtan uca sınar. Altyapı provisioning, restore, validation ve traffic switch birlikte uygulanır. Gerçek RTO bu testte daha doğru ölçülür. Planlı bakım penceresi gerekebilir. Sonuçlar üst düzey iş hedefleriyle karşılaştırılmalıdır.
GameDay
GameDay ekiplerin önceden tanımlanmış arıza senaryosuna karşı pratik yapmasını sağlar. Örneğin database region kaybı veya bozuk backup senaryosu uygulanabilir. Amaç ekip reflekslerini ve otomasyon kalitesini görmek olmalıdır. Gözlemciler süreleri ve karar noktalarını kaydeder. Öğrenilenler runbook ve otomasyona geri beslenir.
Chaos Engineering
Chaos engineering kontrollü hata oluşturarak sistem dayanıklılığını test eder. Database bağlantısı, node veya network bileşeni planlı biçimde devre dışı bırakılabilir. Production uygulaması yapılacaksa risk sınırları çok açık tanımlanmalıdır. Backup ve recovery sistemleri için önce test ortamında uygulanması daha güvenlidir. Amaç hata üretmek değil beklenen recovery davranışını doğrulamaktır.
Recovery Runbook Nasıl Otomatikleştirilir?
Recovery runbook olay sırasında izlenecek teknik ve operasyonel adımları tanımlar. Otomasyon tekrar eden işlemleri workflow haline getirerek hata riskini ve süreyi azaltabilir. Incident detection, catalog query, recovery point approval, restore, validation ve traffic activation tek akışta yönetilebilir. İnsan kararı gereken kritik noktalarda approval bırakılabilir. Recovery sonunda otomatik rapor oluşturmak hem audit hem de sonraki iyileştirmeler için değer sağlar.
Incident Detection
Incident detection güvenilir monitoring sinyallerinden oluşmalıdır. Tek metrik yerine database, application ve network göstergeleri birlikte değerlendirilebilir. False positive otomatik failover riskini artırır. Severity eşiği sistem kritikliğine göre belirlenmelidir. Olay kaydı açıldığında recovery workflow başlatılabilir.
Backup Catalog Query
Workflow olay tipine uygun recovery noktalarını catalog üzerinden listeler. Son doğrulanmış backup, timestamp ve restore test sonucu dikkate alınabilir. PITR destekleniyorsa log zinciri durumu kontrol edilir. Kirli veya şüpheli recovery noktaları filtrelenebilir. Operatör seçim için net bilgi görür.
Recovery Point Approval
Recovery point approval veri kaybı etkisinin kabul edildiği karar noktasıdır. Özellikle production restore işlemi geri dönüşü zor sonuçlar doğurabilir. Sistem seçilen noktanın RPO etkisini açıkça göstermelidir. Yetkili kişi onayladıktan sonra workflow devam eder. Approval kaydı audit log içinde saklanır.
Automated Restore
Restore adımı önceden test edilmiş komut ve workflow'larla çalışmalıdır. Altyapı yoksa önce otomatik provision yapılır. Backup download, decrypt ve engine restore işlemleri sırayla yürütülür. Progress metrikleri merkezi panelde gösterilir. Hata halinde workflow güvenli biçimde durup detaylı log üretir.
Validation
Restore edilen sistem database ve application seviyesinde doğrulanmalıdır. Schema, row count ve kritik sorgular kontrol edilir. Application smoke testleri gerçek bağlantıyı sınar. Beklenen recovery timestamp'i ayrıca doğrulanır. Validation başarısızsa traffic activation engellenir.
Traffic Activation
Traffic activation kullanıcılardan gelen trafiğin recovery ortamına yönlendirilmesini sağlar. DNS, load balancer veya service routing kullanılabilir. Geçiş kademeli yapılarak error rate izlenebilir. Geri alma mekanizması hazır tutulmalıdır. Aktivasyon zamanı resmi recovery süresine kaydedilir.
Stakeholder Notification
Recovery sürecinde teknik ve iş paydaşlarının doğru bilgi alması önemlidir. Workflow olay başlangıcı, recovery durumu ve tahmini teknik aşamaları otomatik bildirebilir. Bildirim içerikleri gerçek veriye dayanmalıdır. Gereksiz sık mesaj yerine önemli state değişimleri gönderilmelidir. Tamamlandığında recovery sonucu ve veri kaybı bilgisi paylaşılabilir.
Post-Recovery Report
Post-recovery report olayın zaman çizelgesini ve recovery adımlarını özetler. Kullanılan backup, gerçek RPO ve gerçek RTO belirtilmelidir. Hatalı veya yavaş adımlar ayrı gösterilir. Aksiyon maddeleri sorumlu ve hedef tarih bilgisiyle takip edilebilir. Rapor sonraki DR testlerinin odak alanını belirler.
Self-Service Database Restore
Self-service restore geliştiricilerin kontrollü biçimde production backup'ından test veya analiz ortamı oluşturabilmesini sağlar. Manuel ticket yükünü azaltırken approval, data masking ve TTL gibi korumalarla güvenlik korunabilir. Kullanıcı yalnızca izin verilen recovery point ve environment seçeneklerini görmelidir. Workflow gerekli altyapıyı açar, backup'ı restore eder ve kişisel verileri maskeler. Süre dolduğunda ortam otomatik kapatılarak maliyet ve veri riski azaltılır.
Geliştirici Restore Talebi
Geliştirici portal veya workflow üzerinden restore talebi oluşturabilir. Database, amaç ve gerekli tarih seçilir. Production'a doğrudan restore yetkisi verilmez. Talep audit log içine alınır. Kritik veri setlerinde ek approval gerekebilir.
Approval Workflow
Approval workflow veri sınıfına ve ortama göre karar sürecini yönetir. Düşük riskli test restore otomatik onaylanabilir. Kişisel veri içeren production backup için veri sahibi onayı gerekebilir. Onay bilgisi kayıt altına alınır. Süre aşan talepler otomatik iptal edilebilir.
Environment Seçimi
Kullanıcı yalnızca yetkili olduğu test veya development ortamlarını seçebilmelidir. Network production'dan izole olabilir. Kaynak boyutu varsayılan olarak maliyet kontrollü tutulabilir. Performans testleri için daha büyük profile approval gerekebilir. Environment policy kod olarak yönetilebilir.
Recovery Point Seçimi
Portal son doğrulanmış recovery noktalarını listeler. Kullanıcı tarih seçerken backup freshness ve validation sonucu görülebilir. PITR destekleniyorsa izin verilen zaman aralığı sunulabilir. Şüpheli veya doğrulanmamış backup seçenekleri gösterilmemelidir. Seçim metadata olarak workflow'a aktarılır.
Otomatik Provisioning
Self-service restore yeni database instance veya namespace'i otomatik oluşturur. IaC standardı network, IAM ve sizing ayarlarını uygular. Kullanıcı altyapı ayrıntılarıyla uğraşmaz. Provisioning failure otomatik loglanır. Başarılı olduktan sonra restore adımı başlar.
Data Masking
Test ortamına production kişisel verisi taşımak risk oluşturabilir. Data masking e-posta, telefon, kimlik veya diğer hassas alanları güvenli biçimde değiştirebilir. Masking kuralları schema version ile uyumlu tutulmalıdır. Restore sonrası otomatik çalıştırılması insan hatasını azaltır. Kullanıcı erişimi masking tamamlanmadan açılmamalıdır.
TTL ile Otomatik Temizleme
TTL geçici restore ortamının belirlenen süreden sonra otomatik silinmesini sağlar. Unutulan test database'lerinin maliyet ve veri riski oluşturmasını önler. Kullanıcı süre uzatmak isterse yeni approval süreci çalışabilir. Silme öncesi bildirim gönderilebilir. Audit kaydı ortamın ne zaman ve neden silindiğini göstermelidir.
Backup'tan Dev/Test Ortamı Üretme
Production backup'ından geçici dev veya test database üretmek gerçekçi test verisi sağlayabilir. Ancak production verisini doğrudan geliştiricilere açmak güvenlik ve KVKK açısından risklidir. Data masking, anonymization veya synthetic data dönüşümü uygulanmalıdır. Ephemeral database yaklaşımı her test için temiz ve izole ortam oluşturabilir. Otomatik refresh, ekiplerin eski test verisiyle çalışmasını önler.
Production Clone
Production clone gerçek verinin kopyasını yeni ortama taşır. Bu yöntem performans ve migration testlerinde yüksek gerçekçilik sağlar. Hassas veriler nedeniyle erişim ve masking zorunlu olabilir. Clone production network'üne yazma erişimi taşımamalıdır. TTL ile geçici kullanım süresi sınırlandırılabilir.
Ephemeral Database
Ephemeral database kısa süreli test için otomatik oluşturulan geçici database'dir. CI pipeline veya geliştirici isteğiyle başlatılabilir. Test bitince kaynak otomatik silinir. Her run için temiz ortam test güvenilirliğini artırır. Backup restore performansı da bu süreçte sürekli sınanmış olur.
PII Masking
PII masking kişisel verilerin test ortamında gerçek kimlikle kullanılmasını engeller. Email, telefon, adres ve kimlik bilgileri değiştirilebilir. İlişkisel bütünlük gerekiyorsa deterministic masking kullanılabilir. Masking kodu version control içinde tutulmalıdır. Yeni hassas kolonlar schema değişikliklerinde otomatik tespit edilebilir.
Anonymization
Anonymization verinin kişiyle yeniden ilişkilendirilmesini zorlaştırmayı amaçlar. Basit maskelemeden daha kalıcı veri dönüşümleri gerekebilir. Test ihtiyacını karşılayacak minimum veri korunmalıdır. Yeniden kimliklendirme riski değerlendirilmelidir. Süreç veri koruma politikasıyla uyumlu olmalıdır.
Synthetic Data
Synthetic data gerçek kişisel veriyi kullanmadan test senaryoları oluşturmayı sağlar. Belirli dağılımlar ve edge case'ler kontrollü biçimde üretilebilir. Production davranışını tam temsil etmeyebilir. Bu nedenle bazı performans ve migration testlerinde maskelenmiş gerçek veri daha uygun olabilir. Test amacına göre yöntem seçilmelidir.
Otomatik Test Veritabanı Refresh
Test database belirli schedule ile yeni backup'tan otomatik yenilenebilir. Restore, masking ve validation tek workflow içinde çalışır. Ekipler güncel schema ve veri dağılımıyla test yapar. Refresh sırasında test verilerinin üzerine yazılacağı açıkça yönetilmelidir. Başarısız refresh eski ortamı bozmadan durmalıdır.
Büyük Veritabanlarında Restore Performansı
Büyük veritabanlarında backup almaktan daha zor olan konu çoğu zaman restore süresidir. Veri boyutu büyüdükçe disk IOPS, network throughput, CPU, decompression ve index rebuild aşamaları RTO üzerinde belirleyici olur. Backup formatı restore paralelliğini doğrudan etkileyebilir. En hızlı backup formatı her zaman en hızlı restore formatı değildir. Bu nedenle kararlar gerçek recovery benchmark sonuçlarına dayanmalıdır.
Restore Süresinin Veri Boyutuyla İlişkisi
Restore süresi veri boyutu arttıkça genellikle yükselir fakat artış her zaman doğrusal değildir. Index oluşturma ve constraint işlemleri son aşamada ek süre yaratabilir. Storage throughput sabit kalırsa büyüyen veri doğrudan daha uzun recovery üretir. Compression ve paralellik bu ilişkiyi değiştirebilir. Capacity planning düzenli büyüme tahminlerini RTO ile birlikte değerlendirmelidir.
Disk IOPS
Disk IOPS restore sırasında random write ve metadata işlemlerinin hızını etkileyebilir. Yüksek throughput tek başına yeterli olmayabilir. Database motorunun write pattern'i storage seçimini belirler. Restore testleri farklı disk profile'larıyla karşılaştırılabilir. DR ortamının production'dan çok daha yavaş storage kullanması RTO riskini artırır.
Network Throughput
Backup uzak object storage'da ise restore sırasında network throughput önemli darboğaz olabilir. Terabayt büyüklüğünde dosyalarda indirme süresi toplam RTO'nun büyük bölümünü oluşturabilir. Parallel download veya aynı region storage kullanılabilir. Egress limitleri ve bandwidth quota önceden kontrol edilmelidir. Testler gerçek backup konumundan yapılmalıdır.
CPU
CPU özellikle compression, decompression ve logical restore sırasında önemli rol oynar. Çok düşük CPU restore worker'larının verimli çalışmasını engelleyebilir. Daha büyük recovery instance geçici olarak kullanılabilir. Cost ile RTO arasında denge kurulmalıdır. Benchmark optimum vCPU sayısını belirlemeye yardımcı olur.
Decompression
Sıkıştırılmış backup network ve storage avantajı sağlarken restore sırasında decompression zamanı ekler. Algoritma seçimi CPU kapasitesine göre yapılmalıdır. Çok yüksek compression oranı kısa RTO isteyen sistemlerde uygun olmayabilir. Parallel decompression destekleniyorsa süre azaltılabilir. Backup ve restore birlikte benchmark edilmelidir.
Index Rebuild
Logical restore sonrasında index rebuild uzun sürebilir. Büyük tablolar üzerinde bu aşama toplam recovery süresinin önemli bölümünü oluşturabilir. Paralel index oluşturma seçenekleri değerlendirilebilir. Önce kritik tabloları erişilebilir hale getirip diğer indexleri sonra oluşturmak bazı senaryolarda mümkün olabilir. Uygulama performansı etkisi test edilmelidir.
Parallel Restore
Parallel restore birden fazla nesne veya dosyanın eş zamanlı işlenmesini sağlar. Worker sayısı artırıldığında belirli noktaya kadar performans yükselir. Storage ve CPU doygunluğundan sonra ek worker fayda sağlamaz. Farklı concurrency değerleri benchmark edilmelidir. En uygun ayar runbook içinde sabitlenebilir.
Backup Formatı Seçimi
Backup formatı restore paralelliği ve object-level recovery kapasitesini etkiler. Tek büyük SQL dosyası basit olabilir fakat paralel restore açısından sınırlı kalabilir. Directory veya physical format daha hızlı recovery sunabilir. Format uyumluluğu database sürümüyle birlikte değerlendirilmelidir. RTO hedefi seçimde temel kriter olmalıdır.
Backup ve Restore Benchmark Nasıl Yapılır?
Backup ve restore benchmark gerçek performansı tahmin yerine ölçmeye yarar. Backup throughput, restore throughput, compression ratio, CPU, I/O ve network kullanımı birlikte kaydedilmelidir. Farklı veri boyutlarında P50 ve P95 restore süreleri hesaplanabilir. Test production'a yakın storage ve network koşullarında yapılmalıdır. Sonuçlar gerçek RTO hedefiyle karşılaştırılarak kapasite planı güncellenmelidir.
Backup Throughput
Backup throughput saniye veya dakika başına ne kadar veri yedeklendiğini gösterir. Veri büyüdükçe backup penceresinin ne kadar uzayacağını tahmin etmeye yardımcı olur. Compression aktifse logical ve physical throughput ayrı yorumlanmalıdır. Network veya disk darboğazı metric correlation ile bulunabilir. Trend zaman içinde kapasite ihtiyacını gösterir.
Restore Throughput
Restore throughput recovery sırasında ne kadar verinin geri yazılabildiğini gösterir. RTO planlamasında backup hızından daha önemli olabilir. Uzak storage indirme süresi de ölçüme dahil edilmelidir. Parallel restore worker sayıları karşılaştırılabilir. Gerçek production data size üzerinden hedef süre hesaplanmalıdır.
Compression Ratio
Compression ratio ham veri ile backup boyutu arasındaki oranı gösterir. Yüksek oran storage tasarrufu sağlarken CPU maliyetini artırabilir. Veri tipi sonucu doğrudan etkiler. Zaten sıkıştırılmış binary veri daha az kazanç sağlayabilir. Seçim cost ve RTO birlikte değerlendirilerek yapılmalıdır.
CPU Kullanımı
Backup ve restore sırasında CPU kullanımı production etkisini anlamaya yardımcı olur. Logical dump ve compression CPU tüketimini yükseltebilir. Restore worker sayısı CPU kapasitesine göre sınırlandırılmalıdır. Sürekli yüzde yüz CPU performans stabilitesini bozabilir. Benchmark kaynak kullanımını gerçek kullanıcı yüküyle birlikte gözlemlemelidir.
I/O Kullanımı
I/O backup sırasında yoğun read, restore sırasında yoğun write davranışı oluşturabilir. Disk queue ve latency değerleri takip edilmelidir. Backup job production sorgularının storage performansını etkilememelidir. Throttle veya replica backup yöntemi gerekebilir. RTO testinde recovery storage kapasitesi production'a yakın olmalıdır.
Network Kullanımı
Off-site backup ve restore network kapasitesini önemli ölçüde kullanabilir. Bandwidth sınırlıysa upload süresi RPO üzerinde etki yaratabilir. Restore sırasında download süresi RTO'yu uzatabilir. Network throttling diğer uygulamaların etkilenmesini önleyebilir. DR region bağlantısı düzenli benchmark edilmelidir.
P50 / P95 Restore Süresi
P50 restore süresi ortanca performansı gösterirken P95 daha kötü koşullardaki deneyimi anlamaya yardımcı olur. Tek başarılı test RTO güveni için yeterli değildir. Düzenli tatbikatlardan toplanan süreler dağılım olarak izlenmelidir. Veri büyümesiyle P95 değerinin artması erken kapasite sinyali verir. Hedef RTO özellikle yüksek yüzdelik değerlerle karşılaştırılmalıdır.
Gerçek RTO
Gerçek RTO yalnızca database restore komutunun süresi değildir. Olay tespiti, approval, infrastructure provisioning, backup transferi, restore, validation ve traffic switch toplamı ölçülmelidir. Manuel beklemeler de bu süreye dahildir. Otomasyon en fazla bu bekleme alanlarında fayda sağlar. Tatbikat raporları gerçek RTO ile hedef RTO arasındaki farkı göstermelidir.
Backup Sistemlerinin Başarısı Hangi KPI'larla Ölçülür?
Backup sistemi yalnızca günlük job başarı yüzdesiyle değerlendirilmemelidir. Restore success rate, RPO compliance, RTO compliance, freshness, coverage ve unprotected database sayısı daha anlamlı görünüm sağlar. Backup süresi ve restore süresi zaman içinde kapasite risklerini gösterebilir. Failed restore test sayısı teknik borç için güçlü sinyaldir. KPI'lar yönetim ve operasyon ekiplerinin aynı recovery hedeflerini konuşmasını kolaylaştırır.
Backup Success Rate
Backup success rate başarılı tamamlanan job oranını gösterir. Yüksek oran önemlidir fakat tek başına yeterli değildir. Başarılı job eksik veri üretmiş olabilir. Verification ve restore sonuçlarıyla birlikte yorumlanmalıdır. Kritik sistemler için başarısız tek job bile RPO ihlali yaratabilir.
Restore Success Rate
Restore success rate test edilen backup'ların kaçının başarıyla geri açıldığını gösterir. Bu metrik backup kalitesinin en önemli göstergelerinden biridir. Başarısız restore nedenleri kategorize edilmelidir. Tool, storage, key ve data validation hataları ayrı takip edilebilir. Hedef kritik sistemlerde mümkün olduğunca tam başarı olmalıdır.
RPO Compliance
RPO compliance gerçek recovery point yaşının hedef değer içinde olup olmadığını ölçer. Job success yerine kullanılabilir recovery noktasına bakar. Replica lag veya log upload gecikmesi bu metriği etkiler. Her database kritiklik sınıfına göre farklı hedefe sahip olabilir. İhlaller otomatik alarm üretmelidir.
RTO Compliance
RTO compliance gerçek recovery süresinin hedef süre içinde kalıp kalmadığını gösterir. Düzenli restore ve DR testlerinden veri toplanır. Veri büyüdükçe compliance oranı düşebilir. Otomasyon ve daha hızlı storage ile iyileştirme yapılabilir. RTO hedefleri yalnızca teorik dokümanda bırakılmamalıdır.
Backup Freshness
Backup freshness son doğrulanmış recovery noktasının yaşını gösterir. Düşük RPO isteyen sistemlerde kritik metriktir. PITR kullanılıyorsa son archive log zamanı dahil edilmelidir. Dashboard her database için freshness durumunu renk koduyla gösterebilir. Eşik aşımı nöbet ekibine yönlendirilmelidir.
Ortalama Backup Süresi
Ortalama backup süresi kaynak kullanımı ve veri büyümesini izlemeye yardımcı olur. Ani artış production performansı üzerinde baskı oluşturabilir. Ortalama tek başına uç değerleri gizlediği için P95 ile birlikte takip edilmelidir. Schedule çakışmaları süre trendinden görülebilir. Capacity plan bu veriye göre güncellenebilir.
Ortalama Restore Süresi
Ortalama restore süresi recovery performansının genel görünümünü verir. Farklı database boyutları ayrı gruplarda değerlendirilmelidir. Tek küçük database'in hızlı restore edilmesi büyük sistem sorunlarını gizleyebilir. P95 ve en büyük database sonuçları ayrıca izlenmelidir. RTO hedefleriyle düzenli karşılaştırma yapılmalıdır.
Failed Restore Test Sayısı
Failed restore test sayısı backup sistemindeki gizli sorunların ne kadar sık ortaya çıktığını gösterir. Tekrar eden aynı hata root cause çözülmediğini gösterebilir. Kategorilere göre trend çıkarılmalıdır. Kritik restore failure açık incident olarak takip edilebilir. Düşüş eğilimi recovery olgunluğunun önemli göstergesidir.
Unprotected Database Sayısı
Unprotected database sayısı backup policy uygulanmamış veritabanlarını gösterir. Yeni oluşturulan database'ler inventory dışında kalabilir. Discovery otomasyonu düzenli tarama yapmalıdır. Policy bulunmayan kaynak alarm üretmelidir. Hedef değer kritik ortamlar için sıfır olmalıdır.
Backup Coverage
Backup coverage envanterdeki veritabanlarının ne kadarının uygun policy ile korunduğunu gösterir. Sadece herhangi bir backup bulunması yeterli değildir. Kritiklik sınıfına uygun RPO, retention ve restore testi aranmalıdır. Coverage dashboard yönetim için anlaşılır bir özet sağlar. Yeni sistem deployment sürecinde policy otomatik atanmalıdır.
Backup Maliyeti Nasıl Optimize Edilir?
Backup maliyeti yalnızca storage faturası değildir. Compute, network, egress, restore testi ve operasyon zamanı toplam maliyeti oluşturur. Incremental backup, compression, deduplication ve lifecycle policy doğru kullanıldığında giderler azaltılabilir. Ancak maliyet uğruna recovery penceresini veya RTO'yu bozmak yanlış optimizasyon olur. Cost per protected GB gibi metrikler koruma seviyesini maliyetle birlikte değerlendirmeye yardımcı olur.
Storage Cost
Storage backup sisteminin en görünür maliyet kalemlerinden biridir. Retention süresi ve full backup sıklığı doğrudan alan ihtiyacını etkiler. Eski backup'lar daha düşük maliyetli tier'a taşınabilir. Immutable storage ek maliyet yaratabilir fakat güvenlik değeri yüksektir. Maliyet analizi recovery gereksinimini koruyarak yapılmalıdır.
Compute Cost
Backup compression, restore test ve database clone işlemleri compute tüketir. Otomatik test ortamları yalnızca gerektiğinde açılarak maliyet azaltılabilir. Ephemeral instance yaklaşımı burada faydalıdır. Çok küçük instance kullanmak restore süresini uzatıp RTO'yu bozabilir. Optimum boyut benchmark ile belirlenmelidir.
Network Cost
Cross-region backup kopyaları network transfer maliyeti oluşturabilir. Büyük veri hacimlerinde bu kalem önemli hale gelir. Incremental backup aktarılacak veri miktarını azaltabilir. Compression da network kullanımını düşürebilir. Bölgesel DR gereksinimi varsa maliyet buna göre kabul edilmelidir.
Egress Cost
Backup'ın farklı platform veya region'a restore edilmesi egress maliyeti yaratabilir. Bu maliyet normal dönemde görünmeyebilir fakat DR testlerinde ortaya çıkar. Restore tatbikatı ekonomik planlamaya gerçek veri sağlar. Çok sık full restore yerine risk tabanlı test programı uygulanabilir. Kritik sistemlerde maliyet recovery güvenliğinin önüne geçmemelidir.
Compression
Compression storage ve transfer maliyetini azaltır. CPU maliyetini artırabileceği için toplam maliyet analizi yapılmalıdır. Düşük maliyetli compute üzerinde yüksek compression bazen avantajlı olabilir. Restore sırasında decompression süresi RTO'yu etkiler. Optimum ayar gerçek benchmark ile bulunmalıdır.
Deduplication
Deduplication tekrar eden veri bloklarını tekil olarak saklayarak storage kullanımını azaltabilir. Özellikle benzer full backup setlerinde önemli tasarruf sağlayabilir. Kullanılan sistemin recovery performansına etkisi ölçülmelidir. Metadata kaybı deduplication yapılarında kritik risk olabilir. Restore testi bu nedenle önemini korur.
Incremental Backup
Incremental backup yalnızca değişen veriyi saklayarak günlük storage ve transfer maliyetini azaltır. Ancak restore zinciri uzayabilir. Çok uzun incremental chain RTO riskini artırabilir. Periyodik full veya synthetic full ile zincir dengelenebilir. Retention dependency yönetimi otomatik olmalıdır.
Storage Tiering
Storage tiering yeni backup'ları hızlı storage üzerinde, eskileri daha ucuz katmanda tutar. Sık kullanılan recovery noktaları hızlı erişilebilir kalır. Archive tier'dan geri alma saatler sürebilir. Bu süre RTO hedefiyle uyumlu olmalıdır. Tier transition lifecycle policy ile otomatikleştirilebilir.
Lifecycle Policy
Lifecycle policy backup objelerini yaşına göre taşıma veya silme işlemlerini otomatikleştirir. Günlük dosyalar belirli süreden sonra archive tier'a geçebilir. Silme kuralları full ve incremental bağımlılıklarını bozmayacak biçimde tasarlanmalıdır. Immutable lock süreleri dikkate alınmalıdır. Policy değişiklikleri review sürecinden geçmelidir.
Cost per Protected GB
Cost per protected GB toplam backup maliyetini korunan veri miktarına oranlar. Storage, compute ve network giderleri dahil edilebilir. Farklı database sınıfları arasında karşılaştırma sağlar. Çok düşük maliyetin zayıf recovery hizmeti anlamına gelmediği doğrulanmalıdır. KPI, RPO ve restore success metrikleriyle birlikte yorumlanmalıdır.
KVKK ve Veritabanı Backup'ları
Backup dosyaları üretim verisinin bir kopyasını içerdiği için KVKK kapsamındaki kişisel verileri de taşıyabilir. Bu nedenle backup storage, erişim yetkisi, retention ve test restore ortamları veri koruma politikasının dışında bırakılmamalıdır. Gereksiz uzun retention kişisel verilerin ihtiyaçtan fazla süre saklanmasına neden olabilir. Şifreleme ve audit trail erişim riskini azaltır. Test ortamlarında data masking uygulanması özellikle önemlidir.
Kişisel Verilerin Backup İçinde Saklanması
Production database kişisel veri içeriyorsa backup da çoğu zaman aynı veriyi içerir. Bu kopyalar farklı storage alanlarında bulunduğu için veri envanterine dahil edilmelidir. Kimlerin erişebildiği açıkça tanımlanmalıdır. Backup dosyası paylaşım veya test amaçlı gelişigüzel kullanılmamalıdır. Veri sınıflandırması backup policy'yi yönlendirmelidir.
Backup Retention
Retention kişisel verinin ne kadar süre backup içinde kalacağını belirler. İş ve yasal gereksinimden uzun saklama gereksiz risk oluşturabilir. Silme yükümlülükleri immutable storage ayarlarıyla uyumlu planlanmalıdır. Farklı veri sınıfları için farklı retention gerekebilir. Policy düzenli hukuk ve güvenlik değerlendirmesinden geçmelidir.
Encryption
Backup encryption kişisel verinin storage veya dosya ele geçirilmesi durumunda okunmasını zorlaştırır. At rest ve in transit encryption birlikte kullanılabilir. Key erişimi sınırlı tutulmalıdır. Şifreleme tek başına erişim yetkilendirmesinin yerine geçmez. Restore testleri gerekli key erişimini de doğrulamalıdır.
Erişim Yetkilendirmesi
Backup verisine erişim sadece gerekli rollerle sınırlandırılmalıdır. Geliştiricilerin production backup dosyalarına doğrudan erişmesi önlenebilir. Restore talepleri approval workflow üzerinden yürütülebilir. Audit log kimlerin hangi backup'a eriştiğini kaydetmelidir. Kullanılmayan yetkiler düzenli olarak kaldırılmalıdır.
Test Restore Ortamında Kişisel Veriler
Restore testi production verisini geçici ortama taşıdığı için veri koruma riski oluşturabilir. Test ortamı network açısından izole edilmelidir. Kullanıcı erişimi minimum tutulmalıdır. Mümkün olan durumlarda masking restore sonrasında otomatik çalıştırılmalıdır. Test tamamlanınca environment TTL ile silinmelidir.
Data Masking
Data masking kişisel alanları test amacı korunacak biçimde değiştirir. Gerçek e-posta, telefon veya kimlik yerine sahte değerler üretilebilir. Referential ilişki gereken alanlarda tutarlı dönüşüm yöntemi kullanılmalıdır. Masking policy schema değişiklikleriyle güncellenmelidir. Sonuç otomatik validation ile kontrol edilmelidir.
Backup Silme Politikaları
Backup silme politikası retention süresi dolan kopyaların kontrollü biçimde kaldırılmasını sağlar. Silme işlemi loglanmalıdır. Incremental zincirin gerekli parçaları yanlışlıkla silinmemelidir. Legal hold gibi durumlar policy içinde dikkate alınabilir. Manuel silme yetkileri sınırlı tutulmalıdır.
Audit Trail
Audit trail backup oluşturma, erişim, restore ve silme işlemlerinin geçmişini tutar. Kim, ne zaman ve hangi backup üzerinde işlem yaptı bilgisi görünür olur. Güvenlik olaylarında araştırma kolaylaşır. Loglar backup administrator tarafından kolayca değiştirilemeyecek ayrı sistemde saklanabilir. Retention süresi kurum politikasına göre belirlenmelidir.
Ransomware'a Dayanıklı Database Backup Tasarımı
Ransomware'a dayanıklı database backup tasarımında en önemli konu saldırganın production erişimiyle backup'ları da silememesidir. Immutable kopya, ayrı backup account, farklı credentials ve object lock birlikte güçlü koruma sağlar. Offline veya air-gapped copy ek güvenlik katmanı oluşturabilir. Backup delete protection yanlış veya kötü niyetli silmeyi sınırlar. Düzenli otomatik recovery testing ise saldırıdan sonra güvenilir kopyanın gerçekten kullanılabilir olduğunu önceden kanıtlar.
Immutable Backup
Immutable backup saldırı sırasında backup dosyasının değiştirilmesini veya silinmesini zorlaştırır. Retention lock policy kritik dönem boyunca koruma sağlar. Production admin hesabının bu kilidi kaldıramaması tercih edilebilir. Lock süresi veri politikasıyla uyumlu olmalıdır. Restore testi immutable kopyadan yapılmalıdır.
Ayrı Backup Account
Backup'ı farklı account içinde tutmak production credential ele geçirilmesi riskini sınırlar. Hesaplar arasında yalnızca gerekli write veya copy yetkileri açılabilir. Delete yetkisi günlük job'da bulunmayabilir. Recovery için ayrı approval rolü kullanılabilir. Cross-account restore düzenli test edilmelidir.
Ayrı Credentials
Backup storage için production database credential'larından farklı kimlik bilgileri kullanılmalıdır. Aynı parola veya access key birden fazla sistemde tekrar edilmemelidir. Secret manager ve workload identity daha güvenli yaklaşım sağlar. Rotation otomatik yapılabilir. Yetki seviyesi sadece gerekli işlemlerle sınırlandırılmalıdır.
Object Lock
Object Lock backup objelerini belirlenen süre boyunca silmeye karşı koruyabilir. Ransomware saldırganı storage hesabına erişse bile kopyaları kaldıramayabilir. Policy oluşturulduktan sonra gerçek davranış test edilmelidir. Lock yönetimi günlük operasyon rollerinden ayrılabilir. Restore okuma erişimi kilitten etkilenmemelidir.
Offline / Air-Gapped Copy
Offline veya air-gapped copy production network'ünden sürekli erişilemeyen ek kopya sağlar. Saldırganın aynı anda tüm kopyalara ulaşmasını zorlaştırır. Fiziksel veya mantıksal yöntem kullanılabilir. Recovery süresi online kopyaya göre daha uzun olabilir. Kritik sistemlerde bu gecikme DR planında hesaba katılmalıdır.
Backup Delete Protection
Backup delete protection yanlışlıkla veya kötü niyetle yapılan silme işlemlerini sınırlar. Multi-party approval veya bekleme süresi kullanılabilir. Daily backup service account silme yetkisine sahip olmayabilir. Büyük retention değişiklikleri review gerektirebilir. Audit log tüm delete denemelerini kaydetmelidir.
Otomatik Recovery Testing
Otomatik recovery testing ransomware sonrası kullanılacak backup'ın gerçekten açılabildiğini düzenli olarak doğrular. İzole environment seçilmesi güvenliği artırır. Restore sonrası corruption ve application behavior kontrol edilir. Son başarılı temiz recovery point catalog içinde işaretlenir. Olay anında hangi backup'ın kullanılacağı daha hızlı belirlenebilir.
Backup Sistemlerinde Yapılan Yaygın Hatalar
Backup sistemlerinde en sık görülen sorun teknik aracın eksikliğinden çok süreç tasarımındaki boşluklardan çıkar. Aynı sunucuda backup saklamak, restore testini atlamak veya RPO ve RTO tanımlamamak yaygın örneklerdir. Başarılı job ekranı yanlış güven hissi yaratabilir. WAL, binlog veya transaction log zincirindeki tek eksik dosya PITR planını bozabilir. Sağlıklı operasyon düzenli monitoring, encryption, retention ve application-level validation gerektirir.
Backup'ı Aynı Sunucuda Saklamak
Backup'ı production database ile aynı sunucuda tutmak donanım kaybında iki kopyayı birlikte riske atar. Aynı disk veya volume kullanımı daha da yüksek risk yaratır. Local backup hızlı olabilir fakat off-site kopyayla desteklenmelidir. Farklı account veya region ek izolasyon sağlar. 3-2-1 yaklaşımı bu hatayı önlemeye yardımcı olur.
Sadece Full Dump Kullanmak
Sadece günlük full dump kullanmak düşük RPO isteyen sistemlerde yetersiz kalabilir. Olay backup'tan saatler sonra gerçekleşirse büyük veri kaybı oluşur. WAL, binlog veya transaction log ile PITR seçeneği eklenebilir. Büyük database'lerde full dump restore süresi de uzun olabilir. Recovery hedefi yöntemi belirlemelidir.
Restore Testi Yapmamak
Restore testi yapılmayan backup'ın çalışacağı varsayılamaz. Dosya bozuk, şifreleme anahtarı eksik veya chain kırık olabilir. İlk gerçek restore denemesinin kriz anında yapılması ciddi risk yaratır. Otomatik restore testleri bu problemi erken gösterir. Sonuçlar RTO metriği olarak da kullanılabilir.
Backup Job Başarısını Recovery Başarısı Sanmak
Job'ın exit code sıfır dönmesi yalnızca belirli bir komutun tamamlandığını gösterir. Dosyanın doğru storage'a ulaştığını veya tüm tabloları içerdiğini kanıtlamaz. Recovery success restore ve validation ile ölçülmelidir. KPI dashboard'da iki oran ayrı gösterilmelidir. Yönetim raporlarında yalnızca backup success kullanılması yanıltıcı olabilir.
RPO ve RTO Tanımlamamak
RPO ve RTO olmadan backup sıklığı ve restore mimarisi tahmine dönüşür. Her gece backup almak iş gereksinimiyle uyumlu olmayabilir. Kritik database 15 dakikalık RPO isterken başka sistem 24 saat toleranslı olabilir. Hedefler database inventory içinde tutulmalıdır. Teknik tasarım bu hedeflerden türetilmelidir.
WAL / Binlog / Transaction Log Zincirini Korumamak
PITR için base backup kadar transaction log zinciri de gereklidir. Tek bir eksik WAL veya binlog hedef recovery noktasına ulaşmayı engelleyebilir. Log retention backup retention ile birlikte planlanmalıdır. Sequence gap monitoring otomatik yapılmalıdır. Düzenli PITR restore testi zincirin gerçek durumunu gösterir.
Monitoring Kurmamak
Monitoring yoksa backup günlerce çalışmadan kalabilir. Scheduler veya storage problemi kullanıcı fark edene kadar görünmeyebilir. Freshness, size, duration ve upload status takip edilmelidir. Dead man's switch sessiz scheduler arızalarını yakalar. Alarm doğru ekibe yönlendirilmelidir.
Backup Encryption Yapmamak
Şifrelenmemiş backup production verisinin açık bir kopyasını oluşturur. Dosya kaybolduğunda veya yanlış kişiye erişim verildiğinde veri açığa çıkabilir. Storage ve file encryption birlikte değerlendirilebilir. Key management planı restore süreciyle birlikte test edilmelidir. Encryption zorunluluğu policy as code ile kontrol edilebilir.
Production Credentials Kullanmak
Backup script'inde production admin credential kullanmak gereksiz yetki riski yaratır. Dedicated backup user daha güvenli olabilir. Restore gibi yüksek yetkili işlemler ayrı kimlikle yapılmalıdır. Credential secret manager üzerinden sağlanabilir. Rotation ve audit düzenli uygulanmalıdır.
Retention Politikası Olmaması
Retention olmadan backup storage kontrolsüz büyüyebilir. Ters durumda manuel silme eski ama gerekli recovery noktalarını kaybettirebilir. Günlük, haftalık ve aylık katmanlar policy içinde tanımlanmalıdır. Incremental bağımlılıklar otomatik hesaplanmalıdır. Silme işlemi audit edilmelidir.
Application-Level Validation Yapmamak
Database'in açılması uygulamanın çalışacağını garanti etmez. Eksik schema veya bozuk business data sorun yaratabilir. Smoke test ve kritik API çağrıları restore sürecine eklenmelidir. Driver ve connection ayarları da bu sayede doğrulanır. Recovery ancak uygulama temel işlevleri geçtiğinde tamamlanmış sayılmalıdır.
Restore Süresini Hiç Ölçmemek
Restore süresi ölçülmeden RTO yalnızca tahmin olarak kalır. Veri büyüdükçe eski tahminler hızla geçersiz hale gelebilir. Periyodik benchmark ve automated restore test süreleri kaydedilmelidir. P95 değerleri daha güvenilir kapasite görünümü sağlar. Gerekirse daha hızlı storage veya farklı backup formatı seçilebilir.
Backup Otomasyonu İçin Hangi Programlama Dili Kullanılır?
Backup otomasyonu için tek bir en iyi programlama dili yoktur. Bash küçük Linux script'lerinde, Python API ve workflow entegrasyonunda, PowerShell Windows ortamlarında ve Go cloud-native araçlarda güçlü seçenekler sunar. SQL ise database içi verification ve bakım işlemlerinde önemlidir. Dil seçiminden daha önemli konu hata yönetimi, secret güvenliği, test edilebilirlik ve gözlemlenebilirliktir. Karmaşık workflow için genel amaçlı kod yerine orchestration platformu kullanmak çoğu zaman daha sürdürülebilir olabilir.
Bash
Bash database backup komutlarını Linux üzerinde birleştirmek için pratiktir. pg_dump, mysqldump ve upload komutları hızlı biçimde script'e alınabilir. Küçük görevlerde ek runtime gerektirmez. Karmaşık hata yönetimi büyüdükçe bakım zorlaşabilir. Script'ler shellcheck benzeri kalite kontrolleri ve testlerle korunmalıdır.
Linux ve Cron Otomasyonu
Bash ile cron küçük backup görevlerinde yaygın kombinasyondur. Script pre-check, backup ve upload adımlarını çalıştırabilir. Exit code doğru biçimde yönetilmelidir. Loglar merkezi sisteme gönderilmelidir. Cron servisinin çalışmadığı durum freshness alarmıyla yakalanmalıdır.
Python
Python API entegrasyonu, storage yönetimi ve validation için esnek bir seçenektir. Cloud SDK'ları ve database client kütüphaneleriyle kolay otomasyon kurulabilir. Retry, structured logging ve test desteği Bash'e göre daha rahat yönetilebilir. Büyük workflow'larda kod modüllere ayrılabilir. Secret değerler environment yerine güvenli secret provider üzerinden alınabilir.
API ve Workflow Orchestration
Python farklı database ve cloud API'lerini tek workflow içinde birleştirebilir. Backup job başlatma, status polling ve restore automation uygulanabilir. Structured data kullanımı catalog entegrasyonunu kolaylaştırır. Retry ve timeout açık olarak tanımlanmalıdır. Workflow büyüdüğünde özel orchestrator kullanmak daha doğru olabilir.
Validation
Python restore sonrası database sorguları ve API testleri çalıştırmak için uygundur. Row count, schema ve business validation kodlanabilir. Sonuçlar JSON olarak merkezi sisteme gönderilebilir. Test fonksiyonları CI içinde ayrı çalıştırılabilir. Validation kuralları database schema değiştikçe güncellenmelidir.
PowerShell
PowerShell Windows ve SQL Server otomasyonunda güçlü bir seçenektir. Native sistem yönetimi ve database modülleri birlikte kullanılabilir. Backup, file copy, event log ve API işlemleri tek script içinde yönetilebilir. Credentials güvenli store üzerinden sağlanmalıdır. ErrorAction ve exit code davranışı açık biçimde tasarlanmalıdır.
SQL Server ve Windows
PowerShell SQL Server backup ve restore görevlerini Windows scheduler veya orchestration sistemiyle çalıştırabilir. Database listesi dinamik alınabilir. Backup dosyaları network veya cloud storage'a aktarılabilir. Restore test instance'ı otomatik hazırlanabilir. Sonuçlar monitoring sistemine gönderilmelidir.
Go
Go tek binary üretmesi ve düşük runtime bağımlılığı nedeniyle cloud-native backup araçlarında sık tercih edilir. Parallel upload ve API service geliştirme için uygundur. Container image boyutu küçük tutulabilir. Güçlü concurrency modeli büyük dosya transferlerinde fayda sağlar. Geliştirme maliyeti basit script işlerinde Bash veya Python'a göre daha yüksek olabilir.
Cloud-Native Backup Araçları
Go Kubernetes ve cloud API'leriyle çalışan backup servisleri geliştirmek için uygun özellikler sunar. Controller veya operator mimarileri oluşturulabilir. Binary dağıtımı kolaydır. Resource kullanımının öngörülebilir olması avantaj sağlar. Backup formatı ve recovery logic yine database engine yeteneklerine dayanmalıdır.
SQL
SQL backup dosyası taşıma aracı olmaktan çok database içi kontrol ve bazı native backup komutları için kullanılır. SQL Server gibi sistemlerde backup ve restore komutları doğrudan SQL ile çalıştırılabilir. Validation sorguları için vazgeçilmezdir. Kritik veri kontrolleri SQL script'leriyle version control içine alınabilir. Yetkiler sadece gerekli database işlemleriyle sınırlandırılmalıdır.
Database-Level Backup ve Verification
Database-level backup komutları engine'in kendi recovery mekanizmasını kullanır. SQL üzerinden backup history veya recovery metadata kontrol edilebilir. Verification query'leri schema ve veri durumunu sınayabilir. Otomasyon dış katmanda bu sorguları çalıştırıp sonuçları yorumlayabilir. Böylece native engine yetenekleri merkezi workflow ile birleşir.
En İyi Programlama Dili Yerine Doğru Otomasyon Aracı Nasıl Seçilir?
En iyi dil aramak yerine işin boyutu ve operasyon riskine bakmak daha faydalıdır. Beş satırlık düzenli job için Bash yeterli olabilir. Çoklu database ve cloud ortamı için workflow engine veya Python servis daha uygun olabilir. Windows ağırlıklı ortamda PowerShell doğal seçimdir. Karar bakım kolaylığı, gözlemlenebilirlik, ekip becerisi ve recovery güvenilirliğiyle verilmelidir.
Open Source Database Backup Araçları
Açık kaynak database backup araçları farklı motorlar ve storage modelleri için güçlü seçenekler sunar. PostgreSQL tarafında pgBackRest, Barman ve WAL-G, MySQL tarafında Percona XtraBackup, Kubernetes ortamında Velero gibi araçlar değerlendirilebilir. Restic ve BorgBackup genel dosya backup ihtiyaçlarında kullanılabilir. Araç seçimi community büyüklüğünden çok restore kabiliyeti, bakım durumu ve kurumun teknik ihtiyacıyla yapılmalıdır. Her aracın gerçek backup ve recovery akışı kendi ortamınızda test edilmelidir.
pgBackRest
pgBackRest PostgreSQL için full, differential ve incremental backup senaryolarını destekleyebilir. Repository ve retention yönetimi büyük sistemlerde faydalıdır. Parallel backup ve restore kapasitesi performansı artırabilir. WAL arşivleme ile PITR akışına entegre olabilir. Kullanıma alınmadan gerçek database boyutunda test edilmelidir.
Barman
Barman PostgreSQL sunucularının backup ve recovery operasyonlarını merkezi olarak yönetmeye yardımcı olabilir. Birden fazla database server için catalog görünürlüğü sağlar. WAL yönetimi ve retention gibi işlevleri destekleyebilir. Merkezi servis kritik altyapı haline geldiği için kendi recovery planına ihtiyaç duyar. Runbook Barman erişiminin olmadığı senaryoyu da düşünmelidir.
WAL-G
WAL-G object storage odaklı PostgreSQL backup ve WAL arşivleme senaryolarında kullanılabilir. Compression ve parallel transfer büyük veri setlerinde avantaj sağlayabilir. Cloud credentials güvenli kimlik yöntemiyle verilmelidir. Upload başarısızlıkları freshness metric ile izlenmelidir. Restore testleri object storage'dan gerçek indirme süresini ölçmelidir.
Percona XtraBackup
Percona XtraBackup MySQL için hot physical backup yaklaşımı sunabilir. Büyük database'lerde logical dump'a göre daha iyi recovery performansı hedeflenebilir. Full ve incremental zincir yönetimi dikkat ister. Prepare ve restore adımları otomasyon içinde test edilmelidir. Version compatibility düzenli takip edilmelidir.
Velero
Velero Kubernetes resource ve desteklenen storage backup senaryolarında kullanılabilir. Cluster configuration recovery'sini kolaylaştırabilir. Stateful database için native backup mekanizması yine önemli olabilir. Kubernetes manifest ile data recovery birlikte test edilmelidir. Object storage erişimleri ayrı IAM policy ile korunmalıdır.
Restic
Restic dosya tabanlı backup ve object storage kullanımında değerlendirilebilen açık kaynak bir araçtır. Deduplication ve encryption gibi özellikler sunabilir. Database dosyalarını doğrudan kopyalamadan önce application consistency konusu çözülmelidir. Database-native dump dosyalarını off-site saklamak için kullanılabilir. Restore performansı ve repository bütünlüğü test edilmelidir.
BorgBackup
BorgBackup dosya tabanlı backup ihtiyaçlarında deduplication ve compression özellikleri sunabilir. Database dump dosyalarını uzun dönem saklamak için bir katman olarak kullanılabilir. Canlı database dosyalarının doğrudan backup edilmesi consistency riski taşıyabilir. Repository erişimi ve encryption key korunmalıdır. Düzenli verify ve restore testleri yapılmalıdır.
Open Source ve Managed Backup Karşılaştırması
Açık kaynak çözümler daha fazla kontrol ve özelleştirme sunabilir. Managed hizmetler operasyon yükünü azaltabilir. Açık kaynak yaklaşımında patch, monitoring ve capacity sorumluluğu ekibe aittir. Managed modelde platform sınırları ve bağımlılıkları değerlendirilmelidir. Seçim RPO, RTO, ekip kapasitesi, güvenlik ve maliyet birlikte değerlendirilerek yapılmalıdır.
Open Source ve İşbirliğinin Backup Ekosistemindeki Rolü
Backup alanındaki güçlü çözümlerin önemli bölümü açık kaynak topluluklarının ortak üretimiyle gelişir. Gerçek restore senaryoları, bug raporları ve performans testleri araçların daha güvenilir hale gelmesine katkı sağlar. GitHub üzerinde dokümantasyon, test veya kod katkısı yapmak yalnızca projeye değil katkı sağlayan geliştiricinin teknik gelişimine de destek olur. Üniversite ve sektör işbirliği disaster recovery laboratuvarları ve ortak eğitimler için iyi fırsatlar oluşturabilir. Yazılım toplulukları bu bilgi paylaşımını yerelde sürekli hale getirebilir.
GitHub Üzerinden Backup Araçlarına Katkı
Açık kaynak backup projelerine katkı yalnızca büyük kod değişiklikleri yapmak anlamına gelmez. Dokümantasyon düzeltmeleri, test case eklemek ve issue doğrulamak da değerlidir. Restore edge case'leri proje kalitesine doğrudan katkı sağlar. Küçük pull request'ler geliştiricilerin proje yapısını öğrenmesini kolaylaştırır. Katkılar gerçek production problemlerinden öğrenilen teknik bilgiyi toplulukla paylaşmanın etkili yoludur.
Restore Test Framework'leri
Restore test framework'leri farklı database motorlarında ortak validation standardı oluşturabilir. Backup seçimi, geçici environment oluşturma ve kritik sorgu çalıştırma modüllere ayrılabilir. Açık kaynak yaklaşımı farklı ekiplerin test senaryolarını paylaşmasını sağlar. Database-specific plugin yapısı genişlemeyi kolaylaştırır. Böyle bir proje eğitim ve gerçek kullanım için güçlü bir topluluk çalışması olabilir.
Ortak Disaster Recovery Senaryoları
Ortak DR senaryoları ekiplerin aynı hata türlerini düzenli olarak çalışmasını sağlar. Region loss, ransomware, yanlış migration ve bozuk backup gibi örnekler kullanılabilir. Senaryo tanımları açık biçimde paylaşılırsa farklı ekipler sonuçlarını karşılaştırabilir. Runbook kalitesi zaman içinde gelişir. Yerel topluluk etkinliklerinde GameDay formatı öğrenmeyi pratik hale getirir.
Topluluk Benchmark'ları
Topluluk benchmark'ları farklı backup formatlarının ve restore yöntemlerinin gerçek donanımda karşılaştırılmasını sağlayabilir. Sonuçlar veri boyutu, CPU, disk ve network bilgisiyle birlikte paylaşılmalıdır. Tek bir sayı yerine test koşulları açıkça belirtilmelidir. Katılımcılar farklı PostgreSQL veya MySQL senaryolarını deneyebilir. Bu çalışmalar yeni başlayanlar için performans ölçümünü somut hale getirir.
Üniversite–Sektör İşbirliği
Üniversite ve sektör ortak çalışmaları database reliability ve disaster recovery alanında uygulamalı eğitim fırsatı oluşturabilir. Öğrenciler gerçekçi ancak anonimleştirilmiş veri setleriyle backup laboratuvarları kurabilir. Sektör ekipleri teknik senaryo ve mentorluk sağlayabilir. Çıkan açık kaynak projeler yerel ekosisteme kalıcı katkı bırakabilir. Eğitim programları SQL, Linux, storage ve recovery başlıklarını birlikte ele almalıdır.
Yazılım Topluluklarının Rolü
Yazılım toplulukları teorik database bilgisini uygulamalı deneyime dönüştürmek için güçlü bir ortam oluşturur. Workshop, GameDay ve açık kaynak proje çalışmaları katılımcıların gerçek recovery senaryoları görmesini sağlar. Deneyimli kişiler farklı yaklaşımların nedenlerini aktarabilir. Yeni başlayanlar küçük görevlerle projelere katılabilir. Diyarbakır Yazılım Topluluğu hakkında daha fazla bilgi için https://www.diyarbakiryazilim.com.tr/about adresi ziyaret edilebilir.
PostgreSQL Workshop'ları
PostgreSQL workshop'larında pg_dump, pg_basebackup ve WAL archiving uygulamalı biçimde gösterilebilir. Katılımcılar önce backup alıp ardından kontrollü yanlış DELETE senaryosu çalıştırabilir. PITR ile olay öncesi noktaya dönmek konuyu somutlaştırır. Restore süresinin ölçülmesi RTO kavramını pratik hale getirir. Workshop sonunda otomatik backup script'i küçük proje olarak geliştirilebilir.
DevOps Workshop'ları
DevOps workshop'larında backup pipeline CI/CD, IaC ve monitoring ile birlikte ele alınabilir. CronJob, secret manager ve object storage entegrasyonu uygulamalı kurulabilir. Katılımcılar failure senaryolarını test edebilir. Backup as Code ve Recovery as Code yaklaşımı küçük örneklerle gösterilebilir. Böylece backup konusu yalnızca DBA sorumluluğu olarak görülmez.
Disaster Recovery GameDay'leri
GameDay etkinlikleri kontrollü disaster senaryosunda ekiplerin pratik yapmasını sağlar. Yanlış deployment, region erişim kaybı veya bozuk backup senaryosu kullanılabilir. Katılımcılar recovery point seçer, restore yapar ve validation çalıştırır. Süreler ölçülerek gerçek RTO hesaplanır. Etkinlik sonunda eksikler ortak değerlendirmeyle iyileştirme listesine dönüştürülür.
Açık Kaynak Backup Projeleri
Açık kaynak backup projeleri yerel geliştiricilerin gerçek DevOps problemleri üzerinde birlikte çalışmasını sağlar. Dashboard, restore validator veya monitoring agent gibi küçük modüller geliştirilebilir. Kod GitHub üzerinde açık tutulabilir. Issue ve pull request süreçleri ekip çalışmasını öğretir. Proje çıktıları başka toplulukların da kullanabileceği kalıcı kaynaklara dönüşebilir.
Diyarbakır Yazılım Ekosistemi İçin Backup ve DR Proje Fikirleri
Diyarbakır'da geliştiriciler için backup ve disaster recovery alanı hem eğitim hem açık kaynak üretim açısından güçlü proje fırsatları sunuyor. PostgreSQL backup dashboard, Türkçe restore validation platformu veya Kubernetes DR laboratuvarı gerçek teknik problemleri çözmeye odaklanabilir. Projeler üniversite öğrencileri, sistem yöneticileri ve backend geliştiricileri ortak çalışmaya teşvik edebilir. Küçük çalışan prototiple başlanıp monitoring ve automation özellikleri aşamalı eklenebilir. Diyarbakır Yazılım Topluluğu'nun proje çalışmalarına https://www.diyarbakiryazilim.com.tr/projects üzerinden göz atılabilir.
Açık Kaynak PostgreSQL Backup Dashboard
Bir PostgreSQL backup dashboard son backup zamanı, WAL freshness ve restore test sonucunu tek ekranda gösterebilir. Backend PostgreSQL metadata ve object storage bilgilerini toplayabilir. Frontend RPO ihlallerini görünür hale getirebilir. Alarm entegrasyonu ikinci aşamada eklenebilir. Böyle bir proje hem DevOps hem backend geliştirme becerilerini bir araya getirir.
Türkçe Restore Validation Platformu
Türkçe restore validation platformu kullanıcıların backup seçip otomatik test restore başlatmasını sağlayabilir. Platform database açılışı, schema kontrolü ve kritik sorguları çalıştırabilir. Sonuçları Türkçe anlaşılır rapor halinde gösterebilir. PostgreSQL ile başlayıp MySQL desteği eklenebilir. Eğitim amaçlı açık kaynak proje olarak güçlü bir kullanım alanı vardır.
Backup Monitoring Servisi
Backup monitoring servisi farklı database motorlarından heartbeat ve backup metadata toplayabilir. Son başarılı backup yaşı ve dosya boyutu merkezi dashboard'a gönderilir. RPO ihlali olduğunda bildirim üretilir. Basit REST API ve agent mimarisiyle başlanabilir. Daha sonra anomaly detection ve restore test entegrasyonu eklenebilir.
Kubernetes Disaster Recovery Laboratuvarı
Kubernetes DR laboratuvarı StatefulSet, CSI snapshot ve database-native backup senaryolarını uygulamalı gösterebilir. Katılımcılar bir PostgreSQL pod'unu silip recovery çalıştırabilir. Sonraki aşamada tüm namespace veya cluster kaybı simüle edilebilir. IaC ile yeni ortam oluşturulması eklenebilir. Bu laboratuvar cloud-native ve database recovery bilgisini birleştirir.
Diyarbakır Yazılım Topluluğunda DevOps ve DBA İşbirliği
DevOps ve DBA ekiplerinin birlikte çalışması backup sistemlerinin gerçek operasyon ihtiyaçlarına göre tasarlanmasını kolaylaştırır. DBA database tutarlılığı ve recovery mekanizmasını, DevOps ise orchestration, storage ve monitoring katmanını güçlendirebilir. Ortak workshop'lar bu iki uzmanlık alanını bir araya getirir. Küçük açık kaynak projeler yeni katılımcıların deneyim kazanmasını sağlar. Veritabanı yedekleme ve sistem yönetimi danışmanlığı yakınımda araması yapan kişiler için de yerel teknik topluluklar bilgi paylaşımı ve doğru uzmanlık alanına yönelme açısından değerli başlangıç noktalarıdır.
Yazılımcılar Veritabanı Backup ve Recovery Alanında Nasıl Uzmanlaşabilir?
Backup ve recovery alanında uzmanlaşmak yalnızca birkaç komut ezberlemekle mümkün değildir. SQL, Linux, database motorları, scripting, cloud, Kubernetes ve storage temelleri birlikte öğrenilmelidir. En hızlı gelişim yolu laboratuvar kurup hata senaryolarını bilinçli olarak üretmek ve ardından recovery yapmaktır. Açık kaynak projelerde küçük katkılar gerçek kod tabanlarını görmeye yardımcı olur. Düzenli GameDay ve restore testleri teori ile operasyon deneyimi arasındaki farkı kapatır.
SQL
SQL veri yapısını ve transaction davranışını anlamanın temelidir. Backup sonrası validation sorguları yazmak için de gereklidir. JOIN, transaction, index ve constraint bilgisi recovery sırasında çok faydalıdır. Yanlış DELETE gibi hata senaryoları SQL bilgisiyle daha doğru analiz edilir. Öğrenme yalnızca SELECT sorgularıyla sınırlı tutulmamalıdır.
Linux
Linux bilgisi PostgreSQL ve MySQL gibi sistemlerin production yönetiminde önemlidir. File permission, process, systemd, disk ve network konuları backup operasyonunu doğrudan etkiler. Cron ve shell script otomasyon için temel sağlar. Log analizi recovery sırasında önemli beceridir. Küçük bir sanal makine laboratuvarı iyi başlangıç olabilir.
PostgreSQL ve MySQL
En az bir relational database motorunu derin öğrenmek faydalıdır. PostgreSQL WAL ve MySQL binlog recovery mantığını anlamak PITR kavramını somutlaştırır. Logical ve physical backup yöntemleri uygulanmalıdır. Replication ile backup arasındaki fark laboratuvarda test edilmelidir. Sonraki aşamada farklı motorlar karşılaştırılabilir.
Bash / Python
Bash basit job otomasyonu için hızlı başlangıç sağlar. Python büyüyen workflow ve API entegrasyonlarında daha esnektir. Backup script yazarken error handling ve logging öğrenilmelidir. Secret management uygulamalı kullanılmalıdır. Restore test otomasyonu iyi bir öğrenme projesidir.
Cloud Platformları
Cloud platformları managed database, object storage ve IAM kavramlarını öğrenmek için önemlidir. Snapshot, cross-region copy ve KMS gibi özellikler pratiğe dökülebilir. Free veya düşük maliyetli laboratuvar kaynakları kontrollü kullanılmalıdır. Cost monitoring baştan kurulmalıdır. Aynı recovery senaryosu self-managed ve managed ortamda karşılaştırılabilir.
Kubernetes
Kubernetes stateful workload yönetimini öğrenmek modern database operasyonlarında faydalıdır. StatefulSet, PVC ve CSI snapshot temel konulardır. Database operator yapısı incelenebilir. Backup job Kubernetes CronJob ile çalıştırılabilir. Tam recovery senaryosu yeni namespace üzerinde test edilmelidir.
Storage Temelleri
Storage performansı restore süresini doğrudan etkiler. IOPS, throughput, latency ve durability kavramları öğrenilmelidir. Snapshot ile backup farkı storage seviyesinde daha net anlaşılır. Object storage lifecycle ve immutability özellikleri incelenebilir. Benchmark küçük testlerle yapılabilir.
Disaster Recovery
Disaster recovery yalnızca database restore işleminden daha geniştir. Network, DNS, IAM, application configuration ve iletişim süreçlerini kapsar. Tabletop exercise ile başlanabilir. Sonrasında otomatik DR laboratuvarı kurulabilir. RPO ve RTO her testte ölçülmelidir.
Açık Kaynak Projelere Katkı
Açık kaynak katkısı gerçek backup araçlarının kod ve dokümantasyon yapısını görmeyi sağlar. İlk adım bug raporu veya küçük dokümantasyon düzeltmesi olabilir. Test eklemek recovery davranışını anlamak açısından çok öğreticidir. Pull Request süreci teknik iletişim becerisini geliştirir. Düzenli katkı zaman içinde güçlü uzmanlık portföyü oluşturur.
Örnek Bir Veritabanı Backup Otomasyon Projesi Nasıl Kurulur?
İyi bir backup otomasyon projesi araç seçimiyle değil veritabanı envanteri ve iş hedefleriyle başlar. Önce hangi database'in ne kadar kritik olduğu, kabul edilebilir veri kaybı ve recovery süresi belirlenir. Ardından backup türü, PITR, storage, encryption, retention ve monitoring tasarlanır. Otomatik restore testing ve data validation sistemin gerçek kalitesini doğrular. Son aşamada DR drill ve sürekli iyileştirme döngüsü kurularak backup sistemi yaşayan bir operasyon sürecine dönüştürülür.
Adım 1 — Veritabanı Envanteri Çıkarma
İlk adım tüm veritabanlarını merkezi envantere almaktır. Database motoru, sürüm, boyut, owner ve ortam bilgisi kaydedilir. Unutulmuş küçük database'ler ciddi veri riski oluşturabilir. Cloud ve on-prem kaynaklar otomatik discovery ile bulunabilir. Envanter düzenli olarak güncellenmelidir.
Adım 2 — Kritiklik Sınıfı Belirleme
Her database iş etkisine göre sınıflandırılmalıdır. Kritik ödeme veya müşteri sistemleri ile geçici raporlama database'i aynı policy'ye ihtiyaç duymaz. Seviyeler Gold, Silver, Bronze gibi basit modelle tanımlanabilir. Her seviye farklı RPO ve RTO hedefi alır. Owner sınıflandırmayı iş etkisine göre doğrulamalıdır.
Adım 3 — RPO ve RTO Belirleme
RPO kabul edilebilir veri kaybını, RTO ise recovery süresini tanımlar. Bu değerler teknik ekip tarafından tek başına uydurulmamalıdır. İş birimi kayıp ve kesinti etkisini belirtmelidir. Hedefler database inventory içinde saklanır. Tüm backup tasarımı bu iki değerden türetilir.
Adım 4 — Backup Türünü Seçme
Logical, physical, full, incremental veya differential seçenekleri ihtiyaca göre belirlenir. Küçük database için logical dump yeterli olabilir. Büyük ve kısa RTO isteyen sistemde physical backup daha uygun olabilir. Tek bir yöntem tüm hata senaryolarını çözmeyebilir. Tasarım gerçek restore benchmark sonucuna göre doğrulanmalıdır.
Adım 5 — PITR Gereksinimini Belirleme
Yanlış DELETE veya migration riskine karşı belirli zamana dönüş gerekiyorsa PITR planlanmalıdır. PostgreSQL WAL, MySQL binlog veya SQL Server transaction log mekanizması buna göre etkinleştirilir. Log retention RPO hedefini kapsamalıdır. Continuous upload monitoring kurulmalıdır. PITR restore testi zorunlu hale getirilmelidir.
Adım 6 — Storage Mimarisini Kurma
Backup storage production'dan ayrı hata alanında olmalıdır. Object storage, farklı region ve farklı account seçenekleri değerlendirilebilir. Capacity ve lifecycle policy oluşturulur. Immutable koruma ransomware riski için eklenebilir. Restore throughput storage seçiminin önemli kriteridir.
Adım 7 — Backup Job'larını Otomatikleştirme
Backup job cron, systemd, workflow engine veya platform scheduler ile otomatik çalıştırılır. Pre-check ve error handling script'in parçası olur. Job output merkezi log sistemine gider. Backup artifact metadata catalog'a yazılır. Scheduler failure freshness alarmıyla bağımsız izlenir.
Adım 8 — Encryption
Backup at rest ve in transit şifrelenmelidir. Gerekirse dosya seviyesi encryption eklenir. Key'ler backup storage'dan ayrı yönetilir. Recovery region key erişimi test edilir. Rotation politikası uygulanır.
Adım 9 — Retention
Günlük, haftalık ve aylık recovery noktaları belirlenir. Compliance gereksinimleri retention süresine eklenir. Incremental zincir bağımlılıkları otomatik hesaplanır. Eski backup'lar lifecycle ile ucuz storage'a taşınabilir. Silme işlemleri audit log'a yazılır.
Adım 10 — Monitoring
Backup success, freshness, size ve duration izlenir. Storage capacity ve upload status ayrı metrik olur. Restore test sonucu dashboard'a eklenir. Alarm routing owner bilgisine göre yapılır. RPO compliance yönetim metriği haline getirilir.
Adım 11 — Automated Restore Testing
Belirlenen aralıklarla son backup izole ortama restore edilir. Infrastructure gerektiğinde otomatik oluşturulur. Database health ve schema kontrol edilir. Sonuç başarılıysa recovery point doğrulanmış olarak işaretlenir. Test ortamı otomatik kaldırılır.
Adım 12 — Data Validation
Restore sonrası kritik tablo row count değerleri kontrol edilir. Referential integrity ve business query'ler çalıştırılır. Application smoke test eklenebilir. Validation kuralı version control içinde tutulur. Başarısız sonuç backup'ın kullanılabilirlik statüsünü düşürür.
Adım 13 — RTO/RPO Benchmark
Restore tatbikatından gerçek RTO ölçülür. Son recovery point zamanı gerçek RPO'yu gösterir. Hedef ve gerçek değer karşılaştırılır. Darboğaz storage, network veya manuel approval olabilir. İyileştirme bu ölçümlere göre yapılır.
Adım 14 — Disaster Recovery Drill
DR drill daha geniş felaket senaryosunu test eder. Yeni region veya yeni altyapı üzerinde database restore edilir. Application configuration ve traffic switching de uygulanır. Ekip rolleri ve iletişim süreci gözlemlenir. Sonuçlar runbook güncellemesine dönüştürülür.
Adım 15 — Sürekli İyileştirme
Backup sistemi kurulduktan sonra bitmiş sayılmamalıdır. Veri büyüklüğü, database sürümü ve iş hedefleri zaman içinde değişir. Restore süreleri düzenli izlenir. Yeni hata senaryoları GameDay programına eklenir. Policy ve otomasyon gerçek sonuçlara göre sürekli güncellenir.
Veritabanı Backup Otomasyonunun Geleceği
Backup otomasyonunun yönü manuel job yönetiminden policy-driven ve sürekli doğrulanan recovery sistemlerine doğru ilerliyor. Backup as Code ve Recovery as Code yaklaşımları configuration ile operasyon arasındaki farkı azaltıyor. Continuous restore verification backup'ın yalnızca üretilmesini değil sürekli kullanılabilir olduğunu kanıtlamayı hedefliyor. Anomali analizi şüpheli backup değişimlerini daha erken fark etmeye yardımcı olabilir. Uzun vadede Database Reliability Engineering yaklaşımı backup, HA, performance ve disaster recovery konularını tek güvenilirlik çerçevesinde bir araya getiriyor.
Backup as Code
Backup as Code policy'leri Git üzerinden yönetilebilir hale getirir. Schedule, retention ve storage ayarları tekrar edilebilir olur. Yeni database aynı standarda otomatik dahil edilebilir. Drift detection manuel değişiklikleri fark eder. Audit geçmişi configuration repository üzerinden görülebilir.
Recovery as Code
Recovery as Code restore adımlarını tekrar çalıştırılabilir workflow haline getirir. Altyapı provisioning, restore ve validation aynı tanımda bulunabilir. Manuel runbook bağımlılığı azalır. Recovery testleri CI veya schedule ile otomatik çalıştırılabilir. Gerçek RTO daha öngörülebilir hale gelir.
Policy-Driven Backup
Policy-driven backup database'in kritiklik sınıfına göre doğru koruma seviyesini otomatik uygular. Gold sınıfı düşük RPO ve sık restore testi alabilir. Daha düşük sınıflar maliyet odaklı policy kullanabilir. Yeni database oluşturulduğunda policy otomatik atanır. Uyumsuz ayar deployment sırasında engellenebilir.
Continuous Restore Verification
Continuous restore verification belirli backup örneklerini sürekli veya çok sık geri açarak recovery kabiliyetini ölçer. Böylece sorunlar aylık tatbikata kadar beklemez. Ephemeral environment maliyetin kontrol edilmesini sağlar. Validation sonuçları trend olarak izlenir. Backup güvenilirliği canlı bir metrik haline gelir.
AI Tabanlı Backup Anomaly Detection
Veri analizi tabanlı anomali modelleri backup boyutu, süre ve başarısızlık desenlerini inceleyebilir. Normal davranıştan farklılaşan job'lar daha erken işaretlenebilir. Çıktı otomatik silme veya recovery kararı için tek başına kullanılmamalıdır. İnsan review ve restore testleri temel kontrol olarak kalmalıdır. En fazla değer, çok sayıda database bulunan ortamlarda önceliklendirme sağlamasıdır.
Otomatik Recovery Point Seçimi
Otomatik recovery point seçimi catalog, validation sonucu ve olay zamanı bilgisini birlikte değerlendirebilir. Sistem en yeni temiz ve doğrulanmış noktaları önerebilir. Ransomware olayında şüpheli zaman aralığı filtrelenebilir. Nihai production kararı için approval bırakılabilir. Bu yaklaşım olay anındaki analiz süresini azaltabilir.
Self-Healing Backup Pipeline
Self-healing backup pipeline geçici upload veya scheduler hatalarını otomatik giderme yeteneği sunar. Başarısız job farklı node üzerinde yeniden çalıştırılabilir. Storage quota sorunu için güvenli cleanup workflow tetiklenebilir. Otomasyon tekrarlayan root cause'u gizlememelidir. Her otomatik düzeltme loglanmalı ve trend olarak izlenmelidir.
Otonom Disaster Recovery
Otonom DR yaklaşımı detection, provisioning, restore ve validation adımlarının büyük bölümünü otomatikleştirmeyi hedefler. Production traffic activation gibi yüksek riskli kararlar yine kontrollü approval gerektirebilir. Otomasyon hız kazandırırken yanlış failover riskine karşı çoklu doğrulama gerekir. Sistem düzenli GameDay ile test edilmelidir. Güven, yalnızca kodun varlığından değil tekrar eden başarılı tatbikatlardan oluşur.
Database Reliability Engineering
Database Reliability Engineering veritabanı güvenilirliğini performans, erişilebilirlik, backup ve recovery ile birlikte ele alır. SLO ve error budget gibi yaklaşımlar database operasyonuna uygulanabilir. Backup freshness ve restore success birer reliability metriği olur. Otomasyon tekrarlayan manuel işi azaltır. Bu disiplin backup'ı ayrı bir gece görevi olmaktan çıkarıp hizmet güvenilirliğinin temel parçasına dönüştürür.
Sıkça Sorulan Sorular
Veritabanı backup ve recovery konusunda en sık sorulan sorular genellikle hangi backup türünün kullanılacağı, ne sıklıkta yedek alınacağı ve restore'un gerçekten nasıl doğrulanacağı etrafında toplanır. Doğru cevap database motoruna, veri büyüklüğüne, RPO ve RTO hedeflerine göre değişir. Tek bir yöntem her sistem için uygun değildir. Aşağıdaki yanıtlar karar verirken kullanılabilecek pratik bir çerçeve sunar. Kritik production sistemlerinde her öneri gerçek restore testiyle doğrulanmalıdır.
Veritabanı yedekleme otomasyonu nedir?
Veritabanı yedekleme otomasyonu backup oluşturma sürecinin schedule ve workflow üzerinden otomatik çalıştırılmasıdır. İyi otomasyon yalnızca dump üretmez. Encryption, checksum, upload, retention, monitoring ve restore testi de sürece dahil edilir. Başarısızlıkta alarm üretir. Böylece backup yönetimi tekrar edilebilir ve ölçülebilir hale gelir.
Database backup nasıl otomatikleştirilir?
Önce RPO ve RTO belirlenir, ardından uygun logical veya physical backup aracı seçilir. Cron, systemd timer, SQL Server Agent veya workflow engine schedule için kullanılabilir. Backup sonrasında compression, encryption ve off-site upload çalıştırılır. Monitoring son başarılı recovery point'i takip eder. Düzenli automated restore testing ile süreç doğrulanır.
Veritabanı backup'ı ne sıklıkta alınmalıdır?
Backup sıklığı kabul edilebilir veri kaybına göre belirlenmelidir. RPO 24 saat ise günlük backup yeterli olabilir. RPO 15 dakika ise log arşivleme veya daha sık incremental yöntem gerekir. Transaction hacmi ve backup yükü de schedule kararını etkiler. Gerçek RPO son kullanılabilir recovery point üzerinden ölçülmelidir.
Full, incremental ve differential backup arasındaki fark nedir?
Full backup belirlenen veri setinin tamamını kopyalar. Incremental backup önceki backup'tan sonra değişen veriyi saklar. Differential backup son full backup'tan sonra değişen verilerin tamamını içerir. Incremental daha az storage kullanabilir fakat restore zinciri uzayabilir. Differential restore zincirini kısaltırken zamanla daha büyük dosya üretir.
Logical ve physical backup arasındaki fark nedir?
Logical backup veriyi tablo, şema ve kayıt gibi mantıksal nesneler halinde dışa aktarır. Physical backup database veri dosyalarını veya bloklarını korur. Logical yöntem taşınabilirlik ve object-level restore açısından avantajlıdır. Physical yöntem büyük database'lerde daha hızlı recovery sağlayabilir. Seçim RTO, veri boyutu ve migration ihtiyacına göre yapılmalıdır.
RPO ve RTO nedir?
RPO kabul edilebilir maksimum veri kaybı aralığıdır. RTO ise sistemin ne kadar sürede tekrar çalışır hale gelmesi gerektiğini belirtir. Bu değerler backup sıklığını ve recovery mimarisini belirler. İş birimleriyle birlikte tanımlanmalıdır. Düzenli tatbikatla gerçek değerler ölçülmelidir.
Point-in-time recovery nedir?
Point-in-time recovery veritabanını seçilen belirli zamana geri getirme yöntemidir. Base backup restore edilir ve transaction log kayıtları hedef noktaya kadar uygulanır. Yanlış DELETE ve migration hatalarında çok değerlidir. Log zinciri eksiksiz olmalıdır. PITR düzenli test edilmelidir.
PostgreSQL PITR nasıl çalışır?
PostgreSQL PITR base backup ile WAL arşivlerini birlikte kullanır. Önce base backup açılır. Ardından WAL kayıtları hedef timestamp veya transaction noktasına kadar replay edilir. Gerekli WAL segmentlerinden biri eksikse recovery zinciri durabilir. Continuous archiving ve restore testi bu nedenle önemlidir.
PostgreSQL WAL nedir?
WAL PostgreSQL'in Write-Ahead Log mekanizmasıdır. Veri sayfalarındaki değişikliklerden önce transaction bilgisi log'a yazılır. Crash recovery ve replication süreçlerinde kullanılır. Arşivlendiğinde PITR için gerekli transaction geçmişini sağlar. WAL retention backup politikasıyla birlikte yönetilmelidir.
MySQL binlog ile recovery nasıl yapılır?
Önce uygun full backup restore edilir. Ardından backup sonrasındaki binary log dosyaları mysqlbinlog gibi araçlarla hedef zamana veya event position'a kadar uygulanır. Log zincirinin eksiksiz olması gerekir. Timestamp seçiminde saat senkronizasyonu önemlidir. Restore sonucu test ortamında doğrulanmalıdır.
SQL Server transaction log backup ne işe yarar?
Transaction log backup Full Recovery Model kullanılan SQL Server veritabanlarında değişiklik geçmişini recovery için korur. Sık log backup düşük RPO hedeflerine yardımcı olur. Full ve differential backup sonrası hedef zamana kadar loglar uygulanabilir. Chain kırılırsa bazı recovery seçenekleri kaybolabilir. Log backup freshness merkezi olarak izlenmelidir.
Replication backup'ın yerini tutar mı?
Hayır, replication backup'ın yerini tutmaz. Yanlış DELETE veya hatalı UPDATE gibi işlemler replica sistemlere de yayılabilir. Backup tarihsel recovery noktası sağlar. Immutable ve off-site kopyalar production erişiminden bağımsız koruma sunabilir. En iyi yapı HA, replication ve backup'ı birlikte kullanır.
Snapshot ile backup arasındaki fark nedir?
Snapshot storage seviyesinde hızlı veri görüntüsü oluşturur. Database-aware backup veritabanının transaction ve recovery mekanizmasını dikkate alır. Crash-consistent snapshot her zaman application-consistent olmayabilir. Snapshot aynı storage alanına bağlıysa off-site koruma sağlamaz. Birçok sistem iki yöntemi birlikte kullanabilir.
Backup'ın gerçekten çalıştığı nasıl test edilir?
En güvenilir yöntem backup'ı izole ortama restore etmektir. Dosya checksum kontrolü yalnızca ilk seviyedir. Database açılmalı, schema doğrulanmalı ve kritik veriler kontrol edilmelidir. Uygulama smoke testleri ek güven sağlar. Test süresi RTO metriği olarak kaydedilmelidir.
Automated restore testing nedir?
Automated restore testing backup'ın belirli aralıklarla otomatik olarak geri yüklenmesi sürecidir. Sistem recovery environment oluşturur, backup'ı seçer ve restore eder. Ardından validation sorguları çalıştırılır. Test tamamlandığında geçici ortam silinir. Başarısızlık alarm ve rapor üretir.
Backup'lar ransomware'a karşı nasıl korunur?
Immutable storage ve Object Lock güçlü koruma sağlar. Backup production hesabından farklı account içinde tutulabilir. Delete yetkisi günlük backup hesabından ayrılmalıdır. Air-gapped kopya ek güvenlik sağlayabilir. En önemli kontrol temiz backup'ın düzenli restore edilmesidir.
Database backup için hangi programlama dili kullanılır?
Bash, Python, PowerShell, Go ve SQL farklı kullanım alanlarında kullanılabilir. Küçük Linux job'larında Bash pratiktir. Python API ve workflow entegrasyonunda güçlüdür. Windows ve SQL Server ortamında PowerShell doğal seçenektir. Dil seçiminden daha önemli konu güvenilir hata yönetimi ve restore doğrulamasıdır.
En iyi açık kaynak database backup araçları nelerdir?
Doğru araç database motoruna ve recovery hedeflerine göre değişir. PostgreSQL için pgBackRest, Barman ve WAL-G gibi seçenekler değerlendirilebilir. MySQL için Percona XtraBackup physical backup ihtiyacında kullanılabilir. Kubernetes tarafında Velero cluster kaynakları için yardımcı olabilir. Araç seçimi gerçek restore testi sonucuna göre yapılmalıdır.
Cloud database backup mı self-managed backup mı daha iyidir?
Managed backup operasyon kolaylığı sağlar. Self-managed yaklaşım daha fazla kontrol ve özelleştirme sunabilir. Managed çözümde platform retention ve restore sınırları iyi anlaşılmalıdır. Self-managed sistemde bakım ve monitoring sorumluluğu ekibe aittir. Seçim RPO, RTO, güvenlik, ekip kapasitesi ve maliyete göre yapılmalıdır.
Backup maliyeti nasıl azaltılır?
Incremental backup, compression ve lifecycle policy storage maliyetini azaltabilir. Eski backup'lar düşük maliyetli tier'a taşınabilir. Ephemeral restore ortamları compute maliyetini sınırlar. Cross-region transfer ve egress ayrıca izlenmelidir. Maliyet optimizasyonu recovery hedeflerini bozmayacak biçimde yapılmalıdır.
Veritabanı yedekleme ve restorasyon süreçleri nasıl otomatikleştirilir?
Süreç önce database envanteri, RPO ve RTO hedeflerinin belirlenmesiyle başlatılır. Ardından uygun backup aracı schedule edilerek backup creation, encryption, checksum, off-site upload ve retention adımları pipeline içine alınır. Monitoring son recovery point'in güncelliğini takip eder. Düzenli automated restore testing ile backup gerçek database ortamında açılır ve validation uygulanır. Böylece veritabanı yedekleme ve geri yükleme nasıl otomatikleştirilir sorusu yalnızca script yazma değil uçtan uca recovery sistemi kurma yaklaşımıyla cevaplanmış olur.
Otomatik veritabanı yedeklerinde full incremental ve differential backup yöntemlerinden hangisi tercih edilmelidir?
Full backup recovery açısından basit fakat storage ve süre açısından maliyetli olabilir. Incremental backup daha az veri saklar ancak restore zincirini uzatabilir. Differential backup son full backup'a dayanarak zinciri kısaltır fakat zaman içinde büyür. Büyük sistemlerde full ve incremental kombinasyonu sık kullanılır. En doğru seçim gerçek restore süresi, storage maliyeti ve RTO hedefi ölçülerek yapılmalıdır.
PostgreSQL MySQL ve SQL Server için zamanlanmış yedekleme ve geri yükleme senaryoları nasıl oluşturulur?
PostgreSQL için pg_dump, pg_basebackup ve WAL arşivleme; MySQL için logical veya physical backup ile binlog; SQL Server için full, differential ve transaction log backup birlikte planlanabilir. Schedule cron, systemd timer, SQL Server Agent veya merkezi workflow engine üzerinden kurulabilir. Her job'ın metadata'sı merkezi catalog içine yazılabilir. Recovery workflow uygun backup zincirini otomatik seçip test ortamına restore eder. Başarılı sonuç schema, veri ve application validation testleriyle doğrulanmalıdır.
Yedeklerin şifrelenmesi saklama politikaları felaket kurtarma ve düzenli restore testleri nasıl yönetilmelidir?
Encryption at rest ve in transit temel güvenlik katmanı olarak kullanılmalıdır. Kritik backup'larda dosya seviyesi encryption ve ayrı key management eklenebilir. Retention günlük, haftalık ve aylık recovery ihtiyaçlarıyla mevzuat şartlarını birlikte karşılamalıdır. Felaket kurtarma için farklı region veya account üzerinde bağımsız kopyalar tutulabilir. Düzenli otomatik restore testleri yedeğin gerçekten açılabildiğini ve hedef RTO içinde kullanılabilir olduğunu doğrulamalıdır.
Veritabanı yedekleme ve restorasyon otomasyonu konusunda yakınımda danışmanlık veya eğitim nerede bulabilirim?
Yerel yazılım toplulukları, DevOps etkinlikleri ve uygulamalı workshop'lar backup ve recovery alanında öğrenmek için iyi başlangıç noktaları sunabilir. Diyarbakır'da PostgreSQL, Linux, DevOps, cloud ve disaster recovery konularında ortak çalışmalar geliştirmek isteyenler Diyarbakır Yazılım Topluluğu'nun çalışmalarını inceleyebilir. Topluluk hakkında bilgi için https://www.diyarbakiryazilim.com.tr/about adresi kullanılabilir. Proje ve işbirliği alanlarını görmek için https://www.diyarbakiryazilim.com.tr/projects sayfasına göz atılabilir. Veritabanı yedekleme ve sistem yönetimi danışmanlığı yakınımda şeklinde arama yapan kişiler de önce ihtiyaçlarını RPO, RTO, database motoru ve veri büyüklüğü açısından netleştirerek doğru uzmanlık alanını daha kolay belirleyebilir.
Sonuç
Veritabanı Yedekleme ve Restorasyon Otomasyonları, bir backup dosyasının her gece oluşturulmasından çok daha geniş bir güvenilirlik yaklaşımıdır. İyi tasarlanmış sistem full ve incremental backup, PITR, şifreleme, immutable storage, off-site kopya, retention, monitoring ve otomatik restore doğrulamasını tek çerçevede birleştirir. En önemli ölçüt backup job'ın yeşil görünmesi değil, ihtiyaç anında doğru recovery noktasının hedef RTO içinde çalışır hale getirilebilmesidir. Kendi backup ve disaster recovery mimarinizi geliştirmek, açık kaynak projelerde yer almak veya yerel teknik işbirliklerine katılmak istiyorsanız https://www.diyarbakiryazilim.com.tr üzerinden Diyarbakır Yazılım Topluluğu'na ulaşabilirsiniz. Uygulanabilir bir ilk adım olarak bugün bir kritik veritabanı seçin, gerçek RPO ve RTO değerini yazın, son backup'ı izole ortamda restore edin ve ölçtüğünüz gerçek recovery süresini kaydedin.
share: