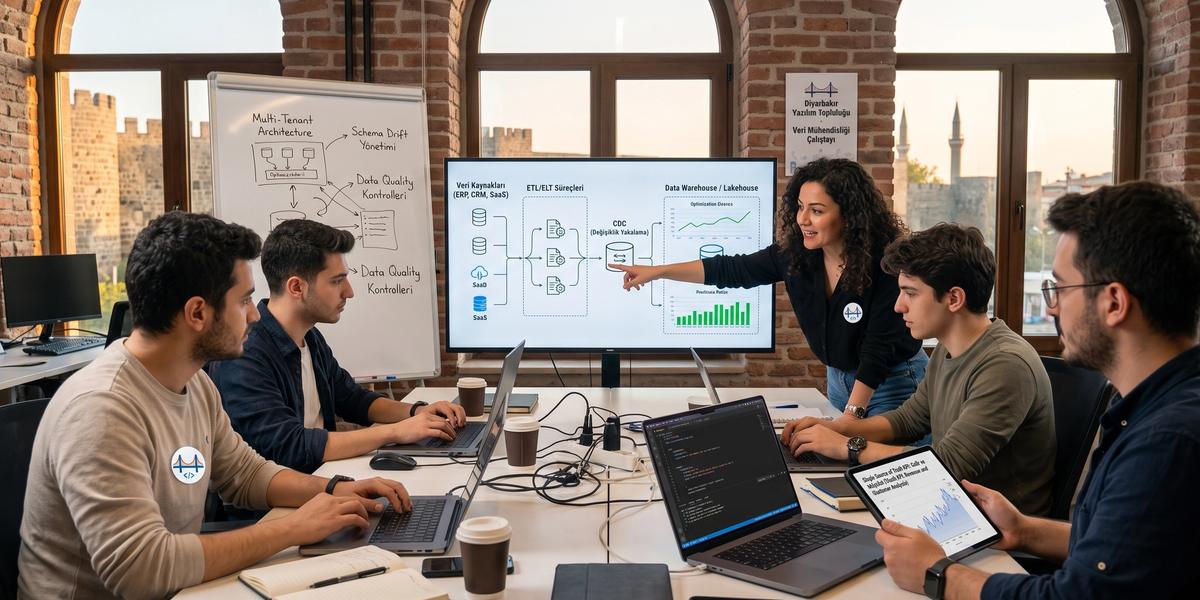
Veri Ambari (Data Warehouse) Sistemlerine Entegrasyon

Diyarbakır Yazılım
16.08.2026
#Yazılım#Teknoloji#Topluluk
Bir kurumda satış rakamı finans ekranında farklı, CRM raporunda farklı, yönetim panelinde ise bambaşka görünüyorsa sorun çoğu zaman raporlama aracından değil veri entegrasyonundan kaynaklanır. On yılı aşkın veri mühendisliği projelerinde gördüğüm en belirgin ortak nokta, güvenilir analitiğin iyi tasarlanmış bir veri taşıma ve dönüştürme süreci olmadan kurulamadığıdır. Veri Ambari (Data Warehouse) Sistemlerine Entegrasyon çalışmaları yalnızca tabloları bir veritabanından diğerine kopyalamak anlamına gelmez; veri sahipliği, kalite, geçmiş kayıtlar, güvenlik, tekrar işleme ve veri sözleşmeleri aynı tasarımın parçasıdır. Bu rehberde veri ambarı sistemlerine entegrasyon nasıl yapılır, kurumsal veriler data warehouse sistemine nasıl aktarılır ve ETL ELT süreçleri ile veri ambarı entegrasyonu nasıl yapılır sorularına uygulamaya dönük cevaplar bulacaksınız. Ayrıca API veritabanı ve bulut kaynaklarından data warehouse veri entegrasyonu, CDC, veri modelleme, kalite kontrolleri, KVKK, BI ve veri pipeline gözlemlenebilirliği gibi production ortamında doğrudan sonuç üreten başlıkları birlikte ele alacağız.
Veri Ambarı Entegrasyonu Nedir?
Veri ambarı entegrasyonu, kurum içinde veya dışında bulunan farklı veri kaynaklarının analitik amaçlarla ortak bir veri yapısına aktarılması, temizlenmesi, eşleştirilmesi ve kullanılabilir hale getirilmesidir. Buradaki amaç kaynak sistemleri basit biçimde kopyalamak değil, farklı uygulamalardan gelen kayıtları ortak iş anlamı altında birleştirmektir. İyi tasarlanmış bir entegrasyon süreci verinin nereden geldiğini, hangi dönüşümlerden geçtiğini, ne kadar güncel olduğunu ve hangi raporların bu veriye bağlı olduğunu gösterebilmelidir. Bu nedenle Veri Ambari (Data Warehouse) Sistemlerine Entegrasyon projesi yalnız teknik connector seçimiyle sınırlı düşünülmemelidir. İş birimi, veri sahibi, veri mühendisi ve BI ekipleri aynı veri tanımlarında uzlaşmadığında teknik pipeline başarılı çalışsa bile kurum yine birbiriyle çelişen raporlar üretmeye devam edebilir.
Data Warehouse Nedir?
Data warehouse, farklı kaynaklardan gelen verilerin analitik sorgulama, raporlama ve tarihsel karşılaştırma amacıyla merkezi biçimde tutulduğu veri platformudur. Operasyonel veritabanlarının aksine çok sayıda küçük transaction yerine büyük veri taramaları, aggregation ve dönemsel analizler için optimize edilir. Müşteri, ürün, satış, finans ve operasyon gibi konular ortak model altında birleştirilerek iş birimlerinin aynı metrikleri kullanması hedeflenir. Veri ambarı aynı zamanda geçmişteki durumların korunmasına izin verdiği için yalnız bugünü değil zaman içindeki değişimleri de analiz etmeyi kolaylaştırır. Modern yapılarda bu platform bulut veri ambarı, lakehouse veya katmanlı veri mimarisi biçiminde kurulabilir, ancak temel amaç değişmez: güvenilir, anlaşılır ve yeniden kullanılabilir analitik veri üretmek.
Data Warehouse Integration Ne Anlama Gelir?
Data warehouse integration, kaynak uygulamalardan verinin alınması, hedef platforma taşınması ve iş kurallarına göre ortak modele dönüştürülmesi sürecidir. ERP içindeki sipariş kaydı CRM'deki müşteri bilgisiyle eşleştirilebilir ve e-ticaret kaynağındaki kullanıcı davranışı aynı müşteri görünümüne bağlanabilir. Böylece rapor hazırlayan ekip her sistemden ayrı dosya toplamak yerine merkezi modele güvenebilir. Entegrasyon sırasında source key, update davranışı, delete politikası, timestamp ve veri tiplerinin doğru anlaşılması gerekir. İyi bir entegrasyon yalnız başarılı çalışan job anlamına gelmez; eksik kayıtları, şema değişikliklerini, geç gelen veriyi ve yeniden işleme ihtiyacını da kontrollü biçimde yönetebilmelidir.
Data Ingestion ile Data Integration Arasındaki Fark
Data ingestion veriyi kaynaktan alıp hedef veya ara katmana taşımaya odaklanır. Data integration ise taşınan verinin başka kaynaklarla birleştirilmesi, standartlaştırılması, temizlenmesi ve iş açısından anlamlı modele dönüştürülmesini kapsar. Örneğin CRM tablosunu raw katmana kopyalamak ingestion işlemidir, CRM müşterisini ERP hesap kaydıyla eşleştirmek ise integration çalışmasıdır. Bu ayrım mimari sorumlulukların daha açık kurulmasına yardımcı olur. Pipeline izleme ekranında dosyanın başarıyla gelmiş olması entegrasyonun tamamlandığını göstermez, çünkü kayıtların doğru müşteriyle eşleşip eşleşmediği ve iş kuralının doğru uygulanıp uygulanmadığı ayrıca test edilmelidir.
Veri Taşımak ile Veriyi Birleştirmek Arasındaki Fark
Veri taşımak genellikle kaynak tablonun başka sisteme aktarılması anlamına gelir ve teknik açıdan oldukça nettir. Veriyi birleştirmek ise müşteri, ürün veya hesap gibi aynı iş varlığının farklı kaynaklardaki kayıtlarını anlamlandırmayı gerektirir. CRM sistemindeki customer_id ile ERP içindeki account_id doğal olarak aynı değere sahip olmayabilir. Bu nedenle mapping, identity resolution ve source of record kuralları devreye girer. Kurumsal veri projelerinde en fazla iş değeri basit taşıma adımından değil, birbirinden kopuk kaynakları kullanıcıların güvenebileceği ortak bir iş modeline dönüştürme aşamasından çıkar.
Kurumsal Tek Doğru Veri Kaynağı (Single Source of Truth) Nedir?
Single Source of Truth kurumun aynı metriği veya iş kavramını birden fazla farklı tanımla üretmesini önlemeyi amaçlayan veri yönetimi yaklaşımıdır. Bu kavram bütün fiziksel verinin tek veritabanında olması gerektiği anlamına gelmez. Daha önemli olan revenue, aktif müşteri, sipariş ve ürün gibi kritik kavramların merkezi ve onaylanmış tanımlarının bulunmasıdır. Semantic layer, data mart ve business glossary bu yapıyı destekleyebilir. İyi kurulan tek doğru veri kaynağı sayesinde finans ekibi ile satış ekibi aynı döneme baktığında farklı SQL ifadeleri yerine ortak veri tanımından sonuç alır ve rapor tartışmaları sayıları doğrulamaktan iş kararlarını konuşmaya kayar.
Kurumlar Neden Veri Ambarı Entegrasyonuna İhtiyaç Duyar?
Kurumlar büyüdükçe operasyonel veriler farklı ekiplerin kullandığı uygulamalara dağılır. Satış CRM kullanırken finans ERP, pazarlama farklı SaaS çözümleri ve operasyon ayrı veritabanları kullanabilir. Bu sistemler tek tek başarılı çalışsa bile ortak rapor oluşturulmak istendiğinde veri siloları ciddi zaman ve kalite kaybına neden olur. Data warehouse entegrasyonu kaynakları ortak analitik yapı altında birleştirerek raporlamayı standartlaştırır ve operasyonel sistemlerden ağır sorgu yükünü uzaklaştırır. Aynı altyapı güvenilir BI, self-service analitik ve veri tabanlı karar süreçlerinin temelini oluşturur.
Veri Silolarının Ortadan Kaldırılması
Veri silosu bir ekip veya uygulamadaki bilginin kurumun diğer bölümleriyle kolayca birleştirilememesi durumudur. Müşteri bilgisi CRM'de, tahsilat ERP'de ve kullanıcı davranışı web analytics sisteminde bulunabilir. Bu kaynaklar ilişkilendirilmediğinde müşteri kârlılığı veya kampanya getirisi gibi sorular doğru cevaplanamaz. Veri ambarı entegrasyonu farklı sistemlerdeki kayıtları ortak anahtarlar ve iş kurallarıyla ilişkilendirir. Veri silolarını azaltmak yalnız teknik erişimi kolaylaştırmaz, farklı departmanların aynı müşteri ve ürün görünümü üzerinden konuşmasını da sağlayarak karar süreçlerinde ciddi zaman kazandırır.
Tutarlı KPI ve Raporlama
KPI tanımları merkezi olmadığında her ekip aynı metriği kendi sorgusuyla hesaplayabilir. Bir ekip iade edilen satışları revenue hesabından çıkarırken başka ekip çıkarmadığında yönetim raporları uyuşmaz. Veri ambarı dönüşüm katmanında ortak business rule uygulanması bu farkı azaltır. Semantic layer ve test edilmiş data mart modelleri metriğin farklı BI araçlarında aynı biçimde hesaplanmasını sağlar. Bu yaklaşım rapor güvenini yükseltirken analistlerin her yeni dashboard için aynı iş mantığını baştan yazma ihtiyacını da azaltır.
Tarihsel Analiz
Operasyonel sistemler çoğunlukla kaydın güncel halini tutmaya odaklanır. Müşteri segmenti değiştiğinde eski değer üzerine yazılabilir ve geçmiş ayın raporunun hangi bilgiyle üretildiği kaybolabilir. Veri ambarında Slowly Changing Dimension gibi yöntemlerle tarihsel durum korunabilir. Böylece satış gerçekleştiği tarihte müşterinin hangi segmentte olduğu veya ürünün hangi kategoriye bağlı bulunduğu analiz edilebilir. Tarihsel veri yalnız raporlama açısından değil fiyat değişimleri, müşteri davranışı ve süreç performansının dönemsel olarak değerlendirilmesi açısından da değerli bir kurumsal hafıza oluşturur.
Operasyonel Sistemlerin Analitik Yükten Korunması
ERP veya sipariş veritabanı günlük işlemleri hızlı ve güvenilir yürütmek için tasarlanmıştır. Analitik kullanıcıların milyonlarca satırı tarayan rapor sorgularını aynı sistem üzerinde çalıştırması transaction performansını etkileyebilir. Veri ambarı bu ağır sorguları ayrı platforma taşıyarak operasyonel sistemin temel işine odaklanmasını sağlar. CDC veya incremental load kullanıldığında kaynak sistemden yalnız değişen veriler alınarak ek yük daha da azaltılabilir. Bu ayrım özellikle yoğun operasyonel veritabanlarında analitik büyümenin müşteri işlemleri üzerinde performans problemi oluşturmasını önlemeye yardımcı olur.
Self-Service BI
Self-service BI iş kullanıcılarının her rapor ihtiyacında teknik ekipten SQL geliştirmesi istemeden güvenilir veriyle analiz yapabilmesini amaçlar. Bunun gerçekleşmesi için ham kaynak tabloların doğrudan kullanıcıya açılması yeterli değildir. Anlaşılır dimension, fact ve merkezi KPI tanımlarının bulunması gerekir. Data mart ve semantic layer bu ihtiyacı karşılayarak kullanıcıya iş diliyle veri sunar. İyi veri ambarı entegrasyonu teknik sistem isimlerini arka planda bırakır ve kullanıcıların müşteri, ürün, satış veya bölge gibi tanıdıkları kavramlarla çalışmasına izin verir.
Yapay Zeka ve Makine Öğrenmesi İçin Güvenilir Veri
Model kalitesi büyük ölçüde training verisinin doğruluğuna ve tutarlılığına bağlıdır. Farklı kaynaklarda aynı müşterinin farklı kimliklerle tutulması veya zaman bilgisinin hatalı aktarılması tahmin sonuçlarını doğrudan etkileyebilir. Veri ambarı entegrasyonu temizlenmiş, test edilmiş ve geçmişi korunmuş veri setleri sağlayarak model geliştirme ekiplerine ortak temel sunar. Feature engineering aşamasında tekrar tekrar kaynak sistem sorgulamak yerine onaylanmış veri modelleri kullanılabilir. Böylece analitik ve makine öğrenmesi ekipleri aynı veri tanımlarından beslenerek üretim ortamındaki sonuçların yeniden üretilebilirliğini güçlendirir.
Veri Ambarına Hangi Sistemler Entegre Edilebilir?
Modern veri ambarları yalnız ilişkisel veritabanlarından veri almakla sınırlı değildir. ERP, CRM, SaaS uygulamaları, dosyalar, API'ler, IoT akışları ve message broker sistemleri aynı analitik platformun kaynakları olabilir. Her kaynağa aynı entegrasyon yöntemini uygulamak doğru değildir, çünkü değişiklik hızı, API limiti, veri hacmi ve delete davranışı farklılık gösterir. Kaynak bazında ingestion yöntemi belirlemek daha güvenli sonuç verir. API veritabanı ve bulut kaynaklarından data warehouse veri entegrasyonu planlanırken veri sahibinin, teknik erişim yönteminin ve beklenen freshness seviyesinin başlangıçta belgelenmesi sonraki geliştirme süresini önemli ölçüde azaltır.
ERP
ERP sistemleri finans, sipariş, stok, üretim ve tedarik süreçlerine ait kurumsal verinin önemli bölümünü içerir. Bu nedenle veri ambarı projelerinde en kritik kaynaklardan biri olarak değerlendirilir. ERP verisi çoğu zaman yüksek iş değeri taşırken karmaşık tablo ilişkileri ve özel iş kuralları nedeniyle dikkatli modellenmelidir. Direkt veritabanı erişimi, API, export veya CDC seçenekleri sistemin izin verdiği yönteme göre kullanılabilir. Finansal mutabakat gerektiren verilerde source-target reconciliation ve delete davranışlarının test edilmesi özellikle önemlidir.
SAP
SAP sistemlerindeki veri geniş süreç kapsamı nedeniyle veri ambarı entegrasyonunda dikkatli kaynak analizi gerektirir. Hangi modülün hangi iş kavramının ana kaynağı olduğu iş ekipleriyle birlikte belirlenmelidir. Extract yöntemi mevcut SAP altyapısına, lisans koşullarına ve sistem yüküne göre seçilir. Büyük tabloların sürekli full load edilmesi yerine incremental veya desteklenen değişiklik yakalama yöntemleri değerlendirilir. Finansal ve operasyonel raporların güvenilir olması için SAP içerisindeki document status, currency, organizational unit ve tarih alanlarının anlamı hedef veri modelinde açık biçimde korunmalıdır.
Oracle ERP
Oracle ERP kaynaklarında finans, tedarik ve operasyon verisi ortak kurumsal analitik modele aktarılabilir. API veya desteklenen extract mekanizmaları source sistem sürümüne ve kurum mimarisine göre tercih edilir. Veri hacmi yüksekse tam tablo aktarımı yerine değişiklik odaklı yöntemler daha verimli olur. Accounting period ve transaction status gibi alanlar raporların yorumlanmasını doğrudan etkiler. Kaynak tabloların teknik isimlerini doğrudan BI kullanıcısına taşımak yerine staging ve business dönüşüm katmanları üzerinden anlaşılır model oluşturulması bakım maliyetini azaltır.
Microsoft Dynamics
Microsoft Dynamics kaynakları CRM ve ERP verisini merkezi warehouse yapısına taşımak için farklı API ve entegrasyon yöntemleri sunabilir. Cloud sürümlerde platformun sağladığı connector veya export seçenekleri tercih edilebilir. API rate limit ve pagination davranışı ingestion tasarımının önemli parçasıdır. Günlük değişiklik miktarı yüksek değilse incremental batch yeterli olabilir, daha düşük latency gereksiniminde event veya değişiklik odaklı yaklaşım değerlendirilebilir. Entity isimleri ve option set benzeri kod değerleri business kullanıcılarının anlayacağı açıklamalarla semantic modele taşınmalıdır.
Odoo
Odoo satış, muhasebe, stok ve CRM süreçlerini aynı platformda tutabildiği için veri ambarı açısından zengin bir kaynak olabilir. PostgreSQL erişimi veya uygulama API'leri kurumun mimari tercihine göre değerlendirilebilir. Doğrudan veritabanı entegrasyonu yapılırken uygulama şemasındaki özel modül değişikliklerinin takip edilmesi gerekir. update_date gibi alanlar incremental load için kullanılabilir, ancak hard delete davranışı ayrıca test edilmelidir. Model tanımları değiştikçe schema drift kontrolü yapılması, Odoo yükseltmelerinden sonra pipeline'ın beklenmedik biçimde bozulmasını önlemeye yardımcı olur.
CRM
CRM verileri müşteri kimliği, satış fırsatları, iletişim geçmişi ve kampanya etkileşimleri açısından önemli analitik değer taşır. Veri ambarında ERP veya e-ticaret kayıtlarıyla birleştirildiğinde müşteri yaşam döngüsü daha bütünlüklü görülebilir. CRM customer ID her zaman kurum genelindeki ana müşteri kimliği olmayabilir. Bu nedenle identity resolution ve mapping kuralları önemlidir. API limitleri, silinen kayıtlar, custom field'lar ve kullanıcı tarafından değiştirilebilen enum değerleri pipeline tasarımında düzenli olarak izlenmelidir.
Salesforce
Salesforce verisi account, contact, opportunity ve activity gibi nesneler üzerinden kurumsal raporlamaya aktarılabilir. API tabanlı ingestion yapılırken rate limit, incremental timestamp ve deleted records davranışı başlangıçta incelenmelidir. Custom object ve field sayısı arttıkça schema evolution ihtiyacı yükselir. CRM kullanıcılarının rapor amaçlı oluşturduğu alanların bütününün warehouse'a taşınması yerine gerçekten tüketilen verilerin önceliklendirilmesi maliyet ve bakım açısından daha sağlıklıdır. Müşteri görünümü ERP ve diğer kanallarla birleştirilecekse Salesforce identifier'ı kurumsal entity mapping tablosunun yalnız bir parçası olarak değerlendirilmelidir.
HubSpot
HubSpot entegrasyonunda contact, company, deal ve marketing activity gibi kayıtlar veri ambarına aktarılabilir. API limitleri ve pagination ingestion hızını sınırlandırabileceği için connector tasarımında kontrollü retry ve checkpoint kullanmak gerekir. Custom property değişiklikleri schema drift oluşturabilir. Incremental sync mümkün olduğunda update timestamp veya platformun sağladığı değişiklik sinyalleri kullanılabilir. Pazarlama raporlarında HubSpot verisi web analytics ve satış verileriyle birleştirildiğinde lead oluşumundan gelir gerçekleşmesine kadar daha anlamlı funnel analizi yapılabilir.
E-Ticaret Sistemleri
E-ticaret sistemleri sipariş, ödeme, ürün, kampanya, sepet ve kullanıcı davranışı gibi yüksek hacimli veri üretir. Bu verinin ERP finans kayıtları ve CRM müşteri bilgileriyle eşleştirilmesi gelir ve müşteri analizini güçlendirir. Sipariş status değişimleri ve iade olayları incremental pipeline içinde doğru biçimde ele alınmalıdır. Webhook veya event verisi düşük latency sağlayabilir, ancak kayıp event riskine karşı periyodik reconciliation yapılması faydalıdır. Ürün ve kullanıcı kimliklerinin farklı platformlarda değişebilmesi nedeniyle source identifier ile kurumsal identifier ayrı tutulmalıdır.
Muhasebe ve Finans Sistemleri
Finans sistemleri gelir, gider, fatura, ödeme ve hesap hareketleri gibi kurumsal açıdan kritik verileri içerir. Bu kaynaklardan gelen kayıtların veri ambarında değiştirilmeden izlenebilir raw kopyasının tutulması denetim açısından faydalıdır. Dönüşüm sonrasında ortaya çıkan finansal tablolar source control total ile karşılaştırılmalıdır. Currency conversion, accounting period ve reversal işlemleri iş kurallarına doğru yansıtılmalıdır. Finansal reconciliation yapılmadan yalnız row count kontrolüne güvenmek, sayı olarak eksiksiz görünen fakat tutar açısından hatalı raporların production'a çıkmasına neden olabilir.
Üretim ve MES Sistemleri
Üretim ve MES sistemleri makine, iş emri, üretim miktarı, kalite ve duruş bilgisi gibi operasyonel veri sağlar. Veri çoğu zaman yüksek frekansta üretildiği için batch ile streaming arasında kaynak bazında seçim yapılmalıdır. Her sensör olayını gerçek zamanlı warehouse'a taşımak maliyetli olabilir. İş ihtiyacı dakika veya saat seviyesinde ise micro-batch daha ekonomik çözüm sunabilir. Üretim verisi ERP sipariş ve maliyet bilgileriyle birleştirildiğinde kapasite, verimlilik ve birim maliyet analizleri daha güçlü hale gelir.
IoT ve Sensör Verileri
IoT kaynakları yüksek hacim ve hız nedeniyle klasik tablo entegrasyonundan farklı tasarım gerektirebilir. Event streaming veya object storage landing katmanı bu veriler için uygun olabilir. Ham sensör kayıtlarının tamamını warehouse compute üzerinde tutmak yerine uzun dönem storage ve aggregate katmanlarını ayırmak maliyeti azaltabilir. Device clock farklılıkları nedeniyle event time ve processing time ayrı tutulmalıdır. Out-of-order veri ve geç gelen event'ler analitik sonuçları etkileyebileceği için watermark ve grace period yaklaşımı pipeline tasarımına dahil edilmelidir.
Web ve Mobil Analytics
Web ve mobil analytics verileri ziyaret, ekran, dönüşüm ve kullanıcı davranışı analizlerinde kullanılır. Event bazlı yapı yüksek hacim ürettiği için partitioning ve incremental processing önemlidir. Anonymous kullanıcı ile authenticated customer kimliğinin daha sonra birleştirilmesi gerekebilir. Consent ve kişisel veri kapsamı KVKK açısından ayrıca değerlendirilmelidir. Bu kaynak e-ticaret siparişi ve CRM müşteri kaydıyla birleştirildiğinde pazarlama kanalından gerçek gelire kadar uzanan uçtan uca attribution analizi yapılabilir.
SaaS Uygulamaları
Kurumlar insan kaynakları, destek, proje yönetimi ve pazarlama gibi alanlarda çok sayıda SaaS uygulaması kullanabilir. Bu platformların çoğunda veri erişimi API üzerinden gerçekleşir. API limit, pagination, token rotation ve schema değişiklikleri connector bakımının önemli parçalarıdır. Her SaaS kaynağı için ayrı custom kod geliştirmek yerine desteklenen connector ekosistemi bakım maliyetini azaltabilir. Yine de managed connector kullanılsa bile source owner, freshness SLA ve veri kalitesi sorumluluğu kurum içinde açık biçimde tanımlanmalıdır.
Dosya, SFTP ve Object Storage
CSV, JSON, Parquet veya Excel benzeri dosyalar hâlâ birçok kurumsal entegrasyonun parçasıdır. SFTP üzerinden gelen dosyalarda isim standardı, teslim zamanı ve duplicate dosya kontrolü belirlenmelidir. Object storage raw landing katmanı için düşük maliyetli ve yeniden işlenebilir bir temel sağlayabilir. Dosyanın geldiğini görmek yeterli değildir; satır sayısı, schema, checksum ve içerik kalitesi de kontrol edilmelidir. Aynı dosya ikinci kez geldiğinde pipeline'ın duplicate kayıt üretmemesi için idempotent dosya işleme modeli kurulmalıdır.
REST ve GraphQL API'ler
REST ve GraphQL API entegrasyonlarında rate limit, pagination, retry ve authentication temel teknik konulardır. API response schema değiştiğinde pipeline bozulabilir veya alanlar sessizce boş gelmeye başlayabilir. Incremental endpoint varsa full history çekmek yerine cursor veya updated_at kullanılmalıdır. API'de delete edilmiş kayıtların nasıl bildirildiği ayrıca kontrol edilmelidir. API kaynaklarında source system yükünü azaltmak için extraction window ve concurrency değerleri platform limitleriyle uyumlu belirlenmelidir.
Mesaj Kuyrukları ve Event Stream'leri
Mesaj kuyruğu ve event stream kaynakları veri ambarına düşük gecikmeli ingestion sağlamada kullanılır. Kafka gibi sistemlerden event alınırken partition, offset ve delivery semantics dikkatle yönetilmelidir. At-least-once teslimat duplicate üretme ihtimali taşıdığı için hedef yükleme idempotent olmalıdır. Event schema değişiklikleri schema registry veya data contract ile kontrol edilebilir. Streaming verinin ham kopyasını uzun süre saklamak replay ve backfill ihtiyacında büyük operasyon kolaylığı sağlar.
Entegrasyon Öncesi Kaynak Sistem Envanteri Nasıl Çıkarılır?
Başarılı veri ambarı projelerinde kod yazmadan önce kaynak sistem envanteri hazırlanır. Her kaynağın sahibinin kim olduğu, veri hacmi, günlük değişiklik miktarı, erişim yöntemi ve freshness ihtiyacı belgelenir. Bu çalışma connector seçimi, kapasite ve SLA tasarımını doğrudan etkiler. Kaynak hakkında bilinmeyen delete veya update davranışı daha sonra veri kaybına yol açabilir. Basit bir envanter tablosu bile proje boyunca teknik ekip, iş birimi ve güvenlik ekiplerinin aynı bilgiler üzerinden konuşmasını sağlayarak gereksiz yeniden geliştirmeleri azaltır.
Source Owner
Source owner kaynağın iş ve teknik sorumluluğunu taşıyan kişiyi veya ekibi tanımlar. Şema değişikliği, erişim problemi veya veri anlamı hakkında ilk başvurulacak taraf bu sahiplik üzerinden belirlenir. Owner belli değilse pipeline sorunu sırasında herkes birbirini yönlendirebilir ve çözüm süresi uzar. Data contract sürecinde producer sorumluluğu da source owner ile ilişkilendirilebilir. Kurumsal veri envanterinde her kaynağın teknik sahibi ve iş sahibi ayrı alanlar olarak tutulursa hem erişim hem anlam sorunları daha hızlı çözülür.
Veri Hacmi
Kaynak veri hacmi ingestion stratejisini belirleyen temel ölçülerden biridir. On bin satırlık tablo ile milyarlarca kayıt içeren event kaynağı aynı yöntemle taşınmamalıdır. Mevcut toplam hacim kadar yıllık büyüme oranı da hesaba katılmalıdır. Full load bugün hızlı olsa bile birkaç ay sonra sürdürülemez hale gelebilir. Storage, network ve warehouse compute maliyeti veri hacmi üzerinden yaklaşık hesaplanarak mimari kararların finansal etkisi daha geliştirme başlamadan görülebilir.
Günlük Değişiklik Miktarı
Toplam tablo büyük olsa bile günlük değişiklik oranı düşük olabilir. Bu durumda CDC veya incremental load full refresh'e göre çok daha düşük kaynak ve hedef maliyeti üretir. Günlük insert, update ve delete sayıları ayrı ölçülmelidir. Yalnız insert oranına bakmak güncellenen eski kayıtların kaçırılmasına neden olabilir. Değişiklik profili bilindiğinde extraction window, batch size ve warehouse merge stratejisi gerçek workload'a göre seçilebilir.
Schema
Kaynak schema tablo, kolon, veri tipi ve ilişki bilgilerini içerir. Entegrasyon başlamadan schema snapshot alınması ilerideki değişiklikleri takip etmeyi kolaylaştırır. Nested JSON veya semi-structured veri ayrıca belgelenmelidir. Her kolonun business anlamını yalnız teknik isimden çıkarmak güvenilir değildir. Schema metadata ile business glossary bağlantısı kurulması dönüşüm kodunun daha anlaşılır ve sürdürülebilir olmasını sağlar.
Primary Key
Primary key veya doğal tekil anahtar incremental load ve deduplication açısından kritik bilgidir. Bir tabloda güvenilir key yoksa aynı kayıtları farklı batch'lerde ayırt etmek zorlaşır. Composite key gerekebilir veya kaynak tarafından üretilen stabil identifier kullanılabilir. Teknik olarak unique görünen alanın zaman içinde yeniden kullanılıp kullanılmadığı source owner ile doğrulanmalıdır. Hedef warehouse upsert ve merge işlemi bu anahtarın davranışına göre tasarlanmalıdır.
Update ve Delete Davranışı
Kaynağın kayıtları nasıl güncellediği ve sildiği mutlaka anlaşılmalıdır. Bazı sistemler hard delete yaparken bazıları deleted flag kullanır. Timestamp tabanlı incremental load hard delete edilmiş satırı doğal olarak göremez. Bu durumda CDC, tombstone event veya periyodik reconciliation gerekebilir. Delete davranışını proje sonunda fark etmek geçmişte silinen verilerin warehouse'ta aktif görünmeye devam etmesine neden olabileceği için entegrasyon tasarımının ilk aşamasında test edilmelidir.
API Limitleri
API kaynaklarında dakika veya gün başına request limitleri extraction hızını belirleyebilir. Pagination ve rate limit davranışına uygun retry kullanılmalıdır. Çok agresif paralel sorgu üretmek kaynak uygulamanın normal kullanıcılarını etkileyebilir veya API hesabının engellenmesine neden olabilir. Connector checkpoint kullanarak kaldığı yerden devam edebilmelidir. API limitleri kapasite planına eklenirse backfill sırasında günlük normal ingestion'ın kesintiye uğraması engellenebilir.
Veri Hassasiyeti
Kaynak sistemde kişisel, finansal veya ticari açıdan hassas veri bulunup bulunmadığı belirlenmelidir. Bu sınıflandırma network, encryption, masking ve erişim kurallarını etkiler. Her alanın warehouse'a taşınması iş gereksinimi olmayabilir. Data minimization yaklaşımı gereksiz kişisel veri kopyalarını azaltır. Hassasiyet bilgisi data catalog içinde metadata olarak tutulduğunda downstream kullanıcıların hangi veriyle çalıştığını anlaması ve güvenlik politikalarının otomatik uygulanması kolaylaşır.
Freshness Gereksinimi
Freshness verinin kaynakta değiştikten ne kadar sonra warehouse'ta görünmesi gerektiğini tanımlar. Her tablo için saniyelik gerçek zamanlı hedef belirlemek maliyet ve operasyon yükünü gereksiz artırır. Finans kapanış verisi saatlik yeterli olabilirken fraud veya stok senaryosu dakikalık güncellik isteyebilir. İş birimiyle gerçek ihtiyaç konuşulmalıdır. Freshness SLO kaynak bazında tanımlandığında batch, micro-batch veya streaming seçimi teknik tercih yerine ölçülebilir iş ihtiyacına dayanır.
System of Record Nasıl Belirlenir?
Aynı müşteri veya ürün bilgisi farklı sistemlerde bulunduğunda hangisinin ana kaynak kabul edileceği açıkça belirlenmelidir. CRM müşteri iletişim bilgisi açısından güçlü olabilirken finansal hesap bilgisi ERP'de daha güvenilir olabilir. System of Record kararı alan bazında bile değişebilir. Bu nedenle tek uygulamayı bütün entity için mutlak kaynak kabul etmek her zaman doğru değildir. Source priority kuralları data contract ve business glossary içinde belgelenirse çakışan verilerin warehouse modeline nasıl yansıtılacağı ekipler için öngörülebilir hale gelir.
Aynı Verinin Birden Fazla Sistemde Bulunması
Müşteri adı, telefon veya adres hem CRM hem ERP hem e-ticaret uygulamasında bulunabilir. Bu alanlar zaman içinde farklı tarihlerde güncellendiği için değerler çakışabilir. En yeni timestamp'i seçmek her zaman doğru değildir, çünkü her sistem aynı alanın yetkili sahibi olmayabilir. Alan bazında source priority veya stewardship kuralı gerekir. Reconciliation tablosu çakışmaları görünür hale getirerek iş biriminin hangi kaynağın güvenilir olduğunu doğrulamasına yardımcı olur.
Müşteri İçin Ana Kaynak
Müşteri ana kaynağı kurumun iş modeline göre CRM, ERP veya merkezi MDM olabilir. CRM genellikle iletişim ve satış ilişkisi açısından güçlüdür. ERP ise faturalama ve resmi hesap bilgisi için ana kaynak olabilir. Golden customer record oluşturulurken farklı alanların farklı kaynaklardan seçilmesi mümkündür. Bu kuralın açıkça belgelenmesi hem veri ambarı hem operasyonel aktivasyon sistemlerinin aynı müşteri tanımını kullanmasını sağlar.
Ürün İçin Ana Kaynak
Ürün bilgisi ERP, PIM veya e-ticaret platformunda farklı amaçlarla tutulabilir. SKU ve maliyet ERP'den, açıklama ve görsel metadata e-ticaret veya PIM sisteminden gelebilir. Tek sistem bütün alanların en güvenilir kaynağı olmak zorunda değildir. Product master modelinde attribute ownership belirlemek gerekir. Aynı SKU farklı kaynaklarda farklı kategoriye bağlıysa öncelik kuralı olmadan raporlar zaman içinde değişken sonuç üretebilir.
Finansal Veri İçin Ana Kaynak
Finansal raporlarda resmi muhasebe sistemi çoğu zaman ana kaynak kabul edilir. Sipariş sistemi ödeme veya satış olayını daha erken gösterebilir, fakat gelir muhasebeleştirme kuralı farklı olabilir. Yönetim raporlarında bu iki kavramın karıştırılmaması gerekir. Warehouse modelinde operational sales ve recognized revenue ayrı ölçüler olarak tutulabilir. Finans source of record kuralı özellikle dönem kapanışı ve reconciliation süreçlerinde açık biçimde uygulanmalıdır.
Çakışan Değerlerde Öncelik Kuralı
Çakışan değerlerde hangi kaynağın seçileceği deterministic olmalıdır. Source priority, son güncelleme zamanı veya data steward onayı gibi kurallar kullanılabilir. Aynı pipeline iki kez çalıştığında farklı sonuç üretmemelidir. Kurallar SQL veya dönüşüm kodunda saklanırken business açıklaması catalog içinde belgelenmelidir. Böylece kullanıcı bir alanın neden belirli değeri taşıdığını lineage üzerinden anlayabilir.
Modern Veri Ambarı Entegrasyon Mimarisi
Modern entegrasyon mimarisi kaynak sistemlerden başlayıp BI ve analitik tüketim katmanına kadar farklı sorumlulukları ayırır. Ingestion yalnız veriyi getirmeye, transformation iş modelini oluşturmaya ve semantic layer ortak metrikleri sunmaya odaklanabilir. Raw veri tutulması yeniden işleme ve audit açısından büyük avantaj sağlar. Governance ve observability ise bütün katmanların güvenilir çalışmasını destekler. Bu ayrım ekiplerin bir pipeline problemini hangi aşamada araması gerektiğini netleştirir ve yeni kaynak ekleme sürecini daha standart hale getirir.
Source Systems
Source systems operasyonel uygulamalar, SaaS çözümleri, API'ler ve event platformlarını kapsar. Her kaynağın sahibi ve erişim yöntemi farklı olabilir. Kaynak üzerinde mümkün olduğunca az yük oluşturmak entegrasyon tasarımının temel ilkelerinden biridir. Production transaction tablosunu sık full scan etmek yerine incremental extraction tercih edilir. Kaynak değişiklikleri producer sorumluluğu altında data contract ile tüketicilere bildirilirse downstream kesinti riski önemli ölçüde azalır.
Ingestion Layer
Ingestion layer kaynak veriyi warehouse veya landing bölgesine taşır. Connector, CDC agent veya event consumer bu katmanda yer alabilir. Temel hedef veriyi mümkün olduğunca kaynağa yakın biçimde güvenli şekilde almak ve extraction state'ini korumaktır. İş dönüşümlerinin tamamını connector içine gömmek bakım zorluğu yaratabilir. Ingestion ve transformation sorumlulukları ayrıldığında yeniden işleme ve connector değişikliği daha kolay yönetilir.
Raw / Landing Layer
Raw veya landing katmanı kaynaktan gelen verinin mümkün olduğunca değişmeden saklandığı bölgedir. Bu katman reprocessing, audit ve schema evolution açısından güvenli geri dönüş noktası sağlar. Source metadata, ingestion timestamp ve batch ID gibi teknik alanlar eklenebilir. Raw verinin retention süresi maliyet ve yeniden işleme ihtiyacına göre belirlenir. Ham veriyi tamamen kaybetmek dönüşüm mantığı değiştiğinde kaynak sistemden yeniden büyük backfill yapılmasını zorunlu hale getirebilir.
Staging Layer
Staging katmanı kaynak verinin hedef modele hazırlanması için kullanılan ara bölgedir. Veri tipi düzeltme, temel cleaning, kolon isim standardı ve duplicate kontrolü burada yapılabilir. Staging modelleri business kullanıcılarının doğrudan tüketmesi için tasarlanmak zorunda değildir. Kaynak değişikliklerini business modelden izole etmek bakım açısından fayda sağlar. Her source için benzer staging convention kullanılması yeni geliştiricilerin pipeline akışını daha hızlı anlamasına yardımcı olur.
Transformation Layer
Transformation layer veriyi iş kurallarına göre birleştirir ve analitik modele dönüştürür. Müşteri eşleştirme, currency conversion, status standardization ve metric hesapları burada yapılabilir. SQL tabanlı ELT yaklaşımı modern warehouse sistemlerinde yaygındır. Dönüşüm kodu version control ve test süreçlerine dahil edilmelidir. İş kuralı değiştiğinde lineage üzerinden hangi downstream tabloların ve dashboard'ların etkilendiği görülebilmelidir.
Core Warehouse
Core warehouse kurum genelinde yeniden kullanılabilir temel entity ve fact modellerini barındırır. Customer, product, order ve financial transaction gibi alanlar burada ortak kurallarla temsil edilir. Data mart modellerinin aynı kavramları tekrar tekrar farklı biçimde hesaplaması önlenir. Tarihsel değişiklikler ve conformed dimension yaklaşımı bu katmanda yönetilebilir. Sağlam core model yeni rapor ihtiyaçlarının daha hızlı karşılanmasını sağlar çünkü kaynak sistemlerin ayrıntısını her dashboard geliştiricisinin yeniden anlaması gerekmez.
Data Mart
Data mart belirli iş biriminin veya analitik konunun kullanımına uygun veri modellerini içerir. Satış, finans, pazarlama veya operasyon için ayrı mart oluşturulabilir. Core warehouse verileri bu katmanda iş kullanıcılarının kolay anlayacağı tablo yapısına dönüştürülür. Star schema sık kullanılan tasarım yaklaşımıdır. Mart katmanında tutulan metric tanımları semantic layer ile birlikte yönetildiğinde farklı BI raporları arasında tutarlılık artar.
Semantic Layer
Semantic layer revenue, active customer ve conversion rate gibi metriklerin merkezi tanımını sağlar. BI kullanıcıları fiziksel tablo join detaylarını bilmeden onaylanmış kavramlarla çalışabilir. Aynı metric Power BI, Tableau veya başka tüketiciler tarafından tekrar kullanılabilir. Metric drift böylece azaltılır. Semantic model iş terimleriyle veri modelini birbirine bağlayan katman olarak kurumsal self-service analitiğin önemli temelidir.
BI / Analytics / AI Layer
Bu katman veri ambarının gerçek iş değerine dönüştüğü tüketim alanıdır. Dashboard, ad hoc analiz, veri bilimi ve makine öğrenmesi aynı güvenilir veri temelini kullanabilir. Farklı consumer türlerinin performance ve freshness beklentileri farklı olabilir. BI için aggregate mart, AI için daha granular feature dataset hazırlanabilir. Tüketim pattern'leri warehouse model ve compute optimizasyonunun nasıl yapılacağını belirlemede önemli geri bildirim sağlar.
Governance ve Observability
Governance veri sahipliği, erişim, catalog ve data contract kurallarını kapsarken observability pipeline'ın gerçekten beklendiği gibi çalışıp çalışmadığını gösterir. Job success tek başına yeterli değildir. Veri hacmi yarıya düşmüş olsa bile task teknik olarak başarılı bitebilir. Freshness, volume, schema ve quality metrikleri birlikte izlenmelidir. Bu iki alan mimarinin yan özelliği değil, güvenilir veri platformunun sürekli çalışmasını sağlayan temel kontrol katmanı olarak tasarlanmalıdır.
ETL Nedir?
ETL Extract, Transform ve Load adımlarından oluşan klasik veri entegrasyon yöntemidir. Kaynak veri önce alınır, warehouse dışında veya ara işlem katmanında dönüştürülür ve son hali hedef sisteme yüklenir. Özellikle hedef platforma yalnız temizlenmiş veya güvenlik açısından filtrelenmiş veri gönderilmesi gereken senaryolarda hâlâ uygun bir yaklaşımdır. Transformation engine ayrı compute kaynağı kullandığı için warehouse üzerindeki işlem yükü azaltılabilir. Buna karşılık dönüşüm kuralları veri yüklenmeden önce çalıştığı için ham verinin yeniden işlenmesi için ayrıca retention stratejisi gerekebilir.
Extract
Extract adımı kaynak sistemden gerekli verinin alınmasıdır. Database query, API, dosya veya connector kullanılabilir. Kaynak üzerinde oluşacak yük bu aşamada dikkatle yönetilmelidir. Incremental extraction mümkünse full scan yerine tercih edilir. Extraction checkpoint ve watermark bilgisi korunursa pipeline hata sonrasında kaldığı yerden güvenli biçimde devam edebilir.
Transform
Transform adımı verinin hedef modele uygun hale getirildiği aşamadır. Data cleaning, mapping, standardization ve business rule işlemleri uygulanabilir. Kişisel veri warehouse'a gitmeden önce maskelenebilir. Transformation logic test edilmeli ve version control altında tutulmalıdır. Büyük veri hacminde transformation compute kapasitesi ayrı performans darboğazı oluşturabilir.
Load
Load dönüştürülmüş verinin hedef warehouse'a yazılmasıdır. Bulk loading tek tek insert işlemine göre daha verimli olabilir. Incremental load sırasında upsert veya merge kullanılması gerekebilir. Transaction sınırı ve retry davranışı idempotency ile uyumlu olmalıdır. Load tamamlandıktan sonra source-target reconciliation yapmak veri kaybı veya duplicate riskini görünür hale getirir.
Geleneksel ETL Ne Zaman Kullanılmalı?
Veri warehouse'a ulaşmadan önce zorunlu güvenlik veya kalite dönüşümü yapılması gerekiyorsa ETL uygun olabilir. Kaynak verinin tamamını hedef platformda tutmak hukuki veya mali açıdan istenmeyebilir. Legacy data warehouse sistemleri de external transformation engine kullanımını gerektirebilir. Çok ağır dönüşümler hedef compute kapasitesini tüketiyorsa ETL mantıklı seçenek olabilir. Yöntem seçimi teknoloji trendinden çok güvenlik, maliyet, yeniden işleme ve operasyon gereksinimleri üzerinden yapılmalıdır.
ETL'nin Avantajları
ETL hedef sisteme yalnız işlenmiş ve gerekli verinin yüklenmesini sağlar. Sensitive field'lar daha önce maskelenebilir. Warehouse storage gereksiz raw data ile büyümez. Dönüşüm compute maliyeti ayrı platformda kontrol edilebilir. Ayrıca uzun yıllardır kullanılan araç ve operational pattern'lerin bulunması büyük kurumsal ortamlarda önemli uygulama kolaylığı sağlar.
ETL'nin Dezavantajları
ETL yaklaşımında ham veri dönüşümden önce kaybedilirse yeni business rule için geçmişi yeniden işlemek zorlaşır. Transformation platformu ayrı altyapı ve bakım gerektirebilir. Kaynak schema değişiklikleri transform kodunu doğrudan bozabilir. Büyük veri hacminde ara taşıma maliyeti artabilir. Modern cloud warehouse compute özelliklerinden yeterince yararlanılmadığında gereksiz ek mimari katman oluşabilir.
ELT Nedir?
ELT veriyi önce hedef warehouse'a yükleyip dönüşümleri daha sonra warehouse compute üzerinde çalıştıran yaklaşımdır. Cloud data warehouse sistemlerinin yüksek işlem kapasitesi ve ölçeklenebilirliği bu modeli yaygın hale getirmiştir. Raw veri saklandığı için business logic değiştiğinde kaynak sistemden tekrar extraction yapmadan reprocessing mümkündür. SQL tabanlı dönüşüm geliştirme analist ve veri mühendislerinin aynı araçlarla çalışmasını kolaylaştırır. Buna karşılık hassas verinin raw katmana taşınması güvenlik ve data minimization açısından dikkatli yönetilmelidir.
Extract
ELT modelinde extract yine kaynak sistemden verinin alınmasıyla başlar. Hedef ilk aşamada veriyi çok az değişiklikle kabul ettiği için connector logic daha sade olabilir. Source metadata korunmalıdır. Incremental ve CDC yöntemleri extraction maliyetini azaltır. Kaynak değişikliklerinin raw katmanda izlenebilir olması sonraki dönüşümlerin güvenilirliğini artırır.
Load
Veri dönüşüm yapılmadan veya minimum normalize edilerek warehouse raw katmanına yüklenir. Bulk ve parallel load performans açısından önemlidir. Raw tabloya ingestion timestamp ve source metadata eklenebilir. Bu katman tekrar işleme için güvenli kaynak görevi görür. Storage maliyeti ucuz olduğunda uzun raw retention işletim esnekliği sağlar.
Warehouse İçinde Transform
Transform SQL veya warehouse-native işlem motoru üzerinde çalıştırılır. dbt gibi araçlar model dependency, test ve documentation işlevlerini destekleyebilir. Compute kaynakları workload'a göre ölçeklenebilir. Transformation logic Git altında versionlanabilir. Büyük modellerde incremental processing compute maliyetini azaltır.
Cloud Data Warehouse ile ELT
Cloud warehouse sistemleri storage ve compute kaynaklarını elastik yönetebildiği için ELT yaklaşımıyla iyi uyum sağlar. Raw veri hızlı yüklenir ve business dönüşümleri gerektiğinde ölçeklenen compute üzerinde çalışır. Farklı ekipler ayrı compute warehouse kullanarak birbirini daha az etkileyebilir. Yine de sınırsız compute düşüncesi maliyet kontrolünü ortadan kaldırmaz. Query optimization, partitioning ve incremental model kullanımı ELT maliyet yönetiminin temel parçasıdır.
ELT'nin Avantajları
ELT raw veriyi koruduğu için yeniden işleme ve yeni model geliştirme kolaylaşır. SQL tabanlı transform farklı ekipler tarafından daha kolay incelenebilir. Connector katmanı business logic taşımadığı için sadeleşir. Cloud compute ihtiyaç olduğunda artırılabilir. Data lineage ve model dependency araçları transformation katmanında güçlü software engineering süreçleri kurulmasına izin verir.
ELT'nin Dezavantajları
Raw verinin hedef platformda tutulması güvenlik ve kişisel veri yönetimini zorlaştırabilir. Gereksiz büyük verinin sürekli saklanması maliyet oluşturur. Kötü yazılmış transformation sorguları compute giderini hızla artırabilir. Warehouse provider'a özgü SQL özellikleri vendor bağımlılığı yaratabilir. Ekipler maliyet ve erişim yönetişimi kurmadan yalnız kolay yükleme avantajına odaklanırsa platform zaman içinde kontrolsüz büyüyebilir.
ETL mi ELT mi?
ETL ve ELT arasında tek doğru seçim yoktur. Veri hacmi, güvenlik gereksinimi, cloud warehouse compute kapasitesi ve yeniden işleme ihtiyacı yöntemi belirler. Bir kurum aynı platformda bazı kaynakları ETL, bazılarını ELT yaklaşımıyla taşıyabilir. ETL ELT süreçleri ile veri ambarı entegrasyonu nasıl yapılır sorusuna en doğru cevap kaynak bazında karar vermektir. Architecture standardı gereklidir, ancak bütün kaynakları aynı modele zorlamak yerine teknik ve iş gereksinimlerinin desteklediği yöntemi seçmek daha sürdürülebilir olur.
Veri Hacmi
Büyük veri hacminde veriyi transformation engine'e taşıyıp tekrar warehouse'a göndermek ek network maliyeti oluşturabilir. ELT warehouse compute üzerinde dönüşüm yaparak bu hareketi azaltabilir. Buna karşılık gereksiz ham kolonların tamamının yüklenmesi storage maliyetini artırır. Küçük veri setlerinde iki yaklaşım arasındaki fark sınırlı olabilir. Hacim ve günlük değişiklik miktarı kararın maliyet boyutunu belirleyen temel girdilerdir.
Veri Gizliliği
Hassas veri hedef warehouse'a ham biçimde taşınmamalıysa ETL avantaj sağlayabilir. Masking veya tokenization load öncesinde uygulanabilir. ELT kullanılacaksa raw layer erişimleri çok daha sıkı olmalıdır. Column-level security ve encryption tek başına data minimization ihtiyacını ortadan kaldırmaz. KVKK kapsamındaki alanlar için gerçekten hangi verinin analitik amaçla gerekli olduğu başlangıçta belirlenmelidir.
Transformation Karmaşıklığı
Dönüşümler yoğun SQL aggregation ve join işlemlerinden oluşuyorsa modern warehouse ELT için uygun olabilir. Özel Python veya domain-specific processing gereken işlerde external ETL engine daha doğal çözüm sunabilir. Transformation kodunu birden fazla platforma bölmek lineage yönetimini zorlaştırabilir. Ekip yetkinliği de önemlidir. İş kurallarının mümkün olduğunca ortak ve test edilebilir katmanda tutulması hangi yöntem seçilirse seçilsin bakım kolaylığı sağlar.
Warehouse Compute Maliyeti
ELT dönüşümleri warehouse compute üzerinde çalıştığı için sorgu maliyeti doğrudan platform giderine yansır. Full table dönüşümlerin sürekli çalıştırılması gereksiz compute tüketir. Incremental model ve partition pruning maliyeti azaltabilir. ETL external compute kullansa bile o kaynak da ücretsiz değildir. Karşılaştırma toplam compute, network, storage ve engineering maliyeti üzerinden yapılmalıdır.
Ham Verinin Saklanması
Raw veri saklamak audit ve reprocessing için önemli avantajdır. Source sistemi yıllar sonra aynı geçmiş veriyi sağlayamayabilir. ELT bu modeli doğal destekler. ETL yaklaşımında da object storage üzerinde raw landing tutulabilir. Retention süresi veri hassasiyeti, maliyet ve yeniden işleme ihtiyacına göre belirlenmelidir.
Reprocessing Gereksinimi
Business rule sık değişiyorsa geçmiş veriyi yeniden hesaplamak gerekebilir. Raw veri warehouse veya data lake üzerinde bulunuyorsa reprocessing daha kolaydır. Kaynaktan tekrar extraction yapmak API limitleri veya operasyon yükü nedeniyle pahalı olabilir. ELT bu açıdan avantaj sağlayabilir. ETL kullanılıyorsa dönüşüm öncesi raw kopya saklamak aynı esnekliği sağlayabilir.
ETL–ELT Karar Matrisi
Yüksek güvenlik gereksinimi ve pre-load masking ihtiyacında ETL güçlü adaydır. Büyük cloud warehouse, sık reprocessing ve SQL ağırlıklı transform ihtiyacında ELT çoğu zaman daha verimli olur. Legacy sistemler için mevcut ETL altyapısını korumak anlamlı olabilir. Yeni SaaS ve database kaynakları ELT ile daha hızlı devreye alınabilir. Karar matrisi veri hacmi, hassasiyet, latency, maliyet ve ekip yetkinliği eksenlerinde hazırlanırsa teknoloji seçimi kişisel tercihten çıkarak ölçülebilir kurumsal karara dönüşür.
Full Load ve Incremental Load Arasındaki Fark
Full load hedef veri setini her çalışmada baştan yüklerken incremental load yalnız yeni veya değişen kayıtları işler. Küçük referans tablolarında full refresh basit ve güvenilir olabilir. Büyük transaction tablolarında ise sürekli full load kaynak, network ve warehouse maliyetini hızlı biçimde artırır. Incremental yaklaşım state ve watermark yönetimi gerektirdiği için biraz daha fazla engineering ister. Veri büyüme beklentisi başlangıçtan düşünülürse bugün kolay görünen full load yönteminin ileride pahalı migration gerektirmesi önlenebilir.
Full Refresh
Full refresh hedef tablonun tamamını yeniden oluşturur veya bütün kaynak veriyi tekrar yükler. Küçük veri setinde deterministic ve kolay yönetilebilir bir çözümdür. Delete değişikliklerini doğal olarak yansıtır. Veri hacmi büyüdükçe çalışma süresi ve compute maliyeti artar. Kaynak sistem full scan altında zorlanıyorsa production performansına olumsuz etki yapabilir.
Incremental Load
Incremental load son başarılı çalışmadan bu yana değişen kayıtları hedefe taşır. Kaynak üzerindeki okuma miktarını ve network trafiğini azaltır. Hedefte upsert veya merge gerekebilir. State kaybı duplicate veya eksik veri oluşturabileceği için checkpoint güvenilir saklanmalıdır. Periodic reconciliation incremental pipeline'ın sessiz veri kaybı üretmediğini doğrulamaya yardımcı olur.
Watermark
Watermark pipeline'ın hangi noktaya kadar veriyi işlediğini temsil eden işarettir. Timestamp, sequence veya event offset olabilir. Yeni çalıştırma bu değerden sonraki kayıtları alır. Watermark yalnız başarılı target commit sonrasında güncellenmelidir. Aksi halde load başarısızken source position ilerletilirse veri kaybı oluşabilir.
High-Water Mark
High-water mark işlenen en yüksek sequence, ID veya timestamp değerini gösterir. Incremental query bir sonraki batch'i bu değerden başlayarak alabilir. Key'in monoton artması yöntemin güvenilirliğini etkiler. Eski kayıt sonradan güncelleniyorsa yalnız ID high-water mark değişikliği yakalayamaz. Bu nedenle source update behavior mutlaka doğrulanmalıdır.
Timestamp-Based Incremental Load
updated_at benzeri alan incremental extraction için sık kullanılır. Aynı timestamp değerine sahip birden fazla kayıt olabileceği için tie-breaker primary key eklemek güvenli olur. Source clock ve timezone davranışı açık olmalıdır. Timestamp sonradan değiştirilmiyorsa update'ler kaçırılabilir. Kısa overlap window kullanıp hedefte deduplication yapmak sınırdaki kayıt kayıplarını azaltabilir.
Sequence / ID Based Load
Monoton artan sequence yeni insert kayıtlarını yakalamak için oldukça basittir. Yüksek performanslı range query oluşturabilir. Update ve delete değişikliklerini tek başına takip edemez. Append-only event kaynaklarında iyi çalışır. Transaction tablosu sonradan güncelleniyorsa ek CDC veya update timestamp yöntemi gerekir.
Full Load Ne Zaman Kullanılmalı?
Küçük ve yavaş değişen reference tablolarında full load tercih edilebilir. Kaynak sistem incremental state sağlamıyorsa basit başlangıç çözümü olabilir. Veri boyutu birkaç saniye içinde taşınıyorsa ek state yönetimi gereksiz olabilir. Yine de gelecekteki büyüme göz önünde bulundurulmalıdır. Full load süresi freshness SLA'nın önemli bölümünü tüketmeye başladığında incremental tasarıma geçiş değerlendirilmelidir.
Change Data Capture (CDC) Nedir?
CDC kaynak veritabanında oluşan insert, update ve delete değişikliklerini yakalayıp downstream sistemlere aktarma yaklaşımıdır. Büyük tabloları sürekli yeniden taramak yerine yalnız değişen kayıtlar işlendiği için kaynak yükünü ciddi biçimde azaltabilir. Log-based CDC transaction log üzerinden değişiklikleri takip ettiği için düşük gecikmeli entegrasyonlarda yaygın kullanılır. Pipeline doğru tasarlanırsa analytics platform kaynağa yakın güncellikte veri alabilir. CDC'nin en önemli avantajlarından biri hard delete gibi timestamp tabanlı incremental yöntemlerin kaçırabileceği olayları da taşıyabilmesidir.
CDC Neden Kullanılır?
CDC büyük ve sık değişen tabloların verimli biçimde senkronize edilmesini sağlar. Full scan ihtiyacını azaltır. Düşük latency dashboard ve event-driven analitik senaryolarında kullanılabilir. Delete ve update olaylarını açık biçimde taşıyabilir. Kaynak sistem yükü düşerken warehouse verisinin freshness seviyesi iyileşir.
Log-Based CDC
Log-based CDC database transaction log veya benzeri değişiklik günlüğünü okur. Uygulama tablolarında ek trigger oluşturmak gerekmez. Insert, update ve delete olayları commit sırasına yakın biçimde alınabilir. Connector log position bilgisini saklamalıdır. Transaction log retention değeri connector uzun süre durduğunda gerekli geçmişin kaybolmayacağı biçimde planlanmalıdır.
Trigger-Based CDC
Trigger-based yöntem kaynak tablodaki değişiklikleri database trigger ile ayrı audit veya change tablosuna yazar. Log erişiminin mümkün olmadığı durumlarda kullanılabilir. Her transaction sırasında trigger çalıştığı için kaynak write performansına ek yük oluşturabilir. Trigger hatası production işlemlerini etkilememelidir. Yüksek transaction sistemlerinde benchmark yapılmadan kullanılmamalıdır.
Timestamp-Based CDC
Timestamp tabanlı yöntem updated_at alanına göre değişiklikleri sorgular. Kurulumu log-based CDC'ye göre daha kolay olabilir. Hard delete olayını doğal olarak göremez. Timestamp alanının bütün update işlemlerinde güvenilir biçimde değişmesi gerekir. Küçük kaynaklarda gerçek CDC altyapısına göre yeterli ve ekonomik çözüm olabilir.
Query-Based Incremental Capture
Query-based capture belirli aralıklarla kaynağı sorgulayıp yeni veya değişen kayıtları çeker. Indexlenmiş timestamp veya sequence alanı performans açısından önemlidir. Sorgu sıklığı freshness ile source load arasında denge kurar. Çok sık polling database üzerinde gereksiz yük oluşturabilir. Küçük ve orta ölçekli sistemlerde yönetimi kolay pratik yöntemdir.
CDC ile Kaynak Sistem Yükünün Azaltılması
Full reload milyonlarca satırı tekrar tekrar okurken CDC yalnız yeni değişiklikleri işler. Bu durum source database CPU ve I/O kullanımını azaltır. Analitik entegrasyon production transaction sorgularıyla daha az rekabet eder. Log-based CDC yine database log üretimi ve connector erişimi gerektirir. Kaynak üzerindeki gerçek etki load test ve database monitoring ile doğrulanmalıdır.
CDC'de Insert, Update ve Delete Nasıl Yönetilir?
CDC pipeline'ın güvenilir olması için yalnız insert değil update ve delete olaylarının hedefte doğru etkisini üretmesi gerekir. Insert yeni kayıt eklerken update mevcut satırı değiştirebilir veya history modeli kullanıyorsa yeni versiyon oluşturabilir. Hard delete hedefte fiziksel silme veya business ihtiyacına göre silindi işareti oluşturabilir. Tombstone event log-compacted stream yapılarında silme bilgisini taşıyabilir. Delete propagation ihmal edildiğinde source'ta silinen müşteriler veya siparişler warehouse raporlarında yıllarca aktif görünmeye devam edebilir.
Insert
Insert olayı yeni source record oluşturulduğunu gösterir. Hedef raw katmanda append edilebilir. Current-state tabloda primary key üzerinden yeni satır oluşturulur. Duplicate delivery ihtimaline karşı idempotent key kullanılmalıdır. Insert timestamp ile ingestion timestamp ayrı tutulursa pipeline gecikmesi ölçülebilir.
Update
Update mevcut kaydın değerlerini değiştirir. Current-state modelde merge ile son değer yazılabilir. SCD Type 2 gereken dimension'larda eski satır kapatılıp yeni versiyon oluşturulur. Update sırasının korunması önemlidir. Geç gelen eski update'in daha yeni değeri yanlışlıkla ezmemesi için source sequence veya event time kontrol edilebilir.
Hard Delete
Hard delete source tablodaki satırı fiziksel olarak kaldırır. Timestamp incremental query artık bu kaydı göremez. Log-based CDC delete olayını yakalayabilir. Warehouse'ta fiziksel silme yerine deleted flag tutulması audit açısından daha kullanışlı olabilir. KVKK silme gereksiniminde raw ve downstream kopyaların da uygun politikayla temizlenmesi gerekir.
Soft Delete
Soft delete kaydı kaldırmak yerine is_deleted veya status alanıyla pasif hale getirir. Incremental update pipeline bu değişikliği görebilir. BI modelleri varsayılan olarak aktif kayıtları filtrelemelidir. Tarihsel raporlar silinme zamanını korumak isteyebilir. Kaynak sistemin soft delete politikasının bütün tablolarda aynı olduğu varsayılmamalıdır.
Tombstone Event
Tombstone event belirli key'in artık geçerli olmadığını bildiren özel event'tir. Log-compacted streaming sistemlerinde delete temsilinde kullanılabilir. Consumer bu olayı hedef current-state tablodan kaydı kaldırmak veya deleted işareti koymak için kullanır. Event schema açık biçimde tanımlanmalıdır. Tombstone kaybı stale record problemine yol açacağı için delivery semantics önemlidir.
Delete Propagation
Delete propagation kaynakta silinen kaydın bütün downstream katmanlarda doğru biçimde işlenmesini ifade eder. Raw layer audit amacıyla olayı tutabilir. Core ve mart modelleri business politikasına göre kaydı dışlayabilir. Reverse ETL kullanılan sistemlerde silme bilgisinin operasyonel hedeflere geri gönderilmesi de gerekebilir. Delete lineage özellikle kişisel veri silme süreçlerinde kritik önem taşır.
Initial Snapshot'tan CDC'ye Geçiş
CDC başlatılırken mevcut tabloda zaten bulunan geçmiş kayıtların da hedefe alınması gerekir. Bunun için ilk full snapshot oluşturulur ve ardından transaction log içindeki değişiklik akışına geçilir. En riskli bölüm snapshot devam ederken source sistemde yeni değişikliklerin oluşmasıdır. Log position doğru tutulmazsa kayıt kaybı veya duplicate meydana gelir. Güvenilir handoff önce log konumunu belirleyip snapshot ile change stream arasındaki sınırı deterministik biçimde kurmalıdır.
İlk Full Snapshot
Initial snapshot source tablodaki mevcut kayıtların tamamını hedefe taşır. Büyük tablolarda source I/O yükü izlenmelidir. Snapshot parallel alınabilir ancak consistency davranışı database özelliklerine göre kontrol edilmelidir. Snapshot başladığı ana ait log position saklanabilir. Sonrasında CDC aynı noktadan değişiklikleri uygulayarak hedefi güncele getirir.
Snapshot Sırasında Oluşan Değişiklikler
Snapshot saatler sürerken source'ta insert ve update işlemleri devam edebilir. Bu değişiklikler snapshot ile çakışabilir. CDC log'u snapshot boyunca tutulursa sonradan replay edilebilir. Hedef merge işlemi idempotent olmalıdır. Snapshot row'unun daha yeni CDC update'ini ezmemesi için sequence sırası korunmalıdır.
Log Position / LSN
LSN veya eşdeğer log position transaction log içindeki kesin konumu gösterir. Connector hangi olaya kadar işlediğini bu state üzerinden bilir. Snapshot ve CDC geçişinde başlangıç position kaydedilir. State güvenilir ve yedekli saklanmalıdır. Position kaybı durumunda full resnapshot gerekebileceği için disaster recovery planına dahil edilmelidir.
Duplicate Riskinin Önlenmesi
Snapshot ve CDC aynı kaydı iki kez üretebilir. Hedef upsert veya deduplication logic duplicate'i kontrol eder. Primary key ve source sequence birlikte kullanılabilir. Exactly-once iddiası yerine retry-safe idempotent target tasarımı daha pratik olabilir. Duplicate metric düzenli izlenmelidir.
Veri Kaybı Olmadan Handoff
Snapshot ile CDC arasında boşluk oluşmaması gerekir. Önce log position güvence altına alınır, sonra snapshot alınır ve ardından log değişiklikleri uygulanır. Connector çözümünün bu süreci otomatik desteklemesi operasyon riskini azaltır. Büyük production tablolarda handoff staging ortamında test edilmelidir. Son aşamada source-target reconciliation ile toplam kayıt ve kritik control total doğrulanmalıdır.
Batch, Micro-Batch ve Streaming Entegrasyon
Veri entegrasyonunda her kaynağın gerçek zamanlı olması gerekmez. Batch işlemler belirli aralıklarla toplu veri taşırken micro-batch daha kısa pencerelerde çalışır. Streaming ise event'leri sürekli işleyerek saniyelere yakın latency sağlayabilir. Freshness azaldıkça altyapı ve operasyon maliyeti genellikle artar. İş biriminin gerçekten hangi karar için ne kadar güncel veriye ihtiyaç duyduğu bilinmeden realtime mimari kurmak gereksiz teknik ve finansal yük oluşturabilir.
Batch Integration
Batch integration veriyi saatlik, günlük veya başka zaman aralıklarında toplu olarak işler. Uygulaması ve operasyonu streaming'e göre daha kolaydır. Finans kapanışı veya günlük yönetim raporları için yeterli olabilir. Bulk load verimli kullanılırsa yüksek veri hacmi ekonomik biçimde taşınabilir. Batch window freshness SLO ile uyumlu olmalıdır.
Micro-Batch
Micro-batch birkaç dakika gibi kısa aralıklarla küçük veri grupları işler. Batch modelinin basitliğini korurken daha düşük latency sağlar. Her event için sürekli stream infrastructure işletmek gerekmeyebilir. Çok kısa interval small files problemi yaratabilir. Batch büyüklüğü latency, file size ve compute startup maliyeti dikkate alınarak seçilmelidir.
Real-Time Streaming
Streaming event'i oluştuğu anda downstream pipeline'a taşır. Fraud, operasyon dashboard'u veya gerçek zamanlı personalization gibi kullanım alanlarında değerlidir. Broker, schema management ve stateful stream processing ek operasyon sorumluluğu getirir. Message ordering ve duplicate davranışı açık olmalıdır. Realtime sistemin kendisi de monitoring ve replay desteğine sahip olmalıdır.
Her Veri Gerçek Zamanlı Olmalı mı?
Gerçek zamanlı veri etkileyici görünse de her iş sorusu için gerekli değildir. Aylık bütçe raporunun saniyelik güncellenmesi karar kalitesini artırmayabilir. Streaming daha fazla infrastructure, on-call sorumluluğu ve maliyet oluşturabilir. Freshness ihtiyacı kullanıcıyla net konuşulmalıdır. Saatlik batch iş değerini karşılıyorsa daha sade çözüm uzun vadede daha güvenilir olabilir.
Latency–Cost–Complexity Trade-Off
Latency düşürüldükçe daha sürekli çalışan compute ve messaging altyapısı gerekir. Bu durum maliyet ve operasyon yükünü artırır. Batch daha yüksek latency karşılığında düşük yönetim yükü sunar. Micro-batch birçok kurumsal senaryoda iyi ara seçenek olabilir. Karar tablosunda iş değeri, kabul edilen gecikme, veri hacmi ve ekip operasyon kapasitesi birlikte değerlendirilmelidir.
Gerçek Zamanlı Veri Ambarı Entegrasyonu
Gerçek zamanlı data warehouse entegrasyonu kaynak değişikliklerinin saniyeler veya dakikalar içinde analitik katmana ulaşmasını hedefler. CDC ve event streaming bu mimarinin temel giriş yöntemleridir. Stream processing bazı dönüşümleri event akışı üzerinde uygulayabilir. Warehouse'ın streaming ingestion veya micro-batch özellikleri hedef tasarımı etkiler. Realtime dashboard gerçekten operasyonel karar üretiyorsa bu yatırım anlamlıdır, aksi halde daha basit batch model çoğu ekip için daha düşük risk taşır.
Change Data Capture
CDC operasyonel database değişikliklerini düşük latency ile yakalar. Transaction log kullanımı source query yükünü azaltabilir. Event'ler broker üzerinden warehouse'a taşınabilir. Delete ve update olayları eksiksiz desteklenmelidir. CDC lag metric gerçek freshness seviyesini gösterir.
Event Streaming
Event streaming uygulamaların iş olaylarını doğrudan publish etmesini sağlar. OrderCreated veya PaymentCompleted gibi semantic event'ler database row değişikliğinden daha anlamlı olabilir. Event contract producer ve consumer arasında yönetilmelidir. Replay ve retention downstream recovery için değerlidir. Transactional outbox gibi pattern'ler database commit ile event publish tutarlılığını güçlendirebilir.
Kafka
Kafka yüksek throughput ve durable event log özelliğiyle veri entegrasyonunda yaygın kullanılır. Partition ordering ve offset consumer state sağlar. CDC event'leri Kafka üzerinden farklı consumer'lara dağıtılabilir. Retention geçmiş event replay olanağı sunar. Partition sayısı throughput ve ordering sınırlarına göre planlanmalıdır.
Stream Processing
Stream processing sürekli event akışı üzerinde filtering, enrichment ve aggregation yapar. Stateful işlem gerektiğinde checkpoint ve recovery mekanizması önemlidir. Event time ve watermark geç gelen veriyi yönetir. Dönüşümün tamamını stream katmanına taşımak bakım maliyetini artırabilir. Realtime gerekli olmayan ağır business transform'lar warehouse ELT katmanında bırakılabilir.
Streaming ETL
Streaming ETL event'leri hedefe ulaşmadan önce dönüştürür. Sensitive veriyi erken maskelemek veya format standardization yapmak için kullanılabilir. Her event üzerinde pahalı join çalıştırmak throughput'u düşürebilir. Reference data cache veya stream-table join kullanılabilir. Pipeline state recovery ve replay test edilmelidir.
Real-Time Dashboard Senaryoları
Operasyon merkezi, fraud monitoring veya canlı üretim takibi düşük latency dashboard'dan gerçek iş değeri sağlayabilir. Kullanıcı dashboard'a bakarak hemen aksiyon alıyorsa realtime yatırım anlamlıdır. Yönetim KPI'larının çoğu için birkaç dakikalık veya saatlik latency yeterli olabilir. Dashboard refresh sıklığı warehouse query maliyetini de etkiler. Realtime tüketim katmanı ile günlük resmi raporlama aynı dataset üzerinde farklı freshness beklentileriyle çalışabilir.
Veri Pipeline'larında Delivery Semantics
Delivery semantics bir event veya kaydın hedefe kaç kez ulaşabileceğini tanımlar. Network ve worker failure nedeniyle aynı veri yeniden işlenebilir. Analitik pipeline'larda duplicate önleme çoğu zaman tam exactly-once altyapısından daha ekonomik biçimde idempotent merge ile sağlanabilir. Delivery model açık değilse retry davranışı raporlarda tekrar kayıt oluşturabilir. Source ve target arasında hangi garantiye sahip olunduğu dokümante edilmelidir.
At-Most-Once
At-most-once modelinde kayıt tekrar gönderilmez, bu yüzden duplicate oluşma ihtimali düşüktür. Failure sırasında veri kaybı mümkündür. Kritik finansal pipeline için genellikle uygun değildir. Geçici telemetry veya düşük değerli metric akışında kabul edilebilir olabilir. Veri kaybı toleransı iş birimi tarafından açıkça onaylanmalıdır.
At-Least-Once
At-least-once teslimat kaybı azaltmak için başarısız durumda retry yapar. Aynı event birden fazla kez hedefe ulaşabilir. Idempotent merge duplicate sorununu kontrol eder. Broker sistemlerinde yaygın modeldir. Message ID veya source primary key deduplication için kullanılabilir.
Exactly-Once
Exactly-once tek kaydın etkisinin bir kez oluşmasını hedefler. Dağıtık sistemde bunun uygulanması transaction ve checkpoint koordinasyonu gerektirebilir. Altyapı desteği olsa bile downstream side effect'ler ayrıca düşünülmelidir. Yüksek maliyetli garanti her analitik pipeline için gerekli değildir. İş sonucu açısından duplicate etkisini önlemek daha önemli olabilir.
Effectively-Once
Effectively-once at-least-once delivery ile idempotent target işleme kombinasyonudur. Event tekrar gelebilir ancak hedef sonuç değişmez. Warehouse merge ve unique key bu modeli destekleyebilir. Retry mekanizması daha sade hale gelir. Kurumsal analitik pipeline'larda pratik ve güvenilir çözüm olarak sık kullanılabilir.
Analitik Pipeline İçin Hangi Model Yeterlidir?
Çoğu analitik workload at-least-once ve idempotent target yaklaşımıyla güvenilir çalışabilir. Finansal kayıtlar daha güçlü reconciliation gerektirir. Geçici telemetry bazı durumlarda küçük kaybı tolere edebilir. Tek bir delivery modeli bütün kaynaklara zorlanmamalıdır. İş etkisi ve veri kritikliği garanti seviyesini belirlemelidir.
Idempotent Data Pipeline Nasıl Tasarlanır?
Idempotent pipeline aynı batch veya event tekrar işlendiğinde hedefte farklı sonuç üretmemelidir. Retry güvenliğinin temel şartı budur. Unique business key, merge ve deterministic transformation kullanılabilir. Batch kimliği veya event ID tekrarları kontrol etmeye yardımcı olur. İdempotency olmadan geçici network hatası basit bir retry sonrasında raporlarda duplicate satış veya ödeme kayıtlarına dönüşebilir.
Idempotency Nedir?
Idempotency aynı işlemin birden fazla uygulanmasının tek uygulamayla aynı sonucu üretmesidir. Veri pipeline'ında bu özellik failure recovery'yi kolaylaştırır. Worker hangi aşamada hata verdiğinden emin olmadığında batch güvenli biçimde tekrar çalıştırılabilir. Target table unique key ve merge behavior bu garantiyi sağlar. Transform logic'in current timestamp gibi nondeterministic değerleri kontrolsüz kullanması idempotency'yi bozabilir.
Aynı Batch'in Yeniden Çalıştırılması
Batch tekrarlandığında eski verinin nasıl temizleneceği veya güncelleneceği belirlenmelidir. Partition overwrite belirli tarih aralığında pratik yöntemdir. Incremental merge key üzerinden aynı kayıtları update edebilir. Append-only tabloya kontrolsüz tekrar yazmak duplicate üretir. Backfill ve retry aynı ortak yükleme mekanizmasını kullanabilirse operasyon daha sade olur.
Duplicate Insert Sorunu
Network timeout sonrası client insert'in başarılı olup olmadığını bilemeyebilir ve retry yapabilir. Unique constraint yoksa aynı kayıt ikinci kez eklenir. Event ID veya source primary key duplicate'i önler. Warehouse bazı durumlarda constraint enforcement yapmayabilir, bu nedenle transformation deduplication gerekir. Duplicate rate data quality metric olarak izlenebilir.
Upsert / Merge
Merge source key üzerinden hedef kaydı insert veya update eder. Incremental CDC ve batch pipeline'larında yaygın kullanılır. Büyük hedef tabloda merge performansı partition ve clustering tasarımına bağlıdır. Gereksiz bütün tablo scan'i compute maliyetini artırır. Source batch'i önce deduplicate etmek target merge davranışını daha deterministic hale getirir.
Idempotency Key
Idempotency key işleme alınan event veya operasyonu tekil tanımlar. Source transaction ID iyi aday olabilir. Key tekrar geldiğinde önceki sonuç yeniden kullanılabilir veya event atlanabilir. Rastgele ingestion ID aynı source event tekrar geldiğinde farklı olacağı için duplicate'i önlemez. Key semantics producer ve consumer arasında açıkça belgelenmelidir.
Retry-Safe Pipeline
Retry-safe tasarım başarısız task'ın güvenli biçimde tekrar çalıştırılmasını sağlar. External side effect'ler de idempotent olmalıdır. Watermark yalnız target commit tamamlandıktan sonra ilerletilir. Partial output cleanup veya transactional staging kullanılabilir. Bu yaklaşım on-call sırasında manuel veri düzeltme ihtiyacını önemli ölçüde azaltır.
Backfill Nedir?
Backfill geçmişteki belirli veri aralığının yeniden veya ilk kez işlenmesidir. Yeni metric ekleme, eksik partition düzeltme veya tarihsel migration gibi durumlarda kullanılır. Backfill normal günlük pipeline ile aynı source ve target kaynaklarını kullandığı için production kapasitesini etkileyebilir. Job'lar düşük öncelikli compute veya kontrollü batch boyutuyla çalıştırılmalıdır. Sağlam raw data retention backfill sürecini kaynak operasyonel sistemlere yeniden ağır sorgu göndermeden yürütmeyi kolaylaştırır.
Historical Backfill
Historical backfill geçmiş dönem verisini yeni data model içine yükler. Warehouse migration veya yeni fact table oluşturma sırasında gerekebilir. Veri hacmi normal günlük ingestion'dan çok daha büyük olur. Compute ve source rate limit buna göre planlanmalıdır. Tarih aralıkları chunk'lara bölünerek kontrollü ilerlemek failure recovery'yi kolaylaştırır.
Eksik Tarih Aralığının Yeniden Yüklenmesi
Pipeline hatası nedeniyle birkaç günlük veri eksik kalabilir. Eksik interval metadata üzerinden belirlenmelidir. Yalnız ilgili tarih aralığı yeniden işlenir. Target overwrite veya merge duplicate'i önler. Backfill sonrasında source-target reconciliation eksikliğin gerçekten kapandığını doğrular.
Yeni Kolon İçin Backfill
Yeni business alanı modelde eklendiğinde eski satırların da doldurulması gerekebilir. Raw layer alanı geçmişte içeriyorsa source sistemden tekrar extraction gerekmez. Transform logic tarihsel veri üzerinde çalıştırılır. Büyük table update maliyeti yüksek olabilir. Kolon başlangıçta nullable eklenip backfill kontrollü biçimde tamamlanabilir.
Full vs Partial Backfill
Full backfill bütün geçmişi yeniden işler. Partial backfill yalnız etkilenen tarih veya entity aralığını işler. Etki alanı biliniyorsa partial yaklaşım maliyet ve süreyi azaltır. Business rule bütün tarihi etkiliyorsa full reprocessing gerekir. Lineage değişikliğin hangi modellere yayıldığını belirlemeye yardımcı olur.
Production Trafiğini Etkilemeden Backfill
Backfill ayrı compute pool veya düşük concurrency ile çalıştırılabilir. Source API ve database rate limit korunmalıdır. Warehouse normal BI sorgularının kaynakları tüketilmemelidir. Job priority ve schedule yoğun olmayan saatlere ayarlanabilir. Progress metric ve estimated remaining partitions operasyon ekibine görünür olmalıdır.
Replay ve Reprocessing Nasıl Yönetilir?
Replay event log içindeki geçmiş mesajların tekrar tüketilmesini, reprocessing ise geçmiş verinin yeni logic ile yeniden hesaplanmasını ifade eder. Raw data ve durable event retention bu işlemleri mümkün kılar. Pipeline kodu değiştiğinde hangi versiyonun hangi tarihe uygulandığı izlenmelidir. Reprocessing compute maliyeti büyük olabilir. Planlı replay mekanizması bulunmayan sistemlerde production verisini düzeltmek çoğu zaman manuel SQL işlemlerine dönüşür ve hata riski artar.
Pipeline Logic Değiştiğinde Geçmiş Veriyi Yeniden İşleme
Business kuralı değiştiğinde yalnız bugünden sonraki kayıtları düzeltmek tarihsel raporları tutarsız bırakabilir. Yeni transformation versiyonu raw history üzerinde çalıştırılabilir. Etkilenen dönem business tarafından belirlenmelidir. Reprocessing çıktısı mevcut production modelle karşılaştırılmalıdır. Cutover öncesinde finansal veya kritik KPI reconciliation yapılmalıdır.
Raw Data Retention
Raw data retention yeniden işleme esnekliği sağlar. Çok kısa retention eski dönemleri yeniden oluşturmayı zorlaştırır. Çok uzun retention storage ve KVKK yükü yaratabilir. Veri sınıfına göre farklı süre uygulanabilir. Retention politikası business history ve hukuki gereksinimle birlikte belirlenmelidir.
Event Replay
Event replay consumer'ın eski offset veya sequence noktasından mesajları yeniden okumasıdır. Kafka gibi log tabanlı sistemler bunu doğal destekler. Consumer logic idempotent olmalıdır. Çok büyük replay normal realtime consumer'ların lag'ini artırabilir. Ayrı consumer group veya compute kapasitesi kullanılabilir.
Backfill ile Replay Arasındaki Fark
Backfill genellikle tarih aralığını dataset bazında yeniden yükler. Replay event log sırasını tekrar tüketir. İki yöntem aynı hedef sonucu üretebilir fakat source ve semantics farklıdır. Event ordering önemliyse replay daha doğal olabilir. Aggregate historical modelde partition backfill daha kolay olabilir.
Reprocessing Maliyeti
Yıllarca veriyi yeniden dönüştürmek yüksek warehouse compute harcayabilir. Historical partition pruning kullanılmalıdır. Gerekli olmayan downstream modeller aynı anda yeniden çalıştırılmamalıdır. Cost estimate job başlamadan hesaplanabilir. Reprocessing kapasitesi platform bütçesinde normal operasyon dışında ayrıca düşünülmelidir.
Late-Arriving ve Out-of-Order Veri
Gerçek veri akışlarında kayıtlar her zaman oluşma sırasıyla gelmez. Mobil cihaz geç bağlantı kurabilir, batch dosya gecikebilir veya event broker retry nedeniyle eski mesajı sonradan teslim edebilir. Event time ve processing time ayrımı bu nedenle önemlidir. Warehouse modelleri geç gelen fact ve dimension kayıtlarını düzeltebilmelidir. Watermark ve grace period performans ile doğruluk arasında dengeli bir sınır sağlar.
Geç Gelen Fact Kayıtları
Satış olayı pazartesi gerçekleşip çarşamba warehouse'a ulaşabilir. Event date pazartesi olarak korunmalıdır. Partition logic yalnız ingestion date'e bağlıysa historical partition güncellenmeyebilir. Incremental model late window kullanabilir. Finansal raporların geçmiş gün tutarlarının sonradan değişebilmesi business kullanıcılarına açıkça anlatılmalıdır.
Geç Gelen Dimension Kayıtları
Fact geldiğinde ilgili müşteri dimension henüz warehouse'ta bulunmayabilir. Unknown member veya placeholder key kullanılabilir. Dimension daha sonra geldiğinde fact record yeniden eşleştirilebilir. Natural key korunması bu süreci kolaylaştırır. Referential integrity testi geçici eksikliği ve kalıcı veri problemini ayırt edebilmelidir.
Event Time
Event time olayın source'ta gerçekten gerçekleştiği zamandır. Analitik çoğu zaman bu tarihe göre yapılır. Client clock güvenilir değilse server timestamp ile karşılaştırılabilir. Timezone normalize edilmelidir. Event time business chronology'nin temelidir.
Processing Time
Processing time pipeline'ın olayı işlediği zamanı gösterir. Event time ile fark data latency ölçümünü sağlar. Büyük fark source, network veya pipeline lag işareti olabilir. Processing time partition operasyonel monitoring için kullanılabilir. Business raporları çoğunlukla event time üzerinden hesaplanmalıdır.
Watermark ve Grace Period
Watermark sistemin hangi event time seviyesine kadar veriyi büyük ölçüde tamamlanmış kabul ettiğini gösterir. Grace period biraz daha geç gelen event'lere izin verir. Çok kısa süre data accuracy düşürür. Çok uzun süre state ve compute maliyetini artırır. Gerçek lateness distribution ölçülerek threshold seçilmelidir.
Tarihsel Verinin Güncellenmesi
Late event eski tarih partition'ını değiştirebilir. Incremental pipeline son birkaç günü yeniden hesaplayabilir. Daha eski event için özel backfill gerekebilir. Dashboard cache historical correction'ı yansıtmalıdır. Data freshness ile finality kavramlarının ayrı tanımlanması kullanıcı beklentisini yönetir.
Schema Drift Nedir?
Schema drift kaynak veri yapısının zaman içinde değişmesidir. Yeni kolon ekleme genellikle kolay yönetilirken kolon silme veya type değişikliği pipeline'ı doğrudan bozabilir. Otomatik connector schema değişikliğini fark etse bile business modelin anlamı kendiliğinden güncellenmez. Schema monitoring ve data contract değişikliklerin production'a ulaşmadan görülmesini sağlar. API ve SaaS kaynaklarında drift düzenli beklenti olarak kabul edilmelidir.
Yeni Kolon
Kaynağa yeni kolon eklenmesi çoğu sistemde backward compatible değişikliktir. Raw layer alanı otomatik alabilir. Downstream modeller yeni alanı kullanmıyorsa hemen değişmek zorunda değildir. Sensitive data yeni kolonla gelebileceği için automatic ingestion güvenlik taramasından geçmelidir. Business anlamı catalog içine eklenmelidir.
Kolon Silme
Consumer hâlâ alanı kullanıyorsa kolon silme breaking change oluşturur. SQL modeli compile veya runtime hatası verebilir. Producer önceden deprecation süresi tanımalıdır. Data contract hangi consumer'ların etkilendiğini göstermelidir. Lineage impact analysis silme öncesinde çalıştırılabilir.
Kolon Adı Değiştirme
Rename çoğu teknik sistem için eski kolonun silinip yenisinin eklenmesi gibi görünür. Downstream SQL kırılabilir. Geçiş döneminde iki isim bir süre birlikte sağlanabilir. Semantic modelde stable business naming source değişikliğini izole edebilir. Producer ve consumer version planı yapılmalıdır.
Data Type Değişikliği
Integer alanın string'e dönüşmesi parse hatası veya yanlış aggregation oluşturabilir. Widening conversion bazı durumlarda güvenli olabilir. Breaking type değişikliği data contract review gerektirir. Raw layer original value koruyabilir. Target cast failure invalid record quarantine'e yönlendirilebilir.
Nested Schema Değişikliği
JSON veya event payload içindeki nested alanlar da schema drift yaşayabilir. Parser yalnız top-level kolonları izlemediğinden iç değişiklik gözden kaçabilir. Schema registry nested structure'u versionlayabilir. Optional ve required alan kuralları açık olmalıdır. Semi-structured veride automated schema inference tek başına güvenilir governance sağlamaz.
Schema Drift'in Pipeline'a Etkisi
Drift job failure, null artışı veya sessiz veri kaybı oluşturabilir. En tehlikeli durum pipeline başarılı çalışırken kolonun artık farklı anlam taşımasıdır. Schema metric ve distribution testleri bu sorunu yakalayabilir. Contract violation alarmı source owner'a yönlendirilmelidir. Drift yönetimi connector özelliği kadar organizasyonel iletişim sürecidir.
Schema Evolution Nasıl Yönetilir?
Schema evolution değişikliklerin kontrollü biçimde producer'dan consumer'lara aktarılmasını sağlar. Versioned schema ve compatibility kuralları temel araçlardır. Yeni field ekleme ile mevcut field anlamını değiştirme aynı risk seviyesinde değildir. Breaking change planlı migration gerektirir. Otomatik detection hız sağlarken insan onayı business semantics açısından hâlâ önemlidir.
Schema Registry
Schema registry event veya dataset şemalarının merkezi kayıt alanıdır. Producer publish öncesinde compatibility kontrolü yapabilir. Consumer hangi version'ı desteklediğini bilir. Avro, JSON Schema veya Protobuf benzeri formatlarla çalışılabilir. Registry availability streaming platform için kritik dependency olabilir.
Versioned Schema
Her schema değişikliği version numarasıyla izlenebilir. Hangi event'in hangi schema ile üretildiği bilinir. Consumer eski ve yeni version'ları geçiş döneminde destekleyebilir. Version metadata lineage'e eklenebilir. Geriye dönük troubleshooting kolaylaşır.
Backward Compatibility
Backward compatible değişiklik yeni producer çıktısının eski consumer tarafından okunabilmesini sağlar. Optional field ekleme tipik örnektir. Required field eklemek breaking olabilir. Default değerler migration'ı kolaylaştırabilir. Compatibility rule CI pipeline'da otomatik test edilebilir.
Forward Compatibility
Forward compatibility eski producer verisinin yeni consumer tarafından işlenebilmesini ifade eder. Rolling deployment ve replay sırasında önemlidir. Consumer unknown field'ları tolere edebilir. Removed field için default logic gerekebilir. Protocol ve dataset tasarımında iki yönlü uyumluluk düşünmek migration riskini azaltır.
Breaking Change
Breaking change consumer kodunun değişmesini gerektiren schema güncellemesidir. Kolon silme, type daraltma veya semantik anlam değiştirme örnek olabilir. Önceden announcement ve migration window gerekir. Yeni version paralel yayınlanabilir. Consumer adoption tamamlandıktan sonra eski schema kaldırılmalıdır.
Otomatik Schema Detection
Connector yeni alanları otomatik algılayıp raw layer'a ekleyebilir. Bu özellik operasyonu kolaylaştırır. Sensitive veya çok büyük kolonların kontrolsüz taşınması risk oluşturur. Type inference yanlış sonuç verebilir. Automatic detection yanında allowlist ve alert mekanizması kullanmak daha güvenli olur.
Data Contract Nedir?
Data contract producer ile consumer arasında veri şeması, kalite ve hizmet beklentilerini tanımlayan sözleşmedir. Sadece kolon listesi değil freshness, nullability ve sahiplik gibi kuralları da kapsayabilir. Kaynak ekip breaking change yapmadan önce consumer etkisini görür. Veri ekibi de pipeline beklentisini açık biçimde ifade eder. Bu yaklaşım veri entegrasyonunu plansız schema değişikliklerine karşı daha dayanıklı hale getirir.
Producer–Consumer Sözleşmesi
Producer hangi veriyi hangi formatta sağlayacağını taahhüt eder. Consumer hangi alanlara bağımlı olduğunu belirtir. Owner bilgileri incident sırasında iletişimi hızlandırır. Contract code repository içinde versionlanabilir. CI compatibility kontrolü plansız breaking change'i production öncesinde durdurabilir.
Zorunlu Alanlar
Required field null veya eksik olamaz. Customer ID veya transaction amount gibi kritik alanlar buna örnek olabilir. Producer bu garantiye uymadığında contract violation oluşur. Pipeline fail-fast veya quarantine seçebilir. Business etkisi alan önemine göre belirlenmelidir.
Data Type
Data type downstream işlemin nasıl yapılacağını belirler. Decimal finansal veri için float'a göre daha güvenli olabilir. Timestamp timezone bilgisi içermelidir. Type değişikliği compatibility sürecinden geçmelidir. Catalog teknik tip ile business açıklamasını birlikte gösterebilir.
Nullability
Bir alanın null olabilmesi business anlam taşır. Null ile boş string aynı şey olmayabilir. Source yeni process nedeniyle null oranını artırırsa data quality alarmı oluşabilir. Nullability contract içinde açık olmalıdır. Downstream modeller missing value davranışını tanımlamalıdır.
Freshness
Contract veri ne kadar güncel olmalı sorusunu da içerebilir. Örneğin source değişikliğinin 30 dakika içinde warehouse'a ulaşması beklenebilir. Bu hedef observability metric'e dönüştürülür. SLA ihlali owner'a bildirilir. Freshness business önemiyle uyumlu seçilmelidir.
Quality Expectations
Unique, range, accepted values ve completeness kuralları contract içinde yer alabilir. Quality threshold tamamen sıfır hata olmak zorunda değildir. Telemetry kaynağında küçük eksiklik tolere edilebilirken finansal tablo için çok daha sıkı kural gerekir. Testler otomatik çalışmalıdır. Quality score zaman içindeki bozulmayı görünür hale getirir.
Breaking Change Süreci
Producer önce proposed change oluşturur. Etkilenen consumer lineage üzerinden belirlenir. Migration deadline ve yeni schema version yayınlanır. Consumer'lar geçiş yaptıktan sonra eski alan kaldırılır. Bu disiplin source ekip ile data platform arasındaki plansız kesintileri önemli ölçüde azaltır.
Hatalı Veriler Pipeline'ı Durdurmalı mı?
Her hatalı kayıt için bütün pipeline'ı durdurmak bazı sistemlerde gereksiz availability kaybı oluşturabilir. Buna karşılık kritik finansal veri hatasını sessizce atlamak daha büyük risk yaratır. Hata sınıfları business önemine göre ayrılmalıdır. Quarantine veya dead-letter yaklaşımı bozuk kayıtları izole edip sağlam verinin ilerlemesine izin verir. Fail-fast stratejisi kritik schema veya control total ihlalinde kullanılabilir.
Fail-Fast
Fail-fast ciddi hata görüldüğünde işlemi hemen durdurur. Schema breaking change veya finansal reconciliation farkı buna adaydır. Yanlış verinin downstream dashboard'a yayılmasını önler. Incident hızlı görünür hale gelir. Çok küçük tekil kayıt hatalarında gereksiz kesinti oluşturabileceği için seçici kullanılmalıdır.
Quarantine Table
Quarantine table validation'dan geçmeyen kayıtları ayrı tutar. Ana pipeline sağlam satırlarla devam edebilir. Hata nedeni ve source metadata kayıtla birlikte saklanmalıdır. Data steward sonradan düzeltme yapabilir. Düzelen kayıt kontrollü reprocessing ile ana modele alınabilir.
Dead-Letter Queue
DLQ streaming veya messaging pipeline'ında işlenemeyen event'leri toplar. Parser hatası veya invalid schema buna neden olabilir. Queue monitoring olmadan DLQ sessiz veri mezarlığına dönüşebilir. Retry policy belirlenmelidir. Hatanın düzeltilmesi sonrası replay yapılabilmelidir.
Invalid Record Store
Invalid record store dosya veya database ingestion'daki bozuk satırların saklandığı alandır. Original payload mümkün olduğunca korunur. Kişisel veri içeriyorsa erişim politikası uygulanmalıdır. Error code analizi en sık kaynak veri problemlerini gösterir. Producer quality iyileştirmeleri bu istatistiklerden beslenebilir.
Hatalı Kayıtları Sonradan Yeniden İşleme
Hata düzeltildikten sonra kayıtların source'tan tekrar çekilmesi gerekmemelidir. Quarantine payload yeniden pipeline'a verilebilir. Idempotency hedefte duplicate'i önler. Reprocessing audit log ile izlenmelidir. Başarı sonrası invalid store kaydı processed olarak işaretlenebilir.
Kritik ve Kritik Olmayan Veri Hataları
Finansal tutar kaybı kritik kabul edilirken optional marketing property eksikliği uyarı seviyesinde kalabilir. Error severity business owner ile belirlenmelidir. Pipeline davranışı bu sınıfa göre fail, quarantine veya warn olabilir. Tek standart bütün dataset'lere uygulanmamalıdır. Bu yaklaşım data availability ile data correctness arasında daha dengeli operasyon sağlar.
Veri Dönüşümü Nasıl Tasarlanır?
Veri dönüşümü yalnız kolon isimlerini değiştirmek değildir. Temizleme, standardization, entity matching ve business rule uygulaması aynı katmanın parçaları olabilir. Her transform deterministic, test edilebilir ve lineage ile izlenebilir olmalıdır. Source veriyi geri döndürülemez biçimde değiştirmek yerine raw kopya korunmalıdır. Transformation katmanı teknik source model ile iş kullanıcılarının anlayacağı analitik model arasında açık sınır oluşturur.
Data Cleaning
Cleaning bozuk tarih, gereksiz whitespace veya invalid character gibi teknik veri problemlerini düzeltir. Hangi düzeltmenin otomatik yapılabileceği tanımlanmalıdır. Yanlış değeri sessizce başka değere çevirmek veri kalitesini gizleyebilir. Invalid record quarantine daha güvenli olabilir. Cleaning rule test ile doğrulanmalıdır.
Standardization
Standardization aynı kavramı ortak formatta temsil eder. Telefon, ülke kodu veya tarih formatı örnek olabilir. Farklı kaynakların aynı business entity üzerinde birleştirilmesini kolaylaştırır. Original source value raw katmanda korunur. Standardization rule merkezi modelde yeniden kullanılabilir.
Normalization
Normalization burada veri değerlerinin ortak ölçek veya representation'a dönüştürülmesini ifade edebilir. Unit conversion veya case normalization örnek verilebilir. Business anlamı kaybolmamalıdır. Analitik warehouse modelinde relational normalization her zaman ana hedef değildir. Transform amacı kullanım senaryosuyla açık biçimde belgelenmelidir.
Deduplication
Aynı entity veya event birden fazla kez gelebilir. Primary key, event ID veya fuzzy matching ile duplicate belirlenebilir. Hangi kaydın kazanacağı deterministic olmalıdır. Latest updated record veya trusted source önceliği kullanılabilir. Deduplication sonucu kalite metriği olarak raporlanabilir.
Data Enrichment
Enrichment mevcut kayda başka kaynaktan ek anlam kazandırır. Posta kodundan bölge veya product ID'den kategori eklenebilir. External lookup dependency pipeline latency'sini artırabilir. Reference table warehouse içinde tutulabilir. Enrichment source ve version lineage içinde görünmelidir.
Field Mapping
Field mapping source alanını canonical model alanına bağlar. CRM customer_name ile ERP account_name aynı business field'e karşılık gelebilir. Mapping dokümante edilmezse dönüşüm kodu anlaşılmaz hale gelir. Data catalog source-to-target mapping gösterebilir. Değişiklik impact analysis bu metadata'dan yararlanır.
Business Rules
Business rule analitik metriğin nasıl hesaplandığını belirler. Revenue tanımı iade, vergi ve currency behavior içerebilir. SQL kodu business owner onayıyla geliştirilmelidir. Rule değişikliği historical reprocessing gerektirebilir. Semantic layer aynı kuralın BI araçları arasında tekrar kullanılmasını sağlar.
Kaynaklar Arasında Entity Reconciliation
Farklı uygulamalardaki aynı gerçek dünya varlığını tek kimlikle eşleştirmek kurumsal veri entegrasyonunun en zor fakat en değerli alanlarından biridir. CRM customer ID, ERP account ID ve e-ticaret user ID birbirinden farklı olabilir. Mapping table deterministic eşleşmeleri merkezi olarak tutabilir. Daha belirsiz durumlarda identity resolution kuralları gerekir. Bu çalışma yapılmadan müşteri bazlı gelir veya çok kanallı davranış analizi güvenilir sonuç üretmez.
CRM Customer ID
CRM ID satış ve iletişim süreçlerinde müşteri referansı olabilir. ERP'nin resmi hesap numarasıyla aynı değildir. Mapping table iki kimliği ilişkilendirir. CRM record merge olduğunda eski ID behavior kontrol edilmelidir. Golden customer key warehouse tarafında source ID'lerden bağımsız tutulabilir.
ERP Account ID
ERP account ID fatura ve finans kayıtları için ana kimlik olabilir. Aynı şirket birden fazla account'a sahip olabilir. Müşteri entity definition business ekip tarafından belirlenmelidir. Parent-child account ilişkisi korunabilir. Mapping yalnız string eşitliğine dayanmamalıdır.
E-Ticaret User ID
E-ticaret user ID web platformundaki kullanıcı hesabını temsil eder. Guest checkout durumunda ID bulunmayabilir. E-posta veya verified identifier sonradan eşleşme sağlayabilir. Kişisel veri kullanımında hukuki amaç sınırı dikkate alınmalıdır. Anonymous ve authenticated identity history ayrı tutulabilir.
Aynı Kişinin Tekil Kimliğe Bağlanması
Email, telefon veya resmi identifier kullanılabilir. Ancak tek alan her zaman güvenilir değildir. Fuzzy matching yanlış positive risk taşır. Confidence score ve manual review gerekebilir. Golden ID değişiklikleri downstream modellerde tarihsel tutarlılığı bozmayacak biçimde yönetilmelidir.
Cross-System Mapping Table
Mapping table canonical entity ID ile source system ID'lerini eşleştirir. Source, valid_from ve match_method metadata eklenebilir. Mapping değişikliği versionlanabilir. Reverse ETL için aynı tablo operasyonel hedefleri bulmada kullanılabilir. Table ownership MDM veya data platform ekibinde açık biçimde tanımlanmalıdır.
Identity Resolution
Identity resolution birden fazla kaydın aynı entity olup olmadığını belirleme sürecidir. Deterministic rule mümkün olduğunda tercih edilir. Probabilistic matching yalnız gerekli alanlarda kullanılmalıdır. False merge önemli iş hatası oluşturabilir. Match quality test ve sample review ile sürekli izlenmelidir.
Master Data Management ile Veri Ambarı Entegrasyonu
MDM müşteri, ürün ve referans verilerinde merkezi sahiplik ve golden record yaklaşımı oluşturur. Veri ambarı bu mastered entity'leri analitik modellerde kullanabilir. Böylece her pipeline aynı duplicate resolution kuralını tekrar geliştirmez. Master data ownership business ekiplerle birlikte belirlenmelidir. MDM ve warehouse birbirinin yerine geçmez, ancak ortak entity modelini güçlendiren tamamlayıcı sistemlerdir.
Golden Customer Record
Golden customer record farklı kaynaklardaki en güvenilir alanları tek müşteri görünümünde birleştirir. Her attribute'un source priority'si farklı olabilir. Match ve merge history audit için tutulabilir. Warehouse fact kayıtları surrogate customer key üzerinden bu kayda bağlanır. Golden record güncellendiğinde tarihsel dimension politikası belirlenmelidir.
Golden Product Record
Golden product record SKU, kategori ve marka gibi ürün bilgisini merkezi hale getirir. ERP ve e-ticaret kaynakları farklı attribute sağlayabilir. Duplicate SKU veya eski ürün kodları mapping ile yönetilir. Product hierarchy raporlar için kritik olabilir. Master değişikliği conformed dimension'lara yansıtılır.
Duplicate Entity Resolution
Duplicate entity aynı gerçek varlığın birden fazla kayıtla temsil edilmesidir. MDM match rule bu kayıtları birleştirir. Merge sonrası eski source ID'ler kaybolmamalıdır. Historical fact'ler yeni golden key ile ilişkilendirilebilir. Yanlış merge geri alınabilir olmalıdır.
Reference Data
Ülke kodu, currency veya organization listesi reference data örnekleridir. Merkezi yönetim farklı sistemlerdeki kod farklarını azaltır. Warehouse transform aynı mapping'i kullanır. Version değişiklikleri downstream impact oluşturabilir. Küçük reference dataset bile data contract ve owner bilgisinden fayda görür.
Master Data Ownership
Teknik ekip hangi müşteri adresinin doğru olduğuna tek başına karar vermemelidir. Business owner attribute ownership'i belirler. Data steward kalite sorunlarını yönetir. Teknik platform rule'u uygular ve lineage sağlar. Bu görev ayrımı MDM sürecinin sürdürülebilir olmasını sağlar.
Veri Ambarı Modelleme Yaklaşımları
Veri ambarı modelleme yöntemi kurumun raporlama, history ve geliştirme ihtiyaçlarına göre seçilir. Inmon, Kimball ve Data Vault farklı avantajlar sunar. Modern ELT platformları katmanlı modelleme ile bu yaklaşımların bazı özelliklerini birlikte kullanabilir. Tek bir metodolojiyi dogmatik biçimde uygulamak yerine veri ürününün kullanım amacına bakmak gerekir. Model kullanıcıların kolay sorgulayacağı kadar anlaşılır, source değişikliklerine dayanacak kadar da kontrollü olmalıdır.
Inmon
Inmon yaklaşımı merkezi ve normalize kurumsal veri ambarını önce kurmayı hedefler. Data mart'lar bu temel üzerinden türetilir. Kurumsal bütünlük açısından güçlüdür. İlk teslim süresi geniş kapsam nedeniyle uzayabilir. Büyük organizasyonlarda merkezi data model governance ile uyumlu olabilir.
Kimball
Kimball dimensional modeling ve business process odaklı data mart yaklaşımıyla bilinir. Fact ve dimension tabloları BI sorgularını kolaylaştırır. Conformed dimension farklı süreçleri ortak analiz etmeyi sağlar. İş birimine hızlı değer üretmek için etkilidir. Grain tanımı model doğruluğunun temelidir.
Data Vault
Data Vault source değişikliklerine dayanıklı history-oriented model kurmayı amaçlar. Hub, link ve satellite yapıları kullanılır. Büyük ve değişken kurumsal kaynaklarda audit açısından güçlü olabilir. BI kullanıcılarının doğrudan sorgulaması zor olabilir. Business vault veya mart katmanı gerekir.
Modern ELT / Layered Modeling
Modern ELT raw, staging, core ve mart katmanlarını kullanabilir. Source yapı önce korunur, sonra business model adım adım oluşturulur. dbt benzeri araçlar dependency ve test yönetimini kolaylaştırır. Kimball mart ile Data Vault core aynı platformda birlikte bulunabilir. Katman sınırlarının açık olması yöntem isminden daha önemlidir.
Hangi Yaklaşım Ne Zaman Kullanılmalı?
BI ağırlıklı hızlı analitik ihtiyaçta Kimball güçlü seçenek olabilir. Çok sayıda source ve audit history gereken büyük yapılarda Data Vault değerlendirilebilir. Merkezi enterprise model isteyen kurumlarda Inmon yaklaşımından yararlanılabilir. Küçük ekipler gereksiz model katmanı oluşturmamalıdır. Karar ekip kapasitesi, veri değişkenliği ve tüketim pattern'iyle birlikte verilmelidir.
Star Schema Nedir?
Star schema merkezi fact table ve onu çevreleyen dimension tablolarından oluşan dimensional modeldir. BI kullanıcılarının join yapısını anlamasını kolaylaştırır. Fact table ölçüleri ve business event'leri, dimension tabloları ise açıklayıcı özellikleri taşır. Model grain başlangıçta açık belirlenmelidir. Yanlış grain duplicate aggregate ve hatalı KPI sonuçlarına neden olabilir.
Fact Table
Fact table satış, ödeme veya işlem gibi ölçülebilir business event'leri tutar. Foreign key'lerle dimension'lara bağlanır. Amount, quantity veya duration gibi metric alanları bulunabilir. Grain her satırın neyi temsil ettiğini açıkça tanımlar. Fact büyüdükçe partitioning ve clustering performans açısından önem kazanır.
Dimension Table
Dimension table müşteri, ürün, tarih veya bölge gibi açıklayıcı entity bilgisi sağlar. BI filter ve grouping burada yapılır. Surrogate key tarihsel versiyonları ayırmayı kolaylaştırır. SCD strategy source değişikliğine göre seçilir. Conformed dimension farklı fact tablolarını ortak analiz etmeyi sağlar.
Grain
Grain fact tablodaki tek satırın anlamıdır. Sipariş satırı mı, sipariş mi yoksa günlük ürün toplamı mı olduğu belirlenmelidir. Metric aggregation grain'e bağlıdır. Grain değişikliği model redesign gerektirebilir. Tasarım dokümanında ilk yazılması gereken bilgilerden biridir.
Surrogate Key
Surrogate key warehouse tarafından oluşturulan teknik dimension kimliğidir. Source natural key'den bağımsızdır. SCD Type 2 aynı müşteri için birden fazla tarihsel satır oluşturduğunda her versiyona ayrı key verir. Fact doğru tarihsel versiyona bağlanabilir. Source key yine dimension içinde korunmalıdır.
Degenerate Dimension
Degenerate dimension ayrı dimension tablosu olmadan fact içinde tutulan business identifier'dır. Order number veya invoice number örnek olabilir. Açıklayıcı başka attribute yoksa ayrı dimension gereksiz olabilir. Drill-through analizinde kullanışlıdır. Cardinality yüksek olduğundan clustering etkisi ayrıca değerlendirilmelidir.
Conformed Dimensions
Conformed dimension birden fazla fact veya mart tarafından aynı tanımla kullanılan dimension'dır. Customer veya date ortak örneklerdir. Satış ve destek verisi aynı müşteri dimension üzerinden analiz edilebilir. Farklı ekiplerin ayrı customer definition üretmesi önlenir. Enterprise KPI tutarlılığını güçlendirir.
Slowly Changing Dimensions (SCD)
SCD dimension attribute değişikliklerinin tarihsel olarak nasıl saklanacağını belirleyen yöntemlerdir. Her alan aynı history ihtiyacına sahip değildir. Müşteri adı yalnız son değerle tutulabilirken segment değişimi tarihsel analiz için korunabilir. SCD tipi business sorusuna göre seçilmelidir. Gereksiz history model boyutunu artırırken history saklamamak geçmiş raporların bugünkü değerlerle yeniden yorumlanmasına neden olabilir.
SCD Type 0
Type 0 ilk değeri değişmeden korur. Doğum tarihi gibi değişmemesi beklenen attribute'larda kullanılabilir. Source farklı değer gönderirse data quality sorunu olarak değerlendirilebilir. Warehouse update yapmaz. Rule business anlamıyla açıkça belgelenmelidir.
SCD Type 1
Type 1 mevcut değeri yeni değerle overwrite eder. History korunmaz. Yazım düzeltmesi veya yalnız current-state gereken alanlarda uygundur. Uygulaması basittir. Geçmiş raporlar yeni dimension değerini görür.
SCD Type 2
Type 2 her değişiklikte yeni dimension satırı oluşturur. Effective date ve expiry date ile versiyon geçerliliği tutulur. Fact olay zamanında geçerli dimension version'a bağlanabilir. Tarihsel segment veya bölge analizi mümkündür. Model ve merge logic Type 1'e göre daha fazla dikkat gerektirir.
SCD Type 3
Type 3 mevcut ve önceki değeri ayrı kolonlarda tutar. Sınırlı history gereken durumda kullanılabilir. Çok sayıda değişiklik için uygun değildir. Örneğin mevcut ve önceki bölge birlikte gösterilebilir. Kullanım senaryosu nispeten sınırlıdır.
Tarihsel Değişikliklerin Korunması
History sayesinde geçmiş dönemin raporu o dönemin entity bilgisiyle üretilebilir. Customer segment değişikliği buna tipik örnektir. Source sadece son durumu tutsa bile CDC event history sağlayabilir. Warehouse surrogate key bu versiyonları bağlar. History retention business ve KVKK gereksinimiyle uyumlu olmalıdır.
Effective Date ve Expiry Date
Effective date versiyonun geçerliliğe başladığı tarihi gösterir. Expiry date ne zaman sona erdiğini gösterir. Current row için açık uç değer veya flag kullanılabilir. Interval overlap data quality testiyle kontrol edilmelidir. Fact lookup event time üzerinden doğru interval'ı seçmelidir.
Raw, Staging, Core ve Mart Katmanları
Katmanlı data modeling source veriden kullanıcı dostu analitik modele kontrollü geçiş sağlar. Raw kaynak kopyasını, staging teknik standardization'ı, core kurumsal modeli ve mart iş kullanımını temsil edebilir. Bronze, Silver ve Gold isimleri benzer kavramları farklı terminolojiyle ifade eder. Önemli olan katman sorumluluğunun anlaşılır olmasıdır. Aynı business logic'in birden fazla katmanda tekrar edilmesi lineage ve bakım zorluğu yaratır.
Raw / Bronze
Raw veya Bronze kaynaktan gelen veriyi minimum değişiklikle saklar. Ingestion metadata eklenebilir. Audit ve reprocessing için kullanılır. Business user doğrudan tüketmemelidir. Access hassas veri nedeniyle kısıtlı olabilir.
Clean / Silver
Silver katmanda veri tipleri, standardization ve temel quality işlemleri uygulanır. Duplicate ve invalid record kontrolü yapılabilir. Source modelleri daha tutarlı forma getirilir. Business logic'in bir bölümü burada başlayabilir. Reusable clean entity modelleri downstream geliştirmeyi hızlandırır.
Business / Gold
Gold katman iş kullanıcılarının tüketimine uygun model içerir. KPI ve aggregate tablolar bulunabilir. Star schema veya semantic-ready yapı tercih edilebilir. Performans için denormalization yapılabilir. Metric tanımları merkezi olmalıdır.
Staging
Staging source-specific dönüşümleri izole eder. Kolon rename, cast ve basit cleaning burada yapılabilir. Bir source değiştiğinde core modeli daha az etkilenir. Modeller genellikle internal kullanım içindir. Naming standard ekip onboarding'ini kolaylaştırır.
Data Mart
Data mart belirli departman veya konu için optimize edilmiş modeldir. Finance mart ve sales mart örnek olabilir. Core data reuse edilir. BI performansı için aggregate tablolar eklenebilir. Aynı metric farklı mart'larda farklı hesaplanmamalıdır.
Katmanlar Arası Data Contract
Yalnız external producer değil internal katmanlar arasında da sözleşme gerekir. Staging model core consumer'a schema ve quality garantisi sağlayabilir. Değişiklik impact analysis yapılır. Internal contract CI testleriyle korunabilir. Böylece büyük transformation graph içinde beklenmedik kırılmalar azalır.
dbt ile Veri Ambarı Dönüşümleri
dbt SQL tabanlı transformation süreçlerini software engineering pratikleriyle yönetmeye yardımcı olur. Model dependency, test, documentation ve lineage aynı proje içinde tutulabilir. ELT yaklaşımında raw warehouse verisinden business model üretmek için kullanılabilir. Incremental model büyük tablolarda compute maliyetini azaltabilir. Tool tek başına iyi veri modelini garanti etmez, fakat kod standardı ve deployment sürecini daha düzenli hale getirir.
SQL-Based Transformation
Business dönüşümleri SQL select ifadeleriyle tanımlanır. Warehouse optimizer compute işini yürütür. Analist ve data engineer aynı dili kullanabilir. Modüler model büyük tek SQL script'ten daha kolay test edilir. SQL style ve linting code review kalitesini artırır.
Model Dependency
ref benzeri dependency tanımları model çalışma sırasını oluşturur. Manuel tablo isimleri azaltılır. DAG lineage görünür hale gelir. Upstream değişikliğin downstream etkisi kolay bulunur. Cyclic dependency tasarım problemi olarak erken fark edilir.
Incremental Model
Incremental model her çalışmada yalnız değişen veriyi işler. Büyük fact tablolarında compute süresini azaltır. Unique key ve incremental predicate dikkatle seçilmelidir. Business logic değiştiğinde full refresh gerekebilir. Late-arriving data için lookback window kullanılabilir.
Snapshot
Snapshot source record değişikliklerini tarihsel olarak izlemek için kullanılabilir. SCD Type 2 benzeri history oluşturabilir. Timestamp veya check strategy seçilebilir. Source key stabil olmalıdır. Büyük snapshot tablolarında performance ve storage izlenmelidir.
Test
Not null, unique ve relationship testleri model kalitesini otomatik kontrol eder. Custom business rule testleri eklenebilir. Test failure deployment gate olabilir. Severity dataset kritikliğiyle uyumlu seçilir. Test coverage yalnız sayı değil risk temelinde artırılmalıdır.
Documentation
Model ve kolon açıklamaları kodla birlikte tutulabilir. Business user data catalog üzerinden bu bilgiyi görebilir. Owner ve metric tanımları eklenebilir. Documentation CI ile güncel tutulabilir. Boş doküman alanları quality debt olarak izlenebilir.
Lineage
Lineage model dependency'den otomatik türetilebilir. Source'tan mart'a veri akışı görülür. Incident sırasında etkilenen downstream tablolar bulunabilir. Column-level lineage her durumda otomatik olmayabilir. Business dashboard bağlantısıyla değer daha da artar.
Pipeline Orkestrasyonu
Orchestration farklı ingestion ve transformation işlerinin doğru sırada, zamanda ve hata yönetimiyle çalışmasını sağlar. Pipeline bağımlılıkları büyüdükçe manuel cron yaklaşımı yetersiz hale gelebilir. DAG modeli workflow ilişkilerini açık hale getirir. Retry, timeout ve SLA ortak platformdan yönetilebilir. İyi orchestrator veri logic'ini tamamen içine gömmek yerine execution ve dependency sorumluluğuna odaklanmalıdır.
Orchestration Nedir?
Orchestration işleri ne zaman ve hangi sırada çalıştıracağını yönetir. Upstream tamamlanmadan downstream başlamaz. Failure status merkezi görünür. Retry ve alert standardı uygulanabilir. Veri pipeline operasyonunu tekrarlanabilir hale getirir.
DAG
DAG task'lar arasındaki yönlü ve döngüsüz bağımlılık grafiğidir. Source ingestion tamamlanınca staging, sonra mart çalışabilir. Graph çok büyüdüğünde domain bazlı ayrım faydalıdır. Dynamic task generation kontrollü kullanılmalıdır. DAG görselleştirme troubleshooting'i kolaylaştırır.
Scheduling
Schedule pipeline'ın hangi sıklıkta çalışacağını belirler. Freshness ihtiyacıyla uyumlu olmalıdır. Bütün job'ları aynı saatte başlatmak warehouse contention yaratabilir. Timezone ve daylight saving behavior kontrol edilmelidir. Event-triggered execution bazı kaynaklarda cron'dan daha uygun olabilir.
Dependency Management
Task dependency yalnız zaman sırasına değil veri hazır olma durumuna dayanmalıdır. Upstream dosya gelmediyse downstream rapor çalışmamalıdır. Dataset-aware scheduling kullanılabilir. External dependency timeout tanımlanmalıdır. Cross-team pipeline sözleşmeleri önemlidir.
Retry
Transient network veya API hataları otomatik retry ile çözülebilir. Exponential backoff kaynak sistem üzerindeki baskıyı azaltır. Data quality hatası sonsuz retry edilmemelidir. Idempotency retry güvenliği sağlar. Retry count incident metric olarak izlenebilir.
Timeout
Task sonsuza kadar running durumda kalmamalıdır. Historical baseline üzerinden makul timeout belirlenir. Çok kısa timeout normal büyük batch'i kesebilir. Çok uzun timeout SLA ihlalini geç fark ettirir. Timeout sonrası cleanup davranışı tasarlanmalıdır.
Backfill
Orchestrator tarih aralığı için geçmiş run oluşturmayı destekleyebilir. Backfill normal schedule ile çakışmamalıdır. Resource pool ayrı kullanılabilir. Progress ve failure partition görülebilir olmalıdır. Aynı data interval tekrar çalıştırıldığında idempotent davranmalıdır.
SLA
SLA belirli dataset'in kullanıcıya ne zaman hazır olması gerektiğini ifade eder. Task success zamanı business availability ile aynı olmayabilir. Quality test tamamlanmadan dataset ready sayılmamalıdır. SLA miss alert ilgili owner'a gitmelidir. İş birimi önceliğine göre farklı hedefler tanımlanabilir.
Açık Kaynak Orkestrasyon Araçları
Açık kaynak orchestration ekosistemi farklı kullanım modelleri sunar. Araç seçerken yalnız popülerlik değil workflow tipi, ekip yetkinliği, deployment ve observability ihtiyacı değerlendirilmelidir. Çok sayıda batch DAG için bir çözüm uygunken data asset odaklı ekip başka yaklaşımı tercih edebilir. Gereksiz tool migration uzun süreli mühendislik maliyeti yaratır. Mevcut ihtiyaç açıkça yazılıp pilot workload üzerinden seçim yapmak daha güvenli olur.
Apache Airflow
Airflow DAG tabanlı batch orchestration için yaygın açık kaynak araçlardan biridir. Python ile workflow tanımlanabilir. Scheduler ve worker ölçeklendirmesi workload'a göre yapılır. Çok kısa sürekli stream processing için task scheduler olarak kullanılmamalıdır. Operational metadata ve alert entegrasyonu önemlidir.
Dagster
Dagster data asset ve software-defined yaklaşımıyla orchestration sunar. Veri bağımlılıklarını asset odaklı modellemek bazı ekipler için daha anlaşılır olabilir. Type ve test entegrasyonları geliştirme deneyimini güçlendirir. Deployment modeli ekip platformuna göre değerlendirilmelidir. Pilot pipeline ile öğrenme maliyeti ölçülmelidir.
Prefect
Prefect Python workflow geliştirmede esnek model sunar. Dynamic execution ve deployment seçenekleri bulunabilir. Takım mevcut Python data pipeline'larını daha az değişiklikle orchestration altına alabilir. Scheduler ve worker observability production için önemlidir. Tool versiyonu ve hosting modeli seçimde dikkate alınmalıdır.
Apache NiFi
NiFi görsel flow tabanlı data movement ve routing için kullanılabilir. Çok sayıda sistem arasında ingestion akışını yönetmede pratik olabilir. Backpressure ve processor kavramları dataflow kontrolü sağlar. Complex business transformation için her zaman ideal katman olmayabilir. Flow versioning ve deployment standardı baştan belirlenmelidir.
Tool Seçim Kriterleri
Workflow sayısı, task süresi ve ekip geliştirme dili ilk kriterlerdir. HA, RBAC ve alert ihtiyaçları ayrıca değerlendirilir. Managed veya self-hosted maliyeti karşılaştırılır. Backfill ve dynamic mapping davranışı gerçek senaryoyla test edilir. Platform operasyonu için gereken insan zamanı toplam sahip olma maliyetine dahil edilmelidir.
Veri Kalitesi Nasıl Ölçülür?
Veri kalitesi yalnız null oranından ibaret değildir. Accuracy, completeness, consistency, timeliness ve uniqueness gibi farklı boyutlar birlikte değerlendirilmelidir. Her dataset için bütün metrikler aynı öneme sahip değildir. Finansal tabloda completeness kritik olabilirken marketing event verisinde timeliness daha önemli olabilir. Quality expectation business owner ile belirlenip otomatik test ve monitoring metric'e dönüştürülmelidir.
Accuracy
Accuracy verinin gerçek dünyadaki doğru değeri temsil edip etmediğini ölçer. Otomatik doğrulaması diğer metric'lere göre zor olabilir. Reference system veya sample audit kullanılabilir. Yanlış currency conversion accuracy problemidir. Finansal reconciliation önemli kontrol yöntemidir.
Completeness
Completeness beklenen kayıt veya alanların ne kadarının mevcut olduğunu gösterir. Row count düşüşü pipeline eksikliğine işaret edebilir. Required field null oranı izlenebilir. Source ile target count karşılaştırılır. Yüzde yüz completeness her kaynak için gerekli olmayabilir.
Consistency
Consistency aynı kavramın farklı tablolarda uyumlu olmasını ifade eder. Order status ile payment status mantıksal olarak çelişmemelidir. CRM customer count ile core customer model arasında açıklanabilir fark olmalıdır. Cross-table testler kullanılabilir. Semantic metric tanımları consistency'yi artırır.
Timeliness
Timeliness verinin ihtiyaç duyulan süre içinde hazır olup olmadığını gösterir. Freshness lag bu metric'in teknik karşılığıdır. Günlük dashboard saat 09:00'a kadar hazır olmalıysa SLA ölçülebilir. Source geç gelmesi ile pipeline yavaşlığı ayrılmalıdır. Incident owner doğru katmana yönlendirilir.
Uniqueness
Unique olması gereken key'lerde duplicate bulunmamasını kontrol eder. Customer ID veya transaction ID örnek olabilir. Duplicate merge veya retry hatasını gösterebilir. Composite uniqueness gerekebilir. Duplicate trend'i release sonrası regression sinyali olabilir.
Validity
Validity değerlerin izin verilen format veya aralıkta olup olmadığını gösterir. Negative quantity business'e göre geçersiz olabilir. Enum değerleri accepted values testiyle kontrol edilir. Tarih formatı parse edilmelidir. Invalid record quarantine'e alınabilir.
Referential Integrity
Fact foreign key'lerinin ilgili dimension kaydını bulabilmesi beklenir. Late-arriving dimension geçici violation oluşturabilir. Threshold buna göre seçilmelidir. Orphan kayıtlar rapor aggregation'ını bozabilir. Unknown member stratejisi kontrollü fallback sağlar.
Otomatik Veri Kalitesi Testleri
Data quality kontrolleri manuel dashboard incelemesine bırakılmamalıdır. Pipeline çalışırken veya model build sonrasında otomatik testler uygulanabilir. Not null ve unique gibi basit testler düşük maliyetle büyük hata sınıflarını yakalar. Business rule testleri domain bilgisini teknik kontrol haline getirir. Freshness testi de başarılı görünen fakat saatlerdir güncellenmeyen tabloları görünür hale getirir.
Not Null Testi
Kritik alanların null olmadığını doğrular. Primary business key ve event timestamp sık adaydır. Bütün kolonlara zorunlu test eklemek gereksiz alarm üretir. Null violation sample record ile raporlanabilir. Threshold sıfır veya kabul edilen küçük oran olabilir.
Unique Testi
Unique key duplicate olup olmadığını kontrol eder. Incremental merge regression'larını yakalar. Büyük tabloda full unique scan pahalı olabilir. Partition bazlı veya approximate check kullanılabilir. Kritik finansal identifier için kesin test gerekebilir.
Relationship Testi
Foreign key'in parent tabloda bulunmasını kontrol eder. Fact-to-dimension ilişkisinde kullanılır. Late arrival toleransı belirlenebilir. Büyük violation source integration hatası gösterebilir. Orphan count dashboard'da izlenebilir.
Accepted Values
Status veya type alanının izin verilen değerler arasında olup olmadığı test edilir. Source yeni enum eklediğinde test değişikliği hemen görünür hale getirir. Producer contract ile uyumlu olmalıdır. Unknown değer doğrudan yanlış kategoriye map edilmemelidir. Yeni değer business owner tarafından değerlendirilmelidir.
Range Testi
Numeric ve tarih alanları makul sınırlarla kontrol edilir. Percentage 0 ile 100 arasında olabilir. Gelecekteki transaction date çoğu sistemde şüphelidir. Hard-coded limit yerine business rule kullanılmalıdır. Outlier her zaman invalid olmayabilir.
Business Rule Testi
Birden fazla alanı birlikte kontrol eder. Cancelled order için shipped_at olmaması gibi kurallar yazılabilir. Domain bilgisini data pipeline içine taşır. Owner değişiklikleri approve etmelidir. Failure sample record debugging'i hızlandırır.
Freshness Testi
Son kayıt veya son successful ingestion zamanını kontrol eder. Expected update interval aşılırsa alarm üretir. Kaynak hafta sonu veri üretmiyorsa schedule dikkate alınmalıdır. Freshness source ve target timestamp karşılaştırmasıyla daha doğru ölçülebilir. Critical mart için SLO metric'e bağlanabilir.
Source–Target Reconciliation Nasıl Yapılır?
Reconciliation kaynak ve hedef verinin beklenen ölçülerde eşleştiğini doğrular. Sadece row count yeterli değildir, çünkü duplicate ve eksik kayıt birbirini sayı olarak dengeleyebilir. Sum, checksum ve tarih aralığı kontrolleri birlikte kullanılabilir. Finansal veri için control total özellikle önemlidir. Migration ve büyük backfill sonrasında reconciliation production geçişinin temel kabul kriterlerinden biri olmalıdır.
Row Count
Kaynak ve hedef kayıt sayıları karşılaştırılır. Filter ve soft delete kuralları aynı olmalıdır. Küçük farkın açıklaması bulunmalıdır. Partition bazlı count problemi daraltır. Approximate count hızlı monitoring için kullanılabilir.
Sum / Control Total
Amount veya quantity toplamı finansal doğruluğu daha iyi gösterir. Row count eşitken tutar farkı dönüşüm hatasını ortaya çıkarabilir. Currency ve tax logic aynı basis'te karşılaştırılmalıdır. Period bazlı control total faydalıdır. Tolerance business tarafından belirlenebilir.
Checksum
Checksum birçok kolonun birlikte değişimini özetleyebilir. Row ordering dikkate alınmalıdır. Hash collision teorik risk taşır ancak pratik hızlı kontrol sağlayabilir. Büyük dataset sampling ile desteklenebilir. Sensitive value hash öncesi uygun şekilde yönetilmelidir.
Min / Max Date
Minimum ve maksimum event date veri aralığının tamamlanıp tamamlanmadığını gösterir. Incremental load geride kalmışsa max date farkı görünür. Çok eski beklenmeyen date source quality sorununu gösterebilir. Partition coverage ile birlikte kullanılabilir. Tarih timezone standardı eşit olmalıdır.
Sample Record Comparison
Rastgele veya risk odaklı sample kayıtlar field-level karşılaştırılır. Otomatik aggregate testlerin kaçırdığı mapping hatalarını bulabilir. High-value transaction örnekleri seçilebilir. Manual review kısa migration döneminde faydalıdır. Uzun vadede kritik mapping testleri otomatikleştirilmelidir.
Finansal Reconciliation
Finance verisi için ledger veya resmi report total referans alınabilir. Warehouse sonucu dönem ve account bazında karşılaştırılır. Rounding ve currency conversion açık kurala sahip olmalıdır. Fark threshold aşarsa release durdurulabilir. Reconciliation sonucu audit amacıyla saklanmalıdır.
Data Lineage Nedir?
Data lineage verinin kaynaktan hedef rapora kadar hangi sistem ve dönüşümlerden geçtiğini gösterir. Incident sırasında hatalı source alanının hangi dashboard'ları etkilediği hızlıca bulunabilir. Migration ve schema değişikliklerinde impact analysis kolaylaşır. Table-level lineage temel görünürlük sağlarken column-level lineage daha ayrıntılı etki analizi sunar. Lineage metadata otomatik toplandığında güncel kalma ihtimali manuel dokümantasyona göre daha yüksektir.
Source-to-Target Lineage
Kaynak tablonun hangi target modellere aktarıldığını gösterir. Connector, staging ve transform adımları görülebilir. Incident root cause aramasını hızlandırır. Migration'da eski source bağımlılıkları bulunur. Data catalog içinde kullanıcıya sunulabilir.
Table-Level Lineage
Bir tablonun upstream ve downstream tablo ilişkilerini gösterir. SQL parser veya orchestrator metadata'dan üretilebilir. Büyük model graph'ta hangi mart'ın etkilendiği görülebilir. Table rename impact'i anlaşılır. Business dashboard bağlantısı eklenirse daha değerli olur.
Column-Level Lineage
Belirli kolonun hangi source field'dan türediğini gösterir. Revenue kolonunun hangi amount alanlarını kullandığı takip edilebilir. Complex SQL ve UDF'lerde otomatik çıkarım zorlaşabilir. Hassas veri propagation analizi için güçlüdür. KVKK kapsamında kişisel verinin hangi downstream kolonlara gittiğini anlamaya yardımcı olur.
Transformation Lineage
Hangi SQL veya kodun veriyi dönüştürdüğünü gösterir. Logic version ile bağlanabilir. Business rule değişikliği geçmiş sonuçların neden farklı olduğunu açıklamaya yardımcı olur. Reprocessing hangi modelden başlamalı sorusunu cevaplar. Code repository link'i metadata'ya eklenebilir.
Dashboard Lineage
Warehouse table ile BI dashboard arasındaki bağı gösterir. Table incident olduğunda etkilenen rapor sahipleri hızlı bulunur. Deprecated model silmeden önce kullanımdaki dashboard'lar kontrol edilir. Usage metric ile lineage birlikte analiz edilebilir. Data product owner iletişimi kolaylaşır.
Impact Analysis
Impact analysis planlanan değişikliğin downstream etkisini önceden değerlendirir. Column delete veya business rule değişikliğinde kullanılır. Lineage etkilenen modelleri listeler. Owner'lara migration bildirimi yapılabilir. Plansız production kırılmaları ciddi ölçüde azalır.
Metadata ve Data Catalog
Data catalog kullanıcıların hangi verinin bulunduğunu, ne anlama geldiğini ve kimin sorumlu olduğunu keşfetmesini sağlar. Technical metadata tablo ve kolon yapısını, business metadata ise kullanım anlamını açıklar. Data owner ve steward bilgilerinin görünür olması incident ve quality süreçlerini hızlandırır. Business glossary KPI ve terimlerde ortak dil oluşturur. Catalog veri üretmeyi değil güvenilir veriyi bulmayı ve doğru yorumlamayı kolaylaştırır.
Technical Metadata
Schema, type, partition ve source gibi teknik bilgiler içerir. Otomatik scanner ile warehouse'tan toplanabilir. Last updated ve row count eklenebilir. Lineage ile birleştirildiğinde teknik etki analizi yapılır. Güncelliği otomasyonla korunmalıdır.
Business Metadata
Tablonun hangi iş sürecini temsil ettiğini açıklar. Revenue veya customer status gibi alanların business anlamı yazılır. Teknik isimleri kullanıcı diline çevirir. Owner ve sensitivity bilgisi eklenebilir. Documentation adoption self-service BI kalitesini artırır.
Data Owner
Data owner dataset'in business sorumluluğunu taşır. Quality expectation ve access policy kararlarına katılır. Teknik platform ekibi owner yerine business anlamına karar vermemelidir. Owner değişikliği catalog'da güncellenmelidir. Critical dataset'lerde açık sahiplik SLA yönetimini kolaylaştırır.
Data Steward
Data steward günlük quality ve tanım yönetiminde rol alabilir. Duplicate veya business glossary sorunlarını takip eder. Owner ile teknik ekip arasında köprü oluşturur. Stewardship modeli kurum büyüklüğüne göre değişir. Sorumluluklar ölçülebilir process'lerle desteklenmelidir.
Business Glossary
Business glossary kurum terimlerinin onaylı tanımlarını tutar. Active customer veya net revenue gibi kavramlar açıklanır. Aynı kelimenin departmanlara göre farklı anlamı varsa scope belirtilir. Semantic metric bu glossary ile bağlanabilir. Toplantılardaki tanım tartışmaları azalır.
Data Discovery
Kullanıcı ihtiyaç duyduğu dataset'i arama ve filtre ile bulabilir. Certified ve deprecated etiketleri güvenilir seçim sağlar. Usage ve quality score keşif deneyimine eklenebilir. Aynı rapor için yeni duplicate tablo üretme ihtiyacı azalır. Catalog adoption platform başarısının önemli ölçüsüdür.
Semantic Layer Neden Önemlidir?
Semantic layer fiziksel veri modelini business metric ve dimension kavramlarına dönüştürür. Kullanıcılar her dashboard'da revenue formülünü yeniden yazmaz. Merkezi metric tanımı BI araçları arasındaki farkları azaltır. Access policy semantic seviyede de uygulanabilir. Data warehouse entegrasyonunun gerçek iş değeri ancak kullanıcıların aynı veriyi aynı anlamla tüketmesiyle ortaya çıkar.
KPI'ların Merkezi Tanımı
KPI formülü tek yerde versionlanabilir. Filter ve denominator kuralları açık olur. Dashboard geliştiricileri aynı metric'i reuse eder. Değişiklik bütün consumer'lara kontrollü yansır. Business owner approval süreci uygulanabilir.
Revenue
Revenue gross, net veya recognized gibi farklı anlamlara sahip olabilir. Refund ve tax davranışı tanımlanmalıdır. Currency conversion tarihi açık olmalıdır. Semantic metric isimlendirmesi yanlış yorum riskini azaltır. Finance owner tanımı onaylamalıdır.
Active Customer
Active customer belirli dönemde sipariş veren, login olan veya aboneliği bulunan kişi olarak tanımlanabilir. Tek doğru tanım iş bağlamına bağlıdır. Farklı kullanım için farklı metric adı kullanılmalıdır. Hidden filter kullanıcıya açıklanmalıdır. Merkezi tanım segment raporlarını tutarlı hale getirir.
Conversion Rate
Numerator ve denominator event tanımları açık olmalıdır. Session conversion ile user conversion farklıdır. Time window sonucu etkiler. Semantic layer bu detayları tek metric altında yönetebilir. Pazarlama ve ürün ekipleri ortak oran üzerinden konuşabilir.
Metric Drift'in Önlenmesi
Aynı KPI farklı SQL dosyalarında çoğaldıkça zaman içinde tanımlar ayrışır. Semantic layer duplicate logic'i azaltır. Metric version değişiklikleri kontrollü yapılır. Dashboard lineage hangi consumer'ların metric kullandığını gösterir. Drift regression test ile de yakalanabilir.
BI Araçları Arasında Tutarlılık
Power BI ve başka araçlarda aynı metric farklı hesaplanmamalıdır. Semantic API veya shared model kullanılabilir. Tool-specific presentation logic sınırlı tutulur. Merkezi metric warehouse veya semantic platformda bulunur. Multi-tool kurumlarda bu yaklaşım özellikle değerlidir.
Data Pipeline Observability
Pipeline observability yalnız job failed alarmından daha geniştir. Veri zamanında gelebilir fakat beklenen hacmin yarısı eksik olabilir. Schema değişebilir veya belirli segment dağılımı aniden bozulabilir. Freshness, volume, distribution ve quality metric'leri birlikte izlenmelidir. Gözlemlenebilirlik data incident'ı kullanıcı dashboard'da fark etmeden önce tespit etmeyi hedefler.
Freshness
Son başarılı data timestamp ölçülür. Expected interval aşılırsa alert oluşur. Source delay ile pipeline delay ayrılmalıdır. Dataset bazında SLO bulunmalıdır. Freshness dashboard business user'a da gösterilebilir.
Volume
Row veya event sayısı historical baseline ile karşılaştırılır. Ani yüzde 80 düşüş source extraction hatasını gösterebilir. Beklenen sezonluk değişimler dikkate alınır. Partition bazlı volume analizi daha açıklayıcıdır. Threshold statik veya anomaly-based olabilir.
Schema
Kolon ekleme, silme ve type değişikliği izlenir. Breaking drift alert üretir. Contract ile comparison yapılabilir. Raw layer auto-evolution ayrıca izlenmelidir. Sensitive kolon eklendiğinde security workflow tetiklenebilir.
Distribution
Column değer dağılımı değiştiğinde pipeline teknik olarak başarılı olsa bile veri problemi olabilir. Null rate veya status oranı izlenebilir. Mean ve quantile metric'leri numeric field'larda faydalıdır. Data drift analitik ve ML modellerini etkiler. Baseline zaman içinde güncellenmelidir.
Pipeline Duration
Job runtime historical trend ile izlenir. Süre giderek artıyorsa veri büyümesi veya query regression olabilir. SLA breach oluşmadan capacity action alınabilir. Task-level duration root cause belirler. Backfill run'ları normal baseline'dan ayrılmalıdır.
Failed Records
Quarantine veya DLQ sayısı metric olarak tutulur. Toplam volume içindeki oran önemlidir. Error reason distribution source problemine işaret eder. Ani artış schema değişikliği gösterebilir. Kritik record failure threshold sıfır olabilir.
Data Quality Score
Birden fazla quality metric özet skora dönüştürülebilir. Tek skor ayrıntıyı gizlememelidir. Kullanıcı certified dataset karşılaştırmasında faydalanabilir. Weight business kritikliğiyle uyumlu seçilir. Trend score platform sağlığını üst seviyede gösterir.
Veri Pipeline'ı İçin SLO ve SLA
SLO teknik sistemin hedef performansını, SLA ise çoğu durumda iş veya müşteriyle verilen hizmet taahhüdünü ifade eder. Data platform için freshness, availability ve completeness temel hedefler olabilir. Her dataset aynı SLA seviyesine sahip olmamalıdır. Kritik finansal tablo ile deneysel analiz datasının önceliği farklıdır. Açık SLO olmadan ekip hangi incident'ın önce çözülmesi gerektiğini objektif biçimde belirlemekte zorlanır.
Freshness SLO
Dataset source değişikliğinden belirli süre sonra güncel olmalıdır. P95 freshness 30 dakika gibi hedef tanımlanabilir. Her pipeline run aynı sürede bitmek zorunda değildir. Business tüketim zamanı dikkate alınır. Alert error budget yaklaşımıyla yönetilebilir.
Availability SLO
Kullanıcı dataset'i sorgulayabiliyor mu sorusunu ölçer. Warehouse erişimi açık olsa bile model build başarısızsa data unavailable sayılabilir. Certified table availability tanımlanmalıdır. Planned maintenance ayrıca ele alınır. BI consumer deneyimiyle uyumlu metric seçilir.
Completeness SLO
Beklenen verinin ne kadarının mevcut olduğu ölçülür. Source-target reconciliation temel sinyaldir. Yüzde 99.9 gibi hedef dataset'e göre değişir. Eksik küçük segment kritik business etkisi yaratabilir. Aggregate oran yanında critical key coverage da izlenebilir.
Pipeline Success Rate
Successful run oranı operasyon sağlığını gösterir. Retry sonrası başarı ile ilk deneme başarısı ayrı izlenebilir. Sürekli retry normal kabul edilmemelidir. Backfill job'ları production schedule metric'inden ayrılabilir. Success rate data correctness yerine geçmez.
Recovery Time
Incident sonrası dataset'in tekrar sağlıklı hale gelme süresidir. RTO data platform için ölçülebilir. Backfill ve replay kapasitesi recovery süresini etkiler. Runbook hızlı çözüm sağlar. Düzenli failure drill hedefin gerçekçi olduğunu doğrular.
İş Birimi ile SLA Belirleme
Teknik ekip saniyelik freshness'in değerini tek başına belirlememelidir. İş birimi gecikmenin karar üzerindeki etkisini açıklar. Daha düşük latency'nin ek maliyeti görünür hale getirilir. Kritik saat veya dönemler ayrıca tanımlanabilir. Böylece SLA teknoloji hedefi değil ölçülebilir iş gereksinimi olur.
Data Incident Management
Data incident yanlış veya eksik verinin downstream kullanıcıları etkilediği operasyonel olaydır. Application incident yönetimine benzer disiplin gerekir. Etkilenen tablolar, dashboard'lar ve iş süreçleri hızla belirlenmelidir. Incident owner koordinasyonu yürütür. Düzeltme sonrasında yalnız pipeline'ın çalışması değil data reconciliation ile sonuç doğruluğu kontrol edilmelidir.
Hatalı Veri Tespiti
Quality veya anomaly alert incident'ı erken yakalayabilir. User report hâlâ önemli sinyaldir. Detection timestamp recovery metriğinin başlangıcı olabilir. False positive alarm yorgunluğu yaratır. Monitor zamanla gerçek incident pattern'leriyle ayarlanmalıdır.
Etkilenen Tablolar
Upstream problem lineage üzerinden downstream modellere yayılır. Impact list hızla oluşturulmalıdır. Criticality tag öncelik verir. Geçici olarak certification kaldırılabilir. Kullanıcılar riskli dataset konusunda bilgilendirilir.
Etkilenen Dashboard'lar
Dashboard lineage business etkiyi gösterir. Executive report ve operasyon paneli farklı önceliğe sahip olabilir. BI owner incident iletişimine dahil edilir. Cached report yanlış veriyi göstermeye devam edebilir. Fix sonrası refresh tetiklenmelidir.
Downstream Blast Radius
Tek source field yüzlerce model ve raporu etkileyebilir. Blast radius değişiklik riskini ölçer. Büyük radius için rollout daha kontrollü yapılmalıdır. Lineage metadata bu analizi otomatikleştirir. Platform tasarımı aşırı coupling'i azaltmalıdır.
Incident Owner
Tek owner karar ve iletişim sorumluluğunu alır. Teknik çözümü kendisi yapmak zorunda değildir. Source, platform ve BI ekiplerini koordine eder. Status düzenli paylaşılır. Postmortem action item'larının takibini sağlar.
Veri Düzeltme ve Reprocessing
Kök neden giderildikten sonra historical data düzeltilmelidir. Backfill scope belirlenir. Idempotent pipeline kullanılır. Reconciliation sonuçları doğrular. Kullanıcıya hangi dönemlerin değiştiği bildirilir.
Postmortem
Postmortem suç aramak yerine sistem iyileştirmesine odaklanır. Detection neden geç oldu sorusu sorulur. Contract, test veya runbook eksikleri belirlenir. Action item owner ve tarih alır. Tekrarlayan incident pattern'leri platform roadmap'e girer.
Data Pipeline CI/CD
Veri pipeline kodu da uygulama kodu gibi version control, test ve kontrollü deployment gerektirir. SQL değişikliklerinin doğrudan production'da denenmesi veri güvenini zedeler. Pull request review business logic ve performance etkisini erken yakalar. Staging environment production promotion öncesinde integration test imkânı sağlar. Schema ve data quality testleri deployment gate olarak kullanılabilir.
Git ile Versiyon Kontrol
SQL, DAG ve config Git repository içinde tutulur. Değişiklik history ve author görünür olur. Rollback kolaylaşır. Branch stratejisi ekip akışına göre seçilir. Secret değerler repository'ye yazılmamalıdır.
Pull Request
PR başka geliştiricinin transformation logic'i incelemesini sağlar. Business rule description eklenmelidir. Generated query ve performance impact gerekirse kontrol edilir. Data owner approval kritik metric değişikliğinde istenebilir. Automated tests PR aşamasında çalışır.
SQL Linting
SQL style standard readability sağlar. Basit anti-pattern'ler otomatik yakalanabilir. Linter business correctness'i garanti etmez. Warehouse dialect'e uygun yapılandırılmalıdır. Çok katı style kuralları üretkenliği gereksiz düşürmemelidir.
Schema Tests
Beklenen kolon ve type değişiklikleri doğrulanır. Breaking change CI'da yakalanabilir. Migration dosyası gerekebilir. Consumer contract ile comparison yapılır. Production schema drift ayrıca monitoring ile izlenir.
Unit Tests
Küçük input dataset üzerinden transform output doğrulanabilir. Edge case business rules test edilir. SQL unit test araçları kullanılabilir. Fast test PR feedback'i hızlandırır. Integration testlerin yerini tamamen almaz.
Integration Tests
Gerçek warehouse engine veya test environment üzerinde pipeline çalıştırılır. Connector ve permission problemleri görülür. Sample source-target flow doğrulanır. Cost nedeniyle bütün history kullanılmaz. Critical path coverage önceliklendirilir.
Dev → Staging → Production Promotion
Aynı artifact environment'lar arasında ilerlemelidir. Production'a özel manuel code değişikliği yapılmamalıdır. Config environment variable veya secret üzerinden ayrılır. Promotion approval dataset criticality'ye göre değişebilir. Rollback ve forward fix süreçleri test edilmelidir.
Veri Pipeline'ında Neler Versiyonlanmalı?
Yalnız transformation SQL'i versionlamak tam tekrar üretilebilirlik sağlamaz. Schema, connector config, DAG ve data contract da değişiklik geçmişine sahip olmalıdır. Infrastructure as Code deployment ortamını yeniden kurmayı kolaylaştırır. Pipeline run belirli code version ile ilişkilendirilebilir. Böylece geçmiş bir raporun hangi logic ve config ile üretildiği incident veya audit sırasında anlaşılabilir.
Transformation SQL
Business logic değişikliği Git commit ile izlenir. Model version release ile bağlanabilir. Historical reprocessing hangi version'ı kullandığını kaydeder. Code review zorunlu olabilir. SQL yanında macro ve UDF'ler de versionlanmalıdır.
Data Model
Fact ve dimension yapısı schema definition olarak tutulabilir. Grain değişikliği breaking kabul edilir. Migration plan repository içinde bulunur. Diagram otomatik üretilebilir. Model documentation code ile birlikte güncellenmelidir.
Schema
Source contract ve target schema versionlanır. Migration sequence tekrarlanabilir olmalıdır. Manual production alteration azaltılır. Drift ile expected change ayrıştırılır. Schema version pipeline metadata'ya eklenebilir.
Connector Configuration
Source table listesi, interval ve connector options versionlanabilir. Password ve token hariç tutulmalıdır. Config değişikliği code review'dan geçer. Backfill sırasında kullanılan özel config ayrı kaydedilir. Environment-specific değerler template üzerinden yönetilir.
DAG
Dependency ve schedule değişiklikleri version control altında olmalıdır. Task rename impact oluşturabilir. Deployment tarihçesi incident analizine yardımcı olur. Backfill behavior DAG version'a bağlı olabilir. Orchestrator UI tek source of truth olmamalıdır.
Data Contract
Contract schema ve quality expectation history'si tutulmalıdır. Producer breaking change planı görünür olur. Consumer adoption version bazında izlenebilir. Deprecation date kaydedilebilir. CI compatibility kontrolü contract dosyasını kullanır.
Infrastructure as Code
Warehouse role, storage, network ve orchestrator altyapısı kodla tanımlanabilir. Environment'lar tutarlı kurulur. Manual drift azalır. Security review change üzerinden yapılır. Disaster recovery ortamı daha hızlı yeniden oluşturulabilir.
Dev, Staging ve Production Veri Ortamları
Veri pipeline geliştirmesi doğrudan production verisi üzerinde yapılmamalıdır. Dev ve staging environment değişikliklerin güvenli testini sağlar. Production datasının non-prod ortama kopyalanması kişisel ve hassas veri riski oluşturur. Masking, anonymization veya synthetic data kullanılabilir. Promotion gate test ve reconciliation sonuçlarına göre production geçişini kontrol eder.
Ayrı Warehouse / Schema Kullanımı
Environment izolasyonu yanlış sorgunun production modeli değiştirmesini önler. Ayrı account veya database daha güçlü sınır sağlar. Küçük ekipler schema bazlı izolasyon kullanabilir. Permission least privilege olmalıdır. Cost attribution environment bazında izlenebilir.
Production Verisinin Non-Prod'a Taşınması
Gerçek veri test doğruluğu açısından cazip görünür. Ancak kişisel veri exposure riskini artırır. Yalnız gerekli subset alınmalıdır. Approval ve retention uygulanmalıdır. Alternatif olarak maskeli snapshot kullanılabilir.
Data Masking
Email, telefon veya kimlik bilgileri non-prod'da maskelenebilir. Format korumalı masking bazı testleri destekler. Referential consistency korunmalıdır. Masking deterministic gerekebilir. Original value geri çıkarılamamalıdır.
Anonymization
Anonymization kişisel veriyle birey arasındaki ilişkiyi geri döndürülemeyecek biçimde kaldırmayı hedefler. Basit hashing her zaman anonimleştirme değildir. Re-identification riski değerlendirilmelidir. İşlevsel test için gereken pattern korunabilir. Hukuki kriterler güvenlik ekibiyle doğrulanmalıdır.
Synthetic Data
Synthetic dataset gerçek schema ve edge case'leri taklit eder. Kişisel veri riski düşüktür. Production distribution tam temsil edilmeyebilir. Performance test için gerçekçi volume oluşturulabilir. Generator version control altında tutulabilir.
Production Promotion Gate
Unit, integration ve quality testleri geçmeden deploy yapılmaz. Critical model için sample reconciliation istenebilir. Schema breaking check uygulanır. Manual approval dataset riskine göre eklenebilir. Post-deploy smoke test production health'i doğrular.
Veri Ambarı Entegrasyonunda Güvenlik
Veri ambarı birçok kaynaktan bilgi topladığı için kurumun en hassas veri alanlarından biri haline gelebilir. Service account, least privilege ve secret management temel güvenlik kontrolleridir. Network mümkün olduğunca private tutulmalıdır. Transit ve at-rest encryption standart olmalıdır. Pipeline geliştirme kolaylığı uğruna geniş admin yetkileri vermek uzun vadede önemli güvenlik riski oluşturur.
Service Accounts
Her pipeline insan kullanıcı hesabı yerine dedicated service identity kullanmalıdır. Yetki yalnız gerekli source ve target kaynaklarla sınırlandırılır. Owner ve kullanım amacı belgelenir. Kullanılmayan hesap kapatılır. Audit log hangi pipeline'ın hangi veriye eriştiğini gösterir.
Least Privilege
Connector yalnız okuması gereken source tablolara erişmelidir. BI user raw sensitive layer'a ihtiyaç duymayabilir. Role hierarchy açık tasarlanır. Periodic permission review yapılır. Gereksiz yetkiler zamanla kaldırılır.
Secret Management
Password ve API token kod repository'de tutulmamalıdır. Merkezi secret store kullanılabilir. Runtime'da güvenli injection yapılır. Loglara secret değeri yazılmamalıdır. Access audit edilir.
Credential Rotation
Credential belirli aralıklarla veya incident sonrası yenilenmelidir. Rotation pipeline kesintisi oluşturmamalıdır. Dual credential geçişi kullanılabilir. Expiry öncesi alert verilir. Kullanılmayan eski secret revoke edilir.
Private Networking
Warehouse ve source bağlantısı mümkün olduğunda public internet yerine private network üzerinden kurulabilir. Firewall yalnız gerekli port ve subnet'e izin verir. SaaS API için egress control uygulanabilir. DNS ve certificate validation korunmalıdır. Network erişimi infrastructure as code ile yönetilebilir.
Encryption in Transit
Database ve API bağlantıları TLS kullanmalıdır. Certificate validation kapatılmamalıdır. Internal network güvenli varsayılmamalıdır. Broker ve object storage transferleri de encryption kullanır. Protocol version güvenlik standardına göre güncel tutulur.
Encryption at Rest
Warehouse, object storage ve backup verisi disk üzerinde şifrelenmelidir. Managed key veya customer-managed key kullanılabilir. Key rotation politikası belirlenir. Encryption erişim kontrolünün yerine geçmez. Backup kopyaları da aynı korumaya sahip olmalıdır.
Row-Level ve Column-Level Security
Warehouse'a erişen herkes bütün satır ve kolonları görmemelidir. Row-level security tenant veya departman bazlı erişim sağlar. Column-level policy hassas alanları yetkiye göre kısıtlar. Dynamic masking düşük yetkili kullanıcıya değeri gizleyebilir. BI katmanındaki yetki warehouse güvenliğini tamamlamalı, onun yerine geçmemelidir.
Hassas Kolonların Korunması
Email, telefon ve finansal bilgi sınıflandırılmalıdır. Default erişim kapalı tutulabilir. Yetkili rol açıkça tanımlanır. Query audit hassas alan kullanımını izler. Downstream export riskine karşı ek kontrol gerekebilir.
Departman Bazlı Veri Erişimi
Finance yalnız finansal ayrıntıya, regional manager kendi bölgesine erişebilir. Row policy user role üzerinden uygulanır. BI filter tek güvenlik mekanizması olmamalıdır. Policy test user'larıyla doğrulanır. Organization değişikliğinde entitlement güncellenmelidir.
Dynamic Data Masking
Yetkisiz kullanıcı gerçek değerin maskeli halini görür. Son dört hane gibi kısmi görünüm sağlanabilir. Masking export ve derived table davranışıyla birlikte test edilmelidir. Admin erişimi ayrıca loglanır. Maskeleme data minimization yerine geçmez.
Tokenization
Sensitive identifier token ile değiştirilebilir. Analitik join aynı deterministic token üzerinden yapılabilir. Mapping güvenli ayrı sistemde tutulur. Token reversibility gereksinimi kullanım alanına bağlıdır. Key management dikkatle yapılmalıdır.
BI Katmanında Yetki
BI workspace ve dataset permission kullanıcı deneyimini kontrol eder. Warehouse role ile uyumlu olmalıdır. DirectQuery durumunda source security passthrough kullanılabilir. Export permission ayrıca sınırlandırılabilir. Permission testleri release sürecine dahil edilebilir.
KVKK ve Veri Ambarı Entegrasyonu
Veri ambarı entegrasyonu kişisel verinin farklı sistemlerden merkezi platforma taşınmasına neden olduğu için KVKK açısından planlı yönetim gerektirir. Hangi kişisel verinin hangi amaçla işlendiği envanterde görünmelidir. Gereksiz alanların warehouse'a kopyalanması data minimization ilkesine aykırılık riski yaratabilir. Retention ve silme süreçleri raw, staging ve mart dahil bütün katmanları kapsamalıdır. Yurt dışı aktarım ve cloud lokasyonu kurumun hukuki değerlendirmesiyle birlikte ele alınmalıdır.
Kişisel Veri Envanteri
Hangi tablo ve kolonun kişisel veri içerdiği catalog'da sınıflandırılabilir. Source ve downstream lineage tutulur. Data owner ve hukuki amaç kaydedilir. Yeni kolon geldiğinde classification workflow tetiklenebilir. Envanter erişim ve silme süreçlerini kolaylaştırır.
Data Minimization
Analitik amaç için gerekmeyen kişisel veri taşınmamalıdır. Her source kolonunu otomatik warehouse'a kopyalamak kolay fakat riskli olabilir. Kullanım amacı sorgulanmalıdır. Raw layer bile sınırsız kopya alanı değildir. Daha az veri güvenlik ve maliyet açısından da avantaj sağlar.
Amaçla Sınırlılık
Veri belirlenen işleme amacı doğrultusunda kullanılmalıdır. Pazarlama için toplanan veri her analitik projede otomatik kullanılmamalıdır. Dataset purpose metadata olarak kaydedilebilir. Yeni kullanım için hukuki değerlendirme gerekebilir. Access request süreçleri bu bilgiden yararlanır.
Retention
Her veri sonsuza kadar saklanmamalıdır. Business ve hukuki gereksinime göre retention süresi belirlenir. Raw backup kopyaları unutulmamalıdır. Automated lifecycle policy uygulanabilir. Retention silme işlemi audit edilebilir olmalıdır.
Silme ve Anonimleştirme
Silme talebi source'tan warehouse downstream modellerine kadar propagate edilmelidir. Fact history bazı durumlarda anonimleştirme ile korunabilir. Backup restore sonrası silinmiş verinin yeniden ortaya çıkması engellenmelidir. Delete lineage bu süreci destekler. Teknik tasarım hukuki politika ile birlikte yapılmalıdır.
Yurt Dışı Veri Aktarımı
Cloud region ve SaaS connector verinin ülke dışında işlenmesine neden olabilir. Hukuki değerlendirme yapılmalıdır. Data residency teknik mimariyi etkileyebilir. Cross-region backup da transfer sayılabilecek durumlar yaratabilir. Platform seçimi yalnız performans ve maliyet üzerinden yapılmamalıdır.
Audit Logging
Kim hangi hassas dataset'e erişti bilgisi loglanmalıdır. Admin activity ayrı izlenebilir. Log retention güvenlik politikasına göre belirlenir. Kullanıcı payload'ı gereksiz loglanmamalıdır. Audit kayıtları değiştirilemez veya kontrollü depoda tutulabilir.
Data Virtualization Nedir?
Data virtualization veriyi fiziksel olarak merkezi warehouse'a taşımadan farklı kaynakları ortak sorgu katmanı üzerinden erişilebilir hale getirir. Federated query bazı kullanım alanlarında ingestion süresini ortadan kaldırır. Buna karşılık sorgu yükü doğrudan source sistemlere gidebilir. Büyük analitik taramalarda operasyonel sistem performansı risk altına girebilir. Bu nedenle virtualization çoğu kurumda physical warehouse ile birlikte seçici kullanılan hybrid model olarak daha güvenli sonuç verir.
Veriyi Taşımadan Sorgulamak
Query engine remote source'a bağlanır ve sonucu kullanıcıya getirir. Duplicate data storage azalabilir. Freshness doğal olarak source'a yakındır. Network ve source query performance sınırlayıcıdır. Governance merkezi query katmanında uygulanabilir.
Federated Query
Tek SQL farklı database ve storage sistemlerini join edebilir. Ad hoc discovery için kullanışlıdır. Büyük cross-source join pahalı olabilir. Predicate pushdown performans açısından önemlidir. Query plan farklı source yeteneklerine göre değişir.
Avantajları
Yeni source hızlı erişilebilir hale gelebilir. Full ingestion pipeline geliştirmek gerekmeyebilir. Güncel source data doğrudan görülebilir. Küçük lookup ve keşif senaryolarında faydalıdır. Storage duplication azalabilir.
Kaynak Sistem Performans Riski
BI kullanıcısının ağır query'si source production database'e gidebilir. Query concurrency sınırlandırılmalıdır. Cache veya read replica kullanılabilir. Source owner kullanım politikasını onaylamalıdır. Critical operational system için virtualization dikkatli uygulanmalıdır.
Physical Warehouse ile Hybrid Kullanım
Sık kullanılan büyük data warehouse'a fiziksel yüklenebilir. Nadir lookup virtualization üzerinden yapılabilir. Semantic layer iki kaynağı kullanıcıdan saklayabilir. Performance pattern gözlemlenip hot data materialize edilebilir. Hybrid yapı esneklik ve performans arasında denge sağlar.
Zero-ETL Nedir?
Zero-ETL kavramı bazı vendor platformlarının kaynak ile analitik hedef arasında düşük yönetim yüküyle native replication sağlamasını ifade eder. İsim ETL ihtiyacının tamamen ortadan kalktığı anlamına gelmez. Veri yine ingestion, schema mapping ve downstream business transformation gerektirir. Avantaj connector operasyonunun platform tarafından yönetilmesidir. Buna karşılık vendor lock-in ve desteklenen source-target kombinasyonları dikkate alınmalıdır.
Vendor-Native Entegrasyon
Aynı ekosistem içindeki database ve warehouse arasında managed replication kurulabilir. Credential ve network setup sadeleşir. CDC altyapısını vendor işletir. Monitoring platform tarafından sunulabilir. Custom source için yine ayrı connector gerekir.
Gerçekten ETL'siz mi?
Source data hedefe otomatik gelse de business dönüşümü hâlâ gerekir. Customer mapping ve KPI tanımı ortadan kalkmaz. Data quality testleri yine uygulanmalıdır. Raw replication entegrasyonun yalnız bir bölümüdür. Zero-ETL ismi operasyonel ingestion kolaylığını ifade eder.
Avantajları
Connector bakım yükü azalabilir. Setup süresi kısalır. Low-latency replication kolaylaşır. Vendor support operasyon sorunlarını hızlandırabilir. Küçük ekipler için önemli verim sağlayabilir.
Vendor Lock-In
Native entegrasyon belirli cloud veya database ekosistemine bağlanabilir. Source değiştirmek migration maliyeti yaratır. Pricing model uzun vadede değerlendirilmelidir. Raw data portable formatta tutulabilir. Critical business logic vendor-specific feature'a gereksiz bağlanmamalıdır.
Zero-ETL ile CDC Arasındaki Fark
CDC değişiklik yakalama tekniğidir. Zero-ETL managed ürün deneyimini ifade eder. Bir zero-ETL çözümü arka planda CDC kullanabilir. CDC kendi pipeline'ınız içinde bağımsız kurulabilir. Kavramlar birbirinin alternatifi olmaktan çok farklı seviyelerdeki tanımlardır.
Data Lake, Data Warehouse ve Lakehouse Entegrasyonu
Modern veri platformlarında warehouse tek storage katmanı olmayabilir. Data lake düşük maliyetli object storage üzerinde büyük ham veri tutarken warehouse yapılandırılmış analitik sorgulara odaklanır. Lakehouse açık tablo formatlarıyla iki yaklaşımın özelliklerini birleştirmeye çalışır. Apache Iceberg ve Delta Lake schema evolution ve transaction özellikleri sunabilir. Hibrit mimaride verinin hangi katmanda tutulacağı erişim pattern'i ve maliyet üzerinden seçilmelidir.
Data Warehouse
Yapılandırılmış analitik model ve BI workload için optimize edilir. SQL ve governance güçlüdür. Compute maliyeti object storage'a göre yüksek olabilir. Curated business data burada tutulabilir. Semantic layer ile iyi uyum sağlar.
Data Lake
Object storage üzerinde raw ve semi-structured data ekonomik biçimde saklanabilir. Schema-on-read yaklaşımı esneklik sağlar. Governance zayıf kurulursa data swamp riski oluşur. Catalog ve partition standardı gereklidir. Reprocessing için güçlü raw history alanıdır.
Lakehouse
Lakehouse object storage üzerinde warehouse benzeri table semantics sağlamayı amaçlar. ACID transaction ve schema evolution desteklenebilir. BI ve data science aynı data üzerinde çalışabilir. Engine compatibility değerlendirilmelidir. Operational governance yine kurum sorumluluğundadır.
Apache Iceberg
Iceberg büyük analytical table'lar için açık table formatıdır. Snapshot ve schema evolution özellikleri sunar. Partition evolution physical layout değişikliklerini kolaylaştırabilir. Farklı query engine'lerle kullanılabilir. Metadata maintenance ve file compaction operasyonu gerekir.
Delta Lake
Delta Lake transaction log üzerinden data lake tablolarına ACID yetenekleri sağlar. Merge ve time travel gibi özellikler bulunur. Streaming ve batch aynı table üzerinde çalışabilir. Platform integration değerlendirilmelidir. Small files compaction önemli operasyon konusudur.
Hibrit Mimari
Raw data lake üzerinde, curated mart warehouse'ta tutulabilir. Büyük event history düşük maliyetli storage'da kalır. BI için gerekli subset warehouse'a materialize edilir. Data movement maliyeti izlenmelidir. Lineage iki platformu kapsamalıdır.
Reverse ETL Nedir?
Reverse ETL warehouse'ta oluşturulan temiz ve zenginleştirilmiş veriyi tekrar operasyonel SaaS veya uygulamalara göndermeyi ifade eder. Müşteri segmenti CRM'e veya marketing platformuna aktarılabilir. Böylece analytics yalnız rapor üretmek yerine operasyonel aksiyonları besler. Ancak warehouse artık bir aktivasyon kaynağı olduğunda source of truth sınırları dikkatle belirlenmelidir. Operasyonel sistemde yapılan değişiklik reverse flow ile tekrar warehouse'a dönüp sonsuz döngü oluşturmamalıdır.
Warehouse'tan Operasyonel Sisteme Veri Gönderme
Curated table belirli aralıkla CRM veya API hedeflerine sync edilir. Incremental change detection kullanılabilir. Target rate limit dikkate alınmalıdır. Upsert key güvenilir olmalıdır. Delivery ve error response loglanmalıdır.
CRM Aktivasyonu
Customer health score veya segment CRM alanına yazılabilir. Satış ekibi analitik bilgiyi günlük workflow içinde görür. Field ownership net olmalıdır. CRM kullanıcısı manually edit edebiliyorsa conflict policy gerekir. Sync frequency business ihtiyacına göre seçilir.
Pazarlama Segmentleri
Warehouse segmentleri campaign platformuna gönderilebilir. Consent ve purpose limitation korunmalıdır. Segment membership incremental sync yapılabilir. Silinen veya segmentten çıkan kullanıcılar target'tan çıkarılmalıdır. Audience count reconciliation faydalıdır.
Personalization
Product recommendation veya customer tier operational uygulamaya aktarılabilir. Low latency gerekirse reverse batch yeterli olmayabilir. Online feature store alternatif olabilir. Stale data user experience'i etkiler. Freshness SLA açık olmalıdır.
Reverse ETL'de Source of Truth Problemi
Aynı alan hem CRM'de hem warehouse'ta değiştiriliyorsa conflict oluşur. Field ownership belirlenmelidir. Reverse ETL target'a yazdığı değeri tekrar source ingestion ile okuyabilir. Loop prevention metadata kullanılabilir. Data contract iki yönlü akışı tanımlamalıdır.
Açık Kaynak Veri Entegrasyonu ve İşbirliği Ekosistemi
Açık kaynak veri araçları connector, CDC, orchestration ve transformation katmanlarında geniş seçenekler sunar. Airbyte, Debezium, Kafka, Airflow, NiFi ve dbt Core farklı sorumluluklara odaklanır. Tek platform yerine composable architecture kurulabilir. Bunun karşılığında upgrade ve operasyon sorumluluğu kurumda kalır. Community-driven connector ekosistemi yeni kaynaklara hızlı destek sağlarken production kalitesi her connector için ayrıca test edilmelidir.
Airbyte
Airbyte çok sayıda source ve destination connector yaklaşımı sunar. SaaS ve database ingestion için kullanılabilir. Connector kalitesi kaynak bazında değişebilir. Schema evolution ve incremental behavior pilot test edilmelidir. Self-hosted operasyon maliyeti hesaba katılmalıdır.
Debezium
Debezium log-based CDC için yaygın açık kaynak çözümüdür. Farklı relational database transaction log'larını event stream'e dönüştürebilir. Initial snapshot ve offset yönetimi önemlidir. Kafka ile sık kullanılır. Schema ve delete event behavior tüketici tarafından anlaşılmalıdır.
Apache Kafka
Kafka durable event log ve yüksek throughput messaging sağlar. CDC ve application event'lerini taşıyabilir. Partition ve retention capacity planına dahil edilir. Consumer lag observability önemlidir. Platform operasyonu deneyimli ekip gerektirebilir.
Apache Airflow
Airflow batch orchestration için kullanılabilir. Connector job ve transformation dependency yönetir. Data movement engine olarak kullanılmamalıdır. Scheduler scaling ve metadata database operasyonu önemlidir. DAG standardı ekipler arasında ortaklaştırılabilir.
Apache NiFi
NiFi flow-based ingestion ve routing sağlar. Görsel geliştirme bazı integration ekipleri için uygundur. Backpressure ve provenance özellikleri değerlidir. Çok büyük flow sayısında governance gerekir. Version control süreçleri kurulmalıdır.
dbt Core
dbt Core warehouse içi SQL transformation için kullanılır. Model test ve lineage geliştirir. Ingestion yapmaz. Orchestrator ile birlikte çalışır. Ekip SQL engineering standardını güçlendirebilir.
Open Source Connector Ekosistemi
Community connector yeni SaaS kaynaklarına hızlı erişim sağlayabilir. Bakım seviyesi her projede aynı değildir. Critical source için code activity ve issue geçmişi incelenmelidir. Custom fork uzun vadeli bakım sorumluluğu yaratır. Connector test suite kurum içinde eklenebilir.
Community-Driven Integration
Kullanıcılar bug fix ve yeni connector katkısı yapabilir. Reproducible issue paylaşmak upstream çözümü hızlandırır. Kurum kendi patch'ini topluluğa geri vererek fork maliyetini azaltabilir. Community deneyimi edge case'leri görünür kılar. Production verisi veya credential paylaşılmamalıdır.
Vendor Lock-In'in Azaltılması
Açık format ve tool kullanımı platform değişikliğini kolaylaştırabilir. Bütün business logic vendor-specific UI içinde tutulmaz. SQL ve schema repository'de versionlanabilir. Object storage açık format kullanabilir. Yine de operasyon maliyeti ile portability arasında denge kurulmalıdır.
Managed Platform mı Açık Kaynak mı?
Managed platform operasyon yükünü azaltırken açık kaynak daha fazla kontrol sunabilir. Build vs buy kararı yalnız lisans fiyatına göre verilmemelidir. Connector bakımına ayrılan mühendislik zamanı ve on-call maliyeti de hesaba katılmalıdır. Managed ürün güçlü SLA sunabilir, fakat vendor bağımlılığı ve usage pricing yaratabilir. Kurumsal data warehouse entegrasyonu ve veri mühendisliği hizmeti planlanırken toplam sahip olma maliyeti birkaç yıllık perspektifle değerlendirilmelidir.
Build vs Buy
Hazır platform commodity integration işini hızlandırabilir. Çok özel source veya compliance gereksiniminde custom build gerekebilir. Kendi connector framework'ünü kurmak yüksek bakım yüküdür. Differentiating logic ile commodity plumbing ayrılmalıdır. Pilot proje gerçek engineering eforunu gösterir.
Connector Sayısı
Çok sayıda SaaS kaynağı managed platform avantajını artırır. Her API için ayrı custom kod yazmak pahalıdır. Connector coverage yalnız sayı değil gerekli object ve incremental support üzerinden değerlendirilmelidir. Critical source eksikse custom development gerekir. Roadmap vendor'a bağımlı olabilir.
Bakım Maliyeti
API version değişikliği connector maintenance gerektirir. Open source kullanıldığında ekip upgrade sorumluluğu taşır. Managed vendor bu işi hizmete dahil edebilir. Incident resolution süresi de maliyet kalemidir. İnsan zamanı fiyat karşılaştırmasına eklenmelidir.
SLA
Managed ürün contractual availability sunabilir. Self-hosted çözümde SLA kurumun operasyon ekibine bağlıdır. Critical ingestion için support response önemlidir. Vendor SLA data freshness garantisi vermeyebilir. Gerçek kapsam dikkatle okunmalıdır.
Güvenlik
Managed platform source credential ve data transit akışında üçüncü taraf olur. Compliance değerlendirmesi gerekir. Self-hosted daha fazla network kontrolü sağlar. Patch yönetimi kurum sorumluluğudur. Güvenlik yalnız hosting modeline göre iyi veya kötü kabul edilmemelidir.
Customization
Open source custom connector ve logic açısından daha esnek olabilir. Managed platform belirli extension noktaları sunar. Çok fazla customization upgrade'i zorlaştırabilir. Standard use case hazır özelliklerle çözülmelidir. Custom code gerçekten business farkı yaratan alana ayrılmalıdır.
Vendor Lock-In
Connector config ve transform logic proprietary formatta tutulursa migration zorlaşır. SQL ve açık schema portability sağlar. Raw data kurum kontrolündeki storage'da tutulabilir. Exit plan kritik platform seçiminde düşünülmelidir. Lock-in maliyeti operasyon kolaylığıyla birlikte değerlendirilir.
Toplam Sahip Olma Maliyeti
Lisans, compute ve storage görünen maliyetlerdir. Engineering, on-call ve upgrade eforu da eklenmelidir. Incident nedeniyle kaybedilen iş zamanı önemlidir. Üç yıllık karşılaştırma daha gerçekçi sonuç verir. En ucuz lisans her zaman en düşük toplam maliyeti üretmez.
Veri Ambarı Entegrasyon Araçları Nasıl Seçilir?
Tool seçimi demo ekranındaki kullanım kolaylığından daha geniş kriterlere dayanmalıdır. Connector coverage, CDC, schema evolution ve backfill production ihtiyaçlarıdır. Security ve deployment model kurum standartlarıyla uyumlu olmalıdır. Monitoring eksikliği operasyon sırasında büyük sorun yaratabilir. Cost yalnız normal günlük load değil historical backfill ve büyüme senaryosu üzerinden de hesaplanmalıdır.
Source Connector Desteği
Gerekli object ve endpoint'lerin gerçekten desteklenip desteklenmediği kontrol edilir. Incremental sync davranışı test edilir. Custom field support önemlidir. Delete handling ayrıca doğrulanır. Connector release sıklığı bakım kalitesini gösterir.
CDC Desteği
Database source için log-based CDC gerekiyorsa platform desteği kontrol edilir. Initial snapshot ve schema change behavior test edilir. Offset recovery güvenilir olmalıdır. Supported database version listesi incelenir. Log retention requirement belgelenir.
Batch ve Streaming
Her workload streaming gerektirmez. Tool hem schedule batch hem continuous ingest destekleyebilir. Streaming latency benchmark yapılmalıdır. Cost modeli sürekli worker kullanımını etkileyebilir. Hybrid kullanım pratik avantaj sağlar.
Schema Evolution
Yeni kolon nasıl hedefe yansıtılıyor sorusu test edilir. Breaking type değişikliğinde behavior önemlidir. Automatic alteration production policy ile uyumlu olmalıdır. Contract integration değerlidir. Silent field drop kabul edilmemelidir.
Backfill
Historical range kolay seçilebilmelidir. Backfill normal ingestion state'ini bozmamalıdır. Rate limit kontrolü gerekir. Parallelism yönetilebilir olmalıdır. Progress ve retry gözlemlenebilir olmalıdır.
Monitoring
Record count, latency ve error metric sunulmalıdır. Sadece job status yetersizdir. Prometheus veya API export faydalıdır. Alert integration ekip standardıyla uyumlu olmalıdır. Per-source lag görünür olmalıdır.
Security
Secret management ve encryption özellikleri incelenir. RBAC ve audit log gereklidir. Private networking desteklenebilir. Credential scope least privilege olmalıdır. Compliance gereksinimleri doğrulanır.
Deployment Modeli
SaaS, managed private veya self-hosted seçenekleri olabilir. Network erişim modeli source sistemlere uygun olmalıdır. Upgrade ve HA sorumluluğu değişir. Kubernetes deployment ekstra operasyon gerektirebilir. Organizasyon platform kapasitesiyle uyumlu seçim yapılmalıdır.
Cost
Fiyat row, volume, connector veya compute üzerinden hesaplanabilir. Peak backfill normal aylık maliyeti aşabilir. Egress ve API ücretleri ayrıca vardır. Minimum commitment değerlendirilir. Büyüme senaryosu finans planına eklenir.
Veri Ambarı Entegrasyonunda Performans Optimizasyonu
Entegrasyon performansı source extraction, network, target load ve transformation aşamalarının toplamıdır. Sadece warehouse query tuning yeterli değildir. Parallel load uygun kaynaklarda throughput artırırken source limitleri korunmalıdır. Incremental processing büyük dataset üzerinde tekrar işlemeyi azaltır. Partitioning, clustering ve bulk loading target maliyetini düşürerek freshness hedeflerinin daha az compute ile karşılanmasına yardımcı olur.
Parallel Loading
Bağımsız partition veya table'lar paralel yüklenebilir. Source connection limiti göz önünde bulundurulur. Aşırı parallelism database CPU'yu doygun hale getirebilir. Target load concurrency de sınırlandırılabilir. Benchmark optimum worker sayısını belirler.
Incremental Processing
Yalnız değişen partition veya kayıtlar dönüştürülür. Full model scan azaltılır. Late data için lookback window eklenebilir. Unique key merge gerekir. Incremental logic full refresh sonucu ile periyodik karşılaştırılmalıdır.
Partitioning
Büyük fact tablolar event date gibi alanla partition edilebilir. Query yalnız ilgili partition'ı tarar. Çok küçük partition metadata yükünü artırabilir. Partition key kullanım pattern'ine göre seçilir. Backfill belirli partition'ı kolayca yeniden işler.
Clustering
Clustering sık filter ve join edilen kolonlarda data locality sağlar. Warehouse engine'e göre davranış değişir. Çok yüksek cardinality her zaman kötü değildir, ancak benefit ölçülmelidir. Maintenance maliyeti olabilir. Query profile üzerinden seçim yapılmalıdır.
Bulk Loading
Dosya veya batch API üzerinden toplu yükleme row-by-row insert'e göre daha hızlıdır. Optimal file size önemlidir. Compression network maliyetini azaltabilir. Error handling partial file behavior'ını tanımlamalıdır. Staging table sonrası merge kullanılabilir.
Pushdown Transformation
Dönüşüm işlemi verinin bulunduğu engine üzerinde çalıştırılır. Büyük data network üzerinden taşınmaz. Cloud warehouse ELT bu yaklaşımı kullanır. External function gereksiz transfer oluşturabilir. Compute cost ve SQL optimizer performansı ölçülmelidir.
Merge Optimization
Merge target table'ın tamamını tararsa incremental avantaj kaybolur. Partition predicate eklenebilir. Source batch deduplicate edilir. Cluster key join performansını iyileştirebilir. Execution profile düzenli izlenmelidir.
Small Files Problemi
Streaming veya çok kısa micro-batch pipeline binlerce küçük dosya üretebilir. Object storage açısından dosya sayısı mümkün olsa da query engine her dosya için metadata ve open işlemi yapmak zorunda kalır. Bu durum scan performansını düşürür. Compaction küçük dosyaları daha büyük parçalarda birleştirir. Micro-batch interval ve hedef file size birlikte ayarlanarak problem kaynağında azaltılabilir.
Streaming'in Çok Sayıda Küçük Dosya Üretmesi
Her kısa interval ayrı file yazılırsa file count hızla büyür. Partition sayısı da bu etkiyi artırır. Çok az event içeren partition'lar özellikle sorunludur. Buffering belirli size'a kadar bekleyebilir. Latency hedefiyle file size arasında denge kurulur.
Query Performansına Etkisi
Engine binlerce metadata entry okumak zorunda kalır. Planning süresi artar. Remote object request sayısı yükselir. Aynı toplam byte daha yavaş taranabilir. Query profile file count metric'i gösterir.
Compaction
Background job küçük dosyaları büyük dosyalarda birleştirir. Eski file'lar transaction log üzerinden kaldırılabilir. Compaction compute tüketir. Çok sık çalıştırmak gereksiz maliyet oluşturur. Threshold file count veya size dağılımına göre seçilir.
Micro-Batch Ayarı
Batch interval uzatıldığında her file daha fazla kayıt içerir. Latency biraz artar. Warehouse query performansı iyileşebilir. Her source için aynı interval gerekli değildir. Freshness SLO optimum değeri sınırlar.
File Size Optimization
Hedef file size query engine recommendation'ına göre seçilebilir. Çok büyük file parallel scan'i azaltabilir. Çok küçük file metadata overhead yaratır. Compression ratio dikkate alınmalıdır. Real workload benchmark doğru aralığı belirler.
Veri Ambarı Entegrasyonunda Maliyet Nasıl Hesaplanır?
Toplam maliyet yalnız warehouse storage fiyatı değildir. Connector, source API, network, compute, backfill ve monitoring giderleri birlikte hesaplanmalıdır. Engineering zamanı da önemli bir maliyet kalemidir. Realtime mimari sürekli çalışan broker ve compute nedeniyle batch'e göre daha pahalı olabilir. Maliyet modeli kaynak ve workload bazında hazırlandığında hangi verinin hangi freshness seviyesinde taşınmasının gerçekten değer ürettiği daha açık görülür.
Connector Maliyeti
Managed platform volume veya connector başına ücret alabilir. Self-hosted çözümde infrastructure ve bakım maliyeti vardır. Çok sayıda source fiyatı hızla artırabilir. Kritik olmayan connector'lar daha seyrek çalıştırılabilir. Contract ve support maliyeti ayrıca değerlendirilir.
Source API Maliyeti
Bazı SaaS API kullanımı ücret veya quota tüketir. Full backfill büyük request sayısı oluşturabilir. Export API daha ekonomik olabilir. Rate limit engineering süresini de etkiler. Source vendor pricing değişikliği izlenmelidir.
Network ve Egress
Cloud'lar arası transfer ücretli olabilir. Raw büyük dataset taşımak egress maliyeti yaratır. Compression yardımcı olabilir. Aynı region seçimi transferi azaltabilir. Multi-region replication ayrıca hesaplanmalıdır.
Warehouse Compute
Transformation ve BI query compute tüketir. Incremental model scan miktarını azaltır. Auto-suspend boşta maliyeti düşürebilir. Ağır backfill ayrı compute pool kullanabilir. Query cost attribution team bazında raporlanabilir.
Storage
Raw, staging ve history katmanları data duplication yaratır. Compression maliyeti azaltır. Retention policy uygulanır. Time travel veya snapshot ekstra storage kullanabilir. Business değeri olmayan ara tablolar temizlenmelidir.
Transformation
Her modelin günlük compute maliyeti ölçülebilir. Gereksiz materialization kaldırılır. Çok sık çalışan model schedule azaltılabilir. Shared intermediate model duplicate computation'ı önler. Cost per data product hesaplanabilir.
Backfill
Normal günlük load'dan katlarca büyük olabilir. Warehouse compute ve source API cost artar. Önceden estimate yapılmalıdır. Low-priority schedule kullanılabilir. Tarih aralığı mümkün olduğunca dar tutulur.
Monitoring
Log ve metric storage da maliyet oluşturur. Her row veya payload loglanmamalıdır. High-cardinality metric pahalıdır. Retention incident ihtiyacına göre seçilir. Sampling telemetry maliyetini azaltabilir.
Engineering Maliyeti
Custom connector geliştirme ve on-call insan zamanı gerektirir. Managed platform fiyatı bu eforla karşılaştırılmalıdır. Data incident business kullanıcılarının zamanını da etkiler. Platform standardization tekrar geliştirmeyi azaltır. TCO kararında insan maliyeti mutlaka yer almalıdır.
Veri Ambarı Entegrasyonu İçin Disaster Recovery
Data platform disaster recovery yalnız warehouse backup almak değildir. Connector offset, watermark ve pipeline config kaybolursa kaynakla hedef arasındaki senkronizasyon bozulabilir. Replay ve backfill prosedürü önceden test edilmelidir. Recovery sonrası source-target reconciliation yapılmalıdır. İşlem günlükleri ve veri kurtarma yaklaşımını daha geniş bağlamda incelemek için https://www.diyarbakiryazilim.com.tr/posts/islem-gunlukleri-transaction-logs-ve-veri-kurtarma içeriği de yararlı bir devam noktasıdır.
Connector State
CDC offset ve API cursor connector state'in parçasıdır. State kaybı duplicate veya full resync gerektirebilir. Yedeklenmelidir. HA metadata store kullanılabilir. Restore prosedürü test edilmelidir.
Watermark Backup
Incremental pipeline'ın son başarılı position bilgisi korunur. Database table veya reliable metadata store kullanılabilir. Watermark update transactional olmalıdır. Backup eskiyse overlap ile yeniden yükleme yapılabilir. Idempotency duplicate riskini azaltır.
Pipeline Configuration Backup
Config Git ve infrastructure as code içinde bulunmalıdır. Manual UI setting ayrıca export edilebilir. Secret değerler ayrı backup politikasına sahiptir. Yeni environment aynı config ile kurulabilmelidir. Restore drill config eksiklerini gösterir.
Replay
Durable event log disaster sonrası missing event'leri tekrar sağlayabilir. Retention RPO hedefini kapsamalıdır. Consumer idempotent olmalıdır. Büyük replay normal workload'u etkilememelidir. Lag metric recovery progress'i gösterir.
Backfill
Raw data veya source üzerinden eksik dönem yeniden işlenir. Scope belirlenir. Production compute kapasitesi korunur. Recovery tamamlandıktan sonra reconciliation yapılır. Backfill run audit amacıyla kaydedilir.
Warehouse Backup
Platform snapshot veya replication özelliği kullanılabilir. Backup retention business RPO'ya göre belirlenir. Restore ayrı environment'ta test edilir. Security policy backup için de geçerlidir. Metadata ve access policy restore planına dahil edilmelidir.
Recovery Sonrası Reconciliation
Sistem çalışıyor görünse bile veri eksik olabilir. Row count, control total ve max date karşılaştırılır. Critical mart ve dashboard doğrulanır. Incident kapanışı bu kontrol tamamlanmadan yapılmamalıdır. Sonuç postmortem dokümanına eklenir.
Veri Ambarı Migrasyonu Sırasında Entegrasyon
Warehouse migration eski sistemden yeni platforma yalnız tarihsel veri kopyalamak değildir. Mevcut kaynak entegrasyonlarının da yeni hedefe yönlendirilmesi gerekir. Geçiş döneminde dual load iki sistemi paralel besleyebilir. Historical backfill sonrasında dashboard sonuçları karşılaştırılır. Cutover ve rollback planı kullanıcı etkisini azaltır.
Eski ve Yeni Warehouse'u Paralel Beslemek
Kaynak pipeline bir süre iki hedefe veri gönderebilir. Sonuçlar paralel karşılaştırılır. Source üzerinde iki kat extraction yapılmaması için shared landing kullanılabilir. Cost geçiş süresinde artar. Paralel dönem yeterli confidence sağladığında eski sistem kapatılır.
Dual Load
Aynı batch iki warehouse'a yüklenebilir. Transactional coordination gerekli olmayabilir ancak consistency izlenmelidir. Error bir hedefte oluşabilir. Reconciliation farkı gösterir. Connector logic mümkün olduğunca duplicate edilmemelidir.
Historical Backfill
Eski history yeni platforma taşınır. Partition bazlı yapılabilir. Source operational system yerine mevcut warehouse veya archive tercih edilebilir. Büyük volume için bulk export/import kullanılır. Backfill süresi migration timeline'ın büyük bölümünü oluşturabilir.
Source–Target Reconciliation
Eski ve yeni warehouse aynı period için karşılaştırılır. Row count yanında KPI ve financial total kullanılır. Bilinen model değişiklikleri fark listesinde açıklanır. Automated comparison release confidence artırır. Critical dataset sıfır açıklanamayan fark hedefleyebilir.
Dashboard Parallel Validation
Aynı dashboard eski ve yeni backend ile çalıştırılabilir. Performance ve number comparison yapılır. BI semantic değişiklikleri ayrıca test edilir. User acceptance kritik raporlarda faydalıdır. Cache temizlenerek adil karşılaştırma yapılmalıdır.
Cutover
Consumer bağlantıları yeni warehouse'a yönlendirilir. Freeze window gerekebilir. Monitoring yoğunlaştırılır. Rollback criteria önceden tanımlanır. Kullanıcı iletişimi yapılır.
Rollback
Yeni platform ciddi problem yaşarsa eski sistem geçici olarak tekrar kullanılabilir. Paralel load rollback'i kolaylaştırır. Schema veya business logic compatibility korunmalıdır. Rollback veri kaybı yaratmamalıdır. Plan migration öncesinde test edilmelidir.
Veri Ambarının BI Araçlarıyla Entegrasyonu
Warehouse değerini çoğu kullanıcı BI aracı üzerinden görür. Connection mode performans, freshness ve maliyeti etkiler. Import model hızlı dashboard sunabilir ancak ek refresh süreci gerektirir. DirectQuery daha güncel veri sağlarken warehouse'a daha fazla canlı query gönderir. Semantic layer ve erişim politikaları hangi araç kullanılırsa kullanılsın merkezi tutulmalıdır.
Power BI
Power BI import ve DirectQuery seçenekleriyle warehouse'a bağlanabilir. Dataset model boyutu ve refresh süresi izlenir. Incremental refresh büyük fact'lerde faydalıdır. RLS warehouse veya BI katmanında uygulanabilir. KPI tanımları semantic modelle uyumlu tutulmalıdır.
Tableau
Tableau extract veya live connection kullanabilir. Extract performans sağlayabilir ancak veri kopyası oluşturur. Live query warehouse compute tüketir. Workbook-level custom SQL kontrol edilmelidir. Certified datasource standardization sağlar.
Looker
Looker semantic modeling katmanı üzerinden warehouse sorguları üretebilir. Metric ve dimension tanımları merkezi yönetilebilir. Query performance generated SQL üzerinden izlenmelidir. Cache freshness business ihtiyacıyla uyumlu olmalıdır. Model ownership data ve BI ekipleri arasında belirlenmelidir.
Import
Veri BI engine içine kopyalanır. Dashboard etkileşimi hızlıdır. Refresh schedule freshness'i sınırlar. Büyük dataset memory ve refresh süresi oluşturur. Incremental refresh maliyeti azaltabilir.
DirectQuery / Live Connection
Her kullanıcı interaction warehouse query üretebilir. En güncel veri sunulur. Concurrency warehouse compute'u etkiler. Aggregate table ve caching performansı iyileştirebilir. Query limit kullanıcı deneyimini korur.
Composite Model
Bazı tablolar import, bazıları live olabilir. Hot dimension memory'de tutulabilir. Real-time fact doğrudan warehouse'a gider. Relationship behavior dikkatle test edilmelidir. Model karmaşıklığı kullanıcıya yansıtılmamalıdır.
Semantic Layer
BI araçlarının aynı KPI'ları kullanmasını sağlar. Tool migration kolaylaşır. Access policy merkezi olabilir. Metric governance artar. Warehouse ile kullanıcı arasında iş dili katmanı oluşturur.
Veri Ambarının AI ve ML Sistemleriyle Entegrasyonu
AI ve ML sistemleri güvenilir ve tekrar üretilebilir training verisine ihtiyaç duyar. Warehouse curated business data sağlayarak bu süreci kolaylaştırır. Feature engineering için aynı dönüşümler farklı notebook'larda tekrar edilmemelidir. Feature store online ve offline feature consistency sağlayabilir. RAG uygulamalarında da veri kaynağının sahipliği ve freshness seviyesi önemlidir.
Feature Engineering
Model input feature'ları warehouse SQL ile üretilebilir. Historical point-in-time correctness önemlidir. Future data leakage engellenmelidir. Feature logic versionlanmalıdır. Training ve inference aynı tanımı kullanmalıdır.
Training Dataset
Training dataset model version ile birlikte snapshot edilebilir. Source lineage korunur. PII minimization uygulanır. Dataset quality testleri model eğitiminden önce çalışır. Reproducibility için date range ve code commit kaydedilir.
Feature Store
Feature store ortak feature tanımlarını yönetir. Offline warehouse ve online low-latency store arasında senkronizasyon olabilir. Freshness feature türüne göre değişir. Duplicate logic azaltılır. Governance model lifecycle ile bütünleşir.
AI İçin Trusted Data
Model yalnız büyük veri değil güvenilir veri ister. Certified warehouse model source belirsizliğini azaltır. Quality score ve lineage training dataset'e ek metadata sağlar. Bias ve temsil sorunları ayrıca değerlendirilmelidir. Analitik doğruluk model performansının temel girdisidir.
RAG Veri Kaynakları
RAG sistemleri structured ve unstructured kurumsal kaynak kullanabilir. Warehouse metadata ve business glossary retrieval için kullanılabilir. Kişisel veri erişimi authorization ile korunmalıdır. Freshness embedding veya index refresh sürecini etkiler. Source citation kullanıcı güvenini artırabilir.
Analytics ve AI İçin Ortak Veri Temeli
Aynı customer ve product definition hem dashboard hem model tarafından kullanılabilir. Metric ve feature farkları açık biçimde belgelenir. Tekrarlanan ingestion azaltılır. Data governance iki kullanım alanını birlikte kapsar. Platform yatırımı daha fazla ekip tarafından yeniden kullanılır.
Örnek Kurumsal Veri Entegrasyon Mimarisi
Örnek bir kurumda ERP, CRM ve e-ticaret sistemleri aynı warehouse'a farklı yöntemlerle alınabilir. SaaS API kaynakları batch connector ile, operasyonel database CDC ile taşınabilir. Raw layer bütün kaynakları audit için korur. dbt transformation core warehouse ve data mart modellerini oluşturur. Catalog, lineage ve monitoring bütün pipeline'ın güvenilirliğini izler.
ERP + CRM + E-Ticaret Kaynakları
Üç kaynak farklı entity ID kullanabilir. Mapping table customer ve product ilişkisini kurar. ERP finans için source of record olabilir. CRM iletişim alanlarını sağlar. E-ticaret order ve behavior event'leri analitik görünümü zenginleştirir.
Batch SaaS Ingestion
CRM API her 30 dakikada incremental alınabilir. Rate limit uygulanır. Connector state merkezi tutulur. Schema drift izlenir. Delete behavior periyodik reconciliation ile doğrulanır.
Database CDC
Sipariş database transaction log üzerinden CDC ile izlenir. Event broker'a yazılır. Raw table append olarak saklanır. Current-state model merge edilir. Lag metric saniye bazında ölçülür.
Raw Layer
Bütün source payload source metadata ile saklanır. Retention data class'a göre seçilir. Access yalnız data engineering role'lerine açıktır. Reprocessing buradan yapılır. Schema history korunur.
dbt Transformation
Staging source isimlerini canonical modele çevirir. Core customer ve order model oluşturulur. Tests quality'yi kontrol eder. Incremental model cost düşürür. Documentation catalog ile publish edilir.
Core Warehouse
Customer, product ve transaction ortak modeli bulunur. Source-specific ayrıntı gizlenir. SCD history yönetilir. Conformed dimension farklı mart'larca paylaşılır. Entity ownership açık tutulur.
Data Mart
Sales ve finance mart ayrı kullanım için optimize edilir. Star schema BI sorgularını kolaylaştırır. Aggregate günlük tablolar performans sağlar. Metric logic semantic layer ile uyumludur. Mart owner iş birimiyle birlikte belirlenir.
BI ve AI Consumers
BI certified mart kullanır. Data science gerektiğinde granular core modele erişir. Hassas kolon izinleri farklıdır. Usage metric hangi dataset'in gerçekten değer ürettiğini gösterir. Consumer ihtiyaçları model roadmap'e geri bildirim sağlar.
Catalog, Lineage ve Monitoring
Her model owner ve description ile catalog'da bulunur. Lineage source'tan dashboard'a kadar gösterilir. Freshness ve volume alertleri çalışır. Incident etkisi hızlı belirlenir. Platform güveni yalnız teknik uptime yerine veri güvenilirliğiyle ölçülür.
Veri Ambarı Entegrasyonu İçin Adım Adım Yol Haritası
Veri ambarı entegrasyonu teknoloji kurulumundan önce iş ihtiyaçlarını anlamakla başlamalıdır. Kaynak envanteri ve system of record kararları veri modelinin temelidir. Her source için ETL, ELT veya CDC yöntemi ayrı seçilebilir. Quality, security ve observability ilk production release'ten önce kurulmalıdır. Kurumsal data warehouse entegrasyonu ve veri mühendisliği hizmeti planlanırken bu yol haritası proje kapsamının connector listesinden çok daha geniş olduğunu görünür hale getirir.
1. İş Gereksinimlerini Belirleyin
Hangi karar ve raporların destekleneceği yazılır. KPI owner belirlenir. Freshness ihtiyacı konuşulur. Kullanıcı sayısı ve BI aracı not edilir. Teknik kapsam gerçek iş değerine bağlanır.
2. Kaynak Sistem Envanterini Çıkarın
Source owner, volume ve erişim yöntemi belgelenir. API ve database limitleri kaydedilir. Sensitive data işaretlenir. Primary key ve update behavior doğrulanır. Unknown source riskleri görünür olur.
3. System of Record'ları Belirleyin
Customer, product ve finance için ana kaynak tanımlanır. Attribute-level ownership gerekebilir. Conflict rule yazılır. Business owner onay verir. Mapping ve MDM tasarımı buna dayanır.
4. Freshness ve SLA Hedeflerini Belirleyin
Her dataset için gerekli latency belirlenir. Gereksiz realtime hedeflerinden kaçınılır. Critical reporting time tanımlanır. SLO metric seçilir. Cost trade-off iş birimiyle paylaşılır.
5. ETL/ELT/CDC Yöntemini Kaynak Bazında Seçin
Database change rate CDC gerektirebilir. SaaS API batch olabilir. Sensitive source ETL masking isteyebilir. Cloud warehouse ELT avantajı sağlayabilir. Tek yöntem bütün kaynaklara zorlanmaz.
6. Raw ve Staging Katmanını Kurun
Raw immutable source history tutar. Staging type ve naming standardization yapar. Metadata alanları ortaklaştırılır. Retention belirlenir. Access policy uygulanır.
7. Data Model'i Tasarlayın
Business process ve grain tanımlanır. Fact ve dimension belirlenir. History strategy seçilir. Core ve mart sınırları çizilir. User query pattern dikkate alınır.
8. Data Contract'ları Oluşturun
Required field ve type tanımlanır. Freshness expectation eklenir. Owner belirlenir. Breaking change süreci yazılır. CI compatibility testi uygulanır.
9. Veri Kalitesi Testlerini Ekleyin
Unique ve not null temel testlerdir. Business rule eklenir. Source-target reconciliation kurulur. Failure severity belirlenir. Quality result monitoring'e taşınır.
10. Pipeline Orchestration Kurun
Dependency ve schedule merkezi yönetilir. Retry ve timeout standardı belirlenir. Backfill desteklenir. SLA miss alert kurulur. DAG ownership tanımlanır.
11. Lineage ve Catalog Ekleyin
Source-to-target ilişkiler toplanır. Dataset description yazılır. Owner görünür olur. Dashboard lineage eklenir. Impact analysis kullanılabilir hale gelir.
12. Security ve KVKK Kontrollerini Uygulayın
Least privilege role tasarlanır. PII classification yapılır. Masking ve encryption uygulanır. Retention ve delete process kurulur. Audit logging etkinleştirilir.
13. Observability ve Alerting Kurun
Freshness ve volume izlenir. Schema drift alarmı eklenir. Pipeline duration baseline oluşturulur. Quality score dashboard hazırlanır. On-call routing owner bilgisine bağlanır.
14. Backfill ve Recovery Senaryolarını Test Edin
Historical partition yeniden yüklenir. Connector state restore denenir. Event replay test edilir. Source-target reconciliation yapılır. Recovery time SLO ile karşılaştırılır.
15. BI ve AI Tüketim Katmanlarını Açın
Certified mart'lar kullanıcıya sunulur. Semantic metric tanımları doğrulanır. AI team trusted dataset kullanır. Usage monitoring başlatılır. Feedback sonraki veri ürünleri için backlog'a eklenir.
En Sık Yapılan Veri Ambarı Entegrasyon Hataları
Veri entegrasyonu projelerinde sorunların çoğu kullanılan teknolojiden daha çok temel tasarım kararlarından çıkar. Her kaynağa full load uygulamak başlangıçta kolay görünür fakat veri büyüdükçe sürdürülemez hale gelir. Delete, schema drift ve backfill gibi durumlar baştan düşünülmezse production veri güveni düşer. Monitoring yalnız job success gösterdiğinde sessiz quality problemleri haftalarca fark edilmeyebilir. Veri Ambari (Data Warehouse) Sistemlerine Entegrasyon çalışmalarında en güçlü yaklaşım hata senaryolarını normal tasarımın parçası olarak görmektir.
Her Kaynağa Aynı Entegrasyon Yöntemini Uygulamak
SaaS API ve transaction database aynı davranmaz. Her source'un volume ve latency ihtiyacı farklıdır. Standardization yararlıdır fakat method source-specific olmalıdır. CDC yalnız gerektiğinde kullanılır. Basit source gereksiz altyapı yükü taşımamalıdır.
Gereksiz Yere Her Veriyi Real-Time Yapmak
Streaming operasyon maliyetini artırır. Saatlik rapor saniyelik latency istemeyebilir. İş değeri sorulmalıdır. Micro-batch yeterli olabilir. Realtime yalnız gerçekten karar hızını etkileyen alanlarda kullanılmalıdır.
Full Reload ile Büyümeye Çalışmak
Bugün küçük tablo yarın milyarlarca satıra çıkabilir. Full load source ve warehouse'u zorlar. Incremental design erken düşünülmelidir. High-water mark veya CDC kullanılabilir. Growth projection mimari kararın parçasıdır.
Hard Delete'leri Yakalamamak
Timestamp incremental hard delete görmez. Warehouse stale record tutar. CDC veya reconciliation gerekir. Delete policy business modele yansıtılır. KVKK açısından özellikle önemlidir.
Pipeline'ı Idempotent Tasarlamamak
Retry duplicate üretir. Backfill riskli hale gelir. Unique key ve merge kullanılmalıdır. Watermark commit sırası doğru olmalıdır. Idempotency recovery'yi sadeleştirir.
Schema Drift'i İzlememek
Source değişikliği sessiz null artışı oluşturabilir. Pipeline başarılı görünür. Contract ve schema monitoring gerekir. Breaking change production öncesi yakalanmalıdır. Owner iletişimi otomatikleştirilebilir.
Backfill Planı Olmaması
Data bug düzeltildiğinde geçmiş nasıl onarılacak bilinmez. Raw retention yoksa source'a tekrar yük bindirilir. Historical job önceden tasarlanmalıdır. Idempotent model gereklidir. Backfill capacity test edilmelidir.
Data Contract Kullanmamak
Producer kolon silebilir ve consumer habersiz kalır. Owner belirsiz olur. Freshness expectation yazılı değildir. Contract bu sınırları açıklar. CI değişiklikleri erken kontrol eder.
Kaynak ve Hedef Veriyi Reconcile Etmemek
Job success veri doğruluğu değildir. Eksik kayıt fark edilmeyebilir. Row count ve control total karşılaştırılmalıdır. Critical source için günlük reconciliation yapılabilir. Migration cutover bununla doğrulanmalıdır.
Entity Resolution'ı İhmal Etmek
Aynı müşteri farklı ID'lerle kalır. Revenue parçalanır. Customer 360 raporu yanlış olur. Mapping ve MDM gerekir. Identity quality ölçülmelidir.
Production Verisini Maskesiz Test Ortamına Kopyalamak
Non-prod erişim daha geniş olabilir. PII riski artar. Masking veya synthetic data kullanılmalıdır. Minimum subset tercih edilir. Retention kısa tutulabilir.
Data Quality'yi Dashboard'da Fark Etmek
Kullanıcı hatayı ilk bulan kişi olmamalıdır. Pipeline quality testleri erken alarm verir. Volume ve distribution monitoring gerekir. Certified dataset health gösterilebilir. Incident detection süresi azalır.
Pipeline Kodunu Versiyonlamamak
Production SQL değişikliğinin kim tarafından yapıldığı bilinmez. Rollback zorlaşır. Git ve PR kullanılmalıdır. Config de versionlanmalıdır. Deployment tekrarlanabilir hale gelir.
Lineage Olmadan Production'a Çıkmak
Incident etkisi bulunamaz. Column change yüzlerce dashboard'u bozabilir. Impact analysis yapılamaz. En az table-level lineage erken kurulmalıdır. Kullanım büyüdükçe ayrıntı artırılabilir.
Monitoring Yerine Sadece Job Success Durumuna Bakmak
Job başarıyla biterken sıfır kayıt işleyebilir. Freshness gecikebilir. Schema veya distribution bozulabilir. Data observability bu boşluğu kapatır. Job status yalnız bir sinyaldir.
Sık Sorulan Sorular
Veri ambarı entegrasyonu hakkında en sık sorulan sorular genellikle ETL, ELT, CDC ve veri kalitesi çevresinde toplanır. Kurumların kaynak ve kullanım şekilleri farklı olduğu için her sorunun tek bir teknoloji cevabı yoktur. Doğru yöntem veri hacmi, freshness, güvenlik ve operasyon kapasitesine göre belirlenir. Aşağıdaki yanıtlar karar verirken kullanılabilecek temel çerçeveyi sunar. Daha ayrıntılı tasarımda source inventory ve gerçek workload ölçümleri mutlaka dikkate alınmalıdır.
Veri ambarı entegrasyonu nedir?
Farklı kaynaklardaki verinin merkezi analitik platforma alınması ve ortak modele dönüştürülmesidir. Yalnız kopyalama işlemi değildir. Data quality, entity matching ve history yönetimi de kapsama girer. BI ve analitik ekipler güvenilir ortak dataset kullanır. Source-to-target lineage izlenebilir olmalıdır.
Veri ambarına hangi sistemler bağlanabilir?
ERP, CRM, e-ticaret, database, SaaS ve API kaynakları bağlanabilir. Dosya ve object storage da kullanılabilir. Event broker streaming ingestion sağlayabilir. Her source için erişim ve update behavior farklıdır. Connector yöntemi buna göre seçilir.
ETL ve ELT arasındaki fark nedir?
ETL dönüşümü load öncesinde yapar. ELT önce veriyi warehouse'a yükleyip dönüşümü sonra çalıştırır. Cloud warehouse ELT için güçlü compute sağlar. Sensitive veri ETL avantajı yaratabilir. Raw retention ihtiyacı seçimde önemlidir.
ETL mi ELT mi tercih edilmelidir?
Tek bir evrensel cevap yoktur. SQL ağırlıklı cloud dönüşümlerde ELT uygundur. Load öncesi masking gerekiyorsa ETL güçlüdür. Aynı kurum farklı source'larda iki yöntemi birlikte kullanabilir. Karar maliyet ve güvenlik üzerinden verilmelidir.
CDC nedir ve neden kullanılır?
CDC kaynak değişikliklerini yakalar. Full scan yerine yalnız insert, update ve delete taşınır. Source yükü azalır. Low-latency analytics mümkün olur. Hard delete yakalama önemli avantajdır.
Batch ve streaming arasındaki fark nedir?
Batch belirli aralıklarla toplu işlem yapar. Streaming event'i sürekli işler. Streaming daha düşük latency fakat daha yüksek operasyon yükü sunar. Micro-batch ara seçenek olabilir. Business freshness ihtiyacı yöntemi belirler.
Gerçek zamanlı data warehouse gerekli midir?
Her kurum veya dataset için gerekli değildir. Operasyonel karar saniyelik değişiyorsa anlamlı olabilir. Yönetim raporları çoğu zaman daha yüksek latency tolere eder. Realtime maliyet ve operasyon yükü getirir. İş değeri açık değilse batch daha sade çözümdür.
Incremental load nasıl yapılır?
Timestamp, sequence veya CDC kullanılabilir. Watermark son başarılı position'ı tutar. Target merge duplicate'i önler. Delete handling ayrıca tasarlanmalıdır. Periyodik reconciliation güvenilirliği artırır.
Schema drift nasıl yönetilir?
Schema monitoring değişiklikleri yakalar. Data contract breaking change'i kontrol eder. Versioned schema migration sağlar. Automatic detection dikkatli kullanılmalıdır. Consumer impact lineage ile bulunur.
Data contract nedir?
Producer ve consumer arasındaki veri sözleşmesidir. Schema, nullability ve freshness içerebilir. Owner bilgisi bulunur. Breaking change süreci tanımlanır. CI compatibility testi uygulanabilir.
Backfill nedir?
Geçmiş verinin yeniden işlenmesidir. Eksik dönem veya yeni business rule için kullanılır. Raw data süreci kolaylaştırır. Production capacity korunmalıdır. Target idempotent olmalıdır.
Veri pipeline'larında idempotency neden önemlidir?
Retry ve backfill güvenli hale gelir. Aynı batch tekrarlandığında duplicate oluşmaz. Merge ve unique key kullanılır. Failure recovery kolaylaşır. Manual data cleanup ihtiyacı azalır.
Veri kalitesi nasıl ölçülür?
Completeness, uniqueness ve timeliness temel boyutlardır. Business rule testleri eklenir. Source-target reconciliation yapılır. Quality metric monitoring'de tutulur. Kritik dataset daha sıkı threshold kullanır.
Açık kaynak ETL araçları nelerdir?
Airbyte ingestion, Debezium CDC ve dbt transformation için kullanılabilir. Airflow orchestration sağlar. NiFi flow tabanlı entegrasyon sunar. Kafka event taşıma katmanıdır. Araçların sorumlulukları birbirinden farklıdır.
Data warehouse ile data lake arasındaki fark nedir?
Warehouse yapılandırılmış analitik sorgulara odaklanır. Data lake object storage üzerinde daha esnek ham veri tutar. Lakehouse iki yaklaşımın bazı özelliklerini birleştirir. Hibrit mimari sık kullanılır. Veri kullanım pattern'i doğru katmanı belirler.
Reverse ETL nedir?
Warehouse verisini operasyonel sistemlere geri gönderir. CRM segment aktivasyonu örnektir. Target rate limit yönetilir. Source of truth kuralı önemlidir. Data loop önlenmelidir.
Veri ambarı KVKK açısından nasıl korunmalıdır?
Kişisel veri envanteri çıkarılmalıdır. Gereksiz alanlar taşınmamalıdır. Encryption ve least privilege uygulanmalıdır. Retention ve silme süreci bütün katmanları kapsamalıdır. Yurt dışı aktarım ayrıca değerlendirilmelidir.
Veri Ambarı Entegrasyonu Hakkında Ek Sık Sorulan Sorular
Kurumsal entegrasyon projelerinde teknik ekiplerin yanı sıra yönetim ve iş birimlerinin de benzer soruları bulunur. Hangi yöntemle başlanacağı, farklı sistemlerin nasıl eşleştirileceği ve performans hedeflerinin nasıl belirleneceği projenin ilk aşamasında netleşmelidir. Bu soruların cevabı vendor ismine göre değil veri davranışına göre verilmelidir. Veri Ambari (Data Warehouse) Sistemlerine Entegrasyon çalışmalarında source envanteri, veri sözleşmeleri ve quality kontrolleri teknik araç seçiminden önce gelmelidir. Aşağıdaki yanıtlar proje planlaması sırasında kullanılabilecek kısa karar çerçeveleri sunar.
Veri ambarı (Data Warehouse) sistemlerine entegrasyon nasıl yapılır?
İlk adım hangi iş sorularının cevaplanacağını ve hangi kaynak sistemlerin gerekli olduğunu belirlemektir. Ardından source owner, veri hacmi, primary key, update ve delete davranışı ile freshness ihtiyacı kayıt altına alınır. Her source için ETL, ELT, incremental load veya CDC yöntemlerinden uygun olanı seçilir. Raw ve staging katmanları kurulduktan sonra ortak business model, data quality testleri, lineage ve observability eklenir. Production'a çıkmadan önce source-target reconciliation, backfill ve recovery senaryoları test edildiğinde entegrasyon yalnız çalışan bir connector değil sürdürülebilir veri ürünü haline gelir.
ETL ve ELT yöntemlerinden hangisi veri ambarı entegrasyonu için tercih edilmelidir?
ELT modern cloud warehouse ortamlarında SQL tabanlı dönüşüm ve raw history ihtiyacı bulunan ekipler için güçlü seçenektir. ETL ise verinin hedefe ulaşmadan önce maskelenmesi veya external engine üzerinde işlenmesi gereken durumlarda avantaj sağlayabilir. Büyük veri hacmi ve reprocessing ihtiyacı ELT lehine karar üretebilir. Veri gizliliği ve warehouse compute maliyeti ise kararın diğer tarafını etkiler. En sağlıklı model kurumun tek bir yöntemi standart ilan etmesi yerine kaynak bazında karar kriterleri tanımlamasıdır.
ERP CRM ve operasyonel veritabanlarındaki veriler merkezi veri ambarına nasıl aktarılır ve senkronize edilir?
ERP ve CRM kaynakları API, connector veya database erişimi üzerinden ingest edilebilir. Operasyonel database yüksek değişiklik oranına sahipse log-based CDC source yükünü azaltarak düşük latency sunabilir. CRM gibi SaaS kaynaklarında updated_at tabanlı incremental API sync daha pratik olabilir. Kaynaklardaki farklı customer ve product ID değerleri cross-system mapping ve identity resolution ile canonical entity'lere bağlanmalıdır. Hedefte merge ve reconciliation kullanıldığında retry, update ve delete olaylarının merkezi modelde doğru biçimde yansıdığı düzenli olarak doğrulanabilir.
Veri ambarı entegrasyonlarında veri kalitesi gerçek zamanlı veri akışı ve performans nasıl yönetilmelidir?
Quality için not null, unique, relationship, freshness ve business rule testleri otomatik uygulanmalıdır. Streaming veya CDC kullanılıyorsa lag, consumer backlog ve duplicate rate izlenmelidir. Batch pipeline'larda runtime ve source-target row count önemli operasyon ölçüleridir. Performance tarafında incremental processing, bulk load, partitioning ve merge optimization kullanılarak gereksiz full scan azaltılır. Her veriyi gerçek zamanlı yapmaya çalışmak yerine freshness SLO iş ihtiyacına göre belirlendiğinde hem maliyet hem operasyon yükü daha kontrollü kalır.
Veri ambarı sistemleri entegrasyonu ve veri mühendisliği konusunda yakınımda danışmanlık veya eğitim nerede bulabilirim?
Veri ambarı entegrasyonu ve BI danışmanlığı yakınımda araması yapan ekiplerin yalnız connector kurulumu değil, veri modelleme, kalite, güvenlik ve operasyon süreçlerini birlikte değerlendiren teknik destek araması faydalıdır. Diyarbakır Yazılım Topluluğu'nun çalışmaları ve yaklaşımı hakkında https://www.diyarbakiryazilim.com.tr/about adresinden bilgi alınabilir. Gerçekleştirilen yazılım ve teknoloji çalışmalarını incelemek için https://www.diyarbakiryazilim.com.tr/projects adresi kullanılabilir. Kurumsal data warehouse entegrasyonu ve veri mühendisliği hizmeti planlanırken kaynak envanteri, ETL veya ELT seçimi, CDC, data quality, lineage, KVKK ve BI semantic layer başlıklarının tek değerlendirme içinde ele alınması daha sağlıklı sonuç verir. Eğitim tarafında ise yalnız tool kullanımına değil gerçek bir kaynağın ingestion, transformation, test, deployment ve incident süreçleriyle uçtan uca işletilmesine odaklanan uygulamalı çalışma modeli daha kalıcı öğrenme sağlar.
Sonuç
Veri ambarı entegrasyonu farklı sistemlerden veri toplamanın ötesinde, kurumun güvenilir analitik temelini kurma çalışmasıdır. İyi tasarlanan pipeline source değişikliklerine dayanır, delete ve schema drift olaylarını yönetir, backfill ve replay desteği sunar ve veri kalitesini kullanıcı fark etmeden önce ölçer. ETL, ELT, CDC, batch veya streaming seçimi teknoloji popülerliğine göre değil veri hacmi, freshness, güvenlik ve toplam maliyet üzerinden verilmelidir. Veri modeli, data contract, lineage ve semantic layer teknik entegrasyonu gerçek kurumsal değere dönüştüren katmanlardır. Bu disiplinler birlikte uygulandığında raporlama ekipleri veri doğrulamakla zaman kaybetmek yerine güvenilir ortak bilgi üzerinden karar üretmeye başlayabilir.
Kuruluşunuzda ERP, CRM, API veya operasyonel veritabanlarından gelen veriler birbirinden kopuksa ilk olarak yeni araç satın almak yerine kaynak sistem envanterini ve mevcut veri akışını görünür hale getirin. Hangi sistemin hangi entity için ana kaynak olduğunu belirleyin, freshness hedeflerini yazın ve en kritik birkaç veri setinde source-target reconciliation kurun. Ardından incremental load, CDC veya ELT gibi yöntemleri gerçek veri hacmi üzerinde ölçerek seçin. Diyarbakır Yazılım Topluluğu'nun yazılım, veri ve teknoloji çalışmaları hakkında daha fazla bilgi için https://www.diyarbakiryazilim.com.tr adresini ziyaret edebilirsiniz. Güvenilir bir veri ambarı tek seferlik migration projesi değil, veri kalitesi, güvenlik, gözlem ve kontrollü değişiklik süreçlerinin sürekli işletildiği yaşayan bir kurumsal sistemdir.
share: