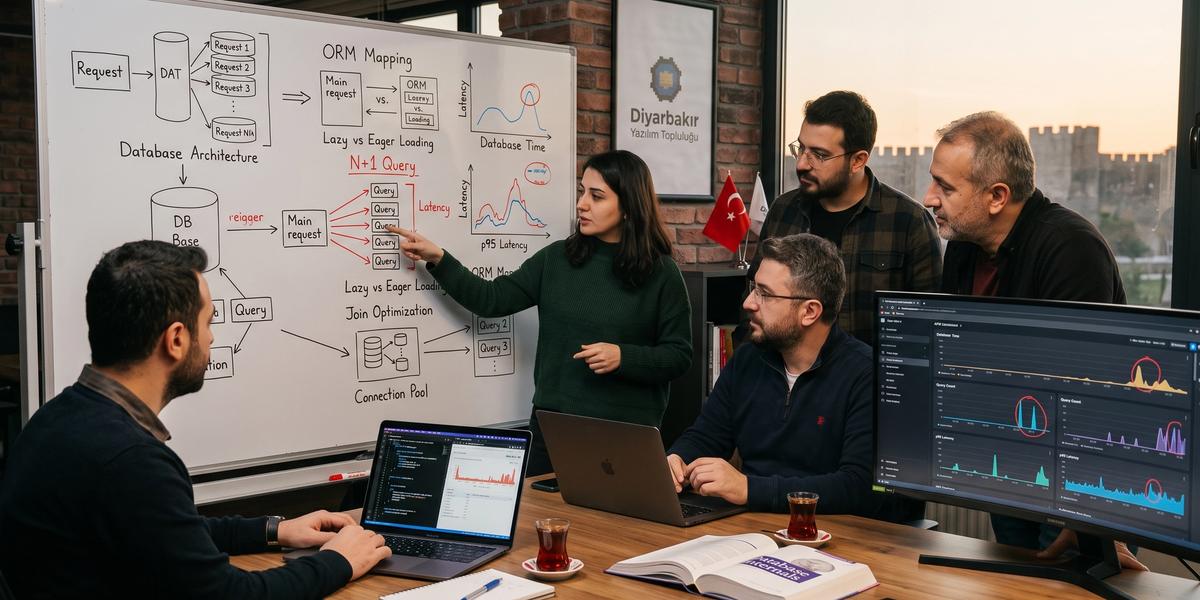
ORM (Object-Relational Mapping) Araçlarının Performans Etkileri

Diyarbakır Yazılım
16.08.2026
#Yazılım#Teknoloji#Topluluk
ORM kullanmak geliştiriciye ciddi hız kazandırabilir, ancak bu rahatlık veritabanı tarafında görünmeyen maliyetler oluşturabilir. Özellikle veri büyüdüğünde, eş zamanlı kullanıcı sayısı arttığında ve production ortamındaki ağ gecikmesi devreye girdiğinde küçük görünen tercihler belirgin performans sorunlarına dönüşebilir. ORM (Object-Relational Mapping) Araçlarının Performans Etkileri konusu bu nedenle yalnızca kullanılan kütüphanenin hızlı veya yavaş olmasıyla açıklanamaz. Asıl mesele üretilen SQL, sorgu sayısı, taşınan veri miktarı, nesne oluşturma maliyeti, connection pool davranışı ve uygulamanın veri erişim stratejisidir. Bu rehberde problemi ölçmeyi, doğru fetch stratejisini seçmeyi, N+1 sorgularını yakalamayı ve gerektiğinde ORM ile raw SQL arasında bilinçli karar vermeyi ele alacağız.
Bir ekipte ORM kullanımı veritabanı performansını nasıl etkiler sorusunun cevabı çoğu zaman uygulamanın gerçek trafik profiline bağlıdır. Aynı ORM, bir projede son derece verimli çalışırken başka bir projede yanlış sorgu kalıpları nedeniyle darboğaz yaratabilir. Bu yüzden ORM performans sorunları nasıl tespit edilir ve optimize edilir sorusuna yalnızca birkaç kod örneğiyle değil, ölçüm ve gözlemlenebilirlik yaklaşımıyla cevap vermek gerekir. Benzer biçimde ORM ile raw SQL performans karşılaştırması hangi durumda hangisi kullanılmalı sorusu da tek bir kazananı olmayan mühendislik kararıdır. Rehber boyunca ORM N+1 query lazy loading eager loading ve connection pooling optimizasyonu gibi başlıkları production bakış açısıyla değerlendireceğiz.
ORM (Object-Relational Mapping) Nedir?
ORM, uygulama kodundaki nesneler ile ilişkisel veritabanındaki tablolar arasında bir eşleme katmanı kurar. Geliştirici doğrudan her işlem için SQL yazmak yerine entity, model, repository veya query API gibi kavramlarla veri üzerinde çalışabilir. Bu yaklaşım geliştirme hızını artırabilir ve uygulama kodunun veri erişim bölümünü daha tutarlı hale getirebilir. Bununla birlikte ORM hiçbir zaman veritabanını ortadan kaldırmaz ve SQL davranışını önemsiz hale getirmez. Production performansı açısından bakıldığında ORM'nin sunduğu soyutlamanın altında hangi sorgunun üretildiğini ve bu sorgunun veritabanında nasıl çalıştığını bilmek hâlâ gereklidir.
ORM Ne İşe Yarar?
ORM'nin temel görevi veritabanındaki satırları uygulama içindeki nesnelere dönüştürmek ve nesne değişikliklarını tekrar veritabanı işlemlerine çevirmektir. Kullanıcı, ürün veya sipariş gibi alan modelleri üzerinden çalışmak SQL metinlerini uygulamanın her yerine dağıtmaktan daha anlaşılır bir yapı sağlayabilir. ORM ayrıca relation yönetimi, transaction kullanımı, migration ve change tracking gibi işlevleri ortak bir çatı altında sunabilir. Bu özellikler özellikle büyük ekiplerde kod standartlarını korumayı kolaylaştırır. Ancak performans açısından ORM'nin ne yaptığı kadar hangi SQL'i oluşturduğu, kaç sorgu gönderdiği ve sonuçları bellekte nasıl işlediği de önemlidir.
Nesneler ile İlişkisel Tablolar Nasıl Eşleştirilir?
Bir ORM genellikle sınıfları tablolara, sınıf özelliklerini kolonlara ve nesneler arasındaki ilişkileri foreign key yapısına eşler. Örneğin bir Order nesnesinin Customer alanı, veritabanında customer_id gibi bir foreign key üzerinden temsil edilebilir. One-to-many veya many-to-many ilişkilerde ORM ek metadata kullanarak hangi tabloların ve join koşullarının gerektiğini belirler. Bu eşleme annotation, fluent configuration, schema dosyası veya convention yaklaşımıyla tanımlanabilir. Performans açısından önemli nokta, nesne modelindeki kolay bir property erişiminin arka planda yeni bir SQL sorgusu oluşturabileceğini hiçbir zaman unutmamaktır.
ORM Kullanmanın Avantajları
ORM kullanmanın en büyük faydası yalnızca daha az SQL yazmak değildir. Asıl değer, veri erişim kurallarını ortak bir model altında toplayarak ekiplerin benzer problemleri tekrar tekrar çözmesini engellemesidir. CRUD işlemleri, relation yönetimi, transaction sınırları ve model değişiklikleri daha standart biçimde ele alınabilir. Bu durum test edilebilirliği ve bakım kolaylığını da artırabilir. Yine de performans avantajı otomatik değildir, çünkü hız kazandıran geliştirme soyutlaması yanlış kullanıldığında fazla sorgu, gereksiz veri transferi veya yüksek bellek tüketimi yaratabilir.
Geliştirme Hızı
ORM, tekrar eden veri erişim kodunu azalttığı için yeni özelliklerin daha hızlı geliştirilmesini sağlayabilir. Basit listeleme, filtreleme, kayıt ekleme ve güncelleme işlemleri çoğu zaman birkaç satırlık query API ile tamamlanabilir. Bu hız özellikle iş kurallarının yoğun olduğu projelerde ekibin SQL yazımından çok ürün davranışına odaklanmasını sağlar. Deneyimli ekiplerde ORM, standart sorgular için önemli bir üretkenlik avantajı sunarken kritik sorgular için yine SQL bilgisine ihtiyaç bırakır. Sağlıklı yaklaşım, geliştirme hızını performans ölçümüyle birlikte değerlendirmektir.
Type Safety
Type safety, birçok ORM'nin sorgu oluştururken model alanlarını derleme zamanı veya geliştirme zamanı kontrollerine dahil etmesini sağlar. Bir kolonun adı değiştiğinde uygulamanın belirli bölümlerinde erken hata alınması, string tabanlı SQL kullanımına göre daha güvenli olabilir. IDE tamamlama desteği de büyük modellerde geliştiricinin doğru alanlarla çalışmasını kolaylaştırır. Bununla birlikte type safety bir sorgunun hızlı olduğunun garantisi değildir. Tip açısından doğru olan bir query, yanlış join, yüksek cardinality veya gereksiz projection nedeniyle yine de veritabanında pahalı çalışabilir.
Tekrarlayan SQL Kodunun Azalması
ORM, benzer INSERT, UPDATE, DELETE ve SELECT kalıplarını uygulamanın farklı noktalarında tekrar yazma ihtiyacını azaltır. Aynı entity için kullanılan filtreleme ve ilişki tanımları merkezi bir yapıda tutulabilir. Bu yaklaşım kod tekrarını düşürdüğü gibi veri erişim davranışını değiştirmeyi de kolaylaştırabilir. Ancak tekrarın azalması geliştiricinin SQL'i tamamen görmezden gelmesi anlamına gelmemelidir. Kritik endpoint'lerde üretilen SQL düzenli olarak incelenmeli ve sorgunun uygulama beklentisiyle gerçekten eşleşip eşleşmediği kontrol edilmelidir.
Change Tracking
Change tracking, ORM'nin yüklediği entity'lerin başlangıç durumunu izleyerek hangi alanların değiştiğini belirlemesine yardımcı olur. Bu sayede geliştirici çoğu zaman ayrı UPDATE ifadeleri yazmadan nesne üzerinde değişiklik yapıp işlemi kaydedebilir. İş odaklı uygulamalarda bu yaklaşım kodu oldukça sade hale getirir. Buna karşılık binlerce entity'nin aynı context veya session içinde takip edilmesi CPU ve bellek kullanımını artırabilir. Özellikle salt okunur endpoint'lerde tracking davranışının kapatılması önemli bir performans kazanımı sağlayabilir.
Migration Yönetimi
ORM migration mekanizmaları model değişikliklerini veritabanı şemasına taşımayı daha kontrollü hale getirebilir. Kolon ekleme, index oluşturma veya relation değiştirme gibi işlemler kod deposunda sürümlendirilebilir. Bu özellik ekiplerin geliştirme, staging ve production ortamlarını daha tutarlı yönetmesine yardımcı olur. Yine de migration dosyasının ORM tarafından üretilmiş olması işlemin production için güvenli ve hızlı olduğu anlamına gelmez. Büyük tablolar üzerinde index veya kolon değişikliği yapılırken veritabanının lock davranışı, işlem süresi ve deployment stratejisi ayrıca değerlendirilmelidir.
ORM Kullanmanın Dezavantajları
ORM'nin dezavantajları genellikle soyutlamanın yanlış anlaşılmasıyla ortaya çıkar. Geliştirici yazdığı kodun arka planda kaç SQL sorgusuna dönüştüğünü görmediğinde performans sorunları büyüyebilir. Bazı ORM varsayılanları küçük veri setlerinde sorun yaratmazken milyonlarca satır ve yüksek eş zamanlılık altında pahalı hale gelebilir. Ayrıca database-specific özelliklerden yararlanmak gerektiğinde soyutlama katmanı yeterince esnek olmayabilir. Sağlıklı kullanım, ORM'yi kolaylık sağlayan bir araç olarak görmek ve veritabanı davranışını ayrı bir mühendislik alanı olarak izlemeye devam etmektir.
Abstraction Overhead
ORM sorguyu oluşturmak, expression yapısını çevirmek, sonucu entity'lere dönüştürmek ve gerekirse change tracker'a eklemek için ek işlem yapar. Bu maliyet çoğu iş uygulamasında veritabanı süresinin yanında küçük kalabilir. Ancak çok düşük gecikme hedeflenen hot path'lerde veya saniyede çok yüksek sayıda küçük sorgu çalışan sistemlerde fark görünür hale gelebilir. Bu nedenle ORM overhead'i yalnızca tek bir mikro benchmark ile değerlendirilmemelidir. Uygulamanın gerçek request profili, bellek tahsisi, CPU kullanımı ve database süresi birlikte ölçülmelidir.
Üretilen SQL'in Görünmezleşmesi
ORM kullanırken en yaygın risklerden biri geliştiricinin yalnızca uygulama kodunu görmesi ve üretilen SQL'i incelememesidir. Basit görünen bir relation erişimi yeni bir sorgu oluşturabilir veya birkaç Include benzeri ifade büyük bir join sonucuna dönüşebilir. SQL görünürlüğü olmadığında N+1, gereksiz kolon transferi ve kötü execution plan gibi sorunlar geç fark edilir. Bu nedenle development ortamında query logging ve production ortamında güvenli database span gözlemi önemlidir. ORM kullanmak SQL bilgisini gereksiz hale getirmez, aksine generated SQL'i yorumlama becerisini daha değerli hale getirir.
Database-Specific Optimizasyonların Kaybı
ORM'ler farklı veritabanlarıyla çalışabilmek için ortak bir sorgu modeli sunmaya çalışır. Bu ortak katman bazı database-specific fonksiyonların, index türlerinin, window function kullanım biçimlerinin veya özel sorgu ipuçlarının doğrudan kullanılmasını zorlaştırabilir. Çoğu standart CRUD akışında bu durum sorun değildir. Reporting, büyük aggregation veya yüksek performanslı batch işlemlerinde ise veritabanının güçlü özelliklerini doğrudan kullanmak daha verimli olabilir. Bu noktada ORM içinde raw SQL çalıştırmak veya özel query katmanı kullanmak çoğu zaman dengeli bir çözümdür.
Yanlış Varsayılanların Production Etkisi
ORM varsayılanları genellikle geliştirici deneyimini kolaylaştırmak için seçilir, ancak her sistemin production yüküne uygun olmayabilir. Lazy loading, automatic tracking veya sınırsız relation yükleme gibi davranışlar küçük test verisinde görünmez maliyetler oluşturabilir. Gerçek kullanıcı sayısı arttığında bu maliyet database round-trip, connection wait ve p99 latency olarak ortaya çıkar. Production sorunlarının önemli bir bölümü yanlış ORM seçmekten değil, varsayılan davranışları ölçmeden kabul etmekten kaynaklanır. Bu nedenle her kritik uygulamada sorgu sayısı, query süresi, result-set boyutu ve pool kullanımı gözlemlenmelidir.
Popüler ORM Araçları Nelerdir?
ORM ekosistemi kullanılan programlama dili ve framework'e göre farklı seçenekler sunar. Her aracın query API'si, tracking modeli, relation yükleme seçenekleri ve performans özellikleri farklı olabilir. Buna rağmen temel performans problemleri şaşırtıcı biçimde benzerdir: N+1, büyük result-set, yanlış eager loading, gereksiz tracking ve zayıf pagination bunların başında gelir. Araç seçerken yalnızca benchmark tablosuna bakmak yerine ekip deneyimini, sorgu görünürlüğünü ve gerektiğinde raw SQL'e geçiş kolaylığını değerlendirmek gerekir. ORM performansı çoğunlukla kütüphane isminden daha fazla, kütüphanenin nasıl kullanıldığıyla belirlenir.
Entity Framework Core
Entity Framework Core, .NET uygulamalarında yaygın kullanılan bir ORM'dir ve LINQ üzerinden güçlü bir query modeli sunar. Include, projection, AsNoTracking, compiled query ve split query gibi performans açısından önemli seçenekleri vardır. Özellikle read-heavy API'lerde projection ve no-tracking kullanımı belirgin fark yaratabilir. Include zincirlerinin kontrolsüz kullanımı ise büyük join sonuçları veya gereksiz veri transferi oluşturabilir. EF Core ile çalışırken generated SQL, query count ve execution plan birlikte incelendiğinde ORM'nin sunduğu üretkenlik korunurken production performansı da yönetilebilir.
Hibernate / JPA
Hibernate ve JPA ekosistemi Java uygulamalarında güçlü entity mapping ve persistence özellikleri sağlar. Lazy loading, fetch join, batch fetching ve first-level cache gibi özellikler doğru kullanıldığında oldukça verimli olabilir. Buna karşılık relation yapılandırmalarının dikkatsiz kullanılması N+1 sorgularının sık görülen nedenlerinden biridir. Hibernate üzerinde performans çalışırken yalnızca Java tarafındaki süreye değil, gönderilen SQL'lerin sayısına ve veritabanı execution plan'ına bakmak gerekir. Batch size, fetch strategy ve session kapsamı production yüküne göre ayarlandığında sistem daha öngörülebilir davranır.
Django ORM
Django ORM, Python tabanlı uygulamalarda sade model tanımları ve güçlü query API sunar. select_related ve prefetch_related gibi araçlar relation yükleme performansını yönetmek için kritik öneme sahiptir. Yanlış relation erişimleri template veya serializer katmanında fark edilmeden N+1 sorgusu oluşturabilir. Bu nedenle Django projelerinde request başına query sayısını görmek ve duplicate query'leri takip etmek faydalıdır. Büyük listeleme endpoint'lerinde values, values_list veya kontrollü projection benzeri yaklaşımlar kullanmak gereksiz model oluşturma ve veri transferini azaltabilir.
SQLAlchemy
SQLAlchemy hem ORM hem de daha düşük seviyeli SQL expression yaklaşımı sunduğu için performans açısından esnek seçenekler sağlar. joinedload, selectinload ve lazy loading seçenekleri relation cardinality'sine göre ayrı ayrı değerlendirilebilir. Büyük collection'larda select-in loading çoğu zaman dev join sonuçlarından kaçınmaya yardımcı olur. SQLAlchemy kullanan ekiplerin session yaşam döngüsü, transaction sınırları ve identity map davranışını anlaması önemlidir. Gerektiğinde ORM seviyesinden daha doğrudan SQL expression kullanımına geçilebilmesi, performans açısından kontrollü bir geçiş yolu sunar.
Prisma
Prisma, özellikle TypeScript ekosisteminde güçlü type desteği ve geliştirici deneyimiyle öne çıkan veri erişim araçlarından biridir. Relation sorguları, select yapıları ve transaction API'leri uygulama kodunu okunabilir tutabilir. Performans açısından hangi alanların seçildiğini ve relation sorgularının kaç database round-trip oluşturduğunu gözlemlemek gerekir. Büyük payload döndüren endpoint'lerde açık select kullanmak ağ ve serialization maliyetini azaltabilir. Prisma ile performans çalışırken query logları, veritabanı execution plan'ları ve application latency metriklerini aynı request bağlamında değerlendirmek yararlı olur.
TypeORM
TypeORM, Node.js ve TypeScript projelerinde entity tabanlı veri erişimi için kullanılan seçeneklerden biridir. Repository ve query builder yaklaşımı sayesinde basit CRUD ile daha kontrollü sorgular arasında geçiş yapılabilir. Relation seçenekleri dikkatsiz kullanıldığında gereğinden fazla join veya sorgu oluşabilir. Bu nedenle kritik endpoint'lerde generated SQL'i görmek ve select edilen kolonları sınırlandırmak önemlidir. TypeORM performans değerlendirmesi yapılırken Node.js event loop davranışı, connection pool limiti ve veritabanı round-trip süreleri de birlikte izlenmelidir.
Sequelize
Sequelize, Node.js tarafında model tanımları ve relation yönetimi sağlayan köklü ORM seçeneklerinden biridir. Include tabanlı relation yükleme, doğru cardinality ile kullanıldığında sorgu sayısını azaltabilir. Çok sayıda collection aynı sorguda join edildiğinde sonuç seti beklenenden ciddi ölçüde büyüyebilir. Bu yüzden limit, pagination, attribute seçimi ve ayrı sorgu stratejileri birlikte düşünülmelidir. Sequelize kullanılan production sistemlerinde SQL logging ve endpoint başına query sayısı gibi basit metrikler bile performans problemlerini erken yakalamada güçlü sinyaller verir.
Active Record
Active Record yaklaşımında veri ve persistence davranışı çoğu zaman aynı model sınıfı çevresinde toplanır. Bu yaklaşım özellikle CRUD ağırlıklı uygulamalarda hızlı geliştirme sağlayabilir. Ancak relation zincirleri view, serializer veya business logic içinde kolayca gizli sorgular oluşturabilir. Includes, preload veya eager_load benzeri seçeneklerin hangi SQL davranışına dönüştüğünü kontrol etmek gerekir. Active Record kullanan ekiplerde request başına query count ve duplicate query takibi, N+1 sorunlarını kullanıcı trafiğine yansımadan yakalamak için oldukça değerlidir.
ORM, Micro-ORM ve Raw SQL Arasındaki Fark
Full ORM entity yaşam döngüsü, relation yönetimi ve change tracking gibi kapsamlı özellikler sunarken micro-ORM daha ince bir mapping katmanı sağlar. Raw SQL ise sorgunun tamamını geliştiricinin kontrol etmesine izin verir ve soyutlama maliyetini en aza indirebilir. Buna karşılık raw SQL'de mapping, tekrar eden sorgu yapıları ve bakım sorumluluğu daha fazla geliştiriciye kalır. Performans açısından fark yalnızca sorgu gönderme süresinde değil, hydration, tracking ve API tasarımında ortaya çıkar. En sağlıklı seçim, tüm uygulama için tek yaklaşımı zorlamak yerine iş yüküne göre ORM, micro-ORM ve raw SQL'i dengeli kullanmaktır.
ORM Gerçekten Uygulamayı Yavaşlatır mı?
ORM'nin uygulamayı yavaşlatıp yavaşlatmadığı sorusu tek başına anlamlı değildir, çünkü performans birçok katmanın toplamıdır. Bazen ORM translation maliyeti ölçülebilir düzeydeyken asıl sorun veritabanında saniyeler süren kötü bir sorgudur. Başka bir durumda sorgu hızlıdır fakat yüzlerce küçük query nedeniyle network round-trip süresi request'i yavaşlatır. Büyük result-set'lerde object materialization ve serialization maliyetleri de veritabanı süresini aşabilir. Bu nedenle ORM (Object-Relational Mapping) Araçlarının Performans Etkileri incelenirken uçtan uca request maliyeti parçalarına ayrılmalıdır.
ORM'nin Kendi Runtime Overhead'i
ORM runtime sırasında query nesnesi oluşturma, mapping metadata okuma, SQL üretme ve sonuçları entity'lere dönüştürme gibi işlemler gerçekleştirir. Bu işlemler CPU ve bellek açısından belirli bir maliyet oluşturur. Basit iş uygulamalarında bu maliyet çoğunlukla network ve database execution süresinin altında kalır. Çok kısa sorguların çok yüksek frekansta çalıştığı sistemlerde ise ORM overhead'i daha görünür olabilir. Bu farkın gerçekten önemli olup olmadığını anlamak için yalnızca query duration değil, ORM CPU, allocated memory ve request throughput birlikte ölçülmelidir.
ORM'nin Ürettiği SQL'in Maliyeti
ORM performansında en kritik noktalardan biri üretilen SQL'in veritabanında ne kadar iş yaptığıdır. Gereksiz JOIN, SELECT edilen fazla kolonlar, kötü predicate veya yanlış pagination yöntemi sorgu maliyetini ciddi ölçüde artırabilir. ORM kodu kısa ve temiz görünse bile SQL yüzlerce satır olabilir veya beklenenden fazla tabloyu işleyebilir. Bu nedenle uygulama tarafındaki query ifadesine bakarak performans kararı vermek yeterli değildir. Generated SQL'i görmek ve execution plan üzerinden gerçek satır sayılarıyla değerlendirmek daha güvenilir sonuç verir.
Database Execution Maliyeti
Database execution maliyeti sorgunun index kullanımı, join algoritması, sıralama işlemleri ve okunan satır sayısıyla doğrudan ilişkilidir. ORM aynı SQL'i üretiyorsa veritabanı genellikle sorgunun ORM'den geldiğini bilmez ve aynı execution plan mantığını uygular. Bu nedenle kötü index tasarımını ORM değiştirmek tek başına çözmez. Seq scan, yüksek sort maliyeti veya yanlış cardinality tahmini gibi problemler veritabanı seviyesinde incelenmelidir. ORM optimizasyonunun önemli bir bölümü aslında generated SQL ile veritabanı tasarımını birlikte iyileştirmekten oluşur.
Network Round-Trip Maliyeti
Her database query uygulama ile veritabanı arasında en az bir iletişim turu oluşturur. Aynı bölgede çalışan sistemlerde birkaç milisaniyelik gecikme küçük görünebilir, ancak yüz sorguluk N+1 durumunda toplam gecikme hızla büyür. Cross-region veritabanı kullanımında tek bir gereksiz round-trip bile çok daha pahalı hale gelebilir. Bu nedenle query sayısı sadece veritabanı CPU'sunu değil, doğrudan kullanıcı latency'sini de etkiler. Round-trip maliyetini azaltmak için relation fetching, batch query ve projection stratejileri birlikte değerlendirilmelidir.
Object Materialization Maliyeti
Veritabanından gelen her satırın uygulama tarafında entity veya DTO nesnesine dönüştürülmesi ek CPU ve bellek maliyeti yaratır. Binlerce satır ve çok sayıda kolon içeren sorgularda bu maliyet belirgin hale gelir. ORM proxy oluşturuyorsa veya identity resolution yapıyorsa süreç biraz daha ağırlaşabilir. Yalnızca gerekli alanları DTO veya scalar projection ile almak bu maliyeti azaltır. Özellikle API endpoint'lerinde veritabanından alınan tüm entity'yi hemen JSON'a çevirmek yerine kullanım senaryosuna uygun daha küçük veri modelleri tercih edilmelidir.
Change Tracking Maliyeti
Change tracking, yüklenen entity'lerin değişip değişmediğini takip etmek için ORM'nin ek state tutmasına neden olur. Birkaç entity üzerinde bu maliyet ihmal edilebilirken binlerce entity'nin uzun süre aynı context içinde kalması memory ve CPU yükünü artırabilir. Read-only query'lerde tracking çoğu zaman gereksizdir. Bu yüzden ORM'nin no-tracking veya stateless query seçenekleri araştırılmalıdır. Güncelleme yapılacak iş akışlarında ise tracking değerli olduğundan tamamen kapatmak yerine kullanım amacına göre seçici davranmak daha doğru olur.
Gerçek Darboğaz Nasıl Belirlenir?
Gerçek darboğazı bulmanın ilk adımı request süresini katmanlara ayırmaktır. Database time, query count, connection wait, application CPU, serialization ve dış servis süreleri ayrı ayrı izlenmelidir. ORM performans sorunları nasıl tespit edilir ve optimize edilir sorusunun en güvenilir cevabı gözlem verilerinden başlar. Bir endpoint yavaş olduğunda önce en pahalı birkaç span bulunmalı, ardından generated SQL ve result-set büyüklüğü incelenmelidir. Ölçmeden yapılan ORM değişiklikleri bazen sorgu sayısını azaltırken network payload'ını büyütebilir ve toplam performansı daha kötü hale getirebilir.
ORM Performans Maliyet Modeli
ORM performansını anlamak için query süresini tek bir sayı olarak görmek yerine maliyet zinciri olarak düşünmek faydalıdır. Query oluşturma uygulama CPU'sunda başlar, ardından SQL translation, connection acquisition ve network aşamalarından geçer. Veritabanı sorguyu çalıştırır, satırlar uygulamaya taşınır ve ORM bunları nesnelere dönüştürür. Daha sonra identity resolution, tracking ve serialization gibi ek adımlar devreye girebilir. Bu zincirde hangi aşamanın ağır olduğunu bilmek, optimizasyon çalışmasının doğru noktaya yönelmesini sağlar.
Query Construction
Query construction, geliştiricinin filtre, sıralama, include ve projection seçeneklerinden sorgu nesnesi oluşturduğu aşamadır. Dynamic filter builder kullanılan uygulamalarda bu aşama her request'te farklı query shape üretebilir. Küçük sorgularda maliyet genellikle düşüktür, fakat karmaşık expression yapılarında CPU tüketimi artabilir. Query construction süresini optimize etmek için önce gerçekten hot path olup olmadığı ölçülmelidir. Çoğu sistemde asıl kazanç, construction maliyetinden çok oluşturulan sorgunun daha az veri okumasını sağlamaktan gelir.
Query Translation
Query translation, uygulama dilindeki expression veya query API'nin SQL'e çevrildiği aşamadır. ORM'nin provider katmanı hangi operasyonların veritabanına taşınabileceğine bu aşamada karar verir. Desteklenmeyen veya kötü çevrilen ifadeler beklenmeyen SQL üretebilir. Dynamic query'lerde sık değişen expression şekilleri translation ve cache davranışını da etkileyebilir. Production performansı için kritik sorguların generated SQL çıktısının test edilmesi, yalnızca uygulama kodunun doğru görünmesine güvenmekten daha sağlıklı bir yaklaşımdır.
Query Compilation
Bazı ORM'ler oluşturulan query yapısını tekrar kullanılabilir biçimde derleyebilir veya cache içinde saklayabilir. Aynı query shape çok sık çalışıyorsa compilation maliyetinin paylaşılması CPU kullanımını azaltabilir. Buna karşılık nadiren çalışan yüzlerce sorguyu önceden compile etmek gereksiz kod ve bakım yükü yaratır. Compiled query özelliği genellikle çok sık çalışan hot path'lerde anlamlıdır. Önce profiler ile hangi sorguların yüksek frekansta çalıştığı belirlenmeli, sonra compilation etkisi ölçülerek karar verilmelidir.
Connection Acquisition
Query çalışmadan önce uygulamanın pool içinden kullanılabilir bir database connection alması gerekir. Pool doluysa sorgu veritabanına ulaşmadan önce beklemeye başlar. Bu bekleme çoğu zaman slow query listesinde görünmez ve sorun yanlışlıkla veritabanı execution süresine bağlanabilir. Connection wait metriğinin ayrı izlenmesi bu nedenle önemlidir. Uzun transaction, yavaş streaming veya yüksek eş zamanlı query sayısı pool üzerinde baskı oluşturuyorsa yalnızca max pool size değerini artırmak yerine connection kullanım süresi de azaltılmalıdır.
Network
Network maliyeti uygulama ile veritabanının fiziksel ve mantıksal konumuna göre değişir. Aynı veri merkezindeki birkaç milisaniyelik gecikme, yüzlerce sorgu olduğunda yine ciddi toplam süre oluşturabilir. Farklı region'larda çalışan servislerde round-trip maliyeti çok daha belirgin hale gelir. Network yalnızca query sayısından değil, taşınan byte miktarından da etkilenir. Projection, compression uygun olduğunda veri azaltımı ve relation fetching stratejisi network maliyetini kontrol altında tutmak için birlikte düşünülmelidir.
Database Execution
Database execution, SQL'in optimizer tarafından planlanması ve gerçek veriler üzerinde çalıştırılması aşamasıdır. Index seçimi, join algoritması, sort, aggregation ve disk erişimi bu sürenin temel bileşenleridir. ORM seviyesinde yapılan değişikliğin iyi olup olmadığını anlamak için execution plan karşılaştırması yapmak faydalıdır. Sorgu sayısını azaltırken tek sorgunun milyonlarca ara satır üretmesi mümkün olduğundan yalnızca query count yeterli bir metrik değildir. Actual rows, buffer kullanımı ve execution time birlikte incelendiğinde database maliyeti daha net anlaşılır.
Row Transfer
Veritabanı sorguyu tamamladıktan sonra sonuç satırları uygulamaya taşınır. Çok fazla kolon veya satır dönen sorgularda transfer süresi database execution süresinden bile daha uzun olabilir. TEXT, JSON ve BLOB alanları bu maliyeti hızlı biçimde büyütebilir. Gereksiz SELECT * kullanımı ORM projelerinde bu nedenle dikkat edilmesi gereken bir konudur. Endpoint'in gerçekten kullandığı alanları seçmek hem ağ trafiğini azaltır hem de sonraki materialization ve serialization aşamalarını daha hafif hale getirir.
Materialization / Hydration
Materialization veya hydration, satırların uygulama içindeki entity, model veya DTO nesnelerine dönüştürülmesidir. ORM bu aşamada tip dönüşümü, null kontrolü, constructor çağrısı ve relation bağlama gibi işler yapabilir. Result-set büyüdükçe CPU ve allocated memory maliyeti artar. Projection kullanımı yalnızca database tarafında değil, bu aşamada da önemli performans kazancı sağlar. Büyük raporlama sorgularında tam entity oluşturmak yerine daha hafif result modelleri kullanmak çoğu zaman daha düşük bellek tüketimi sağlar.
Identity Resolution
Identity resolution, aynı primary key'e sahip satırların tek entity örneğiyle temsil edilmesini sağlar. Join sorgularında aynı parent satırı birçok kez dönüyorsa bu davranış nesne tekrarını azaltabilir. Buna karşılık her satır için identity map kontrolü yapılması ek CPU ve memory işlemi gerektirir. Küçük sonuçlarda maliyet önemsizken dev result-set'lerde fark ölçülebilir hale gelebilir. ORM'nin tracking ve no-tracking modlarında identity resolution davranışını bilmek, büyük relation sorgularında doğru seçimi yapmayı kolaylaştırır.
Change Tracking
Change tracking aşamasında ORM entity durumunu ve bazı durumlarda başlangıç değerlerini saklar. Güncelleme yapılacak transaction'larda bu mekanizma geliştiriciye önemli kolaylık sağlar. Salt okunur listelerde ise aynı maliyet herhangi bir iş değeri üretmeden devam eder. Bu nedenle dashboard, rapor ve public API sorgularında no-tracking yaklaşımı değerlendirilmelidir. Context içinde izlenen entity sayısı arttıkça SaveChanges veya flush sırasında değişiklik taraması da pahalı hale gelebileceğinden unit of work sınırları kontrollü tutulmalıdır.
Serialization
ORM işlemi bittikten sonra API yanıtının JSON veya başka bir formata çevrilmesi de toplam request maliyetinin parçasıdır. Büyük entity graph'ları serialization sırasında ciddi CPU ve bellek kullanabilir. Lazy loading açıksa serializer'ın property okuması yeni database query'leri bile tetikleyebilir. Bu nedenle veri erişimi ile response model tasarımı birbirinden bağımsız düşünülmemelidir. DTO projection kullanmak hem gereksiz relation yüklemeyi azaltır hem de serialization aşamasında daha küçük ve öngörülebilir payload üretir.
ORM Overhead Nasıl Ölçülür?
ORM overhead ölçümü için tek bir stopwatch değeri yeterli değildir. Aynı request içinde database, network, connection wait, materialization ve application CPU sürelerini mümkün olduğunca ayırmak gerekir. Ölçüm endpoint, query shape ve veri hacmi bazında yapılırsa hangi optimizasyonun sonuç verdiği daha kolay anlaşılır. Production benzeri veri ve concurrency olmadan yapılan ölçümler yanıltıcı olabilir. İyi bir performans paneli latency kadar query count, row count, allocation ve pool saturation metriklerini de birlikte gösterir.
Query Başına Süre
Query başına süre en temel performans ölçümlerinden biridir, ancak tek başına yeterli değildir. Bir request yüz adet 2 milisaniyelik sorgu çalıştırıyorsa slow query görünmeyebilir fakat toplam database zamanı yüksek olabilir. Bu metrik query shape veya query tag ile gruplandırıldığında hangi sorguların sürekli pahalı olduğu daha net görülür. p95 ve p99 değerleri ortalamadan daha anlamlı olabilir. Query süresi izlenirken connection wait ile gerçek database execution süresinin mümkün olduğunca ayrı tutulması gerekir.
Request Başına Query Sayısı
Request başına query sayısı N+1 problemini erken tespit etmek için son derece güçlü bir metriktir. Normalde üç sorgu çalıştırması gereken bir endpoint'in bir release sonrasında elli sorguya çıkması açık bir regression sinyalidir. Query count değerini endpoint ve response büyüklüğüyle birlikte izlemek daha anlamlı sonuç verir. Bazı iş akışları doğal olarak daha fazla sorguya ihtiyaç duyabilir, bu nedenle herkes için tek limit belirlemek doğru değildir. Kritik endpoint'ler için query budget tanımlamak ve CI testlerinde bu sınırı korumak etkili bir yöntemdir.
Database Time / Request
Database time per request, bir HTTP veya job işlemi boyunca veritabanına harcanan toplam süreyi gösterir. Bu değer tek bir slow query'nin yanı sıra çok sayıda küçük query nedeniyle de yükselebilir. Request latency yükseldiğinde database time oranı problemi hangi katmanda aramak gerektiğine dair iyi bir ipucu verir. Database time düşükse serialization, CPU veya harici servisler incelenmelidir. Yüksekse query count, generated SQL, execution plan ve connection wait metrikleri daha ayrıntılı analiz edilmelidir.
ORM CPU / Request
ORM CPU per request, database dışında query translation, materialization, tracking ve identity resolution için harcanan işlemci zamanını anlamaya yardımcı olur. Özellikle database query'leri çok hızlı olan sistemlerde ORM tarafındaki CPU daha görünür hale gelebilir. Büyük result-set veya yoğun projection mapping bu değeri artırabilir. Profiling sırasında yalnızca framework fonksiyonlarına bakmak yerine allocation ve garbage collection davranışı da incelenmelidir. ORM CPU gerçekten baskın değilse daha düşük seviyeli veri erişimine geçmek beklenen performans kazanımını sağlamayabilir.
Allocated Memory
Allocated memory, ORM'nin her request sırasında ne kadar yeni nesne oluşturduğunu gösteren önemli bir metriktir. Binlerce entity, navigation collection ve proxy nesnesi kısa sürede yüksek allocation oluşturabilir. Bu durum garbage collector üzerinde baskı yaratarak yalnızca ilgili request'i değil tüm uygulamayı etkileyebilir. DTO projection, streaming veya daha küçük page size ile allocation azaltılabilir. Benchmark sırasında latency kazanımı görülmese bile allocation düşüşü yüksek trafik altında throughput ve p99 açısından önemli sonuçlar yaratabilir.
Returned Row Count
Dönen satır sayısı sorgunun veri hacmini anlamanın en basit yollarından biridir. Bir endpoint kullanıcıya yirmi kayıt gösterirken database'den on bin satır alıyorsa pagination veya filtreleme yanlış yerde uygulanıyor olabilir. Join nedeniyle parent satırlarının tekrar etmesi de row count değerini beklenmedik biçimde büyütebilir. Bu metrik özellikle Cartesian explosion tespitinde değerlidir. Query duration ile row count birlikte izlendiğinde performans sorununun sorgu planından mı yoksa taşınan veri miktarından mı kaynaklandığı daha kolay anlaşılır.
Transferred Bytes
Transferred bytes, database ile uygulama arasında taşınan gerçek veri miktarını gösterir. Satır sayısı düşük olsa bile büyük JSON veya BLOB kolonları network yükünü artırabilir. Projection uygulanmasının etkisi bu metrik üzerinden açık biçimde görülebilir. Cross-region bağlantılarda byte miktarı maliyet ve latency açısından daha da önemli hale gelir. Uygulamanın kullanmadığı kolonları seçmemek, relation graph'ını sınırlandırmak ve büyük içerikleri ayrı endpoint'lerle taşımak bu metriği düşürmeye yardımcı olabilir.
Connection Wait Time
Connection wait time, sorgunun pool içinden connection almak için ne kadar beklediğini gösterir. Database sorguları hızlı olduğu halde request'ler yavaşsa bu metrik sorunun kaynağını ortaya çıkarabilir. Uzun transaction, çok düşük pool limiti veya aynı anda gereğinden fazla query çalıştırılması pool saturation oluşturabilir. Pool size değerini artırmak kısa süreli rahatlama sağlayabilir ancak database connection limitlerini zorlayabilir. Kalıcı çözüm connection'ın ne kadar süre tutulduğunu ve gereksiz eş zamanlı sorgu davranışını optimize etmektir.
p50 / p95 / p99 Latency
p50 tipik kullanıcı deneyimini gösterirken p95 ve p99 sistemin yavaş uçlarını anlamaya yardımcı olur. ORM performans sorunları çoğu zaman ortalama değerde görünmeden yüksek percentile'larda ortaya çıkar. Pool beklemesi, lock contention, cache miss veya büyük tenant verisi p99 değerini ciddi biçimde etkileyebilir. Bu nedenle yalnızca average latency takip etmek production davranışını eksik gösterir. Endpoint bazında database span ve request latency percentile'larını karşılaştırmak, ORM optimizasyonunun gerçek kullanıcı deneyimine etkisini ölçmek için güçlü bir yöntemdir.
Throughput
Throughput, sistemin belirli sürede tamamlayabildiği request veya işlem sayısını gösterir. Bir optimizasyon tek request latency'sini çok değiştirmese bile CPU ve connection kullanımını azalttığı için throughput'u artırabilir. Özellikle yüksek trafik alan sistemlerde ORM'nin allocation ve tracking maliyetleri bu açıdan önem kazanır. Load test yapılırken throughput ile error rate ve p99 birlikte değerlendirilmelidir. Daha yüksek throughput uğruna connection pool veya database CPU tamamen doygun hale geliyorsa sistemin güvenli çalışma payı azalabilir.
N+1 Query Problemi Nedir?
N+1 query problemi, bir ana sorgudan alınan N kayıt için her kayıt başına ek bir sorgu çalıştırılmasıdır. Örneğin yüz sipariş alındıktan sonra her siparişin müşterisi ayrı ayrı sorgulanıyorsa toplam 101 query oluşabilir. Local geliştirme ortamında küçük veri seti ve düşük network latency nedeniyle problem kolay fark edilmeyebilir. Production'da ise yüzlerce round-trip, pool tüketimi ve database CPU artışı kullanıcı gecikmesine dönüşür. Bu nedenle N+1 ORM performans çalışmalarında ilk kontrol edilen sorgu kalıplarından biri olmalıdır.
1 + N Sorgu Nasıl Oluşur?
1 + N sorgu genellikle önce ana entity listesinin alınması ve ardından her entity'nin ilişkili verisine ayrı erişilmesiyle oluşur. Kod içinde basit bir loop veya property erişimi bulunduğu için problem gözle görülmeyebilir. Örneğin elli ürün yüklendikten sonra her ürünün kategorisi ayrı sorgulanırsa bir ana sorguya elli ek query eklenir. Relation verisi eager veya batch şekilde alınmadığı sürece query sayısı veri büyüklüğüyle birlikte artar. Bu nedenle request başına query count metriği 1 + N kalıbını tespit etmek için doğrudan kullanılabilir.
Lazy Loading ile N+1
Lazy loading relation verisini yalnızca property'ye ilk erişildiğinde yüklediği için N+1 probleminin yaygın nedenlerinden biridir. Liste halinde yüklenen entity'lerin her biri için aynı relation'a erişildiğinde ayrı query gönderilebilir. Kod tarafında yalnızca property okunuyor gibi görünmesi problemi daha da görünmez hale getirir. Lazy loading tamamen yanlış değildir, ancak toplu listeleme senaryolarında dikkatli kullanılmalıdır. Collection işlenecekse relation ihtiyacı önceden biliniyorsa eager loading, select-in loading veya explicit batch query daha öngörülebilir performans sağlar.
Serializer İçinde N+1
Serializer entity graph'ını response modeline dönüştürürken navigation property'leri okuyabilir. Lazy loading açıksa her property erişimi yeni database sorgusu tetikleyebilir. Bu nedenle controller veya service kodunda query sayısı normal görünürken serialization aşamasında onlarca ek sorgu oluşması mümkündür. Çözüm response için ihtiyaç duyulan veriyi query aşamasında açıkça projection ile almaktır. Serializer'ın database erişimini dolaylı biçimde tetiklemesine izin vermemek, sorgu davranışını daha görünür ve test edilebilir hale getirir.
Template İçinde N+1
Server-side template kullanılan uygulamalarda model relation'larına view katmanında erişmek N+1 problemini gizleyebilir. Geliştirici template içinde müşteri adı veya kategori ismi gösterirken her satır için yeni sorgu çalıştığını fark etmeyebilir. Development verisi küçük olduğunda sayfa hızlı görünebilir. Production'da liste yüzlerce elemana çıktığında query sayısı doğrudan büyür. View'ın ihtiyaç duyduğu ilişkiler controller veya query katmanında önceden belirlenmeli ve query logging ile template rendering sırasında yeni sorgu oluşmadığı doğrulanmalıdır.
GraphQL Resolver İçinde N+1
GraphQL resolver yapısı field bazlı veri erişimine izin verdiği için N+1 açısından özel dikkat gerektirir. Bir liste resolver'ı parent kayıtları döndürdükten sonra child field resolver'ları her parent için ayrı database sorgusu çalıştırabilir. Bu davranış client'ın istediği alanlara göre değiştiğinden klasik endpoint testlerinde kolay görünmeyebilir. DataLoader benzeri request-scoped batching yaklaşımı aynı tipteki relation isteklerini tek sorguda birleştirebilir. GraphQL sistemlerinde resolver başına değil, tam operation başına query count ve database time izlemek daha doğru sonuç verir.
Neden Development Ortamında Fark Edilmez?
Development ortamında veri miktarı genellikle küçüktür ve veritabanı uygulamayla aynı makinede veya yakın ağda çalışır. Bu nedenle yüz küçük sorgu bile kullanıcıya hızlı görünebilir. Tek geliştirici trafiği connection pool veya database CPU üzerinde gerçek baskı oluşturmaz. Production'da veri, latency ve concurrency birlikte arttığında aynı sorgu kalıbı ciddi gecikmeye dönüşür. Bu yüzden performans testleri production benzeri veri hacmiyle yapılmalı ve local deneyime güvenmek yerine query count ile percentile latency ölçülmelidir.
N+1 Performansı Nasıl Etkiler?
N+1 problemi tek bir pahalı sorgu üretmek yerine çok sayıda küçük maliyeti üst üste bindirir. Her sorgu network round-trip, connection kullanımı, query parsing ve database execution gibi sabit maliyetler oluşturur. Bu nedenle her query birkaç milisaniye sürse bile toplam süre yüksek olabilir. Kullanıcı sayısı arttığında aynı kalıp connection pool ve database concurrency üzerinde ek baskı yaratır. N+1'i düzeltmek yalnızca tek request'i hızlandırmaz, tüm sistemin daha az kaynakla daha fazla yük taşımasına yardımcı olabilir.
Database Round-Trip
Her database round-trip uygulamanın sorguyu göndermesi ve sonucu geri alması için ek bekleme süresi oluşturur. N+1 durumunda bu sabit maliyet N kadar tekrar eder. Veritabanı çok hızlı olsa bile ağ gecikmesi toplam request süresini yükseltebilir. Özellikle cross-region bağlantılarda round-trip süresi onlarca milisaniyeye çıkabilir. Birden çok ilişki verisini uygun batch query ile toplamak, sorgu sayısını azaltarak bu sabit maliyetin tekrarını önemli ölçüde düşürür.
Network Latency
Network latency, N+1 probleminin production'da local ortama göre daha ağır hissedilmesinin temel nedenlerinden biridir. Her query ayrı paket alışverişi ve protokol işlemleri gerektirir. Tek sorguda 5 milisaniye önemsiz görünen gecikme yüz sorguda yarım saniyeye yaklaşabilir. Buna database execution ve uygulama işlemleri de eklendiğinde kullanıcı latency'si daha da büyür. Bu nedenle distributed mimaride ORM relation fetching stratejileri veritabanının coğrafi konumu dikkate alınarak seçilmelidir.
Connection Pool Kullanımı
N+1 sorguları tek request'in daha uzun süre database connection ihtiyacı duymasına neden olabilir. Yük altında yüzlerce request aynı davranışı gösterdiğinde pool hızla doygun hale gelir. Pool dolduğunda yeni sorgular connection beklemeye başlar ve p99 latency yükselir. Bu durum bazen veritabanı sorgularının yavaşlamasıyla karıştırılır. N+1'i azaltmak connection başına yapılan işi daha verimli hale getirir ve aynı pool kapasitesiyle daha yüksek throughput elde edilmesine yardımcı olur.
Database CPU
Her ek query optimizer, executor ve buffer yönetimi gibi database kaynaklarını kullanır. Sorgular basit olsa bile binlerce request altında toplam CPU maliyeti önemli hale gelebilir. Aynı veriyi batch veya join ile daha az sorguda almak çoğu zaman database CPU yükünü azaltır. Yine de tek dev join oluşturmak da başka bir maliyet yaratabileceği için sonucu ölçmek gerekir. Hedef yalnızca query sayısını en aza indirmek değil, toplam database işini ve kullanıcı latency'sini dengeli biçimde azaltmaktır.
p99 Latency
N+1 problemi p99 latency üzerinde ortalamadan daha sert etki gösterebilir. Her ek query lock, pool wait veya kısa süreli database yoğunluğundan etkilenmek için yeni bir fırsat yaratır. Bir request içindeki onlarca round-trip'ten sadece birkaçının gecikmesi bile toplam sürenin yüksek percentile'a çıkmasına neden olabilir. Bu nedenle query count ile p99 database time arasında korelasyon aranmalıdır. N+1 düzeltmeleri bazen average latency'de küçük, p99 değerinde ise çok daha büyük iyileşme sağlar.
Veri Büyüdükçe Lineer Maliyet Artışı
N+1 yapısında N değeri çoğu zaman response'taki kayıt sayısıyla birlikte büyür. On kayıt için kabul edilebilir görünen yapı yüz veya bin kayıt için doğrusal biçimde daha fazla sorgu üretir. Bu büyüme hem latency hem database load açısından öngörülemez production davranışı oluşturur. Pagination yapılmadığında problem daha hızlı büyür. Query sayısının veri boyutundan bağımsız veya sınırlı kalmasını sağlayan batch fetching ve projection yaklaşımları bu nedenle daha güvenli ölçeklenir.
N+1 Problemi Nasıl Tespit Edilir?
N+1 tespiti için en etkili yöntem sorguları request bağlamıyla birlikte görünür hale getirmektir. SQL logging development ortamında hızlı geri bildirim verirken APM span'leri production trafiğindeki gerçek kalıpları gösterir. Aynı SQL şeklinin kısa sürede çok kez tekrar etmesi güçlü bir sinyaldir. Query count assertion gibi testler bilinen endpoint'lerin tekrar N+1'e düşmesini engelleyebilir. En iyi sonuç, manuel inceleme ile otomatik regression kontrollerinin birlikte kullanılmasıyla elde edilir.
SQL Logging
SQL logging, ORM'nin gerçekten hangi sorguları gönderdiğini görmenin en hızlı yollarından biridir. Bir request çalıştırıldığında aynı SELECT ifadesinin farklı parametrelerle tekrar tekrar gönderilmesi N+1 sinyali olabilir. Development ortamında query süresi ve parametre yapısı kontrollü biçimde loglanabilir. Production'da hassas verilerin loga yazılmaması için parametre redaction uygulanmalıdır. Logları endpoint veya correlation ID ile ilişkilendirmek, hangi uygulama davranışının hangi SQL'i oluşturduğunu anlamayı kolaylaştırır.
Aynı Query'nin Tekrarlarını Bulmak
N+1 sorgularında SQL metninin şekli çoğu zaman aynıdır ve yalnızca relation ID parametresi değişir. Log veya APM sistemi query fingerprint oluşturarak aynı sorgunun bir request içinde kaç kez çalıştığını gösterebilir. Duplicate query count metriği bu nedenle oldukça değerlidir. Aynı fingerprint'in on veya yüz kez tekrar etmesi relation loading davranışını incelemek için güçlü bir işarettir. Bununla birlikte bazı batch iş akışlarında tekrar doğal olabilir, bu nedenle metriği endpoint bağlamıyla yorumlamak gerekir.
Request Başına Query Count
Request başına query count doğrudan N+1 regression'larını yakalamaya yardımcı olur. Örneğin ürün listeleme endpoint'i normalde dört query çalıştırıyorsa testte bu sayı için makul bir üst sınır tanımlanabilir. Yeni kod değişikliği sayı otuzu geçtiğinde pipeline uyarı veya hata üretebilir. Bu yaklaşım performans problemini production'a çıkmadan yakalar. Query count testi sonuç verisinin boyutuyla birlikte çalıştırılırsa küçük fixture nedeniyle gizlenen N+1 davranışları da daha güvenilir biçimde tespit edilebilir.
APM Database Span'leri
APM araçları request içindeki database çağrılarını span olarak gösterdiğinde N+1 görsel olarak oldukça belirgin hale gelir. Aynı SQL fingerprint'inin art arda onlarca kez görünmesi relation erişimi konusunda hızlı ipucu sağlar. Span süreleri connection wait ve database execution ayrımı sunuyorsa problem daha ayrıntılı analiz edilebilir. Correlation sayesinde yavaş kullanıcının hangi endpoint ve sorgu dizisiyle karşılaştığı görülebilir. Production optimizasyonunda bu veri, yalnızca local profiler çıktısından çok daha gerçekçi bir önceliklendirme sağlar.
ORM Profiler
ORM profiler araçları query sayısı, generated SQL, materialization ve tracking davranışı gibi framework'e özgü ayrıntıları görünür hale getirebilir. Geliştirme sırasında relation yükleme kalıplarını anlamak için kullanışlıdır. Bazı profiler'lar duplicate query veya N+1 olasılığını otomatik olarak işaretleyebilir. Bu uyarılar kesin hüküm olarak değil, inceleme başlangıcı olarak değerlendirilmelidir. Gerçek karar yine production benzeri veri, execution plan ve endpoint latency sonuçlarıyla desteklenmelidir.
CI İçinde Query Count Assertion
CI içinde query count assertion kullanmak bilinen performans sözleşmelerini otomatik korumaya yardımcı olur. Test, belirli endpoint'i gerçekçi sayıda kayıtla çalıştırır ve izin verilen maksimum sorgu sayısını kontrol eder. Bu yöntem özellikle serializer, template veya resolver değişikliklerinin N+1 üretmesini erken yakalar. Limit çok katı seçilirse normal geliştirmeyi zorlaştırabilir, bu nedenle iş akışına göre makul budget belirlenmelidir. Query count testi latency benchmark yerine geçmez ancak performans regression savunmasında düşük maliyetli ve etkili bir katman oluşturur.
Lazy Loading Nedir?
Lazy loading, ilişkili verinin ana entity ile birlikte hemen yüklenmesi yerine ihtiyaç anında alınması yaklaşımıdır. Bu davranış bazı kullanım senaryolarında gereksiz relation verisinin taşınmasını önleyebilir. Buna karşılık query'nin ne zaman çalıştığını kod akışında görünmez hale getirdiği için production performansı açısından dikkat gerektirir. Özellikle loop, serializer ve template içinde property erişimi N+1 oluşturabilir. Lazy loading kullanılıyorsa query count gözlemi ve açık kod standartları ile hangi katmanlarda izin verildiği belirlenmelidir.
Relation'ın İlk Erişimde Yüklenmesi
Lazy loading aktifken relation property ilk kez okunduğunda ORM ilgili veriyi database'den getirir. Bu davranış tek bir entity için oldukça kullanışlı görünebilir. Sorun, aynı işlem yüzlerce entity üzerinde tekrarlandığında ortaya çıkar. Relation ihtiyacının önceden bilindiği listeleme senaryolarında toplu yükleme genellikle daha verimlidir. Bu nedenle property erişiminin yalnızca nesne içi işlem olmadığını, arka planda I/O başlatabileceğini ekipte herkesin bilmesi gerekir.
Proxy Nesneleri
Bazı ORM'ler lazy loading için entity yerine veya entity çevresinde proxy nesneleri kullanır. Proxy, relation property erişimini yakalar ve gerekli sorguyu çalıştırır. Bu mekanizma geliştirici açısından rahat olsa da davranışın görünürlüğünü azaltabilir. Proxy oluşturma ve runtime interception küçük ek maliyetler de yaratır. Daha önemlisi, serialization veya mapping kütüphanesinin proxy property'lerine dokunması beklenmedik database çağrılarına yol açabileceğinden sınırlar açık biçimde belirlenmelidir.
Avantajları
Lazy loading'in temel avantajı kullanılmayan relation verisini baştan yüklememektir. Bir entity'nin ilişkili verisine çoğu request'te ihtiyaç duyulmuyorsa gereksiz join veya transfer engellenebilir. Domain odaklı kodda ilişkilere doğal property erişimiyle ulaşmak geliştirici deneyimini de kolaylaştırabilir. Küçük ve kontrollü transaction'larda bu yaklaşım pratik olabilir. Ancak avantajların korunması için request başına query sayısı izlenmeli ve liste işlemlerinde lazy loading'in otomatik biçimde yayılmasına izin verilmemelidir.
Gizli Query Riski
Lazy loading'in en önemli riski database sorgusunun kodda açık biçimde görünmemesidir. Bir property okumak normalde ucuz bir bellek işlemi gibi görünürken gerçek I/O başlatabilir. Bu durum code review sırasında performans etkisinin gözden kaçmasına neden olur. Serializer, template veya logging kodu bile istemeden relation yükleyebilir. Production sistemlerinde query davranışının öngörülebilir olması önemliyse lazy loading sınırlanabilir ve relation erişimleri explicit query veya projection üzerinden yapılabilir.
Lazy Loading Ne Zaman Kullanılmalı?
Lazy loading relation verisine nadiren ihtiyaç duyulan ve entity sayısının küçük olduğu akışlarda faydalı olabilir. Tek bir aggregate üzerinde çalışan iş mantığı, liste endpoint'lerine göre daha uygun bir örnektir. Network latency düşük ve transaction sınırı net olduğunda ek query maliyeti kabul edilebilir olabilir. Buna rağmen kullanım ölçülmeli ve ilişki erişiminin kaç sorgu ürettiği bilinmelidir. Büyük collection, API serialization veya GraphQL resolver gibi ortamlarda daha açık fetching stratejileri genellikle daha öngörülebilir sonuç verir.
Production'da Lazy Loading Kısıtlanmalı mı?
Birçok ekip production kodunda lazy loading kullanımını tamamen kapatmayı veya belirli katmanlarla sınırlamayı tercih eder. Bunun nedeni özelliğin kötü olması değil, sorgu davranışını görünmez hale getirebilmesidir. Explicit loading ve projection kullanıldığında code review sırasında database erişimi daha kolay fark edilir. Lazy loading açık kalacaksa query count alarmı ve duplicate query gözlemi mutlaka bulunmalıdır. En doğru karar ekip deneyimi, uygulama tipi ve gerçek performans metriklerine göre verilmelidir.
Eager Loading Nedir?
Eager loading, kullanılacağı bilinen relation verisinin ana sorguyla birlikte veya önceden planlanmış ek sorgularla yüklenmesidir. Bu yaklaşım N+1 problemini azaltmak için yaygın biçimde kullanılır. Ancak bütün relation'ları her zaman eager yüklemek de gereksiz data transferi ve büyük result-set oluşturabilir. Özellikle birden fazla collection join edildiğinde parent satırları tekrar ederek Cartesian explosion benzeri büyümeler yaşanabilir. Eager loading stratejisinin relation cardinality, pagination ve network latency dikkate alınarak seçilmesi gerekir.
Relation'ların Önceden Yüklenmesi
Eager loading'de uygulama hangi relation'lara ihtiyaç duyacağını sorgu çalışmadan önce belirtir. ORM bu bilgiyi tek join query veya birden fazla kontrollü query şeklinde uygulayabilir. Böylece loop sırasında beklenmedik database çağrıları oluşmaz. Query sayısı daha öngörülebilir hale geldiği için production gözlemi ve test yazımı kolaylaşır. Bununla birlikte gereksiz relation yüklemek hem transfer edilen byte miktarını hem materialization maliyetini artıracağından yalnızca gerçekten kullanılacak veri seçilmelidir.
JOIN-Based Eager Loading
JOIN-based eager loading parent ve relation tablolarını tek SQL sorgusunda birleştirir. One-to-one ve many-to-one ilişkilerde bu yaklaşım çoğu zaman verimlidir, çünkü satır çoğalması sınırlıdır. One-to-many collection'larda parent kolonları her child satırı için tekrar gönderilebilir. Birden fazla collection join edildiğinde sonuç seti beklenenden çok daha hızlı büyüyebilir. Bu nedenle JOIN eager loading seçilirken yalnızca query sayısı değil, result-set amplification ve network byte miktarı da ölçülmelidir.
Select-In / Batch Eager Loading
Select-in loading önce parent kayıtlarını alır, ardından ilgili child kayıtlarını parent ID listesini kullanan bir IN query ile toplu olarak yükler. Böylece N adet child sorgusu yerine bir veya birkaç batch sorgusu oluşur. Büyük one-to-many ilişkilerde dev join sonucundan kaçınmak için iyi bir denge sağlayabilir. Query sayısı join yaklaşımından biraz fazla olsa da transfer edilen tekrar veri daha az olabilir. Batch size ve database parameter limitleri dikkate alınarak gerçek veri hacmi üzerinde test yapılması gerekir.
Eager Loading Neden Her Zaman Çözüm Değildir?
Eager loading N+1'i azaltırken gereksiz relation yükleme veya büyük join sonuçları nedeniyle yeni sorunlar oluşturabilir. Kullanıcı yalnızca beş kolon görürken bütün entity graph'ını almak network ve memory maliyetini artırır. Collection cardinality yüksekse tek query milyonlarca ara satır üretebilir. Pagination ile collection join'lerinin birleşimi de beklenmeyen sonuçlara neden olabilir. Bu yüzden hedef bütün sorguları tek query yapmak değil, iş yüküne göre en düşük toplam maliyeti sağlayan fetch stratejisini seçmektir.
Lazy Loading mi Eager Loading mi?
Lazy loading ile eager loading arasında evrensel bir kazanan yoktur. Karar relation cardinality, veriye ne sıklıkta ihtiyaç duyulduğu, page size ve network latency gibi faktörlere bağlıdır. Küçük ve nadiren erişilen relation için lazy loading kabul edilebilirken liste endpoint'lerinde eager veya batch yaklaşımı daha güvenli olabilir. Büyük collection'larda join-based eager loading yerine select-in loading daha iyi sonuç verebilir. En doğru seçim production benzeri veri üzerinde query count, transferred bytes ve p95 latency karşılaştırılarak yapılmalıdır.
Relation Cardinality
Cardinality, bir parent kaydının ortalama ve maksimum kaç child kayda sahip olduğunu gösterir. One-to-one relation'larda join çoğu zaman düşük risklidir. One-to-many relation yüzlerce child içeriyorsa join sonucu parent kolonlarının tekrar etmesine neden olabilir. Many-to-many ilişkilerde ara tablo nedeniyle büyüme daha da belirgin hale gelebilir. Fetch stratejisi seçerken yalnızca ortalama cardinality değil, büyük tenant veya uç kullanıcıların worst-case değerleri de hesaba katılmalıdır.
Kullanım Senaryosu
Aynı relation farklı endpoint'lerde farklı biçimde yüklenebilir. Detay sayfası parent ile birlikte birkaç relation'a gerçekten ihtiyaç duyarken liste sayfası yalnızca isim ve durum alanlarını gösterebilir. Bu iki kullanım için aynı eager loading ayarını zorlamak gereksiz maliyet yaratır. Query tasarımı endpoint'in gerçek veri ihtiyacına göre yapılmalıdır. Projection tabanlı okuma modelleri, kullanım senaryosuna özel veri erişimi sağlayarak genel entity graph yükleme ihtiyacını azaltabilir.
Pagination
Pagination kullanılan sorgularda relation fetching stratejisi ayrı dikkat gerektirir. Parent kayıtları sayfalanmadan önce collection join uygulanırsa database'in limit davranışı beklenmeyen sonuçlar oluşturabilir. Bazı ORM'ler bu durumu alt sorgu veya split query ile yönetir. Büyük collection için önce parent sayfasını seçmek, ardından child verisini batch almak daha öngörülebilir olabilir. Pagination tasarımında query sayısı kadar doğru ve stabil sonuç üretimi de korunmalıdır.
Network Latency
Network latency yüksek olduğunda çok sayıda küçük query'nin maliyeti hızlı biçimde büyür. Bu durumda eager veya batch loading round-trip sayısını azaltarak önemli avantaj sağlayabilir. Buna karşılık tek query çok büyük payload döndürüyorsa network byte maliyeti de artabilir. Bu nedenle latency ile payload arasında denge kurulmalıdır. Cross-region database kullanımında tek bir ekstra round-trip bile pahalı olabileceğinden fetch stratejisi local geliştirme sonuçlarına bakılarak seçilmemelidir.
Result-Set Boyutu
Result-set boyutu fetching kararında çoğu zaman query sayısından daha belirleyici olabilir. Tek join query yalnızca bir round-trip oluşturur ancak yüz bin satır döndürüyorsa toplam süre yine yüksek olacaktır. Parent kolonlarının tekrar edilmesi ağ ve materialization maliyetini büyütür. Batch query yaklaşımı birkaç round-trip karşılığında daha küçük toplam veri taşıyabilir. Karar verirken returned rows ve transferred bytes metrikleri query count ile birlikte incelenmelidir.
Karar Matrisi
Pratik bir karar matrisinde one-to-one ve düşük cardinality many-to-one ilişkiler join eager loading için güçlü adaydır. Orta büyüklükte one-to-many collection'larda select-in veya batch yaklaşımı genellikle daha güvenlidir. Çok büyük collection'larda relation'ı ayrı sayfalamak veya ayrı endpoint üzerinden sunmak daha iyi olabilir. Nadiren kullanılan küçük relation'larda kontrollü lazy loading kabul edilebilir. Nihai karar p95 latency, database time, row count ve network payload ölçümleriyle doğrulanmalıdır.
Fetch Join ile N+1 Nasıl Çözülür?
Fetch join, ilişkili veriyi ana entity ile aynı sorguda yükleyerek N+1 query sayısını azaltmayı amaçlar. Birçok ORM aynı fikri farklı API isimleriyle sunar. Düşük cardinality ilişkilerde fetch join oldukça etkili olabilir ve uygulama kodunda relation erişimini güvenli hale getirir. Collection ilişkilerde ise duplicate parent row ve result-set amplification riski oluşur. Bu yüzden fetch join uygulanırken query count düşüşünün yanı sıra dönen satır sayısı ve transfer edilen byte miktarı da ölçülmelidir.
JOIN FETCH
JOIN FETCH Hibernate ve JPQL dünyasında relation'ı aynı query ile yüklemek için kullanılan temel yaklaşımlardan biridir. Normal join yalnızca filtre veya seçim amacı taşıyabilirken fetch join relation'ın entity graph içinde yüklenmesini sağlar. Many-to-one ilişkilerde çoğu zaman verimli sonuç verir. One-to-many collection ile birden fazla fetch join kullanıldığında satır sayısı hızla büyüyebilir. Bu nedenle generated SQL ve actual row count kontrol edilmeden yalnızca N+1'i ortadan kaldırdığı için başarılı kabul edilmemelidir.
Include
EF Core'da Include ve ThenInclude relation verisini eager yüklemek için kullanılır. Basit navigation ilişkilerinde kullanımı oldukça rahattır. Birden fazla collection Include edildiğinde tek query stratejisi büyük sonuç seti oluşturabilir, bu durumda split query yaklaşımı değerlendirilebilir. Liste endpoint'lerinde yalnızca gerekli alanlar isteniyorsa Include yerine projection daha verimli olabilir. Include kullanımından sonra generated SQL ve query plan kontrolü, production performansını güvence altına almak için önemlidir.
select_related
Django ORM'deki select_related çoğunlukla foreign key ve one-to-one ilişkileri SQL JOIN ile önceden yüklemek için kullanılır. Bu sayede relation property erişiminde ek sorgu ihtiyacı azalır. Düşük cardinality ilişkiler için oldukça uygun bir araçtır. Collection ilişkilerinde ise prefetch_related yaklaşımı daha uygun olabilir, çünkü ayrı query ile batch loading yapar. Django projelerinde iki yöntemin query count ve response veri hacmi üzerindeki etkisi test edilerek seçilmesi en sağlıklı yaklaşımdır.
joinedload
SQLAlchemy'deki joinedload relation'ı join tabanlı biçimde yüklemek için kullanılan seçeneklerden biridir. Ana sorgunun iş mantığını değiştirmeden relation fetching stratejisini ayarlamaya yardımcı olabilir. Many-to-one ve küçük collection ilişkilerinde verimli çalışabilir. Büyük collection'larda selectinload daha düşük result-set amplification sağlayabilir. SQLAlchemy performans çalışmasında joinedload ve selectinload seçenekleri aynı production benzeri veri üzerinde karşılaştırıldığında cardinality'nin gerçek etkisi kolayca görülebilir.
ORM'lere Göre Fetch Join Örnekleri
Farklı ORM'ler aynı fetching fikrini farklı isim ve davranışlarla uygular. EF Core Include, Hibernate JOIN FETCH, Django select_related ve SQLAlchemy joinedload bunun yaygın örnekleridir. API isimleri değişse de temel soru aynıdır: relation tek query içinde mi yoksa ayrı batch sorgusunda mı alınacak. Araçların varsayılan davranışları ve pagination etkileşimi farklı olabileceği için dokümantasyon incelenmelidir. Ekip içinde ORM adına göre ezber yapmak yerine join cardinality, row amplification ve round-trip maliyetine dayalı ortak performans prensipleri oluşturmak daha değerlidir.
Fetch Join'in Sınırları
Fetch join N+1 için güçlü bir çözüm olsa da her relation graph'ında uygun değildir. Birden fazla büyük collection aynı sorguya eklendiğinde Cartesian explosion yaşanabilir. Pagination, distinct ve ordering gibi işlemler de generated SQL'i daha ağır hale getirebilir. Ayrıca gereksiz kolonlar yükleniyorsa tek query olması network maliyetini çözmez. Fetch join'in sınırları görüldüğünde projection, split query, select-in loading veya ayrı endpoint tasarımı gibi alternatifler değerlendirilmelidir.
Batch Fetching Nedir?
Batch fetching, relation verisini entity başına ayrı query ile almak yerine bir grup parent ID için toplu sorgulama yaklaşımıdır. N+1 problemini azaltırken büyük join sonuçlarından kaçınma fırsatı verir. Tipik olarak parent listesi alındıktan sonra child kayıtlar WHERE parent_id IN (...) benzeri sorguyla getirilir. Batch size doğru seçildiğinde query sayısı sınırlı kalır ve result-set tekrarları azalır. Özellikle orta ve yüksek cardinality one-to-many ilişkilerde güçlü bir seçenek olabilir.
N Query Yerine IN Query
N ayrı query yerine IN query kullanmak database round-trip sayısını dramatik biçimde azaltabilir. Yüz parent için yüz child sorgusu yerine tek veya birkaç WHERE parent_id IN (...) sorgusu çalıştırılır. Bu yaklaşım database'in set-based çalışma gücünden yararlanır. Çok büyük ID listelerinde parameter limitleri ve plan davranışı dikkate alınmalıdır. Uygun batch boyutu seçildiğinde hem latency hem connection pool kullanımı açısından N+1'e göre çok daha istikrarlı sonuç elde edilir.
Batch Size
Batch size, tek sorguda kaç parent veya parametrenin gruplanacağını belirler. Çok küçük değer query sayısını gereksiz artırırken çok büyük değer SQL parametre limitlerini veya query plan verimliliğini zorlayabilir. En uygun sayı database türü, network latency ve relation cardinality'ye göre değişir. Varsayılan değeri körlemesine kullanmak yerine benchmark yapmak gerekir. Production gözleminde query duration ve transferred bytes birlikte izlenerek batch size ayarı zaman içinde güncellenebilir.
Select-In Loading
Select-in loading ORM'nin parent ID listesini kullanarak relation'ları ayrı batch sorgularla yüklemesidir. Join tabanlı eager loading'e göre parent satırı tekrarını azaltabilir. Özellikle collection ilişkilerinde birkaç query karşılığında daha küçük toplam result-set üretmek mümkündür. Network latency çok yüksek olduğunda ek round-trip maliyeti yine değerlendirilmelidir. Bu yüzden select-in ile join loading karşılaştırması cardinality ve gerçek veri dağılımı kullanılarak yapılmalıdır.
Pagination ile Batch Fetching
Pagination ile batch fetching çoğu liste endpoint'i için dengeli bir kombinasyon olabilir. Önce yalnızca ilgili sayfadaki parent kayıtları seçilir, ardından bu küçük ID listesi için child verileri toplu alınır. Böylece tüm tablo relation'larını yüklemek yerine yalnızca gösterilecek sayfa işlenir. Query sayısı genellikle sabit veya düşük kalır. Özellikle one-to-many listelerde bu yaklaşım hem doğru pagination davranışı hem de kontrollü result-set boyutu sağlamaya yardımcı olur.
Hangi Cardinality'de Daha Avantajlıdır?
Batch fetching özellikle bir parent'ın birden fazla child'a sahip olduğu orta ve yüksek cardinality ilişkilerde avantaj sağlar. One-to-one ilişkilerde join çoğu zaman daha basit ve ucuz olabilir. Child sayısı yüzlere çıktığında join'in parent kolonlarını tekrar etmesi network yükünü büyütebilir. Many-to-many yapılarda batch yaklaşımı ara tablo üzerinden kontrollü veri çekme imkânı verir. Yine de gerçek avantaj veri dağılımına bağlı olduğundan average cardinality ile worst-case cardinality ayrı ayrı ölçülmelidir.
N+1'i Çözerken Cartesian Explosion Yaratmak
N+1 problemini fark eden ekipler bazen bütün relation'ları tek query içinde JOIN ederek sorunu çözmeye çalışır. Bu yaklaşım query sayısını düşürürken result-set boyutunu katlayabilir. Bir parent'ın iki ayrı collection'ı join edildiğinde child kombinasyonları birbirini çoğaltır ve database beklenenden çok daha fazla satır üretir. Bu durum network, hydration ve memory maliyetini yükseltir. N+1'i çözmek kadar yeni bir Cartesian explosion oluşturmamak da ORM performans optimizasyonunun temel parçalarından biridir.
Cartesian Explosion Nedir?
Cartesian explosion, birden fazla one-to-many veya many-to-many ilişkinin aynı sorguda birleştirilmesiyle satır kombinasyonlarının hızla çoğalmasıdır. Örneğin bir siparişin on ürünü ve beş ödemesi varsa iki collection'ın aynı join içinde yüklenmesi elli satırlık ara sonuç oluşturabilir. Parent verisi bu satırların her birinde tekrar eder. Collection sayısı ve cardinality arttıkça sonuç çok daha hızlı büyür. Query sayısı bir olsa bile database execution, network transfer ve materialization maliyeti ağırlaşabilir.
Birden Fazla Collection JOIN Edildiğinde Ne Olur?
Bir parent tabloya iki collection join edildiğinde her collection'ın satırları diğer collection ile kombinasyon oluşturabilir. Bu durum bağımsız relation'ların birbirini çarpmasına neden olur. ORM sonuçları entity graph'a dönüştürürken duplicate parent kayıtlarını birleştirse bile database ve network tüm ara satırları işlemiş olur. Uygulama tarafında doğru sayıda entity görmek problemi gizleyebilir. Bu nedenle generated SQL kadar actual row count ve transferred bytes metriklerine de bakmak gerekir.
Result-Set Amplification
Result-set amplification, kullanıcıya döndürülen gerçek entity sayısına göre database'den çok daha fazla satır alınmasıdır. Yüz parent entity için on bin SQL satırı taşınıyorsa relation join yapısı kontrol edilmelidir. Amplification ağ trafiğini, materialization CPU'sunu ve allocated memory değerini artırır. Bu sorun özellikle büyük kolonlara sahip parent tablolarda daha pahalı hale gelir. Split query, select-in loading veya projection kullanmak tekrar eden veriyi azaltabilir.
Parent Row Duplication
Collection join'lerinde parent kolonları her child satırı için tekrar taşınır. Parent entity genişse bu tekrar network byte miktarını ciddi şekilde büyütebilir. ORM identity resolution ile tek parent nesnesi oluşturabilir, ancak tekrar veri database'den uygulamaya gelmiş olur. Özellikle TEXT veya JSON kolonlarının parent tabloda bulunması etkiyi artırır. Projection ile yalnızca gerekli kolonları seçmek veya child collection'ı ayrı query ile almak duplication maliyetini azaltabilir.
Network Trafiğine Etkisi
Cartesian explosion network üzerinde gereksiz byte transferine neden olur. Tek query olduğu için round-trip sayısı düşük görünür, ancak payload çok büyük olabilir. Cross-region database bağlantılarında bu maliyet daha da belirgin hale gelir. Network metric'leri izlenmeden yalnızca query count'a bakmak bu problemi görünmez bırakabilir. Fetch stratejisi karşılaştırılırken toplam transferred bytes, query süresi ve p95 request latency birlikte değerlendirilmelidir.
Materialization Maliyeti
Büyük join sonucundaki duplicate satırlar ORM'nin daha fazla satırı parse etmesine ve identity resolution çalıştırmasına neden olur. Sonuçta entity sayısı küçük olsa bile CPU maliyeti yüksek olabilir. Mapping ve navigation collection oluşturma işlemleri de artar. Bu durum allocation ve garbage collection baskısını yükseltebilir. Split query veya projection ile satır sayısını düşürmek, database dışındaki ORM maliyetini de önemli ölçüde azaltabilir.
Single Query mi Split Query mi?
Single query ve split query arasında seçim yapmak round-trip ile result-set amplification arasındaki dengeyi yönetmek anlamına gelir. Tek JOIN query network turunu azaltabilir ancak collection ilişkilerinde çok büyük sonuç üretebilir. Split query birkaç küçük sorgu kullanarak tekrar eden satırları azaltabilir. Buna karşılık network latency yüksekse ek round-trip maliyeti daha görünür hale gelir. En doğru yaklaşım relation cardinality, transaction tutarlılığı ve uygulama ile database arasındaki fiziksel mesafe birlikte değerlendirilerek seçilmelidir.
Tek JOIN Query
Tek JOIN query bütün gerekli relation verisini bir database round-trip içinde getirebilir. Düşük cardinality ve küçük result-set senaryolarında oldukça verimli olabilir. One-to-one ve many-to-one ilişkiler bunun tipik örnekleridir. Birden fazla collection olduğunda satır çoğalması riski hızla artar. Tek query seçildiğinde execution plan, returned rows ve transferred bytes ölçülmeden yalnızca query count düşüşüne bakılmamalıdır.
Birden Fazla Küçük Query
Split query yaklaşımı parent ve relation verisini birkaç daha küçük sorguya böler. Bu sayede parent kolonlarının her child için tekrar taşınması azaltılabilir. ORM sonuçları uygulama tarafında birleştirerek aynı entity graph'ı oluşturabilir. Ek round-trip maliyeti network latency'ye bağlı olarak değişir. Büyük collection içeren sistemlerde toplam satır ve byte miktarının düşmesi, birkaç ekstra sorgunun maliyetinden daha değerli olabilir.
Round-Trip Trade-Off
Split query'nin temel bedeli ek database round-trip sayısıdır. Uygulama ve database aynı region'daysa bu bedel düşük kalabilir. Cross-region ortamında her ek sorgu onlarca milisaniye ekleyebilir. Bu nedenle query sayısı ile payload büyüklüğü arasında gerçek ölçüm yapılmalıdır. Bazı durumlarda iki küçük sorgu tek büyük join'den hızlıyken başka bir altyapıda tek query daha iyi sonuç verebilir.
Cartesian Explosion Trade-Off
Single query seçimi collection cardinality arttıkça Cartesian explosion riski taşır. Split query bu riski azaltır ancak daha fazla round-trip oluşturur. Hangi maliyetin daha büyük olduğu veri dağılımına bağlıdır. Ortalama child sayısı düşükken join iyi çalışabilir, fakat birkaç büyük tenant dev result-set üretebilir. Benchmark yalnızca ortalama veriyle değil, worst-case collection boyutlarıyla da yapılmalıdır.
Transaction Consistency
Split query birden fazla SQL çalıştırdığı için sorgular arasında verinin değişmesi teorik olarak farklı snapshot sonuçları oluşturabilir. Transaction isolation seviyesi bu davranışı etkiler. Tek query genellikle aynı statement içinde daha doğal tutarlılık sağlar. Split query kritik iş akışında kullanılıyorsa transaction sınırı ve isolation gereksinimi açık biçimde belirlenmelidir. Performans kazanımı veri tutarlılığı ihtiyacının önüne geçmemelidir.
Cross-Region Database Durumunda Seçim
Cross-region database kullanımında network latency her round-trip için yüksek olabilir. Bu durumda single query avantaj kazanabilir, ancak dev payload yine ağ maliyetini artırabilir. Projection ile veri boyutunu düşürmek single query stratejisini daha verimli hale getirebilir. Batch ve split yaklaşımı gerekiyorsa sorguların sayısı sınırlı tutulmalıdır. Gerçek region mimarisi üzerinde ölçüm yapılmadan local benchmark sonuçlarıyla karar vermek güvenilir değildir.
Benchmark ile Karar Verme
Single ve split query karşılaştırması aynı veri seti, aynı concurrency ve aynı endpoint davranışı üzerinde yapılmalıdır. Query count, database time, transferred bytes, allocated memory ve p95 latency ölçülmelidir. Yalnızca bir query'nin stopwatch süresine bakmak eksik sonuç verir. Büyük tenant ve normal tenant senaryoları ayrı ayrı test edilmelidir. Son karar gerçek workload altında daha stabil percentile değerleri sağlayan stratejiye göre verilmelidir.
ORM Fetch Strategy Karar Matrisi
Fetch strategy seçimi relation türü ve kullanım amacına göre yapılmalıdır. One-to-one relation ile çok yüksek cardinality many-to-many relation için aynı çözümü kullanmak doğru değildir. Pagination, network latency ve response modeli de kararı değiştirebilir. Pratikte join, select-in, projection ve ayrı query seçenekleri birlikte değerlendirilir. Karar matrisi kesin kurallar koymaktan çok hangi risklerin önce kontrol edilmesi gerektiğini gösteren bir rehber olarak kullanılmalıdır.
One-to-One
One-to-one relation çoğu zaman join-based eager loading için uygun adaydır. Her parent satırı en fazla bir relation satırıyla eşleştiği için result-set amplification sınırlıdır. Relation sık kullanılıyorsa tek query round-trip avantajı sağlar. Relation nadiren gerekiyorsa projection ile ihtiyaca göre seçmek gereksiz kolon transferini önleyebilir. Yine de geniş TEXT veya JSON alanları varsa yalnızca gerekli kolonları almak daha verimli olabilir.
Many-to-One
Many-to-one ilişkiler de genellikle join ile verimli biçimde yüklenebilir. Birçok child aynı parent'a bağlansa bile child başına tek parent eşleşmesi bulunduğu için satır çarpılması sınırlıdır. Liste endpoint'lerinde kategori veya müşteri adı gibi küçük relation alanları projection içinde alınabilir. Tam parent entity'yi yüklemek her zaman gerekli değildir. Generated SQL ve covering index ihtiyacı kullanım senaryosuna göre kontrol edilmelidir.
One-to-Many
One-to-many relation fetch stratejisinde cardinality kritik rol oynar. Küçük collection join ile rahatça alınabilirken büyük collection parent row duplication oluşturabilir. Select-in veya batch fetching bu durumda daha dengeli olabilir. Kullanıcı yalnızca collection sayısını görüyorsa bütün child entity'leri yüklemek yerine aggregate query kullanılmalıdır. Collection'ın gerçek maksimum boyutu bilinmeden eager loading kararı verilmemelidir.
Many-to-Many
Many-to-many ilişkiler ara tablo nedeniyle daha yüksek join maliyeti oluşturabilir. Her iki taraftaki cardinality yükseldiğinde result-set hızla büyüyebilir. Batch loading veya kullanım amacına özel projection çoğu zaman daha güvenli olur. Büyük relation listeleri ayrıca sayfalanabilir. Execution plan içinde join sırası ve index kullanımı incelenerek ara tablo üzerindeki composite index tasarımı da doğrulanmalıdır.
Büyük Collection
Büyük collection'ı parent entity ile birlikte her request'te yüklemek genellikle kötü bir varsayımdır. Kullanıcı yüzlerce veya binlerce child kaydı aynı anda kullanmayabilir. Collection ayrı endpoint ile sayfalanabilir veya yalnızca gerekli aggregate değerler alınabilir. Batch fetching kullanılacaksa page size ve memory etkisi ölçülmelidir. Büyük collection tasarımında veri erişim modeli kullanıcı arayüzünün gerçek ihtiyacına göre şekillendirilmelidir.
Pagination Kullanımı
Pagination fetch stratejisinde veri sınırını kontrol etmenin en önemli yollarından biridir. Önce parent sayfasını seçmek ve relation verisini yalnızca bu parent'lar için almak çoğu zaman daha güvenlidir. Deep OFFSET sorunları oluşuyorsa keyset pagination değerlendirilebilir. Collection join'leri pagination davranışını değiştirebileceği için generated SQL incelenmelidir. Stabil sıralama ve primary key tie-breaker kullanımı tekrar veya eksik kayıt riskini azaltır.
Yüksek Network Latency
Yüksek network latency round-trip sayısını daha pahalı hale getirir. Bu ortamda tek veya sınırlı sayıda batch query avantaj sağlayabilir. Ancak tek sorguda dev payload oluşturmak da ağ maliyetini yükseltir. Projection kullanmak latency ile payload arasındaki dengeyi iyileştirir. Fetch stratejisi uygulamanın gerçekten çalıştığı network topolojisinde ölçülmelidir.
Çok Yüksek Cardinality
Çok yüksek cardinality ilişkilerde eager loading'in tamamını tek request içinde yapmak çoğu zaman ölçeklenmez. Relation ayrı sayfalanmalı, filtrelenmeli veya aggregate edilmelidir. Kullanıcıya on kayıt gösterirken on bin child entity yüklemek gereksiz maliyet yaratır. ORM'nin kolay navigation erişimi bu gerçeği değiştirmez. Veri modelinin büyük collection davranışı API tasarımında açık biçimde ele alınmalıdır.
Projection ORM Performansını Nasıl İyileştirir?
Projection, tam entity yüklemek yerine yalnızca kullanım senaryosunun ihtiyaç duyduğu alanları seçmeyi sağlar. Bu yaklaşım database'den daha az kolon okunmasına, ağ üzerinden daha az veri taşınmasına ve uygulamada daha az nesne oluşturulmasına yardımcı olur. Read-only endpoint'lerde projection çoğu zaman en etkili ORM optimizasyonlarından biridir. Ayrıca relation graph'ın kontrolsüz biçimde genişlemesini engeller. DTO veya scalar projection kullanımı performansı artırırken response modelini veritabanı entity'sinden ayırarak mimari açıdan da daha kontrollü bir yapı sunabilir.
Entity Projection
Entity projection tam entity yerine belirli entity yapılarının kontrollü biçimde seçilmesini ifade edebilir. Bazı ORM'lerde entity oluşturulduğu için tracking veya identity resolution maliyeti devam edebilir. Yine de gereksiz relation'ları yüklememek önemli kazanç sağlar. Güncelleme yapılacak senaryolarda entity projection işlevsel olabilir. Salt okunur endpoint'lerde daha hafif DTO veya scalar projection çoğu zaman daha düşük memory ve CPU maliyeti üretir.
DTO Projection
DTO projection query sonucunu doğrudan response veya application modeline uygun küçük nesnelere dönüştürür. Yalnızca gerekli kolonlar seçildiği için SELECT * kullanımından kaçınılır. Relation alanları da gerektiği kadar join veya subquery ile alınabilir. Bu yaklaşım tracking ihtiyacını azaltır ve serialization modelini sadeleştirir. Listeleme API'lerinde DTO projection genellikle ORM performansı için en yüksek getirili değişikliklerden biridir.
Scalar Projection
Scalar projection yalnızca tekil kolonlar veya küçük değer grupları seçer. Örneğin bir dropdown için entity yerine yalnızca id ve name alanlarının alınması yeterli olabilir. Bu yaklaşım network payload ve hydration maliyetini minimumda tutar. Aggregate ve count işlemlerinde de tam entity yüklemek yerine scalar sonuç almak çok daha verimlidir. ORM query API'si database tarafında hesaplama yapabiliyorsa sonuçları uygulamaya taşıyıp sonradan işlemekten kaçınılmalıdır.
Raw Result
Raw result yaklaşımı bazı raporlama veya hot path sorgularında entity lifecycle özelliklerinden tamamen kaçınmayı sağlar. ORM veya driver sonucu satır tabanlı daha hafif bir yapıda döndürebilir. Bu yöntem change tracking ve navigation yönetimi gerekmeyen işlemler için uygundur. Kod okunabilirliği ve type safety ihtiyacı ayrıca değerlendirilmelidir. Kritik sorguda kazanç varsa raw result kullanımını sınırlı ve iyi belgelenmiş bir veri erişim katmanında tutmak bakım kolaylığını korur.
Yalnızca Gereken Kolonları Çekmek
Yalnızca gereken kolonları seçmek database, network ve application maliyetini aynı anda azaltır. Kullanılmayan geniş kolonların taşınmaması özellikle JSON, TEXT ve BLOB içeren tablolarda büyük fark yaratabilir. Covering index fırsatları da daha küçük projection ile artabilir. ORM'nin entity yükleme varsayılanı bütün kolonları getiriyorsa liste endpoint'lerinde açık select kullanmak gerekir. Bu optimizasyon genellikle düşük riskli olduğu için performans çalışmasında erken denenebilir.
Read-Only Endpoint'ler İçin Projection
Read-only endpoint'in amacı veri göstermekse entity'nin tüm davranışlarını ve tracking state'ini yüklemek çoğu zaman gereksizdir. Projection doğrudan API'nin ihtiyaç duyduğu modele veri seçebilir. Bu sayede database'den gelen veri azalır ve ORM daha az nesne oluşturur. Response modeli entity'den ayrıldığı için istemeden lazy relation serialize etme riski de düşer. Dashboard, arama ve listeleme endpoint'leri projection için özellikle uygun adaylardır.
SELECT * Neden ORM Performans Problemi Olabilir?
SELECT * kullanımı tablo üzerindeki tüm kolonları istemeden query sonucuna dahil eder. ORM entity yüklerken doğal olarak bütün mapped kolonları seçebilir ve geliştirici bunun maliyetini fark etmeyebilir. Geniş tablolar, JSON alanları veya büyük metin kolonları network trafiğini hızla büyütür. Ayrıca her kolonun parse edilmesi ve entity'ye yazılması materialization maliyeti oluşturur. Read-only ekranlarda yalnızca ihtiyaç duyulan alanları projection ile seçmek bu nedenle genellikle daha verimli ve daha öngörülebilir bir yaklaşımdır.
Gereksiz Kolon Transferi
Kullanılmayan kolonların database'den uygulamaya taşınması doğrudan network ve memory maliyetidir. Tablo küçükken fark görünmeyebilir, ancak milyonlarca request altında toplam byte miktarı ciddi hale gelir. Aynı zamanda database buffer ve driver parsing işlemleri de gereksiz veri üzerinde çalışır. Projection ile bu maliyet kolayca azaltılabilir. Endpoint'in contract'ı hangi alanlara ihtiyaç duyduğunu açıkça gösteriyorsa query'nin de aynı sınırı takip etmesi tercih edilmelidir.
TEXT / JSON / BLOB Alanları
TEXT, JSON ve BLOB alanları satır başına veri miktarını büyük ölçüde artırabilir. Kullanıcı liste ekranında yalnızca başlık görmek isterken megabyte düzeyinde içerik taşınması gereksizdir. Bu alanlar detay endpoint'inde ayrı alınabilir veya projection dışında bırakılabilir. Bazı database'lerde büyük kolonların storage davranışı farklı olsa da transfer maliyeti yine önemlidir. ORM entity seçiminin bu alanları otomatik getirip getirmediği generated SQL üzerinden kontrol edilmelidir.
Network Payload
Network payload büyüdükçe database ile uygulama arasındaki transfer süresi artar. Aynı region'da bile yüksek concurrency altında network kapasitesi ve driver buffer kullanımı etkilenebilir. Cross-region mimaride maliyet daha belirgin hale gelir. Query duration düşük görünürken response gecikmesinin transfer aşamasında artması mümkündür. Transferred bytes metriğini gözlemlemek SELECT * sorununu somut biçimde ölçmeye yardımcı olur.
Object Hydration
Her seçilen kolon ORM tarafından okunmalı, uygun tipe çevrilmeli ve nesne üzerindeki alana yazılmalıdır. Kullanılmayan kolonlar bile bu hydration maliyetini oluşturur. Büyük result-set'lerde işlem CPU ve allocation açısından hissedilir hale gelir. DTO projection daha küçük nesneler oluşturarak maliyeti azaltabilir. Bu nedenle query optimizasyonu yalnızca database execution plan'a değil, application-side hydration süresine de bakmalıdır.
Memory Pressure
Geniş entity'lerin büyük listeler halinde yüklenmesi uygulamanın bellek tüketimini artırır. Aynı anda çok sayıda request çalıştığında allocation ve garbage collection baskısı yükselir. Bu durum latency spike ve throughput düşüşüne yol açabilir. Projection ve pagination memory footprint'i sınırlamak için birlikte kullanılabilir. Read-only raporlarda streaming yaklaşımı da tüm result-set'i aynı anda RAM'e almaktan daha uygun olabilir.
Deferred Column Loading Riski
Büyük kolonları başta yüklememek bazı ORM'lerde deferred loading ile mümkün olabilir. Ancak deferred kolon daha sonra her entity için ayrı erişildiğinde yeni bir N+1 problemi oluşabilir. Bu nedenle deferred loading'in hangi kullanım senaryosunda çalıştığı açıkça bilinmelidir. Liste ekranında kolon gerçekten gerekmiyorsa hiç erişilmemesi en iyi sonuçtur. Detay ihtiyacı varsa ayrı ve açık bir query çalıştırmak gizli lazy loading davranışından daha öngörülebilir olabilir.
Object Materialization ve Hydration Maliyeti
Database query süresi düşük olsa bile büyük sonuçların uygulama nesnelerine dönüştürülmesi request'i yavaşlatabilir. ORM her satır için nesne oluşturur, tip dönüşümleri yapar ve relation bağlarını kurabilir. Tracking açıksa entity state'i ayrıca kaydedilir. Bu işlemler CPU, allocation ve garbage collection maliyeti üretir. Büyük listelerde projection ve daha küçük page size kullanmak hydration maliyetini azaltarak database dışındaki performans darboğazlarını hafifletebilir.
Database Row'dan Entity Oluşturma
Her database satırı entity'ye dönüştürülürken kolon değerleri okunur ve model alanlarına atanır. Null kontrolü, enum dönüşümü ve özel type converter işlemleri ek CPU kullanabilir. Binlerce satırda bu küçük maliyetler birikir. ORM profiler veya CPU profiler bu aşamanın request süresindeki payını gösterebilir. Yalnızca gerekli veriyi DTO'ya dönüştürmek, entity lifecycle özelliklerine ihtiyaç olmayan sorgularda daha hafif sonuç verir.
Constructor / Proxy Maliyeti
Bazı ORM'ler entity oluştururken özel constructor, interception veya proxy mekanizması kullanır. Tek nesnede ihmal edilebilir olan bu maliyet yüz binlerce satırda görünür hale gelebilir. Lazy loading proxy'leri ek metadata ve runtime kontrolü gerektirebilir. Büyük reporting sorgularında proxy gerekmiyorsa daha hafif result modeli seçmek faydalıdır. Yine de bu optimizasyona geçmeden önce profiler ile constructor veya proxy maliyetinin gerçekten önemli olduğu doğrulanmalıdır.
Navigation Property'ler
Navigation property'ler entity'ler arasındaki relation bağlantılarını temsil eder. Hydration sırasında ORM child kayıtlarını parent collection'a ekleyebilir ve karşılıklı relation fix-up işlemleri yapabilir. Büyük graph'larda bu işlemler CPU kullanımını artırabilir. Gereksiz relation'ların yüklenmemesi hem query hem de graph oluşturma maliyetini azaltır. Read-only endpoint'lerde düz DTO yapıları karmaşık navigation graph'larından daha verimli ve daha kolay serialize edilebilir.
Identity Map
Identity map aynı primary key'e sahip entity'nin tek nesne olarak temsil edilmesini sağlar. Join sonuçlarında duplicate parent satırları varsa bu davranış önemli olabilir. Ancak her satırda map lookup yapılması belirli bir CPU maliyeti oluşturur. Çok büyük sonuçlarda identity map memory tüketimi de artabilir. Eğer identity semantics gerekli değilse no-tracking veya raw result yaklaşımı daha düşük overhead sağlayabilir.
Garbage Collection
ORM çok sayıda kısa ömürlü nesne oluşturduğunda garbage collector daha sık çalışabilir. Bu durum yüksek trafik altında latency spike oluşturabilir. Allocation profili yalnızca toplam bellek kullanımından daha açıklayıcıdır, çünkü nesnelerin ne kadar hızlı üretildiğini gösterir. Projection, page size küçültme ve streaming allocation hızını azaltabilir. Büyük unit of work içinde binlerce tracked entity tutmak ise nesnelerin yaşam süresini uzatarak bellek baskısını daha da artırabilir.
Büyük Result-Set'lerde Hydration Maliyeti
Büyük result-set sorgularında database execution yalnızca toplam sürenin bir bölümü olabilir. Uygulamanın yüz binlerce satırı entity'ye dönüştürmesi CPU ve memory açısından çok daha ağır olabilir. Bu tür işlemlerde pagination, streaming veya database tarafında aggregation düşünülmelidir. Kullanıcıya özet bilgi gerekiyorsa bütün satırları uygulamaya taşımak yerine SQL içinde hesaplamak daha verimlidir. Hydration süresini ayrı metric olarak görmek bu farkı ortaya çıkarmaya yardımcı olur.
Change Tracking ORM Performansını Nasıl Etkiler?
Change tracking ORM'nin entity değişikliklerini otomatik belirlemesine yardımcı olur, ancak ücretsiz değildir. Context veya session içinde yüklenen her tracked entity için state tutulabilir ve SaveChanges sırasında kontrol yapılabilir. Küçük transaction'larda bu maliyet genellikle sorun oluşturmaz. Büyük read-only listelerde veya uzun yaşayan context'lerde gereksiz tracking bellek ve CPU tüketimini artırır. ORM performansını optimize ederken her query için gerçekten update yapılacak mı sorusunu sormak önemli bir adımdır.
Change Tracker Nedir?
Change tracker, ORM'nin yüklediği entity'lerin durumunu izleyen mekanizmadır. Entity'nin yeni, değiştirilmiş, silinmiş veya değişmemiş olduğunu belirleyerek uygun SQL işlemlerinin üretilmesini sağlar. Bu özellik CRUD uygulamalarında geliştirici işini ciddi biçimde kolaylaştırır. Bunun karşılığında ORM entity metadata ve state bilgisi saklar. Çok sayıda entity'nin aynı context içinde tutulması durumunda change tracker maliyeti ölçülebilir hale gelir.
Snapshot Tracking
Snapshot tracking yaklaşımında ORM entity'nin başlangıç değerlerini veya değişiklik belirlemek için gereken bilgileri saklar. SaveChanges sırasında mevcut değerlerle karşılaştırma yapabilir. Bu mekanizma doğal bir programlama modeli sağlar ancak her tracked entity için ek memory kullanır. Binlerce entity içeren unit of work'lerde maliyet büyür. Büyük batch işlemlerinde daha set-based update yöntemleri veya daha küçük transaction parçaları kullanmak snapshot yükünü azaltabilir.
Dirty Checking
Dirty checking entity üzerindeki hangi alanların değiştiğini belirleme sürecidir. Bazı ORM'ler bunu property interception, bazıları snapshot karşılaştırmasıyla yapar. Entity sayısı arttıkça kontrol edilmesi gereken state miktarı da artar. Uzun yaşayan session'larda bu durum flush süresini yükseltebilir. Unit of work kapsamını kısa tutmak ve gereksiz entity'leri detach veya clear etmek büyük işlemlerde daha stabil performans sağlayabilir.
Identity Resolution
Tracking modunda identity resolution genellikle aynı database kaydının context içinde tek entity örneğiyle temsil edilmesini sağlar. Bu durum ilişki bütünlüğü ve update senaryoları için faydalıdır. Ancak map lookup ve entity state saklama maliyetini beraberinde getirir. Read-only sorgularda aynı davranış her zaman gerekli değildir. ORM'nin no-tracking with identity resolution gibi ara seçenekleri varsa duplicate entity problemi bulunan özel sorgularda değerlendirilebilir.
Read-Only Query'de Tracking Gerekli mi?
Read-only query sonucundaki entity'ler daha sonra güncellenmeyecekse change tracking çoğu zaman gereksizdir. Dashboard, rapor, arama ve listeleme endpoint'leri bunun tipik örnekleridir. Tracking'i kapatmak memory kullanımını ve bazı ORM işlemlerini azaltabilir. Daha da iyi sonuç için projection ile birlikte kullanılabilir. Ancak aynı request içinde entity'nin sonradan update edilmesi planlanıyorsa no-tracking seçimi ek attach veya update yönetimi gerektirebilir.
No-Tracking Query
No-tracking query ORM'ye sonuç entity'lerinin değişiklik için izlenmeyeceğini bildirir. Bu yaklaşım read-only workload'larda daha düşük memory ve CPU maliyeti sağlayabilir. Özellikle büyük liste sorgularında fark daha belirgin olur. Yine de entity identity davranışı ve relation fix-up özellikleri ORM'ye göre değişebilir. Kullanım öncesinde uygulamanın bu entity'leri gerçekten yalnızca okuduğu doğrulanmalı ve performans etkisi benchmark ile ölçülmelidir.
EF Core'da AsNoTracking Ne Zaman Kullanılmalı?
EF Core'da AsNoTracking, sorgu sonucundaki entity'lerin change tracker'a eklenmemesini sağlar. Salt okunur endpoint'lerde memory ve tracking maliyetini azaltmak için yaygın biçimde kullanılır. Ancak entity daha sonra aynı context içinde güncellenecekse tracking gerekli olabilir. AsNoTracking kullanımı varsayılan hale getirilecekse uygulama mimarisinin read ve write akışlarını açık biçimde ayırması faydalıdır. Yüksek trafikli API'lerde projection ile birlikte kullanıldığında gereksiz entity lifecycle maliyetini önemli ölçüde azaltabilir.
Read-Only API
Read-only API endpoint'leri AsNoTracking için en doğal kullanım alanlarından biridir. Sonuç entity'leri response'a dönüştürülür ve transaction içinde tekrar güncellenmez. Tracking yapılmaması context memory kullanımını azaltabilir. Projection kullanılıyorsa tam entity oluşturmaya da gerek kalmayabilir. Endpoint benchmark'ında allocation ve p95 latency karşılaştırması yapılarak kazanç net biçimde görülebilir.
Dashboard
Dashboard sorguları genellikle çok sayıda kaydı okuyup özet veri gösterir. Bu sonuçların update edilmesi beklenmediği için tracking çoğu zaman gereksizdir. AsNoTracking ile birlikte aggregate ve DTO projection kullanmak daha küçük veri transferi sağlar. Dashboard'da her widget için ayrı query çalışıyorsa query count da ayrıca izlenmelidir. Tracking optimizasyonu N+1 veya kötü execution plan sorunlarını çözmez, yalnızca ORM tarafındaki belirli maliyeti azaltır.
Reporting
Reporting workload'ları büyük result-set ve aggregation içerebilir. Entity tracking bu tür işlemlerde genellikle ek değer üretmez. AsNoTracking kullanmak memory tüketimini azaltabilir, ancak daha güçlü kazanç çoğu zaman database tarafında aggregation ve projection ile elde edilir. Çok büyük raporlarda raw SQL veya özel result modeli de değerlendirilebilir. Report tasarımı kullanıcının gerçekten hangi ayrıntıya ihtiyaç duyduğuna göre yapılmalıdır.
Listeleme Endpoint'leri
Listeleme endpoint'lerinde sonuçlar çoğu zaman yalnızca görüntülenir. Bu nedenle AsNoTracking ve projection birlikte iyi bir başlangıç noktasıdır. Page size sınırı koymak memory ve network maliyetini kontrol eder. Relation bilgisi gerekiyorsa geniş Include yerine DTO projection ile sadece gereken alanlar seçilebilir. Bu üç yaklaşım birlikte uygulandığında query, materialization ve serialization maliyetleri aynı anda azaltılabilir.
AsNoTrackingWithIdentityResolution
AsNoTrackingWithIdentityResolution, tracking state'i tutmadan aynı primary key için tek entity örneği üretmeye yardımcı olan özel bir seçenektir. Join sonucunda duplicate entity oluşumunun sorun olduğu read-only sorgularda faydalı olabilir. Normal AsNoTracking'e göre identity resolution için ek işlem yapar. Bu nedenle her sorguda varsayılan olarak kullanmak yerine ihtiyaç olduğunda tercih edilmelidir. Benchmark ile normal tracking ve no-tracking seçenekleri karşılaştırılarak gerçek maliyet görülmelidir.
Tracking Gerekli Olan Senaryolar
Entity üzerinde değişiklik yapılıp SaveChanges ile kalıcı hale getirilecekse tracking önemli kolaylık sağlar. Aggregate üzerinde birden fazla alan değişikliği yapılan transaction'larda change tracker uygulama kodunu sadeleştirir. Concurrency token veya relationship fix-up gibi özellikler de tracking davranışından yararlanabilir. Bu senaryolarda AsNoTracking kullanıp entity'leri tekrar attach etmek daha fazla kod ve hata riski oluşturabilir. Performans optimizasyonu özellikleri körlemesine kapatmak yerine ihtiyaca göre seçmek anlamına gelir.
Büyük Unit of Work Performans Problemi
Unit of work çok büyüdüğünde ORM aynı context veya session içinde binlerce entity'nin state'ini taşımaya başlayabilir. Bu durum memory growth, dirty checking ve flush süresinde artış oluşturur. Uzun transaction'lar aynı zamanda lock ve connection kullanımını da uzatabilir. Batch işlemleri daha küçük parçalara bölmek ve belirli aralıklarla context clear etmek çoğu zaman daha stabil performans sağlar. Büyük işlerin set-based SQL ile çözülüp çözülemeyeceği de ayrıca değerlendirilmelidir.
Binlerce Tracked Entity
Binlerce tracked entity change tracker veri yapılarının büyümesine neden olur. Her entity için state, identity ve bazı durumlarda snapshot bilgisi tutulur. SaveChanges sırasında bu koleksiyonun taranması CPU maliyetini artırabilir. Memory kullanımındaki artış garbage collection davranışını da etkiler. Büyük batch işlerinde entity sayısını sınırlı tutan chunk yaklaşımı daha öngörülebilir performans sağlar.
Memory Growth
Uzun yaşayan context içindeki tracked entity'ler garbage collector tarafından serbest bırakılamaz çünkü hâlâ referans altında tutulur. İşlem ilerledikçe memory kullanımı sürekli büyüyebilir. Bu durum background job veya import işlemlerinde özellikle belirgin olur. Belirli batch sonlarında context temizlemek veya yeni context açmak memory seviyesini kontrol altında tutar. Yine de transaction sınırlarının iş bütünlüğü ihtiyacıyla uyumlu olması gerekir.
Flush / SaveChanges Süresi
SaveChanges veya flush sırasında ORM değişiklikleri tespit eder, SQL komutlarını hazırlar ve database'e gönderir. Tracked entity sayısı çok yüksek olduğunda bu aşama yavaşlayabilir. SQL batching desteği varsa round-trip sayısı azalabilir ancak change detection maliyeti devam eder. Büyük update işlemlerinde set-based update daha verimli olabilir. Profiling ile sürenin change detection mı yoksa database execution mı olduğu ayrıştırılmalıdır.
Batch İşleme
Batch işleme büyük veri setini daha küçük gruplara bölerek memory ve transaction süresini sınırlar. Örneğin on bin kayıt tek context yerine beş yüzlük parçalarla işlenebilir. Her batch sonunda save ve context clear yapılabilir. Batch size çok küçük seçilirse round-trip sayısı artar, çok büyük seçilirse memory baskısı geri gelir. Uygun değer production benzeri workload üzerinde ölçülerek belirlenmelidir.
Session/Context Clear
Session veya context clear işlemi ORM'nin takip ettiği entity'leri bırakmasına yardımcı olur. Büyük import ve migration benzeri işlerde memory growth sorununu azaltabilir. Ancak clear sonrasında entity identity ve tracking state'i kaybolacağı için devam eden iş mantığı buna göre tasarlanmalıdır. Transaction içinde referans verilen nesnelerin davranışı ORM'ye göre farklılık gösterebilir. Bu nedenle clear stratejisi küçük testlerde değil, gerçek işlem akışı üzerinde doğrulanmalıdır.
Bulk Insert, Update ve Delete İşlemleri
Bulk işlemler ORM performansının kolayca sınandığı alanlardan biridir. Binlerce entity'yi tek tek yükleyip değiştirmek hem database round-trip hem change tracking maliyeti oluşturabilir. Set-based UPDATE veya DELETE ifadeleri aynı işi veritabanında tek operasyonla çözebilir. Bulk insert mekanizmaları da batching ve database-specific protokoller sayesinde daha yüksek throughput sağlayabilir. Buna karşılık entity lifecycle hook, validation ve audit davranışlarının atlanıp atlanmadığı mutlaka kontrol edilmelidir.
Entity'leri Tek Tek Güncellemek
Binlerce entity'yi önce SELECT ile yükleyip ardından tek tek değiştirmek çoğu bulk update için pahalı bir yaklaşımdır. Uygulama gereksiz data transferi, hydration ve tracking işlemi yapar. Sonrasında çok sayıda UPDATE komutu gönderilebilir. Eğer güncelleme basit bir predicate ve set işlemiyle ifade edilebiliyorsa database tarafında set-based update daha verimlidir. Entity lifecycle iş kuralları gerekiyorsa performans ile davranış doğruluğu arasında bilinçli seçim yapılmalıdır.
SQL Batching
SQL batching birden fazla INSERT veya UPDATE komutunu daha az network round-trip ile göndermeyi amaçlar. ORM'nin desteklediği batching mekanizması küçük ve orta büyüklükte yazma işlemlerinde önemli kazanç sağlayabilir. Batch size çok büyüdüğünde parameter limitleri veya transaction boyutu sorun oluşturabilir. Database log ve latency metrikleriyle uygun ayar bulunmalıdır. Batching set-based operation kadar verimli olmayabilir, ancak entity lifecycle davranışını korumak gerektiğinde iyi bir ara çözüm sunar.
Bulk Insert
Bulk insert büyük miktarda veriyi veritabanına yüksek throughput ile yazmayı hedefler. Database'in copy, bulk protocol veya multi-row insert özellikleri ORM'nin normal entity ekleme akışından çok daha hızlı olabilir. Import ve event ingestion gibi senaryolarda fark belirgin hale gelir. Bulk mekanizması kullanılırken transaction boyutu, index maintenance ve constraint maliyeti de göz önünde bulundurulmalıdır. İşlem sonrasında ORM context state'inin database ile uyumlu kalıp kalmadığı kontrol edilmelidir.
Set-Based Update
Set-based update koşula uyan kayıtların database tarafında tek UPDATE ifadesiyle değiştirilmesini sağlar. Entity'leri uygulamaya taşıma ihtiyacı olmadığı için network ve hydration maliyeti ortadan kalkar. Büyük veri setlerinde bu yaklaşım çok daha ölçeklenebilir olabilir. Buna karşılık entity-level validation veya callback mekanizmaları çalışmayabilir. Audit ve business rule gereksinimleri varsa set-based operation tasarımında açıkça ele alınmalıdır.
Set-Based Delete
Set-based delete de benzer biçimde kayıtları tek tek yüklemek yerine doğrudan database tarafında siler. Büyük temizlik ve retention işlemlerinde performans avantajı sağlar. Foreign key cascade, trigger ve lock etkisi yine dikkatle incelenmelidir. Çok büyük delete işlemleri transaction log ve replication yükü oluşturabileceği için parçalı çalışma gerekebilir. ORM'nin bulk delete API'si generated SQL ve affected row count açısından doğrulanmalıdır.
ORM Lifecycle Hook Trade-Off'ları
Bulk ve set-based işlemler bazı ORM lifecycle hook'larını atlayabilir. Entity callback, domain event veya automatic audit alanları normal SaveChanges akışında çalışırken bulk SQL'de devre dışı kalabilir. Bu fark yalnızca teknik değil, iş doğruluğu açısından kritiktir. Performans kazancı elde edilirken veri bütünlüğü kuralları korunmalıdır. Gerekirse bulk operation için ayrı audit veya domain event mekanizması tasarlanmalıdır.
ORM'de Batch Size Nasıl Seçilir?
Batch size için her veritabanına ve her uygulamaya uyan tek bir sayı yoktur. Network latency, parameter limitleri, statement boyutu, transaction süresi ve workload tipi uygun değeri etkiler. Çok küçük batch fazla round-trip oluştururken çok büyük batch memory veya lock baskısını artırabilir. Bu nedenle başlangıç için makul bir değer seçilip production benzeri benchmark ile test edilmelidir. Throughput, p95 latency, database CPU ve connection kullanımına göre ayar yapılması daha güvenilir sonuç verir.
INSERT Batch Size
INSERT batch size aynı anda kaç kaydın gönderileceğini belirler. Büyük batch round-trip sayısını azaltır ve throughput'u artırabilir. Buna karşılık statement boyutu, parameter sayısı ve transaction log yükü büyür. Çok büyük değer lock süresini uzatabilir. Import workload'unda farklı batch boyutlarını karşılaştırarak throughput ile resource kullanımı arasında dengeli nokta bulunmalıdır.
UPDATE Batch Size
UPDATE batching çok sayıda ayrı entity update işlemini daha az network turuyla gönderebilir. Batch size arttıkça command payload ve transaction süresi büyüyebilir. Güncellemeler aynı predicate ile ifade edilebiliyorsa set-based update daha iyi seçenek olabilir. Entity bazlı hook gereksinimi varsa batching değerli bir ara çözüm sunar. Database lock ve log davranışı benchmark sırasında ayrıca izlenmelidir.
Fetch Batch Size
Fetch batch size relation ID'lerinin kaçlı gruplar halinde sorgulanacağını etkiler. Çok küçük değer N+1'e yaklaşan fazla query üretebilir. Çok büyük değer IN listesi ve parameter limitlerini zorlayabilir. Relation cardinality ile network latency birlikte düşünülmelidir. Query duration ve total transferred bytes ölçülerek dengeli değer belirlenebilir.
Network Paketleri
Batch büyüdükçe tek request içinde gönderilen ve alınan network verisi artar. Daha az round-trip avantajı, büyük paket ve buffer maliyetiyle dengelenmelidir. Özellikle cross-region bağlantıda round-trip azaltımı önemli olabilir. Aynı zamanda çok büyük payload uygulama memory'sini etkileyebilir. Network metrikleri batch tuning çalışmasının doğal bir parçası olmalıdır.
Database Parameter Limitleri
Veritabanları ve driver'lar tek statement içinde kullanılabilecek parameter sayısına sınır koyabilir. Büyük IN listeleri veya multi-row statement bu limite yaklaşabilir. ORM bazı durumlarda batch'i otomatik böler, ancak davranış doğrulanmalıdır. Limit aşıldığında hata almak yerine güvenli bir batch size belirlemek gerekir. Database türü değiştiğinde aynı ayarın geçerli olacağı varsayılmamalıdır.
Gerçek Benchmark ile Ayarlama
Batch size tuning yalnızca teoriyle yapılmamalıdır. Production benzeri veri hacmi, network ve concurrency kullanılarak birkaç aday değer test edilmelidir. Throughput, p95 latency, database CPU, connection wait ve memory ölçülmelidir. Tek kullanıcı benchmark'ı yüksek concurrency etkisini göstermez. Sonuçlar workload değiştikçe yeniden gözden geçirilmeli ve ayar kalıcı bir sabit olarak kabul edilmemelidir.
Connection Pool ORM Performansını Nasıl Etkiler?
Connection pool, her query için yeni database bağlantısı açma maliyetini azaltmak amacıyla hazır bağlantıları yeniden kullanır. ORM çoğu zaman bu pool'u doğrudan kendisi değil database driver üzerinden kullanır. Pool doğru çalıştığında connection establishment maliyeti düşer ve throughput artar. Pool doygun hale geldiğinde ise query başlamadan önce connection wait oluşur. Bu nedenle ORM performansı incelenirken database query süresi kadar connection pool saturation ve bekleme süresi de izlenmelidir.
Database Connection Pool Nedir?
Database connection pool önceden açılmış veya tekrar kullanılabilir bağlantıları yönetir. Uygulama query çalıştırmak istediğinde pool içinden connection alır ve işlem bitince geri bırakır. Bu yaklaşım TCP, TLS ve authentication maliyetlerinin sürekli tekrar etmesini engeller. Pool kapasitesi sınırlıdır ve aynı anda çok fazla işlem olduğunda bekleme oluşabilir. Connection'ın gereğinden uzun tutulması pool verimliliğini doğrudan düşürür.
ORM Context/Session Pool ile Farkı
ORM context veya session pool, database connection pool ile aynı şey değildir. Context pooling ORM nesnesinin setup maliyetini azaltmak için instance reuse sağlayabilir. Database connection pool ise gerçek network bağlantılarını yönetir. Context reuse olsa bile query sırasında pool'dan database connection alınması gerekir. İki kavramı ayrı izlemek, performans probleminin hangi kaynaktan geldiğini doğru anlamak açısından önemlidir.
Pool Exhaustion
Pool exhaustion bütün connection'ların kullanımda olması ve yeni işlemlerin boş connection beklemesi durumudur. Uzun transaction, yavaş query veya çok yüksek concurrency bu sonucu oluşturabilir. N+1 query davranışı da aynı request içinde connection kullanım süresini uzatarak baskıyı artırabilir. Pool size artırmak tek çözüm değildir çünkü database'in toplam connection limiti vardır. Asıl amaç connection'ları kısa süre tutmak ve gereksiz paralel query davranışını azaltmaktır.
Connection Wait
Connection wait query execution'dan önce oluştuğu için slow SQL analizi sırasında gözden kaçabilir. Kullanıcı request'i yavaşken database tarafında sorgular hızlı görünebilir. APM sistemi connection acquisition span'ini ayrı gösteriyorsa problem kolayca anlaşılır. Wait süresi yüksekse transaction uzunluğu, query concurrency ve pool size birlikte incelenmelidir. Bu metriğin p95 ve p99 değerleri production kapasitesi hakkında güçlü sinyal verir.
Max Pool Size
Max pool size aynı anda kaç database connection kullanılabileceğini sınırlar. Değeri artırmak daha fazla paralellik sağlayabilir, ancak database CPU ve memory kaynaklarını da zorlayabilir. Çok yüksek pool limiti uygulama instance sayısı arttığında toplam connection sayısını tehlikeli biçimde büyütebilir. Bu nedenle ayar yalnızca tek servis instance'ına bakılarak yapılmamalıdır. Capacity planning sırasında instance sayısı, database connection limiti ve beklenen concurrency birlikte hesaplanmalıdır.
Database Connection Limiti
Her veritabanının pratik veya yapılandırılmış bir connection kapasitesi vardır. Uygulama pool'larının toplamı bu kapasiteyi aşarsa sistem instability yaşayabilir. Auto-scaling ortamında yeni application instance'ları eklenirken toplam pool kapasitesi de büyür. Bu yüzden max pool size değerinin deployment ölçeğiyle birlikte düşünülmesi gerekir. Connection proxy veya pooler çözümleri bazı mimarilerde yardımcı olabilir, ancak kötü query ve uzun transaction problemlerinin yerine geçmez.
ORM Context Pooling Nedir?
Context pooling, ORM context veya session nesnelerinin tekrar kullanılmasını sağlayarak oluşturma maliyetini azaltmayı amaçlar. Bu özellik database connection pooling'den farklıdır ve çoğu zaman uygulama tarafındaki setup overhead'ini hedefler. Yüksek frekanslı kısa request'lerde fayda sağlayabilir. Ancak context içinde request'e özel veya tenant'a özel state tutuluyorsa reuse ciddi hata riski yaratabilir. Performans kazanımı kadar state reset davranışı ve multi-tenant güvenliği de dikkatle değerlendirilmelidir.
Context Oluşturma Maliyeti
ORM context oluşturulurken model metadata, service wiring ve internal state yapıları hazırlanabilir. Modern ORM'ler bu maliyetin bir bölümünü cache'lese de çok yüksek request frekansında kalan maliyet ölçülebilir olabilir. Context pooling hazır instance'ları tekrar kullanarak allocation azaltabilir. Kazancın büyüklüğü uygulama ve ORM sürümüne bağlıdır. Önce profiler ile context creation'ın gerçekten hot path olduğu doğrulanmalıdır.
Context Reuse
Context reuse işlem tamamlandıktan sonra aynı context instance'ının başka request için hazırlanmasını gerektirir. ORM tracking state, transaction ve custom state'i doğru biçimde temizlemelidir. Framework'ün desteklediği resmi pooling mekanizması kullanılmalıdır. Manuel context reuse kolayca stale state veya concurrency hatası oluşturabilir. Context nesnesinin thread-safe olduğu varsayılmamalı ve birden fazla eş zamanlı request tarafından paylaşılmamalıdır.
Multi-Tenant State Riski
Multi-tenant uygulamalarda context üzerinde tenant ID gibi request-specific state tutulabilir. Pooling sonrası bu state doğru reset edilmezse bir tenant'ın filtresi başka request'e taşınabilir. Bu yalnızca performans değil ciddi veri izolasyonu sorunudur. Global query filter veya custom interceptor kullanılıyorsa reuse davranışı test edilmelidir. Tenant state'in context lifetime'ına nasıl bağlandığı açık bir tasarım kararı olmalıdır.
Context Pool ile Connection Pool Farkı
Context pool uygulama içindeki ORM nesnelerini, connection pool ise database bağlantılarını yeniden kullanır. Context pool açıkken her context sürekli bir database connection tutmak zorunda değildir. Query çalıştığında connection driver pool'dan alınabilir ve işlem sonunda geri verilir. Bu ayrım bilinmediğinde pool ayarları yanlış yorumlanabilir. Monitoring panelinde context creation ve connection wait gibi metriklerin ayrı gösterilmesi daha doğru teşhis sağlar.
Transaction Yönetimi ORM Performansını Nasıl Etkiler?
Transaction sınırları database lock süresi, connection kullanımı ve concurrency üzerinde doğrudan etkilidir. ORM bazı işlemleri otomatik transaction içinde çalıştırabilir, geliştirici de birden fazla adımı explicit transaction ile gruplayabilir. Transaction gereğinden uzun tutulduğunda lock wait ve pool starvation riski artar. Özellikle transaction içindeyken harici API çağrısı yapmak connection ve lock süresini gereksiz uzatabilir. Performans ile veri bütünlüğü arasında doğru sınırı bulmak için transaction yalnızca gerçekten atomik olması gereken database işlemlerini kapsamalıdır.
Implicit Transactions
ORM'ler SaveChanges veya flush gibi işlemleri çoğu zaman otomatik transaction içinde çalıştırır. Bu davranış veri bütünlüğü açısından güvenlidir ve geliştiriciye kolaylık sağlar. Ancak büyük batch işlemde transaction süresi beklenenden uzun olabilir. Generated SQL ve transaction log gözlemi gerçek davranışı anlamaya yardımcı olur. Çok büyük write operation'larda işlem parçalara ayrılacaksa atomiklik gereksinimi ayrıca değerlendirilmelidir.
Explicit Transactions
Explicit transaction birden fazla database adımının aynı atomik sınır içinde çalışmasını sağlar. Transfer, stok güncelleme veya birden fazla tablo değişikliği gibi durumlarda gerekli olabilir. Buna karşılık transaction kapsamına gereksiz query veya uygulama işlemi eklemek lock süresini artırır. Transaction mümkün olduğunca kısa tutulmalıdır. Performans optimizasyonu transaction'ı kaldırmak değil, iş gereksinimi için gereken en küçük güvenli kapsamı oluşturmaktır.
Uzun Transaction'lar
Uzun transaction'lar row veya table lock'larının daha uzun tutulmasına neden olabilir. Aynı verilere erişen diğer request'ler beklemeye başlar ve p99 latency yükselir. Ayrıca database connection transaction boyunca kullanımda kalabilir. Yüksek concurrency altında bu durum pool exhaustion riskini artırır. Büyük işlemleri parçalara bölmek mümkünse consistency gereksinimiyle birlikte değerlendirilmelidir.
Lock Süresi
Lock süresi yalnızca query execution süresine değil, transaction'ın açık kaldığı toplam süreye bağlı olabilir. Uygulama business logic veya network çağrısı yaparken lock tutulması gereksiz contention yaratır. Database lock monitoring ile hangi transaction'ların uzun süre kaynak tuttuğu görülebilir. ORM abstraction lock davranışını görünmez hale getirmemelidir. Kritik write endpoint'lerinde transaction başlangıç ve bitiş noktaları kodda açık biçimde anlaşılmalıdır.
Connection Pool Starvation
Transaction açık kaldığı sürece connection çoğu durumda pool'a geri dönemez. Çok sayıda uzun transaction eş zamanlı çalışırsa yeni request'ler connection bekler. Bu durum database CPU düşük olsa bile uygulamayı yavaşlatabilir. Connection wait metriği problemi ortaya çıkarır. Transaction sürelerini kısaltmak çoğu zaman max pool size artırmaktan daha sürdürülebilir çözüm sağlar.
Transaction İçinde Harici API Çağrısı Yapmak
Transaction içinde harici API çağrısı yapmak database kaynaklarını network yanıtı gelene kadar gereksiz yere tutabilir. Harici servis yavaşladığında transaction süresi saniyelere çıkabilir. Lock ve connection bu süre boyunca diğer request'leri etkileyebilir. Mümkünse dış servis çağrısı transaction dışında yapılmalı veya workflow farklı şekilde tasarlanmalıdır. Dağıtık sistemlerde veri tutarlılığı yaklaşımları için https://www.diyarbakiryazilim.com.tr/posts/dagitik-sistemlerde-veri-tutarliligini-data-consistency-saglamak içeriği bu konuyu daha geniş mimari çerçevede ele almak için yararlı bir devam noktasıdır.
Query Compilation Maliyeti
ORM query API'si çoğu zaman uygulama expression'ını analiz edip SQL'e çevirmek için belirli bir compilation maliyeti taşır. Aynı query shape sık çalışıyorsa ORM cache veya compiled query özelliğiyle bu maliyet azaltılabilir. Ancak database execution süresi çok yüksekse compilation optimizasyonu toplam latency üzerinde küçük etki yaratır. Bu nedenle compiled query yalnızca ölçümle belirlenen hot path'lerde kullanılmalıdır. Query compilation iyileştirmesi generated SQL ve index problemlerinin yerine geçmez.
Expression Tree
Birçok ORM sorguyu expression tree veya benzer ara temsil üzerinden analiz eder. Filtre, projection ve ordering bu yapı içinde tutulur. Dynamic query builder her request'te farklı shape üretirse cache verimliliği düşebilir. Expression oluşturma maliyeti yüksek frekansta CPU tüketimine dönüşebilir. Ancak optimizasyon öncesinde profiler ile toplam request süresindeki payı ölçülmelidir.
Query Translation
Translation aşaması expression yapısını database dialect'ine uygun SQL'e çevirir. Karmaşık sorgular daha fazla analiz gerektirebilir. ORM provider bazı ifadeleri farklı SQL kalıplarıyla üretebilir ve bu durum execution plan'ı etkileyebilir. Translation maliyetini azaltmak kadar üretilen SQL'in kalitesini kontrol etmek önemlidir. Hot query'lerde generated SQL snapshot testleri regression riskini azaltabilir.
Query Cache
Query cache aynı query shape için translation veya compilation bilgisinin tekrar kullanılmasını sağlar. Parameter değerleri değişse bile query yapısı aynı kalıyorsa cache hit elde edilebilir. Dynamic constant kullanımı query shape'i değiştirerek cache miss oluşturabilir. Cache hit rate metriği yüksek frekanslı sorgularda faydalı olabilir. Düşük cache veriminde önce query builder'ın her request'te farklı expression üretip üretmediği incelenmelidir.
Compiled Queries
Compiled query özelliği belirli query'nin önceden hazırlanmış yürütme yolunu tekrar kullanmasını sağlar. Çok sık çalışan ve şekli sabit sorgularda application CPU maliyetini düşürebilir. Kullanımı kodu biraz daha özel hale getirebilir. Bu nedenle bütün query'leri compile etmek yerine gerçekten sıcak olan birkaç sorguya odaklanmak daha anlamlıdır. Benchmark sonuçları ORM sürümü değiştiğinde yeniden kontrol edilmelidir.
Hangi Query'ler Compiled Olmalı?
Yüksek frekansta çalışan, shape'i sabit ve database execution süresi düşük query'ler compiled query için iyi adaydır. Saniyede çok az çalışan rapor sorgusunda compilation kazancı toplam sistem üzerinde önemsiz kalabilir. Profiling ile CPU hot path'leri belirlenmelidir. Query cache zaten yüksek verim sağlıyorsa ek compiled API'nin katkısı sınırlı olabilir. Uygulama karmaşıklığını artırmadan ölçülebilir kazanç sağlayan sorgular seçilmelidir.
Hot Path Analizi
Hot path analizi uygulamanın en sık veya en pahalı çalışan kod yollarını belirler. ORM optimizasyonu bu alanlara odaklandığında yatırımın getirisi daha yüksek olur. Bir sorgu tek başına hızlı olsa bile saniyede binlerce kez çalışıyorsa toplam CPU tüketimi yüksek olabilir. APM ve profiler birlikte kullanılarak frequency ile cost çarpımı değerlendirilmelidir. Compiled query, projection veya raw SQL kararı bu analizden sonra verilmelidir.
Dynamic Query'ler Neden Performans Sorunu Oluşturabilir?
Dynamic query kullanıcı filtreleri veya farklı iş kurallarına göre her request'te farklı sorgu şekli oluşturabilir. Bu esneklik cache davranışı ve database plan reuse üzerinde olumsuz etki yaratabilir. Constant değerlerin expression içine gömülmesi her değer için farklı SQL üretimine yol açabilir. Çok sayıda farklı query shape plan cache pollution oluşturabilir. Dynamic query builder tasarlanırken parametre kullanımı, izin verilen filtre kombinasyonları ve generated SQL görünürlüğü birlikte düşünülmelidir.
Her Request'te Farklı Query Shape
Query shape her request'te değiştiğinde ORM query cache aynı planı tekrar kullanamayabilir. Çok sayıda optional filter rastgele expression ağacı üretiyorsa cache hit rate düşer. Aynı durum database tarafında da farklı SQL metinleri nedeniyle plan reuse oranını azaltabilir. Dynamic filtering gereken sistemlerde belirli ortak query kalıpları korunabilir. Query fingerprint dağılımını izlemek gereksiz shape çeşitliliğini tespit etmeye yardımcı olur.
Query Cache Miss
Query cache miss ORM'nin aynı translation ve compilation işini yeniden yapmasına neden olabilir. Tek request için maliyet küçük olsa da yüksek trafik altında CPU tüketimi artabilir. Cache miss oranı yüksekse expression builder davranışı incelenmelidir. Constant değerleri doğrudan tree içine gömmek yerine parameter kullanmak çoğu zaman daha stabil shape oluşturur. Önce query cache metriğinin gerçekten sorun olduğunu doğrulamak gerekir.
Database Plan Cache Pollution
Database her farklı SQL metni için ayrı execution plan tutmak zorunda kalabilir. Binlerce benzer ama text olarak farklı sorgu plan cache üzerinde baskı yaratır. Bu durum compilation CPU'sunu ve cache eviction oranını artırabilir. Parameterized SQL plan reuse ihtimalini yükseltir. Yine de parameter sensitivity gibi durumlarda tek plan her değer için ideal olmayabileceğinden database davranışı execution plan verileriyle değerlendirilmelidir.
Constant Yerine Parameter Kullanımı
Parameter kullanımı aynı SQL yapısının farklı değerlerle tekrar kullanılmasını sağlar. Bu hem ORM query cache hem database plan cache açısından avantajlı olabilir. String birleştirme veya constant inlining gereksiz query shape çeşitliliği oluşturabilir. Ayrıca parameterized SQL güvenlik açısından da önemlidir. Dynamic filtre builder'lar değerleri parametre olarak gönderirken yalnızca güvenli kolon ve operator setinin dinamik seçilmesine izin vermelidir.
Dynamic Filter Builder Tasarımı
İyi bir dynamic filter builder her kullanıcı girdisini doğrudan SQL yapısına dönüştürmez. İzin verilen alanlar ve operator'lar açık bir whitelist üzerinden seçilebilir. Değerler parameter olarak gönderilir ve ortak query shape'ler mümkün olduğunca korunur. Çok geniş filtre kombinasyonları varsa query fingerprint sayısı monitoring ile izlenmelidir. Sık kullanılan filtreler için uygun composite index tasarımı da query builder mimarisiyle birlikte düşünülmelidir.
Query Parameterization Neden Önemlidir?
Query parameterization hem güvenlik hem performans açısından temel bir veri erişim prensibidir. Değerlerin SQL metnine gömülmesi yerine parameter olarak gönderilmesi plan reuse ihtimalini artırabilir. ORM'ler çoğu normal query API'sinde bunu otomatik yapar. Raw SQL kullanıldığında ise geliştiricinin parameterized API'yi bilinçli biçimde seçmesi gerekir. Parameterization plan cache davranışını iyileştirebilir, ancak parameter sensitivity gibi database-specific konular yine execution plan üzerinden izlenmelidir.
Prepared Statements
Prepared statement aynı SQL yapısının farklı parameter değerleriyle tekrar kullanılmasına yardımcı olabilir. Driver ve database davranışına bağlı olarak parsing veya planning maliyeti azalabilir. Yüksek frekanslı küçük sorgularda bu kazanç daha görünür olur. ORM'nin prepared statement kullanım modeli provider'a göre değişebilir. Production performansı için driver ayarları ve database plan cache metrikleri birlikte değerlendirilmelidir.
Query Plan Reuse
Plan reuse database'in aynı query shape için daha önce oluşturduğu execution plan'dan yararlanmasını sağlar. Bu durum planning CPU maliyetini azaltabilir. Parameterized SQL plan reuse ihtimalini yükseltir. Ancak veri dağılımı çok dengesizse her parameter için aynı plan ideal olmayabilir. Bu nedenle yüksek latency gösteren query'lerde actual execution plan değerleri ayrıca incelenmelidir.
Constant Inlining
Constant inlining parameter değerini doğrudan SQL veya expression şekline yerleştirir. Bu davranış her farklı değer için farklı query text oluşturabilir. Plan cache ve ORM query cache verimliliği düşebilir. Bazı özel optimizasyonlarda constant plan seçimini iyileştirebilir, ancak varsayılan yaklaşım olarak kullanılmamalıdır. Kullanım database plan davranışı ölçülerek bilinçli biçimde seçilmelidir.
Plan Cache
Plan cache database'in daha önce derlediği query execution plan'larını saklar. Cache hit yüksek olduğunda planning maliyeti azalır. Çok fazla unique query text cache pollution oluşturabilir. ORM dynamic query davranışı bu nedenle database tarafındaki plan cache metrikleriyle ilişkilendirilmelidir. Yalnızca application code profiler kullanmak bu katmandaki problemi göstermez.
Parameter Sniffing / Parameter Sensitivity
Bazı veritabanlarında execution plan ilk veya belirli parameter değerlerine göre seçilebilir. Veri dağılımı çok dengesizse bir tenant için iyi plan başka tenant için kötü çalışabilir. Bu durum parameterization'ın yanlış olduğu anlamına gelmez, ancak plan sensitivity yönetimi gerektiğini gösterir. Large tenant ve small tenant sorguları ayrı ölçülmelidir. Database'in sunduğu plan seçenekleri ve query tasarımı birlikte değerlendirilerek daha stabil sonuç hedeflenmelidir.
ORM'nin Ürettiği SQL Nasıl İncelenir?
ORM performansını yönetmenin temel koşulu generated SQL'i görünür hale getirmektir. Query API ne kadar okunabilir olursa olsun veritabanının çalıştırdığı gerçek ifade SQL'dir. Development ortamında logging ve query debugging kullanılabilir, production'da ise güvenli query fingerprint ve APM span yaklaşımı tercih edilebilir. Query tag ve correlation ID ile SQL'in hangi endpoint'ten geldiği belirlenebilir. Hassas parameter değerleri loglanmadan da performans açısından yeterli gözlem kurulabilir.
SQL Logging
SQL logging geliştirme sırasında ORM davranışını anlamak için son derece yararlıdır. Generated statement, duration ve query source bilgisi N+1 veya gereksiz join problemlerini hızlıca gösterir. Production ortamında log hacmi ve hassas veri riski nedeniyle dikkatli yapılandırma gerekir. Tam parameter yerine fingerprint ve süre kaydı tercih edilebilir. Slow ve duplicate query alarmı logging verisini operasyonel performans aracına dönüştürebilir.
Query Debugging
Query debugging ORM query nesnesinin hangi SQL'e dönüştüğünü çalıştırmadan veya test sırasında görmeyi sağlar. Bu yöntem code review ve unit integration testlerinde faydalıdır. Özellikle projection, include ve dynamic filter değişikliklerinde SQL shape karşılaştırılabilir. Debug çıktısı execution plan yerine geçmez. Doğru SQL görüldükten sonra gerçek database üzerinde plan ve timing kontrolü yapılmalıdır.
Query Tags
Query tag SQL'e yorum veya metadata ekleyerek sorgunun application source'unu belirlemeyi kolaylaştırır. Endpoint veya feature adıyla tag kullanıldığında database monitoring ekranında sorgular daha hızlı eşleştirilebilir. Tag plan cache davranışını etkileyip etkilemediği kullanılan database ve ORM için kontrol edilmelidir. Çok yüksek cardinality tag değerleri kullanılmamalıdır. Correlation ID gibi her request'te değişen değeri doğrudan SQL text'e eklemek plan reuse açısından olumsuz olabilir.
Correlation ID
Correlation ID bir request'in application log, APM span ve database event'leri arasında takip edilmesini sağlar. Slow user request'i incelerken hangi SQL dizisinin çalıştığını bulmak kolaylaşır. ID'nin SQL text'i değiştirerek plan cache'i bozmayacak biçimde taşınması tercih edilir. APM context propagation veya database session metadata kullanılabilir. Gözlemlenebilirlik tasarımında query ile endpoint ilişkisinin kurulması performans teşhis süresini önemli ölçüde kısaltır.
Development Logging
Development logging daha ayrıntılı olabilir ve parameter değerleri test verisiyle birlikte incelenebilir. Geliştirici bir endpoint çalıştırdığında query count ve generated SQL'i hemen görebilmelidir. Bu geri bildirim N+1 problemlerinin daha kod yazılırken fark edilmesini sağlar. Log seviyesi sürekli yüksek tutulursa gürültü oluşabilir. Bu nedenle development profili performans debugging sırasında kolay açılıp kapanacak biçimde tasarlanmalıdır.
Production'da Hassas Parametreleri Loglamamak
Production loglarında kullanıcı verisi, token, e-posta veya kişisel içerik gibi hassas parameter'lar yer almamalıdır. Performans analizi için çoğu zaman SQL fingerprint, duration ve row count yeterlidir. Parameter gerekiyorsa güvenli redaction veya sınırlı kategorik metadata kullanılabilir. Log sistemi erişim ve retention politikalarıyla birlikte tasarlanmalıdır. Güvenli gözlem yaklaşımı performans görünürlüğünü korurken veri sızıntısı riskini azaltır.
Execution Plan Nasıl Analiz Edilir?
Execution plan, veritabanının bir SQL sorgusunu hangi adımlarla çalıştırdığını gösterir. ORM generated SQL'i yavaşsa problemin gerçekten nerede olduğunu anlamak için plan analizi gerekir. Seq scan, index scan, join türleri, sort ve estimated versus actual rows temel sinyaller arasındadır. Plan yalnızca teorik maliyet değil, mümkün olduğunda gerçek çalışma istatistikleriyle değerlendirilmelidir. ORM kodunu değiştirmeden önce yanlış index veya kötü cardinality tahmini gibi database kaynaklı sorunların bulunması gereksiz uygulama değişikliklerini önleyebilir.
EXPLAIN
EXPLAIN sorgunun tahmini execution plan'ını gösterir. Database optimizer hangi index'i, join sırasını ve scan türünü seçmeyi planladığını ortaya koyar. Production'da sorguyu gerçekten çalıştırmadan plan görmek güvenli bir başlangıç olabilir. Tahmini satır sayıları veri istatistiklerine dayanır. Estimate değerleri gerçek dağılımdan çok sapıyorsa optimizer yanlış plan seçebilir.
EXPLAIN ANALYZE
EXPLAIN ANALYZE sorguyu gerçekten çalıştırarak actual time ve row count gibi değerleri gösterir. Bu nedenle özellikle write query veya ağır production sorgularında dikkatli kullanılmalıdır. Staging veya güvenli read replica üzerinde analiz yapmak daha uygun olabilir. Estimated ve actual rows farkı plan problemlerini anlamada çok değerlidir. ORM optimizasyonu yapılırken generated SQL'in gerçek çalışma davranışı bu verilerle doğrulanabilir.
Seq Scan
Sequential scan tablonun büyük bölümünün veya tamamının okunması anlamına gelir. Küçük tablolarda bu davranış tamamen normal ve hızlı olabilir. Büyük tabloda çok seçici bir filtre için seq scan görülüyorsa index eksikliği veya SARGability problemi araştırılmalıdır. ORM expression'ı kolon üzerinde function üretiyorsa index kullanımı engellenebilir. Her seq scan'i hata kabul etmek yerine okunan satır sayısı ve toplam maliyet değerlendirilmelidir.
Index Scan
Index scan query'nin uygun index üzerinden ilgili satırlara eriştiğini gösterir. Bu genellikle seçici filtrelerde iyi bir sinyaldir. Ancak çok fazla random lookup gerekiyorsa büyük sonuçlarda seq scan daha ucuz olabilir. Covering index kullanımı table lookup ihtiyacını azaltabilir. ORM query projection'ı index tasarımıyla uyumlu olduğunda database daha az I/O ile sonuç üretebilir.
Nested Loop
Nested loop küçük outer result ve iyi index bulunduğunda oldukça verimli join algoritmasıdır. Outer satır sayısı tahminden çok büyük çıktığında maliyet hızla artabilir. N+1 mantığı database plan içinde de benzer biçimde çok sayıda index lookup olarak görülebilir. Actual row sayıları bu nedenle önemlidir. ORM filter veya relation join'i beklenenden geniş sonuç üretiyorsa nested loop pahalı hale gelebilir.
Hash Join
Hash join büyük ve eşitlik tabanlı join'lerde verimli olabilir. Database bir tarafı hash tablosuna dönüştürür ve diğer tarafla eşleştirir. Yeterli memory yoksa disk spill oluşabilir ve süre artabilir. ORM'nin join ettiği tablo sayısı arttıkça plan daha ağır hale gelebilir. Execution plan'daki memory ve actual row değerleri fetch strategy kararlarını desteklemek için kullanılabilir.
Sort
Sort işlemi ORDER BY, DISTINCT veya bazı aggregation adımlarında ortaya çıkar. Uygun index sıralamayı doğal biçimde sağlayabiliyorsa sort maliyeti azalabilir. Büyük result-set'in memory dışında sıralanması disk kullanımına neden olabilir. Pagination query'lerinde ORDER BY kolonlarının index tasarımı özellikle önemlidir. ORM'nin otomatik eklediği ordering ifadeleri generated SQL üzerinden kontrol edilmelidir.
Estimated vs Actual Rows
Estimated ve actual row farkı optimizer'ın veri dağılımını ne kadar doğru tahmin ettiğini gösterir. Büyük fark yanlış join algoritması veya index seçimine yol açabilir. İstatistiklerin eski olması, skew veya parameter sensitivity bu durumu oluşturabilir. Multi-tenant sistemlerde büyük tenant ile küçük tenant arasında tahmin problemleri daha sık görülür. ORM query shape sabit olsa bile parameter değerlerinin plan davranışı üzerindeki etkisi bu metrikle anlaşılabilir.
ORM Kullanırken Index Tasarımı
ORM kullanmak index ihtiyacını ortadan kaldırmaz. Foreign key, filtre, sıralama ve join kolonlarının doğru index yapısına sahip olması veritabanı performansının temelidir. ORM migration araçları index oluşturmayı kolaylaştırabilir, ancak hangi index'in gerekli olduğuna business query pattern karar verir. Çok fazla index write maliyetini ve storage kullanımını artırabilir. Bu nedenle index tasarımı generated SQL ve execution plan gözlemlerine dayalı yapılmalıdır.
Primary Key Index
Primary key çoğu veritabanında otomatik olarak unique index ile desteklenir. Entity lookup işlemleri bu index'ten yararlanır. ORM identity mapping de primary key bilgisini temel alır. Büyük tabloda primary key üzerinden pagination veya relation lookup sık kullanılıyorsa index kritik öneme sahiptir. Primary key tasarımı insertion pattern ve clustering davranışı açısından database-specific olarak ayrıca değerlendirilmelidir.
Foreign Key Index
Foreign key constraint tanımlamak her database'de otomatik index oluşturulduğu anlamına gelmez. Relation join ve child lookup sık kullanılıyorsa foreign key kolonunda index önemli olabilir. ORM relation metadata'sı bunu her zaman garanti etmez. N+1 düzeltildikten sonra batch query parent_id IN (...) şeklinde çalışıyorsa foreign key index daha da değerli hale gelir. Migration ve schema kontrolünde relation ile index ayrı ayrı doğrulanmalıdır.
Composite Index
Composite index birden fazla kolonu aynı index içinde belirli sırayla tutar. Sık kullanılan tenant_id, status ve created_at gibi filtre kombinasyonlarında etkili olabilir. Kolon sırası query predicate ve sorting yapısına göre seçilmelidir. Her olası kombinasyon için ayrı index oluşturmak doğru değildir. Query frequency ve execution plan verileri hangi composite index'in gerçekten değer ürettiğini göstermelidir.
Covering Index
Covering index query'nin ihtiyaç duyduğu kolonların tamamını index içinde sağlayarak table lookup ihtiyacını azaltabilir. Projection kullanan küçük read query'lerde özellikle güçlü sonuç verir. ORM full entity seçiyorsa covering index oluşturmak çok daha zor veya gereksiz büyük olabilir. Bu nedenle projection ile index tasarımı birbirini destekler. Index boyutu ve write amplification maliyeti yine göz önünde bulundurulmalıdır.
Partial / Filtered Index
Partial veya filtered index yalnızca belirli koşulu sağlayan satırları indexler. Soft delete kullanılan tabloda yalnızca aktif kayıtlar için index oluşturmak önemli avantaj sağlayabilir. Index daha küçük olur ve sık query'ler daha az veri üzerinde çalışır. Database desteği ve ORM migration yeteneği kontrol edilmelidir. Generated query filter'ın partial index predicate ile uyumlu olması gerekir.
ORM Relation Tanımı Index Garantisi midir?
ORM'de relation tanımlamak schema'da gereken bütün index'lerin otomatik bulunduğu anlamına gelmez. Bazı framework veya provider'lar foreign key için index oluşturabilir, bazıları oluşturmayabilir. Ayrıca gerçek query pattern composite veya filtered index gerektirebilir. Migration dosyaları production'a çıkmadan önce review edilmelidir. Relation modeli ile database physical design iki ayrı sorumluluk olarak ele alınmalıdır.
SARGability ve ORM
SARGability, query predicate'inin index tarafından etkili biçimde kullanılabilmesini ifade eder. ORM expression'ları bazen kolon üzerinde function veya type conversion üreterek index kullanımını zorlaştırabilir. Kod tarafında okunabilir olan bir filtre database tarafında seq scan oluşturabilir. Bu nedenle generated SQL ve execution plan birlikte incelenmelidir. SARGable predicate tasarımı büyük tablolar üzerindeki filtreleme performansında dramatik fark yaratabilir.
Index Kullanabilen Predicate
Index kullanabilen predicate genellikle indexed kolonun doğrudan karşılaştırıldığı koşullardır. Örneğin created_at değerini belirli aralıkta filtrelemek uygun index ile verimli olabilir. Kolon üzerinde gereksiz transform uygulanmazsa optimizer index range scan seçebilir. ORM query API'si predicate'i nasıl çevirdiği açısından kontrol edilmelidir. Özellikle tarih ve string filtrelerinde SQL çıktısı performans için belirleyicidir.
Kolon Üzerinde Function
Kolon üzerinde LOWER, DATE veya başka bir function kullanmak bazı database'lerde normal index'in kullanımını engelleyebilir. ORM'de string veya tarih helper metodu çağrısı böyle SQL üretebilir. Çözüm predicate'i range biçiminde yazmak veya uygun functional index kullanmak olabilir. Hangi seçenek daha iyi olduğu workload'a bağlıdır. Execution plan üzerinden index kullanımının gerçekten değişip değişmediği doğrulanmalıdır.
Leading Wildcard
LIKE '%kelime' gibi leading wildcard aramaları standart B-tree index'ten yararlanamayabilir. ORM contains benzeri string fonksiyonları bu SQL'e dönüşebilir. Küçük tabloda sorun görünmezken büyük arama tablolarında ciddi scan maliyeti oluşur. Full-text search veya database-specific index seçenekleri değerlendirilmelidir. Kullanıcı arama özelliğinin gerçek beklentisi query tasarımını belirlemelidir.
Implicit Type Conversion
Kolon ile parameter tipi uyumsuz olduğunda database implicit conversion yapabilir. Conversion kolon tarafında gerçekleşirse index kullanımı olumsuz etkilenebilir. ORM model tipi ile database column tipi bu nedenle uyumlu olmalıdır. Generated SQL parameter type bilgisi debugging sırasında kontrol edilebilir. Özellikle string uzunluğu, numeric tip ve date type farkları plan davranışını etkileyebilir.
ORM Expression'ın Ürettiği SQL'i Kontrol Etmek
SARGability problemi çoğu zaman uygulama expression'ına bakılarak anlaşılmaz. Aynı helper fonksiyon farklı provider'larda farklı SQL üretebilir. Bu nedenle kritik filtreler için generated SQL snapshot veya integration test faydalıdır. Execution plan index scan yerine seq scan gösteriyorsa predicate shape incelenmelidir. ORM abstraction'ın altında gerçek database behavior'ın kontrol edilmesi performans çalışmalarının temel alışkanlığı olmalıdır.
Pagination ORM Performansını Nasıl Etkiler?
Pagination büyük result-set'i kontrollü sayfalara bölerek network, hydration ve memory maliyetini sınırlar. ORM'ler genellikle OFFSET ve LIMIT benzeri yapıları kolayca üretir. İlk sayfalarda bu yöntem hızlı olabilir, fakat çok derin sayfalarda database atlanacak satırları yine işlemek zorunda kalabilir. Veri büyüdükçe deep pagination maliyeti artar. Stabil ordering gerektiren yüksek hacimli API'lerde keyset veya cursor pagination daha ölçeklenebilir alternatif olabilir.
OFFSET/LIMIT
OFFSET/LIMIT uygulaması basit ve sayfa numarası tabanlı arayüzler için pratiktir. İlk sayfalarda database az satır atladığı için maliyet düşüktür. OFFSET değeri yüz binlere çıktığında database istenen sayfaya ulaşmadan önce çok sayıda satırı okuyup atabilir. Uygun index bunu tamamen ortadan kaldırmaz. Büyük tabloda kullanım pattern'i deep pagination içeriyorsa cursor yaklaşımı değerlendirilmelidir.
Deep Pagination Problemi
Deep pagination kullanıcı çok ileri sayfaya gittiğinde OFFSET değerinin büyümesiyle oluşur. Database sıralamayı korumak için önceki satırları işleyebilir. Query duration veri büyüdükçe artar ve p99 latency yüksek sayfalarda belirginleşir. Bot veya export işlemleri çok derin sayfa gezintisi yapıyorsa sorun daha ağır hale gelir. Keyset pagination son görülen sort değerinden devam ederek bu maliyeti büyük ölçüde azaltabilir.
Database'in Satırları Okuyup Atması
OFFSET yaklaşımında database çoğu zaman atlanacak satırları da plan içinde işler. Kullanıcı yalnızca yirmi kayıt alırken yüz bin satır üzerinden geçmek gerekebilir. Bu CPU ve I/O maliyetini artırır. Execution plan actual rows değeri problemi gösterebilir. Deep page query'leri monitoring içinde ayrı fingerprint veya parameter bucket ile izlenmelidir.
Data Büyüdükçe Artan Maliyet
OFFSET maliyeti tablo büyüdükçe aynı sayfa numarası için bile değişebilir. Yeni kayıtlar sıralamanın başına eklendikçe derin sayfaya ulaşmak daha pahalı hale gelebilir. Production veri hacmi local testten çok büyük olduğunda fark dramatik olur. Bu nedenle pagination benchmark'ı gerçekçi row count ile yapılmalıdır. Büyük veri setlerinde keyset yaklaşımına geçiş için kullanıcı arayüzünün random page gereksinimi de değerlendirilmelidir.
Keyset / Cursor Pagination
Keyset pagination bir önceki sayfanın son sıralama değerini cursor olarak kullanır ve sonraki query'yi bu değerden devam edecek biçimde kurar. Database büyük OFFSET değerini işlemek zorunda kalmaz. Uygun index ile sabit ve düşük latency elde etmek daha kolaydır. Buna karşılık doğrudan 500. sayfaya atlama gibi random access senaryoları zorlaşır. API, feed ve infinite scroll uygulamalarında cursor yaklaşımı çoğu zaman daha iyi ölçeklenir.
Cursor Nedir?
Cursor sonraki sayfanın nereden başlayacağını belirleyen bir referanstır. Genellikle son kaydın sort değeri ve unique tie-breaker bilgisi encode edilir. Kullanıcı cursor'ı doğrudan anlamak zorunda değildir. API sonraki sayfa token'ı olarak döndürebilir. Cursor tasarımı stable ordering ve filtre değişiklikleriyle uyumlu olmalıdır.
Stable Sort
Keyset pagination için sıralamanın kararlı olması gerekir. Yalnızca created_at gibi duplicate değer içerebilen kolonla sıralama yapılırsa kayıt atlama veya tekrar riski oluşabilir. Bu nedenle sort key'e unique bir tie-breaker eklenir. created_at ve id birlikte yaygın bir örnektir. Composite index de aynı sıralamayı destekleyecek biçimde tasarlanabilir.
Tie-Breaker Primary Key
Primary key tie-breaker aynı sort değerine sahip kayıtların kesin sırasını belirler. Query örneğin created_at eşitse id üzerinden devam eder. Bu yapı cursor pagination'ın deterministik çalışmasını sağlar. Composite predicate generated SQL açısından dikkatle kontrol edilmelidir. ORM query builder bu koşulu desteklemiyorsa custom expression veya raw SQL kullanılabilir.
OFFSET'e Göre Avantajları
Keyset pagination'ın temel avantajı deep page maliyetinin veri büyüdükçe dramatik biçimde artmamasıdır. Database uygun index üzerinden son görülen değerden devam edebilir. Büyük OFFSET taraması ortadan kalkar. Bu durum p95 ve p99 latency'yi daha stabil hale getirir. Özellikle sürekli ileri doğru gezilen feed ve API listelerinde güçlü bir seçenektir.
Random Page Access Dezavantajı
Cursor pagination doğrudan belirli sayfa numarasına atlamayı doğal biçimde desteklemez. Kullanıcının 37. sayfaya gitmesi gerekiyorsa önceki cursor zincirine ihtiyaç olabilir. Yönetim panelleri gibi klasik sayfa numarası deneyiminde bu dezavantaj önemlidir. Hybrid yaklaşım veya sınırlı OFFSET kullanılabilir. Pagination yöntemi yalnızca database performansına değil, ürün deneyimine göre de seçilmelidir.
API ve Infinite Scroll İçin Kullanım
API ve infinite scroll kullanıcıları genellikle sıradaki kayıt grubunu ister. Bu davranış cursor pagination ile doğal biçimde uyumludur. Response içinde next_cursor dönülerek istemci sonraki sayfayı talep eder. Stable sort ve filter state korunmalıdır. Büyük veri setlerinde bu yaklaşım hem database maliyetini azaltır hem kullanıcı scrolling deneyimini daha stabil hale getirir.
COUNT(*) ve Toplam Sayfa Maliyeti
Pagination arayüzleri çoğu zaman toplam kayıt ve toplam sayfa göstermek için COUNT(*) çalıştırır. Küçük tabloda bu işlem ucuz olabilir, ancak büyük ve karmaşık filtrelerde count query ayrı bir pahalı operasyon haline gelebilir. Kullanıcı aslında yalnızca sonraki sayfanın olup olmadığını bilmek isteyebilir. Böyle durumlarda page size + 1 kayıt çekerek hasNext bilgisi üretmek daha ucuz olabilir. Toplam count'ın gerçekten ürün gereksinimi olup olmadığı sorgulanmalıdır.
Her Request'te Total Count
Her liste request'inde total count çalıştırmak database yükünü iki katına yakın artırabilir. Ana query ve count query farklı execution plan kullanabilir. Çok sık güncellenen büyük tabloda kesin count pahalı hale gelir. UI'nin her yenilemede toplam sayıya gerçekten ihtiyacı yoksa cache veya hasNext yaklaşımı kullanılabilir. Count metriği ayrı query fingerprint olarak monitoring içinde izlenmelidir.
Büyük Tablolarda COUNT
Büyük tabloda exact COUNT(*) database türü ve filtreye göre yüksek I/O maliyeti oluşturabilir. Index üzerinden sayım bazı durumlarda daha ucuz olabilir ancak her zaman sabit zamanlı değildir. Karmaşık join ve tenant filter count maliyetini daha da büyütür. Reporting için count kabul edilebilirken kullanıcı request path'inde pahalı olabilir. Gerçek execution plan ve latency ölçülerek ürün gereksinimiyle birlikte karar verilmelidir.
Approximate Count
Approximate count kesin sayı yerine database istatistiklerinden veya ayrı aggregate yapısından yaklaşık değer döndürür. Dashboard ve genel büyüklük göstergelerinde yeterli olabilir. Kullanıcı finansal veya hukuki sonuç bekliyorsa yaklaşık değer uygun değildir. Cache ile periyodik count hesaplama da alternatif olabilir. Performans kazanımı için doğruluk gereksinimi açık biçimde tanımlanmalıdır.
Has Next Page Yaklaşımı
Has next page yaklaşımında page size kadar kayıt yerine bir fazla kayıt çekilir. Ek kayıt varsa sonraki sayfanın bulunduğu anlaşılır ve fazladan kayıt response'a eklenmez. Böylece pahalı total count query'si atlanabilir. Cursor pagination ile birlikte oldukça doğal çalışır. Kullanıcıya toplam sayfa göstermek zorunlu değilse yüksek trafikli API'lerde etkili bir optimizasyon olabilir.
Infinite Scroll
Infinite scroll kullanıcıya toplam sayfa sayısını göstermek zorunda değildir. Bu nedenle cursor ve hasNext yaklaşımıyla count query tamamen kaldırılabilir. Büyük feed sistemlerinde database yükü önemli ölçüde azalabilir. Kullanıcı deneyimi açısından geri dönme ve konum koruma gibi detaylar ayrıca tasarlanmalıdır. Veri erişim modeli ürün interaction biçimiyle uyumlu olduğunda hem performans hem sadelik kazanılır.
Buffering ve Streaming Arasındaki Fark
Buffering tüm result-set'in uygulama belleğine alınmasını, streaming ise satırların geldikçe işlenmesini ifade eder. Küçük sonuçlarda buffering daha basit ve yeterlidir. Büyük export veya batch işlemlerinde ise tüm veriyi RAM'e almak yüksek memory baskısı oluşturabilir. Streaming memory kullanımını azaltırken connection'ın daha uzun süre açık kalmasına neden olabilir. Bu nedenle memory ile connection pool kapasitesi arasında uygun denge kurulmalıdır.
Tüm Result-Set'i RAM'e Alma
Buffering query tamamlandıktan sonra bütün sonuçları collection olarak bellekte tutar. Uygulama aynı veriye birden fazla kez erişecekse pratik olabilir. Büyük result-set'te memory kullanımı hızla artar. ORM tracking açıksa entity state'i de ek maliyet yaratır. Pagination veya streaming daha kontrollü seçenek olabilir.
Streaming Row Processing
Streaming satırları sırayla işleyerek aynı anda bellekte tutulan veri miktarını azaltır. Büyük export, migration ve batch processing için faydalıdır. Uygulama her satırı işledikten sonra referansı bırakabilir. Buna karşılık database reader ve connection işlem tamamlanana kadar açık kalabilir. Uzun süren CPU işlemleri streaming loop içinde yapılacaksa connection pool etkisi dikkatle değerlendirilmelidir.
Server-Side Cursor
Bazı database ve driver'lar server-side cursor ile sonuçları parça parça iletebilir. Bu yaklaşım büyük query sonucunun tek seferde client memory'sine alınmasını engeller. ORM desteği ve transaction davranışı framework'e göre değişebilir. Cursor uzun süre açık kaldığında database kaynakları da tutulabilir. Büyük veri işleme tasarımında fetch size ve timeout değerleri gerçek workload ile test edilmelidir.
Memory Kullanımı
Streaming'in en belirgin avantajı peak memory kullanımını düşürmesidir. Buffering yüz binlerce entity oluşturduğunda uygulama container memory limitine yaklaşabilir. Daha düşük memory kullanımı garbage collection baskısını da azaltabilir. Ancak ORM her satırı tracked entity olarak tutuyorsa streaming tek başına yeterli olmayabilir. No-tracking ve context clear gibi stratejilerle birlikte kullanılmalıdır.
Connection'ın Daha Uzun Süre Açık Kalması
Streaming sırasında result reader tamamlanana kadar connection pool'dan alınan bağlantı tutulabilir. İşlem uzun sürerse diğer request'ler connection beklemeye başlayabilir. Bu nedenle streaming loop içindeki ağır CPU veya external API işlemlerinden kaçınılmalıdır. Gerekirse veriler makul chunk'lar halinde okunup connection serbest bırakılabilir. Memory kazanımı pool starvation oluşturmayacak biçimde tasarlanmalıdır.
Async ORM Kullanımı Performansı Artırır mı?
Async veri erişimi tek bir SQL sorgusunun database'de daha hızlı çalışmasını sağlamaz. Asıl fayda uygulama thread'inin I/O beklerken başka işler yapabilmesine izin vermesidir. Yüksek concurrency altında thread scalability iyileşebilir. Bununla birlikte database connection pool limiti hâlâ geçerlidir ve async kullanmak sınırsız paralellik anlamına gelmez. N+1 sorguları async çalıştırmak da query sayısını azaltmadığı için temel problemi çözmez.
Async Query Daha Hızlı mıdır?
Async query aynı SQL ve aynı database koşullarında çoğu zaman sync query'den daha hızlı execute olmaz. Database execution süresi değişmez. Kazanç uygulama thread'inin bekleme sırasında bloklanmamasıdır. Düşük concurrency command-line işinde fark sınırlı olabilir. Web server gibi çok sayıda eş zamanlı I/O işlemi olan sistemlerde scalability açısından daha değerlidir.
Thread Scalability
Sync I/O sırasında thread database yanıtını beklerken kullanılamaz durumda kalabilir. Async model thread'i serbest bırakarak başka request'lerin ilerlemesine olanak tanır. Bu durum yüksek concurrency altında thread pool baskısını azaltabilir. Yine de application CPU yoğun ise async faydası sınırlı kalır. ORM ve driver'ın gerçek async I/O desteği olup olmadığı kontrol edilmelidir.
I/O Wait
Database query'nin önemli bölümü network ve database yanıtı beklemekten oluşur. Async programlama bu bekleme süresinde uygulama execution kaynaklarını daha verimli kullanır. Kullanıcı latency'si aynı kalabilir fakat toplam throughput artabilir. Query yavaşsa async yalnızca bekleme biçimini değiştirir. Asıl sorgu optimizasyonu yine generated SQL, index ve fetch strategy üzerinden yapılmalıdır.
Connection Pool Limitleri
Async kullanmak database connection sayısını otomatik artırmaz. Aynı anda yüzlerce async query başlatılırsa pool limiti nedeniyle çoğu connection bekleyebilir. Gereksiz parallel query kullanımı database'i de aşırı yükleyebilir. Concurrency limiter veya semaphore bazı batch işlerinde gerekebilir. Async tasarım connection pool ve database capacity ile birlikte ele alınmalıdır.
Async N+1 Problemi Yine N+1'dir
N+1 sorgularını async çalıştırmak round-trip sayısını azaltmaz. Hatta hepsini paralel başlatmak connection pool üzerinde ani baskı oluşturabilir. Query count ve database CPU yine yüksek kalır. Doğru çözüm relation verisini batch, join veya projection ile daha az sorguda almaktır. Async performans optimizasyonu query tasarımının yerine geçmemelidir.
ORM Caching Katmanları
ORM ve uygulama performansında cache farklı katmanlarda kullanılabilir. First-level cache ve identity map genellikle context içindeki entity tekrarlarını azaltırken second-level cache context'ler arasında veri paylaşabilir. Query cache bazı ORM'lerde sorgu sonuçlarını değil, query compilation bilgisini ifade eder. Application ve distributed cache ise daha üst seviyede response veya domain verisini saklayabilir. Cache tasarımında hit rate kadar invalidation, stale data ve consistency maliyeti de hesaba katılmalıdır.
First-Level Cache
First-level cache genellikle ORM context veya session kapsamındadır. Aynı primary key yeniden istendiğinde ORM database'e gitmeden mevcut tracked entity'yi döndürebilir. Bu özellik kısa transaction içinde faydalıdır. Uzun yaşayan session'da ise stale data ve memory growth riski oluşturabilir. Context lifetime mümkün olduğunca iş akışı sınırıyla uyumlu tutulmalıdır.
Identity Map
Identity map aynı database kaydının context içinde tek nesneyle temsil edilmesini sağlar. Relation graph tutarlılığı için önemli bir davranıştır. Aynı entity farklı query'lerde tekrar alındığında ek nesne oluşturulmasını azaltabilir. Buna karşılık map memory ve lookup maliyeti taşır. Büyük read-only sorgularda bu özelliğin gerekli olup olmadığı no-tracking seçenekleriyle değerlendirilmelidir.
Second-Level Cache
Second-level cache context veya session ömrünün ötesinde entity veya query verisini saklayabilir. Read-heavy ve az değişen reference data için database yükünü azaltabilir. Çok sık güncellenen transactional veride invalidation daha zor hale gelir. Multi-node uygulamalarda cache consistency ayrıca çözülmelidir. Cache kullanılmadan önce hit rate ve veri tazelik toleransı açık biçimde tanımlanmalıdır.
Query Cache
Query cache terimi bazı ORM'lerde query translation veya plan metadata cache'ini ifade eder. Bazı eklentiler ise gerçek result cache sağlayabilir. Bu iki davranış karıştırılmamalıdır. Compilation cache performansı CPU tarafında etkilerken result cache database erişimini azaltabilir. Monitoring sırasında hangi cache türünün ölçüldüğü açık olmalıdır.
Application Cache
Application cache iş mantığına yakın veriyi uygulama process'i içinde saklar. Çok sık okunan ancak az değişen konfigürasyon veya lookup verileri için basit ve hızlıdır. Birden fazla instance olduğunda her instance farklı cache state taşıyabilir. Invalidation ve memory sınırı yönetilmelidir. ORM query'sini cachelemek yerine domain açısından anlamlı veri parçalarını cachelemek çoğu zaman daha kontrollü olur.
Distributed Cache
Distributed cache birden fazla application instance'ının ortak cache verisine erişmesini sağlar. Multi-node ortamda consistency yönetimini kolaylaştırabilir. Buna karşılık her cache erişimi network çağrısıdır ve serialization maliyeti vardır. Cache hit hızlı olsa bile database sorgusundan her zaman daha ucuz olduğu varsayılmamalıdır. Hit rate, payload size ve invalidation trafiği birlikte ölçülmelidir.
Second-Level Cache Ne Zaman Kullanılmalı?
Second-level cache en çok sık okunan ve seyrek değişen verilerde fayda sağlar. Reference data, kategori listeleri veya uzun süre değişmeyen configuration entity'leri bunun tipik örnekleridir. Transactional ve sürekli güncellenen veride invalidation maliyeti cache kazancını azaltabilir. Multi-node sistemlerde stale data toleransı ve consistency modeli açıkça belirlenmelidir. Cache eklemeden önce database query'sinin gerçekten önemli bir load kaynağı olup olmadığı ölçülmelidir.
Read-Heavy Data
Read-heavy data çok sık okunup nadiren değişiyorsa cache için güçlü adaydır. Aynı query'nin binlerce kez database'e gitmesi yerine cache hit ile sonuç döndürülebilir. Bu database CPU ve connection kullanımını azaltabilir. Cache key cardinality kontrol edilmelidir. Hit rate düşükse cache memory ve invalidation maliyeti beklenen faydayı sağlamayabilir.
Reference Data
Ülke, kategori veya sabit lookup tabloları reference data örnekleridir. Bu veri genellikle az değiştiği için uzun TTL veya explicit invalidation ile cachelenebilir. ORM second-level cache bu kullanım için uygun olabilir. Uygulama başlangıcında tamamen memory'ye almak da küçük veri setlerinde seçenektir. Değişiklik olduğunda bütün instance'ların güncel veriye ulaşması sağlanmalıdır.
Az Değişen Entity'ler
Az değişen entity'ler yüksek cache hit potansiyeli taşır. Ancak entity'nin relation'ları sık değişiyorsa cache invalidation beklenenden daha geniş olabilir. Cache boundary dikkatle seçilmelidir. Tam entity yerine ihtiyaca özel küçük view modeli cachelemek bazen daha kolaydır. Veri tazelik gereksinimi ürün ekibiyle birlikte netleştirilmelidir.
Transactional Data'da Risk
Sipariş durumu, bakiye veya stok gibi transactional veri sık güncellenebilir. Cache stale bilgi gösterirse kullanıcı veya iş süreci açısından ciddi sorun oluşabilir. Strong consistency gereken akışlarda database source of truth olarak doğrudan kullanılabilir. Cache yalnızca yardımcı veya kısa TTL katmanı olarak tasarlanabilir. Performans kazanımı veri doğruluğu gereksiniminin önüne geçmemelidir.
Cache Invalidation
Cache invalidation değişen verinin eski cache kopyalarını temizleme veya güncelleme sürecidir. Entity birden fazla cache key altında bulunuyorsa invalidation zorlaşabilir. Event-driven invalidation, TTL veya versioned key gibi yöntemler kullanılabilir. Her yöntemin consistency ve operational maliyeti farklıdır. Cache tasarımında invalidation mekanizması ilk günden düşünülmelidir.
Multi-Node Consistency
Birden fazla application node aynı veriyi cachelediğinde değişikliklerin tüm node'lara yansıması gerekir. Local memory cache bu konuda ek koordinasyon gerektirir. Distributed cache ortak state sağlayabilir ancak network dependency ekler. Event propagation gecikirse kısa süreli stale data oluşabilir. Sistem hangi consistency seviyesini kabul ettiğini açık biçimde tanımlamalıdır.
ORM Cache Her Zaman Performansı Artırır mı?
Cache eklemek otomatik performans kazanımı anlamına gelmez. Hit rate düşükse uygulama hem cache kontrolü hem database query maliyetini ödemeye devam eder. Serialization, network ve invalidation işlemleri yeni kaynak tüketimi oluşturur. Yanlış TTL stale data problemleri yaratabilir. Cache kararı gerçek query maliyeti, hit potansiyeli ve consistency gereksinimi ölçülerek verilmelidir.
Cache Hit Rate
Cache hit rate isteklerin ne kadarının database'e gitmeden cache tarafından karşılandığını gösterir. Yüksek hit rate genellikle cache yatırımını daha anlamlı hale getirir. Çok yüksek key cardinality veya kısa TTL hit oranını düşürebilir. Endpoint bazında hit rate izlemek daha doğru yorum sağlar. Düşük hit değerinde cache stratejisi yeniden tasarlanmalıdır.
Serialization Cost
Distributed cache kullanıldığında nesneler serialize ve deserialize edilir. Büyük entity graph'ları bu işlemde ciddi CPU ve network maliyeti oluşturabilir. Cache hit olsa bile response üretimi pahalı kalabilir. Daha küçük DTO veya precomputed response modeli cachelemek faydalı olabilir. Serialization süresi monitoring içinde ayrı metric olarak görünür hale getirilebilir.
Stale Data
Cache eski veriyi döndürdüğünde kullanıcı gerçeği yansıtmayan bilgi görebilir. Bazı içerik listelerinde birkaç saniyelik gecikme kabul edilebilirken finansal veride kabul edilemez. TTL seçimi iş gereksinimine bağlıdır. Invalidation event'leri gecikebilir veya kaybolabilir. Cache consistency davranışı uygulama contract'ının bir parçası olarak düşünülmelidir.
Invalidation Overhead
Sık güncellenen veride cache invalidation trafiği yüksek olabilir. Her update birçok cache key'ini temizlemek zorunda kalabilir. Bu durum database load azaltmak yerine ek application ve network yükü oluşturur. Cache dependency graph büyüdükçe bakım zorlaşır. Basit query optimizasyonu veya index düzeltmesi bazen cache eklemekten daha ucuz ve güvenilir çözüm olabilir.
Cache Stampede
Cache stampede popüler bir key expire olduğunda çok sayıda request'in aynı anda database'e yönelmesidir. Bu ani yük database'i zorlayabilir. Request coalescing, distributed lock veya jittered TTL gibi yöntemler kullanılabilir. Hot key'ler monitoring ile belirlenmelidir. Cache layer performans problemi çözerken yeni bir trafik patlaması kaynağı oluşturmamalıdır.
ORM ile Raw SQL Performans Karşılaştırması
ORM ile raw SQL karşılaştırması yapılırken aynı işi yapan sorgular karşılaştırılmalıdır. ORM aynı SQL'i gönderiyorsa database execution süresi büyük ölçüde aynı olabilir. Fark query translation, hydration, tracking ve mapping katmanlarında ortaya çıkar. Raw SQL daha az overhead sağlayabilir, ancak bakım, type safety ve geliştirici verimliliği maliyeti taşır. ORM ile raw SQL performans karşılaştırması hangi durumda hangisi kullanılmalı sorusunun cevabı bu nedenle yalnızca birkaç milisaniyelik mikro benchmark sonucuna indirgenmemelidir.
Aynı SQL Çalışıyorsa Database Süresi
Database aynı parameter ve aynı SQL'i aldığında sorgunun ORM veya raw driver tarafından gönderildiğini genellikle önemsemez. Execution plan aynıysa database süresi de benzer olur. Fark uygulama tarafındaki hazırlık ve sonuç işleme aşamalarında oluşur. Bu nedenle ORM'yi değiştirmeden önce generated SQL'in raw SQL ile gerçekten aynı olup olmadığı kontrol edilmelidir. Asıl sorun kötü query ise data access katmanını değiştirmek tek başına çözüm sağlamaz.
ORM Translation Overhead
ORM query expression'ını SQL'e çevirmek için CPU kullanır. Query cache veya compiled query bu maliyeti azaltabilir. Çok sık çalışan küçük sorgularda translation farkı ölçülebilir hale gelir. Uzun süren database query'sinde ise toplam latency içindeki payı düşük kalabilir. Karar profiler verisiyle verilmelidir.
Hydration Overhead
ORM sonuçları entity'lere dönüştürürken metadata, type conversion ve relation fix-up işlemleri yapabilir. Raw driver daha basit row mapping ile daha az CPU kullanabilir. Büyük result-set'lerde fark daha belirgin hale gelebilir. DTO projection ORM hydration maliyetini zaten ciddi biçimde azaltabilir. Raw SQL'e geçmeden önce daha hafif projection seçeneği denemek çoğu zaman daha düşük bakım maliyetli çözümdür.
Tracking Overhead
Full ORM tracking özelliği update senaryolarında değerli, read-only sorgularda ise ek maliyettir. Raw SQL doğal olarak change tracker state'i oluşturmaz. ORM no-tracking seçeneği bu farkı önemli ölçüde azaltabilir. Bu nedenle benchmark tracking açık ORM ile raw driver arasında yapılırsa sonuç adil olmayabilir. Aynı iş semantiği ve aynı lifecycle davranışı karşılaştırılmalıdır.
Raw Driver Overhead
Raw driver da sıfır maliyetli değildir. Connection yönetimi, parameter binding, network I/O ve result parsing yine yapılır. Geliştirici mapping kodunu kendisi yazıyorsa application CPU maliyeti devam eder. ORM ile fark çoğunlukla ek abstraction ve lifecycle özelliklerinden gelir. Küçük kazanım için bütün veri erişim katmanını yeniden yazmak toplam mühendislik maliyeti açısından mantıklı olmayabilir.
Gerçekçi Benchmark Gereksinimi
ORM ve raw SQL benchmark'ı aynı database, schema, index ve query semantics ile yapılmalıdır. Warm-up ve connection pool ayarları eşit olmalıdır. Production benzeri veri ve concurrency kullanılmadan yapılan sonuçlar genellenmemelidir. p95, p99, throughput ve memory allocation birlikte ölçülmelidir. Yalnızca tek query'nin ortalama latency'si üzerinden teknoloji kararı vermek eksik bir değerlendirmedir.
Raw SQL Ne Zaman Kullanılmalı?
Raw SQL, ORM'nin ifade etmekte zorlandığı veya gereksiz overhead yarattığı belirli sorgularda güçlü bir araçtır. Kompleks reporting, window function, recursive CTE ve bulk operation gibi database-centric işlemler doğal adaylardır. Çok kritik hot path'lerde ORM overhead'i ölçülebilir düzeydeyse raw SQL değerlendirilir. Ancak raw SQL kullanmak başarısızlık değil, uygun katmanda doğru aracı seçmek anlamına gelir. Parameterization, transaction yönetimi ve test edilebilirlik standartları korunmalıdır.
Kompleks Reporting
Kompleks reporting sorguları çok sayıda aggregation, conditional expression ve join içerebilir. ORM query API'si bu yapıyı zor okunur veya kötü SQL üreten hale getirebilir. Raw SQL report mantığını database'e daha doğal biçimde ifade edebilir. Sonuç tam entity yerine özel report DTO'suna map edilebilir. Query plan ve index tasarımı doğrudan report kullanımına göre optimize edilmelidir.
Aggregation
SUM, AVG, GROUP BY ve diğer aggregation işlemleri database'in güçlü olduğu alanlardır. Bütün satırları ORM ile yükleyip uygulama tarafında toplamak gereksiz transfer ve hydration oluşturur. ORM doğru aggregate SQL üretebiliyorsa raw SQL'e ihtiyaç olmayabilir. Üretilen query yetersizse explicit SQL daha iyi kontrol sağlayabilir. Karar result-set boyutu ve execution plan ölçümüyle verilmelidir.
Window Functions
Window functions ranking, running total ve partition bazlı hesaplamalarda etkili SQL özellikleridir. Bazı ORM'ler bunları iyi desteklerken bazı sürümlerde API sınırlı olabilir. Karmaşık workaround kullanmak yerine raw SQL daha okunabilir olabilir. Database-specific index ve ordering tasarımı performance için önemlidir. Query'nin sonucunu hafif DTO modeline taşımak ORM entity overhead'ini azaltabilir.
Recursive CTE
Recursive CTE hiyerarşik veri ve graph benzeri ilişkiler için uygun olabilir. ORM relation navigation ile çok sayıda round-trip yapmak yerine database tek sorguda hiyerarşiyi çözebilir. Framework bu yapıyı doğal desteklemiyorsa raw SQL kullanılabilir. Depth limit ve cycle kontrolü güvenlik açısından düşünülmelidir. Execution plan büyük hierarchy üzerinde test edilmelidir.
Database-Specific Özellikler
Her database performans ve sorgu yeteneği açısından kendine özgü özellikler sunabilir. Specialized index, JSON operator veya özel aggregation fonksiyonları ORM abstraction içinde tam desteklenmeyebilir. Kritik query bu özellikten belirgin fayda sağlıyorsa database-specific SQL kullanmak mantıklıdır. Bu bağımlılık kod içinde sınırlı bir data access modülünde tutulmalıdır. Database değiştirme ihtimali varsa trade-off açıkça belgelenmelidir.
Bulk Operations
Bulk insert, update ve delete işlemleri raw veya database-specific API ile çok daha verimli olabilir. Entity başına tracking ve round-trip maliyeti ortadan kalkar. Import ve data maintenance işleri bunun tipik örnekleridir. Lifecycle hook ve audit davranışlarının korunup korunmadığı kontrol edilmelidir. Bulk SQL performans için güçlü olsa da iş kurallarını bypass etmemelidir.
Çok Kritik Hot Path'ler
Saniyede çok yüksek frekansta çalışan ve latency budget'ı çok düşük olan query'lerde ORM overhead'i anlamlı hale gelebilir. Önce profiling ile bu payın gerçek olduğu kanıtlanmalıdır. Projection, compiled query ve no-tracking gibi ORM optimizasyonları denenebilir. Hâlâ yeterli değilse raw SQL daha düşük overhead sağlayabilir. Raw SQL yalnızca bu hot path ile sınırlandırılarak uygulamanın geri kalanında ORM üretkenliği korunabilir.
ORM ile Raw SQL Birlikte Kullanılabilir mi?
ORM ve raw SQL aynı uygulamada rahatlıkla birlikte kullanılabilir. Aslında birçok production sisteminde standart CRUD işlemleri ORM ile, yüksek performans veya kompleks query gerektiren bölümler raw SQL ile çözülür. Bu yaklaşım ekip üretkenliği ile runtime performansı arasında iyi denge sağlar. Raw SQL'in parameterization, transaction ve audit standartlarına uyması gerekir. Tek veri erişim politikasını bütün iş yüklerine zorlamak yerine query ihtiyacına göre araç seçmek daha sağlıklı sonuç verir.
Repository İçinde Raw Query
Raw SQL belirli repository veya data access service içinde kapsüllenebilir. Bu sayede SQL uygulamanın her yerine dağılmaz. Method contract entity yerine DTO veya domain result döndürebilir. Test ve monitoring daha merkezi hale gelir. Raw query kullanım noktaları kolayca bulunabildiği için bakım maliyeti kontrol altında tutulur.
Parameterized SQL
Raw SQL kullanıcı veya uygulama değerlerini string birleştirme ile eklememelidir. Driver veya ORM'nin parameterized query API'si kullanılmalıdır. Bu yaklaşım SQL injection riskini azaltır ve plan reuse avantajı sağlayabilir. Dynamic kolon veya ORDER BY gerekiyorsa yalnızca izin verilen değerler whitelist üzerinden seçilmelidir. Parameterization raw SQL standardının vazgeçilmez bir parçası olmalıdır.
SQL Injection'dan Korunma
Raw SQL'in en önemli risklerinden biri yanlış string interpolation ile SQL injection açığı oluşturmaktır. Kullanıcı girdileri hiçbir zaman doğrudan SQL yapısına eklenmemelidir. Parameter binding güvenli veri değerleri için kullanılmalıdır. Dynamic identifier gerekli olduğunda sabit whitelist uygulanmalıdır. Security testleri raw query katmanını özellikle kapsamalıdır.
Transaction Paylaşımı
ORM ve raw SQL aynı transaction içinde çalışacaksa aynı connection ve transaction context'i paylaşmaları gerekebilir. Framework'ün resmi API'si kullanılmalıdır. Ayrı connection açılması atomiklik beklentisini bozabilir. Transaction boundary kodda açık biçimde görünmelidir. Integration testleri ORM ve raw SQL adımlarının rollback davranışını doğrulamalıdır.
Audit Edilebilir SQL Katmanı
Raw SQL sorgularını merkezi bir katmanda tutmak code review ve security audit süreçlerini kolaylaştırır. Query tag, timeout ve logging standartları burada uygulanabilir. Kritik sorgular için execution plan ve benchmark sonucu dokümante edilebilir. SQL değişikliği normal code review sürecinden geçmelidir. Bu yaklaşım raw SQL kullanımını kontrolsüz bir istisna yerine yönetilebilir mühendislik aracı haline getirir.
Full ORM, Micro-ORM ve Raw Driver Karşılaştırması
Full ORM, micro-ORM, query builder ve raw driver aynı problem alanına farklı abstraction seviyeleri sunar. Full ORM entity lifecycle ve relation yönetiminde güçlüdür, raw driver ise en doğrudan kontrolü sağlar. Micro-ORM ve query builder bu iki uç arasında denge kurabilir. Runtime performansı önemli olsa da developer productivity ve maintainability de teknoloji seçiminde hesaba katılmalıdır. En başarılı mimariler genellikle bütün sistemi tek seçenekle sınırlamak yerine kullanım senaryosuna göre katmanlı yaklaşım kullanır.
Full ORM
Full ORM change tracking, identity map, migration ve relation management gibi kapsamlı özellikler sunar. CRUD ve domain-heavy uygulamalarda geliştirici üretkenliği yüksektir. Bu özellikler runtime overhead ekleyebilir. No-tracking, projection ve batch seçenekleriyle maliyetin önemli bölümü kontrol edilebilir. Takımın generated SQL ve database performansı konusunda bilgi sahibi olması full ORM kullanımını daha güvenli hale getirir.
Micro-ORM
Micro-ORM daha ince mapping katmanı sunarak SQL kontrolünü geliştiricide bırakır. Full entity lifecycle özellikleri sınırlı olduğu için runtime overhead daha düşük olabilir. Buna karşılık relation management ve change tracking gibi kolaylıklar azalır. Read-heavy veya SQL-centric servislerde iyi bir seçenek olabilir. Takımın SQL yazma ve schema bilgisi yüksekse maintainability açısından güçlü sonuç verebilir.
Query Builder
Query builder raw SQL string'lerine göre daha yapısal bir sorgu oluşturma API'si sunar. Dynamic filter ve conditional query senaryolarında kullanışlıdır. Full ORM tracking özelliklerine ihtiyaç duymadan parameterized SQL üretilebilir. Generated SQL yine kontrol edilmelidir. Çok karmaşık query'lerde builder kodu SQL'in kendisinden daha zor okunur hale geliyorsa raw SQL değerlendirilmelidir.
Raw Driver
Raw driver database protokolüne en yakın uygulama seviyesini sunar. Query, parameter ve result mapping sorumluluğu büyük ölçüde geliştiricidedir. Runtime overhead düşük olabilir. Buna karşılık tekrar eden boilerplate ve bakım maliyeti artabilir. En kritik hot path veya özel database işlemlerinde kullanılması, bütün uygulamayı raw driver ile yazmaktan daha dengeli olabilir.
Developer Productivity
Developer productivity yalnızca ilk kod yazma hızını değil, değişiklik ve bakım maliyetini de kapsar. ORM standart CRUD ve relation işlemlerini hızlandırabilir. Raw SQL'de her değişiklik schema bilgisi ve mapping güncellemesi gerektirebilir. Büyük ekiplerde ortak convention'lar önemlidir. Runtime kazancı küçükse developer productivity kaybı toplam ürün maliyetini artırabilir.
Runtime Performance
Runtime performance query translation, mapping, tracking ve database davranışının toplamıdır. Raw driver en az abstraction'a sahip olabilir, ancak kötü SQL yine yavaştır. Full ORM doğru projection ve no-tracking ile oldukça yakın sonuç verebilir. Benchmark aynı query semantics üzerinde yapılmalıdır. Teknoloji etiketi yerine ölçülen request latency ve resource kullanımı esas alınmalıdır.
Maintainability
Maintainability veri erişim kodunun okunabilir, test edilebilir ve değiştirilebilir olmasını ifade eder. ORM domain model ile entegrasyonu kolaylaştırabilir. Raw SQL karmaşık report logic'ini daha net ifade edebilir. Kötü sınırlar her iki yaklaşımda da bakım sorununa dönüşebilir. Data access katmanını açık contract'larla tasarlamak kullanılan araçtan daha önemli olabilir.
Karar Matrisi
CRUD ve relation-heavy uygulamalarda full ORM güçlü başlangıç seçeneğidir. SQL-centric read service veya report katmanında micro-ORM ve query builder avantajlı olabilir. Database-specific kritik hot path için raw SQL veya raw driver değerlendirilebilir. Aynı servis içinde birden fazla yaklaşım kullanılabilir. Karar developer productivity, runtime performance, ekip yetkinliği ve bakım maliyeti birlikte değerlendirilerek verilmelidir.
ORM Benchmark Nasıl Doğru Yapılır?
Doğru ORM benchmark'ı yalnızca iki kod parçasını stopwatch ile karşılaştırmak değildir. Aynı database, schema, index, query semantics ve connection koşulları kullanılmalıdır. Warm-up sonrası p95, p99, throughput ve memory allocation gibi metrikler toplanmalıdır. Production benzeri dataset ve concurrency gerçek davranışı görmenin temel şartıdır. Benchmark'ın amacı bir kütüphaneyi kazanan ilan etmek değil, belirli workload için hangi yaklaşımın daha iyi sonuç verdiğini ölçmektir.
Aynı Database
Karşılaştırılan çözümler aynı database engine ve sürümü üzerinde çalışmalıdır. Farklı database kullanmak optimizer ve protocol etkisini ORM farkıyla karıştırır. Hardware ve resource limitleri de eşit tutulmalıdır. Test ortamı mümkün olduğunca izole olmalıdır. Cloud database kullanılıyorsa burst ve autoscaling davranışları benchmark sonucuna not edilmelidir.
Aynı Schema
Schema yapısı her benchmark varyantında aynı olmalıdır. Kolon tipleri, constraints ve relation yapıları performansı doğrudan etkiler. ORM migration ile oluşturulan schema raw SQL testinden farklıysa sonuç adil değildir. Schema checksum veya migration version ile eşitlik doğrulanabilir. Özellikle foreign key ve index tanımları dikkatle kontrol edilmelidir.
Aynı Query Semantics
İki sorgunun aynı sonucu üretmesi performans karşılaştırmasının temel şartıdır. Bir ORM query full entity ve relation yüklerken raw SQL yalnızca üç kolon seçiyorsa benchmark eşit değildir. Tracking davranışı da mümkün olduğunca aynı iş gereksinimine göre ayarlanmalıdır. Pagination ve ordering aynı olmalıdır. Karşılaştırılan şey teknoloji değil, aynı işin iki farklı implementation biçimi olmalıdır.
Aynı Index'ler
Index farkı query performansında ORM overhead'inden çok daha büyük etki yaratabilir. Benchmark database'lerinde aynı index seti kullanılmalıdır. Statistics mümkün olduğunca benzer olmalıdır. Test öncesi schema kontrolü otomatikleştirilebilir. Index değişikliği deneniyorsa bu ayrı bir benchmark değişkeni olarak ele alınmalıdır.
Warm-Up
İlk query ORM model initialization, JIT, connection establishment veya cache doldurma maliyeti taşıyabilir. Bu nedenle warm-up çalıştırmaları ölçüm dışında bırakılmalıdır. Aynı şekilde database buffer cache durumu senaryoya göre kontrol edilmelidir. Cold start ayrı ölçülecekse normal steady-state benchmark'tan ayrılmalıdır. Sonuç raporunda hangi cache durumunun kullanıldığı açık biçimde belirtilmelidir.
Connection Pool Ayarları
Connection pool benchmark throughput ve latency üzerinde büyük etkiye sahiptir. İki çözüm farklı pool size veya timeout ile test edilirse sonuç yanıltıcı olur. Driver ve ORM pool davranışı ayrı kontrol edilmelidir. Test boyunca connection wait metriği izlenmelidir. Pool tamamen saturate olduğunda ölçülen latency ORM overhead'inden çok kapasite sınırını yansıtabilir.
Concurrency
Tek thread benchmark gerçek web uygulaması davranışını göstermez. Production'daki eş zamanlı request sayısını temsil eden birkaç concurrency seviyesi test edilmelidir. Düşük, normal ve peak trafik senaryosu ayrı ölçülebilir. Database CPU ve pool saturation ile birlikte throughput değerlendirilmelidir. Yük arttıkça hangi çözümün daha stabil p99 verdiği önemli bir karar kriteridir.
Production-Like Dataset
Dataset yalnızca satır sayısı değil, cardinality ve veri dağılımı açısından da production'a benzemelidir. Küçük fixture N+1 ve kötü execution plan sorunlarını gizler. Büyük tenant ve skew senaryoları ayrıca temsil edilmelidir. TEXT ve JSON kolonları gerçekçi boyutta olmalıdır. Benchmark sonucu ancak veri şekli production'a yaklaştığında anlamlı hale gelir.
p95 / p99
Average latency sistemin yavaş uçlarını gizleyebilir. p95 ve p99 pool wait, lock ve cache miss gibi sorunları görünür hale getirir. ORM optimizasyonu average değeri az değiştirip p99'u ciddi biçimde iyileştirebilir. Yeterli sample sayısı olmadan percentile değeri güvenilir değildir. Benchmark süresi ve request sayısı istatistiksel olarak anlamlı sonuç üretecek düzeyde olmalıdır.
Throughput
Throughput belirli kaynak sınırında sistemin ne kadar iş tamamladığını gösterir. Daha az allocation veya daha kısa connection kullanımı throughput'u artırabilir. Latency ile birlikte değerlendirilmelidir. Throughput artarken error rate veya p99 kötüleşiyorsa sistem sınırı aşılmış olabilir. Capacity planning için birkaç yük seviyesi üzerinden throughput eğrisi çıkarılabilir.
Memory Allocation
ORM comparison sırasında allocated memory önemli bir fark gösterebilir. Tracking, entity graph ve proxy mekanizmaları allocation miktarını artırabilir. Raw veya DTO projection daha az nesne oluşturabilir. High traffic sistemde küçük request başına fark toplam GC yükünü etkiler. Memory metric'i latency sonucuyla birlikte raporlanmalıdır.
Mikro-Benchmark Sonuçları Neden Yanıltıcı Olabilir?
Mikro-benchmark küçük kod parçalarının saf overhead farkını göstermek için değerlidir, ancak production sistem davranışını tek başına temsil etmez. Localhost network, küçük dataset ve warm cache ORM ile raw SQL arasındaki farkı olduğundan farklı gösterebilir. Gerçek sistemde connection contention, lock, serialization ve concurrent workload devreye girer. Vendor benchmark'ları da kendi ürününün güçlü olduğu senaryoyu seçebilir. Bu nedenle mikro sonuçlar kararın bir girdisi olmalı, tek karar kaynağı olmamalıdır.
localhost Network Latency
Localhost database testinde network round-trip neredeyse yok denecek kadar düşüktür. Production'da database ayrı host veya region'da olabilir. N+1 maliyeti local benchmark'ta bu yüzden olduğundan küçük görünür. Fetch strategy karşılaştırması gerçek network koşulunda tekrarlanmalıdır. Gerekirse test ortamında latency injection ile daha gerçekçi koşul oluşturulabilir.
Çok Küçük Dataset
Bin satırlık tablo çoğu query plan'ını hızlı gösterir. Production'da milyonlarca satır olduğunda index ve cardinality davranışı tamamen değişebilir. Cartesian explosion küçük collection'larda görünmeyebilir. Benchmark dataset'i row count kadar relation büyüklüğünü de temsil etmelidir. Worst-case tenant senaryosu ayrı test edilmelidir.
Tek Query Türü
Bir ORM yalnızca primary key lookup testinde çok hızlı görünebilir. Gerçek uygulama filtering, joins, pagination ve writes gibi farklı query türleri çalıştırır. Teknoloji kararı workload dağılımına göre verilmelidir. En kritik birkaç endpoint ayrı benchmark senaryosu olmalıdır. Tek synthetic query gerçek sistem maliyetini temsil etmez.
Tek Thread
Tek thread testi pool, lock ve scheduler davranışını göstermez. Web uygulaması yüksek concurrency altında çalışır. ORM'nin allocation veya async davranışı tek thread'de görünmeyebilir. Load test farklı concurrency seviyelerinde yapılmalıdır. Database saturation noktasına yaklaşırken latency eğrisi daha anlamlı hale gelir.
Warm Cache
Warm database buffer ve application cache query'leri normalden hızlı gösterebilir. Production'da bazı request'ler cold data erişimi yapabilir. Testin cache durumu açık biçimde belirtilmelidir. Hem steady-state warm hem daha soğuk senaryolar gerekebilir. Karşılaştırılan çözümler aynı cache koşulunda çalıştırılmalıdır.
Production Contention'ın Olmaması
Isolated benchmark'ta başka query veya transaction bulunmadığı için database kaynakları tamamen test sürecine ayrılır. Production'da farklı workload'lar aynı CPU, I/O ve lock kaynaklarını paylaşır. Bu contention p99 latency üzerinde büyük etki yaratır. Staging load test'inde karma workload oluşturmak daha gerçekçi sonuç verir. Özellikle write-heavy sistemlerde lock senaryoları dahil edilmelidir.
Vendor Benchmark Bias Riski
Bir ürünün kendi benchmark'ı en iyi çalıştığı configuration ve query türünü seçebilir. Bu sonuç yanlış olmak zorunda değildir, ancak sizin workload'unuzu temsil etmeyebilir. Methodology ve source code varsa incelenmelidir. Aynı test kendi altyapınızda tekrar edilmelidir. Teknoloji seçimi bağımsız production-like benchmark ile doğrulanmalıdır.
Production Veri Hacmi ile Test Yapmak
Production performansını tahmin etmek için test verisinin gerçek sistemin büyüklüğünü ve dağılımını temsil etmesi gerekir. Sadece toplam row count yeterli değildir. Relation cardinality, tenant büyüklüğü, tarih dağılımı ve skew execution plan davranışını değiştirir. Büyük tenant çoğu zaman average kullanıcıdan çok farklı query maliyeti oluşturur. Test dataset'i normal, peak ve worst-case veri profillerini kapsayacak biçimde hazırlanmalıdır.
Gerçekçi Row Count
Tablo satır sayısı optimizer plan seçimini ve index maliyetini doğrudan etkiler. Production'da yüz milyon satır bulunan tabloyu on bin satırla test etmek güvenilir değildir. Gerçek veri kullanılamıyorsa synthetic dataset benzer büyüklükte üretilmelidir. Storage ve statistics üretimi de tamamlanmalıdır. Load test başlamadan database'in gerçekçi fiziksel durumda olduğu doğrulanmalıdır.
Cardinality
Relation başına child sayısı join ve batch fetching performansını belirler. Ortalama değer tek başına yeterli değildir. Bazı parent'ların on bin child'a sahip olması p99 davranışını değiştirebilir. Dataset cardinality dağılımı production'a benzemelidir. Fetch strategy benchmark'ı bu dağılım üzerinde yapılmalıdır.
Data Distribution
Filtre kolonlarındaki veri dağılımı index selectivity ve plan seçimini etkiler. Status kolonunda kayıtların yüzde doksanı aynı değerdeyse optimizer davranışı eşit dağılımdan farklı olur. Synthetic veri gerçek dağılımı yansıtmalıdır. Tarih ve tenant pattern'leri de önemlidir. Query plan testleri yalnızca rastgele uniform veriyle yapılmamalıdır.
Skew
Skew bazı değerlerin diğerlerinden çok daha sık bulunması durumudur. Multi-tenant sistemde birkaç tenant toplam verinin büyük bölümünü tutabilir. Aynı parameterized query küçük tenant için hızlı, büyük tenant için yavaş olabilir. Benchmark bu iki ucu ayrı ölçmelidir. Parameter sensitivity ve index tasarımı skew altında incelenmelidir.
Large Tenant Senaryosu
Large tenant query'leri average tenant'tan çok daha fazla row okuyabilir. Pagination, count ve relation fetch performansı burada farklı davranabilir. Capacity planning large tenant workload'unu ayrı sınıf olarak ele almalıdır. Query budget da tenant boyutuna göre farklı olabilir. Production p99 sorunlarının önemli bölümü bu uç müşterilerden gelebilir.
Worst-Case Dataset
Worst-case dataset sistemin karşılaşabileceği en pahalı meşru veri durumunu temsil eder. Büyük collection, yüksek skew veya çok eski tarih aralığı gibi senaryolar içerebilir. Bu test yalnızca average performansı değil, dayanıklılığı ölçer. Timeout ve memory limitleri burada doğrulanabilir. Kullanıcı girdisiyle pahalı query oluşturulabiliyorsa rate limit veya query sınırı gibi korumalar da test edilmelidir.
ORM ve Multi-Tenant Sistem Performansı
Multi-tenant sistemlerde ORM query'leri çoğu zaman tenant filter ile çalışır. Bu filtre her query'ye otomatik eklenirse geliştirici açısından güvenli ve rahat olabilir. Ancak index tasarımı tenant_id kolonunu dikkate almazsa büyük tablolar yavaşlayabilir. Context pooling tenant state leakage riski taşıyabilir. Büyük ve küçük tenant veri dağılımı arasındaki fark query plan ve capacity planning için ayrı ayrı değerlendirilmelidir.
Tenant Filter
Tenant filter her query'nin yalnızca ilgili müşterinin verisini görmesini sağlar. ORM query builder içinde explicit veya global biçimde uygulanabilir. Performans için tenant_id çoğu sık query'de index stratejisinin parçası olmalıdır. Filter unutulması ciddi veri izolasyonu sorunu yaratır. Security ve performance gereksinimi aynı query tasarımında birlikte ele alınmalıdır.
Global Query Filter
Global query filter tenant koşulunu her entity query'sine otomatik ekleyebilir. Bu yaklaşım güvenliği artırır ancak generated SQL'in her yerde doğru predicate kullandığı doğrulanmalıdır. Complex joins ve raw SQL bu filter'ı bypass edebilir. Query plan üzerinde tenant filter selectivity etkisi incelenmelidir. Testler farklı tenant boyutlarında çalıştırılmalıdır.
Composite Index
Multi-tenant query'lerde tenant_id genellikle composite index'in ilk kolonlarından biri olabilir. Sonraki kolonlar sık filter ve ordering pattern'lerine göre seçilir. Örneğin tenant_id, status ve created_at kombinasyonu yaygın olabilir. Her query için ayrı index oluşturmak write maliyetini artırır. Query frequency ve execution plan üzerinden en değerli birkaç index seçilmelidir.
Context Pooling
Context pooling multi-tenant sistemde ekstra dikkat gerektirir. Reuse edilen context eski tenant state'ini taşıyamamalıdır. Framework'ün reset mekanizması custom state'i otomatik temizlemeyebilir. Tenant ID request scope'tan güvenli biçimde alınmalıdır. Security testinde farklı tenant request'leri aynı pooled context üzerinden sırayla çalıştırılarak leakage olmadığı doğrulanmalıdır.
Tenant State Leakage
Tenant state leakage bir request'in tenant bilgisinin sonraki request'e taşınmasıdır. Bu durum veri izolasyonu ihlaline yol açabilir. Context field, query filter ve cache key tasarımı bu risk açısından incelenmelidir. Performance optimization güvenlik sınırlarını zayıflatmamalıdır. Pooling ve caching değişiklikleri multi-tenant test seti olmadan production'a çıkarılmamalıdır.
Büyük Tenant vs Küçük Tenant
Aynı query küçük tenant için birkaç satır, büyük tenant için milyonlarca satır üzerinde çalışabilir. Database optimizer farklı plan ihtiyacı duyabilir. Parameter sensitivity ve statistics davranışı burada önem kazanır. SLA ve query budget tenant büyüklüğüne göre analiz edilebilir. Large tenant workload'u production monitoring içinde ayrı label ile takip etmek p99 problemlerini daha hızlı anlamayı sağlar.
Soft Delete ORM Performansını Nasıl Etkiler?
Soft delete kayıtları fiziksel olarak silmek yerine deleted flag veya deleted_at alanıyla görünmez hale getirir. ORM global query filter kullanarak aktif kayıtlara otomatik koşul ekleyebilir. Zaman içinde tablo büyümeye devam ettiği için query ve index maliyeti artabilir. Partial index ve archive stratejisi bu yükü azaltabilir. Soft delete yalnızca uygulama mantığı değil, uzun vadeli database capacity planının da bir parçası olmalıdır.
Global Soft-Delete Filter
Global soft-delete filter her normal query'ye deleted_at IS NULL benzeri koşul ekler. Bu yaklaşım unutulan filtre riskini azaltır. Ancak bütün sorgular ek predicate ile çalıştığı için index tasarımı buna göre yapılmalıdır. Raw SQL ve özel query'ler filter'ı bypass edebilir. Generated SQL testleri soft delete koşulunun kritik endpoint'lerde doğru bulunduğunu doğrulamalıdır.
Tablo Boyutunun Büyümesi
Soft delete fiziksel satırı kaldırmadığı için tablo sürekli büyüyebilir. Aktif veri az olsa bile index ve storage üzerinde eski kayıtlar kalır. Backup, vacuum veya maintenance maliyeti database türüne göre artabilir. Query plan eski kayıtları yeterince dışlayamazsa performans düşer. Belirli retention süresinden sonra archive veya physical purge stratejisi gerekebilir.
Partial Index
Yalnızca aktif kayıtları kapsayan partial index soft delete tablolarında çok etkili olabilir. Index daha küçük olur ve sık kullanılan query'ler doğrudan aktif subset üzerinde çalışır. ORM generated predicate ile partial index koşulu uyumlu olmalıdır. Database desteği kontrol edilmelidir. Write ve maintenance maliyeti normal index'e göre ayrıca ölçülmelidir.
Query Plan
Soft-delete filter execution plan'ın index seçimini etkileyebilir. deleted_at distribution çok dengesizse statistics doğru plan için önemlidir. Büyük tabloda seq scan görülüyorsa active subset için uygun index değerlendirilmelidir. Count query'leri de soft-delete koşuluyla pahalı hale gelebilir. Plan analizi normal ve büyük tenant senaryolarında ayrı yapılmalıdır.
Archive Stratejisi
Uzun süredir silinmiş kayıtları ayrı archive tablo veya storage katmanına taşımak ana tablonun boyutunu kontrol edebilir. Bu işlem ürün ve compliance gereksinimlerine göre planlanmalıdır. Archive sırasında foreign key ve audit ihtiyaçları korunmalıdır. Büyük migration lock veya replication yükü oluşturabilir. Periyodik küçük batch yaklaşımı daha güvenli olabilir.
ORM Inheritance Mapping Performansı
Inheritance mapping object modeldeki kalıtımı relational schema'ya dönüştürmek için farklı stratejiler kullanır. Table per hierarchy daha az join ile çalışabilirken table per type veya joined inheritance daha fazla tablo birleştirmesi gerektirebilir. Polymorphic query bütün alt tipleri istediğinde generated SQL büyüyebilir. Veri modeli seçimi yalnızca kod estetiğine göre yapılmamalıdır. Sık çalışan query pattern'leri ve entity sayısı inheritance strategy kararında performans açısından değerlendirilmelidir.
Table per Hierarchy
Table per hierarchy bütün tipleri tek tabloda discriminator kolonu ile saklar. Polymorphic query genellikle join gerektirmez. Bunun karşılığında tablo genişleyebilir ve bazı kolonlar birçok satır için null olabilir. Index tasarımı discriminator ve sık filtrelere göre yapılabilir. Büyük hierarchy tablolarında row width ve storage etkisi ölçülmelidir.
Table per Type
Table per type her tipe ayrı tablo vererek normalize bir yapı sunabilir. Base ve derived alanları almak için join gerekebilir. Derin inheritance zincirinde sorgu çok sayıda tabloya bağlanabilir. Polymorphic listelerde bu maliyet belirgin hale gelir. Kullanım sık ise generated SQL ve execution plan dikkatle incelenmelidir.
Joined Inheritance
Joined inheritance base ve derived tablolar arasında primary key join kullanır. Domain model temiz görünebilir, ancak her entity yüklemede ek join maliyeti oluşabilir. Çok sayıda subtype içeren polymorphic query daha ağır hale gelir. Index ve foreign key tasarımı doğru olmalıdır. Hot path'te inheritance yerine composition veya ayrı read model düşünmek bazen daha verimli olabilir.
JOIN Sayısına Etkisi
Inheritance strategy query başına gereken join sayısını doğrudan etkiler. Relation include'ları da eklendiğinde SQL hızla büyüyebilir. Optimizer çok sayıda tablo arasında daha zor plan seçebilir. Result-set ve compile time artabilir. Model değişikliği öncesinde representative query'ler benchmark edilmelidir.
Polymorphic Query Maliyeti
Polymorphic query base type üzerinden bütün subtype'ları almak isteyebilir. ORM bunun için UNION veya çok sayıda JOIN üretebilir. Küçük tablolarda sorun görünmezken büyük dataset'te pahalı olabilir. Query yalnızca belirli subtype'a ihtiyaç duyuyorsa filter ile kapsam daraltılmalıdır. Projection ve ayrı read model seçenekleri de değerlendirilebilir.
Locking ve ORM Performansı
ORM transaction ve concurrency özelliklerini kolaylaştırsa da database lock davranışı yine temel performans faktörüdür. Optimistic ve pessimistic locking farklı workload'larda farklı maliyetler yaratır. Isolation level daha güçlü hale geldikçe consistency artabilir ancak concurrency azalabilir. Lock wait ve deadlock p99 latency üzerinde ciddi etki oluşturur. ORM retry mekanizması transient sorunları hafifletebilir, ancak sürekli contention problemi varsa veri erişim tasarımı düzeltilmelidir.
Optimistic Locking
Optimistic locking kayıt üzerinde uzun süre lock tutmak yerine update sırasında version kontrolü yapar. Conflict nadirse yüksek concurrency için verimli olabilir. İki kullanıcı aynı kaydı değiştirirse biri conflict alır ve işlem tekrar ele alınır. ORM version column yönetimini otomatik yapabilir. High-contention workload'da çok sayıda retry oluşması performansı kötüleştirebilir.
Pessimistic Locking
Pessimistic locking kayıt üzerinde diğer transaction'ları bekleten lock alır. Kritik ve kısa transaction'larda tutarlılık için gerekli olabilir. Lock uzun tutulursa concurrency düşer. ORM'nin FOR UPDATE veya eşdeğer API'si generated SQL üzerinden doğrulanmalıdır. External API çağrısı gibi yavaş işlemler lock kapsamına alınmamalıdır.
Isolation Levels
Isolation level transaction'ların birbirinin değişikliklerini ne ölçüde görebileceğini belirler. Daha güçlü isolation bazı anomaly türlerini engellerken lock veya version storage maliyetini artırabilir. Her endpoint için en güçlü seviye seçmek gereksiz overhead oluşturabilir. İş gereksinimi hangi consistency seviyesini gerektiriyorsa o kullanılmalıdır. Database-specific MVCC davranışı da performans analizine dahil edilmelidir.
Lock Wait
Lock wait query'nin başka transaction'ın tuttuğu kaynağı beklediği süredir. Slow query olarak görünse de asıl neden sorgunun kendi execution maliyeti olmayabilir. Database lock monitoring blocking chain'i gösterir. Uzun transaction ve yanlış update sırası incelenmelidir. APM query span'leri lock wait ile ilişkilendirildiğinde p99 problemleri daha hızlı çözülür.
Deadlock
Deadlock iki veya daha fazla transaction'ın birbirinin tuttuğu kaynakları beklemesiyle oluşur. Database genellikle bir transaction'ı abort ederek döngüyü kırar. ORM bunu exception olarak uygulamaya iletir. Consistent lock ordering ve kısa transaction deadlock riskini azaltabilir. Retry uygulanacaksa sınırlı backoff kullanılmalı ve kök neden göz ardı edilmemelidir.
ORM Retry Mekanizması
ORM retry mekanizması transient connection veya deadlock hatalarında işlemi tekrar deneyebilir. Bu özellik dayanıklılığı artırır. Ancak yüksek contention sırasında retry sayısı çoğalırsa database yükü daha da artabilir. Retry count ve success rate monitoring içinde izlenmelidir. Sürekli retry görülüyorsa transaction ve locking tasarımı yeniden değerlendirilmelidir.
Optimistic Concurrency Performansı
Optimistic concurrency çoğu web uygulamasında uzun database lock'larından kaçınmak için uygun bir modeldir. Entity üzerinde version veya timestamp alanı tutulur ve update sırasında önceki değer kontrol edilir. Conflict nadirse sistem yüksek concurrency ile verimli çalışır. Conflict oranı arttığında retry ve kullanıcı hata akışı maliyeti büyür. Bu nedenle yoğun şekilde aynı kaydın güncellendiği workload'larda contention oranı ayrı metric olarak izlenmelidir.
Version Column
Version column her başarılı update'te değişen concurrency token'dır. ORM UPDATE koşuluna eski version değerini ekler. Affected rows sıfırsa başka işlem kaydı değiştirmiş olabilir. Bu kontrol genellikle düşük maliyetlidir. Version kolonunun index ihtiyacı query pattern ve primary key koşuluna göre değerlendirilmelidir.
Conflict Detection
Conflict detection update sırasında beklenen version bulunmadığında gerçekleşir. ORM exception veya result üzerinden uygulamaya bilgi verebilir. Uygulama kullanıcıya yeniden deneme veya merge seçeneği sunabilir. Conflict rate düşükse overhead küçüktür. Yüksek conflict oranı domain tasarımında aynı kayda gereğinden fazla yazma yapıldığını gösterebilir.
Retry
Retry optimistic conflict sonrasında veriyi tekrar okuyup işlemi yeniden çalıştırabilir. Her iş akışı otomatik retry için uygun değildir. Kullanıcı kararına bağlı değişiklikler yanlışlıkla overwrite edilebilir. Teknik olarak güvenli işlemde sınırlı retry ve backoff kullanılabilir. Retry latency ve database query sayısını artırdığı için metric olarak izlenmelidir.
High-Contention Workload
Aynı kaydın çok sayıda request tarafından sürekli güncellendiği workload optimistic concurrency için zorlayıcıdır. Conflict sayısı yükselir ve başarılı işlem başına daha fazla retry gerekir. Bu durum database CPU ve user latency'yi artırır. Data model sharding veya counter aggregation gibi farklı tasarımlar gerekebilir. Sorun ORM ayarından çok iş yükünün paylaşılan state yapısından kaynaklanabilir.
Retry Storm Riski
Bir conflict dalgası başladığında bütün request'lerin hemen tekrar denemesi yeni bir yük dalgası oluşturabilir. Buna retry storm denebilir. Exponential backoff ve jitter baskıyı azaltabilir. Maksimum retry sınırı olmalıdır. Alert sistemi yüksek conflict ve retry rate'i production sorunu olarak görünür hale getirmelidir.
ORM Query Observability Nasıl Kurulur?
ORM query observability, endpoint ile SQL davranışını aynı request bağlamında izleyebilmek anlamına gelir. Database span, query duration, query count, row count ve connection wait temel metriklerdir. Materialization time ve error rate eklenirse application tarafındaki ORM maliyeti de görünür hale gelir. Query fingerprint hassas parameter değerlerini toplamadan benzer sorguları gruplayabilir. Bu yapı kurulduğunda production performans sorunları tahmin yerine veri üzerinden analiz edilebilir.
Database Span
Database span her query'nin request trace içindeki yerini gösterir. Query duration ve parent operation bilgisi bulunmalıdır. Aynı endpoint içinde onlarca benzer span N+1 sinyali olabilir. Span'a query fingerprint ve database operation eklenebilir. Hassas SQL parameter'ları doğrudan trace içine yazılmamalıdır.
Query Duration
Query duration database call'ın toplam süresini gösterir. Mümkünse connection wait ve execution time ayrı ölçülmelidir. Percentile dağılımı average değerden daha değerlidir. Query fingerprint bazında slowest queries listesi oluşturulabilir. Duration değişimi release sonrası regression tespitinde kullanılabilir.
Query Count
Query count request'in database ile kaç kez konuştuğunu gösterir. Endpoint ve response row count ile birlikte değerlendirildiğinde N+1 problemi kolay fark edilir. Baseline değerler release bazında izlenebilir. Ani artış alarm üretebilir. Query budget yaklaşımı critical API'lerde regression guard olarak kullanılabilir.
Rows Returned
Rows returned query'nin ne kadar veri ürettiğini gösterir. Kullanıcıya on kayıt dönen endpoint'in on bin database row işlemesi fetch problemi gösterebilir. Cartesian explosion bu metrikte belirginleşir. Slow query olmadan da yüksek row count system load oluşturabilir. Query duration ile birlikte dashboard'a eklenmesi faydalıdır.
Connection Wait
Connection wait pool saturation sorununu query execution'dan ayırır. Database hızlı olduğu halde request yavaşsa bu metric kritik ipucu verir. p95 ve p99 wait değeri capacity planning için kullanılabilir. Long transaction ve yüksek concurrency ile korelasyon aranmalıdır. Pool size değişikliklerinin etkisi bu metric üzerinden doğrulanabilir.
ORM Materialization Time
Materialization time database sonucunun entity veya DTO'ya dönüşme süresini gösterir. Büyük result-set ve tracking bu değeri artırabilir. Database duration düşükken request yavaşsa application-side mapping incelenmelidir. CPU profiler ile ORM materialization fonksiyonları doğrulanabilir. Projection değişikliklerinin etkisi bu metric üzerinden ölçülebilir.
Error Rate
Database timeout, deadlock ve pool timeout gibi hatalar performans kapasitesinin aşıldığını gösterebilir. Error rate query fingerprint ve endpoint bazında izlenmelidir. Retry mekanizması ilk hatayı gizleyebileceği için retry count da ayrıca kaydedilmelidir. Load arttıkça error rate'in yükselmesi saturation sinyalidir. Performans dashboard'u yalnızca latency değil başarısız işlem oranını da göstermelidir.
Endpoint ile SQL'i Eşleştirme
Bir SQL'in hangi endpoint veya job tarafından üretildiğini bilmek çözüm süresini büyük ölçüde kısaltır. Trace context ve query tag bu ilişkiyi kurabilir. Aynı SQL farklı feature'lar tarafından kullanılıyorsa kullanım oranları ayrı görülebilir. Database monitoring ile APM verisi ortak fingerprint üzerinden bağlanabilir. Böylece DBA ve application ekibi aynı query hakkında ortak veri üzerinden konuşabilir.
ORM Performance Dashboard'ında Hangi Metrikler Olmalı?
İyi bir ORM performance dashboard yalnızca slow query listesinden oluşmamalıdır. Query count, database time, duplicate query, connection pool saturation ve row count gibi metrikler birlikte görünmelidir. p95 ve p99 değerleri kullanıcıların yavaş uç deneyimini gösterir. Query cache hit rate dynamic query sorunlarını ortaya çıkarabilir. Dashboard endpoint ve release bazında filtrelenebildiğinde performance regression'ları çok daha hızlı teşhis edilir.
Queries per Request
Queries per request N+1 ve chatty database access kalıplarını gösterir. Endpoint türüne göre baseline belirlenebilir. Ortalama yanında p95 query count da izlenebilir. Büyük response doğal olarak biraz daha fazla query üretebilir, ancak lineer artış şüphelidir. Release sonrası ani yükseliş alarm olarak değerlendirilebilir.
Database Time per Request
Database time per request bütün query span sürelerinin toplamını gösterir. Kullanıcı latency'si içindeki database payı kolayca anlaşılır. Query count düşükken değer yüksekse birkaç pahalı sorgu vardır. Query count yüksekken her query kısa olsa bile toplam süre büyüyebilir. İki metrik birlikte yorumlanmalıdır.
Slow Query Count
Slow query count belirli duration threshold üzerindeki sorgu sayısını gösterir. Threshold database ve endpoint türüne göre değişebilir. Tek bir sabit değer bütün workload'lar için anlamlı olmayabilir. Query fingerprint ve p95 ile birlikte incelenmelidir. Slow query sayısı düşerken toplam database time yükseliyorsa çok sayıda orta hızlı query problemi olabilir.
Duplicate Query Count
Duplicate query count aynı request içinde benzer SQL fingerprint'lerinin tekrarını gösterir. N+1 tespitinde yüksek değer önemli bir sinyaldir. Aynı query bazı business akışlarında meşru biçimde tekrar edebilir. Bu nedenle endpoint baseline ile değerlendirilmelidir. New release sonrası duplicate count artışı otomatik regression alarmına dönüştürülebilir.
p95/p99 Database Latency
Database latency percentile'ları ortalamanın gizlediği tail sorunlarını gösterir. Lock wait, pool wait ve cache miss bu değerleri yükseltebilir. Query fingerprint bazında p99 izlemek en sorunlu sorguları ayırır. Endpoint p99 ile database p99 karşılaştırılması root cause analizini kolaylaştırır. Peak trafik dönemleri ayrıca işaretlenmelidir.
Connection Pool Saturation
Pool saturation kullanılabilir connection kapasitesinin ne kadarının dolu olduğunu gösterir. Sürekli yüksek değer yeni request'lerin bekleme riskini artırır. Active, idle ve waiting connection sayıları birlikte gösterilebilir. Application instance sayısı değiştiğinde toplam database connection etkisi izlenmelidir. Saturation yüksekse yalnızca pool size değil query ve transaction süresi de incelenmelidir.
Rows per Query
Rows per query gereksiz büyük result-set'leri fark etmeye yardımcı olur. Query hızlı olsa bile milyonlarca row uygulamaya taşımak sürdürülebilir değildir. Projection ve pagination eksiklikleri bu metric'te görünür. Join amplification için kullanıcıya dönen entity sayısıyla karşılaştırma yapılabilir. Büyük artış release regression işareti olabilir.
Query Cache Hit Rate
Query cache hit rate ORM veya database cache türüne göre ayrı adlandırılmalıdır. Dynamic query shape çok fazlaysa compilation cache hit düşebilir. Database plan cache metriği farklı anlam taşır. Dashboard metric tanımlarını açık biçimde belgelemelidir. Cache hit oranı düşükse constant inlining ve query builder davranışı incelenebilir.
Query Budget Nedir?
Query budget bir endpoint'in kabul edilebilir database maliyetini sayısal sınırlarla tanımlar. Maksimum query count, database time ve returned row gibi değerler budget'ın parçası olabilir. Amaç her endpoint'i aynı sınıra zorlamak değil, beklenen performans davranışını test edilebilir hale getirmektir. CI testleri bu bütçeyi aşan regression'ları release öncesinde durdurabilir. Query budget performansı kişisel tahminden çıkarıp ekip sözleşmesine dönüştürür.
Endpoint Başına Maksimum Query Sayısı
Her endpoint için normal query count belirlenebilir. Basit detay endpoint'i üç query beklerken kompleks report farklı limite sahip olabilir. Test gerçekçi fixture ile çalıştırılmalıdır. Sınırın gereksiz sert olması geliştirme akışını zorlaştırır. Amaç normal davranıştan belirgin sapmaları yakalamaktır.
Maksimum Database Süresi
Database time budget endpoint latency hedefinden türetilebilir. Örneğin toplam 300 milisaniye hedeflenen request'in database'e ayırabileceği pay belirlenebilir. CI ortamında absolute latency değişken olabileceği için threshold dikkatli seçilmelidir. Performance test environment daha stabil sonuç sağlar. Production SLO metric'i nihai doğrulama kaynağıdır.
Maksimum Row Sayısı
Returned row budget büyük result-set regression'larını yakalar. Kullanıcıya yirmi item dönen query'nin on bin row üretmesi şüpheli durumdur. JOIN amplification bu sınırı kolayca aşabilir. Test instrumentation database driver seviyesinde row count toplayabilir. Projection ve fetch strategy değişikliği sonrası değer karşılaştırılmalıdır.
CI'da Query Budget Testi
CI testi endpoint'i integration environment içinde çalıştırıp query metric'lerini toplar. Baseline ile karşılaştırma yapılabilir. N+1, query count ve generated SQL değişiklikleri otomatik yakalanabilir. Test verisinin yeterince büyük olması gerekir. Çok değişken latency yerine deterministik query count ve SQL shape testleri daha stabil olabilir.
Regression Durumunda Pipeline'ı Durdurmak
Kritik endpoint'in query count veya row budget'ı ciddi biçimde aşıldığında pipeline durdurulabilir. Daha yumuşak eşikler uyarı olarak başlayabilir. Ekip false positive oranını gözlemleyerek kuralları ayarlar. Override gerekiyorsa performans etkisi açıklanmalıdır. Böylece query regression görünmez teknik borç olarak production'a taşınmaz.
ORM Performance Regression Testing
Performance regression testing daha önce optimize edilmiş query davranışının sonraki değişikliklerle bozulmasını engeller. N+1, query count, latency, allocation ve generated SQL için farklı test seviyeleri kullanılabilir. Execution plan snapshot bazı kritik sorgularda faydalı olabilir, ancak database sürümü değişiklikleri sonucu etkileyebilir. Testler gerçekçi data fixture ile çalıştırılmalıdır. Amaç her milisaniyeyi sabitlemek değil, anlamlı performans sapmalarını erken fark etmektir.
N+1 Regression
N+1 regression çoğu zaman relation veya serializer değişikliği sonrası ortaya çıkar. Test response'ta birden fazla parent kaydı kullanarak query count'un sabit kaldığını doğrulayabilir. Dataset yalnızca tek parent içerirse problem görünmez. Duplicate query fingerprint kontrolü de eklenebilir. Bu test düşük maliyetle büyük production sorunlarını engelleyebilir.
Query Count Regression
Query count regression endpoint'in normalden daha fazla SQL çağrısı yapmasıdır. Baseline değer versiyon kontrolünde veya test expectation içinde tutulabilir. Yeni feature gerçekten ek query gerektiriyorsa budget bilinçli olarak güncellenir. Değişikliğin açıklanması code review kalitesini artırır. Query sayısı tek başına performans değil, davranış sinyali olarak kullanılır.
Latency Regression
Latency testleri environment noise nedeniyle query count testlerinden daha değişkendir. Dedicated performance environment daha güvenilir sonuç verir. p95 veya distribution comparison kullanılabilir. Tek çalıştırma yerine birden fazla sample alınmalıdır. Anlamlı eşik üzerindeki artış pipeline uyarısı oluşturabilir.
Allocation Regression
Allocation regression yeni code path'in request başına daha fazla nesne oluşturduğunu gösterir. ORM include veya tracking değişikliği bu değeri hızla artırabilir. Memory benchmark daha stabil olduğu için CI'da faydalı olabilir. Büyük artış garbage collection ve throughput üzerinde production etkisi yaratabilir. Projection değişiklikleri allocation testinde net sonuç verir.
Generated SQL Snapshot
Generated SQL snapshot kritik query'nin şeklinin beklenmedik biçimde değişmesini yakalar. ORM version upgrade veya refactor sonrası yeni JOIN veya kolonlar hemen fark edilir. Parameter değerleri normalize edilmelidir. Snapshot her küçük formatting farkında kırılmamalıdır. Sorgunun semantic ve performance açısından önemli bölümleri gözden geçirilmelidir.
Execution Plan Regression
Execution plan regression database'in aynı query için daha pahalı plan seçmeye başlamasıdır. Statistics, data distribution veya schema değişikliği buna neden olabilir. Plan hash veya önemli node'lar izlenebilir. Plan snapshot environment'a bağlı olduğu için yorum dikkatli yapılmalıdır. Kritik sorgular production monitoring ile actual latency üzerinden ayrıca doğrulanmalıdır.
ORM Performansını Optimize Etmek İçin Adım Adım Yaklaşım
ORM performans optimizasyonunda en iyi yaklaşım ölçümden başlayıp en büyük maliyeti sırayla azaltmaktır. Önce yavaş endpoint bulunur, query count ve database time ayrıştırılır. Ardından generated SQL, N+1, result-set büyüklüğü ve execution plan incelenir. Projection, fetch strategy, index ve tracking değişiklikleri kontrollü biçimde uygulanır. Her adım benchmark ve regression testiyle doğrulanır, böylece bir problemi çözerken başka bir maliyet oluşturma riski azalır.
1. Önce Yavaş Endpoint'i Ölçün
İlk adım kullanıcıya gerçekten sorun yaratan endpoint'i seçmektir. APM p95 ve p99 latency ile en pahalı yolları gösterebilir. Average değer tek başına öncelik vermek için yeterli değildir. Traffic volume da dikkate alınmalıdır. Çok sık kullanılan orta hızlı endpoint toplam sistem maliyetinde tek bir nadir slow report'tan daha önemli olabilir.
2. Request Başına Query Sayısını Bulun
Yavaş endpoint'in kaç database query çalıştırdığı ölçülmelidir. Query count beklenenden yüksekse N+1 veya tekrar eden lookup araştırılır. Endpoint response boyutuyla query count ilişkisi incelenmelidir. Kayıt sayısı arttıkça query sayısı lineer artıyorsa güçlü N+1 sinyali vardır. Duplicate query fingerprint listesi sorunun hangi relation'dan geldiğini gösterebilir.
3. Generated SQL'i İnceleyin
ORM query kodu ile gerçek SQL arasında beklenmeyen farklar olabilir. Gereksiz JOIN, SELECT * veya complex subquery kontrol edilmelidir. Parameterization ve ordering davranışı görülmelidir. Generated SQL doğrudan database client içinde plan analizi için kullanılabilir. Query'yi anlamadan yapılan ORM refactor'ı hedefi kaçırabilir.
4. N+1 Kontrolü Yapın
Log ve APM span'lerinde aynı query'nin farklı ID değerleriyle tekrar edip etmediği kontrol edilir. Serializer ve template katmanı da incelemeye dahil edilmelidir. Lazy loading açıksa navigation access noktaları bulunmalıdır. Batch, eager veya projection seçeneklerinden uygun olanı seçilir. Düzeltme sonrası query count'un veri boyutundan bağımsız kaldığı test edilmelidir.
5. Result-Set Boyutunu Ölçün
Returned rows ve transferred bytes query'nin veri yükünü gösterir. Tek query hızlı görünse bile çok fazla veri uygulamaya taşınabilir. Join amplification ve SELECT * bu aşamada ortaya çıkar. User response ile database result arasında büyük fark varsa projection veya split strategy değerlendirilmelidir. Memory allocation değişimi de birlikte ölçülebilir.
6. Projection Ekleyin
Endpoint'in gerçekten kullandığı alanlar belirlenir. Full entity yerine DTO veya scalar projection ile yalnızca bu kolonlar seçilir. Relation verisi de gerektiği kadar alınır. Tracking ihtiyacı yoksa kaldırılır. Bu değişiklik database, network, hydration ve serialization maliyetlerini aynı anda azaltabilir.
7. Fetch Strategy'yi Optimize Edin
Relation cardinality ve query count bilgisiyle join, select-in veya split query seçilir. Düşük cardinality relation join ile uygun olabilir. Büyük collection batch fetching gerektirebilir. Network latency karar üzerinde etkili olur. Düzeltme sonrası row amplification ve p95 database time yeniden ölçülür.
8. Execution Plan'i İnceleyin
Generated SQL database execution plan ile analiz edilir. Seq scan, join algoritması, sort ve estimated rows kontrol edilir. Actual row count büyük sapma gösteriyorsa statistics veya parameter sensitivity araştırılır. Sorgu tarafındaki filtrelerin SARGable olup olmadığı görülür. Uygulama değişikliği ancak plan verisiyle destekleniyorsa yapılmalıdır.
9. Index'leri Kontrol Edin
Filter, join ve ordering kolonlarında uygun index bulunup bulunmadığı kontrol edilir. Foreign key tanımı index garantisi olarak kabul edilmez. Composite index query pattern'e göre tasarlanır. Gereksiz index write maliyetini artırabileceği için yalnızca ölçülebilir fayda üreten index eklenir. Deployment sırasında büyük tablo index creation etkisi ayrıca planlanır.
10. Tracking'i Gerektiği Yerde Kapatın
Read-only query'ler change tracking'e ihtiyaç duymuyorsa no-tracking moduna alınabilir. Büyük listelerde memory ve CPU kazanımı ölçülür. Update yapılacak akışlarda tracking korunur. Projection kullanılıyorsa entity tracking ihtiyacı zaten azalabilir. Değişiklik allocation benchmark ile doğrulanır.
11. Pagination'ı Optimize Edin
Büyük listeler sınırsız alınmamalıdır. OFFSET deep page sorunları varsa keyset pagination değerlendirilir. Stable sort ve tie-breaker primary key kullanılır. Count query'nin gerçekten gerekli olup olmadığı sorgulanır. Page size user experience ile memory ve database maliyeti arasında dengelenir.
12. Bulk İşlemleri Set-Based Hale Getirin
Binlerce entity update ediliyorsa entity-by-entity yaklaşım yeniden değerlendirilir. Set-based update veya delete database içinde aynı işi çok daha az round-trip ile yapabilir. Bulk insert API'leri import işlemlerini hızlandırabilir. Lifecycle hook ve audit gereksinimleri korunmalıdır. Transaction size ve lock süresi benchmark ile ölçülmelidir.
13. Connection Pool'u Ölçün
Connection wait ve pool saturation metric'leri kontrol edilir. Query hızlı olduğu halde wait yüksekse bottleneck pool tarafındadır. Long transaction ve streaming kullanım süresi incelenir. Max pool size artırılmadan önce database total connection kapasitesi hesaplanır. Peak load test ile yeni ayar doğrulanır.
14. Gerekirse Raw SQL'e Geçin
ORM optimizasyonlarından sonra kritik hot path hâlâ hedefi karşılamıyorsa raw SQL değerlendirilebilir. Aynı query semantics ile benchmark yapılmalıdır. Parameterized SQL ve transaction paylaşımı korunmalıdır. Raw query data access katmanında kapsüllenmelidir. Bu geçiş yalnızca ölçülebilir fayda sağladığında yapılmalıdır.
15. Regression Test Ekleyin
Performans sorunu çözüldükten sonra tekrar oluşmasını engellemek gerekir. Query count, generated SQL veya allocation için test eklenebilir. Kritik endpoint'lerde performance benchmark baseline tutulabilir. Release monitoring değişiklik sonrası p95 ve p99 değerlerini kontrol eder. Optimizasyon böylece tek seferlik müdahale yerine sürdürülebilir mühendislik pratiğine dönüşür.
ORM Optimizasyonunda Yanlış Yaklaşımlar
ORM performans sorunları görüldüğünde hızlı ama aşırı genellemeci çözümler üretmek kolaydır. ORM'yi tamamen kaldırmak, her relation'ı eager yapmak veya her şeyi cache'e taşımak yeni problemler oluşturabilir. İyi optimizasyon problemi ölçer ve maliyetin hangi katmandan geldiğini ayırır. Query sayısı, result-set, execution plan, tracking ve pool davranışı birlikte değerlendirilmelidir. Teknoloji tercihlerinden önce workload'un gerçek özelliklerine bakmak daha güvenilir kararlar üretir.
“ORM Yavaş, Tamamen Kaldıralım”
Bir endpoint yavaş olduğunda bütün ORM'yi suçlamak kök nedeni gözden kaçırabilir. Sorun N+1, kötü index veya gereksiz SELECT * olabilir. Aynı kötü SQL raw driver üzerinden çalıştırıldığında database yine yavaş olur. Önce profiling yapılmalıdır. Yalnızca belirli hot path raw SQL gerektiriyorsa bütün uygulamayı yeniden yazmak yerine sınırlı müdahale daha düşük risklidir.
“Tek Query Her Zaman En Hızlıdır”
Tek query round-trip sayısını azaltabilir ancak dev join sonucu oluşturabilir. Birden fazla collection join edildiğinde Cartesian explosion yaşanabilir. İki veya üç küçük batch query toplamda daha az data taşıyabilir. Network latency ve cardinality kararın yönünü değiştirir. Benchmark olmadan query sayısını minimuma indirmek tek başına doğru hedef değildir.
“Her Relation EAGER Olsun”
Her relation'ı eager yüklemek N+1 riskini azaltırken gereksiz veri transferi yaratabilir. Kullanıcının hiç görmediği relation'lar sürekli database'den alınır. Büyük collection memory ve network maliyetini artırır. Kullanım senaryosuna özel projection veya fetch strategy daha uygundur. Eager loading seçici biçimde kullanılmalıdır.
“Her Şeyi Cache'leyelim”
Cache database sorgusunu azaltabilir ancak invalidation ve stale data sorunları yaratır. Hit rate düşükse ekstra network ve serialization maliyeti eklenir. Sık değişen transactional veri için cache karmaşık hale gelebilir. Önce query ve index problemi çözülmelidir. Cache yalnızca gerçek read pattern ve consistency toleransı destekliyorsa eklenmelidir.
“Index Sayısı Ne Kadar Fazlaysa O Kadar İyi”
Her index read query için potansiyel fayda sağlarken write işlemlerine ek maliyet yükler. INSERT ve UPDATE sırasında ilgili index'ler de güncellenir. Çok fazla index storage ve maintenance yükünü artırır. Query plan hangi index'in gerçekten kullanıldığını göstermelidir. Duplicate veya unused index'ler düzenli olarak gözden geçirilmelidir.
“Async Kullanırsak N+1 Sorunu Çözülür”
Async N+1 query sayısını azaltmaz. Yüz sorguyu async göndermek hâlâ yüz database operation demektir. Paralel çalıştırmak pool saturation ve database load'u artırabilir. Doğru çözüm batch veya appropriate eager loading ile sorgu sayısını düşürmektir. Async yalnızca I/O bekleme sırasında thread kullanımını iyileştirir.
“Staging'de Hızlıysa Production'da da Hızlıdır”
Staging veri hacmi ve concurrency çoğu zaman production'dan küçüktür. Network topology farklı olabilir. Cache ve database resource payı da production davranışını temsil etmeyebilir. Production-like load test bu boşluğu azaltır. Gerçek production observability nihai doğrulama kaynağıdır.
“Raw SQL Her Zaman ORM'den Hızlıdır”
Raw SQL daha düşük abstraction overhead sağlayabilir, ancak aynı SQL çalışıyorsa database execution süresi değişmez. ORM projection ve no-tracking ile fark oldukça küçülebilir. Raw mapping kodu da CPU kullanır. Developer productivity ve maintainability maliyeti ayrıca vardır. Raw SQL yalnızca ölçülebilir ve anlamlı kazanç sağladığı noktada tercih edilmelidir.
“Slow Query Yoksa Database Sorunu Yoktur”
Yüzlerce küçük query tek başına slow threshold'u aşmayabilir. Buna rağmen toplam database time yüksek olabilir. Connection wait ve pool saturation da slow SQL listesinde görünmeyebilir. Duplicate query count ve database time per request bu boşluğu kapatır. Performance dashboard yalnızca slow query ekranına indirgenmemelidir.
Open Source ORM Araçları ve İşbirliği Ekosistemi
Açık kaynak ORM projeleri performans iyileştirmelerinin topluluk tarafından incelenmesini ve paylaşılmasını sağlar. Issue tracker, benchmark suite ve profiler araçları framework davranışını anlamak için değerli kaynaklardır. Kullanıcılar yalnızca bug bildirmekle kalmayıp reproducible benchmark ve test katkısı da sunabilir. ORM sürüm yükseltmelerinde release notlarındaki query translation ve performance değişiklikleri gözden geçirilmelidir. Açık kaynak ekosisteminden yararlanırken her benchmark sonucunun kendi workload'unuzda doğrulanması gerekir.
Hibernate
Hibernate geniş kullanıcı kitlesi ve uzun yıllara yayılan performans deneyimi bulunan açık kaynak ORM projelerindendir. Fetch strategy, batching ve caching davranışı hakkında güçlü community bilgi birikimi vardır. Issue tracker'da belirli query translation problemleri araştırılabilir. Sürüm yükseltmelerinde generated SQL değişiklikleri test edilmelidir. Projeye küçük reproducible benchmark ile katkı sunmak gerçek performans problemlerinin çözümünü hızlandırabilir.
Entity Framework Core
Entity Framework Core açık kaynak geliştirme modeli sayesinde issue ve performance discussion'larının incelenmesine imkân verir. Query translation ve materialization iyileştirmeleri sürümler arasında değişebilir. Benchmark sonucu kullanılan EF Core sürümüyle birlikte değerlendirilmelidir. Yeni sürümde generated SQL farklılaşırsa regression testler önem kazanır. Community issue'larına minimal reproduction eklemek teknik iletişimi kolaylaştırır.
Django ORM
Django ORM framework'ün genel release döngüsü içinde sürekli geliştirilmektedir. select_related, prefetch_related ve query expression davranışları sürüme göre gelişebilir. Upgrade öncesi kritik query count testleri çalıştırılmalıdır. Community ticket'ları aynı problemle karşılaşan geliştiricilerin çözüm deneyimini gösterebilir. Production uygulama kendi query profiliyle sonucu doğrulamalıdır.
SQLAlchemy
SQLAlchemy ORM ve SQL expression katmanını birlikte sunan güçlü açık kaynak projelerinden biridir. Loader strategy seçenekleri performans tuning için geniş esneklik sağlar. Sürüm değişiklikleri session ve query API davranışını etkileyebilir. Migration öncesi representative benchmark faydalıdır. Community dokümantasyonu ve issue tracker query davranışını anlamak için önemli referans noktalarıdır.
Prisma
Prisma modern TypeScript projelerinde sık kullanılan açık kaynak veri erişim araçlarından biridir. Query engine ve client davranışı sürümlerle birlikte gelişir. Performance issue'larında generated query ve reproduction örneği paylaşmak faydalıdır. Database provider farkları benchmark sonucunu etkileyebilir. Upgrade sonrasında kritik relation query'leri tekrar ölçülmelidir.
TypeORM
TypeORM açık kaynak yapısı sayesinde query builder ve relation davranışlarına ilişkin topluluk tartışmalarına erişim sağlar. Framework sürümü generated SQL davranışını değiştirebilir. Büyük projelerde upgrade öncesi integration ve query snapshot testleri çalıştırılmalıdır. Performance issue açılırken schema, query ve sample data davranışı açıkça belirtilmelidir. Community çözümü production workload üzerinde yeniden doğrulanmalıdır.
Açık Kaynak Profiler ve Monitoring Araçları
Open source profiler ve monitoring çözümleri query duration, tracing ve database metrics toplamak için kullanılabilir. Araç seçiminde ORM-specific detail ile genel observability ihtiyacı ayrılmalıdır. OpenTelemetry tabanlı tracing birçok stack arasında ortak context sağlayabilir. Database exporter'ları pool ve execution metriklerini tamamlayabilir. Araçtan daha önemli olan metric standardının ekip içinde tutarlı biçimde kullanılmasıdır.
Community Benchmark'ları
Community benchmark'ları farklı ORM'lerin potansiyel overhead farkları hakkında fikir verebilir. Ancak dataset, query shape ve network koşulları sizin uygulamanızdan farklı olabilir. Benchmark methodology incelenmelidir. Sonuçlar teknoloji seçimi için başlangıç verisi olarak kullanılabilir. Nihai karar kendi production-like workload ölçümünüzle doğrulanmalıdır.
Upstream Performance İyileştirmelerine Katkı
Gerçek bir ORM performance problemi framework kaynaklıysa upstream katkı uzun vadeli çözüm sağlayabilir. Minimal reproduction ve benchmark problemi anlaşılır hale getirir. Patch ile birlikte correctness test ve performance measurement sunmak contribution kalitesini artırır. Böyle bir iyileştirme yalnızca tek uygulamaya değil tüm ekosisteme fayda sağlar. Kurum içinde edinilen performans bilgisinin topluluğa geri aktarılması sürdürülebilir açık kaynak kullanımının değerli bir parçasıdır.
Küçük Projelerde ORM Performans Kontrol Listesi
Küçük projelerde çok ağır monitoring altyapısı kurmadan da temel ORM problemleri önlenebilir. Query logging, N+1 kontrolü, projection, pagination ve index review en yüksek getirili adımlardır. Read-only query'lerde no-tracking kullanılabilir. Test verisinin birkaç gerçekçi relation örneği içermesi önemlidir. Basit uygulamalarda bile bu kontroller erken yapılırsa proje büyüdüğünde performans borcu daha düşük olur.
Query Logging
Development ortamında query logging kolay açılabilir olmalıdır. Geliştirici endpoint çalıştırdığında kaç SQL gönderildiğini görebilmelidir. Slow ve duplicate query'ler kısa sürede fark edilir. Hassas production verisi loglanmamalıdır. Küçük ekipte bu basit alışkanlık pahalı APM olmadan da büyük değer sağlar.
N+1 Kontrolü
Liste endpoint'i en az on veya yirmi kayıtla test edilmelidir. Query count kayıt sayısıyla birlikte artıyorsa N+1 araştırılır. Relation loading strategy açık biçimde seçilir. Serializer ve template erişimleri unutulmamalıdır. Basit integration test query count'u koruyabilir.
Projection
Liste ve arama ekranları tam entity yerine gereken alanları seçmelidir. Bu yaklaşım network ve memory maliyetini düşük tutar. TEXT veya JSON kolonları gereksiz taşınmaz. DTO modeli API contract'ını da sadeleştirir. Küçük projede projection erken alışkanlık haline gelirse ileride büyük refactor ihtiyacı azalır.
Pagination
Liste endpoint'lerinde makul page size sınırı bulunmalıdır. Kullanıcı input'u sınırsız limit belirleyememelidir. Deep OFFSET ihtiyacı yoksa klasik pagination yeterli olabilir. Veri büyümeye başladığında cursor seçeneği değerlendirilir. Pagination database kadar response serialization maliyetini de kontrol eder.
Index
Primary key dışında sık filter ve relation kolonları kontrol edilmelidir. Foreign key index otomatik varsayılmamalıdır. Her yeni index'in query pattern ile gerekçesi olmalıdır. Execution plan gerekirse staging'de incelenebilir. Küçük projede doğru birkaç index onlarca gereksiz index'ten daha değerlidir.
Read-Only No-Tracking
Salt okunur sorgularda tracking gerekmiyorsa kapatılabilir. Bu özellikle listeleme ve dashboard query'lerinde memory kullanımını azaltabilir. ORM'nin özel API'si doğru kullanılmalıdır. Update path ile read path karıştırılmamalıdır. Projection ile birlikte daha güçlü kazanç elde edilebilir.
Production-Like Test Data
Test database yalnızca üç kayıt içeriyorsa performans sorunları görünmez. En azından gerçek relation cardinality'sini temsil eden veri seti hazırlanmalıdır. Büyük collection örnekleri eklenmelidir. Deep pagination ve N+1 bu veriyle daha kolay yakalanır. Production verisi kullanılmadan synthetic ama gerçekçi fixture oluşturulabilir.
Kurumsal Sistemlerde ORM Performans Kontrol Listesi
Kurumsal sistemlerde ORM performansı yalnızca geliştiricinin local kontrolüne bırakılamaz. Query budget, APM, execution plan monitoring, regression test ve pool monitoring gibi otomatik mekanizmalar gerekir. Load test ve capacity planning release sürecinin parçası olmalıdır. ORM ve raw SQL kullanım sınırları ekipler arasında ortak standarda bağlanmalıdır. Kurumsal ORM ve veritabanı performans optimizasyon hizmeti ihtiyacı da genellikle bu ölçüm, yönetişim ve production tuning katmanlarının birlikte ele alınmasını gerektirir.
Query Budget
Kritik endpoint'ler için query count ve database time bütçesi tanımlanabilir. Bu sınırlar test ve monitoring üzerinden izlenir. Yeni feature performans maliyetini görünür hale getirir. Büyük değişiklikte budget bilinçli biçimde revize edilir. Böylece performans beklentisi ekipler arasında ortak sözleşmeye dönüşür.
APM
APM request ile database span'lerini aynı trace içinde gösterir. p95 ve p99 latency, query count ve error rate gözlemlenir. Service ve endpoint bazında filtreleme yapılabilir. Release marker'ları regression analizini kolaylaştırır. Hassas parameter ve kullanıcı verisi trace sistemine taşınmamalıdır.
DB Execution Plan Monitoring
Kritik query'lerin execution plan değişiklikleri production performansını etkileyebilir. Plan hash veya slow query repository takip edilebilir. Statistics ve schema değişiklikleri sonrası plan regression kontrol edilir. Automatic plan capture database desteğine bağlıdır. Application ekibi generated SQL ile DBA plan verisini ortak fingerprint üzerinden eşleştirebilmelidir.
Performance Regression Testleri
Critical path'ler için query count, allocation ve load benchmark testleri uygulanabilir. Her test aynı CI aşamasında olmak zorunda değildir. Hızlı deterministik testler pull request sırasında, ağır load testler scheduled pipeline'da çalışabilir. Baseline ve threshold versiyonlanmalıdır. Regression çıktısı geliştiricinin hangi metric'in değiştiğini anlayacağı kadar açıklayıcı olmalıdır.
Connection Pool Monitoring
Active, idle ve waiting connection sayıları production dashboard'da görünmelidir. Max pool size ile database connection limitleri birlikte izlenmelidir. Auto-scaling servisler toplam connection kapasitesini değiştirebilir. Pool wait p99 önemli alarm metriğidir. Long transaction trace'leri saturation anında hızlı teşhis sağlar.
Slow ve Duplicate Query Alarmı
Slow query alarmı tekil pahalı sorguları, duplicate query alarmı N+1 benzeri tekrarları yakalar. İki sinyal birbirini tamamlar. Threshold endpoint ve database türüne göre ayarlanmalıdır. Gürültülü alarm zamanla dikkate alınmamaya başlar. Bu yüzden alert yalnızca aksiyon gerektiren performans sapmalarında tetiklenmelidir.
Load Test
Load test normal ve peak concurrency seviyelerini temsil etmelidir. Database CPU, pool saturation, throughput ve p99 birlikte izlenir. Dataset production büyüklüğüne yakın olmalıdır. Write ve read workload oranı gerçek sisteme benzemelidir. Test sonunda yalnızca maksimum RPS değil güvenli operating range belirlenmelidir.
Capacity Planning
Capacity planning kullanıcı ve veri büyümesiyle database kaynak ihtiyacını öngörür. Query efficiency bu hesabın temel girdilerindendir. Aynı traffic için query count yarıya düşerse connection ve CPU ihtiyacı da önemli ölçüde azalabilir. Tenant büyüme tahminleri dahil edilmelidir. Scaling kararı yalnızca hardware eklemek yerine query optimizasyonu fırsatlarıyla birlikte değerlendirilmelidir.
ORM/Raw SQL Governance
Kurumsal ekiplerde hangi durumlarda ORM, query builder veya raw SQL kullanılabileceği ortak prensiplere bağlanabilir. Raw SQL yasaklanmak yerine parameterization, review ve monitoring standartlarıyla yönetilmelidir. ORM query'leri için generated SQL review ve query budget uygulanabilir. Takımların aynı performans terminolojisini kullanması troubleshooting hızını artırır. Benzer yazılım ve veri erişim çalışmalarından örnekleri https://www.diyarbakiryazilim.com.tr/projects adresinde incelemek mümkündür.
En Sık Yapılan ORM Performans Hataları
ORM performans hatalarının önemli bir bölümü birkaç tekrar eden kalıptan oluşur. N+1, gereksiz eager loading, SELECT *, tracking ve derin OFFSET bunların başında gelir. Büyük update işlemlerini entity entity yapmak ve connection'ı uzun transaction içinde tutmak da production kapasitesini düşürür. En riskli durum ise bütün bu davranışların ölçülmemesidir. Query count, execution plan ve production-like benchmark alışkanlığı hata ihtimalini ciddi biçimde azaltır.
N+1 Query'yi Fark Etmemek
N+1 küçük veri setinde kolayca gizlenir. Kullanıcı sayısı ve network latency arttığında production sorunu haline gelir. Request başına query count en basit tespit yöntemidir. Duplicate query fingerprint de güçlü sinyal verir. Fetch strategy düzeltildikten sonra regression testi eklenmelidir.
Bütün Relation'ları EAGER Yapmak
Bütün relation'ları eager yapmak query count'u düşürürken gereksiz data transferi oluşturabilir. Büyük collection'lar her request'te yüklenmeye başlar. Entity graph serialization maliyeti de artar. Relation ihtiyacı endpoint bazında değerlendirilmelidir. Projection ve select-in loading daha dengeli alternatifler sunabilir.
N+1'i Dev JOIN ile Çözmeye Çalışmak
Birden fazla collection'ı aynı JOIN query içine eklemek Cartesian explosion oluşturabilir. Query sayısı bire düşse bile returned row count binlerce kat artabilir. Parent data tekrar tekrar network üzerinden taşınır. Split query veya batch fetching denenmelidir. Düzeltme query count kadar transferred bytes ile de ölçülmelidir.
SELECT * Kullanmak
SELECT * kullanılmayan kolonları da database'den taşır. Geniş JSON ve TEXT alanları maliyeti büyütür. Hydration ve serialization daha fazla CPU kullanır. DTO projection yalnızca ihtiyaç duyulan kolonları seçebilir. Özellikle read-only endpoint'lerde bu değişiklik yüksek getiri sağlayabilir.
Read-Only Query'leri Track Etmek
Read-only query sonucu güncellenmeyecekse tracking ek memory ve state maliyeti oluşturur. Büyük listelerde fark belirgin hale gelir. ORM'nin no-tracking modu kullanılabilir. Projection ile birlikte daha az entity oluşturulabilir. Tracking kapatılmadan önce write workflow ile karışmadığı doğrulanmalıdır.
Büyük Collection'ları Sayfalamadan Yüklemek
Büyük collection tek request'te alındığında database, network ve memory aynı anda zorlanır. Kullanıcı çoğu zaman bütün kayıtları aynı anda kullanmaz. Pagination veya separate endpoint daha uygun olabilir. Export işlemi varsa streaming düşünülebilir. Maximum page size API tarafından sınırlandırılmalıdır.
OFFSET ile Çok Derin Pagination Yapmak
Deep OFFSET database'in çok sayıda satırı okuyup atmasına neden olur. Veri büyüdükçe latency artar. Cursor pagination ileri yönde gezinme için daha ölçeklenebilir olabilir. Stable sort ve tie-breaker gereklidir. Random page access ihtiyacı ürün gereksinimi olarak ayrıca değerlendirilmelidir.
Foreign Key Index'lerini Unutmak
Relation tanımı foreign key index'in kesin var olduğu anlamına gelmez. Child lookup ve join query'leri büyük tabloda yavaşlayabilir. Schema migration kontrol edilmelidir. Batch fetching parent_id IN query kullanıyorsa index özellikle önemlidir. Execution plan index scan davranışını doğrulamalıdır.
Execution Plan Bakmadan ORM Kodunu Optimize Etmek
Yavaş query'nin nedeni uygulama expression'ı değil database plan olabilir. Yanlış index, statistics veya data skew sorunları ORM refactor ile çözülmez. Generated SQL plan analizi yapılmalıdır. Estimated ve actual row farkı önemli ipucu sağlar. Optimizasyon data ile yönlendirilmelidir.
Büyük Update'leri Entity Entity Yapmak
Binlerce entity'yi yükleyip tek tek update etmek gereksiz hydration ve tracking oluşturur. Set-based update aynı işi tek SQL ile çözebilir. Lifecycle hook gerekiyorsa batching değerlendirilebilir. Transaction ve lock etkisi ölçülmelidir. Büyük job'larda throughput farkı ciddi olabilir.
Connection'ı Transaction İçinde Gereksiz Tutmak
Transaction açıkken connection pool'dan alınan bağlantı uzun süre kullanımda kalabilir. External API veya uzun CPU işlemi transaction içinde yapılmamalıdır. Pool saturation ve lock wait artar. Transaction yalnızca gerekli database işlemlerini kapsamalıdır. Trace üzerinden transaction duration görünür hale getirilmelidir.
Production'da Query Count İzlememek
Slow query monitoring tek başına N+1'i yakalamaz. Query count endpoint davranışının temel metric'lerinden biri olmalıdır. Release sonrası artış hızlı regression sinyalidir. Duplicate query count eklenirse teşhis kolaylaşır. Bu metrik düşük maliyetle büyük production problemlerini önleyebilir.
Benchmark'ı Küçük Local Dataset Üzerinde Yapmak
Local küçük dataset index ve cardinality problemlerini gizler. Network latency de production'dan çok düşüktür. Sonuç bu nedenle fazla iyimser olabilir. Production-like veri ve concurrency kullanılmalıdır. Büyük tenant ve worst-case senaryolar ayrı test edilmelidir.
Raw SQL Kullanmayı Başarısızlık Sanmak
Raw SQL uygun problemde doğru mühendislik aracıdır. ORM'nin her database özelliğini ifade etmesi gerekmez. Complex report veya kritik hot path raw SQL ile daha net olabilir. Önemli olan parameterization, test ve bakım standardını korumaktır. ORM ve raw SQL birlikte kullanıldığında her iki yaklaşımın güçlü taraflarından yararlanılabilir.
Sık Sorulan Sorular
ORM performansı hakkında sorular genellikle aynı birkaç kavram çevresinde toplanır. Ekipler ORM'nin raw SQL'e göre ne kadar yavaş olduğunu, N+1 problemini, lazy loading davranışını ve index ihtiyacını anlamak ister. Bu soruların çoğunda tek bir evrensel cevap bulunmaz. Veri hacmi, cardinality, query shape ve production altyapısı sonucu değiştirir. Aşağıdaki yanıtlar karar verirken hangi ölçümlere bakılması gerektiğini kısa ve uygulanabilir biçimde özetler.
ORM nedir?
ORM, uygulamadaki nesneler ile ilişkisel database tabloları arasında eşleme sağlayan veri erişim katmanıdır. SQL yazımını tamamen ortadan kaldırmasa da birçok CRUD işlemini model ve query API üzerinden ifade etmeyi kolaylaştırır. Relation, migration ve change tracking gibi ek özellikler sunabilir. Performans açısından ORM'nin generated SQL davranışı mutlaka bilinmelidir. İyi ORM kullanımı SQL bilgisini gereksiz hale getirmek yerine doğru sorguyu daha sürdürülebilir biçimde üretmeye yardımcı olur.
ORM kullanmak performansı düşürür mü?
ORM belirli runtime overhead ekler, ancak uygulamanın yavaş olacağı anlamına gelmez. Birçok sistemde database execution ve network maliyeti ORM overhead'inden daha büyüktür. Asıl sorun çoğu zaman N+1, gereksiz kolon transferi veya yanlış index tasarımıdır. Projection ve no-tracking gibi seçenekler ORM maliyetini azaltabilir. Gerçek cevap profiling ve production-like benchmark ile belirlenmelidir.
ORM raw SQL'den ne kadar yavaştır?
Bu fark için evrensel bir yüzde vermek doğru değildir. Aynı SQL ve aynı mapping yapısı kullanıldığında database execution süresi benzer olabilir. ORM translation, hydration ve tracking ek maliyet oluşturabilir. Raw SQL'in avantajı workload'a göre sıfıra yakın veya belirgin olabilir. Karşılaştırma aynı query semantics, dataset ve concurrency ile yapılmalıdır.
N+1 query problemi nedir?
N+1 önce bir ana query, ardından alınan her kayıt için ek relation query çalıştırılmasıdır. On kayıt için on bir query, yüz kayıt için yüz bir query oluşabilir. Network round-trip ve pool kullanımı veriyle birlikte büyür. Lazy loading sık nedenlerden biridir. Batch fetching, eager loading veya projection ile query sayısı kontrol altına alınabilir.
Lazy loading performansı nasıl etkiler?
Lazy loading kullanılmayan relation'ların yüklenmesini engelleyebilir. Buna karşılık property erişiminde gizli database query çalıştırabilir. Loop veya serializer içinde kullanıldığında N+1 oluşturabilir. Küçük ve kontrollü entity akışlarında faydalı olabilir. Liste ve API response senaryolarında daha açık fetching stratejileri genellikle daha öngörülebilirdir.
Eager loading her zaman daha hızlı mıdır?
Eager loading her zaman daha hızlı değildir. Birden fazla büyük collection aynı query içinde yüklenirse Cartesian explosion oluşabilir. Query sayısı düşerken network payload ve materialization maliyeti artabilir. Düşük cardinality relation'larda join iyi çalışabilir. Büyük collection'larda batch veya split query daha verimli olabilir.
N+1 ile Cartesian explosion arasındaki fark nedir?
N+1 çok sayıda küçük database query üreten problemdir. Cartesian explosion ise genellikle tek query içinde relation kombinasyonları nedeniyle çok fazla satır üretilmesidir. Biri round-trip sayısını, diğeri result-set büyüklüğünü artırır. N+1'i dev JOIN ile çözmeye çalışırken Cartesian explosion yaratmak mümkündür. Query count ve row count birlikte ölçülmelidir.
ORM'de projection neden önemlidir?
Projection yalnızca ihtiyaç duyulan kolonları ve hesaplanmış değerleri seçer. Database'den daha az veri taşınır. ORM daha az entity veya daha küçük DTO oluşturur. Tracking ve serialization maliyeti de azalabilir. Read-only API'lerde projection en etkili performans iyileştirmelerinden biridir.
Change tracking performansı nasıl etkiler?
Change tracking entity state'ini tutarak update işlemlerini kolaylaştırır. Bunun karşılığında memory ve CPU kullanır. Binlerce entity aynı context içinde takip edildiğinde maliyet büyür. Read-only query'lerde tracking çoğu zaman gereksizdir. No-tracking modu ve kısa unit of work sınırları performance için faydalı olabilir.
AsNoTracking ne zaman kullanılmalıdır?
AsNoTracking EF Core'da update edilmeyecek entity sonuçları için uygundur. Liste, dashboard ve reporting endpoint'leri yaygın kullanım alanıdır. Memory ve tracking overhead'ini azaltabilir. Entity aynı context içinde güncellenecekse tracking gerekebilir. Projection ile birlikte kullanıldığında read path daha hafif hale gelir.
Split query nedir?
Split query relation graph'ını tek büyük JOIN yerine birkaç daha küçük SQL sorgusuyla yükler. Parent row duplication ve Cartesian explosion riskini azaltabilir. Ek database round-trip oluşturur. Network latency yüksekse bu maliyet daha önemli hale gelir. Relation cardinality ve transferred bytes ölçülerek single query ile karşılaştırılmalıdır.
ORM kullanırken index gerekir mi?
Evet, ORM kullanmak database index ihtiyacını ortadan kaldırmaz. Filter, join, foreign key ve ordering kolonları uygun index gerektirebilir. ORM relation tanımı her zaman index oluşturulduğunu garanti etmez. Execution plan index kullanımını doğrulamak için incelenmelidir. Fazla index de write maliyeti oluşturduğu için query pattern'e göre seçilmelidir.
ORM query'lerinin SQL çıktısı nasıl görülür?
Çoğu ORM development logging, debug API veya query inspection özelliği sunar. Generated SQL kritik query'lerde düzenli olarak kontrol edilmelidir. APM ve query fingerprint production davranışını güvenli biçimde izleyebilir. Hassas parameter değerleri loglanmamalıdır. SQL görüldükten sonra execution plan analizi performans probleminin database tarafını açıklamaya yardımcı olur.
OFFSET yerine cursor pagination ne zaman kullanılmalıdır?
Cursor pagination özellikle büyük veri seti ve ileri yönde sürekli gezinme gereken API'lerde uygundur. Deep OFFSET query'lerinin artan maliyetini azaltır. Stable sort ve unique tie-breaker gerektirir. Random page access ihtiyacı varsa klasik pagination daha pratik olabilir. Kullanıcı deneyimi ile database ölçeklenebilirliği birlikte değerlendirilmelidir.
Raw SQL'e ne zaman geçilmelidir?
Complex reporting, window functions, recursive CTE, bulk operation ve ölçülmüş hot path'ler raw SQL için iyi adaydır. ORM aynı sorguyu verimli üretebiliyorsa geçiş gereksiz olabilir. Önce projection, no-tracking ve fetch strategy optimizasyonları denenmelidir. Raw SQL parameterized ve test edilebilir bir data access katmanında tutulmalıdır. Geçiş kararını benchmark sonucu desteklemelidir.
ORM performansı production'da nasıl izlenir?
Production'da query count, database time, duplicate query, rows returned, connection wait ve p95/p99 latency birlikte izlenmelidir. APM database span'leri endpoint ile SQL'i eşleştirebilir. Slow query tek başına yeterli değildir. Query budget ve release regression alarmı sistemi daha güvenli hale getirir. Hassas query parametreleri loglamadan da güçlü observability kurulabilir.
ORM Performansı Hakkında Ek Sık Sorulan Sorular
ORM (Object-Relational Mapping) araçları uygulama ve veritabanı performansını nasıl etkiler?
ORM araçları query translation, object materialization, identity resolution ve change tracking gibi ek application-side işlemler oluşturabilir. Bununla birlikte production performansındaki en büyük maliyet çoğu zaman ORM'nin kendisinden değil, üretilen SQL'in davranışından kaynaklanır. N+1 query, gereksiz JOIN, büyük result-set ve yanlış pagination veritabanı ile network yükünü hızlı biçimde artırabilir. ORM (Object-Relational Mapping) Araçlarının Performans Etkileri bu yüzden yalnızca framework benchmark'larına bakılarak değerlendirilmemelidir. Doğru yaklaşım query count, database time, transferred bytes, tracking maliyeti ve p95 ile p99 latency değerlerini birlikte ölçmektir.
ORM kullanımında N+1 sorgu problemi nedir ve nasıl önlenir?
N+1 problemi bir ana query sonrasında her parent kayıt için ayrı relation query çalıştırılmasıdır. Problem lazy loading, serializer, template veya GraphQL resolver içinde fark edilmeden oluşabilir. Önlemek için request başına query count ve duplicate query fingerprint izlenmelidir. Relation yapısına göre fetch join, batch fetching, select-in loading veya projection uygulanabilir. En iyi çözüm bütün relation'ları tek query içine doldurmak değil, query sayısı ile result-set boyutunu birlikte optimize etmektir.
Lazy Loading ile Eager Loading arasındaki farklar nelerdir ve performans açısından hangisi tercih edilmelidir?
Lazy loading relation verisini ilk erişimde getirirken eager loading veriyi önceden planlanmış biçimde yükler. Lazy yaklaşım gereksiz relation transferini azaltabilir, ancak N+1 query riskini artırır. Eager loading round-trip sayısını düşürebilir, fakat büyük collection join'lerinde Cartesian explosion oluşturabilir. Düşük cardinality ilişkilerde join-based eager loading, büyük collection'larda batch veya select-in loading çoğu zaman daha dengeli sonuç verir. Seçim relation cardinality, network latency, pagination ve gerçek result-set büyüklüğü ölçülerek yapılmalıdır.
ORM tabanlı uygulamalarda sorgu optimizasyonu indeksleme caching ve bağlantı yönetimi nasıl yapılmalıdır?
Önce generated SQL ve execution plan incelenmeli, ardından filtre ve join kolonlarında uygun index bulunup bulunmadığı kontrol edilmelidir. Projection, pagination ve no-tracking ile uygulamaya taşınan veri miktarı azaltılabilir. Cache yalnızca read-heavy ve veri tazelik toleransı uygun senaryolarda kullanılmalı, hit rate ile invalidation maliyeti izlenmelidir. Connection pool tarafında active connection, waiting request ve connection wait p99 değerleri gözlemlenmelidir. ORM N+1 query lazy loading eager loading ve connection pooling optimizasyonu birlikte ele alındığında tek noktaya odaklanan değişikliklerden daha dengeli production sonucu elde edilir.
ORM performans analizi ve veritabanı optimizasyonu konusunda yakınımda danışmanlık veya eğitim nerede bulabilirim?
ORM ve veritabanı performans danışmanlığı yakınımda araması yapan ekipler için en önemli konu yalnızca genel eğitim almak değil, kendi uygulamalarındaki gerçek query davranışını inceleyebilecek teknik destek bulmaktır. Diyarbakır Yazılım Topluluğu'nun yaklaşımı, yazılım geliştiricilerin veri erişimi ve production performansı gibi konularda bilgi paylaşımını güçlendirmeye odaklanır. Topluluğun çalışmaları ve yaklaşımı hakkında https://www.diyarbakiryazilim.com.tr/about adresinden bilgi alınabilir. Kurumsal ORM ve veritabanı performans optimizasyon hizmeti veya eğitim planlanırken query observability, execution plan analizi, index tasarımı ve regression testing başlıklarının birlikte değerlendirilmesi önerilir. Böylece yalnızca tek bir yavaş query değil, ekipte sürdürülebilir performans geliştirme alışkanlığı oluşturulabilir.
Sonuç
ORM kullanımı doğru ölçüm ve doğru veri erişim stratejisiyle birlikte yürütüldüğünde geliştirme hızından vazgeçmeden güçlü production performansı elde etmek mümkündür. En kritik nokta ORM'yi otomatik SQL üreticisi olarak görüp veritabanı davranışını göz ardı etmemektir. Query count, N+1, result-set büyüklüğü, projection, change tracking, connection pool ve execution plan aynı performans zincirinin parçalarıdır. ORM (Object-Relational Mapping) Araçlarının Performans Etkileri üzerinde çalışan ekipler önce ölçüm yapmalı, ardından en pahalı katmana müdahale etmeli ve sonucu regression test ile korumalıdır. ORM, micro-ORM veya raw SQL seçimi de ideolojik bir tercih değil, workload'a göre verilmesi gereken teknik bir karardır.
Uygulamanızda query sayısı artıyor, p95 latency yükseliyor veya production ortamında database darboğazları yaşıyorsanız ilk iş olarak en yoğun endpoint'lerinizi ölçmeye başlayın. Generated SQL'i görün, duplicate query'leri bulun ve kullanıcıya gerçekten gereken veri miktarını sorgulayın. Ardından fetch strategy, index, projection ve connection pool ayarlarını sırayla doğrulayın. Yazılım, backend ve veri erişimi konularında topluluk içeriklerini takip etmek ve benzer teknik çalışmaları incelemek için https://www.diyarbakiryazilim.com.tr adresini ziyaret edebilirsiniz. Sağlam ORM performansı tek seferlik bir optimizasyon değil, ölçüm, gözlem ve bilinçli teknik kararların sürekli uygulandığı bir geliştirme disiplinidir.
share: