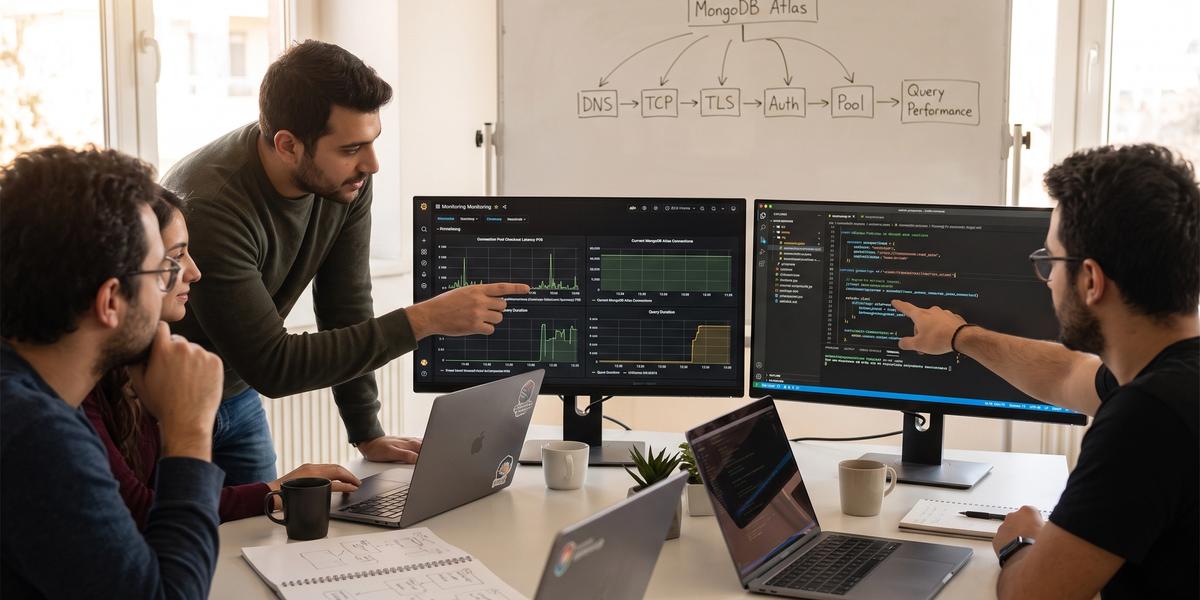
MongoDB Atlas Sunucu Bağlantı Optimizasyonu ve Sorun Giderme

Diyarbakır Yazılım
16.08.2026
#Yazılım#Teknoloji#Topluluk
Production ortamında MongoDB bağlantısı kesildiğinde ilk refleks çoğu zaman connection string'i kontrol etmek veya timeout değerini yükseltmek oluyor. On yıllık backend ve production sistem deneyimimde ise bağlantı sorunlarının çoğunun tek bir ayardan değil DNS, TCP, TLS, authentication, connection pool ve query performansı gibi birbirini takip eden katmanlardan çıktığını gördüm. MongoDB Atlas Sunucu Bağlantı Optimizasyonu ve Sorun Giderme yaklaşımında amaç hata mesajını susturmak değil, bağlantının hangi aşamada bozulduğunu ölçerek bulmaktır. Bu rehberde MongoDB Atlas bağlantı performansı nasıl optimize edilir sorusundan connection storm, Private Endpoint, Kubernetes ve serverless senaryolarına kadar production'da karşılaşabileceğiniz konuları sistematik biçimde ele alacağız. Rehberin sonunda bir Atlas bağlantısını DNS'ten query execution'a kadar katman katman analiz edebilecek, connection pool bütçesi oluşturabilecek ve tekrar eden kesintiler için uygulanabilir bir incident runbook hazırlayabileceksiniz.
MongoDB Atlas Bağlantısı Nasıl Çalışır?
MongoDB Atlas bağlantısını tek bir socket açma işlemi olarak düşünmek sorun giderirken önemli ayrıntıları gizler. Uygulama önce hostname'i çözümlemeli, doğru MongoDB node veya router adreslerini öğrenmeli, TCP bağlantısı oluşturmalı, TLS görüşmesini tamamlamalı ve ardından kimlik doğrulaması yapmalıdır. Driver bundan sonra cluster topology bilgisini izler ve database operasyonları için connection pool içinden uygun bağlantıları kullanır. Bu zincirin herhangi bir noktasındaki gecikme uygulamada benzer bir timeout veya server selection hatası olarak görülebilir. Bu nedenle production analizinde bağlantıyı ayrı katmanlara bölerek her adımı bağımsız doğrulamak en güvenilir yöntemdir.
MongoDB Atlas Nedir?
MongoDB Atlas, MongoDB veritabanlarının yönetilen cloud ortamlarında çalıştırılmasını sağlayan bir database platformudur. Cluster kurulumu, replica set yönetimi, monitoring, backup, network access ve ölçekleme gibi pek çok operasyonel görev platform üzerinden yönetilir. Uygulama tarafında ise yine resmî MongoDB driver'ları aracılığıyla normal MongoDB protokolü kullanılır. Atlas kullanmak connection lifecycle sorumluluğunu tamamen ortadan kaldırmaz, çünkü uygulamanın egress ağı, DNS resolver'ı, driver sürümü ve connection pool ayarları sizin çalışma ortamınızda bulunur. Production bağlantı güvenilirliği bu nedenle Atlas ayarları ile uygulama altyapısının birlikte tasarlanmasını gerektirir.
Uygulama ile Atlas Arasındaki Bağlantı Akışı
Bir uygulama `mongodb+srv://` connection string kullandığında süreç DNS SRV sorgusuyla başlar. Driver gerçek cluster hostlarını öğrendikten sonra uygun adreslere TCP socket açmaya çalışır ve TLS handshake gerçekleştirir. Kimlik doğrulama başarılı olduğunda driver topology bilgisini alır, primary ve secondary üyeleri tanır ve gerekli connection pool'ları oluşturur. Bir query geldiğinde uygun server seçilir, pool'dan connection checkout edilir, operasyon çalıştırılır ve bağlantı tekrar havuza döner. Bu zinciri log ve metric olarak ayrı ayrı gözlemlemek, tek bir “MongoDB yavaş” yorumundan çok daha fazla bilgi verir.
DNS Resolution
DNS resolution özellikle `mongodb+srv://` kullanan Atlas bağlantılarının ilk kritik adımıdır. Driver SRV kayıtları üzerinden cluster adreslerini öğrenir ve gerektiğinde TXT kaydındaki connection seçeneklerini de değerlendirir. DNS resolver sorunluysa uygulama MongoDB sunucusuna tek bir TCP paketi bile gönderemeden hata verir. `querySrv ECONNREFUSED`, `ENOTFOUND` ve `EAI_AGAIN` gibi mesajlar bu nedenle önce DNS katmanında incelenmelidir. Testi kendi bilgisayarınızdan değil uygulamanın gerçekten çalıştığı container, pod veya serverless çalışma ortamından yapmak teşhis kalitesini belirgin biçimde artırır.
TCP Connection
DNS başarılı olduktan sonra driver ilgili host ve porta TCP bağlantısı kurar. Bu aşamada firewall, route table, security group, NetworkPolicy veya Atlas IP Access List bağlantıyı engelleyebilir. TCP seviyesinde başarısızlık yaşanırken kullanıcı adı veya database role değiştirmek sonuç vermez, çünkü authentication aşamasına henüz ulaşılmamıştır. `nc` gibi araçlarla hedef host ve port erişimini test etmek sorunu hızla daraltabilir. Public Atlas bağlantılarında uygulama ortamının gerekli Atlas portlarına outbound trafik gönderebildiğinden emin olmak gerekir.
TLS Handshake
Atlas bağlantıları güvenli iletişim için TLS kullanır ve uygulamanın sertifika zincirini doğrulayabilmesi gerekir. TCP socket açılmış olsa bile CA store eksikse veya kurumsal proxy TLS trafiğine müdahale ediyorsa handshake başarısız olabilir. Container image içinde gerekli CA certificate paketlerinin bulunmaması production'da sık gördüğüm nedenlerden biridir. SNI ve hostname doğrulaması da sertifikanın beklenen Atlas hostname ile eşleşmesini sağlar. TLS validation'ı kapatmak sorunun yerini gösterebilir fakat kalıcı production çözümü değildir.
Authentication
TLS bağlantısı kurulduktan sonra driver database user bilgileriyle authentication gerçekleştirir. Atlas web arayüzüne giriş yaptığınız kullanıcı ile MongoDB database user aynı hesap türü değildir. Yanlış username, yanlış password, yanlış `authSource` veya eksik database role authentication hatasına yol açabilir. Connection string içindeki özel karakterlerin percent-encoding ile doğru yazılması da bu aşamada önemlidir. Credential rotation sonrasında uygulama hâlâ eski secret version'ı kullanıyorsa sorun yalnız belirli instance'larda veya rollout sırasında ortaya çıkabilir.
Server Discovery
Driver yalnız ilk hosta bağlanıp orada kalmaz, cluster topology bilgisini sürekli izler. Replica set içindeki primary değiştiğinde veya bir node erişilemez olduğunda Server Discovery and Monitoring mekanizması güncel topology görünümünü oluşturur. Read preference hangi server'ların operasyon için uygun olduğunu etkiler. Primary election sırasında kısa süreli server selection beklemeleri normal olabilir, ancak uzun süren `ReplicaSetNoPrimary` durumu network veya topology problemini gösterebilir. SDAM event'lerini loglamak bu aşamada yalnız hata mesajına bakmaktan daha anlamlı kanıt sağlar.
Connection Pool
MongoDB driver her query için sıfırdan TCP ve TLS bağlantısı açmak yerine açık bağlantıları pool içinde tekrar kullanır. Bu yaklaşım latency'yi azaltır ve Atlas tarafındaki toplam connection sayısının kontrol altında tutulmasına yardımcı olur. Her `MongoClient` kendi pool'larını oluşturduğu için uygulamada gereksiz yere çok sayıda client oluşturmak connection sayısını hızla büyütür. Pool dolduğunda yeni database operasyonları connection checkout için beklemeye başlar. Bu bekleme çoğu zaman “MongoDB bağlantısı yavaş” olarak yorumlansa da gerçek neden pool saturation veya yavaş query olabilir.
Database Operation
Bağlantı hazır olduktan sonra query veya write operasyonu seçilen server üzerinde çalıştırılır. Buradaki süre connection establishment süresinden ayrı ölçülmelidir. Query birkaç saniye sürüyorsa connection o süre boyunca checkout durumda kalır ve başka request'ler pool'da beklemeye başlayabilir. Böylece query performance problemi zamanla connection pressure problemine dönüşür. Production monitoring tasarımında query duration ile connection checkout latency aynı dashboard üzerinde birlikte görülmelidir.
MongoDB Atlas Bağlantı Problemleri Neden Zordur?
Atlas bağlantı sorunlarının zor görünmesinin ana nedeni birçok bağımsız sistemin tek request zincirinde buluşmasıdır. DNS resolver, container ağı, cloud NAT, firewall, TLS trust store, Atlas user configuration ve driver pool davranışı aynı bağlantının farklı parçalarını oluşturur. Bir katmandaki kesinti üst katmanda genel bir timeout mesajı üretebilir. Ayrıca yavaş query veya connection saturation gerçek network problemi olmadan benzer kullanıcı belirtileri oluşturabilir. Etkili troubleshooting bu nedenle hata metninden tahmin yürütmek yerine katmanları ölçerek elemeyi gerektirir.
Tek Hata Mesajının Birden Fazla Kök Nedeni Olabilmesi
`MongoServerSelectionError` tek başına kök nedeni söylemez. Driver belirlenen süre içinde uygun server bulamadığında DNS, firewall, TLS, topology veya cluster availability kaynaklı birçok durum aynı hata ailesinde görünebilir. Error object içindeki topology description ve alt hata mesajları bu nedenle mutlaka loglanmalıdır. Yalnız üst seviye message'i monitoring sistemine göndermek değerli teşhis bilgisini kaybettirir. Incident sırasında aynı hatayı farklı uygulama instance'larında karşılaştırmak network segment farklarını ortaya çıkarabilir.
Network ve Database Problemlerinin Karıştırılması
Bir query cevap vermediğinde ekipler bazen doğrudan network bağlantısını suçlar. Oysa connection pool hazır olabilir ve problem indexesiz bir sorgunun CPU veya disk üzerinde uzun süre çalışması olabilir. Tersi durumda database CPU düşük olduğu için sistem sağlıklı sanılabilir, fakat uygulama firewall nedeniyle cluster'a ulaşamıyor olabilir. TCP connectivity, pool checkout ve query execution sürelerini ayrı metric olarak izlemek bu karışıklığı azaltır. Sorunu doğru katmanda çözmek gereksiz timeout veya cluster scale değişikliklerini de önler.
Local Çalışıp Production'da Çalışmama
Local ortam ile production'ın DNS resolver, public egress IP, TLS CA store ve network route'ları aynı değildir. Geliştiricinin IP adresi Atlas Access List'te olabilirken Kubernetes NAT Gateway IP'si listede bulunmayabilir. Laptop normal public DNS kullanırken kurumsal production resolver SRV sorgularını filtreleyebilir. Container image local işletim sisteminizde bulunan CA certificate paketlerine sahip olmayabilir. Bu nedenle “lokalde çalışıyor” yalnız uygulama kodunun bazı bölümlerini doğrular, production network yolunun sağlıklı olduğunu kanıtlamaz.
Intermittent Bağlantı Hataları
Kesintinin sürekli olmaması teşhisi zorlaştırır. DNS resolver zaman zaman cevap vermiyor, NAT connection tracking kapasitesi doluyor veya deployment sırasında eski ve yeni pod'lar birlikte connection sayısını yükseltiyor olabilir. Primary election veya kısa network interruption driver tarafından toparlanırken yalnız belirli request'ler etkilenebilir. Timestamp'i deployment, autoscaling ve Atlas event timeline ile karşılaştırmak burada güçlü ipucu verir. Tek hata örneği yerine belirli zaman aralığındaki connection creation rate, heartbeat failure ve query latency birlikte incelenmelidir.
Connection Problemi Gibi Görünen Query Performance Sorunları
Yavaş query connection'ı daha uzun süre kullanımda tutar. Concurrent traffic devam ettiğinde pool'daki boş connection sayısı azalır ve yeni operasyonlar checkout queue içinde bekler. Pool büyümeye devam ederse Atlas connection sayısı artabilir, fakat gerçek kök neden yine query latency'dir. Bu durumda yalnız `maxPoolSize` artırmak geçici olarak daha fazla yavaş query'nin aynı anda çalışmasına izin verir ve cluster üzerindeki baskıyı büyütebilir. Query duration, documents examined ve pool utilization birlikte analiz edildiğinde bu zincir daha kolay görülür.
MongoDB Atlas Connection String Nedir?
Connection string uygulamanın MongoDB deployment'ını nasıl bulacağını ve hangi connection seçeneklerini kullanacağını tanımlayan URI'dir. Atlas arayüzü cluster için uygun URI'yi otomatik üretir ve production'da mümkün olduğunca bu kaynak kullanılmalıdır. URI username, password, hostname, database ve query option alanları içerebilir. Yanlış string birleştirme özellikle özel karakter içeren credentials nedeniyle parse veya authentication hatasına yol açabilir. MongoDB Atlas connection string'i secret manager üzerinden yönetip application config'e tek bir değer olarak aktarmak operasyonel hataları azaltır.
mongodb+srv://
`mongodb+srv://` DNS seedlist connection biçimidir. Driver SRV kaydını sorgulayarak cluster'ın gerçek hostlarını öğrenir. Bu yöntem topology adreslerinin connection string içinde tek tek yazılmasını gerektirmez. Atlas cluster değişikliklerinde DNS kayıtları güncellenebildiği için uygulama daha taşınabilir bir bağlantı tanımı kullanır. SRV sorgusunun çalışmadığı network ortamlarında ise DNS katmanını ayrıca test etmek gerekir.
mongodb://
`mongodb://` standard connection string biçimidir ve host veya host listesi URI içinde açıkça verilebilir. Replica set bağlantısında birden fazla seed host yazılabilir. SRV DNS problemi araştırılırken Atlas tarafından sağlanan standard URI diagnostic amaçla yararlı olabilir. Bununla birlikte private endpoint veya sharded cluster gibi yapılarda Atlas'ın önerdiği bağlantı biçimi öncelikli tutulmalıdır. Elle tahmin edilen hostname ve port listesi production topology değişikliklerinde kolayca eskiyebilir.
Username
Username MongoDB database user kimliğinin bir parçasıdır. Atlas UI hesabınızın e-posta veya kullanıcı adıyla aynı olmak zorunda değildir. Uygulamalar mümkün olduğunca ayrı service identity kullanmalıdır. Aynı credential'ı onlarca servis arasında paylaşmak rotation ve audit işlemlerini zorlaştırır. Username connection string içine ekleniyorsa URI güvenliği secret yönetimi kapsamında değerlendirilmelidir.
Password
Password database user authentication için kullanılır ve source code repository içinde tutulmamalıdır. Özel URI karakterleri bulunuyorsa percent-encoding uygulanmalıdır. Password rotation sırasında eski ve yeni application replica'ların deployment sırası planlanmalıdır. Secret manager versioning geçişi güvenli hâle getirebilir. Log veya error reporting sistemi connection string'i otomatik olarak maskeliyor mu production öncesi doğrulanmalıdır.
Host
Host bölümü standard URI'de doğrudan server adresini, SRV URI'de ise DNS seedlist hostname'ini temsil eder. Host'u Atlas panelinden kopyalamak yazım hatalarını azaltır. Private endpoint connection string'i public connection string'den farklı hostname kullanabilir. DNS çözüm sonucu public veya RFC1918 private IP olması network tasarımına göre değişir. Hostname'i sabit IP ile değiştirmek TLS hostname doğrulaması ve topology discovery açısından yanlış sonuçlar doğurabilir.
Database
URI içindeki database alanı varsayılan database seçiminde veya authentication davranışında rol oynayabilir. Database adı ile `authSource` aynı kavram değildir. Uygulama belirli database'i kullanırken credential başka authentication database içinde tanımlanmış olabilir. Driver `client.db()` çağrısıyla operasyon database'ini ayrıca seçebilir. Connection string migration sırasında database bölümünü sessizce değiştirmek authorization sorunlarına yol açabilir.
Query Parameters
Query parameters retry, timeout, read preference ve başka driver davranışlarını tanımlayabilir. Bütün ayarları connection string içine eklemek zorunlu değildir, driver options object daha okunabilir olabilir. Security-sensitive veya environment-specific ayarlar merkezi configuration katmanında tutulabilir. Atlas tarafından verilen URI içindeki varsayılan seçenekleri silmeden önce etkileri anlaşılmalıdır. Aynı option hem URI hem code içinde farklı değerle tanımlanırsa hangi değerin geçerli olduğunu driver dokümantasyonuna göre doğrulamak gerekir.
SRV ve Standard Connection String Arasındaki Fark
SRV ve standard URI arasındaki temel fark host keşfinin nasıl başlatıldığıdır. SRV bağlantısında DNS seedlist üzerinden server adresleri öğrenilirken standard URI başlangıç hostlarını doğrudan taşır. Atlas modern kullanımda SRV bağlantılarını geniş biçimde destekler ve topology değişikliklerinde DNS tabanlı yaklaşım operasyonu kolaylaştırır. Standard URI ise DNS SRV sorgusunun çalışmadığını doğrulamak için diagnostic fallback olarak değerli olabilir. Kalıcı production seçimi cluster türü, private connectivity ve Atlas'ın sağladığı connection string önerisine göre yapılmalıdır.
DNS Seedlist
DNS seedlist tek hostname üzerinden driver'a bir grup başlangıç server'ı sağlar. Driver `_mongodb._tcp` SRV kaydını sorgular. TXT kaydı belirli connection option'ları sağlayabilir. Cluster member adreslerini application config içinde tek tek güncelleme ihtiyacı azalır. DNS dependency arttığı için production resolver'ın SRV ve TXT sorgularını desteklediği test edilmelidir.
Static Host List
Standard URI içinde bir veya birden fazla host açıkça yazılır. Driver bu seed hostlardan topology bilgisini öğrenmeye devam eder. DNS SRV gerekmez, fakat yazılan host adlarının normal A veya AAAA çözümlemesi yine gerekir. Private endpoint portlarının dinamik davranabildiği yapılarda static port listesi daha kırılgan olabilir. Atlas'ın verdiği standard URI yalnız diagnostic veya desteklenen kullanım için tercih edilmelidir.
Automatic Topology Discovery
MongoDB driver seed hostlara bağlandıktan sonra replica set veya sharded topology bilgisini discovery mekanizmasıyla öğrenir. SRV kullanmak topology discovery'nin kendisi değildir, yalnız başlangıç seed listinin DNS'ten alınmasını sağlar. Primary değişikliği driver'ın SDAM mekanizmasıyla takip edilir. Bu nedenle connection string'de tek hostname görmek uygulamanın yalnız o server'a bağlı kalacağı anlamına gelmez. Driver event'leri hangi server'ların topology içinde bulunduğunu production log'larında gösterebilir.
SRV'nin Avantajları
SRV URI daha kısa ve yönetilebilir connection string sağlar. Atlas tarafından yapılan topology veya endpoint değişiklikleri DNS kayıtları üzerinden uygulamaya yansıtılabilir. Sharded cluster ve private endpoint bağlantılarında Atlas'ın optimize ettiği connection string modellerinden faydalanmayı kolaylaştırır. TLS gibi belirli seçenekler de SRV kullanımında doğal şekilde devreye girebilir. Dezavantajı, uygulama ortamının güvenilir SRV DNS resolution'a bağımlı hâle gelmesidir.
Standard URI'nin Avantajları
Standard URI SRV lookup kullanmadığı için kurumsal DNS'in SRV sorgularını bozduğu durumlarda önemli teşhis aracıdır. Host ve port listesinin açık olması packet ve firewall analizini kolaylaştırabilir. Bazı legacy araçlar SRV formatıyla sınırlı compatibility gösterebilir. Buna rağmen URI cluster değişikliklerinde daha fazla operasyonel bakım gerektirebilir. Atlas private endpoint gibi dynamic port yapılarını kullanırken standard URI'nin güncelliği özellikle takip edilmelidir.
DNS Sorunlarında Standard URI'yi Diagnostic Fallback Olarak Kullanmak
`mongodb+srv://` hata verip Atlas'ın standard URI'si çalışıyorsa problem büyük olasılıkla SRV DNS sorgu zincirindedir. Bu test database user veya temel TCP erişiminin çalıştığını ayrı olarak gösterir. Diagnostic test kalıcı mimari karar yerine kök nedeni daraltmak için kullanılmalıdır. Corporate resolver SRV sorgusunu engelliyorsa DNS ekibiyle kalıcı çözüm üretilmelidir. Production application'ı yalnız sorunu gizlemek amacıyla elle oluşturulan static host listesine taşımak ileride topology değişikliklerinde yeni risk yaratabilir.
Sharded Cluster'larda SRV Kullanmanın Önemi
Sharded Atlas cluster birden fazla `mongos` router üzerinden erişim sunabilir. SRV kayıtları driver'ın uygun router listesine ulaşmasını kolaylaştırır. Private endpoint kullanan belirli AWS sharded cluster'larda Atlas optimize SRV connection string ile `mongos` başına connection fan-out'unu azaltabilir. Bu yapı özellikle yüksek connection spike yaşayan sistemlerde önemlidir. Driver compatibility ve Atlas tarafından üretilen URI kullanılmadan özel SRV hostname tasarlanmamalıdır.
MongoDB SRV DNS Çözümlemesi Nasıl Çalışır?
MongoDB SRV bağlantısını anlamak `querySrv` hatalarını çözmeyi çok kolaylaştırır. Driver connection string içindeki hostname üzerinden `_mongodb._tcp` servis kaydını sorgular. SRV sonucu gerçek host ve port bilgilerini sağlar, TXT kayıtları ise desteklenen connection option'larını taşıyabilir. Driver bu seed bilgisiyle MongoDB server'larına bağlanıp gerçek topology'yi öğrenir. DNS'in yalnız hostname'i IP'ye çeviren A kaydından ibaret olmadığını bilmek production troubleshooting için önemlidir.
_mongodb._tcp
`_mongodb._tcp` DNS SRV service name yapısının MongoDB için kullanılan kısmıdır. Driver `mongodb+srv://cluster.example.com` gördüğünde ilgili SRV kaydını otomatik sorgular. Kullanıcı normalde bu prefix'i connection string içine yazmaz. `dig SRV _mongodb._tcp...` komutu diagnostic sırasında doğrudan kayıt sonucunu görmeye yardımcı olur. SRV query reddediliyorsa A record sorgusunun çalışması bağlantının sağlıklı olduğunu kanıtlamaz.
SRV Record
SRV record bir servisin hangi host ve portlarda bulunduğunu tanımlayabilir. MongoDB Atlas DNS seedlist bu mekanizmayı cluster endpoint'lerini yayınlamak için kullanır. Driver sonuçları seed list olarak değerlendirir ve topology discovery'ye devam eder. DNS response TTL değişikliklerin ne kadar hızlı görülebileceğini etkiler. Resolver cache veya corporate DNS forwarding yanlış çalışıyorsa eski veya boş SRV sonuçları görülebilir.
TXT Record
TXT record MongoDB SRV connection için belirli default URI option'larının taşınmasına yardımcı olabilir. Driver SRV sorgusuna ek olarak TXT kaydını okuyabilir. Diagnostic sırasında `dig TXT` ile beklenen değerin ulaşıp ulaşmadığı kontrol edilir. Kurumsal DNS yalnız SRV'yi değil TXT query'lerini de filtreleyebilir. Connection option'ı hem TXT hem URI query parameter'ında bulunuyorsa conflict davranışı driver specification'a göre değerlendirilmelidir.
authSource
`authSource` credential'ın hangi MongoDB database içinde doğrulanacağını belirtir. SRV bağlantısında authentication database davranışı connection string ve default database bilgisine göre belirlenebilir. Authentication hatası görülüyorsa user'ın hangi database üzerinde tanımlandığı kontrol edilmelidir. Atlas database users çoğu standart bağlantıda platform tarafından üretilen URI ile doğru kullanım modeline yönlendirilir. Elle değiştirilen `authSource` gereksiz login problemlerinin yaygın nedenidir.
Replica Set Bilgisi
Driver seed server'a ulaştıktan sonra replica set üyelerini server response üzerinden öğrenir. Primary ve secondary roller zaman içinde election nedeniyle değişebilir. SRV kaydı tüm runtime topology bilgisini taşımak zorunda değildir. SDAM mekanizması yeni primary seçimini izleyip operation routing kararını günceller. Bu nedenle yalnız DNS çıktısına bakarak replica set sağlık durumunu değerlendirmek yeterli değildir.
Driver'ın Gerçek Hostları Bulması
Driver önce DNS seedlist'ten başlangıç adreslerini alır ve bu adreslere bağlantı açar. Server discovery sonucunda topology içinde bulunan diğer üyeleri tanıyabilir. Driver monitoring socket'leriyle bu üyelerin durumunu izlemeye devam eder. Firewall yalnız ilk seed hostu açıp diğer üyeleri engelliyorsa başlangıç bağlantısı varmış gibi görünüp daha sonra server selection sorunları yaşanabilir. Production network policy bütün gerekli Atlas endpoint'lerine erişimi desteklemelidir.
MongoDB Atlas DNS Sorunları Nasıl Test Edilir?
DNS problemi araştırırken tek `ping` komutuna güvenmek yeterli değildir. MongoDB SRV bağlantısı SRV, TXT ve sonrasında A veya AAAA çözümlemesi gerektirir. Testlerin uygulamanın gerçek network namespace'i içinde yapılması özellikle Docker ve Kubernetes için önemlidir. Aynı hostname'i public DNS resolver ve kurum resolver'ı üzerinden karşılaştırmak sorunun kaynağını hızla daraltabilir. MongoDB Atlas IP access list connection string TLS ve ağ bağlantı sorunları birbirine karıştırılmadan ayrı adımlarda test edildiğinde incident süresi ciddi biçimde kısalır.
nslookup
`nslookup` temel hostname ve DNS server davranışını kontrol etmek için kullanılabilir. Hangi resolver'ın cevap verdiğini görmek özellikle container veya VPN ortamında değerlidir. Normal A kaydı çözülse bile SRV sorgusunu ayrıca çalıştırmak gerekir. Çıktıda timeout veya refused görülüyorsa problem MongoDB authentication aşamasından önce oluşur. Aynı komutu host işletim sistemi ve container içinde karşılaştırmak farklı resolver yapılarını ortaya çıkarabilir.
dig
`dig` DNS record türlerini daha açık biçimde sorgulamayı sağlar. SRV, TXT, A ve AAAA kayıtları ayrı ayrı görülebilir. Response status, authority ve hangi DNS server'ın kullanıldığı teşhis için değerlidir. Public resolver ile corporate resolver sonucu farklıysa network veya DNS ekibine somut kanıt sunulur. Production image içinde `dig` bulunmuyorsa geçici diagnostic pod veya aynı network'e bağlı araç kullanılabilir.
SRV Lookup
SRV lookup `_mongodb._tcp` prefix'iyle Atlas seed hostname üzerinde yapılır. Sonuç boşsa veya resolver request'i reddediyorsa `mongodb+srv://` bağlantısı çalışmayabilir. Target host ve port değerleri çıktıda görünür. Private endpoint SRV sonuçları public connection string sonuçlarından farklı olabilir. Kullandığınız URI ile test ettiğiniz hostname'in aynı olduğundan emin olmak gerekir.
TXT Lookup
TXT lookup SRV connection string için ek option bilgilerinin DNS üzerinden ulaşabildiğini doğrular. Bazı resolver'lar record türlerine farklı policy uygulayabilir. SRV çalışırken TXT sorgusu sorunluysa driver beklenmedik connection option davranışı gösterebilir. `dig TXT` ile response doğrudan incelenebilir. Resolver cache temizliği yalnız gerçekten stale response kanıtı varsa kullanılmalıdır.
A/AAAA Lookup
SRV sonucundaki target hostname'lerin IP adresine dönüşmesi için A veya AAAA sorgusu gerekir. IPv6 tercih davranışı runtime ve network configuration'a göre connection sorunlarına yol açabilir. Bir hostname yalnız IPv6 dönüyor fakat network IPv6 route taşımıyorsa connect timeout görülebilir. Node.js driver modern sürümlerde IPv4 ve IPv6 seçimi için ilgili socket seçeneklerini destekler. Diagnostic sırasında iki record türünü ayrı görmek sorunu anlaşılır kılar.
Farklı DNS Resolver ile Test
Corporate resolver başarısızken public resolver doğru SRV sonucu döndürüyorsa Atlas tarafındaki kayıt büyük ihtimalle sağlıklıdır. Bu test kalıcı olarak public DNS kullanmanız gerektiği anlamına gelmez. Güvenlik ve kurum policy'si gereği internal resolver düzeltilebilir. VPN split DNS veya on-prem forwarding rule'ları ayrıca kontrol edilmelidir. Private endpoint kullanırken public resolver ile test sonucu özel DNS tasarımını doğru temsil etmeyebilir.
Aynı Testi Uygulamanın Çalıştığı Host İçinden Yapmak
Developer laptop'tan başarılı DNS sonucu production pod'un aynı sonucu alacağını garanti etmez. Kubernetes CoreDNS, Docker embedded DNS veya serverless platform resolver'ı farklı olabilir. Diagnostic shell uygulamayla aynı VPC, namespace ve mümkünse aynı image içinde çalıştırılmalıdır. Bu yaklaşım network path ve resolver farklılıklarını doğrudan test eder. Incident sırasında en sık kaybettiren zamanlardan biri, yanlış ortamdan yapılan başarılı test nedeniyle gerçek sorunun elenmesidir.
querySrv ECONNREFUSED Hatası
`querySrv ECONNREFUSED` driver'ın SRV DNS sorgusuna yanıt alamadığını veya resolver tarafından bağlantının reddedildiğini gösteren güçlü bir DNS işaretidir. Atlas'ın kendi troubleshooting rehberleri de bu durumda resolver ve standard connection string ile izolasyon testini önerir. Authentication veya pool size değiştirmek bu hata için doğru ilk adım değildir. Corporate DNS, VPN ve container resolver path'i tek tek karşılaştırılmalıdır. Kök neden bulunduğunda kalıcı resolver düzeltmesi yapılmalı, yalnız workaround ile production bırakılmamalıdır.
DNS Resolver Problemi
Resolver SRV query türünü desteklemiyor, yanlış forward ediyor veya geçici olarak erişilemiyor olabilir. `/etc/resolv.conf` ve runtime'ın gerçekten hangi DNS server'ını kullandığı kontrol edilmelidir. Aynı sorgu public resolver üzerinde çalışıyorsa sorun daraltılmış olur. Resolver loglarına erişim varsa refused response'un policy mi yoksa servis problemi mi olduğu görülebilir. DNS availability database SLO'nun dış bağımlılığı olarak monitoring kapsamına alınabilir.
Corporate DNS
Kurumsal DNS güvenlik filtreleri veya proxy policy nedeniyle SRV kayıtlarını beklenmedik biçimde engelleyebilir. Bazı ağlarda yalnız A ve AAAA sorguları yaygın test edildiği için sorun uzun süre fark edilmeyebilir. DNS ekibine `_mongodb._tcp` sorgusunun gerçek çıktısı iletilmelidir. Split-horizon DNS kullanılıyorsa farklı network segmentleri farklı sonuç alabilir. Workstation resolver ile production resolver aynı kabul edilmemelidir.
VPN
VPN aktifken DNS server ve route table değişebilir. Laptop normal bağlantıda Atlas SRV kaydını çözerken VPN üzerinde kurum resolver'ına geçip hata verebilir. Tersi durumda private endpoint hostname yalnız VPN bağlıyken çözülebilir. VPN açılıp kapatılarak aynı `dig SRV` testi karşılaştırılabilir. Production servis VPN kullanmıyorsa geliştirici ortamındaki VPN sonucu doğrudan production'a genellenmemelidir.
Docker DNS
Docker container host DNS yapılandırmasını kendi embedded resolver mekanizması üzerinden kullanabilir. Host işletim sisteminde çalışan SRV sorgusu container içinde başarısız olabilir. Aynı image içine geçici DNS araçları eklemek yerine diagnostic container aynı Docker network'te çalıştırılabilir. Docker daemon DNS config ve kurum VPN etkisi birlikte incelenmelidir. Container yalnız public DNS'e zorlanmadan önce kurum güvenlik policy'si değerlendirilmelidir.
Kubernetes DNS
Kubernetes pod'ları çoğunlukla CoreDNS üzerinden çözümleme yapar. CoreDNS upstream resolver'a ulaşamıyor veya yoğunluk altında timeout veriyorsa MongoDB SRV sorguları etkilenebilir. Pod içinden doğrudan SRV ve TXT testleri yapılmalıdır. CoreDNS pod restart, CPU throttling ve error logları incident timeline ile karşılaştırılabilir. Uygulama replica sayısı arttıkça DNS query hacminin de değişebileceği unutulmamalıdır.
Public Resolver ile Karşılaştırma
Public resolver testinin amacı Atlas DNS kaydının dış dünyada doğru yayınlanıp yayınlanmadığını kontrol etmektir. Public resolver çalışıyor, kurum resolver çalışmıyorsa problem application code yerine DNS path'inde aranır. Private endpoint hostname için bu yöntem her zaman geçerli değildir, çünkü private DNS yalnız belirli network içinde çözülmelidir. Karşılaştırma sonucunu kalıcı configuration olarak değil diagnostic kanıt olarak kullanmak gerekir. Resolver seçimi kurumun privacy ve güvenlik gereksinimleriyle uyumlu olmalıdır.
Standard Connection String ile İzolasyon Testi
Atlas'ın sağladığı non-SRV connection string ile uygulama bağlanabiliyorsa TCP, TLS ve authentication zincirinin önemli bölümü çalışıyor demektir. Bu durum SRV resolver sorununu güçlendiren bir kanıttır. Test yalnız kısa diagnostic amaçla yapılabilir. Private endpoint veya sharded topology için Atlas'ın sunduğu doğru standard URI kullanılmalıdır. Elle uydurulan host listesi gerçek topolojiyi yanlış temsil edebilir.
querySrv ENOTFOUND Hatası
`ENOTFOUND` DNS resolver'ın istenen SRV hostname için kayıt bulamadığını gösterir. En basit neden connection string hostname'inin yanlış kopyalanmasıdır. Private endpoint henüz doğru kurulmamışsa Atlas ilgili private SRV kaydını yayınlamıyor olabilir. Multi-region private endpoint yapılandırmasında eksik region da DNS resolution'ı etkileyebilir. İlk adım connection string'i Atlas Connect ekranından yeniden alıp aynı hostname üzerinde SRV sorgusu yapmaktır.
Yanlış Cluster Hostname
Cluster yeniden adlandırılmış, eski environment variable kullanılıyor veya copy-paste sırasında hostname bozulmuş olabilir. Secret manager içindeki URI ile Atlas UI'daki güncel URI karşılaştırılmalıdır. Hostname'i manuel düzenlemek yerine yeniden üretmek daha güvenlidir. Bir environment çalışıp diğeri çalışmıyorsa secret version farkları kontrol edilmelidir. Loglara tam credential yazmadan yalnız hostname ve connection mode güvenli biçimde kaydedilebilir.
DNS SRV Kaydı Bulunamaması
Resolver NXDOMAIN dönüyorsa sorgulanan hostname için SRV kaydı bulunmamıştır. Yanlış domain dışında DNS propagation veya private endpoint state problemi olabilir. Public Atlas SRV record normalde Atlas tarafından yönetilir. `dig SRV` çıktısındaki status ve authority bilgisi incelenmelidir. Uygulama retry ile sonsuza kadar bekletilmemeli ve startup health davranışı net olmalıdır.
Private Endpoint DNS Problemi
Private endpoint bağlantısında DNS sonucu endpoint'e özel private adresleri göstermelidir. Endpoint status hazır değilse veya private DNS association yanlışsa SRV kaydı bulunamayabilir. Multi-region Atlas cluster'da her gerekli region için endpoint configuration tamamlanmalıdır. VPC veya VNet içinden yapılan DNS testi public workstation testinden daha anlamlıdır. Endpoint state ve DNS association birlikte incelenmelidir.
Cluster Connection String'ini Atlas'tan Yeniden Almak
Connection string'i wiki veya eski deployment manifest'ten kopyalamak yerine Atlas'ın güncel Connect ekranından almak en güvenilir yöntemdir. Atlas cluster topology veya private endpoint seçimine göre uygun URI'yi üretir. Driver version bilgisi de connection yöntemi seçiminde dikkate alınabilir. Yeniden alınan URI secret manager'a kontrollü rotation süreciyle yazılmalıdır. Production rollout öncesinde staging üzerinde DNS ve authentication smoke testi çalıştırılmalıdır.
EAI_AGAIN Hatası
`EAI_AGAIN` çoğunlukla geçici DNS resolution failure veya resolver timeout durumuna işaret eder. Error sürekli değilse network veya DNS servisinin kısa süreli kapasite problemi olabilir. Container ve Kubernetes ortamlarında resolver health özellikle incelenmelidir. Blind retry kısa kesintileri gizleyebilir ama resolver sistematik olarak bozuksa request storm oluşturabilir. Retry, exponential backoff ve jitter ile sınırlı bir budget içinde uygulanmalıdır.
Geçici DNS Resolution Failure
Resolver kısa süre erişilemez olduğunda aynı sorgu saniyeler sonra başarılı olabilir. Bu durum deployment veya network değişimi sırasında görülebilir. Uygulama hata oranının zaman grafiği resolver incident'iyle karşılaştırılmalıdır. Sürekli retry yapıp başarı oranını yalnız uygulama seviyesinde saklamak altyapı sorununu görünmez kılabilir. DNS failure rate monitoring'e ayrı sinyal olarak eklenmelidir.
Resolver Timeout
Resolver request'e belirlenen süre içinde cevap vermezse runtime geçici çözümleme hatası üretebilir. Upstream DNS latency veya packet loss bunun nedeni olabilir. Pod ve node seviyesinde network latency karşılaştırması yapılmalıdır. Aynı resolver üzerinde başka domain sorgularının da yavaş olup olmadığı kontrol edilir. Timeout değerini yükseltmek altyapı kapasite problemini tek başına çözmez.
Docker ve Kubernetes Ortamlarında DNS
Container runtime kendi DNS forwarding katmanını ekleyebilir. Kubernetes CoreDNS cluster içi service discovery ile external lookup'u aynı servis üzerinden gerçekleştirebilir. Resource limit, upstream connectivity veya network policy external MongoDB DNS query'lerini etkileyebilir. Uygulama pod'u ile diagnostic pod aynı node'da test edilirse node-specific problem bulunabilir. DNS health deployment readiness'in doğrudan MongoDB bağlantısı açmadan kontrol edilebilecek önemli parçasıdır.
CoreDNS Sağlığı
CoreDNS replica sayısı, CPU kullanımı ve error logları incelenmelidir. Yüksek query volume altında throttling veya timeout görülebilir. NodeLocal DNS Cache gibi architecture seçenekleri büyük cluster'larda resolver yükünü azaltabilir. ConfigMap içindeki forward veya stub domain kuralları private Atlas domain'i etkileyebilir. Değişiklik production'a alınmadan önce normal service discovery üzerinde yan etki oluşturmadığı test edilmelidir.
Retry Stratejisi
Geçici DNS failure için birkaç kontrollü retry mantıklı olabilir. Retry aralığı exponential backoff ve jitter kullanarak bütün instance'ların aynı anda tekrar sorgu göndermesini önlemelidir. Maximum attempt ve toplam retry budget API request deadline'ın altında kalmalıdır. Startup sırasında sonsuz retry uygulamanın hazır olmadığı hâlde pod'u uzun süre belirsiz durumda tutabilir. Persistent DNS problemi alert üretmeli ve insan müdahalesine taşınmalıdır.
Atlas IP Access List Nasıl Çalışır?
Atlas public network bağlantılarında project seviyesindeki IP Access List hangi kaynak IP veya CIDR bloklarının database deployment'a ulaşmasına izin verildiğini sınırlar. Uygulamanın gördüğünüz private pod IP'si değil, Atlas'a gerçekten çıkan public egress IP'si önemli olabilir. NAT Gateway veya cloud egress architecture bu değeri değiştirir. Geçici troubleshooting entry'leri otomatik expiry ile sınırlandırmak güvenlik açısından daha iyidir. Production bağlantısında mümkün olan en küçük network aralığına izin vermek güvenli varsayımdır.
Project-Level Network Access
IP Access List Atlas project scope içinde yönetilir ve project içindeki database deployment'lara network erişimini kontrol eder. Uygulama database credential'a sahip olsa bile source network listede değilse bağlantı kurulamaz. Network erişimi authentication'dan önce bir güvenlik katmanı oluşturur. Farklı environment'lar aynı project'i paylaşıyorsa gereksiz geniş allowlist oluşabilir. Büyük organizasyonlarda prod ve non-prod network sınırlarını ayrı project yapılarıyla ayırmak değerlendirilebilir.
Public Source IP
Atlas public endpoint'e bağlanan uygulamanın görünen source IP'si egress NAT sonrası adrestir. Kubernetes pod IP veya VM private IP doğrudan Atlas Access List'e yazılmayabilir. `curl` ile public IP discovery servisi kullanmak diagnostic amaçla yardımcı olabilir, ancak kurum policy'sine uygun araç seçilmelidir. Cloud provider egress architecture üzerinden authoritative IP bilgisi daha güvenilirdir. Autoscaling yeni NAT veya route üzerinden çıkabiliyorsa source IP set'i değişebilir.
CIDR
CIDR tek IP yerine belirli ağ aralığını tanımlar. `/32` yalnız tek IPv4 adresine izin vermek için kullanılabilir. Daha geniş blok yalnız gerçekten gerekli network aralığını kapsamalıdır. `0.0.0.0/0` bütün IPv4 internetini kapsadığı için production'da güçlü risk oluşturur. Network erişimi credential güvenliğini tamamlayan ikinci savunma katmanı olarak düşünülmelidir.
Dynamic IP
Geliştirici laptop'u veya bazı serverless platformlar sabit public egress IP sunmayabilir. IP sürekli değişiyorsa dar Atlas Access List yönetimi zorlaşır. Static NAT, platform egress seçeneği veya Private Endpoint gibi architecture çözümü değerlendirilebilir. Her IP değişiminde `0.0.0.0/0` açmak sürdürülebilir çözüm değildir. Dynamic environment'ın connectivity requirement'ı deployment tasarım aşamasında belirlenmelidir.
NAT Gateway
NAT Gateway private subnet'teki workload'ların public internet'e belirli egress adresleri üzerinden çıkmasını sağlayabilir. Bu adresler Atlas IP Access List için sabit source olarak kullanılabilir. High availability için birden fazla region veya zone NAT kullanılıyorsa bütün olası egress adresleri hesaba katılmalıdır. NAT connection tracking ve port kapasitesi yüksek connection rate altında ayrıca izlenmelidir. Private Endpoint kullanımı internet ve NAT bağımlılığını azaltabilir.
Cloud Egress IP
Cloud platformunun uygulamaya sağladığı outbound IP listesi Atlas network access için kullanılabilir. Platform autoscaling veya region değişimi bu listeyi değiştirebilir. Deployment manifest yanında egress architecture dokümante edilmelidir. Infrastructure as Code Access List ile egress resource'larını aynı pipeline içinde yönetirse manuel drift azalır. IP değişikliği uygulama release'inden bağımsız network incident yaratabileceği için monitoring önemlidir.
Temporary Access Entry
Geçici Access List entry belirli süre sonunda otomatik expire olacak şekilde oluşturulabilir. Incident sırasında geliştirici IP'sine kısa süreli erişim vermek için kalıcı allowlist'ten daha güvenlidir. Expiry süresi iş tamamlanacak kadar uzun, gereksiz açık kalmayacak kadar kısa seçilmelidir. Entry açıklamasına ticket veya amaç bilgisi eklemek audit'i kolaylaştırır. Production troubleshooting bittikten sonra erişimin gerçekten kapandığı doğrulanmalıdır.
0.0.0.0/0 Kullanılmalı mı?
`0.0.0.0/0` bütün IPv4 adreslerinden network erişimine izin verir ve Atlas da wildcard IP kullanımında güvenlik uyarıları sunar. Development sırasında problemin Access List kaynaklı olup olmadığını kısa süreli izole etmek için kullanılabilir, fakat production standardı yapılmamalıdır. Database authentication bulunuyor olsa bile public saldırı yüzeyi gereksiz biçimde büyür. Static egress veya private connectivity daha sağlıklı seçeneklerdir. Geçici kullanım zorunluysa expiry, audit ve hızlı geri alma adımları birlikte planlanmalıdır.
Development Troubleshooting
Connection sorununun gerçekten Access List olup olmadığını anlamak için kontrollü development ortamında çok kısa süreli wildcard test yapılabilir. Test başarılı olursa dar source IP belirlenip hemen restriction geri getirilmelidir. Production data içeren cluster'da aynı yaklaşım tercih edilmemelidir. Temporary Access List özelliği daha güvenli diagnostic seçenek sunar. Test sonucu runbook'a kaydedilirse ekip tekrar aynı geniş izni vermek zorunda kalmaz.
Public Internet Riski
Wildcard Access List Atlas endpoint'ini internetteki bütün source IP'lere network seviyesinde açık hâle getirir. Authentication saldırılarını ve credential sızıntısının etkisini genişletir. Network restriction database password'den bağımsız savunma katmanıdır. Organization resource policy ile `/0` kullanımını tamamen yasaklamak mümkündür. Güvenlik standardı environment bazında istisna süreci içermelidir.
Production'da Static Egress IP
Production workload için sabit NAT veya platform egress IP kullanmak Access List'i dar tutmayı kolaylaştırır. Autoscaling yeni instance oluştursa bile outbound trafik aynı kontrollü IP set'inden çıkar. Multi-region deployment bütün bölgesel egress adreslerini hesaba katmalıdır. Egress değişikliği Infrastructure as Code üzerinden Access List update'iyle aynı release sürecine bağlanabilir. Bu yaklaşım public endpoint kullanan sistemler için basit ve anlaşılır güvenlik modelidir.
Private Connectivity
Private Endpoint veya network peering database trafiğini public internet üzerinden göndermeden taşıyabilir. Atlas dedicated cluster'larda AWS PrivateLink, Azure Private Link ve GCP Private Service Connect seçeneklerini destekler. Bu yapı network exposure'ı azaltırken DNS, route ve endpoint lifecycle gibi yeni operasyon sorumlulukları getirir. Security gereksinimi yüksek production sistemlerde güçlü tercihtir. Cost ve operasyon yetkinliği architecture kararına dahil edilmelidir.
Temporary Allowlist
Incident sırasında belirli engineer veya diagnostic runner IP'si kısa süreli Access List'e eklenebilir. Otomatik expiry manuel unutma riskini azaltır. Wildcard yerine yalnız gerekli `/32` kaynak tercih edilmelidir. Change ticket ve sorumlu kişi entry açıklamasında bulunabilir. Incident kapanırken temporary rule kontrolü runbook'un zorunlu adımı olmalıdır.
Uygulamanın Gerçek Çıkış IP'si Nasıl Bulunur?
Atlas Access List problemi çözerken private interface IP'sine bakmak genellikle yeterli değildir. Önemli olan Atlas public endpoint'inin request'i hangi public source IP'den gördüğüdür. Bu değer local makinede ISP adresi, Kubernetes'te NAT Gateway ve serverless ortamda platform egress adresi olabilir. VPN kullanımı da source IP'yi değiştirebilir. Gerçek egress bilgisini environment'ın network architecture'ından doğrulamak tahmine dayalı allowlist değişikliklerini önler.
Lokal Makine
Developer laptop doğrudan internet kullanıyorsa public IP ISP veya router NAT adresidir. VPN bağlı olduğunda egress kurumsal gateway üzerinden çıkabilir. Atlas UI geçici olarak current IP ekleme seçeneği sunabilir. Dynamic residential IP zaman içinde değişeceği için kalıcı production rule olarak kullanılmamalıdır. Local testin başarılı olması production egress configuration hakkında bilgi vermez.
Docker Host
Local Docker container çoğunlukla host üzerinden NAT yaparak internete çıkar. Cloud VM üzerinde Docker kullanılıyorsa egress VM public IP veya subnet NAT üzerinden olabilir. Container içindeki `ip addr` çıktısı Atlas'ın gördüğü source IP değildir. Diagnostic request'i container network namespace içinden yapılmalıdır. Docker host firewall outbound 27017 trafiğini ayrıca engelleyebilir.
Kubernetes Node/NAT
Private Kubernetes pod'ları çoğu production cluster'da NAT Gateway veya egress gateway üzerinden internete çıkar. Pod IP Atlas Access List için uygun olmayabilir. Multiple node pool veya region farklı egress yolları kullanabilir. CNI ve egress policy architecture'ı network ekibiyle doğrulanmalıdır. HPA ile yeni pod'lar farklı node'a taşındığında egress adresinin değişip değişmediği test edilmelidir.
AWS Lambda
Lambda'nın network path'i VPC configuration'a bağlıdır. VPC dışındaki default egress sabit allowlist için uygun olmayabilir, VPC içindeki private subnet ve NAT Gateway sabit public egress sağlayabilir. PrivateLink kullanıldığında public source IP Access List modeli yerine private endpoint route devreye girer. MongoClient handler dışında oluşturularak warm invocation'larda reuse edilmelidir. Egress ve connection reuse birlikte tasarlanmadığında serverless scaling connection sayısını hızla büyütebilir.
Cloud Run
Cloud Run instance'larının outbound davranışı doğrudan veya VPC connector üzerinden yapılandırılabilir. Sabit public egress gerekiyorsa cloud network üzerinden NAT architecture tasarlanabilir. Instance autoscaling connection pool multiplication etkisi yaratır. Connection limit planlamasında yalnız request concurrency değil instance sayısı da hesaba katılmalıdır. Private Service Connect kullanılacaksa DNS ve region routing ayrıca doğrulanmalıdır.
Vercel / Serverless
Serverless platformlarda function instance sayısı trafikle dinamik biçimde değişebilir. Platform sabit egress IP sağlamıyorsa Atlas public Access List daraltmak güçleşir. Bazı plan veya network seçenekleri static egress sunabilir ve güncel platform dokümantasyonu kontrol edilmelidir. Database client reuse module scope'ta yapılabilse bile her function instance kendi pool'unu oluşturur. Architecture serverless connection budget'ını baştan hesaplamalıdır.
VPN Etkisi
VPN bütün internet trafiğini kurumsal gateway'e yönlendiriyorsa public egress IP değişir. Split tunnel configuration yalnız belirli domain veya network'leri VPN üzerinden gönderebilir. Local Atlas bağlantısının VPN açıkken çalışıp kapalıyken çalışmaması Access List veya DNS farkını gösterebilir. Private endpoint'e on-prem erişim için VPN veya Direct Connect farklı route gerektirebilir. Incident notlarında VPN durumu mutlaka kaydedilmelidir.
Port 27017 Bağlantısı Nasıl Test Edilir?
DNS doğru sonuç verdiği hâlde bağlantı kurulamıyorsa bir sonraki adım TCP erişimini doğrulamaktır. Public Atlas deployment'larında çoğu bağlantı 27017 çevresindeki MongoDB portlarını kullanır ve firewall outbound trafiğe izin vermelidir. Private endpoint yapılarında provider'a göre daha geniş dinamik port aralıkları kullanılabildiği için Atlas'ın verdiği endpoint documentation izlenmelidir. `nc` veya benzer TCP testleri authentication gerektirmeden network path'i kontrol eder. Test başarılıysa sorun TLS veya daha üst katmanlara doğru daraltılabilir.
nc
`nc` hedef host ve portta TCP connection kurulup kurulamadığını hızlıca test eder. `nc -vz host 27017` benzeri kullanım bağlantı sonucunu birkaç saniyede gösterebilir. Host SRV target listesinden alınmalıdır. Private endpoint portu farklıysa Atlas connection string'deki gerçek port test edilmelidir. Başarılı `nc` MongoDB authentication'ın çalıştığını değil yalnız TCP path'in açık olduğunu kanıtlar.
telnet
`telnet` de basit TCP port erişimi testinde kullanılabilir. Modern minimal container image'larda paket bulunmayabilir. Connection established mesajı firewall ve route katmanının önemli bölümünü doğrular. TLS veya MongoDB wire protocol response'u beklenmediği için session hemen kapatılabilir. Diagnostic araç seçimi production image'a kalıcı gereksiz paket eklemek zorunda değildir.
Firewall
Host veya network firewall outbound MongoDB trafiğini engelleyebilir. Policy destination hostname yerine IP ve port üzerinden tanımlanıyorsa Atlas topology değişiklikleri rule bakımını zorlaştırabilir. MongoDB Atlas public bağlantıları için gerekli outbound port aralığı güncel Atlas documentation'a göre izinli olmalıdır. Private endpoint farklı port aralığı kullanabilir. Firewall logları dropped packet'i doğrulamak için değerlidir.
Security Group
Cloud security group application instance veya private endpoint interface üzerinde trafik policy'si uygulayabilir. AWS PrivateLink senaryosunda workload security group outbound ve endpoint security group inbound kuralları birlikte değerlendirilir. Stateful security group response trafiğini otomatik yönetebilir. Yanlış source group veya port range bağlantıyı sessizce timeout'a düşürebilir. Infrastructure as Code plan diff'i incident öncesi network değişikliğini gösterebilir.
Network ACL
Network ACL subnet seviyesinde stateless trafik kontrolü uygulayabilir. Outbound destination port kadar return traffic ephemeral port kuralları da önemlidir. Security group açık olduğu hâlde NACL trafiği engelleyebilir. Cloud flow log dropped packet'i bulmaya yardımcı olabilir. NACL değişikliği geniş blast radius taşıdığı için yalnız database bağlantısına bakılarak rastgele gevşetilmemelidir.
Corporate Firewall
On-prem veya corporate egress firewall bilinmeyen database portlarını engelleyebilir. Atlas hostname veya IP aralıkları security team tarafından allowlist edilmelidir. TLS inspection MongoDB wire protocol üzerinde farklı sorun yaratabilir. Proxy yalnız HTTP destekliyorsa raw MongoDB TCP bağlantısını forward edemez. Network tasarımı Atlas'a doğrudan TCP veya private connectivity sunacak şekilde yapılmalıdır.
Outbound Filtering
Birçok ekip inbound firewall'a odaklanırken uygulama subnet'inden outbound filtering'i gözden kaçırır. Atlas'a ulaşmak için request'in workload'dan dışarı çıkmasına izin verilmelidir. DNS çalışıyor olması TCP egress'in de açık olduğunu göstermez. Destination ve port testleri ayrı yapılmalıdır. Production network policy değişiklikleri deployment sonrası synthetic connectivity check ile doğrulanabilir.
DNS Çalışıyor Ama TCP Bağlantısı Kurulamıyorsa Ne Yapılmalı?
DNS sonucunun doğru olması yalnız hedef adresin bulunduğunu gösterir. TCP handshake gerçekleşmiyorsa Atlas Access List, local firewall, route, NAT veya cloud security policy incelenmelidir. Timeout ile immediate connection refused farklı network belirtileri sunabilir. Aynı hosta aynı environment içinden `nc` testi yapılmalıdır. Private endpoint kullanılıyorsa route ve endpoint-specific port configuration public bağlantı kurallarından ayrı ele alınmalıdır.
IP Access List
Public Atlas bağlantısında gerçek source egress IP Access List içinde bulunmalıdır. NAT değişikliği deployment code'u değişmeden connection failure yaratabilir. CIDR entry'nin active durumda olduğu kontrol edilmelidir. Temporary entry expire olmuş olabilir. Wide-open rule eklemek yerine authoritative egress IP belirlenmelidir.
Firewall
Application host firewall veya kurumsal perimeter firewall destination portu engelleyebilir. Firewall log üzerinden drop olup olmadığı kontrol edilmelidir. DNS target IP zamanla değişebileceği için static IP rule kırılgan olabilir. Atlas'ın önerdiği network configuration izlenmelidir. Firewall değişikliği minimum scope ile uygulanmalıdır.
Routing
Destination için uygun route yoksa TCP SYN hedefe ulaşmaz. Private subnet default route NAT veya private endpoint'e yönlenmelidir. VPC peering route table doğru CIDR'ları içermelidir. Overlapping CIDR yanlış route seçimine yol açabilir. Traceroute her cloud ortamında eksiksiz sonuç vermese de route table ve flow log birlikte güçlü kanıt sağlar.
NAT
NAT Gateway public Atlas'a çıkışta source translation sağlar. NAT route eksikse private subnet internete ulaşamaz. Çok yüksek outbound connection rate port exhaustion gibi capacity sorunları yaratabilir. Database connection reuse NAT üzerindeki yeni socket sayısını da azaltır. NAT metric'leri connection storm timeline ile karşılaştırılmalıdır.
Security Group
Application resource security group outbound rule Atlas endpoint'e izin vermelidir. Private endpoint interface security group inbound rule application source'u kabul etmelidir. Port range provider-specific Atlas requirement'a uygun olmalıdır. Security group referansı cross-account veya cross-VPC durumda farklı davranabilir. Testte geçici geniş rule kullanılırsa incident sonunda geri alınmalıdır.
Private Endpoint Route
Private endpoint hostname doğru private IP'ye çözülse bile application subnet endpoint'e route taşımalıdır. Endpoint farklı region veya VPC'deyse peering veya transit architecture gerekebilir. Multi-region deployment her region için bağlantı tasarımını ayrı değerlendirmelidir. DNS ve route birlikte çalışmadıkça private connectivity tamamlanmış sayılmaz. Endpoint status Atlas ve cloud provider tarafında hazır görünmelidir.
Port Connectivity Test
SRV sonucundaki her hedef için TCP test yapmak belirli node veya router erişim problemini gösterebilir. Tek host başarılı diye topology'nin tamamı erişilebilir kabul edilmemelidir. Replica set secondary veya sharded router farklı network path'e sahip olabilir. Test sonuçları hostname ve timestamp ile kaydedilmelidir. Atlas support veya network ekibiyle paylaşırken somut packet-level kanıt sağlar.
MongoDB Atlas TLS Bağlantısı
MongoDB Atlas database trafiğinde TLS zorunlu güvenlik katmanıdır. TLS yalnız encryption sağlamaz, uygulamanın bağlandığı server'ın sertifika kimliğini doğrulamasına da yardımcı olur. Driver ve runtime güncel CA store'a sahip olmalıdır. Kurumsal TLS inspection veya eski runtime certificate chain'i bozabilir. Production bağlantı standardında TLS validation hiçbir zaman geçici diagnostic workaround nedeniyle kalıcı olarak gevşetilmemelidir.
TLS Neden Zorunludur?
Database trafiği credential ve kullanıcı verisi taşıdığı için ağ üzerinde plaintext gönderilmemelidir. TLS bağlantı boyunca confidentiality ve integrity sağlar. Server certificate doğrulaması yanlış endpoint'e yönlendirme riskini azaltır. Atlas production security architecture TLS'i temel katman olarak kabul eder. Network private olsa bile TLS güvenliğin ayrı katmanı olarak devam eder.
Certificate Chain
Server certificate güvenilir root CA'ya uzanan chain üzerinden doğrulanır. Runtime trust store chain içindeki gerekli root veya intermediate authority'yi tanımıyorsa handshake başarısız olabilir. Çok eski container image güncel CA bundle taşımayabilir. `openssl s_client` certificate chain'i diagnostic olarak gösterebilir. Uygulama image base layer'ının düzenli security update alması bu nedenle connection reliability açısından da önemlidir.
CA Store
CA store runtime'ın hangi certificate authority'lere güvendiğini belirler. Node.js, işletim sistemi veya container distribution farklı CA source kullanabilir. Local bilgisayar çalışırken minimal Alpine veya distroless image başarısızsa CA package kontrol edilmelidir. Custom corporate CA yalnız kurum policy'si gerekiyorsa eklenmelidir. Invalid certificate bypass etmek yerine güvenilir root chain doğru kurulmalıdır.
SNI
Server Name Indication TLS handshake sırasında hedef hostname bilgisinin server'a iletilmesini sağlar. Shared cloud endpoint'lerde doğru certificate seçimi için önemlidir. Hostname yerine doğrudan IP kullanmak SNI ve certificate hostname validation davranışını bozabilir. Bu nedenle Atlas connection string hostnames korunmalıdır. Proxy veya custom network appliance SNI bilgisini değiştirmemelidir.
TLS Handshake
TCP connection sonrasında client ve server desteklenen TLS version, cipher ve certificate bilgileri üzerinden handshake yapar. Handshake latency yeni connection oluşturma maliyetinin önemli bölümünü oluşturabilir. Connection pool reuse bu maliyetin her request'te tekrarlanmasını önler. Connection storm sırasında yüzlerce eşzamanlı TLS handshake CPU ve network yükünü artırabilir. Driver connection event'lerindeki ready duration bu süreci gözlemlemek için yararlı olabilir.
Outdated Runtime / Driver Problemleri
Eski runtime TLS protocol veya certificate standardlarıyla uyumsuz olabilir. Driver support matrix server sürümü ve authentication özellikleri açısından da önemlidir. EOL driver security ve connection bug fix'lerini alamaz. Upgrade staging cluster üzerinde connectivity, failover ve load testleriyle doğrulanmalıdır. Runtime ve driver major upgrade aynı release'te yapılacaksa rollback planı açık olmalıdır.
TLS Problemleri Nasıl Test Edilir?
TLS sorunlarında doğrudan driver error message'i dışında bağımsız handshake testi yapmak çok değerlidir. `openssl s_client` hedef hostname ve port üzerinden certificate chain ile TLS negotiation sonucunu gösterebilir. Corporate proxy veya inspection varsa certificate issuer beklenenden farklı görünebilir. Container içinden yapılan test local host testinden daha güvenilirdir. TLS problemi doğrulandığında certificate validation'ı kapatmak yerine CA store ve network appliance configuration düzeltilmelidir.
openssl s_client
`openssl s_client` TLS handshake'i manuel başlatıp certificate ve protocol bilgilerini gösterir. SNI için `-servername` parametresi gerçek Atlas hostname ile verilmelidir. Connection string SRV kullanıyorsa önce gerçek target host bulunabilir. Private endpoint portu standard 27017 olmayabilir. Çıktı sensitive credential içermez, bu nedenle incident kaydında güvenli biçimde kullanılabilir.
Certificate Chain
OpenSSL çıktısındaki issuer ve chain sırası trust problemini anlamaya yardımcı olur. Missing intermediate veya bilinmeyen root CA belirlenebilir. Corporate inspection sertifikası görünüyorsa network appliance TLS trafiğini yeniden imzalıyor olabilir. Container ile host chain sonucu farklıysa runtime trust store karşılaştırılır. CA bundle güncellemesi base image pipeline'ına kalıcı olarak eklenmelidir.
Hostname Validation
Sertifika Subject Alternative Name alanı bağlanılan hostname ile eşleşmelidir. Hostname yerine IP kullanmak validation failure oluşturabilir. Yanlış private endpoint URI de certificate mismatch'e neden olabilir. Driver'ın Atlas tarafından sağlanan hostname'i kullanması en doğru yaklaşımdır. `tlsAllowInvalidHostnames` production çözümü olarak kullanılmamalıdır.
Corporate TLS Inspection
Bazı kurumlar outbound TLS trafiğini inspection proxy üzerinden geçirir. MongoDB raw TLS bağlantısı HTTP inspection araçlarıyla uyumlu olmayabilir. Proxy certificate replacement yaparsa driver default CA store bunu güvenilir bulmayabilir. Database traffic için bypass veya desteklenen network path security ekibiyle tasarlanmalıdır. Private connectivity çoğu durumda inspection ihtiyacını farklı biçimde çözebilir.
Proxy
MongoDB driver belirli SOCKS proxy seçenekleri sunabilir, ancak her kurumsal HTTP proxy raw database bağlantısını taşıyamaz. Proxy latency ve idle timeout connection behavior'ını etkiler. Proxy arkasında kullanılan `maxIdleTimeMS` proxy'nin idle cutoff değerinden kısa tutulabilir. Proxy connection reset event'leri network monitoring ile ilişkilendirilmelidir. Gereksiz proxy katmanı database connection path'inden çıkarılabiliyorsa architecture sadeleşir.
Container CA Certificates
Minimal container image boyutu azaltırken CA certificates paketini içermeyebilir. Uygulama local çalışıp container içinde TLS failure veriyorsa ilk kontrollerden biri bu olmalıdır. Base image security updates certificate root değişikliklerini de getirir. CA file'ı repository'ye rastgele kopyalamak yerine distribution package üzerinden güncel tutulmalıdır. Image scanning ve regular rebuild connection güvenilirliğine katkı sağlar.
TLS Doğrulamasını Kapatmak Neden Çözüm Değildir?
TLS validation'ı kapatmak certificate probleminin TLS katmanında olduğunu göstermeye yarayan kısa diagnostic test olabilir. Fakat production'da invalid certificate veya hostname kabul etmek server kimliği doğrulamasını ortadan kaldırır. Bu yaklaşım man-in-the-middle riskini ciddi biçimde artırır. Gerçek çözüm doğru CA trust store ve Atlas hostname kullanmaktır. Debug configuration production secret veya deployment values içine taşınmamalıdır.
tlsAllowInvalidCertificates
`tlsAllowInvalidCertificates` driver'ın geçersiz certificate nedeniyle connection'ı reddetmesini engelleyebilir. Resmî driver dokümantasyonu bu seçeneğin yalnız test amacıyla kullanılması gerektiğini belirtir. Kalıcı olarak açık bırakılması güvenlik kontrolünü devre dışı bırakır. Diagnostic test tamamlanınca configuration hemen geri alınmalıdır. CI policy production environment'ta bu option'ın true olmasını engelleyebilir.
Man-in-the-Middle Riski
Certificate doğrulaması server'ın gerçekten beklenen Atlas endpoint'i olduğunu doğrulamaya yardımcı olur. Validation kapalıysa saldırgan veya yanlış proxy sahte certificate ile bağlantıyı kabul ettirebilir. Network private olması bu doğrulamanın değerini sıfırlamaz. Credential ve database içeriği güvenilir olmayan endpoint'e gidebilir. Security review connection string option'larını da application code kadar incelemelidir.
Debug ile Production Ayarlarını Ayırmak
Debug sırasında kullanılan gevşek option'lar environment-specific ve kısa ömürlü tutulmalıdır. Production configuration code review ile güvenli default'a zorlanabilir. Feature flag veya environment variable yanlışlıkla açık kalabiliyorsa startup validation uygulamayı fail ettirebilir. Configuration schema unsafe option'ları production mode'da reddedebilir. Bu yaklaşım incident workaround'un kalıcı güvenlik açığına dönüşmesini önler.
Doğru CA Certificate Kullanmak
Doğru çözüm runtime'ın Atlas certificate chain'ini güvenilir root üzerinden doğrulayabilmesidir. İşletim sistemi CA bundle güncellenmeli veya kurumsal güvenlik gereksinimi varsa doğru corporate CA kurulmalıdır. Custom `tlsCAFile` yalnız gerekli durumda kullanılmalıdır. Certificate expiry ve rotation uygulamanın manual intervention olmadan çalışabileceği şekilde standard trust chain üzerinden yönetilmelidir. Staging smoke testleri base image güncellemesinden sonra TLS bağlantısını doğrulayabilir.
MongoDB Atlas Authentication Nasıl Çalışır?
Atlas database bağlantısında network erişimi sağlandıktan sonra ayrı database user ile authentication yapılır. Atlas web platform kullanıcısı organization ve project yönetimi içindir, doğrudan application database credential'ı değildir. Database user belirli role ve authentication mechanism ile cluster verilerine erişir. Least privilege yaklaşımı application'ın yalnız ihtiyacı olan database ve operation yetkilerini almasını sağlar. Authentication failed hatasında username, password, `authSource` ve credential rotation history birlikte kontrol edilmelidir.
Atlas User
Atlas user platform arayüzüne, organization veya project yönetimine erişen kimliktir. Project Owner gibi Atlas rollerini taşıyabilir. Bu kullanıcının credential'ı application connection string içinde kullanılmaz. İnsan kullanıcı hesabıyla service database credential kavramlarını ayırmak security ve audit açısından önemlidir. Production runbook bu terminolojiyi açık tutmalıdır.
Database User
Database user MongoDB cluster üzerinde authentication yapan kimliktir. Atlas Database Access bölümünden oluşturulabilir. SCRAM, X.509, AWS IAM veya desteklenen başka mekanizmalar kullanılabilir. Role'lar hangi database ve operasyonlara erişilebildiğini belirler. Application başına ayrı user rotation ve audit işlemlerini kolaylaştırır.
İki Kullanıcı Türünün Farkı
Atlas hesabı cloud control plane'e, database user ise data plane'e erişir. Web UI'ye login olabilmeniz database connection credential'ınız olduğu anlamına gelmez. Yeni ekip üyeleri bu iki hesabı sık karıştırabilir. Connection error dokümantasyonunda hangi kullanıcı türünün kullanıldığı açıkça belirtilmelidir. IAM ve SSO gibi çözümler de ilgili plane'in kimlik modeline göre ayrı değerlendirilir.
authSource
`authSource` driver'ın credential'ı hangi database üzerinde doğrulayacağını belirtir. Yanlış değer doğru username ve password olsa bile authentication failure üretebilir. Atlas tarafından verilen connection string çoğu standart senaryoda doğru configuration sunar. Connection URI elle düzenlenmişse `authSource` kontrol edilmelidir. Authentication database ile application'ın query yaptığı database birbirinden farklı olabilir.
Database Roles
Database roles read, readWrite veya daha özel yetki kümeleri sağlayabilir. Uygulamanın yalnız belirli database'e yazması gerekiyorsa global admin rolü verilmemelidir. Migration veya maintenance job farklı role gerektirebilir ve ayrı credential kullanabilir. Permission error authentication success sonrasında ortaya çıkabilir. Role değişiklikleri audit log ve Infrastructure as Code süreçleriyle yönetilmelidir.
Least Privilege
Least privilege service user'a yalnız işini yapması için gereken minimum yetkiyi vermeyi hedefler. Credential sızdığında etkilenebilecek database ve operation alanı küçülür. Read-only analytics service ile write API aynı role sahip olmamalıdır. Role requirement release sırasında review edilmelidir. Geçici yüksek yetki verildiyse iş bittikten sonra geri alınması otomatikleştirilebilir.
Authentication Failed Hatası
Authentication failed mesajı network ve TLS katmanlarının önemli bölümünün aşıldığını gösterir. Bu noktada credential ve authentication database üzerinde yoğunlaşmak daha verimlidir. URI parse hatası veya percent-encoding problemi doğru password'ün farklı okunmasına neden olabilir. Credential rotation deployment'ın yalnız bir kısmında güncellendiyse intermittent authentication failure görülebilir. Secret version, pod revision ve error timestamp birlikte incelenmelidir.
Yanlış Username
Username case ve karakterleri doğru olmalıdır. Eski environment variable deployment manifest'te kalmış olabilir. Database user silinmiş veya yeniden oluşturulmuşsa eski credential artık çalışmaz. Secret değerini loglamak yerine hash veya version identifier ile hangi revision'ın kullanıldığı izlenebilir. Atlas Database Access ekranındaki aktif user listesi authoritative kaynaktır.
Yanlış Password
Password rotation sonrası environment'ın eski secret'ı kullanması sık görülen production problemidir. Secret manager update etmek çalışan pod memory'sindeki değeri otomatik değiştirmeyebilir. Rollout gerekebilir. Connection string içindeki special characters percent-encoded olmalıdır. Password hiçbir troubleshooting ekranında plaintext paylaşılmamalıdır.
Atlas Account ile Database User'ı Karıştırmak
Atlas web hesabının kullanıcı adı ve şifresi database authentication için kullanılamaz. Application özel database user kullanmalıdır. Yeni cluster kurulumunda Connect flow gerekli database user oluşturma adımını gösterir. Runbook içinde “Atlas user” ve “database user” terimleri açıkça ayrılmalıdır. Bu basit ayrım yeni ekip üyelerinin gereksiz network troubleshooting yapmasını önler.
Yanlış authSource
User hangi database üzerinde tanımlandıysa authentication o kaynağa yönelmelidir. Yanlış `authSource` driver'ın doğru credential'ı yanlış database üzerinde aramasına neden olur. Atlas-generated URI kullanmak manuel hata riskini azaltır. Legacy connection string migration sırasında authSource farkı özellikle test edilmelidir. Driver upgrade ile default davranış varsaymak yerine connection specification kontrol edilmelidir.
Yetkisiz Database
Authentication başarılı olsa bile user hedef database üzerinde gerekli role sahip olmayabilir. Bu durumda hata authorization veya permission seviyesinde görülür. Application role'ları operasyon türlerine göre kontrol edilmelidir. Query read yaparken çalışan credential write sırasında hata verebilir. Permission error'ın login failure gibi genel “database connection error” mesajına dönüştürülmesi teşhisi zorlaştırır.
Credential Rotation Sonrası Eski Secret
Secret rotation eski credential'ın ne zaman kapatılacağını planlamalıdır. Önce yeni secret deploy edilip bütün instance'ların güncellendiği doğrulanabilir, ardından eski credential kaldırılabilir. Blue-green deployment sırasında iki version kısa süre birlikte çalışabilir. Secret version metric veya deployment annotation hangi pod'un hangi revision'ı kullandığını gösterebilir. Rotation testleri staging üzerinde düzenli yapılmalıdır.
Connection String İçindeki Özel Karakterler
MongoDB URI standard URL sözdizimini kullandığı için username ve password içinde belirli karakterler doğrudan yazılamaz. `:`, `/`, `?`, `#`, `[`, `]` ve `@` gibi karakterler percent-encoding gerektirir. `%` karakteri de encoding bağlamında dikkatle ele alınmalıdır. Password'ü string concatenation ile URI içine eklemek encoding hatası ve secret leak riski üretir. Mümkün olduğunda Atlas'ın verdiği template ve güvenilir URI encoding fonksiyonları kullanılmalıdır.
@
`@` URI içinde credential bölümü ile hostname arasındaki ayırıcı olarak kullanılır. Password içinde literal `@` bulunursa encoded biçimde yazılması gerekir. Aksi durumda parser host başlangıcını yanlış yerde görebilir. JavaScript `encodeURIComponent` gibi güvenilir araçlar credential component'ını encode edebilir. Bütün URI'yi encode etmek yerine yalnız username veya password bileşeni dönüştürülmelidir.
:
`:` username ve password ayrımında veya host ile port arasında özel anlam taşır. Password içindeki iki nokta percent-encoded olmalıdır. String split ile connection string parse eden custom code yazılmamalıdır. Driver'ın URI parser'ı kullanılmalıdır. Secret rotation testinde özel karakter içeren örnek credential tercih etmek encoding problemini erken ortaya çıkarır.
/
`/` URI içinde path ve database bölümünü ayırır. Password içinde kullanıldığında encoded olması gerekir. Aksi durumda connection string structure bozulabilir. Password policy random karakter üretiyorsa bu durum olağandır ve şifreyi değiştirmek yerine doğru encoding kullanılmalıdır. Plain password secret manager'da, encoded representation ise URI oluşturma katmanında yönetilebilir.
?
`?` URI query parameter bölümünün başlangıcıdır. Password içinde encode edilmezse sonraki karakterler option olarak yorumlanabilir. Bu durum bazen parse error yerine authentication failure üreterek teşhisi zorlaştırır. URI builder library kullanmak manuel string concatenation riskini azaltır. Unit test password içinde reserved character senaryolarını kapsamalıdır.
#
`#` URL fragment semantiği taşıdığı için credential içinde percent-encoded olmalıdır. Shell veya environment file formatında da comment karakteri olarak özel davranış gösterebilir. `.env` dosyasındaki quoting kuralları ayrıca kontrol edilmelidir. Secret manager değerinin doğru olup application process'e geçerken bozulup bozulmadığı karşılaştırılabilir. Raw credential loglanmadan uzunluk veya secret version üzerinden debug yapılabilir.
%
`%` percent-encoding başlangıç karakteridir. Password zaten encoded ise tekrar encode etmek farklı credential üretir. Raw secret ile URI-safe representation arasındaki lifecycle açık olmalıdır. Secret manager'a encoded veya raw değer kaydetme standardı ekip genelinde belirlenmelidir. Double encoding authentication failure'ın zor fark edilen nedenlerinden biridir.
Percent-Encoding
Percent-encoding reserved URI karakterlerini `%HH` formatına dönüştürür. MongoDB driver documentation username ve password içindeki özel karakterlerin encode edilmesini açıkça ister. Application framework'ün URL builder veya standard encoding fonksiyonu kullanılmalıdır. Encoded değerin loglarda görünmesi secret olmadığı anlamına gelmez. Connection string'in tamamı yine credential kabul edilerek korunmalıdır.
URI'yi String Birleştirerek Oluşturmamak
`"mongodb://"+user+":"+password+"@"+host` gibi manuel birleştirme encoding ve logging hatalarına açıktır. Connection string Atlas'tan secret olarak alınabiliyorsa uygulama onu doğrudan kullanabilir. Dinamik credential gerekiyorsa URL-safe component builder uygulanmalıdır. Tests reserved character set ile çalıştırılmalıdır. URI oluşturma kodu bütün servislerde tekrar edilmek yerine shared güvenli helper içinde tutulabilir.
MongoDB Credentials Nasıl Saklanmalı?
MongoDB connection string veya password source code repository içinde bulunmamalıdır. Development environment variable kolay başlangıç sağlarken production için managed secret store daha iyi rotation ve audit özellikleri sunar. Kubernetes Secret tek başına encryption-at-rest garantisi olarak görülmemeli ve cluster secret management politikasıyla desteklenmelidir. Cloud provider secret manager servisleri IAM tabanlı erişim ve versioning sağlar. Credential erişimi application runtime identity ile minimum scope üzerinden verilmelidir.
Environment Variable
Environment variable application config'e secret aktarmanın yaygın yoludur. Değer repository'ye yazılmadığı sürece source leak riskini azaltır. Ancak process environment debug dump veya yanlış logging üzerinden sızabilir. Local `.env` dosyaları `.gitignore` ve secret scanning ile korunmalıdır. Production'da variable çoğunlukla secret manager'dan deployment sırasında inject edilmelidir.
Secret Manager
Managed secret manager credential versioning, IAM policy ve audit kayıtları sunar. Rotation sırasında yeni version publish edilip application rollout yönetilebilir. Application yalnız gerekli secret path'e read yetkisi almalıdır. Secret fetch her request'te yapılmamalı ve uygun lifecycle'da cache edilebilir. Secret manager outage'ın application startup üzerindeki etkisi resilience planında düşünülmelidir.
Kubernetes Secret
Kubernetes Secret environment variable veya mounted file olarak pod'a aktarılabilir. etcd encryption ve RBAC cluster security configuration'ına bağlıdır. Namespace içindeki gereksiz service account'lara secret read yetkisi verilmemelidir. External Secrets benzeri controller managed cloud secret store ile entegrasyon sağlayabilir. Rotation sonrası pod'un yeni değeri ne zaman göreceği deployment modeline göre test edilmelidir.
AWS Secrets Manager
AWS Secrets Manager Atlas credential veya connection URI saklamak için kullanılabilir. IAM role yalnız belirli secret ARN'e erişim alabilir. Lambda execution role doğrudan secret okuyabilir veya deployment environment'a inject edilebilir. Rotation workflow database user update'iyle koordineli olmalıdır. CloudTrail audit hangi identity'nin secret'a eriştiğini takip etmeye yardımcı olur.
GCP Secret Manager
GCP Secret Manager versioned secret saklama ve IAM erişim kontrolü sunar. Cloud Run veya GKE workload identity belirli secret version'a erişebilir. Secret value image veya source repository içine bake edilmemelidir. Rotation latest alias üzerinden yapılacaksa rollback için eski version kısa süre korunabilir. Audit log production credential erişimini görünür kılar.
Azure Key Vault
Azure Key Vault secret, certificate ve key yönetimi için kullanılabilir. Managed Identity application'ın static cloud credential taşımadan secret'a erişmesini sağlar. Atlas connection string Key Vault içinde versioned tutulabilir. Network access private endpoint ile sınırlandırılabilir. Application startup ve rotation davranışı integration test ile doğrulanmalıdır.
Git Repository'ye Connection String Yazmamak
Private repository bile credential depolamak için güvenli secret store değildir. Commit history'den silmek zor olabilir ve fork veya backup kopyalarında kalabilir. Secret yanlışlıkla commit edildiyse yalnız dosyayı silmek yetmez, credential rotate edilmelidir. Secret scanning CI ve repository platformunda aktif tutulabilir. Örnek configuration gerçek credential yerine placeholder kullanmalıdır.
MongoDB Driver Sürümü Neden Önemlidir?
Driver connection protocol, server discovery, TLS, pooling ve retry davranışını uygulayan temel application dependency'sidir. Eski driver Atlas'ın güncel server özelliklerini tam desteklemeyebilir veya düzeltilmiş connection bug'larını taşıyabilir. Upgrade yalnız package.json version artırmak olarak görülmemelidir. Connection options ve deprecated davranışlar release note üzerinden kontrol edilmelidir. Production rollout öncesinde failover, pool ve timeout testleri driver upgrade regression'larını yakalayabilir.
Server-Driver Compatibility
MongoDB server feature compatibility ile driver support matrix birlikte değerlendirilmelidir. Yeni server version bazı eski driver'larla temel bağlantı kurabilse bile yeni özellik ve authentication mekanizmaları sınırlı olabilir. Atlas upgrade planında application driver inventory tutulmalıdır. EOL driver'lar migration backlog'una alınmalıdır. Driver version telemetry servis bazında merkezi olarak görülebilirse risk yönetimi kolaylaşır.
TLS Desteği
Driver runtime'ın TLS implementation'ını kullanarak secure connection kurar. Eski runtime modern TLS requirement'larını karşılamayabilir. Certificate validation ve SNI bug fix'leri driver veya runtime release'lerinde giderilebilir. TLS error'da yalnız Atlas certificate değiştirmeye çalışmak yerine client stack version'ı incelenmelidir. Support edilen LTS runtime kullanmak production standardı olmalıdır.
SRV Desteği
`mongodb+srv://` connection string için driver DNS seedlist specification'ını desteklemelidir. Çok eski driver SRV formatını tanımayabilir. Optimized SRV private endpoint kullanımlarında minimum driver version requirement ayrıca önem kazanır. Atlas Connect ekranı uygun driver ve URI bilgisini sunar. Driver upgrade sonrası SRV discovery ve DNS retry behavior load altında test edilebilir.
Connection Pool Bug Fix'leri
Pool lifecycle zaman içinde driver release'lerinde önemli düzeltmeler alabilir. Örneğin idle connection cleanup davranışı belirli Node.js driver sürümlerinde iyileştirilmiştir. EOL sürümde kalmak connection leak veya edge-case recovery bug'larını kalıcılaştırabilir. Release note connection pool değişiklikleri production workload açısından okunmalıdır. Upgrade öncesi mevcut pool event baseline kaydedilirse davranış farkı ölçülebilir.
EOL Driver Kullanmanın Riski
End-of-life driver security ve bug fix desteği alamaz. Yeni Atlas feature veya server version ile compatibility garantisi azalır. Incident sırasında vendor support eski driver için önce upgrade isteyebilir. Migration cost büyümeden düzenli minor ve major update takvimi tutmak daha sağlıklıdır. Test automation driver upgrade'i rutin bakım işi hâline getirir.
Driver Upgrade Testleri
Upgrade testleri yalnız CRUD happy path ile sınırlı olmamalıdır. DNS interruption, primary failover, connection pool saturation ve credential error gibi failure senaryoları da çalıştırılmalıdır. Connection count ve HMR değil, driver event davranışı ve retry semantics karşılaştırılmalıdır. Latency baseline değişimi load test ile ölçülmelidir. Canary deployment production traffic'in küçük bölümünde gerçek davranışı doğrulayabilir.
MongoClient Nasıl Kullanılmalıdır?
Node.js application'da en önemli connection lifecycle kurallarından biri aynı process içinde MongoClient'ı tekrar kullanmaktır. Her HTTP request için yeni client oluşturmak yeni pool, monitoring socket ve TLS connection maliyeti üretir. Shared client process'in yaşam süresi boyunca database erişimini yönetebilir. Startup sırasında connection doğrulanabilir veya driver'ın lazy davranışı kullanılabilir. Graceful shutdown sırasında yeni request kabulü durdurulduktan sonra client kontrollü biçimde kapatılmalıdır.
Process Başına Client Reuse
Her application process için bir MongoClient oluşturmak çoğu backend için sağlıklı varsayımdır. Client kendi connection pool'larını yönetir. Request handler yalnız `client.db()` veya collection reference kullanır. Worker process modeli kullanılıyorsa her process ayrı memory space olduğu için ayrı client ve pool oluşturur. Toplam connection budget hesaplanırken worker sayısı mutlaka çarpan olarak eklenmelidir.
Her Request'te Yeni MongoClient Oluşturmamak
Her request yeni MongoClient açarsa TCP ve TLS handshake sürekli tekrarlanır. Traffic arttıkça Atlas tarafında yüzlerce gereksiz connection oluşabilir. Request tamamlandığında client kapatmak da connection reuse avantajını tamamen ortadan kaldırır. Bu pattern latency ve connection storm riskini aynı anda artırır. Code review checklist MongoClient creation noktasının application bootstrap katmanında olduğunu doğrulamalıdır.
Singleton / Shared Client
Singleton terimi burada process scope'unda tek shared instance anlamında kullanılabilir. Global mutable state'e gereksiz bağımlılık oluşturmadan dependency injection ile client service katmanına aktarılabilir. Testlerde client mock veya test-specific instance ile değiştirilebilir. Serverless environment'da module-level cached client warm invocation arasında reuse sağlayabilir. Her runtime instance yine kendi client'ına sahip olacağı için global deployment connection sayısı ayrıca hesaplanmalıdır.
Startup Connection
Application startup sırasında `client.connect()` ve basit `ping` çalıştırmak database erişimini readiness öncesinde doğrulayabilir. Bu yaklaşım yanlış credential veya DNS probleminde hızlı fail sağlar. Database kısa süre unavailable olduğunda bütün pod'ların sürekli restart loop'a girmemesi için liveness ve startup policy dikkatle tasarlanmalıdır. Retry budget sınırlı olmalıdır. Service ancak temel dependency'leri kullanabilecek durumdaysa traffic almaya başlamalıdır.
Lazy Connection
MongoDB driver ilk operation sırasında bağlantı kurabilecek lazy behavior sunabilir. Çok az kullanılan background worker için startup süresini azaltabilir. Ancak ilk kullanıcı request'i DNS, TCP ve TLS handshake maliyetini ödeyebilir. Production API için readiness sırasında connection warm-up daha öngörülebilir latency sağlayabilir. Seçim workload cold start ve availability beklentisine göre yapılmalıdır.
Graceful Close
Application kapanırken `MongoClient.close()` idle sockets'i kapatır ve kullanımda olan bağlantıları operasyonlar döndükçe sonlandırır. SIGTERM alındığında önce readiness kapatılmalı ve yeni HTTP request alınmamalıdır. In-flight işlemlerin tamamlanması için sınırlı süre tanınmalıdır. Ardından MongoClient kapatılıp process çıkmalıdır. Kubernetes termination grace period bu akışın tamamlanmasına yetecek kadar uzun olmalıdır.
MongoDB Connection Pool Nedir?
Connection pool açık TCP bağlantılarının driver tarafından tekrar kullanılmak üzere tutulduğu yapıdır. Her database operation yeni bağlantı oluşturmak yerine uygun server pool'undan hazır socket alır. Bu işlem TLS handshake ve authentication maliyetini azaltır. Pool size aynı zamanda uygulamanın database üzerinde ne kadar eşzamanlı operation çalıştırabileceğini dolaylı biçimde sınırlar. MongoDB Atlas connection pool ayarları nasıl yapılandırılır sorusunun doğru cevabı sabit bir sayı değil concurrency, query duration ve replica sayısına dayalı ölçümdür.
Pool'un Amacı
Pool'un temel amacı connection establishment maliyetini amorti etmektir. Açık bağlantı birden fazla operation arasında tekrar kullanılabilir. Böylece latency azalır ve database connection churn düşer. Pool aynı zamanda concurrency üzerinde doğal bir üst sınır oluşturur. Çok küçük pool throughput'u kısıtlarken çok büyük pool database'e gereksiz paralel yük bindirebilir.
Connection Reuse
Bir operation tamamlandığında connection kapatılmak yerine pool'a geri döner. Sonraki operation aynı socket'i kullanabilir. Bu reuse NAT, TLS ve authentication yükünü de azaltır. Idle connection'ın ne kadar tutulacağı `maxIdleTimeMS` ile kontrol edilebilir. Reuse oranı yüksek backend sistemlerinde connection creation rate düşük ve stabil olmalıdır.
Concurrent Requests
Aynı anda database operasyonu yapan request sayısı pool ihtiyacını belirleyen ana sinyallerden biridir. Yüz concurrent HTTP request'in tamamı aynı anda MongoDB çağrısı yapmayabilir. Query duration kısa ise küçük pool yüksek throughput sağlayabilir. Uzun query connection'ı daha uzun checkout tuttuğu için aynı traffic altında daha büyük concurrency oluşturur. Pool size request count yerine gerçek concurrent database operation üzerinden ölçülmelidir.
Pool per MongoClient
Her MongoClient kendi connection pool altyapısını taşır. Aynı process içinde on farklı MongoClient oluşturmak pool limitlerini onla çarpabilir. Bu nedenle shared client kullanımı connection budget'ın temelidir. Farklı credentials veya cluster'lar gerçekten ayrı client gerektirebilir. Client inventory application architecture dokümanında açıkça tutulmalıdır.
Pool per Server
Driver topology içindeki server'lar için ayrı pool'lar yönetebilir. Primary-only read workload çoğunlukla primary pool'unu kullanırken secondary read preference diğer node pool'larını büyütebilir. Monitoring için ayrıca server başına socket'ler bulunur. Bu nedenle `maxPoolSize=100` ifadesi bütün cluster için kesin toplam 100 connection anlamına gelmez. Topology ve read preference connection budget hesabında mutlaka dikkate alınmalıdır.
Monitoring Connections
Driver database operasyonlarından ayrı monitoring connection'ları kullanarak server health ve topology değişikliklerini takip eder. Replica set'te her server için monitoring socket'leri toplam connection sayısına eklenir. Application pool hesabı yaparken Atlas metric'inde gördüğünüz sayı bu ek bağlantıları da içerebilir. Küçük pool kullanan çok sayıda instance'ta monitoring overhead oransal olarak daha görünür olabilir. Connection budget güvenlik payı bu bağlantıları da kapsamalıdır.
maxPoolSize Nedir?
`maxPoolSize` belirli server pool'unda tutulabilecek application connection sayısına üst sınır koyar. Node.js driver güncel dokümantasyonunda varsayılan değer 100'dür. Pool içindeki bütün connection'lar kullanımdayken yeni operation uygun connection boşalana kadar queue içinde bekler. Büyük sayı otomatik olarak daha yüksek throughput sağlamaz, çünkü database CPU, disk veya query execution kapasitesi sınır olabilir. `maxPoolSize` load test ve connection budget ile birlikte ayarlanmalıdır.
Maksimum Pool Connection Sayısı
Bu değer driver'ın tek server için pool içinde aynı anda kaç connection tutabileceğini sınırlar. Replica set ve read preference nedeniyle başka server pool'ları da bulunabilir. Birden fazla MongoClient veya process bu limiti ayrı ayrı uygular. Dolayısıyla deployment toplamı yalnız `maxPoolSize` değerine bakılarak hesaplanamaz. Instance, process ve topology çarpanları birlikte düşünülmelidir.
Default Değer
Node.js MongoDB driver'da güncel default `maxPoolSize` değeri 100'dür. Bu değer birçok application için başlangıç noktasıdır, optimum production ayarı değildir. Düşük traffic serviste 100 bağlantıya hiç ulaşılmayabilir. Çok yoğun servis daha küçük pool ile bile query latency düşükse yeterli throughput sağlayabilir. Default'u değiştirmeden önce pool checkout latency ve active connection verisi toplanmalıdır.
Pool Dolduğunda Ne Olur?
Bütün pool connection'ları kullanımdayken yeni operation connection checkout için bekler. `waitQueueTimeoutMS` belirlenmişse bekleme süresi bu sınırı aşınca hata oluşabilir. Varsayılan sınırsız bekleme API latency'sinin kontrolsüz büyümesine yol açabilir. Pool saturation çoğunlukla concurrency veya slow query belirtisidir. Önce neden dolduğunu anlamadan limit artırmak problemi başka yere taşıyabilir.
Daha Büyük Pool Her Zaman Daha Hızlı mı?
Hayır, database aynı anda yalnız belirli miktarda işi verimli çalıştırabilir. Pool'u büyütmek daha fazla query'nin paralel çalışmasına izin verir ve CPU veya disk contention artırabilir. Latency yükseldikçe connection'lar daha uzun checkout kalır ve problem döngüye girer. Throughput artmadan P95 ve P99 latency kötüleşebilir. Optimal nokta load test'te pool size ve database resource metric'leri birlikte izlenerek bulunur.
Database Capacity ile Uyumu
Application pool toplam concurrency'si Atlas cluster capacity ile uyumlu olmalıdır. On pod ve her birinde 100 connection teorik olarak çok yüksek bağlantı bütçesi oluşturabilir. Cluster tier connection limitinin altında kalmak tek hedef değildir, CPU ve disk kapasitesi de korunmalıdır. Slow query load altında daha küçük pool backpressure görevi görebilir. Capacity planning application ve database ekiplerinin ortak sorumluluğudur.
minPoolSize Nedir?
`minPoolSize` pool'un düşük trafikte bile belirli sayıda connection'ı açık tutmasını sağlar. Node.js driver default değeri 0'dır. Warm connection latency'si kritik workload'larda küçük bir minimum yararlı olabilir. Serverless veya uzun idle dönemleri olan servislerde gereksiz açık connection sayısını yükseltebilir. Connection storm riskini azaltmak veya artırmak workload'un startup pattern'ine bağlı olduğundan değer ölçülerek seçilmelidir.
Warm Connections
Minimum pool connection'ları request gelmeden hazır tutulursa ilk yoğunlukta TCP ve TLS establishment bekleme süresi azalabilir. Latency-sensitive service bu avantajdan faydalanabilir. Ancak yüzlerce replica aynı anda minimum pool'u doldurursa deployment sırasında connection spike oluşabilir. Warm-up kademeli yapılmalıdır. Min pool değeri yalnız ortalama traffic değil rollout davranışıyla birlikte düşünülmelidir.
Cold Traffic
Günün büyük bölümünde az request alan servis açık connection'ları gereksiz yere tutabilir. `minPoolSize=0` ve uygun `maxIdleTimeMS` connection'ların idle dönemde kapanmasına izin verebilir. Sonraki request yeniden connection establishment maliyeti öder. Bu trade-off latency ve resource kullanımı arasında yapılır. SLO hangi yaklaşımın daha uygun olduğunu belirlemelidir.
Connection Storm Riski
Yüz pod aynı anda başlatılıp her biri minimum yirmi connection açmaya çalışırsa kısa sürede binlerce yeni TLS connection oluşabilir. Cluster normal steady-state traffic'i kaldırsa bile deployment spike nedeniyle zorlanabilir. `maxConnecting`, startup jitter ve rollout surge ayarları bu riski azaltır. Minimum pool yalnız tek instance perspektifinden seçilmemelidir. Deployment maximum simultaneous replica sayısı hesaplamaya eklenmelidir.
Idle Workload
Idle workload'da minimum pool yüksek tutulursa connection limitinin önemli bölümü gerçek iş yapmadan tüketilebilir. Multi-tenant veya çok sayıda küçük microservice bu durumu büyütebilir. Atlas Connections metric ile idle saatlerde baseline connection sayısı gözlenmelidir. Baseline beklenenden yüksekse client ve min pool inventory yapılmalıdır. Gereksiz connection'ları azaltmak cluster scale ihtiyacını erteleyebilir.
Serverless Kullanım
Serverless function instance'ları kısa ömürlü ve çok sayıda olabilir. Her instance yüksek `minPoolSize` ile başlarsa concurrency artışında connection explosion oluşabilir. Serverless workload için çoğunlukla küçük veya sıfır minimum daha uygundur. Warm invocation client reuse yine latency'yi azaltabilir. Platform instance lifecycle ve function concurrency değerleri load test'te gerçekçi biçimde modellenmelidir.
maxConnecting Nedir?
`maxConnecting` pool'un aynı anda kaç yeni connection establishment işlemi başlatabileceğini sınırlar. Node.js driver güncel default değeri 2'dir. Bu değer pool warm-up hızını ve connection storm şiddetini doğrudan etkiler. Çok düşük değer ani traffic artışında checkout tail latency oluşturabilir, çok yüksek değer ise TLS handshake ve Atlas connection spike'ını büyütebilir. Değer özellikle autoscaling ve deployment davranışıyla birlikte test edilmelidir.
Aynı Anda Kaç Yeni Connection Açılabilir?
Pool yeni capacity gerektiğinde birden fazla TCP bağlantısını parallel açabilir. `maxConnecting` bu parallel establishment sayısını sınırlar. Pool'un toplam `maxPoolSize` değerinden farklıdır. Bir pool yüz connection tutabilecek olsa bile aynı anda yalnız belirli sayıda yenisini kurabilir. Bu throttling database ve network üzerinde ani connection baskısını azaltır.
Pool Warm-Up
Cold application yoğun trafik aldığında pool talebe göre büyür. `maxConnecting` yüksekse hızlı büyür, düşükse request'ler daha uzun checkout bekleyebilir. Startup öncesi kontrollü warm-up belirli latency-sensitive servislerde tercih edilebilir. Warm-up bütün replica'larda tam aynı anda çalıştırılmamalıdır. Jitter ve deployment batch size birlikte tasarlanmalıdır.
Connection Establishment Throttling
Connection establishment DNS, TCP, TLS ve authentication maliyeti taşır. Bu işlemleri sınırsız parallel başlatmak source NAT ve database üzerinde burst oluşturabilir. `maxConnecting` bu burst'ü pool seviyesinde kontrol eder. Application autoscaling yine toplam pool sayısını çoğalttığı için global limit değildir. Deployment-level rate limiting ayrıca gerekebilir.
Çok Yüksek Değerin Connection Storm Riski
Bir pod aynı anda onlarca yeni connection açarsa yüz podluk rollout büyük spike üretir. TLS handshake CPU ve network kullanımını artırır. Atlas Connections metric kısa sürede limit alarmına yaklaşabilir. Normal steady state'te sorun görünmediği için yalnız deployment anında incident yaşanabilir. Load test yeni replica burst senaryosunu ayrıca içermelidir.
Çok Düşük Değerin Tail Latency Etkisi
Traffic spike sırasında pool capacity yavaş büyürse request'ler connection checkout queue'da bekler. P50 normal kalırken P95 veya P99 belirgin biçimde kötüleşebilir. Throughput database capacity'nin altında olsa bile connection establishment throttling bottleneck olabilir. Driver pool event'leri checkout wait süresini görmeye yardımcı olur. Değer yalnız ortalama latency üzerinden ayarlanmamalıdır.
maxIdleTimeMS Nedir?
`maxIdleTimeMS` kullanılmayan connection'ın pool içinde ne kadar süre tutulabileceğini belirler. Node.js driver default olarak sıfır, yani idle süre sınırı olmadan çalışır. Firewall veya proxy bağlantıyı daha erken kapatıyorsa driver'ın daha kısa idle timeout kullanması stale connection sorunlarını azaltabilir. Çok kısa değer ise sürekli reconnect ve TLS handshake maliyeti doğurur. Uygulamanın traffic pattern'i ile network cihazlarının idle timeout değerleri birlikte düşünülmelidir.
Idle Connection Lifecycle
Connection operation tamamlandıktan sonra pool'a döner ve yeni iş gelene kadar idle kalabilir. Belirlenen `maxIdleTimeMS` aşıldığında driver connection'ı kapatabilir. Daha sonra traffic geldiğinde yeni connection gerekir. Bu lifecycle serverless veya periyodik background job'larda belirgin önem taşır. Connection created ve closed event rate beklenen traffic ile uyumlu olmalıdır.
Firewall Idle Timeout
Network firewall uzun süre kullanılmayan TCP connection'ı kendi policy'siyle kapatabilir. Driver bu kapanışı ancak sonraki kullanımda fark ederse request kısa bir failure veya reconnect yaşayabilir. `maxIdleTimeMS` firewall timeout'tan daha kısa seçilerek connection'ın driver kontrolünde kapanması sağlanabilir. Kesin değer network ekibinden alınmalıdır. Rastgele çok düşük timeout connection churn oluşturur.
Load Balancer Idle Timeout
Private endpoint veya proxy arkasındaki load balancer idle connection'ları belirli sürede sonlandırabilir. Driver connection'ı bu süreden uzun tutuyorsa reset görülebilir. Atlas private endpoint port ve load balancer davranışı provider modeline göre değerlendirilmelidir. Connection closed reason driver event'lerinde izlenebilir. Network timeout bilgisi architecture runbook'ta kayıtlı olmalıdır.
Serverless Workload
Function instance uzun süre idle kalabilir veya kısa sürede tamamen yok olabilir. Çok yüksek idle connection sayısı sıcak instance'larda gereksiz resource tüketebilir. MongoDB Atlas guidance düşük activity workload'larda `minPoolSize=0` ve uygun idle yönetiminin yararlı olabileceğini belirtir. Warm invocation reuse ile cold reconnect arasında denge kurulmalıdır. Function timeout ve platform freeze behavior'ı benchmark edilmelidir.
Çok Agresif Idle Timeout'un Reconnect Maliyeti
Idle timeout birkaç saniyeye indirildiğinde normal aralıklı traffic bile her request'te yeni connection açabilir. TLS handshake ve authentication latency yeniden ortaya çıkar. Connection creation rate yükselir ve Atlas metric'inde gereksiz churn görülür. NAT port ve CPU kullanımı da artabilir. Değer expected idle period ile network timeout arasındaki mantıklı aralığa göre seçilmelidir.
waitQueueTimeoutMS Nedir?
`waitQueueTimeoutMS` pool doluyken bir operation'ın available connection bekleyebileceği maksimum süreyi belirler. Node.js driver'da varsayılan değer sıfırdır ve bu sınırsız bekleme anlamına gelir. API request'in toplam deadline'ı on saniyeyken database connection checkout'un yirmi saniye beklemesi anlamsızdır. Bu nedenle production servislerde fail-fast davranışı ve timeout budget birlikte tasarlanmalıdır. Queue timeout hatası pool'u büyütmeden önce query latency ve concurrency analizini tetiklemelidir.
Pool Checkout Queue
Pool'daki bütün connection'lar usage durumundaysa yeni operation queue'ya girer. Connection check-in edildiğinde sıradaki operation bunu kullanabilir. Queue uzunluğu ve checkout wait latency saturation'ın en erken sinyallerindendir. Driver event'leri checkout started ve checked out arasındaki süreyi ölçmeye yardımcı olur. Application metric olarak P95 checkout latency izlenmelidir.
Pool Saturation
Pool saturation her connection'ın aynı anda operation çalıştırdığı anlamına gelir. Bu normal kısa spike olabilir veya kalıcı capacity problemine işaret edebilir. Query duration artmışsa aynı traffic pool'u daha kolay doldurur. Replica sayısı azalmış veya yeni release database çağrı sayısını artırmış olabilir. Pool size değiştirmeden önce bu nedenler araştırılmalıdır.
Sınırsız Bekleme Problemi
Default unlimited queue application request'lerinin uzun süre memory'de tutulmasına neden olabilir. Upstream HTTP client çoktan timeout olsa bile backend database connection beklemeye devam edebilir. Bu durum resource tüketimini ve cascading failure riskini artırır. Bounded queue ve deadline propagation daha öngörülebilir failure sağlar. Error rate artsa bile sistemin tamamen kilitlenmesi önlenebilir.
Fail-Fast Tasarımı
Database capacity aşıldığında belirli request'leri hızlı hata ile geri çevirmek bütün sistemin latency'sini sınırsız artırmaktan daha sağlıklı olabilir. Retry yalnız uygun idempotent operation ve sınırlı budget içinde yapılmalıdır. Circuit breaker veya load shedding daha üst application katmanında değerlendirilebilir. Queue timeout kullanıcıya doğru HTTP status ve retry guidance ile map edilmelidir. Observability bu hatayı network timeout'tan ayrı sınıflandırmalıdır.
API Request Deadline ile Uyumluluk
Database checkout timeout HTTP request deadline'dan daha kısa olmalıdır. Örneğin toplam API budget beş saniyeyse connection bekleme, server selection ve query execution bu süreyi paylaşır. Her katmana ayrı ayrı beş saniye vermek toplam latency'nin çok daha uzun olmasına yol açar. Deadline request context üzerinden alt dependency'lere aktarılabilir. Timeout budget architecture standardı bütün servislerde tutarlı hâle getirilebilir.
Connection Pool Nasıl Boyutlandırılır?
Pool sizing için tek bir evrensel sayı yoktur. Gerçek concurrent database operation sayısı, query duration, application replica ve worker process sayısı birlikte hesaplanmalıdır. Read preference farklı server pool'larını aktif edebilir. Sharded topology connection fan-out'u replica set'ten farklıdır. En güvenilir yöntem küçük bir başlangıç pool'u belirleyip load test sırasında throughput, checkout latency ve Atlas resource metric'lerini birlikte ölçmektir.
Concurrent Database Operations
HTTP concurrency doğrudan database concurrency değildir. Bir request birkaç milisaniye CPU işi yapıp yalnız kısa süre database connection kullanabilir. Instrumentation aynı anda checkout edilmiş connection sayısını gösterir. P95 concurrency peak traffic altında ölçülmelidir. Pool biraz headroom ile bu gerçek ihtiyaca göre boyutlandırılabilir.
Query Duration
Little's Law mantığıyla aynı throughput altında query duration arttıkça concurrent in-flight operation sayısı da artar. Yüz request/s ve on milisaniyelik query ile yüz request/s ve bir saniyelik query aynı pool ihtiyacına sahip değildir. Slow query pool pressure'ı büyütür. Bu yüzden pool tuning query optimization'dan bağımsız yapılmamalıdır. Index iyileştirmesi bazen pool büyütmekten çok daha büyük kazanç sağlar.
Application Replica Sayısı
Her replica kendi process ve MongoClient pool'una sahipse toplam potansiyel connection sayısı replica sayısıyla çarpılır. Autoscaling maksimum replica sayısı hesapta kullanılmalıdır. Steady-state üç pod olsa bile HPA on beş poda çıkabiliyorsa budget buna göre kurulmalıdır. Deployment surge sırasında eski ve yeni pod'lar birlikte çalışabilir. Connection headroom bu geçiş anını da kapsamalıdır.
Worker Process Sayısı
Node.js cluster mode veya process manager dört worker çalıştırıyorsa her worker ayrı MongoClient oluşturabilir. Tek VM görünmesine rağmen dört ayrı pool vardır. Container başına worker sayısı horizontal replica çarpanına eklenmelidir. Worker restart connection churn yaratabilir. Modern container deployment'larında çoğu zaman process başına bir worker daha anlaşılır capacity modeli sağlar.
MongoClient Sayısı
Aynı process içinde farklı module'lerin kendi MongoClient'ını oluşturması görünmeyen connection multiplication yaratır. Dependency injection veya shared database module bunu engelleyebilir. Multi-tenant için tenant başına client oluşturmak ciddi connection riski taşır. Aynı cluster ve credential kullanımında database handle değiştirmek çoğu zaman yeni client gerektirmez. Runtime client inventory startup log'unda sayısal metric olarak tutulabilir.
Read Preference
Primary read preference yalnız primary üzerinde application pool büyütebilir. Secondary veya nearest gibi preference'lar farklı server pool'larının aktif kullanımını artırır. Toplam Atlas connection sayısı bu nedenle read scaling stratejisiyle değişir. Secondary okumalar primary CPU'yu azaltırken network ve connection budget'ı genişletebilir. Read preference consistency requirement temelinde seçilmeli, yalnız connection dağıtmak için kullanılmamalıdır.
Cluster Topology
Replica set, sharded cluster ve private endpoint connection fan-out davranışı farklıdır. Sharded cluster çok sayıda `mongos` router içeriyorsa driver birden fazla pool oluşturabilir. AWS private endpoint için optimize SRV connection string belirli koşullarda `mongos` başına bağlantı sayısını azaltmaya yardımcı olur. Topology değişikliği connection budget'ı yeniden hesaplama tetikleyicisi olmalıdır. Cluster scale işlemi yalnız CPU değil client connection graph açısından da değerlendirilmelidir.
Toplam Connection Sayısı Nasıl Hesaplanır?
Basit ilk yaklaşım application instance sayısını her instance'ın etkin pool kapasitesiyle çarpmaktır. Ancak worker process, monitoring socket, secondary pool, background job ve deployment surge eklendiğinde gerçek sayı daha yüksek olur. Bu hesap teorik maximum ile observed steady-state değerini ayrı tutmalıdır. Atlas Connections graph gerçek kullanımın doğrulama kaynağıdır. Safety headroom sayesinde failover veya autoscaling anında limitin hemen aşılmasının önüne geçilir.
Application Instances × Pool Size
On instance ve her instance'ta `maxPoolSize=50` ilk bakışta 500 application connection potansiyeli oluşturur. Ancak bu server başına pool davranışı ve topology nedeniyle basitleştirilmiş üst sınırdır. Her pool her zaman max değere ulaşmaz. Capacity plan teorik maksimum ile load test'te görülen active connection değerini karşılaştırmalıdır. HPA maksimum replica sayısı bu formülde normal replica sayısından daha önemlidir.
Worker Process Multiplication
Her instance dört worker process çalıştırıyorsa MongoClient sayısı dörde katlanabilir. On instance artık kırk pool owner process anlamına gelir. Process manager config değişikliği database connection sayısını fark edilmeden büyütebilir. Worker count deployment metadata olarak monitoring sistemine gönderilebilir. Connection alert geldiğinde ilk kontrol edilen değişkenlerden biri olmalıdır.
Monitoring Connections
Driver topology health için operation pool'undan ayrı monitoring connection'ları açabilir. Node.js driver dokümantasyonu server başına iki monitoring connection'a kadar ek socket olabileceğini açıklar. Küçük pool'larda bu sayı toplam connection yüzdesini etkileyebilir. Topology node sayısı arttıkça monitoring socket sayısı da büyür. Budget yalnız maxPoolSize toplamından oluşmamalıdır.
Secondary Read Pool'ları
Read preference secondary node'lara query gönderiyorsa bu üyelerin connection pool'ları da büyür. Primary-only workload ile aynı maxPool config farklı toplam connection sayısı üretebilir. Atlas metric node bazında incelenmelidir. Secondary read scaling latency ve replication lag etkisiyle birlikte düşünülmelidir. Connection limit her Atlas node için ayrı uygulanabildiği için distribution önemlidir.
Background Jobs
Queue worker, cron job ve analytics processor ana API'den ayrı deployment olsa bile aynı Atlas cluster'a bağlanabilir. Bunların pool'ları capacity hesabına eklenmelidir. Gece batch job başlarken API traffic devam ediyorsa connection spike oluşabilir. Job concurrency database capacity'ye göre sınırlandırılmalıdır. Ortak Atlas project için service inventory tutulması bu görünmeyen bağlantıları ortaya çıkarır.
Deployment Sırasında Eski + Yeni Replica'ların Birlikte Çalışması
Rolling deployment `maxSurge` nedeniyle kısa süre normal replica sayısından daha fazla pod çalıştırabilir. Eski pod'lar in-flight request tamamlamadan yeniler pool warm-up yaparsa connection count iki katına yaklaşabilir. Graceful shutdown hızlı connection release sağlar. Startup jitter yeni pod connection açılışını dağıtır. Capacity test deployment anını da simüle etmelidir.
Safety Headroom
Connection limitini normal trafikte yüzde yüz kullanmak failover ve traffic spike için alan bırakmaz. Headroom cluster tier, autoscaling ve incident recovery davranışına göre tanımlanmalıdır. Connections % alert bu güvenlik payının erken uyarısı olabilir. Sadece hard limit geldiğinde alarm üretmek çok geçtir. SLO içinde minimum connection headroom yüzdesi tanımlamak faydalıdır.
Horizontal Scaling Connection Sayısını Nasıl Etkiler?
Horizontal scaling application throughput kapasitesini artırırken her yeni instance kendi MongoClient pool'unu oluşturduğu için database connection sayısını da çoğaltır. HPA yalnız CPU veya HTTP latency'ye göre ölçekleniyorsa database connection budget gözden kaçabilir. Bir instance için güvenli görünen `maxPoolSize` yüz instance'ta tehlikeli olabilir. Autoscaling policy database-side constraints ile uyumlu olmalıdır. Scale testleri yalnız application response değil Atlas Connections metric'ini de izlemelidir.
1 Instance
Tek instance connection davranışını anlamak için en basit baseline'dır. Pool utilization, query concurrency ve monitoring socket'leri kolayca ölçülebilir. Ancak production high availability için tek instance genellikle yeterli değildir. Bu baseline daha sonra horizontal scale multiplication hesabında kullanılır. Bir instance'ın maksimum pool'a gerçekten ulaşıp ulaşmadığı load test ile görülebilir.
10 Instance
On instance küçük pool'ları bile toplamda ciddi connection sayısına dönüştürebilir. Her biri 50 connection'a kadar büyüyorsa teorik server pool kapasitesi 500'e ulaşabilir. Deployment surge ve background worker'lar bunu daha da artırır. Atlas cluster tier limitine yaklaşılmadan önce alarm verilmelidir. Pool size tek instance latency yerine deployment bütçesine göre yeniden değerlendirilmelidir.
100 Instance
Yüz instance serverless veya microservice architecture'da şaşırtıcı olmayan sayıdır. Her instance yalnız on connection açsa bile bin connection oluşabilir. Multi-server topology bu sayıyı daha fazla büyütebilir. Bu ölçekte client reuse ve connection budget zorunlu platform standardı hâline gelir. Database proxy veya architecture değişikliği gerekip gerekmediği workload modeline göre incelenebilir.
Her Instance'ın Ayrı Pool Oluşturması
Connection pool process memory'sinde bulunduğu için farklı container veya VM arasında paylaşılmaz. Kubernetes replica'ları aynı Service altında görünse de pool'ları bağımsızdır. Horizontal scale doğrudan pool count'u artırır. Bu nedenle application autoscaling dashboard'ında database connection forecast göstermek değerlidir. HPA config değişikliği database capacity review tetikleyebilir.
Autoscaling ile Connection Explosion
Traffic spike HPA'yı hızlı scale-out yaptığında onlarca yeni pod aynı anda startup connection açabilir. Her pod yüksek min pool veya maxConnecting kullanıyorsa kısa sürede connection storm oluşur. Database latency yükselirse application daha fazla pod açarak negatif feedback loop yaratabilir. HPA metric yalnız latency ise bu risk daha yüksektir. Maximum replica ve pool size ortak connection budget ile sınırlandırılmalıdır.
Pool Size'ı Replica Sayısına Göre Ayarlamak
Replica sayısı büyüdükçe instance başına pool'u küçültmek toplam database concurrency'yi sabit tutabilir. Örneğin vertical scale'den horizontal scale'e geçerken eski maxPoolSize aynen bırakılmamalıdır. Load balancer request dağılımı her pod'un gerçekte ne kadar concurrency gördüğünü belirler. Minimum gerekli pool size P95 per-instance database concurrency üzerinden bulunabilir. HPA maximum replica sayısıyla çarpılıp Atlas headroom kontrol edilmelidir.
Connection Storm Nedir?
Connection storm kısa sürede çok sayıda yeni database connection establishment işleminin başlamasıdır. Deployment, autoscaling, failover veya application restart bunun tipik nedenleridir. Slow query pool'ları doldurduğunda driver'ın yeni connection açma ihtiyacını artırarak dolaylı storm oluşturabilir. Her yeni connection TCP, TLS ve authentication maliyeti taşır. Atlas connection limitine ulaşılmasa bile handshake load ve application tail latency belirgin biçimde kötüleşebilir.
Ani Connection Spike
Connections graph normal baseline'dan saniyeler içinde keskin biçimde yükseliyorsa storm ihtimali vardır. Application deployment ve HPA timeline aynı grafiğe eklenmelidir. Connection created event rate de spike'ın client tarafındaki kanıtıdır. Traffic aynı kalırken connection count yükseliyorsa client reuse veya restart problemi düşünülmelidir. Spike sonrası connection'lar hızla kapanıyorsa churn ayrıca incelenmelidir.
Application Restart
Bütün application replica'ları aynı anda restart edildiğinde mevcut pool'lar kapanır ve yenileri birlikte kurulmaya başlar. Rolling deployment bu riski dağıtır. PodDisruptionBudget ve rollout strategy aynı anda kaç instance'ın değişeceğini kontrol edebilir. Startup connection jitter kısa süreli burst'ü azaltır. Restart incident mitigation olarak kullanıldığında ikinci bir storm oluşturabileceği unutulmamalıdır.
Deployment
Yeni release eski ve yeni pod'ların aynı anda çalıştığı surge dönemi oluşturabilir. Yeni code ayrıca maxPoolSize veya client creation davranışını değiştirmiş olabilir. Connection alert deployment dakikasında başladıysa diff ilk incelenecek kaynaklardan biridir. Canary release connection metric'i erken gösterir. Deployment success kriterine Atlas connection baseline sapması eklenebilir.
Autoscaling
HPA birkaç dakika içinde replica sayısını katlayabilir. Her yeni pod yeni pool açar. Database zaten yavaşsa application latency scaling trigger'ı daha fazla pod üretip connection baskısını artırabilir. HPA max replica database budget ile uyumlu sınırlandırılmalıdır. Scale-out event'leri observability timeline'da connection metric ile ilişkilendirilmelidir.
Failover
Primary failover sırasında driver eski server pool'larını temizleyebilir ve yeni primary'ye connection oluşturur. Çok sayıda client aynı anda topology değişikliğini gördüğünde reconnect burst oluşabilir. Retryable operation ve SDAM mekanizması recovery sağlar. Application-level agresif retry ikinci bir storm yaratmamalıdır. Failover load testi gerçek deployment instance sayısına yakın ortamda yapılmalıdır.
Cold Start
Serverless function veya autoscaled container ilk invocation sırasında client ve pool oluşturur. Aynı anda yüz cold instance açılırsa connection establishment yoğunlaşır. Client module scope'ta cache edilse bile her yeni instance ilk kez connection kurmak zorundadır. Max connecting ve pool size serverless scale modeline göre küçük tutulabilir. Cold-start benchmark yalnız function execution değil database ready süresini de ölçmelidir.
Yavaş Query Kaynaklı Pool Growth
Query duration arttığında checkout edilmiş connection'lar daha geç pool'a döner. Driver concurrent request talebini karşılamak için pool'u maxPoolSize'a kadar büyütebilir. Bu durum Atlas Connections graph'ta connection spike gibi görünür. Pool'u küçültmek backpressure oluşturabilir, ancak asıl çözüm slow query ve capacity problemidir. Query profiler ile connection metric aynı zaman aralığında incelenmelidir.
Connection Storm Nasıl Tespit Edilir?
Storm tespitinde yalnız toplam connection sayısı değil connection creation rate ve application timeline önemlidir. Atlas Connections graph baseline'dan sapmayı gösterir. Driver event'leri yeni connection'ın ne sıklıkla oluşturulduğunu ve hazır hâle gelmesinin ne kadar sürdüğünü ölçebilir. Deployment veya autoscaling event'iyle aynı zamandaki spike güçlü korelasyon sağlar. Query latency de birlikte yükseliyorsa database-side pressure bağlantı artışını besliyor olabilir.
connections.current
MongoDB serverStatus connection dokümanındaki current benzeri metric'ler açık connection sayısını göstermeye yardımcı olur. Atlas UI bunları daha anlaşılır Connections grafikleriyle sunabilir. Current değer tek başına bağlantıların aktif query çalıştırıp çalıştırmadığını göstermez. Baseline ve cluster tier limitine oranı önemlidir. Spike başlangıç zamanı deployment event'leriyle karşılaştırılmalıdır.
connections.active
Active connection gerçek operation çalıştıran veya kullanımdaki connection baskısını anlamaya yardımcı olabilir. Current yüksek, active düşükse çok sayıda idle connection tutuluyor olabilir. İkisi birlikte yüksekse gerçek concurrency veya slow query söz konusu olabilir. Metric availability deployment type ve MongoDB version'a göre değerlendirilebilir. Application checked-out connection metric ile cross-check yapılması daha güvenilir sonuç verir.
connections.totalCreated
Total created counter zaman içinde kaç connection oluşturulduğunu anlamak için rate'e dönüştürülebilir. Current sabit olduğu hâlde totalCreated hızla yükseliyorsa connection churn vardır. Firewall idle reset veya client'ın sürekli yeni connection açması buna neden olabilir. Restart sonrası doğal kısa artış normaldir. Rate uzun süre yüksek kalıyorsa pool lifecycle incelenmelidir.
TLS Handshake Süresi
Driver `connectionReady` event'inde connection creation sonrası handshake tamamlanma süresi gözlenebilir. Storm sırasında ready duration yükselirse network veya server handshake baskısı oluşmuş olabilir. P95 connection establishment metric SLO'nun parçası yapılabilir. DNS ve TCP süresini ayrıca instrumentation ile ayırmak daha ayrıntılı teşhis sağlar. Handshake duration normal fakat checkout latency yüksekse pool saturation daha olasıdır.
Atlas Connections Graph
Atlas Connections chart cluster üzerindeki connection sayısını zaman içinde gösterir. Limit yüzdesiyle birlikte incelendiğinde headroom görünür. Deployment annotation Atlas UI dışında observability platformunda aynı grafiğe eklenebilir. Bir node diğerlerinden belirgin farklıysa read preference veya topology dağılımı incelenir. Scale tier değişiklikleri historical baseline yorumunda not edilmelidir.
Application Deployment Timeline
Connection spike'ın hemen öncesinde rollout, restart veya config değişikliği varsa güçlü kök neden adayıdır. Deployment revision ve commit hash metric annotation olarak saklanmalıdır. HPA replica değişiklikleri aynı timeline'a eklenebilir. Incident sonrası “tam o sırada ne değişti?” sorusu log aramadan yanıtlanabilir. Observability yalnız database değil deployment metadata'yı da içermelidir.
Connection Storm Nasıl Önlenir?
Storm prevention tek bir pool option'a bağlı değildir. Process başına MongoClient reuse, ölçülü maxPoolSize, kontrollü `maxConnecting` ve deployment jitter birlikte çalışır. Autoscaling maximum replica database capacity'ye göre sınırlandırılmalıdır. Yavaş query'ler düzeltilmezse connection pool tekrar baskı altına girebilir. En iyi çözüm connection establishment rate'i normal traffic artışından daha yavaş ve öngörülebilir tutmaktır.
MongoClient Reuse
Shared client storm prevention'ın ilk şartıdır. Her request'te client oluşturmak traffic'i connection creation rate'e doğrudan çevirir. Module veya application scope client pool'u reuse eder. Serverless function'da handler dışı client warm invocation için aynı avantajı sağlar. Code scanning veya lint rule yanlış `new MongoClient` kullanımını tespit edebilir.
Doğru maxPoolSize
Pool upper bound gerçek concurrency ihtiyacına göre belirlenmelidir. Çok yüksek değer storm anında her instance'ın daha fazla connection açmasına izin verir. Çok düşük değer sürekli queue saturation yaratabilir. Load test optimum throughput ve P95 latency noktasını bulur. Deployment maksimum replica sayısıyla toplam limit kontrol edilir.
maxConnecting
Connection establishment parallelism'i sınırlamak burst'ü yumuşatır. Default değer çoğu workload için sağlıklı başlangıçtır. Çok hızlı pool warm-up ihtiyacı ölçülmeden artırılmamalıdır. Tail latency ve connection spike birlikte değerlendirilir. HPA ölçeğinde toplam parallel establishment yine replica sayısıyla çarpılır.
Pool Warm-Up
Latency-sensitive servis deployment sonrası traffic almadan önce birkaç connection açabilir. Bütün pool'u max size'a zorla doldurmak gereksizdir. Warm-up random jitter ile pod'lar arasında dağıtılabilir. Readiness gerçek database connectivity doğrulandıktan sonra açılabilir. Warm-up sırasında Atlas connection alert tetikleniyorsa rollout strategy yeniden tasarlanmalıdır.
Jittered Application Startup
Replica'ların connection açılışını küçük random gecikmelerle dağıtmak synchronized storm'u azaltır. Bu özellikle büyük Kubernetes deployment ve incident sonrası toplu restart'ta değerlidir. Jitter toplam startup SLO'yu gereksiz uzatmayacak sınırda tutulmalıdır. Orchestrator rolling strategy ana kontrol, jitter ek koruma olarak kullanılabilir. Uygulama içindeki sonsuz random sleep sağlıklı deployment tasarımı değildir.
Autoscaling Limit
HPA maximum replica database connection budget'ın aşamayacağı değere göre sınırlandırılmalıdır. Traffic daha fazla instance gerektiriyorsa database tier veya architecture capacity'si birlikte ölçeklenmelidir. Application scale-out database'i otomatik olarak scale etmez. Alert HPA maximuma yaklaşmadan önce capacity planning sürecini tetiklemelidir. Scaling policy load test'te end-to-end doğrulanmalıdır.
Slow Query'leri Düzeltmek
Connection storm'un altında yavaş query varsa pool tuning yalnız semptomu değiştirir. Index, query shape veya schema iyileştirmesi connection hold time'ı azaltır. Pool daha hızlı connection check-in alır ve yeni connection ihtiyacı düşer. Performance Advisor ve Query Profiler bu noktada doğrudan kullanışlıdır. Query optimization sonrası pool size yeniden azaltılabilir.
“Too Many Connections” Hatası
Atlas deployment'ların cluster tier ve node türüne göre concurrent connection sınırları bulunur. Limit aşıldığında yeni connection kabul edilemez. Free ve Flex gibi düşük katmanlarda limit daha küçüktür, dedicated tier büyüdükçe kapasite artar. Sharded cluster'da limit `mongos` router seviyesinde değerlendirilir ve Atlas kendi operasyonları için belirli bağlantıları rezerve edebilir. Uygulama pool'larının toplamını hesaplamadan yalnız cluster scale-up yapmak tekrarlayan maliyet yaratabilir.
Atlas Cluster Tier Connection Limitleri
Atlas tier'ların connection limitleri farklıdır ve güncel değerler Atlas documentation üzerinden kontrol edilmelidir. Örneğin güncel dokümantasyon Free ve Flex cluster'larda 500, M10 cluster'da 1500 connection örneği verir. Daha büyük tier'lar daha yüksek limit sağlayabilir. Capacity plan yalnız hard limit değil güvenli headroom üzerinden yapılmalıdır. Tier değişikliği connection sorununu çözse bile application leak varsa yeni limite tekrar ulaşılır.
Node Başına Limit
Dedicated replica set'te connection limit her node için uygulanır. Read preference connection'ları farklı üyeler arasında dağıtabilir. Primary üzerinde yoğun write ve read workload connection sayısını tek node'da artırabilir. Atlas node-level chart distribution'ı görmek için incelenmelidir. Cluster toplamı tek sayıya indirgenmeden member bazında kapasite düşünülmelidir.
Sharded Cluster'da mongos Başına Limit
Sharded cluster'da application bağlantısı `mongos` router'larına gider. Atlas connection limitleri mongos başına değerlendirilebilir. Driver birden fazla mongos için ayrı pool oluşturduğunda connection fan-out büyür. AWS private endpoint optimize SRV connection string bu fan-out'u belirli koşullarda azaltabilir. Shard sayısı arttığında connection architecture yeniden gözden geçirilmelidir.
Atlas Reserved Connections
Atlas kendi monitoring ve operasyon ihtiyaçları için connection capacity'nin bir bölümünü rezerve edebilir. Bu nedenle advertised maximum ile application'ın güvenli kullanabileceği sayı aynı olmayabilir. Atlas documentation ilgili tier için reserve ayrıntılarını sağlar. Application hard limite kadar gitmek yerine headroom bırakmalıdır. Alert threshold reserve alanına girmeden önce müdahale fırsatı vermelidir.
Application Pool'larını Toplamak
Bütün servis, replica, worker ve background job pool'ları inventory edilmelidir. Aynı cluster'a bağlanan forgotten script veya BI tool da connection tüketebilir. Atlas metric ile expected formula arasındaki fark bilinmeyen client'ları gösterebilir. Driver applicationName option servis kimliğini monitoring'de ayırt etmeye yardımcı olabilir. Capacity planning merkezi service catalog ile daha güvenilir olur.
Cluster Scale-Up Ne Zaman Gerekir?
Application connection lifecycle doğru ve pool size optimize olduğu hâlde gerçek workload connection veya compute kapasitesini aşıyorsa cluster scale-up gerekir. CPU, disk latency ve query latency de yüksekse daha büyük tier güçlü gerekçe oluşturur. Connection limit tek bottleneck ise architecture fan-out veya pool configuration önce incelenebilir. Scale-up maliyet artışı getirir. Load forecast ile ne kadar süre kapasite sağlayacağı hesaplanmalıdır.
Pool'u Büyütmek mi Cluster'ı Büyütmek mi?
Bu karar gerçek bottleneck'e göre verilmelidir. Pool saturation yaşanırken Atlas CPU ve disk boşsa application daha fazla concurrency'den faydalanabilir. Cluster zaten yüksek CPU veya disk latency altındaysa pool büyütmek işleri daha fazla parallel çalıştırıp durumu kötüleştirebilir. Query latency yüksekse önce query ve index analizi yapılmalıdır. Pool, application concurrency kontrolü; cluster tier ise database compute ve connection capacity aracıdır.
Pool Saturation
Checkout queue büyüyor fakat database resource metric'leri rahatsa pool küçük olabilir. P95 checkout latency ve active connections birlikte incelenir. Pool'u kademeli artırıp throughput değişimi ölçülmelidir. Throughput artmadan query latency kötüleşiyorsa başka bottleneck vardır. Tek seferde çok büyük artış production riskini yükseltir.
Server Connection Capacity
Pool artırıldığında Atlas node connection limitine ne kadar yaklaşılacağı hesaplanmalıdır. Application replica sayısı ve secondary pool'lar hesaba katılır. Headroom bırakılmadan pool büyütülmemelidir. Limit yakınsa cluster tier scale-up veya connection architecture değişikliği gerekebilir. Alert threshold yeni configuration'a göre güncellenmelidir.
CPU
Database CPU uzun süre yüksekse daha fazla concurrent query throughput yerine contention oluşturabilir. Query profiler hangi operation'ın CPU tükettiğini gösterebilir. Index optimization CPU'yu cluster scale'den daha ekonomik biçimde azaltabilir. CPU burst ile sürekli saturation ayrılmalıdır. Scale-up yalnız connection limit değil compute ihtiyacını da karşılayabilir.
Disk
Disk IOPS veya latency limitine ulaşılmışsa connection sayısını artırmak storage bottleneck'ini ağırlaştırır. Query scanning fazla document okuyorsa index iyileştirmesi ilk çözümdür. Working set memory'e sığmıyorsa cache miss disk yükünü artırabilir. Atlas metric'leri disk throughput ve latency'yi gösterir. Cluster tier veya storage config gerektiğinde bu verilerle seçilmelidir.
Query Latency
Query latency connection pool'dan bağımsız server execution süresini temsil etmelidir. Query zaten yavaşsa yeni connection yalnız daha fazla yavaş query'yi paralel başlatır. P95 ve P99 query duration change timeline ile izlenmelidir. New release query shape değişikliği connection incident gibi görünebilir. Slow query düzeltildikten sonra pool saturation kendiliğinden ortadan kalkabilir.
Gerçek Bottleneck'i Belirlemek
Application request timeline DNS, checkout, server selection ve query execution aşamalarına ayrılmalıdır. En uzun ve saturation ile korele aşama gerçek başlangıç noktasıdır. Atlas, driver event ve application tracing aynı correlation id çevresinde birleştirilebilir. Resource metric normal diye database tamamen elenmemelidir, query-level problem olabilir. Ölçüm olmadan pool veya cluster scale değişikliği yapmak pahalı deneme yanılmaya dönüşür.
Yavaş Query Nasıl Connection Problemine Dönüşür?
Yavaş query bir connection'ı daha uzun süre checkout durumda tutar. Aynı traffic devam ettiğinde aynı anda aktif connection sayısı artar. Pool max kapasiteye ulaşınca yeni request'ler queue'da bekler. Driver ihtiyaç oldukça yeni connection oluşturarak pool'u büyütür ve Atlas Connections metric yükselir. Böylece asıl query problemi kullanıcıya connection timeout veya “too many connections” şeklinde yansıyabilir.
Connection'ın Daha Uzun Süre Checkout Kalması
On milisaniyelik query connection'ı çok hızlı pool'a döndürür. Aynı query iki saniyeye çıktığında tek request connection'ı iki yüz kat daha uzun tutabilir. Traffic değişmese bile concurrency yükselir. Checked-out duration metric query latency ile birlikte artar. Bu güçlü korelasyon connection pool sorununu query katmanına bağlar.
Active Connection Artışı
Daha uzun operation duration aynı anda daha fazla in-flight query oluşturur. Active connection sayısı pool limitine yaklaşır. Atlas CPU veya disk metric de yükselebilir. Application instance sayısı aynı kaldığı hâlde connection count artışı görülebilir. Bu durumda autoscaling daha fazla pod eklemeden önce database latency trigger'ı anlaşılmalıdır.
Wait Queue Artışı
Pool dolduğunda yeni operation connection bekler. Queue latency kullanıcı response süresine doğrudan eklenir. Upstream timeout olsa bile database request henüz başlamamış olabilir. `waitQueueTimeoutMS` bounded failure sağlar. Queue growth alarmı connection limit alarmından daha erken uyarı olabilir.
Yeni Connection Açılması
Pool maxPoolSize'a ulaşmamışsa artan concurrency driver'ı yeni connection açmaya iter. Connection creation TLS ve authentication overhead getirir. Aynı anda birçok instance bunu yaptığında storm oluşabilir. Creation rate ile query duration aynı zaman ekseninde gösterilmelidir. Query normale dönünce pool'un idle connection davranışı ayrıca izlenir.
Connection Storm
Slow query kaynaklı storm deployment kaynaklı storm'dan timeline ile ayrılabilir. Deployment yokken query latency önce yükselir, connection creation daha sonra takip ederse database-side neden güçlüdür. Pool tuning semptomu geciktirebilir. Query plan veya index düzeltmesi root cause çözümüdür. Incident RCA bu causal zinciri açık biçimde yazmalıdır.
Tail Latency Artışı
Queue oluştuğunda ilk etkilenen metric çoğunlukla P95 ve P99 response süresidir. Ortalama latency normal kalabilir çünkü bazı request'ler boş connection bulur. User experience worst-case latency ile bozulur. Pool checkout ve query execution tail değerleri ayrı izlenmelidir. SLO average yerine percentile temelli kurulmalıdır.
Query Performance ile Connection Pool Birlikte Nasıl Analiz Edilir?
Query ve pool metric'lerini ayrı dashboard'larda izlemek causal ilişkiyi görmeyi zorlaştırır. Aynı zaman ekseninde query duration, checkout latency, active connection, CPU ve disk I/O bulunmalıdır. Documents examined / returned oranı query efficiency hakkında ek bilgi verir. Pool saturation query latency artışından sonra başladıysa index veya database resource problemi araştırılır. Pool saturation önce başladıysa application concurrency veya configuration değişikliği daha güçlü adaydır.
Query Duration
Query duration operation'ın database tarafında ne kadar sürdüğünü gösterir. Query shape bazında P95 metric genel database latency'den daha açıklayıcıdır. Bir yeni release tek query shape'i yavaşlatmış olabilir. Slow operation logları timestamp ile pool metric'e bağlanabilir. Duration düşürüldüğünde connection checkout süresinin de düşmesi beklenir.
Pool Utilization
Pool utilization checked-out connection sayısının kullanılabilir capacity'ye oranı olarak düşünülebilir. Driver doğrudan veya event tabanlı metric ile bu değer üretilebilir. Uzun süre yüzde yüze yakın kullanım queue riskini gösterir. Çok düşük kullanım ve yüksek maxPoolSize gereksiz capacity tanımlandığını gösterebilir. Hedef oran workload burst karakterine göre seçilmelidir.
Active Connections
Atlas node-level active veya total connection metric application pool görünümüyle karşılaştırılmalıdır. Atlas çok yüksek, uygulama düşük connection raporluyorsa başka client'lar veya idle pool'lar olabilir. ApplicationName ile client kaynakları ayrıştırılabilir. Read preference node dağılımını değiştirebilir. Failover sonrası kısa spike normal kabul edilebilir.
Wait Queue
Checkout waiting operation sayısı veya timeout rate pool saturation'ın doğrudan göstergesidir. Queue oluşurken database CPU düşükse pool configuration veya client misuse araştırılır. CPU da yüksekse database capacity veya query problemine yönelinir. Queue latency API SLO ile aynı ölçekte izlenmelidir. Alert yalnız error oluştuğunda değil latency threshold aşıldığında tetiklenebilir.
CPU
CPU yoğun query'ler connection'ı uzun süre tutabilir. Atlas CPU metric query profiler sonuçlarıyla korele edilmelidir. Short spike autoscaling veya burst workload için normal olabilir. Sürekli yüksek CPU throughput limitine işaret eder. Index veya schema optimizasyonu cluster scale'den önce değerlendirilebilir.
Disk I/O
Collection scan ve working set cache miss disk I/O artırabilir. Disk latency yükseldikçe query duration ve pool occupancy artar. Documents examined yüksek query'ler güçlü adaydır. Storage tier veya index çözümü workload'a göre seçilir. Disk metric normal ama query yavaşsa lock, network veya CPU gibi diğer sinyaller incelenir.
Documents Examined / Returned
Bir query yüz bin document inceleyip on document döndürüyorsa targeting verimsizdir. Performance Advisor bu tür query shape'leri index önerisi için analiz eder. Ratio tek başına kesin index kararı değildir, write maliyeti ve query frequency düşünülmelidir. Query improvement connection hold time'ı doğrudan azaltabilir. Production before-after metric etkisini doğrular.
MongoDB Atlas Performance Advisor
Atlas Performance Advisor slow query'leri analiz eder ve uygun olduğunda index önerileri üretir. Öneriler query shape ve workload metric'lerine dayanır. Impact değeri potansiyel iyileştirmeyi sıralamaya yardımcı olur. Her öneriyi otomatik uygulamak doğru değildir, çünkü yeni index write maliyeti ve storage tüketimi getirir. Connection pressure yaşanan incident'te Performance Advisor özellikle query latency ile pool saturation arasında ilişki kurmak için değerlidir.
Slow Query Analizi
Performance Advisor cluster'ın slow operation verilerini analiz eder. Slow threshold workload'a göre Atlas tarafından dinamik yönetilebilir. Query shape tekrar eden verimsiz operasyonları gruplar. Tek bir çok yavaş query ile sürekli orta yavaş query'nin impact'i farklı olabilir. Incident zaman aralığına uygun filtre kullanmak en alakalı sonuçları gösterir.
Index Suggestions
Advisor query pattern'e uygun yeni index önerileri sunabilir. Öneri docs scanned, returned ve execution frequency gibi sinyallere dayanır. Existing index'lerle overlap kontrol edilmelidir. Her yeni index write path'i ve storage'ı etkiler. Staging benchmark ve production canary ile gerçek kazanç doğrulanmalıdır.
Impact Score
Impact önerilerin olası performans etkisine göre sıralanmasına yardımcı olur. Atlas bunu query inefficiency ve wasted bytes gibi workload verilerinden hesaplar. Yüksek impact öneri otomatik olarak doğru architecture kararı değildir. Collection write rate ve index maintenance maliyeti ayrıca değerlendirilmelidir. En kritik customer-facing query'ler business priority açısından ayrı ağırlık alabilir.
Önerileri Körlemesine Uygulamamak
Index sayısı arttıkça write operation her index'i güncellemek zorunda kalır. Memory ve disk kullanımı da büyür. Advisor belirli query shape'i optimize ederken başka workload etkisini tam olarak business context ile bilmez. Proposed index explain plan ve load test ile doğrulanmalıdır. Index governance duplicate ve unused index cleanup sürecini de içermelidir.
Connection Pressure ile Query Problemini Korele Etmek
Connection alert zaman aralığında Advisor slow query sayısı artmışsa güçlü ilişki olabilir. Query duration önce yükseliyor, ardından connections ve wait queue büyüyorsa causal sıra anlaşılır. Index fix sonrası connection count ve checkout latency düşüyor mu ölçülmelidir. Bu yaklaşım pool size'ı gereksiz büyütmeyi önler. RCA içinde before-after grafikler kalıcı öğrenme sağlar.
Atlas Query Profiler
Query Profiler slow operations hakkında query shape, duration ve namespace gibi ayrıntılar sunar. Collection scan veya verimsiz planları bulmak connection troubleshooting'in önemli parçasıdır. Profiling production'da overhead oluşturabileceği için kullanım kapsamı ve sampling yaklaşımı dikkatle seçilmelidir. Sensitive query field değerleri access control gerektirir. Query profiler çıktısı driver connection metric'leriyle birleştirildiğinde application latency'nin hangi bölümünün database execution olduğunu gösterebilir.
Slow Operations
Slow operations belirlenen threshold'u aşan database işlemleridir. Aynı query shape'in sürekli yavaş olması index veya data distribution problemi gösterebilir. Tek seferlik backup veya maintenance spike farklı yorumlanmalıdır. Operation timestamp application trace ile eşleştirilebilir. High-frequency slow operation pool pressure için yüksek önceliklidir.
Query Shape
Query shape literal değerlerden bağımsız sorgu yapısını gruplamaya yardımcı olur. Aynı endpoint farklı user id'leriyle aynı shape'i çalıştırabilir. Bu sayede en sık ve en pahalı pattern bulunur. Index suggestion shape üzerinden değerlendirilebilir. Application release yeni query shape eklediyse deployment regression daha hızlı tespit edilir.
Duration
Operation duration connection'ın ne kadar süre işgal edildiğini anlamada temel metriktir. P95 ve max değerler burst riskini gösterir. Duration network round trip'i ve server execution'ı birlikte yansıtabilir, daha ayrıntılı tracing gerektiğinde application instrumentation eklenir. Query plan değişikliği duration distribution'ı dramatik biçimde değiştirebilir. Index rollout sonrası aynı shape karşılaştırılmalıdır.
Namespace
Namespace database ve collection bilgisini belirtir. Connection pressure hangi collection workload'undan kaynaklanıyor hızlıca görülebilir. Multi-tenant shared database'de namespace tek başına tenant ayrımı sağlamayabilir. Application query tag veya comment gerektiğinde tracing'i geliştirebilir. Sensitive business bilgisi loglarda gereksiz tutulmamalıdır.
COLLSCAN
COLLSCAN collection'ın önemli bölümünün veya tamamının tarandığını gösterebilir. Küçük collection için her zaman problem değildir. Büyük collection ve yüksek frequency query'de ciddi CPU ve disk maliyeti oluşturabilir. Explain plan ile uygun index olup olmadığı kontrol edilir. Query targeting değeri return edilen document sayısına göre tarama maliyetini daha iyi gösterir.
Query Plan
MongoDB query planner uygun index ve execution path seçer. Explain output winning plan ve execution statistics sunabilir. Plan cache veya data distribution zamanla farklı plan seçimine neden olabilir. Production probleminde query ve index değişmeden latency değiştiyse plan davranışı incelenebilir. Explain'in production data üzerinde ağır seçenekleri dikkatle kullanılmalıdır.
Production Overhead
Profiling seviyesini çok agresif açmak production overhead ve log hacmini artırabilir. Atlas Architecture guidance profiler'ı seçici kullanmayı önerir. Incident sırasında geçici detay seviyesi artırılabilir. Data retention ve sensitive field exposure security review gerektirir. Normal dönemde sampling ve slow threshold yeterli observability sağlamalıdır.
serverSelectionTimeoutMS Nedir?
`serverSelectionTimeoutMS` driver'ın belirli operation için uygun MongoDB server seçmeye ne kadar süre çalışacağını sınırlar. Node.js driver default değeri güncel dokümantasyonda 30000 milisaniyedir. DNS, topology veya primary availability problemi bu sürenin sonunda MongoServerSelectionError olarak görülebilir. Timeout'u artırmak network veya Access List problemini çözmez, yalnız hatanın kullanıcıya daha geç ulaşmasını sağlar. Değer API request deadline ve failover toleransıyla birlikte seçilmelidir.
Server Selection Süreci
Driver read preference, server type ve latency bilgisine göre eligible server set'i oluşturur. Primary write için uygun primary bulunmalıdır. Topology monitoring sürekli server description'ları günceller. Suitable server yoksa driver timeout süresi boyunca bekleyebilir. Error log topology state'i de içermelidir.
Topology Discovery
Driver replica set veya sharded cluster üyelerinin durumunu SDAM mekanizmasıyla izler. DNS yalnız seed aşamasıdır. Heartbeat failure topology view'i güncelleyebilir. Ağın yalnız bazı node'lara erişebilmesi `ReplicaSetNoPrimary` gibi sonuçlar üretebilir. TopologyDescription incident log'unda kritik kanıttır.
Primary Seçimi
Write operation ve primary read preference uygun primary gerektirir. Election sırasında kısa süre primary olmayabilir. Driver yeni primary seçimini heartbeat ve server discovery üzerinden fark eder. Timeout failover'un normal recovery süresinden çok kısa seçilirse gereksiz application error artabilir. Çok uzun değer ise gerçek outage'ı kullanıcı request'inde uzun süre saklar.
Timeout'u Artırmak Kök Nedeni Çözer mi?
Hayır, Access List yanlışsa driver daha uzun süre yanlış network yolunu denemiş olur. DNS ENOTFOUND veya firewall drop yine devam eder. Timeout yalnız failure budget'ını değiştirir. Önce error alt nedeni sınıflandırılmalıdır. Sonra SLO gereksinimi doğrultusunda değer ayarlanır.
API Deadline ile Uyumluluk
HTTP request toplam budget on saniyeyse server selection timeout otuz saniye olduğunda upstream çoktan bağlantıyı kapatabilir. Database client gereksiz işlem yapmaya devam eder. Daha kısa deadline propagation resource kullanımını sınırlar. Failover toleransı isteyen background job farklı timeout profile kullanabilir. Tek global timeout bütün operation türleri için ideal olmayabilir.
connectTimeoutMS Nedir?
`connectTimeoutMS` tek bir TCP socket bağlantısının kurulması için izin verilen süreyi belirler. Node.js driver default değeri 30000 milisaniyedir. Bu option server selection timeout'tan farklıdır, çünkü biri belirli server'a TCP establishment süresini, diğeri uygun server bulma toplam sürecini sınırlar. Ulaşılamayan replica member yüksek connect timeout ile discovery'yi yavaşlatabilir. Değer en kötü beklenen network latency'den düşük olmamalı, fakat request budget'ı aşacak kadar da büyük seçilmemelidir.
TCP Connection Establishment
TCP handshake SYN ve response paketleri üzerinden socket kurulmasını sağlar. Firewall packet'i drop ederse connection hemen refused yerine timeout olabilir. Connect timeout bu bekleme süresini sınırlar. DNS süresi bunun dışında gerçekleşebilir. Network trace veya `nc` testi aynı hostta behavior'ı doğrulayabilir.
Network Latency
Regionlar arası yüksek network latency connection establishment süresini artırabilir. TLS handshake birkaç ek round trip ekler. Application ve Atlas region mümkün olduğunca yakın seçilmelidir. Multi-region architecture latency ve failover arasında trade-off taşır. Connect timeout normal P99 round trip'ten güvenli marjla yüksek olmalıdır.
Ulaşılamayan Replica Member
Driver topology'de bulunan bir member'a route olmayan networkte connect timeout bekleyebilir. Firewall yalnız primary hostname'e izin verip secondary'leri engelliyorsa failover sırasında problem büyür. Bütün gerekli Atlas endpoints erişilebilir olmalıdır. Private endpoint configuration region kapsamını tam sağlamalıdır. SDAM event hangi member'ın sürekli timeout verdiğini gösterebilir.
Çok Düşük Timeout Riski
Normal network jitter sırasında connection establishment gereksiz yere başarısız olabilir. Driver tekrar başka server veya connection deneyebilir ve churn yaratır. Multi-region setup doğal olarak daha yüksek latency taşır. Test ortamındaki düşük gecikmeye göre production timeout seçilmemelidir. P99 establishment metric karar için daha iyi veridir.
Çok Yüksek Timeout Riski
Ulaşılamayan server için dakikalarca beklemek API request'i ve worker resource'unu gereksiz tutar. Server selection zinciri de gecikebilir. Upstream timeout daha kısa ise kullanıcı zaten request'ten vazgeçmiştir. Timeout budget bütün dependency katmanlarında tutarlı olmalıdır. Fail-fast ve retry stratejisi birlikte düşünülmelidir.
socketTimeoutMS Nedir?
`socketTimeoutMS` kurulmuş bir socket üzerinde send veya receive işleminin ne kadar süre hareketsiz kalabileceğini sınırlar. Node.js driver default değeri sıfırdır ve socket-level timeout uygulanmaması anlamına gelir. Uzun query ile gerçek network stall birbirinden ayrılmalıdır. Operation-level `maxTimeMS` server'ın query execution süresini sınırlar ve farklı bir katmandır. Socket timeout kullanılıyorsa en yavaş normal operation'dan güvenli biçimde yüksek seçilmelidir.
Açık Socket Üzerinde Read/Write
TCP connection kurulmuş olsa bile packet akışı daha sonra durabilir. Network cihazı veya server stall buna neden olabilir. Socket timeout application'ın sonsuza kadar aynı I/O üzerinde kalmasını önler. Driver socket'i kapatıp sonraki retry davranışını uygulayabilir. Connection close event reason troubleshooting'de izlenmelidir.
Uzun Query
Gerçekten uzun çalışan analytics query socket üzerinde uzun süre response bekletebilir. Socket timeout query'nin normal süresinden kısa ise valid operation yanlışlıkla kesilir. Bu nedenle transaction ve background job için farklı profile gerekebilir. Daha iyi çözüm query-specific `maxTimeMS` ile server execution budget tanımlamaktır. Slow query mümkünse optimize edilmelidir.
Network Stall
Connection fiziksel olarak açık görünürken packet delivery durabilir. Load balancer, firewall veya network path failure buna neden olabilir. Socket timeout bu zombie connection'ların sınırsız kalmasını önleyebilir. Heartbeat ve server monitoring de server health değişimini algılar. Network event application loglarıyla korele edilmelidir.
Operation Timeout ile Farkı
Socket timeout network I/O seviyesindedir. `maxTimeMS` ise MongoDB server'ın bir operation'ı ne kadar çalıştıracağını sınırlar. Server selection timeout uygun server bulma aşamasını kapsar. Tek “timeout” ayarı yoktur ve her biri farklı failure stage'i temsil eder. Incident raporunda hangi timeout'un tetiklendiği açık yazılmalıdır.
Timeout Değerleri Nasıl Standardize Edilmeli?
Timeout standardizasyonu her katmana bağımsız büyük değerler vermek yerine tek bir request budget üzerinden yapılmalıdır. HTTP deadline, database checkout, server selection, TCP connect ve operation süresi aynı toplam bütçeyi paylaşır. MongoDB Atlas server selection timeout ve connection timeout hataları nasıl çözülür sorusunun kalıcı cevabı da bu ayrımı doğru kurmaktır. User-facing API ile uzun çalışan batch job aynı timeout profile'ına sahip olmak zorunda değildir. Standard değerler gerçek P95 ve P99 latency ölçümleriyle periyodik olarak gözden geçirilmelidir.
HTTP Request Deadline
Toplam kullanıcı request'i için üst süre belirlenir. Reverse proxy veya client timeout bu değerden daha kısa olmamalıdır. Dependency call'ları bu budget'ın tamamını tek başına tüketmemelidir. Request iptal edildiğinde mümkünse database operation da cancellation sinyali almalıdır. SLO ve user experience bu üst sınırı belirler.
Database Operation Deadline
Query veya write için kabul edilen server execution süresi HTTP budget'tan kısa olmalıdır. `maxTimeMS` bazı operation'larda server-side limit sağlar. Bulk background job daha uzun süre kullanabilir. Timeout olduğunda query shape telemetry'de işaretlenmelidir. Sürekli timeout limit yükseltmek yerine query optimize edilmelidir.
Server Selection
Server selection failover toleransı ve API deadline arasında dengelenir. Kısa transient election'ı tolere etmek isteyebilirsiniz. Ancak gerçek Access List probleminde on saniyelerce beklemek kullanıcı deneyimini bozar. Error rate ve failover recovery metric baseline sağlar. Service criticality farklı timeout profile gerektirebilir.
TCP Connect
Connect timeout normal network P99 değerinden yüksek ama total deadline'ın küçük bölümü olmalıdır. Cross-region topology daha fazla marj ister. Unreachable node için çok uzun bekleme server selection'ı yavaşlatır. Network test environment production'a yakın olmalıdır. Private endpoint latency public endpoint'ten farklı olabilir.
Socket Operation
Socket timeout en yavaş normal operation süresinden düşük olmamalıdır. Driver guidance bu değerin beklenen en yavaş operation'ın birkaç katı olabileceğini belirtir. Infinite default bazı workload'larda kabul edilebilir, fakat stuck network durumunda application-level deadline yine olmalıdır. Transaction ve streaming benzeri use case'ler ayrıca değerlendirilir. Timeout tetiklenmesi connection churn metric'ine eklenmelidir.
Timeout Budget
Örneğin beş saniyelik API budget içinde 500 ms pool checkout, bir saniye server selection ve kalan süre query execution için ayrılabilir. Bu yalnız örnek modeldir ve gerçek latency verisine göre değişmelidir. Bir aşama budget'ını sürekli tüketiyorsa optimization oraya odaklanır. Timeout katmanları toplamı upstream deadline'dan büyük olmamalıdır. Configuration service ekipler arasında ortak template sağlayabilir.
MongoServerSelectionError Nedir?
`MongoServerSelectionError` driver'ın operation için uygun server seçemediğini gösterir. Bu error DNS'ten TLS'e kadar birçok alt neden taşıyabilir. `reason` veya topology description içeriği loglanmadan yalnız error class üzerinden teşhis yapılamaz. Primary unavailable, firewall veya Access List problemi benzer üst seviye hata üretebilir. Troubleshooting DNS, TCP, TLS, authentication ve topology sırasıyla ilerlemelidir.
DNS Problemi
SRV veya host resolution başarısızsa driver server listesine ulaşamaz. Error chain `ENOTFOUND`, `EAI_AGAIN` veya `querySrv` mesajı içerebilir. DNS test doğrudan application environment'ta yapılmalıdır. Standard URI diagnostic olarak kullanılabilir. Resolver problemi çözüldükten sonra application restart gerekip gerekmediği driver behavior'a göre değerlendirilir.
IP Access List
Atlas'a TCP connection kaynak IP nedeniyle engellenirse driver suitable server bulamayabilir. Production egress IP Access List ile karşılaştırılır. NAT change deployment'tan bağımsız problem yaratabilir. Public connection kullanmıyorsanız private endpoint path kontrol edilir. Wildcard açmak kalıcı çözüm değildir.
Firewall
Outbound firewall belirli Atlas node'larını engelliyorsa topology incomplete görünebilir. Primary erişilemezken secondary erişimi server selection'ı write için çözmez. Port test her target üzerinde yapılabilir. Cloud flow logs dropped traffic'i gösterebilir. Firewall policy hostname değişimine dayanıklı biçimde tasarlanmalıdır.
TLS
TCP connection kurulduktan sonra TLS handshake failure server'ı usable hâle getirmez. Error reason certificate veya hostname validation mesajı içerebilir. Container CA store ve corporate inspection kontrol edilmelidir. Invalid certificate option kalıcı açılmamalıdır. OpenSSL test driver dışında bağımsız kanıt sağlar.
ReplicaSetNoPrimary
Topology description replica set içinde primary bulunmadığını gösterebilir. Gerçek election kısa süreli olabilir. Ancak application yalnız bazı members'a ulaşabiliyorsa driver uzun süre primary göremeyebilir. Atlas event ve heartbeat failure birlikte incelenmelidir. Failover test normal recovery süresini baseline olarak verir.
Timeout
Server selection belirlenen süre sonunda başarılamazsa error döner. Timeout value semptomun ne kadar geç görüleceğini belirler. Değeri artırmak DNS veya firewall root cause'u düzeltmez. Error occurrence duration SLO ile karşılaştırılmalıdır. Upstream request timeout'tan daha uzun değer kullanılmamalıdır.
Topology Description'ı Okumak
Topology description hangi server'ların Unknown, Primary veya Secondary görüldüğünü ve alt error'ları gösterebilir. Bu veri tek string log message'den çok daha değerlidir. Credential veya full URI gibi secret alanları loglanmamalıdır. Structured logging server address ve state değişimini ayrı field'larda tutabilir. Incident runbook topology description snapshot'ını zorunlu veri olarak isteyebilir.
ReplicaSetNoPrimary Hatası
`ReplicaSetNoPrimary` driver topology görünümünde kullanılabilir primary bulunmadığını belirtir. Normal election sırasında kısa süre görülebilir. Uzun sürüyorsa Atlas cluster health, network reachability ve driver topology view birlikte incelenmelidir. Tüm replica members'a network erişimi sağlanmıyorsa yeni primary seçilmiş olsa bile application onu göremeyebilir. Hata sürekli timeout artırılarak gizlenmemelidir.
Primary Election
Replica set primary kaybedildiğinde eligible secondary üyelerden biri yeni primary seçilir. Bu süreç kısa availability etkisi yaratabilir. Driver heartbeat ile topology değişikliğini öğrenir. Retryable operation bazı transient hataları otomatik toparlayabilir. Application SLO failover recovery süresini test edilmiş değer üzerinden kabul etmelidir.
Network Problemi
Primary gerçekte sağlıklı olsa bile application network path onu göremiyorsa driver için unavailable kabul edilir. Partial network partition özellikle yanıltıcıdır. Atlas UI sağlıklı görünürken tek VPC veya subnet'teki application hata verebilir. Host bazlı TCP ve TLS test yapılmalıdır. Cloud flow log veya NetworkPolicy incelenmelidir.
Tüm Replica Members'a Ulaşamamak
Firewall yalnız başlangıç seed hostuna izin veriyorsa failover sonrası yeni primary başka member olduğunda connection bozulabilir. Driver discovery edilen bütün gerekli members'a bağlanabilmelidir. Atlas public host ve private endpoint topology kuralları takip edilmelidir. Normal operasyon testinin yanında primary failover testi bu eksikliği ortaya çıkarır. Network policy static tek IP'ye bağlanmamalıdır.
DNS
Replica member hostname'lerinden bazıları çözülemiyorsa topology incomplete olabilir. SRV seed başarılı olsa bile target A veya AAAA resolution ayrıca başarısız olabilir. Private DNS region association eksikliği multi-region cluster'da belirli member'ları etkileyebilir. DNS result bütün members için karşılaştırılmalıdır. Resolver error rate heartbeat failure ile birlikte analiz edilir.
Firewall
Firewall bütün MongoDB node ve gerekli portlara erişimi desteklemelidir. Private endpoint provider-specific port range kullanabilir. Bir member port testinde timeout veriyorsa topology recovery bozulabilir. Firewall rule change audit log incident timestamp ile karşılaştırılır. Least privilege korunurken Atlas'ın dinamik topology gereksinimleri göz önünde bulundurulmalıdır.
Driver Topology View
SDAM event'leri driver'ın hangi server'ı ne zaman Primary veya Unknown gördüğünü gösterir. Atlas cluster event'iyle karşılaştırıldığında application discovery gecikmesi ölçülebilir. `serverHeartbeatFailed` belirli endpoint network sorununu gösterebilir. Topology event logging sample edilerek production overhead kontrol edilir. Failover SLO bu event zaman farklarından hesaplanabilir.
Failover Sırasında Uygulama Nasıl Davranmalıdır?
Replica set failover production'da beklenen bir olaydır ve application bunu kısa süreli transient failure olarak yönetebilmelidir. Driver yeni primary'yi discovery ederek uygun operasyonları tekrar yönlendirir. Retryable reads ve writes desteklenen işlemlerde recovery'yi kolaylaştırabilir. Application aynı operation'ı körlemesine tekrar tekrar göndererek duplicate veya retry storm üretmemelidir. Failover testleri gerçek kullanıcı etkisini ve recovery time'ı production öncesinde ölçmelidir.
Primary Election
Eski primary unavailable olduğunda replica set yeni primary seçer. Bu sırada write operation geçici olarak suitable server bulamayabilir. Election süresi network ve cluster health'e bağlıdır. Atlas event'leri primary change zamanını gösterir. Application timeout bu normal davranışı tolere edecek ama gerçek outage'ı uzatmayacak şekilde ayarlanmalıdır.
Driver Server Discovery
Driver heartbeat ve server description event'leriyle yeni primary'yi öğrenir. Application'ın kendisi primary hostname hard-code etmemelidir. SRV veya replica set aware connection string kullanılmalıdır. Driver current version olmalıdır. Discovery event süreleri failover benchmark'ta ölçülebilir.
Retryable Reads
MongoDB driver'ları desteklenen read operation'ları transient network veya failover hatalarında retry edebilir. Her read aynı semantics'e sahip değildir ve transaction içindeki davranış farklı olabilir. Driver retry ile application retry üst üste geldiğinde gereksiz request sayısı oluşabilir. Retry sonucu latency budget içinde kalmalıdır. Hata türü retryable değilse hızlıca üst katmana taşınmalıdır.
Retryable Writes
Desteklenen acknowledged write operation'lar retryable write mekanizmasından faydalanabilir. Modern driver'larda bu davranış yaygın olarak varsayılan etkin durumdadır. Transaction içindeki individual writes ayrı retry semantics taşır. Application kendi retry'sini eklerken driver'ın zaten ne yaptığını bilmelidir. Business idempotency yine kritik operation'larda ayrıca tasarlanmalıdır.
Temporary Errors
Primary election sırasında network ve server selection error oranı kısa süre yükselebilir. Alert sistemi her tek transient hata için büyük incident açmamalıdır. Error budget ve recovery threshold tanımlanabilir. Ancak sürekli primary kaybı normal kabul edilmemelidir. Repeated failover cluster veya network health problemine işaret eder.
Application-Level Error Handling
Driver retry sonrasında error devam ederse application kullanıcıya kontrollü sonuç döndürmelidir. Idempotent GET kısa backoff ile tekrar denenebilir. Payment veya side-effect write business idempotency key olmadan körlemesine retry edilmemelidir. Error log topology ve request context içermelidir. User message teknik MongoDB error ayrıntısını expose etmemelidir.
Retryable Reads ve Retryable Writes
Retry mekanizması kısa network interruption ve failover sırasında availability'yi artırabilir. Ancak retry'nin güvenli olması operation semantics ve idempotency'ye bağlıdır. Driver'ın kendi retry davranışı application-level retry ile bilinçli biçimde birleştirilmelidir. Her hata yeniden denenebilir değildir. Retry budget toplam request deadline'ın içinde kalmalı ve downstream outage sırasında traffic amplification üretmemelidir.
Transient Network Failure
Kısa packet loss veya connection reset tek operation'ı etkileyebilir. Driver uygun hata durumunda retry gerçekleştirebilir. Network sürekli bozuksa retry yalnız latency'yi artırır. Error rate threshold circuit breaker veya incident alert tetikleyebilir. Retry success rate ayrı metric olarak tutulursa network quality hakkında bilgi verir.
Failover
Primary değişimi sırasında ilk write eski primary'ye giderken hata alabilir. Driver yeni topology öğrenip supported operation'ı tekrar deneyebilir. Bu davranış application'a kısa failover'u daha az görünür kılar. Yine de user-facing P99 latency artabilir. Failover test retry success ve recovery time'ı ölçmelidir.
Idempotency
Aynı business operation iki kez çalıştığında duplicate sonuç oluşmaması idempotency'nin temelidir. Driver retryable writes protocol seviyesinde belirli duplicate execution risklerini yönetebilir. Application-level retry daha geniş business transaction için idempotency key gerektirebilir. Order creation veya ödeme gibi işlemler özellikle dikkat ister. Retry policy operation type bazında tanımlanmalıdır.
Hangi İşlemler Retry Edilebilir?
MongoDB documentation desteklenen retryable read ve write operation listesini belirtir. Transaction davranışı farklıdır. Application kendi domain işlemini tek MongoDB command ile karıştırmamalıdır. Bir request iki farklı write içeriyorsa tek write retry semantics bütün business flow'u idempotent yapmaz. Driver documentation her major upgrade'de yeniden kontrol edilmelidir.
Application Retry ile Driver Retry'ı Çakıştırmamak
Driver zaten bir operation'ı retry ederken application üç kez tekrar deniyorsa backend beklenenden fazla attempt yapabilir. Downstream outage sırasında bu retry storm yaratır. Observability attempt sayısını driver ve application katmanında ayrı gösterir. Retry ownership belirli layer'a atanmalıdır. Exponential backoff ve maximum attempts toplam budget üzerinden hesaplanmalıdır.
Exponential Backoff ve Jitter
Retry bütün instance'lar aynı anda ve sabit aralıklarla yapılırsa kısa outage'ın yükünü büyütebilir. Exponential backoff her başarısız denemede bekleme süresini artırır. Jitter bu süreye randomness ekleyerek synchronized retry dalgasını dağıtır. Maximum attempt ve toplam retry budget sınırsız tekrarın önüne geçer. Database recovery sırasında application'ın yardımcı olması, yeni bir connection storm üretmemesi gerekir.
Immediate Retry Storm
Bin request hata alıp aynı milisaniyede tekrar gönderildiğinde database toparlanmak için zaman bulamaz. Network ve connection pool üzerindeki baskı artar. Driver reconnect işlemleri de aynı anda devreye girebilir. Retry rate limiting bu dalgayı azaltır. Production chaos test bu senaryoyu görünür hâle getirir.
Fixed Retry
Her attempt arasında sabit 100 ms beklemek bütün client'ların yine senkronize olmasına neden olabilir. Kısa outage boyunca aynı pattern tekrar eder. Küçük tek-instance sistemde sorun olmayabilir. Büyük horizontal deployment'ta exponential ve jitter daha güvenlidir. Retry schedule metric olarak gözlemlenebilir.
Exponential Backoff
Backoff süresi her başarısızlıkta iki kat gibi artan model kullanabilir. İlk retry hızlı, sonraki retry'lar daha seyrek olur. Maximum delay üst sınırla kontrol edilir. User-facing request'te toplam süre yine kısa tutulmalıdır. Background job daha geniş recovery budget kullanabilir.
Jitter
Jitter belirlenen backoff süresine random dağılım ekler. Böylece yüz application instance aynı anda reconnect etmeye çalışmaz. Full jitter ve decorrelated jitter gibi farklı yöntemler vardır. Ekip tek shared retry library kullanarak davranışı standardize edebilir. Randomness testlerde deterministic seed veya range assertion ile kontrol edilebilir.
Maximum Attempts
Sınırsız retry failure'ı görünmez hâle getirir ve resource tüketir. Maximum attempt operation criticality ve expected transient outage süresine göre seçilir. Limit aşıldığında error upstream'e veya dead-letter queue'ya taşınabilir. Retry count monitoring metric olur. Sürekli maximuma ulaşılması dependency health alarmı üretmelidir.
Retry Budget
Retry budget yalnız attempt sayısı değil toplam zaman ve traffic amplification sınırı olarak düşünülmelidir. API request beş saniyeyse retries bu sürenin içinde kalmalıdır. Sistem genelinde outage sırasında toplam retry QPS sınırlandırılabilir. Driver ve application retry budget aynı dokümanda tanımlanmalıdır. SLO error budget ile retry strategy birlikte gözden geçirilebilir.
Read Preference Bağlantı Sayısını Nasıl Etkiler?
Read preference hangi replica set üyelerinin read operation için eligible olduğunu belirler. Primary-only kullanım bir node pool'unu ağırlıklı kullanırken secondary veya nearest farklı member pool'larını aktif hâle getirebilir. Bu connection distribution Atlas node-level limitleri açısından önemlidir. Read preference yalnız connection yaymak amacıyla değil consistency ve latency requirement'a göre seçilmelidir. Multi-region sistemde network latency ve replication lag karara dahil edilmelidir.
primary
`primary` read operation'ları mevcut primary node'a yönlendirir. Strongest read-after-write beklentileri için yaygın varsayımdır. Read ve write workload aynı node üzerinde yoğunlaşabilir. Application connection pool esas olarak primary'de büyür. Primary failover sırasında yeni primary seçilene kadar read'ler de bekleyebilir.
primaryPreferred
`primaryPreferred` primary mevcutsa onu kullanır, unavailable olduğunda secondary'lere düşebilir. Failover sırasında read availability artabilir. Secondary data replication lag nedeniyle biraz geride olabilir. Connection pool secondary'lerde de gerektiğinde büyüyebilir. Consistency requirement bu trade-off'u kabul etmelidir.
secondary
`secondary` read'leri yalnız secondary üyelerden yapar. Analytics veya read scaling use case'lerinde kullanılabilir. Write operation yine primary gerektirir. Secondary pool'ları aktif connection sayısını artırır. Staleness ve region tag ayarları doğru kullanılmalıdır.
secondaryPreferred
`secondaryPreferred` uygun secondary varsa onu, yoksa primary'yi kullanır. Read load primary'den uzaklaştırılabilir. Failover sırasında daha esnek server selection sağlayabilir. Fakat stale read ihtimali business modeline göre kabul edilmelidir. Connection budget primary ve secondary pool'ları birlikte kapsamalıdır.
nearest
`nearest` latency window içindeki en yakın eligible member'ları seçer. Primary ve secondary birlikte aday olabilir. Multi-region read latency'yi azaltabilir. Consistency davranışı read concern ve application requirement ile birlikte düşünülmelidir. Driver farklı node pool'larında connection açabileceği için toplam connection dağılımı genişleyebilir.
Secondary Pool'ları
Secondary üzerine query gönderildiğinde driver ilgili server pool'unda application connection oluşturur. Birden fazla secondary aktif kullanılıyorsa toplam connection sayısı primary-only modele göre büyüyebilir. Atlas node limitleri ayrı olduğu için dağılım bazı durumlarda avantaj sağlayabilir. Ancak monitoring socket ve pool fan-out budget'a eklenmelidir. Read preference değişikliği release öncesi connection forecast gerektirir.
Latency vs Consistency
Nearest veya regional secondary latency'yi düşürebilir fakat replication lag nedeniyle en güncel veriyi garanti etmeyebilir. Financial veya transactional flow primary requirement taşıyabilir. Analytics dashboard stale read'i kabul edebilir. Read preference teknik performance ayarı değil business consistency kararıdır. Architecture decision bu trade-off'u açıkça belgelemelidir.
Write Concern ve Bağlantı Dayanıklılığı
Write concern MongoDB write operation'ın başarılı sayılması için ne kadar acknowledgement gerektiğini belirler. Daha güçlü durability garantisi latency üzerinde ek maliyet oluşturabilir. Atlas-generated connection string çoğu modern kullanımda retryable writes ve majority write concern gibi güvenli varsayımlar sunar. Connection sorununu çözmek için write concern rastgele gevşetilmemelidir. Business durability requirement açık olmadan latency kazanımı adına veri güvenliği azaltılmamalıdır.
w: 1
`w: 1` primary write'ı kabul ettiğinde acknowledgement döndürür. Replica majority confirmation beklenmez. Latency daha düşük olabilir. Primary hemen sonra kaybedilirse durability semantics majority'den farklıdır. Kullanım business riskine göre seçilmelidir.
w: majority
`w: majority` write'ın replica set majority tarafından acknowledged edilmesini bekler. Failover dayanıklılığı açısından güçlü varsayımdır. Network ve replication latency write response süresine eklenebilir. Multi-region topology bu maliyeti artırabilir. Critical data workload çoğu zaman bu trade-off'u kabul eder.
Journaling
Journaling write durability'nin storage katmanında korunmasına yardımcı olur. Write concern ile birlikte server acknowledgement semantics belirler. Atlas deployment configuration ve MongoDB version davranışı güncel documentation üzerinden izlenmelidir. Application developer yalnız latency azaltmak için journal güvenliğini değiştirmemelidir. Recovery requirement architecture tarafından tanımlanmalıdır.
Write Latency
Write latency network round trip, server execution ve replication acknowledgement sürelerinin birleşimidir. Connection pool yalnız checkout bölümünü etkiler. Slow write connection'ı daha uzun süre kullanımda tutar. Write concern değişikliği latency distribution'ını etkileyebilir. Before-after load test yapılmadan production SLO tahmini yapılmamalıdır.
Durability
Durability kullanıcıya başarı döndükten sonra verinin failure karşısında ne kadar güvenli kaldığını ifade eder. Daha düşük write concern kısa latency için daha zayıf garanti verebilir. Her endpoint aynı durability requirement'a sahip olmayabilir. Audit veya financial kayıtlar daha güçlü garanti ister. Karar business owner ve database architecture birlikte verilmelidir.
Retryable Writes
Retryable writes transient network failure veya failover sırasında supported write operation'ın driver tarafından yeniden denenebilmesini sağlar. Majority write concern ile birlikte resilience tasarımının önemli parçası olabilir. Application business operation'ı yine idempotent tasarlanmalıdır. Driver retry behavior monitoring'de görünür olmalıdır. Retry'ı kapatmak connection problemini çözme yöntemi değildir.
Mongoose ile MongoDB Atlas Bağlantısı
Mongoose Node.js MongoDB driver üzerinde ODM katmanı sunar. `mongoose.connect()` altında MongoDB driver'ın connection pool ve server selection davranışları kullanılmaya devam eder. Mongoose kendi buffering özelliği nedeniyle connection kurulmadan model operation'larını geçici olarak bekletebilir. Bu kullanım kolaydır fakat startup connection probleminde application'ın çalışıyor gibi görünmesine neden olabilir. Production readiness ve connection event monitoring bu nedenle Mongoose kullanan servislerde ayrıca önemlidir.
mongoose.connect()
`mongoose.connect()` URI ve option'ları alarak default Mongoose connection'ı açar. Çoğu MongoDB driver option'ı Mongoose tarafından underlying driver'a aktarılır. Initial connection promise reject ettiği için startup error try/catch ile yönetilebilir. Aynı process içinde gereksiz tekrar connect çağrıları yapılmamalıdır. Application bootstrap connection ownership için en uygun yerdir.
Connection Lifecycle
Mongoose initial connect, disconnect ve reconnect durumlarını event'lerle bildirir. Initial failure otomatik olarak sonsuz retry edilmeyebilir. Established connection kaybında driver reconnect mekanizması çalışır. Application readiness connection lifecycle ile ilişkilendirilebilir. Shutdown sırasında `mongoose.disconnect()` veya ilgili connection close kontrollü biçimde çağrılmalıdır.
Connection Events
Mongoose connection EventEmitter üzerinden `connected`, `disconnected`, `error` ve başka event'ler üretir. Bu event'ler observability için kullanılabilir. Her event'i yüksek hacimli loglamak yerine state transition olarak kaydetmek yeterlidir. Underlying driver SDAM event'leri daha ayrıntılı topology bilgisi sağlar. Mongoose ve driver metric'leri aynı incident timeline'da birlikte değerlendirilebilir.
connected
`connected` initial connection başarıyla kurulduğunda veya connectivity tekrar sağlandığında emit edilebilir. Event application'ın ilk readiness açılışında kullanılabilir. Tek event database'in her operation için hızlı olduğu anlamına gelmez. Reconnection sayısı sıklaşıyorsa network health problemi araştırılır. Metric olarak reconnect rate tutulabilir.
disconnected
`disconnected` Mongoose'un MongoDB bağlantısını kaybettiğini bildirebilir. Replica set primary connectivity kaybı bu event'i etkileyebilir. Tek transient event otomatik process restart sebebi yapılmamalıdır. Heartbeat ve server selection event'leriyle birlikte incelenmelidir. Uzun süre disconnected kalınırsa readiness kapatılabilir.
error
`error` connection sırasında veya sonrasında bazı hata durumlarını bildirir. Mongoose dokümantasyonu connectivity kaybının her zaman error event üretmeyebileceğini ve `disconnected` event'in de dinlenmesini önerir. Error listener process crash riskini azaltır. Sensitive URI error object serialization sırasında maskelenmelidir. Structured classification DNS, auth ve timeout hatalarını ayırmalıdır.
Native Driver ile Farkı
Mongoose schema, model, middleware ve ODM abstraction ekler. Connection pooling yine MongoDB Node.js driver üzerinden yönetilir. Native driver daha düşük abstraction ve doğrudan command API sunar. Mongoose buffering gibi ek behavior troubleshooting sırasında bilinmelidir. Araç seçimi domain model ve ekip ihtiyaçlarına göre yapılmalıdır.
Mongoose Buffering Bağlantı Problemlerini Gizleyebilir mi?
Evet, Mongoose model operation'larını connection hazır olana kadar buffer edebilir. Bu behavior local development'ta rahatlık sağlarken production startup problemi sırasında request'in hemen hata vermek yerine beklemesine yol açabilir. Kullanıcı application process'in ayakta olduğunu görür fakat database operation'ları buffer timeout bekler. Readiness gerçek connection durumunu yansıtmalıdır. Fail-fast isteyen servislerde buffering ayarı bilinçli biçimde kapatılabilir veya süresi sınırlandırılabilir.
Command Buffering
Mongoose connection kurulmadan çağrılan model method'larını geçici queue içinde bekletebilir. Connection daha sonra açıldığında operation çalışır. Bu davranış initial startup delay'i kullanıcıdan gizleyebilir. Connection hiç kurulmazsa buffer timeout sonunda hata gelir. Production SLO kısa ise uzun buffer uygun olmayabilir.
Uygulamanın “Çalışıyor Gibi” Görünmesi
HTTP server port dinlemeye başladığı için orchestrator pod'u ready sanabilir. İlk gerçek request Mongoose buffer içinde bekler. Monitoring yalnız process health bakıyorsa database outage fark edilmez. Readiness database dependency durumunu kontrollü biçimde değerlendirmelidir. Liveness ise dependency outage nedeniyle process'i sürekli restart etmemelidir.
Startup Readiness
Startup sırasında `mongoose.connect()` tamamlanmadan readiness açılmaması güvenli modeldir. Connection transient unavailable ise bounded retry uygulanabilir. Retry süresi aşılırsa process fail veya unready durumda kalabilir. Orchestrator restart policy storm üretmeyecek şekilde yapılandırılmalıdır. Readiness endpoint her probe'da yeni database connection açmamalıdır.
Connection Health
Mongoose readyState ve connection event'leri basic health sinyali sunar. Gerçek end-to-end database capability gerektiğinde mevcut pool üzerinden lightweight ping kullanılabilir. Probe frequency database'e gereksiz load oluşturmamalıdır. Health signal ile user request performance metric ayrı tutulmalıdır. Query latency yüksek olsa da connection state “connected” kalabilir.
Fail-Fast Tasarımı
Critical API database olmadan iş yapamıyorsa uzun buffering yerine hızlı controlled error daha iyi olabilir. `bufferCommands` configuration bu behavior'ı etkiler. Upstream load balancer unready instance'a traffic göndermemelidir. Error kullanıcıya retryable service unavailable biçiminde dönebilir. Database recovery sonrası readiness tekrar açılabilir.
Node.js'te Tek MongoClient Kullanım Pattern'i
Node.js production servislerinde database client application lifecycle'ın parçası olarak tasarlanmalıdır. Startup'ta tek MongoClient oluşturulur, handler'lar shared `Db` veya collection reference kullanır ve shutdown sırasında client kapatılır. Bu pattern connection pool'un process boyunca reuse edilmesini sağlar. Test isolation için production singleton'ını global hack olarak kullanmak yerine factory ve dependency injection uygulanabilir. Böylece hem connection sayısı kontrol edilir hem testlerde bağımsız client sağlanır.
Application Startup
Config ve secret yüklendikten sonra MongoClient oluşturulur. `connect()` ve `ping` readiness öncesi çalıştırılabilir. Startup timeout belirli budget içinde tutulur. Başarısızlık structured log ile DNS, auth veya server selection olarak sınıflandırılır. Server dinlemeye başlamadan database dependency policy uygulanır.
Shared Client
Client module export veya dependency container üzerinden servis katmanlarına verilebilir. Her repository function yeni client oluşturmamalıdır. Client option'ları tek configuration noktasında tutulur. Connection event listener'ları da burada register edilir. Bu yapı pool tuning'i bütün application için tutarlı hâle getirir.
Shared DB Instance
`client.db("app")` ile elde edilen Db handle hafif bir object'tir ve tekrar kullanılabilir. Her request'te `db()` çağrısı yeni network connection açmaz. Collection handles da shared service içinde tutulabilir. Multi-database application hangi DB'nin hangi request context'te kullanılacağını açıkça yönetmelidir. Tenant başına yeni MongoClient oluşturmak çoğu durumda gerekli değildir.
Request Handler
Request handler yalnız mevcut collection veya service API'sini çağırmalıdır. Connection open ve close logic handler içine konmamalıdır. Request deadline operation timeout'a aktarılabilir. Error mapping database technical detayını kullanıcıdan gizler. Trace span pool checkout ve query duration'ı ayrı gösterebilir.
Graceful Shutdown
SIGTERM geldiğinde HTTP server yeni request kabulünü durdurur. In-flight request'ler tamamlanır. Ardından MongoClient close çağrılır. Hard shutdown deadline aşılırsa process çıkabilir. Kubernetes termination grace period bu süreye göre belirlenir.
Test Isolation
Test suite shared production singleton'a bağımlı olmamalıdır. Factory test database URI ile ayrı client oluşturabilir. Her test file değil suite scope client reuse yapabilir. Cleanup collection veya database seviyesinde tasarlanabilir. Parallel testler connection limitini aşmayacak concurrency ile çalıştırılmalıdır.
Serverless Ortamlarda MongoDB Atlas
Serverless platformlarda process ve instance lifecycle klasik uzun ömürlü server'dan farklıdır. Bir function instance warm kaldığı sürece module-level MongoClient reuse edilebilir, fakat yeni instance kendi pool'unu oluşturur. Traffic spike yüzlerce instance açarsa toplam connection sayısı hızla büyüyebilir. Dynamic egress IP public Access List yönetimini ayrıca zorlaştırabilir. Function timeout, cold start ve Atlas connection budget birlikte tasarlanmalıdır.
Cold Start
Cold start runtime boot, application initialization ve ilk database connection maliyetini içerir. DNS, TCP, TLS ve authentication ilk invocation latency'sine eklenebilir. Client module scope'ta oluşturulsa bile ilk cold instance bu maliyeti öder. Provisioned veya minimum instance seçenekleri workload'a göre kullanılabilir. Connection warm-up ile cost arasında denge kurulmalıdır.
Function Instance
Her serverless instance ayrı memory ve process environment taşır. MongoClient başka instance ile paylaşılamaz. Warm invocation aynı instance içindeki client'ı reuse edebilir. Platform instance sayısını her zaman doğrudan kontrol etmeyebilirsiniz. Maximum concurrency ve scaling limit database budget açısından önemlidir.
Connection Pool per Instance
Her instance kendi pool'una sahip olduğu için `maxPoolSize` serverless ortamda özellikle dikkatle seçilmelidir. Geleneksel server'daki 100 default yüzlerce function instance ile çok yüksek teorik capacity oluşturabilir. Function concurrency düşükse küçük pool yeterli olabilir. Gerçek driver ve runtime behavior load test edilmelidir. Atlas Connections graph scale pattern ile karşılaştırılmalıdır.
Horizontal Scaling
Serverless platform traffic'e göre instance sayısını otomatik artırır. Bu application compute capacity'sini büyütür ama Atlas tier aynı kalır. Database connection ve query concurrency limiti ortak bottleneck olabilir. Platform maximum instance ayarı database capacity ile uyumlu tutulmalıdır. Scale-out incident sırasında geçici çözüm olarak daha da artırılmamalıdır.
Dynamic Egress IP
Bazı serverless platformlarda default outbound IP sabit değildir. Atlas Access List'i dar tutmak için static egress veya private networking gerekebilir. Platformun güncel network seçenekleri kontrol edilmelidir. Wildcard Access List security riskini büyütür. Network architecture application release'ten bağımsız altyapı bileşeni olarak yönetilmelidir.
Function Timeout
Function maximum execution süresi database timeout budget'ın üst sınırını oluşturur. Server selection timeout function timeout'tan uzun olmamalıdır. Request kesildiğinde retry background'da devam etmemelidir. Query-specific maxTimeMS function budget ile uyumlu seçilebilir. Timeout error monitoring platform ve MongoDB tarafında ayrı sınıflandırılmalıdır.
AWS Lambda ile Atlas Connection Optimization
MongoDB'nin Atlas için yayınladığı AWS Lambda guidance MongoClient'ın handler dışında oluşturulmasını özellikle önerir. Bu sayede warm invocation mevcut database connection'larını reuse edebilir. Her invocation içinde yeni client oluşturmak latency ve connection count'u gereksiz artırır. Sharded cluster kullanılıyorsa host fan-out için `srvMaxHosts` gibi Atlas'ın önerdiği seçenekler belirli senaryolarda değerlendirilebilir. VPC, PrivateLink ve IAM authentication production security modeline göre birlikte tasarlanabilir.
MongoClient'ı Handler Dışında Oluşturmak
Module scope'ta oluşturulan MongoClient Lambda execution environment warm kaldığı sürece korunabilir. Sonraki invocation aynı pool'u kullanır. Bu MongoDB'nin resmî serverless guidance'ında açıkça önerilen pattern'dir. Handler içinde client açıp kapatmak cold connection maliyetini her request'e taşır. Client initialization error monitoring startup context ile ilişkilendirilmelidir.
Warm Invocation'da Connection Reuse
Warm Lambda environment memory state'ini sonraki invocation için koruyabilir. Driver pool'daki açık connection'lar kullanılabilir durumda kalabilir. AWS bu environment'ın ne kadar süre yaşayacağını garanti etmediği için application her invocation'da client'ın varlığını güvenli biçimde kullanmalıdır. Idle network cihazı connection'ı kapatmışsa driver reconnect edebilir. Reuse performance benchmark cold ve warm invocation ayrı ölçülmelidir.
maxIdleTimeMS
Lambda instance idle kalırken connection pool'un açık socket'leri tutulabilir. Çok uzun idle sürede network timeout stale socket yaratabilir. MongoDB guidance workload'a göre `maxIdleTimeMS` ayarının serverless kullanımda düşünülmesini önerir. Çok kısa değer her invocation yakınında reconnect maliyeti oluşturur. Metric ile gerçek idle distribution ölçülmelidir.
Instance Scaling
AWS concurrency arttıkça daha fazla execution environment oluşturabilir. Her environment ayrı MongoClient ve pool taşır. Reserved concurrency database connection budget'ı koruyan bir üst sınır olarak kullanılabilir. Traffic burst öncesi Atlas cluster capacity hesaplanmalıdır. Lambda scale ile database scale otomatik eşleşmez.
AWS IAM Authentication
Atlas desteklenen driver'larla AWS IAM authentication kullanabilir. Bu model static database password taşıma ihtiyacını azaltabilir. Lambda execution role temporary AWS credentials sağlar. Connection string ve auth mechanism doğru yapılandırılmalıdır. IAM policy least privilege ve Atlas database role birlikte değerlendirilmelidir.
VPC / PrivateLink
Lambda VPC içinden Atlas AWS PrivateLink endpoint'ine bağlanabilir. Bu durumda private DNS ve security group configuration kritik olur. NAT ihtiyacı database traffic için ortadan kalkabilir. Private endpoint dedicated Atlas cluster gerektirir. Multi-region ve availability zone tasarımı yüksek availability testleriyle doğrulanmalıdır.
Vercel ve Benzeri Serverless Platformlarda Atlas
Serverless web platformlarında deployment instance sayısı kullanıcı tarafından doğrudan görülmeyebilir. Module-level connection cache yine önemlidir, ancak her yeni runtime instance ayrı pool oluşturur. Development hot reload yanlış singleton implementation'ında çok sayıda MongoClient yaratabilir. Dynamic egress IP Access List tasarımını etkiler. Platformun current networking ve connection reuse davranışı production öncesi kendi workload'unuzla ölçülmelidir.
Dynamic Instance Count
Request artışı yeni function veya serverless container instance'ları oluşturabilir. Bu sayı application server replica kavramının daha dinamik biçimidir. Database connection budget maximum olası instance sayısıyla hesaplanmalıdır. Platform hard max sunmuyorsa application rate limit veya database proxy architecture düşünülmelidir. Atlas connection alert serverless scaling event'leriyle korele edilmelidir.
Connection Cache
MongoClient Promise veya instance module scope'ta cache edilerek aynı warm runtime içinde reuse sağlanabilir. Development hot reload global cache pattern gerektirebilir. Cache implementation concurrent ilk request'lerde iki client oluşturmamalıdır. Failed connect promise'in sonsuza kadar cache edilmemesi gerekir. Testler connection creation sayısını doğrulayabilir.
Development Hot Reload
Framework development server module'leri tekrar evaluate ederek yeni MongoClient oluşturabilir. Production'da olmayan connection leak local Atlas Connections metric'ini yükseltebilir. Development-only global cache bu durumu azaltabilir. Production singleton ile dev workaround açıkça ayrılmalıdır. Hata gerçek serverless scaling sanılmadan önce environment kontrol edilmelidir.
Dynamic Egress IP
Platform sabit outbound IP sunmuyorsa narrow Atlas public Access List zordur. Enterprise network özelliği veya secure connector kullanılabilir. Private connectivity support platforma göre değişir. Wildcard IP yalnız kolaylık için production standardına dönüştürülmemelidir. Egress requirement platform seçim kriterlerinden biri olabilir.
Pool Size
Her function instance az concurrent request çalıştırıyorsa default büyük pool gereksiz olabilir. Küçük pool toplam deployment connection sayısını sınırlar. Çok küçük pool tek instance yüksek concurrency alıyorsa checkout latency yaratabilir. Platform concurrency modelini bilmek gerekir. Load test gerçek instance scaling behavior'ını tetikleyecek şekilde yapılmalıdır.
Serverless Architecture Limitleri
Database connection-heavy workload sınırsız horizontal function scaling ile doğal olarak uyumlu değildir. Database finite shared resource'tur. Connection pooling instance-local olduğu için global connection limiter yoktur. Maximum instance, queue veya rate limit gibi backpressure gerekir. Architecture selection yalnız frontend deployment kolaylığına göre yapılmamalıdır.
Docker İçinden MongoDB Atlas'a Bağlanamıyorum
Docker bağlantı probleminde host bilgisayarın çalışması container'ın da çalışacağını göstermez. Container DNS, outbound route, proxy, CA store ve environment variable set'i farklı olabilir. Testleri container network namespace'i içinden yapmak gerekir. Minimal image diagnostic tool taşımıyorsa aynı network'e debug container eklenebilir. Host ile container arasındaki farklar sistematik biçimde karşılaştırıldığında sorun genellikle hızlı bulunur.
Container DNS
Container `/etc/resolv.conf` host'tan farklı resolver gösterebilir. `mongodb+srv://` için SRV ve TXT lookup container içinden test edilmelidir. Docker daemon custom DNS configuration kullanabilir. VPN host resolver'ını değiştirdikten sonra Docker restart gerekebilir. DNS sorunu authentication ayarı değiştirilerek çözülmez.
Host DNS ile Fark
Host `dig` başarılı, container başarısızsa problem Atlas DNS kaydı değil runtime resolver path'idir. İki ortam aynı resolver IP'yi kullanıyor mu kontrol edilir. Search domain veya DNS option farklı olabilir. Docker Desktop ve native Linux networking behavior aynı değildir. Production container runtime local Docker sonucu ile birebir varsayılmamalıdır.
Outbound Network
Container bridge veya overlay network internet egress'e sahip olmalıdır. Host firewall Docker subnet'ten çıkan trafiği engelleyebilir. Cloud VM security group host trafiğini de sınırlar. `nc` ile gerçek Atlas target port test edilir. DNS resolution başarılıysa bu aşama ayrı kanıt sağlar.
Proxy
Container environment HTTP_PROXY değişkenleri taşıyor olabilir, ancak MongoDB raw TCP trafiği normal HTTP proxy üzerinden otomatik geçmez. SOCKS proxy gerekiyorsa driver'ın desteklenen seçenekleri kullanılmalıdır. Corporate network direct egress engelliyorsa doğru network architecture kurulmalıdır. Proxy'nin TLS inspection davranışı certificate hatası üretebilir. Host browser'ın internete çıkabilmesi MongoDB socket için yeterli değildir.
CA Certificate
Minimal container CA store içermiyorsa TLS handshake hata verir. Host işletim sistemi güncel CA store'a sahip olduğundan local test başarılı olabilir. Image Dockerfile uygun CA package'i kurmalıdır. Corporate CA gerekiyorsa controlled build pipeline ile eklenmelidir. TLS validation kapatmak image problemine kalıcı çözüm değildir.
Environment Variable
Container'a MongoDB URI gerçekten aktarılıyor mu kontrol edilmelidir. Compose veya orchestrator secret key adı yanlış olabilir. Shell special character quoting URI'yi bozabilir. Log yalnız hostname ve secret version gibi güvenli alanları göstermelidir. Local `.env` ile container production secret değerlerinin aynı olduğu varsayılmamalıdır.
Container İçinden nslookup / nc Testi
İlk test SRV DNS resolution, ikinci test target TCP port erişimidir. İkisi de container içinde başarılıysa TLS ve authentication aşamasına geçilir. Diagnostic output timestamp ve container id ile kaydedilebilir. Aynı image farklı hostta çalışıyorsa host network configuration karşılaştırılır. Bu katmanlı yöntem random package update denemelerinden daha hızlı sonuç verir.
Kubernetes'ten MongoDB Atlas'a Bağlantı
Kubernetes Atlas bağlantısı DNS, pod egress, NAT, NetworkPolicy ve secret yönetimini aynı anda içerir. HPA replica sayısını değiştirdiği için connection budget klasik VM deployment'a göre daha dinamik olabilir. Private Endpoint kullanıldığında pod subnet'lerinin endpoint'e route'u ve DNS association'ı doğru olmalıdır. CoreDNS external SRV sorgularının reliability'si de kritiktir. Production cluster'da synthetic connectivity check ve driver pool metric'leri birlikte kullanılmalıdır.
CoreDNS
Pod dış domain resolution için çoğunlukla CoreDNS'e güvenir. CoreDNS upstream timeout MongoDB SRV hatası olarak application'a yansıyabilir. Replica capacity ve resource limit izlenmelidir. Private DNS forwarding rule Atlas private endpoint domain'ini doğru resolver'a göndermelidir. DNS failure application restart storm'a dönüşmemelidir.
Pod Egress
Pod public Atlas endpoint'e ulaşmak için node veya egress gateway üzerinden dışarı çıkmalıdır. CNI implementation source IP davranışını etkiler. Egress NetworkPolicy belirli destination'a izin vermelidir. Atlas Access List gerçek NAT source IP'yi içermelidir. Pod içinden network test yapılmadan node testine güvenilmemelidir.
NAT Gateway
Private Kubernetes node'ları public Atlas için NAT Gateway kullanabilir. Static egress IP Access List yönetimini kolaylaştırır. Çok yüksek connection churn NAT port ve connection tracking baskısı yaratabilir. Multi-AZ NAT design failover egress IP set'ini büyütür. Private Endpoint database trafiğini NAT'tan çıkarabilir.
NetworkPolicy
Kubernetes NetworkPolicy egress'i namespace veya pod seviyesinde sınırlayabilir. MongoDB Atlas hostname doğrudan policy engine tarafından desteklenmeyebilir ve IP ranges dinamik olabilir. Egress gateway veya provider-specific network control daha uygun olabilir. DNS trafiğine izin verilmesi de gerekir. Policy değişikliği deployment pipeline'da connectivity test ile doğrulanmalıdır.
Secret
MongoDB URI Kubernetes Secret olarak inject edilebilir. RBAC yalnız application service account'a read yetkisi vermelidir. Secret rotation rollout veya mounted file refresh davranışına göre planlanır. GitOps repository encrypted secret veya external secret reference kullanabilir. Plain connection string manifest içine yazılmamalıdır.
Private Endpoint
Atlas Private Endpoint dedicated cluster ve cloud provider virtual network arasında private path kurar. Pod subnet endpoint'e ulaşabilmeli ve private DNS doğru çözülmelidir. AWS tarafında endpoint security group port range gereksinimleri Atlas documentation'a göre uygulanmalıdır. Multi-region cluster her region için endpoint planı isteyebilir. Endpoint health cluster readiness'den ayrı monitor edilmelidir.
Pod Autoscaling
HPA database connection count'un en önemli deployment çarpanlarından biridir. Her pod kendi pool'unu oluşturur. Scale-out sırasında min pool ve maxConnecting aynı anda connection spike üretir. HPA maximum replica connection budget ile uyumlu olmalıdır. Scale test P95 HTTP latency yanında Atlas Connections metric'ini de gözlemlemelidir.
Kubernetes HPA Connection Explosion Nasıl Oluşturabilir?
HPA yüksek application latency veya CPU gördüğünde pod sayısını artırır. Her yeni pod kendi MongoClient pool'unu açtığı için database connection sayısı da yükselir. Eğer latency'nin gerçek nedeni MongoDB'deki slow query ise daha fazla pod database'e daha fazla parallel query göndererek problemi büyütebilir. Deployment surge ek geçici replica'lar üretir. Bu nedenle HPA maximum replica, pool size ve Atlas tier tek connection budget içinde değerlendirilmelidir.
Replica Sayısı
Replica sayısı connection pool sayısının doğrudan çarpanıdır. Normal üç pod ile peak yirmi pod farklı budget gerektirir. HPA minimum değil maximum değeri capacity planında kullanılmalıdır. Historical scaling graph gerçek peak'i gösterir. Yeni product launch öncesi expected replica sayısı güncellenmelidir.
Her Pod'un Ayrı Pool'u
Pod'lar memory paylaşmadığı için tek global MongoClient yoktur. Her process kendi pool ve monitoring connection'larını açar. Aynı Kubernetes Service altında olmaları bunu değiştirmez. Pool size application config üzerinden pod başına uygulanır. Global connection hedefi replica sayısına bölünerek per-pod üst sınır seçilebilir.
Deployment Sırasında Surge Pods
Rolling update `maxSurge` ile geçici olarak fazladan pod başlatabilir. Eski pod'lar drain olurken yeniler pool warm-up yapar. Normal HPA max değeri ile surge birlikte daha yüksek effective replica sayısı oluşturabilir. Connection budget deployment maximum concurrent pod sayısını kullanmalıdır. Graceful shutdown eski pool'ların daha erken kapanmasına yardımcı olur.
maxPoolSize × Pod Sayısı
Bu çarpım basit ama güçlü ilk risk göstergesidir. Örneğin 20 pod ve 50 pool teorik 1000 application connection potansiyeli oluşturur. Topology server sayısı ve monitoring connection'ları ek etki yaratır. Gerçek kullanım daha düşük olabilir, fakat failure scenario maximuma yaklaşabilir. Alert threshold bu theoretical budget'ın güvenli bölümünde konumlandırılmalıdır.
HPA Maximum Replica
HPA max yalnız compute cost kontrolü değil database protection mekanizmasıdır. Unlimited scale shared database'i aşırı yükleyebilir. Maximum değeri peak traffic model ve Atlas throughput ile belirlenmelidir. Queue-based workload'da backlog scale ederken database concurrency ayrıca limiter ile sınırlandırılabilir. Capacity review HPA değişikliğinin onay sürecine eklenebilir.
Connection Budget
Connection budget bütün pod, worker, background job ve monitoring socket'leri kapsayan toplam hedeftir. Atlas hard limitinden güvenli headroom çıkarılarak application bütçesi belirlenebilir. Farklı servisler bu budget'tan quota alabilir. Observed connection usage quota'ya göre dashboard'da gösterilebilir. Yeni servis cluster'a bağlanmadan önce capacity review yapılmalıdır.
Graceful Shutdown ile MongoDB Connection Yönetimi
Graceful shutdown deployment sırasında connection churn ve failed request sayısını azaltır. SIGTERM alındığında pod hemen process exit yapmamalıdır. Önce readiness kapatılır, yeni request kabulü durdurulur ve mevcut işler tamamlanır. Sonra MongoClient kontrollü biçimde kapatılır. Kubernetes termination grace period bu sıranın tamamlanmasına yeterli süre vermelidir.
SIGTERM
Kubernetes pod sonlandırırken container'a SIGTERM gönderir. Node.js process bu signal için handler tanımlayabilir. Handler idempotent olmalıdır, çünkü shutdown birden fazla kaynaktan tetiklenebilir. Hard timeout sonunda SIGKILL gelebilir. Shutdown logları başlangıç ve bitiş timestamp'i içermelidir.
Readiness'i Kapatmak
Shutdown başlarken readiness false yapılır. Load balancer pod'u yeni request hedefi olarak seçmemeye başlar. Endpoint removal propagation birkaç saniye sürebilir. Bu nedenle process hemen kapanmamalıdır. Readiness liveness ile aynı endpoint olsa bile semantics ayrı uygulanmalıdır.
Yeni Request Kabulünü Durdurmak
HTTP server `close()` benzeri mekanizmayla yeni connection kabulünü durdurabilir. Keep-alive connection'lar kontrollü biçimde drain edilmelidir. Queue consumer yeni message fetch etmeyi bırakmalıdır. Background scheduler shutdown flag'e uymalıdır. Yeni iş gelmediğinde in-flight operation sayısı hızla sıfıra iner.
In-Flight İşlemleri Tamamlamak
Aktif request'lere sınırlı süre verilir. Sonsuz query shutdown'ı bloke etmemelidir. Request deadline mevcut olduğundan drain süresi öngörülebilir. Timeout sonrası kalan operation cancel veya process exit ile sonlandırılabilir. Business transaction recovery modeli yarım kalan işleri ele almalıdır.
MongoClient Close
In-flight workload tamamlandıktan sonra `client.close()` çağrılır. Driver idle sockets'i kapatır ve kullanımda olanları operation tamamlandıkça serbest bırakır. Shutdown sırasında yeni database operation başlatılmamalıdır. Close error loglanabilir fakat process sonsuza kadar beklememelidir. Connection count deployment sonrası eski pod'lar kapandıkça düşmelidir.
Kubernetes Termination Grace Period
Grace period application'ın drain ve client close süresinden uzun olmalıdır. Çok kısa değer SIGKILL ile connection'ların abrupt kapanmasına neden olur. Çok uzun değer stuck pod deployment'ı gereksiz yavaşlatabilir. P99 request duration ve shutdown metric kullanılarak uygun süre seçilebilir. PreStop hook gerekiyorsa readiness propagation behavior ile birlikte test edilmelidir.
Atlas Public Connection mı Private Connection mı?
Public Atlas bağlantısı doğru IP Access List ve TLS ile birçok production workload için güvenli biçimde kullanılabilir. Private connection ise database trafiğini public internet yerine cloud provider private network path'i üzerinden taşımayı sağlar. Security gereksinimi yüksek kurumlar private endpoint'i tercih edebilir. Bunun karşılığında private DNS, endpoint availability ve ek maliyet yönetilir. Seçim compliance, network architecture, operasyon kapasitesi ve cost birlikte değerlendirilerek yapılmalıdır.
Public IP + Access List
Public endpoint kullanıldığında application egress IP Atlas project Access List içinde bulunur. TLS yine zorunlu güvenlik sağlar. Static NAT dar `/32` rules kullanımını kolaylaştırır. Setup private endpoint'e göre daha basittir. Dynamic serverless egress bu modeli zorlaştırabilir.
VPC/VNet Peering
Network peering application virtual network ile Atlas network arasında private routing sağlar. Dedicated cluster'larda kullanılabilir. CIDR overlap peering'in önemli tasarım kısıtlarından biridir. Route table ve DNS configuration doğru olmalıdır. Peering trust boundary private endpoint'ten daha geniş olabilir.
Private Endpoint
Private Endpoint application VPC veya VNet içinde Atlas service'e özel private interface sunar. AWS PrivateLink, Azure Private Link ve GCP Private Service Connect desteklenen provider teknolojileridir. Connection tek yönlü private access modeli sunar. Dedicated cluster gerektirir. Endpoint başına cloud ve Atlas maliyetleri bulunabilir.
Security
Public bağlantıda saldırı yüzeyi Access List ve credential ile sınırlanır. Private endpoint public route ihtiyacını azaltarak network exposure'ı daha fazla daraltır. İki modelde de TLS ve least-privilege authentication korunmalıdır. Private network tek başına database authorization yerine geçmez. Security model defense-in-depth olarak tasarlanmalıdır.
Operasyonel Karmaşıklık
Private connectivity ek DNS zone, endpoint lifecycle, security group ve multi-region routing sorumluluğu getirir. Public Access List static egress ile daha basit olabilir. Ekip cloud networking konusunda yeterli gözlemlenebilirliğe sahip değilse private incident süreleri uzayabilir. Infrastructure as Code bu yükü azaltır. Seçim yalnız security checklist değil gerçek operasyon yetkinliği üzerinden de yapılmalıdır.
Cost
Private endpoint provider ve Atlas tarafında saatlik veya data processing maliyeti oluşturabilir. NAT Gateway public traffic de kendi maliyetini taşır. Multi-region architecture endpoint sayısını artırabilir. Network data transfer pricing ayrıca hesaba katılmalıdır. Toplam cost security ve reliability faydasıyla birlikte değerlendirilmelidir.
Hangi Ortamda Hangisi?
Development küçük ekip için dar Access List ile public connection yeterli olabilir. Regüle production workload private endpoint gerektirebilir. Serverless platform private network desteği sınırlıysa static egress seçeneği pratik olabilir. Multi-cloud sistem her provider için farklı private connectivity modeli isteyebilir. Architecture decision environment ve data sensitivity bazında alınmalıdır.
MongoDB Atlas Private Endpoint
Atlas Private Endpoint dedicated cluster'ları cloud provider'ın private connectivity servisi üzerinden application network'üne bağlar. AWS PrivateLink, Azure Private Link ve GCP Private Service Connect desteklenir. Uygulama public IP üzerinden Atlas'a çıkmak zorunda kalmaz. DNS Atlas tarafından endpoint-aware connection string'e göre private adreslere çözülür. High availability için region ve availability zone planı cloud topology ile birlikte yapılmalıdır.
AWS PrivateLink
AWS tarafında Atlas private endpoint service ile application VPC içindeki interface endpoint arasında PrivateLink bağlantısı kurulur. Interface endpoint private IP'ler taşır. Security group application kaynaklarının gerekli portlara erişmesine izin vermelidir. Atlas DNS seedlist connection string port değişikliklerini daha güvenli yönetir. Multi-region cluster için endpoint region coverage tamamlanmalıdır.
Azure Private Link
Azure Private Link Atlas'a VNet üzerinden private endpoint erişimi sağlar. Private DNS zone hostname'i endpoint private IP'sine çözmelidir. Network security group ve route configuration kontrol edilir. Multi-region deployment region bazında tasarlanmalıdır. Atlas UI ve Azure portal endpoint status'ları birlikte doğrulanmalıdır.
GCP Private Service Connect
GCP Private Service Connect Atlas service'e private forwarding path sağlar. Private endpoint'ler dedicated cluster'larda kullanılabilir. GCP tarafında forwarding rule private IP ve Atlas'ın kullandığı port aralığına network izinleri gerekir. Multi-region cluster için gerekli region endpoint'leri oluşturulmalıdır. DNS çözümünün ilgili private IP'leri döndürdüğü test edilmelidir.
Private IP
Private endpoint hostname RFC1918 veya provider private address'lerine çözülür. Bu IP public internet üzerinden route edilmez. Application aynı VPC, peered network veya desteklenen transit path üzerinden erişmelidir. DNS doğru private IP döndürse bile route bulunmuyorsa TCP timeout oluşur. IP'yi connection string'e hard-code etmek yerine Atlas hostname kullanılmalıdır.
Private DNS
Private DNS connection string hostname'ini endpoint-specific private IP'ye çözer. VPC/VNet association yanlışsa application public veya NXDOMAIN sonucu alabilir. On-prem resolver conditional forwarding ile private cloud DNS'e yönlendirilmelidir. SRV ve CNAME zinciri birlikte test edilmelidir. DNS configuration endpoint lifecycle'ın ayrılmaz parçasıdır.
Dedicated Cluster Gereksinimi
Atlas private endpoint özelliği dedicated cluster'lar için desteklenir. Free ve Flex cluster'larda bu capability bulunmaz. Environment architecture private connectivity zorunluysa cluster tier seçimi baştan buna göre yapılmalıdır. Sonradan private endpoint'e geçiş network ve connection string migration gerektirir. Cost plan dedicated tier ve endpoint ücretlerini birlikte kapsamalıdır.
Private Endpoint DNS Sorunları
Private Endpoint kurulumu tamamlanmış görünse bile DNS yanlışsa application endpoint'e ulaşamaz. Önce Atlas ve cloud provider endpoint status'ları kontrol edilir. Ardından private DNS zone association ve SRV çözüm zinciri doğrulanır. Connection hostname'in RFC1918 private IP'lere ulaştığı görülmelidir. On-prem environment kullanılıyorsa conditional forwarding ayrıca test edilmelidir.
Endpoint Status
Atlas private endpoint state Available benzeri hazır durumda olmalıdır. Cloud provider interface endpoint de accepted ve available olmalıdır. Tek tarafta hazır görünmek bağlantının tamamlandığını garanti etmez. Provisioning sırasında DNS kaydı henüz publish edilmemiş olabilir. Infrastructure automation status ready olmadan application rollout başlatmamalıdır.
Private DNS Zone
Private DNS zone ilgili VPC veya VNet'e bağlı olmalıdır. Yanlış subscription veya project içinde oluşturulmuş zone application network tarafından görülmeyebilir. Record conflict public resolution'ı override edebilir. DNS query hangi resolver ve zone'dan cevap geldiğini göstermelidir. Zone değişiklikleri Infrastructure as Code ile yönetilmelidir.
VPC/VNet Association
DNS zone yalnız bağlı virtual network'lerde geçerlidir. Application başka VPC'den transit olarak geliyorsa DNS association ayrıca gerekebilir. Peering DNS forwarding behavior provider'a göre değişir. Route mevcut fakat DNS public IP döndürüyorsa connection yanlış path'e gider. Association listesi architecture diagram ile uyumlu tutulmalıdır.
SRV Record
Private connection string kendi SRV hostname'ini kullanır. Public cluster SRV ile karıştırılmamalıdır. `dig SRV` sonucu private endpoint-specific host ve portlar gösterebilir. Multi-region configuration eksikse Atlas bazı private SRV kayıtlarını yayınlamayabilir. Connection string Atlas'tan yeniden alınarak test edilmelidir.
CNAME
Private endpoint-aware hostname CNAME üzerinden provider endpoint DNS adına yönlenebilir. CNAME zincirinin sonunda private IP beklenir. Intermediate record yanlış zone'a gidiyorsa resolution başarısız olabilir. `dig +trace` private DNS ortamında her zaman tam çalışmayabilir, fakat explicit CNAME lookup yardımcıdır. Record'u elle override etmek yerine endpoint configuration düzeltilmelidir.
RFC1918 IP Resolution
Private endpoint DNS sonucunda `10.0.0.0/8`, `172.16.0.0/12` veya `192.168.0.0/16` gibi private adresler görülebilir. Bu adres application network'ünden route edilebilmelidir. Public laptop'tan aynı IP'ye erişememek normal olabilir. Diagnostic pod endpoint VPC içinde çalıştırılmalıdır. Route table ve security group TCP test ile birlikte doğrulanır.
On-Premises DNS Forwarding
On-prem application private endpoint kullanıyorsa internal resolver cloud private DNS zone'a conditional forward yapmalıdır. Route Direct Connect, VPN veya peering üzerinden sağlanabilir. Public resolver private record'u bilmez. DNS ve network ekiplerinin configuration'ı birlikte gerekir. Disaster recovery region için forwarding rule ayrıca test edilmelidir.
VPC Peering Sorun Giderme
Peering private routing sağlasa da yalnız connection object oluşturmak yeterli değildir. Peering state active olmalı, CIDR blokları çakışmamalı ve iki taraf route table'ları doğru network'leri bilmelidir. Security group ve DNS de ayrı katmanlardır. Transitive peering birçok provider'da doğrudan desteklenmez. Application packet path architecture diagram üzerinden adım adım kontrol edilmelidir.
Peering Status
Atlas ve cloud provider tarafında peering active görünmelidir. Pending acceptance veya failed state route oluşmasını engeller. Infrastructure automation status kontrolü yapmalıdır. Manual console değişiklikleri drift oluşturabilir. Incident sırasında son peering config değişikliği audit logdan incelenir.
CIDR Overlap
İki VPC aynı veya çakışan private CIDR kullanıyorsa routing ambiguous olabilir. Atlas peering tasarımında CIDR planı baştan yapılmalıdır. Sonradan network genişletme overlap yaratabilir. Route table yalnız specific prefix'e göre çalışır. Büyük organizasyon merkezi IPAM sistemi kullanarak bu riski azaltabilir.
Route Tables
Application subnet Atlas CIDR'a route taşımalıdır. Atlas tarafında dönüş route'u peering configuration tarafından yönetilir. Custom route daha specific prefix ile trafiği başka gateway'e gönderebilir. Flow log packet'in hangi interface'e gittiğini gösterebilir. Route değişikliği security group açmakla çözülemez.
Security Groups
Application instance outbound ve gerekli Atlas network policy birlikte çalışmalıdır. Peering kullanıldığında Atlas IP Access List veya security group integration provider modeline göre uygulanabilir. Yanlış source CIDR route açık olsa bile TCP'yi engeller. Security group rule minimum gerekli port ve source ile sınırlandırılmalıdır. Rule test sonrası gereksiz geniş bırakılmamalıdır.
DNS
Peering private hostname resolution için DNS configuration gerekebilir. Public Atlas hostname public IP döndürürken private peering connection string farklı olabilir. Atlas Connect ekranı uygun URI'yi sağlar. On-prem forwarding veya VPC DNS setting'leri doğrulanmalıdır. `dig` sonucu route architecture ile uyumlu olmalıdır.
Transitive Peering Sınırlamaları
VPC A Atlas'a peered diye VPC B'nin A üzerinden otomatik Atlas'a erişeceği varsayılmamalıdır. Cloud peering çoğu durumda transitive routing sağlamaz. Transit gateway veya private endpoint gibi alternatif architecture gerekebilir. Network diagram actual packet route'u göstermelidir. Yeni region eklenirken bu sınırlama yeniden değerlendirilmelidir.
Multi-Region Atlas Bağlantı Tasarımı
Multi-region architecture latency ve availability arasında yeni kararlar getirir. Application region ile Atlas node region yakınlığı network round trip'i doğrudan etkiler. Private endpoint her region için tasarlanabilir. Read preference local secondary üzerinden read latency'yi azaltabilir, fakat consistency requirement değişir. Failover sırasında application'ın uzak region primary'sine ulaşabildiği chaos test ile doğrulanmalıdır.
Application Region
Application compute database'e mümkün olduğunca yakın region'da çalıştırılmalıdır. Cross-region her query ek round trip maliyeti taşır. Kullanıcı global olsa bile backend data placement architecture ile birlikte düşünülmelidir. Multi-region active-active app connection count'u region sayısıyla artırabilir. Region başına pool budget ayrı hesaplanmalıdır.
Atlas Region
Atlas primary ve secondary placement application latency ve disaster recovery hedeflerini etkiler. Write-heavy workload primary'ye yakın compute'tan faydalanır. Secondary region read traffic için kullanılabilir. Cloud provider egress cost cross-region communication'da artabilir. Region değişikliği connection SLO benchmark ile doğrulanmalıdır.
Network Latency
Cross-region RTT query duration'ın minimum tabanını yükseltir. Her operation birden fazla network round trip gerektirebilir. Connection establishment TLS handshake sırasında da etkilenir. Pool reuse latency'yi tamamen ortadan kaldırmaz ama handshake tekrarını azaltır. P95 network RTT synthetic check ile sürekli izlenebilir.
Regional Private Endpoint
Multi-region cluster private connectivity kullanıyorsa ilgili regionlarda endpoint oluşturulması gerekebilir. Atlas regionalized private endpoint özelliği belirli sharded cluster senaryolarında kullanılabilir. Application mümkün olduğunca local endpoint üzerinden bağlanabilir. DNS region-aware connection string davranışı test edilmelidir. Endpoint failure başka regiona geçiş planı ile birlikte değerlendirilmelidir.
Read Preference
Read preference region tag'leri ve latency seçim mekanizmasıyla local read sağlayabilir. `nearest` veya secondary preference consistency trade-off taşır. Stale data kabul edilmeyen flow primary kullanmalıdır. Connection pool her selected region server'ında büyüyebilir. Metric region bazında izlenmelidir.
Failover
Primary başka regiona geçtiğinde network latency ve private route değişebilir. Application bütün eligible region endpoint'lerine erişebilmelidir. DNS ve firewall yalnız normal primary region'a göre kurulmuşsa disaster recovery çalışmaz. Planned failover test gerçek bağlantı yolunu doğrular. Recovery time SLO ve user impact kaydedilmelidir.
Sharded Cluster Connection Optimization
Sharded cluster'da application doğrudan shard replica setlerine değil `mongos` router katmanına bağlanır. Driver birden fazla mongos endpoint'i keşfedebilir ve her biri için connection pool oluşturabilir. Router sayısı arttıkça connection fan-out büyüyebilir. AWS Private Endpoint kullanan uygun Atlas sharded cluster'larda optimize SRV connection string load balancer üzerinden bu fan-out'u azaltabilir. Cluster topology ve driver compatibility connection planning'in merkezinde olmalıdır.
mongos
`mongos` application query'lerini doğru shard'lara yönlendiren stateless router'dır. Sharded Atlas deployment birden fazla mongos instance içerebilir. Driver topology bu router'lara connection açabilir. Her mongos connection limitine sahip olabilir. Router availability ve latency ayrı metric olarak takip edilmelidir.
Driver Topology
Driver seed list üzerinden mongos'ları keşfeder ve uygun router'a operation gönderir. Bir router unavailable olduğunda diğerine geçebilir. Çok geniş router listesi her application client'ın daha fazla pool oluşturmasına yol açabilir. `srvMaxHosts` veya Atlas optimized connection modeli belirli workload'larda fan-out'u azaltabilir. Driver event'leri topology member count'u gösterir.
Connection Pool per mongos
Her mongos için ayrı pool oluşabildiğinden toplam connection sayısı `maxPoolSize` ile router sayısının çarpımına yaklaşabilir. Birden fazla application instance bunu daha da büyütür. Connection budget sharded cluster'a geçildiğinde yeniden hesaplanmalıdır. Pool'ların tamamı max kapasiteye ulaşmayabilir. Atlas connection graph router bazında incelenmelidir.
Connection Fan-Out
Fan-out application instance'ın birden fazla router veya server'a aynı anda connection açmasıdır. Cluster büyüdükçe bu sayı beklenmedik seviyeye çıkabilir. Connection storm sırasında handshake yükü de fan-out ile çoğalır. Optimized SRV veya `srvMaxHosts` yalnız desteklenen Atlas guidance doğrultusunda kullanılmalıdır. Routing resilience ile connection azaltma arasında denge vardır.
Private Endpoint
AWS private endpoint sharded cluster'ı endpoint service arkasından erişilebilir hâle getirebilir. Atlas optimize SRV belirli koşullarda load balancer hedefleri üzerinden daha az connection fan-out sunar. Azure ve GCP için aynı optimized connection özelliği desteklenmeyebilir. Provider-specific documentation takip edilmelidir. Endpoint port range ve security group kuralları ayrıca uygulanmalıdır.
Optimized SRV Connection String
Atlas uygun AWS sharded private endpoint cluster için optimize SRV URI üretebilir. Bu URI genellikle hostname içinde `lb` göstergesi taşır. Amaç application ile mongos katmanı arasındaki connection sayısını azaltmaktır. Minimum driver version ve cluster koşulları sağlanmalıdır. Legacy URI'den geçiş staging ve failover testiyle yapılmalıdır.
MongoDB Atlas Optimized SRV Connection String Nedir?
Optimized SRV connection string Atlas'ın AWS private endpoint arkasındaki belirli sharded cluster'lar için ürettiği bağlantı biçimidir. Load balancer katmanından yararlanarak client'ın her mongos router'a ayrı ayrı çok sayıda connection açma ihtiyacını azaltmayı hedefler. Feature MongoDB 5.0+ ve desteklenen driver gibi belirli ön koşullar taşır. Multi-region kullanımında regionalized private endpoint şartları ayrıca devreye girebilir. URI yalnız Atlas Connect ekranından alınmalı ve manual olarak dönüştürülmemelidir.
AWS Private Endpoint
Optimize SRV bugün Atlas documentation'a göre AWS PrivateLink private endpoint senaryosunda desteklenir. Azure veya GCP private endpoint'te aynı optimization sunulmaz. AWS endpoint service load balancer connection modelinin temelidir. Application VPC endpoint security group doğru port range'e izin vermelidir. Feature seçimi cloud provider constraint'ini dikkate almalıdır.
Sharded Cluster
Optimize connection string replica set değil sharded cluster connection fan-out problemini hedefler. Cluster MongoDB sürümü ve topology requirement'ları Atlas tarafından kontrol edilir. Atlas şartları sağlandığında Connect ekranında optimized URI sunabilir. Legacy URI desteklenmeye devam edebilir. Migration gereksizse normal Atlas-provided URI kullanılmalıdır.
Load Balancer
Load balancer application connection'larını uygun mongos hedeflerine yönlendirir. Client daha az addressable target ile çalışabilir. Connection spike sırasında router başına connection count daha kontrollü olabilir. Load balancer mode driver compatibility gerektirir. Monitoring serviceId gibi driver event alanları load-balanced topology'de önem kazanabilir.
mongos Başına Connection Sayısını Azaltmak
Legacy private endpoint bağlantısı çok sayıda mongos ile her client'ta yüksek fan-out oluşturabilir. Optimized SRV load balancer kullanarak bu dağılımı azaltmayı hedefler. Özellikle çok shard ve çok application instance bulunan sistemde fark büyüyebilir. Before-after Atlas Connections metric ile doğrulanmalıdır. Query routing semantics aynı application code açısından korunmalıdır.
Legacy SRV ile Farkı
Legacy SRV router endpoint'lerini daha doğrudan seed list içinde sunabilir. Optimized URI load balancer-aware hostname kullanır. Atlas uygun cluster'da iki seçeneği bir süre birlikte gösterebilir. URI formatını kendiniz değiştirerek optimized mode'a geçilmemelidir. Driver ve endpoint requirements sağlandığı doğrulanmalıdır.
Kullanım Öncesi Driver Compatibility
Optimized connection string load-balanced connection behavior destekleyen minimum driver sürümü gerektirir. Atlas Connect ekranı güncel client guidance sağlar. EOL driver ile deneme yapmak production riskidir. Upgrade staging environment'ta query, transaction ve failover testleriyle doğrulanmalıdır. Driver inventory migration planına dahil edilmelidir.
Connection Problemi mi Query Problemi mi?
En etkili ayrım request latency'yi connection establishment, pool checkout, server selection, network round trip ve query execution bölümlerine ayırmaktır. DNS ve TCP hızlı, checkout bekliyor ve query yavaşsa problem network değildir. Checkout hızlı ama query execution uzun sürüyorsa database planı incelenir. Server selection uzun sürüyorsa topology veya connectivity öne çıkar. Bu ayrım problem çözme süresini dramatik biçimde azaltır.
Connection Establishment Latency
Yeni connection'ın created event'inden ready event'ine kadar geçen süre DNS dışındaki TCP, TLS ve authentication maliyetini gösterebilir. Startup veya storm sırasında yükseliyorsa network ve handshake pressure düşünülebilir. Steady-state'te connection reuse nedeniyle bu süre user request'lerin küçük bölümünde görünmelidir. Sürekli yeni connection kuruluyorsa churn vardır. Metric P95 olarak SLO'ya eklenebilir.
Pool Checkout Latency
Operation connection istemeye başladığı an ile checked-out event arasındaki süre pool pressure'ı gösterir. Sıfıra yakınsa pool yeterli capacity sunar. Uzun süre query başlamadan önce application bekliyor demektir. `waitQueueTimeoutMS` bu aşamada sınır koyar. Query duration ile birlikte yorumlanmalıdır.
Query Execution Latency
Command started ve succeeded event arasındaki süre database operation latency hakkında sinyal verir. Network round trip de bu sürenin içindedir. Query profiler server-side execution hakkında ek ayrıntı sağlar. Aynı query shape'in latency değişimi index veya data growth problemini gösterebilir. Pool tuning bu süreyi doğrudan düşürmez.
Network Round Trip
Application ile Atlas region arasındaki RTT her database interaction'ın taban maliyetini etkiler. Multi-region veya public internet route değişimi latency artışı oluşturabilir. Synthetic TCP/TLS check sürekli ölçülebilir. Query server execution kısa ama total duration yüksekse network güçlü adaydır. Region placement architecture ile çözülmelidir.
Server Selection
Suitable server hemen bulunuyorsa selection latency düşük olur. Failover veya partial network partition bunu yükseltir. Driver SDAM event timestamp'leri selection problemi hakkında context sağlar. Server selection timeout error olmadan önce de latency artışı yaşanabilir. Metric ayrı ölçülürse failover user impact'i görünür olur.
Ayrı Ayrı Ölçmek
Tek “MongoDB duration” metric bu katmanları birbirine karıştırır. OpenTelemetry span veya driver event'leri connection, checkout ve command aşamalarına ayrılabilir. Sensitive query values tracing'e eklenmemelidir. Dashboard aynı request flow'un breakdown'ını göstermelidir. Optimization en büyük latency bileşenine odaklanmalıdır.
Atlas'ta Hangi Connection Metrikleri İzlenmeli?
Atlas Connections chart temel başlangıçtır, fakat connection limit yüzdesi, creation rate ve network traffic ile birlikte yorumlanmalıdır. Active connection application-side checked-out metric ile karşılaştırılabilir. Request count artmadan connection sayısı yükseliyorsa leak veya pool configuration problemi düşünülebilir. Network bytes değişimi data transfer trendini gösterir. Metric threshold sabit sayıdan çok historical baseline ve cluster tier headroom üzerinden ayarlanmalıdır.
Total Connections
Total open connections cluster veya host üzerindeki genel connection yükünü gösterir. Baseline deployment replica sayısıyla birlikte değerlendirilmelidir. Geceleri traffic düşükken connection yüksek kalıyorsa idle pool'lar olabilir. Sudden spike deployment veya storm göstergesidir. Hard limite yaklaşmadan önce alert verilmelidir.
Connections % of Limit
Percentage metric cluster tier capacity'ye göre connection headroom'u anlaşılır hâle getirir. Atlas alert koşulları configured limit yüzdesi üzerinden tanımlanabilir. Yüzde seksene yaklaşmak bazı workload'larda erken capacity review için uygun olabilir. Exact threshold business ve burst profile'a göre seçilir. Scale-up sonrası percentage düşse bile absolute connection trend takip edilmelidir.
Active Connections
Active connection gerçek iş yükü ile idle baseline'ı ayırmaya yardımcı olur. Total yüksek, active düşükse min pool veya fazla client sayısı incelenir. Active ve query latency birlikte yüksekse database pressure olabilir. Node distribution read preference'i gösterir. Metric sampling granularity kısa spike'ları kaçırabilir, driver event telemetry bunu tamamlar.
Connection Creation Rate
Atlas veya application-side totalCreated delta yeni connection churn'ünü gösterir. Steady traffic altında düşük ve stabil olması beklenir. Yüksek creation rate idle timeout, network reset veya yanlış client lifecycle işareti olabilir. Deployment anındaki kısa burst normal kabul edilebilir. Rate alert baseline deviation üzerinden kurulabilir.
Network Bytes In
Network bytes in client'tan database'e gelen trafik hacmini gösterir. Bulk write veya büyük query payload'ı artışı connection issue ile aynı anda görülebilir. Yüksek network tek başına problem değildir. Bandwidth saturation latency'yi etkileyebilir. Application request count ile normalize etmek data size değişimini gösterir.
Network Bytes Out
Network bytes out database'in client'lara gönderdiği data miktarını gösterir. Büyük result set connection'ı daha uzun süre kullanımda tutabilir. Pagination veya projection eksikliği query latency ve network maliyetini artırabilir. Per-request bytes telemetry faydalıdır. Cross-region transfer cost da bu metric'ten etkilenir.
Request Count
Operation veya request rate connection ve query metric'lerini trafik hacmine göre normalize etmek için gereklidir. Connection sayısı iki katına çıktıysa traffic de iki katına çıkmış olabilir. Traffic sabitken connection spike daha şüphelidir. Request type dağılımı read ve write workload değişimini gösterir. Release sonrası aynı user traffic'in daha fazla database call üretip üretmediği izlenmelidir.
Driver Connection Pool Event'leri
Node.js driver connection pool monitoring event'leri pool'un içindeki davranışı görünür kılar. Connection creation, ready, checkout, checkin, failure ve pool clear event'leri production incident analysis için çok değerlidir. Bu event'leri doğrudan yüksek hacimli log'a çevirmek yerine metric ve sampled trace olarak kullanmak daha verimlidir. Checkout duration pool saturation'ı, ready duration establishment latency'yi gösterir. Pool cleared event failover veya connection error dönemleriyle korele edilebilir.
Connection Created
`connectionCreated` yeni connection object oluşturulduğunda emit edilir. Connection henüz handshake tamamlayıp operation'a hazır olmayabilir. Event rate pool growth veya churn'ü gösterir. Deployment sırasında beklenen spike baseline olarak kaydedilebilir. Sürekli yüksek rate connection reuse problemine işaret eder.
Connection Ready
`connectionReady` connection handshake tamamlayıp kullanıma hazır olduğunda emit edilir. Created ile Ready timestamp farkı establishment duration sağlar. TLS veya authentication yavaşlığı bu sürede görülür. P95 duration network health SLO'suna eklenebilir. Failure varsa created event'in ready ile tamamlanmama oranı izlenebilir.
Connection Closed
`connectionClosed` socket pool'dan çıkarıldığında oluşur ve reason bilgisi taşıyabilir. Idle timeout, pool close veya error gibi nedenler ayrıştırılabilir. Creation ve closure rate birlikte churn metric oluşturur. High closure rate network appliance idle timeout'a işaret edebilir. Expected graceful shutdown closure incident olarak sayılmamalıdır.
Connection Checked Out
`connectionCheckedOut` operation'ın pool'dan connection aldığını gösterir. Concurrent checked-out sayısı gerçek application database concurrency'sine yakındır. Started ile checked-out arasındaki duration pool wait ölçümü sağlar. Count maxPoolSize'a uzun süre dayanıyorsa saturation vardır. Endpoint veya query type ile label cardinality kontrollü tutulmalıdır.
Connection Checked In
Operation tamamlandığında connection pool'a geri döner ve checked-in event oluşur. Checked-out ile checked-in arasındaki süre connection hold duration için sinyal olabilir. Query command duration ile birlikte yorumlanır. Missing checkin event driver error veya connection close ile açıklanabilir. Metric state machine double-count riskine karşı dikkatle uygulanmalıdır.
Checkout Failed
`connectionCheckOutFailed` request'in pool'dan connection alamadığını gösterir. Wait queue timeout veya pool closure gibi reason bulunabilir. Error rate kullanıcı latency probleminden önce yükselmeye başlayabilir. Alert production threshold üzerinden kurulabilir. Root cause pool size, slow query veya topology event'leriyle araştırılır.
Pool Cleared
`connectionPoolCleared` driver'ın belirli server pool'undaki connection'ları temizlediğini gösterir. Failover veya network error sonrası görülebilir. Çok sık pool clear connection storm ve latency üretir. SDAM heartbeat failure aynı timestamp'te aranmalıdır. Driver upgrade regression'ı karşılaştırmak için önemli metriktir.
Server Discovery Monitoring Event'leri
SDAM event'leri driver'ın MongoDB topology'sini nasıl gördüğünü kaydeder. Server opening ve description change event'leri primary election veya network partition teşhisinde değerlidir. Heartbeat failure belirli host'a connectivity problemini gösterebilir. Topology changed event failover recovery süresinin ölçülmesine yardımcı olur. Connection pool event'leriyle aynı trace veya timeline'da kullanıldığında application'ın cluster değişikliğine nasıl tepki verdiği netleşir.
Server Opening
Driver topology içinde yeni server için monitoring başladığında server opening event görülebilir. Startup ve topology expansion sırasında normaldir. Beklenmedik sık opening connection churn gösterebilir. Address alanı hangi hostun etkilendiğini gösterir. Secret connection string event log'a yazılmamalıdır.
Server Closed
Server topology monitoring'den çıkarıldığında closed event oluşur. Client shutdown sırasında normaldir. Runtime ortasında sık tekrarlanıyorsa DNS veya network instability olabilir. Atlas maintenance event timeline ile karşılaştırılmalıdır. Server address distribution region-specific problemi ortaya çıkarabilir.
Server Description Changed
Server Secondary'den Primary'ye veya Unknown'a geçtiğinde description changed event oluşur. Election recovery'nin en açık client-side sinyallerindendir. Eski ve yeni description structured metric'e dönüştürülebilir. Çok sık role change cluster instability gösterebilir. Event sayısı normal maintenance pattern'iyle karşılaştırılmalıdır.
Topology Changed
Topology description changed event replica set veya mongos yapısındaki genel değişimi gösterir. Failover sırasında yeni primary görünmesi bu event'le izlenebilir. Application'ın usable server bulması için geçen süre SLO olarak ölçülebilir. High cardinality full topology object'i loglamak yerine gerekli state özetlenebilir. Incident sırasında full snapshot ayrı debug log olarak alınabilir.
Server Heartbeat Failed
Heartbeat driver'ın server health check request'idir. Failure belirli MongoDB instance'a ulaşım veya response problemine işaret eder. Aynı hostta TCP ve TLS synthetic test yapılabilir. Tek failure transient olabilir, ardışık failure daha anlamlıdır. Network flow log ve Atlas host status ile korele edilmelidir.
Failover Investigation
Failover incident'inde önce Atlas primary event timestamp'i alınır. Driver server description ve topology change zamanlarıyla karşılaştırılır. Ardından pool clear ve new connection ready event'leri incelenir. Son olarak user-facing error ve latency recovery zamanı hesaplanır. Bu zincir failover SLO'nun gerçek değerini verir.
Connection SLO Nasıl Oluşturulur?
Database availability yalnız query success rate ile ölçülmemelidir. Connection success rate, establishment P95, pool checkout P95 ve server selection failure oranı ayrı SLI olarak tanımlanabilir. Reconnect rate network stability hakkında sinyal verir. Connection headroom capacity riskini önceden gösterir. SLO kullanıcı experience'e bağlı threshold'larla belirlenmeli ve incident sonrası gerçek verilerle güncellenmelidir.
Connection Success Rate
Yeni connection attempt'lerinin ne kadarının ready durumuna ulaştığı ölçülebilir. Normal steady state'te attempt sayısı düşük olabilir. Deployment ve failover pencerelerinde oran daha anlamlıdır. DNS veya TLS failure success rate'i düşürür. Error reason dağılımı root cause trendini gösterir.
Connection Establishment P95
Created ile Ready arasındaki P95 süre kullanıcı cold-start deneyimini temsil eder. Region veya network path değişikliği bu değeri etkiler. P50 normal kalırken P95 storm sırasında yükseliyorsa burst capacity sorunu vardır. Threshold historical baseline üzerinden tanımlanmalıdır. Serverless cold ve warm metric ayrı tutulabilir.
Pool Checkout P95
Checkout P95 operation'ın database'e başlamadan ne kadar beklediğini gösterir. Yüksek değer pool saturation veya slow query etkisidir. User-facing latency ile yüksek korelasyon taşır. Alert timeout oluşmadan önce tetiklenebilir. Deployment replica artışı sonrası değer düşmüyor ve database CPU yükseliyorsa scale-out fayda sağlamamış olabilir.
Server Selection Failure Rate
Suitable server bulunamadığı için fail olan operation oranı availability SLI olabilir. Failover sırasında kısa spike error budget içinde kabul edilebilir. Sürekli düşük seviyeli failure partial network problemine işaret edebilir. Error reason DNS, topology ve timeout olarak ayrılmalıdır. Application-level retries sonrası user-visible failure ayrıca ölçülmelidir.
Reconnect Rate
Normal application uzun ömürlü connection'ları reuse ettiği için reconnect rate düşük olmalıdır. Firewall idle timeout veya network reset rate'i yükseltebilir. Deployment event'leri metric'ten ayrı label ile işaretlenebilir. High reconnect TLS handshake ve CPU maliyeti üretir. Trend artışı incident olmadan önce network health warning sağlayabilir.
Connections % Headroom
Configured connection limit ile mevcut kullanım arasındaki fark capacity SLI olarak kullanılabilir. Örneğin belirli minimum headroom yüzde hedefi tanımlanabilir. Autoscaling ve deployment surge bu alanı tüketir. Alert yalnız yüzde yüz limite ulaşıldığında değil güvenli eşik aşıldığında gelmelidir. Tier scale kararları forecast üzerinden planlanmalıdır.
Atlas Connection Alert'leri
Atlas connection ve host health alert'leri connection limitine ulaşmadan önce müdahale fırsatı sağlar. Connections ve Connections % of configured limit doğrudan capacity ile ilgilidir. Host down veya replica set has no primary availability riskidir. CPU, memory, network ve replication lag connection pressure'ın altında yatan database sorunlarını gösterebilir. Alert'ler tek tek değil aynı incident context içinde korele edilmelidir.
Connections
Connections alert belirli host üzerindeki connection sayısı threshold'u aştığında tetiklenebilir. Absolute sayı tier scale değişiminde yeniden ayarlanmalıdır. Baseline application replica artışıyla doğal büyüyebilir. Alert message service owner ve runbook link'i içermelidir. Auto-restart ilk müdahale olmamalıdır.
Connections % of Configured Limit
Percentage alert tier-specific hard limit değişse bile normalize edilmiş risk görünümü sağlar. Atlas bu condition'ı project alert configuration içinde sunar. Threshold normal peak'ten yüksek, safety headroom kaybolmadan düşük seçilmelidir. Alert geldiğinde application pool ve replica değişikliği ilk kontrol listesinde olmalıdır. Scale-up yalnız leak elendikten sonra düşünülmelidir.
Host Down
Host down replica member availability problemidir. Replica set diğer üyelerle service vermeye devam edebilir. Driver SDAM event hangi host'un unreachable olduğunu gösterebilir. Atlas maintenance veya cloud incident bilgisi kontrol edilir. Tüm hostların aynı anda etkilenmesi application network problemine de işaret edebilir.
Replica Set Has No Primary
Primary yoksa write operation yapılamaz ve primary read'ler bekler. Election sırasında kısa alert false positive ihtimali olabilir, bu yüzden after-waiting interval yapılandırılabilir. Süre uzuyorsa cluster ve network health incelenmelidir. Driver ReplicaSetNoPrimary error rate user impact'i gösterir. Failover recovery SLO bu alert ile birlikte ölçülebilir.
CPU
High CPU slow query ve connection hold duration artışına neden olabilir. Connection alert ile aynı anda CPU yükseliyorsa pool değil database compute bottleneck olabilir. Query Profiler en pahalı operation'ları gösterir. Scale-up veya index optimization kararı workload'a göre seçilir. CPU alert threshold sustained duration ile ayarlanmalıdır.
Memory
Working set memory'e sığmadığında disk I/O artabilir. Memory pressure database latency ve dolaylı pool saturation yaratır. Atlas managed environment cache ve memory metric'lerini sağlar. Application connection leak ile database memory metric aynı şey değildir. Query/index footprint capacity planına dahil edilmelidir.
Network
Network bytes veya latency spike büyük result set ve cross-region traffic sorunlarını gösterebilir. Connection storm handshake traffic'i de network activity artırır. Packet loss application tarafında ayrıca izlenmelidir. Cloud provider network incident Atlas status ile karşılaştırılır. Private endpoint ve public path metric'leri mümkünse ayrılmalıdır.
Replication Lag
Secondary read kullanan application replication lag nedeniyle stale data görebilir. Failover sırasında geride kalan secondary primary olmaya uygun olmayabilir. Heavy write workload lag'i artırabilir. Connection problemi olmasa da user consistency sorunu ortaya çıkar. Read preference ve max staleness policy business requirement'a göre ayarlanmalıdır.
Connection % Alert Geldiğinde Nasıl Müdahale Edilir?
Connection percentage alert geldiğinde ilk iş cluster tier yükseltmek olmamalıdır. Deployment, replica sayısı, traffic, pool config ve query latency son değişikliklerle birlikte kontrol edilmelidir. Connection sayısı arttı ama traffic artmadıysa client leak veya pool behavior daha güçlü adaydır. Query latency artışı connection hold time'ını yükseltmiş olabilir. Kısa vadeli mitigation ile kalıcı root cause action birbirinden ayrılmalıdır.
Deployment Oldu mu?
Alert timestamp'i deployment history ile karşılaştırılır. Yeni release MongoClient creation veya pool option değişikliği taşımış olabilir. Rolling deployment surge geçici spike üretmiş olabilir. Canary metric baseline'dan sapmışsa rollback hızlı mitigation olabilir. Diff database client initialization kodunu özellikle incelemelidir.
Replica Sayısı Arttı mı?
HPA veya manual scale-out pool sayısını doğrudan artırır. Replica timeline Atlas Connections graph ile karşılaştırılır. Connection artışı replica ile lineer ise behavior normal ama budget yetersiz olabilir. Per-pod pool küçültmek veya tier capacity artırmak değerlendirilir. HPA neden scale etti ayrıca incelenmelidir.
Trafik Arttı mı?
Request count ve database operation rate birlikte kontrol edilir. Gerçek business traffic iki katına çıktıysa connection artışı doğal olabilir. Query duration aynı kaldı mı kontrol edilir. Traffic spike kısa kampanya ise temporary capacity yeterli olabilir. Kalıcı büyüme capacity forecast gerektirir.
Pool Config Değişti mi?
`maxPoolSize`, `minPoolSize`, `maxConnecting` veya idle timeout config change connection baseline'ını değiştirebilir. Environment variable yanlış type veya default değer almış olabilir. Deployment manifest diff incelenir. Config canary ile doğrulanmalıdır. Platform-level default change bütün servisleri aynı anda etkileyebilir.
Query Latency Arttı mı?
Slow query connection'ları daha uzun kullanımda tutar. Query P95 alert öncesinde yükseldiyse root cause olabilir. Performance Advisor ve Query Profiler incelenir. Index regression veya data growth kontrol edilir. Query düzeldiğinde connection sayısının düşüp düşmediği gözlenir.
Bağlantılar Tekrar Düşüyor mu?
Connection created ve closed rate yüksekse churn connection count trendini farklı etkileyebilir. Firewall idle reset veya TLS error olabilir. Driver pool clear event'leri incelenir. Reconnect storm cluster'a ek yük bindirir. Network ve client lifecycle birlikte düzeltilmelidir.
Cluster Tier Yeterli mi?
Application connection management doğru, query latency sağlıklı ve traffic kalıcı biçimde büyümüşse mevcut tier yetersiz olabilir. Connection limit yanında CPU, memory ve disk headroom değerlendirilir. Scale-up tek risk alanını değil genel workload capacity'sini çözmelidir. Cost forecast eklenir. Scale sonrası alert threshold ve pool budget yeniden hesaplanır.
Synthetic MongoDB Connectivity Check
Synthetic connectivity check gerçek kullanıcı request'i gelmeden DNS, TCP, TLS, authentication ve basit database operation zincirini periyodik olarak doğrulayabilir. Check production application network'üne benzer location'dan çalışmalıdır. Her check yeni MongoClient oluşturup connection storm üretmemelidir. Basit ping veya küçük read yeterlidir. Latency aşamalar halinde ölçülürse network ve database health ayrıştırılabilir.
DNS Test
SRV ve target hostname resolution periyodik doğrulanabilir. Resolver response time ve failure rate metric üretilir. Private endpoint check private VPC içinden çalışmalıdır. Public DNS sonucu private route için anlamlı değildir. DNS failure kullanıcı hatası oluşmadan alert verebilir.
TCP Test
Resolved target portuna socket connection süresi ölçülür. Authentication yapılmadan network path health görülür. Çok sık TCP connection açmak gereksiz load oluşturabileceği için check frequency makul tutulmalıdır. Private endpoint'te gerçek port kullanılır. Timeout region-level network problemine işaret edebilir.
TLS Test
TLS handshake certificate chain ve hostname validation'ı doğrular. Synthetic runner runtime CA store production application ile benzer olmalıdır. Certificate expiry veya corporate proxy değişikliği erken tespit edilebilir. Handshake duration P95 takip edilir. Invalid certificate bypass test sisteminde bile standard check'in parçası olmamalıdır.
Authentication
Dedicated low-privilege synthetic database user kullanılabilir. Credential normal application user'dan ayrı rotate edilebilir. Authentication success network ve TLS'in üst katmanını doğrular. User'a yalnız ping veya küçük read için gereken minimum role verilir. Secret monitoring sisteminde güvenli tutulmalıdır.
ping Command
MongoDB `ping` command server'a minimal operation göndererek bağlantının çalıştığını doğrular. Application data collection'a erişmek zorunda değildir. Connection pool reuse edilirse check database'e gereksiz connection eklemez. Ping latency query performance'ın tamamını temsil etmez. Yalnız connectivity SLI olarak değerlendirilmelidir.
Basit Read
Gerçek application namespace üzerinde küçük indexed read daha end-to-end health göstergesi olabilir. Synthetic document dedicated ve düşük maliyetli olmalıdır. Yetki ve routing path gerçek production operation'a benzemelidir. Heavy query health check'e konmamalıdır. Result correctness basit expected value ile doğrulanabilir.
End-to-End Latency
DNS, connect ve query adımlarının toplamı kullanıcıya yakın availability metriği sunar. Breakdown hangi katmanın yavaşladığını gösterir. Region başına synthetic runner multi-region problem tespitini kolaylaştırır. Alert birkaç ardışık failure sonrası tetiklenebilir. Monitoring sisteminin kendi outage'ı database outage olarak yanlış yorumlanmamalıdır.
Production Readiness Probe Database'e Bağlanmalı mı?
Readiness probe'un database dependency'yi ne kadar kontrol edeceği application'ın çalışma modeline bağlıdır. Database olmadan hiçbir request hizmet veremiyorsa mevcut pool üzerinden hafif health sinyali değerlendirilebilir. Ancak her probe yeni connection açmamalıdır. Liveness database outage nedeniyle pod'u sürekli restart ettirmemelidir. Dependency health ile process health ayrımı Kubernetes restart storm'unu önler.
Liveness ile Readiness Farkı
Liveness process'in kilitlenip kilitlenmediğini belirler ve başarısızlık restart tetikleyebilir. Readiness instance'ın yeni traffic almaya hazır olup olmadığını gösterir. Database geçici olarak down olduğunda process sağlıklı kalabilir fakat unready olmak isteyebilir. İkisini aynı dependency check'e bağlamak bütün pod'ların restart olmasına neden olabilir. Probe semantics açıkça tasarlanmalıdır.
Her Probe'da Yeni Connection Açmamak
Kubernetes birkaç saniyede bir probe çağırabilir. Her çağrıda yeni MongoClient açılırsa yüz pod ciddi connection churn üretir. Mevcut shared client state veya hafif ping kullanılmalıdır. Probe timeout kısa tutulur. Check failure normal user query queue'sunu büyütmemelidir.
Database Kesintisinin Tüm Podları Restart Etmesini Önlemek
Database global dependency ise bütün pod'lar aynı anda failure görür. Liveness database ping'e bağlıysa orchestrator hepsini restart eder ve database geri gelirken connection storm yaratır. Process sağlıklıysa restart yerine readiness false daha doğru olabilir. Backoff ve deployment controller behavior test edilmelidir. Chaos test database outage senaryosunu içermelidir.
Dependency Health Stratejisi
Application critical dependency listesini tanımlamalıdır. Readiness yalnız gerekli dependency'leri ve fail-open veya fail-closed kararını yansıtır. Cache fallback varsa database outage sırasında bazı endpoint'ler çalışabilir. Tek global readiness bütün route'lar için fazla katı olabilir. Architecture kullanıcıya hangi fonksiyonların degraded mode sunabileceğini belirlemelidir.
MongoDB Atlas Load Test Nasıl Yapılır?
Load test yalnız HTTP request/s ölçmek yerine database connection ve query davranışını gerçekçi biçimde modellemelidir. Production'a benzer replica sayısı, pool settings ve query mix kullanılmalıdır. P95 ve P99 latency ile error rate ana output'tur. Atlas connection, CPU ve disk metric'leri aynı test timeline'ında toplanmalıdır. Test sonunda daha yüksek throughput değil sürdürülebilir SLO altında en yüksek güvenli kapasite aranmalıdır.
Gerçekçi Concurrent Request
Production traffic burst ve think time pattern'i test script'e yansıtılmalıdır. Bir anda on bin request göndermek gerçek kullanıcı davranışını temsil etmeyebilir. Read ve write oranı doğru olmalıdır. Authentication ve cache layer test amacına göre dahil edilir. Database concurrency ayrı instrumentation ile ölçülür.
Pool Size
Test farklı maxPoolSize değerlerini karşılaştırabilir. Küçük pool checkout latency, büyük pool database resource saturation yaratabilir. Throughput plateau noktası bulunur. Her deneyde diğer config sabit tutulmalıdır. Optimal değer application replica sayısıyla birlikte hesaplanmalıdır.
Application Replica
Tek pod load test production HPA behavior'ını göstermez. Birden fazla replica aynı cluster'a pool açtığında connection count farklılaşır. Test deployment surge ve scale-out aşamalarını simüle edebilir. Per-pod metric ayrı tutulur. Load balancer request distribution eşitsizse bazı pool'lar önce saturate olabilir.
Query Mix
Production workload yalnız basit indexed read'den oluşmaz. Slow report, write, aggregation ve transaction oranları gerçek kullanım dağılımına yakın olmalıdır. Query mix pool hold duration'ı belirler. Synthetic data cardinality production'a benzemelidir. Sensitive production data test ortamına kopyalanmamalıdır.
Connection Count
Atlas Connections metric test boyunca izlenir. Ramp-up sırasında connection growth profile kayıt altına alınır. Steady-state bağlantı sayısı expected formula ile karşılaştırılır. Test sonunda idle connection cleanup gözlenir. Hard limitin güvenli headroom altında kalması gerekir.
P95 / P99 Latency
Average latency saturation başlangıcını geç gösterebilir. P95 ve P99 özellikle checkout queue oluştuğunda hızlı yükselir. Breakdown connection wait ve query execution olarak ayrılmalıdır. SLO threshold aşıldığı load level capacity sınırı olarak kaydedilebilir. Release regression baseline ile karşılaştırılır.
Error Rate
Server selection, checkout timeout ve query timeout error'ları ayrı kategoriye ayrılır. Tek total error rate root cause bilgisini kaybettirir. Retry sonrası success ve initial failure iki farklı metric olabilir. Load artırıldığında error'ın hangi kaynak seviyesinde başladığı önemlidir. Capacity threshold error görülmeden önce latency ile belirlenebilir.
Connection Pool Load Testi
Pool load testi farklı havuz boyutlarının throughput ve tail latency üzerindeki etkisini ölçer. Küçük pool doğal backpressure yaratırken büyük pool database'i daha fazla parallel iş ile yükler. Optimal nokta en büyük pool değil SLO'yu sağlayan en küçük yeterli pool olabilir. Wait queue ve database CPU aynı anda izlenmelidir. Test application replica sayısını production scale'e yaklaştırmalıdır.
Küçük Pool
Küçük pool başlangıçta checkout wait oluşturabilir. Database CPU düşük kalır ve throughput stabilse biraz büyütmek fayda sağlayabilir. Tail latency queue nedeniyle yükselir. Error rate `waitQueueTimeoutMS` ile belirginleşebilir. Bu test lower bound hakkında bilgi verir.
Büyük Pool
Büyük pool checkout wait'i azaltabilir ama database CPU ve disk yükünü artırabilir. Throughput bir noktadan sonra artmaz. P99 query latency daha da kötüleşebilir. Connection count cluster limitine yaklaşabilir. Bu sonuç pool'u küçültmenin neden bazen sistemi hızlandırdığını gösterir.
Wait Queue
Queue size ve wait duration pool capacity'nin direct sinyalidir. Ramp test sırasında hangi concurrency seviyesinde oluştuğu kaydedilir. Query optimization queue onset noktasını daha ileri taşıyabilir. Queue hiç oluşmuyor ama database CPU yüzde yüze yakınsa pool zaten fazla büyük olabilir. Bu iki metric birlikte yorumlanmalıdır.
Throughput
Throughput saniyede tamamlanan başarılı database-backed request sayısıdır. Pool büyüdükçe önce artabilir sonra plateau yapabilir. Plateau sonrası daha fazla connection yalnız latency ve resource maliyeti ekler. Optimal pool plateau'dan önceki verimli bölgede seçilebilir. Business SLO throughput hedefiyle birlikte tanımlanır.
Tail Latency
P95 ve P99 saturation'ın kullanıcı etkisini gösterir. Pool çok küçükse queue, çok büyükse database contention tail latency'yi artırabilir. U-shaped sonuç sık görülür. Test farklı query mix'lerle tekrarlanmalıdır. Optimization yalnız P50 değerine göre yapılmamalıdır.
Database CPU
CPU pool büyüdükçe parallel query sayısıyla artabilir. Throughput artışı CPU artışıyla orantılıysa capacity iyi kullanılıyor olabilir. CPU yüzde yüze yaklaşırken throughput sabitlenirse saturation vardır. Query profiler high-CPU shape'leri belirler. Cluster scale veya query optimization sonraki adımdır.
Optimal Noktayı Bulmak
Optimal nokta SLO altında gerekli throughput'u en az connection ve resource ile sağlayan config'tir. Tek sayı tüm traffic dönemleri için aynı olmayabilir. Auto scaling pool config dinamik değiştirmek yerine deployment capacity uygun seçilir. Headroom burst ve failover için korunur. Benchmark sonuçları architecture decision record içinde saklanabilir.
Failover Testi Nasıl Yapılır?
Production resilience yalnız replica set varlığıyla garanti edilmez. Application driver'ın yeni primary'yi ne kadar hızlı bulduğu ve temporary error'ları nasıl yönettiği test edilmelidir. Atlas dedicated cluster'larda test failover capability sunar. Test sırasında user traffic'e benzer workload çalıştırılabilir. Recovery time, error count ve connection storm behavior ölçülmelidir.
Primary Failover
Kontrollü test mevcut primary'yi step down ederek election başlatabilir. Change window ve business impact önceden planlanmalıdır. Test production benzeri staging cluster'da başlayabilir. Atlas event timestamp baseline olur. Application logs aynı zaman aralığında toplanır.
Driver'ın Yeni Primary'yi Bulması
SDAM topology changed event yeni primary discovery zamanını gösterir. Server selection errors bu pencere içinde görülebilir. Discovery beklenenden uzunsa network tüm members'a açık mı kontrol edilir. Driver version ve heartbeat config gözden geçirilir. Hard-coded host kullanımının olmadığı doğrulanır.
Temporary Errors
Election sırasında bazı request'ler transient error alabilir. Retryable operation otomatik toparlanabilir. User-facing error rate SLO içinde kalmalıdır. Error class ve duration kaydedilir. Alert system kısa planlı test için maintenance window kullanabilir.
Retryable Operations
Supported read ve writes retry behavior'ı test edilir. Business duplicate oluşmadığı doğrulanır. Application-level retry count driver retry ile birlikte gözlenir. Retry storm oluşuyorsa policy sadeleştirilir. Transaction scenario ayrı test gerektirir.
Recovery Time
Eski primary loss ile başarılı steady-state operation arasındaki süre ölçülür. P50 değil maximum user impact daha değerlidir. Connection pool recovery ve new connection ready süresi ayrıca kaydedilir. SLO örneğin birkaç saniyelik recovery hedefleyebilir. Gerçek değer architecture documentation'a yazılır.
Kullanıcı Etkisi
Failover teknik olarak başarılı olsa bile kullanıcı form submit'i kaybedebilir. UI retry ve error message behavior test edilmelidir. Idempotent write duplicate üretmemelidir. Read-only endpoint degrade olabilir. Post-test product ve engineering etkisi birlikte değerlendirilir.
Network Chaos Testleri
Chaos test network failure'larını kontrollü ortamda oluşturarak application recovery behavior'ını ölçer. DNS failure, latency, packet loss, port block ve connection reset ayrı senaryolardır. Amaç sistemi bozmak değil runbook ve retry varsayımlarını doğrulamaktır. Production benzeri staging topology kullanılmalıdır. Her testte steady-state, disruption ve recovery metric'leri kayıt altına alınmalıdır.
DNS Failure
Resolver response geçici olarak engellenebilir veya test domain yanlış yönlendirilebilir. Existing connection'lar çalışmaya devam ederken yeni discovery'nin nasıl etkilendiği gözlenir. Retry behavior ve alert gecikmesi ölçülür. DNS geri geldiğinde recovery otomatik olmalıdır. Test real public DNS'e zarar vermeyecek isolated ortamda yapılmalıdır.
Packet Loss
Belirli yüzde packet loss TCP retransmission ve query latency artırabilir. Connection reset veya socket timeout rate izlenir. Driver heartbeat failure threshold'u gözlenir. Application retry traffic'i problemi büyütüyor mu kontrol edilir. Network normalleşince pool recovery süresi ölçülür.
Latency
Artificial network latency multi-region kötü durumunu simüle edebilir. Query execution hızlı olsa bile total response uzar. Timeout budget'ın doğru çalıştığı kontrol edilir. HPA latency nedeniyle gereksiz scale-out yapıyor mu gözlenir. Pool occupancy duration arttığı için connection pressure oluşabilir.
Port Block
Firewall kuralıyla MongoDB portu geçici engellenebilir. DNS çalışırken connect timeout oluşması beklenir. Incident runbook'un TCP test adımı bu senaryoyu doğru sınıflandırmalıdır. Liveness restart storm üretmemelidir. Rule kaldırılınca automatic recovery doğrulanır.
Private Endpoint Failure
Test environment'ta endpoint route veya security group kontrollü biçimde bozulabilir. Private DNS hâlâ doğru çözülürken TCP failure görülür. Multi-region fallback varsa diğer endpoint'e geçiş test edilir. Public fallback security policy'ye göre açık veya kapalı olabilir. Endpoint monitor alarm süresi ölçülür.
Connection Reset
Existing TCP connection'lar network cihazı tarafından reset ediliyormuş gibi simüle edilir. Driver pool connection'ı kapatıp yenisini oluşturmalıdır. Application error ve retry behavior gözlenir. Çok sayıda simultaneous reset connection storm üretebilir. `maxConnecting` recovery'nin hız ve yük dengesini etkiler.
Recovery
Chaos condition kaldırıldığında sistemin manual restart olmadan normale dönmesi tercih edilir. Connection creation rate kısa süre spike yapabilir. Query latency ve error rate baseline'a ne kadar sürede döndüğü ölçülür. Orphaned retry veya stuck queue kalmamalıdır. Recovery metric SLO ve runbook improvement için kullanılır.
MongoDB Atlas Incident Runbook
Runbook incident anında rastgele ayar değiştirmek yerine aynı diagnostic sırasını uygular. Önce hata mesajı ve environment belirlenir, ardından Atlas status ve event'leri kontrol edilir. DNS, TCP, TLS ve authentication katmanları sırayla test edilir. Pool ve query metric'leri bağlantı kurulduktan sonraki performance problemlerini ayırır. Mitigation sonrası root cause ve kalıcı action yazılarak aynı incident'in tekrar süresi azaltılır.
Hata Mesajını Kaydet
Error class, message, cause ve topology description credential içermeden kaydedilir. Timestamp ve request correlation id eklenir. Stack trace code path'i gösterir. Yalnız ekran görüntüsü yerine structured text tercih edilir. Aynı error başka instance'larda var mı hızlıca aranır.
Etkilenen Environment'ı Belirle
Production, staging veya belirli region mı etkileniyor belirlenir. Tek pod veya bütün deployment farkı root cause'u daraltır. Local working bilgisi not edilir ama production testinin yerine geçmez. Serverless instance veya Kubernetes node distribution kontrol edilir. Environment-specific secret ve network config karşılaştırılır.
Atlas Status ve Events
Atlas cluster health ve maintenance event'leri kontrol edilir. Primary election veya scaling işlemi timestamp ile eşleştirilir. Platform-wide incident varsa application config değiştirmek gereksiz olabilir. Event yoksa client/network tarafı daha güçlü adaydır. Status bilgisi RCA'ya eklenir.
DNS Testi
SRV, TXT ve target A/AAAA lookup application host içinde çalıştırılır. Resolver bilgisi kaydedilir. Public resolver ile karşılaştırma gerekiyorsa yalnız diagnostic amaçla yapılır. Private endpoint'te private DNS sonucu beklenir. Failure bulunursa database ayarlarına geçmeden DNS çözülür.
TCP Testi
Resolved hedef ve gerçek port `nc` ile test edilir. Timeout Access List, firewall veya route araştırmasını tetikler. Refused farklı bir network/server durumu gösterebilir. Tüm topology endpoints gerektiğinde test edilir. Sonuç hostname ve timestamp ile kaydedilir.
TLS Testi
OpenSSL ile SNI kullanarak certificate chain kontrol edilir. CA error veya corporate inspection belirlenir. Container ve host farkı karşılaştırılır. Invalid certificate bypass production'da uygulanmaz. TLS başarılıysa authentication aşamasına geçilir.
Authentication Testi
Database user'ın varlığı ve role'ları doğrulanır. URI special character encoding kontrol edilir. Secret version deployment ile eşleştirilir. Atlas account credential ile database user karıştırılmadığı doğrulanır. Test credential'ı loglara yazılmaz.
Pool Metrics
Checked-out count, checkout P95, creation rate ve pool clear event incelenir. Replica ve worker sayısı hesaplanır. Recent maxPoolSize değişikliği kontrol edilir. Wait queue yüksekse query latency ile korelasyon yapılır. Client creation code review gerekebilir.
Query Metrics
Slow query count ve Performance Advisor sonuçları incelenir. CPU, disk ve documents examined değerleri değerlendirilir. Query latency alert öncesi artmış mı bakılır. Problemli query shape deployment change ile eşleştirilir. Index veya query mitigation gerekli olabilir.
Mitigation
Mitigation root cause'a göre seçilir. Yanlış Access List düzeltilir, kötü release rollback edilir veya slow query geçici olarak rate-limit edilebilir. Cluster scale acil capacity sağlayabilir ama leak varsa kalıcı çözüm değildir. Her değişiklik tek tek uygulanıp metric etkisi gözlenir. Birden fazla rastgele değişiklik RCA'yı zorlaştırır.
Root Cause Analysis
RCA olay sırasını ve neden sonuç zincirini açıkça yazar. “MongoDB timeout oldu” kök neden değildir. Örneğin HPA scale-out, yüksek min pool ve slow query birleşimi connection limit alarmı üretmiş olabilir. Detection gap ve missing metric belirlenir. Action item owner ve tamamlanma tarihiyle kaydedilir.
Hata Mesajına Göre Hızlı Troubleshooting Matrisi
Hata mesajı doğru başlangıç katmanını seçmeye yardımcı olur, ancak tek başına kesin kök neden değildir. DNS hata aileleri önce resolver ve hostname üzerinde incelenmelidir. Network timeout Access List, firewall ve route kontrolünü öne çıkarır. Authentication ve parse error credential veya URI katmanına yönlendirir. Topology ve too many connections hataları ise driver discovery ve capacity analizi gerektirir.
querySrv ECONNREFUSED
Bu hata SRV DNS query'sinin resolver tarafından reddedildiğini güçlü biçimde düşündürür. Corporate DNS, VPN, Docker veya Kubernetes resolver path'i kontrol edilir. Public resolver diagnostic karşılaştırma olarak kullanılabilir. Atlas standard URI geçici izolasyon testi sağlayabilir. Kalıcı çözüm DNS infrastructure'da yapılmalıdır.
DNS Resolver
Resolver address ve query type support kontrol edilir. SRV request doğrudan `dig` ile çalıştırılır. Response refused ise DNS ekibiyle policy incelenir. Private endpoint için doğru private resolver kullanılmalıdır. Uygulama retry yalnız kısa transient failure için kullanılmalıdır.
ENOTFOUND
Hostname veya SRV record bulunamadığında görülür. Connection string Atlas UI'dan yeniden alınır. Private endpoint state ve DNS publish durumu kontrol edilir. Yanlış environment secret eski hostname taşıyor olabilir. Resolver'ın NXDOMAIN response'u doğrudan kaydedilir.
DNS / Hostname
Hostname karakter karakter manuel kontrol yerine authoritative connection string ile karşılaştırılır. SRV ve A lookup ayrı yapılır. Public ve private URI karıştırılmamalıdır. DNS zone association incelenir. Sorun düzelmeden timeout değerleri değiştirilmez.
EAI_AGAIN
Geçici DNS resolution failure veya timeout belirtisidir. CoreDNS veya corporate resolver health kontrol edilir. Error burst mü sürekli mi timeline üzerinden görülür. Backoff ve jitter ile sınırlı retry kullanılabilir. Kalıcı yüksek rate resolver capacity problemi olarak ele alınır.
Geçici DNS Failure
İkinci sorgu birkaç saniye sonra başarılı olabilir. Yine de error rate monitoring'de tutulmalıdır. Upstream resolver latency ölçülür. Application replica artışı DNS load'u yükseltmiş olabilir. Sürekli failure normal transient olarak kabul edilmemelidir.
ETIMEOUT
Timeout connection path veya operation katmanlarının farklı noktalarında oluşabilir. Hangi option veya call'un timeout verdiği belirlenmelidir. DNS çalışıyorsa TCP Access List ve firewall test edilir. Server selection timeout topology'yi ayrıca düşündürür. Error context olmadan genel timeout olarak sınıflandırılmamalıdır.
Network / Access List / Firewall
Gerçek egress IP Access List ile karşılaştırılır. Target port container veya pod içinden test edilir. Security group ve route table incelenir. Private endpoint kullanılıyorsa endpoint-specific port range kontrol edilir. Packet drop flow log üzerinden doğrulanabilir.
ECONNRESET
Established TCP connection karşı taraf veya network cihazı tarafından reset edilmiş olabilir. Firewall idle timeout, proxy veya transient network failure düşünülebilir. Driver connection closed event reason incelenir. Reconnect rate ve pool clear spike kontrol edilir. Sürekli reset query timeout artırılarak çözülmez.
Network / Resource / Socket
Socket idle süresi network appliance timeout ile karşılaştırılır. Atlas host health ve application node network metric kontrol edilir. Resource exhaustion process socket davranışını etkileyebilir. Packet loss veya NAT issue araştırılır. `maxIdleTimeMS` yalnız network timeout bilgisine göre ayarlanır.
Authentication failed
Network ve TLS zinciri büyük ölçüde tamamlanmıştır. Database username, password ve authSource doğrulanır. Atlas user ile database user ayrımı kontrol edilir. Password percent-encoding incelenir. Credential rotation history deployment revision ile karşılaştırılır.
Credentials / authSource
Secret manager'daki current version doğrulanır. User role ve authentication database kontrol edilir. URI special character'ları encode edilir. Secret loglanmadan test connection yapılır. Başarılı test sonrası eski credential revoke edilir.
MongoParseError
URI syntax veya unsupported option problemi olabilir. Elle string birleştirilmiş connection string ilk şüphelidir. Driver version option support'u kontrol edilir. Atlas-generated template ile karşılaştırılır. Percent-encoding hatası düzeltilebilir.
URI Encoding
Reserved credential characters güvenilir encoder ile dönüştürülür. Bütün URI encode edilmez. Double encoding kontrol edilir. Unit test farklı password karakterleri kullanır. Secret representation standardı dokümante edilir.
ReplicaSetNoPrimary
Driver suitable primary göremiyor demektir. Atlas election veya network partition kontrol edilir. Tüm replica members DNS ve TCP açısından erişilebilir olmalıdır. SDAM event hangi hostların Unknown olduğunu gösterir. Uzun süre devam ediyorsa normal failover değildir.
Topology / Network / Election
Atlas primary event timestamp alınır. Driver topology description karşılaştırılır. Firewall yalnız bazı members'ı mı engelliyor test edilir. DNS target list tam mı kontrol edilir. Recovery süresi failover SLO ile karşılaştırılır.
Too many connections
Atlas node veya mongos connection capacity aşılmıştır. Application instance ve pool sayısı toplanır. Recent autoscaling veya deployment spike kontrol edilir. Connection leak veya per-request client creation araştırılır. Cluster scale ancak application lifecycle doğruysa kalıcı çözüm olarak değerlendirilir.
Pool / Scale / Cluster Tier
maxPoolSize ve replica count teorik budget hesaplanır. Atlas Connections % metric headroom gösterir. Query latency pool hold time'ı artırıyor mu bakılır. Gerekiyorsa pool küçültme, scaling veya tier büyütme seçenekleri load test ile karşılaştırılır. Kalıcı action RCA'da açıkça atanır.
“Localde Çalışıyor Production'da Çalışmıyor” Checklist
Bu senaryoda ilk varsayım kodun tamamen hatalı olmadığı, environment farkının araştırılması gerektiğidir. Production egress IP, DNS resolver ve firewall local ortamdan farklıdır. Secret version ve TLS CA store da container image'a özgü olabilir. Private networking yalnız production'da kullanılıyorsa tamamen farklı hostname ve route devreye girer. Checklist environment farklarını sırayla eleyerek incident süresini azaltır.
Production Egress IP
Pod veya VM private IP'si yerine Atlas'a çıkan public source IP belirlenir. NAT Gateway veya egress gateway config kontrol edilir. Access List'teki CIDR ile karşılaştırılır. Multi-region bütün olası egress IP'leri kapsamalıdır. Değişken egress varsa architecture çözümü gerekir.
Network Access List
Production project Access List entry active mı kontrol edilir. Temporary entry expire olmuş olabilir. Yanlış Atlas project düzenlenmiş olabilir. Wildcard ile kalıcı çözüm yapılmaz. Infrastructure config drift kontrol edilir.
Production DNS Resolver
Pod içinden SRV ve TXT lookup yapılır. Resolver local laptop'tan farklı olabilir. CoreDNS veya corporate DNS health incelenir. Private endpoint domain'i doğru private zone'dan çözülmelidir. Public resolver yalnız diagnostic comparison için kullanılır.
Firewall
Production subnet outbound policy development'tan daha sıkı olabilir. Atlas target port test edilir. Security group ve NetworkPolicy birlikte incelenir. Flow log dropped packet gösterebilir. Private endpoint port requirement public 27017 varsayımıyla karıştırılmamalıdır.
Secret
Production secret adı ve version doğrulanır. Staging connection string yanlışlıkla production'a deploy edilmiş olabilir. Password rotation sonrası rollout tamamlanmış mı kontrol edilir. Secret loglanmaz. Application startup validation missing URI'yi erken yakalamalıdır.
TLS CA Store
Production container minimal image kullanıyorsa CA certificate eksik olabilir. OpenSSL test container içinde çalıştırılır. Corporate CA yalnız production network'te gerekebilir. Runtime version localden farklı mı kontrol edilir. TLS validation disable edilmez.
Driver Version
Local package lock ile production image gerçekten aynı driver version'ı kullanıyor mu doğrulanır. Multi-stage Docker build eski lockfile kopyalıyor olabilir. Driver support Atlas cluster version ile uyumlu olmalıdır. Release artifact dependency manifest saklanabilir. Version drift reproducibility problemidir.
Private Networking
Production private endpoint veya peering kullanıyorsa public local bağlantı testi aynı path'i doğrulamaz. Private DNS, route ve endpoint status incelenir. On-prem forwarding veya VPC association kontrol edilir. Atlas Connect ekranındaki private URI kullanılmalıdır. Public fallback security policy'ye göre kapalı olabilir.
Container Environment Variables
Deployment manifest variable adı ile application'ın okuduğu key aynı olmalıdır. Quoting special characters URI'yi değiştirebilir. Environment dump secret maskelenerek yalnız key presence kontrolü yapabilir. Config validation startup'ta eksik variable için açık hata vermelidir. Secret mounted file kullanılıyorsa path ve permission kontrol edilir.
“Compass Çalışıyor Ama Uygulama Çalışmıyor” Checklist
Compass bağlantısının başarılı olması Atlas cluster'ın genel olarak erişilebilir olduğuna dair ipucu verir, fakat application'ın aynı network path'i kullandığını kanıtlamaz. Compass laptop'ta, application container veya serverless ortamda çalışıyor olabilir. Connection string, user, resolver ve driver version farklı olabilir. Application timeout ayarları Compass'tan daha kısa olabilir. İki client arasındaki bütün farklar tek tek karşılaştırılmalıdır.
Aynı Host'tan mı Test Ediliyor?
Compass developer laptop'ta çalışıyorsa production pod network'ünü test etmez. Mümkünse aynı host veya VPC içinden `mongosh` gibi diagnostic client kullanılır. Egress IP farklı olabilir. Private endpoint yalnız application network'ünde çalışabilir. Test location runbook'a kaydedilmelidir.
Aynı Connection String mi?
Compass Atlas UI'dan yeni URI kullanırken application eski secret kullanıyor olabilir. Hostname ve query options credential maskelenerek karşılaştırılır. Public ve private URI farkı kontrol edilir. Atlas-generated string yeniden alınabilir. Manual editler minimum tutulmalıdır.
Aynı User mı?
Compass kişisel database user, application service user kullanabilir. Role ve authSource farklıdır. Application user credential rotation kontrol edilir. Compass admin role ile çalışıyor diye application permission problemi elenmez. Test mümkünse service user ile yapılmalıdır.
Aynı DNS Resolver mı?
Laptop corporate VPN dışında public resolver kullanabilir. Application Kubernetes CoreDNS üzerinden sorgu yapar. SRV lookup sonuçları karşılaştırılır. Private DNS yalnız VPC içinde farklı sonuç döndürebilir. Resolver farkı querySrv hatalarının ana kaynağı olabilir.
Driver Uyumluluğu
Compass kendi güncel MongoDB driver stack'ini taşır. Application eski Node, Java veya başka driver kullanıyor olabilir. TLS ve SRV support farkı oluşabilir. Driver version support matrix incelenir. Upgrade staging test ile uygulanır.
Application Timeout Ayarları
Compass uzun server selection timeout kullanırken API yalnız birkaç saniye bekleyebilir. Connection gerçekte yavaş ama başarılı olabilir. Application deadline ve network latency karşılaştırılır. Timeout'u körlemesine Compass değerine çıkarmak yerine bottleneck bulunur. Connection establishment P95 ölçülür.
Application Network Namespace
Container veya pod farklı route, firewall ve proxy policy'sine sahiptir. Host-level test bunu doğrulamaz. Diagnostic command aynı namespace içinde çalıştırılmalıdır. Kubernetes ephemeral container faydalı olabilir. Network team packet path'i gerçek application source'tan analiz etmelidir.
“Uygulama Başlangıçta Bağlanıyor, Sonra Kopuyor” Checklist
Başlangıç bağlantısının başarılı olması DNS, authentication ve ilk network path'in çalıştığını gösterir. Daha sonra kopma firewall idle timeout, network interruption, failover veya pool clear davranışıyla ilişkili olabilir. `maxIdleTimeMS` network cihazı timeout'una göre değerlendirilir. Heartbeat failure ve connection closed reason zaman çizelgesi oluşturur. Sürekli reconnect connection storm'a dönüşmeden kök neden bulunmalıdır.
Firewall Idle Timeout
Firewall uzun süre kullanılmayan socket'i kapatabilir. Application sonraki operation'da reset görür. Network team idle timeout değerini sağlamalıdır. Driver idle timeout daha kısa seçilebilir. Connection creation rate düzeltme sonrası düşmelidir.
maxIdleTimeMS
Idle connection lifecycle network environment'a göre ayarlanabilir. Sıfır default sınırsız driver idle süresi anlamına gelir. Serverless düşük traffic workload'da uygun finite değer yararlı olabilir. Çok kısa değer sürekli reconnect üretir. Before-after metric karşılaştırılır.
Network Interruption
Packet loss veya route flap existing connection'ları bozabilir. Cloud network event ve flow log kontrol edilir. Driver yeni connection kurarak recovery yapmalıdır. Repeated interruption application retry storm yaratabilir. Synthetic check kullanıcı error'ından önce alarm verebilir.
Failover
Primary değişimi mevcut primary pool'unun temizlenmesine yol açabilir. Driver yeni primary'yi bulur. Kısa disconnect normal resilience scenario olabilir. Recovery süresi beklenenden uzunsa tüm replica members connectivity test edilir. Failover test baseline ile karşılaştırılır.
Connection Pool Clear
Driver belirli network veya topology error sonrasında pool'u clear edebilir. `connectionPoolCleared` event rate izlenir. Tek failover sırasında beklenen olabilir. Sürekli clear network veya driver issue gösterebilir. Driver version release note kontrol edilir.
Driver Retry
Retryable operation transient disconnect'i kullanıcıdan gizleyebilir. Ancak her request retry edilemez. Application error rate ile underlying retry rate ayrı metric olmalıdır. Çok sık retry normal kabul edilmemelidir. Root cause network veya failover katmanında çözülmelidir.
Heartbeat Events
Server heartbeat failure connectivity kaybını erken gösterir. Belirli host sürekli fail ediyorsa network path daraltılır. Topology changed event ile recovery zamanı ölçülür. Heartbeat frequency aşırı düşürülmemelidir. Mongoose disconnected event bu mekanizmanın üst katman görünümü olabilir.
“Yoğun Trafikte Bağlantı Kopuyor” Checklist
Yalnız yüksek trafikte sorun görülmesi capacity veya pool saturation ihtimalini güçlendirir. Connections % limit, checkout queue, replica count ve query latency birlikte incelenmelidir. Database CPU veya disk bottleneck connection hold süresini yükseltebilir. HPA daha fazla pod açarak connection storm yaratabilir. Load test production incident'i kontrollü ortamda yeniden üretmek için kullanılmalıdır.
Connections % Limit
Traffic peak sırasında percentage hard limite yaklaşıyor mu kontrol edilir. Alert threshold yeterli headroom bırakmalıdır. Limit aşılmadan query latency artabilir. Scale-up yalnız capacity gerçekse yapılır. Application connection leak elenmelidir.
maxPoolSize
Pool çok küçükse queue, çok büyükse database overload görülebilir. Per-instance active connection gerçek değerle karşılaştırılır. HPA max replica ile total budget hesaplanır. Load test birkaç farklı değer dener. Değişiklik canary release ile yapılabilir.
Wait Queue
High trafficte checkout wait yükseliyorsa pool saturation vardır. Query duration da yükseliyorsa database-side bottleneck olabilir. `waitQueueTimeoutMS` sınırsız latency yerine controlled failure sağlayabilir. Queue P95 alert olarak izlenir. Retry load'u queue'yu daha da büyütmemelidir.
Application Replica Count
Traffic artınca HPA kaç pod'a çıktı kontrol edilir. Connection count replica ile birlikte büyüyor mu bakılır. Surge pod ve worker process eklenir. Per-pod pool aynı kaldıysa total database concurrency katlanmıştır. Scaling policy database capacity'ye göre yeniden ayarlanır.
Query Latency
Peak traffic data set veya cache behavior nedeniyle query latency yükseltebilir. Slow operation ve index efficiency incelenir. Connection sayısı artışından önce latency yükseldiyse root cause güçlüdür. Query fix pool pressure'ı azaltır. Batch operation peak saat dışında planlanabilir.
CPU
Atlas CPU sustained high ise daha fazla parallel connection fayda sağlamayabilir. Expensive query shape belirlenir. Scale tier veya query optimization değerlendirilir. CPU normal ama queue yüksekse pool config araştırılır. Application CPU da database request dispatch rate'i etkileyebilir.
Cluster Capacity
Connection, CPU, disk ve memory birlikte capacity görünümü sağlar. Tek metric üzerinden scale kararı verilmez. Load test maximum sustainable throughput'u belirler. Growth forecast yeni tier ihtiyacını önceden gösterir. Autoscaling database tier capability varsa limitleri bilinmelidir.
Connection Storm
Traffic spike yeni application instances ve yeni pool'ları aynı anda açmış olabilir. Connection creation rate total connection'dan daha açıklayıcıdır. `maxConnecting`, startup jitter ve HPA max sınırı incelenir. Storm sonrası normal baseline'a dönüş süresi ölçülür. Incident tekrarını önlemek için rollout ve scaling policy güncellenir.
MongoDB Atlas Güvenli Connection Standardı
Production standardı Atlas-provided SRV URI, güncel resmî driver, aktif TLS validation ve least-privilege database user üzerine kurulmalıdır. Secret'lar managed store içinde tutulur ve network access mümkün olan en dar scope ile sınırlandırılır. Hassas workload private endpoint kullanabilir. Credential rotation düzenli ve test edilmiş süreç olmalıdır. Security ile performance birbirine karşıt hedefler değildir, doğru connection reuse ve private networking çoğu zaman ikisini birlikte iyileştirir.
SRV URI
Atlas Connect ekranından alınan SRV URI topology management'i kolaylaştırır. DNS resolver SRV ve TXT sorgularını desteklemelidir. Private endpoint'te endpoint-aware URI kullanılır. Standard URI yalnız uygun diagnostic veya özel requirement için seçilir. Connection string source olarak wiki copy yerine Atlas veya secret manager kullanılmalıdır.
Current Official Driver
Desteklenen güncel major veya LTS-compatible driver kullanmak security ve bug fix erişimi sağlar. Upgrade cadence belirlenmelidir. EOL dependency inventory alert üretmelidir. Driver release note pool ve timeout behavior açısından okunur. Production canary upgrade riskini azaltır.
TLS Validation
TLS certificate ve hostname doğrulaması aktif kalmalıdır. Invalid certificate options production config'te yasaklanabilir. CA store düzenli güncellenir. Corporate inspection gerekiyorsa supported trust model tasarlanır. TLS failure runbook'u bypass yerine root cause çözümünü hedefler.
Least-Privilege Database User
Her service yalnız ihtiyacı olan database ve role erişimine sahip olmalıdır. Shared admin credential kullanılmamalıdır. Read-only worker ayrı user kullanabilir. Rotation application deploy süreciyle test edilir. Audit user activity'yi service identity ile ilişkilendirebilir.
Secret Manager
Connection URI ve password managed secret store içinde tutulmalıdır. Runtime identity minimum read permission alır. Secret application logs veya metrics içine yazılmamalıdır. Versioning rollback ve rotation sağlar. Repository secret scanning ek güvenlik katmanıdır.
Restricted Network Access
Public connection static egress IP veya dar CIDR ile sınırlandırılmalıdır. Wildcard IPv4 production standardı olmamalıdır. Network resource policy geniş rule'ları engelleyebilir. Private connectivity security-sensitive workload için değerlendirilebilir. Access List değişikliği audit ve change control altında tutulmalıdır.
Private Endpoint Gerektiren Workload'lar
Regülasyon, network isolation veya public internet kullanmama gereksinimi private endpoint'i zorunlu kılabilir. Dedicated cluster ve provider cost hesaba katılır. Multi-region endpoint planı high availability requirement'ı karşılamalıdır. Private DNS ve route monitoring kurulmalıdır. Public fallback policy açıkça belirlenmelidir.
Credential Rotation
Password veya key düzenli rotation schedule'a sahip olmalıdır. New credential önce deploy edilir, bütün replica'lar doğrulanır ve eski credential sonra revoke edilir. Rotation sırasında connection pool eski authenticated sockets'i bir süre kullanabilir. Controlled reconnect planlanmalıdır. Rotation chaos test gibi periyodik çalıştırılabilir.
Production Öncesi MongoDB Atlas Connection Checklist
Production readiness checklist bağlantıyı yalnız bir kez başarılı kurmak yerine failure ve scaling senaryolarına hazırlar. DNS, network, TLS, authentication ve secret yönetimi temel güvenlik katmanlarıdır. MongoClient reuse ve ölçülmüş pool size performance tarafını güvenli hâle getirir. Timeout, retry ve alert standardı incident sırasında öngörülebilir davranış sağlar. Failover testi tamamlanmadan yüksek availability varsayımı kabul edilmemelidir.
Connection String Atlas'tan mı Alındı?
URI Atlas Connect ekranından alınmalıdır. Eski wiki veya elle oluşturulmuş host listesi kullanılmamalıdır. Public ve private connection mode doğru seçilmelidir. Driver version template ile uyumlu olmalıdır. Secret manager authoritative runtime source olmalıdır.
SRV DNS Çözülüyor mu?
Production host içinden SRV ve TXT lookup çalıştırılır. Resolver latency kaydedilir. Private endpoint'te private IP result doğrulanır. Multi-region bütün region path'leri test edilir. DNS synthetic monitoring kurulabilir.
Production Egress IP Biliniyor mu?
Public connection kullanılıyorsa gerçek NAT source IP inventory'de bulunmalıdır. HPA veya region değişimi yeni egress yaratıyor mu bilinmelidir. Access List bu adresleri minimum CIDR ile kapsar. Dynamic platform egress architecture çözümü ister. IP değişikliği alert ve change control ile yönetilir.
Network Access Minimumda mı?
Wildcard IP rule bulunmamalıdır. Temporary entry expiry ile sınırlandırılmalıdır. Firewall yalnız gerekli destination ve portlara izin verir. Private endpoint kullanılıyorsa public path gerekmiyorsa kapatılabilir. Security review network diagram'ı doğrular.
TLS Doğrulanıyor mu?
Driver invalid certificate option kullanmamalıdır. Container CA store güncel olmalıdır. OpenSSL staging test başarılıdır. Corporate proxy database traffic'i bozmamalıdır. TLS protocol policy organization standardına uymalıdır.
Database User Least-Privilege mı?
Service user yalnız gerekli role'lara sahiptir. Admin role gereksizse kaldırılmıştır. Read ve write workload ayrı identity kullanabilir. Authentication database doğrudur. Rotation procedure test edilmiştir.
Secret'lar Güvenli mi?
URI repository'de bulunmamalıdır. Secret manager veya güvenli deployment secret mekanizması kullanılır. CI log secret'ı maskeler. Runtime identity minimum access alır. Secret scanning aktif olmalıdır.
Tek MongoClient Reuse Ediliyor mu?
Process içinde MongoClient creation noktaları code search ile kontrol edilir. Request handler yeni client oluşturmamalıdır. Serverless handler dışında cache kullanılmalıdır. Worker process çarpanı bilinmelidir. Connection creation rate load test'te beklenen seviyede olmalıdır.
maxPoolSize Ölçülerek Ayarlandı mı?
Default değer otomatik optimum kabul edilmemelidir. P95 database concurrency ölçülür. Load test farklı pool size'ları karşılaştırır. Atlas connection limit headroom korunur. HPA max replica toplam budget'a dahil edilir.
Application Replica Sayısı Hesaba Katıldı mı?
Normal, HPA maximum ve deployment surge replica sayıları ayrı hesaplanır. Worker process sayısı eklenir. Background jobs inventory'e dahil edilir. Multi-region deployment region başına budget taşır. Capacity model architecture documentation'da tutulur.
waitQueueTimeoutMS Belirlendi mi?
Unlimited default API için bilinçli olarak değerlendirilmelidir. Checkout wait HTTP deadline'dan kısa sınırlandırılabilir. Timeout error doğru metric'e dönüştürülür. Pool saturation runbook'u hazırdır. Değer load test ile doğrulanır.
Timeout Budget Var mı?
Server selection, connect, socket ve operation timeout birbirinden ayrılır. Toplamı user request deadline ile uyumludur. Background job farklı profile kullanabilir. Timeout increase change review gerektirir. Metric hangi timeout'un tetiklendiğini gösterir.
Retry Stratejisi Var mı?
Driver retry behavior bilinmektedir. Application retries yalnız güvenli operation'larda kullanılır. Exponential backoff ve jitter uygulanır. Maximum attempt ve total budget sınırlıdır. Chaos test retry storm oluşturmadığını doğrular.
Connection Alert'leri Aktif mi?
Connections ve percentage alert güvenli threshold ile kurulmuştur. Host down ve no primary alert'leri owner'a yönlenir. CPU ve query latency bağlantı alert'iyle korele edilebilir. Runbook alarm mesajına bağlıdır. Alert test notification kanalı doğrulanır.
Failover Test Edildi mi?
Primary failover controlled ortamda çalıştırılmıştır. Driver recovery ve retry behavior ölçülmüştür. User-facing error rate kabul edilebilir düzeydedir. Private endpoint bütün members veya region path'lerine erişebilmektedir. Recovery time SLO kaydedilmiştir.
Uçtan Uca Örnek: Node.js + MongoDB Atlas Production Connection
Production Node.js bağlantısında connection string secret manager veya environment üzerinden alınır, tek MongoClient application scope'ta oluşturulur ve pool seçenekleri ölçülmüş workload'a göre verilir. Timeout değerleri HTTP request budget ile uyumlu seçilir. Driver monitoring event'leri metrics'e aktarılır ve shutdown sırasında client kontrollü kapatılır. Bu yapı her request'te connection açma hatasını önler. Aşağıdaki yaklaşım sabit değer reçetesi değil production architecture için örnek bir iskelettir.
import { MongoClient } from "mongodb";

const uri = process.env.MONGODB_URI;

const client = new MongoClient(uri, {
  maxPoolSize: 30,
  minPoolSize: 0,
  maxConnecting: 2,
  waitQueueTimeoutMS: 1000,
  serverSelectionTimeoutMS: 5000,
  connectTimeoutMS: 5000,
  retryWrites: true
});

export async function connectDatabase() {
  await client.connect();
  await client.db("admin").command({ ping: 1 });
  return client;
}

export function getDatabase() {
  return client.db("app");
}

export async function closeDatabase() {
  await client.close();
}
Environment Variable
`MONGODB_URI` source code yerine deployment secret mekanizmasından gelmelidir. Startup sırasında undefined ise application açık hata ile fail etmelidir. URI loglanmamalıdır. Environment-specific public veya private connection string doğru seçilmelidir. Secret version deployment metadata ile ilişkilendirilebilir.
MongoClient
Client module scope'ta bir kez oluşturulur. Service function'lar bu instance'ı reuse eder. Unit test production singleton'ına bağımlı olmadan dependency injection kullanabilir. Driver option'ları merkezi config'te bulunur. Client event listeners aynı module içinde register edilebilir.
Connection Pool
Örnekteki pool değerleri production için doğrudan kopyalanmamalıdır. Gerçek concurrency ve replica sayısı ölçülür. Load test optimal maxPoolSize'ı belirler. Min pool düşük traffic pattern'e göre seçilir. Wait queue metric sürekli izlenir.
Timeout Settings
Server selection ve connect timeout API deadline'a göre belirlenir. Socket timeout gerekirse operation duration'dan güvenli yüksek seçilir. `maxTimeMS` query bazında eklenebilir. Tek timeout her failure stage'i yönetmez. Timeout error type ayrı metric olur.
Retry
Driver retryable writes supported operation'larda resilience sağlar. Application ek retry yalnız idempotent flow'da yapılır. Exponential backoff ve jitter kullanılır. Total attempt request deadline'ı aşmaz. Retry success rate monitoring'e eklenir.
Health Monitoring
Startup ping connection readiness'i doğrular. Driver pool ve SDAM event'leri metric'e dönüştürülebilir. Health endpoint her request'te yeni MongoClient açmaz. Synthetic check farklı network location'dan ek güvence sağlar. Query performance connectivity health'ten ayrı izlenir.
Graceful Shutdown
SIGTERM handler önce traffic drain sürecini başlatır. Yeni request kabulü durur. In-flight database operation'lar tamamlanır. `closeDatabase()` çağrılır. Hard shutdown timeout orchestrator grace period içinde tutulur.
Error Logging
Error class, code, topology reason ve operation context structured biçimde kaydedilir. Connection string ve password redacted olmalıdır. DNS ve auth hataları ayrı category alır. Correlation id application trace ile Atlas event'i eşleştirmeye yardımcı olur. Error volume log system'i aşmaması için sampling uygulanabilir.
Uçtan Uca Örnek: Connection Storm'u Çözmek
Gerçek bir production senaryosunda Connections alert'i geldiğinde ilk iş pool'u artırmak değildir. Önce application instance sayısı ve MongoClient count kontrol edilir. Ardından query latency ile pool saturation ilişkisi incelenir. Slow query veya yanlış client lifecycle düzeltildikten sonra maxPoolSize daha uygun değere getirilebilir. Deployment sonrası aynı traffic altında connection baseline tekrar ölçülerek çözüm doğrulanır.
Atlas Connections Alert
Alert timestamp ve percentage değeri kaydedilir. Atlas graph'ta spike başlangıcı bulunur. CPU ve query latency aynı zaman aralığında açılır. Deployment annotation karşılaştırılır. Hard limite ne kadar headroom kaldığı hesaplanır.
Application Instance Sayısını Kontrol Etmek
HPA beklenenden fazla replica açmış olabilir. Deployment surge geçici extra pod üretmiş olabilir. Worker process sayısı da sayılır. Serverless platformda active instance tahmini alınır. Connection artışı instance artışıyla normalize edilir.
MongoClient Sayısını Kontrol Etmek
Code search bütün `new MongoClient` çağrılarını bulur. Runtime metric client initialization count tutabilir. Request path içinde client creation varsa hemen root cause adayıdır. Shared client pattern uygulanır. Deploy sonrası connection creation rate belirgin düşmelidir.
Pool Settings
maxPoolSize ve minPoolSize son config change ile karşılaştırılır. Çok yüksek min pool deployment storm yaratmış olabilir. WaitQueue timeout ve maxConnecting gözden geçirilir. Configuration environment bazında farklı mı kontrol edilir. Değerler load test sonucu olmadan artırılmaz.
Slow Query Analizi
Connection spike'tan hemen önce query P95 yükselmiş mi bakılır. Performance Advisor ve Query Profiler query shape'leri gösterir. High documents examined index problemi işaret edebilir. Query fix staging load test ile doğrulanır. Production canary sonrası pool occupancy izlenir.
maxPoolSize Ayarlamak
Gerçek per-instance concurrency ölçülerek yeni pool üst sınırı belirlenir. HPA max ile çarpılıp Atlas budget kontrol edilir. Küçültme queue yaratıyorsa query latency de değerlendirilir. Değişiklik canary rollout ile yapılır. P95 checkout ve throughput aynı anda izlenir.
Deployment Sonrası Tekrar Ölçmek
Aynı traffic profile altında Connections baseline karşılaştırılır. Creation rate, checkout P95 ve query latency düşmüş olmalıdır. Alert headroom geri gelmelidir. User error rate normale dönmelidir. RCA çözümün metric kanıtını içerir.
Uçtan Uca Örnek: SRV DNS Hatasını Teşhis Etmek
SRV hata senaryosunda database pool tuning ile zaman kaybetmeden DNS katmanı izole edilir. Error message sınıflandırılır, SRV ve TXT lookup gerçek container içinden çalıştırılır. Public resolver sonucu yalnız karşılaştırma için alınır. Standard Atlas URI diagnostic test olarak kullanılabilir. Kalıcı çözüm application'ın kullandığı resolver veya private DNS infrastructure üzerinde yapılır.
Hata Mesajını Sınıflandırmak
`querySrv ECONNREFUSED`, `ENOTFOUND` veya `EAI_AGAIN` birbirinden ayrılır. Timestamp ve pod id kaydedilir. Error bütün instance'larda mı tek node'da mı kontrol edilir. DNS resolver bilgisi loglanır. Authentication değişikliği yapılmaz.
dig SRV
Connection string hostname için `_mongodb._tcp` SRV sorgusu yapılır. Target ve port listesi kaydedilir. Response status incelenir. Container ve host sonucu karşılaştırılır. Private endpoint'te private SRV hostname kullanılmalıdır.
dig TXT
Aynı seed hostname için TXT lookup yapılır. Resolver TXT query'yi destekliyor mu görülür. Unexpected option veya empty result documentation ile karşılaştırılır. Public resolver diagnostic sonucu alınabilir. DNS cache farklılıkları TTL ile değerlendirilir.
Public DNS ile Karşılaştırmak
Public Atlas hostname için public resolver sonucu kurum resolver'ıyla karşılaştırılır. Public çalışıyor internal çalışmıyorsa DNS infrastructure root cause adayıdır. Private endpoint için public resolver'ın NXDOMAIN dönmesi normal olabilir. Comparison amacı açıkça belirtilmelidir. Production resolver'ı güvenlik policy'sini atlayarak kalıcı değiştirmek yapılmamalıdır.
Container İçinden Test
Application ile aynı network namespace'te test yapılır. CoreDNS veya Docker DNS path'i böylece doğrulanır. `/etc/resolv.conf` kaydedilir. Aynı node'daki başka pod sonucu karşılaştırılır. Node-specific resolver veya CNI problemi bulunabilir.
Standard URI ile Diagnostic Test
Atlas'ın sağladığı standard connection string SRV lookup'u bypass ederek diğer katmanları test eder. Bağlantı başarılıysa DNS SRV problemi daha güçlü kanıtlanır. Test URI secret olarak korunur. Sharded/private endpoint topology için doğru Atlas-generated string kullanılır. Permanent workaround kararı architecture review olmadan verilmez.
Kalıcı DNS Çözümü
Corporate resolver SRV forwarding düzeltilir veya CoreDNS upstream yapılandırması iyileştirilir. Private DNS zone doğru VPC'ye bağlanır. Capacity problemiyse resolver replica ve resource artırılır. Synthetic SRV check tekrarını önlemek için alert sağlar. Incident RCA DNS ownership ve runbook adımlarını günceller.
Uçtan Uca Örnek: AWS PrivateLink ile Atlas
AWS PrivateLink senaryosunda önce dedicated Atlas cluster ve private endpoint service hazırlanır. AWS VPC içinde interface endpoint oluşturulur ve Atlas ile eşleştirilir. Private DNS bağlantı string'i endpoint-specific adreslere çözmelidir. Application public URI yerine Atlas private connection string kullanır. DNS, security group ve high availability testleri production traffic öncesinde tamamlanır.
Dedicated Cluster
Private endpoint Free veya Flex cluster için desteklenmez. Uygun dedicated tier seçilir. Cluster region application VPC ile uyumlu planlanır. Multi-region requirement endpoint sayısını etkiler. Cost estimate cluster ve PrivateLink ücretlerini birlikte içerir.
Private Endpoint
Atlas project içinde AWS PrivateLink endpoint service oluşturulur. Atlas service name AWS tarafında interface endpoint kurulumu için kullanılır. Endpoint ID tekrar Atlas'a bağlanır. Status available olana kadar application rollout yapılmaz. Configuration Infrastructure as Code ile yönetilebilir.
VPC Endpoint
AWS interface endpoint bir veya birden fazla subnet içinde private IP alır. High availability için farklı availability zone subnet'leri değerlendirilebilir. Endpoint security group application source trafiğini kabul etmelidir. DNS option private hostname resolution'ı desteklemelidir. Endpoint metric ve CloudTrail audit izlenebilir.
Private DNS
Atlas private SRV hostname VPC içinden endpoint private IP'lerine çözülür. `dig SRV` ve `nslookup` application subnet'te çalıştırılır. Public workstation aynı sonucu vermek zorunda değildir. On-prem access varsa conditional forwarding gerekir. DNS association değişikliği production connection'ı doğrudan etkiler.
Atlas Private Connection String
Connection URI Atlas Connect ekranında Private Endpoint seçilerek alınır. Standard public URI kullanılmamalıdır. Sharded cluster ve uygun şartlarda optimized SRV seçeneği görülebilir. Driver minimum version kontrol edilir. URI secret manager'a environment-specific olarak yazılır.
DNS Test
SRV record endpoint-specific target'ları vermelidir. Target CNAME zinciri private interface endpoint IP'sine ulaşır. A lookup RFC1918 address gösterir. Farklı availability zone subnet'lerinden test tekrarlanır. DNS failure deployment gate'i durdurabilir.
Application Deployment
Application private subnet'te endpoint route'u ile çalışır. Security group outbound gerekli port aralığına izin verir. Shared MongoClient pool kullanılır. Public Access List connection için gereksizse policy ile kapatılabilir. Deployment canary synthetic ping ile doğrulanır.
High Availability Test
Bir availability zone endpoint path'i geçici devre dışı bırakılarak failover test edilebilir. Multi-region cluster'da region endpoint planı ayrıca doğrulanır. Driver recovery ve DNS resolution behavior ölçülür. User error rate SLO içinde kalmalıdır. Test sonucu architecture recovery documentation'a eklenir.
MongoDB Atlas Bağlantılarında Sık Yapılan Hatalar
Atlas connection incident'lerinin önemli bölümü birkaç tekrar eden uygulama ve altyapı hatasından çıkar. Her request'te MongoClient oluşturmak connection lifecycle'ın en pahalı örneklerinden biridir. Timeout'ları rastgele artırmak ve TLS validation'ı kapatmak kök nedeni gizler. HPA sonrası pool budget'ı yeniden hesaplamamak production scale'de beklenmedik limit aşımı yaratır. Query problemini yalnız connection configuration ile çözmeye çalışmak da sistemi daha fazla yük altına sokabilir.
Her Request'te Yeni MongoClient
Her request yeni pool ve monitoring connection oluşturur. TLS handshake sürekli tekrarlanır. Traffic connection count'a doğrudan dönüşür. Shared process-level client kullanmak temel çözümdür. Code review bu pattern'i otomatik kontrol edebilir.
maxPoolSize'ı Gereksiz Yere Çok Yüksek Tutmak
Büyük pool throughput garantisi değildir. Database capacity aşılırsa latency artar. HPA toplam theoretical connection sayısını büyütür. Load test optimal değeri göstermelidir. Headroom hard limitten önce korunmalıdır.
Her Timeout'u Artırarak Problemi Gizlemek
DNS veya firewall sorunu timeout artışıyla düzelmez. Kullanıcı yalnız daha uzun bekler. Hangi timeout'un tetiklendiği önce belirlenir. Budget request deadline'a göre tasarlanır. Root cause ilgili katmanda çözülür.
0.0.0.0/0 ile Production Çalıştırmak
Wildcard IPv4 bütün internetten network erişimi açar. Database password olsa bile gereksiz risk oluşturur. Static egress veya private endpoint kullanılmalıdır. Temporary troubleshooting entry kısa süreli olabilir. Organization policy wildcard rule'u yasaklayabilir.
TLS Validation'ı Kapatmak
Invalid certificate kabul etmek server identity validation'ı kaldırır. Diagnostic test production config'e taşınmamalıdır. CA store ve hostname problemi çözülmelidir. CI unsafe option kontrolü yapabilir. Private network TLS ihtiyacını ortadan kaldırmaz.
Atlas User ile Database User'ı Karıştırmak
Atlas control plane user application database login'i değildir. Service için database user oluşturulur. Role minimum yetkiyle atanır. Runbook iki terimi açıkça ayırır. Authentication error network troubleshooting'e gereksiz zaman harcamaz.
Password URL-Encoding Yapmamak
Reserved URI karakterleri password parse davranışını bozar. Percent-encoding doğru component'a uygulanmalıdır. Manuel string concatenation kullanılmamalıdır. Secret raw value güvenli store'da tutulabilir. Test password'leri özel karakter içermelidir.
HPA Sonrası Connection Budget'ı Yeniden Hesaplamamak
Replica sayısı arttığında pool count da artar. Eski maxPoolSize yeni architecture için fazla olabilir. Deployment surge ek çarpan getirir. Atlas limit ve headroom yeniden hesaplanır. HPA config review database owner onayı isteyebilir.
Query Problemini Connection Problemi Sanmak
Slow query pool'u doldurarak checkout timeout üretir. Pool büyütmek daha fazla slow query'yi parallel çalıştırabilir. Query Profiler ve Performance Advisor incelenmelidir. Documents examined ve CPU metric karar verir. Root cause query ise index veya code düzeltilmelidir.
Failover Testi Yapmamak
Replica set var diye application'ın otomatik recovery edeceği varsayılmamalıdır. Network bütün members'a açık olmayabilir. Driver version veya timeout failover'u bozabilir. Controlled test user impact'i ölçer. Runbook gerçek recovery süresiyle güncellenir.
MongoDB Atlas İçin En İyi Programlama Dili Hangisidir?
MongoDB Atlas için tek bir “en iyi” programlama dili yoktur. JavaScript, Python, Java, C# ve Go dahil birçok dil için resmî MongoDB driver ecosystem bulunur. Production güvenilirliğini belirleyen asıl unsur connection lifecycle, pooling, timeout ve network davranışını doğru uygulamaktır. Ekip bildiği dili ve framework'ü seçerken driver support ve observability capability'lerini değerlendirmelidir. Aynı kötü connection pattern farklı programlama dillerinde aynı production sorunlarını üretir.
JavaScript / TypeScript
Node.js resmî MongoDB driver ve Mongoose ecosystem nedeniyle yaygın backend seçeneğidir. Async I/O yüksek concurrent API workload'larına uygundur. MongoClient pool process içinde reuse edilmelidir. TypeScript application model ve config type güvenliği sağlar. Driver event'leri observability katmanına kolayca bağlanabilir.
Python
PyMongo MongoDB'nin resmî Python driver'ıdır. Web API, data processing ve automation workload'larında kullanılabilir. MongoClient thread-safe connection pooling davranışı sunar. Process ve worker architecture pool count'u etkiler. Async Python kullanılıyorsa güncel driver guidance takip edilmelidir.
Java
MongoDB Java driver uzun ömürlü enterprise backend sistemlerinde güçlü ecosystem sunar. JVM connection pool ve monitoring ayarları production tuning için geniş control sağlar. Spring Data MongoDB gibi framework'ler driver üzerinde abstraction ekler. Application context client lifecycle'ı yönetmelidir. Thread pool ile database pool concurrency birlikte düşünülmelidir.
C# / .NET
MongoDB .NET/C# driver async database operation ve connection pooling desteği sağlar. MongoClient uzun ömürlü ve shared kullanılmalıdır. ASP.NET dependency injection singleton client lifecycle için doğal yapı sunar. Serializer ve LINQ query behavior query performance açısından incelenmelidir. Driver command monitoring observability için kullanılabilir.
Go
MongoDB Go driver cloud-native servislerde yaygın tercih olabilir. Context deadline timeout propagation için güçlü model sağlar. Client reuse ve pool config yine temel prensiptir. Goroutine concurrency database concurrency'yi kolayca büyütebilir. Load test pool size ve context timeout davranışını birlikte ölçmelidir.
MongoDB'nin Resmî Driver Ekosistemi
Resmî driver kullanmak server feature compatibility ve support açısından güçlü varsayımdır. Her driver option adları ve default değerlerde küçük farklılıklar taşıyabilir. Bu rehberde verilen Node.js default'ları başka dile doğrudan kopyalanmamalıdır. Driver documentation deployment dili için ayrıca okunmalıdır. EOL version'lar merkezi dependency inventory'de görünür olmalıdır.
En İyi Dilden Daha Önemli Olan Connection Lifecycle Bilgisi
Programlama dili seçimi production connection hatalarının yalnız küçük bölümünü belirler. DNS, TLS, pool sizing ve retry davranışı her platformda öğrenilmelidir. Developer connection'ın hangi aşamalardan geçtiğini anlayabiliyorsa farklı driver API'lerine kolayca adapte olur. Cloud networking bilgisi modern database engineering'in önemli parçasıdır. Sağlıklı lifecycle bilgisi framework trendlerinden daha uzun ömürlü bir yetkinliktir.
Yazılımcı Olmak İçin Ne Yapmalı? MongoDB Backend Yol Haritası
MongoDB backend öğrenmek yalnız CRUD method'larını ezberlemek değildir. Bir programlama dili temelinin ardından networking, DNS ve TLS bilgisi production troubleshooting yeteneğini oluşturur. MongoDB query, index ve connection pooling konuları bunun üzerine eklenir. Docker ve cloud networking deployment dünyasını anlamayı sağlar. Observability ve production incident pratiği geliştiriciyi tutorial seviyesinden gerçek sistem geliştirme seviyesine taşır.
Bir Programlama Dili
JavaScript, Python, Java, C# veya Go dillerinden biriyle sağlam temel oluşturulabilir. Async programming ve error handling öğrenilmelidir. HTTP API geliştirip database entegrasyonu yapılabilir. Test ve package management bilgisi eklenmelidir. Dil sık değiştirmek yerine bir ecosystem içinde gerçek proje tamamlamak daha değerlidir.
Networking
TCP connection, port, IP, NAT ve firewall kavramları öğrenilmelidir. `nc` ve basic network diagnostic araçları kullanılmalıdır. Public ve private network farkı anlaşılmalıdır. Cloud security group ve route table uygulamalı çalışılmalıdır. Database connection sorunlarının önemli bölümü bu bilgiyi kullanır.
DNS
A, AAAA, CNAME, SRV ve TXT kayıtları öğrenilmelidir. `dig` ve `nslookup` kullanımı pratik yapılmalıdır. Resolver ve cache davranışı anlaşılmalıdır. Private DNS ve split-horizon senaryoları test edilebilir. MongoDB `mongodb+srv://` bu bilginin doğrudan kullanım alanıdır.
TLS
Certificate, CA chain, hostname validation ve SNI kavramları öğrenilmelidir. OpenSSL ile handshake incelenebilir. TLS validation neden kapatılmamalı uygulamalı görülmelidir. Client certificate authentication ayrı konu olarak çalışılabilir. Security ile networking arasındaki ilişki netleşir.
MongoDB
Document model, CRUD, aggregation ve replica set temelleri öğrenilmelidir. Atlas üzerinde küçük cluster oluşturulabilir. Database user ve Access List kurulumu yapılabilir. Failover ve read preference kavramları incelenir. Query explain plan kullanımı erken aşamada öğrenilmelidir.
Indexing
Single-field ve compound index davranışı gerçek dataset üzerinde test edilmelidir. Explain execution statistics okunmalıdır. Documents examined ve returned karşılaştırılır. Fazla index'in write cost'u ölçülür. Performance Advisor önerileri neden doğru veya yanlış olabilir tartışılmalıdır.
Connection Pooling
Her request'te connection açma ile shared pool benchmark edilmelidir. maxPoolSize farklı değerlerle load test yapılabilir. Checkout queue gözlemlenir. Query latency arttığında pool behavior incelenir. Connection budget hesaplama pratik edilir.
Docker
Application container içine alınır. Container DNS ve environment variable behavior test edilir. CA certificate eksik image örneği çözülebilir. Docker network üzerinden Atlas bağlantısı yapılır. Secret image layer içine yazılmamalıdır.
Cloud Networking
VPC, subnet, NAT Gateway ve private endpoint temel kavramları öğrenilir. Atlas PrivateLink veya equivalent provider setup laboratuvar ortamında kurulabilir. Route ve security group hatası bilinçli oluşturulup düzeltilir. Multi-region latency ölçülür. Networking bilgisi database engineer için güçlü avantaj sağlar.
Observability
Application metric, log ve trace birlikte kullanılmalıdır. MongoDB driver connection event'leri metric'e dönüştürülebilir. P95 ve P99 latency kavramları öğrenilir. Dashboard query ve pool verisini aynı yerde gösterir. Alert runbook bağlantısı gerçek incident pratiği sağlar.
Production Troubleshooting
DNS failure, firewall block ve failover chaos testleri yapılmalıdır. Hata mesajından hangi katmana bakılacağı ezber yerine mantıkla anlaşılmalıdır. Incident timeline yazma alışkanlığı geliştirilir. Mitigation ile root cause ayrılır. Her laboratuvar sonunda kısa RCA hazırlanması öğrenmeyi güçlendirir.
Open Source ve İşbirliği ile MongoDB Yetkinliği
MongoDB ecosystem açık kaynak driver, ODM ve observability araçları üzerinden öğrenme fırsatı sunar. GitHub issue okumak gerçek production edge case'lerini görmenin etkili yollarından biridir. Bir driver bug'ı şüphesinde minimal reproduction hazırlamak yalnız issue açmak için değil problemi gerçekten anlamak için değerlidir. Benchmark sonuçları başkalarının aynı config'i değerlendirmesine yardımcı olur. Açık kaynak katkısı kod kadar teknik iletişim ve test disiplini de kazandırır.
MongoDB Drivers
Resmî driver repository'leri connection pool ve protocol implementation'ını incelemek için güçlü kaynaktır. Release note hangi bug'ların düzeltildiğini gösterir. Issue tracker edge-case connection sorunlarını içerir. Küçük documentation fix contribution başlangıç için uygundur. Specification repository'leri driverlar arası ortak behavior'ı anlamaya yardımcı olur.
Mongoose
Mongoose açık kaynak ODM olarak Node.js community'sinde geniş kullanıma sahiptir. Connection buffering ve model lifecycle source code üzerinden incelenebilir. Issue reproduction hazırlamak framework ile native driver farkını öğretir. Documentation contribution yeni geliştirici için değerli başlangıçtır. Production bug report version ve minimal repo içermelidir.
OpenTelemetry
OpenTelemetry distributed tracing ve metric standardları sunar. MongoDB client operation'ları application request trace'iyle ilişkilendirilebilir. Sensitive query data instrumentation sırasında filtrelenmelidir. Driver event'leri custom metric üretmek için kullanılabilir. Open source collector ve exporter ecosystem observability altyapısını esnek kılar.
GitHub Issue İncelemek
Issue ararken aynı error message tek başına yeterli değildir. Driver version, runtime ve topology ile filtrelemek gerekir. Closed issue resolution release note'a yönlendirebilir. Community workaround production'a uygulanmadan önce resmî documentation ile doğrulanmalıdır. Issue okumak debugging pattern öğrenmenin iyi yoludur.
Driver Bug'ları İçin Minimal Reproduction
Minimal repository yalnız problemi oluşturan code ve configuration'ı içerir. Secret ve gerçek production hostname kaldırılır. Driver ve Node version açıkça yazılır. Beklenen ve gerçek behavior adım adım belirtilir. Maintainer'ın problemi hızlı tekrar etmesi fix süresini kısaltır.
Benchmark Paylaşımı
Pool veya driver benchmark hardware ve workload bilgisi olmadan anlamlı değildir. Query mix, replica sayısı ve Atlas tier yazılmalıdır. Cold ve warm sonuçlar ayrılmalıdır. P95 latency average ile birlikte sunulmalıdır. Reproducible script community'nin sonucu doğrulamasını sağlar.
Open Source Monitoring Araçları
Prometheus, OpenTelemetry ve dashboard araçları driver metric'lerini toplamak için kullanılabilir. Araç seçimi production security ve retention requirement'a göre yapılmalıdır. High-cardinality labels observability cost'u artırır. Database credential hiçbir metric veya trace attribute'a eklenmemelidir. Shared dashboard template ekiplerin aynı SLI'ları izlemesini kolaylaştırır.
Diyarbakır Yazılım Topluluğu ile MongoDB Atlas Çalışmaları
MongoDB Atlas gibi production odaklı konular en iyi gerçek laboratuvar ve ortak troubleshooting çalışmalarıyla öğrenilir. Diyarbakır Yazılım Topluluğu içinde backend geliştiriciler connection pooling, DNS ve cloud networking konusunda küçük açık kaynak projeler oluşturabilir. Böyle çalışmalar yeni başlayanların yalnız CRUD değil production düşüncesi geliştirmesine yardımcı olur. Topluluk projeleri ve teknik çalışmalar için https://www.diyarbakiryazilim.com.tr/projects adresi incelenebilir. Frontend tarafında kullanıcı deneyimini etkileyen performans çalışmalarına farklı bir örnek görmek isteyenler https://www.diyarbakiryazilim.com.tr/posts/kullanici-etkilesimlerini-yavaslatmayan-animasyon-teknikleri içeriğine de göz atabilir.
Diyarbakır Yazılım Topluluğu İçinde Backend Çalışmaları
Backend çalışma grupları Node.js, Python veya Java üzerinden ortak Atlas örnekleri geliştirebilir. Her ekip farklı connection failure senaryosu hazırlayabilir. Sonuçlar tek troubleshooting dokümanında birleştirilebilir. Code review yalnız feature code değil pool ve secret yönetimini de kapsayabilir. Bu çalışma katılımcılara gerçek production bakış açısı kazandırır.
MongoDB Atlas Workshopları
Workshop ilk bölümde Atlas cluster ve database user kurulumu ile başlayabilir. Sonra SRV DNS, Access List ve TLS testleri uygulanabilir. İkinci bölüm connection pool load test'e ayrılabilir. Son bölüm failover ve incident runbook pratiği içerebilir. Her katılımcı kendi metric sonuçlarını karşılaştırarak neden tek pool değerinin herkese uymadığını görebilir.
Connection Pool Laboratuvarı
Küçük Node.js API farklı maxPoolSize değerleriyle yük altında çalıştırılabilir. Driver checkout event'leri Prometheus metric'e dönüştürülebilir. Slow query bilinçli eklenip pool saturation gözlemlenir. Query index eklendikten sonra connection behavior tekrar ölçülür. Bu laboratuvar query ve pool ilişkisinin teoriden çok daha hızlı anlaşılmasını sağlar.
DNS ve Network Troubleshooting Atölyesi
SRV DNS record `dig` ile incelenebilir. Docker container'a yanlış resolver verilerek `EAI_AGAIN` veya benzeri sorunlar simüle edilebilir. Firewall port block ile TCP timeout üretilebilir. TLS CA eksik container ayrı senaryo olabilir. Katılımcılar hata mesajına göre doğru katmanı seçerek runbook oluşturur.
Open Source ve İşbirliği Projeleri
Topluluk reusable connection monitoring package geliştirebilir. Driver event'lerini OpenTelemetry metric'lerine dönüştüren modül açık kaynak yayınlanabilir. Documentation Türkçe ve İngilizce hazırlanabilir. Issue'lar beginner ve advanced etiketleriyle ayrılabilir. Review süreci gerçek ekip çalışma alışkanlığı kazandırır.
Diyarbakır'daki En İyi Yazılımcılarla Teknik Deneyim Paylaşımı
Bir geliştiriciyi yalnız kullandığı framework sayısıyla değerlendirmek doğru değildir. Production incident çözme, network katmanını anlama ve ölçümle karar verme önemli göstergelerdir. Topluluk teknik sunumları farklı deneyim seviyelerini aynı problem üzerinde buluşturabilir. Katılımcılar gerçek fakat anonimleştirilmiş incident senaryoları paylaşabilir. Topluluk hakkında daha fazla bilgi için https://www.diyarbakiryazilim.com.tr/about adresi kullanılabilir.
Ortak Proje Fikirleri
Ortak projeler yalnız demo CRUD uygulaması yerine production tooling problemlerine odaklanabilir. Connection monitor, benchmark aracı veya incident dashboard'u gerçek teknik değer üretir. Projeler küçük bağımsız issue'lara bölünerek yeni katkıcılara giriş alanı sağlar. CI, test ve documentation baştan eklenmelidir. Açık kaynak yayınlanan sonuçlar yerel topluluğun dışındaki geliştiriciler için de kullanılabilir.
MongoDB Atlas Connection Monitor
Node.js driver pool ve SDAM event'lerini toplayan küçük monitoring service geliştirilebilir. Checkout P95, creation rate ve topology change metric'leri üretilebilir. Sensitive field'lar hiçbir zaman kaydedilmez. Prometheus exporter veya OpenTelemetry output eklenebilir. Proje connection troubleshooting için doğrudan kullanılabilir açık kaynak araç hâline gelebilir.
Node.js Connection Pool Benchmark
Farklı maxPoolSize ve maxConnecting kombinasyonlarını otomatik test eden benchmark repository hazırlanabilir. Query duration sentetik olarak kontrol edilir. Replica sayısı Docker veya Kubernetes ile değiştirilebilir. Sonuçlar throughput ve P99 latency tablosu hâline getirilir. Hardware ve Atlas tier bilgisi raporda mutlaka yer almalıdır.
Private Endpoint Laboratuvarı
Test AWS hesabında Atlas PrivateLink setup Infrastructure as Code ile kurulabilir. DNS SRV ve CNAME zinciri incelenir. Security group hatası bilinçli oluşturulup düzeltilir. Multi-AZ endpoint davranışı test edilir. Maliyet kontrolü için kaynakların workshop sonunda otomatik silinmesi sağlanmalıdır.
Atlas Incident Dashboard
Dashboard Atlas connection, CPU ve network metric'lerini application deployment event'leriyle aynı timeline'da gösterebilir. Driver checkout ve pool clear metric'leri de eklenir. Incident sırasında tek ekrandan causal ilişki görülür. Alert link'i doğrudan ilgili dashboard zaman aralığını açabilir. Open source template farklı projelere kolayca uyarlanabilir.
Sık Sorulan Sorular
MongoDB Atlas connection sorunlarında en fazla soru connection string, DNS, pool size ve timeout değerleri üzerine geliyor. Tek bir ayarı değiştirerek bütün production senaryolarını çözmek mümkün değildir. Network path ile query performance ayrı ölçülmelidir. Driver ve Atlas metric'leri birlikte kullanıldığında doğru karar vermek çok daha kolaylaşır. Aşağıdaki kısa yanıtlar en sık karşılaşılan soruların temel karar noktalarını özetler.
MongoDB Atlas'a neden bağlanamıyorum?
En yaygın nedenler yanlış IP Access List, DNS resolution, firewall, TLS ve authentication ayarlarıdır. Önce SRV DNS sorgusunu application host içinde test edin. Ardından TCP port erişimini ve TLS handshake'i ayrı kontrol edin. Bunlar başarılıysa database user ve URI encoding'e geçin. Tek bir genel timeout mesajıyla doğrudan password değiştirmeyin.
MongoDB Atlas IP whitelist nasıl yapılır?
Atlas güncel terminolojide IP Access List kullanır. Project Network Access bölümünde source IP veya CIDR eklenebilir. Production için mümkün olan en dar source range tercih edilmelidir. Static NAT egress `/32` entry kullanımını kolaylaştırır. Wildcard IPv4 permanent production çözümü olmamalıdır.
mongodb+srv nedir?
`mongodb+srv://` DNS seedlist connection formatıdır. Driver SRV kayıtlarını kullanarak başlangıç cluster hostlarını bulur. TXT kaydı bazı connection option'ları sağlayabilir. URI host listesini elle yönetme ihtiyacını azaltır. DNS resolver SRV sorgularını desteklemelidir.
mongodb:// ile mongodb+srv:// arasındaki fark nedir?
Standard `mongodb://` hostları URI içinde açıkça listeler. SRV formatı host seed bilgisini DNS'ten alır. İki format da driver topology discovery kullanabilir. SRV Atlas değişikliklerine daha kolay uyum sağlayabilir. Standard URI DNS SRV problemi için diagnostic fallback olarak değerlidir.
querySrv ECONNREFUSED nasıl çözülür?
Önce application ortamındaki DNS resolver kontrol edilir. `_mongodb._tcp` SRV sorgusu `dig` ile çalıştırılır. Corporate DNS, VPN veya container DNS farkları incelenir. Public resolver sonucu karşılaştırma için kullanılabilir. Atlas standard URI çalışıyorsa problem SRV resolver tarafında daha güçlü biçimde doğrulanır.
EAI_AGAIN ne demektir?
Genellikle geçici DNS resolution failure veya resolver timeout anlamına gelir. Kubernetes CoreDNS ve Docker resolver health kontrol edilmelidir. Birkaç jittered retry transient problemi toparlayabilir. Sürekli hata resolver capacity veya network problemi olarak ele alınmalıdır. Timeout'u artırmak kalıcı çözüm değildir.
MongoServerSelectionError neden oluşur?
Driver uygun MongoDB server bulamadığında oluşur. DNS, Access List, firewall, TLS veya no-primary topology bunun nedeni olabilir. Error içindeki topology description ve nested cause okunmalıdır. Hangi server'ın Unknown görüldüğü incelenir. Troubleshooting DNS'ten topology'ye katmanlı ilerlemelidir.
Server selection timeout nasıl çözülür?
Önce server'ın neden seçilemediği bulunmalıdır. DNS ve TCP path doğru mu kontrol edilir. Replica set primary mevcut mu Atlas event'lerinden bakılır. Timeout yalnız request SLO'ya göre sonra ayarlanır. Kök neden bozuk network iken süreyi artırmak sorunu çözmez.
ReplicaSetNoPrimary ne demektir?
Driver topology görünümünde usable primary bulunmadığını gösterir. Normal election sırasında kısa süre görülebilir. Uzun sürerse bütün replica members'a network erişimi kontrol edilir. SDAM event'leri hangi member'ların görüldüğünü gösterir. Atlas cluster health de aynı anda incelenmelidir.
MongoDB Atlas authentication failed nasıl çözülür?
Database username, password ve `authSource` kontrol edilmelidir. Atlas web user yerine database user kullanılmalıdır. Password reserved URI karakterleri percent-encoded olmalıdır. Credential rotation sonrası eski secret kalıp kalmadığı incelenir. User role hedef database operation'ı için yeterli olmalıdır.
MongoDB connection pool nedir?
Driver'ın açık database connection'larını tekrar kullanmak için tuttuğu havuzdur. Her operation yeni TCP ve TLS connection açmak zorunda kalmaz. Pool latency ve connection churn'ü azaltır. Her MongoClient kendi pool'larına sahiptir. Pool size application concurrency ve cluster capacity ile birlikte ayarlanmalıdır.
maxPoolSize kaç olmalıdır?
Tek doğru sayı yoktur. Concurrent database operations, query duration ve replica sayısı ölçülmelidir. Node.js driver default değeri 100 olsa da bu optimum anlamına gelmez. Küçük başlayıp checkout latency ve throughput load test ile izlenebilir. Toplam deployment connection budget Atlas limitinden güvenli biçimde düşük tutulmalıdır.
minPoolSize ne işe yarar?
Pool'da minimum belirli sayıda connection'ı hazır tutar. Warm traffic latency'sini azaltabilir. Node.js driver default değeri 0'dır. Serverless veya idle workload'da yüksek minimum gereksiz connection tüketebilir. Deployment storm etkisi mutlaka hesaplanmalıdır.
maxConnecting nedir?
Bir pool'un aynı anda kaç yeni connection kurabileceğini sınırlar. Node.js driver güncel default değeri 2'dir. Değer pool warm-up hızını kontrol eder. Çok yüksek değer connection storm riskini artırır. Çok düşük değer traffic spike sırasında checkout tail latency oluşturabilir.
waitQueueTimeoutMS nedir?
Pool doluyken operation'ın boş connection bekleyeceği maksimum süredir. Node.js driver default değeri 0, yani limitsiz beklemedir. Production API'de bu davranış request deadline ile uyumlu değerlendirilmelidir. Sınır aşıldığında checkout error oluşabilir. Queue timeout root cause olarak slow query ve pool saturation analizini tetiklemelidir.
Node.js'te her request için MongoDB bağlantısı açılır mı?
Açılmamalıdır. Process başına shared MongoClient kullanmak önerilen yaklaşımdır. Driver kendi connection pool'u üzerinden socket'leri request'ler arasında reuse eder. Her request yeni client açmak latency ve connection count'u artırır. Serverless ortamda da mümkün olduğunca warm instance içinde client reuse edilmelidir.
Serverless MongoDB bağlantıları nasıl optimize edilir?
MongoClient function handler dışında oluşturulup warm invocation'larda reuse edilmelidir. Pool size instance concurrency'ye göre düşük tutulabilir. Maximum function instance sayısı Atlas connection budget ile sınırlandırılmalıdır. Dynamic egress için static NAT veya private connectivity değerlendirilebilir. Cold-start ve warm latency ayrı ölçülmelidir.
Docker içinden MongoDB Atlas'a nasıl bağlanılır?
Container doğru URI ve secret'ı almalıdır. SRV DNS container içinden çözülmelidir. Outbound TCP route ve firewall açık olmalıdır. CA certificates TLS doğrulaması için image içinde bulunmalıdır. Hostta çalışan test container bağlantısını otomatik olarak doğrulamaz.
Kubernetes'ten MongoDB Atlas'a nasıl bağlanılır?
CoreDNS, pod egress, NAT ve NetworkPolicy doğru yapılandırılmalıdır. Public endpoint için NAT egress IP Access List'e eklenir. Private endpoint kullanılıyorsa private DNS ve route kontrol edilir. MongoClient pod process'inde reuse edilir. HPA replica sayısı connection budget'a dahil edilir.
Private Endpoint nedir?
Atlas ile cloud virtual network arasında public internet kullanmadan private bağlantı kuran network yöntemidir. AWS PrivateLink, Azure Private Link ve GCP Private Service Connect desteklenir. Dedicated Atlas cluster gerektirir. Private DNS ve endpoint security configuration gerekir. Security avantajı karşılığında ek network operasyonu ve maliyet getirir.
MongoDB Atlas bağlantı limiti nedir?
Limit cluster tier ve node türüne göre değişir. Free ve Flex ile dedicated tier'lar aynı capacity'ye sahip değildir. Sharded cluster'da mongos başına limit dikkate alınabilir. Güncel değer deployment tier documentation'ından kontrol edilmelidir. Application hard limite ulaşmadan safety headroom bırakmalıdır.
Connection storm nedir?
Kısa sürede çok sayıda yeni database connection açılmasıdır. Deployment, HPA, restart veya failover tetikleyebilir. Slow query pool growth üzerinden dolaylı storm oluşturabilir. MongoClient reuse, maxConnecting ve startup jitter riski azaltır. Connection creation rate tespit için önemli metriktir.
MongoDB Atlas için en iyi programlama dili hangisidir?
Tek bir en iyi dil yoktur. MongoDB JavaScript, Python, Java, C#, Go ve başka diller için resmî driver'lar sunar. Ekip deneyimi ve workload gereksinimi daha önemlidir. Connection lifecycle her dilde doğru uygulanmalıdır. Driver'ın güncel ve desteklenen sürümü kullanılmalıdır.
MongoDB öğrenen yazılımcı nereden başlamalıdır?
Önce bir backend dili ve temel networking bilgisi öğrenilmelidir. MongoDB CRUD ardından index ve aggregation konularına geçilebilir. DNS, TLS ve connection pooling production bilgisi için önemlidir. Docker ve cloud networking uygulamalı çalışılmalıdır. Son aşamada observability ve incident troubleshooting pratiği yapılmalıdır.
Open source ve işbirliği MongoDB kariyerine nasıl katkı sağlar?
Driver ve Mongoose issue'larını incelemek gerçek production problemlere erişim sağlar. Minimal reproduction hazırlamak debugging becerisini geliştirir. Documentation veya test contribution code review deneyimi kazandırır. Benchmark paylaşımı performance düşüncesini güçlendirir. Topluluk projeleri profesyonel network ve portfolyo için somut çalışma oluşturur.
MongoDB Atlas sunucu bağlantısı nasıl optimize edilir?
İlk adım tek MongoClient kullanıp connection pool'u process boyunca reuse etmektir. Pool size gerçek concurrency ve query duration üzerinden ölçülmelidir. DNS, TCP ve TLS establishment latency ayrı takip edilmelidir. Slow query'ler connection'ı uzun süre checkout tuttuğu için index ve query performansı da optimization'ın parçasıdır. MongoDB Atlas Sunucu Bağlantı Optimizasyonu ve Sorun Giderme yalnız driver option ayarlamak değil application, network ve database kapasitesini aynı modelde yönetmektir.
MongoDB Atlas bağlantısında Server Selection Timeout hatası nasıl çözülür?
Önce error'ın altında DNS, firewall, Access List veya no-primary durumlarından hangisinin bulunduğu tespit edilmelidir. Driver topology description bu konuda güçlü ipucu verir. Target hostlara TCP erişimi ve TLS handshake bağımsız test edilir. Atlas cluster event'leri primary election açısından kontrol edilir. `serverSelectionTimeoutMS` yalnız root cause çözüldükten sonra application request budget'a uygun seviyede ayarlanmalıdır.
MongoDB Atlas bağlantı sorunlarında IP Access List DNS connection string ve firewall ayarları nasıl kontrol edilir?
Application'ın gerçek egress IP'si bulunup Atlas IP Access List ile karşılaştırılır. Aynı runtime ortamında SRV, TXT ve A kayıtları DNS araçlarıyla sorgulanır. Connection string Atlas Connect ekranından yeniden alınarak hostname doğrulanır. SRV sonucundaki target portlara `nc` ile TCP connectivity test edilir. DNS çalışıyor fakat port timeout veriyorsa firewall, route, NAT ve private endpoint güvenlik kuralları incelenir.
MongoDB Atlas performansını artırmak için connection pooling timeout ve bağlantı limitleri nasıl yapılandırılmalıdır?
Önce concurrent database operation ve query duration ölçülmelidir. `maxPoolSize` application replica ve worker sayısıyla birlikte total connection budget içine yerleştirilir. `waitQueueTimeoutMS`, server selection ve connect timeout değerleri HTTP request deadline'ın altında anlamlı bir budget paylaşmalıdır. Atlas connection headroom ile CPU ve query latency aynı anda izlenmelidir. Daha büyük pool ancak load test throughput artışı gösteriyorsa tercih edilmelidir.
MongoDB Atlas bağlantı optimizasyonu ve sorun giderme konusunda yakınımda danışmanlık veya eğitim nerede bulabilirim?
Yerel teknik topluluklar backend, cloud networking ve database performansı konusunda uygulamalı çalışma fırsatı sunabilir. MongoDB Atlas ve veritabanı performans danışmanlığı yakınımda araması yaparken yalnız MongoDB komutlarını bilen değil DNS, TLS, pooling ve observability konularını birlikte ele alan teknik yaklaşımı değerlendirmek faydalıdır. Kurumsal MongoDB Atlas bağlantı ve veritabanı performans optimizasyon hizmeti gereksinimlerinde de önce mevcut connection metric ve incident verileri üzerinden ölçüm yapılmalıdır. Diyarbakır Yazılım Topluluğu'nun çalışma ve iletişim bilgileri için https://www.diyarbakiryazilim.com.tr/about adresi kullanılabilir. Proje çalışmalarını görmek için https://www.diyarbakiryazilim.com.tr/projects adresi incelenebilir.
Sonuç: MongoDB Atlas Bağlantı Problemlerini Katman Katman Çözün
MongoDB Atlas Sunucu Bağlantı Optimizasyonu ve Sorun Giderme sürecinde en güçlü yaklaşım bağlantıyı tek bir hata mesajı yerine DNS, TCP, TLS, authentication, topology, pool ve query aşamalarına bölmektir. Böyle çalıştığınızda `querySrv` hatasında pool size değiştirmek veya slow query sırasında firewall aramak gibi yanlış müdahalelerden kaçınırsınız. Connection pool'u application replica sayısıyla birlikte planlamak, timeout'ları request budget'a bağlamak ve driver event'lerini Atlas metric'leriyle birleştirmek production davranışını çok daha görünür hâle getirir. Failover, DNS failure ve connection storm gibi senaryolar production öncesinde test edildiğinde gerçek incident sırasında karar vermek kolaylaşır. MongoDB, backend mimarisi ve açık kaynak teknik çalışmalar için Diyarbakır Yazılım Topluluğu'na https://www.diyarbakiryazilim.com.tr üzerinden ulaşabilirsiniz.
Önce DNS'i Doğrulayın
SRV connection kullanıyorsanız troubleshooting DNS'ten başlamalıdır. Application host içinde SRV, TXT ve target address resolution test edilmelidir. Resolver doğru çalışmıyorsa database'e henüz ulaşılmamıştır. Private endpoint'te public DNS değil private resolution beklenir. DNS kanıtı elde edilmeden authentication veya pool option değişikliği yapılmamalıdır.
Ardından TCP ve Network Access'i Kontrol Edin
DNS başarılı olduktan sonra target host ve port TCP seviyesinde test edilir. Egress IP Atlas Access List'te olmalıdır. Firewall, security group ve route table birlikte incelenir. Private endpoint provider-specific port gereksinimleri dikkate alınır. TCP başarılıysa TLS katmanına geçilir.
TLS ile Authentication'ı Ayrı Test Edin
TLS handshake certificate ve server identity doğrulamasıdır. Authentication database user kimliğini kontrol eder. İki hata türü farklı kök nedenlere sahiptir. OpenSSL TLS'i, driver veya shell database credential'ı test edebilir. TLS validation kapatılarak production bırakılmamalıdır.
Tek MongoClient ve Kontrollü Connection Pool Kullanın
Process başına shared MongoClient connection reuse sağlar. Her request yeni client açmak connection storm üretir. maxPoolSize gerçek concurrency ile ölçülür. Wait queue bounded failure sağlayabilir. Driver pool event'leri capacity kararını veriyle destekler.
Replica/Worker Sayısını Pool Budget'a Dahil Edin
Per-instance pool değeri tek başına anlamlı değildir. Kubernetes pod, serverless instance ve worker process sayısı çarpan olarak eklenir. Deployment surge temporary connection sayısını artırır. Read preference başka server pool'larını aktif edebilir. Safety headroom Atlas limitinin altında korunmalıdır.
Timeout Değerlerini Rastgele Artırmayın
Her timeout farklı connection aşamasını sınırlar. Server selection, TCP connect, socket ve query operation süreleri ayrı değerlendirilmelidir. Büyük değerler gerçek outage'ı yalnız kullanıcıdan daha uzun süre saklayabilir. HTTP request deadline üst budget olmalıdır. Timeout change metric ve root cause ile gerekçelendirilmelidir.
Connection Storm'un Altında Yavaş Query Olabileceğini Unutmayın
Slow query connection'ı daha uzun kullanımda tutar. Pool büyür ve checkout queue oluşur. Driver yeni connection açınca Atlas graph connection spike gösterir. Pool size artırmak geçici olarak daha fazla slow query çalıştırabilir. Query Profiler ve Performance Advisor root cause analizi için kullanılmalıdır.
Atlas Metrics ve Driver Event'lerini Birlikte İzleyin
Atlas total connection ve CPU gibi server-side görünüm sunar. Driver checkout, pool clear ve topology change application-side davranışı gösterir. Aynı timeline iki tarafın neden sonuç ilişkisini ortaya çıkarır. Deployment metadata üçüncü önemli katmandır. Bu üç kaynak tek dashboard'da birleştiğinde incident teşhisi hızlanır.
Failover ve Network Hatalarını Production Öncesinde Test Edin
Replica set varlığı application resilience'ını otomatik garanti etmez. Primary failover, DNS outage ve connection reset kontrollü test edilmelidir. Retry ve timeout policy gerçek davranışla doğrulanır. User-facing error ve recovery time SLO ile karşılaştırılır. Runbook test sonuçlarına göre güncellenir.
Connection Yönetimini Kod Detayı Değil Production Architecture Konusu Olarak Ele Alın
Connection lifecycle application code, cloud network, database capacity ve deployment scaling arasında ortak bir konudur. Tek geliştiricinin MongoClient option'ı olarak görülürse HPA veya private endpoint değişikliği budget'ı kolayca bozar. Platform, backend ve database ekipleri ortak metric ve limit standardı kullanmalıdır. MongoDB Atlas bağlantı performansı nasıl optimize edilir sorusunun sürdürülebilir cevabı da burada yatar. Ölçüm, kontrollü test ve açık runbook birlikte kullanıldığında production bağlantıları daha öngörülebilir ve yönetilebilir hâle gelir.
share: