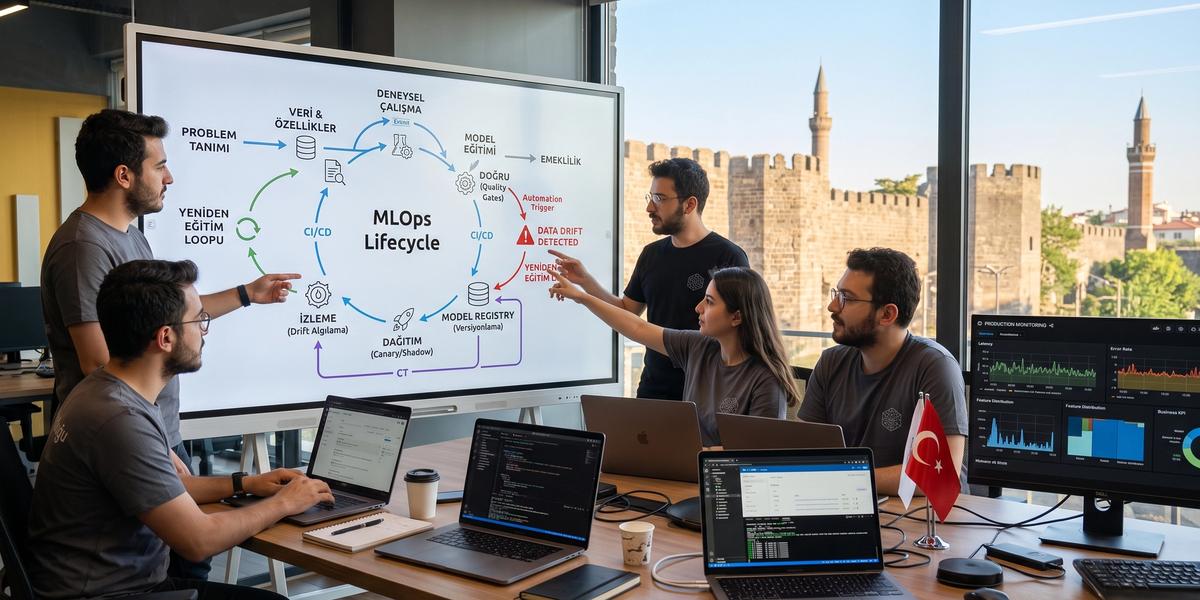
MLOps: Makine Öğrenmesi Dağıtım Yaşam Döngüsü

Diyarbakır Yazılım
16.08.2026
#Yazılım#Teknoloji#Topluluk
Bir makine öğrenmesi modelini Jupyter Notebook içinde yüzde 94 doğrulukla çalıştırmak işin yalnızca başlangıcıdır. On yıllık yazılım, sunucu ve üretim sistemi deneyimimde en sık gördüğüm sorun, iyi çalışan modelin production ortamına geçtiğinde veri değişimi, gecikme, maliyet veya versiyonlama nedeniyle kısa sürede güvenilmez hâle gelmesidir. MLOps: Makine Öğrenmesi Dağıtım Yaşam Döngüsü tam olarak bu noktada devreye girer ve modeli tek seferlik dosya olmaktan çıkarıp ölçülebilir, izlenebilir ve tekrar üretilebilir bir yazılım servisine dönüştürür. Bu rehberde MLOps makine öğrenmesi model yaşam döngüsü nasıl yönetilir, MLOps pipeline ile model eğitimi test ve üretime dağıtım nasıl yapılır ve makine öğrenmesi modellerinde CI/CD sürekli eğitim ve otomatik deployment süreçleri nasıl tasarlanır sorularını adım adım ele alacağız. Ayrıca model registry, data drift, model monitoring, retraining, güvenlik, KVKK, rollback ve model retirement gibi production aşamasında gerçekten fark yaratan konulara uygulama odaklı yaklaşacağız.
MLOps Nedir?
MLOps, makine öğrenmesi modellerinin geliştirme aşamasından production kullanımına, izlenmesine, yeniden eğitilmesine ve sonunda devreden çıkarılmasına kadar geçen süreci sistematik biçimde yönetme yaklaşımıdır. Data science, software engineering, DevOps, veri mühendisliği ve platform operasyonlarını ortak bir yaşam döngüsünde buluşturur. Amaç yalnızca hızlı model eğitmek değildir, aynı modelin hangi veriyle, hangi kodla, hangi environment içinde üretildiğini ve production ortamında nasıl davrandığını sürekli bilmektir. İyi bir MLOps yapısında model dosyası kadar dataset version, Git commit, feature tanımı, container image ve deployment configuration da izlenir. Ben MLOps'u çoğu ekip için “modeli production'a göndermek” yerine “modelin bütün yaşamını kontrollü biçimde işletmek” olarak tanımlamayı daha doğru buluyorum.
Machine Learning Operations Ne Anlama Gelir?
Machine Learning Operations, model geliştirme ile production işletimi arasındaki kopukluğu azaltmayı amaçlar. Data scientist deney yaparken platform ekibi güvenli deployment, observability ve ölçeklenebilirlik gereksinimlerini yönetir. MLOps bu iki çalışma alanını ortak pipeline, registry, test ve monitoring süreçleriyle birbirine bağlar. Model değişikliği kod değişikliği gibi izlenebilir hâle gelir ve production'a geçmeden önce belirlenmiş quality gate kontrollerinden geçer. Böylece model başarısı kişinin bilgisayarında çalışan notebook'a değil, ekip tarafından tekrar üretilebilen ve denetlenebilen bir sisteme dönüşür.
MLOps Neden Gereklidir?
Makine öğrenmesi sistemleri zamanla değişen veriye bağımlıdır ve bu durum klasik yazılım servislerinden farklı bir operasyon ihtiyacı oluşturur. Kod hiç değişmese bile kullanıcı davranışı, ürün yapısı veya veri dağılımı değiştiğinde model kalitesi düşebilir. Dataset'in hangi sürümünün kullanıldığı bilinmiyorsa aynı modeli yeniden üretmek zorlaşır ve hata araştırması gereksiz yere uzar. Production modelinin latency, error rate ve business KPI etkisi izlenmezse offline testte başarılı görünen model gerçek iş sonucunda başarısız olabilir. MLOps bu riskleri versiyonlama, otomasyon, quality gate, monitoring, retraining ve rollback süreçleriyle daha yönetilebilir hâle getirir.
MLOps ile DevOps Arasındaki Fark
DevOps kod tabanlı uygulamaların güvenilir biçimde build, test ve deploy edilmesini yönetirken MLOps bu sürece veri ve model boyutlarını ekler. Bir web API'sinde aynı kod genellikle aynı girdiye aynı davranışı verirken ML modeli probabilistik sonuçlar üretebilir. MLOps pipeline yalnızca unit test çalıştırmaz, dataset validation, model metric, fairness, drift ve feature parity kontrollerini de değerlendirebilir. Modelin production'a çıkması için source code başarılı olsa bile yeni modelin mevcut production baseline'dan daha kötü olmaması gerekir. Bu nedenle MLOps, DevOps prensiplerini kullanır ancak veri ve model yaşam döngüsü nedeniyle daha geniş bir kontrol alanına sahiptir.
Kod Bağımlılığı
ML sistemi yine normal yazılım gibi source code'a bağımlıdır. Training script, feature transformation, API server ve evaluation kodu Git üzerinden versiyonlanmalıdır. Aynı model artifact'ın hangi Git commit ile üretildiği registry metadata'sında bulunmalıdır. Kod değiştiğinde yalnızca unit test değil model çıktısının da değişip değişmediği değerlendirilmelidir. Böylece production incident sırasında hangi kod değişikliğinin model davranışını etkilediği daha hızlı bulunabilir.
Veri Bağımlılığı
Makine öğrenmesi sisteminin davranışı source code kadar eğitim verisine de bağlıdır. Aynı kod farklı dataset snapshot üzerinde çalıştırıldığında farklı model ortaya çıkabilir. Bu nedenle training data version, schema ve temel dağılım istatistikleri kayıt altında tutulmalıdır. Veri kaynağındaki sessiz değişiklik model performansını kod değişmeden bozabilir. MLOps pipeline bu yüzden data validation ve lineage kontrollerini normal CI sürecinin yanına ekler.
Model Bağımlılığı
Production uygulaması belirli model artifact ve model version'a bağlıdır. Modelin weight dosyası değiştirilirse source code değişmese bile kullanıcı sonucu değişebilir. Registry hangi modelin staging, approved veya production durumunda olduğunu açıkça göstermelidir. Deployment configuration model version'ı sabit biçimde referanslamalıdır. Bu yaklaşım rollback sırasında önceki güvenilir model sürümüne hızlı dönmeyi sağlar.
Probabilistik Çıktılar
ML modelleri çoğu zaman deterministik business rule gibi kesin davranmaz. Prediction olasılık, skor veya tahmin içerir ve model kalitesi dağılım üzerinden değerlendirilir. Tek örneğin doğru olması production modelinin sağlıklı olduğu anlamına gelmez. Precision, recall, calibration, latency ve business KPI birlikte izlenmelidir. Bu probabilistik yapı MLOps monitoring'ini klasik uptime kontrolünden daha kapsamlı hâle getirir.
MLOps ile DataOps Arasındaki Fark
DataOps veri pipeline'larının güvenilirliği, kalitesi, teslimatı ve gözlemlenebilirliği üzerinde yoğunlaşır. MLOps ise bu güvenilir veri katmanını model training, registry, deployment ve monitoring süreçleriyle devam ettirir. Data engineer dataset'in doğru ve zamanında hazır olmasını sağlarken ML pipeline aynı dataset'ten tekrar üretilebilir model üretmeye çalışır. İki alan arasında data quality, lineage ve orchestration açısından güçlü örtüşme vardır. Kurumsal projelerde DataOps zayıfsa MLOps pipeline ne kadar gelişmiş olursa olsun model kalitesi güvenilir olmaz.
MLOps ile LLMOps Arasındaki Fark
LLMOps büyük dil modeli uygulamalarının prompt, embedding, RAG, evaluation, agent ve model provider gibi ek bileşenlerini yönetmeye odaklanır. MLOps daha geniş makine öğrenmesi model yaşam döngüsünü kapsar ve klasik classification, regression veya vision modelleri için de geçerlidir. LLM uygulamalarında prompt version, retrieval quality ve token maliyeti gibi yeni gözlem alanları bulunur. Bununla birlikte registry, deployment, monitoring, security ve rollback ilkeleri iki yaklaşımda da ortaktır. Şirket içi agent mimarilerini MLOps ve LLMOps yaklaşımıyla birlikte değerlendirmek isteyenler https://www.diyarbakiryazilim.com.tr/posts/sirket-ici-yapay-zeka-ajanlari-agents-olusturma-rehberi adresindeki uygulama rehberini de inceleyebilir.
MLOps Yaşam Döngüsü Nedir?
MLOps yaşam döngüsü iş probleminin tanımlanmasıyla başlar, veri ve feature süreçlerinden geçer ve model production'dan kaldırılana kadar devam eder. Model training bu zincirin yalnızca bir aşamasıdır. Registry, deployment, monitoring ve retraining production başarısını belirleyen diğer önemli halkalardır. Her aşamanın input, output, kalite kriteri ve sorumlu ekibi açıkça belirlenmelidir. Böyle bir yapı kurulduğunda MLOps makine öğrenmesi model yaşam döngüsü nasıl yönetilir sorusuna kişiye bağlı operasyon yerine ölçülebilir bir süreçle cevap verilebilir.
MLOps Neden Doğrusal Değil Döngüsel Bir Süreçtir?
Model production'a çıktığında süreç tamamlanmış sayılmaz çünkü veri ve kullanıcı davranışı sürekli değişebilir. Monitoring yeni drift veya performance problemi tespit ettiğinde sistem tekrar veri toplama ve training aşamasına döner. Business hedef değiştiğinde aynı modelin metric ve feature gereksinimleri de değişebilir. Yeni candidate model eski production modeline karşı tekrar doğrulanır ve controlled rollout uygulanır. Bu nedenle MLOps yaşam döngüsü başlangıçtan sona ilerleyen tek çizgi değil sürekli geri bildirim üreten bir döngüdür.
Uçtan Uca MLOps Lifecycle
Uçtan uca lifecycle problem definition, data, feature, experiment, training, validation, registry, deployment, monitoring, retraining ve retirement aşamalarını içerir. Bu aşamalar farklı araçlarla gerçekleştirilebilir ancak aralarındaki metadata bağlantısı kopmamalıdır. Dataset version training run ile, training run model artifact ile, model artifact deployment version ile ilişkilendirilmelidir. Production prediction gerektiğinde bu zincir üzerinden hangi model ve hangi veriden geldiğine kadar izlenebilmelidir. MLOps değerini araç sayısından değil bu bağlantının ne kadar güvenilir ve otomatik olduğundan alır.
Problem Definition
İlk aşamada modelin hangi iş problemini çözeceği açık biçimde tanımlanmalıdır. “Churn tahmini yapacağız” tek başına yeterli değildir, çünkü tahminin hangi karar sürecini değiştireceği bilinmelidir. Offline metric ve business KPI birlikte belirlenmelidir. Latency, throughput ve compliance beklentileri daha model seçilmeden kaydedilmelidir. Bu aşama yanlış problemi çok iyi modelle çözme riskini azaltır.
Data
Modelin ihtiyaç duyduğu veri kaynakları ve veri sahipleri belirlenir. Batch veya streaming ingestion yapısı tasarlanır. Schema ve data quality kontrolleri pipeline başlangıcında uygulanır. Dataset snapshot veya version bilgisi training ile ilişkilendirilir. Verinin hukuki ve güvenlik sınıfı da aynı envanter içinde tutulmalıdır.
Features
Ham veriden modelin kullanacağı feature'lar üretilir. Feature logic kod ve metadata olarak versiyonlanmalıdır. Training ve serving sırasında aynı transformation davranışının kullanılması önemlidir. Point-in-time correctness geçmiş eğitim verisine gelecekteki bilginin karışmasını önler. Feature store ihtiyaç varsa paylaşım ve yeniden kullanım için merkezi katman sağlar.
Experiment
Data scientist farklı model ve hyperparameter kombinasyonlarını kontrollü deneylerle karşılaştırır. Her run dataset version, code commit ve environment bilgisiyle kaydedilmelidir. Sadece en iyi run değil başarısız deneyler de ileride değerli referans olabilir. Metric karşılaştırması ekip içinde tekrar üretilebilir olmalıdır. Experiment tracking notebook içindeki dağınık sonuçların production kararına dönüşmesini kolaylaştırır.
Training
Training pipeline model üretimini otomatik ve tekrar çalıştırılabilir hâle getirir. Environment dependency'leri sabitlenir ve kullanılan dataset açıkça belirlenir. Büyük modeller için distributed training veya GPU scheduling uygulanabilir. Training sonucu yalnızca weight değil metric, artifact ve lineage metadata üretmelidir. Başarılı job henüz production'a çıkmaya hazır model anlamına gelmez.
Validation
Validation candidate modelin teknik ve business kriterlerini karşılayıp karşılamadığını kontrol eder. Baseline karşılaştırması, schema, fairness, robustness ve latency testleri yapılabilir. Quality gate başarısız olduğunda model promotion durdurulur. Belirli yüksek riskli modeller insan onayı gerektirebilir. Validation aşaması otomatik retraining'in otomatik production deployment'a dönüşmesini engelleyen temel güvenlik kapısıdır.
Registry
Model registry onaylanan veya değerlendirme bekleyen model artifact'larını merkezi biçimde yönetir. Version, metric, lineage ve lifecycle status burada tutulur. Candidate, staging veya production benzeri durumlar ekip sürecine göre tanımlanabilir. Registry deployment sistemine hangi modelin izinli olduğunu gösteren güvenilir kaynak hâline gelir. Önceki model sürümleri rollback için erişilebilir tutulabilir.
Deployment
Deployment modelin belirli environment içine kontrollü şekilde alınmasıdır. Batch, online, streaming, edge veya serverless serving yöntemlerinden biri seçilebilir. Canary, blue-green veya shadow strategy risk seviyesine göre uygulanır. Deployment version container image ve model version ile ilişkilendirilir. Production'a geçiş sonrasında gerçek trafik metric'leri yakından izlenmelidir.
Monitoring
Monitoring yalnızca API uptime değerini takip etmez. Latency, error rate, prediction distribution, drift ve gerçek label geldiğinde model performance izlenir. CPU, GPU ve memory kullanımı altyapı sağlığını gösterir. Business KPI modelin gerçek iş sonucuna etkisini ölçer. Alarm ve dashboard'lar model degradation durumunda retraining veya rollback sürecini tetikleyebilir.
Retraining
Retraining yeni veri veya yeni koşullar nedeniyle candidate modelin yeniden eğitilmesidir. Takvim, drift, performance veya business event ile tetiklenebilir. Yeni model yine aynı validation ve quality gate sürecinden geçmelidir. Training tamamlandı diye production alias otomatik değiştirilmemelidir. Controlled rollout ile yeni candidate önce sınırlı trafik üzerinde gözlemlenebilir.
Retirement
Model artık kullanılmayacaksa yalnızca endpoint kapatmak yeterli değildir. Consumer servisler yeni modele taşınmalıdır. Artifact retention ve audit metadata saklama süresi belirlenmelidir. Kullanılmayan compute ve endpoint kaynakları temizlenmelidir. Böylece eski model hem güvenlik hem maliyet açısından production ortamında gereksiz yük oluşturmaz.
Aşama 1 — İş Problemi ve Model Gereksinimlerinin Belirlenmesi
Başarılı MLOps projesi model framework seçimiyle değil iş problemiyle başlar. Teknik ekip model metric'ini optimize ederken ürün ekibi farklı bir business KPI bekliyorsa production başarısı zayıf kalır. Latency, throughput, maliyet ve compliance gibi gereksinimler model seçiminden önce bilinmelidir. Başarı kriteri hem offline evaluation hem gerçek production etkisini içermelidir. Ben bu aşamada kısa bir model gereksinim dokümanı hazırlamayı, ileride yapılacak bütün teknik kararlar için ortak referans olarak kullanmayı faydalı buluyorum.
Model Hangi İş Problemini Çözecek?
Modelin hangi kararı destekleyeceği açıkça tanımlanmalıdır. Örneğin churn tahmini yalnızca müşterinin ayrılma olasılığını hesaplamak için değil hangi müşteriye hangi aksiyonun uygulanacağını belirlemek için kullanılır. Prediction çıktısının kim tarafından tüketileceği bilinmelidir. Modelin yanlış pozitif veya yanlış negatif üretmesinin business maliyeti farklı olabilir. Bu bilgi threshold, metric ve monitoring tasarımını doğrudan etkiler.
Offline Model Metriği Nasıl Belirlenir?
Accuracy her problem için doğru metric değildir. Dengesiz fraud dataset'inde precision, recall veya PR-AUC daha anlamlı olabilir. Regression modelde MAE ile büyük hatalara hassas metric'ler farklı business davranışı gösterir. Metric seçimi model hatasının gerçek iş maliyetine bağlanmalıdır. Offline metric production başarısını tam temsil etmediği için business KPI ile birlikte kullanılmalıdır.
Business KPI Nasıl Belirlenir?
Business KPI modelin gerçek iş sürecine kattığı değeri ölçer. Churn modelinde retention oranı, öneri modelinde dönüşüm veya gelir, fraud modelinde engellenen kayıp takip edilebilir. Model accuracy yükselirken business KPI düşebileceği için ikisini ayrı izlemek gerekir. KPI modelin kontrol edemediği başka faktörlerden etkilenebilir. Bu nedenle experimentation ve causal değerlendirme bazı projelerde gerekli olabilir.
Latency ve Throughput Gereksinimleri
Modelin cevap süresi serving architecture kararını doğrudan etkiler. Gerçek zamanlı ödeme kontrolü birkaç yüz milisaniye içinde sonuç isterken günlük rapor modeli batch çalışabilir. Throughput aynı anda kaç prediction gerektiğini gösterir. GPU batching throughput'u artırırken tek request latency'sini etkileyebilir. P95 ve P99 latency hedefleri average değerlerden daha anlamlı production hedefleri sunar.
Güvenlik ve Compliance Gereksinimleri
Training dataset kişisel veya ticari hassas veri içerebilir. Access control, secret management ve audit requirement baştan tanımlanmalıdır. Production inference loglarında hangi alanların saklanabileceği belirlenmelidir. KVKK veya sektörel gereksinimler data retention ve deployment region kararlarını etkileyebilir. Compliance son aşamada eklendiğinde architecture değişikliği çok daha maliyetli olur.
Başarı Kriterleri ve Production SLO'ları
Başarı kriteri yalnızca model metric eşiği olmamalıdır. Availability, latency, cost ve business KPI için production SLO belirlenebilir. Örneğin model yüzde 99,9 availability sağlarken P95 latency 300 milisaniyenin altında tutulabilir. Model quality için minimum recall veya calibration hedefi bulunabilir. Bu değerler monitoring ve automatic rollback politikasının temelini oluşturur.
Aşama 2 — Veri Toplama ve Ingestion
Model kalitesi veri pipeline kalitesiyle başlar. Batch ve streaming kaynaklar farklı hata modlarına sahiptir ve ingestion aşamasında schema doğrulama yapılmalıdır. Eksik değer, duplicate kayıt veya ani distribution değişimi training sonucunu ciddi biçimde etkileyebilir. Data quality gate yanlış verinin model pipeline içine sessizce girmesini engeller. Production MLOps sisteminde “veri geldi” kontrolünden daha çok “beklenen veri doğru format ve dağılımla geldi” kontrolü yapılmalıdır.
Batch Data Ingestion
Batch ingestion belirli zaman aralıklarında toplu veri işler. Günlük transaction export veya haftalık CRM snapshot buna örnek olabilir. Pipeline idempotent tasarlanırsa aynı batch tekrar çalıştırıldığında duplicate veri üretmez. Partition ve watermark hangi verinin işlendiğini takip etmeyi kolaylaştırır. Büyük dataset için incremental load full reload maliyetini azaltır.
Streaming Data Ingestion
Streaming ingestion event verisini düşük gecikmeyle sisteme taşır. Fraud, recommendation veya telemetry modelleri gerçek zamanlı feature üretebilir. Event ordering ve late-arriving data dikkate alınmalıdır. Schema registry producer ve consumer arasında veri contract'ını korur. Streaming pipeline'daki küçük veri kaybı model feature dağılımını zamanla etkileyebilir.
Veri Şeması Doğrulama
Schema validation kolon adı, tip ve zorunluluk kurallarını kontrol eder. Integer beklenen alana string gelmesi training job'ı bozabilir veya sessiz type conversion oluşturabilir. Nullable alanlar açıkça tanımlanmalıdır. Schema change backward compatibility açısından değerlendirilmelidir. Data contract yaklaşımı upstream ekiplerin değişiklik etkisini daha production'a ulaşmadan görmesini sağlar.
Data Quality Gates
Data quality gate training pipeline'ın devam edip etmeyeceğini belirleyen otomatik kontrollerdir. Missing rate, range, duplicate ve distribution kuralları birlikte uygulanabilir. Eşiklerin gerçek iş bağlamına göre belirlenmesi gerekir. Her küçük sapmada pipeline durursa operasyon yükü artabilir. Kritik alanlarda fail-closed, düşük riskli alanlarda warning yaklaşımı kullanılabilir.
Missing Values
Eksik değer oranı feature bazında izlenmelidir. Normalde yüzde bir missing olan feature bir günde yüzde kırka çıkarsa upstream problem olabilir. Imputation bu sorunu gizlememelidir. Missing pattern model için sinyal de taşıyabilir. Pipeline normal aralık dışındaki değişimi alarm olarak değerlendirmelidir.
Schema Violations
Schema violation beklenen data contract'ın bozulmasıdır. Yeni kolon eklenmesi her zaman problem değildir ancak required kolonun kaldırılması kritik olabilir. Training pipeline unknown schema ile devam etmemelidir. Compatibility rule açıkça tanımlanmalıdır. Hata upstream data owner'a otomatik bildirim gönderebilir.
Range Validation
Feature değerleri business olarak makul aralıkta olmalıdır. Yaş değerinin eksi olması veya yüzde alanının bin değerini alması veri hatasına işaret eder. Hard limit ile statistical range ayrı kontrol edilebilir. Outlier her zaman yanlış veri değildir. Pipeline hangi durumda reject, clip veya warning uygulanacağını açıkça tanımlamalıdır.
Duplicate Records
Duplicate kayıt training örneklerinin ağırlığını yapay biçimde artırabilir. Event retry veya batch yeniden yükleme duplicate üretmenin yaygın nedenidir. Unique key veya idempotency mekanizması kullanılabilir. Duplicate rate baseline olarak izlenmelidir. Data quality raporu model training run ile birlikte saklanabilir.
Distribution Checks
Feature distribution önceki güvenilir dataset ile karşılaştırılabilir. Ani mean, variance veya kategori oranı değişimi data source problemine işaret edebilir. Her distribution değişimi kötü değildir, gerçek concept değişimini de gösterebilir. Statistical threshold business bağlamıyla birlikte yorumlanmalıdır. Büyük değişim candidate training başlasa bile human review gerektirebilir.
Fail-Open ve Fail-Closed Pipeline Tasarımı
Fail-closed yaklaşım quality gate başarısız olduğunda pipeline'ı tamamen durdurur. Kritik finans veya sağlık modellerinde bu daha güvenli olabilir. Fail-open yaklaşım warning üretip sürecin devam etmesine izin verir ve düşük riskli analytics modellerinde kullanılabilir. Her veri kontrolü için aynı davranış uygulanmamalıdır. Severity seviyeleri belirlenerek hangi hatanın training'i durduracağı açıkça dokümante edilmelidir.
Aşama 3 — Veri Versiyonlama ve Lineage
Modeli yeniden üretmek istiyorsanız yalnızca Git commit bilmek yeterli değildir. Aynı training kodu farklı dataset üzerinde farklı model üretir. Dataset snapshot veya table version model run ile ilişkilendirilmelidir. Data lineage verinin hangi source ve transformation adımlarından geçtiğini gösterir. Bu bağlantı olmadan production probleminde “hangi veriyle eğitilmişti?” sorusunun cevabı manuel araştırmaya dönüşür.
Eğitim Verisi Neden Versiyonlanmalıdır?
Training dataset zamanla yeni kayıt ve düzeltmelerle değişir. Model v12'nin hangi veri anına göre üretildiği bilinmelidir. Dataset version karşılaştırma ve rollback için temel referanstır. Veri hatası bulunduğunda hangi model sürümlerinin etkilendiği lineage üzerinden belirlenebilir. Versioning aynı training deneyini yeniden çalıştırabilmenin temel şartlarından biridir.
Dataset Snapshot
Dataset snapshot belirli zamandaki veri durumunu temsil eder. Physical copy veya table snapshot teknolojisi kullanılabilir. Büyük dataset için her run tam kopya oluşturmak pahalı olabilir. Immutable snapshot veya time-travel özellikleri daha verimli olabilir. Snapshot ID experiment tracking kaydına eklenmelidir.
Data Lineage
Data lineage source'tan feature ve modele kadar veri hareketini gösterir. Hangi SQL job, transformation veya pipeline step'in veriyi değiştirdiği kayıt altına alınır. Upstream tablo problemi downstream modelleri otomatik bulmayı kolaylaştırır. Compliance açısından hangi kişisel verinin hangi modelde kullanıldığı da izlenebilir. Lineage yalnızca doküman değil otomatik metadata sistemi olduğunda daha güvenilir olur.
Kod ile Dataset Versiyonunun İlişkilendirilmesi
Training run tek kimlik altında code commit ve dataset version bilgisini saklamalıdır. Model registry bu run'a link vermelidir. Böylece model artifact'tan geriye doğru bütün üretim zinciri bulunabilir. Reproducibility testi aynı kod ve veriyle aynı veya kabul edilebilir model sonucu üretmeyi kontrol edebilir. Environment dependency'leri de bu zincire eklenmelidir.
Veri Versiyonlama Araçları
Veri versiyonlama için tek araç bütün ekipler açısından doğru değildir. Dosya tabanlı ML projelerinde bir yaklaşım, büyük lakehouse sistemlerinde farklı bir yaklaşım daha uygun olabilir. Seçim dataset boyutu, storage türü ve mevcut data platformuna göre yapılmalıdır. Araçtan bağımsız olarak her training run değişmez bir veri referansına bağlanmalıdır. Operasyon ekibi version restore ve access yöntemini düzenli olarak test etmelidir.
DVC
DVC veri ve model artifact'larını Git çalışma biçimine yakın şekilde izlemek için kullanılabilir. Büyük dosyanın kendisi Git repository içinde tutulmak yerine remote storage referansı yönetilebilir. Küçük ve orta ölçekli ekiplerde data science workflow'una kolay uyum sağlayabilir. Dataset ile code commit arasındaki ilişki anlaşılır hâle gelir. Production kullanımında remote storage erişim ve backup politikaları ayrıca yönetilmelidir.
lakeFS
lakeFS object storage üzerindeki veri için Git benzeri branching ve version yaklaşımı sağlayabilir. Data pipeline değişikliği ayrı branch üzerinde test edilebilir. Large data lake senaryolarında full copy ihtiyacını azaltabilir. Merge ve revert işlemleri data engineering workflow'una version control davranışı kazandırır. Kullanılan storage ve catalog mimarisiyle integration ihtiyacı önceden değerlendirilmelidir.
Delta Lake / Iceberg
Delta Lake ve Iceberg gibi table formatları versioned table ve time-travel yetenekleri sunabilir. Büyük analytical dataset için snapshot referansı training run'a bağlanabilir. Partition ve schema evolution özellikleri veri platformu yönetimini kolaylaştırır. MLOps pipeline belirli table version üzerinden reproducible training yapabilir. Hangi teknolojinin seçileceği mevcut query engine ve lakehouse architecture'a göre belirlenmelidir.
Aşama 4 — Feature Engineering ve Feature Management
Feature engineering model performansını doğrudan etkiler ancak production hatalarının da önemli kaynaklarından biridir. Training sırasında hesaplanan feature ile online serving sırasında hesaplanan feature farklıysa model beklenmeyen sonuç üretir. Feature store bu logic ve metadata'yı merkezi yönetmeye yardımcı olabilir. Feature version ve point-in-time correctness özellikle zaman bağımlı verilerde kritik önemdedir. İyi MLOps yapısı feature kodunu notebook içinde kaybolan geçici logic olmaktan çıkarıp test edilen production bileşenine dönüştürür.
Feature Pipeline Nedir?
Feature pipeline ham veriyi modelin kullanacağı değerlere dönüştüren işlem zinciridir. SQL, Python veya streaming transformation içerebilir. Aynı feature training ve inference ortamında tutarlı hesaplanmalıdır. Pipeline code version control altında tutulmalıdır. Feature output için schema ve quality testleri eklenmelidir.
Feature Store Nedir?
Feature store tekrar kullanılan feature tanımlarını ve değerlerini merkezi biçimde yönetmeye yardımcı olur. Data scientist aynı müşteri feature'ını her model için yeniden hesaplamak zorunda kalmaz. Feature metadata ve owner bilgisinin registry benzeri katalogda tutulması governance sağlar. Online serving düşük latency feature erişimi sunabilir. Her ekip için feature store zorunlu değildir, ihtiyaç ölçek ve tekrar kullanım oranına göre değerlendirilmelidir.
Offline ve Online Feature Store
Offline store büyük geçmiş veriyi training ve batch analiz için saklar. Online store düşük latency prediction sırasında son feature değerlerini sağlar. İki store arasında aynı feature tanımının farklı değer üretmesi training-serving skew oluşturabilir. Senkronizasyon ve materialization pipeline izlenmelidir. Point-in-time query geçmiş eğitim örneğine yalnızca o tarihte mevcut bilgiyi vermelidir.
Feature Registry
Feature registry feature adı, açıklama, tip, owner ve transformation bilgisini tutar. Aynı anlamda birden fazla feature üretilmesini azaltır. Data scientist mevcut feature'ları arayıp yeniden kullanabilir. Sensitive feature için erişim etiketi eklenebilir. Registry feature lineage ve version kontrolünü daha görünür hâle getirir.
Feature Versioning
Feature logic değiştiğinde yeni version oluşturulmalıdır. “Müşteri son 30 günlük harcaması” hesabındaki filtre değişikliği model davranışını etkiler. Eski model eski feature version'a ihtiyaç duyabilir. Deployment sırasında model ile feature version uyumluluğu doğrulanmalıdır. Rollback planı feature katmanını da kapsamalıdır.
Point-in-Time Correctness
Point-in-time correctness geçmiş training örneğine gelecekte oluşmuş bilgiyi eklememeyi sağlar. Churn modelini eğitirken müşterinin sonraki ay gerçekleşen davranışını feature içine almak leakage yaratır. Offline feature join event zamanını dikkate almalıdır. Feature store bunu query seviyesinde destekleyebilir. Validation set üzerinde olağanüstü yüksek metric görülmesi leakage araştırmasını tetiklemelidir.
Data Leakage Nasıl Önlenir?
Training sırasında target veya geleceğe ait bilgi feature içine karışmamalıdır. Dataset split zaman sırasını korumalı olabilir. Transformation kodu label üretiminden bağımsız çalışmalıdır. Feature lineage her alanın kaynağını göstermelidir. Leakage testleri model metric'i normal dışı yükseldiğinde otomatik kontrol olarak çalıştırılabilir.
Training-Serving Skew Nedir ve Nasıl Önlenir?
Training-serving skew modelin eğitim sırasında gördüğü feature hesaplama davranışı ile production inference sırasında aldığı davranışın farklı olmasıdır. Data scientist notebook'ta farklı preprocessing kullanıp production API başka kod çalıştırdığında bu sorun kolayca oluşur. Model offline testte başarılı görünürken production accuracy hızla düşebilir. Aynı transformation kodu, feature contract ve parity testleri skew riskini azaltır. Production feature drift monitoring de iki ortam arasındaki dağılım farkını erken görmeye yardımcı olur.
Training ve Production Feature Farklılıkları
Training dataset batch SQL ile, production feature ise online service tarafından hesaplanabilir. Küçük rounding veya null handling farkı bile prediction dağılımını etkileyebilir. Category mapping iki ortamda aynı version olmalıdır. Timestamp timezone farkları sık görülen başka problemdir. Train ve serve sample'ları düzenli karşılaştırılmalıdır.
Aynı Transformation Kodunun Kullanılması
Mümkün olduğunda preprocessing tek reusable library veya pipeline olarak tanımlanmalıdır. Training ve inference aynı package version'ı kullanabilir. Böylece iki farklı ekip aynı logic'i tekrar yazmak zorunda kalmaz. Library değişikliği semantic version ile izlenir. Model registry metadata hangi transformation version'ın gerekli olduğunu saklayabilir.
Feature Contract Yaklaşımı
Feature contract modelin beklediği feature adı, tip, range ve semantic anlamı tanımlar. Serving service request'i bu contract'a göre doğrular. Feature kaldırılması veya type değişikliği deployment öncesinde fark edilir. Contract model version ile birlikte versiyonlanmalıdır. Bu yapı ML modelini veri pipeline değişikliklerinden daha kontrollü korur.
Train-Serve Parity Testleri
Aynı örnek offline ve online feature pipeline üzerinden geçirilerek sonuçlar karşılaştırılabilir. Tolerance dışındaki fark deployment'ı durdurabilir. Golden dataset test fixture olarak kullanılabilir. Özellikle feature engineering değişikliklerinde parity test önemli quality gate olur. Test düzenli CI pipeline içinde çalıştırılabilir.
Feature Drift Monitoring
Production feature dağılımı training referansıyla karşılaştırılmalıdır. Mean, category frequency veya statistical distance metric kullanılabilir. Drift tek başına model quality düşüşü anlamına gelmez. Ancak data source ve user behavior değişimini erken gösteren sinyaldir. Alarm sonrasında upstream pipeline ve prediction quality birlikte incelenmelidir.
Aşama 5 — Model Experimentation ve Training
Model geliştirme sırasında onlarca farklı hyperparameter, feature set ve algorithm denenebilir. Bu deneyler sistematik kaydedilmezse neden belirli modelin seçildiği birkaç hafta sonra unutulur. Experiment tracking metric, parameter, dataset ve artifact bilgilerini tek run altında toplar. Reproducible training başka ortamda aynı deneyin tekrar çalıştırılmasını sağlar. Distributed training kullanıldığında environment ve hardware metadata'sının da kaydedilmesi performans karşılaştırmasını kolaylaştırır.
Deney Takibi Neden Gereklidir?
Notebook hücreleri experiment history için güvenilir yöntem değildir. Hangi hyperparameter ile hangi sonuç elde edildiği otomatik kayıt altına alınmalıdır. Team member aynı run'ı inceleyebilmelidir. Model seçimi metric ve business constraint üzerinden açıklanabilir hâle gelir. Experiment tracking model registry için doğal provenance kaynağı oluşturur.
Hangi Bilgiler Kaydedilmelidir?
Her training run model sonucunu yeniden anlamaya yetecek metadata taşımalıdır. Hyperparameter, dataset version ve Git commit temel bilgilerdir. Environment ve dependency version reproducibility için önemlidir. Metric ve artifact değerlendirme sürecini destekler. Run ID bütün bu bilgileri model registry'ye bağlayan ortak kimlik olabilir.
Hyperparameters
Learning rate, depth, regularization veya batch size model davranışını etkiler. Deney tracking sistemi bu değerleri otomatik kaydetmelidir. Default parameter'lar da kayıt içinde görünmelidir. Hyperparameter karşılaştırması metric değişimini anlamayı kolaylaştırır. Production modelin parametreleri audit sırasında erişilebilir olmalıdır.
Dataset Version
Run kullanılan dataset snapshot ID'yi saklamalıdır. “latest data” gibi değişken referans reproducibility için yeterli değildir. Dataset version immutable olmalıdır. Data quality report aynı version ile ilişkilendirilebilir. Veri hatası bulunduğunda etkilenen run'lar hızlıca sorgulanabilir.
Code Commit
Training code Git commit SHA ile kaydedilmelidir. Dirty working tree kullanılıyorsa run işaretlenebilir veya engellenebilir. Commit üzerinden feature ve model logic yeniden bulunabilir. Release candidate sadece reviewed branch'ten üretilebilir. Model lineage code provenance ile tamamlanır.
Environment
Python, framework ve dependency version model sonucunu etkileyebilir. Container image digest environment için güçlü referanstır. GPU driver ve accelerator bilgisi performans analizi için kaydedilebilir. Reproducible build environment drift'i azaltır. Production serving environment model compatibility testinden geçmelidir.
Model Metrics
Training ve validation metric'leri run metadata'sına eklenmelidir. Tek metric yerine problem için gerekli metric seti tutulabilir. Confusion matrix artifact olarak saklanabilir. Segment veya fairness metric'leri de model değerlendirmesine eklenebilir. Production baseline ile karşılaştırma otomatik yapılabilir.
Artifacts
Model weight, plots, evaluation report ve preprocessing object artifact olarak saklanabilir. Artifact storage versioned ve erişim kontrollü olmalıdır. Büyük dosyalar experiment database yerine object storage üzerinde bulunabilir. Registry model artifact'a kalıcı referans verir. Artifact retention policy eski deneylerin maliyetini kontrol altında tutar.
Hyperparameter Optimization
Hyperparameter optimization çok sayıda deneyin otomatik yürütülmesini sağlar. Grid, random veya Bayesian yaklaşım kullanılabilir. Sadece metric'i maksimum yapmak yerine training cost ve latency de objective olarak değerlendirilebilir. Her trial experiment tracking sistemine kaydedilmelidir. Best trial doğrudan production'a değil validation gate'e candidate olarak gönderilmelidir.
Reproducible Training
Reproducible training aynı input, code ve environment ile benzer model sonucu üretmeyi amaçlar. Random seed tek başına yeterli olmayabilir. GPU operation'ları belirli seviyede nondeterministic davranabilir. Dataset snapshot ve dependency pinning temel gereksinimlerdir. Reproducibility production incident ve audit süreçlerinde model güvenilirliğini ciddi biçimde artırır.
Distributed Training
Büyük dataset veya model birden fazla GPU ve node üzerinde eğitilebilir. Distributed training network bandwidth ve synchronization maliyeti getirir. Worker failure ve checkpoint recovery tasarlanmalıdır. Training run kullanılan cluster configuration bilgisini kaydetmelidir. Scaling verimliliği GPU sayısını artırmadan önce benchmark edilmelidir.
Aşama 6 — Model Validation ve Testing
Model validation yalnızca validation accuracy hesaplamak değildir. Data schema, baseline karşılaştırması, fairness, robustness, latency, load ve security testleri production riskini farklı açılardan ölçer. Model quality yüksek olsa bile API P99 latency hedefini karşılamıyorsa deployment uygun olmayabilir. Validation sonuçları quality gate olarak otomatik değerlendirilebilir. İnsan onayı yalnızca gerçekten riskli veya business kararı gerektiren aşamalarda devreye alınmalıdır.
Offline Performance Testleri
Candidate model holdout veya time-based test set üzerinde ölçülmelidir. Metric seçimi iş problemine uygun olmalıdır. Segment bazlı performans global metric yanında incelenebilir. Confidence interval küçük farkların gerçekten anlamlı olup olmadığını gösterir. Test dataset training pipeline'dan bağımsız tutulmalıdır.
Model Baseline Karşılaştırması
Yeni model eski production modelinden daha iyi olduğunu göstermelidir. Sadece önceki deney değil gerçek champion baseline kullanılmalıdır. Metric iyileşmesi latency veya maliyet kaybıyla birlikte değerlendirilir. Belirli tolerans içinde eşit performans daha ucuz model lehine karar sağlayabilir. Promotion rule bu karşılaştırmayı otomatik yapabilir.
Data Validation Testleri
Model validation başlamadan kullanılan data schema ve quality doğrulanmalıdır. Test set içinde duplicate veya leakage bulunması metric'i yanıltabilir. Feature range training expectation ile eşleşmelidir. Label distribution değişimi açıklanmalıdır. Data validation raporu model evaluation artifact'ı olarak saklanabilir.
Model Schema Testleri
Model input ve output contract açıkça tanımlanmalıdır. Feature sırası veya type değişikliği serving hatasına yol açabilir. Model signature CI pipeline içinde doğrulanabilir. Output probability range gibi invariants test edilebilir. Schema compatibility deployment öncesi otomatik gate olabilir.
Fairness Testleri
Model farklı kullanıcı segmentlerinde sistematik performans farkı gösterebilir. Uygun fairness metric problem ve hukuki bağlama göre seçilmelidir. Protected attribute her projede kullanılabilir olmayabilir. Segment sample size yeterli olmalıdır. Threshold aşıldığında candidate model review'a gönderilebilir.
Robustness Testleri
Model missing, noisy veya edge-case girdiler altında test edilmelidir. Küçük input değişiminin büyük prediction değişimi oluşturması riskli olabilir. Adversarial robustness bazı vision veya security modellerinde ayrıca değerlendirilebilir. Out-of-distribution sample davranışı kontrol edilmelidir. Failure durumunda güvenli fallback tasarlanmalıdır.
Latency Benchmark
Inference latency production'a benzer hardware üzerinde ölçülmelidir. Warm ve cold start değerleri ayrı test edilebilir. P50 yanında P95 ve P99 raporlanmalıdır. Batch size ve model optimization latency'yi etkiler. Quality gate production SLO ile karşılaştırma yapmalıdır.
Load Testing
Model API gerçek beklenen throughput altında test edilmelidir. Concurrency arttıkça queue ve GPU saturation gözlemlenir. Autoscaling davranışı ölçülmelidir. Error rate peak trafik altında kabul edilebilir kalmalıdır. Load test sonucu infrastructure sizing kararına doğrudan girdi sağlar.
Security Testing
Inference endpoint authentication ve authorization test edilmelidir. Container image vulnerability scan'den geçmelidir. Model artifact güvenilir source ve signature ile doğrulanabilir. Abuse ve extraction amaçlı yüksek query pattern'leri değerlendirilebilir. Secret veya training data'nın log ve error response içinde sızmadığı kontrol edilmelidir.
Model Promotion Quality Gate Nasıl Tasarlanır?
Quality gate candidate modelin production'a ilerlemeden önce geçmesi gereken ölçülebilir şartları tanımlar. Minimum accuracy tek başına yeterli değildir. Baseline farkı, fairness, latency, cost ve güvenlik kontrolleri birlikte değerlendirilebilir. Bazı düşük riskli modeller tamamen otomatik promotion kullanabilirken kritik sistemler human approval isteyebilir. Gate başarısız olduğunda pipeline açık sebep ve metric ile durmalıdır.
Minimum Model Kalitesi
Model için kabul edilebilir minimum offline metric belirlenmelidir. Threshold geçmiş model performansı ve business ihtiyacıyla uyumlu olmalıdır. Çok düşük değer kalitesiz model geçişine izin verir. Aşırı yüksek değer gereksiz deployment blokları oluşturabilir. Threshold dataset ve problem değiştikçe gözden geçirilmelidir.
Production Baseline Karşılaştırması
Candidate mevcut production modeline karşı aynı test set üzerinde karşılaştırılmalıdır. Daha yeni model otomatik olarak daha iyi değildir. Improvement threshold istatistiksel anlamlılıkla desteklenebilir. Business KPI proxy metric'i eklenebilir. Candidate belirgin kötüleşme gösteriyorsa promotion durdurulmalıdır.
Fairness Threshold
Segmentler arası metric farkı belirli sınırı aşmamalıdır. Threshold hukuki ve ürün riskiyle birlikte belirlenir. Global accuracy iyileşirken küçük grup performansı bozulabilir. Gate bu durumu görünür hâle getirir. İstisna gerekiyorsa gerekçeli human approval kaydedilmelidir.
Latency Threshold
Model SLO içinde inference yapmalıdır. P95 ve P99 ölçümü production beklentisine göre seçilir. Daha doğru fakat iki kat yavaş model gerçek zamanlı servis için uygun olmayabilir. Hardware benchmark standardize edilmelidir. Threshold aşılırsa optimization veya farklı serving seçeneği değerlendirilir.
Cost Threshold
Inference veya training cost model promotion kriteri olabilir. Cost per prediction önceki modelle karşılaştırılır. GPU gerektiren model business faydası yeterli değilse reddedilebilir. Token veya external API maliyeti de belirli modellerde hesaba katılır. Cost gate platform bütçesini görünür ve ölçülebilir tutar.
Human Approval
Human approval kritik veya düzenlenmiş modellerde son karar kontrolü sağlar. Reviewer evaluation report ve metric'leri görmelidir. Onay yalnızca kişisel değerlendirmeye değil belgelenmiş kriterlere dayanmalıdır. Kim ve ne zaman onay verdiği audit log'a yazılmalıdır. Düşük riskli modelde gereksiz manuel gate delivery hızını azaltabilir.
Deployment'ın Otomatik Durdurulması
Quality gate başarısız olduğunda CI/CD pipeline promotion adımına geçmemelidir. Hangi threshold'un başarısız olduğu açık loglanmalıdır. Candidate registry'de rejected veya review durumunda kalabilir. Notification ilgili owner'a gönderilir. Aynı başarısız modeli tekrar deploy etmeyi engelleyen policy eklenebilir.
Aşama 7 — Model Registry ve Model Versiyonlama
Model registry production ML sisteminde model artifact'larının güvenilir merkezi kaynağıdır. Registry model version, metric, lineage, signature ve lifecycle metadata taşır. Deployment sistemi mümkün olduğunda dosya yolundan rastgele model çekmek yerine registry üzerinden onaylı sürümü kullanmalıdır. Model promotion ve rollback daha kontrollü hâle gelir. Güncel model registry yaklaşımında versioning ve lineage yönetiminin merkezi rolü resmî MLflow dokümantasyonunda da açık biçimde vurgulanmaktadır.
Model Registry Nedir?
Model registry eğitilmiş modelleri organize eden ve yaşam döngülerini yöneten katalogdur. Model artifact ile metadata arasında kalıcı ilişki kurar. Yeni version aynı model ailesi altında kaydedilebilir. Tags veya aliases deployment sürecinde kullanılabilir. Production modelinin hangi training run'dan geldiği registry üzerinden bulunabilmelidir.
Model Artifact Nedir?
Model artifact eğitimin somut çıktısıdır. Weight, serialized object veya portable model formatı olabilir. Preprocessing object veya tokenizer da artifact setinin parçası olabilir. Artifact checksum ve size metadata ile saklanabilir. Storage erişimi production güvenlik seviyesine uygun olmalıdır.
Model Metadata
Metadata modelin nasıl üretildiğini ve nasıl kullanılacağını açıklar. Metric, framework version, dataset ve owner bilgisi tutulabilir. Input signature deployment compatibility için değerlidir. Risk ve approval etiketleri governance sürecini destekler. Metadata otomatik pipeline tarafından üretildiğinde manuel hatalar azalır.
Model Lineage
Model lineage artifact'ın dataset, feature, code ve training run bağlantılarını gösterir. Incident sırasında kötü data source'tan etkilenen modeller bulunabilir. Model lineage audit ve reproducibility için önemlidir. Deployment version da zincire eklenmelidir. Production prediction gerektiğinde model version'a kadar geriye izlenebilmelidir.
Model Lifecycle Status
Lifecycle status modelin geliştirme ve production sürecindeki konumunu belirtir. Takımlar farklı isimler kullanabilir ancak meaning açık olmalıdır. Candidate henüz değerlendirilirken approved production için izinli olabilir. Deprecated yeni kullanımın durdurulduğunu gösterir. Archived uzun dönem audit veya geçmiş referans için saklanabilir.
Candidate
Candidate training tamamlamış fakat henüz bütün quality gate'lerden geçmemiş modeldir. Evaluation sonuçları oluşturulur. Candidate production trafiği almamalıdır. Registry metadata eksiksiz olmalıdır. Başarısız olursa rejected veya archived duruma taşınabilir.
Staging
Staging production'a benzer test ortamında model davranışını doğrulamak için kullanılabilir. Integration ve load test burada yapılır. Gerçek kişisel veri kullanımı gerekiyorsa güvenlik policy korunmalıdır. Staging endpoint production consumer'dan ayrıdır. Test tamamlandığında model approval sürecine ilerler.
Approved
Approved model belirlenen teknik ve business gate'leri geçmiş sürümdür. Production deployment için izinli kabul edilir. Approval actor ve tarih metadata olarak tutulur. Model hemen production olmak zorunda değildir. Release window veya canary planı bekleyebilir.
Production
Production status gerçek kullanıcı veya business akışında aktif modeli belirtir. Champion alias benzeri yaklaşım kullanılabilir. Monitoring dashboard version bilgisiyle metric toplamalıdır. Rollback için önceki production version erişilebilir tutulur. Yeni promotion olduğunda audit event oluşur.
Deprecated
Deprecated model yeni deployment için önerilmez. Mevcut consumer migration sürecinde geçici olarak çalışmaya devam edebilir. EOL tarihi belirtilmelidir. Security veya data issue nedeniyle hızlı deprecation gerekebilir. Kullanıcı ekipler migration bildirimi almalıdır.
Archived
Archived model aktif workflow'dan çıkarılmıştır. Audit ve geçmiş karşılaştırma için metadata saklanabilir. Artifact retention policy storage maliyetini belirler. Kullanılmayan endpoint veya compute kaynağı kalmamalıdır. Geri açılması gerekiyorsa yeniden validation gerekebilir.
Uçtan Uca Model Lineage Nasıl Kurulur?
Uçtan uca lineage modelin üretim zincirindeki bütün version kimliklerini birbirine bağlar. Dataset, feature, Git commit, training run, model artifact, container image ve deployment version aynı iz sürme zincirinde bulunmalıdır. Production prediction gerektiğinde hangi model container'ının hangi training verisine dayandığı görülebilir. Bu yapı incident response ve audit süresini ciddi biçimde azaltır. Lineage metadata manuel forma değil pipeline tarafından otomatik üretilen immutable kayda dayanmalıdır.
Dataset Version
Training run immutable dataset referansı taşımalıdır. Snapshot, commit veya table version kullanılabilir. Dataset değiştirilemez olmalıdır. Data quality result aynı ID ile ilişkilendirilmelidir. Silinen veya bozuk dataset'in etkilediği modeller lineage sorgusuyla bulunabilir.
Feature Version
Modelin kullandığı feature logic version kaydedilmelidir. Online store aynı version veya uyumlu contract kullanmalıdır. Feature transformation değişikliği model behavior değişikliği olarak görülmelidir. Rollback sırasında eski feature version gerektiğinde erişilebilir olmalıdır. Feature owner lineage metadata'sında bulunabilir.
Git Commit
Source commit training code'un kesin referansını sağlar. Branch adı tek başına yeterli değildir çünkü branch değişebilir. Commit review ve build metadata ile ilişkilendirilir. Dirty code production candidate üretmemelidir. CI pipeline commit hash'i experiment run içine otomatik ekleyebilir.
Training Run
Training run dataset, code, parameter ve environment bilgisini bir araya getirir. Run ID model registry'nin source bağlantısıdır. Metric ve artifact run altında tutulur. Başarısız ve başarılı run geçmişi karşılaştırılabilir. Promotion süreci yalnızca doğrulanmış run artifact'ını kabul etmelidir.
Model Artifact
Artifact immutable version altında storage içinde saklanmalıdır. Hash integrity kontrolü sağlar. Registry URI artifact'ı gösterir. Tek model version birden fazla yardımcı artifact içerebilir. Artifact silinirse lineage zinciri eksik kalacağı için retention bilinçli yönetilmelidir.
Container Image
Deployable environment model artifact ile birlikte container image olarak paketlenebilir. Image digest immutable referanstır. Dependency ve serving code aynı image içinde bulunur. Registry scanning ve signing uygulanabilir. Deployment record image digest ile model version'ı birlikte saklamalıdır.
Deployment Version
Deployment version yalnızca model version değildir. Replica, resource, environment variable ve feature endpoint configuration da davranışı etkileyebilir. IaC commit deployment metadata'sına eklenebilir. Canary version ayrı deployment ID taşımalıdır. Rollback hangi configuration setine dönüleceğini açıkça bilmelidir.
Production Prediction
Prediction log minimum metadata ile model version bilgisini saklayabilir. Request ID üzerinden deployment version bulunmalıdır. Hassas input'u loglamak gerekmez. Ground truth geldiğinde prediction aynı version ile eşleştirilir. Böylece production quality model release bazında doğru hesaplanabilir.
Aşama 8 — Model Packaging
Training sonucu elde edilen weight dosyası doğrudan production servisi değildir. Dependency, preprocessing, inference code ve API contract birlikte paketlenmelidir. Docker bu environment'ı tekrar üretilebilir biçimde taşımaya yardımcı olur. Portable model formatları bazı platform bağımlılıklarını azaltabilir. Reproducible build aynı source ve dependency ile aynı deployable artifact'ın üretilebilmesini hedefler.
Model Artifact ile Deployable Artifact Farkı
Model artifact weight veya serialized model dosyasıdır. Deployable artifact ise bu modeli çalıştırmak için gereken runtime bileşenlerini içerir. Container image en yaygın deployable artifact örneklerinden biridir. Model weight aynı kalırken serving code değişebilir. Versioning bu iki katmanı ayrı fakat ilişkili biçimde yönetmelidir.
Dependency Management
Python ve native library version'ları sabitlenmelidir. Development laptop'taki environment production için referans olmamalıdır. Lock file veya container build dependency setini netleştirir. Security scan vulnerable package'ları kontrol eder. Dependency update model regression testini yeniden tetiklemelidir.
Docker ile Model Paketleme
Docker inference environment'ını image olarak paketler. Base image minimum ve güvenilir kaynaktan seçilmelidir. Model artifact build sırasında veya runtime registry üzerinden alınabilir. Non-root user güvenlik açısından tercih edilir. Image digest deployment record içine eklenmelidir.
ONNX ve Portable Model Formatları
Portable format modelin farklı runtime üzerinde çalışmasını kolaylaştırabilir. Framework bağımlılığını azaltmak vendor lock-in riskini düşürebilir. Export sonrası numerical parity test yapılmalıdır. Bütün model operation'ları seçilen format tarafından desteklenmeyebilir. Performance target hardware üzerinde benchmark edilmelidir.
Model API Contract
API contract request ve response schema'yı tanımlar. Field adı, type ve optional behavior açık olmalıdır. Model version değiştiğinde contract mümkün olduğunca backward compatible kalmalıdır. Consumer kırılmasını önlemek için schema testleri yapılabilir. Prediction error standard response format ile döndürülmelidir.
Container Image Versioning
Mutable latest tag production için risklidir. Semantic version veya build ID kullanılabilir. Image digest kesin artifact referansı sağlar. Registry retention rollback ihtiyacına göre eski image'ları saklar. Security issue durumunda hangi deployment'ın hangi image'ı kullandığı hızla bulunmalıdır.
Reproducible Builds
Aynı source commit'in aynı image içeriğini üretmesi hedeflenir. Dependency version ve base image digest sabitlenir. Build timestamp gibi nondeterministic metadata yönetilmelidir. Artifact signature trusted CI pipeline'ı doğrular. Reproducible build supply chain güvenliğini ve rollback güvenilirliğini artırır.
CI/CD/CT: MLOps Otomasyonunun Temeli
MLOps pipeline ile model eğitimi test ve üretime dağıtım nasıl yapılır sorusunun teknik cevabı çoğu zaman CI, CD ve CT süreçlerinin birlikte tasarlanmasıdır. CI kod, data ve model testlerini otomatik çalıştırır. CT yeni veri veya trigger geldiğinde candidate model üretir. CD doğrulanan artifact'ı staging veya production ortamına kontrollü taşır. Bu üç süreç birbirine bağlı olsa da retraining tamamlanmasının production deployment anlamına gelmemesi güvenilir MLOps tasarımının temelidir.
Continuous Integration (CI)
CI source değişikliği geldiğinde otomatik test ve build süreçlerini çalıştırır. ML projelerinde unit test yanında data, feature ve model testleri de bulunur. Training pipeline code quality kontrolünden geçer. Small smoke training hızlı validation sağlayabilir. Başarısız test merge veya artifact üretimini durdurabilir.
Unit Tests
Feature function ve yardımcı kod küçük parçalar hâlinde test edilmelidir. Deterministik transformation için input ve expected output karşılaştırılır. Edge case ve null davranışı dahil edilir. Fast unit test developer feedback süresini kısaltır. Heavy model training unit test aşamasında çalıştırılmamalıdır.
Data Tests
Schema ve kalite kontrolleri CI veya pipeline girişinde çalışabilir. Sample dataset test fixture olarak kullanılabilir. Required column ve range doğrulanır. Production data privacy nedeniyle CI environment'a kopyalanmamalıdır. Data contract değişikliği explicit review gerektirir.
Feature Tests
Feature transformation semantic beklentiyi karşılamalıdır. Train-serve parity test edilebilir. Point-in-time query future data kullanmamalıdır. Feature schema contract doğrulanır. Version değişikliği downstream model impact analizini tetikleyebilir.
Model Tests
Model smoke test artifact'ın load ve predict yapabildiğini kontrol eder. Minimum metric threshold küçük test dataset üzerinde doğrulanabilir. Input signature test edilir. Deterministic invariants varsa kontrol edilir. Full evaluation CT veya validation pipeline içinde daha kapsamlı çalıştırılır.
Continuous Delivery / Deployment (CD)
CD doğrulanmış model artifact'ının environment'lara taşınmasını otomatikleştirir. Continuous delivery production release'i insan onayına hazır hâle getirirken continuous deployment gate'leri geçen değişikliği otomatik yayınlayabilir. Model serving ve infrastructure configuration birlikte deploy edilir. Canary veya blue-green strategy CD pipeline'ın parçası olabilir. Rollback mechanism deployment başlamadan hazır olmalıdır.
Continuous Training (CT)
CT yeni veri veya belirli trigger oluştuğunda training pipeline'ı otomatik çalıştırır. Amaç güncel koşullara uyumlu candidate model üretmektir. Scheduled, drift veya performance trigger kullanılabilir. Training sonucu registry'ye candidate olarak kaydedilir. Validation başarısızsa production model değişmeden kalır.
CI/CD ile CI/CT/CD Arasındaki Fark
Klasik CI/CD source code değişikliği merkezlidir. ML sisteminde veri değişimi de yeni artifact ihtiyacı yaratabilir. CT bu nedenle code commit olmadan yeni model training'i başlatabilir. Yeni candidate tekrar CI benzeri validation ve quality gate süreçlerinden geçer. CI/CT/CD veri ve model döngüsünü klasik software delivery akışına ekler.
Model Promotion ve Deployment Gate'leri
Promotion gate modelin registry lifecycle içinde ilerlemesini kontrol eder. Metric, fairness, latency ve security sonuçları otomatik kontrol edilir. Approved model deployment gate'e ulaştığında canary plan başlatılabilir. Production telemetry belirli süre gözlemlenir. Başarısız sinyal automatic rollback veya promotion stop oluşturur.
Aşama 9 — Makine Öğrenmesi Modelinin Dağıtılması
Model deployment eğitilmiş ve onaylanmış modelin hedef environment içinde kullanıma alınmasıdır. Deployment serving yöntemi, infrastructure, secret, scaling ve network configuration gibi bileşenleri içerir. Model dosyasını sunucuya kopyalamak production deployment için yeterli değildir. Infrastructure as Code ortamın tekrar üretilebilir olmasını sağlar. Kurumsal MLOps pipeline ve makine öğrenmesi model dağıtım hizmeti tasarlanırken deployment'ın test, rollout, monitoring ve rollback aşamaları tek release süreci olarak düşünülmelidir.
Model Deployment Nedir?
Deployment model artifact'ını çalışan production configuration içine yerleştirme işlemidir. Batch job, API endpoint veya edge application olabilir. Model version açıkça belirtilmelidir. Deployment health check ile doğrulanır. Release sonrası monitoring yeni sürümün gerçek davranışını ölçer.
Model Serving ile Deployment Arasındaki Fark
Serving modelin prediction request'lerini nasıl cevapladığını ifade eder. Deployment ise serving bileşeninin environment'a nasıl yerleştirildiği ve güncellendiği süreçtir. Aynı serving framework blue-green veya canary ile farklı deployment strategy kullanabilir. Batch serving bile deployment pipeline gerektirir. Kavramları ayırmak architecture tartışmasını daha açık hâle getirir.
Production Ortamı Gereksinimleri
Production environment availability ve güvenlik hedeflerini karşılamalıdır. CPU veya GPU capacity load test sonucuna göre seçilir. Network ve storage erişimi minimum yetkiyle sınırlandırılır. Logging ve metrics endpoint aktif olmalıdır. Staging mümkün olduğunca production'a benzer configuration kullanmalıdır.
Deployment Configuration
Replica, resource limit, timeout ve model version configuration olarak tutulmalıdır. Environment variable version control dışında secret içermemelidir. IaC change review sürecinden geçer. Configuration drift otomatik tespit edilebilir. Rollback eski config ve model ikilisini birlikte geri getirebilmelidir.
Secret ve Credential Management
Database password veya API token container image içine yazılmamalıdır. Secret manager runtime credential sağlar. Short-lived workload identity static secret'a göre tercih edilebilir. Rotation production kesintisi olmadan test edilmelidir. Secret access audit log ile izlenmelidir.
Infrastructure as Code
IaC network, compute ve deployment kaynaklarını code üzerinden tanımlar. Environment tekrar oluşturulabilir hâle gelir. Pull request infrastructure change review sağlar. Policy-as-code yanlış region veya public endpoint oluşturmayı engelleyebilir. Production ve staging arasındaki fark açık parameter'larla yönetilmelidir.
Model Serving Yöntemleri
Model serving yöntemi kullanım pattern'ine göre seçilmelidir. Her modelin REST API olarak sunulması gereksiz maliyet ve operasyon oluşturabilir. Günlük rapor modeli batch inference ile daha kolay çalışabilirken fraud modeli real-time endpoint gerektirir. Streaming ve asynchronous yöntemler yüksek hacimli olay akışlarında faydalıdır. Edge ve serverless seçenekleri latency, veri yerelliği ve trafik dalgalanmasına göre değerlendirilebilir.
Batch Inference
Batch inference belirli veri kümesine toplu prediction uygular. Job saatlik, günlük veya ihtiyaç üzerine çalışabilir. Online endpoint gerektirmediği için operasyon daha basittir. Büyük batch GPU utilization açısından verimli olabilir. Sonuç database veya object storage'a yazılabilir.
Ne Zaman Kullanılmalı?
Prediction anlık kullanıcı kararını etkilemiyorsa batch uygundur. Günlük churn listesi veya ürün scoring buna örnektir. Veri zaten warehouse içinde bulunabilir. Throughput latency'den daha önemliyse batch avantaj sağlar. Scheduling ve retry mekanizması güvenilir olmalıdır.
Avantajları ve Dezavantajları
Batch serving yüksek throughput ve düşük birim maliyet sağlayabilir. Infrastructure sürekli açık kalmak zorunda değildir. Buna karşılık sonuç tazeliği job sıklığıyla sınırlıdır. Büyük batch başarısız olduğunda retry maliyeti yüksek olabilir. Consumer job tamamlanmasını beklemek zorundadır.
Online / Real-Time Inference
Online inference request geldiği anda prediction döndürür. Düşük latency ve yüksek availability temel beklentidir. API authentication ve rate limit uygulanmalıdır. Autoscaling trafik artışına cevap verebilir. Model warm-up ve GPU memory yönetimi production performansını etkiler.
REST
REST HTTP ekosistemiyle kolay integration sağlar. JSON request geliştirme ve debugging açısından pratiktir. Büyük tensor payload için serialization overhead oluşabilir. Versioned endpoint veya header contract kullanılabilir. Çoğu web ve business ML integration için yeterlidir.
gRPC
gRPC binary protocol ve schema tabanlı interface sunar. Internal high-throughput servislerde düşük overhead avantajı sağlayabilir. Streaming desteği bazı inference senaryolarında kullanışlıdır. Client code generation contract uyumunu kolaylaştırır. Public browser integration REST kadar doğrudan olmayabilir.
Streaming Inference
Streaming inference event akışı üzerinde sürekli prediction üretir. Kafka benzeri stream platformları ile entegre olabilir. Fraud veya sensor anomaly kullanımına uygundur. Event ordering ve exactly-once gereksinimi business bağlamına göre değerlendirilir. Model version change stream processing state ile uyumlu olmalıdır.
Asynchronous Inference
Asynchronous inference request'i queue'ya alıp sonucu daha sonra üretir. Uzun süren model işlemleri için HTTP connection'ı açık tutma ihtiyacını azaltır. Worker scale queue uzunluğuna göre ayarlanabilir. Client job ID ile sonucu sorgulayabilir. Retry ve idempotency duplicate prediction etkisini kontrol eder.
Edge Inference
Edge inference modeli kullanıcı veya veri kaynağına yakın cihazda çalıştırır. Network latency ve data transferi azalır. Offline kullanım mümkün olabilir. Model update ve device compatibility operasyon yükü getirir. Model compression edge hardware sınırları nedeniyle önemli hâle gelir.
Serverless Inference
Serverless inference trafik olmadığında compute kullanımını azaltabilir. Scale-to-zero maliyet avantajı sağlar. Cold start latency kritik uygulamada problem olabilir. GPU serverless seçeneklerinin maliyet ve availability özellikleri ayrıca değerlendirilmelidir. Burst trafik için uygun autoscaling sağlar.
Doğru Model Serving Yöntemi Nasıl Seçilir?
Serving seçimi teknik popülerliğe göre değil workload gereksinimine göre yapılmalıdır. Latency, throughput, trafik pattern'i, model boyutu ve hardware ihtiyacı ana kriterlerdir. Güncelleme sıklığı deployment yöntemini etkiler. Maliyet de sürekli açık GPU endpoint ile batch job arasında büyük fark oluşturabilir. Architecture decision küçük benchmark ve load test sonuçlarına dayanmalıdır.
Latency
Kullanıcının kabul edebileceği cevap süresi belirlenmelidir. Real-time fraud düşük latency ister. Offline scoring saatler içinde tamamlanabilir. P95 ve P99 tail latency izlenmelidir. Network ve preprocessing model inference kadar süre tüketebilir.
Throughput
Throughput saniyede veya dakikada kaç prediction işlendiğini gösterir. Dynamic batching GPU verimliliğini artırabilir. Concurrency queue oluşumunu etkiler. Peak throughput normal ortalamadan ayrı planlanmalıdır. Load test gerçek kapasiteyi ölçer.
Trafik Pattern'i
Sabit trafik sürekli replica için uygundur. Günün belirli saatlerinde yoğunluk varsa autoscaling avantaj sağlar. Çok seyrek trafik scale-to-zero ile maliyet azaltabilir. Ani burst queue veya serverless yaklaşımını gerekli kılabilir. Historical request pattern capacity planning için kullanılmalıdır.
Model Boyutu
Büyük model startup ve memory ihtiyacını artırır. Bir GPU üzerinde kaç replica çalışacağı model boyutuna bağlıdır. Model loading süresi canary rollout'u etkileyebilir. Quantization memory ihtiyacını azaltabilir. Edge deployment daha küçük model gerektirebilir.
CPU/GPU Gereksinimi
Her model GPU gerektirmez. Tree model CPU üzerinde çok ekonomik olabilir. Deep learning GPU ile daha yüksek throughput sağlayabilir. Hardware seçimi gerçek benchmark ile yapılmalıdır. GPU utilization düşük kalıyorsa batching veya CPU alternatifi değerlendirilebilir.
Maliyet
Serving cost compute, network ve managed platform ücretlerinden oluşur. Cost per prediction karşılaştırılabilir metric'tir. Overprovisioned GPU endpoint ciddi israf yaratabilir. Autoscaling ve batch yaklaşımı maliyeti azaltır. Business KPI kazancı infrastructure cost ile birlikte değerlendirilmelidir.
Güncelleme Sıklığı
Sık retraining yapan model hızlı ve güvenilir rollout pipeline ister. Edge model update cihaz filosu nedeniyle daha yavaş olabilir. Batch model yeni version'ı job schedule ile kolay değiştirebilir. Real-time model canary strategy gerektirebilir. Update frequency registry ve retention politikasını da etkiler.
Model Deployment Stratejileri
Yeni modeli bütün trafiğe tek seferde vermek production riskini artırır. Rolling, blue-green, canary ve shadow deployment farklı risk azaltma yöntemleri sunar. A/B testing business sonuçlarını karşılaştırırken champion-challenger sürekli model yarışına uygun olabilir. Strategy seçiminde geri dönüş süresi ve gerçek ground truth availability dikkate alınmalıdır. Kritik modellerde küçük trafikle başlayan kontrollü rollout çoğu zaman en güvenli yaklaşımdır.
Rolling Deployment
Rolling deployment eski replica'ları kademeli olarak yeni sürümle değiştirir. Ek çift infrastructure ihtiyacı sınırlıdır. Bir süre iki version aynı anda trafik alabilir. Feature compatibility korunmalıdır. Hata görülürse rollout durdurulabilir veya geri çevrilebilir.
Blue-Green Deployment
Blue-green iki tam environment kullanır. Mevcut production blue çalışırken yeni green ortam hazırlanır. Test tamamlanınca trafik tek hareketle green'e yönlendirilir. Rollback eski blue ortama geri yönlendirme ile hızlıdır. Ek environment maliyeti strategy'nin temel dezavantajıdır.
Avantajları
Yeni environment production trafiği almadan tamamen doğrulanabilir. Traffic switch hızlıdır. Rollback için eski environment hazır kalır. Infrastructure configuration değişikliklerinde güçlü izolasyon sağlar. Büyük model upgrade'lerinde operasyon riskini azaltır.
Rollback Süreci
Rollback load balancer veya routing katmanını eski environment'a çevirir. Eski model ve feature dependency çalışır durumda kalmalıdır. Database schema backward compatible olmalıdır. Switch sonrası error ve latency monitoring yapılmalıdır. Yeni green environment root cause analysis için izole tutulabilir.
Canary Deployment
Canary yeni modeli küçük trafik yüzdesine verir. Gerçek production metric'leri kontrollü risk altında ölçülür. Başarılı oldukça trafik kademeli artırılır. Threshold aşılırsa rollback otomatik olabilir. Model quality ground truth gecikmeli geliyorsa proxy metric ve system metric birlikte kullanılmalıdır.
Trafik Yüzdesinin Artırılması
İlk canary yüzde bir veya düşük bir oranla başlayabilir. Daha sonra yüzde beş, yirmi ve elli gibi adımlar kullanılabilir. Her adım belirli gözlem süresi içerir. Traffic segment random veya belirli kullanıcı grubuna göre seçilebilir. Sample bias canary sonucunu yanıltmamalıdır.
Promotion Kriterleri
Error rate baseline'ı aşmamalıdır. Latency ve resource consumption SLO içinde kalmalıdır. Business KPI yeterli sample varsa değerlendirilir. Fairness metric belirli segmentlerde bozulmamalıdır. Bütün gate'ler geçildiğinde canary full production'a promotion alır.
Shadow Deployment
Shadow deployment gerçek request'i yeni modele kopyalar ancak kullanıcıya eski modelin sonucu gösterilir. Böylece yeni model production data üzerinde risksiz gözlemlenir. Prediction sonucu offline karşılaştırılır. Ek compute maliyeti iki model aynı anda çalıştığı için yükselir. Side-effect üreten servislerde shadow request'in dış sisteme işlem yapmaması gerekir.
A/B Testing
A/B testing kullanıcı gruplarına farklı model sonuçlarını gerçekten gösterir. Business KPI üzerindeki causal etki ölçülebilir. Random assignment segment bias'ı azaltır. Deney sample size önceden hesaplanmalıdır. Risk shadow deployment'a göre daha yüksektir çünkü challenger kullanıcı kararını etkiler.
Champion–Challenger
Champion mevcut production modelidir. Challenger yeni candidate olarak sürekli karşılaştırılır. Offline veya online metric üzerinden daha iyi model belirlenir. Challenger otomatik veya kontrollü promotion alabilir. Bu yaklaşım sürekli model iyileştirmesi yapılan sistemlerde yararlıdır.
Multi-Armed Bandit
Multi-armed bandit trafik dağılımını model performansına göre dinamik ayarlayabilir. Daha iyi sonuç veren seçeneğe zamanla daha fazla trafik gönderilir. Exploration ve exploitation dengesi gerekir. A/B test gibi sabit trafik oranından farklıdır. Business experiment ile production optimization birleşebilir ancak yorumlama daha dikkatli yapılmalıdır.
Shadow Deployment ile A/B Testing Arasındaki Fark
Shadow ve A/B testing çoğu zaman karıştırılır ancak kullanıcı etkisi açısından temel fark vardır. Shadow model prediction üretir fakat kullanıcı sonucunu görmez. A/B testing'de challenger sonucu gerçek kullanıcı davranışını etkiler. Ground truth toplama şekli ve risk seviyesi bu nedenle farklıdır. Yeni modelin güvenliği bilinmiyorsa shadow daha güvenli ilk production testi sunar.
Kullanıcıya Hangi Modelin Sonucu Gösterilir?
Shadow durumda kullanıcı yalnızca champion sonucunu görür. Challenger arka planda aynı request üzerinde prediction yapar. A/B testte belirli kullanıcı challenger sonucunu alır. Bu nedenle A/B business KPI ölçümüne daha uygundur. Shadow technical ve prediction parity analizine odaklanır.
Ground Truth Toplama
Shadow prediction gerçek outcome ile sonradan eşleştirilebilir. Ancak kullanıcı challenger kararını görmediği için bazı business etkiler ölçülemez. A/B test gerçek intervention etkisini ölçer. Label latency her iki yöntemde değerlendirme süresini uzatabilir. Prediction ID ground truth join için kaydedilmelidir.
Risk Seviyesi
Shadow kullanıcı sonucunu değiştirmediği için daha düşük risklidir. Compute ve data processing maliyeti yine oluşur. A/B test kötü challenger nedeniyle gerçek business zararı oluşturabilir. Traffic oranı bu riski kontrol eder. Kritik sistemde önce shadow sonra canary veya A/B sıralaması kullanılabilir.
Hangi Senaryoda Hangisi Kullanılmalı?
Modelin technical compatibility ve prediction distribution'ını test etmek için shadow uygundur. Business conversion veya kullanıcı davranışı etkisini ölçmek için A/B gerekir. Ground truth gecikmesi uzun ise shadow dönemi uzayabilir. Yüksek riskli finans kararlarında A/B sıkı approval gerektirebilir. Düşük riskli recommendation sisteminde A/B daha hızlı uygulanabilir.
Canary Deployment Başarısı Nasıl Ölçülür?
Canary başarısı yalnızca endpoint error vermiyor diye kabul edilmemelidir. Prediction quality, latency, resource ve business metric birlikte değerlendirilmelidir. Fairness belirli kullanıcı segmentlerinde ayrıca izlenebilir. Automatic promotion yeterli sample ve gözlem süresi oluşmadan çalışmamalıdır. Başarısız metric automatic rollback için açık threshold'a bağlanabilir.
Prediction Quality
Ground truth hızlı geliyorsa model metric canary sırasında hesaplanabilir. Label gecikiyorsa prediction distribution ve proxy metric kullanılabilir. Champion ile disagreement oranı izlenebilir. Confidence ve calibration dağılımı karşılaştırılabilir. Büyük fark root cause review gerektirir.
Error Rate
HTTP veya serving error rate baseline ile karşılaştırılır. Model serialization veya feature lookup problemi canary'de ortaya çıkabilir. Small sample nedeniyle yüzde metric yanıltıcı olabilir. Absolute error count de dikkate alınmalıdır. Threshold aşılırsa trafik artırılmamalıdır.
P95/P99 Latency
Tail latency kullanıcı deneyimini daha iyi gösterir. Yeni model average olarak hızlı olsa bile P99 kötü olabilir. GPU queue ve cold start incelenmelidir. Canary trafik düşük olduğunda tam load behavior görünmeyebilir. Promotion öncesi load test sonucu da dikkate alınmalıdır.
Resource Consumption
CPU, GPU ve memory model version bazında ölçülür. Yeni model aynı trafik için iki kat GPU kullanıyorsa maliyet yükselir. Memory leak zaman içinde ortaya çıkabilir. Autoscaling daha fazla replica oluşturabilir. Resource metric cost threshold ile birlikte değerlendirilmelidir.
Business KPI
Conversion, fraud loss veya retention gibi KPI canary modelinin gerçek değerini gösterir. Sample size küçükse erken karar verilmemelidir. Seasonality ve segment farkları dikkate alınmalıdır. Model technical metric'i iyi olsa bile KPI kötüleşebilir. Promotion rule business owner ile birlikte belirlenmelidir.
Fairness Metrics
Canary belirli segmentlerde farklı etki oluşturabilir. Sample yeterliyse group metric karşılaştırılır. Traffic assignment segmentleri dengeli temsil etmelidir. Threshold dışı fark promotion'ı durdurabilir. Fairness monitoring privacy gereksinimleriyle uyumlu tasarlanmalıdır.
Automatic Promotion ve Rollback
Metric'ler belirli süre stabil kaldığında promotion otomatik ilerleyebilir. Minimum sample count kuralı eklenmelidir. Bir critical SLO ihlali automatic rollback tetikleyebilir. Rollback event audit log'a yazılır. İnsan ekibi neden rollback olduğunu açık dashboard üzerinden görebilmelidir.
Model Rollback Stratejisi Nasıl Tasarlanır?
Rollback production deployment başlamadan önce tasarlanmalıdır. Önceki model artifact, container image ve feature dependency erişilebilir olmalıdır. Sadece model version geri almak schema veya feature değişikliği nedeniyle yeterli olmayabilir. Traffic routing hızlı geri dönüş sağlayacak şekilde hazırlanmalıdır. Rollback sonrası incident kapatılmadan root cause analysis yapılmalıdır.
Rollback Tetikleyicileri
Error rate veya availability kritik threshold'u aşabilir. Latency SLO ihlali rollback sebebi olabilir. Model quality ve business KPI belirgin düşerse geri dönüş gerekir. Security issue immediate rollback gerektirebilir. Tetikleyiciler otomatik ve manuel kategorilere ayrılmalıdır.
Önceki Model Versiyonuna Dönüş
Registry önceki approved production version'ı saklamalıdır. Deployment pipeline aynı artifact'ı tekrar kullanabilmelidir. Mutable artifact rollback güvenilirliğini bozar. Eski dependency ve container image korunmalıdır. Rollback smoke test ile doğrulanmalıdır.
Traffic Routing
Canary ve blue-green routing katmanı rollback'i hızlandırır. Load balancer eski backend'e trafik gönderir. Session affinity varsa davranış incelenmelidir. Queue içindeki eski request'ler yönetilmelidir. Routing change metric dashboard'da event olarak görünmelidir.
Feature Compatibility Problemleri
Yeni model için feature schema değişmiş olabilir. Eski model aynı feature version'ı bulamazsa rollback başarısız olur. Backward compatible feature contract tercih edilmelidir. Breaking change çift version bir süre birlikte çalıştırılabilir. Rollback test staging ortamında düzenli yapılmalıdır.
Database ve Schema Compatibility
Prediction result schema downstream database ile ilişkili olabilir. Yeni model ek alan yazdıysa eski consumer etkilenebilir. Database migration backward compatible olmalıdır. Destructive schema change model rollout ile aynı anda yapılmamalıdır. Rollback runbook data schema adımını da kapsamalıdır.
Rollback Sonrası Root Cause Analysis
Rollback hizmeti hızlı düzeltir ancak problemin nedenini çözmez. Data, feature, model, serving ve infrastructure katmanları ayrı incelenmelidir. Timeline deployment event ve metric'lerle oluşturulur. Root cause ve corrective action kayıt altına alınır. Aynı problemin tekrarını önlemek için test veya gate eklenmelidir.
Aşama 10 — Production Model Monitoring
Production monitoring MLOps model registry versiyonlama data drift ve model monitoring nasıl yapılır sorusunun en kritik bölümüdür. Sistem sağlığı, model kalitesi ve infrastructure metric'leri ayrı fakat ilişkili izlenmelidir. Accuracy ground truth gelene kadar bilinmeyebilir, bu nedenle drift ve proxy metric geçici sinyal olarak kullanılır. Dashboard model version bazında karşılaştırma sağlamalıdır. Monitoring sonucu yalnızca alarm üretmemeli, retraining, rollback veya investigation workflow'una bağlanmalıdır.
Sistem Sağlığı Metrikleri
Serving endpoint normal uygulama gibi availability ve latency metric'lerine sahiptir. Throughput kapasite kullanımını gösterir. Error rate model veya dependency hatasını erken ortaya çıkarabilir. Tail latency özellikle online serving için önemlidir. Bu metric'ler SLO ve error budget ile ilişkilendirilebilir.
Availability
Availability başarılı prediction servis süresini ölçer. Health check sadece process'in açık olmasını değil dependency erişimini de değerlendirebilir. Multi-zone deployment availability'yi artırabilir. SLO business criticality'ye göre belirlenmelidir. Scheduled maintenance ayrıca tanımlanmalıdır.
Throughput
Throughput sistemin işlediği prediction sayısını gösterir. Trafik artışı capacity plan için sinyal sağlar. Drop görüldüğünde upstream problem olabilir. GPU utilization ile birlikte değerlendirilmelidir. Queue depth asynchronous sistemlerde ek metric'tir.
Error Rate
Serving exception ve invalid request ayrı kategorilerde izlenmelidir. 5xx infrastructure veya model loading problemini gösterebilir. Schema mismatch error yeni client release'ine işaret edebilir. Error rate model version ile ilişkilendirilmelidir. Ani artış rollback trigger olabilir.
P50/P95/P99 Latency
P50 tipik kullanıcı deneyimini gösterir. P95 ve P99 tail problemlerini görünür kılar. Average latency ağır outlier etkisini gizleyebilir. Dependency ve model inference süresi trace ile ayrıştırılabilir. SLO genellikle percentile bazında tanımlanmalıdır.
Model Sağlığı Metrikleri
Model health gerçek prediction kalitesini ölçer. Accuracy, precision, recall ve calibration problem türüne göre kullanılabilir. Label gecikmesi varsa metric gerçek zamanlı hesaplanamayabilir. Production segment bazlı performans offline sonucu doğrular. Model version değişiminde baseline karşılaştırması yapılmalıdır.
Accuracy
Accuracy doğru prediction oranını gösterir. Dengesiz sınıflarda yanıltıcı olabilir. Ground truth gerektirir. Zaman penceresine göre trend izlenmelidir. Segment metric global değeri tamamlar.
Precision ve Recall
Precision positive prediction'ın ne kadarının doğru olduğunu gösterir. Recall gerçek positive örneklerin ne kadarının yakalandığını ölçer. Business maliyet hangi metric'in daha önemli olduğunu belirler. Threshold değişikliği iki metric arasında denge kurar. Production distribution değiştikçe optimum threshold değişebilir.
Calibration
Calibration model olasılık skorunun gerçek olasılıkla ne kadar uyumlu olduğunu ölçer. Risk scoring sistemlerinde önemlidir. Model ranking doğru olsa bile probability aşırı güvenli olabilir. Calibration drift ayrıca izlenebilir. Threshold ve business decision probability interpretation'a bağlıysa kritik metric'tir.
Infrastructure Metrikleri
Model performansı hardware saturation nedeniyle düşebilir. CPU, GPU, memory ve GPU memory izlenmelidir. Resource metric model version ile etiketlenirse yeni modelin maliyet etkisi görülür. Autoscaling threshold bu ölçümlere dayanabilir. Resource leak uzun süreli trend üzerinden tespit edilir.
CPU
CPU preprocessing ve bazı model inference için ana kaynaktır. Uzun süre yüksek kullanım latency artışına yol açabilir. Thread ve process sayısı optimize edilmelidir. CPU throttling container limitinden kaynaklanabilir. Scale decision traffic ve utilization birlikte değerlendirilerek verilmelidir.
GPU
GPU utilization inference verimliliğini gösterir. Düşük utilization overprovisioning veya yetersiz batching anlamına gelebilir. Çok yüksek kullanım queue oluşturabilir. GPU model ve driver metadata izlenmelidir. Cost per prediction için utilization temel girdidir.
Memory
Memory model loading, preprocessing ve cache tarafından kullanılır. Leak zaman içinde pod restart'ına neden olabilir. Working set trend izlenmelidir. OOM kill error metric ile ilişkilendirilir. Resource request ve limit gerçek ölçüme göre ayarlanmalıdır.
GPU Memory
GPU memory model boyutu ve batch size ile doğrudan ilişkilidir. OOM inference failure oluşturabilir. Bir GPU üzerinde kaç replica çalışacağı VRAM kapasitesine bağlıdır. Quantization memory ihtiyacını azaltabilir. Memory fragmentation uzun çalışan servislerde ayrıca izlenebilir.
ML Sistemlerinde Drift Türleri
Drift tek bir kavram değildir ve yanlış türün yanlış yöntemle izlenmesi gereksiz retraining oluşturabilir. Data drift genel input dağılım değişimidir. Feature drift tek feature üzerinde, prediction drift model output dağılımında görülür. Concept drift input ile target arasındaki ilişkinin değişmesidir. Label drift ise target sınıf dağılımının değişmesini ifade eder.
Data Drift
Data drift production input dağılımının training referansından değişmesidir. Kullanıcı profili veya ürün mix zamanla farklılaşabilir. Statistical distance metric kullanılabilir. Drift model quality'yi kesin olarak düşürmez. Ground truth ile performance sonucu birlikte değerlendirilmelidir.
Feature Drift
Feature drift tek veya belirli feature gruplarının dağılım değişimidir. Upstream pipeline hatası veya gerçek davranış değişimi nedeni olabilir. Feature bazında alert root cause'u hızlandırır. Missing rate ve category frequency gibi metric'ler kullanılabilir. Kritik feature drift training trigger olabilir.
Prediction Drift
Prediction drift model output dağılımındaki değişimi ölçer. Positive rate aniden artabilir. Input drift veya model deployment değişikliği sebep olabilir. Ground truth yokken erken monitoring sinyali sağlar. Business event değişimi de prediction dağılımını doğal biçimde etkileyebilir.
Concept Drift
Concept drift feature ile gerçek target arasındaki ilişkinin değişmesidir. Eski pattern artık aynı sonucu göstermeyebilir. Sadece input distribution izlemek bunu her zaman yakalamaz. Ground truth gerektirir. Retraining için en güçlü sinyallerden biri olabilir.
Label Drift
Label drift target sınıf oranının değişmesidir. Fraud oranı dönemsel olarak artabilir. Model threshold ve calibration etkilenebilir. Training sampling stratejisi yeniden değerlendirilmelidir. Business seasonality ile gerçek drift ayrılmalıdır.
Drift Türleri Nasıl Birbirinden Ayrılır?
Input feature metric data drift'i gösterir. Prediction distribution model output değişimini gösterir. Label geldiğinde target distribution ve performance hesaplanabilir. Concept drift için input-target ilişkisi analiz edilir. Tek dashboard bütün türleri farklı katmanlarda birlikte sunmalıdır.
Ground Truth Gecikmesi Model Monitoring'i Nasıl Etkiler?
Birçok production modelde gerçek sonuç prediction anında bilinmez. Kredi temerrüdü aylar, churn haftalar sonra ortaya çıkabilir. Bu durumda accuracy gerçek zamanlı izlenemez. Proxy metric ve unsupervised drift sinyalleri erken uyarı sağlar. Ground truth geldiğinde gecikmeli performance evaluation önceki prediction version'larıyla eşleştirilmelidir.
Label Latency Nedir?
Label latency prediction ile gerçek outcome'un bilindiği zaman arasındaki farktır. Fraud label birkaç gün içinde kesinleşebilir. Medical outcome aylar sürebilir. Monitoring design bu gecikmeyi hesaba katmalıdır. Retraining trigger gerçek label bekleme süresine göre tasarlanmalıdır.
Gerçek Sonucun Aylar Sonra Geldiği Sistemler
Kredi risk modeli ödeme davranışını uzun dönem izler. Bu sürede yeni modelin gerçek accuracy'si bilinmez. Shadow ve canary sonucu proxy sinyal kullanır. Büyük drift görülürse daha dikkatli rollout uygulanır. Gecikmeli backfill evaluation dashboard geçmiş model version'ları için güncellenmelidir.
Proxy Metrics
Proxy metric gerçek business sonucuyla ilişkili erken sinyaldir. Prediction confidence veya kısa dönem davranış kullanılabilir. Proxy ile final target korelasyonu düzenli doğrulanmalıdır. Yanlış proxy yanlış retraining kararına yol açabilir. Metric yalnızca geçici gözlem aracı olarak kullanılmalıdır.
Unsupervised Drift Monitoring
Label olmadan feature ve prediction dağılımları izlenebilir. Statistical distance baseline ile karşılaştırılır. Segment drift ayrı hesaplanabilir. Bu yöntem concept drift'i kesin kanıtlamaz. Alarm investigation başlatan erken sinyal olarak kullanılmalıdır.
Gecikmeli Performance Evaluation
Ground truth geldiğinde prediction ID ile eski kayıt eşleştirilir. Model version metadata sayesinde doğru release metric'i hesaplanır. Evaluation window label maturity seviyesine göre belirlenir. Dashboard geçmiş dönem metric'lerini sonradan günceller. Retraining policy gecikmeli performance trendini kullanabilir.
Aşama 11 — Retraining ve Continuous Training
Retraining modeli yeni veri ve koşullara uyarlamak için kullanılır. Her model aynı sıklıkta yeniden eğitilmemelidir. Scheduled, drift, performance, data-volume veya business event trigger'ları farklı kullanım alanlarına sahiptir. Training cost ve label availability karar üzerinde etkili olmalıdır. CT candidate model üretir ancak quality gate olmadan production değişikliğine yol açmamalıdır.
Scheduled Retraining
Model belirli takvimle yeniden eğitilir. Haftalık veya aylık schedule operasyon açısından basittir. Veri çok yavaş değişiyorsa gereksiz training maliyeti oluşturabilir. Hızlı değişen concept için schedule geç kalabilir. Schedule gerçek drift ve business cycle verisiyle belirlenmelidir.
Drift-Triggered Retraining
Feature veya prediction drift threshold aşınca training başlatılabilir. Tek anlık spike yerine belirli süre persistent drift aranmalıdır. Data pipeline problemi önce araştırılmalıdır. Drift gerçek behavior change ise yeni dataset snapshot hazırlanır. Candidate yine full evaluation'dan geçer.
Performance-Triggered Retraining
Ground truth geldiğinde model metric SLO altına düşerse retraining tetiklenebilir. Bu en doğrudan kalite sinyalidir. Label latency kararın gecikmesine neden olabilir. Segment performansı global metric'ten önce bozulabilir. Trigger threshold noise nedeniyle sürekli training başlatmayacak şekilde tasarlanmalıdır.
Data-Volume-Triggered Retraining
Belirli sayıda yeni labeled örnek toplandığında retraining yapılabilir. Küçük dataset projelerinde anlamlıdır. Schedule yerine bilgi kazanımına göre training çalışır. Data quality gate yeni örnekleri doğrular. Yeni volume distribution eski dataset ile karşılaştırılmalıdır.
Business-Event-Triggered Retraining
Fiyat politikası veya ürün yapısı büyük değiştiğinde eski model hızlı biçimde geçersiz olabilir. Business event otomatik retraining trigger olabilir. Önce feature ve label definition değişmiş mi kontrol edilmelidir. Historical data yeni concept'i temsil etmeyebilir. Yeni model daha fazla human review gerektirebilir.
Otomatik Retraining Neden Otomatik Deployment Anlamına Gelmemeli?
Training job'ın başarılı olması yeni modelin production'dan daha iyi olduğunu garanti etmez. Veri kalitesi veya distribution değişikliği candidate performansını bozabilir. Yeni model fairness, latency veya cost threshold'larını aşabilir. Bu nedenle CT ve CD arasında evaluation ve quality gate bulunmalıdır. Otomatik candidate üretimi güvenlidir, otomatik production promotion ise ancak güçlü ve ölçülmüş gate'lerle uygulanmalıdır.
Candidate Model Üretimi
Retraining sonucu model registry'ye candidate version olarak kaydedilir. Training run metadata eksiksiz olmalıdır. Dataset ve code version ilişkilendirilir. Candidate henüz production trafik almaz. Evaluation pipeline otomatik başlatılır.
Yeniden Evaluation
Aynı standard test set yeni candidate üzerinde çalıştırılır. Yeni veri distribution için ek test gerekebilir. Fairness ve robustness yeniden ölçülür. Latency benchmark deployable artifact üzerinde yapılır. Sonuçlar registry metadata'sına eklenir.
Production Model ile Karşılaştırma
Candidate champion modelle aynı metric setinde karşılaştırılır. Accuracy artışı cost veya latency düşüşüyle dengelenir. Segment metric dikkate alınır. İstatistiksel anlamlılık küçük farkları yorumlamaya yardımcı olur. Candidate bariz kötü ise otomatik reddedilir.
Quality Gate
Quality gate minimum şartları otomatik uygular. Model metric, fairness, latency ve security kontrol edilir. Her gate sonucu açık rapor üretir. Failure promotion pipeline'ını durdurur. Exception süreci gerekirse human approval ister.
Approval
Kritik modellerde son karar model risk veya ürün owner tarafından verilebilir. Reviewer metric ve değişiklik özetini görür. Approval süreli ve audit edilebilir olmalıdır. Manual adım rutin küçük modelleri gereksiz yavaşlatmamalıdır. Risk sınıfına göre approval policy farklılaştırılabilir.
Controlled Rollout
Approved model hemen yüzde yüz trafik almamalıdır. Shadow veya canary kullanılabilir. Production metric yeni version için ayrı izlenir. Promotion step otomatik olabilir. Anomali durumunda rollback hızlı çalışmalıdır.
MLOps Gözlemlenebilirliği ve Root Cause Analysis
Observability model servisi neden kötü davranıyor sorusuna hızlı cevap vermeyi amaçlar. Metrics trendi, logs detayları, traces request yolunu ve model events deployment zamanını gösterir. Prediction düşüşü modelden değil upstream feature pipeline'dan kaynaklanabilir. Trace ve lineage birlikte incelendiğinde problem katmanı daha hızlı bulunur. Root cause analysis sonucunda kalıcı test veya monitoring kontrolü eklenmelidir.
Metrics
Metrics time-series biçiminde sistem ve model sağlığını gösterir. Latency, error, drift ve resource ölçümleri dashboard'a gider. Label geldikçe model quality metric eklenir. Model version label olarak kullanılmalıdır. High-cardinality user identifier metric sistemine eklenmemelidir.
Logs
Logs error ve operasyon context sağlar. Request body yerine request ID kullanmak privacy riskini azaltır. Structured logging query ve alert oluşturmayı kolaylaştırır. Model version ve trace ID eklenebilir. Retention ve erişim policy belirlenmelidir.
Traces
Distributed trace prediction request'in feature, model ve downstream servis yolunu gösterir. Hangi span latency oluşturuyor görülebilir. Feature store yavaşlığı model latency gibi görünmekten çıkar. Trace sampling maliyeti kontrol eder. Hassas payload span attribute olarak yazılmamalıdır.
Model Events
Deployment, promotion, rollback ve retraining olayları time-series dashboard üzerinde gösterilmelidir. Metric değişimi release ile kolayca ilişkilendirilir. Feature version change ayrıca event olabilir. Business event de timeline'a eklenebilir. Incident investigation bu context ile hızlanır.
Hata Modelden mi Altyapıdan mı Kaynaklanıyor?
Model metric düşüşü tek başına modelin bozulduğunu göstermez. Data ingestion, feature transformation veya serving dependency problemi olabilir. Layered health check root cause'u ayırır. Lineage son değişiklikleri gösterir. Sistem her katman için ayrı owner ve alert route tanımlamalıdır.
Data Failure
Upstream source eksik veya bozuk veri gönderebilir. Schema ve quality gate bunu yakalamalıdır. Distribution change data issue olabilir. Data lineage etkilenen model ve feature'ı gösterir. Pipeline yeniden çalıştırılmadan önce source düzeltilmelidir.
Feature Failure
Transformation kodu yanlış sonuç üretebilir. Online feature store stale değer taşıyabilir. Train-serve parity testi farkı gösterir. Feature version değişikliği event olarak loglanmalıdır. Rollback eski feature logic'e gerek duyabilir.
Model Failure
Model artifact yanlış version olabilir veya quality gerçek veride düşmüş olabilir. Prediction distribution ve ground truth metric incelenir. Registry lineage artifact kaynağını doğrular. Rollback champion modele yapılabilir. Sonraki training yeni data ile başlatılabilir.
Serving Failure
Model load veya API code error üretebilir. Container log ve trace incelenir. Schema mismatch client request'ten kaynaklanabilir. Replica health ve rollout version kontrol edilir. Serving failure model quality probleminden ayrılmalıdır.
Infrastructure Failure
CPU, GPU veya network saturation latency ve error oluşturabilir. Node failure replica kaybına yol açabilir. Autoscaling beklenen tepkiyi vermeyebilir. Infrastructure metric ve event'ler root cause'u gösterir. Capacity ve resilience planı sonrasında güncellenmelidir.
Model SLO, SLA ve Error Budget
SLO model servisinin hedeflenen güvenilirlik ve performans seviyesini tanımlar. SLA müşteri veya business tarafına verilen daha resmi taahhüt olabilir. Error budget SLO'nun izin verdiği başarısızlık miktarını operasyon kararına dönüştürür. ML sisteminde availability yanında latency ve model quality SLO'su da bulunabilir. Error budget tükendiğinde yeni feature deployment yerine reliability çalışmasına öncelik verilebilir.
Prediction Service SLO
Prediction endpoint belirli success rate hedefi taşıyabilir. Valid request'lerin yüzde kaçı başarılı prediction alıyor ölçülür. Client validation error SLO hesabından ayrı tutulabilir. Dependency outage service availability'yi etkiler. SLO business criticality'ye göre seçilir.
Latency SLO
P95 veya P99 latency belirli threshold altında tutulabilir. Average değer kullanıcıların kötü tail deneyimini gizleyebilir. Region ve model version bazında metric incelenir. Cold start ayrı raporlanabilir. SLO ihlali autoscaling veya rollback trigger olabilir.
Availability SLO
Availability belirli zaman penceresinde servisin kullanılabilir olmasını hedefler. Multi-zone architecture daha yüksek hedef için gerekli olabilir. Dependency availability model endpoint'i sınırlar. Maintenance window policy açık olmalıdır. Error budget bu hedef üzerinden hesaplanır.
Model Quality SLO
Quality SLO minimum precision, recall veya business score belirleyebilir. Ground truth gecikmesi nedeniyle hesaplama periyodik olabilir. Segment bazlı SLO bazı riskli sistemlerde gereklidir. Model drift quality SLO'yu etkileyebilir. İhlal retraining veya model rollback başlatabilir.
Error Budget Tükendiğinde Ne Yapılmalı?
Error budget tüketimi release hızını güvenilirlikle dengelemek için kullanılır. Budget bittiğinde riskli model değişiklikleri geçici durdurulabilir. Root cause ve reliability backlog'a öncelik verilir. Capacity veya test eksikleri giderilir. SLO tekrar stabil olduğunda normal release akışı devam eder.
MLOps'ta Maliyet Optimizasyonu
MLOps platformu yalnızca teknik kalite değil maliyet görünürlüğü de sağlamalıdır. Training ve inference cost ayrı takip edilir. Cost per prediction farklı model ve serving strategy karşılaştırmasını kolaylaştırır. CPU, GPU, batching, autoscaling ve quantization maliyeti ciddi biçimde etkileyebilir. Business KPI kazancı olmayan pahalı modelin daha yüksek offline accuracy sağlaması production için yeterli gerekçe değildir.
Training Cost
Training compute saat, storage ve data processing maliyetinden oluşur. Experiment sayısı arttıkça harcama büyür. Early stopping gereksiz compute kullanımını azaltabilir. GPU utilization düşükse training pipeline optimize edilmelidir. Run metadata tahmini maliyeti kaydedebilir.
Inference Cost
Inference sürekli production gideridir. Replica sayısı ve hardware tipi maliyeti belirler. Trafik gece azalırken sabit GPU açık kalıyorsa israf oluşabilir. Autoscaling ve batching maliyeti düşürür. Cost model version bazında raporlanmalıdır.
Cost per Prediction
Toplam serving cost prediction sayısına bölünerek karşılaştırılabilir. Model optimization etkisi net görülür. Canary sırasında yeni modelin birim maliyeti baseline ile karşılaştırılabilir. External API kullanılıyorsa request fee dahil edilir. Business value ile birlikte izlenmelidir.
CPU vs GPU
Küçük modeller CPU üzerinde daha ekonomik olabilir. GPU yüksek throughput deep model için avantaj sağlar. GPU kullanmak otomatik olarak daha hızlı veya ucuz değildir. Benchmark gerçek batch ve traffic altında yapılmalıdır. Hybrid serving farklı model tiplerini uygun hardware'e yönlendirebilir.
Dynamic Batching
Dynamic batching kısa süre içinde gelen request'leri tek GPU batch içinde birleştirir. Throughput ve utilization artar. Bekleme penceresi latency ekler. Interactive servis için küçük batch timeout seçilmelidir. Metric ile optimum değer ayarlanır.
Autoscaling
Autoscaling trafik ve resource metric'e göre replica sayısını değiştirir. Minimum replica latency hedefini korur. GPU scale-up süresi CPU servisinden uzun olabilir. Queue depth custom metric olarak kullanılabilir. Scale event cost dashboard'da görünmelidir.
Scale-to-Zero
Trafik yokken replica sayısını sıfıra düşürmek maliyeti azaltır. Cold start yeni request'i geciktirir. Büyük model load süresi dakikalara yaklaşabilir. Internal ve seyrek kullanılan servislerde uygundur. Production SLA güçlü ise minimum warm replica tercih edilir.
Spot/Preemptible Instances
Kesilebilir compute training maliyetini düşürebilir. Job checkpoint sayesinde interruption sonrası devam etmelidir. Critical real-time inference için uygun değildir. Distributed training worker loss davranışı test edilmelidir. Savings ile retry overhead birlikte hesaplanmalıdır.
Model Compression ve Quantization
Quantization model memory ve compute ihtiyacını azaltabilir. Accuracy etkisi evaluation ile ölçülmelidir. Smaller model edge deployment'ı kolaylaştırır. Throughput artabilir. Optimized artifact ayrı version olarak registry'de tutulmalıdır.
MLOps Güvenliği
MLOps pipeline geniş veri ve production yetkilerine sahip olduğu için güvenlik açısından kritik altyapıdır. Training data access, registry, secret, container ve inference endpoint ayrı korunmalıdır. Supply chain saldırısı kötü dependency veya model artifact üzerinden production sistemine ulaşabilir. Artifact signing ve image scanning build zincirini güçlendirir. Audit log hangi kullanıcı veya workload'un hangi modeli production'a taşıdığını açıkça göstermelidir.
Training Data Access Control
Training job yalnızca gerekli dataset'e read erişimi almalıdır. Data scientist production database'e geniş doğrudan yetki taşımamalıdır. Temporary credential veya managed identity kullanılabilir. Sensitive dataset access audit edilir. Export ve download işlemleri sınırlandırılmalıdır.
Model Registry Security
Registry write ve production promotion yetkileri ayrılmalıdır. Developer artifact ekleyebilir ancak tek başına production alias değiştiremeyebilir. Authentication ve RBAC uygulanmalıdır. Artifact storage public olmamalıdır. Audit log model version değişikliklerini kaydetmelidir.
Secrets Management
API key ve database password repository'ye yazılmamalıdır. Secret manager kullanılmalıdır. Runtime workload identity tercih edilebilir. Rotation otomatikleştirilebilir. CI logları secret değerlerini maskeler.
Container Image Scanning
Image dependency vulnerability açısından taranmalıdır. Critical vulnerability release'i durdurabilir. Base image düzenli güncellenmelidir. Gereksiz package image'dan çıkarılır. Scan sonucu build artifact metadata'sına eklenebilir.
Model Artifact Signing
Model artifact trusted training pipeline tarafından imzalanabilir. Deployment signature doğrulamadan modeli yüklemez. Artifact değiştirilirse doğrulama başarısız olur. Signing key güvenli key manager içinde tutulur. Revocation prosedürü supply chain incident için hazırlanmalıdır.
Supply-Chain Security
Dependency, base model ve container source doğrulanmalıdır. Package lock ve hash pinning uygulanabilir. CI runner internetten kontrolsüz artifact çekmemelidir. SBOM kullanılan dependency'leri görünür kılar. Production yalnızca trusted internal registry kullanabilir.
Inference Endpoint Security
API authentication ve authorization kullanmalıdır. Rate limit extraction ve abuse riskini azaltır. TLS zorunlu tutulur. Input size ve schema doğrulanır. Error response internal model veya secret detayını açıklamamalıdır.
Audit Logging
Model publish, registry change ve privileged access loglanmalıdır. User ve workload identity ayrı görünmelidir. Loglar merkezi ve değiştirilemez storage'a gönderilebilir. Retention security ihtiyacına göre belirlenir. Hassas training data audit log içine yazılmamalıdır.
MLOps ve KVKK
Kişisel veri kullanan makine öğrenmesi sistemlerinde MLOps pipeline veri yaşam döngüsünü KVKK gereksinimleriyle uyumlu yönetmeye yardımcı olabilir. Training dataset, inference log ve model lineage bu değerlendirmenin parçalarıdır. Veri minimizasyonu yalnızca compliance dokümanı değil feature ve log tasarımına uygulanabilecek teknik ilkedir. Retention pipeline üzerinden otomatik uygulanabilir. Silme talebi dataset, feature ve gerekirse yeniden eğitim süreçlerine kadar yayılmalıdır.
Eğitim Verilerindeki Kişisel Veriler
Training data kişisel veri içeriyorsa source ve işleme amacı bilinmelidir. Dataset erişimi sınırlandırılmalıdır. Gereksiz identifier training öncesi kaldırılabilir. Data lineage hangi model version'ın hangi dataset ile eğitildiğini göstermelidir. Hukuki değerlendirme kurumun veri koruma uzmanlarıyla birlikte yapılmalıdır.
Inference Loglarında Kişisel Veri
Prediction request gerçek kullanıcı verisi taşıyabilir. Full request logging varsayılan davranış olmamalıdır. PII redaction uygulanabilir. Request ID troubleshooting için çoğu zaman yeterlidir. Log retention ve erişim role bazında yönetilmelidir.
Data Minimization
Modelin kullanmadığı feature training ve inference payload'dan çıkarılmalıdır. Monitoring için ham input yerine aggregate metric tercih edilebilir. Minimization security riskini ve storage maliyetini azaltır. Feature importance teknik karar için yardımcı olabilir. Business owner gereksiz veri kullanımını düzenli review etmelidir.
Retention Politikaları
Dataset, prediction ve log için aynı retention süresi gerekmez. Lifecycle rule süre dolduğunda otomatik silme yapabilir. Backup retention ayrıca değerlendirilmelidir. Model audit metadata daha uzun tutulabilir. Policy business ve hukuki gereksinimle uyumlu olmalıdır.
Model Lineage ve Auditability
Lineage hangi verinin hangi modelde kullanıldığını gösterir. Audit sırasında model decision history daha anlaşılır olur. Training run ve dataset version birlikte kaydedilir. Production deployment approval loglanır. Bu yapı silme ve incident analizini kolaylaştırır.
Silme Taleplerinin ML Pipeline'ına Etkisi
Kişisel kayıt dataset'ten kaldırıldığında mevcut model weight üzerindeki etkisi ayrıca değerlendirilmelidir. Bazı durumlarda retraining gerekebilir. Feature store ve prediction log kopyaları da silme akışına dahil edilmelidir. Backup retention politika doğrultusunda yönetilir. MLOps orchestration silme event'ini ilgili sistemlere dağıtabilir.
Responsible AI Kontrollerini MLOps Pipeline'ına Eklemek
Responsible AI kontrolleri production'a geçmeden önce otomatik pipeline içinde çalıştırıldığında daha güvenilir olur. Fairness ve bias regression model release'leri arasında karşılaştırılabilir. Explainability report yüksek riskli kullanımda review sürecine eklenebilir. Model card teknik ve business bilgiyi tek dokümanda toplar. Production monitoring fairness değişimini ground truth geldikçe takip edebilir.
Fairness Tests
İlgili kullanıcı segmentlerinde metric karşılaştırılır. Problem için doğru fairness tanımı seçilmelidir. Sample size yetersizse sonuç dikkatli yorumlanmalıdır. Threshold promotion gate olabilir. Test sonucu model card içinde saklanabilir.
Bias Regression Testing
Yeni model eski modelden belirli segmentte daha kötü olmamalıdır. Regression test release değişikliğini doğrudan karşılaştırır. Global metric iyileşmesi segment kaybını gizleyebilir. Allowed tolerance açıkça tanımlanmalıdır. Failure human review'a yönlendirilir.
Explainability Tests
Model explanation method'un tutarlı çalıştığı doğrulanabilir. Feature importance beklenmeyen hassas alanlara aşırı bağımlı olabilir. Local explanation sample üzerinde incelenebilir. Explanation latency online kullanımda ayrıca ölçülmelidir. Açıklama yöntemi model davranışının tamamı olarak yorumlanmamalıdır.
Model Cards
Model card amaç, dataset, metric, limitation ve risk bilgilerini içerir. Model registry version ile ilişkilendirilebilir. Her release'te otomatik bölümler güncellenebilir. Business owner ve model risk ekibi aynı belge üzerinden review yapabilir. Deprecated model card geçmiş audit için saklanabilir.
Human Approval
Yüksek etkili modellerde insan approval release gate olarak kullanılabilir. Reviewer fairness ve model card sonuçlarını görür. Approval actor audit edilir. Low-risk internal modelde otomatik process daha uygun olabilir. Risk classification approval seviyesini belirlemelidir.
Production Fairness Monitoring
Offline fairness production distribution değiştiğinde farklılaşabilir. Ground truth geldikçe segment metric hesaplanmalıdır. Data privacy nedeniyle group attribute kullanımı dikkatle yönetilmelidir. Threshold ihlali investigation başlatır. Retraining tek çözüm değildir, business policy de etkili olabilir.
Model Retirement ve Decommissioning
Model yaşam döngüsünün son aşaması çoğu ekipte unutulur. Eski endpoint çalışmaya devam ederse güvenlik ve maliyet riski oluşturur. Consumer migration tamamlanmadan servis kapatılamaz. Artifact ve audit metadata farklı retention sürelerine sahip olabilir. Decommission runbook modelin bütün compute, secret ve routing kaynaklarını temizlemelidir.
Bir Model Ne Zaman Emekliye Ayrılmalı?
Model artık business tarafından kullanılmıyor olabilir. Yeni champion bütün consumer'ları devralmış olabilir. Security veya data policy modeli kullanılamaz hâle getirebilir. Maintenance cost sağladığı değeri aşabilir. Retirement kararı owner ve consumer listesiyle birlikte verilmelidir.
Eski Model Endpoint'inin Kapatılması
Traffic metric sıfır olduğu doğrulanmalıdır. Consumer inventory eksikse endpoint kapatmak production incident oluşturabilir. Deprecation notice önceden verilir. Routing kaldırılır ve DNS veya service kaydı temizlenir. Monitoring bir süre beklenmeyen request'i takip edebilir.
Consumer Migration
Her client yeni model contract'a uyarlanmalıdır. Versioned API geçiş sürecini kolaylaştırır. Migration owner ve deadline belirlenir. Eski endpoint request log consumer bulmaya yardımcı olur. Breaking schema change için adapter katmanı kullanılabilir.
Model Artifact Retention
Eski artifact audit veya reproducibility için saklanabilir. Her model sonsuza kadar tutulmamalıdır. Retention risk ve storage maliyetine göre belirlenir. Critical model daha uzun geçmiş gerektirebilir. Artifact silinse bile temel metadata saklanabilir.
Audit İçin Saklanacak Metadata
Model version, dataset, code commit ve approval kaydı korunabilir. Production active tarih aralığı tutulmalıdır. Metric ve model card saklanabilir. Consumer ve deployment history incident için değerlidir. Kişisel data içermeyen metadata uzun süre tutulabilir.
Deployment Kaynaklarının Temizlenmesi
Replica, GPU ve load balancer kaynağı kaldırılmalıdır. Secret ve service account revoke edilir. Monitoring dashboard archive edilir. Registry status archived yapılabilir. Infrastructure drift scan unutulan kaynağı tespit edebilir.
Disaster Recovery ve Business Continuity
Model serving kritik business sürecinin parçasıysa disaster recovery planı gerekir. Registry ve artifact storage kaybı deployment kapasitesini etkiler. Multi-zone servis lokal failure'a karşı dayanıklılık sağlar. Multi-region daha yüksek availability sunar ancak veri yerelliği ve maliyet etkisi değerlendirilmelidir. RTO ve RPO business tarafından kabul edilebilir kesinti ve veri kaybı seviyesini belirler.
Model Registry Backup
Registry metadata database düzenli yedeklenmelidir. Backup artifact storage referanslarıyla uyumlu olmalıdır. Restore test ayrı environment'ta yapılmalıdır. Version ve alias bilgisi korunmalıdır. Backup erişimi production kadar güvenli tutulmalıdır.
Artifact Storage Backup
Model ve preprocessing artifact'ları object storage üzerinde bulunabilir. Versioning ve replication kullanılabilir. Backup region compliance policy'ye uymalıdır. Integrity checksum ile doğrulanabilir. Restore sonrası model load smoke test yapılmalıdır.
Multi-Zone Deployment
Replica farklı availability zone'lara dağıtılabilir. Tek zone outage service'i tamamen durdurmaz. Load balancer healthy replica'ya trafik yönlendirir. Feature store ve database de zone resilient olmalıdır. Cost daha yüksek availability ile birlikte artar.
Multi-Region Serving
Global kullanıcı düşük latency ve region dayanıklılığı elde edebilir. Model ve feature replication gerekir. Data residency requirement her region için incelenmelidir. Failover routing test edilmelidir. Model version consistency region'lar arasında korunmalıdır.
Recovery Time Objective
RTO hizmetin kabul edilebilir maksimum geri dönüş süresini tanımlar. Kritik fraud servisi dakikalar isteyebilir. Internal analytics modeli saatler kabul edebilir. Architecture RTO hedefine göre maliyetlenir. DR tatbikat gerçek recovery süresini ölçmelidir.
Recovery Point Objective
RPO kabul edilebilir veri veya metadata kayıp miktarını tanımlar. Registry değişiklikleri için düşük RPO gerekebilir. Batch prediction sonucu yeniden üretilebilir olabilir. Backup frequency RPO hedefine göre seçilir. Training dataset snapshot ayrıca korunmalıdır.
Açık Kaynak MLOps Araçları ve İşbirliği Ekosistemi
Açık kaynak MLOps ekosistemi experiment tracking'den serving ve monitoring'e kadar farklı araçlar sunar. Her kategoride çok sayıda ürün kullanmak platform operasyonunu büyütebilir. Küçük ekip minimum stack ile başlamalıdır. Kurumsal ekip integration, governance ve support ihtiyacını ayrıca değerlendirmelidir. Açık kaynak projeler öğrenme, özelleştirme ve vendor bağımlılığını azaltma açısından önemli avantaj sağlar.
Experiment Tracking ve Model Registry
Experiment tracking run, parameter, metric ve artifact metadata'sını yönetir. Model registry candidate ve production lifecycle'ı düzenler. Aynı platform iki işlevi birlikte sunabilir. Remote merkezi deployment ekip collaboration için daha uygundur. Access control ve backup production kullanımında önemlidir.
MLflow
MLflow experiment tracking ve model registry için yaygın açık kaynak seçeneklerinden biridir. Run metadata ve artifact kaydı sağlar. Registry model version, lineage ve metadata yönetimini destekler. Production ortamında merkezi tracking server ve kalıcı backend kullanılabilir. Araç bütün MLOps ihtiyaçlarını tek başına çözmez ve orchestration, serving veya governance için ek bileşen gerekebilir.
Data Versioning
Data versioning training reproducibility'nin temelidir. Dataset değişim geçmişi model run ile ilişkilendirilir. Dosya ve lakehouse verisi için farklı çözümler kullanılabilir. Storage maliyeti ve snapshot davranışı değerlendirilmelidir. Version restore süreci test edilmelidir.
DVC
DVC Git tabanlı data science workflow'una veri artifact takibi ekleyebilir. Büyük dosya remote storage üzerinde tutulabilir. Dataset reference code commit ile ilişkilendirilir. Küçük ekiplerde hızlı başlangıç sağlar. Büyük merkezi data platformlarında table versioning yaklaşımı daha uygun olabilir.
Pipeline Orchestration
Orchestrator training ve data job'larının bağımlılıklarını yönetir. Schedule, retry ve parameterization sağlar. Pipeline step'leri container veya task olarak çalışabilir. Metadata ve log merkezi toplanmalıdır. ML-specific artifact desteği araçlara göre değişir.
Airflow
Airflow DAG tabanlı workflow orchestration için kullanılabilir. Batch data ve training job'ları schedule edilebilir. Geniş entegrasyon ekosistemi avantaj sağlar. Heavy model execution worker yerine external compute üzerinde çalıştırılabilir. Pipeline code review ve deployment süreci kurulmalıdır.
Kubeflow Pipelines
Kubeflow Pipelines Kubernetes üzerinde container tabanlı ML workflow'ları kurmaya odaklanır. Training ve evaluation step'leri ayrı component olabilir. Artifact ve parameter metadata taşınabilir. Kubernetes deneyimi gerektirir. Küçük ekip için operasyon maliyeti ihtiyacın üzerinde olabilir.
Argo Workflows
Argo Workflows Kubernetes-native DAG ve workflow çalıştırabilir. Container tabanlı training pipeline için kullanılabilir. GitOps ekosistemiyle iyi uyum gösterebilir. ML-specific experiment özellikleri ayrı platform gerektirebilir. Cluster security ve resource quota dikkatle yönetilmelidir.
Model Serving
Serving platform model endpoint, autoscaling ve rollout gibi operasyonları yönetebilir. Framework model server standardı sağlayabilir. Kubernetes-native veya standalone seçenekler vardır. Model type ve traffic ihtiyacı seçimde önemlidir. Basit model için büyük serving platform gereksiz olabilir.
KServe
KServe Kubernetes üzerinde model serving için kullanılan açık kaynak projelerden biridir. Inference service abstraction ve autoscaling gibi özellikler sunabilir. Farklı model runtime'ları entegre edilebilir. Kubernetes altyapısı prerequisite olarak operasyon yükü getirir. Production design model storage ve network security ile birlikte yapılmalıdır.
Seldon
Seldon model serving ve deployment workflow'ları için değerlendirilebilen açık kaynak seçeneklerinden biridir. Routing ve inference graph gibi kullanım alanları bulunabilir. Platform seçimi güncel proje kapsamı ve maintenance durumuna göre yapılmalıdır. Kubernetes ihtiyacı operasyon yetkinliği gerektirir. Model monitoring ayrıca ek araçlarla tamamlanabilir.
BentoML
BentoML model packaging ve serving workflow'larını sadeleştirmek için kullanılabilir. Python modelini service artifact hâline getirmeye yardımcı olur. Container deployment ve API serving senaryolarına uygundur. Küçük ve orta ekip için Kubernetes dışı başlangıç sağlayabilir. Scale ve governance ihtiyacı büyüdüğünde platform entegrasyonları değerlendirilmelidir.
Feature Store
Feature store tekrar kullanılan feature logic ve değerlerini yönetir. Offline ve online erişim arasında parity sağlamaya yardımcı olur. Her model projesinin feature store'a ihtiyacı yoktur. Çok ekipli ve real-time feature kullanan ortamlarda değeri artar. Governance ve owner metadata önemli bileşenlerdir.
Feast
Feast açık kaynak feature store seçeneklerinden biridir. Offline data source ve online store arasında feature materialization yapılabilir. Feature definition kod veya registry üzerinden yönetilir. Point-in-time retrieval training leakage riskini azaltmaya yardımcı olur. Production deployment mevcut data platformuna göre tasarlanmalıdır.
Monitoring
MLOps monitoring system ve model metric'lerini birlikte ele alır. Infrastructure monitoring için genel observability stack kullanılabilir. Drift ve model quality için ML odaklı araçlar eklenebilir. Ground truth pipeline en kritik veri bağlantılarından biridir. Alert gerçek aksiyon workflow'una bağlanmalıdır.
Evidently
Evidently model ve data monitoring raporları oluşturmak için kullanılabilecek açık kaynak araçlardan biridir. Data drift ve model quality analizleri yapılabilir. Batch report veya monitoring pipeline içine entegre edilebilir. Threshold ve metric business bağlamına göre ayarlanmalıdır. Tool tek başına doğru retraining kararını otomatik garanti etmez.
Prometheus ve Grafana
Prometheus time-series infrastructure ve service metric toplamada yaygın kullanılır. Grafana dashboard ve alert görünümü sağlar. Model version label ile latency ve error karşılaştırılabilir. High-cardinality prediction data Prometheus için uygun değildir. Model quality metric aggregate biçimde export edilebilir.
Açık Kaynak MLOps Stack Avantajları
Açık kaynak stack infrastructure üzerinde daha fazla kontrol sağlar. Vendor lock-in belirli ölçüde azalır. Ekip kendi integration ve plugin'lerini geliştirebilir. Lisans maliyeti düşük olsa bile operasyon personeli maliyeti vardır. Upgrade ve security patch sorumluluğu kurumda kalır.
Vendor Lock-In Riski
Managed platform hızlı başlangıç sağlar ancak proprietary pipeline ve model formatları migration'ı zorlaştırabilir. Data egress maliyeti exit planını etkiler. Open artifact format ve container standardı bağımlılığı azaltır. Model lineage external olarak export edilebilmelidir. Platform seçiminde çıkış planı daha ilk günden düşünülmelidir.
Community ve Kurumsal İşbirliği
Açık kaynak MLOps projeleri contribution ve ortak öğrenme fırsatı sunar. Issue ve pull request süreçleri production engineering pratiği kazandırır. Topluluk içinde örnek pipeline ve monitoring projeleri geliştirilebilir. Diyarbakır Yazılım Topluluğu proje alanlarını https://www.diyarbakiryazilim.com.tr/projects üzerinden inceleyebilirsiniz. Küçük bir açık kaynak MLOps stack kurup gerçek deployment ve rollback denemesi yapmak öğrenmeyi hızlandırır.
MLOps Platformu Seçerken Nelere Dikkat Edilmeli?
MLOps platformu seçimi özellik listesinden daha çok ekip ve workload uyumuna göre yapılmalıdır. Build veya buy kararı internal platform mühendisliği kapasitesini etkiler. Managed hizmet operasyonu azaltırken self-hosted daha fazla kontrol sağlar. Kubernetes her MLOps projesi için zorunlu değildir. Governance, integration, scale ve toplam sahip olma maliyeti birlikte değerlendirilmelidir.
Build vs Buy
Hazır platform hızlı deployment ve support sağlar. Internal build özel ihtiyaçları daha iyi karşılayabilir. Platform engineering ekibi yoksa sıfırdan sistem uzun bakım yükü oluşturur. Differentiating olmayan bileşen satın alınabilir. Kritik proprietary workflow internal geliştirme olarak tutulabilir.
Managed vs Self-Hosted
Managed platform upgrade ve availability sorumluluğunu azaltır. Self-hosted data residency ve customization kontrolü sağlar. Security patch self-hosted ekip sorumluluğundadır. Managed service contract ve data processing şartları incelenmelidir. Seçim compliance ve ekip kapasitesine dayanmalıdır.
Cloud vs On-Premise
Cloud GPU esnekliği ve managed service avantajı sağlar. On-premise data control ve sabit yüksek utilization için uygun olabilir. Hybrid approach hassas data'yı internal tutabilir. Network egress ve latency maliyeti hesaplanmalıdır. Platform aynı pipeline'ı farklı compute target'larında çalıştırabiliyorsa esneklik artar.
Kubernetes Gerekliliği
Kubernetes güçlü orchestration sağlar ancak operasyon maliyeti vardır. Küçük birkaç model için Docker ve basit VM yeterli olabilir. Çok model, autoscaling ve multi-team platform ihtiyacında Kubernetes değer kazanır. Ekip cluster işletmeyi bilmiyorsa MLOps projesi yerine cluster problemiyle uğraşabilir. İhtiyaç ölçülmeden Kubernetes seçilmemelidir.
Entegrasyon Kabiliyeti
Platform mevcut data lake, Git, CI ve identity sistemiyle çalışmalıdır. Open API ve SDK integration'ı kolaylaştırır. Model framework desteği incelenmelidir. Artifact export mümkün olmalıdır. Kapalı integration vendor lock-in'i artırabilir.
Governance
Model approval ve audit requirement kurumsal platform için önemlidir. Role-based access uygulanabilmelidir. Dataset ve model lineage görünür olmalıdır. Model card ve risk metadata desteklenebilir. Policy otomatik deployment gate'e dönüşebilmelidir.
Ölçeklenebilirlik
Platform bir modelden yüzlerce modele büyüdüğünde performansını korumalıdır. Concurrent training ve deployment sayısı kapasiteyi etkiler. Metadata database ve artifact storage ölçeklenmelidir. Multi-team isolation gerekli olabilir. Scale ihtiyacı ilk günden aşırı büyük platform kurmak anlamına gelmez.
Toplam Sahip Olma Maliyeti
TCO lisans veya cloud faturasıyla sınırlı değildir. Platform engineer zamanı, upgrade ve incident maliyeti dahil edilmelidir. Managed service premium destek karşılığında personel ihtiyacını azaltabilir. Self-hosted ucuz software ancak pahalı operation yaratabilir. Üç yıllık maliyet senaryosu daha doğru karşılaştırma sağlar.
MLOps Maturity Model
MLOps maturity ekiplerin manuel notebook sürecinden self-service platforma doğru gelişimini anlamaya yardımcı olur. Her kurumun en yüksek seviyeye çıkması gerekmez. Küçük ekip için seviye iki veya üç yeterli olabilir. Maturity tool sayısıyla değil otomasyon, reproducibility ve governance davranışıyla ölçülmelidir. Önce en büyük operasyon problemini çözmek, daha sonra yeni katman eklemek daha sağlıklı ilerler.
Seviye 0 — Manuel ML
Model notebook içinde manuel eğitilir. Dataset version açık olmayabilir. Artifact dosya sistemi üzerinden paylaşılır. Deployment kişisel komutlarla yapılır. Bu seviye prototip için hızlı ancak production için yüksek risklidir.
Seviye 1 — Deney ve Artifact Takibi
Git ve experiment tracking kullanılmaya başlanır. Model artifact merkezi storage'a alınır. Dataset referansı kaydedilebilir. Metric karşılaştırması görünür hâle gelir. Deployment hâlâ kısmen manuel olabilir.
Seviye 2 — Otomatik Training Pipeline
Data ingestion ve training orchestrator üzerinden çalışır. Reproducible environment kullanılır. Model validation otomatikleşir. Registry candidate version üretir. Retraining schedule ile başlatılabilir.
Seviye 3 — CI/CD/CT
Code ve data değişikliği otomatik pipeline'ı tetikler. Candidate model quality gate'den geçer. Deployment canary veya controlled strategy kullanır. Registry promotion otomatik veya onaylıdır. Rollback pipeline hazırdır.
Seviye 4 — Continuous Monitoring ve Governance
Drift, quality, cost ve fairness sürekli izlenir. Policy-as-code deployment kararına katılır. Audit ve lineage uçtan uca görünürdür. Retraining metric tabanlı tetiklenebilir. Model retirement formal süreç hâline gelir.
Seviye 5 — Self-Service ML Platform
Data scientist standart template ile pipeline oluşturabilir. Platform team reusable component ve policy sağlar. Deployment, monitoring ve governance varsayılan olarak gelir. Team isolation ve chargeback uygulanabilir. Self-service hız sağlarken merkezi security standardını korur.
Küçük Bir Ekip İçin Minimum MLOps Stack
Küçük ekip yüzlerce platform kurmak zorunda değildir. Git, veri versiyonlama, experiment tracking, Docker, CI/CD ve temel monitoring güçlü başlangıç sağlar. Amaç tooling göstermek değil reproducibility ve kontrollü deployment elde etmektir. Basit VM veya managed container servisi çoğu ilk production modeli için yeterli olabilir. Ekip büyüdükçe orchestration ve feature store gibi bileşenler gerçek ihtiyaç oluştuğunda eklenmelidir.
Git
Source ve configuration version control altında tutulur. Pull request code review sağlar. Commit model run ile ilişkilendirilir. Tag release referansı olabilir. Secret repository'ye yazılmamalıdır.
DVC
Küçük file tabanlı dataset için DVC veri version takibini kolaylaştırabilir. Remote storage kullanılabilir. Dataset code commit ile bağlanır. Data scientist workflow'una fazla operasyon eklemeden reproducibility sağlar. Büyük warehouse kullanılıyorsa başka snapshot yöntemi seçilebilir.
MLflow
Experiment tracking run ve metric kaydını merkezi yapar. Model registry version yönetimi ekleyebilir. Tek remote server küçük ekip için yeterlidir. Artifact storage ayrı object store olabilir. Backup ve access control production'a geçerken eklenmelidir.
Docker
Training ve serving environment container ile standardize edilir. Developer laptop farkları azalır. Image CI içinde build edilir. Dependency security scan uygulanır. Production aynı tested image'ı kullanır.
CI/CD
Pull request unit ve model smoke test çalıştırır. Main branch image ve candidate artifact üretir. Deployment manual approval ile başlayabilir. Otomasyon zamanla artırılır. Rollback komutu pipeline içinde bulunmalıdır.
Basit Model Monitoring
İlk aşamada latency, error, prediction distribution ve temel drift izlemek yeterli olabilir. Full platform kurmak zorunlu değildir. Prometheus metric ve scheduled drift report kullanılabilir. Ground truth geldiğinde periyodik performance job çalışır. Alert business owner'a ulaşmalıdır.
Kurumsal Bir Ekip İçin MLOps Referans Mimarisi
Kurumsal reference architecture veri katmanından governance'a kadar açık sorumluluk sınırları tanımlar. Data, feature, experiment, pipeline, registry, serving ve observability ayrı bileşen olabilir. CI/CT/CD bu katmanları ortak release sürecinde bağlar. Security ve governance çapraz katman olarak bütün sisteme uygulanır. Platform self-service hedeflese bile production policy merkezi biçimde korunmalıdır.
Data Layer
Raw ve curated data source bu katmanda bulunur. Schema, quality ve lineage uygulanır. Dataset snapshot training'e verilir. Access classification'a göre sınırlandırılır. Retention ve compliance burada başlar.
Feature Layer
Reusable feature tanımları yönetilir. Offline ve online store olabilir. Version ve point-in-time correctness sağlanır. Feature access model service identity ile kontrol edilir. Drift monitoring feature seviyesinde yapılır.
Experimentation Layer
Data scientist güvenli workspace içinde deney yapar. Experiment tracking otomatik metadata toplar. Compute quota maliyeti kontrol eder. Dataset erişimi role bazlıdır. Candidate model pipeline'a buradan gönderilir.
Pipeline Orchestration
Training ve evaluation step'leri DAG olarak yönetilir. Retry ve scheduling merkezi yapılır. Pipeline version code ile ilişkilendirilir. Artifact geçişleri metadata ile izlenir. Failure notification doğru owner'a gider.
Model Registry
Registry model lifecycle'ın merkezi kaynağıdır. Candidate, approved ve production durumları yönetilir. Lineage ve model card bağlanır. Production promotion policy kontrollüdür. Registry backup kritik metadata'yı korur.
CI/CT/CD
CI code ve data testlerini çalıştırır. CT candidate model üretir. CD approved modelin deployment'ını yönetir. Quality gate aşamalar arasında kontrol sağlar. Audit log bütün transition'ları kaydeder.
Model Serving
Batch ve online workload farklı platform kullanabilir. Autoscaling ve resource quota uygulanır. API security merkezi gateway'den yönetilebilir. Model version metric ile etiketlenir. Canary rollout standart capability olur.
Observability
Metrics, logs ve traces merkezi platforma gönderilir. Model drift ve quality metric eklenir. Deployment event dashboard üzerinde görünür. Alert SLO ve model risk seviyesine göre yönlendirilir. Cost monitoring aynı telemetry katmanını kullanabilir.
Governance ve Security
RBAC, approval, lineage ve audit bütün pipeline'a uygulanır. Dataset classification external kullanım policy'sini belirler. Artifact signing supply chain'i korur. Responsible AI gate riskli modellerde devreye girer. Platform policy istisnaları kayıtlı ve süreli olmalıdır.
MLOps Ekip Rolleri
MLOps tek bir kişinin görevi değildir. Data scientist model kalitesine, ML engineer production koduna, data engineer veriye ve platform engineer altyapıya odaklanabilir. SRE availability ve operasyon, model risk ekibi fairness ve governance konularında rol alabilir. Product owner business KPI'yı belirler. Roller arasındaki açık sorumluluk ayrımı production incident sırasında kimin hangi sistemi yönettiğini netleştirir.
Data Scientist
Model ve feature deneylerini yürütür. Offline metric ve evaluation tasarlar. Experiment tracking kullanır. Production requirement'ı ML engineer ile paylaşır. Notebook code'un reusable pipeline'a dönüşmesine katkı sağlar.
Machine Learning Engineer
Training ve serving code'u production standardına getirir. Model packaging ve API contract geliştirir. CI/CD ve monitoring integration yapar. Data scientist ile model performance konusunda çalışır. Platform team'in sunduğu standard component'leri kullanır.
Data Engineer
Data ingestion ve quality pipeline'ı yönetir. Dataset lineage ve schema contract sağlar. Feature source güvenilirliğini korur. Streaming veya batch platformu işletir. ML değişikliklerinin upstream data etkisini değerlendirir.
Platform Engineer
Reusable training ve serving altyapısı kurar. Kubernetes, compute ve registry platformunu yönetebilir. Self-service template sağlar. IAM ve resource policy uygular. Platform reliability ve upgrade sorumluluğu taşır.
DevOps / SRE
CI/CD, availability ve incident response alanında katkı sağlar. SLO ve error budget tanımlar. Observability stack'i yönetir. Disaster recovery testleri yürütür. ML-specific quality metric için ML ekibiyle birlikte çalışır.
Model Risk / Responsible AI
Fairness, explainability ve risk değerlendirmesi yapar. Model card ve approval sürecine katılır. Yüksek riskli deployment için gate belirler. Production fairness monitoring sonuçlarını inceler. Policy değişikliklerini platform ekibine aktarır.
Product Owner
Modelin business problemini ve KPI'sını tanımlar. Offline metric ile iş sonucu arasındaki ilişkiyi değerlendirir. Deployment risk toleransını belirler. A/B test sonucunu yorumlar. Model retirement kararında consumer ihtiyacını temsil eder.
Roller Arasında Sorumluluk Paylaşımı
RACI veya benzeri sorumluluk matrisi kritik aşamalar için hazırlanabilir. Dataset owner ve model owner farklı kişiler olabilir. Production deployment kimin onayladığı açık olmalıdır. Incident sırasında escalation yolu önceden bilinmelidir. Küçük ekipte kişiler birden fazla rol üstlense bile sorumluluklar kavramsal olarak ayrılmalıdır.
MLOps'ta En Sık Yapılan Hatalar
MLOps hatalarının çoğu fazla araç kullanmamaktan değil temel süreçleri atlamaktan kaynaklanır. Notebook'tan direkt production'a çıkmak reproducibility probleminin başlangıcıdır. Dataset version ve registry olmadan rollback güvenilir değildir. Offline accuracy'yi tek başarı ölçüsü kabul etmek business etkisini gözden kaçırır. Monitoring, retraining ve retirement baştan tasarlanmadığında model kısa sürede kontrolsüz production yüküne dönüşebilir.
Jupyter Notebook'tan Doğrudan Production'a Çıkmak
Notebook exploration için güçlü araçtır. Ancak cell execution order reproducibility sorunları oluşturabilir. Dependency ve secret dağınık kalabilir. Production logic package veya pipeline hâline getirilmelidir. Notebook referans ve analiz ortamı olarak kullanılabilir.
Eğitim Verisini Versiyonlamamak
Dataset değiştiğinde aynı model yeniden üretilemez. Hata bulunan veri hangi modelleri etkilediği bilinmez. Training run belirsiz “latest” datasına bağlı kalır. Snapshot veya table version kullanılmalıdır. Lineage model registry'ye bağlanmalıdır.
Model Registry Kullanmamak
Dosya adıyla model yönetmek hızla sorun çıkarır. Hangi model production'da olduğu karışabilir. Metadata ve approval history kaybolur. Rollback manuel aramaya dönüşür. Registry küçük ekipte bile ciddi düzen sağlar.
Offline Accuracy'yi Tek Başına Başarı Kabul Etmek
Offline dataset production distribution'ı tam temsil etmeyebilir. Latency ve cost business kullanımını etkiler. Model high accuracy ile düşük conversion üretebilir. Fairness veya calibration problem olabilir. Production KPI ile model metric birlikte izlenmelidir.
Training-Serving Skew'i İzlememek
Feature preprocessing iki ortamda farklı olabilir. Model offline testte başarılı iken production'da bozulur. Parity test bu riski azaltır. Feature contract uygulanmalıdır. Drift monitoring farkı erken yakalayabilir.
Canary veya Shadow Testi Yapmadan Model Değiştirmek
Full traffic deployment riski bütün kullanıcıya yayar. Production data development testinden farklı olabilir. Shadow düşük riskli gözlem sağlar. Canary kademeli gerçek kullanım sunar. Rollback path deployment öncesinde hazır olmalıdır.
Rollback Planı Olmadan Deployment Yapmak
Yeni model başarısız olduğunda ekip manuel çözüm arar. Eski artifact veya feature version bulunamayabilir. Rollback süresi uzar. Deployment strategy geri dönüşü standartlaştırmalıdır. Düzenli rollback tatbikatı yapılmalıdır.
Drift ile Concept Drift'i Karıştırmak
Input değişimi model kalitesinin kesin düştüğünü göstermez. Concept drift target ilişkisi değişimidir. Data drift gerçek seasonality olabilir. Retraining her drift alarmında otomatik yapılmamalıdır. Ground truth ve business context değerlendirilmelidir.
Retraining Sonrası Modeli Otomatik Production'a Göndermek
Yeni data kötü quality taşıyabilir. Candidate baseline'dan düşük performans gösterebilir. Fairness veya cost değişebilir. Evaluation ve quality gate zorunlu olmalıdır. Controlled rollout production riskini azaltır.
Business KPI'ları Takip Etmemek
Model metric teknik başarıyı gösterir. Business KPI gerçek faydayı gösterir. Threshold veya product behavior metric bağlantısını değiştirebilir. Model improvement business'e yansımayabilir. Product owner monitoring sürecine dahil olmalıdır.
Model Retirement Planı Oluşturmamak
Eski model endpoint'leri açık kalır. Security patch ve compute maliyeti devam eder. Consumer kimliği bilinmez. Artifact storage gereksiz büyür. Lifecycle başlangıçtan retirement'a kadar tanımlanmalıdır.
MLOps Uygulamak İçin Adım Adım Yol Haritası
MLOps'a başlarken bir anda büyük platform kurmak yerine aşamalı ilerlemek daha sağlıklıdır. İlk hedef kod ve verinin izlenebilir olmasıdır. Ardından experiment tracking ve reproducible training eklenir. Registry, quality gate, CI/CT/CD ve monitoring süreçleri sonraki adımları oluşturur. Governance ve retirement en başta düşünülse de operasyon olgunlaştıkça otomasyon seviyesi artırılabilir.
1. İş Problemini ve KPI'ları Belirleyin
Modelin hangi kararı etkilediğini yazın. Offline metric seçin. Business KPI tanımlayın. Latency ve cost hedefi belirleyin. Başarı kriterini ekip içinde ortaklaştırın.
2. Kod ve Veriyi Versiyonlayın
Git source code için temel olsun. Dataset immutable version taşısın. Feature logic versionlansın. Her training run bu referansları kaydetsin. Reproducibility testi yapın.
3. Experiment Tracking Kurun
Run parameter ve metric otomatik kaydedilsin. Artifact merkezi storage'a yazılsın. Dataset ve commit metadata olsun. Team aynı dashboard'u kullansın. Best run seçimi şeffaf hâle gelsin.
4. Reproducible Training Pipeline Oluşturun
Notebook logic pipeline component'e taşınsın. Container veya locked environment kullanın. Input dataset açık parameter olsun. Training output standard artifact üretsin. Aynı run başka environment'ta tekrar çalıştırılabilsin.
5. Model Registry Ekleyin
Model version merkezi katalogda tutulsun. Lifecycle status tanımlayın. Lineage registry ile bağlansın. Approval metadata kaydedilsin. Deployment sadece registry artifact kullansın.
6. Validation Gates Oluşturun
Minimum metric belirleyin. Baseline karşılaştırması ekleyin. Latency ve cost threshold tanımlayın. Fairness veya security gerekliyse gate'e ekleyin. Failure deployment'ı durdursun.
7. CI/CT/CD Pipeline Kurun
CI code ve testleri çalıştırsın. CT yeni candidate üretsin. CD approved modeli environment'a taşısın. Stage'ler birbirinden ayrılmış olsun. Audit log bütün transition'ları kaydetsin.
8. Kontrollü Deployment Stratejisi Seçin
Shadow veya canary ile başlayın. Traffic step belirleyin. Promotion metric'leri tanımlayın. Rollback trigger hazırlayın. Full rollout öncesi yeterli gözlem süresi kullanın.
9. Monitoring ve Alerting Kurun
System metric toplayın. Prediction ve drift trendini izleyin. Ground truth geldiğinde model quality hesaplayın. Business KPI ekleyin. Alert owner ve runbook ile ilişkilendirilsin.
10. Retraining Pipeline Oluşturun
Scheduled veya metric trigger seçin. Yeni dataset snapshot üretin. Candidate otomatik training'den geçsin. Quality gate zorunlu kalsın. Production promotion controlled rollout kullansın.
11. Governance ve Güvenlik Kontrollerini Ekleyin
RBAC ve secret management uygulayın. Artifact signing ekleyin. Model card ve approval tanımlayın. Audit ve lineage tamamlanmış olsun. KVKK ve sektör gereksinimlerini data lifecycle ile ilişkilendirin.
12. Model Retirement Sürecini Tanımlayın
Deprecation policy yazın. Consumer inventory tutun. Endpoint kapatma ve resource cleanup otomatikleştirilsin. Artifact retention belirleyin. Audit metadata gerekli süre boyunca saklansın.
Sık Sorulan Sorular
MLOps: Makine Öğrenmesi Dağıtım Yaşam Döngüsü konusunda sorular genellikle modelin production'a nasıl çıkarıldığı ve sonrasında nasıl izlendiği üzerinde yoğunlaşır. MLOps yalnızca deployment otomasyonu değildir, veri ve model yaşam döngüsünün bütününü kapsar. CI, CT ve CD farklı sorumluluklara sahip olsa da aynı release zincirinin parçalarıdır. Küçük ekipler basit stack ile başlayabilir ve ihtiyaç büyüdükçe platform olgunluğunu artırabilir. Aşağıdaki cevaplar temel MLOps kararlarını hızlı biçimde özetler.
MLOps nedir ve neden kullanılır?
MLOps makine öğrenmesi modellerinin geliştirilmesi, test edilmesi, production'a alınması, izlenmesi ve yeniden eğitilmesini yöneten engineering yaklaşımıdır. Kod, veri ve model version'larını birlikte takip eder. Reproducible training ve kontrollü deployment sağlar. Drift ve model quality production ortamında izlenir. Amaç güvenilir ve sürdürülebilir ML servisi oluşturmaktır.
MLOps yaşam döngüsünün aşamaları nelerdir?
Problem tanımı ve data ingestion ilk aşamalardır. Feature engineering ve experimentation bunları takip eder. Model training ve validation sonrasında registry'ye alınır. Deployment ve monitoring production döngüsünü başlatır. Retraining ve retirement yaşam döngüsünü tamamlar.
MLOps ile DevOps arasındaki fark nedir?
DevOps ağırlıklı olarak code build ve deployment sürecini yönetir. MLOps buna dataset, feature ve model dependency'lerini ekler. Model probabilistik çıktılar üretir. Production data drift nedeniyle code değişmeden quality düşebilir. Bu nedenle monitoring ve continuous training MLOps'ta daha merkezi rol oynar.
CI/CD ve CI/CT/CD arasındaki fark nedir?
CI/CD code değişikliğini test edip deploy eder. CT yeni data veya trigger ile model training'i otomatik çalıştırır. Candidate model production'a doğrudan gitmez. Evaluation ve promotion gate uygulanır. CI/CT/CD ML sisteminin veri kaynaklı değişimini de release sürecine dahil eder.
Model registry nedir?
Model registry model artifact ve metadata'nın merkezi kataloğudur. Version ve lineage bilgisi tutar. Lifecycle status veya aliases deployment sürecinde kullanılır. Approval ve model card kayıtları eklenebilir. Rollback önceki model version'a güvenilir erişim sağlar.
Makine öğrenmesi modeli production'a nasıl alınır?
Model önce validation ve quality gate'lerden geçirilmelidir. Artifact registry'ye kaydedilir. Docker veya başka runtime ile paketlenir. Staging ve canary testleri yapılır. Monitoring stabil sonuç gösterdiğinde full production'a promotion uygulanır.
Canary deployment nedir?
Canary deployment yeni modeli küçük trafik oranına verir. Production metric gerçek kullanıcı üzerinde izlenir. Trafik kademeli artırılır. Error veya quality problemi olursa rollback yapılır. Full rollout riskini önemli ölçüde azaltır.
Shadow deployment nedir?
Shadow deployment gerçek request'i challenger modele kopyalar. Kullanıcı champion model sonucunu görür. Challenger prediction offline analiz edilir. Kullanıcı etkisi düşük olduğu için güvenli test sağlar. Ek compute maliyeti oluşturur.
Model drift ve data drift arasındaki fark nedir?
Data drift input distribution değişimidir. Model performance düşüşü bunun sonucu olabilir ancak zorunlu değildir. Concept drift input-target ilişkisindeki değişimdir. Prediction drift output dağılımını gösterir. Ground truth gerçek model quality değişimini doğrular.
Model ne zaman yeniden eğitilmelidir?
Takvim bazlı retraining kullanılabilir. Drift persistent hâle geldiğinde training tetiklenebilir. Ground truth performance SLO altına düşerse retraining güçlü adaydır. Yeni labeled data volume yeterli seviyeye ulaştığında da training yapılabilir. Business event eski modeli geçersiz kılıyorsa erken retraining gerekir.
MLflow MLOps için yeterli midir?
MLflow experiment tracking ve model registry için güçlü temel sağlayabilir. Ancak data ingestion, orchestration, serving, monitoring ve infrastructure ihtiyaçları ayrı bileşenler gerektirebilir. Küçük ekip MLflow, Git, Docker ve CI/CD ile iyi başlangıç yapabilir. Platform büyüdükçe data versioning ve serving araçları eklenebilir. Araç seçimi gerçek operasyon ihtiyacına göre yapılmalıdır.
Kubernetes MLOps için zorunlu mudur?
Hayır, küçük ekipler Kubernetes olmadan güvenilir MLOps kurabilir. VM, container service veya serverless platform yeterli olabilir. Kubernetes çok model ve autoscaling ihtiyacında güçlü avantaj sağlar. Bununla birlikte cluster operation bilgi ve zaman gerektirir. Platform ihtiyacı oluşmadan Kubernetes kullanmak delivery süresini gereksiz uzatabilir.
Küçük ekipler MLOps'a nasıl başlamalıdır?
Önce Git ve dataset versioning kurun. Experiment tracking ekleyin. Training'i script veya pipeline hâline getirin. Docker ve basit CI/CD ile controlled deployment oluşturun. Son olarak temel latency, error ve drift monitoring ekleyerek olgunluğu kademeli artırın.
MLOps ve Makine Öğrenmesi Dağıtım Yaşam Döngüsü Hakkında Sık Sorulan Sorular
MLOps: Makine Öğrenmesi Dağıtım Yaşam Döngüsü gerçek production ortamında code, data, model ve infrastructure değişikliklerinin tek operasyon zincirinde yönetilmesini gerektirir. Kurumsal MLOps pipeline ve makine öğrenmesi model dağıtım hizmeti planlayan ekiplerin araç seçmeden önce model sayısını, latency ihtiyacını, governance seviyesini ve data altyapısını anlaması önemlidir. MLOps ve makine öğrenmesi danışmanlığı yakınımda şeklinde destek arayan işletmeler için de yalnızca model eğitimi değil CI/CT/CD, registry, monitoring, security ve rollback konularını birlikte ele alan yaklaşım daha faydalıdır. Aşağıdaki sorular uygulamada en sık karşılaşılan karar noktalarını özetler. Bu cevapları kendi model risk seviyenize ve ekip yapınıza göre uyarlamak production başarısını artırır.
MLOps nedir ve makine öğrenmesi model yaşam döngüsü nasıl yönetilir?
MLOps modelin problem tanımından retirement aşamasına kadar bütün yaşamını yönetir. Dataset, feature, code ve model version'ları birbirine bağlanır. Training ve validation pipeline otomatik çalıştırılır. Registry onaylı modeli deployment sistemine iletir ve production monitoring yeni modelin gerçek davranışını izler. MLOps makine öğrenmesi model yaşam döngüsü nasıl yönetilir sorusunun pratik cevabı, bu aşamaların manuel kişisel işlemler yerine versionlanmış ve ölçülebilir pipeline üzerinden yürütülmesidir.
MLOps sürecinde veri hazırlama, model eğitimi, doğrulama ve üretime dağıtım aşamaları nasıl otomatikleştirilir?
Data ingestion schema ve quality gate ile başlatılır. Training orchestrator immutable dataset version ve code commit kullanarak model üretir. Validation pipeline baseline, fairness, latency ve cost kontrollerini çalıştırır. Gate'leri geçen artifact model registry'ye approved olarak alınır ve CD pipeline staging veya canary deployment başlatır. MLOps pipeline ile model eğitimi test ve üretime dağıtım nasıl yapılır sorusunun güvenli cevabı, her aşamanın açık input, output ve otomatik durdurma kriterine sahip olmasıdır.
Makine öğrenmesi modellerinde CI/CD ve sürekli eğitim (CT) süreçleri nasıl uygulanır?
CI source değişikliklerinde unit, data, feature ve model smoke test çalıştırır. CT yeni veri, drift veya schedule trigger ile candidate model üretir. Candidate full evaluation ve quality gate'den geçmeden production'a ilerlemez. CD yalnızca approved artifact'ı controlled rollout ile deploy eder. Makine öğrenmesi modellerinde CI/CD sürekli eğitim ve otomatik deployment süreçleri bu üç bileşenin sorumluluklarını ayırdığınızda daha güvenilir ve geri alınabilir hâle gelir.
Üretime alınan ML modellerinde performans, model drift ve veri drift nasıl izlenir ve yeniden eğitim süreci nasıl yönetilir?
Production monitoring sistem metric, prediction distribution, feature drift ve ground truth performance değerlerini birlikte takip etmelidir. Data drift input değişimini, concept drift ise input ile gerçek target ilişkisi değişimini gösterir. Ground truth gecikmeli geliyorsa proxy metric ve unsupervised drift erken sinyal sağlar. Retraining schedule, drift veya performance trigger ile başlatılabilir fakat yeni model tekrar quality gate'den geçmelidir. MLOps model registry versiyonlama data drift ve model monitoring nasıl yapılır sorusunun temelinde model version ile bütün production metric'lerini aynı lineage içinde ilişkilendirmek bulunur.
MLOps ve makine öğrenmesi dağıtım yaşam döngüsü konusunda yakınımda eğitim veya danışmanlık nerede bulabilirim?
MLOps ve makine öğrenmesi danışmanlığı yakınımda şeklinde araştırma yaparken yalnızca model eğitimi anlatan değil Linux, Docker, Git, CI/CD, registry, monitoring ve production operasyonlarını birlikte ele alan bir yaklaşım aramak faydalıdır. Diyarbakır'da açık kaynak, yazılım ve yapay zeka alanlarında birlikte öğrenmek isteyenler Diyarbakır Yazılım Topluluğu hakkında https://www.diyarbakiryazilim.com.tr/about adresinden bilgi alabilir. Toplulukta geliştirilen ve geliştirilebilecek projeleri https://www.diyarbakiryazilim.com.tr/projects adresinden inceleyebilirsiniz. Küçük bir MLflow, Docker ve CI/CD laboratuvarı kurup modeli canary ile deploy etmek ve ardından rollback denemesi yapmak teorik eğitimden çok daha fazla production deneyimi kazandırır. Özellikle deployment sonrasında drift ve business KPI izlemek model geliştirme ile MLOps arasındaki farkı doğrudan görmenizi sağlar.
Sonuç: Production-Ready MLOps Yaşam Döngüsü Nasıl Kurulur?
MLOps: Makine Öğrenmesi Dağıtım Yaşam Döngüsü bir modeli notebook'tan API'ye taşımaktan ibaret değildir. Güvenilir production sistemi dataset versioning, reproducible training, experiment tracking, registry, quality gate, controlled deployment, monitoring, retraining ve retirement süreçlerinin birlikte çalışmasını gerektirir. CI, CT ve CD bu döngüyü otomatikleştirirken validation gate yanlış modelin production'a ilerlemesini engeller. Drift ve ground truth monitoring modelin zamanla değişen gerçek dünyaya karşı ne kadar sağlıklı kaldığını gösterir. Rollback ve disaster recovery ise beklenmeyen durumda hizmeti hızlı biçimde güvenilir önceki duruma döndürür.
Ben yeni bir MLOps projesine başlarken ilk aşamada Kubernetes veya büyük platform seçmek yerine modelin hangi veriyle üretildiğini tekrar gösterebilmeyi hedefliyorum. Git, dataset versioning, experiment tracking, model registry ve basit CI/CD kurulduğunda ekip kısa sürede önemli bir operasyon disiplini kazanır. Sonraki aşamada canary deployment, drift monitoring, CT, governance ve self-service platform eklenebilir. Diyarbakır'da MLOps, açık kaynak, yapay zeka ve production yazılım projeleri üzerine birlikte çalışmak isterseniz https://www.diyarbakiryazilim.com.tr adresinden Diyarbakır Yazılım Topluluğu'na ulaşabilirsiniz. En iyi başlangıç küçük bir modeli uçtan uca versionlayıp test etmek, registry'ye almak, production'a kontrollü dağıtmak ve gerçek metric'lerle yaşam döngüsünü baştan sona işletmektir.
share: