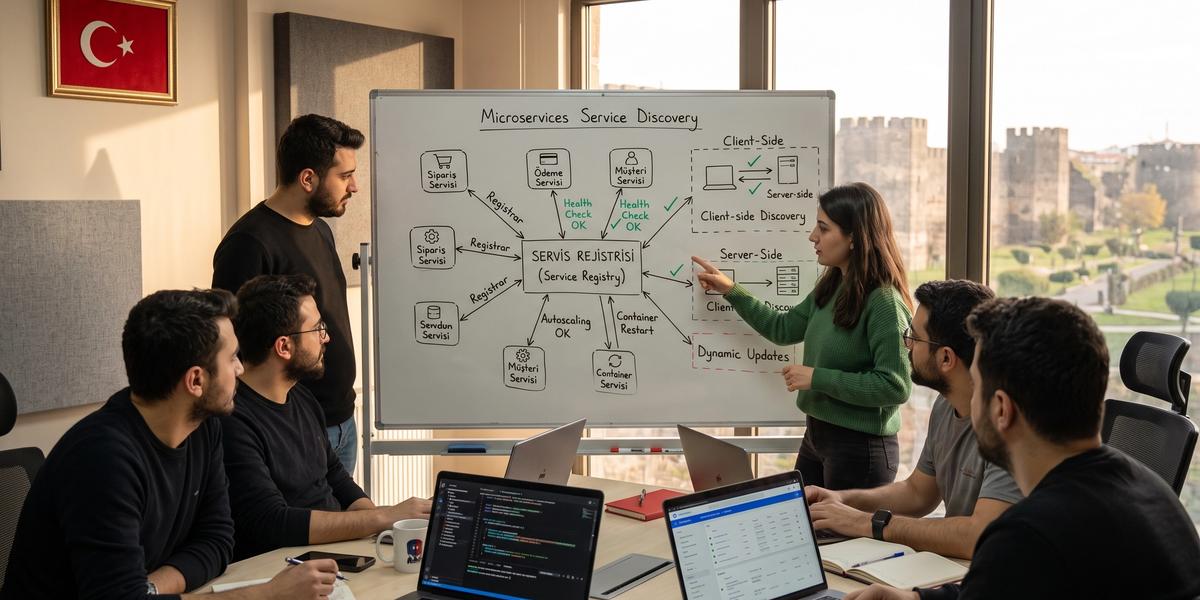
Mikroservislerde Servis Keşfi (Service Discovery) ve Yönetimi

Diyarbakır Yazılım
16.08.2026
#Yazılım#Teknoloji#Topluluk
Mikroservis sayısı birkaç taneden onlarca servise çıktığında, servislerin birbirini hangi IP adresinde ve hangi portta bulacağı gerçek bir operasyon konusu hâline gelir. Bir container yeniden başladığında IP adresi değişebilir, autoscaling sırasında yeni instance'lar eklenebilir ve rolling deployment sırasında eski instance'lar birkaç dakika içinde sistemden çıkabilir. Bu nedenle Mikroservislerde Servis Keşfi (Service Discovery) ve Yönetimi, yalnızca ağ seviyesinde adres bulma işlemi olarak görülmemelidir. Sağlıklı bir yapı; servis kaydı, health check, yük dengeleme, failover, güvenlik, gözlemlenebilirlik ve yaşam döngüsü yönetimini birlikte ele alır. Bu rehberde mikroservislerde service discovery nasıl çalışır sorusundan Kubernetes, Consul, Eureka, service mesh ve çok bölgeli mimarilere kadar uzanan pratik bir çerçeve kuracağız.
Sahada gördüğüm projelerde en sık yapılan hata, servis keşfini yalnızca bir registry kurmak şeklinde yorumlamaktır. Oysa mikroservis mimarisinde servis keşfi nasıl yapılandırılır sorusunun cevabı, kullandığınız platforma, servis sayısına, iletişim protokollerine ve hata toleransı beklentinize göre değişir. Kubernetes Consul ve Eureka service discovery karşılaştırması yapılırken de yalnızca özellik listesine bakmak yeterli değildir. Mikroservislerde servis kaydı health check load balancing ve failover yönetimi birlikte tasarlanmadığında güçlü bir registry kullanmak tek başına kesintileri önlemez. Bu yazının sonunda kendi sisteminiz için hangi yaklaşımın daha uygun olduğunu değerlendirebilecek teknik bir kontrol çerçevesine sahip olacaksınız.
Service Discovery Nedir?
Service Discovery, bir uygulamanın ihtiyaç duyduğu başka bir servisin çalışan instance'larını dinamik biçimde bulmasını sağlayan mekanizmadır. Temel amaç, uygulama kodunun değişken IP adreslerini ve portları doğrudan bilme zorunluluğunu ortadan kaldırmaktır. Bir servis ölçeklendiğinde, yeniden başladığında veya farklı bir node'a taşındığında discovery mekanizması güncel endpoint bilgisini istemcilere ulaştırır. Böylece servisler fiziksel ağ konumuna değil, mantıksal servis adına göre iletişim kurabilir. Sağlam bir discovery tasarımı, değişken altyapıyı uygulama açısından daha öngörülebilir hâle getirir.
Mikroservislerde Servis Keşfi Ne İşe Yarar?
Mikroservislerde servis keşfi, çalışan servis instance'larının bulunmasını ve trafiğin kullanılabilir endpoint'lere yönlendirilmesini kolaylaştırır. Sipariş servisi ödeme servisine bağlanmak istediğinde sabit IP bilmek yerine ödeme servisini mantıksal adıyla çağırabilir. Discovery katmanı o anda sağlıklı olan instance listesini sağlar ve seçimin yapılacağı zemini oluşturur. Autoscaling, container restart ve node kaybı gibi olaylarda uygulama yapılandırmasını elle güncellemek gerekmez. Bu yaklaşım özellikle yüzlerce instance'ın sürekli değiştiği sistemlerde operasyon yükünü belirgin biçimde azaltır.
Service Instance Nedir?
Service instance, aynı mikroservisin çalışan tek bir kopyasını ifade eder. Örneğin ödeme servisi üç replica ile çalışıyorsa ağ üzerinde üç ayrı service instance bulunur. Her instance farklı IP adresine, porta, node bilgisine veya zone bilgisine sahip olabilir. Discovery sistemi bu instance'ları tek bir mantıksal servis adı altında toplar ve sağlık durumlarını takip eder. Böylece istemci belirli bir süreç yerine servisin çalışan kopyalarından uygun olanına erişebilir.
Service Endpoint Nedir?
Service endpoint, bir servis instance'ına ağ üzerinden ulaşmak için kullanılan adres bilgisidir. Genellikle IP adresi ve port birleşimi şeklinde düşünülür, ancak protokol ve metadata bilgileri de endpoint tanımına eşlik edebilir. Bir instance yeniden başladığında endpoint değişebilir ve registry'nin bu değişikliği hızlı biçimde yansıtması gerekir. İstemciler eski endpoint'i kullanmaya devam ederse bağlantı hataları veya gereksiz retry trafiği oluşabilir. Bu nedenle endpoint yaşam döngüsü, service discovery tasarımının en önemli parçalarından biridir.
Logical Service Name Nedir?
Logical Service Name, fiziksel IP adreslerinden bağımsız olarak bir servisi temsil eden mantıksal isimdir. Örneğin payment-service veya inventory-service gibi bir isim, birden fazla çalışan instance'ı tek kimlik altında temsil edebilir. Uygulama kodu bu adı kullanırken altyapı katmanı gerçek endpoint listesini çözümler. Böylece deployment ortamı değişse bile servis çağrılarında kullanılan temel isim sabit kalabilir. İsimlendirme standardı iyi tasarlandığında operasyon, observability ve güvenlik politikaları da daha kolay yönetilir.
Service Discovery Olmadan Mikroservisler Nasıl Haberleşir?
Service discovery bulunmadığında servisler çoğunlukla sabit IP, statik configuration dosyası veya manuel güncellenen endpoint listeleri üzerinden haberleşir. Bu yöntem küçük ve değişmeyen sistemlerde kısa süreli olarak çalışabilir. Container tabanlı ortamlarda IP adreslerinin değişmesi, ölçekleme ve deployment süreçleri kısa sürede ciddi bakım yükü oluşturur. Her değişiklikte istemcilerin configuration bilgisini güncellemek gerekebilir ve yanlış bir kayıt doğrudan erişim sorununa yol açabilir. Bu nedenle dinamik altyapılarda discovery olmadan sürdürülebilir servis iletişimi kurmak giderek zorlaşır.
Mikroservislerde Service Discovery Neden Gereklidir?
Mikroservis mimarisinde servis konumları sabit kabul edilemez. Container platformları, autoscaling mekanizmaları ve orkestrasyon sistemleri workload'ları sürekli yeniden konumlandırabilir. Service discovery bu değişimi uygulama kodundan ayırarak servis iletişimini daha dayanıklı hâle getirir. Aynı zamanda deployment ve failover süreçlerinin elle endpoint güncellemeden ilerlemesine yardımcı olur. Özellikle production ortamlarında discovery ihtiyacı, servis sayısı ve altyapı hareketliliği arttıkça daha görünür olur.
Dinamik IP Adresleri
Container ve pod tabanlı sistemlerde IP adresleri çoğu zaman geçicidir. Bir pod silinip yeniden oluşturulduğunda aynı IP adresini tekrar alacağı garanti edilmez. İstemciler doğrudan eski IP adresine bağlıysa servis yeniden başladığında bağlantı başarısız olur. Discovery sistemi güncel endpoint bilgisini tutarak bu değişimin uygulamaya daha az yansımasını sağlar. Bu nedenle servis adı ile fiziksel ağ adresini birbirinden ayırmak mikroservis mimarisinin temel tasarım kararlarından biridir.
Container Restart'ları
Container restart işlemleri bakım, hata, autoscaling veya deployment sırasında sık yaşanabilir. Restart sonrasında proses yeni bir IP adresinde veya farklı bir node üzerinde çalışmaya başlayabilir. Registry veya platform discovery mekanizması yeni instance'ı kaydetmeli, eski kaydı ise kullanılabilir endpoint listesinden kaldırmalıdır. Bu güncelleme gecikirse istemciler artık bulunmayan adreslere trafik gönderebilir. Sağlıklı registration ve deregistration akışı, restart olaylarının kullanıcıya yansımasını azaltır.
Horizontal Autoscaling
Horizontal autoscaling sırasında servis instance sayısı trafik veya kaynak kullanımına göre artıp azalabilir. Yeni instance'ların kullanıma hazır hâle geldiklerinde discovery sistemine eklenmesi gerekir. Ölçek küçülürken kapanacak instance'ların da yeni trafik almadan önce havuzdan çıkarılması önemlidir. Bu süreç elle yönetildiğinde otomasyonun sağladığı fayda büyük ölçüde kaybolur. Service discovery, autoscaling ile load balancing arasında güncel endpoint bilgisini sağlayan önemli bağlantıyı oluşturur.
Rolling Deployment
Rolling deployment sırasında eski ve yeni uygulama sürümleri kısa bir süre aynı anda çalışır. Discovery sistemi hazır hâle gelen yeni instance'ları trafiğe dahil ederken kapanacak eski instance'ları havuzdan çıkarmalıdır. Readiness kontrolü bu noktada kritik bir sinyal görevi görür. Yeni sürüm henüz başlatma işlemlerini tamamlamadan trafik alırsa deployment sırasında hata oranı yükselebilir. Doğru discovery entegrasyonu rolling deployment işlemini kullanıcı açısından daha kesintisiz hâle getirir.
Node Failure
Bir node tamamen erişilemez hâle geldiğinde üzerinde çalışan birden fazla servis instance'ı aynı anda kaybolabilir. Discovery mekanizmasının bu endpoint'leri makul sürede sağlıksız olarak işaretlemesi gerekir. Aksi durumda load balancing katmanı artık erişilemeyen node'a trafik göndermeye devam eder. Health detection süresi ile yanlış pozitif riskinin dengeli biçimde ayarlanması önemlidir. Hızlı ama aşırı hassas kontroller, geçici network sorunlarını gerçek servis arızası gibi yorumlayabilir.
Multi-Region Deployment
Multi-region yapılarda aynı servis birden fazla coğrafi bölgede çalışabilir. Discovery katmanı yalnızca hangi instance'ların mevcut olduğunu değil, hangi region veya zone içinde bulunduğunu da değerlendirebilir. İstemcinin en yakın bölgedeki instance'ı seçmesi gecikmeyi ve bölgeler arası veri transferi maliyetini azaltabilir. Bir region kullanılamaz olduğunda kontrollü failover mekanizması diğer bölgedeki instance'lara geçiş sağlayabilir. Bu nedenle multi-region discovery, basit endpoint listesinden daha fazla topology bilgisi gerektirir.
Statik IP ve Hard-Coded Endpoint Problemi
Hard-coded endpoint kullanımı ilk bakışta hızlı bir çözüm gibi görünebilir. Ancak IP, port veya hostname değiştiğinde uygulama configuration bilgisinin yeniden dağıtılması gerekebilir. Büyük sistemlerde bu bağımlılık deployment sürecini yavaşlatır ve hata riskini artırır. Statik bilgi aynı zamanda otomatik ölçekleme ve dinamik failover özellikleriyle iyi uyuşmaz. Servislerin mantıksal isimler üzerinden bulunması, altyapının değişmesine daha rahat uyum sağlayan bir model sunar.
Service Discovery Nasıl Çalışır?
Service discovery akışı çoğunlukla registration, health detection, lookup, instance selection ve deregistration adımlarından oluşur. Bir servis ayağa kalktığında kendisini veya onu yöneten platformu registry'ye tanıtır. Registry çalışan endpoint'leri ve gerekli metadata bilgisini saklar. İstemci ya doğrudan registry'yi sorgular ya da proxy, DNS veya platform katmanından güncel hedef bilgisini alır. Instance kullanım dışına çıktığında kaydın temizlenmesi ve cache'lerin güncellenmesi gerekir.
Service Registration
Service registration, yeni bir servis instance'ının discovery sistemine tanıtılması işlemidir. Kayıt sırasında servis adı, IP, port, protokol, zone ve sürüm gibi bilgiler gönderilebilir. Bazı sistemlerde servis uygulaması kendi kaydını yaparken bazı ortamlarda bu işi orkestrasyon platformu veya agent üstlenir. Registration ancak instance gerçekten trafik almaya hazır olduğunda kullanılabilir endpoint üretmelidir. Aksi durumda başlatma aşamasındaki servisler istemci hatalarına neden olabilir.
Service Registry
Service registry, servislerin ve çalışan instance'ların güncel durumunu tutan merkezî veya dağıtık kayıt katmanıdır. Registry istemcilere hangi endpoint'lerin mevcut olduğunu bildirir ve health bilgilerini saklayabilir. Bu bileşenin erişilemez hâle gelmesi yeni discovery işlemlerini etkileyebileceği için yüksek erişilebilirlik önemlidir. İstemci cache'i gibi mekanizmalar kısa süreli registry kesintilerinin etkisini azaltabilir. Registry tasarımı yapılırken veri tutarlılığı, convergence süresi ve failure senaryoları birlikte değerlendirilmelidir.
Health Detection
Health detection, bir instance'ın trafik almaya devam edip edemeyeceğini belirlemek için kullanılan süreçtir. HTTP, TCP, heartbeat veya TTL tabanlı yöntemler kullanılabilir. Kontrol çok seyrek yapılırsa bozuk endpoint uzun süre listede kalabilir. Kontrol aşırı agresif olursa kısa süreli network gecikmeleri instance'ın gereksiz yere havuzdan çıkarılmasına yol açabilir. Bu nedenle health check ayarları uygulamanın gerçek çalışma karakteristiğine göre belirlenmelidir.
Service Lookup
Service lookup, istemcinin belirli bir mantıksal servis adına karşılık gelen endpoint listesini istemesidir. Lookup işlemi registry API, DNS, client library veya proxy üzerinden gerçekleşebilir. Sonuç genellikle bir veya daha fazla sağlıklı instance içerir. Bazı sistemler zone, version veya tag gibi filtrelerle daha özel sorgulara da izin verir. Lookup gecikmesi yüksek olduğunda uygulama performansı etkilenebileceği için cache ve push tabanlı güncelleme modelleri önem kazanır.
Instance Selection
Instance selection, bulunan endpoint'ler arasından isteğin gönderileceği hedefin seçilmesidir. Round robin, random, least requests veya locality-aware gibi algoritmalar kullanılabilir. Seçim mantığı istemci tarafında, proxy üzerinde veya merkezi load balancer katmanında çalışabilir. Her algoritmanın trafik profiline göre farklı avantajı vardır. Özellikle uzun süreli bağlantılarda yalnızca basit round robin kullanmak beklenen dağılımı her zaman sağlamayabilir.
Request Routing
Request routing, seçilen instance'a gerçek network isteğinin gönderilmesi aşamasıdır. Routing sırasında timeout, retry, mTLS, authorization veya traffic policy gibi ek kurallar devreye girebilir. Discovery yalnızca hedefin bulunmasını sağlar, isteğin başarıyla tamamlanacağını garanti etmez. Proxy veya service mesh kullanılan yapılarda routing politikaları merkezi şekilde uygulanabilir. Uygulama içinde yapılan routing ise daha fazla client kodu ve standartlaştırma ihtiyacı doğurabilir.
Deregistration
Deregistration, artık trafik almaması gereken bir instance'ın discovery listesinden çıkarılmasıdır. Planlı kapanışlarda işlem, servis süreci sonlandırılmadan önce başlatılmalıdır. Instance önce readiness durumunu kapatmalı, yeni trafik kabulünü durdurmalı ve aktif isteklerin tamamlanmasını beklemelidir. Beklenmedik crash durumlarında registry heartbeat veya health timeout üzerinden kaydı geçersiz sayabilir. Doğru deregistration akışı stale endpoint oluşma ihtimalini önemli ölçüde azaltır.
Service Registry Nedir?
Service registry, mikroservislerin çalışma anındaki adres ve durum bilgilerinin tutulduğu discovery veri kaynağıdır. Bir telefon rehberi benzetmesi yapılabilir, ancak registry yalnızca isim ve adres tutmakla kalmaz. Health status, version, zone ve metadata gibi bilgiler de routing kararlarında kullanılabilir. Registry'nin güncel kalması discovery doğruluğu için doğrudan önem taşır. Bu nedenle registration, heartbeat ve deregistration süreçleri registry mimarisinin ayrılmaz parçalarıdır.
Registry'de Hangi Bilgiler Tutulur?
Registry içinde tutulacak bilgi miktarı sistemin ihtiyaçlarına göre değişir. En temel kayıt servis adı, IP adresi ve port bilgisinden oluşur. Production yapılarda protocol, health status, version, zone ve metadata gibi ek alanlara ihtiyaç duyulur. Bu bilgiler routing, güvenlik ve observability politikalarında da kullanılabilir. Ancak gereksiz metadata yüklemek yönetim ve tutarlılık maliyetini artırabileceği için gerçekten kullanılan alanlar tercih edilmelidir.
Service Name
Service name, instance'ların hangi mantıksal servise ait olduğunu belirtir. Aynı uygulamanın onlarca instance'ı tek servis adı altında listelenebilir. Bu isim DNS çözümlemesinde, authorization politikasında veya observability ekranlarında ortak kimlik olarak kullanılabilir. İsimlendirme standardının ekipler arasında ortak olması operasyon sırasında büyük kolaylık sağlar. Service name değişiklikleri bağımlı istemcileri etkileyebileceği için migration planı ile yapılmalıdır.
IP Address
IP address, ilgili service instance'ın network üzerinde bulunduğu adresi gösterir. Container ortamlarında bu adres geçici olabilir ve instance yeniden yaratıldığında değişebilir. Registry güncel IP bilgisini hızlı biçimde yansıtmazsa stale endpoint sorunu oluşabilir. Bazı yapılarda istemciler IP'yi doğrudan kullanırken bazı yapılarda proxy veya sanal IP katmanı üzerinden erişim sağlanır. IP adresi tek başına servis kimliği olarak değerlendirilmemelidir.
Port
Port bilgisi, servisin hangi network portundan trafik kabul ettiğini belirtir. Aynı IP üzerinde birden fazla servis veya protokol çalışabildiği için port discovery açısından önemlidir. Dinamik port tahsisi kullanılan platformlarda registry'nin güncel port bilgisini saklaması gerekir. SRV kayıtları gibi DNS mekanizmaları port bilgisini discovery sonucunun bir parçası olarak sağlayabilir. İstemci portu hard-code etmek yerine mümkünse platform tarafından sunulan servis bilgisini kullanmalıdır.
Protocol
Protocol bilgisi endpoint ile hangi iletişim yönteminin kullanılacağını tanımlar. HTTP, HTTPS, gRPC veya özel TCP protokolleri farklı bağlantı davranışlarına sahiptir. Discovery metadata'sında protokol tutulması gateway veya proxy katmanının doğru routing ayarını seçmesine yardımcı olabilir. Özellikle mTLS ve HTTP/2 kullanılan yapılarda protokol bilgisi yapılandırma hatalarını önler. Farklı protokoller aynı servis adı altında sunuluyorsa port ve protokol eşleşmesi açık biçimde tanımlanmalıdır.
Health Status
Health status, bir instance'ın yeni trafik almaya uygun olup olmadığını gösteren önemli bir bilgidir. Sağlıksız endpoint listede görünse bile routing havuzuna dahil edilmemelidir. Health değişikliklerinin registry'ye ne kadar hızlı yayıldığı failover süresini doğrudan etkiler. Bununla birlikte health status tek bir aşırı derin kontrolün sonucuna bağlanmamalıdır. Uygulamanın kendisi çalışırken bağımlı sistemlerden biri kısa süreli kapalı diye tüm instance'ları düşürmek istenmeyen sonuçlar oluşturabilir.
Version
Version bilgisi, aynı servisin farklı sürümlerini discovery katmanında ayırmak için kullanılabilir. Canary veya blue-green deployment sırasında v1 ve v2 instance'ları aynı anda çalışabilir. Routing katmanı version metadata'sına göre belirli trafik yüzdesini yeni sürüme yönlendirebilir. Bu bilgi rollback sürecinde de hedef grubun hızlı biçimde değiştirilmesini kolaylaştırır. Version bilgisinin uygulama paket sürümüyle tutarlı olması observability açısından önemlidir.
Region / Zone
Region ve zone metadata'sı instance'ın fiziksel veya mantıksal yerleşimini gösterir. Locality-aware routing bu bilgiyi kullanarak istemciye yakın endpoint'leri önceliklendirebilir. Böylece gecikme ve bölgeler arası network maliyeti düşürülebilir. Zone arızasında diğer zone'lardaki instance'lara kontrollü geçiş yapılabilir. Ancak topology bilgisi yanlışsa trafik beklenmeyen bölgelere yönlenebilir, bu nedenle otomatik platform metadata'sı tercih edilmelidir.
Metadata ve Tags
Metadata ve tags, service instance hakkında routing veya yönetim amacıyla ek bilgiler taşır. Environment, version, capability veya deployment grubu gibi alanlar burada tutulabilir. Consul benzeri sistemlerde tags, servis sorgularını filtrelemek için kullanılabilir. Fazla sayıda serbest metin tag kullanmak zamanla standardizasyon sorunlarına yol açabilir. Ekiplerin hangi metadata alanlarının zorunlu olduğunu önceden tanımlaması yönetimi kolaylaştırır.
Service Catalog ile Service Registry Aynı Şey midir?
Service catalog ve service registry birbirine yakın kavramlar olsa da aynı amaca hizmet etmez. Registry çalışma anında hangi instance'ın nerede ve hangi durumda olduğunu takip eder. Organizational service catalog ise servis sahibini, repository adresini, API dokümantasyonunu, SLO bilgisini ve yaşam döngüsü durumunu gösterebilir. Registry daha çok runtime ihtiyaçlarına, catalog ise ekiplerin servis envanterini yönetmesine odaklanır. İyi bir platform yaklaşımında bu iki sistem birbirinden veri alabilir ancak sorumlulukları ayrı tutulur.
Registry Neden High Availability Olmalıdır?
Registry discovery akışının kritik bileşenlerinden biri olduğu için tek instance olarak çalıştırılması risklidir. Registry çöktüğünde mevcut cache'ler bir süre yardımcı olabilir, ancak yeni instance kaydı veya güncel endpoint sorguları aksayabilir. High availability tasarımı replication, quorum ve multi-zone dağıtım gibi mekanizmalar içerebilir. İstemcilerin registry kesintisinde last-known-good endpoint'lerle nasıl davranacağı da önceden belirlenmelidir. Amaç, control plane sorunu yaşandığında çalışan veri trafiğinin gereksiz yere tamamen durmasını önlemektir.
Service Registration Modelleri
Service registration işlemi uygulamanın kendisi, platform veya yardımcı bir agent tarafından gerçekleştirilebilir. Seçilen model uygulama kodunun altyapıya ne kadar bağımlı olacağını belirler. Polyglot ortamlarda platform tabanlı registration çoğu zaman ekipler arasında daha tutarlı davranış sağlar. Uygulama tabanlı modeller ise servis özelinde daha fazla kontrol sunabilir. Karar verirken geliştirme deneyimi, operasyon sorumluluğu ve kullanılan deployment platformu birlikte değerlendirilmelidir.
Self-Registration
Self-registration modelinde mikroservis çalışmaya başladığında kendi endpoint bilgisini registry'ye kaydeder. Uygulama ayrıca heartbeat gönderme ve kapanırken deregistration işlemini gerçekleştirme sorumluluğunu üstlenebilir. Bu model servis ekibine ayrıntılı kontrol sağlar ancak discovery client kodunu uygulamanın parçası hâline getirir. Farklı programlama dilleri kullanıldığında her dil için uygun client kütüphanesi gerekir. Platform değişiklikleri de uygulama koduna daha fazla yansıyabilir.
Avantajları
Self-registration servis ekibine registration zamanlaması üzerinde doğrudan kontrol verir. Uygulama gerçekten hazır olduğunda kayıt yapabilir ve ihtiyaç duyduğu metadata bilgisini kendisi gönderebilir. Registry ile iletişim mantığı servis özelinde özelleştirilebilir. Bazı geleneksel VM ortamlarında bu yaklaşım uygulaması kolay bir seçenek olabilir. Özellikle belirli bir ekosistemde standart client kütüphanesi kullanılıyorsa geliştirme deneyimi oldukça rahat olabilir.
Dezavantajları
Self-registration uygulama kodunu registry teknolojisine daha fazla bağlar. Birden fazla dil kullanılan sistemlerde aynı davranışı sağlayan farklı client kütüphanelerinin yönetilmesi gerekir. Heartbeat, retry ve deregistration mantığında ekipler arasında farklı uygulamalar oluşabilir. Registry değiştirildiğinde çok sayıda serviste kod veya dependency güncellemesi gerekebilir. Bu nedenle platform seviyesinde standardizasyon isteyen organizasyonlarda ek operasyon ve bakım yükü doğurabilir.
Third-Party Registration
Third-party registration modelinde servis kendi kaydını doğrudan yapmaz. Ayrı bir platform bileşeni, agent veya controller çalışan workload'ları gözlemleyerek registry bilgisini günceller. Böylece application code discovery teknolojisinden daha fazla ayrıştırılmış olur. Kubernetes gibi orkestrasyon sistemlerinde platform bu role doğal biçimde yaklaşır. Polyglot mikroservislerde ortak davranış elde etmek için bu model çoğu zaman daha uygun bir seçenek olabilir.
Platform-Based Registration
Platform-based registration, servis kaydının orkestrasyon veya deployment platformu tarafından otomatik yapılmasını ifade eder. Kubernetes Service ve EndpointSlice mekanizması bu yaklaşımın güçlü örneklerinden biridir. Uygulama yalnızca doğru label ve readiness bilgisiyle çalışırken platform endpoint listesini yönetebilir. Servis ekiplerinin registry client kodu yazması gerekmez. Bu yaklaşım uygulama ile altyapı sorumluluğunu ayırarak daha sade bir geliştirme modeli oluşturabilir.
Sidecar-Based Registration
Sidecar-based registration modelinde uygulamanın yanında çalışan yardımcı bir proses registry ile iletişim kurar. Sidecar servis bilgilerini kaydedebilir, health durumunu izleyebilir ve proxy görevini üstlenebilir. Uygulama discovery API'sini doğrudan bilmeden yerel sidecar üzerinden haberleşebilir. Bu yaklaşım service mesh tasarımlarında sık görülür. Bunun karşılığında her workload yanında ek CPU, memory ve yaşam döngüsü yönetimi gerektiren bir bileşen oluşur.
Hangi Registration Modeli Ne Zaman Seçilmeli?
Kubernetes üzerinde çalışan servislerde mümkün olduğunda platform-native registration ile başlamak çoğu proje için mantıklıdır. VM ve bare metal ortamlarında Consul agent gibi third-party modeller daha uygun olabilir. Sadece Java ve Spring tabanlı bir altyapıda uygulama client'larının standartlaştırıldığı senaryolarda self-registration kullanılabilir. Çok dilli ve çok platformlu sistemlerde uygulamayı registry teknolojisinden ayırmak genellikle uzun vadede avantaj sağlar. Seçim yapılırken yalnızca ilk kurulum değil, üç yıl sonraki bakım ve migration maliyeti de düşünülmelidir.
Client-Side Service Discovery
Client-side discovery modelinde istemci doğrudan registry veya discovery kaynağından endpoint listesini alır. Ardından hangi instance'ın kullanılacağını istemci tarafındaki load balancing mantığı belirler. Bu yaklaşım ek proxy hop ihtiyacını azaltabilir ve routing üzerinde yüksek kontrol sağlar. Buna karşılık discovery ve load balancing kodu her istemci ekosisteminde yönetilmelidir. Özellikle çok sayıda programlama dili bulunan sistemlerde bu sorumluluk önemli bir standardizasyon konusu hâline gelir.
Client Registry'yi Nasıl Sorgular?
Client registry'yi HTTP API, DNS veya özel bir discovery protokolü üzerinden sorgulayabilir. Bazı kütüphaneler periyodik olarak registry snapshot'ı indirirken bazıları değişiklikleri watch mekanizmasıyla takip eder. Sorgu sonucu genellikle sağlıklı instance listesi ve ilgili metadata bilgisidir. Client daha sonra kendi routing algoritmasını kullanarak bir hedef seçer. Registry sorgusunu her request öncesinde yapmak yerine kontrollü cache kullanmak gecikme ve registry yükünü azaltır.
Local Endpoint Cache
Local endpoint cache, istemcinin son bilinen servis endpoint listesini bellekte saklamasını sağlar. Bu yaklaşım registry her request için sorgulanmadığından latency ve control plane yükünü azaltır. Registry kısa süreli erişilemez olduğunda cache sayesinde çalışan servislerle iletişim devam edebilir. Buna karşılık cache fazla uzun tutulursa stale endpoint riski artar. Bu nedenle TTL, push update veya watch mekanizmaları ile freshness dengesi kurulmalıdır.
Client-Side Load Balancing
Client-side load balancing, endpoint seçiminin isteği gönderen uygulama veya client library tarafından yapılmasıdır. İstemci registry'den aldığı birden fazla instance arasında uygun algoritmayı uygular. Bu yöntem ek merkezi load balancer ihtiyacını azaltabilir. Ancak her programlama dili ve client kütüphanesinin aynı davranışı göstermesi gerekir. Retry, connection pooling ve uzun süreli bağlantılar da algoritmanın gerçek trafik dağılımını etkileyebilir.
Round Robin
Round robin, mevcut instance'lara sırayla trafik gönderen basit bir load balancing algoritmasıdır. Benzer kapasitedeki stateless servislerde anlaşılması ve uygulanması kolaydır. Her instance'ın aynı performansa sahip olduğu varsayımına dayanır. Uzun süreli bağlantılarda veya instance kapasiteleri farklı olduğunda ideal sonuç vermeyebilir. Buna rağmen başlangıç noktası olarak birçok sistemde yeterli ve tahmin edilebilir davranış sunar.
Random
Random algoritması her istek için kullanılabilir instance'lardan rastgele birini seçer. Büyük istek hacimlerinde dağılım çoğu zaman dengeli bir yapıya yaklaşır. Merkezi sayaç veya sıra tutmaya ihtiyaç duymaması uygulamayı basitleştirebilir. Düşük trafik hacminde kısa süreli dengesizlikler görülebilir. Ayrıca instance kapasiteleri farklıysa ağırlıklı bir seçim mekanizması daha uygun olabilir.
Least Connections
Least connections algoritması aktif bağlantı sayısı daha düşük olan instance'ı tercih eder. Uzun süren request veya bağlantıların bulunduğu sistemlerde round robin yönteminden daha dengeli sonuç verebilir. Bunun için load balancer'ın aktif connection durumunu güvenilir biçimde takip etmesi gerekir. Client-side yapılarda tüm istemcilerin global connection bilgisini görmesi mümkün değildir. Bu nedenle algoritma merkezi proxy veya load balancer üzerinde daha doğru uygulanabilir.
Latency-Aware Routing
Latency-aware routing, endpoint seçiminde geçmiş veya güncel gecikme ölçümlerini dikkate alır. Amaç yalnızca trafiği eşit bölmek değil, daha hızlı yanıt veren instance'ları tercih etmektir. Ölçümler yeterli örnek olmadan agresif biçimde kullanılırsa trafik sürekli birkaç instance üzerinde toplanabilir. Algoritmanın failure ve recovery davranışı da açık biçimde tanımlanmalıdır. Özellikle multi-region sistemlerde latency bilgisi topology verisiyle birlikte kullanıldığında önemli fayda sağlayabilir.
Client-Side Discovery Avantajları
Client-side discovery doğrudan endpoint bağlantısı sayesinde ek proxy hop ihtiyacını azaltabilir. İstemci kendi request tipine uygun load balancing algoritmasını seçebilir. Registry snapshot'ı cache'lenerek control plane kesintilerine karşı belirli ölçüde dayanıklılık sağlanabilir. Uygulama seviyesinde ayrıntılı routing kontrolü isteyen ekipler için esnek bir modeldir. Özellikle tek teknoloji yığını kullanılan sistemlerde standart client library ile oldukça verimli çalışabilir.
Client-Side Discovery Dezavantajları
Client-side discovery'nin temel dezavantajı altyapı mantığının uygulama kütüphanelerine taşınmasıdır. Registry entegrasyonu, caching, retry ve load balancing davranışı her client için doğru uygulanmalıdır. Çok sayıda dil kullanıldığında aynı politika farklı kütüphanelerde farklı sonuç verebilir. Güncelleme yapmak için çok sayıda servisin dependency sürümünü yükseltmek gerekebilir. Bu durum merkezi network politikası uygulamak isteyen ekipler için önemli bir bakım yükü oluşturur.
Polyglot Mikroservislerde Client Library Problemi
Polyglot mikroservislerde Java, Go, Python, .NET ve Node.js gibi farklı diller aynı platformda çalışabilir. Her dil için discovery ve load balancing davranışını eşit seviyede destekleyen kütüphane bulmak her zaman kolay değildir. Retry veya DNS cache gibi ayrıntılar runtime'lar arasında farklı davranabilir. Bu nedenle platform ekipleri discovery sorumluluğunu proxy veya service mesh katmanına taşımayı tercih edebilir. Infrastructure-owned discovery yaklaşımı uygulama ekiplerinin daha tutarlı network davranışı elde etmesine yardımcı olur.
Server-Side Service Discovery
Server-side discovery modelinde istemci doğrudan registry bilgisini kullanmaz. İstek önce load balancer, router veya proxy gibi bir ara bileşene gönderilir. Bu bileşen registry'den güncel endpoint listesini alır ve uygun backend'i seçer. Uygulama kodu daha sade kalırken routing politikaları merkezi biçimde yönetilebilir. Bunun karşılığında router katmanının performansı ve yüksek erişilebilirliği mimarinin kritik konusu hâline gelir.
Load Balancer veya Proxy'nin Rolü
Load balancer veya proxy, istemciden gelen isteği uygun servis instance'ına yönlendiren katmandır. Registry veya platform API üzerinden güncel endpoint listesini takip edebilir. Health durumu, zone, version veya ağırlık gibi metadata bilgilerini routing kararında kullanabilir. Retry, timeout ve connection pooling gibi ek davranışlar da burada uygulanabilir. Bu merkezi nokta standartlaştırmayı kolaylaştırırken kapasite ve failure planlamasının iyi yapılmasını gerektirir.
Client Neden Registry'yi Bilmez?
Server-side discovery yaklaşımında client yalnızca sabit bir proxy, gateway veya service adıyla iletişim kurar. Registry protokolü ve endpoint seçimi uygulamanın dışında tutulur. Böylece farklı programlama dillerindeki servislerin aynı discovery kütüphanesini kullanması gerekmez. Registry değişikliği çoğu zaman uygulama kodunu etkilemeden yapılabilir. Bu ayrım özellikle büyük platform ekiplerinde altyapı sorumluluğunu merkezi yönetmek için avantaj sağlar.
Server-Side Load Balancing
Server-side load balancing, instance seçiminin istemci dışında çalışan proxy veya load balancer tarafından yapılmasıdır. Merkezi katman tüm backend bağlantılarını daha geniş açıdan görebildiği için least connections veya outlier detection gibi algoritmaları daha doğru uygulayabilir. Routing politikaları servis ekiplerinden bağımsız olarak güncellenebilir. Bununla birlikte merkezi katmanda yapılan yanlış configuration çok sayıda servisi aynı anda etkileyebilir. Bu nedenle değişikliklerin kontrollü rollout ve observability ile yapılması önemlidir.
Ek Network Hop Maliyeti
Proxy üzerinden geçen her request bir ek network hop oluşturabilir. Bu hop genellikle milisaniyenin küçük bir bölümü seviyesinde olsa da yüksek hacimli veya düşük latency gerektiren sistemlerde ölçülmelidir. Proxy aynı zamanda CPU, memory ve connection yönetimi maliyeti oluşturur. Buna karşılık merkezi policy, mTLS ve telemetry gibi yetenekler sağladığında bu maliyet kabul edilebilir olabilir. Karar benchmark verisi ve gerçek trafik karakteristiği üzerinden verilmelidir.
Router Katmanının High Availability Gereksinimi
Server-side discovery modelinde router katmanı kritik veri yolunun parçasıdır. Tek instance çalışan bir proxy, service discovery'yi doğrudan tek hata noktasına dönüştürebilir. Router bileşenlerinin birden fazla node ve zone'a dağıtılması gerekir. Load balancing ve health checking mekanizmaları router katmanının kendisi için de uygulanmalıdır. Ayrıca capacity planning yapılırken normal trafik yanında failover sırasında oluşacak ek yük de hesaba katılmalıdır.
Server-Side Discovery Hangi Senaryolarda Tercih Edilir?
Server-side discovery çok dilli mikroservis ortamlarında güçlü bir tercihtir. Uygulama ekiplerinin discovery library yönetmesini istemeyen platformlar merkezi proxy yaklaşımından faydalanabilir. mTLS, observability veya merkezi traffic policy ihtiyacı varsa service mesh benzeri çözümler de bu modeli destekler. Geleneksel VM ortamlarında load balancer tabanlı mimariler de benzer yaklaşımı kullanabilir. Ancak çok düşük latency gerektiren ve proxy maliyetinin önemli olduğu sistemlerde client-side seçenek ayrıca değerlendirilmelidir.
Client-Side ve Server-Side Service Discovery Karşılaştırması
Client-side ve server-side discovery arasında tek bir doğru seçim yoktur. Karar latency, programlama dili çeşitliliği, merkezi policy ihtiyacı ve operasyon modeline göre verilmelidir. Client-side model daha doğrudan bağlantı sunarken uygulama sorumluluğunu artırır. Server-side model bu sorumluluğu altyapı katmanına taşıyarak tutarlılık sağlayabilir. Büyük ölçekli sistemlerde iki yaklaşımın farklı trafik tiplerinde birlikte kullanılması da mümkündür.
Latency
Client-side discovery doğrudan backend bağlantısı kurduğu için ek proxy hop ihtiyacını azaltabilir. Server-side yaklaşımda proxy üzerinden geçiş belirli bir gecikme ekler. Ancak connection reuse ve node-local proxy gibi teknikler bu maliyeti oldukça düşürebilir. Gerçek fark kullanılan protokol, network topology ve proxy kapasitesine bağlıdır. Bu nedenle yalnızca teorik hop sayısına göre karar vermek yerine yük testi yapılmalıdır.
Client Complexity
Client-side model discovery ve load balancing sorumluluğunu istemci uygulamasına taşır. Her client cache, retry ve endpoint update davranışını doğru yönetmelidir. Server-side modelde bu ayrıntılar proxy katmanında toplanır ve uygulama daha sade kalır. Buna karşılık proxy altyapısının işletilmesi ayrı bir platform sorumluluğu yaratır. Ekip yapısı ve operasyon yetkinliği hangi maliyetin daha kabul edilebilir olduğunu belirler.
Polyglot Support
Polyglot sistemlerde server-side discovery genellikle daha tutarlı deneyim sunar. Uygulamalar HTTP, gRPC veya TCP gibi standart protokollerle proxy'ye bağlanabilir. Client-side modelde her dil için discovery library desteği gerekir. Library sürümlerindeki farklılıklar routing davranışını değiştirebilir. Bu nedenle çok sayıda programlama dili bulunan organizasyonlarda platform seviyesinde discovery daha kolay yönetilebilir.
Load Balancing Esnekliği
Client-side yaklaşım uygulamanın request bilgisini bildiği için çok özel routing kararları verebilir. Server-side proxy ise tüm trafik üzerinde merkezi load balancing politikası uygulayabilir. Outlier detection, weighted routing ve locality-aware seçim gibi özellikler proxy katmanında standart hâle getirilebilir. Hangi modelin daha esnek olduğu ihtiyaç duyulan kontrol seviyesine bağlıdır. Genel platform politikaları için server-side, servis özelindeki kararlar için client-side yaklaşım öne çıkabilir.
Operasyonel Maliyet
Client-side discovery merkezi proxy altyapısının maliyetini azaltabilir ancak uygulama kütüphanelerinin yönetimini artırır. Server-side modelde proxy'lerin kapasitesi, güncellemeleri ve gözlemlenebilirliği platform ekibinin sorumluluğundadır. Küçük ekiplerde bu ek altyapı gereksiz olabilir. Büyük organizasyonlarda merkezi yönetim toplam bakım yükünü azaltabilir. Operasyonel maliyet yalnızca sunucu kaynağı değil, ekip zamanı ve hata riskini de içermelidir.
Vendor Coupling
Discovery client library'si uygulama koduna doğrudan entegre edildiğinde belirli bir teknolojiye bağımlılık artabilir. Server-side yaklaşım uygulamayı bu ayrıntıdan daha fazla ayırabilir. Ancak proxy configuration formatı veya control plane API'leri de farklı bir bağımlılık oluşturabilir. Açık standartlar ve protokoller migration maliyetini azaltmaya yardımcı olur. xDS, DNS ve standart HTTP gibi arayüzlerin tercih edilmesi uzun vadeli esneklik sağlayabilir.
High Availability
Her iki discovery modelinde de high availability farklı katmanlarda ele alınmalıdır. Client-side modelde registry erişilebilirliği ve local cache davranışı önemlidir. Server-side modelde registry yanında router veya proxy katmanının da yedekli olması gerekir. Control plane arızasının çalışan data plane trafiğini hemen kesmemesi tercih edilir. Failure testleri yapılmadan yalnızca bileşen sayısına bakarak yüksek erişilebilirlik varsayılmamalıdır.
Kullanım Senaryoları
Java ağırlıklı ve standart library kullanılan yapılarda client-side discovery uygun olabilir. Kubernetes veya service mesh kullanan polyglot sistemlerde server-side veya platform-native discovery daha doğal bir seçimdir. Hybrid cloud ortamlarında Consul benzeri ortak catalog ve proxy modeli değerlendirilebilir. Çok düşük latency gerektiren iç servislerde doğrudan client-side bağlantılar tercih edilebilir. Karar gerçek deployment modeli ve operasyon beklentileri üzerinden verilmelidir.
DNS Tabanlı Service Discovery
DNS tabanlı discovery, servis adının IP veya servis bilgisine standart DNS sorguları üzerinden çevrilmesini sağlar. Uygulamaların çoğu zaten DNS çözümleme yeteneğine sahip olduğu için entegrasyon basittir. Kubernetes Service discovery büyük ölçüde bu yaklaşımı kullanır. DNS caching davranışı ve TTL ayarları endpoint değişikliklerinin ne kadar hızlı görüleceğini etkiler. Basitlik güçlü bir avantaj olsa da gelişmiş metadata ve özel routing ihtiyacında ek mekanizmalar gerekebilir.
A ve AAAA Records
A kaydı bir hostname'i IPv4 adresine, AAAA kaydı ise IPv6 adresine eşler. Service discovery sistemlerinde bir servis adı bir veya birden fazla adres döndürebilir. İstemcinin DNS cevabındaki adresleri nasıl kullandığı runtime ve connection library davranışına bağlıdır. Uzun süreli connection kullanan uygulamalar yeni DNS sonuçlarını hemen kullanmayabilir. Bu nedenle DNS çözümlemesi ile gerçek connection yaşam döngüsü birlikte incelenmelidir.
SRV Records
SRV kayıtları yalnızca adres değil, servis portu ve öncelik bilgisi de taşıyabilir. Bu özellik dinamik port kullanan veya birden fazla endpoint'i ayrıntılı biçimde tanımlayan sistemlerde faydalıdır. İstemcinin SRV kayıtlarını desteklemesi gerekir. Her uygulama kütüphanesi SRV çözümlemesini varsayılan olarak kullanmaz. Bu nedenle DNS altyapısı uygun olsa bile client davranışı doğrulanmadan tasarım tamamlanmış sayılmamalıdır.
Port
SRV kaydındaki port alanı, servisin hangi porta bağlanılması gerektiğini bildirir. Böylece istemci port bilgisini ayrı configuration dosyasında tutmak zorunda kalmaz. Dinamik port tahsisi yapılan ortamlarda bu yaklaşım yararlı olabilir. İstemci SRV cevabını doğru yorumlamıyorsa port bilgisi kullanılamaz. Bu nedenle seçilen runtime veya client library'nin SRV desteği test edilmelidir.
Priority
Priority alanı birden fazla SRV hedefi arasında hangi grubun önce tercih edilmesi gerektiğini ifade eder. Daha düşük priority değerine sahip kayıtlar önce kullanılabilir. Bu özellik primary ve backup servis grupları gibi senaryolarda kullanılabilir. Ancak uygulamanın SRV seçim kurallarını gerçekten uygulaması gerekir. Failover davranışı ayrıca health ve timeout mekanizmalarıyla test edilmelidir.
Weight
Weight alanı aynı priority seviyesindeki hedefler arasında trafik dağılımını etkileyebilir. Daha yüksek weight değeri belirli endpoint'in daha sık seçilmesini sağlayabilir. Bu özellik kapasitesi farklı instance gruplarını yönetmek için kullanılabilir. DNS client'larının weight davranışı her zaman aynı olmayabilir. Bu nedenle production öncesinde gerçek client implementasyonu ile trafik testi yapmak önemlidir.
CNAME
CNAME kaydı bir DNS adını başka bir canonical hostname'e yönlendirir. Service discovery yapılarında isim soyutlaması veya servis alias oluşturmak için kullanılabilir. Ancak CNAME doğrudan port veya health bilgisi taşımaz. Ayrıca DNS zincirlerinin uzaması çözümleme süresini artırabilir. Bu nedenle CNAME basit isim yönlendirme amacıyla kullanılırken runtime discovery ihtiyacı için tek başına yeterli görülmemelidir.
DNS Service Discovery Avantajları
DNS discovery'nin en güçlü tarafı standart ve yaygın bir protokole dayanmasıdır. Uygulamaların çoğu ek client library olmadan DNS kullanabilir. Platformlar servis isimlerini doğal biçimde hostname olarak sunabilir. Operasyon ekipleri mevcut DNS gözlemleme ve cache araçlarından yararlanabilir. Özellikle basit servis bulma ihtiyacında ek registry client entegrasyonu gerektirmemesi önemli bir avantajdır.
DNS Service Discovery Dezavantajları
DNS discovery cache nedeniyle endpoint değişikliklerini anında yansıtmayabilir. Health metadata, version veya ayrıntılı routing bilgisi standart A ve AAAA kayıtlarıyla sınırlıdır. Runtime'ların DNS cache davranışı birbirinden farklı olabilir. Uzun ömürlü connection'lar DNS güncellense bile eski backend'e bağlı kalabilir. Bu nedenle DNS tabanlı discovery kullanırken TTL, connection pooling ve failure detection birlikte tasarlanmalıdır.
DNS TTL ve Cache Problemi
DNS tabanlı discovery'de en fazla gözden kaçan konulardan biri cache davranışıdır. Registry veya DNS sunucusu güncel cevabı verse bile client eski kaydı kullanmaya devam edebilir. TTL değeri bu davranışın yalnızca bir kısmını belirler çünkü işletim sistemi ve runtime kendi cache politikasını uygulayabilir. Connection pool da DNS yeniden çözümlemesinden bağımsız şekilde eski bağlantıyı koruyabilir. Bu nedenle DNS değişikliğinin uygulamaya ne zaman ulaştığı uçtan uca test edilmelidir.
TTL Nedir?
TTL, bir DNS kaydının cache içinde ne kadar süre geçerli kabul edilebileceğini belirtir. Yüksek TTL DNS sorgu sayısını azaltırken değişikliklerin geç görülmesine neden olabilir. Düşük TTL ise daha hızlı güncelleme sağlayabilir fakat DNS altyapısına ek yük oluşturur. Runtime belirlenen TTL'yi her zaman aynı şekilde uygulamayabilir. Service discovery için TTL seçimi değişim sıklığı ve DNS kapasitesi birlikte değerlendirilerek yapılmalıdır.
Stale DNS Entry
Stale DNS entry, artık geçerli olmayan bir endpoint bilgisinin cache üzerinden kullanılmaya devam edilmesidir. Instance kapanmış veya başka bir adrese taşınmış olsa bile client eski IP'ye bağlanabilir. Sonuç connection timeout, retry ve artan hata oranı olabilir. Kısa TTL stale süresini azaltabilir ancak tek çözüm değildir. Connection pool ve runtime cache ayarları da aynı test senaryosuna dahil edilmelidir.
JVM DNS Cache
JVM kendi DNS cache davranışına sahiptir ve bu davranış kullanılan Java sürümü ile security ayarlarından etkilenebilir. İşletim sistemi DNS kaydını yenilese bile JVM eski sonucu belirli süre kullanabilir. Özellikle uzun süre çalışan Java servislerinde bu durum discovery güncellemelerini geciktirebilir. Java tabanlı mikroservislerde DNS TTL yalnızca DNS sunucusu üzerinden değerlendirilmemelidir. Production ile aynı JVM ayarları kullanılarak endpoint değişim testi yapılması faydalıdır.
Operating System Cache
İşletim sistemi veya yerel resolver katmanı DNS cevaplarını cache'leyebilir. Uygulama yeni sorgu yaptığını düşünse bile cevap yerel cache'den gelebilir. Container runtime veya node üzerinde çalışan DNS bileşenleri de ek cache katmanı oluşturabilir. Bu yapı sorgu performansını artırırken stale bilgi süresini uzatabilir. Sorun analizinde yalnızca merkezi DNS loglarına değil, istemci tarafındaki resolver zincirine de bakılmalıdır.
Negative DNS Cache
Negative DNS cache, bulunamayan bir hostname sonucunun belirli süre saklanmasıdır. Servis ilk sorgu sırasında henüz oluşturulmamışsa NXDOMAIN cevabı cache'e girebilir. Servis birkaç saniye sonra hazır olsa bile client bir süre daha bulunamadığını düşünebilir. Deployment sırasında oluşan kısa süreli isim çözümleme hatalarında bu davranış önem kazanır. Negative cache süresi runtime ve resolver seviyesinde kontrol edilmelidir.
Düşük TTL'nin DNS Yüküne Etkisi
Düşük TTL değeri istemcilerin daha sık DNS sorgusu göndermesine neden olur. Binlerce pod bulunan sistemlerde bu durum DNS bileşenlerinin CPU ve network yükünü belirgin biçimde artırabilir. Cache katmanları bu yükü azaltabilir ancak yanlış yapılandırıldığında discovery freshness etkilenir. Ölçek büyüdükçe DNS query rate temel bir observability metriği hâline gelir. TTL değeri yalnızca hızlı güncelleme amacıyla mümkün olan en düşük sayıya çekilmemelidir.
Connection Pool DNS Değişikliğini Görür mü?
Connection pool mevcut açık bağlantıları tekrar kullandığında yeni DNS sorgusu yapılmayabilir. DNS kaydı değişse bile istemci eski backend ile bağlantısını sürdürür. HTTP keep-alive ve HTTP/2 gibi uzun süreli bağlantı modellerinde bu davranış daha belirgin olabilir. Connection lifetime veya pool rotation ayarları gerektiğinde discovery stratejisinin parçası olmalıdır. Özellikle gRPC trafiğinde DNS güncellemesi ile connection dağılımının ayrı kavramlar olduğu unutulmamalıdır.
Service Discovery ve Load Balancing Arasındaki Fark
Service discovery ve load balancing sık birlikte kullanıldığı için aynı kavram gibi düşünülebilir. Discovery'nin görevi hangi instance'ların kullanılabilir olduğunu bulmaktır. Load balancing ise bulunan instance'lar arasından trafiğin hangi hedefe gönderileceğini belirler. İki mekanizma birbirini tamamlar ancak farklı sorumluluklara sahiptir. Mimari tasarımda bu ayrımı yapmak sorun giderme ve observability açısından büyük kolaylık sağlar.
Discovery'nin Sorumluluğu
Discovery servis adını mevcut endpoint listesine dönüştürür. Registration, deregistration ve health durumlarının güncel listede yansıtılması bu sorumluluğun parçasıdır. Discovery hangi endpoint'lerin aday olduğunu belirler ancak mutlaka trafik dağıtım algoritmasını seçmez. DNS veya registry API bu bilgiyi sunabilir. Başarılı discovery tasarımı doğru ve yeterince güncel endpoint bilgisi sağlamaya odaklanır.
Load Balancer'ın Sorumluluğu
Load balancer, discovery tarafından sunulan kullanılabilir endpoint'ler arasından hedef seçer. Round robin, least requests veya weighted routing gibi algoritmalar uygulayabilir. Connection durumu ve backend performansı da seçimde değerlendirilebilir. Load balancer ayrıca bazı sistemlerde health check ve outlier detection görevlerini üstlenir. Ancak endpoint'in sistemde var olduğunu öğrenme işi yine discovery mekanizmasına dayanabilir.
Instance Listesi ile Instance Seçimi
Instance listesi hangi backend'lerin potansiyel hedef olduğunu gösterir. Instance seçimi ise belirli bir request için bu listeden bir hedef belirler. Discovery güncel olmayan bir liste sağlarsa en iyi load balancing algoritması bile yanlış endpoint seçebilir. Buna karşılık güncel liste olsa bile kötü seçim stratejisi trafik dengesizliğine yol açabilir. Bu nedenle iki mekanizmanın metriği ve failure davranışı ayrı ayrı izlenmelidir.
Discovery ve Load Balancing Birlikte Nasıl Çalışır?
Discovery önce kullanılabilir instance listesini sağlar. Load balancer daha sonra bu liste üzerinden request için hedef seçer. Health değişikliği olduğunda discovery veya health katmanı endpoint'i havuzdan çıkarır ve load balancer yeni listeden seçim yapar. Yeni instance eklendiğinde güncelleme yayılır ve trafik dağılımına dahil edilir. Bu akışın hızlı ve tutarlı çalışması autoscaling ile failover başarısını doğrudan etkiler.
Mikroservislerde Health Check Tasarımı
Health check tasarımı service discovery'nin doğruluğunu belirleyen temel konulardan biridir. Amaç uygulamanın gerçekten trafik almaya uygun olup olmadığını düşük maliyetle belirlemektir. Çok yüzeysel kontrol gerçek hataları kaçırabilirken aşırı derin kontrol bağımlı servis sorunlarını zincirleme outage'a çevirebilir. Check interval, timeout ve failure threshold değerleri uygulamanın normal gecikme profiline göre ayarlanmalıdır. Health mekanizması production benzeri failure testleriyle doğrulanmalıdır.
Active Health Check
Active health check, ayrı bir bileşenin belirli aralıklarla servise test isteği göndermesidir. HTTP endpoint, TCP connection veya özel komut kullanılabilir. Belirli sayıda başarısız denemeden sonra instance sağlıksız işaretlenebilir. Çok sık kontrol gereksiz trafik yaratırken çok seyrek kontrol hata algılama süresini uzatır. Timeout ve threshold değerleri servis latency dağılımına uygun seçilmelidir.
Passive Health Check
Passive health check gerçek kullanıcı trafiği sırasında gözlenen başarısızlıklara bakar. Proxy bir backend'in art arda connection hatası verdiğini görürse endpoint'i geçici olarak havuzdan çıkarabilir. Bu yaklaşım ayrı health request maliyetini azaltır ve gerçek trafik davranışını yansıtır. Ancak düşük trafik alan servislerde hata algılama yavaş olabilir. Active ve passive kontroller birlikte kullanıldığında daha dengeli sonuç alınabilir.
Heartbeat
Heartbeat modelinde servis belirli aralıklarla registry'ye hayatta olduğunu bildiren sinyal gönderir. Registry belirlenen süre içinde heartbeat almazsa instance'ı sağlıksız kabul edebilir. Network partition durumunda servis çalışmaya devam etse bile heartbeat ulaşmayabilir. Bu nedenle timeout değerinin geçici network sorunlarına tolerans göstermesi gerekir. Heartbeat yalnızca prosesin çalıştığını gösterebilir, uygulamanın gerçekten request işleyebildiğini garanti etmez.
TTL-Based Health
TTL-based health modelinde belirli süre içinde yenilenmeyen sağlık kaydı otomatik olarak geçersiz kabul edilir. Uygulama veya agent düzenli şekilde TTL bilgisini günceller. Güncelleme durursa registry instance'ı unhealthy olarak işaretler. Bu yöntem özel health logic ile birlikte kullanılabilir. Ancak uygulamanın ana iş parçacığı bozulduğu hâlde TTL güncelleyen ayrı thread çalışmaya devam ediyorsa yanlış sağlıklı sonucu üretilebilir.
HTTP Health Check
HTTP health check, belirli bir endpoint'e istek göndererek servisin durumunu ölçer. Endpoint hızlı cevap vermeli ve gereksiz ağır işlemler gerçekleştirmemelidir. Readiness kontrolü servisin yeni trafik almaya hazır olup olmadığını göstermelidir. Veritabanına pahalı sorgu çalıştırmak her health request'ini ek production yüküne dönüştürebilir. Health endpoint tasarımında amaç düşük maliyetli ve anlamlı bir sinyal üretmektir.
TCP Health Check
TCP health check belirli porta bağlantı kurulup kurulamadığını kontrol eder. Uygulama protokolünün ayrıntılarını bilmediği için basit ve hızlı bir yöntemdir. Port açık olsa bile uygulamanın request işleyemediği bazı hataları kaçırabilir. Bu nedenle L4 seviyesinde erişilebilirlik ölçümü olarak görülmelidir. Uygulama semantiğini doğrulamak gerekiyorsa HTTP veya custom check ile desteklenebilir.
Custom Health Check
Custom health check uygulamaya özel bir sağlıklı çalışma koşulunu test eder. Queue bağlantısı, kritik worker durumu veya belirli internal state bu kontrolde değerlendirilebilir. Ancak kontrol kapsamı genişledikçe false negative riski artar. Bir downstream servis geçici olarak kapalı diye bütün upstream instance'ları unhealthy yapmak çoğu zaman doğru değildir. Custom check tasarlanırken hangi hatanın gerçekten yeni trafik almaya engel olduğu açık biçimde tanımlanmalıdır.
Liveness, Readiness ve Startup Arasındaki Fark
Liveness, readiness ve startup kontrolleri farklı sorulara cevap verir. Liveness prosesin yeniden başlatılması gerekip gerekmediğini anlamaya çalışır. Readiness instance'ın yeni trafik almaya hazır olup olmadığını belirler. Startup ise yavaş başlayan uygulamalara başlatma döneminde ayrı tolerans sağlar. Bu üç kontrolü aynı endpoint ve aynı eşiklerle kullanmak gereksiz restart veya trafik kesintilerine neden olabilir.
Liveness Probe
Liveness probe uygulamanın geri döndürülemez bir durumda takılıp takılmadığını anlamak için kullanılır. Kontrol sürekli başarısız olursa orkestrasyon platformu container'ı yeniden başlatabilir. Bu nedenle geçici downstream problemi liveness başarısızlığına dönüştürülmemelidir. Aksi durumda çalışan servisler gereksiz restart döngüsüne girebilir. Liveness mümkün olduğunca uygulamanın kendi proses sağlığına odaklanmalıdır.
Readiness Probe
Readiness probe instance'ın şu anda yeni request kabul etmeye uygun olup olmadığını gösterir. Başarısız olduğunda instance genellikle trafik havuzundan çıkarılır fakat container hemen yeniden başlatılmaz. Deployment sırasında uygulama hazırlık işlemlerini tamamlayana kadar readiness false kalabilir. Graceful shutdown başlarken readiness kapatılarak yeni trafik durdurulabilir. Service discovery ile routing arasındaki en önemli sinyallerden biri readiness durumudur.
Startup Probe
Startup probe yavaş başlayan uygulamaların liveness kontrolü nedeniyle erken yeniden başlatılmasını önler. Uygulama başlangıç işlemlerini tamamlayana kadar daha uzun süre tolerans sağlayabilir. Startup başarılı olduktan sonra normal liveness ve readiness kontrolleri devreye girer. Büyük cache yükleyen veya migration yapan servislerde bu ayrım yararlı olabilir. Bununla birlikte çok uzun startup süresi deployment problemlerini saklamamalı ve ayrıca izlenmelidir.
Readiness ile Service Discovery Arasındaki İlişki
Readiness durumu bir instance'ın discovery sonucunda trafik adayı olup olmayacağını belirleyebilir. Kubernetes gibi platformlarda hazır olmayan pod'lar normal servis trafiğinden çıkarılabilir. Böylece application process çalışıyor olsa bile henüz hazır olmayan instance'a request gönderilmez. Deployment ve shutdown aşamalarında bu davranış kesintisiz geçiş için önemlidir. Readiness sinyalinin yanlış tasarlanması discovery havuzunun gereksiz biçimde boşalmasına da yol açabilir.
Yanlış Health Check'in Outage Üretmesi
Health check her dependency'yi zorunlu olarak kontrol ederse küçük bir altyapı problemi geniş çaplı outage'a dönüşebilir. Örneğin ortak bir veritabanı kısa süre erişilemez olduğunda tüm servis instance'ları readiness dışına çıkabilir. Ardından load balancer'ın yönlendireceği sağlıklı endpoint kalmaz. Asıl bağımlılık birkaç saniye sonra dönse bile servis havuzunun toparlanması ek süre alabilir. Bu nedenle health kontrolleri failure domain ve bağımlılık yapısı düşünülerek tasarlanmalıdır.
Deep Health Check Anti-Pattern
Deep health check, bir servisin bütün bağımlılıklarını ayrıntılı biçimde kontrol ederek tek bir sağlık sonucu üretmesidir. İlk bakışta güvenli görünse de geniş mikroservis sistemlerinde zincirleme problem oluşturabilir. Bir dependency kesintisi kendisini kullanan tüm servisleri unready hâle getirebilir. Bu davranış hata alanını küçültmek yerine büyütebilir. Shallow health ile detaylı diagnostic health endpoint'lerini ayrı amaçlarla kullanmak çoğu zaman daha güvenli bir yaklaşımdır.
Downstream Database'i Readiness'e Bağlamak
Readiness endpoint'inin her çağrıda downstream database'e zorunlu sorgu göndermesi risklidir. Veritabanında kısa süreli latency artışı olduğunda bütün servis instance'ları aynı anda unready olabilir. Bu durum gerçek kullanıcı trafiğinin tamamen kesilmesine yol açabilir. Uygulama bazı request tiplerini cache veya alternatif veri kaynağıyla karşılayabiliyorsa bu kesinti gereksizdir. Readiness yalnızca instance'ın yeni trafiği anlamlı biçimde işleyip işleyemediğine odaklanmalıdır.
Cascading Unready Problemi
Cascading unready, bir downstream arızasının bağımlı servislerde toplu readiness başarısızlığı üretmesidir. Bir servis havuzdan çıktığında onu kullanan başka servislerin health check'leri de başarısız olabilir. Kısa süre içinde çok sayıda servis discovery listesinden kaybolabilir. Bu durum teknik olarak çalışan process'lerin trafik alamaz hâle gelmesine neden olur. Health dependency graph incelenerek böyle zincirlerin production öncesinde test edilmesi gerekir.
Dependency Outage'ın Bütün Servisi Havuzdan Düşürmesi
Bir dependency outage her zaman upstream servisin tamamen kullanılamaz olduğu anlamına gelmez. Servis bazı endpoint'leri veya read-only işlevleri sunmaya devam edebilir. Readiness kontrolü tek bir bağımlılığa bağlıysa bu kısmi kapasite kaybedilir. Graceful degradation yaklaşımı mümkün olduğunda kullanılabilir. Hangi fonksiyonların kritik, hangilerinin azaltılmış modda çalışabilir olduğu servis tasarımında açık biçimde belirlenmelidir.
Shallow ve Deep Health Check Ayrımı
Shallow health check prosesin temel olarak request kabul edebildiğini hızlı biçimde doğrular. Deep health check ise bağımlılıkları ve uygulama içi durumları daha ayrıntılı inceleyebilir. Deep check observability veya diagnostic amaçla kullanılabilir fakat doğrudan readiness kararı için dikkatli değerlendirilmelidir. Bu ayrım outage sırasında daha kontrollü davranış sağlar. Ekipler farklı endpoint'lerin hangi otomasyon tarafından kullanılacağını dokümante etmelidir.
Service Registry'de Stale Endpoint Problemi
Stale endpoint, artık geçerli olmadığı hâlde discovery sonucunda görünmeye devam eden servis adresidir. Bu sorun process crash, network partition, gecikmiş heartbeat veya uzun cache TTL nedeniyle ortaya çıkabilir. İstemci stale endpoint'e request gönderdiğinde timeout ve retry oluşabilir. Yoğun trafik altında bu hatalar diğer sağlıklı instance'ların yükünü de artırabilir. Registry freshness ve istemci cache politikası bu nedenle birlikte izlenmelidir.
Graceful Deregistration
Graceful deregistration planlı kapanış sırasında endpoint'in registry'den kontrollü biçimde çıkarılmasıdır. Servis önce yeni trafik almamaya geçmeli ve discovery katmanının güncellenmesi için kısa bir süre tanımalıdır. Aktif request'ler tamamlandıktan sonra process sonlandırılabilir. Bu sıra ters uygulanırsa kapalı instance bir süre daha discovery sonucunda görünebilir. Deployment script ve shutdown hook'larının bu yaşam döngüsünü desteklemesi gerekir.
Process Crash
Process crash sırasında uygulamanın deregistration çağrısı yapma fırsatı olmayabilir. Registry bu nedenle yalnızca gönüllü deregistration mekanizmasına güvenmemelidir. Heartbeat, active health check veya platform state bilgisi üzerinden endpoint'in kullanılabilir olmadığı anlaşılmalıdır. Detection süresi çok uzunsa istemciler stale endpoint'e trafik göndermeye devam eder. Çok kısa süre ise geçici network sorununun yanlış failure olarak yorumlanma riskini artırır.
Heartbeat Timeout
Heartbeat timeout, registry'nin bir instance'dan ne kadar süre sinyal gelmediğinde onu sağlıksız kabul edeceğini belirler. Değer servis heartbeat interval'inden belirgin biçimde yüksek olmalıdır. Network jitter veya kısa GC duraklamaları da heartbeat gecikmesine neden olabilir. Eşik aşırı agresifse sağlıklı instance'lar gereksiz yere havuzdan çıkar. Aşırı uzun timeout ise gerçek crash sonrasında stale endpoint süresini artırır.
TTL Süresi
TTL süresi discovery veya health bilgisinin ne kadar süre geçerli kabul edileceğini belirleyebilir. Kısa TTL hızlı convergence sağlar ancak yenileme trafiğini artırabilir. Uzun TTL registry yükünü azaltırken eski endpoint'lerin daha uzun kullanılmasına neden olabilir. Tek bir sabit değer bütün servis türleri için uygun olmayabilir. Trafik hacmi ve failure hassasiyetine göre farklı sınıflar tanımlamak daha dengeli sonuç verebilir.
Last-Known-Good Cache
Last-known-good cache, registry geçici olarak erişilemez olduğunda istemcinin son çalışan endpoint listesini kullanmasına olanak tanır. Bu mekanizma control plane kesintisinin çalışan data plane trafiğini hemen durdurmasını engelleyebilir. Ancak listedeki endpoint'ler zamanla stale hâle gelebilir. Cache kullanımı sınırsız süre devam etmemeli ve failure metriği üretmelidir. Registry geri döndüğünde güncel listenin hızlı biçimde alınması gerekir.
Stale Endpoint'e Retry Riski
Stale endpoint'e gönderilen request başarısız olduğunda client veya proxy retry yapabilir. Discovery listesi güncellenmemişse retry tekrar aynı bozuk instance'a gidebilir. Birden fazla katmanın aynı anda retry yapması trafik çoğalmasına neden olabilir. Endpoint outlier detection veya failure-aware seçim mekanizması bu riski azaltabilir. Retry yalnızca timeout ve retry budget politikası ile birlikte kullanılmalıdır.
Graceful Shutdown ve Service Deregistration
Graceful shutdown, servis instance'ının ani trafik kaybı oluşturmadan kontrollü biçimde kapanmasını amaçlar. Süreç yalnızca SIGTERM yakalamaktan ibaret değildir. Discovery, readiness, connection draining ve aktif request tamamlama adımları belirli bir sırada ilerlemelidir. Orkestrasyon platformunun termination süresi uygulamanın gerçek request süreleriyle uyumlu olmalıdır. Bu akış rolling deployment ve autoscaling sırasında kullanıcı hatalarını ciddi biçimde azaltabilir.
Yeni Trafik Kabulünü Durdurmak
Kapanacak instance ilk olarak yeni trafik kabul etmeyi bırakmalıdır. Bunun için readiness false yapılabilir veya load balancer havuzundan çıkarılma sinyali gönderilebilir. Amaç process kapanmadan önce discovery ve routing katmanlarının güncellenmesini sağlamaktır. Yeni request gelmeye devam ederse aktif bağlantıların bitmesi mümkün olmayabilir. Shutdown prosedürünün ilk adımı bu nedenle trafik girişini kontrollü biçimde kesmektir.
Readiness'i Kapatmak
Readiness kapatıldığında orkestrasyon platformu instance'ı yeni request'ler için uygun görmemeye başlar. Kubernetes ortamında endpoint güncellemeleri bu sinyali takip edebilir. Değişikliğin bütün proxy ve cache katmanlarına ulaşması anlık olmayabilir. Bu nedenle process hemen sonlandırılmamalıdır. Kısa bir draining penceresi stale route etkisini azaltmaya yardımcı olur.
Registry'den Çıkmak
Registry tabanlı sistemlerde instance shutdown sırasında deregistration çağrısı gönderebilir. Bu işlem endpoint'in yeni lookup sonuçlarından çıkarılmasını sağlar. Deregistration başarısız olursa TTL veya health check mekanizması yedek güvenlik görevi görmelidir. Uygulama yalnızca deregistration cevabı beklerken sonsuza kadar kapanmamalıdır. Timeout ve fallback davranışı shutdown prosedüründe açık biçimde tanımlanmalıdır.
Connection Draining
Connection draining, mevcut bağlantıların kontrollü biçimde tamamlanmasına izin verirken yeni bağlantıların durdurulmasıdır. HTTP keep-alive, gRPC stream ve WebSocket gibi uzun süreli bağlantılarda bu aşama özellikle önemlidir. Proxy istemcilere bağlantının kapanacağını bildirebilir veya yeni stream kabulünü durdurabilir. Draining süresi uygulama protokolüne göre ayarlanmalıdır. Çok kısa süre aktif request'leri yarıda bırakırken aşırı uzun süre deployment süresini uzatabilir.
Aktif Request'leri Tamamlamak
Instance yeni trafik almamaya başladıktan sonra hâlen işlenen request'lerin tamamlanması beklenmelidir. Uygulama aktif request sayısını takip ederek shutdown kararını buna göre verebilir. Uzun süren request'ler için maksimum bekleme süresi belirlenmesi gerekir. Sonsuz bekleme deployment'ın ilerlemesini engelleyebilir. Timeout sonrasında kalan request'lerin nasıl sonlandırılacağı ve istemcinin retry davranışı ayrıca tasarlanmalıdır.
Process'i Sonlandırmak
Readiness kapandıktan, registry güncellendikten ve aktif request'ler tamamlandıktan sonra process sonlandırılabilir. Bu sıra, istemcilerin kapalı endpoint'e request gönderme ihtimalini azaltır. Orkestrasyon platformunun termination grace period değeri bütün akışa yeterli süre tanımalıdır. Uygulama shutdown log ve metric üreterek beklenmeyen kapanışların analizini kolaylaştırmalıdır. Bu süreç düzenli deployment testlerinin parçası hâline getirilmelidir.
Kubernetes'te Service Discovery
Kubernetes service discovery için platform-native bir model sunar. Uygulamalar genellikle pod IP'lerini doğrudan bilmek yerine Kubernetes Service isimlerini kullanır. CoreDNS bu isimleri cluster içindeki DNS kayıtlarına dönüştürür. Service ve EndpointSlice kaynakları hazır backend'lerin temsilinde önemli rol oynar. Çoğu tek cluster Kubernetes projesinde ek bir registry kurmadan temel discovery ihtiyacı karşılanabilir.
Kubernetes Service Nedir?
Kubernetes Service, bir grup pod için sabit mantıksal erişim noktası sağlar. Pod'lar yeniden oluşturulup IP değiştirse bile Service adı ve çoğu durumda ClusterIP sabit kalır. Label selector üzerinden hangi pod'ların backend olacağı belirlenebilir. Platform hazır endpoint bilgisini EndpointSlice nesneleriyle takip eder. Uygulamalar bu sayede geçici pod adreslerine doğrudan bağımlı olmaz.
ClusterIP
ClusterIP, Kubernetes Service için cluster içinde kullanılan sanal IP adresidir. İstemciler bu sabit adrese trafik gönderirken altyapı isteği uygun backend pod'a yönlendirebilir. Pod listesi değişse bile istemci configuration bilgisinin güncellenmesi gerekmez. ClusterIP yalnızca cluster içi erişim için kullanılabilir. External traffic için farklı Service türleri veya ingress ve gateway katmanları gerekir.
Stable Service Name
Stable Service Name, uygulamaların değişken pod IP'leri yerine sabit DNS adını kullanmasına olanak tanır. Örneğin payment isimli Service aynı namespace içinden payment adıyla çözümlenebilir. Pod'lar ölçeklendiğinde veya yeniden başladığında isim değişmez. Bu soyutlama application configuration yönetimini önemli ölçüde basitleştirir. Service adlarının ekip genelinde tutarlı ve DNS uyumlu seçilmesi gerekir.
CoreDNS
CoreDNS Kubernetes cluster içinde servis isimlerinin DNS çözümlemesinde yaygın olarak kullanılan bileşendir. Service ve bazı pod kayıtlarını Kubernetes API bilgisinden üretir. Uygulamalar normal DNS sorgusu yaparak servis adına karşılık gelen adresi bulabilir. DNS query rate, latency ve error metriği büyük cluster'larda izlenmelidir. CoreDNS kapasite problemi doğrudan servis iletişiminde isim çözümleme hatalarına dönüşebilir.
Pod IP'leri Değişirken Service Name Neden Değişmez?
Kubernetes Service, pod'ların yaşam döngüsünden ayrı bir API kaynağıdır. Pod yeniden yaratıldığında yeni IP alabilir ancak Service kaynağı aynı isimle yaşamaya devam eder. EndpointSlice güncel pod adreslerini Service ile ilişkilendirir. İstemci yalnızca Service adını bildiği için pod değişikliklerini doğrudan takip etmek zorunda kalmaz. Bu ayrım Kubernetes service discovery'nin temel soyutlamalarından biridir.
Ready Pod'lara Trafik Yönlendirme
Kubernetes readiness durumunu endpoint seçiminde kullanabilir. Readiness başarısız olan pod normal Service trafiği için uygun backend olarak değerlendirilmez. Böylece başlatma aşamasındaki veya shutdown sürecindeki pod'lara yeni request gönderilmesi azaltılır. Readiness endpoint'inin doğru tasarlanması bu nedenle service discovery davranışını doğrudan etkiler. Aşırı hassas readiness bütün pod'ların aynı anda havuzdan çıkmasına neden olabileceği için dikkatli test edilmelidir.
Kubernetes Service DNS İsimlendirmesi
Kubernetes DNS isimlendirmesi servislerin namespace ve cluster domain yapısını kullanır. Aynı namespace içindeki servisler kısa adla çözümlenebilirken farklı namespace için daha uzun isim gerekebilir. Tam DNS formatı service, namespace ve svc.cluster.local benzeri cluster domain bileşenlerinden oluşabilir. Bu yapı servis isimlerinin cluster içinde öngörülebilir olmasını sağlar. Namespace tasarımı doğru yapılmadığında benzer isimli servislerin yanlış çağrılması mümkün olabilir.
Service Name
Service name Kubernetes DNS kaydının ilk bölümünü oluşturur. Aynı namespace içinde benzersiz olmalıdır. Uygulamalar çoğunlukla bu kısa adı kullanarak servis çağrısı yapabilir. İsim değişikliği bağımlı servislerin configuration bilgisini etkileyebileceği için dikkatli migration gerektirir. DNS uyumlu ve anlamlı isimler debugging sürecini kolaylaştırır.
Namespace
Namespace, Kubernetes kaynaklarını mantıksal gruplara ayırmak için kullanılır. Aynı service name farklı namespace'lerde tekrar kullanılabilir. Cross-namespace çağrılarda namespace bilgisinin DNS adına eklenmesi gerekir. Bu yapı environment veya ekip izolasyonu için yararlı olabilir. Ancak namespace'i yalnızca isim çakışmasını çözmek için kullanmak yerine operasyon ve güvenlik sınırlarıyla birlikte düşünmek daha sağlıklıdır.
svc.cluster.local
svc.cluster.local Kubernetes ortamlarında sık görülen tam servis DNS suffix yapısıdır. Cluster domain farklı yapılandırılmışsa bu değer değişebilir. Tam isim kullanıldığında service ve namespace bilgisi açık biçimde belirtilmiş olur. Uygulama configuration bilgisini doğrudan belirli cluster domain'e bağlamak migration sırasında ek iş çıkarabilir. Çoğu iç çağrıda uygun kısa isim kullanımı daha taşınabilir olabilir.
Aynı Namespace İçinden Çözümleme
Aynı namespace içindeki pod genellikle Service adını tek başına kullanarak DNS çözümlemesi yapabilir. Resolver search domain ayarları eksik bölümleri otomatik olarak tamamlar. Bu kullanım application configuration bilgisini sadeleştirir. Ancak aynı isim farklı namespace'lerde bulunuyorsa hangi servisin çağrıldığı ekipler tarafından anlaşılır olmalıdır. Debugging sırasında tam FQDN kullanmak hedefi doğrulamayı kolaylaştırabilir.
Cross-Namespace Resolution
Farklı namespace içindeki servise erişirken service-name.namespace biçimi kullanılabilir. Gerekirse tam cluster domain de eklenebilir. Bu kullanım servis bağımlılığının namespace sınırını geçtiğini açık biçimde gösterir. NetworkPolicy ve authorization kuralları cross-namespace trafiği ayrıca sınırlandırabilir. Discovery'nin bir servisi bulabilmesi erişim yetkisi olduğu anlamına gelmez.
Kubernetes EndpointSlice Nedir?
EndpointSlice, Kubernetes Service backend endpoint'lerini ölçeklenebilir biçimde temsil eden API kaynağıdır. Eski tek büyük Endpoints nesnesine göre çok sayıda backend bulunan servislerde daha verimli güncelleme sağlar. Endpoint'ler küçük gruplara ayrılarak control plane üzerindeki veri değişimi azaltılabilir. Ready durumu ve topology bilgileri burada temsil edilebilir. Büyük cluster'larda service discovery performansı açısından önemli bir mekanizmadır.
EndpointSlice Neden Ortaya Çıktı?
Tek bir Endpoints nesnesinin çok sayıda backend adresi taşıması büyük servislerde ölçek problemi oluşturabiliyordu. Küçük bir endpoint değişikliği bütün nesnenin yeniden işlenmesine yol açabiliyordu. EndpointSlice bu listeyi daha küçük parçalara ayırarak güncelleme maliyetini azaltır. Watch yapan bileşenler yalnızca değişen slice bilgisini işleyebilir. Böylece network ve API server üzerindeki güncelleme yükü daha kontrollü hâle gelir.
Pod Endpoint'lerinin Temsili
EndpointSlice Service'e bağlı backend adreslerini ve ilgili metadata bilgisini tutabilir. Pod IP adresleri endpoint olarak temsil edilir. Ready condition gibi durumlar routing bileşenlerinin hangi backend'i kullanabileceğini anlamasına yardımcı olur. Zone bilgisi topology-aware routing için değerlendirilebilir. EndpointSlice application tarafından doğrudan yönetilmek yerine çoğunlukla Kubernetes controller'ları tarafından otomatik güncellenir.
Ready Endpoint
Ready endpoint yeni trafik almaya uygun backend'i ifade eder. Pod readiness durumu bu bilginin oluşmasında rol oynayabilir. Readiness false olduğunda endpoint normal trafik havuzundan çıkarılabilir. Bu değişikliğin proxy veya kube-proxy benzeri bileşenlere yayılması kısa bir convergence süresi gerektirir. Shutdown ve deployment tasarımında bu propagation gecikmesi hesaba katılmalıdır.
Çok Sayıda Backend'de Ölçeklenebilirlik
Binlerce backend içeren servislerde tek nesne üzerinden endpoint yönetmek pahalı olabilir. EndpointSlice endpoint'leri gruplara ayırarak güncelleme boyutunu küçültür. Bu yaklaşım API server, controller ve network bileşenlerinin daha az veri işlemesine yardımcı olur. Büyük cluster'larda service discovery convergence süresi için önemli bir optimizasyon sağlar. Yine de EndpointSlice sayısı ve update rate observability kapsamında izlenmelidir.
Service ve EndpointSlice İlişkisi
Service istemcilerin kullandığı sabit mantıksal erişim noktasıdır. EndpointSlice ise bu Service'in arkasındaki gerçek backend adreslerini temsil eder. Label ve controller mekanizmaları iki kaynağı birbiriyle ilişkilendirir. Pod listesi değiştikçe EndpointSlice güncellenirken Service adı aynı kalabilir. Bu ayrım Kubernetes'te logical service ile physical endpoint kavramlarının nasıl ayrıldığını gösterir.
Kubernetes Headless Service Nedir?
Headless Service, Kubernetes'te ClusterIP tahsis edilmeden doğrudan backend endpoint'lerin DNS üzerinden bulunmasını sağlayan Service türüdür. clusterIP alanı None olarak ayarlanır. İstemci DNS sorgusunda pod adreslerini görebilir ve kendi instance seçimini yapabilir. StatefulSet ve gRPC gibi bazı kullanım senaryolarında bu davranış avantaj sağlar. Bunun karşılığında load balancing sorumluluğunun önemli bir kısmı client veya başka bir proxy katmanına geçebilir.
clusterIP: None
Headless Service tanımlanırken clusterIP değeri None olarak ayarlanır. Böylece standart sanal ClusterIP load balancing katmanı kullanılmaz. DNS cevabı doğrudan backend endpoint bilgilerini yansıtabilir. İstemci birden fazla adres arasından seçim yapmak durumunda kalabilir. Bu yaklaşım yalnızca istemci davranışı doğru biçimde tasarlandığında beklenen trafik dağılımını sağlar.
DNS'in Pod IP'lerini Döndürmesi
Headless Service DNS çözümlemesinde istemciye doğrudan birden fazla pod IP adresi sunabilir. Bu davranış client-side discovery için kullanılabilir. Ancak DNS cevabındaki tüm adreslerin uygulama tarafından gerçekten değerlendirilmesi gerekir. Bazı client library'ler yalnızca ilk adresi kullanabilir. Production öncesinde runtime DNS davranışı ve connection pool yapısı mutlaka test edilmelidir.
Client-Side Load Balancing
Headless Service kullanıldığında client birden fazla backend adresi görebilir. Bu adresler arasında trafik dağılımı client library veya uygulama tarafından yapılabilir. gRPC gibi protokollerde uygun resolver ve load balancing policy kullanılması gerekir. Yalnızca DNS'in birden fazla IP döndürmesi otomatik olarak dengeli trafik garantisi vermez. Connection yaşam süresi ve seçim algoritması gerçek dağılımı belirler.
StatefulSet Kullanımı
StatefulSet pod'ları sabit ordinal isimlere sahip olduğu için headless Service ile birlikte sık kullanılır. Her pod için öngörülebilir DNS ismi oluşturulabilir. Dağıtık veritabanları veya cluster üyeliği gerektiren uygulamalar bu adresleme modelinden faydalanabilir. Her instance'ın kimliğinin önemli olduğu sistemlerde normal load-balanced Service yerine doğrudan pod kimliği gerekebilir. Bununla birlikte application replication protokolünün topology ve failure davranışı ayrıca yönetilmelidir.
gRPC ile Headless Service Kullanımı
gRPC HTTP/2 üzerinden uzun ömürlü connection kullanabildiği için tek ClusterIP bağlantısı uzun süre tek backend'e bağlı kalabilir. Headless Service client'a birden fazla pod adresini doğrudan sunarak client-side load balancing olanağı sağlar. Uygun gRPC resolver ve load balancing policy kullanıldığında birden fazla backend'e bağlantı kurulabilir. DNS değişikliklerinin connection pool'a nasıl yansıdığı test edilmelidir. Büyük trafik sistemlerinde bu yaklaşım daha dengeli backend kullanımı sağlayabilir.
gRPC ve Service Discovery
gRPC service discovery tasarımı klasik kısa HTTP request modelinden farklı değerlendirilmelidir. HTTP/2 connection üzerinde çok sayıda request veya stream taşınabilir. Tek connection uzun süre aynı backend'e bağlı kalırsa yeni instance'lar otomatik olarak trafik alamayabilir. Bu nedenle headless discovery, client-side load balancing, xDS veya service mesh seçenekleri önem kazanır. Gerçek çözüm kullanılan gRPC client ve platform özelliklerine göre seçilmelidir.
HTTP/2 Long-Lived Connection
HTTP/2 tek TCP connection üzerinde çok sayıda paralel stream taşıyabilir. Bu verimlilik connection sayısını azaltırken load balancing davranışını da değiştirir. Bir client tek backend'e uzun süre bağlı kalırsa round robin DNS sonucu pratikte kullanılmayabilir. Autoscaling ile yeni pod eklense bile mevcut connection devam edebilir. Connection rotation veya gRPC-aware load balancing mekanizması bu nedenle değerlendirilmelidir.
Tek Connection'ın Tek Backend'e Bağlanması
Bir HTTP/2 connection kurulduğunda bağlantı belirli bir backend endpoint ile devam eder. Connection üzerindeki yüzlerce request aynı backend'e gidebilir. Bu durum eşit kapasitedeki pod'lar arasında beklenmeyen trafik dengesizliği oluşturabilir. Kubernetes ClusterIP bağlantı başlangıcında hedef seçse bile sonraki stream'ler aynı connection üzerinde kalır. Sorunun çözümü application veya proxy seviyesinde gRPC bağlantı davranışını dikkate almaktır.
ClusterIP ile Dengesiz Trafik Riski
ClusterIP L4 seviyesinde connection bazlı dağıtım yaptığı için uzun ömürlü gRPC bağlantılarında her request'i ayrı backend'e yönlendirmez. Az sayıda client connection varsa bazı pod'lar yoğun, bazıları boş kalabilir. Horizontal scaling yapıldığında yeni pod'lar mevcut bağlantılardan trafik alamayabilir. Bu durum CPU dağılımı ve tail latency üzerinde olumsuz etki yaratabilir. Headless discovery, gRPC client-side balancing veya L7 proxy bu problemi azaltmak için değerlendirilebilir.
Headless Service
Headless Service gRPC client'a backend pod adreslerini doğrudan sağlayabilir. Client resolver DNS sonucundaki adresleri izleyerek connection havuzu oluşturabilir. Uygun load balancing policy ile request'ler birden fazla channel veya subchannel üzerinden dağıtılabilir. Client implementasyonunun DNS güncellemelerini düzenli takip ettiğinden emin olunmalıdır. Headless yaklaşım network davranışını istemciye taşıdığı için observability ve retry politikası da birlikte tasarlanmalıdır.
gRPC Client-Side Load Balancing
gRPC client-side load balancing resolver tarafından bulunan birden fazla backend arasında seçim yapabilir. Round robin gibi policy'ler uygun configuration ile kullanılabilir. Client backend değişikliklerini algıladığında connection setini güncelleyebilir. Health ve outlier davranışı kullanılan client sürümüne göre değişebilir. Büyük sistemlerde tüm dillerde aynı policy desteğinin bulunup bulunmadığı kontrol edilmelidir.
xDS-Based Discovery
xDS gRPC client veya Envoy benzeri proxy'lere dinamik cluster ve endpoint configuration sağlayabilir. EDS üzerinden endpoint listeleri push tabanlı biçimde güncellenebilir. Bu model DNS polling ihtiyacını azaltarak daha merkezi traffic policy oluşturabilir. Control plane güvenilirliği ve configuration doğrulaması önemli hâle gelir. Proxyless gRPC senaryolarında application client doğrudan xDS control plane'den discovery bilgisi alabilir.
Service Mesh ile gRPC Routing
Service mesh gRPC trafiğini L7 seviyesinde anlayarak routing ve resiliency politikaları uygulayabilir. Proxy her request veya stream hakkında daha fazla bilgi gördüğü için weighted routing ve outlier detection gibi özellikler kullanılabilir. mTLS ve observability de aynı katmanda sunulabilir. Sidecar veya ambient modele göre data path farklılıkları oluşabilir. Mesh kullanımı ek operasyon yükü getirdiği için yalnızca gerçek ihtiyaç varsa tercih edilmelidir.
Kubernetes Service Discovery'de Traffic Policy
Kubernetes discovery yalnızca endpoint bulmakla sınırlı değildir, trafik politikaları topology bilgisinden faydalanabilir. Internal ve external traffic farklı davranışlar gerektirebilir. Locality-aware routing aynı node veya zone içindeki backend'leri tercih ederek gecikme ve network maliyetini azaltabilir. Ancak yerel backend kapasitesi yetersizse aşırı local tercih dengesizlik yaratabilir. Politika seçimi gerçek trafik ve failure testleriyle doğrulanmalıdır.
Internal Traffic
Internal traffic cluster içindeki servisler arasındaki iletişimi ifade eder. Bu trafik çoğunlukla ClusterIP veya servis DNS isimleri üzerinden akar. Aynı zone içindeki backend'leri tercih etmek latency avantajı sağlayabilir. Bununla birlikte zone kapasitesinin yeterli olmadığı durumda cross-zone fallback gerekir. Internal traffic policy uygulanırken availability ve locality dengesi birlikte ele alınmalıdır.
External Traffic
External traffic cluster dışından gelen kullanıcı veya sistem trafiğidir. LoadBalancer, ingress veya gateway gibi bileşenler bu trafiği cluster içindeki backend'lere yönlendirebilir. Source IP koruma veya local node tercihleri gibi gereksinimler policy seçimini etkileyebilir. External traffic failover davranışı internal service discovery'den farklı olabilir. Edge ve cluster routing katmanlarının birlikte izlenmesi gerekir.
Locality
Locality endpoint'in istemciye göre node, zone veya region yakınlığını ifade eder. Yakın endpoint kullanımı genellikle daha düşük network latency sağlar. Aynı zamanda cloud ortamlarında cross-zone veri transfer maliyetini azaltabilir. Ancak yalnızca yakınlık üzerinden seçim yapmak kapasitesi düşük zone üzerinde yoğunluk oluşturabilir. Locality politikası load ve availability bilgisiyle dengelenmelidir.
Topology-Aware Routing
Topology-aware routing backend seçiminde zone veya benzer yerleşim bilgisini kullanır. Amaç mümkün olduğunda trafiği yakın endpoint'e göndermektir. Zone bazında replica dağılımı dengesizse beklenen fayda azalabilir. Autoscaling ve topology spread ayarlarının routing policy ile uyumlu olması gerekir. Failure durumunda diğer zone'lara geçiş mekanizması mutlaka test edilmelidir.
Cross-Zone Traffic Maliyeti
Cloud sağlayıcılarında zone'lar arası veri transferi ek maliyet oluşturabilir. Yüksek hacimli servis çağrılarında bu maliyet önemli seviyeye ulaşabilir. Service discovery ve locality-aware balancing aynı zone içindeki endpoint'leri önceliklendirebilir. Ancak maliyet azaltmak adına availability feda edilmemelidir. Zone kapasitesi ve failover senaryoları ekonomik analizle birlikte değerlendirilmelidir.
HashiCorp Consul ile Service Discovery
Consul, VM, bare metal ve Kubernetes gibi farklı çalışma ortamlarında service discovery ve service catalog ihtiyaçları için kullanılabilir. Agent ve server mimarisi üzerinden servis kayıtlarını, health check'leri ve metadata bilgisini yönetir. DNS ve HTTP API arayüzleri farklı istemcilerin registry'ye erişmesini sağlar. Multi-datacenter özellikleri hibrit altyapılar için dikkat çekicidir. Kubernetes Consul ve Eureka service discovery karşılaştırması yapılırken Consul özellikle polyglot ve çok platformlu kullanım tarafında değerlendirilmelidir.
Consul Agent
Consul agent client veya server modunda çalışabilir. Client agent node üzerindeki servislerin registration ve health check işlemlerini yönetebilir. Uygulamalar local agent üzerinden catalog bilgisine erişebilir. Bu model uygulamanın merkezi server'lara doğrudan bağlanma ihtiyacını azaltabilir. Agent yaşam döngüsü ve configuration dağıtımı platform operasyonunun parçası olarak ele alınmalıdır.
Consul Server
Consul server cluster state ve catalog bilgisinin yönetiminde görev alır. Birden fazla server quorum oluşturarak high availability sağlayabilir. Raft consensus mekanizması ile state değişiklikleri koordine edilir. Server sayısı ve failure tolerance planlaması production ortamı için önemlidir. Aynı failure domain içinde toplanan server'lar gerçek yüksek erişilebilirlik sağlamayabilir.
Service Catalog
Consul service catalog kayıtlı servisleri ve instance bilgilerini tutar. Tags, metadata ve health durumu discovery sorgularında kullanılabilir. DNS veya HTTP API üzerinden catalog sonuçlarına erişilebilir. Multi-datacenter yapıda servislerin farklı lokasyonlardaki kayıtları yönetilebilir. Catalog bilgisinin application runtime registry görevi ile organizasyonel servis kataloğu kavramından farklı olduğu unutulmamalıdır.
DNS Interface
Consul DNS interface, uygulamaların standart DNS sorguları üzerinden servis discovery yapmasına olanak tanır. Bu yaklaşım özel HTTP client entegrasyonu gerektirmeden servis isimlerinin çözülmesini kolaylaştırır. SRV kayıtları port bilgisi gibi ek veriler sunabilir. DNS TTL ve cache davranışı yine istemci tarafında dikkatle yönetilmelidir. Çok yoğun sistemlerde DNS query rate ve latency izlenmelidir.
HTTP API
Consul HTTP API catalog, health ve configuration işlemlerine programatik erişim sağlayabilir. Client uygulamalar ayrıntılı metadata veya filtre gerektiren discovery sorgularında API kullanabilir. HTTP API doğrudan uygulamaya entegre edildiğinde registry bağımlılığı application code'a yaklaşır. Proxy veya agent üzerinden soyutlama bu coupling seviyesini azaltabilir. Authentication ve ACL politikaları API erişiminde zorunlu olarak düşünülmelidir.
Service Metadata
Service metadata, instance hakkında zone, version veya capability gibi ek bilgiler taşıyabilir. Routing politikaları bu alanları kullanarak belirli instance gruplarını seçebilir. Metadata standardı ekipler arasında ortak belirlenmezse zamanla tutarsız kayıtlar oluşabilir. Özellikle environment ve version bilgisi kontrollü vocabulary ile yönetilmelidir. Gereksiz metadata registry sorgularını ve yönetim süreçlerini zorlaştırmamalıdır.
Health Checks
Consul HTTP, TCP, script veya TTL gibi farklı health check yöntemlerini destekleyen bir yapı sunar. Health durumu discovery sorgularında sağlıklı instance'ların filtrelenmesine yardımcı olabilir. Check interval ve timeout değerleri servis karakteristiğine göre belirlenmelidir. Aşırı derin check bütün dependency zincirini outage'a dönüştürebilir. Health sonuçları monitoring sistemi üzerinden ayrıca izlenmelidir.
Multi-Datacenter Discovery
Consul çok datacenter içeren ortamlarda servislerin farklı lokasyonlarda bulunmasını destekleyen mekanizmalar sunar. Her datacenter kendi server cluster'ına sahip olabilir. WAN federation veya uygun peering modelleriyle discovery bilgisi lokasyonlar arasında kullanılabilir. Region veya datacenter failure senaryoları network partition koşullarıyla birlikte test edilmelidir. Global discovery yapılırken latency ve locality policy'leri ayrıca tasarlanmalıdır.
Consul'da Service Registration
Consul registration agent, configuration dosyası veya API üzerinden yapılabilir. Servis tanımı name, port, tags ve health check gibi bilgileri içerebilir. Agent kayıt bilgisini Consul server cluster'a iletir. Planlı shutdown sırasında deregistration, beklenmedik failure durumunda ise health mekanizması önem kazanır. Registration standardının deployment otomasyonu içinde merkezi biçimde tanımlanması insan hatasını azaltır.
Agent-Based Registration
Agent-based registration node üzerinde çalışan Consul agent'ın servis kaydını yönetmesini sağlar. Servis tanımı local agent'a gönderilir ve agent bunu catalog sistemine aktarır. Uygulama merkezi registry server'larıyla doğrudan konuşmak zorunda kalmayabilir. VM tabanlı altyapılarda bu model kolay yönetilebilir. Agent'ın kendisinin health ve configuration durumu da operasyon ekibi tarafından izlenmelidir.
Service Definition
Service definition servis adı, port, tags ve gerekli metadata alanlarını tanımlar. Aynı servis farklı instance'larda benzer standarda göre kayıt edilmelidir. Environment veya version gibi bilgiler açık kurallarla yönetilmelidir. Configuration otomasyonu kullanılmadığında yazım hataları farklı servis kimlikleri oluşmasına neden olabilir. Infrastructure as code yaklaşımı service definition değişikliklerinin izlenmesini kolaylaştırır.
Health Check Definition
Health check definition Consul'un bir instance'ın durumunu nasıl doğrulayacağını belirtir. HTTP endpoint, TCP port veya TTL gibi farklı check türleri seçilebilir. Timeout ve interval ayarları gerçek uygulama davranışına göre oluşturulmalıdır. Çok sık check hem servis hem agent üzerinde gereksiz yük oluşturabilir. Failure threshold ve recovery süresi production testleri ile doğrulanmalıdır.
TTL Checks
TTL check uygulamanın veya agent'ın belirli süre içinde health bilgisini yenilemesini bekler. Sinyal zamanında gelmezse servis sağlıksız kabul edilir. Bu model uygulama özelindeki durumları registry'ye aktarmak için esnek olabilir. Ancak heartbeat üretiminin uygulamanın gerçek request işleme kapasitesinden bağımsız hâle gelmemesi gerekir. TTL değeri network ve process gecikmelerine makul tolerans tanımalıdır.
Tags ve Metadata
Tags ve metadata servis instance'larını özelliklerine göre sınıflandırmak için kullanılabilir. Canary, version veya zone gibi bilgiler sorgu ve routing kararlarında değerlendirilebilir. Serbest biçimde yüzlerce tag üretmek yönetimi güçleştirir. Ortak naming ve metadata şeması ekipler arasında anlaşılabilirlik sağlar. Güvenlik açısından hassas veriler registry metadata'sına yazılmamalıdır.
Deregistration
Deregistration artık kullanılmayacak instance'ın catalog listesinden çıkarılmasıdır. Planlı shutdown sırasında bu işlem otomatik deployment akışının parçası olmalıdır. Instance crash olduğunda health check ve timeout mekanizması kaydı etkisiz hâle getirebilir. Çok uzun deregistration delay stale endpoint sorununa yol açabilir. Çok agresif süre ise kısa network kesintilerinde sağlıklı servislerin gereksiz yere kaybolmasına neden olabilir.
Consul Cluster ve High Availability
Consul server cluster high availability için birden fazla server ve consensus mekanizmasına dayanır. Production ortamında tek server kullanmak registry'yi kritik hata noktasına dönüştürür. Quorum kaybı bazı state değişikliklerinin yapılamamasına neden olabilir. Server'ların farklı failure domain'lere dağıtılması gerçek dayanıklılık sağlar. Backup, recovery ve network partition testleri tasarımın ayrılmaz parçası olmalıdır.
Server Quorum
Quorum cluster'ın state değişikliklerini güvenli biçimde kabul edebilmesi için gerekli çoğunluğu ifade eder. Server sayısı arttıkça belirli sayıda node kaybına tolerans sağlanabilir. Ancak yalnızca çok sayıda server kurmak yeterli değildir. Node'lar aynı fiziksel veya mantıksal failure domain içinde bulunuyorsa ortak arıza hepsini etkileyebilir. Quorum planlaması zone ve network topology bilgisiyle birlikte yapılmalıdır.
Raft Consensus
Raft consensus dağıtık server'ların ortak state üzerinde anlaşmasını sağlar. Leader yazma işlemlerini koordine eder ve değişiklikları follower node'lara yayar. Network partition olduğunda quorum tarafı state değişikliklerine devam edebilir. Consensus gecikmesi server'lar arasındaki network latency'den etkilenebilir. Bu nedenle birbirinden çok uzak region'ları tek Raft cluster içinde toplamak dikkatle değerlendirilmelidir.
Leader Election
Leader election mevcut leader kullanılamadığında yeni server'ın lider seçilmesini sağlar. Election süresince kısa süreli control plane gecikmeleri görülebilir. Client cache ve data plane tasarımı bu geçişin kullanıcı trafiğine etkisini azaltabilir. Leader değişikliklerinin sıklığı monitoring sistemi üzerinden takip edilmelidir. Sürekli election yaşanması network veya server kaynak problemine işaret edebilir.
Failure Tolerance
Failure tolerance cluster'ın belirli sayıda server veya zone kaybında hizmet verebilme kabiliyetidir. Bu kapasite server sayısı ve quorum yapısına bağlıdır. Ancak registry'nin erişilebilir olması application endpoint'lerinin de erişilebilir olduğu anlamına gelmez. Discovery control plane ve application data plane için ayrı failure analizleri yapılmalıdır. Chaos testleri gerçek tolerans seviyesini doğrulamak için kullanılabilir.
Multi-Datacenter Federation
Multi-datacenter federation farklı lokasyonlardaki service catalog yapılarını birbirine bağlamayı sağlar. Her datacenter kendi yerel failure domain'ini koruyabilir. Cross-datacenter discovery belirli network bağlantılarına ve federation mekanizmasına dayanır. Link kesildiğinde local servislerin çalışmaya devam etmesi tercih edilir. Global failover politikası network partition ve stale bilgi riskini dikkate almalıdır.
WAN Federation
WAN federation farklı Consul datacenter'ları arasındaki control plane iletişimini destekleyen yaklaşımlardan biridir. Coğrafi olarak uzak lokasyonlarda latency ve bağlantı kaybı olasılığı daha yüksektir. Federation tasarımı local discovery'nin uzak datacenter sorunu nedeniyle etkilenmemesini sağlamalıdır. Network güvenliği ve mTLS bu bağlantılarda önem taşır. Multi-region testleri yalnızca normal çalışma değil link kopması durumunu da kapsamalıdır.
Netflix Eureka ile Service Discovery
Eureka özellikle Java ve Spring tabanlı mikroservis mimarilerinde bilinen service discovery çözümlerinden biridir. Eureka Client servis registration, heartbeat ve registry fetch işlemlerini uygulama tarafında yönetebilir. Client-side discovery modeli servislerin registry snapshot'ını kullanmasına dayanır. Spring Cloud LoadBalancer ile endpoint seçimi application tarafında gerçekleştirilebilir. Kubernetes tabanlı yeni platformlarda native discovery çoğu zaman ilk seçenek olsa da mevcut Spring sistemlerinde Eureka hâlen değerlendirilmesi gereken bir teknolojidir.
Eureka Server
Eureka Server kayıtlı service instance bilgilerini tutan registry görevi görür. Client'lar registration ve heartbeat mesajlarını server'a gönderir. İstemciler ayrıca registry bilgisini periyodik olarak server'dan çekebilir. High availability için birden fazla server instance kullanılması gerekir. Registry'nin kısa süreli erişilemez olması durumunda client cache davranışı sistemin dayanıklılığını etkiler.
Eureka Client
Eureka Client uygulamanın registry ile iletişimini yöneten kütüphanedir. Uygulama başladığında servis bilgisini kaydedebilir ve düzenli heartbeat gönderebilir. Client registry snapshot'ını alarak diğer servis instance'larını bulabilir. Bu yapı application code ve runtime'ı Eureka ekosistemine daha fazla bağlar. Java ve Spring ağırlıklı sistemlerde standardizasyon varsa bu coupling kabul edilebilir olabilir.
Service Registration
Eureka registration sırasında application name, host, port ve metadata gibi bilgiler gönderilebilir. Instance'ın doğru environment ve zone bilgisiyle kayıt olması routing davranışını etkileyebilir. Otomatik registration uygulama başlangıcına entegre edilebilir. Readiness kavramı ile Eureka registration davranışı aynı şey olmadığı için health stratejisi ayrıca düşünülmelidir. Shutdown sırasında deregistration ve lease expiration davranışı test edilmelidir.
Heartbeat
Eureka Client belirli aralıklarla server'a heartbeat göndererek instance'ın çalıştığını bildirir. Heartbeat kesildiğinde belirli lease süresi sonunda kayıt geçersiz kabul edilebilir. Çok uzun süre stale endpoint riskini artırırken çok kısa süre geçici network hatalarına hassasiyet yaratabilir. Network partition senaryosu özellikle test edilmelidir. Heartbeat varlığı uygulamanın tüm request tiplerini sağlıklı işlediğini tek başına kanıtlamaz.
Registry Fetch
Eureka client'lar registry bilgisini periyodik olarak çekerek local cache oluşturabilir. Bu model her request öncesinde merkezi server sorgusu yapılmasını önler. Registry kısa süreli erişilemez olduğunda son bilinen liste ile çalışma sürdürülebilir. Ancak endpoint değişikliklerinin istemciye ulaşması belirli bir convergence süresi gerektirir. Failure testlerinde bu sürenin gerçek hata oranına etkisi ölçülmelidir.
Client-Side Discovery
Eureka yaygın olarak client-side discovery modeliyle kullanılır. Uygulama local registry snapshot'ından hedef servis instance'larını bulur. Ardından client-side load balancing mekanizması uygun endpoint'i seçebilir. Bu yaklaşım ek merkezi proxy hop ihtiyacını azaltır. Buna karşılık her istemci ekosisteminin registry ve load balancing davranışını desteklemesi gerekir.
Spring Cloud LoadBalancer
Spring Cloud LoadBalancer Spring uygulamalarında client-side load balancing için kullanılabilir. Discovery client tarafından sağlanan instance listesi üzerinden hedef seçimi yapılabilir. Round robin benzeri stratejiler application context içinde uygulanabilir. Retry ve timeout davranışının başka katmanlarla çakışmadığından emin olunmalıdır. Çok sayıda Spring servisi bulunan sistemlerde ortak configuration standardı davranış tutarlılığını artırır.
Eureka High Availability
Eureka Server'ın tek instance çalıştırılması registry katmanında risk oluşturur. Birden fazla server ile peer yapı kurulabilir ve istemciler birden fazla registry adresiyle yapılandırılabilir. Server failure durumunda client cache mevcut bağlantıların devam etmesine yardımcı olabilir. Ancak yeni service registration ve güncel endpoint bilgisi için control plane erişilebilirliği önemlidir. Gerçek high availability düzenli failure testleriyle doğrulanmalıdır.
Spring Boot ve Eureka
Spring Boot uygulamaları Eureka client entegrasyonu ile service registration ve discovery işlemlerini otomatikleştirebilir. Application name çoğunlukla mantıksal service ID olarak kullanılır. Instance metadata zone, version veya özel routing bilgisi taşıyabilir. Spring Cloud LoadBalancer discovery sonucunu client-side seçimde kullanabilir. Bu model Spring ağırlıklı altyapıda rahat çalışsa da platform bağımsızlığı gerektiren yapılarda farklı seçenekler değerlendirilmelidir.
Eureka Client
Spring Boot içinde Eureka Client uygulamanın registry ile iletişimini kolaylaştırır. Registration, heartbeat ve registry fetch işlemleri configuration üzerinden yönetilebilir. Geliştirici düşük seviyeli HTTP çağrıları yazmak zorunda kalmaz. Bununla birlikte dependency sürümleri ve Spring Cloud uyumluluğu düzenli olarak yönetilmelidir. Discovery davranışının application testlerinde mock değil gerçek registry ile de doğrulanması faydalıdır.
Application Name / Service ID
Application name diğer servislerin bu uygulamayı discovery üzerinden hangi mantıksal kimlikle bulacağını belirleyebilir. Tutarlı service ID standardı logging ve observability ekranlarında da fayda sağlar. Aynı servisin farklı environment'larını isimle ayırmak bazı yapılarda kolay görünse de environment bilgisini namespace veya deployment scope ile yönetmek daha esnek olabilir. İsim değişikliği istemci configuration bilgisini etkileyebilir. Bu nedenle service naming uzun vadeli bir platform standardı olarak düşünülmelidir.
Instance Metadata
Instance metadata service version, zone veya deployment tipi gibi bilgiler taşıyabilir. Client veya routing katmanı metadata üzerinden filtreleme yapabilir. Canary deployment için belirli instance gruplarını ayırmak mümkün olabilir. Metadata alanlarının serbest biçimde çoğalması zamanla yönetimi zorlaştırır. Ekipler merkezi bir metadata sözlüğü oluşturarak hangi alanların kullanılacağını tanımlamalıdır.
Health Checks
Eureka ile Spring Boot sağlık bilgisini entegre etmek mümkündür ancak health semantics dikkatli tasarlanmalıdır. Application health endpoint'inin bütün downstream bağımlılıkları nedeniyle sürekli değişmesi istenmeyen deregistration davranışına yol açabilir. Liveness ve readiness ayrımı korunmalıdır. Registry health bilgisinin ne kadar hızlı güncellendiği ölçülmelidir. Failure sırasında client'ların stale kayıtları nasıl ele aldığı ayrıca test edilmelidir.
Zones ve Regions
Zone ve region bilgisi endpoint seçiminde locality tercihleri için kullanılabilir. Client aynı zone içindeki instance'ları önceliklendirebilir. Bu yaklaşım network latency ve bölgeler arası veri transferini azaltabilir. Ancak local zone kapasitesi yetersiz olduğunda fallback davranışı gereklidir. Metadata ile gerçek deployment topology arasında tutarlılık sağlanmalıdır.
Spring Cloud LoadBalancer
Spring Cloud LoadBalancer service instance listesi üzerinden client-side seçim sağlar. Varsayılan veya özelleştirilmiş stratejilerle trafik dağılımı yapılabilir. Application tarafında çalıştığı için routing davranışı dependency sürümüne bağlıdır. Çok sayıda serviste farklı configuration kullanılması beklenmeyen davranış farklarına yol açabilir. Platform ekipleri ortak starter ve configuration standardı oluşturarak bu farkları azaltabilir.
Eureka mı Consul mu?
Eureka ve Consul farklı altyapı ihtiyaçlarına hitap eden service discovery yaklaşımları sunar. Eureka özellikle Java ve Spring ekosistemiyle doğal biçimde ilişkilendirilirken Consul polyglot ve multi-platform ortamlarda daha geniş kullanım alanı bulabilir. Kubernetes kullanılıyorsa her iki çözümü eklemeden önce platform-native Service discovery'nin yeterli olup olmadığı değerlendirilmelidir. Multi-datacenter, health check ve configuration ihtiyaçları seçimde önemlidir. Teknoloji seçimi özellik sayısından çok mevcut işletim modeline göre yapılmalıdır.
Java/Spring Ekosistemi
Java ve Spring ağırlıklı sistemlerde Eureka client entegrasyonu geliştiriciler için tanıdık olabilir. Application name, registry fetch ve client-side load balancing Spring yapılandırmasıyla entegre edilebilir. Organizasyon zaten Eureka kullanıyorsa migration maliyeti de karar üzerinde etkili olur. Yeni Kubernetes projelerinde ise Service ve DNS mekanizması çoğu ihtiyacı karşılayabilir. Bu nedenle yalnızca Spring kullanıldığı için otomatik olarak Eureka kurmak gerekli değildir.
Polyglot Mikroservisler
Polyglot sistemlerde farklı programlama dilleri discovery client desteği açısından eşit olmayabilir. Consul DNS ve HTTP API arayüzleri birçok runtime tarafından kullanılabilir. Agent veya proxy yaklaşımı application code bağımlılığını azaltabilir. Eureka ise Java ekosisteminde daha doğal bir client deneyimi sunar. Çok dilli sistemlerde platform-level discovery genellikle daha sürdürülebilir bir seçenek olur.
Kubernetes
Kubernetes kendi Service, CoreDNS ve EndpointSlice mekanizmalarını sunduğu için temel discovery ihtiyacı zaten karşılanır. Ek registry ancak multi-platform catalog, özel federation veya organizasyonel gereksinim varsa anlamlı olabilir. Aynı bilgiyi iki farklı registry'de tutmak tutarlılık ve debugging maliyetini artırabilir. İlk soru hangi ürünün daha iyi olduğu değil, ek bir registry'ye gerçekten ihtiyaç olup olmadığıdır. Kubernetes-native yaklaşım çoğu basit cluster için daha sade olur.
VM ve Bare Metal
VM ve bare metal ortamlarında Kubernetes Service discovery bulunmadığı için ayrı registry ihtiyacı daha belirgin olabilir. Consul agent tabanlı model node üzerindeki servislerin kaydını yönetebilir. Eureka da Java uygulamalarında self-registration yaklaşımıyla kullanılabilir. Polyglot ve farklı workload türleri varsa platform bağımsız arayüzler avantaj sağlayabilir. Network topology ve deployment otomasyonu seçimde önemli rol oynar.
Multi-Datacenter
Multi-datacenter service discovery local ve uzak servislerin nasıl bulunacağını yönetmek zorundadır. Consul bu kullanım için federation ve catalog özellikleri sunabilir. Eureka tabanlı mimariler de region veya zone kavramlarını kullanabilir ancak operasyon modeli farklıdır. Cross-datacenter network partition ve failover testleri ürün seçimi kadar önemlidir. Global registry tasarımı local servislerin uzak bölge sorunu nedeniyle etkilenmemesini sağlamalıdır.
Health Checking
Consul agent farklı türde active health check tanımları sunabilir. Eureka daha çok heartbeat ve client registration modeliyle bilinir. Her iki yaklaşımda da yanlış health semantics outage riskini artırabilir. Gerçek uygulama health davranışı ürünün varsayılan ayarlarına bırakılmamalıdır. Liveness, readiness ve registry health sinyallerinin rolleri ayrı ayrı tanımlanmalıdır.
Configuration Management
Service discovery ve configuration management birbirinden farklı problemler olsa da bazı platformlar her iki alanda yetenek sunabilir. Consul key-value özellikleri belirli configuration senaryolarında kullanılabilir. Eureka'nın ana odağı service registry ve discovery tarafındadır. Configuration yönetimini registry seçiminin tek kriteri yapmak doğru olmaz. Secret, dynamic configuration ve deployment configuration ihtiyaçları ayrı araç ve güvenlik modeliyle değerlendirilebilir.
Operasyonel Karmaşıklık
Her ek control plane bileşeni backup, monitoring, upgrade ve security sorumluluğu getirir. Kubernetes zaten discovery sağlıyorsa Consul veya Eureka eklemek operasyon yükünü artırabilir. Mevcut VM altyapısında ortak catalog gerekiyorsa ek ürün kullanımı bu yükü haklı çıkarabilir. Ekip yetkinliği ve on-call kapasitesi seçimde dikkate alınmalıdır. En fazla özelliğe sahip çözüm yerine en az gereksiz bileşenle ihtiyacı karşılayan tasarım tercih edilmelidir.
etcd ve ZooKeeper Service Discovery İçin Kullanılabilir mi?
etcd ve ZooKeeper dağıtık coordination ve key-value store yetenekleri sayesinde service discovery için teknik olarak kullanılabilir. Endpoint kayıtları belirli key'ler altında saklanabilir ve watch mekanizmasıyla değişiklikler takip edilebilir. Ancak ham storage API'si üzerine production-grade discovery davranışı inşa etmek önemli mühendislik sorumluluğu getirir. Health, TTL, cache, authorization ve client behavior ayrıca tasarlanmalıdır. Hazır discovery platformu çoğu ekip için daha düşük bakım maliyeti sunabilir.
Distributed Key-Value Store Yaklaşımı
Distributed key-value store içinde servis adı key prefix olarak, endpoint bilgisi ise value olarak tutulabilir. Client belirli prefix'i sorgulayarak çalışan instance listesini alabilir. Lease veya ephemeral node mekanizması stale kayıtların temizlenmesine yardımcı olabilir. Ancak data model standardı ekip tarafından oluşturulmalıdır. Registry API ve uygulama arasındaki coupling de ayrıca yönetilmelidir.
Watch Mechanism
Watch mechanism client'ın registry değişikliklerini polling yapmadan takip etmesini sağlar. Yeni instance kaydı veya deregistration olduğunda client'a event gönderilebilir. Bu model endpoint update propagation süresini azaltabilir. Watch bağlantısının kopması durumunda yeniden senkronizasyon yapılması gerekir. Event kaçırma ve snapshot consistency davranışı production testlerinde doğrulanmalıdır.
Strong Consistency
Strong consistency registry state değişikliklerinin istemcilere tutarlı sıra ile görünmesini sağlayabilir. Bu özellik bazı koordinasyon senaryolarında değerlidir. Ancak discovery çoğu zaman düşük latency ve yüksek availability ihtiyacı da taşır. Her endpoint güncellemesinde güçlü consistency maliyetine gerçekten ihtiyaç olup olmadığı değerlendirilmelidir. Kısa süreli stale bilgi toleransı olan sistemler farklı trade-off seçebilir.
Doğrudan Registry Olarak Kullanmanın Maliyeti
Ham etcd veya ZooKeeper API'sini registry olarak kullanmak basit bir prototipte kolay görünebilir. Production ortamında health check, lease yenileme, client cache, failover ve authorization gibi birçok özellik ayrıca geliştirilmelidir. Her programlama dili için sağlam client davranışı gerekir. Registry schema değişiklikleri application code'a yansıyabilir. Bu nedenle hazır discovery çözümü kullanmak çoğu ekip için daha az özel kod ve daha kolay operasyon sağlar.
Ne Zaman Hazır Discovery Platformu Tercih Edilmeli?
Ekip service discovery konusunda özel control plane geliştirmek istemiyorsa hazır platform tercih etmek mantıklıdır. Multi-language client, health check, DNS interface veya federation gibi özellikler gerekiyorsa hazır ürün önemli zaman kazandırır. Kubernetes ortamında platform-native Service discovery zaten hazır bir seçenek sunar. VM ağırlıklı ortamlarda Consul benzeri çözümler değerlendirilebilir. Özel registry ancak standart çözümlerle karşılanamayan açık bir gereksinim varsa düşünülmelidir.
Service Discovery ve API Gateway Arasındaki Fark
Service discovery ile API Gateway farklı trafik katmanlarında rol oynar. Discovery çoğunlukla servislerin birbirini runtime sırasında bulmasına odaklanır. API Gateway ise dış istemcilerin backend servislerine kontrollü erişimini yönetir. Gateway arka planda discovery registry veya Kubernetes Service bilgisinden faydalanabilir. Ancak authentication, rate limiting ve public API routing gibi gateway görevleri discovery'nin sorumluluğu değildir.
East-West Traffic
East-west traffic cluster veya veri merkezi içindeki servisler arası iletişimi ifade eder. Service discovery bu trafik türünde kritik role sahiptir. Ödeme servisi envanter servisini DNS veya registry üzerinden bulabilir. Service mesh de east-west traffic üzerinde routing, security ve telemetry uygulayabilir. Internal servis isimleri dış istemcilere açılmak zorunda değildir.
North-South Traffic
North-south traffic dış kullanıcı veya sistemlerden platform içine giren trafiği ifade eder. API Gateway, ingress veya edge load balancer bu akışı yönetebilir. Authentication, rate limiting ve public routing kuralları burada uygulanabilir. Gateway backend servisleri discovery üzerinden bulabilir. Dış trafik yönetimi ile internal service discovery sorumluluklarının ayrı tasarlanması bakım açısından faydalıdır.
API Gateway'in Rolü
API Gateway dış istemciler ile backend servisler arasında kontrollü giriş noktası sağlar. Routing, authentication, quota ve request transformation gibi işlevler uygulayabilir. Gateway gerekli backend endpoint bilgisini discovery mekanizmasından alabilir. Ancak registry state'ini yönetmek gateway'in temel görevi değildir. Gateway high availability ve capacity planning ayrıca ele alınmalıdır.
Registry'nin Rolü
Registry hangi service instance'larının çalıştığını ve nasıl erişilebileceğini tutar. Application veya proxy bu bilgiyi endpoint lookup için kullanabilir. Registry public API güvenliği veya rate limit uygulamak için tasarlanmamıştır. Runtime service state'e odaklanan bir control plane bileşenidir. API Gateway discovery bilgisini tüketebilir ancak registry'nin yerini almaz.
Gateway Registry'yi Kullanabilir mi?
Gateway dinamik backend listesi oluşturmak için service registry'yi kullanabilir. Böylece deployment sırasında endpoint adreslerinin gateway configuration dosyasına elle yazılması gerekmez. Registry update'leri gateway'e push veya polling ile iletilebilir. Health ve version metadata canary routing gibi kararları destekleyebilir. Bu entegrasyonda registry kesintisinin mevcut gateway trafiğine etkisi test edilmelidir.
Service Discovery ve Service Mesh Arasındaki Fark
Service discovery hangi servisin nerede olduğunu bulma problemine odaklanır. Service mesh ise discovery bilgisini kullanarak trafik yönetimi, güvenlik ve observability gibi daha geniş network yetenekleri sunar. Mesh discovery'nin üzerine inşa edilebilir ancak discovery kavramını ortadan kaldırmaz. Proxy'lerin güncel endpoint bilgisini bir control plane veya platform registry'den alması gerekir. Mesh kullanımı yalnızca endpoint bulmak için kuruluyorsa ek operasyon maliyeti gereksiz olabilir.
Discovery Hangi Soruyu Çözer?
Discovery temel olarak bir servis adı için hangi sağlıklı endpoint'lerin mevcut olduğu sorusunu çözer. Registration ve health bilgisi bu cevabın güncel kalmasını sağlar. İstemci veya proxy bulunan endpoint'lerden birini seçebilir. Discovery tek başına authentication, encryption veya retry policy sağlamaz. Bu ayrım mimari bileşenlerin görevlerini anlaşılır tutar.
Mesh Hangi Soruları Çözer?
Service mesh servisler arası iletişimde daha geniş bir policy katmanı oluşturur. mTLS, traffic splitting, retry, circuit breaking ve observability gibi yetenekler sunabilir. Discovery bilgisi proxy configuration üretmek için kullanılır. Application bu network işlevlerinden büyük ölçüde ayrıştırılabilir. Buna karşılık control plane ve data plane işletmek ek kaynak ve operasyon gerektirir.
Traffic Management
Traffic management belirli servis sürümlerine ağırlıklı trafik yönlendirme, locality seçimi veya failover gibi politikaları kapsar. Service mesh bu kuralları proxy seviyesinde merkezi şekilde uygulayabilir. Canary deployment sırasında v2 sürümüne yüzde bazlı trafik göndermek mümkün olabilir. Routing değişiklikleri application deployment gerektirmeden yapılabilir. Yanlış merkezi configuration çok geniş etki oluşturabileceği için değişiklik kontrolü önemlidir.
mTLS
mTLS hem istemci hem sunucu tarafının sertifika ile kimliğini doğruladığı güvenli bağlantı modelidir. Service mesh sertifika dağıtımı ve rotation işlemlerini otomatikleştirebilir. Network trafiği şifrelenirken workload identity bilgisi authorization için kullanılabilir. Yalnızca mTLS açmak hangi servisin hangi servise erişebileceğini belirlemez. Authorization politikalarının ayrıca tanımlanması gerekir.
Authorization
Authorization doğrulanmış bir service identity'nin hangi kaynağa erişebileceğini belirler. Service mesh servisler arası deny-by-default politikaları uygulayabilir. IP adresi yerine workload identity kullanmak dinamik ortamlarda daha güvenilir olabilir. Policy değişiklikleri audit kayıtlarıyla izlenmelidir. Yanlış veya çok geniş izinler mTLS var olsa bile güvenlik riskine yol açabilir.
Observability
Service mesh proxy seviyesinde request latency, error rate ve traffic volume gibi metrikleri standart biçimde toplayabilir. Uygulama dilleri farklı olsa bile network telemetry formatı tutarlı olabilir. Distributed tracing context'i proxy üzerinden taşınabilir ancak application span'ları için kod entegrasyonu yine gerekebilir. Proxy metrikleri application business metric'lerinin yerini tutmaz. İki veri seti birlikte kullanıldığında problem analizi daha hızlı yapılabilir.
Retries ve Circuit Breaking
Mesh proxy retry ve circuit breaking politikalarını uygulama kodundan bağımsızlaştırabilir. Bu özellikler geçici network hatalarında faydalı olabilir. Ancak application da retry yapıyorsa istek sayısı katlanarak artabilir. Retry budget ve idempotency kuralları merkezi policy içinde tanımlanmalıdır. Circuit breaker eşikleri gerçek trafik profiline göre test edilmeden varsayılan değerlerle bırakılmamalıdır.
Service Mesh Nasıl Çalışır?
Service mesh genellikle data plane ve control plane katmanlarından oluşur. Data plane proxy'leri gerçek application trafiğini taşır. Control plane service discovery, policy ve security bilgilerini proxy configuration'a dönüştürür. Endpoint değişiklikleri dinamik biçimde proxy'lere iletilebilir. Bu model application code'u network policy ayrıntılarından ayırmayı hedefler.
Data Plane
Data plane gerçek request trafiğinin geçtiği proxy veya network bileşenlerinden oluşur. Proxy destination selection, mTLS ve telemetry gibi işlemleri uygulayabilir. Data plane doğrudan kullanıcı trafiğinin yolunda olduğu için latency ve reliability açısından kritiktir. Control plane geçici olarak kaybolsa bile mevcut configuration ile trafik taşımaya devam etmesi tercih edilir. Proxy kaynak tüketimi ve connection kapasitesi izlenmelidir.
Control Plane
Control plane proxy'lerin ihtiyaç duyduğu discovery ve policy configuration bilgisini üretir. Kubernetes API veya başka registry kaynaklarından service state alabilir. Policy değişikliklerini data plane'e dinamik olarak dağıtır. Control plane erişilemez olduğunda yeni configuration yayılması durabilir. Ancak çalışan data plane'in son bilinen configuration ile trafik taşımaya devam etmesi failure etkisini azaltır.
Service Registry
Mesh control plane'in güncel endpoint bilgisine ihtiyacı vardır. Kubernetes Service registry veya harici catalog bu veriyi sağlayabilir. Control plane registry değişikliklerini izleyerek proxy endpoint configuration bilgisini günceller. Registry tamamen stale ise proxy de yanlış backend listesine sahip olabilir. Bu nedenle discovery freshness service mesh observability içinde ayrıca izlenmelidir.
Proxy Configuration
Proxy configuration cluster, endpoint, listener ve route bilgilerini içerebilir. Control plane bu configuration'ı workload kimliği ve policy bilgisine göre üretebilir. Dinamik update mekanizması uygulama restart gerektirmeden yeni endpoint'lerin kullanılmasını sağlar. Hatalı configuration proxy'nin trafik kabul etmemesine yol açabileceği için validation önemlidir. Configuration rollout kademeli ve gözlemlenebilir biçimde yapılmalıdır.
Dynamic Endpoint Updates
Yeni pod eklendiğinde veya instance kapandığında endpoint değişikliği proxy'lere dinamik biçimde ulaştırılabilir. Push tabanlı model polling gecikmesini azaltabilir. Çok büyük cluster'larda update fan-out control plane üzerinde önemli yük oluşturabilir. Incremental update mekanizmaları gereksiz veri transferini azaltır. Endpoint propagation time düzenli olarak ölçülmesi gereken service discovery KPI'larından biridir.
xDS
xDS, Envoy ve uyumlu istemcilere dinamik discovery configuration sağlayan API ailesidir. Control plane cluster, endpoint, listener ve route bilgisini ayrı discovery servisleri üzerinden iletebilir. Bu yapı statik proxy configuration dosyalarının sürekli yeniden dağıtılmasına ihtiyacı azaltır. Stream tabanlı update modelleri değişikliklerin hızlı yayılmasını sağlar. xDS kullanan mimarilerde control plane ölçeklenebilirliği ve configuration doğruluğu kritik önem taşır.
CDS
CDS, Cluster Discovery Service kavramını ifade eder. Proxy hangi upstream cluster'ların mevcut olduğunu bu mekanizma üzerinden öğrenebilir. Cluster tanımı load balancing ve connection gibi politikaları içerebilir. Yeni servis veya cluster tanımı control plane tarafından dinamik olarak gönderilebilir. Cluster silme işlemi aktif connection davranışı dikkate alınarak yönetilmelidir.
EDS
EDS, Endpoint Discovery Service üzerinden belirli cluster için backend endpoint listesini sağlar. Service instance ekleme ve çıkarma değişiklikleri proxy'lere iletilebilir. Zone ve locality bilgileri endpoint seçiminde kullanılabilir. Discovery propagation süresi failover performansını doğrudan etkiler. Çok büyük endpoint listelerinde incremental update verimlilik açısından önemlidir.
LDS
LDS, Listener Discovery Service ile proxy'nin hangi port ve adreslerde trafik kabul edeceğini tanımlar. Listener configuration filter chain ve protokol işlemlerini içerebilir. Control plane yeni listener ayarlarını dinamik biçimde dağıtabilir. Yanlış listener değişikliği inbound veya outbound trafiği doğrudan kesebilir. Bu nedenle configuration validation ve staged rollout gereklidir.
RDS
RDS, Route Discovery Service üzerinden HTTP routing kurallarının dinamik yönetilmesini sağlar. Host, path, header veya weighted destination gibi kurallar tanımlanabilir. Canary ve traffic splitting senaryolarında sık kullanılır. Route değişikliklerinin application deployment gerektirmemesi operasyon esnekliği sağlar. Bununla birlikte yanlış route policy geniş kullanıcı grubunu etkileyebileceği için gözlemleme ve rollback mekanizması bulunmalıdır.
Sidecar Service Mesh Modeli
Sidecar service mesh modelinde her application instance yanında bir proxy process veya container çalışır. Uygulamanın inbound ve outbound trafiği bu local proxy üzerinden geçirilir. Proxy service discovery, mTLS ve routing policy uygular. Bu yaklaşım network işlevlerini application code'dan ayırır. Her workload başına ek proxy bulunması kaynak tüketimi ve upgrade yönetimi açısından dikkate alınmalıdır.
Envoy Sidecar
Envoy sidecar application pod veya workload yanında çalışan network proxy'dir. Control plane'den discovery ve routing configuration alabilir. Uygulama localhost veya normal service address üzerinden trafik gönderirken proxy transparan biçimde devreye girebilir. mTLS ve telemetry işlevleri burada uygulanabilir. Proxy crash veya resource exhaustion application trafiğini etkileyebileceği için sidecar health ayrıca izlenmelidir.
Local Proxy
Local proxy uygulamaya çok yakın data plane noktası sağlar. Network hop çoğunlukla aynı pod veya node sınırında gerçekleşir. Bu model merkezi proxy darboğazı yerine dağıtık kapasite sunar. Her workload kendi proxy kaynağını tükettiği için toplam CPU ve memory maliyeti artabilir. Proxy configuration sayısının büyümesi control plane ölçeklenebilirliğini etkileyebilir.
Application'ın Discovery'den Ayrıştırılması
Sidecar yaklaşımında application registry API'sini doğrudan bilmek zorunda değildir. Proxy service discovery bilgisini control plane'den alır ve uygun backend'e route eder. Java, Go veya Python servisleri aynı network davranışını paylaşabilir. Discovery teknolojisi değiştiğinde application library güncelleme ihtiyacı azalabilir. Bu ayrım özellikle polyglot sistemlerde platform standardizasyonunu kolaylaştırır.
Sidecar CPU ve Memory Overhead
Her workload yanında proxy çalıştırmak ek CPU ve memory tüketir. Yüzlerce veya binlerce pod bulunan cluster'larda toplam kaynak maliyeti önemli seviyeye ulaşabilir. Trafik yoğunluğu düşük servislerde proxy kaynağı application kaynağına yakın olabilir. Resource request ve limit değerleri gerçek load test verisiyle ayarlanmalıdır. Overhead yalnızca ortalama kaynak değil peak connection ve TLS işlem maliyetini de içermelidir.
Sidecar Upgrade Yönetimi
Proxy sürümü güncellendiğinde çok sayıda workload'un yeniden başlatılması gerekebilir. Bu durum mesh upgrade sürecini application deployment yaşam döngüsüyle ilişkilendirir. Kademeli rollout ve compatibility testleri gereklidir. Eski ve yeni proxy sürümleri kısa süre aynı ortamda çalışabileceği için control plane uyumluluğu korunmalıdır. Upgrade prosedürü production trafiği üzerinde düzenli olarak prova edilmelidir.
Istio Ambient Mode ve Sidecar'sız Yaklaşım
Istio Ambient Mode, her pod içine sidecar eklemek yerine bazı network işlevlerini node seviyesindeki bileşenlere taşımayı hedefler. ztunnel L4 seviyesinde secure connectivity ve identity işlemlerine yardımcı olabilir. L7 özellikler gerektiğinde waypoint proxy kullanılabilir. Bu model sidecar kaynak maliyetini ve workload restart ihtiyacını azaltabilir. Mimari karar verilirken hangi trafiğin yalnızca L4, hangisinin L7 policy gerektirdiği açık biçimde belirlenmelidir.
ztunnel
ztunnel ambient data plane içinde node seviyesinde çalışan bileşendir. Workload trafiğini L4 seviyesinde güvenli taşıma ve identity işlemleri için kullanabilir. Her pod'a ayrı sidecar eklenmediği için proxy sayısı azalır. Node üzerindeki data plane bileşeni kritik hâle geldiğinden capacity ve failure davranışı dikkatle izlenmelidir. Workload identity ile network routing arasındaki ilişki doğru configuration ile yönetilmelidir.
Node-Level L4 Proxy
Node-level L4 proxy birden fazla workload'un temel network ve security işlemlerini ortak bileşende gerçekleştirebilir. Bu yaklaşım pod başına sidecar overhead'ini azaltabilir. L4 seviyesinde application HTTP route ayrıntıları görülmez. Yalnızca servis kimliği ve connection tabanlı policy gereken trafik için yeterli olabilir. L7 ihtiyaçları ayrı waypoint katmanına aktarılabilir.
Waypoint Proxy
Waypoint proxy belirli workload veya namespace grubu için L7 policy uygulamak amacıyla kullanılabilir. HTTP routing, authorization veya gelişmiş traffic management ihtiyaçları burada ele alınabilir. Her pod başına proxy çalıştırmak yerine ortak L7 proxy modeli sunabilir. Kapasite planlamasında aynı waypoint üzerinden geçen toplam trafik dikkate alınmalıdır. Failure domain sidecar modelinden farklı olduğu için yüksek erişilebilirlik tasarımı ayrıca yapılmalıdır.
L4 ve L7 Ayrımı
L4 policy connection, IP, port ve workload identity gibi daha temel ağ bilgilerine odaklanır. L7 policy HTTP path, method, header veya gRPC method gibi application seviyesindeki ayrıntıları kullanabilir. Her trafik için L7 proxy ihtiyacı yoktur. Gereksiz L7 inspection ek latency ve resource maliyeti oluşturabilir. Ambient model bu ayrımı daha açık yaparak yalnızca ihtiyaç duyulan yerde L7 proxy kullanımını mümkün kılabilir.
Sidecar ve Ambient Birlikte Kullanılabilir mi?
Migration dönemlerinde farklı workload gruplarında sidecar ve ambient yaklaşımların bir arada bulunması gerekebilir. Bu tür hibrit kullanımda routing, identity ve policy davranışının uyumluluğu test edilmelidir. Aynı servisin bazı instance'larının farklı data plane modelinde çalışması observability analizini zorlaştırabilir. Geçiş adımları küçük workload gruplarıyla başlatılmalıdır. Hedef mimari ve geri dönüş planı deployment öncesinde tanımlanmalıdır.
Ambient Modelin Operasyonel Etkileri
Ambient model sidecar injection ve pod restart ihtiyacını azaltarak bazı operasyon süreçlerini sadeleştirebilir. Buna karşılık node-level ztunnel ve waypoint kapasitesinin yönetimi yeni failure alanları oluşturur. Monitoring dashboard'ları yeni data path yapısını gösterecek şekilde güncellenmelidir. Incident sırasında trafiğin hangi katmandan geçtiği ekip tarafından hızlı anlaşılabilmelidir. Model seçimi yalnızca kaynak tasarrufuna değil, ekip operasyon alışkanlıklarına göre de değerlendirilmelidir.
Istio ile Service Discovery
Istio Kubernetes service registry bilgisini kullanarak mesh içindeki servis ve endpoint'leri control plane'e aktarabilir. Istiod bu bilgiyi işleyerek Envoy veya diğer data plane bileşenlerine configuration dağıtır. Kubernetes dışındaki servisler ServiceEntry gibi kaynaklarla mesh'e eklenebilir. VM workload discovery de uygun entegrasyonlarla mümkün olabilir. Böylece mesh yalnızca cluster içindeki pod'larla sınırlı kalmadan daha geniş servis topolojisini yönetebilir.
Kubernetes Service Registry
Istio Kubernetes API üzerinden Service, EndpointSlice ve workload bilgilerini takip edebilir. Bu veriler mesh içindeki logical service ve endpoint modeline dönüştürülür. Pod lifecycle değişiklikleri control plane tarafından gözlenir. Güncel endpoint listesi proxy'lere dinamik biçimde yayılır. Kubernetes discovery sağlıklı değilse mesh routing de bundan etkilenebilir.
Istiod
Istiod Istio control plane'in temel bileşenidir. Service discovery, configuration ve certificate yönetimi gibi görevlerde rol oynar. Kubernetes state ve mesh policy bilgisini data plane configuration'a dönüştürebilir. High availability için birden fazla replica ve uygun resource planlaması gerekir. Control plane failure sırasında mevcut proxy'lerin son configuration ile trafik taşımaya devam etmesi hedeflenir.
Envoy Endpoint Configuration
Envoy upstream cluster'lara ait endpoint listesini dynamic configuration üzerinden alabilir. Endpoint health, locality ve weight bilgileri load balancing kararında kullanılabilir. Yeni pod eklendiğinde control plane güncellemeyi proxy'ye iletir. Çok büyük mesh'lerde configuration boyutu ve update rate önemli performans metriğidir. Proxy config dump gibi araçlar discovery sorunlarının debug edilmesinde kullanılabilir.
ServiceEntry
ServiceEntry mesh'in varsayılan service registry'sinde bulunmayan dış servisleri tanımlamak için kullanılabilir. Harici API veya VM workload adresi bu kaynakla mesh modeline eklenebilir. Routing ve security policy bu servisler için uygulanabilir. Yanlış ServiceEntry tanımı beklenmeyen trafik yönlendirmesine yol açabilir. External dependency envanteri ile ServiceEntry kayıtlarının tutarlı tutulması gerekir.
Harici Servislerin Mesh'e Eklenmesi
Harici servis mesh'e eklendiğinde proxy bu destination için kontrollü routing uygulayabilir. TLS policy, timeout ve observability merkezi biçimde tanımlanabilir. DNS veya statik endpoint modeli kullanım senaryosuna göre seçilebilir. Harici servisin SLA ve failure karakteristiği internal servisten farklı olabilir. Retry ve timeout değerleri bu farkı dikkate alarak ayarlanmalıdır.
VM Workload Discovery
Service mesh yalnızca Kubernetes pod'larıyla sınırlı olmak zorunda değildir. VM workload'lar uygun registration ve identity mekanizmalarıyla mesh service modeline dahil edilebilir. Bu yaklaşım migration döneminde Kubernetes ve VM servislerinin ortak discovery ve security politikasını paylaşmasını sağlayabilir. Network reachability ve DNS entegrasyonu dikkatle planlanmalıdır. VM lifecycle bilgisinin registry'de güncel kalması stale endpoint riskini azaltır.
Service Discovery ve mTLS
Service discovery endpoint'i bulurken mTLS bağlantının kimler arasında güvenli biçimde kurulacağını belirler. IP adresi network konumunu gösterir ancak güvenilir service identity olarak kullanılmamalıdır. Workload identity yaklaşımı sertifikaları servis kimliğiyle ilişkilendirir. Discovery ve identity birlikte çalıştığında doğru endpoint'e güvenli bağlantı kurulabilir. Authorization ise bu doğrulanmış kimliğin hangi servise erişebileceğini ayrıca belirler.
Network Location ile Service Identity Arasındaki Fark
IP adresi bir workload'un o andaki network konumudur. Container yeniden başladığında IP değişebilir fakat servis kimliği aynı kalır. Güvenlik politikasını yalnızca IP'ye bağlamak dinamik platformlarda kırılgan olabilir. Workload identity uygulamanın mantıksal kimliğini network adresinden ayırır. Discovery adresi, identity ise o adresteki workload'un gerçekten kim olduğunu doğrulamaya yardımcı olur.
SPIFFE
SPIFFE workload'lara standart biçimde kimlik tanımlamak için kullanılan bir specification yaklaşımıdır. SPIFFE ID servis veya workload kimliğini network adresinden bağımsız hâle getirir. Sertifika veya token tabanlı SVID mekanizmaları authentication için kullanılabilir. Service mesh platformları benzer identity modellerinden faydalanabilir. Kimlik standardı multi-platform güvenlik politikalarının daha taşınabilir olmasına yardımcı olur.
Workload Identity
Workload identity belirli bir application process veya workload'un güvenilir kimliğini temsil eder. Pod IP, node adresi veya environment variable gibi değişken bilgilerden farklıdır. mTLS sırasında karşı tarafın kimliği sertifika üzerinden doğrulanabilir. Authorization policy bu identity'ye göre erişim kararı verebilir. Dynamic infrastructure içinde güvenlik sınırlarının servis adı ve kimlik üzerinden kurulmasını kolaylaştırır.
Certificate Rotation
Short-lived certificate kullanıldığında sertifikaların düzenli olarak otomatik yenilenmesi gerekir. Manual rotation büyük mikroservis sistemlerinde ölçeklenebilir değildir. Service mesh veya identity platformu sertifika issuance ve rotation işlemini otomatikleştirebilir. Expiration ve rotation failure metric'leri izlenmelidir. Sertifika yenileme sorunu connection kesintisine dönüşmeden önce alarm üretilmesi önemlidir.
Service-to-Service Authentication
Service-to-service authentication bir servisin karşı taraftaki workload kimliğini doğrulamasını sağlar. mTLS bu işlem için güçlü bir mekanizma sunabilir. Discovery yalnızca endpoint bilgisi sağladığı için authentication ayrı bir güvenlik katmanıdır. Sertifika güven zinciri ve identity mapping doğru yönetilmelidir. Authentication başarılı olsa bile authorization izni yoksa request reddedilmelidir.
Authorization'ın Ayrı Tasarlanması
Authentication bir workload'un kim olduğunu doğrular. Authorization ise bu kimliğin hangi işlem veya servise erişebileceğini belirler. mTLS açmak otomatik olarak least privilege sağlamaz. Her servis için gerekli inbound ve outbound erişim ilişkileri tanımlanmalıdır. Deny-by-default ve açık izin politikası geniş ağ erişiminden daha güvenli bir model oluşturabilir.
Load Balancing Stratejileri
Load balancing endpoint listesindeki trafiğin nasıl dağıtılacağını belirler. Basit round robin birçok stateless servis için yeterli olabilir. Kapasite, latency veya connection süresi farklı olduğunda daha gelişmiş algoritmalar fayda sağlayabilir. Seçim algoritmasının retry ve connection pooling davranışıyla birlikte test edilmesi gerekir. En iyi algoritma teorik olarak değil, gerçek trafik dağılımı ve SLO sonuçlarıyla değerlendirilmelidir.
Round Robin
Round robin instance'ları sırayla seçer ve anlaşılması kolay bir trafik dağılımı sağlar. Backend kapasiteleri benzer olduğunda iyi başlangıç noktasıdır. Uzun request süreleri veya farklı instance performansı olduğunda eşit request sayısı eşit yük anlamına gelmeyebilir. Connection bazlı sistemlerde distribution beklenenden farklı olabilir. Basitliği nedeniyle ilk tercih olsa da metric sonuçlarına göre değiştirilmelidir.
Weighted Round Robin
Weighted round robin farklı kapasitedeki instance veya version gruplarına farklı ağırlık verir. Daha güçlü backend daha fazla request alabilir. Canary deployment sırasında yeni sürüme düşük ağırlık vermek için de kullanılabilir. Weight değerleri gerçek kapasiteye dayanmıyorsa trafik dengesizliği oluşabilir. Dinamik autoscaling ile weight bilgisinin nasıl güncelleneceği ayrıca tanımlanmalıdır.
Least Connections
Least connections aktif bağlantı sayısı en düşük backend'i seçmeye çalışır. Uzun süreli bağlantıların bulunduğu servislerde faydalı olabilir. Merkezi load balancer global connection durumunu daha iyi görebilir. Client-side uygulamada her istemci yalnızca kendi connection'larını gördüğü için sonuç sınırlı olabilir. Connection sayısı ile gerçek CPU yükünün her zaman aynı şeyi göstermediği unutulmamalıdır.
Least Requests
Least requests aktif request sayısı daha düşük olan backend'i tercih eder. Request süreleri değişken olduğunda round robin'den daha iyi denge sağlayabilir. Proxy'nin backend başına aktif request durumunu izlemesi gerekir. Çok hızlı değişen trafik altında seçim metrikleri kısa süreli dalgalanabilir. Algorithm benchmark'ı gerçek request duration dağılımıyla yapılmalıdır.
Random
Random seçim büyük trafik hacminde basit ve yeterli dağılım sunabilir. Merkezi state ihtiyacını azaltır. İki rastgele seçimden daha az yüklü olanı seçmek gibi varyasyonlar dengeyi iyileştirebilir. Düşük trafik hacminde dağılım kısa süreli olarak dengesiz olabilir. Instance kapasitesi farklı olduğunda weight desteği değerlendirilmelidir.
Consistent Hashing
Consistent hashing belirli key'e ait request'leri çoğunlukla aynı backend'e yönlendirmek için kullanılabilir. Cache locality veya session affinity gerektiren sistemlerde faydalıdır. Backend eklenip çıkarıldığında bütün key'lerin yeniden dağıtılmasını azaltır. Ancak instance kaybında belirli key grubu üzerinde ani yük değişimi olabilir. Hash key seçimi güvenlik ve veri dağılımı açısından dikkatle yapılmalıdır.
Latency-Aware Routing
Latency-aware routing daha hızlı yanıt veren backend'leri tercih edebilir. Bu yaklaşım tail latency azaltma hedefinde faydalı olabilir. Ölçüm hatası veya geçici congestion birkaç instance'ın gereksiz yere dışlanmasına neden olabilir. Recovery mekanizması endpoint'lerin yeniden trafiğe alınmasını sağlamalıdır. Multi-region sistemlerde network latency ile application latency ayrı metrikler olarak izlenmelidir.
Locality-Aware Routing
Locality-aware routing istemciye yakın zone veya region içindeki endpoint'leri tercih eder. Bu yaklaşım latency ve data transfer maliyetini azaltabilir. Yerel kapasite yetersiz olduğunda uzak endpoint'e fallback yapılmalıdır. Availability her zaman locality tercihinden daha yüksek öncelikte olabilir. Topology spread ve replica dağılımı routing politikasıyla uyumlu olmalıdır.
Service Discovery ve Resilience Patterns
Service discovery sağlıklı endpoint'i bulmayı kolaylaştırır ancak tek başına dayanıklılık sağlamaz. Timeout, retry, circuit breaker, bulkhead ve failover gibi pattern'ler request başarısızlıklarını yönetmek için ayrıca gerekir. Yanlış retry politikası discovery sorununu daha büyük trafik problemine dönüştürebilir. Resilience mekanizmaları farklı katmanlarda tekrar edilmemelidir. Her pattern gerçek failure senaryosuyla test edilmelidir.
Retry
Retry geçici failure durumunda request'i yeniden denemeyi sağlar. Yeni deneme aynı stale endpoint yerine farklı sağlıklı instance'a gönderilebilir. Ancak non-idempotent işlemlerde tekrar yan etki oluşturabilir. Retry sayısı ve backoff politikası sınırlı olmalıdır. Birden fazla katmanın retry yapması request amplification riskini artırır.
Timeout
Timeout istemcinin bir request için ne kadar süre bekleyeceğini sınırlar. Çok uzun timeout bozuk endpoint üzerinde kaynakların gereksiz tutulmasına neden olabilir. Çok kısa timeout normal tail latency sırasında başarılı olabilecek işlemleri başarısız sayabilir. Timeout değeri dependency SLO ve request bütçesi üzerinden belirlenmelidir. Retry kullanılacaksa toplam deadline içinde kalan süre hesaba katılmalıdır.
Circuit Breaker
Circuit breaker sürekli hata veren dependency'ye yeni request gönderimini geçici olarak sınırlar. Bu davranış kaynak tüketimini ve gereksiz timeout beklemelerini azaltabilir. Breaker çok hassas ayarlanırsa geçici hata sırasında sağlıklı kapasite kullanılmayabilir. Half-open recovery aşaması servisin yeniden hazır olduğunu kontrollü biçimde test eder. Metric ve alert'ler circuit state değişikliklerini görünür kılmalıdır.
Bulkhead
Bulkhead bir dependency probleminden kaynaklanan kaynak tüketimini diğer iş akışlarından ayırır. Ayrı connection pool, thread pool veya concurrency limit kullanılabilir. Bir servis yavaşladığında bütün worker kapasitesini tüketmesi engellenebilir. Discovery sağlıklı endpoint bulsa bile downstream yavaşlığı için bulkhead gerekli olabilir. Limit değerleri gerçek trafik hacmi ve kritik request türlerine göre belirlenmelidir.
Outlier Detection
Outlier detection diğer backend'lere kıyasla olağandışı hata veren instance'ı geçici olarak trafik havuzundan çıkarabilir. Passive health verisi bu kararda kullanılabilir. Kısa süreli tek hata nedeniyle endpoint'i hemen dışlamak dengesizlik yaratabilir. Eşik ve eject süresi gerçek error distribution üzerinden ayarlanmalıdır. Instance recovery olduğunda kontrollü biçimde havuza yeniden alınmalıdır.
Failover
Failover bir endpoint, zone veya region kullanılamaz olduğunda alternatif hedefe geçiş yapılmasıdır. Discovery alternatif instance listesini sağlayabilir. Load balancing ve routing policy hangi yedeğin seçileceğini belirler. Failover kapasitesi normal trafikten daha yüksek yük alabileceği için önceden planlanmalıdır. Düzenli failure testleri olmadan failover mekanizmasına güvenmek risklidir.
Discovery Tek Başına Resilience Sağlar mı?
Discovery yalnızca hangi endpoint'lerin mevcut olduğunu bulmaya yardımcı olur. Network timeout, dependency overload veya partial failure gibi sorunları tek başına çözmez. Retry, timeout ve circuit breaker gibi mekanizmalar ayrıca gereklidir. Health bilgisi de her zaman anlık ve kusursuz değildir. Dayanıklılık, discovery ile request lifecycle politikalarının birlikte tasarlanmasıyla oluşur.
Retry Storm Problemi
Retry storm, başarısız request'lerin tekrar tekrar denenmesi sonucunda servis üzerindeki yükün hızla büyümesidir. Bir dependency zaten kapasite problemi yaşıyorsa kontrolsüz retry durumu daha da kötüleştirebilir. Client, gateway ve proxy aynı anda retry yaparsa tek kullanıcı isteği çok sayıda backend request'ine dönüşebilir. Retry budget ve exponential backoff bu riski azaltır. Idempotency ve farklı instance'a retry davranışı açık biçimde tanımlanmalıdır.
Birden Fazla Katmanda Retry
Application, service mesh ve gateway katmanlarının aynı request için ayrı retry politikası olabilir. Her katman iki kez deneme yaptığında toplam backend çağrısı beklenenden çok daha yüksek olabilir. Hangi katmanın retry sorumluluğunu taşıdığı platform standardında belirlenmelidir. Application semantiğini bilen katman bazı işlemlerde daha doğru karar verebilir. Network seviyesindeki retry ise yalnızca güvenli ve sınırlı failure türleri için kullanılmalıdır.
Retry Amplification
Retry amplification bir failure sırasında request sayısının katlanarak büyümesini ifade eder. Örneğin üç katmanın üçer denemesi tek logical request için çok sayıda backend çağrısı üretebilir. Bu trafik sağlıklı instance'ların da kapasitesini tüketebilir. Request tracing ve retry count metric'i problemi görünür kılmalıdır. Retry budget sistemin kabul edeceği toplam ek trafik oranını sınırlar.
Retry Budget
Retry budget belirli zaman aralığında retry request'lerinin toplam trafik içinde alabileceği maksimum payı sınırlar. Böylece outage sırasında sınırsız tekrar denemesi engellenir. Budget service SLO ve normal error rate'e göre belirlenebilir. Retry yalnızca kalan deadline yeterliyse yapılmalıdır. Bu yaklaşım resilience mekanizmasının kendisinin yeni bir yük problemine dönüşmesini önler.
Idempotent ve Non-Idempotent Requests
Idempotent request birden fazla kez işlendiğinde aynı sonucu üretmeye uygun işlemdir. GET veya doğru tasarlanmış idempotent PUT örnek olabilir. Para transferi gibi non-idempotent işlemlerde otomatik retry duplicate yan etki oluşturabilir. Idempotency key mekanizması güvenli tekrar denemeyi destekleyebilir. Retry policy HTTP method'a değil, gerçek business semantics bilgisine göre değerlendirilmelidir.
Discovery Sonrası Farklı Instance'a Retry
Bir endpoint connection hatası verdiğinde retry farklı sağlıklı instance'a yönlendirilebilir. Aynı stale endpoint'e tekrar gitmek retry'nin faydasını azaltır. Client veya proxy failure bilgisini kısa süreli outlier state olarak tutabilir. Ancak instance hemen kalıcı olarak silinmemelidir çünkü geçici network sorunu yaşanmış olabilir. Retry ve health detection mekanizmalarının birbirini gereksiz yere tetiklememesi gerekir.
Service Versioning ve Discovery
Service discovery version bilgisini kullanarak aynı servisin farklı sürümlerini ayırt etmeye yardımcı olabilir. Canary, blue-green ve weighted routing stratejileri bu metadata üzerinden uygulanabilir. Logical service name sabit kalırken backend grupları version bilgisiyle ayrılabilir. Routing katmanı belirli kullanıcı veya trafik yüzdesini yeni sürüme gönderebilir. Rollback gerektiğinde trafik eski stabil gruba hızlı biçimde döndürülebilir.
Service v1 / v2
v1 ve v2 instance'ları aynı logical service altında birlikte çalışabilir. Discovery metadata'sı hangi endpoint'in hangi sürüme ait olduğunu gösterebilir. Routing policy her iki gruba farklı oranlarda trafik gönderebilir. Client'ın doğrudan version-specific service name kullanması migration esnekliğini azaltabilir. Sürüm ayrımı mümkün olduğunda routing policy tarafından yönetilmelidir.
Version Metadata
Version metadata service instance kaydına deployment sürümü hakkında bilgi ekler. Canary veya observability araçları bu alan üzerinden trafik gruplarını ayırabilir. Metadata application artifact version ile otomatik oluşturulursa manuel hata riski azalır. Serbest metin formatı yerine standart version şeması kullanılmalıdır. Version bilgisi hassas internal build detaylarını gereksiz yere dışarı açmamalıdır.
Canary Deployment
Canary deployment yeni sürümün küçük trafik yüzdesiyle production ortamında test edilmesini sağlar. Discovery yeni version endpoint'lerini kullanıma hazır olarak sunar. Routing katmanı örneğin yüzde beş trafiği canary grubuna yönlendirebilir. Error rate ve latency normal kalırsa oran kademeli artırılabilir. Problem görülürse trafik hızlı biçimde eski sürüme döndürülmelidir.
Blue-Green Deployment
Blue-green modelde eski ve yeni sürüm ayrı tam ortam veya backend grupları olarak çalışabilir. Discovery her iki grubun endpoint bilgisini tutabilir. Trafik bir policy değişikliğiyle yeni gruba geçirilebilir. Rollback gerektiğinde eski grup korunuyorsa geri dönüş hızlıdır. İki ortamı aynı anda çalıştırmanın kaynak maliyeti kapasite planına dahil edilmelidir.
Weighted Routing
Weighted routing backend gruplarına belirli oranlarda trafik göndermeyi sağlar. Version, zone veya capacity bilgisi ağırlık belirlemede kullanılabilir. Canary deployment sırasında yeni sürüm düşük ağırlıkla başlatılabilir. Ağırlık değişiklikleri merkezi configuration üzerinden otomatikleştirilebilir. Gerçek request dağılımının tanımlanan yüzdelere yakın olduğu monitoring ile doğrulanmalıdır.
Traffic Splitting
Traffic splitting aynı logical service'e gelen trafiği birden fazla destination grubuna böler. Header, user group veya yüzdelik ağırlık gibi kriterler kullanılabilir. Service mesh bu işlemi application code değişmeden uygulayabilir. Sticky session veya long-lived connection dağılımı teorik yüzdeleri etkileyebilir. Deployment automation gerçek trafik metriğine göre ilerleme kararı vermelidir.
Automated Rollback
Automated rollback yeni sürüm belirlenen SLO eşiklerini aştığında trafiği eski sürüme döndürür. Error rate, latency veya business KPI tetikleyici olarak kullanılabilir. Discovery eski sürüm endpoint'lerini hâlen hazır tutuyorsa dönüş hızlı olur. Yanlış alarm gereksiz rollback yaratabileceği için metrik penceresi dikkatli seçilmelidir. Rollback sonrası root cause analizi için deployment ve discovery event'leri kaydedilmelidir.
Multi-Cluster Service Discovery
Multi-cluster discovery aynı servislerin birden fazla Kubernetes cluster içinde bulunmasını yönetir. Her cluster kendi local Service kaydına sahip olabilir. Cross-cluster discovery global service name veya export ve import mekanizmaları üzerinden gerçekleştirilebilir. Network reachability ve DNS tasarımı bu mimarinin temel konularındandır. Cluster failure durumunda trafiğin diğer cluster'a geçebilmesi için kapasite ve policy önceden hazırlanmalıdır.
Cluster-Local Service
Cluster-local service yalnızca bulunduğu cluster içindeki istemciler tarafından keşfedilir. Bu model bağımlılıkların çoğunu yerel tutarak latency ve network riskini azaltır. Servisin başka cluster'da kopyası bulunabilir ancak isim çözümlemesi otomatik olarak global değildir. Local-first yaklaşım failure domain'lerini ayırmaya yardımcı olur. Gerçek cross-cluster ihtiyaç varsa açık export politikası kullanılmalıdır.
Cross-Cluster Discovery
Cross-cluster discovery bir cluster'daki istemcinin başka cluster'daki service endpoint'lerini bulmasını sağlar. Bu işlem DNS, service mesh veya özel multi-cluster API ile yapılabilir. Network routing iki cluster arasında endpoint erişimini desteklemelidir. Discovery bir adres döndürse bile network yolu yoksa request başarısız olur. Bu nedenle discovery ve connectivity birlikte test edilmelidir.
Service Export / Import
Service export ve import yaklaşımı hangi servislerin cluster sınırını aşacağını kontrollü biçimde tanımlar. Her internal servis otomatik olarak global görünür yapılmaz. Export edilen servis diğer cluster'da mantıksal isimle temsil edilebilir. Ownership ve security politikaları bu sınır üzerinde uygulanmalıdır. İsim çakışmaları ve version farkları için açık resolution stratejisi gerekir.
Global Service Name
Global service name bir servisin birden fazla cluster'daki instance'larını ortak mantıksal kimlik altında temsil edebilir. İstemci tek isim kullanırken discovery katmanı en uygun cluster endpoint'ini seçebilir. Locality ve health bilgisi routing kararında önemlidir. Aynı isim altında uyumsuz application sürümleri çalışması risk oluşturabilir. Global naming standardı version ve environment stratejisiyle uyumlu tasarlanmalıdır.
Cluster Failover
Cluster failover yerel cluster'daki servis kullanılamaz olduğunda başka cluster'a trafik yönlendirilmesini sağlar. Detection süresi ve global discovery propagation bu geçişin hızını belirler. Alternatif cluster'ın ek yükü taşıyacak kapasitesi bulunmalıdır. Stateful servislerde veri tutarlılığı network routing kadar önemlidir. Failover düzenli chaos testleriyle doğrulanmalıdır.
Network Reachability
Cross-cluster discovery ancak endpoint'ler ağ açısından birbirine erişebiliyorsa işe yarar. Overlapping IP ranges, firewall veya routing sorunları endpoint kullanımını engelleyebilir. Gateway veya east-west network bileşenleri gerekli olabilir. Network path mTLS ve authorization politikalarıyla korunmalıdır. Connectivity testleri discovery test setinin doğal parçası olmalıdır.
Split-Brain Senaryoları
Split-brain iki cluster veya region birbirinden koptuğunda her tarafın kendi state bilgisini doğru kabul etmesiyle ortaya çıkabilir. Stateless request routing açısından durum yönetilebilir görünse de stateful servislerde veri çakışması oluşabilir. Discovery katmanı hangi region'ın aktif olduğunu tek başına belirlememelidir. Leader election veya data consistency mekanizması ayrıca gerekir. Network partition testleri bu nedenle yalnızca endpoint erişimine odaklanmamalıdır.
Multi-Region Service Discovery
Multi-region discovery coğrafi olarak ayrı lokasyonlardaki servis instance'larını yönetir. Amaç normal durumda trafiği yakın region içinde tutarken failure durumunda alternatif bölgeye geçiş sağlamaktır. Global registry, DNS veya service mesh federation bu süreçte kullanılabilir. Network latency ve veri sovereignty gibi faktörler routing kararını etkileyebilir. Active-active ve active-passive modellerin discovery davranışı birbirinden farklıdır.
Region-Local Discovery
Region-local discovery istemcinin önce kendi bölgesindeki endpoint'leri kullanmasını sağlar. Bu yaklaşım latency ve cross-region maliyetini azaltır. Yerel registry geçici olarak uzak region sorunlarından bağımsız çalışabilir. Local kapasite tükendiğinde veya region failure oluştuğunda global fallback gerekir. Local-first politika availability hedefleriyle birlikte tasarlanmalıdır.
Global Registry
Global registry birden fazla region'daki service endpoint bilgisini ortak görünümde sunabilir. Centralized model basit görünse de global control plane failure riskini artırabilir. Dağıtık replication latency ve consistency trade-off oluşturur. Region'ların local çalışmaya devam edebilmesi için cache veya yerel registry katmanı yararlıdır. Global registry'nin her request yolunda zorunlu dependency olması tercih edilmemelidir.
Geo-Aware Routing
Geo-aware routing istemcinin coğrafi konumuna veya region bilgisine göre yakın backend seçer. Bu yöntem kullanıcı latency'sini azaltabilir. Routing kararı yalnızca coğrafi mesafeye değil, health ve kapasite bilgisine de bakmalıdır. Bir region yoğun olduğunda daha uzak ancak sağlıklı hedef tercih edilebilir. Geo policy'nin veri yerleşimi ve yasal gereksinimlerle uyumlu olması gerekir.
Region Failover
Region failover bir bölge tamamen kullanılamaz olduğunda trafiğin alternatif bölgeye geçirilmesidir. Discovery health sinyali region seviyesinde değerlendirilebilir. Failover çok hızlı yapılırsa geçici network problemi büyük trafik hareketine neden olabilir. Çok yavaş yapılırsa kullanıcı kesintisi uzar. Detection threshold ve recovery policy düzenli tatbikatlarla belirlenmelidir.
Latency-Aware Routing
Multi-region latency-aware routing yalnızca statik coğrafi yakınlık yerine gerçek network gecikmesini ölçebilir. Bazı kullanıcılar fiziksel olarak yakın region'a network açısından daha kötü rota üzerinden erişebilir. Dinamik ölçüm bu farkı yakalayabilir. Ölçüm dalgalanmaları trafik sürekli region değiştiriyorsa stabilizasyon mekanizması gerekir. Hysteresis veya minimum tercih süresi bu davranışı kontrol etmeye yardımcı olabilir.
Active-Active
Active-active modelde birden fazla region aynı anda gerçek production trafiği taşır. Discovery istemciyi uygun region'a yönlendirir ve her region normal kapasite planının parçasıdır. Bir region kaybolduğunda diğer bölgelerin ek yükü karşılaması gerekir. Stateful data replication bu modelin en zor konularından biridir. Routing failure ile veri consistency failure ayrı ayrı test edilmelidir.
Active-Passive
Active-passive modelde ana region normal trafiği taşırken yedek region standby durumda kalır. Failure algılandığında discovery veya global routing yedek bölgeyi aktif hâle getirir. Yedek kapasitenin gerçekten hazır olduğu düzenli olarak doğrulanmalıdır. Uzun süre trafik almayan region'da configuration drift oluşabilir. Periyodik failover tatbikatı bu riski azaltır.
Hybrid Cloud ve Service Discovery
Hybrid cloud yapıda servisler Kubernetes, VM, on-prem ve cloud ortamlarına dağılabilir. Tek platformun native discovery mekanizması tüm workload'ları kapsamayabilir. Ortak service catalog veya federation katmanı platformlar arasında adres bulmayı kolaylaştırabilir. Consul gibi teknolojiler bu tür çoklu ortam senaryolarında değerlendirilebilir. Network connectivity, DNS ve identity yönetimi discovery kadar önemli hâle gelir.
Kubernetes + VM
Kubernetes pod'ları platform-native Service discovery kullanırken VM servisleri farklı registry modeline sahip olabilir. İki dünya arasında ortak isimlendirme ve routing katmanı oluşturulması gerekebilir. VM servislerinin dinamik registration yapması stale kayıt riskini azaltır. Kubernetes workload'ları harici servisleri DNS veya mesh üzerinden bulabilir. Migration döneminde çift registry yerine açık bir source-of-truth stratejisi oluşturulmalıdır.
On-Prem + Cloud
On-prem ve cloud ağları farklı DNS ve routing alanlarına sahip olabilir. Service discovery bu iki ortam arasında yalnızca isim değil erişilebilir endpoint bilgisi sağlamalıdır. VPN, private link veya benzer network bağlantısı olmadan discovery sonucu pratikte kullanılamaz. Latency ve bandwidth farklılıkları load balancing policy'ye yansıtılmalıdır. Security boundary iki ortam arasında açık biçimde tanımlanmalıdır.
Serverless Workload'lar
Serverless workload'lar klasik uzun ömürlü service instance modelinden farklı çalışabilir. Endpoint çoğunlukla platform tarafından sabit gateway veya service URL olarak sunulur. İç instance yaşam döngüsü application tarafından görünmeyebilir. Hybrid discovery catalog bu endpoint'i diğer servislerle aynı logical name altında temsil edebilir. Cold start ve concurrency davranışı routing ve timeout politikalarında dikkate alınmalıdır.
Ortak Service Catalog
Ortak service catalog farklı platformlardaki servislerin tek envanterde görülmesini sağlar. Runtime endpoint registry ile organizasyonel ownership bilgisini aynı sistemde tutmak zorunlu değildir. Catalog servis sahibi, repository, environment ve erişim modelini gösterebilir. Discovery kaynakları catalog'a otomatik veri sağlayabilir. Bu yapı ekiplerin hangi servisin nerede çalıştığını anlamasını kolaylaştırır.
Consul ile Platformlar Arası Discovery
Consul Kubernetes, VM ve farklı datacenter ortamlarında ortak service catalog amacıyla kullanılabilir. Agent, DNS ve API arayüzleri farklı workload türlerine erişim seçenekleri sunar. Ancak platform-native discovery ile Consul bilgisinin nasıl senkronize olacağı açık biçimde belirlenmelidir. Aynı servisin iki farklı source-of-truth kaynağına sahip olması debugging sorunlarına yol açabilir. Entegrasyon tasarımı registration ownership kuralıyla başlamalıdır.
Network Connectivity ve DNS
Hybrid discovery doğru endpoint'i bulsa bile network route yoksa iletişim kurulamaz. DNS suffix, firewall ve overlapping IP alanları sık rastlanan entegrasyon sorunlarıdır. Service name çözümlemesi her environment içinde aynı sonucu vermek zorunda değildir. Split-horizon DNS veya gateway yaklaşımı kullanılabilir. Connectivity testleri her iki yöndeki trafik ve failure senaryolarını kapsamalıdır.
Service Discovery'de Cache Stratejisi
Cache service discovery performansını artırırken registry bağımlılığını azaltabilir. Bunun karşılığında endpoint bilgisinin eski kalma riski oluşur. TTL, push update, watch ve last-known-good davranışı birlikte düşünülmelidir. Registry erişilemez olduğunda cache'in ne kadar süre kullanılacağı açık biçimde tanımlanmalıdır. Cache metriği olmadan stale data kaynaklı sorunları tespit etmek zorlaşır.
Endpoint Cache
Endpoint cache client veya proxy'nin son aldığı service instance listesini bellekte tutar. Her request için registry sorgusu yapılmasına gerek kalmaz. Bu yaklaşım latency ve control plane yükünü azaltır. Endpoint değişiklikleri cache'e hızlı ulaşmazsa stale route oluşabilir. Cache refresh mekanizması push veya kısa polling interval ile desteklenebilir.
Last-Known-Good
Last-known-good stratejisi discovery kaynağı geçici olarak kullanılamadığında son başarılı endpoint listesini korur. Çalışan servislerin registry failure nedeniyle aniden erişilemez olmasını engelleyebilir. Ancak cache süresi uzadıkça listede kapanmış instance bulunma ihtimali artar. Failure telemetry üretilmeli ve eski veri kullanıldığı açık biçimde görünmelidir. Registry geri geldiğinde full resync yapılmalıdır.
Cache TTL
Cache TTL endpoint bilgisinin yenilenmeden ne kadar süre kullanılabileceğini belirler. Kısa TTL güncelliği artırırken registry query rate'i yükseltir. Uzun TTL control plane yükünü azaltır ancak stale endpoint süresini artırabilir. Push update varsa TTL daha çok güvenlik ağı olarak kullanılabilir. Farklı servis sınıfları için farklı TTL değerleri gerekebilir.
Push vs Poll Updates
Polling modelinde client belirli aralıklarla registry'yi sorgular. Push modelinde değişiklik oluştuğunda control plane güncellemeyi istemciye iletir. Push daha hızlı propagation sağlayabilir ancak uzun süreli stream yönetimi gerektirir. Polling daha basit olabilir fakat update interval kadar gecikme oluşturur. Büyük sistemlerde hibrit model ve periodic resync güvenli bir seçenek olabilir.
Watch / Subscription Modeli
Watch modeli client'ın belirli service değişikliklerine abone olmasını sağlar. Endpoint ekleme veya çıkarma event'i hızlı biçimde alınabilir. Stream koparsa client hangi event'leri kaçırdığını belirlemek zorundadır. Bu nedenle reconnect sonrasında snapshot veya revision tabanlı resync gerekebilir. Watch connection sayısı registry kapasite planına dahil edilmelidir.
Registry Kapalıyken Ne Olur?
Registry kapalı olduğunda mevcut cache'e sahip istemciler bir süre çalışmaya devam edebilir. Yeni servisler keşfedilemez ve endpoint değişiklikleri alınamaz. Zaman geçtikçe cache stale hâle gelmeye başlar. Client'ın her registry hatasında data plane trafiğini hemen durdurması çoğu sistem için uygun değildir. Graceful degradation ve alarm mekanizması birlikte uygulanmalıdır.
Registry Tutarlılık Modeli
Registry consistency modeli endpoint değişikliklerinin istemcilere nasıl göründüğünü belirler. Strong consistency daha güncel ve sıralı state sunabilir ancak network partition sırasında availability üzerinde maliyet oluşturabilir. Eventual consistency daha yüksek erişilebilirlik sağlayabilir fakat kısa süreli stale endpoint görülebilir. Service discovery çoğu zaman küçük bir stale pencereyi tolere edebilir. Yine de ödeme veya leader selection gibi özel sistemlerde farklı gereksinimler bulunabilir.
Strong Consistency
Strong consistency state değişikliği tamamlandığında sonraki okumalarda güncel değerin görülmesini hedefler. Quorum tabanlı registry sistemleri bu modeli belirli işlemlerde kullanabilir. Network latency write işlemlerini etkileyebilir. Discovery için her lookup'ın güçlü consistency gerektirmesi performans maliyeti oluşturabilir. Gereksinim endpoint lifecycle ve failure tolerance üzerinden belirlenmelidir.
Eventual Consistency
Eventual consistency farklı replica'ların kısa süre farklı endpoint bilgisi göstermesine izin verir. Zaman içinde state aynı sonuca yakınsar. Bu model yüksek availability ve düşük latency açısından avantajlı olabilir. Ancak deregister olmuş instance kısa süre bazı client'larda görünmeye devam edebilir. Retry ve health mekanizmaları bu stale pencereyi tolere edecek şekilde tasarlanmalıdır.
Availability vs Freshness
Discovery sisteminde her zaman en güncel endpoint bilgisi ile her durumda cevap verebilme hedefi arasında trade-off bulunabilir. Registry network partition yaşadığında stale cache ile cevap vermek çalışan trafiği koruyabilir. Buna karşılık yeni kapanmış endpoint'in hâlen listede olması bazı request'leri başarısız yapabilir. İş yükünün failure toleransı bu dengeyi belirler. SLO hem availability hem freshness için ayrı hedefler içermelidir.
Stale Endpoint Toleransı
Her sistem stale endpoint'i aynı ölçüde tolere edemez. Çok kısa timeout ve hızlı retry bulunan stateless servisler birkaç saniyelik stale bilgiyi yönetebilir. Uzun request süreli servislerde aynı stale oranı ciddi latency oluşturabilir. Bu nedenle registry freshness SLO service sınıfına göre farklı olabilir. Gerçek failure testleri kabul edilebilir stale süresini belirlemeye yardımcı olur.
CAP Perspektifi
Network partition dağıtık registry sistemlerinde tutarlılık ve erişilebilirlik kararlarını görünür hâle getirir. Her ürün farklı operasyon için farklı trade-off seçebilir. Service discovery çoğunlukla kısa süreli stale cache ile availability korumayı tercih edebilir. Ancak registration veya leader state gibi işlemler daha güçlü consistency gerektirebilir. CAP kavramını tek bir ürün etiketi yerine belirli operation davranışı üzerinden değerlendirmek daha anlamlıdır.
Discovery İçin Hangi Tutarlılık Seviyesi Gerekir?
Çoğu stateless mikroservis discovery senaryosunda milisaniye seviyesinde tam global consistency gerekmez. Birkaç saniyelik endpoint propagation gecikmesi timeout ve retry ile tolere edilebilir. Stateful leader endpoint veya kritik control plane servislerinde daha güçlü tutarlılık gerekebilir. Karar uygulamanın failure semantics bilgisine göre verilmelidir. Registry ürünü seçmeden önce kabul edilebilir stale süre ve failover hedefi tanımlanmalıdır.
Service Discovery Güvenliği
Discovery sistemi servislerin birbirini bulduğu kritik control plane olduğu için güçlü biçimde korunmalıdır. Yetkisiz biri sahte servis kaydı oluşturabilirse trafik zararlı endpoint'e yönlendirilebilir. Authentication, authorization, ACL ve TLS gibi mekanizmalar birlikte kullanılmalıdır. Registry metadata'sında hassas bilgi saklanmamalıdır. Güvenlik standardı hakkında ek okuma için https://www.diyarbakiryazilim.com.tr/posts/guvenli-sifreleme-ve-hassas-veri-depolama-standartlari adresindeki içerik de faydalı bir çerçeve sunar.
Registry Authentication
Registry authentication hangi client veya workload'un control plane'e bağlandığını doğrular. Anonymous registration production ortamlarında ciddi risk oluşturur. Workload identity, token veya certificate tabanlı mekanizmalar kullanılabilir. Credential rotation otomatik ve gözlemlenebilir olmalıdır. Authentication bilgileri application log'larına veya registry metadata'sına yazılmamalıdır.
Registry Authorization
Authorization doğrulanmış client'ın registry üzerinde hangi işlemleri yapabileceğini belirler. Her service yalnızca kendi kaydını değiştirebilmeli ve ihtiyaç duyduğu katalog bilgisine erişebilmelidir. Yönetim işlemleri ayrı role bağlanmalıdır. Geniş admin token'ların application pod'larına dağıtılması güvenli değildir. Least privilege politikası kayıt silme veya sahte endpoint ekleme riskini azaltır.
ACL
ACL registry kaynaklarına erişimi servis, path veya operation bazında sınırlayabilir. Read ve write izinleri ayrı tanımlanmalıdır. Service discovery okumaları geniş olabilirken registration yetkisi daha sıkı tutulabilir. ACL policy değişiklikleri audit log ile izlenmelidir. Deneme ortamındaki geniş izinler production'a kopyalanmamalıdır.
TLS
TLS client ile registry arasındaki network trafiğini şifreler. Bu sayede endpoint ve metadata bilgisinin ağ üzerinde okunması veya değiştirilmesi zorlaşır. Server certificate doğrulaması zorunlu olmalıdır. Certificate rotation ve expiration monitoring unutulmamalıdır. Internal network olduğu için plaintext bağlantı kullanmak zero trust yaklaşımıyla uyumlu değildir.
mTLS
mTLS registry bağlantısında hem server hem client kimliğinin certificate ile doğrulanmasını sağlar. Workload identity ile birlikte kullanıldığında güçlü authentication modeli sunar. Sertifikaların kısa ömürlü ve otomatik yenilenen yapıda olması tercih edilir. Certificate issuance sistemi ayrı bir yüksek erişilebilirlik konusu hâline gelir. Authorization policy mTLS kimliğini gerçek izin kararına dönüştürmelidir.
Fake Service Registration
Fake service registration saldırısında yetkisiz bir endpoint gerçek servis adı altında registry'ye eklenebilir. İstemciler bu endpoint'i sağlıklı kabul ederse trafik saldırgan kontrolündeki hedefe yönlenebilir. Registration için güçlü authentication ve service-specific authorization gereklidir. Registry değişiklikleri audit log ve alert sistemiyle izlenmelidir. Beklenmeyen yeni instance kayıtları otomatik güvenlik sinyali olarak değerlendirilebilir.
Registry Poisoning
Registry poisoning mevcut servis kaydının kötü niyetli veya hatalı bilgiyle değiştirilmesidir. Yanlış IP, port veya metadata trafiğin yanlış hedefe gitmesine neden olabilir. Write permission çok sınırlı tutulmalıdır. Configuration ve registration değişiklikleri imzalı deployment pipeline üzerinden yapılabilir. Anormal endpoint değişim hızı monitoring ile tespit edilmelidir.
DNS Spoofing
DNS spoofing istemciye yanlış servis adresi döndürülmesine yol açabilir. Internal DNS altyapısı güvenli network politikalarıyla korunmalıdır. DNSSEC her internal discovery senaryosunda kullanılmasa da resolver ve upstream güvenliği önemlidir. Service mesh mTLS kullanılıyorsa yanlış endpoint'e yönlenen client karşı tarafın geçerli workload identity taşımadığını fark edebilir. Discovery security ile transport identity bu nedenle birbirini tamamlar.
Zero Trust Service Discovery
Zero trust yaklaşımı network içinde bulunmanın otomatik güven anlamına gelmediğini kabul eder. Discovery bir endpoint'i bulsa bile istemci karşı workload'un kimliğini doğrulamalıdır. IP tabanlı güven yerine workload identity ve kısa ömürlü certificate kullanımı daha sağlam bir model sunar. Deny-by-default authorization servisler arası erişimi açık izinlere bağlar. Discovery, identity ve policy birlikte tasarlandığında dinamik altyapıda daha kontrollü güvenlik elde edilir.
IP Adresi Yerine Workload Identity
IP adresleri pod restart ve autoscaling sırasında değişebilir. Bu nedenle IP'yi kalıcı service identity olarak kullanmak uygun değildir. Workload identity mantıksal servis kimliğini network adresinden ayırır. mTLS certificate'ı karşı endpoint'in gerçekten beklenen identity'ye sahip olduğunu gösterebilir. Bu yaklaşım zero trust policy'lerini dinamik platformlarla daha uyumlu hâle getirir.
SPIFFE ID
SPIFFE ID workload için standartlaştırılmış kimlik formatı sunar. Cluster veya platform sınırları arasında ortak identity modeli oluşturmak için kullanılabilir. Authorization policy endpoint IP'si yerine SPIFFE ID üzerinden tanımlanabilir. Identity lifecycle deployment yaşam döngüsüyle otomatik yönetilmelidir. Kimlik namespace yapısı organizasyon ve environment sınırlarını doğru yansıtmalıdır.
Short-Lived Certificates
Kısa ömürlü certificate uzun süre sızdırılmış credential kullanılma riskini azaltır. Sertifikalar otomatik olarak yenilenmelidir. Rotation failure gerçekleşirse trafik kesintisi oluşabileceği için expiration metriği izlenmelidir. Manuel certificate dağıtımı yüzlerce mikroservis için sürdürülebilir değildir. Identity platformu issuance ve revocation sürecini otomatikleştirmelidir.
Deny-by-Default
Deny-by-default modelde açık izin verilmeyen servis trafiği engellenir. Böylece yeni bir workload ağa eklendiğinde otomatik olarak bütün iç servislere erişemez. Gerekli dependency ilişkileri policy olarak tanımlanır. Service catalog dependency graph bu izinların hazırlanmasına yardımcı olabilir. Policy rollout sırasında yanlış engelleme riskini azaltmak için audit veya dry-run modları kullanılabilir.
Service-to-Service Authorization
Service-to-service authorization hangi workload identity'nin hangi servise hangi işlemi yapabileceğini belirler. L4 seviyesinde service identity tabanlı izin yeterli olabilir. HTTP veya gRPC method seviyesinde daha ayrıntılı L7 policy gerekebilir. Discovery sonucu bir endpoint bulunması authorization izni olduğu anlamına gelmez. Policy enforcement noktası ile identity source arasındaki güven zinciri açık biçimde tanımlanmalıdır.
Service Discovery Observability
Service discovery yalnızca çalışırken fark edilmeyen bir altyapı olmamalıdır. Registration, deregistration ve health transition event'leri gözlemlenebilir olmalıdır. Query latency, failed lookup ve stale endpoint oranı incident sırasında önemli ipuçları sağlar. DNS ve proxy katmanı birlikte izlenmelidir. Distributed tracing request'in hangi endpoint'e ve hangi discovery kararıyla gittiğini anlamayı kolaylaştırabilir.
Registration Events
Registration event yeni service instance'ın discovery sistemine eklendiğini gösterir. Deployment sırasında beklenen sayıda registration gerçekleşip gerçekleşmediği izlenebilir. Çok sık registration churn restart loop veya autoscaling problemi gösterebilir. Event üzerinde service name, version ve zone bilgisi bulunması debugging sürecini kolaylaştırır. Beklenmeyen service registration güvenlik alarmı olarak da değerlendirilebilir.
Deregistration Events
Deregistration event instance'ın discovery listesinden çıkarıldığını gösterir. Rolling deployment sırasında düzenli deregistration beklenen davranıştır. Aynı serviste kısa sürede çok sayıda deregistration node failure veya health policy sorununa işaret edebilir. Graceful ve timeout kaynaklı deregistration mümkünse ayrı reason olarak kaydedilmelidir. Event log ile application termination log'u zaman açısından ilişkilendirilebilmelidir.
Health Status Changes
Health status transition sayısı servis stabilitesi hakkında önemli sinyal sağlar. Sürekli healthy ve unhealthy arasında gidip gelen instance flapping problemi yaşıyor olabilir. Check threshold veya network latency bu davranışın nedeni olabilir. Alert sistemi tek event yerine belirli süre içindeki transition oranına bakabilir. Health event'leri node ve dependency metric'leriyle birlikte incelenmelidir.
Registry Query Rate
Registry query rate client'ların discovery sistemine ne kadar yük oluşturduğunu gösterir. Ani artış cache'in devre dışı kalması veya retry loop göstergesi olabilir. Query rate servis sayısı ve client replica miktarıyla birlikte değerlendirilmelidir. Registry kapasitesi peak deployment sırasında oluşan ekstra sorguları da karşılamalıdır. Cache hit ratio ile birlikte incelendiğinde davranış daha anlaşılır hâle gelir.
DNS Query Rate
DNS query rate özellikle düşük TTL kullanılan Kubernetes ortamlarında önemlidir. CoreDNS üzerinde ani sorgu artışı latency ve timeout oluşturabilir. Uygulamaların gereksiz her request için DNS çözümlemesi yapması bu yükü artırır. Node-local cache gibi mekanizmalar sorgu hacmini azaltabilir. DNS error ve latency metric'leri service discovery dashboard'unda görünür olmalıdır.
Discovery Failures
Discovery failure servis adı için kullanılabilir endpoint bulunamadığında veya registry sorgusu başarısız olduğunda oluşabilir. Bu hata application failure'dan ayrı izlenmelidir. DNS NXDOMAIN, registry timeout ve empty endpoint list farklı error reason olarak kaydedilebilir. Deployment sırasında kısa süreli artış beklenebilir ancak uzun sürmesi incident göstergesidir. Alert eşiği service criticality ve normal churn oranına göre belirlenmelidir.
Routing Failures
Discovery başarılı olsa bile route edilen endpoint bağlantı kabul etmeyebilir. Bu durum stale endpoint, network policy veya application crash kaynaklı olabilir. Routing failure metriği discovery sonucunun gerçek kullanılabilirliğini doğrulamaya yardımcı olur. Endpoint identity ve zone bilgisi log'a eklenebilir. Tek backend üzerinde yoğunlaşan hata outlier detection için sinyal oluşturabilir.
Distributed Tracing
Distributed tracing request'in servisler arasında nasıl ilerlediğini gösterir. Span metadata'sına seçilen upstream service ve instance bilgisi eklenebilir. Retry yapıldığında farklı endpoint'lere giden denemeler görülebilir. Discovery latency doğrudan trace span olarak ölçülebiliyorsa control plane etkisi anlaşılır. Ancak yüksek kardinaliteli IP veya instance ID alanları telemetry maliyeti açısından kontrollü kullanılmalıdır.
Service Discovery İçin Takip Edilmesi Gereken KPI'lar
Service discovery başarısını yalnızca registry'nin up olmasıyla ölçmek yeterli değildir. Availability yanında lookup latency, endpoint freshness ve failover time gibi metrikler izlenmelidir. Registration ile trafiğe hazır olma arasındaki convergence süresi deployment kalitesini gösterir. Stale endpoint rate gerçek kullanıcı hatalarıyla ilişkilendirilebilir. KPI seti SLO tanımlarına dönüştürüldüğünde operasyon hedefleri daha ölçülebilir hâle gelir.
Registry Availability
Registry availability control plane'in sorgu ve registration işlemlerine cevap verebilme oranını gösterir. Yüksek availability önemli olsa da data plane davranışı ayrıca ölçülmelidir. Registry birkaç dakika erişilemezken cache kullanan servisler çalışmaya devam edebilir. Bu nedenle control plane SLO ile end-user SLO aynı şey değildir. Multi-zone ve failover testleri availability hedefini doğrulamalıdır.
Discovery Latency
Discovery latency bir service lookup işleminin ne kadar sürede tamamlandığını gösterir. DNS, registry API veya proxy update mekanizmasına göre ölçüm yöntemi değişebilir. Yüksek latency request startup süresini veya connection establishment zamanını artırabilir. Cache kullanılan sistemlerde hit ve miss latency ayrı izlenmelidir. P95 ve P99 değerleri ortalama süreden daha anlamlı olabilir.
Registration Convergence Time
Registration convergence time yeni instance ayağa kalktıktan sonra istemcilerin onu discovery sonucunda görebilmesine kadar geçen süredir. Autoscaling performansı bu metrikten etkilenir. Yeni pod saniyeler içinde hazır olsa bile proxy update'i gecikiyorsa kapasite trafiğe geç katılır. Registration event ve first successful request zamanı birlikte ölçülebilir. Hedef değer platform büyüklüğüne göre belirlenmelidir.
Endpoint Update Propagation Time
Endpoint update propagation time registry değişikliğinin bütün ilgili client veya proxy'lere ulaşma süresidir. Deregistration sırasında uzun propagation stale endpoint hatalarına yol açabilir. Push tabanlı sistemlerde control plane fan-out kapasitesi bu metriği etkiler. DNS tabanlı modelde TTL ve resolver cache davranışı belirleyicidir. Production failure testleri gerçek propagation dağılımını ölçmek için kullanılmalıdır.
Health Detection Time
Health detection time bozulan instance'ın sağlıksız olarak işaretlenmesine kadar geçen süredir. Çok uzun değer kullanıcı hatalarının sürmesini sağlar. Çok kısa değer transient network sorunlarında false positive üretebilir. Check interval, timeout ve threshold birlikte toplam detection süresini oluşturur. SLO belirlenirken application request timeout süresi de dikkate alınmalıdır.
Stale Endpoint Rate
Stale endpoint rate discovery sonucunda artık geçerli olmayan adreslerin ne sıklıkla kullanıldığını gösterir. Routing error veya connection failure verisinden türetilebilir. Yüksek oran deregistration veya cache freshness problemine işaret eder. Tek bir instance crash sonrasında kısa artış normal olabilir. Sürekli yüksek değer discovery pipeline'ın güncellik sorununu gösterir.
Failed Lookup Rate
Failed lookup rate service name için endpoint bulunamayan discovery sorgularının oranıdır. DNS NXDOMAIN, registry timeout veya empty healthy set gibi nedenler ayrı ölçülmelidir. Deployment sırasında kısa süreli boş endpoint penceresi varsa bu metrik görünür hâle gelir. Yüksek oran application error rate ile korelasyon gösterebilir. Alert threshold servis criticality'sine göre belirlenmelidir.
Failover Time
Failover time bir endpoint, zone veya region kaybından sonra başarılı trafiğin alternatif hedefe yönelmesine kadar geçen süredir. Detection, discovery update ve routing değişikliği toplam süreyi oluşturur. Yalnızca DNS TTL değerine bakmak gerçek failover süresini göstermez. Connection pool ve client retry de etkili olabilir. Chaos testleri uçtan uca failover time ölçmek için en iyi yöntemlerden biridir.
Cache Hit Ratio
Cache hit ratio discovery sorgularının ne kadarının local cache üzerinden karşılandığını gösterir. Yüksek oran registry yükünü azaltabilir. Aşırı yüksek oran ve uzun TTL birlikte stale data riskine işaret edebilir. Cache miss sırasında latency artışı ayrıca ölçülmelidir. Registry failure anında cache kullanım oranının nasıl değiştiği incident analizinde değerli bilgi sağlar.
Service Discovery SLO Nasıl Tanımlanır?
Service discovery SLO yalnızca control plane uptime yüzdesi olmamalıdır. Endpoint freshness, lookup latency, failure detection ve recovery süresi kullanıcı etkisini daha iyi gösterir. Her service sınıfı aynı hedefe ihtiyaç duymayabilir. Kritik ödeme trafiği ile batch worker discovery beklentileri farklı olabilir. Error budget yaklaşımı platform değişikliklerinin riskini sayısal olarak yönetmeye yardımcı olur.
Availability SLO
Availability SLO registry veya DNS hizmetinin belirli zaman aralığında başarılı cevap verme oranını tanımlar. Bu değer control plane için ayrı ölçülmelidir. Client cache nedeniyle registry failure her zaman application downtime oluşturmaz. Buna rağmen uzun kesintiler stale endpoint ve yeni registration sorununa yol açar. Availability SLO failure domain ve redundancy tasarımıyla uyumlu seçilmelidir.
Endpoint Freshness SLO
Endpoint freshness SLO bir registration veya deregistration değişikliğinin belirli süre içinde istemcilere ulaşmasını hedefler. Örneğin kapanan endpoint'lerin büyük çoğunluğunun birkaç saniye içinde routing havuzundan çıkması istenebilir. Ölçüm control plane event zamanı ile client update zamanı karşılaştırılarak yapılabilir. DNS tabanlı sistemlerde cache katmanları ölçümü zorlaştırabilir. Gerçek kullanıcı routing failure verisi freshness hedefini doğrulamaya yardımcı olur.
Lookup Latency SLO
Lookup latency SLO service discovery sorgularının kabul edilebilir süre içinde tamamlanmasını tanımlar. Cache hit ve registry miss davranışı ayrı hedeflere sahip olabilir. P95 veya P99 latency tail sorunlarını daha iyi gösterir. Çok sık lookup yapan uygulamalarda küçük latency artışı bile toplam request süresini etkileyebilir. Client'ın her request öncesi discovery yapmaması genellikle daha verimli bir modeldir.
Failure Detection SLO
Failure detection SLO bozuk instance'ın ne kadar sürede sağlıksız olarak algılanacağını tanımlar. Hedef çok agresif seçilirse false positive oranı artabilir. Detection süresi application timeout ve retry davranışıyla birlikte değerlendirilmelidir. Node failure ve process crash farklı mekanizmalar üzerinden algılanabilir. SLO gerçek chaos testleriyle doğrulanmalıdır.
Recovery SLO
Recovery SLO servis tekrar sağlıklı olduğunda discovery ve routing sisteminin onu ne kadar sürede kullanmaya başlayacağını ölçer. Çok uzun recovery süresi kapasitenin gereksiz yere kullanılmamasına neden olabilir. Health threshold çoğunlukla belirli sayıda başarılı check bekler. Flapping önlemek için kontrollü recovery faydalıdır. Hedef failure detection ile birlikte dengelenmelidir.
Error Budget
Error budget SLO dışında kalabilecek kabul edilebilir hata miktarını tanımlar. Discovery platformunda sık configuration değişikliği yapılıyorsa budget tüketimi değişiklik hızını sınırlayabilir. Freshness veya lookup failure kaynaklı hatalar ayrı budget kategorileri olarak incelenebilir. Bu yaklaşım reliability ve geliştirme hızı arasında ölçülebilir denge kurar. Budget sürekli tüketiliyorsa yeni özellik yerine platform stabilizasyonuna öncelik verilebilir.
Service Discovery Failure Senaryoları
Service discovery tasarımı normal çalışma kadar failure davranışı üzerinden değerlendirilmelidir. Registry, DNS, network veya health sistemi ayrı ayrı bozulabilir. Control plane failure'ın data plane trafiğini hemen durdurmaması tercih edilir. Cache ve graceful degradation mekanizmaları bu amaçla kullanılabilir. Failure senaryoları düzenli olarak test edilmediğinde teorik high availability production olayında beklenenden farklı davranabilir.
Registry Tamamen Çökerse
Registry tamamen çöktüğünde yeni registration ve güncel lookup işlemleri başarısız olabilir. Local endpoint cache'i bulunan client'lar son bilinen backend'lerle çalışmaya devam edebilir. Zaman geçtikçe stale endpoint riski artar. Yeni autoscaling instance'ları trafiğe dahil olamayabilir. Bu senaryo için last-known-good policy, alert ve recovery prosedürü önceden tanımlanmalıdır.
Registry Network Partition
Network partition sırasında bazı client veya server'lar registry'nin yalnızca bir bölümüne erişebilir. Farklı taraflar farklı endpoint state görebilir. Consistency modeli hangi değişikliklerin kabul edileceğini belirler. Local cache kısa süreli trafiği koruyabilir. Partition giderildiğinde state reconciliation ve endpoint convergence süresi izlenmelidir.
DNS Çökerse
DNS hizmeti kullanılamaz olduğunda yeni hostname çözümlemeleri başarısız olabilir. Mevcut connection'lar çalışmaya devam edebilir ve local resolver cache bir süre yardımcı olabilir. Connection yeniden kurulması gerektiğinde problem görünür hâle gelir. Node-local cache veya redundant DNS server etkisini azaltabilir. DNS failure testi application connection pool davranışını da kapsamalıdır.
Eski Endpoint Cache'de Kalırsa
Stale endpoint cache'de kaldığında client artık çalışmayan instance'a request gönderebilir. Timeout ve retry kullanıcı latency'sini artırır. Outlier detection bozuk endpoint'i geçici olarak seçimden çıkarabilir. Cache refresh gelene kadar hata tamamen bitmeyebilir. Stale rate metric'i bu sorunun sıklığını ölçmeye yardımcı olur.
Yanlış Health Check Bütün Instance'ları Düşürürse
Ortak bir dependency health check'e bağlandıysa tek downstream problemi bütün servis instance'larını unhealthy yapabilir. Discovery sonucu boş kaldığında bütün request'ler başarısız olur. Bu olay health logic hatasının geniş failure domain oluşturduğunu gösterir. Shallow readiness ve deep diagnostic check ayrımı kullanılmalıdır. Chaos testi dependency outage sırasında endpoint havuzunun davranışını doğrulamalıdır.
Control Plane Kaybolursa
Service mesh control plane kaybolduğunda data plane proxy'leri son configuration ile çalışmaya devam edebilir. Yeni endpoint ve policy değişiklikleri alınamaz. Zaman geçtikçe configuration stale hâle gelir. Mevcut servisler stabil ise trafik bir süre normal sürebilir. Control plane recovery sonrasında full reconciliation yapılması gerekir.
Cross-Region Link Koparsa
Cross-region link kaybı global discovery ve remote endpoint erişimini etkileyebilir. Local servislerin çalışmaya devam etmesi ideal davranıştır. Active-active sistemde her region kendi local trafiğini taşıyabilir. Global registry state farklılaşabilir ve partition sonrası reconciliation gerekir. Failover policy yanlışsa trafik erişilemeyen region'a yönlenmeye devam edebilir.
Service Registry'yi Tek Hata Noktası Olmaktan Çıkarmak
Registry tek hata noktası olmaktan çıkarılmak için yalnızca replica sayısını artırmak yeterli değildir. Replication, quorum, multi-zone placement ve client cache birlikte düşünülmelidir. Ayrıca registry failure sırasında application data plane'in ne yapacağı açık biçimde tanımlanmalıdır. Last-known-good endpoint kullanımı kısa süreli dayanıklılık sağlayabilir. Graceful degradation, control plane sorununu doğrudan kullanıcı kesintisine çevirmemeyi hedefler.
Replication
Replication registry state'in birden fazla server üzerinde tutulmasını sağlar. Tek server kaybında diğer replica hizmet vermeye devam edebilir. Replication gecikmesi endpoint freshness üzerinde etkili olabilir. Replica'ların aynı zone içinde bulunması ortak failure riskini ortadan kaldırmaz. Veri ve server placement farklı failure domain'lere dağıtılmalıdır.
Quorum
Quorum state değişikliklerinin güvenli çoğunluk tarafından kabul edilmesini sağlar. Server sayısı ve tolerans hesaplaması doğru yapılmalıdır. Network partition sırasında quorum olmayan tarafta write işlemleri durabilir. Read davranışı kullanılan registry ürününe göre değişebilir. Quorum kaybı senaryosu production öncesinde kontrollü olarak test edilmelidir.
Multi-Zone Deployment
Registry server'larını birden fazla zone'a dağıtmak tek zone kaybına karşı dayanıklılık sağlar. Replica sayısı zone sayısıyla dengeli olmalıdır. Network latency consensus performansını etkileyebilir. Zone failure sırasında kalan node'ların kapasitesi yeterli olmalıdır. Placement policy otomasyonla korunmazsa zaman içinde bütün replica'lar aynı zone'a toplanabilir.
Client Cache
Client cache registry erişilemez olduğunda son bilinen endpoint listesini kullanabilir. Bu mekanizma control plane failure'ın uygulamayı hemen durdurmasını engeller. Cache süresi sınırsız olmamalıdır. Stale endpoint failure'ları outlier detection ve timeout ile yönetilmelidir. Registry tekrar kullanılabilir olduğunda client hızlı resync yapmalıdır.
Last-Known-Good Endpoints
Last-known-good endpoint listesi son başarılı discovery snapshot'ını temsil eder. Registry error verdiğinde empty list kullanmak yerine bu snapshot tercih edilebilir. Böylece çalışan backend'lerle iletişim devam eder. Liste yaşlandıkça risk arttığı için age metric izlenmelidir. Belirli maksimum süre sonrasında sistem daha güvenli fallback moduna geçebilir.
Graceful Degradation
Graceful degradation tam fonksiyon yerine sınırlı kapasiteyle hizmet vermeye devam etmeyi amaçlar. Registry kesintisinde mevcut endpoint cache'i ile read işlemleri sürdürülebilir. Yeni deployment veya autoscaling işlemleri geçici olarak durdurulabilir. Bu davranış business criticality'ye göre farklı servislerde farklı tasarlanabilir. Degraded mode kullanıcı ve operasyon ekipleri tarafından görünür olmalıdır.
Service Discovery Nasıl Test Edilir?
Service discovery yalnızca unit test ile doğrulanabilecek bir altyapı değildir. Registration, health transition, autoscaling ve failure koşulları gerçek integration ortamında test edilmelidir. DNS cache ve connection pool gibi runtime davranışları production benzeri konfigürasyon gerektirir. Network partition ve registry failure testleri beklenmeyen bağımlılıkları ortaya çıkarır. Test sonuçları failover time ve endpoint freshness gibi KPI'lara dönüştürülebilir.
Registration Test
Registration test yeni instance başlatıldığında registry veya platform endpoint listesine doğru biçimde eklenip eklenmediğini doğrular. Service name, port ve metadata alanları kontrol edilmelidir. Instance hazır olmadan discovery sonucunda görünmemelidir. Birden fazla replica eş zamanlı başladığında yarış koşulları test edilmelidir. Registration convergence time ölçülerek SLO ile karşılaştırılabilir.
Deregistration Test
Deregistration test planlı shutdown sırasında endpoint'in ne kadar sürede havuzdan çıktığını ölçer. Readiness kapandıktan sonra yeni trafik gönderilmemesi beklenir. Process tamamen sonlanmadan discovery update'inin gerçekleşmesi kontrol edilmelidir. Zorla process kill edilerek graceful olmayan senaryo ayrıca test edilir. Stale endpoint süresi gerçek routing log'larıyla ölçülmelidir.
Health Check Test
Health check test uygulama healthy, slow ve failed durumdayken registry sonucunun nasıl değiştiğini doğrular. Tek dependency outage bütün instance'ları düşürüyor mu kontrol edilmelidir. Timeout ve threshold değerlerinin false positive üretmediği gözlenmelidir. Recovery sırasında instance'ın tekrar havuza ne kadar sürede döndüğü ölçülmelidir. Test farklı network latency seviyelerinde tekrarlanmalıdır.
Autoscaling Test
Autoscaling test yeni replica'ların discovery havuzuna doğru sürede eklenmesini doğrular. Trafik artışı sırasında scale-out gerçekleştiğinde yeni instance'ların gerçekten request aldığı ölçülmelidir. Scale-in sırasında kapanacak pod'ların önce havuzdan çıkarılması beklenir. gRPC gibi uzun connection protokollerinde yeni instance'ların trafik alıp almadığı ayrıca kontrol edilmelidir. Test yalnızca replica sayısına değil gerçek load distribution'a bakmalıdır.
Rolling Deployment Test
Rolling deployment test eski ve yeni version instance'larının geçiş sırasında doğru routing almasını doğrular. Yeni pod readiness olmadan trafik almamalıdır. Eski pod shutdown sırasında active request'i yarıda bırakmamalıdır. Error rate deployment boyunca kabul edilebilir sınırda kalmalıdır. Version metadata ve canary policy kullanılıyorsa trafik yüzdeleri ayrıca doğrulanmalıdır.
Registry Failure Test
Registry failure test control plane tamamen kapatıldığında client davranışını gözlemler. Mevcut endpoint cache'i ile request'lerin sürüp sürmediği kontrol edilir. Yeni instance registration ve endpoint update işlemlerinin beklendiği gibi başarısız olduğu doğrulanır. Registry geri geldiğinde resync süresi ölçülür. Bu test last-known-good stratejisinin gerçekten çalıştığını gösterir.
DNS Cache Test
DNS cache test service IP veya endpoint değiştiğinde application runtime'ın yeni kaydı ne zaman gördüğünü ölçer. DNS TTL düşürmek tek başına yeterli kabul edilmemelidir. JVM, işletim sistemi ve connection pool katmanları ayrı ayrı incelenmelidir. Uzun süreli bağlantılar yeni DNS sonucunu kullanmayabilir. Test production ile aynı runtime ve resolver ayarlarında yapılmalıdır.
Network Partition Test
Network partition test client ile registry veya cluster'lar arasındaki bağlantının kesildiği durumu simüle eder. Cache ve local discovery davranışı gözlenir. Partition sırasında farklı taraflarda registration değişiklikleri yapılabilir. Bağlantı geri geldiğinde state convergence kontrol edilmelidir. Bu test consistency ve availability varsayımlarını gerçek ortamda doğrular.
Failover Test
Failover test seçili endpoint, zone veya region devre dışı bırakıldığında trafiğin alternatif hedefe geçmesini doğrular. Detection ve routing değişikliği arasındaki toplam süre ölçülmelidir. Alternatif kapasite peak trafiği karşılayabilmelidir. Retry storm veya connection saturation oluşup oluşmadığı izlenmelidir. Recovery sonrasında trafiğin eski hedefe dönüş politikası da test edilmelidir.
Chaos Engineering ile Service Discovery
Chaos engineering discovery sisteminin gerçek failure davranışını kontrollü ortamda görmeye yardımcı olur. Instance kill, DNS failure ve network packet loss gibi deneyler teorik varsayımları doğrular. Amaç production'ı rastgele bozmak değil, belirli hipotezi ölçülebilir deneyle test etmektir. Etki alanı küçük başlatılmalı ve otomatik durdurma koşulları tanımlanmalıdır. Sonuçlar SLO ve runbook güncellemelerinde kullanılmalıdır.
Instance Kill
Instance kill deneyinde çalışan bir service instance aniden sonlandırılır. Registry'nin failure'ı ne kadar sürede algıladığı ölçülür. Client'ların stale endpoint'e kaç request gönderdiği incelenir. Retry farklı sağlıklı instance'a yönleniyor mu kontrol edilir. Autoscaling yeni kapasite oluşturuyorsa registration süresi de aynı deneyde ölçülebilir.
Registry Kill
Registry kill deneyinde discovery control plane'in bir veya daha fazla node'u kapatılır. Quorum davranışı ve client cache kullanımı gözlenir. Mevcut data plane trafiğinin devam edip etmediği ölçülür. Yeni registration işlemleri ayrı kontrol edilir. Registry recovery sonrasında endpoint state'in doğru biçimde senkronize olduğu doğrulanır.
DNS Failure
DNS failure deneyinde resolver veya DNS service geçici olarak erişilemez hâle getirilir. Mevcut connection'ların davranışı ile yeni connection kurulumu karşılaştırılır. Local cache'in ne kadar süre yardımcı olduğu ölçülür. Application retry'nin DNS altyapısına ek yük oluşturup oluşturmadığı incelenir. Recovery sonrasında negative cache etkisi kontrol edilmelidir.
Packet Loss
Packet loss network bağlantısının tamamen kesilmediği ancak belirli oranda paket kaybı yaşadığı durumu simüle eder. Health check timeout ve heartbeat mekanizmaları bu durumda farklı davranabilir. Registry sağlıklı instance'ı yanlışlıkla unhealthy işaretleyebilir. Request latency ve retry sayısı artabilir. Threshold değerlerinin gerçek network koşullarına toleransı bu deneyle görülebilir.
Delayed Health Checks
Delayed health check senaryosu health endpoint cevaplarının normalden yavaşlatılmasını içerir. Check timeout değerinin ne kadar hassas olduğu gözlenir. Instance gerçek kullanıcı request'lerini karşılayabilirken health kontrolü timeout oluyorsa yanlış eviction oluşabilir. Birden fazla instance aynı anda etkilenirse discovery havuzu küçülebilir. Bu test health check bütçesinin application latency profiliyle uyumunu ölçer.
Stale Registry Entries
Stale registry entry deneyi bilinçli olarak artık çalışmayan endpoint'in listede tutulmasıyla yapılabilir. Client timeout ve retry davranışı ölçülür. Outlier detection varsa endpoint'in ne kadar hızlı seçimden çıkarıldığı gözlenir. Kullanıcı latency'sine etkisi kayıt altına alınır. Bu deney kabul edilebilir endpoint freshness SLO belirlemeye yardımcı olur.
Region Failure
Region failure deneyi multi-region mimarinin en kritik testlerinden biridir. Bir bölgeye network erişimi kesildiğinde global routing ve discovery failover davranışı ölçülür. Diğer region'ların kapasite artışı gözlenir. Data consistency ve state replication sorunları ayrıca kontrol edilir. Gerçek RTO ve RPO hedefleri bu tür tatbikatlarla doğrulanmalıdır.
Local Development Ortamında Service Discovery
Local development ortamı production discovery yapısını tamamen taklit etmek zorunda değildir. Ancak geliştiricilerin servis isimleri ve dependency davranışını benzer şekilde deneyebilmesi önemlidir. localhost ve sabit portlar küçük projelerde yeterli olabilir. Docker Compose service name veya local Kubernetes daha gerçekçi discovery sağlayabilir. Development parity arttıkça production'da yalnızca ortam farkından kaynaklanan hatalar azalır.
localhost ve Fixed Ports
Küçük local projelerde servisler localhost üzerinde sabit portlarla çalıştırılabilir. Bu yöntem hızlıdır ve ek altyapı gerektirmez. Servis sayısı arttığında port çakışmaları ve configuration yönetimi zorlaşır. Production'da dinamik discovery kullanılıyorsa local sabit port yaklaşımı bazı hataları gizleyebilir. Ortam farkı geliştirici dokümantasyonunda açık biçimde belirtilmelidir.
Docker Compose Service Names
Docker Compose servisleri ortak network içinde service name üzerinden DNS ile bulabilir. Bu davranış mikroservisler için basit bir local discovery deneyimi sunar. Developer sabit container IP adresi kullanmak zorunda kalmaz. Compose environment production Kubernetes ile tamamen aynı değildir ancak logical service name alışkanlığı kazandırır. Health check ve startup dependency davranışı ayrıca test edilebilir.
Local Consul
Production altyapısı Consul kullanıyorsa local Consul agent veya küçük dev cluster kurulabilir. Servis registration ve health check davranışları geliştirici ortamında denenebilir. Configuration mümkün olduğunca production standardına yakın tutulmalıdır. Çok ağır multi-server setup local development için gerekli olmayabilir. Amaç application integration hatalarını erken aşamada yakalamaktır.
Local Kubernetes
Local Kubernetes ortamı Service, DNS ve readiness davranışlarını gerçek platforma yakın şekilde test etmeyi sağlar. Geliştiriciler pod restart ve rolling deployment senaryolarını deneyebilir. Resource tüketimi Docker Compose yaklaşımından daha yüksek olabilir. Geliştirme süresi uzamaması için otomatik manifest ve hızlı build akışı önemlidir. Production parity gerektiren discovery sorunlarında local cluster büyük fayda sağlar.
Production Discovery ile Development Parity
Development parity production'daki service naming ve network davranışının local ortamda mümkün olduğunca benzer olmasıdır. Tam birebir altyapı kopyası her zaman gerekli değildir. En kritik konu uygulamanın IP hard-code etmeden logical service name kullanmasıdır. Health ve retry ayarları da production ile benzer configuration modeli üzerinden yönetilebilir. Parity arttıkça environment-specific hata sayısı azalır.
CI/CD ve Service Discovery
CI/CD pipeline deployment sonrası servis discovery yaşam döngüsünü dikkate almalıdır. Yeni instance'ın yalnızca process başladığı için trafiğe alınması doğru değildir. Readiness başarılı olduktan sonra endpoint routing havuzuna eklenmelidir. Eski instance kapatılırken graceful deregistration yapılmalıdır. Canary ve rollback otomasyonu discovery ve traffic policy event'leriyle birlikte çalışmalıdır.
Deployment Sonrası Registration
Yeni instance deployment ile başlatıldıktan sonra service discovery kaydı oluşturulur. Registration application gerçekten hazır olmadan kullanılabilir endpoint anlamına gelmemelidir. Kubernetes platformunda Service endpoint durumu readiness ile ilişkilendirilebilir. Registry tabanlı sistemlerde registration zamanlaması ayrıca yönetilebilir. Pipeline registration convergence time metriğini deployment başarısının parçası olarak değerlendirebilir.
Readiness Başarısı
Readiness başarılı olmadan yeni instance'a production trafiği gönderilmemelidir. Startup işlemleri, dependency initialization veya cache hazırlığı bu aşamada tamamlanabilir. Readiness sürekli başarısızsa deployment otomatik olarak ilerlememelidir. Failure log ve metric'leri pipeline tarafından görünür hâle getirilebilir. Bu yaklaşım bozuk sürümün bütün replica'lara yayılmasını önler.
Traffic Enable
Traffic enable aşamasında hazır instance gerçek request almaya başlar. Canary deployment varsa ilk trafik oranı düşük tutulabilir. Error ve latency metrikleri yeni sürüm için ayrı izlenmelidir. Discovery endpoint listesi ile load balancer backend listesi arasında tutarlılık kontrol edilebilir. Başarılı sonuç sonrasında rollout bir sonraki aşamaya geçebilir.
Rolling Update
Rolling update eski ve yeni replica'ların kontrollü biçimde yer değiştirmesini sağlar. maxUnavailable ve benzeri kapasite ayarları servis SLO'suna göre belirlenmelidir. Her yeni instance hazır olmadan eski instance kapatılırsa toplam kapasite düşebilir. Discovery update propagation süresi deployment hızını etkiler. Uygulama uzun connection kullanıyorsa draining süresi ayrıca hesaba katılmalıdır.
Old Instance Deregistration
Eski instance kapatılmadan önce discovery havuzundan çıkarılmalıdır. Yeni trafik kesildikten sonra aktif request'lerin tamamlanması beklenebilir. Deregistration gerçekleşmeden process öldürülürse stale endpoint oluşabilir. Pipeline termination adımının bu sırayı koruması gerekir. Shutdown failure metriği deployment dashboard'unda izlenebilir.
Canary Traffic
Canary traffic yeni version'a sınırlı gerçek kullanıcı trafiği gönderir. Routing header, user segment veya ağırlık üzerinden yapılabilir. Error rate normal sınırın dışına çıkarsa trafik oranı artırılmamalıdır. Canary instance sayısı düşük olduğundan metric sample size dikkatle yorumlanmalıdır. Discovery version metadata'sı trafik grubunun doğru seçilmesine yardımcı olabilir.
Automated Rollback
Automated rollback belirlenen sağlık veya SLO kriterleri bozulduğunda eski stabil sürüme dönüş yapar. Discovery yeni version endpoint'lerini havuzdan çıkarabilir veya routing ağırlığı sıfırlanabilir. Eski version yeterli kapasitede tutuluyorsa recovery daha hızlı olur. Rollback nedeni log ve deployment event olarak kaydedilmelidir. Otomasyon yanlış telemetry nedeniyle sık tetikleniyorsa eşikler yeniden değerlendirilmelidir.
Service Catalog ve Mikroservis Yönetimi
Runtime discovery sistemde çalışan endpoint'leri yönetirken service catalog ekiplerin servis envanterini anlamasına yardımcı olur. Catalog owner, repository, API dokümantasyonu ve SLO bilgisi gibi operasyonel metadata tutabilir. Bu bilgiler incident sırasında doğru ekibe hızlı ulaşmayı sağlar. Discovery event'leri catalog ile ilişkilendirildiğinde servis topolojisi daha görünür hâle gelir. Diyarbakır Yazılım Topluluğu hakkında bilgi için https://www.diyarbakiryazilim.com.tr/about adresi ziyaret edilebilir.
Teknik Discovery ile Organizational Catalog Farkı
Teknik discovery milisaniye ve saniye ölçeğinde endpoint yaşam döngüsünü yönetir. Organizational catalog ise ekipler, dokümantasyon ve servis sahipliği gibi daha yavaş değişen bilgileri tutar. Registry'nin her pod IP'sini catalog ekranına taşımak gerekli değildir. Catalog logical service seviyesinde görünüm sağlar. İki sistem arasında otomatik senkronizasyon yapılabilir ancak amaçları ayrı tutulmalıdır.
Service Owner
Service owner servis için teknik ve operasyonel sorumluluğu taşıyan ekip veya rolü gösterir. Incident sırasında kimin çağrılacağını hızlı bulmak büyük zaman kazandırır. Ownership bilgisi düzenli olarak güncellenmelidir. Takım değişikliklerinde eski owner kaydı bırakılmamalıdır. Catalog bu bilgiyi repository veya deployment metadata'sından otomatik güncelleyebilir.
Team
Team bilgisi servisin geliştirilmesi ve işletilmesinden sorumlu organizasyon grubunu gösterir. Büyük mikroservis yapılarında yüzlerce servis arasında sorumluluk dağılımını anlaşılır kılar. On-call schedule veya iletişim kanalı bu bilgiyle ilişkilendirilebilir. Team adı değiştiğinde catalog kaydı otomatik güncellenmelidir. Runtime service name ile organizational team name birbirine zorunlu olarak bağlanmamalıdır.
Repository
Repository linki servisin kaynak koduna hızlı erişim sağlar. Incident sırasında ilgili configuration ve deployment değişikliklerinin bulunmasını kolaylaştırır. Tek servisin birden fazla repository'si varsa ana repository açık biçimde belirtilmelidir. Catalog kaydı CI/CD pipeline tarafından otomatik oluşturulabilir. Eski veya arşivlenmiş repository bağlantılarının düzenli temizlenmesi gerekir.
API Documentation
API documentation servisin hangi endpoint veya RPC yöntemlerini sunduğunu gösterir. OpenAPI veya protobuf dokümantasyonu catalog ile ilişkilendirilebilir. Discovery bir servisin nerede olduğunu gösterirken API dokümanı onun nasıl kullanılacağını açıklar. Güncel olmayan doküman yanlış integration davranışına yol açabilir. Dokümantasyon build pipeline üzerinden source code ile birlikte güncellenebilir.
Dependency Graph
Dependency graph hangi servisin hangi başka servislere bağlı olduğunu gösterir. Service discovery traffic telemetry bu graph'ın otomatik oluşturulmasına yardımcı olabilir. Incident sırasında bir downstream outage'ın hangi upstream servisleri etkileyebileceği görülebilir. Authorization policy üretiminde de dependency graph yararlı olabilir. Ancak gözlenen trafik ile izin verilen trafik aynı şey olmadığı için güvenlik kararları ayrıca doğrulanmalıdır.
Lifecycle Status
Lifecycle status servisin development, production, deprecated veya retired gibi hangi aşamada olduğunu gösterir. Yeni servislerin deprecated dependency kullanması bu bilgi sayesinde engellenebilir. Registry yalnızca çalışan endpoint'i bildirdiği için lifecycle bağlamını tek başına sunmaz. Catalog bu organizasyon bilgisini tamamlar. Retired servislerin discovery ve DNS kayıtları kontrollü migration sonrasında temizlenmelidir.
SLA / SLO Metadata
SLA ve SLO metadata servisin reliability beklentisini catalog içinde görünür kılar. Upstream ekip hangi dependency'nin ne seviyede availability sunduğunu görebilir. Timeout ve retry bütçeleri bu hedeflerle uyumlu tasarlanabilir. Kritik servisler için discovery freshness SLO daha sıkı olabilir. Metadata yalnızca belge olarak kalmamalı ve monitoring sistemindeki gerçek SLO tanımlarıyla senkronize edilmelidir.
Service Naming Standards
Service naming küçük sistemlerde önemsiz görünebilir ancak servis sayısı arttıkça kritik bir platform standardına dönüşür. İsim DNS uyumlu, anlamlı ve mümkün olduğunca stabil olmalıdır. Environment, region ve version gibi geçici bilgiler her zaman service name içine gömülmemelidir. Namespace ve metadata bu ayrımları daha esnek yönetebilir. Rename işlemi bağımlı sistemleri etkilediği için migration planı gerektirir.
Logical Service Name
Logical service name servis instance'larının ortak kimliğidir. Fiziksel host veya deployment replica sayısından bağımsız olmalıdır. Business veya teknik fonksiyonu anlaşılır biçimde ifade etmesi debugging sürecini kolaylaştırır. Çok uzun isimler DNS ve observability ekranlarında kullanım zorluğu yaratabilir. Platform naming convention yeni servis şablonlarının parçası hâline getirilmelidir.
Namespace
Namespace aynı service name'i farklı organizational veya environment scope içinde ayırmak için kullanılabilir. Kubernetes namespace bu modele doğal örnektir. Naming yapısını environment string'leriyle doldurmak yerine scope mekanizması daha esnek olabilir. Cross-namespace dependency açık biçimde dokümante edilmelidir. Security policy namespace'i tek başına güvenilir service identity olarak değerlendirmemelidir.
Environment Bilgisini İsme Eklemek
payment-prod veya payment-dev gibi isimler ilk bakışta anlaşılır görünebilir. Ancak aynı application farklı platform ve region'lara yayıldıkça isim yapısı uzayabilir. Environment bilgisini namespace, account veya deployment metadata ile yönetmek daha esnek olabilir. Service name'in mümkün olduğunca stabil kalması client configuration değişikliklerini azaltır. Yine de DNS scope olmayan basit ortamlarda suffix yaklaşımı geçici çözüm olarak kullanılabilir.
Region ve Cluster Bilgisini Yönetmek
Region ve cluster bilgisini logical service name'e zorunlu olarak eklemek global discovery kullanımını zorlaştırabilir. Metadata veya topology field bu bilgiyi daha uygun biçimde taşıyabilir. İstemci aynı service name kullanıp locality policy ile en yakın instance'ı seçebilir. Debugging için resolved endpoint'in region bilgisi telemetry'de görünür olmalıdır. Global ve local isim alanları platform standardında açık biçimde tanımlanmalıdır.
DNS-Compatible Naming
Service name DNS üzerinden kullanılacaksa karakter seti ve uzunluk kurallarına uyumlu olmalıdır. Küçük harf, rakam ve tire tabanlı sade isimler yaygın tercih olur. Alt çizgi veya büyük harf bazı platformlarda uyumsuzluk yaratabilir. Naming validation CI/CD veya service creation template içinde otomatik yapılabilir. Sonradan rename yapmak zor olduğu için isim standardı proje başlangıcında uygulanmalıdır.
Rename / Migration Stratejisi
Service rename birden fazla istemciyi aynı anda etkileyebilir. Eski ve yeni isim belirli süre birlikte çalıştırılabilir. DNS alias veya duplicate service registration migration sürecine yardımcı olabilir. Client'lar kademeli olarak yeni isim kullanacak şekilde güncellenmelidir. Eski isim kullanım metriği sıfıra yaklaştığında güvenli biçimde kaldırılabilir.
Service Discovery Araçları Nasıl Seçilir?
Service discovery aracı seçerken önce deployment platformu ve gerçek ihtiyaçlar belirlenmelidir. Kubernetes kullanan projelerde native Service ve DNS mekanizması çoğu temel gereksinimi karşılar. Hybrid veya multi-datacenter ortamında Consul gibi ek catalog seçenekleri değerlendirilebilir. Java ağırlıklı legacy mikroservis mimarilerinde Eureka mevcut yatırımla uyumlu olabilir. Service mesh ise yalnızca discovery değil, security ve traffic policy ihtiyacı olduğunda anlam kazanır.
Kubernetes Services
Kubernetes Services platform içinde stable name ve endpoint abstraction sağlar. CoreDNS ile service name çözümlemesi doğal biçimde gelir. EndpointSlice large-scale backend yönetimini destekler. Tüm workload'lar Kubernetes içinde ve routing ihtiyacı basitse ek registry gerekmeyebilir. En az bileşenle çalışan çözüm operasyon açısından çoğu zaman avantajlıdır.
HashiCorp Consul
Consul VM, Kubernetes ve farklı datacenter ortamlarında ortak discovery ve catalog ihtiyacı bulunan sistemlerde değerlendirilebilir. DNS ve HTTP API arayüzleri polyglot client desteğini kolaylaştırır. Health check ve metadata yetenekleri zengindir. Bunun karşılığında ayrı server cluster, agent ve security operasyonu gerekir. Sadece Kubernetes içi basit discovery için eklemek çoğu zaman gereksiz olabilir.
Netflix Eureka
Eureka Java ve Spring tabanlı mikroservis sistemlerinde client-side discovery modeli sunar. Mevcut Spring Cloud mimarilerinde migration ihtiyacı yoksa kullanılmaya devam edilebilir. Yeni greenfield Kubernetes projelerinde platform-native discovery çoğu zaman daha sade olur. Polyglot sistemlerde client library standardizasyonu daha zor olabilir. Seçim mevcut uygulama portföyü ve bakım planına göre yapılmalıdır.
etcd
etcd güçlü consistency ve watch mekanizması sunan dağıtık key-value store'dur. Kubernetes'in kendi control plane state'i için de kullanılır. Uygulamaların doğrudan etcd'yi service registry olarak kullanması mümkün olsa da özel data model ve client davranışı geliştirmeyi gerektirir. Production-grade discovery için hazır platform çoğu ekip açısından daha düşük bakım maliyeti sunar. etcd daha çok altyapı control plane bileşeni olarak değerlendirilmelidir.
ZooKeeper
ZooKeeper distributed coordination ve ephemeral node özellikleriyle discovery benzeri sistemlerin temelini oluşturabilir. Watch mekanizması service state değişikliklerini takip etmeye yardımcı olur. Ancak application ekiplerinin ham ZooKeeper API üzerine kendi registry katmanını kurması ek mühendislik gerektirir. Modern platformlarda daha yüksek seviyeli discovery çözümleri genellikle daha kolay işletilir. Existing infrastructure ve özel coordination ihtiyacı varsa ZooKeeper değerlendirilebilir.
Istio
Istio discovery yanında mTLS, traffic management ve observability gibi service mesh yetenekleri sağlar. Sadece bir servis adı çözmek için Istio kurmak gereksiz olabilir. Çok sayıda mikroserviste merkezi security ve routing policy gerekiyorsa faydası artar. Kubernetes service registry bilgisi mesh control plane tarafından kullanılabilir. Sidecar veya ambient data plane seçimi kaynak ve operasyon beklentisine göre yapılmalıdır.
Linkerd
Linkerd service mesh yaklaşımıyla servisler arası trafik için proxy tabanlı özellikler sunar. Discovery platform bilgisiyle birlikte çalışabilir ve application code'dan network politikalarını ayırabilir. Kullanım kararı mevcut ekosistem ve gereken L7 özelliklere göre verilmelidir. Her mesh ürününün resource ve operational model'i farklıdır. Proof of concept gerçek trafik ve observability ihtiyacıyla değerlendirilmelidir.
Cilium
Cilium eBPF tabanlı networking, security ve observability yetenekleriyle Kubernetes service networking alanında kullanılabilir. Service discovery kaynakları Kubernetes API ile ilişkilidir. L4 load balancing ve network policy gibi işlevler kernel seviyesinde uygulanabilir. Service mesh yetenekleri gereken senaryolarda ayrıca değerlendirilebilir. Seçim mevcut CNI mimarisi ve ekip networking deneyimiyle uyumlu olmalıdır.
Platforma Göre Karar Matrisi
Tek Kubernetes cluster ve basit HTTP trafiğinde Kubernetes Service çoğu zaman yeterlidir. VM ağırlıklı polyglot ortamda Consul gibi ortak registry değerlendirilebilir. Mevcut Spring Cloud sisteminde Eureka doğal devam seçeneği olabilir. Merkezi mTLS, canary routing ve observability gerekiyorsa service mesh gündeme gelebilir. Karar matrisi deployment platformu, ekip yetkinliği, failure domain ve güvenlik gereksinimlerini aynı tabloda değerlendirmelidir.
Kubernetes Service Discovery Ne Zaman Yeterlidir?
Kubernetes Service discovery çoğu cluster içi mikroservis iletişimi için yeterli bir başlangıç noktasıdır. Stable Service name, CoreDNS ve EndpointSlice temel endpoint lifecycle sorunlarını çözer. Tüm workload'lar aynı veya bağlı Kubernetes cluster'larında çalışıyorsa ek registry ihtiyacı azalır. Gelişmiş global catalog veya cross-platform federation gerekmiyorsa ek control plane kurmak gereksiz yük oluşturabilir. Basit çözümle başlayıp gerçek ihtiyaç ortaya çıktığında genişlemek daha sağlıklı bir stratejidir.
Tek Cluster
Tek cluster içindeki servisler için Kubernetes native discovery oldukça güçlüdür. Service isimleri ve namespace yapısı logical routing sağlar. Pod IP değişiklikleri application code'a yansımaz. CoreDNS ve EndpointSlice otomatik platform yönetimi sunar. Ek registry kurmadan önce native çözümün hangi ihtiyacı karşılamadığı açık biçimde yazılmalıdır.
Tüm Workload'ların Kubernetes'te Olması
VM veya dış platform servisi bulunmuyorsa ortak cross-platform registry ihtiyacı azalır. Kubernetes API bütün workload lifecycle bilgisinin doğal source-of-truth kaynağı olur. Ayrı registry aynı endpoint bilgisini ikinci kez tutabilir. Bu duplication consistency ve debugging sorunlarına yol açabilir. Native discovery ile application ihtiyacı karşılanıyorsa ek bileşen kullanmamak avantajlıdır.
Basit Routing
Round robin benzeri temel trafik dağılımı ve stable service name yeterliyse Kubernetes Service iyi çözüm sunar. Header-based canary veya ayrıntılı L7 policy yoksa service mesh gerekmeyebilir. Basitlik deployment ve incident çözüm süresini azaltabilir. Platform özellikleri gerçek load test ile doğrulanmalıdır. gRPC gibi uzun connection protokollerinde connection-level dağılım ayrıca incelenmelidir.
Ek Registry Kurmamanın Avantajı
Ek registry kurulmaması server, backup, upgrade ve monitoring sorumluluğunu azaltır. Security yüzeyi küçülür. Application ekipleri platform-native service name kullanarak daha standart davranış elde eder. Source-of-truth tek yerde kaldığı için endpoint debugging daha kolay olabilir. Ekip yalnızca gerçekten ihtiyaç olduğunda yeni control plane bileşeni ekleyebilir.
Consul Eklemek Ne Zaman Gereksizdir?
Tüm servisler Kubernetes içinde ve yalnızca cluster içi discovery gerekiyorsa Consul eklemek çoğu zaman gereksizdir. Native Service ve DNS zaten endpoint lifecycle yönetir. İkinci registry aynı bilgiyi senkronize etme yükü oluşturabilir. Consul ancak hybrid workload, multi-datacenter catalog veya açık başka bir ihtiyaç sağlıyorsa değer üretir. Teknoloji seçimi özellik merakı yerine operasyon ihtiyacına dayanmalıdır.
Service Mesh Ne Zaman Kullanılmalıdır?
Service mesh yalnızca mikroservis sayısı arttığı için otomatik olarak gerekli hâle gelmez. Merkezi mTLS, authorization, traffic policy ve tutarlı telemetry gibi ihtiyaçlar belirgin olduğunda değer sunar. Polyglot sistemlerde network davranışını application library'lerinden ayırabilir. Canary routing ve outlier detection gibi özellikleri merkezi uygulamak kolaylaşır. Bunun karşılığında data plane ve control plane operasyonu eklendiği için fayda ile maliyet birlikte ölçülmelidir.
Çok Sayıda Mikroservis
Servis sayısı arttıkça her application içinde ayrı network policy yönetmek zorlaşabilir. Service mesh ortak retry, timeout ve security standartları sağlayabilir. Ancak servis sayısı tek başına mesh gerekçesi değildir. Basit HTTP routing ve platform-native discovery yeterliyse ek katman gerekmeyebilir. Önce tekrarlanan operasyon problemlerinin gerçekten mesh ile çözülebileceği belirlenmelidir.
Polyglot Sistemler
Farklı programlama dilleri aynı retry veya mTLS kütüphanesini eşit kalitede uygulamayabilir. Service mesh proxy katmanı bu davranışları application dilinden bağımsızlaştırabilir. Böylece Java, Go ve Python servisleri ortak network policy kullanabilir. Application business logic daha sade kalabilir. Proxy kaynak maliyeti ve debugging yöntemi ekip eğitimine dahil edilmelidir.
mTLS Gereksinimi
Servisler arası bütün trafiğin karşılıklı authentication ve encryption ile korunması gerekiyorsa service mesh güçlü seçenek olabilir. Certificate issuance ve rotation otomatikleştirilebilir. Workload identity authorization politikalarında kullanılabilir. mTLS tek başına erişim kontrolü sağlamadığı için policy ayrıca tanımlanmalıdır. Certificate ve identity metric'leri security monitoring kapsamına alınmalıdır.
Merkezi Traffic Policy
Timeout, retry ve locality policy'lerini yüzlerce application repository'sinde ayrı yönetmek zor olabilir. Service mesh bu kuralları merkezi configuration üzerinden uygulayabilir. Standardizasyon hız kazandırırken yanlış configuration'ın etki alanını büyütebilir. Policy rollout kademeli yapılmalıdır. Servis ekiplerinin hangi politikayı override edebileceği açık governance ile belirlenmelidir.
Canary Routing
Canary routing yeni sürüme düşük trafik yüzdesi göndermeyi sağlar. Mesh header veya weight tabanlı routing ile bu işlemi application code değişmeden yapabilir. Deployment controller metric sonucuna göre trafik oranını artırabilir. Uzun connection protokollerinde teorik request yüzdesi gerçek dağılımdan farklı olabilir. Canary telemetry version bazında ayrıştırılmalıdır.
Tutarlı Observability
Proxy katmanı bütün servis trafiği için ortak latency, error ve request rate metriği üretebilir. Polyglot sistemlerde bu standartlaştırma büyük avantajdır. Application instrumentation eksik olsa bile network görünürlüğü sağlanabilir. Business metric ve application trace'leri yine ayrıca gereklidir. Mesh telemetry maliyeti kardinalite ve retention politikasıyla kontrol edilmelidir.
Mesh Kullanmanın Gereksiz Olduğu Senaryolar
Az sayıda servis, tek programlama dili ve basit Kubernetes routing ihtiyacında mesh gereksiz olabilir. Yalnızca service discovery için mesh kurmak fazla operasyon katmanı ekler. Ekip proxy debugging ve control plane yönetimine hazır değilse incident süresi uzayabilir. Native Service, TLS library ve gateway mevcut ihtiyacı karşılayabilir. Mesh gerçek problemi çözdüğü açıkça gösterildiğinde devreye alınmalıdır.
Service Discovery İçin Hangi Programlama Dili Kullanılır?
Service discovery belirli bir programlama diline bağlı değildir. Java, .NET, Go, Python ve Node.js uygulamaları DNS, platform API veya proxy üzerinden discovery kullanabilir. Modern platformlarda discovery sorumluluğunu application library yerine altyapıya taşımak çoğu zaman daha taşınabilir bir model sunar. Dil seçimi business logic ve ekip deneyimine göre yapılmalıdır. Discovery teknolojisi uygulamanın dilini belirleyen ana kriter olmamalıdır.
Java / Spring
Java ve Spring ekosisteminde Eureka, Spring Cloud LoadBalancer ve Kubernetes Service discovery gibi farklı seçenekler bulunur. Existing Spring Cloud uygulamalarında client-side discovery yaygın olabilir. Yeni Kubernetes servislerinde DNS ve platform-native Service yaklaşımı application bağımlılığını azaltabilir. HTTP client ve gRPC library DNS cache davranışı ayrıca test edilmelidir. Ortak starter kullanımı platform configuration standardını kolaylaştırır.
Eureka
Eureka Java uygulamalarında service registration ve registry fetch işlemlerini client library üzerinden yönetebilir. Spring entegrasyonu developer deneyimini kolaylaştırır. Client local registry cache kullanarak endpoint seçebilir. Bu model application'ı Eureka dependency'sine bağlar. Kubernetes migration planı varsa native discovery veya proxy tabanlı model ayrıca değerlendirilmelidir.
Spring Cloud LoadBalancer
Spring Cloud LoadBalancer discovery client tarafından sunulan instance listesinden hedef seçebilir. Client-side routing uygulama process'i içinde gerçekleşir. Round robin gibi stratejiler configuration ile değiştirilebilir. Retry ve timeout başka library'lerle çakışmayacak şekilde yönetilmelidir. Ortak platform starter'ı bütün servislerde benzer davranış sağlayabilir.
.NET
.NET uygulamaları DNS, Kubernetes Service veya framework destekli service discovery abstraction'ları kullanabilir. HttpClient connection pooling DNS değişikliklerinin görülme zamanını etkileyebilir. Platform-native discovery tercih edildiğinde application belirli registry API'sine bağlanmak zorunda kalmaz. Hybrid ortamlarda proxy veya Consul DNS gibi seçenekler değerlendirilebilir. Runtime connection lifetime ayarları production discovery davranışıyla birlikte test edilmelidir.
Microsoft.Extensions.ServiceDiscovery
Microsoft.Extensions.ServiceDiscovery .NET uygulamalarında logical service name çözümleme senaryolarını destekleyen framework yaklaşımı sunabilir. Uygulama doğrudan fiziksel endpoint yerine abstraction kullanabilir. Gerçek resolver altyapısı platform ve configuration'a göre değişebilir. Connection handler davranışı DNS ve endpoint update süresini etkileyebilir. Framework entegrasyonu kullanılırken production resolver ile integration testi yapılmalıdır.
Go
Go application'lar standart DNS resolver, Kubernetes API veya gRPC resolver mekanizmaları üzerinden discovery kullanabilir. Küçük runtime footprint platform sidecar veya proxy seçenekleriyle birlikte esnek çalışır. Custom registry client yazmak kolay görünse de cache ve failure davranışı dikkatle tasarlanmalıdır. Context deadline timeout yönetiminde aktif kullanılmalıdır. gRPC connection pool ve resolver update davranışı load test ile doğrulanmalıdır.
Python
Python servisleri DNS veya proxy tabanlı service discovery ile kolay biçimde çalışabilir. Async runtime kullanıldığında connection pool ve DNS resolver davranışı kullanılan HTTP client library'ye göre değişir. Registry API'sine doğrudan bağlanmak application dependency'sini artırabilir. Kubernetes ve service mesh ortamında logical service name kullanmak daha sade olabilir. DNS refresh ve long-lived connection testleri production öncesinde yapılmalıdır.
Node.js
Node.js DNS ve HTTP agent davranışı service discovery üzerinde doğrudan etki gösterebilir. Keep-alive connection'lar eski endpoint'e uzun süre bağlı kalabilir. Application-level registry client yerine platform-native DNS tercih edildiğinde entegrasyon sadeleşebilir. Resolver ve connection rotation ayarları gerçek autoscaling senaryosuyla test edilmelidir. gRPC kullanılıyorsa client-side balancing policy ayrıca değerlendirilmelidir.
En İyi Programlama Dili Yerine Platform-Native Discovery Nasıl Seçilir?
Discovery için en iyi programlama dili sorusundan önce servisin hangi platformda çalışacağı sorulmalıdır. Kubernetes Service, DNS veya service mesh kullanıldığında uygulama dili büyük ölçüde discovery kararından ayrılır. Bu yaklaşım polyglot sistemlerde ortak network davranışı sağlar. Application ekibi business logic için uygun dili seçebilir. Infrastructure ekipleri discovery, identity ve routing standardını platform seviyesinde yönetebilir.
Open Source Service Discovery Ekosistemi
Open source ekosistemi service discovery ve service networking için çok sayıda yapı taşı sunar. Kubernetes, CoreDNS, Envoy ve service mesh projeleri farklı katmanlarda birlikte çalışabilir. Bu projeler açık API ve community katkıları sayesinde geniş entegrasyon seçenekleri oluşturur. Teknoloji seçerken yalnızca GitHub popülerliği değil, projenin bakım durumu ve kendi platformunuzla uyumu değerlendirilmelidir. Açık kaynak kullanmak operasyon sorumluluğunu ortadan kaldırmaz.
Kubernetes
Kubernetes Service ve EndpointSlice kaynakları cluster içi discovery için temel yapı sağlar. Platform workload lifecycle bilgisini zaten bildiği için registration otomatik gerçekleşebilir. CoreDNS servis isimlerini DNS üzerinden sunar. Bu native entegrasyon ek registry ihtiyacını azaltabilir. Multi-cluster veya hybrid gereksinimde ek katmanlar değerlendirilebilir.
CoreDNS
CoreDNS plugin tabanlı DNS server mimarisiyle Kubernetes service discovery'de önemli rol oynar. Kubernetes API'den service ve endpoint bilgisini kullanabilir. Cache ve forwarding configuration performansı etkiler. DNS query rate büyük cluster'larda kapasite planlamasına dahil edilmelidir. Monitoring olmadan DNS kaynaklı service failure'ları application problemi gibi görünebilir.
Consul
Consul service catalog ve health check özellikleriyle multi-platform discovery için kullanılabilir. DNS ve HTTP API arayüzleri açık entegrasyon sağlar. Server cluster ve agent mimarisi ayrıca işletilmelidir. Kubernetes dışında VM workload'ların bulunduğu ortamlarda daha fazla değer üretir. Security ve ACL configuration production tasarımının temel parçasıdır.
Eureka
Eureka client-side service discovery yaklaşımıyla özellikle Spring tabanlı sistemlerde kullanılır. Registration, heartbeat ve registry fetch işlemleri application client üzerinden yürütülebilir. Existing Java platformlarda işlevsel çözüm sunar. Yeni Kubernetes projelerinde native discovery daha sade olabilir. Migration kararı yalnızca teknoloji trendine değil mevcut uygulama bağımlılıklarına göre verilmelidir.
Envoy
Envoy dinamik configuration ve xDS desteğiyle service discovery sonuçlarını data plane routing kararlarına dönüştürebilir. EDS endpoint listelerini proxy'ye aktarabilir. Load balancing, outlier detection ve mTLS gibi özellikler uygulayabilir. Tek başına registry değildir ve control plane veya discovery kaynağına ihtiyaç duyar. Service mesh mimarilerinin önemli data plane bileşenlerinden biridir.
Istio
Istio service mesh control plane ve policy modeliyle Kubernetes discovery bilgisini daha geniş trafik yönetimiyle birleştirir. mTLS, authorization ve weighted routing uygulanabilir. Sidecar ve ambient yaklaşım farklı data plane seçenekleri sunar. Ek control plane işletme sorumluluğu bulunduğu için yalnızca ihtiyaç varsa kullanılmalıdır. Platform ekiplerinin upgrade ve troubleshooting süreçlerini önceden planlaması gerekir.
Linkerd
Linkerd service mesh alanında proxy ve control plane yaklaşımı sunar. Service discovery bilgisi platform kaynaklarından alınarak proxy routing için kullanılabilir. Basit operation hedefi bazı ekipler açısından avantaj olabilir. Gerekli protocol ve policy özelliklerinin proje ihtiyacını karşıladığı doğrulanmalıdır. Mesh karşılaştırması gerçek workload üzerinde yapılmalıdır.
Cilium
Cilium eBPF tabanlı networking ve security yetenekleri sunar. Kubernetes service forwarding ve policy enforcement gibi alanlarda kernel seviyesindeki mekanizmalardan faydalanabilir. Observability için flow görünürlüğü sağlayabilir. Service mesh seçenekleri de belirli senaryolarda kullanılabilir. Platform seçiminde mevcut CNI yatırımı ve network gereksinimi birlikte değerlendirilmelidir.
SPIFFE / SPIRE
SPIFFE workload identity için standart tanımlar sunarken SPIRE bu modelin uygulamalarından biridir. Service discovery endpoint bulma işini yaparken SPIFFE identity güvenilir service authentication için kullanılabilir. Short-lived certificate veya token yapıları dynamic workload'lara uygundur. Multi-platform zero trust tasarımında standart identity önemli avantaj sağlar. Identity lifecycle ile workload lifecycle senkronizasyonu temel gereksinimdir.
Open Source ve İşbirliğinin Service Discovery'deki Rolü
Service discovery dağıtık sistemler, networking ve security alanlarının kesişiminde bulunduğu için açık kaynak işbirliği büyük değer taşır. Ortak protocol ve API'ler farklı ürünlerin birlikte çalışmasını kolaylaştırır. Community tarafından paylaşılan benchmark ve failure deneyleri ekiplerin yalnızca dokümantasyona bağlı kalmadan karar vermesine yardımcı olur. Üniversite ve sektör işbirliği yeni routing ve distributed system çalışmalarını daha erişilebilir hâle getirebilir. Yerel topluluk projeleri geliştiricilerin gerçek sistem problemlerini güvenli laboratuvar ortamında öğrenmesini sağlar.
CNCF Ekosistemi
CNCF ekosistemi Kubernetes, CoreDNS, Envoy ve SPIFFE gibi service networking ile ilişkili birçok projeyi bir araya getirir. Ortak community yapısı entegrasyon ve standardizasyon çalışmalarını destekler. Proje maturity seviyeleri teknoloji seçiminde ek sinyal sağlayabilir. Ancak her CNCF projesi her sistem için uygun değildir. Gereksinim analizi ve proof of concept yine ekip sorumluluğundadır.
GitHub Üzerinden Katkı
GitHub üzerinden açık kaynak projelere issue, documentation ve code katkısı yapılabilir. Service discovery öğrenmek isteyen geliştiriciler küçük bug veya test katkılarıyla başlayabilir. Code review süreci dağıtık sistem tasarım kararlarını gerçek örnekler üzerinden görmeyi sağlar. Katkı öncesinde contribution guide ve community kuralları okunmalıdır. Düzenli katkı teknik öğrenmeyi yalnızca teorik içerikten daha uygulamalı hâle getirir.
Discovery Protocol ve API'leri
Açık discovery API'leri farklı control plane ve client bileşenlerinin birlikte çalışmasını kolaylaştırır. DNS en yaygın standart arayüzlerden biridir. xDS daha dinamik proxy configuration senaryolarında açık bir ecosystem oluşturmuştur. Proprietary client API uygulamayı belirli ürüne daha fazla bağlayabilir. Standart protokol tercih etmek migration esnekliğini artırabilir.
xDS Ekosistemi
xDS yalnızca Envoy değil, uyumlu client ve control plane projelerinde de kullanılabilir. Cluster, endpoint ve route discovery API'leri dynamic service networking için ortak model sunar. Proxyless gRPC gibi kullanım alanları discovery'nin application client'a kadar taşınmasına izin verebilir. API version uyumluluğu platform upgrade planında dikkate alınmalıdır. Büyük update stream'lerinde control plane ölçek testi önemlidir.
Community Plugins
Community plugin'leri DNS, monitoring veya registry entegrasyonlarına ek özellikler sağlayabilir. Ancak plugin kalitesi ve bakım durumu ana proje kadar güçlü olmayabilir. Production kullanımı öncesinde release sıklığı ve security geçmişi incelenmelidir. Kritik discovery path'inde az bakım gören plugin yüksek risk oluşturabilir. Gereksiz plugin sayısını düşük tutmak upgrade sürecini kolaylaştırır.
Ortak Performance Benchmark'ları
Performance benchmark'ları farklı discovery ve proxy yaklaşımlarının latency ve resource etkisini karşılaştırmaya yardımcı olur. Sonuçların test ortamı, hardware ve traffic modeli bilinmeden doğrudan production'a uygulanması doğru değildir. Kendi workload profilinizle tekrar test yapmak gerekir. P50 yanında P99 latency ve failure recovery süresi ölçülmelidir. Benchmark yalnızca normal trafik değil endpoint churn durumunu da kapsamalıdır.
Üniversite–Sektör İşbirliği
Üniversite ve sektör işbirliği distributed systems konularında uygulamalı araştırma ortamı oluşturabilir. Öğrenciler service discovery, consensus ve network failure senaryolarını gerçek sistemler üzerinde deneyebilir. Sektör ekipleri akademik çalışmalardan yeni measurement ve routing yöntemleri öğrenebilir. Ortak workshop ve açık kaynak laboratuvar projeleri bilgi paylaşımını güçlendirir. Bu çalışmalar yerel yazılım ekosisteminde teknik derinliğin artmasına katkı sunabilir.
Diyarbakır Yazılım Topluluğu İçin Service Discovery Proje Fikirleri
Service discovery yalnızca okunarak değil, gerçek failure senaryoları uygulanarak daha iyi öğrenilir. Diyarbakır Yazılım Topluluğu içinde küçük laboratuvar projeleri Kubernetes, Consul ve Eureka davranışlarını karşılaştırmak için kullanılabilir. Her proje ölçülebilir bir hedef içermeli ve registration, failure, recovery gibi adımları gözlemlemelidir. Ortaya çıkan örnekler açık kaynak repository olarak paylaşılabilir. Topluluğun mevcut proje çalışmalarını görmek için https://www.diyarbakiryazilim.com.tr/projects adresi incelenebilir.
Kubernetes Service Discovery Laboratuvarı
Basit laboratuvarda üç mikroservis ve bir Kubernetes cluster kurulabilir. Pod restart sırasında Service DNS adının değişmeden kaldığı gözlemlenebilir. EndpointSlice update süreleri metric veya kubectl çıktılarıyla takip edilebilir. Readiness kapatıldığında trafik davranışı test edilebilir. Son aşamada CoreDNS failure ve cache etkisi kontrollü deneyle ölçülebilir.
Consul + VM + Kubernetes Hybrid Demo
Hybrid demo bir VM üzerinde çalışan servis ile Kubernetes içindeki uygulamayı ortak service catalog üzerinden buluşturabilir. Registration ve health check davranışları gözlemlenebilir. DNS ve HTTP API sorguları karşılaştırılabilir. VM kapatıldığında stale endpoint'in ne kadar sürede kaybolduğu ölçülebilir. Proje hybrid cloud discovery konusunda gerçekçi bir öğrenme ortamı sunar.
Spring Eureka Eğitim Projesi
Spring Boot ile iki veya üç servis Eureka Server'a kayıt olacak şekilde hazırlanabilir. Client registry fetch ve Spring Cloud LoadBalancer davranışı gözlemlenebilir. Bir instance kapatıldığında heartbeat expiration süresi ölçülebilir. Daha sonra aynı proje Kubernetes Service discovery ile yeniden kurulup mimari farklar karşılaştırılabilir. Bu çalışma teknoloji seçiminde yalnızca teori yerine uygulamalı gözlem sağlar.
Service Discovery Monitoring Dashboard'u
Monitoring dashboard registration event, lookup latency ve failed lookup rate gibi metrikleri gösterebilir. DNS query rate ve stale endpoint error ayrı panellerde izlenebilir. Chaos test sırasında dashboard davranışı gözlenerek alert eşikleri geliştirilebilir. Version ve zone filtreleri troubleshooting sürecini kolaylaştırabilir. Proje observability ile distributed systems bilgisini aynı çalışma içinde birleştirir.
Istio Ambient Mesh Workshop'u
Workshop Kubernetes cluster üzerinde ambient mode'un temel data path yapısını gösterebilir. ztunnel ve waypoint rolleri farklı trafik örnekleriyle incelenebilir. mTLS identity ve authorization policy adım adım uygulanabilir. Sidecar ve ambient kaynak tüketimi küçük benchmark ile karşılaştırılabilir. Katılımcılar yalnızca configuration kopyalamak yerine her bileşenin hangi problemi çözdüğünü ölçebilir.
Open Source Mikroservis Referans Mimarisi
Referans mimari birkaç service, database, queue ve observability bileşeninden oluşabilir. Kubernetes Service discovery temel çözüm olarak kullanılabilir. Ayrı branch'lerde Consul veya service mesh entegrasyonu gösterilebilir. Failure test script'leri repository içinde paylaşılabilir. Böyle bir proje topluluk üyelerinin pull request ve documentation katkısı yapabileceği uzun ömürlü öğrenme alanı oluşturur.
Yazılımcılar Mikroservis Service Discovery Alanında Nasıl Uzmanlaşabilir?
Service discovery konusunda uzmanlaşmak tek bir registry ürününün configuration dosyasını öğrenmekten daha fazlasını gerektirir. TCP/IP, DNS, HTTP, gRPC ve load balancing temelleri anlaşılmalıdır. Ardından Docker ve Kubernetes gibi deployment platformları üzerinde gerçek uygulama kurulmalıdır. Failure testleri distributed systems düşünme biçimini geliştirir. Açık kaynak katkısı ve observability çalışmaları teknik bilginin daha kalıcı hâle gelmesini sağlar.
TCP/IP ve DNS
TCP connection establishment, timeout ve connection reuse konuları service discovery davranışını doğrudan etkiler. DNS A, AAAA ve SRV kayıtları öğrenilmelidir. Resolver cache ve TTL farkları deneysel olarak test edilmelidir. Packet capture araçlarıyla gerçek connection hedefi gözlenebilir. Bu temel bilgiler olmadan registry seviyesindeki sorunları anlamak zorlaşır.
HTTP ve gRPC
HTTP/1.1 keep-alive ile HTTP/2 multiplexing arasındaki fark load balancing davranışını değiştirir. gRPC uzun connection kullandığı için endpoint discovery farklı ele alınabilir. Timeout, retry ve idempotency konuları protocol seviyesinde anlaşılmalıdır. Header-based routing veya gRPC method policy service mesh çalışmalarında sık kullanılır. Küçük load testleri connection dağılımını görmeyi kolaylaştırır.
Docker
Docker container network ve service lifecycle kavramlarını öğrenmek için iyi başlangıç noktasıdır. Container yeniden başladığında IP davranışı gözlenebilir. Docker Compose service names temel DNS discovery deneyimi sunar. Health check ve restart policy etkileri test edilebilir. Bu bilgi Kubernetes pod ve Service modelini anlamayı kolaylaştırır.
Kubernetes
Kubernetes service discovery öğrenirken Service, CoreDNS, EndpointSlice ve readiness kavramları birlikte incelenmelidir. Pod restart ve scale işlemleri canlı olarak gözlenebilir. Headless Service ile normal ClusterIP davranışı karşılaştırılabilir. NetworkPolicy discovery ile authorization arasındaki farkı göstermek için kullanılabilir. Daha sonra multi-cluster ve service mesh konularına geçilebilir.
Load Balancing
Round robin, least requests ve consistent hashing algoritmaları temel düzeyde uygulanmalıdır. Farklı request duration dağılımlarında sonuçlar karşılaştırılabilir. Long-lived connection'ın trafik dağılımına etkisi ölçülmelidir. Load balancer metric'leri endpoint health bilgisiyle ilişkilendirilebilir. Böylece discovery ve balancing kavramları pratik olarak birbirinden ayrılır.
Distributed Systems
Consensus, replication, network partition ve eventual consistency kavramları registry davranışını anlamak için gereklidir. CAP yalnızca ezberlenen teori yerine failure deneyleriyle öğrenilmelidir. Leader election ve quorum kaybı küçük cluster üzerinde gözlenebilir. Stale cache'in availability sağlarken freshness kaybettirdiği örneklerle gösterilebilir. Bu temel bilgi herhangi bir discovery ürününe geçişi kolaylaştırır.
Consul / Eureka
Consul ve Eureka'yı öğrenirken yalnızca kurulum yapılmamalıdır. Registration, heartbeat, cache ve failure davranışları karşılaştırılmalıdır. Aynı demo servis her iki platformda çalıştırılarak application coupling farkı görülebilir. Registry kapatıldığında client davranışı ölçülmelidir. Bu yöntem ürün özelliklerinden daha öğretici sonuçlar verir.
Service Mesh
Service mesh öğrenirken önce service discovery ve proxy temelini anlamak gerekir. Ardından mTLS, authorization ve traffic splitting gibi özellikler eklenebilir. Envoy config dump veya xDS update akışı incelenmelidir. Sidecar ve ambient data path farkı küçük örneklerle test edilebilir. Mesh troubleshooting yeteneği yalnızca YAML configuration yazmaktan daha değerlidir.
Observability
Discovery problemi çoğu zaman application error olarak görünür. DNS latency, registry query ve endpoint update metric'leri bu nedenle öğrenilmelidir. Distributed tracing request'in hangi backend'e gittiğini gösterebilir. Logs, metrics ve traces ortak service name ve instance metadata kullanmalıdır. Incident senaryoları dashboard üzerinden analiz edilerek gözlemleme alışkanlığı geliştirilebilir.
Açık Kaynak Projelere Katkı
Açık kaynak katkısı gerçek production problem ve design discussion'larını görme fırsatı sunar. Documentation veya test issue'ları başlangıç için uygundur. Service discovery projelerindeki bug raporları edge case öğrenmeyi sağlar. Community review teknik iletişim becerisini de geliştirir. Düzenli katkı uzmanlığı yalnızca sertifika veya eğitim içeriğine bağlı olmaktan çıkarır.
Örnek Bir Service Discovery Mimarisi Nasıl Kurulur?
Örnek mimari kurulurken önce teknoloji seçmek yerine servis envanteri ve platform belirlenmelidir. Discovery pattern, registration, health ve load balancing kararları birbirine bağlıdır. Security ve observability sonradan eklenen özellik olarak görülmemelidir. Autoscaling, registry failure ve multi-zone testleri production öncesinde çalıştırılmalıdır. Aşağıdaki adımlar mikroservis mimarisinde servis keşfi nasıl yapılandırılır sorusuna uygulamalı bir başlangıç çerçevesi sunar.
Adım 1: Servisleri ve Bağımlılıkları Envanterleme
Önce bütün servisler ve aralarındaki dependency ilişkileri çıkarılmalıdır. Hangi trafik HTTP, gRPC veya TCP üzerinden akıyor belirlenmelidir. Stateful ve stateless servisler ayrılmalıdır. Kritik dependency'ler ve SLO hedefleri kaydedilmelidir. Bu envanter discovery ve failover tasarımının gerçek ihtiyaçlarını görünür kılar.
Adım 2: Deployment Platformunu Belirleme
Servislerin Kubernetes, VM, bare metal veya hybrid ortamda çalışıp çalışmadığı belirlenmelidir. Platform-native discovery yetenekleri incelenmelidir. Kubernetes varsa ek registry kurmadan önce Service ve DNS çözümünün yeterliliği test edilmelidir. VM workload varsa ortak catalog ihtiyacı ortaya çıkabilir. Platform seçimi registration modelini doğrudan etkiler.
Adım 3: Discovery Pattern Seçimi
Client-side, server-side veya DNS tabanlı discovery modellerinden uygun olan seçilir. Polyglot sistemlerde proxy veya platform-native yaklaşım daha tutarlı olabilir. Tek teknoloji stack'inde client library modeli yeterli olabilir. Latency ve operasyon maliyeti karşılaştırılmalıdır. Pattern proof of concept üzerinde gerçek traffic testiyle doğrulanmalıdır.
Adım 4: Registration Modelini Belirleme
Self-registration, platform-based veya agent-based model seçilir. Uygulama code'unun registry teknolojisine ne kadar bağlanacağı değerlendirilir. Kubernetes ortamında platform registration genellikle doğal seçenektir. VM ortamında agent modeli avantaj sağlayabilir. Registration ve deregistration yaşam döngüsü deployment otomasyonuna eklenmelidir.
Adım 5: Service Naming Standardı
Logical service name formatı ekipler arasında ortak belirlenir. DNS uyumlu kısa ve anlamlı isimler tercih edilir. Environment veya region bilgisi gereksiz yere service name içine eklenmez. Namespace ve metadata stratejisi ayrıca tanımlanır. Rename işlemleri için alias ve migration prosedürü hazırlanır.
Adım 6: Health Check Tasarımı
Liveness, readiness ve startup rolleri ayrılır. Readiness servisin yeni trafik alıp alamayacağını göstermelidir. Downstream dependency'nin kısa outage'ı bütün instance'ları düşürmemelidir. Check timeout ve threshold değerleri load test ile belirlenir. Failure ve recovery süreleri SLO olarak ölçülür.
Adım 7: Load Balancing Stratejisi
Backend kapasitesi ve request davranışına göre load balancing algoritması seçilir. Stateless eşit kapasitede round robin yeterli olabilir. gRPC veya uzun request trafiğinde least requests veya client-aware yaklaşım değerlendirilebilir. Locality gerekiyorsa zone bilgisi kullanılır. Gerçek load distribution monitoring ile doğrulanır.
Adım 8: Graceful Shutdown
Shutdown sırasında önce readiness kapatılır ve yeni trafik kesilir. Registry veya endpoint listesi güncellenir. Connection draining uygulanır. Aktif request'lerin tamamlanması için bounded grace period verilir. Son adımda process güvenli biçimde sonlandırılır.
Adım 9: Cache ve Failure Politikası
Client veya proxy endpoint cache süresi belirlenir. Registry erişilemez olduğunda last-known-good davranışı tanımlanır. Stale endpoint'e retry sınırları oluşturulur. Cache age ve hit ratio metric'leri izlenir. Recovery sonrasında full resync mekanizması test edilir.
Adım 10: Security
Registry authentication ve authorization politikaları tanımlanır. TLS veya mTLS ile control plane iletişimi korunur. Workload identity service-to-service authentication için kullanılır. Fake registration ve registry poisoning riskleri audit event'leriyle izlenir. Secret ve certificate rotation otomatikleştirilir.
Adım 11: Observability
Registration, deregistration ve health event'leri merkezi monitoring sistemine gönderilir. Discovery latency ve failed lookup rate dashboard'a eklenir. DNS query error ve proxy routing failure ayrı metriklerdir. Distributed tracing endpoint seçim sorunlarını analiz etmeye yardımcı olur. Alert eşikleri SLO hedeflerine bağlanır.
Adım 12: Autoscaling Testi
Scale-out sırasında yeni instance'ın ne kadar sürede trafiğe girdiği ölçülür. Scale-in sırasında kapanacak instance'ın stale endpoint oluşturup oluşturmadığı kontrol edilir. gRPC bağlantılarında yeni pod'ların trafik alıp almadığı ayrıca test edilir. Load distribution ve CPU kullanımı birlikte incelenir. Sonuçlar autoscaling ve discovery ayarlarının güncellenmesinde kullanılır.
Adım 13: Registry Failure Testi
Registry kontrollü biçimde devre dışı bırakılır. Existing client cache ile trafiğin sürüp sürmediği gözlenir. Yeni registration davranışı ve alarm sistemi doğrulanır. Registry recovery sonrasında state convergence süresi ölçülür. Test sonucu runbook içinde belgelenir.
Adım 14: Multi-Zone Testi
Bir zone'daki endpoint'ler veya network bağlantısı devre dışı bırakılır. Locality ve failover policy'nin diğer zone'a geçtiği doğrulanır. Kalan zone kapasitesi izlenir. Cross-zone latency ve network maliyeti ölçülebilir. Recovery sırasında trafiğin dengeli biçimde geri dönmesi kontrol edilir.
Adım 15: Production Monitoring
Production'a geçildikten sonra discovery yalnızca uptime metriğiyle izlenmez. Endpoint freshness, lookup latency ve stale rate dashboard'ları takip edilir. Deployment event'leri metric zaman çizgisiyle ilişkilendirilir. Capacity trend ve registry query rate düzenli gözden geçirilir. Incident sonrası yeni failure senaryoları test setine eklenir.
Service Discovery'de Yapılan Yaygın Hatalar
Service discovery hatalarının önemli bölümü ürün seçiminden değil, yaşam döngüsü ve failure davranışının eksik tasarlanmasından kaynaklanır. Pod IP hard-code etmek veya her projeye ek registry kurmak kısa vadede kolay görünür. Yanlış health check, gereksiz retry ve eksik graceful shutdown production sırasında daha büyük sorunlara dönüşebilir. Discovery metrikleri izlenmediğinde root cause bulmak zorlaşır. Aşağıdaki hatalar yeni mikroservis platformlarında özellikle kontrol edilmelidir.
Pod veya Container IP'sini Hard-Code Etmek
Pod ve container IP adresleri geçici olabilir. Configuration içine doğrudan yazılan adres restart sonrasında geçersiz hâle gelebilir. Uygulama logical service name veya platform Service kaynağını kullanmalıdır. Hard-coded endpoint autoscaling ve rolling deployment avantajlarını azaltır. Bu anti-pattern küçük development ortamından production'a taşınmamalıdır.
Her Kubernetes Projesine Consul Eklemek
Kubernetes zaten Service ve DNS tabanlı discovery sunar. Ek Consul ancak native çözümün karşılamadığı açık bir gereksinim varsa kullanılmalıdır. İkinci registry endpoint bilgisinin duplicate tutulmasına neden olabilir. Backup, monitoring ve security yükü de artar. Hybrid workload veya multi-datacenter catalog gibi gerçek ihtiyaç yoksa native discovery daha sade olur.
Discovery ile Load Balancing'i Aynı Sanmak
Discovery hangi endpoint'lerin bulunduğunu gösterir. Load balancing bu endpoint'lerden hangisinin kullanılacağını seçer. İki problemi aynı kavram olarak değerlendirmek yanlış debugging yapmaya neden olabilir. Registry güncel olsa bile kötü balancing trafiği dengesiz dağıtabilir. İki katmanın metric ve SLO'ları ayrı tanımlanmalıdır.
Liveness ve Readiness'i Karıştırmak
Liveness failure container restart tetikleyebilirken readiness yalnızca yeni trafik alımını etkileyebilir. Aynı deep health endpoint'ini iki amaç için kullanmak outage sırasında restart storm oluşturabilir. Downstream problem liveness başarısızlığına dönüşmemelidir. Startup davranışı için ayrı probe kullanılabilir. Her probe'un yan etkisi deployment testinde doğrulanmalıdır.
Registry'yi Tek Instance Çalıştırmak
Tek registry instance control plane'i açık bir hata noktasına dönüştürür. Instance maintenance veya crash sırasında registration ve lookup işlemleri kesilebilir. Production sisteminde replication ve failure domain dağılımı gerekir. Client cache kısa süre yardımcı olsa da kalıcı çözüm değildir. High availability gerçek node kill testiyle doğrulanmalıdır.
Registry Failure İçin Cache Kullanmamak
Client her request öncesinde registry'yi zorunlu dependency olarak sorgularsa küçük control plane sorunu bütün application trafiğini durdurabilir. Local endpoint cache bu bağımlılığı azaltır. Last-known-good liste kısa süreli outage sırasında kullanılabilir. Cache age ve stale riskini izlemek gerekir. Registry geri geldiğinde hızlı resync yapılmalıdır.
Çok Uzun DNS TTL Kullanmak
Uzun TTL DNS query yükünü azaltabilir ancak endpoint değişikliklerinin görülmesini geciktirir. Kapanan instance uzun süre istemci cache'inde kalabilir. Kubernetes gibi dinamik ortamlarda bu davranış timeout ve retry artışına neden olur. Düşük TTL de aşırı DNS yükü oluşturabileceği için denge gerekir. Runtime ve OS cache davranışı aynı testte değerlendirilmelidir.
gRPC Long-Lived Connection Davranışını Görmezden Gelmek
gRPC tek HTTP/2 connection üzerinde çok sayıda request taşıyabilir. ClusterIP connection başında backend seçse bile sonraki request'ler aynı hedefte kalabilir. Yeni pod'lar scale-out sonrasında trafik alamayabilir. Headless Service, client-side balancing veya L7 proxy seçenekleri değerlendirilebilir. Gerçek request dağılımı load test ile ölçülmelidir.
Graceful Deregistration Yapmamak
Process discovery listesinden çıkmadan kapatılırsa client bir süre stale endpoint'e trafik gönderebilir. Önce readiness kapatılmalı, ardından deregistration ve draining yapılmalıdır. Active request'ler tamamlandıktan sonra process sonlandırılmalıdır. Shutdown hook yalnızca normal exit durumuna bağlı olmamalıdır. Crash için health timeout yedek mekanizma olarak çalışmalıdır.
Retry Budget Olmadan Proxy Retry Açmak
Proxy seviyesinde sınırsız retry outage sırasında backend trafiğini artırabilir. Application da retry yapıyorsa amplification etkisi oluşur. Retry sayısı, backoff ve toplam deadline açık biçimde tanımlanmalıdır. Non-idempotent request'ler otomatik retry için ayrıca değerlendirilmelidir. Retry budget belirli zaman aralığında ek trafik miktarını sınırlar.
Service Mesh'i İhtiyaç Olmadan Kurmak
Mesh güçlü özellikler sunar ancak control plane, proxy ve policy yönetimi gerektirir. Basit Kubernetes Service discovery ihtiyacı için gereksiz olabilir. Ekip troubleshooting deneyimine sahip değilse incident süresi uzayabilir. Mesh kullanımı mTLS, merkezi traffic policy veya observability gibi açık ihtiyaçlarla gerekçelendirilmelidir. Küçük proof of concept operasyon maliyetini görmeye yardımcı olur.
mTLS Açıp Authorization Yapmamak
mTLS karşı tarafın identity'sini doğrular ve trafiği şifreler. Ancak her authenticated servis otomatik olarak bütün servislere erişmemelidir. Authorization policy least privilege ilişkisini tanımlar. Deny-by-default yaklaşım daha kontrollü erişim modeli sunar. Audit log'ları reddedilen ve izin verilen request'leri görünür kılmalıdır.
Discovery Metriklerini İzlememek
Registry up görünürken endpoint propagation yavaş olabilir. DNS error, stale endpoint ve failed lookup metric'leri olmadan gerçek problem görünmez kalır. Deployment sırasında registration convergence time izlenmelidir. Routing failure endpoint freshness ile ilişkilendirilebilir. Discovery dashboard platform monitoring'in kalıcı parçası olmalıdır.
Mikroservislerde Service Discovery'nin Geleceği
Service discovery giderek application library'lerinden platform ve infrastructure katmanına taşınıyor. Kubernetes, service mesh ve xDS tabanlı yaklaşımlar endpoint yaşam döngüsünü application code'dan ayırıyor. Sidecar dışındaki node-level ve ambient networking modelleri kaynak ve operasyon yapısını değiştiriyor. eBPF ve proxyless gRPC gibi yaklaşımlar data path üzerinde yeni seçenekler sunuyor. Gelecekte discovery'nin identity, policy ve multi-cluster routing ile daha yakın çalışması bekleniyor.
Platform-Native Discovery
Platform-native discovery workload lifecycle bilgisini doğrudan orkestrasyon sisteminden alır. Uygulamanın kendi registration kodunu yazması gerekmez. Kubernetes Service bunun açık örneğidir. Bu yaklaşım application dependency'sini azaltır ve polyglot support sağlar. Yeni projelerde ayrı registry kurmadan önce platform yeteneklerini kullanmak çoğu zaman daha sade başlangıç sunar.
Client Library'den Infrastructure-Owned Discovery'ye Geçiş
Client library tabanlı discovery her servis ekibine cache ve balancing sorumluluğu yükler. Infrastructure-owned model proxy veya platform katmanında ortak davranış sağlar. Böylece farklı diller aynı discovery policy'yi paylaşabilir. Application upgrade gerektirmeden routing değişikliği yapılabilir. Bunun karşılığında platform ekibinin reliability ve capacity sorumluluğu artar.
Sidecar'dan Ambient / Node-Level Networking'e Geçiş
Node-level networking pod başına proxy ihtiyacını azaltmayı hedefler. Bu yaklaşım resource overhead ve sidecar upgrade yükünü düşürebilir. L4 işlemler ortak node data plane'de yürütülebilir. L7 policy gerekiyorsa ayrı waypoint veya proxy katmanı kullanılabilir. Failure domain değiştiği için observability ve capacity modelinin yeniden tasarlanması gerekir.
eBPF Service Networking
eBPF kernel seviyesinde network gözlemleme ve trafik yönlendirme yetenekleri sağlar. Service load balancing belirli senaryolarda kullanıcı alanı proxy hop'u olmadan uygulanabilir. Policy enforcement ve observability de aynı altyapıdan faydalanabilir. L7 application semantiği için yine proxy veya farklı katman gerekebilir. Teknoloji seçimi latency kadar operasyon ve debug deneyimine göre yapılmalıdır.
Proxyless gRPC ve xDS
Proxyless gRPC client'ın xDS control plane'den doğrudan discovery ve routing configuration almasını sağlar. Sidecar proxy gerektirmeden client-side balancing yapılabilir. Bu yaklaşım proxy overhead'ini azaltabilir. Buna karşılık application runtime xDS compatibility ve library sürüm yönetimi yeniden önem kazanır. Polyglot sistemlerde bütün dillerin aynı özellik seviyesinde desteklenmesi kontrol edilmelidir.
Multi-Cluster Service Discovery
Platformlar birden fazla cluster'a yayıldıkça global service identity ihtiyacı artıyor. Local-first discovery ve cross-cluster failover temel pattern'ler hâline geliyor. Service export ve import mekanizmaları hangi servisin global görünür olacağını kontrol edebilir. Network reachability ve identity federation kritik konular olarak kalır. Global discovery stateful data consistency problemini tek başına çözmez.
Identity-Aware Routing
Identity-aware routing endpoint seçiminde yalnızca IP veya hostname değil workload identity bilgisini de kullanabilir. Bu model zero trust policy'lerle uyumludur. İstemci yalnızca güvenilir identity taşıyan instance'lara bağlanabilir. Service version veya tenant policy identity metadata ile birlikte değerlendirilebilir. Routing ve authorization sınırlarının açık tutulması yine önemlidir.
Policy-Driven Service Networking
Policy-driven networking routing kararlarını merkezi, deklaratif kurallarla yönetmeyi hedefler. Locality, security ve resilience politikaları application code dışında tanımlanabilir. Platform policy değişikliği yüzlerce servis üzerinde tutarlı biçimde uygulanabilir. Yanlış policy geniş etki oluşturabileceği için validation ve staged rollout gerekir. Policy as code yaklaşımı değişikliklerin review ve audit sürecini kolaylaştırır.
Otonom Traffic Management
Traffic management sistemleri metric ve SLO verisini kullanarak bazı routing kararlarını otomatik verebilir. Canary ağırlığı error rate'e göre artırılabilir veya azaltılabilir. Zone latency yükseldiğinde trafik farklı region'a yönlendirilebilir. Otomasyon güvenli limitler ve manuel override mekanizmasıyla çalışmalıdır. Tam otomatik karar yerine kontrollü feedback loop çoğu production ortamı için daha güvenli başlangıçtır.
Sıkça Sorulan Sorular
Bu bölümde service discovery hakkında en çok karşılaşılan teknik sorulara kısa ama uygulamaya dönük cevaplar veriyorum. Yanıtları okurken tek bir ürünün bütün sistemler için doğru olmadığını akılda tutmak gerekir. Deployment platformu, programlama dili çeşitliliği ve failure hedefleri seçimleri değiştirir. Kubernetes kullanan küçük sistem ile hybrid multi-region bir platformun discovery ihtiyaçları aynı değildir. Bu nedenle cevaplar karar vermek için başlangıç çerçevesi olarak kullanılmalıdır.
Service discovery nedir?
Service discovery çalışan servis instance'larının network adreslerini dinamik biçimde bulmayı sağlayan mekanizmadır. Uygulama sabit IP kullanmak yerine logical service name ile hedefi arar. Registry, DNS veya platform API güncel endpoint listesini sağlayabilir. Health bilgisi kullanılabilir instance'ların filtrelenmesine yardımcı olur. Load balancing ise bulunan endpoint'lerden hangisinin kullanılacağını ayrıca belirler.
Mikroservislerde service discovery neden gereklidir?
Mikroservis instance'larının IP ve yaşam döngüsü sürekli değişebilir. Autoscaling, restart ve rolling deployment bu değişimi daha sık hâle getirir. Discovery application configuration bilgisini fiziksel endpoint adreslerinden ayırır. Böylece yeni instance'lar otomatik eklenebilir ve kapanan instance'lar havuzdan çıkarılabilir. Dinamik container platformlarında bu yaklaşım operasyon yükünü belirgin biçimde azaltır.
Service registry nedir?
Service registry çalışan servislerin isim, adres, port ve health bilgisini tutan kayıt katmanıdır. Client veya proxy endpoint lookup için registry'yi kullanabilir. Registry high availability olacak şekilde kurulmalıdır. Client cache kısa süreli control plane failure'ına karşı koruma sağlayabilir. Registration ve deregistration süreçleri registry bilgisinin güncel kalmasını sağlar.
Client-side ve server-side discovery arasındaki fark nedir?
Client-side discovery modelinde istemci registry'den endpoint listesini alır ve hedefi kendisi seçer. Server-side modelde bu işi proxy veya load balancer yapar. Client-side ek network hop azaltabilir ancak application library yükünü artırır. Server-side model polyglot sistemlerde policy standardizasyonu sağlar. Seçim latency, ekip yapısı ve platform gereksinimine göre yapılmalıdır.
Service discovery ile load balancing arasındaki fark nedir?
Discovery hangi service instance'larının mevcut olduğunu bulur. Load balancing bu instance'lar arasından request hedefi seçer. Discovery listesi güncel değilse load balancer stale endpoint seçebilir. Load balancer kötü yapılandırılmışsa güncel endpoint listesi olsa bile trafik dengesiz olabilir. Bu nedenle iki kavram ayrı metric ve testlerle yönetilmelidir.
Kubernetes service discovery nasıl çalışır?
Kubernetes Service logical ve stabil erişim noktası sağlar. CoreDNS Service isimlerini DNS üzerinden çözer. EndpointSlice hazır backend pod'ların adreslerini temsil eder. Pod IP'leri değişse bile Service adı sabit kalır. Readiness durumu hangi pod'ların normal trafik için uygun olduğunu etkileyebilir.
CoreDNS nedir?
CoreDNS Kubernetes cluster içinde DNS hizmeti sunan yaygın bileşendir. Service isimlerini Kubernetes API bilgisi üzerinden çözebilir. Uygulamalar standart DNS sorgusu yaparak backend Service adresine ulaşır. Query latency ve error oranı büyük cluster'larda izlenmelidir. CoreDNS capacity problemi servis iletişiminde isim çözümleme hatalarına dönüşebilir.
EndpointSlice nedir?
EndpointSlice Kubernetes Service backend adreslerini ölçeklenebilir biçimde temsil eder. Büyük endpoint listelerini daha küçük nesnelere böler. Ready ve topology bilgisi routing bileşenleri tarafından kullanılabilir. Pod ekleme veya silme olaylarında ilgili slice güncellenir. Büyük cluster'larda eski tek Endpoints nesnesine göre daha verimli update davranışı sağlar.
Headless Service nedir?
Headless Service ClusterIP tahsis etmeden backend endpoint'lerin DNS üzerinden doğrudan bulunmasını sağlar. clusterIP alanı None olarak ayarlanır. Client birden fazla pod IP adresi görebilir. StatefulSet ve client-side load balancing senaryolarında kullanılabilir. İstemcinin DNS sonucu ve connection pool davranışı doğru biçimde test edilmelidir.
gRPC için headless Service neden kullanılır?
gRPC uzun ömürlü HTTP/2 connection kullandığı için tek ClusterIP connection uzun süre tek backend'e bağlı kalabilir. Headless Service client'a doğrudan birden fazla pod adresi sunar. gRPC client-side load balancing bu adresler arasında connection dağılımı yapabilir. Yeni pod'lar scale-out sonrasında daha kolay trafik alabilir. Uygun resolver ve load balancing policy olmadan yalnızca headless Service kullanmak yeterli değildir.
Consul ne işe yarar?
Consul service registration, catalog, health check ve multi-datacenter discovery gibi yetenekler sunar. DNS ve HTTP API arayüzleri farklı uygulamaların registry'ye erişmesini sağlar. VM ve Kubernetes gibi birden fazla platformu kapsayan sistemlerde kullanılabilir. Production kurulumu server quorum, ACL ve TLS tasarımı gerektirir. Sadece Kubernetes içi basit discovery için eklenmesi her zaman gerekli değildir.
Eureka ne işe yarar?
Eureka service registry ve client-side discovery amacıyla kullanılabilir. Client uygulamalar registration, heartbeat ve registry fetch işlemlerini gerçekleştirir. Java ve Spring ekosisteminde kullanımı yaygındır. Local registry cache control plane failure'ında belirli ölçüde dayanıklılık sağlar. Yeni Kubernetes platformlarında native Service discovery alternatif olarak değerlendirilmelidir.
Consul mu Eureka mı kullanılmalı?
Java ve Spring ağırlıklı mevcut sistemlerde Eureka uygun olabilir. Polyglot, VM ve multi-datacenter yapılarda Consul daha geniş entegrasyon seçenekleri sunabilir. Kubernetes ortamında önce native Service ve DNS çözümünün yeterli olup olmadığı kontrol edilmelidir. Ek registry her zaman ek operasyon yükü getirir. Karar mevcut platform, ekip yetkinliği ve gerçek discovery gereksinimine göre verilmelidir.
Service mesh service discovery'nin yerini alır mı?
Service mesh discovery bilgisini kullanır ancak discovery ihtiyacını ortadan kaldırmaz. Proxy'lerin hangi endpoint'lerin mevcut olduğunu öğrenmesi gerekir. Kubernetes Service registry veya başka catalog bu bilgiyi sağlayabilir. Mesh bu bilginin üzerine mTLS, routing ve observability ekler. Yalnızca endpoint bulmak için mesh kurmak çoğu küçük sistemde gereksiz olabilir.
Istio service discovery nasıl çalışır?
Istio Kubernetes API veya tanımlı external service kaynaklarından service ve endpoint bilgisini alır. Istiod bu veriyi data plane configuration'a dönüştürür. Envoy veya ilgili proxy dynamic endpoint update alabilir. ServiceEntry harici servisleri mesh modeline eklemek için kullanılabilir. Endpoint propagation time ve control plane availability izlenmelidir.
Istio ambient mode nedir?
Istio ambient mode her pod içine sidecar eklemeden mesh yetenekleri sağlamayı hedefleyen data plane yaklaşımıdır. ztunnel node seviyesinde L4 işlemler üstlenebilir. L7 policy gerektiğinde waypoint proxy kullanılabilir. Sidecar kaynak ve upgrade yükü azalabilir. Buna karşılık node-level failure domain ve waypoint kapasitesi ayrıca yönetilmelidir.
Service discovery için hangi programlama dili kullanılmalıdır?
Service discovery belirli bir programlama dili gerektirmez. Java, Go, Python, .NET ve Node.js aynı platform discovery mekanizmasını kullanabilir. Kubernetes DNS veya service mesh kullanıldığında application dili discovery kararından büyük ölçüde ayrılır. Dil seçimi application ihtiyacı ve ekip deneyimine göre yapılmalıdır. Platform-native discovery polyglot sistemlerde en tutarlı yaklaşımı sağlayabilir.
Kubernetes kullanırken ayrıca Consul gerekli midir?
Çoğu tek cluster Kubernetes projesinde ayrıca Consul gerekli değildir. Service, CoreDNS ve EndpointSlice temel discovery ihtiyacını karşılar. Consul hybrid VM workload, multi-datacenter catalog veya özel federation ihtiyacı varsa değer sağlayabilir. Ek registry kurmak duplicate state ve operasyon sorumluluğu oluşturur. Önce native platform çözümünün hangi gereksinimi karşılamadığı açıkça belirlenmelidir.
Service registry çökerse mikroservisler çalışmaya devam eder mi?
Bu durum client ve cache tasarımına bağlıdır. Local endpoint cache kullanan servisler registry kısa süre erişilemez olduğunda mevcut backend'lerle çalışmaya devam edebilir. Yeni registration ve endpoint değişiklikleri alınamaz. Zaman ilerledikçe stale endpoint riski artar. Last-known-good ve recovery policy bu nedenle service discovery tasarımının temel parçasıdır.
Service discovery nasıl test edilir?
Registration, deregistration, health check ve autoscaling senaryoları integration ortamında test edilmelidir. Registry failure, DNS cache ve network partition deneyleri yapılmalıdır. Endpoint propagation ve failover süresi metric olarak ölçülmelidir. gRPC gibi uzun connection protokolleri ayrı test setine sahip olmalıdır. Chaos engineering kontrollü failure deneylerini düzenli hâle getirmek için kullanılabilir.
Sıkça Sorulan Ek Sorular
Mikroservislerde Servis Keşfi (Service Discovery) ve Yönetimi konusunda uygulama ekiplerinden gelen sorular çoğunlukla ürün seçiminden çok doğru mimari sınırların belirlenmesine odaklanır. Kurulumdan önce mevcut platformun hangi yetenekleri sunduğunu görmek gerekir. Discovery, health check, load balancing ve failover aynı tasarımın parçalarıdır ancak farklı sorumluluklara sahiptir. Kurumsal mikroservis service discovery ve altyapı entegrasyon hizmeti arayan ekipler için ihtiyaç analizi yapılmadan ürün seçmek ileride gereksiz migration maliyeti oluşturabilir. Aşağıdaki cevaplar karar sürecini daha pratik hâle getirmek için hazırlanmıştır.
Mikroservislerde servis keşfi (Service Discovery) nedir ve nasıl çalışır?
Service discovery, servislerin birbirini sabit IP adresi kullanmadan logical service name üzerinden bulmasını sağlar. Servis instance'ları registry veya platform tarafından kaydedilir ve health durumu izlenir. Client, DNS veya proxy güncel endpoint listesini alır ve load balancing katmanı uygun hedefi seçer. Instance kapandığında deregistration veya health timeout ile listeden çıkarılır. Bu akış autoscaling, rolling deployment ve failover sırasında manuel endpoint yönetimi ihtiyacını azaltır.
Client-Side ve Server-Side Service Discovery arasındaki farklar nelerdir?
Client-side modelde service lookup ve backend seçimi uygulama veya client library içinde gerçekleşir. Server-side modelde istemci sabit proxy veya load balancer'a gider ve endpoint seçimini bu katman yapar. Client-side yaklaşım ek proxy hop azaltabilir fakat polyglot sistemlerde library yönetimi zorlaşır. Server-side yaklaşım routing ve security policy'lerini merkezi yönetmeyi kolaylaştırır. Seçim latency, ekip sorumluluğu ve platform standardizasyonu üzerinden yapılmalıdır.
Eureka Consul ve Kubernetes DNS gibi servis keşif çözümlerinden hangisi tercih edilmelidir?
Kubernetes üzerinde çalışan ve yalnızca cluster içi discovery gereken projelerde Kubernetes Service ve CoreDNS çoğu zaman ilk seçenektir. Java ve Spring ağırlıklı mevcut bir mimaride Eureka kullanımına devam etmek operasyon açısından daha düşük maliyetli olabilir. VM, bare metal ve Kubernetes workload'larını ortak catalog altında birleştirmek isteyen sistemlerde Consul değerlendirilebilir. Hiçbir çözüm bütün senaryolarda otomatik olarak en iyi değildir. Platform yetenekleri, ekip deneyimi, multi-region gereksinimi ve failure hedefleri karşılaştırılarak karar verilmelidir.
Mikroservislerde Service Registry health check yük dengeleme ve servislerin otomatik kayıt süreçleri nasıl yönetilmelidir?
Mikroservislerde servis kaydı health check load balancing ve failover yönetimi tek bir yaşam döngüsü olarak ele alınmalıdır. Instance yalnızca gerçekten hazır olduğunda discovery havuzuna girmeli ve shutdown sırasında yeni trafik kesilmeden process sonlandırılmamalıdır. Health check hızlı, düşük maliyetli ve gerçek trafik kabul durumunu yansıtan yapıda olmalıdır. Load balancing discovery listesinden seçim yaparken stale endpoint ve retry riskini de yönetmelidir. Registry failure sırasında local cache ve last-known-good stratejisi kullanıcı trafiğinin hemen kesilmesini önleyebilir.
Mikroservislerde Service Discovery kurulumu ve yönetimi konusunda yakınımda danışmanlık veya eğitim nerede bulabilirim?
Mikroservis mimarisi ve service discovery danışmanlığı yakınımda şeklinde arama yapan geliştiriciler için yerel topluluk etkinlikleri uygulamalı öğrenme açısından iyi bir başlangıç olabilir. Kubernetes, Consul, service mesh ve observability konularında laboratuvar çalışmaları gerçek sistem davranışını görmeyi sağlar. Diyarbakır Yazılım Topluluğu'nun çalışmalarını ve iletişim kanallarını incelemek için https://www.diyarbakiryazilim.com.tr/about adresine göz atabilirsiniz. Topluluk projeleri için https://www.diyarbakiryazilim.com.tr/projects sayfası kullanılabilir. Eğitim veya teknik işbirliği planlanırken mevcut altyapının küçük bir örneği üzerinde registration, failure ve recovery senaryolarını birlikte çalışmak en verimli yöntemlerden biridir.
Sonuç
Mikroservislerde Servis Keşfi (Service Discovery) ve Yönetimi, servislerin yalnızca birbirinin adresini bulması değil, değişen altyapı koşullarında güvenilir biçimde iletişim kurabilmesi anlamına gelir. Kubernetes Service ve CoreDNS çoğu cluster içi senaryoda güçlü bir temel sağlarken Consul hybrid altyapılarda, Eureka ise belirli Spring tabanlı sistemlerde uygun seçenek olabilir. Service mesh discovery'nin üzerine mTLS, merkezi routing ve observability gibi yetenekler ekler fakat her proje için zorunlu değildir. Sağlam mimari; doğru health check, graceful shutdown, kontrollü retry, endpoint cache, güvenlik, observability ve düzenli failure testlerini birlikte ele alır. Kendi mikroservis platformunuz için teknik proje, eğitim veya topluluk çalışması geliştirmek istiyorsanız Diyarbakır Yazılım Topluluğu'na https://www.diyarbakiryazilim.com.tr üzerinden ulaşabilir ve mevcut çalışmalara katılabilirsiniz.
share: