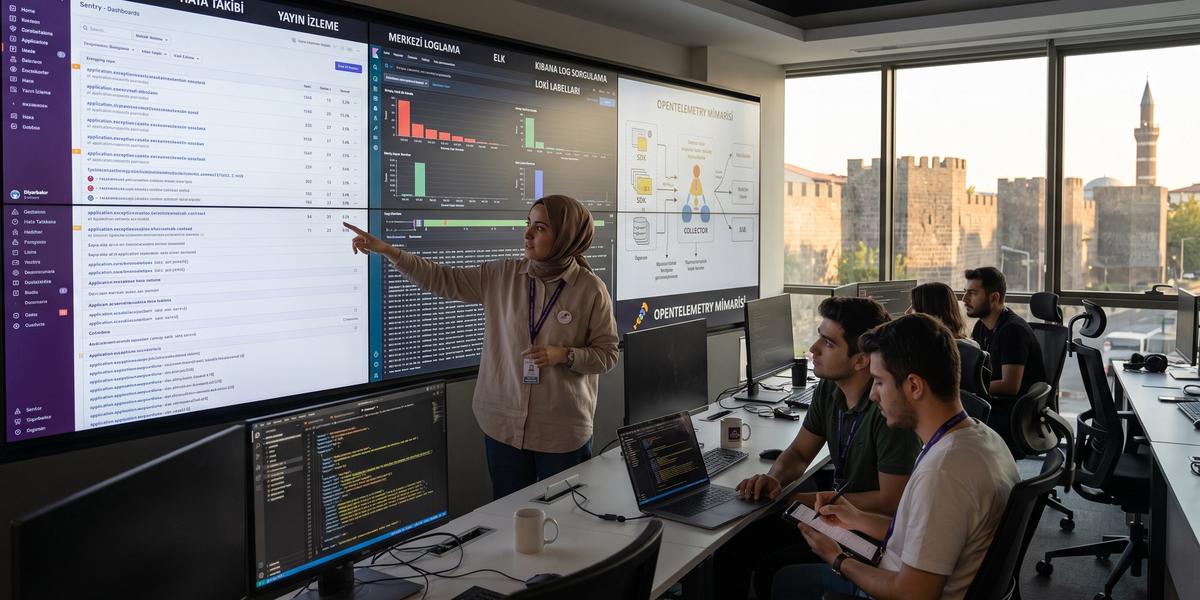
Kurumsal Yazılımlarda Loglama ve Hata Takip Sistemleri

Diyarbakır Yazılım
16.08.2026
#Yazılım#Teknoloji#Topluluk
Production ortamında bir hata yaşandığında ilk soru genellikle aynıdır: Ne oldu ve neden oldu? İyi kurulmuş loglama, hata takibi ve observability altyapısı bu soruya tahminlerle değil, ölçülebilir verilerle cevap verir. On yılı aşkın yazılım geliştirme pratiğinde gördüğüm en belirgin fark, olgun ekiplerin hataları yalnızca düzeltmemesi, sistemin neden o noktaya geldiğini tekrar üretilebilir biçimde anlayabilmesidir. Bu rehberde Kurumsal Yazılımlarda Loglama ve Hata Takip Sistemleri konusunu uygulama loglarından distributed tracing yaklaşımına, Sentry kullanımından ELK ve OpenTelemetry mimarisine kadar pratik bir bakışla ele alacağız. Amaç, kurumsal yazılımlarda merkezi loglama ve hata takip sistemi nasıl kurulur sorusuna uygulanabilir bir mimari çerçeve sunmaktır.
Kurumsal Yazılımlarda Loglama Nedir?
Kurumsal loglama, uygulamanın davranışını daha sonra anlamayı sağlayacak olayların planlı ve ortak bir standartla kaydedilmesidir. Burada amaç yalnızca hata mesajı yazmak değil, sistemde gerçekleşen önemli teknik ve iş olaylarına anlamlı bir iz bırakmaktır. İyi bir yapı hangi servis, hangi sürüm, hangi istek ve hangi işlem üzerinde sorun yaşandığını birkaç sorguyla gösterebilir. Uygulama logları nasıl toplanır ve analiz edilir sorusunun cevabı da aslında veri üretim standardıyla başlar. Log üretimi rastgele bırakıldığında güçlü bir merkezi platform bile ekip için sınırlı fayda sağlar.
Application Log Nedir?
Application log, çalışan uygulamanın kendi işleyişi sırasında ürettiği olay kayıtlarını ifade eder. Bir API isteğinin başlaması, ödeme işleminin tamamlanması veya arka plan görevinin bitmesi bu kapsama girebilir. Faydalı bir application log yalnızca mesaj taşımaz, olayın bağlamını da içerir. Örneğin service name, request ID, transaction ID ve duration alanları araştırmayı ciddi biçimde hızlandırır. Bu nedenle uygulama loglarını programcının anlık ihtiyacından çok operasyon ekibinin gelecekte soracağı sorular düşünülerek tasarlamak gerekir.
Error Log Nedir?
Error log, uygulamanın beklenen şekilde çalışmasını engelleyen veya müdahale gerektirebilen sorunların kaydıdır. Exception türü, hata kodu, stack trace ve ilgili request bilgileri çoğu durumda temel alanlardır. Ancak her başarısız sonuç ERROR seviyesinde değerlendirilmemelidir, çünkü beklenen kullanıcı hataları sistem arızası değildir. Örneğin hatalı form girişi normal bir validation sonucudur ve operasyon alarmına dönüşmemelidir. Sağlıklı error log tasarımı teknik problem ile beklenen iş davranışını birbirinden ayırır.
Audit Log Nedir?
Audit log, özellikle güvenlik ve yönetişim açısından önemli kullanıcı ve yönetici işlemlerinin izini tutar. Hangi kullanıcının hangi kaydı ne zaman değiştirdiği veya hangi yetkinin kim tarafından verildiği buna örnektir. Debug amacıyla yazılan normal uygulama loglarından farklı olarak audit kayıtlarının bütünlüğü ve erişim kontrolü daha güçlü olmalıdır. Birçok kurum bu kayıtları daha uzun süre saklar ve değiştirilmelerini sınırlayan depolama politikaları uygular. Audit log tasarlarken kişisel veri, erişim yetkisi ve kurumun hukuki yükümlülükleri birlikte değerlendirilmelidir.
Transaction Log Nedir?
Transaction log, iş veya veri işlemlerinin belirli bir süreç boyunca izlenebilmesini sağlayan kayıt yapısıdır. Sipariş, ödeme, transfer veya abonelik değişikliği gibi hareketler işlem kimliğiyle birbirine bağlanabilir. Böylece başlangıç, ara adımlar ve sonuç tek bir transaction ID üzerinden incelenebilir. Finansal veya yüksek hacimli sistemlerde bu yaklaşım operasyon ekibinin kayıp işlem araştırmasını önemli ölçüde kolaylaştırır. Transaction log tasarımında teknik kayıtlarla resmi muhasebe veya veri tabanı transaction loglarının aynı kavram olmadığını ayırmak önemlidir.
Loglama Neden Production Sistemlerin Temel Parçasıdır?
Production ortamı geliştiricinin doğrudan debugger bağlayabileceği kontrollü bir geliştirme ortamı değildir. Sorun ortaya çıktığında geriye dönük inceleme yapılabilmesi için sistemin daha önce anlamlı kanıt üretmiş olması gerekir. Loglar bu kanıtların en erişilebilir parçalarından biridir ve hata anındaki context bilgisini korur. Log bulunmadığında ekipler çoğu zaman tahmin yürütür, kullanıcıdan ekran görüntüsü ister veya hatayı yeniden üretmeye çalışır. Bu durum müdahale süresini artırırken müşteri etkisini de gereksiz biçimde uzatabilir.
Küçük Proje Loglaması ile Kurumsal Loglama Arasındaki Fark
Küçük bir uygulamada birkaç dosyaya yazılan loglar kısa süre için yeterli görünebilir. Kurumsal sistemlerde ise onlarca servis, farklı deployment sürümleri ve yüksek trafik aynı anda veri üretir. Bu ölçekte ortak schema, merkezi toplama, erişim kontrolü, retention ve correlation olmadan loglar hızla dağınık hale gelir. Kurumsal ekip ayrıca maliyet, güvenlik ve incident yönetimi gibi operasyonel konuları da hesaba katmalıdır. Bu nedenle ölçek büyüdükçe loglama bir kod satırından çok mimari bir yetkinliğe dönüşür.
Logging, Monitoring, Error Tracking ve Observability Arasındaki Fark
Bu kavramlar sık sık birbirinin yerine kullanılsa da aslında farklı sorulara cevap verir. Logging olay detayını, monitoring ölçülen durumları, error tracking istisnaların yönetimini, tracing ise dağıtık işlem akışını gösterir. Observability bunların birlikte kullanılarak sistemin iç durumunu dış sinyallerden anlayabilme yaklaşımıdır. Pratikte olgun bir sistem tek veri kaynağına bağımlı kalmaz. Metric bir sorunu gösterebilir, trace sorunun yerini daraltabilir ve log gerçek neden hakkında ayrıntı sağlayabilir.
Logging
Logging, uygulamada gerçekleşen olayların metin veya yapılandırılmış veri halinde kaydedilmesidir. Logların değeri yalnızca miktarlarından değil, anlamlı context sağlamalarından gelir. Bir satırda service, version, trace ID ve event name bulunması incelemeyi çok hızlandırabilir. Buna karşılık serbest metin şeklinde yazılmış binlerce kayıt ekip için yüksek gürültü üretebilir. Logging stratejisinin amacı daha fazla veri değil, daha kullanılabilir veri üretmektir.
Error Tracking
Error tracking, beklenmeyen uygulama hatalarını toplama, gruplama ve ekiplerin yönetebileceği issue yapısına dönüştürme sürecidir. Sentry gibi sistemler aynı exception türlerini tek olay altında gruplayarak binlerce tekrarın ayrı ayrı incelenmesini önleyebilir. Stack trace, release bilgisi, user context ve breadcrumbs araştırmaya yardımcı olur. Error tracking özellikle frontend ve backend runtime hatalarının hangi sürümde başladığını anlamada değerlidir. Ancak normal iş akışı kayıtlarının tamamını error tracking sistemine göndermek doğru bir kullanım değildir.
Monitoring
Monitoring, önceden belirlenen metriklerin ve durum göstergelerinin sürekli izlenmesini ifade eder. CPU, memory, request rate, availability ve error rate sık kullanılan örneklerdir. Monitoring sayesinde sistem belirlenen eşikleri geçtiğinde uyarı üretilebilir. Bu yaklaşım neyi izleyeceğinizi önceden bildiğiniz senaryolarda oldukça etkilidir. Beklenmeyen ilişkileri anlamak gerektiğinde monitoring verisini log ve trace sinyalleriyle tamamlamak daha iyi sonuç verir.
Application Performance Monitoring
Application Performance Monitoring, uygulamanın performans davranışını servis ve işlem seviyesinde ölçmeye odaklanır. Endpoint gecikmeleri, database query süreleri ve external dependency performansı bu kapsamdadır. APM sayesinde yalnızca sistem yavaş mı sorusu değil, yavaşlığın hangi bileşende oluştuğu da araştırılabilir. Dağıtık sistemlerde trace verisi APM görünürlüğünün önemli bir parçasıdır. Sağlıklı APM kullanımı performans hedeflerini gerçek kullanıcı etkisiyle ilişkilendirir.
Distributed Tracing
Distributed tracing, tek kullanıcı isteğinin birden fazla servis arasında nasıl ilerlediğini takip eder. Her işlem trace ID ile, işlem içindeki alt adımlar ise span ID ile ilişkilendirilir. Bu yöntem özellikle microservice sistemlerinde gecikmenin ve hatanın hangi bileşende oluştuğunu gösterir. HTTP çağrıları, queue işlemleri ve database sorguları aynı trace altında görülebilir. Trace context doğru taşınmadığında bu zincir kopar ve sistem görünürlüğü önemli ölçüde azalır.
Observability
Observability, sistemin dışarı verdiği sinyaller üzerinden iç davranışını anlamayı hedefleyen daha geniş bir mühendislik yaklaşımıdır. Logs, metrics ve traces bu yaklaşımın temel kaynaklarını oluşturur. Error events, profiles ve session replay gibi ek sinyaller de uygulamaya göre değer katabilir. Observability kurulumu yalnızca araç satın almakla tamamlanmaz, doğru telemetry standardı ve operasyon süreci de gerekir. En iyi sonuç, üretim verisinin incident yönetimi ve geliştirme süreçleriyle doğrudan bağlanmasıyla elde edilir.
Hangi Problem İçin Hangi Sinyal Kullanılmalı?
Her operasyon sorusunu aynı veri türüyle çözmeye çalışmak gereksiz maliyet ve zaman kaybına yol açar. Sistem genelinde hata oranının yükselip yükselmediğini metric daha hızlı gösterebilir. Belirli isteğin hangi serviste geciktiğini trace daha iyi açıklarken uygulama logu olayın ayrıntılı nedenini verir. Runtime exception yönetiminde error tracking, kullanıcı tarafındaki davranış sorunlarında session replay ek bağlam sağlayabilir. Bu nedenle observability tasarımı yapılırken önce ekiplerin soracağı sorular çıkarılmalıdır.
Logs
Logs, belirli olayların ayrıntılı context bilgisine ihtiyaç duyulduğunda en güçlü sinyallerden biridir. Örneğin başarısız ödeme işleminin hangi hata koduyla sonuçlandığını log üzerinden görebilirsiniz. Structured logging kullanıldığında event name, tenant ID ve transaction ID gibi alanlar sorgulanabilir hale gelir. Ancak logların yüksek hacimde indislenmesi maliyeti hızla artırabilir. Bu nedenle hangi kayıtların gerçekten operasyonel değer taşıdığı baştan belirlenmelidir.
Metrics
Metrics, zaman içindeki sayısal davranışı düşük maliyetle takip etmek için uygundur. Request rate, error rate, latency percentile ve queue depth sık kullanılan örneklerdir. Dashboard ve alert sistemleri çoğunlukla metric sinyalleri üzerinden daha verimli çalışır. Tekil kullanıcı olayının ayrıntısını metric verisinden çıkarmak ise genellikle mümkün değildir. Bu nedenle metric, problemi fark etmek için güçlü, nedeni açıklamak için ise tamamlayıcı bir araçtır.
Traces
Traces, bir isteğin sistem içindeki yolculuğunu servisler ve bağımlılıklar boyunca gösterir. Yavaş bir endpoint araştırılırken hangi span'ın toplam sürenin büyük bölümünü kullandığı kolayca görülebilir. Trace ID loglara da eklendiğinde teknik inceleme çok daha hızlı ilerler. Sampling politikaları trace hacmini kontrol etmek için önemlidir. Kritik hata trace'lerini koruyup yüksek hacimli başarılı işlemleri örneklemek dengeli bir yaklaşım olabilir.
Errors
Error event'leri uygulamadaki beklenmeyen başarısızlıkların geliştirici tarafından yönetilebilir hale gelmesini sağlar. Aynı exception'ın yüzlerce tekrarını tek issue altında toplamak gürültüyü azaltır. Release ve environment etiketleri hatanın hangi deployment ile başladığını göstermeye yardımcı olur. Error monitoring sistemi yalnızca hata saymak yerine issue lifecycle yönetimi de sağlamalıdır. Ownership ve routing tanımlandığında doğru ekip doğru probleme daha hızlı ulaşabilir.
Profiles
Profiles, uygulamanın CPU zamanı ve fonksiyon seviyesindeki çalışma maliyetleri gibi ayrıntıları incelemeye yarar. Özellikle yavaşlığın kod içindeki hangi fonksiyonlardan kaynaklandığını araştırmak için değerlidir. Profiling sürekli veya örneklemeli biçimde uygulanabilir. Üretim sisteminde kaynak tüketimi ve veri hacmi mutlaka göz önünde bulundurulmalıdır. Profil verisi trace ile ilişkilendirildiğinde yavaş request üzerinde daha hedefli performans analizi yapılabilir.
Session Replay
Session replay, frontend tarafındaki kullanıcı etkileşiminin hata anındaki bağlamını anlamaya yardımcı olur. Kullanıcının hangi ekranlardan geçtiği veya hangi aksiyonun ardından hata gördüğü incelenebilir. Bu teknoloji güçlü olduğu kadar veri güvenliği açısından da dikkatli tasarım ister. Form alanları, kişisel bilgiler ve hassas ekran bölümleri maskelenmelidir. Session replay her oturum için zorunlu değil, belirli hata ve örnekleme senaryoları için kontrollü biçimde kullanılmalıdır.
Kurumsal Bir Yazılım Neleri Loglamalı?
Kurumsal sistemde neyin loglanacağı belirlenirken teknik değer, iş değeri ve güvenlik birlikte ele alınmalıdır. Her fonksiyon çağrısını kaydetmek kullanılabilirlik sağlamaz, aksine sorgu maliyetini ve gürültüyü artırır. Kritik state değişiklikleri, authentication olayları, dependency hataları ve deployment bilgileri genellikle yüksek değer taşır. İyi bir başlangıç yöntemi incident sırasında hangi soruların sorulduğunu incelemektir. Cevabı daha önce bulunamayan her önemli soru yeni bir log veya telemetry ihtiyacına işaret edebilir.
Uygulama Başlangıç ve Kapanış Olayları
Uygulamanın ne zaman başladığı ve hangi nedenle kapandığı operasyon açısından temel bilgidir. Başlangıç kaydında service version, environment ve önemli configuration sürümleri bulunabilir. Beklenmeyen kapanış ile planlı restart birbirinden ayrılmalıdır. Container ortamında restart count metriğiyle bu kayıt birlikte incelendiğinde crash döngüleri daha kolay yakalanır. Başlangıç olayı deployment zaman çizelgesini doğrulamak için de kullanışlıdır.
Authentication Olayları
Başarılı ve başarısız girişler güvenlik ve kullanıcı deneyimi açısından anlamlı olaylardır. Ancak parola, token veya credential içeriği hiçbir zaman loga yazılmamalıdır. Authentication event'inde yöntem, sonuç, güvenli kullanıcı referansı ve hata kategorisi gibi alanlar yeterlidir. Çok sayıda başarısız deneme anomali tespiti için kullanılabilir. Bu kayıtlar güvenlik ekibinin yanı sıra kullanıcı destek süreçlerine de fayda sağlar.
Authorization Olayları
Authorization logları kullanıcının erişmeye çalıştığı kaynağa neden izin verilmediğini anlamaya yardımcı olur. Rol, policy ve resource türü gibi bilgiler güvenli biçimde kaydedilebilir. Hassas izin verileri ve kişisel detaylar gereksiz yere eklenmemelidir. Yetki değişiklikleri ayrıca audit log kapsamında daha kalıcı biçimde izlenmelidir. Bu ayrım güvenlik soruşturmaları ile günlük uygulama debugging ihtiyaçlarını birbirinden ayırır.
Business-Critical İşlemler
Sipariş oluşturma, ödeme alma, abonelik yenileme ve kritik onay süreçleri business event olarak kaydedilmelidir. Bu olaylar yalnızca teknik debugging için değil, operasyonel KPI üretimi için de kullanılabilir. Her kritik işlemde stabil event name ve business identifier bulunması araştırmayı kolaylaştırır. Başarılı ve başarısız sonuçlar aynı taxonomy içinde farklı status alanlarıyla temsil edilebilir. Böylece teknik ekip ile iş ekibi aynı olay dilini kullanmaya başlar.
API Hataları
API hatalarında endpoint, status code, duration ve güvenli hata kodu temel bilgiler arasındadır. Request body içeriğini varsayılan olarak kaydetmek güvenlik ve KVKK riski oluşturabilir. Beklenen 4xx sonuçları ile sunucu kaynaklı 5xx hataları aynı seviyede değerlendirilmemelidir. Correlation ID sayesinde istemciden gelen destek kaydı ilgili backend olayına bağlanabilir. Bu yapı yüksek trafikte hangi endpoint'in hata üretmeye başladığını hızlı biçimde gösterir.
Database Hataları
Database timeout, connection pool exhaustion ve constraint ihlalleri operasyon için değerli sinyallerdir. Loglarda connection string, parola veya hassas query parametreleri bulunmamalıdır. Query adı veya operasyon türü gibi güvenli bir identifier çoğu zaman yeterlidir. Slow query metrikleri ve tracing span'ları database loglarını tamamlar. Böylece yalnızca hata değil, performans bozulması da erken aşamada görülebilir.
Harici Servis Hataları
Kurumsal uygulamalar ödeme, mesajlaşma, kimlik veya başka harici servislerle sıkça konuşur. Bu çağrılarda dependency adı, operasyon, status, latency ve retry sayısı kaydedilebilir. Harici servisin döndürdüğü ham response içeriğini olduğu gibi loglamak güvenli değildir. Circuit breaker olayları ayrıca izlenerek bağımlılık kaynaklı zincirleme sorunlar anlaşılabilir. Dependency health dashboard'u oluşturulduğunda üçüncü taraf etkisi daha hızlı ayırt edilir.
Queue ve Background Job Hataları
Asenkron işlemler kullanıcı isteği tamamlandıktan sonra çalışabildiği için görünürlükleri özellikle önemlidir. Job ID, correlation ID, attempt count ve queue name gibi alanlar loglarda yer alabilir. Retry mekanizması sürekli başarısız olan işleri gizlememelidir. Dead letter queue olayları kritik uyarılar için güçlü bir sinyal olabilir. Background job araştırmalarında başlangıç, bitiş ve başarısızlık event'lerini ayrı kaydetmek faydalıdır.
Deployment ve Configuration Değişiklikleri
Birçok production problemi kod veya configuration değişikliğinin hemen ardından ortaya çıkar. Deployment ID, release version ve Git commit bilgisi observability verisine eklenmelidir. Kritik configuration değişiklikleri de audit edilebilir biçimde izlenmelidir. Incident başladığında son deployment bilgisi aynı dashboard üzerinde görülürse araştırma süresi kısalır. Bu yaklaşım rollback kararlarının daha fazla veriye dayanmasını sağlar.
Performans Anormallikleri
Sadece exception oluştuğunda log üretmek performans sorunlarının önemli bölümünü kaçırabilir. Uzun süren request, anormal database gecikmesi veya queue bekleme süresi de izlenmelidir. Her yavaş işlem için büyük log üretmek yerine metric ve trace sinyalleriyle birlikte çalışmak daha verimlidir. Belirlenen eşikleri aşan işlemlere özel event eklemek araştırmayı kolaylaştırır. Performans olaylarının release bilgisiyle ilişkilendirilmesi regression tespitinde güçlü sonuç verir.
Hangi Veriler Loglanmamalı?
Loglama sisteminin en ciddi risklerinden biri, hata araştırmayı kolaylaştırmaya çalışırken hassas veriyi gereksiz yere çoğaltmaktır. Log depoları çoğu zaman çok sayıda ekip üyesi tarafından sorgulandığı için normal uygulama veri tabanından farklı bir risk profiline sahiptir. Parola, secret, token ve ödeme bilgileri hiçbir debugging kolaylığı gerekçesiyle loglanmamalıdır. Kişisel verilerde de veri minimizasyonu temel yaklaşım olmalıdır. En güvenli model, neyin engelleneceğini listelemek yerine hangi alanların loglanabileceğini açıkça tanımlayan allowlist yaklaşımıdır.
Parolalar
Parolaların plaintext, hash veya başka bir temsil biçimiyle uygulama loglarında bulunmaması gerekir. Login hatası araştırılırken parola içeriği teknik olarak gerekli değildir. Bunun yerine authentication result, güvenli user reference ve error reason gibi alanlar kullanılabilir. Framework veya middleware otomatik request logging yapıyorsa parola alanları özellikle kontrol edilmelidir. Sensitive data leakage testleri bu tür hataları deployment öncesinde yakalamaya yardımcı olur.
API Key ve Secret'lar
API key ve secret değerleri loglandığında yetkisiz servis erişimine doğrudan kapı açabilir. Özellikle environment variable dump veya configuration logları bu riski taşır. Secret alanları merkezi redaction mekanizmasıyla maskeleme kapsamına alınmalıdır. Uygulama seviyesindeki kontrole ek olarak collector seviyesinde ikinci koruma uygulanabilir. Bir secret loga düştüyse yalnızca kaydı silmek değil, ilgili secret'ı yenilemek de gerekir.
Access ve Refresh Token'lar
Access ve refresh token değerleri oturum ele geçirme riski nedeniyle loglarda bulunmamalıdır. Authorization header'ın ham biçimde kaydedilmesi sık görülen tehlikeli uygulamalardan biridir. İhtiyaç varsa token'ın kendisi yerine doğrulama sonucu veya güvenli bir identifier kullanılabilir. Reverse proxy ve API gateway logları da bu açıdan ayrıca incelenmelidir. Merkezi redaction standardı farklı ekiplerin aynı güvenlik kuralını uygulamasını kolaylaştırır.
Session Cookie'leri
Session cookie içerikleri kullanıcı oturumunu temsil ettiği için hassas kabul edilmelidir. Request header'larını topluca loglamak bu verinin merkezi depoya taşınmasına yol açabilir. Cookie isimleri bile bazı sistemlerde uygulama davranışı hakkında gereksiz bilgi verebilir. Log schema yalnızca gerekli header alanlarına izin verecek şekilde tasarlanmalıdır. Production testlerinde örnek bir oturum üzerinden leakage kontrolü yapılması faydalıdır.
Kredi Kartı Bilgileri
Kart numarası, CVV ve benzeri ödeme verilerinin uygulama loglarında bulunmaması gerekir. Ödeme sorunlarını araştırmak için provider transaction ID veya maskelenmiş referanslar çoğu zaman yeterlidir. Ham request body loglama ödeme endpoint'lerinde özellikle büyük risk oluşturur. Frontend telemetry sistemleri de form alanlarını otomatik toplamamalıdır. Ödeme akışlarında log tasarımı güvenlik incelemesinin ayrı bir maddesi olmalıdır.
Hassas Kişisel Veriler
Kişisel verinin loglanması yalnızca teknik gereksinim açısından değil, hukuki ve operasyonel açıdan da değerlendirilmelidir. Sağlık, kimlik ve benzeri hassas alanların debug amacıyla kopyalanması ciddi risk oluşturabilir. Çoğu durumda gerçek değer yerine pseudonymous identifier kullanmak yeterlidir. Log erişimi ayrıca rol bazlı sınırlandırılmalıdır. Kurumun KVKK süreçleri, saklama politikası ve veri aktarımı kararları hukuk ve bilgi güvenliği ekipleriyle birlikte ele alınmalıdır.
Ham Request/Response Body Loglamanın Riskleri
Ham request ve response body loglamak geliştirme sırasında pratik görünse de production ortamında yüksek risk taşır. Body içinde parola, token, kişisel veri veya büyük dosya parçaları bulunabilir. Ayrıca bu yaklaşım log hacmini beklenenden çok daha hızlı büyütür. İhtiyaç duyulan alanları açıkça seçmek hem maliyet hem güvenlik açısından daha sağlıklıdır. Hata anında body gerekli görülüyorsa yalnızca kontrollü ve maskelenmiş alanlar geçici olarak toplanmalıdır.
Allowlist Tabanlı Logging Yaklaşımı
Allowlist yaklaşımında sistem hangi alanların loglanmasına izin verildiğini önceden tanımlar. Böylece yeni bir request alanı eklendiğinde otomatik olarak log deposuna taşınmaz. Bu model blacklist yaklaşımına göre daha güvenli bir varsayılan davranış sunar. Ortak logging library içinde güvenli field helper'ları kullanmak ekiplerin standardı uygulamasını kolaylaştırır. Schema testleri allowlist dışındaki alanların production telemetry akışına girmediğini doğrulayabilir.
Structured Logging Nedir?
Structured logging, log mesajlarını serbest metin yerine belirli alanlardan oluşan makine tarafından işlenebilir kayıtlar şeklinde üretir. JSON bu amaçla en sık kullanılan formatlardan biridir. Event name, severity, service ve correlation ID ayrı alanlar olduğunda sorgu ve dashboard oluşturmak kolaylaşır. Kurumsal uygulamalarda structured logging distributed tracing ve error monitoring nasıl uygulanır sorusunun temel cevabı ortak bir telemetry schema kurmaktır. Yapılandırılmış kayıtlar ekipler arasında ortak bir dil oluşturduğu için ölçek büyüdükçe değeri daha da artar.
Plain Text Logların Problemleri
Plain text loglar ilk bakışta okunabilir olsa da büyük hacimde analiz edilmesi zorlaşır. Aynı olay farklı geliştiriciler tarafından farklı cümlelerle yazıldığında güvenilir sorgu oluşturmak mümkün olmaz. Regex tabanlı parsing kırılgan hale gelir ve mesaj değişikliği dashboard'ları bozabilir. Ayrıca alanların tipi kaybolduğu için sayı ve tarih karşılaştırmaları zorlaşır. Bu nedenle serbest metni tamamen kaldırmak yerine insan okunabilir message alanını structured field'larla desteklemek daha sağlıklıdır.
JSON Structured Logging
JSON log formatı field tabanlı veri üretimi için pratik ve yaygın bir seçenektir. Her kayıtta timestamp, level, event name ve context alanları ayrı tutulabilir. Collector bu veriyi ek parsing ihtiyacı olmadan merkezi sisteme aktarabilir. JSON kullanmak tek başına yeterli değildir, schema ve naming convention da sabitlenmelidir. Aynı alanın bir serviste userId, diğerinde user_id olması merkezi analiz kalitesini düşürür.
Machine-Readable Logların Avantajları
Machine-readable loglar otomatik sorgu, alert ve dashboard üretimini kolaylaştırır. Alan değerleri type bilgisiyle saklandığında aggregation işlemleri daha güvenilir hale gelir. Correlation ID veya tenant ID üzerinden arama yapmak saniyeler içinde mümkün olabilir. Collector seviyesinde filtering ve redaction işlemleri de alan bazlı uygulanabilir. Bu yapı logların yalnızca insanlar için yazılmış metin olmaktan çıkıp operasyonel veri kaynağına dönüşmesini sağlar.
Stable Event Name Kullanımı
Stable event name, aynı iş olayının uygulama sürümleri arasında değişmeyen bir isimle temsil edilmesini sağlar. Mesaj metni geliştirilebilir fakat event name mümkün olduğunca stabil kalmalıdır. Bu sayede dashboard, alert ve analiz sorguları uygulama metin değişikliklerinden etkilenmez. Event isimleri kısa, açıklayıcı ve hiyerarşik bir convention izleyebilir. Takım içinde event catalog tutmak duplicate veya anlamı belirsiz isimlerin oluşmasını azaltır.
auth.login
auth.login kullanıcı giriş olayını teknik olarak anlaşılır ve sabit biçimde temsil edebilir. Event data içinde result, authentication method ve güvenli user reference bulunabilir. Başarısız giriş nedeni ayrı bir error code alanıyla taşınabilir. Parola ve token gibi credential bilgileri hiçbir koşulda bu event'e eklenmemelidir. Bu yapı güvenlik dashboard'u ile uygulama debugging ihtiyacını aynı event üzerinden destekleyebilir.
payment.capture
payment.capture ödeme tahsilat sürecindeki önemli bir business event için kullanılabilir. Transaction ID, provider reference, currency ve güvenli amount bilgisi iş ihtiyacına göre eklenebilir. Başarısız sonuçlarda retryable alanı operasyon davranışını belirlemeye yardımcı olur. Kart bilgileri veya provider secret değerleri kesinlikle kayda dahil edilmemelidir. Event aynı zamanda ödeme başarı oranını hesaplayan operasyonel metriklerin kaynağı olabilir.
order.created
order.created yeni sipariş oluşumunu temsil eden anlaşılır bir event name örneğidir. Order ID ve tenant ID gibi business context alanları olayın daha sonra bulunmasını kolaylaştırır. Event başarılı creation tamamlandıktan sonra üretilirse anlamı daha net olur. İşlem başlamasını ayrıca takip etmek gerekiyorsa order.create_started gibi farklı bir event kullanılabilir. Böylece aynı event ismine farklı lifecycle anlamları yüklenmemiş olur.
Event Name ile Event Data'yı Ayırmak
Event name olayın ne olduğunu, event data ise o olayın hangi bağlamda gerçekleştiğini anlatmalıdır. Örneğin order.created sabit kalırken order ID her olayda farklı olabilir. Değişken değerleri event name içine koymak cardinality ve sorgu problemlerine yol açar. Bu ayrım dashboard ve alert kurallarını daha dayanıklı hale getirir. Event catalog hazırlanırken isim ile context arasındaki sınır açıkça tanımlanmalıdır.
Kurumsal Log Schema Nasıl Tasarlanmalı?
Kurumsal log schema farklı ekiplerin ürettiği kayıtların ortak biçimde sorgulanmasını sağlayan temel sözleşmedir. Schema yalnızca teknik alanları değil, gerekli business context alanlarını da tanımlamalıdır. Her alan için isim, veri tipi, zorunluluk ve hassasiyet sınıfı belirlemek faydalıdır. Schema versioning sayesinde değişiklikler kontrollü şekilde yapılabilir. En iyi schema her olası bilgiyi taşıyan değil, incident sırasında gerçekten işe yarayan bilgileri tutarlı biçimde taşıyan yapıdır.
Her Logda Bulunması Gereken Alanlar
Her log kaydında ortak alan seti bulunması merkezi sorgulamayı ciddi biçimde kolaylaştırır. Timestamp, severity, service name, service version ve environment çoğu sistem için temel başlangıçtır. Request ID, correlation ID, trace ID ve span ID gerektiğinde bağlantılı işlemleri bir araya getirir. Event name ise kaydın semantik anlamını sabitler. Ortak logging library bu alanların geliştirici tarafından her seferinde elle eklenmesi ihtiyacını ortadan kaldırabilir.
Timestamp
Timestamp olayın hangi anda gerçekleştiğini tutarlı bir zaman standardıyla göstermelidir. Dağıtık sistemlerde UTC kullanımı farklı bölgelerdeki servislerin zaman çizelgesini karşılaştırmayı kolaylaştırır. Milisaniye veya daha yüksek çözünürlük performans araştırmalarında gerekebilir. Uygulama ve altyapı sunucularının saat senkronizasyonu da önemlidir. Yanlış saat ayarı incident timeline analizini yanıltıcı hale getirebilir.
Severity
Severity olayın operasyonel önemini ifade eden kontrollü bir alan olmalıdır. TRACE, DEBUG, INFO, WARN, ERROR ve CRITICAL gibi seviyeler ortak anlamlarla kullanılmalıdır. Ekipler seviyeleri farklı yorumladığında merkezi alert sistemi gürültülü hale gelir. Severity tek başına alert üretme kararı olmamalıdır. Event type, error rate ve kullanıcı etkisi gibi ek sinyallerle değerlendirmek daha doğru sonuç verir.
Event Name
Event name olayın stabil ve sorgulanabilir kimliğidir. İsimler kısa, anlaşılır ve ekipler arasında ortak convention kullanacak biçimde belirlenmelidir. Değişken ID veya kullanıcı verisi event name içine konulmamalıdır. Böylece event cardinality kontrol altında tutulur ve dashboard sorguları korunur. Event catalog üzerinden sahiplik ve açıklama bilgisi de yönetilebilir.
Service Name
Service name kaydın hangi uygulama bileşeninden geldiğini açık biçimde göstermelidir. Microservice ortamında bu alan olmadan merkezi log deposu hızla anlaşılması zor hale gelir. Service adları deployment, tracing ve metric sistemlerinde de aynı convention ile kullanılmalıdır. Böylece farklı telemetry kaynakları birbirine bağlanabilir. Yeniden adlandırma gerektiğinde migration planı hazırlanması dashboard kırılmalarını önler.
Service Version
Service version belirli hatanın hangi release ile ilişkili olduğunu anlamayı sağlar. Semver, build number veya Git SHA ile desteklenen release kimliği kullanılabilir. Aynı anda farklı sürümlerin çalıştığı rolling deployment sırasında bu alan özellikle değerlidir. Regression analizi version bilgisi olmadan çok daha zor yapılır. CI/CD pipeline bu değeri uygulamaya otomatik olarak geçmelidir.
Environment
Environment alanı production, staging ve diğer ortamların telemetry verisini ayırır. Aynı event'in test ortamındaki tekrarları production alertlerini etkilememelidir. Ortam isimleri serbest metin yerine sınırlı bir değer seti kullanmalıdır. Sentry release tracking ve log dashboard'larında bu alan temel filtrelerden biri olur. Yanlış environment etiketi test hatalarının gerçek incident gibi görünmesine yol açabilir.
Request ID
Request ID tek bir HTTP isteğini benzersiz şekilde tanımlamak için kullanılır. API gateway veya ilk backend katmanı bu değeri üretebilir. İstemci tarafından gelen değer güvenilir kabul edilmeden önce format ve güvenlik açısından kontrol edilmelidir. Aynı servis içindeki tüm ilgili loglara request ID eklenmelidir. Birden fazla servis zinciri için correlation veya trace context daha geniş kapsam sağlar.
Correlation ID
Correlation ID birden fazla teknik işlem veya servis çağrısını aynı business akışına bağlamak için kullanılabilir. HTTP request, background job ve message queue olayları arasında taşınması güçlü bir araştırma kolaylığı sağlar. Değer kullanıcı verisi taşımayan benzersiz bir identifier olmalıdır. Sisteme giriş noktasında yoksa güvenli biçimde üretilebilir. Log, error event ve gerektiğinde business event üzerinde aynı correlation değeri kullanılabilir.
Trace ID
Trace ID distributed tracing sisteminde uçtan uca işlem zincirinin kimliğidir. Aynı trace altında frontend, backend, database ve external API span'ları bulunabilir. Trace ID loglara eklendiğinde kullanıcı log ekranından doğrudan trace detayına geçebilir. Bu korelasyon incident araştırmasını önemli ölçüde hızlandırır. OpenTelemetry kullanımı trace context'in standart biçimde taşınmasını kolaylaştırır.
Span ID
Span ID trace içindeki tek bir operasyonu temsil eder. Bir HTTP handler, database query veya external request ayrı span olarak modellenebilir. Log kaydı span ID içerdiğinde tam olarak hangi operasyon sırasında üretildiği bulunabilir. Parent ve child ilişkileri işlem akışının hiyerarşisini gösterir. Çok geniş span'lar yerine anlamlı operasyon sınırları belirlemek tracing kalitesini artırır.
Business Context Alanları
Teknik alanlar hatanın nerede oluştuğunu gösterirken business context kullanıcı etkisini anlamayı sağlar. Tenant, order veya transaction identifier gibi alanlar incident'in iş boyutunu ortaya koyabilir. Bu alanlar doğrudan kişisel veri içermemeli ve güvenlik sınıflandırması yapılmalıdır. Her event'e bütün business alanlarını eklemek yerine olay için gerekli olanları seçmek daha doğrudur. İyi business context müşteri destek ekibinin teknik ekiple daha hızlı ortak dil kurmasını sağlar.
Tenant ID
Tenant ID çok kiracılı sistemlerde olayın hangi müşteri alanıyla ilişkili olduğunu gösterir. Tenant bazlı hata oranı veya performans analizi için güçlü bir filtredir. Ancak identifier'ın kendisi hassas bilgi haline gelebileceği için erişim politikası uygulanmalıdır. İnsan tarafından okunabilir müşteri adı yerine pseudonymous ID kullanmak daha güvenli olabilir. Tenant telemetry verisinin farklı ekipler tarafından görülmesi kurum politikalarına göre sınırlandırılmalıdır.
Order ID
Order ID sipariş yaşam döngüsündeki teknik ve business olayları bir araya getirmeye yardımcı olur. Destek ekibinden gelen belirli sipariş problemi doğrudan ilgili loglara bağlanabilir. ID formatı kişisel bilgi içermemeli ve tahmin edilebilir güvenlik riski yaratmamalıdır. Order ID yüksek cardinality üretebileceği için her metric label'ı olarak kullanılmamalıdır. Log ve trace aramasında ise son derece değerli olabilir.
Transaction ID
Transaction ID ödeme veya başka kritik işlem zincirlerinin farklı adımlarını ilişkilendirir. Retry gerçekleştiğinde aynı business transaction ile teknik attempt identifier'ı ayrı tutulmalıdır. Böylece tek işlemde kaç deneme olduğu doğru biçimde görülebilir. Provider reference ile internal transaction ID birbirinden açıkça ayrılmalıdır. Hassas finansal içerikler yerine güvenli identifier kullanımı tercih edilmelidir.
Schema Naming Convention
Schema naming convention alanların ekipler arasında aynı biçimde kullanılmasını sağlar. camelCase veya snake_case seçeneklerinden biri belirlenmeli ve ortak standarda dönüştürülmelidir. Aynı anlam için birden fazla alan adı kullanılması merkezi sorguları zorlaştırır. Event catalog ve schema documentation bu standardın görünür olmasını sağlar. Lint veya test kuralları convention dışındaki alanları geliştirme aşamasında yakalayabilir.
Log Schema Versioning
Log schema zaman içinde yeni ihtiyaçlara göre değişeceği için versioning planı gereklidir. Breaking değişiklikler dashboard ve alert sorgularını doğrudan etkileyebilir. Schema version alanı geçiş sürecinde eski ve yeni kayıtları ayırmaya yardımcı olur. Mümkünse mevcut alanların anlamı değiştirilmek yerine yeni alan eklemek tercih edilmelidir. Değişikliklerin migration notları ve sahipleri event catalog üzerinde tutulabilir.
Log Seviyeleri Nasıl Kullanılmalı?
Log seviyeleri operasyonel önemi ifade etmek için ortak bir dil oluşturur. Sorun, seviyelerin her ekip tarafından farklı yorumlanmasıyla başlar. INFO normal işleyişi, WARN müdahale gerektirmeyen anormalliği, ERROR ise başarısız teknik işlemi temsil edecek şekilde tanımlanabilir. CRITICAL seviyesi sistemin önemli bölümünün çalışamaz durumda olduğu durumlara ayrılmalıdır. Bu standart yazılı hale getirildiğinde alert ve dashboard davranışı daha öngörülebilir olur.
TRACE
TRACE en ayrıntılı çalışma bilgilerini taşımak için kullanılır. Fonksiyon akışları veya düşük seviyeli teknik detaylar bu seviyede bulunabilir. Production ortamında sürekli açık tutulması yüksek veri hacmi yaratabilir. Geçici debugging veya sampling ile kontrollü biçimde etkinleştirilebilir. Hassas veri kuralları TRACE seviyesi için de aynen geçerlidir.
DEBUG
DEBUG geliştiricinin uygulama davranışını ayrıntılı anlamasına yardımcı olan teknik kayıtlardır. Normal production trafiğinde yüksek hacim üretebileceği için dikkatli kullanılmalıdır. Dinamik log level mekanizması belirli servis veya kısa zaman aralığı için faydalı olabilir. Debug mesajlarında dahi token veya request body gibi hassas veriler bulunmamalıdır. Sorun çözüldükten sonra geçici debug ayarı otomatik veya kontrollü biçimde kapatılmalıdır.
INFO
INFO seviyesi sistemin beklenen normal davranışındaki önemli olayları temsil eder. Uygulamanın başlaması, kritik business event'in başarıyla tamamlanması veya job bitişi buna örnek olabilir. Her başarılı request'i INFO olarak yazmak yüksek trafikte gereksiz hacim üretebilir. Değerli olaylar ile rutin gürültü arasında denge kurulmalıdır. Metric ile takip edilebilecek bazı yüksek hacimli olayların loglanması şart değildir.
WARN
WARN sistem çalışmaya devam ederken dikkat gerektiren olağan dışı durumları ifade edebilir. Geçici dependency gecikmesi, fallback kullanımı veya retry başlangıcı buna örnek verilebilir. Her WARN için alert üretmek kısa sürede alert fatigue oluşturur. Warning oranındaki kalıcı artış dashboard veya anomaly detection ile takip edilebilir. WARN seviyesi expected business validation hatalarını toplamak için kullanılmamalıdır.
ERROR
ERROR bir operasyonun beklenmedik teknik nedenle başarısız olduğunu ifade etmelidir. Unhandled exception, sürekli dependency failure veya veri işleme problemi buna örnek olabilir. Error kaydı exception, error code ve correlation bilgisi taşımalıdır. Aynı hatayı katmanlar boyunca tekrar tekrar ERROR olarak yazmak duplicate gürültü üretir. Hatanın sahiplenildiği uygun katmanda tek ve zengin bir kayıt çoğu zaman daha faydalıdır.
FATAL / CRITICAL
FATAL veya CRITICAL sistemin önemli fonksiyonunun devam edemediği durumları temsil eder. Uygulamanın başlatılamaması, temel dependency'nin tamamen erişilemez olması veya veri bütünlüğü riski buna örnek olabilir. Bu seviye çok sınırlı kullanılmalıdır. Her normal exception'ın critical olarak işaretlenmesi seviyenin anlamını yok eder. Gerçek critical event'ler yüksek öncelikli incident routing mekanizmasına bağlanabilir.
Production'da DEBUG Kullanılmalı mı?
Production'da DEBUG tamamen yasak olmak zorunda değildir, ancak kontrollü olmalıdır. Belirli servis, kullanıcı dışı teknik context veya kısa zaman penceresi için dinamik olarak açılması faydalı olabilir. Sürekli açık DEBUG logları maliyeti ve güvenlik riskini yükseltir. Sampling ve collector filtering bu hacmi kontrol altında tutabilir. En önemli kural, DEBUG seviyesinde bile hassas veri politikasının gevşetilmemesidir.
ERROR Olarak Loglanmaması Gereken Durumlar
Kullanıcının yanlış parola girmesi, form validation hatası veya yetkisiz kaynağa erişmeye çalışması her zaman sistem hatası değildir. Bu beklenen sonuçları ERROR seviyesine taşımak gerçek arızaları görünmez hale getirebilir. Domain kurallarıyla reddedilen işlemler uygun business outcome olarak modellenmelidir. Gerektiğinde INFO veya WARN ile kayıt tutulabilir. Error tracking sistemi beklenmeyen teknik sorunlara odaklandığında geliştirici verimliliği artar.
Expected Error ve Unexpected Error Ayrımı
Kurumsal hata yönetiminde en önemli sınıflandırmalardan biri expected ve unexpected error ayrımıdır. Expected error sistemin tasarım gereği öngördüğü sonuçları ifade eder. Unexpected error ise uygulamanın normal kontrol akışı dışında kalan teknik başarısızlıklardır. Bu ayrım yapılmadığında Sentry gibi error tracking sistemleri kullanıcı kaynaklı normal durumlarla dolar. Sağlıklı taxonomy hem alert gürültüsünü azaltır hem de gerçek production risklerinin önceliklendirilmesini kolaylaştırır.
Validation Error
Validation error kullanıcının veya istemcinin kurala uymayan veri göndermesiyle oluşur. Eksik alan, geçersiz format veya desteklenmeyen değer buna örnek olabilir. Bu hata genellikle expected error kategorisindedir. Response içinde anlaşılır ve güvenli bir error code dönmek yeterlidir. Aynı validation durumunu error tracking sistemine issue olarak göndermek çoğu uygulamada gereksizdir.
Authentication Error
Authentication error kimlik doğrulama işleminin başarısız olduğunu gösterir. Yanlış parola veya süresi dolmuş oturum gibi durumlar normal kullanıcı davranışı kapsamında olabilir. Ancak authentication servisinin çökmüş olması farklı bir dependency failure kategorisidir. Aynı HTTP status altında farklı operasyonel anlamlar olabileceği için error taxonomy önemlidir. Güvenlik açısından credential içeriği hiçbir error context içinde saklanmamalıdır.
Authorization Error
Authorization error doğrulanmış kullanıcının belirli kaynak veya işlem için yetkili olmadığını gösterir. Bu durum çoğunlukla beklenen bir erişim kontrol sonucudur. Çok sayıda olağan dışı yetki ihlali girişimi güvenlik sinyali olarak ayrıca izlenebilir. Uygulama hatası ile güvenlik olayını aynı error bucket içinde değerlendirmek doğru değildir. Role ve policy bilgileri güvenli seviyede loglandığında araştırma daha kolay yapılabilir.
Business Rule Error
Business rule error sistemin iş kuralına göre işlemi kabul etmemesidir. Stok bulunmaması veya belirli durumda sipariş iptalinin engellenmesi buna örnektir. Bu sonuçlar çoğu zaman exception yerine domain result olarak modellenebilir. Kullanıcıya anlaşılır mesaj, sisteme ise stabil error code verilmelidir. İş kuralı hatalarının oranı ürün davranışı açısından metric olarak değerli olabilir.
Dependency Failure
Dependency failure uygulamanın ihtiyaç duyduğu harici servis veya iç servisin beklenen yanıtı verememesidir. Timeout, bağlantı problemi ve yüksek hata oranı bu kategoriye girer. Retryable bilgisi incident ve otomasyon kararları için önemlidir. Circuit breaker state değişiklikleri ayrıca kaydedilebilir. Aynı dependency'nin çok sayıda servisi etkilemesi cascading failure analizinde kolayca görülebilmelidir.
Infrastructure Failure
Infrastructure failure container, node, network, storage veya platform bileşenlerinden kaynaklanan sorunları kapsar. Uygulama exception'ı olarak görünen belirtilerin gerçek nedeni altyapıda olabilir. Metric, platform event ve application trace birlikte incelendiğinde ayrım daha hızlı yapılır. Ownership otomatik routing açısından önemlidir. Platform ekibinin görebileceği dashboard ile uygulama ekibinin context'i aynı incident altında birleştirilebilir.
Unhandled Exception
Unhandled exception uygulamanın açıkça ele almadığı beklenmeyen runtime hatasıdır. Bu tür olaylar error tracking sistemi için güçlü adaylardır. Stack trace, release, environment ve trace ID otomatik olarak eklenmelidir. Kullanıcıya teknik exception mesajının doğrudan gösterilmesi güvenlik ve deneyim açısından uygun değildir. Aynı hatanın tekrarları grouping ile tek issue altında yönetilebilir.
Hangi Hatalar Error Tracking Sistemine Gönderilmeli?
Error tracking sistemi geliştirici müdahalesi gerektiren beklenmeyen hatalara odaklanmalıdır. Unhandled exception, beklenmeyen dependency davranışı ve önemli regression'lar genellikle gönderilebilir. Validation veya normal authorization sonuçları issue olarak gönderildiğinde sistem hızlı biçimde gürültü üretir. Sampling, ignore rules ve custom fingerprint mekanizmaları gerektiğinde kullanılabilir. En iyi ölçüt, bu olay geldiğinde bir geliştiricinin gerçekten aksiyon alıp almayacağıdır.
Kurumsal Error Taxonomy Nasıl Oluşturulur?
Error taxonomy farklı servislerin hataları ortak kategorilerle tanımlamasını sağlar. Her hata için category, code, severity, retry bilgisi ve ownership gibi alanlar belirlenebilir. Bu yapı hem API response standardını hem de observability sorgularını güçlendirir. Hata mesajına göre sınıflandırma yapmak yerine stabil error code kullanmak daha dayanıklıdır. Taxonomy zaman içinde versioning ve dokümantasyonla yönetilmelidir.
Error Category
Error category hatanın genel sınıfını temsil eder. Validation, authentication, authorization, dependency ve infrastructure gibi kategoriler başlangıç için kullanılabilir. Kategori sayısı gereksiz büyütülmemelidir. Çok ayrıntılı sınıflandırma ekiplerin doğru değeri seçmesini zorlaştırır. Category dashboard seviyesinde hata dağılımını görmek için oldukça faydalıdır.
Error Code
Error code belirli hata durumunu mesaj metninden bağımsız olarak tanımlar. PAYMENT_PROVIDER_TIMEOUT gibi stabil bir kod operasyon ve client davranışı için kullanılabilir. Kodların içinde kişisel veya değişken veri bulunmamalıdır. API consumer'ları kullanıcı mesajına değil error code'a göre karar verebilir. Dokümante edilmiş merkezi katalog duplicate kodların oluşmasını önler.
Severity
Error severity olayın teknik ve business etkisini ifade eder. Her exception aynı kullanıcı etkisine sahip değildir. Örneğin arka plandaki düşük öncelikli job hatası ile ödeme sisteminin tamamen çalışmaması aynı seviyede değerlendirilmemelidir. Severity incident priority ve alert routing kararlarını destekleyebilir. Otomatik severity hesaplamasında error rate, affected users ve service criticality birlikte değerlendirilebilir.
Retryable / Non-Retryable Error
Retryable alanı işlemin tekrar denenmesinin anlamlı olup olmadığını belirtir. Network timeout geçici olabilirken validation hatasını tekrar denemek çoğu zaman sonuç değiştirmez. Bu bilgi queue ve background job sistemlerinde özellikle önemlidir. Sınırsız retry cascading failure ve maliyet sorunları yaratabilir. Retry politikası exponential backoff ve maksimum attempt sayısıyla birlikte tanımlanmalıdır.
User-Facing / Internal Error
User-facing error kullanıcıya güvenli biçimde açıklanabilen sonuçları temsil eder. Internal error ise teknik ayrıntılar içerir ve dışarıya doğrudan gösterilmemelidir. Bu ayrım güvenlik açısından önemlidir. Stack trace veya database mesajı API response içinde kullanıcıya dönmemelidir. Error code ile güvenli kullanıcı mesajı aynı taxonomy üzerinden eşleştirilebilir.
Ownership
Ownership belirli error kategorisinin veya servisin hangi ekip tarafından yönetildiğini gösterir. Error tracking sisteminde otomatik issue routing bu bilgiyle yapılabilir. CODEOWNERS, service catalog veya deployment metadata kaynak olarak kullanılabilir. Sahipsiz hata zaman kaybına ve incident gecikmesine yol açar. Ownership değişiklikleri organizasyon yapısıyla birlikte güncellenmelidir.
Error Code Naming Standardı
Error code isimleri insan tarafından anlaşılır ve makine tarafından stabil biçimde işlenebilir olmalıdır. DOMAIN_REASON biçimindeki kontrollü bir convention ekipler için pratik olabilir. Sayısal kod kullanılacaksa merkezi dokümantasyon daha da önem kazanır. Aynı hata için farklı servislerde farklı isim kullanılmaması hedeflenmelidir. Error code değişikliklerinin geriye uyumluluk etkisi API tasarımında dikkate alınmalıdır.
Correlation ID Nedir ve Neden Kritik?
Correlation ID dağıtık işlemleri ortak bir kimlik altında takip etmeyi sağlayan en pratik observability araçlarından biridir. Kullanıcının tek isteği backend, queue ve background job arasında ilerlediğinde aynı identifier zinciri koruyabilir. Böylece support kaydındaki bir ID ile birden fazla servis üzerinde ilgili olaylar bulunabilir. Correlation standardı yoksa ekip her serviste zaman ve kullanıcı bilgisiyle manuel arama yapmak zorunda kalır. Bu nedenle correlation uygulama mimarisinin başından itibaren düşünülmesi gereken ortak bir sözleşmedir.
Request ID ile Correlation ID Farkı
Request ID çoğu zaman tek bir HTTP request'i temsil eder. Correlation ID ise aynı iş akışındaki birden fazla request veya async işlemi bağlayabilir. Basit sistemlerde iki değer aynı tutulabilir, ancak kavramsal farkı bilmek önemlidir. Distributed tracing kullanıldığında trace ID daha standart bir uçtan uca context sağlar. Kurum kendi destek veya business süreçleri için ek correlation alanı kullanmaya devam edebilir.
Correlation ID Nasıl Üretilir?
Correlation ID yeterince benzersiz ve kullanıcı verisinden bağımsız şekilde üretilmelidir. UUID veya benzeri rastgele identifier formatları yaygın seçimlerdir. Dışarıdan gelen değer güvenlik ve format kontrolünden geçirilmelidir. Güvenilir değer yoksa uygulamanın giriş katmanı yeni bir ID oluşturabilir. Oluşturulan değer response header ile istemciye döndürülürse destek süreçlerinde kullanılabilir.
HTTP Header Üzerinden Propagation
Correlation ID servisler arasında HTTP header üzerinden taşınabilir. Header adı kurum standardında tek biçimde tanımlanmalıdır. İstek başka servise gönderilirken client middleware bu değeri otomatik eklemelidir. Elle propagation geliştiricilerin bazı çağrıları unutmasına yol açabilir. OpenTelemetry trace context için standart propagation mekanizmaları sağladığından mümkün olduğunda bunlarla uyumlu tasarım tercih edilmelidir.
Microservice'ler Arasında Correlation
Microservice mimarisinde aynı kullanıcı aksiyonu çok sayıda servis üzerinden geçebilir. Her servis correlation veya trace context'i koruduğunda merkezi sorgu tek zinciri gösterebilir. Retry işlemlerinde attempt ID ile ana correlation ID ayrı tutulmalıdır. Böylece hem business akış hem teknik deneme sayısı görünür kalır. Ortak middleware veya SDK bu standardın tüm servislerde uygulanmasını kolaylaştırır.
Background Job'larda Correlation
Background job kullanıcı request'i tamamlandıktan sonra çalıştığı için context kolayca kaybolabilir. Job payload veya message metadata içinde güvenli correlation bilgisi taşınmalıdır. Worker logları aldığı correlation ID'yi tüm ilgili kayıtlara eklemelidir. Yeni child trace başlatılıyorsa parent context ilişkisi korunabilir. Bu yaklaşım kullanıcı işlemi ile saatler sonra çalışan arka plan görevini aynı akışta incelemeyi sağlar.
Message Queue Sistemlerinde Correlation
Message queue sistemlerinde correlation bilgisi message header veya metadata alanında taşınabilir. Payload içine rastgele eklemek domain modelini telemetry ayrıntılarıyla gereksiz biçimde karıştırabilir. Producer ve consumer instrumentation ortak standardı uygulamalıdır. Retry ve dead letter süreçleri ana correlation değerini korumalıdır. Böylece queue kaynaklı gecikme ve başarısızlıklar uçtan uca görülebilir.
Trace ID ve Span ID ile Dağıtık Sistemleri İzlemek
Trace ID ve span ID modern distributed tracing yaklaşımının temel kimlikleridir. Trace ID tüm işlem zincirini, span ID ise zincirdeki belirli operasyonu temsil eder. Bu yapı microservice, database, queue ve external API çağrılarını aynı zaman çizelgesine getirir. Kurumsal uygulamalarda merkezi loglama tek başına güçlü olsa da tracing eklendiğinde neden sonuç ilişkisi çok daha net görünür. Loglarda trace ID bulunması iki veri dünyası arasında pratik bir geçiş noktası oluşturur.
Distributed Trace Nedir?
Distributed trace tek bir işlemin farklı sistem bileşenlerinde oluşturduğu span'ların bütünüdür. Kullanıcının web isteği backend servisine, oradan başka servise ve database'e ilerleyebilir. Her adımın başlangıç süresi, bitiş süresi ve status bilgisi kaydedilebilir. Trace görselleştirmesi darboğazın hangi noktada oluştuğunu gösterir. Özellikle yüksek servis sayısında manuel log zaman eşleştirmesine göre büyük avantaj sağlar.
Trace ID
Trace ID bütün distributed işlem akışının benzersiz kimliğidir. Aynı trace'e ait tüm span'lar bu değeri paylaşır. Log, error event ve gerektiğinde business event üzerinde trace ID tutulabilir. Trace ID metric label olarak kullanıldığında yüksek cardinality sorununa yol açabileceği için dikkat edilmelidir. En iyi kullanım alanı detaylı sorgu ve cross navigation bağlantısıdır.
Span ID
Span ID trace içindeki tek operasyonu ayırt eder. Her servis çağrısı veya önemli local işlem ayrı span oluşturabilir. Span üzerindeki attribute'lar endpoint, dependency ve status gibi bilgileri taşır. Log kaydına span ID eklemek belirli operasyonun detayına hızlı geçiş sağlar. Gereksiz derecede küçük fonksiyonları span yapmak veri hacmini artırabileceği için anlamlı sınırlar seçilmelidir.
Parent Child Span İlişkisi
Parent ve child span ilişkisi işlem ağacının hangi adımlardan oluştuğunu gösterir. Backend request span'ı database query veya external API span'larının parent'ı olabilir. Bu hiyerarşi toplam latency içinde hangi alt operasyonun etkili olduğunu anlamayı kolaylaştırır. Async işlerde causal relationship doğru modellenmelidir. Yanlış parent ilişkileri trace görselleştirmesini yanıltıcı hale getirebilir.
Frontend'den Backend'e Trace Context Taşımak
Frontend ve backend arasında trace context taşındığında gerçek kullanıcı etkileşimi uçtan uca izlenebilir. Browser instrumentation uygun header'ları izin verilen origin'lere göndermelidir. CORS ve güvenlik politikaları bu süreçte dikkate alınmalıdır. Üçüncü taraf domain'lere iç telemetry context'i gereksiz yere gönderilmemelidir. Frontend error event'i backend trace ile bağlandığında aynı kullanıcı sorununu tek akışta incelemek mümkün olur.
Database ve External API Span'ları
Database ve external API çağrıları çoğu uygulamada latency'nin önemli bölümünü oluşturur. Otomatik instrumentation bu operasyonlar için span üretebilir. Query parameter veya hassas URL verileri span attribute olarak kontrolsüz biçimde eklenmemelidir. Dependency name, operation ve response status çoğu araştırma için yeterlidir. Bu span'lar service level performans analizi ve dependency health değerlendirmesinde kullanılır.
OpenTelemetry Nedir?
OpenTelemetry uygulamalardan traces, metrics ve logs gibi telemetry sinyallerini üretmek ve taşımak için açık standartlar ve araçlar sunan bir ekosistemdir. En önemli avantajlarından biri uygulamayı tek bir observability sağlayıcısının özel SDK modeline bağlama ihtiyacını azaltmasıdır. SDK, auto instrumentation, Collector ve OTLP birlikte esnek bir telemetry pipeline kurulmasını sağlar. Özellikle çok dilli kurumsal sistemlerde ortak semantic conventions büyük değer üretir. Sentry ELK ve OpenTelemetry hata izleme ve log yönetimi karşılaştırması yapılırken OpenTelemetry'nin doğrudan bir log arama arayüzü değil, telemetry üretim ve taşıma katmanı olduğu unutulmamalıdır.
Vendor-Neutral Observability Yaklaşımı
Vendor-neutral yaklaşım uygulama instrumentation'ını belirli backend ürününün özel API'lerinden mümkün olduğunca ayırır. Böylece veri hedefi değiştirilmek istendiğinde uygulama kodunun tamamını yeniden yazmak gerekmez. OpenTelemetry bu amaçla ortak API ve protocol yaklaşımı sunar. Yine de backend özellikleri arasında fark olabileceği için tamamen sıfır bağımlılık garantisi beklenmemelidir. En büyük kazanım telemetry üretim katmanında standartlaşmadır.
OpenTelemetry SDK
OpenTelemetry SDK uygulama içinde span, metric ve diğer telemetry verilerini üretme ve işleme görevini üstlenir. Dil ekosistemlerine göre API ve instrumentation desteği değişebilir. Resource attribute'ları service name ve version gibi ortak bilgileri merkezi biçimde tanımlamaya yardımcı olur. Sampling ve exporter ayarları SDK seviyesinde yapılabilir. Kurumsal kullanımda SDK configuration'ının shared library veya platform standardıyla yönetilmesi faydalıdır.
Auto Instrumentation
Auto instrumentation yaygın framework ve kütüphaneler için minimum kod değişikliğiyle telemetry üretmeyi sağlar. HTTP, database ve messaging operasyonları otomatik span oluşturabilir. Bu yaklaşım hızlı başlangıç için oldukça değerlidir. Ancak business event ve domain context otomatik olarak bilinmediği için manuel instrumentation yine gerekebilir. Üretilen attribute'ların hassas veri açısından gözden geçirilmesi de unutulmamalıdır.
OpenTelemetry Collector
OpenTelemetry Collector telemetry verisini uygulamalardan alıp işleyen ve farklı backend'lere gönderen merkezi bileşendir. Receiver, processor ve exporter mantığıyla esnek pipeline kurulabilir. Filtering, batching ve redaction gibi işlemler uygulama kodundan ayrılabilir. Collector agent veya gateway topolojisinde dağıtılabilir. Yüksek erişilebilirlik ve backpressure davranışı production tasarımında ayrıca planlanmalıdır.
OTLP
OTLP OpenTelemetry Protocol ifadesinin kısaltmasıdır ve telemetry aktarımı için standart iletişim yaklaşımı sunar. gRPC ve HTTP transport seçenekleri deployment ortamına göre kullanılabilir. Uygulamaların Collector veya uyumlu backend'e ortak protokolle veri göndermesi entegrasyonu sadeleştirir. Network timeout ve retry politikaları veri kaybı riskine göre tasarlanmalıdır. Telemetry trafiği encryption in transit ile korunmalıdır.
Semantic Conventions
Semantic conventions yaygın telemetry attribute'larının ortak isim ve anlamlarla kullanılmasını sağlar. HTTP method, status code ve service bilgileri gibi alanlar standardize edilebilir. Bu yaklaşım farklı programlama dillerinden gelen verinin aynı sorgularla analiz edilmesini kolaylaştırır. Custom business attribute'ları eklemek mümkündür. Ancak hazır convention varken aynı anlamı taşıyan yeni isim üretmek gereksiz veri dağınıklığına yol açar.
Resource Attributes
Resource attributes telemetry üreten servis veya çalışma ortamı hakkında kalıcı context sağlar. Service name, service version ve deployment environment sık kullanılan örneklerdir. Kubernetes metadata gibi altyapı bilgileri collector veya resource detector üzerinden eklenebilir. Bu alanlar her span'a manuel yazılmak zorunda kalmaz. Ortak resource standardı log, metric ve trace kaynaklarını aynı servis kimliği altında birleştirmeyi kolaylaştırır.
Log Trace Correlation
Log ve trace correlation aynı olayın ayrıntılı metin kaydıyla distributed trace görünümünü birleştirir. Log kaydında trace ID ve span ID bulunduğunda kullanıcı iki veri kaynağı arasında doğrudan geçiş yapabilir. Bu özellik incident araştırmasında zaman kazandırır. Logging library ve OpenTelemetry context entegrasyonu otomatik alan eklemeyi sağlayabilir. Elle eklenen context kolay unutulduğu için middleware veya instrumentation tabanlı yaklaşım daha güvenlidir.
OpenTelemetry Collector ile Merkezi Telemetry Pipeline
Merkezi Collector pipeline uygulamalar ile observability backend'leri arasına kontrollü bir işleme katmanı ekler. Telemetry önce receiver tarafından alınır, processor aşamasında düzenlenir ve exporter ile hedef sisteme gönderilir. Böylece sampling, redaction ve batching kararları farklı uygulamalarda tekrar edilmez. Kurumsal sistemlerde bu yapı governance açısından güçlü bir kontrol noktasıdır. Collector'ın kendisi kritik altyapı bileşeni haline geldiği için health, queue ve dropped telemetry metrikleri ayrıca izlenmelidir.
Receiver
Receiver Collector'ın telemetry verisini kabul eden giriş katmanıdır. OTLP, platform logları veya farklı protokoller için uygun receiver'lar kullanılabilir. Gereksiz port ve protokolleri açık tutmamak güvenlik açısından önemlidir. Receiver kapasitesi beklenen telemetry hacmine göre boyutlandırılmalıdır. Authentication ve transport security gereksinimleri deployment modeline göre uygulanmalıdır.
Processor
Processor gelen telemetry üzerinde işleme yapan pipeline aşamasıdır. Batching, filtering, sampling ve redaction gibi işlemler burada uygulanabilir. Processor sırası sonuç üzerinde etkili olabilir. Örneğin hassas verinin mümkün olduğunca erken redaction aşamasından geçmesi güvenli bir yaklaşım sağlar. Configuration değişiklikleri test ortamında doğrulanmadan production'a alınmamalıdır.
Batch
Batch processor küçük telemetry kayıtlarını gruplandırarak exporter verimliliğini artırır. Daha az network çağrısı CPU ve bağlantı maliyetini azaltabilir. Batch boyutu ile gecikme arasında denge kurulmalıdır. Çok büyük batch bellek kullanımını artırabilir. Collector kapasite testleri gerçek trafik özellikleriyle yapılmalıdır.
Filtering
Filtering gereksiz veya düşük değerli telemetry verisinin pipeline içinde elenmesini sağlar. Health check request'leri veya aşırı yüksek hacimli rutin event'ler buna örnek olabilir. Filtre koşulları version control altında tutulmalıdır. Yanlış filtre production hatalarının görünmez hale gelmesine neden olabilir. Bu nedenle dropped event oranları ve örnek kayıtlar düzenli olarak incelenmelidir.
Sampling
Sampling özellikle trace hacmini ve maliyetini kontrol etmek için kullanılır. Tüm başarılı request'leri saklamak büyük sistemlerde gereksiz olabilir. Kritik error trace'lerini koruyan tail based yaklaşım bazı senaryolarda daha değerlidir. Sampling oranları servis önemine göre değişebilir. Karar verirken hata araştırması için gerekli minimum coverage göz önünde bulundurulmalıdır.
Redaction
Redaction hassas alanların telemetry backend'e ulaşmadan önce kaldırılması veya maskelenmesidir. Token, cookie ve kişisel veri alanları merkezi policy ile işlenebilir. Uygulama seviyesinde redaction yine de ilk savunma katmanı olmalıdır. Collector ikinci bir güvenlik bariyeri sağlar. Redaction kurallarının test edilmesi ve değişen schema ile güncellenmesi gerekir.
Exporter
Exporter işlenmiş telemetry verisini seçilen backend veya depolama sistemine gönderir. Birden fazla exporter aynı pipeline üzerinde kullanılabilir. Retry ve queue ayarları geçici hedef kesintilerinde veri kaybını azaltabilir. Süresiz retry bellek ve disk baskısı oluşturabileceği için sınırlar belirlenmelidir. Exporter hata oranları Collector health dashboard'unda izlenmelidir.
Birden Fazla Observability Backend'ine Veri Göndermek
Aynı telemetry verisi ihtiyaç halinde birden fazla backend'e yönlendirilebilir. Örneğin trace verisi farklı analiz sistemi ve arşiv hedefi arasında paylaşılabilir. Bu esneklik migration veya karşılaştırma süreçlerinde faydalıdır. Ancak iki hedefe sürekli veri göndermek maliyeti artırabilir. Routing kararları gerçek kullanım senaryosuna ve veri yönetişimi politikasına göre verilmelidir.
Vendor Lock-In Riskini Azaltmak
Vendor lock-in riski yalnızca fiyat değil, uygulama kodunun belirli platform API'lerine bağlanmasıyla da oluşur. OpenTelemetry instrumentation ve OTLP kullanımı bu bağımlılığın bir bölümünü azaltabilir. Collector sayesinde exporter hedefi uygulama kodundan bağımsız değiştirilebilir. Backend'e özgü dashboard ve query dili için yine migration maliyeti olabilir. Bu nedenle standart telemetry ile taşınabilir sorgu ve alert tasarımını mümkün olduğunca dengelemek gerekir.
Merkezi Loglama Mimarisi Nasıl Kurulur?
Merkezi loglama mimarisi uygulama tarafından üretilen kayıtların güvenilir biçimde toplanıp aranabilir bir sisteme aktarılmasını sağlar. Basit model application, collector, storage, query ve alert katmanlarından oluşur. Container veya cloud ortamında logların local disk üzerinde kalmasına güvenmek doğru değildir. Collector logu standartlaştırabilir, hassas alanları kaldırabilir ve backend'e kontrollü biçimde gönderebilir. Kurumsal log yönetimi ve hata takip sistemi kurulum hizmeti değerlendirilirken yalnızca ürün kurulumu değil, schema, güvenlik, retention ve incident süreçleri birlikte ele alınmalıdır.
Application → Collector → Storage → Query → Alert Modeli
Uygulama structured log üretir ve collector bu veriyi güvenilir biçimde alır. Collector gerekli processing adımlarından sonra merkezi storage katmanına gönderir. Query katmanı geliştiricilerin ve operasyon ekiplerinin kayıtları incelemesini sağlar. Alert sistemi belirli pattern veya oranların kritik hale gelmesi durumunda aksiyon üretir. Bu katmanların birbirinden ayrılması ölçek ve teknoloji değişikliklerini daha yönetilebilir hale getirir.
Merkezi Loglamanın Avantajları
Merkezi sistem farklı sunucu ve servislerden gelen kayıtları tek arama deneyiminde birleştirir. Correlation ID üzerinden birden fazla servisin logları saniyeler içinde bulunabilir. Access control, retention ve redaction politikaları merkezi olarak uygulanabilir. Dashboard ve alert üretimi standardize edilir. Incident sırasında hangi node üzerinde hangi dosyanın bulunduğunu aramak yerine doğrudan olayın kendisine odaklanılır.
Dağıtık Logların Problemleri
Logların her sunucuda ayrı dosyada kalması ölçek büyüdükçe operasyon yükünü artırır. Container restart olduğunda local kayıtlar tamamen kaybolabilir. Saat farklılıkları ve format çeşitliliği olayları eşleştirmeyi zorlaştırır. Arama yapmak için sunucuya doğrudan erişim verilmesi güvenlik riskini büyütür. Merkezi toplama bu sorunları önemli ölçüde azaltır.
Container ve Kubernetes Logları
Container tabanlı sistemlerde uygulamanın stdout ve stderr üzerinden yapılandırılmış log üretmesi yaygın bir yaklaşımdır. Node seviyesindeki collector bu kayıtları merkezi sisteme taşıyabilir. Kubernetes metadata service, namespace ve pod bilgisi eklemek için kullanılabilir. Pod adı gibi yüksek değişkenli alanların indis stratejisi dikkatli planlanmalıdır. Container lifecycle kısa olduğu için local dosya tabanlı araştırmaya bağımlı kalmamak gerekir.
Cloud Service Logları
Managed cloud servisleri kendi platform loglarını ve audit kayıtlarını üretebilir. Bu verilerin uygulama telemetry sistemiyle nasıl ilişkilendirileceği baştan planlanmalıdır. Cloud account, region ve resource identifier gibi alanlar yararlı context sağlayabilir. Servis provider loglarının tamamını merkezi platforma taşımak ciddi ingestion maliyeti oluşturabilir. Kullanım senaryosuna göre gerekli kategoriler seçilmelidir.
Database Logları
Database logları connection, slow query ve engine hataları hakkında önemli altyapı sinyalleri sağlar. Uygulama loglarıyla birebir aynı retention veya erişim politikası gerekmeyebilir. Query text içinde hassas veri bulunabileceği için log ayarları dikkatle yapılandırılmalıdır. Slow query analizi tracing verisiyle birleştirildiğinde uygulama üzerindeki etkisi daha kolay anlaşılır. Database audit logları ise normal performans loglarından ayrı değerlendirilebilir.
Network ve Gateway Logları
Network ve gateway logları request'in uygulamaya ulaşmadan önceki davranışını anlamaya yardımcı olur. Status code, route, latency ve upstream bilgisi yararlı alanlardır. Authorization header ve cookie gibi hassas bilgiler kayıt dışı bırakılmalıdır. Gateway request ID uygulama correlation standardıyla uyumlu hale getirilebilir. Böylece istemci, gateway ve backend aynı incident zincirinde görüntülenebilir.
ELK Stack ile Kurumsal Loglama
ELK Stack uzun süredir merkezi loglama ve arama ihtiyacında kullanılan güçlü bir mimari yaklaşımı temsil eder. Elasticsearch indeksleme ve arama, Logstash veri işleme, Kibana ise sorgu ve görselleştirme tarafında rol oynar. Modern yapılarda Fluent Bit veya farklı collector seçenekleri Logstash'in bazı görevlerini üstlenebilir. ELK yüksek sorgu esnekliği sunarken kapasite, shard ve retention yönetimi deneyim gerektirir. Özellikle büyük log hacminde maliyetin veri üretim standardı kadar cluster yönetimine bağlı olduğu unutulmamalıdır.
Elasticsearch
Elasticsearch dağıtık arama ve indeksleme yetenekleri sayesinde structured log analizi için güçlü bir backend olabilir. Alanlar üzerinde filtre, aggregation ve full text sorguları yapılabilir. Mapping tasarımı yanlış olduğunda storage ve performans sorunları oluşabilir. Her dinamik alanı otomatik indislemek özellikle yüksek cardinality veride risklidir. Index lifecycle yönetimi log retention ve maliyet kontrolünün temel parçalarındandır.
Logstash
Logstash farklı kaynaklardan veri alıp işleyerek hedef sistemlere yönlendirebilen pipeline aracıdır. Parsing, enrichment ve filtering gibi işlemlerde kullanılabilir. Ağır pipeline'larda kaynak tüketimi yakından izlenmelidir. Yeni mimarilerde bazı görevler Fluent Bit veya OpenTelemetry Collector gibi daha hafif bileşenlerle çözülebilir. Araç seçimi ekibin kullanım senaryosu ve mevcut operasyon yetkinliğine göre yapılmalıdır.
Kibana
Kibana Elasticsearch üzerindeki veriyi sorgulamak ve görselleştirmek için kullanılır. Geliştiriciler filtreler, dashboard'lar ve kaydedilmiş sorgular üzerinden incident araştırabilir. Rol bazlı erişim özellikle farklı ekiplerin ortak cluster kullandığı ortamlarda önemlidir. Dashboard'ların sahipliği ve bakım süreci tanımlanmalıdır. Gereksiz yüzlerce panel yerine incident sırasında gerçekten kullanılan göstergelere odaklanmak daha etkilidir.
Beats / Fluent Bit
Beats ve Fluent Bit log toplama katmanında sık kullanılan hafif araçlar arasındadır. Node, container veya dosya kaynaklarından veri alınarak merkezi sisteme aktarılabilir. Fluent Bit özellikle container ortamlarında düşük kaynak tüketimi nedeniyle tercih edilebilir. Parsing ve buffering davranışı yük testleriyle doğrulanmalıdır. Collector kaybı veya backpressure sırasında ne olacağı production tasarımının önemli parçasıdır.
ELK'nin Avantajları
ELK esnek sorgu, güçlü indexing ve geniş ekosistem avantajı sunar. Farklı log kaynaklarını tek veri modeli altında bir araya getirmek mümkündür. Self hosted kullanım kurumun veri yerleşimi üzerinde daha fazla kontrol sağlayabilir. Büyük topluluk ve geniş bilgi kaynağı operasyon öğrenimini kolaylaştırır. Bunun karşılığında cluster kapasitesi ve tuning sorumluluğu kuruma aittir.
ELK'nin Operasyonel Maliyetleri
Elasticsearch cluster yönetimi disk, memory, shard ve index lifecycle konularında sürekli operasyon gerektirir. Log hacmi büyüdükçe storage ve replication maliyeti belirgin hale gelir. Yanlış mapping veya aşırı field sayısı cluster kaynaklarını gereksiz tüketebilir. Upgrade ve kapasite planı da düzenli çalışma ister. Bu nedenle yalnızca lisans maliyetine bakarak toplam sahip olma maliyetini değerlendirmek yanıltıcıdır.
Büyük Log Hacminde Elasticsearch Yönetimi
Büyük hacimde index lifecycle, shard boyutu ve retention stratejisi kritik hale gelir. Her servis için kontrolsüz index üretmek shard sayısını hızla büyütebilir. Hot, warm ve archive katmanları veri erişim ihtiyacına göre ayrılabilir. Yüksek cardinality alanları yalnızca ihtiyaç varsa indislemek önemli tasarruf sağlar. Production kapasitesi gerçek ingestion ve query pattern'leriyle load test edilmelidir.
Grafana Loki ile Loglama
Grafana Loki log verisini özellikle label temelli indeks yaklaşımıyla yönetmesi nedeniyle Elasticsearch'ten farklı bir model sunar. Log içeriğinin tamamını indislemek yerine seçilmiş label'lar üzerinden erişim sağlamayı hedefler. Grafana ile yakın entegrasyonu metric, trace ve log korelasyonu açısından pratik olabilir. Loki maliyet ve operasyon açısından bazı ekipler için daha uygun bir seçenek oluşturabilir. Ancak label cardinality yanlış tasarlanırsa beklenen verim avantajı hızla kaybolabilir.
Loki Nasıl Çalışır?
Loki log stream'lerini sınırlı sayıda label üzerinden organize eder. Log içeriği Elasticsearch benzeri biçimde tam alan indekslemesine dayanmaz. Bu yaklaşım storage ve indexing maliyetini azaltabilir. Sorgu sırasında log satırlarının içeriği filtrelenebilir. Label seçimi bu nedenle mimarinin en kritik kararlarından biridir.
Promtail ve Alternatif Collector'lar
Promtail uzun süre Loki ekosisteminde yaygın collector seçeneklerinden biri olmuştur. Kurumlar yeni veya mevcut mimarilerine göre farklı collector çözümleri de kullanabilir. OpenTelemetry Collector veya Fluent Bit gibi araçlar merkezi telemetry stratejisine uyum sağlayabilir. Collector seçerken buffering, retry, parsing ve metadata enrichment özellikleri değerlendirilmelidir. Amaç log üreticisini backend seçimine mümkün olduğunca az bağımlı hale getirmektir.
Grafana Entegrasyonu
Grafana metric, trace ve log verisini aynı gözlem ekranlarında birleştirmek için güçlü bir kullanıcı deneyimi sunabilir. Metric panelinden ilgili log sorgusuna geçiş incident araştırmasını hızlandırır. Trace ID kullanımı log ile trace arasında doğrudan bağlantı kurulmasını sağlar. Dashboard'ların servis ownership yapısıyla eşleştirilmesi faydalıdır. Ortak dashboard template'leri yeni servislerin gözlemlenebilir hale gelmesini kolaylaştırır.
Loki vs Elasticsearch
Loki ve Elasticsearch aynı ihtiyaca farklı veri modellemeleriyle yaklaşır. Elasticsearch alan bazlı güçlü arama ve aggregation konusunda geniş esneklik sunar. Loki daha sınırlı indeks yaklaşımıyla log maliyetini azaltmayı hedefler. Seçim yalnızca performansa değil, sorgu alışkanlığına, ekip deneyimine ve veri hacmine göre yapılmalıdır. Bazı kurumlar farklı log kategorileri için iki yaklaşımı birlikte de kullanabilir.
Loki Hangi Kurumlar İçin Uygundur?
Loki özellikle Grafana ve Prometheus ekosistemini aktif kullanan ekipler için doğal bir seçenek olabilir. Container ağırlıklı sistemlerde label tabanlı servis filtreleme pratik sonuç verir. Log üzerinde sürekli karmaşık full text veya field aggregation ihtiyacı olan ekipler ihtiyaçlarını önceden test etmelidir. Self hosted operasyon sorumluluğu yine kurum tarafında kalır. Pilot uygulama gerçek sorgu senaryolarıyla yapılırsa araç uygunluğu daha sağlıklı ölçülür.
Sentry ile Hata Takibi
Sentry uygulamadaki runtime exception ve benzeri hataları geliştiricinin yönetebileceği issue'lara dönüştürme konusunda odaklı bir yaklaşım sunar. Özellikle stack trace, release, environment ve breadcrumbs gibi context bilgileri debugging süresini kısaltabilir. Log yönetimi platformundan farklı olarak temel değeri hata grouping ve issue lifecycle tarafındadır. Sentry kullanırken beklenen business error'ları filtrelemek gürültüyü önemli ölçüde azaltır. En güçlü sonuç release tracking ve source map süreçleri CI/CD ile otomatikleştirildiğinde elde edilir.
Sentry Hangi Problemi Çözer?
Sentry geliştiricinin production'da oluşan uygulama hatalarını merkezi biçimde görmesini sağlar. Aynı hata tekrarlarını gruplayarak tek issue üzerinden takip edebilir. Hatanın hangi release ve environment'ta başladığı görülebilir. Stack trace ve context bilgisi yeniden üretme süresini azaltır. Error tracking görevini genel log aramasından ayırması ekip iş akışını daha anlaşılır hale getirir.
Exception Capture
Exception capture beklenmeyen runtime hatalarının SDK üzerinden kaydedilmesini sağlar. Global handler'lar yakalanmamış exception'lar için temel güvenlik ağı oluşturabilir. Elle yakalanan hatalarda yalnızca gerçekten geliştirici müdahalesi gerektiren olaylar gönderilmelidir. Context eklerken hassas veri politikası uygulanmalıdır. Aynı exception'ın hem global hem local seviyede iki kez gönderilmemesi için entegrasyon test edilmelidir.
Stack Trace
Stack trace hatanın kod içinde hangi çağrı zinciri üzerinden oluştuğunu gösterir. Backend ortamında semboller ve source bilgisi anlaşılır tutulmalıdır. Frontend build'lerinde minification nedeniyle source map desteği kritik hale gelir. Gereksiz framework frame'leri filtrelenerek uygulama kodu öne çıkarılabilir. Stack trace tek başına yeterli olmadığından release ve request context ile birlikte değerlendirilmelidir.
Breadcrumbs
Breadcrumbs hata oluşmadan önce gerçekleşen önemli olayların kısa zaman çizelgesini gösterir. Navigation, network request veya belirli kullanıcı aksiyonları context sağlayabilir. Her olayı breadcrumb yapmak gürültüyü artırabilir. Hassas URL parametreleri ve kullanıcı verileri temizlenmelidir. Doğru kullanıldığında hata anına giden yolu yeniden oluşturmak ciddi biçimde kolaylaşır.
Tags ve Context
Tags issue'ların environment, service veya feature gibi boyutlarda filtrelenmesini kolaylaştırır. Context alanları daha ayrıntılı fakat her zaman indexed olmayan bilgiler taşıyabilir. Yüksek cardinality alanlarını tag yapmak maliyet veya sorgu verimliliğini etkileyebilir. User ID gibi değerler veri politikası çerçevesinde ele alınmalıdır. Tag standardı ekiplerin aynı problemi farklı isimlerle sınıflandırmasını önler.
User Context
User context belirli hatanın kaç kullanıcıyı etkilediğini anlamada değerli olabilir. Gerçek isim veya e posta yerine pseudonymous internal identifier çoğu senaryoda yeterlidir. Gereksiz kişisel veri gönderimi engellenmelidir. Kullanıcı context'i error rate ve impact önceliklendirmesinde yarar sağlar. Erişim ve retention politikaları observability backend'inde de uygulanmalıdır.
Environment Yönetimi
Environment etiketi production, staging ve test hatalarını birbirinden ayırır. Alertler yalnızca production issue'larına göre yapılandırılabilir. Environment isimleri deployment pipeline tarafından otomatik set edilmelidir. Geliştiricinin elle verdiği serbest değerler zamanla veri dağınıklığı oluşturur. Release ve environment birlikte kullanıldığında regression analizi daha güvenilir hale gelir.
Frontend Projelerinde Sentry Entegrasyonu
Frontend hataları backend hatalarından farklı olarak kullanıcının tarayıcısında gerçekleşir ve geliştirici sunucu loglarına doğrudan yansımaz. Bu nedenle JavaScript runtime exception, promise rejection ve render hatalarının merkezi error tracking sistemine iletilmesi önemlidir. Framework entegrasyonu, source map ve release tracking birlikte düşünülmelidir. Network error'larında response içeriğini kontrolsüz biçimde göndermek veri riski yaratabilir. Frontend telemetry tasarımında kullanıcı context'i ve session replay gibi özellikler veri minimizasyonu yaklaşımıyla uygulanmalıdır.
JavaScript ve TypeScript Error Tracking
JavaScript uygulamalarında runtime hataları farklı tarayıcı ve cihazlarda ortaya çıkabilir. TypeScript compile zamanı güvenliği sağlasa da production runtime hatalarını tamamen ortadan kaldırmaz. Error tracking SDK'sı uncaught exception ve promise rejection olaylarını yakalayabilir. Release metadata source map eşleşmesi için önemlidir. Browser extension veya üçüncü taraf script hataları gerektiğinde filtrelenmelidir.
React Error Tracking
React uygulamalarında render ve component lifecycle hataları kullanıcı ekranının bozulmasına yol açabilir. Error boundary yaklaşımı belirli component ağacındaki hataları kontrol altında tutar. Error tracking sistemi boundary tarafından yakalanan exception'ı context ile kaydedebilir. Kullanıcıya güvenli fallback ekranı gösterilmelidir. Aynı hata global handler tarafından tekrar gönderiliyorsa deduplication davranışı test edilmelidir.
Next.js Error Tracking
Next.js hem client hem server tarafında çalışan kod içerdiği için observability yapılandırması iki çalışma modelini de kapsamalıdır. Server side ve browser exception'ları doğru environment ve runtime bilgisiyle ayrılmalıdır. Source map ve release ayarları build sürecine entegre edilmelidir. Edge veya serverless çalışma ortamlarında telemetry gönderim süresi ayrıca test edilmelidir. Bu tür mimarilerin genel maliyet yaklaşımını değerlendirirken https://www.diyarbakiryazilim.com.tr/posts/sunucu-bagimsiz-serverless-mimarilerin-kurumsal-maliyet-analizi içeriği de yararlı bir tamamlayıcı olabilir.
Global Error Handler
Global error handler yakalanmamış frontend hataları için son güvenlik ağıdır. Handler yalnızca hatayı göndermekle kalmamalı, duplicate event davranışını da kontrol etmelidir. Context içinde URL kullanılıyorsa query parametrelerindeki hassas değerler temizlenmelidir. Global handler uygulama recovery stratejisinin yerine geçmez. Hata sonrası kullanıcıya güvenli ve anlaşılır bir deneyim sunmak ayrıca tasarlanmalıdır.
Unhandled Promise Rejection
Unhandled promise rejection async işlemlerde kolayca gözden kaçabilen önemli bir hata türüdür. Global listener bu olayları merkezi error tracking sistemine aktarabilir. Cancellation veya beklenen network timeout durumları otomatik olarak gerçek bug kabul edilmemelidir. Error reason güvenli ve sınıflandırılmış biçimde gönderilmelidir. Tekrarlanan hatalar grouping sayesinde aynı issue altında tutulabilir.
Network Error'ları
Frontend network error'ları bağlantı problemi, timeout veya backend response hatası nedeniyle oluşabilir. Endpoint route, status code ve request duration değerli context sağlar. Request veya response body varsayılan olarak error event'e eklenmemelidir. Backend correlation ID response header üzerinden frontend'e taşınabilir. Böylece tarayıcıdaki hata ilgili backend log ve trace kayıtlarına bağlanabilir.
React Error Boundary
React Error Boundary component ağacındaki render hatalarını kontrollü biçimde yakalamaya yardımcı olur. Kullanıcıya boş ekran yerine fallback UI gösterilebilir. Boundary içinde error tracking çağrısı yapılarak component stack bilgisi kaydedilebilir. Her component için ayrı boundary kullanmak gerekmez, anlamlı kullanıcı deneyimi sınırları seçilmelidir. Kritik ekranlarda boundary davranışı otomatik testlerle doğrulanmalıdır.
Source Map Neden Error Tracking İçin Kritiktir?
Frontend production build'leri genellikle minify ve bundle edildiği için stack trace orijinal kaynak dosyalarını doğrudan göstermez. Source map, minified kod konumlarını geliştiricinin gerçek TypeScript veya JavaScript kaynaklarına eşlemeyi sağlar. Bu dosyalar doğru release ile bağlanmadığında error tracking ekranındaki satır numaraları anlamsız kalabilir. CI/CD pipeline içinde upload ve release eşleşmesi otomatikleştirilmelidir. Source map yönetimi frontend observability kalitesinin temel unsurlarından biridir.
Minified Stack Trace Problemi
Minified build değişken isimlerini ve kod yapısını küçülttüğü için stack trace okunabilirliğini azaltır. Hata app.ab12.js içindeki tek satıra işaret edebilir. Geliştiricinin gerçek kaynak dosyasını elle bulması zaman kaybettirir. Source map bu konumu orijinal dosya ve satıra dönüştürebilir. Release eşleşmesi yanlışsa map mevcut olsa bile sonuç doğru olmayabilir.
Source Map Upload
Source map dosyaları build tamamlandıktan sonra error tracking sistemine güvenli biçimde yüklenebilir. Upload işlemi manuel bırakıldığında sürüm kaçırma olasılığı yüksektir. CI pipeline build artifact ile aynı release identifier'ı kullanmalıdır. Upload başarısızlığı deployment kalite kontrolünde görünür hale getirilmelidir. Gerekli değilse source map dosyalarının public web sunucusunda servis edilmesi önlenebilir.
CI/CD İçinde Otomatik Source Map Gönderimi
Otomatik source map upload tekrarlanabilir ve güvenilir release süreci oluşturur. Build tamamlandığında ilgili dosyalar release identifier ile birlikte gönderilir. Pipeline secret'ları güvenli secret store üzerinden sağlanmalıdır. Upload step başarısızsa ekip bunun farkına varmalıdır. Production deployment sonrası test hatasıyla symbolication doğrulanabilir.
Source Map ile Release Eşleşmesi
Source map'in doğru çalışması için error event'in release bilgisi ile upload edilen artifact sürümü eşleşmelidir. Git SHA veya build version bu amaçla kullanılabilir. Frontend cache nedeniyle farklı build'ler aynı anda kullanıcıda bulunabileceği için release kimliği önemlidir. Artifact path mapping de bundler yapılandırmasıyla uyumlu olmalıdır. Deployment testinde gerçek production dosyası üzerinden doğrulama yapmak yararlıdır.
Source Map'lerin Kullanıcılara Açık Olmasının Riskleri
Source map dosyaları uygulamanın orijinal kaynak yapısı hakkında ek bilgi sağlayabilir. Her projede doğrudan kritik güvenlik açığı anlamına gelmese de gereksiz ifşa riskini artırabilir. Production sunucusunda public servis edilmesi zorunlu değilse yalnızca error tracking backend'ine yüklenmesi tercih edilebilir. Secret değerlerin kaynak koda gömülmemesi source map'ten bağımsız temel güvenlik kuralıdır. Build ve deployment ayarları bu politika doğrultusunda kontrol edilmelidir.
Release Tracking ile Hataları Deployment'a Bağlamak
Release tracking production hatalarının hangi kod sürümüyle başladığını anlamayı sağlar. Bir issue'nun deployment sonrasında ilk kez görülmesi regression açısından güçlü bir sinyaldir. Release version, Git SHA ve deployment ID telemetry event'lerine otomatik eklenmelidir. Bu bilgiler incident timeline ile birleştirildiğinde rollback kararı daha hızlı verilebilir. Release tracking olmadan aynı hata için ne değişti sorusu çoğu zaman manuel araştırma gerektirir.
Release Version
Release version deployment edilen uygulama paketini benzersiz biçimde tanımlamalıdır. Frontend ve backend farklı release cadence kullanıyorsa servis bazlı version bilgisi tutulabilir. Telemetry, artifact ve deployment platformunda aynı identifier tercih edilmelidir. Aynı version'ın farklı içerikle tekrar yayınlanması izlenebilirliği bozar. Immutable build yaklaşımı bu nedenle daha güvenilir sonuç verir.
Git Commit SHA
Git commit SHA telemetry verisini doğrudan kaynak kod değişikliğiyle ilişkilendirir. CI pipeline bu değeri build sırasında uygulamaya geçebilir. Issue ekranından ilgili commit'e ulaşmak root cause araştırmasını hızlandırır. Monorepo kullanılıyorsa servis kapsamı ayrıca belirtilmelidir. Kirli veya elle değiştirilmiş production build'ler bu izlenebilirliği bozabileceği için engellenmelidir.
Deployment ID
Deployment ID aynı release'in farklı ortamlara veya birden fazla denemeyle dağıtılmasını ayırt eder. Rollback ve redeploy süreçlerinde faydalıdır. Deployment platformu bu değeri telemetry resource attribute olarak sağlayabilir. Incident timeline üzerinde deployment event olarak gösterilmesi araştırmayı kolaylaştırır. Kim, ne zaman ve hangi sürümü dağıttı bilgisi audit ihtiyacına göre ayrıca kaydedilebilir.
İlk Görüldüğü Release
Bir hatanın ilk görüldüğü release regression tespiti için önemli bir ipucudur. Önceki sürümlerde hiç görülmeyen exception yeni deployment ile güçlü ilişki gösterebilir. Trafik hacmi ve feature flag değişiklikleri de değerlendirilmelidir. Sadece zaman yakınlığı root cause kanıtı değildir. Yine de araştırmanın başlangıç noktasını önemli ölçüde daraltır.
Regression Detection
Regression detection daha önce çözülmüş issue'nun yeni release ile tekrar oluşmasını gösterir. Error tracking sistemi closed issue'yu otomatik reopened durumuna getirebilir. Release bilgisi olmadığında bu ilişki zayıf kalır. Regression alarmı yüksek sinyal değerine sahip olduğu için normal error count uyarısından farklı önceliklendirilebilir. Aynı feature'ın yeniden bozulması test coverage açısından da aksiyon üretmelidir.
Release Health
Release health yeni sürümün hata oranı ve kullanıcı etkisi açısından önceki sürümlerle karşılaştırılmasını sağlar. Crash free session veya error rate gibi göstergeler kullanılabilir. Trafik dağılımı dikkate alınmadan yalnızca toplam hata sayısını karşılaştırmak yanıltıcıdır. Canary veya phased rollout kullanan ekipler release health ile dağıtım kararlarını destekleyebilir. Threshold aşımında manuel inceleme veya otomatik rollback tetiklenebilir.
Otomatik Rollback İçin Error Rate Kullanımı
Error rate otomatik rollback kararlarında güçlü fakat tek başına yeterli olmayan bir sinyaldir. Yeni deployment sonrasında baseline'a göre anlamlı artış varsa risk yükselir. Trafik düşük olduğunda birkaç hata oranı yapay biçimde büyütebilir. Availability, latency ve kritik business KPI gibi ek koşullar kullanmak daha güvenlidir. Otomatik rollback mekanizması staging ve kontrollü production senaryolarında düzenli olarak test edilmelidir.
Error Grouping ve Deduplication
Error tracking sisteminin değeri binlerce ham exception'ı yönetilebilir issue sayısına indirmesiyle artar. Aynı kök nedene sahip hatalar stack trace veya fingerprint üzerinden gruplanabilir. Yanlış grouping birbirinden farklı sorunları tek issue altında gizleyebilir. Aşırı parçalı grouping ise binlerce duplicate issue üretir. Bu nedenle default algoritmalar izlenmeli ve yalnızca gerekli durumlarda custom fingerprint kullanılmalıdır.
Aynı Hatanın Binlerce Issue Oluşturması Problemi
Her exception occurrence ayrı issue olduğunda ekip kısa sürede error tracking ekranını kullanamaz hale gelir. Asıl önemli sorunlar tekrar sayısının içinde kaybolur. Grouping aynı kök nedene sahip olayları tek issue altında toplar. Issue üzerinde frequency ve affected users yine ölçülebilir. Bu sayede ekip occurrence değil problem bazında çalışır.
Stack Trace Tabanlı Grouping
Stack trace tabanlı grouping hatanın oluştuğu call stack benzerliğini kullanır. Runtime exception'larda çoğu zaman başarılı sonuç verir. Ancak dinamik wrapper fonksiyonlar veya farklı build yapıları grouping davranışını etkileyebilir. Framework frame'leri gerektiğinde normalize edilebilir. Custom kural eklemeden önce default davranışın gerçek örnekler üzerinde incelenmesi önerilir.
Custom Fingerprint
Custom fingerprint geliştiricinin hangi error event'lerinin aynı issue altında toplanacağını kontrol etmesini sağlar. Örneğin aynı exception türü farklı external provider için ayrı issue olarak tutulabilir. Fingerprint içine request ID gibi yüksek cardinality alanları koymak büyük hata olur. Stabil error code veya operasyon adı daha uygun seçimdir. Custom kural dokümante edilmeli ve gereksiz yere çoğaltılmamalıdır.
Error Code Tabanlı Grouping
Stabil error code grouping için güçlü bir business veya teknik sinyal olabilir. Aynı hata mesajının farklı dil veya parametrelerle değişmesi grouping'i etkilemez. Code tek başına yeterli değilse stack context ile birlikte kullanılabilir. Çok genel error code farklı kök nedenleri tek issue altında birleştirebilir. Taxonomy tasarımı bu nedenle error tracking kalitesini doğrudan etkiler.
Regression ve Reopened Issue
Çözülmüş issue'nun tekrar görülmesi regression olarak ele alınabilir. Yeni occurrence release bilgisiyle birlikte değerlendirilmelidir. Aynı stack trace farklı root cause nedeniyle oluşabiliyorsa issue yeniden incelenmelidir. Otomatik reopened davranışı ekibin eski problemlerin geri döndüğünü erken görmesini sağlar. Regression sayısı ayrıca kalite KPI'larından biri olarak izlenebilir.
Noise Reduction
Noise reduction error tracking sisteminin geliştiriciler tarafından güvenilir kabul edilmesi için gereklidir. Beklenen hatalar ignore rule ile dışarıda bırakılabilir. Bot, browser extension veya üçüncü taraf script kaynaklı hatalar ayrı filtrelenebilir. Sampling yalnızca çok yüksek hacimli düşük değerli olaylarda kullanılmalıdır. Kritik error'ların tamamını korumak çoğu sistemde daha doğru yaklaşımdır.
Error Ownership Nasıl Belirlenmeli?
Hatanın doğru ekibe otomatik yönlendirilmesi incident süresini ciddi biçimde azaltabilir. Service ownership, code ownership ve error taxonomy birlikte kullanılabilir. Sahiplik yalnızca organizasyon şemasına bağlı bırakılmamalıdır, çünkü servis sorumlulukları zamanla değişebilir. Merkezi service catalog ownership bilgisinin güncel kaynağı olabilir. Error tracking platformu bu metadata üzerinden otomatik routing yaptığında manuel triage yükü azalır.
Service Ownership
Her production servisinin teknik sahibi açıkça tanımlanmalıdır. Owner bilgisi service catalog, deployment metadata veya repository config içinde tutulabilir. Incident sırasında kimin bakacağı tartışması yaşamamak için on call ilişkisi de tanımlanabilir. Birden fazla ekip ortak sorumluluk taşıyorsa primary owner belirlenmelidir. Ownership değişiklikleri servis yaşam döngüsüyle birlikte güncellenmelidir.
Code Owners
Code owners repository içindeki dosya veya modüllerin sorumlu ekiplerini belirtir. Error stack trace dosya yoluyla eşleşiyorsa issue routing için kullanılabilir. Ancak runtime service ownership ile code ownership her zaman aynı olmayabilir. Ortak library hatalarında birden fazla servis etkilenebilir. Bu nedenle routing kuralı service metadata ile code owner bilgisini birlikte değerlendirebilir.
Frontend Ekibi
Frontend ekibi browser runtime, rendering ve client side integration hatalarının ana sahibi olabilir. Source map doğruluğu bu ekibin debugging kalitesini doğrudan etkiler. Backend kaynaklı 5xx response frontend error olarak görünse bile root ownership backend'e yönlenmelidir. Correlation ID bu ayrımı kolaylaştırır. Error taxonomy client ve server kaynaklarını açık biçimde ayırmalıdır.
Backend Ekibi
Backend ekibi API, business logic ve service dependency hatalarının büyük bölümünü yönetir. Error event üzerinde service name ve route bilgisi routing için kullanılabilir. Database veya platform kaynaklı root cause söz konusuysa issue ilgili owner'a aktarılmalıdır. Ortak incident süreci ekipler arasındaki bu geçişi yönetir. Backend loglarının structured olması triage süresini önemli ölçüde kısaltır.
Platform / DevOps Ekibi
Platform veya DevOps ekibi container, cluster, deployment pipeline ve shared observability altyapısından sorumlu olabilir. Collector failure veya storage capacity problemi uygulama ekibine yanlış yönlenmemelidir. Infrastructure error taxonomy bu ayrımı güçlendirir. Ortak dashboard uygulama ve platform sinyallerini yan yana gösterebilir. Ownership sınırları incident playbook içinde açık şekilde yazılmalıdır.
Otomatik Issue Routing
Otomatik routing service name, error code, code owner ve environment gibi alanları kullanabilir. Bu sayede yeni issue doğrudan doğru takım kuyruğuna gider. Routing kuralının yanlış olması hatanın sahipsiz kalmasından daha iyi değildir. Fallback owner ve escalation mekanizması tanımlanmalıdır. Routing doğruluğu düzenli olarak ölçülerek kurallar iyileştirilebilir.
Alerting Sistemi Nasıl Tasarlanmalı?
Alert sistemi log üretmekten farklı bir amaç taşır: bir insanın veya otomasyonun aksiyon alması gereken durumu bildirmek. Her ERROR kaydı alert olmamalıdır. Error rate, latency, availability ve business KPI gibi aggregate sinyaller daha güvenilir uyarılar üretir. Threshold tek başına değil, süre ve trafik hacmiyle birlikte değerlendirilmelidir. İyi alert açık sahiplik, öncelik, context ve önerilen ilk kontrol adımlarını içerir.
Alert ile Log Arasındaki Fark
Log sistemde gerçekleşen olayı kaydeder, alert ise müdahale gerektiren koşulu bildirir. Bir servis dakikada yüzlerce normal INFO log üretebilir fakat bunların hiçbiri alert değildir. Aynı şekilde tek bir ERROR occurrence sistem sağlığını etkilemeyebilir. Alert aggregate davranış, kritik business impact veya SLO ihlali üzerinden üretilebilir. Bu ayrım alert fatigue riskini ciddi biçimde azaltır.
Error Count Alert
Error count belirli süre içindeki hata adedini izler. Trafiği çok stabil sistemlerde temel alarm olarak işe yarayabilir. Trafik arttığında normal olarak hata sayısı da artabileceği için tek başına yanıltıcı olabilir. Minimum request count veya error rate ile desteklenmesi daha güvenlidir. Yeni release sonrası ani count artışı regression sinyali olarak ayrıca değerlendirilebilir.
Error Rate Alert
Error rate toplam request içinde başarısız işlemlerin oranını gösterir. Trafik değişikliklerine raw count'tan daha iyi uyum sağlar. Düşük trafik dönemlerinde birkaç hata yüksek oran üretebileceği için minimum volume koşulu kullanılabilir. SLO ve burn rate alerting ile birleştirildiğinde daha anlamlı sonuç verir. Kritik endpoint'ler için servis geneline göre ayrı threshold belirlenebilir.
Latency Alert
Latency alert kullanıcı deneyimini bozan performans artışlarını yakalamak için kullanılır. Ortalama yerine p95 veya p99 percentile çoğu zaman daha açıklayıcıdır. Trafik ve endpoint sınıfına göre threshold değişebilir. Deployment sonrası baseline'a göre ani sapma güçlü bir sinyaldir. Trace linki alert context'ine eklenirse araştırma daha hızlı başlar.
Availability Alert
Availability alert servisin başarılı request veya health davranışını izler. Sadece internal health endpoint'i değil, mümkünse gerçek kullanıcı yolunu temsil eden synthetic kontrol de değerlidir. Kısa network dalgalanmaları için uygun süre penceresi kullanılmalıdır. Çok sık açılıp kapanan alertler operatör güvenini azaltır. Critical servislerde multi region veya dependency context'i eklenebilir.
Business KPI Alert
Teknik metrikler normal görünürken business akışı bozulmuş olabilir. Örneğin ödeme başarı oranı veya sipariş tamamlanma sayısı anormal biçimde düşebilir. Business KPI alert teknik monitoring'in göremediği bu durumu yakalar. Sezonsal trafik değişimleri threshold tasarımında hesaba katılmalıdır. Teknik owner ile business owner birlikte alert anlamını ve müdahale adımını tanımlamalıdır.
Anomaly Detection
Anomaly detection sabit threshold yerine geçmiş davranıştan sapmaları belirlemeye çalışır. Trafiği gün içinde değişen sistemlerde yararlı olabilir. Model veya algoritma her anomaliyi incident kabul etmemelidir. Alert doğruluğu gerçek operasyon sonuçlarıyla düzenli değerlendirilmelidir. Basit ve anlaşılır threshold işe yarıyorsa gereksiz derecede gelişmiş kurallar eklemek şart değildir.
Dynamic Threshold
Dynamic threshold zaman, trafik ve geçmiş baseline'a göre değişen alarm sınırları kullanır. Özellikle hafta içi ve hafta sonu trafiği farklı sistemlerde daha doğru sinyal üretebilir. Kuralların operatör tarafından anlaşılabilir olması önemlidir. Beklenmeyen threshold değişimi kritik hatayı gizlememelidir. Dynamic ve hard safety threshold birlikte kullanılabilir.
Alert Fatigue Nasıl Önlenir?
Alert fatigue ekiplerin çok fazla veya düşük kaliteli uyarı nedeniyle gerçek kritik olayları kaçırmaya başlamasıdır. Bunun temel çözümü daha fazla bildirim kanalı değil, daha yüksek sinyal kalitesidir. Her alert için sahip, öncelik ve beklenen aksiyon bulunmalıdır. Aksiyon gerektirmeyen bildirim dashboard veya rapor olarak kalabilir. Alert precision ve false positive rate düzenli ölçülürse sistem zaman içinde iyileştirilebilir.
Her Error İçin Alert Göndermemek
Tek bir error occurrence çoğu production sisteminde pager alarmı gerektirmez. Error rate, affected users veya kritik işlem tipi daha anlamlı kriterlerdir. Beklenen error kategorileri alert dışında bırakılmalıdır. Yeni ve yüksek etkili exception için error tracking notification kullanılabilir. Amaç geliştiriciyi her hatada rahatsız etmek değil, gerçek incident'i erken göstermektir.
Warning ve Critical Seviyeleri
Warning yaklaşan risk için, critical ise acil müdahale gereken durum için kullanılabilir. Her ikisinin aynı kanala ve aynı ses seviyesine gitmesi ayrımı anlamsız hale getirir. Warning mesai içi takip kuyruğuna, critical on call kanalına yönlenebilir. Escalation süresi servis önemine göre ayarlanmalıdır. Severity kriterleri yazılı ve ölçülebilir olmalıdır.
Deduplication
Deduplication aynı incident'in çok sayıda benzer alert üretmesini engeller. Service, error code ve zaman penceresi gibi alanlar grouping için kullanılabilir. Correlated dependency failure birden fazla downstream servisi etkileyebilir. Root cause alert'i önceliklendirip türev alarmları bastırmak faydalıdır. Deduplication kuralları gerçek incident kayıtları üzerinden düzenli iyileştirilmelidir.
Cooldown
Cooldown aynı koşul devam ederken sürekli yeni alert gönderilmesini engeller. İlk alertten sonra belirli süre yeni notification bastırılabilir. Ancak critical durumun hâlâ devam ettiğini hatırlatan kontrollü tekrarlar gerekebilir. Cooldown süresi servisin response beklentisine göre seçilmelidir. Çok uzun cooldown yeni incident'i eski olayla karıştırma riski yaratabilir.
Escalation
Escalation ilk sahibin belirli sürede yanıt vermemesi durumunda alert'in bir sonraki seviyeye aktarılmasıdır. On call ve incident commander modelleri bu süreçte kullanılabilir. Critical servislerde escalation path önceden tanımlanmalıdır. Kimin aranacağı incident anında tartışılmamalıdır. Escalation testleri planlı tatbikatlarla doğrulanabilir.
Alert Ownership
Her alert'in açık sahibi olmalıdır. Shared channel'a gönderip herkesin bakmasını beklemek çoğu zaman kimsenin sorumluluk almamasına yol açar. Service catalog owner bilgisi routing kaynağı olabilir. Alert içeriği sorumlu servisi ve dashboard linkini göstermelidir. Sahipsiz alertler otomatik olarak platform veya merkezi operasyon ekibine fallback yapabilir.
Slack, Teams ve PagerDuty Routing
Bildirim kanalı alert seviyesine ve çalışma modeline göre seçilmelidir. Düşük öncelikli operasyon sinyalleri ekip kanalına giderken kritik incident pager sistemine yönlenebilir. Aynı alert'in tüm kanallara gönderilmesi gürültüyü artırır. Routing rule service ownership ve severity verisini kullanabilir. Bildirim metninde kısa özet, etki, başlangıç zamanı ve araştırma bağlantıları bulunmalıdır.
Log, Metric ve Trace Birlikte Nasıl Kullanılır?
Observability'nin gerçek değeri farklı sinyallerin tek soru etrafında birlikte kullanılmasından gelir. Metric sistemde olağan dışı davranış olduğunu gösterir. Trace problemli request'in hangi servis veya dependency üzerinde zaman kaybettiğini ortaya çıkarır. Log ise o spesifik operasyonun neden başarısız olduğuna dair ayrıntı verir. Error tracking bu teknik bulguyu issue lifecycle içinde sahiplenilebilir bir iş haline getirir.
Metric ile Problemi Tespit Etmek
Metric geniş sistem davranışını düşük veri maliyetiyle izler. Error rate veya latency artışı incident'in ilk sinyali olabilir. Dashboard servis bazında hangi bölümün etkilendiğini gösterir. Alert gerektiğinde ilgili exemplar veya trace linkini içerebilir. Metric tek kullanıcının ayrıntısını değil, sistem ölçeğindeki değişimi anlamak için idealdir.
Trace ile Problemin Yerini Bulmak
Trace hata veya gecikmenin distributed işlem içindeki konumunu daraltır. Hangi servis veya database span'ı anormal süre almış kolayca görülebilir. Dependency call status bilgisi root cause araştırmasına yön verir. Trace üzerinden ilgili span'ın loglarına geçiş sağlanabilir. Böylece onlarca servis arasında zaman eşleştirmek gerekmez.
Log ile Nedenini Anlamak
Log ilgili operasyonun business ve teknik context'ini ayrıntılı biçimde gösterir. Error code, retry sayısı ve güvenli dependency response bilgisi neden hakkında ipucu sağlar. Trace ID üzerinden yalnızca ilgili kayıtlar filtrelenebilir. Free text yerine structured alanlar sorguyu hızlandırır. Root cause bulunduğunda logların incident timeline'a katkısı da netleşir.
Error Tracking ile Issue'yu Yönetmek
Error tracking bulunan teknik hatayı geliştirici iş akışına taşır. Issue owner atanabilir, release bilgisi görülebilir ve regression takip edilebilir. Aynı problem tekrar ettiğinde ayrı araştırma başlatmak yerine mevcut issue güncellenir. Stack trace ve breadcrumbs debugging context'i sağlar. Resolution sonrası yeni occurrence oluşup oluşmadığı sistem tarafından izlenebilir.
Tek Correlation ID Üzerinden İnceleme
Tek correlation ID support, log ve tracing sistemleri arasında güçlü bağ oluşturur. Kullanıcı destek ekibi ID'yi ticket içine ekleyebilir. Geliştirici merkezi logda aynı değerle arama yaparak ilgili servis zincirine ulaşır. Trace ID ayrıca bulunduğunda distributed trace açılabilir. Bu basit mekanizma özellikle tekrar üretilemeyen production sorunlarında büyük zaman kazandırır.
Microservice Mimarilerinde Loglama
Microservice mimarisinde observability servis sayısı arttıkça daha kritik hale gelir. Her servis kendi log formatını ve hata standardını oluşturursa merkezi analiz kısa sürede zorlaşır. Ortak logging library, telemetry schema ve context propagation bu nedenle güçlü temel oluşturur. Async iletişim ve message broker kullanımında correlation context'in kaybolmaması gerekir. Cascading failure araştırması için retry, timeout ve circuit breaker olayları da görünür olmalıdır.
Her Serviste Ortak Log Standardı
Ortak log standardı service name, event name, severity ve correlation alanlarını tanımlar. Programlama dili farklı olsa bile semantik aynı kalmalıdır. Shared library veya framework adapter standardı uygulamayı kolaylaştırır. Schema testleri yeni servislerin merkezi pipeline ile uyumunu doğrulayabilir. Standart olmadan ortak dashboard ve alert üretmek zorlaşır.
Service Name ve Version
Service name ve version her telemetry kaydında güvenilir biçimde bulunmalıdır. Deployment pipeline bu bilgiyi otomatik eklemelidir. Aynı anda çalışan farklı sürümler rolling deployment sırasında ayırt edilebilir. Hata yalnızca belirli version üzerinde görülüyorsa regression analizi hızlanır. Service isimleri metric ve trace tarafında da aynı olmalıdır.
Distributed Context Propagation
Distributed context propagation trace ve correlation bilgisinin servisler arasında korunmasını sağlar. HTTP ve messaging protokollerinde standart carrier mekanizmaları kullanılabilir. Client ve server middleware bu işi otomatik yapmalıdır. Elle header ekleme unutulma riskini artırır. Güvenilmeyen dış kaynaktan gelen context değerleri uygun güvenlik kontrollerinden geçirilmelidir.
Async İşlemler
Async işlemlerde parent request bitse bile business işlem devam edebilir. Correlation ID ve gerektiğinde trace link bilgisi job veya message metadata içinde taşınmalıdır. Retry attempt'leri ayrı identifier ile izlenebilir. Uzun süren işler için span modelinin uygunluğu dikkatle düşünülmelidir. Job start, complete ve fail event'leri operasyon görünürlüğünü artırır.
Message Broker
Message broker producer ve consumer arasında önemli observability sınırıdır. Message publish, consume, retry ve dead letter olayları izlenebilir. Payload tamamını loglamak yerine message type ve güvenli identifier kullanılmalıdır. Queue depth ve consumer lag metric olarak takip edilmelidir. Trace context message header üzerinden taşındığında async zincir korunabilir.
Retry ve Circuit Breaker Event'leri
Retry mekanizması geçici hataları kullanıcıya yansıtmadan çözebilir, ancak görünmez olmamalıdır. Retry count ve final outcome log veya metric olarak izlenebilir. Circuit breaker open ve close durumları ayrı event olarak kaydedilmelidir. Sürekli retry downstream sistem üzerindeki yükü artırabilir. Bu olaylar dependency health analizi için önemli bağlam sağlar.
Cascading Failure Analizi
Cascading failure bir dependency probleminin çok sayıda servisi zincirleme etkilemesidir. Tek tek servis error alertleri root cause'u gizleyebilir. Distributed trace, dependency metric ve circuit breaker event'leri birlikte incelenmelidir. Ortak correlation yaklaşımı etkilenen istekleri takip etmeyi kolaylaştırır. Incident sonrası dependency timeout ve bulkhead politikaları kalıcı aksiyon olarak değerlendirilebilir.
Multi-Tenant Kurumsal Sistemlerde Logging
Multi tenant sistemlerde aynı altyapı farklı müşteri veya organizasyonların işlemlerini yürütür. Tenant context'i operasyonel analiz için değerli olsa da veri izolasyonu açısından hassas bir alandır. Tenant ID kullanımı log aramalarını ve müşteri bazlı hata analizini kolaylaştırabilir. Bununla birlikte her kullanıcının başka tenant telemetry verisine erişememesi gerekir. Dashboard ve retention politikaları tenant verisinin niteliğine göre tasarlanmalıdır.
Tenant ID Kullanımı
Tenant ID log ve trace üzerinde business context olarak tutulabilir. ID'nin doğrudan müşteri adı içermemesi daha güvenli bir tasarımdır. Her event'e tenant ID eklemek teknik olarak gerekmediği durumlarda veri hacmini artırabilir. Critical business event ve request context'lerinde yüksek değer sağlar. Access policy tenant ID üzerinden filtreleme yapabiliyorsa veri izolasyonu güçlenir.
Tenant Bazlı Hata Analizi
Tenant bazlı hata analizi problemin tüm sistemi mi yoksa belirli müşteriyi mi etkilediğini gösterir. Error rate tenant boyutunda karşılaştırılabilir. Yüksek cardinality nedeniyle tenant ID'nin metric label olarak sınırsız kullanımı dikkat gerektirir. Log veya trace sorgusunda daha uygun olabilir. Büyük müşteri etkisi incident priority hesabına dahil edilebilir.
Tenant Verisi İzolasyonu
Telemetry platformunda tenant verisinin kimler tarafından görülebileceği açık biçimde tanımlanmalıdır. Role based access ve query restriction mekanizmaları kullanılabilir. Ortak dashboard istemeden başka müşteri verisini göstermemelidir. Export veya paylaşım süreçleri ayrıca audit edilmelidir. İzolasyon testleri yalnızca uygulama database'i için değil observability katmanı için de yapılmalıdır.
Tenant ID'nin Hassas Veri Haline Gelmesi
Tenant ID tek başına anlamsız görünse bile başka verilerle birleştirildiğinde müşteri kimliğini açığa çıkarabilir. Bu nedenle hassasiyet sınıflandırması kurumun veri modeli üzerinden yapılmalıdır. İnsan okunabilir tenant adını kullanmak yerine opaque identifier tercih edilebilir. Gerekirse pseudonymization uygulanabilir. Log erişimi teknik ihtiyaç kadar veri yönetişimi kurallarıyla da sınırlandırılmalıdır.
Tenant Bazlı Dashboard ve Alert
Tenant bazlı dashboard kritik müşterilerin servis sağlığını ayrı izlemeye yardımcı olabilir. Alert yalnızca belirli tenant ID'ye bağlı olmamalı, iş etkisi ve hata oranını birlikte değerlendirmelidir. Çok sayıda tenant için ayrı dashboard üretmek bakım yükü yaratabilir. Parametreli dashboard daha ölçeklenebilir olabilir. Tenant bilgisine erişim yetkisi dashboard katmanında da kontrol edilmelidir.
Frontend Loglama Stratejisi
Frontend observability yalnızca console.log ifadelerine bırakılamaz. Tarayıcı hataları, network problemleri, Web Vitals ve kullanıcı bağlamı merkezi sistemle kontrollü biçimde ilişkilendirilmelidir. Browser ortamında kişisel veri ve session bilgisi toplama riski backend'e göre daha yüksektir. Bu nedenle allowlist tabanlı context ve redaction özellikle önemlidir. Frontend ile backend correlation kurulduğunda kullanıcı şikayetinden server root cause'a ulaşmak çok daha kolay hale gelir.
Browser Console Logları Production İçin Yeterli mi?
Browser console yalnızca problemi yaşayan kullanıcının cihazında bulunur. Kullanıcı sayfayı kapattığında geliştirici çoğu zaman bu kayıtlara erişemez. Console logları merkezi alert veya trend analizi sağlamaz. Ayrıca hassas verinin geliştirici araçlarında görünmesine yol açabilir. Production için kontrollü error tracking ve telemetry altyapısı çok daha güvenilir bir yaklaşımdır.
JavaScript Runtime Hataları
JavaScript runtime hataları tarayıcı, cihaz ve kullanıcı akışına göre farklı koşullarda oluşabilir. Global handler temel yakalama mekanizması sağlar. Stack trace source map ile orijinal koda çevrilmelidir. Browser ve release bilgisi debugging için yararlı context'tir. Kullanıcının kişisel detaylarını varsayılan olarak event'e eklemek gerekli değildir.
Network Request Hataları
Network request hataları frontend deneyiminin önemli bölümünü etkiler. Status code, endpoint pattern ve duration kaydedilebilir. Full URL query parametreleri hassas veri taşıyabileceği için normalize edilmelidir. Backend response correlation ID frontend event'e eklenebilir. Böylece kullanıcı tarafındaki hata doğrudan ilgili server trace'e bağlanır.
Web Vitals
Web Vitals gerçek kullanıcı deneyimi hakkında performans sinyali sağlar. Bu veriler release ve page type boyutunda analiz edilebilir. Her kullanıcı identifier'ını metric label olarak kullanmak gerekli değildir. Performance regression deployment sonrasında hızlı biçimde görülebilir. Frontend error rate ile birlikte incelendiğinde kullanıcı deneyiminin daha geniş resmi ortaya çıkar.
Kullanıcı Context'i
Kullanıcı context'i sorunun kaç kişiyi etkilediğini anlamada yararlı olabilir. Pseudonymous internal ID çoğu durumda yeterlidir. E posta, isim veya hassas profil alanları gereksiz yere gönderilmemelidir. Consent ve kurumun veri politikası frontend telemetry kullanımında dikkate alınmalıdır. Debugging ihtiyacı ile veri minimizasyonu arasında açık bir denge kurulmalıdır.
Session Replay
Session replay kullanıcı davranışını hata öncesi adımlarla birlikte görmeye yardımcı olabilir. Form ve metin alanlarının varsayılan masking davranışı test edilmelidir. Hassas ekranlarda replay tamamen kapatılabilir. Tüm oturumları kaydetmek yerine sampling uygulanabilir. Replay erişimi yalnızca gerçekten ihtiyaç duyan rollerle sınırlandırılmalıdır.
Frontend Backend Correlation
Frontend ve backend correlation ortak request veya trace context sayesinde kurulabilir. Backend response header içinde güvenli correlation ID döndürebilir. Frontend error event bu değeri context alanına ekleyebilir. Support ekibi aynı ID'yi kullanıcıya gösterebilir veya ticket'a kaydedebilir. Bu zincir yeniden üretilemeyen hataların araştırılmasını önemli ölçüde hızlandırır.
Backend Loglama Stratejisi
Backend loglama request lifecycle, business event, database, external API ve async işlemleri dengeli biçimde kapsamalıdır. Her katmanın aynı hatayı tekrar tekrar loglaması yerine sorumluluk sınırları belirlenmelidir. Middleware ortak request ve correlation alanlarını otomatik ekleyebilir. Service layer domain açısından anlamlı event'leri üretirken altyapı katmanı dependency telemetry'sini sağlar. Error tracking yalnızca beklenmeyen hataları issue olarak yönetmelidir.
HTTP Request Logları
HTTP request loglarında method, route pattern, status ve duration temel alanlardır. Full URL veya raw body hassas veri taşıyabilir. Route pattern kullanımı dynamic ID nedeniyle oluşan cardinality problemini azaltır. Request ID ve trace ID merkezi debugging için eklenmelidir. Health endpoint'leri yüksek hacim oluşturuyorsa sampling veya filtering uygulanabilir.
Service Layer Event'leri
Service layer business davranışın en anlamlı context'ini bilen katmandır. order.created veya payment.capture gibi event'ler burada üretilebilir. Controller loglarından farklı olarak domain sonucunu daha doğru ifade eder. Exception mesajı yerine stabil event ve error code kullanmak faydalıdır. Böylece business KPI ve debugging aynı telemetry modelinden yararlanabilir.
Database Operation'ları
Database işlemlerinde latency, operation type ve failure category takip edilebilir. Full SQL ve parameter değerleri kontrolsüz loglanmamalıdır. Trace span database performansını request bağlamında gösterebilir. Connection pool metric'leri altyapı kapasitesi hakkında ek bilgi sağlar. Slow operation threshold uygulama ihtiyacına göre ayarlanmalıdır.
External API Call'ları
External API telemetry dependency name, operation, status ve duration içermelidir. Request veya response payload yerine güvenli referanslar kullanılmalıdır. Timeout ve retry sayısı ayrı alanlarla izlenebilir. Trace span dependency'nin toplam latency üzerindeki etkisini gösterir. Hata oranı belirli eşikleri aşıyorsa circuit breaker veya alert devreye girebilir.
Timeout ve Retry
Timeout değerleri dependency beklentisine göre açıkça tanımlanmalıdır. Sonsuz bekleme kullanıcı deneyimini ve thread kapasitesini bozabilir. Retry yalnızca retryable error'larda uygulanmalıdır. Her attempt telemetry üzerinde görülebilir olmalı, ancak duplicate error issue üretmemelidir. Final failure ayrı ve daha yüksek sinyalli event olarak kaydedilebilir.
Queue Consumer Hataları
Queue consumer hatalarında message type, attempt count ve correlation bilgisi önemlidir. Payload tamamını loglamak yerine güvenli business identifier kullanılmalıdır. Retry sonrası başarı ve dead letter sonucu ayrı takip edilmelidir. Consumer lag metric'i sistemin işleme kapasitesini gösterir. Poison message durumları otomatik isolation veya manual review sürecine yönlendirilebilir.
Background Job'lar
Background job başlangıç, başarı, başarısızlık ve süre bilgisiyle izlenebilir. Job ID tek çalışmayı, business ID ise ilgili işlemi temsil edebilir. Scheduler kaynaklı gecikme ile job execution süresi ayrı ölçülmelidir. Uzun süren işlerde heartbeat veya progress metric faydalı olabilir. Başarısız job'ların sahiplik ve retry politikası açık olmalıdır.
Business Event Logging
Business event logging teknik bileşenlerden bağımsız olarak şirket açısından önemli state değişikliklerini kaydeder. Sipariş, ödeme, iade ve abonelik gibi olaylar operasyon ekiplerinin de anlayabileceği isimlerle temsil edilir. Bu olaylar teknik loglardan tamamen kopuk olmamalı, correlation ve trace context taşıyabilmelidir. Böylece teknik incident'in business etkisi hesaplanabilir. Business event verisi analytics sistemi yerine geçmek zorunda değildir, ancak operasyonel KPI için güçlü bir kaynak oluşturabilir.
Teknik Log ile Business Event Arasındaki Fark
Teknik log uygulama davranışı hakkında implementation context'i taşır. Business event ise iş açısından anlamlı sonucu ifade eder. Database query completed teknik bir olayken order.created iş olayıdır. İki türün retention ve tüketici kitlesi farklı olabilir. Aynı structured telemetry altyapısını kullanırken event taxonomy ile ayrım yapılabilir.
Sipariş Oluşturma
Sipariş oluşturma olayı order.created gibi stabil event name ile kaydedilebilir. Order ID, tenant ID ve channel gibi güvenli context alanları eklenebilir. Ürün detaylarının tamamını loga kopyalamak gereksizdir. Başarılı creation ile validation rejection ayrı event veya result alanıyla ayrılabilir. Bu veriden operasyonel sipariş başarı oranı hesaplanabilir.
Ödeme
Ödeme event'leri authorization, capture ve refund gibi ayrı lifecycle adımlarına bölünebilir. Transaction ID ve provider reference güvenli biçimde ilişkilendirilebilir. Kart bilgileri hiçbir event içinde tutulmamalıdır. Error code ve retryable bilgisi başarısız işlem davranışını açıklar. Ödeme başarısı business KPI alertlerinde kritik bir sinyal olabilir.
İade
İade event'i refund.requested, refund.completed veya refund.failed gibi lifecycle isimleriyle modellenebilir. Order ve transaction context gerekli minimum seviyede tutulmalıdır. Aynı iade için birden fazla attempt varsa attempt ID ayrı tutulmalıdır. Failure reason stabil error taxonomy üzerinden verilmelidir. Bu kayıtlar destek ve operasyon ekiplerinin süreç görünürlüğünü artırır.
Abonelik
Abonelik oluşturma, yenileme, iptal ve ödeme başarısızlığı ayrı business event'ler olarak izlenebilir. Subscription ID olayları birbirine bağlar. Kullanıcının kişisel veya ödeme verileri event'e gereksiz yere eklenmemelidir. Renewal failure oranı business alert için değerli olabilir. Teknik dependency hatası ile normal kullanıcı iptali açık biçimde ayrılmalıdır.
İş Akışı Durum Değişiklikleri
Uzun iş akışlarında state transition event'leri sürecin nerede kaldığını gösterir. Önceki state, yeni state ve business identifier güvenli biçimde kaydedilebilir. Her geçişin event name olarak ayrı yazılması yerine state alanlarıyla daha ölçeklenebilir model kurulabilir. Yetkili kullanıcı tarafından yapılan kritik değişiklikler audit log kapsamına da girebilir. Böylece operasyonel trace ile yönetişim kaydı birbirini tamamlar.
Business Event'lerden Operasyonel KPI Üretmek
Structured business event'ler başarı oranı, işlem hacmi ve süre gibi KPI'ların kaynağı olabilir. Metric pipeline event'lerden aggregate sayılar üretebilir. Yüksek cardinality identifier'lar metric label olarak kullanılmamalıdır. Teknik error rate ile business success rate aynı dashboard üzerinde karşılaştırılabilir. Bu yaklaşım kullanıcı etkisini yalnızca CPU veya 5xx sayısından daha iyi gösterir.
Audit Logging Nasıl Tasarlanmalı?
Audit logging kim tarafından hangi kritik değişikliğin ne zaman yapıldığını güvenilir biçimde kaydetmeye odaklanır. Normal debug logdan farklı olarak bütünlük, erişim kontrolü ve saklama süresi daha önemli olabilir. Özellikle admin işlemleri, yetki değişiklikleri ve veri export olayları audit kapsamına alınabilir. Önceki ve yeni değerler hassas veri içermeyecek biçimde seçilmelidir. Audit log tasarımı kurumun güvenlik ve hukuki gereksinimleriyle birlikte yapılmalıdır.
Kim?
Audit kaydı işlemi yapan aktörü güvenli biçimde tanımlamalıdır. User ID, service account veya system actor gibi türler ayrılabilir. Gerçek isim yerine güvenli identifier çoğu zaman yeterlidir. Impersonation veya admin acting on behalf gibi senaryolar ayrıca modellenmelidir. Actor bilgisi sonradan değiştirilemeyecek biçimde korunmalıdır.
Neyi?
Audit event hangi resource veya işlem üzerinde değişiklik yapıldığını açıkça göstermelidir. Resource type ve resource ID çoğu senaryoda yeterlidir. Tüm nesne içeriğini loglamak gereksiz veri çoğalmasına yol açar. Hassas alanlar maskelenmeli veya tamamen dışarıda bırakılmalıdır. İşlem adı stabil event taxonomy kullanmalıdır.
Ne Zaman?
Audit kaydındaki timestamp güvenilir ve standart zaman formatında olmalıdır. UTC kullanımı farklı bölgelerdeki olayları karşılaştırmayı kolaylaştırır. Saat senkronizasyonu kritik öneme sahiptir. Olayın gerçekleşme zamanı ile ingestion zamanı ayrı tutulabilir. Böylece pipeline gecikmeleri audit timeline'ını bozmaz.
Nereden?
İşlemin geldiği uygulama, servis veya network context'i gerektiğinde audit verisine eklenebilir. IP adresi kişisel veri niteliği taşıyabileceğinden kurum politikasına göre değerlendirilmelidir. Device veya user agent detayları yalnızca gerçek kullanım senaryosu varsa tutulmalıdır. Admin paneli gibi kritik kaynaklar source application alanıyla ayrılabilir. Gereksiz context audit deposunu riskli veri havuzuna dönüştürmemelidir.
Önceki Değer
Önceki değer değişikliğin etkisini anlamayı kolaylaştırır. Ancak bütün nesnenin snapshot'ını tutmak veri minimizasyonuyla çelişebilir. Yalnızca değişen ve audit açısından gerekli alanlar kaydedilebilir. Secret veya parola alanları hiçbir durumda önceki değer olarak tutulmamalıdır. Hassas kişisel alanlarda hash veya kategorik değişiklik bilgisi yeterli olabilir.
Yeni Değer
Yeni değer yapılan değişikliğin sonucunu gösterir. Önceki değer gibi yalnızca gerekli alanlarla sınırlandırılmalıdır. Token veya secret değerleri yeni değer olarak da kaydedilmemelidir. Büyük metin alanları yerine değişiklik özeti kullanılabilir. Audit ihtiyaçları domain ve regülasyon gereksinimine göre ayrı tanımlanmalıdır.
Admin İşlemleri
Admin işlemleri geniş yetki nedeniyle audit açısından yüksek öneme sahiptir. Kullanıcı hesabı kapatma, veri değiştirme veya sistem ayarı güncelleme gibi hareketler izlenmelidir. Admin actor ve hedef resource açıkça kaydedilmelidir. Gerekli durumlarda reason veya ticket reference alanı eklenebilir. Bu kayıtların erişimi normal application loglarından daha sıkı tutulmalıdır.
Yetki Değişiklikleri
Rol ve permission değişiklikleri güvenlik açısından kritik audit event'leridir. Kimin hangi kullanıcıya hangi yetkiyi eklediği veya kaldırdığı kayıt altına alınmalıdır. Önceki ve yeni yetki durumu açık biçimde temsil edilmelidir. Self privilege escalation gibi riskli pattern'ler alert üretebilir. Bu event'lerin uzun retention ihtiyacı kurum politikasına göre belirlenmelidir.
Veri Export İşlemleri
Toplu veri export işlemleri veri güvenliği açısından yüksek değerli audit olaylarıdır. Actor, export type, record count ve hedef sistem gibi bilgiler kaydedilebilir. Export edilen verinin kendisi audit loga kopyalanmamalıdır. Büyük veya olağan dışı export davranışı security alert üretebilir. Yetki ve onay süreci event context içinde referanslanabilir.
Audit Log ile Debug Log Neden Ayrılmalı?
Audit log ve debug log farklı amaçlara hizmet ettiği için aynı retention ve erişim modelinde tutulmaları genellikle doğru değildir. Debug log geliştiricinin teknik sorun araştırmasına, audit log ise işlem geçmişi ve accountability ihtiyacına yöneliktir. Debug verisi yüksek hacimli ve kısa ömürlü olabilir. Audit verisi daha uzun süre ve daha güçlü bütünlük kontrolleriyle saklanabilir. Ayrı pipeline veya index politikası kurumun güvenlik modelini daha açık hale getirir.
Farklı Kullanım Amaçları
Debug log kod davranışını anlamak için kullanılır. Audit log ise kim hangi kritik işlemi yaptı sorusuna cevap verir. İki veri türünü aynı event standardına zorlamak gerekli değildir. Ortak timestamp ve actor convention gibi bazı alanlar paylaşılabilir. Ama schema ve erişim modeli kullanım amacı üzerinden ayrılmalıdır.
Farklı Retention Politikaları
Debug kayıtları maliyet nedeniyle günler veya haftalar içinde silinebilir. Audit kayıtlarının daha uzun saklanması gerekebilir. Saklama süresi kurumun iş, güvenlik ve hukuki gereksinimine göre belirlenmelidir. Her veriyi sonsuza kadar saklamak güvenlik açısından da doğru değildir. Otomatik lifecycle policy retention kararlarını uygulanabilir hale getirir.
Farklı Access Control
Geliştiricilerin debug loglarına erişmesi günlük operasyon için gerekli olabilir. Audit kayıtları ise daha sınırlı güvenlik veya compliance rollerine açık tutulabilir. Aynı platform kullanılsa bile index veya dataset seviyesinde erişim ayrımı uygulanabilir. Audit log erişiminin kendisi de ayrıca kaydedilebilir. Least privilege yaklaşımı her iki veri türünde temel olmalıdır.
Immutable Audit Log Gereksinimi
Audit logların sonradan değiştirilmesi veya silinmesi güvenilirliği azaltır. Immutable veya append only storage yaklaşımı kritik senaryolarda kullanılabilir. Tamper detection mekanizmaları kayıt bütünlüğü hakkında ek güvence sağlar. Bununla birlikte veri silme yükümlülükleriyle teknik immutability tasarımının hukuki açıdan birlikte değerlendirilmesi gerekir. Kurum ihtiyaçlarına göre arşiv ve erişim modeli planlanmalıdır.
KVKK Açısından Log Yönetimi
Log kayıtları teknik veri olarak görülse bile içerdikleri identifier, IP veya kullanıcı context nedeniyle kişisel veri niteliği kazanabilir. Bu yüzden observability altyapısı veri yönetişiminin dışında düşünülmemelidir. Veri minimizasyonu, masking, pseudonymization ve retention politikaları birlikte uygulanmalıdır. Üçüncü taraf telemetry hizmetlerine veri gönderildiğinde aktarım ve işleme koşulları ayrıca değerlendirilmelidir. Uygulama ekibinin teknik kararı kurumun hukuk ve bilgi güvenliği süreçleriyle uyumlu olmalıdır.
Loglar Kişisel Veri İçerebilir mi?
Evet, loglar kullanıcı ID, IP adresi, e posta veya başka identifier'lar nedeniyle kişisel veri içerebilir. Bir alanın teknik amaçla üretilmesi kişisel veri niteliğini otomatik olarak ortadan kaldırmaz. Bu nedenle schema tasarımında her alanın veri sınıfı belirlenmelidir. Gereksiz kullanıcı verisi varsayılan olarak toplanmamalıdır. Kullanım amacı olmayan alanın kaydedilmemesi en güvenli yaklaşımdır.
Veri Minimizasyonu
Veri minimizasyonu yalnızca problem çözmek için gerçekten gerekli bilgilerin loglanmasını hedefler. Full request body yerine endpoint ve güvenli identifier çoğu durumda yeterlidir. Daha az veri daha düşük güvenlik riski ve daha düşük storage maliyeti sağlar. Her yeni field için operasyonel kullanım senaryosu sorulmalıdır. Kullanılmayan alanlar düzenli schema review sırasında kaldırılabilir.
Maskeleme
Maskeleme hassas değerin yalnızca gerekli bölümünü görünür bırakır. Kart veya telefon gibi alanlarda kullanım senaryosuna göre uygulanabilir. Sabit uzunlukta maske gerçek değerin tahmin edilmesini zorlaştırmalıdır. Maskeleme uygulama ve collector seviyesinde yapılabilir. Ancak mümkünse hassas değer log pipeline'a hiç girmemelidir.
Pseudonymization
Pseudonymization doğrudan kimlik bilgisini farklı bir identifier ile temsil etmeyi sağlar. User email yerine internal opaque ID kullanılabilir. Gerekirse mapping ayrı ve daha korumalı sistemde tutulur. Pseudonymous veri yine güvenlik politikasının dışında kabul edilmemelidir. Reidentification riskine göre erişim ve retention kontrolleri sürdürülmelidir.
Retention
Retention logların ne kadar süre tutulacağını belirleyen temel veri yönetimi politikasıdır. Her log kategorisinin aynı süreye sahip olması gerekmez. Debug, security ve audit kayıtları farklı ihtiyaçlara sahiptir. Süre yalnızca storage maliyetine göre değil, iş amacı ve veri riskiyle birlikte belirlenmelidir. Süre dolduğunda otomatik silme veya archive politikası uygulanmalıdır.
Silme Politikaları
Silme politikası retention süresi dolan telemetry verisinin güvenilir biçimde kaldırılmasını sağlar. Backup ve archive kopyaları da policy kapsamına alınmalıdır. Yalnızca aktif index'i silmek verinin tüm kopyalarını ortadan kaldırmayabilir. Silme işlemleri otomatik ve izlenebilir olmalıdır. Kurumun hukuki yükümlülükleriyle teknik lifecycle tasarımı birlikte değerlendirilmelidir.
Üçüncü Taraf Observability Servislerine Veri Aktarımı
Telemetry verisi üçüncü taraf hizmete gönderildiğinde hangi alanların hangi bölgede işlendiği değerlendirilmelidir. Data residency, subprocessor ve erişim kontrolleri kurum politikasında önem taşıyabilir. Hassas alanlar mümkünse backend'e gitmeden önce redaction işleminden geçirilmelidir. Sözleşmesel ve hukuki değerlendirme ilgili uzman ekiplerle yapılmalıdır. Teknik ekip vendor entegrasyonunda yalnızca varsayılan ayarlara güvenmemelidir.
Log Güvenliği Nasıl Sağlanır?
Log platformları sistemin çok sayıda teknik detayını içerdiği için yüksek değerli hedeflerdir. Güvenlik yalnızca storage encryption ile sınırlı değildir. Role based access, least privilege, network security, audit ve tamper detection birlikte uygulanmalıdır. Log platformuna kimlerin hangi dataset üzerinde sorgu yapabildiği açık biçimde belirlenmelidir. Backup ve incident recovery planı telemetry altyapısı için de hazırlanmalıdır.
Role-Based Access Control
Role based access control kullanıcıların yalnızca görevleri için gerekli loglara erişmesini sağlar. Frontend ekibi her security audit kaydını görmek zorunda değildir. Dataset veya tenant bazlı rol tasarımı yapılabilir. Admin yetkisi sınırlı sayıda kullanıcıda tutulmalıdır. Rol değişiklikleri düzenli access review sürecine dahil edilmelidir.
Least Privilege
Least privilege her kullanıcı ve servise minimum gerekli yetkinin verilmesini hedefler. Collector'ın backend üzerinde yönetici yetkisine ihtiyacı olmamalıdır. Read only dashboard kullanıcıları veri silme hakkına sahip olmamalıdır. Geçici debug erişimleri süre sınırıyla verilebilir. Yetki modeli düzenli olarak gerçek kullanım üzerinden gözden geçirilmelidir.
Encryption in Transit
Telemetry verisi uygulama, collector ve backend arasında ağ üzerinden taşınırken korunmalıdır. TLS kullanımı interception riskini azaltır. Certificate validation devre dışı bırakılmamalıdır. Internal network güvenilir kabul edilse bile hassas telemetry için encryption önemlidir. OTLP ve log forwarding endpoint'leri güvenli protokollerle yapılandırılmalıdır.
Encryption at Rest
Storage üzerindeki log verisi disk veya object storage katmanında şifrelenebilir. Encryption key yönetimi kurumun security standardıyla uyumlu olmalıdır. Backup kopyaları da aynı koruma yaklaşımına dahil edilmelidir. Encryption access control'ün yerine geçmez. Yetkili uygulama katmanı veriyi çözebildiği için rol ve audit kontrolleri yine gereklidir.
Log Access Auditing
Hassas loglara kimin eriştiğinin kaydı tutulabilir. Özellikle audit ve security dataset'lerinde bu özellik önemlidir. Toplu export veya olağan dışı query davranışı ayrıca izlenebilir. Log access audit verisinin kendisi normal kullanıcılar tarafından değiştirilememelidir. Bu kayıtlar insider risk araştırmalarında faydalı olabilir.
Immutable Storage
Immutable storage belirli kayıtların retention süresi boyunca değiştirilememesini sağlar. Security ve audit loglarında kullanım alanı vardır. Her application debug logu için aynı maliyetli model gerekli olmayabilir. İmmutability silme yükümlülükleri ve kurum politikalarıyla birlikte tasarlanmalıdır. Storage sınıfı veri kategorisine göre seçilmelidir.
Tamper Detection
Tamper detection log kayıtlarının sonradan değiştirilip değiştirilmediğini anlamaya yardımcı olur. Hash zinciri, signed event veya immutable backend gibi teknikler değerlendirilebilir. Özellikle güvenlik soruşturması için kullanılan kayıtlarda bütünlük önemlidir. Detection mekanizmasının kendisi de izlenmelidir. Her uygulama logunda aynı güvence seviyesine ihtiyaç olmayabilir.
Backup
Observability backend kaybı incident sırasında ciddi görünürlük problemi yaratabilir. Kritik configuration, dashboard ve gerekli log dataset'leri için backup planı hazırlanmalıdır. Her logu yedeklemek storage maliyetini gereksiz artırabilir. Audit ve security kayıtları daha yüksek koruma seviyesine sahip olabilir. Recovery prosedürü düzenli olarak test edilmelidir.
Log Injection Saldırıları
Log injection kullanıcı girdisinin kontrolsüz biçimde log formatını manipüle etmesiyle ortaya çıkabilir. Saldırgan yeni satır karakterleri veya özel syntax kullanarak sahte kayıt görünümü oluşturabilir. Structured logging bu riski azaltmaya yardımcı olsa da input validation ve sanitization yine gereklidir. Log viewer'ın HTML veya script içeriğini nasıl render ettiği de güvenlik açısından önemlidir. Kullanıcı girdisi hiçbir zaman log mesajı formatını belirleyen güvenilir veri olarak kabul edilmemelidir.
Log Injection Nedir?
Log injection saldırganın log kaydının yapısını veya yorumlanma biçimini değiştirmeye çalışmasıdır. Amaç sahte event eklemek, gerçek olayları gizlemek veya log viewer üzerinde farklı etki yaratmak olabilir. Serbest metin concatenation riski artırır. Field tabanlı structured logging girdiyi ayrı değer olarak tutar. Yine de backend ve UI escaping davranışı test edilmelidir.
CR/LF Injection
CR ve LF karakterleri satır sonu kontrolü için kullanılır. Kullanıcı girdisi doğrudan plain text loga eklenirse yeni log satırı görünümü oluşturabilir. Input sanitization ve structured encoder bu riski azaltır. Header veya username gibi dış girdiler özellikle dikkat gerektirir. Güvenlik testlerinde newline içeren değerlerle log formatı doğrulanabilir.
User Input'u Doğrudan Loglamanın Riskleri
User input yalnızca injection değil, kişisel veri ve yüksek hacim riski de taşır. Arama kutusundaki metni tamamen kaydetmek çoğu zaman gerekli değildir. Güvenli field'lar allowlist üzerinden seçilmelidir. Uzunluk sınırı uygulanması storage abuse riskini azaltabilir. Kullanıcı kontrollü string hiçbir zaman event name veya label olarak doğrudan kullanılmamalıdır.
Sanitization
Sanitization dış girdinin log sisteminde güvenli biçimde temsil edilmesini sağlar. Control character'lar ve beklenmeyen formatlar normalize edilebilir. Sanitization hassas veriyi kaldırma işlemiyle aynı şey değildir. PII redaction ayrıca uygulanmalıdır. Ortak logging library bu kontrolleri merkezi hale getirebilir.
Structured Logging'in Güvenlik Avantajı
Structured logging kullanıcı girdisini mesaj formatından ayrı field olarak taşır. Bu yapı sahte satır üretme riskini azaltır. JSON encoder gerekli escaping işlemlerini otomatik yapabilir. Yine de log viewer'ın field değerlerini güvenli render etmesi gerekir. Structured model güvenlik kontrolünü kolaylaştırır fakat tek başına tüm saldırıları engellemez.
Log Retention Politikası Nasıl Oluşturulur?
Retention politikası log maliyeti ve veri riskini aynı anda yönetir. Her kayıt türünü yıllarca online storage üzerinde tutmak genellikle gerekli değildir. Hot, warm ve archive katmanları erişim sıklığına göre kullanılabilir. Debug log kısa, audit veya security kayıtları daha uzun saklanabilir. Süreler iş ihtiyacı, incident geçmişi ve kurumun hukuki gereksinimleri üzerinden belirlenmelidir.
Her Log Aynı Süre Saklanmalı mı?
Hayır, log kategorilerinin değeri ve risk seviyesi farklıdır. Debug log birkaç gün sonra işlevini kaybedebilir. Audit kaydı çok daha uzun süre gerekli olabilir. Tek retention kuralı ya gereksiz maliyet ya da yetersiz veri sağlar. Dataset bazlı lifecycle policy daha doğru yaklaşımdır.
Hot Storage
Hot storage en sık sorgulanan yeni kayıtlar için kullanılır. Hızlı index ve query performansı sağlar. Buna karşılık maliyeti diğer storage katmanlarından yüksek olabilir. Son birkaç gün veya hafta verisi burada tutulabilir. Süre gerçek incident araştırma alışkanlıklarına göre belirlenmelidir.
Warm Storage
Warm storage daha az sorgulanan fakat hızlı erişim ihtiyacı devam eden eski veriler için kullanılabilir. Daha düşük maliyetli node veya disk sınıfı tercih edilebilir. Query performansı hot katmana göre düşük olabilir. Otomatik lifecycle policy veriyi belirlenen yaşta warm katmana taşıyabilir. Dashboard'ların varsayılan sorgu aralığı hot veriyle sınırlandırılabilir.
Cold / Archive Storage
Cold veya archive storage nadiren erişilen uzun süreli kayıtlar için uygundur. Object storage maliyet açısından avantaj sağlayabilir. Sorgudan önce restore veya rehydrate işlemi gerekebilir. Incident ve audit ihtiyaçları restore süresini kabul edebilir olmalıdır. Archive verisinin encryption ve access policy'si aktif veri kadar önemlidir.
Debug Log Retention
Debug log yüksek hacimli ve kısa ömürlü bilgi taşır. Production'da sürekli açık değilse retention birkaç günle sınırlı tutulabilir. Geçici debugging sırasında artan hacim otomatik expiration ile kontrol edilmelidir. Hassas veri kuralları retention kısa olsa bile gevşetilmez. Kullanılmayan debug dataset'i maliyet raporlarında hızlıca fark edilmelidir.
Error Log Retention
Error log incident ve regression analizi için debug logdan daha uzun süre değer taşıyabilir. Release cycle ve müşteri destek süresi retention kararını etkiler. Aynı error event ayrıca error tracking sisteminde özetleniyorsa raw log ihtiyacı azaltılabilir. Çok uzun retention kişisel veri ve maliyet riskini artırır. En iyi süre kurumun gerçek araştırma geçmişi üzerinden belirlenir.
Audit Log Retention
Audit log saklama süresi güvenlik, iş ve hukuki gereksinimlere göre belirlenmelidir. Debug loglarla aynı kısa lifecycle'a bağlanmamalıdır. Storage bütünlüğü ve erişim kontrolü retention boyunca korunmalıdır. Archive katmanı maliyeti azaltabilir. Silme zamanı geldiğinde backup ve replica kopyaları da policy kapsamında ele alınmalıdır.
Security Log Retention
Security loglar tehdit araştırması ve geriye dönük olay analizi için uzun dönem değer taşıyabilir. Retention saldırgan dwell time ve kurum response modeline göre düşünülmelidir. Tüm security veriyi pahalı hot storage'da tutmak şart değildir. Hot ve archive kombinasyonu uygulanabilir. Erişim ve bütünlük kontrolleri retention süresince devam etmelidir.
Loglama Maliyetleri Nasıl Kontrol Edilir?
Observability maliyetinin büyük bölümü uygulamanın ne kadar telemetry ürettiğiyle doğrudan ilişkilidir. Ingestion, storage, indexing, query ve network egress ayrı maliyet kalemleri oluşturabilir. En pahalı problemi çözmek için önce hangi servis ve event'in en fazla veri ürettiği ölçülmelidir. Her şeyi loglamak yerine kullanım senaryosu odaklı sampling ve filtering uygulanabilir. Log yönetimi ve uygulama monitoring danışmanlığı yakınımda araması yapan kurumların da hizmet sağlayıcı değerlendirirken maliyet görünürlüğünü, retention modelini ve telemetry bütçesini açıkça sorması faydalıdır.
Ingestion Cost
Ingestion cost backend'e giren toplam veri hacmiyle ilişkilidir. Debug veya request body logları bu hacmi hızla artırabilir. Byte bazlı servis raporu en büyük üreticileri gösterir. Collector filtering gereksiz kayıtları backend'e ulaşmadan azaltabilir. Maliyeti kontrol etmek için geliştirici ekiplerine görünür telemetry bütçesi sunmak etkilidir.
Storage Cost
Storage maliyeti günlük ingestion ile retention süresinin bileşimidir. Compression ve storage tier seçimi sonucu etkiler. Her veriyi aynı performans sınıfında tutmak gerekmez. Eski loglar warm veya archive katmanına taşınabilir. Retention değişikliğinin debugging ihtiyacına etkisi ölçülmelidir.
Indexing Cost
Indexing sorgu hızını artırırken CPU, memory ve disk maliyeti oluşturur. Her field'ın indislenmesi gerekli değildir. Request ID gibi yüksek cardinality alanlar kullanım modeline göre dikkatle değerlendirilmelidir. Elasticsearch mapping veya Loki label tasarımı bu maliyet üzerinde doğrudan etkilidir. Schema governance indexing kararlarını merkezi hale getirebilir.
Query Cost
Büyük zaman aralığında ve geniş dataset üzerinde yapılan sorgular ciddi kaynak tüketebilir. Dashboard varsayılan zaman aralığı makul tutulmalıdır. Sık kullanılan filtreler veri modelinde optimize edilebilir. Kullanıcıların wildcard full text sorgularına bağımlı kalması schema sorununa işaret edebilir. Query performans metrikleri observability platformunun kendi health dashboard'unda izlenmelidir.
Network Egress
Telemetry farklı region veya cloud provider'a gönderildiğinde network egress maliyeti oluşabilir. Collector'ı uygulamaya yakın konumlandırmak veri transfer modelini iyileştirebilir. Compression ve batching network hacmini azaltabilir. Gereksiz duplicate export maliyeti hızla büyütür. Multi region mimaride data residency gereksinimiyle egress maliyeti birlikte değerlendirilmelidir.
En Fazla Log Üreten Servisleri Bulmak
Her servis için günlük log byte miktarı ölçülmelidir. Log count tek başına yeterli değildir, çünkü bazı event'ler çok büyük olabilir. Service ve event name bazında kullanım raporu hazırlanabilir. En yüksek hacimli kayıtların gerçekten operasyonel değeri sorgulanmalıdır. Küçük bir schema veya sampling değişikliği toplam maliyette büyük düşüş sağlayabilir.
Observability Bütçesi Oluşturmak
Observability bütçesi servis ekiplerine telemetry maliyetini görünür hale getirir. Aylık ingestion, retention ve backend maliyeti servis bazında raporlanabilir. Kritik servisler daha yüksek telemetry coverage hakkına sahip olabilir. Bütçe yalnızca maliyet kısmak için değil, harcanan verinin değerini artırmak için kullanılmalıdır. MTTD ve MTTR iyileşmesi maliyet değerlendirmesine birlikte dahil edilmelidir.
Sampling ve Filtering Stratejileri
Sampling ve filtering yüksek telemetry hacmini kontrollü biçimde azaltmanın temel yöntemleridir. Ancak yanlış uygulandığında incident sırasında en gerekli kanıtların kaybolmasına neden olabilir. Kritik error event'leri mümkün olduğunca tam korunurken yüksek hacimli başarılı işlemler örneklenebilir. Trace sampling için head based ve tail based yaklaşımlar farklı avantajlar sunar. Collector seviyesinde merkezi policy kullanmak farklı servislerde davranış tutarlılığı sağlar.
Debug Sampling
Debug loglar yüksek hacim nedeniyle sampling için doğal adaydır. Belirli oranda kayıt tutulabilir veya yalnızca seçilmiş service ve request'lerde etkinleştirilebilir. Error context içindeki debug zincirini korumak için conditional sampling uygulanabilir. Rastgele sampling yapılırken hangi olayların kaybolabileceği bilinmelidir. Debug sampling oranı incident sırasında geçici olarak artırılabilir.
Trace Sampling
Trace sampling tüm request trace'lerini saklama maliyetini azaltır. Servis trafiği arttıkça oran dinamik biçimde değişebilir. Error veya yüksek latency trace'leri daha yüksek öncelikle korunabilir. Sampling kararının downstream servislerde tutarlı olması gerekir. Coverage metriği gerçek saklama oranını ekip için görünür hale getirmelidir.
Head-Based Sampling
Head based sampling trace'in başında saklanıp saklanmayacağına karar verir. Uygulaması basit ve kaynak kullanımı düşüktür. Ancak trace'in sonunda hata oluşup oluşmayacağı başlangıçta bilinmez. Bu nedenle nadir kritik error trace'leri kaçırılabilir. Düşük maliyet ve basitlik öncelikli sistemlerde uygun olabilir.
Tail-Based Sampling
Tail based sampling trace tamamlandıktan sonra sonuç bilgisine göre karar verir. Error veya yüksek latency trace'lerini yüzde yüz korumak mümkün olabilir. Bunun karşılığında Collector daha fazla state ve kaynak kullanır. Yüksek trafik altında kapasite planı önemlidir. Sampling rule servis kritikliği ve business attribute'lara göre şekillendirilebilir.
Error'ları %100 Saklamak
Beklenmeyen production error trace ve event'lerini tam saklamak çoğu sistem için değerli bir politikadır. Error hacmi zaten çok yüksekse önce underlying problemi veya gürültülü expected error sınıflandırmasını düzeltmek gerekir. Sampling ile gerçek hatayı gizlemek kalıcı çözüm değildir. Çok sık tekrarlayan aynı issue error tracking tarafında grouping ile yönetilebilir. Raw occurrence retention maliyeti ayrıca optimize edilebilir.
High-Volume Success Event'lerini Örneklemek
Başarılı health check veya rutin read request'leri çok yüksek hacim üretebilir. Bu event'lerin tamamını loglamak çoğu zaman ek değer sağlamaz. Metric başarılı trafik hacmini zaten daha ekonomik biçimde gösterebilir. Belirli oranda örnek kayıt debugging için korunabilir. Sampling oranı servis trafik ve incident ihtiyacına göre belirlenmelidir.
Collector Seviyesinde Filtering
Collector filtering uygulama kodunu değiştirmeden merkezi veri azaltımı sağlar. Belirli route, event veya severity koşulları filtrelenebilir. Production error kayıtlarının yanlışlıkla silinmesini önlemek için configuration test edilmelidir. Filtrelenen veri miktarı metric olarak izlenebilir. Version control ve code review Collector policy değişiklikleri için de uygulanmalıdır.
High Cardinality Problemi Nedir?
High cardinality bir alanın çok fazla benzersiz değer üretmesi durumudur. User ID, request ID ve UUID bunun tipik örnekleridir. Bu alanlar log aramasında değerli olsa da metric label veya Loki label olarak kontrolsüz kullanıldığında maliyet ve performans sorunları yaratabilir. Cardinality tasarımı telemetry backend'in veri modeline göre yapılmalıdır. Aynı alanın log field olması güvenliyken metric dimension olarak uygun olmaması oldukça normaldir.
User ID
User ID potansiyel olarak milyonlarca benzersiz değer üretebilir. Metric label olarak kullanılması time series sayısını patlatabilir. Log ve error context içinde kontrollü biçimde kullanılabilir. Veri minimizasyonu açısından pseudonymous ID tercih edilmelidir. Kullanıcı etkisi metric gerekiyorsa aggregate yöntemler düşünülmelidir.
Request ID
Request ID doğal olarak her request için benzersizdir. Bu nedenle metric label veya Loki indexed label olarak kullanılması uygun değildir. Log field olarak incident aramasında çok değerlidir. Trace ID benzer cardinality özelliğine sahiptir. Backend tasarımı searchable field ile indexed dimension arasındaki farkı dikkate almalıdır.
URL
Raw URL path içindeki dynamic ID'ler çok yüksek cardinality üretebilir. /orders/123 yerine /orders/:id gibi route pattern kullanmak daha doğru olur. Query string kişisel veya hassas veri de taşıyabilir. Metric ve dashboard boyutu olarak normalize route kullanılmalıdır. Full URL yalnızca gerçekten gerekli ve güvenli durumlarda log context'e eklenmelidir.
UUID
UUID tasarım gereği çok büyük değer uzayına sahiptir. Her UUID'yi label yapmak index ve series maliyetini artırır. Business transaction aramasında raw field olarak yararlı olabilir. Aggregation ihtiyacı varsa event type veya status gibi düşük cardinality alanlar tercih edilmelidir. Schema review sırasında UUID alanlarının index davranışı özellikle kontrol edilmelidir.
Cardinality'nin Maliyete Etkisi
Yüksek cardinality time series ve index yapılarını büyütür. Memory kullanımı, query süresi ve storage maliyeti artabilir. Sorun yalnızca veri byte miktarıyla açıklanamaz. Küçük ama milyonlarca benzersiz label kombinasyonu pahalı olabilir. Platform cost dashboard'u cardinality büyümesini servis bazında göstermelidir.
Hangi Alanlar Indexlenmeli?
Sık filtrelenen ve düşük ya da yönetilebilir cardinality değerleri index için iyi adaydır. Service name, environment, severity ve event name genellikle faydalıdır. Request ID ve trace ID için backend'in exact lookup yetenekleri değerlendirilmelidir. Kullanılmayan field'ların otomatik indexlenmesi kapatılabilir. Index kararı gerçek sorgu geçmişi üzerinden düzenli gözden geçirilmelidir.
SaaS mı Self-Hosted Loglama mı?
SaaS ve self hosted modeller arasında tek bir doğru seçim yoktur. SaaS operasyon yükünü azaltabilir, self hosted ise altyapı ve veri yerleşimi üzerinde daha fazla kontrol sağlayabilir. Karar yalnızca aylık ürün fiyatına göre verilmemelidir. Personel zamanı, upgrade, kapasite, güvenlik, backup ve incident sorumluluğu toplam maliyete dahildir. Kurumun ekip yetkinliği ve veri egemenliği gereksinimi seçimde belirleyici olmalıdır.
SaaS Observability
SaaS observability platformu backend altyapısının önemli bölümünü servis sağlayıcının yönetmesini sağlar. Hızlı kurulum ve otomatik ölçeklenme avantajı sunabilir. Buna karşılık ingestion hacmi arttıkça fiyat hızlı büyüyebilir. Data residency ve üçüncü taraf veri işleme şartları değerlendirilmelidir. Export ve migration imkanları vendor lock in açısından önemlidir.
Self-Hosted Stack
Self hosted stack kurumun observability backend'ini kendi altyapısında çalıştırmasıdır. Veri kontrolü ve özelleştirme avantajı sağlar. Cluster yönetimi, upgrade ve on call sorumluluğu kurumda kalır. Personel zamanı toplam maliyetin önemli bölümünü oluşturabilir. Yeterli platform ekibi olmadan büyük self hosted sistem beklenenden daha pahalı hale gelebilir.
İlk Kurulum Maliyeti
SaaS ilk kurulumda daha düşük operasyon maliyeti sağlayabilir. Self hosted cluster için infrastructure, deployment ve security tasarımı gerekir. Ancak uzun dönem hacim büyüdüğünde maliyet dengesi değişebilir. Pilot çalışma gerçek ingestion rakamıyla yapılmalıdır. Sadece demo trafik üzerinden bütçe tahmini yanıltıcı olur.
Operasyon Maliyeti
Operasyon maliyeti monitoring, upgrade, backup, security patch ve incident yönetimini içerir. Self hosted modelde bu işler kurum personelinin zamanını kullanır. SaaS modelinde de integration ve cost governance ihtiyacı devam eder. Backend yönetimi dışarıda olsa bile telemetry schema sorumluluğu kurumda kalır. Toplam sahip olma maliyeti bu nedenle geniş çerçevede hesaplanmalıdır.
Veri Egemenliği
Veri egemenliği telemetry verisinin nerede saklandığı ve kim tarafından işlendiğiyle ilgilidir. Bazı kurumlarda log verisi hassas müşteri veya güvenlik bilgisi taşıyabilir. Self hosted model daha doğrudan kontrol sağlayabilir. SaaS sağlayıcının region ve data processing seçenekleri ayrıntılı incelenmelidir. Teknik karar bilgi güvenliği ve hukuk ekipleriyle birlikte verilmelidir.
Ölçeklenebilirlik
SaaS platformlar ani telemetry artışını otomatik yönetebilir. Self hosted sistemde kapasite önceden veya otomatik scaling ile planlanmalıdır. Storage ve index büyümesi düzenli izlenmelidir. Çok yüksek ingestion için collector ve network katmanı da ölçeklenmelidir. Ölçek yalnızca backend node sayısından ibaret değildir.
Vendor Lock-In
Vendor lock in query language, dashboard, alert ve özel SDK kullanımından kaynaklanabilir. OpenTelemetry uygulama instrumentation bağımlılığını azaltmaya yardımcı olur. Collector üzerinden birden fazla exporter kullanmak migration esnekliği sağlayabilir. Yine de backend'e özgü dashboard'ların taşınması maliyetli olabilir. Seçim yapılırken veri export imkanları ve standart protokol desteği değerlendirilmelidir.
Hangi Kurum Hangisini Seçmeli?
Küçük platform ekibi hızlı sonuç istiyorsa SaaS uygun başlangıç olabilir. Güçlü infrastructure ekibi ve özel veri gereksinimi olan kurum self hosted modeli tercih edebilir. Hibrit kullanım da mümkündür. Örneğin kritik audit verisi kurum içinde, error tracking ayrı bir hizmette tutulabilir. Karar gerçek iş yükü, güvenlik ve üç yıllık maliyet tahmini üzerinden verilmelidir.
Sentry, ELK, Loki, Datadog ve Benzeri Sistemler Aynı İşi mi Yapar?
Bu araçları tek kategoride değerlendirmek doğru değildir. Bazıları error tracking, bazıları log management, bazıları ise daha geniş observability deneyimine odaklanır. Sentry uygulama exception yönetiminde güçlü bir kullanım sunarken ELK ve Loki merkezi log depolama ve sorgulama tarafında farklı modeller sağlar. Full stack platformlar metric, trace, log ve APM'i tek deneyimde bir araya getirebilir. Araç seçerken önce hangi sorunun çözüleceği belirlenmelidir.
Error Tracking Platformları
Error tracking platformları exception'ları issue olarak gruplayıp geliştiricinin aksiyon almasını kolaylaştırır. Stack trace, release ve regression takibi temel değerleri arasındadır. Her log satırını bu sisteme göndermek doğru değildir. Expected error filtrelemesi sinyal kalitesini artırır. Frontend source map entegrasyonu bu kategoride özellikle önemlidir.
Log Management Platformları
Log management platformları farklı sistemlerden gelen kayıtları toplama, saklama ve sorgulamaya odaklanır. Structured field'lar üzerinden search ve aggregation yapılabilir. Retention, index ve access control temel tasarım konularıdır. Error tracking'teki issue lifecycle davranışı aynı derinlikte olmayabilir. İki sistem çoğu kurumda birbirini tamamlayabilir.
Full-Stack Observability Platformları
Full stack observability platformları logs, metrics, traces ve APM özelliklerini tek ürün deneyiminde sunabilir. Cross signal navigation önemli kullanım kolaylığı sağlar. Bunun karşılığında lisans ve ingestion maliyeti dikkatle değerlendirilmelidir. Vendor özel instrumentation uzun dönem bağımlılık oluşturabilir. OpenTelemetry uyumu bu riski azaltmaya yardımcı olabilir.
Tek Bir Araç Yeterli mi?
Bazı küçük sistemlerde tek platform yeterli olabilir. Büyük kurumsal yapılarda error tracking, metric ve log ihtiyaçlarının aynı ürün tarafından eşit kalitede karşılanması her zaman mümkün değildir. Ekip deneyimi de kullanım başarısını etkiler. Araç sayısını gereksiz artırmak operasyon yükü oluşturur. Minimum araç setiyle gerekli sinyalleri kapsamak iyi bir hedeftir.
Hibrit Tooling Stratejisi
Hibrit strateji her probleme en uygun aracı kullanırken ortak telemetry standardını korur. OpenTelemetry Collector farklı backend'lere veri yönlendirebilir. Error tracking ayrı, log storage ayrı sistemde çalışabilir. Trace ID ve release bilgisi cross navigation bağlantısını korur. Tool sayısı arttıkça ownership ve maliyet görünürlüğü daha önemli hale gelir.
Kurumsal Loglama Sisteminde Dashboard Tasarımı
Dashboard üretim sisteminin durumunu birkaç dakika içinde anlayacak biçimde tasarlanmalıdır. Her metriği tek ekrana koymak yerine error rate, request rate, latency ve dependency health gibi temel sinyaller öne çıkarılmalıdır. Servis, release ve tenant boyutları gerektiğinde filtrelenebilir olmalıdır. Dashboard incident sırasında hangi sorunun sorulacağını düşünerek hazırlanmalıdır. Panel sahipliği ve bakım sorumluluğu olmazsa zaman içinde güvenilirliğini kaybeder.
Error Rate
Error rate toplam request içindeki başarısız işlem oranını gösterir. 5xx oranı teknik availability için temel göstergelerden biridir. Business error'lar ayrı sınıflandırılmalıdır. Release annotation grafikte deployment sonrası değişimi görünür hale getirir. SLO threshold'u aynı panelde gösterilebilir.
Request Rate
Request rate servisin trafik hacmini gösterir. Error count yorumlanırken mutlaka trafik değişimiyle birlikte değerlendirilmelidir. Ani düşüş upstream routing problemi anlamına gelebilir. Ani artış load veya abuse sinyali olabilir. Endpoint veya region boyutunda gerektiğinde filtrelenebilir olmalıdır.
Latency
Latency kullanıcı isteklerinin ne kadar sürede tamamlandığını gösterir. Ortalama tek başına tail latency problemlerini gizleyebilir. p50, p95 ve p99 gibi percentile değerleri daha açıklayıcıdır. Deployment ve dependency değişiklikleri grafik üzerinde işaretlenebilir. SLO hedef çizgisi kullanıcı etkisini değerlendirmeyi kolaylaştırır.
Top Errors
Top errors paneli en sık görülen error code veya issue'ları listeler. Ham exception message yerine stabil grouping kullanmak gerekir. Frequency yanında affected users ve first seen release bilgisi de faydalıdır. Bir hata çok sık ama düşük etkili olabilir. Prioritization için business criticality ayrıca değerlendirilmelidir.
Errors by Service
Errors by service hangi bileşenin hata yükünü taşıdığını gösterir. Microservice ortamında incident triage için hızlı başlangıç sağlar. Trafiği yüksek servis doğal olarak daha fazla error count üretebilir. Bu nedenle count ile rate birlikte gösterilmelidir. Ownership bilgisi panel veya drill down görünümüne eklenebilir.
Errors by Release
Release bazlı hata grafiği deployment regression'larını hızlıca gösterir. Yeni version hata oranında belirgin artış yaratıyorsa rollback adayı olabilir. Canary trafiği düşük olduğunda oranı sample size ile birlikte yorumlamak gerekir. Previous release baseline olarak gösterilebilir. Git SHA üzerinden doğrudan source change incelemesine geçiş sağlanabilir.
Errors by Tenant
Tenant bazlı görünüm belirli müşterinin orantısız şekilde etkilenip etkilenmediğini gösterir. Tenant ID hassasiyetine göre dashboard erişimi sınırlandırılmalıdır. Çok yüksek tenant cardinality nedeniyle tüm değerleri aynı grafikte göstermek kullanışlı olmayabilir. Top affected tenant yaklaşımı daha pratiktir. Business criticality incident severity hesabına dahil edilebilir.
External Dependency Health
Dependency health harici ve iç servislerin latency ve error rate davranışını gösterir. Circuit breaker state ve timeout oranları ek sinyal sağlar. Birden fazla uygulama aynı dependency'den etkileniyorsa root cause daha hızlı anlaşılır. Provider response code'ları normalize edilmelidir. Dashboard internal servis health ile dependency health'i yan yana gösterebilir.
SLI, SLO ve Error Budget ile Observability
SLI ve SLO observability verisini iş açısından anlamlı güvenilirlik hedeflerine bağlar. Sadece kaç hata var sorusu yerine kullanıcıya vaat edilen hizmet seviyesinin korunup korunmadığı ölçülür. Error budget belirli süre içinde ne kadar başarısızlığın kabul edilebileceğini gösterir. Bu yaklaşım alerting'i daha anlamlı hale getirir. Burn rate yüksek olduğunda ekip error budget'ın hızlı tüketildiğini erken görebilir.
SLI Nedir?
SLI Service Level Indicator ifadesidir ve kullanıcı deneyimini temsil eden ölçümdür. Availability, latency veya successful transaction rate örnek olabilir. SLI doğrudan ölçülebilir veri kaynağına dayanmalıdır. Teknik metric ile kullanıcı etkisi arasında anlamlı ilişki kurulmalıdır. Aynı servis için birden fazla SLI gerekebilir.
SLO Nedir?
SLO Service Level Objective ifadesidir ve SLI için hedef değeri tanımlar. Örneğin başarılı request oranının belirli dönem boyunca yüzde 99,9 olması hedeflenebilir. Hedef rastgele değil, iş ve kullanıcı beklentisine göre belirlenmelidir. Yüzde 100 hedef çoğu sistemde gereksiz maliyetli olabilir. SLO incident ve release kararlarına yön verebilir.
Error Budget Nedir?
Error budget SLO'nun izin verdiği başarısızlık payını ifade eder. Sistem hedefin üzerinde güvenilir çalışıyorsa ekip daha fazla değişiklik yapma alanına sahip olabilir. Budget hızla tükeniyorsa reliability çalışmalarına öncelik verilebilir. Error budget ürün ve platform ekipleri arasında ortak karar çerçevesi sağlar. Hesaplama ve reporting otomatik yapılmalıdır.
Availability SLO
Availability SLO başarılı kullanıcı isteklerinin oranını hedefler. Health endpoint yerine gerçek service operation sonucunu ölçmek daha anlamlıdır. Planlı bakımın hesaba dahil edilip edilmeyeceği açıkça tanımlanmalıdır. 4xx gibi kullanıcı kaynaklı sonuçların formülü bozup bozmadığı belirlenmelidir. SLO tanımı herkesin aynı matematiği kullanacağı kadar açık olmalıdır.
Latency SLO
Latency SLO belirli request yüzdesinin hedef sürenin altında tamamlanmasını bekler. Örneğin request'lerin yüzde 95'inin belirli süre içinde tamamlanması hedeflenebilir. Ortalama latency bu amaç için yeterli değildir. Endpoint veya işlem türüne göre farklı hedef gerekebilir. Trace verisi ihlal edilen request'lerin root cause analizinde kullanılır.
Error Rate SLO
Error rate SLO başarısız request oranının kabul edilen seviyede kalmasını hedefler. Error taxonomy hangi sonuçların gerçek servis hatası olduğunu belirlemelidir. Expected validation sonuçları SLO hesabını bozmamalıdır. Release bazlı error rate regression analizine de katkı sağlar. Alertler kısa süreli gürültü yerine budget etkisine göre çalışabilir.
Burn Rate Alerting
Burn rate error budget'ın ne hızla tüketildiğini ölçer. Kısa sürede çok hızlı tüketim critical incident sinyali olabilir. Uzun pencere daha yavaş ama kalıcı bozulmaları yakalar. Birden fazla zaman penceresiyle alert doğruluğu artırılabilir. Bu yaklaşım sabit error threshold'a göre kullanıcı vaadiyle daha doğrudan ilişkilidir.
Production Hatası Tespit Edildiğinde Ne Olmalı?
Production incident süreci detection ile başlar fakat çözüm deployment yapmakla bitmez. Alert doğru ekibe ulaşmalı, triage yapılmalı, ownership alınmalı ve kullanıcı etkisi belirlenmelidir. Investigation sırasında metric, trace, log ve release bilgileri birlikte incelenir. Mitigation geçici olarak etkiyi azaltırken root cause çözümü kalıcı davranışı düzeltir. Son adım verification ile sistemin gerçekten normale döndüğünün ölçülmesidir.
Detection
Detection problemi kullanıcı bildirmeden önce sistem sinyalleriyle fark etmeyi hedefler. SLO, error rate veya business KPI bu sinyali üretebilir. Her incident aynı detection kaynağından gelmez. Support ticket da geçerli bir başlangıç olabilir. Detection gap postmortem sırasında ayrıca analiz edilmelidir.
Alert
Alert detection sinyalini ilgili owner'a taşır. Mesaj kısa, anlaşılır ve aksiyon alınabilir olmalıdır. Etkilenen servis, başlangıç zamanı ve dashboard linki bulunmalıdır. Aynı incident için duplicate bildirimler bastırılmalıdır. Severity response süresini belirleyebilir.
Triage
Triage olayın gerçek incident olup olmadığını ve etki seviyesini hızlıca belirler. Error rate, affected users ve business KPI incelenir. Son deployment ve dependency health kontrol edilir. Root cause'u tam bulmak triage'ın ilk hedefi değildir. Öncelik incident severity ve doğru owner belirlemektir.
Ownership
Incident'in tek bir sorumlu sahibi veya koordinatörü olmalıdır. Birden fazla ekip çalışsa bile iletişim merkezi kalmalıdır. Service catalog ownership ilk routing kaynağı olabilir. Root cause başka ekipteyse handoff açık biçimde yapılmalıdır. Sahipsiz incident response süresini gereksiz uzatır.
Investigation
Investigation metric, trace, log ve change history üzerinden root cause hipotezlerini test eder. Correlation ID belirli kullanıcı veya transaction akışını izlemeye yardımcı olur. Son deployment ve configuration değişiklikleri kontrol edilir. External dependency davranışı ayrıca incelenir. Her bulgu incident timeline'a eklenirse ekipler aynı araştırmayı tekrar yapmaz.
Mitigation
Mitigation root cause çözülmeden kullanıcı etkisini azaltan geçici veya geri alınabilir aksiyondur. Rollback, feature flag kapatma veya trafik yönlendirme buna örnek olabilir. En hızlı çözüm her zaman kalıcı çözüm değildir. Riskli değişiklik incident sırasında gereksiz genişletilmemelidir. Mitigation sonrası metric ve SLO davranışı hemen doğrulanmalıdır.
Resolution
Resolution incident'in teknik nedenini kalıcı biçimde gideren değişikliktir. Kod düzeltmesi, configuration değişimi veya kapasite iyileştirmesi olabilir. Fix yeni release ile ilişkilendirilmelidir. Test coverage olayın tekrarını önleyecek şekilde geliştirilmelidir. Error tracking issue'su yalnızca production verification sonrası kapatılmalıdır.
Verification
Verification sistemin gerçekten normal davranışa döndüğünü kanıtlar. Error rate, latency ve business KPI kontrol edilir. Yeni release üzerinde ilgili exception'ın tekrar oluşmadığı gözlemlenir. Synthetic veya deliberate test gerektiğinde çalıştırılabilir. Yalnızca deployment başarılı mesajına bakmak yeterli değildir.
Root Cause Analysis Nasıl Yapılır?
Root cause analysis görünen ilk hatayı değil, olayın neden oluştuğunu anlamayı hedefler. Alert yalnızca başlangıç noktasıdır. Error event, trace, log, deployment ve dependency verileri aynı timeline üzerinde incelendiğinde ilişkiler daha net görülür. Kullanıcı etkisi de teknik bulgular kadar önemlidir. RCA suçlu bulma süreci değil, sistemin aynı koşulda tekrar bozulmasını engelleyecek bilgiyi üretme sürecidir.
İlk Alarm
İlk alarm incident'in sistem tarafından hangi sinyalle fark edildiğini gösterir. Error rate mi arttı, latency mi bozuldu, yoksa business KPI mı düştü sorusu önemlidir. Alarm zamanı timeline başlangıcını belirler. Gerçek incident daha önce başlamış olabilir. Detection delay daha sonra iyileştirme alanı olarak analiz edilebilir.
Error Event
Error event exception type, stack trace ve release bilgisi sunar. İlk occurrence ve frequency root cause hakkında ipucu sağlar. Aynı issue'nun farklı environment'ta görülüp görülmediği kontrol edilebilir. Error code taxonomy teknik kategoriyi daraltır. Event üzerindeki trace ID investigation için güçlü geçiş noktasıdır.
Trace
Trace hatalı isteğin hangi servislerden geçtiğini gösterir. Error status olan span veya anormal latency hızlıca bulunabilir. Parent child ilişkileri etkilenme zincirini ortaya çıkarır. External dependency span'ları downstream problem olup olmadığını gösterir. Trace üzerinden ilgili loglara geçildiğinde ayrıntılı neden araştırılabilir.
İlgili Loglar
Loglar trace veya correlation ID ile filtrelendiğinde yalnızca olayla ilgili kayıtlar görünür. Error code, retry ve business context incelenebilir. Incident öncesindeki warning event'leri erken belirti olabilir. Duplicate error kayıtları gürültüyü artırdığı için structured standard önemlidir. Log timeline root cause hipotezinin doğrulanmasına yardımcı olur.
Deployment Değişiklikleri
Incident başlangıcı son deployment veya config değişikliğiyle karşılaştırılmalıdır. Release annotation dashboard üzerinde bu ilişkiyi görünür kılar. Yeni feature flag veya database migration da change event olarak izlenmelidir. Zamansal yakınlık tek başına kanıt değildir. Ancak regression yalnızca yeni release'te görülüyorsa güçlü bir işaret oluşturur.
External Dependency
Harici servis latency ve error rate'i incident sırasında kontrol edilmelidir. Provider timeout arttıysa uygulama retry davranışı etkiyi büyütmüş olabilir. Circuit breaker state önemli context sağlar. Dependency status normal görünse bile belirli endpoint veya region problemi olabilir. Trace span örnekleri gerçek request davranışını doğrular.
Business Impact
RCA yalnızca hangi exception oluştu sorusuyla tamamlanmamalıdır. Kaç kullanıcı, sipariş veya transaction etkilendiği hesaplanmalıdır. Tenant ve business event verisi bu analize yardımcı olur. Kaybedilen veya geciken işlemler için recovery planı gerekebilir. Business impact gelecekteki incident priority ve SLO kararlarını da etkiler.
Root Cause
Root cause olayın tekrarını açıklayan temel sistem koşuludur. Yalnızca NullPointerException oluştu demek root cause değildir. Neden beklenmeyen null değerin production'a ulaştığı araştırılmalıdır. Eksik validation, contract değişikliği veya dependency davranışı gerçek neden olabilir. Kalıcı aksiyon root cause'u veya contributing factor'ı hedeflemelidir.
Postmortem Sürecinde Logların Rolü
Postmortem incident bittikten sonra sistemin neden başarısız olduğunu ve response sürecinin nasıl iyileştirileceğini anlamaya yarar. Loglar timeline oluşturmak için temel kanıt kaynaklarından biridir. Ancak tek başına log yeterli olmayabilir, metric, trace ve deployment event'leriyle desteklenmelidir. İyi postmortem yalnızca root cause'u değil detection ve response açıklarını da ele alır. Action item'lar owner ve hedef sonuçla birlikte takip edilmelidir.
Incident Timeline
Timeline incident'in başlangıçtan resolution'a kadar önemli olaylarını kronolojik biçimde gösterir. Alert, deployment, mitigation ve recovery zamanları eklenmelidir. Log timestamp'leri bu yapıyı doğrulamaya yardımcı olur. Saat senkronizasyonu problemi varsa açıkça belirtilmelidir. Timeline hangi noktada bilgi veya müdahale gecikmesi yaşandığını gösterir.
Root Cause
Postmortemde root cause kısa ve teknik olarak doğrulanabilir biçimde yazılmalıdır. Belirti ile neden birbirinden ayrılmalıdır. Kanıt olarak trace, log veya metric bulguları özetlenebilir. Kişi hatasına odaklanmak yerine sistem koşullarına bakmak daha kalıcı iyileştirme sağlar. Root cause birden fazla contributing factor ile birlikte oluşabilir.
Contributing Factors
Contributing factors tek başına incident yaratmayan ancak etkiyi artıran koşullardır. Eksik timeout, yetersiz alert veya aşırı retry buna örnek olabilir. Bu faktörler düzeltilirse benzer olayın şiddeti azaltılabilir. Her faktör için kalıcı aksiyon gerekmez. Risk ve maliyet üzerinden önceliklendirme yapılmalıdır.
Detection Gap
Detection gap incident'in daha erken fark edilmesini engelleyen eksikliktir. Kullanıcı ticket'ı ilk sinyalse neden monitoring bunu yakalamadı sorusu sorulmalıdır. Eksik SLI veya yanlış threshold sebep olabilir. Yeni alert eklemek tek çözüm değildir. Mevcut dashboard ve error tracking sinyalleri daha doğru yapılandırılabilir.
Response Gap
Response gap problem fark edildikten sonra müdahaleyi yavaşlatan koşulları gösterir. Sahipsiz alert, eksik runbook veya yanlış routing buna örnektir. Logların bulunmasının zor olması da response süresini uzatabilir. Correlation ve dashboard iyileştirmeleri doğrudan MTTR üzerinde etki yaratabilir. Tatbikatlar bu açıkları gerçek incident olmadan önce gösterebilir.
Action Items
Action item belirli, sahipli ve ölçülebilir olmalıdır. Observability iyileştirmesi gerekiyorsa yalnızca monitoring düzelt yazmak yeterli değildir. Örneğin belirli error rate için SLO alert eklemek daha uygulanabilir görevdir. Her aksiyonun owner ve önceliği bulunmalıdır. Tamamlanan işin benzer incident riskini gerçekten azaltıp azaltmadığı takip edilmelidir.
Tekrarlamayı Önleyen Kalıcı Önlemler
Kalıcı önlemler root cause'un yeniden oluşmasını veya etkisinin büyümesini engeller. Contract test, schema validation, circuit breaker veya deployment guard buna örnek olabilir. Yalnızca daha fazla log eklemek her incident için yeterli düzeltme değildir. Test, architecture ve operational process birlikte değerlendirilebilir. En iyi aksiyon insan hafızasına bağımlılığı azaltan sistem değişikliğidir.
CI/CD Sürecine Observability Nasıl Eklenir?
Observability deployment bittikten sonra elle yapılan bir ayar olarak görülmemelidir. Source map upload, release creation, Git SHA, deployment event ve post deployment kontrolleri pipeline'ın parçası olabilir. Böylece her release aynı telemetry standardıyla production'a çıkar. Smoke test ve deliberate error test entegrasyonun gerçekten çalıştığını doğrular. Error rate veya SLO bozulması belirli koşullarda otomatik rollback sürecine bağlanabilir.
Source Map Upload
Frontend build tamamlandığında source map ilgili release ile yüklenmelidir. Pipeline secret güvenli biçimde yönetilmelidir. Upload başarısız olduğunda step görünür hata üretmelidir. Artifact path ile production bundle eşleşmesi test edilmelidir. Manuel upload süreçleri release kaçırmaya açıktır.
Release Creation
Release CI pipeline tarafından otomatik oluşturulabilir. Identifier build ve telemetry event'lerinde aynı kullanılmalıdır. Deployment öncesi veya sonrası strateji ekip modeline göre seçilebilir. Release metadata environment ve commit bilgisi taşıyabilir. Bu süreç error tracking ve dashboard annotation için temel veri üretir.
Git SHA Etiketleme
Git SHA çalışan kodun kaynak commit'ini kesin biçimde gösterir. Build sırasında environment veya artifact metadata içine eklenebilir. Runtime log ve trace resource üzerinde görünür olmalıdır. Incident sırasında değişiklik setine tek adımda ulaşılır. Reproducible build yaklaşımı bu ilişkiyi güçlendirir.
Deployment Event
Deployment event observability platformuna yeni sürümün ne zaman dağıtıldığını bildirir. Dashboard grafikleri üzerinde annotation olarak gösterilebilir. Environment, version ve deployment ID eklenmelidir. Rollback ayrı bir deployment event olarak kaydedilebilir. Incident timeline oluşturma süresini ciddi biçimde azaltır.
Smoke Test
Smoke test deployment sonrası temel kullanıcı yolunun çalıştığını doğrular. Sadece health endpoint yerine kritik business endpoint de test edilebilir. Test sonucu trace ve log üretmelidir. Böylece telemetry instrumentation da dolaylı olarak doğrulanır. Başarısız smoke test progressive rollout'u durdurabilir.
Deliberate Error Test
Deliberate error test kontrollü bir test hatası üretip error tracking zincirini doğrular. Event'in doğru environment ve release ile geldiği kontrol edilir. Alert routing test ortamında veya güvenli production test kuralıyla doğrulanabilir. Test error gerçek incident dashboard'larını bozmamalıdır. Düzenli doğrulama görünmez entegrasyon kırılmalarını erken yakalar.
Post-Deployment Error Rate Kontrolü
Deployment sonrası kısa pencere error rate regression açısından izlenmelidir. Previous release baseline ile karşılaştırma yapılabilir. Trafik miktarı yeterli değilse karar ertelenebilir veya canary süresi uzatılabilir. Yeni unique error sayısı da güçlü sinyaldir. Otomatik gate insan incelemesiyle birlikte kullanılabilir.
Otomatik Rollback
Otomatik rollback açık ve test edilmiş koşullara dayanmalıdır. Error rate, latency veya kritik business KPI aynı anda değerlendirilebilir. Tek transient error deployment'ı geri almamalıdır. Rollback'in kendisi yeni risk yaratabileceği için database migration uyumluluğu düşünülmelidir. Mekanizma düzenli game day çalışmalarıyla test edilmelidir.
Logging Sisteminin Kendisi Nasıl İzlenir?
Observability altyapısı da production sistemidir ve kendi health sinyallerine ihtiyaç duyar. Collector çökerse uygulama çalışmaya devam ederken görünürlük kaybolabilir. Dropped logs, queue backpressure, ingestion delay ve parsing error kritik metriklerdir. Storage capacity dolduğunda yeni kayıtların kaybolması mümkündür. Bu nedenle telemetry pipeline health için ayrı dashboard ve alert seti bulunmalıdır.
Collector Down Olursa Ne Olur?
Collector kesintisinde uygulamanın bloklanıp bloklanmayacağı tasarım kararıdır. Çoğu sistem telemetry gönderimi nedeniyle business request'in başarısız olmasını istemez. Local buffering kısa kesintilerde veri kaybını azaltabilir. Buffer sınırı dolduğunda drop policy açık olmalıdır. Collector availability metric ve alert ile izlenmelidir.
Dropped Logs
Dropped logs pipeline kapasitesinin veya policy'nin kayıtları kaybettiğini gösterir. Bu sayı mümkün olduğunca sıfıra yakın tutulmalıdır. Sampling nedeniyle bilinçli drop ile kapasite kaynaklı kayıp ayrı metric olmalıdır. Ani artış incident sırasında görünürlüğü doğrudan etkiler. Servis ve reason bazında breakdown root cause'u hızlandırır.
Queue Backpressure
Backpressure backend'in telemetry'yi üretildiği hızda kabul edemediğini gösterir. Collector queue depth bu durumu erken fark ettirebilir. Sürekli büyüyen queue ingestion kapasitesinin yetersiz olduğuna işaret eder. Disk buffering kullanılabilir ancak sınırsız değildir. Exporter latency ve backend health birlikte incelenmelidir.
Ingestion Delay
Ingestion delay event timestamp ile backend görünür olma zamanı arasındaki farktır. Yüksek gecikme alert ve debugging verisinin geç gelmesine yol açar. Collector queue veya backend indexing sorunu sebep olabilir. P95 ingestion latency dashboard üzerinde izlenebilir. Gerçek zamanlı incident sistemlerinde acceptable threshold açıkça tanımlanmalıdır.
Parsing Error
Parsing error log schema veya format değişikliğinin collector tarafından işlenemediğini gösterir. Structured JSON bozuksa kayıt kaybedilebilir veya raw olarak kalabilir. Parsing failure rate alert için değerli bir sinyaldir. Yeni uygulama release'iyle correlation yapılmalıdır. Schema contract test bu problemi production öncesinde yakalayabilir.
Storage Capacity
Storage capacity backend disk veya object storage kullanımını gösterir. Disk dolması ingestion'ın tamamen durmasına neden olabilir. Capacity forecast günlük büyüme hızına göre yapılmalıdır. Retention ve rollover politikaları otomatik çalışmalıdır. Acil alan açma runbook'u önceden hazırlanmalıdır.
Telemetry Pipeline Health Dashboard
Pipeline dashboard collector availability, queue depth, drop rate, exporter error ve ingestion latency gösterebilir. Her bileşenin sahipliği panel üzerinde belirtilmelidir. Backend storage health de aynı görünümde bulunabilir. Alertler kullanıcı uygulamasındaki hatalardan ayrı routing'e sahip olmalıdır. Observability sistemi görünmez biçimde bozulduğunda bu dashboard erken sinyal sağlar.
Loglama Nasıl Test Edilir?
Loglama çoğu projede yalnızca production'da bakılan bir özellik gibi ele alınır, ancak otomatik olarak test edilebilir. Schema, sensitive data, correlation ve error tracking integration testleri kaliteyi önemli ölçüde artırır. Alert mekanizması da kontrollü testlerle doğrulanmalıdır. Load test telemetry pipeline'ın gerçek trafik hacmini taşıyıp taşıyamadığını gösterir. Test edilmeyen observability sistemine kritik incident sırasında güvenmek risklidir.
Unit Test
Unit test belirli domain olayında doğru event'in üretildiğini doğrulayabilir. Event name ve error code beklenen değerlerle karşılaştırılabilir. Log message string'inin tamamına bağımlı test kırılgan olabilir. Structured field'lara odaklanmak daha dayanıklıdır. Sensitive field bulunmadığı da unit seviyesinde test edilebilir.
Integration Test
Integration test middleware, collector veya error tracking SDK'sının birlikte çalışmasını doğrular. Örnek request gönderilip expected telemetry event aranabilir. Correlation ID propagation birden fazla servis arasında test edilebilir. Test backend veya in memory exporter kullanılabilir. CI sürecinde hızlı ve tekrarlanabilir olması önemlidir.
Structured Schema Test
Schema test her event'in zorunlu alanları taşıdığını doğrular. Timestamp, service, environment ve event name gibi alanlar kontrol edilebilir. Field type değişikliği breaking change olarak yakalanabilir. Event catalog ile otomatik validation kurulabilir. Bu test merkezi dashboard'ların beklenmedik schema değişikliğinden bozulmasını önler.
Sensitive Data Leakage Test
Leakage test parola, token ve kişisel veri örneklerinin telemetry çıktısında bulunmadığını kontrol eder. Test request bilerek hassas dummy veri içerebilir. Collector sonrası veri de incelenmelidir. Yalnızca application logger'ı test etmek downstream enrichment kaynaklı sızıntıyı kaçırabilir. Güvenlik regression testleri schema değişikliklerinde tekrar çalıştırılmalıdır.
Correlation ID Test
Correlation test gelen request ID veya correlation değerinin servis boyunca korunduğunu doğrular. Downstream HTTP call ve queue message metadata kontrol edilebilir. Response header içinde uygun değer dönüp dönmediği test edilebilir. Yoksa yeni ID üretimi ayrıca doğrulanmalıdır. Invalid external değerlerin güvenli biçimde ele alınması da test kapsamına girebilir.
Error Tracking Integration Test
Kontrollü exception üretilerek error tracking sisteminde event oluştuğu doğrulanabilir. Release, environment ve stack trace bilgileri kontrol edilmelidir. Frontend'de source map symbolication test edilebilir. Test event production issue istatistiklerini bozmamalıdır. Ayrı environment veya test tag kullanmak bu ayrımı sağlar.
Alert Test
Alert test threshold aşımı simüle edilerek doğru kanal ve owner'a bildirim gittiğini doğrular. Test alert açık biçimde test olarak işaretlenmelidir. Escalation ve deduplication davranışı da kontrol edilebilir. Sadece notification geldi mi değil, içeriğin investigation için yeterli olup olmadığı değerlendirilmelidir. Düzenli tatbikat alert konfigürasyonunun zamanla bozulmasını engeller.
Load Test
Load test uygulama trafiği arttığında telemetry pipeline'ın davranışını ölçer. Collector CPU, memory, queue ve drop rate izlenir. Backend ingestion latency ve index performansı değerlendirilir. Sampling policy yüksek yük altında farklı davranabilir. Kapasite planı gerçek production log boyutu kullanılarak yapılmalıdır.
Kurumsal Logging Standardı Nasıl Uygulanır?
Standardı dokümana yazmak yeterli değildir, geliştiricinin günlük kod akışına gömmek gerekir. Merkezi logging library, shared middleware ve framework adapter'ları bu işi kolaylaştırır. OpenTelemetry instrumentation ortak trace context sağlar. Code review checklist ve lint kuralları standart dışı davranışı erken yakalar. Yeni servis template'i logging ve telemetry özellikleri hazır halde gelirse benimseme oranı ciddi biçimde artar.
Merkezi Logging Library
Merkezi library event schema ve common context eklemeyi standardize eder. Geliştirici her request'te service veya trace ID eklemek zorunda kalmaz. Sensitive field redaction helper'ları ortaklaştırılabilir. Library çok ağır business bağımlılık taşımamalıdır. Version upgrade süreci farklı servislerde yönetilebilir olmalıdır.
Shared Middleware
Shared middleware HTTP request lifecycle telemetry'sini otomatik üretir. Request ID, correlation ve duration gibi alanlar merkezi biçimde eklenebilir. Authentication context güvenli seviyede zenginleştirilebilir. Raw body logging varsayılan olarak kapalı tutulmalıdır. Framework adapter sayesinde farklı servisler aynı standardı kullanabilir.
OpenTelemetry Instrumentation
OpenTelemetry instrumentation HTTP, database ve messaging span'larını ortak standarda taşır. Auto instrumentation başlangıç maliyetini azaltır. Business span ve attribute'lar gerektiğinde manuel eklenebilir. Service resource bilgileri deployment tarafından set edilmelidir. Telemetry output test edilmeden production'a alınmamalıdır.
Framework Adapter'ları
Framework adapter logging standardını kullanılan teknolojiyle doğal biçimde entegre eder. Request middleware, exception handler ve dependency instrumentation bu katmanda bulunabilir. Adapter business kodunu observability ayrıntılarından uzak tutar. Aynı convention farklı framework'lerde uygulanabilir. Framework version yükseltmelerinde adapter compatibility testleri çalıştırılmalıdır.
Logging Coding Standard
Coding standard hangi event'in hangi seviyede ve hangi alanlarla yazılacağını açıklar. Free text yerine stable event name teşvik edilir. Error logging ownership ve duplicate kayıt kuralları tanımlanmalıdır. Sensitive data örnekleri dokümanda açıkça gösterilmelidir. Kısa ve pratik standardın ekip tarafından uygulanma olasılığı daha yüksektir.
Code Review Checklist
Code review sırasında yeni logların schema ve veri güvenliği kontrol edilebilir. Event name uygun mu, PII var mı ve error severity doğru mu soruları checklist'e eklenebilir. Yeni external call için trace instrumentation kontrol edilebilir. Checklist yüzlerce maddeden oluşmamalıdır. Yüksek riskli observability hatalarını hedefleyen kısa liste daha etkilidir.
Static Analysis / Lint Rules
Lint kuralları doğrudan console.log veya yasaklanan logger kullanımını tespit edebilir. Sensitive field isimlerinin log çağrısında kullanımı uyarı üretebilir. Event name convention regex ile kontrol edilebilir. Her kural yüzde yüz doğru sonuç vermeyebilir. False positive oranı yükselirse geliştiriciler uyarıları dikkate almamaya başlar.
Loglama ve Hata Takibinde Sık Yapılan Hatalar
Observability projelerinin başarısız olmasının nedeni çoğu zaman araç yetersizliği değil, veri üretim standardının zayıf olmasıdır. Her şeyi loglamak kadar hiç context eklememek de problemlidir. PII, correlation, release tracking ve alert kalitesi baştan düşünülmelidir. Sadece log kullanıp metric ve trace'i ihmal etmek dağıtık sistemlerde araştırmayı yavaşlatır. En iyi iyileştirmeler gerçek incident deneyimlerinden çıkarılan tekrar eden sorunlara odaklanır.
Her Şeyi Loglamak
Her fonksiyon ve request'i ayrıntılı loglamak güvenli bir yaklaşım gibi görünebilir. Gerçekte maliyet, gürültü ve veri sızıntısı riskini artırır. Metric ile çözülebilecek yüksek hacimli olayları loglamak şart değildir. Logların kullanım senaryosu açık olmalıdır. Düzenli cost review değersiz event'leri bulmaya yardımcı olur.
Hiç Context Eklememek
Hata oluştu mesajı tek başına neredeyse hiçbir araştırma değeri taşımaz. Service, request, trace ve error code context'i gerekir. Structured field'lar arama ve aggregation sağlar. Business identifier gerektiğinde güvenli biçimde eklenebilir. Context standardı shared library ile otomatik hale getirilebilir.
Free-Text Log Kullanmak
Free text hızlı başlangıç sağlar fakat büyük sistemlerde sorgulamayı zorlaştırır. Mesaj değiştiğinde dashboard ve alert bozulabilir. Structured event name daha dayanıklı bir sözleşme sunar. İnsan okunabilir message yine ek alan olarak tutulabilir. Temel filtreleme message string parsing'e bağımlı olmamalıdır.
Her Şeyi ERROR Yapmak
Her başarısız kullanıcı işlemini ERROR olarak loglamak gerçek teknik sorunları görünmez hale getirir. Validation ve authorization sonuçları normal control flow olabilir. Error taxonomy expected ve unexpected ayrımını yapmalıdır. ERROR geliştirici veya operasyon müdahalesi gerektiren teknik durumlara odaklanmalıdır. Böylece alert ve error tracking sinyal kalitesi artar.
PII Loglamak
PII debugging amacıyla gereksiz yere merkezi loglara taşınmamalıdır. User ID gerekiyorsa pseudonymous identifier kullanılabilir. Request body ve header dump büyük risk taşır. Redaction uygulama ve collector seviyesinde uygulanabilir. Sensitive data leakage test bu hatayı release öncesinde yakalayabilir.
Correlation ID Kullanmamak
Correlation olmadan dağıtık request'in hangi loglara ait olduğunu bulmak zorlaşır. Ekip timestamp ve kullanıcı bilgisiyle manuel eşleştirme yapmak zorunda kalır. Request ID, trace ID ve business correlation standardı belirlenmelidir. Middleware propagation işini otomatik yapabilir. Support süreçleri correlation ID'den doğrudan faydalanır.
Release Bilgisi Eklememek
Release bilgisi olmadığında hatanın hangi deployment ile başladığını anlamak zorlaşır. Regression detection zayıflar. CI pipeline version ve Git SHA bilgisini otomatik eklemelidir. Error tracking ve log platformu aynı release identifier'ı kullanmalıdır. Deployment event timeline üzerinde gösterilmelidir.
Her Hataya Alert Üretmek
Her exception occurrence için bildirim üretmek alert fatigue yaratır. Rate, impact ve novelty gibi sinyaller kullanılmalıdır. Grouping aynı issue tekrarlarını tek problem olarak yönetir. Warning ve critical routing farklı olmalıdır. Aksiyon gerektirmeyen event dashboard üzerinde kalabilir.
Logları Sonsuza Kadar Saklamak
Sınırsız retention maliyet ve veri riski yaratır. Kullanılmayan eski debug logların operasyonel değeri düşüktür. Dataset bazlı retention politikası uygulanmalıdır. Archive yalnızca gerçek gereksinim varsa kullanılmalıdır. Silme süreçleri backup ve replica kopyalarını da kapsamalıdır.
Sadece Log Kullanıp Metric ve Trace Kullanmamak
Loglar ayrıntılıdır fakat sistem genelindeki davranışı hızlı göstermede metric kadar verimli değildir. Distributed latency problemi trace olmadan zor analiz edilebilir. Error tracking issue yönetiminde ek değer sağlar. Farklı sinyaller ortak trace veya correlation context'iyle bağlanmalıdır. Observability tek veri türünün hacmini artırmak değil, doğru sinyali doğru soruda kullanmaktır.
Kurumsal Loglama Sistemi Kurulum Yol Haritası
Kurumsal loglama projesine doğrudan ürün kurulumu yaparak başlamak yerine kullanım senaryolarını ve veri standardını belirlemek daha sağlıklıdır. İlk aşamada hangi incident sorularının cevaplanamadığı çıkarılmalıdır. Ardından event taxonomy, log schema ve correlation standardı oluşturulur. Collector, storage, error tracking, dashboard ve alert katmanları bu temel üzerine eklenir. Son aşamada security, retention ve incident process entegrasyonu tamamlanarak sistem gerçek production operasyonuna bağlanır.
Adım 1: Loglama Kullanım Senaryolarını Belirlemek
Önce ekiplerin loglardan hangi sorulara cevap almak istediği belirlenmelidir. Son incident'ler güçlü başlangıç kaynağıdır. Kullanıcı şikayeti, payment failure veya dependency latency gibi gerçek senaryolar listelenebilir. Her senaryo gerekli telemetry alanlarını ortaya çıkarır. Araç seçimi bu ihtiyaçlardan sonra yapılmalıdır.
Adım 2: Event Taxonomy Oluşturmak
Business ve teknik event kategorileri ortak isimlerle tanımlanmalıdır. Stable event name yaklaşımı benimsenmelidir. Error taxonomy ile normal event taxonomy birbirini tamamlamalıdır. Event owner ve açıklama bilgisi catalog içinde tutulabilir. Yeni isim ekleme süreci gereksiz duplicate oluşumunu engellemelidir.
Adım 3: Ortak Log Schema Belirlemek
Timestamp, service, version, environment ve correlation alanları ortak schema içinde tanımlanmalıdır. Business context için kontrollü alanlar eklenebilir. Veri tipi ve hassasiyet sınıfı belgelenmelidir. Naming convention tüm dillerde aynı semantiği korumalıdır. Schema testleri implementation'ı doğrulamalıdır.
Adım 4: Correlation Standardı Kurmak
Request, trace ve business correlation kavramları açıkça ayrılmalıdır. HTTP ve message propagation mekanizmaları belirlenmelidir. Shared middleware context'i otomatik taşımalıdır. Support tarafında kullanıcıya güvenli reference ID gösterilebilir. Cross service integration test bu standardı doğrular.
Adım 5: Collector Seçmek
Collector log ve telemetry kaynaklarına, deployment ortamına ve backend hedeflerine göre seçilmelidir. Buffering, retry, filtering ve redaction özellikleri değerlendirilmelidir. Kubernetes ortamında node agent modeli tercih edilebilir. OpenTelemetry Collector vendor neutral pipeline için güçlü seçeneklerden biridir. Pilot test gerçek throughput ile yapılmalıdır.
Adım 6: Merkezi Storage Kurmak
Storage çözümü sorgu modeli, retention ve maliyet ihtiyacına göre seçilmelidir. ELK veya Loki gibi yaklaşımlar farklı trade off'lara sahiptir. Index ve label stratejisi yüksek cardinality göz önünde bulundurularak tasarlanmalıdır. Access control ve encryption ilk günden uygulanmalıdır. Lifecycle policy production'a çıkmadan hazır olmalıdır.
Adım 7: Error Tracking Eklemek
Error tracking beklenmeyen application exception'larını yönetmek için eklenir. Frontend source map ve backend stack trace entegrasyonu doğrulanmalıdır. Expected error'lar filtrelenmelidir. Release ve environment metadata otomatik gönderilmelidir. Ownership ve issue routing yapılandırılmalıdır.
Adım 8: Dashboard Oluşturmak
Dashboard önce temel servis sağlık sorularına cevap vermelidir. Request rate, error rate, latency ve dependency health başlangıç için yeterlidir. Deployment annotation eklenmelidir. Servis owner panel üzerinde görünür olabilir. Çok sayıda dekoratif panel yerine incident sırasında kullanılan göstergeler tercih edilmelidir.
Adım 9: Alerting Kurmak
Alertler action gerektiren koşullara odaklanmalıdır. Error rate, SLO burn rate veya kritik business KPI kullanılabilir. Her alert'in owner ve severity bilgisi bulunmalıdır. Deduplication ve cooldown gürültüyü azaltır. Test alert ile routing düzenli olarak doğrulanmalıdır.
Adım 10: Security ve Retention Politikası Eklemek
PII redaction, role based access ve encryption policy uygulanmalıdır. Dataset bazlı retention süreleri belirlenmelidir. Audit ve debug log ihtiyaçları ayrılmalıdır. Üçüncü taraf data transfer gereksinimleri kurum süreçleriyle değerlendirilmelidir. Silme ve archive otomatik lifecycle üzerinden yönetilmelidir.
Adım 11: Incident Sürecine Bağlamak
Observability platformu incident yönetiminden ayrı kalmamalıdır. Alert ilgili on call veya ekip kanalına yönlenmelidir. Runbook dashboard ve log sorgularını içermelidir. Postmortem action item'ları telemetry coverage'ı geliştirebilir. MTTD ve MTTR değişimi sistem başarısının temel ölçümlerindendir.
Loglama ve Hata Takip Sisteminin Başarısı Nasıl Ölçülür?
Observability yatırımının başarısı yalnızca günlük log sayısıyla ölçülemez. Asıl hedef production sorunlarını daha erken fark etmek ve daha hızlı çözmektir. MTTD, MTTA ve MTTR bu nedenle önemli göstergelerdir. Alert precision, false positive rate ve observability coverage operasyon kalitesini tamamlar. Maliyet tarafında service bazlı telemetry cost izlenerek sağlanan değer ile harcama birlikte değerlendirilmelidir.
Mean Time to Detect (MTTD)
MTTD incident'in başlaması ile sistem tarafından fark edilmesi arasındaki ortalama süredir. Düşük MTTD kullanıcı etkisini azaltabilir. Alert ve SLO kalitesi bu metrik üzerinde doğrudan etkilidir. Kullanıcı ticket'ı detection kaynağıysa observability gap araştırılmalıdır. Incident kayıtlarında başlangıç ve detection zamanı güvenilir biçimde tutulmalıdır.
Mean Time to Acknowledge (MTTA)
MTTA alert üretildikten sonra sorumlu kişinin olayı kabul etmesine kadar geçen süredir. Routing ve on call süreçleri bu metriği etkiler. Sahipsiz veya gürültülü alertler MTTA'yı yükseltir. Severity bazında ayrı hedefler belirlenebilir. Yalnızca hızlı acknowledge değil, doğru owner'a ulaşma da önemlidir.
Mean Time to Resolve (MTTR)
MTTR incident'in tespitinden veya başlangıcından resolution'a kadar geçen süreyi ölçer. Correlation, tracing ve release tracking bu süreyi azaltabilir. Çok düşük MTTD ama yüksek MTTR investigation görünürlüğü problemini gösterebilir. Incident kategorisine göre ayrı analiz yapmak daha anlamlıdır. Tek ortalama değerin arkasındaki dağılım da incelenmelidir.
Production Error Rate
Production error rate kullanıcı trafiği içindeki gerçek teknik başarısızlık oranını gösterir. Expected error taxonomy doğru değilse metrik yanıltıcı olur. Release bazında trend regression analizi sağlar. Kritik business endpoint'ler servis genelinden ayrı izlenebilir. Hedef SLO ile ilişkilendirilmelidir.
Alert Precision
Alert precision gelen uyarıların ne kadarının gerçek aksiyon gerektirdiğini gösterir. Yüksek precision on call ekibinin sisteme güvenini artırır. Alertlerin çoğu kapatılıp hiçbir işlem yapılmıyorsa kural yeniden tasarlanmalıdır. Severity ve owner bazında precision ölçülebilir. Postmortem kayıtları label kaynağı olabilir.
False Positive Rate
False positive rate gerçek problem olmadığı halde üretilen alert oranını gösterir. Yüksek oran alert fatigue yaratır. Dynamic threshold veya minimum traffic koşulu iyileştirme sağlayabilir. Her false positive'i sıfırlamak hedef olmamalıdır. Önemli olan kritik incident detection'ını bozmadan gürültüyü azaltmaktır.
Tekrarlayan Incident Sayısı
Aynı root cause nedeniyle tekrarlayan incident sayısı kalıcı iyileştirme kalitesini gösterir. Error tracking regression verisi bu analize yardımcı olur. Sadece issue kapatmak sorunu çözmüş sayılmamalıdır. Postmortem action item'ları gerçekten tamamlanmalıdır. Tekrar oranındaki düşüş reliability çalışmalarının değerli sinyalidir.
Observability Coverage
Coverage kaç servisin ortak logging, tracing ve error tracking standardına uyduğunu gösterebilir. Yüzde yüz telemetry volume anlamına gelmez. Kritik servislerin trace ve error context'i eksiksiz olmalıdır. Yeni servisler template üzerinden otomatik coverage kazanabilir. Coverage kalite metriği schema ve sensitive data testleriyle birlikte düşünülmelidir.
Log Cost per Service
Service başına log maliyeti telemetry bütçesini görünür hale getirir. Çok trafik alan servis daha yüksek maliyet üretebilir, bu tek başına sorun değildir. Cost ile incident değeri birlikte değerlendirilmelidir. Aşırı debug veya büyük payload logları kolayca fark edilebilir. Ekip bazlı cost dashboard davranış değişikliğini teşvik eder.
Open Source Loglama ve İşbirliği Ekosistemi
Açık kaynak observability ekosistemi telemetry üretiminden depolamaya ve görselleştirmeye kadar geniş seçenekler sunar. OpenTelemetry, Elasticsearch, OpenSearch, Loki, Fluent Bit, Prometheus ve Grafana farklı katmanlarda kullanılabilir. En önemli avantaj yalnızca lisans değildir, standartlara katkı ve platform davranışını daha yakından anlayabilme imkanıdır. Bunun karşılığında self hosted operasyon sorumluluğu ekip üzerinde kalabilir. Açık kaynak seçiminde proje canlılığı, release süreci ve community desteği teknik özellikler kadar önemlidir.
OpenTelemetry
OpenTelemetry ortak telemetry API, SDK ve Collector yaklaşımı sunar. Polyglot sistemlerde dil bağımsız semantik oluşturmayı kolaylaştırır. Vendor bağımlılığını instrumentation katmanında azaltmaya yardımcı olur. Community geliştirmeleri farklı framework entegrasyonlarını sürekli genişletir. Kurumlar gerektiğinde dokümantasyon veya instrumentation projelerine katkı sağlayabilir.
Elasticsearch / OpenSearch
Elasticsearch ve OpenSearch dağıtık arama tabanlı log analizi için kullanılan platformlardır. Field bazlı sorgu ve aggregation yetenekleri güçlüdür. Cluster yönetimi ciddi operasyon bilgisi gerektirebilir. Mapping ve shard stratejisi ölçek açısından kritiktir. Seçim lisans, ekosistem, operasyon deneyimi ve mevcut altyapıya göre yapılmalıdır.
Grafana Loki
Grafana Loki label temelli log indeks yaklaşımıyla farklı bir maliyet modeli sunar. Grafana ekosistemiyle yakın çalışır. Metric ve trace ile cross navigation kolaylaştırılabilir. Label cardinality dikkatle yönetilmelidir. Gerçek sorgu pattern'leriyle pilot yapmak doğru tercih olup olmadığını gösterir.
Fluent Bit
Fluent Bit düşük kaynak tüketimli log forwarding ihtiyacında yaygın kullanılan açık kaynak seçeneklerden biridir. Container ve edge senaryolarında kullanılabilir. Parsing, filtering ve output plugin desteği geniştir. Buffer ve retry davranışı production öncesinde test edilmelidir. OpenTelemetry pipeline ile birlikte veya alternatif collector olarak konumlandırılabilir.
Prometheus ve Grafana
Prometheus metric toplama ve sorgulama için güçlü açık kaynak araçlardan biridir. Grafana dashboard ve çoklu veri kaynağı görselleştirmesinde yaygın kullanılır. Log ve trace sistemleriyle entegre edildiğinde observability deneyimi güçlenir. High cardinality metric label problemi burada da geçerlidir. SLI ve SLO dashboard'ları bu ekosistem üzerinde kurulabilir.
Açık Kaynak Sistemlerin Avantajları
Açık kaynak sistemler uygulama davranışını ve veri formatını daha yakından kontrol etme imkanı verebilir. Community dokümantasyonu öğrenme sürecini destekler. Vendor seçeneği değiştirilirken açık standartlar migration'ı kolaylaştırabilir. Ancak ücretsiz yazılım sıfır operasyon maliyeti anlamına gelmez. Bakım, upgrade ve güvenlik sorumluluğu bütçeye dahil edilmelidir.
Vendor Lock-In'i Azaltmak
Açık protokol ve veri formatı bağımlılığı azaltmanın en etkili yollarındandır. OpenTelemetry ve OTLP bu amaçta yardımcı olabilir. Dashboard ve query'ler yine backend'e özgü olabilir. Kritik telemetry verisinin export edilebilirliği seçimin başında kontrol edilmelidir. Vendor değişikliği gerekmese bile taşınabilir mimari pazarlık ve operasyon esnekliği sağlar.
Open Source Projelere Katkı Sağlamak
Geliştiriciler bug report, dokümantasyon, test veya instrumentation katkısıyla açık kaynak projelere destek verebilir. Bu süreç kullanılan teknolojinin iç çalışma modelini anlamayı hızlandırır. Küçük documentation düzeltmeleri bile iyi başlangıçtır. Takım içinde contribution day veya workshop düzenlenebilir. Yerel yazılım toplulukları ortak öğrenme için doğal bir ortam oluşturur.
Loglama Sistemleri İçin En İyi Programlama Dili Var mı?
Loglama ve observability problemleri belirli bir programlama dilinden çok sistem mimarisiyle ilgilidir. JavaScript, Java, .NET, Go veya Python kullanan servisler aynı telemetry standardını üretebilir. Dil seçimi SDK olgunluğu ve framework entegrasyonu açısından farklılık yaratabilir. Ancak service name, trace context ve error taxonomy gibi kavramlar teknoloji bağımsızdır. Polyglot kurumlarda OpenTelemetry gibi ortak semantik sağlayan yaklaşımın değeri daha da belirginleşir.
Loglama Teknolojiden Bağımsız Bir Mimari Problemdir
Bir dilin güçlü logger kütüphanesine sahip olması kurumsal observability problemini tek başına çözmez. Ortak schema ve merkezi pipeline yine gereklidir. Security ve retention uygulama dilinden bağımsız konulardır. Incident response da teknoloji stack'inin ötesinde organizasyonel süreçtir. Bu nedenle dil tartışmasından önce telemetry sözleşmesine odaklanmak daha verimlidir.
JavaScript ve TypeScript
JavaScript ve TypeScript frontend ile Node.js backend dünyasında yaygın kullanılır. Structured logger ve OpenTelemetry entegrasyon seçenekleri bulunur. Browser tarafında source map ve session context ayrı önem taşır. Node.js tarafında async context propagation test edilmelidir. Framework middleware'leri ortak request schema uygulamayı kolaylaştırır.
Java ve .NET
Java ve .NET kurumsal backend sistemlerinde güçlü logging ve tracing ekosistemlerine sahiptir. MDC veya benzeri context mekanizmaları correlation bilgisi taşımada kullanılabilir. Structured JSON output merkezi collector ile uyumlu hale getirilebilir. Auto instrumentation başlangıç hızını artırabilir. Business event ve error taxonomy yine kurum tarafından tanımlanmalıdır.
Go
Go cloud native servislerde yaygın kullanılan dillerden biridir. Structured logging için field tabanlı kütüphaneler kolayca kullanılabilir. Context propagation HTTP ve gRPC servislerinde temel tasarım konusu olmalıdır. OpenTelemetry instrumentation distributed trace kurulmasını kolaylaştırır. Performans nedeniyle logging allocation ve payload boyutu yüksek trafikte test edilmelidir.
Python
Python web servisleri, data pipeline ve background job sistemlerinde sık kullanılır. Standart logging altyapısı structured formatter ile genişletilebilir. Async framework'lerde trace context davranışı doğrulanmalıdır. Worker ve task queue sistemlerinde correlation özellikle önemlidir. Exception capture error tracking sistemleriyle doğrudan entegre edilebilir.
Dil Yerine Ortak Telemetry Standardına Odaklanmak
Kurumun gerçek avantajı bütün servislerin aynı event ve context dilini konuşmasıdır. Service version, environment ve trace ID her dilde aynı anlamı taşımalıdır. SDK implementasyonu farklı olabilir. Merkezi schema ve Collector veri tarafında birlik sağlar. Böylece incident ekibi servis dilini bilmeden temel sorguları çalıştırabilir.
OpenTelemetry'nin Polyglot Sistemlerde Avantajı
OpenTelemetry çok sayıda dil için ortak observability kavramları sunar. Semantic conventions servislerin benzer telemetry üretmesini kolaylaştırır. Collector backend hedeflerini uygulama dilinden bağımsızlaştırır. Trace propagation farklı dil servisleri arasında ortak standarda dayanır. Polyglot microservice ortamında bu tutarlılık önemli operasyon avantajı sağlar.
Observability Alanında Yazılımcı Olmak İçin Ne Yapmalı?
Observability alanında gelişmek isteyen bir yazılımcı yalnızca belirli dashboard aracını öğrenmekle yetinmemelidir. Structured logging, Linux, container, distributed systems ve incident management birlikte öğrenilmelidir. OpenTelemetry, Prometheus, Grafana ve log platformları gerçek proje üzerinde kullanıldığında kavramlar daha iyi oturur. Küçük bir microservice sistemi kurup deliberate failure senaryoları üretmek güçlü bir çalışma yöntemidir. Amaç araç ezberlemek değil, production sisteminin neden bozulduğunu veriden okuyabilme becerisi kazanmaktır.
Structured Logging Öğrenmek
İlk adım plain text ile structured event arasındaki farkı anlamaktır. JSON schema, event name ve correlation field'ları gerçek projede uygulanabilir. PII redaction da öğrenme kapsamına alınmalıdır. Basit log sorgularından dashboard üretmeye geçmek faydalıdır. Kendi event catalog'unu oluşturmak kurumsal tasarım pratiği kazandırır.
Linux ve Container Temelleri
Production uygulamalarının önemli bölümü Linux ve container ortamında çalışır. stdout, process lifecycle, file descriptor ve network temellerini bilmek troubleshooting'i kolaylaştırır. Container restart olduğunda local log davranışı test edilmelidir. Kubernetes üzerinde DaemonSet collector modeli incelenebilir. Infrastructure telemetry uygulama loguyla birlikte düşünülmelidir.
Distributed Systems
Distributed systems timeout, retry, partial failure ve consistency kavramlarını anlamayı gerektirir. Observability bu davranışları görünür hale getirir. Trace yalnızca araç özelliği değil, dağıtık causality modelinin yansımasıdır. Queue ve async işlerde context propagation pratiği yapılabilir. Cascading failure senaryoları gerçek öğrenme sağlar.
OpenTelemetry
OpenTelemetry SDK, auto instrumentation ve Collector temel bileşenleri öğrenilmelidir. Basit iki servis arasında trace context taşımak iyi başlangıç projesidir. Log correlation eklenerek sinyaller bağlanabilir. Collector filtering ve sampling configuration denenebilir. Farklı backend exporter'ları vendor neutral yaklaşımı somutlaştırır.
Prometheus ve Grafana
Prometheus ile request rate, error rate ve latency metric'leri üretmek temel observability pratiğidir. Grafana dashboard üzerinde RED veya benzeri servis metrikleri gösterilebilir. Alert rule ve SLO yaklaşımı eklenebilir. High cardinality problemini küçük testlerle görmek oldukça öğreticidir. Metric ile log arasındaki fark uygulamalı olarak daha net anlaşılır.
ELK / OpenSearch
Log indexing ve query mantığını anlamak için küçük Elasticsearch veya OpenSearch cluster kurulabilir. Structured application logları ingest edilip field bazlı sorgular yapılabilir. Mapping ve lifecycle policy denemeleri önemlidir. Büyük cardinality alanının etkisi test ortamında gözlemlenebilir. Cluster operasyonu self hosted sistemlerin gerçek maliyetini anlamaya yardımcı olur.
Sentry ve Error Tracking
Basit frontend veya backend projeye error tracking entegrasyonu yapılabilir. Bilerek exception üretilip grouping, release ve source map davranışı incelenebilir. Expected error filtrelemesi yapılmalıdır. Regression ve issue ownership deneyimi observability'nin geliştirme sürecine nasıl bağlandığını gösterir. Error tracking ile log management arasındaki fark pratikte netleşir.
Incident Management
Observability verisi ancak incident sürecinde kullanılabildiğinde gerçek değer üretir. Triage, mitigation, resolution ve postmortem kavramları öğrenilmelidir. Küçük game day çalışmaları güçlü pratik sağlar. Sahte dependency outage veya latency artışı oluşturulabilir. Ekip MTTD ve MTTR ölçerek altyapısını iyileştirebilir.
Gerçek Bir Observability Projesi Geliştirmek
En iyi öğrenme yolu küçük ama uçtan uca bir production benzeri sistem oluşturmaktır. Frontend, API, queue ve database içeren örnek uygulama yeterlidir. Structured logs, OpenTelemetry traces, Prometheus metrics ve error tracking birlikte kurulabilir. Deliberate failure senaryoları üzerinden incident investigation yapılabilir. Benzer proje örnekleri ve topluluk çalışmalarını incelemek için https://www.diyarbakiryazilim.com.tr/projects adresi kullanılabilir.
Yazılım Topluluklarının Observability Yetkinliğine Katkısı
Observability teorik doküman okumaktan çok gerçek production senaryoları üzerinden gelişen bir yetkinliktir. Yazılım toplulukları farklı deneyim seviyesindeki geliştiricilerin incident örneklerini paylaşmasına ortam sağlar. Workshop, açık kaynak contribution ve incident simulation çalışmaları öğrenmeyi hızlandırır. Yerel topluluklarda yüz yüze veya çevrim içi deneyim paylaşımı özellikle yeni geliştiriciler için güçlü bir öğrenme kanalıdır. Ekipler yalnızca hangi aracın kullanıldığını değil, hangi kararın neden verildiğini tartıştığında daha kalıcı bilgi üretir.
Açık Kaynak Observability Projelerinde İşbirliği
Topluluk üyeleri OpenTelemetry veya başka açık kaynak projelerde küçük katkılarla başlayabilir. Documentation, example project ve bug reproduction değerli katkı türleridir. Birlikte code review yapmak öğrenme hızını artırır. Contribution süreci production kalitesindeki tooling'in nasıl geliştirildiğini gösterir. Bu deneyim geliştiricinin kendi telemetry tasarımına da doğrudan yansır.
Log Analizi Workshop'ları
Workshop formatında gerçek veya simüle edilmiş log dataset'i üzerinden problem araştırılabilir. Katılımcılara yalnızca hata sonucu değil, sınırlı telemetry verilmesi daha öğreticidir. Correlation ID ve structured query kullanımının farkı pratikte görülür. Aynı incident farklı ekipler tarafından çözülüp yöntemler karşılaştırılabilir. Workshop sonunda hangi ek telemetry'nin işleri kolaylaştıracağı tartışılmalıdır.
Incident Simulation Çalışmaları
Incident simulation gerçek sistem bozulmadan response becerisi kazandırır. Dependency timeout, queue backpressure veya deployment regression senaryosu oluşturulabilir. Katılımcılar alert, triage ve mitigation adımlarını uygular. MTTD ve MTTR ölçülerek observability eksikleri bulunur. Simulation sonrası kısa postmortem kalıcı iyileştirme üretir.
Diyarbakır Yazılım Topluluğu Gibi Yerel Topluluklarda Bilgi Paylaşımı
Yerel yazılım toplulukları farklı şirket ve uzmanlık alanlarından geliştiricileri aynı teknik konu etrafında buluşturabilir. Observability gibi deneyim gerektiren alanlarda gerçek senaryoların konuşulması özellikle değerlidir. Sunum, workshop ve açık proje çalışmaları teori ile production pratiği arasındaki boşluğu azaltır. Diyarbakır Yazılım Topluluğu'nun çalışma yaklaşımı hakkında bilgi almak için https://www.diyarbakiryazilim.com.tr/about adresi incelenebilir. Böyle ortamlar geliştiricinin yalnızca araç kullanımını değil, olay çözme ve ekip iletişimi becerisini de güçlendirebilir.
Geliştiricilerin Gerçek Production Problemleri Üzerinden Öğrenmesi
Production problemi geliştiriciye sistemin teoride değil, gerçek yük altında nasıl davrandığını gösterir. Incident örnekleri timeout, retry ve partial failure kavramlarını daha somut hale getirir. Kişisel veya kurumsal hassas bilgi paylaşmadan anonim vaka çalışmaları hazırlanabilir. Katılımcılar hangi log veya trace bilgisinin eksik olduğunu tartışabilir. Bu yöntem observability tasarımında doğrudan kullanılabilecek mühendislik sezgisi oluşturur.
Production Öncesi Logging ve Error Tracking Kontrol Listesi
Production öncesi kontrol listesi observability'nin yalnızca kurulduğunu değil, gerçekten çalıştığını doğrulamalıdır. Structured logging, correlation, PII redaction, source maps, release tracking ve alert routing temel alanlardır. Dashboard'ların veri gösterdiği ve retention policy'nin aktif olduğu kontrol edilmelidir. Kontrollü test hatası gönderilerek error tracking zinciri uçtan uca doğrulanmalıdır. Liste deployment gate'in bir parçası haline geldiğinde yeni servislerin eksik telemetry ile production'a çıkması zorlaşır.
Structured Logging Var mı?
Production loglarının temel event'leri structured formatta üretmesi gerekir. Event name ve ortak context alanları ayrıştırılabilir olmalıdır. Serbest text yalnızca human readable message için kullanılabilir. Collector tarafında ek parsing ihtiyacı minimum tutulmalıdır. Örnek production benzeri kayıtlarla schema doğrulanmalıdır.
Ortak Log Schema Var mı?
Tüm servisler temel alan isimlerinde aynı standardı kullanmalıdır. Service, version, environment ve severity zorunlu alan olabilir. Business context için kontrollü extension noktaları tanımlanmalıdır. Schema version değişiklikleri yönetilmelidir. CI testi standard dışı alanları erken yakalayabilir.
Correlation ID Var mı?
Request ve async akışlarda correlation bilgisi korunmalıdır. Middleware otomatik propagation sağlamalıdır. Queue mesajlarında metadata üzerinden context taşınmalıdır. Support ekiplerinin ID'yi kullanabileceği süreç tanımlanmalıdır. Cross service integration testi bu davranışı doğrulamalıdır.
Trace ID Loglara Ekleniyor mu?
Trace ID loglara otomatik ekleniyorsa log ve trace arasında güçlü bağlantı oluşur. Manual logger çağrılarında context kaybolmamalıdır. Async işlemde context propagation test edilmelidir. Dashboard veya log UI trace detayına doğrudan link verebilir. Sampling olsa bile trace ID üretim davranışı tutarlı olmalıdır.
PII Redaction Var mı?
Parola, token, cookie ve kişisel alanlar telemetry akışından çıkarılmalıdır. Application logger ilk kontrol katmanıdır. Collector merkezi ikinci redaction katmanı sağlayabilir. Leakage test dummy sensitive değerlerle çalıştırılmalıdır. Yeni schema alanları security review kapsamına alınmalıdır.
Error Tracking Çalışıyor mu?
Kontrollü exception doğru environment'a ulaşıyor mu test edilmelidir. Stack trace ve context okunabilir olmalıdır. Expected error filtrelerinin çalıştığı kontrol edilmelidir. Issue grouping duplicate event üretmemelidir. Notification doğru owner'a yönlenmelidir.
Source Maps Doğru mu?
Frontend production build hatası orijinal kaynak satırına çevrilebilmelidir. Source map release ID ile eşleşmelidir. CI upload step başarısı doğrulanmalıdır. Public hosting politikası kontrol edilmelidir. Deliberate browser error ile gerçek symbolication testi yapılmalıdır.
Release Tracking Var mı?
Her event çalışan release version bilgisini taşımalıdır. Git SHA ve deployment ID gerektiğinde eklenebilir. Dashboard deployment annotation göstermelidir. Error tracking first seen release bilgisini doğru hesaplamalıdır. Rolling deployment sırasında sürümler ayırt edilebilmelidir.
Alert Routing Tanımlı mı?
Her critical alert'in owner'ı ve escalation yolu bulunmalıdır. Notification doğru kanal ve on call sistemine gitmelidir. Deduplication davranışı test edilmelidir. Test alert gerçek incident gibi yanlış alarm oluşturmamalıdır. Alert mesajı investigation bağlantılarını içermelidir.
Retention Politikası Var mı?
Debug, error, audit ve security logları için ayrı retention gerekebilir. Lifecycle policy otomatik çalışmalıdır. Archive ve backup kopyaları aynı veri yönetimi planına dahil edilmelidir. Storage cost tahmini gerçek günlük ingestion üzerinden yapılmalıdır. Süresi dolan verinin gerçekten silindiği doğrulanmalıdır.
Dashboard'lar Hazır mı?
Temel servis dashboard'u request rate, error rate, latency ve dependency health göstermelidir. Deployment annotation görünür olmalıdır. SLO hedefleri varsa panelde yer almalıdır. Owner ve runbook bağlantısı eklenebilir. Dashboard gerçek production benzeri trafik üzerinde test edilmelidir.
Test Hatasıyla Sistem Doğrulandı mı?
Kontrollü test hatası telemetry zincirinin en gerçekçi doğrulamalarından biridir. Log, trace ve error event'in aynı correlation altında göründüğü kontrol edilmelidir. Alert gerekiyorsa doğru routing test edilebilir. Test verisi production KPI hesaplarını bozmamalıdır. Deployment sonrası otomatik doğrulama uzun dönemde entegrasyon güvenilirliğini artırır.
Sıkça Sorulan Sorular
Kurumsal yazılımlarda loglama neden önemlidir?
Kurumsal loglama production'da gerçekleşen olayları geriye dönük anlayabilmek için gereklidir. Kullanıcı hatası, dependency problemi ve deployment regression gibi durumların ayrıştırılmasını kolaylaştırır. Structured context sayesinde belirli request veya transaction saniyeler içinde bulunabilir. Loglar metric ve trace ile birlikte kullanıldığında incident çözüm süresi önemli ölçüde kısalır. İyi loglama aynı zamanda güvenlik, audit ve operasyonel KPI ihtiyaçlarını da destekleyebilir.
Structured logging nedir?
Structured logging log kayıtlarını serbest cümle yerine belirli alanlardan oluşan veri olarak üretme yaklaşımıdır. JSON bu amaçla yaygın kullanılan formatlardan biridir. Service, severity, event name ve correlation ID ayrı alanlar olur. Bu yapı arama, dashboard ve alert üretimini kolaylaştırır. Aynı zamanda collector seviyesinde filtering ve redaction uygulamasını daha güvenilir hale getirir.
Loglama ile hata takip sistemi arasındaki fark nedir?
Loglama sistemdeki geniş olay kümesini kaydetmeye ve sorgulamaya odaklanır. Error tracking ise beklenmeyen application hatalarını issue olarak gruplamaya ve yönetmeye odaklanır. Log platformunda aynı exception yüzlerce satır olarak görülebilir. Error tracking sistemi bunu tek issue altında toplayıp release ve regression bilgisi gösterebilir. Olgun bir mimaride iki yaklaşım birbirini tamamlar.
Sentry ne işe yarar?
Sentry runtime exception ve uygulama hatalarını merkezi olarak izlemeye yardımcı olur. Stack trace, breadcrumbs, release ve environment bilgilerini aynı issue içinde gösterebilir. Frontend projelerinde source map desteği minified hataların gerçek kaynak satırına çevrilmesini sağlar. Backend'de unhandled exception ve kritik error event'leri gruplanabilir. Beklenen validation hatalarının sisteme gönderilmemesi sinyal kalitesini artırır.
ELK Stack ne işe yarar?
ELK merkezi log toplama, indeksleme, sorgulama ve görselleştirme ihtiyacında kullanılan bir mimari stack'tir. Elasticsearch arama ve indeksleme, Logstash veri işleme, Kibana görselleştirme rolü üstlenir. Collector katmanında farklı araçlar da kullanılabilir. Büyük hacimde shard, mapping ve retention yönetimi önemlidir. ELK esneklik sunarken self hosted operasyon yükü dikkatle planlanmalıdır.
Grafana Loki mi Elasticsearch mü?
Seçim log sorgu modeli ve operasyon ihtiyacına göre yapılmalıdır. Elasticsearch field bazlı güçlü indeks ve aggregation imkanları sunar. Loki daha sınırlı label indeksleme yaklaşımıyla maliyeti azaltmayı hedefler. Grafana ekosistemini yoğun kullanan ekipler Loki ile doğal entegrasyon avantajı görebilir. Gerçek log hacmi ve sorgu pattern'i üzerinde pilot test yapmak en güvenilir seçim yöntemidir.
OpenTelemetry nedir?
OpenTelemetry telemetry üretimi ve aktarımı için açık standartlar, SDK'lar ve Collector sunan bir ekosistemdir. Logs, metrics ve traces gibi sinyalleri ortak yaklaşımda yönetmeye yardımcı olur. OTLP farklı backend'lere standart veri aktarımı sağlar. Semantic conventions polyglot sistemlerde field anlamlarını ortaklaştırır. OpenTelemetry doğrudan log arama ürünü değil, observability instrumentation ve pipeline katmanıdır.
Correlation ID nedir?
Correlation ID aynı işlem akışına ait farklı request, job veya message event'lerini bağlayan identifier'dır. Microservice sistemlerinde incident araştırmasını önemli ölçüde hızlandırır. HTTP header ve message metadata üzerinden taşınabilir. Log ve error event'lere otomatik eklenmesi faydalıdır. Trace ID ile aynı kavram olmamakla birlikte bazı basit mimarilerde benzer amaçlara hizmet edebilir.
Trace ID ile Request ID arasındaki fark nedir?
Request ID çoğu zaman tek HTTP request'i tanımlar. Trace ID distributed transaction içindeki tüm span'ları ortak kimlik altında birleştirir. Tek trace birden fazla servis request'i içerebilir. Loglarda iki alanın birlikte bulunması investigation'ı kolaylaştırabilir. Distributed tracing kullanıldığında trace context servisler arasında standart biçimde taşınmalıdır.
Production'da DEBUG log kullanılmalı mı?
DEBUG production'da tamamen yasak olmak zorunda değildir, fakat kontrollü kullanılmalıdır. Sürekli açık debug logging yüksek ingestion maliyeti ve veri riski oluşturabilir. Belirli servis ve kısa zaman aralığı için dinamik olarak açılması daha güvenlidir. Sensitive data politikası debug seviyesinde de değişmez. Sampling ve otomatik expiration operasyon yükünü azaltabilir.
Hangi hatalar Sentry'ye gönderilmeli?
Geliştirici müdahalesi gerektiren beklenmeyen runtime hataları error tracking sistemi için uygun adaydır. Unhandled exception ve önemli regression'lar bu gruba girer. Validation ve normal authorization sonuçları çoğu zaman issue olarak gönderilmemelidir. Dependency failure'ın severity ve retry davranışı ayrıca değerlendirilmelidir. Temel ölçüt, bu event görüldüğünde ekip gerçekten aksiyon alacak mı sorusudur.
Loglarda kişisel veri tutulabilir mi?
Loglarda kişisel veri bulunması mümkün olsa da veri minimizasyonu yaklaşımı uygulanmalıdır. Teknik ihtiyaç için gereksiz olan kişisel alanlar hiç toplanmamalıdır. Gerekli durumda pseudonymous identifier veya masking tercih edilebilir. Access control, retention ve üçüncü taraf aktarım politikaları ayrıca değerlendirilmelidir. Kurumun KVKK yükümlülükleri hukuk ve bilgi güvenliği ekipleriyle birlikte ele alınmalıdır.
Loglar ne kadar süre saklanmalıdır?
Tek bir doğru retention süresi yoktur. Debug, error, audit ve security loglarının kullanım amaçları farklıdır. Süre incident araştırma ihtiyacı, maliyet ve veri riskine göre belirlenmelidir. Eski veri archive katmanına taşınabilir. Retention sona erdiğinde aktif storage, backup ve gerekli diğer kopyalar policy kapsamında yönetilmelidir.
Error tracking ile APM arasındaki fark nedir?
Error tracking exception ve issue lifecycle yönetimine odaklanır. APM ise uygulama performance, transaction latency ve dependency davranışını daha geniş ölçekte izler. Aynı platform iki özelliği birlikte sunabilir. Kavramsal olarak birisi hatayı, diğeri uygulama performans akışını merkeze alır. Incident araştırmasında ikisinin verisi birlikte kullanıldığında daha iyi context sağlar.
Log, metric ve trace birlikte nasıl kullanılır?
Metric sistemde anormal davranışı hızlıca gösterir. Trace belirli request'in hangi serviste veya dependency'de sorun yaşadığını daraltır. Log ilgili operasyonun ayrıntılı nedenini açıklar. Error tracking exception'ı issue olarak yönetir. Trace ID ve correlation ID bu sinyaller arasında geçişi kolaylaştırır.
Kurumsal loglama maliyeti nasıl azaltılır?
İlk adım hangi servis ve event'in en fazla byte ürettiğini ölçmektir. Gereksiz debug, health check ve ham request body kayıtları azaltılabilir. Retention, storage tier ve indexing politikaları kullanım senaryosuna göre optimize edilmelidir. Sampling yüksek hacimli başarılı işlemlerde uygulanabilir, kritik error'lar mümkün olduğunca korunmalıdır. Servis başına telemetry bütçesi ekiplerin maliyeti sürekli görmesini sağlar.
Kurumsal yazılımlarda loglama ve hata takip sistemleri neden önemlidir?
Kurumsal Yazılımlarda Loglama ve Hata Takip Sistemleri production sorunlarını kullanıcı bildirimine bağlı kalmadan erken fark etmeyi ve daha hızlı çözmeyi sağlar. Merkezi log, error tracking, metric ve tracing verileri aynı incident'in farklı yönlerini gösterir. Correlation ve release bilgisi eklendiğinde belirli hatanın hangi işlem ve deployment ile ilişkili olduğu anlaşılabilir. İyi tasarlanmış yapı güvenlik, audit ve operasyonel performans ihtiyaçlarını da destekler. Sonuç olarak amaç daha fazla log üretmek değil, doğru anda doğru teknik kanıta ulaşabilmektir.
Uygulama logları merkezi olarak nasıl toplanır, saklanır ve analiz edilir?
Uygulama önce structured log üretir ve bu kayıtlar collector tarafından merkezi pipeline'a alınır. Collector parsing, redaction, filtering ve batching işlemlerini uygulayabilir. Veriler Elasticsearch, Loki veya benzeri uygun storage katmanına gönderilebilir. Dashboard, query ve alert sistemi aynı veri üzerinde operasyon görünürlüğü sağlar. Retention ve access control ilk kurulumdan itibaren mimarinin parçası olmalıdır.
Sentry, ELK Stack, Grafana Loki ve Datadog gibi loglama ve hata takip araçlarından hangisi tercih edilmelidir?
Tek bir araç her kurum için otomatik olarak en iyi seçim değildir. Sentry error tracking tarafına, ELK ve Loki merkezi log yönetimine farklı açılardan odaklanır. Daha geniş observability platformları metric, trace ve log özelliklerini aynı deneyimde birleştirebilir. Seçim log hacmi, ekip yetkinliği, sorgu modeli, veri yerleşimi ve toplam maliyet üzerinden yapılmalıdır. En sağlıklı yöntem gerçek telemetry verisiyle sınırlı bir pilot kurup günlük operasyon senaryolarını test etmektir.
Kurumsal uygulamalarda log seviyeleri, gerçek zamanlı uyarılar ve hata takibi nasıl yapılandırılmalıdır?
Önce TRACE, DEBUG, INFO, WARN, ERROR ve CRITICAL seviyelerinin ekip içinde ortak anlamı tanımlanmalıdır. Expected business error'lar ERROR olarak değerlendirilmemelidir. Alertler tekil log satırı yerine error rate, SLO veya kritik business KPI gibi aggregate sinyallere dayanmalıdır. Error tracking sistemi unhandled exception ve gerçek regression'lara odaklanmalıdır. Service ownership ve escalation yapılandırıldığında uyarılar doğru ekibe hızlı biçimde ulaşır.
Yakınımda kurumsal loglama, izleme ve hata takip sistemleri konusunda danışmanlık veren yazılım firması nasıl bulabilirim?
Danışmanlık ararken yalnızca belirli bir log ürününü kurabilen ekip yerine observability mimarisini uçtan uca ele alabilen teknik yetkinlik aranmalıdır. Structured logging, OpenTelemetry, merkezi log toplama, error tracking, KVKK, retention ve alert tasarımı aynı değerlendirme içinde bulunmalıdır. Referans projelerde incident süresini veya telemetry maliyetini nasıl iyileştirdikleri sorulabilir. Diyarbakır ve çevresindeki yazılım ekosistemiyle bağlantı kurmak veya topluluğun çalışmalarını incelemek için https://www.diyarbakiryazilim.com.tr adresi kullanılabilir. Kurumsal ihtiyaçlarda en doğru başlangıç, mevcut uygulama mimarisinin ve production sorunlarının ölçülebilir bir envanterini çıkarmaktır.
Sonuç
Kurumsal Yazılımlarda Loglama ve Hata Takip Sistemleri yalnızca hata olduğunda açılan bir log ekranından çok daha geniş bir mühendislik alanıdır. Structured logging, correlation ID, distributed tracing, OpenTelemetry, error tracking, merkezi storage, güvenlik ve alerting birlikte ele alındığında production görünürlüğü ciddi biçimde güçlenir. Benim deneyimimde en başarılı ekipler önce araç seçmek yerine hangi soruları hızlı cevaplamak istediklerini tanımlayan ekiplerdir. Ardından ortak schema, telemetry pipeline ve incident süreci kurulduğunda teknoloji seçimi çok daha sağlıklı yapılabilir. Observability, kurumsal yazılımın çalışıp çalışmadığını görmekten öte, neden o şekilde davrandığını kanıtlarla anlayabilme kapasitesidir.
Mevcut uygulamanızda logların dağınık kaldığını, production hatalarının geç fark edildiğini veya hangi servisin ne kadar telemetry ürettiğini göremediğinizi düşünüyorsanız önce küçük bir observability değerlendirmesi yapmak iyi bir başlangıçtır. Kritik servisleri, incident geçmişini, log schema yapısını ve error tracking coverage'ını çıkararak ilk iyileştirme alanlarını belirleyebilirsiniz. Kurumsal log yönetimi ve hata takibi konusunda topluluk çalışmaları, teknik içerikler ve proje örnekleri için https://www.diyarbakiryazilim.com.tr adresine göz atabilirsiniz. Uygulanabilir bir yol haritası oluştururken maliyet, güvenlik ve geliştirici deneyimini aynı anda değerlendirmek uzun vadede daha sağlam sonuç verir. Doğru kurulan observability altyapısı, bir sonraki production hatasında nereden başlayacağınızı düşündürmek yerine doğrudan kanıta götürür.
share: