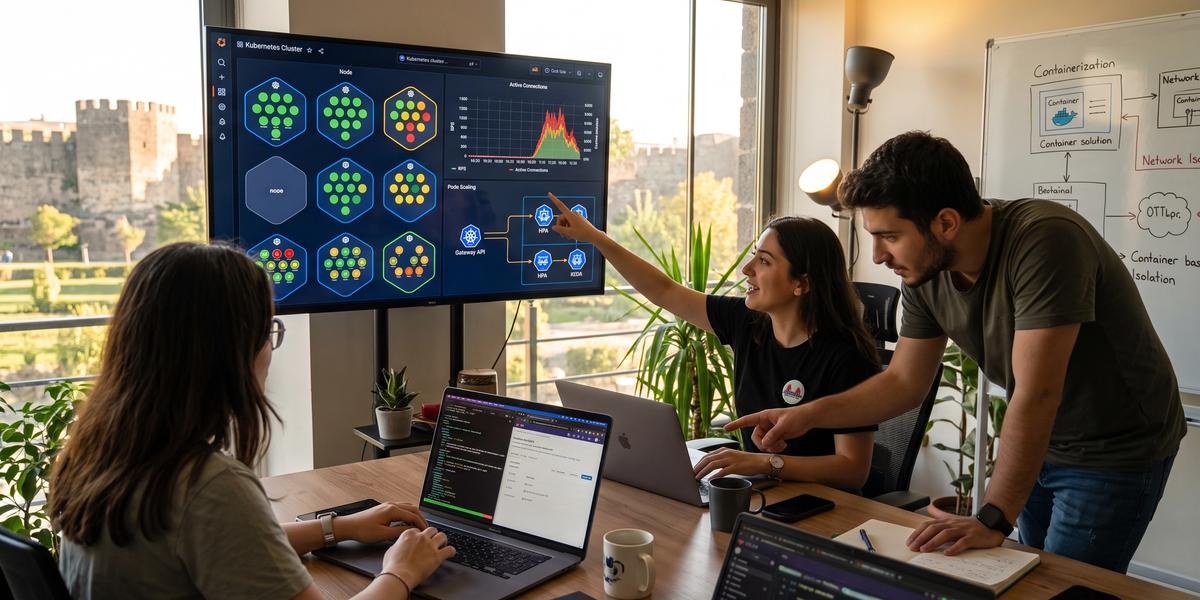
Kubernetes Üzerinde Yük Dengeleme ve Otomatik Ölçekleme

Diyarbakır Yazılım
16.08.2026
#Yazılım#Teknoloji#Topluluk
Kubernetes ortamında bir uygulamayı çalıştırmak çoğu ekip için başlangıç noktasıdır. Asıl mesele, trafik arttığında sistemin nasıl davranacağını önceden tasarlamaktır. İsteklerin doğru Pod'lara dağıtılması, yeni Pod'ların zamanında devreye alınması ve gerektiğinde yeni node kapasitesinin oluşturulması aynı mimarinin parçalarıdır. Bu nedenle Kubernetes Üzerinde Yük Dengeleme ve Otomatik Ölçekleme yalnızca bir HPA manifesti yazmaktan ibaret değildir. Bu rehberde Service, EndpointSlice, Ingress, Gateway API, HPA, KEDA, VPA, Cluster Autoscaler ve node provisioning yaklaşımını birbiriyle bağlantılı şekilde ele alacağız. Özellikle production ortamlarında karşılaştığım en yaygın sorunlardan biri, Pod sayısı artsa bile yeni Pod'ların trafik almaması veya cluster kapasitesinin yeni replica'ları taşıyamamasıdır. Buradaki amaç, yalnızca daha fazla replica üretmek değil, talebin geldiği andan uygulamanın cevap verdiği ana kadar bütün zinciri dengeli hâle getirmektir.
Kubernetes'te Yük Dengeleme ve Otomatik Ölçekleme Nedir?
Kubernetes'te yük dengeleme, gelen trafiğin uygun backend Pod'ları arasında dağıtılmasını ifade eder. Otomatik ölçekleme ise değişen iş yüküne göre Pod veya node kapasitesinin artırılıp azaltılmasıdır. İki kavram birbirinden farklı olsa da production ortamında birbirini tamamlar. Trafiği on Pod arasında dağıtmak için önce gerçekten on hazır Pod'un bulunması gerekir. Ben Kubernetes üzerinde yük dengeleme ve otomatik ölçekleme nasıl yapılır sorusuna cevap verirken her zaman trafik, uygulama kapasitesi ve node kapasitesi olmak üzere üç katmanı birlikte değerlendiririm.
Load Balancing Nedir?
Load balancing, istemciden gelen bağlantı veya isteklerin tek bir uygulama instance'ında birikmesini önleyen dağıtım mekanizmasıdır. Kubernetes içinde Service, kube-proxy veya eBPF veri yolu bu işlemin önemli parçalarını oluşturabilir. Cluster dışındaki trafik için ayrıca harici load balancer, Gateway veya Ingress bileşeni devreye girebilir. İyi bir yük dengeleme yaklaşımı yalnızca trafiği eşit sayıda bağlantıya bölmez, backend'in hazır olup olmadığını da dikkate alır. Özellikle uzun süre açık kalan bağlantılarda matematiksel olarak eşit replica sayısı, gerçek hayatta eşit yük anlamına gelmeyebilir.
Autoscaling Nedir?
Autoscaling, uygulama veya altyapı kapasitesinin metriklere göre otomatik şekilde değiştirilmesidir. HPA yatay olarak Pod sayısını artırır veya azaltır. VPA Pod'ların CPU ve bellek kaynaklarının boyutlandırılmasına odaklanır. Cluster Autoscaler ve Karpenter benzeri node autoscaling yaklaşımları ise scheduler'ın yerleştiremediği Pod'lar için altyapı kapasitesi oluşturabilir. Bu katmanların birlikte değerlendirilmesi, Kubernetes autoscaling HPA VPA ve Cluster Autoscaler karşılaştırması yapılırken en önemli ayrımdır.
Yük Dengeleme ile Ölçekleme Arasındaki Fark
Yük dengeleme mevcut kapasitenin nasıl kullanılacağını belirlerken ölçekleme toplam kapasitenin ne kadar olması gerektiğine odaklanır. Beş Pod'unuz varsa Service bu Pod'lar arasında trafik yönlendirebilir. Fakat talep iki katına çıktığında aynı beş Pod yetersiz kalabilir. HPA replica sayısını artırdığında yeni Pod'ların Ready olması ve Service endpoint listesine eklenmesi gerekir. Bu yüzden yük dengeleme ve autoscaling ayrı controller'lar tarafından yürütülse bile kullanıcı deneyimi açısından tek sistem gibi düşünülmelidir.
İki Mekanizma Neden Birlikte Çalışmalıdır?
Autoscaling yeni kapasite üretirken load balancing bu kapasitenin gerçek trafik tarafından kullanılmasını sağlar. Yeni Pod oluşturulmuş fakat readiness kontrolünden geçmemişse trafik almaması gerekir. Pod sayısı artsa bile node kapasitesi yetersizse replica'lar Pending durumda kalabilir. Node eklense bile yeni endpoint'lerin veri yoluna yansıması tamamlanmadan gerçek kapasite artışı hissedilmez. Bu nedenle production tasarımında scale kararı ile trafik kabul etmeye hazır olma durumu aynı zaman çizelgesi üzerinde izlenmelidir.
Trafiği dağıtmak
Trafik dağıtımının temel amacı tek bir Pod'un aşırı yüklenmesini önlemektir. Service, Gateway veya başka bir veri yolu backend seçiminde rol oynayabilir. Ready endpoint'ler arasındaki dağılım kullanılan ağ uygulamasına göre farklı mekanizmalarla gerçekleşebilir. Bağlantı süresi, session affinity ve topology tercihleri gerçek dağılımı etkileyebilir. Bu nedenle yalnızca toplam RPS değil, Pod başına RPS ve aktif bağlantı sayısı da izlenmelidir.
Pod sayısını artırmak
Pod sayısının artırılması genellikle HPA veya KEDA gibi bir autoscaling mekanizmasıyla yapılır. HPA CPU, bellek veya custom metric değerlerini kullanabilir. KEDA kuyruk uzunluğu, event kaynağı veya harici metrikler üzerinden ölçekleme için güçlü bir seçenektir. Replica artışı yalnızca Pod nesnesinin oluşması anlamına gelmez, uygulamanın gerçekten hazır hâle gelmesi gerekir. Startup ve readiness sürelerini hesaba katmayan autoscaling ayarları ani trafik artışlarında beklenen faydayı sağlamayabilir.
Node kapasitesi eklemek
Yeni Pod'lar scheduler tarafından mevcut node'lara yerleştirilemiyorsa cluster seviyesinde kapasite sorunu oluşur. Bu noktada node autoscaling devreye girer. Cluster Autoscaler mevcut node group yapılarını büyütebilirken dinamik provisioning yaklaşımları iş yüküne uygun node seçeneklerini değerlendirebilir. Yeni node açılana kadar Pod'ların Pending kalması normaldir. Bu gecikme, HPA scale-up süresi hesaplanırken mutlaka dikkate alınmalıdır.
Kubernetes'te İstek Bir Pod'a Nasıl Ulaşır?
Bir HTTP isteğinin kullanıcı cihazından Pod'a ulaşması tek adımlı bir süreç değildir. Trafik önce dış ağ katmanından geçebilir, ardından Gateway veya Ingress üzerinden uygun Service'e yönlendirilebilir. Service kendi backend endpoint'lerini EndpointSlice kaynakları üzerinden temsil eder. Veri yolu uygun endpoint'e paketi iletir ve uygulama isteği işler. Kubernetes Ingress Service LoadBalancer ve HPA birlikte nasıl kullanılır sorusunu anlamanın en iyi yolu bu zinciri uçtan uca takip etmektir.
Client
Client bir tarayıcı, mobil uygulama, başka bir servis veya dış sistem olabilir. İstek DNS çözümlemesiyle uygun IP adresine yönelir. HTTPS kullanılıyorsa bağlantı sırasında TLS işlemleri de devreye girer. Client açısından Kubernetes'in içindeki Pod sayısı görünmez ve çoğu zaman bilinmesine gerek yoktur. İyi tasarımda client sabit ve anlamlı bir servis adresiyle iletişim kurar.
External Load Balancer
External Load Balancer cluster dışından gelen trafiğin giriş noktalarından biridir. Kubernetes Service türü LoadBalancer olduğunda cloud ortamı bir harici veya dahili load balancer oluşturabilir. Bu katman genellikle L4 seviyesinde çalışabilir veya kullanılan çözümün yeteneklerine göre daha üst katman işlevleri sunabilir. Trafik daha sonra cluster node'larına veya ilgili veri yoluna aktarılır. Burada health check ayarlarının Kubernetes endpoint durumu ile uyumlu olması önemlidir.
Gateway veya Ingress
Gateway veya Ingress, uygulama katmanı yönlendirmesini tanımlamak için kullanılabilir. Host, path, TLS ve backend seçimi gibi ihtiyaçlar bu aşamada ele alınır. Gateway API daha gelişmiş rol ayrımı ve route türleri sunar. Ingress hâlen yaygın olarak kullanılsa da yeni projelerde Gateway API değerlendirilmesi anlamlıdır. Route yapılandırması autoscaling'den bağımsız görünse bile yeni replica'ların doğru Service üzerinden trafiğe dahil edilmesi açısından bağlantılıdır.
Service
Service, değişebilen Pod IP'leri üzerinde kararlı bir servis erişim katmanı oluşturur. Selector ile uygun Pod kümesi belirlenebilir. Control plane bu eşleşmeleri EndpointSlice kaynaklarında temsil eder. Service'in kendisi uygulama kodunu çalıştırmaz, erişim soyutlaması sağlar. Autoscaling replica sayısını değiştirdiğinde Service aynı isim ve adres üzerinden çalışmaya devam eder.
EndpointSlice
EndpointSlice, Service backend'lerinin ölçeklenebilir biçimde temsil edilmesini sağlar. Pod sayısı arttıkça yeni uygun endpoint'ler ilgili EndpointSlice kaynaklarına yansır. Ready durumu trafik yönlendirmesi açısından özellikle önemlidir. Terminating veya henüz hazır olmayan Pod'lar veri yolunda farklı şekilde ele alınabilir. Büyük cluster'larda bu yapı, endpoint bilgisinin daha verimli dağıtılmasına yardımcı olur.
Pod
Pod, isteği gerçekten işleyen container veya container grubunu barındırır. Pod'un çalışıyor görünmesi her zaman trafik almaya hazır olduğu anlamına gelmez. Readiness probe bu ayrımı ifade etmek için kullanılır. Uygulama bağımlılıklarını hazırlamadan Ready olursa load balancer çok erken trafik gönderebilir. Bunun sonucu ilk saniyelerde 5xx, timeout veya yüksek latency olabilir.
Uçtan Uca Trafik Akışı
Tipik bir akış client, external load balancer, Gateway veya Ingress, Service, EndpointSlice ve Pod sırasını takip eder. Ancak kullanılan CNI, eBPF veri yolu ve cloud mimarisi bazı ağ adımlarını değiştirebilir. Önemli olan her katmanda hangi bileşenin karar verdiğini bilmektir. Ben troubleshooting sırasında her katmanın metriğini ayrı incelemeyi tercih ederim. Böylece sorun autoscaling kararında mı, scheduler'da mı yoksa trafik dağılımında mı hızla anlaşılır.
Kubernetes Service Nedir?
Kubernetes Service, bir Pod grubuna kararlı ağ erişimi sağlayan temel kaynaklardan biridir. Pod'lar yeniden oluşturulduğunda IP adresleri değişebilir, ancak Service aynı mantıksal servis kimliğini korur. Uygulamalar birbirlerinin Pod IP'lerini takip etmek yerine Service DNS adı veya Service IP'si üzerinden haberleşebilir. Bu yaklaşım autoscaling ile doğal biçimde uyumludur çünkü replica sayısı değişse bile istemci tarafında adres değişikliği gerekmez. Production ortamında Service tasarımını anlamadan sağlıklı bir load balancing stratejisi kurmak zordur.
Pod IP'leri Neden Doğrudan Kullanılmaz?
Pod IP'leri kalıcı servis adresi olarak düşünülmemelidir. Deployment yeni Pod oluşturduğunda önceki Pod'un IP adresi artık geçerli olmayabilir. HPA replica sayısını sürekli değiştirebileceği için doğrudan IP listesi yönetmek operasyonel olarak sürdürülebilir değildir. Service bu değişken backend kümesini tek erişim noktası arkasında toplar. Bu sayede uygulama bileşenleri birbirine daha gevşek bağlı çalışır.
Service Discovery
Service discovery, bir uygulamanın ihtiyaç duyduğu başka bir servisin nerede olduğunu bulmasını sağlar. Kubernetes DNS altyapısı Service isimlerini çözümler. Böylece uygulama kodunda Pod IP'leri saklamaya gerek kalmaz. Namespace yapısı da servis isimlendirmesinde önemli rol oynar. Microservice mimarisinde bu yaklaşım deployment ve autoscaling süreçlerini ciddi biçimde kolaylaştırır.
Stable Virtual IP
ClusterIP türündeki Service genellikle kararlı bir sanal IP üzerinden erişim sağlar. Backend Pod'ların IP adresleri değişse de istemciler aynı Service adresini kullanır. Trafik veri yolu tarafından uygun endpoint'e aktarılır. Bu sanal IP yaklaşımı uygulama keşfi ile backend yaşam döngüsünü birbirinden ayırır. HPA devreye girdiğinde bu özellik özellikle değerlidir.
Selector
Selector, Service'in hangi Pod'larla ilişkilendirileceğini belirleyen label eşleştirmesidir. Yanlış selector kullanıldığında Service hiç endpoint bulamayabilir veya istemediğiniz Pod'lara trafik gönderebilir. Deployment ve Service label'larının uyumlu tutulması bu yüzden önemlidir. GitOps süreçlerinde selector değişiklikleri dikkatle gözden geçirilmelidir. Basit görünen bir label hatası bütün trafiği etkileyebilir.
EndpointSlice
EndpointSlice, Service'in gerçek backend durumunun daha ölçeklenebilir temsilidir. Control plane uygun Pod endpoint'lerini dilimler hâlinde yönetebilir. Bu özellikle yüzlerce veya binlerce endpoint bulunan servislerde önem kazanır. Ready durumu sayesinde trafiğe katılabilecek backend'ler daha doğru temsil edilir. Autoscaling sonrasında yeni Pod'ların görünür hâle geldiği kritik noktalardan biri burasıdır.
Kubernetes Service Türleri
Kubernetes temel olarak farklı erişim gereksinimleri için farklı Service türleri sunar. ClusterIP yalnızca cluster içi erişimin tipik seçimidir. NodePort her node üzerinde belirli bir port üzerinden servis erişimi sağlar. LoadBalancer dış veya özel ağdan yönetilen load balancer entegrasyonu için kullanılır. ExternalName ise DNS seviyesinde başka bir adı işaret etmek istediğiniz durumlarda değerlendirilebilir.
ClusterIP
ClusterIP varsayılan Service türüdür ve çoğu iç servis iletişiminde yeterlidir. Bir backend API'nin yalnızca cluster içindeki diğer uygulamalar tarafından kullanılması buna iyi bir örnektir. Dış dünyadan erişim gerekiyorsa ClusterIP arkasına Gateway veya Ingress bağlanabilir. Böylece uygulama servisi dış erişim ayrıntılarından bağımsız kalır. Production tasarımlarında ben uygulama Service'lerini mümkün olduğunca iç erişim modeliyle tutmayı tercih ederim.
NodePort
NodePort, Service'i cluster node'larının IP adresleri üzerinde belirlenmiş bir porttan erişilebilir hâle getirir. Harici load balancer çözümlerinin bazıları NodePort'u altyapı bileşeni olarak kullanabilir. Ancak son kullanıcıya doğrudan NodePort sunmak çoğu production mimarisinde ilk tercih değildir. Port yönetimi, güvenlik ve erişim modeli daha fazla dikkat gerektirir. Kullanım amacı net değilse ClusterIP veya LoadBalancer yaklaşımı daha anlaşılır olabilir.
LoadBalancer
LoadBalancer türü Service, desteklenen ortamlarda dış veya dahili load balancer kaynağı oluşturulmasını tetikleyebilir. Cloud controller gerekli entegrasyonu sağlar. L4 seviyesinde TCP veya UDP trafiğinin uygulamaya taşınması için sık kullanılır. HTTP seviyesinde gelişmiş yönlendirme gerekiyorsa Gateway veya Ingress katmanı eklemek daha uygun olabilir. Kullanılan platformdaki maliyet modeli de her LoadBalancer Service oluşturulmadan önce değerlendirilmelidir.
ExternalName
ExternalName, trafiği Pod selector'ları üzerinden yönlendirmek yerine DNS adı eşlemesi sağlar. Bu nedenle klasik Service load balancing davranışından farklıdır. Cluster içindeki uygulamaların dış bir DNS adına mantıksal servis ismiyle erişmesini sağlayabilir. Ancak HTTP Host veya TLS sertifika beklentileri gibi ayrıntılar bazı kullanım durumlarında sorun çıkarabilir. Bu yüzden ExternalName kullanmadan önce uygulama protokolünün davranışı kontrol edilmelidir.
Hangi Service Türü Ne Zaman Kullanılmalı?
İç servis iletişimi için genellikle ClusterIP yeterlidir. Dış TCP veya UDP erişiminde LoadBalancer değerlendirilebilir. HTTP ve HTTPS trafiğinde ClusterIP backend'leri Gateway veya Ingress arkasında sunmak güçlü bir modeldir. NodePort daha çok belirli altyapı entegrasyonları veya kontrollü kullanım senaryolarında öne çıkar. Seçim yapılırken erişim kapsamı, güvenlik, cloud maliyeti ve trafik protokolü birlikte değerlendirilmelidir.
ClusterIP ile İç Yük Dengeleme
ClusterIP Service, cluster içindeki istemcilerin değişen backend Pod grubuna kararlı bir adres üzerinden erişmesini sağlar. Bu yapı özellikle microservice trafiğinde temel load balancing katmanlarından biridir. HPA replica sayısını artırdığında yeni Ready Pod'lar endpoint kümesine dahil edilir. İstemcinin yeni Pod IP adreslerini bilmesine gerek yoktur. Bu nedenle ClusterIP, Kubernetes autoscaling ile doğal biçimde birlikte çalışır.
Service VIP
Service VIP, istemcinin gördüğü sanal servis adresidir. Bu adres gerçek bir Pod'a ait değildir. Veri yolu bu hedefi uygun backend endpoint'e yönlendirir. Böylece backend listesi değişse bile istemci tarafında servis adresi sabit kalır. HPA nedeniyle sık değişen replica sayılarında bu soyutlama büyük kolaylık sağlar.
Pod Endpoint'leri
Pod endpoint'leri Service arkasındaki gerçek trafik hedefleridir. Selector ve readiness durumuna göre endpoint listesi değişebilir. Yeni Pod Ready olduğunda trafiğe katılabilir. Pod sonlandırılırken endpoint durumunun hızlı ve doğru güncellenmesi önemlidir. Aksi durumda kapanmakta olan uygulama bağlantı kabul etmeye devam edebilir.
Trafiğin Pod'lara Dağıtılması
Trafik dağılımı kullanılan Service veri yolu uygulamasına göre gerçekleşir. Bağlantı bazlı davranış nedeniyle bütün Pod'ların aynı sayıda request alacağını varsaymak doğru değildir. Özellikle HTTP/2 ve gRPC gibi uzun bağlantılı protokollerde yeni Pod'lar daha az trafik alabilir. Bu yüzden Pod başına gerçek yük metriği izlenmelidir. Autoscaling kararı ortalama metriğe dayanıyorsa dengesiz dağılım ayrıca değerlendirilmelidir.
Ready Olmayan Pod'ların Trafikten Çıkarılması
Readiness kontrolü başarısız olan Pod normal Service trafiği açısından kullanılabilir endpoint olmamalıdır. Bu özellik uygulamanın hazır olmadığı dönemde kullanıcı isteği almamasını sağlar. Başlangıçta migration, cache hazırlığı veya model yükleme gibi işlemler yapan servislerde doğru readiness kontrolü çok değerlidir. Readiness yanlış tanımlanırsa autoscaling sonrası yeni Pod'lar erken trafik alabilir. Sonuç olarak scale-up yaptığınız hâlde hata oranı artabilir.
EndpointSlice Nedir?
EndpointSlice, Kubernetes Service backend'lerini verimli ve ölçeklenebilir biçimde temsil etmek için kullanılan API kaynağıdır. Özellikle endpoint sayısı yükseldiğinde eski tek liste yaklaşımına göre daha uygun bir yapı sunar. Service selector'ı ile eşleşen Pod'lar ilgili EndpointSlice kaynaklarında temsil edilir. Ready, serving ve terminating gibi durum bilgileri trafik kararlarına yardımcı olabilir. Büyük cluster tasarımlarında EndpointSlice davranışını anlamak load balancing troubleshooting açısından değerlidir.
EndpointSlice ile Service İlişkisi
Service istemcinin kullandığı mantıksal ağ kimliğini sunarken EndpointSlice gerçek backend listesini temsil eder. Selector bulunan Service'lerde control plane endpoint bilgilerini otomatik oluşturabilir. Böylece Service nesnesi ile değişken Pod kümesi arasında dinamik bir ilişki kurulur. HPA replica eklediğinde bu ilişki otomatik güncellenir. Uygulama geliştiricisinin endpoint listesini elle yönetmesi gerekmez.
Büyük Sayıda Pod'un Ölçeklenmesi
Yüzlerce veya binlerce backend olduğunda endpoint bilgisinin verimli dağıtılması önem kazanır. EndpointSlice bu ihtiyaca göre tasarlanmıştır. Backend'leri daha küçük gruplar hâlinde temsil etmek, her değişiklikte dev bir endpoint listesinin güncellenmesi ihtiyacını azaltır. Autoscaling yoğun olan ortamlarda bu kontrol düzlemi verimliliği önemlidir. Özellikle kısa ömürlü workload'larda endpoint churn yüksek olabilir.
Ready Condition
Ready condition, bir endpoint'in normal trafiğe hazır olup olmadığını gösteren önemli sinyallerden biridir. Pod'un çalışıyor olması tek başına yeterli değildir. Readiness probe başarılı değilse endpoint'in kullanıcı trafiği almasını istemeyebilirsiniz. Bu ayrım ölçekleme sırasında daha da önem kazanır. Yeni replica'nın kapasite sayımına gerçekten ne zaman dahil edildiği bu sinyalle ilişkilidir.
Serving Condition
Serving condition endpoint'in istekleri karşılayıp karşılayamadığı hakkında daha ayrıntılı bilgi sağlar. Özellikle terminating endpoint'lerin durumunu yorumlarken Ready bilgisinden farklı anlam taşır. Bazı veri yolu uygulamaları bu koşulları farklı şekilde kullanabilir. Production tasarımında kullanılan network çözümünün EndpointSlice condition desteği incelenmelidir. Böylece graceful shutdown davranışı daha öngörülebilir olur.
Terminating Condition
Terminating condition, endpoint'e ait Pod'un sonlandırılma sürecinde olduğunu ifade eder. Bu bilgi connection draining stratejileri açısından değerlidir. Yeni bağlantıların kapanan Pod'a gönderilmesini azaltmak istersiniz. Aynı zamanda mevcut uzun request'lerin tamamlanması için kısa bir süre gerekebilir. Graceful shutdown tasarımı termination state ile uygulama davranışını birlikte ele almalıdır.
Autoscaling Sonrası Yeni Pod'ların EndpointSlice'a Eklenmesi
HPA replica sayısını artırdığında Deployment yeni Pod'lar oluşturur. Pod'lar scheduler tarafından yerleştirilir ve container'lar başlatılır. Readiness koşulları sağlandığında endpoint bilgisi Service arkasında kullanılabilir hâle gelir. Bu süre gerçek scale-up gecikmesinin önemli bölümüdür. Bu yüzden autoscaling performansını yalnızca HPA karar süresiyle ölçmek eksik olur.
kube-proxy Kubernetes Yük Dengelemede Ne Yapar?
kube-proxy, Service trafiğinin backend endpoint'lere taşınmasını sağlayan klasik Kubernetes veri yolu bileşenlerinden biridir. Farklı proxy modları farklı Linux ağ mekanizmalarını kullanabilir. Cluster büyüklüğü ve işletim sistemi özellikleri seçimde etkili olabilir. Güncel Kubernetes sürümlerinde nftables tabanlı yaklaşım da önemli hâle gelmiştir. Bunun yanında bazı CNI çözümleri kube-proxy yerine eBPF tabanlı servis veri yolu sağlayabilir.
kube-proxy Nedir?
kube-proxy her node üzerinde Service ve endpoint değişikliklerini takip ederek gerekli ağ kurallarını yönetebilir. Amacı uygulama trafiğini user space üzerinden sürekli proxy'lemek değildir. Linux çekirdeğindeki ağ mekanizmalarını kullanarak paketlerin uygun backend'e yönlenmesini sağlar. Bu nedenle performans karakteristiği seçilen moda göre değişebilir. Troubleshooting sırasında hangi kube-proxy modunun kullanıldığını bilmek önemlidir.
iptables Modu
iptables modu uzun yıllardır Kubernetes Service veri yolunda yaygın kullanılmıştır. Service ve endpoint sayısı arttıkça çok sayıda kural oluşabilir. Küçük ve orta ölçekli cluster'larda bu yaklaşım uzun süre yeterli olmuştur. Ancak büyük cluster'larda rule update maliyeti ve ölçek davranışı değerlendirilmelidir. Yeni sürümlerde alternatif veri yolları bu nedenle daha fazla ilgi görmektedir.
IPVS Modu
IPVS modu Linux Virtual Server mekanizmasını kullanır. Büyük endpoint kümelerinde daha farklı performans özellikleri sunabilir. Ancak Kubernetes sürümü ve proje yönlendirmesi doğrultusunda kullanılan modun destek durumu ayrıca kontrol edilmelidir. Mevcut production cluster'ını yalnızca teorik benchmark nedeniyle değiştirmek doğru yaklaşım değildir. Gerçek trafik profili ve operasyon ekibinin deneyimi de seçimde rol oynar.
nftables Modu
nftables, Linux paket filtreleme altyapısının daha yeni yaklaşımını kullanır. Kubernetes tarafında Service proxy işlemleri için modern bir seçenek olarak öne çıkmaktadır. Özellikle yüksek Service ve endpoint sayılarında veri yolu ölçeklenebilirliği açısından değerlendirilir. Geçiş kararı verilmeden önce kullanılan Kubernetes sürümünün destek durumu ve node işletim sistemi doğrulanmalıdır. Ağ katmanında değişiklik yaparken load test ve failure test yapılması gerekir.
Büyük Cluster'larda nftables
Büyük cluster'larda ağ kuralı sayısı ciddi seviyelere çıkabilir. Bu noktada rule update süresi, CPU tüketimi ve dataplane gecikmesi önem kazanır. nftables yaklaşımı bu ölçek problemlerine karşı daha uygun mekanizmalar sunabilir. Ancak mimari karar tek bir performans metriğine göre verilmemelidir. CNI, Service sayısı, endpoint churn ve gözlemlenebilirlik ihtiyaçları birlikte değerlendirilmelidir.
kube-proxy'siz eBPF Veri Yolu
Bazı eBPF tabanlı ağ çözümleri Kubernetes Service işlemlerini kube-proxy kullanmadan gerçekleştirebilir. Bu model Service load balancing işlevlerini çekirdek seviyesinde eBPF programlarıyla uygular. Ağ hop sayısını azaltma ve gelişmiş gözlemlenebilirlik gibi avantajlar hedeflenebilir. Fakat geçiş, mevcut network policy ve operasyon araçlarıyla birlikte test edilmelidir. Production cluster'ında dataplane değişikliği kapsamlı doğrulama gerektirir.
eBPF Tabanlı Kubernetes Load Balancing
eBPF, Linux kernel içinde kontrollü programların çalıştırılmasına imkân veren güçlü bir altyapıdır. Kubernetes ağ çözümleri bunu Service load balancing, network policy ve gözlemlenebilirlik için kullanabilir. Özellikle yoğun servis trafiğinde ağ yolunu daha doğrudan hâle getirme potansiyeli bulunur. Bununla birlikte eBPF kullanmak otomatik olarak bütün performans sorunlarını çözmez. Uygulamanın protokolü, bağlantı davranışı ve node kapasitesi yine ölçülmelidir.
eBPF Nedir?
eBPF, kernel içinde doğrulanmış programlar çalıştırılmasına imkân sağlar. Networking, tracing ve security alanlarında yaygın kullanım bulmuştur. Kubernetes dünyasında paketlerin hangi endpoint'e yönleneceği gibi kararlar eBPF tabanlı veri yollarında uygulanabilir. Bu yaklaşım kullanıcı alanında ayrı proxy süreçlerine ihtiyaç duymadan bazı ağ işlemlerini gerçekleştirebilir. Ancak kernel sürümü ve platform desteği mutlaka kontrol edilmelidir.
Cilium Service Load Balancing
Cilium, eBPF kullanarak Kubernetes Service trafiğini yönetebilen açık kaynaklı bir ağ çözümüdür. Service load balancing ve network policy işlevlerini aynı veri yolunda sunabilir. Gözlemlenebilirlik araçları sayesinde flow seviyesinde sorun analizi kolaylaşabilir. Özellikle büyük cluster'larda ağ katmanının görünürlüğü operasyon ekibine ciddi fayda sağlar. Yine de yeni bir CNI seçimi yalnızca tek bir özellik nedeniyle yapılmamalıdır.
kube-proxy Replacement
kube-proxy replacement yaklaşımında Service veri yolu eBPF tabanlı çözüm tarafından ele alınır. Bu model node üzerinde ayrı kube-proxy kural yönetimini ortadan kaldırabilir. Fakat özellik uyumluluğu, DSR seçenekleri ve cloud entegrasyonları deployment öncesinde test edilmelidir. Cluster networking en temel production bileşenlerinden biridir. Bu nedenle geçiş mutlaka aşamalı ve gözlemlenebilir yapılmalıdır.
Network Hop Sayısını Azaltma
Ek network hop'ları latency ve network maliyeti üzerinde etkili olabilir. Özellikle cross-zone trafik çok yüksekse gereksiz yolculuklar cloud faturasında da hissedilebilir. eBPF veri yolları bazı mimarilerde daha doğrudan trafik yolları sunabilir. Ancak gerçek kazancı belirlemek için packet path ve uygulama latency'si birlikte ölçülmelidir. Teorik olarak kısa yol her workload için aynı faydayı sağlamaz.
Gözlemlenebilirlik
Ağ gözlemlenebilirliği Kubernetes troubleshooting süresini ciddi biçimde azaltabilir. Hangi Pod'un hangi Service'e bağlandığını, bağlantının reddedilip reddedilmediğini ve latency'nin nerede oluştuğunu görebilmek değerlidir. Özellikle autoscaling sırasında yeni Pod'ların trafik alıp almadığını doğrulamak kolaylaşır. Ben load test sırasında replica sayısı kadar flow dağılımını da izlemeyi öneririm. Böylece HPA'nın kapasite üretip üretmediğini ve load balancer'ın bu kapasiteyi kullanıp kullanmadığını aynı anda görürsünüz.
Hangi Cluster'larda Mantıklıdır?
eBPF tabanlı veri yolu yüksek trafik, gelişmiş network policy veya güçlü observability ihtiyacı olan cluster'larda değerlendirilebilir. Çok küçük ve basit cluster'larda geçişin operasyon maliyeti elde edilen kazançtan yüksek olabilir. Managed Kubernetes platformunun desteklediği özellikler de karar üzerinde etkilidir. Ekibin Linux networking bilgisi bakım kolaylığını belirler. En iyi seçim teknik yetenek kadar işletim kapasitesiyle de ilgilidir.
Kubernetes'te External Load Balancer Nasıl Çalışır?
External load balancer, cluster dışından gelen trafiği Kubernetes ortamına taşıyan önemli katmandır. `type: LoadBalancer` Service, desteklenen cloud sağlayıcısında load balancer entegrasyonunu tetikleyebilir. Harici veya private ağdan erişim ihtiyacına göre public ve internal seçenekler kullanılabilir. L4 ve L7 davranışları birbirinden ayrılmalıdır. HTTP route, TLS ve host tabanlı kurallar gerekiyorsa Gateway veya Ingress gibi L7 bileşenleri genellikle daha uygun kontrol sağlar.
type: LoadBalancer
Service üzerinde `type: LoadBalancer` tanımlandığında altyapı entegrasyonu bir load balancer oluşturabilir. Service'in durumu dış IP veya hostname bilgisini içerebilir. Backend'e trafik taşıma biçimi sağlayıcı ve implementasyona göre değişebilir. externalTrafficPolicy gibi seçenekler client IP preservation ve trafik yolu üzerinde etkili olabilir. Bu yüzden yalnızca Service manifestine bakmak yerine cloud tarafındaki health check ayarları da izlenmelidir.
Cloud Controller
Cloud controller, Kubernetes kaynakları ile cloud altyapısı arasında entegrasyon sağlar. Load balancer oluşturma veya güncelleme işlemleri bu katman üzerinden yürütülebilir. Service silindiğinde ilişkili cloud kaynağının yaşam döngüsü de yönetilebilir. Eğer cloud controller hatalı çalışıyorsa Service uzun süre external IP bekleyebilir. Troubleshooting sırasında Kubernetes event kayıtları ilk bakılacak yerlerden biridir.
Public Load Balancer
Public load balancer internete açık uygulamalar için kullanılabilir. Güvenlik grupları, firewall kuralları ve TLS politikaları bu noktada önemlidir. Her servisi ayrı public load balancer ile açmak maliyet ve yönetim yükü oluşturabilir. Birçok HTTP servisini tek Gateway arkasında toplamak bazı mimarilerde daha verimli olabilir. Yine de güvenlik izolasyonu gereken sistemlerde ayrı giriş noktaları mantıklı olabilir.
Internal Load Balancer
Internal load balancer yalnızca private ağdan erişilmesi gereken servisler için kullanılır. Kurumsal uygulamalarda veritabanı proxy'si, iç API Gateway veya platform servisi gibi bileşenlerde tercih edilebilir. Public IP gerektirmediği için saldırı yüzeyini azaltmaya yardımcı olur. Ancak private DNS ve network routing doğru yapılandırılmalıdır. Multi-VPC veya hibrit ağlarda erişim rotaları ayrıca test edilmelidir.
L4 Load Balancer
L4 load balancer TCP ve UDP gibi taşıma katmanı bilgilerine göre bağlantı yönlendirir. HTTP path veya header içeriğini anlaması gerekmez. Veritabanı protokolleri, raw TCP servisleri veya bazı yüksek performanslı giriş senaryolarında uygundur. Connection-level dağılım uzun bağlantılarda backend yükünü dengesiz bırakabilir. Bu yüzden L4 autoscaling tasarımında aktif bağlantı sayısı iyi bir metric olabilir.
L7 Load Balancer
L7 load balancer HTTP veya gRPC gibi uygulama protokollerini anlayabilir. Host, path, header veya method gibi bilgilere göre trafik yönlendirebilir. Canary ve weighted routing gibi deployment desenleri bu katmanda daha kolay uygulanır. TLS termination da sık karşılaşılan işlevlerden biridir. Gateway API bu tür trafik politikalarını Kubernetes kaynaklarıyla tanımlamak için güçlü bir model sağlar.
L4 ve L7 Yük Dengeleme Arasındaki Fark
L4 ve L7 ayrımı, yük dengeleyicinin trafik hakkında ne kadar bilgiyle karar verdiğini açıklar. L4 yaklaşımı bağlantı ve port seviyesinde çalışırken L7 HTTP veya benzeri protokol içeriğini anlayabilir. Basit TCP yönlendirmesi için L7 özelliklerine ihtiyaç duymayabilirsiniz. Buna karşılık host, path, header veya gRPC method routing gerekiyorsa L7 kontrolü önem kazanır. Autoscaling metric seçiminde de protokol katmanı önemli ipuçları verir.
TCP/UDP Tabanlı L4
L4 load balancing TCP veya UDP bağlantı özelliklerini kullanır. Paket içindeki HTTP path bilgisine göre karar vermez. Bu nedenle genel amaçlı ve protokolden bağımsız davranabilir. Uzun TCP bağlantıları backend yükünün zaman içinde eşitsiz kalmasına neden olabilir. Connection count ve connection age bu tür servislerde faydalı gözlem metrikleridir.
HTTP/HTTPS Tabanlı L7
L7 load balancing HTTP request özelliklerini değerlendirebilir. Path, hostname veya header üzerinden backend seçmek mümkündür. API ve web uygulamalarında bu esneklik oldukça değerlidir. Request bazlı metrikler autoscaling açısından da daha anlamlı olabilir. Örneğin RPS ve p95 latency CPU metriğinden daha erken talep sinyali verebilir.
Host-Based Routing
Host-based routing aynı giriş noktasında birden fazla alan adını farklı Service'lere yönlendirebilir. Bu model birçok microservice veya tenant yapısında kullanışlıdır. TLS sertifika yönetimi de hostname ile birlikte planlanmalıdır. Yanlış host kuralı trafiğin beklenmeyen backend'e gitmesine yol açabilir. Route değişikliklerinin deployment pipeline içinde test edilmesi önemlidir.
Path-Based Routing
Path-based routing `/api`, `/admin` veya `/media` gibi URL yollarını farklı backend'lere gönderebilir. Böylece aynı domain altında farklı servisler çalıştırılabilir. Ancak path rewrite davranışları controller veya Gateway implementasyonuna göre değişebilir. Uygulamanın base path beklentisi dikkate alınmalıdır. Canary rollout sırasında belirli path'leri yeni sürüme yönlendirmek de mümkündür.
TLS Termination
TLS termination HTTPS bağlantısının belirli giriş katmanında sonlandırılmasını ifade eder. Sertifika yönetimi merkezi hâle getirilebilir. İç ağda yeniden TLS kullanılıp kullanılmayacağı güvenlik gereksinimlerine bağlıdır. mTLS gereken sistemlerde backend bağlantılarının da kimlik doğrulamalı olması gerekebilir. Sertifika yenileme süreci gözlemlenebilir ve otomatik olmalıdır.
Kullanım Senaryosuna Göre Seçim
Basit TCP servisleri için L4 yeterli olabilir. HTTP route ve rollout kontrolü gerekiyorsa L7 daha uygun seçimdir. Çok yüksek bağlantı sayılı servislerde load balancer'ın connection dağılımı ayrıca test edilmelidir. Güvenlik ve TLS ihtiyaçları da kararın parçasıdır. En doğru mimari, protokolü ve operasyon gereksinimini en az ek katmanla karşılayan tasarımdır.
Ingress Nedir?
Ingress, Kubernetes içinde HTTP ve HTTPS trafiğini Service'lere yönlendirmek için kullanılan API kaynaklarından biridir. Ingress kaynağı tek başına trafiği işlemez, bunu uygulayan bir Ingress Controller gerekir. Host ve path routing, TLS termination ve name-based virtual hosting gibi yetenekler sunabilir. Kubernetes projesi Ingress API'yi korumaya devam etse de yeni özellik geliştirmesi açısından API dondurulmuştur. Bu nedenle yeni platform tasarımında Gateway API'yi de değerlendirmek gerekir.
Ingress Resource
Ingress Resource istenen HTTP routing kurallarını deklaratif olarak tanımlar. Hangi hostname veya path'in hangi Service'e gideceği burada belirtilebilir. Kaynak oluşturulduğunda uyumlu controller bu tanımı gerçek proxy veya load balancer yapılandırmasına dönüştürür. Bu ayrım, API ile dataplane'in farklı şeyler olduğunu anlamak açısından önemlidir. Sorun giderirken hem Ingress nesnesi hem controller durumu kontrol edilmelidir.
Ingress Controller
Ingress Controller Ingress kaynaklarını izleyen ve gerçek trafik işleme davranışını uygulayan bileşendir. Kubernetes cluster'ına Ingress kaynağı eklemek tek başına yeterli değildir. En az bir uyumlu controller bulunmalıdır. Controller'ın annotation ve özellik desteği implementasyona göre değişebilir. Bu farklılık portability sorunlarının önemli nedenlerinden biridir.
Host-Based Routing
Ingress ile hostname'e göre backend seçilebilir. Örneğin farklı subdomain'ler farklı Service'lere yönlendirilebilir. Bu yaklaşım tek giriş IP'si altında çok sayıda uygulamayı barındırmayı kolaylaştırır. DNS kayıtları doğru giriş adresine işaret etmelidir. TLS sertifikalarının hostname kapsamı da kontrol edilmelidir.
Path-Based Routing
Path-based routing aynı hostname altında farklı URL yollarını farklı servislerle eşleştirebilir. API gateway benzeri temel kullanım senaryolarında işe yarar. Ancak rewrite, header modification veya gelişmiş traffic splitting özellikleri çoğu zaman controller'a özel ayarlar gerektirebilir. Bu durum standart Kubernetes kaynağının taşınabilirliğini azaltabilir. Gateway API'nin geliştirilme nedenlerinden biri daha ifade gücü yüksek standart trafik modeli sunmaktır.
TLS Termination
Ingress yaygın olarak TLS termination için kullanılır. Sertifika Secret kaynağıyla ilişkilendirilebilir. Controller gelen HTTPS bağlantısını sonlandırıp backend Service'e trafik iletebilir. Backend tarafında yeniden TLS kullanımı ayrı bir mimari karardır. Sertifika yenileme işlemlerinin otomatik ve gözlemlenebilir olması gerekir.
Ingress'in Sınırlamaları
Ingress API temel HTTP routing ihtiyaçlarını karşılar ancak gelişmiş trafik politikalarının önemli kısmı yıllar boyunca controller'a özel annotation'larla uygulanmıştır. Bu durum farklı controller'lar arasında yapılandırma taşımayı zorlaştırabilir. Rol ayrımı ve cross-namespace delegasyon da Gateway API kadar güçlü değildir. TCP ve UDP için standart Ingress modeli yeterli değildir. Yeni projelerde bu nedenlerle Gateway API değerlendirmesi giderek daha anlamlı hâle gelmektedir.
Gateway API Nedir?
Gateway API, Kubernetes ağ trafiğini yönetmek için daha ifade gücü yüksek ve rol tabanlı kaynaklar sunar. GatewayClass altyapı sağlayıcısını, Gateway trafik giriş noktasını ve Route kaynakları uygulama yönlendirmesini tanımlayabilir. HTTPRoute ve GRPCRoute gibi kaynaklar protokole özgü kontrol sağlar. BackendRefs üzerinden Service gibi backend kaynakları hedeflenebilir. Platform ekibi ile uygulama ekiplerinin sorumluluklarını ayırması Gateway API'nin önemli faydalarından biridir.
GatewayClass
GatewayClass, belirli Gateway kaynaklarını hangi controller veya altyapı uygulamasının yöneteceğini ifade eder. Cluster seviyesinde platform yöneticileri tarafından tanımlanması yaygındır. Aynı cluster içinde farklı trafik altyapıları için farklı GatewayClass kaynakları bulunabilir. Uygulama ekipleri doğrudan altyapı controller ayrıntısını bilmeden uygun sınıfı kullanabilir. Bu rol ayrımı kurumsal platformlarda yönetimi kolaylaştırır.
Gateway
Gateway, listener ve trafik kabul noktalarını tanımlar. Port, protocol, TLS ve Route kabul politikaları burada belirtilebilir. Platform ekibi güvenli bir shared Gateway oluşturup uygulama ekiplerinin Route eklemesine izin verebilir. Bu yapı Ingress'teki tek kaynak modelinden daha net sorumluluk ayrımı sunar. Multi-tenant cluster'larda bu özellik özellikle değerlidir.
HTTPRoute
HTTPRoute HTTP isteklerinin Gateway'den backend Service'lere nasıl yönlendirileceğini belirtir. Hostname, path, header ve backendRefs gibi alanlar kullanılabilir. Weighted backendRefs ile canary dağılımı kurulabilir. Birden fazla uygulama ekibi kendi Route nesnesini yönetebilir. Bu yapı progressive delivery senaryolarında oldukça kullanışlıdır.
GRPCRoute
GRPCRoute gRPC trafiğini protokole özgü biçimde yönlendirmek için tasarlanmıştır. Service ve method seviyesinde match tanımlamak HTTP path tabanlı yaklaşıma göre daha açık olabilir. gRPC'ye özgü davranışların standartlaştırılmasına yardımcı olur. Uzun bağlantı davranışı yine load balancing tasarımının parçası olmalıdır. gRPC servislerinde yalnızca replica sayısını artırmak yeni Pod'ların trafik almasını garanti etmez.
TCPRoute
TCPRoute TCP tabanlı trafik için route tanımlamayı amaçlar. HTTP anlamına ihtiyaç duymayan protokoller için uygundur. Veritabanı proxy'leri veya özel TCP servisleri buna örnek olabilir. Implementasyon desteği seçilen Gateway controller'a göre kontrol edilmelidir. Standard veya experimental channel durumu üretim kararı öncesinde doğrulanmalıdır.
UDPRoute
UDPRoute UDP trafiğini Gateway üzerinden backend'lere yönlendirmek için kullanılabilir. DNS veya özel UDP protokolleri gibi kullanım senaryoları düşünülebilir. UDP bağlantısız yapıda olduğu için load balancing davranışı TCP'den farklıdır. Sağlık kontrolü ve session davranışı implementasyona göre değerlendirilmelidir. Production kullanımı öncesinde controller desteği açık şekilde doğrulanmalıdır.
BackendRefs
BackendRefs bir Route kuralının trafiği hangi backend kaynaklarına göndereceğini belirtir. Genellikle Kubernetes Service kaynakları hedeflenir. Weight alanı kullanıldığında trafik oranları göreli ağırlıklarla bölünebilir. Bu mekanizma canary veya blue-green rollout için güçlü bir temel sağlar. Backend'in gerçekten yeterli replica kapasitesine sahip olup olmadığı autoscaling tarafında ayrıca yönetilmelidir.
Gateway API'nin Rol Tabanlı Tasarımı
Gateway API farklı sorumlulukları altyapı yöneticisi, cluster operatörü ve uygulama geliştiricisi arasında ayırmaya uygun tasarlanmıştır. Platform ekibi GatewayClass ve Gateway üzerinde kontrol sağlayabilir. Uygulama ekipleri izin verilen namespace ve listener kapsamlarında kendi Route nesnelerini yönetebilir. Bu model büyük organizasyonlarda değişiklik yetkilerini daha sağlıklı bölmeye yardımcı olur. Cross-namespace kullanımda ReferenceGrant gibi güvenlik mekanizmaları da dikkate alınmalıdır.
Ingress mi Gateway API mi?
Ingress hâlen kullanılabilir ve mevcut sistemlerde çalışmaya devam eder. Ancak Kubernetes projesi Ingress API'yi dondurmuş ve yeni ihtiyaçlar için Gateway kullanımını önermektedir. Gateway API daha geniş protokol desteği, rol ayrımı ve trafik politikası sunmayı hedefler. Yeni bir platform kuruyorsanız controller desteği yeterliyse Gateway API güçlü bir tercih olabilir. Mevcut Ingress ortamını yalnızca yeni olduğu için hemen taşımak yerine gerçek ihtiyaç ve migration maliyeti değerlendirilmelidir.
API Geliştirme Durumu
Ingress API kararlı durumdadır ancak yeni özellik geliştirmesi yapılmamaktadır. Gateway API ise aktif şekilde geliştirilen modern trafik modelidir. Bazı Gateway API özellikleri Standard Channel içinde kararlı olabilirken diğerleri deneysel durumda bulunabilir. Bu nedenle tek bir genel sürüm etiketi yerine kullanılacak Route ve özelliğin durumuna bakılmalıdır. Production kararında controller implementasyon desteği de aynı derecede önemlidir.
Portability
Ingress dünyasında gelişmiş özellikler çoğu zaman controller'a özel annotation gerektirir. Bu da bir controller'dan diğerine geçişi zorlaştırabilir. Gateway API daha fazla davranışı standart kaynak ve alanlarla ifade etmeyi amaçlar. Yine de her implementasyon bütün özellikleri aynı anda desteklemeyebilir. Portability beklentisi compatibility matrix üzerinden test edilmelidir.
Traffic Splitting
Gateway API HTTPRoute backendRefs ağırlıklarıyla standart traffic splitting tanımı sunabilir. Örneğin eski sürüme 90 ve yeni sürüme 10 ağırlık verilebilir. Bu yaklaşım canary rollout'un ağ tarafını deklaratif hâle getirir. Ancak uygulama kapasitesi ve HPA değerleri iki backend için ayrı değerlendirilmelidir. Canary backend iki replica ile çalışıyorsa yüzde 10 trafik bile yoğun bir workload için fazla olabilir.
Cross-Namespace Routing
Gateway API farklı namespace'lerdeki ekiplerin ortak Gateway altyapısını kullanmasını destekleyen daha kontrollü bir model sunar. Route kabul politikaları ve ReferenceGrant güvenlik sınırlarını belirlemeye yardımcı olur. Bu özellik shared platform tasarımında oldukça değerlidir. Her namespace'in kendi load balancer'ını oluşturması gerekmeyebilir. Yine de tenant izolasyonu açık kurallarla tanımlanmalıdır.
HTTP ve gRPC
HTTPRoute HTTP trafiği için ana kaynaktır. GRPCRoute ise gRPC servis ve method eşleştirmesini daha açık ifade edebilir. Bu ayrım protokol özelindeki routing ve gözlemlenebilirlik ihtiyaçlarını daha iyi yansıtır. gRPC uzun bağlantıları autoscaling sırasında ayrıca ele alınmalıdır. Yeni replica oluşturulduğunda mevcut bağlantılar otomatik olarak dağılmayabilir.
TCP ve UDP
Gateway API HTTP dışındaki trafik türleri için de Route modelleri sunar. TCPRoute ve UDPRoute bu ihtiyaca yöneliktir. Ancak kullanılan controller'ın bu kaynakları destekleyip desteklemediği doğrulanmalıdır. Deneysel özelliklerin production kararı ayrıca risk değerlendirmesi gerektirir. Sırf API kaynağı var diye her implementasyonda çalışacağı varsayılmamalıdır.
Yeni Projelerde Hangisi Tercih Edilmeli?
Yeni projelerde Gateway API güçlü bir varsayılan adaydır. Özellikle shared Gateway, gRPC, weighted routing veya rol ayrımı gerekiyorsa avantajı belirginleşir. Basit bir sistemde mevcut Ingress ekosistemi ve operasyon deneyimi hâlâ önemli olabilir. Kararı ekip bilgisi, controller desteği ve migration stratejisiyle birlikte vermek gerekir. Ben yeni platformlarda önce Gateway API desteğini doğrulayıp uygun ise onu temel almayı tercih ederim.
Gateway API ile Weighted Load Balancing
Gateway API backend ağırlıkları, trafiği birden fazla Service arasında kontrollü biçimde bölmeye imkân verir. Ağırlıklar yüzde olmak zorunda değildir, birbirlerine göre oran ifade eder. Örneğin 90 ve 10 toplamda yüzde 90 ile yüzde 10 dağılımına karşılık gelir. Bu özellik rollout sürecinde yeni sürümü küçük trafikle test etmek için çok kullanışlıdır. Autoscaling politikası her backend sürümü için trafik payına uygun kapasite sağlayabilmelidir.
Backend Weight
`backendRefs` içindeki `weight` alanı backend'lerin göreli trafik payını belirler. İki backend'in ağırlıkları 9 ve 1 ise sonuç 90 ve 10 ile aynı orandır. Bu davranış rollout araçlarının trafik yüzdesini kontrollü değiştirmesine imkân verir. Weight sıfır olduğunda backend trafik almayan durumda tutulabilir. Deployment tamamlandığında eski backend daha sonra kaldırılabilir.
90/10 Trafik Dağılımı
90/10 dağılımı canary rollout için sık kullanılan bir örnektir. Mevcut sürüm trafiğin çoğunu taşırken yeni sürüm küçük bir gerçek kullanıcı trafiği alır. Error rate ve latency değerleri karşılaştırılır. Yeni sürüm sağlıklı ise ağırlık adım adım artırılabilir. Yeni backend'in replica sayısı düşükse 10 yüzde trafiğin gerçek RPS karşılığı mutlaka hesaplanmalıdır.
Canary Deployment
Canary deployment yeni sürümü bütün kullanıcılara açmadan önce sınırlı trafikle doğrulamaya yardımcı olur. Weighted routing bu stratejinin ağ tarafını sağlar. Uygulama metriği, error rate ve business KPI birlikte izlenmelidir. Autoscaling sistemi yeni canary sürümünü ayrı hedef olarak ölçekleyebilmelidir. Aksi durumda sorun kodda değil kapasite yetersizliğinde olduğu hâlde rollout başarısız görünebilir.
Blue-Green Deployment
Blue-green modelinde iki ayrı uygulama ortamı veya backend sürümü hazır tutulabilir. Trafik bir sürümden diğerine kontrollü biçimde geçirilebilir. Gateway ağırlıkları geçişi kademeli yapma imkânı sunabilir. Geri dönüş gerektiğinde trafik eski backend'e hızla yönlendirilebilir. Ancak iki ortamı aynı anda hazır tutmak geçici olarak daha yüksek kaynak tüketir.
Progressive Delivery
Progressive delivery deployment ile trafik yönetimini ölçülebilir adımlara böler. Yeni sürüm önce küçük trafik alır, metrikler sağlıklıysa pay artırılır. HPA veya KEDA her aşamada gerçek talebi karşılayacak kapasite oluşturmalıdır. SLO ihlali görüldüğünde rollout geri çevrilebilir. Bu yaklaşım release riskini azaltırken observability gereksinimini artırır.
Session Affinity Nedir?
Session affinity belirli bir istemcinin isteklerini aynı backend Pod'a yönlendirme isteğini ifade eder. Stateless uygulamalarda çoğu zaman buna ihtiyaç duyulmaz. Ancak uygulama session durumunu yalnızca Pod belleğinde tutuyorsa sticky session gereksinimi ortaya çıkabilir. Bu tasarım autoscaling verimliliğini azaltabilir çünkü yeni Pod'ların mevcut kullanıcı trafiğinden pay alması zorlaşır. Mümkünse session verisini harici ve paylaşılan bir store'a taşımak daha esnek ölçekleme sağlar.
Stateless Uygulamalarda Varsayılan Yaklaşım
Stateless servisler request'leri herhangi bir replica üzerinde işleyebildiği için load balancing açısından daha esnektir. Yeni Pod oluşturulduğunda mevcut kullanıcılar özel bir taşıma sürecine ihtiyaç duymadan yeni Pod'a yönlendirilebilir. HPA bu modelde daha verimli çalışır. Pod silinmesi de uygulama session kaybına neden olmaz. Kubernetes yatay ölçekleme için stateless tasarım bu yüzden güçlü bir temeldir.
ClientIP Session Affinity
Kubernetes Service üzerinde ClientIP session affinity belirli istemci IP'sini aynı backend'e yönlendirmek için kullanılabilir. NAT arkasındaki çok sayıda kullanıcı tek client IP gibi görülebilir. Bu durumda bir Pod beklenenden fazla trafik alabilir. HPA ortalama CPU'ya bakıyorsa hotspot oluşumu gözden kaçabilir. ClientIP kullanmadan önce gerçek istemci ağ yapısı anlaşılmalıdır.
Sticky Session
Sticky session L7 proxy seviyesinde cookie veya başka session mekanizmasıyla uygulanabilir. Kullanıcı deneyimini korumak için bazı legacy uygulamalarda gerekli olabilir. Ancak replica dağılımını zamanla dengesiz hâle getirebilir. Yeni Pod'lar sisteme eklense bile eski kullanıcılar eski Pod'lara bağlı kalabilir. Bu nedenle sticky session süreleri ve rebalance davranışı izlenmelidir.
Session Affinity Autoscaling'i Nasıl Etkiler?
Autoscaling yeni replica oluşturduğunda amaç yükün bu kapasiteye yayılmasıdır. Session affinity mevcut trafiği eski Pod'lara sabitlerse bu yayılım gerçekleşmeyebilir. HPA replica artırmaya devam ederken bazı eski Pod'lar hâlâ aşırı yük altında kalabilir. Bu durum ortalama metric ile Pod bazlı maksimum metric arasındaki farkı büyütür. Troubleshooting sırasında replica sayısının yanında Pod başına request dağılımı kontrol edilmelidir.
Stateful Session'ları Harici Store'a Taşımak
Session bilgisini harici paylaşılan store'da tutmak uygulama replica'larını daha stateless hâle getirebilir. Böylece her Pod aynı kullanıcı isteğini işleyebilir. Rolling deployment ve HPA daha rahat çalışır. Harici store yeni bir bağımlılık olduğundan latency ve availability gereksinimleri ayrıca tasarlanmalıdır. Doğru uygulandığında session affinity ihtiyacını önemli ölçüde azaltabilir.
externalTrafficPolicy Nedir?
`externalTrafficPolicy`, dış kaynaklı Service trafiğinin node'lar arasında nasıl yönlendirileceğini etkileyen ayarlardan biridir. `Cluster` daha geniş endpoint kümesini kullanabilirken `Local` yalnızca trafiğin geldiği node üzerindeki uygun endpoint'leri hedeflemeyi amaçlar. Local yaklaşımı client IP preservation veya ek hop azaltımı için tercih edilebilir. Ancak her node üzerinde yeterli Pod yoksa yük dağılımı dengesizleşebilir. HPA ile birlikte kullanırken Pod placement stratejisi mutlaka hesaba katılmalıdır.
Cluster
`Cluster` politikası node üzerindeki yerel Pod'larla sınırlı kalmaz. Trafik cluster içindeki uygun backend endpoint'lere aktarılabilir. Bu, Pod dağılımının eşit olmadığı ortamlarda daha iyi yük paylaşımı sağlayabilir. Buna karşılık ekstra node hop oluşabilir. Client IP'nin nasıl görüleceği kullanılan altyapıya göre ayrıca incelenmelidir.
Local
`Local` yalnızca giriş yapılan node üzerindeki uygun endpoint'leri kullanmayı hedefler. Ek cross-node hop azaltılabilir. Source IP korunması gereken bazı mimarilerde avantaj sağlar. Ancak node üzerindeki Pod sayısı azsa o node'a gelen load balancer trafiği az sayıda Pod üzerinde yoğunlaşabilir. HPA genel replica sayısını artırsa bile Pod'lar başka node'lara yerleşirse sorun devam edebilir.
Client IP Preservation
Gerçek client IP güvenlik logları, rate limiting veya uygulama analitiği için önemli olabilir. External traffic policy seçimi source IP'nin korunması üzerinde etkili olabilir. Ancak cloud load balancer'ın davranışı da bu zincirin parçasıdır. Uygulama yalnızca `X-Forwarded-For` veya proxy protocol gibi mekanizmalara güveniyorsa giriş proxy'sinin doğru yapılandırılması gerekir. IP bilgisini güvenlik kararı için kullanmadan önce spoofing riskleri değerlendirilmelidir.
Ek Network Hop
Trafik node'a geldikten sonra başka node'daki Pod'a iletilirse ek network hop oluşabilir. Bu ekstra latency genellikle küçük görünse de yüksek hacimde network maliyetini artırabilir. Cross-zone hop varsa cloud faturası daha da etkilenebilir. Local politika bu yolu kısaltabilir. Fakat yük dengesizliği riskiyle birlikte değerlendirilmelidir.
Load Imbalance Riski
Load balancer node'lara trafik dağıtırken her node'da eşit sayıda Pod olmayabilir. Local policy kullanıldığında bu dengesizlik doğrudan Pod yüküne yansıyabilir. Örneğin bir node'da bir Pod, başka node'da dört Pod varsa node başına eşit trafik Pod başına eşit trafik değildir. HPA ortalama metric kullandığında bir Pod aşırı yüklenirken cluster geneli normal görünebilir. Topology spread ve Pod başına metric izleme burada önem kazanır.
HPA ile Etkileşimi
HPA replica sayısını artırdığında scheduler yeni Pod'ları uygun node'lara yerleştirir. External traffic policy Local ise yeni replica'nın faydalı olabilmesi için trafik alan node'lara dengeli dağılması önemlidir. Pod topology spread constraints bu konuda yardımcı olabilir. Node sayısı da değişiyorsa load balancer target listesi ve health check durumu izlenmelidir. Scale-up sonrası trafiğin gerçekten yeni replica'lara ulaştığı load test ile doğrulanmalıdır.
internalTrafficPolicy Nedir?
`internalTrafficPolicy`, cluster içindeki trafiğin yalnızca node-local endpoint'lerle sınırlandırılıp sınırlandırılmayacağını belirleyebilir. `Cluster` varsayılan geniş backend yaklaşımını kullanırken `Local` yalnızca aynı node üzerindeki endpoint'leri tercih değil, zorunlu hedef olarak ele alır. Bu nedenle Local seçildiğinde o node'da endpoint yoksa Service erişilemez görünebilir. Düşük latency veya network maliyeti için faydalı olabilir. Ancak autoscaling ve Pod placement birlikte planlanmalıdır.
Cluster
Cluster politikası iç trafiğin cluster genelindeki uygun endpoint'lere ulaşmasına izin verir. Bu seçenek availability açısından daha rahat olabilir. Pod'un bulunduğu node üzerinde backend olmasa bile başka node'daki Service Pod'una trafik gidebilir. Bunun bedeli ek network yolu olabilir. Çoğu genel amaçlı servis için güvenli başlangıç yaklaşımıdır.
Local
Local policy iç trafik için yalnızca aynı node'daki endpoint'leri kullanır. Node-local cache veya proxy gibi bileşenlerde çok faydalıdır. Ancak Service'in her node'da Pod çalıştırmadığı bir durumda bazı istemciler hiç endpoint bulamayabilir. Bu davranış soft preference değildir. Bu nedenle Deployment replica sayısı ve topology yaklaşımı doğru tasarlanmalıdır.
Node-Local Trafik
Node-local trafik ağ yolunu kısaltabilir. Özellikle yüksek hacimli sidecar, cache veya telemetry servislerinde latency ve network kullanımı azalabilir. DaemonSet tabanlı servisler bu modele uygun olabilir. Ancak her node üzerinde gerçekten sağlıklı endpoint bulunması gerekir. Autoscaling ile replica azaltılırken bu garanti bozulmamalıdır.
Latency ve Network Maliyeti
Node dışına çıkmayan trafik teorik olarak daha kısa yol izler. Bu bazı workload'larda latency avantajı sağlar. Cross-zone transferin engellenmesi cloud network maliyetini de azaltabilir. Ancak maliyet kazancı için availability'den vazgeçmek doğru değildir. Gerçek network kullanımını ölçerek karar vermek gerekir.
Local Endpoint Bulunmadığında Ne Olur?
`internalTrafficPolicy: Local` kullanıldığında node üzerinde uygun endpoint yoksa Service o istemci açısından endpoint yokmuş gibi davranabilir. Cluster'ın başka node'larında sağlıklı Pod bulunması bunu değiştirmez. Bu nedenle beklenmeyen connection failure görülebilir. Topology ve replica sayısı bu politikanın ön koşuludur. Local ayarını yalnızca latency optimizasyonu olarak görmek bu yüzden risklidir.
Kubernetes trafficDistribution Nedir?
`trafficDistribution`, Service trafiğinin topolojik olarak yakın endpoint'lere yönelmesi için tercih belirtmeye yarayan mekanizmadır. Bu yaklaşım `internalTrafficPolicy: Local` gibi katı bir zorunluluktan farklıdır. Kubernetes'in güncel Service davranışında `PreferSameZone` ve `PreferSameNode` gibi seçenekler kullanılabilir. Amaç latency ve cross-zone network maliyetini azaltırken uygun endpoint yoksa daha geniş backend kümesine düşebilmektir. Multi-zone cluster'larda autoscaling tasarımına topology boyutu eklediği için dikkatle izlenmelidir.
Trafik Tercihi ve Zorunlu Trafik Politikası Farkı
Traffic policy belirli endpoint kümesini zorunlu şekilde sınırlandırabilir. Traffic distribution ise mümkün olduğunda belirli topology konumunu tercih eder. Bu ayrım availability açısından önemlidir. PreferSameZone kullanıldığında aynı zone endpoint yoksa diğer zone'lara yönelme mümkün olabilir. Local policy'de ise uygun yerel endpoint bulunmaması erişimi engelleyebilir.
PreferSameZone
`PreferSameZone` trafiğin istemci ile aynı availability zone içindeki endpoint'lere yönelmesini tercih eder. Multi-AZ cluster'larda cross-zone network kullanımını azaltabilir. Bunun için Pod'ların zone'lara yeterince dengeli dağılması gerekir. HPA replica sayısını artırdığında yeni Pod'ların tek zone'da toplanması bu faydayı azaltabilir. Topology spread constraints ile birlikte düşünmek mantıklıdır.
PreferSameNode
`PreferSameNode` mümkün olduğunda aynı node üzerindeki endpoint'i tercih eder. Node-local proxy veya cache benzeri workload'larda faydalı olabilir. Zorunlu Local politikasından farklı olarak fallback imkânı sunması availability açısından avantaj sağlayabilir. Ancak kullanılan Kubernetes sürümü ve feature desteği production öncesinde doğrulanmalıdır. Node bazlı trafik hotspot'u oluşup oluşmadığı da izlenmelidir.
Cross-Zone Trafik Azaltma
Cross-zone trafik bazı cloud platformlarında ek maliyet oluşturabilir. Ayrıca fiziksel ağ yolunun uzaması latency üzerinde küçük de olsa etki yaratabilir. Zone-local tercih bu trafiği azaltmaya yardımcı olur. Fakat Pod kapasitesinin her zone'da talebi karşılaması gerekir. HPA yalnızca cluster ortalamasını izliyorsa zone bazlı hotspot görünmeyebilir.
Latency ve Cloud Maliyeti
Topology-aware trafik yönetimi performans ile maliyeti aynı anda iyileştirebilir. Ancak kazanç workload'a göre değişir. Çok düşük RPS sisteminde optimizasyonun ekonomik karşılığı sınırlı olabilir. Çok yüksek east-west trafikte ise network transferi önemli maliyet kalemi hâline gelebilir. Bulut maliyetleri için daha geniş bir yaklaşımı https://www.diyarbakiryazilim.com.tr/posts/bulut-maliyet-yonetimi-ve-finops-stratejileri adresindeki içerikle birlikte değerlendirebilirsiniz.
Topology-Aware Routing
Topology-aware routing, trafiği node veya availability zone yakınlığına göre daha verimli yönlendirmeyi amaçlar. EndpointSlice topology bilgisi ve Service trafik tercihleri bu yaklaşımın parçaları olabilir. Multi-zone cluster'larda özellikle cross-zone network maliyeti nedeniyle önem kazanır. Ancak her zone'daki Pod kapasitesi birbirinden çok farklıysa yakınlık tercihi hotspot oluşturabilir. Bu yüzden topology routing ile HPA ve scheduler kararları birlikte gözlemlenmelidir.
Availability Zone Bilgisi
Kubernetes node label'ları node'un hangi topology zone'unda olduğunu gösterebilir. Scheduler bu bilgiyi Pod dağılımı için kullanabilir. Network routing çözümleri de endpoint konumunu değerlendirebilir. Multi-AZ tasarımda yalnızca node sayısının değil, zone başına hazır Pod sayısının izlenmesi gerekir. Bir zone kapasite kaybettiğinde kalan zone'ların yükü taşıyabilmesi önemlidir.
EndpointSlice Hints
EndpointSlice hints, endpoint'lerin belirli zone'lardaki istemciler için tercih edilmesine yardımcı olabilecek bilgileri taşır. Bu mekanizma topology-aware routing davranışlarında kullanılabilir. Control plane endpoint dağılımına göre hint oluşturabilir. Ancak exact davranış Kubernetes sürümüne göre kontrol edilmelidir. Yeni trafficDistribution seçenekleriyle birlikte kullanılan modelin güncel dokümantasyonu takip edilmelidir.
Same-Zone Routing
Same-zone routing istemcinin bulunduğu zone'daki backend'i tercih ederek network yolunu kısaltabilir. Çok yüksek servis içi trafik bulunan uygulamalarda anlamlı maliyet avantajı oluşabilir. Bunun için her zone'da yeterli replica bulunmalıdır. Bir zone'daki replica sayısı aniden azalırsa fallback davranışı availability için kritik hâle gelir. Load test'i zone failure senaryosuyla birlikte yapmak faydalıdır.
Multi-Zone Cluster
Multi-zone cluster tek availability zone arızasına karşı dayanıklılığı artırabilir. Pod anti-affinity veya topology spread ile replica'lar zone'lara dağıtılabilir. Node autoscaler da her zone'daki kapasite kısıtlarını dikkate almalıdır. Bir zone'da instance bulunamazsa diğer zone'larda provisioning yapılabilmesi önemli olabilir. Stateful workload'larda disk zone bağımlılığı ayrıca değerlendirilmelidir.
Topology Routing ile HPA'nın Etkileşimi
HPA çoğu zaman cluster genelindeki Pod metriklerinin ortalamasını kullanır. Trafik topology nedeniyle zone bazında eşit dağılmıyorsa ortalama metric lokal hotspot'ları gizleyebilir. Bir zone'daki Pod'lar yüzde 90 CPU'da çalışırken diğer zone yüzde 30 seviyesinde olabilir. Bu durumda ortalama değer beklenenden düşük kalabilir. Zone ve Pod bazlı dashboard'lar bu nedenle yalnızca HPA current metric ekranından daha açıklayıcıdır.
Kubernetes Autoscaling Türleri
Kubernetes ekosisteminde autoscaling tek bir controller'dan oluşmaz. HPA replica sayısını yatay olarak değiştirir. VPA Pod kaynaklarının right-sizing ihtiyacına odaklanır. Cluster Autoscaler veya dinamik node provisioning araçları node kapasitesini ayarlar. KEDA ise event-driven ve external metric tabanlı workload'larda HPA mekanizmasını güçlü biçimde tamamlar.
Horizontal Pod Autoscaler
HPA Deployment veya benzeri ölçeklenebilir workload'un replica sayısını metriklere göre değiştirir. CPU ve bellek gibi resource metric'ler en bilinen kullanım biçimidir. Custom ve external metric desteği daha talep odaklı autoscaling kurmaya imkân verir. `minReplicas` ve `maxReplicas` güvenlik sınırlarıdır. Scaling behavior ise replica değişiminin hızını kontrol eder.
Vertical Pod Autoscaler
VPA uygulamanın CPU ve bellek kullanımını inceleyerek daha uygun resource request değerleri önerebilir. Automatic modda Pod kaynaklarının güncellenmesi restart veya yeniden oluşturma gerektirebilir. HPA ile aynı CPU utilization metriğini kullanmak feedback loop oluşturabilir. Bu nedenle iki autoscaler birlikte kullanılacaksa metric tasarımı dikkatli yapılmalıdır. Recommendation-only yaklaşımı production right-sizing sürecinde iyi başlangıç olabilir.
Cluster Autoscaler
Cluster Autoscaler scheduler'ın yerleştiremediği Pod'lar olduğunda node group kapasitesini artırabilir. Kullanılmayan kapasite oluştuğunda belirli koşullar altında node azaltımı yapabilir. HPA yeni replica istediğinde mevcut node kapasitesi yetmiyorsa Cluster Autoscaler tamamlayıcı rol üstlenir. PodDisruptionBudget ve local storage gibi kısıtlar scale-down kararını etkileyebilir. Bu nedenle node autoscaling workload tanımlarından bağımsız değildir.
Karpenter
Karpenter workload gereksinimine göre dinamik node provisioning yaklaşımı sunar. Önceden tanımlanmış küçük bir instance setine bağlı kalmak yerine daha geniş instance seçeneklerini değerlendirebilir. NodePool benzeri kaynaklarla kapasite politikaları tanımlanabilir. Consolidation, boş veya verimsiz node'ları azaltarak maliyet optimizasyonuna yardımcı olabilir. Cloud provider desteği ve kullanılan sürümün özellikleri production tasarımında doğrulanmalıdır.
KEDA
KEDA event-driven workload'ları harici talep sinyallerine göre ölçeklemek için kullanılır. Queue depth, Kafka lag, Prometheus metric veya cron gibi çok sayıda scaler senaryosu desteklenebilir. ScaledObject tipik olarak mevcut bir Deployment veya StatefulSet'i ölçekler. Scale-to-zero KEDA'nın en dikkat çekici kullanım özelliklerinden biridir. Sıfırdan bire aktivasyonu KEDA yönetirken daha yüksek replica ölçekleri HPA mekanizması üzerinden ilerleyebilir.
Hangi Katmanda Neyi Ölçeklerler?
HPA Pod sayısını değiştirir. VPA Pod'un kaynak boyutunu değiştirir veya bunun için öneri verir. KEDA harici olaylardan Pod autoscaling sinyali üretir. Cluster Autoscaler ve Karpenter node kapasitesini yönetir. Production tasarımında doğru araç, bottleneck'in hangi katmanda olduğuna bakılarak seçilmelidir.
Horizontal Pod Autoscaler (HPA) Nedir?
Horizontal Pod Autoscaler, Kubernetes workload replica sayısını gözlenen metriklere göre otomatik değiştiren controller ve API kaynağıdır. HPA'nın temel amacı mevcut kapasiteyi talebe göre artırmak veya azaltmaktır. Kubernetes HPA ile pod otomatik ölçeklendirme nasıl yapılandırılır sorusunda yalnızca CPU hedefi vermek yeterli değildir. Resource requests, startup süresi, metric kalitesi, min ve max replica değerleri ve scale behavior birlikte ayarlanmalıdır. HPA doğru tasarlandığında kullanıcı talebine hızlı yanıt verirken gereksiz kapasiteyi azaltabilir.
HPA Nasıl Çalışır?
HPA belirli aralıklarla hedef workload'un metric değerlerini toplar. Güncel metric değeri hedef değerle karşılaştırılır. Controller gerekli replica sayısını hesaplayıp workload scale alt kaynağına uygular. Deployment yeni replica'ları oluşturur ve scheduler bunları node'lara yerleştirir. Yeni Pod'lar Ready olduktan sonra Service üzerinden trafik almaya başlar.
Desired Replica Hesabı
HPA'nın temel yaklaşımı mevcut replica sayısını güncel metric değerinin hedef değere oranıyla çarpmaktır. Sonuç yukarı yuvarlanarak desired replica sayısı elde edilir. Örneğin ortalama yük hedefin yaklaşık iki katıysa replica sayısının iki katına çıkması beklenebilir. Controller eksik metric ve Ready olmayan Pod durumlarında daha korumacı hesaplar yapar. Bu nedenle gerçek replica kararı basit formülden küçük farklar gösterebilir.
minReplicas
`minReplicas`, HPA'nın workload'u indirebileceği minimum replica sınırıdır. Kritik API servislerinde sıfıra yaklaşmak yerine warm capacity tutmak çoğu zaman daha güvenlidir. Minimum değer availability zone sayısı ve PDB tasarımıyla birlikte düşünülmelidir. İki zone kullanan kritik bir uygulamada tek replica production dayanıklılığı açısından yetersiz olabilir. Minimum replica maliyet değil SLO kararıdır.
maxReplicas
`maxReplicas`, HPA'nın oluşturabileceği maksimum replica sayısını sınırlar. Bu değer kontrolsüz maliyet artışına karşı güvenlik sağlar. Aynı zamanda backend veritabanı veya başka bağımlılıkların kaldırabileceği bağlantı sayısı dikkate alınmalıdır. Çok yüksek max replica her zaman daha yüksek availability demek değildir. Downstream servis kapasitesi sınırları ölçekleme öncesinde bilinmelidir.
Metrics
HPA resource, custom ve external metric türlerini kullanabilir. CPU ve bellek basit başlangıç noktalarıdır. RPS, queue depth veya latency daha doğrudan talep sinyalleri sağlayabilir. Metric seçerken replica sayısı arttığında metric'in anlamlı biçimde düşüp düşmediği kontrol edilmelidir. Ölçeklemenin etkileyemediği bir metric kötü autoscaling sinyali olabilir.
Scaling Behavior
`behavior` alanı scale-up ve scale-down hızlarını ayrı ayrı yönetmeye imkân verir. Replica sayısının ne kadar hızlı artırılacağı Pods veya Percent politikalarıyla sınırlandırılabilir. Scale-down stabilization window kısa süreli metric düşüşlerinde replica'ların hemen silinmesini önler. Çok agresif scale-down cold start ve tekrar scale-up döngüsü oluşturabilir. Production workload'larında default değerleri olduğu gibi bırakmak yerine load test sonucuna göre ayarlamak daha sağlıklıdır.
Metrics Server Nedir?
Metrics Server Kubernetes resource metric'lerini API üzerinden sunan hafif bir bileşendir. HPA'nın CPU ve bellek utilization tabanlı çalışmasında önemli rol oynar. `kubectl top` komutu da bu resource metric'lerinden yararlanır. Metrics Server tam kapsamlı uzun dönem monitoring sistemi değildir. Historical dashboard, alarm veya ayrıntılı sorgulama için Prometheus benzeri ayrı gözlemlenebilirlik altyapısı gerekir.
CPU Metric
CPU metric Pod veya container'ın tükettiği CPU miktarını temsil eder. HPA utilization tipi kullanıldığında bu değer resource request ile karşılaştırılır. Request tanımlanmamış container'lar hesaplamayı bozabilir. Java veya benzeri uygulamaların başlangıç CPU spike'ları da yanlış scale sinyali oluşturabilir. Startup probe ve doğru initialization süresi bu nedenle önemlidir.
Memory Metric
Memory metric Pod'un bellek tüketimini izlemek için kullanılabilir. Ancak bellek CPU gibi anlık ve kolay geri kazanılan kaynak değildir. Cache büyümesi veya garbage collector davranışı metric'i uzun süre yüksek tutabilir. Memory leak durumunda replica artırmak sorunu çözmek yerine toplam bellek tüketimini büyütebilir. Bellek bazlı autoscaling kullanılırken uygulama memory profili anlaşılmalıdır.
Metrics API
Resource metric'ler `metrics.k8s.io` API üzerinden sunulur. HPA controller bu API'den gerekli ölçümleri alabilir. Custom metric için farklı adapter ve API katmanı gerekir. Metrics API erişilemiyorsa HPA status içinde metric hataları görülebilir. Bu nedenle autoscaling troubleshooting sırasında APIService sağlığı da kontrol edilmelidir.
kubectl top
`kubectl top pod` ve `kubectl top node` hızlı kaynak görünürlüğü sağlar. Bu komutlar production monitoring yerine anlık teşhis aracı olarak görülmelidir. HPA'nın neden scale ettiğini anlamak için faydalı başlangıç noktasıdır. Ancak historical trend veya p95 latency göstermez. Derin analiz için merkezi metrik sistemi gerekir.
Metrics Server Olmadan HPA Çalışır mı?
CPU ve bellek resource metric'lerine dayalı standart HPA için Metrics Server veya aynı API'yi sağlayan uygun bir kaynak gerekir. Custom ve external metric kullanan HPA farklı adapter API'lerinden veri alabilir. Bu nedenle HPA tamamen Metrics Server'a bağlı demek doğru değildir. Fakat resource utilization senaryosunda Metrics Server en yaygın çözümdür. Cluster kurulduktan sonra HPA manifestinden önce metric API erişimi test edilmelidir.
Resource Requests HPA İçin Neden Kritiktir?
HPA CPU veya bellek utilization kullandığında mevcut kullanım resource request değerine göre oranlanır. Bu nedenle yanlış request değeri autoscaling davranışını doğrudan değiştirir. Çok düşük request Pod'u sürekli yüksek utilization gösteriyor gibi gösterebilir. Çok yüksek request ise gerçek yük artsa bile HPA'nın geç tepki vermesine neden olabilir. Kubernetes yük dengeleme ve otomatik ölçekleme tasarımında right-sizing bu yüzden yalnızca scheduler konusu değildir.
CPU Request
CPU request scheduler'a Pod'un beklenen minimum CPU ihtiyacını ifade eder. HPA utilization metriği açısından da denominator görevi görür. Örneğin 100m request tanımlanmış Pod 80m CPU kullanıyorsa yaklaşık yüzde 80 utilization görülür. Aynı workload için request 500m yapılırsa aynı 80m tüketim yalnızca yüzde 16 görünür. Bu fark HPA kararını tamamen değiştirebilir.
Memory Request
Memory request scheduler'ın Pod yerleşiminde kullandığı önemli kaynak değeridir. Memory utilization tabanlı HPA kullanıldığında oran hesaplamasında da etkili olabilir. Çok düşük request node üzerinde overcommit riskini artırabilir. Çok yüksek request ise scheduler'ın Pod'u yerleştirmesini zorlaştırabilir. Pending Pod sayısının artması node autoscaler üzerinde de baskı oluşturur.
Utilization Nasıl Hesaplanır?
Utilization genel olarak mevcut kaynak kullanımının request değerine oranı üzerinden değerlendirilir. HPA hedefi yüzde 70 olduğunda controller ortalama kullanımın bu hedef çevresinde tutulmasını amaçlar. Request değerleri değişirse aynı gerçek trafik altında utilization metriği değişir. Bu nedenle request değişikliği HPA tuning değişikliği gibi ele alınmalıdır. VPA ile HPA aynı resource metric üzerinde çalışırken yaşanan temel sorunlardan biri de budur.
Çok Düşük Request'in Etkisi
Request gereğinden düşük tanımlandığında Pod küçük yükte bile yüksek utilization gösterir. HPA gereksiz replica oluşturabilir. Scheduler Pod'ları node'a daha yoğun yerleştirdiği için node gerçek CPU tüketiminde sıkışabilir. Bu durum maliyet ile performans arasında yanlış sinyaller üretir. Right-sizing yalnızca maliyeti düşürmek için değil, autoscaling doğruluğu için de yapılmalıdır.
Çok Yüksek Request'in Etkisi
Request gereğinden yüksek olduğunda utilization metric düşük görünür. HPA gerçek kullanıcı talebi artsa bile beklenen hızda replica artırmayabilir. Scheduler da gereğinden fazla node kapasitesi rezerve eder. Sonuç olarak hem düşük verim hem zayıf scale tepkisi oluşabilir. Request değerleri gerçek load test ve production metric verisine dayanmalıdır.
Hatalı Right-Sizing'in Autoscaling'e Etkisi
Yanlış right-sizing Pod autoscaling ile node autoscaling arasında domino etkisi oluşturur. Çok büyük request yeni replica'ların Pending kalmasına neden olabilir. Cluster Autoscaler gereksiz node ekleyebilir. Çok küçük request ise node'un gerçekte aşırı yüklenmesine yol açabilir. Bu nedenle HPA tuning yapılırken scheduler ve node utilization metrikleri aynı dashboard üzerinde incelenmelidir.
CPU-Based Autoscaling
CPU tabanlı autoscaling basit, anlaşılır ve birçok stateless uygulama için yararlı başlangıç modelidir. CPU kullanımı workload miktarıyla güçlü korelasyon gösteriyorsa HPA iyi tepki verebilir. Ancak dış API bekleyen veya queue'da bloklanan uygulamalarda CPU gerçek talebi geç yansıtabilir. CPU yalnızca kapasite tüketim sinyalidir, kullanıcı talebi değildir. Bu ayrımı anlamak doğru metric seçiminin temelidir.
CPU Kullanımına Göre Replica Artırma
HPA ortalama CPU utilization hedefin üzerine çıktığında desired replica sayısını artırabilir. Yeni replica'lar workload yükünü paylaşmaya başladığında ortalama utilization düşer. Bu model CPU-bound servislerde oldukça anlaşılırdır. Ancak scale-up süresi uygulamanın startup süresine bağlıdır. Hızlı trafik spike'larında sadece CPU sinyali geç kalabilir.
Hangi Uygulamalar İçin Uygundur?
CPU tüketimi doğrudan request miktarıyla artan API servisleri CPU HPA için iyi adaydır. Video işleme veya hesaplama yoğun stateless işlerde de faydalıdır. Uygulamanın replica eklenince throughput'u gerçekten artmalıdır. Paylaşılan veritabanı darboğazı varsa daha fazla Pod CPU sorununu çözmeyebilir. Load test bu ilişkiyi net şekilde ortaya çıkarır.
CPU'nun Kötü Bir Scaling Metric Olduğu Durumlar
Queue consumer bekleme süresinin büyük kısmını I/O ile geçiriyorsa CPU düşük kalabilir. gRPC bağlantıları uzun süre açıkken aktif request sayısı artmasına rağmen CPU geç yükselebilir. Memory-bound uygulamalar CPU sinyalinden yararlanmayabilir. Bir upstream dependency yavaşladığında latency artarken CPU düşebilir. Böyle senaryolarda RPS, concurrency, queue length veya queue age daha anlamlı olabilir.
Memory-Based Autoscaling
Memory tabanlı autoscaling belirli workload türlerinde yararlı olabilir ancak daha dikkatli yorumlanmalıdır. Bellek tüketimi workload sona erdiğinde CPU kadar hızlı düşmeyebilir. Cache, heap ve garbage collection davranışı uzun dönem trend oluşturur. Memory leak bulunan uygulamada replica artırmak gerçek çözüm değildir. Bu nedenle memory metriğini genellikle latency, CPU veya talep metriğiyle birlikte değerlendirmek daha sağlıklıdır.
Memory Utilization
Memory utilization Pod'un kullandığı belleğin tanımlanan request değerine oranını gösterebilir. HPA bu oranı hedef seviyede tutmaya çalışabilir. Request değerinin gerçek workload ihtiyacına yakın olması önemlidir. Bellek kullanımı replica başına iş yüküyle doğru orantılıysa autoscaling faydalı olabilir. Ancak cache yoğun uygulamalarda yeni Pod kendi cache'ini dolduracağı için toplam bellek tüketimi artabilir.
Memory Leak Problemi
Memory leak zaman içinde Pod belleğinin sürekli yükselmesine neden olur. HPA bunu yük artışı sanarak replica sayısını artırabilir. Yeni replica'lar da aynı leak davranışını gösterirse toplam cluster bellek tüketimi hızla büyür. Sorun autoscaling değil uygulama bug'ıdır. Alerting sisteminde memory growth rate ve restart sayısı ayrıca izlenmelidir.
Garbage Collection
Garbage-collected runtime'larda heap kullanımı dalgalı olabilir. GC çalışana kadar bellek yüksek görünür. Çok kısa metric penceresi HPA'nın bu dalgalanmalara gereksiz tepki vermesine yol açabilir. Uygulamanın heap ve GC davranışı load test altında incelenmelidir. Stabilization ayarları kısa süreli dalgalanmayı azaltabilir.
CPU + Memory Kombinasyonu
HPA birden fazla metric kullanabilir. CPU ve memory birlikte tanımlandığında her metric ayrı desired replica hesaplar. HPA bunlar arasındaki en yüksek replica ihtiyacını seçer. Bu yaklaşım iki farklı kaynak baskısına karşı koruma sağlar. Ancak sürekli yüksek tutulan cache belleği gibi bir metric gereksiz replica sayısına yol açabilir.
Custom Metrics ile HPA
CPU ve bellek her uygulamada kullanıcı talebini doğru temsil etmez. Custom metric kullanarak autoscaling kararını request rate, active connection, queue depth veya latency gibi daha anlamlı sinyallere bağlayabilirsiniz. İyi metric, talep artışını kapasite doygunluğundan önce göstermelidir. Replica sayısı arttığında metric'in replica başına değeri de anlamlı biçimde düşmelidir. Production autoscaling kalitesini belirleyen en önemli konulardan biri metric seçimidir.
CPU ve Memory Neden Her Zaman Yeterli Değildir?
Bir servis dış API'den yanıt beklerken CPU düşük olabilir fakat kullanıcı latency'si çok yüksek olabilir. Queue consumer yüksek backlog altında çalışırken CPU sürekli orta seviyede kalabilir. WebSocket uygulaması binlerce bağlantı taşırken request rate düşük görünebilir. Bu örneklerin hepsinde talep başka bir sinyal üzerinden daha erken görülür. Autoscaling talebe yakın metric kullandığında daha hızlı ve kararlı davranabilir.
Requests Per Second
RPS HTTP servislerinde en anlaşılır talep metric'lerinden biridir. Pod başına hedef RPS load test ile belirlenebilir. Gelen toplam RPS arttığında replica sayısı talep daha CPU'yu yükseltmeden hesaplanabilir. Ancak request maliyetleri birbirinden çok farklıysa tek RPS değeri yanıltıcı olabilir. Ağır ve hafif endpoint'ler için weighted metric veya concurrency değerlendirmek gerekebilir.
Active Connections
Active connection metriği WebSocket, gRPC veya uzun TCP bağlantılı servislerde faydalıdır. Her Pod'un taşıyabileceği güvenli bağlantı sayısı load test ile belirlenebilir. HPA replica sayısını connection pressure artmadan büyütebilir. Ancak yeni Pod'ların mevcut bağlantıları otomatik devralmayacağı unutulmamalıdır. Connection age veya istemci reconnect davranışı da dengeleme stratejisinin parçasıdır.
Queue Depth
Queue depth worker uygulamalarında doğrudan iş talebini gösterir. Queue büyümeye başladığında CPU henüz yüksek olmasa bile kapasite yetersizliği anlaşılabilir. KEDA bu tip event-driven scaling için güçlü bir seçenektir. Hedef replica sayısı queue uzunluğu ile worker throughput'una göre belirlenebilir. Queue age ile birlikte kullanmak kullanıcı gecikmesini daha iyi temsil eder.
Kafka Consumer Lag
Kafka consumer lag işlenmeyi bekleyen mesaj miktarını gösterir. CPU'dan daha doğrudan backlog sinyalidir. Ancak replica sayısı partition sayısını geçtiğinde ek consumer'lar fayda sağlamayabilir. Maximum useful replica değeri partition sayısıyla ilişkilendirilmelidir. KEDA Kafka scaler bu tür workload'larda sık kullanılan yaklaşımlardan biridir.
p95 Latency
p95 latency kullanıcı deneyimine daha yakın bir SLO metriğidir. Ancak latency her zaman replica eksikliğinden kaynaklanmaz. Database yavaşlığı veya upstream timeout varsa daha fazla Pod sorunu büyütebilir. Bu nedenle latency scaling metric olarak kullanılmadan önce saturation ile korelasyonu doğrulanmalıdır. RPS veya concurrency ile birlikte değerlendirmek genellikle daha güvenlidir.
Business Metrics
Bazı sistemlerde en anlamlı autoscaling sinyali teknik metric değil business event olabilir. Örneğin aynı anda işlenen sipariş sayısı veya render queue uzunluğu doğrudan kapasite ihtiyacını yansıtabilir. Metric güvenilir ve düşük gecikmeli olmalıdır. İş metriği kaybolduğunda fallback davranışı tanımlanmalıdır. Scaling sisteminin business logic üzerinde beklenmeyen maliyet üretmemesi için max replica sınırı korunmalıdır.
Prometheus ile Kubernetes Autoscaling
Prometheus, Kubernetes workload metriklerini toplamak ve sorgulamak için yaygın kullanılan açık kaynaklı bir izleme sistemidir. HPA custom metric kullanacaksa Prometheus verisini Kubernetes Custom Metrics API üzerinden sunan adapter katmanı kullanılabilir. Böylece RPS, latency veya queue metric'leri HPA tarafından okunabilir. Metric query'sinin performansı ve doğruluğu autoscaling kararını doğrudan etkiler. Autoscaling için kullanılan metriklerin dashboard ve alert tarafında da görünür olması troubleshooting süresini azaltır.
Prometheus
Prometheus uygulama ve altyapı metriklerini scrape modeliyle toplayabilir. Kubernetes ServiceMonitor benzeri mekanizmalarla workload metric'leri keşfedilebilir. HPA doğrudan Prometheus HTTP API'sine bağlanmak yerine adapter aracılığıyla Kubernetes metric API'sini kullanabilir. Metric label cardinality yüksek olduğunda sorgu maliyeti artabilir. Autoscaling metric'leri basit ve güvenilir tutulmalıdır.
Prometheus Adapter
Prometheus Adapter belirli Prometheus metric'lerini Kubernetes custom veya external metrics API biçiminde sunabilir. HPA bu metric'leri standart autoscaling API üzerinden sorgular. Adapter mapping kuralları metric isimlerinin doğru görünmesi için önemlidir. Yanlış query HPA status içinde unknown metric hatasına yol açabilir. Deployment öncesinde metric API cevabı elle test edilmelidir.
Custom Metrics API
`custom.metrics.k8s.io` belirli Kubernetes kaynaklarıyla ilişkili custom metric'leri sunmak için kullanılabilir. HPA autoscaling/v2 bu metric tipini destekler. API aggregation katmanının sağlıklı olması gerekir. Adapter erişilemez olduğunda scale kararı etkilenebilir. Monitoring sistemi autoscaling kontrol döngüsünün bağımlılığı hâline geldiği için availability planı yapılmalıdır.
PromQL
PromQL Prometheus verisini sorgulamak için kullanılan dildir. Autoscaling query'sinde rate, sum ve label filtreleri sık kullanılır. Çok uzun pencere scale-up tepkisini yavaşlatabilir. Çok kısa pencere ise spike'lara aşırı duyarlı sonuç üretebilir. Load test sırasında query penceresi ile HPA stabilization birlikte ayarlanmalıdır.
RPS Bazlı Scaling
RPS bazlı scaling web API'lerinde talep miktarını doğrudan kapasite kararına bağlar. Önce tek Pod'un güvenli RPS kapasitesi load test ile ölçülmelidir. Daha sonra toplam RPS veya Pod başına RPS hedefi kullanılır. Endpoint maliyetleri çok farklıysa tek metric yeterli olmayabilir. p95 latency ile birlikte izlemek kararın doğruluğunu artırır.
Latency Bazlı Scaling
Latency bazlı scaling kullanıcı deneyimine doğrudan yaklaşır. Ancak autoscaling yalnızca kapasite kaynaklı latency'yi çözebilir. Veritabanı lock sorunu veya ağ outage durumunda replica artırmak fayda sağlamaz. Bu nedenle latency metric'i saturation veya request pressure ile birlikte değerlendirilmelidir. Circuit breaker ve timeout politikaları da latency patlamasının retry storm'a dönüşmesini önler.
Hangi Metric ile Scale Edilmeli?
En iyi autoscaling metric'i uygulama kapasitesinin doygunluğa yaklaşmasını erken gösteren ve replica eklenince iyileşen metriktir. CPU her workload için doğru cevap değildir. HTTP servisinde RPS veya concurrency, queue worker'da queue age, Kafka consumer'da lag daha anlamlı olabilir. Latency kullanıcı deneyimini gösterir ancak geç sinyal olabilir. Ben metric seçerken önce tek Pod'un yük altında nasıl bozulduğunu ölçer, sonra bozulmadan hemen önce değişen sinyali belirlerim.
CPU
CPU hesaplama yoğun workload'larda güçlü scaling metric'idir. Metric altyapısı kolaydır ve Metrics Server ile hızlı kurulabilir. Ancak I/O yoğun uygulamalarda talebi geç yansıtabilir. CPU request doğru değilse utilization değeri yanlış yorumlanır. İlk tercih olması kolay olduğu içindir, her zaman en iyi olduğu için değildir.
Memory
Memory bellek baskısı yaşayan workload'larda yararlı olabilir. Fakat cache ve garbage collection nedeniyle yavaş tepki verir. Memory leak gibi uygulama hataları replica artışına yanlış sinyal verebilir. Request right-sizing kritik öneme sahiptir. Genellikle tek başına kullanılmak yerine başka metric'le birlikte değerlendirilmesi daha sağlıklıdır.
RPS
RPS web servisleri için talebe yakın metriktir. Pod başına kapasite load test ile kolay hesaplanabilir. Ani trafik artışını CPU yükselmeden önce gösterebilir. Request maliyetleri çok farklıysa weighting gerekebilir. RPS metriği gateway veya uygulama katmanından güvenilir şekilde toplanmalıdır.
Concurrency
Concurrency aynı anda işlenen request veya bağlantı miktarını ifade eder. Uzun süren request'lerde RPS'den daha açıklayıcı olabilir. Her Pod'un güvenli concurrency sınırı ölçülebilir. Event loop veya thread pool doygunluğu ile güçlü korelasyon gösterebilir. Load test sırasında latency eğrisiyle birlikte incelenmelidir.
Queue Length
Queue length işlenmeyi bekleyen iş miktarını gösterir. Worker kapasitesi yetersiz kaldığında hızlı biçimde büyür. Event-driven autoscaling için iyi bir metric'tir. Ancak mesaj maliyetleri birbirinden farklıysa tek sayı yeterli olmayabilir. Queue age kullanıcı bekleme süresini daha doğrudan gösterebilir.
Queue Age
Queue age en eski bekleyen işin ne kadar süredir kuyrukta olduğunu gösterebilir. SLO ile queue pressure arasında doğrudan bağ kurar. Kısa queue içinde çok uzun süredir bekleyen pahalı işler varsa queue length bunu gizleyebilir. Age metriği backlog'un kullanıcı etkisini daha net gösterir. Event-driven işlerde benim en sevdiğim ek sinyallerden biridir.
Latency
Latency kullanıcı deneyimine yakın metriktir. p95 veya p99 değerleri ortalama latency'den daha anlamlı olabilir. Ancak latency'nin kapasiteyle ilişkili olduğundan emin olmak gerekir. Downstream hata varsa daha fazla replica sorunu çözmez. Bu nedenle latency scaling genellikle saturation metric'iyle desteklenmelidir.
Business KPI
Business KPI doğrudan iş değerini yansıtan metric olabilir. Örneğin dakikadaki ödeme denemesi veya aktif render işi kapasite ihtiyacını gösterebilir. Teknik metric'lerden farklı olarak business değişimlerine daha erken tepki verebilir. Ancak metric pipeline güvenilir olmalıdır. Yanlış business metric kontrolsüz node ve Pod artışına yol açabilir.
En Erken Talep Sinyalini Seçmek
İdeal metric uygulama yavaşlamadan önce talep artışını gösterir. Queue depth çoğu worker sistemi için CPU'dan önce değişir. RPS web servislerinde saturation oluşmadan önce yükselir. Concurrency uzun request'lerde CPU'yu beklemeden kapasite ihtiyacını gösterebilir. En erken ve en güvenilir sinyal load test verisinden çıkarılmalıdır.
HPA Multiple Metrics Nasıl Çalışır?
HPA autoscaling/v2 ile birden fazla metric aynı hedef üzerinde kullanılabilir. Controller her metric için ayrı desired replica hesabı yapar. Daha sonra bu hesaplar arasından en yüksek replica gereksinimini seçer. Bu model CPU normal görünse bile RPS yüksek olduğunda scale-up yapılmasını sağlar. Ancak metric kaynaklarından biri sürekli hata veriyorsa özellikle scale-down davranışı beklenenden farklı olabilir.
CPU + Memory
CPU ve memory birlikte kullanıldığında iki kaynak baskısı aynı anda izlenebilir. CPU hedefi dört replica, memory hedefi altı replica istiyorsa HPA altı replica yönünde karar verir. Bu korumacı yaklaşım capacity shortage riskini azaltır. Ancak memory cache nedeniyle sürekli yüksekse gereksiz replica tutulabilir. İki metric de workload davranışıyla doğrulanmalıdır.
CPU + RPS
CPU ile RPS iyi bir teknik ve talep metriği kombinasyonu olabilir. RPS ani trafik artışına erken tepki verir. CPU ise gerçek hesaplama yükünü doğrular. HPA her iki metric'ten gelen desired replica sonuçları arasında en yüksek olanı kullanır. Bu model web API'lerinde yalnızca CPU kullanımına göre scale etmekten daha hızlı olabilir.
Birden Fazla Metric İçin Replica Hesabı
Her metric kendi hedef değeriyle karşılaştırılır. HPA her metric için ayrı desired replica sayısı üretir. Resource metric, custom metric ve external metric aynı HPA içinde kullanılabilir. Metric semantics doğru kurulmazsa farklı kaynaklar sürekli birbirini yukarı çekebilir. Bu nedenle max replica ve cost alert mutlaka bulunmalıdır.
En Yüksek Replica İhtiyacının Seçilmesi
HPA capacity riskini azaltmak için metric hesaplarından en yüksek replica gereksinimini seçer. CPU dört, RPS sekiz ve latency altı replica öneriyorsa sonuç sekize gider. Bu davranış özellikle scale-up için güvenlidir. Fakat kötü metric sürekli yüksek değer üretirse replica sayısını max sınıra kilitleyebilir. Metric validation ve anomaly alert bu yüzden önemlidir.
HPA Scaling Behavior Nasıl Ayarlanır?
Scaling behavior HPA'nın replica sayısını hangi hızla artırıp azaltacağını kontrol eder. Ani scale-up kritik trafik spike'larında faydalı olabilir. Scale-down ise genellikle daha yavaş ve korumacı tutulur. Stabilization window kısa süreli metric düşüşlerinde Pod'ların hemen silinmesini engeller. Load test sonucunda uygulamanın startup ve warm-up süresiyle uyumlu değerler seçilmelidir.
Scale-Up Policy
Scale-up policy belirli sürede kaç Pod veya yüzde kaç replica eklenebileceğini sınırlar. Çok yavaş policy trafik spike'ında kapasite yetişmemesine neden olabilir. Çok hızlı policy ise aynı anda çok sayıda cold Pod başlatabilir. Backend bağımlılıkları da ani connection artışından etkilenebilir. Scale-up hızı startup kapasitesi ve downstream limitleriyle birlikte ayarlanmalıdır.
Scale-Down Policy
Scale-down policy replica azaltma hızını kontrol eder. Çok agresif düşüş kısa süre sonra tekrar scale-up ihtiyacı oluşturabilir. Uzun request veya bağlantılar kapanan Pod'larda hata üretebilir. Minimum replica ve PDB bu davranışı tamamlar. Production sisteminde scale-down genellikle scale-up'tan daha yavaş tutulmalıdır.
Stabilization Window
Stabilization window geçmiş desired replica önerilerini belirli süre dikkate alır. Özellikle scale-down sırasında metric'in kısa süreli düşmesiyle Pod silinmesini önler. HPA default scale-down davranışında beş dakikalık pencere yaygın başlangıç değeridir. Workload trafik profiline göre bu süre değiştirilebilir. Çok uzun pencere maliyeti artırırken çok kısa pencere thrashing riskini yükseltir.
Replica Artış Hızı
Replica artış hızı ani talebi ne kadar hızlı karşılayabileceğinizi belirler. Fakat control plane kararından sonra Pod startup süresi de eklenir. Container image büyükse node image pull süresi scale-up'ı yavaşlatabilir. Yeni node gerekiyorsa toplam süre daha da uzar. Gerçek kapasiteye ulaşma süresi load test altında ölçülmelidir.
Replica Azalış Hızı
Replica azalış hızı maliyet optimizasyonunu etkiler. Çok yavaş azaltım gereksiz kapasiteyi uzun süre tutabilir. Çok hızlı azaltım ise bağlantı kesintisi ve tekrar scale-up döngüsüne neden olabilir. Uygulamanın request süresi ve graceful shutdown süresi hesaba katılmalıdır. En iyi değer trafik pattern'i ile SLO arasındaki dengedir.
Scaling Thrashing Nedir?
Scaling thrashing, replica sayısının kısa aralıklarla sürekli artıp azalmasıdır. Metric hedef çevresinde dalgalandığında veya HPA davranışı fazla hassas olduğunda görülebilir. Bu durum Pod startup maliyetini, scheduler yükünü ve cloud kapasite hareketini artırır. Kullanıcı açısından latency dalgalanması oluşturabilir. Stabilization window, tolerance ve daha iyi metric seçimi bu davranışı azaltmaya yardımcı olur.
Sürekli Scale-Up ve Scale-Down
HPA beş replica'dan sekize çıkıp birkaç dakika sonra tekrar beşe düşüyorsa sistem kararsız olabilir. Ardından aynı trafik paterni tekrar scale-up tetikleyebilir. Pod oluşturma ve sonlandırma işlemleri uygulamaya ek yük getirir. Node autoscaler da bu döngüyü takip ederse altyapı daha fazla hareket eder. Scale olaylarının zaman serisi bu davranışı açıkça gösterir.
Metric Dalgalanması
Çok kısa metric pencereleri anlık spike'lara duyarlı olabilir. CPU veya RPS birkaç saniye içinde hedefin üstüne ve altına geçebilir. Her dalgalanmaya replica değişikliğiyle cevap vermek faydalı değildir. Aggregation window ve tolerance bu gürültüyü azaltabilir. Metric smoothing yapılırken gerçek spike'ları kaçırmamak gerekir.
Stabilization Window
Stabilization window özellikle scale-down kararlarını geciktirerek thrashing'i azaltır. HPA geçmiş yüksek replica önerisini bir süre korur. Trafik kısa süre sonra yeniden yükselirse replica'lar zaten hazır kalır. Bunun maliyeti birkaç dakika fazla kapasite tutmaktır. Kritik servislerde bu maliyet çoğu zaman daha iyi kullanıcı deneyimine değer.
Tolerance
Tolerance hedef metric çevresindeki küçük değişimlerin scale kararı üretmesini engeller. Böylece yüzde birkaçlık gürültü replica değişikliğine yol açmaz. Kubernetes sürümüne göre per-direction tolerance desteğinin feature durumu kontrol edilmelidir. Cluster-wide default tolerance da HPA davranışını etkileyebilir. Değer çok yüksek ayarlanırsa gerçek talep artışına tepki gecikebilir.
Hysteresis
Hysteresis scale-up ve scale-down eşiklerini aynı noktaya bağlamamak fikridir. Kontrol sistemlerinde kararsız salınımı azaltmak için kullanılır. Kubernetes HPA stabilization ve tolerance mekanizmaları benzer hedefe hizmet eder. Event-driven scaling sistemlerinde activation threshold ve scaling threshold ayrımı da aynı yaklaşımı destekleyebilir. Amaç gereksiz kontrol döngülerini azaltırken gerçek yük değişimine cevap vermektir.
Thrashing'in Maliyet ve Availability Etkisi
Sürekli Pod ve node oluşturmak image pull, startup ve connection churn üretir. Node autoscaler sık kapasite ekleyip çıkarırsa cloud faturasında beklenmeyen hareketler oluşabilir. Kullanıcı trafiği yeni ve henüz ısınmamış Pod'lara sık aktarılır. Bu da p95 latency'nin dalgalanmasına neden olur. Stable scaling çoğu zaman en düşük anlık maliyetten daha değerlidir.
Pod Warm-Up Autoscaling'i Nasıl Etkiler?
Pod'un Running durumuna geçmesi uygulamanın tam performansa ulaştığı anlamına gelmez. JVM JIT warm-up, cache doldurma, model yükleme veya connection pool hazırlama süresi olabilir. HPA yeni replica üretirken bu süre hesaba katılmazsa teorik kapasite artmış görünür ancak gerçek throughput artmaz. Readiness ve startup probe bu geçişi doğru temsil etmelidir. Load test sırasında cold Pod ile warm Pod kapasitesi ayrı ölçülmelidir.
Startup Süresi
Startup süresi autoscaling response time'ın önemli bileşenidir. HPA 15 saniyede karar verse bile Pod iki dakikada hazır oluyorsa gerçek kapasite gecikir. Büyük image indirme süresi de bunu uzatabilir. Node üzerinde image cache bulunması fark yaratabilir. Kritik workload'larda minimum warm replica bu gecikmeyi absorbe eder.
JVM Warm-Up
JVM tabanlı uygulamalar başlangıçtan sonra JIT compilation ve heap davranışı nedeniyle farklı performans gösterebilir. İlk dakikalarda CPU spike görülebilir. HPA bunu gerçek yük sanarsa gereksiz scale-up yapabilir. Startup probe veya doğru readiness gecikmesi bu dönemi filtrelemeye yardımcı olur. Load test sonuçları warm JVM kapasitesi üzerinden değerlendirilmelidir.
Cache Warm-Up
Uygulama local cache kullanıyorsa yeni Pod başlangıçta düşük hit rate ile çalışabilir. İlk istekler backend veritabanına daha fazla yük bindirebilir. Çok sayıda Pod aynı anda scale-up yaptığında cache stampede etkisi oluşabilir. Readiness'i yalnızca cache tamamen dolduğunda açmak her zaman doğru değildir, fakat başlangıç davranışı ölçülmelidir. Shared cache veya kontrollü pre-warm yaklaşımı değerlendirilebilir.
Model Loading
AI inference servislerinde model dosyasının belleğe veya GPU'ya yüklenmesi uzun sürebilir. Pod Running görünse bile request kabul etmek için hazır olmayabilir. Model büyüklüğü autoscaling latency'sini dakikalar seviyesine çıkarabilir. Minimum warm replica ve predictive pre-scaling bu nedenle önem kazanır. Readiness probe modelin gerçekten inference yapabilecek durumda olduğunu doğrulamalıdır.
Yeni Pod'un Erken Trafik Alması
Readiness probe çok erken başarılı olursa yeni Pod tam kapasiteye ulaşmadan trafik almaya başlar. Bu durum latency ve error rate'i yükseltebilir. HPA kullanıcı yükünün yükseldiğini görüp daha fazla replica ekleyebilir. Sorunun kaynağı kapasite eksikliği değil yanlış readiness olabilir. Startup ve readiness eşikleri gerçek uygulama davranışıyla uyumlu olmalıdır.
Startup Probe ve Readiness Probe
Startup probe uygulamanın başlangıç sürecini ayrı değerlendirmeye yardımcı olur. Readiness probe ise uygulamanın trafik almaya hazır olup olmadığını ifade eder. Yavaş başlayan uygulamalarda startup probe liveness tarafından erken öldürülmeyi önleyebilir. Readiness ise Service endpoint katılımını kontrol eder. Autoscaling ile birlikte bu iki probe yeni kapasitenin güvenli şekilde trafiğe açılmasını sağlar.
Readiness Probe ile Load Balancing Arasındaki İlişki
Readiness probe Kubernetes load balancing davranışının en kritik uygulama sinyallerinden biridir. Pod hazır değilse Service normal trafiğinin o Pod'a gitmemesi gerekir. Bu mekanizma deployment, autoscaling ve failure senaryolarında kullanıcı hatalarını azaltır. Yanlış readiness sadece sağlık kontrolü problemi değil kapasite yönetimi problemidir. HPA yeni Pod oluşturduğunda gerçek kapasite ancak readiness başarılı olduktan sonra kullanılabilir.
Pod Ne Zaman Endpoint Olur?
Service selector'ı ile eşleşen Pod endpoint olarak temsil edilebilir. Ancak endpoint'in Ready durumu trafik için önemlidir. Readiness probe başarısızsa backend normal trafik açısından hazır kabul edilmez. Uygulama hazır hâle geldiğinde endpoint condition güncellenir. Load balancer'ın yeni Pod'u kullanma anı burada başlar.
Hazır Olmayan Pod'a Trafik Gönderilmesini Önleme
Readiness probe uygulamanın bağımlılıklarını ve kritik initialization sürecini tamamladığını doğrulayabilir. Başarısız probe sırasında Pod çalışmaya devam eder fakat trafik havuzundan çıkarılır. Bu, restart gerektirmeyen geçici backend sorunlarında da faydalıdır. Ancak readiness check'in downstream bağımlılıkları fazla agresif kontrol etmesi tüm Pod'ları aynı anda unhealthy yapabilir. Probe kapsamı dikkatli seçilmelidir.
Yanlış Readiness Probe'un Autoscaling'e Etkisi
Çok erken Ready olan Pod düşük performansla trafik alabilir. Çok geç Ready olan Pod ise kapasite hazır olduğu hâlde kullanılmaz. HPA metric'i yükselmeye devam ederek daha fazla replica isteyebilir. Bu durum gereksiz maliyet ve Pod churn oluşturur. Readiness tuning autoscaling tuning'in ayrılmaz parçasıdır.
Graceful Shutdown ve Connection Draining
Scale-down veya rolling deployment sırasında Pod'un güvenli şekilde trafiği bırakması gerekir. Kubernetes SIGTERM gönderdiğinde uygulama yeni işi kabul etmeyi durdurmalı ve mevcut işleri mümkün olduğunca tamamlamalıdır. Endpoint'in trafik havuzundan çıkarılması ile prosesin kapanması arasında yarış durumları oluşabilir. PreStop hook ve termination grace süresi bu geçişi yönetmeye yardımcı olur. Yanlış shutdown tasarımı özellikle scale-down sırasında 5xx hatalarının sık nedenlerinden biridir.
SIGTERM
Pod sonlandırılırken container prosesine SIGTERM gönderilir. Uygulama bu sinyali yakalayıp graceful shutdown başlatmalıdır. Yeni request kabulünü durdurmak ve mevcut request'leri tamamlamak iyi yaklaşımdır. SIGTERM görmezden gelinirse grace süresi sonunda zorla kapanma olabilir. Framework'ün default shutdown davranışı production öncesinde test edilmelidir.
terminationGracePeriodSeconds
`terminationGracePeriodSeconds` Pod'un zorla kapatılmadan önce ne kadar süreye sahip olduğunu belirler. Uzun request'leri olan uygulamalarda default süre yetersiz olabilir. Çok yüksek değer ise node drain işlemlerini yavaşlatabilir. Gerçek maksimum request süresi ve shutdown davranışı ölçülmelidir. PDB ve node autoscaling ile birlikte değerlendirmek gerekir.
PreStop Hook
PreStop hook sonlandırma sırasında ek hazırlık işlemi yürütmek için kullanılabilir. Bazı ekipler kısa delay ile endpoint propagation için zaman kazanmaya çalışır. Ancak sleep değerini rastgele seçmek doğru değildir. Uygulamanın kendi graceful shutdown desteği tercih edilmelidir. Hook süresi toplam termination grace süresinden tüketilir.
Endpoint'in Trafikten Çıkarılması
Pod terminating olduğunda endpoint bilgisi güncellenir. Network dataplane'in bu değişikliği görmesi kısa bir süre alabilir. Aynı anda dış load balancer health check gecikmesi de bulunabilir. Bu yüzden uygulamanın SIGTERM aldığı anda mevcut bağlantıları hemen kesmesi risklidir. Kısa draining dönemi daha güvenli olabilir.
Uzun Süren Request'ler
Video processing, report generation veya büyük API işlemleri dakikalar sürebilir. Pod scale-down sırasında bu request'ler kesilirse kullanıcı hatası oluşur. Uygulama mümkünse uzun işleri queue tabanlı asynchronous modele taşımalıdır. Senkron uzun request gerekiyorsa termination grace süresi buna göre ayarlanmalıdır. Load balancer timeout değerleri de aynı profile uyumlu olmalıdır.
Scale-Down Sırasında 5xx Hatalarını Önlemek
Scale-down hatalarını azaltmak için readiness, endpoint removal ve graceful shutdown sırası test edilmelidir. Pod yeni bağlantı kabul etmeyi bırakmalı fakat mevcut bağlantıları tamamlamalıdır. Termination grace uygulamanın gerçek request süresini kapsamalıdır. Load test sırasında replica azaltımı özellikle tetiklenmelidir. Sadece scale-up testi yapmak production readiness için yeterli değildir.
Long-Lived Connection'larda Load Balancing
WebSocket, HTTP/2 ve gRPC gibi uzun süreli bağlantılar klasik request başına load balancing varsayımını bozar. Bir bağlantı kurulduktan sonra yüzlerce veya binlerce mesaj aynı Pod üzerinden geçebilir. HPA yeni replica eklediğinde mevcut bağlantılar otomatik olarak yeni Pod'lara taşınmaz. Bu yüzden replica sayısı artarken bazı Pod'lar yoğun, yeni Pod'lar boş kalabilir. Connection age, max connection duration ve client reconnect stratejileri bu tür sistemlerde önemlidir.
WebSocket
WebSocket bağlantıları uzun süre açık kalabilir. Kullanıcı bağlantısı ilk seçilen Pod'a bağlı kalır. Yeni replica oluşturulduğunda eski bağlantılar yeni Pod'a geçmez. Bu nedenle active connection metriği autoscaling için CPU'dan daha iyi olabilir. Uygulama state'inin Pod içinde tutulması failover davranışını da zorlaştırır.
HTTP/2
HTTP/2 tek TCP bağlantısı üzerinde çok sayıda request taşır. Client veya proxy connection pooling nedeniyle aynı backend uzun süre kullanılabilir. Bu durum yeni replica'ların trafik alma hızını azaltabilir. Load balancer'ın backend connection reuse davranışı incelenmelidir. Connection lifetime sınırlaması bazı mimarilerde rebalance sağlar.
gRPC
gRPC yaygın olarak HTTP/2 üzerinde çalıştığı için uzun bağlantı davranışını taşır. Bir client connection'ı uzun süre aynı backend'e bağlı kalabilir. HPA replica artırdığında bağlantı havuzları yenilenmezse yeni Pod az trafik alır. Client-side load balancing veya proxy seviyesinde connection yönetimi değerlendirilebilir. gRPC latency ve active stream metriği useful scaling sinyali olabilir.
Connection-Level Load Balancing
L4 load balancer çoğu zaman yeni connection oluştuğunda backend seçer. Connection açık kaldığı sürece trafik aynı backend üzerinden devam eder. Bu yaklaşım kısa bağlantılarda dengeli olabilir. Uzun bağlantılarda backend dağılımı zamanla bozulabilir. Pod başına connection count izlenmesi bu nedenle önemlidir.
Yeni Pod'ların Trafik Alamaması Problemi
HPA yeni Pod oluşturduğu hâlde mevcut connection'lar eski Pod'larda kalabilir. Dashboard replica sayısının yükseldiğini gösterir ancak latency düzelmez. Yeni Pod CPU'su neredeyse sıfır olabilir. Bu durumda HPA'yı daha agresif yapmak çözüm değildir. Connection rebalance stratejisi gerekir.
Connection Age ve Rebalancing
Maximum connection age bazı proxy ve client çözümlerinde bağlantıların kontrollü şekilde yenilenmesini sağlar. Eski connection kapanınca yeni bağlantı farklı backend'e gidebilir. Çok kısa age değeri gereksiz handshake maliyeti oluşturur. Çok uzun age ise yeni replica'ların faydasını geciktirir. Değer gerçek trafik davranışıyla test edilmelidir.
Vertical Pod Autoscaler (VPA) Nedir?
VPA, Pod CPU ve memory ihtiyaçlarını gözlemleyerek daha uygun kaynak değerleri önermeye veya uygulamaya yardımcı olur. HPA'nın aksine replica sayısını değiştirmek yerine Pod boyutlandırmasına odaklanır. Özellikle yanlış request değerlerinin belirlenmesi için recommendation mode faydalıdır. Automatic update modlarında Pod'ların yeniden oluşturulması gerekebilir. Stateful veya restart hassas workload'larda değişiklik politikası dikkatle tasarlanmalıdır.
VPA Recommender
Recommender geçmiş resource usage verisini analiz ederek CPU ve memory önerileri üretir. Bu değerler request right-sizing için başlangıç noktasıdır. Sadece ortalama kullanım değil peak davranış da önemlidir. Öneriler SLO ve startup ihtiyaçlarıyla birlikte değerlendirilmelidir. Production ayarını yalnızca otomatik öneriye bırakmak her workload için uygun değildir.
Updater
Updater mevcut Pod'ların önerilen kaynak değerleriyle yeniden oluşturulmasını tetikleyebilir. Resource request çoğu durumda çalışan Pod üzerinde doğrudan değiştirilemez. Bu nedenle eviction veya restart etkisi oluşabilir. PDB ve availability gereksinimleri burada önem kazanır. Güncelleme politikası kritik servislerde korumacı tutulmalıdır.
Admission Controller
Admission Controller yeni oluşturulan Pod'lara VPA önerilerini uygulayabilir. Böylece Deployment yeni replica oluşturduğunda daha uygun request değerleri kullanılabilir. HPA ile aynı workload üzerinde kullanılıyorsa metric etkileşimi değerlendirilmelidir. Admission webhook availability'si de cluster operasyonunun parçası olur. Failure policy yanlış seçilirse Pod creation süreci etkilenebilir.
CPU/Memory Right-Sizing
Right-sizing scheduler verimliliğini ve HPA doğruluğunu artırır. Çok yüksek request cluster'da kullanılmayan kapasite oluşturur. Çok düşük request node pressure ve throttling riskini yükseltir. VPA önerileri gerçek production metriğine dayanan iyi referans sağlayabilir. Ancak latency SLO ve burst ihtiyacı son kararda dikkate alınmalıdır.
Recommendation Mode
Recommendation mode kaynak değerlerini otomatik değiştirmeden öneri üretir. Production'a ilk VPA geçişinde düşük riskli bir yöntemdir. Ekip önerileri mevcut request'lerle karşılaştırabilir. Ani veya anlamsız öneriler workload davranışıyla incelenir. Git üzerinden kontrollü resource update yapmak isteyen ekipler için uygundur.
Automatic Update
Automatic update VPA'nın önerileri workload üzerinde uygulamasına izin verebilir. Bu model operasyon yükünü azaltabilir. Buna karşılık Pod restart veya eviction davranışı availability üzerinde etkili olabilir. HPA ile resource utilization metric çakışması özellikle dikkat edilmelidir. Kritik workload'larda önce recommendation-only analiz yapmak daha güvenli yaklaşımdır.
HPA ve VPA Birlikte Kullanılır mı?
HPA ve VPA aynı workload üzerinde birlikte kullanılabilir ancak aynı CPU veya memory utilization sinyalini birbirini etkileyen biçimde yönetmek risklidir. VPA request değerini değiştirdiğinde HPA utilization hesabının denominator değeri de değişir. Bu durum feedback loop oluşturabilir. HPA custom metric kullanırken VPA CPU ve memory right-sizing yapması daha güvenli kombinasyonlardan biridir. Kubernetes autoscaling HPA VPA ve Cluster Autoscaler karşılaştırması yapılırken bu metric etkileşimi mutlaka anlatılmalıdır.
CPU/Memory Metric Çakışması
HPA CPU utilization ile scale ederken VPA CPU request'i artırırsa aynı gerçek CPU kullanımı daha düşük yüzde olarak görünür. HPA bunun üzerine replica azaltabilir. Daha sonra yük Pod başına artınca VPA veya HPA yeniden farklı yönde tepki verebilir. Bu controller'lar birbirlerinin sinyalini değiştirmiş olur. Aynı resource metriğini iki otomasyonun yönetmesi bu yüzden dikkat gerektirir.
HPA Denominator Problemi
Utilization hesabında resource request denominator olarak kullanılır. VPA request'i değiştirirse HPA'nın gördüğü utilization otomatik olarak değişir. Gerçek kullanıcı trafiği aynı kalsa bile scale kararı farklılaşabilir. Bu mekanik etki yanlış yorumlanmamalıdır. Metric modelinin matematiği architecture review sırasında açıkça yazılmalıdır.
VPA Recommendation + HPA
VPA recommendation mode HPA ile düşük riskli şekilde birlikte kullanılabilir. VPA yalnızca öneri verir, request değerlerini otomatik değiştirmez. Ekip önerileri belirli aralıklarla gözden geçirip Git manifestine uygular. HPA davranışı kontrollü değişikliklerle yeniden test edilir. Bu model özellikle başlangıç right-sizing sürecinde pratiktir.
Custom Metric HPA + VPA
HPA RPS, queue depth veya concurrency gibi resource request'ten bağımsız metric kullanırsa VPA ile etkileşim azalır. VPA CPU ve memory right-sizing yapabilir. HPA ise talep miktarına göre replica sayısını yönetir. Bu separation of concerns daha anlaşılır bir kontrol sistemi oluşturabilir. Yine de Pod boyutu değiştiğinde Pod başına hedef RPS kapasitesi tekrar load test edilmelidir.
Güvenli Kombinasyonlar
VPA recommendation-only ve HPA birlikte kullanımı güvenli başlangıçtır. Custom metric HPA ile VPA resource tuning de güçlü modeldir. Aynı CPU utilization sinyalinin iki controller tarafından dolaylı biçimde değiştirilmesi ise kaçınılması gereken durumdur. Her otomasyonun hangi değişkeni yönettiği açık olmalıdır. Production'da controller event'leri aynı dashboard üzerinde izlenmelidir.
KEDA Nedir?
KEDA, Kubernetes workload'larını harici event ve metric kaynaklarına göre ölçeklemeyi kolaylaştıran açık kaynaklı autoscaling bileşenidir. Queue consumer, event worker ve aralıklı çalışan servislerde özellikle faydalıdır. ScaledObject mevcut Deployment benzeri kaynakları ölçekleyebilir. ScaledJob ise event miktarına göre Job oluşturma senaryolarına yöneliktir. KEDA scale-to-zero özelliği sayesinde boşta bekleyen event-driven workload maliyetini azaltabilir.
Event-Driven Autoscaling
Event-driven autoscaling kapasite kararını CPU yerine iş talebine bağlar. Queue'daki mesaj sayısı veya Kafka lag doğrudan iş birikimini gösterir. Bu sayede worker CPU yükselmeden önce scale-up yapılabilir. Event kaynağı sıfıra indiğinde workload tekrar küçültülebilir. Burst trafiği olan background workload'larda bu model oldukça etkilidir.
ScaledObject
ScaledObject KEDA'nın en yaygın kaynaklarından biridir. `scaleTargetRef` ile ölçeklenecek Deployment, StatefulSet veya desteklenen başka kaynak belirtilir. Trigger bölümü event veya metric kaynağını tanımlar. `minReplicaCount` ve `maxReplicaCount` sınırlar oluşturur. KEDA gerekli HPA entegrasyonunu otomatik yönetebilir.
ScaledJob
ScaledJob uzun süre yaşayan worker replica'ları yerine ayrı Kubernetes Job'ları üretmek için kullanılabilir. Her event veya event grubu ayrı iş olarak ele alınabilir. Batch processing senaryolarında güçlü bir modeldir. Job tamamlandığında Pod kalıcı olarak çalışmaz. Node autoscaling burst kapasitesini desteklemelidir.
External Event Source
KEDA çok sayıda dış event kaynağıyla çalışabilir. Queue, streaming platformu, database metriği veya Prometheus query trigger olabilir. Kimlik bilgileri Secret veya authentication kaynaklarıyla yönetilebilir. Event source erişilemez olduğunda fallback davranışı değerlendirilmelidir. Autoscaling sisteminin dış bağımlılığı yüksek availability ile çalışmalıdır.
Scale-to-Zero
KEDA workload'u sıfır replica'ya kadar indirebilir. `minReplicaCount: 0` bu davranış için temel ayarlardan biridir. Event geldiğinde KEDA sıfırdan bire aktivasyonu yönetir ve daha yüksek replica seviyelerinde HPA mekanizması devreye girebilir. Bu yaklaşım maliyet avantajı sağlar. Ancak cold start kritik API'lerde kullanıcı latency'sini artırabilir.
KEDA Hangi Kaynaklarla Çalışır?
KEDA geniş event source ekosistemi sayesinde farklı queue ve metric sistemlerinden scaling sinyali üretebilir. Kafka ve RabbitMQ mesaj tüketicileri yaygın örneklerdir. Cloud queue servisleri ve Redis tabanlı iş listeleri de kullanılabilir. Prometheus query sonucu custom trigger olarak değerlendirilebilir. Cron scaler ise bilinen trafik saatlerinden önce pre-scaling yapmak için kullanılabilir.
Kafka
Kafka workload'larında consumer lag önemli scaling sinyalidir. KEDA lag miktarına göre replica sayısını artırabilir. Partition sayısı maximum useful replica üzerinde doğal sınır oluşturur. Consumer group davranışı doğru yapılandırılmalıdır. Rebalance süresi çok agresif scaling altında performansı etkileyebilir.
RabbitMQ
RabbitMQ queue length worker talebini gösterebilir. KEDA queue üzerindeki mesaj sayısına göre consumer replica sayısını değiştirebilir. Mesajların işlem süreleri farklıysa queue length tek başına yeterli olmayabilir. Unacked message ve processing latency izlenmelidir. Scale-down sırasında in-flight mesajların güvenli tamamlanması gerekir.
SQS
SQS gibi cloud queue sistemlerinde visible message sayısı autoscaling için kullanılabilir. Worker throughput'u biliniyorsa message count hedef replica sayısına dönüştürülebilir. Visibility timeout processing süresinden kısa olmamalıdır. Retry ve dead-letter queue davranışı load spike sırasında önem kazanır. Node autoscaler burst worker'ları taşıyacak kadar hızlı olmalıdır.
Azure Queue
Azure Queue tabanlı sistemlerde bekleyen mesaj miktarı event-driven scaling sinyali olabilir. Worker replica sayısı queue pressure'a göre artırılır. Authentication ve network erişimi güvenli şekilde yapılandırılmalıdır. Cloud API rate limitleri metric polling davranışını etkileyebilir. Scale-to-zero kullanılıyorsa ilk worker startup süresi ölçülmelidir.
Prometheus
KEDA Prometheus query sonucunu scaling trigger olarak kullanabilir. Bu, uygulamaya özgü metric'leri hızlı biçimde autoscaling'e bağlamayı kolaylaştırır. Query kısa ve güvenilir olmalıdır. Prometheus erişilemezse scaler hata davranışı izlenmelidir. Metric pipeline production control loop'un parçası hâline gelir.
Redis
Redis list, stream veya başka queue benzeri yapılar event-driven worker scaling için kullanılabilir. Bekleyen iş miktarı replica ihtiyacını gösterebilir. Redis'in kendi capacity sınırları da izlenmelidir. Çok agresif consumer scale-up Redis connection sayısını hızla artırabilir. Downstream dependency limitleri max replica değerinde hesaba katılmalıdır.
Cron
Cron scaler belirli saatlerde replica sayısını önceden yükseltmek için kullanılabilir. Trafik her gün aynı saatte artıyorsa reactive scaling'i beklemek gerekmez. Kampanya veya batch window öncesinde warm capacity oluşturulabilir. Cron dönemi bittikten sonra normal event metric kontrolü devam edebilir. Saat dilimi ayarları production deployment öncesinde doğrulanmalıdır.
HPA ile KEDA Arasındaki Fark
HPA Kubernetes'in temel horizontal workload autoscaling mekanizmasıdır. KEDA ise harici event kaynaklarından metric üreterek HPA'yı genişleten ve scale-to-zero aktivasyonunu yöneten güçlü bir katmandır. CPU ve memory gibi resource metric'lerde klasik HPA yeterli olabilir. Queue consumer, Kafka lag veya event-driven workload'larda KEDA daha doğal model sunar. İki araç birbirinin doğrudan alternatifi olmaktan çok farklı talep sinyallerini yönetir.
Resource Metric
HPA CPU ve memory resource metric'lerini doğrudan kullanabilir. Metrics Server bu kullanım için yaygın veri kaynağıdır. Basit stateless API'lerde hızlı başlangıç sağlar. Request right-sizing doğru yapılmalıdır. KEDA da bazı resource scaler'ları sunabilir ancak temel güç alanı external event kaynaklarıdır.
External Metric
External metric Kubernetes nesnesine doğrudan bağlı olmayan harici talep sinyalini temsil eder. Queue uzunluğu veya cloud servis metriği buna örnek olabilir. HPA uygun external metrics adapter ile bu metric'i kullanabilir. KEDA bu entegrasyonların önemli kısmını hazır scaler'larla kolaylaştırır. Operasyon maliyeti açısından KEDA bazı projelerde daha pratik olur.
Event-Driven Workloads
Event-driven workload iş geldiğinde çalışan worker veya consumer modelleridir. CPU bu sistemlerde çoğu zaman geç sinyal verir. Queue backlog iş talebini daha doğrudan gösterir. KEDA bu nedenle event-driven sistemlerde güçlüdür. Scale-to-zero boşta bekleme maliyetini de azaltabilir.
Queue Consumers
Queue consumer replica sayısı backlog miktarına göre değiştirilebilir. Hedef, queue age veya message count'u SLO altında tutmaktır. Consumer başına throughput load test ile ölçülmelidir. Replica sayısı artırıldığında downstream database kapasitesi de kontrol edilmelidir. KEDA queue metric entegrasyonunu kolaylaştırabilir.
Scale-to-Zero
Standart HPA çoğu kullanımda minimum bir replica üzerinden çalışır. KEDA aktivasyon döngüsü workload'u sıfıra indirebilir ve event geldiğinde tekrar başlatabilir. Bu serverless benzeri maliyet avantajı sağlar. Ancak cold start kullanıcı facing servislerde sorun olabilir. Minimum replica ihtiyacı workload SLO'suna göre belirlenmelidir.
Hangi Senaryoda Hangisi?
CPU veya memory ile düzgün ölçeklenen klasik web API için HPA yeterli olabilir. Queue, Kafka veya event source odaklı worker için KEDA daha doğal seçimdir. Prometheus custom metric ile zaten çalışan sağlam bir HPA altyapınız varsa KEDA zorunlu değildir. Scale-to-zero önemliyse KEDA güçlü avantaj sunar. Seçim araç sayısından çok talep sinyalinin niteliğine göre yapılmalıdır.
Scale-to-Zero Kullanılmalı mı?
Scale-to-zero kaynak tüketimini ciddi biçimde azaltabilir ancak her workload için uygun değildir. Event-driven background worker'larda çoğu zaman iyi sonuç verir. Kullanıcı isteğinin doğrudan Pod'u uyandırması gereken servislerde cold start latency'si sorun olabilir. Model yükleyen GPU servislerinde sıfırdan başlama süresi dakikalar sürebilir. Kritik uygulamalarda minimum warm replica tutmak availability açısından daha doğru olabilir.
Maliyet Avantajı
İş gelmediği saatlerde sıfır Pod tutmak compute maliyetini azaltır. Çok sayıda seyrek kullanılan worker bulunan platformlarda toplam tasarruf anlamlı olabilir. Node autoscaler da boş node'ları kaldırabiliyorsa ek kazanç sağlanır. Ancak shared cluster'da birkaç Pod'un kapanması node maliyetini her zaman azaltmaz. Tasarruf gerçek cloud faturasından ölçülmelidir.
Cold Start
Cold start sıfırdan ilk Pod'un hazır hâle gelmesine kadar geçen süredir. Image pull, application startup ve dependency initialization bu süreye dahildir. Yeni node gerekiyorsa süre daha da uzar. Event worker için birkaç saniye kabul edilebilir olabilir. Kullanıcı facing API için aynı gecikme SLO ihlali yaratabilir.
İlk Request Latency
Scale-to-zero kullanıldığında ilk request veya event normalden daha uzun bekleyebilir. HTTP workload'unda request timeout'a uğramadan önce Pod hazır olmalıdır. Queue sisteminde event bekleyebildiği için cold start daha toleranslıdır. Gateway veya HTTP scaling ara katmanı ilk isteği buffer edebiliyorsa davranış değişebilir. Gerçek kullanıcı deneyimi load test ile ölçülmelidir.
Minimum Replica
Minimum replica sıfır olmak zorunda değildir. Bir veya iki warm replica kritik servislerde daha güvenli olabilir. Bu küçük baseline kapasite spike'ın ilk saniyelerini karşılar. Autoscaler ek Pod'ları arkadan üretir. Maliyet ile latency arasında bu değer en önemli tuning noktalarından biridir.
Kritik Uygulamalarda Warm Capacity
Ödeme, authentication veya gerçek zamanlı API gibi kritik servislerde warm capacity tutulması mantıklıdır. Minimum replica sayısı zone redundancy'yi de desteklemelidir. Node autoscaler'ın bütün node grubunu sıfıra indirmesi cold node startup oluşturabilir. Kritik workload için minimum node kapasitesi gerekebilir. SLO ve recovery hedefleri maliyet kararının önünde tutulmalıdır.
Scheduled ve Predictive Scaling
Reactive autoscaling trafik geldikten sonra metric'in yükselmesini bekler. Trafik zirvesi önceden biliniyorsa kapasiteyi daha erken hazırlamak daha iyi sonuç verebilir. Cron tabanlı pre-scaling basit ve güvenilir bir yöntemdir. Kampanya başlangıcı veya günlük login yoğunluğu buna örnek olabilir. Predictive yaklaşım tarihsel veriden tahmin üretirken cron yaklaşımı daha açıklanabilir ve yönetilebilir olabilir.
Cron-Based Pre-Scaling
Cron tabanlı scaling belirli saatte replica sayısını önceden artırır. KEDA cron scaler bu senaryolarda kullanılabilir. Kullanıcı trafiği başlamadan Pod'lar Ready hâle gelir. Cold start kullanıcı tarafından görülmez. Trafik penceresi sona erdiğinde normal autoscaling politikasına dönülebilir.
Bilinen Trafik Zirveleri
Her pazartesi sabahı aynı saatte trafik artıyorsa reactive HPA'yı beklemek gereksizdir. Önceden kapasite hazırlamak latency spike'ını azaltır. Historical monitoring verisi bu pattern'i doğrulamalıdır. Tatil veya kampanya günlerinde schedule ayrı olabilir. Statik schedule gerçek metric autoscaling'in yerini almamalı, onu desteklemelidir.
Kampanya ve Etkinlik Öncesi Kapasite
Büyük kampanya başlangıç zamanı çoğu ekip tarafından önceden bilinir. Bu durumda minimum replica ve node sayısı etkinlikten önce yükseltilebilir. Image'ların node'larda hazır olması için pre-pull düşünülebilir. Database connection limitleri de aynı anda kontrol edilmelidir. Autoscaling yalnızca application Pod katmanını büyütmekle sınırlı kalmamalıdır.
Reactive vs Predictive Scaling
Reactive scaling gerçek metric'e cevap verir ve bilinmeyen talep değişimlerine uyum sağlar. Predictive scaling gelecekteki talebi tahmin ederek kapasiteyi önceden hazırlar. Tahmin yanlışsa gereksiz maliyet oluşabilir. Reactive sistem ise cold start nedeniyle geç kalabilir. En güvenli model çoğu zaman baseline prediction ile reactive HPA'nın birlikte kullanılmasıdır.
Pre-Warming
Pre-warming yalnızca Pod sayısını artırmak değildir. Cache, model, connection pool ve JIT süreçlerinin de hazır olması gerekir. GPU node açıldıktan sonra model yüklenmesi birkaç dakika sürebilir. Kampanya öncesinde synthetic request ile Pod'ların gerçekten warm hâle gelmesi sağlanabilir. Monitoring dashboard'unda ready replica ile gerçek throughput kapasitesi ayrı değerlendirilmelidir.
Cluster Autoscaler Nedir?
Cluster Autoscaler, scheduler tarafından yerleştirilemeyen Pod'lar bulunduğunda mevcut node group kapasitesini büyütebilen Kubernetes ekosistemi bileşenidir. HPA yeni Pod oluşturmak istediğinde cluster'da yer yoksa Pod Pending kalır. Cluster Autoscaler bu durumu değerlendirip uygun node group'u büyütebilir. Kapasite fazlası oluştuğunda belirli koşullarda node scale-down yapabilir. PDB, local storage ve scheduling constraint'leri bu kararları etkiler.
Pending Pod
Pending Pod henüz uygun node'a yerleştirilememiş Pod'dur. Bunun nedeni kaynak yetersizliği olabilir. Ancak affinity, taint veya topology kısıtı da Pending durumuna yol açabilir. Cluster Autoscaler her Pending Pod için mutlaka node eklemez. Önce yeni node eklenirse Pod'un gerçekten schedulable olup olmayacağı değerlendirilir.
Unschedulable Pod
Unschedulable Pod scheduler'ın mevcut node'larda uygun yer bulamadığı Pod'dur. Resource request, node selector veya taint nedenleri event kayıtlarında görülebilir. Node autoscaler bu sinyali capacity ihtiyacı olarak değerlendirebilir. Fakat imkânsız bir node selector varsa hiçbir node group Pod'u karşılamayabilir. Kubernetes event mesajları sorunun nedenini bulmak için önemlidir.
Node Group
Cluster Autoscaler çoğunlukla önceden tanımlı node group'ların boyutunu değiştirir. Her node group belirli instance tipi, zone veya label setine sahip olabilir. Workload yalnızca belirli label'lı node'a gidebiliyorsa uygun group scale edilmelidir. Min ve max group size sınırları bulunur. Cloud quota bu sınırların üzerinde gerçek kapasite oluşmasını engelleyebilir.
Scale-Up
Scale-up unschedulable Pod'ların çalışabilmesi için yeni node eklenmesi sürecidir. Cloud provider'da VM oluşturma süresi toplam gecikmenin önemli kısmıdır. Node Ready olduktan sonra scheduler Pod'u yerleştirir. Image pull ve startup süreleri bundan sonra gelir. Bu nedenle node scale-up cold path dakikalar sürebilir.
Scale-Down
Scale-down az kullanılan node'ların kaldırılmasıyla maliyeti azaltır. Node üzerindeki Pod'ların başka node'lara taşınabilir olması gerekir. PDB veya local storage bazı Pod'ların eviction'ını engelleyebilir. Çok agresif scale-down kısa süre sonra tekrar scale-up ihtiyacı doğurabilir. Node consolidation politikası workload traffic pattern'iyle uyumlu olmalıdır.
Node Drain
Node silinmeden önce workload Pod'ları güvenli şekilde diğer node'lara taşınmalıdır. Drain sırasında eviction kuralları uygulanır. PDB availability sınırını korur. Graceful shutdown uygulama seviyesinde bağlantıların düzgün kapanmasını sağlar. Node autoscaling bu nedenle yalnızca infrastructure işlemi değildir.
HPA ile Cluster Autoscaler Nasıl Birlikte Çalışır?
HPA ve Cluster Autoscaler farklı kontrol döngülerinde çalışır. HPA workload talebine göre daha fazla Pod ister. Scheduler bu Pod'lar için mevcut node'larda yer bulamazsa Pod'lar Pending olur. Cluster Autoscaler yeni node kapasitesi ekleyerek scheduler'a alan oluşturur. Service ise Ready olan yeni Pod'ları backend havuzuna dahil ederek gerçek trafik kapasitesini artırır.
Trafik Artar
İlk sinyal kullanıcı veya event talebinin yükselmesidir. RPS, CPU, queue depth veya başka metric artar. HPA bu metric'i gözlemleyerek replica ihtiyacını hesaplar. Eğer minimum warm kapasite yeterliyse kullanıcı ilk spike'ı sorunsuz görebilir. Değilse latency artışı node açılmadan önce başlayabilir.
HPA Yeni Pod İster
HPA Deployment replica sayısını yükseltir. ReplicaSet yeni Pod nesneleri oluşturur. Scheduler her Pod için uygun node arar. Mevcut node kapasitesi varsa süreç hızlı ilerler. Kapasite yoksa Pod Pending kalır.
Cluster'da Kapasite Yetmez
CPU veya memory request toplamı mevcut node kapasitesini aşabilir. Pod topology constraint veya node selector seçenekleri uygun node sayısını daha da azaltabilir. Scheduler Pod'u yerleştiremez. Event mesajı nedenini açıklar. Bu aşamada node autoscaler devreye girebilir.
Pod Pending Kalır
Pending Pod gerçek uygulama kapasitesine katkı sağlamaz. HPA desired replica sayısını artırmış olsa bile Service yalnızca Ready backend'lere trafik gönderebilir. Dashboard'da desired ve ready replica farkı bu sorunu gösterir. Eğer bu fark dakikalarca sürüyorsa node capacity veya startup sorunu vardır. Autoscaling SLO'sunda Pending süresi ayrı metric olmalıdır.
Cluster Autoscaler Node Ekler
Cluster Autoscaler uygun node group kapasitesini artırabilir. Cloud sağlayıcısı yeni instance başlatır. Node Kubernetes control plane'e katılır ve Ready olur. DaemonSet Pod'ları node üzerinde başlayabilir. Scheduler bundan sonra bekleyen workload Pod'larını yerleştirebilir.
Scheduler Pod'u Yerleştirir
Scheduler yeni node üzerinde resource request ve diğer scheduling constraint'leri kontrol eder. Uygun node seçildiğinde Pod binding gerçekleşir. Container image indirilir ve uygulama başlatılır. Startup ve readiness probe başarılı olmalıdır. Bu aşamadan önce replica yalnızca nesne olarak vardır.
Service Yeni Pod'a Trafik Dağıtır
Pod Ready olduğunda EndpointSlice durumu güncellenir. Service veri yolu yeni endpoint'i kullanabilir. Trafik kademeli olarak yeni Pod'a ulaşmaya başlar. Uzun bağlantılarda bu dağılım anında eşitlenmeyebilir. Gerçek scale-up tamamlanma anı trafik ve latency metric'leriyle doğrulanmalıdır.
HPA Çalışıyor Ama Pod'lar Neden Pending Kalıyor?
HPA'nın desired replica sayısını yükseltmesi scheduler'ın bu Pod'ları çalıştırabileceği anlamına gelmez. Node kapasitesi yetersiz olabilir veya scheduling kısıtları uygun node bulmayı engelleyebilir. Çok büyük resource request sık karşılaşılan nedenlerden biridir. Cloud quota veya uygun instance tipi bulunamaması node autoscaler'ın scale-up yapmasını da engelleyebilir. Troubleshooting sırasında HPA status'tan sonra ilk bakılacak yer Pod event kayıtlarıdır.
Node Kapasitesi Yetmiyor
Mevcut node'larda yeterli allocatable CPU veya memory olmayabilir. Scheduler Pod'u Pending bırakır. Node autoscaler uygunsa yeni node ekleyebilir. Ancak node group max size sınırına ulaşmış olabilir. Capacity dashboard'unda allocatable ve requested kaynaklar birlikte izlenmelidir.
Resource Requests Çok Büyük
Pod request'i tek bir node'un sağlayabileceğinden büyükse node eklemek de sorunu çözmeyebilir. Örneğin 20 CPU isteyen Pod yalnızca 8 CPU node group içinde schedule edilemez. Autoscaler uygun instance tipi olmayan group'u büyütse bile Pod Pending kalır. Request right-sizing veya daha büyük node seçeneği gerekir. Scheduler event'i bu durumu açıkça gösterebilir.
Node Selector
Node selector workload'u belirli label taşıyan node'larla sınırlar. Uygun label'lı node group yoksa Pod hiçbir yere yerleşemez. Autoscaler yanlış group'u büyütse bile sorun devam eder. Label naming standardı platform ekibi tarafından yönetilmelidir. Git review sırasında selector değişiklikleri dikkatle incelenmelidir.
Affinity
Node veya Pod affinity yerleşim seçeneklerini daraltabilir. Required affinity çok katı tanımlanırsa uygun node kalmayabilir. Preferred affinity daha esnek davranır. Multi-zone tasarımda affinity ile topology spread kuralları birbiriyle çelişebilir. Scheduler event'leri conflict nedenini anlamaya yardımcı olur.
Taint ve Toleration
Taint belirli workload'ların node'a schedule edilmesini engellemek için kullanılabilir. Pod uygun toleration taşımıyorsa node kapasitesi boş olsa bile kullanılamaz. GPU veya dedicated workload node pool'larında bu model yaygındır. Autoscaler yeni node eklediğinde aynı taint yeni node üzerinde de bulunur. Toleration hatası kapasite artışıyla düzelmez.
Availability Zone Kısıtı
Persistent Volume veya node affinity workload'u belirli zone'a bağlayabilir. O zone'da cloud kapasitesi yoksa Pod Pending kalabilir. Diğer zone'larda boş node olması çözüm sağlamaz. Multi-AZ node autoscaling bu nedenle zone capacity shortage senaryosunu test etmelidir. Storage topology özellikle StatefulSet workload'larında önemlidir.
Cloud Quota
Cloud hesabının vCPU veya instance quota sınırı yeni node oluşmasını engelleyebilir. Kubernetes tarafında autoscaler scale-up denese bile provider API hatası dönebilir. Bu durum yalnızca Pod event'inde görünmeyebilir. Autoscaler log ve cloud audit kayıtları kontrol edilmelidir. Kampanya öncesinde quota kapasitesi de test planına dahil edilmelidir.
Uygun Instance Type Bulunamaması
Belirli zone veya instance family için kapasite bulunamayabilir. Spot kapasitesi özellikle değişken olabilir. Sadece tek instance type'a bağlı node group failure riskini artırır. Dinamik provisioning daha geniş instance seçenekleri kullanabiliyorsa avantaj sağlar. Workload constraint'leri esnek tutulduğunda capacity shortage riski azalır.
Karpenter Nedir?
Karpenter, workload ihtiyaçlarına göre dinamik compute kapasitesi sağlayan node provisioning yaklaşımıdır. Scheduler'ın yerleştiremediği Pod gereksinimlerini değerlendirerek uygun instance seçeneklerini seçebilir. NodePool politikalarıyla hangi zone, instance family veya kapasite türlerinin kullanılacağı sınırlandırılabilir. Consolidation gereksiz veya verimsiz node'ların azaltılmasına yardımcı olur. Özellikle değişken workload'larda daha geniş instance seçimi kapasite bulunabilirliğini artırabilir.
Dynamic Node Provisioning
Dynamic provisioning önceden sabit birkaç node group boyutuna bağlı kalmadan iş yüküne göre node oluşturmayı amaçlar. Pod request ve scheduling constraint'leri instance seçiminde kullanılır. Böylece büyük Pod için daha büyük node, küçük workload için maliyet odaklı başka instance seçilebilir. Cloud kapasitesi değiştikçe uygun seçenek değerlendirilebilir. Bu model node pool yönetimini farklı bir seviyeye taşır.
NodePool
NodePool hangi tür node'ların provision edilebileceğini ve hangi kısıtların geçerli olduğunu tanımlar. Instance family, zone, architecture veya capacity type gibi seçenekler sınırlandırılabilir. Çok dar constraint kapasite bulunabilirliğini azaltır. Çok geniş constraint ise beklenmeyen instance türleri oluşturabilir. Policy güvenlik ve maliyet hedefleriyle birlikte yazılmalıdır.
Workload Gereksinimine Göre Node Seçimi
Pod resource request ve node selector bilgileri provisioning kararında kullanılabilir. GPU isteyen workload uygun accelerator node'a yönelmelidir. ARM uyumlu workload daha düşük maliyetli instance'ları kullanabilir. Stateful workload disk topology nedeniyle belirli zone'a bağlı olabilir. Workload manifest kalitesi node autoscaling kalitesini doğrudan etkiler.
Instance Type
Instance type CPU, memory, network ve accelerator kapasitesini belirler. Tek bir instance type'a bağlı kalmak capacity shortage riskini artırabilir. Benzer kaynak oranlarına sahip birden fazla family'ye izin vermek esneklik sağlar. Ancak uygulama lisansı veya architecture bağımlılığı sınır getirebilir. Cost-per-request analizi sadece saatlik instance fiyatından daha anlamlıdır.
Availability Zone
Birden fazla zone'a izin vermek node provisioning başarısını artırabilir. Tek zone cloud capacity shortage durumunda darboğaz olur. Stateful disk attachment constraint'leri zone esnekliğini azaltabilir. Pod topology spread zone'lar arasında replica dağılımı sağlar. Node autoscaler bu dağılımın kapasite tarafını desteklemelidir.
Spot ve On-Demand
Spot instance maliyeti azaltabilir fakat interruption riski taşır. Batch job ve fault-tolerant worker workload'larında iyi adaydır. Kritik API baseline kapasitesini yalnızca Spot üzerinde tutmak riskli olabilir. On-Demand minimum kapasite ile Spot burst modeli dengeli çözüm sunabilir. PDB ve graceful shutdown interruption senaryolarında test edilmelidir.
Node Consolidation
Consolidation workload'ları daha verimli node yerleşimine taşıyarak gereksiz node'ları azaltmayı amaçlar. Pod disruption etkisi nedeniyle PDB ile ilişkilidir. Çok agresif consolidation sürekli Pod hareketine yol açabilir. Stateful veya uzun request workload'larında bu davranış kullanıcı deneyimini etkileyebilir. Cost dashboard ile disruption metric birlikte değerlendirilmelidir.
Cluster Autoscaler mı Karpenter mı?
Cluster Autoscaler ve Karpenter node kapasitesi problemine farklı modellerle yaklaşır. Cluster Autoscaler genellikle önceden tanımlanmış node group'ların boyutunu değiştirir. Karpenter workload gereksinimine göre daha dinamik instance seçimi yapabilir. Cloud provider desteği, mevcut platform yapısı ve ekip deneyimi seçimde önemlidir. Mevcut çalışan node group modelini sırf yeni araç kullanmak için değiştirmek yerine gerçek provisioning sorununu tanımlamak gerekir.
Predefined Node Groups
Cluster Autoscaler node group temelli modelde güçlüdür. Ekip hangi instance tiplerinin kullanılacağını önceden belirler. Operasyon davranışı daha öngörülebilir olabilir. Ancak instance çeşitliliği sınırlıysa capacity shortage riski artar. Çok sayıda workload tipi için çok sayıda group yönetmek gerekebilir.
Dynamic Instance Selection
Karpenter daha geniş instance setinden workload için uygun node seçebilir. Bu kapasite bulunabilirliği ve maliyet optimizasyonu açısından avantaj sağlayabilir. Constraint'ler yanlış tanımlanırsa gereğinden pahalı node seçilebilir. Allowed instance family ve architecture açık şekilde sınırlandırılmalıdır. Cost alert ile provisioning kararları izlenmelidir.
Provisioning Speed
Node açılma süresi cloud API ve instance startup süresine bağlıdır. Dinamik provisioning kararının hızlı olması toplam gecikmenin yalnızca bir bölümüdür. Image pull ve daemonset startup da süreye eklenir. En iyi autoscaler bile cold node süresini sıfırlayamaz. Warm node capacity kritik workload'larda hâlâ değerlidir.
Cost Optimization
Instance çeşitliliği daha iyi price-performance seçimi sağlayabilir. Consolidation düşük utilization node'ları azaltabilir. Spot seçenekleri burst kapasitesinde tasarruf yaratabilir. Ancak sürekli node churn network ve startup maliyeti doğurabilir. Gerçek KPI cloud cost per request veya cost per job olmalıdır.
Cloud Provider Desteği
Node autoscaling aracının desteklediği cloud ortamı seçimde belirleyicidir. Bazı çözümler belirli sağlayıcılarda daha güçlü özellik sunar. Managed Kubernetes entegrasyonu operasyon yükünü azaltabilir. Version compatibility ve upgrade planı kontrol edilmelidir. Platform bağımlılığı uzun dönem mimari kararın parçasıdır.
Operasyonel Karmaşıklık
Daha dinamik node provisioning daha fazla policy ve gözlemlenebilirlik ihtiyacı doğurabilir. Ekip hangi Pod'un neden belirli instance üzerine yerleştiğini anlayabilmelidir. Cost anomaly ve scheduling failure için dashboard bulunmalıdır. Çok sayıda esnek seçenek kontrolsüz bırakılmamalıdır. Basit workload için basit node group modeli hâlâ iyi seçim olabilir.
Node Autoscaling ve Scheduler İlişkisi
Node autoscaling scheduler kararlarından bağımsız çalışmaz. Scheduler Pod'u mevcut node'lara yerleştiremediğinde node autoscaler bu talebi yorumlar. Resource request, affinity, taint ve topology constraint'leri hangi node kapasitesinin işe yarayacağını belirler. Yanlış workload manifesti autoscaler'ın kapasite üretmesini engelleyebilir. Bu yüzden scheduling bilgisi node autoscaling troubleshooting'in temelidir.
Resource Requests
Scheduler Pod'un node'a sığıp sığmadığını request değerleriyle değerlendirir. Gerçek anlık kullanım daha düşük olsa bile request kadar kapasite ayrılmış kabul edilir. Çok yüksek request node sayısını gereksiz büyütebilir. Çok düşük request node pressure riskini yükseltir. Autoscaling cost optimizasyonu doğru request ile başlar.
Node Selector
Node selector Pod'u belirli node label'larına bağlar. GPU veya özel compliance node'ları için yararlı olabilir. Ancak gereksiz selector capacity esnekliğini azaltır. Autoscaler yalnızca matching node oluşturabildiğinde Pod schedule edilir. Label standardı platform genelinde tutarlı olmalıdır.
Node Affinity
Node affinity daha gelişmiş node seçim kuralları sunar. Required ve preferred davranışları farklıdır. Required kural kapasite seçeneklerini sert biçimde sınırlar. Preferred yaklaşım scheduler'a fallback esnekliği verir. Cost ve availability açısından gereksiz required constraint'lerden kaçınmak faydalıdır.
Pod Anti-Affinity
Pod anti-affinity replica'ların aynı node veya zone üzerinde toplanmasını önleyebilir. Availability açısından faydalıdır. Çok katı kurallar az node bulunan cluster'da Pending Pod oluşturabilir. HPA replica sayısını artırdığında bu kısıt daha görünür hâle gelir. Topology spread çoğu durumda daha esnek alternatif sunabilir.
Taint/Toleration
Taint dedicated node pool'larını korumak için güçlü mekanizmadır. Toleration taşıyan workload bu node'lara schedule edilebilir. Autoscaler yeni dedicated node oluşturduğunda taint devam eder. Yanlış toleration Pod'u sürekli Pending bırakabilir. Node pool tasarımında label ve taint amaçları net ayrılmalıdır.
Topology Spread Constraints
Topology spread constraints Pod'ların node veya zone'lara dengeli dağıtılmasını sağlar. `maxSkew` kabul edilen dengesizliği belirler. HPA yeni replica eklediğinde scheduler bu kuralları uygular. Multi-AZ availability ve traffic distribution için önemli araçtır. Çok katı constraint kapasite shortage sırasında schedule başarısını azaltabilir.
Pod Topology Spread ile Yük Dengeleme
Load balancing sadece Service seviyesinde yapılmaz, Pod'ların fiziksel yerleşimi de gerçek trafik dağılımını etkiler. Bütün replica'ların aynı node veya zone'da olması failure riskini artırır. Topology spread constraints Pod'ları daha dengeli yerleştirmeye yardımcı olur. ExternalTrafficPolicy Local veya zone-aware routing kullanılıyorsa bu dağılım özellikle önemlidir. HPA yeni Pod oluşturduğunda scheduler'ın bunları doğru topology alanlarına dağıtması gerekir.
Pod'ları Node'lara Dengeli Dağıtmak
Replica'ların farklı node'lara dağıtılması tek node failure etkisini azaltır. Aynı zamanda node-local resource contention riskini düşürür. Topology key olarak hostname kullanılabilir. maxSkew küçük tutulduğunda daha dengeli yerleşim hedeflenir. Ancak node sayısı yetersizse yeni Pod Pending kalabilir.
Availability Zone Dağılımı
Zone bazlı topology spread tek zone arızasına karşı koruma sağlar. Üç zone bulunan cluster'da replica'ların yalnızca bir zone'da toplanması istenmez. HPA scale-up sırasında yeni replica'lar boş zone'lara yayılabilir. Node autoscaler her zone'da kapasite oluşturabilmelidir. Storage topology bazı workload'larda zone hareketini sınırlar.
maxSkew
`maxSkew` topology alanları arasındaki izin verilen Pod sayısı farkını kontrol eder. Değer küçüldükçe daha dengeli dağılım hedeflenir. Ancak katı scheduling davranışı capacity shortage durumunda Pod'u Pending bırakabilir. `whenUnsatisfiable` seçimi bu nedenle önemlidir. Availability ile scheduling esnekliği arasında denge kurulmalıdır.
Single-Zone Hotspot Önleme
Zone-local trafik tercihleri varsa bir zone'da fazla Pod, diğerinde az Pod farklı trafik davranışı oluşturabilir. Topology spread bu dengesizliği azaltır. Zone başına ready replica metric'i izlenmelidir. HPA cluster ortalaması tek başına hotspot'u göstermeyebilir. Load test aynı anda zone bazlı yapılmalıdır.
HPA ile Yeni Pod'ların Dağılımı
HPA replica sayısını artırır ancak nereye schedule edileceğine scheduler karar verir. Topology spread yeni Pod'ların zone ve node dağılımını yönlendirir. Node autoscaler gerekli topology alanında kapasite sağlamazsa Pod Pending kalabilir. Bu durum desired replica yüksek olduğu hâlde real capacity'nin artmamasına neden olur. Autoscaling dashboard'unda zone dağılımı bu yüzden bulunmalıdır.
PodDisruptionBudget ve Autoscaling
PodDisruptionBudget planlı Pod disruption sırasında minimum availability seviyesini korumaya yardımcı olur. Node scale-down veya maintenance sırasında Pod eviction işlemlerini sınırlayabilir. Çok katı PDB node autoscaler'ın boş node'u silememesine neden olabilir. Çok gevşek PDB ise aynı anda çok fazla replica'nın kaybedilmesine izin verebilir. Availability ile cost optimizasyonu arasında doğru denge kurulmalıdır.
PDB Nedir?
PDB gönüllü disruption sırasında workload'un ne kadarının kullanılabilir kalması gerektiğini tanımlar. Node drain önemli kullanım senaryosudur. PDB uygulama için yeni replica üretmez. Sadece belirli eviction işlemlerine sınır koyar. HPA minimum replica değeriyle birlikte değerlendirilmelidir.
minAvailable
`minAvailable` disruption sırasında minimum kaç Pod'un hazır kalması gerektiğini belirtir. Kritik API'de toplam replica sayısının büyük bölümünü koruyabilir. Ancak replica sayısı çok düşükse node maintenance zorlaşabilir. HPA minReplicas değeri PDB gereksinimini desteklemelidir. İki değer çelişirse operasyon işlemleri takılabilir.
maxUnavailable
`maxUnavailable` aynı anda kaç replica'nın kullanılamaz olabileceğini tanımlar. Yüzde veya sayı olarak belirtilebilir. Rolling update ve drain davranışında anlamlı sınır sağlar. Çok küçük değer node scale-down'u yavaşlatabilir. Çok büyük değer availability riskini yükseltir.
Node Scale-Down
Autoscaler düşük kullanım gören node'u silmek isteyebilir. Bunun için üzerindeki workload Pod'larının başka node'lara taşınması gerekir. PDB eviction'a izin vermiyorsa node kaldırılamaz. Cost dashboard node sayısının neden düşmediğini tek başına açıklamayabilir. Autoscaler event ve PDB status birlikte incelenmelidir.
PDB Nedeniyle Node'un Silinememesi
Örneğin iki replica'lı workload `minAvailable: 2` kullanıyorsa tek Pod'u bile gönüllü olarak evict etmek mümkün olmayabilir. Bu Pod node üzerinde kaldığı için node scale-down bloke olur. HPA minimum replica üçe çıkarılırsa daha fazla esneklik oluşabilir. Alternatif olarak PDB değeri SLO'ya göre yeniden değerlendirilebilir. Ama yalnızca maliyet için availability sınırı düşürülmemelidir.
Availability ve Cost Dengesi
PDB daha yüksek availability sağlar ancak node consolidation esnekliğini azaltabilir. Minimum replica da aynı etkiye sahiptir. Cost optimizasyonu için her korumayı kaldırmak doğru değildir. SLO gerekli baseline kapasiteyi belirlemelidir. Cloud cost bunun üzerinde kalan gereksiz kapasiteyi hedeflemelidir.
Stateful Workload'larda Autoscaling
Stateful workload'larda yatay ölçekleme stateless servislerden daha zordur. Yeni replica oluşturmak yalnızca yeni Pod eklemek anlamına gelmez, veri bölümlendirme ve storage davranışı da değişebilir. StatefulSet stabil kimlik ve storage ilişkisi sağlar. Database gibi sistemlerde horizontal scaling uygulamanın kendi replication modeline bağlıdır. VPA right-sizing bazı stateful servislerde yatay scale'den daha güvenli olabilir.
Stateless ve Stateful Farkı
Stateless Pod herhangi bir request'i bağımsız işleyebilir ve kolayca değiştirilebilir. Stateful workload veri veya kimlik durumuna sahiptir. Replica eklenmesi veri dağılımı veya consensus süreçlerini tetikleyebilir. HPA yalnızca Pod sayısını bildiği için uygulama semantiğini anlayamaz. Bu nedenle stateful autoscaling application-aware tasarım gerektirir.
StatefulSet
StatefulSet Pod'lara kararlı isim ve sıralı identity sağlar. Her replica kendi PersistentVolumeClaim kaynağına sahip olabilir. Scale-up yeni ordinal Pod ve disk oluşturabilir. Scale-down disk yaşam döngüsü ayrıca yönetilmelidir. Database workload'unda replica eklemek query kapasitesini otomatik artırmayabilir.
Persistent Volume
Persistent Volume Pod yeniden oluşturulduğunda verinin korunmasını sağlar. Storage class ve zone topology scheduling üzerinde etkili olabilir. Yeni node başka zone'da olsa bile volume attach mümkün olmayabilir. Node autoscaling stateful workload için bu constraint'i dikkate almalıdır. Storage throughput da application capacity'nin parçasıdır.
Database Scaling
Database scaling read replica, sharding veya partitioning gibi uygulamaya özgü mekanizmalar gerektirir. HPA ile rastgele database replica eklemek çoğu sistemde doğru değildir. Consensus cluster üyeliği kontrollü değişmelidir. Operator tabanlı yönetim stateful lifecycle için daha uygun olabilir. Autoscaling kararı database engine'in önerdiği modelle uyumlu olmalıdır.
Horizontal Scaling'in Sınırları
Her workload yatay olarak sonsuza kadar ölçeklenmez. Shared lock, single writer veya central storage bottleneck throughput'u sınırlar. Replica sayısı artırıldığında network ve replication maliyeti artabilir. Load test scaling efficiency eğrisini göstermelidir. Bir noktadan sonra vertical scaling veya partitioning daha etkili olabilir.
VPA Kullanımı
VPA stateful workload'un resource right-sizing ihtiyacında faydalı olabilir. Recommendation mode düşük riskli başlangıçtır. Automatic update restart veya eviction etkisi yaratabileceği için dikkat gerektirir. Database cache belleği kullanımını basit utilization metriğiyle yorumlamak doğru olmayabilir. Vendor veya engine best practice'leri dikkate alınmalıdır.
Kafka Consumer Autoscaling
Kafka consumer workload'larında CPU yerine consumer lag çoğu zaman daha anlamlı scaling metric'idir. Lag arttığında mesajlar tüketim hızından daha hızlı geliyor demektir. KEDA Kafka scaler bu talep sinyalini replica sayısına bağlayabilir. Ancak partition sayısı paralelliğin doğal sınırıdır. On partition bulunan topic için onlarca consumer oluşturmak ekstra throughput sağlamayabilir.
CPU Neden Yetersiz Metric Olabilir?
Consumer mesaj beklerken veya downstream I/O yaparken CPU düşük kalabilir. Buna rağmen lag hızla büyüyor olabilir. CPU HPA geç tepki verir. Lag doğrudan işlenmemiş talebi gösterir. Bu nedenle event-driven worker'larda queue metric genellikle daha güçlüdür.
Consumer Lag
Consumer lag son üretilen offset ile tüketilen offset arasındaki farkı temsil eder. Lag büyüyorsa consumer kapasitesi talebin gerisindedir. Target lag per replica değeri throughput ölçümünden türetilebilir. Lag sıfıra yaklaştığında scale-down yapılabilir. Çok agresif scale-down consumer rebalance sayısını artırabilir.
Partition Sayısı
Kafka consumer group içinde bir partition aynı anda tek consumer tarafından işlenir. Bu nedenle partition sayısı paralel consumer sayısını sınırlar. Daha fazla replica idle kalabilir. Autoscaler max replica değeri partition sayısıyla uyumlu olmalıdır. Topic yeniden partition edilirse autoscaling sınırı da gözden geçirilmelidir.
KEDA
KEDA consumer lag gibi Kafka metric'lerini scaling trigger olarak kullanabilir. Event source doğrudan worker ihtiyacını temsil eder. Scale-to-zero bazı consumer workload'larında uygulanabilir. Ancak consumer group initialization ve rebalance süresi cold start'a eklenir. Production test'inde spike ve partition rebalance birlikte ölçülmelidir.
Maximum Useful Replica Count
Maximum useful replica her zaman HPA maxReplicas ile aynı sayı değildir. Kafka'da partition sayısı doğal üst sınırdır. Downstream database bağlantı limiti daha düşük bir sınır da oluşturabilir. Worker throughput'u replica arttıkça lineer artmıyorsa daha erken saturasyon görülebilir. Load test max replica değerinin teknik temelini sağlamalıdır.
Batch Job'larda Otomatik Ölçekleme
Batch workload'lar trafik serving uygulamalarından farklı ölçekleme modeli gerektirir. İş miktarı queue veya job backlog üzerinden ölçülebilir. KEDA ScaledJob event miktarına göre ayrı Kubernetes Job oluşturmak için kullanılabilir. Burst dönemlerinde node autoscaler geçici compute kapasitesi sağlar. İşler tamamlandığında Pod ve node sayısı tekrar azaltılabilir.
Queue-Based Scaling
Batch işlerin queue içinde tutulması autoscaling için net talep sinyali sağlar. Her job'un ortalama süresi biliniyorsa target concurrency hesaplanabilir. Queue age SLO olarak kullanılabilir. Worker crash olduğunda mesajın yeniden işlenebilmesi gerekir. Idempotency batch sisteminin dayanıklılığını artırır.
KEDA ScaledJob
ScaledJob event talebine göre Job nesneleri oluşturabilir. Uzun süre yaşayan worker yerine her iş bağımsız lifecycle'a sahip olabilir. Bu model farklı iş sürelerinde daha temiz izolasyon sağlayabilir. Job tamamlandığında Pod kaldırılır. Node autoscaler boş kapasiteyi daha sonra azaltabilir.
Node Burst Capacity
Batch sistemi kısa sürede yüzlerce Pod oluşturabilir. Mevcut node kapasitesi yeterli değilse büyük Pending kuyruğu oluşur. Node autoscaler burst hızını taşıyabilmelidir. Cloud API quota ve instance capacity burada kritik hâle gelir. Önceden küçük bir warm node pool tutmak startup süresini azaltabilir.
Spot Instance
Retry edilebilir batch işler Spot kapasite için iyi adaydır. Interruption olduğunda Job başka node üzerinde yeniden çalışabilir. İş checkpoint desteği maliyet verimliliğini artırır. Deadline kritik batch workload'larda yalnızca Spot kapasiteye güvenmek risklidir. On-Demand fallback politikası değerlendirilebilir.
İş Tamamlandıktan Sonra Scale-Down
Queue boşaldığında worker sayısı azaltılır. Node'lar boş kaldığında node autoscaler bunları kaldırabilir. PDB veya daemonset Pod'ları node scale-down davranışını etkileyebilir. Çok uzun cooldown gereksiz maliyet oluşturur. Çok kısa cooldown ise kısa aralıklı batch dalgalarında node churn üretir.
GPU ve AI Workload'larında Autoscaling
GPU workload'larında autoscaling CPU servislerinden daha pahalı ve daha yavaş olabilir. GPU node provisioning süresi, model loading ve büyük container image'ları cold start'ı uzatır. GPU utilization tek başına her zaman doğru metric değildir. Queue depth, concurrent inference ve token throughput daha anlamlı olabilir. Karpenter benzeri dinamik provisioning araçları uygun GPU instance bulmaya yardımcı olabilir.
GPU Node Pool
GPU node'ları pahalı olduğu için ayrı node pool kullanımı yaygındır. Taint ve toleration workload izolasyonu sağlar. Minimum node sayısı cold start gereksinimine göre seçilebilir. Tamamen sıfıra inmek maliyeti azaltır ancak yeni GPU node açılmasını bekletir. Kritik inference servislerinde en az bir warm node daha güvenli olabilir.
GPU Scheduling
Kubernetes GPU kaynaklarını device plugin üzerinden schedule edebilir. Pod request uygun GPU sayısını belirtir. Bir GPU'nun paylaşımı kullanılan runtime ve partitioning teknolojisine göre değişebilir. Scheduler GPU memory utilization bilgisini her zaman doğrudan kapasite kararında kullanmaz. Workload packing stratejisi ayrıca tasarlanmalıdır.
Model Server Replicas
Model server replica sayısı concurrent request ve model throughput'una göre ayarlanmalıdır. Aynı GPU üzerinde birden fazla replica bazen verimsiz olabilir. Büyük model bütün GPU belleğini kullanabilir. Tensor parallel veya sharded serving replica modelini değiştirir. HPA hedefi gerçek inference topolojisine uygun olmalıdır.
GPU Utilization
GPU utilization yüksek görünmesi tek başına kötü değildir. Batch processing sistemi GPU'yu sürekli yüzde 95 kullanmak isteyebilir. Online inference'da ise queue büyümesi ve latency daha anlamlı saturation sinyalleridir. Memory utilization da model boyutuyla sürekli yüksek olabilir. Scaling metric workload SLO'suna göre seçilmelidir.
Queue Depth
Inference queue depth gelen talebin mevcut GPU kapasitesini aştığını erken gösterebilir. CPU henüz normal görünürken queue büyüyebilir. Target queue per replica değerini model benchmark sonucundan çıkarabilirsiniz. Batch size ve dynamic batching bu kapasiteyi değiştirir. Model sürümü değiştiğinde autoscaling eşiği yeniden test edilmelidir.
Karpenter ve GPU Node Provisioning
Dinamik provisioning uygun GPU instance seçenekleri arasından capacity bulmayı kolaylaştırabilir. Ancak GPU instance availability bazı bölgelerde sınırlıdır. Birden fazla zone veya instance family'ye izin vermek başarı oranını artırabilir. Modelin donanım uyumluluğu constraint'leri daraltabilir. Provisioning süresi nedeniyle pre-warming kritik inference servislerinde değerlidir.
LLM Inference Yük Dengeleme
LLM inference workload'larında klasik round-robin her zaman en iyi load balancing yaklaşımı değildir. Request maliyeti prompt uzunluğu, output token sayısı ve model durumuna göre ciddi değişebilir. Bir Pod kısa request'ler alırken başka Pod çok uzun generation işlemleriyle dolabilir. KV cache ve session state backend seçimini etkileyebilir. Bu nedenle load balancing ile model autoscaling birlikte ve model-aware sinyallerle ele alınmalıdır.
Geleneksel Round-Robin Neden Yetersiz Kalabilir?
Round-robin her yeni request'i sırayla backend'lere verir. Fakat bir LLM request'i 100 milisaniye, diğeri onlarca saniye sürebilir. Request sayısı eşit olsa bile GPU işi eşit değildir. Active sequence ve token workload metric'leri daha anlamlı olabilir. Scheduler benzeri model-aware routing bu nedenle araştırılan önemli alandır.
Uzun Süren Inference Request'leri
Uzun generation request'i GPU üzerinde uzun süre kapasite tüketir. RPS düşük olsa bile concurrency yüksek kalabilir. HPA yalnızca RPS ile scale ederse geç tepki verebilir. Queue age ve active token workload daha iyi sinyal olabilir. Timeout değerleri modelin gerçek response süresine göre ayarlanmalıdır.
KV Cache ve Session State
KV cache inference performansını ciddi biçimde etkileyebilir. Aynı conversation state'in farklı backend'e taşınması cache kaybına yol açabilir. Sticky routing performans sağlayabilir ancak yük dengesizliği oluşturabilir. Merkezi veya taşınabilir cache yaklaşımı mimariyi değiştirir. Session affinity autoscaling etkisi burada çok daha belirgin olabilir.
GPU Utilization
LLM serving'de GPU utilization yüksek olduğu hâlde throughput hâlâ artabilir. Dynamic batching GPU'yu daha verimli kullanabilir. Sadece GPU yüzde değerine bakmak queue pressure'ı göstermeyebilir. Memory saturation da model ve KV cache kapasitesini sınırlar. Autoscaling için birden fazla model serving metriği izlemek daha uygundur.
Model-Aware Routing
Model-aware routing backend'in model, KV cache, active sequence ve kapasite durumunu dikkate alabilir. Böylece request yalnızca sıradaki Pod'a değil, iş için daha uygun backend'e gider. Multi-model serving'de model locality önemli olabilir. Yanlış backend seçimi model load cold start oluşturabilir. Routing ve autoscaling controller'larının aynı kapasite sinyallerini paylaşması faydalıdır.
Gateway API Inference Extension
Gateway API ekosisteminde inference workload'larına yönelik model-aware routing uzantıları geliştirilmektedir. Bu tür özelliklerin standardizasyon ve release durumu hızlı değişebileceği için production öncesinde güncel Gateway API dokümantasyonu kontrol edilmelidir. Amaç gateway katmanını yalnızca HTTP path yönlendiren yapıdan daha akıllı inference routing noktasına taşımaktır. Model, backend ve request özelliklerine göre daha uygun seçim yapılabilir. Yeni özellikler değerlendirilirken controller implementasyon desteği ayrıca doğrulanmalıdır.
Load Balancing + Model Autoscaling
Model autoscaling yeni GPU replica üretirken routing katmanı bu kapasiteyi kullanabilmelidir. Yeni Pod model yüklemesini tamamlamadan request almamalıdır. Readiness probe gerçek inference readiness'i yansıtmalıdır. Long-lived streaming response'lar scale-down sırasında connection draining gerektirir. Production test senaryosu prompt dağılımını ve output token varyasyonunu içermelidir.
Multi-AZ Kubernetes Tasarımı
Multi-AZ cluster, tek availability zone kaybına karşı daha yüksek dayanıklılık sağlar. Bunun için Pod'ların, node'ların ve storage kaynaklarının birden fazla zone'a dağıtılması gerekir. Service routing cross-zone veya same-zone tercihleriyle maliyet ve latency açısından optimize edilebilir. Node autoscaler her zone'da capacity shortage riskini dikkate almalıdır. Sadece cluster'ın üç zone'da node bulundurması uygulamanın gerçekten üç zone'a yayıldığı anlamına gelmez.
Pod'ları Birden Fazla Zone'a Dağıtmak
Topology spread constraints replica'ların zone'lara dengeli dağılmasını sağlar. Pod anti-affinity alternatif bir yöntemdir. HPA scale-up sırasında yeni replica'nın uygun zone'a yerleşmesi gerekir. Tek zone'da node kapasitesi yetersizse Pod Pending kalabilir. Node autoscaler aynı topology ihtiyacını karşılamalıdır.
Cross-Zone Traffic
Cross-zone trafik farklı availability zone'lar arasında network transferi oluşturur. Cloud sağlayıcısına göre ek maliyet çıkabilir. Same-zone routing bu maliyeti azaltabilir. Ancak zone'daki Pod kapasitesi yetersizse local preference hotspot oluşturabilir. Cost ve latency metric'leri zone bazında izlenmelidir.
Same-Zone Routing
Same-zone routing istemciye yakın backend'i tercih eder. Ağ yolu kısalabilir ve cross-zone maliyeti azalabilir. Bunun için zone başına yeterli replica gerekir. HPA cluster ortalamasına bakarken zone bazlı yük farkını göremeyebilir. Zone-level RPS ve CPU dashboard'u bu yüzden değerlidir.
Node Autoscaling
Multi-AZ node autoscaling her zone'un kapasitesini ayrı değerlendirebilir. Bir zone'da instance capacity yoksa diğer zone'a fallback önemlidir. Stateful volume topology buna izin vermeyebilir. Node provisioning constraint'leri fazla dar tutulmamalıdır. Zone failure test'i production öncesinde yapılmalıdır.
Zone Capacity Shortage
Cloud provider belirli instance tipini bir zone'da geçici olarak sunamayabilir. Pod topology o zone'u zorunlu kılıyorsa workload Pending kalır. Birden fazla instance family ve zone seçeneği capacity bulunabilirliğini artırır. Critical workload yalnızca Spot kapasiteye bağlı bırakılmamalıdır. Autoscaler log'larında capacity error uyarıları izlenmelidir.
Zone Failure
Bir zone tamamen erişilemez olduğunda kalan zone'lar toplam trafiği taşımalıdır. Minimum replica ve node kapasitesi buna göre planlanmalıdır. HPA failure anında yeni replica isteyebilir ancak node provisioning zaman alır. Warm failover capacity daha hızlı recovery sağlar. Disaster test sırasında DNS, load balancer ve storage failover birlikte kontrol edilmelidir.
Multi-Cluster Load Balancing
Tek cluster çoğu sistem için yeterli olabilir, ancak regional failover veya çok büyük ölçek gereksinimi birden fazla cluster ihtiyacı oluşturabilir. Multi-cluster load balancing kullanıcı trafiğini cluster sağlığı, bölge veya latency gibi kriterlere göre dağıtabilir. Active-active model iki cluster'ı aynı anda kullanırken active-passive model standby kapasite tutar. Kubernetes Service tek başına global traffic manager değildir. DNS, global load balancer veya service networking çözümleri ayrıca gerekir.
Neden Birden Fazla Cluster?
Regülasyon, regional isolation veya blast radius azaltma multi-cluster nedenlerinden olabilir. Çok büyük organizasyonlarda ekip izolasyonu da ayrı cluster gerektirebilir. Disaster recovery için ikinci region başka önemli nedendir. Ancak multi-cluster operasyon maliyeti yüksektir. Tek cluster problemini gereksiz yere dağıtık hâle getirmemek gerekir.
Regional Failover
Regional failover bir region erişilemez olduğunda trafiği diğer region'a taşır. DNS TTL ve global load balancer health check süreleri recovery süresini etkiler. Standby cluster gerekli application ve data kapasitesine sahip olmalıdır. HPA failover anındaki iki kat trafiğe hazırlıklı olmalıdır. Database replication çoğu zaman en zor parçadır.
Global Traffic Management
Global traffic management kullanıcıyı uygun region veya cluster'a yönlendirir. Latency, geography veya health kriterleri kullanılabilir. Application session state region bağımsız değilse failover zorlaşır. DNS tabanlı yöntemlerde client cache süresi önemlidir. Global trafik politikası load test ve chaos test ile doğrulanmalıdır.
Active-Active
Active-active model iki veya daha fazla cluster'ın aynı anda trafik almasını sağlar. Kaynaklar zaten warm olduğu için failover daha hızlı olabilir. Data consistency tasarımı daha zordur. Cross-region write işlemleri latency oluşturabilir. Capacity planında bir cluster kaybolduğunda kalan cluster'ların tüm trafiği taşıyabilmesi gerekir.
Active-Passive
Active-passive model bir cluster'ı primary, diğerini standby tutar. Operasyon modeli daha basit olabilir. Standby kapasitesi düşük tutulursa failover sırasında autoscaling beklenir. Bu da recovery süresini uzatır. Warm standby maliyet ile RTO arasında dengedir.
Multi-Cluster Services
Multi-Cluster Services yaklaşımı cluster'lar arasında servis keşfi ve erişimi standardize etmeyi hedefler. Implementasyon ve platform desteği ayrıca doğrulanmalıdır. Tek bir Service abstraction üzerinden başka cluster backend'lerine erişim mümkün olabilir. Network connectivity ve identity kritik konulardır. Multi-cluster load balancing ile aynı şey olmadığı unutulmamalıdır.
Gateway API ile Gelecek Yaklaşımlar
Gateway API ekosisteminde multi-cluster routing üzerine çalışmalar bulunmaktadır. Bu alanın feature durumu hızla değişebilir. Production mimarisi hazırlanırken kullanılan controller'ın desteklediği spesifik API sürümü kontrol edilmelidir. Standard dışı extension kullanımı portability üzerinde etkili olabilir. Uzun dönem platform planında açık standardizasyon yönü takip edilmelidir.
Kubernetes Autoscaling'de Maliyet Optimizasyonu
Autoscaling maliyet düşürmek için güçlü bir araçtır ancak yanlış ayarlandığında maliyeti artırabilir. Minimum ve maksimum replica sınırları gerçek trafik verisine göre belirlenmelidir. Resource request right-sizing node utilization'ı doğrudan etkiler. Node consolidation ve Spot kullanımı ek tasarruf sağlayabilir. Cross-zone network trafiği ve LoadBalancer maliyetleri de compute kadar önemlidir.
Minimum Replica
Minimum replica gereğinden yüksekse sürekli boş kapasite tutulur. Gereğinden düşükse spike sırasında cold start kullanıcıya yansır. SLO doğru minimum değeri belirler. Zone redundancy de minimum replica hesabına dahil edilmelidir. Basit yüzde CPU hedefi bu kararı veremez.
Maximum Replica
Maximum replica maliyet ve dependency koruma sınırıdır. Kontrolsüz retry storm HPA'yı hızlıca büyütebilir. Max değer database connection capacity'yi aşmamalıdır. Cost alert bu sınıra yaklaşmayı bildirmelidir. Normal load test'te max değere ulaşmak beklenen davranış olmamalıdır.
Resource Requests
Request node scheduler kapasitesini belirler. Gereğinden büyük request düşük node utilization oluşturur. Gereğinden küçük request throttling ve OOM riskini artırır. VPA recommendation doğru başlangıç sağlayabilir. Cost optimization yalnızca request'i azaltmak anlamına gelmez.
VPA Right-Sizing
VPA geçmiş kullanım verisine göre kaynak önerisi sunabilir. Recommendation mode ile risk almadan iyileştirme fırsatları görülebilir. Büyük request'lerin düşürülmesi aynı node'a daha fazla Pod yerleştirmeye imkân verir. Bu node sayısını azaltabilir. Ancak peak workload ve SLO payı korunmalıdır.
Node Consolidation
Node consolidation workload'ları daha az node üzerinde toplayabilir. Böylece düşük utilization node maliyeti azaltılır. PDB ve topology constraint nedeniyle bazı node'lar boşaltılamayabilir. Çok agresif consolidation Pod churn oluşturur. Tasarruf ile disruption arasında denge kurulmalıdır.
Spot Instances
Spot instance burst veya batch kapasitesinde önemli tasarruf sağlayabilir. Interruption toleranslı workload'lar en iyi adaylardır. Critical baseline On-Demand üzerinde tutulabilir. Node provisioning farklı capacity type arasında esnek olmalıdır. Spot interruption event'leri dashboard'da izlenmelidir.
Scale-to-Zero
Seyrek kullanılan worker'larda scale-to-zero compute maliyetini ciddi azaltabilir. Ancak shared node zaten başka workload nedeniyle çalışıyorsa node maliyeti aynı kalabilir. Tasarruf application CPU metric'inden değil cloud faturasından ölçülmelidir. Cold start maliyetinin kullanıcı etkisi de hesaba katılmalıdır. Batch ve event worker'lar genellikle en uygun adaylardır.
Cross-Zone Network Cost
Cross-zone trafik görünmeyen önemli cloud maliyetlerinden biri olabilir. Service trafficDistribution ve topology-aware routing bu trafiği azaltmaya yardımcı olabilir. Pod'lar zone'lara dengeli dağıtılmalıdır. Node autoscaler tek zone'da kapasite yoğunlaştırırsa network maliyeti artabilir. FinOps dashboard'unda network transfer compute'dan ayrı izlenmelidir.
Availability ile Maliyet Arasındaki Denge
En düşük cloud faturası genellikle en düşük kapasiteyi çalıştırmakla elde edilir ancak bu yaklaşım production SLO'su için doğru değildir. Warm capacity ani trafik artışlarını karşılar. Minimum Pod ve node sayısı zone failure veya cold start senaryolarını absorbe eder. Çok agresif scale-down kısa süre sonra pahalı ve yavaş scale-up döngüsü oluşturabilir. Maliyet optimizasyonu SLO sağlandıktan sonra kalan verimsiz kapasiteyi hedeflemelidir.
Çok Agresif Scale-Down
Replica sayısı trafik düşer düşmez azaltılırsa kısa süreli ikinci spike sorun yaratabilir. Yeni Pod'ların tekrar başlaması gerekir. Node autoscaler da node'u silmişse cold start süresi uzar. Stabilization window bu davranışı yumuşatır. Birkaç dakika ek kapasite çoğu zaman daha iyi kullanıcı deneyimi sağlar.
Warm Capacity
Warm capacity hazır ancak tamamen kullanılmayan güvenlik payıdır. Kritik API'lerde kısa spike'ları absorbe eder. GPU inference gibi yavaş başlayan workload'larda özellikle değerlidir. Tamamen boş node tutmak pahalı olabilir. Minimum Pod ile minimum node değerleri ayrı optimize edilmelidir.
Minimum Pod Sayısı
Minimum Pod sayısı availability zone sayısı ve PDB ile birlikte seçilmelidir. Tek Pod production kritik servis için single point of failure oluşturabilir. Üç zone tasarımında en az üç replica mantıklı başlangıç olabilir. Ancak gerçek ihtiyaç SLO ve capacity test'ine bağlıdır. HPA minReplicas buna göre ayarlanmalıdır.
Minimum Node Sayısı
Node autoscaler bazı workload'larda node pool'u çok küçültebilir. İlk spike geldiğinde yeni node açılması beklenir. Bu süre dakikalar olabilir. Critical pool için minimum node kapasitesi cold start'ı azaltır. Shared cluster'da mevcut node'lar zaten yeterli warm kapasite sağlayabilir.
SLO ve Cloud Cost
SLO cloud maliyet kararının üst sınırını belirler. p95 latency hedefini bozacak tasarruf gerçek tasarruf değildir. Cost per successful request daha anlamlı metric olabilir. Autoscaling sonucu error rate yükseliyorsa cloud faturası düşük olsa bile sistem verimsizdir. FinOps ile SRE metrikleri aynı karar sürecinde buluşmalıdır.
Failover Kapasitesi
Zone veya node pool kaybında kalan kapasitenin trafiği taşıyabilmesi gerekir. Tam yüzde 100 failover capacity sürekli tutulmak pahalı olabilir. HPA ve node autoscaler recovery süresiyle birlikte risk hesaplanmalıdır. Kritik sistemlerde N+1 veya zone loss kapasitesi planlanabilir. Chaos test gerçek recovery süresini doğrular.
Autoscaling İçin SLO-Based Yaklaşım
SLO-based autoscaling kullanıcı deneyimini doğrudan koruyan metrikleri merkeze alır. CPU yüzde 60 olması kullanıcı için tek başına anlam ifade etmez. p95 latency, error rate ve queue age daha anlamlı service outcome göstergeleridir. Bununla birlikte SLO metriğinin kapasite problemiyle gerçekten ilişkili olduğu doğrulanmalıdır. Replica artırmanın çözmediği database latency için HPA'yı büyütmek yanlış tepki olur.
CPU Yerine Kullanıcı Deneyimini Ölçmek
CPU düşükken uygulama yavaş olabilir. External dependency veya lock contention bu duruma neden olabilir. Bu yüzden service SLI'ları autoscaling dashboard'unda CPU ile birlikte izlenmelidir. Latency ve error rate kullanıcı etkisini gösterir. Capacity metric ise çözümün replica artırmak olup olmadığını doğrular.
p95 Latency
p95 latency request'lerin yüzde 95'inin belirli sürenin altında tamamlandığını gösterir. Ortalama latency tail problemlerini gizleyebilir. Scale-up öncesi p95 yükseliyorsa capacity saturation erken tespit edilebilir. Yeni Pod'lar Ready olduktan sonra p95 düşmüyorsa sorun başka katmandadır. Bu ilişki load test ile doğrulanmalıdır.
Error Rate
Error rate kapasite yetersizliğinin en önemli kullanıcı etkilerinden biridir. Timeout ve 5xx artışı autoscaling'in geç kaldığını gösterebilir. Ancak application bug veya downstream outage da error rate üretir. Otomatik olarak daha fazla replica oluşturmak her hata için doğru değildir. Error type sınıflandırması yapılmalıdır.
Queue Age
Queue age event-driven workload'un kullanıcı bekleme süresine yakındır. Queue length düşük olsa bile çok eski iş bulunabilir. Target queue age SLO olarak kullanılabilir. KEDA veya custom metric scaling bunu capacity kararına bağlayabilir. Worker throughput ve retry davranışı birlikte incelenmelidir.
Throughput
Throughput sistemin belirli sürede tamamladığı iş miktarıdır. Replica sayısı arttıkça throughput lineer artmıyorsa başka bottleneck vardır. Database, lock veya network saturation buna neden olabilir. Load test scaling efficiency'yi ölçmelidir. Max replica gerçek throughput eğrisine göre seçilmelidir.
Saturation
Saturation kaynak veya internal queue kapasitesinin ne kadar dolu olduğunu ifade eder. CPU yüzde 100 klasik saturation sinyalidir. Thread pool queue, active connection ve GPU sequence count başka örneklerdir. SLO bozulmadan hemen önce saturation yükseliyorsa iyi autoscaling metric olabilir. Talep metriğiyle birlikte kullanmak daha güvenilir kontrol sağlar.
Load Test ile Autoscaling Nasıl Test Edilir?
Autoscaling production'a alınmadan önce kontrollü load test yapılmalıdır. Amaç yalnızca maksimum RPS görmek değildir. HPA'nın ne zaman replica eklediği, Pod'ların ne kadar sürede Ready olduğu ve node autoscaler'ın ne kadar sürede kapasite sağladığı ölçülmelidir. Scale-down ve graceful shutdown da aynı test planının parçası olmalıdır. Ben test sırasında desired replica, ready replica, pending Pod, node count, p95 latency ve error rate'i aynı zaman grafiğinde izlemeyi tercih ederim.
Test Ortamı
Test ortamı production davranışını mümkün olduğunca temsil etmelidir. Pod request, HPA policy ve node type farklıysa sonuç yanıltıcı olur. Database kapasitesi de test ortamında çok düşük olmamalıdır. Gerçek kullanıcı verisi yerine güvenli synthetic dataset kullanılmalıdır. Network ve TLS katmanları da mümkünse production yoluna benzemelidir.
k6
k6 HTTP ve başka protokoller için load test senaryoları oluşturabilen açık kaynaklı araçlardan biridir. RPS artışını kontrollü aşamalarla uygulamak kolaydır. Threshold tanımları SLO ihlalini otomatik gösterebilir. Distributed load gerektiğinde test üreticilerinin kendi kapasitesi izlenmelidir. Test client bottleneck'i server kapasitesi sanılmamalıdır.
Locust
Locust Python tabanlı load scenario geliştirmeyi kolaylaştırır. Kullanıcı davranışı benzeri akışlar oluşturulabilir. Birden fazla endpoint farklı oranlarda çağrılabilir. Distributed worker modeli yüksek yük üretmek için kullanılabilir. Test script'i production traffic mix'i mümkün olduğunca doğru yansıtmalıdır.
Artan RPS
RPS kademeli artırıldığında tek Pod'un saturation noktası kolay görülür. HPA'nın hangi eşikte scale-up yaptığı gözlemlenir. Yeni Pod Ready olduktan sonra latency'nin nasıl değiştiği ölçülür. Her aşama yeterince uzun tutulmalıdır. Çok hızlı ramp gerçek steady-state kapasiteyi göstermeyebilir.
Ani Traffic Spike
Ani spike autoscaling'in en zor senaryolarından biridir. Mevcut warm capacity ilk saniyelerde yükü taşır. HPA metric toplayıp scale kararı verir. Node yoksa provisioning gecikmesi eklenir. Bu test minimum replica değerinin doğru olup olmadığını gösterir.
Sustained Load
Sustained load uzun süre yüksek trafik altında sistemin kararlı davranışını ölçer. Memory leak, connection pool saturation veya database bottleneck bu testte ortaya çıkabilir. HPA sürekli replica artırmamalıdır. Throughput belirli noktada plateau yapıyorsa bottleneck bulunmalıdır. Cost per request uzun testte daha doğru hesaplanabilir.
Scale-Down Testi
Load azaltıldığında HPA stabilization davranışı izlenmelidir. Pod sonlandırılırken 5xx veya connection reset oluşmamalıdır. Node autoscaler node'ları hemen silmek yerine doğru koşulları beklemelidir. PDB node drain'i bloke edebilir. Scale-down testi yapılmadan autoscaling doğrulaması tamamlanmış sayılmamalıdır.
Autoscaling Testinde Hangi Metrikler İzlenmeli?
Autoscaling testinde yalnızca CPU grafiğine bakmak yeterli değildir. Desired replica ile current ve ready replica farkı gerçek kapasite gecikmesini gösterir. Pending Pod sayısı node autoscaler problemine işaret edebilir. RPS, p95 latency ve error rate kullanıcı etkisini gösterir. Node count ve cloud cost ise altyapı tarafındaki sonucu ortaya çıkarır.
Desired Replicas
Desired replicas HPA'nın kaç Pod istediğini gösterir. Bu sayı hızla artıyorsa metric hedefi aşılmış demektir. Ancak desired artması gerçek kapasitenin arttığı anlamına gelmez. Current ve Ready replica ile karşılaştırılmalıdır. Büyük fark startup veya scheduling problemine işaret eder.
Current Replicas
Current replicas workload controller'ın mevcut replica sayısını gösterir. Desired ile fark Deployment'ın henüz yeni Pod oluşturduğunu gösterebilir. Pod oluşturulmuş olsa bile Ready olmayabilir. Bu yüzden current tek başına kapasite metriği değildir. Ready replicas daha gerçekçi serving kapasitesidir.
Ready Replicas
Ready replica uygulamanın trafik alabilecek Pod sayısına daha yakındır. Desired sekiz, Ready üç ise autoscaling henüz kullanıcıya kapasite sağlamamıştır. Startup süresi bu farkın nedenlerinden biridir. Readiness yanlışsa sayı yanıltıcı olabilir. Synthetic health request ile gerçek serving kapasitesi doğrulanmalıdır.
Pending Pods
Pending Pod sayısı cluster capacity problemini hızlı gösterir. HPA yeni replica istemiş ancak scheduler yer bulamamış olabilir. Node autoscaler log'ları kontrol edilmelidir. Resource request veya affinity sorunu da aynı sonucu üretir. Pending duration SLO metric'i olarak takip edilebilir.
Node Count
Node count infrastructure autoscaling hareketini gösterir. Pod scale-up sonrası node sayısı geç yükseliyorsa capacity cold start ölçülebilir. Load düştükten sonra node sayısı hiç azalmıyorsa PDB veya consolidation problemi olabilir. Spot ve On-Demand node sayıları ayrı izlenebilir. Zone bazlı node count multi-AZ analizinde faydalıdır.
CPU/Memory
CPU ve memory saturation sinyalleridir. Pod başına dağılım ortalama değerden daha önemlidir. Bir Pod yüzde 95, diğerleri yüzde 30 ise load imbalance vardır. Node CPU ve Pod CPU birlikte incelenmelidir. Memory leak sustained load test sırasında kolay görülür.
RPS
RPS gerçek trafik hacmini gösterir. Pod başına RPS load balancing kalitesini anlamaya yardımcı olur. HPA replica arttığında toplam RPS aynı kalırken Pod başına RPS düşmelidir. Yeni Pod sıfır RPS alıyorsa trafik dağılımı problemi vardır. Long-lived connection workload'larında RPS yerine active connection metric'i eklenmelidir.
p95/p99 Latency
Tail latency kullanıcı deneyimini ortalamadan daha iyi gösterir. Scale-up başladığında p95 ve p99 değerlerinin ne kadar yükseldiği ölçülmelidir. Ready replica arttıkça latency düşmelidir. Düşmüyorsa bottleneck başka katmandadır. SLO doğrulaması bu metric'ler üzerinden yapılmalıdır.
Error Rate
Error rate load test'in en kritik sonuçlarından biridir. Scale-up sırasında 5xx artıyorsa readiness veya capacity gecikmesi olabilir. Scale-down sırasında artıyorsa graceful shutdown incelenmelidir. Timeout ve connection reset ayrı sınıflandırılmalıdır. Toplam hata yüzdesi kök nedeni tek başına açıklamaz.
Cost
Autoscaling testinin sonunda altyapı maliyeti de ölçülmelidir. Aynı RPS için iki kat node kullanmak verimsiz right-sizing gösterebilir. Cost per request veya cost per job daha anlamlı KPI'dır. Spot oranı ve cross-zone network transferi hesaba katılmalıdır. Cloud maliyetini performans metric'lerinden bağımsız değerlendirmemek gerekir.
Prometheus ve Grafana ile Autoscaling Monitoring
Autoscaling ancak iyi gözlemlendiğinde güvenilir biçimde işletilebilir. Prometheus HPA, KEDA, node autoscaler ve application metric'lerini tek veri katmanında toplayabilir. Grafana bu sinyalleri aynı zaman çizelgesinde karşılaştırmayı kolaylaştırır. Desired replica, pending Pod ve latency aynı panelde görüldüğünde scale problemi saniyeler içinde anlaşılabilir. Kurumsal Kubernetes load balancing ve autoscaling kurulum hizmeti tasarlanırken unified scaling dashboard benim öncelikli çıktılarımdan biridir.
HPA Metrics
HPA desired replica, current replica ve current metric değerleri izlenmelidir. HPA condition ve event'leri de önemlidir. Unknown metric veya max replica limitine ulaşma alert üretebilir. Scale event sayısı thrashing tespiti için kullanılabilir. Workload bazında hedef ve gerçek metric aynı grafikte bulunmalıdır.
KEDA Metrics
KEDA trigger metric'i, scaler error ve activation event'leri izlenmelidir. Scale-to-zero workload'da activation latency önemli SLI olabilir. Queue metric ile ready replica aynı grafikte karşılaştırılmalıdır. Scaler erişim hatası autoscaling'i durdurabilir. Fallback kullanılıyorsa ne zaman devreye girdiği alert üretmelidir.
Node Autoscaler Metrics
Pending Pod, scale-up attempt ve node provisioning duration önemli metric'lerdir. Scale-down block reason cost troubleshooting için değerlidir. Node group max limitine ulaşılması alert oluşturmalıdır. Cloud API error ve quota failure ayrıca izlenmelidir. Zone bazlı node capacity dashboard'u multi-AZ ortamında faydalıdır.
Pod Scheduling Events
Scheduler event'leri Pending Pod'un neden yerleşmediğini açıklar. Insufficient CPU, untolerated taint veya affinity mismatch sık nedenlerdir. Event'leri merkezi log sistemine almak troubleshooting'i hızlandırır. Sadece metric dashboard'u bu ayrıntıyı göstermeyebilir. HPA desired replica arttığında scheduler failure event'leriyle korelasyon kurulmalıdır.
Load Balancer Metrics
Load balancer request count, active connection, backend health ve target response time önemli sinyallerdir. Pod replica artmasına rağmen healthy target sayısı artmıyorsa readiness veya integration sorunu vardır. Backend başına request dağılımı load imbalance'ı gösterebilir. External LB ile Service metriği birlikte izlenmelidir. TLS ve 5xx hata oranları giriş katmanında ayrı tutulmalıdır.
Unified Scaling Dashboard
Unified dashboard trafik, application, Pod ve node katmanını aynı zaman ekseninde birleştirir. RPS yükselir, HPA desired replica artar, Pending Pod görülür, node count yükselir ve Ready replica tamamlanır. Bu zincir görsel olarak çok değerlidir. Her scale olayında latency ve cost etkisi de görülebilir. Böyle bir dashboard autoscaling tuning süresini ciddi biçimde kısaltır.
Kubernetes Autoscaling Troubleshooting
Autoscaling sorunu yaşandığında controller'ları tek tek suçlamak yerine kontrol zinciri izlenmelidir. Önce metric mevcut mu sorusuna cevap verilir. Ardından HPA desired replica değiştiriyor mu kontrol edilir. Yeni Pod oluşuyorsa scheduler ve node kapasitesi incelenir. Son olarak Ready endpoint'lerin gerçekten trafik alıp almadığı doğrulanır.
HPA unknown Metric
HPA metric kaynağına erişemediğinde unknown değer görülebilir. Metrics Server veya custom metrics adapter sağlığı kontrol edilmelidir. Metric ismi ve selector doğru olmalıdır. APIService status useful teşhis sağlar. Metric sorununu çözmeden HPA davranışını tuning etmek anlamsızdır.
HPA Replica Artırmıyor
Metric hedefin altında olabilir. Resource request çok yüksek olduğu için CPU utilization düşük görünebilir. `maxReplicas` sınırına ulaşılmış olabilir. HPA condition ve event mesajları nedeni açıklar. Multiple metric kullanılıyorsa her metric ayrı incelenmelidir.
HPA Sürekli Scale Ediyor
Metric hedef çevresinde dalgalanıyor olabilir. Stabilization window yetersiz kalabilir. Resource request değişiklikleri utilization metric'i etkileyebilir. Long-lived connection nedeniyle Pod yükü dengesiz olabilir. Scale event frequency dashboard'u thrashing'i gösterebilir.
Yeni Pod'lar Pending
Node capacity veya scheduling constraint sorunu vardır. `kubectl describe pod` event'leri ilk ipucunu verir. Resource request, taint ve affinity kontrol edilmelidir. Node autoscaler scale-up yapıyor mu incelenmelidir. Cloud quota ve instance availability ayrıca doğrulanmalıdır.
Node Autoscaler Node Eklemiyor
Pending Pod yeni node eklense bile schedule edilemiyor olabilir. Node group max size sınırında olabilir. Cloud quota scale-up'ı engelleyebilir. Autoscaler log'u neden scale-up yapılmadığını açıklar. Uygun instance tipi veya zone bulunmaması sık nedenlerden biridir.
Node Scale-Down Yapılmıyor
PDB eviction'ı bloke ediyor olabilir. Node üzerinde local storage veya taşınamayan Pod bulunabilir. Utilization scale-down eşiğinin üzerinde olabilir. Consolidation cooldown süresi henüz tamamlanmamış olabilir. Autoscaler reason metric'i cost troubleshooting için önemlidir.
Yeni Pod Trafik Almıyor
Pod Ready değilse Service trafik göndermeyebilir. Service selector yanlış olabilir. EndpointSlice içinde yeni Pod görünmüyor olabilir. Long-lived connection nedeniyle yeni connection oluşmadığı için Pod boş kalabilir. Load balancer backend health durumunu kontrol etmek gerekir.
Load Balancer Bazı Pod'ları Aşırı Yüklüyor
Session affinity backend dengesini bozabilir. ExternalTrafficPolicy Local node başına Pod sayısı farklıysa hotspot oluşturabilir. Long-lived connection eski Pod'ları yoğun bırakabilir. Pod topology tek zone veya node üzerinde dengesiz olabilir. Pod başına RPS, connection count ve CPU aynı grafikte incelenmelidir.
Load Imbalance Neden Oluşur?
Load imbalance replica sayısının eşit olmasına rağmen gerçek request veya bağlantı yükünün Pod'lar arasında farklı dağılmasıdır. Uzun bağlantılar en yaygın nedenlerden biridir. Session affinity ve topology-local routing de belirli backend'leri daha fazla kullanabilir. Scheduler Pod'ları dengesiz node veya zone'lara yerleştirebilir. HPA ortalama metric kullandığında bu hotspot'lar kolayca gizlenebilir.
Long-Lived Connections
Uzun bağlantılar ilk seçilen Pod'da kalır. Yeni Pod eklendiğinde mevcut bağlantılar taşınmaz. Eski Pod'ların active connection sayısı yüksek kalır. Ortalama CPU yeni Pod'lar nedeniyle düşebilir. Connection age ve rebalance mekanizması gerekir.
Session Affinity
Sticky session kullanıcıyı aynı backend'e bağlar. Bazı kullanıcılar çok daha ağır workload üretebilir. Böylece session sayısı eşit olsa bile CPU eşit olmaz. Yeni Pod'lar eski session'ları devralmaz. Stateful session harici store'a taşınabiliyorsa denge iyileşir.
Zone-Local Routing
Same-zone routing her zone'un kendi backend kapasitesini kullanır. Zone'lar farklı trafik alıyorsa Pod sayısı eşit olsa bile yük eşit değildir. HPA cluster average metric bunu gizleyebilir. Zone başına autoscaling yaklaşımı veya daha esnek routing değerlendirilebilir. Zone-level dashboard şarttır.
Uneven Pod Distribution
Replica'ların bazı node veya zone'larda toplanması topology-aware routing altında dengesizlik üretir. Topology spread constraints bunu azaltabilir. Node autoscaler da aynı zone'da yeterli kapasite sunmalıdır. Pod anti-affinity çok katı olmadan availability sağlayabilir. Scheduler dağılımı load balancing tasarımının parçasıdır.
Yanlış Readiness
Bazı Pod'lar Ready görünse de gerçekte yavaş olabilir. Load balancer bu Pod'lara trafik göndermeye devam eder. Diğer Pod'lar sağlıklı olduğu için ortalama metric normal görünebilir. Readiness endpoint'i gerçek serving kapasitesini temsil etmelidir. Dependency degradation senaryoları ayrıca test edilmelidir.
Uygulama İçindeki Connection Pooling
Frontend Pod'lar backend Service'e uzun süreli connection pool kullanabilir. Yeni backend Pod eklendiğinde mevcut connection'lar eski endpoint'lere bağlı kalır. Service load balancing yalnızca yeni connection oluştuğunda etkili olur. Pool max lifetime veya DNS refresh ayarı incelenmelidir. Bu sorun özellikle gRPC ve HTTP/2 servislerde görülebilir.
HPA'nın Ortalama Metrik Kullanması
HPA çoğu metric türünde Pod'lar arasındaki ortalama değeri kullanır. Bir Pod yüzde 100, üç Pod yüzde 20 CPU'da ise ortalama kritik görünmeyebilir. Kullanıcıların bir kısmı aşırı yüklü Pod'a denk gelir. Max Pod CPU veya p99 latency ayrı alarm üretmelidir. Autoscaling ile load balancing birlikte değerlendirilmelidir.
Thundering Herd Problemi
Thundering herd, çok sayıda request veya worker'ın aynı anda aynı kaynağa yüklenmesi durumudur. Trafik spike'ı geldiğinde HPA aynı anda çok sayıda replica oluşturabilir. Yeni Pod'lar cold olduğundan cache ve connection pool aynı anda hazırlanır. Node yoksa çok sayıda cold node da eş zamanlı oluşturulabilir. Pre-scaling, rate limiting, queue ve backpressure bu riski azaltır.
Trafik Ani Geldiğinde Ne Olur?
Mevcut Pod'lar ilk saniyelerde bütün yükü taşır. Metric yükselir ve HPA scale-up kararı verir. Yeni Pod'ların Ready olması zaman alır. Bu aralıkta latency ve error rate yükselebilir. Minimum warm capacity spike'ın ilk bölümünü absorbe eder.
Cold Pod'lar
Yeni Pod image pull ve startup sürecinden geçer. Cache ve JIT henüz hazır olmayabilir. Aynı anda çok sayıda cold Pod backend dependency'lere yük bindirebilir. Readiness yalnızca gerçek serving kapasitesi oluşunca başarılı olmalıdır. Ramp-up trafiği bazı sistemlerde kademeli verilmelidir.
Cold Node'lar
Cluster kapasitesi yoksa yeni node başlatılır. VM boot, kubelet join ve DaemonSet startup süresi eklenir. Pod bundan sonra schedule edilir. Bu cold path birkaç dakika sürebilir. Critical workload için minimum node capacity önemlidir.
Aynı Anda Çok Sayıda Replica
HPA çok hızlı scale-up yaptığında onlarca Pod aynı anda başlayabilir. Her Pod database connection pool açarsa backend ani bağlantı saldırısı yaşayabilir. Cache warm-up aynı veri kaynağına yük bindirebilir. Scale-up policy bu hızın sınırlandırılmasını sağlar. Downstream capacity HPA max replica ile birlikte planlanmalıdır.
Pre-Scaling
Bilinen trafik spike'ından önce Pod ve node sayısı yükseltilebilir. Cron veya deployment automation kullanılabilir. Warm-up işlemi trafik başlamadan tamamlanır. Bu yöntem kampanya ve etkinliklerde oldukça etkilidir. Reactive autoscaling yine beklenmeyen ek yük için açık tutulmalıdır.
Rate Limiting
Rate limiting backend kapasitesini aşan talebi kontrollü biçimde sınırlayabilir. Bu, bütün sistemin çökmesinden daha iyi kullanıcı davranışı sağlar. Retry-After benzeri mekanizmalar client tarafını yönlendirebilir. Gateway veya application seviyesinde uygulanabilir. Rate limit değeri gerçek safe throughput'a dayanmalıdır.
Queue ve Backpressure
Queue ani talebi backend kapasitesinden ayırır. Worker'lar kontrollü hızda işleri tüketir. Backpressure upstream'in sınırsız iş göndermesini engeller. Autoscaling queue depth veya age'e göre yapılabilir. Bu model thundering herd etkisini önemli ölçüde azaltır.
Retry Storm Autoscaling'i Nasıl Bozabilir?
Retry storm, başarısız request'lerin client veya servisler tarafından hızlı şekilde tekrar gönderilmesiyle gerçek kullanıcı trafiğinin katlanmasıdır. İlk kapasite problemi daha fazla retry üretir. CPU ve RPS yükseldiği için HPA replica artırır. Yeni replica'lar backend database'i daha fazla yükleyerek sorunu büyütebilir. Circuit breaker, exponential backoff ve retry bütçesi bu zinciri kırmak için gereklidir.
Timeout
Timeout çok kısa ayarlanırsa sağlıklı ama yavaş request gereksiz yere başarısız kabul edilir. Client hemen retry yapabilir. Böylece backend aynı işi birden fazla kez yürütür. Çok uzun timeout ise kaynakları gereksiz süre meşgul eder. Timeout service SLO ve dependency davranışına göre seçilmelidir.
Retry
Retry geçici network hatalarında faydalıdır. Ancak limitsiz retry ciddi trafik çarpanı oluşturur. Her service zincirinde üç retry varsa downstream kısa sürede çok fazla request görebilir. Retry yalnızca idempotent ve uygun hatalarda yapılmalıdır. Retry budget tanımlamak iyi yaklaşımdır.
Trafik Çarpanı
Normal 1000 RPS trafik iki retry ile teorik olarak 3000 backend attempt seviyesine çıkabilir. Sistem zaten yavaşken bu ek yük sorunu büyütür. HPA artan RPS'i gerçek kullanıcı talebi sanabilir. Load balancer yeni Pod'lara aynı retry trafiğini yayar. Metric dashboard original request ile retry request'i ayrı göstermelidir.
CPU Artışı
Retry storm CPU kullanımını yükseltebilir. HPA bunun üzerine replica ekler. Eğer asıl sorun database lock ise yeni replica daha fazla database connection açar. CPU scaling sorunu semptom üzerinden büyütebilir. Root cause metric'i dependency latency ile birlikte incelenmelidir.
HPA Scale-Up
HPA metric doğru olsa bile retry storm altında sinyalin kaynağını bilmez. Controller yalnızca gözlenen yükü kapasiteye dönüştürür. Bu nedenle application resilience policy autoscaler'ın dışında tasarlanmalıdır. Max replica backend'i aşırı scale'den korur. Scale-up sırasında error type analizi yapılmalıdır.
Circuit Breaker
Circuit breaker başarısız dependency'ye sürekli request gönderilmesini sınırlar. Hata oranı belirli eşik üzerine çıktığında çağrı geçici olarak kesilebilir. Bu retry storm riskini azaltır. Fallback cevabı veya queueing kullanılabilir. Circuit breaker threshold gerçek service behavior'a göre test edilmelidir.
Exponential Backoff
Exponential backoff retry aralığını giderek artırır. Jitter eklemek bütün client'ların aynı anda tekrar denemesini önler. Bu yaklaşım thundering herd riskini azaltır. Maximum retry count yine gereklidir. Client SDK ve service mesh default'ları production öncesinde kontrol edilmelidir.
GitOps ile Autoscaling Yönetimi
Autoscaling configuration production davranışını doğrudan etkilediği için version control altında tutulmalıdır. HPA manifestleri, KEDA ScaledObject kaynakları, NodePool tanımları ve Gateway route'ları Git üzerinden yönetilebilir. Pull request review yanlış max replica veya routing değişikliğini production öncesinde yakalar. GitOps controller cluster durumunu deklaratif kaynağa eşitler. Tuning sonucunda yapılan değişikliklerin nedenleri commit mesajlarında belgelenmelidir.
HPA Manifestleri
HPA min, max, metric ve behavior ayarları Git içinde tutulmalıdır. Manuel `kubectl edit` değişiklikleri kaybolabilir veya denetlenemez. Load test sonucu yapılan tuning pull request ile belgelenebilir. Environment bazında farklı değerler overlay yaklaşımıyla yönetilebilir. Production max replica artışı review gerektirmelidir.
KEDA ScaledObjects
KEDA trigger ve authentication ayarları da deklaratif yönetilmelidir. Queue threshold değişikliği ciddi maliyet etkisi yaratabilir. Secret içeriği Git'e düz metin olarak konulmamalıdır. ScaledObject diff'i rollout review sırasında kolayca görülebilir. Scale-to-zero değişikliği SLO etkisi nedeniyle ayrıca değerlendirilmelidir.
NodePool Tanımları
NodePool instance, zone ve capacity type constraint'lerini içerir. Yanlış değişiklik yüzlerce pahalı node oluşturabilir. Pull request policy ile max limit ve allowed instance family doğrulanabilir. Cost policy as code yaklaşımı kullanılabilir. Node provisioning config uygulama deployment'ı kadar kritik kabul edilmelidir.
Gateway API Routes
HTTPRoute weight değişikliği production trafiğini yeni sürüme aktarabilir. GitOps bu değişikliğin audit trail'ini sağlar. Canary rollout adımları commit veya otomasyon üzerinden yürütülebilir. Route backendRefs review edilmelidir. Yanlış namespace veya Service adı büyük trafik kesintisi yaratabilir.
Git Versioning
Git geçmişi configuration değişikliklerinin ne zaman ve neden yapıldığını gösterir. HPA target CPU yüzde 60'tan yüzde 75'e değiştiğinde nedeni sonradan izlenebilir. Incident sırasında önceki çalışan config'e dönüş kolaylaşır. Branch protection production değişikliklerini güvenli hâle getirir. Tag veya release sistemi platform konfigürasyonuna da uygulanabilir.
Pull Request Review
Pull request otomasyon değişikliğini ikinci gözle kontrol ettirir. `maxReplicas: 1000` gibi yanlış değer erken yakalanabilir. CI manifest schema ve policy kontrolü yapabilir. Load test sonucu veya cost tahmini PR açıklamasına eklenebilir. Platform ve application ekibi aynı değişikliği birlikte değerlendirebilir.
Argo CD / Flux
Argo CD ve Flux Git tabanlı Kubernetes reconciliation için yaygın açık kaynaklı seçeneklerdir. Cluster durumunu repository ile karşılaştırabilirler. Drift oluştuğunda görünür hâle gelir. Autoscaling kaynakları da aynı reconciliation modeline dahil edilebilir. HPA'nın yönettiği `replicas` alanı ile GitOps ownership çakışması yaşamamak için resource ownership dikkatle ayarlanmalıdır.
Kubernetes İçin En İyi Programlama Dili Hangisidir?
Kubernetes alanında tek bir zorunlu programlama dili yoktur. Kubernetes'in önemli bölümü Go ile geliştirildiği için ekosistem controller geliştirmede Go güçlü konumdadır. Python otomasyon, script ve API entegrasyonlarında çok kullanışlıdır. YAML ise programlama dili olmasa da deklaratif Kubernetes yönetiminin günlük aracıdır. Asıl değer Linux, networking, container, observability ve distributed systems temellerini anlamaktan gelir.
Go Neden Kubernetes Ekosisteminde Öne Çıkıyor?
Kubernetes ve birçok cloud-native proje Go ile geliştirilmiştir. Controller-runtime ve client-go gibi kütüphaneler operator geliştirmeyi kolaylaştırır. Statik binary dağıtımı container ortamında pratiktir. Concurrency modeli network servisleri için uygundur. Kubernetes platform geliştiricisi olmak isteyenler için Go güçlü tercihtir.
Python ile Kubernetes Automation
Python hızlı script ve otomasyon geliştirmek için çok uygundur. Kubernetes API client ile deployment veya raporlama araçları yazılabilir. Data analysis tarafında Prometheus metric'lerini işlemek kolaydır. Küçük platform otomasyonlarında development süresi kısadır. Uzun ömürlü controller geliştirirken lifecycle ve performance ihtiyaçları ayrıca değerlendirilmelidir.
YAML ve Declarative Configuration
Kubernetes kaynakları çoğunlukla YAML manifestlerle tanımlanır. Deployment, Service, HPA ve Gateway API kaynakları deklaratif model kullanır. YAML syntax hataları CI validation ile yakalanmalıdır. Çok fazla tekrar olduğunda Helm veya Kustomize yardımcı olabilir. Manifest yazmak Kubernetes öğrenmenin önemli parçasıdır.
Helm Template'leri
Helm tekrar eden Kubernetes manifestlerini parametrelerle yönetmeyi kolaylaştırır. Environment farkları values dosyalarıyla taşınabilir. Çok fazla template logic manifest okunabilirliğini azaltabilir. Schema validation ve chart test faydalıdır. Autoscaling default'ları chart içinde güvenli sınırlarla sunulmalıdır.
Programlama Dilinden Daha Önemli Olan Cloud-Native Temelleri
Networking bilmeden Service troubleshooting yapmak zordur. Linux process ve signal davranışı bilinmeden graceful shutdown doğru tasarlanamaz. Resource request ve cgroup mantığı bilinmeden HPA tuning eksik kalır. Observability olmadan autoscaling kararının doğru çalıştığı kanıtlanamaz. Bu nedenle dil seçimi temellerin üzerine gelmelidir.
Open Source ve İşbirliği ile Kubernetes
Kubernetes ekosisteminin büyük bölümü açık kaynak işbirliğiyle gelişir. Kubernetes, KEDA, Karpenter, Gateway API, Cilium ve Prometheus gibi projelerin issue, proposal ve pull request süreçleri topluluk katılımına açıktır. Open source katkı yalnızca kod yazmak değildir. Dokümantasyon, bug reproducer ve test katkıları da değerlidir. Yerel yazılım toplulukları bu projeleri öğrenmek için ortak laboratuvarlar düzenleyebilir.
Kubernetes Açık Kaynak Projesi
Kubernetes büyük contributor topluluğuna sahip açık kaynak projesidir. SIG yapıları belirli teknik alanlara odaklanır. Yeni başlayanlar issue ve dokümantasyon üzerinden katkı sürecini öğrenebilir. Kod katkısından önce community guideline okumak faydalıdır. Release süreçlerini takip etmek production operasyon bilgisini de geliştirir.
CNCF Ekosistemi
Cloud Native Computing Foundation birçok cloud-native projeye ev sahipliği yapar. Observability, networking ve runtime alanlarında geniş ekosistem bulunur. Tek bir projeyi öğrenmek yerine problem alanlarını anlamak daha değerlidir. Standardizasyon çalışmaları farklı projelerin birlikte çalışmasını kolaylaştırır. Gateway API gibi SIG projeleri Kubernetes networking yönünü takip etmek için iyi örnektir.
KEDA
KEDA event-driven autoscaling alanında açık kaynaklı projedir. Farklı scaler entegrasyonları community katkısıyla genişler. Yeni event source ihtiyacı olan geliştiriciler issue veya code contribution yapabilir. Dokümantasyon örnekleri de önemli katkı alanıdır. Bu süreç Kubernetes controller mimarisini öğrenmek için iyi fırsattır.
Karpenter
Karpenter node provisioning ve capacity yönetimi alanında incelenebilecek önemli açık kaynak projelerden biridir. Scheduler ve cloud capacity ilişkisinin nasıl kurulduğunu görmek öğreticidir. NodePool ve consolidation mantığı modern infrastructure autoscaling yaklaşımını gösterir. Issue tartışmaları gerçek production problemlere dair değerli örnekler sunar. Katkı öncesinde desteklenen provider ve roadmap durumunu incelemek gerekir.
Gateway API
Gateway API Kubernetes trafik yönetiminin gelecekteki standardizasyon yönünü görmek için önemli projedir. GEP dokümanları yeni özelliklerin neden ve nasıl tasarlandığını açıklar. HTTPRoute ve GRPCRoute gibi kaynaklar protocol-aware routing modelini öğretir. Conformance test yaklaşımı portability açısından değerlidir. Networking alanında çalışan geliştiriciler için iyi öğrenme kaynağıdır.
Cilium
Cilium eBPF tabanlı networking ve security yaklaşımını incelemek için güçlü açık kaynak projedir. Service load balancing, network policy ve observability alanlarını bir araya getirir. Linux kernel ve eBPF bilgisi geliştirmek isteyenler için öğreticidir. Production kurulumdan önce platform compatibility iyi anlaşılmalıdır. Contribution süreci networking konusunda derin deneyim kazandırabilir.
Prometheus
Prometheus cloud-native observability ekosisteminin temel projelerinden biridir. Metric model ve PromQL autoscaling tasarımında çok faydalıdır. HPA custom metric pipeline'ı Prometheus Adapter ile kurulabilir. Recording rule ve alert yaklaşımı production monitoring'i geliştirir. Open source contribution yapmak isteyenler için geniş topluluk sunar.
GitHub Üzerinden Katkı
İlk katkı küçük dokümantasyon düzeltmesi olabilir. Issue'yu doğru şekilde yeniden üretmek bile maintainer'lara yardımcı olur. Pull request açıklamasında problem ve test yaklaşımı net yazılmalıdır. Projenin contribution guide ve code of conduct kuralları okunmalıdır. Süreç içinde review kültürü öğrenilir.
Kubernetes Alanında Yazılımcı Olmak İçin Ne Yapmalı?
Kubernetes alanında ilerlemek için yalnızca `kubectl` komutlarını ezberlemek yeterli değildir. Linux, container, network ve distributed system temelleri güçlü olmalıdır. Ardından workload, Service, DNS, Gateway ve observability konuları uygulanmalıdır. Autoscaling ve GitOps production seviyesindeki düşünceyi geliştirir. Küçük laboratuvar projeleri teori ile gerçek hata ayıklama deneyimini birleştirir.
Linux
Process, signal, filesystem ve network namespace kavramlarını öğrenmek çok faydalıdır. Kubernetes container'ları Linux primitive'leri üzerinde çalışır. SIGTERM davranışı graceful shutdown'ı doğrudan etkiler. CPU ve memory cgroup mantığı resource request konusunu anlamayı kolaylaştırır. `ss`, `ip`, `curl` ve log araçları troubleshooting'de sürekli kullanılır.
Docker ve Container Temelleri
Image layer, registry ve container lifecycle anlaşılmalıdır. Büyük image autoscaling startup süresini uzatır. Multi-stage build image boyutunu azaltabilir. Entrypoint ve signal forwarding shutdown davranışını etkiler. Container security de production bilgisine dahil edilmelidir.
Networking
IP, TCP, UDP, DNS ve HTTP bilgisi Kubernetes networking'in temelidir. Service ve Ingress davranışı bu protokoller üzerine kuruludur. NAT ve connection tracking long-lived connection sorunlarını anlamaya yardımcı olur. TLS termination ve mTLS güvenlik katmanını ekler. Packet flow çizmek troubleshooting'in en iyi öğrenme yöntemlerinden biridir.
Kubernetes Workloads
Deployment, StatefulSet, DaemonSet ve Job farkları öğrenilmelidir. HPA hangi workload'un scale subresource'unu yönetebildiğini anlamak önemlidir. Rolling update davranışı production availability'yi etkiler. Probe ve resource tanımları her workload'da temel ayarlardır. Küçük örnek uygulamalarla her controller ayrı test edilmelidir.
Service ve DNS
Service discovery Kubernetes microservice iletişiminin temelidir. ClusterIP ve EndpointSlice ilişkisi öğrenilmelidir. DNS failure application outage gibi görünebilir. Service selector hatası en basit ama sık sorunlardan biridir. Network policy ile Service erişimi birlikte test edilmelidir.
Ingress ve Gateway API
Dış trafik yönetimi için Ingress ve Gateway API temel kavramları öğrenilmelidir. HTTPRoute weighted backend uygulaması iyi laboratuvar konusudur. TLS ve hostname routing gerçek projelerle denenebilir. Gateway role separation platform engineering açısından değerlidir. Controller-specific özelliklerle standard API farkı anlaşılmalıdır.
Observability
Metric, log ve trace olmadan production Kubernetes yönetmek zordur. Prometheus ve Grafana iyi başlangıç araçlarıdır. Request latency ile Pod CPU aynı dashboard'da karşılaştırılabilir. Alert tasarımında kullanıcı etkisi öncelikli olmalıdır. Autoscaling troubleshooting observability bilgisini hızla geliştirir.
Autoscaling
Önce CPU tabanlı basit HPA kurulabilir. Daha sonra RPS custom metric eklenebilir. KEDA ile queue consumer scale-to-zero denenebilir. Node autoscaler ile Pending Pod senaryosu oluşturulabilir. Load test bütün bu katmanların birlikte nasıl çalıştığını gösterir.
Cloud Platformları
Managed Kubernetes servisleri cloud networking ve load balancer entegrasyonunu öğrenmek için faydalıdır. IAM, VPC ve quota konuları Kubernetes dışı görünse de production sorunlarının önemli kısmını oluşturur. Node autoscaling cloud compute API'sine bağlıdır. Storage class cloud disk davranışını belirler. Maliyet takibi teknik kararların gerçek etkisini gösterir.
GitOps
Manifestleri Git üzerinde yönetmek configuration discipline kazandırır. Pull request review değişikliklerin nedenini kayıt altına alır. Argo CD veya Flux ile reconciliation mantığı öğrenilebilir. HPA'nın yönettiği alanlarla Git'in yönettiği alanlar ayrılmalıdır. Rollback ve drift detection production güvenliğini artırır.
Diyarbakır Yazılım Topluluğu İçin Kubernetes Proje Fikirleri
Kubernetes öğrenmenin en iyi yollarından biri küçük ama ölçülebilir laboratuvar projeleri geliştirmektir. Diyarbakır Yazılım Topluluğu içinde ekipler HPA, KEDA ve Gateway API'yi ayrı projelerde deneyebilir. Her projede load test ve dashboard çıktısı hazırlanması teknik öğrenmeyi hızlandırır. Açık kaynak katkı günü ise öğrendiklerinizi gerçek projelere taşıma fırsatı verir. Topluluğun çalışmaları ve proje yaklaşımı için https://www.diyarbakiryazilim.com.tr/projects adresi incelenebilir.
Kubernetes Autoscaling Lab
Basit HTTP API üç replica ile başlatılabilir. CPU tabanlı HPA kurulup k6 ile trafik artırılır. Desired ve Ready replica grafikleri izlenir. Daha sonra node kapasitesi bilinçli olarak sınırlanıp Pending Pod senaryosu oluşturulur. Katılımcılar HPA ve node autoscaler farkını gerçek çıktıda görür.
HPA + Prometheus Workshop
Uygulama `/metrics` endpoint'inde request counter yayınlayabilir. Prometheus metric'i scrape eder. Adapter RPS değerini custom metrics API üzerinden HPA'ya sunar. CPU HPA ile RPS HPA davranışı karşılaştırılır. Hangi metric'in spike'a daha erken tepki verdiği ölçülür.
KEDA Event-Driven Scaling Projesi
Basit queue consumer uygulaması hazırlanabilir. Queue'ya mesaj eklendiğinde KEDA replica sayısını artırır. Queue boşaldığında workload sıfıra indirilebilir. Cold start süresi ölçülür. Minimum replica bir yapıldığında latency farkı karşılaştırılır.
Gateway API Traffic Splitting Demo
Uygulamanın v1 ve v2 sürümleri ayrı Service olarak yayınlanabilir. HTTPRoute backendRefs ile 90/10 trafik dağılımı uygulanır. Her backend farklı response header döndürerek dağılım görünür hâle getirilebilir. Prometheus gerçek oranı ölçer. Canary sürümün HPA davranışı ayrıca izlenir.
Karpenter/Cluster Autoscaler Laboratuvarı
Node kapasitesini aşacak Pod request'i oluşturularak Pending senaryosu hazırlanabilir. Cluster Autoscaler node group büyütür. Alternatif laboratuvarda dinamik provisioning workload request'e uygun node seçer. Provisioning süresi ölçülür. Scale-down ve PDB etkisi ayrıca test edilir.
Kubernetes Open Source Contribution Day
Katılımcılar küçük documentation issue seçebilir. Reproduction adımları hazırlanabilir. Pull request açma ve review süreci birlikte uygulanabilir. Kod yazmayan katılımcılar da dokümantasyon ve test katkısı yapabilir. Bu etkinlik open source çalışma kültürünü somutlaştırır.
Yerel Uygulamalar İçin Cloud-Native Deployment Projesi
Yerel bir örnek uygulama container hâline getirilebilir. Deployment, Service ve Gateway API manifestleri hazırlanabilir. HPA ve monitoring eklenebilir. Load test sonucunda minimum ve maksimum replica ayarlanabilir. Proje GitOps ile otomatik deployment sürecine bağlanabilir.
Uçtan Uca Production Kubernetes Scaling Mimarisi Nasıl Kurulur?
Production scaling mimarisi tek bir manifestten oluşmaz. Trafik profili, SLO, resource request, Service, Gateway, probes, topology, autoscaling ve node kapasitesi aynı tasarım içinde ele alınmalıdır. Load test ve failure test olmadan ayarların doğru olduğu kabul edilmemelidir. Monitoring ve cloud cost sürekli geri bildirim sağlar. Aşağıdaki sıra gerçek projelerde kullandığım pratik bir çalışma akışını özetler.
1. Trafik Profilini Ölçün
Önce günlük RPS, peak RPS ve concurrency değerlerini çıkarın. Trafik spike'larının ne kadar hızlı oluştuğunu ölçün. Request süresi ve endpoint dağılımını analiz edin. Queue veya Kafka kullanıyorsanız backlog trendini inceleyin. Ölçmeden autoscaling threshold belirlemek tahmine dayanır.
2. SLO'ları Belirleyin
p95 latency ve error rate hedefleri açık olmalıdır. Availability hedefi minimum replica kararını etkiler. Queue worker için queue age SLO kullanılabilir. Recovery time hedefi node cold start toleransını belirler. Autoscaling performansı bu hedeflere göre değerlendirilmelidir.
3. Resource Requests Belirleyin
Tek Pod load test ile CPU ve memory davranışı ölçülmelidir. Request değerleri normal kullanım ve burst payına göre seçilmelidir. Çok yüksek request node maliyetini artırır. Çok düşük request HPA ve scheduler davranışını bozar. VPA recommendation ek veri sağlayabilir.
4. Service Oluşturun
Uygulama Pod'larını stable Service arkasına alın. Selector label'larını açık ve basit tutun. Port ve targetPort değerlerini doğrulayın. EndpointSlice içinde Ready Pod'ların göründüğünü kontrol edin. Internal uygulama için ClusterIP genellikle iyi başlangıçtır.
5. Gateway/Ingress Yapısını Kurun
HTTP trafiğini Gateway API veya uygun Ingress üzerinden yönlendirin. TLS ve hostname kurallarını tanımlayın. Route backend olarak Service'i kullanın. Health check ve timeout değerlerini uygulama davranışına göre ayarlayın. Yeni projede Gateway API desteğini değerlendirin.
6. Readiness ve Startup Probe Ekleyin
Startup probe uygulamanın initialization sürecini korur. Readiness probe yalnızca gerçek serving kapasitesi oluştuğunda başarılı olmalıdır. Database erişimindeki kısa hata bütün Pod'ları aynı anda unhealthy yapmamalıdır. Probe timeout ve period değerleri gerçek response süresine uygun olmalıdır. Load test sırasında yeni Pod'un ne zaman trafik aldığı izlenmelidir.
7. Pod Topology Spread Ayarlayın
Replica'ları node ve zone'lara dengeli dağıtın. maxSkew ve whenUnsatisfiable ayarlarını capacity esnekliğiyle birlikte seçin. Multi-AZ uygulamada tek zone hotspot'u önleyin. HPA scale-up sırasında yeni replica'ların dağılımını test edin. Node autoscaler aynı zone'larda kapasite sağlayabilmelidir.
8. HPA veya KEDA Metric'ini Seçin
CPU-bound API için CPU kullanılabilir. HTTP serviste RPS veya concurrency daha erken sinyal olabilir. Queue worker için queue depth veya age tercih edilebilir. Kafka consumer için lag doğal metric'tir. Metric replica eklenince gerçekten iyileşmelidir.
9. Scale-Up/Scale-Down Behavior Ayarlayın
Scale-up spike'ı karşılayacak kadar hızlı olmalıdır. Scale-down daha korumacı tutulmalıdır. Stabilization window trafik dalgalanmasına göre seçilmelidir. Maximum replica dependency kapasitesini aşmamalıdır. Load test ile behavior iteratif ayarlanmalıdır.
10. Node Autoscaling Kurun
HPA yeni replica istediğinde node kapasitesi bulunmalıdır. Cluster Autoscaler veya uygun dynamic provisioning modeli kurulabilir. Node group min ve max sınırları test edilmelidir. Cloud quota kontrol edilmelidir. Cold node provisioning duration ölçülmelidir.
11. PDB Tanımlayın
Planlı disruption sırasında minimum availability korunmalıdır. minAvailable veya maxUnavailable workload replica sayısına göre seçilir. Çok katı PDB node scale-down'u engelleyebilir. Rolling deployment ile birlikte test edilmelidir. PDB tek başına yüksek availability sağlamaz.
12. Load Test Yapın
Kademeli RPS artışıyla saturation noktası bulun. Ani spike senaryosu çalıştırın. Desired ve Ready replica farkını ölçün. Node provisioning süresini kaydedin. p95 latency ve error rate SLO içinde kalmalıdır.
13. Failure Testi Yapın
Bir Pod'u zorla silin. Bir node'u drain edin. Mümkünse zone veya dependency failure senaryosu simüle edin. Autoscaling'in recovery davranışını ölçün. Graceful shutdown sırasında kullanıcı hatası oluşmamalıdır.
14. Monitoring ve Alerting Kurun
RPS, latency, error rate, replica count ve node count aynı dashboard'da bulunmalıdır. HPA max replica'ya ulaştığında alert üretin. Pending Pod süresi için alarm tanımlayın. Scaler metric missing durumunu izleyin. Cost anomaly de operasyon alert'lerinin parçası olabilir.
15. Maliyetleri Ölçün
Compute, load balancer ve network transfer maliyetini ayrı ölçün. Cost per request veya job hesaplayın. Resource right-sizing etkisini görün. Spot ve consolidation tasarrufunu gerçek faturada doğrulayın. Maliyet optimizasyonunu SLO bozmadan yapın.
16. Production'a Alın
Production rollout aşamalı yapılmalıdır. Canary trafik küçük oranla başlatılabilir. Autoscaling limitleri ilk gün daha korumacı tutulabilir. Dashboard deployment boyunca izlenmelidir. Rollback planı hazır olmalıdır.
17. Scaling Parametrelerini Sürekli İyileştirin
Trafik profili zaman içinde değişir. Yeni application version farklı CPU veya memory davranışı gösterebilir. Pod startup süresi image büyüdükçe uzayabilir. Cloud maliyetleri ve instance seçenekleri değişebilir. Autoscaling tuning tek seferlik kurulum değil sürekli performans yönetimidir.
Kubernetes Yük Dengeleme ve Autoscaling'de En Sık Yapılan Hatalar
Kubernetes scaling sorunlarının önemli kısmı controller bug'ından değil eksik mimari varsayımlarından kaynaklanır. Yalnızca HPA oluşturup production ölçeklemesinin tamamlandığını düşünmek en yaygın hatadır. Resource request, readiness, node capacity ve trafik dağılımı aynı sistemin parçalarıdır. Session affinity veya zone routing gibi ağ davranışları replica artışının etkisini azaltabilir. Production öncesi load test yapılmadığında bu problemler gerçek kullanıcı trafiğinde ortaya çıkar.
Yalnızca HPA Kurup Ölçeklemenin Tamamlandığını Sanmak
HPA sadece desired replica sayısını yönetir. Node yoksa Pod Pending kalır. Pod Ready değilse Service kapasite kazanmaz. Long-lived connection varsa yeni Pod trafik almayabilir. HPA bütün scaling zincirinin yalnızca bir katmanıdır.
Resource Requests Tanımlamamak
CPU utilization tabanlı HPA request değerine ihtiyaç duyar. Request olmayan container metric hesabını etkileyebilir. Scheduler da doğru capacity planı yapamaz. Node autoscaler Pod ihtiyacını sağlıklı değerlendiremez. Her production workload için request bilinçli tanımlanmalıdır.
Her Uygulamayı CPU'ya Göre Scale Etmek
CPU kolay metric olduğu için sık seçilir. Queue worker için backlog daha iyi talep sinyali olabilir. WebSocket servisinde active connection daha anlamlıdır. LLM inference'da queue ve token throughput daha doğru olabilir. Metric workload'un capacity modeline göre seçilmelidir.
Readiness Probe Kullanmamak
Readiness olmadan Pod süreç başlar başlamaz trafik alabilir. Cache veya model henüz hazır olmayabilir. Scale-up kullanıcı hatası üretebilir. Rolling update sırasında da aynı risk vardır. Readiness load balancing'in application-level quality gate'idir.
Node Autoscaling Kullanmamak
HPA replica artırırken cluster kapasitesi sabit kalırsa bir noktada Pod'lar Pending olur. Önceden çok büyük node kapasitesi tutmak maliyeti yükseltir. Node autoscaler demand'e göre altyapı büyütür. Critical workload için minimum warm capacity yine gerekebilir. Pod ve node autoscaling birlikte planlanmalıdır.
Çok Agresif Scale-Down
Trafik kısa süre düştüğünde Pod'ları hemen silmek thrashing oluşturabilir. Yeni spike cold start'a yakalanır. Long request scale-down sırasında kesilebilir. Stabilization window bu davranışı azaltır. Maliyet tasarrufu birkaç dakikalık ekstra kapasiteye değmeyebilir.
HPA ve VPA'yı Aynı CPU Metric'inde Çalıştırmak
VPA CPU request'i değiştirdiğinde HPA utilization oranı değişir. İki controller birbirlerinin sinyalini etkileyebilir. Replica ve request sürekli farklı yönlerde hareket edebilir. VPA recommendation-only daha güvenli başlangıçtır. Custom metric HPA ile VPA kombinasyonu daha net separation sunar.
Session Affinity'yi Kontrol Etmemek
Sticky session yeni Pod'ların trafiğe katılmasını zorlaştırabilir. Eski Pod'lar yoğun kalırken yeniler boş olabilir. HPA ortalama metric yanıltıcı hâle gelir. Pod başına RPS ve connection count izlenmelidir. Mümkünse state harici store'a taşınmalıdır.
Zone Dağılımını Görmezden Gelmek
Replica'ların tek zone'da toplanması failure riskini artırır. Same-zone routing diğer zone'larda hotspot oluşturabilir. Node autoscaler farklı zone'larda kapasite sağlamalıdır. Topology spread yeni Pod dağılımını yönetir. Zone failure testi production hazırlığının parçasıdır.
PDB Tanımlamamak
Node drain sırasında çok sayıda replica aynı anda evict edilebilir. PDB planlı disruption için availability sınırı sağlar. Ancak PDB gerçek replica kapasitesiyle uyumlu olmalıdır. Çok katı PDB node scale-down'u bloke eder. Rolling update test'i yapılmalıdır.
Cold Start'ı Hesaba Katmamak
HPA scale kararı anlık kapasite üretmez. Pod startup, image pull ve readiness süresi vardır. Node gerekiyorsa provisioning gecikmesi eklenir. GPU model loading süreyi daha da uzatabilir. Minimum warm capacity bu farkı kapatır.
Production Öncesi Load Test Yapmamak
Default HPA ayarları her workload için uygun değildir. Tek Pod throughput'u bilinmeden target metric seçilemez. Spike ve sustained load davranışı farklıdır. Scale-down hataları yalnızca test sırasında görülür. Load test autoscaling mimarisinin doğrulama aracıdır.
Sadece CPU/Memory İzlemek
CPU ve memory kaynak baskısını gösterir. Kullanıcı deneyimini doğrudan göstermez. RPS, latency, queue age ve error rate birlikte izlenmelidir. Node count ve Pending Pod altyapı katmanını açıklar. Unified dashboard kök nedeni bulmayı kolaylaştırır.
Trafik Dağılımı ile Replica Dağılımını Birlikte İncelememek
On replica bulunması trafiğin on replica'ya eşit gittiğini garanti etmez. Connection pooling ve affinity dağılımı bozabilir. Zone-local routing farklı Pod yükleri oluşturabilir. HPA ortalama metric'i hotspot'u gizleyebilir. Pod başına request ve active connection metric'leri mutlaka incelenmelidir.
Production-Ready Kubernetes Scaling Checklist
Production'a çıkmadan önce scaling sistemini yalnızca manifest doğruluğu üzerinden değil, gerçek kullanıcı akışı üzerinden kontrol etmek gerekir. Networking, uygulama yaşam döngüsü, Pod autoscaling, node autoscaling, availability ve cost birlikte doğrulanmalıdır. Her kontrol maddesi load test veya failure test ile ölçülebilir olmalıdır. Özellikle desired replica ile Ready replica arasındaki süre kritik bir göstergedir. Aşağıdaki kontrol listesi Kubernetes Üzerinde Yük Dengeleme ve Otomatik Ölçekleme çalışmalarında pratik son kontrol olarak kullanılabilir.
Networking
Service, Gateway veya Ingress ve backend health durumu birlikte doğrulanmalıdır. Route doğru olsa bile endpoint Ready değilse gerçek trafik çalışmaz. External ve internal traffic policy ayarları topology davranışını değiştirebilir. Pod başına trafik dağılımı gözlemlenmelidir. TLS ve timeout politikaları uygulama SLO'suna uygun olmalıdır.
Service doğru mu?
Selector doğru Pod label'larıyla eşleşmelidir. Port ve targetPort değerleri doğrulanmalıdır. EndpointSlice içinde beklenen backend'ler görünmelidir. Service türü erişim ihtiyacına uygun olmalıdır. NetworkPolicy erişimi engellemiyor olmalıdır.
Gateway/Ingress doğru mu?
Hostname ve path routing test edilmelidir. TLS sertifikası doğru alan adını kapsamalıdır. Backend Service adı ve portu doğru olmalıdır. Gateway controller Route durumunu Accepted göstermelidir. Canary ağırlıkları gerçek trafik ölçümüyle doğrulanmalıdır.
Trafik yeni Pod'lara ulaşıyor mu?
Yeni Pod Ready olduktan sonra request metric'i artmalıdır. Pod CPU sıfırda kalıyorsa load balancing incelenmelidir. Long-lived connection davranışı yeni backend kullanımını geciktirebilir. Session affinity kontrol edilmelidir. EndpointSlice ve load balancer backend health birlikte izlenmelidir.
Application
Uygulama Kubernetes yaşam döngüsüyle uyumlu davranmalıdır. Stateless tasarım horizontal scaling'i kolaylaştırır. Graceful shutdown scale-down hatalarını azaltır. Probe'lar gerçek serving kapasitesini doğru göstermelidir. Startup süresi autoscaling response time hesabına dahil edilmelidir.
Stateless tasarım
Session state mümkünse Pod belleğine bağlanmamalıdır. Shared store veya token tabanlı session modeli kullanılabilir. Yeni replica kullanıcı state'i taşımadan trafik alabilmelidir. Pod yeniden oluşturulduğunda veri kaybı olmamalıdır. Stateless tasarım load balancing verimliliğini artırır.
Graceful shutdown
Uygulama SIGTERM sinyalini yakalamalıdır. Yeni request kabulü durdurulmalıdır. Mevcut request'ler uygun süre içinde tamamlanmalıdır. Termination grace gerçek request süresine uygun olmalıdır. Scale-down testinde connection reset görülmemelidir.
Health probes
Startup, readiness ve liveness amaçları birbirinden ayrılmalıdır. Readiness trafik kabulü için kullanılmalıdır. Liveness geçici dependency hatasında bütün Pod'u gereksiz restart etmemelidir. Probe timeout gerçek uygulama davranışına göre ayarlanmalıdır. Yeni release probe endpoint'lerini bozmadığından emin olunmalıdır.
Pod Autoscaling
Pod autoscaling talebe yakın metric kullanmalıdır. min ve max replica değerleri SLO ve dependency kapasitesine göre seçilmelidir. Scale behavior traffic pattern'iyle uyumlu olmalıdır. Resource request utilization metric'ini doğrudan etkiler. Multiple metric kullanılıyorsa hangisinin replica sayısını sürüklediği görünür olmalıdır.
Doğru metric
CPU-bound workload için CPU uygundur. HTTP servisinde RPS veya concurrency daha iyi olabilir. Queue worker queue depth veya age ile scale edilebilir. Kafka consumer lag doğal sinyaldir. Metric replica eklenince düşmelidir.
min/max replicas
Minimum replica cold start ve availability ihtiyacını karşılamalıdır. Maximum replica dependency limitini aşmamalıdır. Zone sayısı minimum değeri etkileyebilir. Kampanya döneminde geçici max artışı yapılabilir. Cost alert sınır yaklaşımında çalışmalıdır.
stabilization
Scale-down stabilization thrashing'i azaltır. Trafik sık dalgalanıyorsa pencere biraz uzun tutulabilir. Çok uzun pencere gereksiz kapasite maliyeti yaratır. Scale-up genellikle daha hızlıdır. Load test değerleri tuning için kullanılmalıdır.
Node Autoscaling
Node autoscaling Pod autoscaling'in infrastructure tamamlayıcısıdır. Pending Pod süresi ölçülmelidir. Cloud quota ve instance availability production öncesinde doğrulanmalıdır. Consolidation PDB ile uyumlu çalışmalıdır. Critical workload için minimum warm node kapasitesi gerekebilir.
Uygun node kapasitesi
Node instance tipi Pod request'lerini taşıyabilmelidir. Tek Pod node kapasitesinden büyük olmamalıdır. GPU workload uygun accelerator node'a yönelmelidir. Multi-AZ için zone seçenekleri bulunmalıdır. Instance family esnekliği capacity shortage riskini azaltır.
quota
Cloud vCPU ve instance quota kontrol edilmelidir. Load test gerçekten node scale-up tetiklemelidir. Quota error alert olarak izlenmelidir. Kampanya öncesi limit artışı gerekiyorsa erken planlanmalıdır. Autoscaler max node sayısı cloud quota ile uyumlu olmalıdır.
consolidation
Boş node'ların ne kadar sürede kaldırıldığı ölçülmelidir. PDB node eviction'ı engelleyebilir. Çok agresif consolidation Pod churn oluşturabilir. Spot ve On-Demand maliyet etkisi ayrı izlenmelidir. Cost reduction availability pahasına yapılmamalıdır.
Availability
Availability yalnızca replica sayısından ibaret değildir. PDB, topology spread ve multi-zone kapasite birlikte çalışmalıdır. Tek node veya tek zone failure test edilmelidir. HPA failure sonrası yeterli hızda replica oluşturmalıdır. Node autoscaler capacity recovery süresi SLO içinde olmalıdır.
PDB
PDB planlı disruption sırasında minimum serving kapasitesini korur. minAvailable veya maxUnavailable doğru seçilmelidir. Çok katı PDB maintenance işlemlerini durdurabilir. Replica sayısı PDB gereksinimini karşılamalıdır. Node drain testi yapılmalıdır.
topology spread
Replica'lar node ve zone'lara dengeli dağılmalıdır. maxSkew uygun değerde tutulmalıdır. HPA yeni Pod oluşturduğunda spread kuralı devam etmelidir. Capacity shortage durumunda scheduling davranışı bilinmelidir. Zone-local routing ile birlikte test edilmelidir.
multi-zone
Kritik uygulamalar birden fazla availability zone'a yayılmalıdır. Node ve Pod dağılımı ayrı kontrol edilmelidir. Stateful storage zone constraint'i doğrulanmalıdır. Bir zone kaybında diğer zone'lar trafiği taşımalıdır. Cross-zone network maliyeti izlenmelidir.
Observability
Autoscaling kararı ölçülebilir değilse güvenilir değildir. Trafik, latency, error rate, replica ve node count aynı dashboard'da bulunmalıdır. Scale event'leri zaman çizelgesinde görünür olmalıdır. Pending Pod ve metric error alert üretebilmelidir. Load balancer backend dağılımı Pod bazında izlenmelidir.
RPS
Toplam RPS kullanıcı talebini gösterir. Pod başına RPS load balancing dengesini açıklar. Zone başına RPS topology etkisini gösterir. Retry RPS ayrı tutulmalıdır. HPA target RPS kullanıyorsa aynı metric dashboard'da görünmelidir.
latency
p50 tek başına yeterli değildir. p95 ve p99 tail davranışı gösterir. Scale-up öncesi ve sonrası latency karşılaştırılmalıdır. Dependency latency ayrı panelde bulunmalıdır. SLO violation alert doğrudan kullanıcı etkisini temsil etmelidir.
error rate
5xx, timeout ve connection reset ayrı kategorilerde izlenmelidir. Scale-down sırasında error rate artışı graceful shutdown sorunu gösterebilir. Scale-up sırasında artış warm capacity eksikliğine işaret edebilir. Retry storm toplam request sayısını şişirebilir. Error budget autoscaling kararlarını önceliklendirmeye yardımcı olur.
replica count
Desired, current ve ready replica ayrı gösterilmelidir. Aralarındaki zaman farkı startup latency'yi ortaya çıkarır. Max replica'ya ulaşma alert olmalıdır. Scale event frequency thrashing göstergesidir. Deployment rollout ile HPA hareketi aynı grafikte görülebilir.
node count
Node count altyapı autoscaling sonucunu gösterir. Zone ve capacity type bazında ayrılmalıdır. Pending Pod artarken node count sabit kalıyorsa autoscaler problemi olabilir. Load düşünce node sayısının azalması maliyet optimizasyonunu gösterir. PDB blocked node sayısı ayrıca izlenebilir.
Cost
Cost autoscaling tasarımının sonuç metriğidir. Yalnızca compute değil network, load balancer ve storage giderleri de hesaba katılmalıdır. Right-sizing node verimliliğini artırır. Idle capacity SLO için gerekli warm kapasite ile karşılaştırılmalıdır. Spot ve scale-to-zero tasarrufu gerçek faturada doğrulanmalıdır.
right-sizing
CPU ve memory request değerleri gerçek load test verisine dayanmalıdır. VPA recommendation fikir verebilir. Çok yüksek request node sayısını artırır. Çok düşük request throttling ve OOM riski yaratır. Cost per request tuning sonucunu daha iyi gösterir.
idle capacity
Bir miktar idle capacity kritik servislerde faydalıdır. Sorun kullanılmayan kapasitenin neden tutulduğunun bilinmemesidir. Minimum replica ve node değerleri SLO gerekçesine bağlanmalıdır. Gereksiz idle kapasite consolidation ile azaltılabilir. Kampanya öncesi geçici warm kapasite normal kabul edilebilir.
Spot
Spot workload toleransına göre kullanılmalıdır. Batch ve retry edilebilir worker iyi adaydır. Critical baseline yalnızca Spot üzerinde tutulmamalıdır. Interruption alert izlenmelidir. Savings oranı actual cost ile ölçülmelidir.
network egress
Cross-zone ve internet egress maliyetleri izlenmelidir. Topology-aware routing bazı transferleri azaltabilir. Service mimarisi gereksiz cross-zone hop üretmemelidir. Observability pipeline da yüksek egress oluşturabilir. Cloud cost raporu network kategorisini ayrı göstermelidir.
Sık Sorulan Sorular
Kubernetes autoscaling konusunda en sık gelen sorular genellikle HPA'nın neden beklenen replica sayısını oluşturmadığı veya load balancing ile autoscaling'in nasıl birlikte çalıştığı etrafında toplanıyor. Tek bir cevabı her workload'a uygulamak doğru değildir. Uygulama protokolü, metric seçimi, startup süresi ve node kapasitesi sonucu değiştirir. Bu bölüm temel kavramları hızlı şekilde toparlar. Daha ileri bir uygulamada her cevabın load test ve monitoring verisiyle doğrulanması gerekir.
Kubernetes'te load balancing nasıl çalışır?
Kubernetes Service sabit servis kimliği ile değişken Pod endpoint'lerini birbirinden ayırır. EndpointSlice backend Pod'ları temsil eder. kube-proxy veya eBPF veri yolu uygun endpoint'e trafik yönlendirebilir. Dış HTTP trafiğinde Gateway veya Ingress ek routing katmanı sağlayabilir. Ready olmayan Pod'ların normal trafiğe alınmaması load balancing kalitesi için önemlidir.
Kubernetes otomatik ölçekleme nasıl yapılır?
Pod sayısını HPA veya KEDA ile otomatik değiştirebilirsiniz. Resource metric için Metrics Server kullanılabilir. Custom veya external metric için uygun adapter gerekir. Node kapasitesi yetmediğinde Cluster Autoscaler veya başka node provisioning yaklaşımı eklenmelidir. Production öncesinde scale-up ve scale-down load test'i yapılmalıdır.
HPA nedir?
HPA workload replica sayısını metric'e göre değiştiren Kubernetes controller'ıdır. CPU, memory, custom ve external metric kullanabilir. minReplicas ve maxReplicas sınırları vardır. Behavior alanı scale hızını yönetir. Replica eklenmesi gerçek serving kapasitesine ancak Pod Ready olduğunda dönüşür.
VPA nedir?
VPA CPU ve memory resource right-sizing için öneri veya otomatik güncelleme sağlayabilir. Replica sayısını artırmaz. HPA ile aynı CPU utilization metriğini yönetmek feedback loop riski oluşturabilir. Recommendation mode güvenli başlangıçtır. Resource request iyileştirmesi node utilization'ı da artırabilir.
KEDA nedir?
KEDA event-driven autoscaling için kullanılan açık kaynaklı Kubernetes bileşenidir. Queue, Kafka, Prometheus ve farklı harici kaynaklardan scaling sinyali alabilir. ScaledObject mevcut workload'u ölçekler. ScaledJob batch Job üretimini yönetebilir. Scale-to-zero event-driven workload'larda önemli maliyet avantajı sunabilir.
Cluster Autoscaler nedir?
Cluster Autoscaler unschedulable Pod'lar için node group kapasitesini artırabilir. Kullanılmayan node'ları belirli koşullarda azaltabilir. HPA'nın Pod kapasitesi talebini infrastructure kapasitesiyle tamamlar. PDB ve scheduling constraint'leri davranışını etkiler. Cloud quota scale-up'ın başarılı olmasını engelleyebilir.
Karpenter nedir?
Karpenter workload gereksinimine göre dinamik compute capacity provision etmeyi hedefler. NodePool politikaları instance, zone ve capacity type seçeneklerini sınırlar. Daha geniş instance seçimi capacity bulunabilirliğini artırabilir. Consolidation maliyeti düşürmeye yardımcı olur. Kullanılacak özelliklerin cloud provider ve sürüm desteği doğrulanmalıdır.
HPA ile Cluster Autoscaler arasındaki fark nedir?
HPA Pod sayısını değiştirir. Cluster Autoscaler node sayısını değiştirir. HPA yeni Pod istediğinde node kapasitesi yoksa Pod Pending olur. Cluster Autoscaler yeni node ekleyerek scheduler'a kapasite sağlar. İki controller birlikte production scaling zincirini tamamlar.
KEDA ile HPA arasındaki fark nedir?
HPA Kubernetes'in temel horizontal Pod autoscaler'ıdır. KEDA harici event kaynaklarını scaling sinyaline dönüştürür. Sıfırdan bire aktivasyon ve scale-to-zero KEDA'nın güçlü alanıdır. Bir replica ve üzerindeki scaling sürecinde KEDA oluşturduğu HPA mekanizmasından yararlanabilir. Queue veya Kafka workload'larında KEDA çoğu zaman daha doğal model sunar.
Kubernetes'te Ingress mi Gateway API mi kullanılmalı?
Mevcut Ingress uygulamaları çalışmaya devam eder. Ancak Ingress API yeni özellik geliştirmesi açısından dondurulmuştur. Yeni projede controller desteği uygunsa Gateway API daha güçlü rol ayrımı ve routing modeli sunar. HTTPRoute weighted routing gibi özellikler canary deployment'ı kolaylaştırır. Migration kararı mevcut sistem maliyeti ve platform deneyimiyle birlikte verilmelidir.
ClusterIP ile LoadBalancer arasındaki fark nedir?
ClusterIP tipik olarak yalnızca cluster içi erişim sağlar. LoadBalancer desteklenen platformda dış veya dahili load balancer oluşturabilir. Uygulama backend Service'i ClusterIP olarak tutup Gateway üzerinden dışarı açmak sık kullanılan modeldir. Her Service için ayrı LoadBalancer maliyeti artabilir. Protokol ve erişim gereksinimi seçimde belirleyicidir.
Kubernetes Service trafiği Pod'lara nasıl dağıtır?
Service selector uygun Pod'ları belirler. EndpointSlice bu backend endpoint'lerini temsil eder. Dataplane gelen Service trafiğini uygun Ready endpoint'e aktarır. Trafik dağılımının exact davranışı kullanılan kube-proxy veya eBPF çözümüne bağlı olabilir. Long-lived connection ve affinity gerçek yükü dengesiz hâle getirebilir.
HPA neden Pod sayısını artırmıyor?
Metric hedefin üzerinde olmayabilir. Resource request çok yüksek olduğu için utilization düşük görünebilir. Metrics API erişilemiyor olabilir. maxReplicas sınırına ulaşılmış olabilir. HPA condition ve event mesajları sorunu anlamanın en hızlı yoludur.
HPA çalışırken Pod'lar neden Pending kalır?
HPA yalnızca desired replica sayısını yükseltir. Scheduler uygun node bulamazsa Pod Pending kalır. Node kapasitesi, resource request, affinity veya taint nedeni olabilir. Node autoscaler yeni kapasite sağlayabilir. Cloud quota veya zone capacity shortage scale-up'ı engelleyebilir.
Kubernetes'te CPU dışında hangi metriklerle scale edilebilir?
Memory, RPS, active connections, queue depth ve Kafka lag kullanılabilir. p95 latency veya business metric de belirli workload'larda değerlendirilebilir. Prometheus Adapter custom metric sağlayabilir. KEDA harici event source entegrasyonunu kolaylaştırır. En iyi metric talebi erken gösteren ve replica eklenince iyileşen metriktir.
Kubernetes scale-to-zero destekler mi?
Standart workload autoscaling modeli genellikle minimum replica üzerinde çalışır. KEDA event-driven workload'ları sıfır replica'ya indirebilir. Event geldiğinde yeniden aktivasyon yapabilir. Cold start gecikmesi hesaba katılmalıdır. Kritik API'lerde minimum warm replica daha uygun olabilir.
Kubernetes autoscaling maliyeti azaltır mı?
Doğru kullanıldığında boş kapasiteyi azaltabilir. Ancak çok agresif veya yanlış metric kullanan autoscaling maliyeti artırabilir. Node consolidation ve scale-to-zero ek tasarruf sağlayabilir. Cross-zone network ve load balancer maliyeti ayrıca izlenmelidir. Başarı cloud cost per request veya per job üzerinden ölçülmelidir.
Kubernetes için Go mu Python mı öğrenilmeli?
Kubernetes controller ve operator geliştirmek istiyorsanız Go güçlü tercihtir. Otomasyon ve API script'leri için Python çok pratiktir. Her iki dili öğrenmek de faydalıdır. Linux, networking ve container temelleri dil seçiminden daha önemlidir. Önce gerçek Kubernetes problemi çözüp ihtiyaç duyulan dili kullanmak en hızlı öğrenme yoludur.
Sık Sorulan Sorular
Kubernetes üzerinde yük dengeleme (Load Balancing) nasıl yapılandırılır?
Kubernetes üzerinde yük dengeleme çoğunlukla Service ile backend Pod'ların kararlı bir erişim noktası altında toplanmasıyla başlar. Cluster içi trafik için ClusterIP kullanılabilir, dış trafik için LoadBalancer veya Gateway tabanlı yaklaşım tercih edilebilir. HTTP ve HTTPS yönlendirmesinde Gateway API host, path ve weighted backend gibi daha gelişmiş trafik kuralları tanımlayabilir. Readiness probe doğru çalışmalı ve yalnızca gerçekten hazır Pod'lar trafik havuzuna dahil edilmelidir. Production ortamında Pod başına RPS, active connection ve endpoint health metric'lerini izlemek yalnızca replica sayısına bakmaktan çok daha doğru sonuç verir.
Kubernetes HPA, VPA ve Cluster Autoscaler arasındaki farklar nelerdir?
HPA workload'un yatay kapasitesini, yani replica sayısını değiştirir. VPA Pod başına CPU ve memory request değerlerini right-sizing amacıyla önerir veya belirli modlarda güncelleyebilir. Cluster Autoscaler ise Pod'ların çalışacağı node kapasitesini büyütür veya azaltır. HPA yeni replica oluşturduğunda mevcut node'larda yer yoksa Cluster Autoscaler tamamlayıcı role sahiptir. VPA ile HPA aynı CPU utilization metriğini etkileyebileceği için birlikte kullanımda metric tasarımı dikkatle yapılmalıdır.
Horizontal Pod Autoscaler (HPA) CPU, bellek ve özel metriklere göre nasıl yapılandırılır?
CPU ve bellek için Metrics Server üzerinden resource metric kullanılabilir. HPA `autoscaling/v2` ile birden fazla metric aynı anda tanımlayabilir. Custom metric için Prometheus Adapter gibi bir çözüm üzerinden `custom.metrics.k8s.io` veya uygun external metric API sağlanabilir. Birden fazla metric kullanıldığında HPA her biri için replica ihtiyacını hesaplar ve en yüksek olanı seçer. Scale-up ve scale-down behavior değerleri load test sonucuna göre ayarlanmalı, resource request değerlerinin utilization hesabını doğrudan etkilediği unutulmamalıdır.
Kubernetes Service, Ingress ve LoadBalancer kullanılarak trafik dağıtımı ve otomatik ölçekleme nasıl birlikte yönetilir?
LoadBalancer dış trafiği cluster girişine getirir, Ingress veya Gateway HTTP route kararlarını verir ve Service trafiği uygun backend Pod'lara taşır. HPA bu backend Deployment'ın replica sayısını talebe göre değiştirir. Yeni Pod scheduler tarafından node'a yerleştirildikten ve readiness kontrolünden geçtikten sonra Service endpoint havuzuna katılır. Cluster kapasitesi yetersizse node autoscaler yeni node oluşturmalıdır. Bu nedenle Kubernetes Ingress Service LoadBalancer ve HPA birlikte nasıl kullanılır sorusunun doğru cevabı, bütün trafik ve kapasite zincirini tek sistem olarak izlemektir.
Kubernetes yük dengeleme ve otomatik ölçekleme konusunda yakınımda danışmanlık veya eğitim nerede bulabilirim?
Kubernetes yük dengeleme ve DevOps danışmanlığı yakınımda şeklinde arama yapan ekipler için yalnızca araç kurulumu değil, uygulama davranışının ölçülmesi de önemlidir. Diyarbakır Yazılım Topluluğu çevresindeki teknik çalışmalar, workshop modelleri ve proje fikirleri bu konuları uygulamalı şekilde ele almak için iyi bir başlangıç sunabilir. Topluluğun yaklaşımı ve çalışma alanları için https://www.diyarbakiryazilim.com.tr/about adresini inceleyebilirsiniz. Kurumsal Kubernetes load balancing ve autoscaling kurulum hizmeti planlanırken HPA, KEDA, node autoscaling, observability ve maliyet ölçümü tek proje kapsamında değerlendirilmelidir. Hedef yalnızca Kubernetes kaynaklarını oluşturmak değil, yoğun trafik ve failure anında nasıl davrandığı ölçülmüş bir production mimarisi kurmaktır.
Sonuç
Kubernetes Üzerinde Yük Dengeleme ve Otomatik Ölçekleme doğru kurulduğunda trafik yönetimi, uygulama kapasitesi ve altyapı kapasitesi aynı hedefe hizmet eder. Service ve EndpointSlice hazır backend'leri görünür kılar, Gateway API veya Ingress dış trafiği doğru servise yönlendirir, HPA veya KEDA talebe göre Pod sayısını değiştirir ve node autoscaling gerekli altyapıyı sağlar. Production kalitesini belirleyen nokta bu bileşenlerin tek tek kurulması değil, spike, failure, scale-down ve long-lived connection senaryolarında birlikte test edilmesidir. Resource request, readiness probe, topology spread, PDB, graceful shutdown ve doğru metric seçimi çoğu zaman autoscaler türünden daha büyük fark yaratır. Diyarbakır Yazılım Topluluğu ile cloud-native projeler, Kubernetes laboratuvarları ve uygulamalı teknik çalışmalar hakkında daha fazla bilgi almak için https://www.diyarbakiryazilim.com.tr/about ve https://www.diyarbakiryazilim.com.tr/projects adreslerini ziyaret edebilirsiniz.
share: