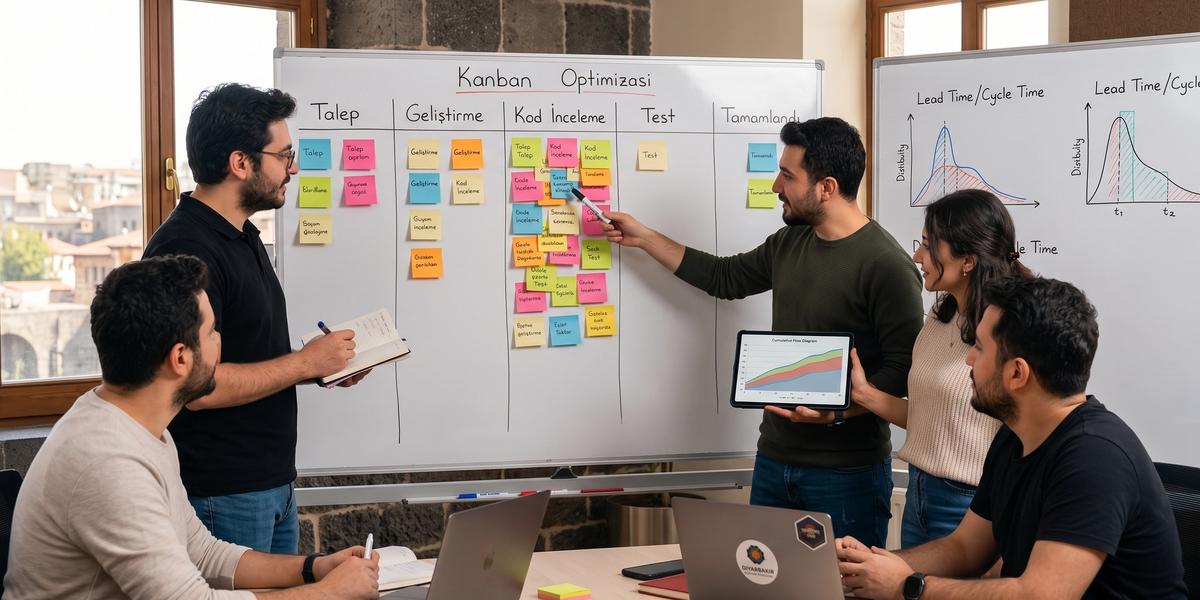
Kanban Board Optimizasyonu ve Darboğaz (Bottleneck) Analizi

Diyarbakır Yazılım
16.08.2026
#Yazılım#Teknoloji#Topluluk
Bir Kanban tahtasında onlarca kartın hareket ediyor olması, işlerin gerçekten akıcı biçimde ilerlediği anlamına gelmez. Takım sürekli çalışıyor, herkes meşgul görünüyor ve kartlar sütunlar arasında hareket ediyor olabilir; buna rağmen teslimatlar yavaşlayabilir, bekleme süreleri büyüyebilir ve aynı noktada tekrar tekrar kuyruk oluşabilir. İşte Kanban Board Optimizasyonu ve Darboğaz (Bottleneck) Analizi, yalnızca tahtayı düzenlemekten çok daha fazlasını ifade eder. Amaç, işin sisteme girişinden müşteriye ulaştığı ana kadar geçen bütün akışı görünür hale getirmek, kapasiteyi doğru yönetmek ve gecikmenin gerçek nedenini bulmaktır. Bu rehberde Kanban board nasıl optimize edilir ve darboğazlar nasıl tespit edilir, Kanban darboğaz analizi ve WIP limitleri nasıl belirlenir, cycle time lead time throughput metrikleri ile Kanban performansı ölçme yöntemleri ve Kanban akışında darboğazları azaltma ve iş akışı optimizasyonu yöntemleri gibi konuları uygulamaya dönük biçimde ele alacağız.
Kanban Board Optimizasyonu Nedir?
Kanban Board optimizasyonu, tahtanın daha güzel görünmesini sağlamak değil, iş akışının daha hızlı, dengeli ve tahmin edilebilir hale gelmesini sağlamaktır. Bunun için sütunların gerçek çalışma adımlarını yansıtması, bekleme noktalarının gizlenmemesi, WIP limitlerinin kapasiteye uygun olması ve akış metriklerinin düzenli izlenmesi gerekir. Bir ekipte optimizasyon çalışması yaparken ilk baktığım konu, kartların ne kadar hızlı hareket ettiği değil, nerelerde hareket etmeden beklediğidir. Çünkü çoğu teslimat gecikmesinin nedeni aktif çalışma süresi değil, işler arasındaki bekleme süreleridir. İyi tasarlanan bir Kanban sistemi bu beklemeyi görünür kılar ve ekibin tahmine değil veriye dayanarak iyileştirme yapmasını sağlar.
Kanban Board Nedir?
Kanban Board, işlerin süreç boyunca hangi aşamada bulunduğunu görsel biçimde takip etmeyi sağlayan bir akış yönetimi aracıdır. Her kart bir iş öğesini, sütunlar ise işin geçtiği süreç adımlarını temsil eder. Tahtanın asıl değeri kartları listelemekten değil, talebin sistem içinde nasıl hareket ettiğini göstermesinden gelir. Örneğin bir yazılım ekibinde analiz, geliştirme, kod inceleme, test ve dağıtım adımları ayrı biçimde görünür olduğunda nerede birikme olduğunu anlamak çok daha kolay hale gelir. Bu nedenle Kanban Board, yalnızca görev takip ekranı olarak değil, sistem davranışını gözlemleyebileceğiniz canlı bir süreç modeli olarak düşünülmelidir.
Kanban Tahtasının Temel Amacı
Kanban tahtasının temel amacı, aynı anda ne kadar işin yürütüldüğünü ve işlerin akış boyunca nerede bulunduğunu herkes için görünür hale getirmektir. Bu görünürlük sayesinde ekip üyeleri yalnızca kendi işlerine değil, sistemin tamamına bakmaya başlar. Örneğin geliştirme sütunu boşken test kuyruğunda on kart bulunuyorsa yeni geliştirme işi başlatmak yerine mevcut test kuyruğunu azaltmak daha değerli olabilir. Tahta bu ortak farkındalığı oluşturduğu zaman ekip içindeki öncelik kararları da daha sağlıklı hale gelir. Sonuçta Kanban'ın hedefi insanları sürekli meşgul tutmak değil, işi mümkün olduğunca dengeli ve kesintisiz biçimde teslim etmektir.
Görselleştirme ile Optimizasyon Arasındaki Fark
Bir süreci görselleştirmek ilk adımdır, ancak tek başına optimizasyon anlamına gelmez. Kartları birkaç sütuna yerleştirmek mevcut durumu görmenizi sağlar fakat sistemin neden yavaş olduğunu açıklamayabilir. Optimizasyon başladığında WIP, Cycle Time, Lead Time, Throughput ve Work Item Age gibi ölçümler devreye girer. Ardından darboğaz olduğu düşünülen noktada küçük değişiklikler denenir ve değişikliğin sonuçları karşılaştırılır. Benim deneyimimde en başarılı ekipler, board'u bir raporlama ekranı gibi değil, her hafta yeni bir süreç hipotezini test edebilecekleri bir öğrenme aracı gibi kullanan ekiplerdir.
Kanban Board Ne Zaman Verimsizleşir?
Bir Kanban Board, gerçek çalışma biçiminden uzaklaşmaya başladığında verimsizleşir. Örneğin kartlar fiziksel olarak Code Review beklerken tahtada hâlâ Development sütununda görünüyorsa önemli bir bekleme noktası görünmez hale gelir. Aynı şekilde ekip WIP limitlerini sürekli ihlal ediyor, bloke kartları ayırmıyor veya tamamlanmış işlerin board üzerinde günlerce beklemesine izin veriyorsa ölçümler anlamını kaybeder. Bir başka belirti de herkesin tahtaya farklı yorum getirmesidir; bir kişinin “Done” dediği iş diğerine göre henüz tamamlanmamış olabilir. Bu durumda önce iş akışı politikalarını netleştirmek, ardından board yapısını gerçek süreçle yeniden eşleştirmek gerekir.
Bir Board'un “Çalışıyor” Olması ile “Optimize” Olması Arasındaki Fark
Çalışan bir board üzerinde kartlar açılır, taşınır ve kapanır. Optimize edilmiş bir board ise bunlara ek olarak darboğazı, kapasite problemini, bekleyen işi ve teslimat riskini erken gösterir. Örneğin optimize edilmiş bir sistemde test aşamasında biriken işler yalnızca fark edilmez, WIP limiti ve Work Item Age verileriyle birlikte değerlendirilir. Böylece ekip hangi kartlara swarm yapması gerektiğini veya yeni iş başlatmayı ne zaman durdurması gerektiğini bilir. Board'un olgunluğunu değerlendirirken bu nedenle “kartlar güncel mi?” sorusundan çok “bu tahta bize bir sonraki iyileştirme kararını verecek kadar bilgi sağlıyor mu?” sorusunu sormak daha değerlidir.
Kanban'da Darboğaz (Bottleneck) Nedir?
Darboğaz, sistemde talebin geldiği hız ile işin işlenebildiği hız arasında sürekli fark oluşan noktadır. İşler bu noktaya ulaştığında kuyruk büyür, bekleme süresi artar ve sistemin toplam teslimat hızı sınırlanır. Darboğaz yalnızca yavaş çalışan bir kişi anlamına gelmez; onay süreci, test ortamı, eksik otomasyon veya belirli bir uzmanlığa aşırı bağımlılık da aynı etkiyi oluşturabilir. Kanban'ın önemli avantajlarından biri bu noktaları kart birikimi ve akış verileri üzerinden görünür hale getirmesidir. Doğru darboğaz analizi, yerel hız artışlarından çok sistemin tamamını iyileştiren kararlar alınmasına yardımcı olur.
Darboğazın Tanımı
Darboğaz, bir iş akışındaki kapasitesi talep seviyesinin altında kalan ve bu nedenle sistemin toplam çıktısını sınırlayan adımdır. Örneğin geliştirme ekibi günde sekiz işi tamamlayabiliyor fakat Code Review ekibi yalnızca dört işi inceleyebiliyorsa review aşamasında zamanla birikme oluşur. İlk birkaç gün bu durum basit yoğunluk gibi görünebilir, ancak düzenli tekrar ediyorsa yapısal bir kısıt haline gelir. Darboğazın etkisi yalnızca o sütunda görülmez; upstream tarafında daha fazla yarım iş, downstream tarafında ise iş bekleme oluşabilir. Bu nedenle darboğazı belirlerken yalnızca bir sütunun hızına değil, bütün sistemde oluşan akış değişimine bakmak gerekir.
Darboğaz ile Blocker Arasındaki Fark
Blocker belirli bir iş öğesinin ilerlemesini engelleyen durumdur, darboğaz ise sistem düzeyinde kapasite problemini ifade eder. Bir kartın üçüncü taraf API erişimi beklemesi blocker olabilir, ancak bütün entegrasyon işlerinin aynı onayı beklemesi zaman içinde darboğaza dönüşebilir. Bu ayrım önemlidir çünkü çözüm yöntemleri farklıdır. Blocker çoğunlukla belirli bir kartı tekrar hareket ettirmeye odaklanırken darboğaz çözümü kapasite, politika veya süreç tasarımı değişikliği gerektirir. Kanban Board üzerinde blocked kartları işaretlemek ve Blocked Time ölçmek, tekrar eden engellerin sistemik bir darboğaza dönüşüp dönüşmediğini anlamanın pratik yollarından biridir.
Darboğaz ile Kuyruk Arasındaki İlişki
Kuyruk, darboğazın en görünür belirtilerinden biridir. Bir süreç adımına gelen iş miktarı o adımın işleyebildiği miktardan yüksek olduğunda bekleyen kart sayısı artmaya başlar. Örneğin QA ekibi günde ortalama beş işi test edebiliyorsa ancak geliştirmeden her gün sekiz kart geliyorsa Ready for QA kuyruğunun giderek büyümesi beklenir. Burada sorun kuyruğun kendisi değil, giriş ve çıkış hızları arasındaki dengesizliktir. Sağlıklı analizde kuyruk uzunluğuna, kuyruktaki kartların yaşına ve bu durumun Cycle Time üzerindeki etkisine birlikte bakmak gerekir.
Geçici ve Yapısal Darboğazlar
Her kart birikimi yapısal darboğaz anlamına gelmez. Tatil, kısa süreli sistem arızası veya beklenmedik yüksek talep nedeniyle birkaç günlük geçici bir birikim oluşabilir. Yapısal darboğaz ise aynı noktada haftalar boyunca tekrar eden ve süreç normal şartlarda çalışırken bile kaybolmayan kapasite dengesizliğidir. Bu ayrımı yapmak için tek günlük board görüntüsüne değil, birkaç haftalık WIP, Throughput ve Cycle Time eğilimlerine bakmak gerekir. Benzer desen tekrar ediyorsa müdahaleyi geçici kapasite artışıyla değil, süreç politikası veya çalışma biçimi değişikliğiyle ele almak daha sağlıklı sonuç verir.
İnsan Kaynaklı ve Süreç Kaynaklı Darboğazlar
Bazı darboğazlar belirli uzmanlıklara bağlı görünse de sorunun kaynağı çoğu zaman kişiden çok sistem tasarımıdır. Örneğin bütün güvenlik kontrollerini yalnızca bir kişinin yapabilmesi ilk bakışta insan kaynağı problemi gibi görünür. Fakat kök neden, bilginin ekip içinde paylaşılmaması veya süreçte otomatik kontroller bulunmaması olabilir. Süreç kaynaklı darboğazlara manuel onaylar, uzun batch'ler, gereksiz handoff noktaları ve net olmayan kabul kriterleri örnek verilebilir. Analizin amacı kişiyi suçlamak değil, sistemin hangi koşullarda bu bağımlılığı ürettiğini görmek ve kapasiteyi daha dayanıklı hale getirmektir.
Darboğaz Neden Sistemin Toplam Hızını Belirler?
Bir sistemde en hızlı aşamanın kapasitesini artırmak toplam teslimat hızını her zaman yükseltmez. Çünkü işler sonuçta en düşük kapasiteye sahip adımdan geçmek zorundadır. Geliştirme hızını iki kat artırdığınız halde test kapasitesi aynı kalıyorsa daha fazla tamamlanmamış iş üretirsiniz ve kuyruk büyür. Bu nedenle sistemin throughput değeri çoğu durumda temel kısıtın kapasitesine yaklaşır. Kanban optimizasyonunda hedef her bölümü ayrı ayrı maksimum hızda çalıştırmak değil, bütün akışı darboğaz çevresinde dengelemek ve gerektiğinde kısıtın kapasitesini artırmaktır.
İyi Tasarlanmamış Kanban Board Darboğazları Nasıl Gizler?
Kanban Board'un yapısı gerçek süreçten daha basitse önemli bekleme noktaları görünmez hale gelir. En yaygın örnek, geliştirme, inceleme ve test gibi farklı çalışma biçimlerini tek bir “Doing” sütununa sıkıştırmaktır. Bu durumda kart hareket etmese bile neden beklediğini anlayamazsınız. Benzer şekilde aktif çalışma ile kuyruğun aynı yerde tutulması WIP miktarını gösterir fakat bunun ne kadarının gerçekten işlenmekte olduğunu açıklamaz. Sağlıklı darboğaz analizi için board, organizasyon şemasını değil gerçek value stream'i yansıtmalıdır.
To Do – Doing – Done Yapısının Sınırları
To Do, Doing ve Done yapısı küçük ve basit iş akışları için başlangıç noktası olabilir. Fakat yazılım geliştirme gibi çok adımlı sistemlerde bu üç sütun gecikmenin nerede oluştuğunu göstermez. Bir kart Doing içinde analiz, geliştirme, review veya test bekliyor olabilir ve bu durumların her biri farklı çözüm gerektirir. Dolayısıyla “Doing'de çok kart var” bilgisi tek başına yeterli değildir. Akış olgunlaştıkça board'un gerçek çalışma aşamalarını ve önemli bekleme noktalarını daha ayrıntılı göstermesi gerekir.
“In Progress” Sütununun Fazla Genel Olması
In Progress sütunu pek çok ekipte farklı faaliyetleri aynı yerde toplar. Bir geliştirici kod yazıyor olabilir, başka bir kart inceleme bekliyor olabilir ve üçüncü kart test ortamı sorunu nedeniyle durmuş olabilir. Üçü aynı sütunda bulunduğunda sistem kapasitesinin hangi aşamada tıkandığını görmek zorlaşır. Bu nedenle önemli çalışma ve bekleme adımları ayrı sütunlar veya split column yapısıyla gösterilmelidir. Ayrımın amacı daha fazla sütun oluşturmak değil, karar vermeyi etkileyen bekleme türlerini görünür hale getirmektir.
Aktif İş ile Bekleyen İşin Aynı Sütunda Tutulması
Aktif iş ile bekleyen iş aynı sütunda tutulduğunda kapasite hakkında yanlış izlenim oluşabilir. Beş kartın Code Review sütununda bulunması, beş kartın aynı anda incelendiği anlamına gelmez. Belki yalnızca bir kart aktif olarak inceleniyor, diğer dört kart reviewer bekliyordur. Waiting ve Reviewing aşamalarını ayırmak, aktif çalışma süresi ile kuyruk süresini karşılaştırmayı mümkün kılar. Bu ayrım Flow Efficiency ölçümü ve darboğaz tespiti açısından çok değerlidir çünkü iyileştirmeniz gereken şey çoğu zaman çalışma hızından çok bekleme süresidir.
Gerçek İş Akışının Board'a Yansıtılmaması
Board üzerinde bulunmayan bir süreç adımını ölçmek oldukça zordur. Örneğin işler geliştirmeden sonra teknik lider onayı alıyor fakat bu adım board üzerinde görünmüyorsa birkaç günlük bekleme Development Cycle Time içine karışabilir. Takım bu durumda geliştirme hızını iyileştirmeye çalışırken asıl gecikme onay noktasında kalır. Board tasarımında ekip üyelerine “kart gerçekten bundan sonra nereye gidiyor?” sorusunu sormak çok faydalıdır. Resmi süreç dokümanından çok gerçek günlük çalışma biçimini modellemek, doğru Kanban optimizasyonunun temelidir.
Görünmeyen Handoff'lar
Handoff, bir işin bir kişi, uzmanlık veya ekipten diğerine geçtiği noktadır. Her handoff potansiyel bekleme süresi yaratır çünkü işi devralacak taraf her zaman hemen müsait olmayabilir. Board bu geçişleri göstermiyorsa teslimat süresindeki boşlukların nereden geldiğini anlamak zorlaşır. Özellikle analizden geliştirmeye, geliştirmeden QA'e ve ekipten güvenlik ekibine geçişlerde kuyruk oluşması yaygındır. Handoff noktalarını görünür hale getirmek, gereksiz aktarımı azaltma ve bazı adımları cross-functional ekip içinde çözme fırsatlarını ortaya çıkarır.
Görünmeyen Approval Süreçleri
Onay süreçleri birçok kurumsal akışta önemli bekleme kaynaklarından biridir. Kart fiilen tamamlanmış olsa bile ürün sahibi, yönetici, güvenlik veya hukuk onayı beklediği için müşteriye ulaşmayabilir. Board üzerinde “Ready for Approval” gibi bir durum bulunmadığında bu süre başka sütunların Cycle Time değerlerini yapay biçimde yükseltir. Approval süresini görünür hale getirdiğinizde onay kuyruğunun büyüklüğünü ve ortalama bekleme süresini ölçebilirsiniz. Böylece delegasyon, açık kabul kriterleri veya daha erken review gibi çözümlerin etkisini veriyle değerlendirmek mümkün olur.
Kanban Board Gerçek Value Stream'e Göre Nasıl Tasarlanır?
İyi bir Kanban Board, takımın organizasyon yapısını değil, müşteri değerinin geçtiği gerçek yolu temsil eder. Tasarım sırasında talebin nereden geldiği, ne zaman commitment verildiği, hangi aşamalarda aktif çalışma yapıldığı ve hangi noktalarda bekleme oluştuğu belirlenmelidir. Ayrıca review, approval ve delivery gibi adımlar görünür hale getirilmelidir. İş analiz süreçlerinin akış hızına etkisini değerlendirirken https://www.diyarbakiryazilim.com.tr/posts/is-analiz-sureclerinin-yazilim-gelistirme-hizina-etkisi içeriği de süreç başlangıcındaki belirsizliklerin downstream üzerindeki etkisini anlamak için yararlı bir referans olabilir. Amaç, her hareketi ayrı sütuna çevirmek değil, yönetim kararı gerektiren önemli durum değişikliklerini görünür kılmaktır.
Talebin Sisteme Giriş Noktası
Kanban akışının başlangıç noktası, müşteriden veya iç paydaştan talebin sisteme ilk kez girdiği andır. Bu nokta Lead Time hesaplaması açısından özellikle önemlidir çünkü müşteri genellikle talebi oluşturduğu andan itibaren beklemeye başlar. Talep havuzu çok büyükse henüz commitment verilmemiş işleri aktif WIP'den ayrı tutmak gerekir. Aksi halde ekip kapasitesinin üzerinde yüzlerce talep aynı board üzerinde aktif iş gibi görünebilir. Sağlıklı tasarımda talep girişi, seçime hazır işler ve gerçekten çalışılmasına karar verilmiş işler birbirinden net biçimde ayrılır.
Commitment Point
Commitment Point, takımın belirli bir işi gerçekten yapmaya karar verdiği noktadır. Cycle Time ölçümünü bu noktadan veya ilk aktif çalışma aşamasından başlatmak birçok ekip için anlamlıdır. Bu ayrım, henüz önceliklendirilmemiş taleplerin çalışma süresini etkilemesini önler. Örneğin Requested sütununda yüz iş bulunabilir ancak Ready'den Development'a çekilen kartlar artık gerçek kapasitenin parçasıdır. Commitment Point konusunda tüm ekibin aynı tanımı kullanması, metriklerin dönemler arasında karşılaştırılabilir olmasını sağlar.
Aktif Çalışma Aşamaları
Aktif çalışma aşamaları, bir kişinin veya sistemin iş üzerinde gerçekten değer ürettiği noktalardır. Analiz, geliştirme, review veya test gibi adımlar süreç tipine göre aktif çalışma kabul edilebilir. Bu aşamaları bekleme durumlarından ayırmak, Flow Efficiency gibi ölçümlerin daha anlamlı hesaplanmasını sağlar. Örneğin bir kartın toplam Cycle Time değeri sekiz gün olabilir fakat aktif çalışma yalnızca iki gün sürmüş olabilir. Bu fark görüldüğünde ekibin kod yazma hızını artırmak yerine altı günlük bekleme süresini azaltmaya odaklanması daha doğru olur.
Bekleme ve Queue Aşamaları
Queue aşamaları, iş hazır olduğu halde bir sonraki faaliyetin başlamasını beklediği durumlardır. Ready for Review, Ready for QA veya Ready for Deployment gibi sütunlar bu nedenle çok değerlidir. Kuyruk miktarı ve kartların kuyruktaki yaşı, kapasite dengesizliğinin erken sinyallerini verir. Bu aşamaları gizlemek kısa vadede board'u sade gösterse de darboğaz analizini zorlaştırır. Sağlıklı Kanban akışında her bekleme durumunu ayrı sütun yapmak gerekmez, ancak sistem davranışını etkileyen önemli kuyrukların mutlaka görünür olması gerekir.
Review ve Approval Aşamaları
Review ve approval aşamaları genellikle işin teknik olarak tamamlandığı fakat teslim edilebilir hale gelmediği ara noktalardır. Bu nedenle ekipler bu süreleri hafife alabilir. Oysa birkaç saatlik geliştirme işinin iki gün review beklemesi toplam Cycle Time değerini ciddi biçimde artırır. Review aşamasını Waiting ve Reviewing biçiminde ayırmak, aktif inceleme kapasitesi ile sırada bekleyen kartları karşılaştırmayı sağlar. Approval süreçlerinde de aynı mantık kullanılarak Ready for Approval ve In Approval gibi durumlar tanımlanabilir.
Delivery Point
Delivery Point, işin müşteriye veya hedef sisteme gerçekten ulaştığı noktadır. Yazılım ekiplerinde kodun merge edilmesi her zaman delivery anlamına gelmez; değer ancak production ortamına çıktığında müşteriye ulaşmış olabilir. Bu nedenle Deployed veya Released gibi durumların süreçte nerede bulunduğu açıkça tanımlanmalıdır. Delivery Point doğru tanımlandığında Lead Time ve teslimat güvenilirliği daha gerçekçi ölçülür. Böylece takım içindeki teknik tamamlanma ile müşteri açısından gerçek tamamlanma arasındaki fark da net biçimde görünür hale gelir.
Done Tanımının Netleştirilmesi
Done tanımı farklı kişiler tarafından farklı yorumlanıyorsa Kanban verileri hızla güvenilirliğini kaybeder. Bir geliştirici için kodun tamamlanması Done olabilirken ürün sahibi için production ortamında doğrulanmış olması gerekebilir. Bu nedenle Done kriterleri açık ve herkes tarafından erişilebilir biçimde tanımlanmalıdır. Kart ancak belirlenen şartları gerçekten sağladığında son sütuna taşınmalıdır. Bu yaklaşım tamamlanmış görünen fakat hâlâ ek iş bekleyen kartların saklanmasını önler ve Throughput ölçümünün gerçek teslimat kapasitesini temsil etmesini sağlar.
Yazılım Takımı İçin Optimize Kanban Board Örneği
Bir yazılım ekibinde optimize Kanban Board yalnızca geliştirme durumunu değil, analizden production'a kadar bütün teslimat akışını göstermelidir. Örnek bir yapı Requested, Ready, Development, Code Review, QA, Ready for Deployment ve Deployed aşamalarından oluşabilir. Development, Code Review ve QA gibi alanlarda split column kullanarak aktif iş ile bekleyen işi ayırmak darboğazları daha erken görünür hale getirir. Buradaki amaç sütun sayısını artırmak değil, işin beklediği önemli noktaları fark edebilmektir. Takımın süreç yapısına göre bazı adımlar kaldırılabilir veya yeni adımlar eklenebilir.
Requested
Requested sütunu henüz çalışma kararı verilmemiş talepleri içerir. Buradaki işler müşteri talepleri, teknik iyileştirmeler, hatalar veya yeni özellik önerileri olabilir. Requested alanının aktif WIP dışında tutulması genellikle daha doğrudur çünkü bu kartların tamamı ekip tarafından commitment alınmış işler değildir. Düzenli replenishment toplantılarında buradan uygun işler Ready durumuna çekilebilir. Bu ayrım sayesinde büyük backlog miktarı, aktif çalışma kapasitesini veya Cycle Time hesaplarını doğrudan bozmaz.
Ready
Ready sütunu üzerinde çalışılmaya hazır ve gerekli ön koşulları karşılayan işleri gösterir. Bu aşamadaki kartların acceptance criteria, gerekli tasarım bilgileri ve temel bağımlılıkları mümkün olduğunca net olmalıdır. Ready kuyruğunun gereğinden fazla büyümesi de sağlıklı değildir çünkü planlanan işlerin gereksiz yere eskimesine neden olabilir. Küçük ve kontrollü bir Ready buffer, downstream ekip için starvation riskini azaltabilir. WIP politikası belirlenirken Ready alanının kapasitesini geliştirme hızına ve talep değişkenliğine göre ayarlamak faydalıdır.
Development
Development alanı geliştiricilerin aktif olarak değer ürettiği temel çalışma bölümüdür. Ancak bu alanı tek durum olarak kullanmak yerine Doing ve Done / Ready for Review şeklinde ikiye ayırmak genellikle daha fazla görünürlük sağlar. Böylece kod yazımı tamamlanmış fakat review başlamamış işler geliştirme kapasitesiyle karıştırılmaz. Development WIP limiti, takımın aynı anda kaç işi gerçekten ilerletebildiğini yansıtmalıdır. Limitin amacı geliştiricileri sınırlamak değil, fazla paralel çalışmanın oluşturduğu context switching ve yarım iş miktarını azaltmaktır.
Doing
Doing, geliştiricinin aktif olarak üzerinde çalıştığı kartları gösterir. Bir kart bu sütunda uzun süre kalıyorsa kapsam büyüklüğü, teknik belirsizlik veya bağımlılık sorunu incelenmelidir. Günlük flow review sırasında yalnızca yeni işlere değil, burada yaşlanan kartlara öncelik vermek daha faydalıdır. Özellikle Work Item Age değeri takımın normal Cycle Time dağılımına yaklaşan işler risk sinyali verebilir. Gerektiğinde işi bölmek, pairing yapmak veya başka ekip üyelerini swarm biçiminde desteğe çağırmak akışın yeniden hızlanmasına yardımcı olabilir.
Done / Ready for Review
Bu durum geliştirme faaliyetinin tamamlandığını fakat Code Review'un henüz başlamadığını gösterir. Ayrı tutulmasının en büyük avantajı review kuyruğunu doğrudan görünür hale getirmesidir. Eğer burada kart sayısı sürekli artıyorsa geliştiricilerin üretim hızı reviewer kapasitesini aşmış olabilir. Böyle bir durumda yeni geliştirme işi başlatmak yerine mevcut pull request'lerin kapanmasına destek vermek daha değerlidir. Ayrıca büyük pull request'leri küçültmek ve otomatik kalite kontrollerini genişletmek review süresini azaltabilir.
Code Review
Code Review yazılım ekiplerinde sık görülen darboğaz noktalarından biridir. Bunun temel nedeni geliştirmenin birçok kişi tarafından yapılabilmesine rağmen review yetkisinin veya uzmanlığının az sayıda kişide yoğunlaşmasıdır. Review aşamasını Waiting ve Reviewing şeklinde ayırmak, bekleme ile gerçek inceleme süresini karşılaştırmayı sağlar. Eğer kartlar saatlerce inceleniyor değil günlerce reviewer bekliyorsa çözüm review hızını artırmaktan farklı olmalıdır. WIP limitleri, küçük pull request'ler, pairing ve ortak kod sahipliği bu noktada etkili olabilir.
Waiting
Waiting sütunu review'a hazır olduğu halde henüz bir reviewer tarafından alınmamış kartları gösterir. Bu kuyruk sürekli büyüyorsa sistem açık biçimde review kapasitesine ilişkin bir sinyal veriyor demektir. Kartların yaşını göstermek, yalnızca toplam bekleyen PR sayısına bakmaktan daha faydalıdır. Örneğin beş yeni PR ile beş gündür bekleyen tek PR aynı risk seviyesinde değildir. Günlük akış toplantısında en yaşlı waiting kartları önce ele almak, Cycle Time dağılımının uzun kuyruğunu azaltmaya yardımcı olabilir.
Reviewing
Reviewing, kartın aktif olarak incelendiği aşamadır. Bu alanda çok fazla iş bulunması reviewerların aynı anda birçok PR arasında geçiş yaptığını gösterebilir. Düşük WIP limiti reviewerların bir incelemeyi tamamladıktan sonra yenisini çekmesini teşvik eder. Ayrıca review süresinin büyüklüğe göre nasıl değiştiğini ölçmek, ideal pull request boyutu için pratik veri sağlar. Çok uzun incelemeler teknik tasarımın geç tartışıldığını da gösterebilir, bu durumda geliştirme öncesi ortak tasarım görüşmeleri faydalı olabilir.
QA
QA aşaması kodun beklenen davranışı sağlayıp sağlamadığının doğrulandığı bölümdür. Test kapasitesi geliştirme kapasitesinden düşük olduğunda Ready for QA kuyruğu hızla büyüyebilir. Bu durumda daha fazla geliştirme yapmak toplam teslimat hızını artırmaz, yalnızca test bekleyen WIP miktarını artırır. Shift-left testing, otomasyon ve geliştiricilerin test sürecine destek vermesi darboğazı azaltabilir. QA alanında aktif test ile test bekleyen işi ayırmak, kapasite sorununu çok daha erken fark etmeyi sağlar.
Ready for QA
Ready for QA, geliştirme ve gerekli review işlemleri tamamlanmış fakat test henüz başlamamış işleri içerir. Bu sütunun genişlemesi downstream darboğazın en net belirtilerinden biridir. Yalnızca kart sayısına değil, ortalama ve maksimum bekleme yaşına da bakmak gerekir. Bazı durumlarda sorun QA çalışanı sayısı değil, test ortamına erişim veya test verisinin hazırlanması olabilir. Bu nedenle kuyruk görüldüğünde hemen personel artırmak yerine Blocked Time ve kök neden kategorileri birlikte analiz edilmelidir.
Testing
Testing sütunu aktif doğrulama yapılan işleri gösterir. Buradaki WIP sayısı test ekibinin gerçek paralel çalışma kapasitesini aşmamalıdır. Çok yüksek Testing WIP değeri, testerların sürekli kart değiştirmesine ve hata geri bildirimlerinin gecikmesine neden olabilir. Testlerin küçük batch'lerle ve mümkün olduğunca erken yapılması geri bildirim döngüsünü kısaltır. Ayrıca test otomasyonu tekrarlanan kontrolleri azaltırken insanların keşifsel test ve riskli senaryolara daha fazla zaman ayırmasına olanak tanır.
Ready for Deployment
Ready for Deployment sütunu teknik olarak tamamlanmış ancak production ortamına henüz aktarılmamış işleri gösterir. Bu alan sürekli büyüyorsa deployment süreci kendi başına bir darboğaz olabilir. Manuel release, sınırlı deployment pencereleri veya çok sayıda onay adımı bekleme süresini artırabilir. CI/CD yaklaşımı ve daha küçük release batch'leri bu kuyruğun azalmasına yardımcı olur. Buradaki bekleme süresini ayrıca ölçmek, geliştirme ekibinin hızlı olmasına rağmen müşteri teslimatının neden yavaş kaldığını gösterebilir.
Deployed
Deployed, işin production ortamına başarıyla ulaştığı ve belirlenen Done kriterlerini karşıladığı noktadır. Throughput ölçümünde tamamlanan iş sayısını bu noktadan saymak, ekip çıktısını müşteri teslimatıyla daha güçlü biçimde ilişkilendirir. Kartların Deployed'a taşınması otomatik hale getirilebilir ancak otomasyonun gerçek deployment sonucuyla eşleşmesi gerekir. Özellikle başarısız release durumlarında kartın yanlışlıkla tamamlandı görünmesi ölçümleri bozabilir. Bu nedenle board otomasyonu ve gerçek sistem durumunun uyumu düzenli olarak kontrol edilmelidir.
Darboğaz Kanban Board Üzerinde Nasıl Anlaşılır?
Darboğaz tespitinde tek bir işarete bakmak yerine birkaç sinyali birlikte değerlendirmek gerekir. Bir sütunda sürekli kart birikmesi, WIP limitinin sık aşılması, kartların uzun süre hareket etmemesi ve Cycle Time değerinin yükselmesi önemli belirtilerdir. Throughput düşüşü veya downstream ekibin aşırı yüklü hale gelmesi de aynı sorunu doğrulayabilir. Kanban darboğaz analizi ve WIP limitleri nasıl belirlenir sorusunun doğru yanıtı da bu nedenle tek bir sayıdan değil, sistem davranışını düzenli gözlemlemekten geçer. Trend verileri tek günlük board görüntülerinden her zaman daha güvenilir bilgi verir.
Bir Sütunda Sürekli Kart Birikmesi
Aynı sütunda günler veya haftalar boyunca kart birikmesi, o aşamanın gelen talebi yeterince hızlı işleyemediğini gösterebilir. Özellikle upstream sütunlardan düzenli olarak yeni işler gelirken çıkış hızı düşük kalıyorsa kuyruk büyür. Bu durumun geçici mi yapısal mı olduğunu anlamak için birkaç haftalık WIP eğilimine bakılmalıdır. Genişleyen bir CFD bandı da aynı sinyali destekler. Müdahale etmeden önce işlerin neden beklediğini kategorilere ayırmak, kapasite yetersizliği ile bağımlılık veya politika problemini ayırmayı kolaylaştırır.
WIP Limitinin Sürekli Aşılması
WIP limitinin nadiren aşılması özel bir durum olabilir, fakat sürekli aşılması sistemin politikasının fiilen çalışmadığını gösterir. Ekip her yoğunluk anında limiti yükseltiyorsa WIP sınırı akışı koruyan bir mekanizma olmaktan çıkar. Limit dolduğunda yeni işe başlamak yerine tamamlanmaya yakın işleri bitirmek, darboğaza destek vermek veya bloke işleri çözmek gerekir. Tekrarlanan ihlaller ayrıca limitin gerçek kapasiteye uymadığını da gösterebilir. Bu durumda veriye dayalı kısa süreli deneylerle farklı limit seviyeleri test edilmelidir.
Kartların Uzun Süre Hareket Etmemesi
Bir kartın aynı sütunda uzun süre kalması, görünür kuyruk oluşmasa bile lokal bir akış problemi gösterebilir. Özellikle kartın Work Item Age değeri takımın normal Cycle Time aralığının üzerine çıkıyorsa dikkat gerekir. Kartın büyük olması, bilinmeyen teknik sorun, onay beklemesi veya dış bağımlılık bu duruma neden olabilir. Günlük toplantılarda yalnızca “dün ne yaptım?” sorusunu konuşmak yerine “hangi kart en uzun süredir hareket etmiyor?” sorusunu sormak daha fazla değer üretir. Bu yaklaşım gecikmeyi iş tamamlandıktan sonra değil, devam ederken fark etmeyi sağlar.
Sürekli Blocked Kartlar
Blocked kart sayısının ve Blocked Time değerinin artması süreçte tekrar eden engeller bulunduğunu gösterir. Tek bir kartın bloke olması normal olabilir, ancak aynı blocker kategorisinin tekrar etmesi sistemik bir probleme işaret eder. Örneğin test ortamı erişimi, dış servis onayı veya eksik acceptance criteria sürekli aynı tür gecikmeyi oluşturabilir. Blocker'ları yalnızca kırmızı etiketle göstermek yerine neden kategorileriyle takip etmek daha faydalıdır. Aylık Pareto analizi, toplam bloke süresinin büyük kısmını üreten birkaç temel nedeni belirlemenize yardımcı olabilir.
Upstream Ekibin Boş, Downstream Ekibin Aşırı Yüklü Olması
Upstream ve downstream kapasitesi arasında ciddi fark olduğunda sistem dengesizleşir. Geliştiriciler yeni iş üreterek kendi kullanım oranlarını yüksek tutmaya çalışırken QA veya review alanında büyük kuyruk oluşabilir. Bu durumda upstream ekibin yeni iş başlatması toplam sistem hızını artırmaz. Bunun yerine ekip üyelerinin test, review veya blocker çözümüne destek vermesi daha etkili olabilir. Kanban'ın sistem düşüncesi yaklaşımı, bireysel kullanım oranı yerine işin baştan sona ne kadar hızlı aktığına odaklanmayı teşvik eder.
Cycle Time'ın Artması
Cycle Time trendinin belirgin biçimde yükselmesi akışta yeni bir gecikme oluştuğunun önemli göstergesidir. Ortalama değere tek başına bakmak yerine medyan ve %85 percentile gibi değerleri de incelemek gerekir. Artışın hangi aşamadan kaynaklandığını bulmak için sütun bazlı süreler ve bekleme süreleri karşılaştırılabilir. Örneğin geliştirme süresi aynı kalırken Ready for QA beklemesi artıyorsa darboğaz QA tarafındadır. Bu ayrım çözümün doğru noktaya uygulanmasını sağlar.
Throughput'un Düşmesi
Throughput belirli zaman aralığında tamamlanan iş sayısını gösterir. Talep seviyesi aynı kaldığı halde throughput düşüyorsa sistemde kapasite kaybı, daha büyük iş öğeleri veya yeni bir darboğaz oluşmuş olabilir. Bu metriği ekip performans puanı gibi kullanmak doğru değildir çünkü iş büyüklüğü ve talep türleri zaman içinde değişebilir. Throughput trendi WIP ve Cycle Time ile birlikte değerlendirildiğinde daha anlamlı hale gelir. WIP yükselirken throughput düşüyorsa sistemde yarım iş birikmesi olduğunu düşünmek için güçlü bir sinyal vardır.
WIP (Work in Progress) Limitleri Nedir?
WIP limiti, sistemde veya belirli bir süreç aşamasında aynı anda bulunabilecek aktif iş sayısını sınırlar. Amaç ekibi yavaşlatmak değil, çok fazla paralel işin oluşturduğu bekleme, context switching ve yarım iş miktarını azaltmaktır. Doğru WIP sınırı ekip üyelerini yeni iş başlatmadan önce mevcut işi bitirmeye yönlendirir. Böylece darboğazlar daha görünür hale gelir ve kuyrukların kontrolsüz büyümesi engellenir. WIP limitinin değerini rastgele seçmek yerine kapasite, Cycle Time, Throughput ve tarihsel akış davranışını birlikte değerlendirmek gerekir.
WIP Limitinin Amacı
WIP limitinin temel amacı aynı anda başlatılan iş miktarını sistemin bitirme kapasitesiyle uyumlu hale getirmektir. Bir ekip on işi başlatıp yalnızca ikisini bitiriyorsa hareket fazla görünse bile gerçek teslimat düşük kalır. WIP sınırı yeni kart çekmeyi sınırlayarak tamamlanmaya yakın işlere odaklanmayı teşvik eder. Ayrıca limit dolduğunda sorun görünür hale gelir ve ekip darboğaza yardım etmek zorunda kalır. Bu davranış zamanla daha kısa Cycle Time, daha az yarım iş ve daha yüksek tahmin edilebilirlik oluşturabilir.
WIP ile Kapasite Arasındaki İlişki
WIP limiti ekip kapasitesinden tamamen bağımsız belirlenmemelidir. Ancak “ekipte beş kişi var, limit beş olsun” yaklaşımı da her zaman doğru değildir. Bazı işler pairing gerektirebilir, bazı ekip üyeleri review veya destek faaliyetlerine zaman ayırabilir ve uzmanlık dağılımı kapasiteyi etkileyebilir. Gerçek kapasite, kaç kişinin bulunduğundan çok sistemin aynı anda kaç işi sağlıklı şekilde ilerletebildiğiyle ilgilidir. Bu nedenle başlangıç limiti basit bir tahminle seçilebilir fakat birkaç haftalık gerçek veri sonrasında yeniden değerlendirilmelidir.
Sütun Bazlı WIP Limiti
Sütun bazlı WIP limiti belirli bir süreç aşamasında kaç iş bulunabileceğini sınırlar. Örneğin Testing sütununda üç işten fazlasına izin verilmemesi test ekibinin gerçek paralel kapasitesini koruyabilir. Limit dolduğunda upstream ekip yeni kart göndermek yerine mevcut işleri tamamlamaya destek verir. Bu yaklaşım özellikle review, QA ve approval gibi kapasitesi sınırlı aşamalarda faydalıdır. Ancak limit yalnızca sayı olarak yazılmamalı, dolduğunda ekibin hangi davranışı uygulayacağı explicit policy biçiminde tanımlanmalıdır.
Global WIP Limiti
Global WIP limiti, commitment point ile delivery point arasındaki toplam aktif iş miktarını sınırlar. Sütun limitleri iyi çalışsa bile ekip kartları bir sütundan diğerine taşıyarak toplam yarım iş miktarını artırabilir. Global sınır bu davranışı kontrol etmek için ek güvenlik sağlar. Özellikle çok sayıda süreç adımına sahip sistemlerde toplam WIP ile Cycle Time arasındaki ilişkiyi yönetmek açısından faydalıdır. Global limitin çok düşük belirlenmesi ise starvation yaratabileceği için throughput üzerindeki etkisi düzenli olarak ölçülmelidir.
WIP Limiti Dolduğunda Ne Yapılmalı?
WIP limiti dolduğunda en kötü refleks yeni iş başlatmak için limiti geçici olarak yükseltmektir. Öncelikle mevcut işlerden hangisinin en hızlı biçimde tamamlanabileceği veya hangi darboğaz noktasına yardım edilebileceği değerlendirilmelidir. Ekip swarming yapabilir, blocker çözebilir, review desteği verebilir veya işi daha küçük parçalara ayırabilir. Limitin dolması sistemin size verdiği bir geri bildirimdir. Bu sinyali kaldırmak yerine neden dolduğunu anlamak Kanban optimizasyonunun en önemli davranışlarından biridir.
WIP Limitini Aşmak mı, Akışı Durdurmak mı?
Genel tercih WIP limitini korumak ve yeni iş başlatmayı geçici olarak durdurmaktır. Bu yaklaşım kulağa verimsiz gelebilir çünkü bazı kişiler kısa süreli olarak boş kalabilir. Ancak boş kapasiteyi yeni yarım işler üretmek yerine darboğaz çözümü, otomasyon, knowledge sharing veya mevcut işlerin tamamlanması için kullanmak sistemi daha sağlıklı hale getirir. Gerçek acil durumlar için açık bir expedite politikası tanımlanabilir. Böylece istisna yapılması gerektiğinde bunun neden yapıldığı ve normal akışa maliyeti görünür kalır.
Kanban'da WIP Limiti Nasıl Belirlenir?
Tek bir doğru WIP limiti yoktur. İdeal değer takımın kapasitesine, iş türüne, throughput değişkenliğine ve süreçteki bekleme davranışına göre değişir. Başlangıçta basit bir limit seçip veriyi gözlemlemek, teorik olarak kusursuz sayı bulmaya çalışmaktan daha etkilidir. Sonraki haftalarda Cycle Time, Throughput, Aging WIP ve starvation sinyalleri değerlendirilerek limit ayarlanabilir. Bu yaklaşım Kanban'da WIP limitleri darboğazları azaltmak için nasıl belirlenmelidir sorusuna da pratik yanıt verir: ölç, küçük değişiklik yap, sonucu karşılaştır ve yalnızca veri destekliyorsa yeni değeri standartlaştır.
Takım Kapasitesine Göre Başlangıç Limiti
Yeni başlayan ekipler WIP limitini yaklaşık takım kapasitesine göre belirleyebilir. Örneğin dört geliştiricinin bulunduğu bir ekip Development alanında dört veya beş kartlık başlangıç limiti deneyebilir. Ancak bu sayı kesin kural değildir çünkü pairing, destek işleri ve iş büyüklüğü gerçek kapasiteyi etkiler. İlk amaç mükemmel değeri bulmak değil, sınırsız paralel çalışmayı önlemektir. İki veya üç haftalık gözlem sonrasında kart yaşları ve throughput davranışı değerlendirilerek limitin artırılması veya azaltılması daha sağlıklı biçimde yapılabilir.
Tarihsel Veriye Göre Limit
Tarihsel veri mevcutsa WIP limiti belirlemek daha güvenilir hale gelir. Son birkaç aylık ortalama WIP, Cycle Time ve Throughput verileri birlikte incelenebilir. Özellikle WIP yükseldiğinde Cycle Time'ın nasıl değiştiğine bakmak sınır için pratik fikir verir. Örneğin WIP sekizin üzerine çıktığında %85 Cycle Time belirgin biçimde artıyorsa yedi veya sekiz civarında bir limit deneyebilirsiniz. Burada amaç geçmiş davranışı kopyalamak değil, sistemin hangi bölgede daha dengeli çalıştığını veriden anlamaktır.
Cycle Time'a Göre Limit
WIP değişikliklerinin Cycle Time üzerindeki etkisi limit ayarlamasında güçlü bir göstergedir. Limit azaltıldığında Cycle Time düşüyor ve throughput korunuyorsa sistem daha az yarım işle aynı çıktıyı üretiyor demektir. Bu genellikle olumlu bir gelişmedir. Ancak Cycle Time düşerken throughput ciddi biçimde azalıyor ve downstream sık sık iş bekliyorsa limit fazla düşük olabilir. Bu nedenle Cycle Time tek başına değil throughput ve starvation sinyalleriyle birlikte değerlendirilmelidir.
Throughput'a Göre Limit
Throughput, sistemin belirli zaman aralığında ne kadar işi bitirdiğini gösterdiği için WIP limit deneylerinde önemli referanstır. Limit değişikliğinden önce birkaç haftalık baz değer oluşturmak faydalıdır. Sonrasında aynı iş türleri için throughput seviyesinin nasıl değiştiği izlenebilir. Amaç her durumda throughput'u maksimum yapmak değildir; daha kısa Cycle Time ve daha yüksek tahmin edilebilirlik de değerli sonuçlardır. WIP azaltılırken throughput korunuyorsa ekip genellikle daha düşük stokla aynı teslimat kapasitesine ulaşmış olur.
Uzmanlık Kapasitesine Göre Limit
Bazı süreçlerde toplam kişi sayısından çok belirli uzmanlığın kapasitesi önemlidir. Örneğin yalnızca iki kişinin güvenlik review yapabildiği ekipte review WIP limitini tüm takım büyüklüğüne göre belirlemek kuyruk yaratabilir. Bu durumda limit kritik uzmanlık kapasitesine yakın seviyede tutulmalıdır. Aynı zamanda uzun vadeli çözüm olarak cross-training, pairing ve bilgi paylaşımı planlanmalıdır. WIP sınırı darboğazı yönetir, fakat uzmanlık bağımlılığının kendisini ortadan kaldırmaz.
Deneysel WIP Limiti Belirleme
WIP limiti belirlemenin en güvenilir yöntemlerinden biri kontrollü deney yapmaktır. Örneğin mevcut Development limitini altıdan beşe indirip iki hafta boyunca Cycle Time, Throughput ve Aging WIP değişimini izleyebilirsiniz. Aynı dönemde iş tipi veya ekip yapısında büyük değişiklik olmaması karşılaştırmayı kolaylaştırır. Sonuç olumluysa yeni limit korunabilir, olumsuzsa eski değere dönülebilir veya farklı bir seviye denenebilir. Bu yaklaşım ekip içindeki “bence limit şu olmalı” tartışmalarını somut veriye dönüştürür.
Limitlerin Periyodik Olarak Yeniden Ayarlanması
WIP limitleri bir kez belirlenip sonsuza kadar aynı kalmamalıdır. Ekip büyüklüğü, otomasyon seviyesi, ürün yapısı ve talep türleri değiştikçe gerçek kapasite de değişir. Özellikle süreçte önemli iyileştirme yapıldıktan sonra eski limit yeni durumu temsil etmeyebilir. Aylık veya çeyreklik flow review sırasında WIP politikalarını gözden geçirmek faydalıdır. Ancak limitleri her haftaki küçük dalgalanmaya göre değiştirmek yerine belirgin ve tekrarlanan verilere dayanarak ayarlamak daha istikrarlı sonuç verir.
WIP Limitinin Çok Yüksek Olduğu Nasıl Anlaşılır?
Çok yüksek WIP limiti görünürde ekibe daha fazla özgürlük verir, fakat gerçekte aynı anda fazla iş başlatılmasına neden olabilir. Bu durumda Cycle Time uzar, kartlar yaşlanır ve ekip üyeleri sürekli işler arasında geçiş yapar. Board üzerinde çok sayıda yarım iş görülürken throughput aynı seviyede kalabilir. Bu tablo, daha fazla iş başlatmanın daha fazla iş bitirmek anlamına gelmediğini gösterir. Yüksek WIP şüphesinde limiti küçük adımlarla azaltıp sistem davranışını gözlemlemek etkili bir iyileştirme deneyidir.
Fazla Multitasking
Bir ekip üyesi aynı anda üç veya dört iş üzerinde çalışıyorsa her iş için tekrar bağlam kurmak zorunda kalır. Bu durum özellikle yazılım geliştirme gibi yüksek odak gerektiren işlerde görünmeyen zaman kaybı yaratır. Kartların hiçbirinin hızla bitmemesi ve hepsinin uzun süre açık kalması WIP'in yüksek olduğuna işaret edebilir. Daha düşük limit, ekip üyelerini bir işi tamamlamadan yenisini başlatmamaya teşvik eder. Bu sayede toplam aktivite azalıyor gibi görünse bile biten iş sayısı ve teslimat akışı iyileşebilir.
Uzayan Cycle Time
WIP yükselirken Cycle Time değerinin de düzenli biçimde artması önemli bir uyarıdır. Daha fazla kart sistem içinde dolaştığında her kart çeşitli kuyruklarda daha uzun süre bekleyebilir. Little's Law da stabil sistem koşullarında WIP ile Cycle Time arasındaki bu ilişkiyi açıklamaya yardımcı olur. Limit azaltıldıktan sonra Cycle Time düşüyor ve throughput büyük ölçüde korunuyorsa önceki WIP muhtemelen gereğinden yüksekti. Özellikle %85 ve %95 Cycle Time değerlerindeki değişim, uç gecikmelerin azalıp azalmadığını görmek için yararlıdır.
Fazla Aging WIP
Aging WIP, hâlâ tamamlanmamış işlerin ne kadar süredir sistemde bulunduğunu gösterir. Çok sayıda kart normal Cycle Time dağılımının üzerine çıkıyorsa sistemde fazla yarım iş olabilir. Bu durum genellikle ekip yeni işleri başlatırken eski işleri tamamlamaya yeterince odaklanmadığında görülür. Kartları yaşlarına göre renklendirmek veya SLE eşiğine yaklaşanları işaretlemek riski görünür hale getirir. Yüksek Aging WIP, WIP limitini azaltma ve “start finishing” davranışını güçlendirme ihtiyacının önemli işaretlerinden biridir.
Sürekli Context Switching
Context switching ekip üyelerinin bir işten diğerine sık geçiş yapmasıdır. Her geçişte önceki işin zihinsel bağlamı kaybolur ve yeni işe tekrar uyum sağlamak gerekir. Çok yüksek WIP limiti bu davranışı teşvik edebilir çünkü herkesin aynı anda birçok açık görevi bulunur. Kart başına aktif çalışma süresi çok değişmese bile bekleme ve yeniden başlama maliyeti Cycle Time'ı artırabilir. Daha küçük WIP sınırları ve net öncelik politikaları ekip üyelerinin daha uzun süre tek iş üzerinde odaklanmasına yardımcı olur.
Çok Sayıda Yarım Kalmış İş
Board üzerinde çok fazla yarım kalmış iş bulunması teslimat riskini artırır. Her yarım kart müşteriye henüz değer üretmemiş bir yatırım anlamına gelir. Ayrıca gereksinimler veya teknik koşullar değiştiğinde bu işlerin tekrar ele alınması gerekebilir. WIP sınırı, yeni iş başlatmadan önce mevcut kartları bitirmeye yönelterek bu stok miktarını azaltır. Sağlıklı sistemde amaç mümkün olan en yüksek aktif kart sayısı değil, mümkün olan en düzenli bitirme akışıdır.
WIP Limitinin Çok Düşük Olduğu Nasıl Anlaşılır?
WIP sınırlarının düşük olması her zaman daha iyi değildir. Limit gerçek kapasitenin çok altında kaldığında downstream aşamalar sık sık iş bekleyebilir ve throughput gereksiz biçimde düşebilir. Bu nedenle WIP optimizasyonunda hedef en küçük sayıyı bulmak değil, akışı dengede tutacak en uygun aralığı bulmaktır. Starvation, boş kapasite ve sık bekleme düşük limit sinyalleri olabilir. Kontrollü deneyler sayesinde limit küçük adımlarla artırılarak sistemin hangi seviyede daha dengeli çalıştığı ölçülebilir.
Kullanılmayan Kapasite
Bazı ekip üyeleri düzenli olarak iş bekliyor ve upstream tarafta hazır iş bulunmasına rağmen WIP politikası yeni kart çekmeyi engelliyorsa limit fazla düşük olabilir. Burada kısa süreli boşluk ile sürekli kullanılmayan kapasiteyi ayırmak önemlidir. Kanban her kişiyi yüzde yüz meşgul etmeyi hedeflemez, dolayısıyla belirli miktarda slack normaldir. Ancak haftalar boyunca tekrar eden boş kapasite throughput'u sınırlıyorsa limit deneyi yapmak anlamlıdır. Yeni değer küçük bir artışla denenmeli ve Cycle Time üzerindeki etkisi birlikte izlenmelidir.
Sık Starvation
Starvation, bir süreç aşamasının çalışmaya hazır yeni iş bulamaması durumudur. Örneğin QA ekibi sık sık test edecek kart bekliyorsa upstream WIP sınırı veya süreç politikası gereğinden kısıtlayıcı olabilir. Bununla birlikte starvation'ın nedeni düşük WIP dışında büyük batch, düzensiz teslimat veya blocker'lar da olabilir. Bu nedenle yalnızca limiti yükseltmeden önce kök neden kontrol edilmelidir. Gerçek neden WIP sınırıysa kontrollü artış sistemin akışını daha dengeli hale getirebilir.
Downstream Ekibin İş Beklemesi
Downstream ekip sürekli upstream'den kart bekliyorsa sistem kapasitesinin tamamı kullanılamıyor olabilir. Bu durum özellikle test veya deployment gibi aşamalarda dalgalı iş akışı yaratır. Birkaç gün aşırı yoğunluk, ardından birkaç gün boşluk görülmesi batch davranışına işaret edebilir. Daha dengeli WIP ve daha küçük iş parçaları downstream'e daha düzenli iş akışı sağlayabilir. Bu nedenle WIP sınırı yanında batch size ve pull politikası da birlikte değerlendirilmelidir.
Throughput'un Gereksiz Düşmesi
WIP limiti azaltıldıktan sonra throughput belirgin ve kalıcı biçimde düşüyorsa sistem gerekli çalışma stokunun altına inmiş olabilir. Bu durum özellikle talep ve iş süresi değişkenliği yüksek sistemlerde görülebilir. Küçük bir buffer, sonraki aşamanın sürekli iş bulmasını sağlayarak akışı stabilize edebilir. Ancak throughput düşüşünü tek hafta üzerinden yorumlamak doğru değildir çünkü doğal varyasyon etkili olabilir. Birkaç haftalık veri ve Cycle Time değişimi birlikte değerlendirilerek daha güvenilir sonuç alınmalıdır.
Limit Değişikliği İçin Deney Tasarlamak
WIP limiti değişikliğini açık bir deney gibi ele almak karar kalitesini yükseltir. Önce mevcut Cycle Time, Throughput, Aging WIP ve starvation sıklığı kaydedilir. Ardından limit yalnızca bir veya iki kart değiştirilerek belirli süre uygulanır. Deney sonunda aynı metrikler karşılaştırılır ve beklenen sonuç gerçekleşip gerçekleşmediği değerlendirilir. Böylece ekip limit kararlarını kişisel görüşlerden çok gözlemlenebilir sistem davranışına dayandırabilir.
Little's Law ile Kanban Akışı Nasıl Analiz Edilir?
Little's Law, akış sistemlerindeki WIP, Throughput ve Cycle Time arasındaki temel ilişkiyi açıklayan güçlü bir modeldir. Stabil koşullarda ortalama WIP, throughput ile ortalama Cycle Time'ın çarpımına eşittir. Kanban ekipleri bu ilişkiyi kullanarak fazla WIP'in teslimat süresine etkisini daha iyi anlayabilir. Ancak formülü mekanik biçimde kullanmak yerine sistemin yeterince stabil olup olmadığını kontrol etmek gerekir. Büyük talep dalgalanmaları veya sürekli değişen iş tipleri bulunduğunda hesaplanan değerler yalnızca yaklaşık gösterge olarak ele alınmalıdır.
Little's Law Nedir?
Little's Law kuyruk sistemlerinde ortalama iş miktarı, akış hızı ve sistemde geçirilen süre arasındaki matematiksel ilişkiyi ifade eder. Kanban bağlamında WIP = Throughput × Cycle Time şeklinde düşünülebilir. Bu eşitlik, sistem dengeli çalışıyorsa üç metrikten ikisini bildiğinizde üçüncüsünü yaklaşık olarak anlamanıza yardımcı olur. Örneğin haftada on iş tamamlanan ve ortalama yirmi WIP bulunan sistemde ortalama Cycle Time yaklaşık iki hafta olabilir. Ancak başlangıç ve bitiş sınırlarının bütün ölçümlerde tutarlı olması şarttır.
WIP, Throughput ve Cycle Time İlişkisi
WIP, Throughput ve Cycle Time birbirinden bağımsız metrikler değildir. Throughput sabit kalırken sistemdeki WIP artarsa işlerin sistemde geçirdiği ortalama süre de artma eğilimindedir. Bu nedenle yeni iş başlatmak kısa vadede hareketlilik yaratabilir ama tamamlanma hızını artırmayabilir. Tam tersine WIP'i kontrollü azaltmak, throughput korunuyorsa Cycle Time'ı düşürebilir. Bu ilişki Kanban sistemlerinde “daha fazla başlatmak” yerine “daha hızlı bitirmek” düşüncesini destekleyen temel mekanizmalardan biridir.
Cycle Time = WIP / Throughput
Little's Law yeniden düzenlendiğinde Cycle Time = WIP / Throughput biçiminde ifade edilebilir. Örneğin sistemde ortalama on iki aktif iş varsa ve haftada altı iş tamamlanıyorsa ortalama Cycle Time yaklaşık iki hafta olur. Aynı throughput korunarak WIP altıya düşürülebilirse teorik ortalama Cycle Time yaklaşık bir haftaya yaklaşabilir. Elbette gerçek süreçte iş türleri ve değişkenlik sonuçları etkileyebilir. Formülün değeri kesin tahmin vermesinden çok, fazla WIP'in teslimat süresini neden uzattığını açık biçimde göstermesidir.
WIP Azaldığında Ne Olur?
WIP kontrollü biçimde azaltıldığında işlerin kuyruklarda geçirdiği süre genellikle azalır. Ekip üyeleri daha az kart arasında geçiş yaptığı için odak süresi artabilir ve kartlar daha hızlı tamamlanabilir. Ancak limit gereğinden fazla düşürülürse bazı aşamalar iş beklemeye başlayabilir ve throughput zarar görebilir. Bu nedenle amaç mümkün olan en düşük WIP değil, akışın stabil kaldığı minimum etkili WIP seviyesidir. Değişiklik sonrasında Cycle Time, Throughput ve starvation birlikte izlenmelidir.
Throughput Sabitken Cycle Time Nasıl Değişir?
Throughput sabit kaldığında Cycle Time büyük ölçüde WIP seviyesine bağlı hareket eder. Örneğin haftada sekiz iş tamamlayan bir sistemde WIP on altıdan sekize düşerse teorik Cycle Time yaklaşık yarıya inebilir. Bu nedenle throughput'u artırmadan da teslimat süresini kısaltmak mümkündür. Ekipler bazen yalnızca daha fazla iş bitirmeye odaklanırken sistemde bekleyen iş miktarını gözden kaçırır. Little's Law bu iki bakışı aynı denklem içinde değerlendirmeyi sağlar.
Little's Law Ne Zaman Yanlış Kullanılır?
Little's Law en sık sistem stabil değilken kesin tahmin aracı gibi kullanıldığında yanlış yorumlanır. WIP sürekli yükseliyorsa, talep yapısı hızla değişiyorsa veya ölçüm sınırları farklıysa denklem yanıltıcı olabilir. Ayrıca story point gibi soyut tahmin birimlerini throughput yerine kullanmak doğru değildir. Başlangıç ve bitiş noktaları aynı veri setinde tutarlı olmalıdır. Formül karar desteği sağlar, fakat gerçek sistem davranışını gözlemlemenin yerini almaz.
Kanban Optimizasyonu İçin Temel Flow Metrics
Kanban sistemini yalnızca board görüntüsüne bakarak optimize etmek mümkün değildir. WIP, Throughput, Cycle Time, Lead Time, Work Item Age, Blocked Time ve Flow Efficiency birlikte değerlendirildiğinde akışın nerede yavaşladığı daha net anlaşılır. Bu yaklaşım cycle time lead time throughput metrikleri ile Kanban performansı ölçme konusunda ortak bir dil oluşturur. Her metriğin farklı soruya yanıt verdiğini unutmamak gerekir. Tek bir metriği hedef haline getirmek yerine birkaç göstergenin birlikte nasıl hareket ettiğini izlemek daha güvenilir sonuç verir.
Work in Progress
Work in Progress, commitment point ile delivery point arasında bulunan tamamlanmamış işlerin sayısını ifade eder. WIP yükseldikçe daha fazla iş sistemde bekler ve Cycle Time genellikle artar. Ancak WIP'i sıfıra yaklaştırmak da gerçekçi değildir çünkü bazı paralellikler ve buffer kapasitesi gereklidir. Takımlar toplam WIP yanında sütun bazlı WIP değişimini de izlemelidir. Özellikle belirli aşamada sürekli yükselen WIP, yerel darboğazın erken işareti olabilir.
Throughput
Throughput belirli bir zaman diliminde tamamlanan iş öğesi sayısıdır. Haftalık veya aylık olarak ölçülebilir ve sistemin gerçek teslimat kapasitesi hakkında önemli bilgi verir. Throughput'u kişi performansı değerlendirmek için kullanmak doğru değildir çünkü işlerin büyüklüğü ve yapısı değişebilir. Bunun yerine sistemin zaman içindeki kapasitesini ve tahmin modellerini desteklemek için kullanılmalıdır. Monte Carlo benzeri tahmin yöntemlerinde geçmiş throughput dağılımı özellikle değerlidir.
Cycle Time
Cycle Time bir işin commitment veya aktif başlangıç noktasından tamamlanmasına kadar geçen süredir. Takım perspektifinden teslimat hızını değerlendirmek için kullanılır. Ortalama yerine medyan ve percentile değerleriyle birlikte incelendiğinde daha güvenilir bilgi sağlar. Cycle Time trendinin yükselmesi daha fazla WIP, artan kuyruk veya blocker problemlerine işaret edebilir. Süreyi aşama bazında parçalamak, gecikmenin hangi noktadan kaynaklandığını anlamayı kolaylaştırır.
Lead Time
Lead Time müşterinin talebi oluşturduğu andan teslimata kadar geçen toplam süreyi temsil eder. Bu nedenle Cycle Time'dan önce başlayan bekleme dönemlerini de içerir. Bir ekip hızlı geliştirme yapabilir fakat backlog'da aylarca bekleyen işler nedeniyle müşteri Lead Time değeri çok yüksek olabilir. Müşteri deneyimi açısından çoğu zaman Lead Time daha anlamlıdır. Talep yönetimi ve önceliklendirme süreçleri de bu metriğin önemli parçalarıdır.
Work Item Age
Work Item Age hâlâ tamamlanmamış bir kartın ne kadar süredir sistemde olduğunu gösterir. Cycle Time yalnızca tamamlanan işler için kesinleşirken Work Item Age devam eden işler hakkında erken uyarı sağlar. Kart yaşı normal Cycle Time percentile seviyelerine yaklaşmaya başladığında ekip riski iş tamamlanmadan önce görebilir. Bu nedenle günlük flow review toplantılarında oldukça değerlidir. Yaşlanan işleri görselleştirmek, sessizce bekleyen kartların unutulmasını önler.
Blocked Time
Blocked Time bir kartın dış veya iç engel nedeniyle ilerleyemediği toplam süreyi ölçer. Bu değer yüksek olduğunda yalnızca blocker sayısını değil, blocker nedenlerini de takip etmek gerekir. Örneğin on küçük engel yerine tek bir uzun güvenlik onayı toplam gecikmenin büyük bölümünü oluşturabilir. Kategorilere ayrılmış Blocked Time verisi Pareto analizi için iyi bir temel sağlar. Böylece ekip en fazla teslimat süresine neden olan engel türlerine öncelik verebilir.
Flow Efficiency
Flow Efficiency aktif çalışma süresinin toplam Cycle Time içindeki oranını gösterir. Bir kart on günde tamamlanıyor ancak yalnızca iki gün aktif çalışılıyorsa flow efficiency yaklaşık yüzde yirmidir. Düşük oran her zaman kötü değildir, fakat bekleme sürelerinin büyüklüğünü görünür hale getirir. İyileştirme çalışmasında aktif çalışma hızını artırmaktan önce uzun kuyrukları azaltmak çoğu zaman daha büyük etki yaratır. Bu nedenle flow efficiency sistemdeki bekleme maliyetini anlamak için güçlü bir yardımcı metriktir.
Lead Time ve Cycle Time Arasındaki Fark
Lead Time ve Cycle Time sık karıştırılan iki temel akış metriğidir. Aralarındaki fark esas olarak ölçümün nerede başladığıyla ilgilidir. Lead Time çoğunlukla müşteri talebinin oluşturulduğu andan teslimata kadar geçen süreyi, Cycle Time ise takımın işi gerçekten üstlendiği veya çalışmaya başladığı andan teslimata kadar geçen süreyi ölçer. İki metriği birlikte kullanmak talep kuyruğu ile aktif çalışma akışını birbirinden ayırmayı sağlar. Bu ayrım, teslimat gecikmesinin backlog yönetiminden mi yoksa çalışma sürecinden mi kaynaklandığını anlamada önemlidir.
Lead Time Nerede Başlar?
Lead Time müşterinin veya paydaşın talebi sisteme girdiği anda başlamalıdır. Kullanıcı bir özellik talebi oluşturduğu halde ekip bu işi üç hafta sonra seçiyorsa bu üç haftalık bekleme müşteri açısından gerçek bekleme süresidir. Bu nedenle Lead Time ölçümü backlog veya Requested aşamasını da kapsayabilir. Başlangıç noktasını açıkça tanımlamak farklı dönemlerde yapılan karşılaştırmaların güvenilir kalmasını sağlar. Kurumlar müşteri deneyimini iyileştirmek istiyorsa yalnızca geliştirme süresine değil bu toplam bekleme penceresine bakmalıdır.
Cycle Time Nerede Başlar?
Cycle Time genellikle ekip işi commitment point üzerinden sisteme çektiğinde veya aktif çalışmaya başladığında ölçülür. Böylece henüz seçilmemiş talepler çalışma performansından ayrılır. Örneğin Requested'dan Ready'ye geçiş henüz commitment değilse Cycle Time Development başlangıcında başlatılabilir. Takımın hangi noktayı kullandığından çok, bu tanımın herkes için tutarlı olması önemlidir. Sürekli değişen ölçüm sınırları trend analizini güvenilmez hale getirir.
Waiting Time'ın Etkisi
Cycle Time yalnızca aktif çalışma süresinden oluşmaz. Bir kartın review, test veya onay beklediği zaman da toplam teslimat süresinin parçasıdır. Bu nedenle birkaç saat aktif işlem gören kartın Cycle Time değeri günler sürebilir. Waiting Time'ı ayrı ölçmek iyileştirme fırsatlarını belirlemeyi kolaylaştırır. Birçok ekipte en büyük kazanım kod yazmayı hızlandırmaktan değil, işin kimse tarafından ele alınmadığı süreleri azaltmaktan gelir.
Müşteri Perspektifi vs. Takım Perspektifi
Lead Time müşterinin ne kadar beklediğini, Cycle Time ise takımın üstlendiği işi ne kadar sürede teslim ettiğini anlamaya yardımcı olur. Bu iki perspektif birbirini tamamlar. Cycle Time iyi görünürken Lead Time yüksekse talep seçimi veya backlog yönetimi sorunlu olabilir. Lead Time düşük ancak Cycle Time dalgalıysa ekip kısa bekleme sayesinde müşteriyi hızlı karşılıyor fakat iç akış tahmin edilebilir olmayabilir. İki metriği birlikte değerlendirmek bütün sistemi daha doğru yorumlamayı sağlar.
Ölçüm Sınırlarını Standartlaştırmak
Akış metriklerinin güvenilirliği ölçüm sınırlarının tutarlılığına bağlıdır. Cycle Time bir ay Development başlangıcından, sonraki ay Ready başlangıcından ölçülürse trend karşılaştırması anlamsız hale gelir. Aynı durum Done ve Deployed gibi bitiş noktalarında da geçerlidir. Ekip ölçüm politikasını yazılı hale getirmeli ve otomasyonların bu tanımla uyumlu çalıştığını kontrol etmelidir. Böylece geçmiş veriler gelecekte tahmin ve iyileştirme çalışmalarında daha güvenilir biçimde kullanılabilir.
Ortalama Cycle Time Neden Tek Başına Yeterli Değildir?
Ortalama değer bazı işlerin çok hızlı, bazılarının ise aşırı yavaş olduğu dağılımları gizleyebilir. Örneğin dokuz iş iki günde, tek bir iş yirmi günde tamamlandıysa ortalama gerçek kullanıcı deneyimini tam olarak temsil etmeyebilir. Bu nedenle medyan, percentile değerleri ve scatterplot gibi araçlar birlikte kullanılmalıdır. Özellikle %85 veya %95 Cycle Time değerleri teslimat tahminlerinde daha yararlı olabilir. Dağılımın şeklini anlamak, yalnızca merkezi değeri takip etmekten daha güçlü süreç içgörüleri sağlar.
Ortalama Değer Problemi
Ortalama bütün gözlemleri tek sayıda topladığı için uç değerlerden kolayca etkilenir. Birkaç çok uzun iş bütün ayın Cycle Time ortalamasını yükseltebilir. Tersi durumda çok sayıda küçük iş ortalamayı düşürerek büyük işlerdeki gecikmeyi saklayabilir. Bu yüzden ortalamaya bakarken dağılımı ve iş türlerini de görmek gerekir. Kanban analizinde ortalama faydalıdır ancak tek başına karar vermek için yeterli değildir.
Medyan
Medyan tamamlanan işlerin yarısının altında, yarısının üzerinde kaldığı Cycle Time değeridir. Uç değerlerden ortalamaya göre daha az etkilenir. Bu nedenle tipik bir işin ne kadar sürdüğünü anlamak için faydalı olabilir. Ancak medyan yalnızca yüzde ellilik noktayı gösterdiği için teslimat riski açısından tek başına yeterli değildir. Daha yüksek güven seviyeleri için %85 veya %95 percentile değerleriyle birlikte değerlendirilmelidir.
Percentile'lar
Percentile değerleri tamamlanan işlerin belirli yüzdesinin hangi süre içinde bittiğini gösterir. Örneğin %85 Cycle Time sekiz gün ise geçmişteki işlerin yaklaşık yüzde seksen beşi sekiz gün veya daha kısa sürede tamamlanmıştır. Bu bilgi SLE oluşturmak ve paydaşlarla olasılığa dayalı beklenti paylaşmak için kullanılabilir. Tek bir kesin süre vermek yerine tarihsel dağılım üzerinden güven aralığı sunar. Özellikle değişken iş akışlarında bu yaklaşım ortalama değerden daha gerçekçi tahminler sağlayabilir.
%50
%50 percentile medyanı ifade eder. Geçmiş işlerin yarısı bu süreden daha kısa, yarısı daha uzun tamamlanmıştır. Tipik teslimat hızını anlamak için faydalı bir referanstır ancak yüksek güven seviyesi sunmaz. Müşteriye güçlü taahhüt verilmesi gereken durumlarda daha yüksek percentile değerleri tercih edilebilir. %50 değeri yine de süreç değişikliklerinden sonra merkezi eğilimin nasıl değiştiğini görmek açısından oldukça kullanışlıdır.
%85
%85 percentile Kanban ekiplerinde SLE belirlemek için sık kullanılan güven seviyelerinden biridir. Geçmiş performansa göre işlerin büyük kısmının bu süre içinde tamamlandığını gösterir. Örneğin %85 Cycle Time on gün ise benzer işlerin çoğunun on gün içinde tamamlanması beklenebilir. Bu kesin garanti değildir, olasılığa dayalı bir beklentidir. Work Item Age değeri bu eşiğe yaklaşan aktif kartlar günlük flow review sırasında öncelikli risk olarak ele alınabilir.
%95
%95 percentile daha yüksek güven seviyesi sunar ancak doğal olarak süre değeri genellikle daha uzundur. Kritik teslimatlarda veya risk toleransının düşük olduğu durumlarda bu değer daha anlamlı olabilir. Örneğin %85 değeri sekiz gün, %95 değeri on dört gün ise küçük bir iş grubunun ciddi biçimde geciktiği anlaşılabilir. Bu fark outlier analizinin önemini gösterir. Darboğaz iyileştirmesi sonrasında özellikle yüksek percentile değerlerinin düşmesi, uç gecikmelerin azaldığını gösterebilir.
Cycle Time Dağılımı
Cycle Time dağılımı işlerin hangi sürelerde yoğunlaştığını ve uzun kuyruğun ne kadar geniş olduğunu gösterir. Dar dağılım daha yüksek tahmin edilebilirlik anlamına gelebilir. Geniş ve sağa uzayan dağılım ise bazı işlerin diğerlerinden çok daha uzun sürdüğünü gösterir. Bu farkların iş tipi, blocker veya belirli süreç aşamalarıyla ilişkisi incelenmelidir. Amaç yalnızca ortalama süreyi azaltmak değil, teslimat varyasyonunu da kontrol altına almaktır.
Outlier'ların Analizi
Outlier işler normal Cycle Time aralığının çok üzerinde tamamlanan kartlardır. Bu kartları “istisna” diyerek dışlamak yerine nedenlerini incelemek önemli öğrenme fırsatı sunar. Büyük kapsam, dış bağımlılık, onay gecikmesi veya belirsiz gereksinimler tekrar eden nedenler olabilir. Outlier'ları kategorize ettiğinizde birkaç temel nedenin uzun gecikmelerin çoğunu oluşturduğu görülebilir. Bu bilgiler sonraki süreç deneyleri için doğrudan girdi sağlar.
Cycle Time Scatterplot Nasıl Kullanılır?
Cycle Time Scatterplot her tamamlanan işin tamamlanma tarihi ile Cycle Time değerini aynı grafik üzerinde gösterir. Böylece ortalama gibi tek değer yerine bütün dağılımı zaman içinde görebilirsiniz. Grafikte yükselen kümeler, artan varyasyon veya belirgin outlier'lar darboğaz dönemlerini anlamanıza yardımcı olabilir. Süreç değişikliği yaptıktan önce ve sonra noktaların dağılımını karşılaştırmak da iyileştirmenin etkisini görselleştirir. Özellikle percentile çizgileri eklendiğinde SLE ve tahmin tartışmaları çok daha somut hale gelir.
Scatterplot Neyi Gösterir?
Scatterplot her tamamlanan kartı tek bir nokta olarak gösterir. Noktanın konumu kartın ne zaman tamamlandığını ve kaç gün sürdüğünü ifade eder. Bu yapı aynı dönemdeki işler arasındaki varyasyonu açık biçimde gösterir. Birkaç yüksek nokta outlier kartları, zamanla yükselen genel dağılım ise kötüleşen Cycle Time trendini gösterebilir. Grafik ayrıca iş tiplerini farklı renklerle ayırarak hangi talep sınıfının daha fazla geciktiğini anlamayı kolaylaştırabilir.
Yatay Eksen
Scatterplot'un yatay ekseni genellikle işin tamamlandığı tarihi gösterir. Böylece Cycle Time davranışını kronolojik olarak izlemek mümkün olur. Belirli sprint, release veya süreç değişikliği sonrası dağılımın nasıl değiştiği kolayca görülebilir. Örneğin WIP limiti 1 Haziran'da düşürüldüyse bu tarihten sonraki noktaların yüksekliğine bakılarak ilk etki gözlemlenebilir. Uzun dönem trendi okumak için yatay eksendeki tarih aralığının yeterince geniş tutulması faydalıdır.
Dikey Eksen
Dikey eksen her kartın Cycle Time değerini, çoğunlukla gün cinsinden gösterir. Nokta ne kadar yukarıdaysa işin tamamlanması o kadar uzun sürmüştür. %50, %85 ve %95 percentile çizgileri bu eksene göre eklenebilir. Böylece belirli güven seviyelerinde beklenen teslimat süresi görsel olarak anlaşılır. Süreç iyileştirmesinden sonra noktaların aşağıya doğru sıkışması hem hızın hem tahmin edilebilirliğin arttığını gösterebilir.
Outlier İşleri Bulmak
Scatterplot yüksek Cycle Time değerine sahip outlier kartları hızlı biçimde görünür hale getirir. Bu noktaların üzerine gidip ilgili iş türü, blocker ve süreç geçmişi incelenebilir. Aynı nedenin birden fazla outlier'da görülmesi sistemik iyileştirme fırsatı oluşturur. Örneğin tüm yüksek noktaların harici güvenlik onayı bekleyen işlerden gelmesi çözümün geliştirme ekibinde olmadığını açıkça gösterir. Bu yaklaşım kök neden analizini genel tahminlerden somut iş örneklerine taşır.
Trendleri Görmek
Noktaların zamanla daha yukarı çıkması Cycle Time'ın kötüleştiğini, aşağı doğru sıkışması ise iyileştiğini gösterebilir. Ancak birkaç günlük değişim üzerinden sonuç çıkarmak yerine yeterli sayıda tamamlanmış iş gözlemlemek gerekir. İş tipleri de trendi etkileyebileceği için mümkünse benzer kategoriler ayrı değerlendirilmelidir. WIP artışı veya ekip değişimi gibi olayları grafiğin zaman çizgisiyle eşleştirmek önemli bağlam sağlar. Böylece trendin yalnızca varlığını değil muhtemel nedenini de anlamak kolaylaşır.
Darboğaz Sonrası Değişimi Ölçmek
Bir darboğaz iyileştirmesi uygulandığında scatterplot önceki ve sonraki dönemi karşılaştırmak için kullanışlıdır. Örneğin Code Review WIP limiti düşürüldükten sonra hem medyan hem %85 Cycle Time değerinin azalması olumlu sinyal olabilir. Bunun yanında outlier sayısının azalması tahmin edilebilirliğin de iyileştiğini gösterir. Sadece throughput artışına bakmak bu etkileri göstermeyebilir. Bu nedenle süreç deneylerini değerlendirmek için birkaç flow metriğini aynı anda kullanmak daha güvenilir sonuç verir.
Work Item Age ile Darboğazı Erken Tespit Etmek
Work Item Age tamamlanmamış kartların yaşını gösterdiği için darboğaz tespitinde erken uyarı sistemi gibi kullanılabilir. Cycle Time bir iş tamamlandıktan sonra kesinleşir, ancak Work Item Age iş devam ederken risk sinyali üretir. Kart normal teslimat süresine yaklaştıkça ekip müdahale edebilir. Özellikle SLE eşiğine yaklaşan kartları günlük flow review toplantısında önceliklendirmek gecikmeyi azaltabilir. Böylece analiz yalnızca geçmiş performansa değil, şu anda oluşmakta olan riske de odaklanır.
Work Item Age Nedir?
Work Item Age aktif bir işin başlangıç noktasından bugüne kadar geçen süredir. Kart tamamlanmadığı için henüz Cycle Time değeri oluşmamıştır. Buna rağmen yaş bilgisi işin normalden yavaş ilerleyip ilerlemediği konusunda güçlü sinyal verir. Örneğin takımın %85 Cycle Time değeri yedi günken bir kart sekizinci gün hâlâ Development'taysa risk artmıştır. Bu kartın neden ilerlemediği hemen incelenebilir.
Cycle Time'dan Farkı
Cycle Time tamamlanan işin geçmiş performansını, Work Item Age ise devam eden işin mevcut durumunu anlatır. Cycle Time analizi retrospektif, Work Item Age analizi daha proaktif kullanım sağlar. İki metrik aynı başlangıç noktasını kullanıyorsa karşılaştırmaları daha anlamlı olur. Aktif kartların yaşını tarihsel Cycle Time dağılımıyla karşılaştırarak gecikme olasılığı hakkında daha iyi fikir edinilebilir. Bu nedenle iki ölçüm birbirinin alternatifi değil tamamlayıcısıdır.
Aging WIP Nedir?
Aging WIP sistemde uzun süredir kalan tamamlanmamış işlerin bütününü ifade eder. Yüksek Aging WIP fazla paralel çalışma, blocker, büyük iş öğeleri veya unutulan kartlar nedeniyle oluşabilir. Bu kartlar genellikle Cycle Time dağılımındaki gelecekteki outlier'ların adaylarıdır. Yaşlanmayı erken görmek ekip için müdahale fırsatı yaratır. Yeni iş çekmek yerine bu kartların tamamlanmasına odaklanmak toplam akış sağlığını iyileştirebilir.
Yaşlanan Kartların Görselleştirilmesi
Kartların yaşını renk, rozet veya sayısal gün değeriyle göstermek board kullanımını güçlendirir. Örneğin normal aralıkta olan işler yeşil, SLE'e yaklaşanlar sarı, eşiği geçenler kırmızı gösterilebilir. Bu sayede ekip yalnızca sütun pozisyonuna değil zaman riskine de bakar. Görselleştirme özellikle büyük board'larda sessizce unutulan kartları bulmayı kolaylaştırır. Ancak renk sınırlarının tarihsel verilere dayanması, rastgele seçilmemesi gerekir.
SLE Eşiğine Yaklaşan İşler
SLE belirli işlerin beklenen süre içinde tamamlanacağına ilişkin olasılığa dayalı beklentidir. Aktif bir kartın yaşı bu eşiğe yaklaştığında gecikme riski yükselir. Ekip bu noktada blocker kontrolü yapabilir, işi küçültebilir veya swarm kararı alabilir. Amaç SLE'yi katı deadline gibi kullanmak değil, risk konuşmasını daha erken başlatmaktır. Böylece son gün yaşanan sürprizler azalır.
Günlük Flow Review'da Aging WIP Kullanımı
Günlük Flow Review toplantısında önce en yaşlı kartlara bakmak oldukça etkili bir alışkanlıktır. Ekip “bugün kim ne yapacak?” yerine “hangi iş teslimat riski taşıyor?” sorusuna odaklanır. SLE'e yaklaşan kartlar ve uzun süredir hareket etmeyen işler öncelikli hale gelir. Gerekirse ekip bu işleri tamamlamak için geçici olarak yeni iş çekmeyi durdurabilir. Bu davranış Stop Starting, Start Finishing yaklaşımını günlük çalışma rutinine dönüştürür.
Cumulative Flow Diagram (CFD) Nedir?
Cumulative Flow Diagram, işlerin zaman içinde süreç aşamalarında nasıl biriktiğini gösteren güçlü Kanban grafiklerinden biridir. Her renk bandı belirli bir workflow durumundaki toplam iş miktarını temsil eder. Bantların genişliği WIP seviyesini, yatay mesafe yaklaşık Cycle Time'ı ve genel ilerleme eğimi throughput davranışını anlamaya yardımcı olur. CFD'nin en büyük avantajı tek günlük board görüntüsü yerine sistemin zaman içindeki yapısını göstermesidir. Darboğaz oluştuğunda belirli bir bandın giderek genişlemesi dikkat çekici bir sinyal haline gelir.
CFD Ne Gösterir?
CFD belirli zaman aralığında işlerin farklı süreç durumlarında nasıl dağıldığını gösterir. Grafiğin üst sınırı sisteme giren toplam işi, alt tamamlanma hattı ise teslim edilen toplam işi temsil edebilir. Aradaki renk bantları her aşamada bulunan iş miktarını gösterir. Zamanla paralel giden bantlar daha stabil akışa işaret ederken genişleyen bantlar birikme olduğunu gösterebilir. Bu nedenle CFD, WIP ve akış dengesi hakkında tek grafik üzerinden önemli bağlam sunar.
CFD Nasıl Okunur?
CFD okurken yalnızca çizgilerin yönüne değil, bantların zaman içinde nasıl genişleyip daraldığına bakılır. Bir bant giderek genişliyorsa o aşamaya gelen iş miktarı çıkan iş miktarından fazladır. Daralan bant ise kapasitenin talebin üzerinde olduğunu veya upstream'den yeterli iş gelmediğini gösterebilir. Genel çizgilerin eğimi throughput davranışını anlamaya yardımcı olur. Ani sıçramalar büyük batch hareketleri veya süreç politikası değişiklikleriyle ilişkili olabilir.
WIP CFD Üzerinde Nasıl Görülür?
Bir süreç aşamasındaki WIP, CFD üzerindeki ilgili bandın dikey genişliğiyle yaklaşık olarak okunabilir. Bant genişledikçe o aşamada daha fazla iş birikiyor demektir. Özellikle haftalar boyunca sürekli genişleyen bant darboğaz ihtimalini güçlendirir. WIP limit değişikliği sonrasında bandın tekrar stabil hale gelip gelmediği gözlemlenebilir. Bu nedenle CFD yalnızca geçmiş raporu değil, süreç deneylerinin etkisini değerlendiren bir araç olarak da kullanılabilir.
Cycle Time CFD Üzerinde Nasıl Görülür?
Cycle Time CFD üzerinde belirli bir işin giriş ve çıkış çizgileri arasındaki yatay zaman mesafesiyle yaklaşık olarak ilişkilendirilebilir. Bantların yatay yönde uzaması işlerin sistemde daha fazla zaman geçirdiğini gösterir. Bu okuma doğrudan scatterplot kadar ayrıntılı değildir ancak genel trendi anlamak için faydalıdır. WIP yükseldikçe yatay mesafenin de büyümesi Little's Law ilişkisinin görsel örneğini oluşturabilir. Kesin percentile hesapları için yine bireysel Cycle Time verisi kullanılmalıdır.
Throughput CFD Üzerinde Nasıl Anlaşılır?
CFD'de tamamlanan işlerin kümülatif çizgisinin eğimi throughput hakkında fikir verir. Çizgi daha dik hale geldikçe belirli zaman aralığında daha fazla iş tamamlanıyor demektir. Eğimin yataylaşması throughput düşüşünü gösterebilir. Bu değişimin aynı anda belirli bant genişlemesiyle eşleşmesi darboğazın etkisini güçlendiren bir işarettir. Throughput değerini net hesaplamak için yine belirli dönemlerde tamamlanan iş sayısını ayrıca ölçmek faydalıdır.
CFD ile Darboğaz Nasıl Tespit Edilir?
CFD üzerinde darboğaz ararken en önemli sinyal bant genişliğinin zaman içinde değişmesidir. Stabil süreçte bantlar yaklaşık paralel hareket eder. Belirli bir aşamanın bandı sürekli genişliyorsa o noktada WIP birikiyor ve çıkış kapasitesi gelen talebi karşılamıyor olabilir. Daralan bantlar ise fazla kapasite veya upstream starvation ihtimalini gösterir. Ani sıçrama ve uzun süre hareketsiz kalan bantlar da batch hareketi veya süreç duraklaması hakkında bilgi verebilir.
Paralel Bantlar
CFD bantlarının uzun dönem boyunca yaklaşık paralel hareket etmesi, sistemdeki WIP seviyelerinin görece stabil olduğunu gösterir. Bu durum her şeyin mükemmel olduğu anlamına gelmez, ancak kontrolsüz birikim bulunmadığına işaret eder. Bantların mutlak genişliği yine de yüksek olabilir. Dolayısıyla paralellik yanında Cycle Time ve toplam WIP seviyesi de değerlendirilmelidir. Stabil fakat yavaş sistemde sonraki hedef WIP'i kontrollü azaltarak teslimat süresini iyileştirmek olabilir.
Stabil Akış
Stabil akışta sisteme giriş ve sistemden çıkış oranları uzun dönem boyunca birbirine yakın seyreder. WIP belirli aralıkta kalır ve Cycle Time dağılımı aşırı dalgalanmaz. Bu yapı tahmin çalışmalarını daha güvenilir hale getirir. Stabilite elde edildiğinde ekip küçük süreç deneylerinin etkisini daha kolay ölçebilir. Sürekli değişen sistemde ise iyileştirmenin hangi faktörden kaynaklandığını ayırmak daha zordur.
Genişleyen Bant
CFD üzerinde belirli bir bandın giderek genişlemesi o süreç aşamasındaki WIP'in arttığını gösterir. Bu çoğu zaman gelen iş oranının çıkış oranından yüksek olmasıyla oluşur. Örneğin Code Review bandı her hafta genişliyorsa review kapasitesi geliştirme çıktısını karşılamıyor olabilir. Genişleme birkaç gün yerine kalıcı hale geldiğinde yapısal darboğaz ihtimali güçlenir. Kök neden belirlemek için kart yaşları, blocked süreleri ve reviewer kapasitesi birlikte incelenmelidir.
Darboğaz
Genişleyen bant tek başına kesin teşhis değildir fakat güçlü darboğaz sinyalidir. Özellikle aynı dönemde Cycle Time artıyor ve downstream starvation oluşuyorsa tablo daha anlamlı hale gelir. Ekip önce burada neden iş biriktiğini anlamalıdır. Kapasite, büyük batch, approval veya uzmanlık bağımlılığı farklı nedenler olabilir. Çözüm kök nedene göre seçilmeli ve CFD üzerindeki bant değişimiyle doğrulanmalıdır.
Artan WIP
CFD bandının genişlemesi doğrudan ilgili aşamada artan WIP anlamına gelir. Artan WIP işlerin daha uzun beklemesine ve Cycle Time'ın büyümesine yol açabilir. Eğer throughput aynı kalıyorsa daha fazla yarım iş sisteme eklenmiş olur. Bu durumda WIP limiti, pull policy ve upstream davranışı yeniden ele alınmalıdır. Yeni iş girişini yavaşlatmak kısa vadede radikal görünse de kuyruğun eritilmesi için gerekli olabilir.
Daralan Bant
Bir CFD bandının zamanla daralması o aşamadaki iş miktarının azaldığını gösterir. Bu durum olumlu bir iyileşme olabileceği gibi upstream starvation belirtisi de olabilir. Örneğin QA bandı daralıyor ve ekip sürekli iş bekliyorsa kapasite gereğinden fazla kalmış olabilir. Ancak daha önce büyük kuyruk bulunan alanda daralma, backlog'un kontrollü şekilde eritildiğini gösterebilir. Yorum yaparken komşu bantlar ve throughput trendi birlikte incelenmelidir.
Fazla Kapasite
Bir aşamanın kapasitesi gelen talebin çok üzerindeyse ilgili bant dar kalabilir. Bu durum her zaman problem değildir ve sistemin değişkenliğe karşı buffer görevi görebilir. Fakat sürekli boş kapasite bulunurken başka aşamada büyük darboğaz varsa yetkinlik paylaşımı düşünülebilir. Cross-training ile kapasitenin bir kısmı kısıtlı aşamaya taşınabilir. Böylece ekip yapısını yalnızca rol sınırlarına göre değil sistem ihtiyacına göre esnek kullanabilir.
Starvation
Starvation bir aşamanın çalışacak yeni iş bulamaması durumudur. CFD üzerinde ilgili bandın daralması veya uzun süre düşük seviyede kalması bu durumu gösterebilir. Upstream'de büyük batch, blocker veya fazla düşük WIP limiti starvation nedeni olabilir. Sorunu çözmek için yalnızca daha fazla iş başlatmak yerine akışın neden düzensiz geldiği incelenmelidir. Küçük batch ve dengeli pull politikaları daha sürekli besleme sağlayabilir.
Ani Sıçramalar
CFD üzerindeki ani sıçramalar bir anda çok sayıda işin aynı duruma taşındığını gösterebilir. Bu durum batch release, toplu backlog temizliği veya board kullanım politikasındaki değişiklik nedeniyle oluşabilir. Büyük batch hareketleri gerçek akış davranışını gizleyebilir ve downstream'de kısa süreli aşırı yük yaratabilir. Düzenli küçük teslimatlar grafiği daha okunabilir hale getirir. Ani değişimler görüldüğünde teknik sorundan önce süreçte özel bir olay yaşanıp yaşanmadığı kontrol edilmelidir.
Uzun Süre Değişmeyen Bantlar
Bir bandın uzun süre değişmemesi o aşamada iş hareketinin durmuş olabileceğini gösterir. Özellikle WIP varken hiçbir çıkış gerçekleşmiyorsa blocker veya operasyonel duraklama ihtimali vardır. Tatil veya planlı bakım gibi geçici nedenler de aynı görünümü oluşturabilir. Bu nedenle CFD tek başına kök nedeni açıklamaz. Board üzerindeki kart detayları ve blocker bilgileriyle birlikte kullanıldığında doğru yoruma ulaşmak daha kolaydır.
Darboğaz Analizi İçin Adım Adım Yöntem
Kanban akışında darboğazları azaltma ve iş akışı optimizasyonu yöntemleri sistematik uygulanırsa daha güvenilir sonuç verir. Önce gerçek akışı görünür hale getirin, ardından WIP birikimini ve yaşlanan işleri bulun. Cycle Time, Work Item Age ve Blocked Time gibi verilerle şüpheyi doğrulayın. Kök neden belirlendikten sonra küçük bir iyileştirme deneyi tasarlayın ve değişikliğin etkisini ölçün. Unutulmaması gereken nokta, bir darboğaz çözüldüğünde sistemin başka noktasında yeni kısıtın ortaya çıkmasının normal olduğudur.
1. Akışı Görselleştirin
İlk adım gerçek çalışma akışını board üzerinde görünür hale getirmektir. Resmi prosedürü değil işin pratikte geçtiği aşamaları modelleyin. Bekleme, review, approval ve handoff noktalarını özellikle belirginleştirin. Aktif çalışma ile kuyruğu mümkün olduğunca ayırın. Akış yanlış modellenmişse sonraki bütün metrikler eksik veya yanıltıcı olacaktır.
2. İş Birikimini Tespit Edin
Board üzerinde hangi sütun veya queue'da sürekli kart biriktiğini inceleyin. Tek günlük görüntü yerine birkaç haftalık trendi değerlendirin. CFD bant genişliği bu aşamada güçlü destek sağlayabilir. Kart sayısının yanında yaş dağılımına da bakın. On yeni kart ile iki haftadır bekleyen dört kart farklı riskler taşır.
3. Cycle Time Verisini İnceleyin
Cycle Time trendini ortalama, medyan ve percentile değerleriyle birlikte analiz edin. Süre yükseliyorsa hangi süreç aşamasının buna katkı verdiğini belirlemeye çalışın. Sütun bazlı bekleme süreleri burada oldukça faydalıdır. İş tiplerine göre ayrıştırma yapmak bazı taleplerin sistematik olarak daha yavaş olduğunu gösterebilir. Tek bir outlier yerine tekrarlanan desenlere odaklanın.
4. Work Item Age'i Kontrol Edin
Devam eden kartların yaşını tarihsel Cycle Time dağılımıyla karşılaştırın. SLE eşiğine yaklaşan işler erken risk olarak değerlendirilmelidir. Özellikle aynı sütunda kümelenen yaşlı kartlar lokal darboğaz işareti olabilir. Bu kartların neden hareket etmediğini ayrı ayrı inceleyin. Gerekirse ekip yeni iş çekmeden önce yaşlanan işlere swarm yapmalıdır.
5. Blocked Time'ı Analiz Edin
Blocker'ların yalnızca sayısını değil toplam süre etkisini ölçün. Aynı neden kategorisinin tekrar edip etmediğini kontrol edin. Test ortamı, dış onay veya eksik gereksinim gibi tekrar eden engeller sistemik problem olabilir. Blocked Time toplam Cycle Time'ın büyük bölümünü oluşturuyorsa aktif çalışma hızını artırmaya odaklanmak yanlış öncelik olacaktır. En fazla zaman kaybettiren blocker kategorisinden başlamak genellikle daha büyük etki yaratır.
6. Kök Nedeni Belirleyin
Darboğazın görüldüğü yer ile nedeninin bulunduğu yer aynı olmayabilir. QA kuyruğu büyüyor olabilir fakat asıl neden geliştiricilerin çok büyük batch halinde iş teslim etmesi olabilir. 5 Why, Fishbone veya Pareto gibi yöntemler semptomdan kök nedene ulaşmayı kolaylaştırır. İnsan kaynaklı gibi görünen durumların arkasında süreç politikası bulunup bulunmadığını kontrol edin. Çözümü seçmeden önce sistem davranışını açıklayan makul bir hipotez oluşturun.
7. Küçük Bir İyileştirme Deneyi Tasarlayın
Kök neden için büyük dönüşüm başlatmak yerine küçük ve ölçülebilir deney tercih edin. Örneğin Code Review WIP limitini üçten ikiye düşürüp iki hafta gözlemleyebilirsiniz. Deney öncesinde hangi metriğin iyileşmesini beklediğinizi yazın. Cycle Time, throughput veya review waiting time gibi ölçümler seçilebilir. Sonuç olumlu değilse değişikliği geri almak kolay olmalıdır.
8. WIP veya Süreç Politikasını Değiştirin
Deney sonucuna göre WIP limiti, pull criteria veya handoff politikası güncellenebilir. Değişikliğin herkes tarafından anlaşılması için board üzerinde görünür hale getirilmesi önemlidir. Örneğin “Review WIP doluysa geliştirici yeni kart çekmez, mevcut PR'lere destek verir” gibi açık politika yazılabilir. Bu davranış yalnızca sayısal limitten daha güçlüdür. İnsanların limit dolduğunda ne yapacağını bilmesi sistemin gerçekten değişmesini sağlar.
9. Etkiyi Ölçün
Değişiklik sonrası aynı metrikleri yeniden ölçmeden iyileştirmenin başarılı olduğunu söylemek doğru değildir. Önceki ve sonraki Cycle Time, WIP, throughput ve blocked süreleri karşılaştırın. Yalnızca bir metriğin iyileşmesi sistem geneli için olumlu sonuç anlamına gelmeyebilir. Örneğin throughput artarken Cycle Time ve defect oranı kötüleşebilir. Bu nedenle değişikliğin toplam sistem davranışına etkisini değerlendirin.
10. Yeni Darboğazı Tespit Edin
Bir darboğaz çözüldüğünde sistemin başka noktasında yeni kısıt oluşması normaldir. Code Review hızlandığında QA kuyruğu büyümeye başlayabilir. Bu durum önceki iyileştirmenin başarısız olduğu anlamına gelmez; akışın yeni sınırı görünür hale gelmiştir. Kanban sürekli iyileştirme yaklaşımı bu döngüyü tekrar tekrar uygular. Amaç hiçbir zaman darboğaz olmaması değil, mevcut kısıtı bilinçli biçimde yönetmek ve sistem kapasitesini kademeli artırmaktır.
Darboğaz Kök Neden Analizi
Bir darboğazı yalnızca görüldüğü yerde çözmeye çalışmak geçici sonuç üretir. Kök neden analizi, kuyruk oluşumunun arkasındaki mekanizmayı anlamaya yardımcı olur. 5 Why, Fishbone Diagram, Pareto, Blocker Clustering ve Value Stream Mapping farklı açılardan destek sağlar. Her yöntemi aynı anda kullanmak gerekmez; problem yapısına en uygun aracı seçmek yeterlidir. Temel prensip, kişileri suçlamak yerine sistemin hangi koşullarda gecikme ürettiğini ortaya çıkarmaktır.
5 Why
5 Why yöntemi görünen problemin arkasındaki nedenleri ardışık “neden?” sorularıyla araştırır. Örneğin QA kuyruğu büyüyor çünkü testler uzun sürüyor olabilir. Testler neden uzun sürüyor, çünkü büyük paketler halinde geliyor olabilir. Neden büyük paketler geliyor, çünkü geliştirme işleri küçük parçalara ayrılmıyor olabilir. Böylece ilk bakışta QA problemi gibi görünen durumun upstream iş dilimleme politikasından kaynaklandığı anlaşılabilir.
Fishbone Diagram
Fishbone Diagram problemi insan, süreç, araç, çevre veya politika gibi kategoriler altında incelemeyi sağlar. Özellikle bir darboğazın birden fazla olası nedeni olduğunda faydalıdır. Ekip birlikte olası nedenleri çıkarıp hangi hipotezlerin veriyle desteklendiğini araştırabilir. Bu yöntem çözümü ilk akla gelen nedene bağlama riskini azaltır. Son aşamada her olası neden için gözlemlenebilir kanıt belirlemek analizi daha güçlü hale getirir.
Pareto Analizi
Pareto analizi gecikmenin büyük bölümünü oluşturan az sayıdaki neden kategorisini bulmaya yardımcı olur. Blocker'lar kategori bazında süreleriyle kaydedilirse toplam gecikmenin hangi nedenlerde yoğunlaştığı görülebilir. Örneğin tüm blocked time'ın yüzde altmışı test ortamı erişiminden kaynaklanıyor olabilir. Bu durumda onlarca küçük problemi aynı anda çözmek yerine test ortamına odaklanmak daha yüksek etki üretir. Pareto yaklaşımı iyileştirme kaynaklarının doğru önceliklendirilmesini sağlar.
Blocker Clustering
Blocker Clustering benzer engelleri ortak kategoriler altında toplamayı ifade eder. Tek tek kartlara bakıldığında problemler bağımsız görünebilir, ancak kümelendiğinde tekrar eden desenler ortaya çıkar. Harici onay, eksik test verisi, belirsiz acceptance criteria veya environment sorunu gibi gruplar oluşturulabilir. Her grubun sıklığı ve toplam gecikme süresi ölçülmelidir. Bu veriler hangi sistemik sorunun önce ele alınması gerektiğini gösterir.
Value Stream Mapping
Value Stream Mapping işin talep oluşumundan teslimata kadar geçtiği bütün aşamaları, aktif çalışma ve bekleme süreleriyle birlikte gösterir. Bu yöntem Kanban Board tasarımını doğrulamak için de oldukça faydalıdır. Harita üzerinde görünmeyen handoff veya onay noktaları ortaya çıkabilir. Her aşamadaki process time ve waiting time karşılaştırılarak iyileştirme fırsatları belirlenir. Özellikle toplam Lead Time'ın büyük bölümü beklemeden oluşuyorsa darboğaz yaklaşımı daha net hale gelir.
Sistem Problemi ile İnsan Problemini Ayırmak
Darboğaz görüldüğünde ilk refleks belirli kişiyi yavaş olmakla suçlamak olmamalıdır. İnsanlar çoğu zaman sistem politikalarının oluşturduğu koşullar içinde çalışır. Bir reviewer sürekli gecikiyorsa aynı kişinin aynı anda geliştirme, toplantı ve support sorumluluğu olup olmadığına bakmak gerekir. Bilgi tek kişide tutuluyorsa bu da bireysel değil organizasyonel dayanıklılık problemidir. Kanban optimizasyonu kişisel performans yerine sistem kapasitesi ve akış davranışına odaklandığında daha sağlıklı iyileştirme kültürü oluşturur.
Theory of Constraints ile Kanban Darboğaz Yönetimi
Theory of Constraints, sistem performansını en fazla sınırlayan kısıta odaklanmayı önerir. Kanban ile birlikte kullanıldığında darboğazın belirlenmesi, kapasitenin korunması ve tüm sistemin bu kısıta göre dengelenmesi daha sistematik hale gelir. Önce kısıt tanımlanır, sonra mevcut kaynaklarla maksimum verim alınmaya çalışılır. Ardından diğer aşamaların davranışı kısıtı gereksiz yüklemeyecek biçimde düzenlenir. Gerekirse kapasite artırılır ve süreç yeni darboğazı bulmak üzere tekrar değerlendirilir.
Kısıtı Tanımla
İlk adım sistemin toplam throughput'unu hangi aşamanın sınırladığını belirlemektir. Sürekli büyüyen queue, uzun waiting time ve düşük çıkış hızı güçlü sinyallerdir. CFD, WIP ve Cycle Time verileri bu teşhisi destekleyebilir. Kısıt her zaman kişi değildir; test ortamı, onay politikası veya teknik bağımlılık olabilir. Doğru kısıt belirlenmeden yapılan kapasite yatırımları sistemin toplam hızında beklenen etkiyi oluşturmayabilir.
Kısıtı Maksimum Verimle Kullan
Kısıtın kapasitesini artırmadan önce mevcut kapasitenin gereksiz işlerle harcanıp harcanmadığı incelenmelidir. Örneğin kıdemli reviewer zamanının önemli bölümünü otomatik kontrol edilebilecek biçimsel hatalara ayırıyor olabilir. Lint, test ve statik analiz gibi kontroller otomatikleştirildiğinde reviewer daha değerli karar noktalarına odaklanabilir. Kısıtın çalışma zamanı mümkün olduğunca kesintisiz korunmalıdır. Blocker veya eksik bilgi nedeniyle kısıtın boş kalması sistem throughput'unu doğrudan etkiler.
Sistemi Kısıta Göre Düzenle
Upstream aşamalar kısıtın işleyebileceğinden daha fazla iş üretmemelidir. Aksi halde büyük WIP kuyruğu oluşur ve Cycle Time yükselir. Bu nedenle WIP limitleri ve pull politikaları darboğaz kapasitesine göre ayarlanabilir. Örneğin QA kısıtsa geliştirme ekibinin yeni işler başlatmak yerine test hazırlığına destek vermesi daha faydalıdır. Amaç her departmanın kendi hızını artırması değil, bütün sistemin kısıt çevresinde dengelenmesidir.
Kısıtın Kapasitesini Artır
Mevcut kapasite daha iyi kullanıldıktan sonra hâlâ ihtiyaç varsa kısıtın kapasitesi artırılabilir. Bu artış otomasyon, eğitim, cross-training, yeni araç veya ek insan kaynağıyla sağlanabilir. Ancak yalnızca personel eklemek her zaman doğru çözüm değildir. Süreç politikası aynı kaldığında yeni kişi de aynı bekleme veya bağımlılık sorununa maruz kalabilir. Kapasite yatırımından önce darboğazın gerçek nedenini anlamak maliyetli yanlış kararları önler.
Yeni Kısıtı Bul
Bir kısıt çözüldüğünde sistemin başka aşaması yeni darboğaz haline gelir. Bu normal ve beklenen bir sonuçtur. Review kapasitesi artırıldığında QA kuyruğunun büyümesi buna örnek olabilir. Kanban ölçümleri yeni kısıtı hızlı biçimde görünür hale getirir. Sürekli iyileştirme döngüsü yeni darboğazı bulup aynı yaklaşımı tekrar uygular.
Lokal Optimizasyondan Kaçınmak
Lokal optimizasyon bir bölümün verimini artırırken sistem geneline zarar verebilir. Geliştirme ekibinin daha fazla kart tamamlaması, QA kapasitesi değişmediyse yalnızca kuyruğu büyütür. Bu durumda geliştirmenin lokal throughput'u artmış olsa bile müşteri teslimatı hızlanmamıştır. Başarı ölçümü commitment point ile delivery point arasındaki toplam akış üzerinden yapılmalıdır. Böylece ekipler kendi bölüm sonuçlarını değil ortak teslimat performansını iyileştirmeye yönelir.
“Stop Starting, Start Finishing” Prensibi
“Stop Starting, Start Finishing” Kanban'ın en güçlü davranış prensiplerinden biridir. Sistem doluyken yeni işler başlatmak yerine mevcut işlerin tamamlanmasına odaklanmayı teşvik eder. Bu yaklaşım WIP'i düşürür, Cycle Time'ı kısaltabilir ve müşteri değerinin daha erken teslim edilmesini sağlar. Özellikle darboğaz oluştuğunda ekip üyelerinin rol sınırlarını geçici olarak esnetmesi önemlidir. Swarming, pairing ve cross-skilling bu prensibin günlük uygulamalarını destekler.
Yeni İş Başlatma Refleksi
Ekip üyeleri kendi işlerini tamamladığında doğal olarak yeni kart çekmek isteyebilir. Fakat downstream darboğaz doluyken bu davranış sistemde daha fazla yarım iş üretir. Board üzerinde WIP limitleri bu refleksi kontrol etmeye yardımcı olur. Limit dolduğunda “neye başlayabilirim?” yerine “neyi bitirmeye yardım edebilirim?” sorusu sorulmalıdır. Kültürel olarak bu değişim Kanban performansında büyük fark yaratabilir.
Mevcut İşi Bitirmeye Odaklanmak
Mevcut işleri bitirmek throughput akışını doğrudan destekler. Yarım kartların azalması aynı zamanda koordinasyon ve context switching maliyetini düşürür. Ekip en yaşlı veya delivery'e en yakın işlere öncelik verebilir. Bu yaklaşım özellikle uzun kuyrukların eritilmesinde etkilidir. Tamamlanma odaklı çalışma board'u görev deposundan gerçek akış yönetimi aracına dönüştürür.
Swarming
Swarming birkaç ekip üyesinin aynı işi veya aynı darboğaz alanını birlikte tamamlamaya odaklanmasıdır. Örneğin QA kuyruğu dolduğunda geliştiriciler test senaryoları hazırlayabilir veya otomasyon desteği verebilir. Amaç herkesin aynı teknik işi yapması değildir. Ekip, darboğazın ilerlemesini hızlandırabilecek farklı katkılar bulur. Bu yöntem rol sınırlarından daha çok sistem sonucuna odaklanan çalışma kültürü oluşturur.
Pair Programming
Pair Programming iki geliştiricinin aynı iş üzerinde birlikte çalışmasını sağlar. İlk bakışta iki kişinin tek işe ayrılması kapasite kaybı gibi görünebilir. Ancak bilgi paylaşımı, daha hızlı geri bildirim ve daha az review düzeltmesi sayesinde toplam Cycle Time düşebilir. Özellikle kritik uzmanlık darboğazlarında pairing cross-skilling için güçlü yöntemdir. Etkisini değerlendirmek için yalnızca Development süresine değil sonraki review ve hata sürelerine de bakmak gerekir.
Cross-Skilling
Cross-skilling ekip üyelerinin yalnızca kendi temel uzmanlıklarında değil, komşu süreç adımlarında da katkı verebilmesini sağlar. Bu esneklik darboğaz oluştuğunda kapasitenin geçici olarak yeniden dağıtılmasını mümkün kılar. Geliştiricinin test otomasyonuna, testerın acceptance criteria hazırlığına veya farklı geliştiricinin review'a destek verebilmesi örnek verilebilir. Cross-skilling uzun vadede tek kişiye bağımlılığı da azaltır. Böylece sistem talep değişimlerine daha dayanıklı hale gelir.
Bir Darboğazı Takım Problemi Olarak Görmek
Darboğaz belirli bir rolde ortaya çıksa bile etkisi bütün takımın teslimatını sınırlar. Bu nedenle “QA'in sorunu” veya “reviewer'ın sorunu” şeklindeki yaklaşım çözümü zorlaştırır. Kanban sistemi ortak teslimat hedefini ön plana çıkarır. Ekip üyeleri darboğazın azaltılmasına nasıl destek verebileceklerini birlikte değerlendirmelidir. Bu bakış hem işbirliğini artırır hem lokal optimizasyon davranışını azaltır.
Büyük İş Öğeleri Akışı Nasıl Bozar?
Büyük iş öğeleri uzun süre WIP tüketir ve sistemdeki varyasyonu artırır. Tek kart haftalarca aynı sütunda kaldığında WIP limitinin önemli bölümünü işgal edebilir. Büyük batch aynı zamanda geç geri bildirim ve yüksek entegrasyon riski yaratır. Bu nedenle işleri müşteri değeri üreten küçük dikey dilimlere ayırmak Kanban optimizasyonunun önemli parçasıdır. Küçük işler daha hızlı öğrenme, daha düzenli throughput ve daha güvenilir Cycle Time dağılımı sağlar.
Büyük Batch Problemi
Büyük batch birçok işin tek seferde sonraki aşamaya aktarılmasıdır. Bu davranış downstream ekibin bir anda aşırı yüklenmesine neden olabilir. Örneğin bir hafta boyunca hiçbir şey QA'e gitmezken cuma günü on kartın birden gelmesi dengeli akışı bozar. Küçük batch'ler daha düzenli teslimat ritmi oluşturur. Ayrıca hata bulunduğunda hangi değişikliğin probleme neden olduğunu anlamak daha kolay hale gelir.
Uzayan Cycle Time
Büyük iş öğeleri doğal olarak daha fazla aktif çalışma gerektirebilir, ancak asıl problem çoğu zaman artan koordinasyon ve bekleme süresidir. İş büyüdükçe daha fazla review, test ve bağımlılık ortaya çıkar. Bu nedenle Cycle Time doğrusal olmayan biçimde büyüyebilir. Büyük kartları daha küçük bağımsız parçalara bölmek dağılımın uzun kuyruğunu azaltır. Böylece tahmin edilebilirlik de iyileşir.
Artan Risk
Büyük işler daha uzun süre sistemde kaldığı için gereksinim değişikliği riskine daha fazla maruz kalır. Teknik hata veya yanlış varsayım da daha geç ortaya çıkabilir. Küçük teslimatlar erken geri bildirim sağlayarak bu riski azaltır. Ayrıca rollback veya düzeltme maliyeti daha küçük olur. Kanban'da batch size optimizasyonu bu nedenle yalnızca hız değil risk yönetimi konusu olarak da ele alınmalıdır.
WIP Limitinin Tek Büyük İş Tarafından İşgal Edilmesi
Bir büyük kart haftalarca aynı aşamada kaldığında WIP kapasitesini uzun süre tüketir. Bu durum diğer küçük işlerin ilerlemesini engelleyebilir veya ekip üyelerini limit ihlaline yöneltebilir. Büyük işi tek kart tutmak yerine bağımsız değer parçalarına ayırmak daha akıcı yapı sağlar. Her parçanın ayrı kabul kriteri bulunması izlenebilirliği artırır. Böylece WIP sınırı gerçek paralel çalışma miktarını daha doğru temsil eder.
Work Item Splitting Teknikleri
İşleri kullanıcı senaryosu, iş kuralı, veri türü, operasyon veya happy path ve edge case gibi boyutlarda bölmek mümkündür. Amaç teknik katmanlara ayırmak yerine mümkün olduğunca uçtan uca değer üreten küçük dilimler oluşturmaktır. Örneğin frontend, backend ve database'i ayrı kartlar yapmak teslimat değeri üretmeyebilir. Bunun yerine tek kullanıcı davranışını baştan sona tamamlayan parça tercih edilebilir. İyi splitting hem Cycle Time'ı düşürür hem feedback döngüsünü hızlandırır.
Batch Size Optimizasyonu
Batch size optimizasyonu işlerin mümkün olduğunca küçük ve düzenli gruplar halinde akmasını hedefler. Çok küçük batch koordinasyon maliyetini artırabilir, çok büyük batch ise kuyruk ve risk yaratır. Takım tarihsel Cycle Time ve throughput verilerini kullanarak uygun büyüklük aralığını deneysel biçimde bulabilir. Pull request boyutu, test paketi ve release kapsamı bu yaklaşımın farklı örnekleridir. Amaç sürekli küçük teslimat davranışını sistemin doğal ritmi haline getirmektir.
Code Review Darboğazı Nasıl Çözülür?
Code Review darboğazı çoğu yazılım ekibinde yüksek bekleme süresinin önemli kaynaklarından biridir. Bekleyen pull request sayısı, review Cycle Time ve reviewer kapasitesi düzenli izlenmelidir. Büyük PR'ler, sınırlı uzmanlık ve geç başlayan review süreçleri kuyruğun büyümesine neden olabilir. WIP limiti, pairing, otomatik kontroller ve açık SLE kullanımı bu alanı iyileştirebilir. En önemli davranış, review kuyruğu büyürken yeni geliştirme işi üretmeye devam etmemektir.
Bekleyen Pull Request Sayısı
Bekleyen PR sayısı review kapasitesi için temel WIP göstergesidir. Sayının günler boyunca yükselmesi darboğaz sinyali verir. Bununla birlikte yalnızca adet değil PR'lerin yaşı ve büyüklüğü de izlenmelidir. Bir günlük beş küçük PR ile bir haftalık üç büyük PR farklı risk taşır. Review queue için düşük bir WIP limiti belirlemek ve yaşlı PR'leri önceliklendirmek akışı iyileştirebilir.
Review Cycle Time
Review Cycle Time PR'nin incelemeye hazır olduğu andan onaylandığı ana kadar geçen süreyi ölçer. Bu süre Waiting ve Reviewing olarak ayrılırsa asıl problemin kuyruk mu aktif inceleme mi olduğu anlaşılır. Çoğu ekipte bekleme süresi aktif review süresinden çok daha yüksektir. Bu durumda reviewer sayısından önce çalışma politikası ve önceliklendirme incelenmelidir. Review SLE belirlemek geciken PR'leri erken fark etmeye yardımcı olur.
Büyük Pull Request Problemi
Büyük pull request'ler reviewer için yüksek bilişsel yük oluşturur. İnceleme daha uzun sürer, yorum sayısı artar ve reviewer işi ertelemeye daha yatkın hale gelebilir. Küçük PR'ler daha hızlı ele alınır ve geri bildirim döngüsünü kısaltır. İş dilimleme ve sık entegrasyon bu nedenle Code Review akışında önemli rol oynar. PR boyutu ile review süresi arasındaki ilişki tarihsel veriden de analiz edilebilir.
Reviewer Uzmanlığına Bağımlılık
Belirli kod alanlarını yalnızca bir kişinin review edebilmesi ciddi darboğaz riski yaratır. Bu kişi izinli olduğunda veya başka işlerle meşgul olduğunda bütün akış durabilir. Pairing ve knowledge sharing ile review yetkinliğini yaymak gerekir. Kod sahipliği politikaları da mümkün olduğunca ortak sorumluluğu desteklemelidir. Uzman bağımlılığı azaldıkça review kapasitesi daha esnek hale gelir.
WIP Limitleri
Code Review alanında WIP limiti belirlemek kuyruk büyümesini kontrol eder. Limit dolduğunda geliştiriciler yeni iş başlatmak yerine mevcut PR'leri review etmeye veya reviewer'a destek vermeye yönelir. Bu davranış sistemin toplam yarım iş miktarını azaltır. Limit gerçek reviewer kapasitesine yakın olmalıdır. Aşırı düşük limit starvation, aşırı yüksek limit ise uzun waiting time yaratabilir.
Pair Programming
Pair Programming geliştirme sırasında iki kişinin aynı değişikliği birlikte anlamasını sağlar. Bu yaklaşım bazı formal review ihtiyaçlarını azaltabilir veya review süresini kısaltabilir. Özellikle kritik alanlarda bilgi tek kişide kalmaz. Pairing sonrası hata ve review düzeltme miktarı da ölçülmelidir. Toplam sistem süresi iyileşiyorsa geliştirme aşamasındaki ek kişi maliyeti anlamlı yatırım olabilir.
Otomatik Kontroller
Biçimlendirme, lint, statik analiz ve otomatik test gibi kontroller reviewer zamanını tekrar eden düşük değerli kontrollerden kurtarır. İnsan review daha çok tasarım, davranış ve risk değerlendirmesine odaklanabilir. Otomasyon mümkün olduğunca PR oluşturulduğu anda geri bildirim vermelidir. Böylece reviewer hatayı bulmadan önce geliştirici düzeltme yapabilir. Ancak otomasyonun kapsamadığı kalite kararlarının hâlâ insan değerlendirmesi gerektirdiği unutulmamalıdır.
Review SLA / SLE
Review için SLE belirlemek PR'lerin ne kadar süre içinde ele alınmasının beklendiğini görünür hale getirir. Örneğin tarihsel veriye göre PR'lerin yüzde seksen beşinin bir iş günü içinde review edilmesi hedeflenebilir. Bu kesin garanti değil akış beklentisidir. Yaşı eşiğe yaklaşan PR'ler board üzerinde uyarı alabilir. Böylece gecikmeler müşteri teslimatını etkilemeden önce ekip tarafından fark edilir.
QA ve Test Darboğazı Nasıl Çözülür?
QA darboğazları genellikle geliştirme çıktısının test kapasitesinden daha hızlı üretildiği sistemlerde ortaya çıkar. Ready for QA kuyruğunun büyümesi ve test bekleme süresinin artması en önemli sinyallerdir. Çözüm yalnızca daha fazla tester eklemek değildir. Test otomasyonu, shift-left yaklaşımı, küçük batch, uygun WIP limiti ve cross-functional çalışma daha kalıcı iyileştirme sağlayabilir. Test ortamı kapasitesi de sık unutulan ancak önemli bir sistem kısıtıdır.
QA Kuyruğunun Görselleştirilmesi
Ready for QA kuyruğu ayrı görünmediğinde test darboğazı Development veya QA süresinin içine karışır. Bu nedenle bekleyen ve aktif test edilen işleri ayırmak faydalıdır. Kuyruktaki kartların sayısı yanında Work Item Age değeri de gösterilmelidir. Yaşlanan kartlar öncelikli risk olarak ele alınabilir. CFD'de QA bandının genişlemesi de yapısal birikimi doğrulayan güçlü sinyaldir.
Developer–QA Handoff Problemi
Geliştirme ile QA arasında sert handoff bulunması işlerin uzun süre sırada beklemesine neden olabilir. Developer “iş bitti” dediğinde sorumluluk tamamen QA'e geçiyorsa ortak sahiplik zayıflar. Daha cross-functional çalışma modelinde geliştirici test verisi, otomasyon veya hata doğrulamasına destek verebilir. Acceptance criteria'nın geliştirme öncesinde birlikte oluşturulması da handoff sorunlarını azaltır. Amaç QA rolünü kaldırmak değil, kalite sorumluluğunu bütün ekibe yaymaktır.
Test Otomasyonu
Tekrarlanan regresyon kontrolleri manuel yürütüldüğünde test kapasitesi hızlı biçimde sınırlanabilir. Uygun alanlarda otomasyon bu yükü azaltarak QA uzmanlarının daha değerli keşifsel testlere odaklanmasını sağlar. Otomasyon yatırımının etkisi yalnız test yürütme süresinden değil toplam Cycle Time ve blocker azalmasından değerlendirilmelidir. Kararsız testler yeni bir darboğaz oluşturabileceği için test güvenilirliği de önemlidir. Küçük ve sürdürülebilir otomasyon adımları genellikle daha iyi sonuç verir.
Shift-Left Testing
Shift-left testing kalite kontrollerini mümkün olduğunca sürecin erken aşamalarına taşımayı amaçlar. Acceptance criteria'nın erken netleştirilmesi, unit test ve entegrasyon kontrollerinin geliştirme sırasında yapılması buna örnektir. Hata ne kadar erken bulunursa düzeltme maliyeti genellikle o kadar düşük olur. Ayrıca QA aşamasına daha temiz iş gelmesi downstream kuyruğunu azaltır. Böylece test darboğazı yalnız kapasite ekleyerek değil hata giriş oranını düşürerek de iyileştirilebilir.
WIP Limiti
QA için WIP limiti test ekibinin aynı anda sağlıklı biçimde ilerletebileceği iş sayısını sınırlar. Limit dolduğunda upstream ekip yeni kart göndermemelidir. Bunun yerine mevcut testlerin tamamlanmasına destek verilmelidir. Bu davranış uzun QA kuyruğunun oluşmasını önler. Limit değeri test türü, uzmanlık ve environment kapasitesine göre deneysel biçimde ayarlanmalıdır.
Test Ortamı Kapasitesi
Bazen gerçek QA darboğazı insan sayısı değil test ortamıdır. Aynı anda yalnızca iki test çalıştırılabiliyorsa beş tester bulunması throughput'u artırmayabilir. Environment provisioning, test verisi veya erişim süreçleri ayrı blocker kategorileri olarak ölçülmelidir. Otomatik ortam oluşturma veya paralel test kapasitesi yatırımı daha yüksek etki sağlayabilir. Kök neden analizi bu nedenle insan kapasitesiyle sınırlı düşünülmemelidir.
Cross-Functional Takım Yapısı
Cross-functional ekip kaliteyi yalnız QA rolünün sorumluluğu olmaktan çıkarır. Geliştirici test otomasyonuna, analist acceptance criteria'ya ve tester erken tasarım görüşmelerine katkı verebilir. Bu yapı handoff sayısını azaltır ve bilgi akışını hızlandırır. Darboğaz oluştuğunda ekip kapasitesi daha esnek biçimde yeniden dağıtılabilir. Uzun vadede teslimat akışı rol bazlı silo modeline göre daha dayanıklı hale gelir.
Onay ve Product Owner Darboğazları
Tek karar vericiye bağlı süreçlerde onay bekleme süresi kolayca sistem darboğazına dönüşebilir. Ready for Approval kuyruğu görünür olmadığında bu gecikme başka süreç aşamalarının süresine karışır. Acceptance criteria, delegation ve açık decision policy kullanımı karar yükünü azaltabilir. Onay süresinin ayrıca ölçülmesi sorunun büyüklüğünü net hale getirir. Product Owner'ın her küçük karara tek başına dahil olması yerine karar sınırlarının önceden tanımlanması daha sürdürülebilir akış oluşturur.
Ready for Approval Kuyruğu
Onaya hazır fakat karar bekleyen kartlar ayrı görünür olduğunda approval kapasitesi ölçülebilir hale gelir. Kuyruğun büyümesi karar sürecinin talebi karşılamadığını gösterebilir. Kartların yaşını takip etmek özellikle önemlidir çünkü bazı işler birkaç saat, bazıları günlerce bekleyebilir. SLE belirlemek riskli onayları erken görünür kılar. Kuyruk sürekli büyüyorsa yalnız onaylayanın daha hızlı çalışmasını istemek yerine politikanın kendisi incelenmelidir.
Tek Karar Vericiye Bağımlılık
Bütün kararların tek Product Owner veya yöneticiye bağlı olması yüksek bus factor ve darboğaz riski yaratır. Kişi toplantıda, izinli veya başka önceliklerle meşgul olduğunda akış durabilir. Hangi kararların delegasyonla başka ekip üyelerine verilebileceği belirlenmelidir. Standart durumlar için açık kriterler oluşturmak manuel onay ihtiyacını azaltır. Tek kişiye bağımlılık azalınca sistem daha tahmin edilebilir hale gelir.
Explicit Policies
Explicit policy karar verme kurallarını herkes için görünür hale getirir. Kartın hangi şartlarda onay alacağı veya hangi durumların ek değerlendirme gerektirdiği açıkça yazılabilir. Bu yaklaşım tekrar eden soruların sayısını azaltır. Ayrıca ekip üyeleri bazı kararları onay beklemeden güvenli biçimde verebilir. Politikalar zaman içinde gerçek vakalara göre güncellenmelidir.
Delegation
Delegation karar yetkisinin uygun durumlarda daha geniş ekip üyelerine dağıtılmasını sağlar. Her karar aynı risk seviyesinde değildir ve düşük riskli standart işler merkezi onay gerektirmeyebilir. Yetki sınırları açık tanımlandığında hız ile kontrol arasında daha iyi denge kurulabilir. Delegasyon ayrıca Product Owner'ın daha stratejik kararlara odaklanmasını sağlar. Onay kuyruğundaki değişim ölçülerek yaklaşımın etkisi doğrulanabilir.
Acceptance Criteria
Net acceptance criteria onay sırasında ortaya çıkan belirsizlikleri azaltır. Ekip işin başında beklenen sonucu biliyorsa son aşamada tekrar tekrar açıklama isteme ihtiyacı düşer. Criteria mümkün olduğunca test edilebilir ve anlaşılır olmalıdır. Product Owner, geliştirici ve QA'in erken birlikte çalışması bu kalitenin artmasına yardımcı olur. Böylece onay süreci uzun tartışma yerine önceden belirlenmiş şartların doğrulanmasına dönüşür.
Onay Süresinin Ölçülmesi
Approval waiting time ayrı ölçülmediğinde süreçteki gerçek gecikme görünmez kalabilir. Ready for Approval ile Approved arasındaki süre düzenli kaydedilmelidir. Medyan ve %85 değerleri onay sürecinin tahmin edilebilirliğini gösterir. Uzun outlier vakaları kök neden analizi için ayrıca incelenebilir. İyileştirme sonrası bu sürenin düşmesi delegasyon ve explicit policy değişikliklerinin etkisini doğrular.
DevOps ve Deployment Darboğazları
Geliştirme ve test tamamlandıktan sonra işlerin production ortamına ulaşması gecikiyorsa darboğaz deployment sürecindedir. Ready for Deployment kuyruğu, deployment frequency ve release batch size bu alanı anlamak için temel göstergelerdir. Manuel adımlar, sınırlı release pencereleri, eksik test ortamı veya yoğun approval gate süreçleri gecikme yaratabilir. CI/CD yaklaşımı tekrar eden operasyonları otomatikleştirebilir ve daha küçük batch'lerle teslimatı destekleyebilir. Ancak pipeline hızını artırırken kalite ve güvenlik kontrollerinin etkinliği korunmalıdır.
Ready for Deployment Kuyruğu
Ready for Deployment alanında işlerin sürekli birikmesi release kapasitesinin geliştirme çıktısını karşılamadığını gösterir. Bu kuyruk ayrı ölçülmezse ekip kodu tamamladığı için teslimat hızlı görünebilir. Müşteri açısından değer production'a ulaşmadığı sürece teslimat tamamlanmamıştır. Kuyruk yaşı ve batch boyutu birlikte takip edilmelidir. Uzun bekleme CI/CD, onay veya operasyon kapasitesi problemine işaret edebilir.
Manuel Release Süreci
Release sürecinin çok sayıda manuel adıma bağlı olması hem süreyi hem hata riskini artırır. İnsanların belirli sırayla komut çalıştırması gerektiğinde release pencereleri büyür ve sık deployment yapmak zorlaşır. Tekrarlanabilir adımlar otomasyona taşındıkça süreç daha hızlı ve güvenilir hale gelebilir. Manuel onay gerektiren noktalar gerçekten risk temelli olmalıdır. Otomasyon amacı yalnız hız değil tutarlılık ve geri alınabilirlik sağlamaktır.
CI/CD
CI/CD küçük değişikliklerin sık entegrasyon ve teslimatını destekler. Otomatik build, test ve deployment adımları Ready for Deployment kuyruğunu azaltabilir. Ancak pipeline'ın kendisi uzun sürüyorsa yeni darboğaz haline gelebilir. Build süresi, test süresi ve deployment başarı oranı düzenli izlenmelidir. CI/CD sistemi akışı hızlandırırken güvenli geri dönüş mekanizmaları da sağlamalıdır.
Test Environment Eksikliği
Yeterli test veya staging ortamı bulunmaması release sürecini önemli ölçüde yavaşlatabilir. İşler sırayla aynı environment'ı beklediğinde teknik kapasite kuyruğu oluşur. Otomatik environment provisioning veya izole test ortamları bu darboğazı azaltabilir. Environment bekleme süresini ayrı ölçmek problemin gerçek etkisini gösterir. İnsan kapasitesi artırmadan önce altyapı sınırlarının kontrol edilmesi bu nedenle önemlidir.
Approval Gate'ler
Her deployment için çok sayıda manuel onay gerekmek zorunda değildir. Risk seviyesi düşük ve otomatik kontrolleri geçen değişiklikler için daha hafif politika kullanılabilir. Kritik değişiklikler ise daha güçlü gate süreçlerinden geçebilir. Risk tabanlı yaklaşım hem güvenliği hem akış hızını dengeler. Approval süresini ölçmek hangi gate'in gerçek darboğaz oluşturduğunu anlamaya yardımcı olur.
Deployment Frequency
Deployment Frequency sistemin ne kadar sık production'a değişiklik çıkardığını gösterir. Düşük sıklık büyük batch ve uzun release bekleme süreleriyle ilişkili olabilir. Daha sık ve küçük deployment geri bildirim döngüsünü kısaltır. Ancak sayı tek başına hedef haline getirilmemelidir. Başarı oranı, Cycle Time ve geri alma sıklığıyla birlikte değerlendirilmesi daha anlamlıdır.
Release Batch Size
Büyük release paketleri çok sayıda değişikliğin aynı anda production'a taşınmasına neden olur. Bu durum test, koordinasyon ve rollback riskini artırır. Daha küçük batch'ler hatanın kaynağını bulmayı ve geri dönüş yapmayı kolaylaştırır. Kanban akışında küçük iş öğeleri kullanmak release batch'ini de doğal olarak küçültür. Bu nedenle iş dilimleme ile DevOps akışı birbirinden bağımsız konular değildir.
Uzman Kişi Darboğazı Nasıl Yönetilir?
Belirli bilgi veya yetkinliğin yalnızca tek kişide bulunması, ekip için önemli akış riski oluşturur. Bu kişi yoğun olduğunda veya erişilemediğinde ilgili işler kuyrukta bekler. Skill Matrix, pairing, knowledge sharing ve cross-training kullanarak uzmanlık daha geniş ekibe dağıtılabilir. WIP limiti de kısa vadede mevcut uzman kapasitesini aşacak kadar işin sisteme girmesini önleyebilir. Amaç uzman kişiyi daha fazla çalıştırmak değil, sistemin ona bağımlılığını azaltmaktır.
Tek Kişiye Bağımlılık
Tek kişinin belirli teknoloji, modül veya onay konusunda tek yetkili olması bus factor riskini artırır. Bu kişi birkaç gün müsait olmadığında teslimat tamamen durabilir. Board üzerinde ilgili queue'nun büyümesi bu bağımlılığı görünür hale getirir. Uzun vadeli çözüm bilgi paylaşımı ve yetki dağılımıdır. Kısa vadede ise WIP sınırı uzman kapasitesine göre ayarlanmalıdır.
Skill Matrix
Skill Matrix ekip içinde hangi kişinin hangi alanlarda temel, orta veya ileri seviyede yetkin olduğunu görünür hale getirir. Böylece tek kişiye bağımlı alanlar hızlı biçimde belirlenebilir. Matris performans puanı olarak değil kapasite riski haritası olarak kullanılmalıdır. Kritik yetkinliklerde ikinci ve üçüncü kişiyi geliştirmek için plan oluşturulabilir. Zaman içinde matris güncellenerek cross-training sonuçları izlenebilir.
Pairing
Pairing uzman bilgiyi gerçek iş üzerinde paylaşmanın etkili yollarından biridir. Uzman kişi işi tek başına tamamlamak yerine başka ekip üyesiyle birlikte çalışır. Kısa vadede daha fazla kişi zamanı kullanılsa da uzun vadede kapasite esnekliği artar. Özellikle tekrar eden kritik işlerde pairing sistem bağımlılığını azaltır. Öğrenmenin gerçek problem üzerinde gerçekleşmesi teorik eğitimden daha hızlı sonuç verebilir.
Knowledge Sharing
Knowledge sharing yalnızca dokümantasyon yazmak anlamına gelmez. Demo, kod inceleme, teknik oturum ve ortak problem çözme gibi yöntemler kullanılabilir. Amaç kritik bilginin tek kişinin zihninde kalmasını önlemektir. Paylaşım faaliyetleri düzenli planlanmalı ve üretim baskısı arttığında tamamen iptal edilmemelidir. Aksi halde kısa vadeli teslimat uğruna uzun vadeli darboğaz riski büyür.
Cross-Training
Cross-training ekip üyelerinin komşu uzmanlıklarda görev alabilecek seviyeye gelmesini sağlar. Herkesin her alanda uzman olması gerekmez. Darboğaz döneminde temel destek verebilmek bile sistem kapasitesini ciddi biçimde artırabilir. Eğitim planı gerçek akıştaki kritik yetkinliklere göre önceliklendirilmelidir. Skill Matrix bu önceliklerin belirlenmesine yardımcı olur.
Bus Factor
Bus Factor belirli kritik bilginin kaç kişiye dağıldığını anlamak için kullanılan pratik bir risk göstergesidir. Değer bir ise tek kişinin yokluğu ciddi aksama yaratabilir. Kanban kuyruklarında aynı uzmana bağlı kartlar düzenli birikiyorsa bu risk artık teorik değildir. Pairing ve knowledge sharing ile factor artırılabilir. Amaç her alanda yüksek sayı değil, kritik akış noktalarında yeterli yedeklilik sağlamaktır.
WIP Limitini Uzman Kapasitesine Göre Tasarlamak
Uzman kapasitesi kısa vadede artırılamıyorsa WIP limiti bu gerçek kapasiteyi koruyacak biçimde ayarlanmalıdır. Uzmanın aynı anda iki işi sağlıklı ilerletebildiği yerde altı kartlık queue oluşturmak teslimatı hızlandırmaz. Limit upstream tarafın gereksiz iş üretmesini engeller. Ekip boş kapasitesini uzmanla pairing veya hazırlık çalışmalarına ayırabilir. Uzmanlık yayıldıkça WIP limiti yeni kapasiteye göre tekrar test edilebilir.
Dış Bağımlılık Kaynaklı Darboğazlar
Kanban akışındaki gecikmeler her zaman takımın kendi kontrolünde oluşmaz. Harici vendor, başka ekip, güvenlik, hukuk, compliance veya müşteri onayı gibi dış bağımlılıklar önemli bekleme süreleri yaratabilir. Bu durumları board üzerinde görünür hale getirmek ve Waiting Time ölçmek gerekir. Dependency Board veya ayrı durum etiketleri hangi kartların hangi dış tarafı beklediğini gösterebilir. Amaç bağımlılığı tamamen ortadan kaldırmak mümkün olmasa bile bekleme süresini ölçmek, erken başlatmak ve riskini yönetmektir.
Harici Vendor
Harici vendor tarafından sağlanan servis veya onaylar ekibin doğrudan kontrolünde değildir. Bu nedenle teslimat süresi değişken olabilir. Vendor bekleme durumunu ayrı işaretlemek, gerçek Cycle Time üzerindeki etkisini ölçmeyi sağlar. Kritik bağımlılıklar mümkün olduğunca erken tetiklenmelidir. Tek vendor'a bağımlılık yüksekse alternatif veya sözleşmesel hizmet seviyesi seçenekleri ayrıca değerlendirilebilir.
Başka Takım
Başka takımdan API, review veya altyapı desteği beklemek sık görülen organizasyonel handoff türüdür. Her ekip kendi backlog'una göre çalıştığında bağımlı işlerin önceliği düşebilir. Ortak dependency policy veya önceden kapasite planlaması beklemeyi azaltabilir. Board üzerinde dış takım bekleme süresi ayrıca görünmelidir. Tekrarlanan bağımlılıklar takım sınırlarının veya sahiplik modelinin yeniden değerlendirilmesini gerektirebilir.
Güvenlik Ekibi
Güvenlik incelemeleri geç aşamada başladığında teslimat öncesi büyük kuyruk oluşabilir. Kritik kontrolleri geliştirme sürecine daha erken taşımak bu riski azaltır. Standart güvenlik kontrolleri otomatikleştirilebilir, yüksek riskli değişiklikler ise uzman review'a ayrılabilir. Böylece güvenlik ekibinin sınırlı kapasitesi daha etkili kullanılır. Waiting Time ve review age ölçümleri darboğazın boyutunu görünür hale getirir.
Hukuk ve Compliance
Hukuk ve compliance onayları bazı sektörlerde zorunlu süreç adımlarıdır. Sorun bu kontrollerin varlığı değil, geç ve belirsiz şekilde devreye girmesidir. Gerekli kriterler erken paylaşılırsa ekip işi baştan uygun biçimde tasarlayabilir. Standart düşük riskli durumlar için önceden onaylı politika şablonları kullanılabilir. Böylece hukuk ekibi yalnız gerçekten yorum gerektiren vakalara odaklanır.
Müşteri Onayı
Müşteri geri bildirimi veya onayı bekleyen işler de aktif kapasiteyi uzun süre tüketebilir. Bu kartların “Development” içinde kalması gerçek süreci gizler. Waiting for Customer gibi açık durum kullanmak bekleme süresini ölçmeyi sağlar. Müşteri onayı için net tarih ve gerekli bilgi önceden paylaşılmalıdır. Sık gecikme varsa süreçte daha erken demo veya küçük teslimat kullanmak feedback döngüsünü kısaltabilir.
Dependency Board
Dependency Board birden fazla ekip veya dış taraf arasında bekleyen bağımlılıkları merkezi biçimde görselleştirebilir. Hangi işin kimi beklediği, ne kadar süredir beklediği ve risk seviyesi burada izlenebilir. Ancak ayrı board kullanıldığında ana Kanban akışıyla bağlantının kaybolmaması gerekir. Kartlar arasında referans veya otomatik senkronizasyon kullanılabilir. Amaç ek bir raporlama yükü yaratmak değil, görünmeyen bağımlılık kuyruklarını yönetilebilir hale getirmektir.
Waiting Time Ölçümü
Dış bağımlılıkların toplam etkisini anlamak için Waiting Time ölçülmelidir. On günlük Cycle Time'ın yedi günü dış onay beklemekten oluşuyorsa geliştirme hızını artırmak çok az etki yaratacaktır. Bekleme süreleri bağımlılık tipine göre kategorize edilebilir. Böylece hangi dış ilişkinin en fazla gecikme oluşturduğu belirlenir. Bu veri süreç tasarımı ve hizmet seviyesi görüşmelerinde somut temel sağlar.
Swimlane'ler Kanban Board'da Nasıl Optimize Edilir?
Swimlane'ler farklı iş sınıflarını aynı board üzerinde ayırmak için kullanılabilir. Feature, bug, technical debt veya expedite işleri farklı satırlarda gösterildiğinde WIP dağılımı daha net görülebilir. Ancak fazla swimlane board'u okunması zor hale getirir ve gerçek akışı parçalayabilir. Swimlane yalnızca farklı politika veya hizmet seviyesi gerektiren iş türleri için kullanılmalıdır. Takım bazlı swimlane kullanımında ise ortak darboğazların görünmez hale gelmemesine dikkat edilmelidir.
Class of Service
Class of Service farklı iş türlerine farklı hizmet politikaları uygulamayı sağlar. Standard, fixed date veya expedite gibi sınıflar kullanılabilir. Her sınıfın pull policy, WIP ve öncelik davranışı açık olmalıdır. Bütün işleri yüksek öncelikli göstermek sistemin anlamını kaybettirir. Sınıflar gerçek ekonomik veya operasyonel ihtiyaçlara dayanmalıdır.
Feature
Feature swimlane'i yeni kullanıcı değeri üreten özellikleri diğer iş türlerinden ayırabilir. Böylece feature WIP ile bakım veya hata WIP'i arasındaki denge görülebilir. Ancak feature'lar çok büyükse swimlane tek başına akışı iyileştirmez. Küçük dikey dilimler kullanmak gerekir. Cycle Time karşılaştırması farklı iş sınıflarının sistem davranışını anlamaya yardımcı olabilir.
Bug
Bug işleri aciliyet ve etki seviyesine göre farklı politikaya ihtiyaç duyabilir. Her bug'ı expedite yapmak normal akışı ciddi biçimde bozabilir. Kritik production hataları için ayrı expedite policy, düşük etkili bug'lar için standart akış kullanılabilir. Bug throughput ve Cycle Time değerleri ayrıca izlenebilir. Sürekli yüksek bug oranı upstream kalite problemi olduğunu gösterebilir.
Technical Debt
Technical debt işleri yalnız boş zaman kalırsa yapılacak faaliyet olarak tutulduğunda sürekli ertelenebilir. Ayrı swimlane veya kapasite politikası bu işleri görünür hale getirebilir. Ancak teknik borç çalışmasının da müşteri ve sistem değeriyle ilişkisi açıklanmalıdır. Çok büyük refactoring kartları yerine küçük ve düzenli iyileştirmeler daha iyi akar. Throughput ve Cycle Time üzerinden teknik borç çalışmalarının teslimat ritmi takip edilebilir.
Expedite
Expedite gerçekten kritik ve gecikme maliyeti yüksek işler için kullanılmalıdır. Bu sınıf normal WIP kurallarından belirli ölçüde öncelikli olabilir. Ancak mutlaka düşük bir WIP limiti bulunmalıdır. Birden fazla expedite kart aynı anda çalışıyorsa “acil” tanımı anlamını kaybeder. Her expedite sonrası neden acil iş oluştuğunu incelemek süreç öğrenmesi sağlar.
Takım Bazlı Swimlane Kullanımı
Takım bazlı swimlane farklı ekiplerin kendi işlerini aynı board üzerinde ayırmasını kolaylaştırabilir. Ancak bu kullanım departman silolarını güçlendirebilir. İş bir ekipten diğerine geçtiğinde kartın gerçek value stream hareketi görünür kalmalıdır. Ortak delivery hedefi ayrı satırlardan daha önemlidir. Takım swimlane'leri kullanılıyorsa ortak WIP ve dependency görünürlüğü mutlaka korunmalıdır.
Fazla Swimlane Kullanmanın Riskleri
Çok fazla swimlane board'u görsel olarak parçalar ve ekip üyelerinin sistem geneline bakmasını zorlaştırır. Her proje, ekip, öncelik ve iş tipi için ayrı satır açmak WIP kontrolünü de zayıflatabilir. Kartların tamamı farklı lane'lerde dağılınca gerçek toplam WIP yüksekliği gözden kaçabilir. Swimlane eklemek için açık karar gerekçesi olmalıdır. Kullanılmayan veya karar kalitesini artırmayan lane'ler periyodik olarak kaldırılmalıdır.
Expedite İşler Akışı Nasıl Etkiler?
Expedite işler diğer kartların önüne geçtiği için sistemde görünmeyen maliyet oluşturur. Bir acil iş başlatıldığında başka bir iş durur, ekip context switching yaşar ve normal Cycle Time dağılımı bozulabilir. Bu nedenle expedite sınıfı sınırlı ve açık kurallarla kullanılmalıdır. Sürekli acil iş çıkması talep yönetimi veya planlama probleminin göstergesi olabilir. Expedite WIP limiti genellikle bir gibi düşük tutulur ve her kullanım sonrası neden analizi yapılır.
Expedite Class of Service
Expedite Class of Service gerçekten bekleyemeyecek kadar yüksek gecikme maliyeti olan işler içindir. Kritik production kesintisi buna örnek olabilir. Bu işin normal kuyruğun önüne geçeceği herkes tarafından bilinmelidir. Ancak hangi koşulların expedite sayılacağı açık policy ile tanımlanmalıdır. Aksi halde güçlü paydaşların bütün işleri “acil” olarak sınıflandırması kolaylaşır.
Acil İşlerin Gerçek Maliyeti
Acil kart yalnız kendi süresini değil, durdurduğu diğer işlerin süresini de etkiler. Geliştirici mevcut işi bıraktığında yeniden bağlam kurma maliyeti oluşur. Review ve QA sıraları da değişebilir. Bu nedenle expedite işin gerçek maliyeti yalnız kartın effort değerinden yüksek olabilir. Her acil iş sonrası ertelenen kartların Cycle Time etkisini incelemek görünmeyen maliyeti daha net hale getirir.
Expedite WIP Limiti
Expedite lane için ayrı ve düşük WIP limiti kullanmak önemlidir. Çoğu ekip için aynı anda yalnızca bir expedite iş mantıklı başlangıç noktasıdır. İkinci bir acil iş geldiğinde hangisinin gerçekten daha kritik olduğu tartışılmak zorunda kalır. Bu kısıt öncelik disiplinini güçlendirir. Limitin sürekli aşılması acil iş tanımının yeniden değerlendirilmesi gerektiğini gösterir.
Sürekli “Acil” İş Anti-Pattern'i
Her hafta çok sayıda expedite kart çıkması normal iş akışının fiilen bozulduğunu gösterir. Bu durumda problem çalışanların hızından çok talep yönetimi veya planlama politikasında olabilir. Acil iş nedenleri kategorilere ayrılmalıdır. Tekrarlanan production hatası, eksik kapasite veya geç karar gibi kök nedenler belirlenebilir. Amaç acil işleri daha hızlı bitirmek kadar neden sürekli acil iş oluştuğunu azaltmaktır.
Normal İşlerin Cycle Time'ına Etkisi
Expedite kartlar normal işlerin bekleme süresini artırdığı için Cycle Time dağılımında dalgalanma yaratabilir. Bu nedenle expedite yoğun dönemlerde normal iş metrikleri ayrıca izlenmelidir. Özellikle %85 ve %95 değerlerinde yükselme görülebilir. İşlerin neden geciktiğini anlamak için class of service bazında analiz yapmak faydalıdır. Böylece acil taleplerin sistem üzerindeki gerçek maliyeti ölçülebilir.
Explicit Policies ile Kanban Board Optimizasyonu
Explicit Policies, ekipte herkesin aynı süreç kurallarına göre çalışmasını sağlar. Kartın ne zaman sonraki sütuna geçebileceği, WIP dolduğunda ne yapılacağı, blocker ve expedite davranışları açıkça tanımlanmalıdır. Bu kurallar board üzerinde görünür tutulduğunda belirsizlik azalır. Politika katı bürokrasi değil, ortak karar çerçevesidir. Gerçek veriler yeni ihtiyaç gösterdiğinde ekip politikaları birlikte güncelleyebilir.
Bir Kart Ne Zaman Bir Sonraki Sütuna Geçebilir?
Her sütun geçişi için temel çıkış kriterlerinin net olması veri kalitesini artırır. Development'tan Review'a geçen kartın testlerinin başarılı olması veya gerekli açıklamaları içermesi istenebilir. Bu kriterler kişiden kişiye değişmemelidir. Aksi halde aynı sütundaki kartlar farklı olgunluk seviyelerini temsil eder. Açık geçiş politikası handoff kalitesini ve Cycle Time yorumunu iyileştirir.
Pull Criteria
Pull Criteria bir işin sonraki aşama tarafından hangi şartlarda çekilebileceğini tanımlar. Kapasite bulunması, gerekli bilgilerin tamamlanması ve öncelik sırasının uygun olması örnek kriterlerdir. Pull yaklaşımı upstream'in işi downstream'e zorla itmesini engeller. Böylece yeni iş yalnız gerçek kapasite oluştuğunda sisteme alınır. Bu davranış WIP limitlerinin pratikte çalışmasını sağlar.
Definition of Ready
Definition of Ready işin çalışmaya başlamadan önce minimum hangi koşulları karşılaması gerektiğini tanımlar. Amaç bütün belirsizliği ortadan kaldırmak değil, gereksiz duraklamaları azaltmaktır. Acceptance criteria, gerekli tasarım veya bağımlılık bilgisi örnek şartlar olabilir. Çok ağır Ready kriteri talep akışını yavaşlatabilir. Bu nedenle yalnız gerçekten çalışma başlangıcını etkileyen maddeler korunmalıdır.
Definition of Done
Definition of Done işin gerçekten tamamlandığını ortak biçimde tanımlar. Kod yazılmış olmak yerine test edilmiş, review edilmiş ve gerektiğinde production'a alınmış olmak gerekebilir. Bu tanım Throughput ve Cycle Time ölçümlerinin güvenilirliği açısından kritiktir. Done kriteri eksikse kartlar erken kapatılabilir. Ekip kriterleri açık tutmalı ve süreç değiştikçe güncellemelidir.
Blocked Policy
Blocked Policy bir kartın hangi durumda blocked sayılacağını ve ekip tarafından nasıl ele alınacağını tanımlar. Blocker işaretlendiğinde neden kategorisi, başlangıç zamanı ve sorumlu takip noktası kaydedilebilir. Belirli sürenin üzerindeki blocker'lar otomatik uyarı oluşturabilir. Günlük flow review'da blocked kartlar öncelikli değerlendirilmelidir. Bu sayede engeller board üzerinde yalnız renk değil aksiyon üreten sinyal haline gelir.
Expedite Policy
Expedite Policy hangi koşulların normal sırayı bozacak kadar kritik olduğunu belirler. Finansal kayıp, güvenlik olayı veya ciddi hizmet kesintisi gibi net kriterler kullanılabilir. Aynı anda izin verilen expedite sayısı da politika içinde yer almalıdır. İş tamamlandıktan sonra neden acil duruma gelindiği gözden geçirilmelidir. Bu yaklaşım “her şey acil” kültürünü azaltır.
WIP Policy
WIP Policy yalnız limit sayısını değil limit dolduğunda yapılacak davranışı da tanımlar. Örneğin Review WIP üçe ulaştığında geliştiriciler yeni kart çekmeden review desteği verebilir. Gerçek istisnaların nasıl ele alınacağı da yazılmalıdır. Politika herkesin kolayca görebileceği yerde bulunmalıdır. Düzenli flow review sırasında limitlerin gerçek kapasiteyle uyumu kontrol edilmelidir.
Service Level Expectation (SLE) Nasıl Kullanılır?
SLE geçmiş Cycle Time verisine dayanarak belirli iş türlerinin ne kadar sürede tamamlanmasının beklendiğini ifade eder. Kesin deadline değildir; olasılığa dayalı bir hizmet beklentisidir. Örneğin standart işlerin yüzde seksen beşinin sekiz gün içinde tamamlanması gibi ifade edilebilir. Aktif kartların Work Item Age değeri SLE'e yaklaştığında risk erken görünür hale gelir. Bu yaklaşım paydaşlarla “ne zaman biter?” konuşmasını daha gerçekçi verilerle yapmayı sağlar.
SLE Nedir?
Service Level Expectation belirli bir iş sınıfının tarihsel performansa göre belirlenen süre içinde tamamlanma beklentisidir. Genellikle percentile tabanlı ifade edilir. Örneğin “standart işlerin %85'i 10 gün içinde tamamlanır” açık bir SLE örneğidir. Bu söz kesin taahhüt değildir fakat planlama için güven seviyesi sağlar. Düzenli aralıklarla yeni Cycle Time verileri kullanılarak güncellenmelidir.
Tarihsel Cycle Time'dan SLE Üretmek
SLE belirlemek için yeterli sayıda benzer tamamlanmış işin Cycle Time verisi kullanılmalıdır. İşler çok farklı hizmet sınıflarına sahipse veriyi ayırmak daha doğru olabilir. Geçmiş dağılımdan %85 gibi güven seviyesi seçilebilir. Örneğin son altı ayda standart kartların %85'i dokuz gün içinde tamamlandıysa başlangıç SLE'i dokuz gün olabilir. Süreç değiştikçe dağılım yeniden hesaplanmalıdır.
Percentile Bazlı Tahmin
Percentile yaklaşımı tek bir ortalama yerine geçmiş işlerin belirli yüzdesinin hangi sürede tamamlandığını gösterir. Bu yöntem teslimat belirsizliğini daha açık ifade eder. %50 daha iyimser, %85 veya %95 daha yüksek güven seviyesidir. Hangi seviyenin kullanılacağı işin riskine göre değişebilir. Paydaşlara “kesin sekiz gün” demek yerine “benzer işlerin %85'i sekiz gün içinde tamamlandı” ifadesi daha gerçekçi beklenti sağlar.
SLE ve Deadline Arasındaki Fark
Deadline işin belirli tarihe kadar tamamlanması gereken iş kuralıdır. SLE ise geçmiş performansa dayalı istatistiksel beklentidir. Her kartın deadline'ı olmayabilir ancak bütün hizmet sınıfları için SLE bulunabilir. Deadline SLE'den daha yakınsa ekip erken risk yönetimi yapmalıdır. Bu iki kavramı birbirine karıştırmamak planlama kalitesini artırır.
Aging WIP ile SLE İlişkisi
Work Item Age aktif kartın yaşını, SLE ise beklenen teslimat sınırını gösterir. İki değer karşılaştırıldığında tamamlanmamış işler için risk seviyesi oluşturulabilir. Kart yaşı SLE'in büyük bölümüne ulaşmış fakat hâlâ erken süreç aşamasındaysa müdahale gerekebilir. Board üzerinde bu oran renk veya uyarıyla gösterilebilir. Böylece ekip gecikmeyi tamamlandıktan sonra ölçmek yerine oluşmadan önce yönetebilir.
Kanban ile Teslimat Tahmini
Kanban tahmini tek bir kesin tarih üretmek yerine tarihsel akış verilerinden olasılığa dayalı aralık oluşturabilir. Throughput ve Cycle Time dağılımları bu yaklaşımın temel girdileridir. Monte Carlo Simulation, geçmiş varyasyonu kullanarak “ne zaman biter?” veya “belirli tarihe kadar kaç iş tamamlanır?” gibi sorulara olasılık dağılımı üretebilir. Bu yöntem tahmin belirsizliğini saklamak yerine görünür hale getirir. Veri kalitesi ve işlerin yeterince benzer olması sonuçların güvenilirliği açısından önemlidir.
Deterministik Tahminlerin Sorunu
“Bu iş kesin on günde biter” gibi tahminler sistemdeki doğal varyasyonu görmezden gelir. Blocker, iş büyüklüğü ve kapasite değişimleri gerçek süreyi etkileyebilir. Tek sayı yönetim açısından rahat görünse de gereksiz kesinlik üretir. Olasılık tabanlı tahmin, farklı güven seviyelerini açıkça gösterir. Böylece risk konuşması teslimat gününe kalmadan yapılabilir.
Throughput Verisi
Geçmiş throughput verisi belirli haftalarda kaç iş tamamlandığını gösterir. Bu dağılım gelecekte belirli dönem içinde kaç iş bitirilebileceğini tahmin etmek için kullanılabilir. Ortalama throughput yerine haftalık gerçek değerlerin dağılımını korumak değişkenliği modele taşır. İş büyüklükleri çok farklıysa sınıflandırma yapmak gerekebilir. Sağlıklı veri seti zaman içinde güncellenmelidir.
Cycle Time Dağılımı
Cycle Time dağılımı tek bir işin tamamlanma süresi hakkında olasılık üretmek için kullanılabilir. Benzer işlerin %50, %85 ve %95 değerleri paydaşlara farklı güven seviyeleri sunar. Outlier işlerin nedenleri ayrıca incelenmelidir. Süreçte büyük değişiklik yapıldıysa çok eski veriyi kullanmak yanıltıcı olabilir. Tahmin modelinin güncel çalışma sistemini temsil etmesi önemlidir.
Monte Carlo Simulation
Monte Carlo Simulation geçmiş throughput veya Cycle Time verilerinden çok sayıda olası gelecek senaryosu üretir. Sonuç tek tarih yerine olasılık dağılımı sağlar. Örneğin backlog'un belirli tarihe kadar bitme ihtimali %50, %85 veya %95 seviyelerinde görülebilir. Bu yöntem belirsizliği sayısal biçimde ifade eder. Ancak simülasyon kötü veriyi düzeltmez, bu nedenle giriş verisinin gerçek akışı temsil etmesi gerekir.
“Ne Zaman Biter?” Tahmini
Belirli sayıdaki backlog işinin ne zaman tamamlanacağını tahmin etmek için throughput dağılımı kullanılabilir. Simülasyon geçmiş haftalardaki bitirme hızlarını tekrar örnekleyerek farklı olası bitiş tarihleri oluşturur. Sonuçlardan güven seviyeleri seçilebilir. Örneğin %85 güvenle 15 Ekim'e kadar tamamlanma ihtimali gibi ifade üretilebilir. Kesin tarih yerine güven seviyesinin paylaşılması beklenti yönetimini daha gerçekçi yapar.
“Bu Tarihe Kadar Kaç İş Biter?” Tahmini
Ters soru belirli tarihe kadar kaç iş tamamlanabileceğini anlamaktır. Throughput dağılımı aynı şekilde kullanılarak olası tamamlanan iş miktarları hesaplanabilir. Bu bilgi release scope veya kapasite planlamasında faydalıdır. Tek bir “20 iş biter” tahmini yerine farklı güven seviyelerinde aralık sunulabilir. Böylece kapsam kararları risk toleransına göre verilebilir.
Kanban Board Otomasyonları
Kanban otomasyonları manuel board bakımını azaltabilir ve risk sinyallerini daha erken görünür hale getirebilir. Kart hareketi, Aging WIP uyarısı, WIP limit alarmı, blocker bildirimi ve SLE hatırlatması otomatikleştirilebilir. Ancak otomasyon gerçek süreç problemini saklamamalıdır. Örneğin kartları yalnız belirli süre geçti diye otomatik sütun değiştirmek veri kalitesini bozabilir. Otomasyonun amacı süreci görünmez yapmak değil, doğru bilgiyi daha hızlı ve tutarlı üretmektir.
Otomatik Kart Hareketi
CI/CD olaylarına bağlı otomatik kart hareketi manuel güncelleme yükünü azaltabilir. Pull request açıldığında kart Review'a, deployment tamamlandığında Deployed'a taşınabilir. Ancak event ile gerçek iş durumu birebir uyumlu olmalıdır. Başarısız pipeline kartı yanlışlıkla Done'a taşırsa metrikler bozulur. Otomasyon politikası düzenli olarak örnek kartlarla doğrulanmalıdır.
Aging WIP Uyarıları
Aktif kart yaşı belirli percentile veya SLE eşiğine yaklaştığında otomatik uyarı üretilebilir. Bu uyarı ekip sohbetine veya board üzerine yansıtılabilir. Amaç her kart için bildirim üretmek değil, gerçekten riskli işleri öne çıkarmaktır. Çok fazla uyarı zamanla göz ardı edilmeye başlanır. Eşikler tarihsel Cycle Time verisine göre ayarlanmalıdır.
WIP Limit Uyarıları
Bir sütun WIP limitine ulaştığında veya aştığında otomatik bildirim ekip davranışını destekleyebilir. Uyarı yalnız “limit aşıldı” demek yerine önerilen policy'yi de hatırlatabilir. Örneğin yeni iş çekmek yerine review kuyruğuna destek verilmesi istenebilir. Sürekli alarm oluşması limitin yanlış olduğunu veya ekibin politikayı uygulamadığını gösterebilir. Her iki durumda da süreç incelemesi gerekir.
Blocker Alert
Bir kart blocked olduğunda ilgili ekip veya bağımlılık sahibine otomatik bildirim gönderilebilir. Uzun süredir çözülemeyen blocker'lar ayrıca escalation seviyesine çıkabilir. Bu otomasyon takip yükünü azaltır. Ancak blocker nedeni açık girilmiyorsa çok sayıda anlamsız uyarı oluşur. Standardize edilmiş blocker kategorileri hem bildirimi hem sonraki analizi iyileştirir.
SLA/SLE Bildirimleri
SLE eşiğine yaklaşan kartlar için zaman tabanlı uyarılar kullanılabilir. Örneğin kart %85 SLE süresinin yüzde seksenine ulaştığında ekip bilgilendirilebilir. Bu yaklaşım gecikme riskini henüz çözüm için zaman varken görünür hale getirir. Uyarı sıklığı gereğinden fazla olmamalıdır. En etkili kullanım günlük Flow Review ile birlikte yapılmasıdır.
Otomasyonun Gerçek Darboğazı Gizleme Riski
Otomasyon bazı durumlarda semptomu temizlerken kök nedeni saklayabilir. Örneğin yaşlı kartları otomatik başka sütuna taşımak board'u temiz gösterir fakat gerçek beklemeyi ortadan kaldırmaz. Benzer şekilde WIP ihlalinde limiti otomatik artırmak sistem sinyalini tamamen yok eder. Her otomasyon için “bu gerçek akışı daha doğru mu gösteriyor?” sorusu sorulmalıdır. Cevap hayırsa otomasyon faydadan çok veri kaybı yaratabilir.
Jira'da Kanban Darboğaz Analizi
Jira kullanan ekipler board sütunları, WIP limitleri, Cumulative Flow Diagram, Control Chart ve JQL filtreleriyle Kanban akışını analiz edebilir. En önemli konu aracın varsayılan yapılarını kullanmak değil, board'u gerçek value stream'e göre uyarlamaktır. Status ve column eşlemesi doğru kurulmadığında Cycle Time ve CFD yorumları yanıltıcı olabilir. Blocked Issues ve yaşlanan kartlar için filtreler oluşturmak günlük Flow Review'u güçlendirir. Araç ne kadar kapsamlı olursa olsun, doğru süreç politikası bulunmadığında tek başına darboğazı çözmez.
Board Sütunları
Jira board sütunları gerçek iş akışındaki önemli durumları yansıtmalıdır. Birden fazla status aynı sütunda tutulabilir ancak bu kullanım kritik bekleme noktalarını gizlememelidir. Development, Review ve QA gibi aşamalar gerekiyorsa ayrı gösterilmelidir. Ready ve Doing ayrımı için workflow status'ları kullanılabilir. Board düzeni süreç değiştikçe yeniden gözden geçirilmelidir.
WIP Limits
Jira Kanban board üzerinde sütun limitleri görünür hale getirilebilir. Limit aşıldığında görsel uyarı ekip için önemli sinyal oluşturur. Ancak araç limit ihlalini otomatik olarak engellemek zorunda değildir. Esas değer, ekibin ihlal anında üzerinde anlaşılmış davranışı uygulamasıdır. Limitler tarihsel flow verisiyle düzenli olarak değerlendirilmelidir.
Cumulative Flow Diagram
Jira'nın Cumulative Flow Diagram görünümü süreç aşamalarındaki WIP trendini analiz etmeye yardımcı olabilir. Belirli bandın genişlemesi darboğaz sinyali olarak değerlendirilebilir. Tarih aralığı yeterince uzun seçildiğinde geçici dalgalanma ile yapısal trendi ayırmak kolaylaşır. Workflow değişikliği yapıldıysa grafik yorumunda bu tarih dikkate alınmalıdır. CFD diğer flow metrikleriyle birlikte kullanılmalıdır.
Control Chart
Control Chart tamamlanan işlerin Cycle Time dağılımını ve trendini anlamaya yardımcı olur. Uzun süren kartlar outlier olarak görülebilir. Filtreler kullanılarak iş tipi veya ekip bazında farklı dağılımlar incelenebilir. Ortalama değer yanında dağılıma ve uç işlere dikkat edilmelidir. Süreç deneyinden önce ve sonra benzer filtrelerle karşılaştırma yapmak daha güvenilir sonuç verir.
Filter ve JQL
JQL kullanarak blocked, yaşlı veya belirli süreç durumunda uzun süredir kalan işleri filtrelemek mümkündür. Bu sorgular günlük Flow Review için özel dashboard oluşturmayı kolaylaştırabilir. Örneğin belirli tarihten önce In Progress'e geçmiş ve hâlâ tamamlanmamış işler ayrı listelenebilir. Filtrelerin gerçek workflow status adlarıyla uyumlu olması gerekir. Gereksiz karmaşık sorgular yerine ekip kararını destekleyen birkaç temel görünüm yeterlidir.
Blocked Issues
Blocked Issues için standardize edilmiş işaretleme kullanmak önemlidir. Label, flag veya özel alan tercih edilebilir. Asıl gereksinim blocker başlangıç ve bitiş zamanının mümkün olduğunca izlenebilir olmasıdır. Kategoriler kullanıldığında blocker clustering yapılabilir. Günlük toplantıda bu işler yeni iş başlatmadan önce ele alınmalıdır.
Aging Work Görselleştirmesi
Jira üzerinde yaşlanan işleri filtre, renk veya dashboard eklentileriyle görünür hale getirmek mümkündür. Temel yaklaşım kartın aktif süreçte geçirdiği süreyi tarihsel SLE ile karşılaştırmaktır. Uzun süredir aynı status'ta kalan işler özellikle incelenmelidir. Board üzerinde yaş görünürlüğü bulunmasa bile JQL tabanlı sorgular yardımcı olabilir. Amaç kartların tamamlanana kadar görünmez risk olarak kalmasını önlemektir.
Azure DevOps'ta Kanban Akış Optimizasyonu
Azure DevOps Boards da Kanban akışını sütunlar, WIP limitleri, split columns ve analytics görünümüyle yönetmeye olanak sağlar. Board tasarımında işin gerçek workflow'u yansıtılmalı ve aktif çalışma ile bekleme durumları mümkün olduğunca ayrılmalıdır. Cumulative Flow, Lead Time ve Cycle Time verileri süreç trendlerini değerlendirmek için kullanılabilir. Araç üzerindeki yapı takımın explicit policy'leriyle eşleştiğinde veri daha anlamlı hale gelir. Teknik araç yalnız görünürlük sağlar; darboğazı azaltan asıl unsur ekip davranışı ve süreç deneyleridir.
Board Column Yapısı
Azure DevOps board sütunları iş akışının temel adımlarını temsil edecek biçimde düzenlenebilir. Varsayılan sütunlar her ekip için yeterli olmayabilir. Review, QA veya deployment bekleme noktaları önemliyse bunları görünür kılacak yapı kullanılmalıdır. Çok fazla sütun eklemek board okunabilirliğini azaltabilir. Karar vermeyi etkileyen durumları göstermek iyi denge sağlar.
WIP Limitleri
Sütun bazlı WIP limitleri ekip kapasitesini korumak için kullanılabilir. Limit aşımları board üzerinde görünür olduğunda ekip yeni iş başlatmadan önce darboğaza odaklanabilir. Limitler ekip büyüklüğüne göre değil gerçek akış davranışına göre ayarlanmalıdır. Cycle Time ve throughput trendleri değişiklik sonrası izlenmelidir. WIP sınırının amacı çalışanların aktivitesini değil yarım iş miktarını sınırlamaktır.
Split Columns
Split Columns aktif çalışma ile bekleyen işi ayırmak için değerli özelliktir. Örneğin Development Doing ve Development Done ayrımı review kuyruğunu daha açık hale getirir. Aynı yapı QA ve review alanlarında da uygulanabilir. Böylece hangi kartın gerçekten işlenmekte olduğu anlaşılır. Flow Efficiency ve waiting time yorumları için bu görünürlük oldukça faydalıdır.
Cumulative Flow
Azure DevOps Cumulative Flow görünümü süreç bantlarının zaman içindeki değişimini gösterir. Genişleyen bant WIP birikimine, daralan bant ise azalan kuyruk veya starvation'a işaret edebilir. Grafik trend bazında değerlendirilmelidir. Büyük workflow değişikliklerinin yapıldığı tarihler yorum sırasında dikkate alınmalıdır. CFD'yi Cycle Time ve Work Item Age verileriyle desteklemek daha güçlü analiz sağlar.
Lead ve Cycle Time
Lead ve Cycle Time ölçümleri işlerin talep ve çalışma aşamalarında ne kadar süre kaldığını anlamaya yardımcı olur. Başlangıç ve bitiş noktaları ekibin workflow tanımıyla tutarlı olmalıdır. Trendler yükseldiğinde hangi sütunda bekleme arttığı incelenebilir. Tek ortalama yerine dağılıma odaklanmak daha gerçekçi görünüm sağlar. Metrikler iyileştirme deneylerinin önce ve sonrasını karşılaştırmak için kullanılabilir.
Analytics Dashboard
Analytics Dashboard flow metriklerini daha düzenli izlemek için ortak görünüm sağlar. WIP, Cycle Time ve throughput trendleri ekip toplantılarında aynı ekran üzerinden değerlendirilebilir. Dashboard mümkün olduğunca az ama karar verdiren metrik içermelidir. Çok sayıda grafik eklemek önemli sinyallerin kaybolmasına neden olabilir. Her gösterge belirli bir operasyonel soruya yanıt vermelidir.
Açık Kaynak ve İşbirliği Kültürü Kanban Akışını Nasıl Güçlendirir?
Kanban yalnız süreç aracı değildir, aynı zamanda ortak sahiplik ve görünür iş kültürüyle daha etkili hale gelir. Açık kaynak topluluklarında sık görülen peer review, ortak problem çözme ve şeffaf blocker yönetimi yaklaşımları ekip akışına da uyarlanabilir. İş bilgisinin yalnız belirli kişilerde kalmaması, darboğaz oluştuğunda daha fazla kişinin katkı verebilmesini sağlar. Diyarbakır Yazılım Topluluğu'nun proje yaklaşımını görmek isteyenler https://www.diyarbakiryazilim.com.tr/projects adresini inceleyebilir. Süreç iyileştirmesinin ekip tarafından ortak tasarlanması, yeni politikaların günlük çalışma içinde daha kalıcı biçimde uygulanmasını destekler.
Görünür İş
İş görünür olduğunda ekip yalnız kendi görevini değil sistemin tamamını değerlendirebilir. Hangi kartın beklediği, hangi aşamanın dolduğu ve hangi blocker'ın tekrar ettiği herkes tarafından görülür. Bu şeffaflık yardımlaşmayı kolaylaştırır. Bilgi kişisel mesajlar veya ayrı tablolar içinde kalmadığında darboğaz daha erken fark edilir. Kanban board bu ortak gerçeklik için merkezi çalışma alanı haline gelir.
Ortak Sahiplik
Ortak sahiplik bir kartın yalnız atanan kişinin sorumluluğunda görülmemesini sağlar. İş teslim edilene kadar ekip sonucu birlikte sahiplenir. Darboğaz oluştuğunda başka üyeler test, review veya analiz desteği verebilir. Bu davranış “benim işim bitti” yaklaşımını azaltır. Sistem throughput'u bireysel aktiviteden daha önemli hale gelir.
Peer Review
Peer review bilgi kalitesini artırırken aynı zamanda öğrenmenin ekip içinde yayılmasını sağlar. Ancak review yalnız birkaç kişiye bağlı kalırsa darboğaz oluşturabilir. Daha geniş review yetkinliği ve küçük değişiklikler bu riski azaltır. Açık geri bildirim kültürü review süresini de kısaltabilir. İnsanlar neye bakacaklarını bildikçe karar süreci daha tutarlı hale gelir.
Swarming
Swarming topluluk ruhunu günlük teslimata taşır. Kritik veya yaşlanan iş için birkaç kişinin birlikte çalışması darboğazı daha hızlı çözebilir. Katkı yalnız kod yazmak zorunda değildir; test, dokümantasyon veya analiz desteği de olabilir. Bu yaklaşım yetkinlik paylaşımını hızlandırır. Zaman içinde ekip darboğazlara karşı daha esnek hale gelir.
Şeffaf Blocker Yönetimi
Blocker'ların görünür olması problemi saklamak yerine ortak çözüm aramayı teşvik eder. Her engelin nedeni ve bekleme süresi kaydedilebilir. Tekrarlanan blocker kategorileri ekip toplantılarında ele alınabilir. Bu davranış suçlama yerine sistem iyileştirmesine odaklanmayı kolaylaştırır. Şeffaflık ayrıca dış bağımlılıkların gerçek etkisini paydaşlarla konuşmayı kolaylaştırır.
Topluluk Tabanlı Problem Çözme
Problem çözme tek uzmana bırakıldığında bilgi ve kapasite darboğazı oluşabilir. Topluluk yaklaşımında farklı deneyim seviyelerindeki kişiler aynı soruna katkı verebilir. Bir kişinin bilmediği konu başka kişinin deneyimiyle hızla çözülebilir. Bu paylaşım yalnız mevcut blocker'ı kaldırmaz, gelecekte benzer sorunun çözüm süresini de azaltır. Kalıcı kapasite artışı çoğu zaman bu ortak öğrenmeden gelir.
Süreç İyileştirmelerinin Ortak Tasarlanması
Kanban politikaları yalnız yönetici tarafından belirlenirse ekip günlük pratikte neden uygulandığını anlamayabilir. WIP limiti, pull criteria veya review policy gibi kararları ekip verisi üzerinden birlikte tasarlamak daha güçlü sahiplenme sağlar. İnsanlar problemin sinyalini ve değişikliğin amacını gördüğünde davranış daha kalıcı olur. Deney sonuçları birlikte değerlendirilebilir. Böylece süreç iyileştirmesi tek seferlik proje değil günlük çalışma kültürü haline gelir.
Yapay Zekâ Çağında Yeni Kanban Darboğazları
Kod üretim araçlarının geliştirme hızını artırması bütün value stream'in aynı oranda hızlanacağı anlamına gelmez. Daha hızlı üretilen kod daha fazla pull request, daha fazla test ihtiyacı ve daha fazla güvenlik incelemesi oluşturabilir. Bu nedenle upstream kapasitesi yükseldiğinde downstream WIP limitlerini ve darboğazları yeniden değerlendirmek gerekir. İnsan review ve kalite doğrulaması daha belirgin kısıt haline gelebilir. Kanban Board Optimizasyonu ve Darboğaz (Bottleneck) Analizi bu yeni kapasite dengesizliğini görünür hale getirerek ekiplerin yalnız üretim hızına değil bütün teslimat sistemine odaklanmasını sağlar.
AI ile Kod Üretim Hızının Artması
Kod üretimi hızlandığında geliştiriciler daha kısa sürede daha fazla değişiklik oluşturabilir. Ancak review, test ve deployment kapasitesi değişmediyse toplam müşteri teslimatı aynı kalabilir. Üstelik upstream daha hızlı çalıştığı için downstream kuyruklar büyüyebilir. Bu durumda geliştirme throughput'u artarken sistem Cycle Time'ı kötüleşebilir. Board'un bütün value stream'i göstermesi bu farkı erken fark etmeyi sağlar.
Code Review Kuyruğunun Büyümesi
Daha fazla kod üretimi daha fazla pull request oluşturabilir. Reviewer kapasitesi aynı kaldığında Waiting for Review WIP hızla büyür. Çözüm yalnız daha fazla reviewer istemek değildir; PR boyutu, otomatik kontroller ve pairing de değerlendirilmelidir. Gerekirse Development WIP limiti yeni review kapasitesine göre azaltılabilir. Böylece sistem toplam yarım iş miktarını kontrol altında tutar.
QA Darboğazı
Kod üretimi artarken test kapasitesi aynı kalırsa QA bir sonraki temel kısıt olabilir. Daha fazla değişiklik daha fazla regresyon ve entegrasyon senaryosu anlamına gelebilir. Test otomasyonu ve shift-left yaklaşımı bu yükü azaltabilir. Ancak üretilen değişikliğin kalitesi düşükse otomasyon da yeterli olmayabilir. Defect escape ve rework süresi akış metrikleriyle birlikte izlenmelidir.
Güvenlik İncelemesi
Daha fazla kod ve bağımlılık güvenlik review miktarını artırabilir. Güvenlik ekibi sınırlı kapasiteye sahipse uzun approval queue oluşur. Otomatik statik analiz ve dependency kontrolleri standart riskleri daha erken yakalayabilir. İnsan uzmanlığı yüksek riskli değişikliklere ayrılabilir. Bu kapasite modeli güvenlik kalitesini korurken waiting time'ı azaltabilir.
AI Üretimi İşlerin Kalite Kontrolü
Üretilen çıktının hızlı olması doğruluğunun otomatik olarak yüksek olduğu anlamına gelmez. Kodun mimari uyumu, güvenliği, test edilebilirliği ve gerçek gereksinimi karşılaması doğrulanmalıdır. Kalite kontrolü yeni value stream adımı oluşturuyorsa board üzerinde görünür hale getirilmelidir. Bu adımın WIP ve Cycle Time etkisi ölçülebilir. Amaç aracı engellemek değil, hız artışının downstream kalite maliyetine dönüşmesini önlemektir.
Upstream Hızlandırmanın Downstream'e Etkisi
Sistemin yalnız ilk aşamasını hızlandırmak downstream queue'yu büyütebilir. Bu Theory of Constraints açısından klasik lokal optimizasyon örneğidir. Geliştirme iki kat hızlanırken QA aynı kapasitede kalırsa toplam throughput QA tarafından sınırlanır. Bu nedenle üretim hızı değiştiğinde bütün value stream kapasitesi yeniden ölçülmelidir. Gerekirse iş giriş hızı veya WIP limitleri yeni dengeye göre ayarlanır.
AI Sonrası WIP Limitlerini Yeniden Kalibre Etmek
Takımın çalışma kapasitesi önemli biçimde değiştiğinde eski WIP limitleri geçerliliğini kaybedebilir. Ancak limitleri otomatik olarak yükseltmek doğru değildir. Önce downstream Cycle Time, throughput ve queue davranışı gözlemlenmelidir. Daha hızlı üretim review kuyruğunu büyütüyorsa Development WIP sınırını korumak veya düşürmek gerekebilir. Yeni limitler kontrollü deneylerle belirlenmelidir.
Kanban Optimizasyonunda Yapılmaması Gerekenler
Kanban uygulamalarındaki birçok hata, insanları daha çok çalıştırmayı sistem akışını iyileştirmekle karıştırmaktan kaynaklanır. Herkesi yüzde yüz meşgul tutmak, sürekli yeni iş başlatmak veya her WIP ihlalinde limiti artırmak kısa vadede hareket üretir ancak uzun vadede Cycle Time'ı büyütebilir. Benzer şekilde darboğaza kör biçimde personel eklemek kök nedeni çözmeyebilir. Flow metriklerini bireysel performans ölçümü olarak kullanmak da ekip davranışını bozabilir. Kanban'ın odağı sistem performansı, müşteri teslimatı ve sürekli öğrenme olmalıdır.
Herkesi %100 Meşgul Tutmaya Çalışmak
Yüzde yüz kullanım oranı kuyruk sistemlerinde bekleme sürelerini ciddi biçimde artırabilir. Küçük talep dalgalanmalarında bile boş kapasite bulunmadığı için işler sırada kalır. Kanban belirli miktarda slack'i faydalı kabul eder. Boş kapasite blocker çözümü, improvement veya cross-training için kullanılabilir. Amaç insan kullanımını maksimum yapmak değil akış süresini optimize etmektir.
Sürekli Yeni İş Başlatmak
Yeni iş başlatmak hızlı ilerleme hissi verir fakat mevcut kartlar tamamlanmıyorsa WIP birikir. Her yeni kart daha fazla koordinasyon ve bekleme yaratır. Limit dolduğunda yeni başlangıç yerine finishing davranışı tercih edilmelidir. Özellikle delivery'e yakın işlerin tamamlanması müşteri değerini daha erken üretir. Başlatılan iş sayısı başarı metriği değildir.
WIP Limitlerini Her İhlalde Artırmak
WIP sınırı her dolduğunda yükseltilirse zamanla sınırsız hale gelir. İhlal sistemin size verdiği kapasite sinyalidir. Önce neden işlerin tamamlanamadığı anlaşılmalıdır. Kalıcı kapasite artışı varsa limit yeniden ayarlanabilir. Ancak yalnız yoğunluğu görünmez yapmak için sayı yükseltmek problemi sonraki kuyruğa taşır.
Darboğaza Körü Körüne Personel Eklemek
Kuyruk görüldüğünde ilk çözüm yeni kişi eklemek olmamalıdır. Darboğazın nedeni onay politikası, ortam kapasitesi veya büyük batch olabilir. Yeni çalışan aynı sistem sorunu içinde çalışır ve beklenen throughput artışı oluşmayabilir. Önce kısıtın mevcut kapasitesinin nasıl kullanıldığı incelenmelidir. Gerçek kapasite ihtiyacı doğrulanırsa personel artışı daha anlamlı yatırım haline gelir.
Yalnız Ortalama Cycle Time Kullanmak
Ortalama Cycle Time yüksek varyasyonu ve uç gecikmeleri gizleyebilir. Medyan, %85, %95 ve scatterplot birlikte kullanıldığında daha gerçekçi görünüm oluşur. İyileştirme yalnız ortalamayı düşürürken outlier sayısı artıyorsa teslimat güvenilirliği kötüleşebilir. Bu nedenle dağılım şekli önemlidir. Müşteri beklentileri için percentile tabanlı SLE daha anlamlı olabilir.
Takımları Throughput ile Yarıştırmak
Throughput takımlar arasında performans yarışı için uygun metrik değildir. İş tipleri, büyüklükleri ve workflow sınırları farklı olabilir. Yarış oluşturulduğunda ekipler işi yapay biçimde küçük bölme veya kolay işleri seçme davranışı geliştirebilir. Throughput aynı sistemin zaman içindeki kapasitesini anlamak için kullanılmalıdır. Karşılaştırma yerine trend ve tahmin amacı daha sağlıklıdır.
Bireysel Cycle Time ile Performans Ölçmek
Cycle Time sistem metriğidir ve bireysel çalışan puanı olarak kullanılması zararlı davranışlar oluşturabilir. İşler review, test veya dış bağımlılık nedeniyle gecikebilir. Çalışanı yalnız kart süresinden değerlendirmek bu sistem faktörlerini görmezden gelir. İnsanlar ölçümü iyileştirmek için zor işlerden kaçınmaya başlayabilir. Metrikler öğrenme ve süreç iyileştirme amacıyla kullanılmalıdır.
Lokal Optimizasyonu Sistem Optimizasyonu Sanmak
Bir departmanın hızını artırmak müşteri teslimatını artırmıyorsa gerçek sistem iyileştirmesi oluşmamıştır. Upstream throughput yükselirken downstream WIP büyüyebilir. Başarı commitment point ile delivery point arasındaki toplam flow üzerinden değerlendirilmelidir. Theory of Constraints yaklaşımı bu nedenle yalnız en hızlı bölümü değil mevcut kısıtı optimize etmeyi önerir. Sistem düşüncesi Kanban'ın temelidir.
Kanban Board'un Başarısı Nasıl Ölçülür?
Başarılı Kanban sistemi yalnız daha fazla kartın Done'a taşınmasıyla ölçülmez. WIP azalırken throughput korunuyor, Cycle Time düşüyor, Work Item Age kontrol altında kalıyor ve teslimat tahmin edilebilirliği artıyorsa sistem daha sağlıklı hale geliyor olabilir. Blocked Time, Flow Efficiency ve SLE Hit Rate bu tabloyu tamamlar. Metrikleri tek tek hedef yapmak yerine birlikte nasıl hareket ettiklerini değerlendirmek gerekir. Kanban Board Optimizasyonu ve Darboğaz (Bottleneck) Analizi açısından başarı, müşteri değerinin daha dengeli ve güvenilir akmasıdır.
WIP
WIP sistemde aynı anda kaç iş bulunduğunu gösterir. Zaman içinde kontrolsüz yükselmeyen WIP daha stabil akışın işareti olabilir. Ancak hedef en düşük WIP değildir. Throughput korunurken daha düşük WIP elde etmek genellikle olumlu sonuçtur. Sütun bazlı WIP trendleri yerel kapasite sorunlarını da gösterebilir.
Throughput
Throughput tamamlanan iş miktarını gösterir ve sistem kapasitesini anlamaya yardımcı olur. Stabil veya artan throughput, Cycle Time iyileşmesiyle birlikte değerlendirildiğinde güçlü sinyal verir. Ancak kalite düşüşü veya iş büyüklüğü değişimi sonuçları etkileyebilir. Bu nedenle throughput tek başına performans puanı değildir. Tahmin modellerinde geçmiş dağılım olarak kullanılması daha değerlidir.
Cycle Time
Cycle Time işin aktif sistemde ne kadar süre kaldığını gösterir. Medyan ve percentile değerlerinin düşmesi teslimat hızının iyileştiğini gösterebilir. Dağılımın daralması tahmin edilebilirlik açısından ayrıca önemlidir. Süre değişimini iş tipine göre incelemek daha sağlıklı karşılaştırma sağlar. Kök neden için aşama bazlı waiting time verileri kullanılmalıdır.
Lead Time
Lead Time müşteri talebinden gerçek teslimata kadar geçen toplam süreyi kapsar. Backlog bekleme süresi yüksek olduğunda Cycle Time iyi olsa bile Lead Time kötü kalabilir. Bu nedenle talep yönetimi ve önceliklendirme sistemin parçasıdır. Müşteri deneyimi açısından en önemli ölçülerden biridir. Lead Time trendi ürün karar süreçleriyle birlikte değerlendirilmelidir.
Work Item Age
Work Item Age aktif işlerin erken risk göstergesidir. Çok sayıda kart SLE'e yaklaşmaya başlıyorsa gelecekte Cycle Time dağılımı kötüleşebilir. Bu nedenle yalnız tamamlanan işlere bakmak yerine devam eden akışı da izlemek gerekir. Yaşlanan kartları günlük review'da önceliklendirmek gecikmeyi azaltabilir. Aging WIP trendinin düşmesi finishing davranışının güçlendiğini gösterebilir.
Flow Efficiency
Flow Efficiency aktif çalışma süresinin toplam Cycle Time içindeki oranıdır. Oranın artması bekleme süresinin azaldığını gösterebilir. Ancak sürekli yüzde yüz hedeflemek doğru değildir. Bazı bekleme ve buffer durumları sistem için normaldir. En büyük değer, aktif ve bekleme sürelerini ayrı düşünmeye yardımcı olmasıdır.
Blocked Time
Blocked Time toplam teslimat süresinin ne kadarının gerçek engeller nedeniyle kaybedildiğini gösterir. Bu değerin düşmesi blocker yönetiminin iyileştiğine işaret edebilir. Neden kategorileri ayrıca takip edilmelidir. Tekrarlanan en büyük blocker ortadan kaldırıldığında sistem geneline önemli etki oluşabilir. Blocked Time'ı gizlemek yerine görünür hale getirmek öğrenme fırsatı yaratır.
Predictability
Predictability benzer işlerin benzer zaman aralıklarında tamamlanma derecesini ifade eder. Ortalama Cycle Time düşük olsa bile dağılım çok genişse müşteriye güvenilir tahmin vermek zordur. Percentile aralıklarının daralması olumlu sinyaldir. Stabil WIP ve düzenli throughput tahmin edilebilirliği destekler. Kanban optimizasyonunda hız kadar güvenilirlik de önemli hedeftir.
SLE Hit Rate
SLE Hit Rate tamamlanan işlerin ne kadarının belirlenen SLE içinde bittiğini gösterir. Örneğin SLE %85 hedefliyorsa uzun dönem gerçekleşme oranının bu değere yakın olması beklenebilir. Sürekli düşük oran eski SLE'in artık gerçek sistemi temsil etmediğini veya süreçte bozulma oluştuğunu gösterebilir. Kök neden incelenmeden SLE süresini sürekli uzatmak doğru değildir. Önce akış problemleri değerlendirilmelidir.
Darboğaz Çözümünün Başarılı Olduğu Nasıl Doğrulanır?
Darboğaz çözümünün başarılı olduğunu yalnız queue'nun geçici olarak küçülmesine bakarak söylemek yeterli değildir. Önce ve sonra Cycle Time, throughput, WIP ve Blocked Time karşılaştırılmalıdır. CFD bandının yeni davranışı ve başka noktada yeni darboğaz oluşup oluşmadığı da izlenmelidir. İyileştirmenin lokal alan dışında sistem geneline etkisi değerlendirilmelidir. Başarılı değişiklik verilerle doğrulandıktan sonra explicit policy haline getirilebilir.
Önceki ve Sonraki Cycle Time
İyileştirme öncesi ve sonrası Cycle Time dağılımları aynı ölçüm sınırlarıyla karşılaştırılmalıdır. Medyan ve %85 değerleri özellikle faydalıdır. Yalnız ortalamanın değişmesi yeterli kanıt değildir. Outlier sayısının azalması ayrıca olumlu gelişme olabilir. İş tipi dağılımı iki dönemde çok farklıysa yorum daha dikkatli yapılmalıdır.
Throughput Değişimi
Darboğaz kapasitesi gerçekten arttıysa sistem throughput'unda yükselme görülebilir. Ancak bazen amaç throughput'u artırmadan Cycle Time'ı düşürmek olabilir. Bu nedenle beklenen sonuç deney başında açıkça belirlenmelidir. WIP azalırken throughput korunuyorsa önemli verim kazanımı elde edilmiş olabilir. Tek haftalık dalgalanma yerine birkaç dönem gözlem yapmak daha güvenilirdir.
WIP Değişimi
Darboğaz çevresindeki WIP'in düşmesi kuyruğun azaldığını gösterir. Ancak kartların başka sütuna taşınarak yalnız görünüşte azaltılmadığından emin olunmalıdır. Global WIP de kontrol edilmelidir. Gerçek iyileştirmede toplam yarım iş miktarı daha kontrollü hale gelir. Bu değişim Cycle Time ile birlikte izlenmelidir.
CFD Bant Genişliği
Darboğaz bandı iyileştirme öncesinde genişliyorsa müdahale sonrası daha paralel hale gelmesi olumlu sinyaldir. Bant aniden daralıp downstream'de başka bir bant genişliyorsa darboğaz taşınmış olabilir. Bu her zaman kötü değildir fakat yeni kısıtın yönetilmesi gerekir. CFD süreç davranışını uzun dönem görmeye yardımcı olur. Kısa süreli dalgalanmaları kalıcı sonuç gibi yorumlamamak önemlidir.
Blocked Time
Çözüm blocker odaklıysa toplam Blocked Time'ın düşmesi beklenir. Özellikle hedeflenen blocker kategorisinin etkisi ayrıca analiz edilmelidir. Kart sayısı azalsa bile tek bir uzun blocker toplam süreyi yüksek tutabilir. Bu nedenle süre bazlı ölçüm adet bazlı ölçümden daha anlamlı olabilir. Yeni blocker türleri de ortaya çıkabilir.
Yeni Darboğazın Ortaya Çıkması
Bir kısıt çözüldüğünde sonraki süreç aşamasında yeni kuyruk oluşması beklenebilir. Bu sistemin artık farklı kapasite sınırına ulaştığını gösterir. Yeni darboğazı hızla görmek sürekli iyileştirme döngüsünün parçasıdır. Önceki çözümü geri almak yerine yeni kısıt değerlendirilmelidir. Böylece sistem kapasitesi adım adım yükselir.
İyileştirmenin Sistem Geneline Etkisi
Lokal bir metrik iyileşirken toplam Lead Time kötüleşiyorsa değişiklik başarılı sayılmamalıdır. Sistem geneli ölçümler bu nedenle önemlidir. Müşteri teslimatı, kalite, WIP ve tahmin edilebilirlik birlikte değerlendirilmelidir. Bazen bir aşamayı biraz yavaşlatmak toplam akışı hızlandırabilir. Kanban sistem düşüncesi bu tür dengeleri görünür hale getirir.
30 Günlük Kanban Board Optimizasyon Planı
Kanban optimizasyonunu büyük dönüşüm projesi yerine dört haftalık ölçülebilir çalışma olarak başlatabilirsiniz. İlk hafta mevcut akışı ve temel metrikleri ölçün. İkinci hafta darboğazı veriyle belirleyin, üçüncü hafta küçük iyileştirme deneyini uygulayın ve dördüncü hafta sonucu karşılaştırıp başarılı davranışı standardize edin. Bu plan özellikle ilk kez flow metrics kullanan ekiplerde net başlangıç noktası sağlar. Daha sonra aynı döngü yeni darboğaz için tekrar uygulanabilir.
1. Hafta – Mevcut Akışı Ölç
İlk hafta hiçbir şeyi hemen değiştirmek yerine mevcut sistemi anlamaya odaklanın. Board sütunlarını gerçek value stream ile karşılaştırın. WIP, Cycle Time ve throughput için başlangıç değerleri oluşturun. Kartların yaşını ve blocker durumlarını gözlemleyin. Amaç sonraki iyileştirmeyi karşılaştırabileceğiniz güvenilir baz veri oluşturmaktır.
Board Audit
Board Audit sırasında her sütunun gerçek süreç durumunu temsil edip etmediğini kontrol edin. Görünmeyen review, approval veya queue noktalarını bulun. Done tanımının ekip içinde ortak olup olmadığını doğrulayın. Aktif iş ile bekleyen iş aynı yerdeyse split column ihtiyacını değerlendirin. Gereksiz sütunları da belirleyin.
WIP
Toplam ve sütun bazlı WIP seviyelerini günlük olarak kaydedin. Hangi alanların sürekli dolu kaldığını gözlemleyin. Mevcut WIP limitleri varsa ne sıklıkla aşıldığını not edin. Henüz limit yoksa bu veriler başlangıç limiti için temel oluşturabilir. WIP'i kişi sayısıyla değil gerçek akış davranışıyla ilişkilendirin.
Cycle Time
Son birkaç aylık tamamlanan işlerin Cycle Time dağılımını çıkarın. Medyan, %85 ve %95 değerlerini hesaplamak faydalıdır. İş türleri belirgin biçimde farklıysa ayrı gruplar oluşturun. Uzun outlier kartların ortak nedenlerini not edin. Bu değerleri sonraki deney için baz kabul edin.
Throughput
Haftalık tamamlanan iş sayısını geçmiş dönemlerden çıkarın. Ortalama yanında haftalar arasındaki değişkenliği de görün. Çok düzensiz throughput büyük batch veya kapasite dalgalanmasına işaret edebilir. Tahmin çalışmalarında dağılımın kendisini kullanmak daha değerlidir. İlk hafta yalnız ölçün ve performans hedefi koymayın.
2. Hafta – Darboğazı Belirle
İkinci hafta elde edilen verilerden sistemin en güçlü kısıtını belirlemeye odaklanın. CFD, Aging WIP ve blocker verilerini birlikte değerlendirin. Birkaç sorun görseniz bile önce sistem throughput'unu en fazla etkileyen noktayı seçin. Kök neden için ekip üyeleriyle birlikte veri üzerinden konuşun. Haftanın sonunda test edilebilir bir iyileştirme hipotezi oluşturun.
CFD
CFD'de haftalar boyunca genişleyen bantları inceleyin. Aynı aşamadaki WIP trendiyle karşılaştırın. Geçici dalgalanmaları yapısal darboğazdan ayırmaya çalışın. İlgili dönemde workflow değişikliği olup olmadığını kontrol edin. En belirgin bant genişlemesini kök neden araştırması için aday olarak alın.
Aging WIP
Aktif kartları yaşlarına göre sıralayın. SLE veya %85 Cycle Time değerine yaklaşan kartları işaretleyin. Bu kartların hangi sütunlarda kümelendiğine bakın. Aynı noktada çok sayıda yaşlı iş bulunması darboğaz sinyalini güçlendirir. Günlük review sırasında bu kartları önce ele alın.
Blockers
Blocked kartları neden ve süre bazında gruplayın. Toplam gecikmenin büyük bölümünü hangi kategori oluşturuyor inceleyin. Tekrarlanan blocker'ları Pareto yaklaşımıyla önceliklendirebilirsiniz. Bir engelin başka departman kaynaklı olması onu analiz dışında bırakmak için neden değildir. Waiting Time yine müşteri Lead Time'ının parçasıdır.
3. Hafta – İyileştirme Deneyi
Üçüncü hafta yalnız bir veya birkaç yakından ilişkili değişiklik uygulayın. Çok fazla değişkeni aynı anda değiştirmek hangi müdahalenin işe yaradığını anlamayı zorlaştırır. WIP, swarming, batch size veya otomasyon deneylerinden biri seçilebilir. Deney başında beklenen metrik değişimini yazın. Hafta boyunca uygulamanın gerçekten policy'ye uygun yürütüldüğünü kontrol edin.
WIP Değişikliği
Darboğaz öncesindeki WIP limitini küçük miktarda azaltmak deney olabilir. Örneğin Development limitini altıdan beşe düşürün. Amaç downstream'e gelen iş hızını dengelemek ve mevcut queue'nun tamamlanmasını sağlamaktır. Throughput, Cycle Time ve starvation sinyallerini izleyin. Sonuç olumsuzsa kolayca eski değere dönebilirsiniz.
Swarming
Darboğaz alanında yaşlanan işlere birkaç ekip üyesinin ortak destek vermesini deneyin. Kimlerin hangi tür katkı sağlayabileceğini önceden belirleyin. Swarming süresini geçici ve hedefli tutun. Amaç kalıcı rol değişikliği değil queue'yu eritmek ve bilgi paylaşmak olabilir. Sonrasında darboğaz bekleme süresinin değişimini ölçün.
Batch Size
Büyük iş veya pull request'leri daha küçük parçalara bölmeyi deneyin. Bir haftalık iş yerine bir veya iki günlük teslim edilebilir dilimler hedeflenebilir. Küçük batch'in review ve test bekleme süresine etkisini izleyin. Throughput sayısı doğal olarak artabileceği için yalnız adet bazlı yorum yapmayın. Cycle Time ve rework değişimini de değerlendirin.
Automation
Tekrarlanan manuel kontrol darboğaz yaratıyorsa küçük otomasyon seçin. Örneğin review öncesi lint ve test doğrulaması otomatik çalıştırılabilir. Otomasyonun hangi waiting veya active time'ı azaltması beklendiğini açıkça tanımlayın. Sonuçta gerçekten süre kazancı oluşup oluşmadığını ölçün. Yeni bakım yükü yaratan otomasyonlar da değerlendirmeye dahil edilmelidir.
4. Hafta – Sonucu Ölç ve Standardize Et
Dördüncü hafta deney öncesi ve sonrası metrikleri karşılaştırın. Değişiklik beklenen yönde sonuç verdiyse yeni davranışı explicit policy haline getirin. Olumsuz veya belirsiz sonuç varsa eski yönteme dönmek başarısızlık değildir; ekip sistem hakkında yeni bilgi edinmiştir. Öğrenimi kısa bir notla kayıt altına alın. Sonraki ay yeni darboğaz için aynı döngüyü tekrar edin.
Önce/Sonra Analizi
Cycle Time, WIP, throughput ve blocker sürelerini aynı ölçüm sınırlarıyla karşılaştırın. Bir haftalık örnek küçükse sonuç için daha uzun dönem gerekebilir. İş tiplerindeki önemli değişiklikleri hesaba katın. Özellikle %85 Cycle Time ve Aging WIP değişimi faydalıdır. Sistem genelinde beklenmedik olumsuz etki olup olmadığını da kontrol edin.
Explicit Policy Güncellemesi
Deney başarılıysa yeni WIP limiti veya çalışma davranışı board üzerinde yazılı politika haline getirilmelidir. Ekip üyeleri değişikliğin neden yapıldığını bilmelidir. Yeni katılan kişilerin de kolayca anlayabileceği açık dil kullanın. Politika gelecekte veriler değiştiğinde yeniden gözden geçirilebilir. Kanban'da standartlaştırma öğrenmenin sonu değil bir sonraki deneyin başlangıç noktasıdır.
Kanban Darboğaz Analizi İçin Haftalık Flow Review
Haftalık Flow Review ekiplerin yalnız görev durumunu değil sistem davranışını konuşmasını sağlar. Toplantıda yaşlanan işler, WIP limitine yaklaşan sütunlar, büyüyen kuyruklar, blocker'lar ve SLE riski taşıyan kartlar değerlendirilir. Amaç uzun durum raporu vermek değildir. Ekip bir sonraki haftada nerede swarm yapacağını veya hangi küçük süreç deneyini uygulayacağını belirlemelidir. Düzenli Flow Review, Kanban optimizasyonunu dönemsel proje olmaktan çıkarıp sürekli çalışma pratiğine dönüştürür.
Hangi İşler Yaşlanıyor?
Önce aktif kartları Work Item Age değerine göre sıralayın. Takımın normal Cycle Time dağılımına yaklaşan işleri belirleyin. Bu kartların neden ilerlemediğini kısa biçimde inceleyin. Büyük kapsam, blocker veya handoff gibi tekrar eden desenler varsa not alın. Yeni iş başlatmadan önce yaşlanan kartları tamamlama fırsatlarını değerlendirin.
Hangi Sütun WIP Limitine Yakın?
Her sütunun mevcut WIP değerini limit ile karşılaştırın. Limit dolmak üzereyse upstream ekip yeni iş göndermeden önce hazırlık yapabilir. Tekrarlanan doluluk yapısal kapasite problemine işaret edebilir. Bir kez oluşan yoğunluk için hemen limit değiştirmeyin. Trend birkaç hafta devam ediyorsa deney tasarlayın.
Nerede Kuyruk Büyüyor?
Waiting sütunlarındaki kart sayısının geçen haftaya göre değişimini inceleyin. CFD bantları bu konuşmayı destekleyebilir. Kuyruğun büyümesi gelen ve çıkan iş oranının dengede olmadığını gösterir. Kart yaşlarıyla birlikte değerlendirmek daha iyi öncelik sağlar. En hızlı büyüyen queue yeni darboğaz adayı olabilir.
Hangi İşler Blocked?
Blocked kartların yalnız durumunu değil ne kadar süredir beklediğini değerlendirin. Uzun blocked time müşteri teslimatını doğrudan etkiler. Aynı blocker nedeni tekrar ediyorsa sistemik aksiyon oluşturun. Dış bağımlılıklarda escalation veya erken talep politikası gerekebilir. Amaç blocker listesini okumak değil engellerin tekrarını azaltmaktır.
SLE Riski Taşıyan İşler Hangileri?
Work Item Age değeri SLE'e yaklaşan kartlar haftalık review'da öne çıkarılmalıdır. Kart henüz erken süreç aşamasındaysa risk daha da yüksek olabilir. Ekip işi bölme, swarm veya blocker çözme seçeneklerini değerlendirebilir. SLE'i geçtikten sonra açıklama yapmak yerine önce müdahale etmek daha etkilidir. Böylece teslimat tahmin edilebilirliği korunur.
Takım Nerede Swarm Olmalı?
Swarming için en doğru yer sistemin mevcut kısıtı veya en yaşlı kritik işidir. Herkesin aynı karta gitmesi gerekmez. Bazı kişiler test, bazıları review veya bağımlılık çözümüne destek olabilir. Amaç bottleneck throughput'unu geçici olarak artırmak ve bilgi paylaşmaktır. Swarm sonrasında işin hareket edip etmediği gözlemlenmelidir.
Hangi Deneyi Uygulamalıyız?
Flow Review'un sonunda gelecek hafta için küçük bir süreç deneyi seçmek faydalıdır. WIP değişikliği, daha küçük batch, yeni review policy veya otomatik uyarı denenebilir. Beklenen etki net yazılmalıdır. Bir sonraki toplantıda aynı metriklerle sonuç değerlendirilir. Bu döngü ekipte veriye dayalı sürekli iyileştirme alışkanlığı oluşturur.
Kanban Board Optimizasyon Kontrol Listesi
Kanban sisteminizi gözden geçirirken yalnız board görünümünü değil workflow, WIP, pull policy, queue, blocker ve flow metrics yapılarını birlikte kontrol etmek gerekir. Aşağıdaki başlıklar düzenli audit için pratik çerçeve sağlar. Her alanın “var” olması yeterli değildir; gerçek ekip davranışını doğru temsil etmesi gerekir. Özellikle Cycle Time, Throughput, Aging WIP, CFD ve SLE gibi ölçümler karar üretmiyorsa dashboard kalabalığından öteye gitmez. Kontrol listesini aylık Flow Review sırasında kullanarak sistemde oluşan yeni kısıtları daha erken fark edebilirsiniz.
Workflow
Workflow gerçek iş akışını temsil ediyor mu kontrol edin. Görünmeyen approval veya handoff noktaları var mı inceleyin. Aktif çalışma ile bekleme ayrımı yeterince açık mı değerlendirin. Resmi süreç ile günlük çalışma arasında fark varsa board'u gerçeğe göre güncelleyin. Workflow değiştikçe ölçüm sınırlarını da yeniden doğrulayın.
WIP Limitleri
Her önemli süreç aşamasında WIP limiti gerekip gerekmediğini değerlendirin. Mevcut limitlerin sık aşılması veya hiç dolmaması kapasite uyumsuzluğu gösterebilir. Limit dolduğunda uygulanacak davranışın ekip tarafından bilinmesi gerekir. Global WIP de unutulmamalıdır. Limitler düzenli deneylerle yeniden kalibre edilmelidir.
Pull Policies
Yeni işin hangi şartlarda sisteme çekileceği açık olmalıdır. Downstream kapasite bulunmadan iş itilmemelidir. Öncelik ve Ready kriterleri ortak biçimde anlaşılmalıdır. Pull policy WIP limitleriyle birlikte çalışır. Kurallar pratikte uygulanmıyorsa board üzerindeki sayıların anlamı azalır.
Board Sütunları
Sütunlar karar vermeyi destekleyecek kadar ayrıntılı olmalıdır. Fazla genel sütunlar darboğazı saklar, çok fazla sütun ise okunabilirliği düşürür. Waiting ve Doing ayrımı kritik aşamalarda faydalıdır. Her sütunun giriş ve çıkış kriteri bulunmalıdır. Gereksiz status'lar periyodik olarak temizlenmelidir.
Queue'lar
Review, QA, approval ve deployment queue'larının görünür olduğundan emin olun. Queue uzunluğu yanında Work Item Age değerini de takip edin. Sürekli büyüyen kuyruk darboğaz sinyali olabilir. Büyük batch hareketleri de queue davranışını etkileyebilir. Kuyrukları gizlemek yerine yönetilebilir hale getirin.
Blockers
Blocked işlerin nasıl işaretlendiği ve ne zaman blocker kabul edildiği standart olmalıdır. Başlangıç ve bitiş sürelerini kaydetmek Blocked Time ölçümünü mümkün kılar. Neden kategorileri tekrar eden sorunları bulmaya yardımcı olur. Uzun blocker'lar Flow Review'da önceliklidir. Çözüm sonrası kök neden notu gelecekte benzer engelleri azaltabilir.
Cycle Time
Cycle Time başlangıç ve bitiş noktaları ekip içinde standardize edilmelidir. Ortalama dışında medyan ve percentile değerleri izlenmelidir. İş sınıflarının dağılımı farklıysa ayrı analiz yapılabilir. Trend artışında sütun bazlı waiting time kontrol edilmelidir. Süreç deneyleri önce ve sonra aynı hesaplama yöntemiyle karşılaştırılmalıdır.
Throughput
Throughput haftalık veya aylık tamamlanan iş miktarıyla izlenebilir. Değişkenlik tahmin kalitesi açısından önemlidir. Takımlar arasında performans yarışı için kullanılmamalıdır. WIP ve Cycle Time ile birlikte değerlendirilmelidir. Stabil throughput Monte Carlo tahminleri için güçlü veri kaynağı sağlar.
Aging WIP
Aging WIP aktif kartların riskini erken gösterir. Yaşlı işler board üzerinde görünür olmalıdır. SLE eşiğine yaklaşan kartlar otomatik uyarı alabilir. Günlük ve haftalık Flow Review'da bu işler yeni kartlardan önce değerlendirilmelidir. Aging WIP'in düşmesi finishing kültürünün güçlendiğini gösterebilir.
CFD
CFD bantlarının uzun dönem davranışını inceleyin. Genişleyen bantlar WIP birikimini, daralan bantlar olası starvation durumunu gösterebilir. Workflow değişikliklerini grafiği yorumlarken dikkate alın. Ani sıçramaları batch hareketleriyle eşleştirin. CFD'yi tek başına değil Cycle Time ve board verileriyle birlikte kullanın.
SLE
SLE tarihsel Cycle Time dağılımına dayanmalıdır. İş sınıfına uygun percentile seviyesi seçilmelidir. Aktif kart yaşları SLE ile karşılaştırılabilir. SLE Hit Rate düzenli izlenmeli ve gerçek sistem değiştiğinde eşik yeniden değerlendirilmelidir. SLE kesin deadline gibi kullanılmamalıdır.
Sürekli İyileştirme
Kanban optimizasyonu tek seferlik board düzenleme çalışması değildir. Her darboğaz çözümü sistemi yeni kapasite sınırına taşır. Ekip düzenli flow review ve küçük deneylerle ilerlemelidir. Başarılı değişiklikler explicit policy olarak standardize edilmelidir. Sonraki veri yeni problem gösterdiğinde aynı öğrenme döngüsü tekrar başlatılır.
Sıkça Sorulan Sorular
Kanban uygulamalarında en çok merak edilen konular genellikle WIP limitleri, Cycle Time, darboğaz tespiti ve CFD yorumuyla ilgilidir. Aşağıdaki yanıtlar günlük ekip kullanımında hızlı referans olarak değerlendirilebilir. Her takımın iş tipi ve kapasitesi farklı olduğu için verilen yaklaşımlar sabit reçete olarak görülmemelidir. En doğru sonuç tarihsel flow verisiyle yapılan küçük deneylerden gelir. Kurumsal Kanban optimizasyonu ve çevik süreç danışmanlığı çalışmalarında da aynı prensip geçerlidir: önce sistemi ölçmek, sonra kontrollü değişiklik yapmak gerekir.
Kanban Board optimizasyonu nedir?
Kanban Board optimizasyonu işlerin daha dengeli, hızlı ve tahmin edilebilir akmasını sağlamak için board yapısının, WIP limitlerinin ve çalışma politikalarının düzenlenmesidir. Amaç görsel düzen değil sistem performansıdır. Gerçek value stream görünür hale getirilir ve bekleme noktaları ayrılır. Cycle Time, throughput ve Aging WIP gibi metriklerle darboğazlar ölçülür. Ardından küçük süreç deneyleriyle akış adım adım iyileştirilir.
Kanban'da darboğaz nasıl tespit edilir?
Darboğaz genellikle belirli sütunda sürekli WIP birikmesi, uzun bekleme süresi ve artan Work Item Age ile kendini gösterir. CFD'de ilgili bandın genişlemesi güçlü sinyaldir. Cycle Time artışı ve throughput düşüşü de analizi destekleyebilir. Tek günlük yoğunluk yerine uzun dönem trendine bakılmalıdır. Kök neden belirlemek için blocker ve queue verileri birlikte incelenmelidir.
Kanban WIP limiti nasıl belirlenir?
WIP limiti takımın gerçek paralel çalışma kapasitesine göre başlangıç değeriyle belirlenebilir. Sonrasında tarihsel Cycle Time ve throughput davranışı kullanılarak ayarlanmalıdır. Limit düşürüldüğünde throughput korunuyor ve Cycle Time iyileşiyorsa olumlu sonuç vardır. Starvation artıyorsa limit fazla düşük olabilir. En sağlıklı yöntem küçük değişikliklerle kontrollü deney yapmaktır.
WIP limiti aşıldığında ne yapılmalıdır?
Öncelikle yeni iş başlatmak durdurulmalıdır. Ekip mevcut kartları bitirmek, blocker çözmek veya darboğaz alanına swarm yapmak için kapasitesini kullanabilir. Limitin neden dolduğu incelenmelidir. Her ihlalde limiti artırmak problemi gizler. Gerçek ve kalıcı kapasite değişimi varsa limit daha sonra veriyle yeniden ayarlanabilir.
Cycle Time ile Lead Time arasındaki fark nedir?
Lead Time müşterinin talebi oluşturduğu andan teslimata kadar geçen toplam süredir. Cycle Time ise takımın işi commitment altına aldığı veya aktif çalışmaya başladığı andan teslimata kadar geçen süreyi ölçer. Bu nedenle Lead Time çoğunlukla Cycle Time'dan uzundur. Aradaki fark backlog ve talep bekleme süresini gösterebilir. İki metriği birlikte kullanmak müşteri ve takım perspektifini aynı anda görmeyi sağlar.
Throughput nedir?
Throughput belirli zaman aralığında tamamlanan iş öğesi sayısıdır. Örneğin ekip bir haftada on kart teslim ettiyse haftalık throughput on olarak ifade edilebilir. Bu metrik sistem kapasitesini ve tahmin dağılımını anlamaya yardımcı olur. Kişi veya takım performans puanı olarak kullanılmamalıdır. WIP ve Cycle Time ile birlikte değerlendirilmesi daha anlamlıdır.
Cumulative Flow Diagram nasıl okunur?
CFD üzerindeki renk bantları süreç aşamalarındaki toplam iş miktarını zaman içinde gösterir. Bant genişliği WIP hakkında bilgi verir. Paralel bantlar stabil akış, genişleyen bantlar birikme ve daralan bantlar starvation ihtimali gösterebilir. Alt tamamlanma çizgisinin eğimi throughput davranışına işaret eder. Grafik uzun dönem trendleri değerlendirmek için kullanılmalıdır.
CFD'de darboğaz nasıl görünür?
Darboğaz çoğunlukla belirli süreç bandının zamanla giderek genişlemesi şeklinde görünür. Bu, aşamaya giren iş miktarının çıkan iş miktarından fazla olduğunu gösterir. Aynı dönemde Cycle Time yükseliyorsa sinyal güçlenir. Bandın yalnız kısa süre genişlemesi geçici yoğunluk olabilir. Yapısal darboğaz için birkaç haftalık trend değerlendirmek daha doğrudur.
Aging WIP nedir?
Aging WIP tamamlanmamış işlerin ne kadar süredir sistemde bulunduğunu ifade eder. Bu değer devam eden kartlarda gecikmeyi erken görmeyi sağlar. SLE'e yaklaşan işler öncelikli risk olarak ele alınabilir. Çok sayıda yaşlı kart yüksek WIP veya blocker problemine işaret edebilir. Günlük Flow Review'da Aging WIP kullanmak finishing davranışını güçlendirir.
Kanban'da Little's Law nasıl kullanılır?
Little's Law stabil akışta WIP, Throughput ve Cycle Time arasındaki ilişkiyi açıklar. Temel ifade WIP = Throughput × Cycle Time şeklindedir. Buradan Cycle Time = WIP / Throughput ilişkisi elde edilir. Throughput sabitken WIP azaltılırsa Cycle Time'ın düşmesi beklenebilir. Ancak formül stabil olmayan sistemlerde kesin tahmin aracı gibi kullanılmamalıdır.
Code Review darboğazı nasıl çözülür?
Önce Waiting for Review ve Reviewing sürelerini ayırarak gerçek problemin kuyruk mu aktif inceleme mi olduğunu belirleyin. Büyük PR'leri küçültmek, review WIP limiti kullanmak ve reviewer yetkinliğini yaymak etkilidir. Otomatik test ve statik kontroller insan review yükünü azaltabilir. Pairing bilgi paylaşımını artırır. Review SLE ise yaşlanan PR'lerin erken fark edilmesini sağlar.
QA darboğazı nasıl azaltılır?
Ready for QA kuyruğunu görünür hale getirmek ilk adımdır. Test otomasyonu, shift-left testing ve küçük batch yaklaşımı QA'e gelen yükü azaltabilir. WIP limiti queue büyümesini kontrol altında tutar. Geliştiricilerin test faaliyetlerine destek vermesi cross-functional kapasite oluşturur. Test environment ve test verisi problemleri de ayrı darboğaz kaynağı olarak ölçülmelidir.
Kanban'da Flow Efficiency nasıl hesaplanır?
Flow Efficiency aktif çalışma süresinin toplam Cycle Time'a bölünmesiyle hesaplanabilir. Örneğin toplam on günlük Cycle Time içinde üç gün aktif çalışma varsa oran yaklaşık yüzde otuzdur. Kalan süre bekleme veya kuyruklarda geçmiştir. Bu metrik aktif iş hızından çok bekleme miktarını görünür hale getirir. Amaç her zaman yüzde yüze ulaşmak değil, gereksiz waiting time'ı azaltmaktır.
WIP limiti kaç olmalıdır?
Bütün takımlar için geçerli tek bir WIP sayısı yoktur. Değer gerçek kapasite, iş büyüklüğü, uzmanlık dağılımı ve akış değişkenliğine bağlıdır. Başlangıç limiti kapasite tahminiyle seçilebilir. Ardından Cycle Time, throughput ve starvation verileriyle deneysel olarak ayarlanmalıdır. En iyi limit, düşük yarım iş miktarıyla stabil throughput sağlayan aralıktır.
Kanban performansı hangi metriklerle ölçülür?
Temel metrikler WIP, Throughput, Cycle Time, Lead Time, Work Item Age, Blocked Time ve Flow Efficiency'dir. Predictability ve SLE Hit Rate ek görünürlük sağlar. Tek metriği hedef haline getirmek yerine bunların birlikte nasıl değiştiğine bakmak gerekir. Örneğin throughput artarken Cycle Time ciddi biçimde yükseliyorsa sonuç tek başına olumlu sayılmaz. Sistem performansı müşteri teslimatı ve akış istikrarıyla birlikte değerlendirilmelidir.
Kanban Board nasıl optimize edilir ve iş akışı daha verimli hale getirilir?
Önce board'u gerçek value stream'e göre düzenlemek gerekir. Aktif çalışma, bekleme, review, QA ve approval noktaları görünür hale getirildikten sonra WIP, Cycle Time, Throughput ve Aging WIP ölçülmelidir. Sürekli biriken sütun veya büyüyen CFD bandı darboğaz adayıdır. Ardından WIP limiti, batch size veya çalışma politikası üzerinde küçük deney yapılabilir. Kanban board nasıl optimize edilir ve darboğazlar nasıl tespit edilir sorusunun kalıcı yanıtı, tek seferlik düzenlemeden çok düzenli ölçüm ve sürekli iyileştirme döngüsüdür.
Kanban Board üzerinde darboğaz (bottleneck) nasıl tespit edilir?
Darboğazı tespit etmek için aynı sütunda sürekli kart birikmesi, artan Work Item Age ve uzun Waiting Time gibi işaretleri birlikte değerlendirin. CFD'de sürekli genişleyen bant önemli görsel sinyaldir. Cycle Time yükseliyor ve throughput düşüyorsa darboğazın sistem etkisi daha belirgin hale gelir. Blocked Time ve kuyruk nedenlerini incelemek kök nedeni ortaya çıkarır. Geçici yoğunluk ile yapısal darboğazı ayırmak için birkaç haftalık trend kullanılması daha güvenilirdir.
WIP limitleri darboğazları azaltmak için nasıl belirlenmelidir?
WIP limitleri ekibin teorik kişi sayısından çok gerçek bitirme kapasitesine göre belirlenmelidir. Başlangıç değeri seçildikten sonra tarihsel throughput ve Cycle Time verileriyle test edilmelidir. Limit düşürüldüğünde Cycle Time azalıyor ve throughput korunuyorsa sistem daha düşük yarım işle aynı çıktıyı üretiyor olabilir. Starvation görülürse sınır küçük miktarda yükseltilebilir. En iyi yöntem limitleri sabit kural değil, ölçülebilir deney parametresi olarak görmektir.
Cycle Time, Lead Time ve Throughput metrikleri Kanban darboğaz analizinde nasıl kullanılır?
Cycle Time işin aktif sistemde ne kadar süre kaldığını, Lead Time müşterinin toplam bekleme süresini ve Throughput belirli dönemde kaç işin tamamlandığını gösterir. Bu metrikler birlikte kullanıldığında sistem davranışının farklı yönleri ortaya çıkar. WIP yükselirken Cycle Time artıyor ve Throughput sabit kalıyorsa fazla yarım iş bulunduğu düşünülebilir. Lead Time ile Cycle Time arasındaki büyük fark backlog veya talep yönetimi sorununu gösterebilir. Cycle Time, Lead Time ve Throughput metrikleri Kanban darboğaz analizinde birlikte değerlendirildiğinde tek bir rakamdan çok daha güçlü karar desteği sağlar.
Kanban Board optimizasyonu ve darboğaz analizi eğitimi yakınımda nerede bulabilirim?
Kanban ve Agile süreç danışmanlığı yakınımda şeklinde arama yapan ekipler için en önemli kriter yalnız araç eğitimi değil, gerçek ekip akışına göre uygulamalı çalışma sunulmasıdır. Board tasarımı, WIP limitleri, Cycle Time, Throughput, CFD ve darboğaz analizi gibi başlıkların gerçek proje örnekleriyle ele alınması öğrenmeyi güçlendirir. Diyarbakır Yazılım Topluluğu'nun çalışmaları ve topluluk yaklaşımı hakkında bilgi almak için https://www.diyarbakiryazilim.com.tr/about adresini inceleyebilirsiniz. Kurumsal Kanban optimizasyonu ve çevik süreç danışmanlığı ihtiyacında mevcut workflow ve ölçüm verileriyle başlamak en doğru adımdır. Eğitim veya danışmanlık yaklaşımının ekiplerin kendi darboğazlarını bağımsız biçimde analiz edebilecek yetkinliği kazanmasını desteklemesi önemlidir.
Sonuç
Kanban Board Optimizasyonu ve Darboğaz (Bottleneck) Analizi, kartları daha düzenli göstermekten çok işin sistem içinde neden beklediğini anlamaya odaklanır. Gerçek value stream'i görünür hale getirmek, WIP limitleri uygulamak, Cycle Time, Lead Time, Throughput, Work Item Age ve CFD verilerini birlikte değerlendirmek bu yaklaşımın temelini oluşturur. Darboğazı bulduktan sonra küçük deneylerle ilerlemek, sonuçları ölçmek ve başarılı politikaları standardize etmek uzun vadede daha dengeli teslimat sistemi yaratır. Özellikle yazılım ekiplerinde Code Review, QA, approval, deployment ve uzman kişi bağımlılıkları görünür hale geldiğinde iyileştirme fırsatları çok daha net görülür. Kanban süreçlerinizi topluluk odaklı öğrenme, yazılım geliştirme deneyimi ve işbirliği yaklaşımıyla geliştirmek istiyorsanız Diyarbakır Yazılım Topluluğu hakkında daha fazla bilgi için https://www.diyarbakiryazilim.com.tr adresini ziyaret edebilirsiniz.
share: