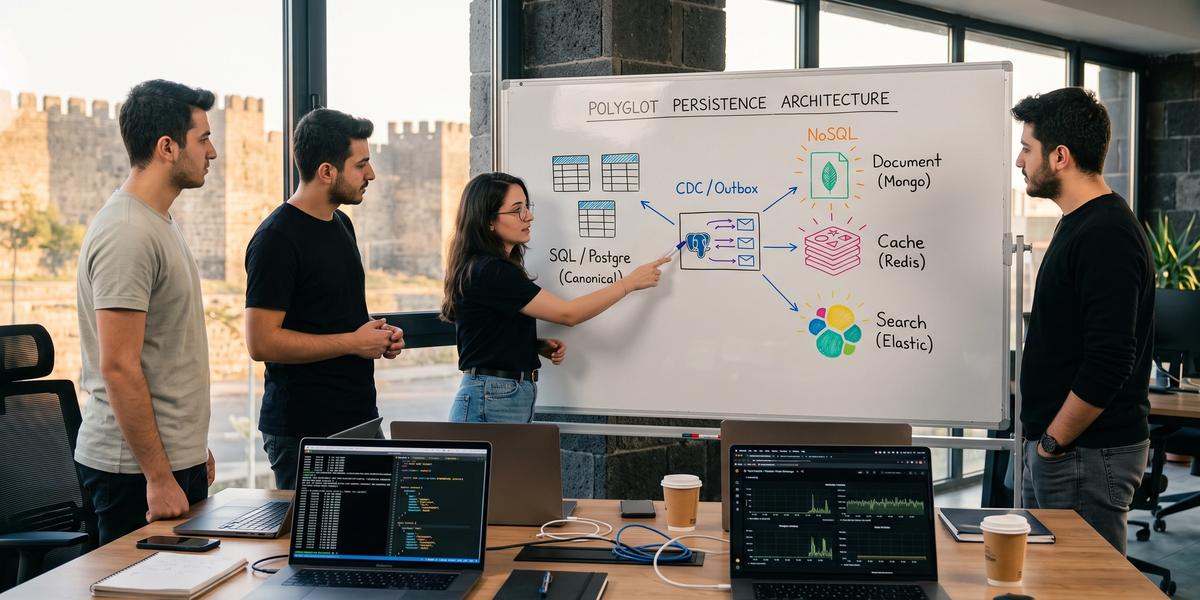
İlişkisel ve İlişkisel Olmayan Veritabanlarının Birlikte Kullanımı

Diyarbakır Yazılım
16.08.2026
#Yazılım#Teknoloji#Topluluk
Bir projede PostgreSQL kullanırken yanına Redis, MongoDB, bir arama motoru veya vector store eklemek teknik olarak kolay görünebilir, fakat gerçek karar yeni bir bağlantı adresi tanımlamaktan çok daha büyüktür. On yılı aşkın backend ve veri mimarisi çalışmalarında gördüğüm en önemli ders, veritabanı teknolojilerinin birbirine rakip gibi seçilmesinin çoğu zaman yanlış mimari soruya cevap verdiğidir. İlişkisel ve İlişkisel Olmayan Veritabanlarının Birlikte Kullanımı, her veri kümesini ihtiyaç duyduğu transaction, sorgulama, ölçekleme, gecikme ve tutarlılık modeliyle eşleştirmeyi amaçlayan bilinçli bir tasarım yaklaşımıdır. Bu rehberde ilişkisel ve NoSQL veritabanları birlikte nasıl kullanılır sorusundan Transactional Outbox, CDC, CQRS, reconciliation, cache, search projection, graph ve vector kullanımına kadar production ortamında karşılaşılan kararları ele alacağız. Hedefimiz daha fazla veritabanı eklemek değil, gerçekten ölçülebilir fayda sağlayan datastore sınırları oluşturmak ve bu sınırlar arasındaki veri akışını güvenilir hale getirmektir.
İlişkisel ve İlişkisel Olmayan Veritabanları Nedir?
İlişkisel ve ilişkisel olmayan veritabanları veriyi farklı modellerle temsil eden, farklı sorgu ve ölçekleme ihtiyaçlarını hedefleyen sistem aileleridir. İlişkisel model tablolar, anahtarlar, ilişkiler ve transaction kuralları etrafında güçlü bir yapı sunarken NoSQL ifadesi document, key-value, graph ve wide-column gibi birbirinden oldukça farklı modelleri kapsar. Bu nedenle SQL ile NoSQL arasındaki farkı yalnızca “biri şemalı, biri şemasız” şeklinde açıklamak eksik kalır. Her iki tarafta da schema yönetimi, transaction, indexing ve distributed deployment konusunda modern özellikler bulunabilir, fakat bunların öncelikleri ve kullanım biçimleri değişir. Mimari karar verirken ürün kategorisinden önce verinin nasıl yazıldığına, nasıl okunduğuna ve hangi doğruluk garantilerinin gerektiğine bakmak daha sağlıklı sonuç verir.
İlişkisel Veritabanı Nedir?
İlişkisel veritabanı veriyi satır ve kolonlardan oluşan tablolar içerisinde yapılandırır ve tablolar arasındaki bağlantıları anahtarlar üzerinden tanımlar. PostgreSQL ve MySQL gibi sistemlerde primary key, foreign key, unique constraint ve transaction kuralları verinin bütünlüğünü korumaya yardımcı olur. JOIN işlemleri normalize edilmiş farklı tablolardaki verilerin sorgu anında bir araya getirilmesini sağlar. Bu model özellikle ödeme, sipariş, finansal kayıt veya stok rezervasyonu gibi birden fazla kaydın tutarlı biçimde değişmesi gereken iş akışlarında güçlüdür. İlişkisel veritabanının avantajı yalnızca SQL kullanması değil, veri üzerinde açık ve enforce edilebilir kurallar tanımlanmasına imkan vermesidir.
NoSQL Veritabanı Nedir?
NoSQL tek bir veri modeli değildir ve document, key-value, wide-column, graph gibi farklı yaklaşım gruplarını ifade eden geniş bir terimdir. Bir document database uygulamanın nesne yapısına yakın JSON benzeri belgeler saklayabilirken key-value store belirli bir anahtar üzerinden çok hızlı erişimi önceliklendirebilir. Graph database ilişkiler ve çok adımlı bağlantılar üzerinde traversal yapmayı kolaylaştırırken wide-column sistemler yüksek write hacmi ve dağıtık partitioning için farklı model sunar. Modern NoSQL sistemlerin bir bölümü transaction veya schema validation özellikleri de sunar, bu nedenle eski “NoSQL transaction yapamaz” genellemesi güvenilir değildir. Doğru kullanım alanı verinin şekli kadar erişim deseni, yatay ölçek ihtiyacı ve kabul edilen consistency modeliyle belirlenir.
Temel Fark Nereden Kaynaklanır?
Temel fark verinin fiziksel ve mantıksal olarak nasıl modellendiği ile hangi kullanım biçiminin önceliklendirildiğinden kaynaklanır. İlişkisel model tekrar eden veriyi normalize ederek ilişkileri sorgu zamanında birleştirme eğilimindedir, birçok NoSQL yaklaşımı ise belirli sorguları hızlandırmak için denormalized veya aggregate odaklı veri saklayabilir. SQL database çoğu zaman güçlü cross-row constraint ve transaction sınırları sunarken özel datastore belirli access pattern üzerinde daha doğrudan performans sağlayabilir. Bunun bedeli veri kopyaları, senkronizasyon mekanizması veya farklı operasyon süreçleri olabilir. Bu nedenle farkı “hangisi daha hızlı?” sorusuyla değil, “hangi sistem hangi garanti ve sorgu biçimini daha doğal karşılıyor?” sorusuyla değerlendirmek gerekir.
Bir Sistem Neden Birden Fazla Veri Modeline İhtiyaç Duyar?
Gerçek uygulamalar tek bir erişim deseninden oluşmaz ve aynı sistem içinde ödeme transaction'ı, ürün araması, session erişimi, recommendation ilişkisi ve telemetry ingestion gibi çok farklı gereksinimler bulunabilir. Sipariş kaydında güçlü transaction isterken ürün aramasında fuzzy matching ve faceting, session tarafında çok düşük latency, recommendation tarafında graph veya vector similarity gerekebilir. Tek database bütün bu işleri yapabiliyor olsa bile her birinde aynı performans ve operasyon maliyetini sunmayabilir. Bununla birlikte her ihtiyaca farklı datastore eklemek de sistemi yönetilmesi zor hale getirir. Birden fazla veri modeli ancak ayrıştırılan iş yükü, ölçülen fayda ve açık data ownership sınırları bulunduğunda anlam kazanır.
İlişkisel Veritabanlarının Temel Özellikleri
İlişkisel veritabanlarını anlamadan polyglot persistence tasarlamak zordur, çünkü çoğu hibrit mimaride transaction açısından kritik verilerin authoritative kaynağı ilişkisel sistem olmaya devam eder. Table, primary key ve foreign key yalnızca veri saklama ayrıntısı değil domain kurallarının database tarafından korunmasını sağlayan mekanizmalardır. JOIN normalize veriyi tekrar birleştirirken constraint hatalı state'in daha database katmanında engellenmesine yardımcı olur. Transaction ve ACID özellikleri birden fazla değişikliğin kontrollü bir bütün halinde yürütülmesini sağlar. Bu yetenekler NoSQL kullanmak için terk edilmesi gereken eski özellikler değil, hangi datastore'un hangi verinin sahibi olacağını belirlerken korunması gereken güçlü araçlardır.
Table
Table aynı domain kavramına ait kayıtların kolon yapısıyla saklandığı temel ilişkisel veri organizasyonudur. Bir sipariş tablosu siparişin kimliği, müşterisi, durumu ve zaman bilgisi gibi alanları taşıyabilir. Tablo yalnızca fiziksel container değildir, constraint ve index tanımlarıyla business rule'ların bir bölümünü de uygular. Normalization sayesinde müşteri, ürün ve sipariş gibi kavramlar birbirinden ayrılarak tekrar eden verinin kontrolsüz çoğalması azaltılır. Polyglot mimaride SQL tablosunun hangi verinin canonical kaydı olduğunu açık biçimde belirtmek, sonraki NoSQL projection'ların rolünü anlamayı kolaylaştırır.
Row ve Column
Row belirli bir entity veya olay kaydını, column ise o kaydın tanımlı özelliklerinden birini temsil eder. Column veri tipi, null davranışı ve constraint gibi kurallarla verinin beklenen biçimini sınırlar. Bu yapı schema evolution'ı migration üzerinden kontrollü hale getirir ve uygulama kodunun hangi alanlara güvenebileceğini belirginleştirir. NoSQL document modelinde benzer alanlar document içinde bulunabilir, fakat farklı belgelerin yapısı daha esnek yönetilebilir. Polyglot persistence sırasında SQL row'un tamamını diğer store'lara birebir kopyalamak yerine her projection'ın ihtiyacı olan alanları seçmek daha doğru olur.
Primary Key
Primary key bir row'un tablo içindeki benzersiz kimliğini tanımlar ve entity'ler arasında güvenilir referans kurulmasını kolaylaştırır. Order ID veya user ID gibi değerler başka datastore'lardaki derived representation'lar için de ortak correlation anahtarı olabilir. Primary key'in stable olması event ve projection senkronizasyonunu önemli ölçüde kolaylaştırır. Kimlik formatı değiştirilirse SQL, cache, search ve document store gibi bütün projection katmanlarının migration süreci etkilenebilir. Bu nedenle canonical entity identifier tasarımı polyglot mimarinin yalnızca SQL tarafına ait küçük bir schema kararı değildir.
Foreign Key
Foreign key bir tablodaki değerin başka tablodaki geçerli kayda referans vermesini sağlar ve referential integrity'yi database seviyesinde korur. Örneğin order kaydının olmayan bir customer ID ile oluşturulmasını engelleyebilir. Microservice ve database-per-service modelinde foreign key sınırı aynı database içindeki bounded context ile sınırlanabilir. Başka service'in database'ine cross-database foreign key kurmak teknik ve operasyonel coupling oluşturduğu için çoğu dağıtık tasarımda tercih edilmez. Service sınırları arasındaki referanslar ID ve API veya event contract üzerinden yönetilirken her domain kendi iç bütünlüğünü kendi store'unda korur.
JOIN
JOIN ilişkili tablolardaki kayıtları sorgu anında bir araya getirerek normalized modelin güçlü yönünü ortaya çıkarır. Aynı database içinde optimizer index, statistics ve join order bilgileriyle etkili execution plan oluşturabilir. Farklı datastore'lar arasında aynı tür optimizer kontrolü bulunmadığı için cross-database join çok daha pahalı ve kırılgan hale gelebilir. Polyglot tasarım bu nedenle ortak sorguları projection veya API composition yoluyla önceden düşünmeyi gerektirir. SQL içinde kolay ve güvenli olan JOIN davranışını dağıtık ağ üzerinde aynen taklit etmeye çalışmak genellikle mimari maliyeti büyütür.
Constraint
Constraint verinin kabul edilebilir durumlarını database seviyesinde sınırlar ve uygulama bug'larına karşı ek güvenlik sağlar. Unique constraint duplicate business key'i, check constraint geçersiz değer aralığını, foreign key ise kopuk ilişkiyi önleyebilir. Derived NoSQL store'da aynı constraint'leri birebir taşımak her zaman gerekli değildir, çünkü o store yeniden üretilebilir projection olabilir. Buna karşılık canonical store üzerinde constraint'in kaldırılması domain bütünlüğünü application koduna tamamen bağımlı hale getirir. Polyglot persistence kullanırken derived view'ların esnekliği uğruna source of truth üzerindeki doğruluk kurallarını gevşetmemek önemlidir.
Transaction
Transaction bir veya daha fazla database işlemini tek mantıksal iş birimi içerisinde yürütmeyi sağlar. Sipariş oluştururken order, line item ve stock reservation gibi değişikliklerin birlikte başarıya ulaşması gerekebilir. Aynı relational database transaction bu değişikliklere güçlü atomicity sağlayabilir. Fakat aynı anda MongoDB veya search index'e yazmaya çalışıldığında local transaction sınırı sona erer ve distributed consistency problemi başlar. Bu yüzden hibrit mimarilerde business transaction'ı canonical store içinde tamamlayıp diğer store güncellemelerini event üzerinden yürütmek sık kullanılan güvenli yaklaşımdır.
ACID
ACID transaction davranışını Atomicity, Consistency, Isolation ve Durability kavramlarıyla açıklar. Bu özellikler özellikle finansal veya inventory gibi birden fazla kaydın tutarlı kalması gereken işlemlerde önemlidir. ACID ifadesi yalnızca ilişkisel database'lere ait mutlak bir kategori değildir, modern farklı datastore'lar çeşitli transaction garantileri sunabilir. Fakat ilişkisel sistemlerde bu model uzun yıllardır temel kullanım biçiminin merkezindedir ve business transaction modellemesi için güçlü araçlar sağlar. Polyglot tasarımda hangi işlemin ACID sınırı içinde kalması gerektiği baştan belirlenirse yanlış cross-store transaction beklentileri büyük ölçüde azaltılır.
ACID Nedir?
ACID bir transaction'ın güvenilir biçimde tamamlanması için kullanılan dört temel özelliği ifade eder. Atomicity işlemlerin birlikte başarı veya başarısızlık göstermesini, consistency tanımlanan veri kurallarının korunmasını, isolation eşzamanlı transaction'ların birbirini nasıl gördüğünü, durability ise commit edilen state'in kalıcılığını ele alır. Bu özelliklerin her biri application correctness açısından farklı probleme cevap verir. Hibrit mimaride local SQL transaction ACID olabilirken dış projection'ların birkaç saniye sonra güncellenmesi mümkündür. Bu ayrımı anlamak, güçlü transaction ile sistem genelinde anlık global consistency beklentisini birbirinden ayırmak açısından önemlidir.
Atomicity
Atomicity bir transaction içindeki değişikliklerin tamamının uygulanmasını veya hiçbirinin uygulanmamasını hedefler. Örneğin sipariş oluşturulup order line kayıtları yazılamıyorsa yarım sipariş bırakılmaması gerekir. Tek relational database bu işi local transaction ile güvenilir biçimde yönetebilir. Aynı operation içinde başka bir bağımsız datastore'a yapılan network write atomicity sınırının dışında kalır ve dual-write problemi ortaya çıkar. Transactional Outbox yaklaşımının değeri business data ile yayınlanacak event kaydını aynı SQL transaction'ı içine alarak bu sınırı güvenilir biçimde kullanmasından gelir.
Consistency
ACID bağlamındaki consistency transaction öncesi ve sonrası verinin database tarafından tanımlanan kuralları ihlal etmemesini ifade eder. Foreign key, check constraint ve unique rule bu kuralların bir bölümünü temsil eder. Distributed mimaride kullanılan eventual consistency kavramıyla aynı anlamda değildir ve iki terimin karıştırılması tasarım tartışmalarını zorlaştırır. Canonical SQL store business invariant'ları enforce ederken search veya cache projection birkaç saniye geride olabilir. Böyle bir sistem projection açısından eventual olsa da source of truth tarafında business consistency'yi güçlü biçimde koruyabilir.
Isolation
Isolation aynı anda çalışan transaction'ların birbirlerinin ara durumlarını hangi ölçüde görebileceğini belirler. Dirty read, non-repeatable read veya serialization anomaly gibi problemler isolation seviyeleriyle ilişkilidir. Her operation için en yüksek isolation seviyesi seçmek concurrency ve throughput maliyeti yaratabilir. Business invariant hangi seviyeyi gerektiriyorsa database ve application modeli ona göre tasarlanmalıdır. Polyglot architecture isolation problemini başka store'a taşımak yerine canonical transaction sınırını net tutup derived store'ların daha gevşek consistency davranışını açık biçimde kabul eder.
Durability
Durability commit edilmiş transaction'ın process veya sistem arızası sonrasında kaybolmamasını hedefler. Database WAL, redo log, replication ve storage mekanizmaları bu garantiyi destekler. Cache olarak kullanılan Redis'te persistence tamamen kapatılabilir, çünkü cache kaybı origin'den yeniden üretilebilir. Aynı Redis session veya primary state taşıyorsa durability beklentisi değişir ve RDB, AOF veya başka recovery stratejileri değerlendirilir. Bu örnek, datastore seçiminin ürün adına değil oradaki verinin sistem için taşıdığı role göre yapılması gerektiğini açık biçimde gösterir.
Hangi Business İşlemlerinde Kritik Hale Gelir?
ACID özellikle birden fazla değişikliğin birlikte doğru kalması gereken finansal, sipariş, stok ve muhasebe akışlarında belirleyici hale gelir. Kullanıcıya hızlı search sonucu göstermek birkaç saniyelik gecikmeyi tolere edebilirken para transferinde yarım state kabul edilemez. Her business operation'ın consistency ve durability gereksinimi aynı değildir. Bu nedenle sistem genelinde “her şey strong consistency” veya “her şey eventual consistency” gibi tek tercih yapmak yerine işlem sınıfı bazında karar verilmelidir. Polyglot persistence doğru uygulandığında bu farklı gereksinimleri birbiriyle karıştırmadan yönetmeye yardımcı olur.
Ödeme
Ödeme işlemleri para hareketinin iki kez işlenmemesi, başarısız transaction'ın tamamlanmış görünmemesi ve audit kaydının korunması gibi güçlü invariant'lar taşır. Payment authorization ile order state farklı servislerdeyse distributed workflow dikkatle tasarlanmalıdır. Local database transaction mümkün olan değişiklikleri tek kaynakta güvenli tutarken dış provider çağrıları idempotency ve saga benzeri mekanizmalarla yönetilebilir. Search veya cache projection ödeme doğruluğunun kaynağı olmamalıdır. Kullanıcı arayüzü eventual projection gecikmesini tolere edebilir, fakat finansal canonical state yalnızca yetkili transaction kaynağından okunmalıdır.
Sipariş
Sipariş oluşturma order header, line items, fiyat snapshot'ı ve bazı durumlarda reservation bilgilerini birlikte yönetir. Bu kayıtların yarısının yazılması business açısından sorun yaratabilir. Canonical order aggregate ilişkisel database içinde transaction ile tutulabilir ve commit sonrasında outbox event üzerinden diğer store'lara aktarılabilir. Search veya document read model müşteri sipariş listesini hızlandırabilir, fakat bu view kaybolduğunda yeniden üretilebilmelidir. Böylece sipariş doğruluğu ile okuma performansı birbirinden ayrılır.
Stok
Stok özellikle yüksek eşzamanlı satış sırasında oversell riskini yönetmek zorundadır. Kullanıcıya ürün detayında gösterilen stok cache'ten gelebilir, fakat satın alma kararı authoritative inventory transaction tarafından doğrulanmalıdır. Reservation veya decrement atomic operation ile korunmalıdır. Search index veya MongoDB catalog kopyası birkaç saniye eski inventory gösterebilir ve bu durum UI seviyesinde kabul edilen consistency window içinde yönetilebilir. İşin kritik noktası hızlı projection ile gerçek satış yetkisinin aynı veri kaynağı gibi davranmamasıdır.
Muhasebe
Muhasebe kayıtlarında auditability, tekrar üretilebilirlik ve değişikliklerin izlenmesi temel gereksinimlerdir. Ledger entry'lerin sonradan sessizce overwrite edilmesi yerine append veya kontrollü adjustment modeli tercih edilebilir. Reporting için columnar veya analytical store'a kopya aktarılabilir, fakat canonical journal kayıtları authoritative sistemde kalmalıdır. ETL veya CDC raporlama store'unu gecikmeli güncelleyebilir. Bu ayrım performans için denormalized analitik yapı kullanırken finansal doğruluğun tek otoritede korunmasını sağlar.
NoSQL Veritabanı Türleri
NoSQL başlığı altında birbirinden tamamen farklı veri modelleri bulunur ve bunları tek teknoloji ailesi gibi düşünmek yanıltıcıdır. Document store aggregate veya esnek document yapısını, key-value store anahtar üzerinden hızlı erişimi, wide-column sistem yüksek hacimli dağıtık kayıtları, graph database ise ilişkilerin traversal'ını önceliklendirebilir. Time-series sistemler zaman bazlı ingestion ve retention için özel yetenekler sağlayabilir. Search engine'ler de document-oriented index yapılarıyla belirli NoSQL özellikleri gösterse de asıl amaçları retrieval ve relevance'dır. Polyglot persistence tasarımında “NoSQL ekleyelim” demek yerine hangi spesifik veri modelinin hangi problemi çözdüğünü açık biçimde belirtmek gerekir.
Document Database
Document database bir entity veya aggregate'e ait ilişkili alanları JSON benzeri belge içerisinde birlikte saklamaya odaklanır. Bu yapı ürün kataloğu veya CMS içeriği gibi farklı kayıtlarda farklı attribute set'lerinin bulunabildiği alanlarda rahat çalışma sağlayabilir. Denormalization sayesinde belirli read işlemleri tek document üzerinden karşılanabilir. Bunun karşılığında aynı bilgi birden fazla document içinde tekrarlandığında update fan-out ve consistency yönetimi ortaya çıkar. Document model seçilirken yalnızca schema flexibility değil document boundary, cardinality, query pattern ve shard key tasarımı birlikte değerlendirilmelidir.
MongoDB
MongoDB document tabanlı veri modeli, index, aggregation, replica set, transaction ve sharding yetenekleri sunan yaygın bir document database örneğidir. Modern sürümlerde replica set ve sharded deployment üzerinde multi-document transaction desteği bulunması, “document database transaction desteklemez” genellemesini geçersiz kılar. Bununla birlikte geniş distributed transaction kullanımı her zaman document modelinin en iyi kullanım biçimi değildir. Aggregate boundary doğru seçildiğinde çoğu operation tek document veya sınırlı kayıt grubu üzerinde tamamlanabilir. PostgreSQL MongoDB Redis birlikte kullanım mimarisi nasıl tasarlanır sorusunda MongoDB ancak gerçekten document-oriented access pattern ve bağımsız ölçek ihtiyacı varsa ayrı store olarak değerlendirilmelidir.
Key-Value Store
Key-value store belirli bir anahtarın karşılığındaki değere hızlı ve doğrudan erişimi önceliklendiren basit ama güçlü bir modeldir. Session, cache, feature state, rate limit counter veya belirli lookup verileri bu modele doğal şekilde uyabilir. Query flexibility genellikle relational veya document sistemlerden daha sınırlıdır, fakat bunun karşılığında lookup path çok sade hale gelir. Key tasarımı partitioning, cardinality ve access distribution üzerinde doğrudan etkilidir. Hot key veya büyük value problemi ortaya çıktığında key-value modelin basitliği bile dikkatli kapasite ve data modeling gerektirir.
Redis
Redis key-value yaklaşımının yanında hash, set, sorted set, stream ve farklı veri yapıları sunar. Cache kullanımında TTL, eviction ve çok düşük latency erişimi önemli avantajdır. Persistence tamamen kapatılabildiği gibi RDB veya AOF seçenekleriyle daha dayanıklı state de tutulabilir, bu nedenle Redis'teki her key'in “cache” olduğu varsayılmamalıdır. Primary state, session ve cache aynı instance'ta karıştırıldığında farklı eviction ve durability beklentileri çatışabilir. SQL + Redis mimarisinde Redis'in rolü açık biçimde cache, coordination veya state store olarak sınıflandırılmalıdır.
DynamoDB
DynamoDB key-value ve document modelini managed distributed altyapıda sunan bir datastore örneğidir. Partition key ve optional sort key veri dağılımı ile sorgu imkanlarının merkezindedir. Relational JOIN yerine erişim desenleri önceden düşünülerek item ve index tasarımı yapılır. Yüksek ölçek sağlanabilse de yanlış partition key hot partition ve maliyet sorunları oluşturabilir. Polyglot mimaride managed NoSQL seçimi yalnızca teknik özelliklerle değil cloud bağımlılığı, maliyet modeli, consistency seçeneği ve operasyon sorumluluğuyla birlikte değerlendirilmelidir.
Wide-Column Database
Wide-column database yüksek hacimli distributed data'yı partition key etrafında yatay ölçeklemeye odaklanan model ailesidir. Row'lar aynı kolon set'ine sahip olmak zorunda olmayabilir ve sorgular genellikle partition tasarımıyla yakından ilişkilidir. Büyük event, telemetry veya zaman serisi benzeri workload'larda yüksek write throughput avantaj sağlayabilir. Relational ad hoc join davranışı beklenmemelidir. Data model query-first yaklaşımıyla tasarlanmalı ve yanlış partition dağılımının tek node üzerinde yük yoğunlaştırabileceği unutulmamalıdır.
Cassandra
Cassandra distributed wide-column modeli ve yatay ölçek yaklaşımıyla yüksek write hacimli workload'larda kullanılan sistemlerden biridir. Partition key verinin cluster üzerindeki dağılımını belirlediği için schema design sorgu pattern'iyle birlikte yapılır. Denormalized tablolar aynı veriyi farklı sorgular için tekrar saklayabilir. Bu tekrar write fan-out ve consistency yönetimi getirir, fakat hedef sorguların node-local ve predictable çalışmasına yardım eder. Relational database'ten Cassandra'ya geçiş yalnızca daha fazla veri bulunduğu için değil, erişim ve availability modeli gerçekten bu yapıya uyduğu için yapılmalıdır.
Graph Database
Graph database entity'leri node, ilişkileri edge olarak temsil ederek bağlantıların birinci sınıf veri haline gelmesini sağlar. Relational database ilişkileri tutabilir fakat çok adımlı ve değişken derinlikte traversal sorguları karmaşık veya pahalı hale gelebilir. Fraud ring, recommendation, network topology ve social relationship gibi problemler graph modelden faydalanabilir. Buna karşılık order transaction veya basit entity CRUD için graph database eklemek gereksiz operasyon maliyeti yaratabilir. Graph store çoğu polyglot mimaride SQL source of truth'tan beslenen yeniden üretilebilir relationship projection olarak konumlandırılabilir.
Neo4j
Neo4j property graph modelini node ve relationship yapılarıyla sunan graph database örneklerinden biridir. Cypher sorgu dili çok adımlı ilişki sorgularını okunabilir biçimde ifade etmeyi kolaylaştırabilir. Relationship-heavy use case için doğal olsa da bütün domain verisini graph'a taşımak gerekli değildir. Canonical customer veya transaction kayıtları SQL'de kalırken fraud veya recommendation için gerekli ilişki projection'ı graph store'a aktarılabilir. Bu yaklaşım graph'ın güçlü yönünden yararlanırken source of truth sorumluluğunu açık tutar.
Time-Series Database
Time-series database timestamp merkezli yüksek hacimli kayıtları, retention ve zaman aralığı sorgularını verimli yönetmek üzere tasarlanır. Sensor, infrastructure metric, observability veya financial tick data örnek olabilir. Downsampling ve time-bucket aggregation uzun dönem storage maliyetini azaltabilir. Master data veya transactional business state'i aynı sisteme taşımak genellikle gerekli değildir. SQL database device metadata'yı tutarken specialized time-series store ölçümleri saklayabilir ve iki alan ID üzerinden ilişkilendirilebilir.
Search Engine'ler Bir NoSQL Store Olarak Değerlendirilebilir mi?
Search engine'ler document-oriented index yapısına sahip oldukları için bazı NoSQL özellikleri gösterir ve application tarafından datastore gibi sorgulanabilir. Bununla birlikte temel amaçları full-text retrieval, relevance scoring, faceting ve search analytics olduğundan primary transactional database olarak konumlandırılmaları çoğu sistemde doğru değildir. Index mapping veya analyzer değişiklikleri nedeniyle yeniden index oluşturma ihtiyacı doğabilir. Derived search document source SQL veya başka canonical store'dan yeniden üretilebiliyorsa operasyon daha güvenli hale gelir. Bu nedenle search engine'i “NoSQL database” etiketiyle değil, arama için optimize edilmiş derived read model olarak değerlendirmek daha faydalıdır.
SQL ve NoSQL Arasındaki Temel Farklar
SQL ve NoSQL arasındaki farklar tek bir özellik listesine indirgenemez, çünkü her iki kategoride de farklı ürün davranışları bulunur. Yine de schema yönetimi, join yaklaşımı, denormalization, transaction sınırı, horizontal scaling ve operational complexity karar sürecinde sık karşılaşılan başlıklardır. Relational model normalize veri ve güçlü constraint yapısını öne çıkarırken birçok NoSQL model belirli access pattern için veriyi doğrudan kullanılabilir biçimde saklar. Bu fark okuma hızını artırabilir fakat duplicate data ve senkronizasyon sorumluluğu yaratabilir. Dolayısıyla seçim teknolojik moda göre değil veri bütünlüğü, trafik ve sorgu ihtiyacının dengesi üzerinden yapılmalıdır.
Schema
Relational database kolon tipleri ve constraint'ler üzerinden açık schema tanımlar. Document database farklı belgelerde değişebilen field yapısına daha fazla esneklik sağlayabilir. Fakat esnek schema, schema olmadığı anlamına gelmez, çünkü application yine field isimleri ve veri tipleri konusunda bir contract'a ihtiyaç duyar. Schema validation veya application-level versioning NoSQL tarafında da önemlidir. Değişimin sık olduğu alanlarda document model faydalı olabilir, ancak güçlü ve kararlı business entity'ler için relational schema önemli güvenlik sağlar.
Data Integrity
Relational sistem primary key, foreign key, unique ve check constraint ile veri bütünlüğünü database seviyesinde güçlü biçimde koruyabilir. NoSQL store'da bazı doğrulamalar desteklenebilir fakat cross-document veya cross-aggregate kuralları farklı şekilde yönetilebilir. Derived projection için bütün relational constraint'lerin tekrar edilmesi gerekmeyebilir, çünkü projection bozulduğunda source'tan yeniden oluşturulur. Canonical data store ise business invariant'ları mümkün olduğunca enforce etmelidir. Polyglot tasarımın en önemli kurallarından biri hızlı read store ile authoritative integrity store rollerini birbirine karıştırmamaktır.
Transaction
Relational database çok satırlı ve çok tablolı transaction kullanımını doğal ve yaygın biçimde destekler. Modern document ve distributed NoSQL sistemlerin bir kısmında da transaction özellikleri bulunabilir. Asıl fark transaction'ın teknik olarak var olup olmamasından çok uygulamanın data modelini hangi boundary etrafında kurduğudur. Çok sayıda distributed transaction'a ihtiyaç duyulan NoSQL model yanlış aggregate sınırına işaret edebilir. SQL ve NoSQL veritabanı hangi durumlarda birlikte kullanılmalı sorusunda transaction-critical write modelini SQL'de, farklı read ihtiyaçlarını derived store'larda tutmak güçlü bir başlangıç yaklaşımıdır.
Join
SQL optimizer aynı database içindeki tabloları çeşitli join algoritmalarıyla birleştirebilir. Document veya key-value modelleri çoğu zaman sorgu zamanında join yerine veriyi birlikte saklamaya veya application composition'a dayanır. Bu yaklaşım belirli read query'lerini hızlandırır. Fakat update sırasında birden fazla kopyanın güncellenmesini gerektirebilir. Çok dinamik ad hoc ilişki sorguları bulunan domain'de relational modelin join esnekliği önemli avantaj olmaya devam eder.
Denormalization
Denormalization sorgu zamanında join ihtiyacını azaltmak için verinin bir kısmını tekrar saklamaktır. Search document, MongoDB read model veya cache payload bu yaklaşımı kullanabilir. Okuma daha hızlı ve basit hale gelir. Bunun karşılığında source value değiştiğinde bütün kopyaların eventual veya synchronous biçimde güncellenmesi gerekir. Derived kopyaların yeniden üretilebilir olması denormalization'ın operasyon riskini önemli ölçüde azaltır.
Horizontal Scaling
Birçok NoSQL sistem başlangıçtan itibaren partitioning ve horizontal scaling'i temel tasarım olarak ele alır. Relational sistemler de replication, partitioning, sharding çözümleri veya distributed varyantlarla yatay büyüyebilir. Bu nedenle “SQL scale olmaz” ifadesi doğru değildir. Fakat scaling modelinin operational ergonomisi ve query capability'si ürünlere göre değişir. Yeni datastore yalnızca “ileride büyürüz” varsayımıyla değil mevcut ve öngörülebilir kapasite verisiyle seçilmelidir.
Query Flexibility
SQL ad hoc filtre, join, aggregation ve farklı query kombinasyonları açısından güçlü esneklik sunar. Key-value veya wide-column model çoğu zaman sorguları schema tasarımı sırasında bilmenizi ister. Document database orta seviyede flexible query sağlayabilir. Search engine text retrieval ve faceting gibi belirli sorgularda ilişkisel database'ten daha güçlü davranabilir. Query flexibility arttıkça index ve optimizer karmaşıklığı da değişebileceği için her workload kendi erişim biçimine göre değerlendirilmelidir.
Operational Complexity
İkinci bir datastore eklemek ikinci backup süreci, security modeli, upgrade planı, metric set'i ve on-call bilgi alanı ekler. Teknik POC'de yalnızca başarılı query latency'si görüldüğünde bu maliyet kolayca gözden kaçabilir. Production mimaride failure recovery ve data reconciliation günlük query hızından daha önemli hale gelebilir. Ekip teknoloji konusunda yeterli uzmanlığa sahip değilse yeni store faydadan fazla risk yaratabilir. Polyglot persistence'ın gerçek bedeli connection string sayısı değil bu uzun dönem operasyon yüküdür.
SQL mi NoSQL mi?
“SQL mi NoSQL mi?” sorusu çoğu gerçek sistem için eksiktir, çünkü farklı veri kümeleri aynı consistency ve access pattern'e sahip değildir. Ödeme kaydı, session, ürün search document'i ve recommendation graph'ı aynı teknoloji seçimini gerektirmeyebilir. Buna karşılık küçük bir uygulamada bunların tamamı tek PostgreSQL üzerinde yeterince iyi çalışabilir. Doğru soru belirli workload'un transaction, query, scale, latency ve schema evolution ihtiyaçlarının neler olduğudur. Gereksinim ölçülmeden teknoloji seçmek hem erken optimizasyona hem datastore sprawl problemine yol açabilir.
Bu Soru Neden Eksiktir?
SQL ve NoSQL birbirini tamamen dışlayan iki seçenek değildir. Bir application aynı anda transaction için PostgreSQL, cache için Redis ve search için ayrı index kullanabilir. Hatta modern relational database JSON, full-text ve vector extension sayesinde geçmişte ayrı sistem gerektiren birçok ihtiyacı tek başına karşılayabilir. Bu nedenle binary tercih yerine workload decomposition yapmak gerekir. Her yeni datastore için hangi ölçülebilir sorunu çözdüğünü açıkça yazamıyorsanız seçim muhtemelen erkendir.
Veritabanını Veri Türüne Göre Değil Access Pattern'e Göre Seçmek
“JSON verim var, MongoDB kullanmalıyım” veya “ilişki var, mutlaka SQL gerekir” gibi kararlar çoğu zaman fazla yüzeyseldir. JSON document PostgreSQL JSONB içinde çok iyi çalışabilir ve graph benzeri ilişki modeli belirli derinliğe kadar relational database ile rahat yönetilebilir. Asıl soru veriye hangi sorguların ne sıklıkta ve hangi latency hedefiyle eriştiğidir. Update pattern, cardinality ve index ihtiyacı da aynı derecede önemlidir. Access pattern'e dayalı seçim, teknoloji özelliğini gerçek business ihtiyacıyla ilişkilendirir.
Transaction Gereksinimi
Bir operation birden fazla entity üzerinde güçlü atomicity istiyorsa relational transaction çok değerli olabilir. Aynı gereksinimi birden fazla independent store'a dağıtmak 2PC, saga veya eventual consistency kararı gerektirir. Bu ek maliyet yeni datastore'un sağladığı faydayla karşılaştırılmalıdır. Eğer bütün reads ve writes zaten aynı transaction boundary içindeyse tek database daha doğru olabilir. Polyglot yapı transaction sınırlarını azaltmalı, onları daha belirsiz hale getirmemelidir.
Query Pattern
Equality lookup, text search, graph traversal ve analytical aggregation farklı query motorlarından faydalanabilir. SQL geniş query flexibility sağlar. Search engine relevance ve tokenization, graph database relationship traversal, Redis ise key lookup üzerinde özel avantaj sunar. Fakat sorgu hacmi düşükse tek database'in yeterli özelliği operasyonel olarak daha iyi seçim olabilir. Query pattern yalnızca teknik capability değil frequency ve business latency hedefiyle birlikte değerlendirilmelidir.
Scale
Veri büyüklüğü ve trafik dağılımı datastore seçimini etkiler. Tek node'a sığmayan dataset yatay partitioning ihtiyacı yaratabilir. Bununla birlikte yüz milyon satır tek başına ayrı NoSQL store gerekçesi değildir, doğru index ve partitioning ile relational database güçlü şekilde çalışabilir. Scale problemi CPU, I/O, storage, write throughput veya single hot key gibi farklı nedenlerden doğabilir. Önce gerçek darboğaz belirlenmeli, sonra uygun scaling modeli seçilmelidir.
Latency
Session veya rate limit counter için birkaç milisaniyenin altındaki erişim önemli olabilir. Redis gibi memory ağırlıklı store bu path'i sadeleştirebilir. Search query yüzlerce milisaniye içinde kabul edilebilirken payment write farklı latency ve correctness dengesi taşır. Her data store için aynı SLO kullanılmamalıdır. Latency requirement business interaction üzerinden belirlenirse gereksiz altyapı yatırımı azalır.
Consistency
Strong consistency gereken state ile birkaç saniye gecikmesi kabul edilen derived view ayrılmalıdır. Search sonuçlarının sipariş database'inden iki saniye geride olması kabul edilebilir olabilir. Account balance için aynı gecikme riskli olabilir. Eventual consistency teknik eksiklik değil bilinçli mimari tercih olduğunda güvenli yönetilebilir. Consistency window ölçülmeli ve kullanıcı deneyiminde gerekli davranışlar tanımlanmalıdır.
Schema Evolution
Hızla değişen metadata document modelden faydalanabilir. Bununla birlikte schema evolution her datastore'da yine yönetilmek zorundadır. Search mapping değişikliği reindex, event schema değişikliği backward compatibility, SQL değişikliği migration gerektirir. “Schema yok” düşüncesi production'da veri contract sorunlarını ortadan kaldırmaz. Yeni store seçerken schema değişikliklerinin deploy ve rollback süreci de değerlendirilmelidir.
Polyglot Persistence Nedir?
Polyglot persistence bir uygulamanın farklı veri ihtiyaçları için birden fazla persistence teknolojisini bilinçli şekilde kullanmasıdır. Buradaki amaç mümkün olduğunca çok database eklemek değil, her workload için ölçülebilir avantaj sağlayan modeli seçmektir. İlişkisel ve İlişkisel Olmayan Veritabanlarının Birlikte Kullanımı bu yaklaşımın en yaygın örneklerinden biridir. SQL transaction store, Redis cache, search engine projection ve graph store aynı sistemde farklı sorumluluklar üstlenebilir. Başarılı tasarımın ana şartı her veri için authoritative source'un, ownership'in ve senkronizasyon akışının açık olmasıdır.
Bir Uygulamada Birden Fazla Datastore Kullanmak
Tek uygulama veya platform içerisinde birden fazla datastore kullanmak teknik olarak kolaydır. Asıl zorluk hangi verinin nerede yaşayacağı, hangi kopyanın yetkili olduğu ve failure sırasında ne yapılacağıdır. Her store kendi connection pool, backup, monitoring ve security politikasına ihtiyaç duyar. Derived store kaybolduğunda yeniden üretilebiliyorsa recovery daha yönetilebilir hale gelir. Data ownership belirsizse aynı entity için iki ekip iki farklı database'i doğru kabul etmeye başlayabilir ve sistem sessizce tutarsızlaşır.
“Doğru İş İçin Doğru Veritabanı”
Bu ifade yararlı olmakla birlikte kolayca aşırı teknoloji kullanımına dönüşebilir. “Doğru iş” yalnızca teknik query türü değil operasyon ekibinin yönetebildiği, backup alabildiği ve güvenli şekilde upgrade edebildiği çözümü de kapsar. PostgreSQL JSONB yeterli olduğu halde yalnızca document ihtiyacı için yeni cluster eklemek her zaman doğru iş için doğru database sayılmaz. Aynı şekilde yoğun fuzzy search'i relational LIKE sorgularına zorlamak da gereksiz maliyet yaratabilir. Karar toplam sahip olma maliyeti ve ölçülen performans üzerinden verilmelidir.
SQL ve NoSQL'i Rakip Değil Tamamlayıcı Görmek
SQL ve NoSQL sistemler farklı güçlü yönleri nedeniyle aynı platformda doğal biçimde birlikte çalışabilir. SQL source of truth güçlü transaction sınırı sağlarken NoSQL projection belirli sorguyu daha hızlı veya kolay hale getirebilir. Bu modelde NoSQL store SQL'in yerine geçmek zorunda değildir. Aynı şekilde relational database her specialized workload'u üzerine almak zorunda değildir. Rekabet bakışını bırakıp data role ve access pattern üzerinden düşünmek daha dengeli mimari kararlar üretir.
Multi-Model Database ile Farkı
Multi-model database tek ürün içinde relational, document, graph veya vector gibi birden fazla veri modeline ait özellikler sunabilir. Polyglot persistence ise farklı ürün veya datastore türlerini aynı application mimarisinde birlikte kullanmayı ifade eder. PostgreSQL'in JSONB, full-text ve vector extension kullanması multi-model benzeri esneklik sağlayabilir fakat hâlâ tek operational database avantajını korur. Ayrı MongoDB, Redis ve search cluster eklemek gerçek polyglot operasyon maliyeti yaratır. İhtiyaç tek database içinde yeterince iyi karşılanıyorsa multi-model capability datastore sayısını azaltmanın güçlü yoludur.
Polyglot Persistence Ne Zaman Mantıklıdır?
Polyglot persistence farklı workload'ların tek database üzerinde ölçülebilir şekilde zorlanmaya başladığı durumlarda anlam kazanır. Search, cache, graph traversal veya yüksek hacimli time-series ingestion relational transaction workload'undan farklı kaynak profili oluşturabilir. Ayrı store hem data modelini hem scaling kararını bağımsızlaştırabilir. Bunun karşılığında consistency, event pipeline ve operasyon maliyeti eklenir. Yeni datastore'un sağladığı fayda bu maliyetlerden açık biçimde büyük olduğunda polyglot yaklaşım sürdürülebilir hale gelir.
Farklı Access Pattern'ler
Order ID lookup, ürün metin araması ve arkadaşın arkadaşını bulma sorgusu aynı erişim desenine sahip değildir. İlkinde B-tree lookup, ikincisinde inverted index, üçüncüsünde graph traversal doğal olabilir. Tek database hepsini belirli ölçüde karşılayabilir, fakat trafik büyüdüğünde specialized engine avantaj kazanabilir. Query frequency ve latency baseline ölçülmelidir. Yalnızca teorik capability farkı yeni datastore eklemek için yeterli gerekçe değildir.
Farklı Consistency Gereksinimleri
Payment transaction anlık doğruluk isterken search projection birkaç saniye gecikmeyi tolere edebilir. Redis cache onlarca saniye staleness kabul edebilirken permission cache çok daha kısa window isteyebilir. Farklı consistency gereksinimleri aynı verinin canonical ve derived temsillerini ayırmayı mantıklı hale getirir. Eventual store üzerinde strong read gerektiren endpoint doğrudan source'a yönlendirilebilir. Böylece her operation en pahalı consistency garantisini kullanmak zorunda kalmaz.
Farklı Scaling Modelleri
Transactional database write-heavy değilken search workload CPU ve memory açısından bağımsız büyüyebilir. Cache QPS'i milyonlara ulaşabilir fakat dataset küçük kalabilir. Time-series store ise storage ve ingestion bakımından hızlı büyür. Ayrı store bu kaynakları birbirinden bağımsız ölçeklemeye izin verir. Bu avantaj ancak monitoring ve capacity planning ekip tarafından gerçekten yönetilebiliyorsa değerlidir.
Search Gereksinimi
Basit full-text PostgreSQL içinde karşılanabilir. Fuzzy matching, autocomplete, faceting, analyzer yönetimi ve çok büyük search trafiği daha özel engine ihtiyacı oluşturabilir. Search index source of truth'tan event veya CDC ile beslenir. Index gerektiğinde yeniden oluşturulabilir olmalıdır. Search nedeniyle transactional schema'yı aşırı denormalize etmek yerine ayrı read projection daha temiz çözüm sunabilir.
Çok Düşük Latency Gereksinimi
Her request'te okunan feature configuration veya session için relational query ek maliyet oluşturabilir. Redis veya local cache microservice request path'ini hızlandırabilir. Bununla birlikte cache hit'in network RTT'si ve serialization maliyeti de ölçülmelidir. Çok küçük local lookup için remote Redis bile gereksiz olabilir. Ultra-low latency ihtiyacı data freshness ve failure behavior ile birlikte ele alınmalıdır.
Graph Traversal
Bir kullanıcının ikinci ve üçüncü derece bağlantılarını, fraud zincirini veya recommendation relationship'lerini aramak variable-depth traversal gerektirebilir. Relational recursive query belirli ölçekte yeterli olabilir. Relationship sayısı ve query çeşitliliği arttığında graph database daha doğal hale gelebilir. Core entity SQL'de tutulup graph sadece relationship projection olabilir. Projection kaybolduğunda event replay veya backfill ile yeniden üretilebilmesi operasyon riskini azaltır.
Yüksek Hacimli Event/Time-Series
Telemetry veya IoT sistemi saniyede çok yüksek write hacmi üretebilir. Transactional customer database aynı ingestion yükünü taşımak zorunda değildir. Specialized time-series veya wide-column store retention ve partitioning modelini bu iş yüküne göre optimize eder. SQL yalnızca device ve account master data'yı tutabilir. Bu ayrım resource contention'ı azaltırken iki store arasındaki identity ve retention policy'nin açık biçimde tanımlanmasını gerektirir.
Polyglot Persistence Ne Zaman Kullanılmamalı?
Polyglot persistence güçlü olduğu kadar pahalıdır ve her proje için uygun değildir. Küçük ekip veya yeni ürün henüz gerçek query ve scale sorunlarını bilmiyorsa erken datastore çeşitliliği development hızını düşürebilir. Tek PostgreSQL instance JSONB, full-text, cache benzeri küçük optimizasyonlar ve vector extension ile birçok ihtiyacı yeterince karşılayabilir. Yeni cluster ancak ölçülen problem veya net functional requirement olduğunda eklenmelidir. Aksi halde sistemin business değerinden daha hızlı büyüyen operasyon yükü oluşur.
Küçük ve Yeni Projeler
Yeni projede trafik, data distribution ve access pattern henüz tahmindir. Beş farklı datastore kurmak future-proof olmak yerine beş farklı migration ve outage yüzeyi oluşturur. Tek güçlü relational database development ve debugging'i hızlandırır. İhtiyaç ortaya çıktığında verinin belirli read modeli dış store'a projekte edilebilir. Erken sadelik gelecekte polyglot mimariye geçişi engellemez.
Tek Database İhtiyacı Karşılayabiliyorsa
PostgreSQL relational data, JSONB, array, full-text ve extension ekosistemiyle geniş ihtiyaçları karşılayabilir. İstenen query latency ve throughput mevcut sistemde sağlanıyorsa ayrı document veya search store zorunlu değildir. Tek database backup ve recovery açısından çok daha basit davranır. Cross-store consistency problemi hiç oluşmaz. Yeni teknoloji ancak belirgin performans veya product capability farkı sağlıyorsa düşünülmelidir.
Ölçülmüş Bir Performance Problemi Yoksa
“İleride yavaşlar” tahmini pahalı mimari kararlar için zayıf gerekçedir. Query profiling, CPU, I/O, latency ve growth trend önce ölçülmelidir. Index veya schema değişikliği sorunu çözebiliyorsa yeni datastore gerekmeyebilir. POC gerçek production benzeri data ve traffic ile karşılaştırma yapmalıdır. Measurable requirement architecture review sürecinin giriş şartı olmalıdır.
Ekip Birden Fazla Database'i Operate Edemiyorsa
Her database backup, restore, patching ve failure bilgisi ister. On-call ekip arıza sırasında hem SQL hem MongoDB hem Redis hem search cluster davranışını anlayabilmelidir. Managed service operasyon yükünü azaltır fakat tamamen ortadan kaldırmaz. Data consistency ve application retry sorunları yine kurumun sorumluluğundadır. Skill ve operasyon kapasitesi yeterli değilse daha az teknoloji daha güvenli sistem anlamına gelir.
Cross-Store Strong Consistency Her İşlemde Gerekiyorsa
Her business transaction'ın SQL ve NoSQL store'larda aynı anda ve atomik olarak görünmesi şartsa polyglot model ciddi coordination maliyeti yaratır. Distributed transaction teknik olarak mümkün bazı ortamlarda kullanılabilir fakat availability ve operational complexity etkilenir. Data model belki tek authoritative database içinde tutulmalıdır. Derived store kullanılıyorsa eventual consistency kabul edilebilmelidir. Strong global consistency gereksinimi yeni datastore eklemeden önce architecture constraint olarak açıkça değerlendirilmelidir.
Önce Tek Database ile Başlamak Neden Mantıklı Olabilir?
Tek database başlangıcı sistemin en önemli avantajlarından biri olan sadeliği korur. Transaction, backup, monitoring ve schema değişiklikleri tek teknoloji üzerinde yönetilir. Ekip domain modelini ve gerçek access pattern'leri gözlemleme fırsatı bulur. Ölçüm sonucunda search veya cache gibi belirli ihtiyaçlar ayrıştırıldığında yeni store'un sınırı daha doğru çizilebilir. Bu yaklaşım polyglot persistence'a karşı olmak değil, onu kanıta dayalı ve aşamalı şekilde uygulamaktır.
Daha Az Operasyonel Karmaşıklık
Tek cluster daha az dashboard, alert ve on-call runbook anlamına gelir. Network policy ve credential yönetimi daha basittir. Backup ve restore prosedürü tek veri kaynağı üzerinde test edilir. Developer local environment daha hızlı kurulur. Business henüz ürün uyumunu ararken altyapı ekibi gereksiz dağıtık sistem yükü taşımaz.
Daha Basit Transaction Modeli
Business değişiklikleri aynı database transaction içerisinde tamamlanabilir. Dual-write ve message delivery problemi daha azdır. Developer local reasoning ile state değişimini takip edebilir. Audit ve rollback daha belirgin hale gelir. Domain büyüyüp bounded context ayrıldığında transaction boundary'leri bilinçli biçimde parçalanabilir.
Daha Basit Backup
Tek database için point-in-time recovery planlamak görece daha kolaydır. İki store farklı zaman noktalarına restore edildiğinde cross-store inconsistency problemi oluşmaz. Backup retention ve encryption politikası tek sistem üzerinde yönetilir. Restore testi daha sık yapılabilir. Polyglot yapıya geçildiğinde bu basitliği kaybetmenin gerçek operasyon bedeli bilinerek karar verilir.
Daha Basit Monitoring
Query latency, connection pool, CPU ve storage metrikleri tek datastore üzerinde incelenir. Root cause sırasında farklı telemetry sistemleri arasında gezinmek gerekmez. Application trace daha kısa dependency chain gösterir. Capacity planning daha kolaydır. Yeni store eklendiğinde hangi metriğin neden gerektiği mevcut baseline üzerinden açık biçimde tanımlanabilir.
Ölçüm Sonrası Uzmanlaşmış Datastore Eklemek
Search query'nin gerçekten CPU tükettiği veya cache ile database QPS'inin önemli ölçüde azalacağı ölçüldüğünde yatırım gerekçesi oluşur. Yeni datastore önce derived view olarak konumlandırılabilir. Source of truth değişmeden migration daha düşük riskle yapılır. Shadow reads ile sonuçlar karşılaştırılır. Böylece teknoloji seçimi varsayımdan değil production verisinden çıkar.
Modern PostgreSQL Tek Başına Ne Kadar İhtiyacı Karşılayabilir?
Modern PostgreSQL yalnızca klasik tablolardan oluşan bir relational engine değildir. JSONB, array, full-text search, extensible index yapıları, geospatial extension ve vector extension gibi seçenekler tek operational database üzerinde farklı veri modellerini destekleyebilir. Güncel PostgreSQL 18 dokümantasyonu JSONB için GIN indexing ve text search için GIN veya GiST yaklaşımını açık biçimde destekler. Bu yetenekler küçük ve orta ölçekli birçok projede ayrı datastore ihtiyacını geciktirebilir veya tamamen ortadan kaldırabilir. Ayrı sistem ancak PostgreSQL üzerinde ihtiyaç artık performans, scaling veya ürün özelliği bakımından doğal sınırları zorluyorsa eklenmelidir.
Relational Tables
PostgreSQL'in temel gücü transactional relational model olmaya devam eder. Foreign key, unique constraint, indexing ve güçlü SQL query capability business core için sağlam temel oluşturur. JSON veya vector gibi özellikler bu temeli terk etmeden ek veri biçimleri kullanmaya imkan verir. Aynı transaction içinde relational ve JSONB alanlar güncellenebilir. Bu birleşim yeni datastore eklemeden önce değerlendirilmesi gereken önemli bir sadelik avantajıdır.
JSONB
JSONB document benzeri veriyi PostgreSQL içinde binary işlenebilir formatta tutar ve çeşitli operator'larla sorgulanabilir. GIN index key, containment ve jsonpath gibi kullanım biçimlerini hızlandırabilir. Belirli JSON path için expression index daha küçük ve hedefli çözüm sağlayabilir. Transaction ve relational JOIN ihtiyacı aynı database içinde kalır. Document hacmi ve horizontal sharding ihtiyacı büyüdüğünde ayrı document store yeniden değerlendirilebilir.
Full-Text Search
PostgreSQL text search metni normalize edilmiş lexeme'lere dönüştürüp tsvector ve tsquery üzerinden sorgulayabilir. GIN text search için tercih edilen index türüdür. Basit ürün veya içerik aramasında ayrı search cluster gerekmeyebilir. Fakat advanced autocomplete, complex relevance, çok büyük faceting veya bağımsız search scaling gerektiğinde ayrı engine avantaj kazanabilir. Önce native capability'nin SLO'yu karşılayıp karşılamadığı benchmark edilmelidir.
Arrays
PostgreSQL array type aynı row içinde birden fazla scalar değer saklama imkanı sağlar. Membership sorguları ve GIN gibi index seçenekleri belirli kullanım biçimlerinde faydalıdır. Buna rağmen her one-to-many ilişki array'e çevrilmemelidir. Bağımsız identity veya constraint isteyen child kayıt relational tablo olarak daha iyi modellenebilir. Array feature specialized tag veya small-value collection ihtiyaçlarında datastore sayısını artırmadan pratik çözüm sağlar.
Geospatial
PostgreSQL extension ekosistemi geospatial ihtiyaçlarda güçlü seçenekler sunabilir. PostGIS geometry ve geography veri tipleri, spatial index ve geniş fonksiyon set'iyle ciddi harita uygulamalarını destekleyebilir. Basit koordinat saklamadan çok daha gelişmiş spatial query mümkün hale gelir. Ayrı geospatial datastore ancak bağımsız scale veya özel ürün gereksinimi varsa düşünülmelidir. Extension kullanımı backup, upgrade ve managed provider compatibility planına dahil edilmelidir.
Vector Search
pgvector PostgreSQL içinde exact ve approximate nearest-neighbor araması sağlar. Güncel proje HNSW ve IVFFlat index tiplerini destekler ve vector aramasını relational filter'larla aynı SQL içerisinde birleştirmeye imkan verir. Metadata ile embedding aynı transaction ve database içinde bulunduğunda operasyon basitleşir. Çok büyük vector dataset veya bağımsız vector QPS arttığında dedicated store daha iyi scale karakteristiği sunabilir. Karar vector sayısı kadar recall, latency, metadata filtering ve operasyon maliyetiyle verilmelidir.
Ne Zaman Ayrı Datastore Gerekir?
PostgreSQL'in feature desteğinin bulunması her workload'u sonsuza kadar aynı instance'ta çalıştırmanız gerektiği anlamına gelmez. Search traffic transactional CPU'yu etkiliyorsa, document workload bağımsız horizontal scaling istiyorsa veya vector index memory ihtiyacı OLTP working set'iyle yarışıyorsa ayrıştırma anlamlı olabilir. Operational isolation da performans kadar önemli gerekçedir. Önce replica veya ayrı cluster gibi PostgreSQL tabanlı seçenekler değerlendirilebilir. Ayrı teknoloji fayda sağlıyorsa migration derived projection ile başlatılmalıdır.
PostgreSQL JSONB mi MongoDB mi?
PostgreSQL JSONB ve MongoDB karşılaştırmasında yalnızca JSON saklayabiliyor olmalarına bakmak doğru değildir. JSONB relational transaction, JOIN ve SQL yetenekleriyle aynı database içerisinde document esnekliği sağlar. MongoDB document-centric model, sharding ve document sorguları etrafında farklı operational yaklaşım sunar. Seçim schema flexibility, document boundary, transaction, query, index, scale ve ekip operasyon deneyimine göre yapılmalıdır. İki sistem aynı projede kullanılabilir, fakat aynı canonical document'i ikisinde de eşit yetkili tutmak consistency problemini büyütür.
Schema Flexibility
JSONB farklı row'larda değişken field set'leri tutabilir. MongoDB document'ler de farklı shape taşıyabilir ve validation kuralları uygulanabilir. Bu nedenle flexibility iki tarafta da mümkündür. Asıl fark uygulamanın geri kalan relational data ile ne kadar join yaptığı ve document access'in ne kadar baskın olduğudur. Flexible schema gereksinimini tek başına MongoDB zorunluluğu olarak görmek doğru değildir.
Transaction
PostgreSQL relational ve JSONB değişikliklerini aynı local transaction içinde yönetebilir. MongoDB modern deployment'larda multi-document transaction desteği sunabilir. Yine de document model çoğu zaman aggregate'i tek document içinde tutarak distributed transaction ihtiyacını azaltmaya çalışır. Eğer business operation sürekli SQL tabloları ve document data arasında atomic update gerektiriyorsa aynı PostgreSQL database avantajlı olabilir. Transaction ihtiyacı gerçek workload üzerinden analiz edilmelidir.
Querying
PostgreSQL SQL ve JSON operator'larını aynı query içinde kullanabilir. Relational JOIN ile document field aynı sorguya dahil edilebilir. MongoDB aggregation pipeline document-oriented dönüşüm ve aggregation için güçlü yapı sunar. Hangi query dilinin daha uygun olduğu ekip deneyimi ve erişim desenine bağlıdır. Cross-domain ad hoc analytics ihtiyacı SQL tarafını daha cazip hale getirebilir.
Indexing
PostgreSQL JSONB üzerinde GIN veya expression index kullanabilir. Belirli path sorguları hedefli index'lerle hızlandırılabilir. MongoDB document fields ve compound patterns üzerinde farklı index seçenekleri sağlar. İki sistemde de indiscriminately her field'i indexlemek write ve storage maliyetini artırır. Index tasarımı gerçek query telemetry üzerinden yapılmalıdır.
Document Cardinality
Document içine sınırsız child data gömmek iki platformda da sorun yaratabilir. Unbounded arrays büyük document ve update maliyeti oluşturur. Child entity bağımsız sorgulanıyor veya sınırsız büyüyorsa ayrı collection veya table daha uygun olabilir. Aggregate boundary business lifecycle ile uyumlu olmalıdır. “Document database kullanıyorum, her şeyi tek belgeye koyayım” yaklaşımı ölçek sorunlarını erkenden yaratır.
Horizontal Scaling
MongoDB sharding veriyi shard key üzerinden birden fazla machine'e dağıtmak üzere tasarlanmıştır. PostgreSQL horizontal scale için replication, partitioning ve çeşitli sharding yaklaşımlarından yararlanabilir. Hangisinin operasyonel olarak daha uygun olduğu kurum altyapısına bağlıdır. Sharding anahtarının yanlış seçilmesi her iki tarafta da hot partition sorunlarına yol açabilir. Scale ihtiyacı mevcut data ve traffic projeksiyonuyla doğrulanmalıdır.
Operational Cost
PostgreSQL zaten kullanılan ana database ise JSONB yeni cluster eklemeden requirement'ı karşılayabilir. MongoDB eklemek ayrı backup, credential, monitoring ve upgrade süreci getirir. Managed deployment bu yükün bir kısmını azaltabilir. Buna karşılık document workload büyükse ayrı scale ve resource isolation operasyon maliyetini haklı çıkarabilir. TCO yalnızca instance fiyatı değil ekip zamanı ve incident riskini de içermelidir.
Karar Kriterleri
Relational JOIN, strong transaction ve moderate document esnekliği birlikte gerekiyorsa JSONB güçlü adaydır. Document access baskın, aggregate boundaries doğal ve bağımsız horizontal scaling gereksinimi yüksekse MongoDB değerlendirilebilir. Tek teknolojiyle SLO karşılanıyorsa ikinci store eklenmemelidir. POC representative data, query ve write workload üzerinde yapılmalıdır. Karar dokümanı yeni store'un hangi ölçülebilir sorunu çözdüğünü açık biçimde göstermelidir.
PostgreSQL Full-Text Search mi Elasticsearch/OpenSearch mü?
Basit full-text search için PostgreSQL oldukça yeterli olabilir ve ayrı cluster gerektirmez. Tokenization, stemming ve GIN index birçok içerik aramasını verimli hale getirir. Elasticsearch/OpenSearch gibi search engine'ler fuzzy search, relevance tuning, faceting, autocomplete ve bağımsız horizontal search scale konusunda daha uzmanlaşmış yetenekler sunar. Ayrı search engine kullanıldığında index derived projection olarak tasarlanmalı ve SQL source of truth'tan yeniden üretilebilmelidir. Search requirement ürünün önemli bir parçası haline gelmeden ikinci datastore eklemek gereksiz olabilir.
Basit Search
Başlık ve içerikte kelime aramak, temel ranking uygulamak ve birkaç filter kullanmak PostgreSQL full-text ile karşılanabilir. GIN index düzenli search yapılan kolonlarda iyi performans sağlar. Transactional data ile search aynı database'de kaldığı için senkronizasyon problemi oluşmaz. Küçük ekip için operasyon yükü düşüktür. Search büyüdükçe query ve latency metrics ayrı izlenerek extraction kararı verilebilir.
Fuzzy Search
Typo tolerance ve benzer kelime eşleşmesi kullanıcı arama deneyiminde önemli olabilir. PostgreSQL trigram veya extension tabanlı çözümlerle belirli fuzzy ihtiyaçları karşılayabilir. Search engine analyzer ve fuzzy query yetenekleri daha kapsamlı olabilir. Çok büyük catalog ve yüksek search QPS'te özel engine avantajı büyür. Fuzzy requirement'ın gerçek kullanıcı dönüşümüne etkisi ölçülmelidir.
Relevance Ranking
Full-text sonuçların yalnızca eşleşmesi değil doğru sırada gelmesi ürün deneyiminin önemli parçasıdır. PostgreSQL text search ranking temel ihtiyaçları karşılayabilir. Search engine field boost, function score ve daha kapsamlı relevance tuning araçları sunabilir. Relevance sürekli optimize edilen bir ürün fonksiyonuna dönüştüğünde ayrı engine daha mantıklı hale gelir. Ranking modelinin business metric'lerle ölçülmesi gerekir.
Faceting
Category, brand, price bucket ve attribute sayımlarının search sonucu ile birlikte sunulması faceting olarak düşünülebilir. PostgreSQL aggregation bunu yapabilir fakat büyük search trafiğinde transactional resources ile yarışabilir. Search engine inverted index ve aggregation yapısıyla bu workload için optimize edilmiştir. Catalog filter sayısı arttıkça search projection denormalized field'lar taşıyabilir. Source data değişiklikleri event üzerinden index'e yansıtılmalıdır.
Autocomplete
Autocomplete her key press ile yüksek QPS üretebilir ve latency beklentisi düşüktür. Prefix, edge n-gram veya özel suggestion model search engine tarafında yönetilebilir. PostgreSQL de prefix search yapabilir fakat çok büyük kullanımda ayrı scale ihtiyacı doğabilir. Client debounce ve minimum karakter sınırı gereksiz backend trafiğini azaltır. Autocomplete index'i ayrı projection olduğu için ana product database'i bu QPS'ten koruyabilir.
Büyük Search Trafiği
Search QPS transactional CRUD'dan çok daha hızlı büyüyebilir. Ayrı search cluster CPU, memory ve replica sayısını bağımsız ölçeklemeye imkan verir. Index refresh ve merge workload'u primary SQL'den izole edilir. Bunun bedeli event pipeline ve consistency window'dur. Search outage durumunda application'ın degrade davranışı önceden belirlenmelidir.
Search Analytics
Arama sorguları, click-through ve zero-result metric'leri search ürününü geliştirmek için önemlidir. Bunlar transactional database'ten ayrı analytics pipeline'a aktarılabilir. Search engine kendi query logs ve aggregation imkanlarıyla bazı insights sunabilir. PII içeren user query'leri retention ve privacy açısından dikkatle yönetilmelidir. Analytics ihtiyacı search index'i source of truth yapmayı gerektirmez.
Ne Zaman Ayrı Search Engine?
Native PostgreSQL search SLO'yu karşılamıyorsa veya ürün advanced relevance, faceting ve autocomplete'e ciddi biçimde bağımlı hale gelmişse ayrı engine değerlendirilir. Search traffic OLTP kaynaklarını etkiliyorsa resource isolation da güçlü gerekçedir. Migration önce SQL source of truth korunarak derived index oluşturmakla başlamalıdır. Shadow query sonuçları karşılaştırılabilir. Rebuild ve replay mekanizması production'a çıkmadan doğrulanmalıdır.
pgvector mı Ayrı Vector Database mi?
pgvector embedding'i relational data ile aynı PostgreSQL içinde tutarak vector search'i operasyonel olarak sadeleştirir. Exact ve approximate arama desteklenir, HNSW ve IVFFlat gibi index seçenekleri kullanılabilir. Metadata filtering SQL üzerinden doğal biçimde yapılabilir. Dedicated vector store ise çok büyük embedding sayısı, bağımsız vector QPS veya özel distributed indexing yetenekleri gerektiğinde avantaj sağlayabilir. Seçim moda değil measured recall, latency, scale ve operasyon maliyetine dayanmalıdır.
Embedding Sayısı
Binlerce veya birkaç milyon embedding için PostgreSQL mevcut altyapıda yeterli olabilir. Dataset büyüdükçe HNSW memory, index build ve storage davranışı izlenmelidir. Yüz milyonlarca vector independent scaling ihtiyacı yaratabilir. Dimension ve representation memory kullanımını doğrudan etkiler. Embedding sayısı tek başına karar vermek yerine query throughput ve filter selectivity ile birlikte değerlendirilmelidir.
Query Throughput
Vector search düşük QPS ise OLTP database içinde rahatlıkla yaşayabilir. Çok yüksek QPS vector CPU ve memory kaynaklarını transactional workload ile yarıştırabilir. Read replica veya ayrı PostgreSQL cluster ilk isolation adımı olabilir. Dedicated vector store ancak bu yaklaşımın yetmediği ölçüldüğünde düşünülmelidir. p95 ve recall birlikte benchmark edilmelidir.
Metadata Filtering
Vector search çoğu gerçek uygulamada tenant, category, permission veya date filter ile birlikte çalışır. PostgreSQL bu metadata'yı relational kolonlarda tutarak aynı query içinde güçlü filtering sağlayabilir. pgvector approximate index sonrasında filtering behavior'ı recall üzerinde etkili olabilir. Dedicated store metadata filter yetenekleri ürünlere göre değişir. Permission filtering correctness açısından özellikle önemlidir.
Operational Simplicity
Zaten PostgreSQL yöneten ekip için pgvector yeni datastore eklemeden vector capability sağlar. Backup, security ve transaction süreçleri mevcut sistemle paylaşılır. Dedicated store yeni credentials, monitoring ve migration getirir. Eğer vector workload küçükse bu maliyet anlamsızdır. Operasyonel sadelik performans kadar gerçek bir mimari avantajdır.
Hybrid Search
Hybrid search lexical ve semantic sonuçları birlikte değerlendirir. PostgreSQL full-text ve pgvector aynı database içinde bu kombinasyonu kurabilir. Rank fusion application veya SQL katmanında uygulanabilir. Büyük search ürününde ayrı text search engine ve vector store birleşimi de kullanılabilir. Hangi yaklaşımın daha iyi olduğu relevance quality ve operational complexity ile ölçülmelidir.
Dedicated Vector Store İçin Karar Kriterleri
Embedding sayısı, index memory, query throughput, recall hedefi ve metadata filter complexity temel kriterlerdir. PostgreSQL instance'ın transactional workload'u vector query yüzünden etkileniyorsa ayrıştırma gerekebilir. Çok hızlı horizontal scale veya specialized vector features ayrı store'u haklı çıkarabilir. Migration source embeddings'i yeniden üretebilir biçimde tasarlanmalıdır. Dedicated store'a geçiş irreversible olmamalı ve shadow validation içermelidir.
SQL + Redis Birlikte Kullanımı
SQL ve Redis birlikte kullanım en yaygın polyglot persistence örneklerinden biridir. PostgreSQL veya MySQL authoritative transactional state'i tutarken Redis cache, session, rate limiting veya realtime counter gibi düşük latency ihtiyaçları karşılayabilir. Bu modelde her Redis key'in rolü açık olmalıdır, çünkü cache ile primary state aynı durability beklentisini taşımaz. Cache-aside uygulanıyorsa Redis kaybı correctness değil performans sorunu oluşturmalıdır. Redis ile yüksek istekli cache tasarımı hakkında ayrıntılı teknik rehber için https://www.diyarbakiryazilim.com.tr/posts/yuksek-istekli-ortamlarda-redis-ile-onbellekleme adresi incelenebilir.
PostgreSQL/MySQL System of Record
SQL database user, order veya inventory gibi canonical kayıtların kaynağı olabilir. Redis'teki değer silinse bile SQL üzerinden yeniden üretilebilmelidir. Mutation önce authoritative database üzerinde tamamlanır. Commit sonrası cache invalidate veya update edilir. Böylece cache failure business doğruluğunu değiştirmez.
Redis Cache
Redis sık okunan SQL query sonuçlarını geçici tutabilir. Cache hit database connection ve CPU ihtiyacını azaltır. TTL stale data riskini sınırlar. Popular key'lerde stampede protection eklenmelidir. Cache hit oranı origin QPS azalmasıyla birlikte ölçülmelidir.
Session Storage
Session Redis'te tutulabilir fakat bu kullanım pure cache'ten farklıdır. Session kaybolduğunda kullanıcı logout olabilir veya state kaybedebilir. Persistence, replica ve eviction policy gereksinimi yükselir. Session ile evict edilebilir cache aynı instance'ta farklı beklentiler taşır. Kritik sistemde ayrı Redis deployment düşünülebilir.
Rate Limiting
Redis atomic counters ve expiration üzerinden distributed rate limit state'i tutabilir. Birden fazla application instance aynı limit bilgisini paylaşır. Fixed window, sliding window veya token bucket gibi modeller uygulanabilir. Redis failure durumunda fail-open veya fail-closed davranışı endpoint riskine göre seçilir. Rate limiter state'i SQL source of truth ile aynı kategoriye konulmamalıdır.
Distributed Lock
Redis lock kısa süreli coordination ihtiyacında kullanılabilir. Lock'ın business transaction veya idempotency yerine geçmediği bilinmelidir. Owner token ve expiration güvenli release için önemlidir. Process pause veya network partition lock geçerliliğini etkileyebilir. Cache refresh gibi toleranslı işler distributed lock için finansal transaction'lardan daha uygun kullanım alanıdır.
Realtime Counters
View count veya geçici metric Redis counter ile hızlı güncellenebilir. Counter SQL'e periyodik veya event tabanlı aktarılabilir. Kesin finansal sayı gerekiyorsa asynchronous write riskleri değerlendirilmelidir. Hot counter tek key bottleneck oluşturabilir. Sharded counter veya batching yüksek write throughput'ta kullanılabilir.
Cache-Aside Pattern
Cache-aside uygulamanın önce cache'e bakıp miss durumunda source database'e gitmesini sağlayan yaygın modeldir. Value SQL'den alındıktan sonra Redis'e TTL ile yazılır. Mutation olduğunda cache çoğunlukla silinir ve sonraki read yeniden populate eder. Bu model source of truth rolünü SQL'de açık tutar. Yüksek trafikte request coalescing ve TTL jitter eklenmeden basit cache-aside yeterli olmayabilir.
Önce Cache'e Bak
Application deterministic key üretir ve Redis'ten value ister. Hit varsa SQL query tamamen atlanır. Redis timeout application request deadline'ından kısa tutulmalıdır. Cache failure uzun bekleme yaratmamalıdır. Metrics bu path'i hit olarak kaydetmelidir.
Cache Miss
Key bulunmadığında miss oluşur. Application authoritative SQL store'a gider. Aynı key için concurrent miss sayısı yüksekse database stampede yaşayabilir. Single-flight aynı process içindeki duplicate fetch'leri azaltır. Distributed coordination çok sıcak key'lerde eklenebilir.
SQL'den Oku
Origin query doğru index ve query plan ile optimize edilmelidir. Cache hiçbir zaman kötü SQL'i düzeltmenin yerine geçmemelidir. Cold cache sırasında query çok daha yüksek QPS görebilir. Connection pool origin fetch concurrency'yi sınırlar. Query failure yanlış value'nun cache'e yazılmasına yol açmamalıdır.
Redis'e Yaz
SQL sonucu başarılı olduğunda serialization sonrası Redis'e yazılır. Cache write başarısız olsa bile pure cache sisteminde kullanıcı response'u yine başarılı olabilir. Populate failure metric sonraki miss artışını açıklar. Büyük payload network ve memory maliyeti yaratabilir. Yalnızca tekrar kullanılması beklenen data cache'e kabul edilmelidir.
TTL
TTL cache value'nun en fazla ne kadar süre eski kalabileceğini sınırlar. Her data type aynı süreyi kullanmamalıdır. Jitter çok sayıda key'in birlikte expire olmasını engeller. Event invalidation güvenilir olsa bile TTL safety net olarak tutulabilir. Business staleness sınırı teknik default'tan daha önemlidir.
Cache Invalidation
SQL mutation sonrası eski Redis key artık doğru değildir. Commit sonrasında key silmek basit ve idempotent yaklaşımdır. Doğrudan update read-after-write hit sağlar fakat concurrent writer ordering riskini artırabilir. Event-driven invalidation microservice cache'lerini güncelleyebilir. TTL kaçırılan event'lerin etkisini sınırlar.
Write-Through ve Write-Behind Cache
Write-through ve write-behind cache write path'ine farklı consistency ve latency davranışları ekler. Write-through değişikliği source database ve cache'e yakın zamanlı uygular. Write-behind önce hızlı katmana yazar ve database update'ini asenkron gerçekleştirir. İkinci model throughput kazandırırken cache'i daha kritik state katmanına dönüştürür. Veri kaybı toleransı ve replay mekanizması pattern seçiminde en önemli kriterdir.
Write-Through
Write-through mutation sırasında SQL ve cache'in güncellenmesini hedefler. Database commit sonrası Redis update yapılabilir. Redis başarısız olursa SQL canonical state doğru kalmalıdır. Concurrent writes stale cache overwrite oluşturabilir. Version-aware update bu riski azaltabilir.
Write-Behind
Write-behind uygulama request'inde cache veya queue'ya yazar ve SQL değişikliğini background worker'a bırakır. Kullanıcı latency'si düşebilir. Database batch write throughput'u artabilir. Pending writes durable değilse Redis kaybında veri kaybı oluşabilir. Bu model basit cache senaryosundan daha güçlü recovery tasarımı ister.
Latency
Write-through iki dependency'yi request path'ine eklediği için write latency yükseltebilir. Write-behind database'i path'ten çıkararak daha hızlı response sağlar. Bunun karşılığında database hemen güncel değildir. User read-after-write davranışı ayrı çözülmelidir. Latency kazancı business consistency riskinden büyük olmalıdır.
Data Loss Riski
Write-behind pending mutation'ların güvenilir şekilde saklanmasını gerektirir. Redis yalnızca memory ve persistence ayarına bağlıysa crash senaryosu incelenmelidir. Durable broker veya stream daha uygun olabilir. Write-through'da risk daha çok iki sistem arasında stale cache kalmasıdır. Her iki model failure injection testine ihtiyaç duyar.
Hangi Senaryoda Hangisi?
Read-after-write cache freshness ve moderate write QPS için write-through düşünülebilir. Çok yüksek write throughput ve eventual persistence kabul edilen telemetry gibi data write-behind kullanabilir. Financial state için asynchronous data loss riski çoğu zaman uygun değildir. Basit CRUD uygulamada cache-aside delete-on-mutation daha güvenli olabilir. Pattern data class bazında seçilmelidir.
Cache Tutarlılığı
Cache tutarlılığı SQL source of truth değiştiğinde Redis kopyasının ne kadar sürede güncelleneceğini tanımlar. Stale cache tamamen ortadan kaldırılamayabilir, ancak izin verilen window kontrol edilebilir. TTL, explicit delete ve event-driven invalidation birlikte kullanılabilir. Versioned key schema değişikliğinde eski payload'ı yeni application'dan ayırır. Consistency beklentisi cache namespace bazında belgelenmelidir.
Stale Cache
Database güncel fakat Redis eski value taşıyorsa stale cache vardır. Bu durum belirli saniye boyunca kabul edilebilir olabilir. Permission veya pricing gibi veriler için risk farklıdır. Cache payload source version veya update time taşıyabilir. Stale incident'lar invalidation pipeline'ın kalitesini ölçmek için analiz edilmelidir.
TTL
TTL stale value için maksimum doğal yaşam süresi sağlar. Event invalidation başarısız olsa bile key sonunda kaybolur. Çok kısa TTL database yükünü artırır. Çok uzun TTL business freshness'i bozar. Veri türüne göre policy uygulanmalıdır.
Explicit Invalidation
Mutation commit olduktan sonra ilgili cache key silinir. Bu yöntem event gecikmesini beklemez. Application crash commit ile delete arasında olursa stale value kalabilir. TTL bu pencerenin üst sınırını koyar. Outbox veya CDC invalidation'ın daha güvenilir yayılmasını sağlayabilir.
Event-Based Invalidation
Domain event cache consumer'a değişikliği bildirir. Consumer kendi key formatını bilir ve ilgili entry'yi siler. Birden fazla service cache'i aynı business event'i dinleyebilir. Event lag staleness window oluşturur. Idempotent delete duplicate event'i güvenli hale getirir.
Versioned Cache Key
product:v2:123 gibi versioned key schema migration'ı sadeleştirir. Yeni deployment eski serialized value'yu okumaz. Eski namespace TTL ile zaman içinde temizlenir. Bunun karşılığında rollout sırasında cold-cache etkisi oluşabilir. Staged warming bu yükü azaltır.
Cache Stampede Problemi
Cache stampede popüler key expire olduğunda çok sayıda request'in aynı anda SQL database'e gitmesidir. Cache normalde origin'i korurken tek expiration olayı bu korumayı aniden kaldırabilir. Connection pool ve database CPU kısa sürede dolar. Request coalescing, distributed lock, TTL jitter ve stale-while-revalidate birlikte kullanılabilir. Hot key'lerde stampede test edilmeden production readiness tamamlanmış sayılmamalıdır.
Aynı Anda Çok Sayıda Cache Miss
Bir key saniyede binlerce request alıyorsa 200 milisaniyelik rebuild penceresinde yüzlerce miss oluşabilir. Her request bağımsız SQL query çalıştırmamalıdır. Origin query ne kadar yavaşlarsa herd daha da büyür. Miss concurrency metric'i total miss oranından daha açıklayıcıdır. Hot key önceden tespit edilmelidir.
Request Coalescing
İlk request origin fetch başlatır. Diğer aynı-key request'leri mevcut promise sonucunu bekler. SQL yalnızca bir kez çalışır. Process-local implementation ucuzdur. Çoklu instance sistemde her instance bir fetch yapabileceği için gerektiğinde distributed coordination eklenir.
Distributed Lock
Instance'lar Redis lock üzerinden yalnızca bir worker'ın refresh yapmasını sağlayabilir. Lock TTL crash durumunda sonsuz beklemeyi önler. Owner token release güvenliğini sağlar. Lock bekleyen request'ler stale value sunabilir. Critical transaction doğruluğu için distributed lock'a tek başına güvenilmemelidir.
TTL Jitter
Jitter farklı key'lerin aynı anda expire olmasını engeller. Temel TTL üzerine küçük random süre eklenir. Freshness üst limiti korunmalıdır. Tek hot key stampede'ini çözmez. Avalanche riskini azaltan tamamlayıcı tekniktir.
Stale-While-Revalidate
Soft TTL geçmiş value kısa süre kullanıcıya sunulur. Bir worker background refresh yapar. Kullanıcı SQL latency'sini beklemez. Hard TTL maksimum staleness sınırını korur. Finansal veya security-sensitive veri için uygun olmayabilir.
SQL + Elasticsearch/OpenSearch Mimarisi
SQL ve search engine birlikte kullanıldığında relational database canonical transactional state'i, search index ise hızlı retrieval için denormalized projection'ı taşır. Product veya content değişikliği event veya CDC ile search index'e aktarılır. Search document query için gerekli alanları birlikte taşıyabilir. Mapping değişirse index yeniden oluşturulabilir. Bu nedenle search index'in source of truth'tan bağımsız yeniden üretilebilir olması temel güvenlik prensibidir.
SQL Source of Truth
Product ID, fiyatın authoritative kaydı veya business constraint SQL'de tutulabilir. Search sonucu kullanıcıya discovery sağlar. Transaction update önce SQL'de commit edilir. Event sonrasında index refresh edilir. Search gecikmesi source record'un doğruluğunu değiştirmez.
Search Index Derived View
Search document farklı SQL tablolarından alanları birleştirebilir. Category name veya seller metadata denormalized biçimde tek document içinde bulunabilir. Bu yapı query-time join ihtiyacını azaltır. Update fan-out event consumer tarafından yönetilir. Projection kaybolduğunda SQL üzerinden yeniden üretilebilir.
Full-Text Search
Search engine metni analyzer üzerinden token'lara ayırır. Fuzzy query, field boost ve relevance scoring kullanılabilir. SQL data yalnızca indexleme için gerekli field'leri gönderir. Search response entity ID döndürüp detay için başka service çağrılabilir. Büyük result hydration N+1 yaratmamalıdır.
Faceted Search
Search sonuçları category, brand veya price range gibi facet sayımlarıyla birlikte sunulabilir. Denormalized fields aggregation'ı hızlandırır. Filter semantics canonical product state ile uyumlu olmalıdır. Update event gecikmesi kısa süre yanlış facet count gösterebilir. Product UX bu consistency window'u tolere etmelidir.
Search Index'in Tekrar Oluşturulabilmesi
Yeni mapping veya analyzer rollout'u full rebuild gerektirebilir. SQL snapshot ve event replay yeni index'i doldurur. Blue-green index ile traffic eski index'ten yenisine atomik alias değişimiyle taşınabilir. Rebuild süresi production RTO planına dahil edilmelidir. Projection canonical veriden bağımsız yedek gibi görülmemelidir.
Search Index Neden Source of Truth Olmamalı?
Search index sorgu ve retrieval için optimize edilmiş derived data yapısıdır. Mapping değişikliği, corruption veya yanlış ingestion nedeniyle yeniden oluşturulması gerekebilir. Search-specific denormalization aynı business verisini farklı biçimde tekrarlar. Bu nedenle authoritative record başka güvenilir store'da bulunmalıdır. Index kaybının business data kaybına dönüşmemesi operasyonel dayanıklılığı önemli ölçüde artırır.
Eventual Consistency
SQL commit ile search index update arasında gecikme vardır. User birkaç saniye eski sonuç görebilir. Search tamamen source of truth olsaydı bu gecikme business transaction'ın doğruluğunu etkilerdi. Derived view modelinde yalnızca discovery freshness etkilenir. Projection lag SLO ile izlenmelidir.
Index Rebuild
Analyzer veya mapping değişikliğinde mevcut index yerine yeni index oluşturmak güvenlidir. Historical data source store'dan backfill edilir. Event stream cutover sırasında güncel değişiklikleri taşır. Validation sonrası traffic yeni index'e geçer. Bu workflow index'in disposable projection olmasını gerektirir.
Search-Specific Denormalization
Product, category ve seller fields tek search document içinde birleşebilir. Bu yapı SQL normalized modelin birebir kopyası değildir. Update geldiğinde document yeniden projekte edilir. Aynı field birden fazla search index'te farklı biçimde bulunabilir. Canonical rule yalnızca source store'da yaşamalıdır.
Mapping Değişiklikleri
Field type veya analyzer değişimi mevcut index üzerinde kolayca uygulanamayabilir. Yeni index version yaratmak daha güvenlidir. Application alias veya config ile yeni index'e geçer. Eski index rollback window boyunca tutulabilir. Source of truth ayrı olduğunda migration riskli data conversion işlemine dönüşmez.
Veri Kaybında Yeniden Üretilebilirlik
Search cluster tamamen kaybedilse bile canonical SQL kayıtları duruyorsa rebuild mümkündür. Snapshot rebuild'i hızlandırabilir fakat correctness kaynağı değildir. Reconciliation missing document'leri bulur. Event replay incremental güncellemeleri tamamlar. Disaster recovery planı rebuild süresini ölçmelidir.
SQL + MongoDB Mimarisi
SQL ve MongoDB birlikte kullanıldığında en önemli konu iki sistemin domain sınırını net çizmek ve aynı kaydı iki tarafta da canonical hale getirmemektir. Transactional core SQL'de kalabilir. Esnek ürün metadata, CMS veya document read modeli MongoDB'de tutulabilir. Document store bağımsız ownership'e sahipse kendi source of truth da olabilir, fakat hangi entity'nin kime ait olduğu açık olmalıdır. Polyglot persistence ile SQL NoSQL veri tutarlılığı ve senkronizasyonu nasıl sağlanır sorusunun cevabı bu ownership kararından başlar.
Transactional Core SQL'de
Order, payment ve inventory gibi güçlü cross-row transaction isteyen state SQL'de tutulabilir. Database constraint business correctness'i korur. MongoDB projection bu kayıtlardan bazı alanları read kolaylığı için alabilir. Transaction commit event yayınının başlangıç noktasıdır. Derived copy doğrudan transaction kararına katılmaz.
Flexible Document Model MongoDB'de
Farklı category'lerde farklı attribute set'lerine sahip product metadata document modelden faydalanabilir. Bu data bağımsız domain ise MongoDB canonical source olabilir. SQL yalnızca product ID ve transaction için gerekli immutable snapshot'ları tutabilir. Cross-store transaction beklentisi azaltılır. Document schema version yine application contract olarak yönetilir.
Ürün Kataloğu
Katalogda elektronik ürünün ekran boyutu varken giyim ürününde kumaş ve beden alanları bulunabilir. Document yapısı bu çeşitliliği doğal taşıyabilir. Search için ayrı denormalized index üretilebilir. Checkout order line içine satış anındaki kritik product ve price snapshot yazılır. Böylece katalog sonradan değişse bile geçmiş sipariş etkilenmez.
Dynamic Metadata
User-defined attributes veya integration payload'ları hızlı schema evolution isteyebilir. MongoDB veya PostgreSQL JSONB bu ihtiyaç için adaydır. Metadata'nın hangi alanlarının query ve index gerektirdiği ölçülmelidir. Limitsiz dinamik field indexing kontrolsüz storage büyümesi yaratabilir. Kritik business constraint flexible metadata içine gömülmemelidir.
Content / CMS
Content document nested blocks ve farklı component türleri taşıyabilir. Document model authoring tarafında doğal olabilir. Publish edilmiş content CDN veya search engine'e projection olarak aktarılabilir. Revision ve workflow history ayrı collection veya SQL domain olarak modellenebilir. CMS esnekliği transactional customer database'ini değiştirmek zorunda değildir.
Verilerin Sınırlarını Net Belirlemek
“User hem SQL'de hem MongoDB'de var” demek yeterli değildir. SQL'deki user canonical identity, MongoDB'deki document profile read projection olabilir. Hangi field'in hangi store tarafından değiştirilebildiği açık olmalıdır. Cross-store mutation yerine domain owner API veya event üzerinden değişiklik yayar. Ownership matrisi ekipler arası anlaşmazlığı ve veri drift'ini azaltır.
SQL + Graph Database Kullanımı
SQL ile graph database birlikte kullanıldığında core entity kayıtları relational store'da, relationship-heavy projection ise graph store'da tutulabilir. Customer, account veya transaction SQL'de authoritative olabilir. Fraud, recommendation veya social traversal için gerekli edges event üzerinden graph'a aktarılır. Graph store kaybolduğunda event replay veya backfill ile yeniden oluşturulur. Bu model graph database'i core business transaction'a zorlamadan ilişki sorgularındaki avantajından yararlanır.
SQL'de Core Entity
User ve account kayıtları SQL constraint ve transaction ile yönetilebilir. Identity ve financial state burada authoritative kalır. Graph store entity ID ve relationship metadata'nın yalnızca gerekli bölümünü taşır. Core update event projection'ı değiştirir. Graph query sonucu final business authorization yerine candidate set üretmek için kullanılabilir.
Graph DB'de Relationship Projection
Graph store ilişkileri doğrudan edge olarak temsil eder. Çok adımlı traversal query daha doğal hale gelir. Projection source event'lerden türetilir. Edge metadata search ihtiyacına göre denormalize edilebilir. Rebuild süreci canonical SQL ve event history üzerinden test edilmelidir.
Fraud Detection
Aynı cihaz, adres veya ödeme aracı üzerinden ilişkili hesaplar graph modeliyle incelenebilir. Fraud engine birden fazla hop içinde şüpheli pattern bulabilir. Sonuç karar değil risk sinyali olarak kullanılabilir. Canonical transaction SQL'de kalır. Graph projection lag risk modelinin freshness SLO'sunda dikkate alınmalıdır.
Recommendation
User-product interaction graph recommendation candidate üretmek için kullanılabilir. Satın alma veya click events relationship projection'ını günceller. Recommendation sonucu cache veya vector model ile birleştirilebilir. Kullanıcının privacy tercihi graph verisine propagate edilmelidir. Projection yeniden üretilebilir olmalıdır.
Social Graph
Follower, friend veya membership ilişkileri graph traversal için doğal örnektir. Core user account başka database'de kalabilir. Graph yalnızca relationship identity'lerini taşır. Block veya privacy update hızlı event ile yansıtılmalıdır. Security-sensitive relation için strong read gerektiğinde authoritative service kontrolü yapılabilir.
Graph Projection'ın Güncellenmesi
Domain event edge create, update veya delete bilgisini taşır. Consumer idempotent operation uygular. Version eski event'in yeni ilişkiyi overwrite etmesini engeller. Reconciliation SQL ilişki kayıtlarıyla graph'ı periyodik karşılaştırabilir. Projection lag gözlemlenebilir olmalıdır.
SQL + Time-Series Database
SQL ve time-series store kombinasyonu master data ile yüksek hacimli ölçüm akışını ayırır. Device, customer ve configuration SQL'de tutulabilir. Sensor measurement, metric veya event specialized store'a yazılır. Retention ve downsampling time-series data'nın uzun dönem maliyetini kontrol eder. İki sistem arasındaki ilişki stable entity ID üzerinden kurulur ve OLTP request path cross-store join'e bağımlı hale getirilmez.
SQL'de Master Data
Device ownership, customer plan ve configuration relational database'de yaşayabilir. Bu kayıtlar transaction ve constraint'ten faydalanır. Time-series event yalnızca device ID taşır. Metadata değiştiğinde historical event'in nasıl yorumlanacağı domain kararına bağlıdır. Analytics gerekirse zaman noktasındaki metadata snapshot'ını ayrıca saklayabilir.
Time-Series Store'da Metrics/Sensor Data
Her sensor saniyede çok sayıda measurement üretebilir. Bu data append-heavy ve timestamp merkezlidir. Specialized store time partitioning ve compression sağlayabilir. Tek tek row update nadir olabilir. Query çoğunlukla time range ve device filter üzerinden yapılır.
High Write Throughput
Telemetry ingestion transactional user database'i saturation'a sokmamalıdır. Buffer veya broker burst traffic'i emebilir. Time-series store batch writes kullanabilir. Backpressure producer tarafına kadar iletilmelidir. Data loss toleransı measurement türüne göre belirlenir.
Retention
Raw telemetry sonsuza kadar saklanmak zorunda değildir. Günler veya aylar sonra daha eski data silinebilir. Retention policy storage maliyetini kontrol eder. Legal veya business requirement ayrı archive katmanı isteyebilir. SQL master data retention'dan bağımsız yaşayabilir.
Aggregation
Dashboard ham milyarlarca measurement yerine dakika veya saat aggregate kullanabilir. Time-series engine aggregate query veya continuous rollup sağlayabilir. Result cache yüksek trafik dashboard'larda ek fayda sağlar. Aggregation logic version değişiminde yeniden hesaplama ihtiyacı oluşabilir. Raw retention süresi bu ihtiyacı etkiler.
Downsampling
Eski data daha düşük resolution ile saklanabilir. Saniyelik ölçüm bir yıl sonra saatlik average olarak tutulabilir. Storage ciddi biçimde azalır. Kullanıcı query time range'e göre uygun resolution'a yönlendirilir. Downsampling irreversible ise raw data retention business gereksinimiyle uyumlu olmalıdır.
SQL + NoSQL İçin E-Ticaret Referans Mimarisi
E-ticaret polyglot persistence için anlaşılır bir örnektir, çünkü transaction, catalog, session, search ve recommendation gereksinimleri belirgin biçimde ayrılır. User accounts, orders, payments ve inventory güçlü transactional model nedeniyle PostgreSQL'de tutulabilir. Product catalog document store'a, sessions Redis'e, search ayrı index'e, recommendation graph veya vector store'a yerleştirilebilir. Bu yalnızca örnek bir referanstır ve küçük e-ticaret uygulaması tümünü PostgreSQL ile gayet başarılı çalıştırabilir. Yeni store ancak scale veya access pattern gerçek ihtiyaç oluşturduğunda eklenmelidir.
User Accounts → PostgreSQL
User account identity, email uniqueness ve authentication metadata güçlü constraint ister. PostgreSQL bu kuralları doğal biçimde enforce eder. Profile projection cache veya document store'a aktarılabilir. Permission değişikliği derived cache'leri invalidate etmelidir. Account deletion bütün downstream copies için event üretmelidir.
Orders → PostgreSQL
Order ve line items transaction içinde oluşturulabilir. Order state transition business rule ile korunur. Search veya customer dashboard için denormalized order read model üretilebilir. Projection gecikmesi canonical order state'i değiştirmez. Audit ve reconciliation source SQL üzerinden yapılır.
Payments → PostgreSQL
Payment record idempotency ve financial audit gerektirir. Provider response immutable veya append-style log ile ilişkilendirilebilir. Cache payment kararının kaynağı olmamalıdır. Analytics copy warehouse'a event ile aktarılabilir. Refund veya charge state transactionally yönetilmelidir.
Inventory → PostgreSQL
Inventory reservation concurrent transaction gerektirebilir. Product page display için cache kullanılabilir. Checkout authoritative inventory'yi tekrar doğrular. Search index stale stock gösterebilir fakat satın alma garantisi vermez. High-scale inventory ayrı service ve specialized storage'a geçebilir, ancak invariant korunmalıdır.
Product Catalog → MongoDB / Document Store
Ürün category attribute'ları büyük farklılık gösteriyorsa document model faydalı olabilir. Catalog kendi domain source of truth'u olarak MongoDB'de yaşayabilir. Order sistemi product snapshot'ı event veya API ile alır. Search index catalog event'lerinden beslenir. Eğer ürün modeli ilişkisel ve kararlıysa PostgreSQL JSONB ayrı store ihtiyacını ortadan kaldırabilir.
Sessions → Redis
Session hızlı key lookup ister. TTL doğal lifecycle sağlar. Session kaybı user experience'ı etkilediği için pure cache'ten daha kritik olabilir. Replication ve persistence gereksinimi risk seviyesine göre belirlenir. Cache ile session aynı eviction policy altında tutulmamalıdır.
Search → Elasticsearch/OpenSearch
Product search denormalized documents kullanır. Catalog event değişiklikleri index consumer'a gider. Facet ve relevance search engine tarafından hesaplanır. Index yeniden üretilebilir olmalıdır. Search outage checkout veya account transaction'larını durdurmamalıdır.
Recommendations → Graph/Vector Store
Recommendation sistemi user behavior ve product embedding kullanabilir. Graph relation veya vector similarity candidate set üretir. Recommendation sonuçları cache'lenebilir. Source behavior events tekrar işlenebilir. Bu datastore e-ticaretin transactional correctness kaynağı değildir.
Hangi Verinin Hangi Database'de Yaşayacağı Nasıl Belirlenir?
Datastore yerleşimi data type adına göre değil business criticality, consistency, transaction boundary ve query pattern üzerinden belirlenmelidir. Aynı JSON veri iki farklı domain'de tamamen farklı store tercihleri gerektirebilir. Read/write oranı, volume, latency ve retention ek kriterlerdir. Her entity için data ownership kartı hazırlamak kararları görünür hale getirir. Bir veri birden fazla store'da bulunabilir, fakat authoritative source yalnızca bir yerde açıkça tanımlanmalıdır.
Business Criticality
Verinin yanlış olması hangi business sonucunu doğuruyor sorusu ilk kriterdir. Ödeme tutarı ile recommendation sırası aynı riskte değildir. Critical data güçlü constraint ve transaction source ister. Derived copies daha gevşek olabilir. Failure sırasında hangi store kapatılabilir sorusu criticality'yi pratik biçimde gösterir.
Consistency
Update bütün okuyuculara ne kadar hızlı görünmek zorunda sorusu store seçimini etkiler. Anlık strong read gerekiyorsa source database tercih edilir. Birkaç saniye gecikme kabul edilirse projection store kullanılabilir. Cache için daha uzun window mümkün olabilir. Consistency requirement endpoint bazında tanımlanabilir.
Transaction Boundary
Aynı business operation hangi kayıtları birlikte değiştirmek zorunda belirlenmelidir. Bu kayıtların aynı local database içinde kalması transaction modelini sadeleştirir. Sınırı farklı store'lara dağıtmak saga veya event consistency gerektirir. Aggregate design datastore boundary ile uyumlu olmalıdır. Cross-store atomicity zorunlu hale geliyorsa yerleşim tekrar düşünülmelidir.
Query Pattern
Veri equality lookup mı, full-text search mü, graph traversal mı gerektiriyor analiz edilir. Query frequency ve latency hedefi ölçülür. Sadece nadir administration query için specialized store eklemek gereksizdir. Sık ve business-critical query daha yüksek öncelik alır. Projection tam olarak hedef access pattern'i destekleyecek biçimde modellenir.
Read/Write Ratio
Read-heavy data cache ve denormalized read modelden faydalanabilir. Write-heavy state duplicate projection update maliyeti oluşturur. Write-behind veya event batching seçenekleri değerlendirilebilir. Read/write oranı gün içinde değişebilir. Peak period metriği average değer kadar önemlidir.
Data Volume
Dataset büyüklüğü storage ve index memory ihtiyacını belirler. Büyük olması tek başına NoSQL gerekçesi değildir. Data distribution ve working set daha önemlidir. Hot subset cache'te tutulabilir. Historical data archive veya analytical store'a taşınabilir.
Latency
Endpoint SLO datastore erişiminin bütçesini belirler. Cache hit birkaç milisaniye, search onlarca milisaniye, analytical query saniyeler olabilir. Her store aynı latency hedefini taşımamalıdır. Network region placement sonucu ciddi etkiler. Tail latency p95 ve p99 üzerinden ölçülmelidir.
Retention
Verinin ne kadar süre saklanacağı datastore maliyetini etkiler. Transaction record yıllarca kalabilir. Cache dakikalar içinde expire olabilir. Raw telemetry birkaç gün sonra downsample edilebilir. Delete propagation ve legal retention policy bütün copies için tanımlanmalıdır.
System of Record Nedir?
System of Record belirli bir veri için authoritative ve güvenilir kaynak olarak kabul edilen sistemdir. Aynı entity search index, cache ve analytics store'da kopyalanabilir. Fakat conflict durumunda hangi kaydın doğru kabul edileceği tek ve açık olmalıdır. Derived copies performance veya query kolaylığı sağlar. Bu rol ayrımı polyglot persistence'ın en önemli governance kurallarından biridir.
Authoritative Data Source
Authoritative source business update'in resmi olarak gerçekleştiği yerdir. Constraint ve transaction burada uygulanır. Downstream projection'lar bu state'ten türetilir. Conflict olduğunda source value kazanır. Recovery workflow bütün copies'i buradan yeniden oluşturabilmelidir.
Bir Veri İçin Tek Otorite
Aynı field iki database tarafından bağımsız değiştirilememelidir. Aksi halde conflict resolution sürekli hale gelir. Ownership domain service'e bağlanabilir. Diğer store'lar read projection veya cache olarak davranır. Write API yalnızca owner üzerinden geçer.
Derived Copy
Derived copy canonical state'in farklı access pattern için dönüştürülmüş halidir. Search document, cache value veya graph edge örnek olabilir. Kaybolduğunda source'tan üretilebilir. Schema canonical ile aynı olmak zorunda değildir. Version projection freshness ve ordering'i yönetmeye yardım eder.
Cache
Cache source verinin geçici hızlı kopyasıdır. TTL ile yaşam süresi sınırlandırılır. Eviction correctness kaybı yaratmamalıdır. Cache stale olursa source read yapılabilir. Cache primary state taşıyorsa artık bu tanım değişir.
Search Projection
Search projection retrieval için denormalized document'tir. Source fields analyzer ve search mapping'e göre dönüştürülür. Index rebuild sırasında yeniden üretilebilir. Search lag kullanıcı discovery'sini etkileyebilir. Business transaction source'u değildir.
Analytics Copy
Analytics store reporting ve historical aggregation için data kopyası taşıyabilir. ETL veya CDC ile beslenir. Data birkaç dakika veya saat gecikmeli olabilir. Reporting correction source record üzerinden yapılır. Warehouse'un business write path'ine geri yazması kontrollü tutulmalıdır.
Aynı Entity Birden Fazla Database'de Bulunabilir mi?
Evet, aynı entity'nin farklı temsilleri birden fazla datastore'da bulunabilir ve polyglot persistence'ın normal parçasıdır. User SQL'de canonical row, Redis'te profile cache, search index'te public search document olarak yaşayabilir. Problem kopyaların varlığı değil yetki sınırının belirsizliğidir. Her derived representation source version veya update sequence taşıyabilir. Rebuild edilebilirlik veri drift'inin kalıcı hale gelmesini önler.
Evet, Ama Aynı Yetkiye Sahip Olmamalı
İki store aynı field'i bağımsız değiştirirse conflict kaçınılmaz hale gelir. Bir store canonical owner olmalıdır. Diğer kopya read veya search amacı taşır. Mutation yalnızca owner üzerinden yapılır. Event projection günceller.
Canonical Record
Canonical record bütün business fields'i taşımak zorunda değildir. Yalnızca domain için authoritative state'i temsil eder. Derived store farklı shape kullanabilir. ID ortak correlation sağlar. Audit canonical değişiklikleri takip eder.
Derived Representation
Search document user name yanında company ve role fields'ini denormalize edebilir. Cache daha küçük summary taşıyabilir. Graph yalnızca node ID ve relationship kullanabilir. Bu farklılık normaldir. Projection mapping açıkça versionlanmalıdır.
Version
Monotonic version event ordering'i yönetir. Projection yalnızca daha yeni version'ı uygular. Duplicate event aynı version ile idempotent hale gelir. Timestamp tek başına clock skew nedeniyle daha zayıf olabilir. Version source transaction ile birlikte üretilmelidir.
Rebuild Edilebilirlik
Derived store tamamen silinip yeniden üretilebilmelidir. Backfill source snapshot'tan başlar. Event log incremental değişiklikleri tamamlar. Validation record count ve hash karşılaştırabilir. Rebuild prosedürü düzenli test edilmelidir.
Data Ownership Nasıl Belirlenir?
Data ownership hangi domain ve service'in belirli veriyi değiştirme yetkisine sahip olduğunu tanımlar. Database teknolojisinden daha önemli bir mimari sınırdır. Başka service'in database'ine doğrudan bağlanmak ownership'i bulanıklaştırır. API veya integration event değişiklikleri açık contract üzerinden yayar. Ownership doğru kurulursa datastore teknolojisi değişse bile diğer servislerin bağımlılığı daha az etkilenir.
Domain Ownership
Customer, order ve payment farklı business domain'lere ait olabilir. Her domain kendi invariants ve lifecycle'ını bilir. Data owner business anlamın sahibidir. Technology team yalnızca storage yönetmez. Domain event dış sistemlere gerekli bilgiyi yayınlar.
Service Ownership
Microservice domain state'inin runtime owner'ı olabilir. Write request bu service API'sinden geçer. Service kendi database schema'sını değiştirebilir. Başka service private table'a bağlanmaz. Contract service boundary'de korunur.
Database Ownership
Bir database cluster birden fazla service tarafından paylaşılsa bile schema ownership tanımlanabilir. Uzun vadede shared table writes coupling yaratır. Database role service bazında minimum permission almalıdır. Migration owner belli olmalıdır. Shared operational platform domain ownership'i ortadan kaldırmamalıdır.
Başka Servisin Database'ine Doğrudan Bağlanmamak
Direct query ilk başta hızlı çözüm gibi görünür. Zamanla schema değişikliği consumer'ı kırar. Owner hangi hidden query'lerin bulunduğunu bilmez. Security boundary genişler. API veya event daha açık bağımlılık oluşturur.
API/Event Boundary Kullanmak
Synchronous bilgi gerektiğinde API kullanılabilir. Async state propagation için event uygundur. Contract versionlanır. Consumer owner'ın internal schema'sından bağımsız kalır. Observability boundary üzerinden dependency'yi görünür yapar.
Database-per-Service Pattern
Database-per-service her microservice'in kendi persistence alanına sahip olmasını hedefler. Bu fiziksel olarak ayrı cluster olmak zorunda değildir, önemli olan başka servislerin private schema'ya doğrudan erişmemesidir. Service teknoloji ihtiyacına göre SQL veya NoSQL seçebilir. Independent deployment ve scaling kolaylaşır. Buna karşılık cross-service query ve transaction artık network ve event mekanizmalarıyla çözülmelidir.
Her Microservice'in Kendi Datastore'u
Service kendi business state'ini kontrol eder. Migration başka service deployment'ını beklemek zorunda kalmaz. Database credential yalnızca owner service'e verilir. Shared reporting için projection üretilir. Operational platform yine ortak cluster sunabilir.
Database Technology Freedom
Catalog document store, payment relational database kullanabilir. Bu özgürlük governance olmadan datastore sprawl yaratabilir. Approved technology list gerekir. Yeni teknoloji measurable benefit göstermelidir. Ekip support sorumluluğunu kabul etmelidir.
Loose Coupling
Service internal table yapısını değiştirebilir. Consumer yalnızca API veya event contract'ına bağlıdır. Data storage implementation detail haline gelir. Contract tests integration'ı korur. Loose coupling tamamen bağımsızlık değil kontrollü bağımlılık demektir.
Independent Deployment
Schema migration owner service release'iyle yönetilir. Başka service'in private SQL query'si olmadığı için kırılma riski azalır. Event schema backward compatible tutulur. Deployment rollback daha kolaydır. Shared broker veya platform dependency yine bulunabilir.
Independent Scaling
Search-heavy service farklı datastore kapasitesi kullanabilir. Payment database daha düşük QPS fakat güçlü durability ister. Resource allocation domain workload'a göre ayarlanır. Noisy neighbor etkisi azalır. Cost attribution service bazında yapılabilir.
Shared Database vs Database-per-Service
Shared database ve database-per-service arasında mutlak doğru tercih yoktur. Küçük ekip shared database ile daha hızlı geliştirebilir ve transaction kolaylığından yararlanabilir. Sistem büyüdükçe shared schema coupling bağımsız deployment'ı zorlaştırabilir. Database-per-service autonomy sağlar fakat distributed query ve consistency maliyeti getirir. Migration aşamalı yapılmalı ve business boundary teknik zorlamadan önce netleşmelidir.
Shared Database Avantajları
Tek connection ve backup modeli daha basittir. Cross-table transaction kolaydır. Ad hoc reporting SQL ile yapılabilir. Küçük ekip debugging'de avantaj görür. Infrastructure cost düşük olabilir.
Shared Database Coupling
Bir service başka service tablosunu doğrudan kullanmaya başlayabilir. Schema migration çok sayıda consumer'ı etkiler. Permission sınırları genişler. Performance noisy neighbor oluşabilir. Ownership zamanla belirsizleşir.
Database-per-Service Avantajları
Schema ve technology owner service tarafından yönetilir. Independent scaling kolaylaşır. Security permission daralır. Failure domain ayrılabilir. Bounded context daha görünür hale gelir.
Cross-Service Query Maliyeti
Tek SQL JOIN yerine birden fazla API çağrısı gerekebilir. Network latency artar. Partial failure yönetilir. CQRS read model bu maliyeti azaltabilir. Reporting ayrı analytical store'a taşınabilir.
Migration Stratejisi
Shared database bir gecede parçalanmamalıdır. Önce ownership ve API boundary tanımlanır. Table erişimleri owner service'e yönlendirilir. CDC veya event projection yeni store'u doldurur. Shadow validation sonrası cutover yapılır.
Başka Servisin Database'ine Doğrudan Query Atmak Neden Risklidir?
Direct database query service boundary'yi görünmez hale getiren güçlü coupling yaratır. Consumer private schema'ya bağımlı olur. Owner kolon veya index değiştirirken başka uygulamayı kırabilir. Security credential gereğinden fazla genişler. Zamanla service autonomy yalnızca isimde kalır.
Schema Coupling
Consumer belirli table ve column adına bağlanır. Owner migration yaparken tüm consumer'ları bilmek zorundadır. Hidden SQL merkezi registry'de görünmeyebilir. Release coordination artar. API contract daha kontrollü change surface sunar.
Security Boundary İhlali
Başka service database credential aldığında normal API authorization atlanabilir. Row-level business permission kaybolabilir. Least privilege uygulamak zorlaşır. Credential compromise daha geniş data erişimi sağlar. Service identity üzerinden API daha net policy sağlar.
Independent Deployment'ın Kaybolması
Schema change downstream query'yi kırabilir. İki service aynı anda release edilmek zorunda kalır. Rollback uyumsuz hale gelir. Database implementation public contract'a dönüşür. Microservice avantajlarından biri kaybolur.
Gizli Dependency
Monitoring yalnızca database query görür, business dependency görünmeyebilir. Owner table'ı kaldırmak istediğinde bilinmeyen consumer çıkar. Incident impact tahmini zorlaşır. Dependency graph eksik kalır. API veya event telemetry bağımlılığı açık hale getirir.
Data Ownership'ın Bozulması
Consumer zamanla read yanında update yapmaya başlayabilir. İki service aynı business rule'u farklı uygular. Canonical owner belirsizleşir. Audit zorlaşır. Write permission yalnızca owner service'e verilmelidir.
Birden Fazla Database Arasında Veri Nasıl Senkronize Edilir?
Birden fazla datastore kullanıldığında veri senkronizasyonu mimarinin merkezine yerleşir. Synchronous dual write en basit görünen fakat partial failure açısından riskli yöntemdir. Event-driven synchronization ve CDC değişiklikları asynchronous biçimde yayar. Batch ETL analytical veya düşük freshness workload için uygundur. Scheduled reconciliation ise kaçırılan veya hatalı projection'ları tespit eden son güvenlik katmanıdır.
Synchronous Dual Write
Application aynı request içinde SQL ve NoSQL'e yazar. İlk write başarılı ikinci başarısız olabilir. Retry duplicate veya ordering problemi yaratabilir. Cross-store atomic transaction yoksa consistency garantisi zayıftır. Bu nedenle direct dual write dikkatle sınırlandırılmalıdır.
Event-Driven Synchronization
Source transaction tamamlanınca domain event yayınlanır. Consumer derived store'u günceller. Eventual consistency kabul edilir. Consumer idempotent olmalıdır. Broker ve projection lag izlenmelidir.
Change Data Capture
CDC database transaction log değişikliklerini okuyarak event üretir. Application code her table change için publish yapmak zorunda kalmaz. Commit edilmiş değişiklikler reliable stream'e aktarılabilir. Semantic business context raw row change'de sınırlı olabilir. Outbox ile CDC birlikte güçlü çözüm sunar.
Batch ETL
Veri belirli aralıklarla source'tan hedef store'a aktarılır. Dakikalık veya günlük freshness yeterliyse basittir. Büyük batch source load oluşturabilir. Checkpoint incremental extraction sağlar. Analytical sistemlerde yaygındır.
Scheduled Reconciliation
Source ve projection belirli periyotta karşılaştırılır. Missing veya version mismatch kayıtlar bulunur. Repair otomatik veya kontrollü yapılabilir. Drift metric synchronization kalitesini gösterir. Reconciliation event pipeline'ın yerine değil safety net olarak çalışır.
Dual-Write Problemi Nedir?
Dual-write problemi tek business operation'ın iki bağımsız datastore'a yazılması sırasında iki işlemin birlikte atomik olmamasından doğar. SQL commit olup NoSQL write başarısız olabilir. Tersi durumda SQL rollback olurken derived store yeni state'i taşıyabilir. Network ve process failure bu ara durumları kaçınılmaz hale getirir. Transactional Outbox ve event-driven projection bu riski azaltmanın yaygın yollarındandır.
SQL Yazımı Başarılı, NoSQL Yazımı Başarısız
Business state SQL'de commit edilmiştir. Application NoSQL request sırasında timeout alır. User success görmüş olabilir. Projection eski kalır. Retry veya event mekanizması gereklidir.
NoSQL Başarılı, SQL Transaction Rollback
Application önce NoSQL'e yazdıysa derived store future state gösterebilir. SQL constraint veya deadlock nedeniyle rollback olabilir. Kullanıcı search veya cache'te var olmayan business kaydı görebilir. Cleanup ayrıca gerekir. Bu yüzden canonical commit genellikle önce tamamlanır.
İki Database Arasında Atomic Transaction Eksikliği
İki bağımsız database aynı local transaction manager'ı paylaşmaz. Network üzerinden atomicity ekstra protocol gerektirir. 2PC bazı teknolojilerde mümkün olabilir. Availability ve operational cost artar. Eventual projection çoğu read-model use case için daha uygun olur.
Partial Failure
Distributed system'de bir dependency çalışırken diğeri başarısız olabilir. Timeout işlemin başarısız olduğunu kesin olarak söylemeyebilir. Remote side write tamamlanmış olabilir. Retry duplicate oluşturabilir. Idempotency bu belirsizliği yönetmenin temel aracıdır.
Neden Basit Dual Write Production'da Tehlikelidir?
Basit dual write normal çalışma sırasında kusursuz görünebilir ve test ortamında yıllarca problem çıkarmayabilir. Production'da network timeout, process crash veya dependency failover tam iki write arasındaki pencerede gerçekleşebilir. Bu durum sessiz data drift yaratır. Retry mekanizması duplicate ve out-of-order update sorunlarını ekleyebilir. Veri tutarlılığı monitoring ve reconciliation olmadan sorun uzun süre fark edilmeyebilir.
Network Failure
İkinci datastore'a request gönderilir fakat response geri gelmez. Application işlemin tamamlanıp tamamlanmadığını bilemez. Blind retry duplicate write yapabilir. Idempotency key gerekir. Event log daha güvenilir durum takibi sağlar.
Process Crash
SQL commit sonrasında process crash olabilir. NoSQL update hiç gönderilmez. Restart sırasında application bu eksikliği bilmeyebilir. Outbox row commit ile birlikte kaldığı için relay sonradan event'i yayınlar. Bu yüzden local durable marker değerlidir.
Timeout
Timeout remote operation'ın başarısızlığı değildir, yalnızca süresinde cevap alınmadığını gösterir. Remote store write'ı tamamlamış olabilir. Retry aynı değişikliği tekrar uygulayabilir. Event ID ve version kullanılmalıdır. Timeout semantics client library seviyesinde anlaşılmalıdır.
Retry
Transient error için retry yararlıdır. Non-idempotent operation tekrarlandığında duplicate state yaratabilir. Exponential backoff ve jitter yük patlamasını azaltır. Retry yalnızca retryable error'larda uygulanmalıdır. Operation ID sonucu deduplicate etmeye yardım eder.
Duplicate Write
Aynı event consumer'a birden fazla kez gelebilir. Exactly-once beklentisi yerine idempotent projection daha dayanıklıdır. Upsert veya event ID dedupe kullanılabilir. Counter increment gibi operation özel dikkat ister. Source version final state update için daha güvenli olabilir.
Inconsistent State
SQL ve NoSQL farklı değer taşıdığında kullanıcı farklı endpoint'lerden çelişkili sonuç alabilir. Drift birkaç saniyelik normal eventual consistency mi yoksa kalıcı hata mı ayrılmalıdır. Projection lag ve version metric bunu gösterir. Reconciliation kalıcı drift'i düzeltir. Business-critical read gerekirse source'a yönlendirilir.
Transactional Outbox Pattern
Transactional Outbox business data ile yayınlanması gereken event'in aynı local database transaction'ında yazılmasını sağlayan pattern'dir. Böylece database commit başarılıysa event kaydı da kalıcı olur. Ayrı relay veya CDC outbox tablosunu okuyup broker'a gönderir. Debezium'un güncel Outbox Event Router yaklaşımı bu modeli destekleyen yaygın uygulamalardan biridir. Pattern external broker write'ını SQL transaction içine zorlamadan dual-write riskini azaltır.
Business Transaction
Application order veya customer değişikliğini normal SQL transaction içinde yapar. Business constraint burada uygulanır. Aynı transaction bitmeden external message broker çağrısı gerekli değildir. Failure rollback bütün local değişiklikleri geri alır. Outbox event de transaction'ın parçasıdır.
Outbox Table
Outbox table event ID, aggregate ID, type ve payload gibi alanlar taşır. Row business data ile birlikte commit edilir. Relay yalnızca committed rows görür. Event ID downstream dedupe için kullanılabilir. Retention processed records'ın büyümesini kontrol eder.
Tek SQL Transaction
Business row ve outbox row aynı ACID transaction içinde yazılır. Birisi başarılı diğeri başarısız durum oluşmaz. Broker geçici olarak down olsa bile event kaydı database'de bekler. Application request broker availability'ye bağımlı değildir. Bu pattern availability'yi de iyileştirebilir.
Message Relay
Relay outbox rows okuyup broker'a publish eder. Polling veya CDC kullanılabilir. Publish sonrası delivery state yönetilir. Crash nedeniyle aynı event tekrar yayınlanabilir. Consumer idempotent olmalıdır.
NoSQL Projection Update
Consumer event'i alır ve MongoDB, Redis veya search index'i günceller. Projection source version kontrol edebilir. Failure retry edilir. Eventual consistency window broker ve consumer lag toplamıdır. Projection delete ve schema change event'leri de desteklemelidir.
Outbox ile SQL → NoSQL Senkronizasyon Akışı
SQL'den NoSQL projection'a güvenilir akış local transaction ve asynchronous delivery olarak iki aşamaya ayrılır. İlk aşamada business state ve outbox event birlikte commit edilir. İkinci aşamada relay veya CDC event'i broker'a taşır. Consumer hedef datastore'u idempotent biçimde günceller. Her aşamanın metric ve retry davranışı ayrı izlenmelidir.
1. SQL Transaction Başlar
Application business command için local transaction açar. Gerekli rows lock veya isolation kuralları altında okunur. Validation yapılır. Henüz external store çağrısı gerekmez. Transaction deadline kontrollü tutulur.
2. Business Data Yazılır
Order veya entity state SQL'e yazılır. Database constraint correctness'i kontrol eder. Version artırılabilir. Audit fields güncellenir. Henüz commit gerçekleşmemiştir.
3. Outbox Event Yazılır
Aynı transaction içinde event row oluşturulur. Aggregate ID ve version payload'a eklenir. Unique event ID üretilir. Consumer için gerekli minimum data taşınır. PII gereksiz yere event'e konulmamalıdır.
4. Transaction Commit Edilir
Business ve outbox rows birlikte görünür hale gelir. Commit başarısızsa ikisi de uygulanmaz. User'a success ancak commit sonrası dönülür. Broker down olsa bile commit mümkündür. Delivery asynchronous olarak devam eder.
5. Relay/CDC Event'i Okur
Relay committed outbox row'u bulur. CDC transaction log üzerinden değişikliği capture edebilir. Event broker'a yayınlanır. Offset veya checkpoint tutulur. Duplicate delivery ihtimali kabul edilir.
6. NoSQL Store Güncellenir
Consumer event'i deserialize eder. Version ve event ID kontrol edilir. Projection upsert veya delete uygulanır. Başarı metric olarak kaydedilir. Error retry veya dead-letter sürecine gider.
Change Data Capture (CDC)
CDC database transaction log içindeki committed değişiklikleri downstream event akışına dönüştürür. Application table update'lerini ayrıca publish etmek zorunda kalmaz. PostgreSQL WAL ve MySQL binlog bu yaklaşım için temel veri kaynaklarıdır. Debezium gibi platformlar log değişikliklerini structured events olarak aktarabilir. CDC raw data change'i güçlü biçimde yakalar, ancak business semantic gerekiyorsa Outbox gibi domain event yaklaşımıyla birleştirmek daha anlamlı olabilir.
Transaction Log
Database durability için değişiklikları transaction log'a yazar. CDC bu authoritative change stream'i okur. Committed ordering bilgisi alınabilir. Table scan yerine incremental capture sağlanır. Log retention connector downtime süresini karşılamalıdır.
PostgreSQL WAL
PostgreSQL Write-Ahead Log değişiklikleri durability ve recovery için kaydeder. Logical decoding bu değişiklikleri daha yüksek seviyeli formatta çıkarabilir. CDC connector replication slot kullanabilir. Slot uzun süre tüketilmezse WAL disk kullanımı büyüyebilir. Monitoring slot lag'i izlemelidir.
MySQL Binlog
MySQL binary log committed değişiklikleri replication ve recovery senaryolarında kullanır. CDC connector binlog event'lerini okuyabilir. Row-based format change capture için yaygındır. Retention connector outage süresinden kısa olmamalıdır. Server ID ve privilege configuration güvenli yapılmalıdır.
Debezium
Debezium yaygın database connector'larıyla CDC event üretir. Snapshot ve streaming aşamaları historical ve ongoing data'yı birleştirir. Outbox Event Router business event pattern'ini destekleyebilir. Connector lag ve schema history monitoring gerektirir. Event contract doğrudan raw table schema'ya bağımlı bırakılmamalıdır.
Near Real-Time Synchronization
CDC committed database değişikliğini saniyeler veya daha kısa süre içinde downstream store'a aktarabilir. Bu yine synchronous transaction değildir. Broker ve consumer lag freshness window oluşturur. Peak traffic sırasında lag artabilir. SLO maximum acceptable delay üzerinden tanımlanmalıdır.
CDC mi Application Event mi?
CDC ile application event aynı problemi farklı seviyelerde çözer. CDC database'de gerçekten değişen row'u güvenilir biçimde yakalar. Application event business anlamı daha açık “OrderShipped” gibi semantic mesajlar üretebilir. Raw row değişikliği consumer'ı storage schema'ya bağlayabilir. Outbox pattern application semantic ile database log reliability'yi birleştiren güçlü ara çözümdür.
Database-Level Change
CDC table row değişikliğini bilir. Business niyetini her zaman bilmez. Bir status update'in neden yapıldığı payload'dan anlaşılmayabilir. Generic data replication için uygundur. Schema change consumer'ı etkileyebilir.
Business-Level Event
Domain event iş anlamını ifade eder. Consumer storage schema yerine business contract'a bağlanır. Event payload minimum gerekli data'yı taşır. Versioning daha kontrollüdür. Publisher event üretimini unutmamalıdır.
Semantic Richness
UPDATE orders SET status='SHIPPED' raw değişikliktir. OrderShipped domain anlamı taşır. Consumer notification veya search update gibi davranışı daha kolay seçer. Semantic event audit için de değerlidir. Yanlış event granularity aşırı coupling yaratabilir.
Operational Complexity
CDC connector, replication slot ve broker operasyonu gerektirir. Application event doğrudan broker'a dual write riski taşır. Outbox bu iki sorunu dengeleyebilir. Küçük sistem polling outbox ile başlayabilir. Scale arttığında CDC relay'e geçilebilir.
Hangi Senaryoda Hangisi?
Generic data replication ve analytics feed için CDC doğal seçimdir. Business integration için domain event daha anlaşılırdır. Güvenilir domain event delivery gerekiyorsa outbox iyi modeldir. Legacy application event üretemiyorsa CDC hızlı başlangıç sağlayabilir. Consumer contract ihtiyacı kararı belirlemelidir.
CQRS ile SQL ve NoSQL Birlikte Kullanımı
CQRS command ve query modellerini ayırarak write için bir datastore, read için farklı projection kullanmaya imkan verir. SQL transactional write store olabilir. MongoDB veya search engine denormalized read store olarak konumlandırılabilir. Domain event write sonrasında projection'ları günceller. Bu yaklaşım güçlüdür fakat basit CRUD uygulama için gereksiz operasyon maliyeti yaratabilir.
Command Model
Command business state'i değiştirme niyetidir. Validation ve invariant write model üzerinde uygulanır. SQL transaction command için güçlü sınır sağlar. Response her zaman projection'ın güncellenmesini beklemek zorunda değildir. Command result canonical version taşıyabilir.
Write Store
Write store source of truth'tur. Normalize schema ve constraints kullanılabilir. Query convenience için aşırı denormalize edilmez. Outbox aynı transaction'da event kaydeder. Backup ve durability en yüksek önceliktedir.
Query Model
Query model kullanıcı ekranının ihtiyacı olan shape'i doğrudan taşıyabilir. Birden fazla source table field'i tek document içinde bulunabilir. Join ihtiyacı azalır. Event consumer modeli günceller. Query model kaybolduğunda rebuild yapılabilir.
Read Store
Read store MongoDB, search engine veya başka optimized store olabilir. Scaling read traffic'e göre bağımsız yapılır. Write permission yalnızca projection consumer'a verilir. User mutation doğrudan read store'a gitmez. Freshness SLO açık biçimde ölçülür.
Projection
Projection event'i read model'e dönüştüren fonksiyondur. Aynı event farklı projection'ları besleyebilir. Idempotent olmalıdır. Version eski event'i engeller. Rebuild aynı projection logic'i historical event veya source snapshot üzerinde çalıştırabilir.
Eventual Consistency
Command commit olduktan sonra read model birkaç saniye eski kalabilir. User hemen query yaptığında eski state görebilir. Read-your-writes teknikleri bunu yönetir. Lag metric SLO ile izlenir. Product UX pending state gösterebilir.
Örnek CQRS Mimarisi
Örnek akışta client command gönderir ve domain service PostgreSQL transaction'ında state'i değiştirir. Aynı transaction outbox event üretir. Broker event'i projection consumer'a taşır. Consumer Elasticsearch veya MongoDB read model'i günceller. Query endpoint doğrudan read store'a giderek hızlı ve denormalized response döndürür.
Command → PostgreSQL
Command API request ile gelir. Domain rules kontrol edilir. PostgreSQL transaction business state'i yazar. Version artar. Outbox record aynı transaction'da oluşturulur.
Domain Event
Event completed business fact'i ifade eder. Aggregate ID ve version taşır. Payload consumer için gerekli alanları içerir. Event immutable kabul edilir. Schema backward compatible geliştirilir.
Message Broker
Broker producer ve consumer'ı zaman açısından ayırır. Consumer geçici down olduğunda event bekleyebilir. Partition key ordering sağlayabilir. Retention replay window oluşturur. Broker failure monitoring gerektirir.
Projection Consumer
Consumer event'i okuyup read model'i günceller. Event ID dedupe yapılabilir. Version ordering kontrol edilir. Error retry edilir. Persistent failure dead-letter veya alert üretir.
Elasticsearch/MongoDB Read Model
Read model UI query'sine uygun denormalized document taşır. Search gerekiyorsa search index, flexible document lookup gerekiyorsa MongoDB seçilebilir. Aynı projection iki store'a da gerekmedikçe yazılmamalıdır. Write owner yalnızca consumer'dır. Rebuild source event veya SQL snapshot'tan yapılır.
Query → Read Store
Client query read service'e gelir. Service optimized store'dan response üretir. SQL JOIN veya cross-service composition gerekmez. Projection lag response metadata'da gerekirse gösterilebilir. Strong read gereken endpoint write store'a yönlenebilir.
Materialized Read Model Nedir?
Materialized read model sık kullanılan sorgu için verinin önceden hesaplanmış ve doğrudan okunabilir biçimde saklanmasıdır. Query zamanında ağır join veya aggregation yapılmaz. Denormalized document, search index veya dashboard view bu modelin örnekleridir. Update maliyeti asynchronous projection pipeline'a taşınır. Derived model yeniden üretilebilir olduğu sürece performance için güçlü araçtır.
Query İçin Önceden Hazırlanmış Veri
UI'nin ihtiyaç duyduğu fields tek record içine projekte edilir. Query yalnızca key lookup yapabilir. Response latency düşer. Update olduğunda projection yeniden hesaplanır. Read/write trade-off bilinçli hale gelir.
Denormalized Document
Order summary customer name ve totals birlikte taşıyabilir. Bu fields source tablolarından gelir. Customer name değiştiğinde relevant documents update gerekebilir. Event fan-out maliyeti oluşur. Read frequency bu maliyeti haklı çıkarmalıdır.
Search Index
Search index text ve filter fields'i preprocessed biçimde taşır. Analyzer write sırasında token üretir. Query hızlı retrieval yapar. Mapping projection modelinin bir parçasıdır. Full rebuild recovery planı olmalıdır.
Dashboard View
Dashboard metric'leri sürekli aggregation yerine önceden hesaplanabilir. Event consumer counter veya summary table günceller. Staleness birkaç saniye olabilir. Critical accounting report canonical data üzerinden yeniden doğrulanabilir. Dashboard latency büyük ölçüde düşer.
Yeniden Üretilebilir Olması
Read model canonical state'ten türetilebilir olmalıdır. Mapping code version control'da bulunur. Backfill ve replay automation hazırlanır. Corruption durumunda yeni index oluşturulur. Rebuild test edilmemiş projection gerçek production riski taşır.
Eventual Consistency Nedir?
Eventual consistency bir write tamamlandıktan sonra bütün derived store'ların aynı state'i anında göstermesinin zorunlu olmamasıdır. Belirli consistency window içinde projection'lar güncellenir. Bu yaklaşım availability ve independent scaling avantajı sağlayabilir. Kullanıcı deneyimi kısa gecikmeyi açık biçimde yönetmelidir. “Bir süre sonra düzelir” ifadesi yeterli değildir, maximum lag ölçülebilir SLO olmalıdır.
Write Sonrası Tüm Store'ların Anında Aynı Olmaması
PostgreSQL commit edildiğinde MongoDB read model henüz eski olabilir. Search index birkaç saniye sonra güncellenebilir. Cache event gelene kadar stale kalabilir. Bu normal mimari davranış olabilir. Critical endpoint canonical source'a yönlenir.
Consistency Window
Consistency window update ile projection'ın güncel hale gelmesi arasındaki süredir. p50 ve p99 olarak ölçülebilir. Broker ve consumer lag toplamı etkiler. SLO business requirement'a göre tanımlanır. Aşım alert üretmelidir.
Projection Lag
Consumer source event'in gerisinde kaldığında lag oluşur. High traffic veya downstream latency nedeni olabilir. Queue depth ve oldest event age izlenir. Autoscaling lag'i azaltabilir. Poison event bütün partition'ı bloke etmemelidir.
Kullanıcı Deneyimine Etkisi
User profile update sonrası eski değer görürse güven kaybı yaşayabilir. UI “güncelleniyor” state gösterebilir. Write response yeni value'yu local state'e uygulayabilir. Strong read endpoint kısa süre source'a gidebilir. Product tasarımı consistency modelini bilmelidir.
Read-Your-Writes Consistency Nasıl Sağlanır?
Read-your-writes kullanıcı kendi yaptığı değişikliği sonraki okumada görmesini hedefler. Bütün sistemin strong consistent olması gerekmez. Write sonrası belirli süre primary source'tan okumak basit yöntemdir. Version token ile projection'ın belirli version'a ulaştığı beklenebilir. UI pending state göstererek asynchronous update'i kullanıcıya açık hale getirebilir.
Write Sonrası Primary Store'dan Okumak
Mutation response source version taşır. Aynı session kısa süre SQL endpoint'e yönlenir. Projection güncellendiğinde normal read store'a dönülür. Bu süre sabit veya lag-aware olabilir. Source QPS artışı sınırlı kullanıcılarla kalır.
Session-Level Version
Client en son gördüğü entity version'ını saklayabilir. Query request minimum required version gönderir. Read service projection version'ı yeterliyse response verir. Gerideyse source fallback veya wait uygulanır. Bu model global strong consistency gerektirmez.
Projection Version Beklemek
Consumer entity version'ı read model'e yazar. Query yeni version gelene kadar kısa bounded wait yapabilir. Timeout olursa source read yapılır. Çok uzun bekleme user latency'sini bozar. Sadece hemen-write-sonrası flow'da kullanmak daha uygundur.
Client'a Pending State Göstermek
Write başarıyla commit edilmiştir fakat projection henüz hazır değildir. UI optimistic update gösterebilir. Background polling veya event notification tamamlanmayı bildirir. Kullanıcı eski server response yerine kendi yeni input'unu görür. Error halinde reconciliation mesajı gerekir.
Stale Data Nasıl Yönetilir?
Stale data eventual consistency kullanan sistemde kaçınılmaz olabilir, fakat görünmez olmamalıdır. Updated-at veya version bilgisi freshness'i değerlendirmeye yardım eder. Kullanıcıya kritik ekranda staleness indicator gösterilebilir. Strong read gereken endpoint source store'a gider. Eventual read endpoint performans için projection kullanır.
Updated-at Timestamp
Projection source update zamanını taşıyabilir. Monitoring beklenen freshness ile karşılaştırır. Clock skew farklı service timestamps'ini karşılaştırmayı zorlaştırabilir. Database commit time daha güvenilir olabilir. Business UI gerektiğinde “son güncelleme” gösterebilir.
Version
Monotonic version freshness ve ordering için güçlü sinyal sağlar. Projection version source'tan düşükse stale olduğu bilinir. Event consumer eski event'i ignore eder. Reconciliation version mismatch bulabilir. Timestamp'ten bağımsız ordering sağlar.
Staleness Indicator
Dashboard birkaç dakika gerideyse kullanıcı bunu bilmek isteyebilir. Response metadata freshness time taşıyabilir. UI kritik olmayan ekranda sessizce kullanabilir. High-risk ekranda warning gösterebilir. Policy domain'e göre değişir.
Strong Read Gereken Endpoint
Payment confirmation veya permission check source store'dan okunabilir. Latency daha yüksek olabilir. Query volume sınırlı tutulur. Cache veya projection bypass edilir. Endpoint contract stronger consistency'yi açıkça belirtir.
Eventual Read Gereken Endpoint
Search, feed veya dashboard projection kullanabilir. Düşük latency ve high throughput sağlar. Lag kabul edilen sınır içindedir. User action final transaction'da tekrar source doğrulaması yapabilir. Bu ayrım sistem kaynaklarını dengeler.
Duplicate Event ve Idempotency
Distributed messaging'de aynı event'in birden fazla kez teslim edilmesi normal kabul edilmelidir. Exactly-once beklentisi yerine idempotent consumer tasarımı daha dayanıklıdır. Event ID, source version veya upsert kullanımı duplicate etkisini azaltır. Counter gibi incremental operation özel dedupe gerektirir. Replay yapılabilmesi de idempotency'nin önemli testidir.
Aynı Update'in Birden Fazla Gelmesi
Producer retry veya consumer acknowledgement kaybı duplicate delivery yaratabilir. Projection iki kez aynı final state'i yazarsa sorun olmayabilir. Increment operation iki kez uygulanırsa yanlış sonuç çıkar. Operation semantiği bilinmelidir. Test duplicate event'i bilinçli göndererek davranışı doğrulamalıdır.
Event ID
Her event globally unique ID taşıyabilir. Consumer processed IDs tutarak duplicate'i atlayabilir. Sonsuz history saklamak maliyetlidir. Retention replay window'a göre seçilir. Entity version çoğu state projection için daha ekonomik olabilir.
Processed Event Store
Consumer event ID'yi işlendikten sonra kaydeder. Projection update ile dedupe record mümkünse aynı local transaction içinde yapılır. Store büyümesi retention ister. Consumer partition reset replay'i güvenli hale gelir. Critical event side effects için değerlidir.
Upsert
Final entity state event'te taşınıyorsa upsert idempotent olabilir. Aynı payload tekrar yazılır. Version condition eski event'i engeller. Delete tombstone ayrıca desteklenmelidir. Update merge semantics dikkatle tanımlanmalıdır.
Idempotent Projection
Projection aynı event'i defalarca işlese de aynı sonuca ulaşmalıdır. Bu property recovery ve replay'i kolaylaştırır. Version check, deterministic mapping ve upsert yardımcı olur. External side effect varsa ayrı idempotency mekanizması gerekir. Unit ve integration test bunu doğrulamalıdır.
Out-of-Order Update Problemi
Distributed event pipeline'da yeni update eski update'ten önce consumer'a ulaşabilir. Farklı partitions veya retry bu sıralamayı bozabilir. Projection yalnızca arrival order'a güvenirse eski data yeni state'i overwrite edebilir. Version veya sequence number bu problemi çözmenin temel aracıdır. Updated-at timestamp tek başına farklı clock'lar nedeniyle daha risklidir.
Version Number
Source entity her mutation'da version artırır. Event bu version'ı taşır. Projection mevcut version'dan büyük event'i uygular. Eski veya duplicate event ignore edilir. Reconciliation source version ile karşılaştırabilir.
Sequence Number
Event stream aggregate bazında sequence üretebilir. Monotonic değer ordering'i belirler. Partition key aggregate ID olduğunda broker ordering'i de destekler. Gap missing event sinyali olabilir. Sequence generation source transaction ile güvenli olmalıdır.
Updated-at Kullanımının Riski
Farklı host clock'ları aynı zamanı paylaşmayabilir. Clock sync hatası late event'i yeni gibi gösterebilir. Timestamp precision eşit update'lerde ordering vermez. Database-generated commit timestamp daha iyi olabilir. Version yine daha açık çözümdür.
Eski Update'i Ignore Etmek
Consumer event version'ını mevcut projection ile karşılaştırır. Düşük veya eşit version uygulanmaz. Metric out-of-order event sayısını gösterebilir. Çok yüksek oran partitioning sorununa işaret eder. Ignore edilen event audit için loglanabilir.
Conflict Resolution
İki kaynak aynı veriyi değiştirebiliyorsa conflict resolution gereksinimi doğar. En güvenli yaklaşım mümkünse tek source-of-truth owner tanımlamaktır. Version-based rule teknik ordering sağlar. Last-write-wins kolay fakat business anlamı kaybedebilir. Gerçek multi-master domain'lerde merge veya manual reconciliation gerekebilir.
Source-of-Truth Wins
Conflict durumunda canonical source value kabul edilir. Derived store üzerine source snapshot yeniden yazılır. Bu kural basit ve deterministic'tir. Projection write permission sınırlı tutulur. Reconciliation otomatik repair yapabilir.
Version-Based Resolution
En yüksek source version kazanır. Clock bağımlılığı yoktur. Old event kolayca ignore edilir. Multi-writer sistemde version üretimi daha zorlaşır. Single owner domain için çok etkilidir.
Last-Write-Wins
En son timestamp taşıyan update kazanır. Uygulaması basittir. Clock skew ve network delay problemi vardır. Business priority dikkate alınmaz. Düşük riskli preference data dışında dikkatle kullanılmalıdır.
Domain-Specific Merge
Shopping cart item set'leri merge edilebilir. User preferences field bazında farklı owner taşıyabilir. Conflict rule domain semantics üzerinden yazılır. Generic database timestamp yeterli değildir. Test concurrent update scenarios içermelidir.
Manual Reconciliation
Bazı financial veya legal conflict otomatik çözülemeyebilir. Incident queue human review'a gider. Source evidence ve event history gösterilir. Correction audit edilir. Frequency yüksekse architecture yeniden düşünülmelidir.
Last-Write-Wins Neden Tehlikeli Olabilir?
Last-write-wins basit olduğu için distributed sistemlerde cazip görünür, fakat zaman sırası business doğruluğu anlamına gelmez. Clock skew farklı node'ların timestamp'ini güvenilmez hale getirebilir. Network gecikmesi daha önce oluşturulan event'i sonradan getirebilir. Late event yanlışlıkla yeni kabul edilebilir. Business semantiği fiyat, stok veya permission gibi alanlarda daha güçlü conflict rule gerektirir.
Clock Skew
İki server saati birkaç saniye farklı olabilir. Daha eski business update daha büyük timestamp alabilir. LWW yanlış state'i seçer. NTP yardımcı olur fakat absolute guarantee değildir. Source sequence tercih edilebilir.
Network Delay
Event A önce üretilir fakat network'te gecikir. Event B consumer'a önce ulaşır. Arrival time source order değildir. LWW source timestamp'e baksa bile clock sorunu devam eder. Version sequence daha güvenlidir.
Late Event
Retry saatler sonra eski event'i yeniden getirebilir. Projection current state'i overwrite etmemelidir. Version check late event'i reddeder. Dead-letter replay sırasında bu önemlidir. Consumer idempotency ile birlikte uygulanmalıdır.
Business Semantiğinin Kaybolması
İki inventory adjustment birbirinin yerine geçecek state değil additive event olabilir. LWW birini tamamen kaybedebilir. Accounting adjustment ordering'den daha fazla rule ister. Domain event model doğru merge behavior'ı tanımlar. Generic timestamp rule business context'i bilmez.
Cross-Database Transaction Nasıl Yönetilir?
Cross-database transaction farklı datastore'larda gerçekleşen değişikliklerin business bütünlüğünü koruma problemidir. Mümkün olduğunda local transaction sınırı tercih edilir. Distributed transaction ve 2PC bazı ortamlarda kullanılabilir. Microservice sistemlerinde saga ve eventual consistency daha esnek seçeneklerdir. Hangi modelin seçileceği failure tolerance ve business invariant'a bağlıdır.
Local Transaction
Her service kendi database değişikliğini atomic yapar. Network side effect transaction dışında kalır. Outbox event sonucu downstream süreç başlar. Failure compensation ile yönetilir. Bu model service autonomy'yi korur.
Distributed Transaction
Birden fazla resource tek global commit protokolüne katılır. Atomicity güçlüdür. Coordinator dependency ve latency eklenir. Bütün datastore'lar protocol'ü desteklemeyebilir. Availability trade-off dikkatle değerlendirilmelidir.
Two-Phase Commit
2PC prepare ve commit aşamalarını kullanır. Participants önce commit'e hazır olduklarını bildirir. Coordinator son karar verir. Failure sırasında locks uzun süre tutulabilir. Modern service architecture'da sınırlı use case için tercih edilir.
Saga
Saga business transaction'ı bir dizi local transaction'a böler. Her adım başarılı olunca sonraki işlem başlar. Failure compensating transaction tetikler. Tam rollback her domain'de mümkün olmayabilir. Business semantics tasarımın merkezindedir.
Eventual Consistency
Cross-store read projection için atomic global transaction çoğu zaman gerekli değildir. Source commit olur ve event projection'ı günceller. Kısa inconsistency window kabul edilir. Lag ölçülür. Strong read gereken anlarda canonical store kullanılır.
Two-Phase Commit (2PC)
Two-Phase Commit birden fazla transactional resource arasında ortak commit kararı vermek için kullanılan coordination protokolüdür. İlk aşamada participants hazırlık yapar ve commit edebileceklerini bildirir. İkinci aşamada coordinator commit veya rollback kararı gönderir. Bu model güçlü atomicity sağlar. Bunun karşılığında coordinator failure, network partition ve lock süreleri availability üzerinde maliyet yaratabilir.
Coordinator
Coordinator transaction'ın global durumunu yönetir. Participants ile iletişim kurar. Prepare cevaplarını toplar. Final kararı yayınlar. Failure recovery coordinator state'ine bağımlıdır.
Prepare
Participant local değişiklikleri hazırlar fakat final commit etmez. Gerekli locks tutulabilir. “Hazırım” cevabı sonrası rollback seçenekleri sınırlanır. Long network delay resource'ları bekletebilir. High throughput sistemde maliyet büyür.
Commit
Coordinator bütün participants hazırsa commit gönderir. Her resource local commit'i tamamlar. Response kaybı recovery gerektirir. Final state loglanmalıdır. Partial communication failure protokol tarafından çözülmeye çalışılır.
Availability Maliyeti
Participants coordinator kararını beklerken ilerleyemeyebilir. Network partition transaction'ı uzatır. Lock contention diğer requests'i etkiler. Cross-region latency maliyeti artırır. Bu nedenle global transaction boundary mümkün olduğunca küçük tutulur.
Modern Microservice Sistemlerinde Neden Sınırlı Kullanılır?
Microservice autonomy farklı database teknolojileri ve bağımsız availability hedefleri taşır. Her datastore aynı distributed transaction protocol'ünü desteklemeyebilir. Long locks scale'i azaltabilir. Saga ve asynchronous event failure'ı farklı şekilde yönetir. Bununla birlikte güçlü atomicity gereken belirli enterprise sistemlerde 2PC hâlâ uygun olabilir.
Saga Pattern
Saga uzun business transaction'ı bir dizi local transaction ve gerektiğinde compensation adımlarına böler. Her service kendi database transaction'ını bağımsız tamamlar. Sonraki adım event veya orchestrator tarafından tetiklenir. Failure global rollback yerine business anlamlı telafi işlemi oluşturur. SQL ve NoSQL side effect'leri bu model içinde açık biçimde yönetilebilir.
Local Transactions
Order service order kaydını kendi SQL database'inde oluşturur. Inventory service reservation'ı kendi store'unda yapar. Payment service ayrı transaction çalıştırır. Hiçbiri global lock paylaşmaz. Event workflow adımları birbirine bağlar.
Choreography
Her service event dinleyip kendi işlemini yapar ve yeni event yayınlar. Merkezi workflow engine yoktur. Loose coupling yüksektir. Event chain büyüdükçe flow'u anlamak zorlaşabilir. Distributed tracing önem kazanır.
Orchestration
Central saga orchestrator hangi adımın sırada olduğunu yönetir. Service'lere command gönderir. State machine workflow'u görünür kılar. Orchestrator business logic için önemli dependency olur. High availability gerektirir.
Compensating Transaction
Payment başarısızsa inventory reservation iptal edilebilir. Bu gerçek database rollback değildir. Fiziksel dünyada kargo gönderildiyse compensation daha zor olabilir. Her step için business reversal tanımlanmalıdır. Bazı işlemler irreversible olabilir.
SQL ve NoSQL Side Effect'leri
Saga adımı SQL row ve NoSQL projection'ı aynı transaction'a zorlamamalıdır. Canonical local transaction tamamlanır. Derived store event ile güncellenir. Projection failure saga business failure'ıyla aynı olmayabilir. Data role ayrımı workflow'u sadeleştirir.
Cross-Database JOIN Yapılmalı mı?
Cross-database JOIN teknik olarak federated araçlarla mümkün olabilir, ancak OLTP request path için çoğu zaman kaçınılması gereken güçlü coupling yaratır. Network latency database optimizer'ın kontrolü dışındadır. Bir store failure bütün query'yi etkiler. Schema bağımlılığı service autonomy'yi bozar. API composition, CQRS veya precomputed projection daha kontrollü seçenekler sunabilir.
Neden Genellikle Kaçınılır?
Local JOIN database optimizer tarafından tek execution plan içinde yönetilir. Cross-store query farklı network ve consistency modellerini birleştirir. Transaction snapshot ortak olmayabilir. Failure debugging zorlaşır. Service boundary görünmez hale gelir.
Network Latency
Remote store'a her row için lookup N+1 network pattern oluşturabilir. Batch fetch yardımcı olsa da latency değişkendir. Cross-region daha da pahalıdır. Request timeout bütün query'yi etkiler. Precomputed view network call sayısını azaltır.
Coupling
Query iki datastore schema'sını aynı anda bilir. Bir taraftaki migration diğerini kırabilir. Team ownership sınırı kaybolur. Testing daha zor olur. Data contract projection ile daha net kurulabilir.
Query Planning
Federated engine her store'un statistics bilgisini sınırlı görebilir. Pushdown capability değişir. Yanlış join order büyük network transferi yaratabilir. OLAP kullanımında kabul edilebilir olabilir. OLTP tail latency için risklidir.
Failure Modes
SQL çalışırken MongoDB down olabilir. Partial result semantiği tanımlanmalıdır. Retry query'yi pahalılaştırabilir. Cross-store snapshot tutarlılığı olmayabilir. Graceful degradation zorlaşır.
Cross-Store Query İçin Alternatifler
Cross-store join yerine farklı integration pattern'leri kullanılabilir. API composition az sayıda service çağrısını birleştirebilir. CQRS sık kullanılan cross-domain query için dedicated read model oluşturur. Data warehouse veya lakehouse analytical sorguları merkezi hale getirir. Search index de user-facing retrieval için denormalized projection görevi görebilir.
API Composition
Aggregator birkaç service'e parallel request gönderir. Response'ları application katmanında birleştirir. Küçük fan-out için pratiktir. Timeout ve partial failure yönetilmelidir. Çok yüksek fan-out latency'yi artırır.
CQRS
Sık kullanılan complex read önceden projection'a dönüştürülür. Request yalnızca bir read store'a gider. Update asynchronous event ile yapılır. Eventual consistency kabul edilir. Read performance predictable hale gelir.
Precomputed Projection
Belirli dashboard veya list view için document önceden hazırlanır. SQL ve başka domain fields event ile birleşir. Query-time network join yoktur. Storage duplicate olur. Rebuild mekanizması gerekir.
Data Warehouse/Lakehouse
Analytical data farklı sources'tan merkezi platforma aktarılır. Cross-store reporting OLTP sistemlerini doğrudan sorgulamaz. ETL freshness dakikalar veya saatler olabilir. Büyük join'ler analytical engine tarafından yapılır. Business dashboard request path'ten ayrılır.
Search Index
Search document farklı sources'tan denormalized fields taşıyabilir. Faceting ve filtering tek index üzerinde çalışır. Source changes projection event üretir. Index canonical değildir. Rebuild ve reconciliation bulunmalıdır.
API Composition Pattern
API composition bir endpoint'in ihtiyaç duyduğu veriyi birden fazla service API'sinden alıp backend katmanında birleştirmesidir. Az sayıda bağımsız call için basit ve esnektir. Parallel requests latency'yi azaltabilir. Timeout ve partial failure kullanıcı response'unun kalitesini etkiler. Fan-out büyüdüğünde precomputed read model daha verimli olabilir.
Birden Fazla Service Çağrısı
Order page customer ve shipment service'e ihtiyaç duyabilir. Aggregator gerekli API'leri çağırır. Ownership korunur. Internal database erişimi yapılmaz. Dependency graph tracing ile görünür olur.
Backend Aggregator
Dedicated backend response composition yapabilir. Client service topology'sini bilmez. Cache composite response için kullanılabilir. Authorization centralized olabilir. Aggregator monolith haline gelmemelidir.
Parallel Requests
Bağımsız calls aynı anda başlatılır. Toplam latency en yavaş dependency'ye yaklaşır. Connection pool ve concurrency limit gerekir. Failures ayrı ele alınır. Request cancellation deadline ile yayılır.
Timeout
Her dependency aynı timeout'u kullanmamalıdır. Overall request budget dağıtılır. Optional data daha kısa timeout alabilir. Timeout sonrası stale cache kullanılabilir. User-critical dependency failure response'u değiştirebilir.
Partial Failure
Recommendation service down iken order details yine gösterilebilir. Response optional section olmadan döner. Contract partial data semantics'i belirtir. Error telemetry kaydedilir. Graceful degradation availability'yi artırır.
Ne Zaman Yeterlidir?
Fan-out küçük ve query frequency moderate ise API composition yeterlidir. Data strong real-time gerekiyorsa projection'dan daha doğru olabilir. Latency SLO karşılanıyorsa yeni datastore gerekmez. Call sayısı büyüdükçe CQRS düşünülür. Ölçüm karar vermelidir.
Data Federation Ne Zaman Kullanılabilir?
Data federation farklı datastore'ları tek query interface üzerinden sorgulamayı sağlar. Analytical use case için kullanışlıdır. Trino veya Presto benzeri query engines farklı sources üzerinde query planlayabilir. OLTP request path'ında network ve failure variability nedeniyle risklidir. Operational ve analytical workload ayrımı federation kullanımında temel kriter olmalıdır.
Analytical Query
Analyst SQL ile relational, object storage ve başka kaynakları birleştirebilir. Query saniyeler veya dakikalar sürebilir. User request SLO'su yoktur. Large scans kabul edilebilir. Resource governance önemlidir.
Trino/Presto Benzeri Query Engines
Federated query engine connector'lar üzerinden farklı sources'a erişir. Predicate pushdown data transferini azaltabilir. Capability connector'a göre değişir. Statistics eksikliği plan kalitesini etkileyebilir. BI ve ad hoc analytics için uygundur.
OLTP Request Path'ında Kullanmanın Riski
Tek user request birden fazla external store'a bağımlı hale gelir. Tail latency artar. Partial failure response'u zorlaştırır. Query engine ek dependency olur. Precomputed projection genellikle daha güvenlidir.
Operational vs Analytical Workloads
Operational query düşük latency ve yüksek predictability ister. Analytical query geniş data tarayabilir. Aynı altyapıya zorlamak resource contention yaratır. Federation analytics için iyi olabilir. OLTP için specialized read model tercih edilir.
Polyglot Persistence ve Microservices
Microservice architecture polyglot persistence ile doğal biçimde ilişkilidir, çünkü her bounded context kendi persistence ihtiyacını yönetebilir. Bununla birlikte her service'e farklı teknoloji seçme özgürlüğü datastore sprawl riskini büyütür. Domain-Driven Design data ownership sınırını business anlam üzerinden kurmaya yardımcı olur. Data contract ve integration event service'ler arası senkronizasyonu sağlar. Service autonomy merkezi governance ile dengelenmelidir.
Bounded Context
Bounded context belirli domain modelinin anlam sınırını tanımlar. Aynı “Customer” farklı context'lerde farklı fields taşıyabilir. Tek global canonical object zorunlu değildir. Context kendi source of truth'una sahip olabilir. Integration events contexts arasında gerekli bilgiyi taşır.
Domain-Driven Design
DDD teknik database seçiminden önce business boundaries üzerinde düşünür. Aggregate transaction boundary belirlemeye yardımcı olur. Repository domain'i storage detayından ayırır. Event business değişikliğini ifade eder. Polyglot persistence ancak domain ownership netse sağlıklı çalışır.
Service Autonomy
Service kendi schema ve deployment'ını yönetir. Başka service private database'e bağlanmaz. Technology choice belirli sınırlar içinde yapılır. Independent scaling mümkündür. Autonomy shared platform standardlarını reddetmek anlamına gelmez.
Data Contract
API veya event payload service'ler arası contract'tır. Internal table schema public contract değildir. Versioning backward compatibility'yi korur. Consumer-driven contract tests kırılmayı erken bulur. PII minimum gerekli alanlarla sınırlandırılır.
Integration Events
Integration event başka bounded context'lerin bilmesi gereken completed fact'i taşır. Internal domain event ile aynı olmak zorunda değildir. Payload stable ve minimal tutulur. Outbox güvenilir delivery sağlar. Consumer kendi projection'ını üretir.
Monolith İçinde Birden Fazla Database Kullanmak
Polyglot persistence yalnızca microservice architecture'a özgü değildir. Monolith application aynı process içinde SQL, Redis ve search engine kullanabilir. Repository veya adapter layer datastore detaylarını domain kodundan ayırır. Transaction boundary bir process içinde olsa bile farklı database'ler arasında atomic hale gelmez. Yeni store yalnızca ölçülen fayda varsa monolith içinde de mantıklı olabilir.
Teknik Olarak Mümkün mü?
Application birden fazla client library kullanabilir. Aynı request farklı store'lara erişebilir. Deployment tek artifact kalabilir. Data ownership module seviyesinde tanımlanabilir. Distributed failure yine network üzerinden mevcuttur.
Repository/Adapter Layer
Domain use case repository interface kullanır. SQL veya NoSQL implementation infrastructure layer'da bulunur. Testing fake adapter ile yapılabilir. Migration sırasında iki adapter shadow çalıştırılabilir. Domain storage query diline bağımlı kalmaz.
Transaction Boundary Problemi
Tek process iki database write'ını local transaction yapamaz. Application crash arada gerçekleşebilir. Outbox yine değerlidir. Module boundary event ile synchronize edilebilir. Monolith olması distributed data problemine istisna oluşturmaz.
Operational Complexity
Tek deploy olsa bile iki database cluster vardır. Backup, metric ve credential ayrı yönetilir. Local development zorlaşır. CI integration tests daha ağır olur. Fayda bu maliyeti karşılamalıdır.
Ne Zaman Mantıklıdır?
Search workload relational database'i ciddi etkiliyorsa monolith search engine ekleyebilir. Redis cache yüksek QPS'i azaltabilir. Document store yalnızca gerçek domain ihtiyacı varsa eklenir. Microservice'e geçmeden specialized storage kullanılabilir. Architecture boundary future extraction'ı kolaylaştırabilir.
Birden Fazla Database İçin Repository/Adapter Tasarımı
Repository ve adapter yaklaşımı domain logic'i belirli datastore API'sinden ayırır. Domain “order kaydet” veya “product ara” gibi interface kullanır. Infrastructure layer SQL, MongoDB veya Redis client detayını yönetir. Bu abstraction bütün database özelliklerini ortak en düşük paydaya indirmemelidir. Her adapter kendi store'un güçlü yönünü kullanırken domain contract business amacını ifade etmelidir.
Domain Layer'ı Datastore'dan Ayırmak
Domain entity MongoDB document annotation'ı taşımak zorunda değildir. SQL row shape doğrudan business object olmayabilir. Mapping infrastructure layer'da yapılır. Storage değişikliği domain rule'u etkilemez. Testing daha sade olur.
Repository Interface
Interface business query'yi ifade eder. findAvailableProducts gibi method generic raw query'den daha anlamlıdır. Pagination ve consistency requirement contract'ta bulunabilir. Implementation store'a özel optimize edilir. Aşırı generic repository performansı kısıtlayabilir.
SQL Adapter
SQL adapter transaction ve query builder detayını yönetir. Index-aware query yazılır. Connection pool kullanılır. Error domain error'a map edilir. Metrics query name bazında kaydedilir.
NoSQL Adapter
NoSQL adapter partition key veya document model kurallarını bilir. Retry semantics store'a göre ayarlanır. Consistency option gerekiyorsa domain use case'den parametre alabilir. Serialization versionlanır. Raw driver object domain dışına çıkmaz.
Infrastructure Concern'leri
Timeout, retry, pool ve tracing adapter katmanında uygulanabilir. Secrets configuration olarak alınır. Circuit breaker dependency bazında tanımlanır. Health check gerçek business operation'dan ayrılır. Observability store-specific metric'leri korur.
Connection Pool Yönetimi
Polyglot application her datastore için farklı connection lifecycle ve kapasite modeline sahiptir. SQL pool fazla büyürse database connection saturation oluşabilir. MongoDB driver kendi pool mekanizmasını taşır. Redis client multiplex veya pool kullanabilir. Her store için bağımsız capacity budget ve timeout tanımlanmalıdır.
SQL Connection Pool
SQL connection server resource tüketir. Pod sayısı ile pool size toplam connection sayısını belirler. Büyük pool throughput'u otomatik artırmaz. Queue wait metriği izlenir. Transaction kısa tutulmalıdır.
MongoDB Pool
MongoDB driver connection pool ve topology discovery yönetir. Her request yeni client oluşturulmamalıdır. Pool size workload'a göre ayarlanır. Replica set failover client behavior'ı test edilir. Server selection timeout önemlidir.
Redis Pool
Redis client modeline göre tek multiplex connection veya pool kullanılabilir. Blocking operation ayrı bağlantı isteyebilir. Her pod sınırsız connection açmamalıdır. Cluster topology daha fazla socket oluşturabilir. Connected clients capacity ile karşılaştırılır.
Her Store İçin Ayrı Capacity
SQL CPU normal iken search cluster saturation yaşayabilir. Pool limitleri dependency kapasitesini yansıtmalıdır. Application concurrency store bazında semaphore ile sınırlandırılabilir. Autoscaling toplam bağlantıları değiştirir. Capacity dashboard bütün dependencies'i birlikte gösterir.
Pool Exhaustion
Bütün connections meşgul olduğunda requests pool bekler. Latency origin query'den önce yükselir. Timeout request backlog'u sınırlar. Cache hit SQL pool kullanımını azaltabilir. Pool büyütmeden önce query süresi ve concurrency incelenmelidir.
Timeout ve Retry Stratejisi
Her datastore aynı timeout ve retry davranışını kullanmamalıdır. Cache timeout kısa olabilirken SQL transaction daha uzun süre isteyebilir. Search optional dependency ise timeout sonrası degraded response dönebilir. Retry yalnızca transient ve idempotent operation'larda uygulanmalıdır. Circuit breaker sürekli başarısız dependency'ye yeni yük göndermeyi durdurur.
SQL Timeout
Query ve transaction deadline farklı olabilir. Long-running query pool'u bloke etmemelidir. Statement timeout server tarafında da uygulanabilir. Retry serialization failure gibi belirli durumlarda yapılabilir. Duplicate business command idempotency gerektirir.
NoSQL Timeout
Server selection, connect ve operation timeout ayrı olabilir. Distributed query farklı nodes'a gidebilir. Too-long timeout tail latency'yi büyütür. Too-short timeout normal failover sırasında gereksiz error yaratır. Production latency dağılımıyla ayarlanmalıdır.
Cache Timeout
Cache performance optimization olduğu için timeout genellikle kısa tutulur. Redis yavaşsa request'i saniyelerce bekletmek mantıklı değildir. Fallback kontrollü şekilde çalışır. Circuit hızlı açılabilir. Cache timeout database fallback storm yaratmamalıdır.
Search Timeout
Search query expensive aggregation yapabilir. User request deadline net olmalıdır. Partial results ürün kararına bağlıdır. Timeout sonrası SQL fallback yalnızca küçük dataset için uygun olabilir. Search overload load shedding gerektirebilir.
Retryable Error
Network reset veya leader change transient olabilir. Validation error retry edilmemelidir. Driver error classes kullanılmalıdır. Exponential backoff jitter ile uygulanır. Global request deadline retry sayısını sınırlar.
Circuit Breaker
Failure threshold aşılınca dependency çağrısı kısa devre edilir. Recovery half-open probe ile test edilir. Her datastore ayrı circuit taşır. Search down iken order write devam edebilir. Circuit state observability dashboard'da görünmelidir.
Bir Datastore Çökerse Sistem Ne Yapmalı?
Polyglot mimarinin gerçek kalitesi normal zamanda değil store'lardan biri çalışmadığında görülür. Primary database failure core writes'i durdurabilir. Cache failure yalnızca latency'yi yükseltmeli, search failure discovery özelliğini degrade etmelidir. Projection store down olduğunda event queue birikerek recovery sonrası replay yapılabilir. Dependency criticality önceden sınıflandırılmazsa bütün failure'lar application outage'a dönüşür.
Primary Database Failure
Authoritative store yoksa yeni business transaction güvenle yapılamayabilir. Failover replica kullanılabilir. Read-only degraded mode bazı özellikleri sürdürebilir. Write queue'ya almak ordering ve user expectation problemi yaratır. RTO ve RPO açıkça tanımlanmalıdır.
Cache Failure
Application origin'e kontrollü fallback yapabilir. Database'e full traffic aktarılmamalıdır. Stale local cache veya default response kullanılabilir. Circuit breaker Redis call'larını keser. Cache recovery sonrası warming gerekebilir.
Search Failure
Search endpoint temporary unavailable olabilir. Basit SQL search sınırlı fallback sunabilir. Browse category ve direct product URL çalışmaya devam edebilir. Search index updates broker'da bekler. Recovery sonrası consumer lag kapatılır.
Projection Store Failure
Write store transaction'ları devam edebilir. Events broker'da tutulur. Consumer recovery sonrası backlog işler. Lag büyür fakat source state güvenlidir. Queue retention outage süresini karşılamalıdır.
Graceful Degradation
Optional features kapatılır. Core business akışı korunur. UI dependency status'a göre daha basit experience sunar. Load shedding saturation'ı önler. Recovery normal traffic'e kademeli dönüş yapar.
Redis Çökerse Uygulama Çalışmaya Devam Etmeli mi?
Redis'in rolüne bağlı olarak cevap değişir. Pure cache ise uygulama kontrollü biçimde SQL source'a dönerek çalışmaya devam edebilir. Session store ise kullanıcı oturumları etkilenebilir. Primary state Redis'te tutuluyorsa failure çok daha kritik hale gelir. Bu nedenle aynı teknoloji adı altında farklı dependency seviyeleri açıkça sınıflandırılmalıdır.
Cache Olarak Kullanılıyorsa
Cache kaybı correctness problemi olmamalıdır. Origin fetch devreye girer. Rate limit database'i korur. Cache warming recovery'yi hızlandırır. User latency geçici yükselir.
Session Store Olarak Kullanılıyorsa
Session kaybı authentication state'i etkiler. Replica ve persistence requirement artar. Failover client tarafından desteklenmelidir. User yeniden login olmak zorunda kalabilir. Business impact değerlendirilmelidir.
Primary State Olarak Kullanılıyorsa
Redis artık cache değildir. Durability ve backup zorunlu hale gelebilir. RDB veya AOF seçenekleri incelenir. Recovery test edilir. Eviction policy state kaybına yol açmamalıdır.
Fallback Strategy
Cache için SQL fallback kullanılabilir. Session için stateless token alternatif olabilir. Primary state için başka replica veya restore gerekir. Tek fallback bütün namespaces'e uygulanmamalıdır. Runbook data role bazında yazılmalıdır.
Search Engine Çökerse Ne Yapılmalı?
Search engine outage transactional source data'nın kaybı olmamalıdır. Search özelliği geçici kapatılabilir veya limited fallback sunulabilir. Index update events broker'da birikmeye devam eder. Recovery sonrası replay projection'ı günceller. Bu tasarım search engine'i disposable derived store olarak konumlandırmanın avantajını gösterir.
Search Özelliğini Geçici Kapatmak
UI search unavailable mesajı gösterebilir. Direct navigation çalışmaya devam eder. Core transaction etkilenmez. Circuit breaker search dependency'yi korur. Incident kapsamı sınırlı kalır.
SQL Fallback
Küçük dataset basic search SQL ile yapılabilir. Feature set fuzzy ve faceting olmadan çalışabilir. Fallback query database'i aşırı yüklememelidir. Rate limit uygulanır. Büyük catalog'da fallback kapatmak daha güvenli olabilir.
Degraded Search
Popular categories veya cached query sonuçları gösterilebilir. Stale index replica varsa read-only kullanılabilir. User experience sınırlı kalır. Freshness warning gerekebilir. Recovery sonrası normal mode'a dönülür.
Queue'da Index Update Biriktirmek
Search consumer down olsa da broker event'leri tutar. Source writes devam eder. Queue retention yeterli olmalıdır. Lag alarm verir. Search geri geldiğinde controlled catch-up yapılır.
Recovery Sonrası Replay
Consumer offset'ten devam eder. Duplicate events idempotent uygulanır. Lag sıfıra yaklaşır. Reconciliation missing records kontrol eder. Gerekirse full rebuild yapılır.
Data Reconciliation Nedir?
Data reconciliation canonical store ile derived store arasındaki kalıcı farkları bulma ve gerektiğinde düzeltme sürecidir. Event pipeline güvenilir olsa bile bug, event loss veya manual operation drift yaratabilir. Record existence, version veya hash karşılaştırılabilir. Mismatch metric synchronization kalitesini gösterir. Repair audit edilerek sistemin neyi neden değiştirdiği izlenebilir.
SQL ve NoSQL Record'larını Karşılaştırmak
Canonical IDs batch halinde alınır. Projection'daki karşılık sorgulanır. Version ve önemli fields karşılaştırılır. Bütün payload network üzerinden taşınmak zorunda değildir. Hash veya checksum kullanılabilir.
Missing Record
SQL record vardır fakat projection yoktur. Event kaçmış olabilir. Repair projection'ı source'tan yeniden oluşturur. Missing rate alarm threshold taşır. Root cause ayrıca araştırılır.
Version Mismatch
İki tarafta record vardır fakat version farklıdır. Projection lag normal window'u aşmış olabilir. Old event consumer bug yaratmış olabilir. Source version kazanır. Repair yeni projection yazar.
Hash Comparison
Canonical fields deterministic normalize edilir. Hash hesaplanır. Projection aynı mapping ile hash taşıyabilir. Büyük payload transferi azalır. Schema version değişiminde hash definition versionlanmalıdır.
Otomatik Repair
Düşük riskli projection otomatik düzeltilebilir. Financial conflict manual review isteyebilir. Repair rate sınırlanır. Audit log source ve old target version'ı kaydeder. Çok fazla repair synchronization pipeline problemi gösterir.
Reconciliation Job Nasıl Tasarlanır?
Reconciliation job production database'i aşırı yüklemeden büyük dataset'i kontrollü karşılaştırmalıdır. Batch size bounded tutulur. Checkpoint job restart sonrasında kaldığı yerden devam etmeyi sağlar. Rate limiting peak traffic'i korur. Drift metrics ve repair audit job'ın değerini görünür hale getirir.
Batch Size
Binlerce veya belirli sayıda entity batch alınabilir. Çok büyük batch memory ve query latency yaratır. Çok küçük batch overhead artırır. Keyset pagination offset'e göre daha stabil olabilir. Tuning production load ile yapılır.
Checkpoint
Last processed ID veya partition state saklanır. Job crash sonrası baştan başlamaz. Checkpoint durable olmalıdır. Data değişimi sırasında snapshot semantics bilinmelidir. Periodic full cycle tamamlanma süresi ölçülür.
Rate Limiting
Reconciliation user traffic ile resource yarışmamalıdır. QPS veya concurrency sınırı konur. Database CPU yükselirse job yavaşlatılır. Off-peak tercih edilebilir. Global sistemde gerçek off-peak olmayabilir.
Drift Metrics
Missing, stale ve extra records ayrı sayılır. Trend synchronization health'i gösterir. Ani spike deployment regression'a işaret eder. Percentage total dataset ile normalize edilir. SLO threshold tanımlanabilir.
Repair Audit Log
Hangi entity'nin neden düzeltildiği kaydedilir. Old ve new version tutulabilir. Sensitive payload loglanmamalıdır. Repeated repair root cause investigation tetikler. Audit compliance için değerli olabilir.
Projection Rebuild
Projection rebuild derived store'un canonical kaynaktan veya event history'den tamamen yeniden oluşturulmasıdır. Search mapping change, MongoDB read model schema değişikliği veya corruption bunu gerektirebilir. Event replay incremental state'i yeniden uygular. Backfill historical base'i oluşturur. Blue-green strategy canlı trafiği kesmeden yeni projection'a geçiş sağlar.
Search Index'i Sıfırdan Oluşturmak
Yeni version index açılır. SQL veya snapshot data batch halinde indekslenir. Ongoing events aynı index'e uygulanır. Validation tamamlanınca alias değiştirilir. Eski index rollback için kısa süre tutulur.
MongoDB Read Model'i Yeniden Üretmek
Yeni collection schema oluşturulabilir. Source records projection mapper ile document'e dönüştürülür. Event consumer cutover position'dan değişiklikleri tamamlar. Shadow queries iki collection'ı karşılaştırır. Eski collection sonra kaldırılır.
Event Replay
Broker yeterli retention taşıyorsa historical events tekrar okunabilir. Consumer idempotent olmalıdır. Projection reset başlangıç offset'i belirlenir. Replay production consumer'ı aşırı yavaşlatmamalıdır. Separate consumer group kullanılabilir.
Backfill
Current source snapshot projection'a yazılır. Batch size controlled olur. Version snapshot sırasında değişebilir. CDC watermark değişiklikleri tamamlar. Validation final record count ve hash kullanabilir.
Blue-Green Index
Blue mevcut production index'tir. Green yeni schema ile build edilir. Traffic cutover atomik config veya alias ile yapılır. Problemde blue'ya geri dönülür. Migration downtime'sız hale gelir.
Backfill Nedir?
Backfill mevcut historical verinin yeni datastore veya projection'a ilk kez taşınmasıdır. Polyglot migration'da yeni MongoDB collection veya search index boş başladığı için gerekli olabilir. Batch processing source'u kontrollü okur. Dual read veya shadow validation yeni store sonuçlarını eski source ile karşılaştırır. Cutover ancak coverage ve consistency yeterli olduğunda yapılmalıdır.
Mevcut Veriyi Yeni Store'a Taşımak
Historical source data query ile çıkarılır. Mapping yeni schema'ya dönüştürür. Upsert hedef store'a yazar. Progress checkpoint tutulur. Error records ayrı retry queue'ya gider.
Batch Processing
Dataset küçük parçalara bölünür. Batch size source load'u kontrol eder. Parallel workers partition bazında çalışabilir. Target rate limit dikkate alınır. Backfill completion time ölçülür.
Dual Read
Application belirli sample requests için eski ve yeni store'u okur. User response hâlâ eski source'tan gelir. Results compare edilir. Difference metric confidence sağlar. Production shadow verification migration riskini azaltır.
Shadow Validation
Yeni store response kullanıcıya dönülmez. Canonical result ile compare edilir. Ordering veya eventual fields normalize edilir. Mismatch reason sınıflandırılır. Threshold karşılanınca cutover yapılır.
Cutover
Read traffic yüzdesi kademeli yeni store'a geçirilir. Error ve latency izlenir. Rollback flag hazırdır. Sync pipeline devam eder. Tam migration sonrası eski read path belirli süre korunabilir.
Tek Database'den Polyglot Persistence'a Migration
Tek database'den polyglot persistence'a geçiş bir big-bang rewrite olmamalıdır. Önce access pattern ve gerçek bottleneck ölçülür. Yeni store derived copy olarak provision edilir. Historical backfill ile current data taşınır, CDC veya event sync ongoing changes'i takip eder. Shadow read ve gradual cutover migration'ın correctness ve rollback güvenliğini artırır.
1. Access Pattern'leri Ölç
Top queries frequency ve latency açısından sıralanır. CPU ve I/O contribution hesaplanır. Data volume ve growth görülür. User SLO belirlenir. Yeni store'un hedef workload'u açıklaşır.
2. Darboğazı Belirle
Problem query plan mı, search capability mi yoksa scaling mi anlaşılır. Index veya schema fix önce denenir. Cache yeterli olabilir. Yeni datastore son çözüm değil doğru çözüm olmalıdır. Baseline metrics kaydedilir.
3. Yeni Store'u Provision Et
Capacity ve HA topology kurulur. Security credential ve network policy tanımlanır. Monitoring baştan eklenir. Backup veya rebuild strategy hazırlanır. Production data henüz authoritative değildir.
4. Historical Data Backfill
Current source data batch ile taşınır. Mapping versionlanır. Checkpoint restart sağlar. Rate limit source'u korur. Coverage metric izlenir.
5. CDC/Event Sync Başlat
Backfill sürerken ongoing writes kaçırılmamalıdır. Watermark veya log position tutulur. Consumer idempotent çalışır. Lag ölçülür. Backfill tamamlandığında sync current state'e ulaşır.
6. Shadow Read Yap
Production requests yeni store'a da gönderilir. User response eski path'ten gelir. Latency ve result difference ölçülür. High-risk queries daha geniş sample alır. New store correctness doğrulanır.
7. Sonuçları Karşılaştır
Field ve ordering normalization yapılır. Expected eventual lag mismatch'ten ayrılır. Error categories root cause gösterir. Threshold architecture review tarafından belirlenir. Mismatch sıfıra yakın olmadan cutover yapılmaz.
8. Trafiği Kademeli Taşı
Canary yüzde 1 ile başlayabilir. Metrics stabilse oran artırılır. Customer segment veya region bazlı rollout yapılabilir. Load distribution gözlenir. Feature flag hızlı rollback sağlar.
9. Rollback Penceresi Tut
Eski read path hemen kaldırılmaz. Sync iki sistemi güncel tutmaya devam eder. Regression görülürse traffic geri alınır. Rollback süresi business riskine göre seçilir. Sonrasında legacy projection veya code temizlenir.
Zero-Downtime Datastore Migration
Zero-downtime migration kullanıcı trafiğini kesmeden yeni datastore'a geçiş yapmayı hedefler. Dual read verification sağlar. Direct dual write riskli olduğu için CDC veya outbox tercih edilebilir. Shadow traffic yeni store performance'ını gerçek workload ile test eder. Gradual cutover ve rollback planı release güvenliğini artırır.
Dual Read
Primary response eski store'dan alınır. Yeni store aynı query'yi arka planda çalıştırır. Difference kaydedilir. Ek load kontrollü sample ile sınırlandırılır. Shadow timeout user request'i etkilemez.
Dual Write'ın Riskleri
İki store'a synchronous write partial failure yaratır. Migration sürecinde kolay görünse de drift oluşabilir. CDC source commit'i takip eder. Outbox business event sağlar. Direct dual write yalnızca güçlü idempotency ve recovery ile kullanılmalıdır.
CDC
Source database log ongoing changes'i taşır. Historical backfill sırasında delta yakalanır. Watermark cutover consistency sağlar. Connector lag izlenir. Schema changes coordinate edilir.
Shadow Traffic
Gerçek production query new store'a kopyalanır. Response kullanıcıya dönmez. Performance p95 ve errors ölçülür. Data privacy kuralları uygulanır. Cost sample rate ile kontrol edilir.
Comparison Metrics
Result equality ve latency ölçülür. Missing documents ayrı sayılır. Ordering farklılığı normalize edilir. Consistency window göz önünde bulundurulur. Dashboard migration confidence gösterir.
Gradual Cutover
Traffic yüzdesi küçük adımlarla değiştirilir. Capacity headroom gözlenir. Error threshold otomatik rollback tetikleyebilir. Sync old ve new store arasında sürer. Full cutover sonrası stabilization period beklenir.
Schema Evolution
Birden fazla datastore kullanıldığında schema evolution her sistemin kendine özgü migration biçimini yönetmeyi gerektirir. SQL column change migration ister. MongoDB document'ler farklı versions taşıyabilir. Search mapping değişikliği reindex gerektirebilir. Event schema backward compatibility bütün projection consumers için kritik hale gelir.
SQL Migration
Column add genellikle backward-compatible yapılabilir. Drop veya type change staged rollout ister. Application old ve new schema'yı kısa süre destekleyebilir. Large table migration locking açısından test edilir. Migration version repository'de tutulur.
MongoDB Document Evolution
Old documents yeni fields taşımayabilir. Application default behavior uygulayabilir. Lazy migration read sırasında yapılabilir. Batch backfill kritik field'leri günceller. Schema version document içinde tutulabilir.
Search Mapping Change
Bazı mapping değişiklikleri yeni index gerektirir. Blue-green reindex güvenli yöntemdir. Source data tekrar projekte edilir. Alias cutover yapılır. Old index rollback için tutulur.
Event Schema Change
Producer ve consumers aynı anda deploy olmayabilir. Yeni optional fields backward compatibility sağlar. Field rename aşamalı yapılır. Schema registry kullanılabilir. Historical replay old event versions'ı desteklemelidir.
Backward Compatibility
Yeni consumer eski event'i okuyabilmelidir. Eski consumer yeni event'i tolere etmelidir. Breaking change yeni event type veya version gerektirebilir. Contract tests CI'da çalışır. Long retention replay compatibility süresini uzatır.
Aynı Entity'nin Farklı Store'lardaki Schema'ları Aynı mı Olmalı?
Hayır, derived store'un amacı canonical schema'yı birebir kopyalamak değil hedef access pattern'i verimli desteklemektir. SQL normalize model kullanabilir. Search index denormalized document taşıyabilir. Cache yalnızca birkaç field'lık key-value representation saklayabilir. Mapping layer bu farklı şekiller arasındaki dönüşümü explicit hale getirir.
Hayır, Access Pattern'e Göre Modelleme
Her store kendi query ihtiyacına göre shape taşımalıdır. Birebir replication unnecessary fields ve cost yaratır. Search için searchable text, cache için hot summary yeterli olabilir. Source version bütün copies'te ortak metadata olabilir. Mapping test edilmelidir.
SQL Normalized Model
Customer ve order ayrı tablolar olabilir. Foreign key ilişkiyi korur. Update tek yerde yapılır. Query join ile birleştirilir. Business integrity bu modelde merkezidir.
Search Denormalized Document
Order search document customer name ve product names'i birlikte taşıyabilir. Query tek index'te çalışır. Customer rename fan-out update gerektirebilir. Event consumer documents'i yeniden projekte eder. Read speed storage duplication karşılığında kazanılır.
Cache Key-Value Representation
Cache yalnızca endpoint response'una gerekli fields'i taşır. Large JSON canonical object gereksizdir. TTL lifecycle'ı yönetir. Key version schema migration sağlar. Cache value source model değildir.
Mapping/Projection Layer
Mapping source entity'yi target schema'ya dönüştürür. Code version control'dadır. Unit tests edge cases'i kapsar. Rebuild aynı mapper'ı kullanır. Mapping business semantics'in rastgele consumer koduna dağılmasını engeller.
Polyglot Persistence'da Data Modeling
Polyglot persistence data modeling yaklaşımını tek global schema fikrinden uzaklaştırır. Her store storage ve access pattern gereksinimine göre farklı model taşıyabilir. Write model business invariants'a, read model query kolaylığına odaklanır. Denormalization performans kazanımı karşılığında synchronization maliyeti getirir. Data modeling dokümantasyonu source, projection ve version ilişkisini açık biçimde göstermelidir.
Storage-Oriented Model
Store'un fiziksel özellikleri model kararını etkiler. Partition key distributed NoSQL için kritiktir. B-tree order relational query'yi belirler. Search analyzer text field modelini etkiler. Technology constraint domain'i tamamen yönetmemelidir.
Access-Pattern-Driven Modeling
En sık query'ler önce belirlenir. Required fields ve filters kaydedilir. Read model bu query'yi minimum work ile karşılar. Yeni query gerekiyorsa yeni projection düşünülebilir. Tek model her kullanım için zorlanmaz.
Write Model
Write model business consistency'yi önceliklendirir. Normalize structure duplicate update riskini azaltır. Transaction aggregate sınırında tutulur. Event change fact'lerini dışarı taşır. Read convenience write model'i gereksiz büyütmez.
Read Model
Read model UI veya API response shape'ine yakın olabilir. Query-time composition azalır. Data duplicate olabilir. Eventual consistency kabul edilir. Rebuild source'tan mümkün olmalıdır.
Denormalization
Denormalization precomputed join gibi düşünülebilir. Read hızlanır. Write fan-out artar. Storage büyür. Projection pipeline ve reconciliation maliyeti kararın parçası olmalıdır.
Denormalization'ın Maliyeti
Denormalization performans avantajı sağlarken veri kopyalarını çoğaltır. Aynı customer name yüz bin order document'inde bulunabilir. Değişiklik update fan-out yaratır. Eventual consistency nedeniyle kopyalar kısa süre farklı olabilir. Bu maliyet ancak read latency ve throughput kazancı business açısından anlamlıysa kabul edilmelidir.
Duplicate Data
Aynı field birçok record'da saklanır. Storage artar. Delete propagation zorlaşır. PII kopyaları privacy riskini büyütür. Canonical source yine tek kalmalıdır.
Update Fan-Out
Tek source değişikliği binlerce derived document'i etkileyebilir. Consumer batch update yapar. Backlog oluşabilir. Bazı projection'lar lazy refresh kullanabilir. Frequency maliyeti belirler.
Consistency
Bütün copies aynı anda güncellenmez. Lag normaldir. Version stale records'ı belirler. Strong read source'a yönlenebilir. SLO maximum lag'i tanımlar.
Storage Cost
Duplicate fields disk ve memory tüketir. Search replicas cost'u çarpar. Backup boyutu büyür. Compression yardımcı olabilir. TCO read benefit ile karşılaştırılır.
Daha Hızlı Read ile Trade-Off
Query-time join ortadan kalkar. Response daha predictable olur. Write pipeline daha karmaşık hale gelir. Read-heavy workload bunu haklı çıkarabilir. Write-heavy data için normalize model daha uygun olabilir.
Backup Stratejisi
Polyglot mimaride her datastore için aynı backup yaklaşımı kullanılamaz. SQL authoritative data için güçlü point-in-time recovery gerekebilir. NoSQL source veya derived rolüne göre farklı backup policy alır. Search index source'tan hızlı rebuild edilebiliyorsa backup gereksinimi daha düşük olabilir. Redis persistence ise cache mi primary state mi olduğuna göre seçilmelidir.
SQL Backup
Full backup ve transaction log archive PITR sağlayabilir. Restore düzenli test edilmelidir. Encryption ve offsite copy kullanılır. RPO business kritikliğine göre seçilir. Backup başarı mesajı restore garantisi değildir.
NoSQL Backup
MongoDB canonical data taşıyorsa consistent backup gerekir. Sharded cluster snapshot coordination önemlidir. Derived read model ise rebuild tercih edilebilir. Backup cost data volume ile ölçülür. Restore testleri yapılmalıdır.
Search Index Backup Gerekli mi?
Source data ve rebuild pipeline güvenilir ise snapshot zorunlu olmayabilir. Çok uzun rebuild süresi RTO'yu aşabilir. Snapshot recovery'yi hızlandırabilir. Mapping ve index template code olarak saklanmalıdır. Canonical correctness snapshot'a bağımlı olmamalıdır.
Redis Persistence
Pure cache için persistence kapatılabilir. RDB snapshot restart warming süresini azaltabilir. AOF daha yüksek durability sağlar. Session veya primary state requirement farklıdır. Persistence operation memory ve disk maliyeti yaratır.
Object Storage
Backup ve export files durable object storage'da tutulabilir. Encryption ve lifecycle policy uygulanır. Region replication DR için kullanılabilir. Access least privilege olur. Restore bandwidth planlanmalıdır.
Cross-Database Point-in-Time Recovery Problemi
Birden fazla authoritative store bulunduğunda her birini farklı zaman noktasına restore etmek cross-store inconsistency yaratabilir. SQL saat 12:00'a, MongoDB 12:05'e dönerse derived ilişkiler farklı state gösterebilir. Event log recovery watermark oluşturabilir. Reconciliation restore sonrası farklılıkları tespit eder. DR planı datastore'ları bağımsız değil birlikte ele almalıdır.
SQL Saat 12:00'a Restore Edildi
SQL son beş dakikalık writes'i kaybetmiş olabilir. Outbox events de aynı noktaya döner. Downstream store daha ileri state taşıyabilir. Projection source'tan yeni snapshot ile düzeltilmelidir. User-facing işlemler reconciliation bitene kadar sınırlanabilir.
NoSQL Saat 12:05'e Restore Edildi
NoSQL SQL'de artık bulunmayan future records taşıyabilir. Eğer derived projection ise temiz rebuild kolaydır. Canonical ikinci source ise conflict daha ciddidir. Recovery sequence önceden tanımlanmalıdır. Audit event history kullanılabilir.
Cross-Store Inconsistency
Entity versions farklı olur. Cache veya search yanlış future state gösterebilir. Reconciliation mismatch bulur. Source-of-truth rule repair direction'ını belirler. Monitoring recovery sırasında daha hassas çalışır.
Event Log ile Reconciliation
Durable event log hangi changes'in hangi zaman aralığında gerçekleştiğini gösterebilir. Restore watermark sonrası events replay edilir. Duplicate events idempotent olmalıdır. Missing source transactions dikkate alınır. Event retention DR window'u karşılamalıdır.
Recovery Watermark
Tüm systems için ortak logical position belirlemek yararlıdır. LSN, event offset veya domain version kullanılabilir. Recovery bu noktadan ilerler. Projection daha ileri state'teyse reset olabilir. Runbook watermark üretimini tanımlar.
Disaster Recovery
Polyglot persistence disaster recovery planını daha geniş hale getirir, çünkü her datastore farklı RPO ve RTO taşıyabilir. Primary SQL önce geri gelmeden derived search index'i restore etmek anlamsız olabilir. Dependency order recovery sequencing'i belirler. Projection store çoğu zaman backup yerine rebuild edilebilir. Gerçek recovery testleri teorik dokümanın çalışıp çalışmadığını doğrular.
RPO
Recovery Point Objective kabul edilen veri kaybı miktarını tanımlar. Payment için çok düşük olabilir. Cache için sıfırdan rebuild kabul edilebilir. Event log RPO projection recovery'sini etkiler. Her datastore ayrı sınıflandırılmalıdır.
RTO
Recovery Time Objective hizmetin ne kadar sürede geri gelmesi gerektiğini belirtir. Search index full rebuild saatler sürebilir. Snapshot RTO'yu azaltabilir. Cache warming recovery süresine eklenir. Business priority sequence'i belirler.
Database Başına DR Planı
SQL replication ve backup farklıdır. Redis cache yeniden oluşturulabilir. MongoDB canonical ise replica ve backup gerekir. Search projection rebuild alabilir. Tek generic DR belgesi yeterli değildir.
Dependency Order
Source database önce ayağa kalkar. Broker ve event pipeline devam eder. Derived projections sonra rebuild edilir. Cache warming en son yapılabilir. Sequence otomasyonla yönetilebilir.
Projection Rebuild
Canonical snapshot target store'a yazılır. Events delta'yı tamamlar. Validation consistency'yi kontrol eder. Traffic kademeli açılır. RTO periyodik olarak ölçülür.
Recovery Testleri
Backup restore ayrı environment'ta denenir. Full region failure simüle edilebilir. Credentials ve DNS dependencies doğrulanır. Runbook süreleri ölçülür. Öğrenilenler automation backlog'una girer.
Multi-Region Polyglot Persistence
Multi-region yapı her datastore için ayrı replication ve consistency kararları gerektirir. SQL synchronous veya asynchronous replication kullanabilir. NoSQL global distribution kendi conflict modelini taşıyabilir. Cache region-local tutulabilir. Search cluster ve data residency gereksinimleri region topolojisini etkiler.
SQL Replication
Cross-region synchronous replication latency ekleyebilir. Asynchronous model düşük write latency sağlar fakat RPO büyür. Read replicas stale olabilir. Primary region failover runbook gerektirir. Transaction model business requirement'a göre seçilir.
NoSQL Global Distribution
Bazı distributed stores multi-region write sunabilir. Conflict resolution modeli anlaşılmalıdır. Data partition locality latency'yi etkiler. Strong consistency option maliyetlidir. Application semantics platform capability'ye uymalıdır.
Cache
Redis cache her region'da local tutulabilir. Cross-region cache lookup'tan kaçınılır. Invalidation events bölgeler arasında yayılır. Staleness biraz artabilir. Region failover cache cold-start yaratır.
Search Cluster
Search data region'a replike edilebilir veya source'tan local index build edilebilir. Query kullanıcıya yakın cluster'a gider. Index lag region bazında değişebilir. Mapping aynı version'da tutulur. DR rebuild prosedürü test edilir.
Data Residency
Bazı kişisel veriler belirli ülkeden çıkmamalıdır. Derived cache ve search copy de bu kurala dahildir. Event payload region sınırlarını ihlal etmemelidir. Tenant routing residency policy'yi uygular. Backup location ayrıca kontrol edilir.
Consistency Model
Global strong consistency yüksek network latency getirebilir. Region-local eventual projections daha hızlıdır. Business transaction hangi region'da authoritative olduğu açık olmalıdır. Conflict handling multi-writer durumda gerekir. SLO latency ve freshness'i birlikte tanımlar.
Polyglot Persistence Güvenliği
Datastore sayısı arttıkça saldırı yüzeyi ve credential yönetimi de büyür. Her service ve datastore için ayrı identity kullanmak breach etkisini sınırlar. TLS network trafiğini korur. Encryption at rest backup dahil uygulanmalıdır. Network segmentation ve secret rotation bütün platform için standardize edilmelidir.
Her Datastore İçin Ayrı Credential
SQL password Redis credential ile aynı olmamalıdır. Service bazında farklı hesap kullanılır. Compromise tek dependency ile sınırlı kalır. Audit access identity'yi gösterir. Shared root credential runtime'a verilmez.
Least Privilege
Projection consumer yalnızca kendi collection veya index'ine write eder. Application read-only store'da write permission almaz. Migration role geçici elevated permission kullanabilir. Permission periyodik review edilir. Default deny yaklaşımı tercih edilir.
TLS
Database connection network üzerinde şifrelenir. Certificate validation aktif olur. Internal network güvenli varsayılmamalıdır. Connection pool handshake cost'u azaltır. Rotation test edilir.
Encryption at Rest
Disk ve backup encrypted tutulur. Managed key veya customer-managed key requirement'a göre seçilir. Derived copies de PII taşıyabilir. Encryption access control'ün yerine geçmez. Key rotation planı bulunur.
Network Segmentation
Datastore public internet'e açılmamalıdır. Service yalnızca gereken network path'e erişir. Environment'lar ayrılır. Search admin endpoint runtime network'ten farklı olabilir. Firewall rules infrastructure as code ile yönetilir.
Secret Rotation
Credential süresiz kalmamalıdır. Dual-secret rollout downtime'ı azaltır. Application connection pool yeni credential ile reconnect eder. Old secret revoke edilir. Secret log veya trace'e yazılmaz.
Microservice'ler Arasında Database Credential Paylaşılmalı mı?
Microservice'ler arasında database credential paylaşmak ownership ve least privilege prensiplerini bozar. Her service kendi identity'sine sahip olmalıdır. Database role yalnızca kendi schema veya collection'ına gerekli permission vermelidir. Cross-service data erişimi API veya event üzerinden yapılmalıdır. Böylece breach, audit ve schema migration etkisi sınırlandırılır.
Hayır
Shared credential hangi service'in işlemi yaptığını gizler. Revocation bütün applications'i etkiler. Permission gereğinden geniş olur. Rotation koordine deployment ister. Ayrı identity daha güvenlidir.
Service Identity
Service workload identity veya dedicated credential kullanabilir. Audit log caller'ı gösterir. Secret manager otomatik rotation sağlayabilir. Environment bazında identity ayrılır. Human access ayrı role kullanır.
Database Role
Role gerekli tables ve commands ile sınırlıdır. Read service write alamaz. Migration role runtime'dan ayrı tutulur. Search projection consumer yalnızca target index'e erişir. Permission code review alır.
Kendi Store'una Minimum Yetki
Owner service bile root yetkisiyle çalışmamalıdır. DDL ve DML credentials ayrılabilir. Backup agent read-specific privilege kullanır. Least privilege incident radius'ını azaltır. Permission test automation'a eklenebilir.
Cross-Service Access'i API/Event Üzerinden Yapmak
Consumer business authorization owner service üzerinden alır. Event replicated data için kullanılır. Internal schema public olmaz. Rate limit ve tracing boundary'de uygulanır. Dependency açık hale gelir.
Kişisel Veri ve KVKK/GDPR
Polyglot persistence kişisel verinin birden fazla store'da kopyalanmasına neden olabilir ve bu durum veri yönetimi sorumluluğunu artırır. Data minimization her projection'ın yalnızca gerçekten gerekli PII'yi taşımasını gerektirir. Retention ve delete propagation cache, search, backup ve analytical copies için düşünülmelidir. Right-to-erasure akışı source deletion ile bitmez. Hukuki yükümlülükler kurumun hukuk ve uyum ekipleriyle birlikte somut kullanım durumuna göre değerlendirilmelidir.
Aynı PII'nin Birden Fazla Store'da Kopyalanması
User email SQL, search ve cache'te bulunabilir. Her copy breach surface'ini artırır. Search gerçekten email'e ihtiyaç duymuyorsa field çıkarılmalıdır. Data inventory bütün locations'ı kaydeder. Ownership deletion akışını tanımlar.
Data Minimization
Projection yalnızca query için gerekli field'leri alır. Whole customer object event'e konulmaz. Tokenization veya pseudonymization kullanılabilir. Logs PII taşımamalıdır. Minimum data security ve migration maliyetini azaltır.
Retention
Her datastore retention süresi tanımlar. Cache TTL otomatik cleanup sağlar. Search document canonical deletion event ile kaldırılır. Backup legal policy'ye göre tutulur. Analytics data ayrı retention gerektirir.
Delete Propagation
Canonical delete event yayınlanır. Consumers kendi copy'sini siler. Retry failure durumunu yönetir. Tombstone replay sırasında deletion bilgisini korur. Reconciliation silinmesi gereken extra records'ı bulur.
Right-to-Erasure
User talebi canonical workflow başlatır. Domain legal exceptions kontrol eder. Approved deletion downstream events üretir. Completion bütün stores üzerinden izlenir. Audit kişisel payload yerine operation metadata tutar.
Search/Cache/Backup'tan Silme
Cache key explicit delete veya TTL ile kaybolur. Search document delete event alır. Backup immutable olabilir ve retention sonunda expire olur. Restore sonrası deletion replay gerekebilir. Policy recovery workflow'da da korunmalıdır.
Data Deletion Event'i Nasıl Tasarlanmalı?
Deletion event bir entity'nin artık downstream store'larda bulunmaması gerektiğini güvenilir biçimde ifade etmelidir. Canonical delete source transaction içinde kaydedilir. Tombstone event replay ve log compaction gibi süreçlerde deletion state'ini koruyabilir. Cache ve search consumers idempotent delete yapar. Retry ve audit deletion'ın bütün copies'e ulaştığını doğrular.
Canonical Delete
Owner service business ve legal rule'a göre deletion yapar. Source state hard veya soft delete olabilir. Transaction outbox event üretir. Operation unique ID taşır. Downstream consumer source kararını değiştirmez.
Tombstone
Tombstone entity artık mevcut değil bilgisidir. Event history deletion'ı korur. Rebuild eski create event sonrasında tombstone uygulayarak doğru state'e ulaşır. Key-compacted stream'de özel anlam taşıyabilir. Schema açıkça tanımlanmalıdır.
Cache Invalidation
User cache keys silinir. Namespace'de farklı variants bulunabilir. Versioning veya key registry yardımcı olur. TTL safety net kalır. Sensitive data için yalnızca TTL beklenmemelidir.
Search Index Delete
Consumer document ID üzerinden delete yapar. Record yoksa operation yine başarılı kabul edilebilir. Duplicate event sorun yaratmaz. Search lag deletion freshness metric'ine yansır. Reconciliation extra document bulabilir.
Retry
Downstream store unavailable olabilir. Event broker'da bekler. Retry backoff kullanır. Permanent error dead-letter alert üretir. Deletion yüksek priority işlem sınıfı olabilir.
Audit
Hangi deletion request'in ne zaman tamamlandığı izlenir. Store-specific completion status tutulabilir. PII audit log'a tekrar yazılmaz. Failure remediation kaydedilir. Compliance reporting bu metadata'yı kullanabilir.
Polyglot Persistence Observability
Birden fazla datastore kullanıldığında yalnızca her database'in kendi metric'lerini izlemek yeterli değildir. SQL, NoSQL, cache ve search latency yanında synchronization pipeline'ın sağlığı da görünür olmalıdır. Projection lag ve sync failure data correctness'in operasyon metric'leridir. Distributed tracing tek user request'in hangi stores'a gittiğini gösterir. Observability ilk günden kurulmadığında eventual consistency sorunu kullanıcı şikayetiyle fark edilir.
SQL Metrics
Query latency, connection pool, locks ve CPU izlenir. Top query total time tuning priority'si sağlar. Replication lag HA durumunu gösterir. Storage growth capacity planına girer. Transaction errors domain reliability'yi etkiler.
NoSQL Metrics
Read/write latency ve throughput temel metric'tir. Shard distribution hotspot'u gösterebilir. Connection count izlenir. Replication health takip edilir. Document size veya partition growth data modeling problemine işaret edebilir.
Cache Metrics
Hit ratio origin offload'u gösterir. Eviction memory pressure sinyalidir. p99 latency hot key veya network sorununu gösterebilir. Connected clients connection explosion'ı ortaya çıkarır. Cache miss origin latency ile korele edilir.
Search Metrics
Query latency ve error rate izlenir. Indexing throughput projection lag'i etkiler. JVM veya process memory search engine'e göre takip edilir. Rejected requests saturation sinyalidir. Zero-result rate product metriği olabilir.
Synchronization Metrics
Broker lag ve consumer error data freshness'i gösterir. Outbox pending row age önemlidir. Retry count transient sorunları gösterir. Dead-letter count kritik alarmdır. Reconciliation mismatch uzun dönem doğruluğu ölçer.
Distributed Tracing
HTTP request trace root span oluşturur. SQL, Redis, MongoDB ve search calls child spans olabilir. Event trace context asynchronous boundary'de taşınabilir. Slow dependency kolayca bulunur. Sampling sensitive data içermemelidir.
İzlenmesi Gereken Temel Metrikler
Polyglot platform için metric set'i latency, freshness ve correctness boyutlarını birlikte kapsamalıdır. SQL ve NoSQL access latency performance'ı gösterir. Cache hit ratio origin tasarrufunu ölçer. Projection lag data freshness'i, reconciliation mismatch ise uzun dönem consistency'yi gösterir. Tek bir dashboard business request ile data pipeline arasındaki ilişkiyi görünür hale getirmelidir.
SQL Query Latency
p50 ve p99 ayrı izlenir. Query name veya fingerprint kullanılır. Pool wait time ayrıca kaydedilir. Cache migration sonrası latency ve QPS düşüşü karşılaştırılır. Slow queries source database'i sınırlayabilir.
NoSQL Read/Write Latency
Operation type ve collection bazında ölçülür. Hot partition tail latency yaratabilir. Retry gerçek user latency'yi gizlememelidir. Server ve client timing karşılaştırılır. SLO workload'a göre belirlenir.
Cache Hit Ratio
Hit divided by total lookup temel orandır. Namespace bazında hesaplanır. L1 ve Redis ayrı ölçülebilir. Yüksek hit stale correctness garantisi değildir. Origin QPS reduction ile birlikte yorumlanır.
Search Latency
Query type ve result size etkiler. Facet-heavy query ayrı metric alabilir. Timeout rate saturation gösterir. User p99 product experience'ı etkiler. Search outage fallback metric'i eklenir.
Projection Lag
Source event zamanı ile target apply zamanı arasındaki farktır. p95 ve maximum izlenir. Backlog büyümesi erken alert verir. SLO business freshness'e bağlanır. Negative lag clock problemi gösterebilir.
Sync Failure Rate
Consumer processing errors toplam events'e oranlanır. Transient ve permanent ayrı sınıflanır. Retry success rate izlenir. Dead-letter sıfıra yakın olmalıdır. Release correlation root cause'u kolaylaştırır.
Reconciliation Mismatch Count
Missing, stale ve extra records ayrı sayılır. Dataset büyüklüğüne oranlanır. Persistent nonzero drift synchronization bug gösterebilir. Repair count metric'e eklenir. SLO consistency health'i ölçer.
Data Consistency İçin SLI/SLO Tanımlanabilir mi?
Evet, eventual consistency kullanan sistemlerde data freshness ölçülebilir hale getirilebilir ve getirilmelidir. Projection freshness veya maximum sync lag teknik SLI olabilir. Reconciliation error rate kalıcı drift'i ölçer. Cache ve search için ayrı staleness hedefleri tanımlanabilir. Böylece “eventually güncelleniyor” belirsiz ifadesi yerine operasyon ekibinin takip edebileceği sınırlar oluşur.
Projection Freshness
Target record source version'a ne kadar yakın ölçülür. Last applied event time kullanılabilir. Endpoint bazında gerekli freshness farklıdır. Dashboard percentile gösterir. SLO violation alert üretir.
Maximum Sync Lag
Normal p95 yanında worst acceptable lag tanımlanır. Örneğin search 30 saniye içinde güncellenmelidir. Queue outage bu sınırı aşabilir. Recovery prioritization metric'e göre yapılır. Business owner threshold'u onaylar.
Reconciliation Error Rate
Sample veya full scan mismatch oranı hesaplanır. Projection permanent drift'i gösterir. Hedef çok düşük olmalıdır. Repair sonrası trend izlenir. Error budget release quality'yi değerlendirebilir.
Cache Staleness
Cache value source version veya timestamp taşıyabilir. Served stale duration ölçülebilir. Soft TTL policy normal staleness'ten ayrılır. Critical cache için lower SLO tanımlanır. Violation explicit invalidation sorununa işaret eder.
Search Freshness
Catalog update ile searchable hale gelme süresi ölçülür. Publish workflow SLO'ya bağlanabilir. User content moderation daha hızlı freshness isteyebilir. Backlog campaign sırasında artabilir. Search product metric'i haline gelir.
Distributed Tracing
Distributed tracing polyglot request'in hangi dependency'lerde zaman harcadığını gösterir. HTTP root span altında SQL, Redis, MongoDB ve search çağrıları görülebilir. Asynchronous event processing trace context ile ayrı span zincirine bağlanabilir. Bu visibility latency ve sync problemi arasındaki ilişkiyi hızla ortaya çıkarır. Trace'e query value veya PII yazılmamalıdır.
HTTP Request
Inbound request root span oluşturur. Route ve request ID kaydedilir. User PII tag olarak eklenmez. Overall latency burada ölçülür. Child spans dependency sürelerini açıklar.
SQL Span
Normalized query veya operation name kullanılır. Connection wait ayrı attribute olabilir. Row count performance sinyali verir. Raw parameter gizlenir. Transaction boundaries trace'te görülebilir.
Redis Span
GET veya SET operation tipi kaydedilir. Full cache key hassas olabilir. Namespace veya hashed key tercih edilir. Hit/miss attribute faydalıdır. Timeout fallback chain trace'te görünür.
MongoDB Span
Collection ve operation type görülebilir. Query payload redacted edilmelidir. Server selection wait ayrı olabilir. Retry trace child events olarak eklenir. Slow operation shard hotspot'u gösterebilir.
Search Span
Search endpoint ve index name kaydedilebilir. Query text PII içerebilir. Hit count veya shard time metric olarak alınabilir. Timeout fallback trace'te görünür. Large response serialization ayrıca ölçülebilir.
Event Processing Span
Producer trace context event header'a aktarılabilir. Consumer processing ayrı span oluşturur. Broker lag ve processing time ayrılır. Projection write dependency span olur. End-to-end write-to-read freshness izlenebilir.
Polyglot Persistence Test Stratejisi
Polyglot persistence yalnızca unit test ile güvenli hale gelmez. Integration test gerçek datastore semantics'ini doğrular. Contract tests service ve event boundaries'ini korur. Synchronization tests duplicate, ordering ve lag behavior'ını test eder. Failure ve end-to-end tests arıza sırasında sistemin nasıl degrade olduğunu gösterir.
Unit Tests
Projection mapper deterministic test edilir. Conflict resolution rules coverage alır. Key generation doğrulanır. Repository domain behavior mock ile test edilebilir. Store-specific semantics unit testte taklit edilmemelidir.
Integration Tests
Gerçek PostgreSQL veya MongoDB container kullanılabilir. Transaction behavior doğrulanır. Index ve query semantics test edilir. Serialization gerçek driver ile çalışır. Cleanup isolated database üzerinden yapılır.
Contract Tests
API consumer expectations doğrulanır. Event schema backward compatibility test edilir. Required fields ve enum changes kontrol edilir. Producer release consumer'ı kırmamalıdır. Contract repository merkezi olabilir.
Synchronization Tests
SQL write sonrası event üretilir. Consumer target store'u günceller. Lag bounded beklenir. Delete propagation test edilir. Reconciliation final state'i doğrular.
Failure Tests
Redis veya MongoDB deliberately durdurulur. Broker timeout enjekte edilir. Partial write senaryosu çalıştırılır. Retry ve circuit gözlenir. Source correctness korunmalıdır.
End-to-End Tests
Client command'dan read projection'a tam flow çalıştırılır. Eventual consistency wait helper kullanılabilir. Real authentication ve network boundaries test edilir. Critical user journey coverage alır. Production'a yakın configuration kullanılır.
Testcontainers ile Çoklu Database Testleri
Testcontainers integration test sırasında gerçek database container'larını programatik olarak başlatmayı kolaylaştırabilir. PostgreSQL, MongoDB, Redis ve search engine aynı test suite içinde gerçek protocol ve behavior ile çalışabilir. Bu yaklaşım mock'ların gizlediği transaction ve serialization farklarını yakalar. Container startup test süresini artırabilir. Test suite layer'lara ayrılarak hızlı unit ve daha ağır integration test dengesi kurulmalıdır.
PostgreSQL Container
Migration gerçek database'e uygulanır. Constraint ve transaction test edilir. Extension gerekiyorsa image hazırlanır. Seed minimum data kullanır. Test isolation schema veya container bazında yapılır.
MongoDB Container
Document indexes gerçek instance'ta oluşturulur. Transaction test gerekiyorsa replica set configuration gerekebilir. Schema mapping doğrulanır. Query behavior mock'tan daha güvenilir olur. Cleanup collection bazında yapılabilir.
Redis Container
TTL ve eviction behavior test edilebilir. Distributed lock script gerçek Redis'te çalışır. Cache failure container stop ile simüle edilir. Persistence config use case'e göre eklenir. Key namespace isolation korunur.
Elasticsearch/OpenSearch Container
Index template ve mapping gerçek engine'de uygulanır. Analyzer behavior test edilir. Reindex flow küçük dataset ile doğrulanabilir. Startup resource kullanımı yüksektir. CI memory planlanmalıdır.
Gerçek Integration Flow
PostgreSQL write outbox event üretir. Test relay event'i consumer'a taşır. Redis ve search projection güncellenir. Assertions eventual wait ile yapılır. Bu flow production architecture'ın küçük versiyonudur.
Consistency Testleri
Consistency testleri yalnızca happy-path state equality kontrol etmemelidir. Duplicate event, out-of-order delivery, projection failure ve replay gibi durumlar özellikle denenmelidir. Reconciliation corrupted target'ı düzeltmelidir. Consumer idempotency test edilmelidir. Bu senaryolar production'daki gerçek distributed failure davranışına daha yakındır.
SQL Write Sonrası Projection
Business transaction commit edilir. Event consumer çalışır. Target version source ile eşleşir. Required fields doğrulanır. Maximum wait SLO'dan türetilir.
Duplicate Event
Aynı event iki kez gönderilir. Final projection değişmemelidir. Counter varsa dedupe doğrulanır. Processed event store test edilir. Metric duplicate count gösterebilir.
Out-of-Order Event
Version 2 önce, version 1 sonra gönderilir. Projection version 2'de kalmalıdır. Old event ignore edilir. Log warning üretilebilir. Reconciliation mismatch olmamalıdır.
Projection Failure
Target store geçici error verir. Consumer retry eder. Source transaction etkilenmez. Event kaybolmaz. Recovery sonrası projection güncellenir.
Replay
Projection temizlenir. Historical events tekrar işlenir. Final state aynı olur. Idempotency doğrulanır. Replay performance ölçülebilir.
Reconciliation
Target record kasıtlı bozulur. Job mismatch bulur. Source wins policy repair yapar. Audit log oluşur. Drift metric sıfıra döner.
Failure Injection Testleri
Failure injection dependency'lerin gerçek arıza davranışını kontrollü ortamda test eder. MongoDB, Redis veya search engine kapatılabilir. Broker outage projection lag yaratır. Network timeout belirsiz operation sonucunu gösterir. Partial write senaryoları outbox ve idempotency tasarımını doğrular.
MongoDB Down
Projection consumer write yapamaz. Event broker'da kalır. Source SQL write devam eder. Alert lag yükselişini gösterir. Recovery sonrası catch-up yapılır.
Redis Down
Cache reads timeout verir. Circuit açılır. Database fallback bounded olur. User latency geçici değişir. Cache recovery warming ile yapılır.
Search Down
Search request degrade edilir. Index events queue'da birikir. Checkout çalışmaya devam eder. Recovery replay yapılır. Lag SLO yeniden normale döner.
Broker Down
Outbox rows birikmeye devam eder. Business transaction broker'dan bağımsız commit olabilir. Relay errors alert verir. Broker dönünce events gönderilir. Outbox storage capacity izlenir.
Network Timeout
Remote operation sonucu bilinmeyebilir. Retry idempotency'yi test eder. Circuit threshold doğrulanır. Trace delay'i gösterir. User deadline aşılmamalıdır.
Partial Write
SQL commit olurken projection update engellenir. Outbox recovery beklenir. Direct dual write kullanılıyorsa inconsistency ortaya çıkar. Test pattern farkını görünür yapar. Reconciliation final state'i doğrular.
Performance Testing
Polyglot architecture performance testinde yalnızca yeni datastore'un hızlı olduğunu göstermek yeterli değildir. Tek database baseline korunmalıdır. Yeni architecture latency ve throughput kazancı ölçülür. Source database CPU azalması hedef faydayı gösterir. Cache hit ve toplam infrastructure cost birlikte değerlendirilmelidir.
Tek Database Baseline
Migration öncesi p50 ve p99 kaydedilir. Database CPU ve I/O ölçülür. Query throughput bulunur. Cost baseline oluşturulur. Aynı workload sonra tekrar kullanılır.
Polyglot Architecture Sonrası Latency
Read store response latency ölçülür. Network hop ve serialization dahil edilir. Miss/fallback ayrı raporlanır. Consistency wait latency'yi etkileyebilir. User endpoint ölçümü temel alınır.
Throughput
Saniyedeki başarılı business requests ölçülür. Store ops/sec tek başına yeterli değildir. Bottleneck başka dependency'ye taşınmış olabilir. Autoscaling behavior izlenir. Peak throughput SLO ile karşılaştırılır.
Database CPU
Cache veya search offload sonrası SQL CPU düşmelidir. Düşmüyorsa target query yanlış seçilmiş olabilir. Write CDC overhead ayrıca ölçülür. Replica CPU dikkate alınır. Cost saving hesaplanabilir.
Cache Hit Rate
Cache architecture'ın read reuse verimini gösterir. High hit source QPS'i azaltmalıdır. Cold cache test ayrıca yapılır. Eviction workload'a göre ölçülür. Hit freshness correctness ile birlikte değerlendirilir.
Cost
Yeni clusters altyapı faturasını artırır. Source scale-down tasarrufu düşülebilir. Engineer operasyon zamanı ayrıca maliyettir. License veya managed service cost eklenir. Performance improvement business value ile karşılaştırılır.
Polyglot Persistence'ın Operasyonel Maliyeti
Polyglot persistence'ın gözden kaçan en büyük bedeli operasyon maliyetidir. Her yeni database cluster backup, monitoring, security, on-call ve upgrade bilgisi ister. Lisans veya cloud maliyeti de artar. Ekiplerin skill set'i daha parçalı hale gelir. Kurumsal SQL NoSQL hibrit veritabanı mimarisi geliştirme hizmeti değerlendirirken teknik tasarım kadar uzun dönem işletim kapasitesini de hesaba katmak gerekir.
Daha Fazla Database Cluster
Her cluster compute ve storage tüketir. Dev, staging ve production ortamları sayıyı çarpar. Network ve DNS yönetimi artar. HA replicas maliyeti büyütür. Kullanım düşük store'lar cleanup adayı olabilir.
Backup
Her source store farklı backup tooling kullanabilir. Schedules koordine edilir. Cross-store recovery problemi oluşur. Restore test süresi artar. Derived stores için rebuild alternatif olabilir.
Monitoring
Yeni metrics ve dashboards gerekir. Alert fatigue riski artar. Store-specific uzmanlık gerekir. Cross-system trace önem kazanır. Monitoring cost yüksek-cardinality metric'lerle büyüyebilir.
On-Call
Incident gece farklı database bilgisi gerektirebilir. Runbooks düzenli güncellenmelidir. Team training zaman alır. Managed service bile application data consistency sorununu çözmez. Ownership açık olmalıdır.
Security
Daha fazla credential ve network endpoint oluşur. Patch surface büyür. Audit farklı sistemlerde toplanır. PII copies çoğalabilir. Security review her store'u kapsar.
Upgrade
Database major versions farklı takvimlerle gelir. Client compatibility test edilir. Migration ve rollback planı gerekir. Search mapping veya cluster protocol değişebilir. Test matrix büyür.
Lisans/Cloud Maliyeti
Managed databases premium fiyat taşıyabilir. Data transfer ve replica cost eklenir. Lisans modeli zamanla değişebilir. Vendor-specific features switching cost yaratır. TCO yıllık olarak gözden geçirilmelidir.
Datastore Sprawl Nedir?
Datastore sprawl organizasyonda gereğinden fazla database teknolojisinin kontrolsüz yayılmasıdır. Her takım kendi tercihine göre yeni teknoloji eklediğinde platform ondan fazla datastore türüne ulaşabilir. Skill fragmentation ve security risk büyür. Operasyon standardı zayıflar. Polyglot persistence bilinçli seçim olduğu sürece yararlıdır, kontrolsüz çeşitlilik haline geldiğinde ise teknik borca dönüşür.
Her Takımın Farklı Teknoloji Seçmesi
Team autonomy tamamen limitsiz bırakılırsa benzer problem farklı database'lerle çözülür. Knowledge paylaşımı azalır. Hiring zorlaşır. Platform tooling her teknolojiye yetişemez. Approved list denge sağlar.
10+ Database Teknolojisi
Her technology için backup ve monitoring gerekir. Upgrade calendar büyür. Incident routing zorlaşır. Bazı stores yalnızca bir feature tarafından kullanılır. Consolidation periyodik yapılmalıdır.
Skill Fragmentation
DBA veya platform ekibi bütün sistemlerde derin uzman olamaz. Developer support gecikir. Best practices tutarsızlaşır. Training cost artar. Daha az standard teknoloji reliability'yi artırabilir.
Security Risk
Farklı auth modelleri yanlış configuration riskini artırır. Patch takibi zorlaşır. Public endpoint yanlışlıkla açık kalabilir. Secret rotation automation her sistemde farklıdır. Security baseline standardize edilmelidir.
Operational Burden
Incident sırasında birkaç az kullanılan database büyük zaman kaybettirebilir. Backup restore hiç denenmemiş olabilir. Vendor support bilinmeyebilir. Cost görünmez şekilde büyür. Technology retirement süreci bulunmalıdır.
Datastore Sprawl Nasıl Önlenir?
Datastore sprawl merkezi yasaklarla değil açık governance ve measurable requirement ile önlenmelidir. Approved technology list ekiplerin desteklenen seçenekleri bilmesini sağlar. Yeni store architecture review'dan geçer. Proof of Concept ve load test gerçek faydayı doğrular. TCO analizi performans kazancını uzun dönem operasyon maliyetiyle karşılaştırır.
Approved Technology List
Kurum desteklenen SQL, cache, search ve document seçeneklerini tanımlar. Platform tooling bu listede güçlü olur. Yeni technology tamamen yasak değildir. Exception requirement üzerinden değerlendirilir. Liste düzenli güncellenir.
Architecture Review
Yeni store'un business ve technical gerekçesi sunulur. Data ownership ve DR planı incelenir. Existing options değerlendirilir. Security sign-off alınır. Decision record kalıcı doküman olur.
Yeni Store İçin Measurable Requirement
Örneğin p99 search 150 ms altında olmalı gibi hedef yazılır. Current system baseline sunulur. Capacity growth tahmini eklenir. Requirement POC'de test edilir. Başarısızsa technology eklenmez.
Proof of Concept
POC gerçek representative data kullanır. Happy path dışında failure test edilir. Operational setup da denenir. Developer ergonomics gözlenir. Marketing demo üzerinden karar verilmez.
Load Test
Production read/write ratio modellenir. Hot partitions test edilir. Failover uygulanır. Tail latency ölçülür. Scale cost hesaplanır.
TCO Analizi
Instance ve storage faturası hesaplanır. Backup, observability ve network cost eklenir. Engineer support zamanı değerlendirilir. Migration ve exit cost düşünülür. Fayda maliyetten büyük olmalıdır.
Yeni Bir Veritabanı Eklemek İçin Karar Kriterleri
Yeni datastore ekleme kararı teknik meraktan değil ölçülmüş gereksinimden çıkmalıdır. Mevcut store'un capability ve tuning seçenekleri önce değerlendirilir. Access pattern temelden farklıysa specialized store değer sağlayabilir. Operasyon ekibinin backup ve DR çözümü bulunmalıdır. Fayda getirilen complexity'den açık biçimde büyük olmalıdır.
Mevcut Store ile Çözülebiliyor mu?
Index, JSONB veya extension requirement'ı karşılayabilir. Read replica isolation sağlayabilir. Cache daha basit olabilir. Schema redesign sorunu çözebilir. Yeni store son seçeneklerden biri olmalıdır.
Ölçülmüş Performance Problemi Var mı?
p99, CPU veya throughput verisi sunulmalıdır. Tahmini future scale tek başına zayıftır. Load test capacity sınırını gösterir. Query tuning baseline alınır. Improvement target net olur.
Access Pattern Temelden Farklı mı?
Full-text veya multi-hop graph traversal specialized engine'i haklı çıkarabilir. Basit ID lookup için yeni database gereksizdir. Pattern frequency önemlidir. Data shape değil query behavior belirleyicidir. User-facing product requirement belgelenir.
Operasyon Ekibi Teknolojiyi Yönetebilir mi?
Backup alınabiliyor mu sorulmalıdır. Failover test edildi mi kontrol edilir. On-call training planı bulunmalıdır. Managed service support incelenir. Security expertise yeterli olmalıdır.
DR ve Backup Çözümü Var mı?
Source data ise backup zorunludur. Derived store ise rebuild RTO ölçülür. Cross-region recovery planı bulunur. Credentials restore sırasında hazır olmalıdır. Test kanıtı istenir.
Fayda Karmaşıklıktan Büyük mü?
Latency veya scale kazancı sayısallaştırılır. Infrastructure ve engineering cost düşülür. Consistency risk hesaba katılır. Migration rollback kolaylığı değerlendirilir. Architecture decision periyodik review edilir.
Polyglot Persistence Karar Ağacı
Karar ağacı datastore seçimini tek marka veya teknoloji üzerinden değil workload gereksinimi üzerinden yönlendirmelidir. Strong multi-row transaction relational database lehine güçlü sinyaldir. Ultra-low-latency key lookup key-value store'a, advanced search search engine'e, multi-hop traversal graph database'e işaret edebilir. Flexible document ihtiyacında önce PostgreSQL JSONB gibi mevcut seçenekler değerlendirilebilir. Massive time-series ingestion specialized model gerektirebilir.
Strong Multi-Row Transaction Gerekiyor mu?
Bir operation birden fazla kaydı atomik değiştirmek zorunda mı sorulur. Foreign key ve constraint önemli mi değerlendirilir. Global distributed transaction gerekip gerekmediği analiz edilir. Local boundary korunabiliyorsa relational model avantajlıdır. Sadece read projection için güçlü transaction gerekli olmayabilir.
Relational Database'i Değerlendir
PostgreSQL veya başka relational sistem transaction core için güçlü adaydır. Normalize model correctness sağlar. JSON veya extension ihtiyacın bir bölümünü aynı database'de çözebilir. Scale önce index ve partitioning ile ölçülür. Derived stores sonradan eklenebilir.
Ultra-Low-Latency Key Lookup mı?
Access yalnızca key üzerinden mi yapılıyor incelenir. Reuse yüksekse cache olabilir. State rebuild edilebilir mi sorulur. Memory cost hesaplanır. Hot key riskine bakılır.
Redis/Key-Value Store
Redis cache veya coordination için değerlendirilebilir. TTL lifecycle'ı kolaylaştırır. Source of truth rolü açık olmalıdır. Persistence requirement state criticality'ye göre seçilir. Failure fallback test edilir.
Schema-Flexible Documents mı?
Entity attributes category bazında değişiyor mu değerlendirilir. Document aggregate doğal mı bakılır. Relational joins ne kadar gerekli ölçülür. Transaction boundary önemlidir. Horizontal scaling requirement doğrulanır.
PostgreSQL JSONB veya Document DB
Mevcut PostgreSQL JSONB önce değerlendirilebilir. GIN index query ihtiyacını karşılayabilir. Independent document scaling gerekiyorsa document database düşünülebilir. Operational cost kıyaslanır. POC representative schema kullanır.
Advanced Full-Text Search mı?
Fuzzy, autocomplete ve relevance tuning product için kritik mi sorulur. PostgreSQL native search baseline olur. Search QPS transactional resources'ı etkiliyor mu ölçülür. Faceting complexity incelenir. Rebuild ihtiyacı planlanır.
Search Engine
Dedicated search engine derived projection olarak kurulur. Source of truth ayrı kalır. CDC veya event sync uygulanır. Blue-green reindex desteklenir. Search outage gracefully degrade edilir.
Multi-Hop Relationship Traversal mı?
Query variable-depth ilişkileri mi geziyor değerlendirilir. Recursive SQL baseline test edilir. Relationship count ve latency ölçülür. Fraud veya recommendation use case olabilir. Graph projection yeniden üretilebilir tasarlanır.
Graph Database
Graph store node ve edge traversal için kullanılabilir. Core entities SQL'de kalabilir. Event pipeline edges'i günceller. Version stale relation'ı engeller. Graph query business decision'ın tek kaynağı olmayabilir.
Massive Time-Series Ingestion mı?
Saniyelik event hacmi ve retention ölçülür. Timestamp range queries dominant mı bakılır. Raw data downsampling ihtiyacı değerlendirilir. SQL partitioning baseline test edilir. Specialized store faydası ölçülür.
Time-Series/Wide-Column Store
High ingestion için partition-oriented sistem kullanılabilir. Master data ayrı SQL'de tutulur. Retention otomatik yönetilir. Aggregates precompute edilebilir. Data loss ve replication SLO tanımlanır.
Örnek Production-Ready Polyglot Persistence Akışı
Production-ready örnekte transactional command SQL'de tamamlanır ve aynı transaction outbox event oluşturur. CDC veya relay bu event'i broker'a taşır. Redis cache, search index ve document read model birbirinden bağımsız consumers tarafından güncellenir. Projection lag ve failure metric'leri gözlemlenir. Reconciliation job uzun dönem drift olmadığını doğrular.
1. Client API Request Gönderir
Client authenticated request gönderir. API validation yapar. Correlation ID oluşturulur. Request domain service'e gider. Trace root span başlar.
2. Domain Service Command'i İşler
Business rules değerlendirilir. Required current state SQL'den okunur. Idempotency kontrol edilir. Domain değişiklik hesaplanır. External projection henüz güncellenmez.
3. Transactional Data SQL'e Yazılır
Local transaction açılır. Business rows güncellenir. Constraints çalışır. Entity version artar. Audit metadata yazılır.
4. Aynı Transaction'da Outbox Event Oluşur
Event ID ve aggregate version kaydedilir. Payload minimal tutulur. Transaction business data ile birlikte commit edilir. Failure ikisini birden rollback eder. Broker availability gerekli değildir.
5. CDC/Relay Event'i Broker'a Gönderir
Committed outbox row okunur. Event broker topic'ine publish edilir. Offset tutulur. Duplicate publish mümkün kabul edilir. Relay lag metric üretilir.
6. Cache Projection Güncellenir
Cache consumer key'i siler veya yeni value yazar. TTL uygulanır. Version kontrol edilebilir. Failure user write'ı geri almaz. Retry yapılır.
7. Search Projection Güncellenir
Search consumer denormalized document oluşturur. Index upsert yapar. Analyzer yeni content'i işler. Search freshness metriği güncellenir. Mapping error dead-letter olabilir.
8. Document Read Model Güncellenir
MongoDB consumer UI read document'ini upsert eder. Version out-of-order event'i engeller. Duplicate event idempotent olur. Query endpoint yeni store'u kullanır. Strong read gerektiğinde SQL fallback bulunur.
9. Projection Lag ve Hatalar İzlenir
Consumer offsets dashboard'da görünür. Oldest event age izlenir. Error rate alert üretir. Dead-letter count kritik kabul edilir. Release annotation correlation sağlar.
10. Reconciliation Job Tutarlılığı Doğrular
Source ve projections periyodik karşılaştırılır. Version mismatch bulunur. Safe records otomatik repair edilir. Audit log tutulur. Drift SLO architecture kalitesini ölçer.
Örnek E-Ticaret Veri Sahipliği
E-ticaret veri sahipliği tablosu her entity için source of truth ve derived stores ayrımını açıkça gösterebilir. Order ve payment ilişkisel source'ta kalır. Product domain ihtiyaçlarına göre PostgreSQL veya document store tarafından sahiplenilebilir. Search ve recommendation projection olarak çalışır. Session ise Redis üzerinde farklı durability sınıfına sahip bağımsız state olabilir.
Order
Order business transaction'ın merkezidir. Line items ve status history ile birlikte yönetilir. Search veya dashboard copies derived olabilir. Canonical version event'lere eklenir. Audit source store'dan yapılır.
Source of Truth → PostgreSQL
PostgreSQL order constraints ve transaction'ı korur. Order creation tek local transaction'da tamamlanır. Outbox event projection'ları besler. Search veya cache kaybı order'ı etkilemez. Recovery canonical SQL üzerinden yapılır.
Product
Product domain farklı category metadata ve publishing workflow taşıyabilir. Canonical store relational veya document model olabilir. Karar access pattern üzerinden verilmelidir. Search ayrı projection'dır. Order geçmişi product current state'e bağlı kalmamalıdır.
Source of Truth → PostgreSQL veya MongoDB
Stable relational product model PostgreSQL'de kalabilir. Flexible document aggregate MongoDB'de yaşayabilir. Aynı product iki tarafta eşit authoritative olmamalıdır. Domain owner tek write API sağlar. Diğer sistemler event üzerinden kopya alır.
Search Projection → Elasticsearch
Search document product source'tan türetilir. Facet ve text fields denormalize edilir. Index rebuild mümkündür. Search mapping source schema'dan farklı olabilir. Product publish event index'i günceller.
Session
Session user request context'ini taşır. Düşük latency önemlidir. TTL lifecycle yönetir. Kaybı user logout etkisi yaratabilir. Cache'ten farklı availability sınıfı değerlendirilebilir.
Redis
Redis session lookup için uygundur. Persistence risk toleransına göre seçilir. Eviction session state'i yanlışlıkla atmamalıdır. HA failover test edilir. Credential application ile sınırlandırılır.
Payment
Payment financial correctness ister. Provider idempotency key tutulur. Audit history önemlidir. Search veya cache authoritative değildir. Analytics copy downstream olabilir.
PostgreSQL
PostgreSQL transaction ve constraint sağlar. Payment state transition kontrollü tutulur. Ledger veya transaction records durable saklanır. Outbox events external consumers'a gider. Backup ve PITR güçlü şekilde test edilir.
Recommendation
Recommendation transactional state değildir. Behavior events üzerinden türetilir. Model yeniden hesaplanabilir. User preference deletion downstream propagate edilmelidir. Low latency için result cache kullanılabilir.
Graph/Vector Store
Graph relationship veya vector embedding candidate üretir. Source events projection'ı besler. Recommendation store kaybolursa rebuild yapılabilir. Search quality offline metrics ile ölçülür. Critical business transaction bu store'a bağımlı olmaz.
Production'a Çıkmadan Önce Kontrol Listesi
Polyglot persistence production'a çıkmadan önce yalnızca connection testlerinin başarılı olması yeterli değildir. Source of truth ve owner bütün data classes için açık olmalıdır. Dual-write, idempotency, out-of-order event ve reconciliation mekanizmaları test edilmelidir. Backup, restore, monitoring ve delete propagation hazır olmalıdır. Bu checklist mimarinin normal çalışma kadar failure ve recovery senaryolarına da hazır olduğunu doğrular.
Her Veri İçin Source of Truth Belli mi?
Entity field ownership tablosu hazırlanmalıdır. Conflict durumunda hangi store kazanıyor bilinmelidir. Derived copies açıkça işaretlenir. Write API yalnızca owner'a gider. Recovery source üzerinden yapılır.
Her Datastore'un Owner'ı Belli mi?
Team sorumluluğu kaydedilir. On-call routing nettir. Schema migration owner tarafından yönetilir. Cost attribution yapılabilir. Sahipsiz datastore production'a alınmamalıdır.
Cross-Database Direct Query Engellendi mi?
Network ve credential policies private store'a erişimi sınırlar. Service API kullanılır. Reporting federation ayrı alanda kalır. Hidden SQL dependency taranır. Architecture testleri permission'ı doğrular.
Dual-Write Problemi Çözüldü mü?
Direct synchronous writes incelenir. Outbox veya saga gerekip gerekmediği belirlenir. Partial failure test edilir. Retry idempotent olmalıdır. Drift senaryosu belgelenir.
Synchronization Mekanizması Tanımlı mı?
CDC, events veya batch model seçilmiştir. Lag SLO vardır. Replay prosedürü bulunur. Schema evolution desteklenir. Monitoring kuruludur.
Consumer/Projection Idempotent mı?
Duplicate event test edilir. Upsert deterministic olmalıdır. Side effects dedupe alır. Event ID veya version kullanılır. Replay aynı sonucu üretmelidir.
Out-of-Order Update Yönetiliyor mu?
Version veya sequence bulunur. Old event ignore edilir. Metrics ordering violation'ı gösterir. Timestamp-only rule gözden geçirilir. Test version 2 sonra version 1 gönderir.
Reconciliation Var mı?
Source-target comparison periyodik çalışır. Missing ve stale records bulunur. Repair policy vardır. Audit tutulur. Drift SLO tanımlanır.
Projection Rebuild Test Edildi mi?
Search veya document store silinip yeniden oluşturulur. Backfill ve replay birlikte çalışır. RTO ölçülür. Blue-green cutover denenir. Runbook güncellenir.
Backup ve Restore Test Edildi mi?
Source database restore gerçek environment'ta yapılır. Encryption keys erişilebilir olmalıdır. Credentials ve network dependencies doğrulanır. Restore sonucu application test edilir. Backup yalnızca log mesajına güvenilmez.
Cross-Store RPO/RTO Tanımlı mı?
Her store için target farklı olabilir. Source recovery önce gelir. Derived rebuild time ayrıca ölçülür. Event retention RPO'yu etkiler. Business owner hedefleri kabul eder.
Monitoring ve Alerting Var mı?
Latency ve errors yanında sync lag izlenir. Dead-letter alert yüksek önceliktedir. Reconciliation drift dashboard'a girer. Distributed tracing aktiftir. Alert runbook link taşır.
Veri Silme Tüm Kopyalara Propagate Ediliyor mu?
Canonical delete event üretilir. Cache ve search consumers siler. Backup retention policy bilinmektedir. Retry ve audit uygulanır. Reconciliation forgotten copy bulabilir.
Sık Yapılan Polyglot Persistence Hataları
Polyglot persistence hatalarının çoğu teknoloji eksikliğinden değil ownership ve consistency kararlarının belirsizliğinden kaynaklanır. Yeni database moda olduğu için eklenebilir veya her service rastgele teknoloji seçebilir. Aynı veri iki source of truth arasında bölünebilir. Direct dual write ve cross-database join kısa vadede kolay görünür. Rebuild, observability ve eventual consistency kullanıcı deneyimi unutulduğunda production sorunları kaçınılmaz hale gelir.
Modaya Uymak İçin Yeni Database Eklemek
Teknik trend measurable requirement değildir. POC gerçek workload kullanmalıdır. Mevcut store tuning önce denenir. Operational cost decision'a eklenir. Fayda yoksa technology eklenmez.
Her Service'in Rastgele Teknoloji Seçmesine İzin Vermek
Autonomy governance olmadan sprawl yaratır. Approved list tutulur. Exception architecture review alır. Platform support kapasitesi dikkate alınır. Team long-term ownership kabul eder.
Aynı Veriye İki Database'i de Source of Truth Yapmak
Conflict kaçınılmaz olur. Hangi value doğru belirsizleşir. Bidirectional sync karmaşıklaşır. Tek field owner tanımlanmalıdır. Derived copy read-only tutulmalıdır.
SQL ve NoSQL'e Senkron Dual Write Yapmak
Partial failure drift yaratır. Timeout belirsiz result oluşturur. Retry duplicate yapabilir. Outbox daha güvenli olabilir. Direct dual write exception olarak kalmalıdır.
Cross-Database Join'e Bağımlı Tasarım Kurmak
Network latency query path'e girer. Failure domain genişler. Schema coupling oluşur. Projection veya API composition değerlendirilir. OLAP federation ayrı tutulur.
Search Index'i Primary Database Yapmak
Mapping rebuild data riskine dönüşür. Search-specific denormalization business source haline gelir. Transaction constraints sınırlıdır. Canonical store ayrı olmalıdır. Index rebuildable projection tasarlanır.
Redis'i Backup Olmadan Kalıcı Veri Kaynağı Gibi Kullanmak
Cache sanılan key aslında critical state olabilir. Persistence kapalı restart data kaybı yaratır. Role classification yapılmalıdır. Session ve primary state HA ister. Backup/recovery test edilmelidir.
Eventual Consistency'yi Kullanıcı Deneyiminde Hesaba Katmamak
User update sonrası eski state görür. Confusion ve duplicate action oluşabilir. Pending UI veya read-your-writes uygulanır. Strong read endpoint belirlenir. Consistency window ölçülür.
Projection Lag'i İzlememek
Queue saatlerce geride kalabilir. User stale data görür. Sistem teknik olarak “up” görünür. Oldest event age alert gerekir. Freshness first-class SLO olmalıdır.
Rebuild/Replay Mekanizması Tasarlamamak
Search corruption kalıcı outage'a dönüşür. Mapping migration korkutucu hale gelir. Event replay idempotent değilse recovery zorlaşır. Backfill automation hazırlanmalıdır. Recovery düzenli test edilmelidir.
Polyglot Persistence Maturity Model
Polyglot persistence maturity tek database'den governed enterprise data platform'a kadar aşamalı gelişebilir. Her seviye daha fazla teknoloji değil daha güçlü ownership ve reliability pratiği temsil eder. SQL + cache başlangıçta büyük performans kazancı sağlayabilir. Event-driven sync, outbox, idempotency ve reconciliation olgunluğu artırır. En ileri seviyede datastore seçimi merkezi governance ve SLO'larla yönetilir.
Seviye 0 — Tek Database
Application bütün data'yı tek relational database'de tutar. Transaction ve backup basittir. Scale yeterlidir. Bu seviye başarısız veya ilkel değildir. Birçok ürün için uzun süre en doğru mimaridir.
Seviye 1 — SQL + Cache
Redis read-heavy workload'u offload eder. SQL source of truth kalır. TTL ve invalidation tanımlanır. Cache failure fallback test edilir. Hit rate ölçülür.
Seviye 2 — SQL + Search/Document Projection
Derived read store eklenir. Search veya complex view ayrı ölçeklenir. Sync başlangıçta basit event olabilir. Source ownership nettir. Projection rebuild planı vardır.
Seviye 3 — Event-Driven Synchronization
Broker integration standard hale gelir. Domain events versionlanır. Consumers asynchronous projection yapar. Lag metric izlenir. Eventual consistency product tarafından kabul edilir.
Seviye 4 — Outbox + Idempotency + Reconciliation
Dual-write risk outbox ile azaltılır. Consumer duplicate-safe çalışır. Ordering version ile yönetilir. Reconciliation drift bulur. Recovery güvenilir hale gelir.
Seviye 5 — CQRS + Data Ownership + SLO
Write ve read models bilinçli ayrılır. Bounded contexts source ownership taşır. Freshness SLO tanımlanır. Strong ve eventual reads ayrılır. Architecture data-driven yönetilir.
Seviye 6 — Governed Enterprise Data Platform
Approved technology list bulunur. Security ve observability ortak platform olarak sunulur. Datastore onboarding architecture review alır. DR ve TCO merkezi standarda sahiptir. Technology retirement süreci de yönetilir.
Sık Sorulan Sorular
Polyglot persistence hakkında sorular genellikle SQL ve NoSQL'in birlikte kullanılıp kullanılamayacağı, source of truth, senkronizasyon ve transaction sınırları etrafında toplanır. Cevapların çoğu belirli bir database ürününden çok veri ownership'i ve consistency beklentisine bağlıdır. Birden fazla store kullanmak teknik olarak kolaydır, güvenilir şekilde işletmek ise disiplin ister. Transactional Outbox, CDC, idempotency ve reconciliation bu güvenilirliğin temel araçlarıdır. Aşağıdaki cevaplar günlük mimari kararlarında en sık karşılaşılan noktaları özetler.
SQL ve NoSQL aynı projede birlikte kullanılabilir mi?
Evet, aynı projede SQL ve NoSQL birlikte kullanılabilir. SQL canonical transactional data'yı, NoSQL belirli read veya scaling ihtiyacını karşılayabilir. Her store'un role ve ownership'i açık olmalıdır. Data senkronizasyonu event veya CDC ile yönetilebilir. İkinci datastore yalnızca ölçülebilir fayda sağlıyorsa eklenmelidir.
Polyglot persistence nedir?
Polyglot persistence bir application içinde farklı persistence modellerini birlikte kullanma yaklaşımıdır. Amaç her workload için uygun storage seçmektir. SQL, cache, search ve graph aynı mimaride farklı sorumluluklar alabilir. Bu yaklaşım daha fazla operasyon maliyeti getirir. Governance ve source-of-truth tanımı zorunludur.
SQL ve MongoDB birlikte nasıl kullanılır?
Transactional core SQL'de tutulabilir. Flexible document domain MongoDB tarafından sahiplenilebilir veya MongoDB derived read model olabilir. Aynı field iki tarafta bağımsız yazılmamalıdır. Event synchronization kullanılır. MongoDB kaybolduğunda projection ise yeniden üretilebilir olmalıdır.
PostgreSQL ve Redis birlikte nasıl kullanılır?
PostgreSQL source of truth, Redis cache olabilir. Application cache-aside ile önce Redis'e bakar. Miss SQL'e gider ve value TTL ile cache'e yazılır. Mutation sonrası cache invalidate edilir. Redis failure database fallback ile kontrollü yönetilir.
PostgreSQL ve Elasticsearch birlikte nasıl kullanılır?
PostgreSQL canonical data'yı tutar. Search index denormalized projection taşır. Outbox veya CDC index updates üretir. Search query index'ten hızlı çalışır. Index gerektiğinde PostgreSQL'den yeniden oluşturulur.
SQL ve NoSQL arasında veri nasıl senkronize edilir?
Synchronous dual write yerine event-driven model tercih edilebilir. Transactional Outbox business data ve event'i aynı SQL transaction'ına alır. CDC event'i broker'a taşıyabilir. Consumer NoSQL projection'ı idempotent günceller. Reconciliation kalıcı drift'i kontrol eder.
Aynı veri iki farklı database'de tutulabilir mi?
Evet, fakat kopyalardan yalnızca biri authoritative olmalıdır. Diğer representation cache veya projection olabilir. Version freshness'i gösterir. Derived copy yeniden üretilebilir tutulur. İki database'in eşit write authority taşıması conflict riskini büyütür.
Source of truth nedir?
Source of truth belirli veri için doğru kabul edilen authoritative kaynaktır. Business mutation burada gerçekleşir. Derived stores bu state'ten beslenir. Conflict durumunda source wins olabilir. Recovery diğer copies'i source'tan oluşturur.
Dual-write problemi nedir?
İki bağımsız datastore'a aynı business operation içinde write yapıldığında atomicity sorunu oluşur. Biri başarılı diğeri başarısız olabilir. Timeout sonucu belirsizleştirir. Retry duplicate yaratabilir. Outbox veya saga çözüm olarak değerlendirilebilir.
Transactional Outbox nedir?
Transactional Outbox business row ile event row'u aynı local transaction'da yazar. Commit başarılıysa event kaydı kalıcı olur. Relay veya CDC event'i sonradan broker'a gönderir. Direct broker dual-write riski azalır. Consumer yine idempotent olmalıdır.
Change Data Capture nedir?
CDC database transaction log değişikliklerini stream'e dönüştürür. PostgreSQL WAL veya MySQL binlog kaynak olabilir. Application ek publish kodu yazmadan row change yakalanır. Debezium benzeri connector kullanılabilir. Business semantic gerekiyorsa Outbox ile birleştirilebilir.
CQRS nedir?
CQRS command ve query modellerini ayırır. Write store transaction correctness'e odaklanır. Read store query performance için denormalize olabilir. Events projection'ı günceller. Eventual consistency doğal olarak ortaya çıkar.
Eventual consistency nedir?
Write sonrası bütün stores anında aynı state'i göstermek zorunda değildir. Projection belirli consistency window içinde güncellenir. Lag ölçülür. User experience pending state veya read-your-writes ile yönetilebilir. Critical read source store'a gidebilir.
Cross-database transaction nasıl yapılır?
2PC bazı teknolojilerde kullanılabilir. Coordinator ve availability maliyeti vardır. Microservice'lerde saga sık alternatiftir. Local transaction ve event propagation daha loosely coupled çalışır. Business requirement hangi modeli gerektirdiğini belirler.
SQL ve NoSQL arasında JOIN yapılabilir mi?
Federated araçlarla teknik olarak mümkün olabilir. OLTP request path'ında latency ve coupling riski taşır. API composition küçük fan-out için uygundur. CQRS veya precomputed projection sık query'ler için daha iyi olabilir. Analytics federation ayrı workload olarak tutulabilir.
Redis database yerine kullanılabilir mi?
Redis kalıcı state tutabilir ve persistence seçenekleri vardır. Bununla birlikte cache, session ve primary database rolleri farklı risk taşır. Relational transaction veya query ihtiyacını doğal olarak karşılamaz. Primary state kullanılıyorsa backup ve durability tasarlanmalıdır. Teknoloji rolüne göre değerlendirilmelidir.
Elasticsearch source of truth olabilir mi?
Teknik olarak data saklayabilir fakat çoğu application architecture'da önerilen rol search projection'dır. Mapping ve index rebuild operasyonları vardır. Search-specific denormalization business canonical modele uygun değildir. Source başka durable store'da tutulursa recovery kolaylaşır. Index kaybı business data kaybına dönüşmez.
PostgreSQL JSONB varken MongoDB gerekli midir?
Her zaman gerekli değildir. JSONB birçok flexible document ihtiyacını transaction ve SQL avantajıyla karşılar. MongoDB bağımsız document scaling veya document-centric workload'da avantaj sağlayabilir. Operasyon maliyeti kıyaslanmalıdır. POC gerçek access pattern üzerinden yapılmalıdır.
pgvector varken ayrı vector database gerekli midir?
Her zaman gerekli değildir. pgvector exact ve approximate vector search sağlar. Metadata relational data ile birlikte tutulabilir. Çok büyük vector scale veya bağımsız QPS dedicated store'u haklı çıkarabilir. Recall, latency ve TCO ölçülmelidir.
Microservice başına ayrı database gerekli midir?
Physical cluster başına bir database zorunlu değildir. Önemli olan ownership ve private schema sınırıdır. Bir cluster birden fazla isolated database barındırabilir. Başka service direct access almamalıdır. Independent scaling gerektiğinde fiziksel ayrım yapılabilir.
Birden fazla database kullanmanın dezavantajları nelerdir?
Backup, monitoring ve security maliyeti artar. Cross-store consistency problemi oluşur. Developer ve on-call skill ihtiyacı büyür. Migration ve DR daha zor hale gelir. Bu nedenle fayda karmaşıklıktan büyük olmalıdır.
İlişkisel ve ilişkisel olmayan veritabanları aynı projede nasıl birlikte kullanılır?
İlişkisel ve İlişkisel Olmayan Veritabanlarının Birlikte Kullanımı için ilk adım her veri kümesinin authoritative kaynağını ve access pattern'ini belirlemektir. Transaction açısından kritik order, payment veya inventory relational database'de kalabilir, Redis cache, MongoDB document projection veya search index belirli okuma ihtiyaçlarını karşılayabilir. Store'lar arasındaki data synchronous dual write yerine Transactional Outbox, CDC veya event-driven synchronization ile aktarılabilir. Derived copies version ve idempotency kullanarak duplicate ve out-of-order event'lere dayanıklı olmalıdır. Reconciliation ve projection rebuild süreçleri ilk production sürümünden itibaren tasarlanırsa hibrit yapı uzun vadede çok daha yönetilebilir olur.
SQL ve NoSQL veritabanlarının birlikte kullanıldığı hibrit veri mimarileri hangi durumlarda tercih edilmelidir?
SQL ve NoSQL veritabanı hangi durumlarda birlikte kullanılmalı sorusunun cevabı farklı access pattern'lerin tek datastore üzerinde artık doğal veya ekonomik çalışmamasıyla başlar. Strong transaction isteyen write model ile yüksek trafikli search, cache, graph veya document read modeli birbirinden ayrılabilir. İkinci store'un latency, throughput veya product capability açısından measurable advantage sağlaması gerekir. Tek PostgreSQL database mevcut SLO'yu karşılıyorsa yeni cluster eklemek yalnızca operasyon maliyeti yaratabilir. Ekip backup, security, failover ve reconciliation süreçlerini yönetebilecek seviyede değilse hibrit tasarım bekletilmelidir.
PostgreSQL MySQL MongoDB Redis ve benzeri veritabanları arasında veri senkronizasyonu nasıl sağlanır?
PostgreSQL veya MySQL gibi authoritative SQL database'lerden MongoDB veya Redis gibi derived stores'a data aktarırken basit synchronous dual write yerine event tabanlı yaklaşım daha güvenilir olabilir. Business transaction ve outbox event aynı SQL transaction içinde commit edilir, ardından relay veya CDC değişikliği broker'a taşır. Consumer hedef store'u idempotent biçimde update eder ve source version üzerinden eski events'i reddeder. PostgreSQL WAL veya MySQL binlog CDC kaynağı olarak kullanılabilir, Debezium benzeri connector bu akışı standardize edebilir. Reconciliation job uzun dönem drift'i bulur ve event pipeline'da kaçırılan kayıtları yeniden source state'e göre onarır.
İlişkisel ve NoSQL veritabanlarının birlikte kullanımında veri tutarlılığı performans ve ölçeklenebilirlik nasıl yönetilir?
Polyglot persistence ile SQL NoSQL veri tutarlılığı ve senkronizasyonu nasıl sağlanır sorusunda consistency, performance ve scale birbirinden bağımsız hedefler gibi yönetilmemelidir. Canonical write store güçlü local transaction kullanırken read projections eventual consistency kabul edebilir ve her projection için maximum sync lag SLO tanımlanabilir. Redis cache hit ratio, search latency, MongoDB read throughput ve SQL CPU aynı observability sistemi içinde izlenir. Consumer idempotency, version ordering ve reconciliation correctness tarafını korurken independent scaling her store'un kendi workload'una göre capacity artırmasına imkan verir. Böylece performans için duplicate data kullanılırken duplicate data'nın kalıcı ve kontrolsüz bir truth kaynağına dönüşmesi engellenir.
Hibrit veritabanı mimarisi ve SQL/NoSQL entegrasyonu konusunda yakınımda danışmanlık veya eğitim nerede bulabilirim?
SQL NoSQL ve veritabanı mimarisi danışmanlığı yakınımda şeklinde araştırma yaparken yalnızca database kurabilen değil transaction boundary, CDC, outbox, reconciliation, backup ve observability konularını birlikte değerlendirebilen yaklaşım tercih edilmelidir. Diyarbakır Yazılım Topluluğu hakkında bilgi için https://www.diyarbakiryazilim.com.tr/about adresi incelenebilir. Topluluk kapsamında geliştirilen teknik çalışmalar ve proje fikirleri için https://www.diyarbakiryazilim.com.tr/projects adresinden devam edilebilir. Kurumsal SQL NoSQL hibrit veritabanı mimarisi geliştirme hizmeti alınırken mevcut sistemin ölçülmesi, yeni datastore için measurable requirement hazırlanması ve zero-downtime migration planının kapsamda olması önemlidir. Eğitim tarafında ise yalnızca query örnekleri değil duplicate event, out-of-order update, datastore outage ve projection rebuild gibi failure senaryolarını uygulamalı çalışmak production bilgisini çok daha hızlı geliştirir.
Sonuç: İlişkisel ve İlişkisel Olmayan Veritabanları Birlikte Nasıl Kullanılmalı?
İlişkisel ve NoSQL sistemleri birlikte kullanırken temel amaç teknoloji sayısını artırmak değil business workload'larını doğru persistence sınırlarına yerleştirmektir. Transactional state güçlü bir authoritative store'da kalmalı, cache, search ve diğer read models ihtiyaç halinde ondan türetilmelidir. Cross-store dual write yerine güvenilir event akışı, idempotency, versioning ve reconciliation kullanılmalıdır. Eventual consistency açık bir ürün ve SLO kararı olarak ele alınmalıdır. İlişkisel ve İlişkisel Olmayan Veritabanlarının Birlikte Kullanımı ancak operasyon ekibinin backup, recovery, security ve monitoring süreçlerini de aynı tasarımın parçası haline getirmesiyle sürdürülebilir olur.
SQL ve NoSQL'i Rakip Teknolojiler Olarak Görmeyin
Relational ve NoSQL farklı problemlere odaklanır. Birinin güçlü olduğu alanda diğerini tamamen dışlamak gerekmez. SQL transaction core olabilir. NoSQL specialized read veya scaling ihtiyacını karşılayabilir. Karar workload üzerinden verilmelidir.
Önce Access Pattern ve Consistency Gereksinimini Belirleyin
Data type karar için yeterli değildir. Query ve mutation sıklığı ölçülür. Strong veya eventual read ihtiyacı tanımlanır. Latency SLO yazılır. Store seçimi bundan sonra yapılır.
Gereksiz Datastore Çeşitliliğinden Kaçının
Her yeni technology operasyon maliyeti getirir. Existing PostgreSQL feature'ları önce değerlendirilmelidir. Approved list kullanılabilir. TCO hesaplanır. Fayda kanıtlanmadan yeni cluster açılmamalıdır.
Her Veri İçin Tek Bir Authoritative Source Tanımlayın
Conflict resolution böylece basitleşir. Derived copies read-only tutulabilir. Write API owner service'den geçer. Recovery direction bellidir. Data governance güçlenir.
Cross-Database Dual Write Yerine Güvenilir Event Senkronizasyonu Kullanın
Transactional Outbox local atomicity sağlar. Relay veya CDC event'i taşır. Consumer idempotent günceller. Retry duplicate-safe olur. Broker outage business transaction'ı durdurmaz.
Derived Store'ları Yeniden Üretilebilir Tasarlayın
Search veya read model silinip rebuild edilebilmelidir. Mapping code saklanır. Backfill automation bulunur. Event replay test edilir. Source data kaybı ile projection kaybı birbirinden ayrılır.
Eventual Consistency'yi Açık Bir Mimari Karar Haline Getirin
Maximum lag SLO tanımlanır. User read-your-writes behavior'ı belirlenir. Strong endpoints source'a gider. Pending state UI'da yönetilir. Eventual consistency görünmez sürpriz olmaktan çıkar.
Reconciliation ve Observability'yi İlk Günden Kurun
Projection lag dashboard'da olmalıdır. Dead-letter alert üretilir. Reconciliation drift'i bulur. Distributed tracing dependency path'i gösterir. Correctness production metric haline gelir.
Backup ve Disaster Recovery'yi Tüm Datastore'lar Birlikte Düşünerek Tasarlayın
Her store'un RPO ve RTO'su farklı olabilir. Recovery dependency order ile yapılır. Source önce ayağa kalkar. Derived store rebuild edilir. Cross-store consistency recovery sonunda doğrulanır.
Polyglot Persistence'ı “Daha Fazla Database Kullanmak” Değil, Her İş Yükü İçin Ölçülebilir Şekilde En Uygun Persistence Modelini Seçmek Olarak Ele Alın
Polyglot persistence'ın başarısı kullanılan teknoloji sayısıyla ölçülmez. Daha az datastore ile aynı SLO sağlanabiliyorsa daha sade sistem genellikle daha değerlidir. Specialized database ancak query, scaling veya product capability açısından açık fayda sunduğunda eklenmelidir. Her değişiklik performans, consistency ve total cost üzerinden tekrar ölçülmelidir. Hibrit veri mimarisi, backend performansı ve ölçeklenebilir sistem çalışmaları için https://www.diyarbakiryazilim.com.tr/projects adresindeki projeleri inceleyebilir ve toplulukla bağlantı kurabilirsiniz.
share: